

De markt voor AI-infrastructuur beweegt zich niet in één richting; ze splitst zich op in twee verschillende werelden. Aan de ene kant bevinden zich geavanceerde trainingsclusters, gebouwd om op grote schaal basismodellen te ontwikkelen, nauw verbonden met eigen technologieën en een beperkt aantal accelerators. Aan de andere kant is er de snelgroeiende realiteit van enterprise inference, waar organisaties modellen inzetten om gebruikers te bedienen, live data te verwerken en meetbare bedrijfswaarde te genereren. De Dell PowerEdge XE7740 is specifiek ontworpen voor deze tweede wereld.
Key Takeaways
- De PowerEdge XE7740 is gebouwd voor inferentietoepassingen in bedrijfsomgevingen. met thermische koeling in twee zones, een gestructureerde PCIe Gen5-topologie en schaalbare netwerkmogelijkheden die zijn afgestemd op daadwerkelijke productieworkloads.
- Het evenwicht in het systeem is opzettelijk. De combinatie van de hoge kerndichtheid van Xeon 6, een hoge geheugenbandbreedte en PCIe Gen 5 E3.S NVMe ondersteunt KV-cache-offload en -orkestratie.
- De flexibiliteit van silicium is essentieel. Ondersteuning bieden voor een breed scala aan PCIe Gen5-acceleratoren zonder dat een herontwerp van de infrastructuur nodig is.
- Het platform schaalt probleemloos mee in de loop van de tijd. van gedeeltelijke GPU-plaatsing in één chassis naar gedistribueerde inferentie over racks met behulp van acht dedicated Gen5 x16 netwerkslots aan de achterzijde.
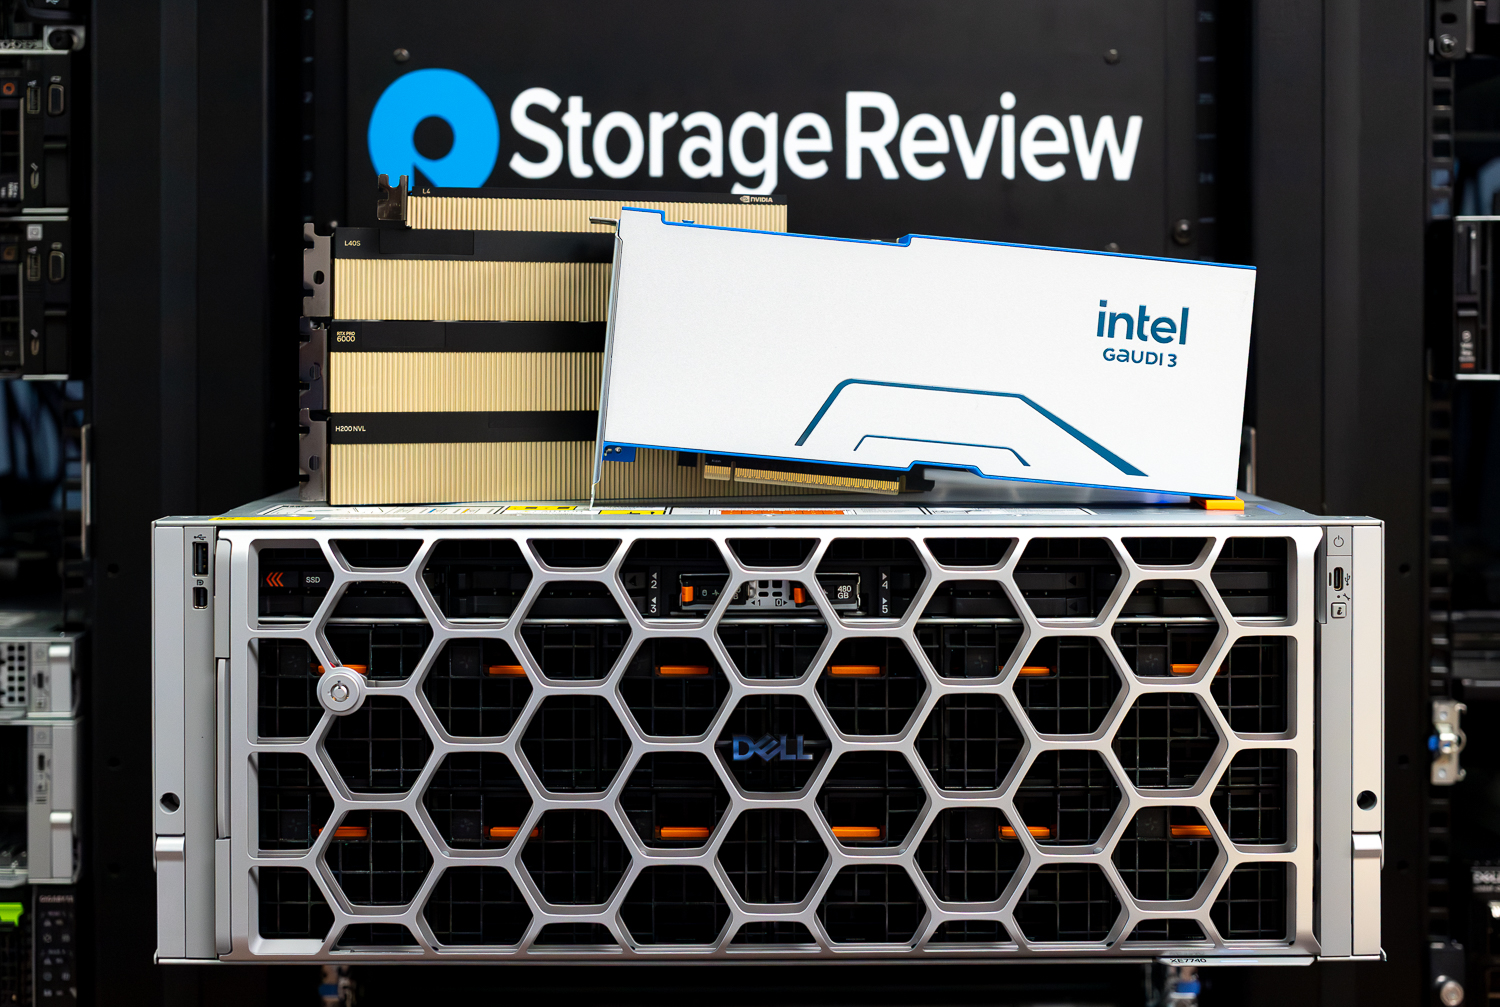
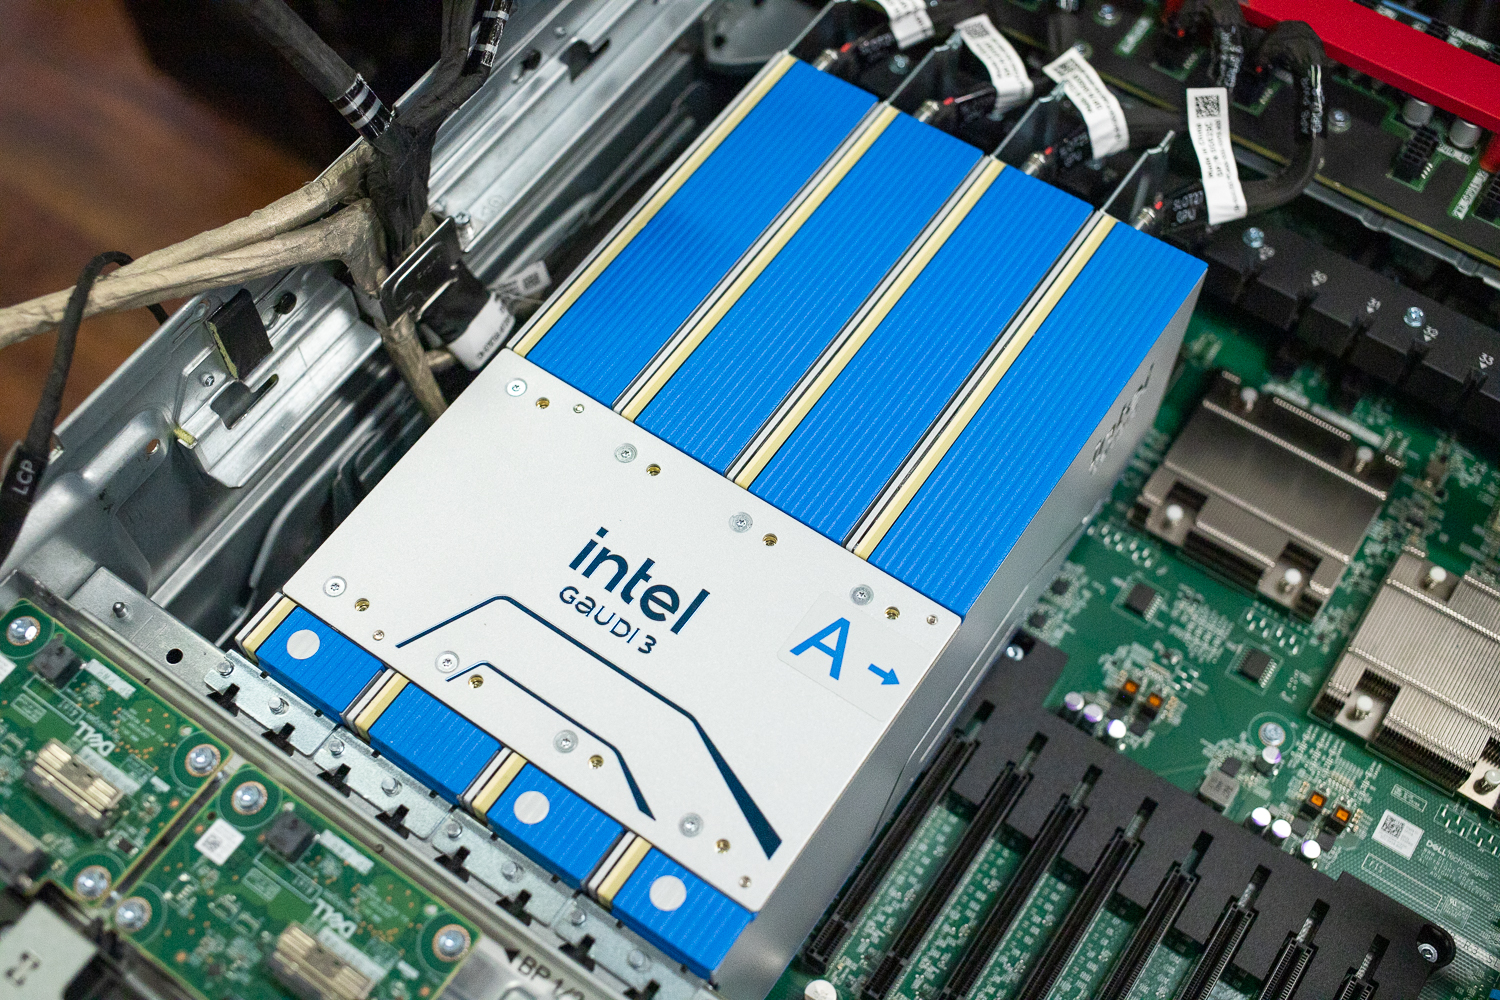
De kern van de XE7740 is de focus op siliciumdiversiteit. In plaats van het platform te verankeren aan één enkele accelerator-roadmap, heeft Dell een systeem ontwikkeld dat zich aanpast aan beschikbaarheid, kosten en de gereedheid van de organisatie. De XE7740 ondersteunt een reeks PCIe Gen5-accelerators, waaronder NVIDIA's RTX PRO 6000, H100/200, L40S, L4 en A16 GPU's voor organisaties die waarde hechten aan brede ecosysteemcompatibiliteit, en Intel Gaudi 3 voor teams die op zoek zijn naar een kosteneffectievere en direct beschikbare inferentiemethode. Gaudi 3-accelerators zijn vandaag al beschikbaar, waardoor organisaties direct van planning naar implementatie kunnen overgaan zonder de vertragingen in de aanschaf die vaak de acceleratorstrategie beïnvloeden.
Naarmate inferentie de dominante taak binnen AI wordt, zijn beschikbaarheid en kostenstructuur van belang. De meeste bedrijven trainen geen modellen op de allergrootste schaal. Ze draaien inferentiepipelines, bedienen middelgrote taalmodellen, ondersteunen workflows voor het genereren van informatie die is aangevuld met retrieval-functionaliteit, en implementeren computervisie in productieomgevingen. In deze context positioneert Gaudi 3 zich als een van de meest betaalbare moderne inferentieversnellers op de markt. Het biedt een eigentijdse architectuur met geheugen met hoge bandbreedte en schaalbaarheid via Ethernet, zonder het hoge prijskaartje van de meest geavanceerde trainings-GPU's. Binnen de XE7740 draait Gaudi 3 minder om vervanging en meer om het mogelijk maken van duurzame inferentie-implementaties.
Het platform rondom de accelerators is eveneens weloverwogen ontworpen. De XE7740 is gebouwd op Intel Xeon 6-processors, en in systemen die gericht zijn op inferentie blijft de CPU een cruciaal onderdeel. Een hoog aantal cores en een grotere geheugenbandbreedte bieden de benodigde ruimte voor schedulers, tokenisatie, preprocessing en orchestratietaken die zich direct in het kritieke pad van de inferentie bevinden. De aan de voorzijde gemonteerde E3.S NVMe-opslag ondersteunt bovendien lokale data-staging en KV-cache-offload, waardoor de belasting van de accelerators wordt verminderd en de algehele systeemefficiëntie wordt verbeterd. Dit uitgebalanceerde ontwerp weerspiegelt het inzicht dat de inferentieprestaties worden bepaald door het gehele systeem, niet alleen door de accelerators.
De XE7740 is ook ontworpen om in de loop der tijd soepel te schalen. Organisaties kunnen beginnen met een bescheiden configuratie, zoals twee of vier accelerators, en direct waarde halen zonder de behuizing volledig te vullen. Naarmate de behoeften toenemen, kan hetzelfde platform verticaal worden opgeschaald of overgaan op gedistribueerde inferentie. Acht PCIe Gen5 x16-slots aan de achterzijde bieden dedicated bandbreedte voor snelle netwerken, waardoor de XE7740 kan dienen als bouwsteen voor schaalbare inferentieclusters. Optionele DPU-ondersteuning vergroot deze flexibiliteit nog verder door netwerk- en communicatietaken te ontlasten naarmate implementaties volwassen worden.
Belangrijkste specificaties van de Dell PowerEdge XE7740
| Specificaties | PowerEdge XE7740 |
|---|---|
| Kenmerken van de PowerEdge XE7740 | |
| Gegevensverwerker | Twee Intel® Xeon® 6-serie processoren, met maximaal 86 kernen per processor. |
| Gokkasten | |
| PCIe-acceleratoren | 8x PCIe Gen 5 x16 DW-FHFL tot 600 W, of
16x PCIe Gen 5 x16 SW-FHFL tot 75 W |
| PCIe NIC's |
|
| Vormfactor | |
| Vormfactor | 4U rackserver |
| Geheugen | |
| DIMM-snelheid, maximale capaciteit | Tot 6400 MT/s, maximaal 4 TB |
| Geheugenmoduleslots | 32 DDR5 DIMM-sleuven Ondersteunt alleen geregistreerde ECC DDR5 RDIMM-modules. |
| Opslag | |
| Voor baaien | Tot 8 x EDSFF E3.S Gen5 NVMe (SSD) max. 122.88 TB |
| Opslagcontrollers | |
| Interne laars | Opstartgeoptimaliseerd opslagsysteem (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2
NVMe SSD's |
| Stroomvoorziening | |
| Stroomvoorziening | 3200 W Titanium 200-240 V AC of 240 V DC, hot-swap redundant
Meerdere capaciteiten voor 3200 W voedingen:
Meerdere capaciteiten voor 2400 W voedingen:
LET OP: Het systeem vereist minimaal één voeding in de CPU-zone en één voeding in de GPU-zone om de BMC en de stand-byvoeding te garanderen. Als er geen voeding in de GPU-zone is geïnstalleerd, blijft het systeem in de wachtstand. Om volledige redundantie te garanderen, installeert u N+N voedingen in elke zone: 1+1 in de CPU-zone en 3+3 in de GPU-zone. Het verwijderen van alle voedingen uit de CPU-zone terwijl het systeem is ingeschakeld, leidt tot een onmiddellijke uitschakeling en mogelijk tot gegevensverlies. |
| Koelopties | |
| Koelopties | Air Cooling |
| Fans | Er kunnen maximaal vier sets hoogwaardige (HPR) platina-ventilatoren (dubbele ventilatormodule) in de middenlade worden geïnstalleerd.
Tot wel twaalf hoogwaardige (HPR) platina-ventilators aan de voorkant van het systeem geïnstalleerd. Ze zijn allemaal fan van hot-swap-technologie. |
| poorten | |
| Netwerkopties | 1 PCIe Gen 5 OCP 3.0-compatibele I/O (ondersteund door x8 PCIe-lanes) |
| Poorten aan de voorkant | 1 x USB 2.0 Type-A (optioneel) 1 x Mini-DisplayPort (optioneel) 1 x USB 2.0 Type-C dual mode (Host/iDRAC Direct-poort) |
| Achterste poorten | 1 x speciale iDRAC/BMC Direct Ethernet-poort 2 x USB 3.1 Type A-poort 1 x VGA |
| Interne poorten | 1 x USB 3.1 Type-A |
XE7740 Ontwerp en constructie
Dual-zone architectuur: scheiding van CPU en GPU
Een van de meest opvallende ontwerpkeuzes van de XE7740 is de fysieke scheiding in twee afzonderlijke zones voor koeling en voeding. Het bovenste 1U-gedeelte herbergt de CPU-zone, bestaande uit beide Xeon 6-processors, alle 32 DIMM-slots, de opslag en de DC-SCM-managementmodule. De CPU-zone maakt gebruik van vier sets krachtige modules met dubbele ventilatoren (40×40×56 mm) die een luchtstroom van 47.4 CFM leveren.
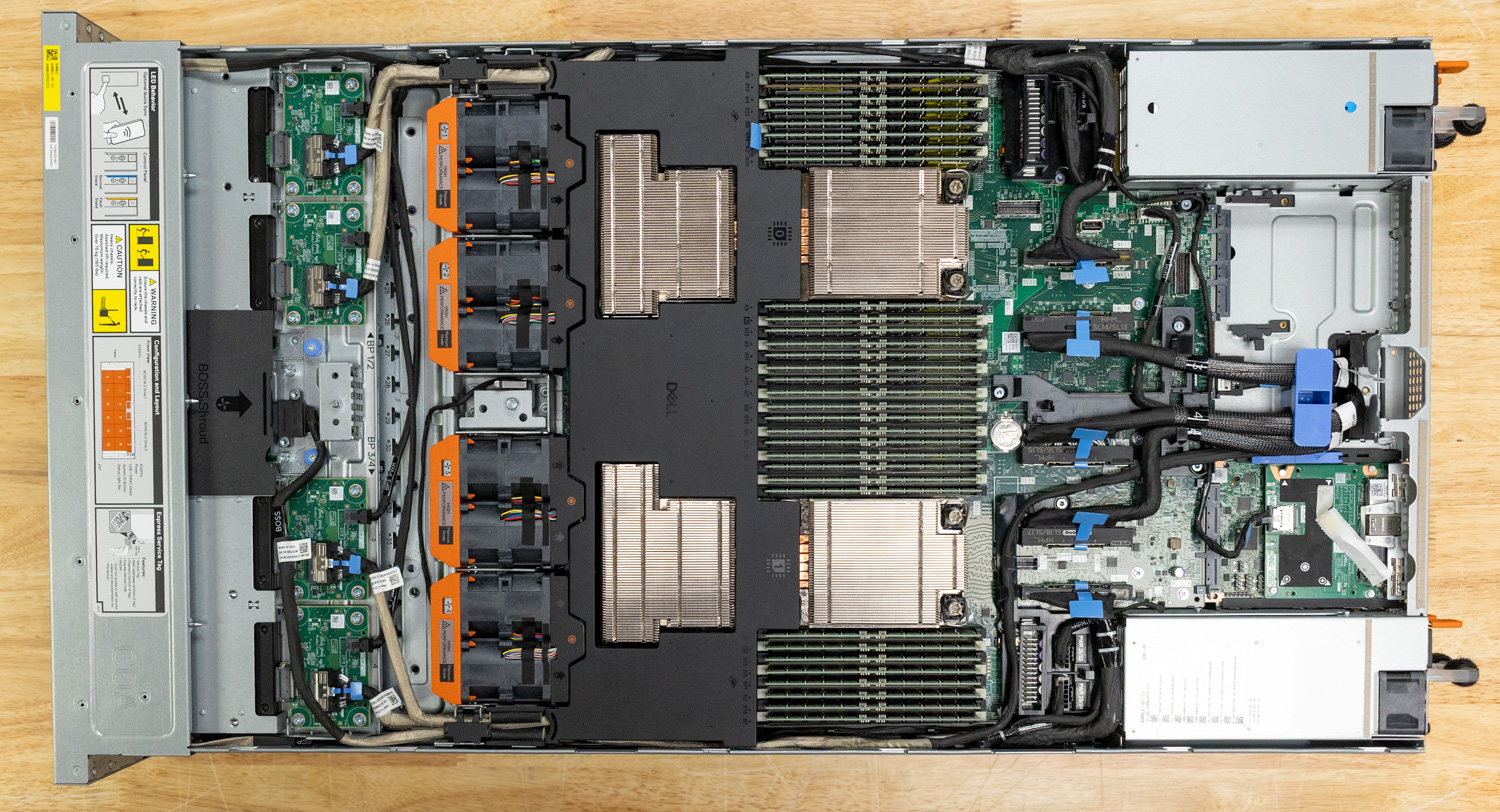
Het onderste 3U-gedeelte is de GPU-zone, met alle accelerator-slots en hun eigen dedicated koelinfrastructuur, naast het PCIe Base Board (PBB), de naar achteren gerichte PCIe-uitbreidingsslots en de OCP NIC-aansluitingen. De GPU-zone maakt gebruik van twaalf grotere, krachtige ventilatoren (60×60×56 mm) met een aanzienlijk hogere luchtstroomcapaciteit tot 122.2 CFM per ventilator in vergelijking met de CPU-ventilatoren. Alle ventilatoren zijn hot-swappable. Deze dual-zone koeling zorgt ervoor dat de thermische eisen van accelerators met een hoog TDP (tot 600 W per kaart) de koeling van de CPU en het geheugen niet in gevaar brengen, en vice versa, in een standaard 19-inch rack.
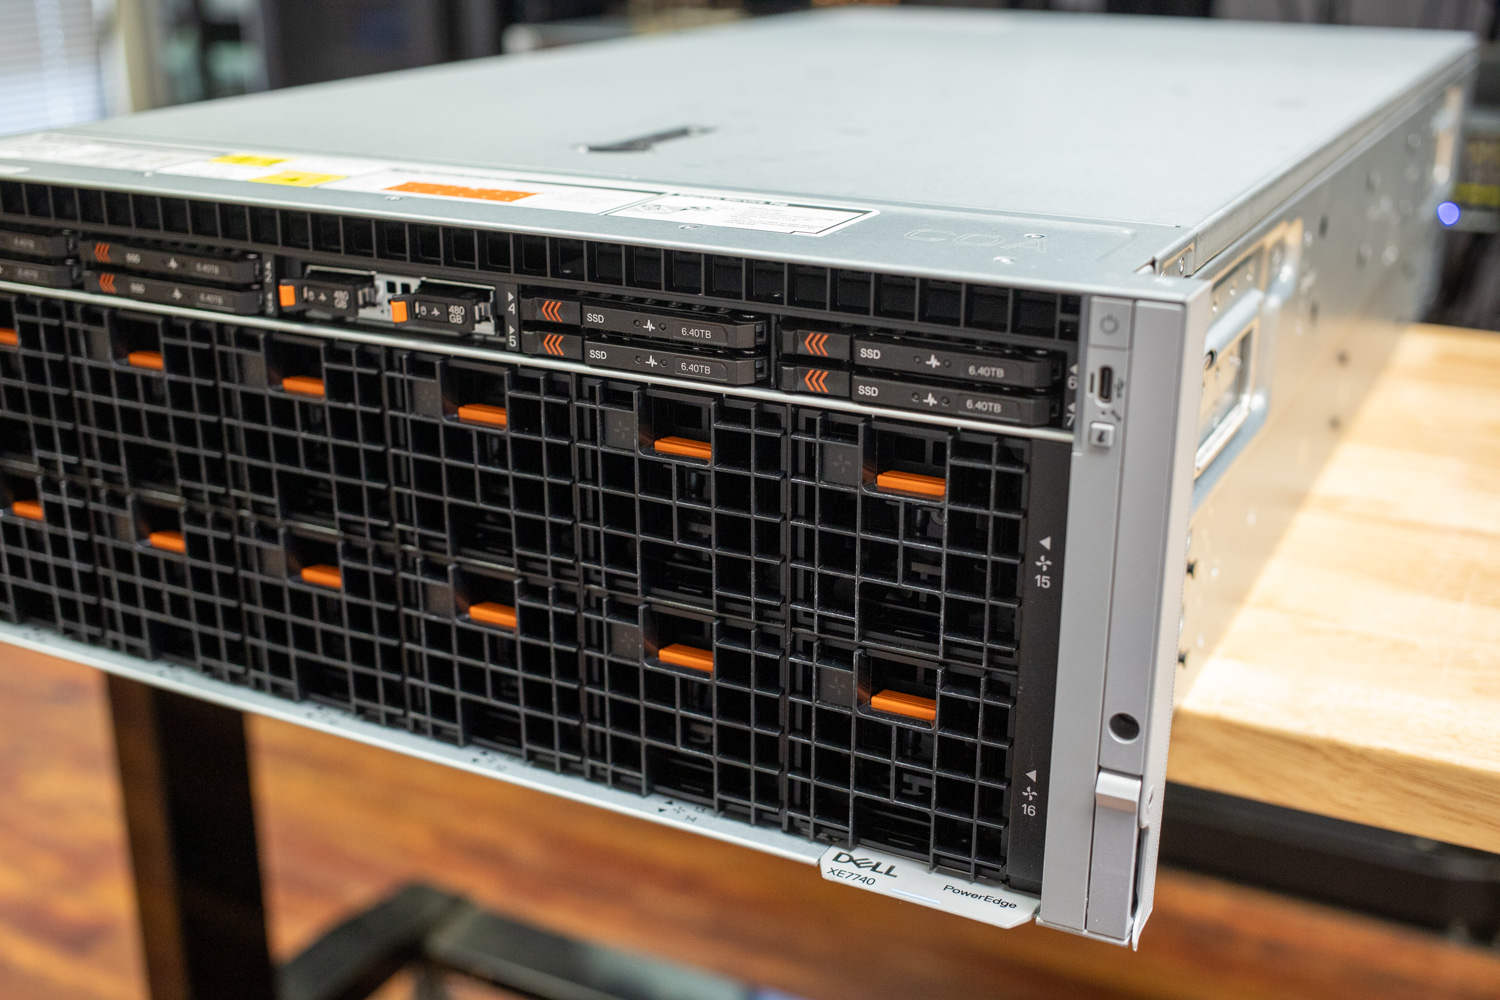
Dell heeft bij de XE7740 veel aandacht besteed aan het optimaliseren van de luchtstroom. Systemen met veel accelerators vereisen inherent veel interne bekabeling, waaronder extra voedingskabels voor de GPU, PCIe-signaalkabels tussen het HPM-bord en de PBB, en aansluitingen voor de ventilator. In de XE7740 worden deze kabels langs de zijwanden van de behuizing geleid met behulp van speciale kabelhouders en kabelafdekkingen. Elke kabel is precies op de juiste lengte gemaakt; er zijn geen overtollige kabelbundels in het systeem. Door de bekabeling buiten het centrale luchtstroomkanaal te houden, zorgt het ontwerp voor een vrije luchtstroom van voor naar achter en minimaliseert het de weerstand in zowel de CPU- als de GPU-koelingszones.
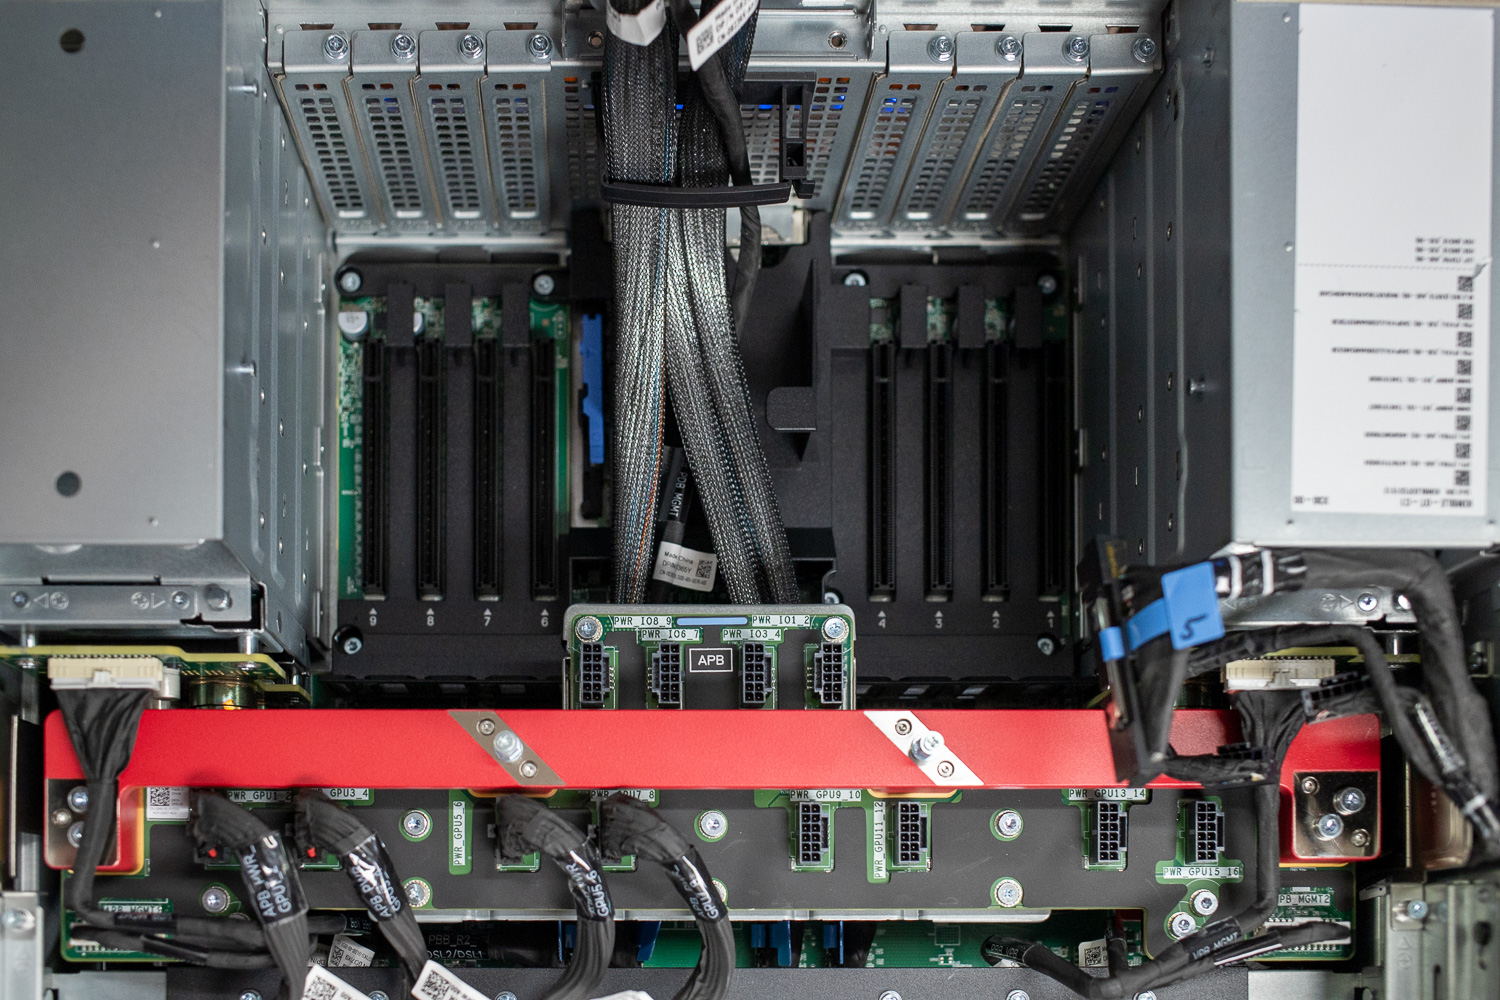
In een behuizing met maximaal acht 600W-acceleratoren kunnen zelfs kleine obstakels in de luchtstroom plaatselijke hotspots veroorzaken en ventilatoren dwingen om op hogere snelheden te draaien, wat zowel het stroomverbruik als de geluidsproductie verhoogt. Dell's aanpak voor kabelbeheer zorgt ervoor dat het midden van de behuizing vrij blijft voor een directe, onbelemmerde luchtstroom naar de componenten die dit het meest nodig hebben.
PCIe-switchtopologie en gegevensstroom
Het PCIe-subsysteem van de XE7740 is opgebouwd rond vier PCIe Gen 5-switches op de PBB (PCIe Base Board), aangeduid als SW1 tot en met SW4. Deze switches vormen de ruggengraat van de I/O-architectuur van het systeem en verbinden accelerators, netwerkapparatuur en opslag met de twee Xeon 6-processoren in een zorgvuldig georganiseerde topologie.
De 16 interne GPU-slots zijn verdeeld in twee groepen van acht, waarbij elke groep wordt bediend door een paar PCIe-switches, die elk stroomopwaarts zijn verbonden met een CPU. Binnen elke groep zijn paren van naast elkaar gelegen GPU-slots met dubbele breedte over de twee switches verdeeld. Aan de CPU0-zijde bedient SW1 GPU-slots 21 en 25, evenals de achterste PCIe-slots 8 en 9, terwijl SW2 GPU-slots 23 en 27 bedient, evenals de achterste PCIe-slots 6 en 7. Aan de CPU1-zijde bedient SW3 GPU-slots 29 en 33, evenals de achterste PCIe-slots 3 en 4, terwijl SW4 GPU-slots 31 en 35 bedient, evenals de achterste PCIe-slots 1 en 2.

Elk CPU-domein beschikt daarom over vier accelerator-slots van dubbele breedte, vier NIC/I/O-slots aan de achterzijde en vier van de acht E3.S NVMe-opslagbays aan de voorzijde. Deze switchtopologie heeft aanzienlijke gevolgen voor de datastroom, met name voor RDMA-verkeer. Omdat elke switch zowel accelerator- als NIC-slots aan de achterzijde heeft, kunnen een accelerator en een netwerkadapter op dezelfde switch RDMA-overdrachten volledig binnen de switchfabric uitvoeren. De data hoeft nooit het rootcomplex van de CPU te passeren, waardoor de CPU-buffer die anders nodig zou zijn wanneer een PCIe-apparaat op de ene rootpoort communiceert met een apparaat op een andere, overbodig wordt. Dit vermindert de latentie, voorkomt het verbruik van kostbare CPU-geheugenbandbreedte en maakt CPU-cycli vrij voor andere taken.
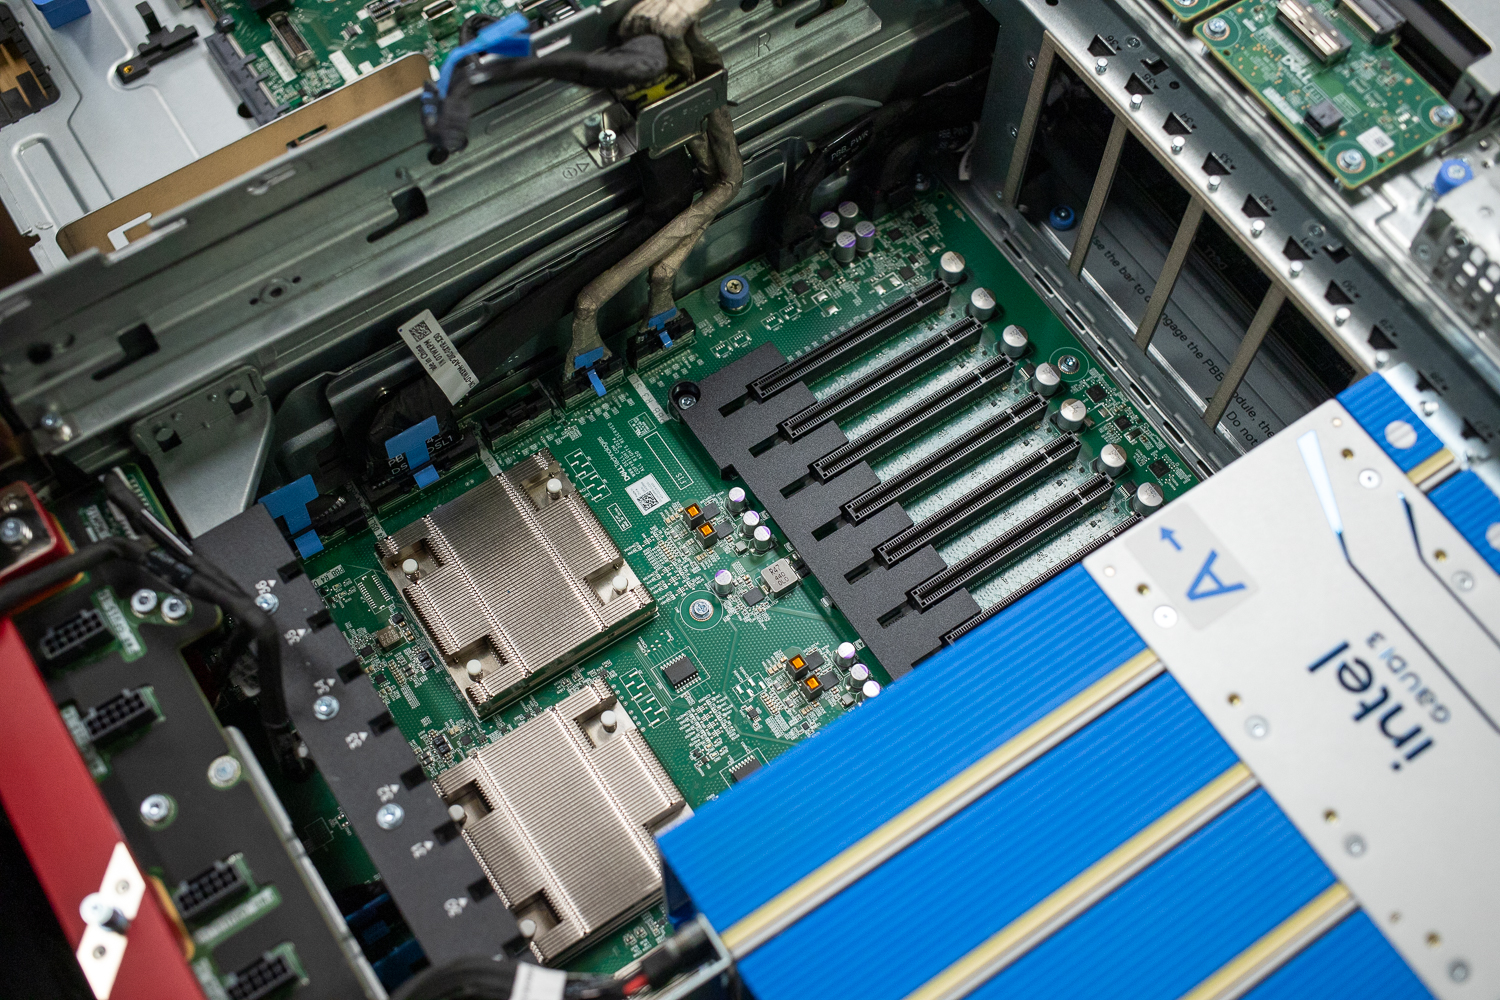
Communicatie binnen het domein van één CPU tussen de twee switches verloopt via het CPU-rootcomplex, maar blijft lokaal binnen die socket. Communicatie tussen CPU's moet echter via de UPI-links tussen de twee Xeon 6-processors verlopen. De 6787P biedt vier UPI 2.0-links van elk 24 GT/s, wat zorgt voor een aanzienlijke bandbreedte tussen sockets. Verkeer tussen een accelerator op de switchbank van CPU0 en een NIC op de switchbank van CPU1 zal echter inherent een hogere latentie hebben dan lokale overdrachten tussen switches of overdrachten binnen dezelfde socket.
De switches zelf zijn niet direct met elkaar verbonden. Al het verkeer tussen switches loopt via het CPU-rootcomplex, dus het is belangrijk om de affiniteit tussen GPU-slots, NIC-slots, opslag en CPU-sockets te begrijpen. Om deze complexiteit voor organisaties te vereenvoudigen, biedt Dell gevalideerde en geoptimaliseerde configuraties voor populaire accelerators.
Voeding met twee zones
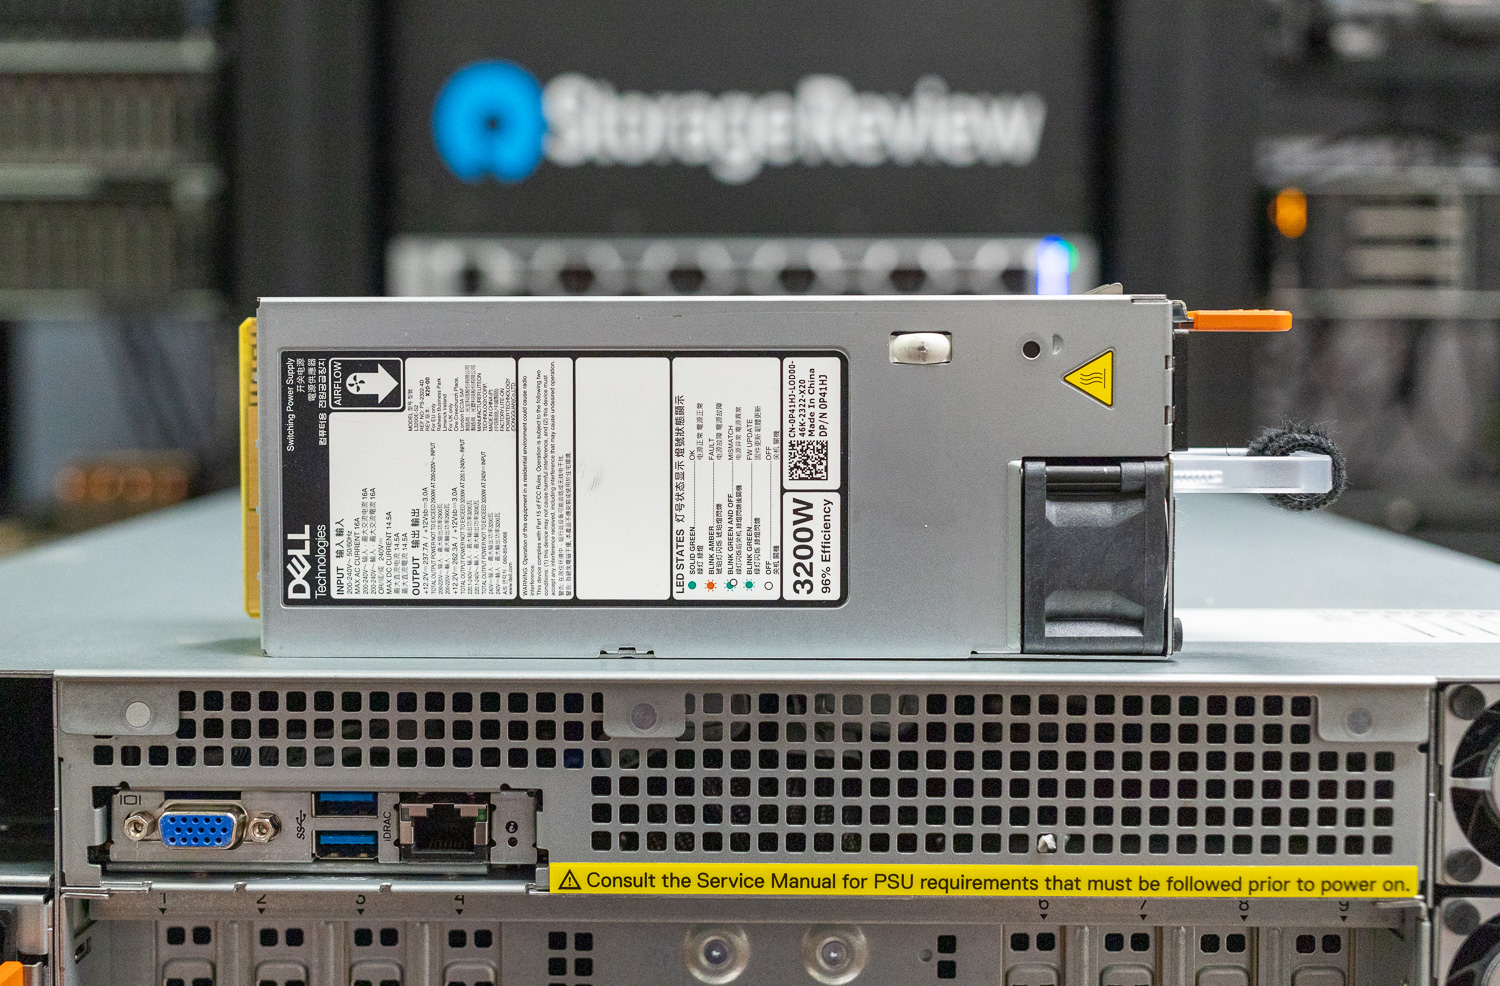
De stroomvoorziening van de XE7740 weerspiegelt de thermische architectuur met een enigszins ongebruikelijk ontwerp van de voeding met twee zones. Het systeem ondersteunt tot acht hot-swappable voedingen, verdeeld over twee zones: Zone 1 (CPU-zone) bevat voedingen 1 en 2, terwijl Zone 2 (GPU-zone) voedingen 3 tot en met 8 bevat.
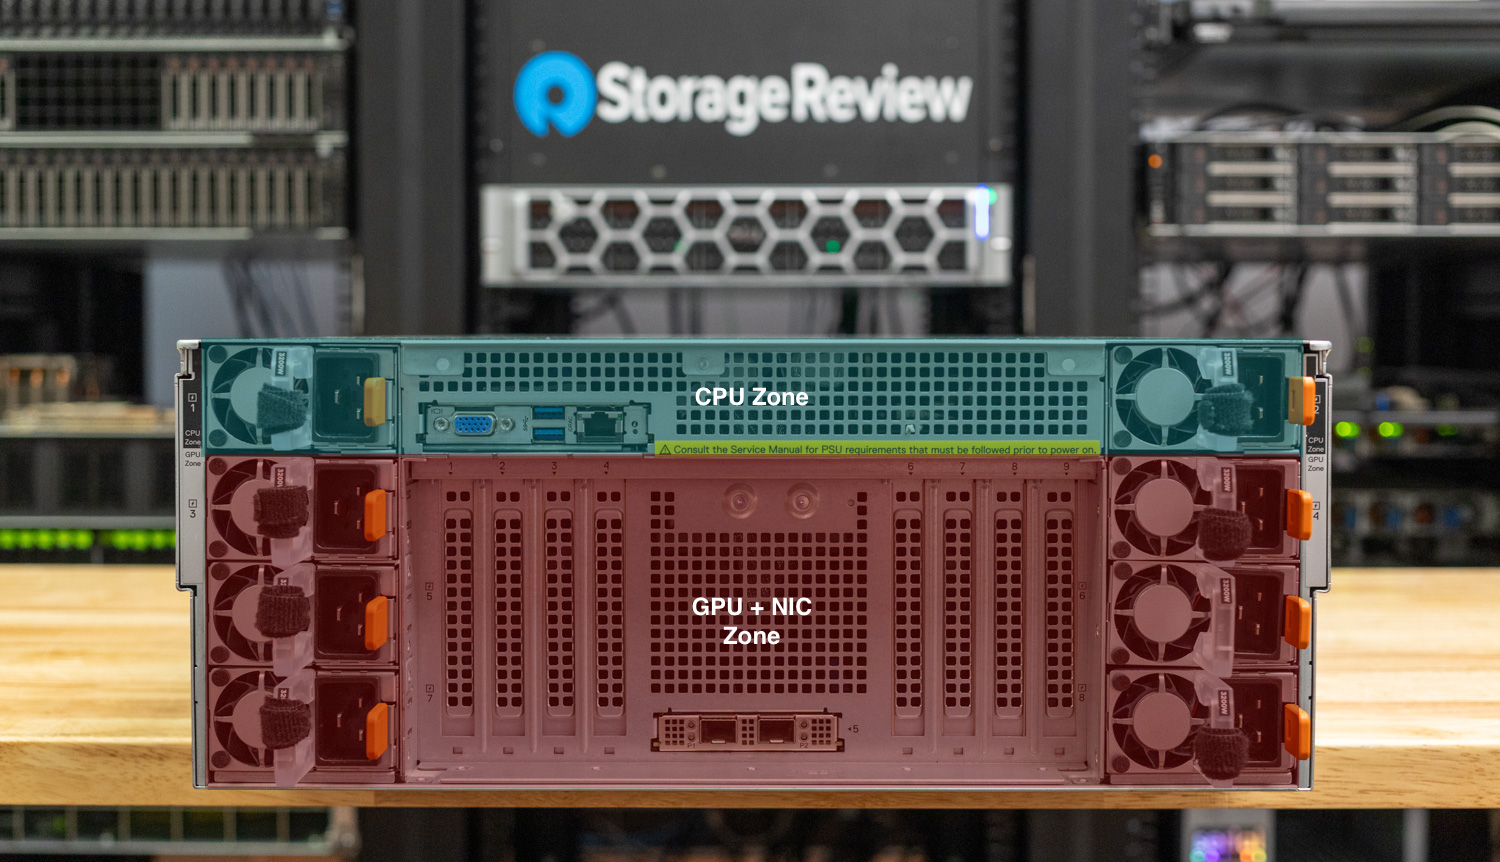
Het systeem vereist minimaal één voedingseenheid (PSU) in elke zone om de BMC en de noodstroomvoorziening te garanderen. Als de netstroom in een van de zones uitvalt terwijl het systeem draait, wordt het systeem onmiddellijk uitgeschakeld om gegevensverlies te voorkomen. De zones zijn onderling afhankelijk voor hun werking, ondanks dat ze fysiek en elektrisch gescheiden zijn. Voor volledige redundantie adviseert Dell een 1+1-configuratie in de CPU-zone en een 3+3-configuratie in de GPU-zone, wat betekent dat alle acht PSU-sleuven bezet moeten zijn voor een volledig redundante implementatie.
Dell AIOps, beheer en betrouwbaarheid voor de hele onderneming
Het PowerEdge-platform van Dell staat in de branche bekend om zijn betrouwbaarheid en onderhoudsgemak. Zakelijke klanten benadrukken steevast dezelfde punten: PowerEdge-systemen zijn gebouwd om lang mee te gaan, de ondersteuningsorganisatie van Dell lost problemen snel op en de beheertools zijn volwassen en goed geïntegreerd. De XE7740 zet deze traditie voort en Dell heeft met deze generatie aanzienlijke vooruitgang geboekt op het gebied van hardwarebeheer en beveiliging.
iDRAC 10
De XE7740 wordt geleverd met Dell's volgende generatie iDRAC 10, een aanzienlijke verbetering ten opzichte van de al zeer capabele iDRAC 9 waarop Dell-klanten al jaren vertrouwen. iDRAC 10 is geïmplementeerd als een Data Center Secure Control Module (DC-SCM) conform de OCP DC-MHS-standaard en is niet zomaar een firmware-update; het vertegenwoordigt nieuwe hardware. De controller beschikt over vier 1 GHz-cores met een 64-bits architectuur en 2 GB DDR4-geheugen (tweemaal zoveel als de vorige generatie), wat resulteert in aanzienlijk verbeterde prestaties en responsiviteit voor beheertaken.
Op het gebied van beveiliging introduceert iDRAC 10 een aantal opmerkelijke verbeteringen. Het platform biedt over de hele linie sterkere cryptografische ondersteuning, waaronder SHA-384- en SHA-512-authenticatie en kwantumveilige AES-256-encryptie, nu de industrie zich voorbereidt op cryptografische dreigingen van na het kwantumtijdperk. Een speciale, geïntegreerde beveiligingsenclave in de iDRAC 10-chip beheert functies voor cyberweerbaarheid, waaronder attestatie op apparaatniveau en Dell's eigen Root-of-Trust. Deze hardwarematige Root-of-Trust zorgt ervoor dat alle firmware (BIOS, iDRAC en componentfirmware) cryptografisch wordt geverifieerd vóór uitvoering, waardoor bescherming wordt geboden tegen aanvallen in de toeleveringsketen en manipulatie van de firmware.
Secured Component Verification valideert dat systemen die vanuit de Dell-fabriek worden geleverd, exact de door de klant gespecificeerde componenten en configuraties bevatten, waardoor de integriteit van productie tot implementatie gewaarborgd blijft. De nieuwste iDRAC 10-firmware biedt bovendien een vernieuwde, modulaire gebruikersinterface die het dagelijkse beheerproces verbetert.
OpenManage Enterprise
Voor grootschalig vlootbeheer biedt Dell OpenManage Enterprise gecentraliseerde monitoring, firmware-updates en configuratiebeheer voor complete PowerEdge-implementaties. Een opmerkelijke recente toevoeging voor AI-gerichte implementaties is dat OME nu direct inzicht biedt in GPU- en acceleratorstatistieken: stroomverbruik, temperatuur, gebruik, foutentellingen en meer, zonder dat daarvoor aparte, leverancierspecifieke tools nodig zijn. Voor organisaties die tientallen of honderden XE7740-nodes in een inferentiecluster beheren, is dit uniforme beheerplatform een aanzienlijke vereenvoudiging van de operationele processen.
Intel Xeon6
De XE7740 wordt aangedreven door twee Intel Xeon 6 6787P-processors, het topmodel van de Xeon 6700P-serie. De 6787P is gebouwd op de Granite Rapids-architectuur met behulp van Intel 3 nm-technologie en levert 86 P-cores (172 threads) per socket met een TDP van 350 W, een basisklokfrequentie van 2.0 GHz en een turboklokfrequentie van 3.8 GHz.
Wat Granite Rapids bijzonder relevant maakt voor AI-infrastructuur, is de combinatie van een hoog aantal cores en het geheugensubsysteem. Elke 6787P-processor biedt acht DDR5-geheugenkanalen met een snelheid tot 6400 MT/s. Met een dual-socket XE7740-moederbord met 32 DIMM's kan het systeem worden geconfigureerd voor een totaal systeemgeheugen van maximaal 4 TB.
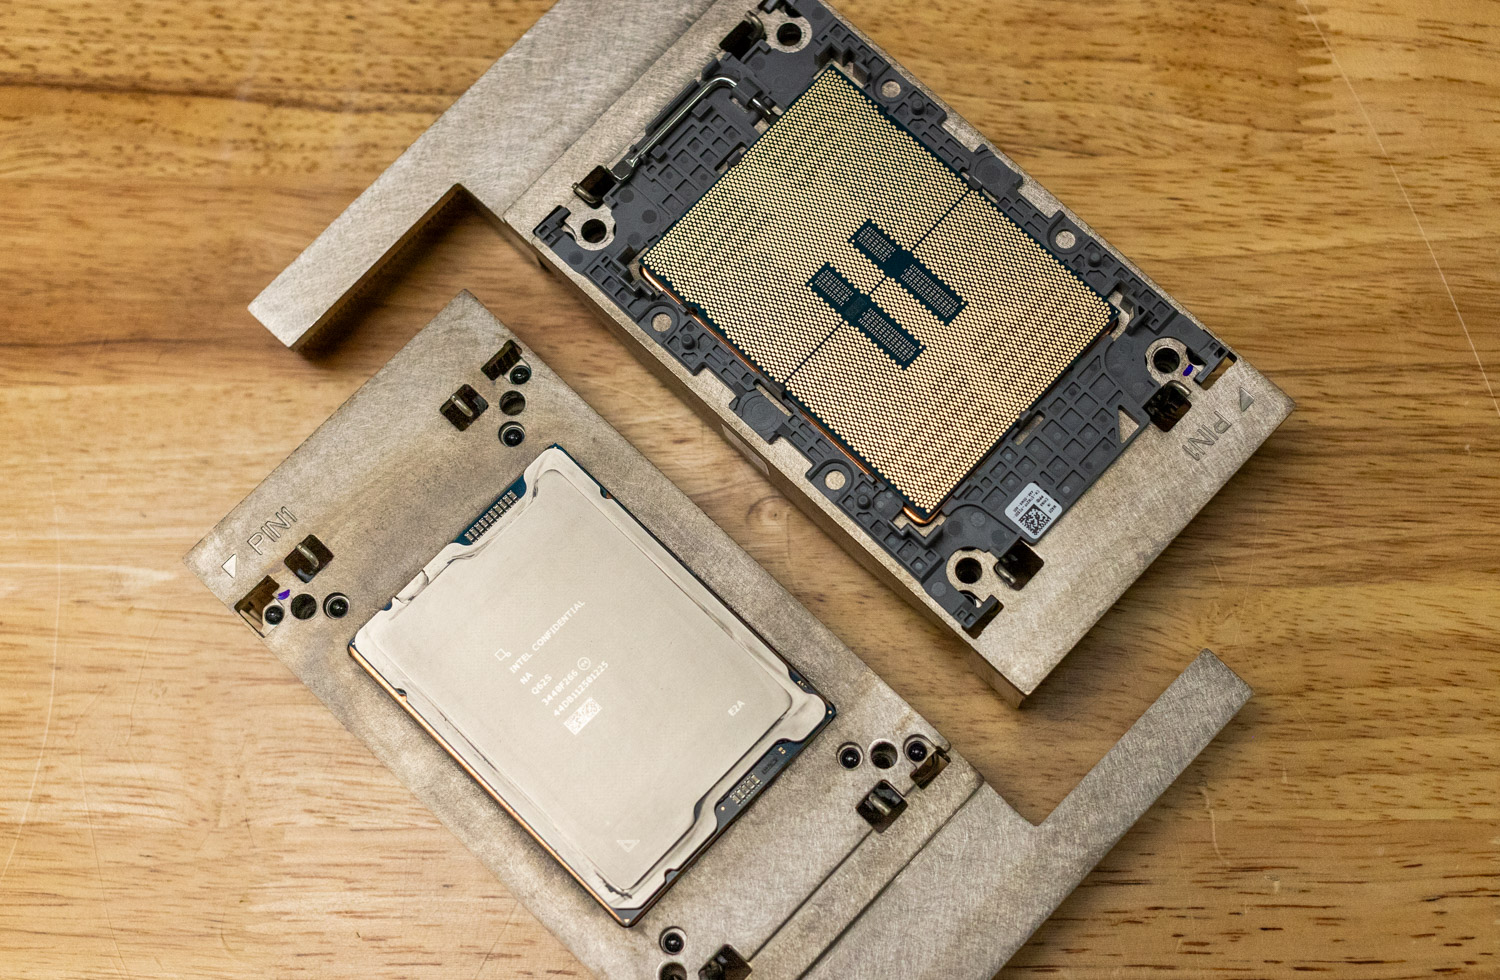
Geheugencapaciteit en bandbreedte zijn cruciaal voor AI-workloads, vooral bij het gebruik van KV-cache-offloading. Naarmate grotere taalmodellen een langere context krijgen, schaalt de KV-cache evenredig mee en kan een aanzienlijke hoeveelheid acceleratorgeheugen in beslag nemen. Door delen van de KV-cache naar het systeemgeheugen of snelle opslag te verplaatsen, kan de HBM van de accelerator efficiënter worden gebruikt voor actieve berekeningen, waardoor de tijd tot het eerste token (TTFT) voor chats met meerdere beurten wordt verkort.
Het is ook de moeite waard om de AMX-tensorunits van de Xeon 6 te vermelden, die een aanzienlijk deel van het werk aan de CPU-kant afhandelen. Dit omvat voorverwerking, tokenisatie en hybride inferentietaken met matrixbewerkingen. Dit is vooral handig bij inferentie-frameworks zoals SGLang, die de CPU gebruiken voor Radix Tree voor KV Cache Management en Zero Overhead scheduling.
Intel Gaudi 3-uitbreidingskaarten: concurrerende inferentie op grote schaal
Intels Gaudi 3 is het vlaggenschip van het bedrijf op het gebied van AI-acceleratoren en werd gelanceerd in het vierde kwartaal van 2024. Intel positioneert deze acceleratoren zeer agressief in plaats van rechtstreeks te concurreren met de beste trainingsacceleratoren voor datacenters. De Gaudi 3 is specifiek gericht op het inferentiesegment.
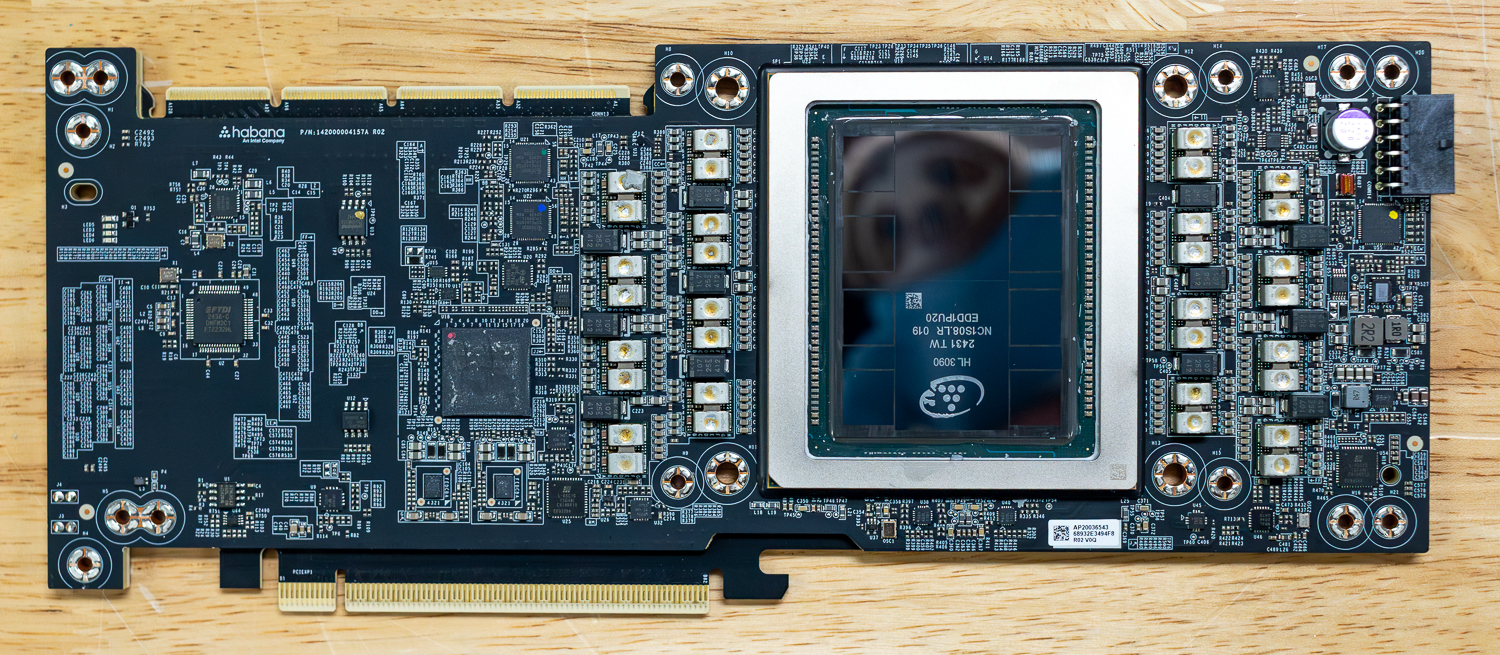
Transformer-gebaseerde modelinferentie in alle populaire LLM's van vandaag is fundamenteel geheugengebonden. Tijdens de decodeerfase van autoregressieve generatie genereert het model tokens één voor één, waarbij de modelgewichten en KV-cache-items voor elk geproduceerd token worden gelezen. De bottleneck zit niet in de rekenkracht, maar in de geheugenbandbreedte, oftewel hoe snel de accelerator gegevens van HBM naar de rekenmachines kan streamen.
De Gaudi 3 beschikt over 128 GB HBM2e-geheugen met een bandbreedte van 3.7 TB/s. De architectuur van de Gaudi 3 is gebaseerd op TSMC's 5nm-procestechnologie en maakt gebruik van een dual-die chiplet-ontwerp: twee identieke siliciumchips die met elkaar verbonden zijn door een interconnect met hoge bandbreedte, waardoor ze voor software als één geïntegreerd apparaat worden gezien. De rekenkracht is georganiseerd in vier Deep Learning Cores (DCORE's), elk met 2 MME's, 16 TPC's en 24 MB lokale SRAM-cache. De totale 96 MB on-die SRAM biedt een interne bandbreedte van 12.8 TB/s. De accelerator integreert ook 14 dedicated mediadecoders (H.265, H.264, JPEG, VP9), waardoor snelle beeldverwerking mogelijk is voor multimodale workloads.
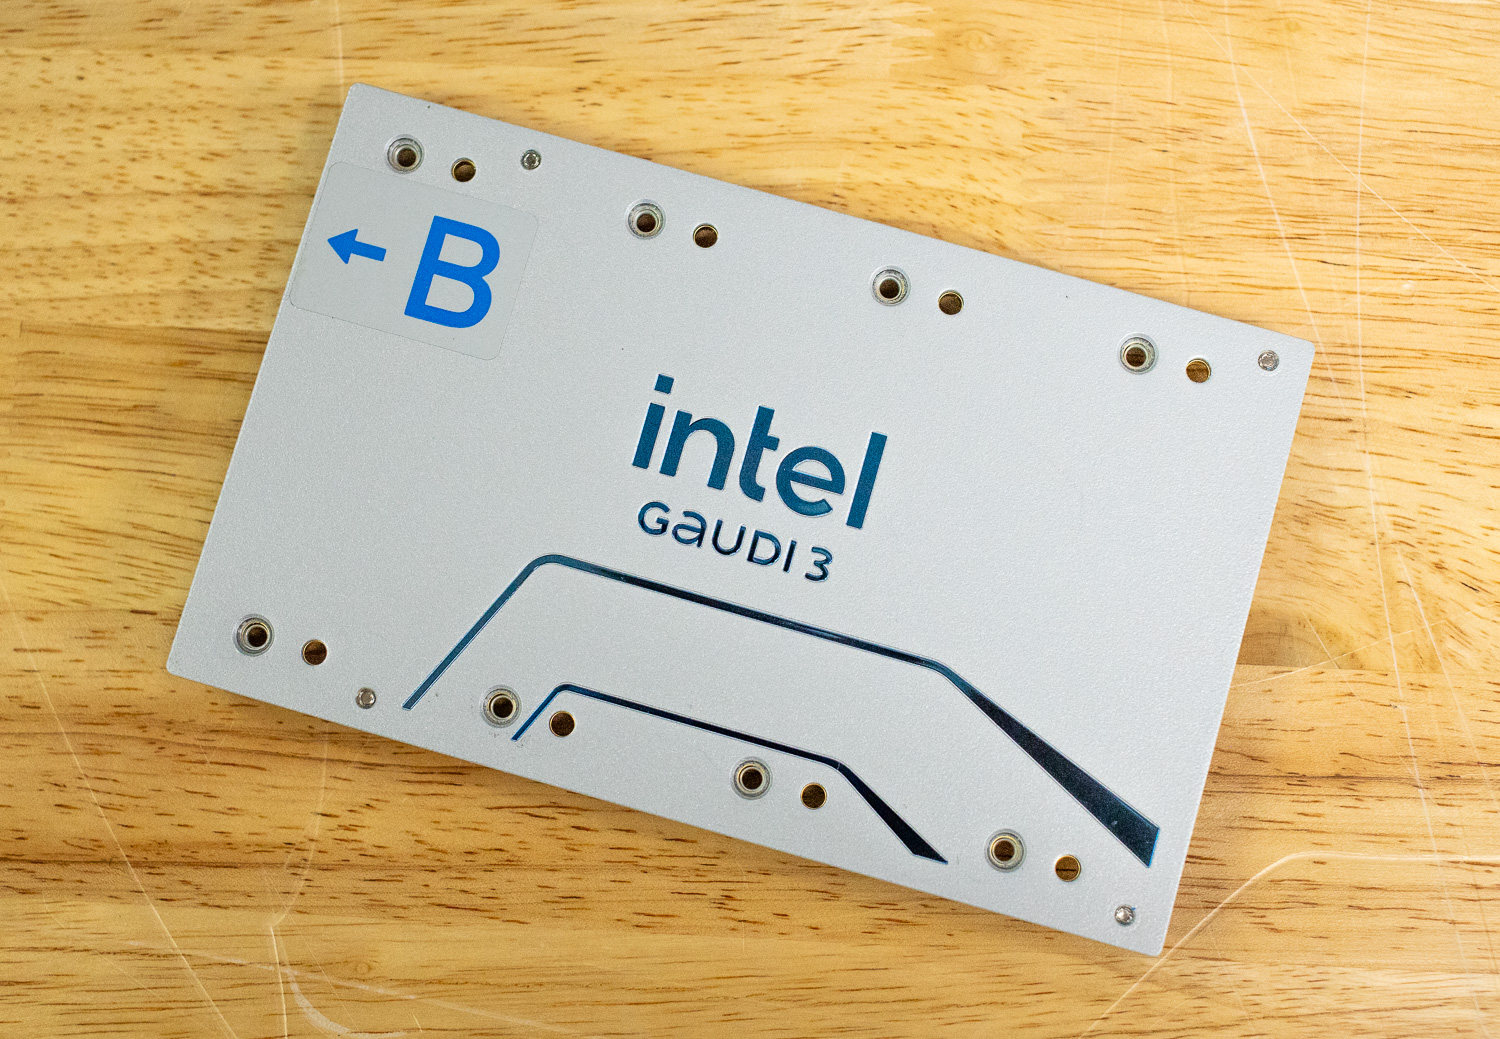
Een groot deel van de meest geavanceerde open-source AI-modellen die tegenwoordig worden uitgebracht, zijn ofwel van nature getraind met FP8, ofwel hybride modellen die FP8 (E4M3) en BF16-gewichten combineren. De Gaudi 3 biedt hiervoor native FP8-acceleratie dankzij de 8 matrixvermenigvuldigingsengines en 64 tensorprocessorkernen, wat resulteert in 1.8 PFlops aan FP8-rekenkracht.
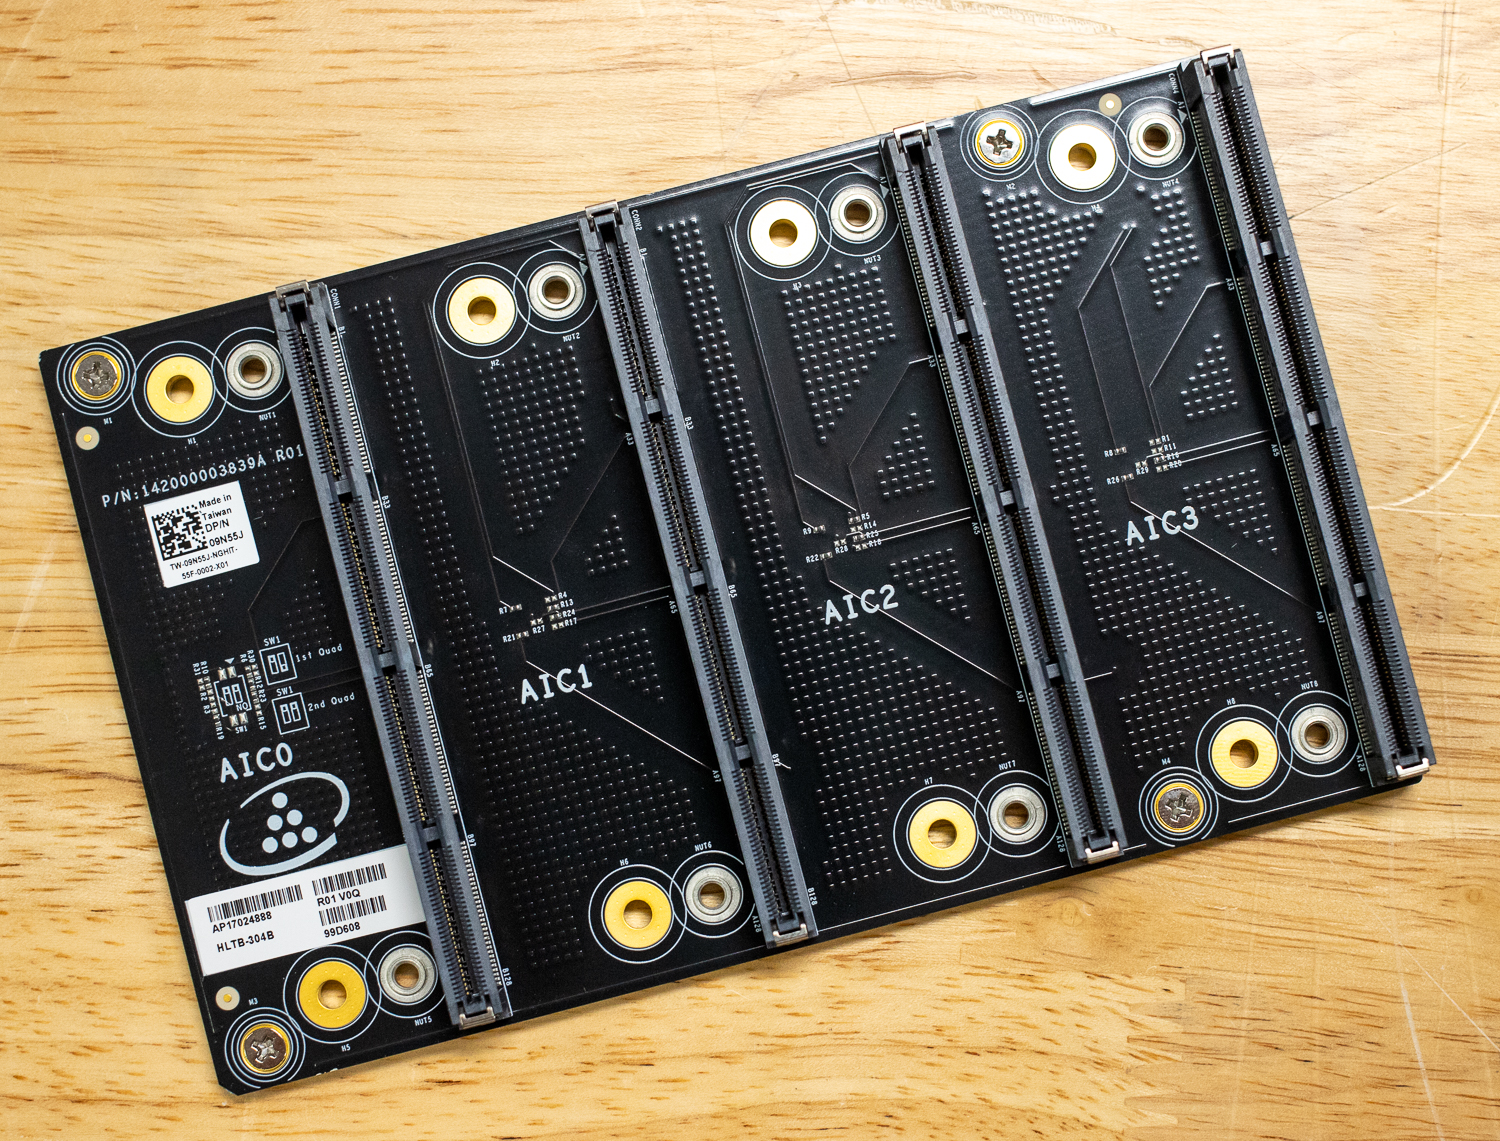
De Gaudi 3 integreert ook RDMA over Converged Ethernet (RoCEv2)-netwerken met 24 x 200 GbE-poorten op de OAM-versie, die direct in de chip zijn ingebouwd. Hoewel de PCIe-uitbreidingskaartvariant die in de XE7740 wordt gebruikt niet al deze poorten op dezelfde manier beschikbaar stelt, ondersteunen de uitbreidingskaartvarianten het overbruggen van 4 kaarten voor snellere communicatie ertussen.
Prestaties en benchmarks
Configuratiegegevens XE7740:
- 2 x Intel Xeon 6787P-processor (86 kernen, 2.00 GHz)
- 2TB DDR5 (32 x 64GB 5200MT/s DDR5
- 4 x Intel Gaudi 3 PCIe AI-accelerator met 128 GB HBM
- Ubuntu 24.04.5-server
vLLM Online Serverprestaties
Om de inferentiemogelijkheden van de Dell XE7740 met Intel Gaudi 3-acceleratoren te evalueren, hebben we de prestaties van vLLM online getest met een reeks populaire modellen, die verschillende architecturen, parameteraantallen en precisieformaten omvatten. Elk model werd getest met drie workloadprofielen, waarbij het aantal gelijktijdige aanvragen varieerde van 1 tot 128.
LLM-inferentie bestaat uit twee afzonderlijke fasen. De prefill-fase verwerkt alle invoertokens parallel voordat er uitvoertokens kunnen worden gegenereerd. Dit maakt het een rekenintensieve bewerking die lineair schaalt met het aantal invoertokens. De decode-fase genereert vervolgens de uitvoertokens één voor één (autoregressief). Elk nieuw token vereist het lezen van de volledige modelgewichten uit het geheugen, maar voert relatief weinig berekeningen per token uit, waardoor het een geheugenbandbreedte-intensieve bewerking is.
Deze twee fasen belasten fundamenteel verschillende onderdelen van de versneller, daarom testen we drie werkbelastingsprofielen die de balans tussen beide verschuiven:
- Gelijk (1024 invoer-/1024 uitvoertokens) staat voor evenwichtige chatinteracties.
- Prefill Heavy (8192 input/1024 output) simuleert retrieval-augmented generation of long-context summarization, waarbij het systeem grote inputcontexten moet verwerken.
- Decode Heavy (1024 input/8192 output) staat voor het genereren van lange teksten, waarbij de constante geheugenbandbreedte de doorvoer bepaalt.
In dit gedeelte richten we ons op twee primaire meetwaarden. De totale tokendoorvoer, gemeten in tokens per seconde, geeft de algehele verwerkingscapaciteit van het systeem onder belasting weer. De tijd tot het eerste token (TTFT) meet de vertraging tussen het indienen van een verzoek en het ontvangen van het eerste gegenereerde token. Omdat het model de volledige prefill-fase moet voltooien voordat het het eerste token kan genereren, is TTFT direct gekoppeld aan de rekenkracht van de accelerator. Dit maakt het scenario met veel prefill (in combinatie met TTFT) een bijzonder nuttige indicator voor de pure rekenkracht van de Gaudi 3-accelerators, aangezien het systeem alle 8,192 invoertokens moet verwerken voordat de gebruiker een reactie ziet.
Omgekeerd test het scenario met veel decodering de geheugenbandbreedte van de accelerators, omdat het systeem een hoge doorvoer moet kunnen handhaven voor duizenden gegenereerde tokens. TTFT (Time To First Time) is cruciaal voor interactieve applicaties waarbij gebruikers wachten op een reactie voordat het streamen kan beginnen. Een systeem kan een uitstekende doorvoer bereiken bij zware batchverwerking, maar toch traag aanvoelen als de TTFT te hoog oploopt. Daarom zijn beide meetwaarden belangrijk voor implementaties in productieomgevingen.
Een opmerking over de FP8-precisieresultaten: hoewel Intel Gaudi 3-acceleratoren native FP8-rekenacceleratie bevatten (en FP8 in theorie een hogere doorvoer zou moeten leveren dan BF16), liggen de FP8-prestaties in onze benchmarks lager dan die van de BF16-varianten. Dit is geen hardwarebeperking, maar eerder een probleem met de softwarevolwassenheid van Intels fork van vLLM. De versie die we hebben getest (vLLM-installatieprogramma 2.7.1 op Gaudi Docker 1.22.2) heeft de FP8-code nog niet volledig geoptimaliseerd. Intel heeft een nieuwe, op plug-ins gebaseerde versie van vLLM in bèta die mogelijk veel van deze prestatieproblemen zal oplossen.
Lama 3.1 8B Instrueer
Llama 3.1 8B Instruct is een compact transformermodel van Meta, wat betekent dat elke parameter actief is voor elk gegenereerd token. Met 8 miljard parameters behoort het tot de meer open-source modellen. Modellen van deze omvang zijn populair voor alledaagse taken zoals het samenvatten van korte documenten, het opstellen van e-mails en berichten, het beantwoorden van eenvoudige vragen en het aansturen van simpele chatbot-interacties waarbij snelheid en kostenefficiëntie belangrijker zijn dan diepgaande redenering.
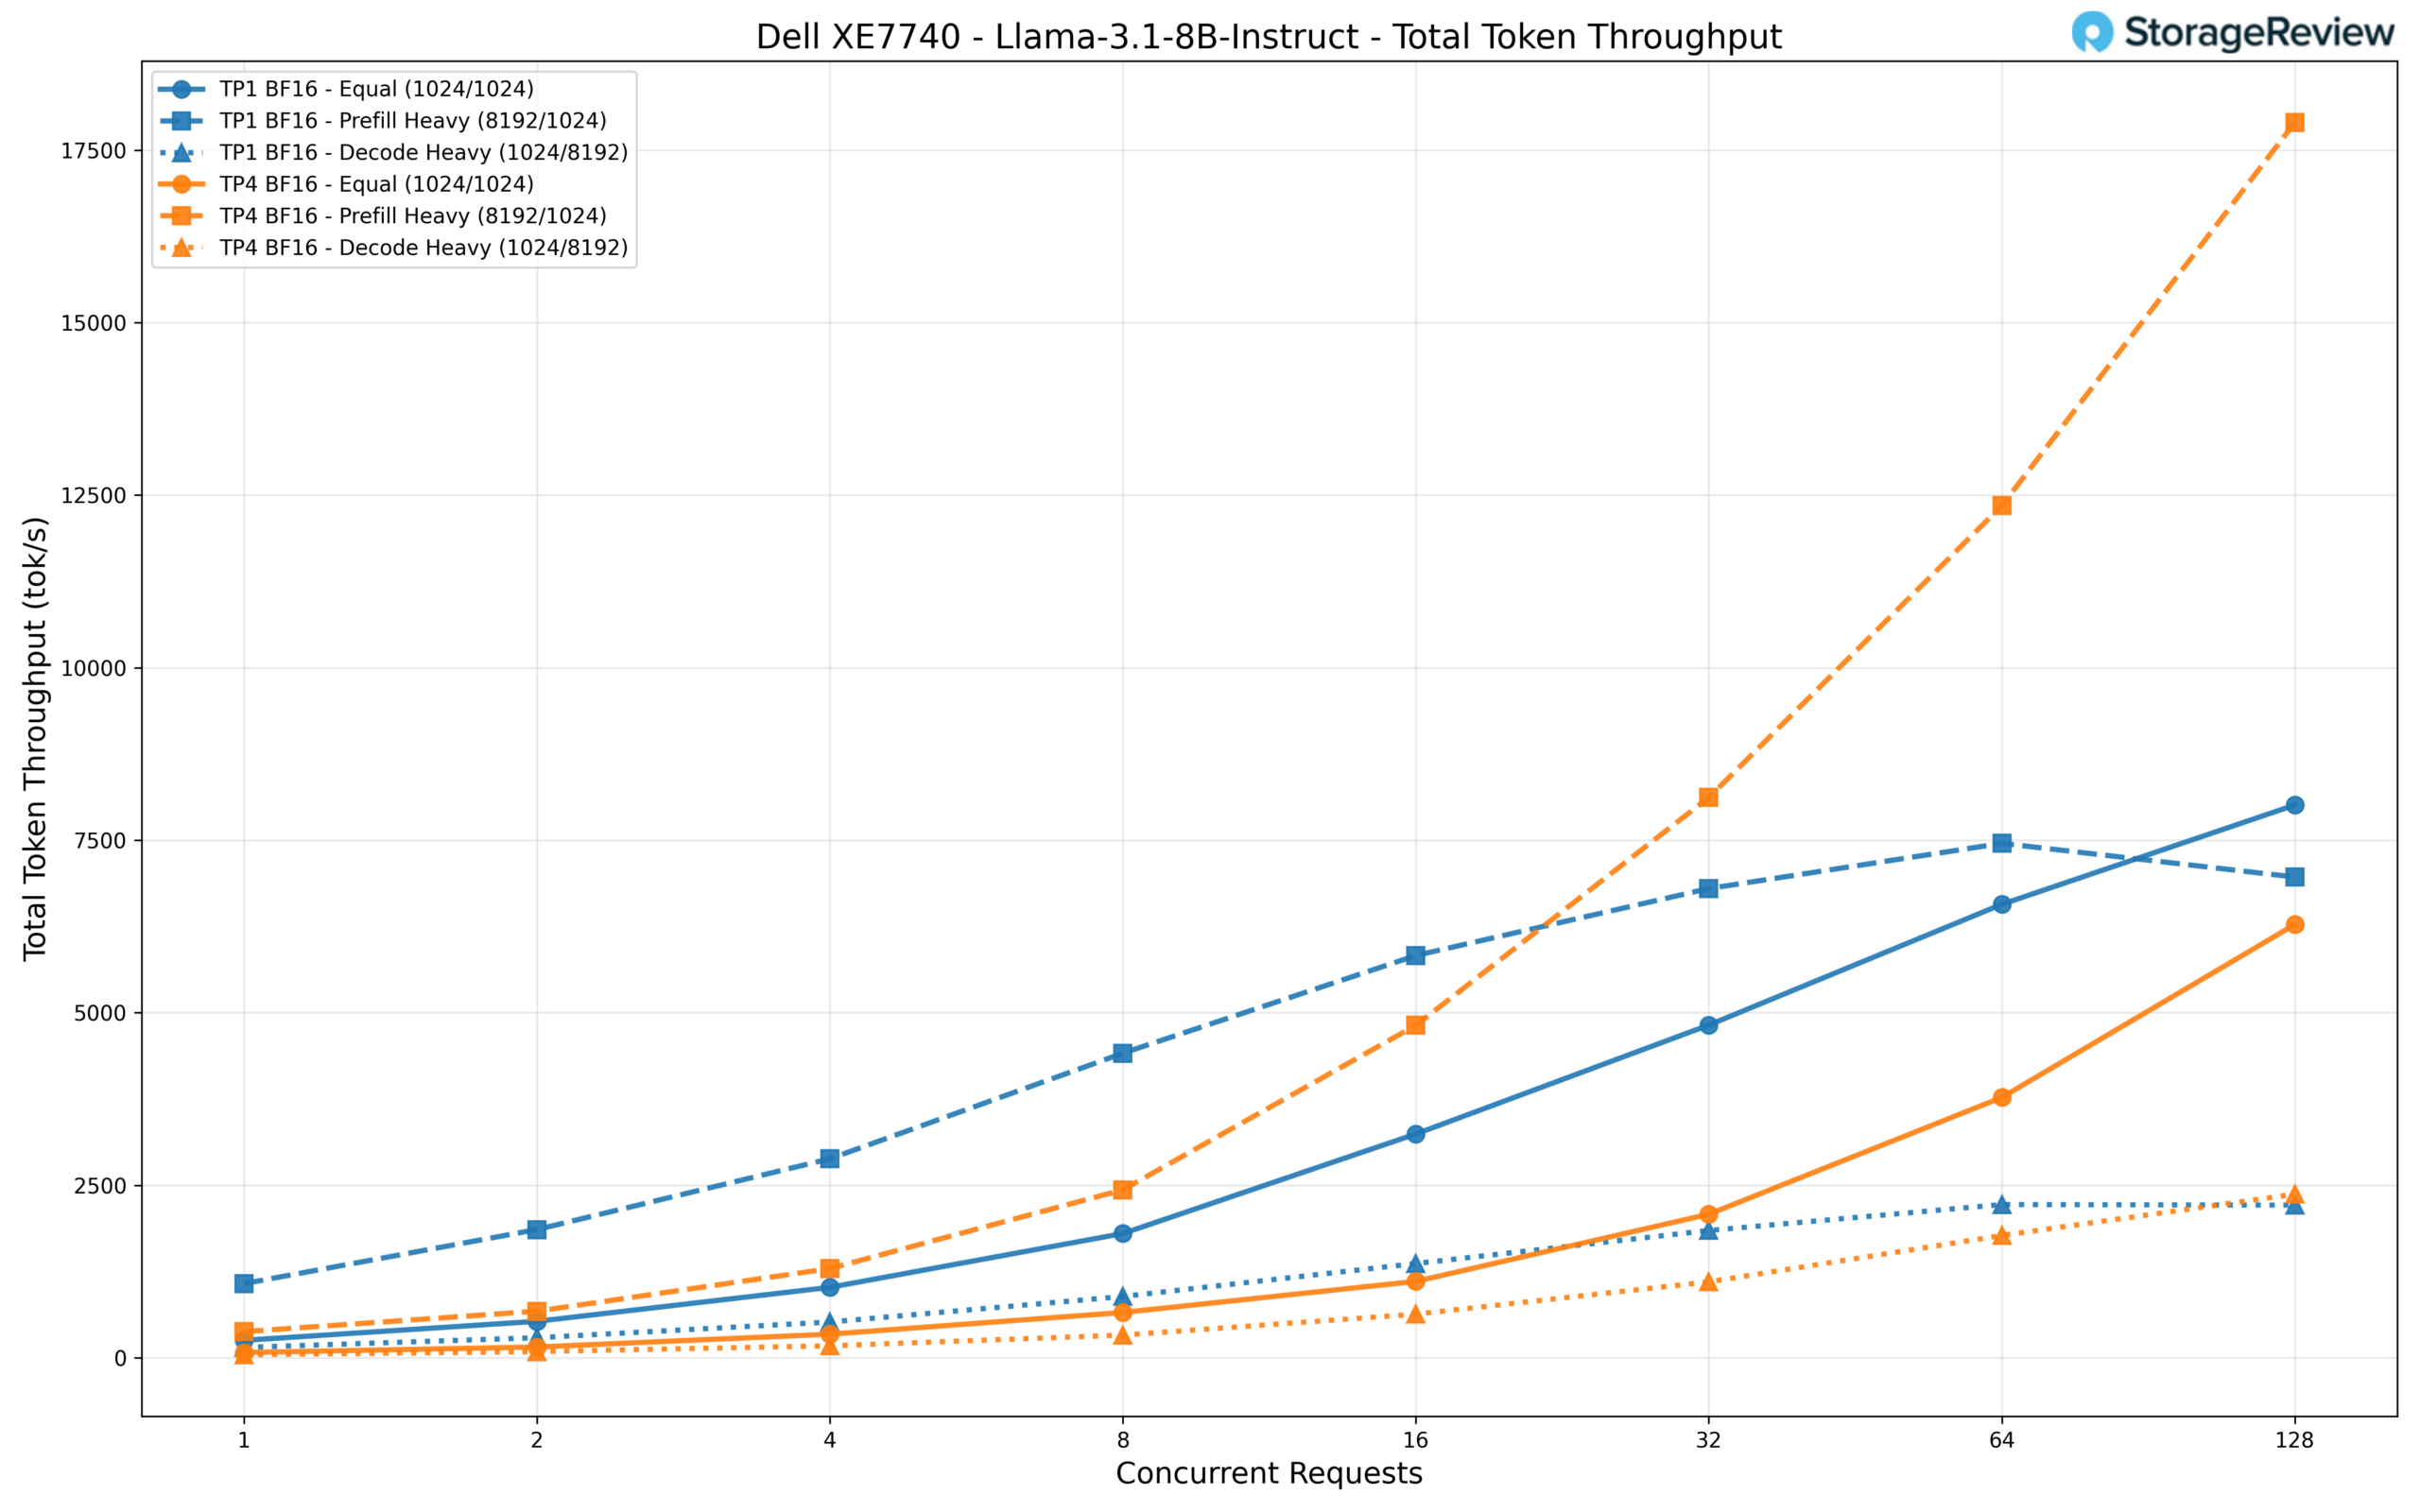
We hebben dit model getest in zowel TP1- (één accelerator) als TP4-configuraties (alle vier Gaudi 3-accelerators). Op TP1 behaalt het model een totale doorvoer van ongeveer 8,000 tok/s bij 128 gelijktijdige verzoeken met een gelijke werklast, waarbij de doorvoer soepel schaalt van ongeveer 250 tok/s bij één enkel verzoek. Het scenario met veel prefill laat een interessant patroon zien: terwijl TP1 piekt op ongeveer 7,000 tok/s, stijgt TP4 naar meer dan 17,900 tok/s bij 128 gelijktijdige verzoeken, waarbij extra accelerators worden ingezet om de grote inputcontext efficiënter te verwerken.
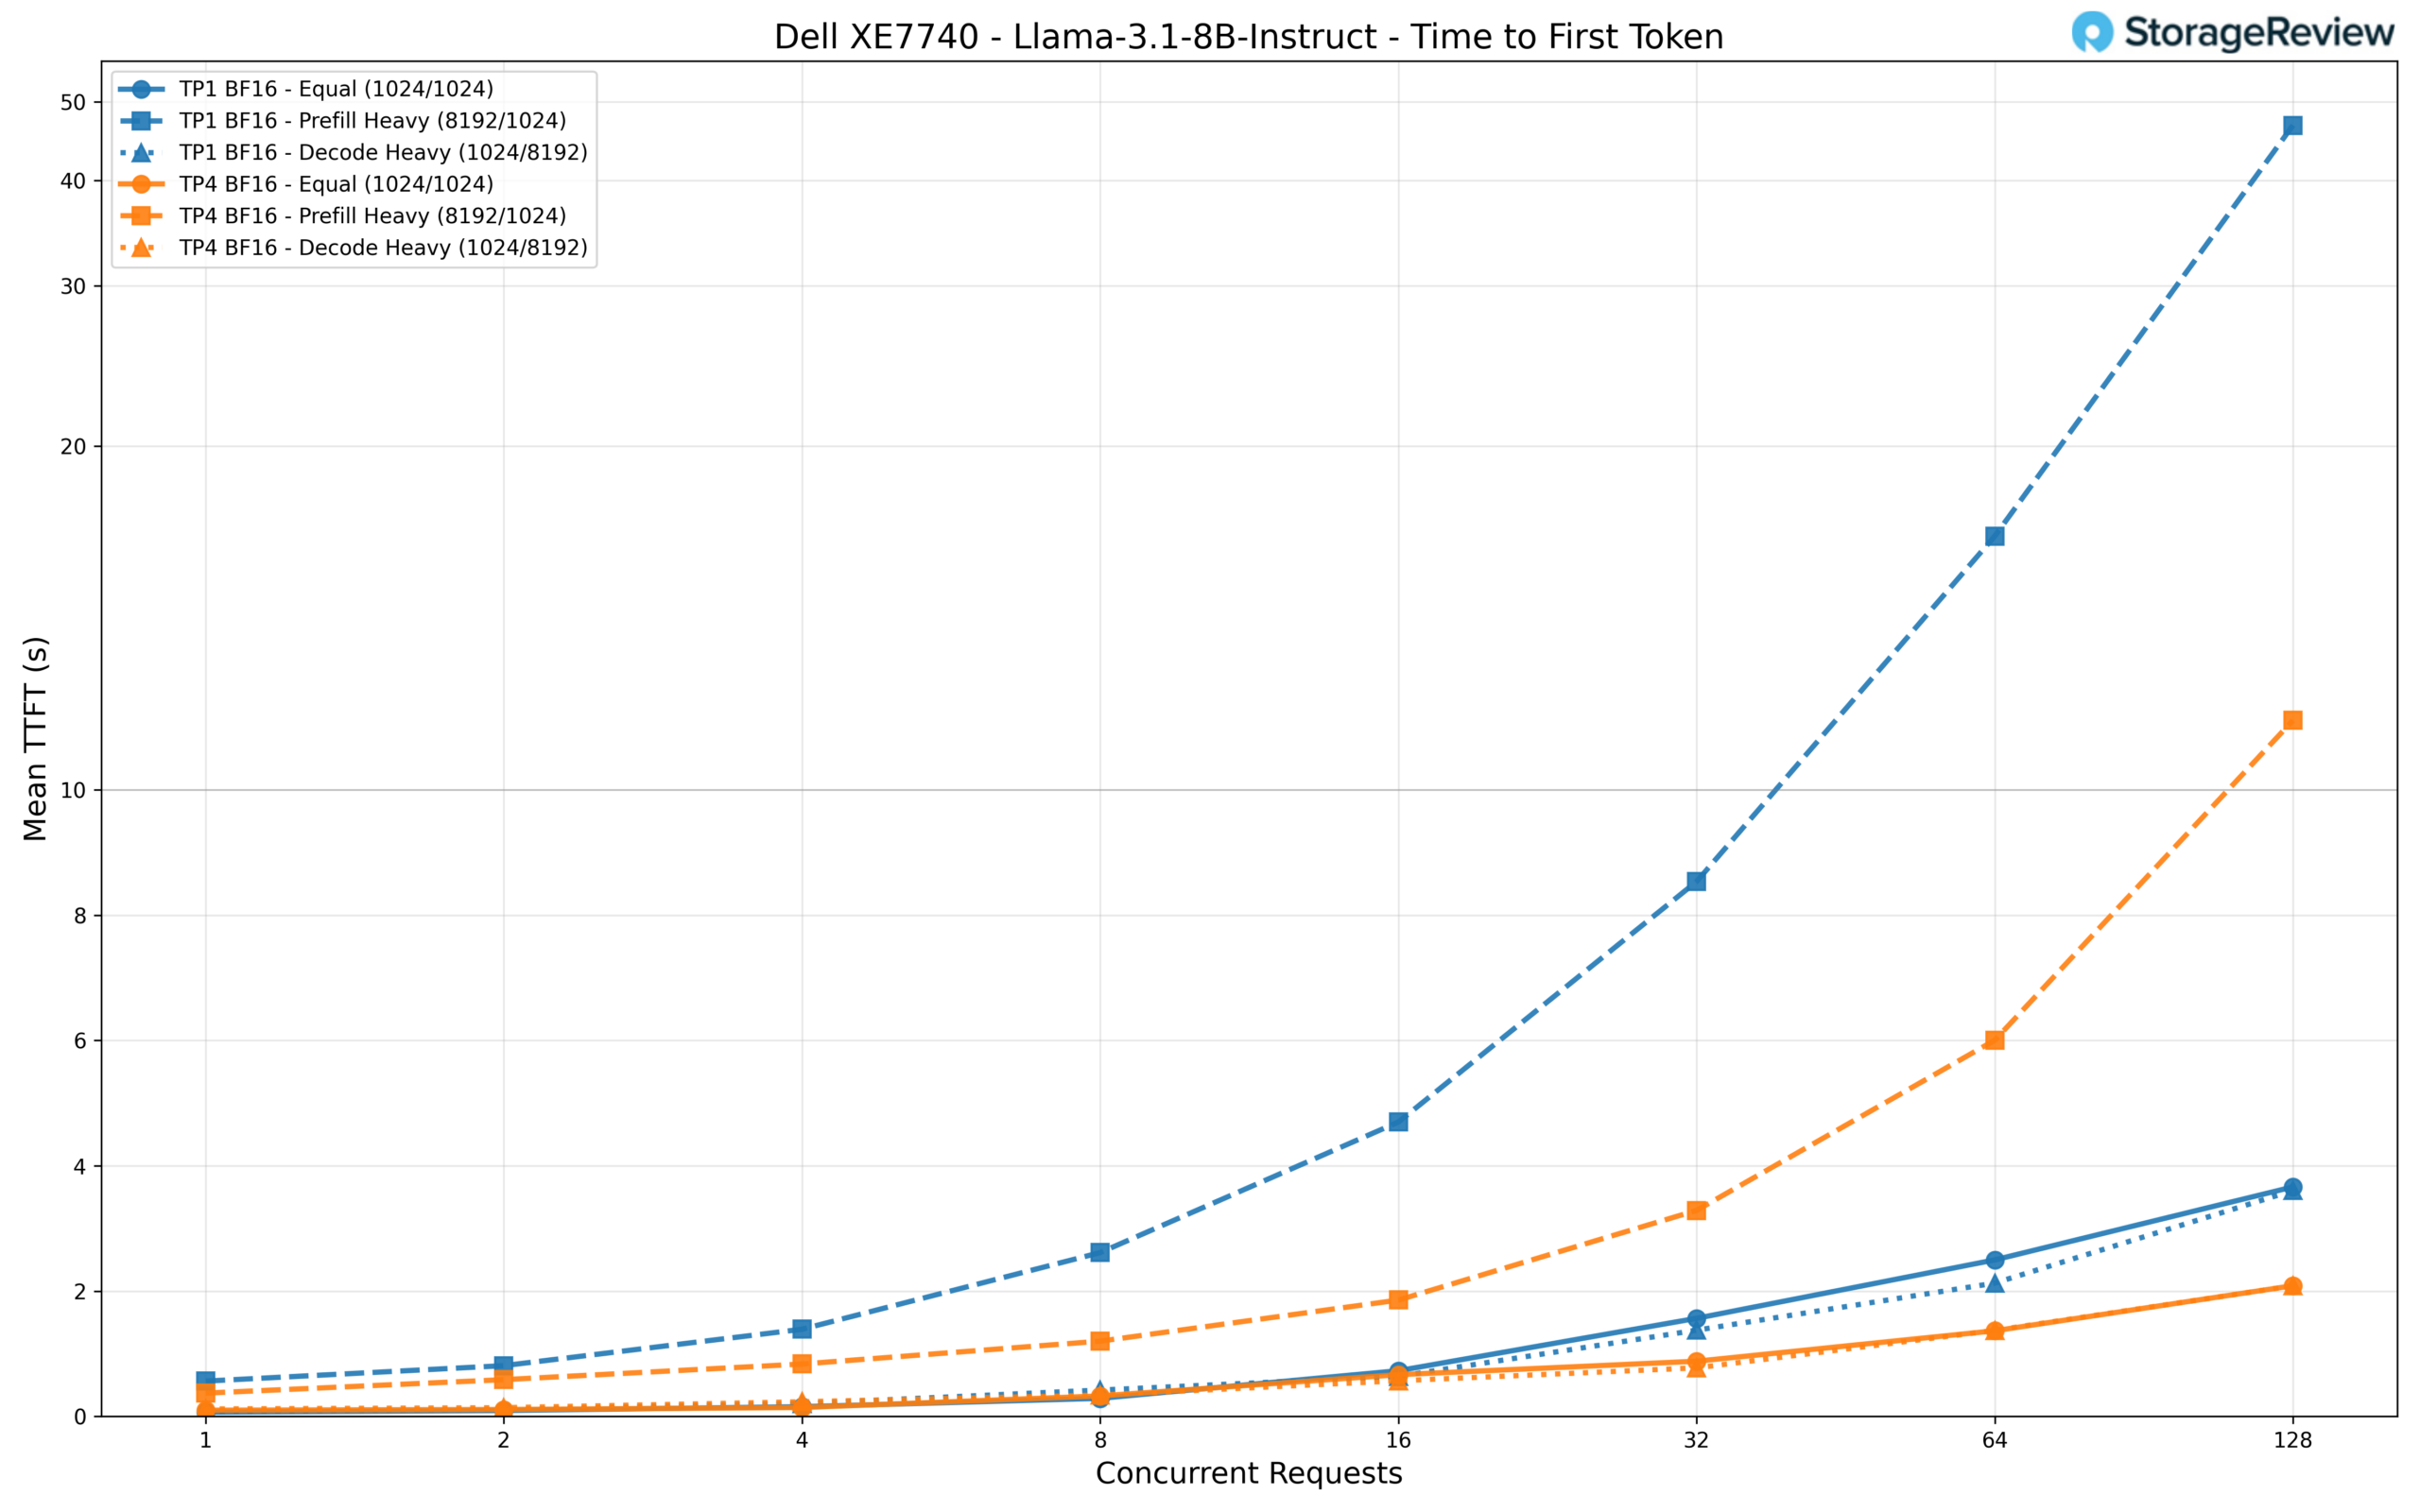
Voor latentie bij één gebruiker levert TP1 bij lage gelijktijdigheid een lagere TTFT (Time To First Time) (67 ms versus 98 ms voor TP4), wat de overhead weerspiegelt van de coördinatie tussen vier accelerators voor een model dat comfortabel op één accelerator past. Naarmate de belasting toeneemt, loopt TP4 echter duidelijk vooruit. Bij 128 gelijktijdige verzoeken houdt TP4 de TTFT rond de 2 seconden voor gelijke en decodeerbelastingen, terwijl TP1 oploopt tot respectievelijk 3.7 seconden en 6.6 seconden. Het verschil is het grootst in het scenario met veel prefill: TP1 bereikt bijna 47 seconden TTFT bij 128 verzoeken, terwijl TP4 dit beperkt tot ongeveer 11 seconden.
Lama 3.1 70B Instrueer
Llama 3.1 70B Instruct is het grotere, compactere model in Meta's Llama 3.1-familie. Met 70B-parameters biedt het aanzienlijk betere mogelijkheden voor het opvolgen van instructies en meertaligheid dan de 8B-variant. Modellen van deze omvang zijn zeer geschikt voor intensievere agentische taken, zoals klantenservicemedewerkers, onderzoeksassistenten met meerdere stappen, complexe documentanalyse en taken die vereisen dat de context gedurende langere interacties behouden blijft.
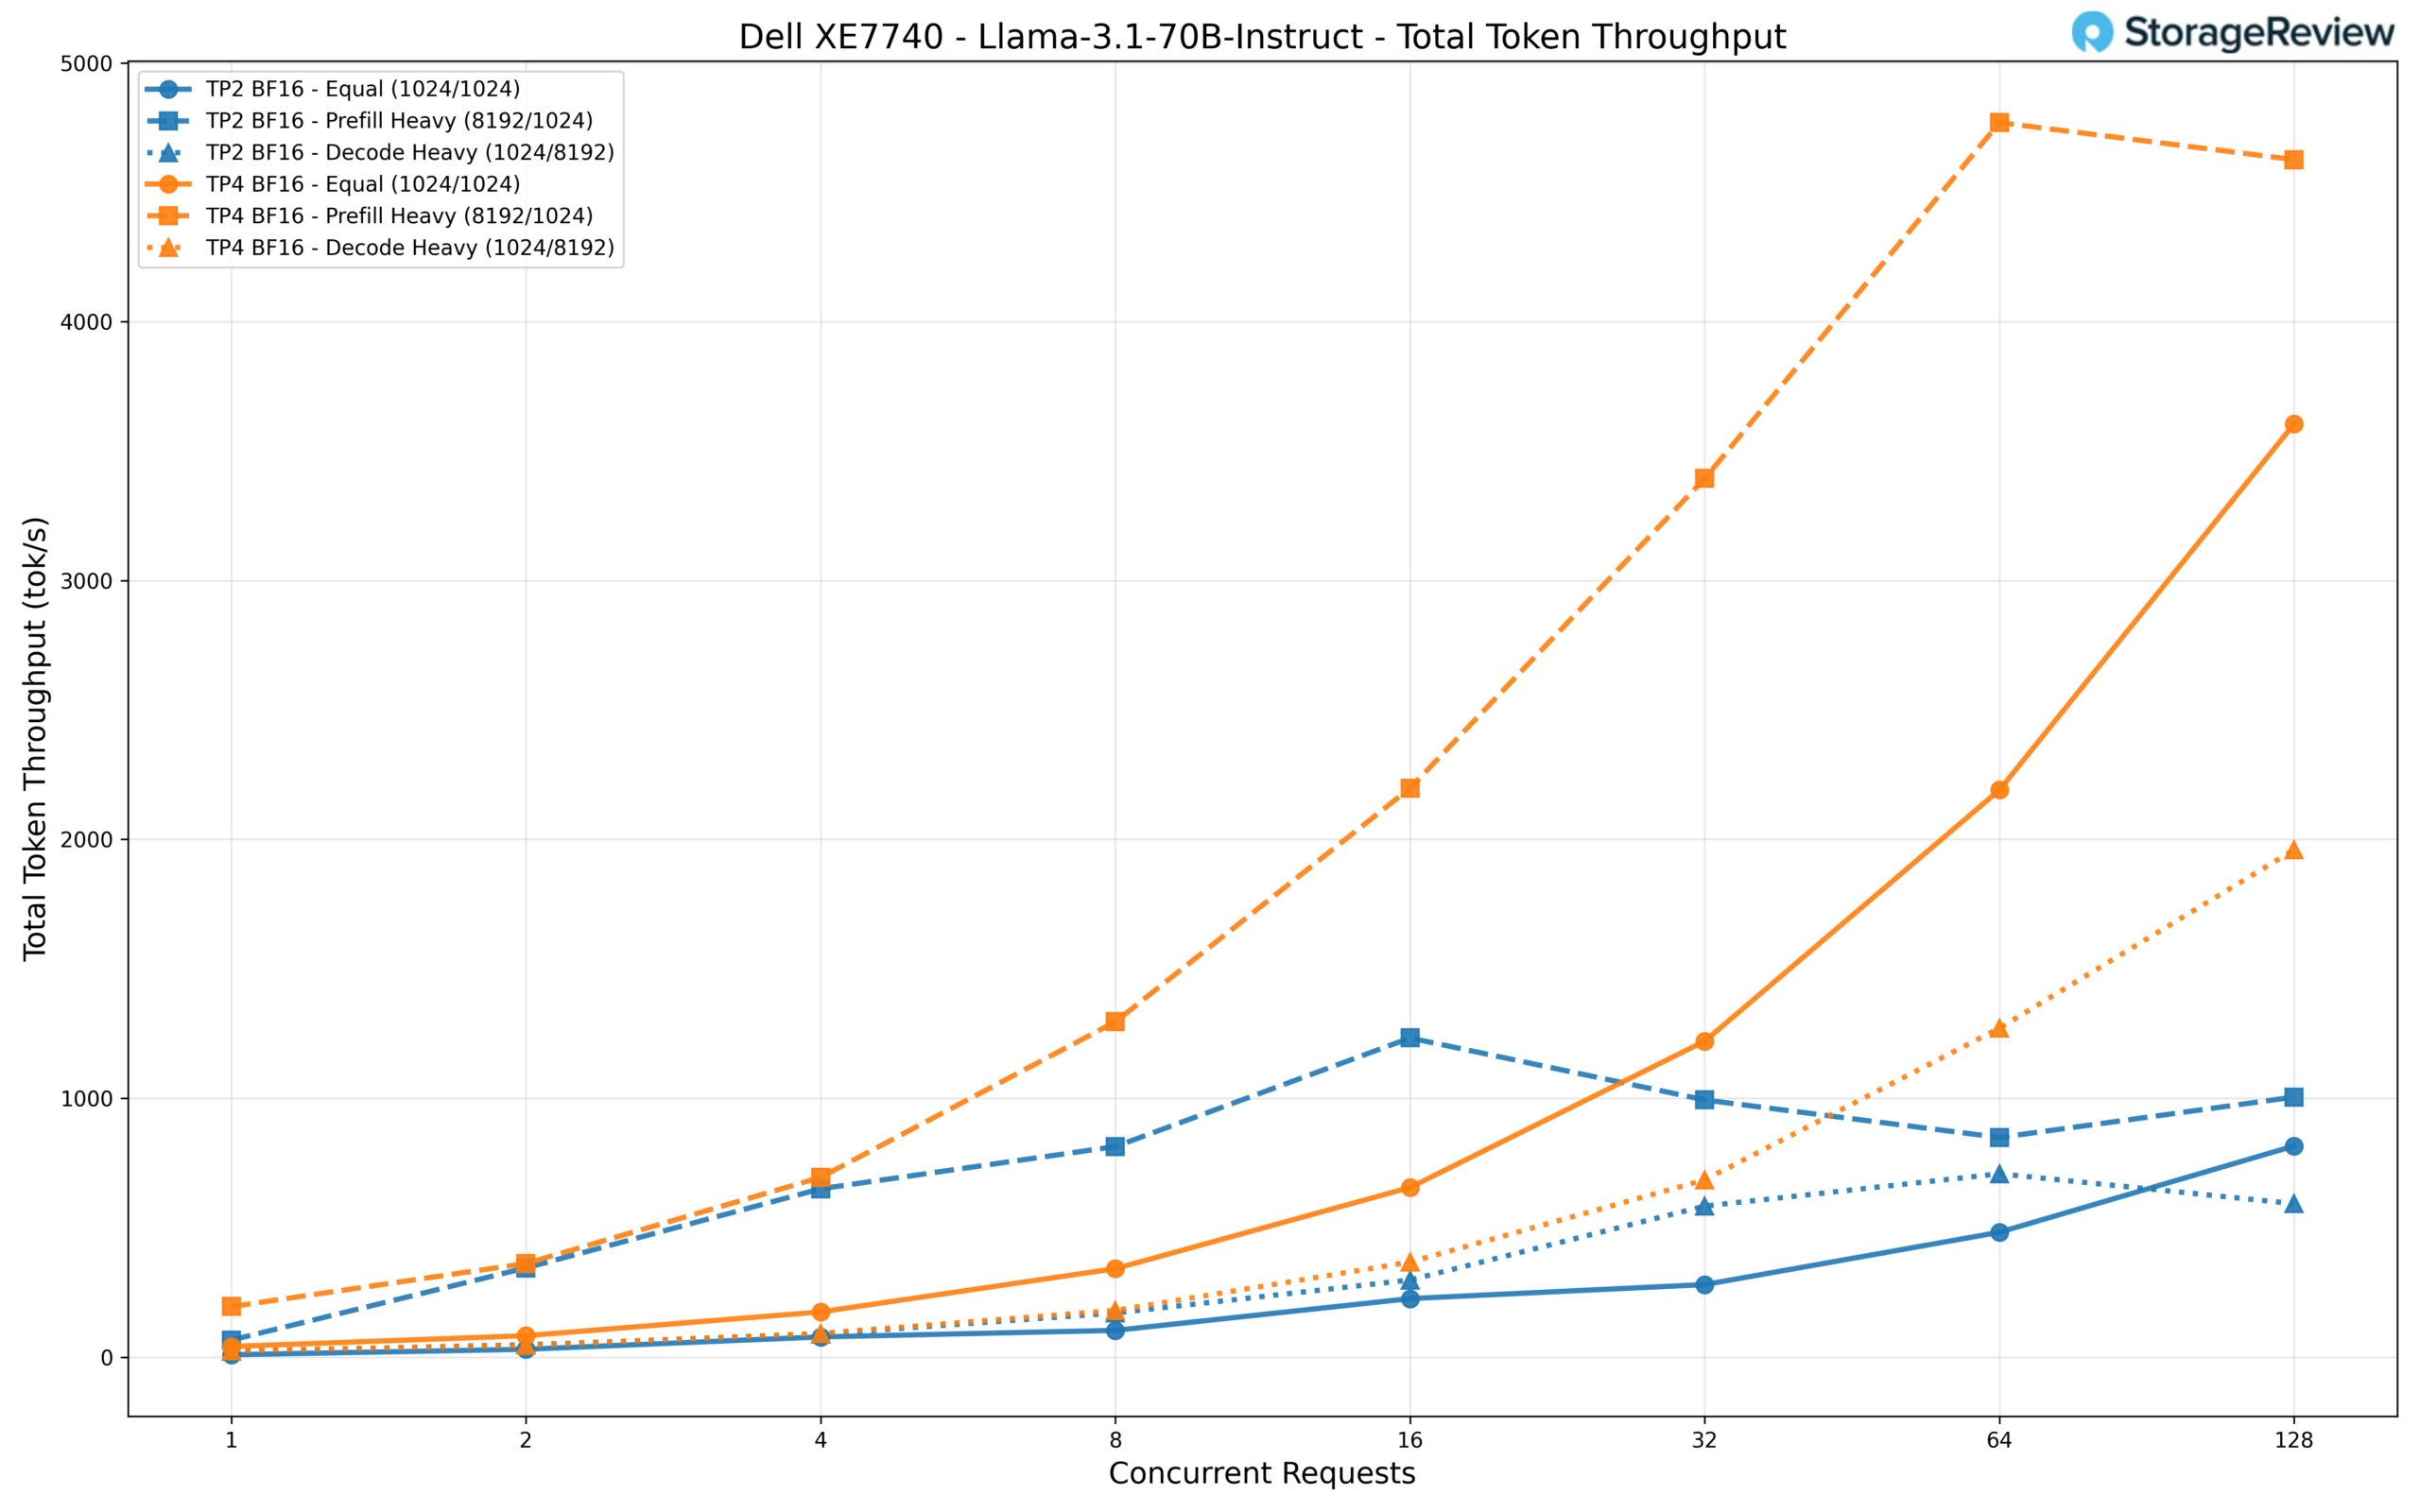
We hebben dit model getest met TP2- en TP4-configuraties. Het verschil in doorvoer tussen de twee is aanzienlijk. Bij 128 gelijktijdige verzoeken levert TP4 ongeveer 3,600 tok/s bij een gelijke werkbelasting en piekt het rond de 4,600 tok/s in het scenario met veel prefill-bewerkingen. Dit is ongeveer 4.4x en 4.6x de doorvoer van TP2, die respectievelijk maximaal ongeveer 816 tok/s en 1,005 tok/s haalt. Zelfs bij een werkbelasting met veel decodeerbewerkingen bereikt TP4 ongeveer 1,960 tok/s, vergeleken met 593 tok/s op TP2.
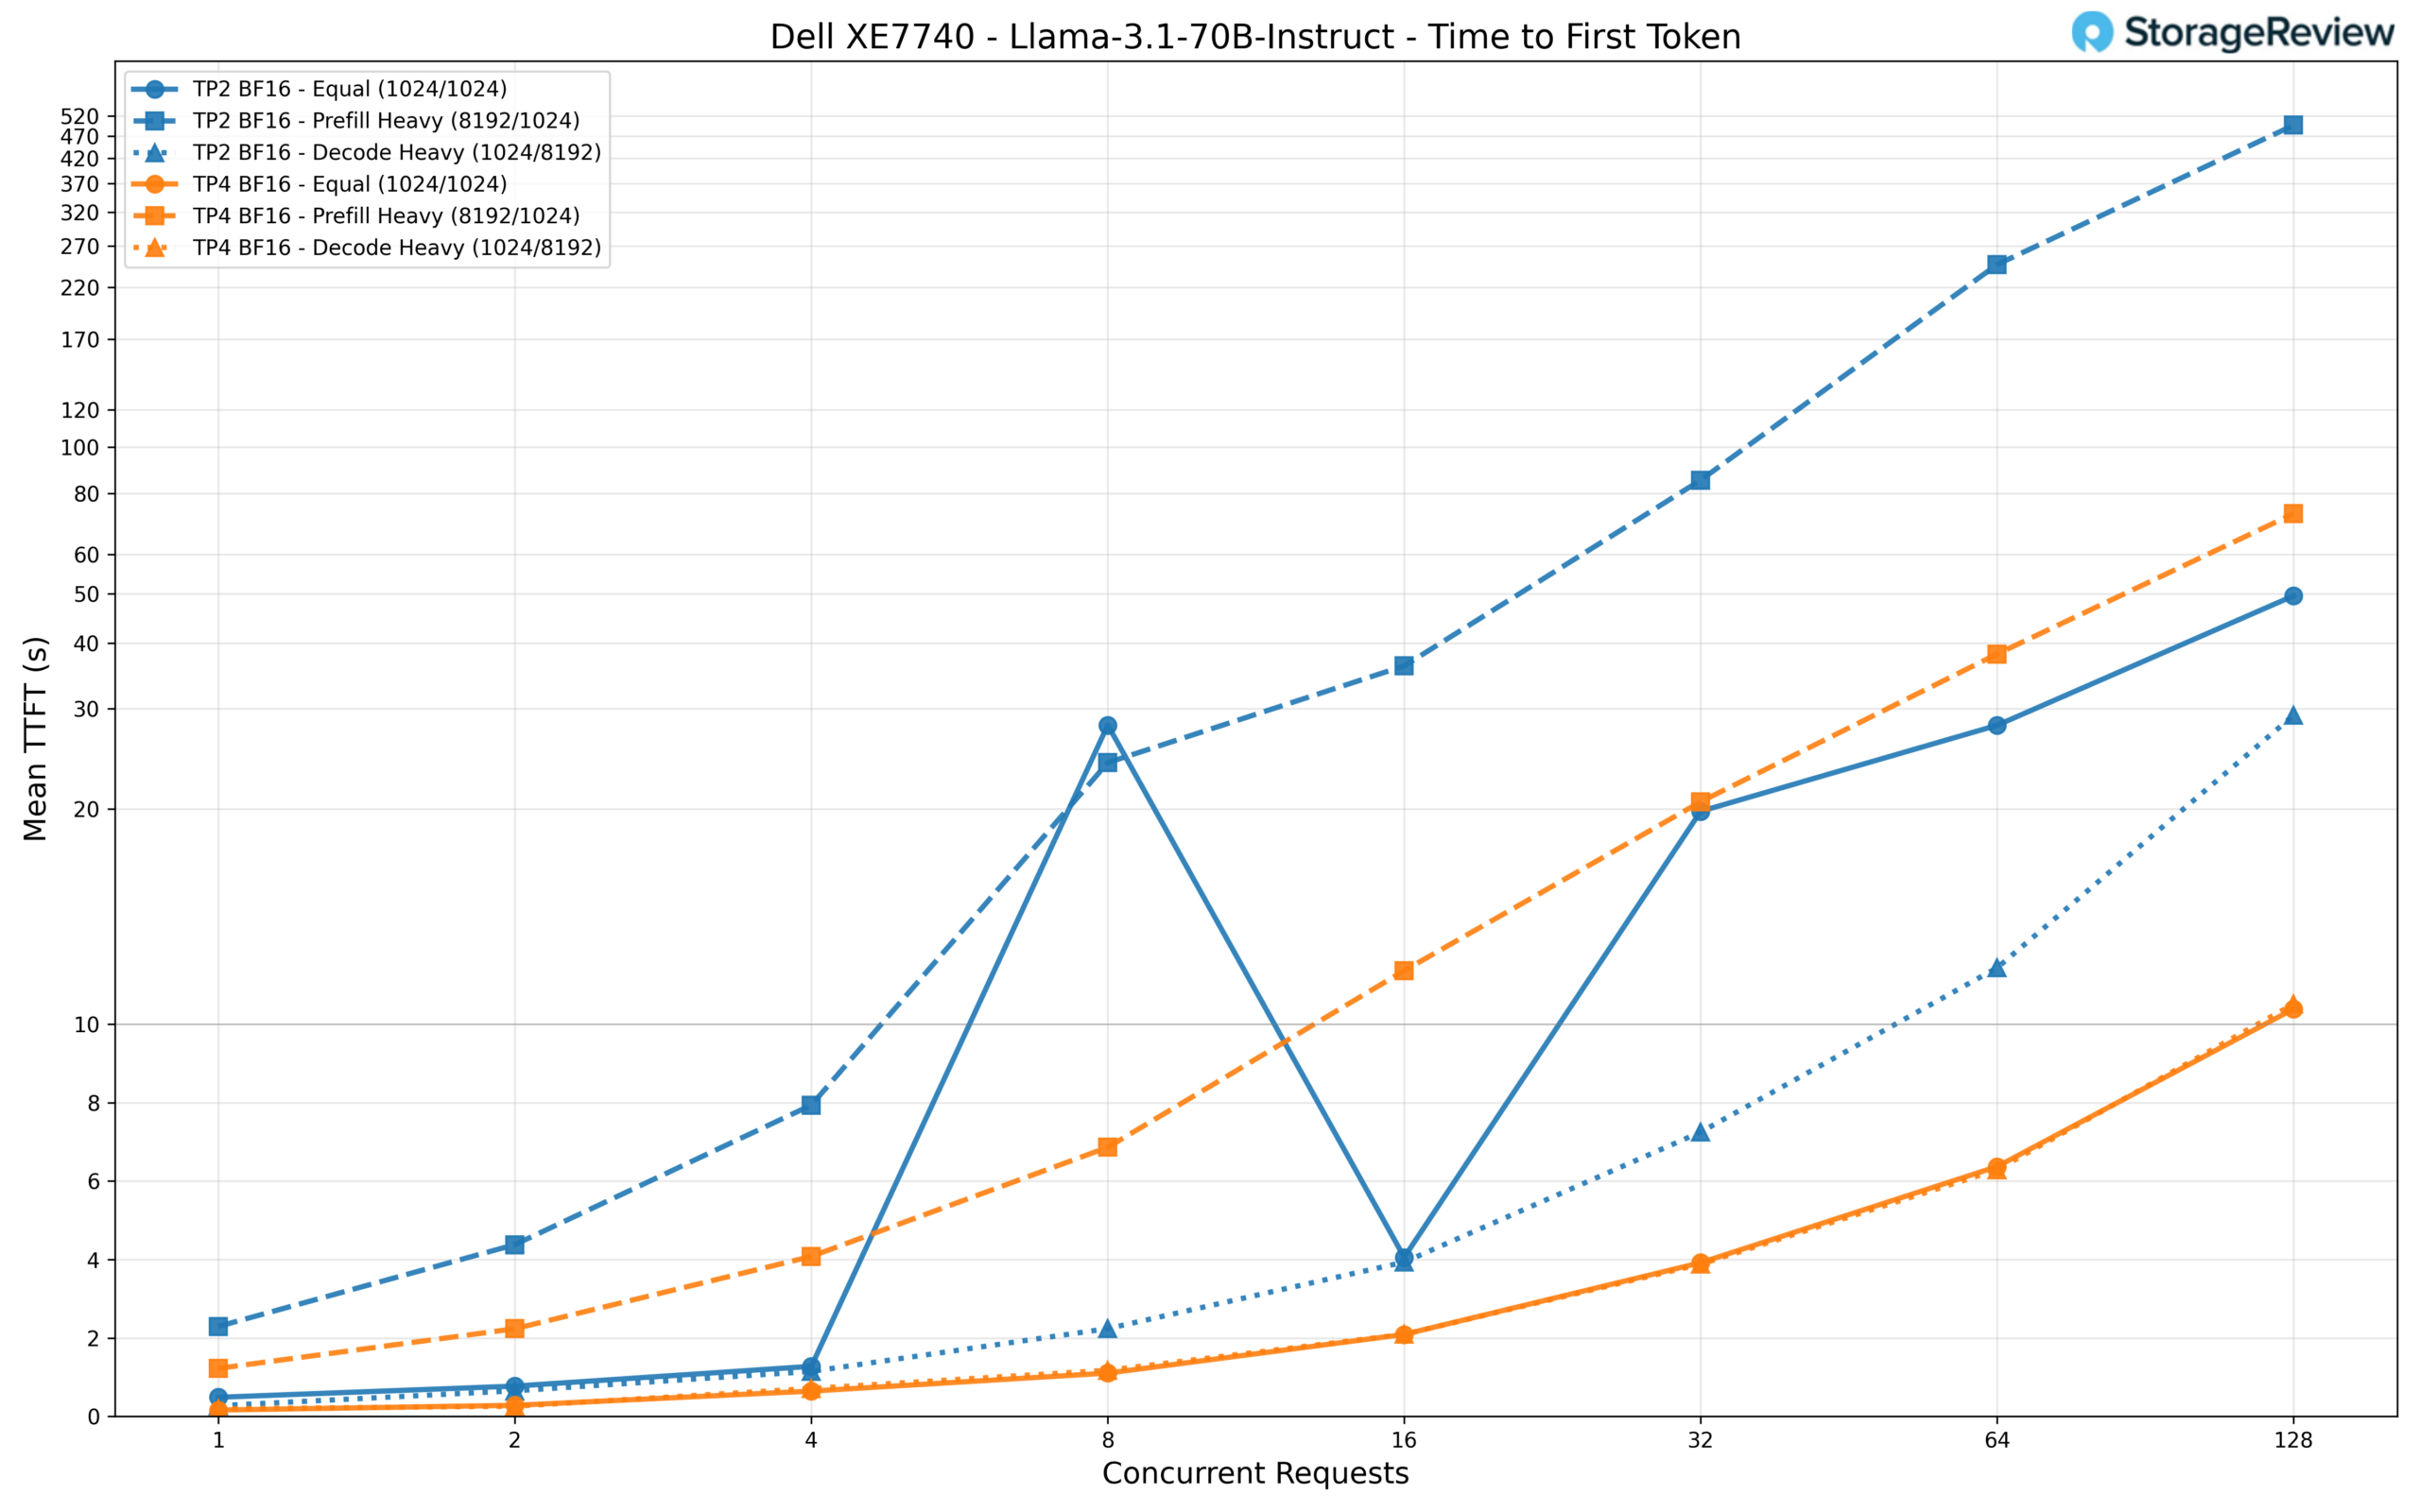
Wat TTFT betreft, heeft TP2 moeite onder belasting met de workload die veel prefill-taken bevat, met een duizelingwekkende TTFT van 496 seconden bij 128 gelijktijdige verzoeken, waardoor het in feite onbruikbaar is voor interactieve applicaties. TP4 brengt dit terug tot ongeveer 73 seconden. Voor de workloads 'equal' en 'decode' houdt TP4 de TTFT op ongeveer 10 seconden bij 128 verzoeken, terwijl TP2 respectievelijk 50 en 29 seconden bereikt. Bij een lage gelijktijdigheid levert TP4 de eerste-tokenrespons in ongeveer 160 ms voor de 'equal' workload, vergeleken met 486 ms op TP2.
Qwen3 Coder 30B-A3B Instructie
Qwen3 Coder 30B-A3B is een van de populairste codeermodellen voor lokale inferentie-implementaties en maakt gebruik van een Mixture-of-Experts (MoE)-architectuur. In tegenstelling tot dense modellen, waarbij elke parameter deelneemt aan elke forward pass, leiden MoE-modellen elk token door een kleine subset van gespecialiseerde expertnetwerken. De Qwen3 Coder behoudt een volledige modelgrootte van 30 miljard parameters met BF16-precisie, terwijl slechts 3 miljard parameters per gegenereerd token worden geactiveerd. Dit spaarzame activeringspatroon betekent dat het model de kwaliteit van een veel groter netwerk kan leveren met slechts een fractie van de rekenkracht per token, waardoor het extreem efficiënt is op hardware die de routeringsoverhead ondersteunt. Voor eindgebruikers is dit model zeer geschikt voor dagelijkse codeerondersteuning, zoals het genereren van boilerplate-code, het aanvullen van functies, het uitleggen van code, het schrijven van unit-tests en het afhandelen van routinematige ontwikkeltaken die baat hebben bij een code-gespecialiseerd model zonder dat er zware redenering nodig is.
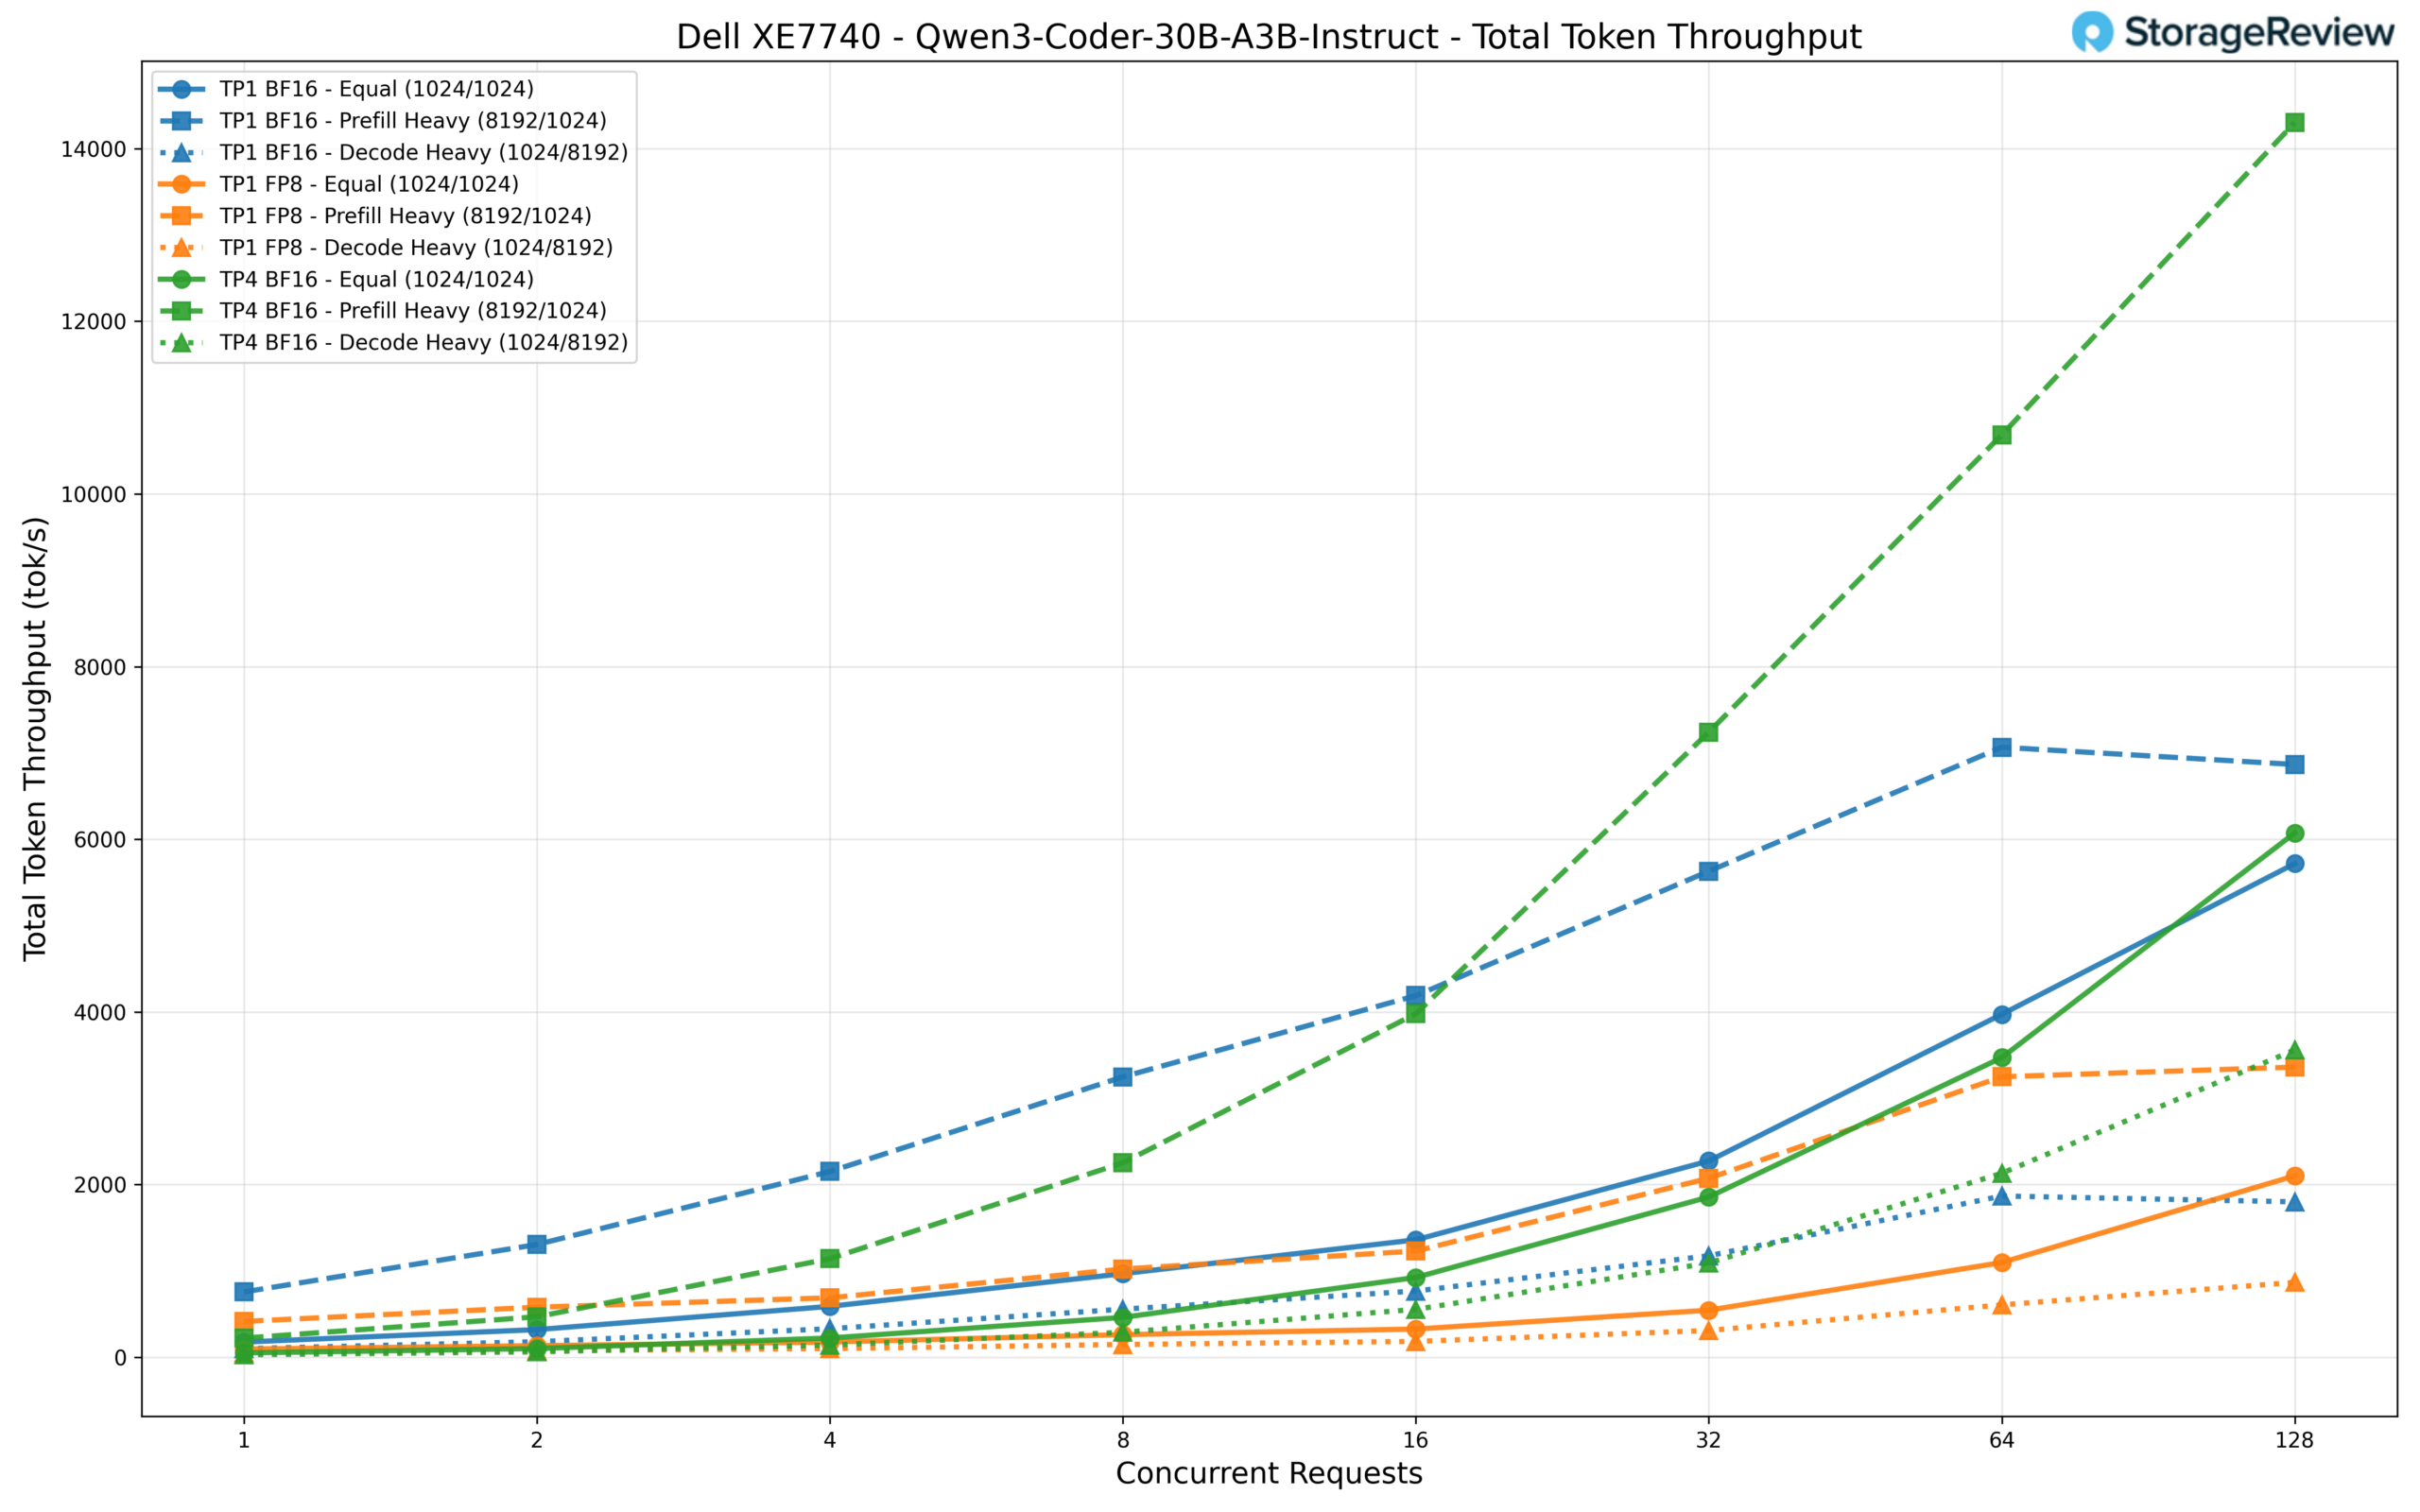
We hebben drie configuraties getest: TP1 BF16, TP1 FP8 en TP4 BF16. Bij 128 gelijktijdige verzoeken loopt TP4 BF16 voorop met ongeveer 14,300 tok/s in het scenario met veel prefill, de hoogste doorvoer die we hebben gemeten voor alle modellen in onze testsuite. TP1 BF16 volgt met ongeveer 6,900 tok/s in hetzelfde scenario, terwijl TP1 FP8 achterblijft met ongeveer 3,360 tok/s. Bij een gelijke werkbelasting wordt het verschil iets kleiner: TP4 haalt 6,073 tok/s, TP1 BF16 5,718 tok/s en TP1 FP8 2,101 tok/s. Zoals besproken in de opmerking over FP8 hierboven, weerspiegelen de lagere FP8-cijfers hier de huidige status van Intels vLLM-fork in plaats van een hardware-bottleneck.
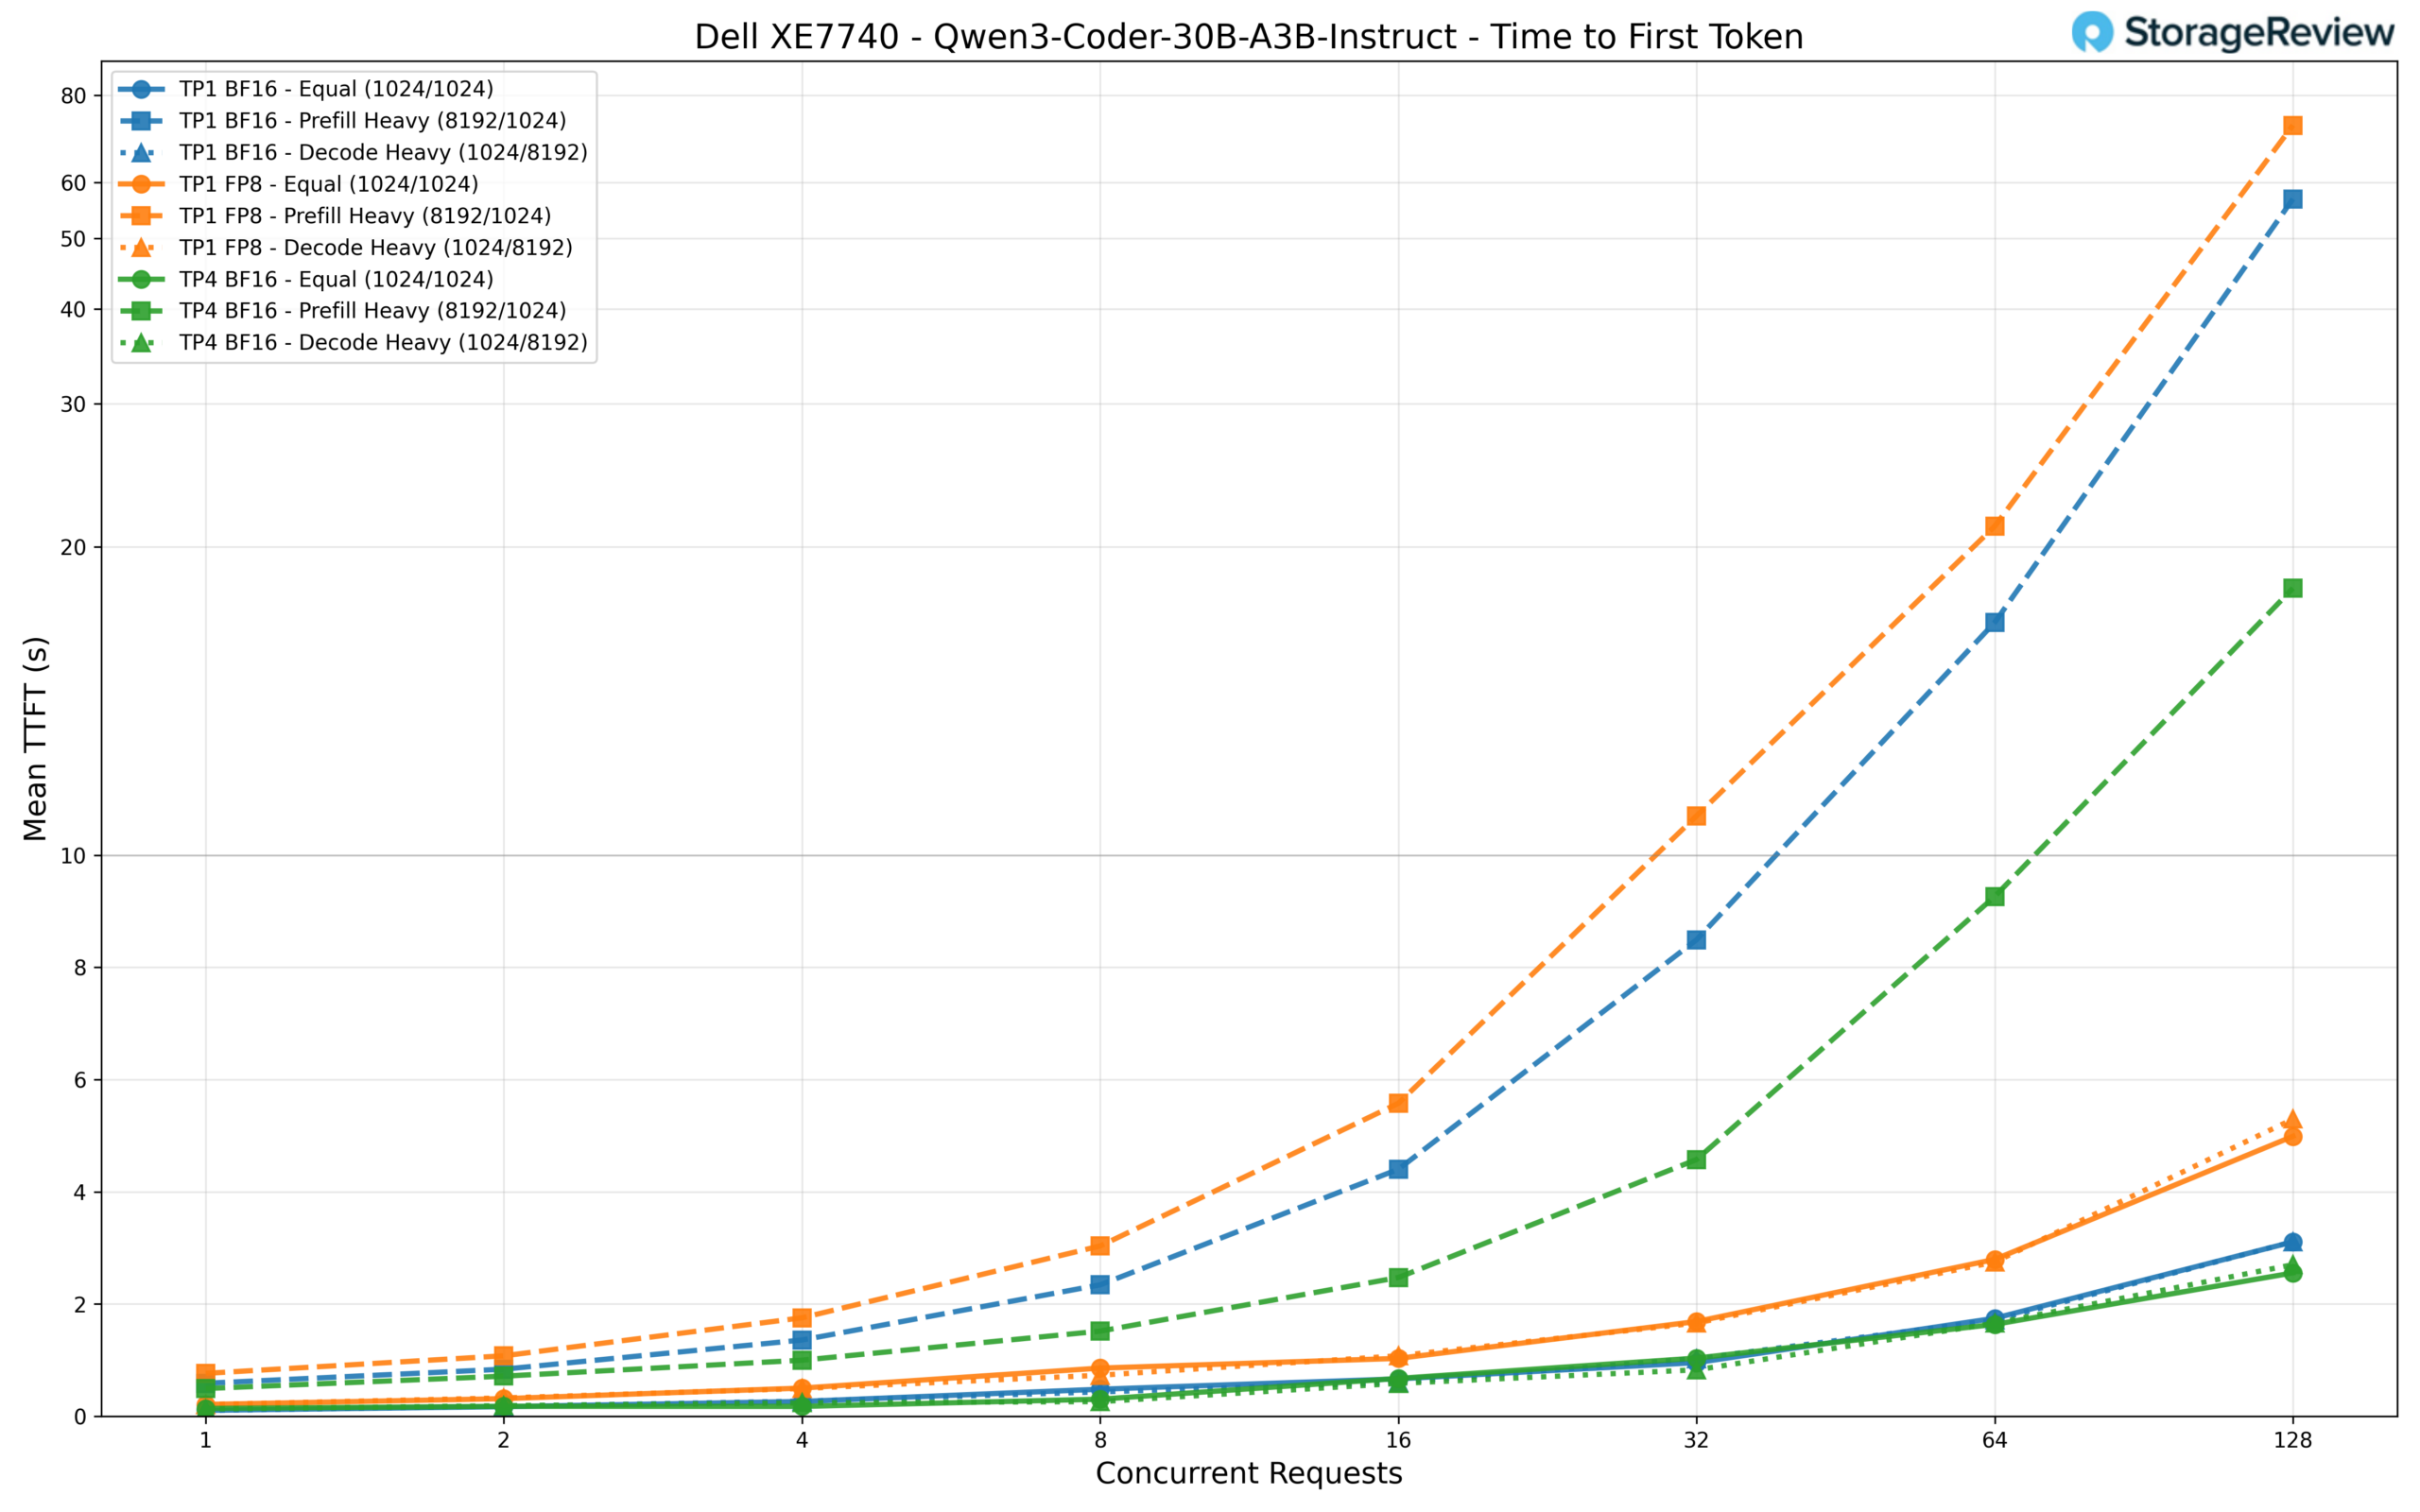
De TTFT blijft laag dankzij het spaarzame activeringspatroon. TP4 BF16 levert een first-token latency van ongeveer 140 ms bij een belasting van één gebruiker en blijft stabiel op ongeveer 2.6 seconden bij 128 gelijktijdige verzoeken onder dezelfde belasting. TP1 BF16 is vergelijkbaar bij een lage gelijktijdigheid (106 ms), maar loopt op tot 3.1 seconden onder volledige belasting. Het scenario met veel prefill laat de verschillen tussen de configuraties duidelijk zien: TP4 bereikt ongeveer 18 seconden bij 128 verzoeken, TP1 BF16 haalt 57 seconden en TP1 FP8 loopt op tot 72 seconden.
Qwen3 235B-A22B Denken
Het grootste model in onze benchmarksuite, Qwen3 235B-A22B Thinking, is een enorm MoE-redeneermodel met in totaal 235 miljard parameters en 22 miljard actieve parameters per token. Naast de enorme schaal beschikt dit model over ingebouwde mogelijkheden voor redeneren in de vorm van een gedachtegang, waardoor het complexe problemen stap voor stap kan ontleden voordat het tot een antwoord komt, ten koste van meer decodeertokens. Dit maakt het bijzonder geschikt voor de meest uitdagende taken: geavanceerde codegeneratie en -debugging, wiskundige probleemoplossing, logisch redeneren in meerdere stappen en complexe, agentische workflows waarbij nauwkeurigheid belangrijker is dan pure snelheid. Dit model vereist TP4 om te draaien en we hebben het getest met zowel BF16- als FP8-precisie.
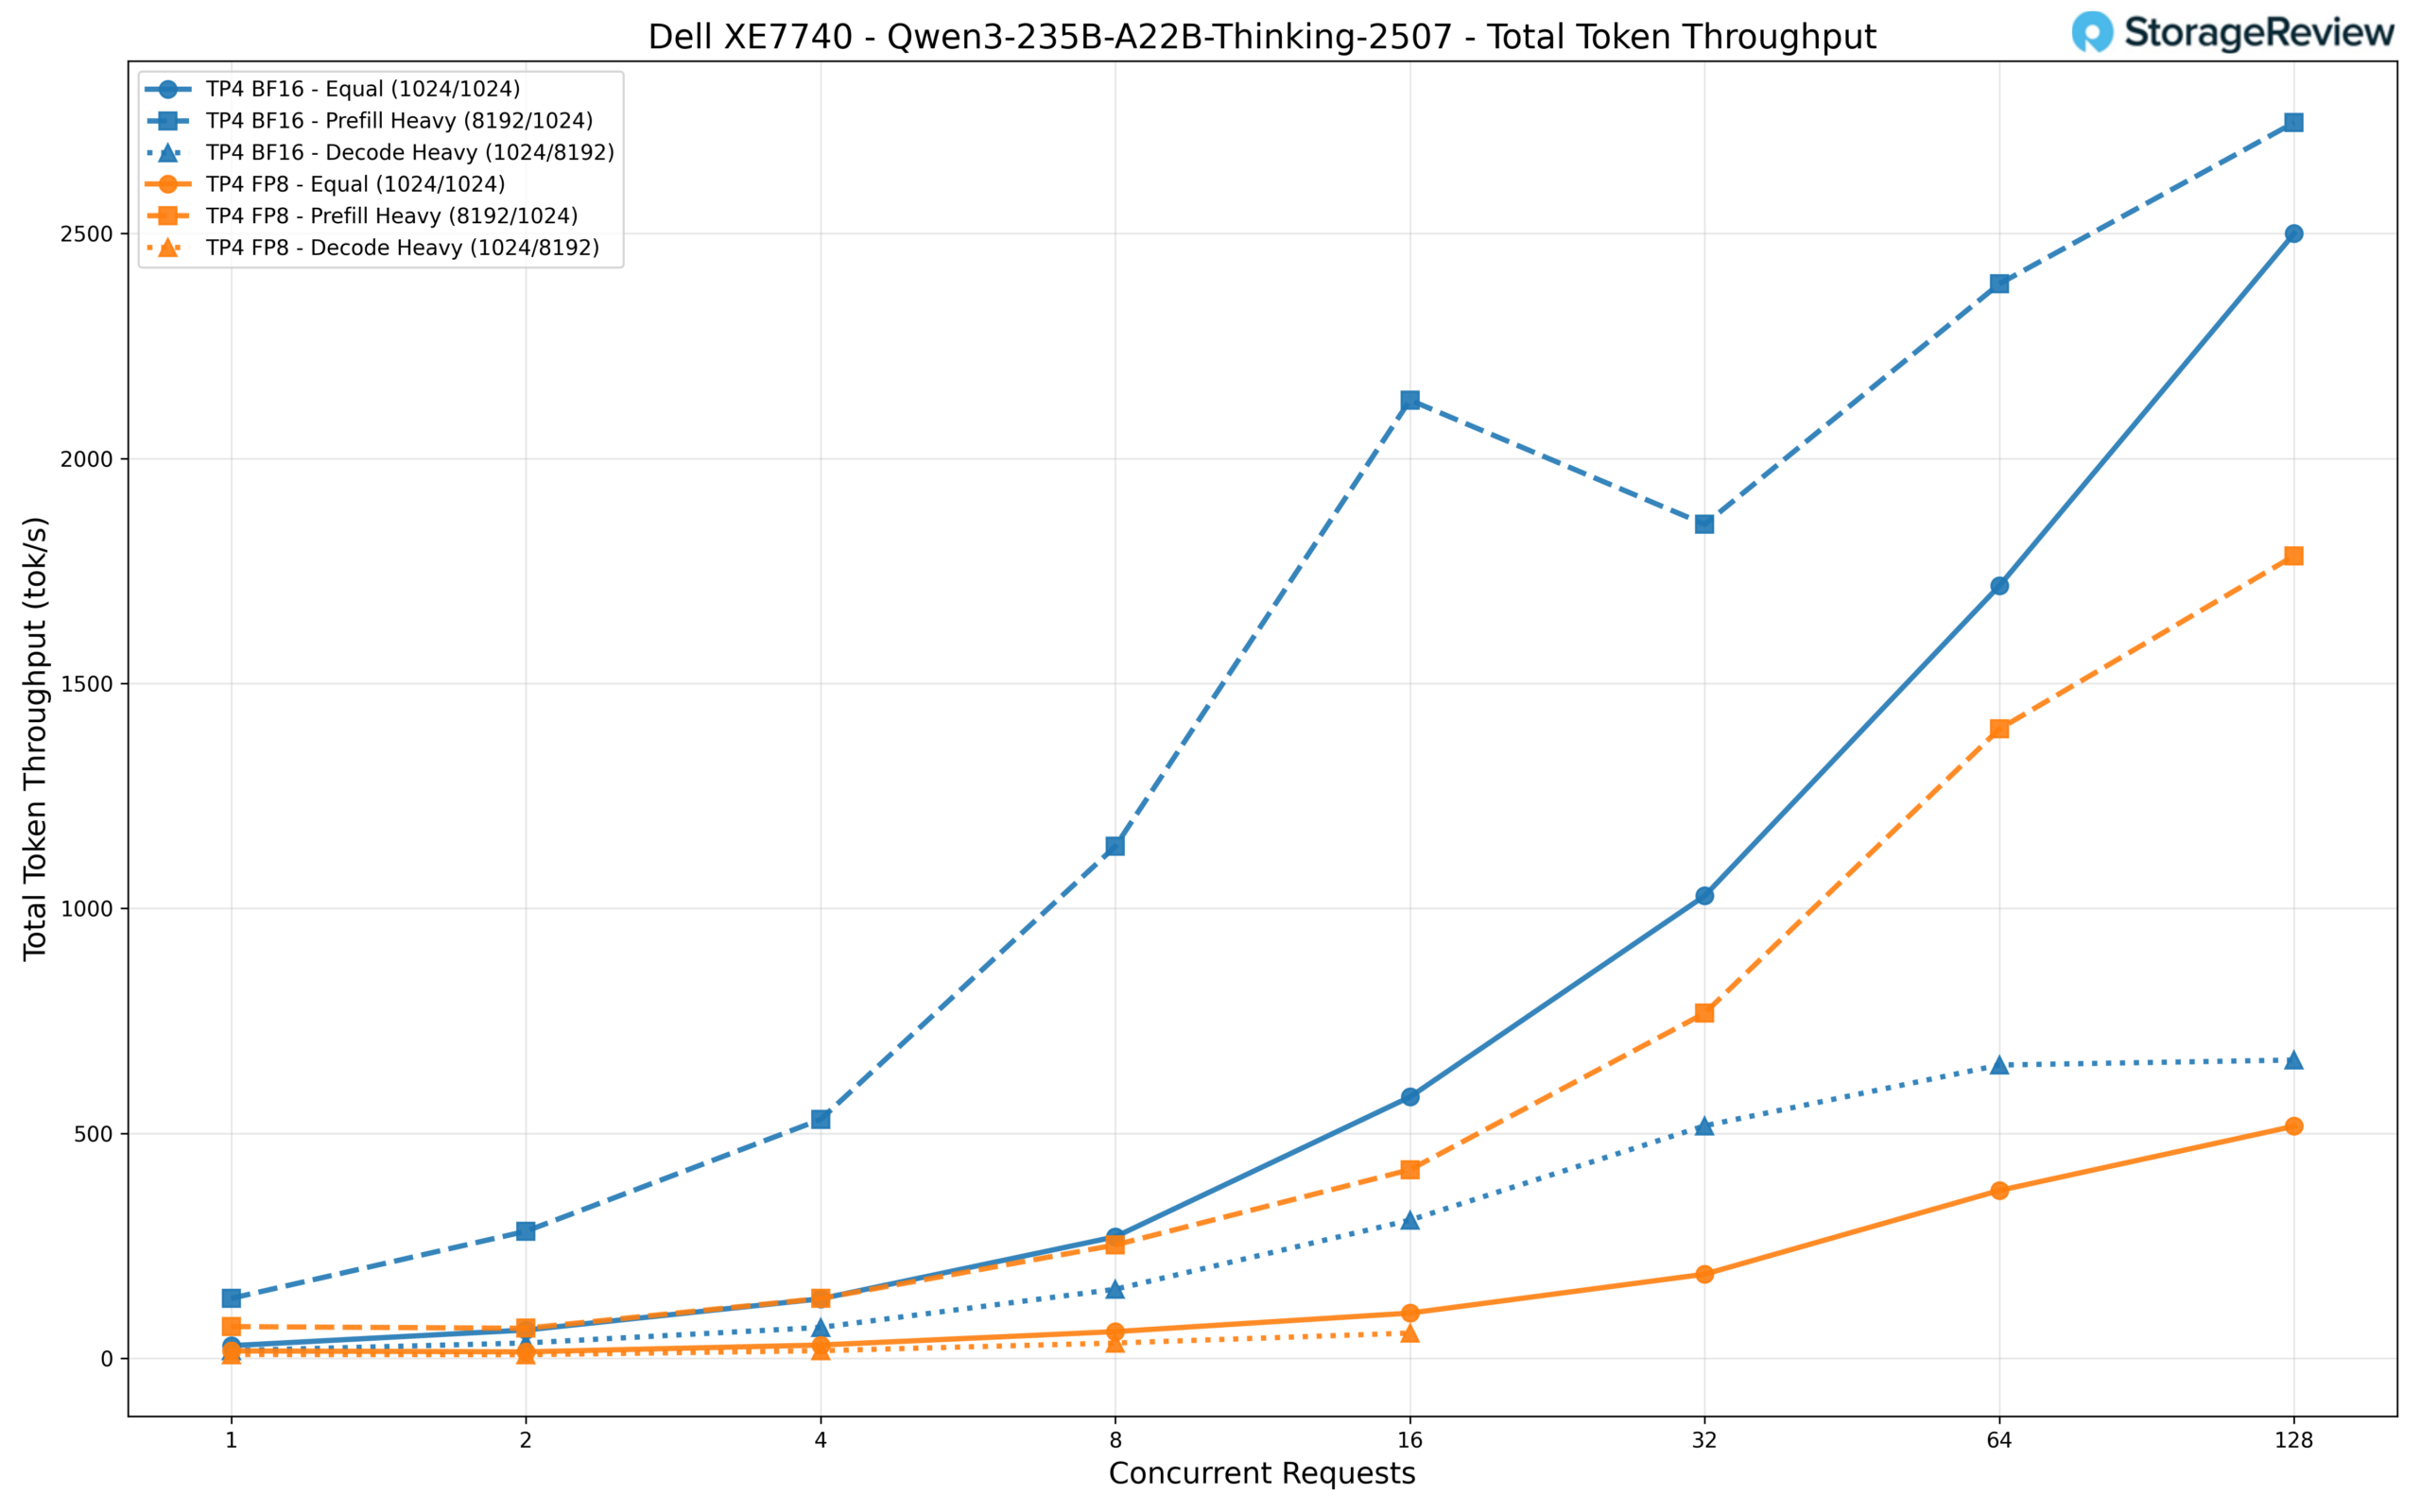
BF16 presteert duidelijk beter dan FP8 op alle fronten. Bij 128 gelijktijdige verzoeken bereikt BF16 ongeveer 2,750 tok/s in de workload met veel voorinvullen en 2,500 tok/s in een gelijke workload, terwijl FP8 respectievelijk ongeveer 1,784 tok/s en 516 tok/s haalt. De FP8-variant ondervond ook time-outs in het scenario met veel decodering bij hogere gelijktijdigheidsniveaus (32+ verzoeken).
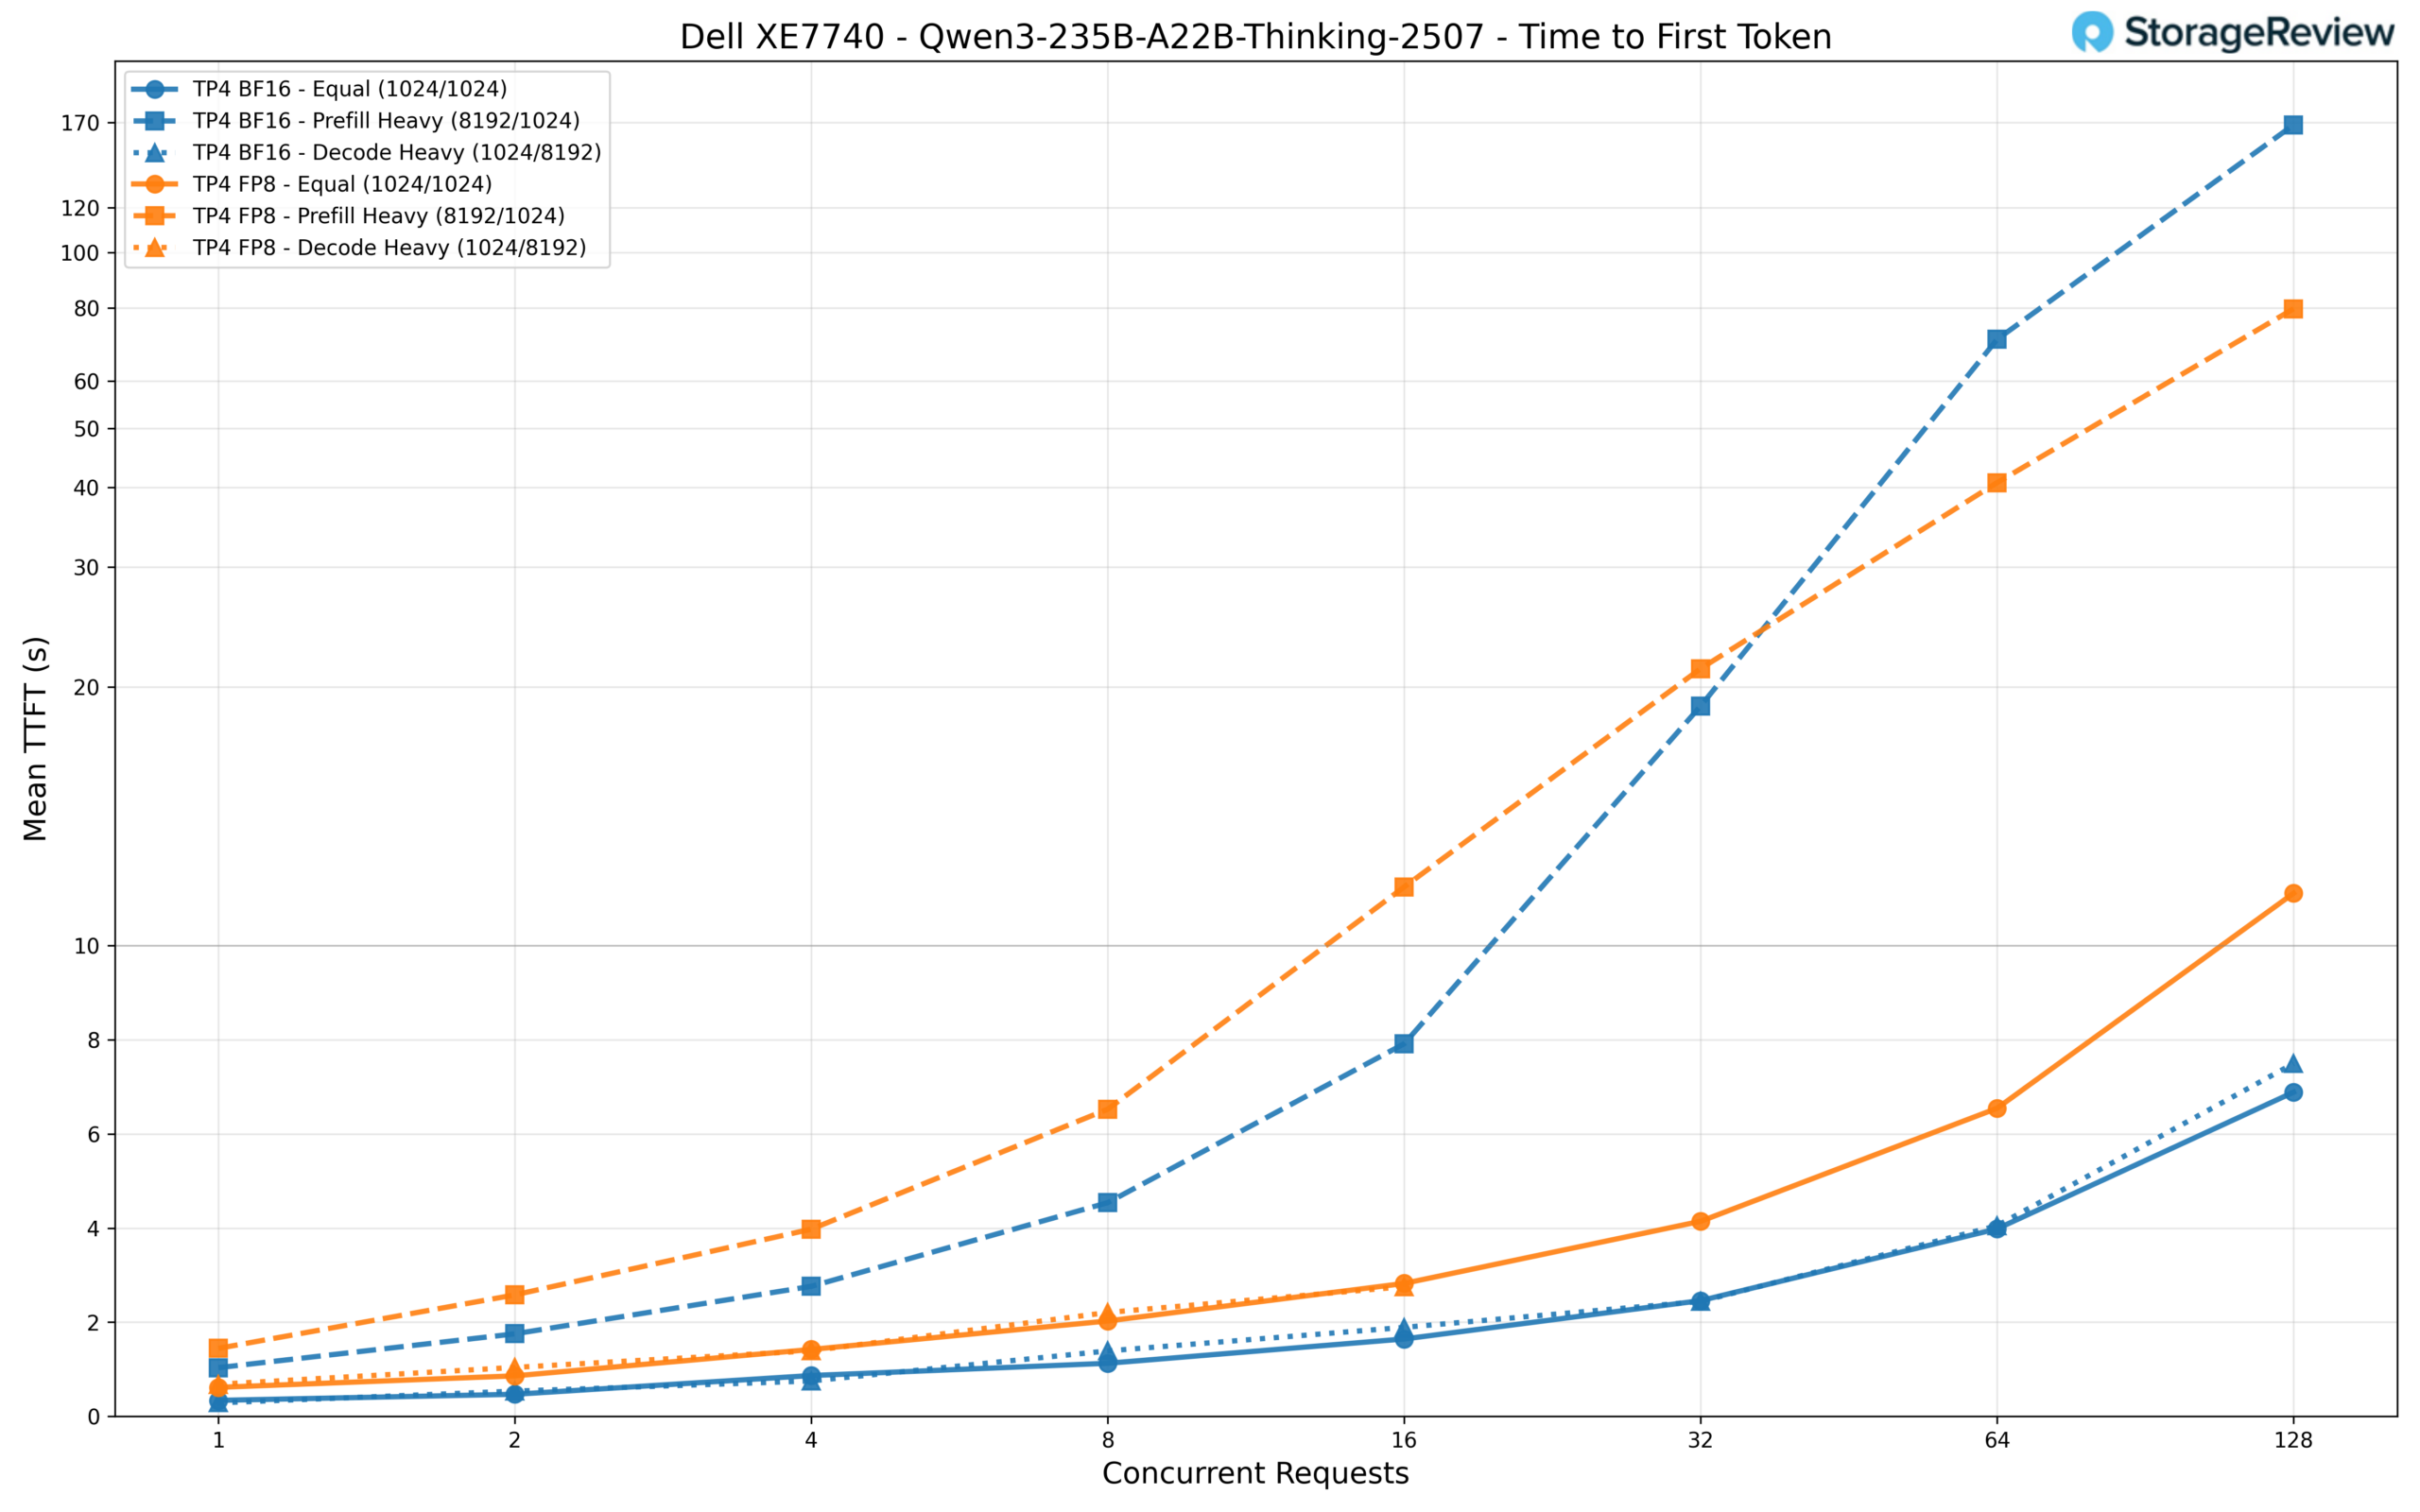
Voor TTFT begint BF16 bij ongeveer 340 ms voor een enkel verzoek van gelijke lengte en schaalt op tot ongeveer 6.9 seconden bij 128 gelijktijdige verzoeken. Dit is behoorlijk responsief voor een model van deze omvang. FP8 is ongeveer twee keer zo traag, beginnend bij 615 ms en oplopend tot ongeveer 11.2 seconden bij volledige belasting. De workload met veel prefill is het meest veeleisende scenario, waarbij BF16 oploopt tot 168 seconden en FP8 tot 80 seconden bij 128 verzoeken.
Voor wie is dit?
De vraag naar inferentie neemt niet af. Of organisaties nu intern modellen inzetten om ontwikkelteams te versnellen, AI integreren in klantgerichte producten of automatiseringspipelines opzetten die 24/7 draaien, de rekenkracht blijft toenemen. En met die vraag komt een bekend knelpunt: de inkoop. De doorlooptijden bij populaire accelerators kunnen maandenlang zijn, waardoor projecten die al gefinancierd en bemand zijn, vastlopen.
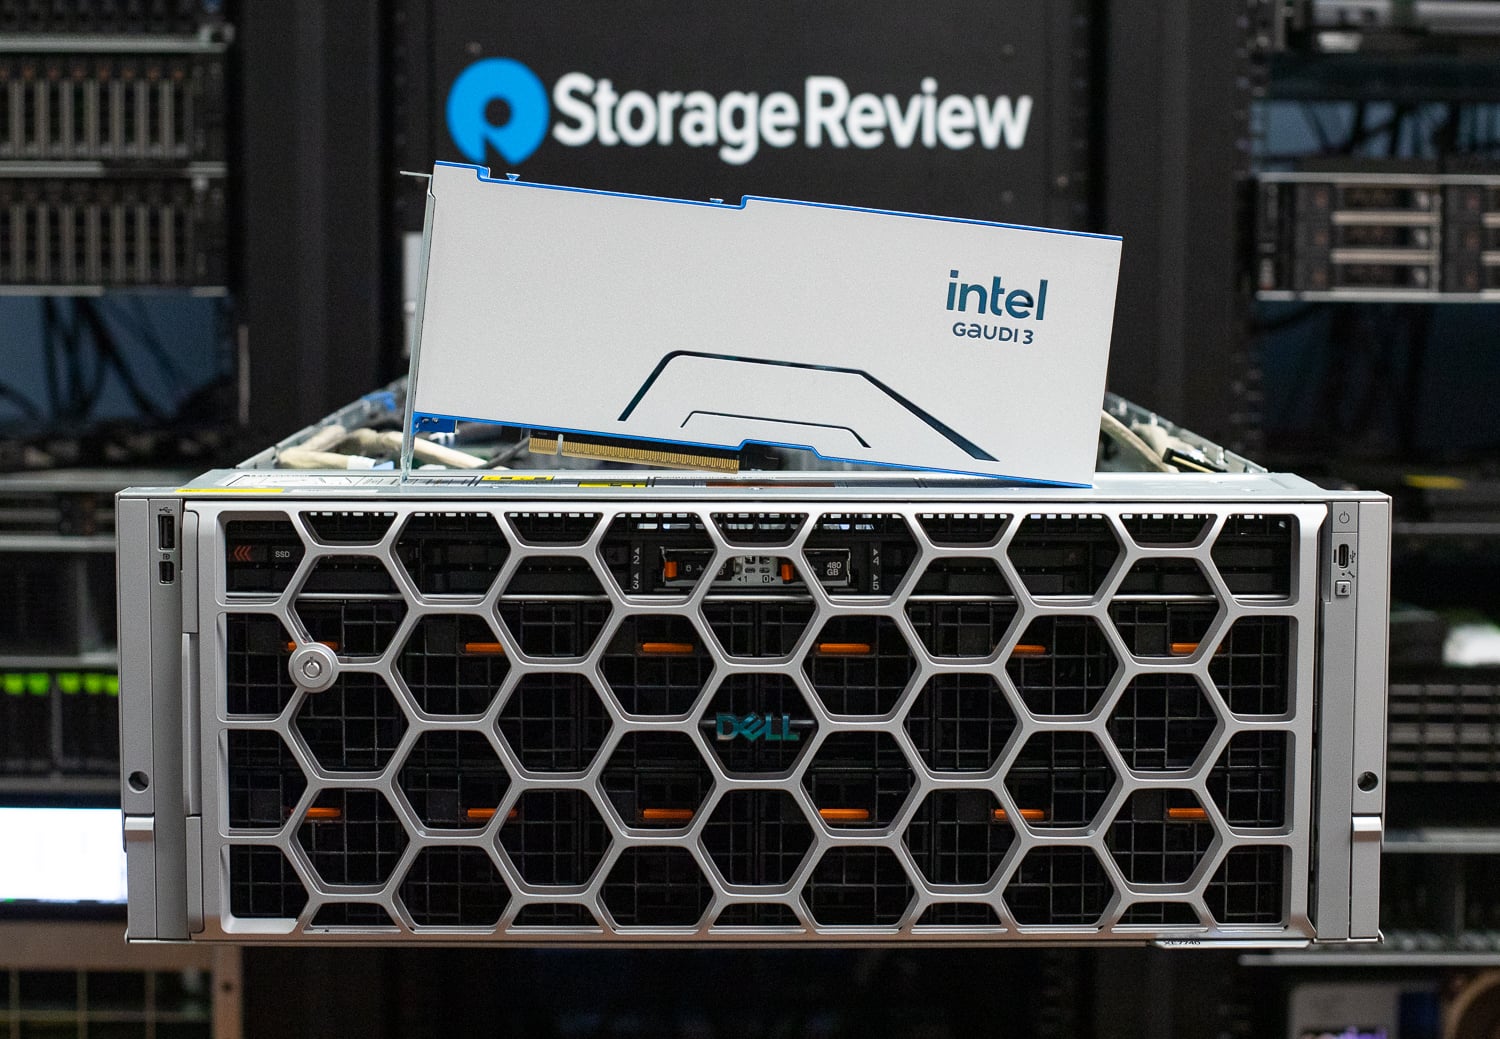
De XE7740, geconfigureerd met Intel Gaudi 3, pakt deze beperking direct aan. Gaudi 3-accelerators zijn nu beschikbaar en Intel levert gevalideerde implementatiesjablonen, zodat teams binnen enkele uren van uitpakken naar inferentie kunnen overstappen. Dell verlaagt de drempel verder met proefprogramma's waarbij XE7740-systemen direct in uw omgeving worden geplaatst. Zo kunt u de prestaties valideren aan de hand van uw daadwerkelijke workloads, data en infrastructuur voordat u overgaat tot een volledige uitrol. Deze combinatie van directe beschikbaarheid, snelle waardecreatie en een evaluatie met een laag risico maakt de Gaudi 3-configuratie bijzonder aantrekkelijk voor organisaties die vandaag inferentiecapaciteit nodig hebben en niet kunnen wachten op toewijzingswachtrijen.
Desondanks is de XE7740 geen platform met slechts één accelerator. Dankzij Dells focus op siliciumdiversiteit is hetzelfde platform verkrijgbaar met diverse opties en alle populaire accelerators op de markt. De juiste keuze hangt volledig af van de workload. Videoverwerkingspipelines lenen zich bijvoorbeeld uitstekend voor NVIDIA L4's, en de XE7740 kan worden uitgerust met 16 L4 GPU's en 8 PCIe Gen5 x16 NIC-slots voor een compromisloos streaming- en transcoderingssysteem. Organisaties die gemengde AI-workloads in verschillende afdelingen uitvoeren, kunnen standaardiseren op het XE7740-chassis en eenvoudig de acceleratorconfiguratie aanpassen aan elke implementatie. Dit vereenvoudigt het beheer van de systemen en stemt de rekenkracht af op de specifieke taak.
Conclusie
De Dell PowerEdge XE7740 is ontworpen voor de realiteit van enterprise inferentie. Het dual-zone thermische ontwerp, de gestructureerde PCIe-topologie, de high-bandwidth geheugenarchitectuur en de schaalbare netwerkcapaciteit vormen een systeem dat gebouwd is voor continue productieworkloads. Dit zijn geen toevallige ontwerpkeuzes; ze weerspiegelen een infrastructuurmodel waarbij inferentie continu draait, voorspelbaar schaalt en naadloos integreert in bestaande datacenteractiviteiten. In deze evaluatie laat Intel Gaudi 3 zien dat de XE7740 vandaag de dag inferentie levert op dense en MoE-architecturen, met voorspelbaar schaalgedrag en een sterke geheugengebonden doorvoer. Softwareoptimalisaties zullen blijven verbeteren, maar de architectonische basis van het platform is nu al solide.
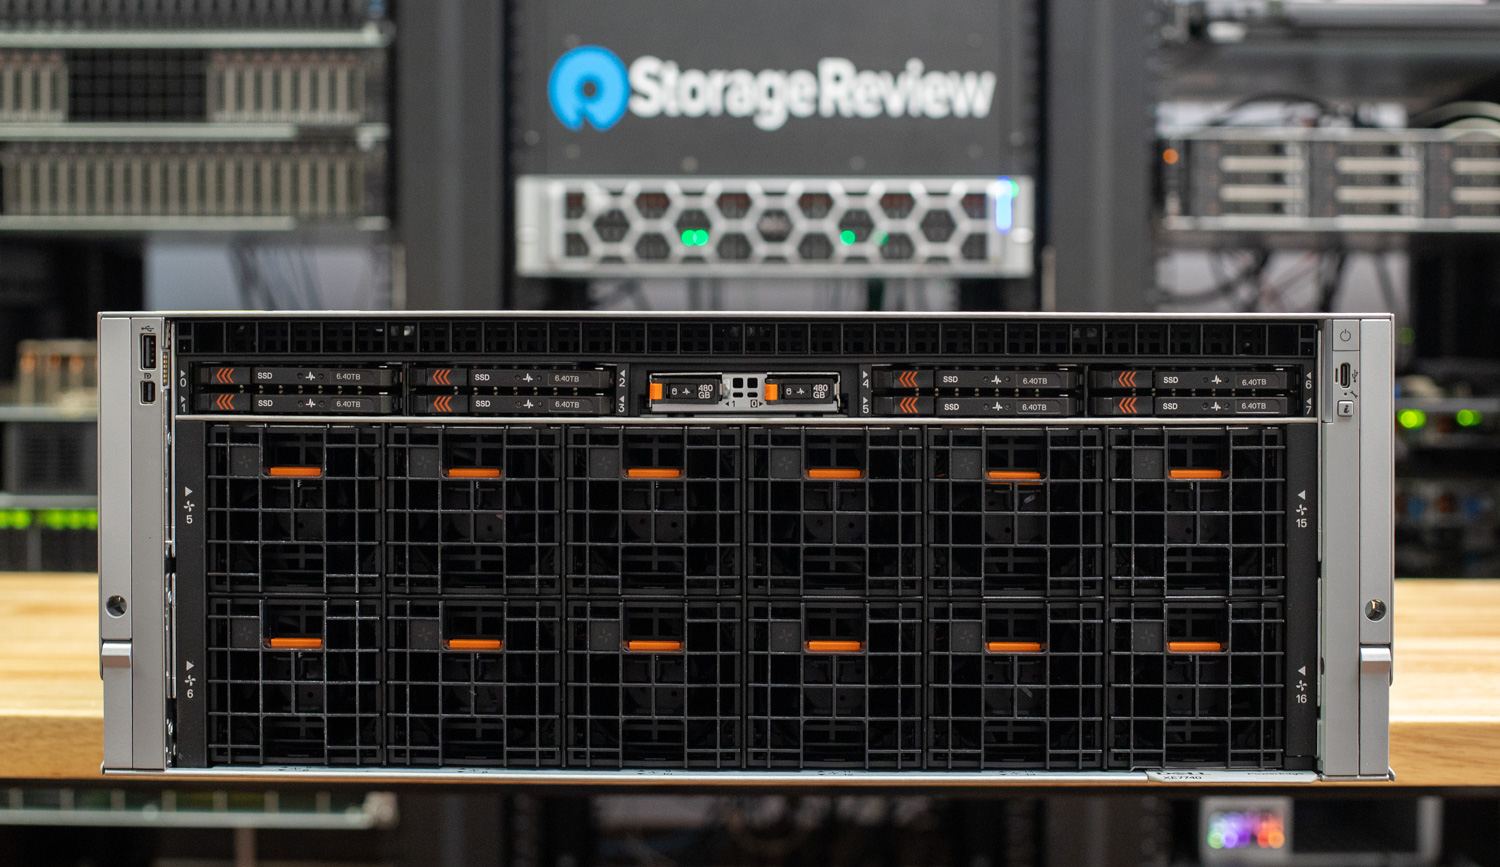
Belangrijker nog, de XE7740 biedt een duurzaam blauwdruk voor AI-infrastructuur binnen bedrijven. Organisaties kunnen standaardiseren op een consistent chassis, beheerstack en implementatiemodel, terwijl ze hun acceleratorstrategie in de loop der tijd kunnen aanpassen. Naarmate modellen groeien, workloads diversifiëren en inferentie dieper verankerd raakt in de bedrijfsvoering, zal de behoefte aan een stabiele, aanpasbare infrastructuur alleen maar toenemen. De PowerEdge XE7740 is perfect gepositioneerd om aan die ontwikkeling te voldoen. Het biedt de architectonische balans, operationele volwassenheid en uitbreidingsmogelijkheden die nodig zijn voor AI binnen bedrijven, van snelle adoptie tot langdurige integratie.
Dit rapport wordt gesponsord door Dell Technologies. Alle standpunten en meningen in dit rapport zijn gebaseerd op onze onbevooroordeelde kijk op het (de) product(en) in kwestie.


 Amazon