

Met de eerste release van NVIDIA's DGX Spark-platform zien we nu dat verschillende fabrikanten de GB10 Grace Blackwell-basis in hun eigen compacte desktopsystemen verwerken. Hoewel het moederbord en de chip zelf gestandaardiseerd blijven, ontstaan er verschillen in het ontwerp van de behuizing, de koeling, de opslagconfiguratie en de algehele prestaties. In deze review richten we ons op de implementatie van GIGABYTE met de AI TOP ATOM.
Binnenin bevindt zich dezelfde GB10 Superchip, die een 20-core Arm CPU-complex combineert met Blackwell AI-acceleratie en 128 GB aan LPDDR5X-geheugen. Deze basis ondersteunt tot 1 petaflop aan FP4-rekenkracht en kan tot 200 miljard parameters modelleren, waarmee het zich stevig positioneert in het AI-segment van werkstations.
De AI TOP ATOM is ondergebracht in een compacte behuizing van 1 liter met afmetingen van 150 x 150 x 50.5 mm en wordt gevoed door een externe adapter van 240 W. Hoewel de rekenkern identiek is aan die van andere Spark-systemen, onderzoeken we hoe de ontwerpkeuzes van GIGABYTE de warmteontwikkeling, het gedrag bij langdurige belasting, de opslagprestaties en het dagelijks gebruiksgemak beïnvloeden.
De opslagmogelijkheden lopen op tot 4 TB Gen5 NVMe, en het systeem wordt geleverd met NVIDIA DGX OS, gebaseerd op Ubuntu, waardoor het direct klaar is voor AI-workloads. Kortom, hoewel de kern van de rekenkracht identiek is aan die van andere Spark-systemen, komen de gebruikerservaring, de warmteontwikkeling, het geluid en de algehele presentatie neer op wat GIGABYTE in zijn compacte behuizing biedt.
In deze review onderzoeken we hoe GIGABYTE's versie van het Spark-platform presteert bij langdurige workloads, koeling en dagelijks gebruik, en of het compacte formaat merkbare nadelen met zich meebrengt.
| Specificaties | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Afmetingen & gewicht | |
| Hoogte | 2 in |
| Breedte | 5.9 in |
| Diepte | 5.9 in |
| Gewicht | 2.64 lb |
| Gegevensverwerker | |
| Processor type | NVIDIA GB10 (Grace Blackwell Superchip) (20 kernen) |
| Geïntegreerde grafische | NVIDIA Blackwell GPU (geïntegreerd) |
| Geheugen | |
| Type geheugen | LPDDR5x (Unified System Memory) |
| Geheugenconfiguratie | 128 GB LPDDR5x, geïntegreerd systeemgeheugen |
| Geheugenbandbreedte | 273 GB/s (8533 MT/s) |
| Besturingssysteem | |
| Ondersteunde besturingssystemen | NVIDIA DGX-besturingssysteem |
| Externe poorten en sleuven | |
| Netwerkpoorten | Eén RJ45 (10GbE) NVIDIA ConnectX-7 NIC (200G × 2 QSFP) |
| USB-poorten | Drie USB 3.2 Gen 2×2 Type-C (20 Gbps) Eén USB 3.2 Gen 2×2 Type-C-poort met PD-ingang |
| Videopoort(en) | Eén HDMI 2.1a |
| Voedingsadapterpoort | USB Type-C (PD IN) |
| Beveiligingssleuf | Geen |
| Wireless | |
| Wi-Fi | WiFi 7 (AW-EM637, 2×2) |
| Bluetooth | Bluetooth 5.4 |
| Opslag | |
| Opslagopties | Tot 4 TB Gen5 NVMe (zelfversleuteling ondersteund) |
| Power Adapter | |
| Type | 240 W externe adapter (USB Type-C) |
GIGABYTE AI TOP ATOM Ontwerp en constructie
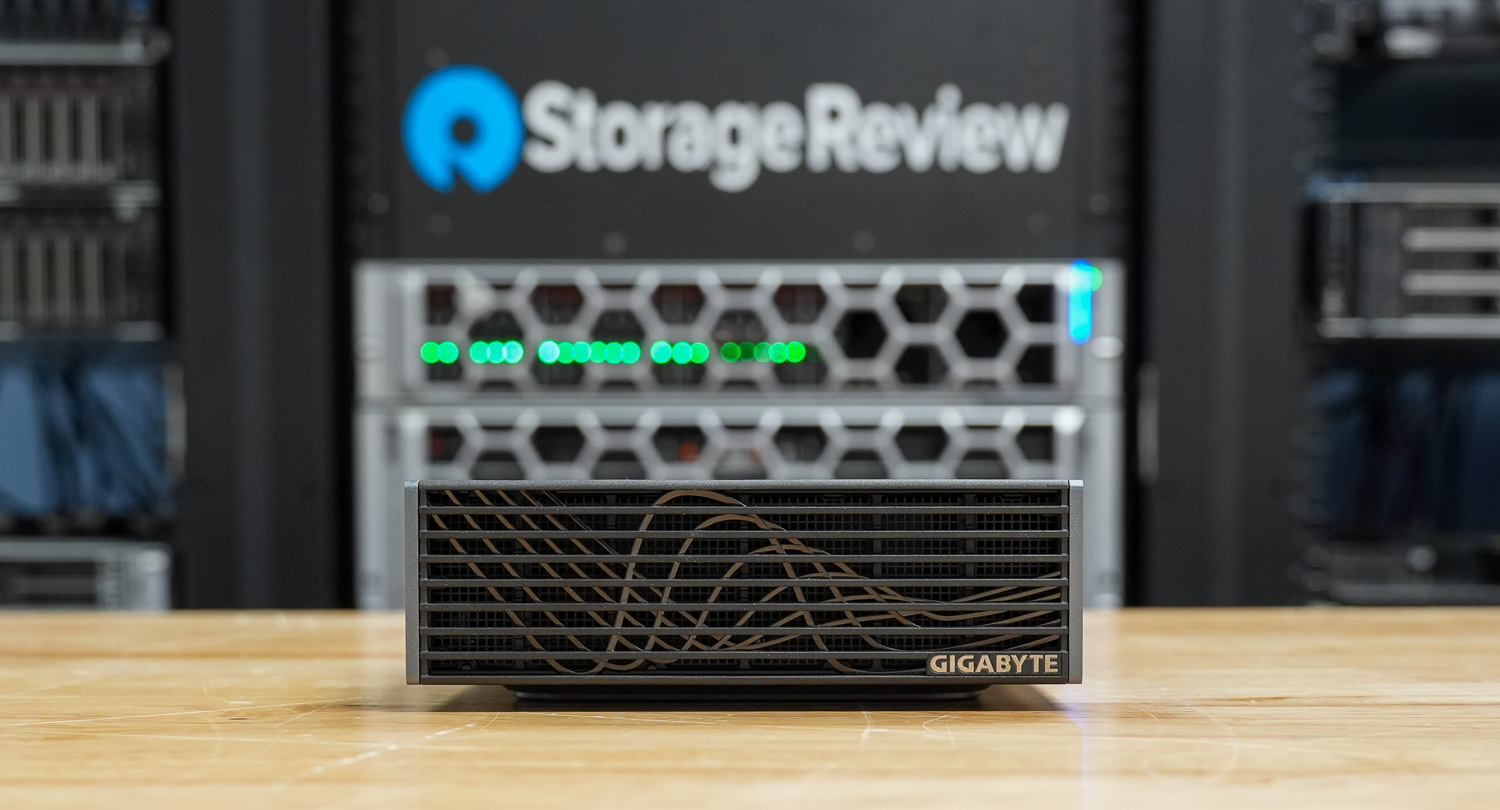
De GIGABYTE AI TOP ATOM behoudt de vertrouwde afmetingen van 150 x 150 mm die we al vaker hebben gezien bij deze op Spark gebaseerde systemen. Hij is 50.5 mm hoog en weegt 1.2 kg. Hij is compact genoeg om op een bureau te passen, maar voelt toch stevig en solide aan. De donkere, matte afwerking geeft hem een meer werkstation-achtige uitstraling.
In plaats van een eenvoudig plat rooster op het voorpaneel, is de hele voorkant opgebouwd uit horizontale lamellen met daarachter een subtiel golfpatroon. Dit geeft het ontwerp diepte en textuur wanneer je het vanuit verschillende hoeken bekijkt. Het is een ontwerp dat gericht is op koeling. Het GIGABYTE-logo bevindt zich in de linkerbenedenhoek en er zijn geen data-aansluitingen of zelfs een aan/uit-knop aan de voorkant, waardoor de voorkant strak en luchtstroomgericht blijft.
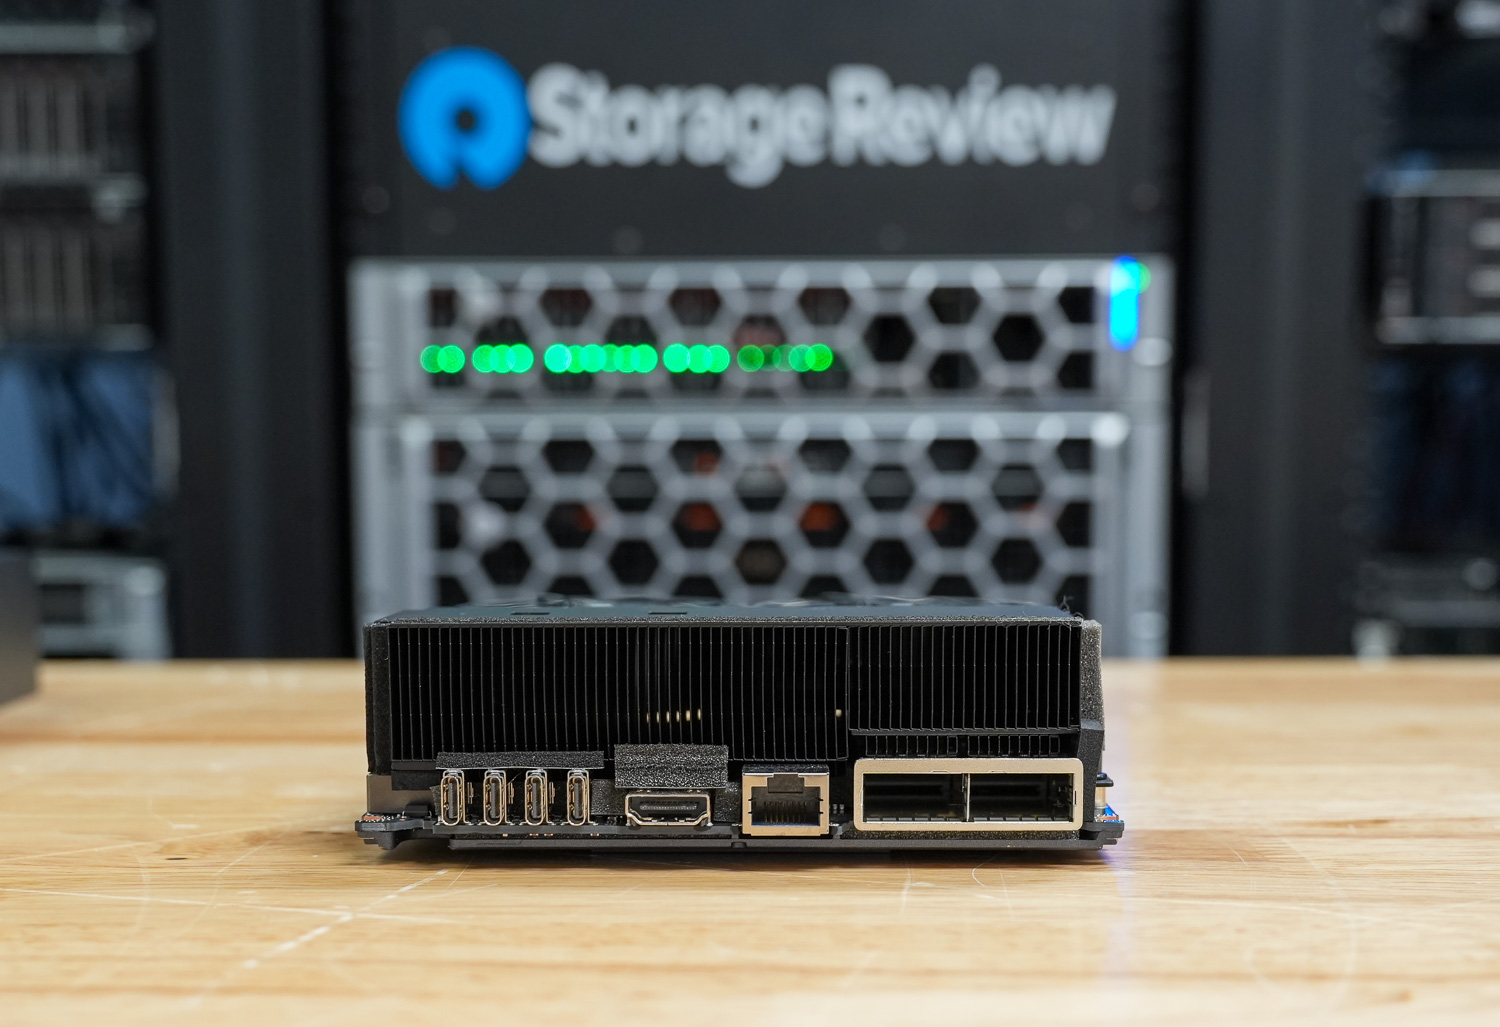
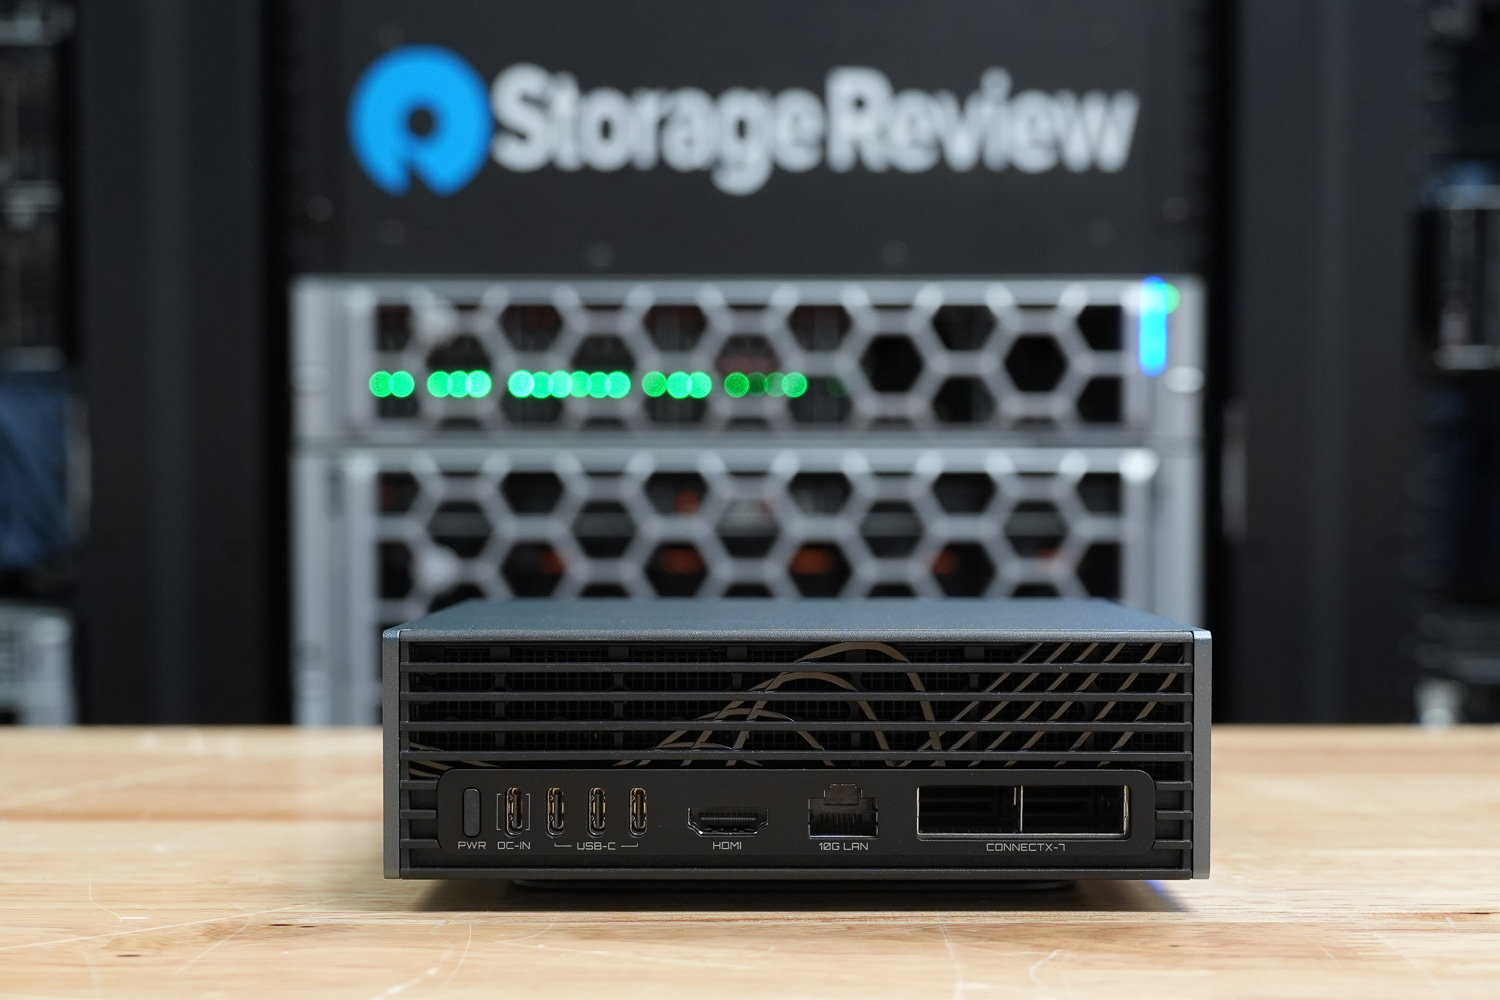
Alle aansluitingen bevinden zich op het achterpaneel. Er zijn drie USB 3.2 Gen 2×2 Type-C-poorten met snelheden tot 20 Gbps, plus een vierde USB Type-C-poort voor de voeding. Voor beelduitvoer is er een enkele HDMI 2.1a-poort. Netwerkmogelijkheden zijn er een 10 GbE RJ-45-poort en een NVIDIA ConnectX-7 SmartNIC, die snelle gegevensoverdracht ondersteunt en het koppelen van meerdere systemen mogelijk maakt voor een grotere configuratie. Aan de zijkant heeft GIGABYTE een Kensington Nano-slot geplaatst.
De AI TOP ATOM draait vanbinnen op NVIDIA's GB10 Grace Blackwell Superchip, een combinatie van een 20-core Arm CPU-configuratie met geïntegreerde Blackwell-graphics. Deze wordt ondersteund door 128 GB LPDDR5x-geheugen op een 256-bits interface, wat een bandbreedte tot 273 GB/s oplevert. Net als de andere GB10-systemen delen de CPU en GPU dezelfde geheugenpool, wat cruciaal is voor de manier waarop deze machines zijn ontworpen om AI-workloads te verwerken.
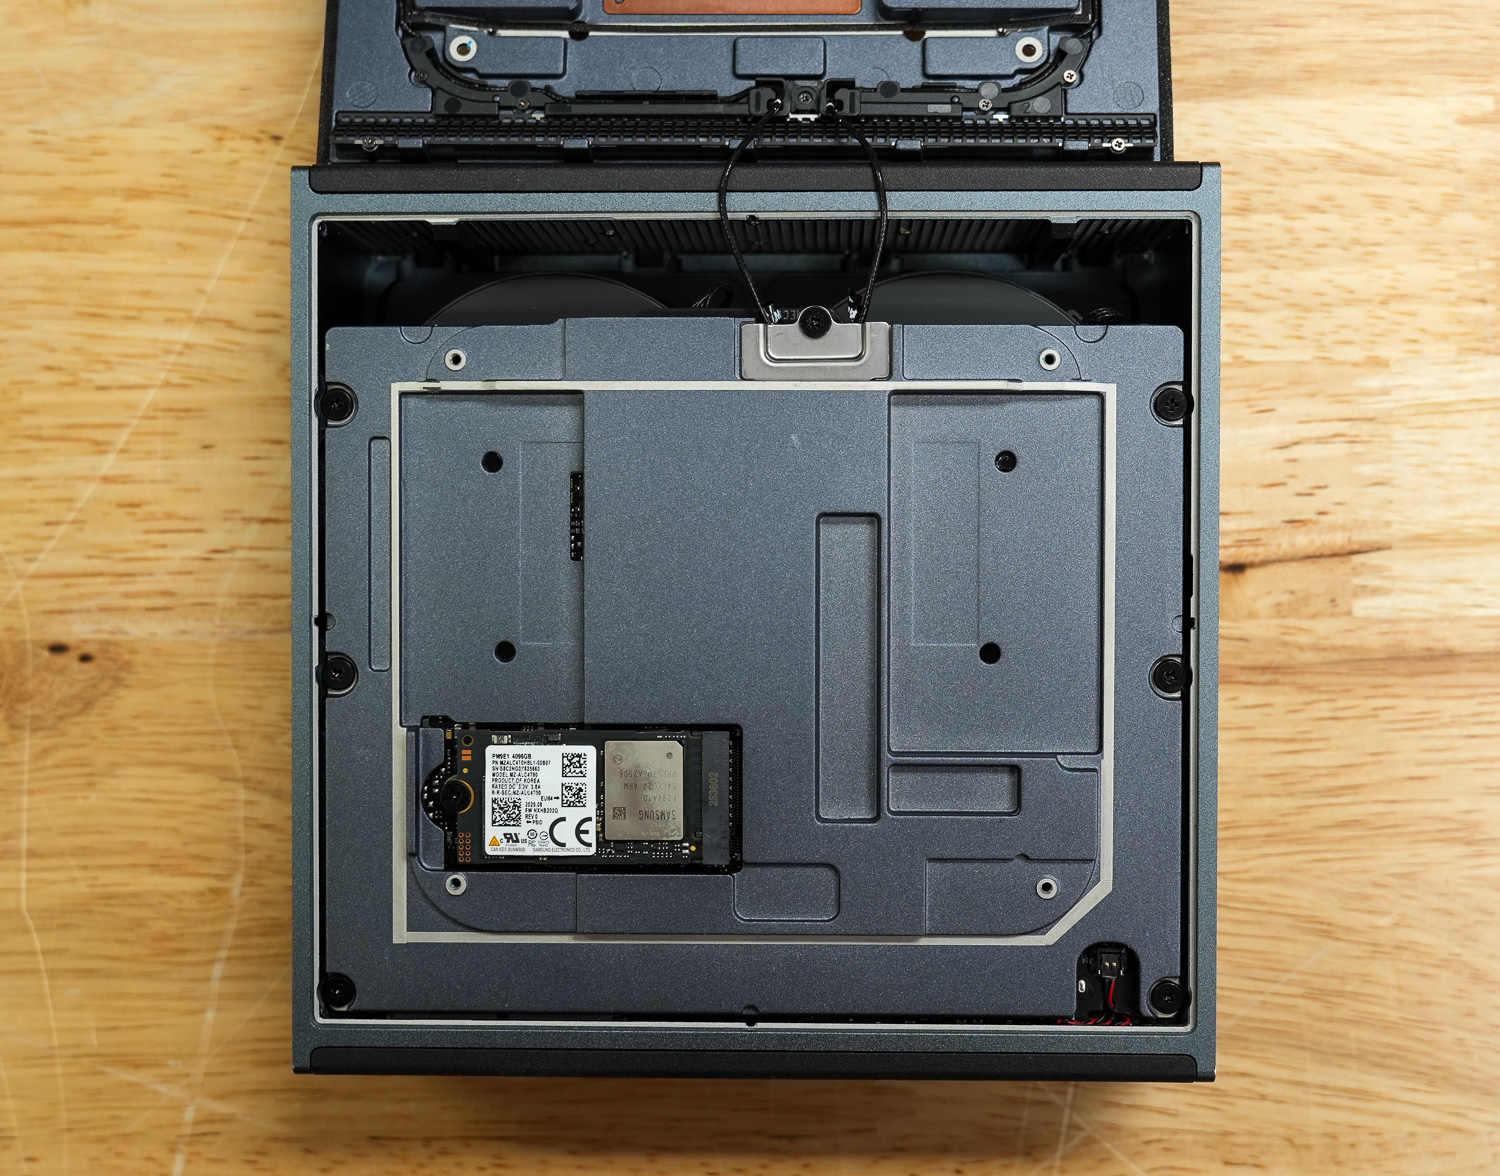
De opslagcapaciteit bedraagt maximaal 4 TB Gen5 NVMe SSD, afhankelijk van de configuratie, en de stroomvoorziening wordt verzorgd door een externe adapter van 240 W. Draadloze connectiviteit omvat WiFi 7 en Bluetooth 5.4, naast de geïntegreerde 10 GbE-netwerkinterface voor bekabelde prestaties.
GIGABYTE AI TOP ATOM Thermische Test
Om de thermische prestaties van de componenten in de GIGABYTE AI TOP ATOM te testen, hebben we deze vergeleken met de Founders Edition en OEM's zoals Asus, Acer en Dell. We hebben dit uitgebreider behandeld in ons artikel over de thermische prestaties van de Spark.
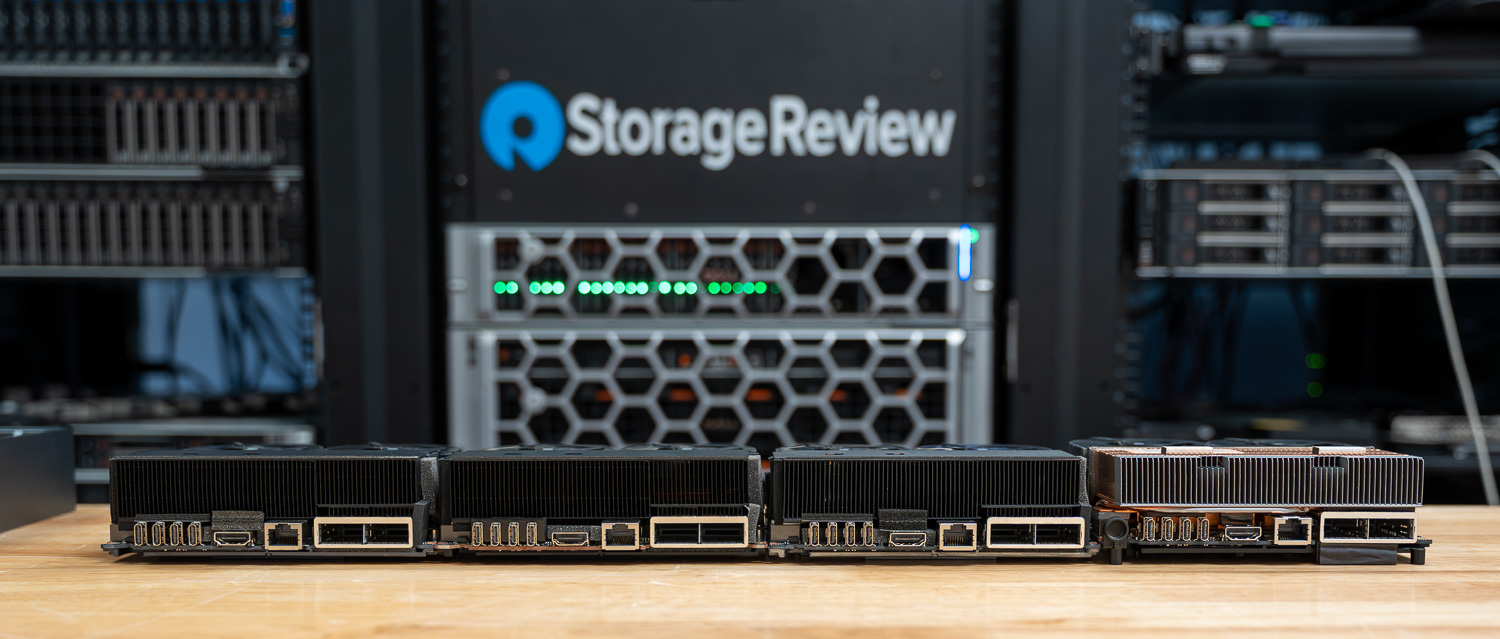
Over de gehele stack hebben we de componenten gedurende een bepaalde tijdsperiode gemonitord, met 3 fasen in de werkbelasting, waarbij het gebruik gedurende ongeveer een uur geleidelijk werd opgevoerd. Dit stelde ons in staat om het apparaat te observeren bij langdurig gebruik en in verschillende werkbelastingsfasen. We hebben de temperaturen van de CPU, GPU, het netwerk en de NVMe-schijf, evenals het totale stroomverbruik, in de gaten gehouden.
CPU Temperatuur
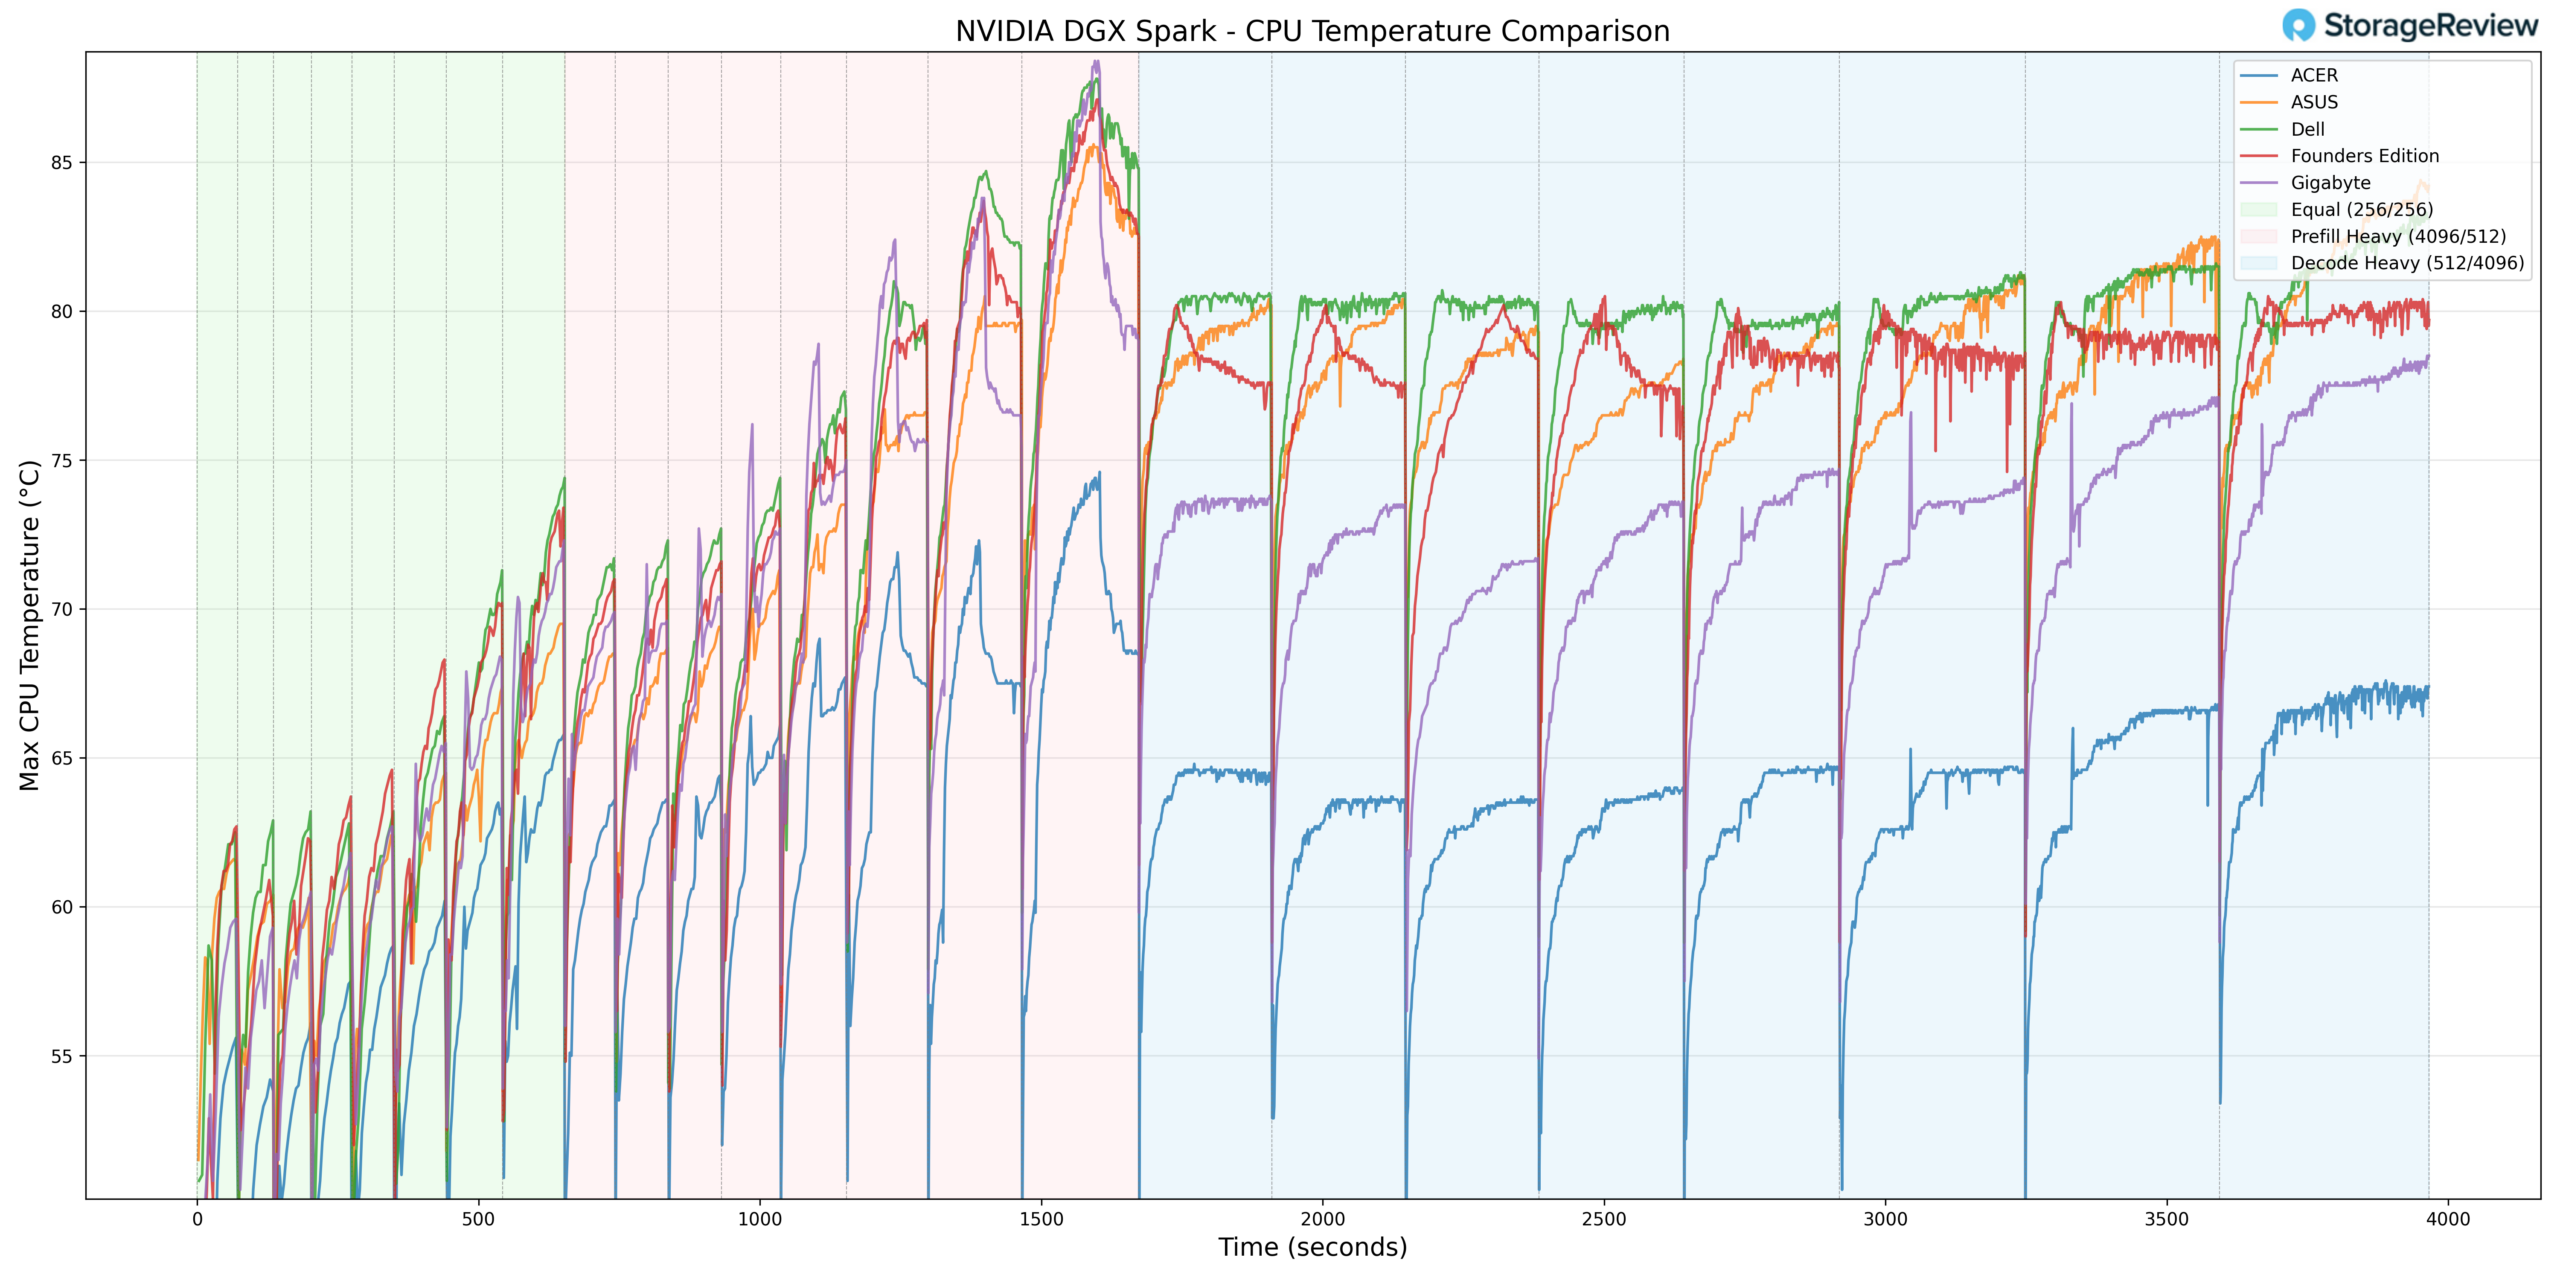
Tijdens de thermische tests van de CPU bereikte het GIGABYTE-systeem een piektemperatuur van 90 °C tijdens piekbelastingen bij het voorvullen. Dit plaatst het systeem aan de bovengrens van de waargenomen CPU-pieken binnen de vergelijkingsgroep tijdens agressieve belastingverhogingen.
Bij de overgang naar Equal ISL/OSL en uiteindelijk Decode Heavy-workloads stabiliseerde de temperatuurcurve in plaats van verder te stijgen. Onder aanhoudende belasting bleef de CPU binnen een gecontroleerd thermisch bereik, wat aantoont dat de hogere piek te wijten was aan kortstondige opwarmingsactiviteiten en niet aan onvoldoende koelcapaciteit op de lange termijn.
Bij de laagste temperaturen registreerde de CPU een minimumtemperatuur van 38.7 °C tijdens inactiviteit of lichte belasting. Deze lage basistemperatuur duidt op een efficiënte warmteafvoer in ruststand en geeft aan dat de koeloplossing voldoende capaciteit behoudt, ook buiten piekbelastingen.
Over het algemeen vertoonde GIGABYTE hogere piektemperaturen van de CPU, maar behield een stabiel gedrag zodra de werkbelasting normaliseerde.
GPU-temperatuur
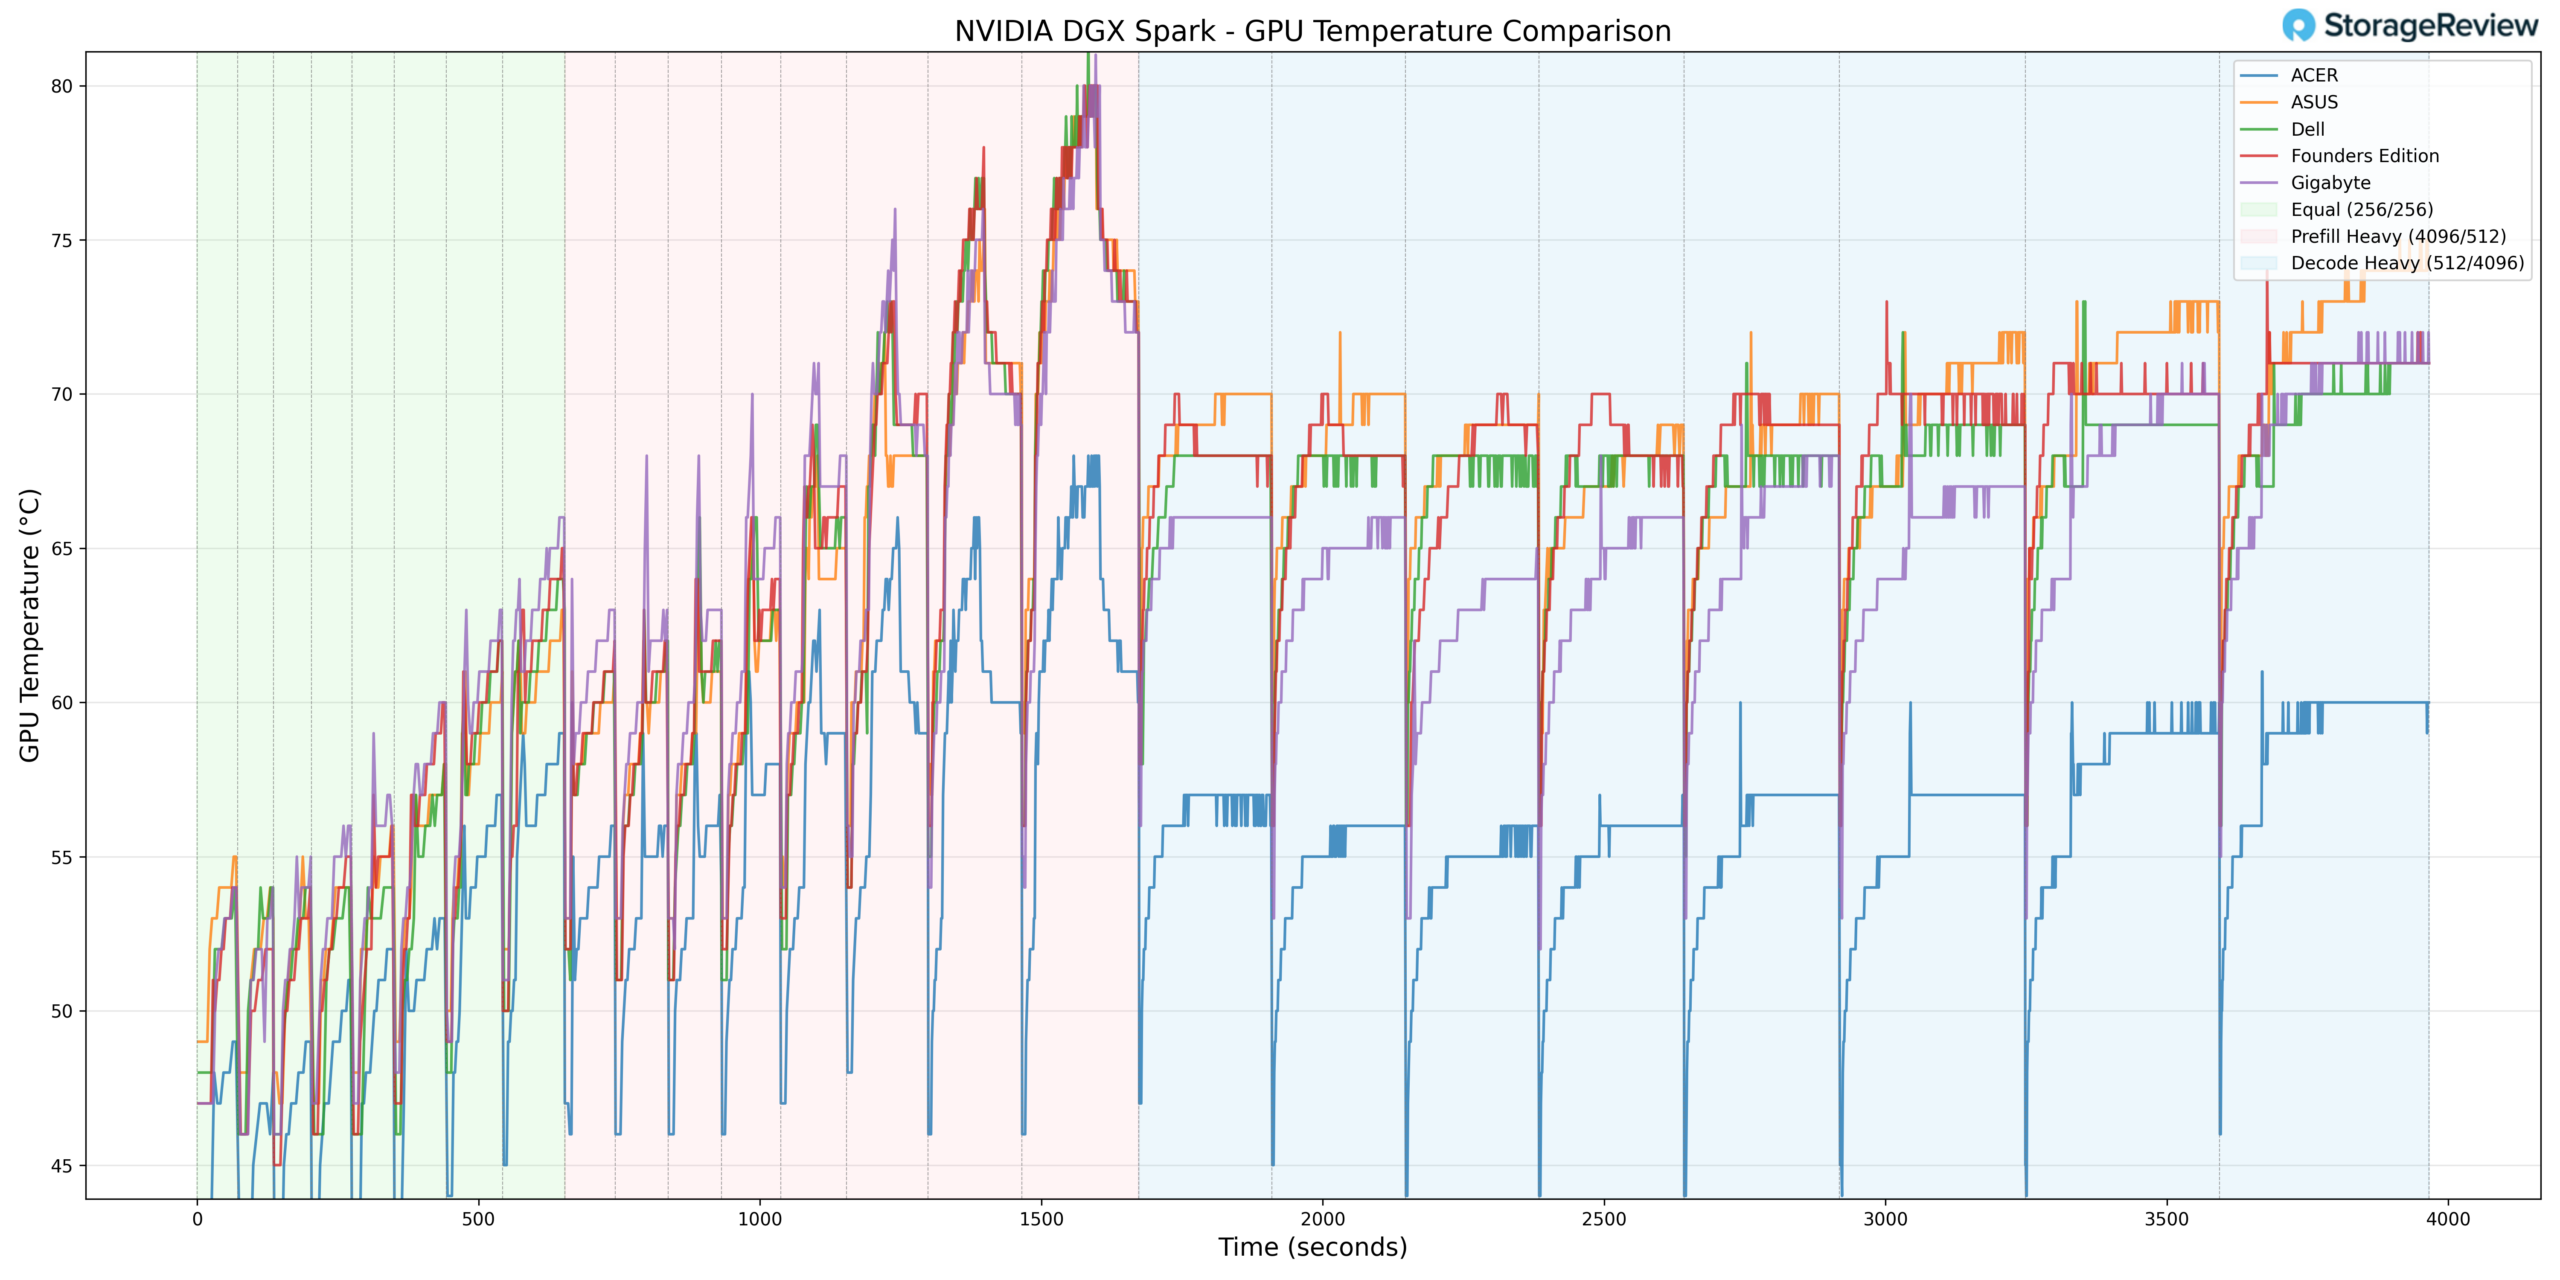
De GPU-temperatuur vertoonde een vergelijkbaar patroon. Tijdens Prefill Heavy-activiteit bereikte de GPU een maximale temperatuur van 81 °C. Dit plaatst hem aan de warmere kant van de groep tijdens piekbelastingen, maar nog steeds binnen de verwachte specificaties voor het GB10-platform.
Naarmate de werkbelasting overging naar de fasen Equal ISL/OSL en Decode Heavy, stabiliseerden de GPU-temperaturen zich in plaats van verder te stijgen.
Bij inactiviteit of lage belasting registreerde de GPU een minimumtemperatuur van 37 °C, wat wijst op een solide basisthermische regeling wanneer het systeem niet onder zware rekenbelasting staat.
Alles bij elkaar genomen, weerspiegelt het GPU-gedrag van GIGABYTE een agressief piekbelastingspatroon in combinatie met stabiele, aanhoudende temperaturen.
NVMe-temperatuur
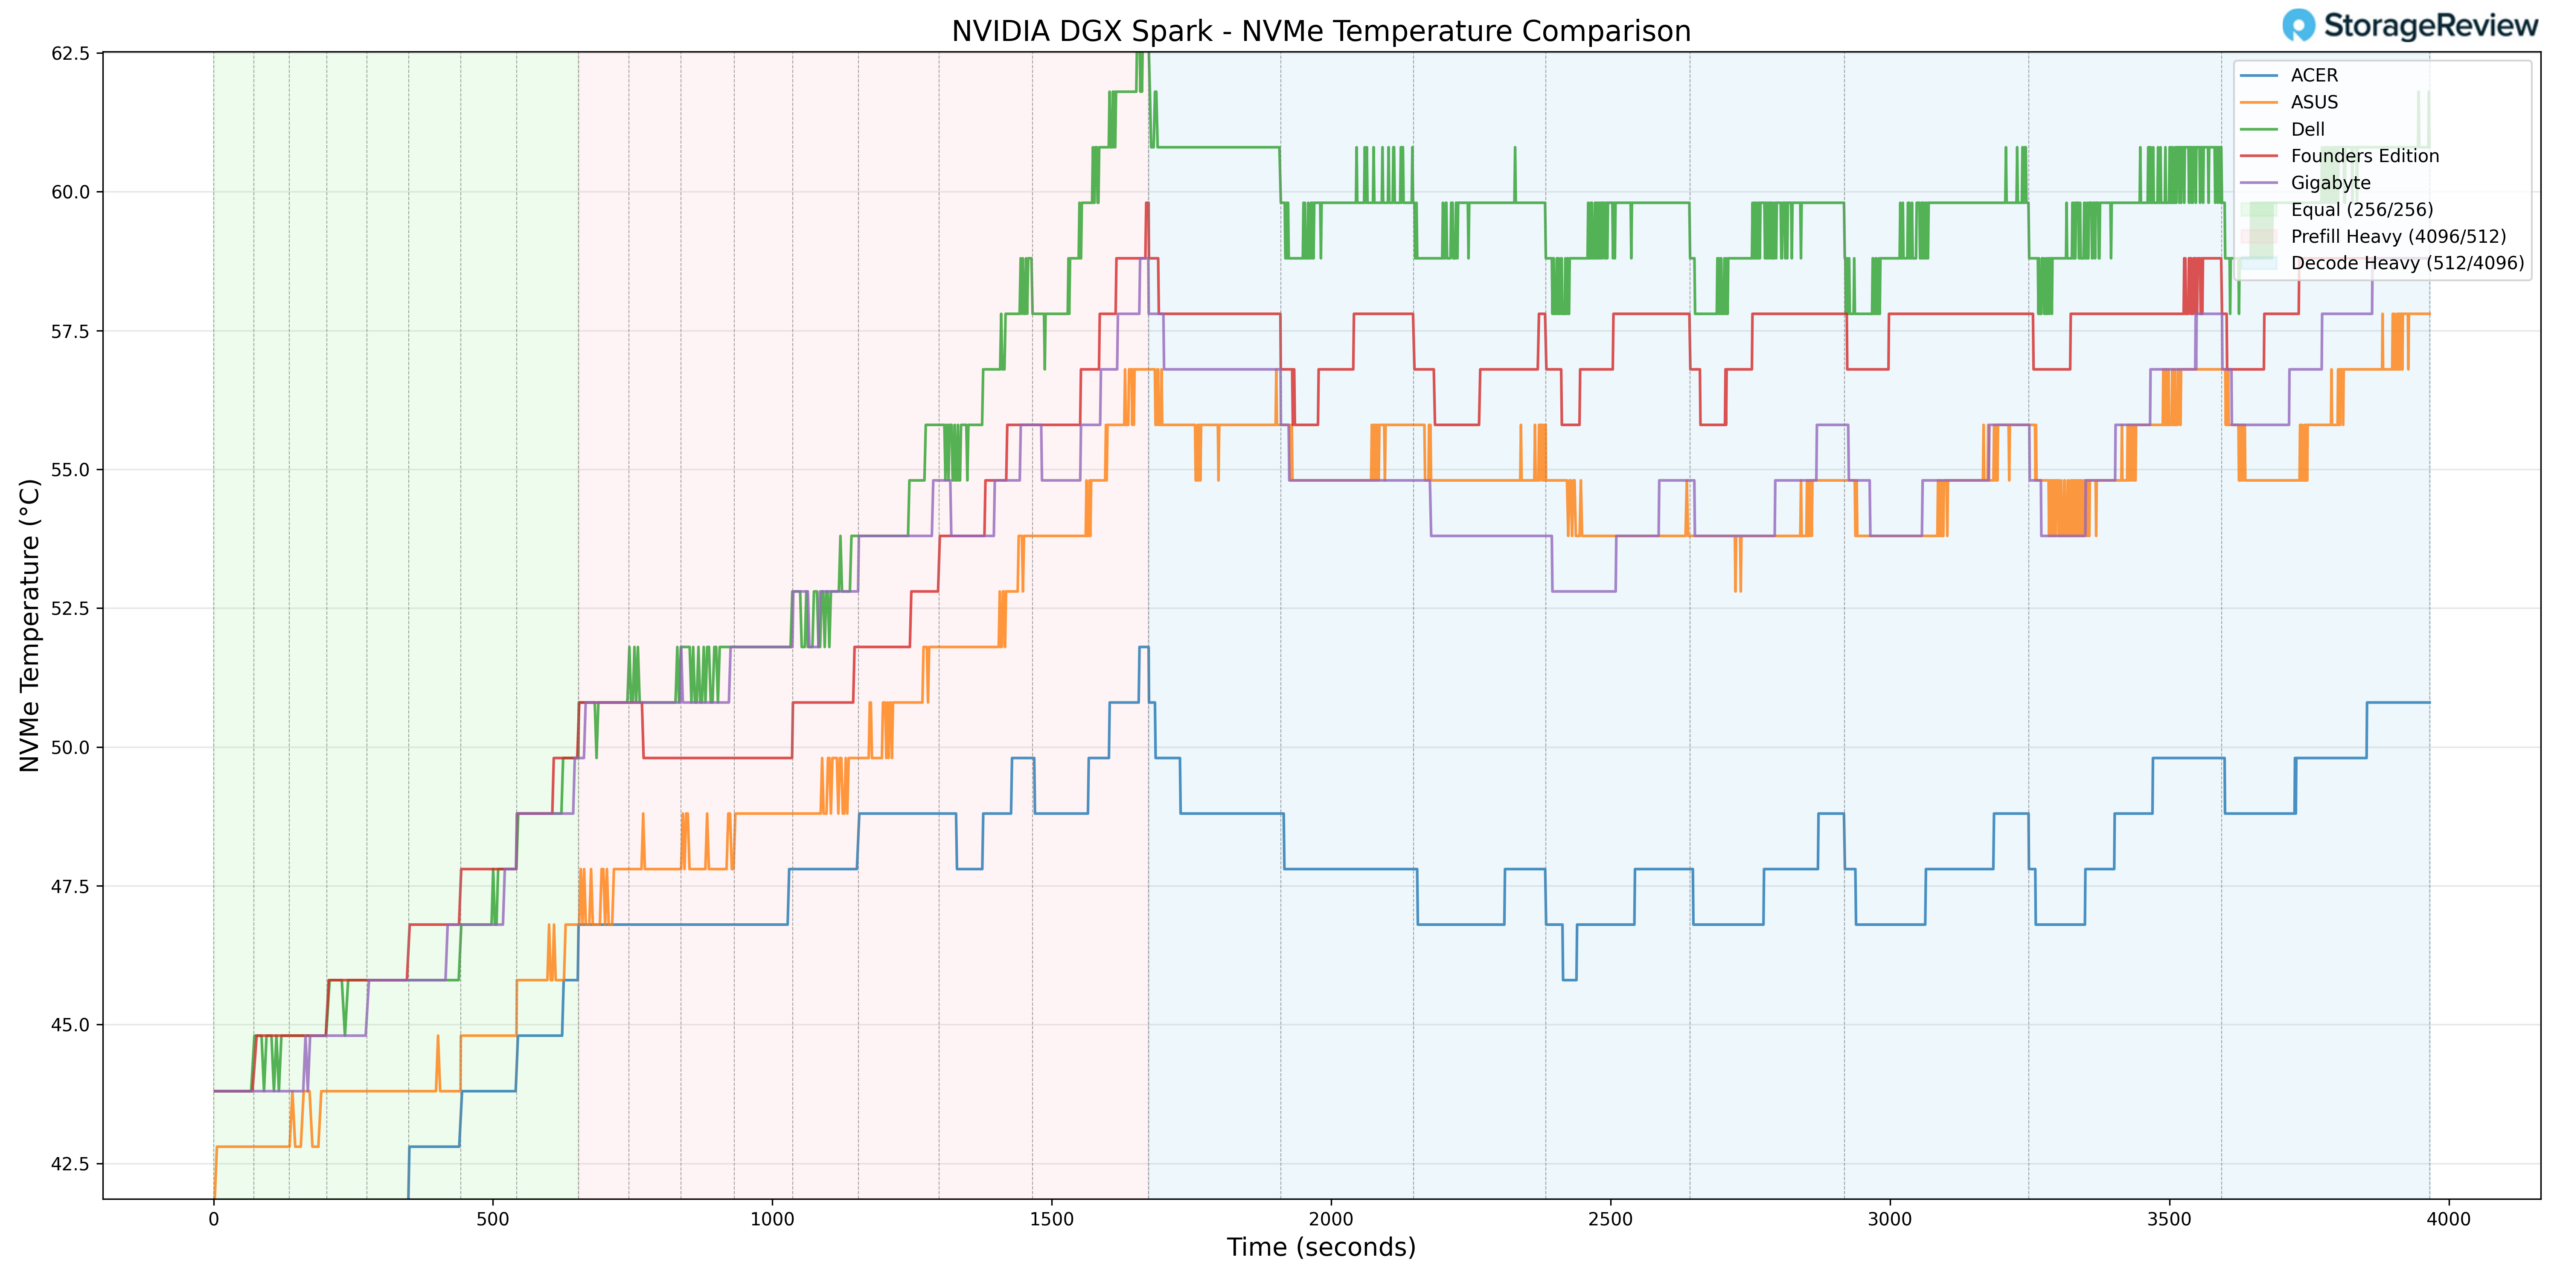
De temperatuur van de opslag bleef gedurende de tests goed onder controle. De NVMe-schijf registreerde een maximale temperatuur van 59.8 °C tijdens de zwaarste werkfasen. Deze piek bleef ruim onder de gebruikelijke drempelwaarden voor prestatievermindering, wat wijst op voldoende luchtstroom of een gunstige plaatsing van de schijf in de behuizing.
Tijdens perioden met een lagere werkbelasting daalde de temperatuur van de NVMe-schijf tot een minimum van 37.8 °C, wat bevestigt dat de thermische prestaties van de opslag in rusttoestand niet beperkt worden.
In vergelijking met sommige compacte, op desktops gerichte implementaties, duidt het feit dat de temperatuur onder belasting onder de 60 °C blijft op een degelijk thermisch beheer van de opslag.
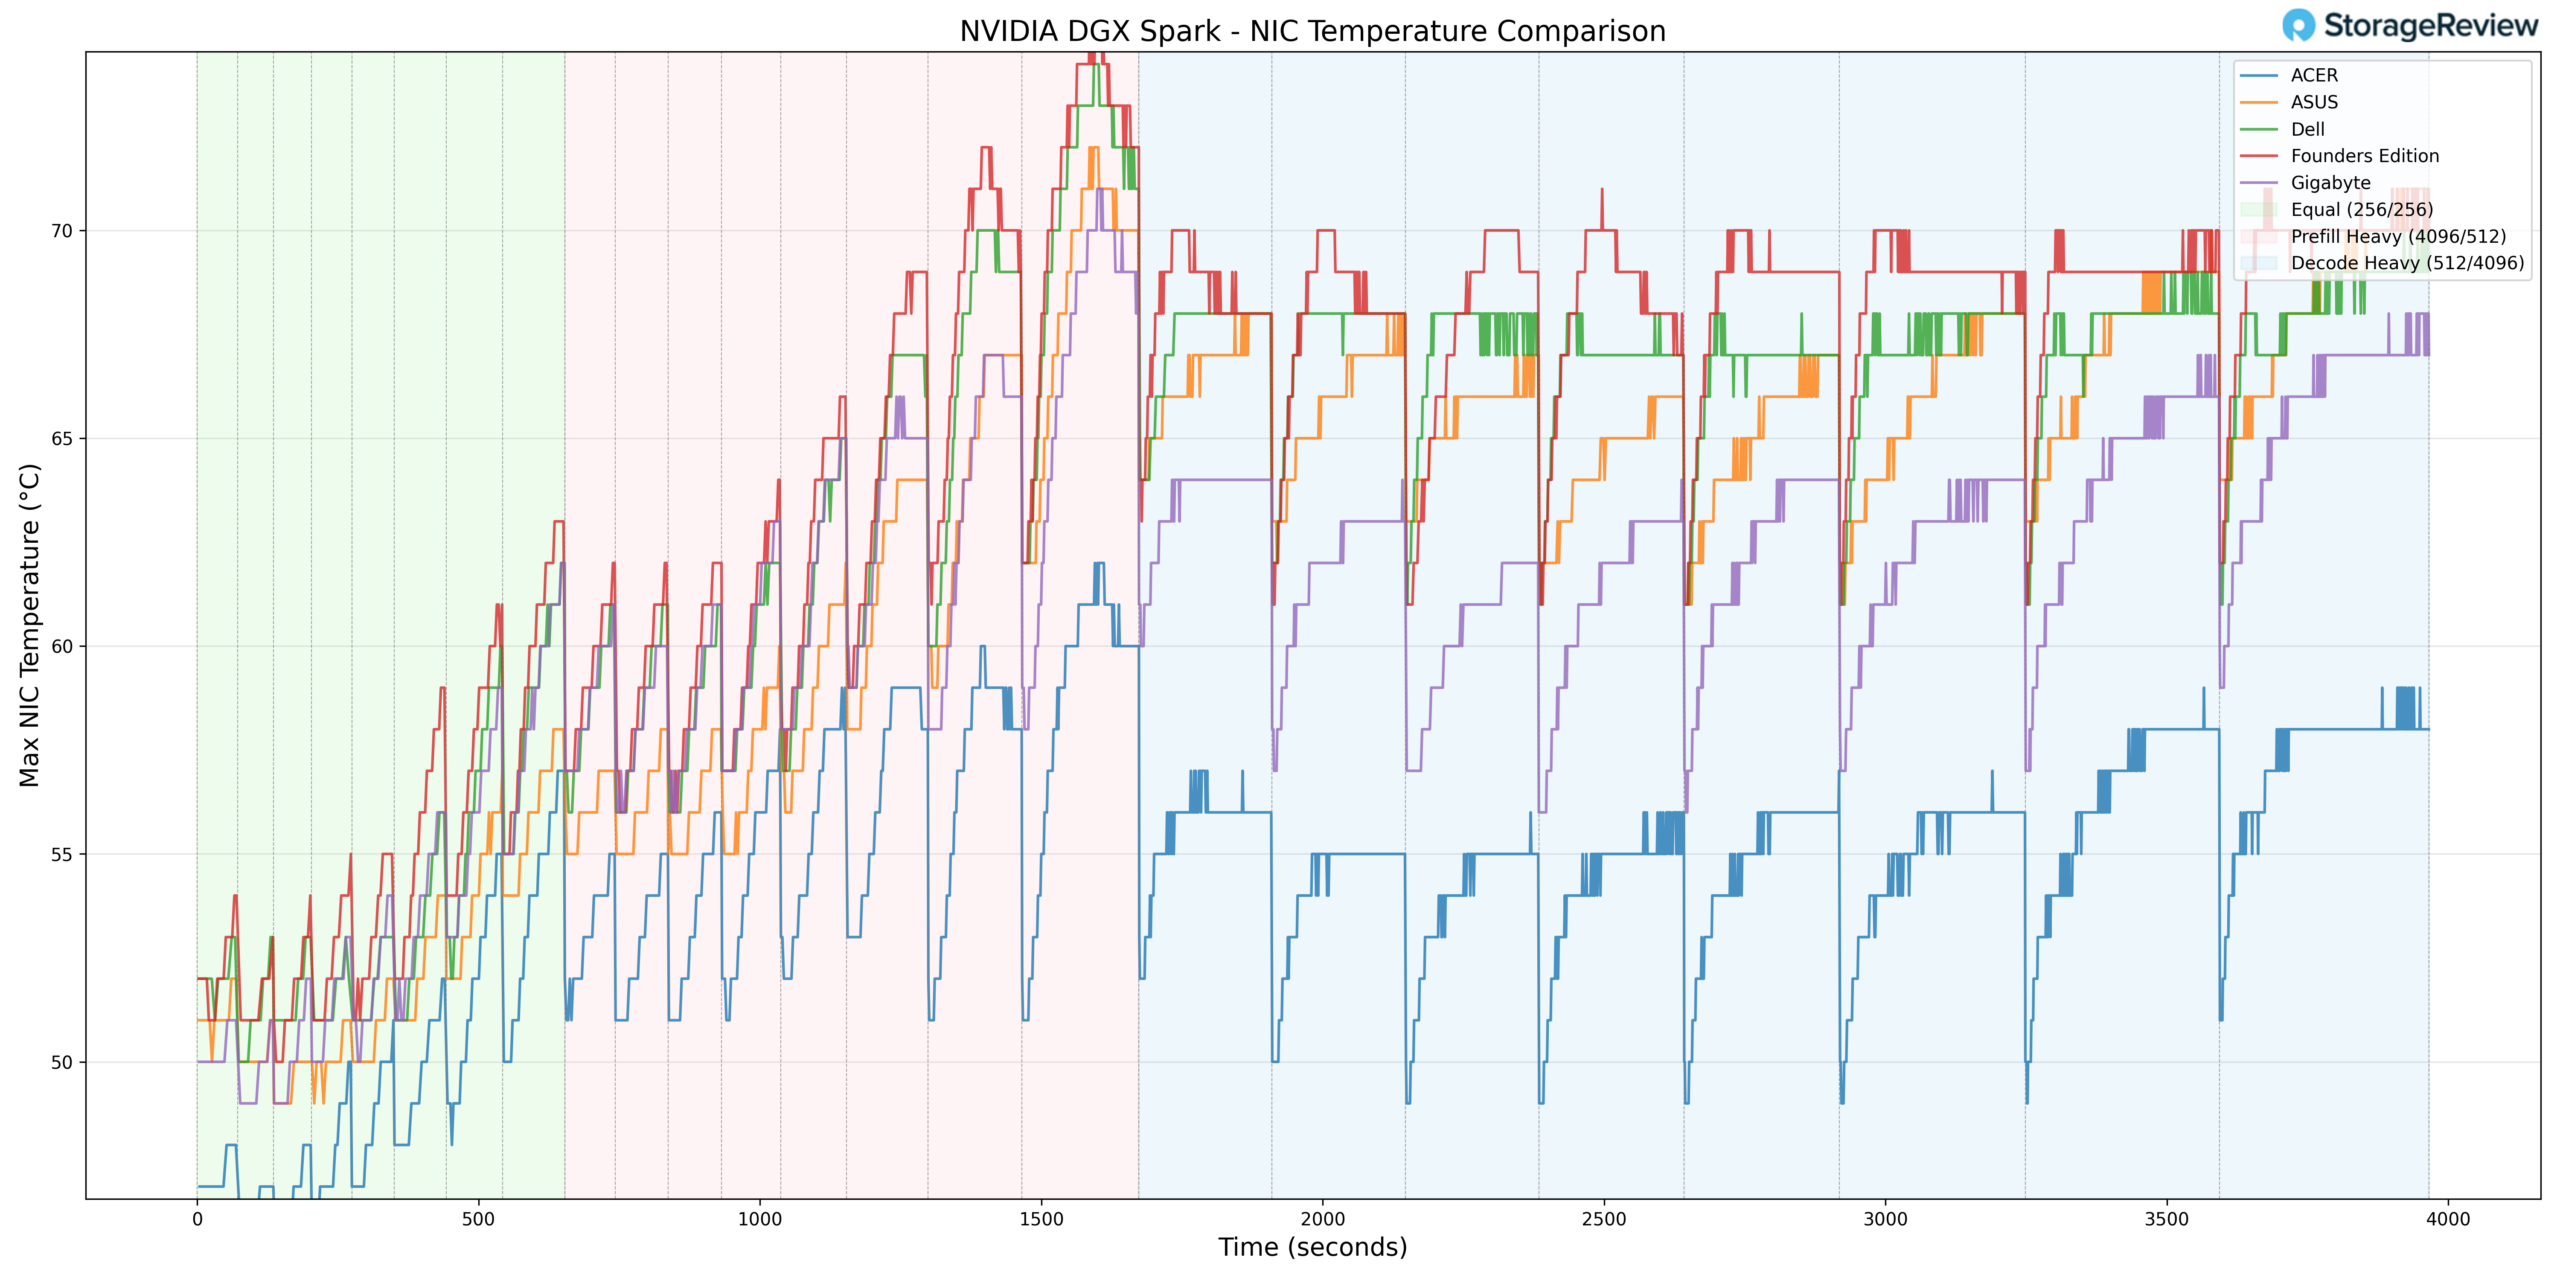
NIC-temperatuur
De temperatuur van de netwerkkaart bereikte een piek van 72 °C tijdens de zwaarste werkbelastingfasen, wat overeenkwam met de verhoogde doorvoer tijdens de overgangen van Prefill en Decode. Hoewel dit de netwerkcontroller in de warmere helft van de stack plaatste tijdens piekactiviteit, bleef de temperatuur binnen de operationele toleranties en vertoonde deze geen pieken.
De laagst gemeten NIC-temperatuur was 41 °C, wat duidt op normaal basisgedrag tijdens lichtere fasen.
Over het algemeen reageerde de netwerkkaart op de algehele systeembelasting zoals verwacht en vertoonde geen abnormale schaalvergroting.
Stroomverbruik van de GPU
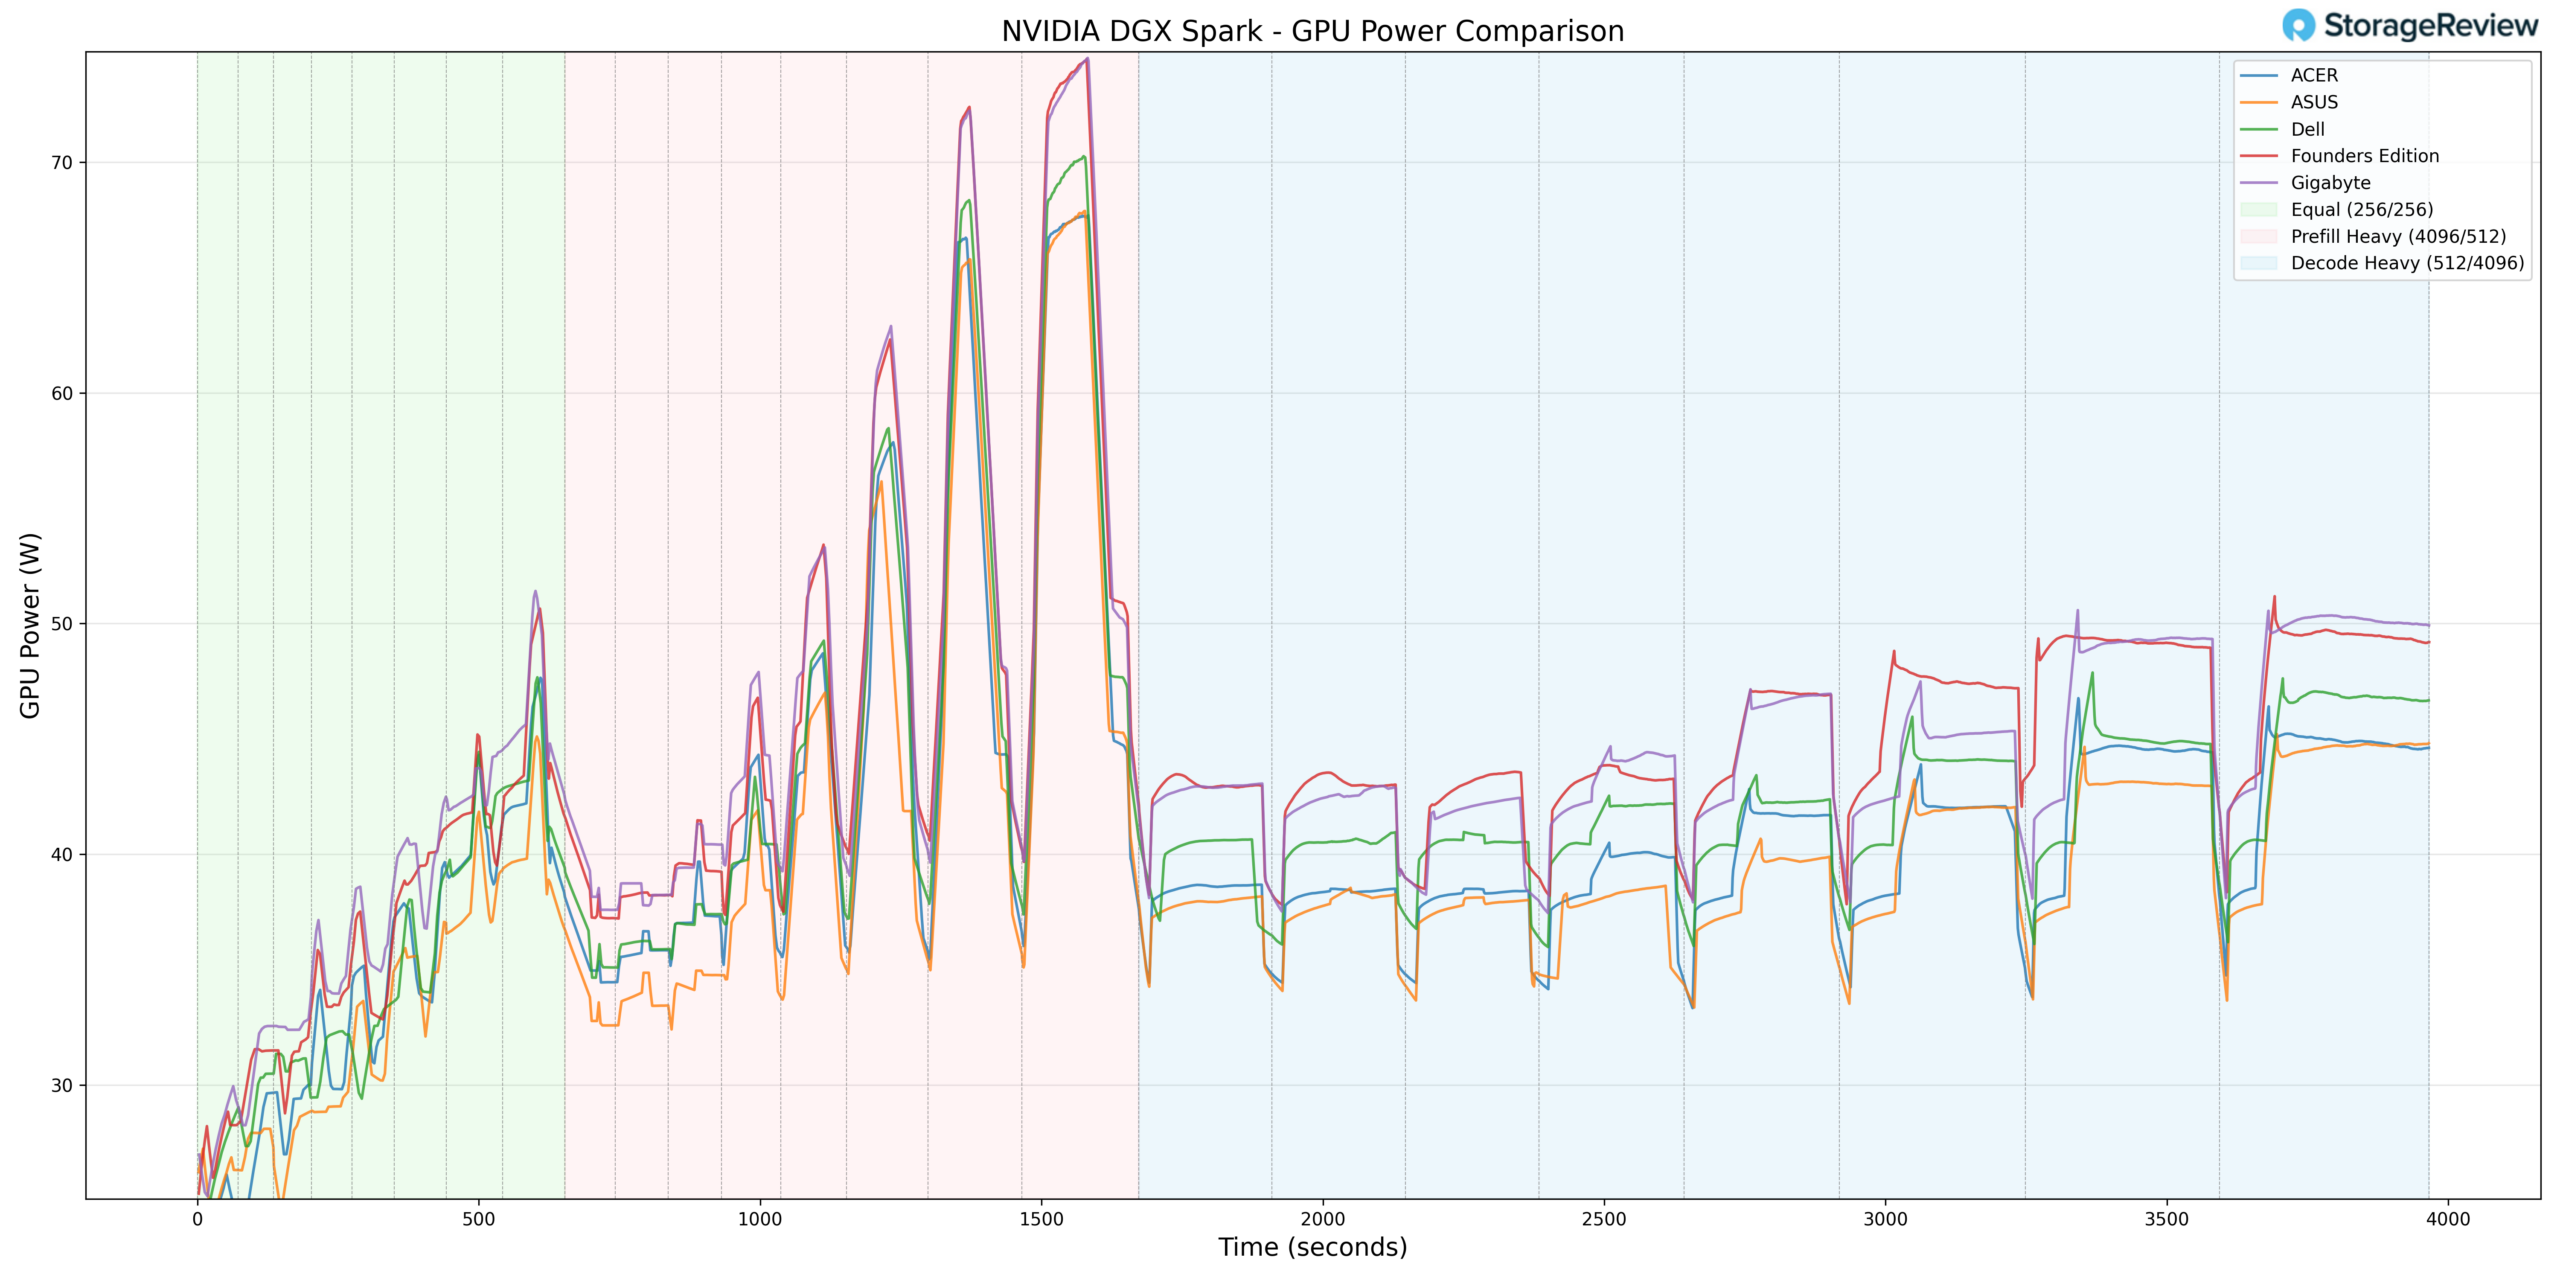
Het stroomverbruik van de GPU helpt de verhoogde piektemperaturen in perspectief te plaatsen. GIGABYTE bereikte een piekvermogen van 75.54 W tijdens Prefill Heavy-overgangen. Dit plaatst de GPU aan de bovenkant van het waargenomen stroomverbruik binnen de geteste GB10-eenheden.
In plaats van het GPU-vermogen kunstmatig te beperken, lijkt GIGABYTE periodes van bijna maximaal vermogen toe te staan, wat direct correleert met de hogere piektemperatuur van de GPU. Naarmate de workloads overgingen in langdurige decodeerfasen, stabiliseerde het stroomverbruik zich dienovereenkomstig.
Vanuit een energieperspectief lijkt het GIGABYTE-systeem niet overbelast te zijn. De hogere piektemperaturen tijdens burstfasen komen eerder overeen met prestatiegerichte energieverdelingsbeslissingen dan met een ongecontroleerd thermisch ontwerp.
Thermische samenvatting
Tijdens het monitoren van de CPU, GPU, NVMe en NIC presteerde de GIGABYTE GB10 met concurrerende temperaturen in ruststand en hogere piekbelastingen tijdens intensieve Prefill-overgangen. De CPU bereikte 90 °C en de GPU 81 °C tijdens maximale acceleratie, terwijl de NVMe onder de 60 °C bleef en de NIC 72 °C bereikte. Het stroomverbruik van de GPU piekte op 75.54 W, wat wijst op piekbelastingen die de limiet bijna bereikten.
Bij aanhoudende Decode-workloads stabiliseerden de temperaturen zich zonder verdere stijging, wat erop wijst dat GIGABYTE weliswaar agressieve prestaties van korte duur mogelijk maakt, maar dat de temperatuur tijdens langdurig gebruik voorspelbaar en gecontroleerd blijft.
GIGABYTE AI TOP ATOM Prestatietests
Om de GIGABYTE AI TOP ATOM te evalueren, hebben we Spark-eenheden getest met behulp van de vLLM Online Serving-benchmark, de meest gebruikte engine voor inferentie en servering met hoge doorvoer voor grote taalmodellen. De vLLM Online Serving-benchmark simuleert realistische productieworkloads door gelijktijdige verzoeken naar een draaiende vLLM-server te sturen en meet belangrijke parameters, waaronder de totale tokendoorvoer (tokens per seconde), de tijd tot het eerste token en de tijd per uitvoertoken, onder verschillende belastingomstandigheden.
Onze tests omvatten een reeks modellen, van dichte architecturen tot micro-schaalbare gegevenstypen. De prestaties werden geëvalueerd aan de hand van drie workloadscenario's: gelijke ISL/OSL-belasting, veel voorinvullen en veel decoderen. Deze scenario's vertegenwoordigen verschillende praktijkpatronen, van evenwichtige input- en outputbelastingen tot rekenintensieve promptverwerking en tokengeneratie met beperkte geheugenbandbreedte.
Naast de GIGABYTE AI TOP ATOM hebben we de NVIDIA Founders Edition Spark als referentiepunt gebruikt, evenals OEM-systemen van Asus, Acer en Dell. Hierdoor konden we de resultaten van GIGABYTE in de bredere concurrentieomgeving plaatsen en begrijpen waar het bedrijf de leiding neemt, meekomt met de concurrentie of achterblijft bij verschillende modellen en soorten workloads.
GPT-OSS-120B
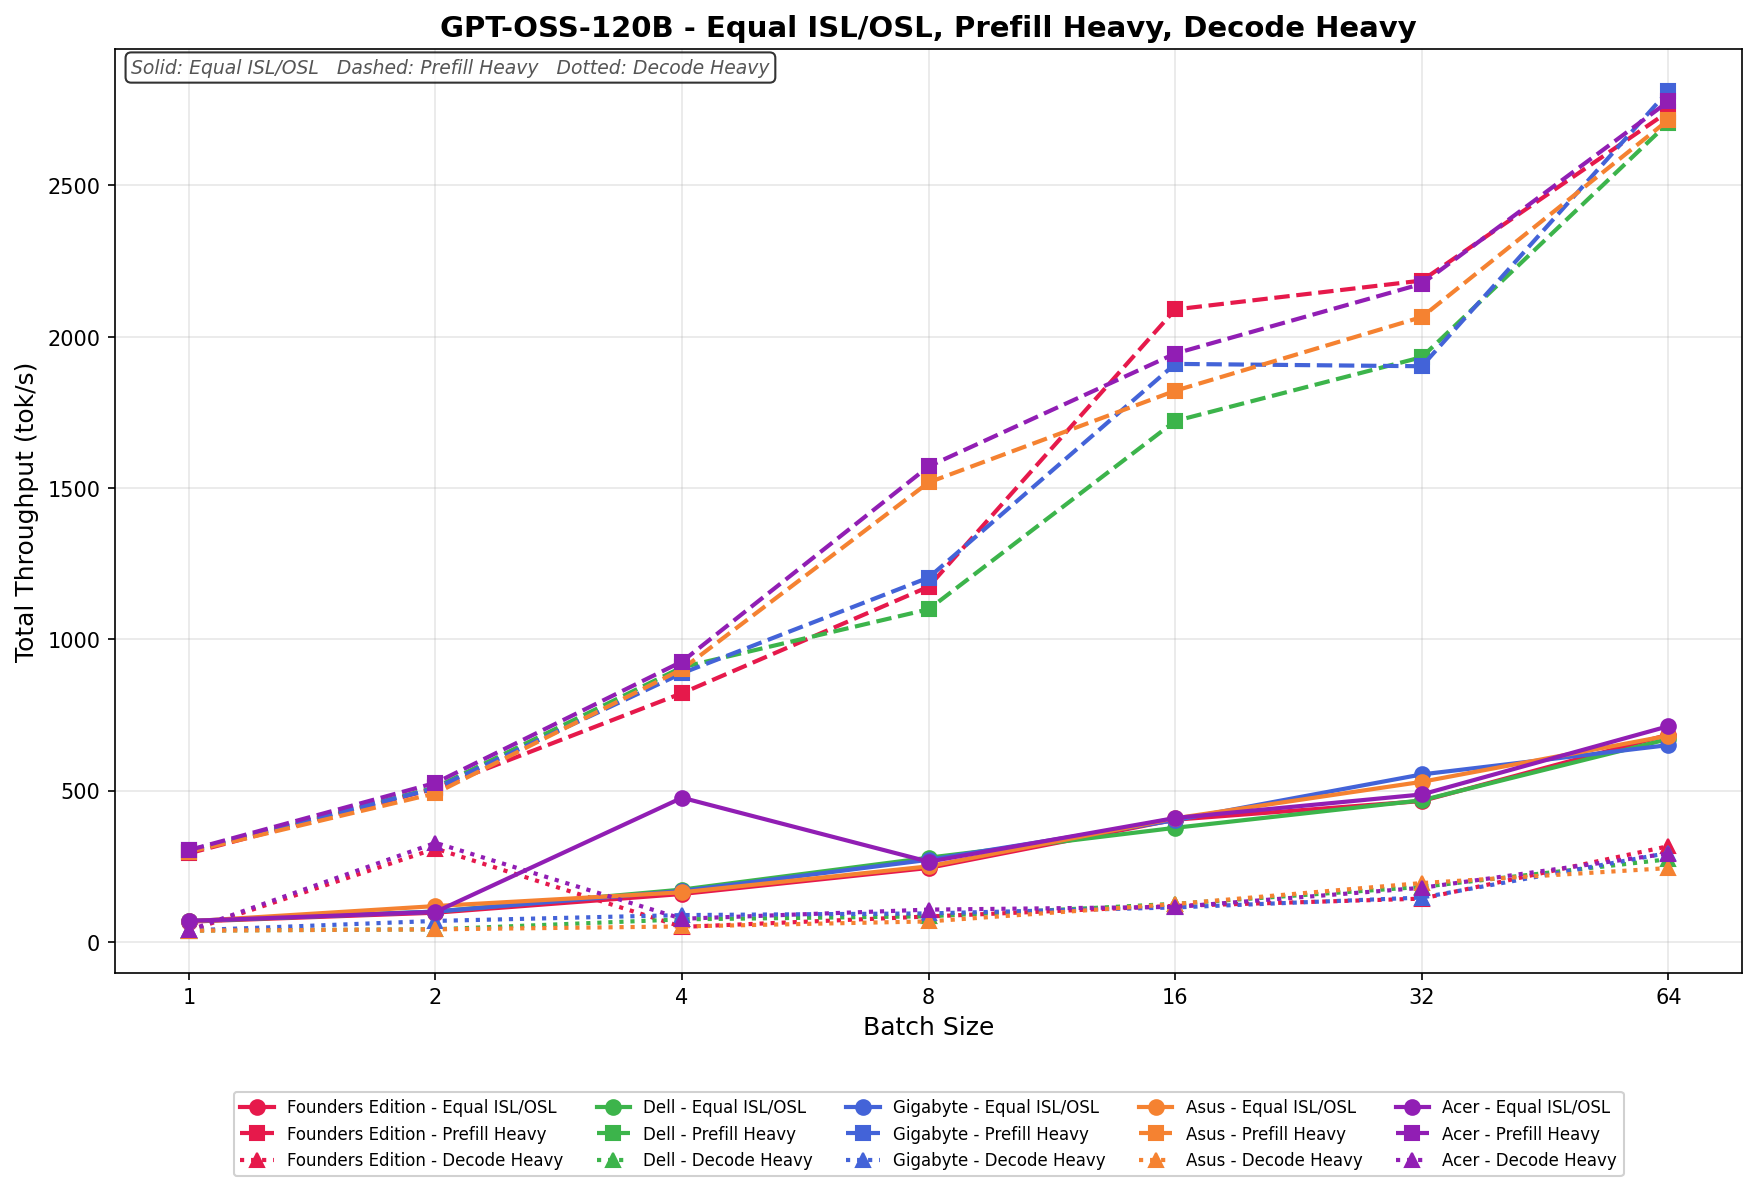
Bij gelijke ISL/OSL-waarden schaalt GIGABYTE van 60.71 tot 649.62 tok/s, waarmee het consistent in het midden van het veld blijft en bij grotere batchgroottes nauw aansluit bij Dell en Asus. De schaalbaarheid is stabiel en lineair tot en met batch 32, met verdere verbeteringen bij batch 64, hoewel het de topprestaties aan de bovenkant niet helemaal overtreft.
Prefill Heavy begint bij 304.63 tok/s en stijgt naar 2,771.38 tok/s bij batchgrootte 64. De groei is sterk tot en met batch 16, waar GIGABYTE kortstondig de derde plaats van de top bekleedt, voordat het bij grotere batchgroottes samenvalt met de rest van de groep. De algehele schaalvergroting is agressief en concurrerend, vooral bij batchgroottes in het middensegment.
Decode Heavy varieert van 47.01 tot 299.41 tok/s, met een geleidelijke en consistente schaalvergroting gedurende de batchverwerking.
GPT-OSS-20B
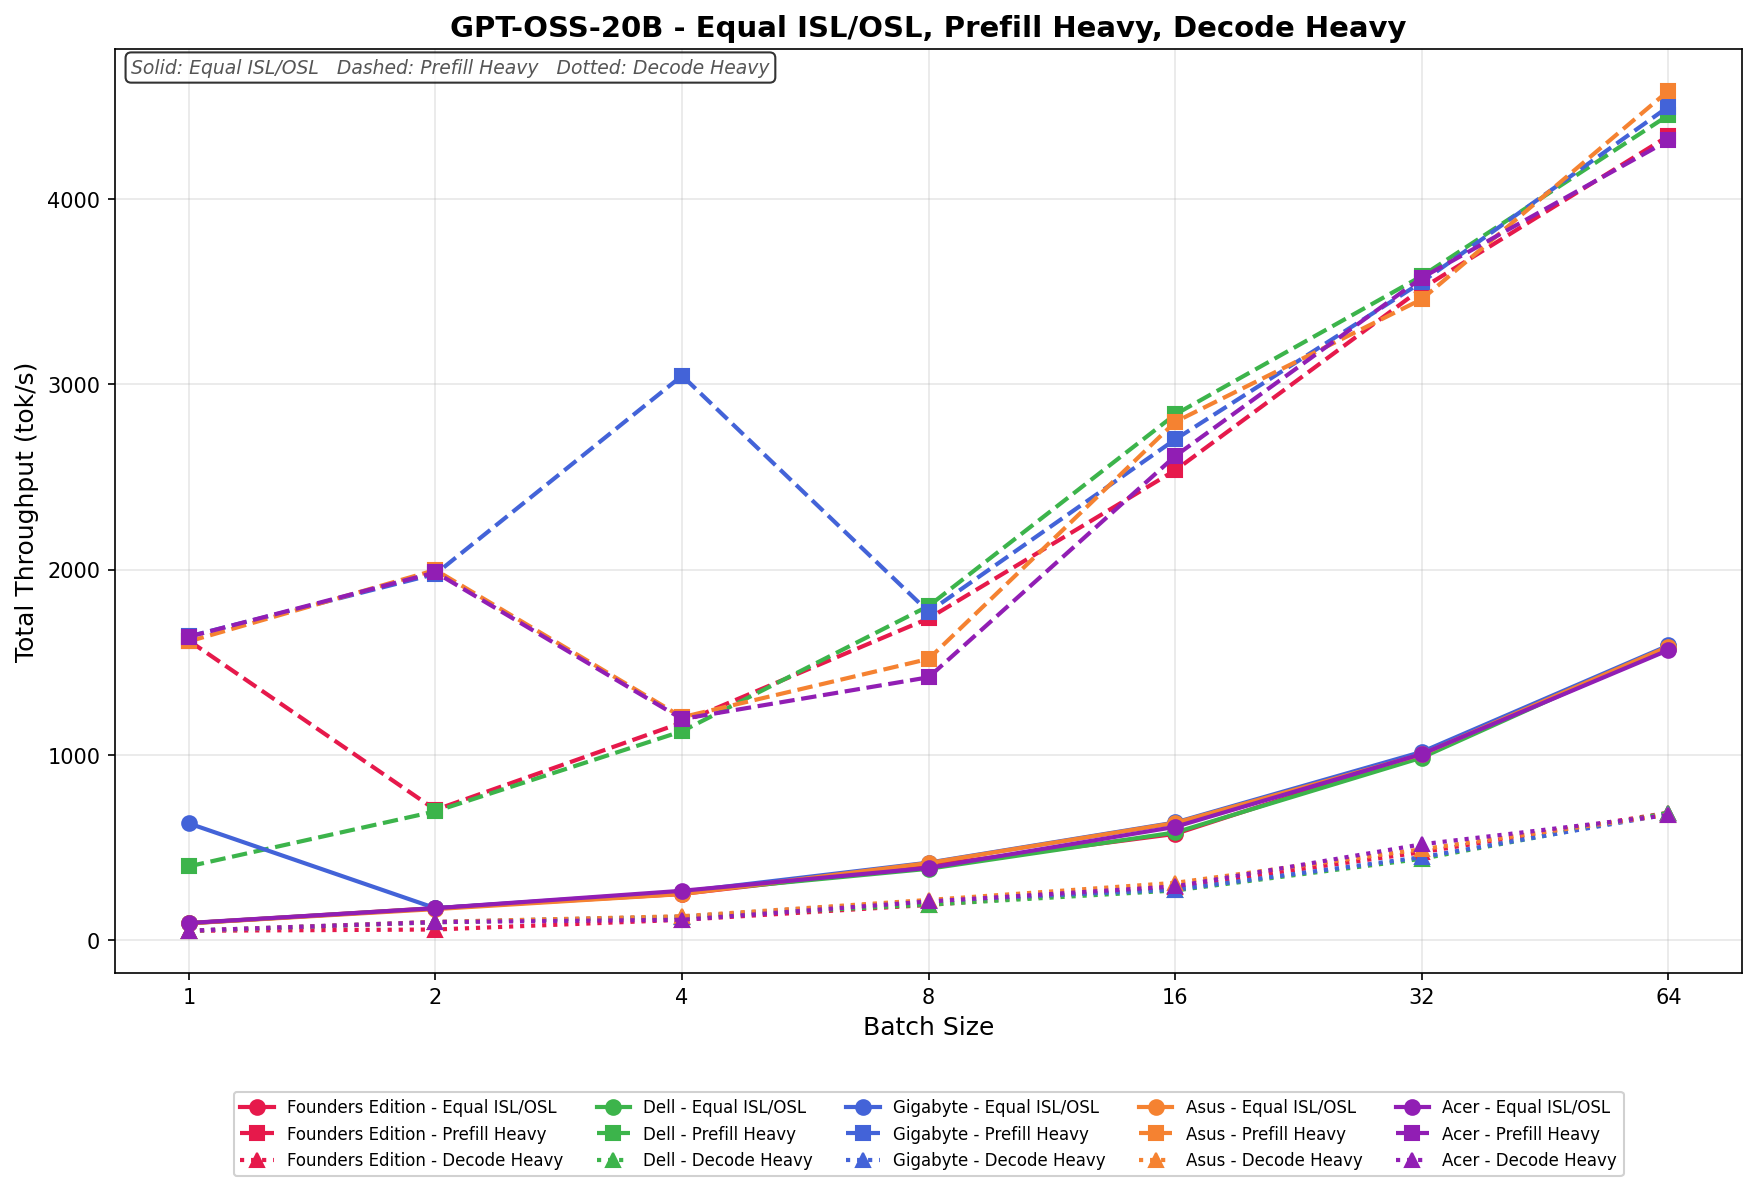
In Equal ISL/OSL schaalt GIGABYTE van 641.73 tot 1,587.62 tok/s, met een sterke start bij batchgrootte 1, een dip bij batch 2 en vervolgens een gestage toename bij grotere batchgroottes. Vanaf batch 8 normaliseert de schaalbaarheid en volgt deze nauw de rest van het veld, om bij batch 64 in de buurt van de top te eindigen.
Prefill Heavy begint bij 1,650.32 tok/s en bereikt een piek van 4,401.27 tok/s bij batchgrootte 64. Vanaf batch 16 is de schaalbaarheid consistent en concurrerend, waardoor Dell en Asus gelijke tred houden met de grotere batchgroottes.
Decode Heavy varieert van 63.18 tot 688.44 tok/s, met een duidelijke lineaire schaling over het hele bereik. De winst is stapsgewijs maar consistent, sluit nauw aan bij de andere platformen en weerspiegelt het meer beperkte schaalgedrag dat kenmerkend is voor workloads met veel decodeerwerk.
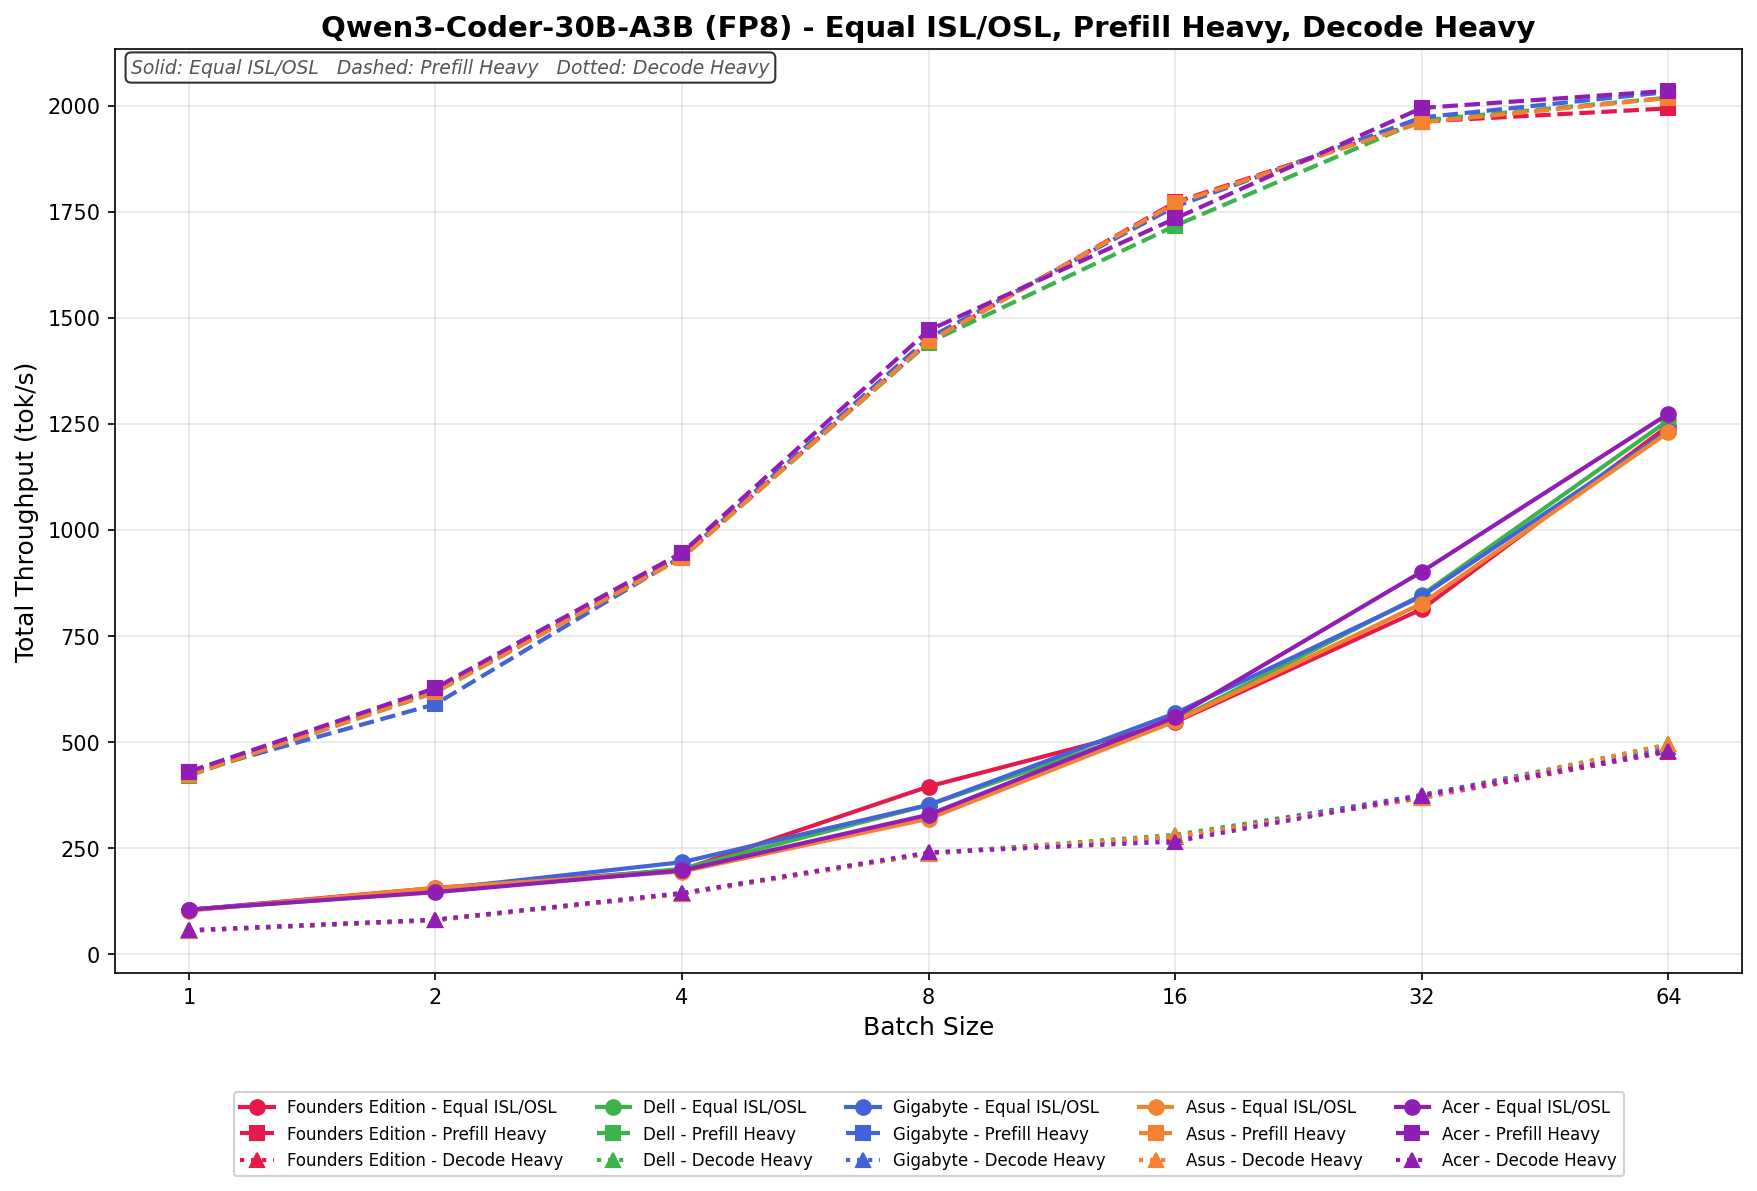
Qwen3 coder 30B A3B FB8
In de Equal ISL/OSL-test schaalt GIGABYTE van 101.27 tot 1,251.84 tok/s, met een gestage lineaire progressie over de hele batch. De prestaties liggen tot en met batch 16 dicht bij die van Dell en Asus, en blijven vervolgens gestaag stijgen tot en met batch 64, om uiteindelijk in de buurt van de top te eindigen zonder merkbare schaalafwijkingen.
Prefill Heavy begint bij 428.66 tok/s en schaalt op tot 2,026.94 tok/s naarmate de batchgrootte toeneemt tot 64. De groei is gestaag en consistent over alle batchgroottes, waarbij GIGABYTE nauw aansluit bij de rest van het veld.
Decode Heavy heeft snelheden variërend van 61.18 tot 482.73 tok/s, met voorspelbare, incrementele verbeteringen naarmate de batchgrootte toeneemt.
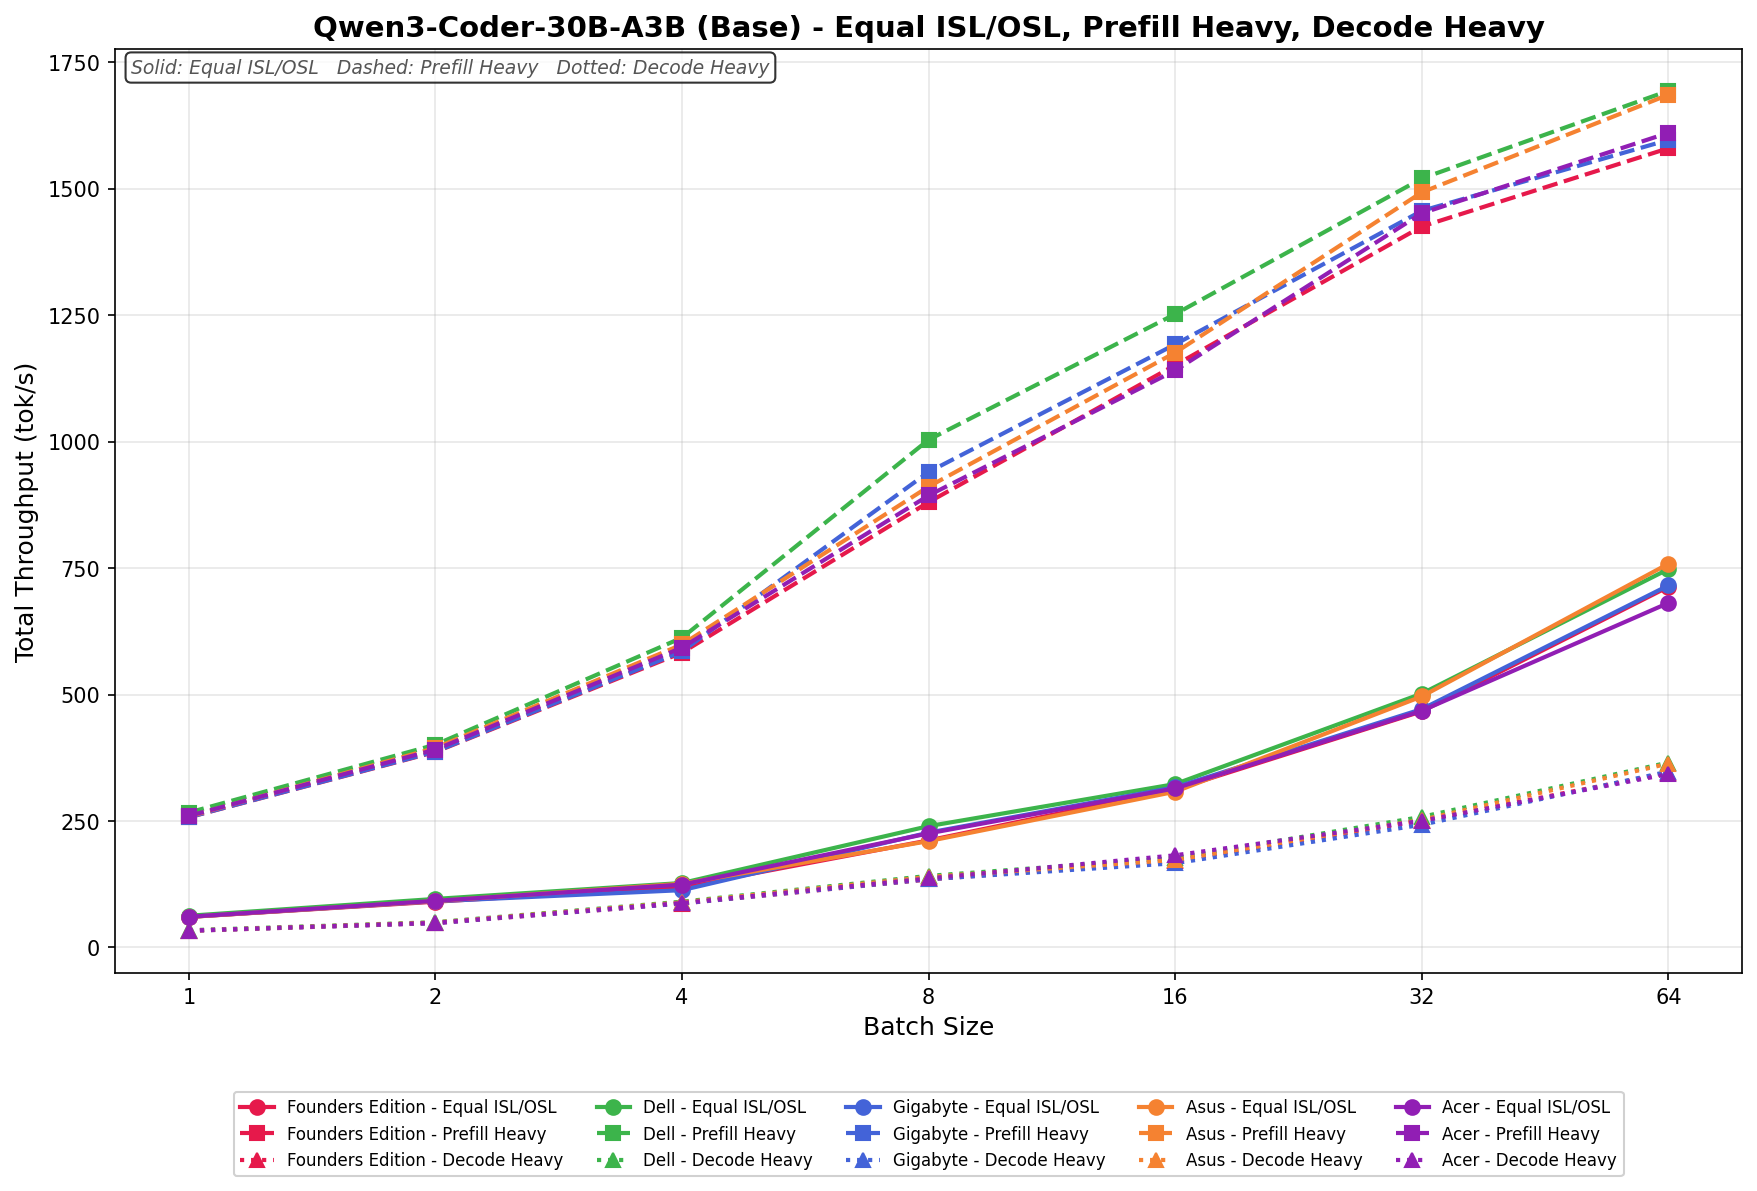
Qwen3 coder 30B A3B Base
In de Equal ISL/OSL-test schaalt GIGABYTE van 63.42 tot 721.08 tok/s, met een gestage verbetering over het hele batchbereik. De prestaties liggen hier dicht bij die van de rest van de markt tot en met batch 16 en schalen vervolgens gestaag door tot en met batch 64, om uiteindelijk concurrerend te eindigen zonder noemenswaardige afwijking van lineair gedrag.
Prefill Heavy begint bij 258.11 tok/s en loopt op tot 1,603.74 tok/s bij een batchgrootte van 64.
Decode Heavy heeft een bereik van 33.57 tot 349.82 tok/s, met een incrementele, lineaire schaalvergroting over het hele bereik.
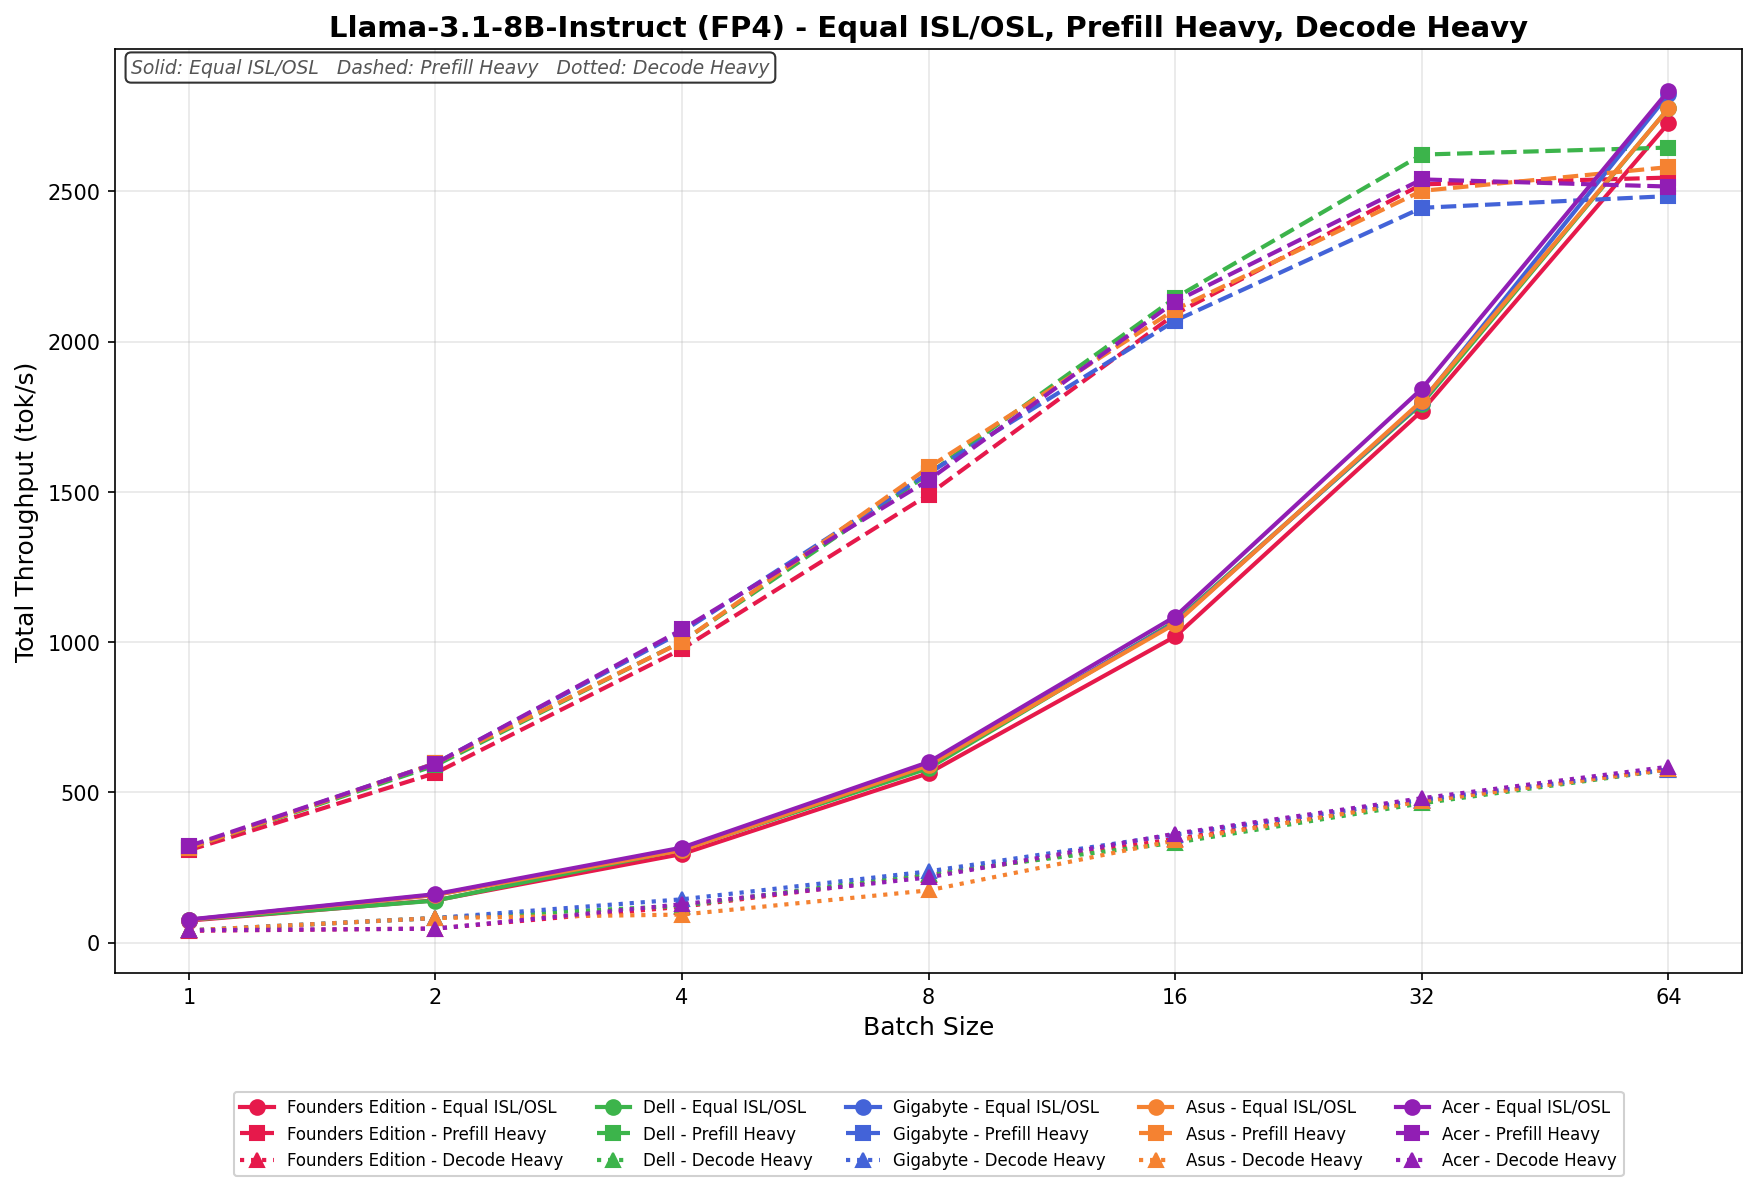
Lama 3.1 8B Instructie FP4
In Equal ISL/OSL stijgt de doorvoer van GIGABYTE van 69.84 naar 2,756.91 tok/s over de batchverwerking. De schaalbaarheid is progressief en evenwichtig tot en met batch 32, waar de doorvoer de hogere niveaus benadert, voordat er een sterke sprong wordt gemaakt bij batch 64, waarmee het zich schaart onder de toonaangevende systemen bij hogere gelijktijdigheidsniveaus.
Prefill Heavy begint bij 321.67 tok/s en bereikt 2,493.52 tok/s bij batchgrootte 64. De groei is gestaag tot en met batch 16 en begint vervolgens iets af te nemen bij grotere batchgroottes ten opzichte van de best presterende batch, wat wijst op een solide, maar niet dominante schaalbaarheid bij grote batches.
Decode Heavy heeft een bereik van 48.92 tot 575.84 tok/s, met consistente incrementele verbeteringen naarmate de batchgrootte toeneemt.
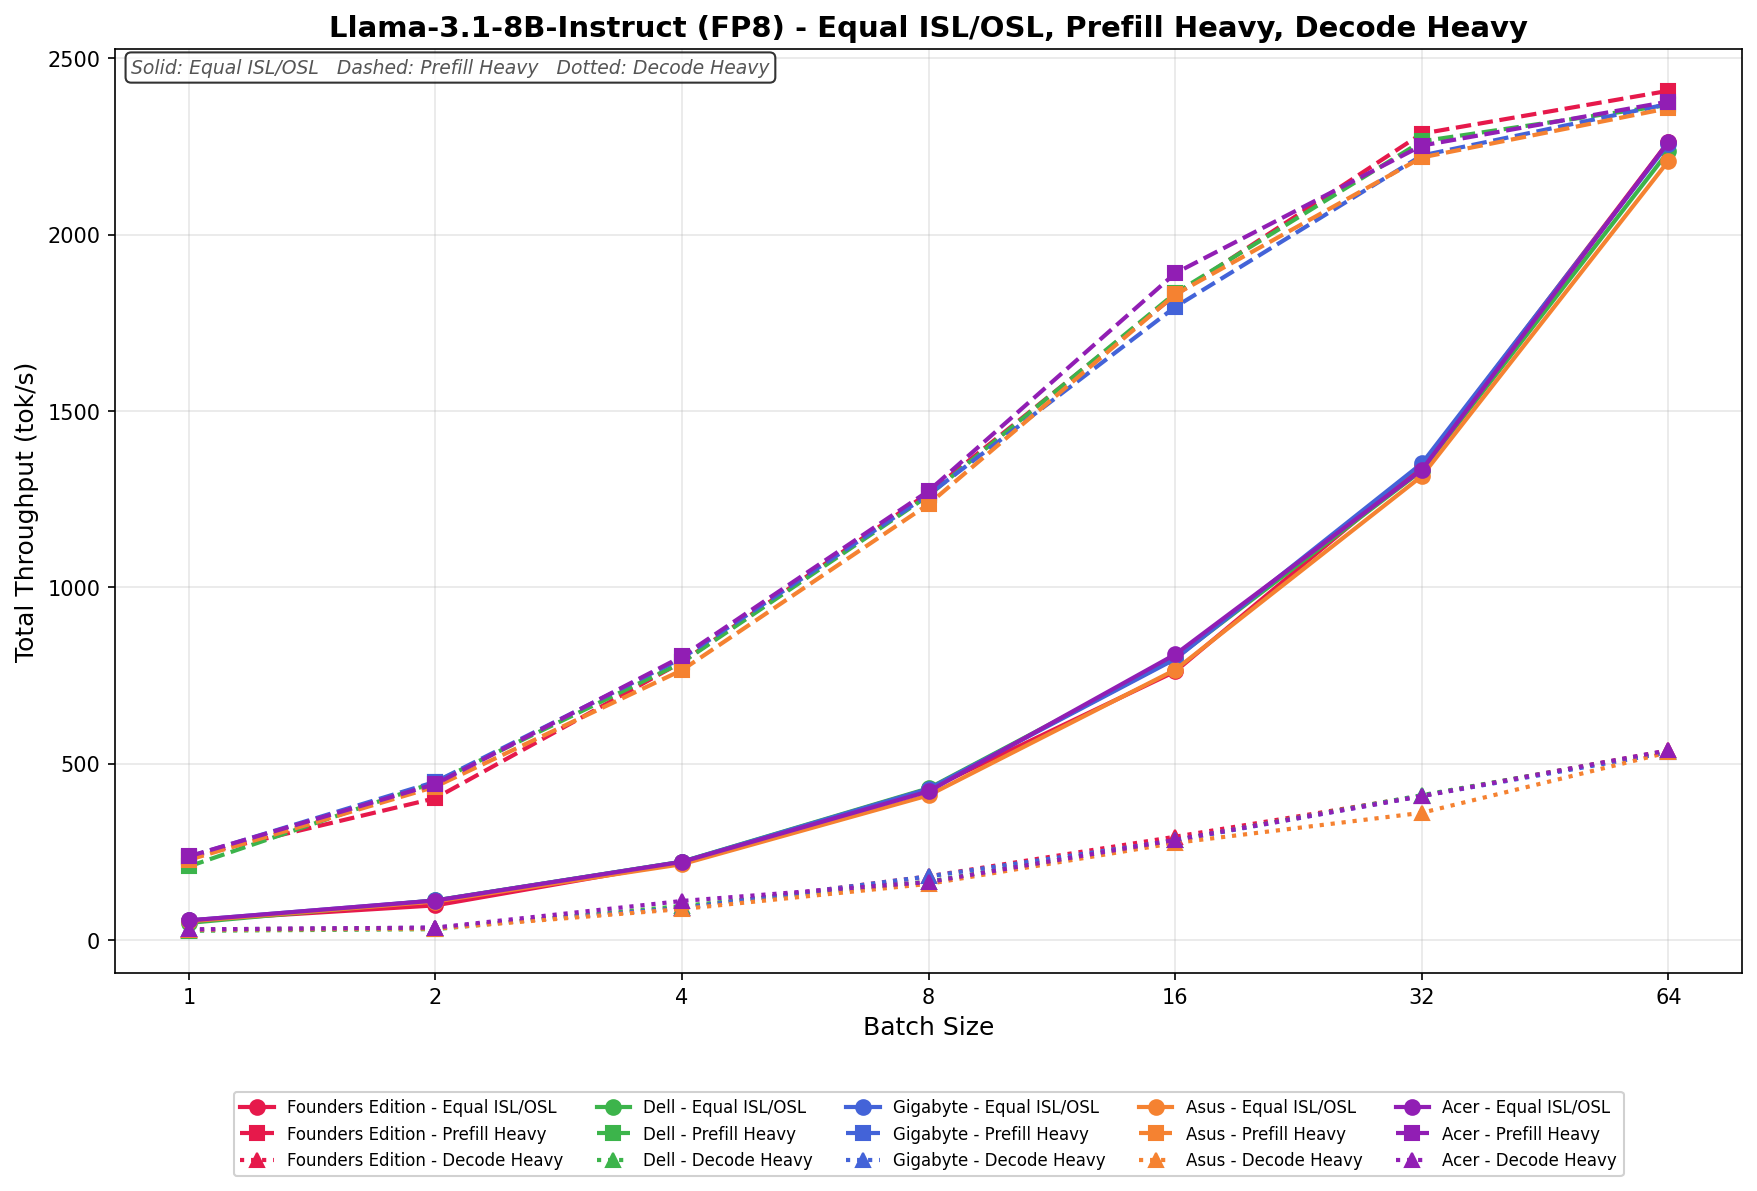
Lama 3.1 8B Instructie FP8
In Equal ISL/OSL schaalt GIGABYTE van 54.12 tot 2,314.87 tok/s, met een vloeiende, lineaire groei tot en met batch 32 en een sterke stijging bij batch 64, waardoor het concurrerend blijft bij hogere gelijktijdigheidsniveaus.
Prefill Heavy begint bij 226.43 tok/s en bereikt 2,332.19 tok/s bij batchgrootte 64. De schaalbaarheid is consistent over het hele bereik, volgt nauw de algemene trend en behoudt een solide efficiëntie bij grotere batchgroottes.
Decode Heavy varieert van 32.88 tot 522.41 tok/s, met een gestage toename naarmate de batchgrootte groter wordt. Zoals verwacht blijft de schaalbaarheid beperkter in vergelijking met Equal- en Prefill-workloads.
GPU directe opslag
Een van de tests die we op de Spark hebben uitgevoerd, was de MagnumIO GPU Direct Storage (GDS)-test. GDS is een door NVIDIA ontwikkelde functie waarmee GPU's de CPU kunnen omzeilen bij het benaderen van gegevens die zijn opgeslagen op NVMe-schijven of andere snelle opslagapparaten. In plaats van gegevens via de CPU en het systeemgeheugen te routeren, maakt GDS directe communicatie tussen de GPU en het opslagapparaat mogelijk, wat de latentie aanzienlijk vermindert en de gegevensdoorvoer verbetert.
Gigabyte gebruikt de 4TB Samsung PM9E1 Gen5 SSD in de AI TOP ATOM, wat tot nu toe de snelste 2242 M.2-schijf is die we op de markt hebben gezien. Dit is dezelfde SSD die we ook aantreffen in de FE Spark en de Acer Veriton GN100.
Hoe GPU Direct Storage werkt
Traditioneel gezien moet een GPU, wanneer gegevens van een NVMe-schijf worden verwerkt, eerst via de CPU en het systeemgeheugen gaan voordat de gegevens de GPU bereiken. Dit proces introduceert knelpunten omdat de CPU als tussenpersoon fungeert, wat leidt tot latentie en het verbruik van waardevolle systeembronnen. GPU Direct Storage elimineert deze inefficiëntie door de GPU in staat te stellen rechtstreeks toegang te krijgen tot de gegevens van het opslagapparaat via de PCIe-bus. Dit directe pad vermindert de overhead van gegevensoverdracht, waardoor snellere en efficiëntere gegevensoverdracht mogelijk is.
AI-workloads, met name die met deep learning, zijn zeer data-intensief. Het trainen van grote neurale netwerken vereist het verwerken van terabytes aan data, en elke vertraging in dataoverdracht kan leiden tot onderbenutte GPU's en langere trainingstijden. GPU Direct Storage pakt deze uitdaging aan door ervoor te zorgen dat data zo snel mogelijk naar de GPU wordt geleverd, waardoor inactieve tijd wordt geminimaliseerd en de rekenefficiëntie wordt gemaximaliseerd.
Bovendien is GDS met name gunstig voor workloads die het streamen van grote datasets omvatten, zoals videoverwerking, natuurlijke taalverwerking of realtime-inferentie. Door de afhankelijkheid van de CPU te verminderen, versnelt GDS de databeweging en maakt CPU-bronnen vrij voor andere taken, wat de algehele systeemprestaties verder verbetert.
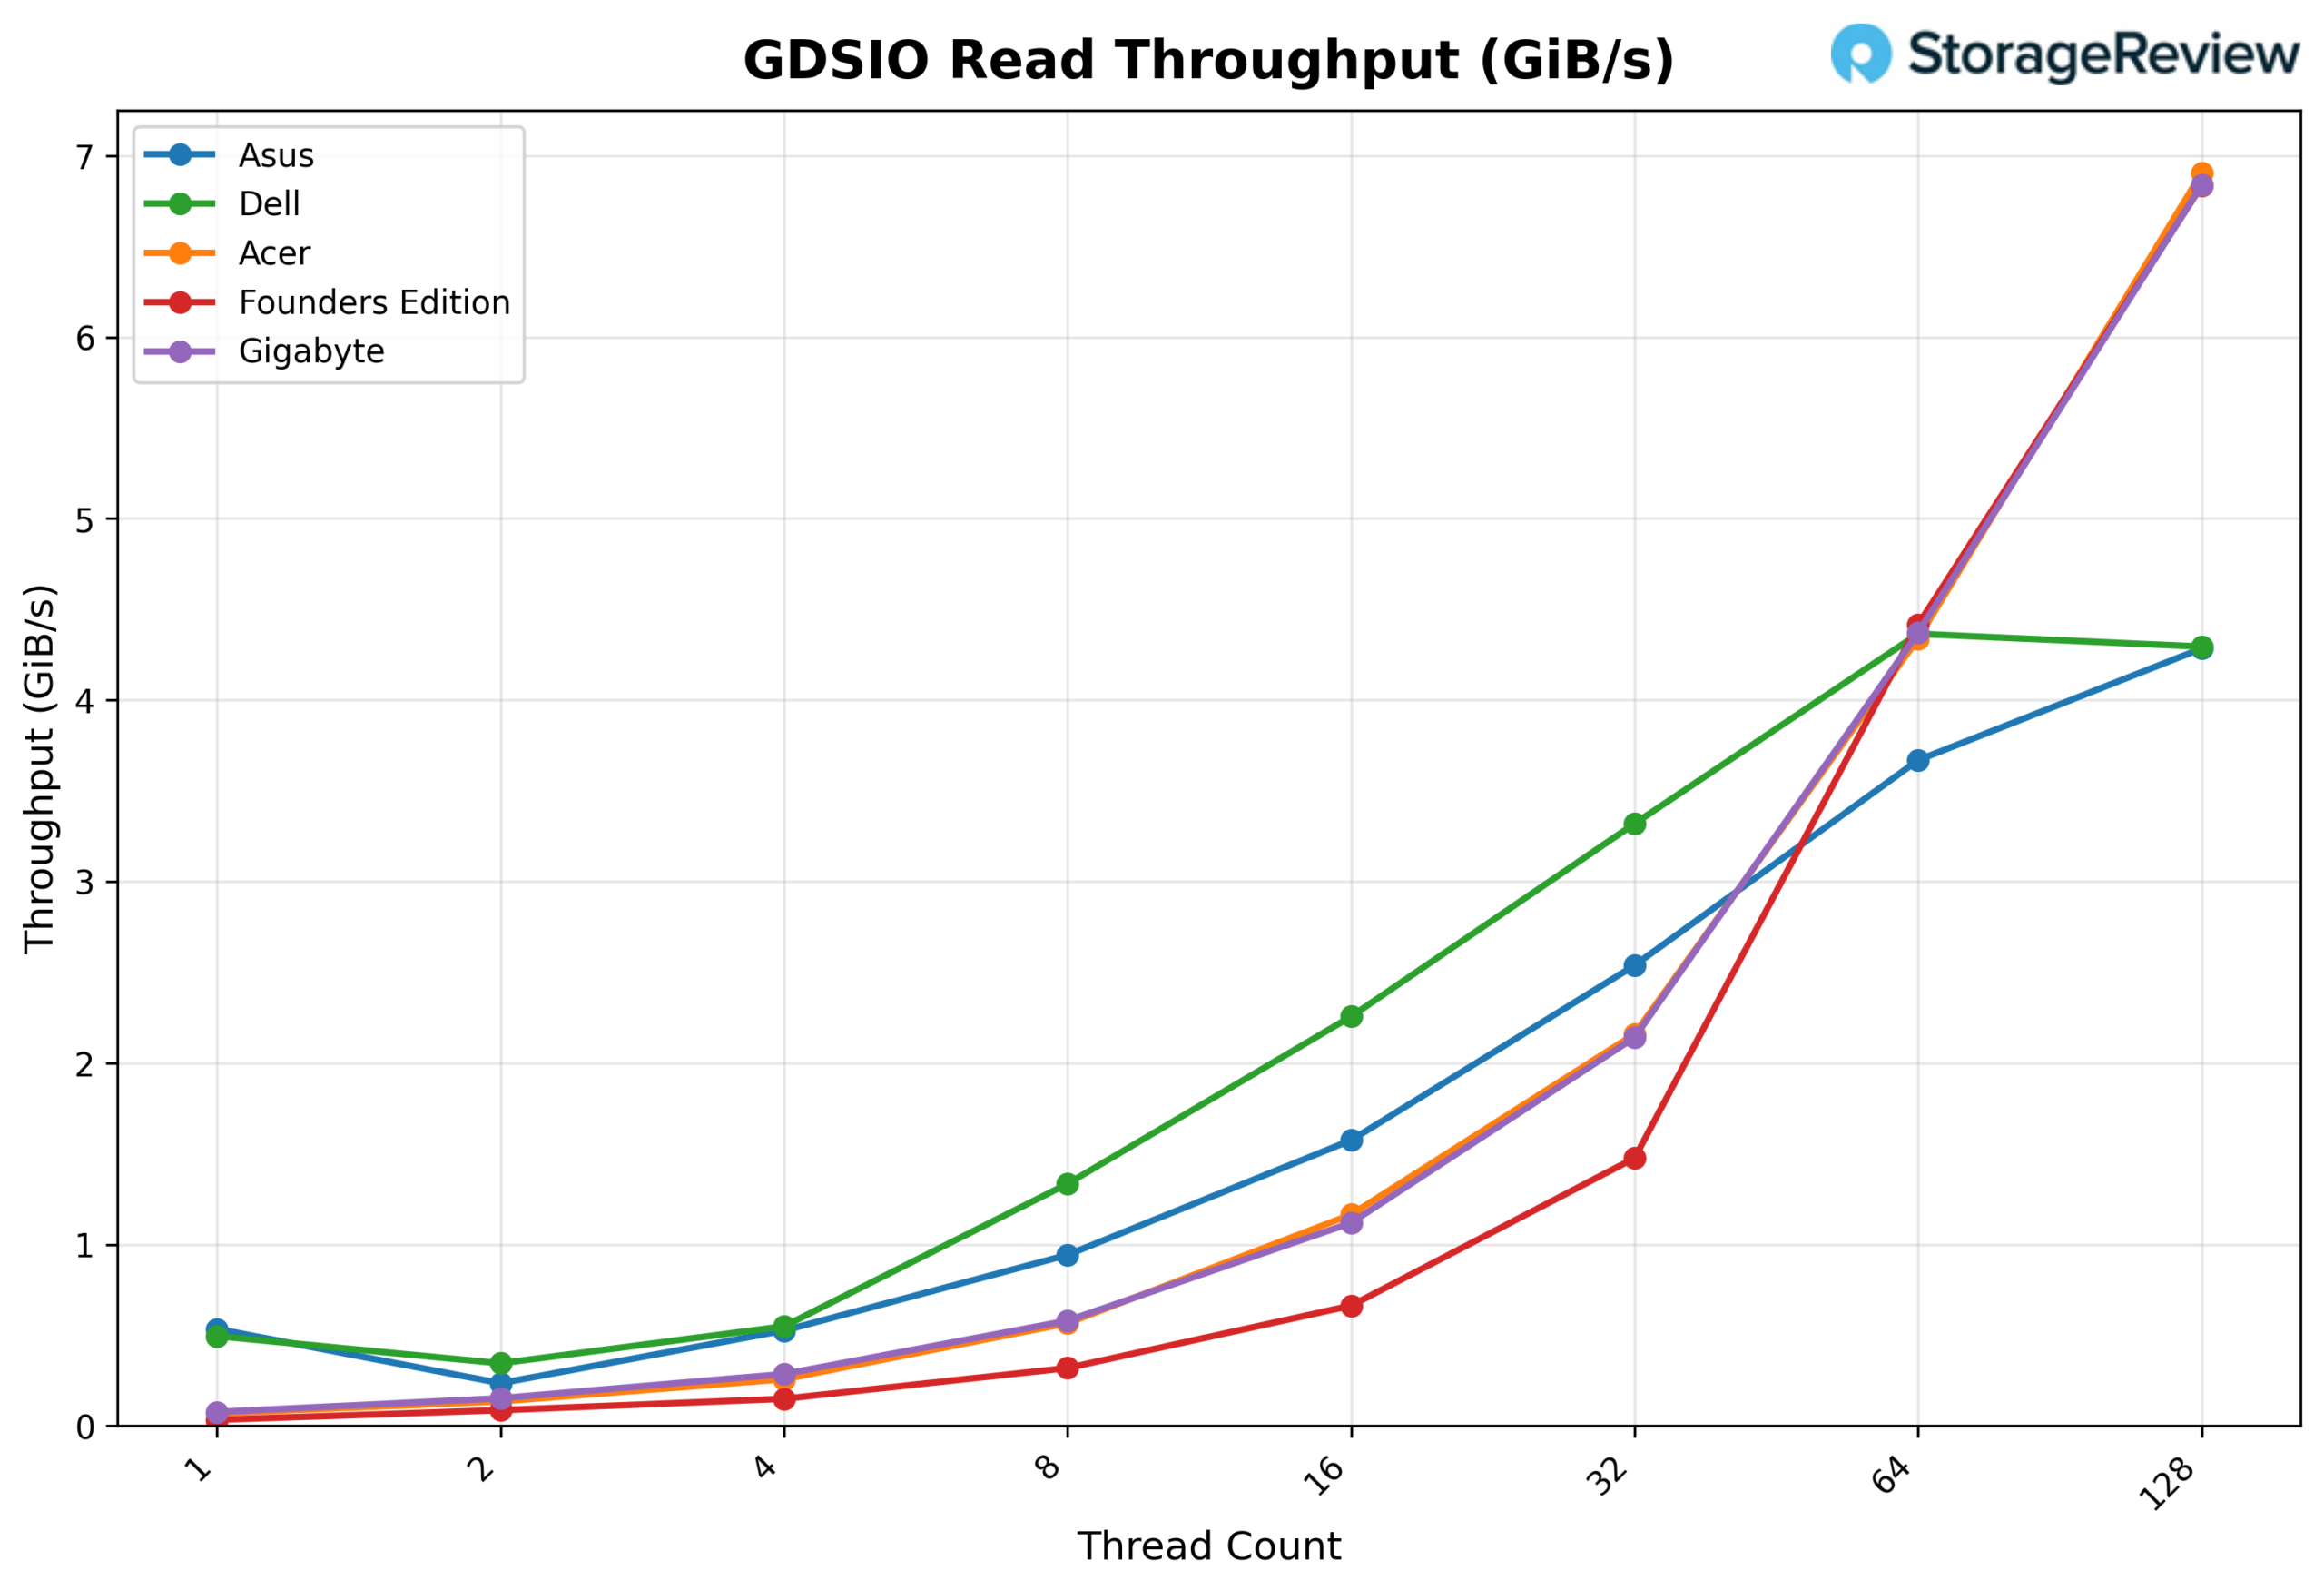
GDSIO leesdoorvoer 16k
Kijkend naar de GDSIO Read Throughput 16K, begint de GIGABYTE bij ongeveer 0.08 GiB/s met 1 thread en loopt op tot 0.58 GiB/s met 8 threads. Vanaf daar schaalt de doorvoer gestaag verder met 16 threads (1.12 GiB/s) en 32 threads (2.14 GiB/s), om vervolgens bij 64 threads een scherpe sprong te maken naar 4.37 GiB/s. Bij 128 threads blijft de GIGABYTE schalen tot 6.84 GiB/s, zonder tekenen van afvlakking aan de bovenkant van het threadbereik.
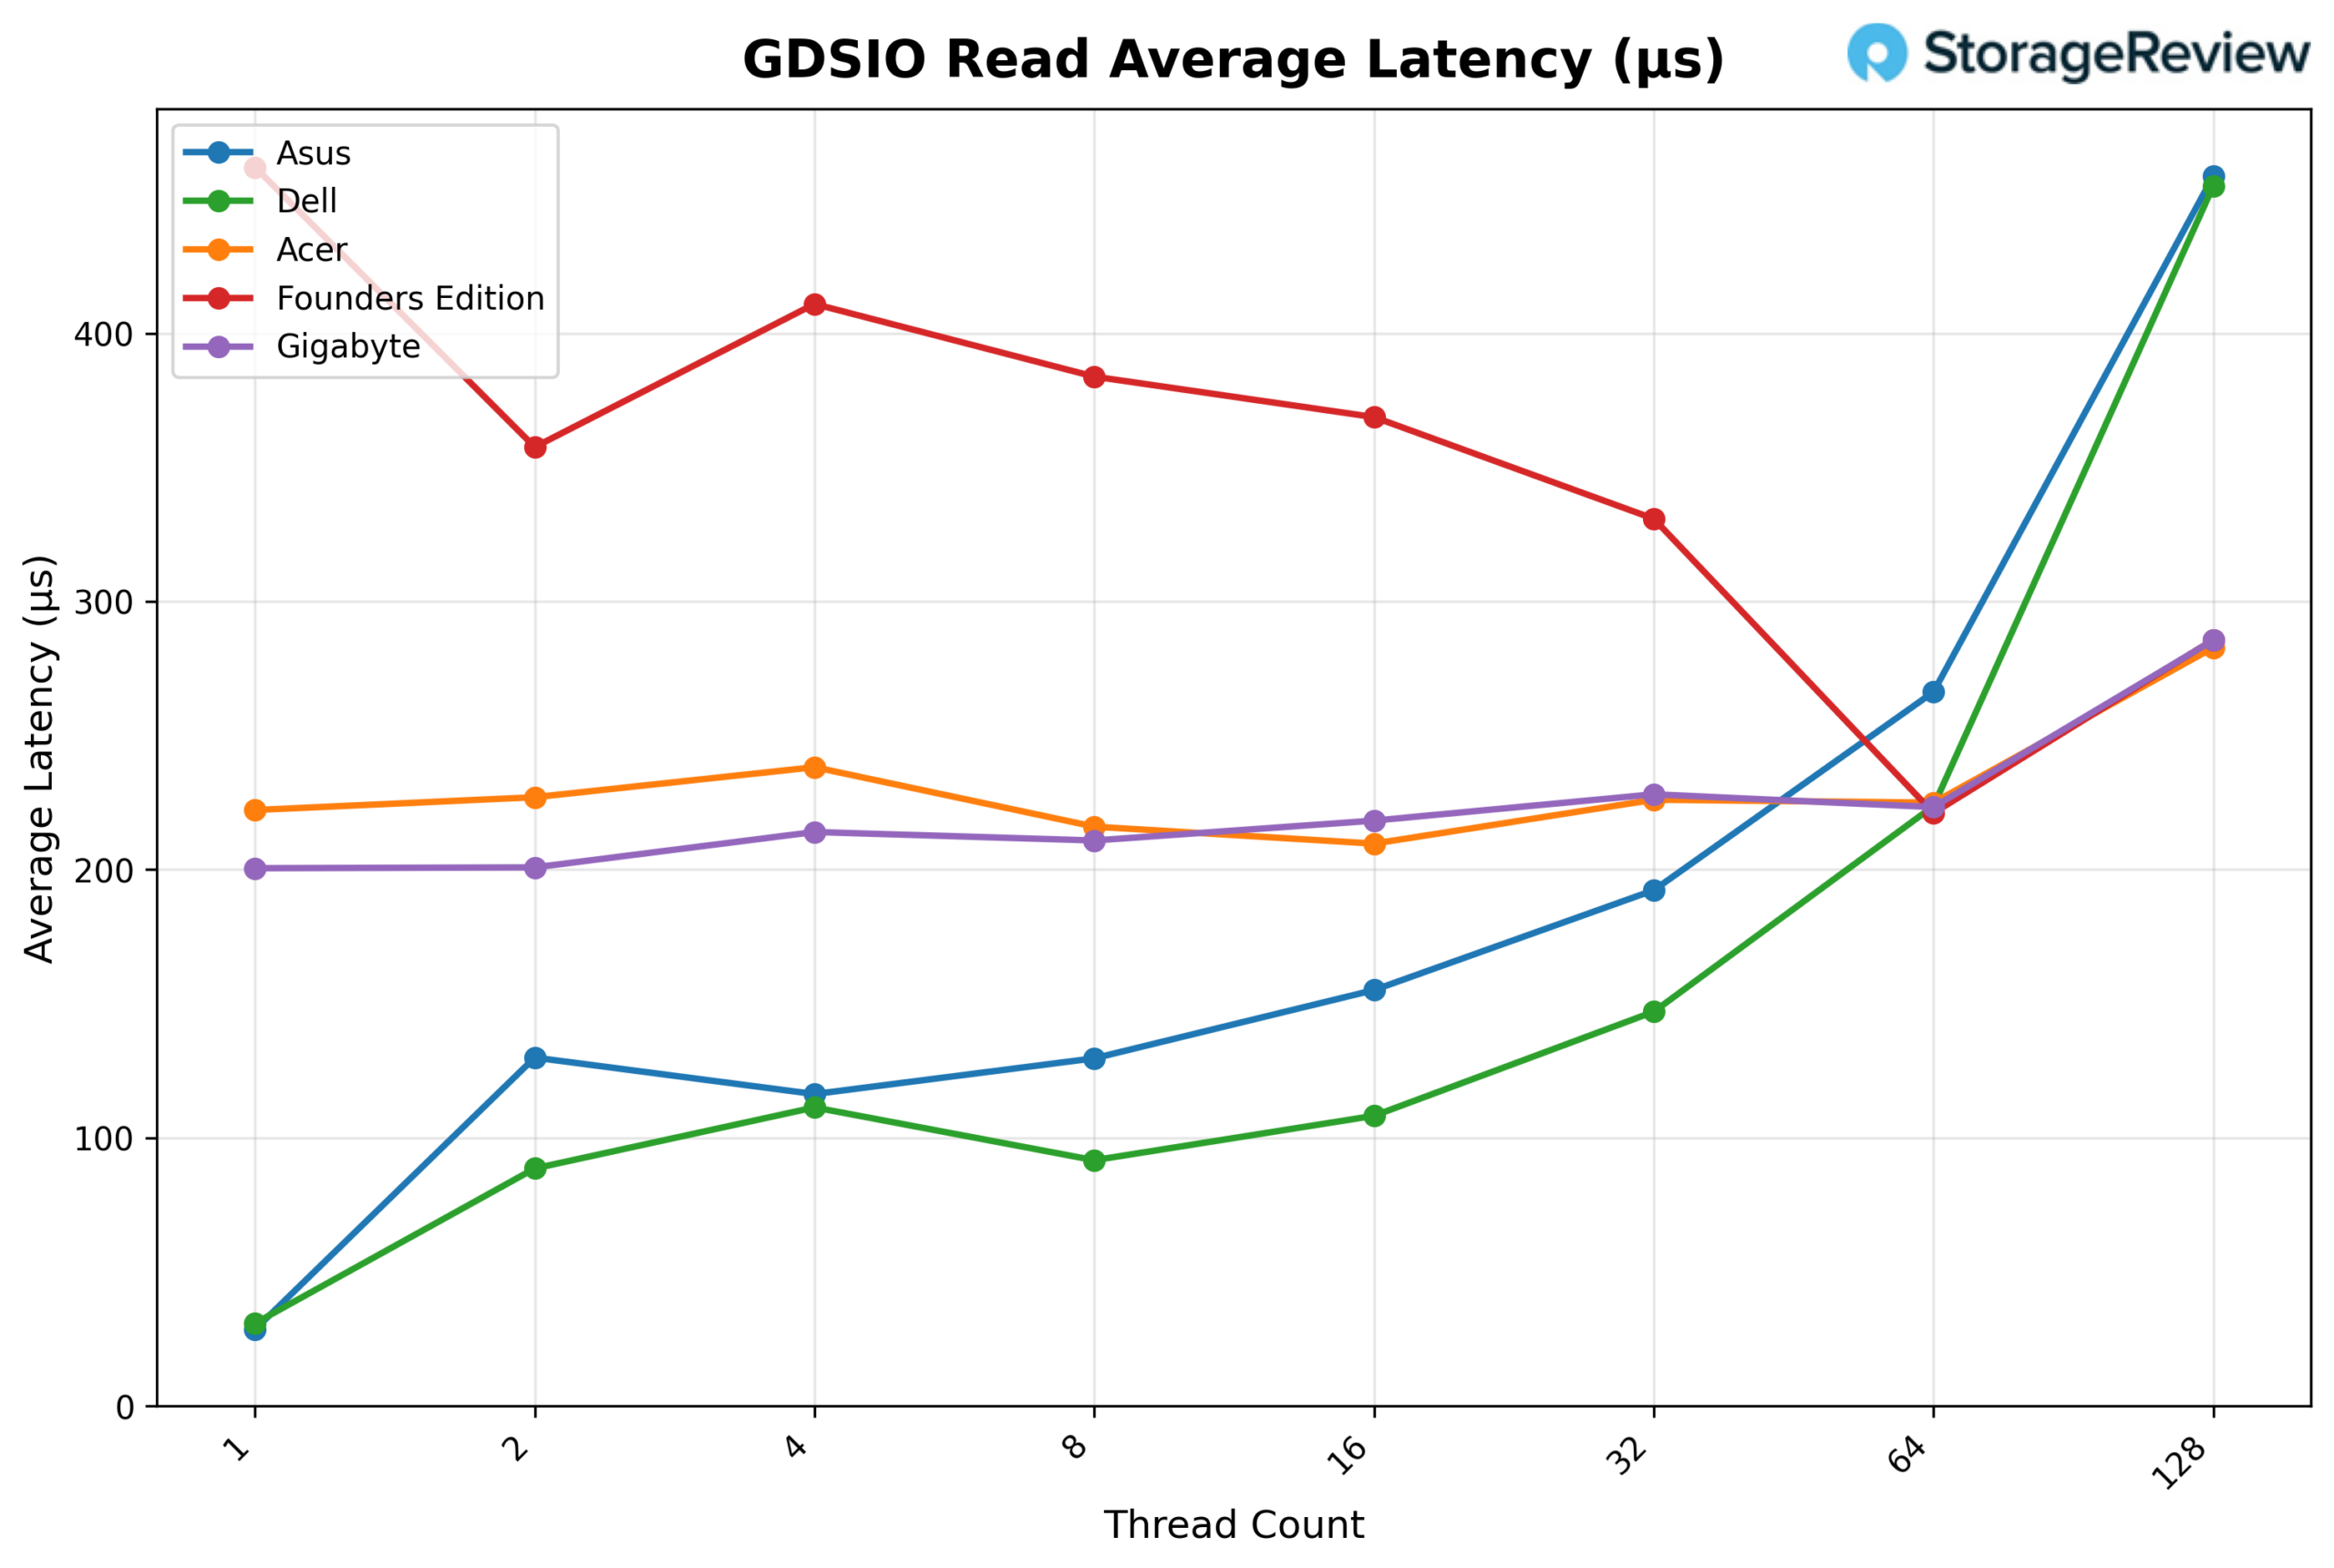
GDSIO Leesgemiddelde latentie 16K
Kijkend naar de gemiddelde leeslatentie van GDSIO (16K), handhaaft GIGABYTE een zeer stabiele latentie over het grootste deel van de curve. Deze begint bij ongeveer 0.201 ms met 1 thread en blijft dicht bij ~0.21–0.23 ms van 2 tot en met 64 threads (bijvoorbeeld 0.211 ms bij 8 threads, 0.218 ms bij 16 threads, 0.228 ms bij 32 threads en 0.223 ms bij 64 threads). Pas bij 128 threads stijgt de latentie merkbaar naar ongeveer 0.286 ms, terwijl de doorvoer blijft toenemen.
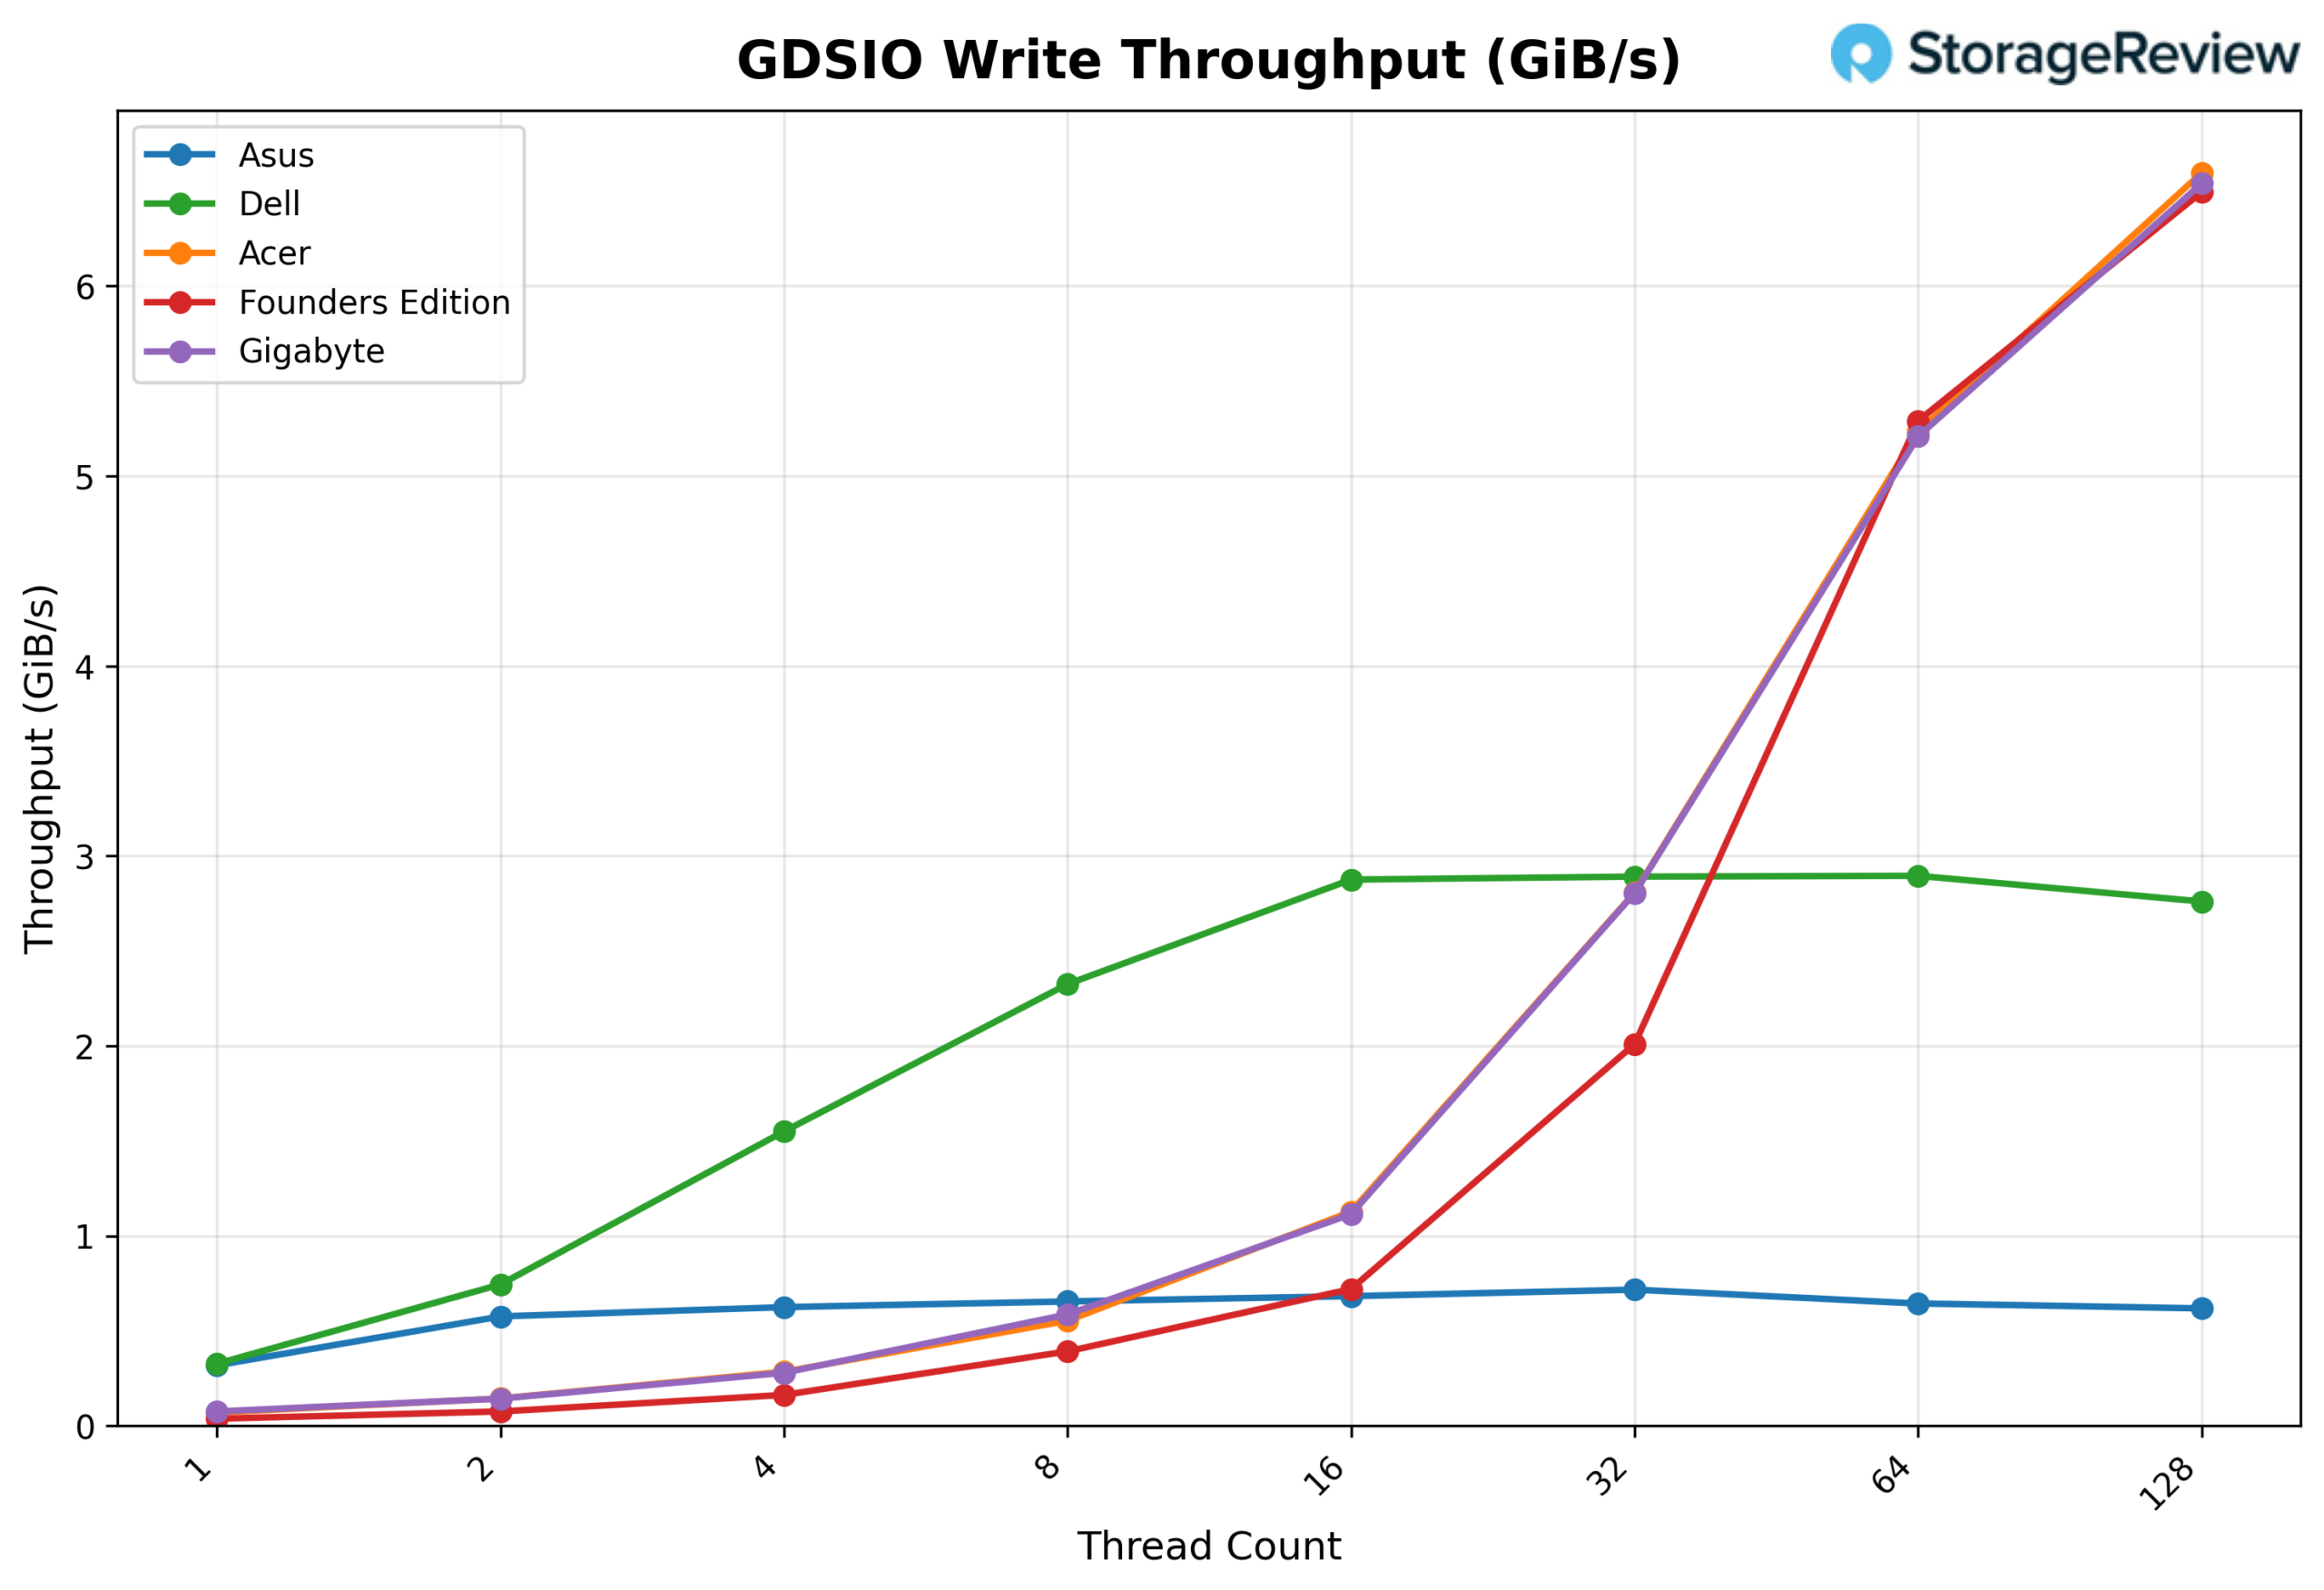
GSDIO schrijfdoorvoer 16K
Kijkend naar de GDSIO Write Throughput 16K, begint de GIGABYTE bij ongeveer 0.08 GiB/s met 1 thread, schaalt gestaag naar 0.14 GiB/s met 2 threads en 0.28 GiB/s met 4 threads. De prestaties blijven gestaag stijgen bij 8 threads (0.59 GiB/s) en 16 threads (1.11 GiB/s) voordat ze agressiever toenemen bij 32 threads (2.80 GiB/s). De schaalbaarheid blijft sterk bij 64 threads (5.21 GiB/s) en bereikt een piek van 6.54 GiB/s bij 128 threads, wat een continue opwaartse beweging zonder een vroege plateau laat zien.
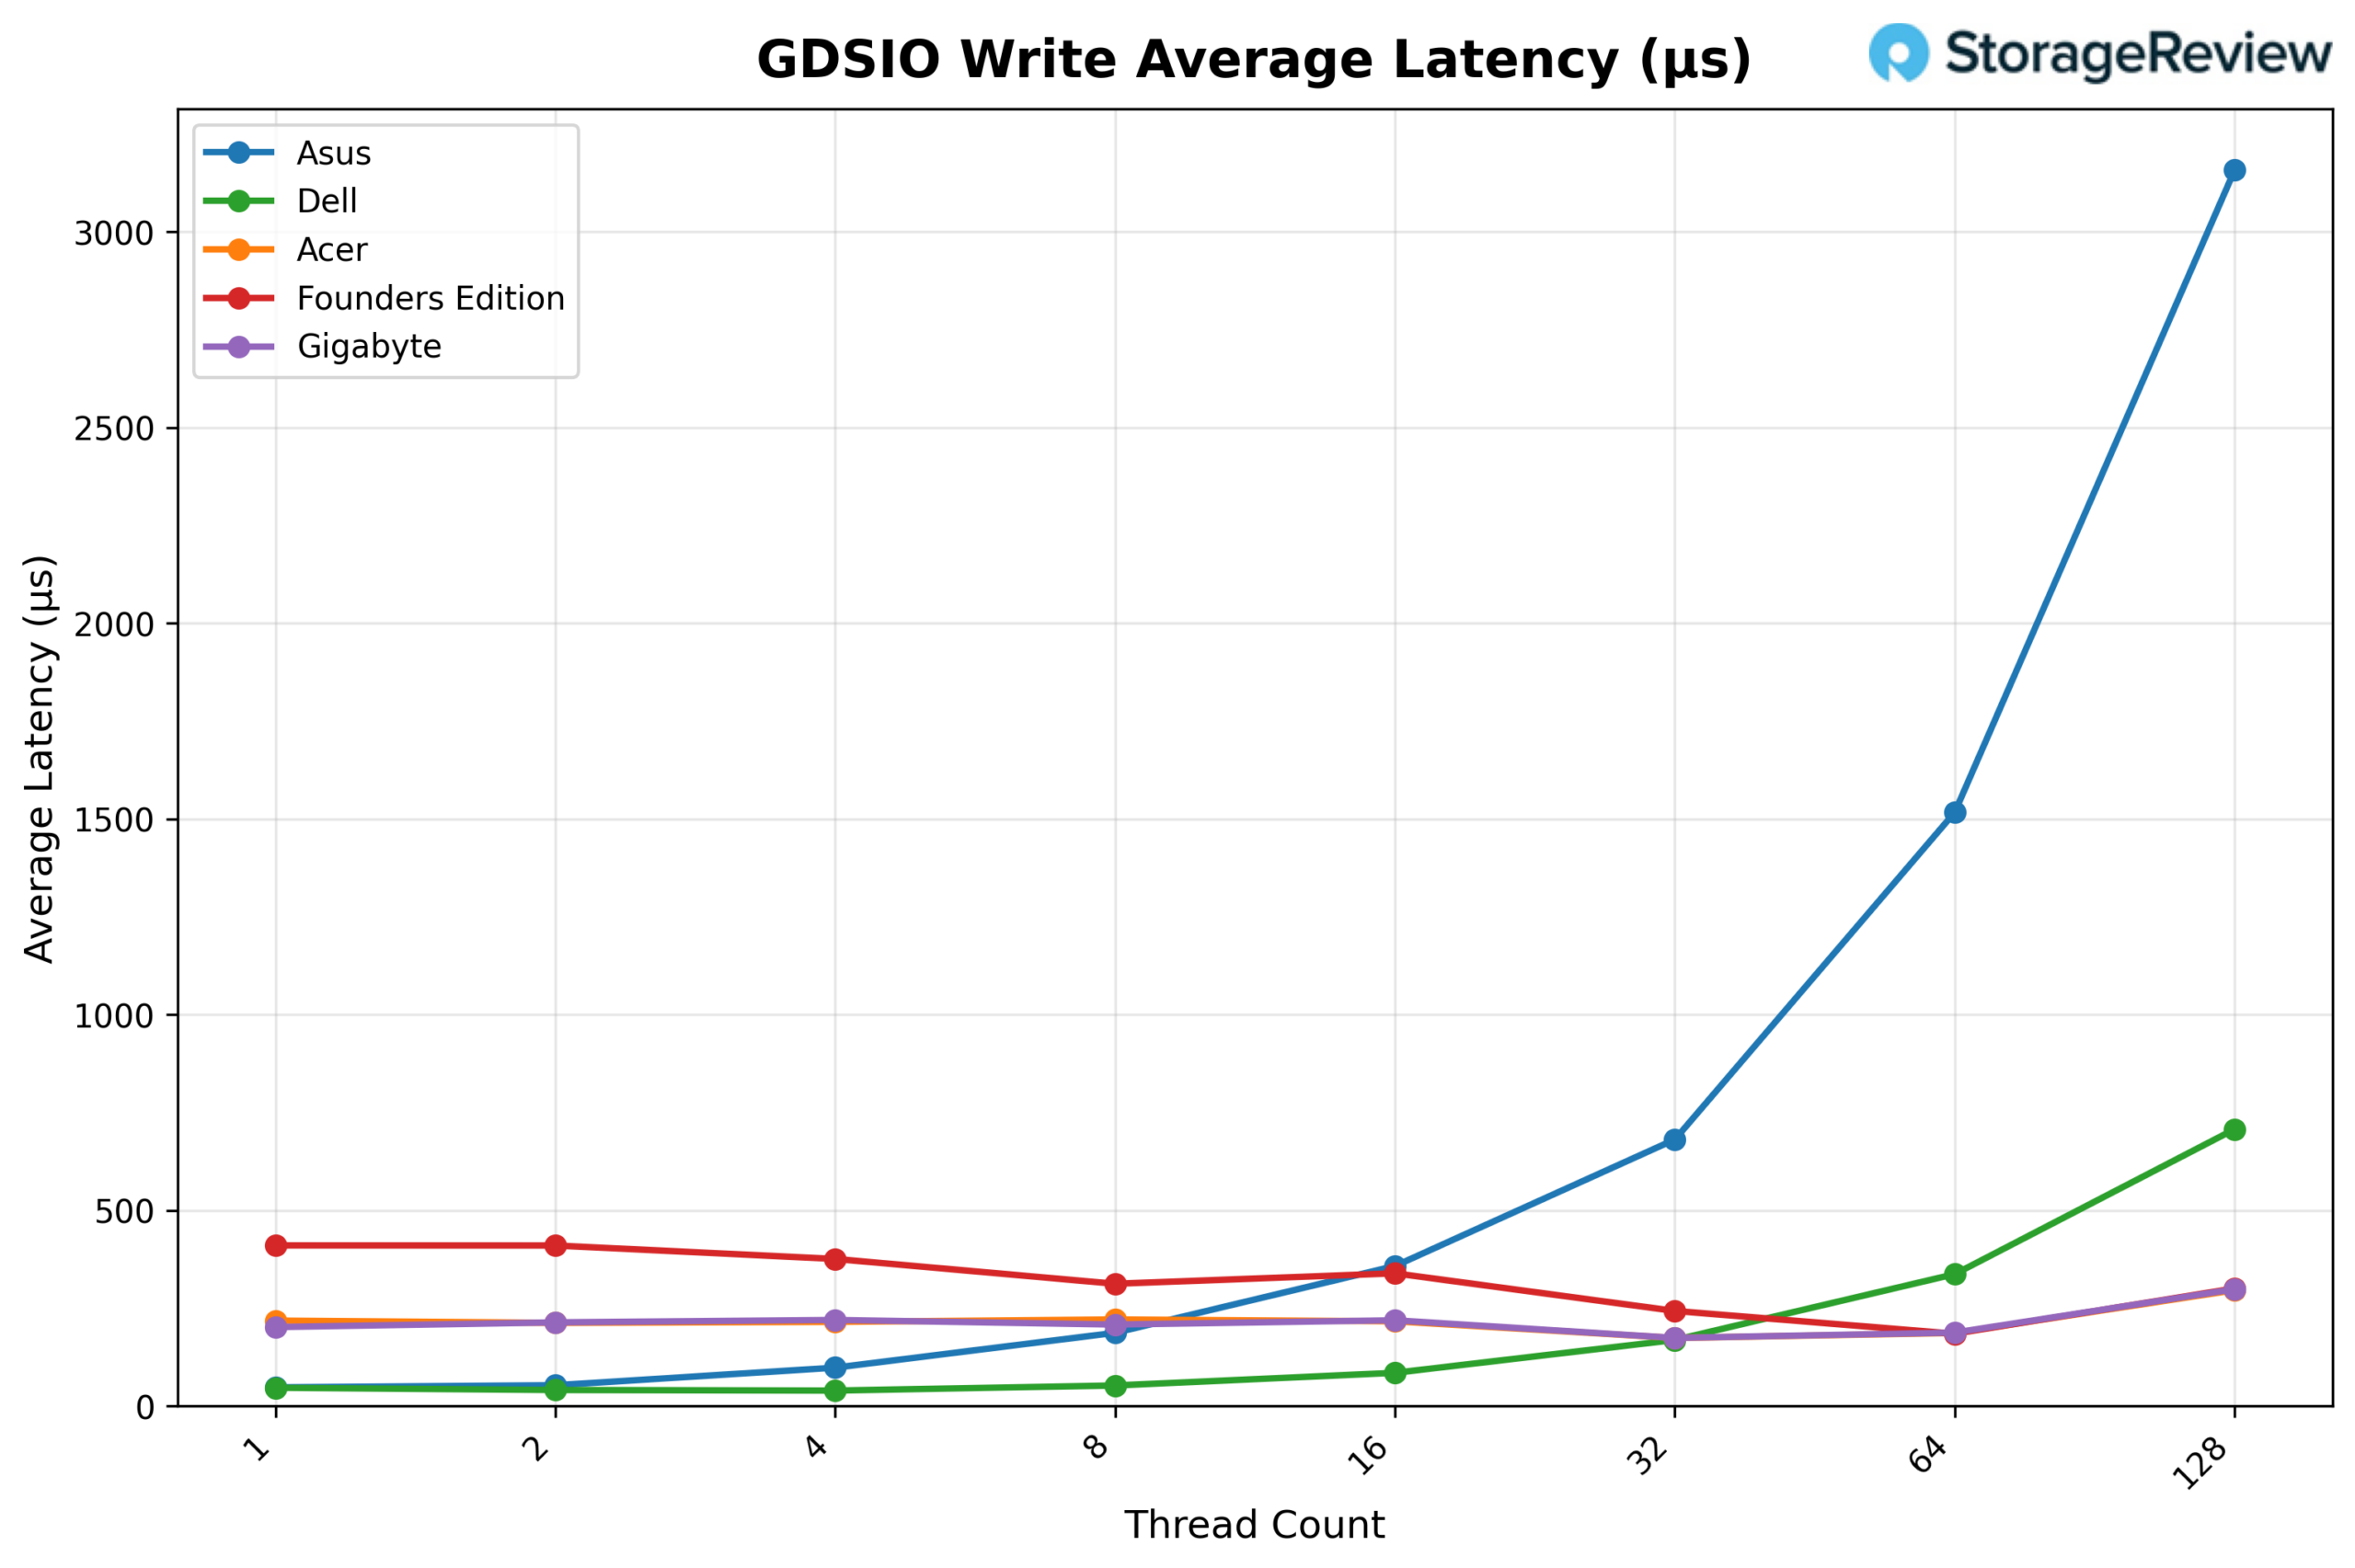
GDSIO gemiddelde schrijflatentie 16K
Kijkend naar de gemiddelde schrijflatentie van GDSIO (16K), handhaaft GIGABYTE een relatief stabiele latentie over het grootste deel van de curve. Deze begint bij ongeveer 0.20 ms bij 1 thread en blijft in het bereik van ~0.21–0.22 ms tot 16 threads. Bij 32 threads verbetert de latentie licht tot ongeveer 0.17 ms, om vervolgens bescheiden te stijgen bij 64 threads (0.19 ms). Pas bij 128 threads neemt de latentie merkbaar toe, tot ongeveer 0.30 ms, wat overeenkomt met het hoogste doorvoerniveau.
GDSIO leesdoorvoer 1M
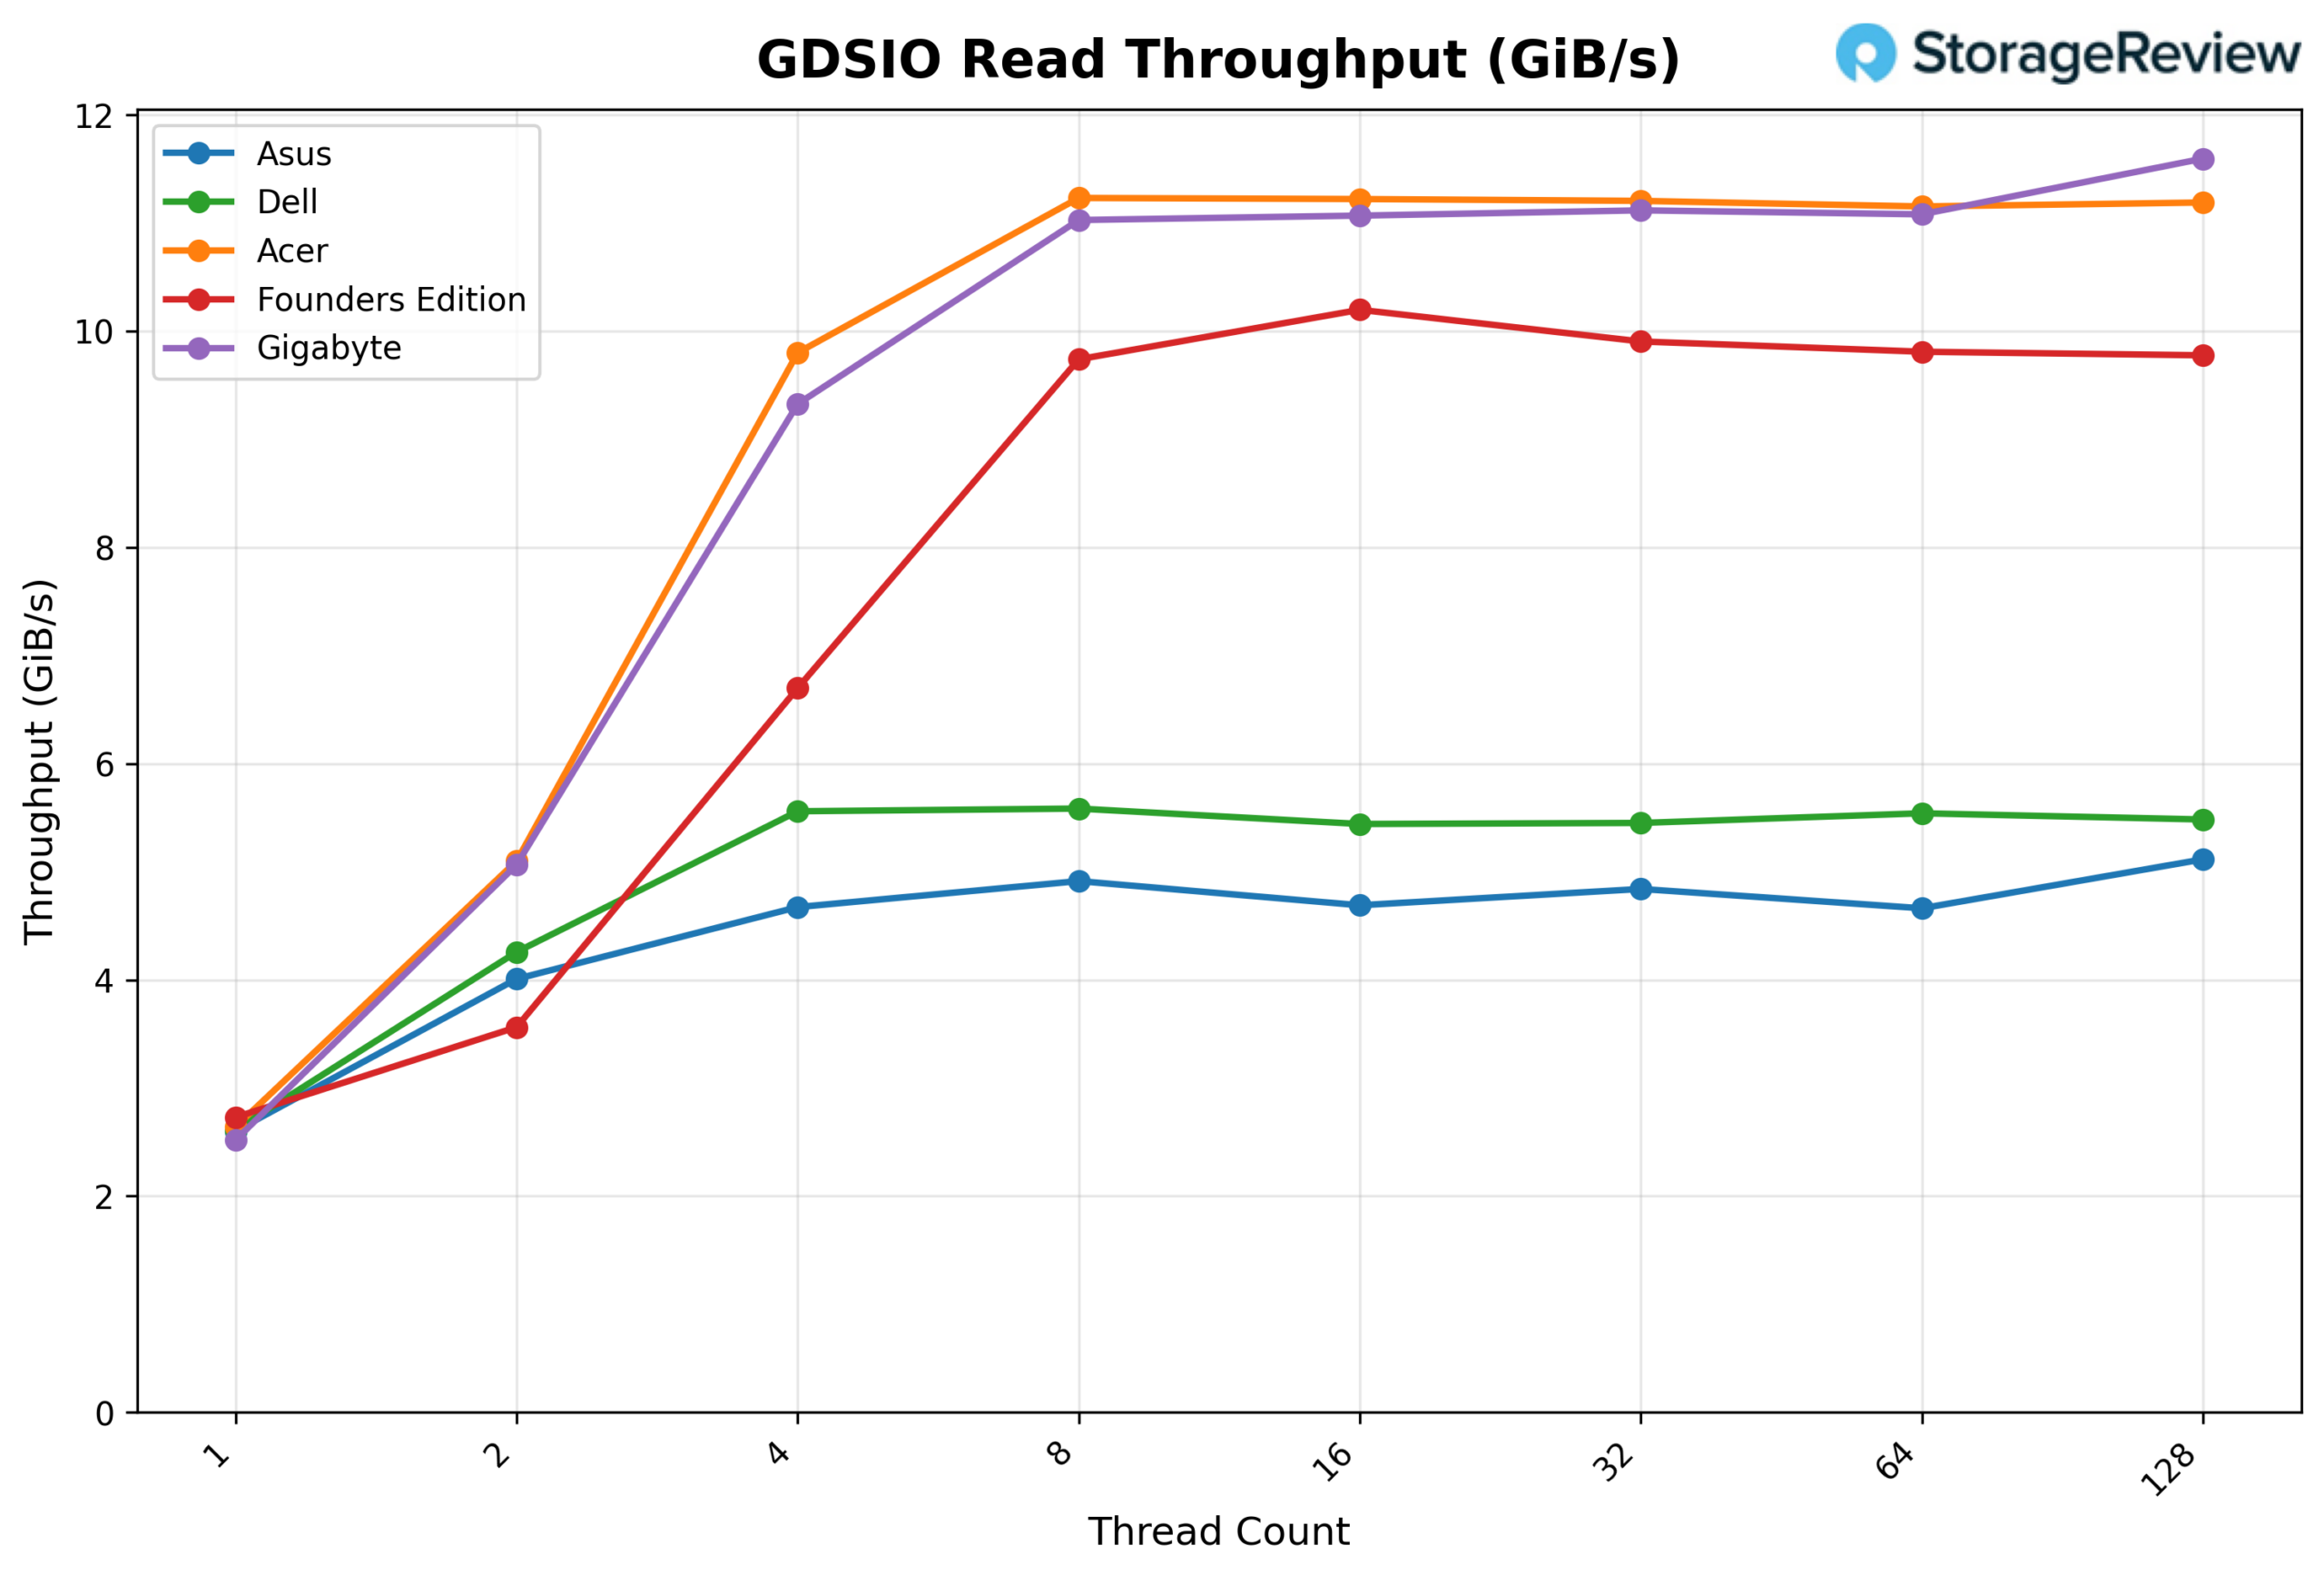
Kijkend naar de GDSIO Read Throughput 1M, begint de GIGABYTE bij 2.52 GiB/s met 1 thread en schaalt naar 5.07 GiB/s met 2 threads en 9.33 GiB/s met 4 threads. Bij 8 threads bereikt de doorvoer 11.03 GiB/s, waarna het platform in feite verzadigd raakt. De prestaties blijven consistent bij 16 threads (11.07 GiB/s), 32 threads (11.12 GiB/s) en 64 threads (11.08 GiB/s), wat een stabiel plateau laat zien. Bij 128 threads neemt de doorvoer licht toe tot 11.60 GiB/s, het hoogste resultaat dat tijdens de test is waargenomen.
GDSIO Gemiddelde leeslatentie 1M
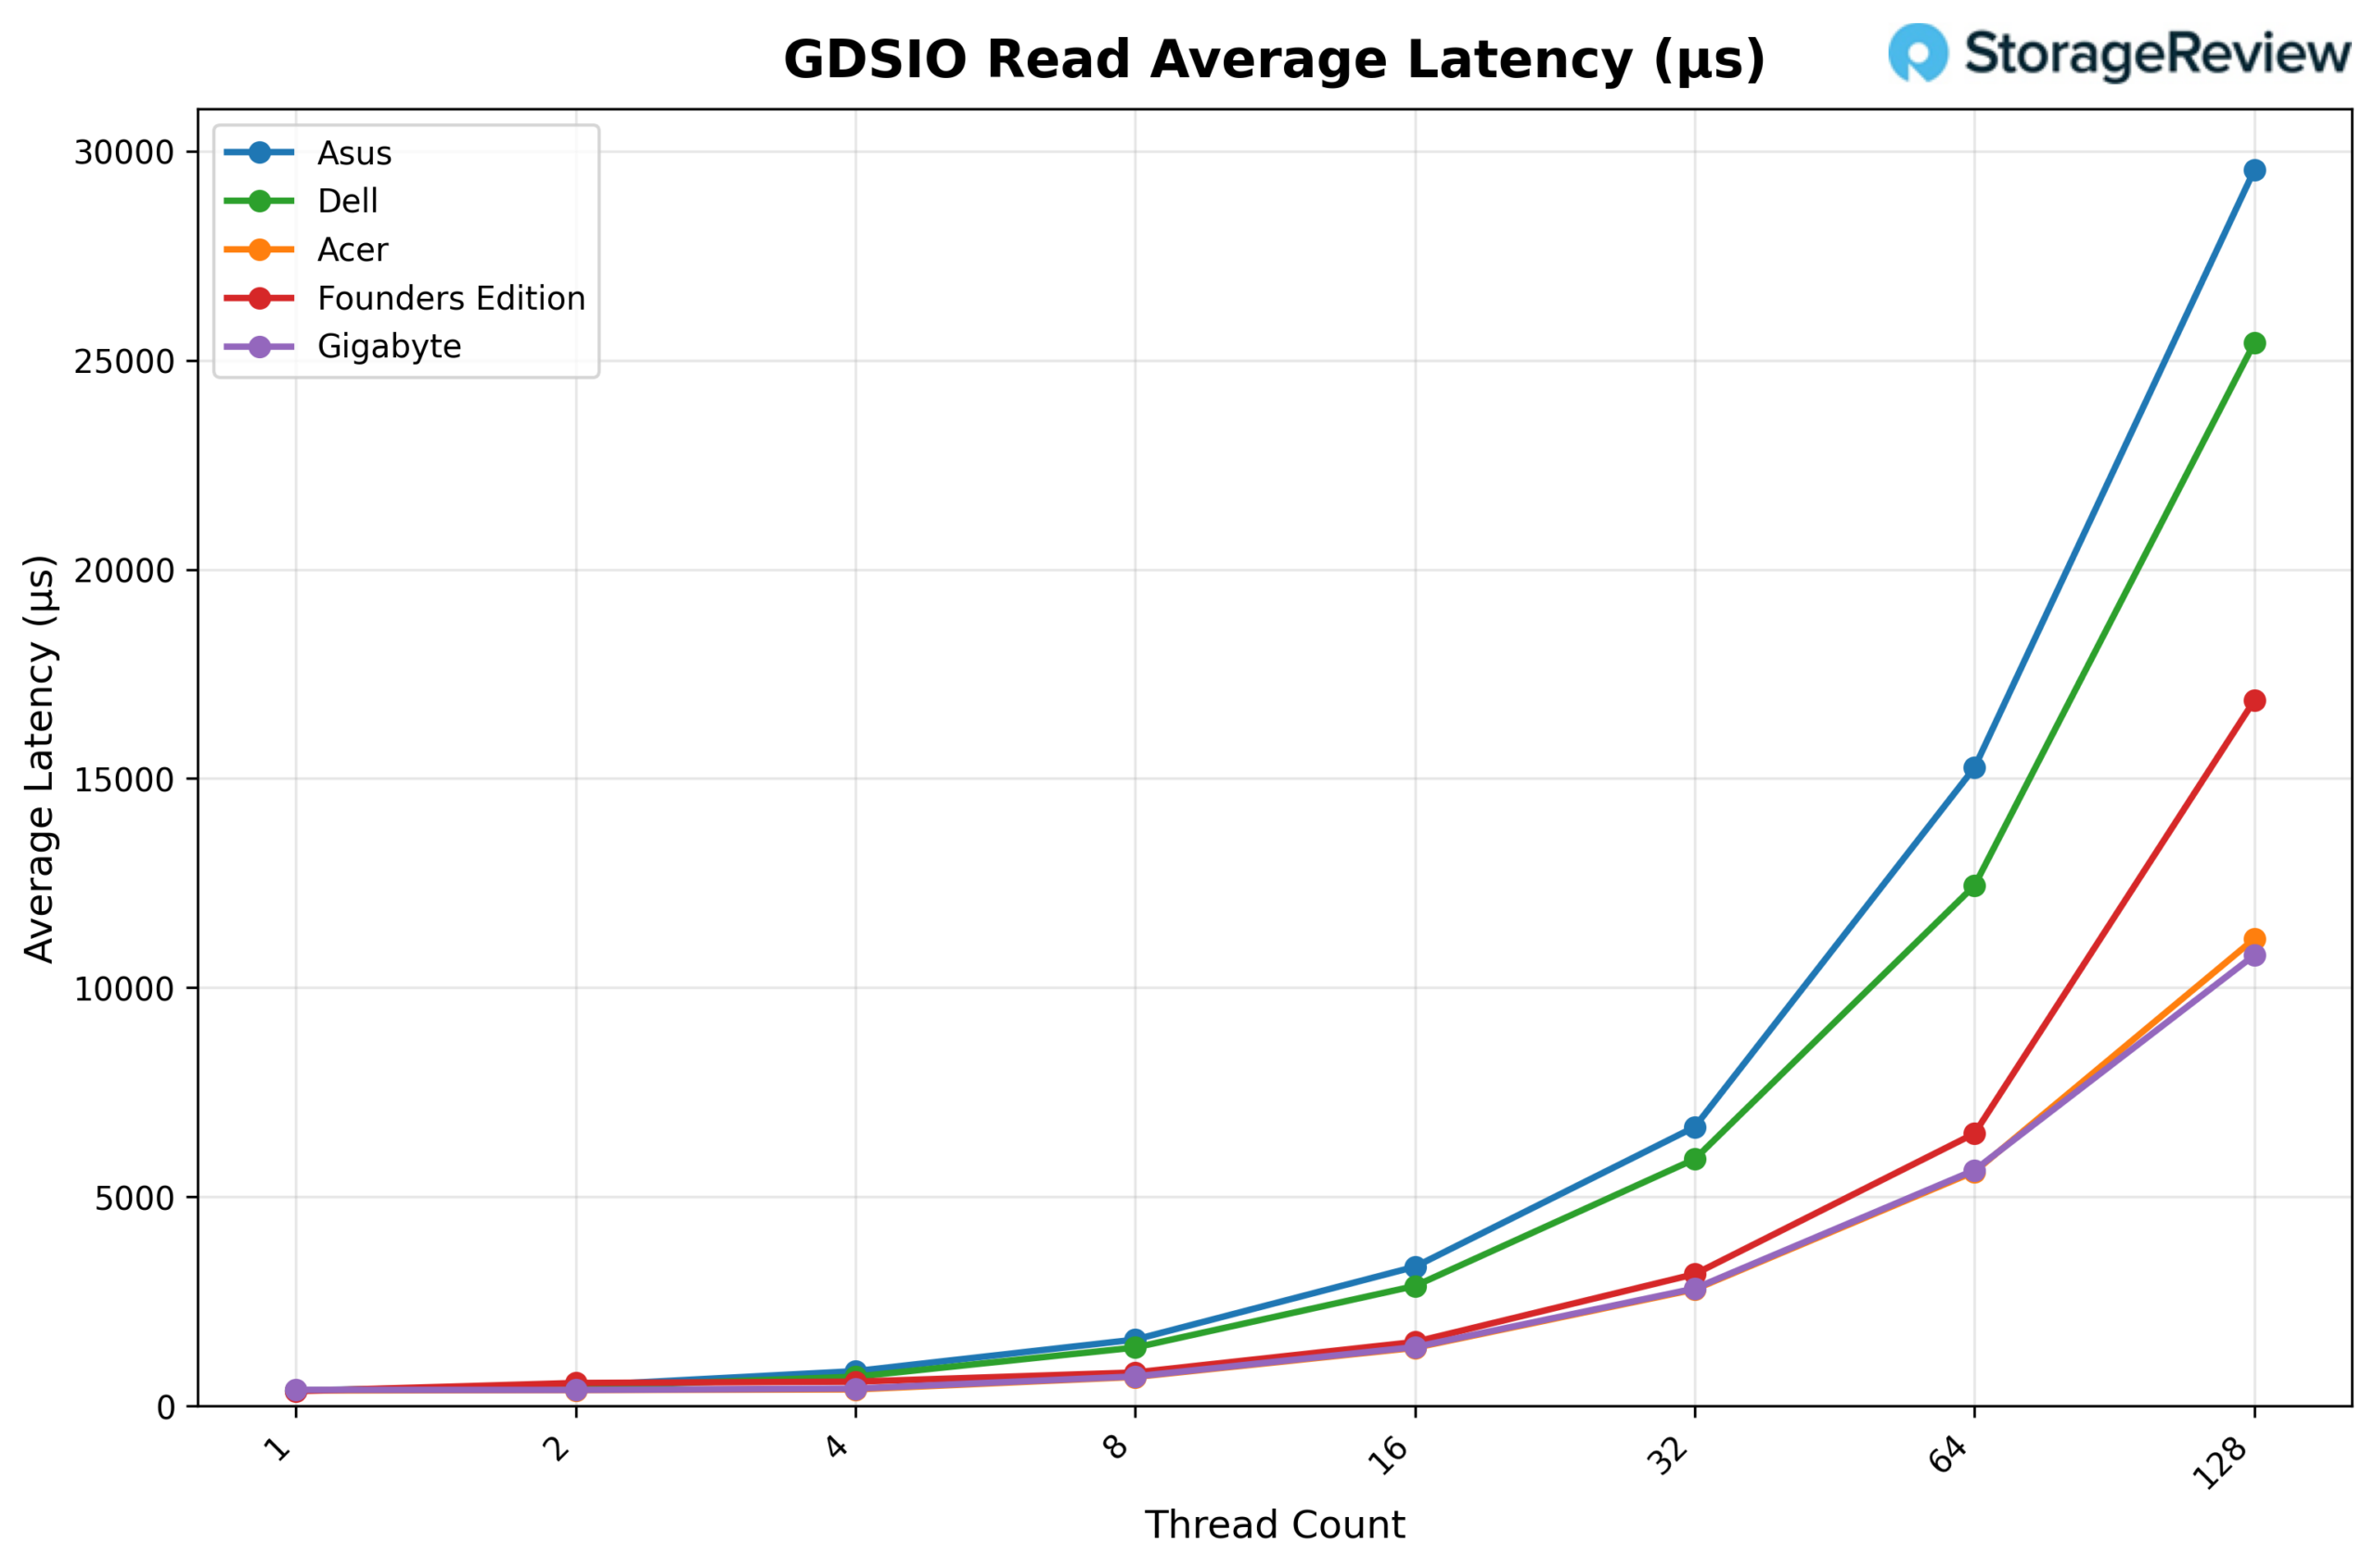
Kijkend naar de gemiddelde leeslatentie (1M) van GDSIO, begint GIGABYTE bij ongeveer 0.39 ms met 1 thread en blijft vergelijkbaar met 2 threads (0.39 ms) en 4 threads (0.42 ms). De latentie neemt toe naarmate het aantal gelijktijdige processen toeneemt, tot 0.71 ms bij 8 threads, 1.41 ms bij 16 threads en 2.81 ms bij 32 threads. De stijgende trend zet zich voort bij 64 threads (5.64 ms) en bereikt 10.78 ms bij 128 threads, wat overeenkomt met de pieken in het aantal gelijktijdige processen, terwijl de doorvoer grotendeels constant blijft.
GDSIO schrijfdoorvoer 1M
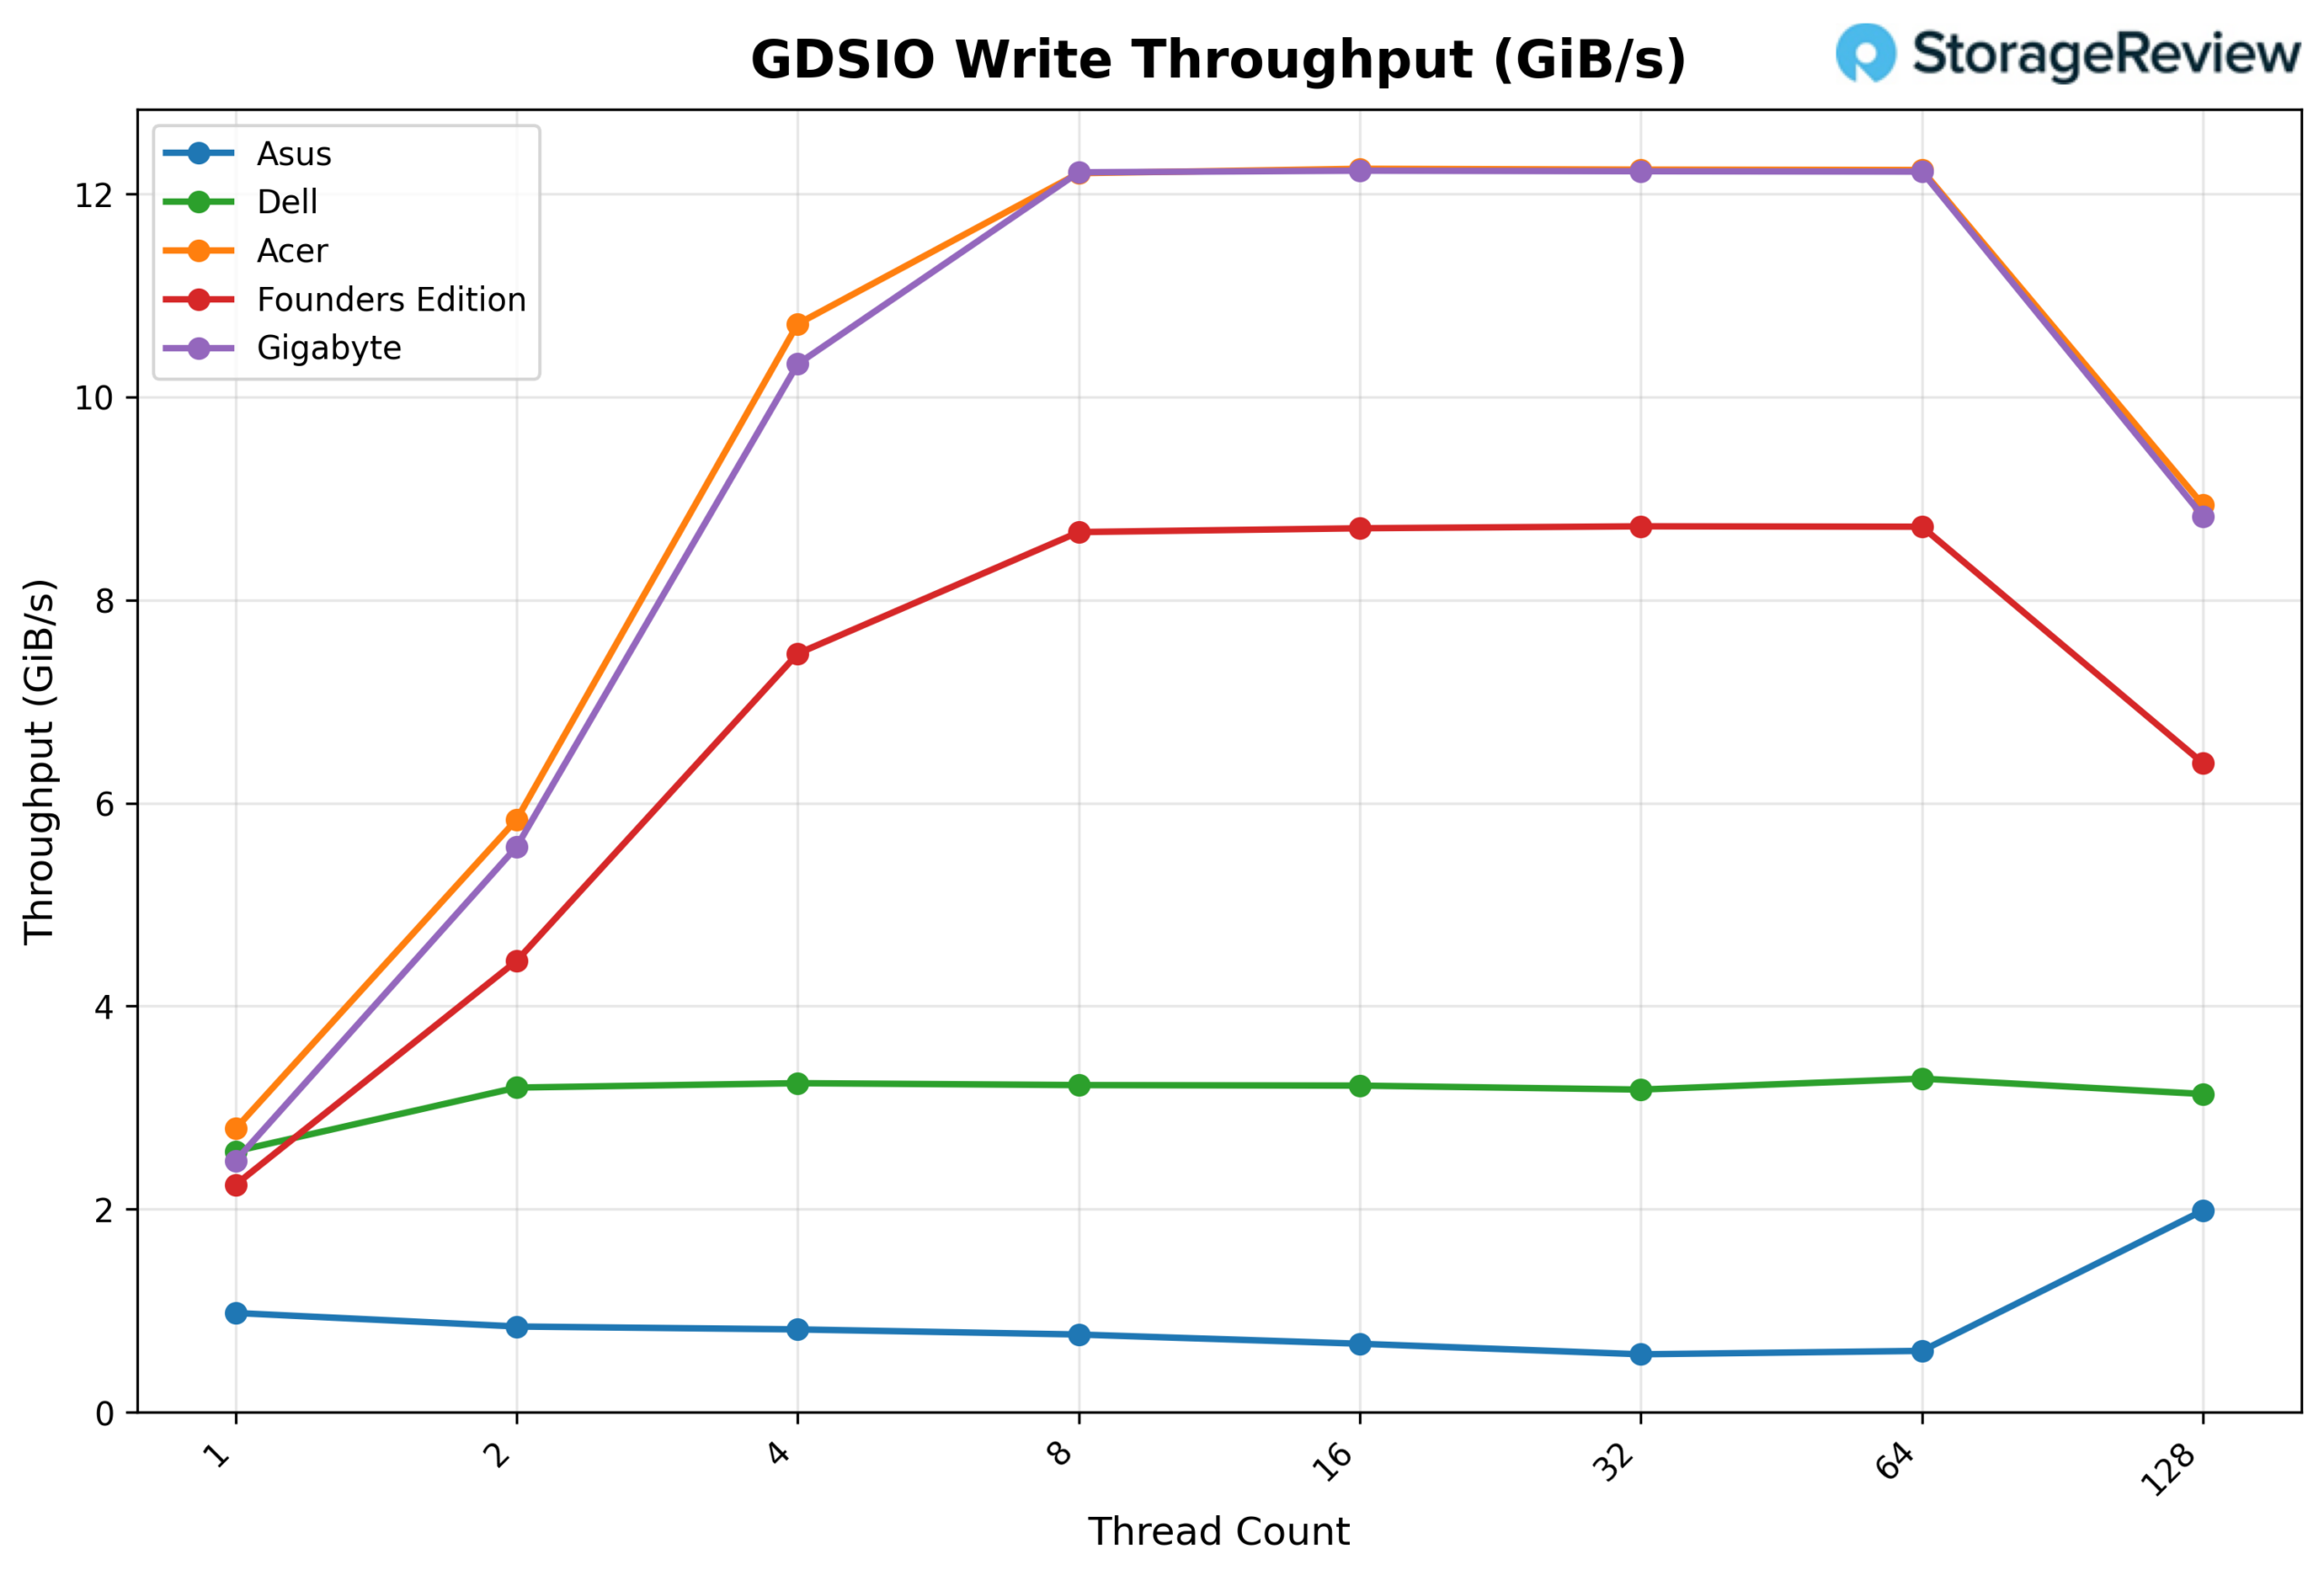
Kijkend naar de GDSIO Write Throughput 1M, begint de GIGABYTE bij 2.48 GiB/s met 1 thread en schaalt dit snel op naar 5.57 GiB/s met 2 threads en 10.32 GiB/s met 4 threads. Bij 8 threads bereikt de doorvoer 12.21 GiB/s, waarmee het platform effectief verzadigd raakt. De prestaties blijven stabiel bij 16 threads (12.23 GiB/s), 32 threads (12.22 GiB/s) en 64 threads (12.22 GiB/s), wat wijst op een vroeg plateau. Bij 128 threads daalt de doorvoer naar 8.82 GiB/s, wat suggereert dat het systeem zijn optimale bereik voor gelijktijdige verwerking heeft overschreden.
GDSIO Schrijfgemiddelde latentie 1M
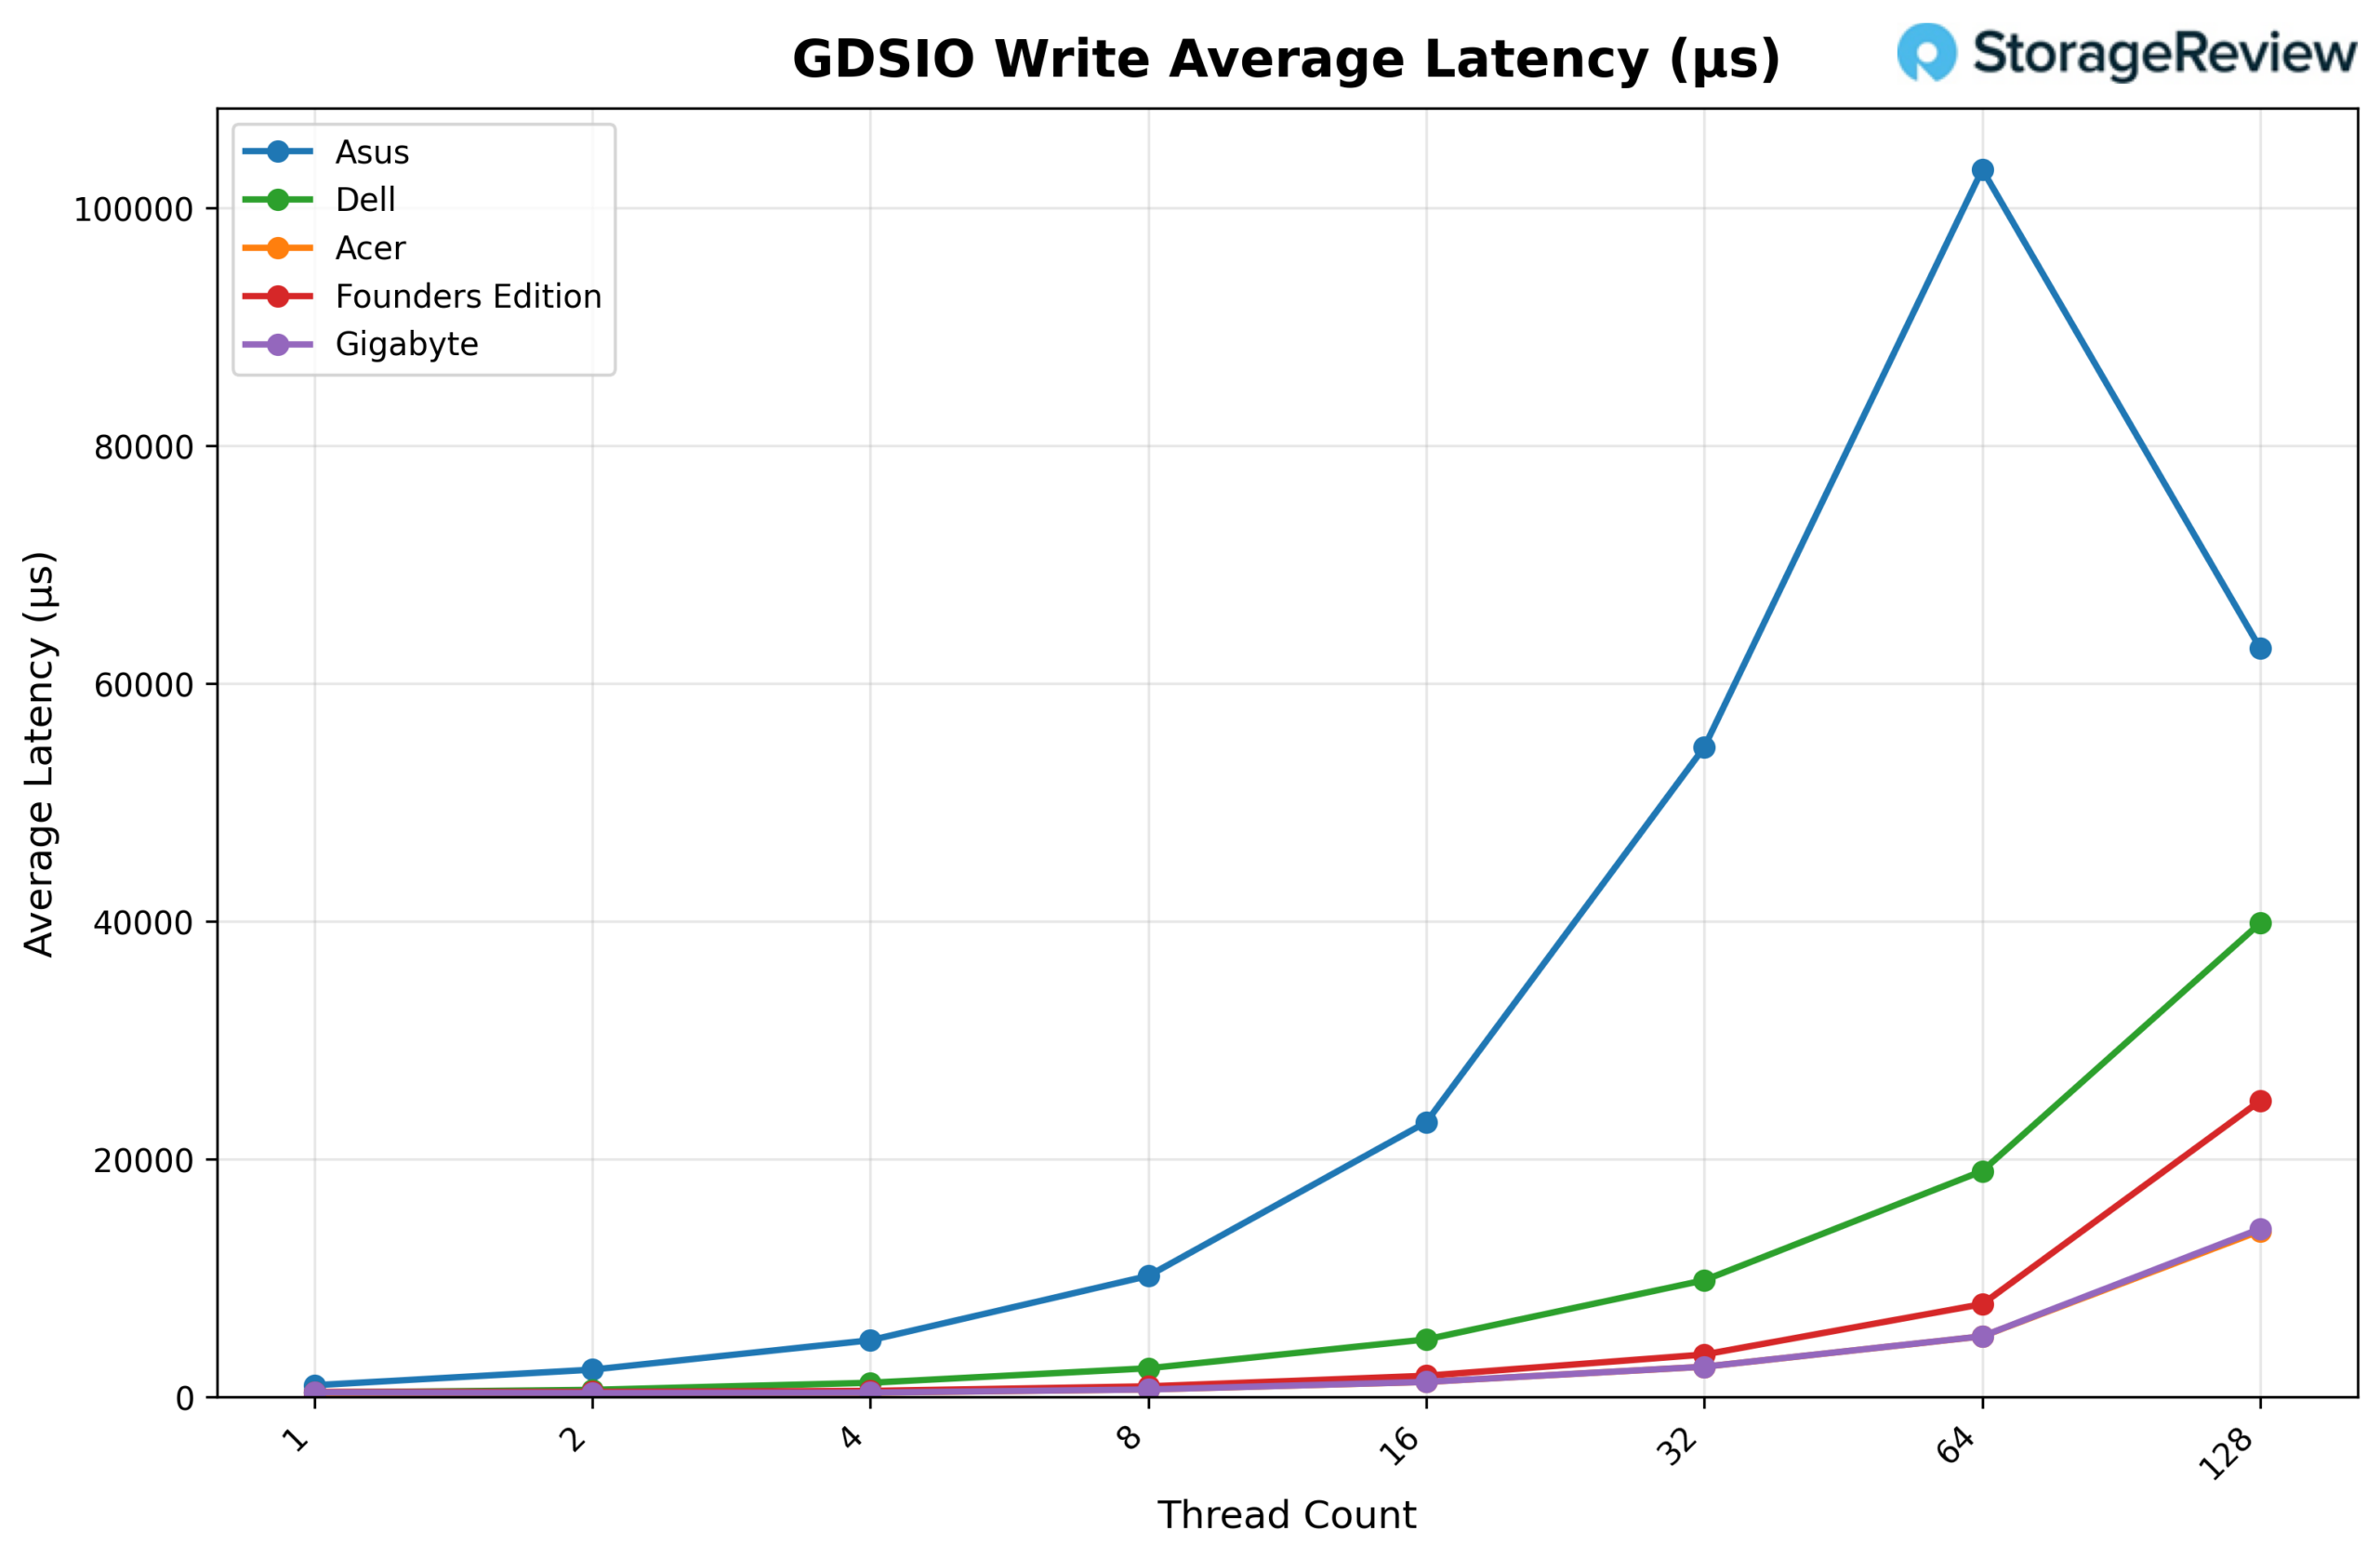
Kijkend naar de gemiddelde schrijflatentie (1M) van GDSIO, begint GIGABYTE bij ongeveer 0.39 ms met 1 thread en blijft relatief laag bij 2 threads (0.35 ms) en 4 threads (0.38 ms). De latentie neemt merkbaar toe bij een hoger aantal threads, tot 0.64 ms bij 8 threads, 1.28 ms bij 16 threads en 2.56 ms bij 32 threads. De trend zet zich voort bij 64 threads (5.11 ms) voordat er een significante piek optreedt bij 128 threads tot 14.16 ms, wat overeenkomt met de waargenomen daling van de doorvoer bij het hoogste aantal gelijktijdige bewerkingen.
Conclusie
De GIGABYTE AI TOP ATOM is een andere implementatie van NVIDIA's op GB10 gebaseerde Spark-platform, gebouwd op hetzelfde moederbord en dezelfde chip die we in de hele productlijn hebben getest. Zoals verwacht, komen de kernprestaties van de vLLM-processors nauw overeen met die van de rest van het testveld. Bij de GPT-OSS-, Qwen3-Coder- en Llama 3.1-modellen bleef het schaalgedrag voorspelbaar, met een sterke Prefill-doorvoer en stabiele Equal- en Decode-prestaties naarmate de gelijktijdigheid toenam.
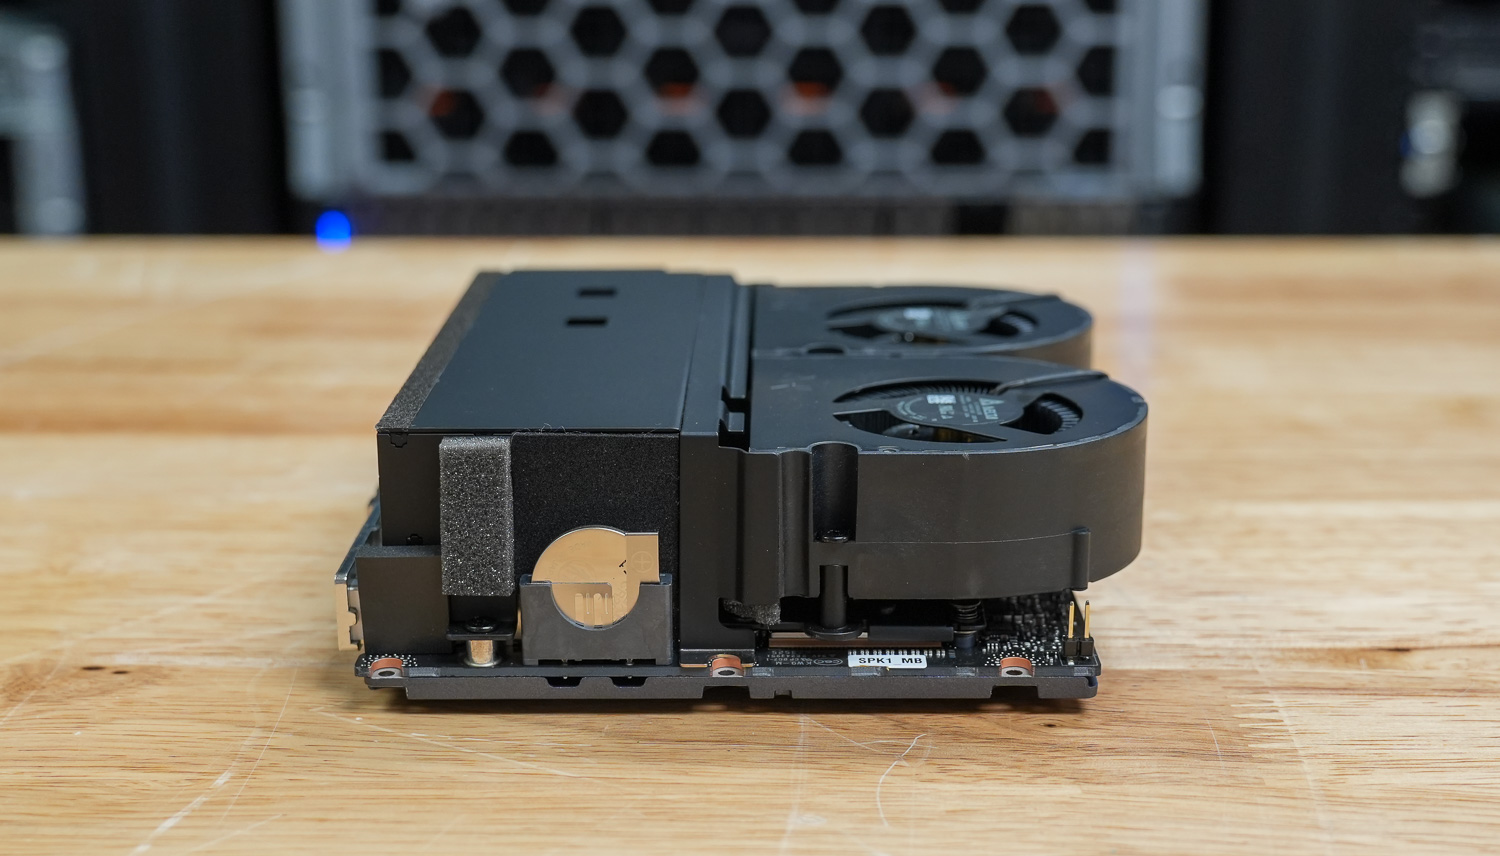
Qua temperatuur stond GIGABYTE iets agressiever piekgedrag toe. De CPU bereikte een piek van 90 °C en de GPU van 81 °C tijdens overgangen met veel prefill, waarbij het GPU-vermogen opliep tot 75.54 W. Zodra de werkbelasting normaliseerde, stabiliseerden de temperaturen zonder tekenen van aanhoudende throttling. In de praktijk weerspiegelen de hogere pieken eerder kortstondige beslissingen over de stroomverdeling dan instabiliteit.
Waar dit apparaat zich duidelijk onderscheidt, is de opslagcapaciteit. Met de 4TB Gen5 Samsung PM9E1 behaalde GIGABYTE enkele van de beste GDSIO-resultaten in de Spark-groep. De lees- en schrijfsnelheid schaalde soepel over zowel 16K- als 1M-workloads, met vroege verzadiging bij de verwachte gelijktijdigheidsniveaus en een toename van de latentie voornamelijk bij het hoogste aantal threads.
Omdat alle Spark-systemen dezelfde GB10-architectuur delen, blijven de verschillen in benchmarkresultaten voor AI-inferentie klein. In de praktijk komt de keuze eerder neer op het ontwerp van de behuizing, het thermische gedrag bij piekbelasting, de opslagconfiguratie en de afstemming met de leverancier, dan op fundamentele verschillen in rekenkracht.
Productpagina – GIGABYTE AI TOP ATOM
Klassement: De GIGABYTE AI TOP ATOM maakt deel uit van het testveld op ons klassement van de beste desktops voor lokale AI.


 Amazon