

Hoge beschikbaarheid is verschoven van een luxe in datacenters naar een vast onderdeel van de standaardplanning voor bedrijfscontinuïteit. Kleine bedrijven en decentrale locaties gebruiken tegenwoordig kassasystemen, bewakingssystemen en gedeelde opslag die geld kosten voor elke minuut dat ze uitvallen. De klassieke oplossing, een enterprise array met twee controllers, is echter ontworpen en geprijsd voor een datacenter in plaats van een serverkast of een wandrack. Deze mismatch heeft ertoe geleid dat kleinere IT-afdelingen wel back-ups en snapshots hebben voor gegevensbescherming, maar niets voor continuïteit: een NAS met één controller, hoe goed ook gebouwd, blijft een single point of failure.
Hoge beschikbaarheid is geen nieuw terrein voor QNAP, dat al hardware met dubbele controllers en op replicatie gebaseerde herstelpaden aanbiedt. Wat wel verandert met QuTS hero h6.0 is de efficiëntie. De nieuwe High Availability Manager integreert clustering in het besturingssysteem op gewone hardware, waardoor twee identieke NAS-units een actief-passief cluster kunnen vormen achter één IP-adres. Als één unit uitvalt, neemt de andere het over en merken clients er nauwelijks iets van. Voor een organisatie die haar IT-investeringen wil optimaliseren, betekent dit hoge beschikbaarheid tegen de kosten van een tweede NAS in plaats van een tweede infrastructuur.
Dat is de insteek: om te zien hoe het in de praktijk presteert, hebben we in het lab een HA-cluster gebouwd met twee QNAP TS-h765eU-systemen, uitgerust met Seagate IronWolf Pro-harde schijven en QNAP E1.S SSD's voor de cache. Vervolgens hebben we geprobeerd het cluster te laten crashen op dezelfde manier als waarop storingen optreden op edge-locaties. We hebben de stroom van het actieve knooppunt midden in een overdracht uitgeschakeld. We hebben de netwerkverbinding verbroken, terwijl de heartbeat intact bleef. In beide gevallen was de vraag hetzelfde: blijft de bestandsoverdracht intact en hoe ziet het herstel eruit wanneer het defecte knooppunt weer opstart?
QNAP TS-h765eU Overzicht
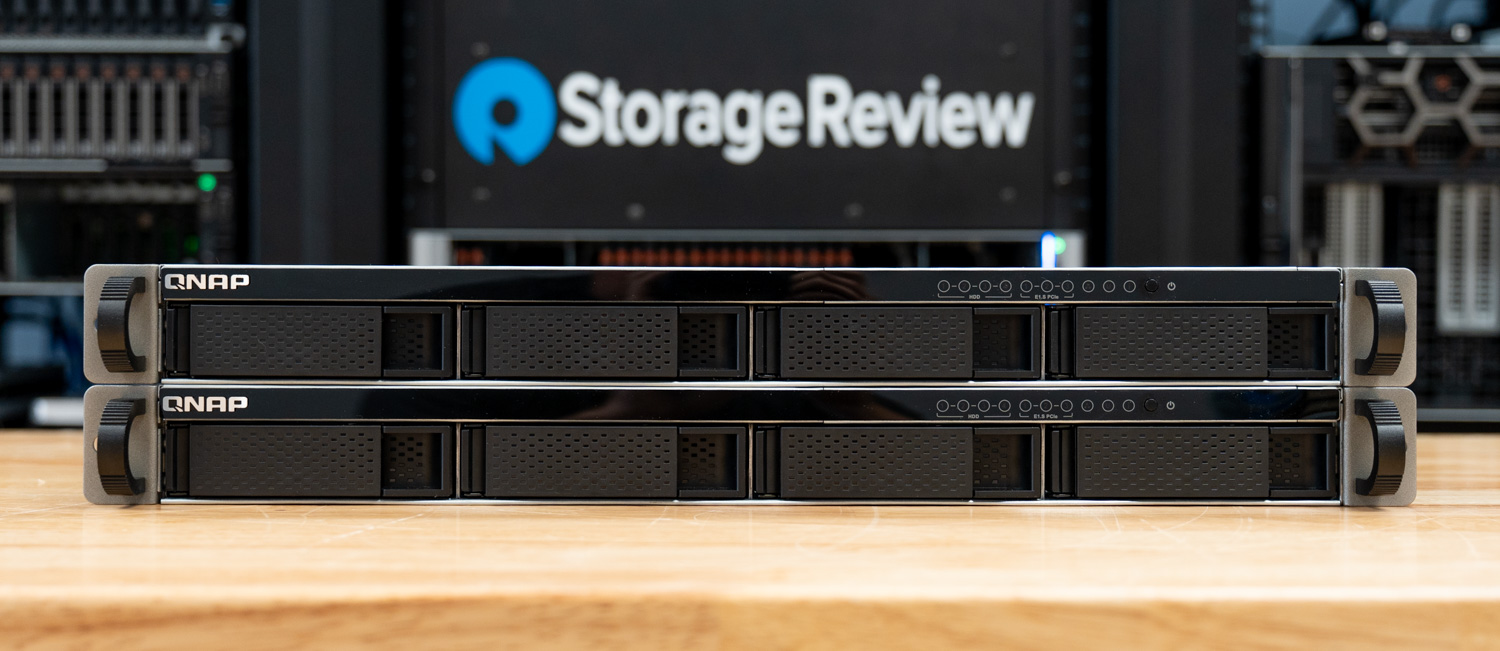
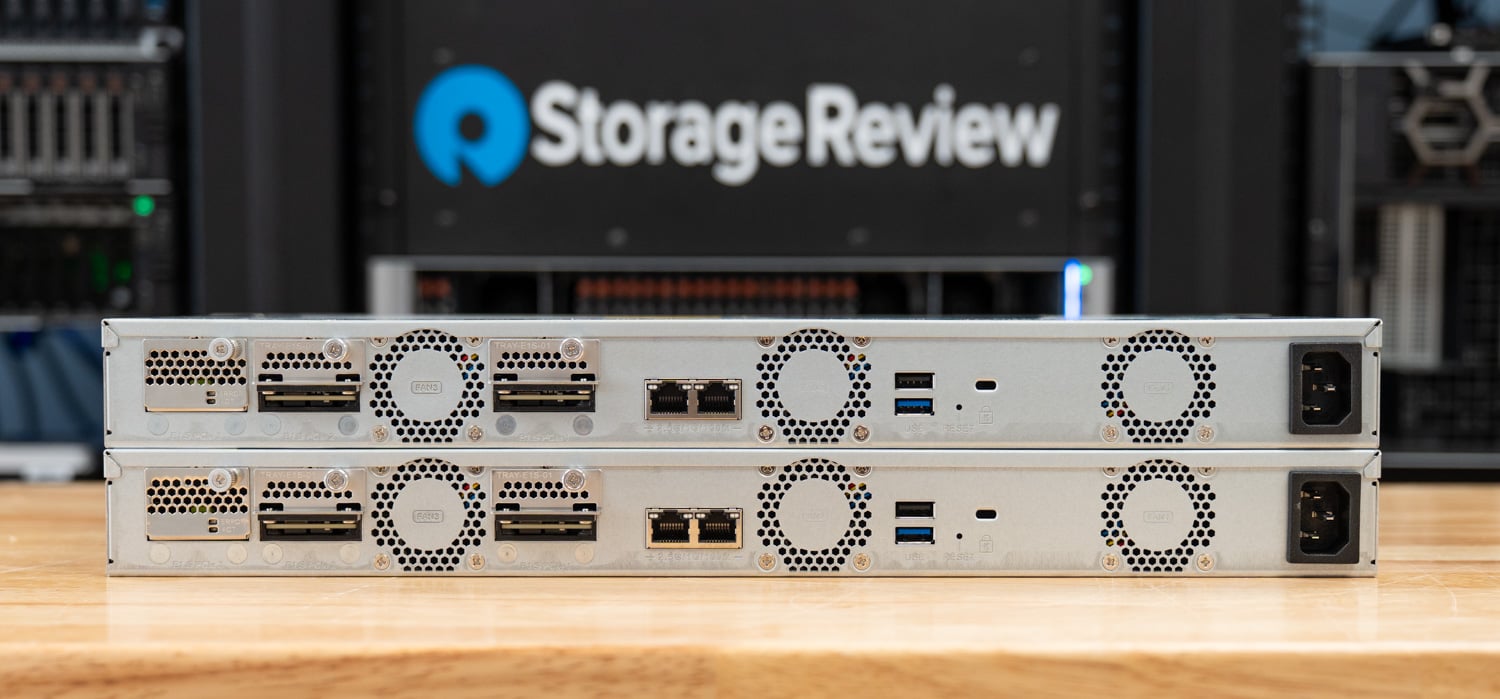
De TS-h765eU is een interessante keuze als bouwsteen voor HA-systemen, juist vanwege de relatief eenvoudige hardware. De behuizing is een 1U rackmount NAS met een geringe diepte van slechts 292.1 mm (12 inch), ontworpen voor kleine mediakasten, wandgemonteerde netwerkracks en edge-implementaties waar een chassis met volledige diepte niet past. Elke unit biedt vier 3.5-inch SATA-schijfposities aan de voorzijde, plus drie E1.S/M.2 PCIe NVMe-slots aan de achterzijde, waardoor het een hybride opslagkarakter heeft: harde schijven voor capaciteit en flashgeheugen voor caching of snelle opslaglagen.
QNAP heeft het ook aangewezen als een langetermijnleveringsmodel met gegarandeerde beschikbaarheid tot 2031, wat belangrijk is voor organisaties die op al hun locaties op één platform standaardiseren.
Aan de binnenkant draait de TS-h765eU op Intel's Atom x7405C, een quad-core chip met een kloksnelheid tot 3.4 GHz, in combinatie met 8 GB DDR5-geheugen, uitbreidbaar tot 16 GB, met In-Band ECC. Netwerkmogelijkheden beginnen met twee 2.5 GbE-poorten, met 10 GbE beschikbaar door een E1.S-bay te vervangen door de QNAP QXG-ES10G1T-module.
| Specificaties | QNAP TS-h765eU |
|---|---|
| CPU | Intel Atom x7405C quad-core, tot 3.4 GHz |
| Geheugen | 8 GB DDR5, uitbreidbaar tot 16 GB (In-Band ECC) |
| Drive Bays | 4 x 3.5-inch SATA |
| Flash-slots | 3 x E1.S / M.2 PCIe NVMe |
| Netwerken | 2 x 2.5GbE, 10GbE via optionele QXG-ES10G1T E1.S-module |
| Form Factor | 1U rackmontage met geringe diepte, 292.1 mm (12 inch) diep |
| Besturingssysteem | QuTS hero h6.0 (op ZFS gebaseerd) |
| Beschikbaarheid | Langetermijnaanbodmodel tot en met 2031 |
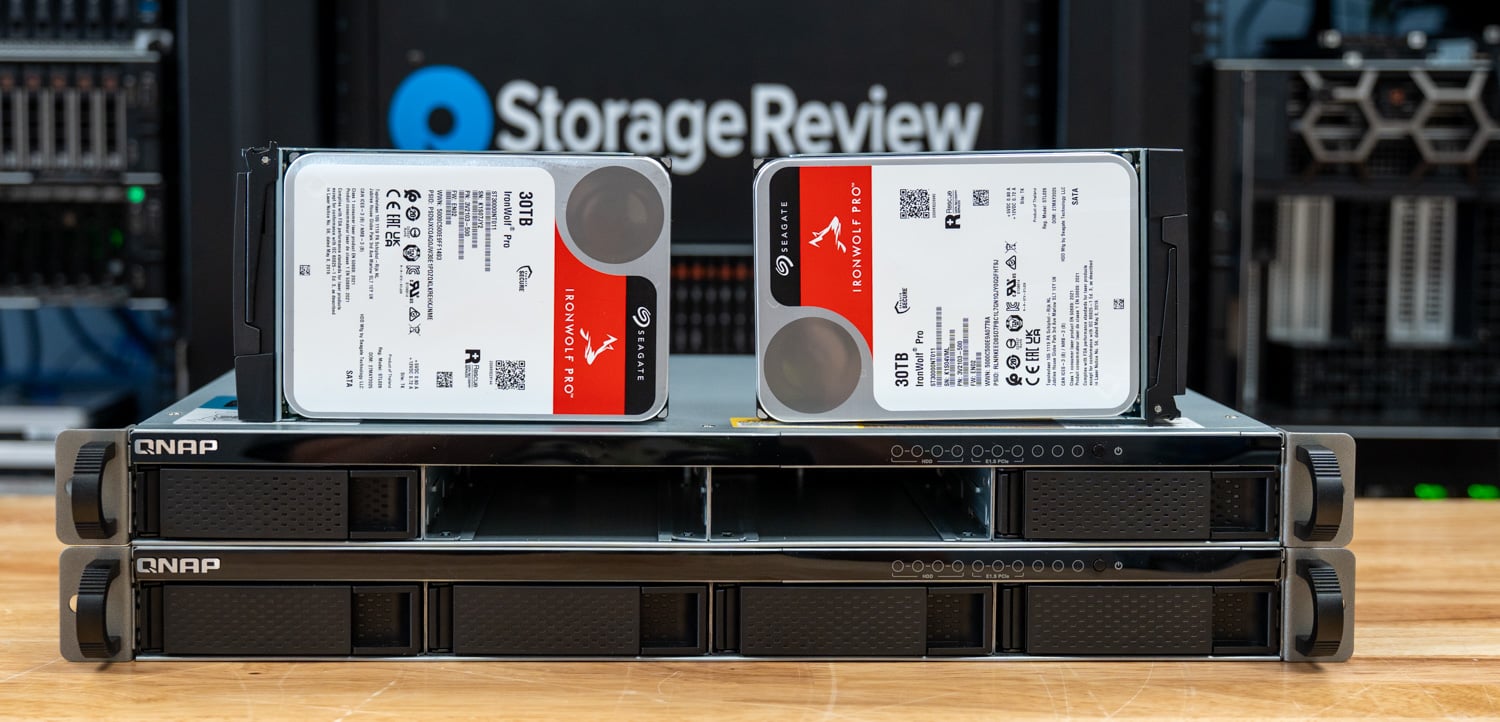
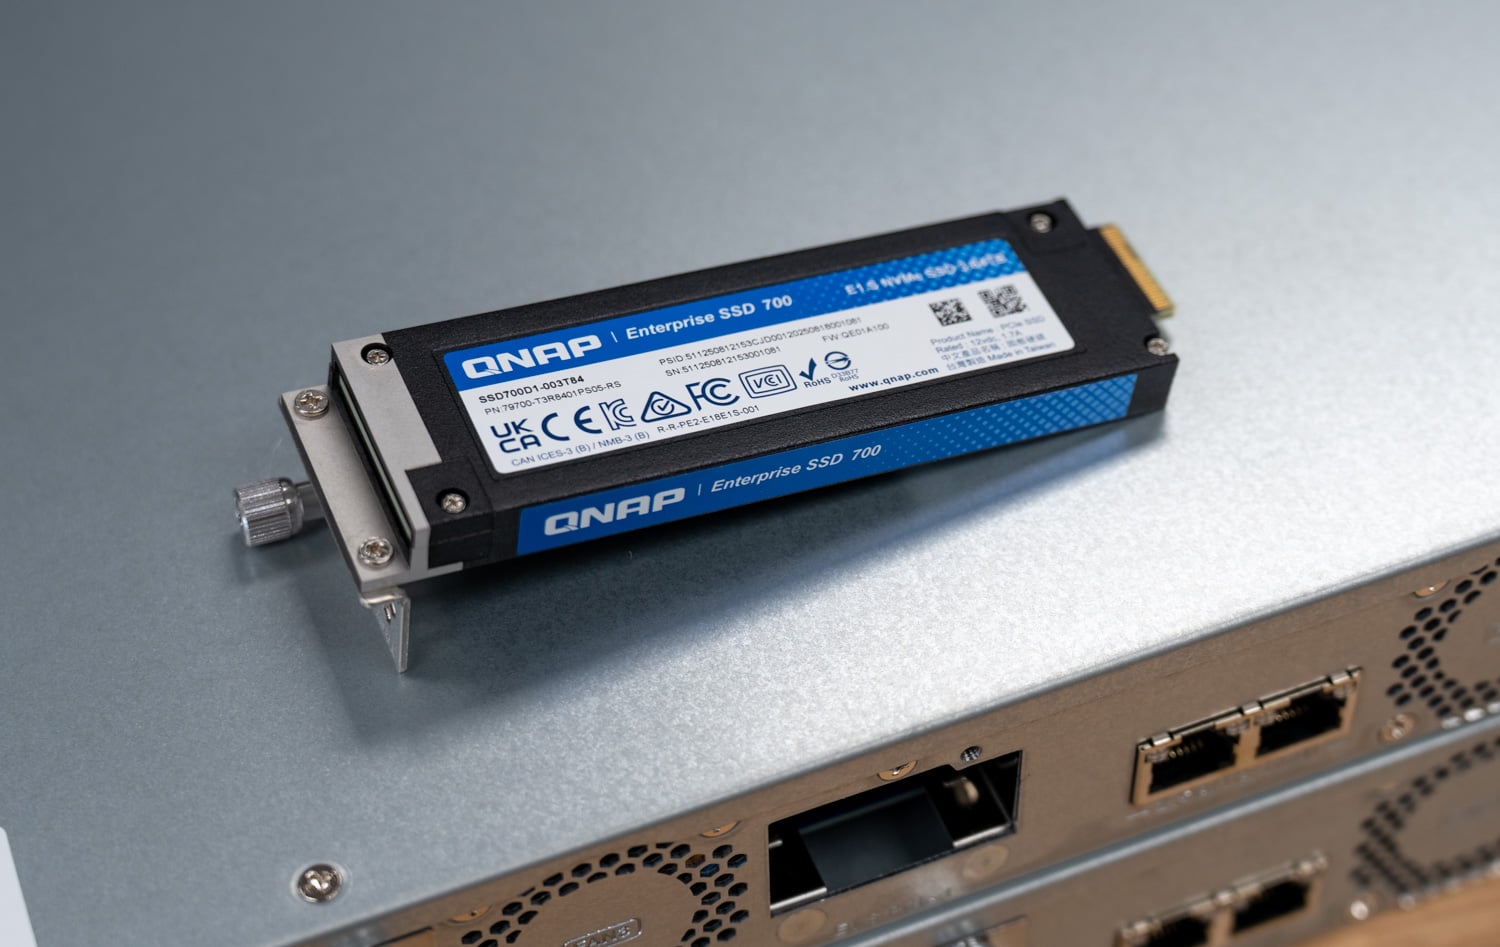
Voor deze evaluatie was elke node voorzien van vier Seagate IronWolf Pro 30TB harde schijven (ST30000NT011) in een RAID 5-opslagpool, plus twee 3.84TB QNAP SSD700 E1.S-schijven (SSD700D1-003T84) in RAID 0 als cache. Beide systemen draaiden QuTS hero h6.0.0.3500 met High Availability Manager 2.0.421.
QuTS hero h6.0 en de HA Manager-architectuur
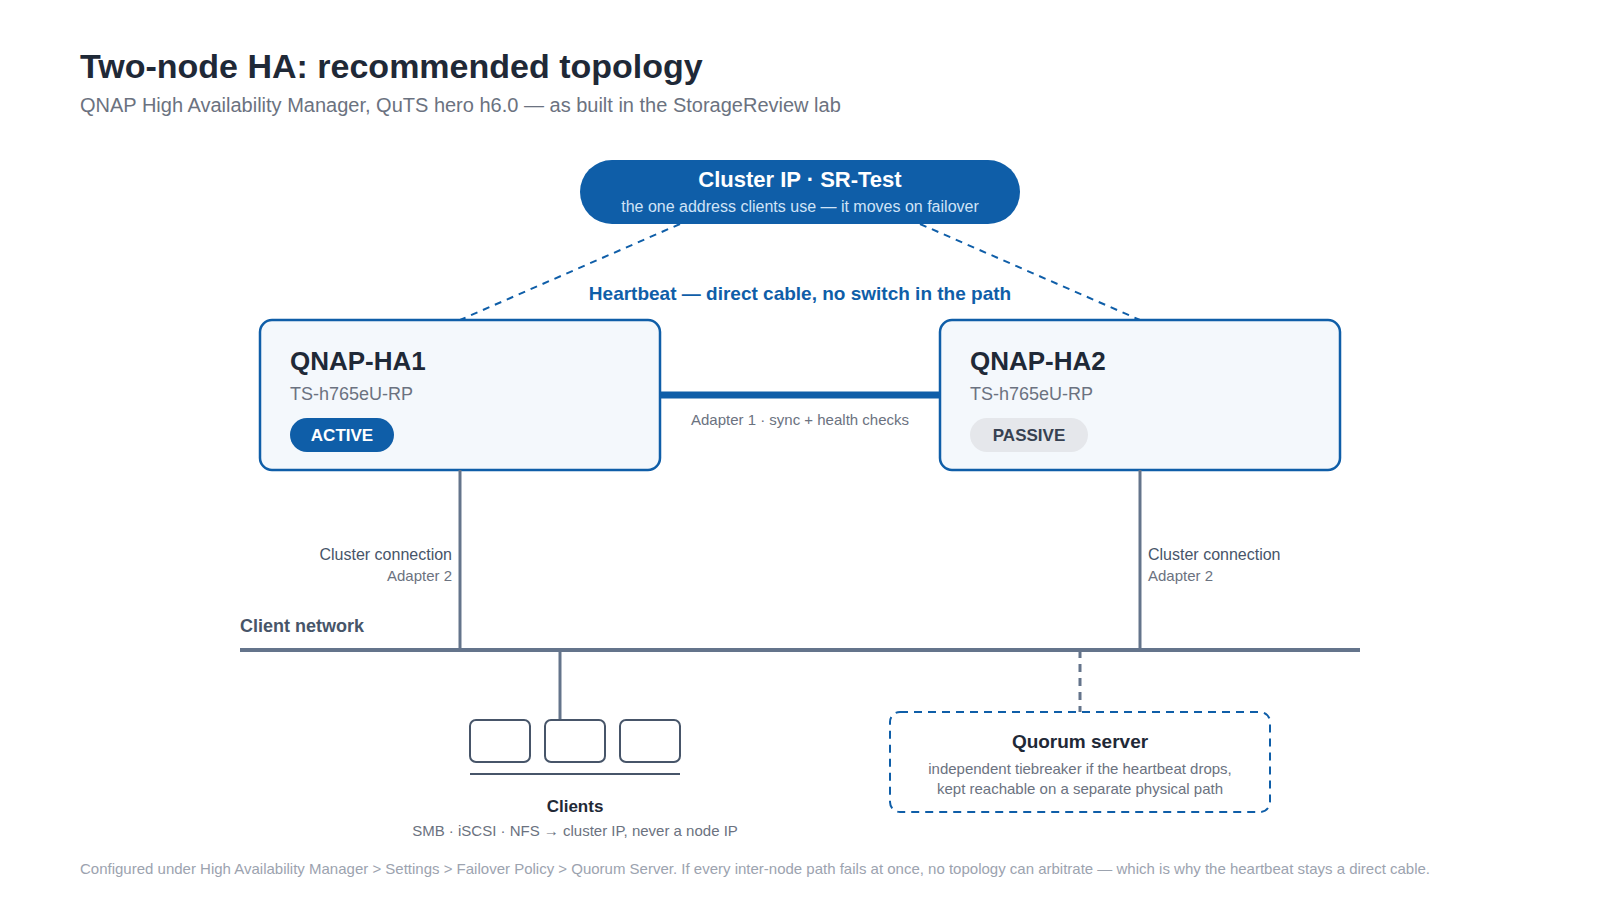
High Availability Manager is de belangrijkste functie van QuTS hero h6.0 en implementeert een klassiek actief-passief ontwerp. Eén NAS, de actieve node, levert alle data en services. De tweede NAS, de passieve node, synchroniseert continu met de actieve node via een speciale heartbeat-verbinding en staat klaar om de taken over te nemen. Clients communiceren nooit rechtstreeks met een van beide nodes; in plaats daarvan presenteert het cluster één IP-adres en hostnaam, en de node die op dat moment actief is, reageert daarop. Bij een failover leidt het cluster-IP-adres het verkeer aan de backend om, zodat toegewezen schijven, iSCSI-initiators en back-uptaken niet opnieuw hoeven te worden geconfigureerd.
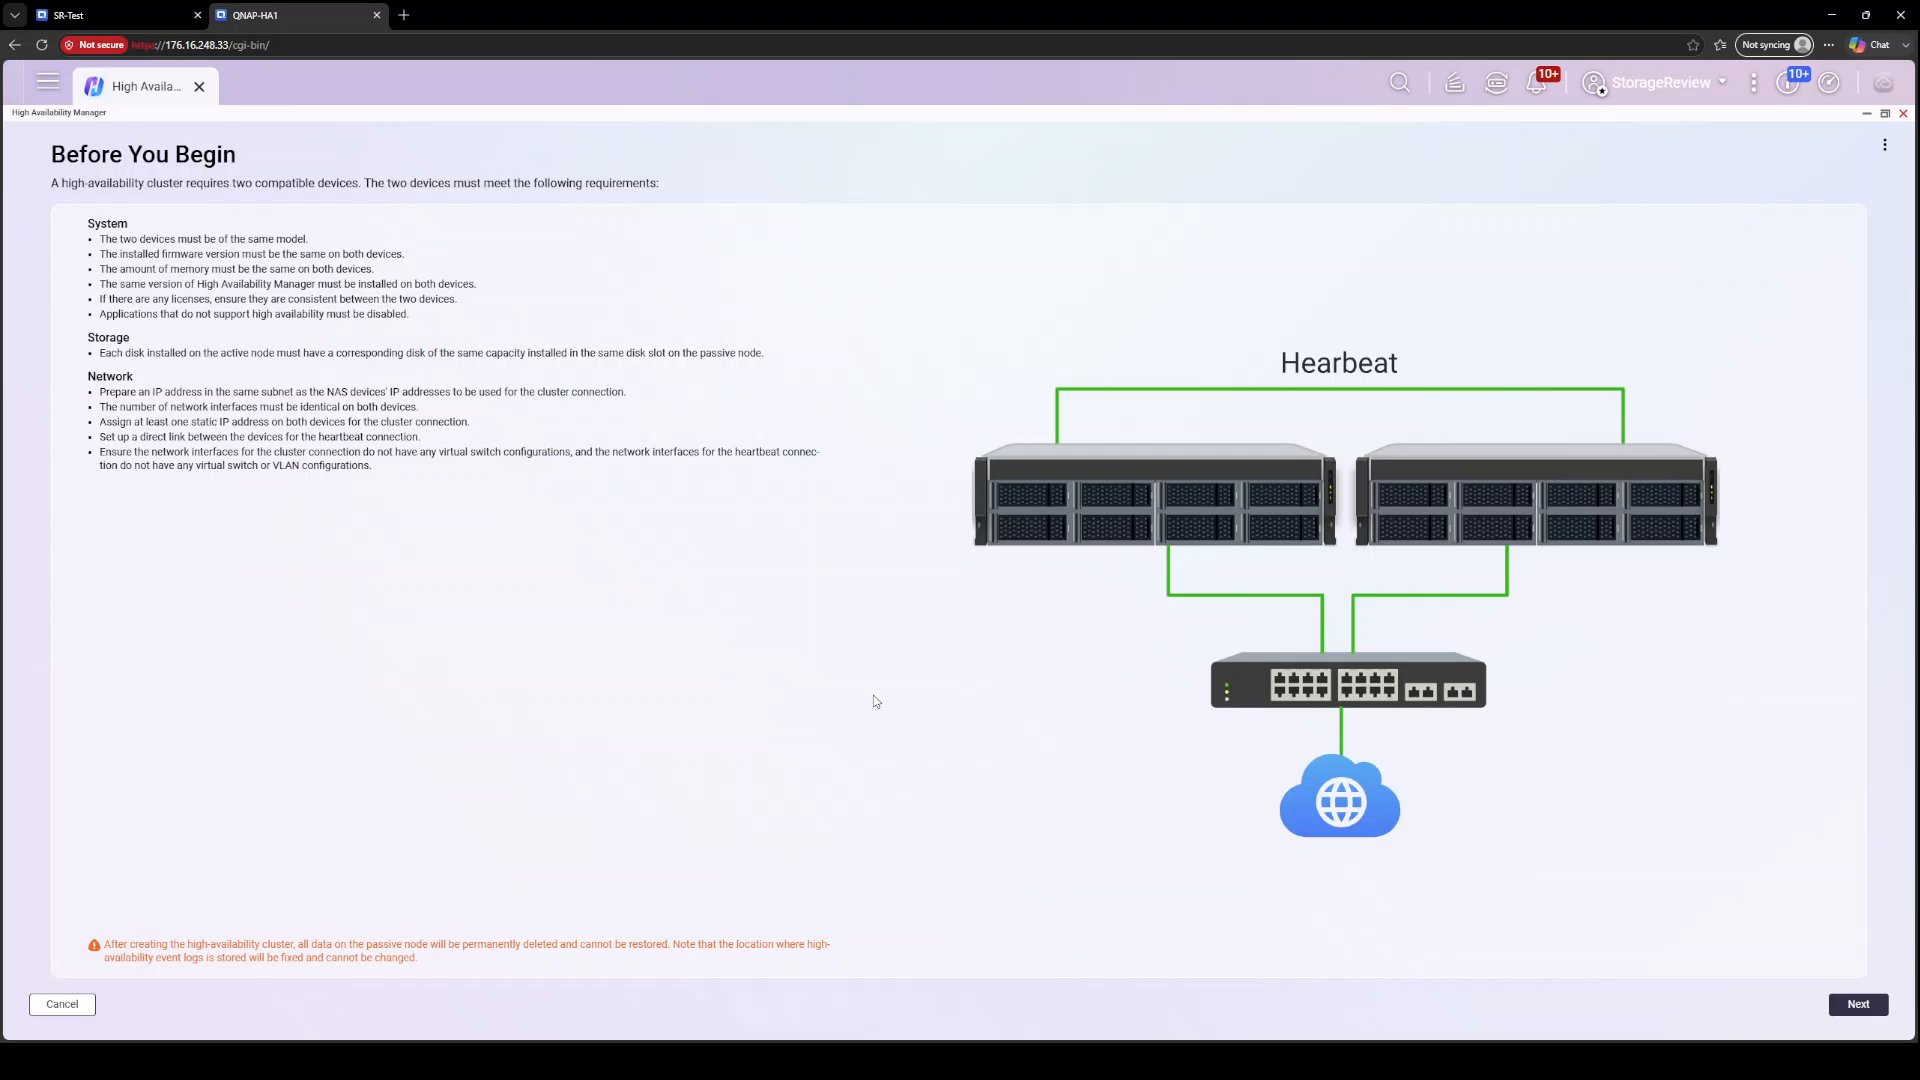
De heartbeat-verbinding vormt de ruggengraat van het ontwerp. QNAP vereist een directe verbinding tussen de twee units, zonder switches ertussen, en deze verbinding transporteert zowel health check-verkeer als datasynchronisatie op blokniveau tussen de nodes. Een aparte clusterverbinding handelt clientverkeer af via het normale netwerk. De bescherming tegen split-brain wordt compleet gemaakt door een quorumserver, een derde witness in het netwerk die een node helpt bepalen of deze zichzelf moet promoveren wanneer de heartbeat stilvalt. We bespreken split-brain en de implementatietopologie die dit voorkomt later in deze review in detail.
QNAP geeft aan dat meer dan 90 procent van de NAS-services geschikt is voor HA in h6.0, en dat de capaciteit van het cluster kan worden uitgebreid met JBOD-uitbreidingsbehuizingen. Er zijn echter wel een paar kanttekeningen. Onveranderlijke snapshots, een andere belangrijke functie van h6.0, worden momenteel niet ondersteund binnen een HA-cluster, dus beheerders zullen voorlopig moeten kiezen tussen de twee beveiligingsopties. HA vereist ook twee identieke systemen, met hetzelfde model en dezelfde firmware, wat de koppelingswizard afdwingt voordat u verder kunt gaan.
Het QNAP HA-cluster bouwen
Het aanmaken van een cluster begint met twee onafhankelijk geconfigureerde TS-h765eU-eenheden met identieke hardware. Vanaf het aangewezen actieve knooppunt doorloopt de High Availability Manager-wizard een kort koppelingsproces. De wizard detecteert het passieve knooppunt via de heartbeat-verbinding en vraagt u vervolgens om rollen toe te wijzen aan uw netwerkinterfaces: een clusterverbinding die dient als communicatiekanaal voor toegang tot het cluster, en de heartbeat-verbinding, die volgens QNAP bedoeld is voor het synchroniseren van gegevens en een directe verbinding tussen de apparaten moet zijn. In onze configuratie heeft de wizard de heartbeat toegewezen aan Adapter 1 en de clusterverbinding aan Adapter 2.
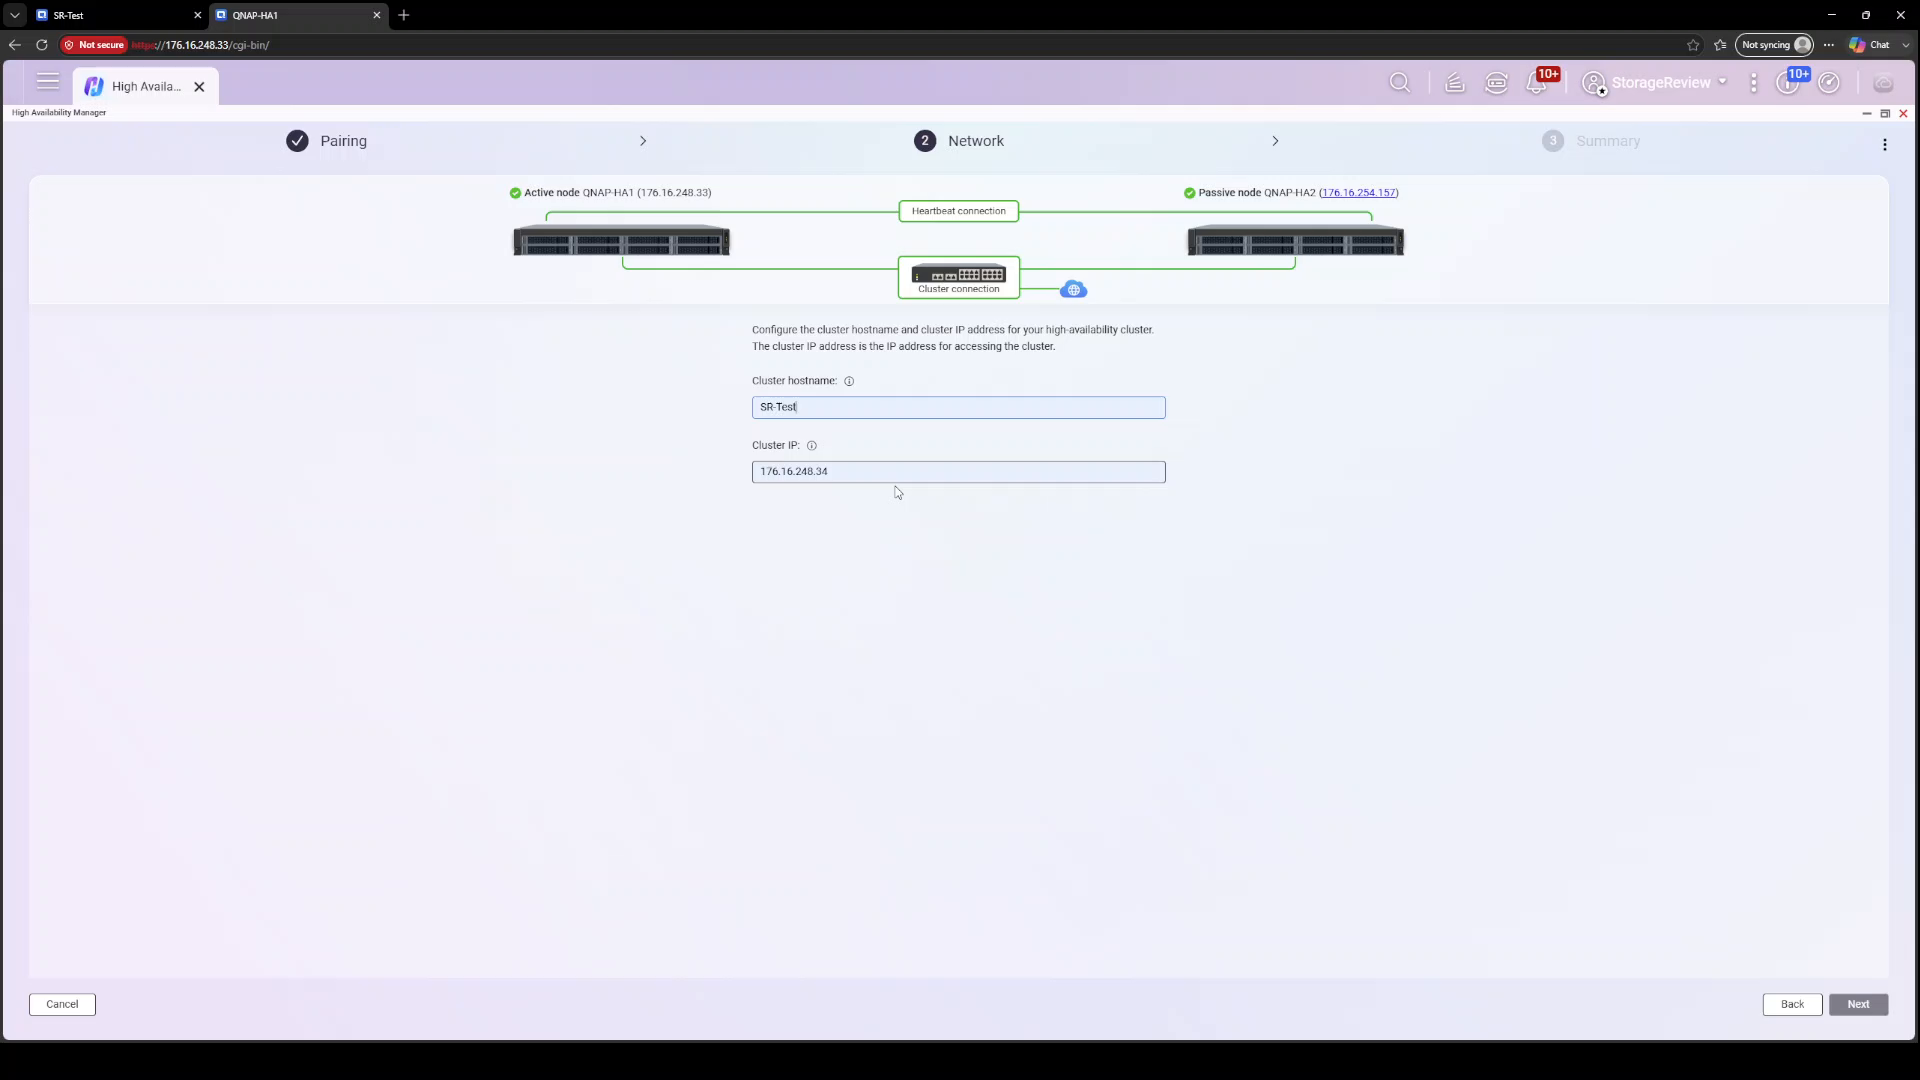
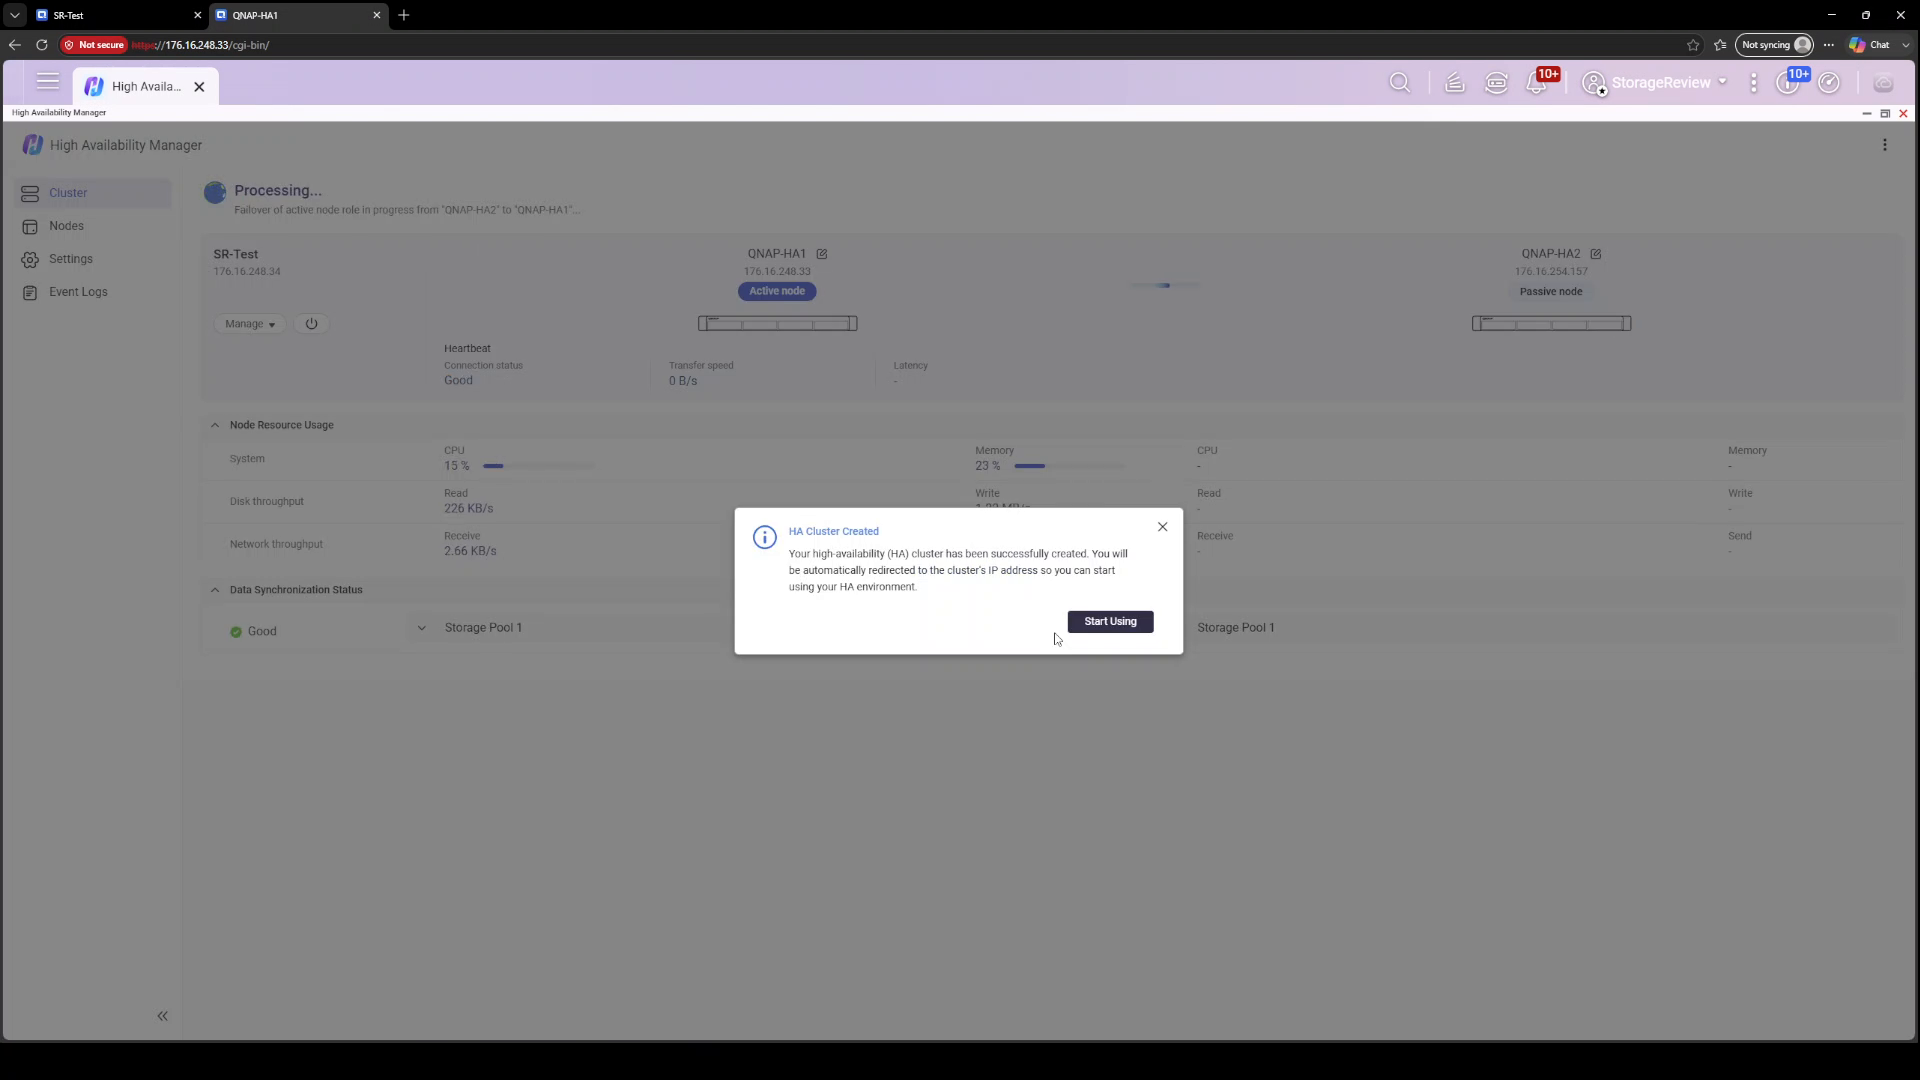
Vervolgens komt de clusteridentiteit aan de beurt. Je wijst een clusterhostnaam en een cluster-IP-adres toe, die vanaf dat moment het enige adres vormen dat clients gebruiken. Ons cluster heette SR-Test en had het IP-adres 176.16.248.34. Het stond voor de nodes QNAP-HA1 (176.16.248.33) en QNAP-HA2 (176.16.254.157), die zich in verschillende /24-subnetten op het labnetwerk bevonden. De wizard koppelde ze zonder problemen.
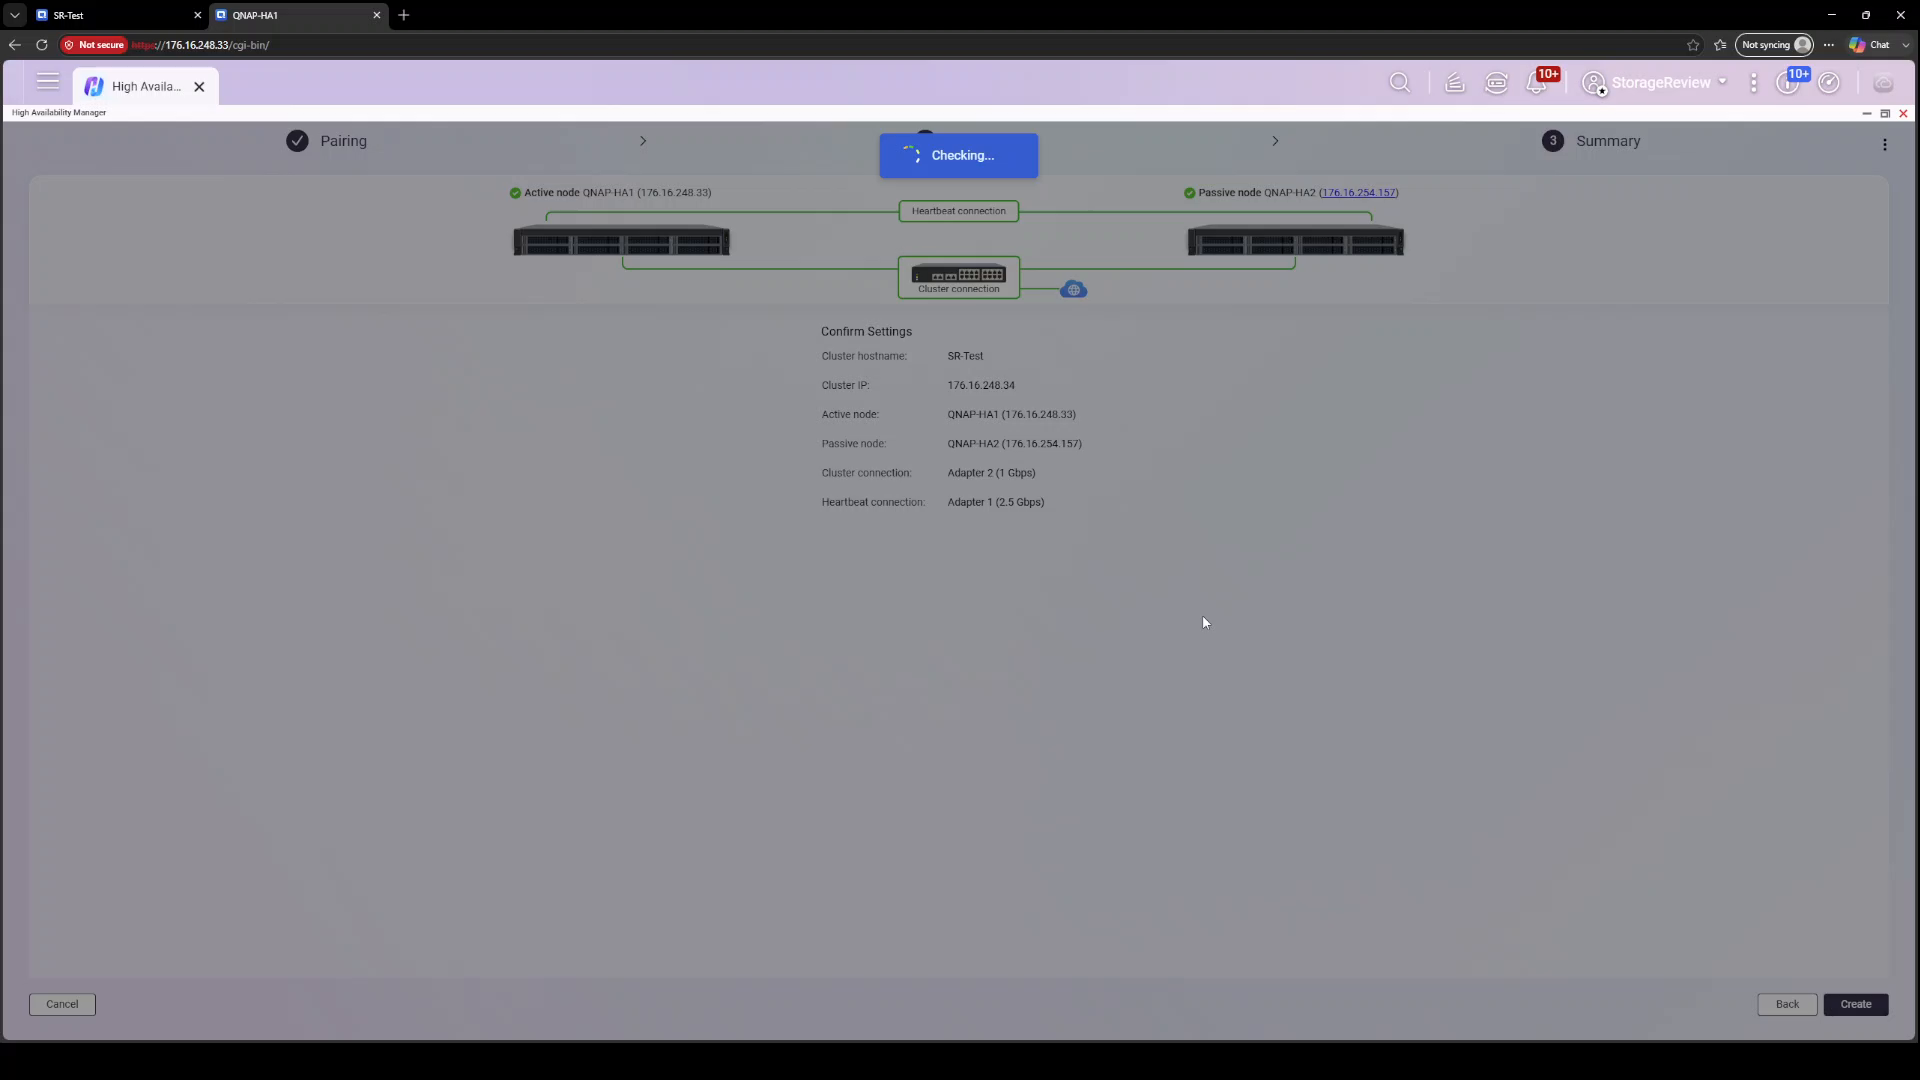
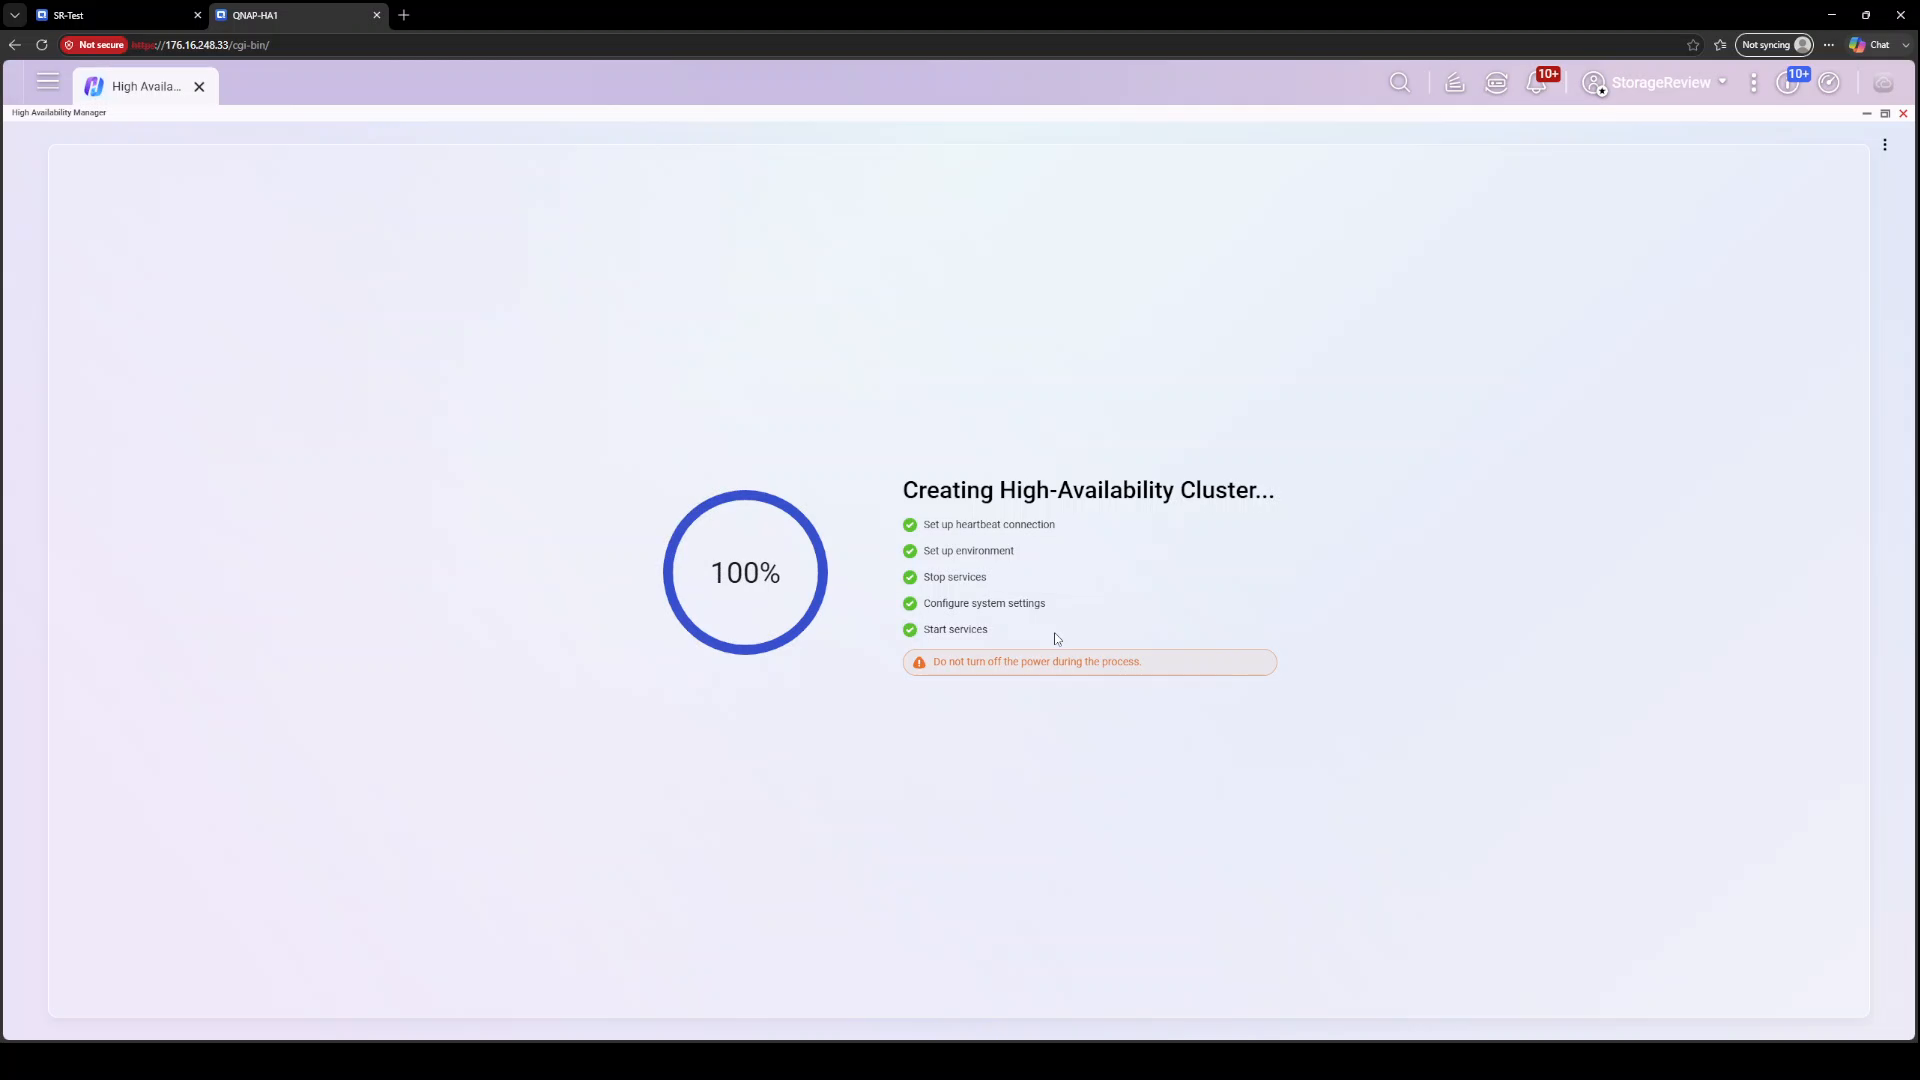
Nadat de instellingen zijn bevestigd, voert de wizard een vijfstappenplan uit voor de installatie: het instellen van de heartbeat-verbinding, het configureren van de omgeving, het stoppen van services, het configureren van de systeeminstellingen en het starten van services. De gebruikersinterface benadrukt dat u tijdens dit proces niets mag uitschakelen. Op onze systemen duurde de installatie zelf ongeveer vijf en een halve minuut, waarna HA Manager meldde dat het cluster was aangemaakt en ons doorverwees naar het IP-adres van het cluster. Van begin tot eind duurde de installatie van twee losstaande NAS-units naar een werkend cluster minder dan tien minuten met behulp van de wizard.
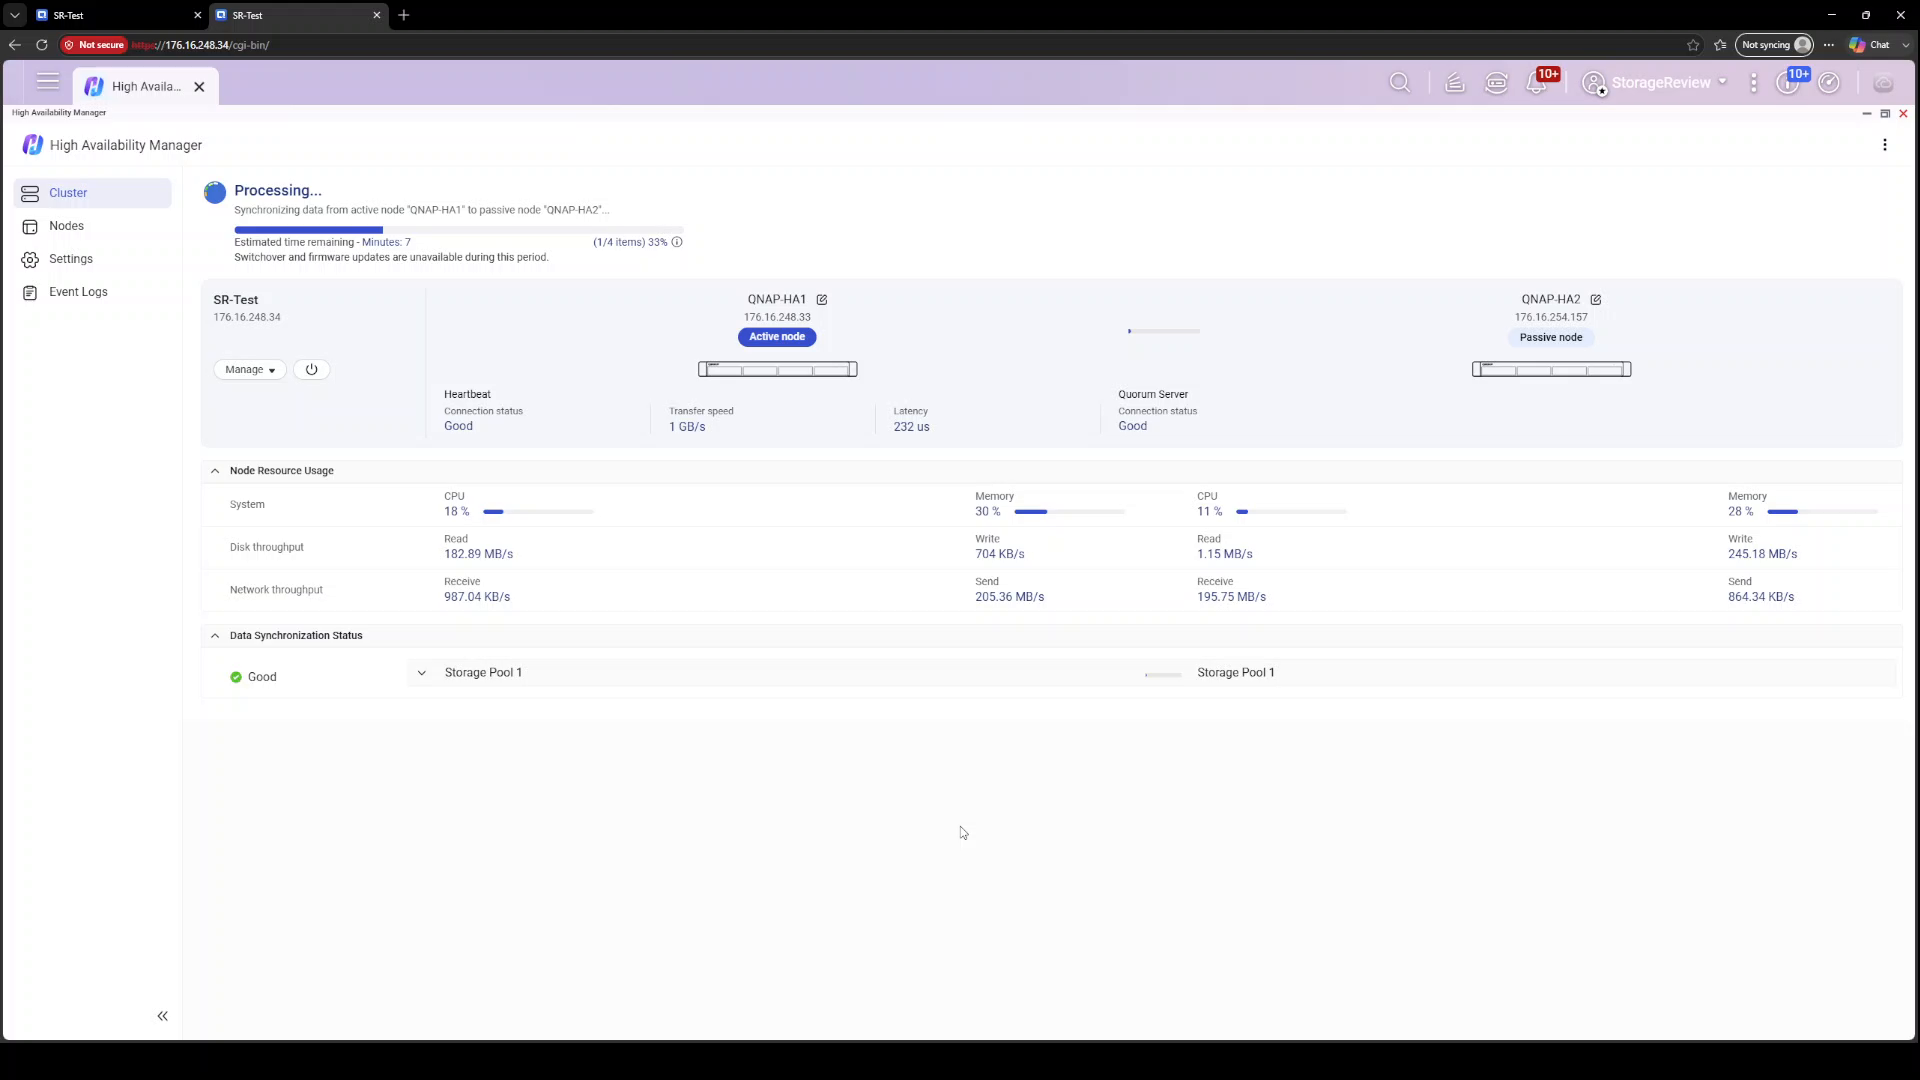
De grootste uitdaging is de initiële synchronisatie, waarbij het actieve knooppunt zijn opslagpool blok voor blok naar het passieve knooppunt kopieert. HA Manager toont dit duidelijk met een voortgangsbalk, het aantal items en een tijdschatting bovenaan het dashboard, samen met een waarschuwing dat omschakeling en firmware-updates niet beschikbaar zijn totdat de synchronisatie is voltooid. Het volgen van de heartbeat-statistieken tijdens deze fase was een van de meest indrukwekkende onderdelen van het proces: de overdrachtssnelheden varieerden van ongeveer 900 MB/s tot 1.2 GB/s, met een latentie van enkele honderden microseconden, inclusief een representatieve meting van 1 GB/s bij 232 microseconden. Onze eerste synchronisatie was in ongeveer tien minuten voltooid, precies zoals de beginschatting van negen minuten op het dashboard aangaf.
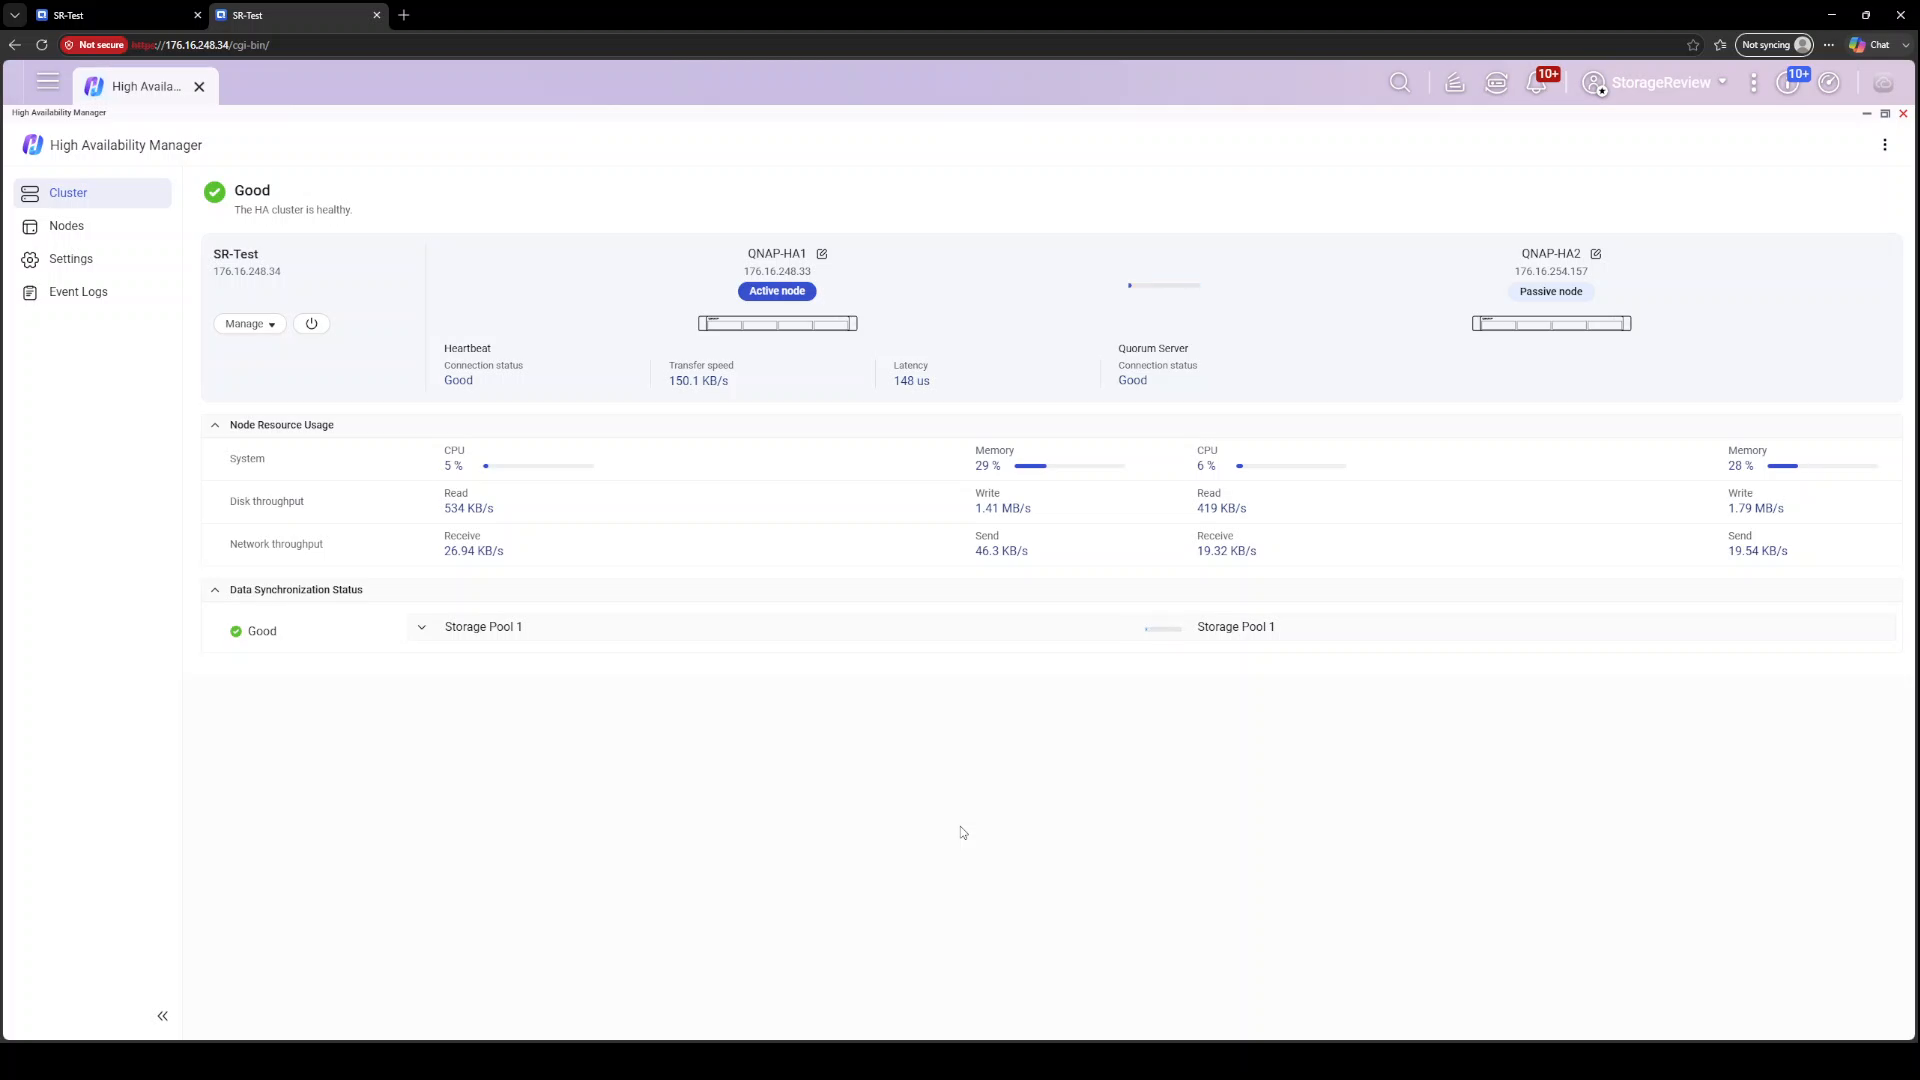
Zodra de synchronisatie is voltooid, krijgt het dashboard de status 'Goed': het cluster is gezond, de heartbeat is verbonden, beide knooppunten zijn zichtbaar met live CPU-, geheugen-, schijfdoorvoer- en netwerkstatistieken naast elkaar, en de synchronisatiestatus per pool wordt daaronder weergegeven. Het is een overzichtelijke, informatierijke weergave die antwoord geeft op de twee vragen die een beheerder zich daadwerkelijk stelt: Is het cluster gezond en zijn mijn gegevens gesynchroniseerd?
Failovertest 1: Stroomuitval op het actieve knooppunt
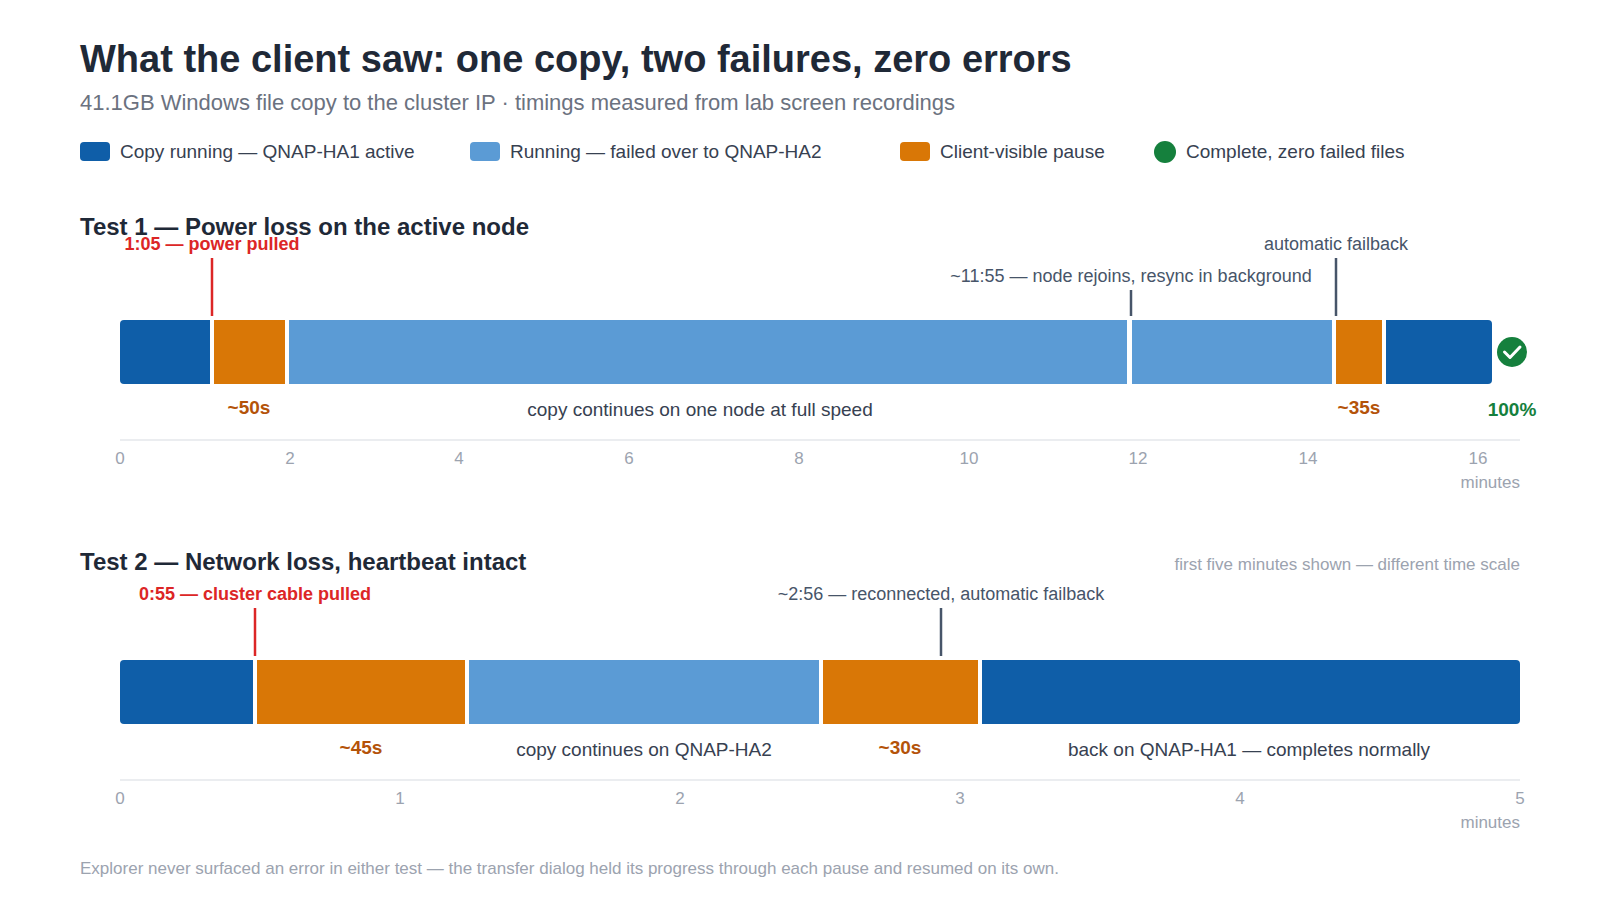
Ons eerste faalscenario is het meest voor de hand liggende: totale stroomuitval op het actieve knooppunt. We waren bezig met het kopiëren van Windows-bestanden van een client naar een SMB-share op het cluster-IP-adres, een batch van 41.1 GB met zes bestanden, waaronder ISO's van Windows 11 en Rocky Linux en twee archieven van Kali Linux-VM's, toen we halverwege de overdracht de stroom van QNAP-HA1 uitschakelden.
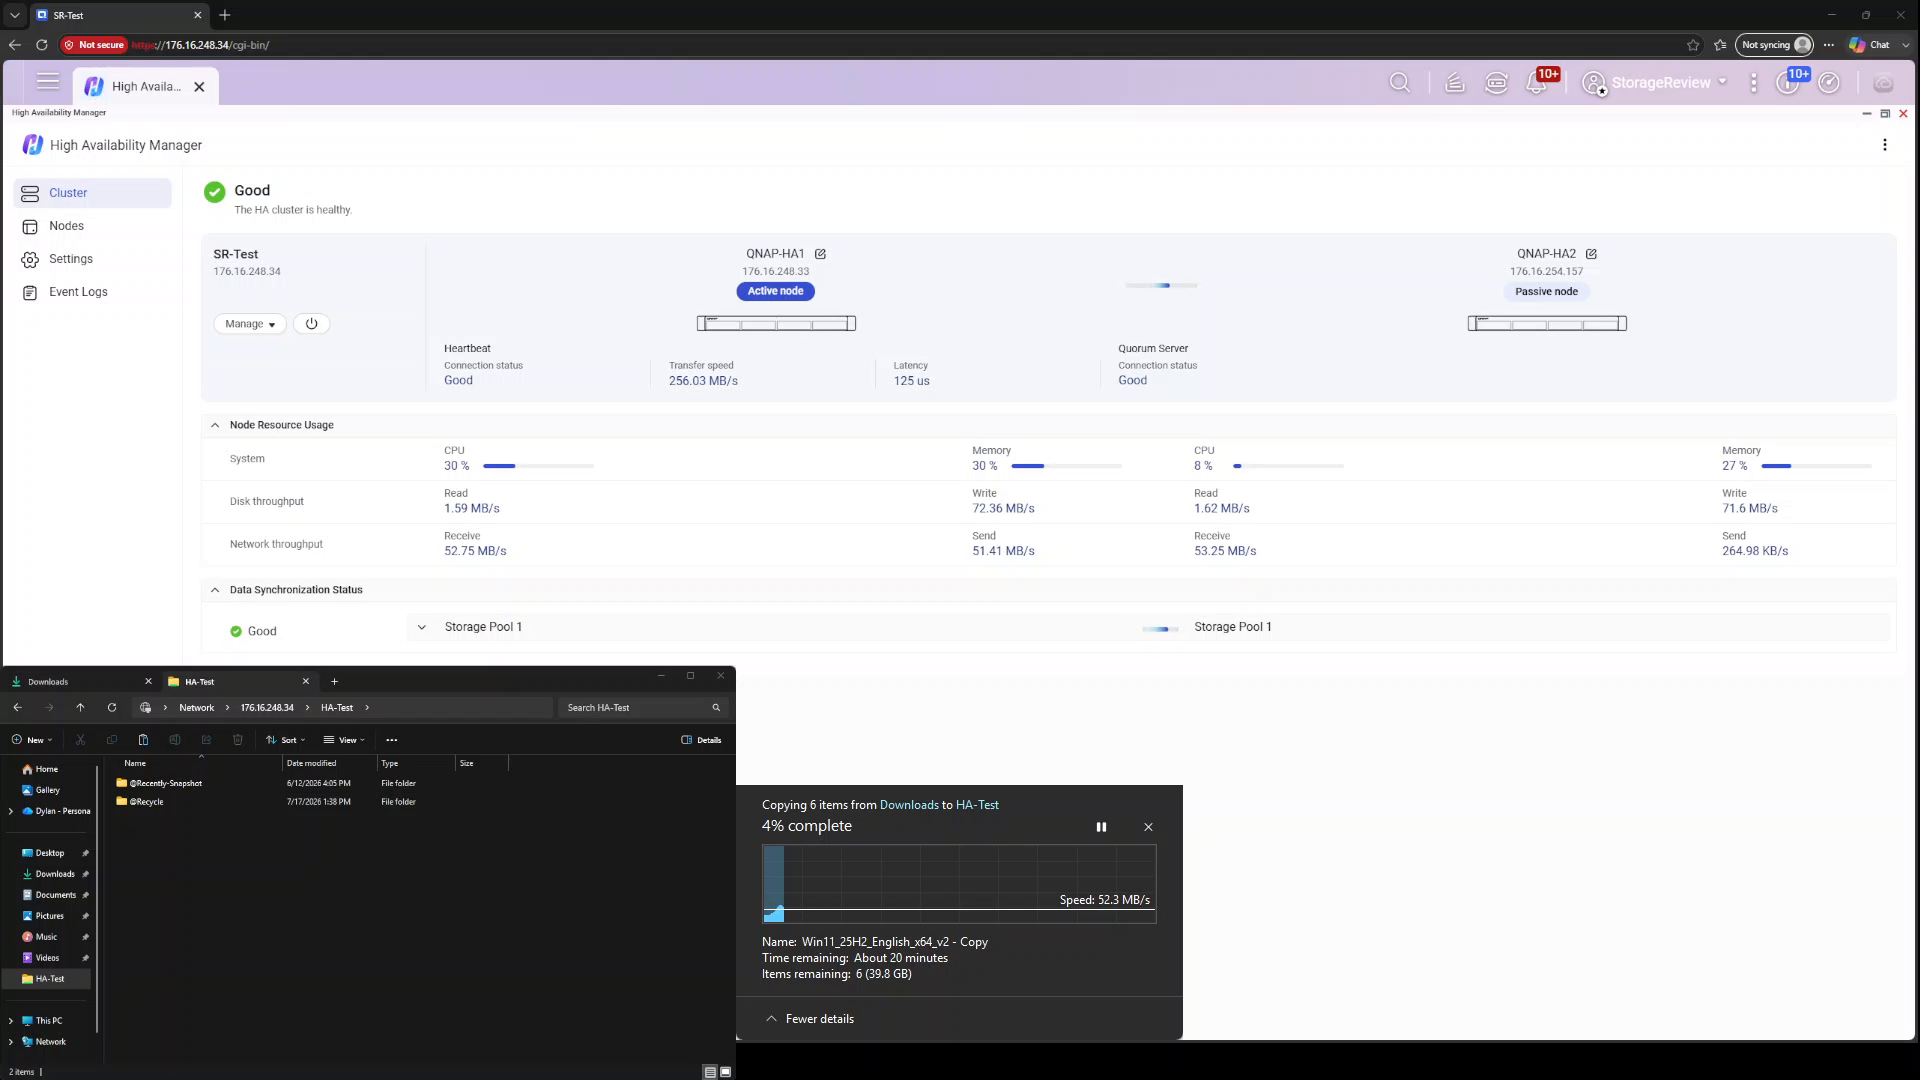
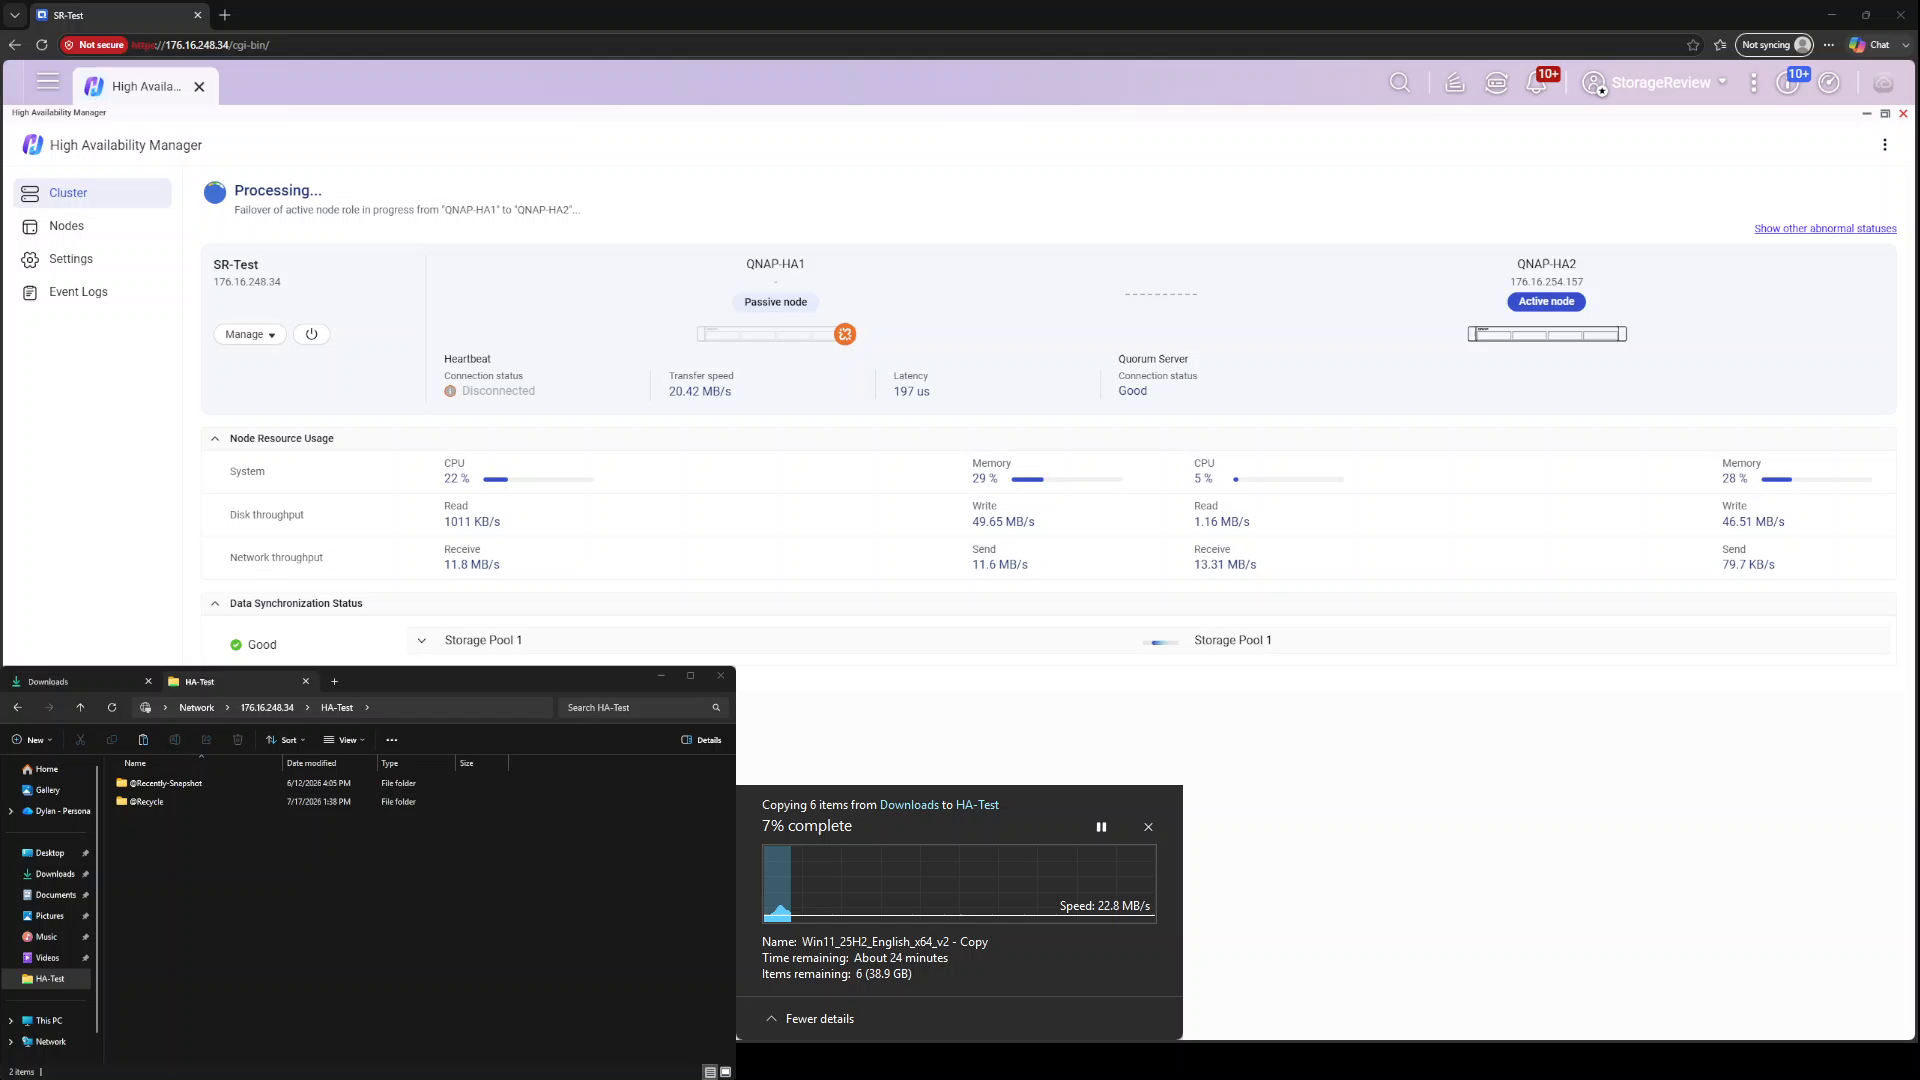
Vanuit het perspectief van de klant bleef het kopiëren iets minder dan een minuut, ongeveer 50 seconden, hangen tussen het moment dat de stroom werd uitgeschakeld en het moment dat de gegevensoverdracht weer op gang kwam. Explorer gaf geen foutmelding weer; het overdrachtsdialoogvenster bleef de voortgang tonen en hervatte deze vervolgens toen QNAP-HA2 zichzelf tot actief node promoveerde. HA Manager meldde kort dat de failover van de actieve node-rol bezig was en gaf vervolgens een waarschuwing weer: passieve node QNAP-HA1 kan niet worden gedetecteerd, met de suggestie om ervoor te zorgen dat de node is ingeschakeld en verbonden met het netwerk. De overdracht ging door met dezelfde cluster-IP op volle snelheid terwijl het cluster op één node draaide, wat precies de beperkte maar operationele status is die HA belooft.
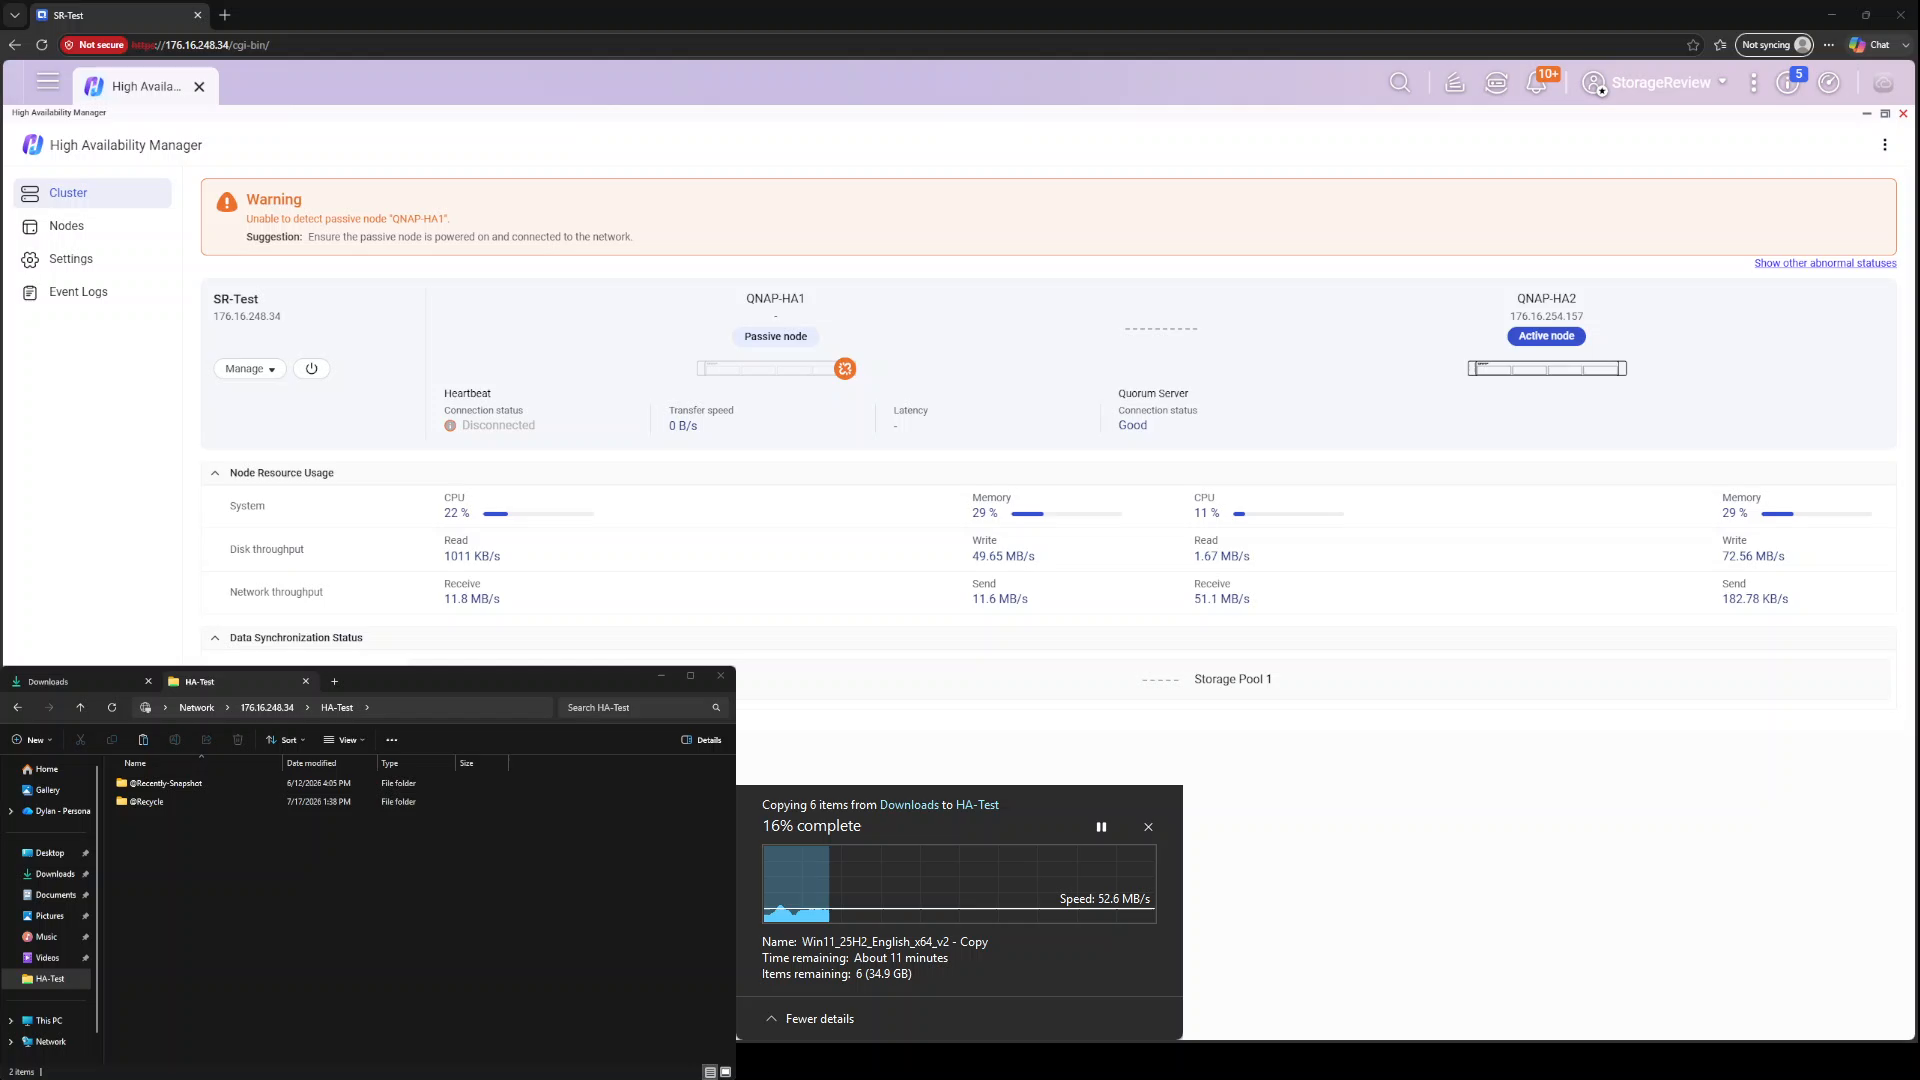
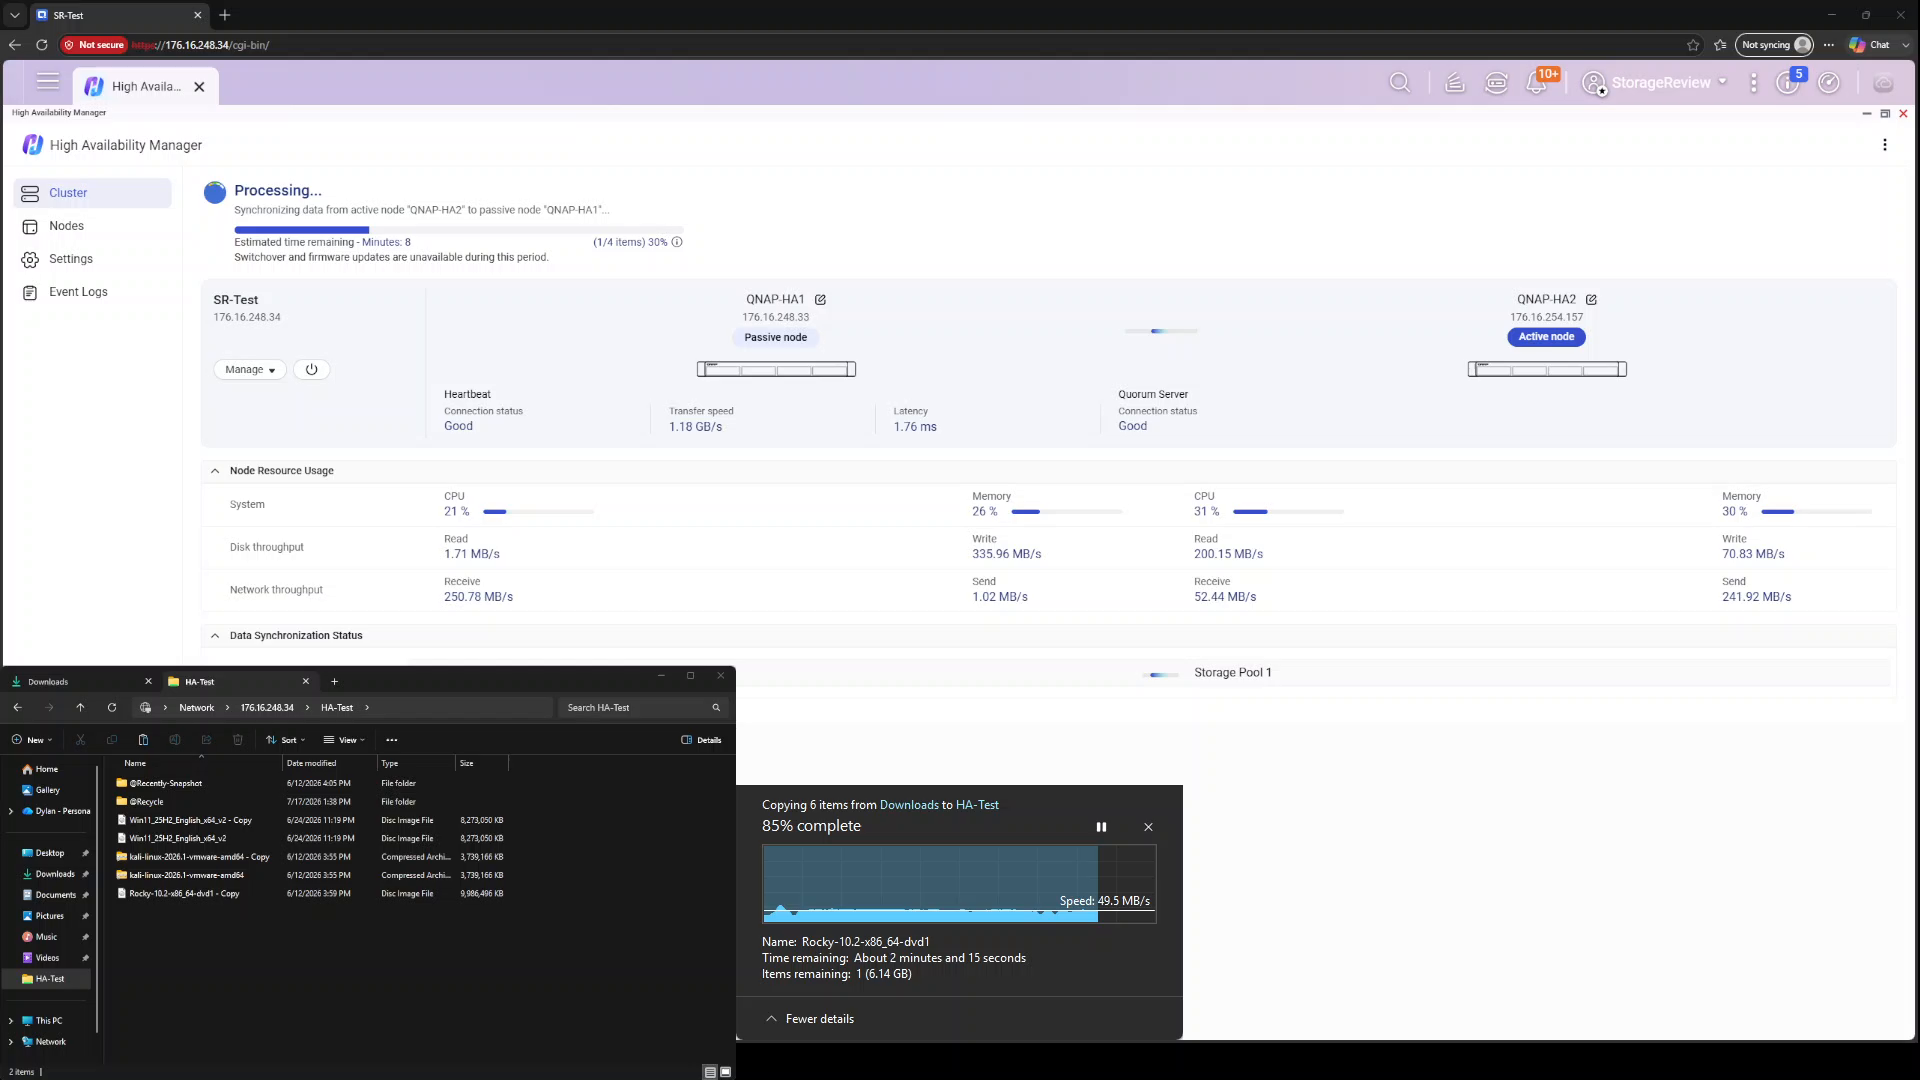
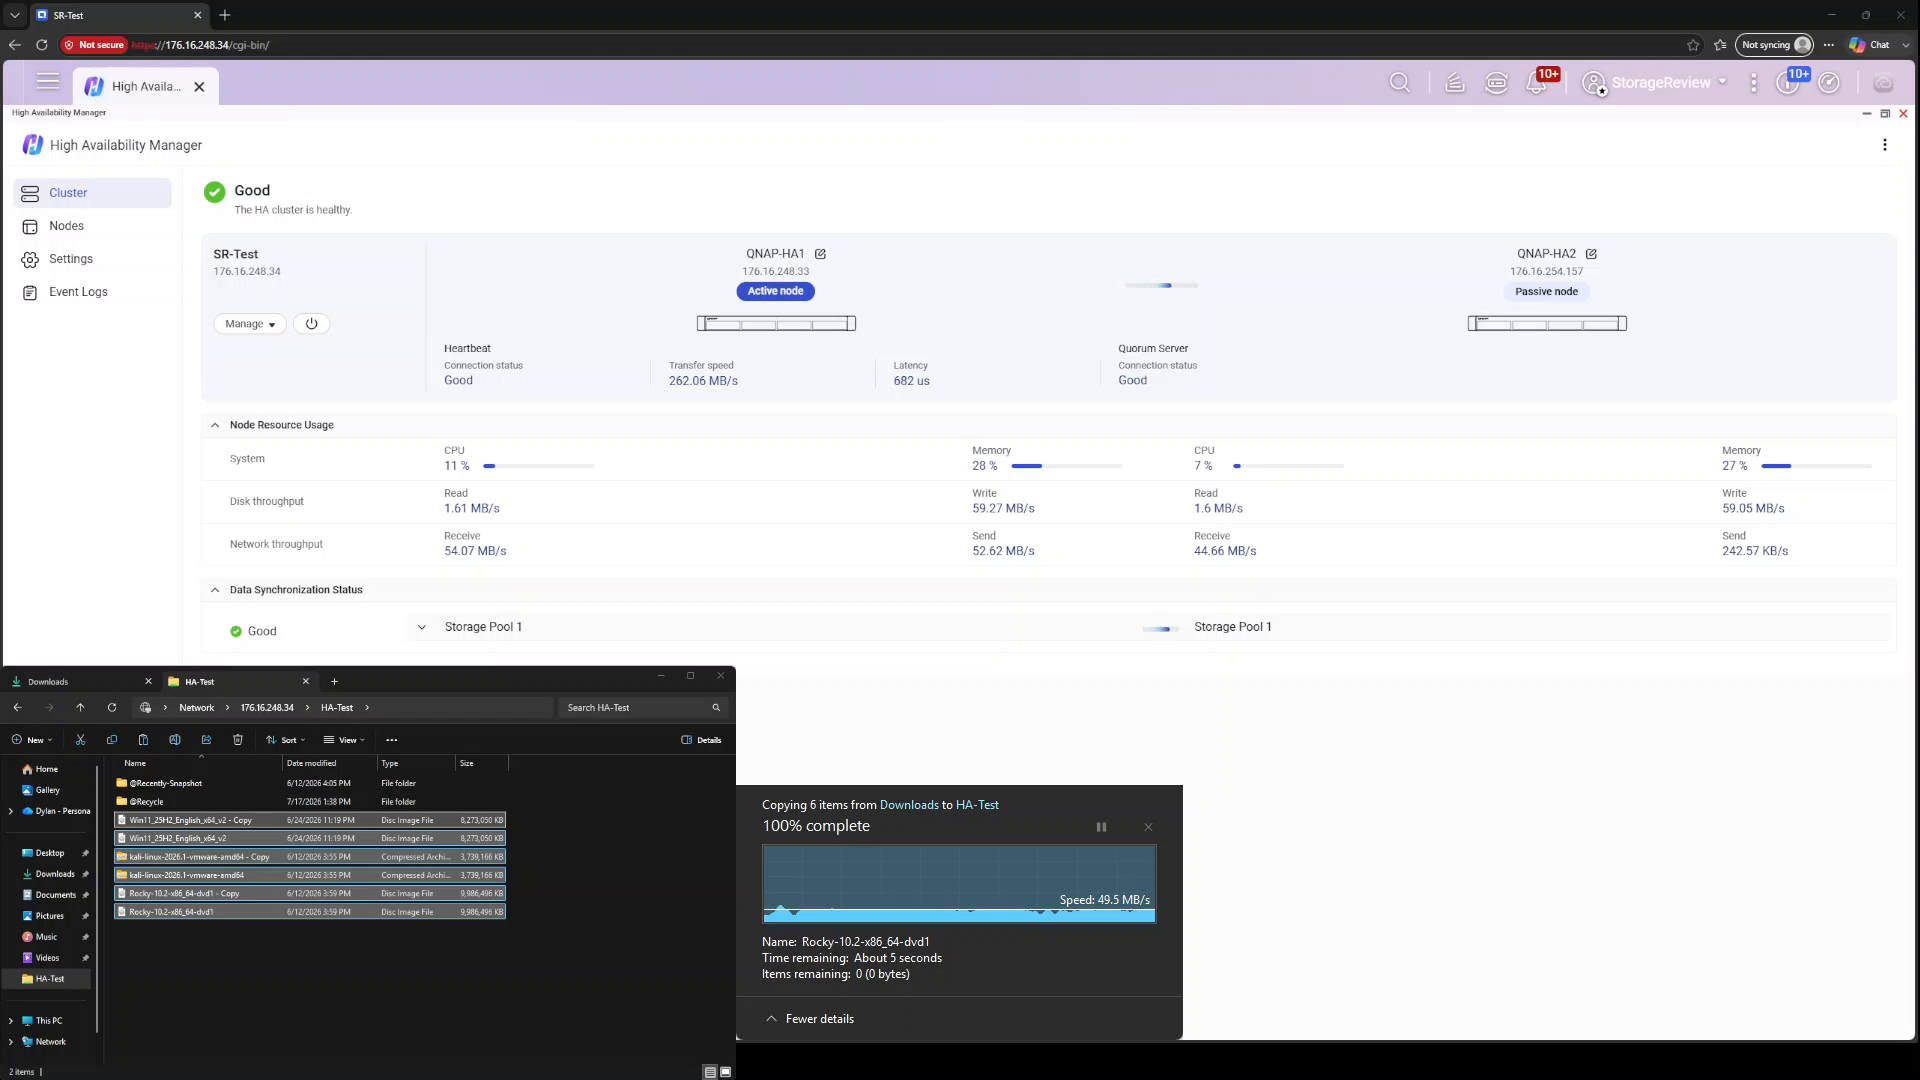
Het herstellen van de stroomtoevoer naar de QNAP-HA1 activeerde automatisch het omgekeerde proces. De node startte op en voegde zich ongeveer tien minuten na de stroomuitval weer bij het netwerk als passief lid. HA Manager begon vervolgens met het synchroniseren van gegevens van de actieve node QNAP-HA2 terug naar QNAP-HA1, waarbij de voortgang en tijdschattingen zichtbaar waren op het dashboard, terwijl het kopiëren van bestanden ongestoord doorging. Failback vereiste geen tussenkomst: zodra de resynchronisatie was voltooid, pauzeerde het cluster de overdracht gedurende ongeveer 35 seconden om de actieve rol terug te geven aan QNAP-HA1, waarna het kopiëren volledig werd voltooid. Aan het einde van de taak had het cluster weer de status 'Goed' met een overdracht van 100 procent, en had het een harde stroomstoring, een periode met één node, een nodeherstel en een failback binnen één kopieertaak doorstaan.
Failovertest 2: Netwerkverlies met intacte heartbeat
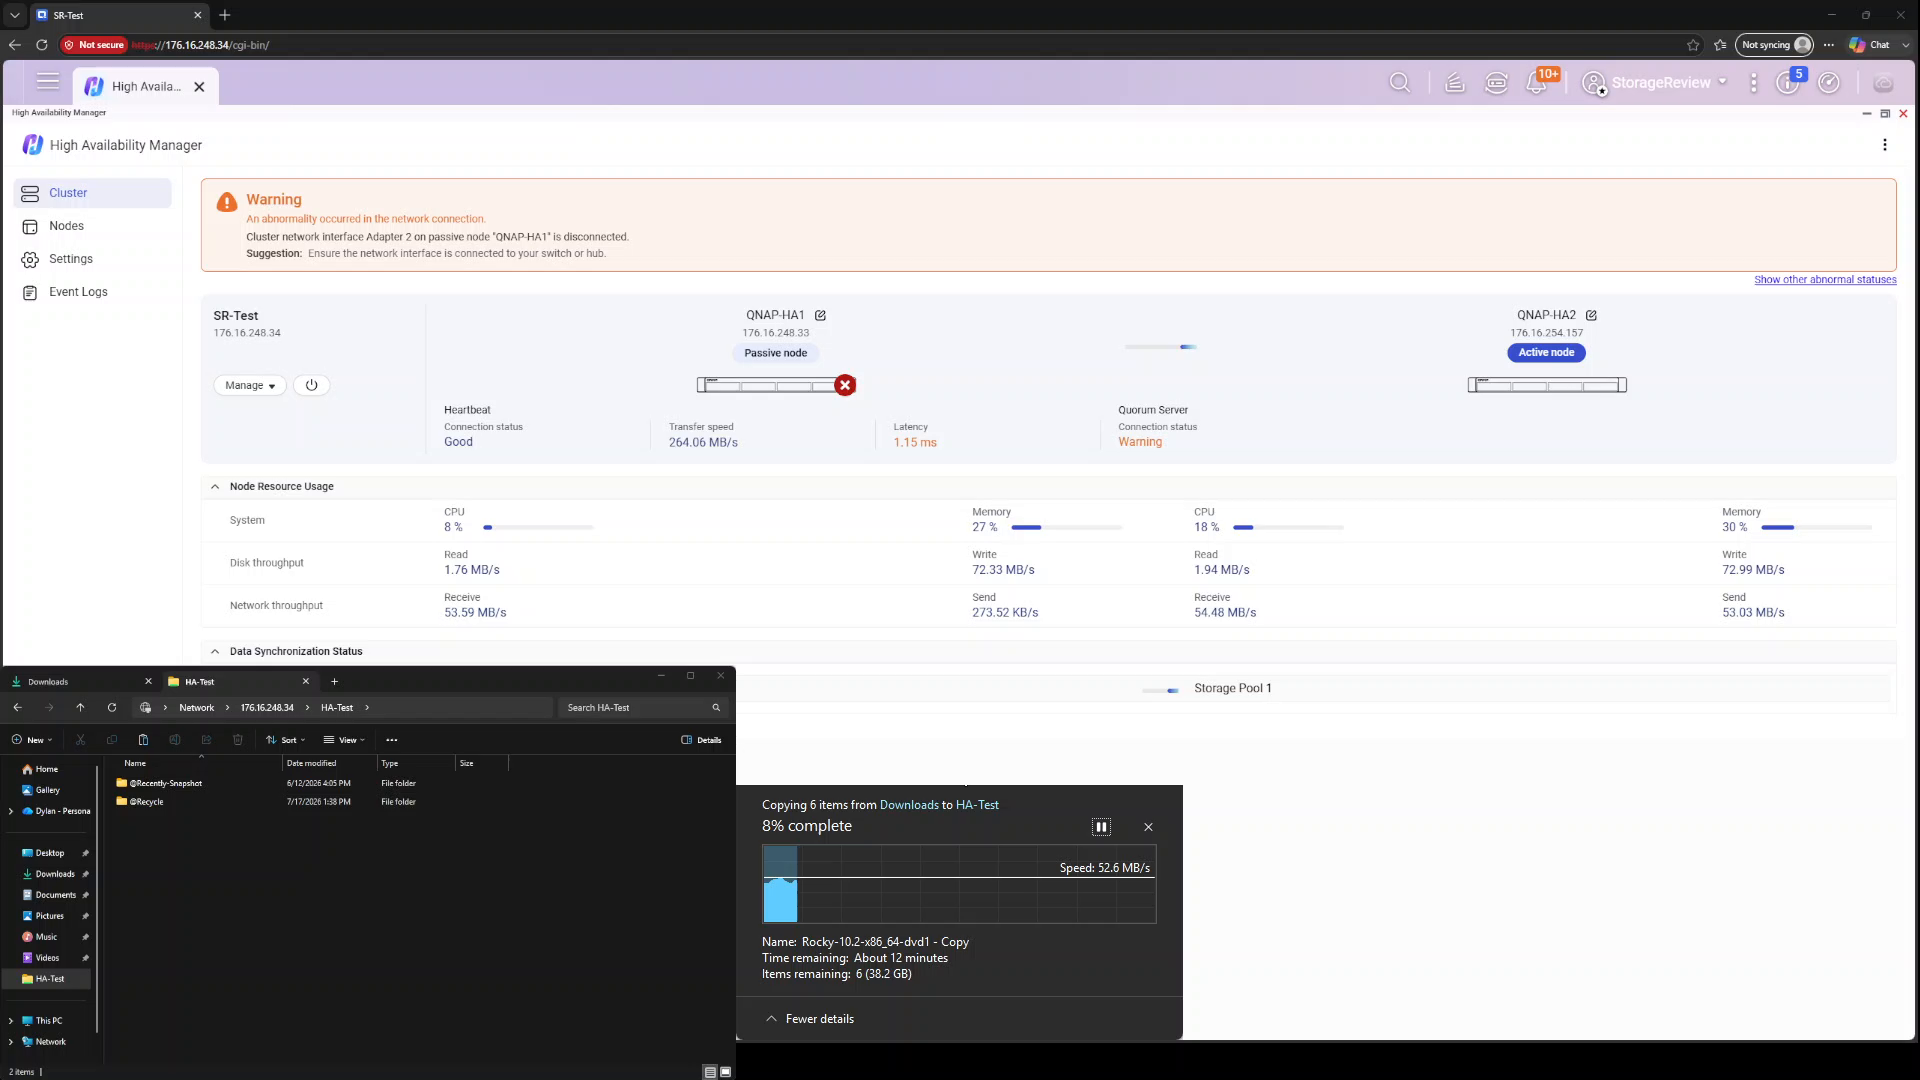
Het tweede scenario is subtieler en wellicht vaker voorkomend in de praktijk: het actieve knooppunt verliest zijn netwerkverbinding met de client (een defecte switchpoort, een losgetrokken kabel of een defecte transceiver), terwijl het knooppunt zelf blijft functioneren en de heartbeat-verbinding intact blijft. In dit geval is bescherming tegen split-brain-situaties cruciaal, omdat beide knooppunten actief zijn en elkaar kunnen zien, en het cluster moet bepalen welk knooppunt het cluster-IP-adres krijgt.
We herhaalden dezelfde Windows-bestandskopie naar het cluster-IP-adres en verbraken de netwerkinterface van het cluster op het actieve knooppunt. De overdracht werd ongeveer 45 seconden onderbroken terwijl het cluster services naar het andere knooppunt verplaatste, waarna deze zonder problemen werd hervat. HA Manager gaf de fout nauwkeurig aan en waarschuwde dat netwerkinterface Adapter 2 op het knooppunt was verbroken en adviseerde een controle van de switchverbinding. Vervolgens werd ook vermeld dat het verbroken knooppunt de quorumserver niet langer via die interface kon bereiken. Deze specificiteit, met vermelding van de exacte interface, het knooppunt en de gevolgen, is veel duidelijker dan de algemene melding 'verslechterde verbinding' die sommige HA-implementaties gebruiken.
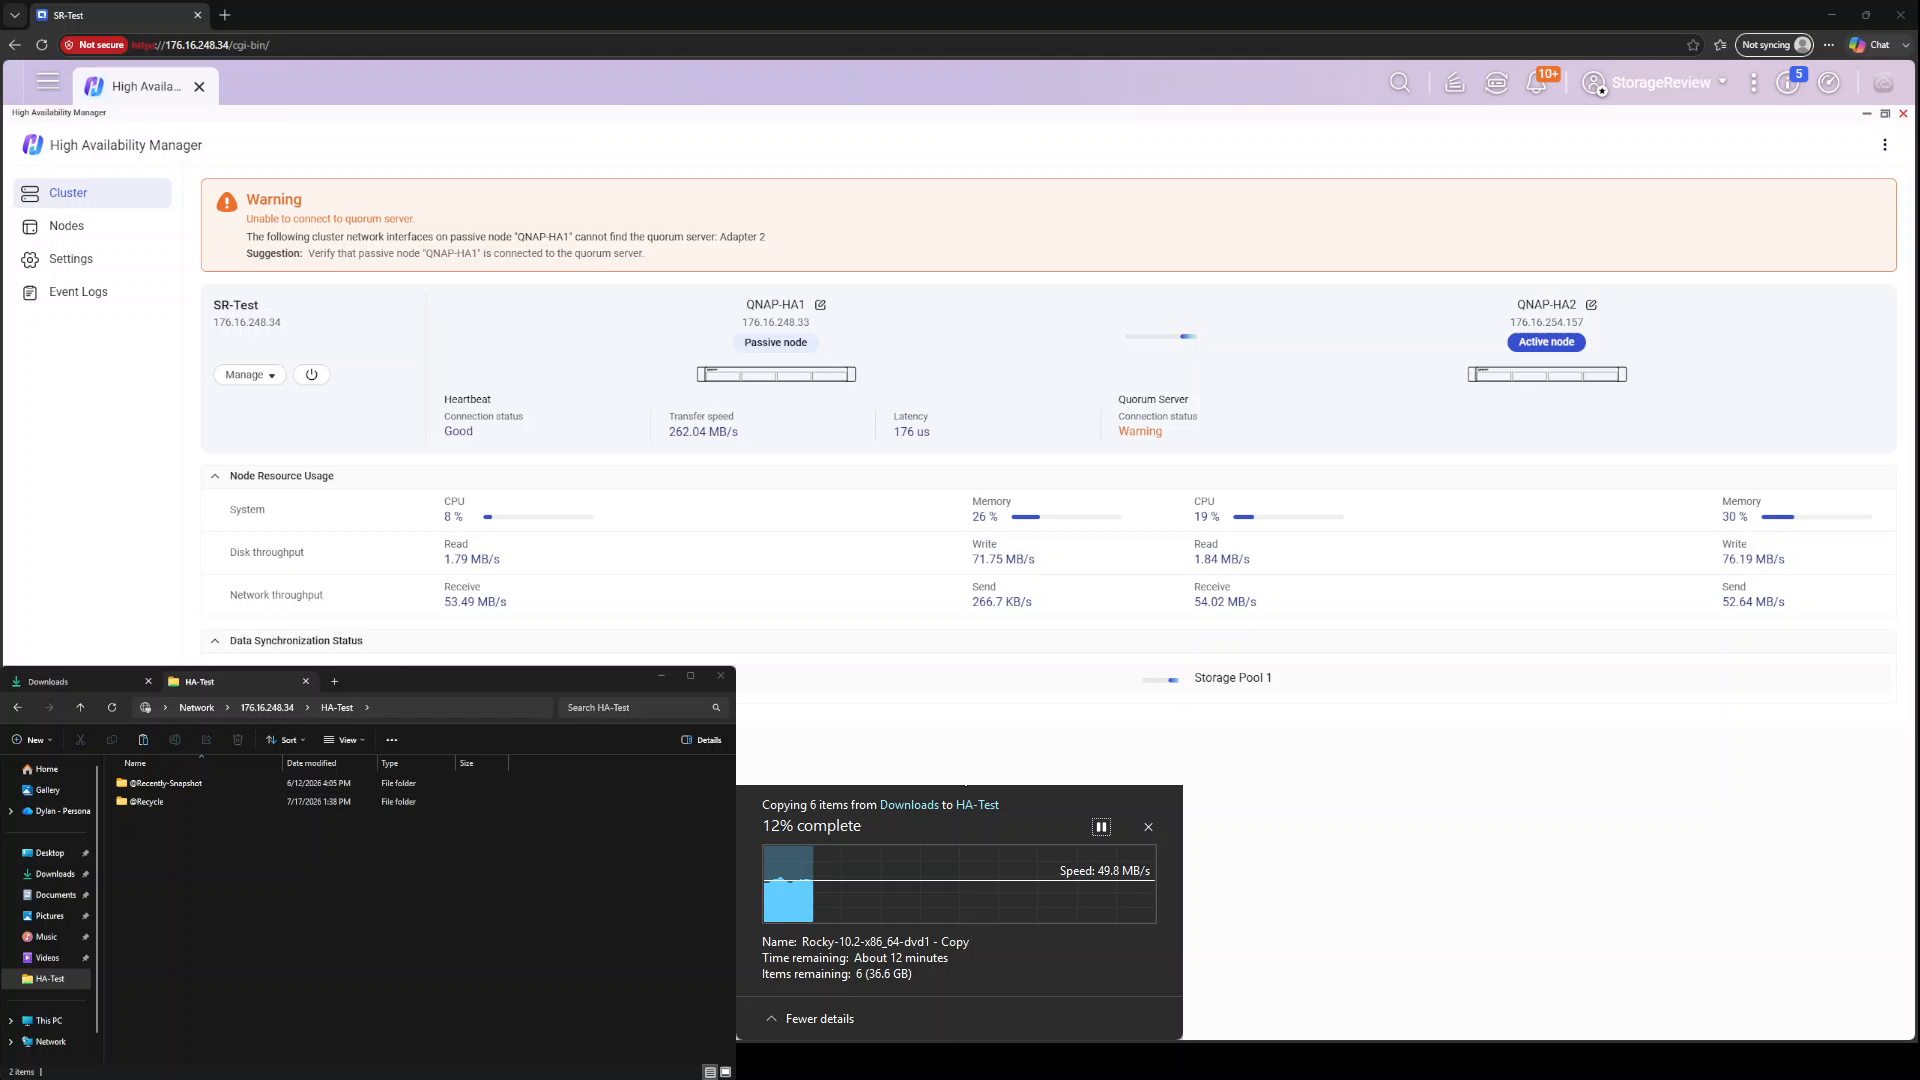
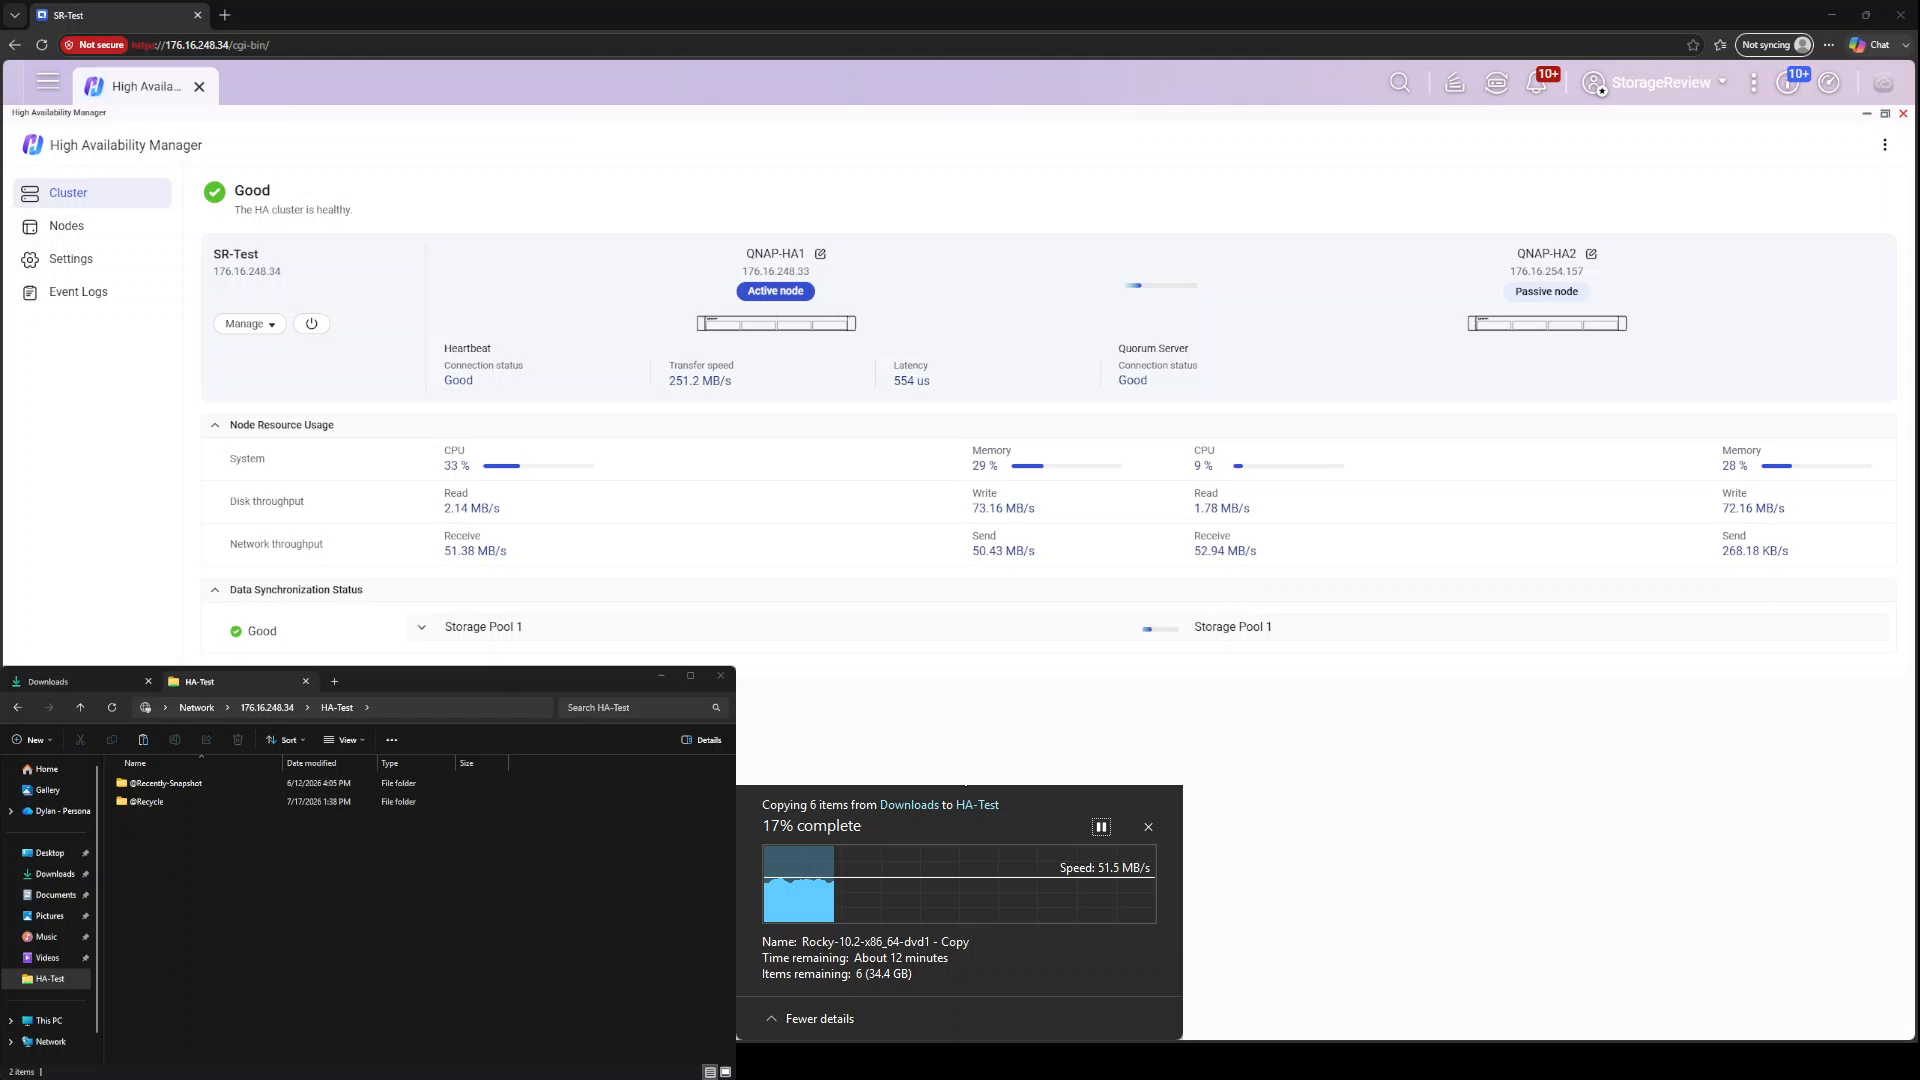
Het herstellen van de netwerkverbinding bracht het knooppunt terug in het cluster en de failback vond binnen een minuut automatisch plaats: een korte pauze van ongeveer 30 seconden, terwijl de actieve rol terugkeerde naar QNAP-HA1, was het enige voor de client zichtbare bewijs dat er iets was gebeurd. Dezelfde kopieertaak doorstond twee opeenvolgende failovers zonder dat er ook maar één bestand verloren ging. Voor iedereen die ooit een SMB-sessie heeft zien vastlopen door veel minder, is dit het belangrijkste resultaat van deze hele oefening.
HA op de juiste manier implementeren: split-brain en netwerktopologie
Failover-testen zoals die van ons bewijzen dat het cluster werkt, maar hoe goed een HA-paar in een productieomgeving presteert, hangt net zozeer af van het omringende netwerk als van de NAS-eenheden zelf. De scenario's waarvoor HA Manager is ontworpen (een defecte node, een defecte switchpoort, een onderbroken uplink) hebben allemaal één gemeenschappelijke aanname: ten minste één communicatiepad tussen de twee nodes blijft intact na de storing. Het beschermen van die aanname is de allerbelangrijkste beslissing bij een HA-implementatie, omdat het alternatief de situatie is die elke high-availability-architectuur juist probeert te vermijden: split-brain.
QNAP beschrijft het scenario. Split-brain treedt op wanneer beide knooppunten de communicatie met elkaar verliezen, maar onafhankelijk van elkaar operationeel blijven en elk de actieve rol op zich nemen. Twee knooppunten, die elk denken dat ze de cluster beheren en elk schrijfbewerkingen accepteren, vormen een recept voor inconsistente data of beschadigde opslag, omdat ze elk tegelijkertijd gedeelde resources proberen te beheren. De gedocumenteerde oorzaken zijn precies wat je zou verwachten: netwerkonderbrekingen tussen knooppunten, heartbeat-fouten en instabiele netwerkpaden. Let op wat deze gemeen hebben. Split-brain wordt niet veroorzaakt door het uitvallen van één enkel knooppunt; het wordt veroorzaakt wanneer alle paden tussen twee gezonde knooppunten tegelijkertijd uitvallen. Dat is een topologieprobleem, en daar is een topologieoplossing voor.
De implementatieregels zijn zoals verwacht:
Laat de heartbeat via een directe kabel tussen de twee nodes lopen. QNAP vereist een directe verbinding voor de heartbeat, en wel hierom: zonder switch, transceiver of gedeelde infrastructuur in het pad, kan alleen een node zelf de heartbeat uitschakelen. Dit is precies de reden waarom failover is ontworpen. In een opstelling met dezelfde rackunits, waar deze compacte TS-h765eU-units waarschijnlijk naast elkaar staan, is er geen reden om iets anders te doen.
Als de nodes gescheiden zijn, zorg er dan voor dat het heartbeat- en clientverkeer fysiek gescheiden paden volgen. Wanneer een directe kabelverbinding niet mogelijk is, leid het heartbeat-verkeer dan via andere switches dan die voor de clusterverbinding worden gebruikt. Zodra beide verbindingen via dezelfde switch lopen, wordt die switch een single point of failure die alle paden tussen de nodes tegelijkertijd kan verbreken, waardoor een gewone switchstoring kan leiden tot een split-brain-situatie. Het hele nut van het aanschaffen van twee NAS-units wordt tenietgedaan als één onderdeel van de gedeelde infrastructuur ze van elkaar kan isoleren. Dit is de logica achter onze testmethode voor netwerkfailover: het loskoppelen van de clientverbinding terwijl het heartbeat-verkeer verbonden blijft, simuleert de switch- of bekabelingsstoring die zich in een correct gescheiden topologie daadwerkelijk zou voordoen, waarbij het heartbeat-verkeer actief blijft om de overname soepel te laten verlopen.
Schakel de quorumserver in. De derde beveiliging van QNAP is een witness-server op het netwerk, geconfigureerd onder High Availability Manager > Instellingen > Failoverbeleid > Quorumserver. Als de knooppunten hun directe verbinding verliezen, maar nog steeds het netwerk kunnen bereiken, blijft de quorumserver beide bewaken en hun status doorgeven. Hierdoor krijgt elk knooppunt een onafhankelijke tiebreaker voordat het zichzelf promoveert. De verbindingsstatus van de quorumserver wordt permanent weergegeven op het HA Manager-dashboard, samen met de heartbeat, zodat de status in één oogopslag zichtbaar is.
Mocht het ergste toch gebeuren, dan handelt QuTS Hero split-brain defensief af. Zodra de verbinding is hersteld en de knooppunten weer met elkaar kunnen communiceren, wisselen ze statusinformatie uit, herkennen ze dat beide de actieve rol hebben gehad en stoppen ze opzettelijk de meeste services, inclusief SMB en iSCSI, om te voorkomen dat twee uiteenlopende datasets worden samengevoegd. HA Manager presenteert vervolgens een wizard 'Herstellen van split-brain' met twee opties. Optie één behoudt de gegevens op één door u geselecteerd knooppunt; het andere knooppunt wordt gewist, gereset als passief lid en opnieuw gesynchroniseerd. Dit is de snelste route als u weet welke kant de juiste gegevens bevat. Optie twee behoudt de gegevens op beide knooppunten door de services op één knooppunt te hervatten terwijl het andere knooppunt volledig uit het cluster wordt verwijderd. Zo kunt u de gegevens controleren en vergelijken voordat u het handmatig weer toevoegt. Het is een verstandig herstelmodel, maar herstel betekent nog steeds downtime en een volledige resynchronisatie. Split-brain is een situatie die u voorkomt door middel van het implementatieontwerp, niet iets waar u van wilt herstellen. De drie bovenstaande regels kosten niets meer dan een kabel en vijf minuten in een instellingenpaneel.
Monitoring en beheer
De operationele status van dag twee is live te volgen via de HA Manager-app, die de clusterstatus, het resourcegebruik per node, gebeurtenislogboeken en nodebeheer, inclusief handmatige omschakeling, in één overzicht samenbrengt. De waarschuwingsbanners op het dashboard bleken tijdens onze tests specifiek genoeg voor de diagnose, omdat ze de exacte interface en node met de fout aangaven in plaats van een algemene melding dat de status was verslechterd.
QNAP heeft HA-functionaliteit ook in de hardware zelf geïntegreerd. In een HA-cluster kan het LCD-scherm op elke NAS de clusternaam, de huidige rol van de node en het cluster-IP-adres weergeven. De status-LED geeft in één oogopslag de HA-status aan: continu groen voor de actieve node, knipperend groen voor de passieve node en continu rood voor een HA-fout. In een rack vol identieke, compacte units is de mogelijkheid om de actieve node te identificeren zonder een browser te hoeven openen een kleine, maar waardevolle toevoeging voor technici. Voor fleet-implementaties biedt AMIZcloud gecentraliseerde cloudmonitoring van HA-groepen, waarmee de clusterstatus, latentie en waarschuwingen op alle locaties worden weergegeven.
Conclusie
High Availability Manager voldeed aan zijn kernbelofte in beide faalscenario's die we hebben getest. Een harde stroomuitval op het actieve knooppunt zorgde ervoor dat onze Windows-bestandskopie ongeveer 50 seconden stilviel, zonder dat er bestanden verloren gingen; een verbroken netwerkverbinding van de client kostte ongeveer 45 seconden. In beide gevallen werd dezelfde kopieertaak na het herstel van het knooppunt en een automatische failover probleemloos voortgezet, met slechts een korte pauze van minder dan een minuut. Clients hoefden niets opnieuw in te stellen. Applicaties, bestandsdeling en gebruikersworkflows bleven via één IP-adres en hostnaam functioneren, zowel voor, tijdens als na de failover. De installatie is bovendien gebruiksvriendelijk; twee losstaande units vormden binnen tien minuten een servercluster met behulp van de installatiewizard, plus een initiële synchronisatie van tien minuten. Het dashboard gaf bovendien precies aan welke interface, welk knooppunt en welke verbinding we moesten controleren als er iets misging.
De complete HA-stack: twee TS-h765eU-units en de IronWolf Pro-schijven die daarin waren geplaatst.
De kosten van HA mogen echter niet worden genegeerd. Je koopt van alles twee exemplaren, en de passieve node is ongebruikte capaciteit totdat deze niet meer nodig is. Onveranderlijke snapshots, de andere belangrijke beveiligingsmaatregel van h6.0, zijn momenteel niet beschikbaar in een HA-cluster, dus beheerders moeten kiezen tussen de twee. En de vereiste van identieke hardware betekent dat upgrades in paren plaatsvinden, wat budgetten kan beperken.
Waar dit uiteindelijk op neerkomt, is een kwestie van de juiste dimensionering, en HA Manager is het meest geschikt voor kleine bedrijven en edge-implementaties. In vergelijking met enterprise-arrays met twee controllers spelen twee compacte TS-h765eU-units een totaal andere financiële rol, terwijl ze wel het faalscenario afdekken dat de meeste aankopen van arrays met twee controllers in het MKB-segment motiveert: het uitvallen van een controller. In vergelijking met doe-het-zelf-replicatieschema's, snapshot-distributie, rsync-taken en back-up en herstel, zit het verschil in hersteltijd: deze schema's beschermen data, maar zorgen ervoor dat je uren bezig bent met het herstellen van clientverbindingen, terwijl de ergste gebeurtenis die HA Manager in onze tests voor de client zichtbaar maakte, een pauze van een minuut was. Net zo belangrijk is dat de storing die HA Manager niet kan opvangen, namelijk het tegelijkertijd uitvallen van alle inter-node-paden, te voorkomen is met een directe heartbeat-kabel, gescheiden netwerkpaden en een ingeschakelde quorumserver: een topologie die slechts één kabel en vijf minuten in een instellingenpaneel vereist.
Nog een laatste punt specifiek voor een ontwerp met twee knooppunten: het meest kwetsbare moment van het cluster is een resynchronisatie, wanneer één knooppunt de enige goede kopie van uw gegevens bevat en de onderliggende schijven op hun zwaarst werken. Dit is een argument om de schijfselectie in een HA-configuratie serieus te nemen, en het verklaart waarom NAS-gecertificeerde schijven zoals de Seagate IronWolf Pro 30TB-schijven in onze configuratie hier belangrijker zijn dan in een standalone systeem: hun taak is om dit moment van onopgemerkt te laten verlopen.
De QNAP TS-h765eU en QuTS hero h6.0 zijn nu verkrijgbaar. Ga voor meer informatie naar de productpagina van de QNAP TS-h765eU.
Dit rapport wordt gesponsord door QNAP. Alle standpunten en meningen die in dit rapport worden geuit, zijn gebaseerd op onze onpartijdige beoordeling van het/de betreffende product(en).


 Amazon