

Het JumpStart-programma van Supermicro heeft zich gevestigd als een van de nuttigste tools in de evaluatiekit voor AI-infrastructuur vóór de aanschaf. In plaats van een gescripte demo in een gedeelde omgeving, biedt JumpStart gekwalificeerde gebruikers gratis, tijdgebonden toegang tot echte productieservers via SSH, IPMI en VNC, waardoor ze workloads op daadwerkelijke hardware kunnen uitvoeren. We hebben het programma afgelopen november uitgebreid behandeld met een X14-systeem met een NVIDIA HGX B200 en kregen toen een duidelijk beeld van wat een week gerichte toegang wel en niet kan onthullen. Deze keer bood Supermicro toegang tot een H14 8U-systeem met een heel ander verhaal over de accelerator.
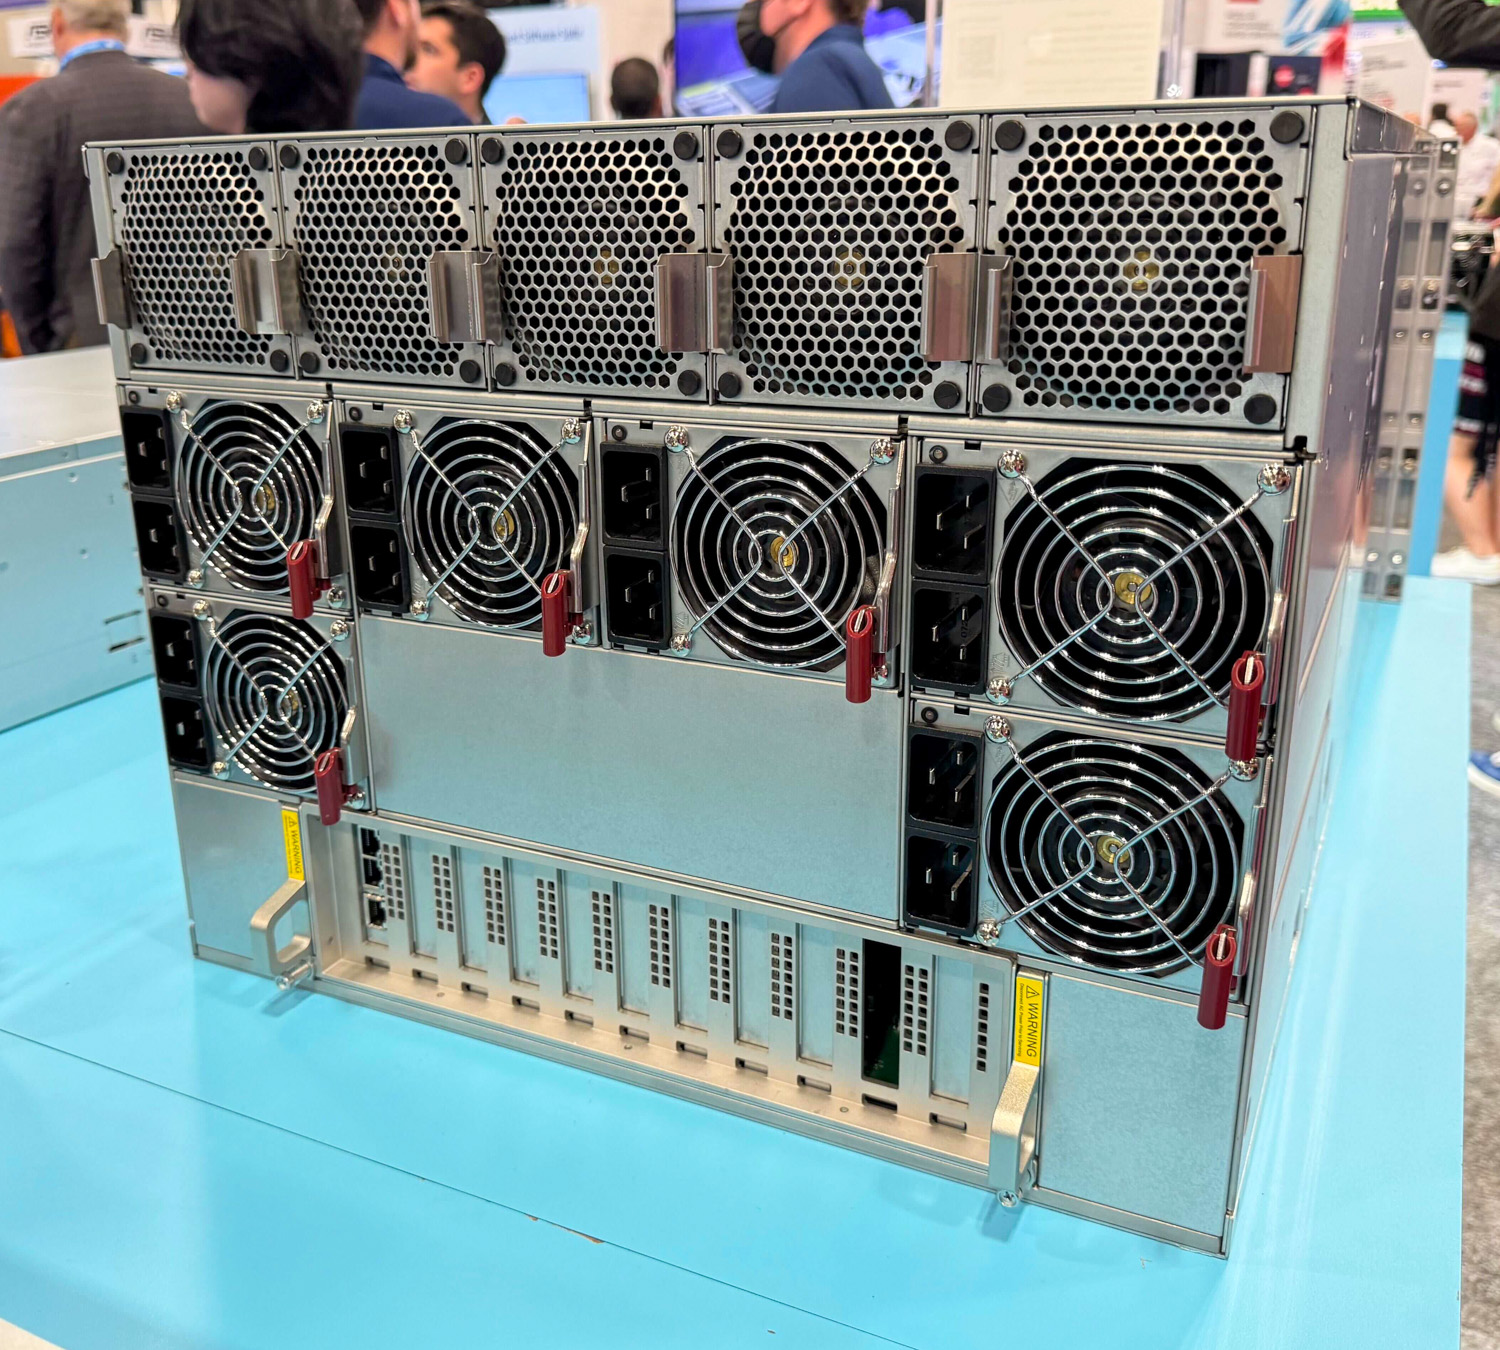
We hebben het AS-8126GS-TNMR- systeem getest , een 8U luchtgekoeld platform gebouwd rond twee AMD EPYC 9575F-processors en acht AMD Instinct MI350X GPU's. De MI350X is AMD's huidige vlaggenschip voor datacenters, gebouwd op de 4e generatie CDNA-architectuur op TSMC's 3nm-node en voorzien van 288 GB HBM3e-geheugen per GPU. Verdeeld over acht GPU's die via AMD Infinity Fabric met elkaar zijn verbonden, biedt de server in totaal 2.3 TB GPU-geheugen in één node, met een gecombineerde bandbreedte van 1,024 GB/s. Het volledige systeem maakt gebruik van zes 5,250W Titanium-voedingen in een 3+3 redundante configuratie, en Supermicro heeft dedicated 400 Gbps-netwerken per GPU voorzien voor schaalbare implementaties.
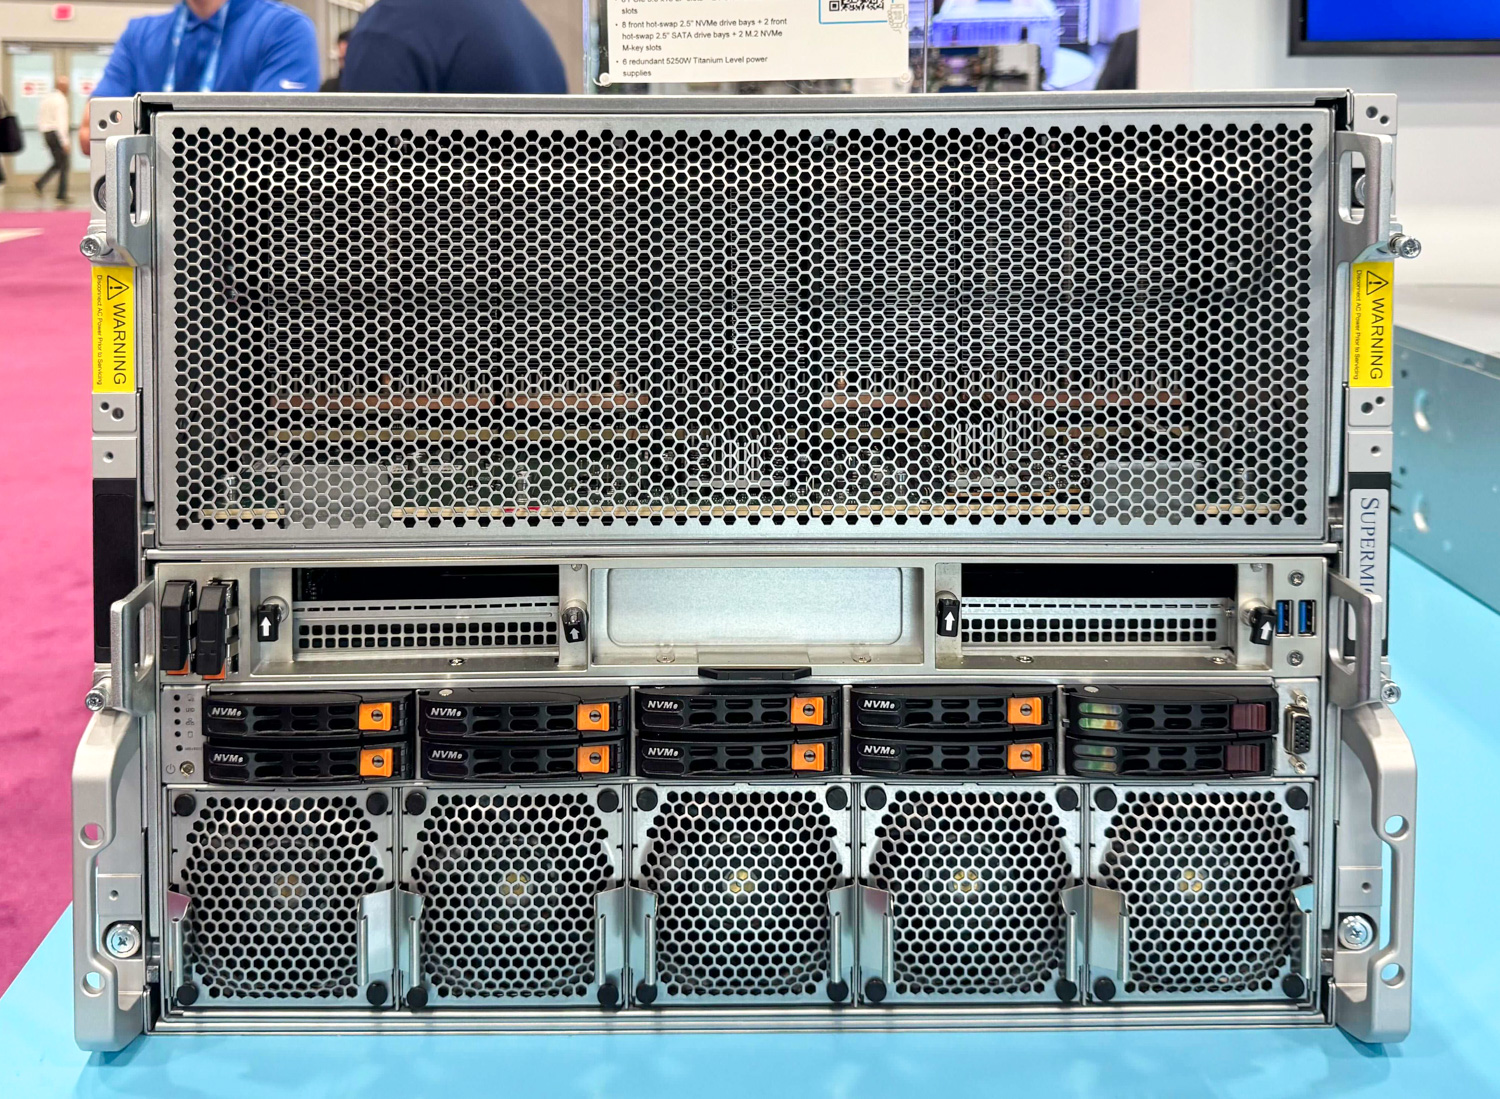
De positie van AMD op de markt voor datacenter-GPU's is de afgelopen twee jaar aanzienlijk veranderd, en de MI350X-generatie vormt een serieuzere concurrentie voor NVIDIA dan welk Instinct-product dan ook in het verleden. ROCm 7, uitgebracht in september 2025 en inmiddels versie 7.2, bracht native MI350X-ondersteuning met zich mee, samen met aanzienlijk verbeterde inferentieprestaties, HIP API-updates die de CUDA-compatibiliteitskloof dichten en uitgebreidere frameworkondersteuning, waaronder PyTorch, JAX, TensorFlow, ONNX Runtime, vLLM en SGLang.
Het vLLM-project voegde eind december 2025 een speciale AMD ROCm CI-pipeline toe, waardoor AMD-hardware een volwaardig platform in die inferentiestack werd in plaats van een afgeleide versie. De acceptatie door het ecosysteem is ook moeilijk te negeren: AMD en Meta kondigden in februari 2026 een meerjarige overeenkomst aan voor de implementatie van 6-gigawatt GPU's van meerdere generaties, voortbouwend op Meta's bestaande productie-implementaties van MI300- en MI350-serie hardware. Zo'n mate van betrokkenheid van een van 's werelds grootste aanbieders van AI-infrastructuur is geen marketingtruc.
Voor organisaties die momenteel AI-acceleratorinfrastructuur evalueren, blijft de levertijd van NVIDIA-hardware een punt van zorg. De vraag is of AMD een geloofwaardig alternatief is in plaats van slechts een noodoplossing. Na een week testen met ROCm 7.2.0 en de huidige vLLM is het antwoord wezenlijk anders dan 18 maanden geleden.
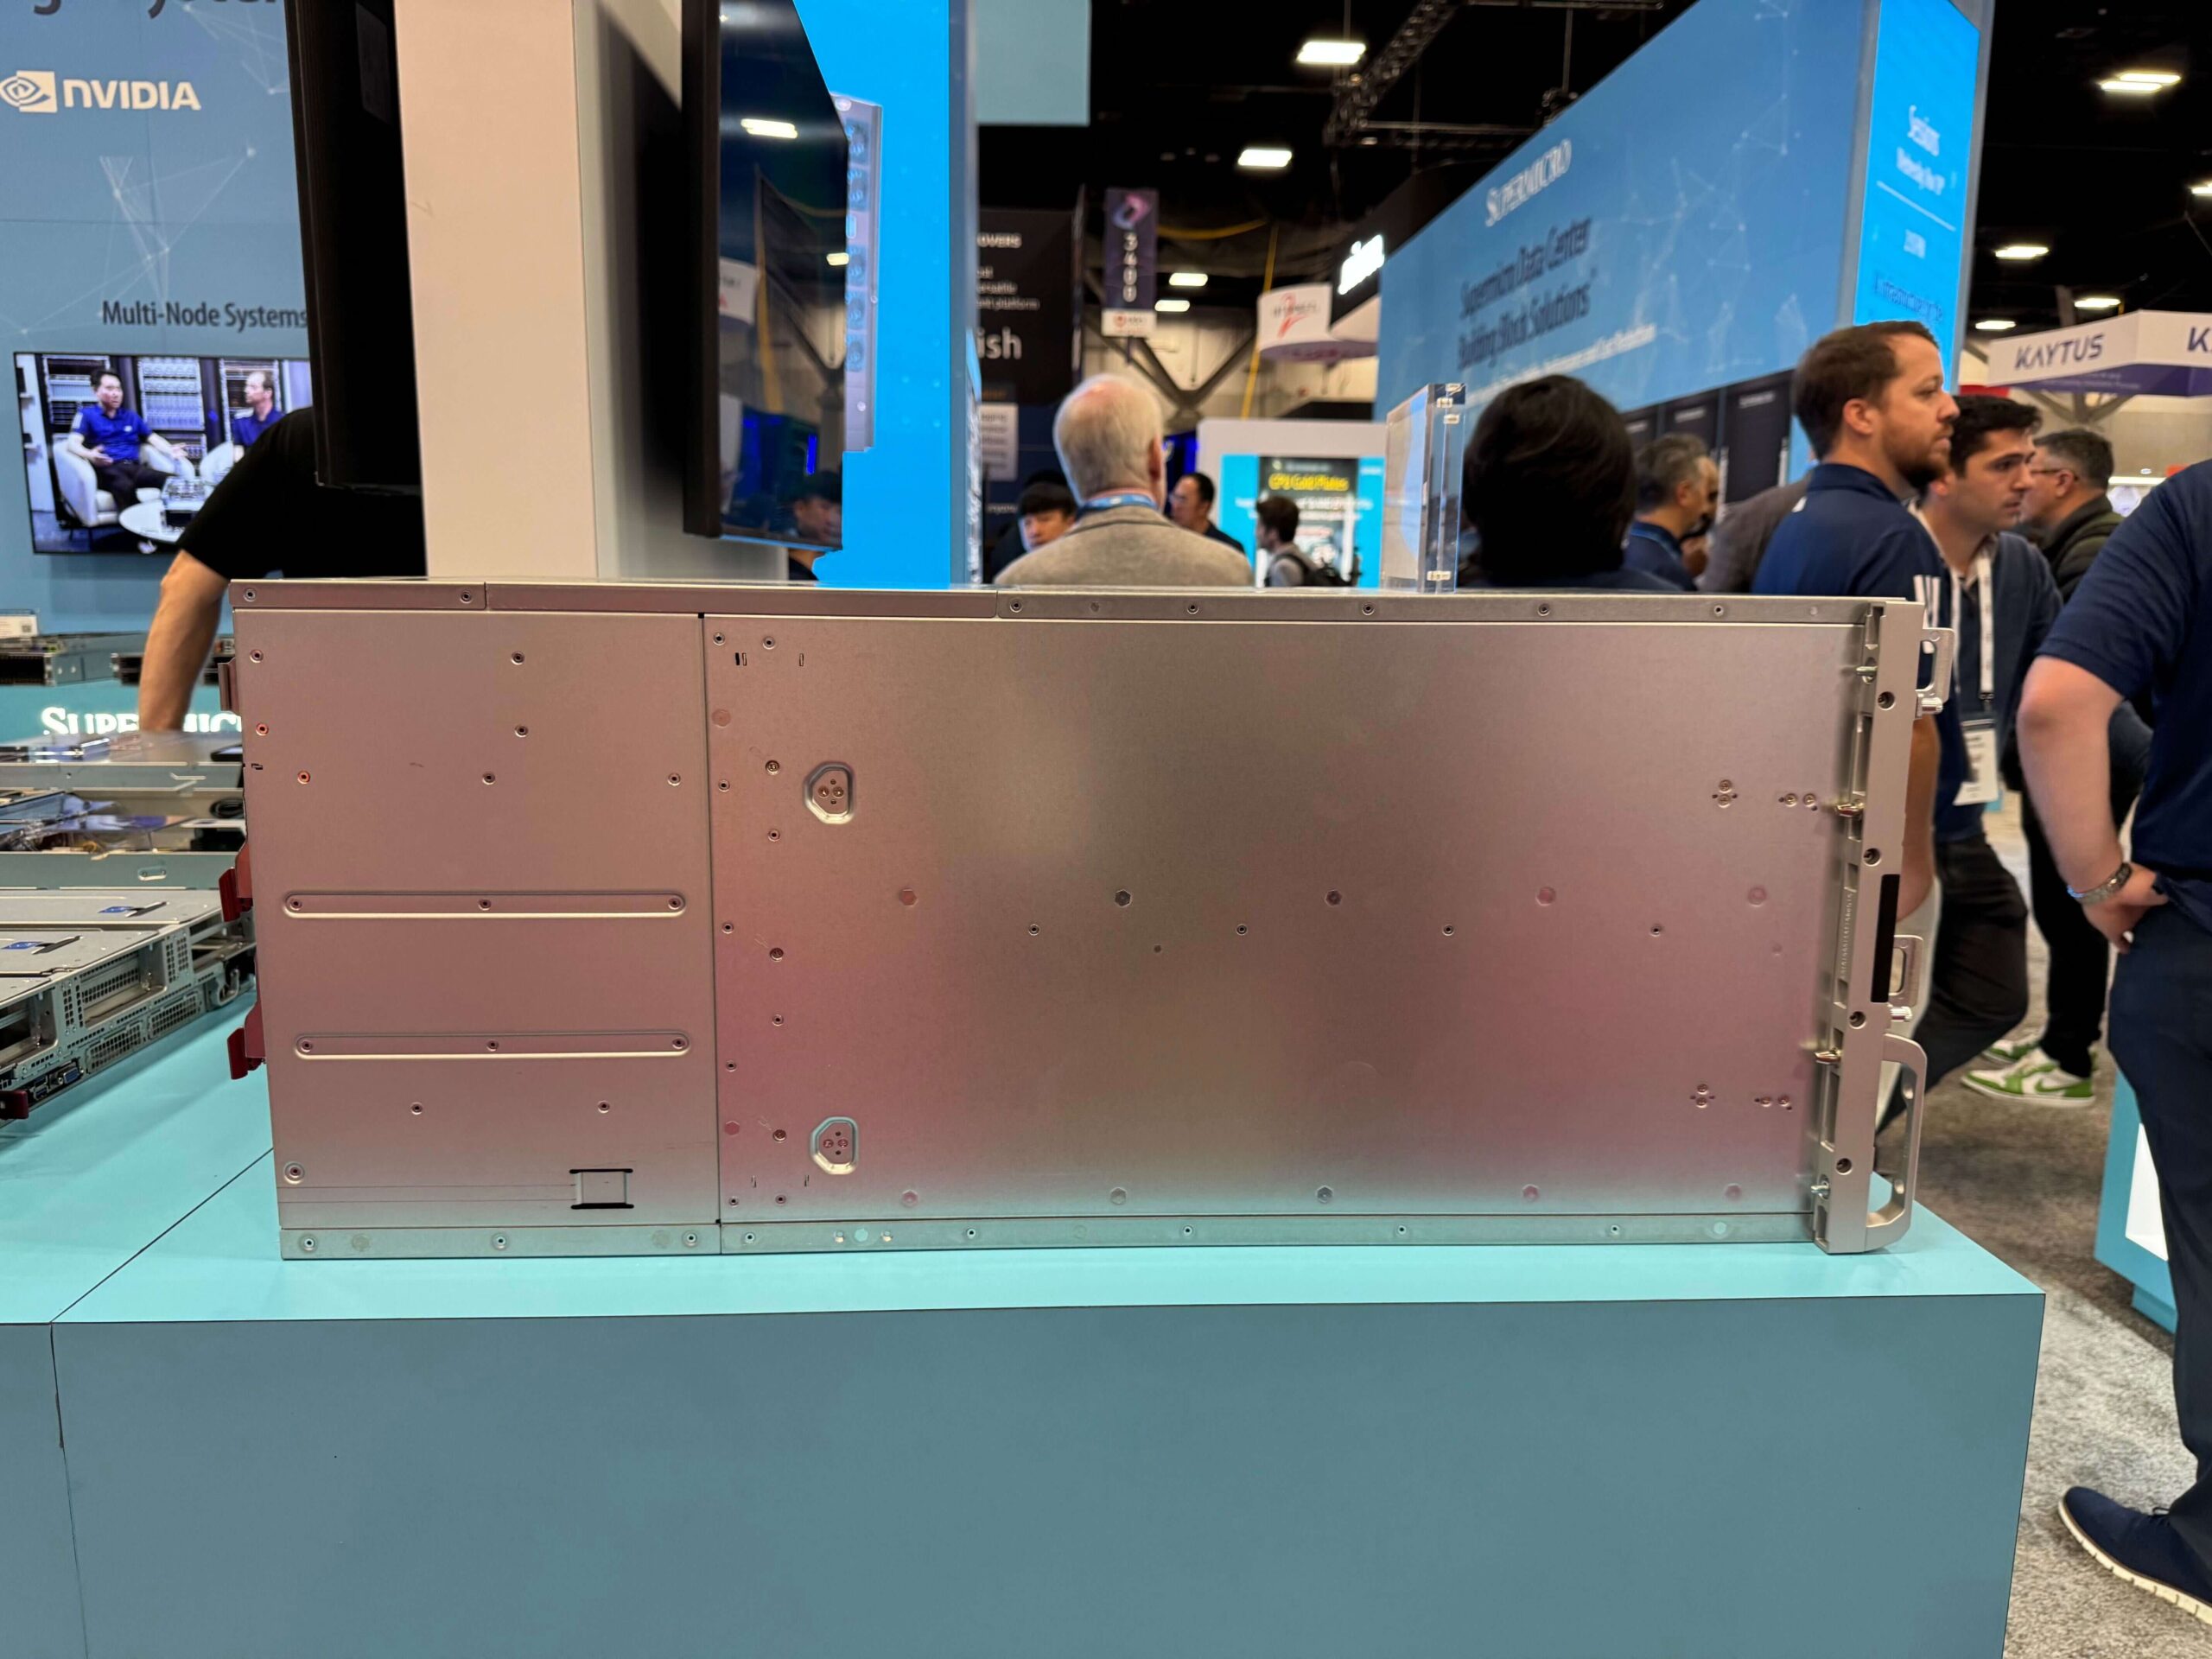
Onze tests omvatten een selectie van populaire modellen; de 2.3 TB aan HBM3e op één enkele node maakte inferentie op één server mogelijk voor modellen met veel parameters, waaronder Moonshot's Kimi K2.5 en MiniMax M2.5.
AMD Instinct MI350X: Architectuur en generatieverbeteringen
De MI350X vertegenwoordigt AMD's meest ambitieuze architectonische generatiesprong in de Instinct-productlijn tot nu toe. Inzicht in de technische keuzes die eraan ten grondslag liggen, biedt belangrijke context voor het interpreteren van de daaropvolgende prestatieresultaten.
CDNA 4 Architectuur en procesknooppuntovergang
De fundamentele verandering van de MI300-serie naar de MI350-serie draait om de toepassing van TSMC's N3P-procestechnologie voor de Accelerator Compute Chiplets (XCD's), in plaats van de 5nm-fabricage die in de vorige generatie werd gebruikt. Het totale aantal transistors bereikt ongeveer 185 miljard, een toename van circa 21% ten opzichte van de MI300-generatie, zonder een overeenkomstige toename van het stroomverbruik.
De MI350X behoudt AMD's beproefde strategie voor het verpakken van meerdere chiplets. De GPU-chip bestaat in de kern uit acht Accelerator Compute Chiplets (XCD's) als de primaire rekenkernen. Elke XCD bevat vier shader-engines, elk met acht actieve CDNA 4-rekeneenheden, wat resulteert in 32 rekeneenheden per XCD en een totaal van 256 rekeneenheden voor de volledige accelerator.
De I/O-chiplaag werd in het CDNA 4-pakketontwerp ook samengevoegd van vier naar twee tegels. Deze reorganisatie stelde AMD in staat de breedte van de Infinity Fabric-bus te verdubbelen, waardoor de bi-sectionele bandbreedte verbeterde en tegelijkertijd de busfrequentie en de bedrijfsspanning werden verlaagd om het stroomverbruik te verminderen.
Herontworpen rekeneenheden en uitgebreidere precisieondersteuning
Met de matrixrekenmogelijkheden van de CDNA 4-rekeneenheden is er een aanzienlijke verbetering: MI350-rekeneenheden leveren een verdubbeling van de doorvoer per rekeneenheid voor 16-bits (BF16, FP16) en 8-bits (FP8, INT8) bewerkingen in vergelijking met hun MI300-tegenhangers.
Naast de aanzienlijke prestatiewinst biedt CDNA 4 hardwareondersteuning voor gegevenstypen met een lagere precisie die ontbraken in de MI300-serie, met name FP6 en FP4, naast de bestaande FP8-ondersteuning die is overgenomen van de vorige generatie.
Naast deze standaardformaten biedt de MI350X ook native hardwareondersteuning voor de OCP-microscalingvarianten: MXFP4, MXFP6 en MXFP8. Microscalingformaten zijn ontworpen om de doorvoervoordelen van berekeningen met lagere precisie te bieden, terwijl de uitvoerkwaliteit dichter bij de basislijn van hogere precisie blijft dan standaardkwantisatie doorgaans toelaat. Dit is geen AMD-specifieke ontwikkeling. NVIDIA's NVFP4-formaat werkt volgens dezelfde microscalingprincipes en is breed geaccepteerd in geavanceerde modelimplementaties, met de GPT-OSS-familie van OpenAI als een van de meest prominente voorbeelden die rond deze formaten zijn gebouwd. De native MXFP4-ondersteuning van de MI350X maakt het mogelijk om deze en vergelijkbare gekwantiseerde modelfamilies te verwerken zonder terug te vallen op software-emulatie of precisieverhoging.
De MI350X levert 9.2 PFLOPs bij MXFP4 en MXFP6, vergeleken met 4.6 PFLOPs bij OCP-FP8, met FP16 op 2.3 PFLOPs en een piekklokfrequentie van 2,200 MHz. Voor implementaties die geoptimaliseerd zijn voor inferentie, waar microscaling-kwantisatie haalbaar is, verdubbelt de rekenkracht ten opzichte van FP8-workloads. Er is ook een nieuwe vector-ALU toegevoegd aan de CDNA 4-rekeneenheid, die 2-bits bewerkingen ondersteunt en BF16-resultaten kan accumuleren naar FP32, wat extra flexibiliteit biedt voor vectorworkloads met lage precisie buiten het primaire matrixrekenpad.
Geheugensubsysteem: HBM3e, Infinity Cache en bandbreedte-efficiëntie
De MI350-serie beschikt over een aanzienlijk verbeterd geheugensubsysteem met acht HBM3e-geheugenstacks, goed voor een totale capaciteit van 288 GB per GPU. Elke stack van 36 GB, bestaande uit 12 24 Gbit-apparaten, werkt op de volledige HBM3e-pinsnelheid van 8 Gbps per pin. De architectuur behoudt AMD's Infinity Cache, een geheugencache die zich tussen de HBM- en de Infinity Fabric/L2-caches bevindt. Deze bestaat uit 128 kanalen, elk ondersteund door 2 MB cache, voor een totaal van 256 MB per GPU. AMD heeft de on-die netwerkbussen in de IOD's verbreed en laat ze werken op een lagere spanning, waardoor de geheugenbandbreedte per watt ongeveer 1.3 keer hoger is dan bij de MI300-serie.
De toename in geheugencapaciteit van 192 GB naar 288 GB in de MI300X vergroot AMD's voorsprong in geheugencapaciteit per GPU, met directe gevolgen voor inferentie met grote modellen. Elke MI350X GPU kan onafhankelijk modellen met meer dan 500 miljard parameters hosten. De totale 2.3 TB HBM3e in een server met acht GPU's elimineert de noodzaak van distributie over meerdere knooppunten, wat implementaties met biljoenen parameters bemoeilijkt, zoals de resultaten van de Kimi K2.5 en MiniMax M2.5 in deze review aantonen.
Flexibele partitionerings- en implementatiearchitectuur
De MI350-serie ondersteunt flexibele GPU-partitionering per socket, waarbij het geheugen is opgesplitst in twee afzonderlijke clusters. Deze flexibiliteit geldt ook voor de XCD's, waarbij het quad XCD-cluster kan worden opgesplitst in dubbele of enkele blokken, waardoor de chip configuraties kan ondersteunen zoals 8 instanties van 70B-modellen in CPX+NPS2. Voor organisaties die heterogene inferentieworkloads uitvoeren over een gedeelde infrastructuur, vermindert deze partitioneringsmogelijkheid de behoefte aan dedicated hardware per modellaag en verbetert de gebruiksefficiëntie in gemengde implementatieomgevingen.
De MI350-serie is bovendien volledig compatibel met de UBB-infrastructuur (Universal Base Board) die in MI300-serie systemen wordt gebruikt. Bestaande serverchassis, stroomvoorziening en koelinfrastructuur kunnen zonder aanpassingen worden overgenomen, waardoor upgrades voor organisaties met actieve MI300-implementaties eenvoudiger verlopen.
MI355X: Het vloeistofgekoelde broertje
De MI350-serie is verkrijgbaar in twee varianten, gebouwd op identieke onderliggende siliciumchips en geoptimaliseerd voor verschillende thermische bedrijfstemperaturen. De hier geteste MI350X is de luchtgekoelde variant, terwijl de MI355X de vloeistofgekoelde tegenhanger is, ontworpen voor toepassingen met een hogere dichtheid waar directe vloeistofkoeling beschikbaar is.
Hoewel beide varianten op dezelfde basishardware zijn gebouwd, maakt het hogere stroomverbruik van de MI355X hogere continue klokfrequenties mogelijk, wat resulteert in een prestatievoordeel van ongeveer 20% in realistische, end-to-end workloads vergeleken met de MI350X. De MI355X heeft een maximaal TBP-vermogen van 1,400W tegenover 1,000W voor de MI350X, met een maximale kloksnelheid van 2.4 GHz vergeleken met 2.2 GHz voor de luchtgekoelde variant.
In termen van generaties levert het MI355X-platform tot wel 4x betere theoretische piekprestaties dan de MI300X, met in de praktijk een inferentiewinst van ongeveer 4.2x bij agent- en chatbotworkloads en ongeveer 3x bij scenario's voor contentgeneratie. Voor organisaties die MI350X-implementaties overwegen, vertegenwoordigt het prestatieverschil van 20% tussen de twee varianten een duidelijk plafond. Faciliteiten met DLC-infrastructuur zouden de MI355X moeten evalueren om te bepalen of de investering in koeling voldoende doorvoerverhoging oplevert voor hun specifieke workloadprofiel, voordat ze op grote schaal overstappen op luchtgekoelde configuraties.
Toegang tot de AMD Instinct MI350X via het Supermicro JumpStart-programma
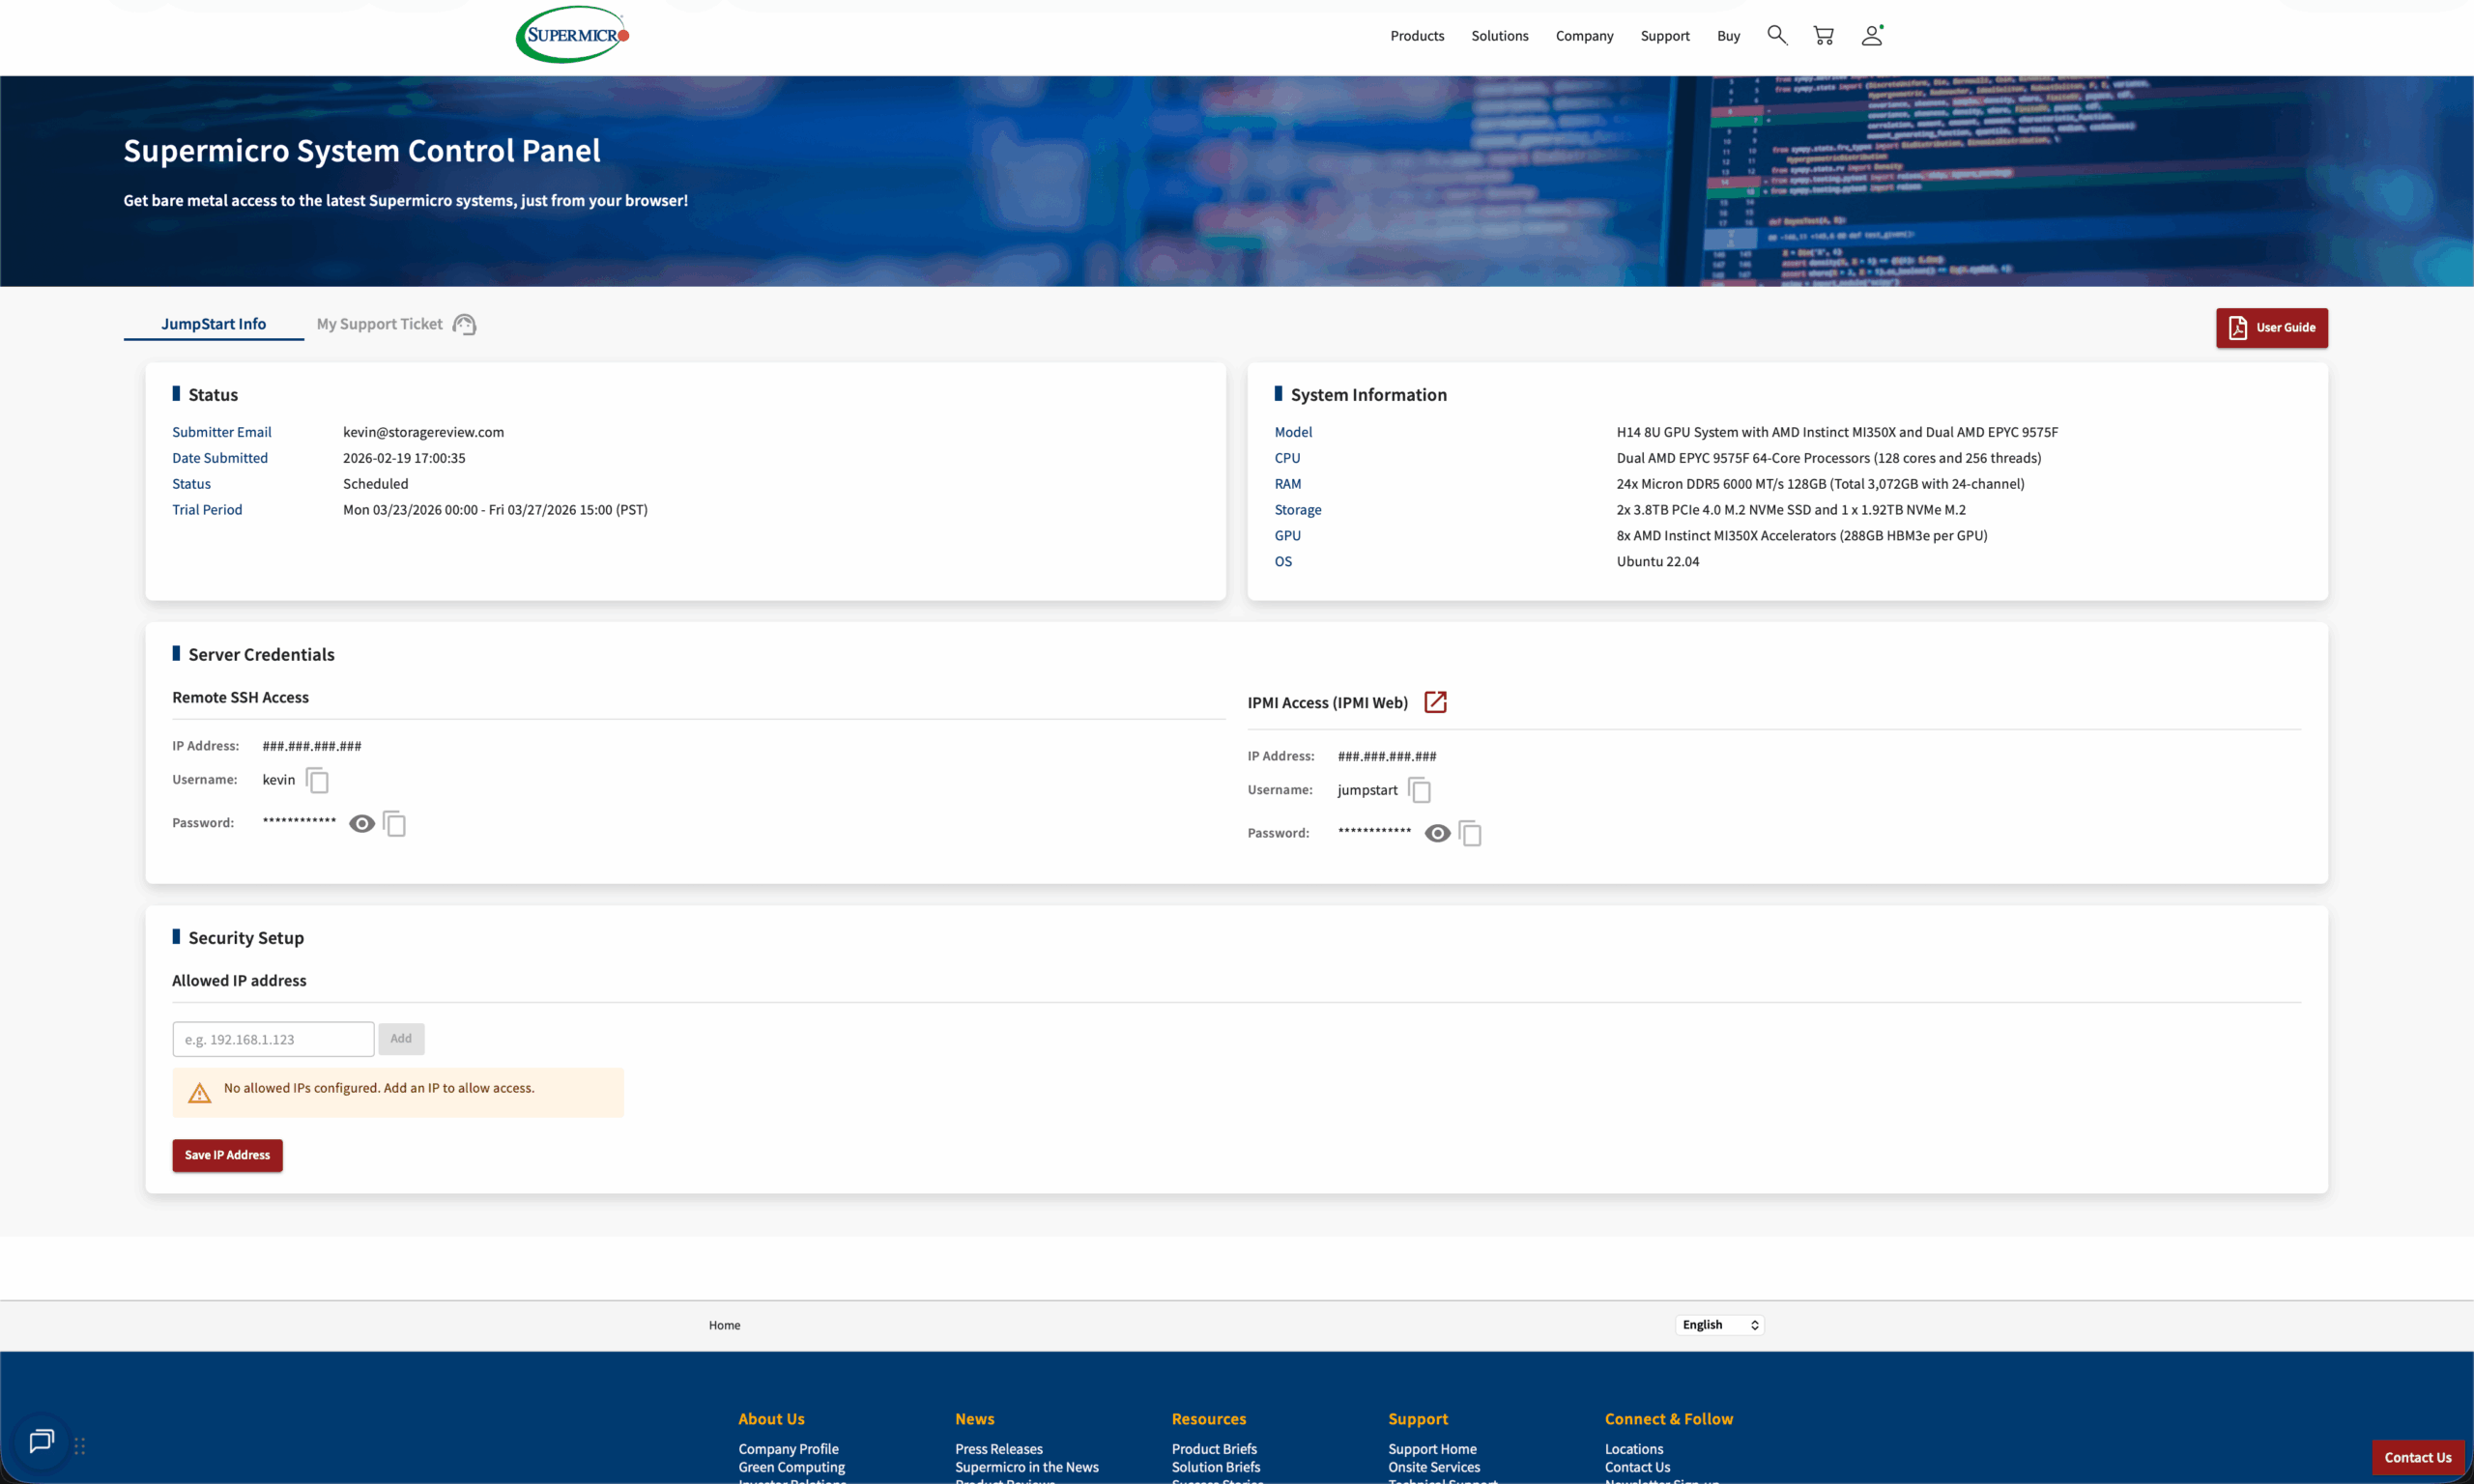
Om met JumpStart aan de slag te gaan, moet u zich registreren op het portaal van Supermicro. Daar kunnen gekwalificeerde gebruikers beschikbare systemen bekijken en een reserveringsperiode inplannen. Na goedkeuring biedt het portaal SSH-gegevens, IPMI-toegang en een webgebaseerde console voor de duur van de reservering. Het systeem wordt geleverd met Ubuntu voorgeïnstalleerd en is direct gebruiksklaar. Er is geen vertraging bij de ingebruikname en er is geen contact met de supportafdeling nodig om te beginnen. Onze reservering liep van 23 tot en met 27 maart 2026, waardoor we een volledige week gebruik konden maken van het platform, net als bij onze eerdere JumpStart-ervaring met de HGX B200.
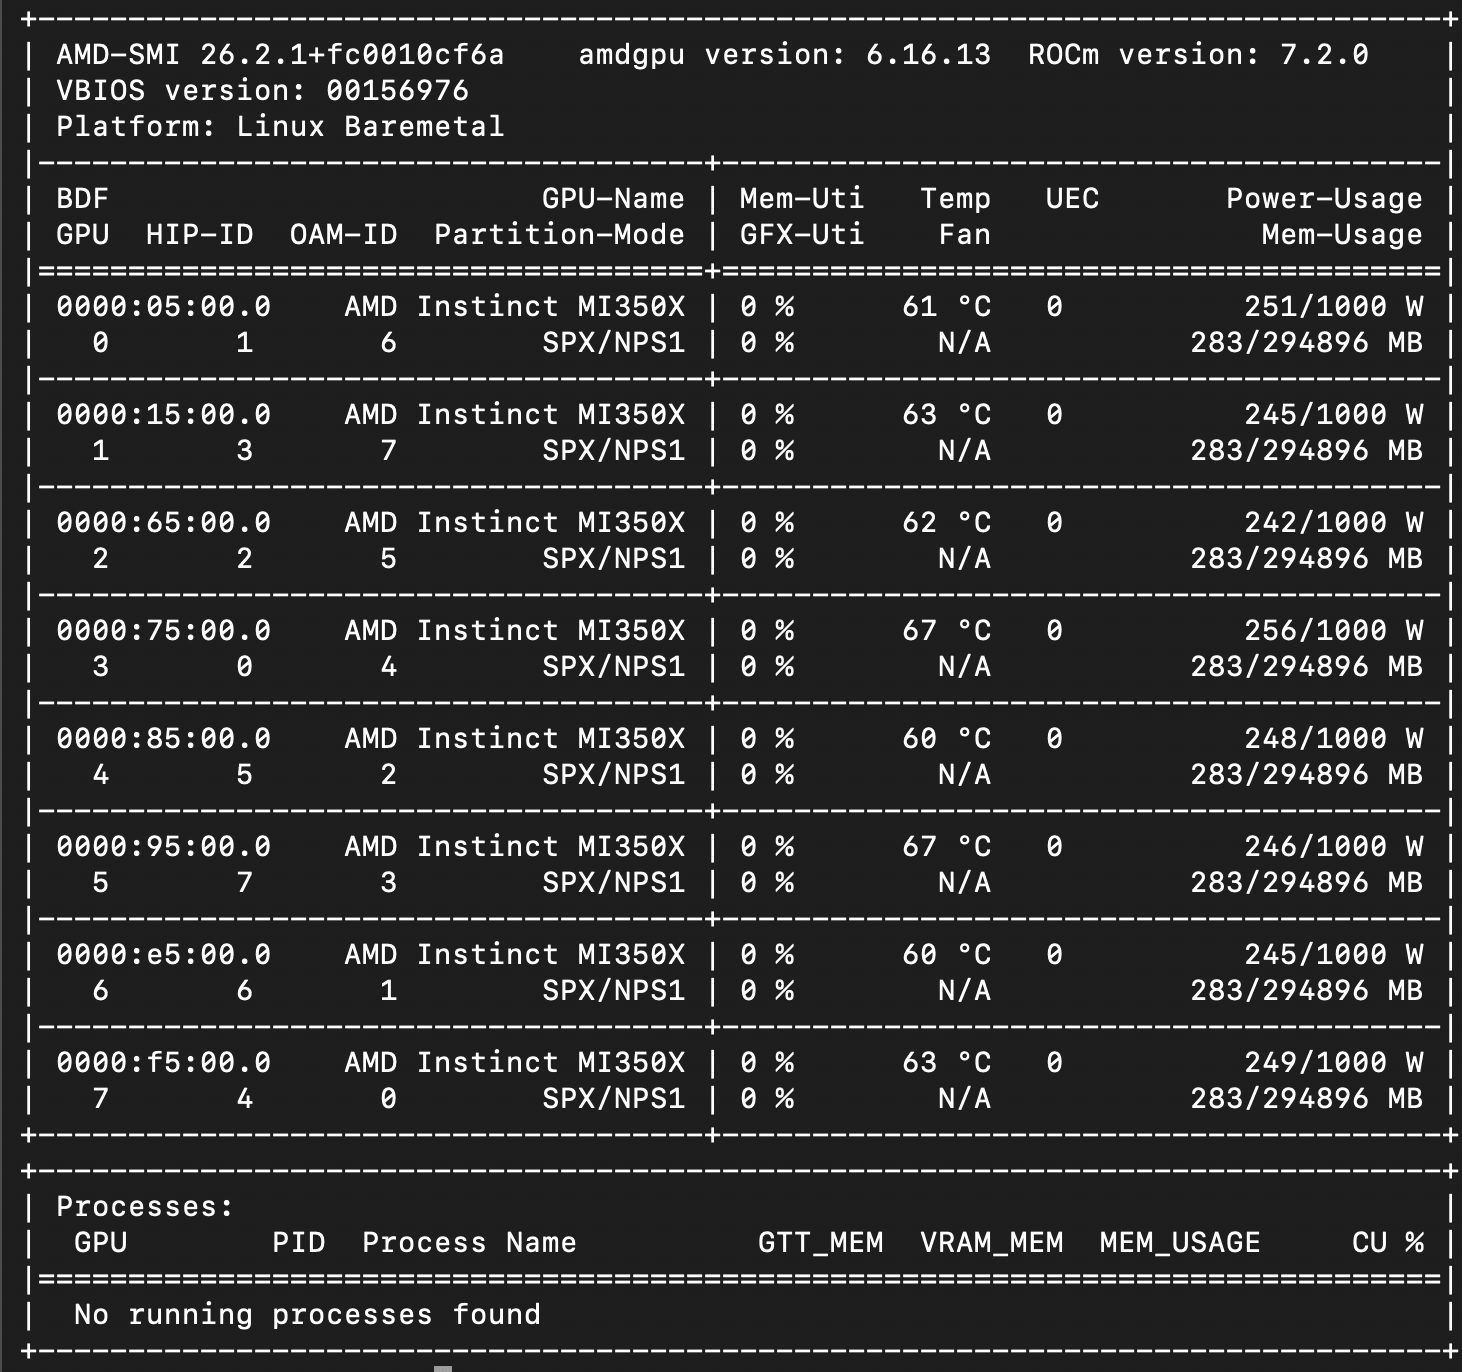
De onderstaande schermafbeelding toont de terminaluitvoer van jumpstart voor het H14-systeem, waarbij de AMD-SMI-tool de acht AMD Instinct MI350X GPU's en hun actieve softwareversies weergeeft.
Prestatietestresultaten van de AMD Instinct MI350X
Systeemconfiguratie
- Chassis: Supermicro H14
- CPU: Dubbele AMD EPYC 9575F
- Geheugen: 3 TB DDR5
- GPU: acht AMD Instinct MI350X
- Opslag: 2x 3.8 TB PCIe 4.0 M.2 NVMe SSD en 1 x 1.92 TB NVMe M.2
Samenvatting van de resultaten
| Model | precisie | Gelijk (256/256) | Voorgevuld - Zwaar (8k/1k) | Decode-intensief (1k/8k) |
|---|---|---|---|---|
| GPT-OSS 20B | NVFP4 | 62,247 | 123,714 | 32,468 |
| GPT-OSS 120B | NVFP4 | 33,538 | 84,018 | 20,602 |
| Lama 3.1 8B Instrueer | BF16 | 51,467 | 77,658 * | 19,326 |
| Mistral Klein 3.1 24B | FP8 | 40,742 | 56,093 | 14,557 |
| Mistral Klein 3.1 24B | BF16 | 30,530 | 53,740 | 13,559 |
| Qwen3 Coder 30B A3B | BF16 | 34,980 | 51,550 | 11,782 |
| Qwen3 Coder 30B A3B | FP8 | 25,928 | 47,179 | 11,014 |
| MiniMax M2.5 | Blokgeschaalde FP8 | 14,391 | 23,689 | 6,068 |
| Kimi K2.5 | INT4 QAT + BF16 | 6,527 | 11,256 | 2,513 |
| Alle waarden in tok/s, piekdoorvoer bij BS=256. *Llama 3.1 8B prefill-heavy piekte bij BS=128 (77,658 tok/s); BS=256 was 76,893 tok/s. | ||||
Claude Code Serveerservice – MiniMax M2.5
Naast traditionele benchmarks voor ruwe LLM-inferentie wilden we evalueren hoe goed deze hardware presteert in een agentische codeerworkflow, met name bij het gelijktijdig uitvoeren van meerdere Claude Code-sessies met een lokaal gehost model. Deze use case is direct relevant voor de productiviteit van een ontwikkelteam: hoeveel engineers kunnen tegelijkertijd een AI-codeerassistent gebruiken die vanaf één node wordt aangeboden, voordat de gebruikerservaring verslechtert?
Om dit te testen, hebben we een benchmark-harness gebouwd die een dataset genereert met programmeerproblemen van gemiddelde moeilijkheidsgraad (taken zoals het implementeren van een LRU-cache, het bouwen van een CLI-todo-applicatie, het schrijven van een Markdown-converter en het construeren van een REST API) en elke Claude Code-sessie uitvoert in een eigen Docker-container tegen de lokale vLLM-server. Een transparante proxy bevindt zich tussen de sessies en het inferentie-eindpunt en legt per verzoek statistieken vast voor elke Claude Code-instantie. Het gebruikte model was MiniMax M2.5, dat via vLLM werd aangeboden op de acht MI350X GPU's. Hoewel M2.5 niet het best presterende programmeermodel is op openbare ranglijsten, is het een capabel model dat door veel gebruikers lokaal wordt gebruikt, waaronder veel van onze ontwikkelaarsvrienden.
Als referentiepunt gebruiken we de gemiddelde uitvoerdoorvoer van Anthropic's Claude Opus 4.6 via OpenRouter.ai, een van de populairste routeringsdiensten voor API-toegang in productieomgevingen. Die basislijn komt uit op ongeveer 37 tokens per seconde per API-verzoek.
We hebben twee belangrijke statistieken gemeten: het gemiddelde aantal uitvoertokens per seconde per Claude Code-sessie (wat elke ontwikkelaar ervaart) en het totale aantal uitvoertokens per seconde over alle sessies (de totale hoeveelheid werk die de server produceert).
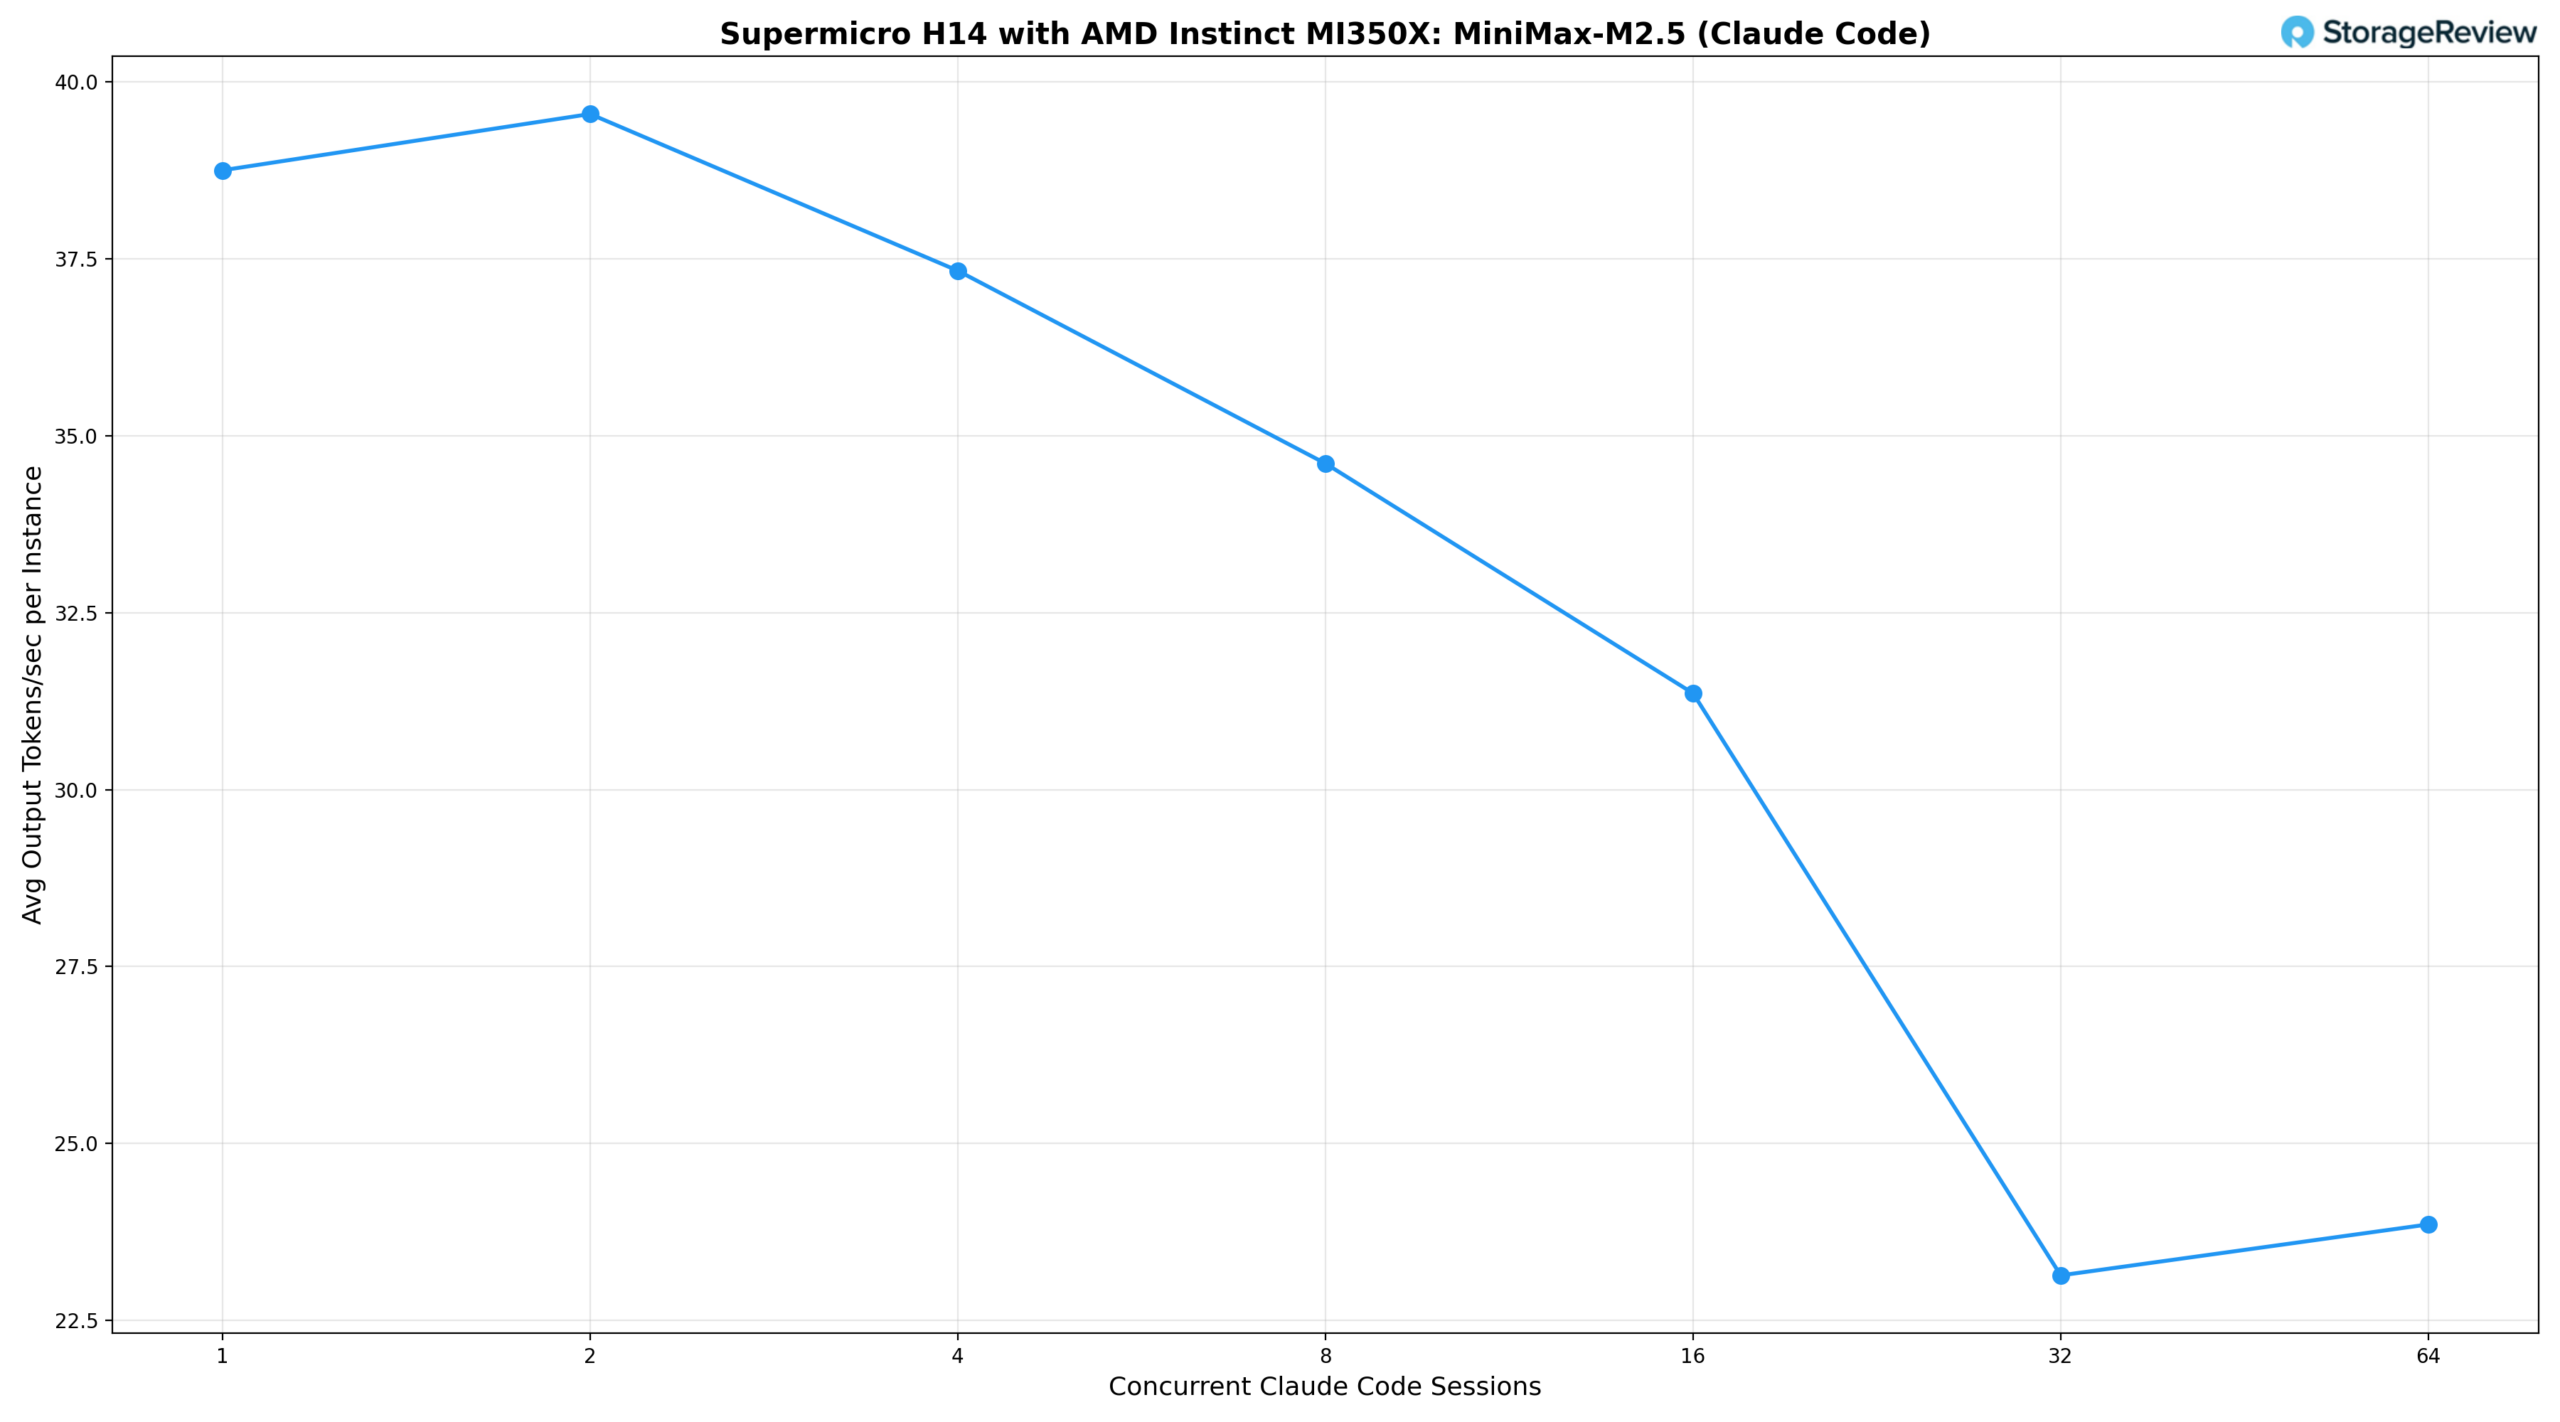
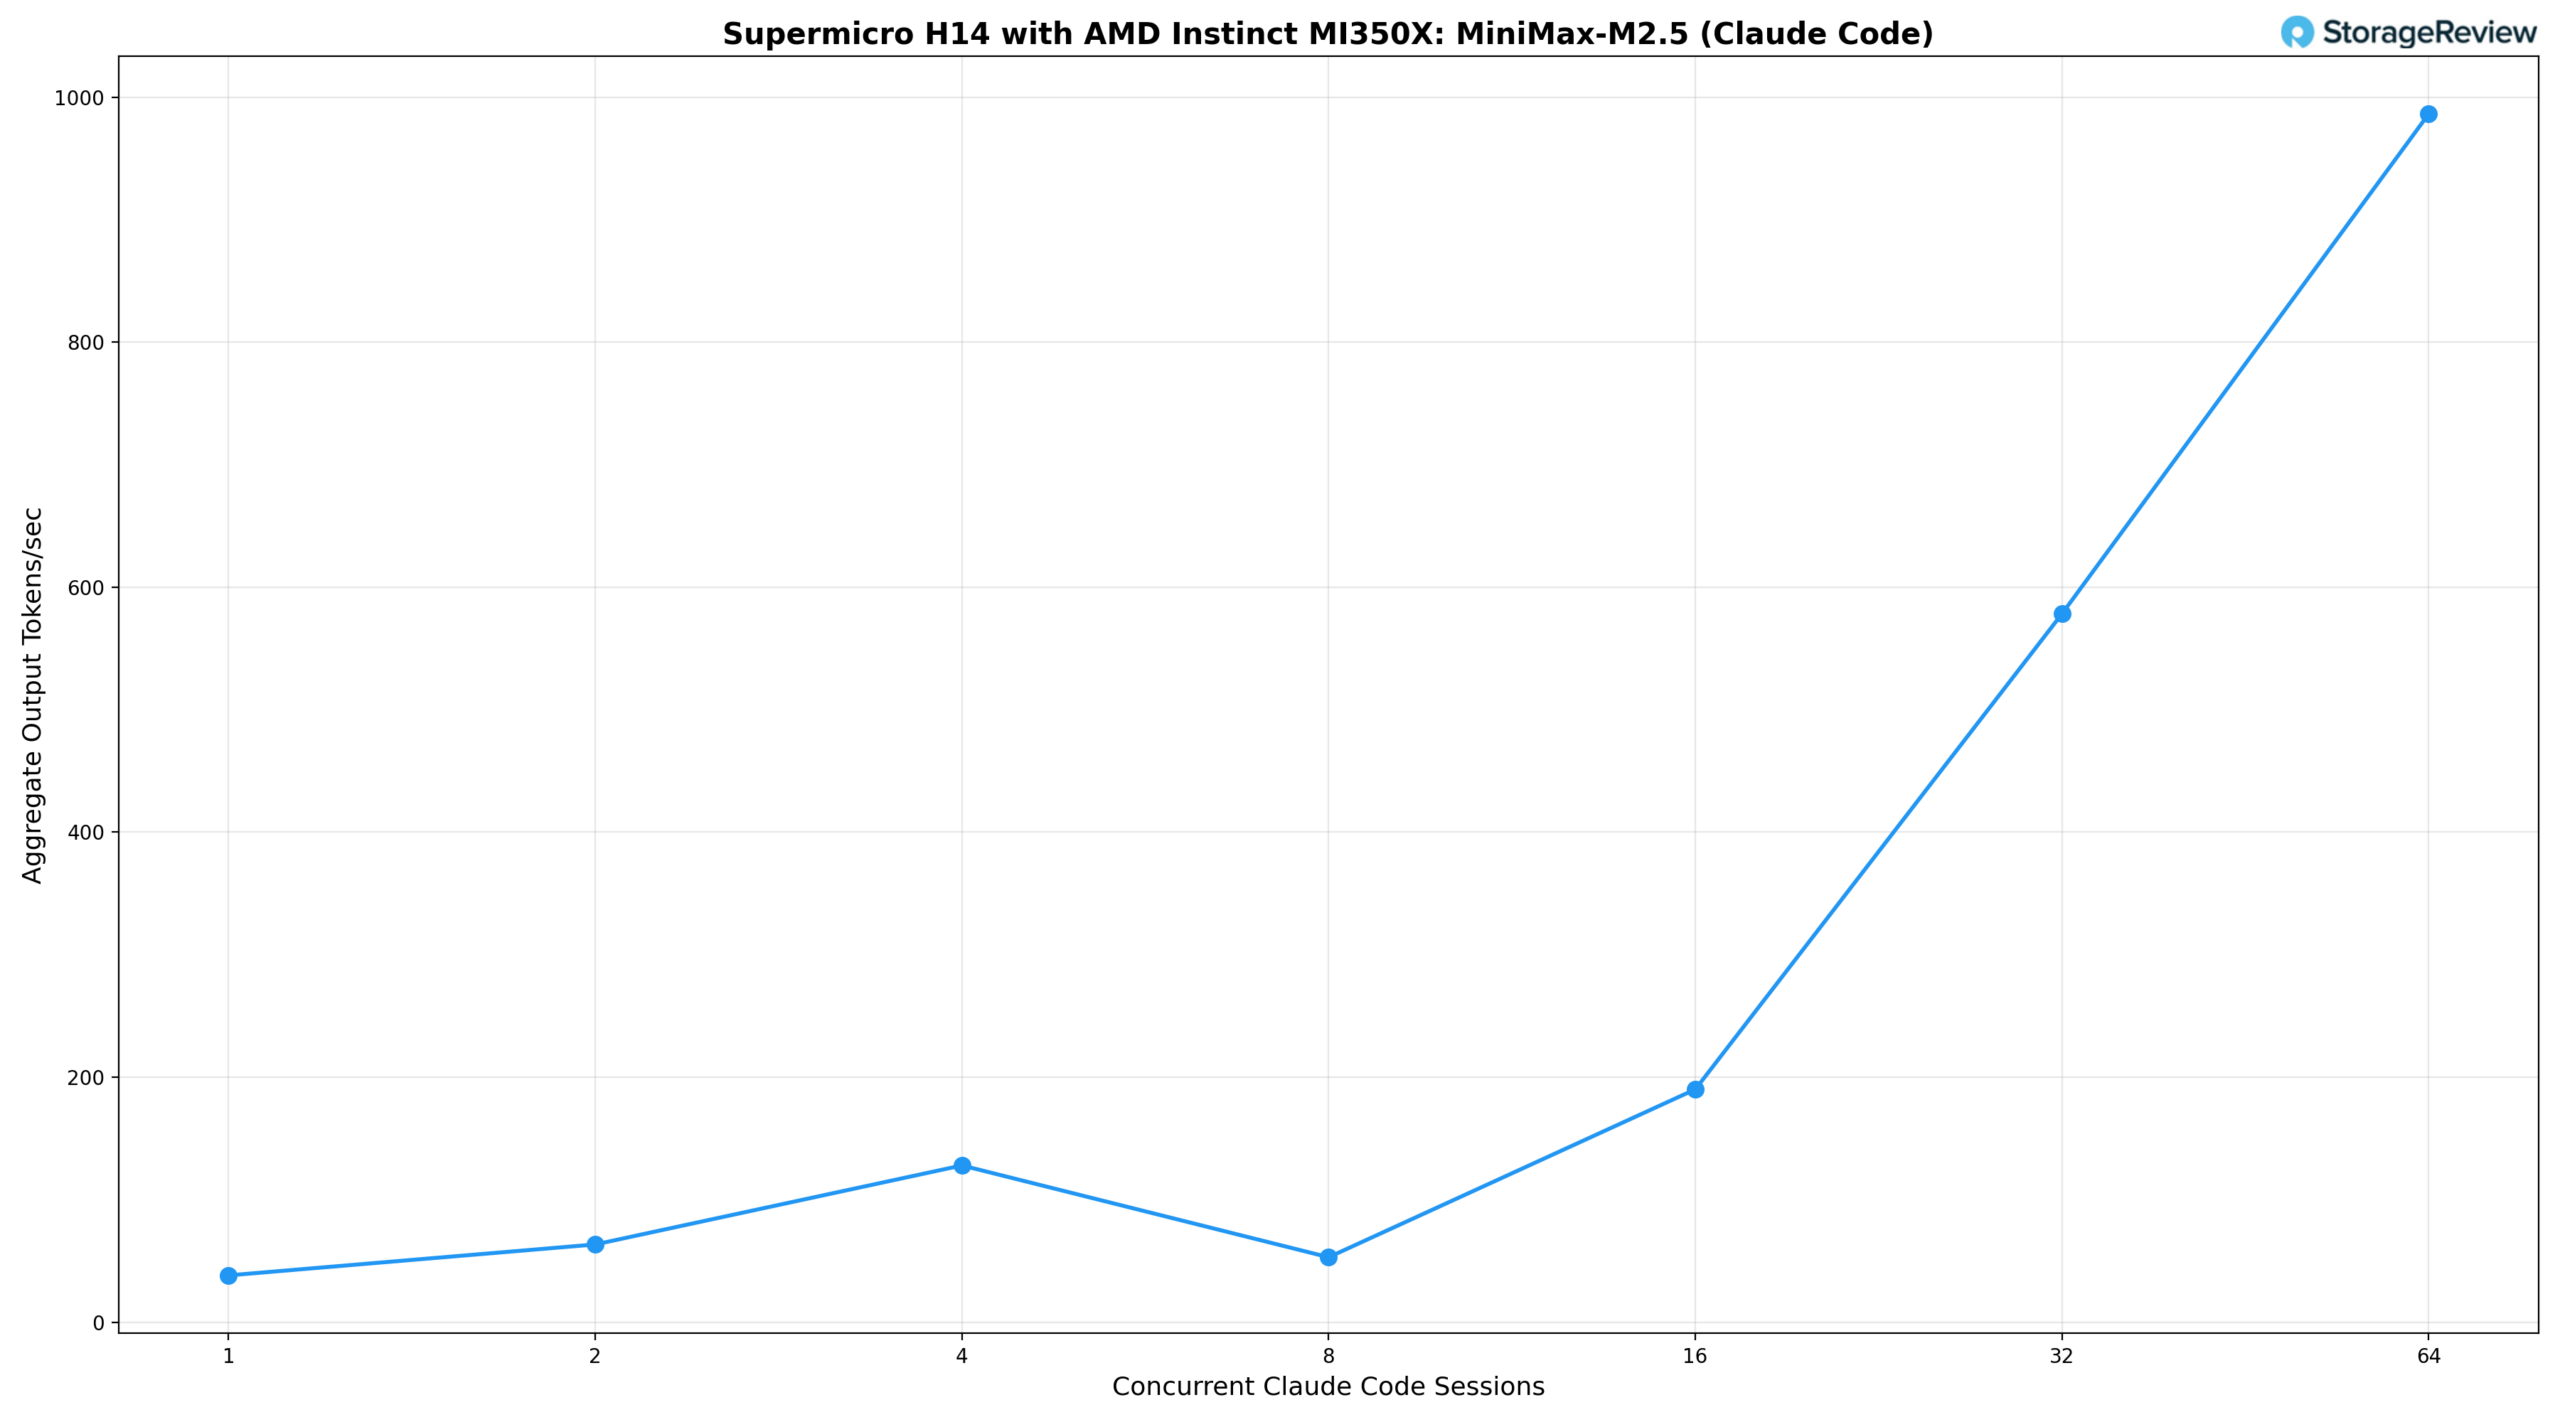
Uit de resultaten blijkt dat één gelijktijdige sessie 38.8 tok/s per gebruiker en 38 tok/s totaal levert, iets boven de OpenRouter cloud-baseline. Bij twee sessies stijgt het systeem naar 39.5 tok/s per gebruiker, omdat de batchverwerking van vLLM de overhead begint te spreiden, waardoor de totale doorvoer oploopt tot 63 tok/s. Vier gelijktijdige sessies leveren 37.3 tok/s per gebruiker, wat overeenkomt met de cloud-baseline, terwijl vier ontwikkelaars tegelijkertijd werken, met een totale doorvoer van 128 tok/s. Vanaf acht sessies begint de doorvoer per instantie af te nemen: 34.6 tok/s per gebruiker bij acht sessies, 31.4 tok/s bij zestien met een totaal van 190 tok/s, en stabiliseert zich rond de 23 tok/s per gebruiker bij 32 en 64 sessies, terwijl de totale doorvoer respectievelijk stijgt naar 578 tok/s en 986 tok/s. Dit is de klassieke afweging tussen batchverwerking en interactiviteit: het systeem kan een aanzienlijk hogere totale doorvoer bereiken door meer verzoeken te bundelen, maar elke gebruiker ervaart tragere reactietijden. Zelfs bij 64 gelijktijdige gebruikers heeft elke ontwikkelaar nog steeds een bruikbare interactieve ervaring, zij het merkbaar trager dan de standaard cloudomgeving.
Voor organisaties die de kosten van tientallen gelijktijdige commerciële API-abonnementen afwegen tegen zelfgehoste infrastructuur, is de afweging duidelijk: één MI350X-node kan een ontwikkelteam van 16 tot 32 engineers bedienen, waarbij de responstijden per gebruiker binnen 60-85% van de cloudbasislijn blijven en een totale output van 600 tot 1,000 tokens per seconde wordt geleverd. Dit biedt extra voordelen zoals datalocaliteit, geen API-kosten per token en volledige controle over de modelselectie.
vLLM Online Serving – LLM Inferentie Prestaties
vLLM is een van de populairste high-throughput inferentie- en serverengines voor LLM's. De vLLM online serverbenchmark evalueert de daadwerkelijke serverprestaties van deze inferentie-engine onder gelijktijdige verzoeken. Het simuleert productieworkloads door verzoeken te sturen naar een draaiende vLLM-server, met configureerbare parameters zoals de verzoekfrequentie, de lengte van de invoer/uitvoer en het aantal gelijktijdige clients. De benchmark meet belangrijke statistieken, waaronder doorvoer (tokens per seconde), tijd tot het eerste token en tijd per uitvoertoken (TPOT), waardoor gebruikers inzicht krijgen in de prestaties van vLLM onder verschillende belastingomstandigheden.
We hebben de inferentieprestaties getest in een uitgebreid pakket aan modellen die verschillende architecturen, parameterschalen en kwantificeringsstrategieën omvatten om de doorvoer onder verschillende gelijktijdigheidsprofielen te evalueren.
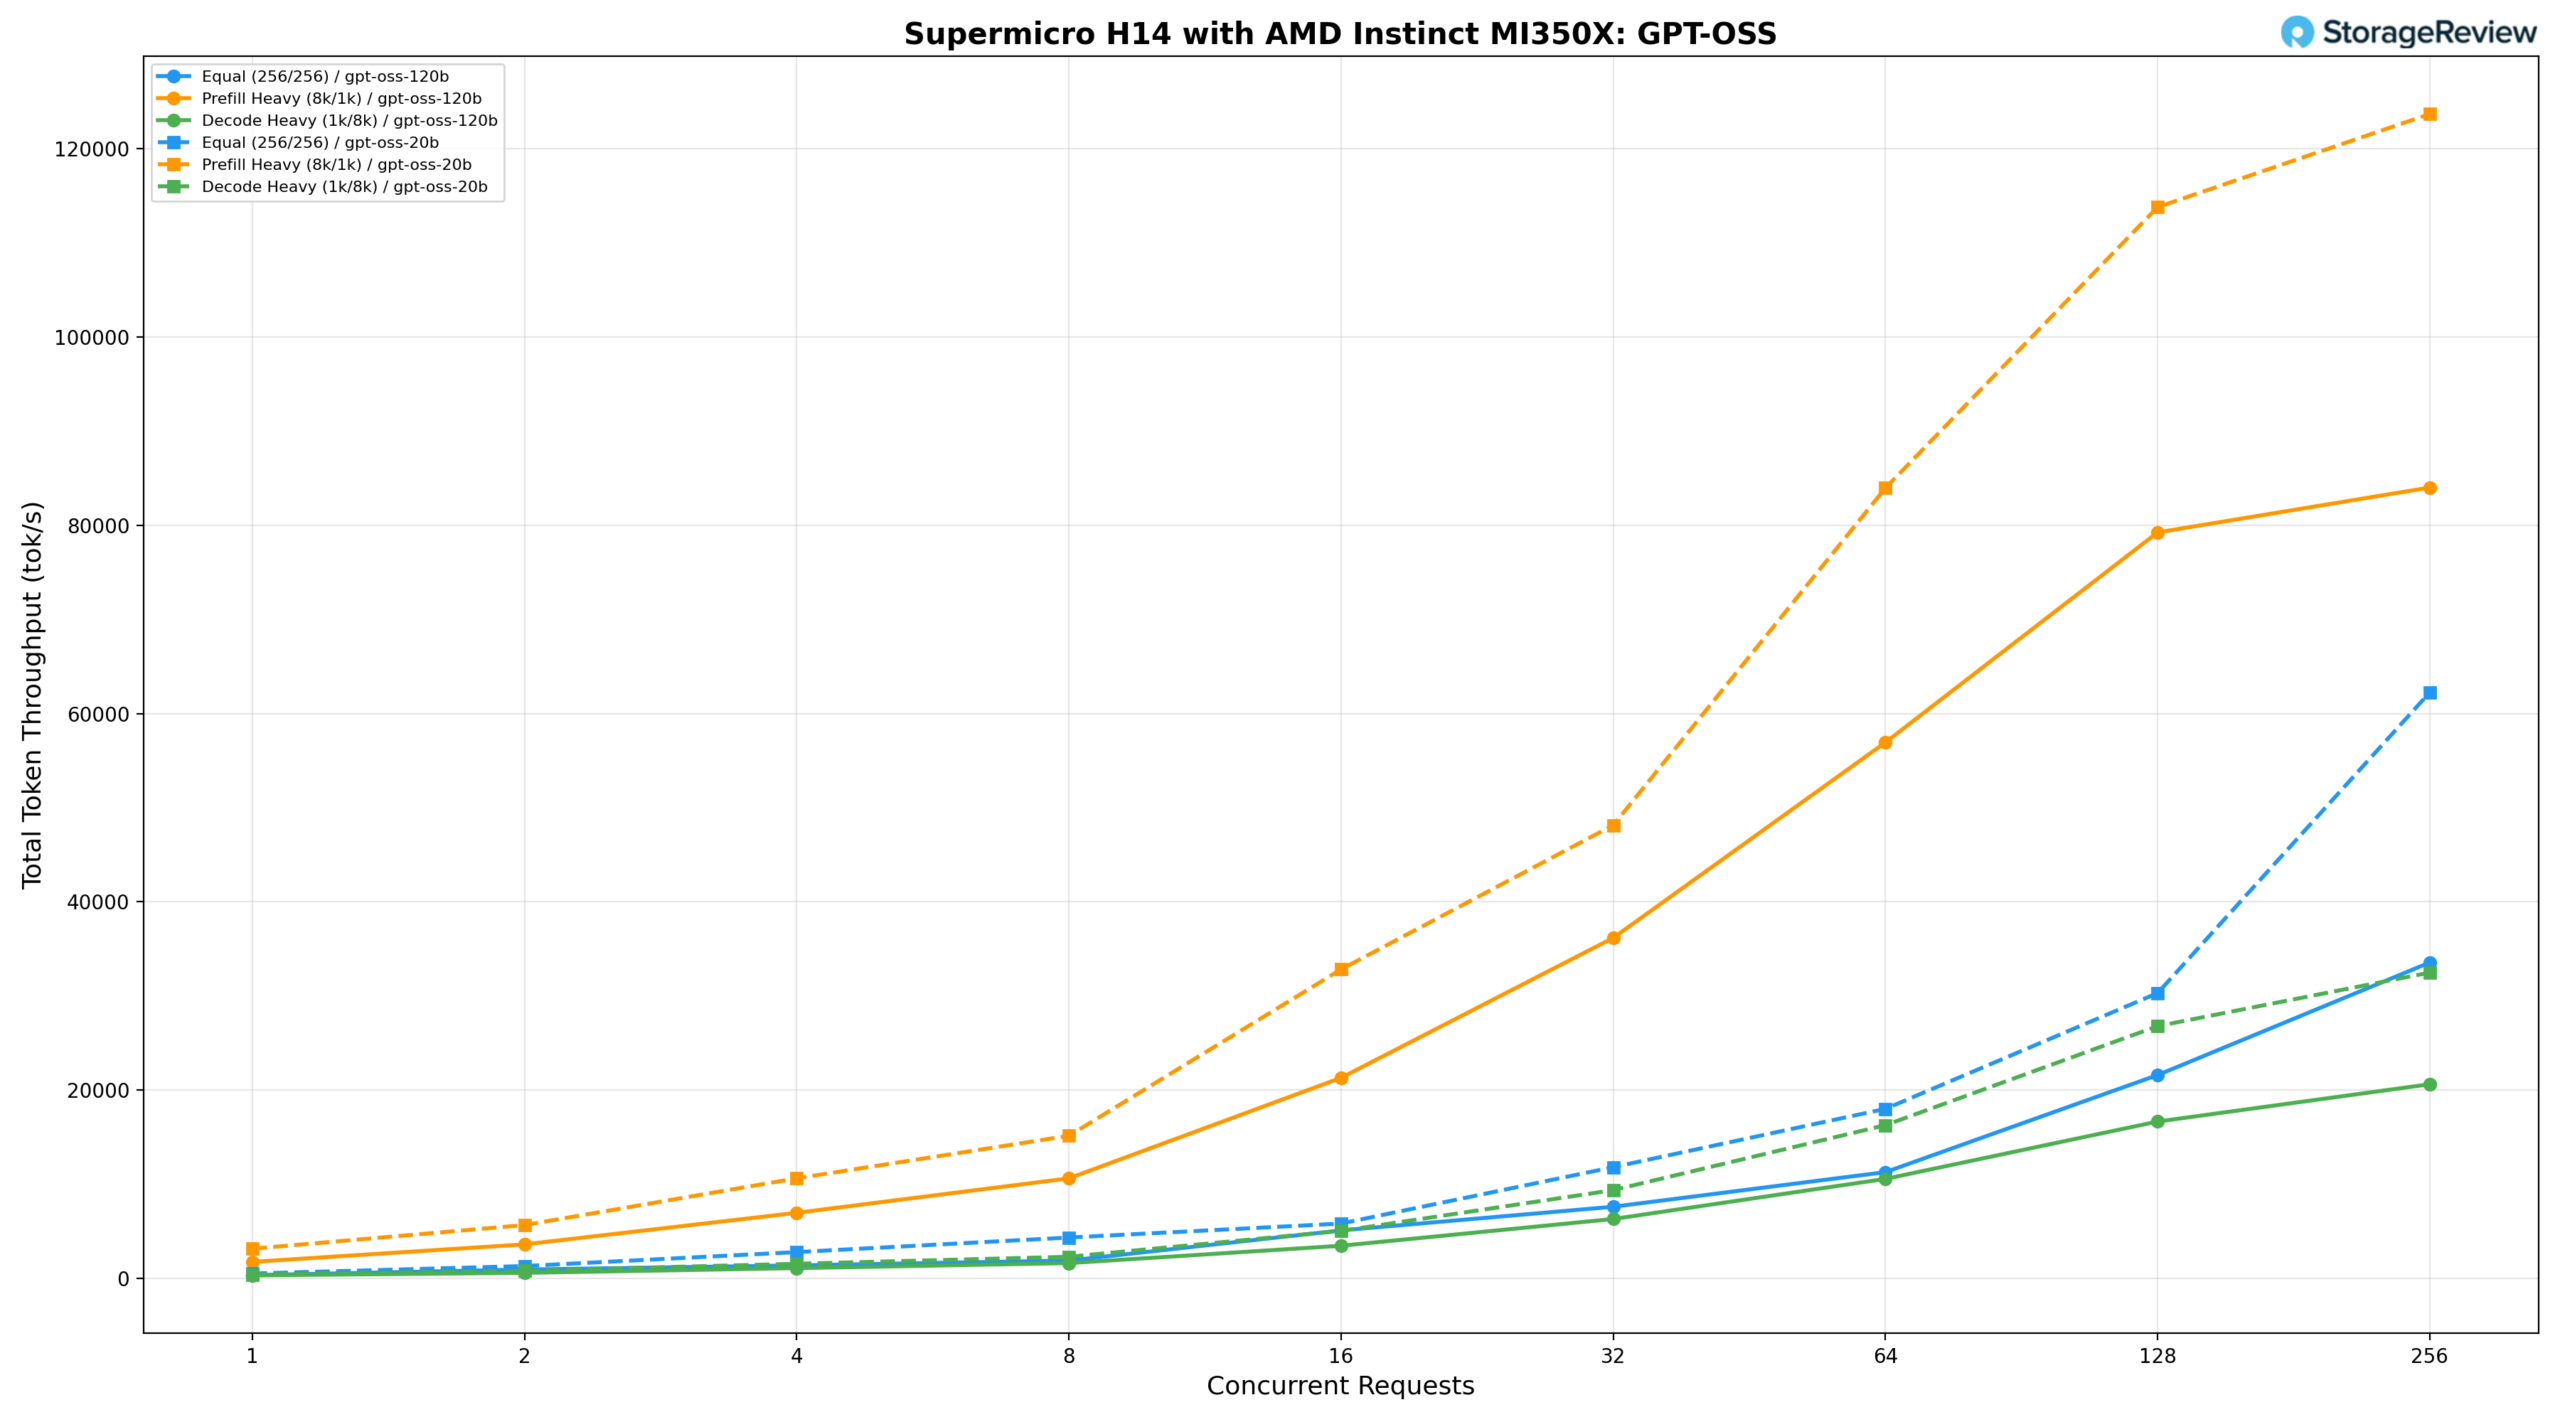
GPT-OSS 120B en 20B
De GPT-OSS-modelfamilie is getest in zowel 120B- als 20B-configuraties op de Supermicro H14.
GPT-OSS 120B
Het 120B-model levert bij een gelijke werkbelasting (256/256) 313.42 tok/s bij BS=1, bereikt 11,261.72 tok/s bij BS=64 en piekt op 33,538.23 tok/s bij BS=256. Bij een zware voorvulling (8k/1k) begint het bij 1,724.84 tok/s, stijgt naar 36,156.80 tok/s bij BS=32 en 79,247.76 tok/s bij BS=128, met een piek van 84,018.79 tok/s bij BS=256. Bij decode-heavy (1k/8k) neemt de latentie toe van 288.90 tok/s bij BS=1 tot 20,602.52 tok/s bij BS=256, waarbij de latentie ook bij lagere gelijktijdigheidsniveaus goed beheersbaar blijft.
GPT-OSS 20B
Het 20B-model levert 485.17 tok/s bij BS=1 onder gelijke werkbelasting, bereikt 17,986.36 tok/s bij BS=64 en piekt op 62,247.52 tok/s bij BS=256. Bij een zware voorvulling begint de doorvoer bij 3,120.72 tok/s, stijgt naar 48,132.52 tok/s bij BS=32 en 83,968.71 tok/s bij BS=64, met een piek van 123,714.50 tok/s bij BS=256 – de hoogste absolute doorvoer bij voorvulling die is gemeten voor beide modelgroottes. De decode-heavy-versie groeit van 378.20 tok/s bij BS=1 naar 32,468.67 tok/s bij BS=256, wat ongeveer 1.6 keer de decode-doorvoer van de 120B oplevert bij maximale gelijktijdigheid, terwijl de latentie gedurende het hele proces lager blijft.
Qwen3 Coder 30B A3B Instructie en FP8 Instructie
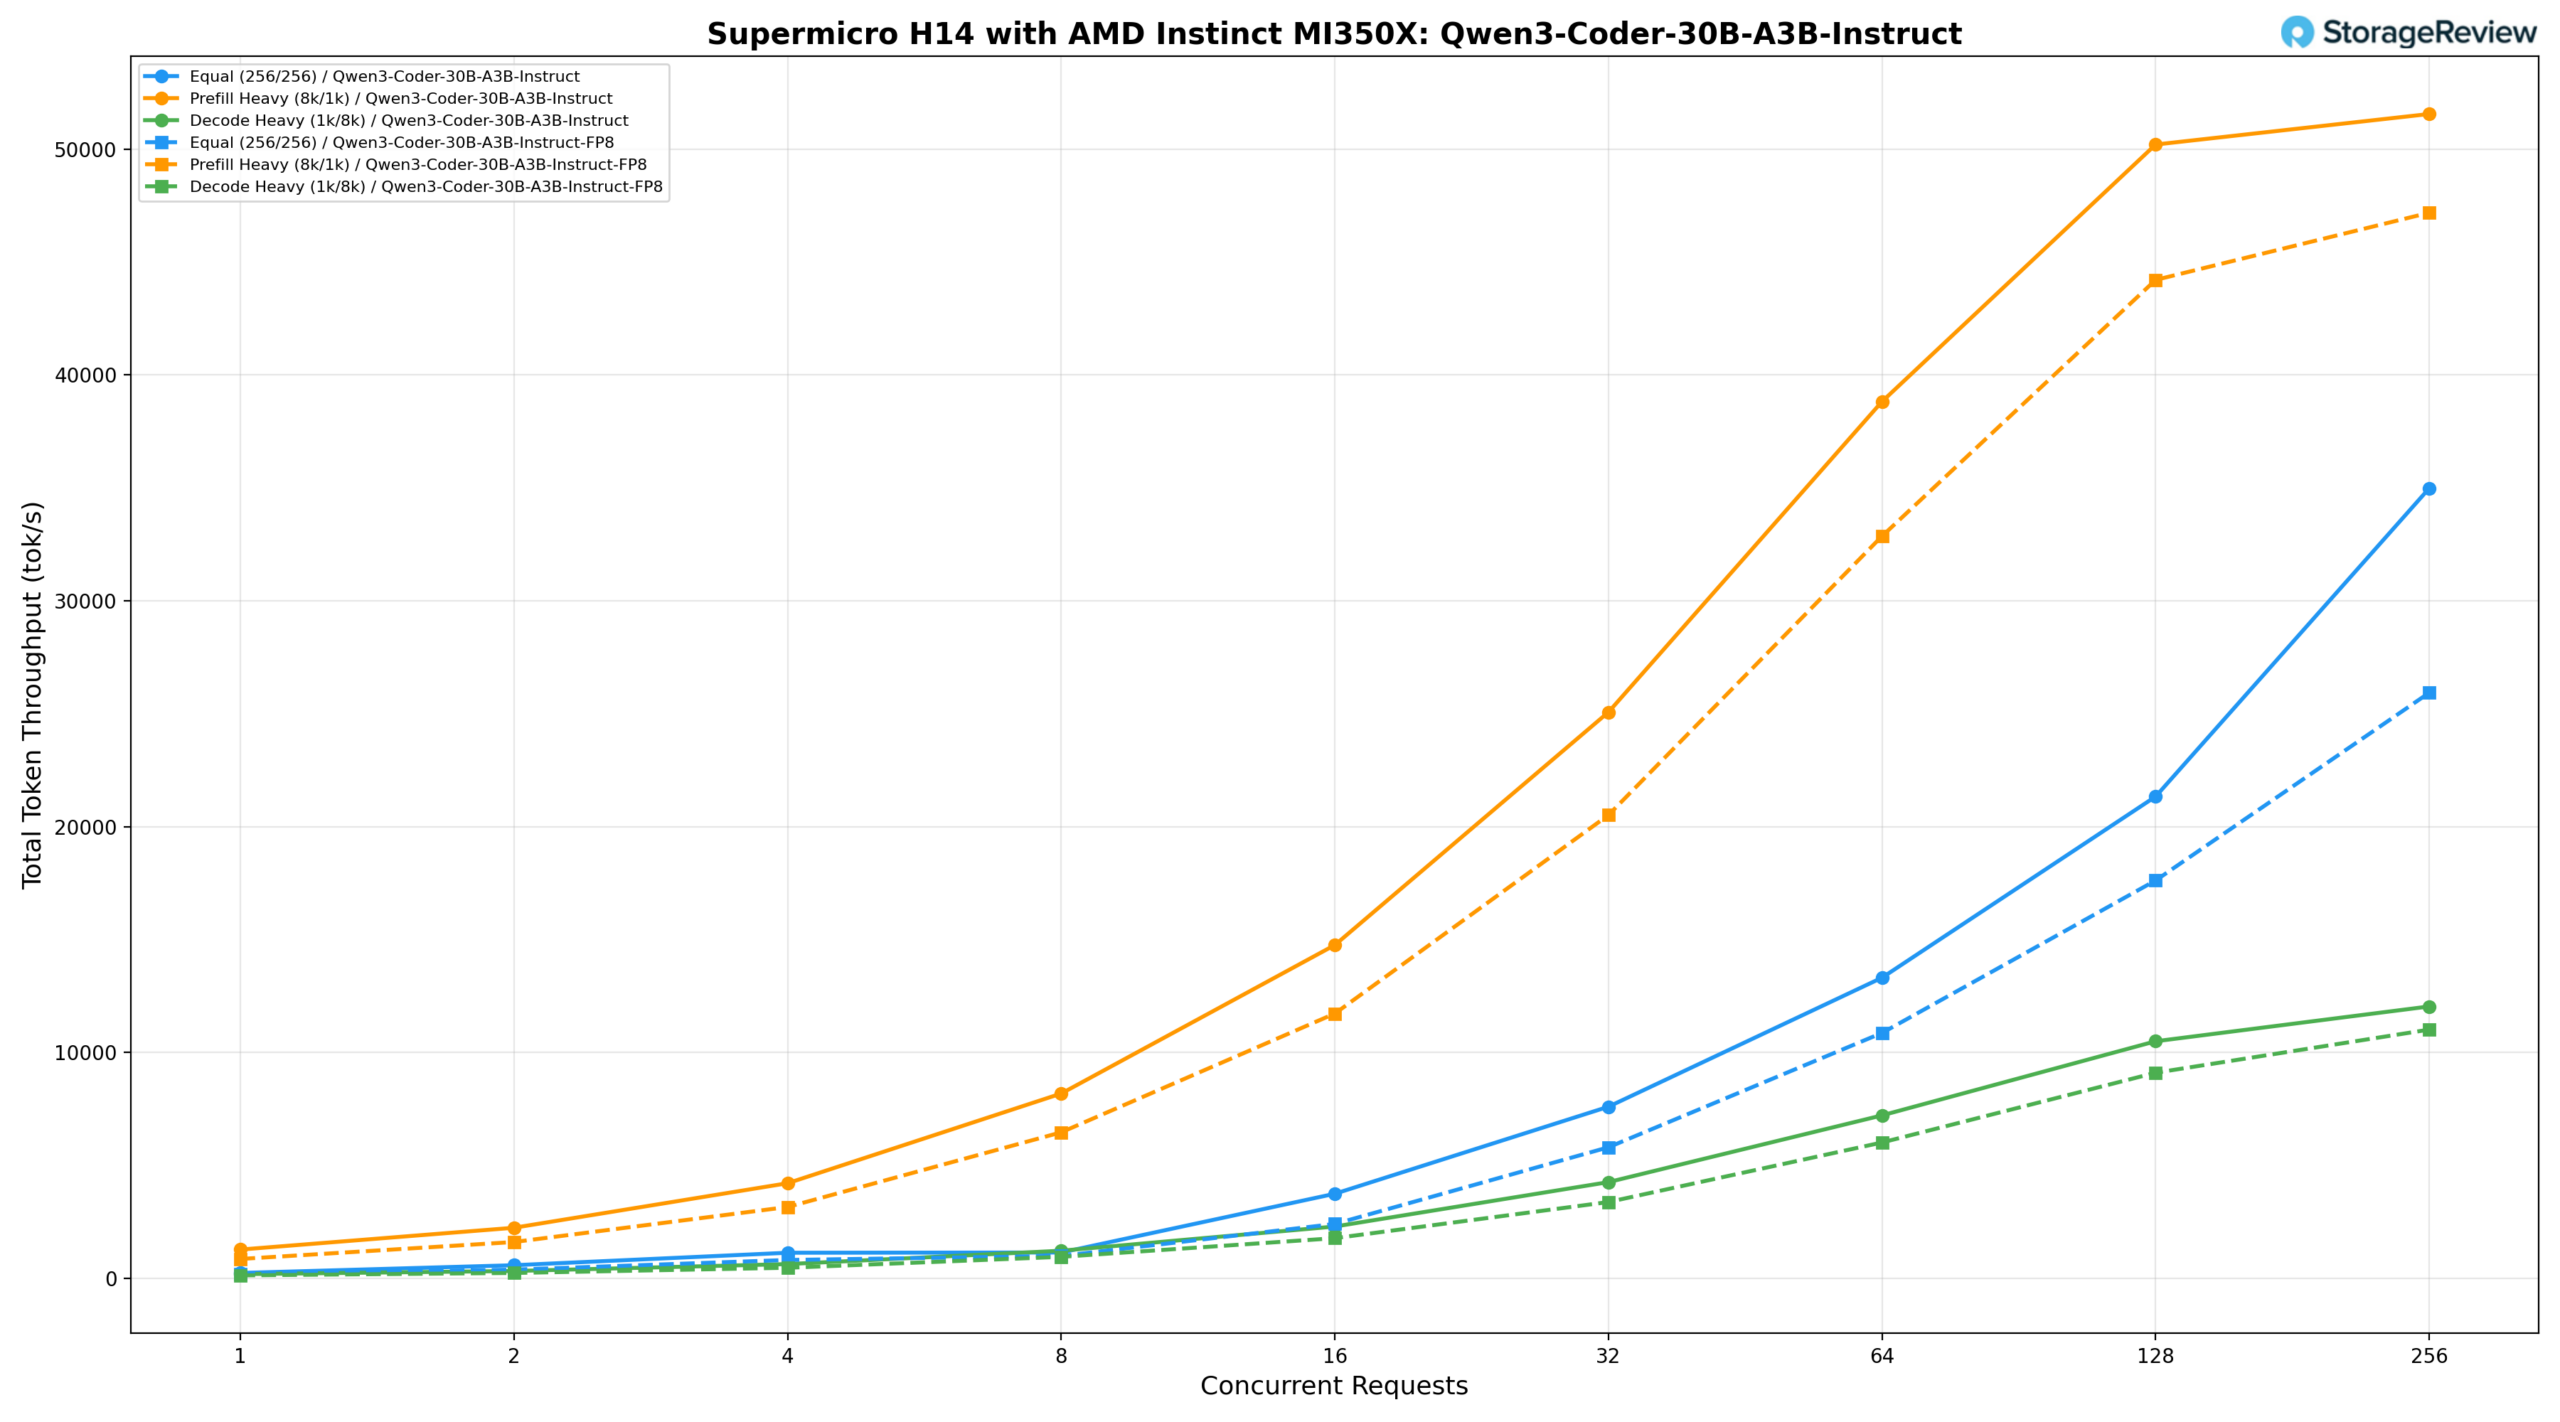
De Qwen3-Coder-30B-A3B-Instruct op de Supermicro H14 is getest met zowel standaard (BF16) als FP8-precisie.
Qwen3-Coder-30B-A3B-Instruct (BF16)
Bij BF16 levert de gelijke werkbelasting (256/256) 240.53 tok/s op bij BS=1, oplopend tot 13,312.70 tok/s bij BS=64 en 21,333.79 tok/s bij BS=128, met een piekdoorvoer van 34,980.97 tok/s bij BS=256. De voorvulling met veel volume (8k/1k) begint bij 1,276.76 tok/s, stijgt naar 25,069.32 tok/s bij BS=32 en 50,198.94 tok/s bij BS=128, met een piek van 51,550.66 tok/s bij BS=256. Bij decode-heavy (1k/8k) neemt de latentie gestaag toe van ongeveer 188 tok/s bij BS=1 tot 11,782 tok/s bij BS=256, waarmee het laagste latentieprofiel van de drie scenario's wordt behouden.
Qwen3-Coder-30B-A3B-Instruct (FP8)
De FP8-variant levert 188.92 tok/s bij BS=1 onder dezelfde werkbelasting, bereikt 10,866.27 tok/s bij BS=64 en 17,617.60 tok/s bij BS=128, met een piek van 25,928.77 tok/s bij BS=256 – iets minder dan de BF16-resultaten over het gehele bereik. Bij een zware prefill-belasting begint de prestatie bij 860.07 tok/s, stijgt naar 20,513.77 tok/s bij BS=32 en 44,205.46 tok/s bij BS=128, met een piek van 47,179.15 tok/s bij BS=256. De decode-heavy-prestatie neemt toe van 133.79 tok/s bij BS=1 tot 11,014.95 tok/s bij BS=256, schaalt consistent en blijft gedurende het hele proces dicht bij BF16.
Mistral Small 3.1 24B Instructie 2503
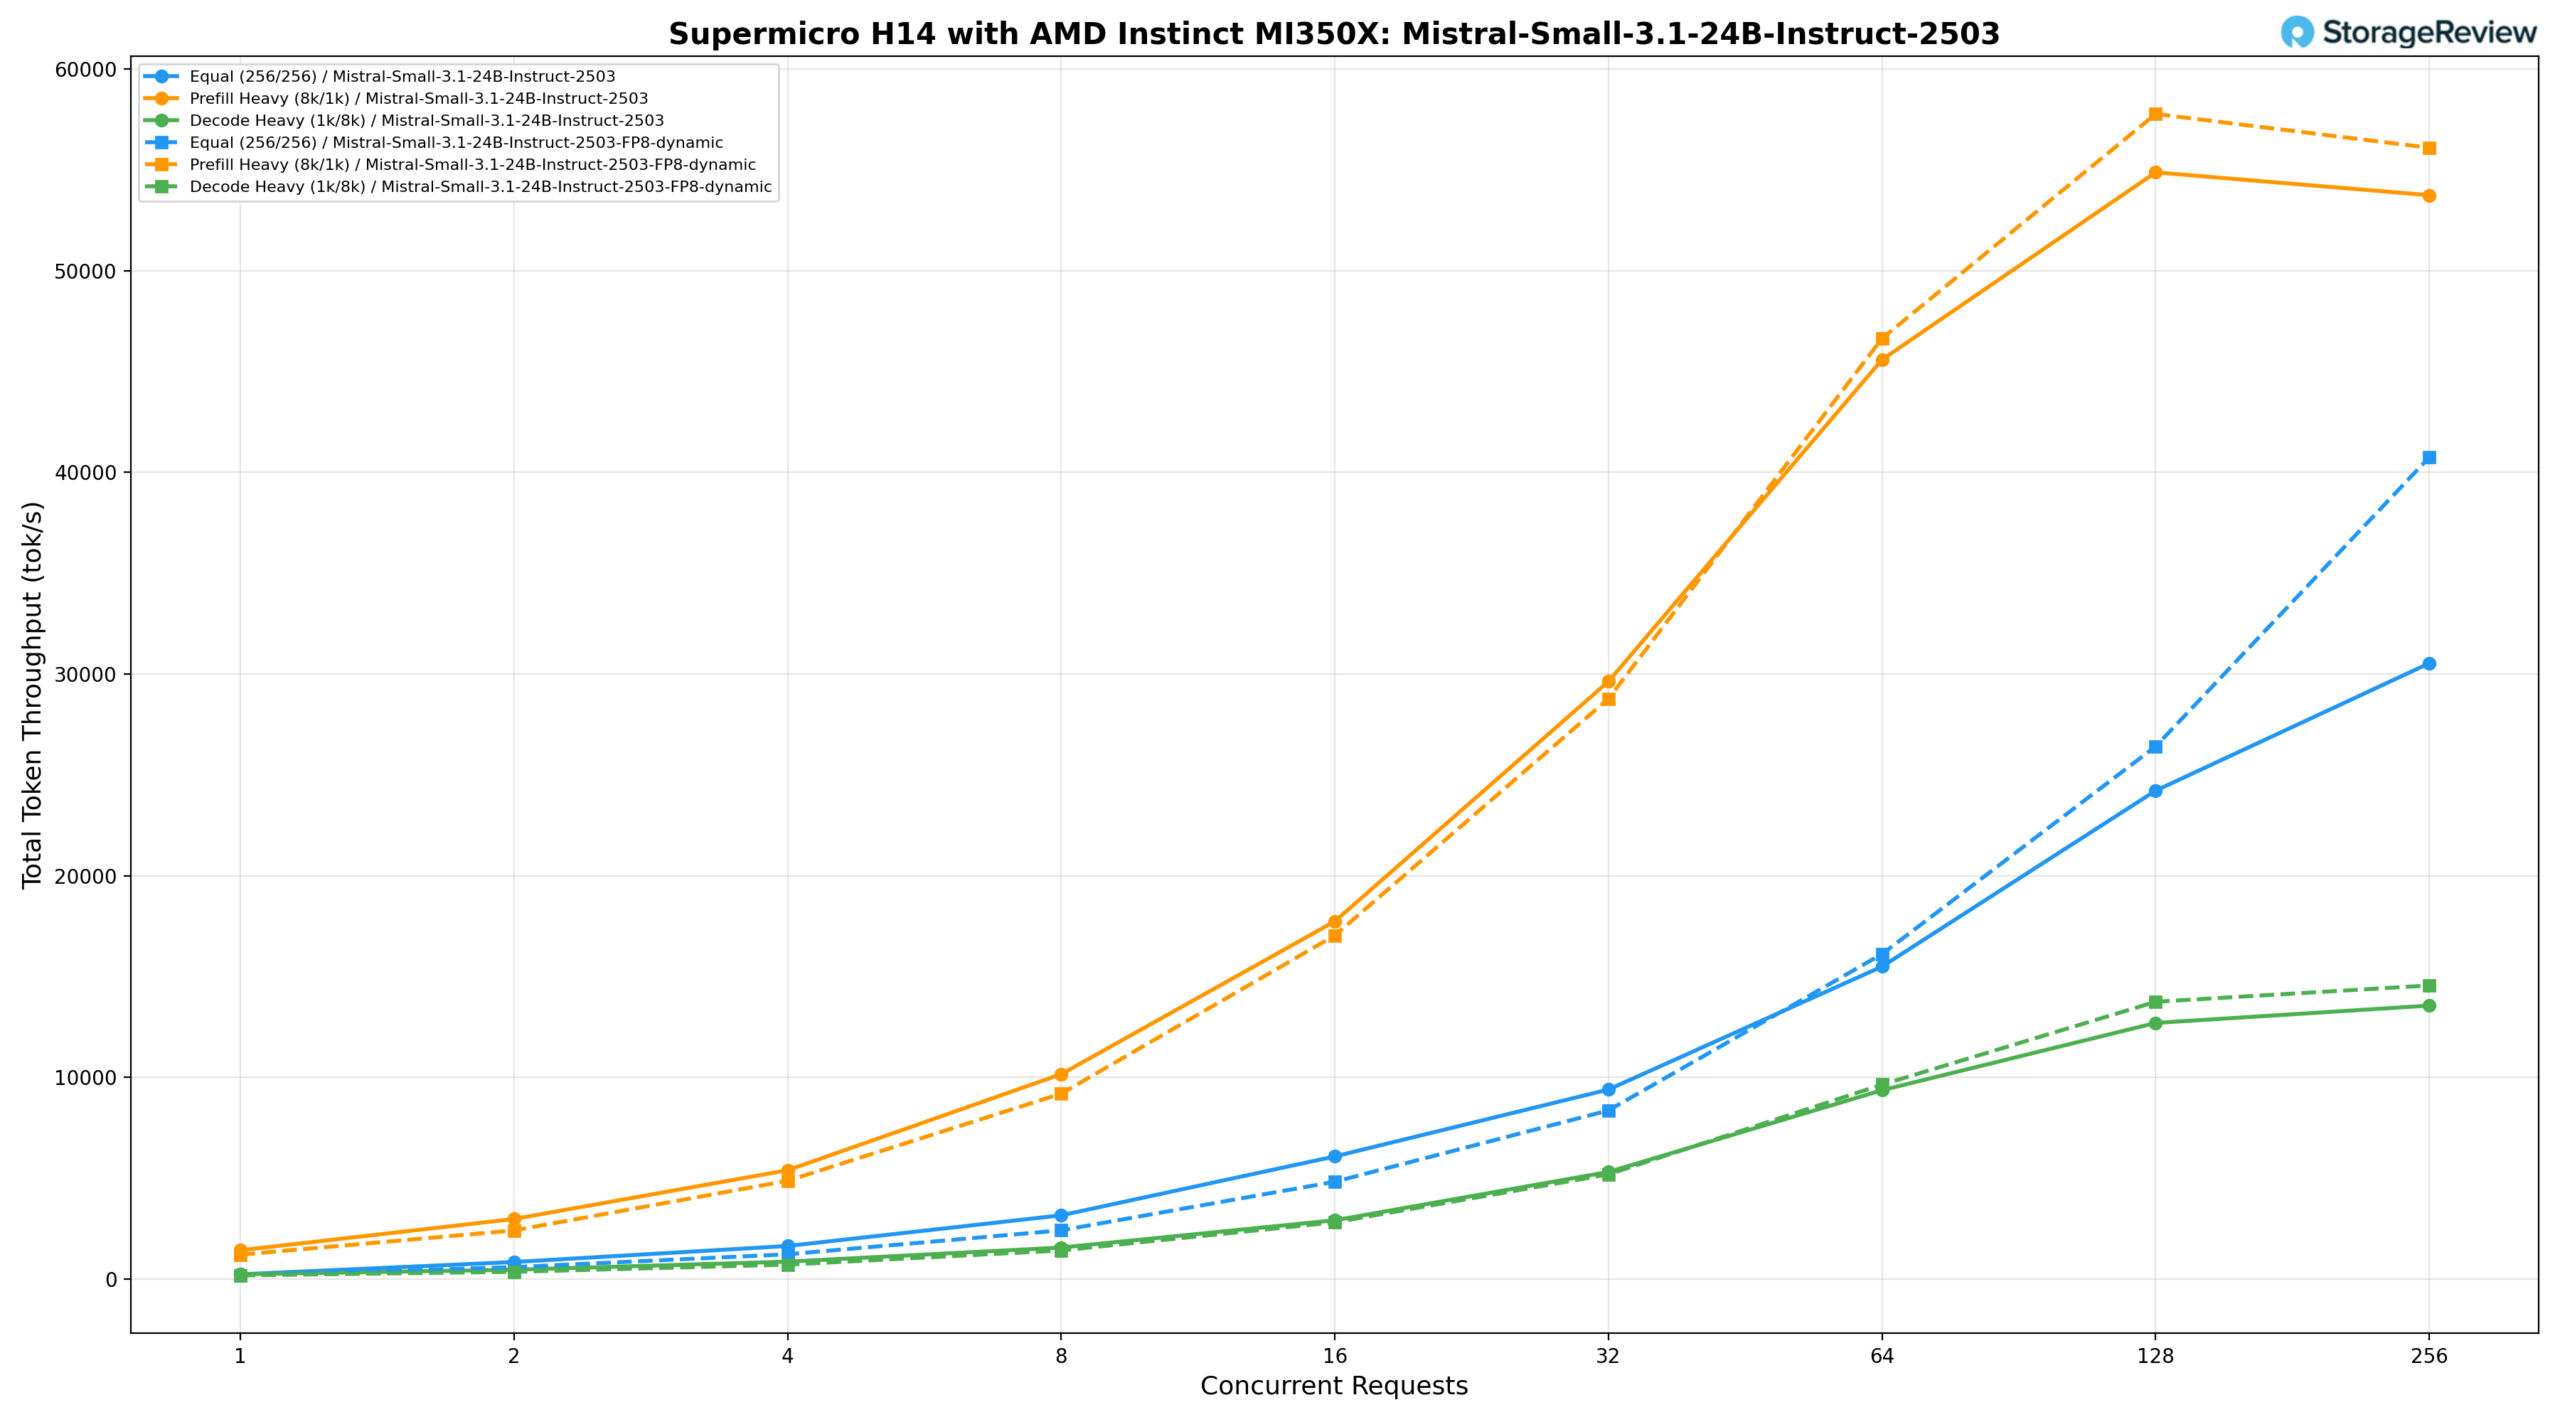
De Mistral-Small-3.1-24B-Instruct-2503 op de H14 is getest met zowel standaard als FP8-dynamische precisie en vertoonde consistente schaalbaarheid over alle drie de workloadprofielen.
Mistral-Small-3.1-24B-Instruct-2503 (BF16)
Met de precisie van BF16 levert de gelijke werkbelasting (256/256) 236.15 tok/s bij BS=1, oplopend tot 15,494.56 tok/s bij BS=64, 24,216.52 tok/s bij BS=128 en piekend op 30,530.54 tok/s bij BS=256. De voorvulling met veel vulling (8k/1k) begint bij 1,429.41 tok/s, stijgt naar 29,631.68 tok/s bij BS=32 en 54,871.74 tok/s bij BS=128, met een piek van 53,740.04 tok/s bij BS=256. De decode-heavy (1k/8k) groeit van 242.66 tok/s bij BS=1 tot 13,559.19 tok/s bij BS=256, en schaalt gestaag over het hele bereik.
Mistral-Small-3.1-24B-Instruct-2503 (FP8-dynamic)
De FP8-dynamische variant levert 184.25 tok/s bij BS=1 onder gelijke werkbelasting, bereikt 16,113.95 tok/s bij BS=64 en 26,409.01 tok/s bij BS=128, met een piek van 40,742.04 tok/s bij BS=256. De variant met veel prefill begint bij 1,210.06 tok/s, stijgt naar 28,773.52 tok/s bij BS=32 en 57,765.02 tok/s bij BS=128, met een piek van 56,093.09 tok/s bij BS=256, en overtreft het resultaat met standaardprecisie vanaf BS=64. Decode-heavy neemt toe van 183.94 tok/s bij BS=1 tot 14,557.94 tok/s bij BS=256, volgt de lijn nauw in het middenbereik en loopt vervolgens iets voor bij BS=128 en BS=256.
Lama 3.1 8B Instrueer
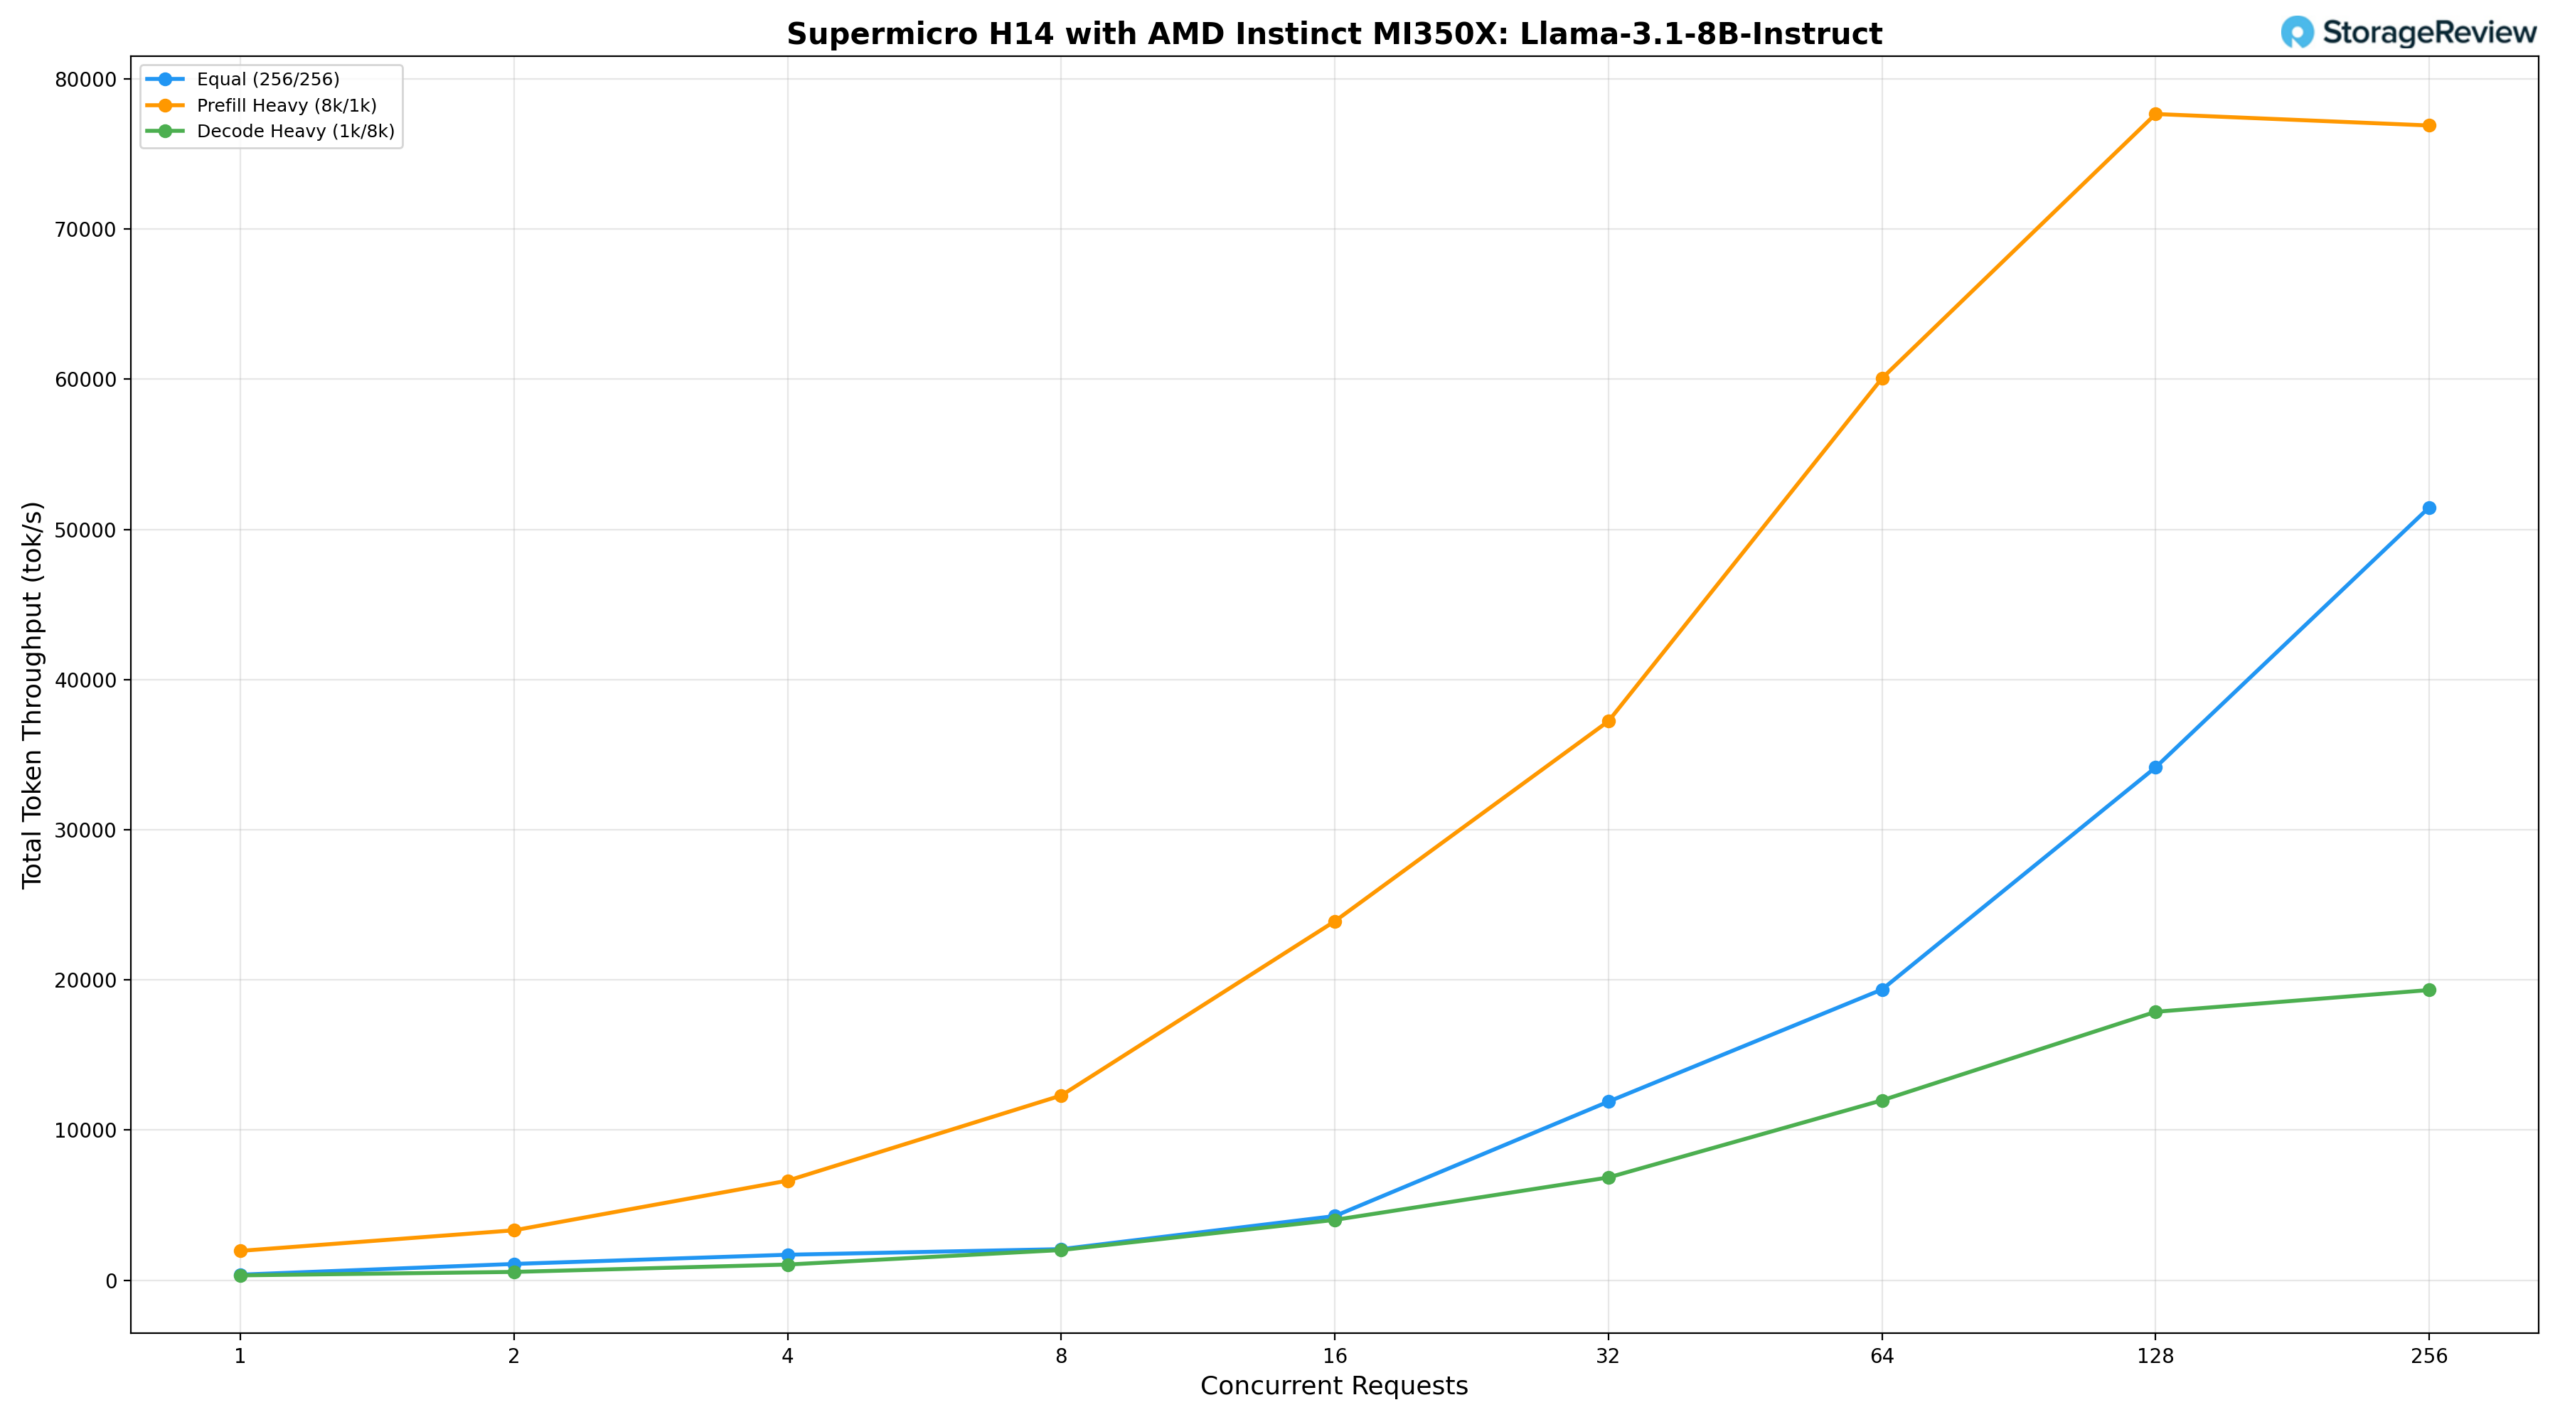
Voor de Llama-3.1-8B-Instruct zagen we dat de gelijke werkbelasting (256/256) een snelheid van 373.26 tok/s oplevert bij BS=1, oplopend tot 19,363.33 tok/s bij BS=64, 34,155.70 tok/s bij BS=128 en een piek van 51,467.30 tok/s bij BS=256. De voorvullingszware belasting (8k/1k) begint bij 1,959.04 tok/s, stijgt naar 37,227.63 tok/s bij BS=32 en 60,062.40 tok/s bij BS=64, met een piek van 77,658.50 tok/s bij BS=128, alvorens iets af te nemen tot 76,893.77 tok/s bij BS=256. Bij de decode-heavy-versie (1k/8k) begint de snelheid bij 326.48 tok/s, bereikt 17,877.52 tok/s bij BS=128 en 19,326.35 tok/s bij BS=256, waarbij de latentie per token lager blijft naarmate het aantal gelijktijdige processen toeneemt dan bij alle grotere geteste modellen.
MiniMax M2.5
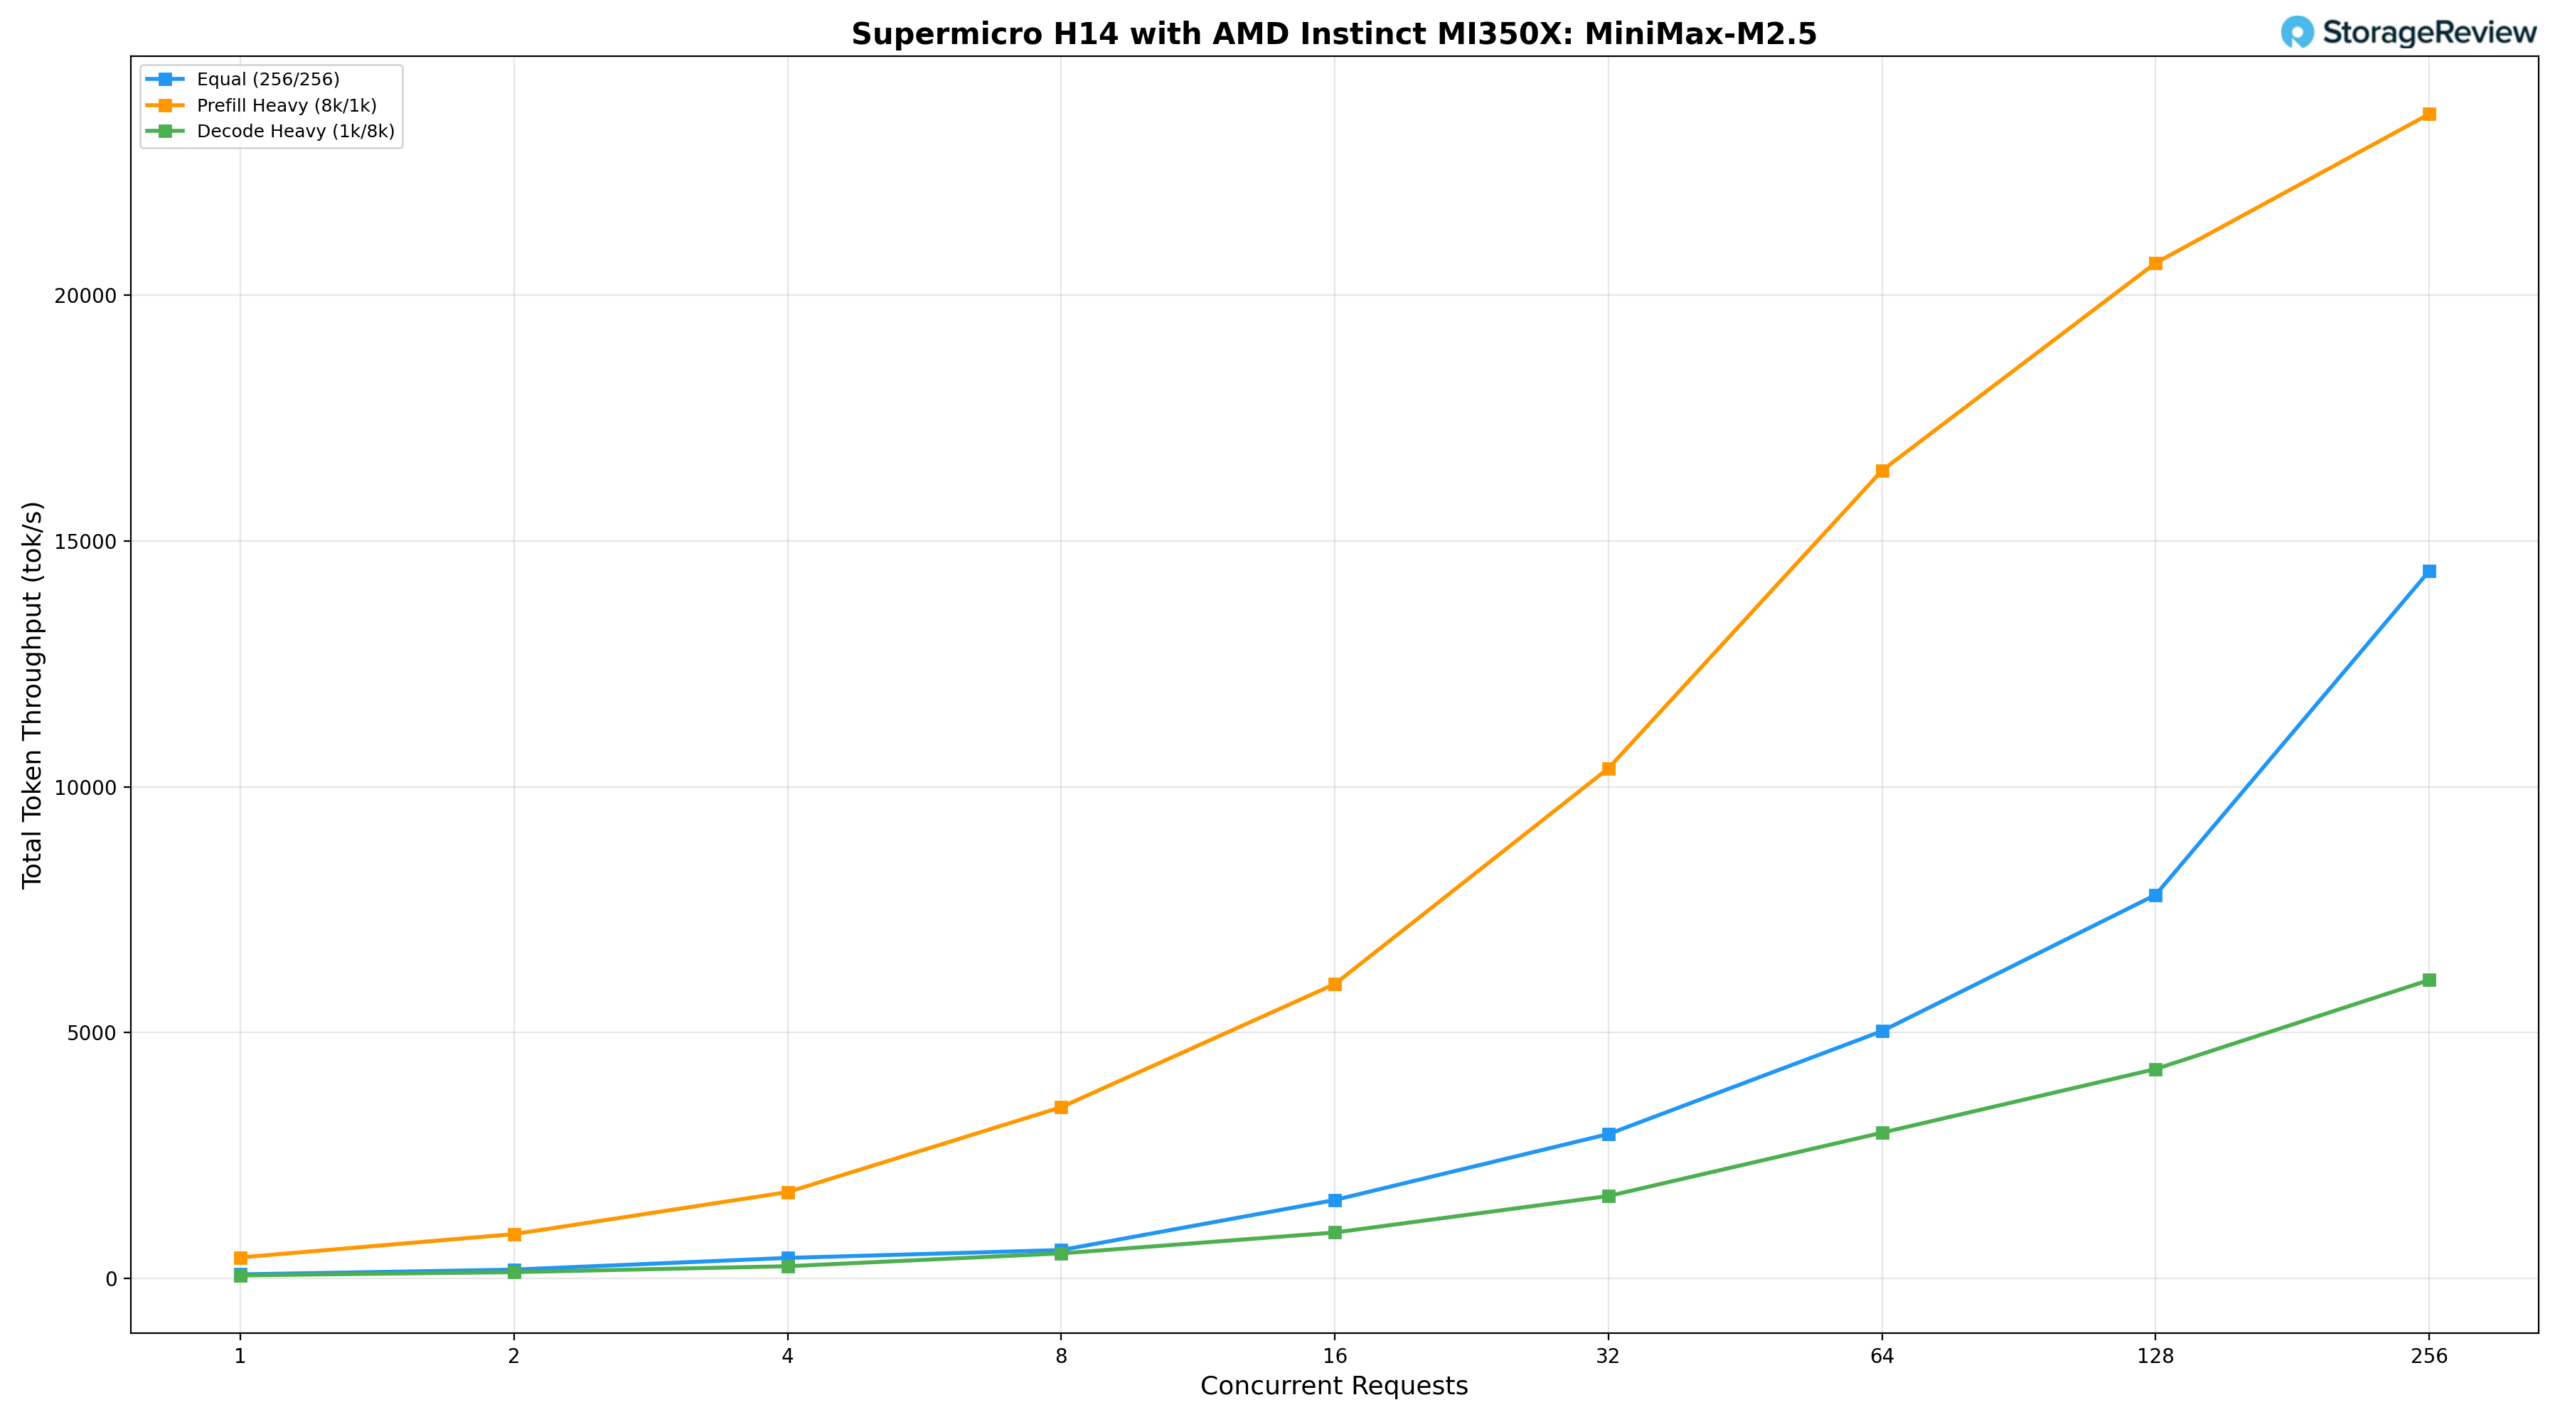
De MiniMax-M2.5 op de H14 completeert het modellenaanbod en positioneert zich qua doorvoerprofiel tussen de Kimi K2.5 en de middelgrote modellen, met kenmerken die de combinatie van expertise weerspiegelen. Bij gelijke workloads (256/256) wordt 79.31 tok/s behaald bij BS=1, 5,029.76 tok/s bij BS=64, 7,801.10 tok/s bij BS=128 en 14,391.98 tok/s bij BS=256. Het scenario met veel prefill (8k/1k) laat de sterkste schaalbaarheid zien van de drie scenario's, beginnend bij 424.41 tok/s en oplopend tot 10,376.75 tok/s bij BS=32 en 20,658.57 tok/s bij BS=128, met een piek van 23,689.18 tok/s bij BS=256. Het scenario met veel decode (1k/8k) schaalt gestaag tot 4,257.68 tok/s bij BS=128 en 6,068.70 tok/s bij BS=256, en biedt de meest consistente latentiegroei over het volledige bereik van gelijktijdigheid.
Kimi K2.5
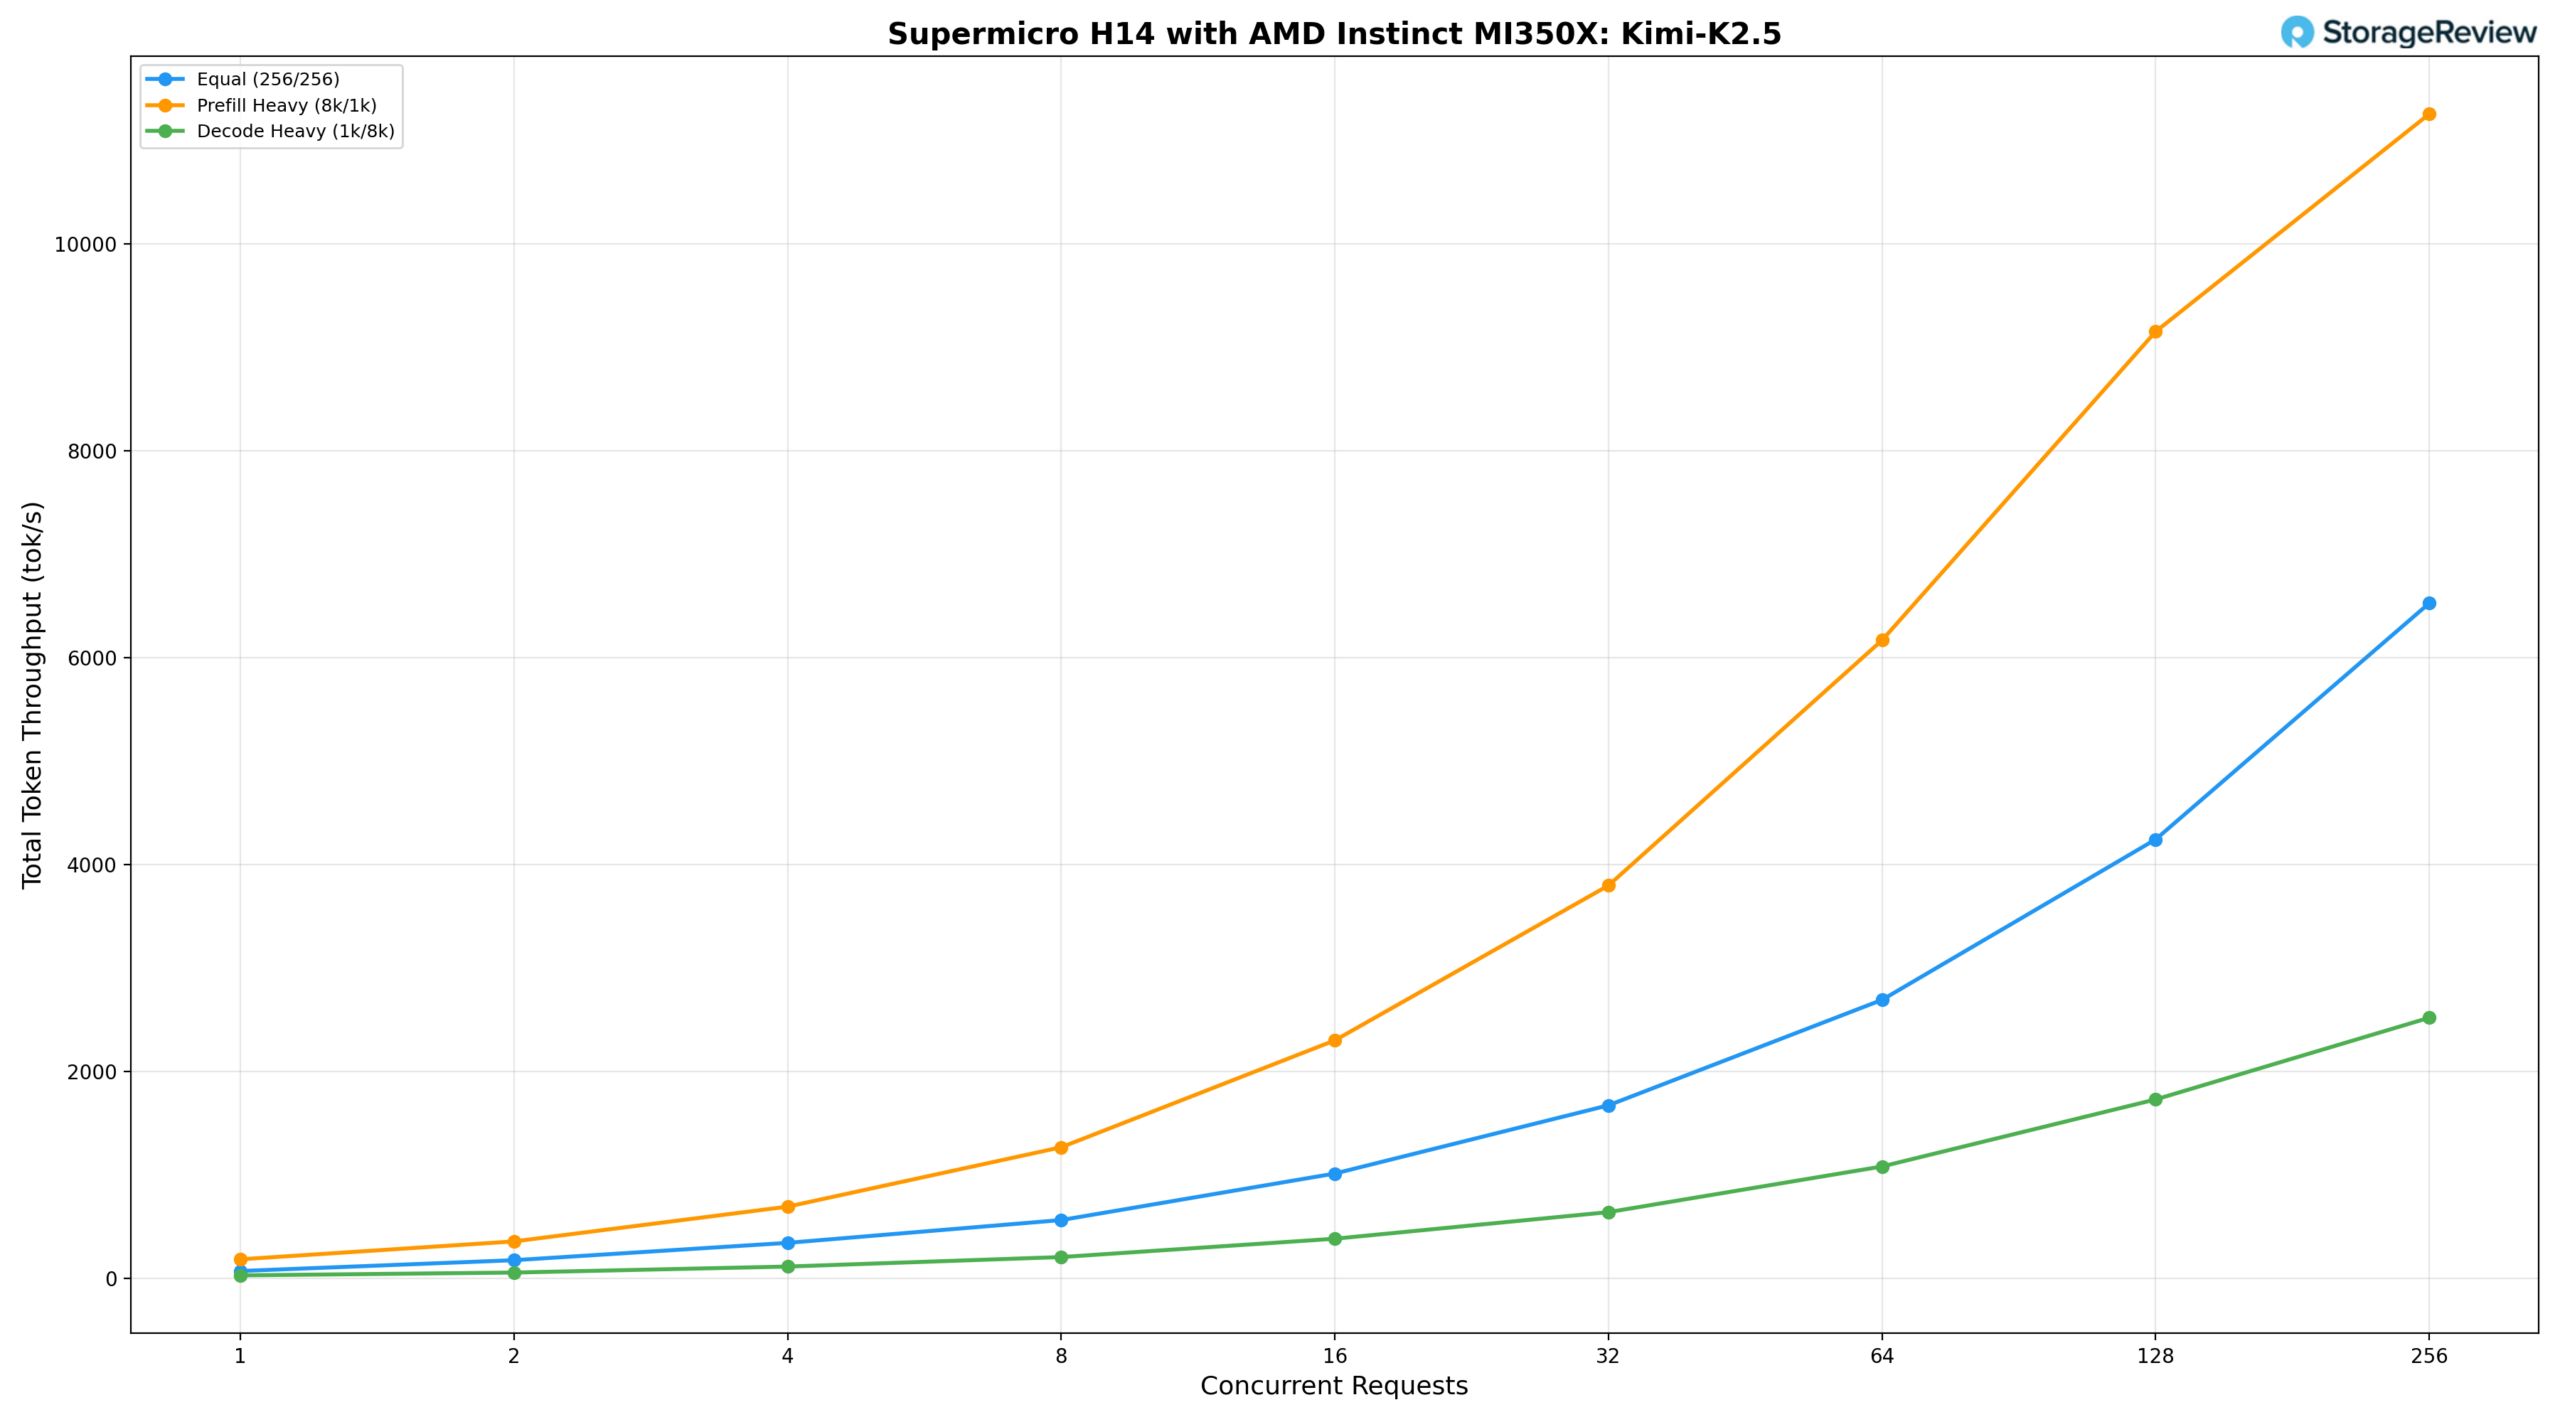
Het Kimi K2.5-model met 1 biljoen parameters op de H14 is het grootste en meest geavanceerde model dat in deze review is getest, en de doorvoer ervan weerspiegelt dat gewicht.
De gelijke werkbelasting (256/256) levert 72.06 tok/s op bij BS=1, oplopend tot 2,693.07 tok/s bij BS=64, 4,244.27 tok/s bij BS=128 en piekend op 6,527.62 tok/s bij BS=256. De prefill-zware configuratie (8k/1k) schaalt agressiever, beginnend bij 185.29 tok/s en oplopend tot 3,798.85 tok/s bij BS=32 en 9,153.12 tok/s bij BS=128, met een piekdoorvoer van 11,256.69 tok/s bij BS=256. De sprong van BS=128 naar BS=256 gaat gepaard met aanzienlijke latencykosten, wat aangeeft dat het systeem bij volledige batchdiepte voor deze modelgrootte zijn geheugen- en rekenlimieten nadert. Bij de decode-heavy configuratie (1k/8k) groeit de doorvoer van 29.88 tok/s bij BS=1 naar 2,513.85 tok/s bij BS=256. Dit levert de strakste schaalcurve op van de drie scenario's en laat tegelijkertijd consistente doorvoerwinsten zien over het volledige bereik.
Conclusie
De AMD Instinct MI350X levert zeer concurrerende inferentieprestaties voor alle hier geteste workloadprofielen, en de Supermicro AS-8126GS-TNMR biedt een goed ontworpen platform om daar optimaal gebruik van te maken. Met 288 GB HBM3e per accelerator en acht GPU's die via Infinity Fabric met elkaar zijn verbonden, is de 2.3 TB aan GPU-geheugen in één node voldoende om modellen met triljoenen parameters zoals Kimi K2.5 en MiniMax M2.5 te verwerken zonder dat distributie over meerdere nodes of workarounds voor modelpartitionering nodig zijn. Deze mogelijkheid vereenvoudigt de implementatiearchitectuur voor grootschalige inferentie aanzienlijk.
Ook kleinere modellen leverden sterke resultaten. De Llama 3.1 8B overtrof 77,000 tok/s bij workloads met veel prefill, en midrange-architecturen zoals de Mistral Small 3.1 24B en de Qwen3 Coder 30B behielden een hoge doorvoer met een goed beheersbare latentie over het gehele gelijktijdigheidsbereik. Over de hele linie wijzen de resultaten op een hardwareplatform dat voorspelbaar schaalt onder belasting, in plaats van abrupt in te storten bij grotere batchgroottes.
ROCm 7.2 brengt aanzienlijke verbeteringen aan de AMD-inferentiesoftware, met name in combinatie met vLLM 0.18. Deze combinatie levert een merkbaar stabielere en beter presterende serverervaring op dan eerdere ROCm-generaties, met bredere frameworkondersteuning en minder van de kinderziektes die eerdere Instinct-implementaties kenmerkten. De groeiende aandacht voor AMD-hardware is ook het vermelden waard: upstream vLLM heeft nu een speciale AMD ROCm CI-pipeline en Meta's commitment aan implementaties van meerdere generaties op een schaal van 6 gigawatt bevestigt dat validatie in productieomgevingen veel verder reikt dan gecontroleerde benchmarkomgevingen.
De evaluatie van de Claude Code-server voegt een praktische dimensie toe aan de ruwe doorvoercijfers. Een enkele MI350X-node handhaafde responssnelheden die bijna gelijk waren aan die van de cloud, voor maximaal 16 gelijktijdige codeersessies, en bleef interactief met maximaal 64 gelijktijdige gebruikers, terwijl er bijna 1,000 token per seconde aan totale output werd geproduceerd. Voor organisaties die de kosten van commerciële API-abonnementen afwegen tegen zelfgehoste infrastructuur, worden de economische voordelen bij deze dichtheid duidelijk, met bijkomende voordelen zoals datalocaliteit, eliminatie van kosten per token en onbeperkte modelselectie.
Het JumpStart-programma van Supermicro bewijst keer op keer zijn waarde in het evaluatieproces van infrastructuur. Dankzij directe toegang tot de productiehardware, zonder de overhead van provisioning, konden we gedurende de volledige testperiode echte workloads onder realistische omstandigheden uitvoeren. Voor teams die accelerators evalueren, is deze mate van praktische toegang veel waardevoller dan het vergelijken van specificaties of het bekijken van vooraf samengestelde demonstraties van leveranciers.


 Amazon