

A NVIDIA anunciou o lançamento da versão de produção do NVIDIA Groq 3 LPX , um acelerador de inferência interativo dedicado, desenvolvido para complementar a plataforma Vera Rubin NVL72. À medida que as cargas de trabalho de IA corporativas migram do pré-treinamento de modelos brutos para o raciocínio em tempo real e a orquestração autônoma de agentes, os requisitos de infraestrutura estão mudando. Os fluxos de trabalho com agentes exigem execução iterativa em várias etapas, onde a latência durante a geração de tokens pode se acumular em caminhos de raciocínio automatizado, consultas a ferramentas externas e comunicações multiagentes.
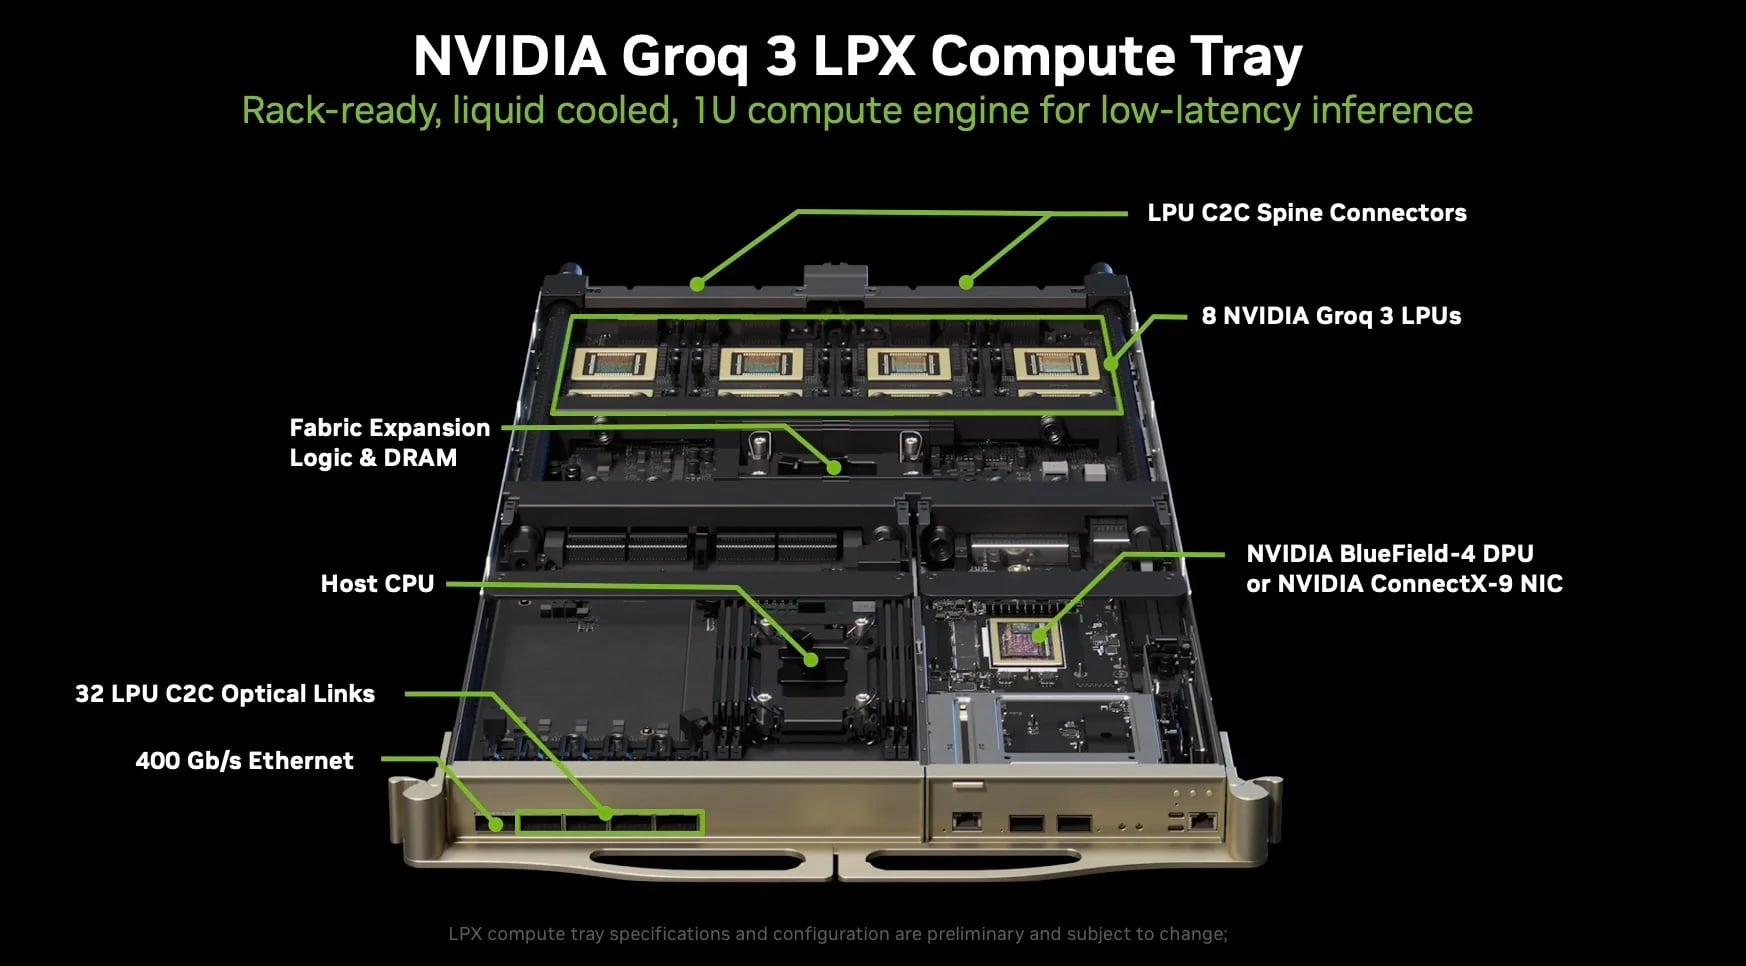
A arquitetura Groq 3 LPX se destaca especificamente nessa fase de decodificação. Cada bandeja de computação 2U com refrigeração líquida comporta dezesseis LPUs Groq 3, juntamente com uma CPU host, lógica de expansão de interconexão e DRAM, além de uma DPU BlueField-4 ou uma NIC ConnectX-9, com 32 links ópticos chip-a-chip entre as LPUs e Ethernet de 400 Gb/s na parte frontal. Em uma implantação heterogênea com sistemas Vera Rubin NVL72, as GPUs NVIDIA Rubin lidam com a ingestão de contexto e os cálculos de preenchimento automático em conjuntos de dados de entrada massivos, enquanto as unidades Groq 3 LPX processam a geração de tokens de saída com baixa latência.
Arquitetura e desempenho de referência
Em avaliações de desempenho padrão da Artificial Analysis, executando o modelo de código aberto Gemma 4 31B com uma janela de contexto ativa de 100,000 tokens, o Groq 3 LPX atingiu uma taxa de saída de 3,400 tokens por segundo. A NVIDIA observa que esse nível de desempenho é 4 vezes mais rápido do que a plataforma alternativa mais próxima com parâmetros de contexto longo idênticos, e a Artificial Analysis o registra como o resultado mais rápido medido para o modelo. A comparação merece atenção: o número da NVIDIA foi obtido em um endpoint privado de pré-lançamento, medido em 21 de agosto, enquanto os números concorrentes são de endpoints de produção serverless em tempo real. Manter uma velocidade de geração extrema em janelas de 100 tokens é essencial para arquiteturas de agentes corporativos que analisam continuamente extensos repositórios de código, esquemas de API complexos e documentação técnica densa.
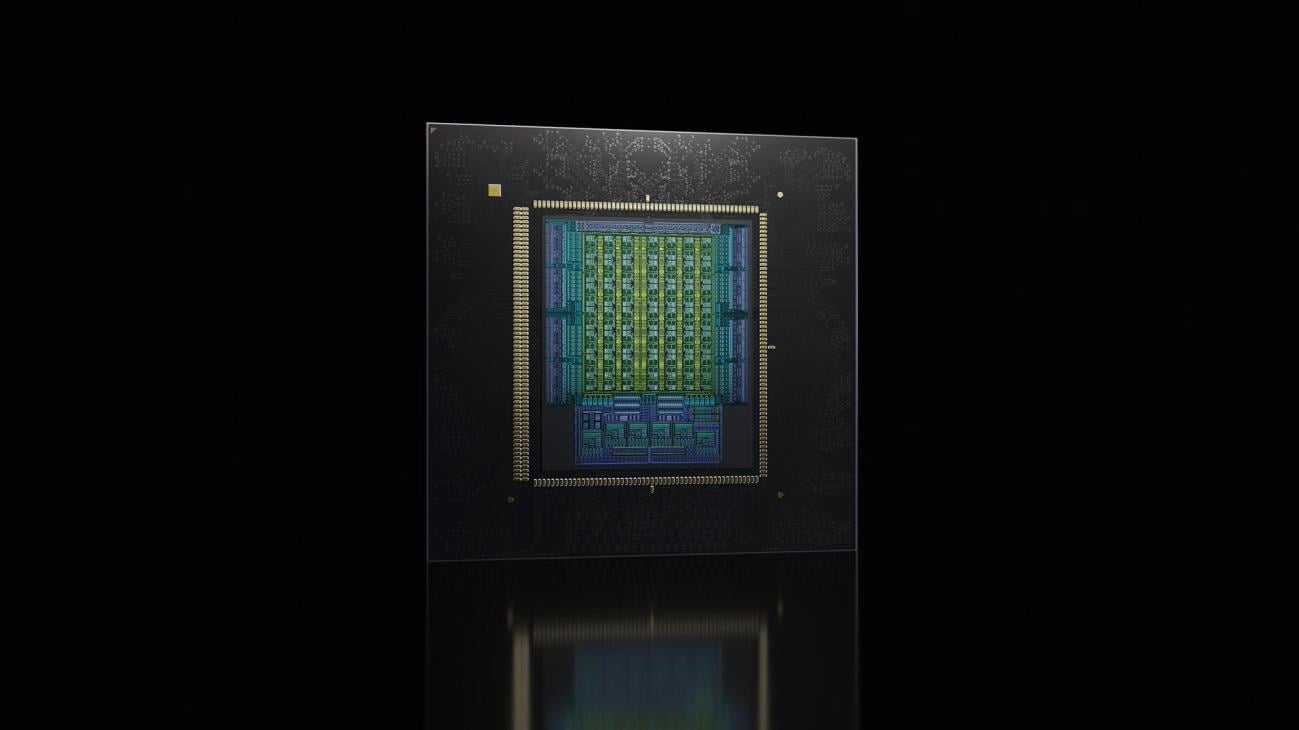

Do ponto de vista da arquitetura física do sistema, uma implementação do Groq 3 LPX em escala de rack incorpora até 256 aceleradores LP30 interligados por meio de interconexões diretas de alta velocidade entre os chips.
Implantações em Nuvem e Ecossistema de Sistemas
A adoção comercial inicial já está em andamento entre provedores de serviços em nuvem especializados. A Nebius foi nomeada a primeira parceira de nuvem de IA a implantar o Groq 3 LPX, com planos de integrar o hardware ao seu serviço de inferência de produção, o Nebius Token Factory. Essa arquitetura foi projetada para permitir que os desenvolvedores acessem a aceleração de inferência em tempo real por meio de interfaces de API existentes, sem a necessidade de migrar bases de código para novas abstrações de framework. O provedor de inferência Groq espera estar entre os primeiros a adotar a plataforma.


A NVIDIA acompanha o lançamento com cálculos de plataforma atualizados para o rack em que o chip é instalado, alegando um desempenho de até 30 vezes maior por megawatt para o Vera Rubin NVL72 em comparação com o GB300 NVL72 em uma carga de trabalho de codificação agentiva de 140,000 tokens, com a vantagem aumentando conforme as metas de interatividade por usuário crescem. A implementação de hardware se encaixa na infraestrutura completa da fábrica de IA Rubin da NVIDIA, que abrange sete chips distintos em cinco configurações de rack projetadas especificamente para essa finalidade.
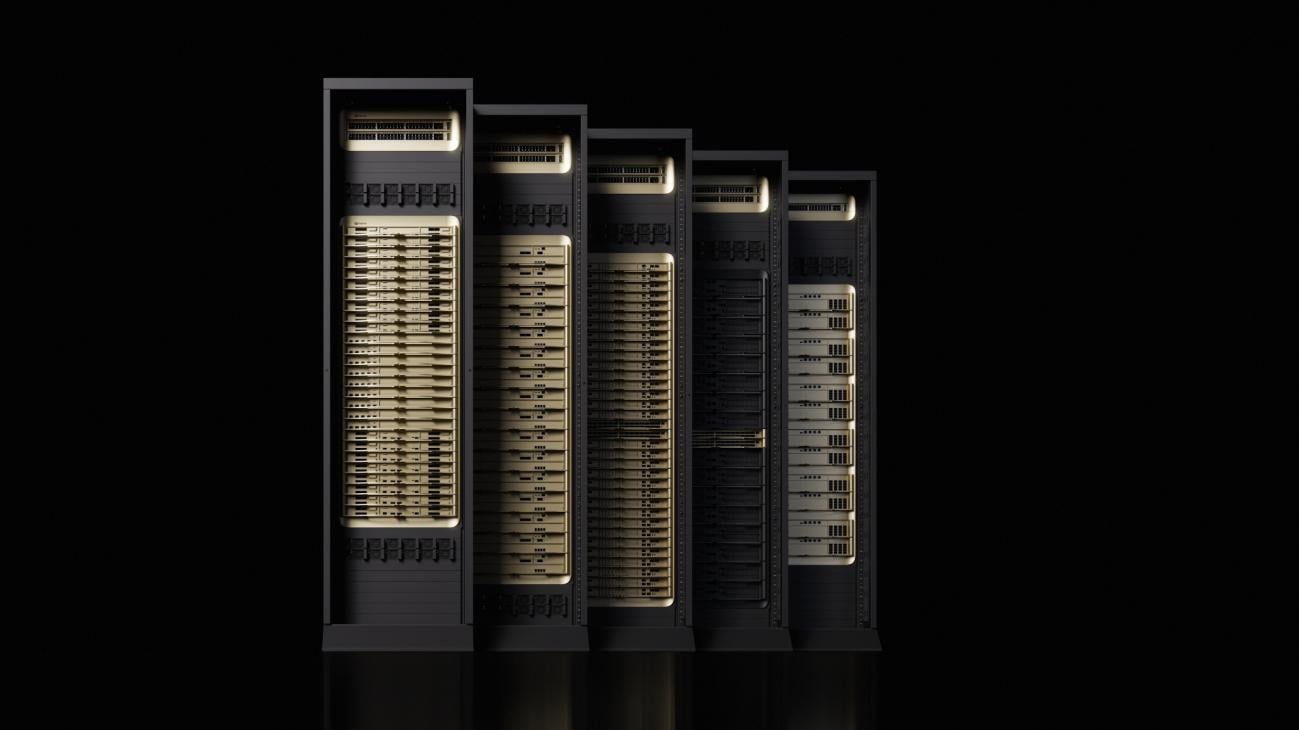
Os elementos do sistema que operam em conjunto com os clusters de computação Rubin e LPX incluem racks de CPU NVIDIA Vera, arrays de armazenamento Vera BlueField-4 STX e redes NVIDIA Spectrum-6 SPX.
O que a NVIDIA e a Nebius dizem
“A inferência é o motor de crescimento da IA. A NVIDIA Grace Blackwell e a NVL72 revolucionaram a inferência de grandes modelos de linguagem com um salto sem precedentes em desempenho e eficiência”, disse Jensen Huang, fundador e CEO da NVIDIA. “Vera Rubin amplia essa visão com configurações de fábrica de IA otimizadas para cargas de trabalho, projetadas para a era da IA agente, expandindo a fronteira de desempenho com LPX para geração ultrarrápida de tokens.”
A Nebius definiu o valor em termos de onde a latência realmente impacta os usuários. "A geração é a fase de inferência que determina o quão responsivo um sistema de IA realmente é, e é exatamente para isso que o NVIDIA Groq 3 LPX foi projetado", disse Danila Shtan, diretora de tecnologia da Nebius. "Como a primeira nuvem de IA a levar isso para produção por meio do Nebius Token Factory, estamos garantindo que cada etapa do ciclo de um agente seja instantânea, por meio da mesma API que os desenvolvedores já usam, sem necessidade de migração para uma nova infraestrutura."
Infraestrutura multiplano e escalável Spectrum-X
Para suportar as enormes demandas de rede dessas fábricas de inferência, a NVIDIA destacou sua arquitetura Ethernet Multiplane Spectrum-X. A expansão tradicional de clusters além dos limites de densidade modernos geralmente exige a adição de uma terceira camada de comutação, o que introduz penalidades de latência, custos de cabeamento óptico e sobrecarga de energia. O Spectrum-X Multiplane contorna isso dividindo as interfaces de rede do host em vários planos independentes, cada um executando uma rede plana de duas camadas que escala para até 512,000 GPUs.

O gerenciamento de tráfego e a mitigação de falhas são tratados em silício pela NVIDIA ConnectX-9 SuperNIC, que suporta velocidades de rede de até 1,600 Gb/s por GPU quando combinada com ASICs Ethernet Spectrum-6 de 102.4 Tb/s. A Ethernet Spectrum-XGS estende o mesmo codesign entre instalações, o que, segundo a NVIDIA, acelera os coletivos NCCL em vários locais em 1.9 vezes. Em uma topologia de oito planos, o failover de hardware redireciona o tráfego instantaneamente em torno de caminhos com falha, mantendo aproximadamente 90% da largura de banda agregada da rede. A NVIDIA afirma que a recuperação por hardware é 11 vezes mais rápida do que o balanceamento de carga multiplano baseado em software, o que, segundo a empresa, se traduz em uma produção 1.6 vezes maior para fábricas de IA.

Em paralelo, a NVIDIA apresentou seu pilar de rede Scale-In, que combina unidades de processamento de dados BlueField-4 com a pilha de software DOCA . O Scale-In visa a infraestrutura norte-sul, descarregando o isolamento multi-inquilino, a criptografia em silício em velocidade de linha, a telemetria e os caminhos de dados de armazenamento de alto desempenho dos processadores host.
NVLink Fusion para integração de silício personalizada
A NVIDIA também apresentou o NVLink Fusion para operadores de hiperescala que necessitam de arquiteturas híbridas. A estrutura permite que XPUs e CPUs personalizadas de terceiros se integrem diretamente às redes de expansão NVLink e NVLink-C2C de sexta geração da NVIDIA. Ao aproveitar os projetos modulares de chassis NVIDIA MGX e o software de gerenciamento, os operadores de data centers podem padronizar os designs de racks de energia, térmicos e de rede compartilhados, ajustando a proporção específica de GPUs, LPUs e silício personalizado conforme as cargas de trabalho evoluem.
A NVIDIA fez um segundo anúncio sobre a arquitetura Vera Rubin no Hot Chips: a SpaceXAI está adotando CPUs Vera para as cargas de trabalho de agentes por trás do Grok e planeja colocar uma Vera Rubin NVL72 otimizada em órbita a bordo de seu satélite Starmind de primeira geração.


 Amazon