

Historicamente, cada operação de armazenamento lida por uma GPU passava pela CPU do host, que gerenciava o sistema de arquivos, enviava comandos e retornava os dados. Essa sobrecarga é insignificante para grandes transferências sequenciais, mas torna-se um fator limitante ao lidar com milhões de operações de 512 bytes por segundo. Na FMS 2026 em Santa Clara, a NVIDIA anunciou um novo software e uma iniciativa da indústria para eliminar esse gargalo.
O principal anúncio é o cuFile, uma API que permite que GPUs leiam e gravem diretamente no armazenamento. A NVIDIA está disponibilizando o cuFile e toda a sua pilha de software de suporte como código aberto, hospedado na nova organização XIO-SIG no GitHub. Os mantenedores fundadores incluem Google, Intel, Meta e NVIDIA. Além disso, a NVIDIA lançou formalmente o Storage-Next, uma iniciativa discutida publicamente desde pelo menos a GTC 2025. O Storage-Next agora inclui mais de 40 fornecedores de armazenamento e flash, como DDN, KIOXIA e Micron, bem como fabricantes de controladores, especialistas em refrigeração e organizações de padrões. Esses participantes estão definindo colaborativamente como os dispositivos de armazenamento devem se comportar quando uma GPU, em vez de uma CPU, for o cliente.
O problema: E/S mediada pelo host
Tradicionalmente, os sistemas de GPU operam sob um modelo de E/S centrado no host. A CPU agenda as tarefas da GPU, prepara os dados e inicia todas as transferências entre a GPU e a rede ou o armazenamento. Cada operação segue uma sequência: o kernel da GPU é concluído, o controle retorna à CPU, a CPU configura a transferência e o próximo kernel é iniciado. O custo por operação, principalmente a sobrecarga de inicialização do kernel e de sincronização CPU-GPU, é medido em microssegundos. Embora insignificante para transferências em massa, essa sobrecarga torna-se significativa para operações de granularidade fina.
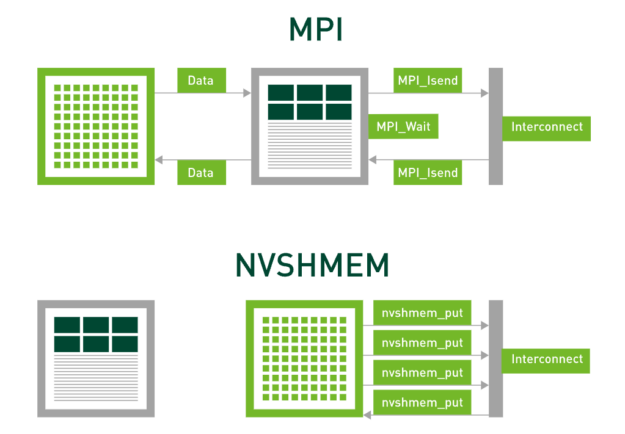
Para a comunicação GPU-para-GPU, a NVIDIA eliminou a participação do host por meio do NVSHMEM, que permite que o código do dispositivo inicie as transferências diretamente e as sobreponha ao processamento. O impacto é substancial: quando o GROMACS migrou sua comunicação de troca de halos do MPI para o NVSHMEM, a comunicação foi removida do caminho crítico e passou a se sobrepor completamente ao processamento.
O armazenamento manteve o modelo mediado pelo host. Uma leitura de uma unidade NVMe ainda retorna o controle para a CPU, executa o sistema de arquivos e aguarda a conclusão. O treinamento tolera isso porque suas leituras são grandes e pouco frequentes. A inferência, não. Servir entradas de cache KV, embeddings e resultados de busca vetorial gera milhões de pequenas leituras aleatórias por segundo, com a CPU no caminho de cada uma delas.
E/S iniciada por GPU e SCADA
O SCADA (acesso a dados escalonado e acelerado) aplica o modelo NVSHMEM ao armazenamento, permitindo que a GPU inicie e gerencie suas próprias operações de E/S de armazenamento.
A pesquisa subjacente é o BaM, ou Big Accelerator Memory, publicada na ASPLOS 2023 pela NVIDIA, IBM, Universidade de Illinois e Universidade de Buffalo. O BaM demonstrou uma GPU gerenciando unidades NVMe diretamente, consolidando e armazenando em cache as pequenas solicitações geradas em seus threads para suportar filas de espera que saturam a unidade, sem a intervenção do host. Em hardware idêntico, o BaM executou cargas de trabalho de análise de dados 5.3 vezes mais rápido do que o acesso iniciado pela CPU e executou cargas de trabalho de grafos a partir da memória flash com um custo de hardware até 21.7 vezes menor do que armazenar os mesmos dados na memória do host.
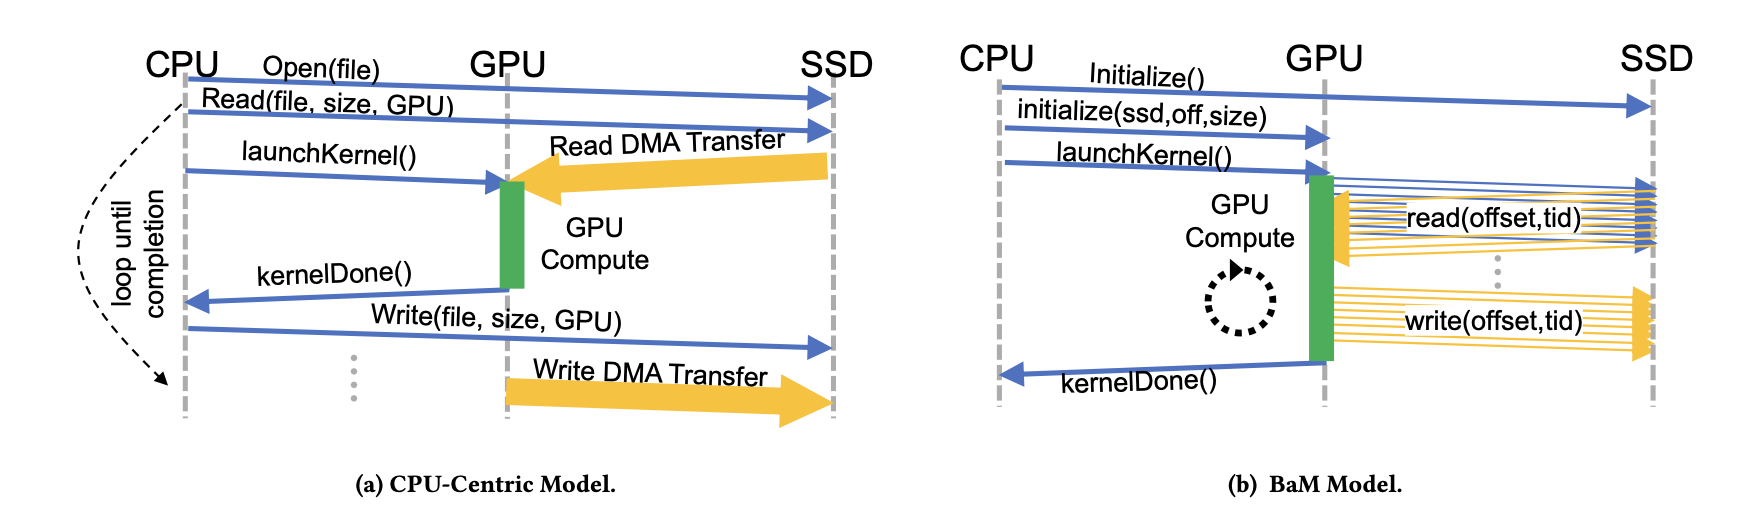
O SCADA é a forma comercializada. Um ambiente de execução na GPU fica entre os threads do kernel e o armazenamento. Ele consolida pequenas solicitações dispersas em leituras atendidas por um cache na GPU ou enviadas para unidades, que podem ser NVMe locais ou um servidor de armazenamento remoto.
O acesso direto ao dispositivo deve ser controlado, pois o acesso bruto a uma unidade compartilhada poderia permitir que um aplicativo lesse ou corrompesse os dados de outro. O design da NVIDIA separa os níveis de privilégio. As partes críticas para o desempenho de um aplicativo são executadas sem privilégios, fora da base de computação confiável. Um componente privilegiado configura o acesso protegido entre cada aplicativo e somente o armazenamento aprovado durante a instalação, usando mecanismos de segurança padrão do Linux. A NVIDIA cita essa separação e a interoperabilidade baseada em Linux como a razão pela qual a pilha é lançada como código aberto, em vez de um componente CUDA fechado.
Como o SCADA difere do armazenamento GPUDirect
Toda operação de armazenamento possui um caminho de dados (os bytes movidos) e um caminho de controle (construção, envio e conclusão da solicitação). O GPUDirect Storage (GDS), lançado em 2019 e disponível desde 2021, removeu a CPU do caminho de dados: por meio do cuFile, os dados são movidos por DMA entre a unidade e a memória da GPU, sem buffer de transferência na RAM do host. Os materiais de lançamento da NVIDIA indicam que o limite do caminho da CPU em um DGX-2 é de 50 GB/s, com o GDS capaz de combinar caminhos para um limite superior próximo a 200 GB/s, e DDN, VAST, WEKA, Pure Storage e outros grandes fornecedores de armazenamento para IA já possuem certificação para essa tecnologia. O caminho de controle permanece na CPU: o software do host ainda decide o que buscar e emite cada solicitação, e a GPU é o destino do DMA, e não a iniciadora.
Para grandes volumes de transferência, essa divisão é adequada. Uma leitura de 1 MB amortiza o custo do caminho de controle a zero. Com 512 bytes, a proporção se inverte. O custo fixo por requisição se torna dominante, e a CPU satura muito antes dos discos rígidos. O SCADA move o caminho de controle para a GPU, que absorve a latência por operação da mesma forma que absorve a latência da memória, mantendo centenas de milhares de operações em andamento.
Os dois coexistem: cuFile para transferências em massa e SCADA para grandes volumes de pequenas leituras aleatórias.
Storage-Next e o problema dos 512 bytes
O SCADA abrange a parte da GPU. O Storage-Next aborda a parte do disco rígido, que atualmente está otimizada para uma carga de trabalho diferente.
Os SSDs corporativos são otimizados para leituras aleatórias de 4 KB há uma década, atendendo aos padrões de acesso de bancos de dados e virtualização. A maioria dos controladores realiza praticamente o mesmo trabalho para atender uma leitura de 512 bytes e uma de 4 KB, portanto, solicitações abaixo de 4 KB têm um custo de 4 KB. Os padrões de acesso de inferência são menores: os embeddings ocupam algumas centenas de bytes e os blocos de cache KV têm bem menos de um kilobyte. Atendê-los a partir de unidades otimizadas para 4 KB impõe uma amplificação de leitura de 8x, desperdiçando largura de banda e cache do controlador. Em dezenas de terabytes de objetos pequenos, essa amplificação determina se o flash é viável como camada de memória.
O Storage-Next é um esforço para reformular unidades, controladores e sistemas em torno de unidades menores. Ele surgiu publicamente na GTC 2025, já em andamento, com o objetivo declarado de maximizar 512 bytes de IOPS por GPU, respeitando as restrições de energia e latência. Na FMS, a NVIDIA concedeu um número de membro, reuniu mais de 40 fornecedores de armazenamento e flash e designou o SCADA como a estrutura para o desenvolvimento.
O resultado de referência é a demonstração SC25 da Micron, que alcançou 230 milhões de IOPS de leitura aleatória de 512 bytes em um único servidor sob o modelo de programação SCADA: 44 SSDs Micron 9650 PCIe Gen6 conectados a três switches Broadcom PEX90000 Gen6, controlados por três controladores H100 em um chassi Falcon 6048 da plataforma H3. Esse valor corresponde a aproximadamente 95% da capacidade combinada de 5.5 milhões de IOPS dos 44 drives.
A composição desse número é importante. 230 milhões de leituras de 512 bytes equivalem a aproximadamente 118 GB/s de carga útil, que quatro ou cinco desses drives poderiam fornecer sequencialmente. A conquista está na quantidade de operações. Sustentá-la por meio de software host consumiria dezenas de núcleos de CPU apenas no processamento de submissão e conclusão, enquanto a única CPU da demonstração estava essencialmente ociosa. Distribuída entre as mais de cem mil threads de uma GPU, a carga é de alguns milhares de operações por thread por segundo.
A capacidade dos SSDs agora é o fator determinante. O 9650 da Micron, o primeiro SSD PCIe Gen6, tem classificação de 28 GB/s sequencial e um recorde de 5.5 milhões de IOPS de leitura aleatória. A Micron relata escalabilidade linear de 1 a 44 unidades na demonstração. A série GP da Kioxia, um SSD XL-Flash projetado para acesso de 512 bytes , está sendo desenvolvida no âmbito do Storage-Next. O roadmap Storage-Next da NVIDIA prevê SSDs PCIe Gen7 capazes de suportar 100 milhões de IOPS cada, uma meta para a qual os fornecedores de controladores, incluindo a Marvell, estão projetando. Atingir esses números exige redesenho do controlador, correção de erros dimensionada para pequenas cargas de trabalho e padrões que definam o comportamento nativo da unidade para GPUs.
Mapeamento para treinamento e inferência
Os dois caminhos correspondem a dois padrões de acesso. O treinamento é limitado pela largura de banda. Ele transmite grandes fragmentos sequenciais e grava periodicamente pontos de verificação de vários terabytes, durante os quais as GPUs ficam ociosas. A sobrecarga da CPU é insignificante nesses tamanhos de transferência, portanto, o GDS e a pilha cuFile, recentemente disponibilizada como código aberto, continuam sendo a interface correta, medida em GB/s por GPU e duração do ponto de verificação.
A inferência é limitada por IOPS. O cache KV, o estado de atenção para cada token já processado em uma conversa, cresce com o comprimento do contexto. Implantações agentivas executam milhares de conversas simultâneas. Rapidamente, a memória da GPU é excedida, e recalcular entradas removidas consome mais tempo de GPU do que lê-las novamente. O design padrão é um cache em camadas que se estende da memória da GPU para a memória do sistema e, em seguida, para a memória flash, sendo reabastecido por meio de um grande volume de pequenas leituras aleatórias. A busca vetorial e as consultas de incorporação produzem o mesmo padrão. Este é o formato de acesso que o SCADA visa, e a razão pela qual a NVIDIA cita IOPS de 512 bytes em vez de largura de banda. Servir o cache KV a partir da memória flash em vez da memória RAM aumenta o número de contextos e usuários simultâneos que cada GPU suporta, o que define o custo de serviço por usuário.
O hardware: Vera BlueField-4 STX e CMX
A camada de plataforma é NVIDIA Vera BlueField-4 STX , a arquitetura de armazenamento em escala de rack apresentada na GTC 2026 e expandida esta semana. A STX combina a plataforma Vera Rubin com processadores de armazenamento BlueField-4, cada um combinando núcleos Vera Arm com 800 Gb/s de rede integrada e aproximadamente 6 vezes a capacidade de processamento do BlueField-3.
Na FMS, a NVIDIA publicou um benchmark para esses núcleos. Um pipeline de compressão e criptografia em dois estágios, representativo dos sistemas de armazenamento de serviços de dados inline que se aplicam a todo o tráfego, atingiu uma taxa de transferência até 3.21 vezes maior do que uma CPU x86 no Vera. A afirmação implícita é que a criptografia, a compressão e a verificação, que atualmente consomem núcleos x86 em controladores de armazenamento, podem ser migradas para o silício Vera com menor consumo de energia. O DOCA, framework de software da NVIDIA para BlueField, aplica a política de segurança no caminho dos dados. O CMX Context Memory Storage , baseado no STX, agrupa a memória flash por trás do BlueField-4 como uma camada de cache KV compartilhada para inferência de contexto longo. Sistemas de parceiros como DDN, Dell, HPE, IBM, VAST Data, WEKA e outros estão previstos para o segundo semestre de 2026.
Pensamentos de Encerramento
A estrutura estratégica é clara: a NVIDIA está publicando a interface que as GPUs usarão para acessar o armazenamento, disponibilizando a implementação em código aberto e organizando mais de 40 fornecedores para padronizar o comportamento do hardware subjacente. Abrir o cuFile representa uma mudança na prática da NVIDIA de manter essa camada dentro do CUDA. Mas uma interface de armazenamento iniciada pela GPU só compensa se os fornecedores de unidades, controladores e arrays desenvolverem soluções compatíveis com ela. A entrada da Intel como mantenedora é um sinal importante. Uma das principais fornecedoras de silício x86 nos sistemas de armazenamento atuais está apoiando um software projetado para remover esse silício do caminho de E/S.
A demonstração da Micron comprova a viabilidade. Três GPUs levaram 44 SSDs Gen6 a aproximadamente 95% de sua capacidade nominal combinada, em um tamanho de bloco que a indústria considerava secundário. O que resta é a execução: o código sendo publicado no GitHub, o SCADA evoluindo de framework para componente CUDA compatível e os fornecedores comercializando SSDs otimizados para leitura de pequeno volume. Os números acima são da NVIDIA e de seus parceiros, não são medições independentes. Testaremos esses dados quando os sistemas STX chegarem ao laboratório no segundo semestre do ano.


 Amazon