

A NVIDIA, a Rebellions e a SK Telecom anunciaram um plano para construir uma infraestrutura soberana de inferência de IA na Coreia do Sul, baseada na unidade de processamento neural R200 de última geração da Rebellions, conectada internamente ao rack com NVIDIA NVLink Fusion e construída sobre a arquitetura de rack NVIDIA MGX. A SK Telecom implantará os sistemas em seu data center de IA, juntamente com seus modelos e serviços. As três empresas esperam que os sistemas R200 estejam prontos para implantação em 2028.
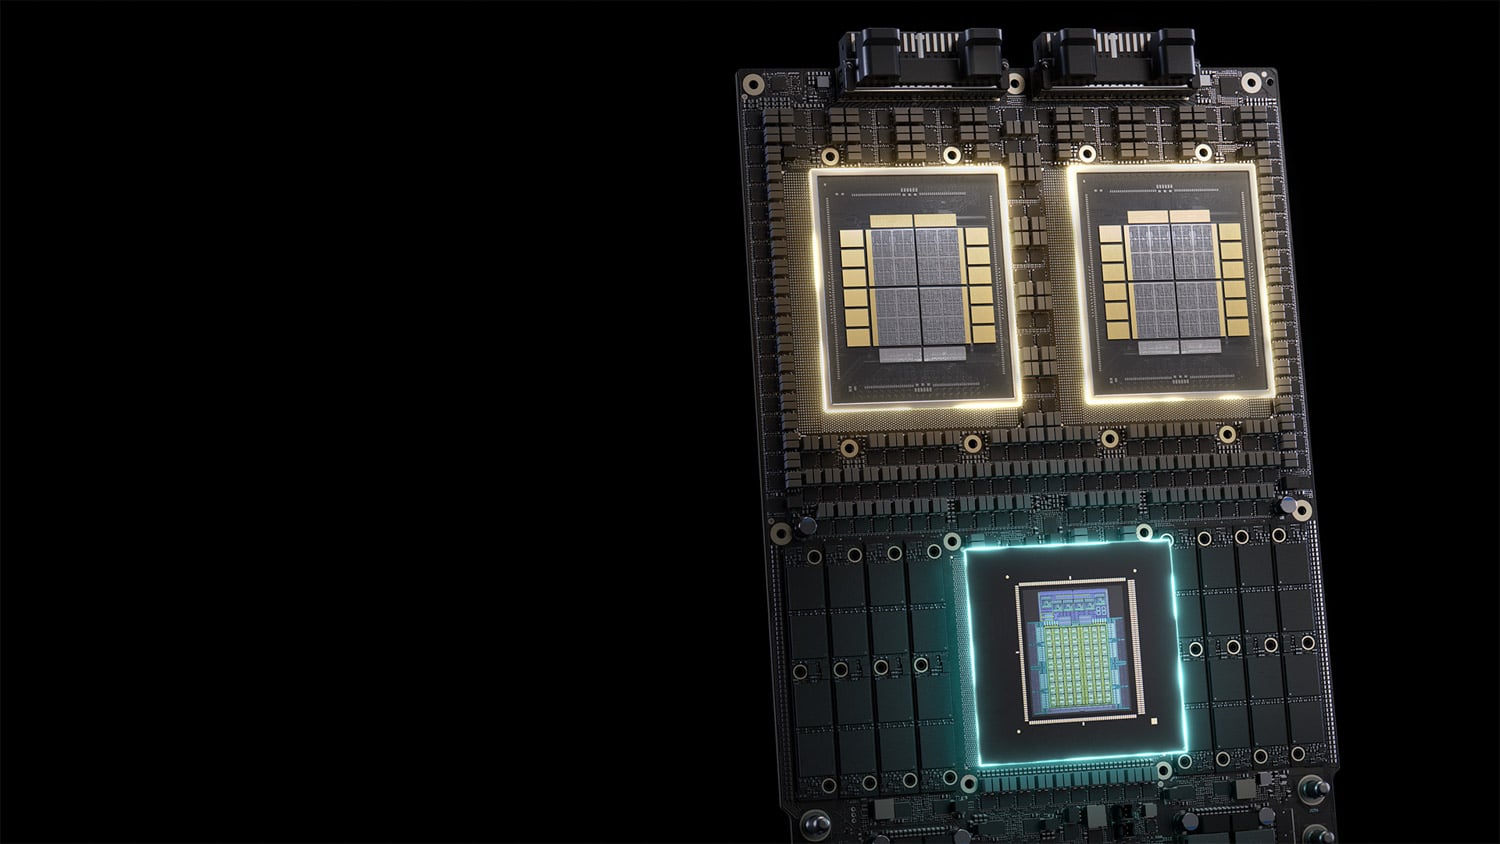
NVLink Fusion conecta NPUs R200
A Rebellions está projetando o R200 para inferência de baixa latência e baixo consumo de energia em modelos de ponta, incluindo modelos de mistura de especialistas com trilhões de parâmetros. O NVLink Fusion é o programa da NVIDIA para integrar silício personalizado à sua infraestrutura de escalabilidade: um fabricante de chips integra o NVLink em seu processador e obtém acesso à comutação NVLink da NVIDIA, à sua rede de alta largura de banda e baixa latência e ao ecossistema de infraestrutura correspondente. A Rebellions planeja utilizá-lo para conectar NPUs R200 dentro de um rack por meio da rede de escalabilidade NVLink e para integrar esses processadores à plataforma NVIDIA como parte de um sistema em escala de rack.
As empresas não divulgaram as especificações do R200, a largura de banda NVLink por NPU ou quaisquer resultados de desempenho para a configuração planejada. A Rebellion lista o Rebel100 como seu chip atual, e o anúncio do R200 não menciona nada sobre memória, processo de fabricação ou consumo de energia, portanto, a diferença entre as duas gerações é desconhecida.
A arquitetura de rack MGX suporta o desenvolvimento de sistemas.
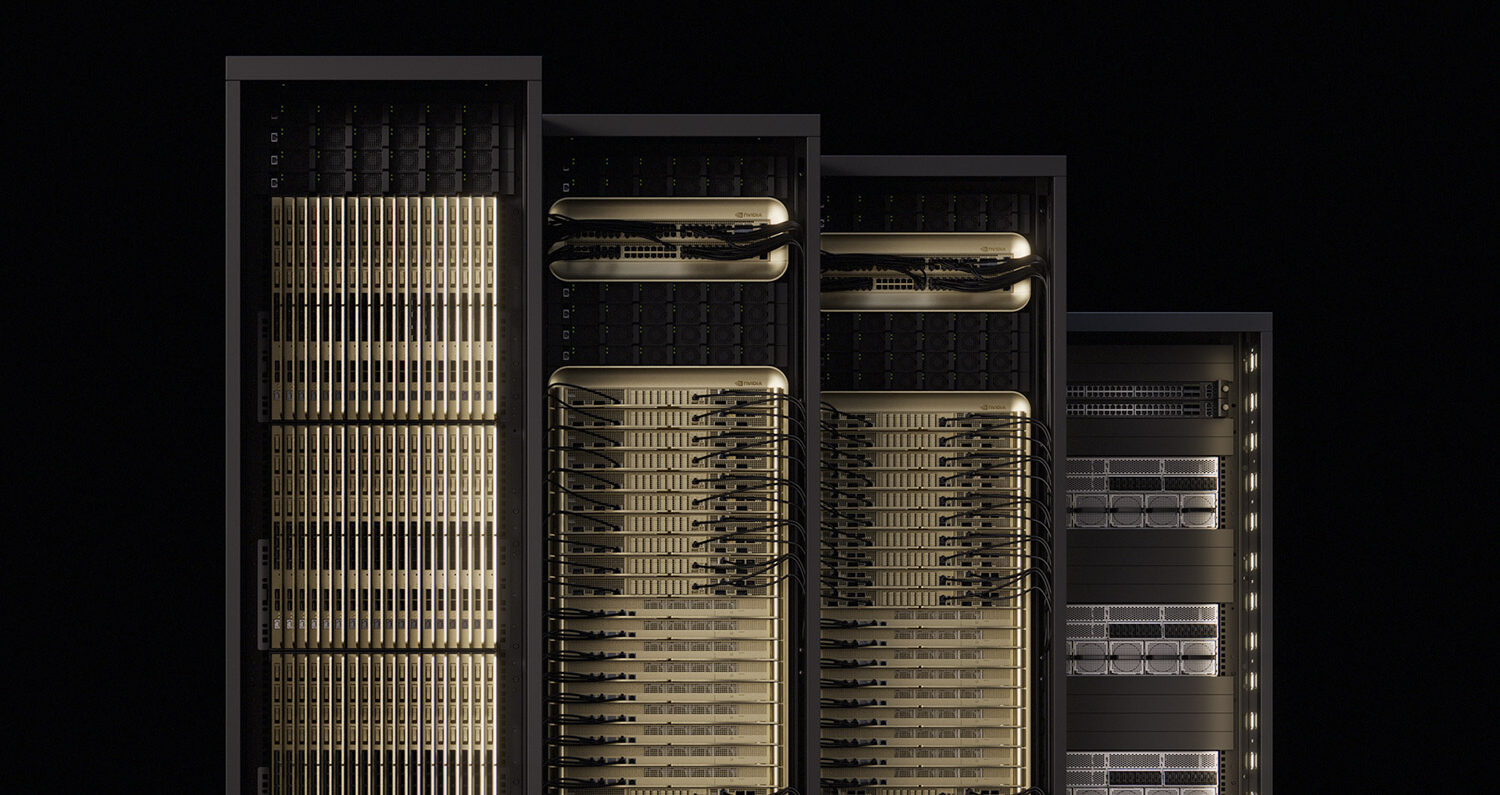
A arquitetura de rack MGX da NVIDIA e os projetos de referência oferecem à Rebellions um ponto de partida para o sistema, além de acesso aos fabricantes de design original e fornecedores de componentes que já produzem hardware MGX. O MGX define as partes compartilhadas de um rack, incluindo espaço ocupado, fornecimento de energia e refrigeração, permitindo que sistemas de GPU e sistemas de NPU ocupem o mesmo espaço no data center. A SK Telecom planeja implantar os sistemas R200 em seu data center de IA no rack MGX padronizado, o que permite o planejamento de energia e refrigeração antes mesmo da finalização do processador.
GPUs para pré-preenchimento, NPUs para decodificação.
O detalhe técnico mais interessante é a divisão da inferência que as três empresas planejam desenvolver. A inferência possui duas fases com diferentes demandas de hardware: o pré-preenchimento, que processa o prompt e geralmente é limitado por poder computacional, e a decodificação, que gera tokens um de cada vez e geralmente é limitada pela largura de banda da memória e pela latência. A configuração proposta executa o pré-preenchimento em GPUs NVIDIA e a decodificação em NPUs Rebellion, com as duas conectadas pela estrutura NVLink.
Os objetivos declarados são maior taxa de transferência de inferência e melhor eficiência energética. O benefício de delegar a decodificação a uma NPU permanece uma intenção de projeto até que os sistemas existam, mas a lógica faz sentido na teoria. O preenchimento e a decodificação desagregados já são práticas comuns em pools de GPUs, inclusive na estrutura de serviço Dynamo da NVIDIA; a novidade está em dividir as duas fases em diferentes arquiteturas de processador por meio do NVLink.
Sunghyun Park, cofundador e CEO da Rebellions, afirmou que a colaboração combina o silício de IA e o design de sistemas da empresa com os recursos de interconexão e escala de rack da NVIDIA e os modelos e operações de data center da SK Telecom, com o objetivo de inferência de baixa latência e eficiência energética para modelos de ponta em grande escala.
A SK Telecom conecta modelos e serviços.
A SK Telecom fornece os modelos e os clientes. Ela planeja executar seus modelos proprietários de base, incluindo o AX K2, na infraestrutura, juntamente com serviços voltados para o público desenvolvidos por meio do projeto AI for All do governo coreano. As operações de data center, os modelos e os serviços da SK Telecom complementam o que as empresas descrevem como uma estratégia soberana de IA completa, e o trabalho se baseia na parceria mais ampla entre a SK e a NVIDIA, anunciada na Korea AI Summit em julho.
O Ministério da Ciência e TIC da Coreia está apoiando a colaboração entre a NVIDIA e empresas coreanas de NPU (Unidades de Processamento de Rede), começando com a Rebellions e a SK Telecom, e descreveu uma cooperação mais ampla que abrange IA física e fornecimento de GPUs. O objetivo é oferecer serviços de IA adaptados ao idioma, às indústrias e às prioridades da Coreia, tanto no setor público quanto no privado.
Disponibilidade
Os sistemas Rebellion R200 deverão estar prontos para implantação em 2028. Não há cronograma de distribuição de amostras, programa de acesso antecipado, data de disponibilidade geral ou preços divulgados.


 Amazon