

A Supermicro anunciou hoje, em parceria com a IBM e a NVIDIA, uma solução de armazenamento em cache KV que transfere o estado de chave-valor por trás da inferência de contexto longo da GPU para uma camada compartilhada totalmente em flash. O pacote combina servidores de armazenamento Petascale da Supermicro com processadores AMD EPYC 9005, IBM Storage Scale, NVIDIA Dynamo e NVIDIA Spectrum-X Ethernet, e as empresas o respaldam com uma arquitetura de referência validada que a IBM publicou como um Redbook. O principal destaque é uma redução de 56 vezes no tempo para o primeiro token em solicitações de 130,000 tokens, em comparação com uma GPU que recalcula o contexto do zero.
Por que o cache KV precisa de uma camada de armazenamento?
A inferência ocorre em duas fases: o preenchimento prévio transforma a solicitação em tokens e os envia através do modelo para produzir os estados intermediários de chave-valor, e a decodificação gera a resposta um token por vez com base nesses estados. Manter o estado de chave-valor em um cache persistente permite que o sistema o reutilize na próxima interação, na próxima etapa do agente ou na próxima solicitação que compartilhe o mesmo contexto, evitando o recálculo.
Fluxos de trabalho com agentes, assistentes de codificação, RAG de contexto longo e aplicativos de múltiplas etapas geram estado suficiente para sobrecarregar rapidamente a memória da GPU e da CPU, e é por isso que a Supermicro, a IBM e a NVIDIA estão criando uma camada de armazenamento em rede.
Nesse projeto, o NVIDIA Dynamo gerencia a hierarquia de cache e move blocos via NIXL; o IBM Storage Scale Erasure Code Edition fornece a camada de arquivos compartilhados; e os servidores Petascale fornecem o flash e as vias PCIe Gen5 subsequentes. A Supermicro afirma que as três empresas testaram a arquitetura em nível de cluster sob alta concorrência e com tráfego de rede ruidoso, e está apresentando o resultado como uma solução pronta para uso, com integração em rack de fábrica e implantação no local, que, segundo a empresa, reduz o tempo de implantação de semanas para dias.
Configuração testada
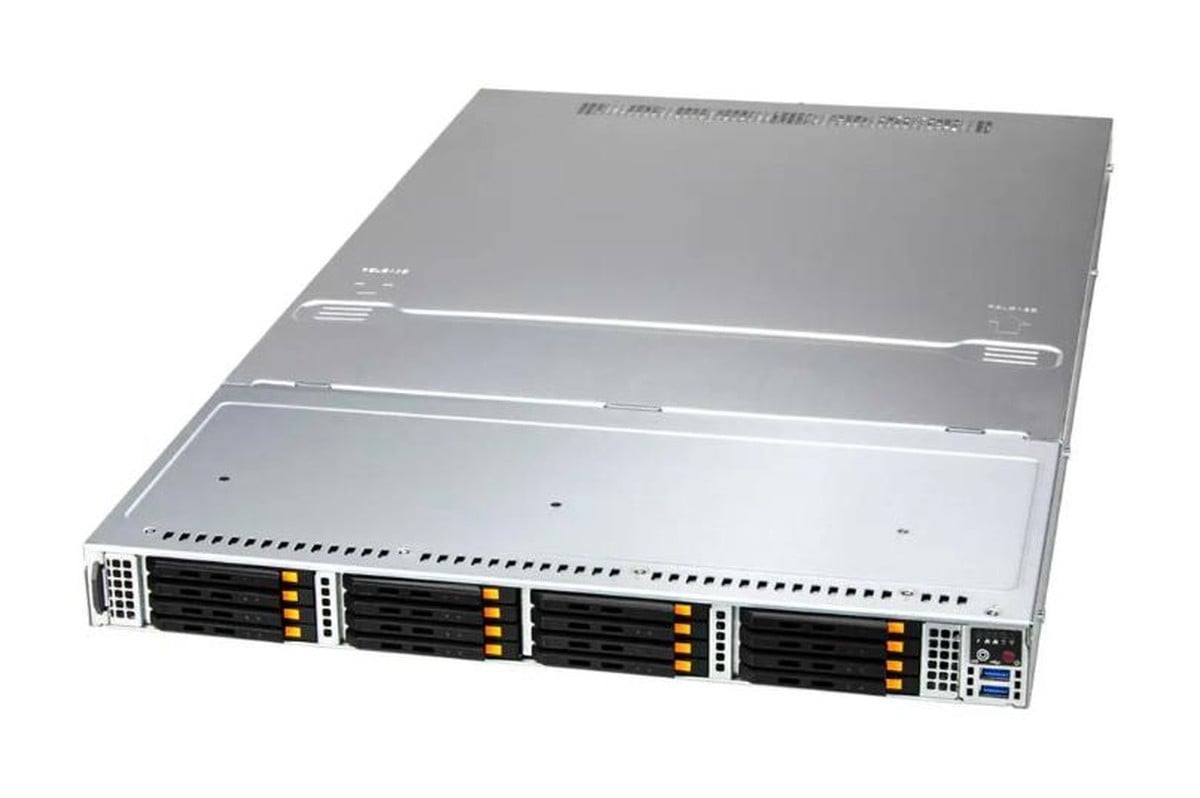
A arquitetura de referência utiliza oito nós Petascale Supermicro ASG-1115S-NE316R, cada um um sistema 1U com um único processador AMD EPYC 9535 e 16 unidades NVMe E3.S de 7.68 TB da 16 Micron, o que resulta em 122.88 TB de flash bruto em cada nó e cerca de 983 TB no total dos oito nós. Cada nó possui um switch NVIDIA BlueField-3 B3220 de 200 Gb com duas portas no lado do cliente e um ConnectX-7 de 400 Gb para o armazenamento de dados, com três switches Spectrum-X SN5600 em um layout spine-leaf e uplinks de 800 Gb/s.
Os nós de armazenamento executam RHEL 9.6 e IBM Storage Scale ECE 6.0.0.1 em um layout de código de apagamento 8+2P, e a IBM estima a taxa de transferência de leitura dessa camada de oito nós em 315 GB/s, com base em testes anteriores.
| Componente | Arquitetura de referência de cache KV (conforme testado) |
|---|---|
| Camada de armazenamento | |
| Nós de armazenamento | 8x Supermicro ASG-1115S-NE316R (1U, soquete único) |
| CPU por nó | AMD EPYC 9535, 128 pistas PCIe Gen5 (64 para NVMe, 64 para rede) |
| Flash por nó | 16x Micron 7.68 TB E3.S NVMe (122.88 TB brutos) |
| Rede por nó | NVIDIA BlueField-3 B3220, porta dupla de 200Gb (lado do cliente) NVIDIA ConnectX-7 400Gb (backend de armazenamento) |
| Mudar | 3x NVIDIA Spectrum-X SN5600, configuração spine-leaf, uplinks de 800 Gb/s |
| Software de armazenamento | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Cliente de inferência | |
| System | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| GPU utilizada para os benchmarks | 1x NVIDIA RTX PRO 6000 Blackwell, com 19.6 GiB restantes para cache KV após ponderação e gráficos CUDA. |
| networking com clientes | 2 placas NVIDIA BlueField-3 B3140H de 400 Gb/s, com largura de banda de até 80 Gb/s para o cliente. |
| Modelo e software | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 com NIXL Cliente de benchmark NVIDIA AIPerf |
| Camadas de cache | Níveis de host e local definidos como zero; todos os 1.4 milhão de tokens em cache são servidos a partir do nível de Escala de Armazenamento. |
O cliente de benchmark é um único sistema Supermicro SYS-212GB-FNR MGX, e os resultados provêm de uma GPU NVIDIA RTX PRO 6000 Blackwell nesse sistema, executando o modelo openai/gpt-oss-120b em MXFP4 sob vLLM 0.14.1 e Dynamo 0.9.0.
Após os pesos e os grafos CUDA, restaram 19.6 GiB de memória da GPU para o cache KV, o suficiente para cerca de 1.14 milhão de tokens na própria GPU. Para os testes, a memória do host e os níveis locais foram definidos como zero, de modo que cada bloco em cache fosse retornado do Storage Scale, para que os resultados medissem o caminho de armazenamento por si só, sem a influência de uma hierarquia mista.
56 vezes mais rápido no tempo até o primeiro token, 22 vezes mais eficiente em termos de produtividade.
Sem cache, o tempo até o primeiro token (TTFT) para o modelo de 120 bytes aumentou de 0.572 segundos com 10,000 tokens de entrada para 32.14 segundos com 130,000 tokens, enquanto a GPU recalculava o contexto completo. Com o cache KV em Storage Scale, o TTFT permaneceu entre 0.193 e 0.57 segundos na mesma faixa, o que representa um aumento de 56 vezes na marca de 130,000 tokens e a variação de 0.377 segundos citada pela Supermicro em seu anúncio. A IBM, a Supermicro e a NVIDIA executaram esses testes, e nós não executamos nem auditamos os resultados.
O teste de throughput enviou 200 requisições em 28 conexões simultâneas, provenientes de 100 solicitações únicas, totalizando 24 milhões de tokens e 825 GB de dados de cache KV, com o cache inicialmente vazio. A linha de base de recálculo atingiu 0.19 requisições por segundo em 1,048 segundos; a camada Storage Scale atingiu 4.26 requisições por segundo em 46.94 segundos, um ganho de 22 vezes que inclui o custo de inicialização a frio para preencher o cache.
Uma terceira execução adicionou quatro clientes, gerando 200 GB/s de tráfego de rede não relacionado na mesma estrutura, e a configuração em cache suportou 3.6 solicitações por segundo e 55.56 segundos para as 200 solicitações, cerca de nove segundos mais lenta do que a execução sem cache e ainda 18 vezes mais lenta do que a linha de base. A IBM atribui a pequena penalidade ao fato da estrutura Spectrum-X isolar o tráfego em cache da carga de fundo.
“A IA ativa e as aplicações de contexto longo dependem da reutilização eficiente do contexto em várias etapas, e o NVIDIA Dynamo ajuda a orquestrar a inferência distribuída para que as empresas possam obter maior taxa de transferência utilizável de cada GPU”, disse Shruti Koparkar, Líder de Produto de Inferência de IA da NVIDIA. “Ao combinar o NVIDIA Dynamo e o Spectrum-X Ethernet com servidores de armazenamento Supermicro Petascale e IBM Storage Scale, essa solução de cache KV cria uma camada de armazenamento compartilhado de alto desempenho que pode reduzir a computação redundante, melhorar o tempo até o primeiro token e ajudar os clientes a escalar serviços de inferência de IA resilientes.”
Dimensionamento e o que não está nos números
O guia de dimensionamento da IBM define uma configuração de quatro nós com 4+2P e 67% de capacidade utilizável para modelos de 7B a 34B e até 64 GPUs; a configuração testada de oito nós com 8+2P e 80% de capacidade utilizável para modelos de 70B a 120B e 100 a 256 GPUs, necessitando de 100 a 300 GB/s de largura de banda de leitura; e 16 ou mais nós com 16+3P e 84% de capacidade utilizável para modelos maiores e 300 ou mais GPUs com 300 GB/s ou mais. O próprio Storage Scale ECE é escalável de três servidores de armazenamento a 256.
A principal ressalva reside na configuração de teste com uma única GPU. A arquitetura de referência foi dimensionada para centenas de GPUs, mas todos os resultados apresentados no artigo provêm de uma única RTX PRO 6000 contra um cluster flash de oito nós e 983 TB, com velocidade de transferência estimada pela IBM em 315 GB/s. Portanto, o armazenamento estava longe da saturação, e os testes não demonstram o desempenho do TTFT quando um cluster completo de GPUs está acessando o cache simultaneamente.
A Supermicro não divulgou preços nem data de disponibilidade para a solução completa, e o anúncio não apresenta dados de utilização da GPU. A abordagem se enquadra na mesma categoria da aceleração de cache KV integrada ao Dynamo da DDN no AI400X3M , com a diferença de que essa solução roda em servidores Supermicro padrão e Ethernet sob o sistema de arquivos da IBM.
“À medida que as cargas de trabalho de IA se expandem do treinamento para a inferência, empresas e neoclouds que implementam cargas de trabalho de inferência de alto desempenho, características da IA agente e da IA generativa de contexto longo e múltiplas etapas, precisam eliminar gargalos para melhorar a eficiência da GPU”, disse Charles Liang, presidente e CEO da Supermicro. “Nossa solução com a IBM e a NVIDIA demonstra claramente esses benefícios de desempenho.”



 Amazon