

A VAST Data lançou uma nova arquitetura de inferência que suporta a plataforma de armazenamento NVIDIA Inference Context Memory. Este sistema é voltado para aplicações de IA que envolvem sessões contínuas e com múltiplas interações, conduzidas por agentes. A VAST apresenta esta plataforma como uma classe de armazenamento projetada para IA, aprimorando o acesso ao cache de chave-valor (KV), permitindo o compartilhamento rápido do contexto de inferência entre nós e melhorando a eficiência energética. O projeto utiliza DPUs NVIDIA BlueField-4 e rede Ethernet Spectrum-X, enquanto o Sistema Operacional de IA da VAST (AI OS) fornece o software necessário para gerenciar este recurso de infraestrutura compartilhada de forma eficaz.
Para saber mais sobre a importância do KV Cache, confira este estudo aprofundado que fizemos com a Pliops.
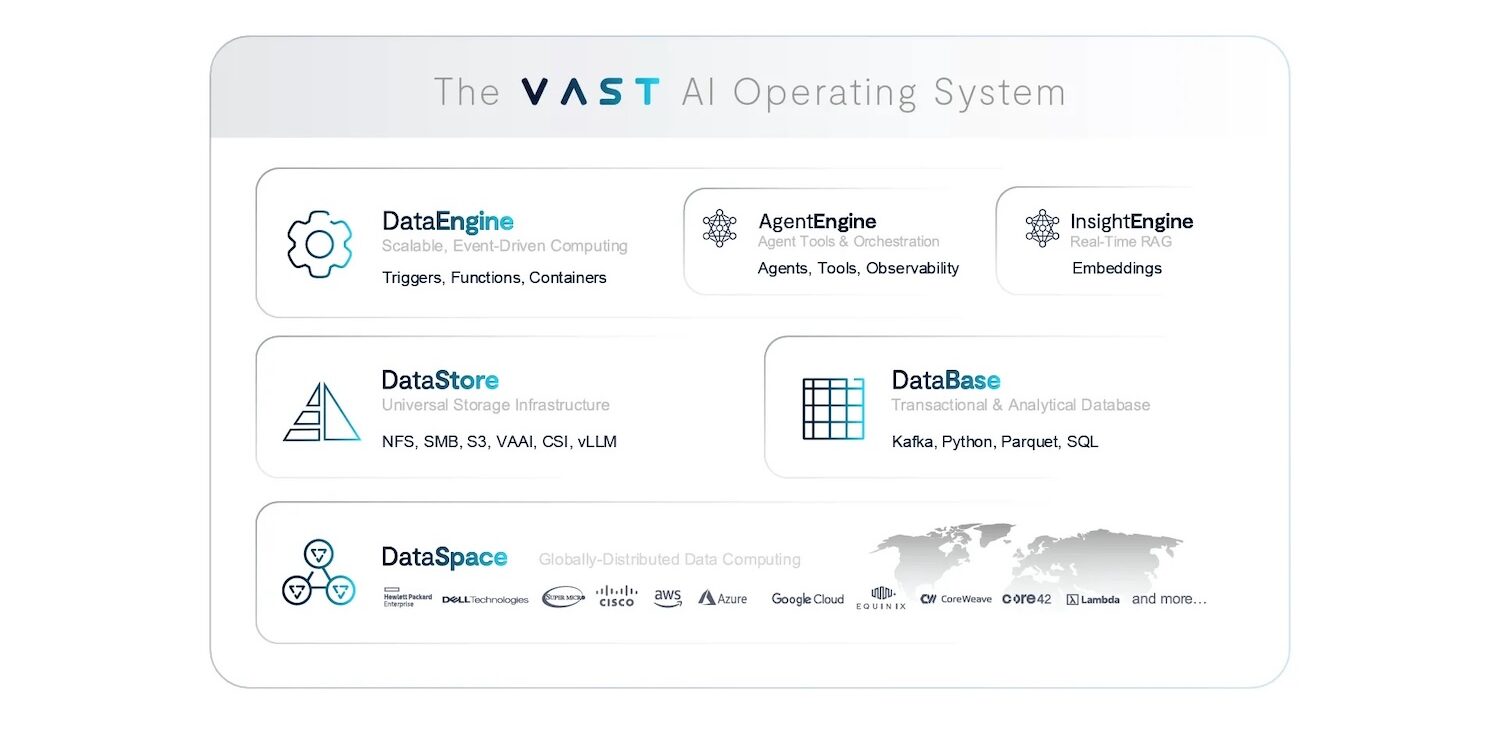
O anúncio sinaliza uma mudança nos fatores que limitam o desempenho da inferência em aplicações do mundo real. À medida que a inferência passa de simples instruções para raciocínio contínuo entre múltiplos agentes e usuários, a ideia de que o contexto permanece dentro de um único servidor de GPU torna-se obsoleta. Nessas situações, o desempenho geral depende cada vez mais de quão bem o histórico de inferência é armazenado, restaurado, reutilizado, estendido e compartilhado durante as operações em andamento. O cache KV evolui de uma otimização interna para um caminho de dados primário, afetando o tempo até o primeiro token (TTFT), o uso da GPU e a eficiência do cluster.
Reconstruindo o caminho de dados de inferência em torno das DPUs
A estratégia da VAST consiste em executar o software VAST AI OS diretamente nas DPUs NVIDIA BlueField-4. Em vez de considerar os serviços de armazenamento e contexto como componentes externos acessados por meio de um modelo típico de cliente-servidor, a arquitetura integra esses serviços de dados diretamente no servidor de GPU, onde a inferência ocorre, além de suportar configurações dedicadas de nós de dados. Essa abordagem visa minimizar gargalos e eliminar cópias e atrasos desnecessários que reduzem o desempenho à medida que a concorrência aumenta.
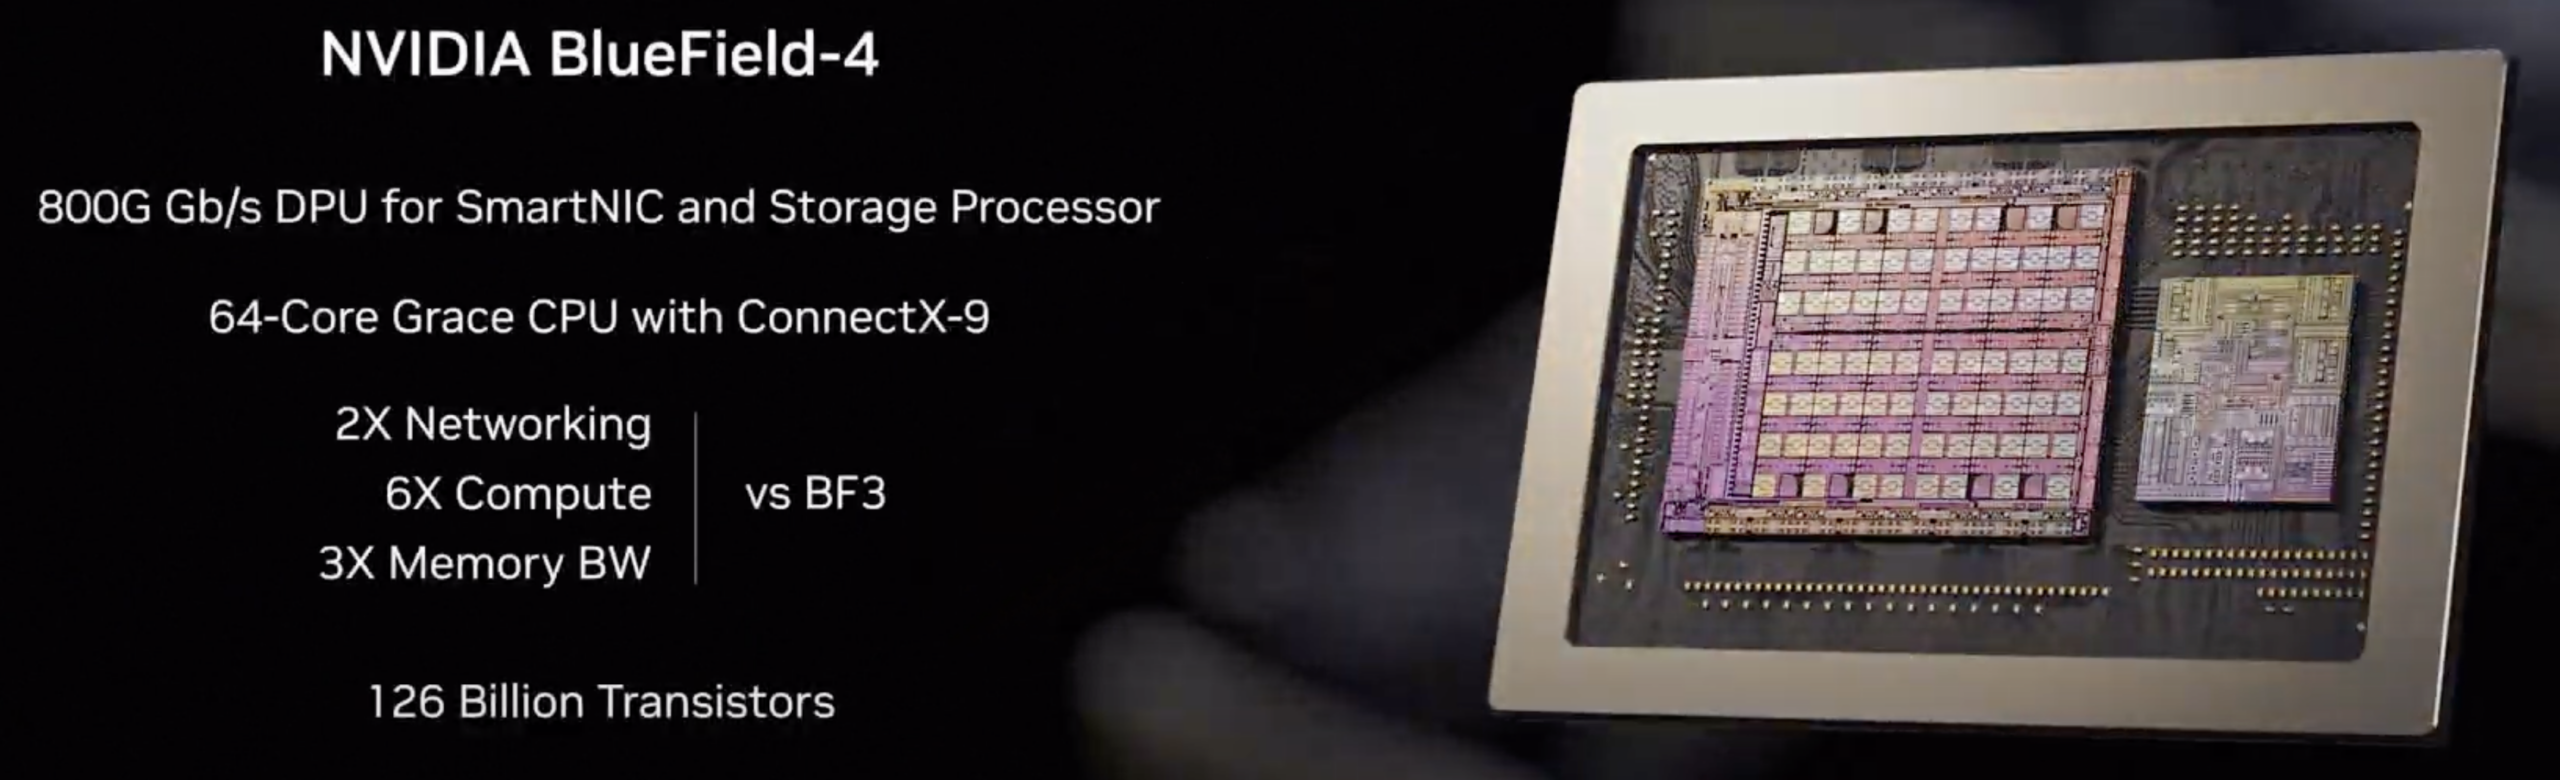
Este design nativo para DPU aborda explicitamente as necessidades práticas de grandes sistemas de inferência. Quando centenas ou milhares de sessões são executadas simultaneamente, o gerenciamento do cache KV se transforma em um trabalho contínuo de entrada/saída (E/S). O sistema precisa ler o contexto rapidamente para manter as sessões em execução, armazená-lo para uso a longo prazo e compartilhá-lo entre os nós de processamento para evitar processamento duplicado quando a infraestrutura direciona as operações por caminhos mais lentos ou requer extensa coordenação. O TTFT (Tempo até a Primeira Fase) aumenta, fazendo com que as GPUs esperem em vez de processar. O VAST afirma que mover o plano de dados para o servidor via BlueField-4 resulta em um tráfego de contexto mais eficiente, maior taxa de transferência e latência mais confiável, mais próximo do loop de processamento da GPU.
O VAST também enfatiza uma rota eficiente da memória da GPU para o armazenamento NVMe persistente usando interconexões RDMA. Isso permite que o contexto seja transferido suavemente entre servidores de GPU e armazenamento, reduzindo o processamento repetitivo de dados comum em sistemas tradicionais. O objetivo é garantir que a movimentação de contexto permaneça "em banda" com redes de alto desempenho, minimizando o envolvimento da CPU e a sobrecarga do lado do cliente.
Contexto compartilhado e coerente em escala
A nova arquitetura funciona em conjunto com o design paralelo de Tudo Compartilhado Desagregado (DASE) do VAST. O VAST explica que isso permite que cada host acesse um namespace de contexto compartilhado e globalmente consistente, sem os custos de coordenação que normalmente surgem em grande escala. Em inferência orientada a agentes e de longa duração, esse detalhe torna-se crucial. O contexto não é apenas amplo, mas também cada vez mais compartilhado.
Sistemas com agentes frequentemente exigem o uso simultâneo de ferramentas, transferências entre múltiplos agentes e comportamento semelhante à memória durante as interações. Isso torna necessário reutilizar o contexto em vez de recriá-lo e compartilhá-lo entre os trabalhadores de inferência em vez de vinculá-lo a um único nó. Se os sistemas não conseguirem manter a localidade do contexto devido a problemas de agendamento, remoção ou recuperação de falhas, eles devem restaurar e continuar as sessões rapidamente, sem reprocessar longos históricos de prompts. Dessa forma, o cache chave-valor se transforma em um recurso vital do cluster, transferindo o desafio para torná-lo amplamente acessível sem se tornar um gargalo de sincronização.
A perspectiva da VAST é que a combinação de serviços de dados baseados em DPU com uma configuração de armazenamento totalmente compartilhada cria uma camada de contexto globalmente acessível que permanece eficiente à medida que o número de sessões simultâneas aumenta. Em vez de escalar adicionando seções de contexto isoladas, a plataforma permite que os clusters se expandam, beneficiando-se ainda da reutilização e do compartilhamento.
Contexto como o Novo Limite de Desempenho
John Mao, executivo da VAST, observou que a vantagem competitiva para grandes sistemas de inferência está migrando da mera capacidade computacional para sistemas de memória e contexto. Ele resumiu que os clusters mais eficazes não serão apenas aqueles com o maior pico de FLOPS; serão aqueles capazes de compartilhamento e gerenciamento de contexto em tempo real. Ele também destacou a importância do acesso instantâneo e sob demanda ao contexto como uma área chave de desempenho, alertando que, sem a recuperação e reutilização rápidas do contexto, as GPUs permanecem ociosas e a eficiência é prejudicada.
Essa visão está alinhada com a experiência de muitos operadores à medida que os modelos escalam e a duração das sessões aumenta. As frotas de inferência são frequentemente configuradas para a produção máxima de tokens, mas a experiência é influenciada pela latência de cauda e pelo TTFT (Tempo até a Primeira Fase) sob estresse. Conforme os prompts se tornam mais longos e as sessões mais prolongadas, o tempo gasto no gerenciamento de contexto aumenta. Se o contexto não puder ser restaurado ou reutilizado rapidamente, os ciclos da GPU são desperdiçados no restabelecimento do estado ou na espera pela movimentação de dados. A abordagem arquitetônica do VAST trata o cache KV como infraestrutura compartilhada, reduzindo esses problemas e aumentando a eficiência geral do cluster.
Da experimentação à inferência de produção governada
A VAST também apresenta a plataforma como uma transição de implantações experimentais para serviços de inferência prontos para produção, inclusive em ambientes regulamentados. À medida que a inferência se torna um serviço gerador de receita com requisitos específicos de segurança e conformidade, o gerenciamento do cache de chave-valor exige mais do que velocidade; exige supervisão.
Em sessões longas, o contexto pode incluir prompts sensíveis, etapas de raciocínio, resultados de ferramentas e informações fornecidas pelo usuário. As empresas exigem cada vez mais controles de políticas, medidas de isolamento, trilhas de auditoria e gerenciamento do ciclo de vida para esse contexto. A VAST afirma que esses serviços de dados nativos de IA estão integrados ao sistema operacional de IA, permitindo que as organizações tratem o cache chave-valor como um recurso gerenciável, em vez de um estado temporário.
Do ponto de vista operacional, o VAST visa solucionar desafios comuns em grandes ambientes de inferência: tempestades de reconstrução de contexto que ocorrem quando caches são perdidos ou não podem ser compartilhados, e desperdício de tempo de GPU quando o contexto se torna o gargalo em vez da computação. A empresa acredita que aprimorar a persistência e a reutilização de contexto reduzirá a recomputação e aumentará o uso, melhorando assim tanto a taxa de transferência por watt quanto a taxa de transferência por dólar à medida que os tamanhos dos contextos e a concorrência de sessões aumentam.
NVIDIA: O gerenciamento de contexto impulsiona a economia de escalabilidade.
Kevin Deierling, Vice-Presidente Sênior de Redes da NVIDIA, enfatizou a importância do contexto em IA, comparando-o à memória humana. Ele afirmou que o gerenciamento eficaz do contexto é essencial para escalar a inferência multi-turn e multi-usuário, o que, por sua vez, altera a forma como a memória de contexto é gerenciada em grande escala. Ele observou que o VAST Data AI OS, em combinação com o NVIDIA BlueField-4, oferece suporte a isso, fornecendo um caminho de dados estável e de alta taxa de transferência à medida que as cargas de trabalho aumentam. Essa parceria é importante porque integra DPUs e a estrutura Ethernet ao contexto central de inferência, não apenas para acesso ao armazenamento primário ou à rede. O ponto principal é que o contexto agora representa um desafio tanto para a rede quanto para o armazenamento, além de ser uma questão relacionada à GPU, e as configurações modernas de inferência exigirão aceleração focada e movimentação de dados confiável para manter as GPUs operando com eficiência.
Se a arquitetura do VAST proporcionar os benefícios prometidos, o impacto real será menos relacionado aos picos de pontuação em benchmarks e mais à consistência do desempenho do serviço: menor TTFT (Tempo até a Primeira Fase) quando muitas sessões estiverem ativas, menos quedas de desempenho com o aumento do contexto, melhor utilização ao reduzir a reconstrução de contexto e um caminho mais direto para inferência em múltiplos nós, onde o compartilhamento de contexto é uma vantagem em vez de uma desvantagem. Além disso, impulsiona a infraestrutura de inferência em direção a um modelo mais "nativo da IA", tratando o cache KV como uma camada de memória gerenciada, suportada por NVMe persistente e compartilhada entre nós com limites de latência rigorosos.
Conferência VAST Forward
A VAST Data apresentará sua estratégia na primeira conferência de usuários VAST Forward, agendada para 24 a 26 de fevereiro de 2026, em Salt Lake City, Utah. A empresa planeja incluir sessões técnicas detalhadas, laboratórios práticos e programas de certificação, com a participação da liderança da VAST , clientes e parceiros.


 Amazon