

A AMD Instinct MI350P é a primeira nova GPU PCIe Instinct da AMD em quatro anos, após a MI210 em 2022. Ela traz a arquitetura CDNA 4 da empresa para uma placa de expansão convencional, com até 4.6 PFLOPS de desempenho MXFP4, 144 GB de HBM3E e 4 TB/s de largura de banda de memória. Tudo isso em uma placa de dois slots com dissipador de 600 W e refrigeração a ar, oferecendo aos clientes mais uma maneira de implementar GPUs Instinct sem precisar migrar para a plataforma OAM MI350/5X de 8 GPUs.
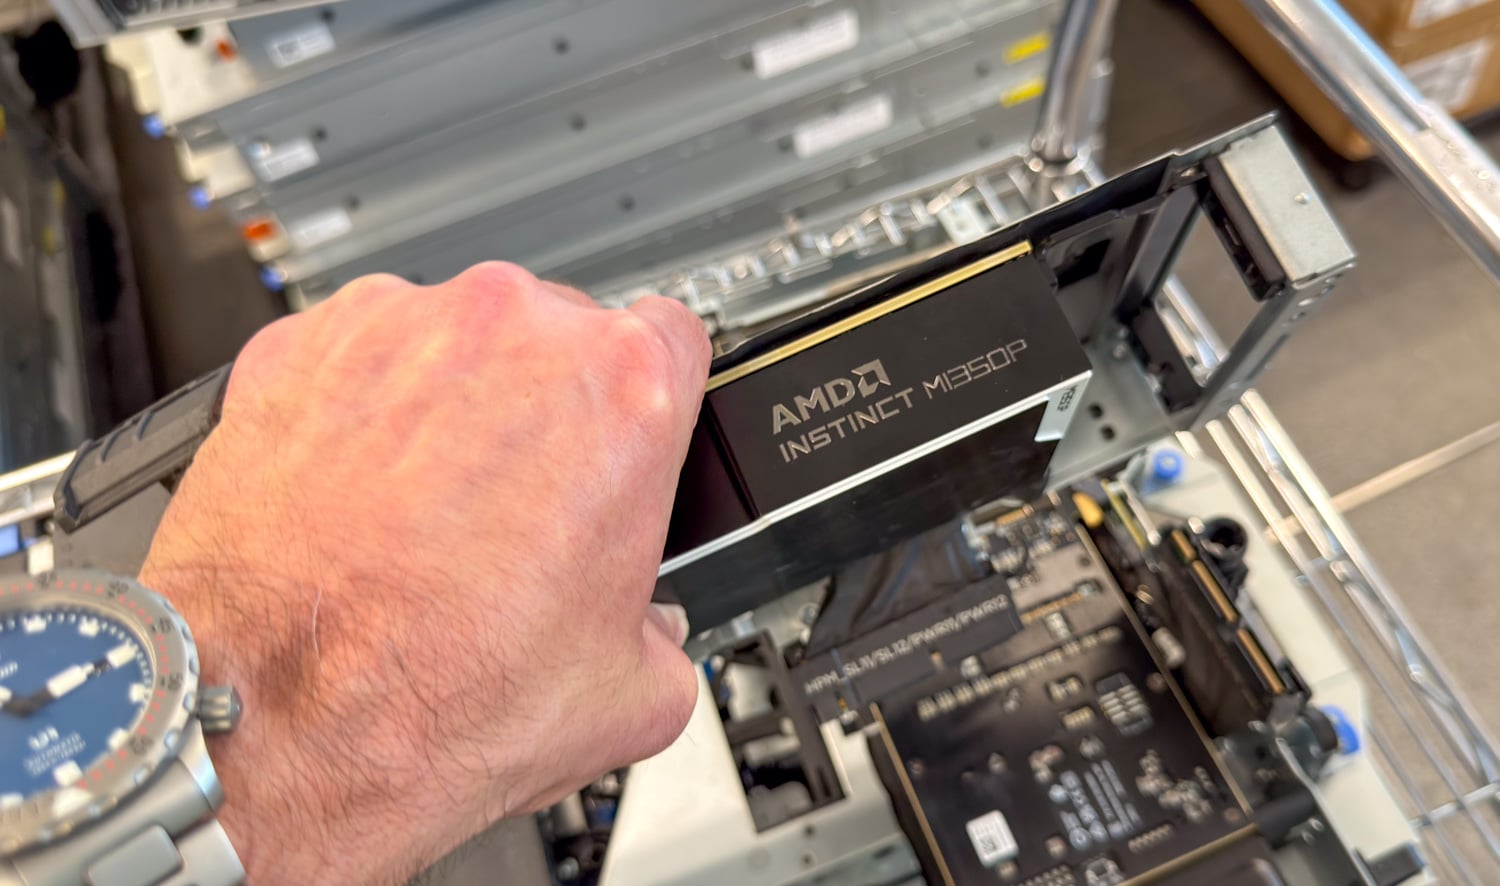
Principais lições
- O grande destaque é a capacidade de armazenar 144 GB em um slot PCIe. A MI350P possui a maior quantidade de memória entre os aceleradores PCIe atuais, 3 GB a mais que a H200 NVL e 48 GB a mais que a RTX PRO 6000 Blackwell, com 4 TB/s de HBM3E. Dez das quatorze combinações de modelo e precisão testadas nesta análise rodaram em uma única placa.
- Medição da área computacional entre as duas placas NVIDIA. Com 450W, o MAMF atingiu 580 TFLOPS em BF16, 1,120 em FP8 e 2,228 em FP4 com escala de bloco, de 36 a 38% acima de uma RTX PRO 6000 de 600W em todas as precisões e atrás da H200 NVL em BF16 e FP8, que não possui caminho FP4.
- O GPT-OSS é o resultado mais forte do MI350P. No AMDGPU 31.60, ROCm 10.1.0 e vLLM 0.32.0, o GPT-OSS-120B atingiu 5,057 tokens de saída por segundo com 128 fluxos na carga de trabalho de bate-papo, 65% à frente do RTX PRO 6000 e 50% à frente do H200 NVL, e a curva continua subindo com 128 fluxos em ambos os formatos de prompt.
- Mensagens curtas, do tamanho ideal para um bate-papo, favorecem o MI350P; mensagens longas apresentam resultados variados. Em testes com 512 tokens, a placa supera a RTX PRO 6000 em todos os modelos FP8, BF16 e GPT-OSS em 35 a 65% com 128 fluxos, e os dois confrontos FP4 contra NVFP4 ficam dentro de 5 e 21%, enquanto em testes com 8,192 tokens, ela lidera em GPT-OSS e Mistral Small e fica atrás em Llama, Qwen FP8 e MiniMax-M2.7, onde sua curva de desempenho se estabiliza logo no início.
- Os resultados com dois cartões estão no ROCm 7.2.3. Os modelos DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 e GLM-5.3 Flash foram obtidos a partir de execuções nessa pilha, porque as passagens do ROCm 10.1 nesses modelos usaram o recurso de descarregamento avançado da CPU e, no caso do DeepSeek, um decodificador especulativo que as execuções da NVIDIA não utilizaram.
- 600W ainda é uma questão em aberto. A Dell documentou oito módulos MI350P operando a 600W no PowerEdge XE7745, e um teste subsequente com potência máxima está planejado.
A AMD também apresentou o MI350P na IFA 2026 em seu protótipo Threadripper Halo Station, onde os mesmos aceleradores eram resfriados a líquido. O conceito de estação de trabalho suporta até quatro MI350Ps juntamente com um processador Threadripper PRO de 96 núcleos, fornecendo 576 GB de capacidade agregada de HBM3E em uma única máquina; a página do produto da AMD, atualizada em outubro, agora lista o sistema para lançamento em 2027. Isso nos dá duas maneiras de ver o MI350P: como um acelerador PCIe para servidores e como o componente fundamental para um sistema de IA de mesa maior, competindo com máquinas como a GB300 DGX Station.
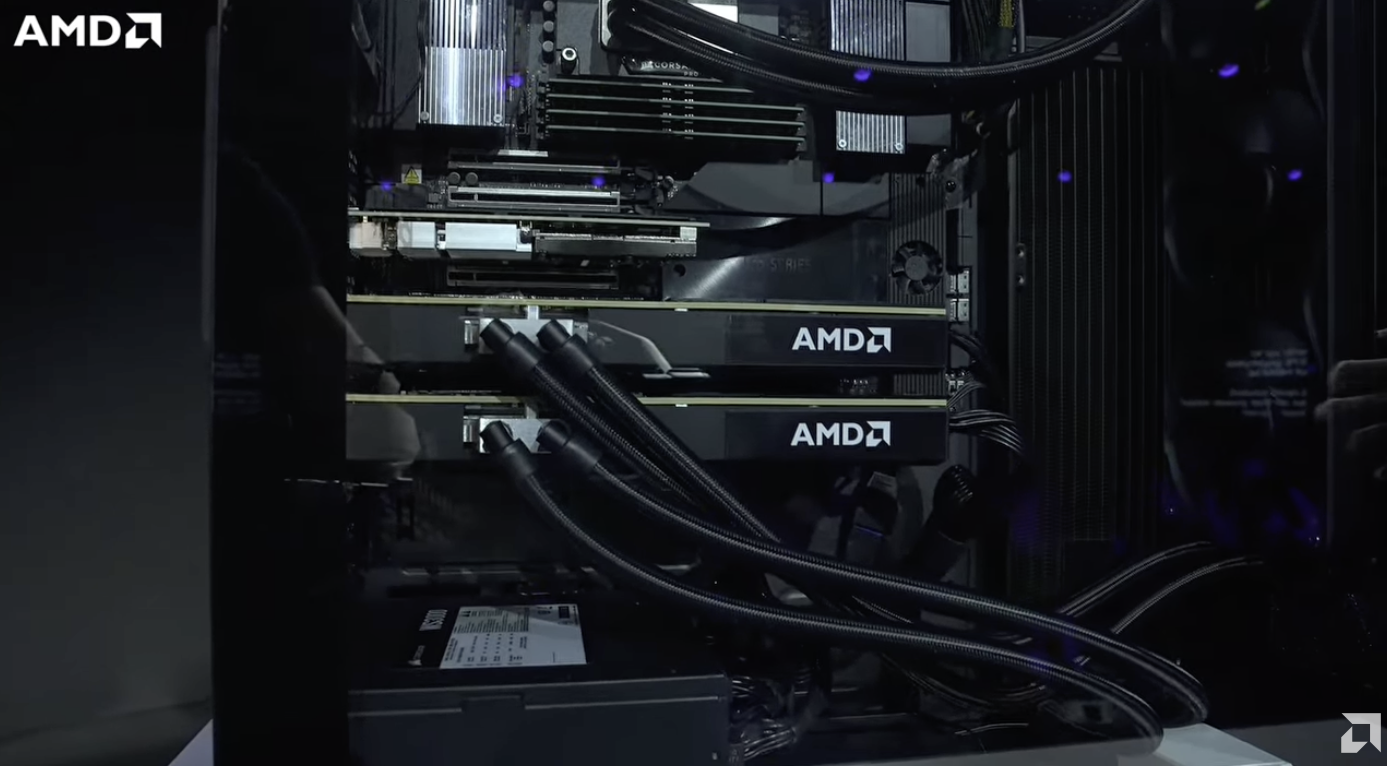
Esta primeira análise adota a perspectiva do servidor, portanto, a comparação relevante para um comprador que especifica um acelerador PCIe é com a NVIDIA RTX PRO 6000 Blackwell, a placa que se encontra na mesma classe de potência e nos mesmos slots. A H200 NVL está presente nos gráficos como a placa de expansão NVIDIA mais capaz para cargas de trabalho onde a largura de banda da memória é crucial. Uma única estação GB300 DGX representa a perspectiva da mesa; trata-se de uma máquina de uma classe diferente, com um preço diferente, e está ali para mostrar o quão superior uma GPU Blackwell Ultra completa é em relação a qualquer uma das placas PCIe.
Especificações do AMD Instinct MI350P
Os números publicados pela AMD indicam que o MI350P se destaca em baixa precisão: 4.6 PFLOPS em MXFP4 e MXFP6, 2.3 PFLOPS em FP8 e 1.15 PFLOPS em FP16 ou BF16, todos valores de alta densidade. O sistema de memória é a outra metade da placa: 144 GB de HBM3E em uma interface de 4,096 bits a 4 TB/s, com um Infinity Cache de 128 MB, que é o que explica os resultados de fluxo único apresentados abaixo. O consumo de energia da placa é de 600 W, com um modo configurável de 450 W; nossa unidade de teste operou a 450 W.
A MI350P utiliza a mesma arquitetura CDNA 4 das GPUs MI350/5X, maiores e de maior potência. A MI350P pode ser considerada, na prática, como metade de uma MI350X. Para entender o porquê, é útil observar como a GPU maior é montada.
O MI350X é um design de chiplets empilhados em 3D, construído na tecnologia CoWoS (Chip-on-Wafer-on-Substrate) da TSMC, sem um único die monolítico. Oito chips de complexo acelerador (XCDs) ficam acima de dois chips de E/S, com quatro XCDs em cada chip de E/S. A tecnologia Infinity Fabric da AMD conecta os chiplets, enquanto oito stacks de HBM3E fornecem a memória da GPU. CoWoS descreve a integração em nível de pacote; o arranjo de computação sobre E/S é o componente vertical empilhado em 3D do design.

O MI350P adota metade dessa configuração: quatro XCDs, um chip de E/S e quatro módulos HBM3E. Cada XCD possui 32 unidades de computação ativas, totalizando 128 CUs em comparação com as 256 do MI350X. Os recursos de memória também foram reduzidos pela metade: 144 GB de HBM3E contra 288 GB, 4 TB/s de largura de banda contra 8 TB/s e 128 MB de Infinity Cache contra 256 MB.

| Especificação | AMD Instinct MI350P |
|---|---|
| Visão geral da plataforma | |
| Plataforma | ADN4 |
| Unidades de cálculo | 128 |
| Processadores de fluxo | 8,192 |
| Núcleos de matriz | 512 |
| Processo | TSMC 3nm e 6nm |
| Transistores | 73 bilhões |
| Relógio de pico do motor | 2,200MHz |
| Memória | |
| Capacidade | 144 GB HBM3E |
| Interface | 4,096-bit |
| Largura de Banda | 4 TB / s |
| Cache do último nível | 128MB |
| ECC | Chip completo |
| Desempenho máximo (declarado pela AMD) | |
| MXFP4 | 4.6 PFLOPS |
| MXFP6 | 4.6 PFLOPS |
| MXFP8 | 2.3 PFLOPS |
| OCP FP8 | 2.3 PFLOPS; 4.6 PFLOPS com esparsidade estruturada |
| FP16 | 1.15 PFLOPS; 2.3 PFLOPS com esparsidade |
| BF16 | 1.15 PFLOPS; 2.3 PFLOPS com esparsidade |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| Potência, refrigeração e formato | |
| Poder de placa típico | Potência máxima de 600 W; configurável para 450 W. |
| Conector de força | 12V-2×6 |
| Resfriamento | Renda |
| Fator de Forma | Placa de expansão PCIe, altura total, slot duplo |
| Comprimento da placa | 10.5 pol. (267 mm) |
| Interface Host | PCIe 5.0 x16 |
| Diferenciais | |
| SR-IOV | Sim |
| Cache Infinity | Sim |
| RAS | Sim |
| Página sobre aposentadoria e prevenção | Sim |
O valor de 600 W é o máximo, e a AMD permite que a placa seja configurada para até 450 W, que foi o consumo observado em nosso servidor 2U. O H200 NVL atingiu os mesmos 450 W no R770, mas a RTX PRO 6000 operou com seus 600 W no XE7740, o que significa que a placa da NVIDIA tinha 150 W a mais de potência disponível em todas as comparações. Os resultados de consumo máximo dependem de um gabinete capaz de refrigerar uma placa passiva de 600 W, e o guia técnico do Dell XE7745 lista oito fontes MI350P com capacidade de 600 W.
Outro detalhe importante: o conector único de 12V-2×6 e a placa de 10.5 polegadas com dois slots permitem que a placa seja instalada nos mesmos risers usados atualmente para uma RTX PRO 6000 ou uma H200 NVL.

A tabela abaixo coloca o MI350P ao lado dos três sistemas NVIDIA em nossos gráficos: o RTX PRO 6000 Blackwell Server Edition, que compartilha o mesmo slot, a mesma faixa de potência e o mesmo link de host PCIe 5.0 x16; o H200 NVL, a placa Hopper com largura de banda de memória compatível; e o GB300 DGX Station, uma única GPU Blackwell Ultra emparelhada com uma CPU Grace via NVLink-C2C.
As primeiras linhas a serem lidas são a capacidade de memória, onde os 144 GB da MI350P são os maiores entre as três placas PCIe, 3 GB acima da H200 NVL e 48 GB acima da RTX PRO 6000; a largura de banda da memória, onde seus 4 TB/s ficam entre as duas; e a linha FP4, onde a AMD cita um valor denso e a NVIDIA cita um valor esparso.
| Especificação | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA H200 NVL PCIe | Estação NVIDIA GB300 DGX |
|---|---|---|---|---|
| Arquitetura GPU | ADN4 | Blackwell | saltador | Blackwell Ultra |
| Fator de forma | Acelerador PCIe | Acelerador PCIe | Acelerador PCIe | Uma GPU Blackwell Ultra emparelhada com uma CPU Grace de 72 núcleos. |
| memória da GPU | 144 GB HBM3E | ECC GDDR96 de 7 GB | 141 GB HBM3E | 252 GB HBM3E |
| largura de banda da memória da GPU | 4 TB / s | 1.6 TB / s | 4.8 TB / s | 7.1 TB / s |
| FP4 | 4.6 PFLOPS MXFP4 (Denso) | 4 PFLOPS NVFP4 (Esparso) | Não há FP4 nativo | 20 PFLOPS NVFP4 (Esparso) |
| FP8 | 2.3 PFLOPS (Denso) | 2 PFLOPS (Esparso) | 3.3 PFLOPS (Esparso) | 10 PFLOPS (Esparso) |
| BF16 | 1.15 PFLOPS (Denso) | 1 PFLOPS (Esparso) | 1.6 PFLOPS (Esparso) | 5 PFLOPS (Esparso) |
| FP32 | 72 TFLOPS (Denso) | 120 TFLOPS (esparso) | 60 TFLOPS (esparso) | 80 TFLOPS (esparso) |
| Conexão do host | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | NVLink-C2C entre Grace e GPU, 900 GB/s (BiDi) |
| Conectividade multi-GPU | baseado em PCIe | baseado em PCIe | NVLink de duas ou quatro vias, até 900 GB/s por GPU (BiDi) | Rede ConnectX-8 de 800 Gb/s entre estações |
| Energia | Configurável de 450 a 600 W | Configurável de 300 a 600 W | Configurável de 450 a 600 W | GPU de até 1200 W com oscilação de energia |
Em comparação com a RTX PRO 6000, a diferença mais imediata da MI350P está no subsistema de memória. Ela possui 50% mais memória de GPU e aproximadamente 2.5 vezes mais largura de banda. Para um modelo que não se encaixa perfeitamente em 96 GB, a capacidade adicional pode determinar se ele funcionará com uma única GPU ou se precisará distribuir a memória entre várias.
A RTX PRO 6000, no entanto, atende a uma gama mais ampla de cargas de trabalho, com hardware para gráficos, ray tracing e vídeo, além de seus recursos de IA. A escolha envolve mais do que apenas dois valores de desempenho máximo de computação; também depende do que mais o sistema precisa fazer.
A H200 NVL é a comparação mais direta para a MI350P entre os aceleradores PCIe de alta memória; as GPUs Blackwell para data centers, maiores, pertencem a uma categoria diferente. A capacidade de memória é quase idêntica, com 144 GB contra 141 GB da H200, ambas utilizando HBM3E, e a H200 oferece 20% mais largura de banda de memória, com 4.8 TB/s. As duas também apresentam diferenças de escalabilidade: todas as três placas PCIe se conectam ao host via PCIe, mas a H200 NVL adiciona conectividade dedicada GPU-para-GPU por meio de pontes NVLink, conectando até quatro GPUs.
Os modelos maiores MI350X e MI355X foram projetados para competir com a Blackwell, mas o MI350P reduz essa configuração de hardware pela metade. Isso o aproxima do H200 NVL em termos de atributos de memória e posicionamento geral. Um ponto em que o MI350P ainda se destaca é o suporte nativo a MXFP4 e MXFP6, o que se torna ainda mais importante à medida que a inferência migra para menor precisão.
O subsistema de memória menor é outro ponto fraco, pois a AMD não compensou a redução nas pilhas HBM com a HBM3E mais rápida, deixando a MI350P com 4 TB/s de largura de banda e atrás da H200 NVL nesse quesito. Isso pode limitar o desempenho em cargas de trabalho limitadas pela largura de banda da memória, independentemente da capacidade computacional disponível, como mostram os resultados de largura de banda da memória e inferência de prompts longos apresentados mais adiante nesta análise.
A comparação com a DGX Station funciona de forma oposta, pois a GB300 Station possui uma GPU B300 completa com uma pilha HBM desativada, um chip de classe datacenter com um orçamento de energia também de datacenter, enquanto o MI350P é metade de um chip de classe datacenter embutido no encapsulamento de 600W de uma placa de expansão PCIe. A AMD precisaria de duas ou quatro MI350Ps para atingir o desempenho de uma única GPU, e, em teoria, duas delas conseguem: 288 GB e 8 TB/s contra os 252 GB e 7.1 TB/s da Station. No entanto, esses recursos estão distribuídos em duas placas, e uma carga de trabalho que abrange ambas troca dados via PCIe ponto a ponto, o que limita o quanto a segunda placa agrega.
Desempenho
Plataforma de Teste
A unidade de teste MI350P é um Dell PowerEdge R7725 com dois processadores AMD EPYC 9555 (64 núcleos cada), 1.5 TB de memória DDR5-6400 distribuída em 24 slots DIMM e duas placas MI350P configuradas para 450 W, o limite para um servidor 2U. As placas RTX PRO 6000 Blackwell Server Edition (600 W) foram testadas no Dell PowerEdge XE7740 que utiliza nossa configuração de inferência com quatro placas; uma única H200 NVL (450 W) foi testada no Dell PowerEdge R770 da nossa análise; e os dados do GB300 são da estação ASUS ExpertCenter Pro ET900N G3 DGX que analisamos em setembro.

O inventário do iDRAC abaixo mostra como as duas placas estão instaladas. Elas estão nos slots PCIe 2 e 7, ambas Gen5 x16 e ambas reportando funcionamento normal. As chaves de dispositivo, 0-139-0 e 1-199-0, indicam que há uma placa atrás de cada soquete EPYC, portanto o tráfego tensor-paralelo entre os dois MI350Ps atravessa o link do soquete em seu caminho entre os complexos raiz. Essa é a configuração padrão de uma implantação com duas placas em um servidor 2U, e vale a pena levar isso em consideração para os resultados da configuração com duas placas mais adiante.

A visualização da memória mostra o restante do host: 24 módulos DIMM de 64 GB DDR5-6400, dual rank, totalizando 1,536 GB em um servidor com capacidade máxima de 6 TB, todos com ECC multibit. Essa margem é importante para a execução do GLM-5.2, onde o checkpoint do MXFP4 não cabe nos 288 GB de duas placas e o vLLM delega parte dos cálculos de otimização para a memória do host.

Máximo FLOPS de Matmul Alcançáveis (MAMF)
Para contextualizar o desempenho computacional do MI350P, executamos o MAMF nos quatro sistemas. O MAMF (Maximum Achievable Matmul FLOPS) é uma métrica prática de desempenho projetada para medir o pico realista de operações de ponto flutuante por segundo que um acelerador atinge durante a multiplicação de matrizes, um benchmark mais útil do que o pico teórico de FLOPS na folha de especificações. Realizamos testes em cada sistema nas resoluções BF16, FP8 e FP4 com escala de bloco e relatamos o melhor resultado sustentado e denso por precisão; as barras hachuradas multiplicam o resultado de cada placa PCIe pela quantidade de placas usadas nas execuções de modelos grandes e são calculadas, sem nenhuma medição subjacente.

Com 450W, uma MI350P atinge 580 TFLOPS em BF16, 1,120 em FP8 e 2,228 em FP4. A RTX PRO 6000 Blackwell vem em seguida com 419, 820 e 1,634, respectivamente, portanto a MI350P tem uma vantagem de 36 a 38% sobre a placa NVIDIA em todas as precisões, mesmo consumindo 150W a menos, com a maior diferença em BF16, chegando a 38.4%.
Os 652 TFLOPS em BF16 e 1,205 em FP8 da H200 NVL a colocam à frente da MI350P em ambos os quesitos, e ela não possui um caminho FP4. A GB300 DGX Station fica acima de todas as três placas PCIe com 1,924, 3,802 e 6,024 TFLOPS, aproximadamente 3.3 vezes o desempenho da MI350P em BF16 e 2.7 vezes em FP4; duas MI350Ps, em teoria, chegam perto de 1,160 e 4,456 TFLOPS, ainda abaixo da GPU única da Station. Os valores do NVIDIA MAMF nesta análise são provenientes de nossos testes mais recentes com cada placa e substituem os resultados de nossos testes anteriores.
Largura de banda da memória da GPU
A capacidade de processamento bruto só é útil se o acelerador conseguir manter suas unidades de execução alimentadas com dados. Isso é especialmente importante para inferência, onde a geração de tokens durante a fase de decodificação é limitada mais pela largura de banda da memória do que pelos FLOPS disponíveis. O teste de largura de banda lê, grava e copia a memória da GPU através dos kernels de computação e do mecanismo de cópia, mostrando a largura de banda disponível em cada GPU em comparação com seu valor nominal.

Uma placa MI350P lê sua memória HBM3E a 3,291 GB/s e grava a 3,204 GB/s, cerca de 80% da classificação de 4 TB/s, com cópias a 1,276 a 1,283 GB/s; uma cópia consome largura de banda duas vezes, uma para ler a origem e outra para gravar o destino. A memória GDDR7 da RTX PRO 6000 atinge 1,540 GB/s em leituras e 1,483 GB/s em gravações, portanto a MI350P oferece cerca de 2.1 vezes mais largura de banda utilizável por placa.
As velocidades de leitura de 4,472 GB/s e de gravação de 4,156 GB/s do H200 NVL superam em 36% e 30%, respectivamente, o MI350P, que apresenta uma classificação de 4.8 TB/s contra 4 TB/s. Já a GB300 DGX Station atinge 6,869 GB/s. Dois MI350Ps medidos em conjunto alcançam 6,529 GB/s em leitura, próximo ao desempenho da Station, mas essa largura de banda é limitada a dois slots PCIe, e um modelo que abranja ambos os slots compensa cada transferência via PCIe.
Inferência
Com os testes de baixo nível concluídos, passamos para a inferência LLM. Nosso teste de serviço online vLLM utiliza um endpoint compatível com OpenAI com um número fixo de fluxos simultâneos e registra os tokens de saída por segundo ao longo da execução. Relatamos dois formatos: 512 tokens de entrada e 512 de saída, o que corresponde ao tamanho de um chat e exige muita decodificação, e 8,192 de entrada e 1,024 de saída, o que corresponde ao tamanho de um documento RAG e exige mais preenchimento automático. A concorrência dobra a partir de um único fluxo, e cada gráfico para na maior concorrência em que todos os cartões foram concluídos. Cada ponto representa duas requisições por fluxo, portanto, os valores para um único fluxo dependem de duas requisições e apresentam maior variabilidade entre execuções do que os pontos de maior concorrência.
Cada modelo foi executado no menor número possível de placas que suportassem seus dados: uma MI350P para tudo, até GPT-OSS-120B e MiniMax-M2.7, e duas para DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 e GLM-5.3 Flash. As execuções da RTX PRO 6000 seguem a mesma regra, com duas placas RTX contra uma MI350P em MiniMax-M2.7 e quatro contra duas em MiniMax-M3 e GLM-5.2. As versões de baixa precisão variam de acordo com o fornecedor: as da AMD são MXFP4 até Quark, as da NVIDIA são NVFP4, e os pares FP4 são rotulados dessa forma em todo o documento. O GPT-OSS é distribuído como MXFP4 e utiliza a mesma quantidade de dados em todas as placas. As versões NVFP4 com H200 não estão incluídas.
| Modelo | MI350P | RTX PRO 6000 Blackwell | H200 NVL | Estação GB300 DGX |
|---|---|---|---|---|
| Flash GLM-5.3 | 2 placas, MXFP4 | Não funciona | Não funciona | NVFP4 |
| GLM-5.2 | 2 placas, MXFP4 (descarregam para a memória do host) | 4 cartões, NVFP4 | Não funciona | NVFP4 (cerca de 215 GB de especialistas na memória Grace) |
| MiniMax-M3 | 2 placas, MXFP4 | 4 cartões, NVFP4 | Não funciona | NVFP4 (uma amostra de especialistas em memória de Grace) |
| DeepSeek-V4-Flash | 2 cartões, FP8 | 2 cartões, FP8 | Não funciona | FP8 |
| MiniMax-M2.7 | 1 cartão, MXFP4 | 2 cartões, NVFP4 | Não funciona | NVFP4 |
| GPT-OSS-120B | 1 cartão, MXFP4 | 1 cartão, MXFP4 | 1 cartão, MXFP4 | MXFP4 |
| GPT-OSS-20B | 1 cartão, MXFP4 | 1 cartão, MXFP4 | 1 cartão, MXFP4 | MXFP4 |
| Qwen3-Coder-30B-A3B | 1 cartão, FP8 e BF16 | 1 cartão, FP8 e BF16 | 1 cartão, FP8 e BF16 | FP8 e BF16 |
| Mistral Pequeno 3.1 24B | 1 cartão, FP8 e BF16 | 1 cartão, FP8 e BF16 | 1 cartão, FP8 e BF16 | FP8 e BF16 |
| Lhama 3.1 8B | 1 placa, MXFP4, FP8 e BF16 | 1 cartão, NVFP4, FP8 e BF16 | 1 cartão, FP8 e BF16 | NVFP4, FP8 e BF16 |
Ao analisar a coluna do MI350P, a primeira coisa que se nota com 144 GB é a quantidade de placas de vídeo. Seis dos dez modelos são executados em um único MI350P, enquanto o MiniMax-M2.7, com seus 96 GB de RTX PRO 6000, precisa de uma segunda placa. Já os dois checkpoints MXFP4, MiniMax-M3 e GLM-5.2, que utilizam dois MI350Ps, necessitam de quatro RTX PRO 6000. O GLM-5.2 é o que ultrapassa até mesmo os 288 GB disponíveis, e o vLLM delega parte de suas operações de especialistas para a memória do host do R7725 durante essa execução; o GB300 faz o mesmo com cerca de 215 GB de especialistas na memória Grace.
Os resultados dos testes com o MI350P, para os modelos de placa única, foram obtidos em 27 de outubro, utilizando AMDGPU 31.60, ROCm 10.1.0 e vLLM 0.32.0. A combinação validada pela Dell é vLLM 0.27 com ROCm 10.0 e AMDGPU 31.5, e nós fomos além, utilizando a versão 10.1 do ROCm, lançada em 5 de outubro. As placas NVIDIA executaram o contêiner vLLM 26.08 no CUDA 13.4.1 durante todo o processo. A tabela lista a versão utilizada em cada execução.
| Modelo | Imagem vLLM |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 Flash MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| Lhama 3.1 8B BF16 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| Lhama 3.1 8B FP8 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| Lhama 3.1 8B MXFP4 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| Mistral Pequeno 3.1 24B BF16 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| Mistral Pequeno 3.1 24B FP8 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 no ROCm 10.1.0, AMDGPU 31.60 (27 de outubro) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lhama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lhama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lhama 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeno 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeno 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lhama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Lhama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeno 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeno 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
Os quatro modelos de duas placas, DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 e GLM-5.3 Flash, são relatados a partir de execuções no ROCm 7.2.3. Nossos testes com o ROCm 10.1 nesses modelos usaram o recurso de descarregamento do CPU Expert durante todo o processo e, no DeepSeek-V4-Flash, um decodificador especulativo que as execuções da NVIDIA não utilizaram, o que os torna um teste diferente. Portanto, eles são mantidos para uma execução limpa na pilha atual, e as tabelas rotulam cada linha MI350P com sua respectiva pilha.
A abordagem preferida da AMD para esses modelos são seus contêineres AIM; a versão Enterprise AI Suite 2.5, lançada em 9 de outubro, foi validada no ROCm 10 e inclui AIMs para GPT-OSS-120B, Llama 3.3 70B e Gemma 3 27B, mas a tabela de aceleradores da AMD lista um perfil otimizado para o MI350P apenas para Wan2.2 até o momento. Portanto, o vLLM padrão ainda é a opção escolhida por quem compra um MI350P atualmente, e foi o que medimos.
Resumo dos resultados da inferência
Há 28 gráficos abaixo, então aqui está a versão resumida em duas tabelas: tokens de saída por segundo para cada modelo na maior concorrência possível, com todas as placas concluídas, começando com a carga de trabalho de 512 entradas e 512 saídas, típica de um chat. Os valores do MI350P correspondem a uma placa a 450 W, a menos que a linha indique o contrário, com uma coluna para a pilha de onde cada linha provém; a Estação GB300 DGX é uma única B300.
| Modelo | Placas (MI350P / RTX PRO 6000) | Pilha MI350P | Streams | MI350P | RTX PRO 6000 | H200 NVL | Estação GB300 DGX |
|---|---|---|---|---|---|---|---|
| Flash GLM-5.3 (MXFP4 vs NVFP4) | 2 / nenhum | ROCm 7.2.3 | 32 | 1,462 | Não funciona | Não funciona | 828 |
| GLM-5.2 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 59 | 40 | Não funciona | 139 |
| MiniMax-M3 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 1,509 | 759 | Não funciona | 1,041 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 1,081 | 829 | Não funciona | 1,766 |
| MiniMax-M2.7 (MXFP4 vs NVFP4) | 1 / 2 | ROCm 10.1 | 128 | 1,524 | 1,932 | Não funciona | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| Mistral Pequeno 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| Mistral Pequeno 24B BF16 | 1 / 1 | ROCm 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Lhama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 8,383 | 8,869 | Não funciona | 28,400 |
| Lhama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| Lhama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
Dois resultados se destacam na tabela de comparação: a MI350P supera a RTX PRO 6000 em todos os modelos FP8, BF16 e GPT-OSS, em 35 a 65% a 128 fluxos, fica atrás das versões NVFP4 da NVIDIA apenas no topo das curvas Llama e MiniMax-M2.7, e praticamente dobra o desempenho da placa NVIDIA em um único fluxo no Llama 3.1 8B e Mistral Small 24B, onde 4 TB/s de HBM3E fazem o trabalho.
O H200 NVL, com 20% mais largura de banda, mantém uma vantagem de 4 a 18% nos modelos densos FP8 e BF16 com 128 fluxos e empata no Llama 3.1 8B FP8; nos dois modelos GPT-OSS, a ordem se inverte, e o MI350P termina com uma vantagem de 50 e 78%.
A segunda tabela repete o exercício com os prompts de 8,192 tokens, onde o preenchimento automático domina a execução e o equilíbrio entre a largura de banda de computação e memória se desloca para as placas NVIDIA.
| Modelo | Placas (MI350P / RTX PRO 6000) | Pilha MI350P | Streams | MI350P | RTX PRO 6000 | H200 NVL | Estação GB300 DGX |
|---|---|---|---|---|---|---|---|
| Flash GLM-5.3 (MXFP4 vs NVFP4) | 2 / nenhum | ROCm 7.2.3 | 32 | 760 | Não funciona | Não funciona | 1,219 |
| GLM-5.2 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 16 | 6 | 9 | Não funciona | 87 |
| MiniMax-M3 (MXFP4 vs NVFP4) | 2 / 4 | ROCm 7.2.3 | 8 | 524 | 444 | Não funciona | 103 |
| DeepSeek-V4-Flash | 2 / 2 | ROCm 7.2.3 | 32 | 621 | 345 | Não funciona | 954 |
| MiniMax-M2.7 (MXFP4 vs NVFP4) | 1 / 2 | ROCm 10.1 | 64 | 331 | 501 | Não funciona | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
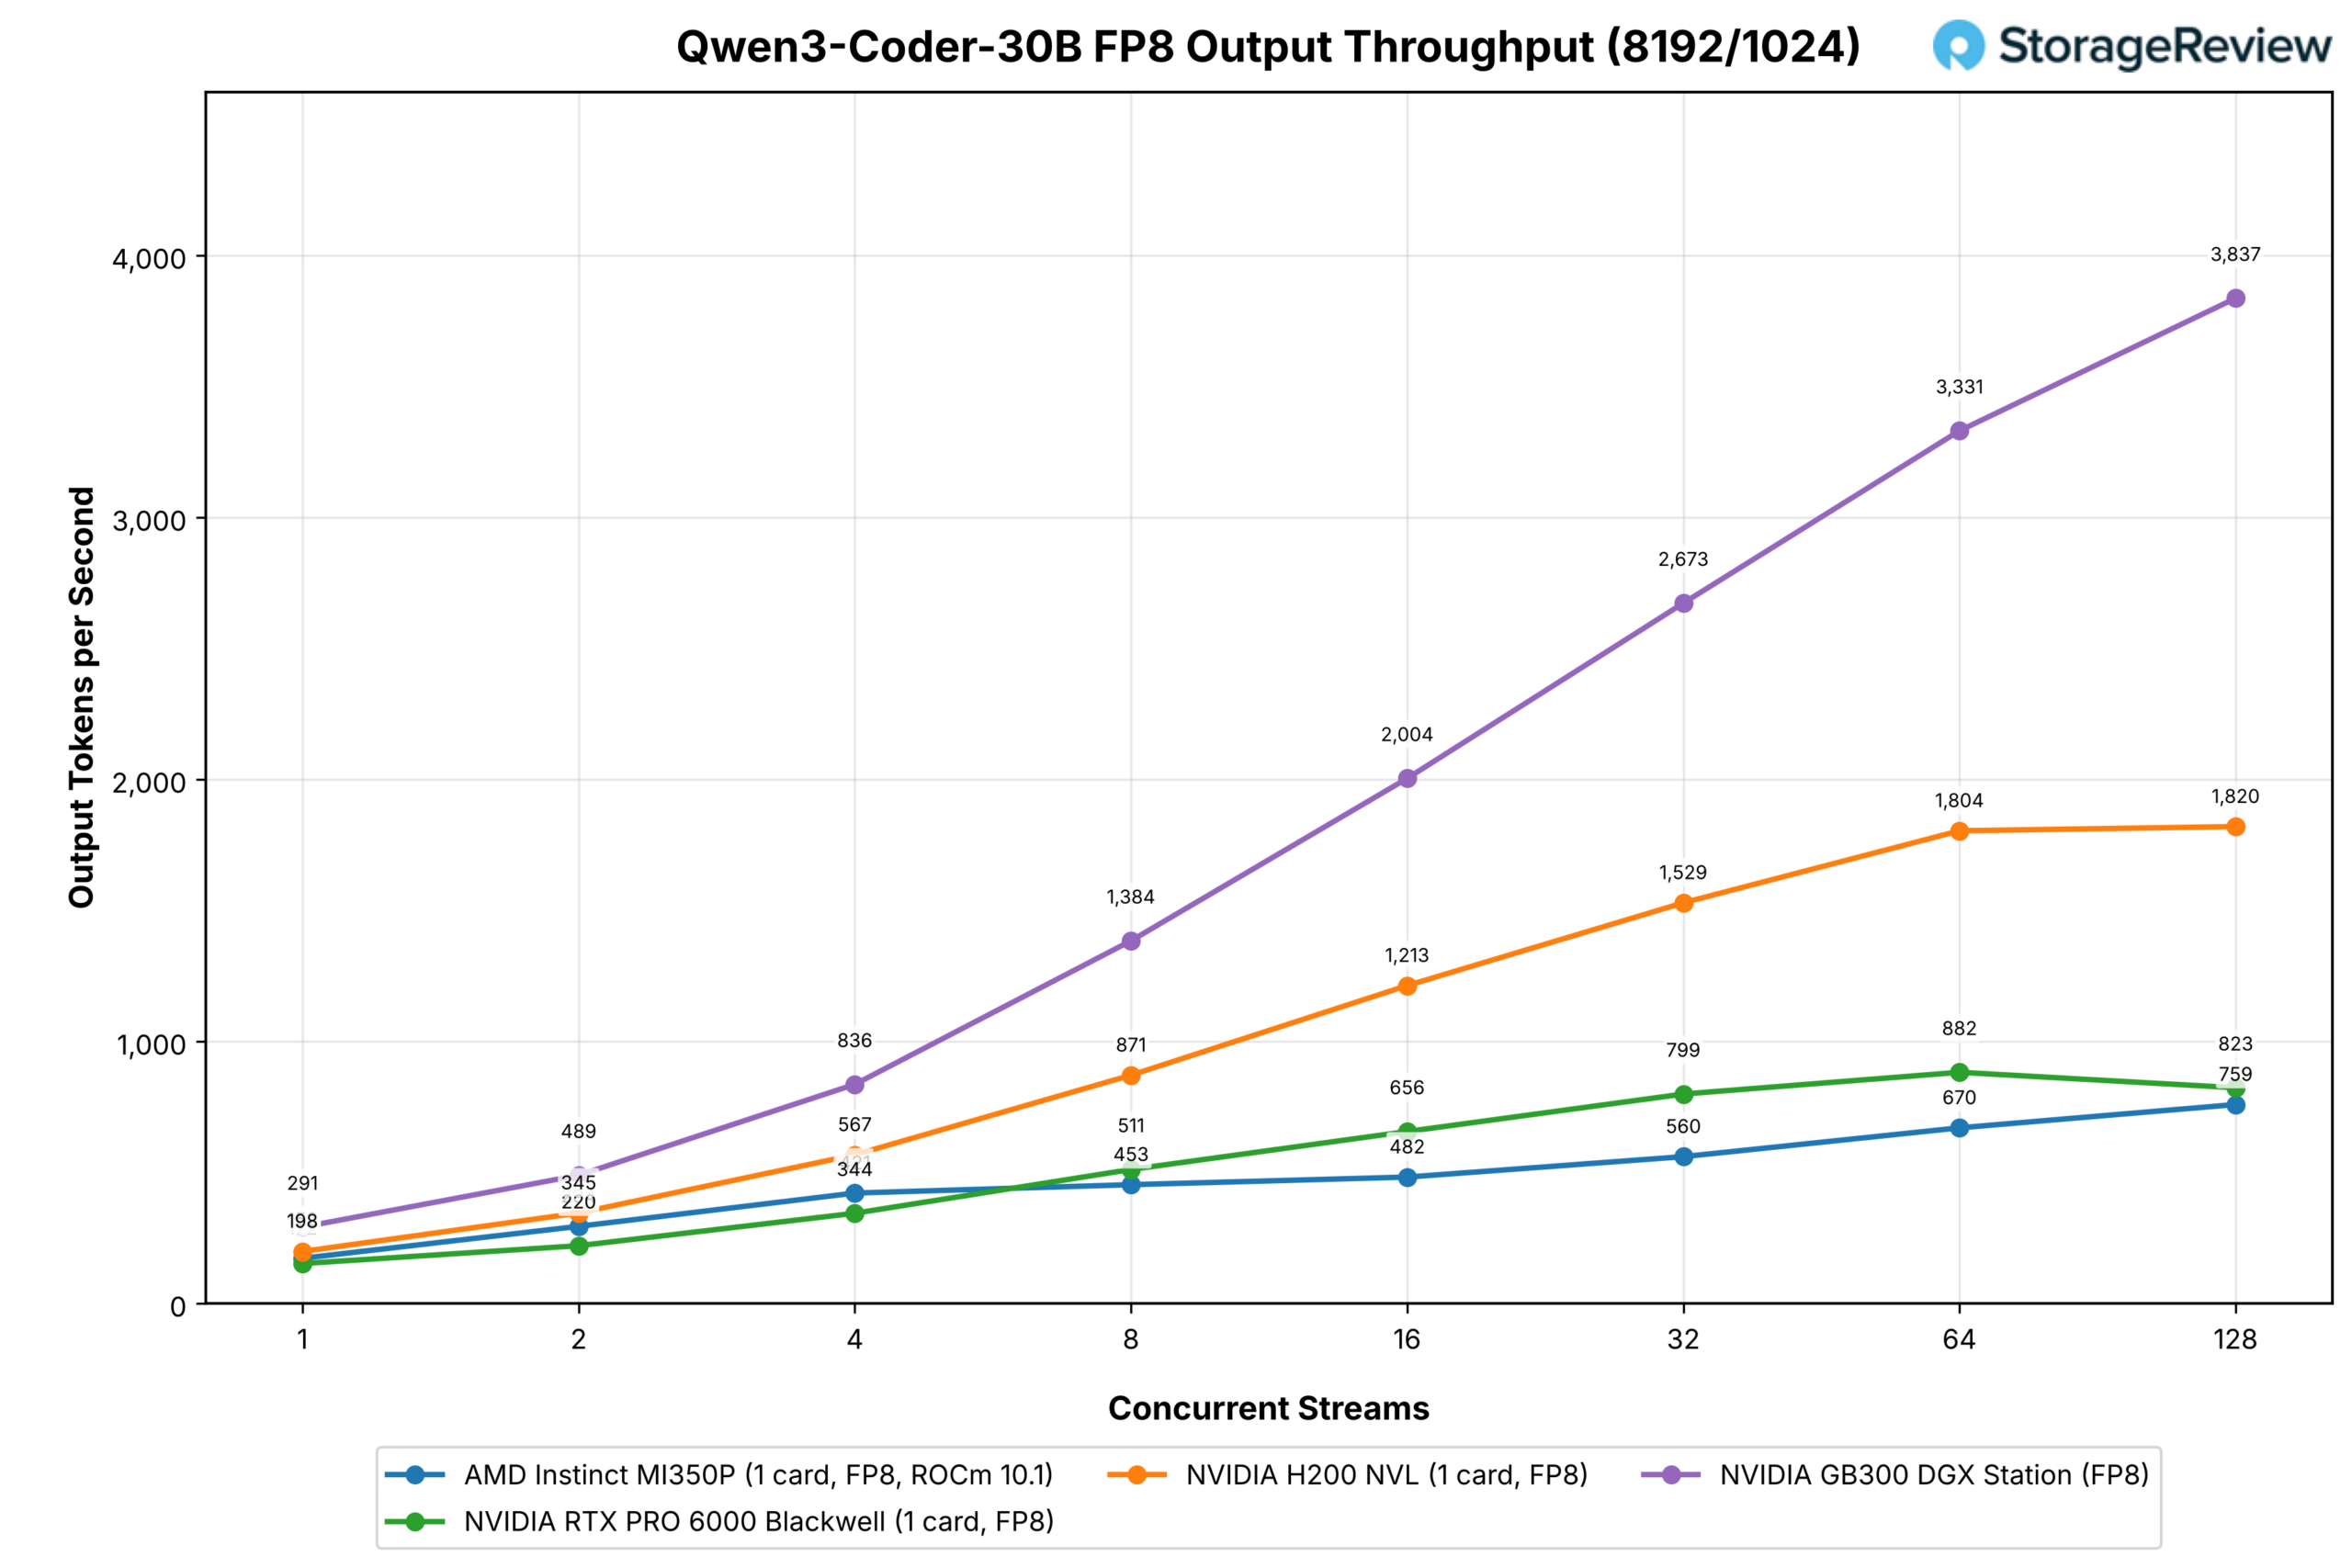
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
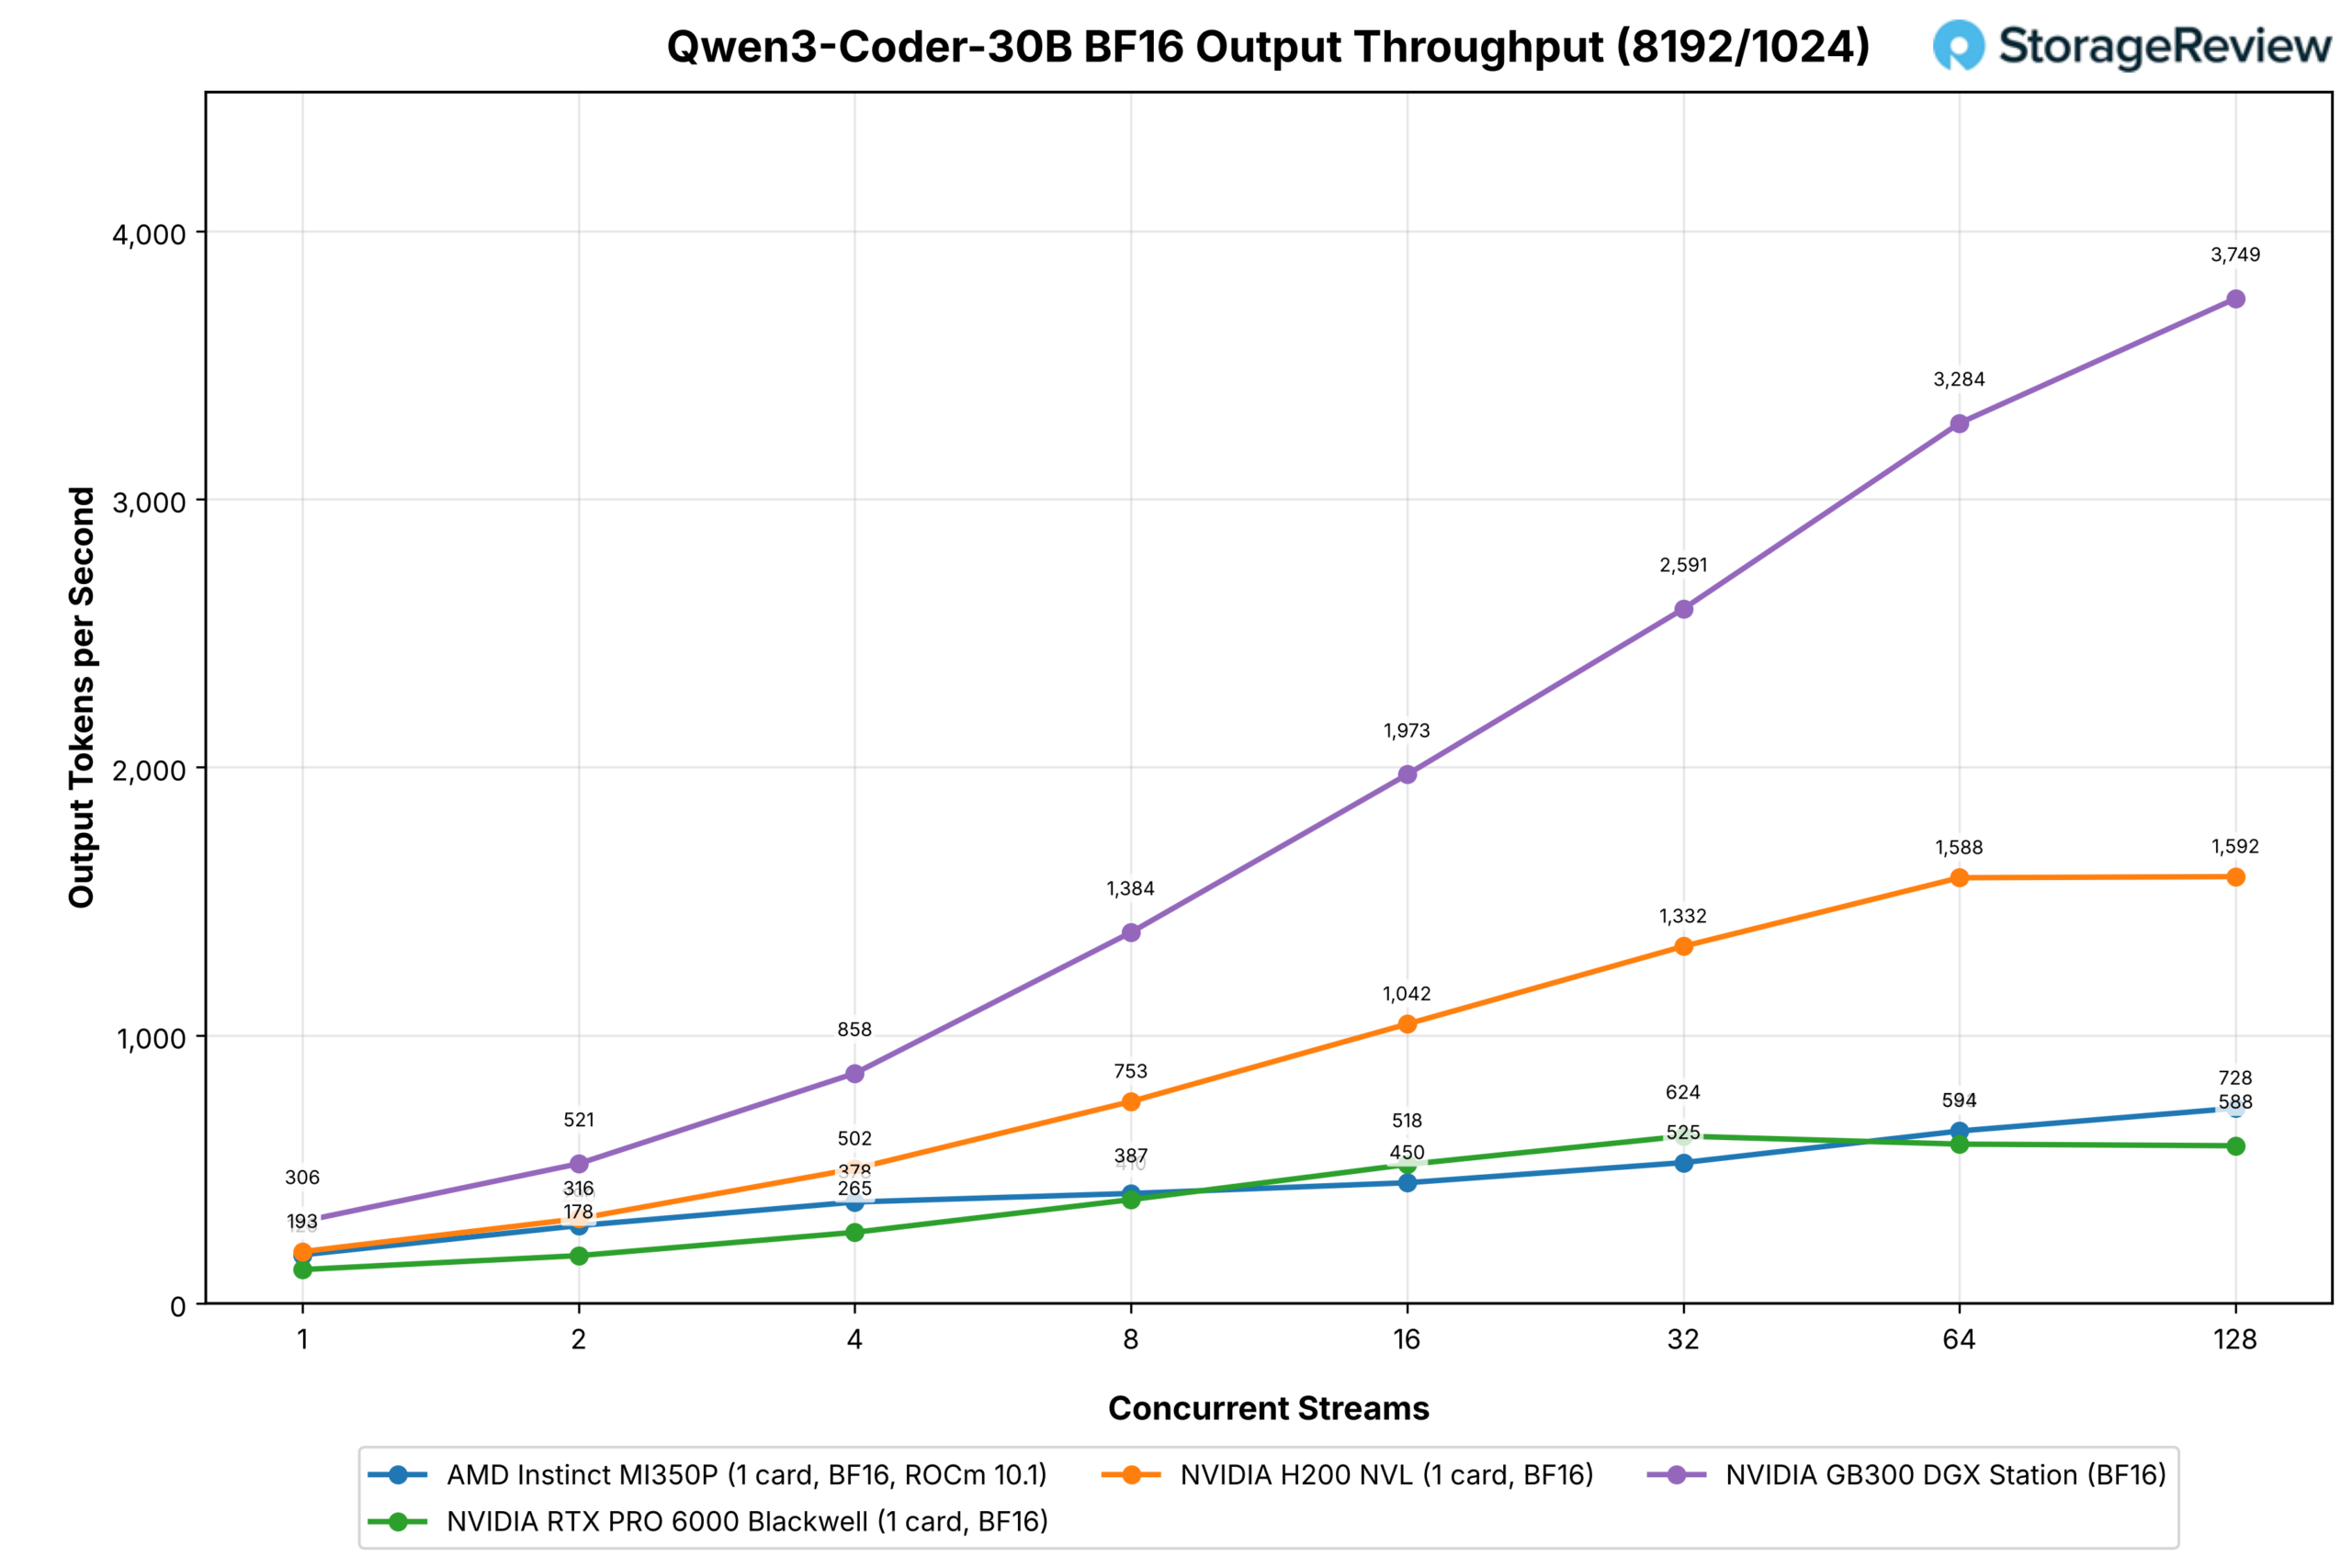
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
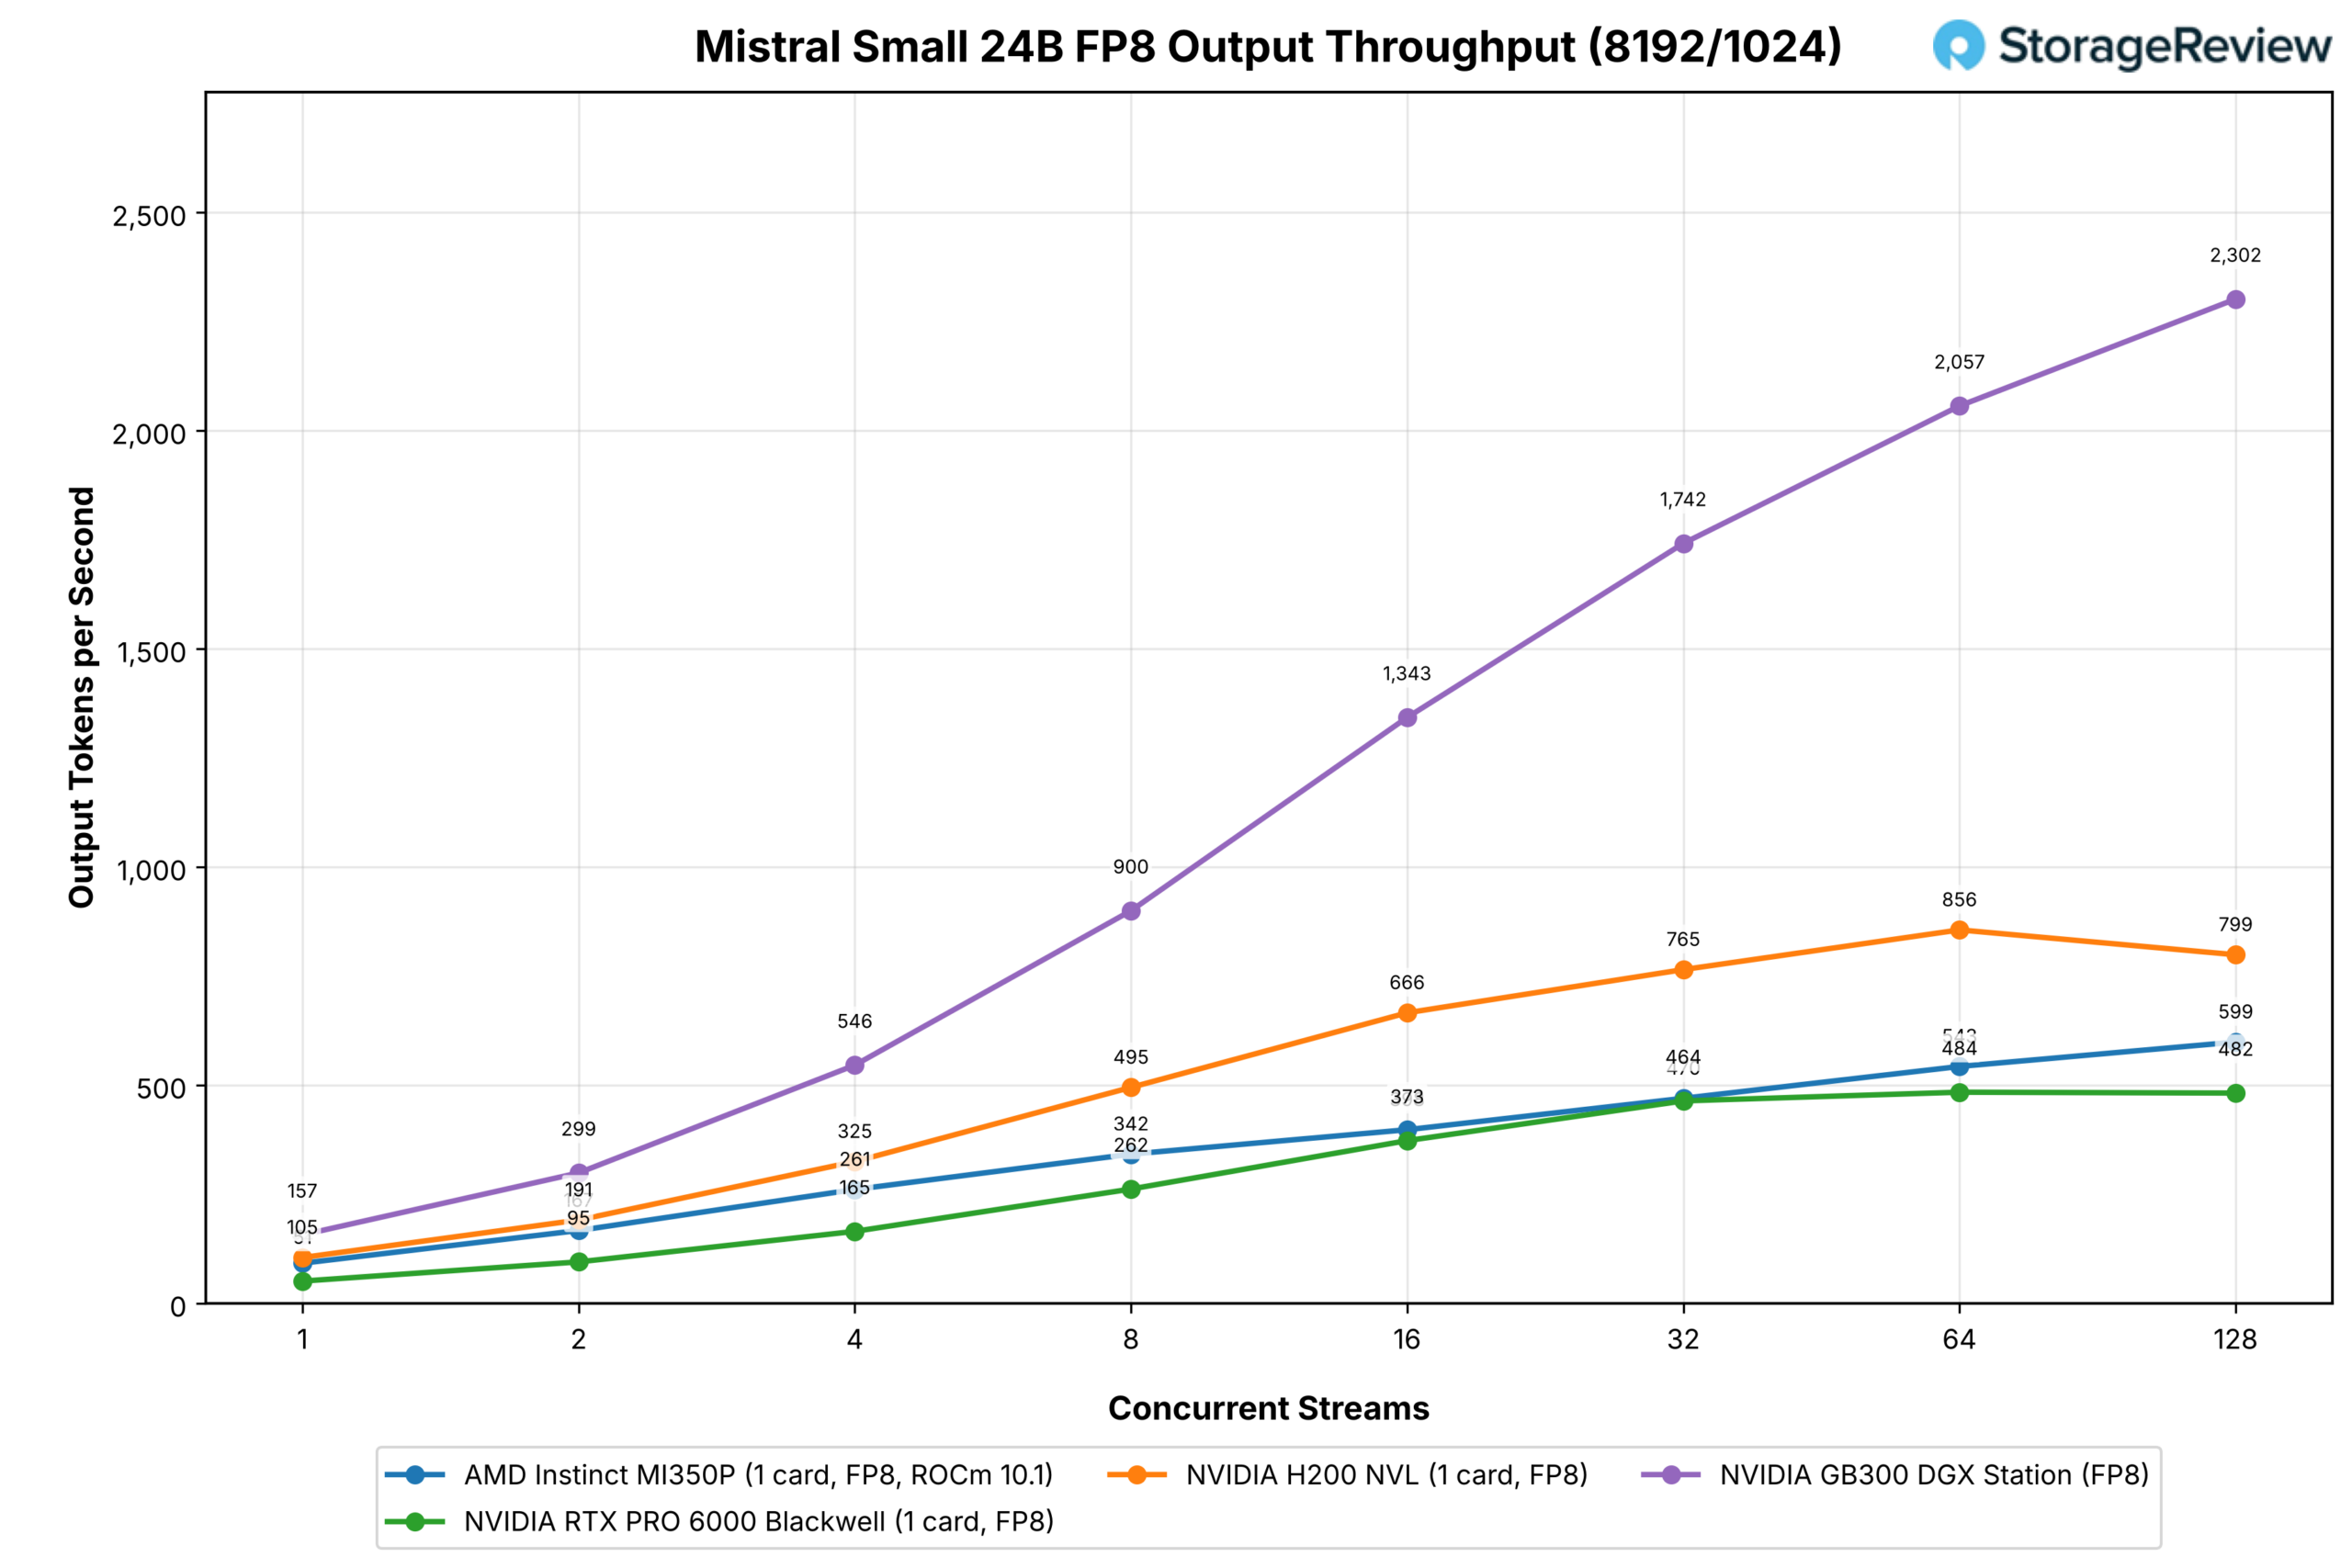
| Mistral Pequeno 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 599 | 482 | 799 | 2,302 |
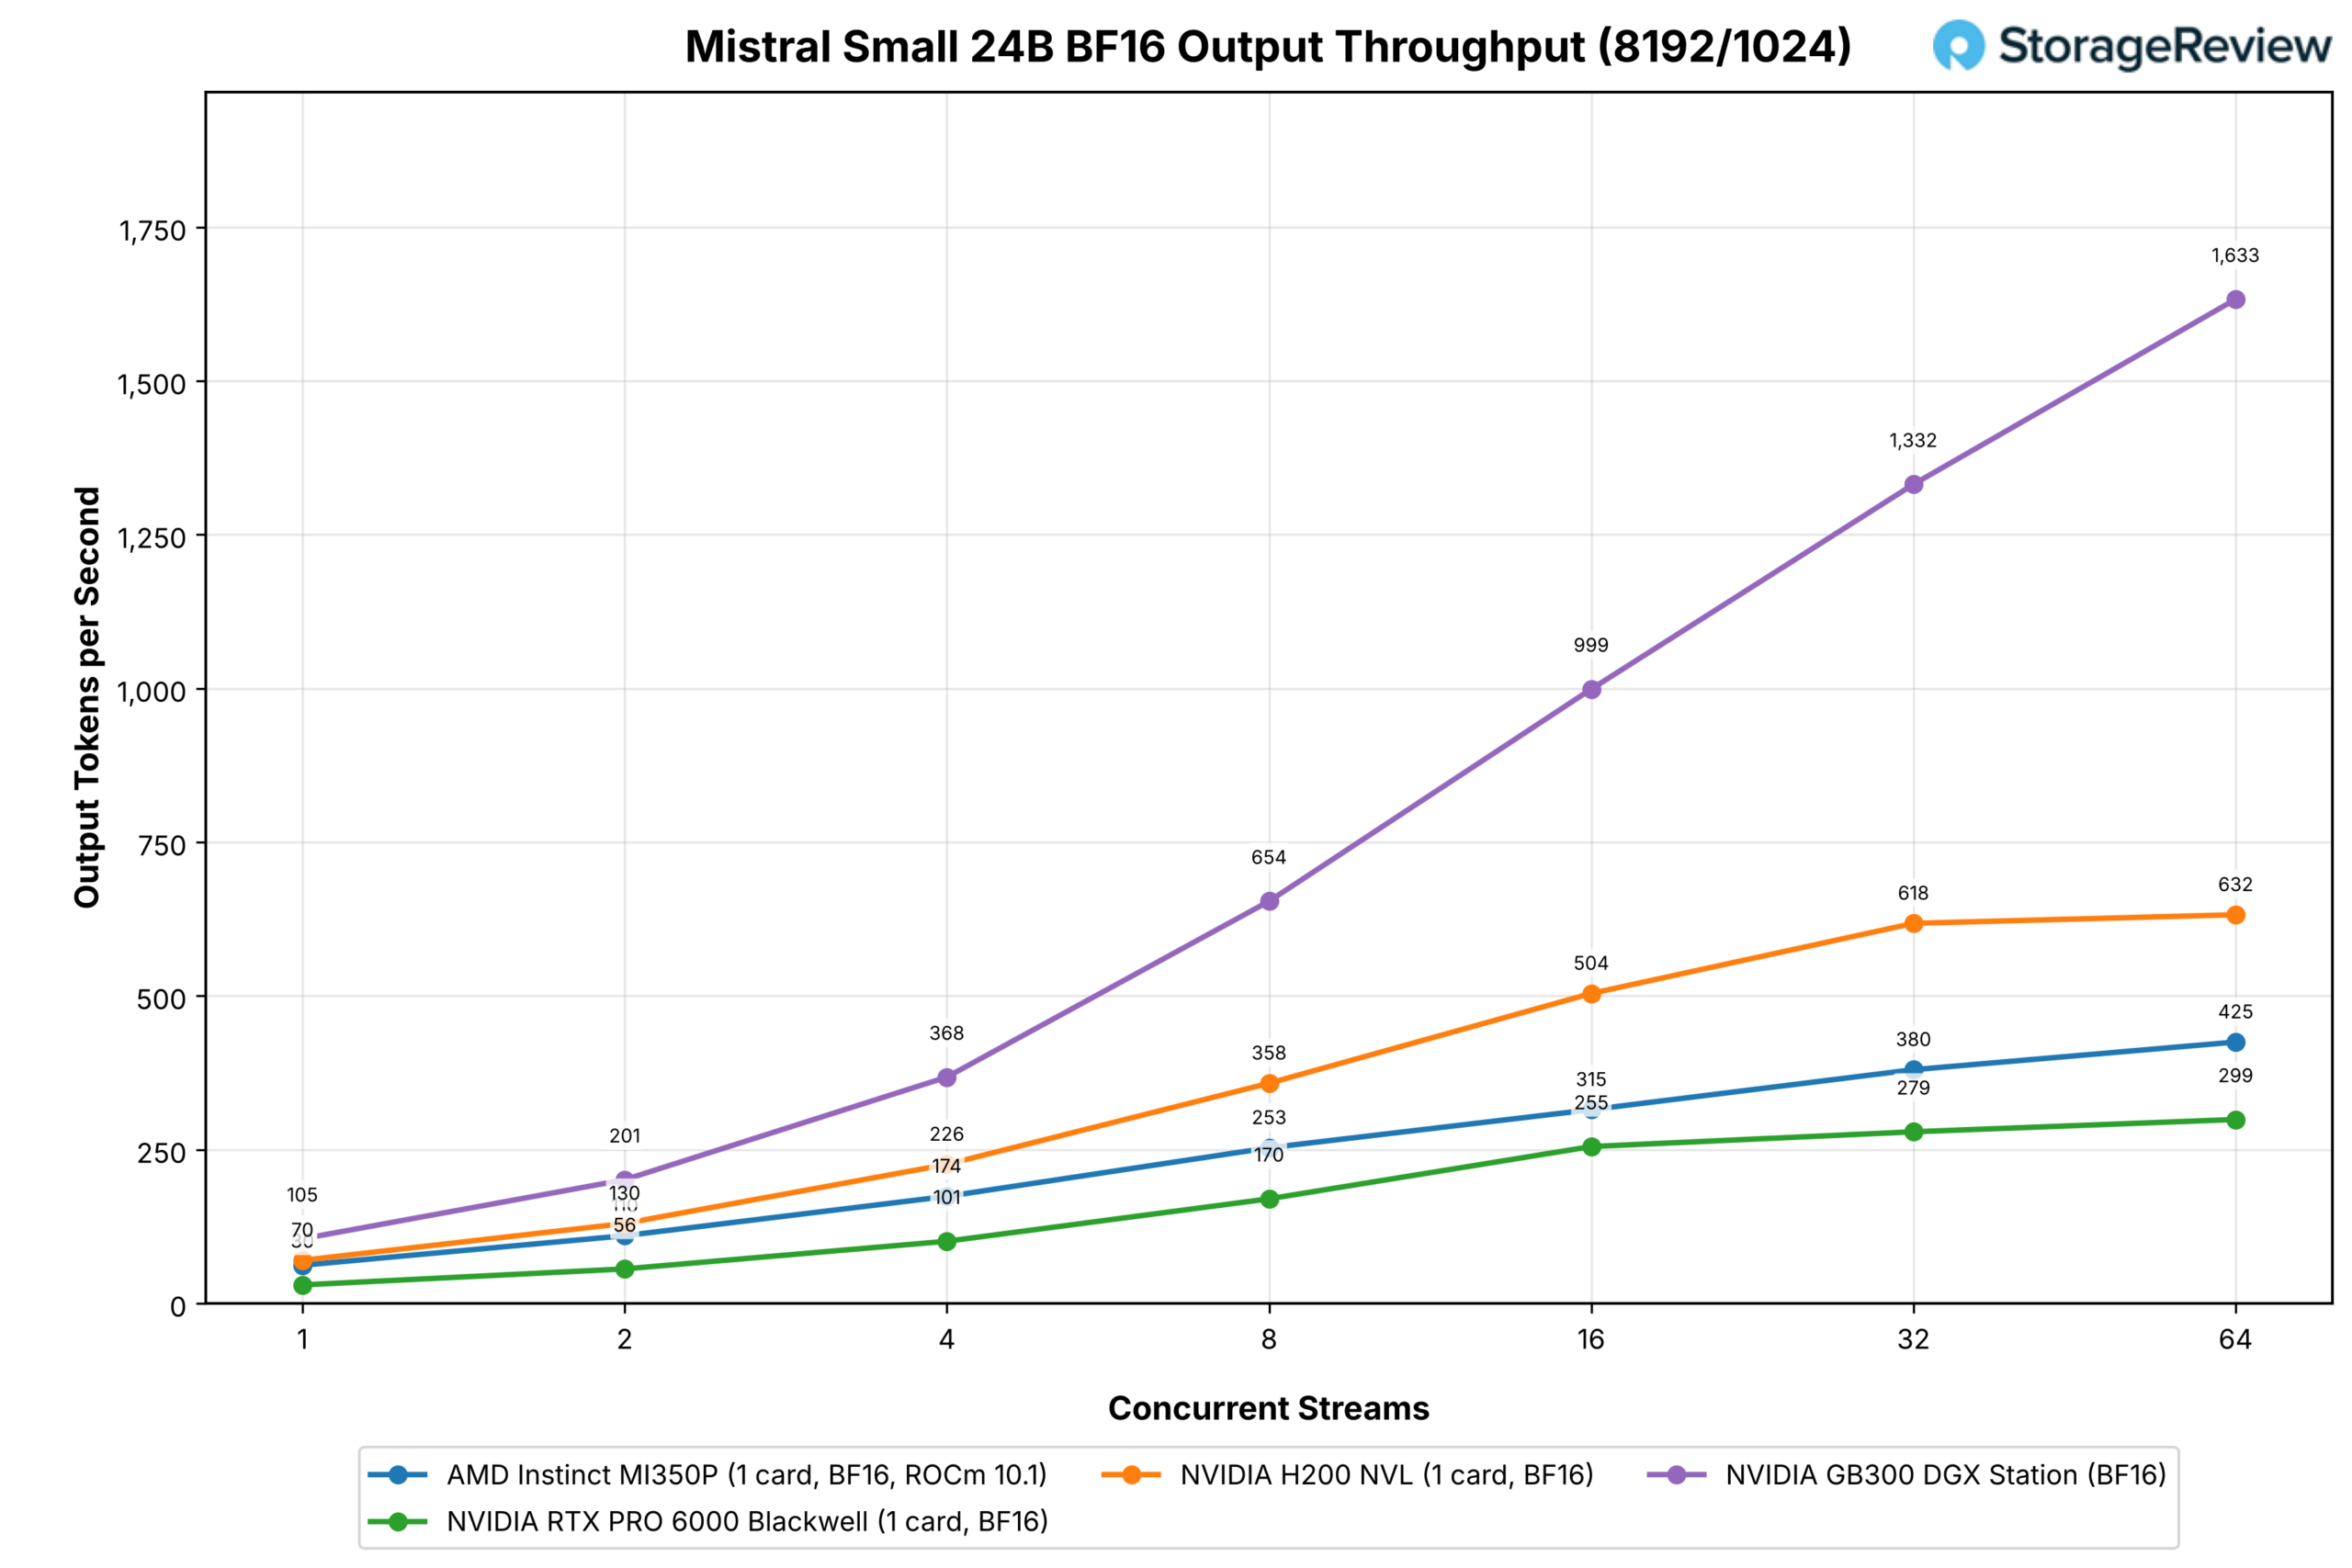
| Mistral Pequeno 24B BF16 | 1 / 1 | ROCm 10.1 | 64 | 425 | 299 | 632 | 1,633 |
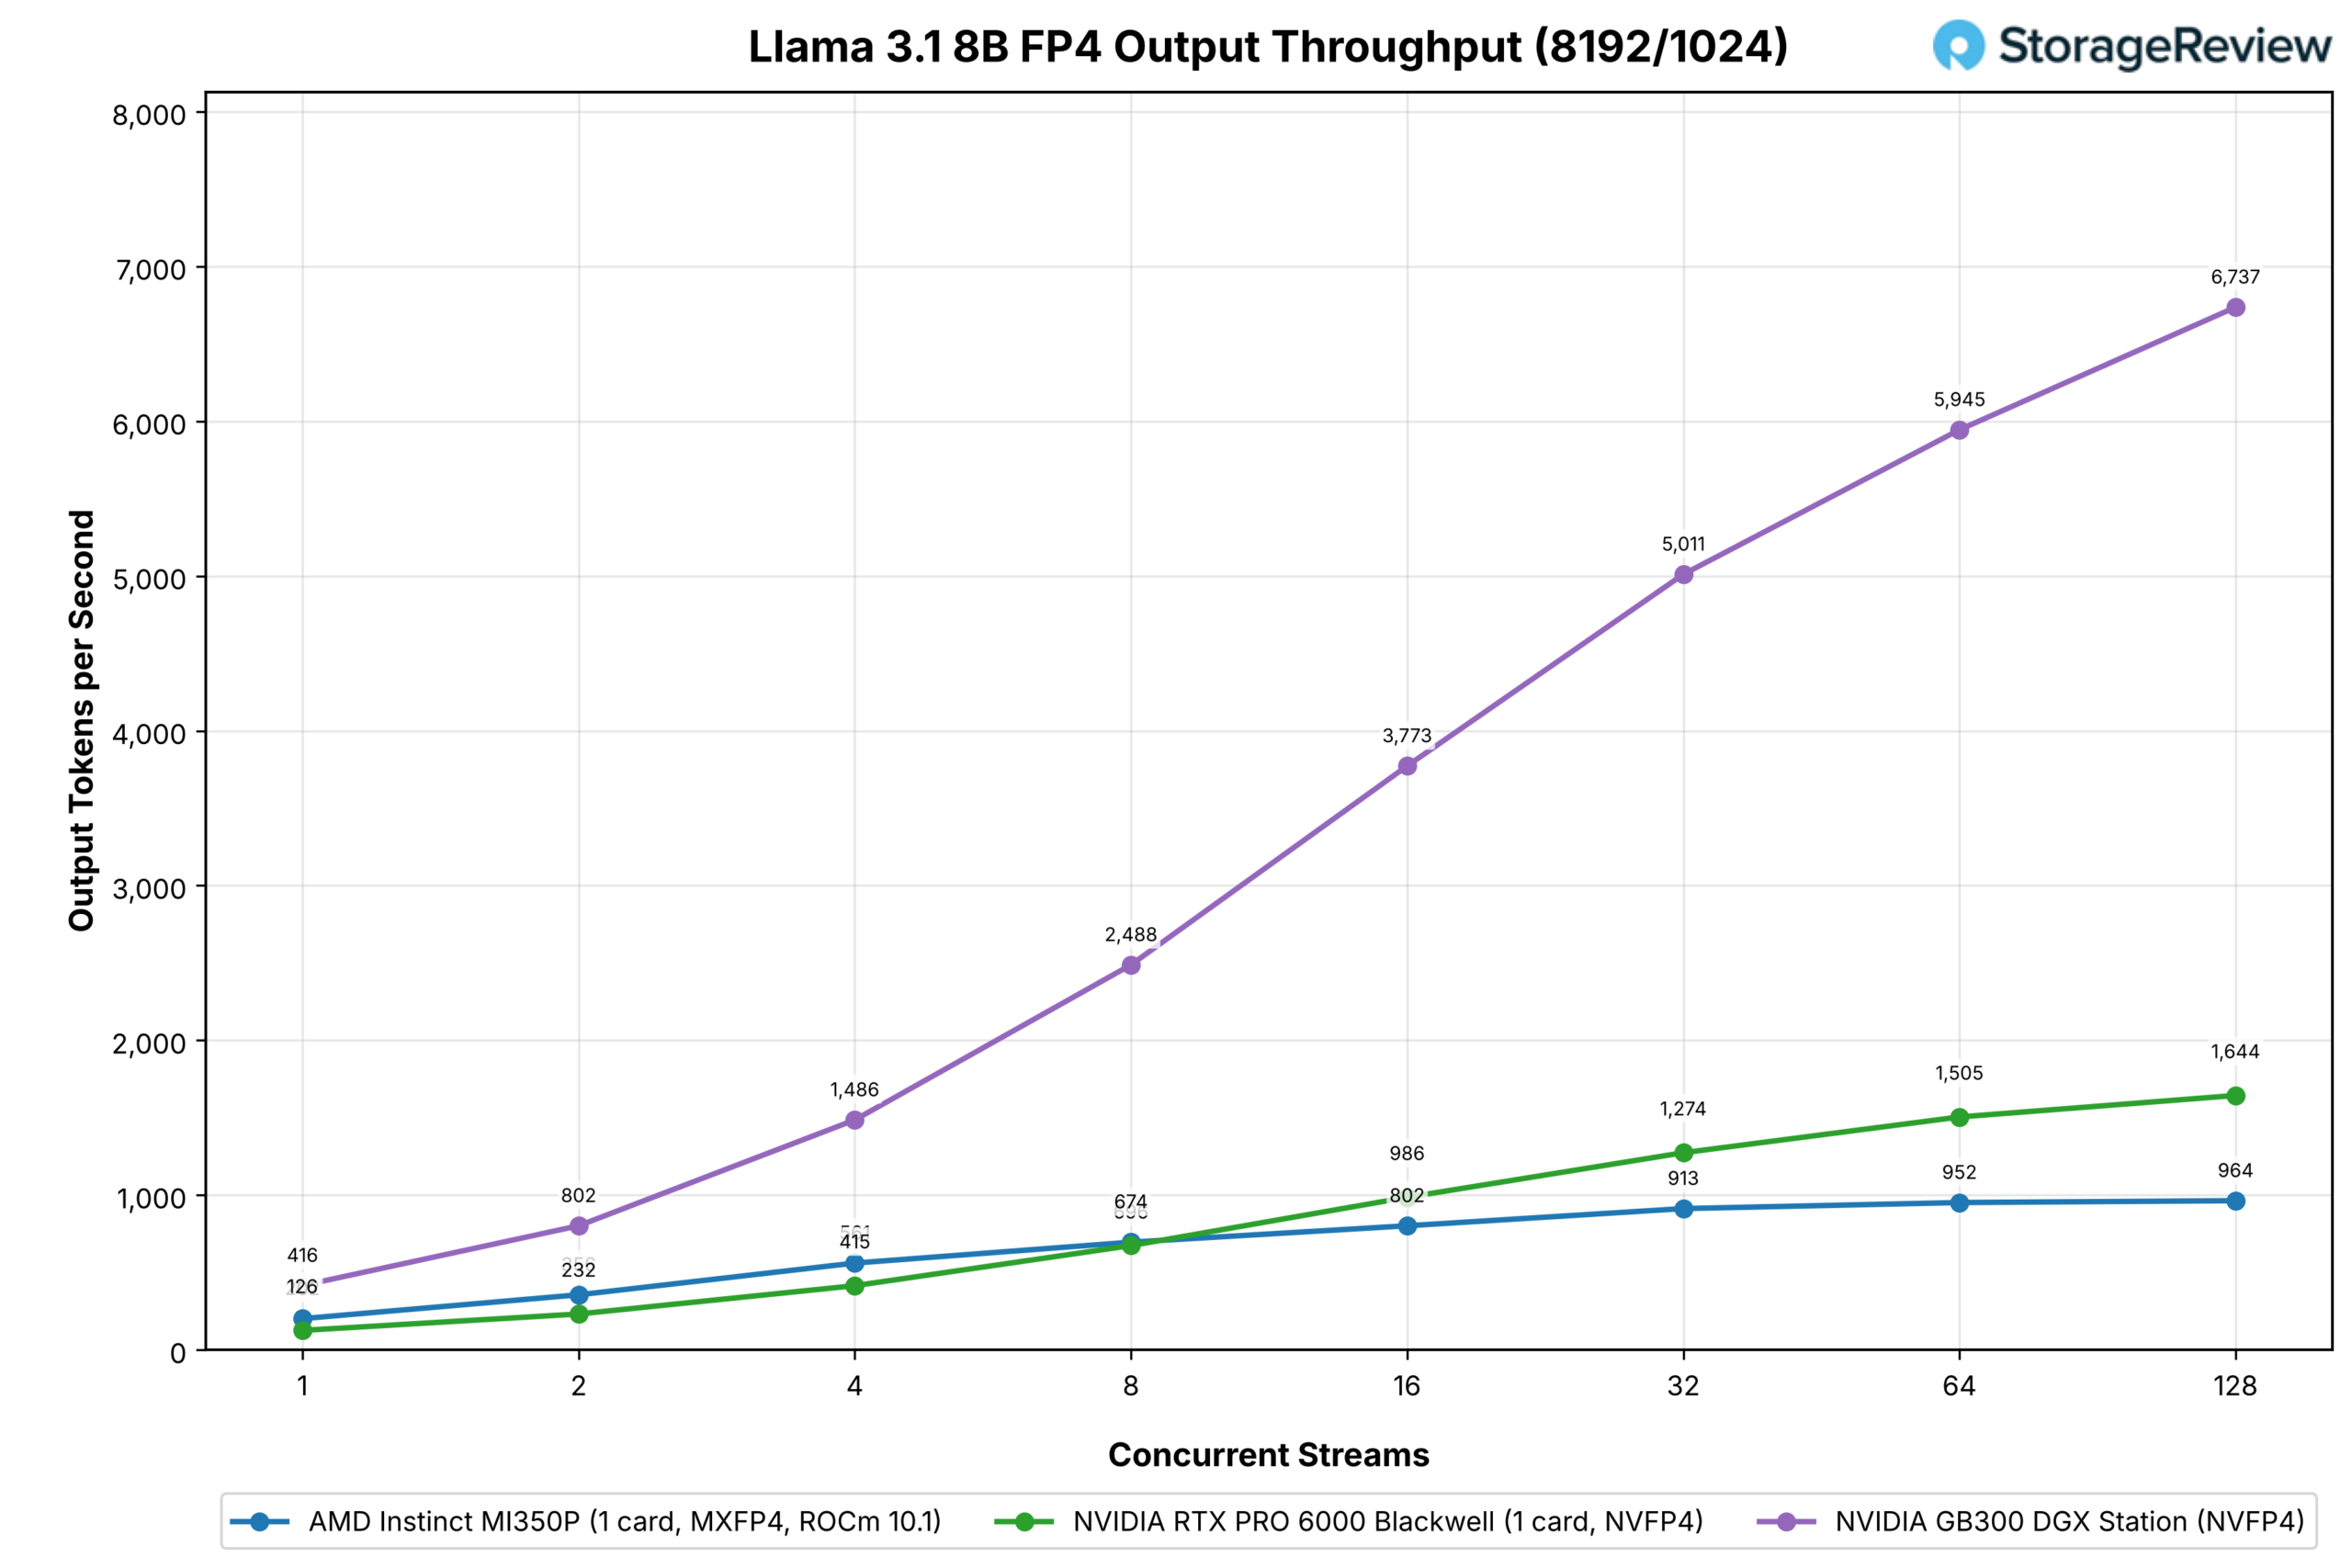
| Lhama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 964 | 1,644 | Não funciona | 6,737 |
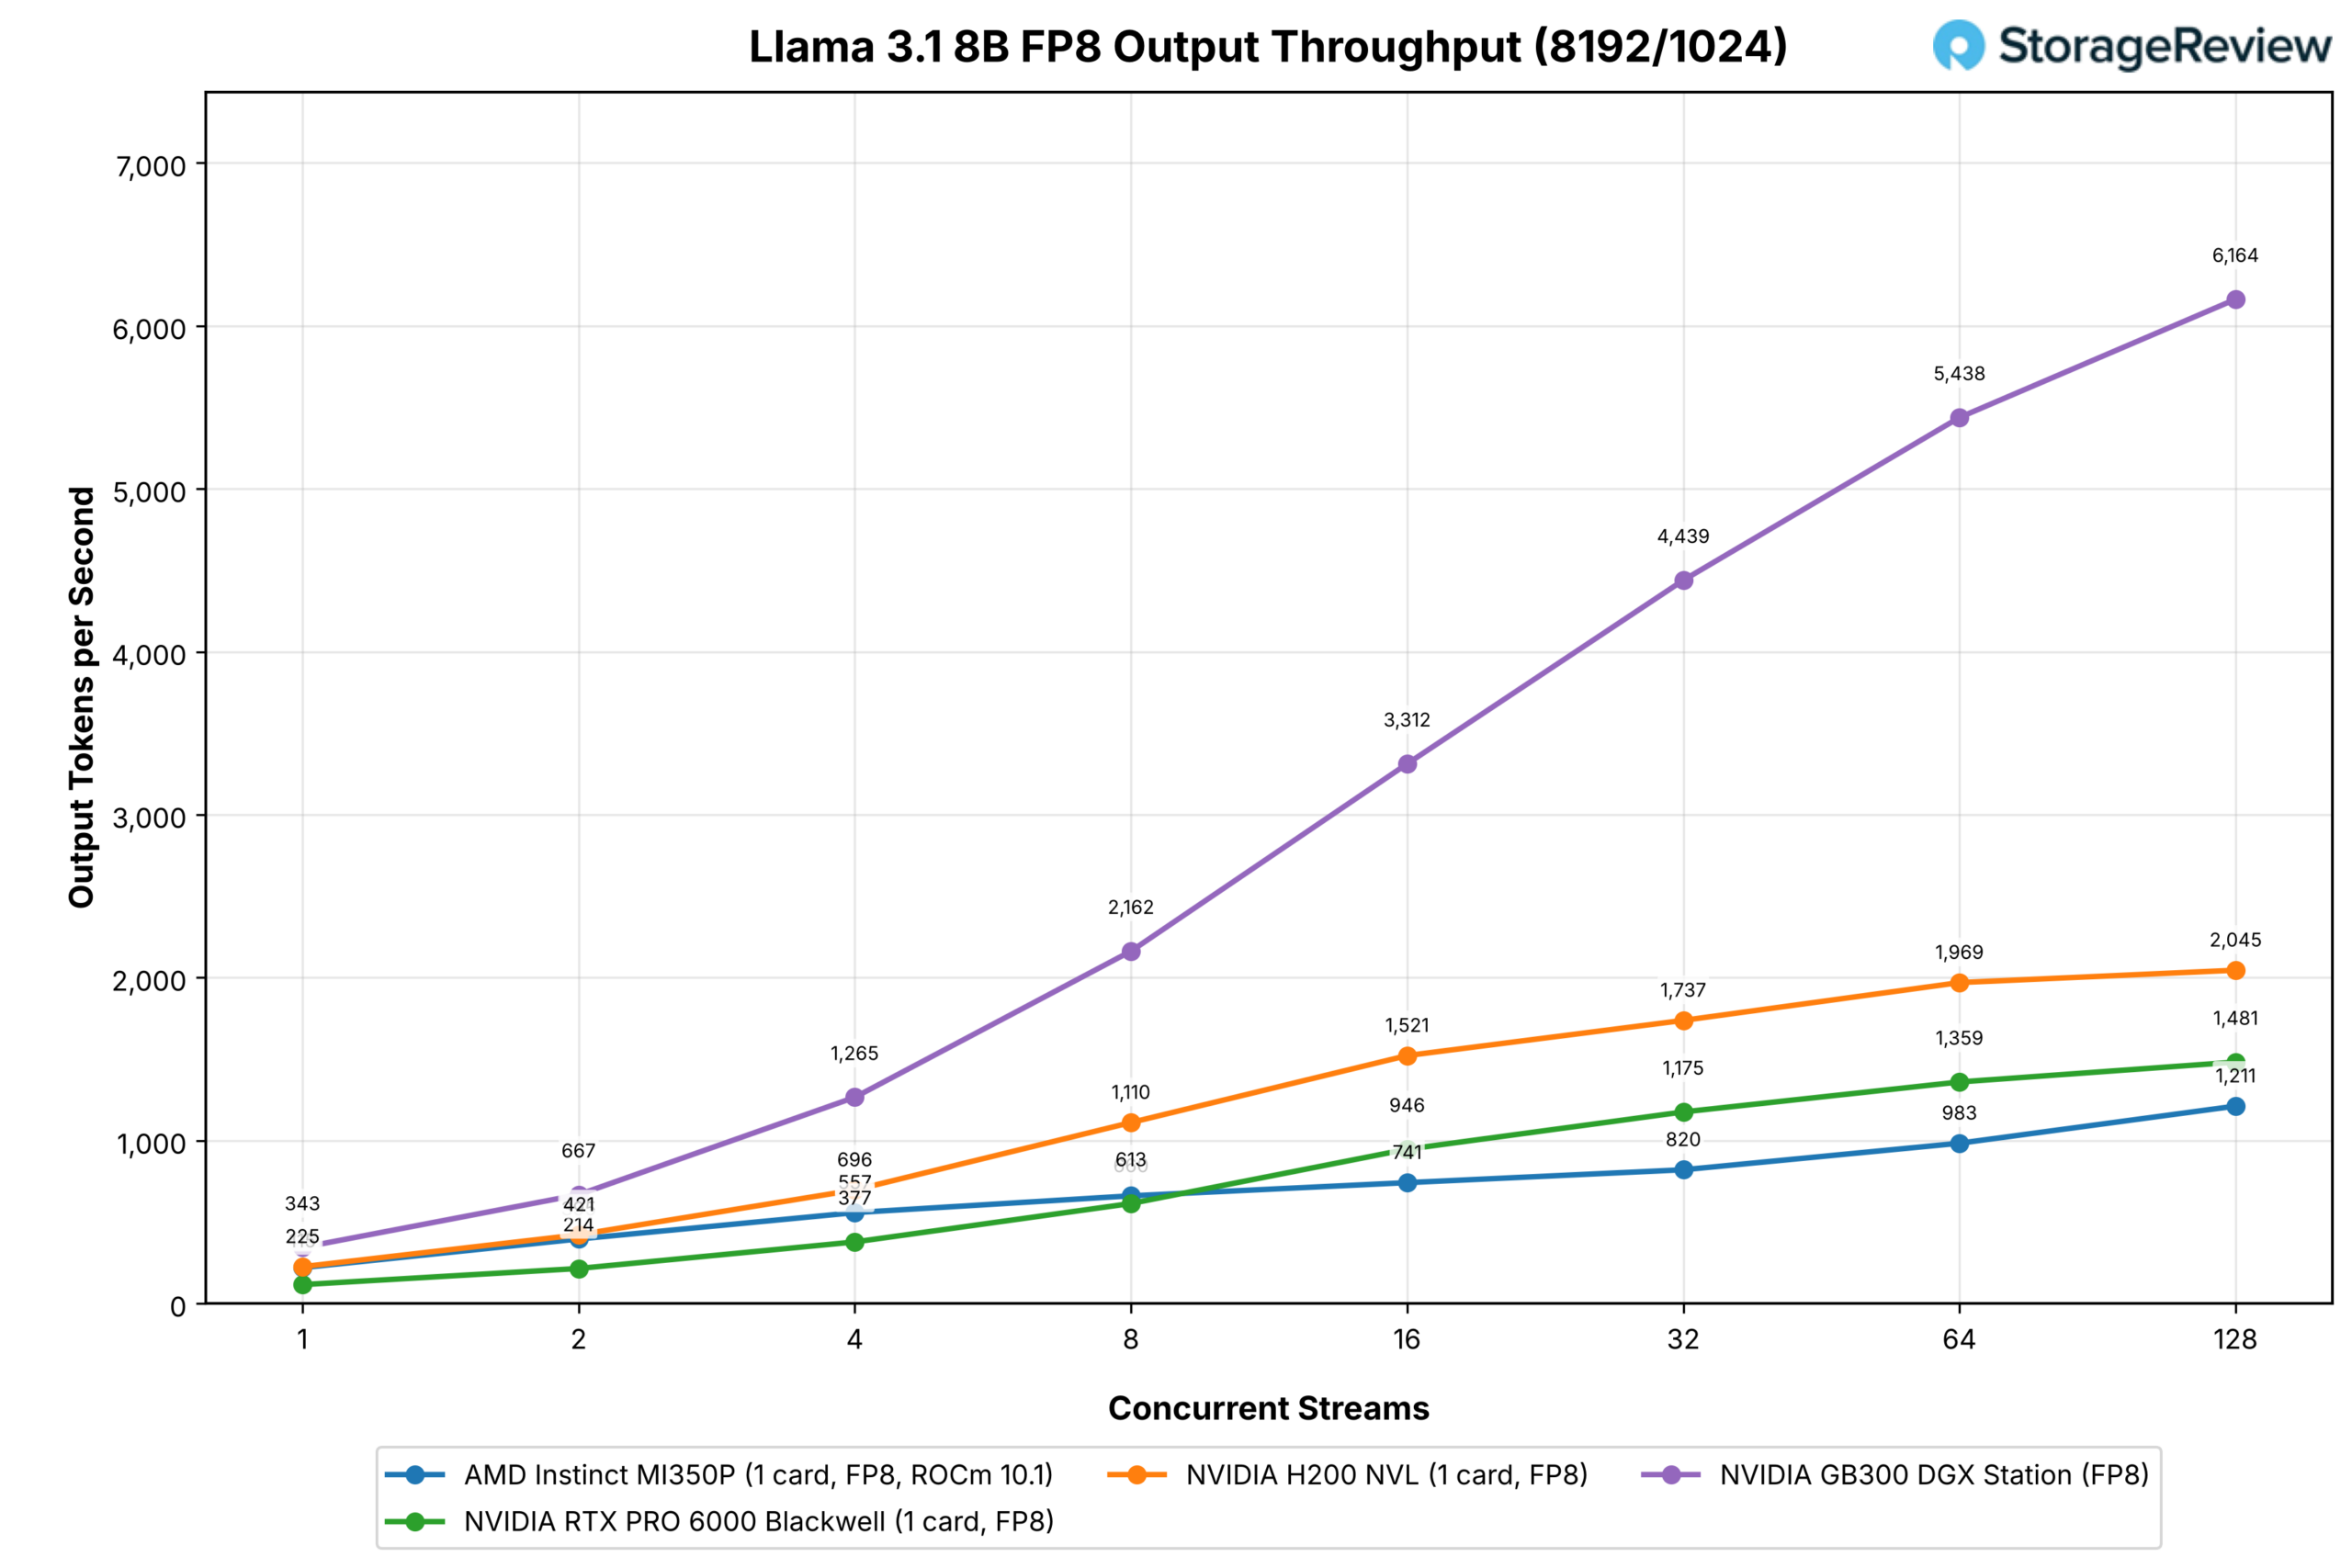
| Lhama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
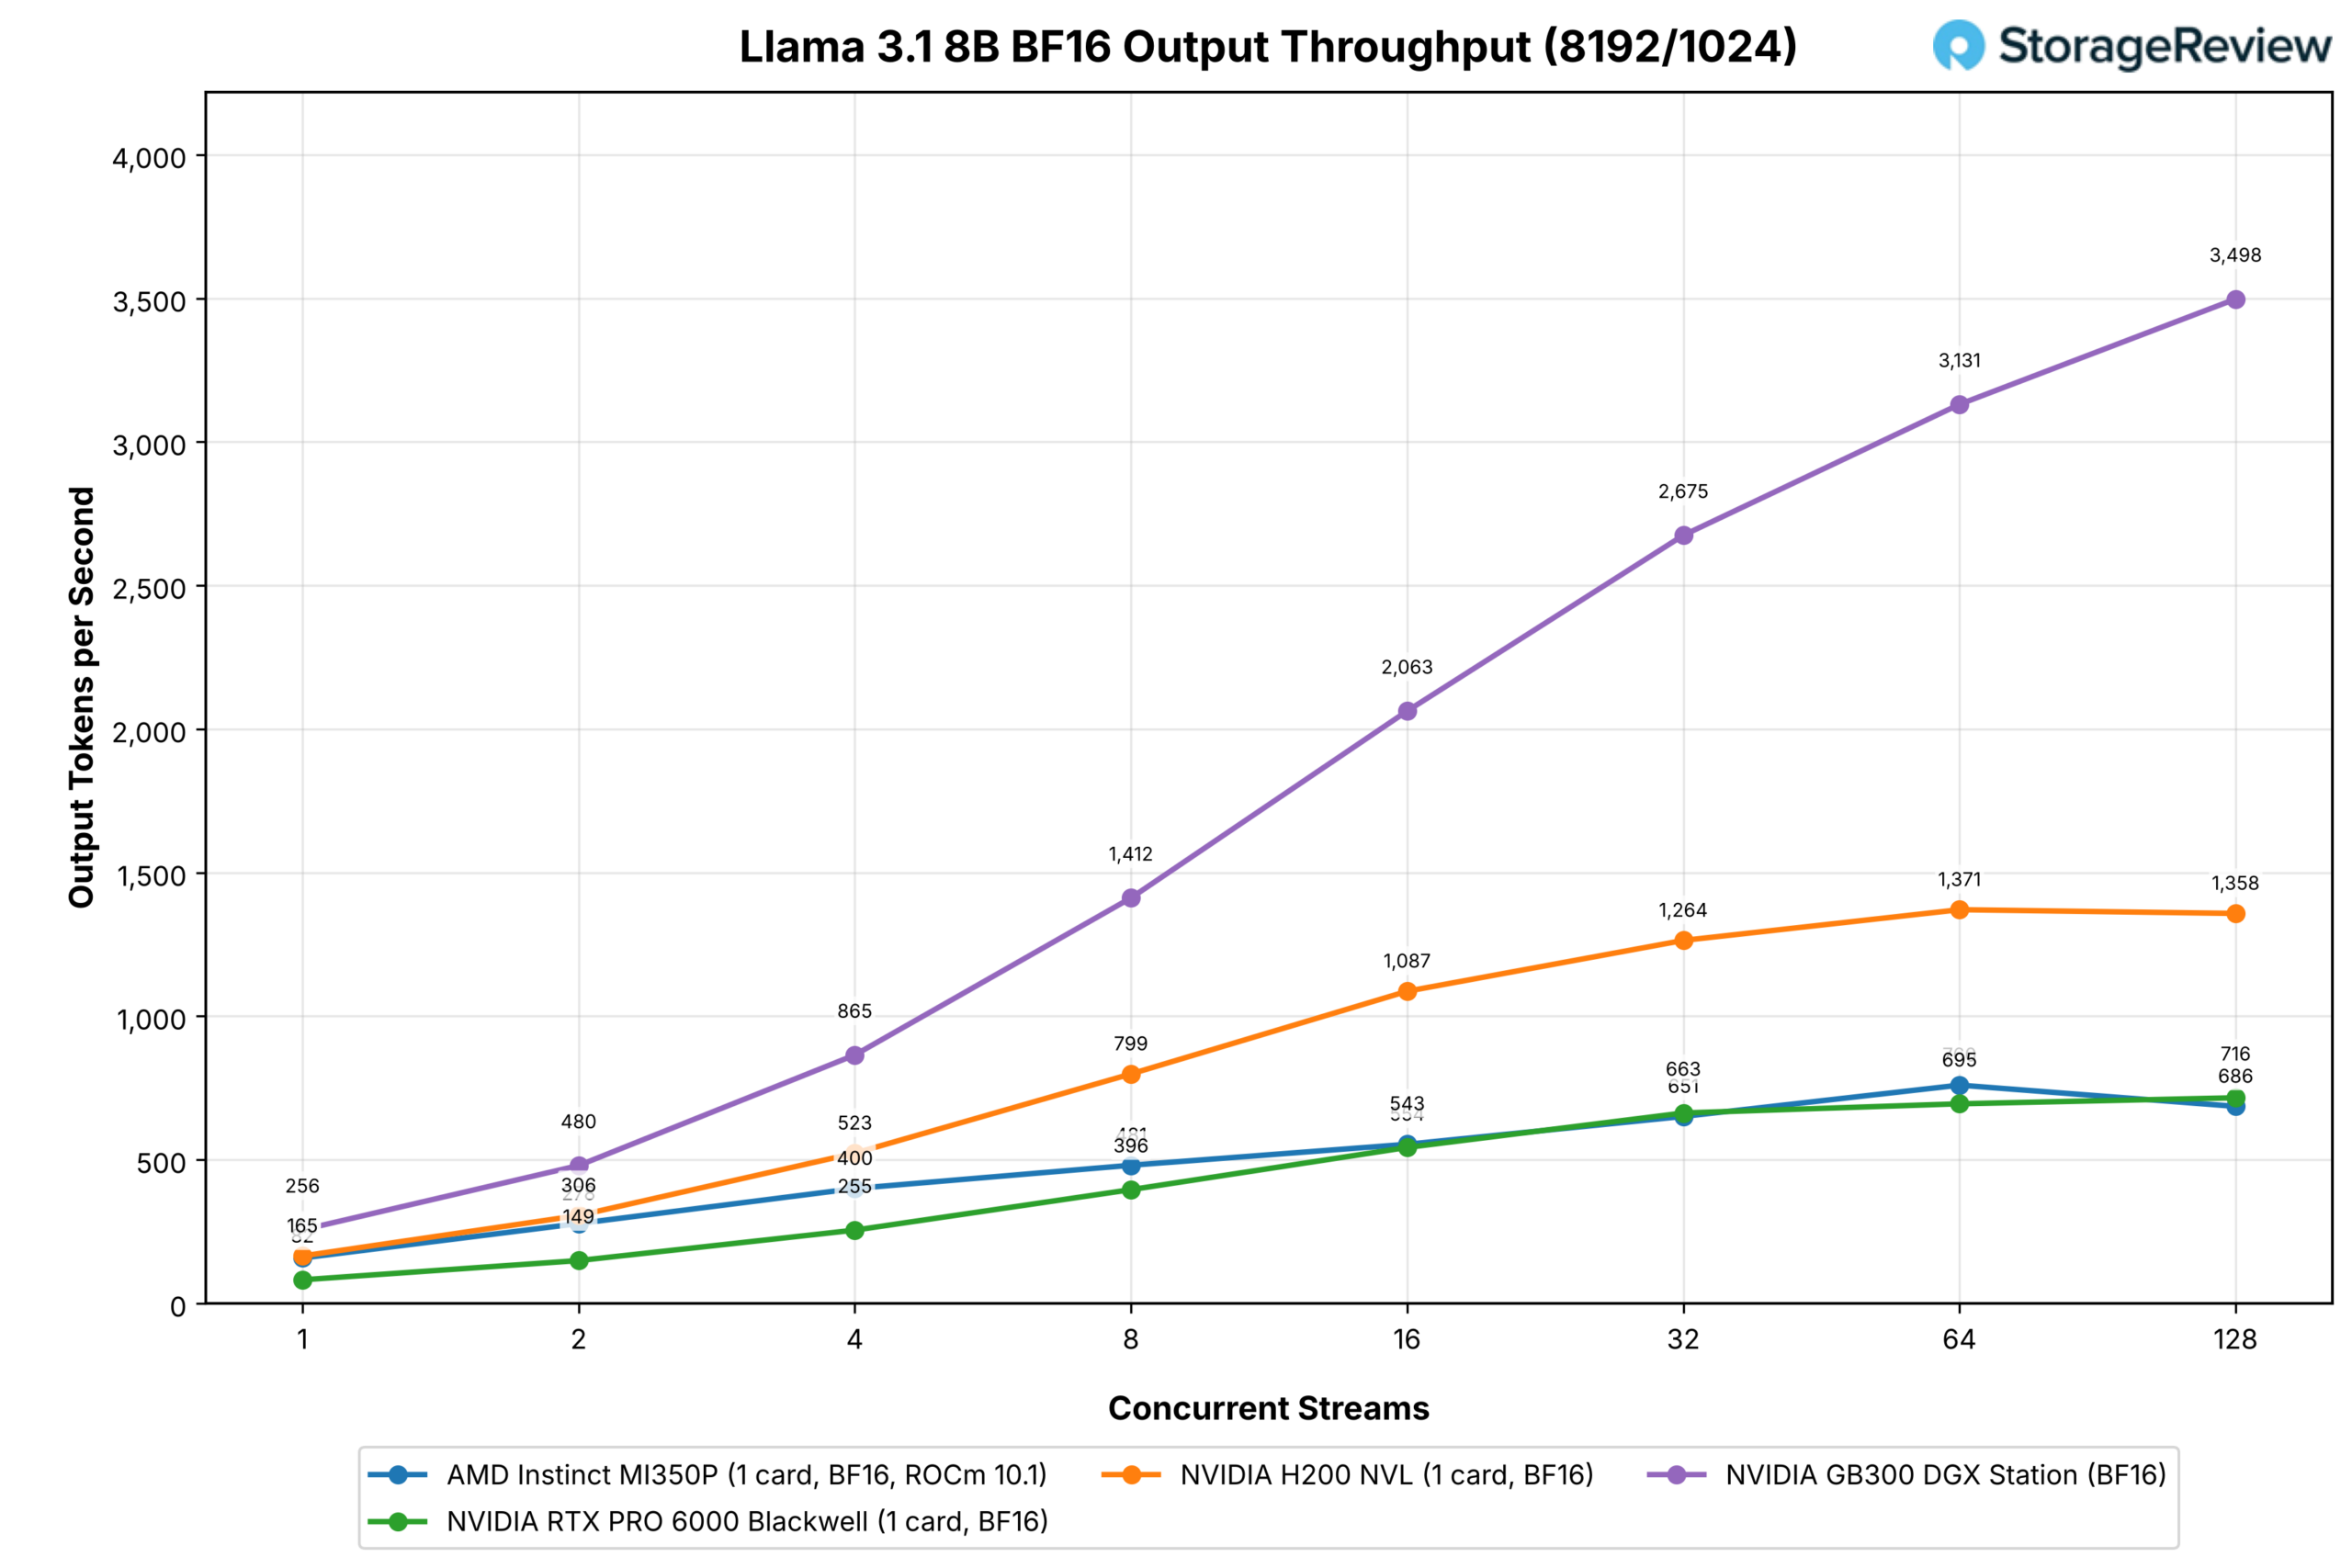
| Lhama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
Em prompts com muitos pré-preenchimentos, o cenário é misto: a MI350P supera a RTX PRO 6000 em ambos os modelos GPT-OSS em todas as contagens de fluxos e no Mistral Small, divide o desempenho no Qwen3-Coder com 128 fluxos (24% à frente no BF16, 8% atrás no FP8) e apresenta uma diferença de 16 fluxos no Llama e no MiniMax-M2.7, onde termina atrás da placa NVIDIA. Contra a H200, ela lidera no GPT-OSS por 15% no modelo de 120 bits e 5% no de 20 bits com 128 fluxos, e fica atrás por 25% a 58% nos modelos com maior densidade de dados.
Nos modelos maiores, onde duas MI350Ps enfrentam quatro RTX PRO 6000s, o conjunto NVIDIA lidera o GLM-5.2 em 16 fluxos na carga de trabalho de bate-papo com 384 GB de GDDR7 contra 288 GB de HBM3E, enquanto no MiniMax-M3 todas as três configurações ficam dentro de uma margem de 10% em oito fluxos antes do quad RTX assumir a liderança em 16. O único GB300 supera todas as configurações PCIe por uma ampla margem em tudo que cabe em seus 252 GB.
Flash GLM-5.3
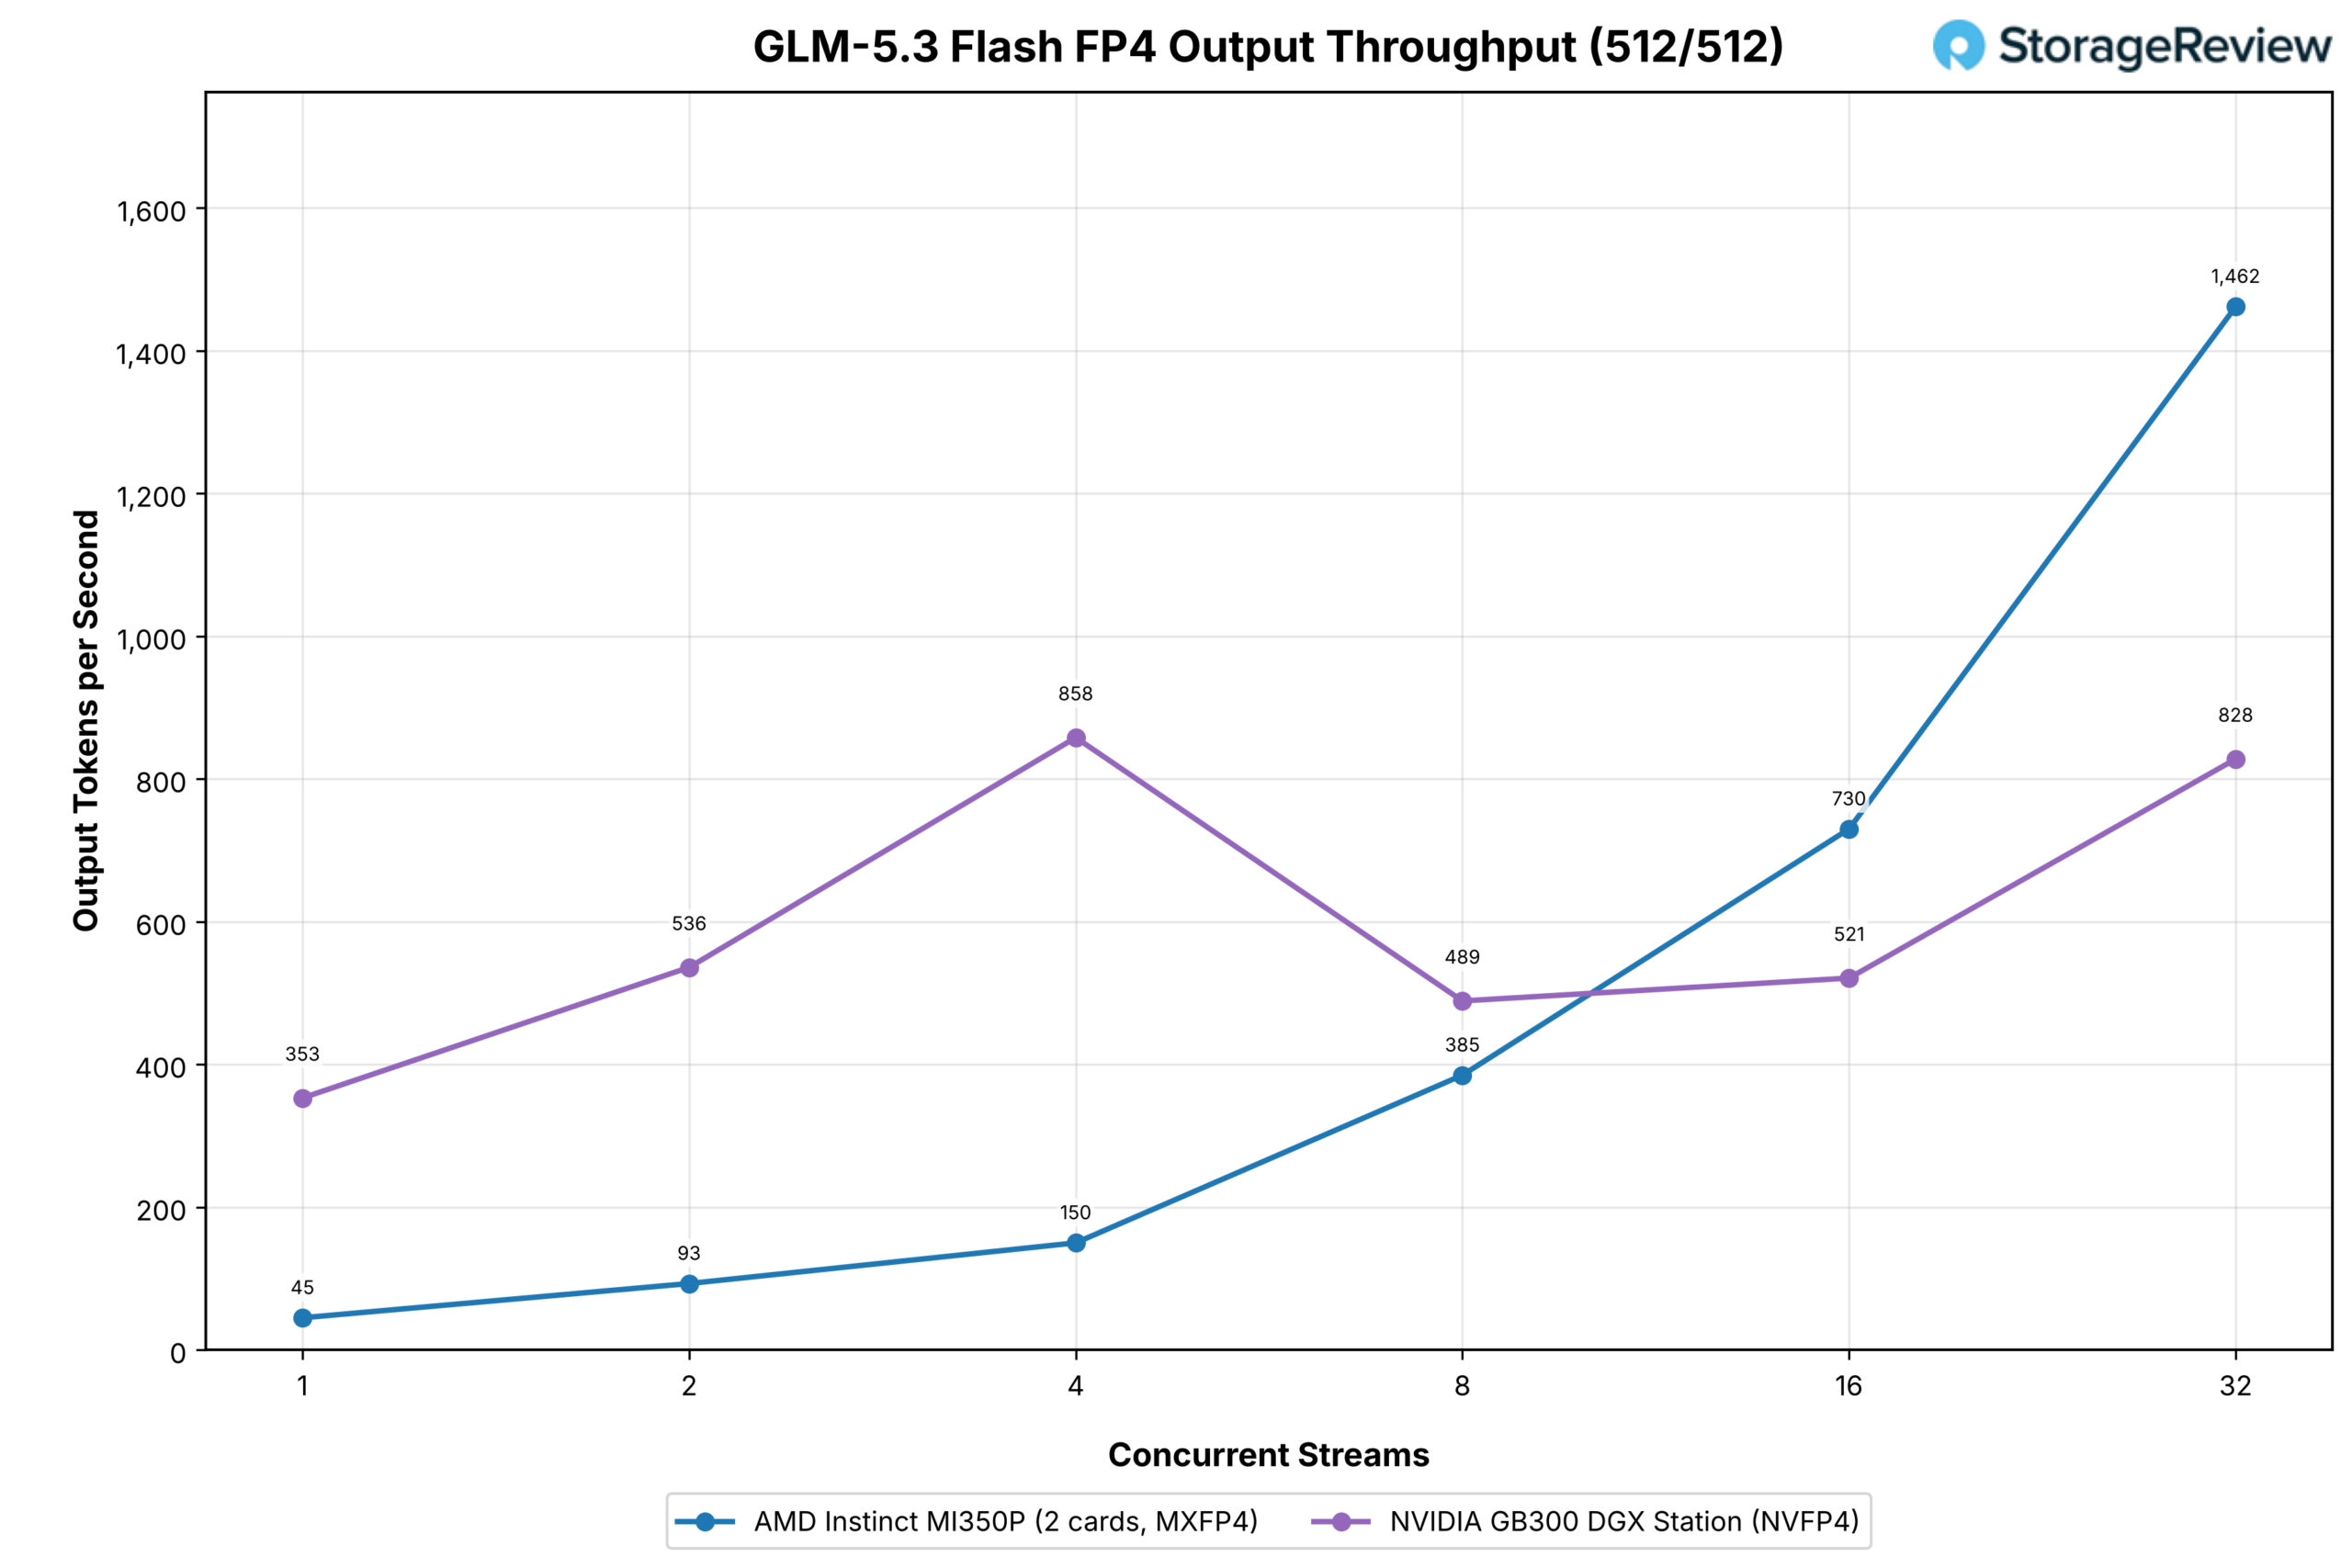
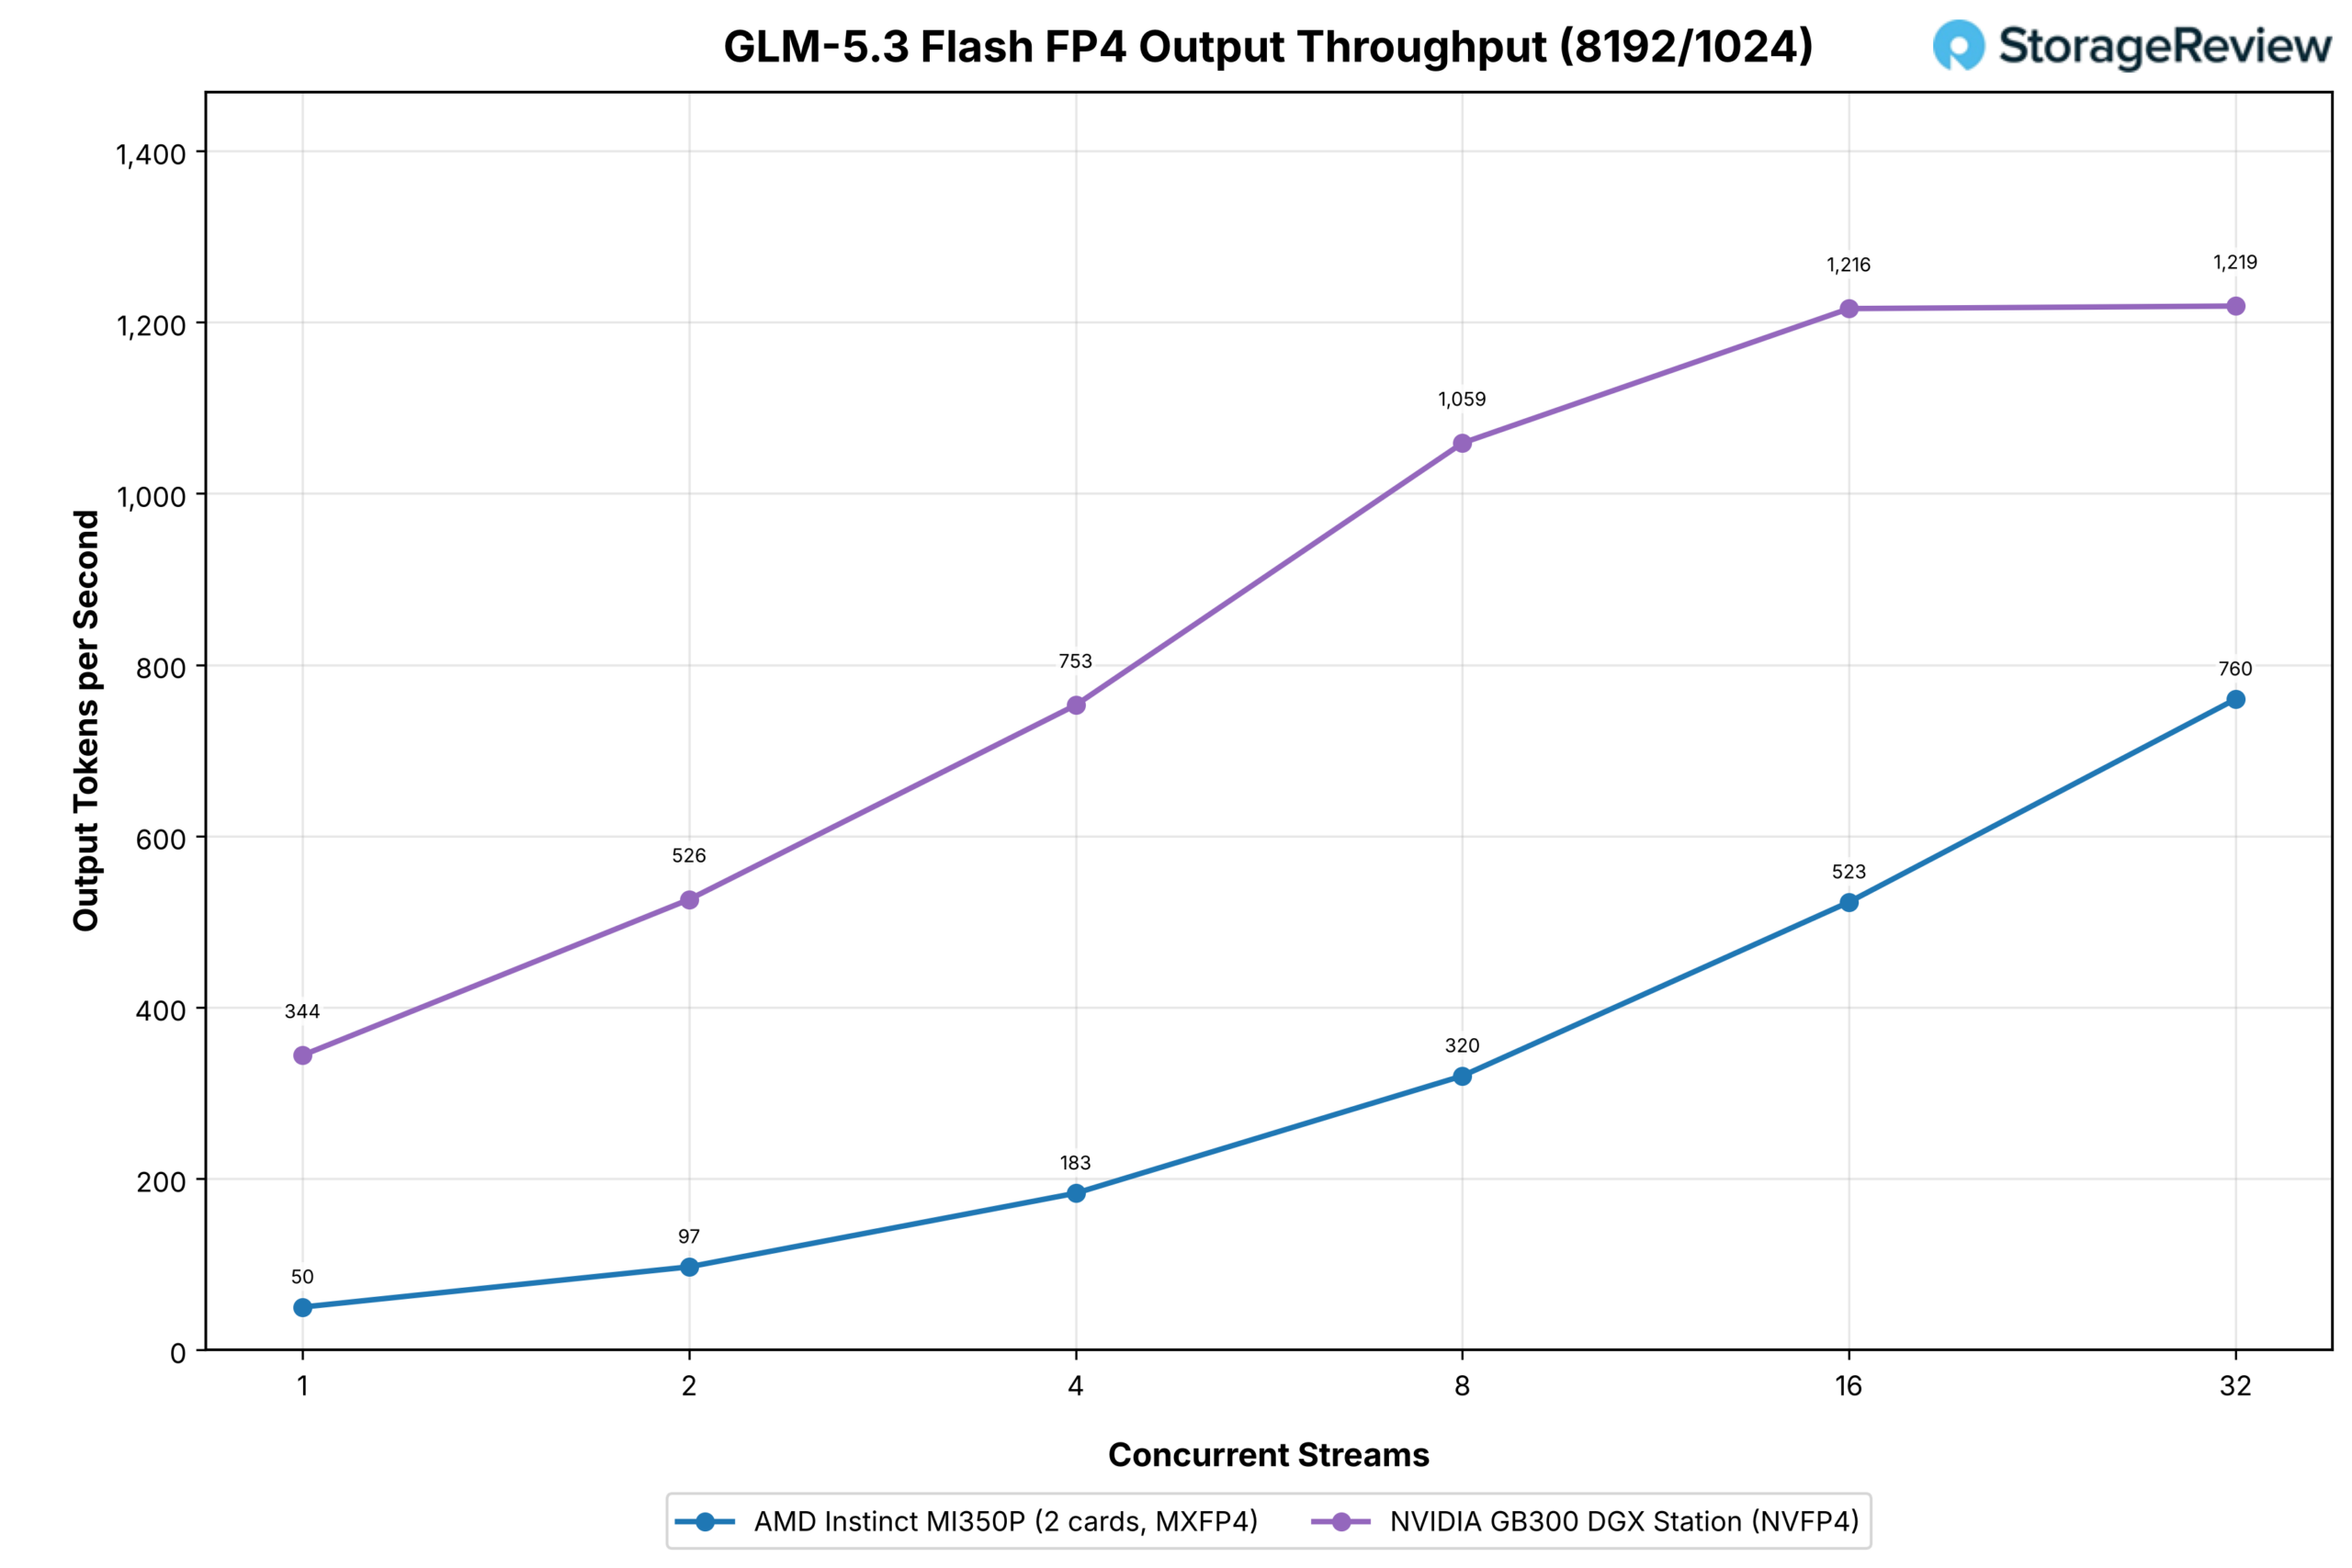
O GLM-5.3 Flash não foi executado na RTX PRO 6000, portanto, a comparação é feita entre duas placas MI350P e uma única GB300 Station, com 32 fluxos de dados. Na carga de trabalho de chat, o par de MI350P começa atrás, com 45 tokens de saída por segundo contra 353 da Station em um fluxo, e ultrapassa a Station em oito fluxos, chegando a 1,462 tokens por segundo em 32 fluxos, contra 828 da Station. Na carga de trabalho com uso intensivo de pré-carregamento, a Station lidera o tempo todo, com 1,219 tokens por segundo contra 760 em 32 fluxos, onde o pré-carregamento do par precisa atravessar a memória PCIe entre as duas placas, enquanto a B300 faz tudo em um único módulo HBM.
GLM-5.2
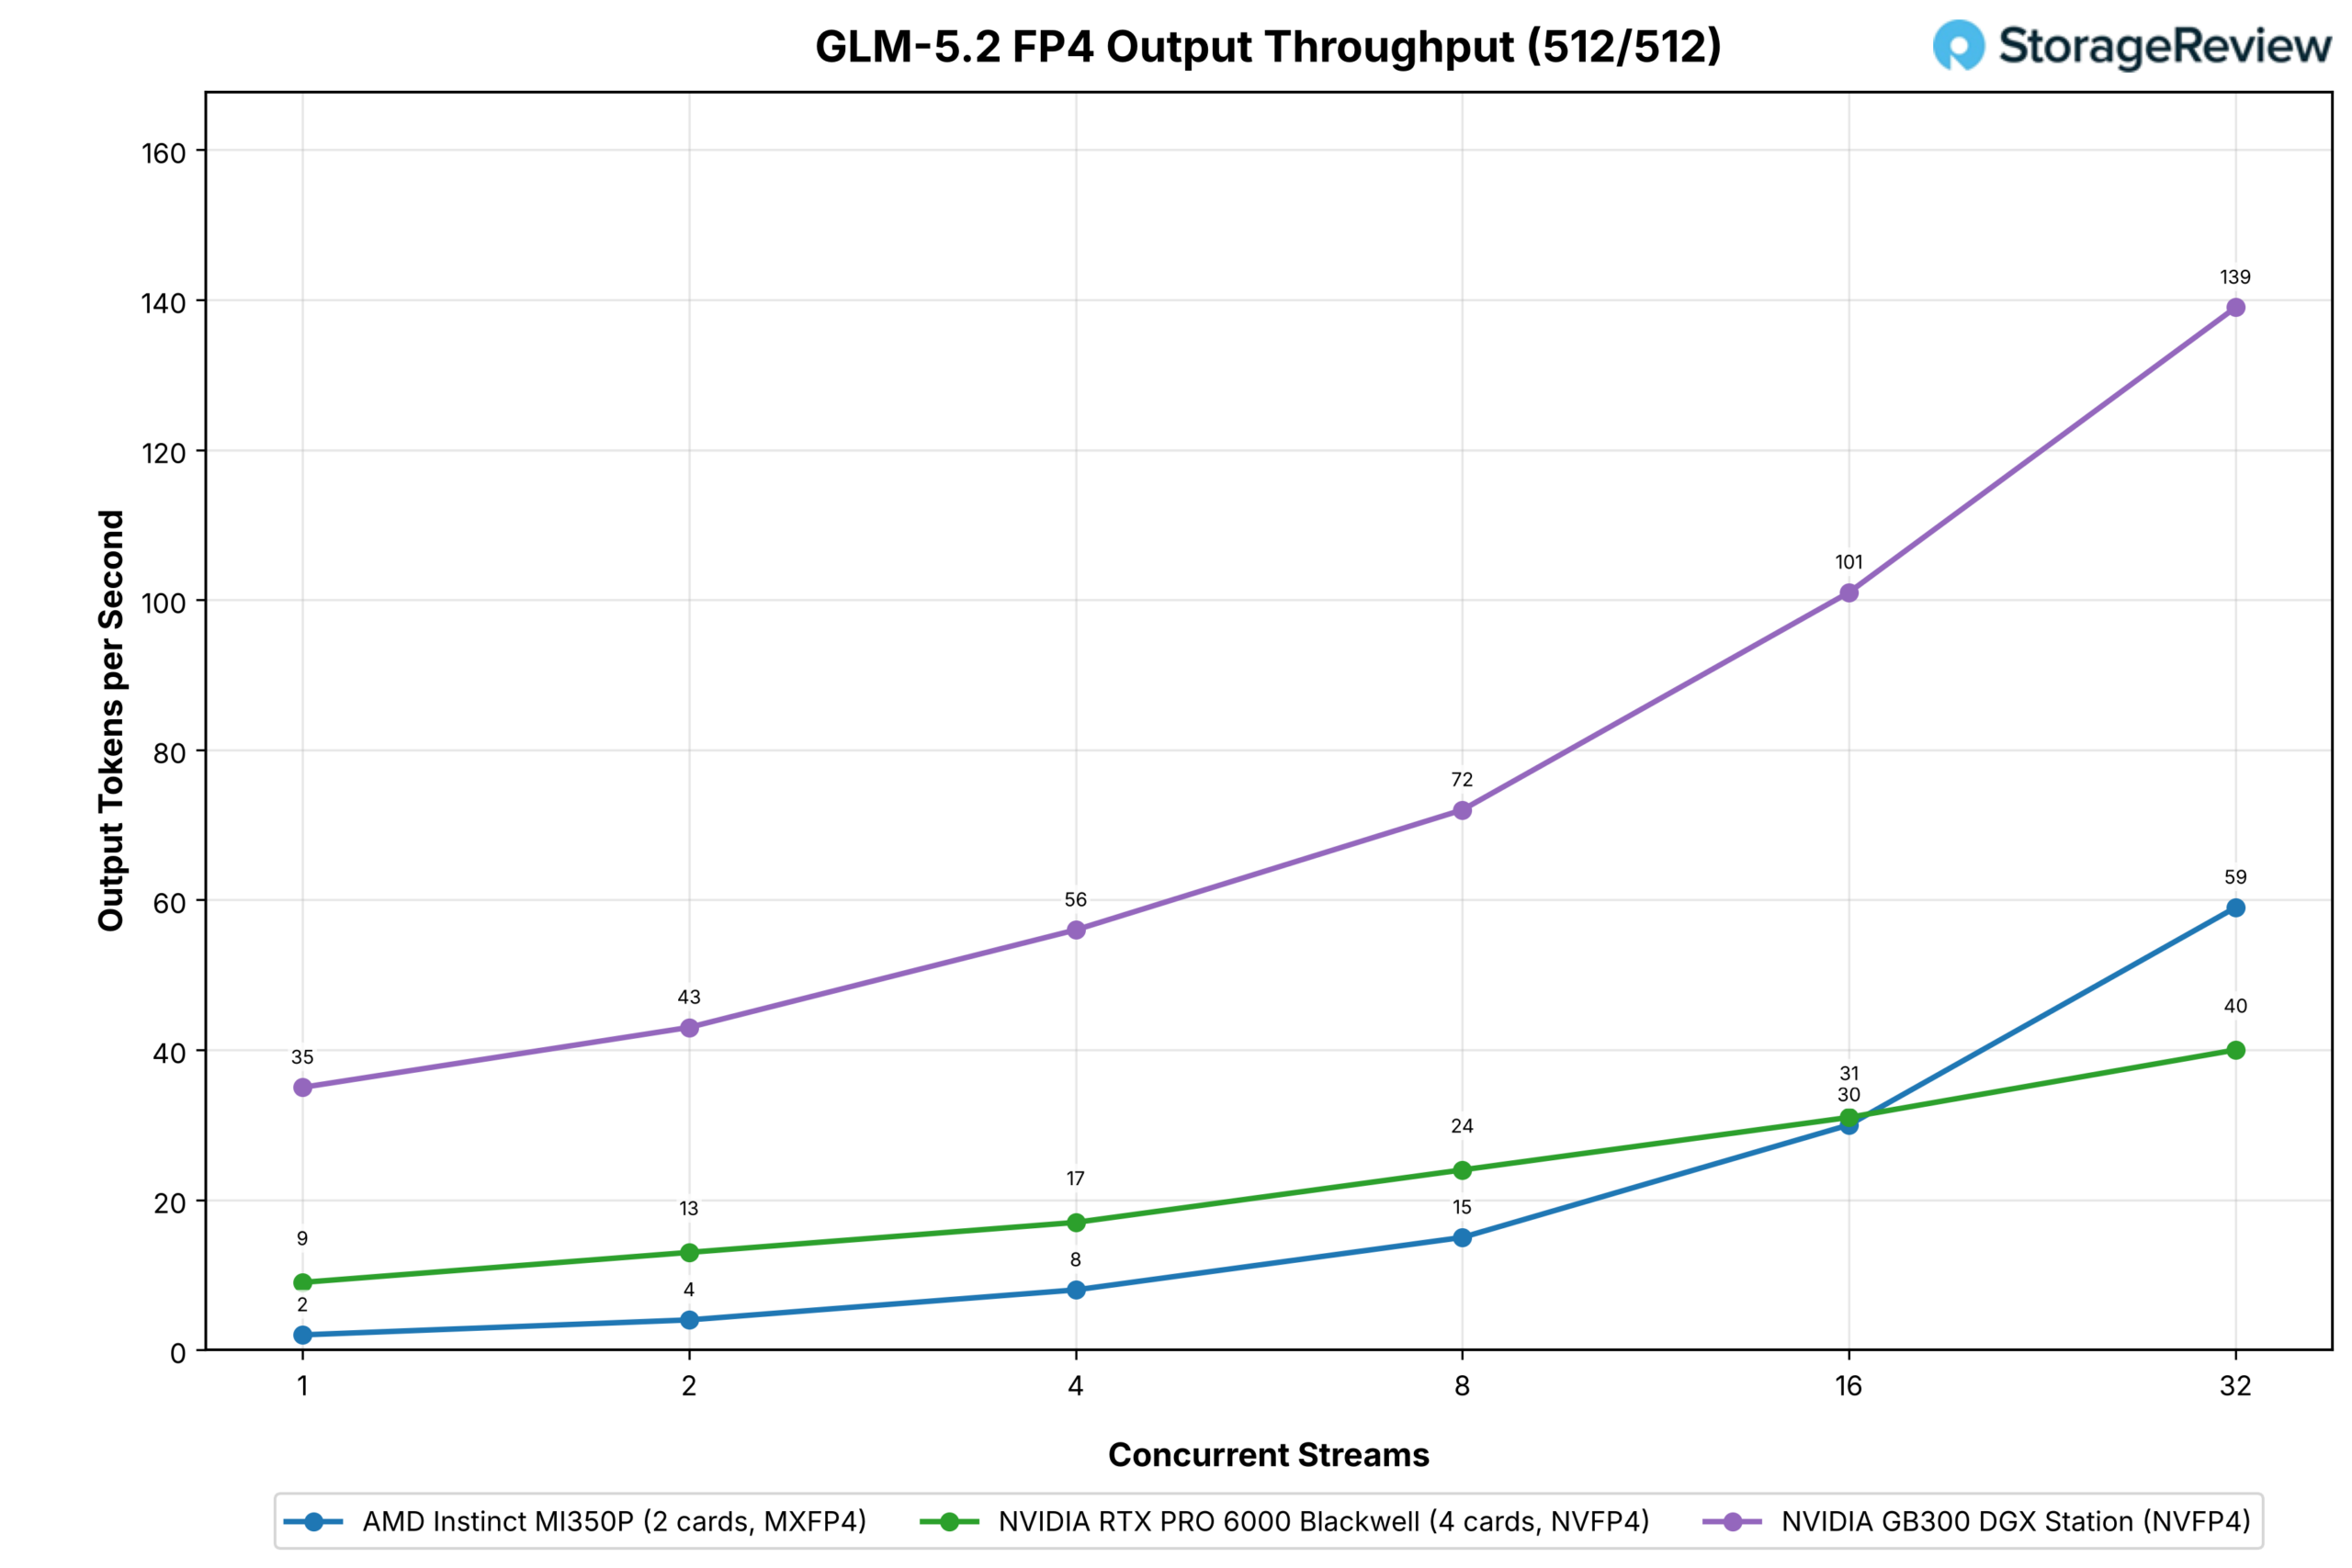
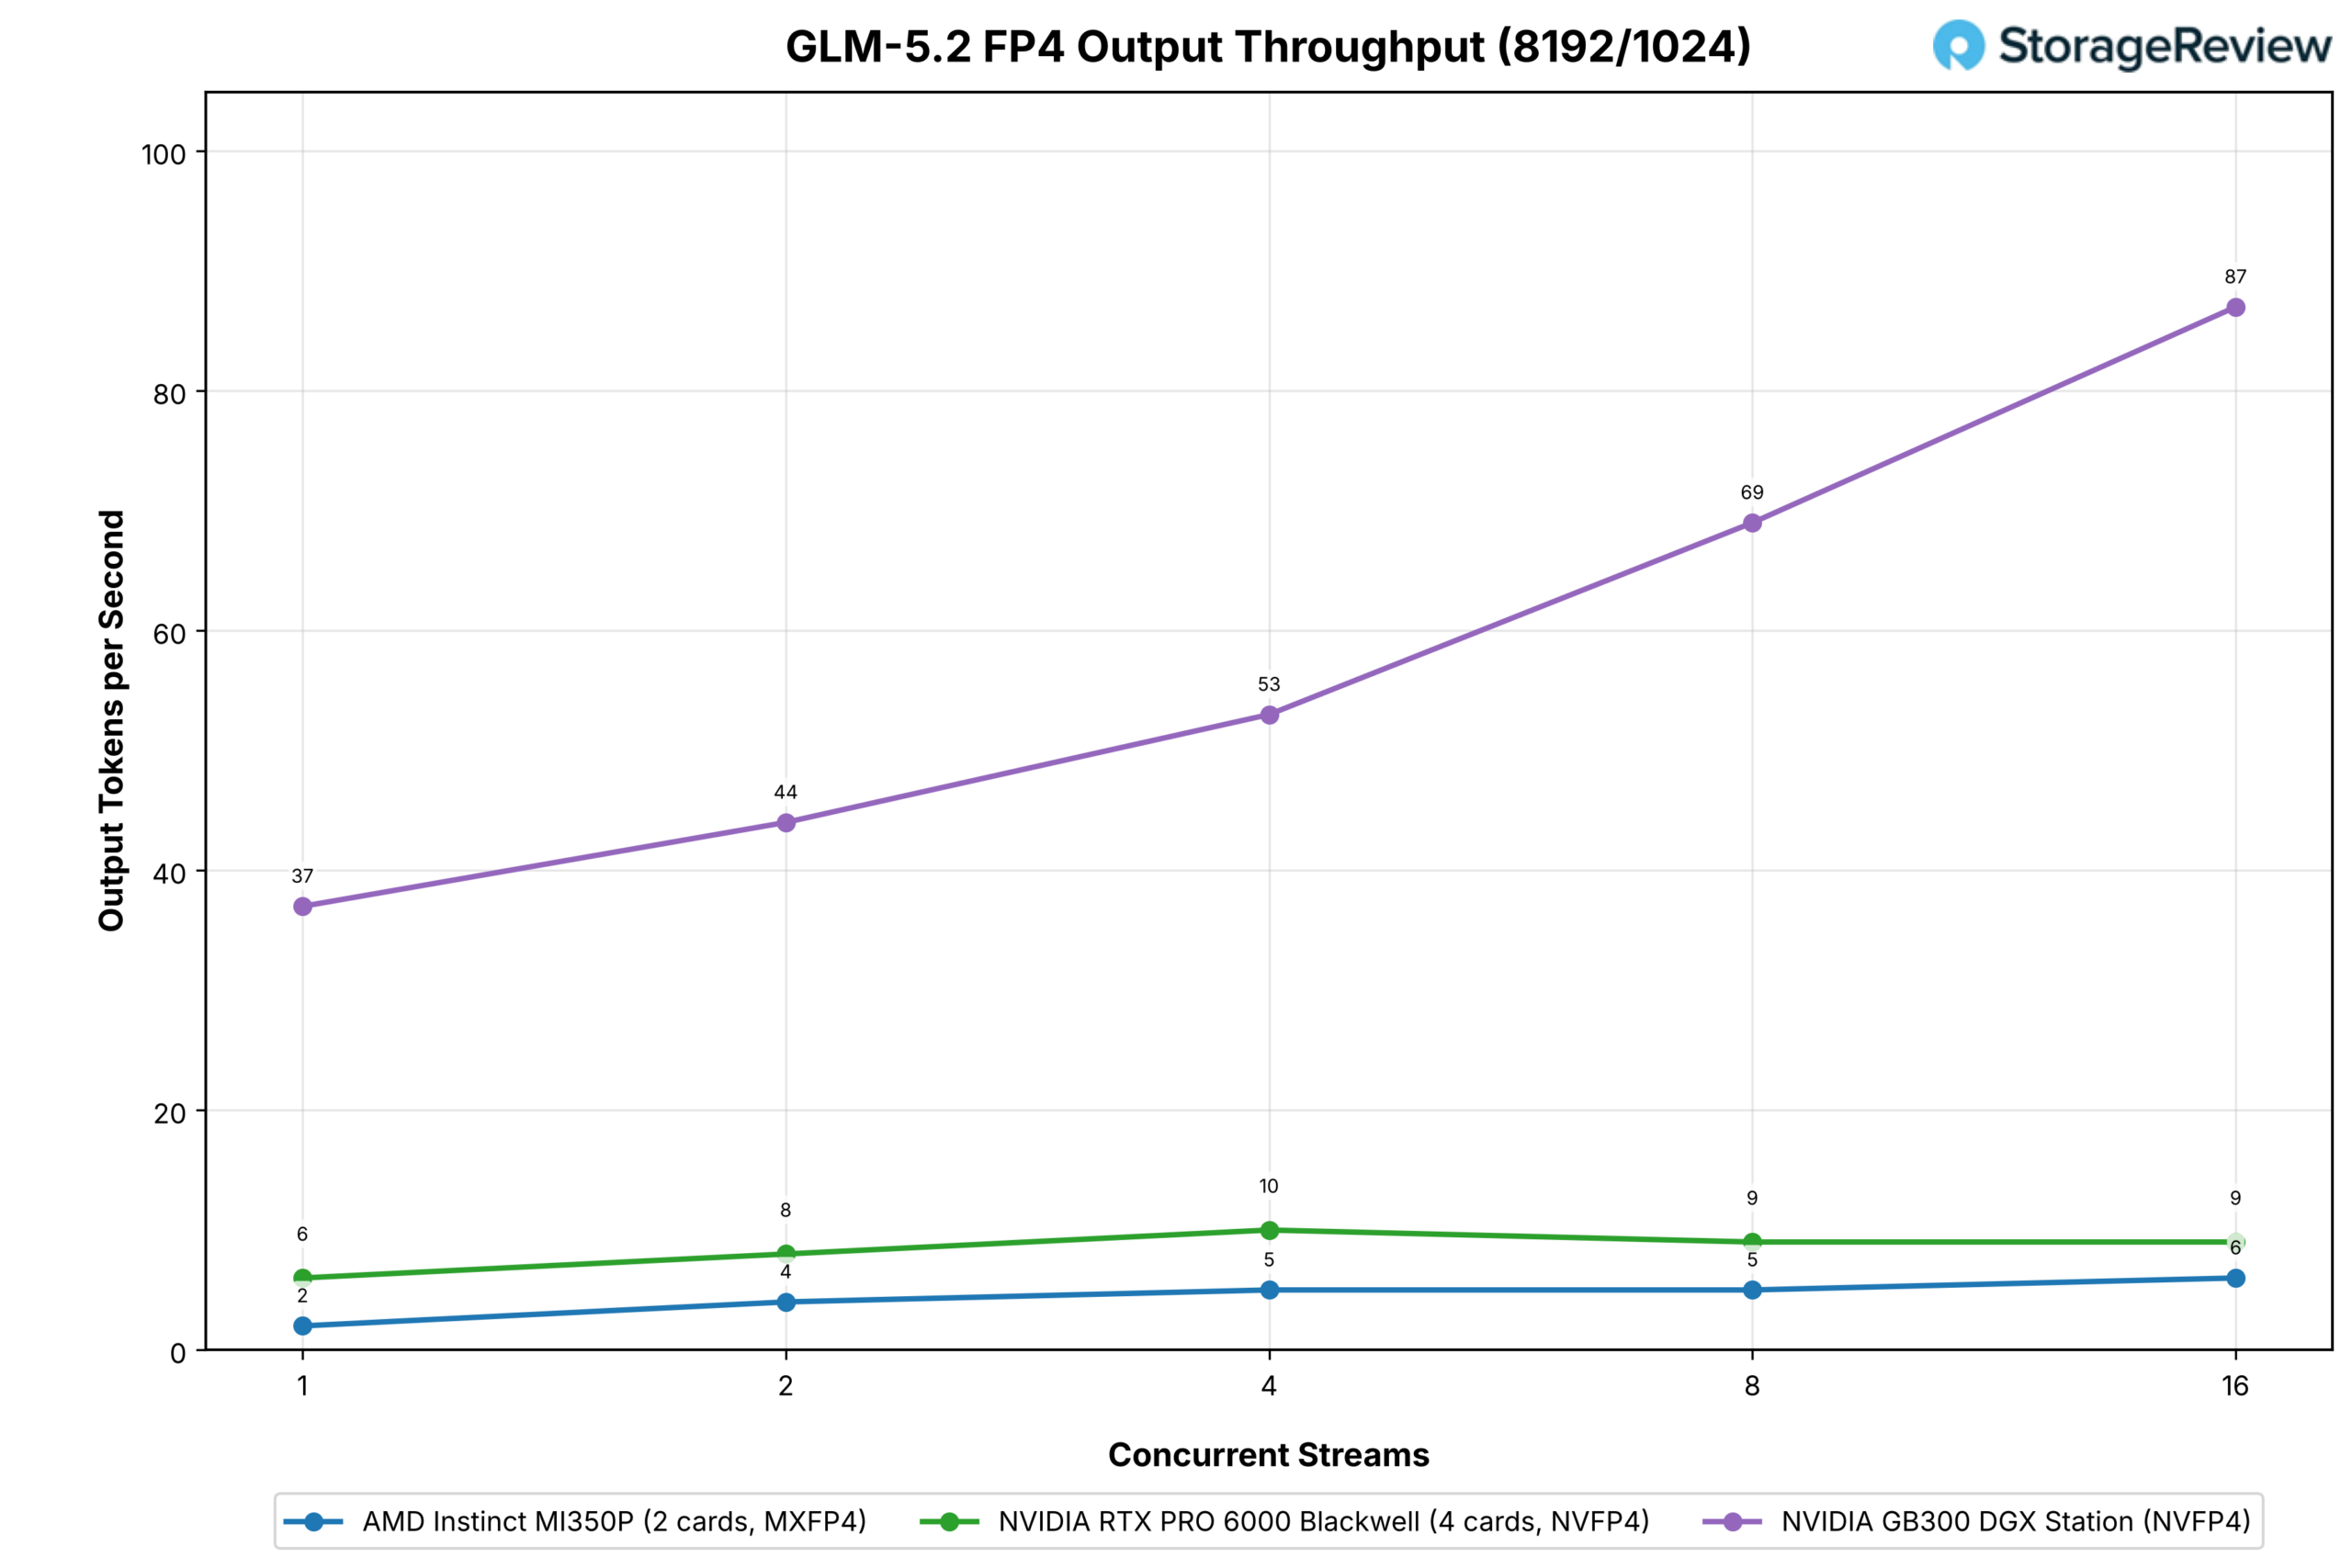
O GLM-5.2 é o destaque deste conjunto em termos de memória. O ponto de verificação MXFP4 ultrapassa os 288 GB das duas placas MI350P e utiliza a memória do host, resultando em uma taxa de transferência de fluxo único de 2 tokens de saída por segundo no par, contra 9 para quatro placas RTX PRO 6000 com o NVFP4 integrado em 384 GB de GDDR7 e 35 para a Station, que delega cerca de 215 GB de pesos de especialistas para a memória Grace. O quad-core RTX lidera em 16 fluxos na carga de trabalho de chat; com 32 fluxos, o par MI350P atinge 59 contra 40, e a Station chega a 139. Em prompts com muitos pré-preenchimentos, nenhuma das configurações PCIe ultrapassa os 10 tokens por segundo em 16 fluxos, contra 87 para a Station.
MiniMax-M3
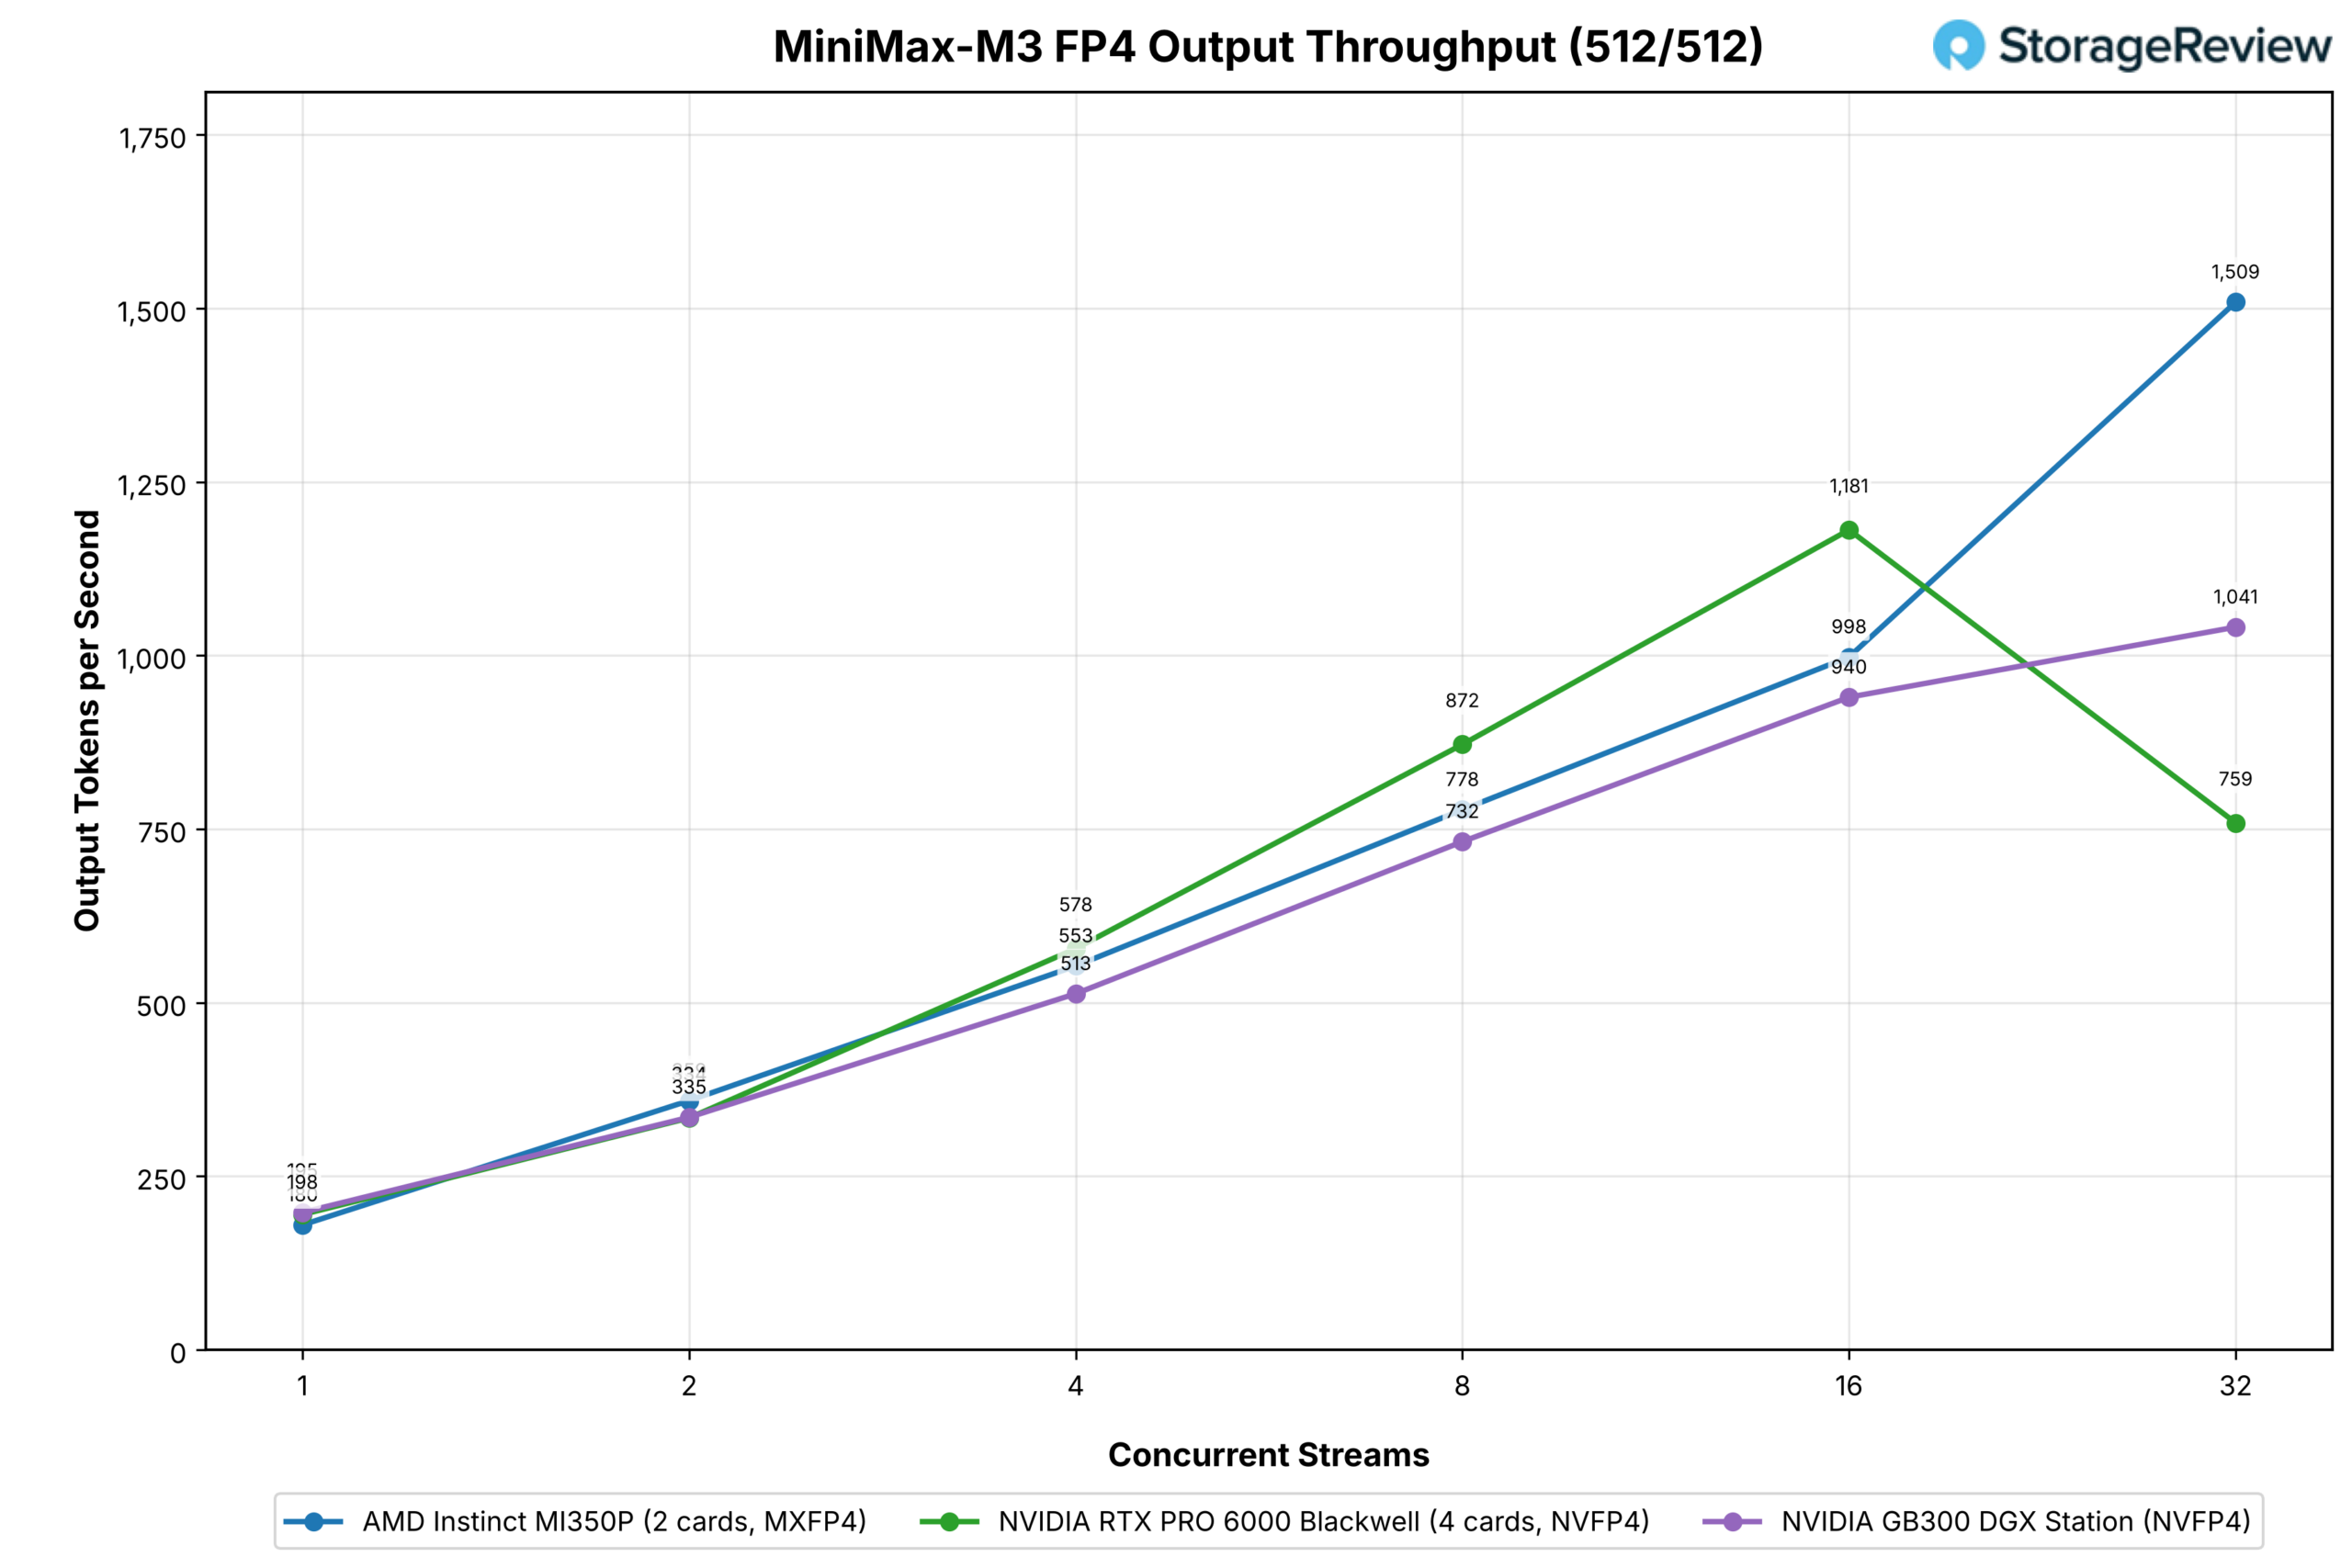
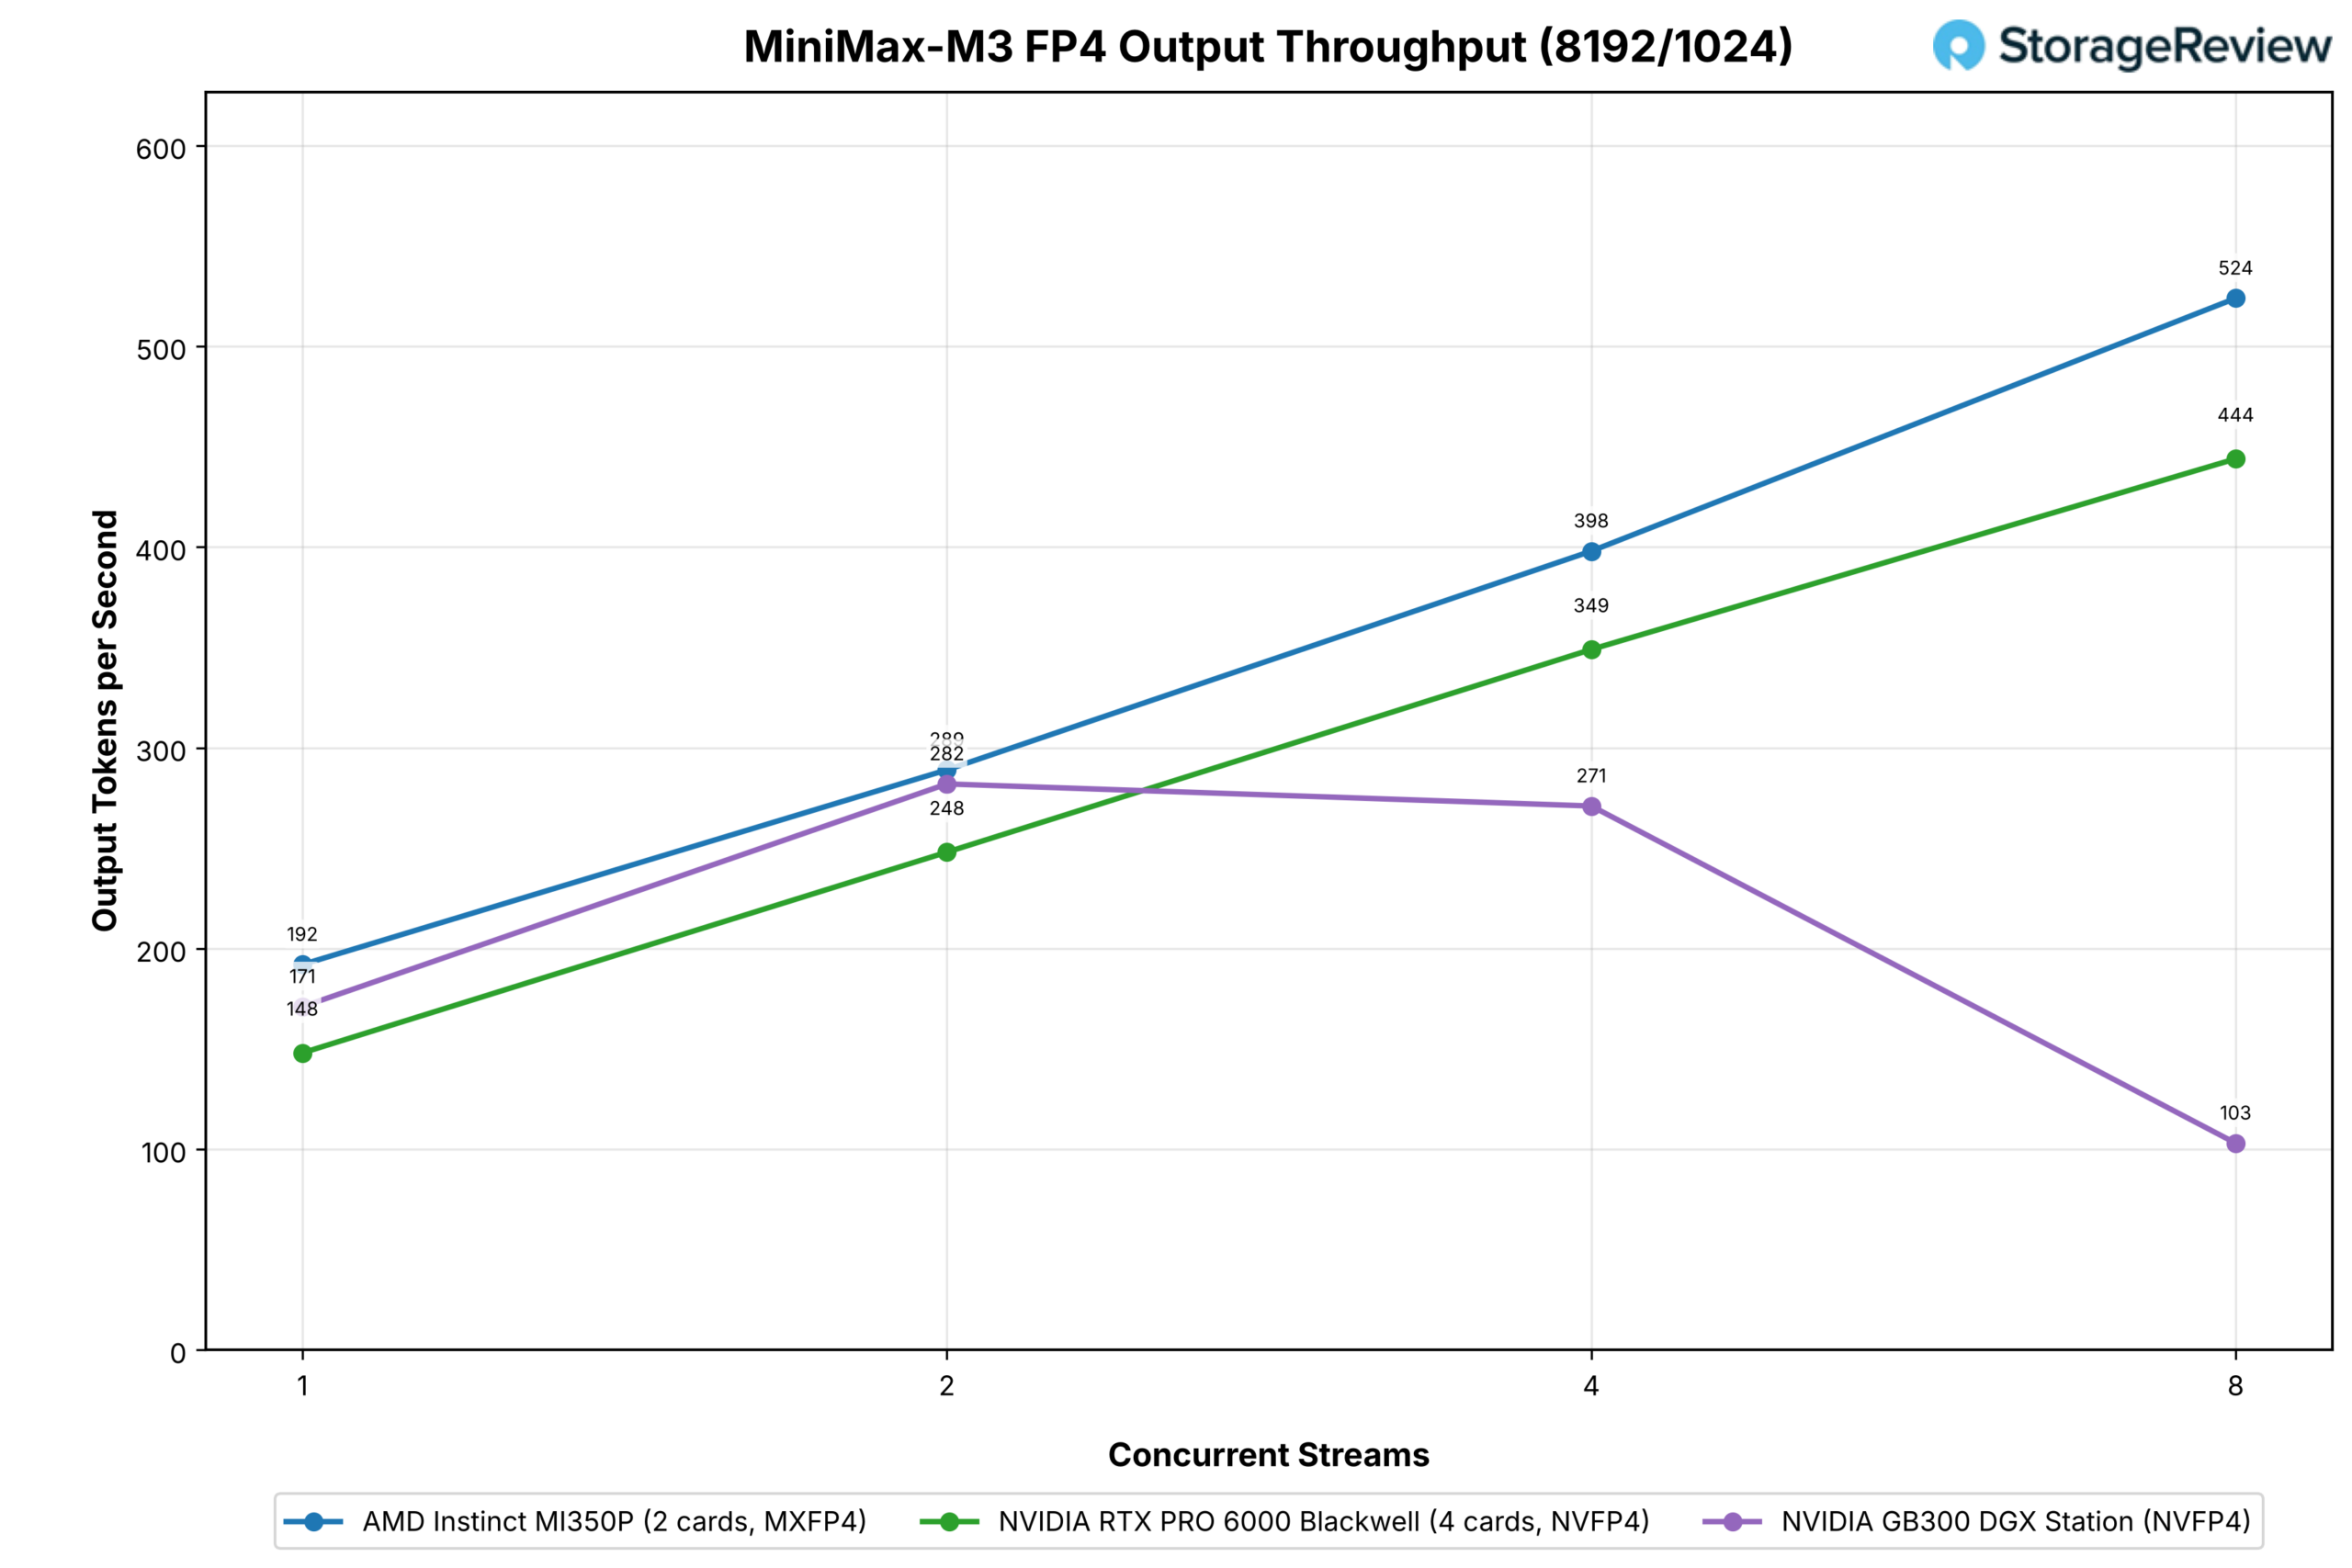
Dois MI350Ps contêm a versão MXFP4 do MiniMax-M3 em 288 GB; o lado da NVIDIA precisa de quatro placas RTX PRO 6000. As três configurações operam com uma diferença de no máximo 10% entre si em oito transmissões com a carga de trabalho de bate-papo; o quad RTX se destaca em 16 (1,181 contra 998 para o par e 940 para a Station), e em 32, o par MI350P registra 1,509 contra 759 para o quad e 1,041 para a Station.
Em comandos com muitas informações pré-preenchidas, o par MI350P lidera em todos os pontos ao longo de oito fluxos, 524 contra 444 do quad, enquanto o Station, que mantém uma parte dos especialistas deste modelo na memória Grace, cai para 103.
DeepSeek-V4-Flash
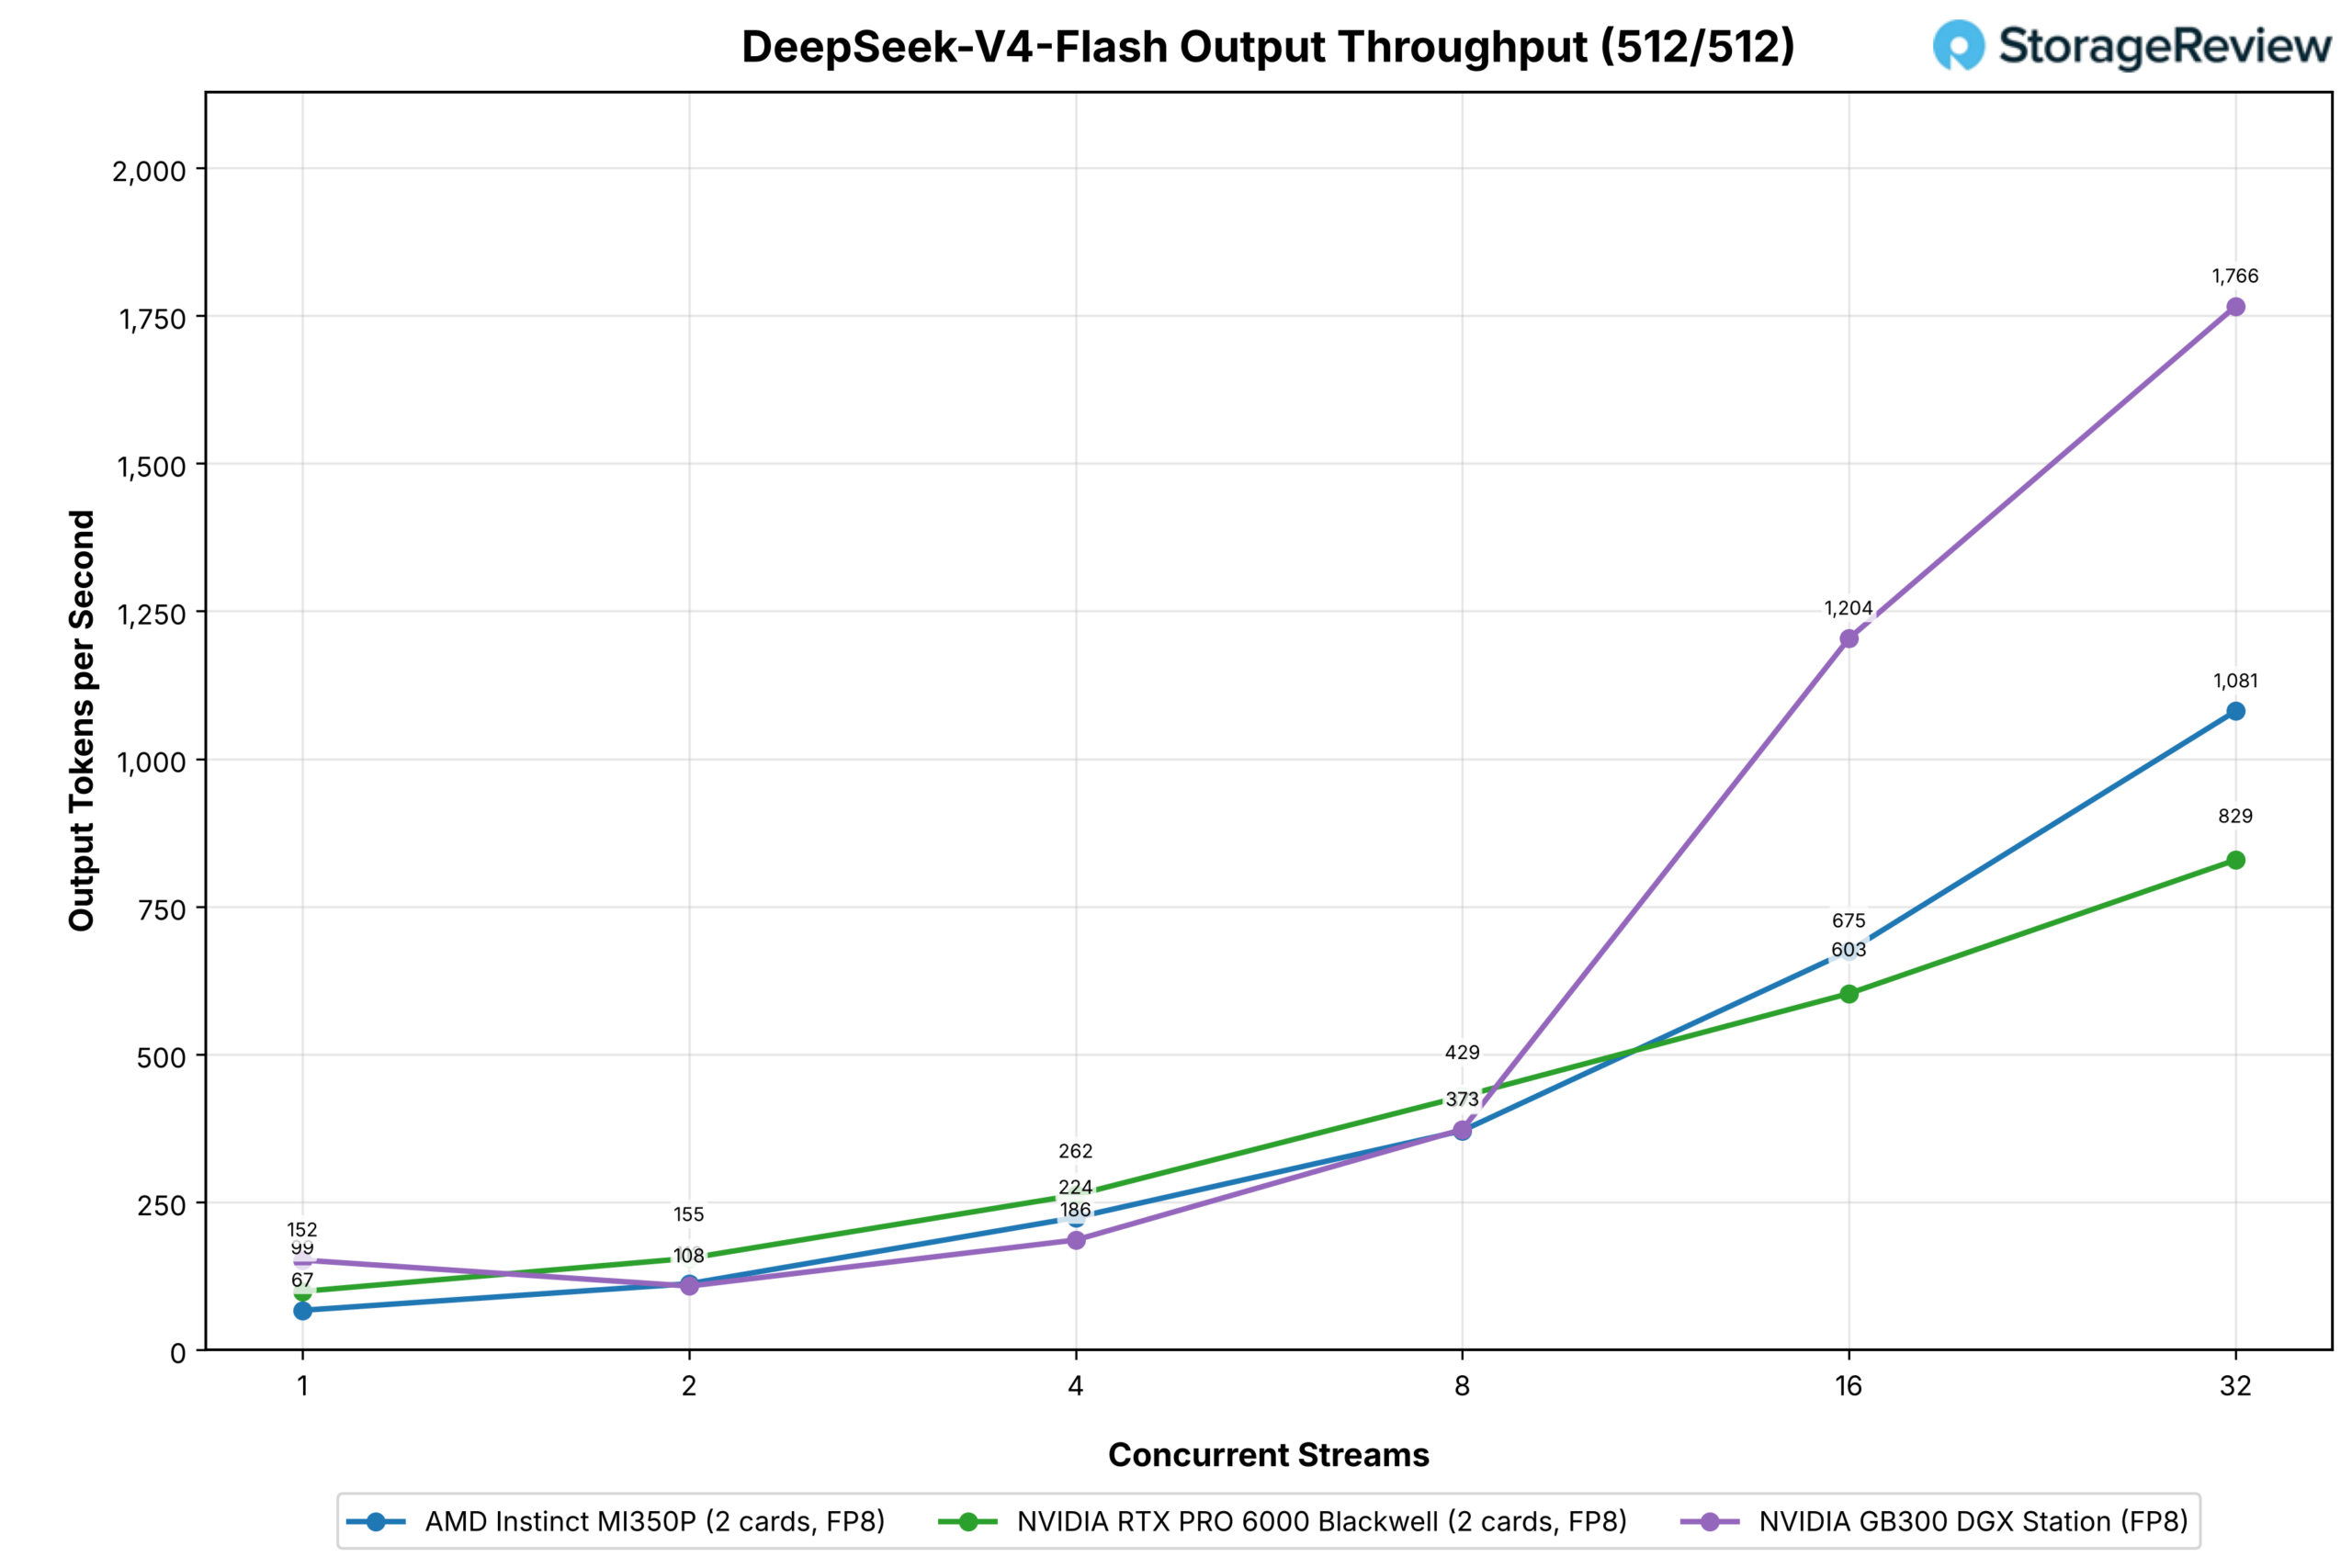
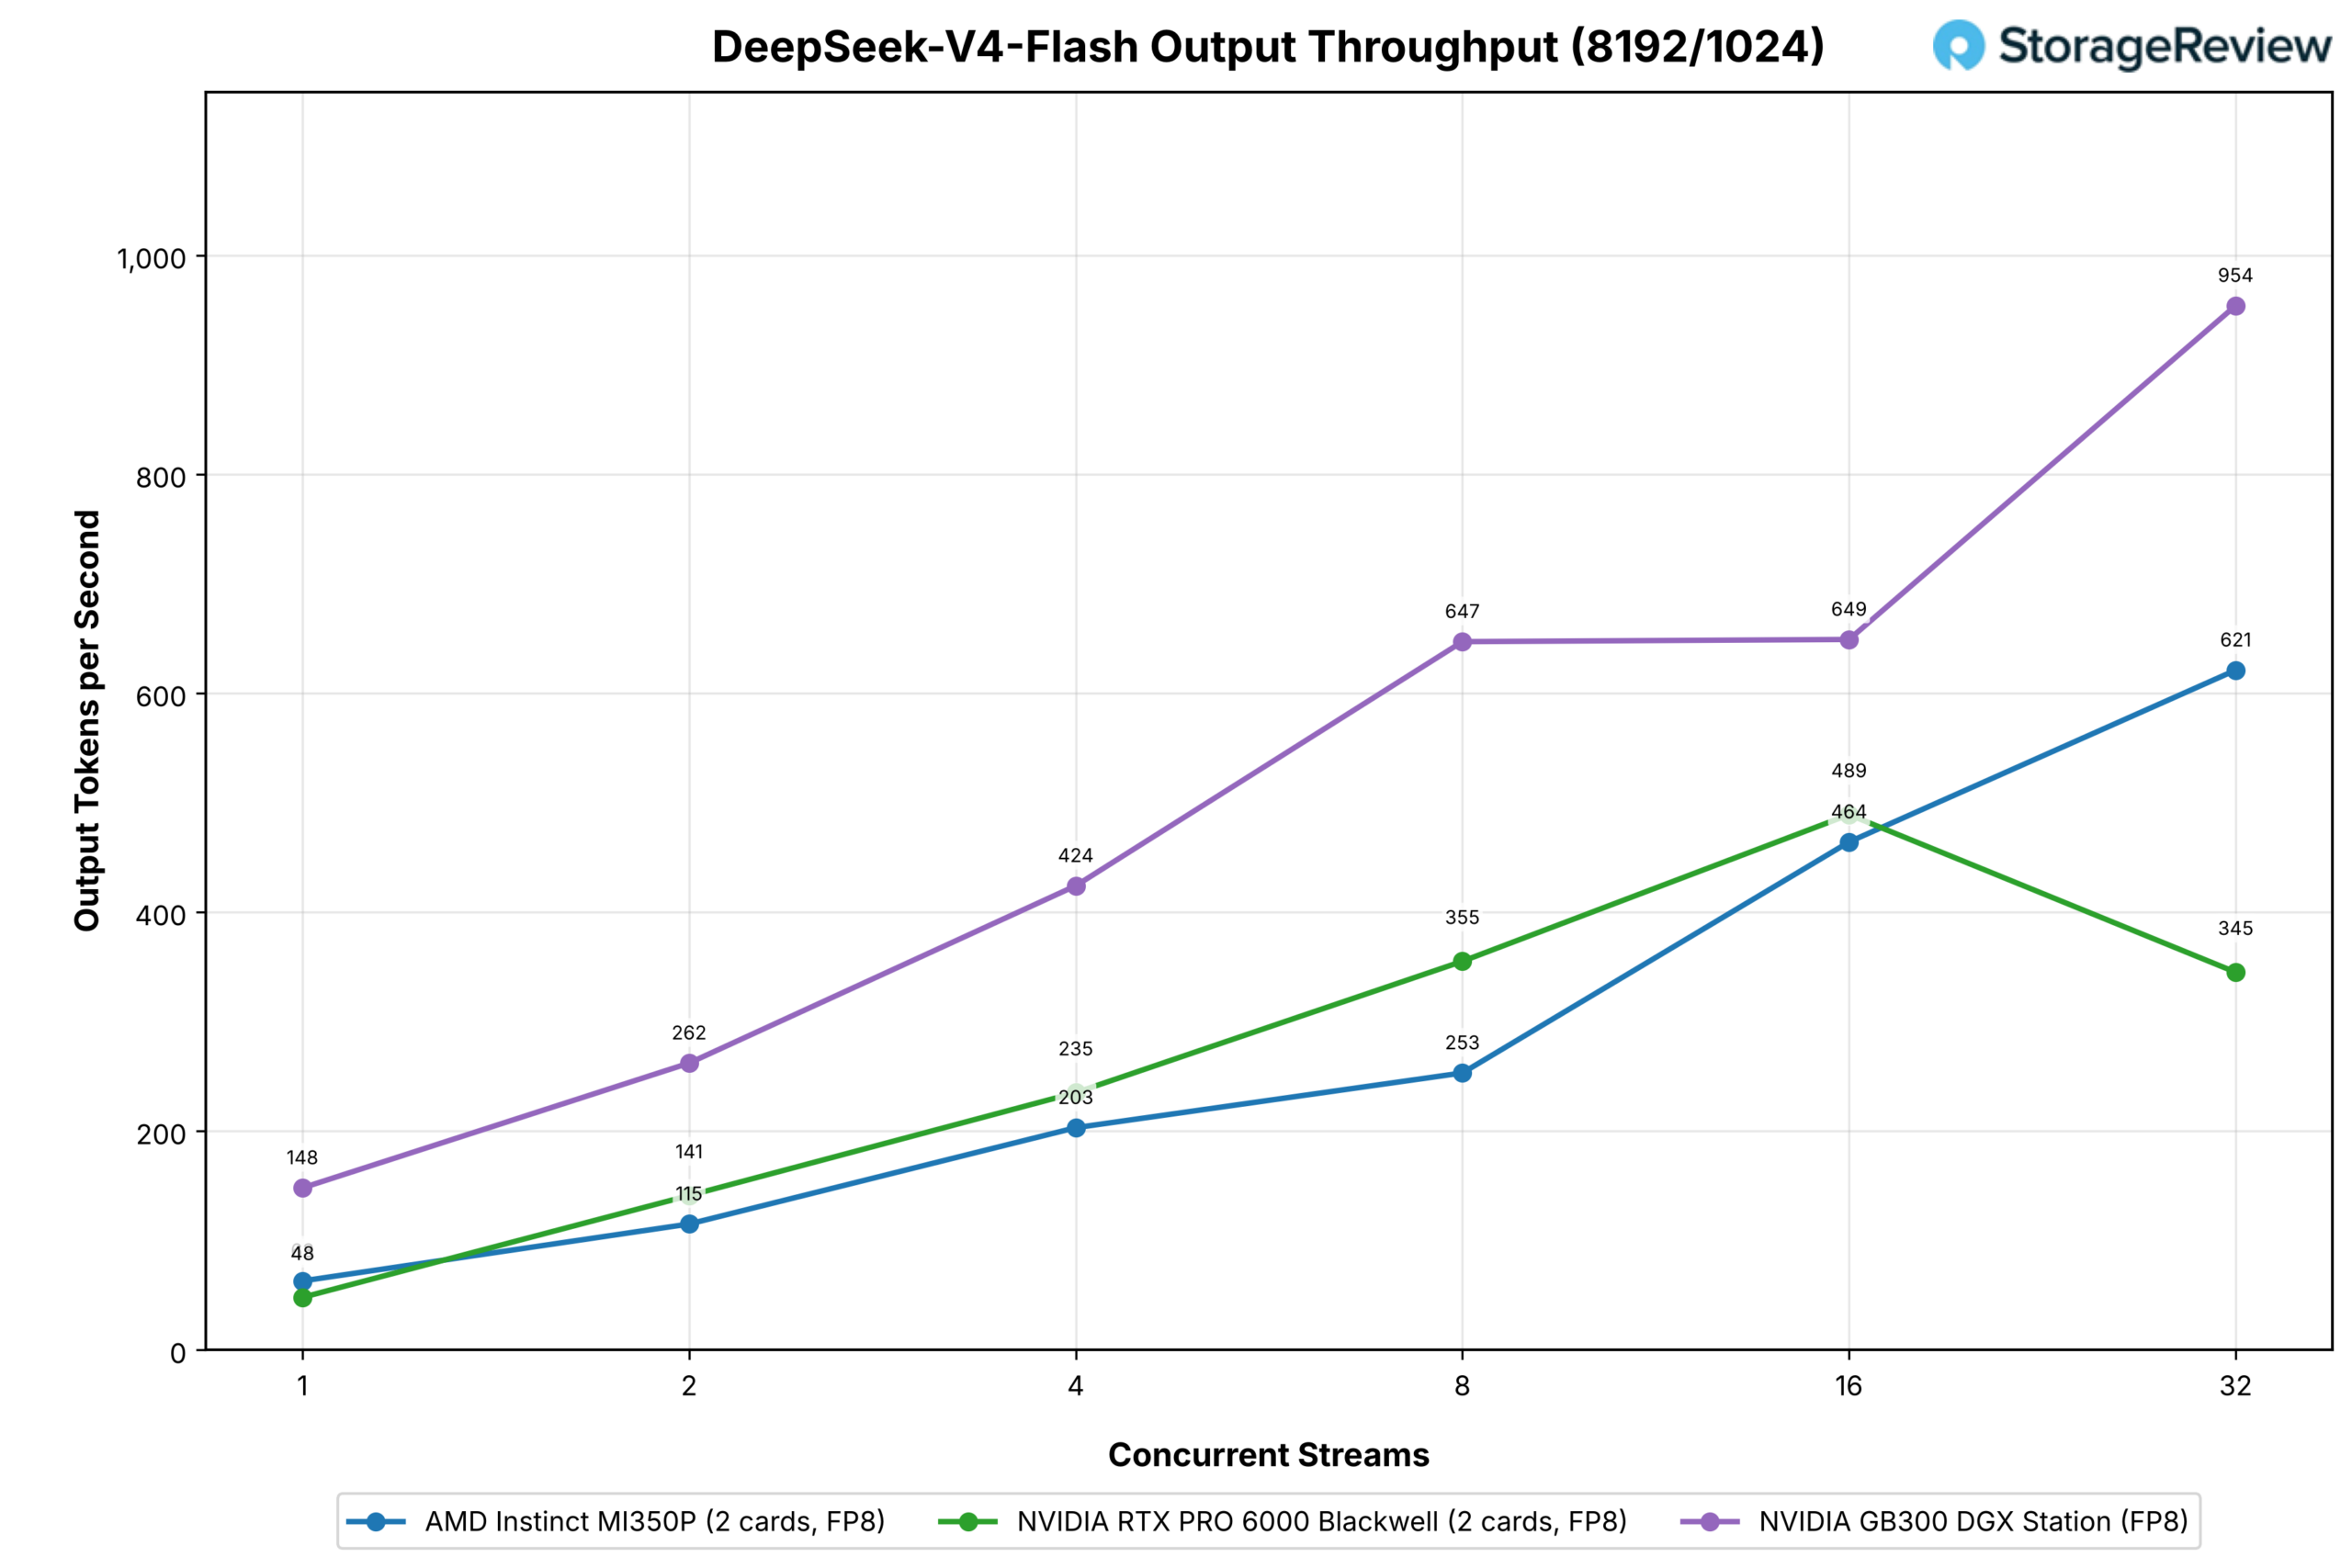
Com duas placas de cada lado e o checkpoint FP8 nativo, o par RTX PRO 6000 lidera em oito fluxos na carga de trabalho de chat, e o par MI350P assume a liderança a partir de 16, terminando com 1,081 contra 829 em 32 fluxos; a Station individual atinge 1,766 no mesmo ponto. A execução com grande quantidade de pré-carregamento segue o mesmo padrão, com o par MI350P em 621 contra 345 para o par RTX em 32 fluxos e 954 para a Station.
MiniMax-M2.7
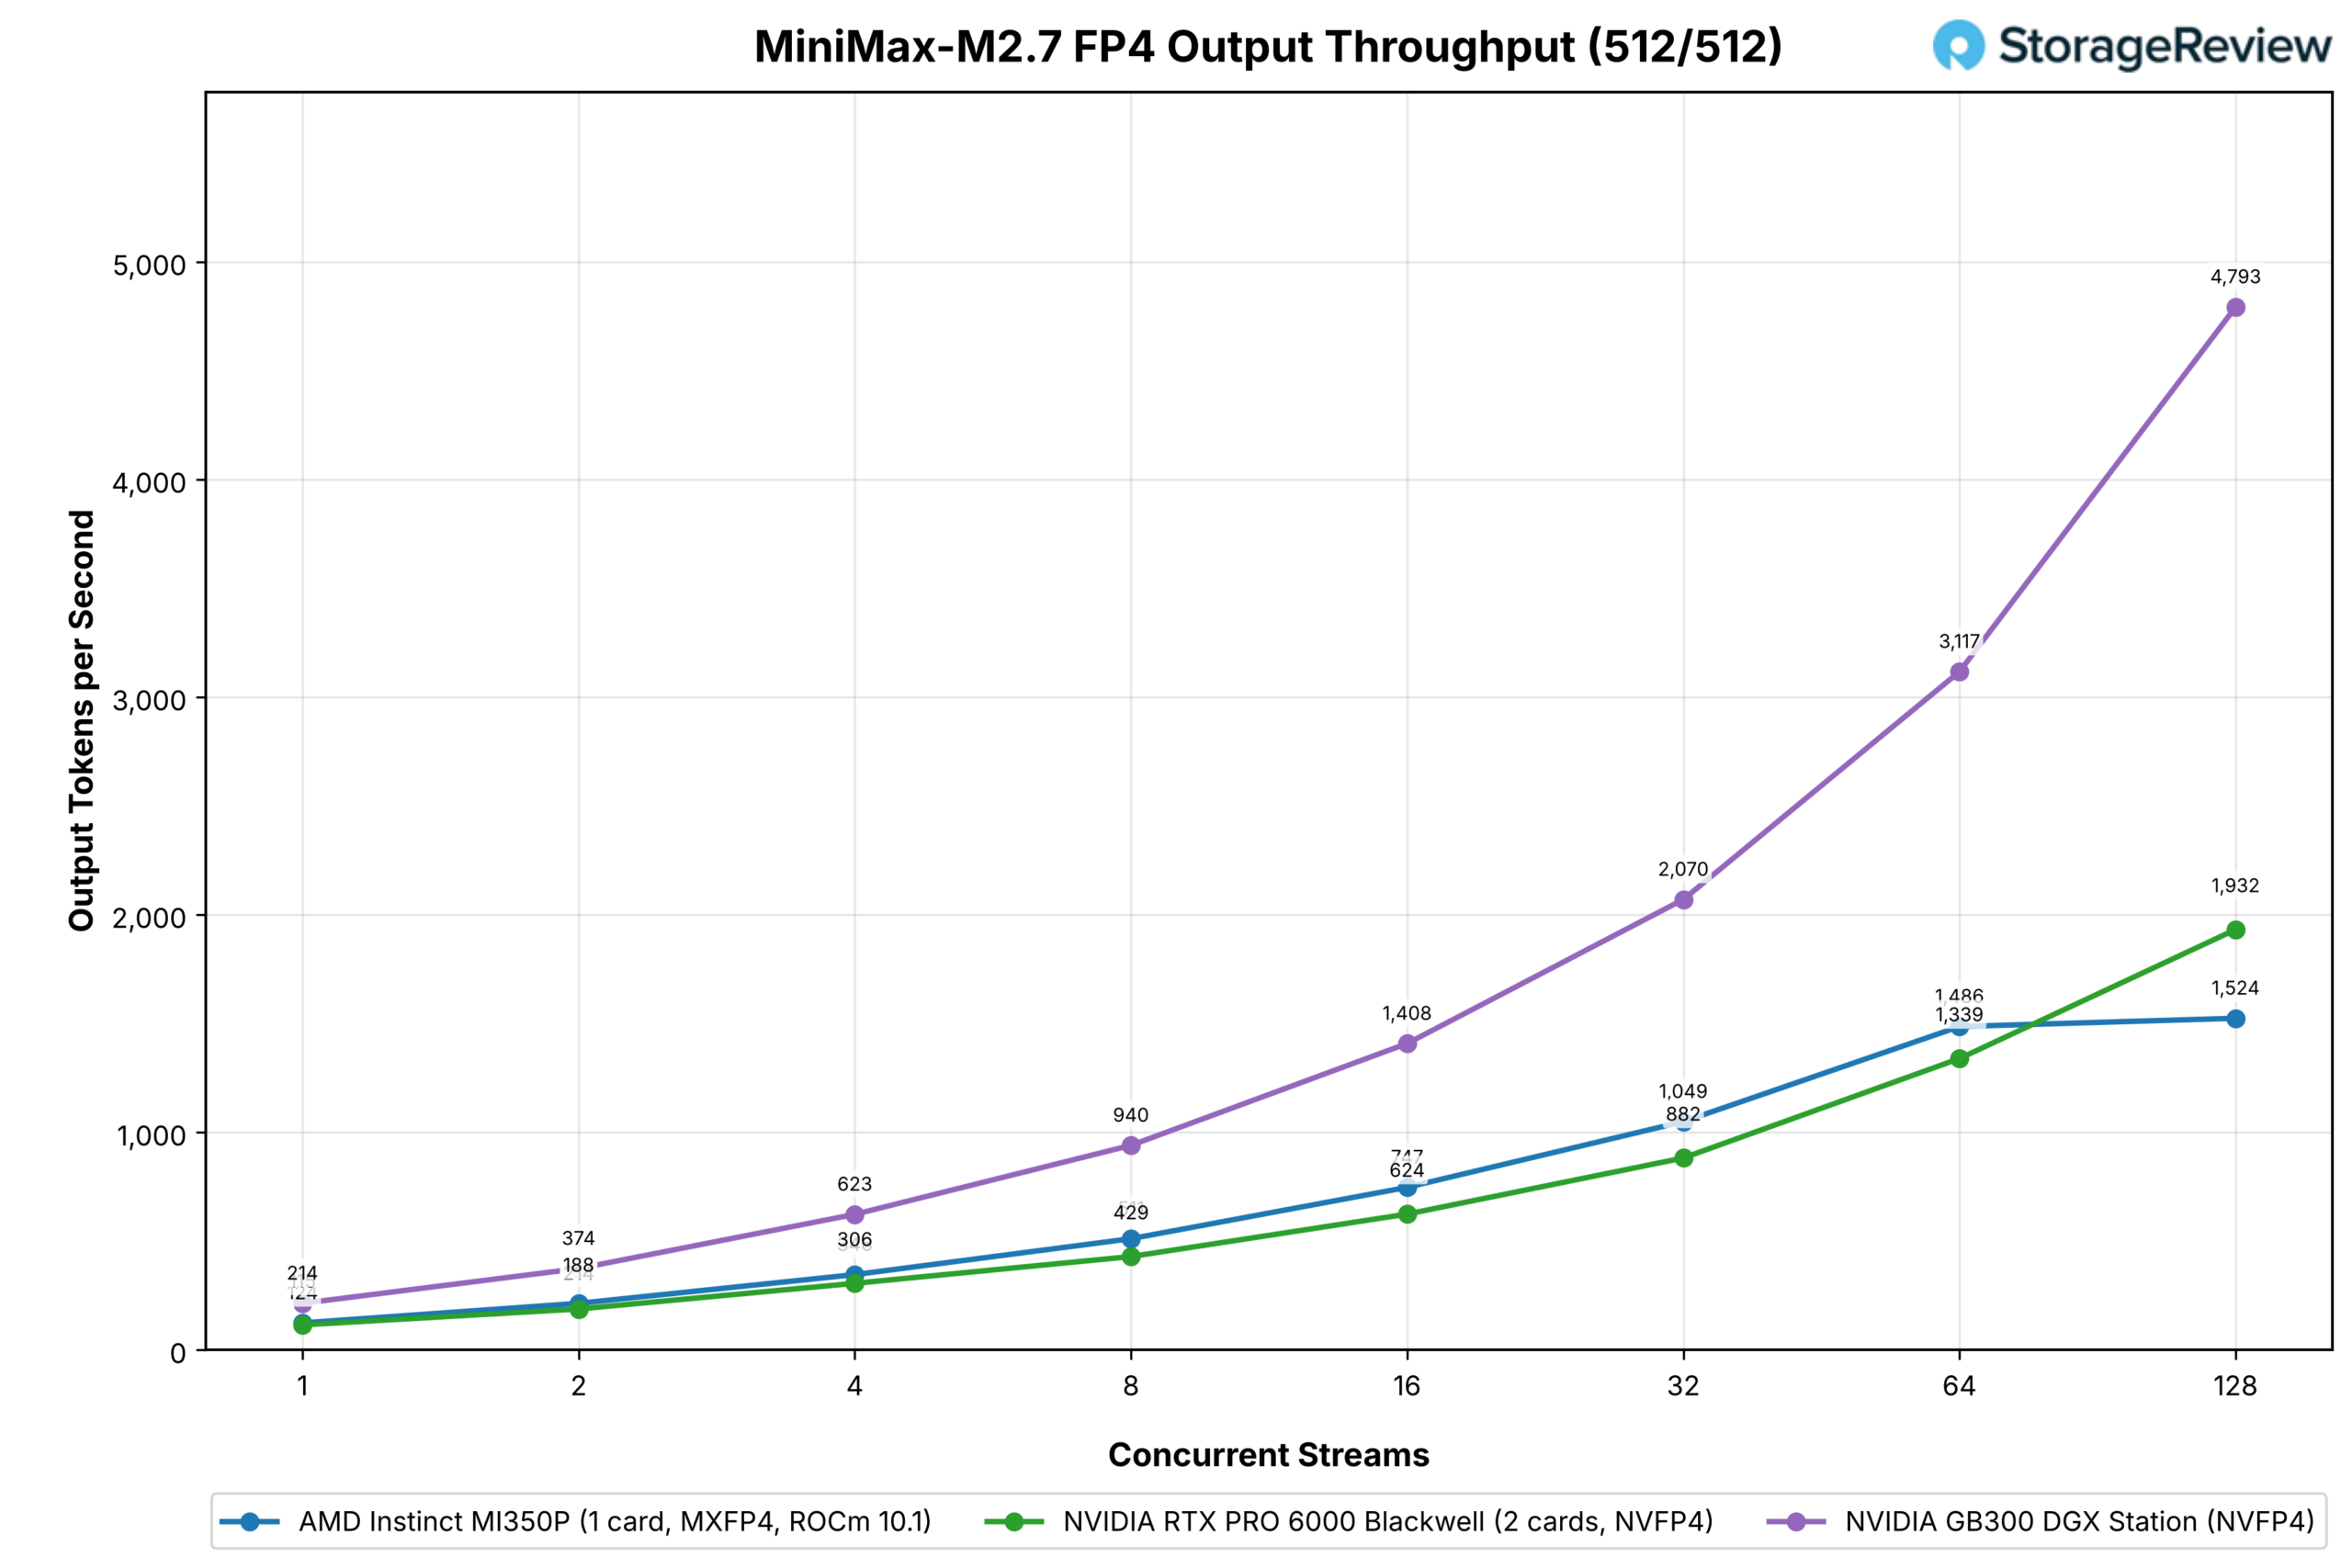
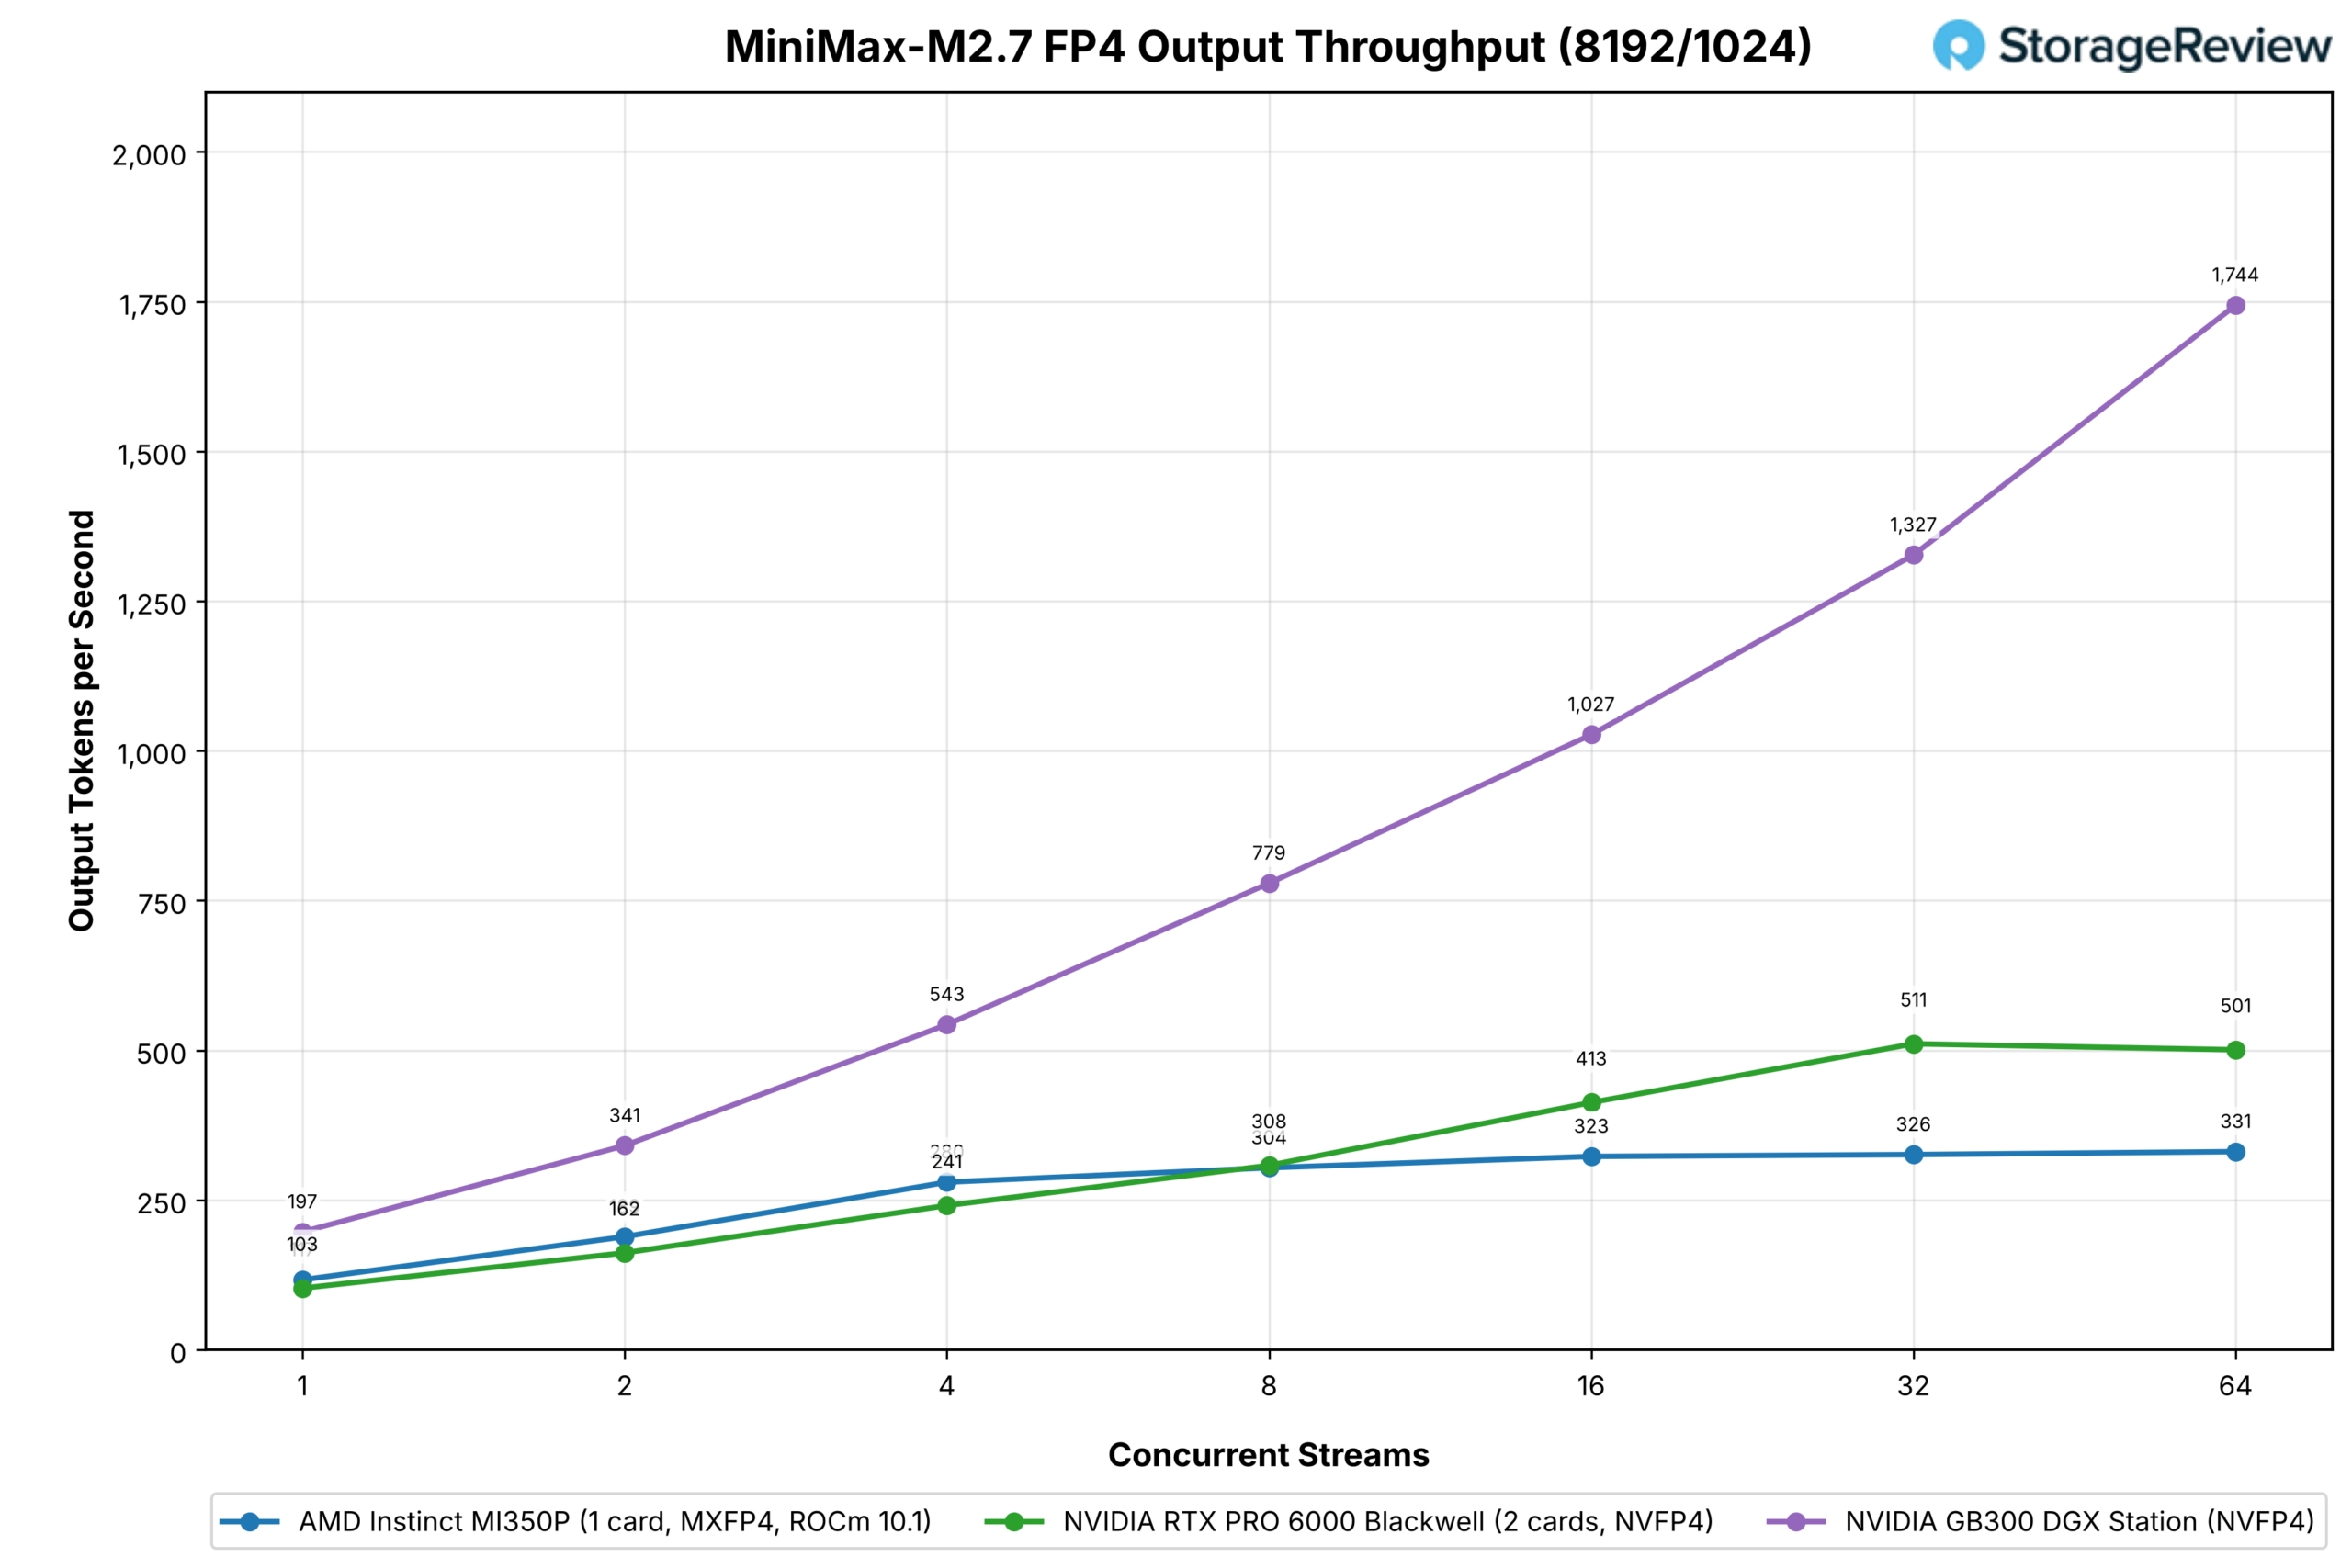
Uma placa MI350P com a versão MXFP4 do MiniMax-M2.7 compete com duas placas RTX PRO 6000 em NVFP4. A MI350P sozinha lidera o par em um fluxo (124 contra 115), mantém uma vantagem de 8 a 20% em 64 fluxos (1,486 contra 1,339), depois se estabiliza em 1,524 em 128 fluxos e 1,557 em 256 fluxos, enquanto o par de placas RTX continua até 1,932 e 2,842; a Station atinge 4,793.
Em cargas de trabalho com grande volume de pré-carregamento, o MI350P mantém uma taxa de saída de 304 a 331 tokens por segundo, de oito a 64 fluxos, contra 501 para o par RTX e 1,744 para a Station.
GPT-OSS-120B
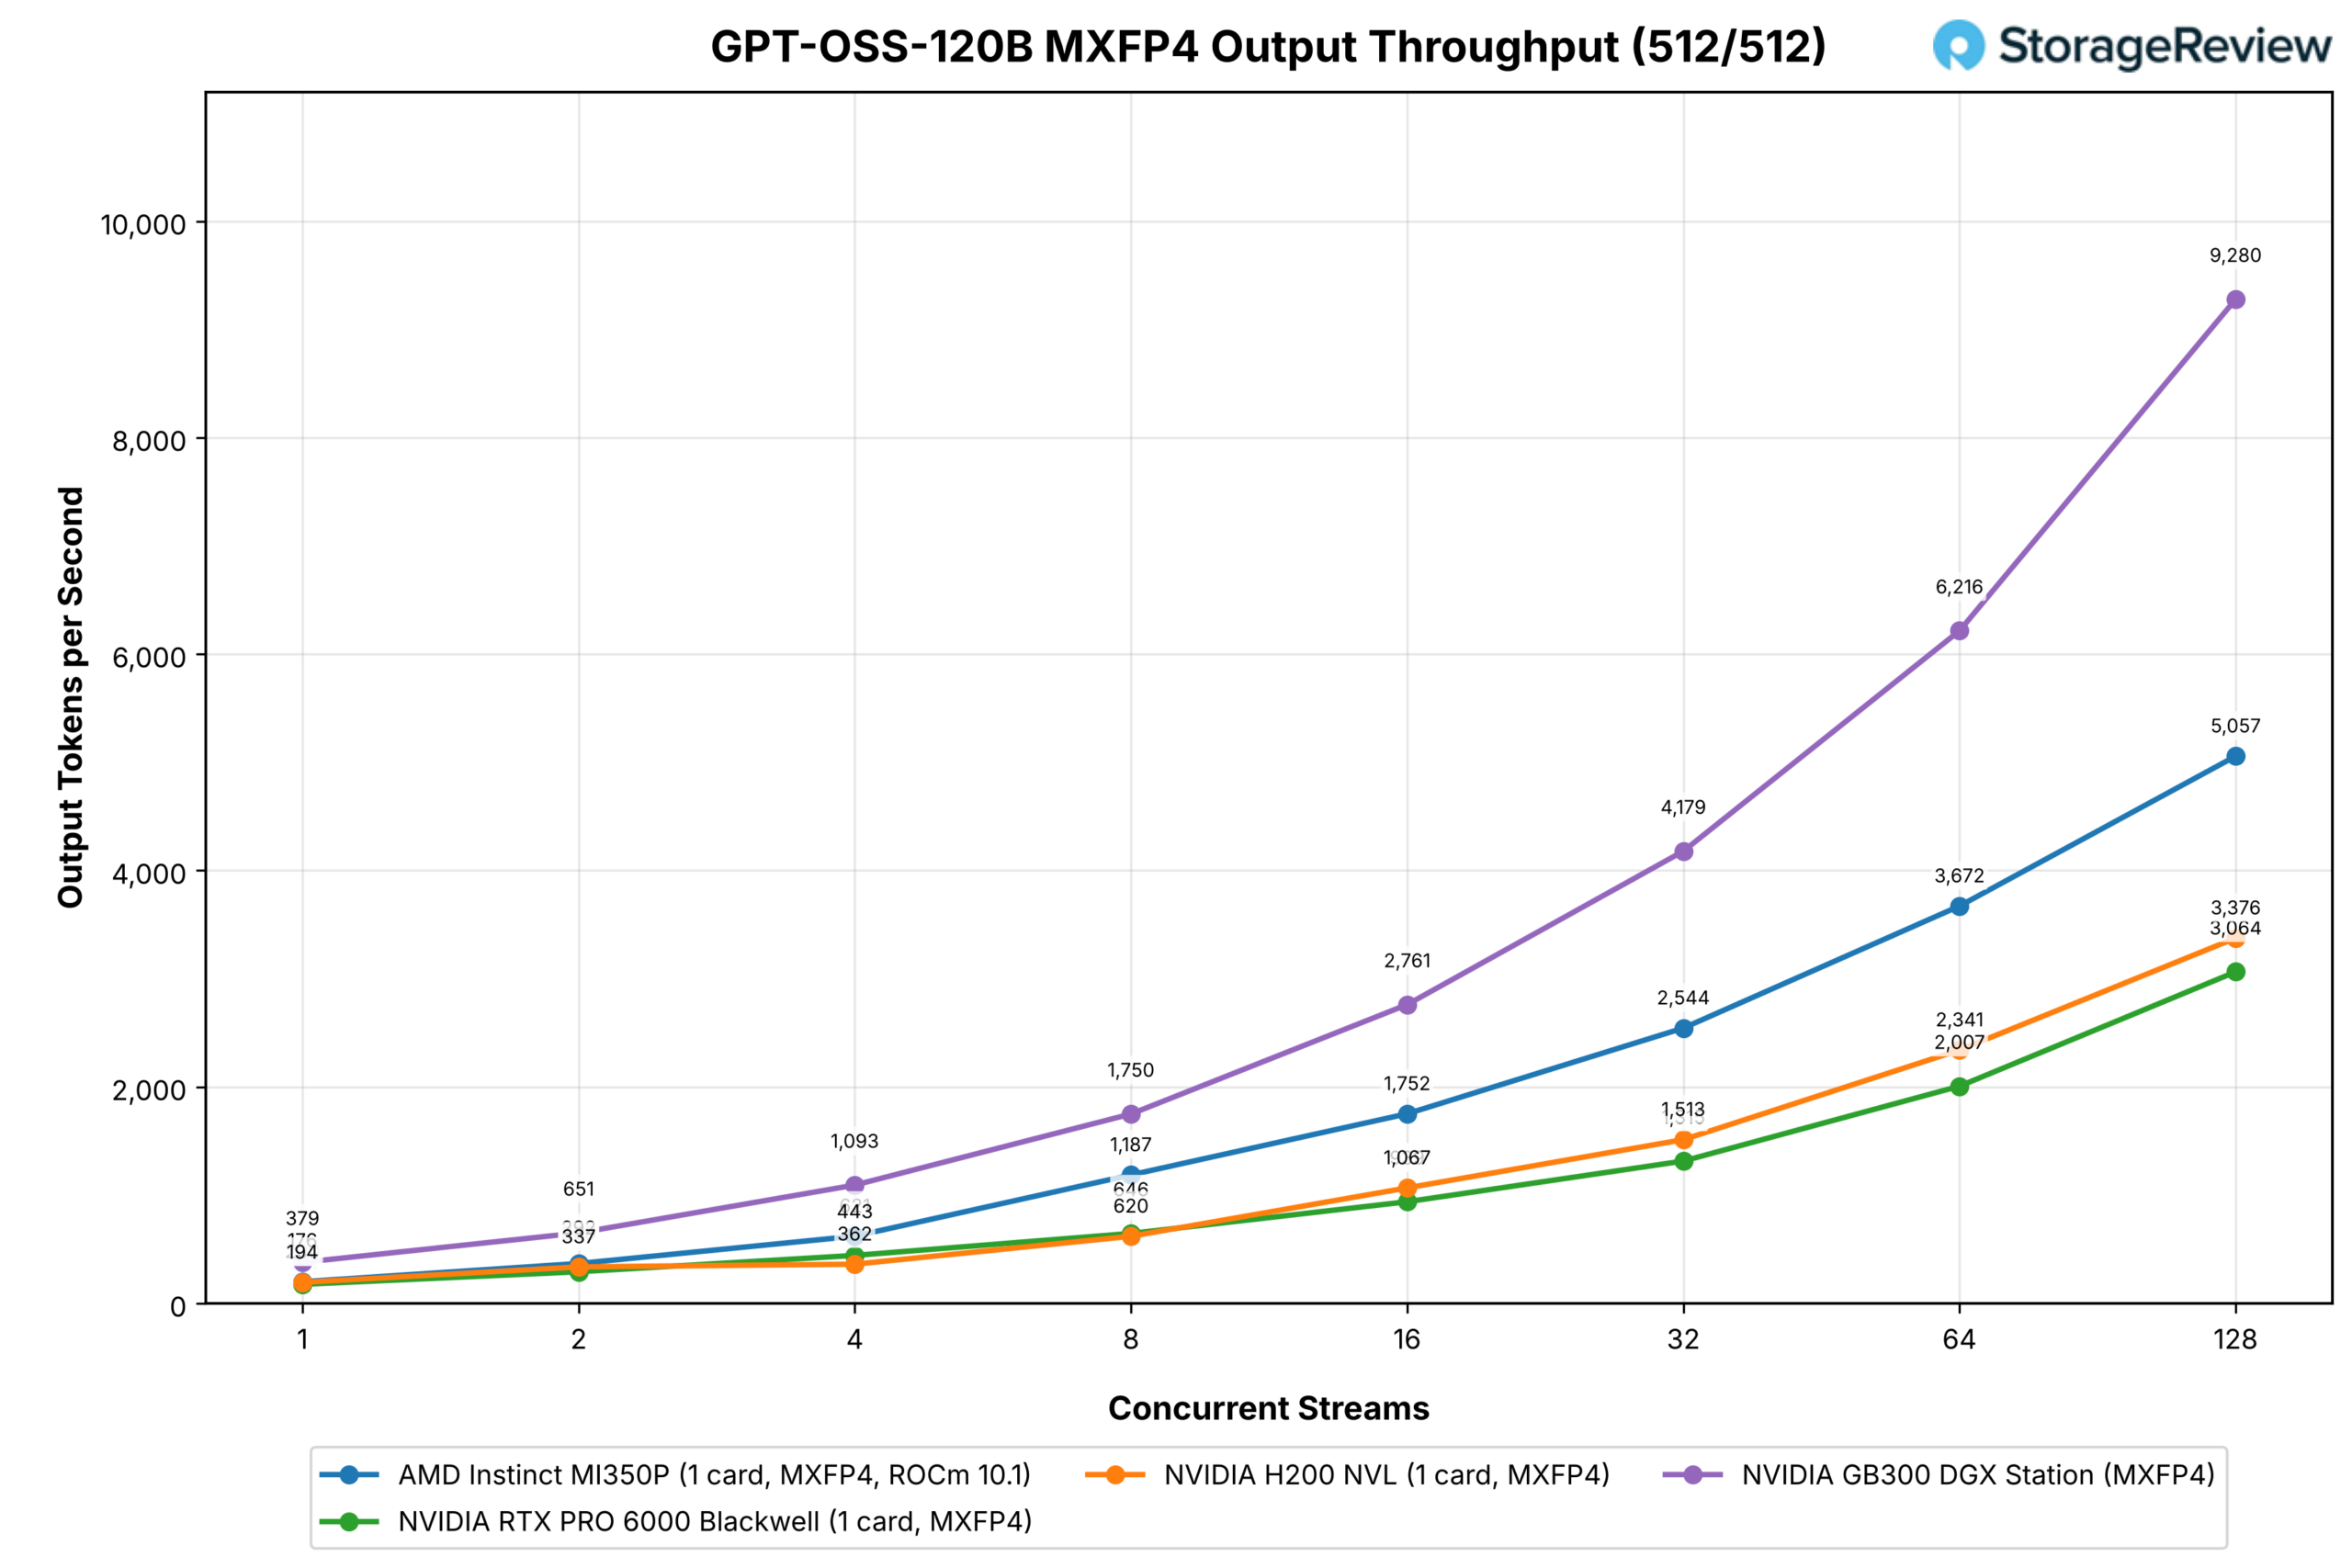
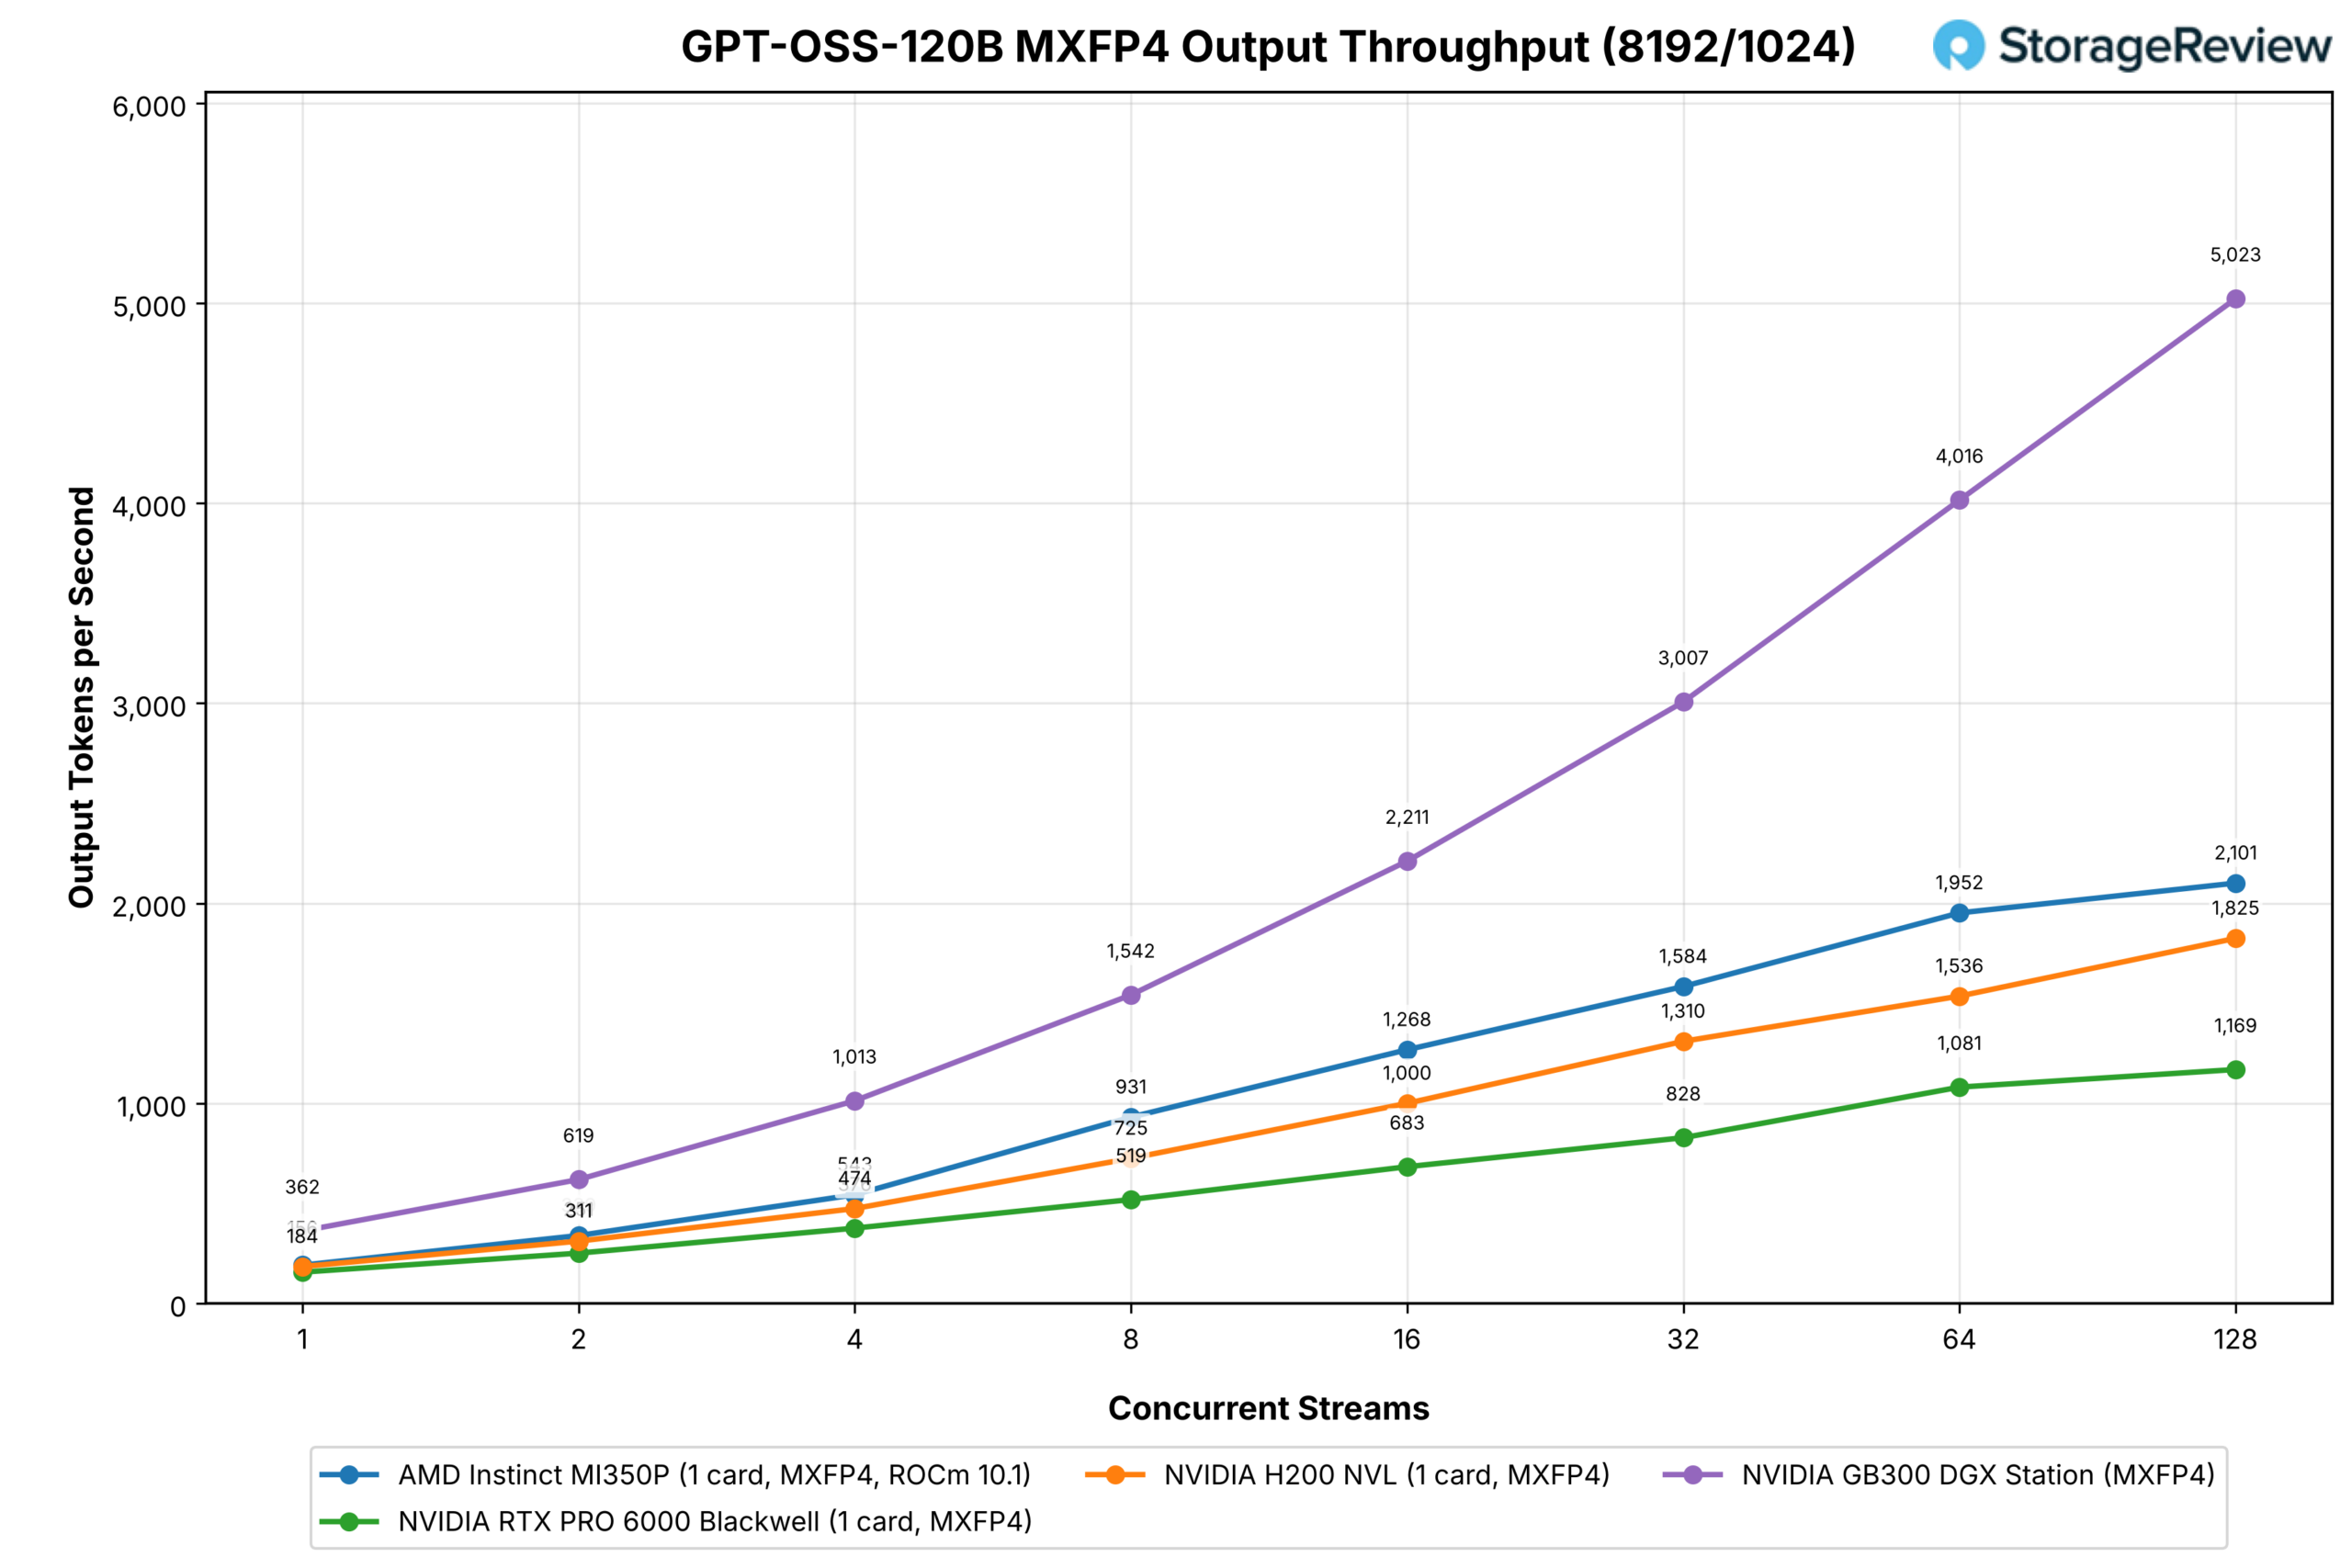
O GPT-OSS é distribuído como MXFP4, portanto, todas as placas executam as mesmas tarefas. Uma MI350P supera uma RTX PRO 6000 em todas as contagens de fluxos em ambas as cargas de trabalho, por 40 a 93% a partir de quatro fluxos, e atinge 5,057 tokens de saída por segundo na carga de trabalho de chat e 2,101 em prompts com preenchimento automático em 128 fluxos, contra 3,064 e 1,169 para a RTX PRO 6000 e 3,376 e 1,825 para a H200 NVL; a Station alcança 9,280 e 5,023.
A submissão da AMD e da Dell para o MLPerf Inference v6.1, de 16 de setembro, estabelece um limite para o mesmo modelo: oito MI350Ps em um PowerEdge XE7745 produziram 48,971 tokens por segundo offline e 40,868 no cenário de servidor com GPT-OSS-120B, o que corresponde a 6,121 e 5,108 por GPU, respectivamente, em uma configuração otimizada para a submissão. Essa configuração e a nossa não são idênticas, mas os 5,057 tokens que medimos com 128 fluxos no vLLM padrão estão no limite inferior dessa faixa.
GPT-OSS-20B
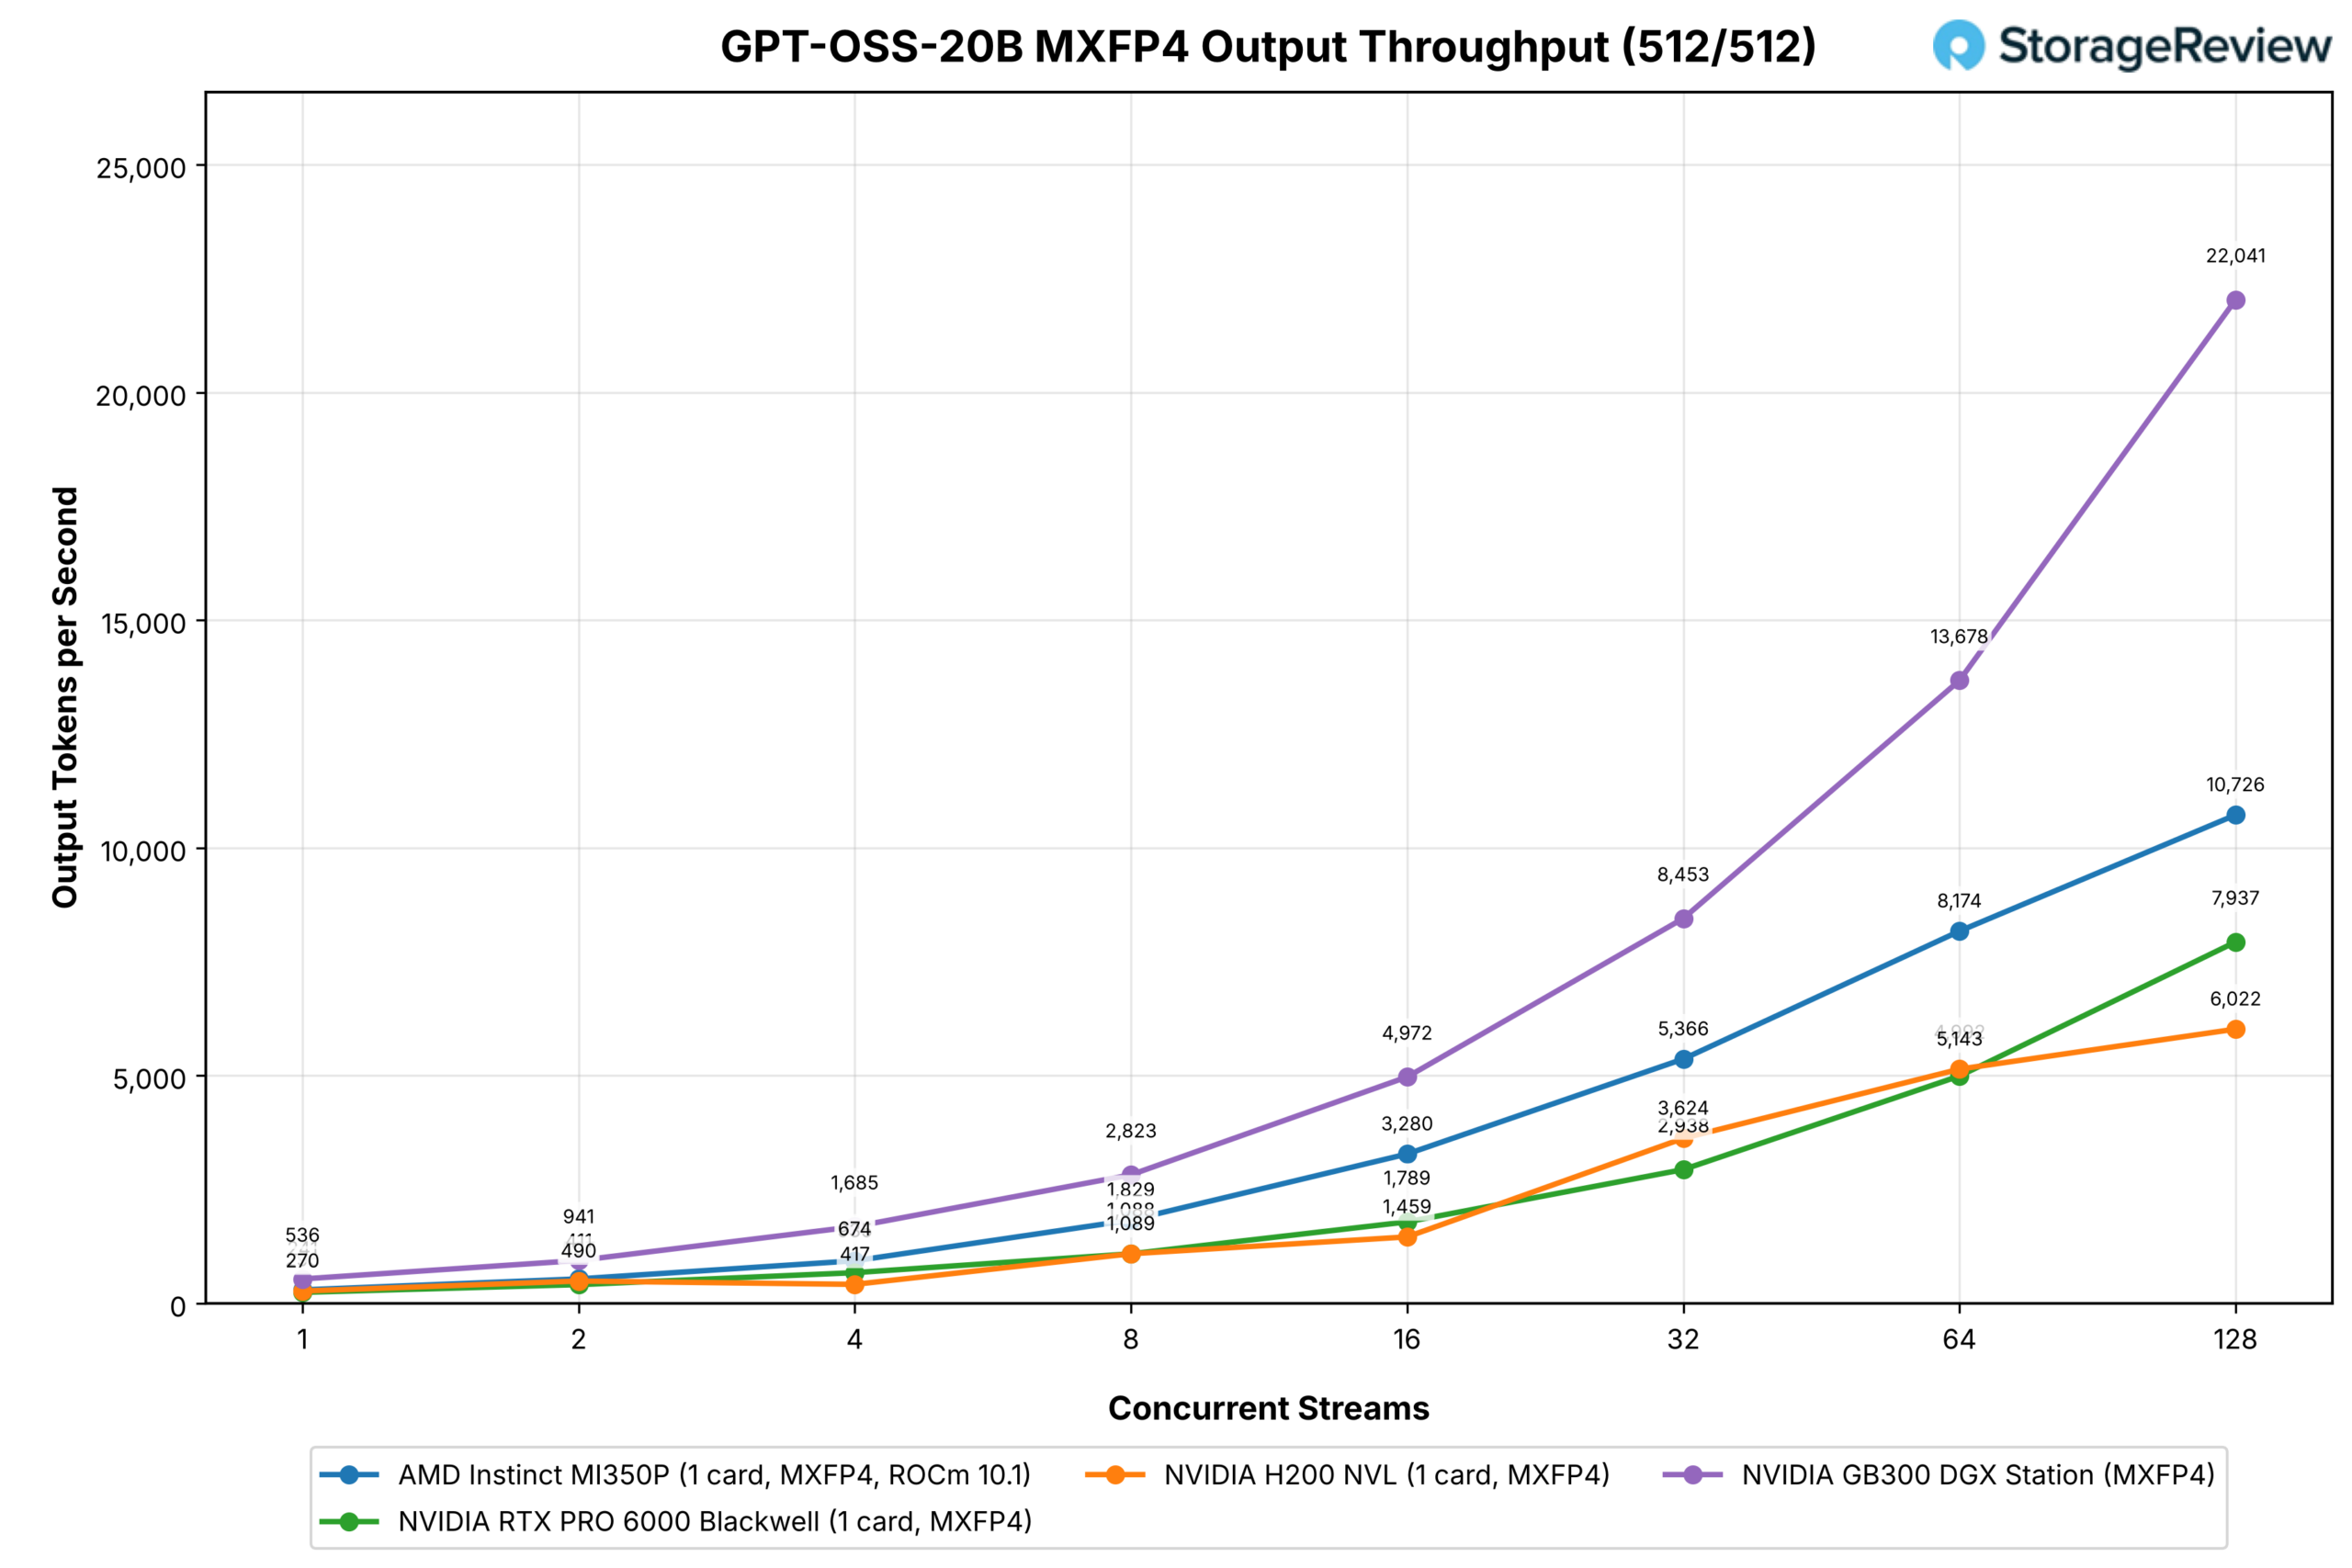
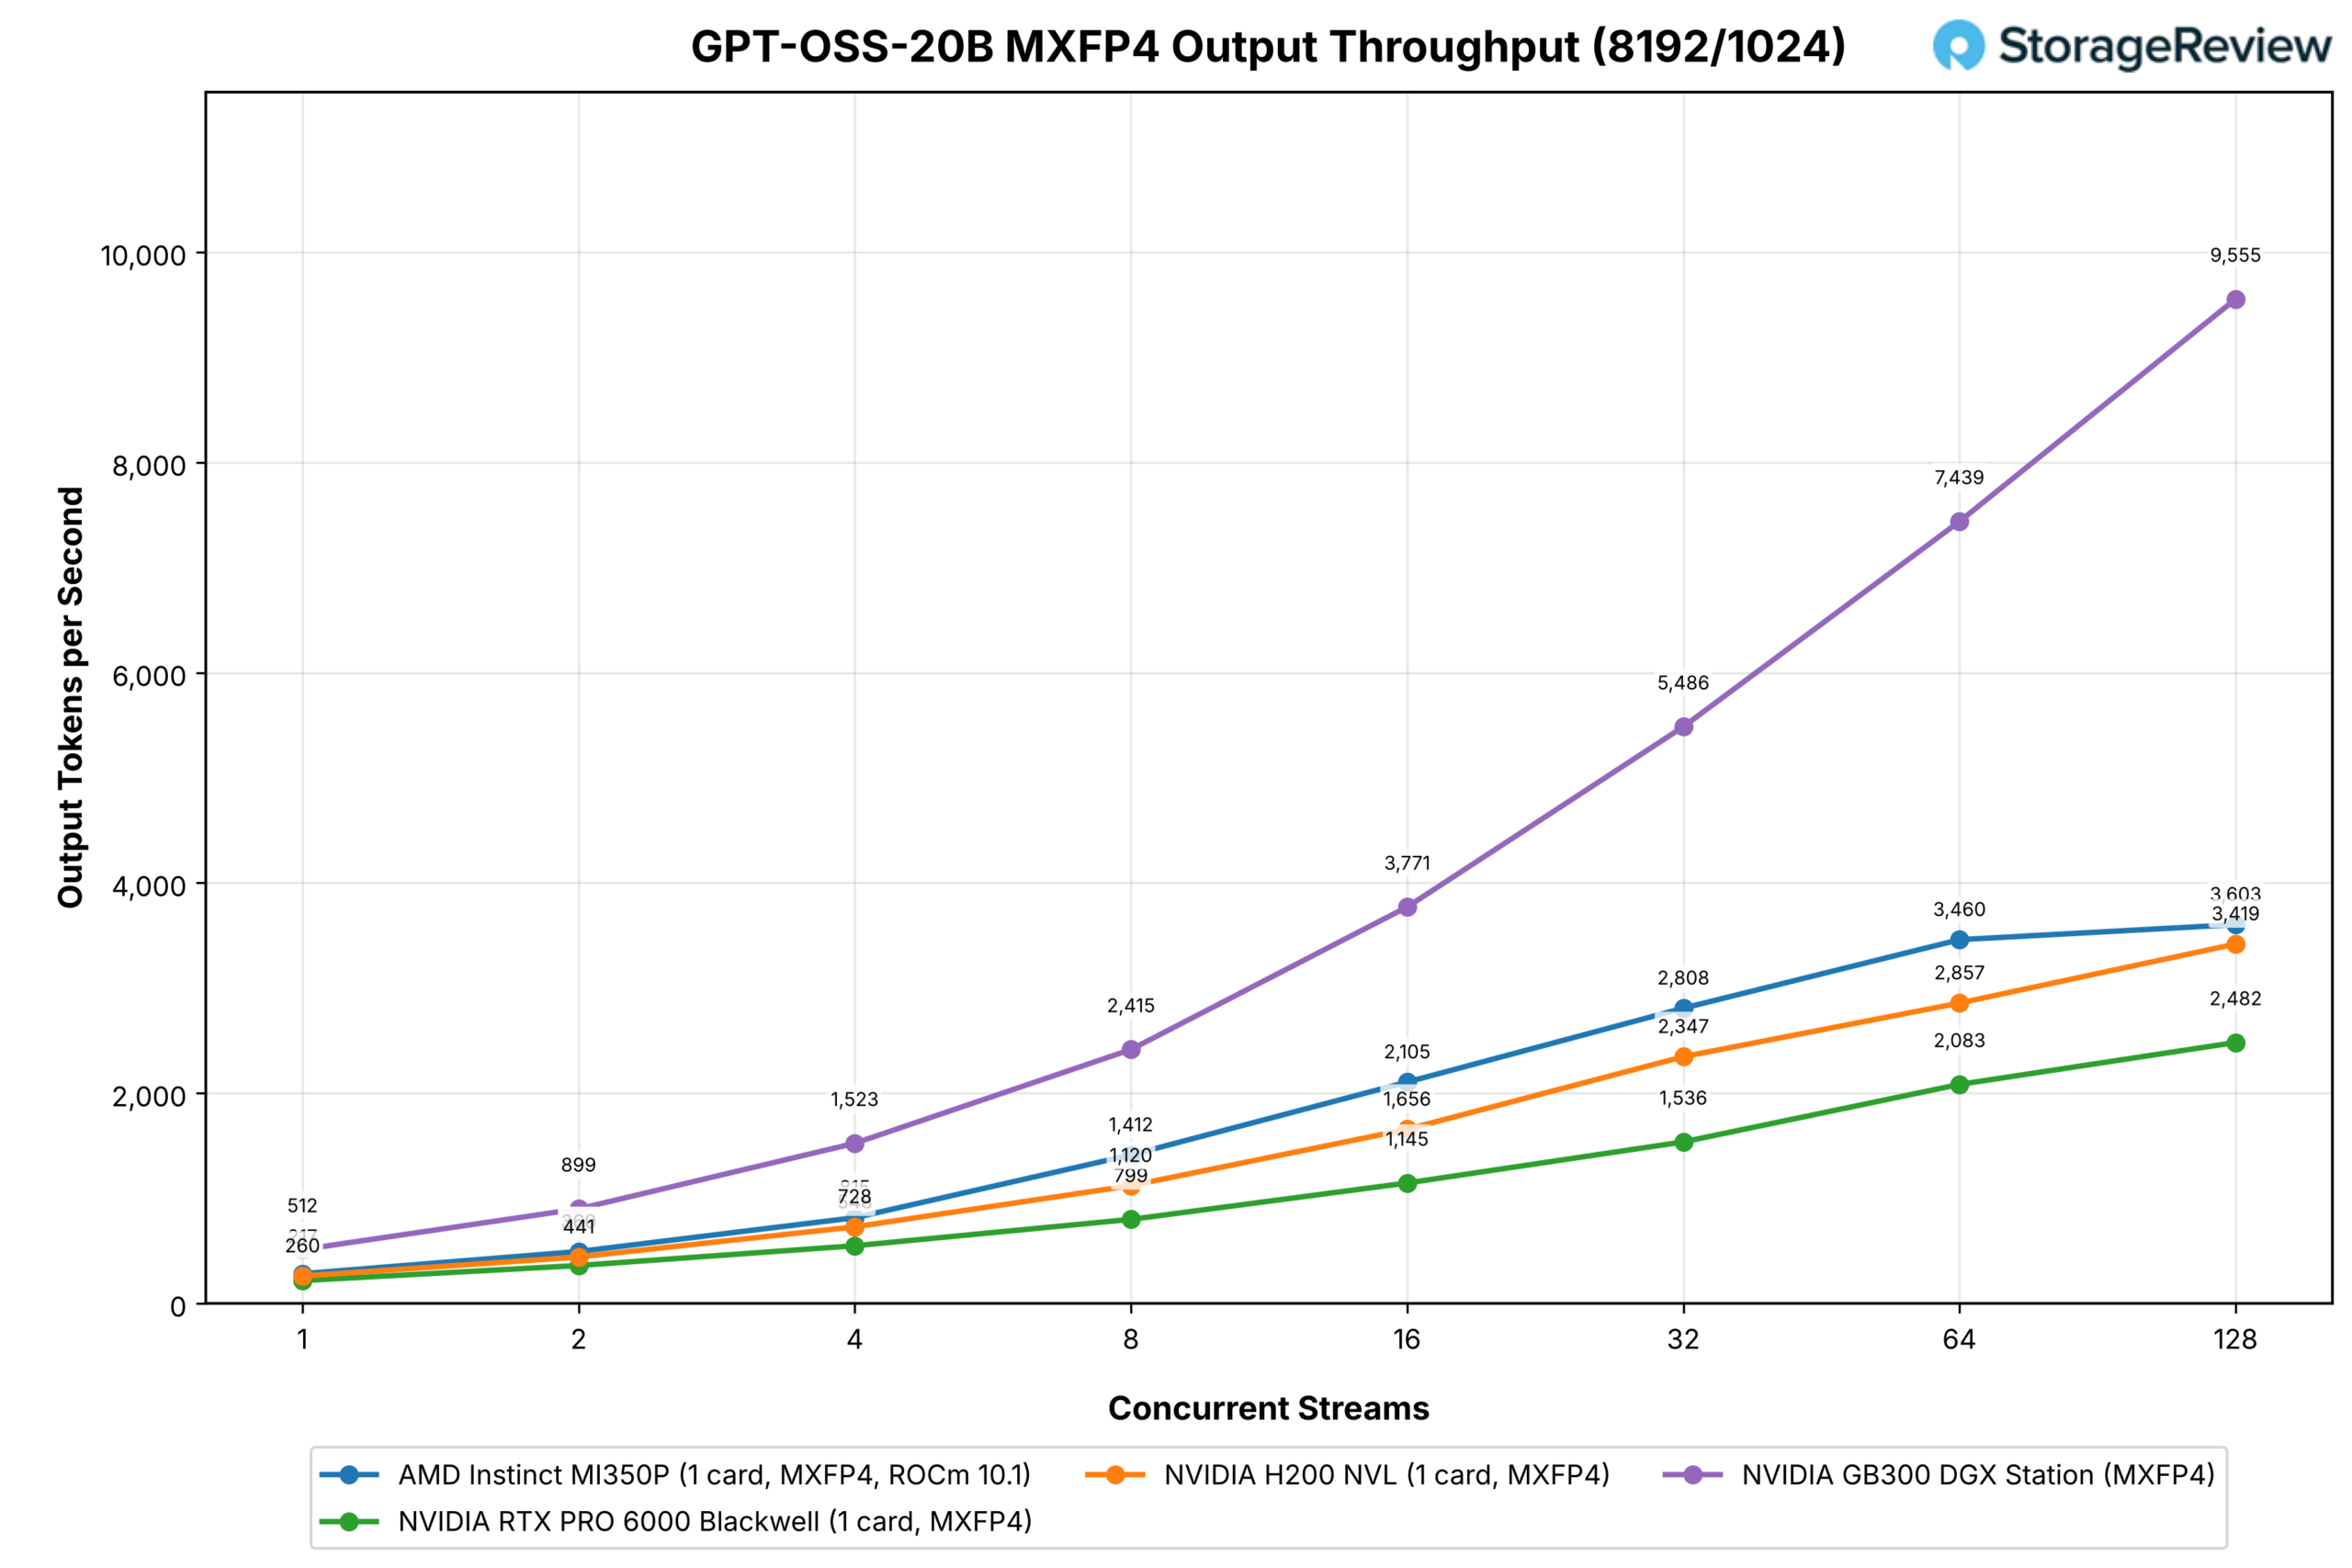
O modelo OpenAI menor segue a mesma curva. O MI350P supera o RTX PRO 6000 em todos os pontos: 8,174 contra 4,992 com 64 fluxos e 10,726 contra 7,937 com 128 fluxos na carga de trabalho de chat; e 3,460 contra 2,083 e 3,603 contra 2,482 em prompts com preenchimento automático. O MI350P atinge 16,406 com 256 fluxos, enquanto o RTX PRO 6000 registra 11,077. O H200 NVL fica atrás do MI350P em ambos os casos, com 6,022 e 3,419 com 128 fluxos, e o Station alcança 22,041 e 9,555.
Qwen3-Coder-30B-A3B
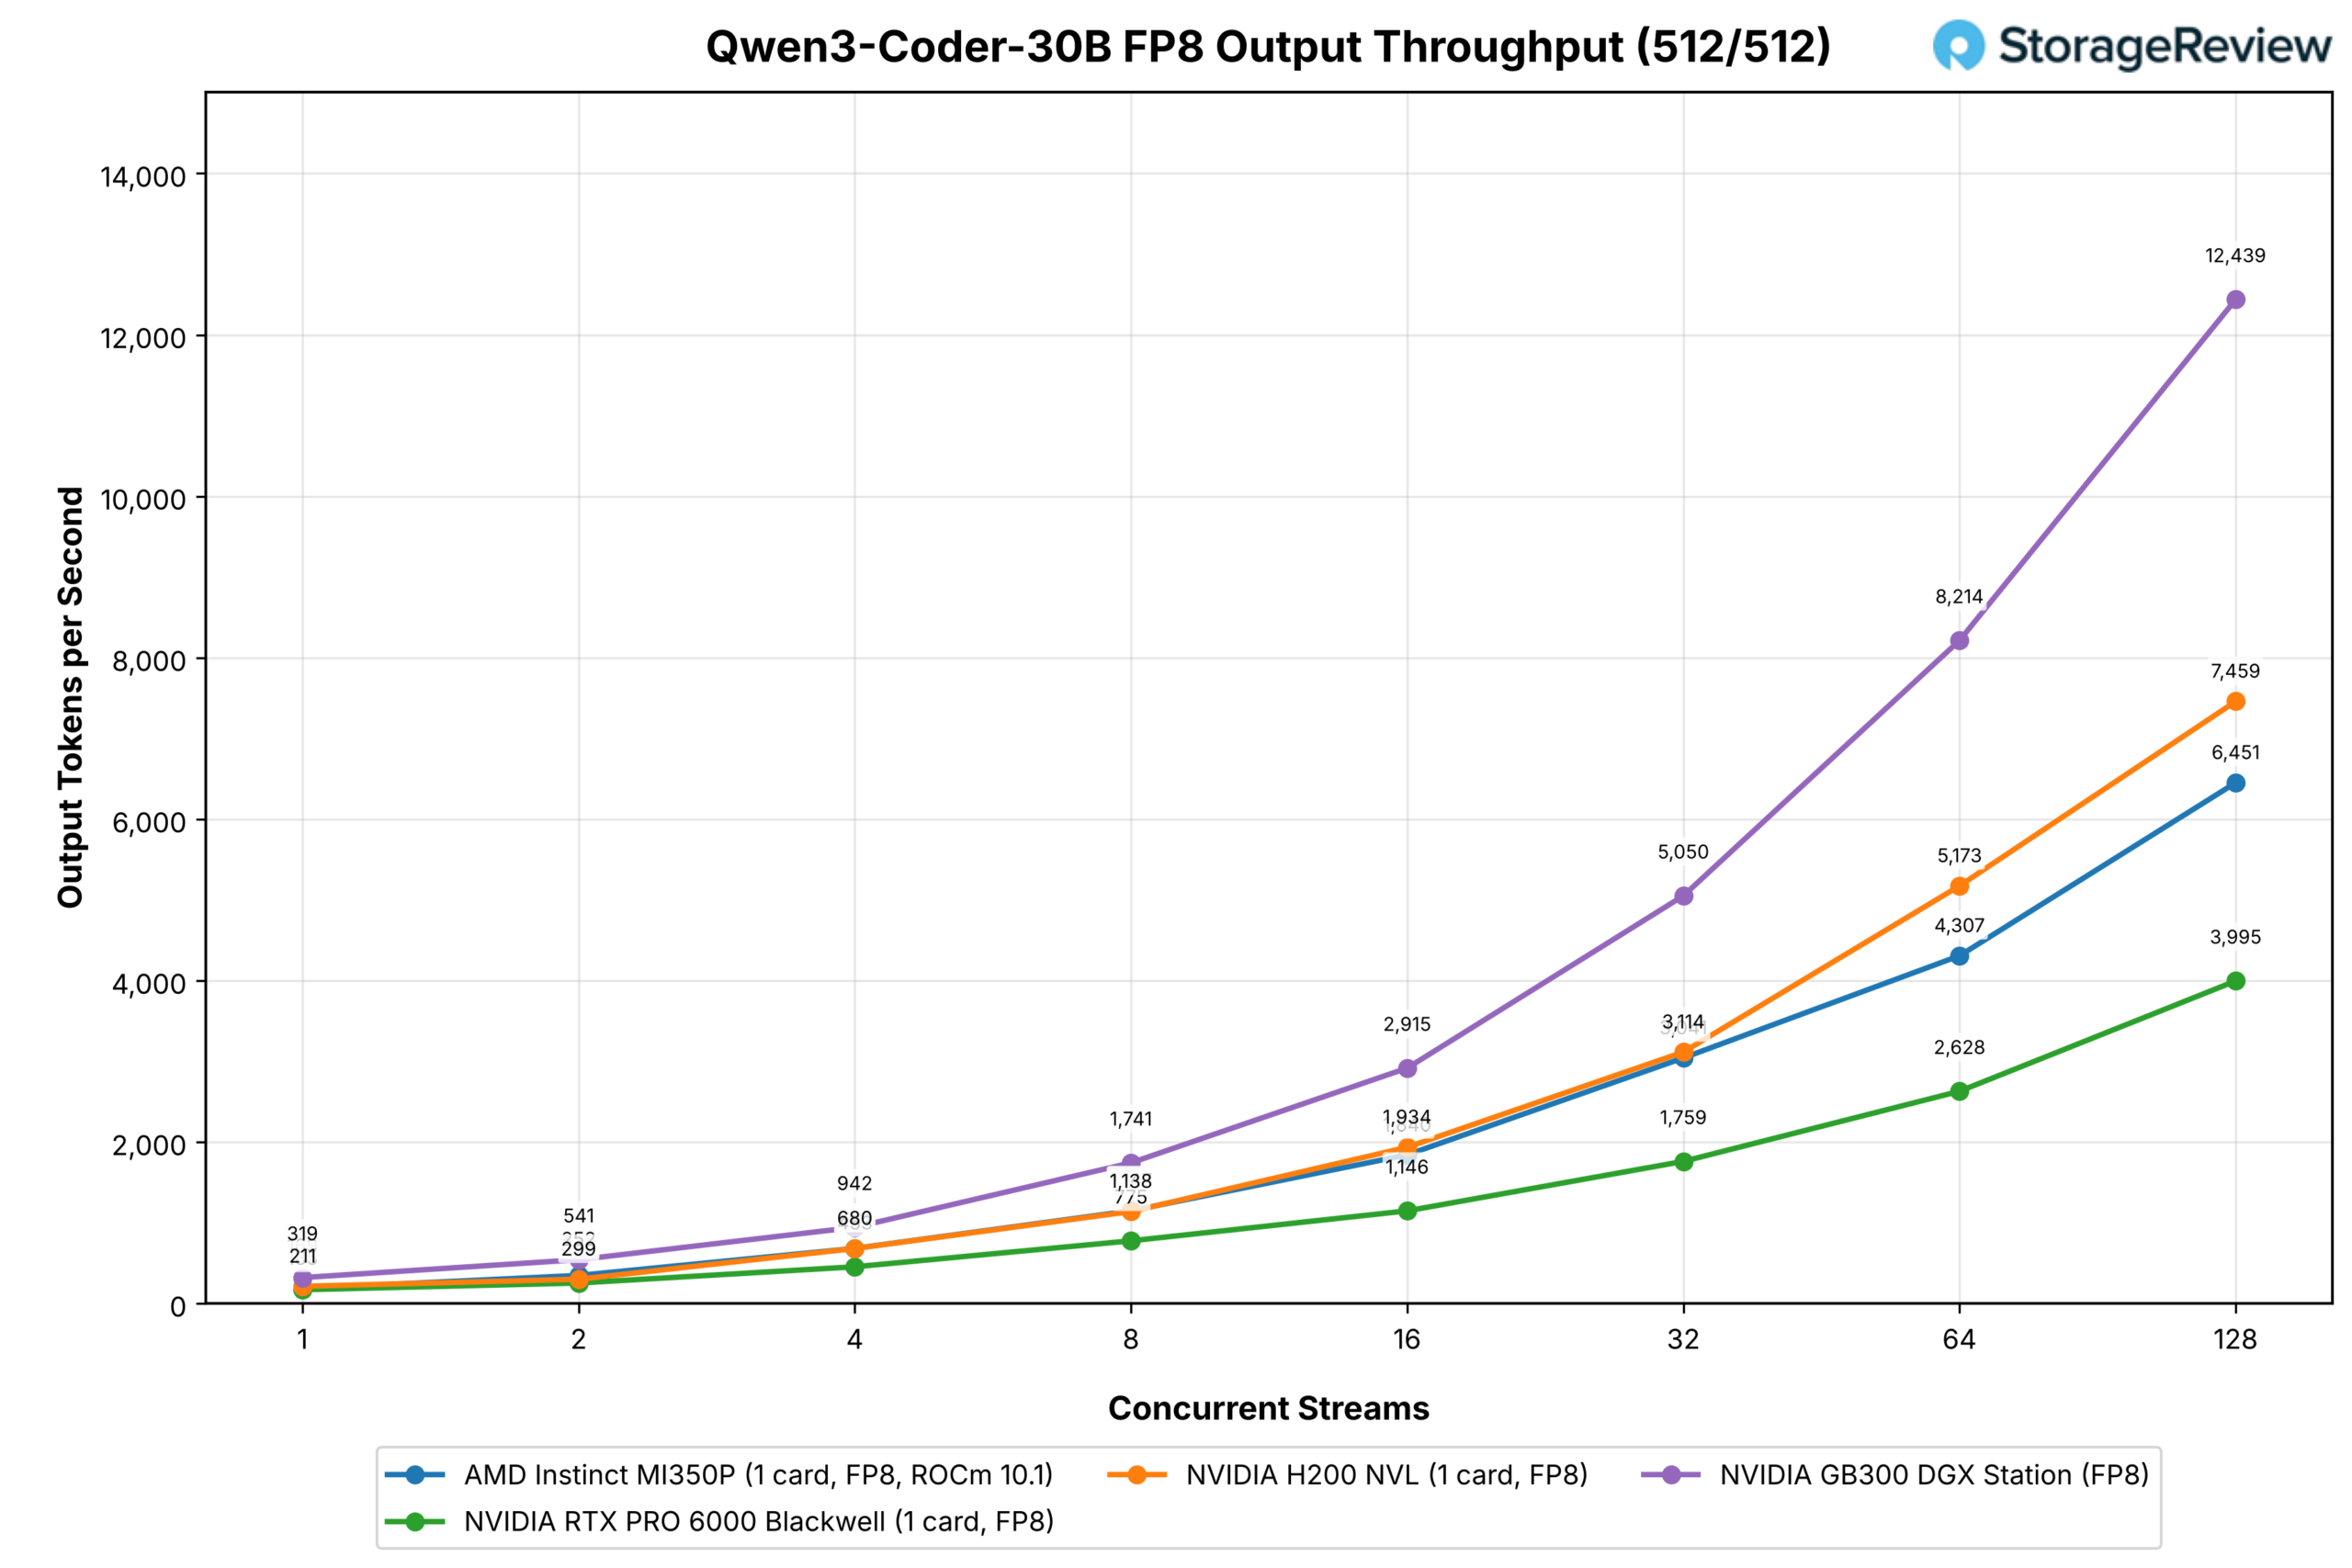
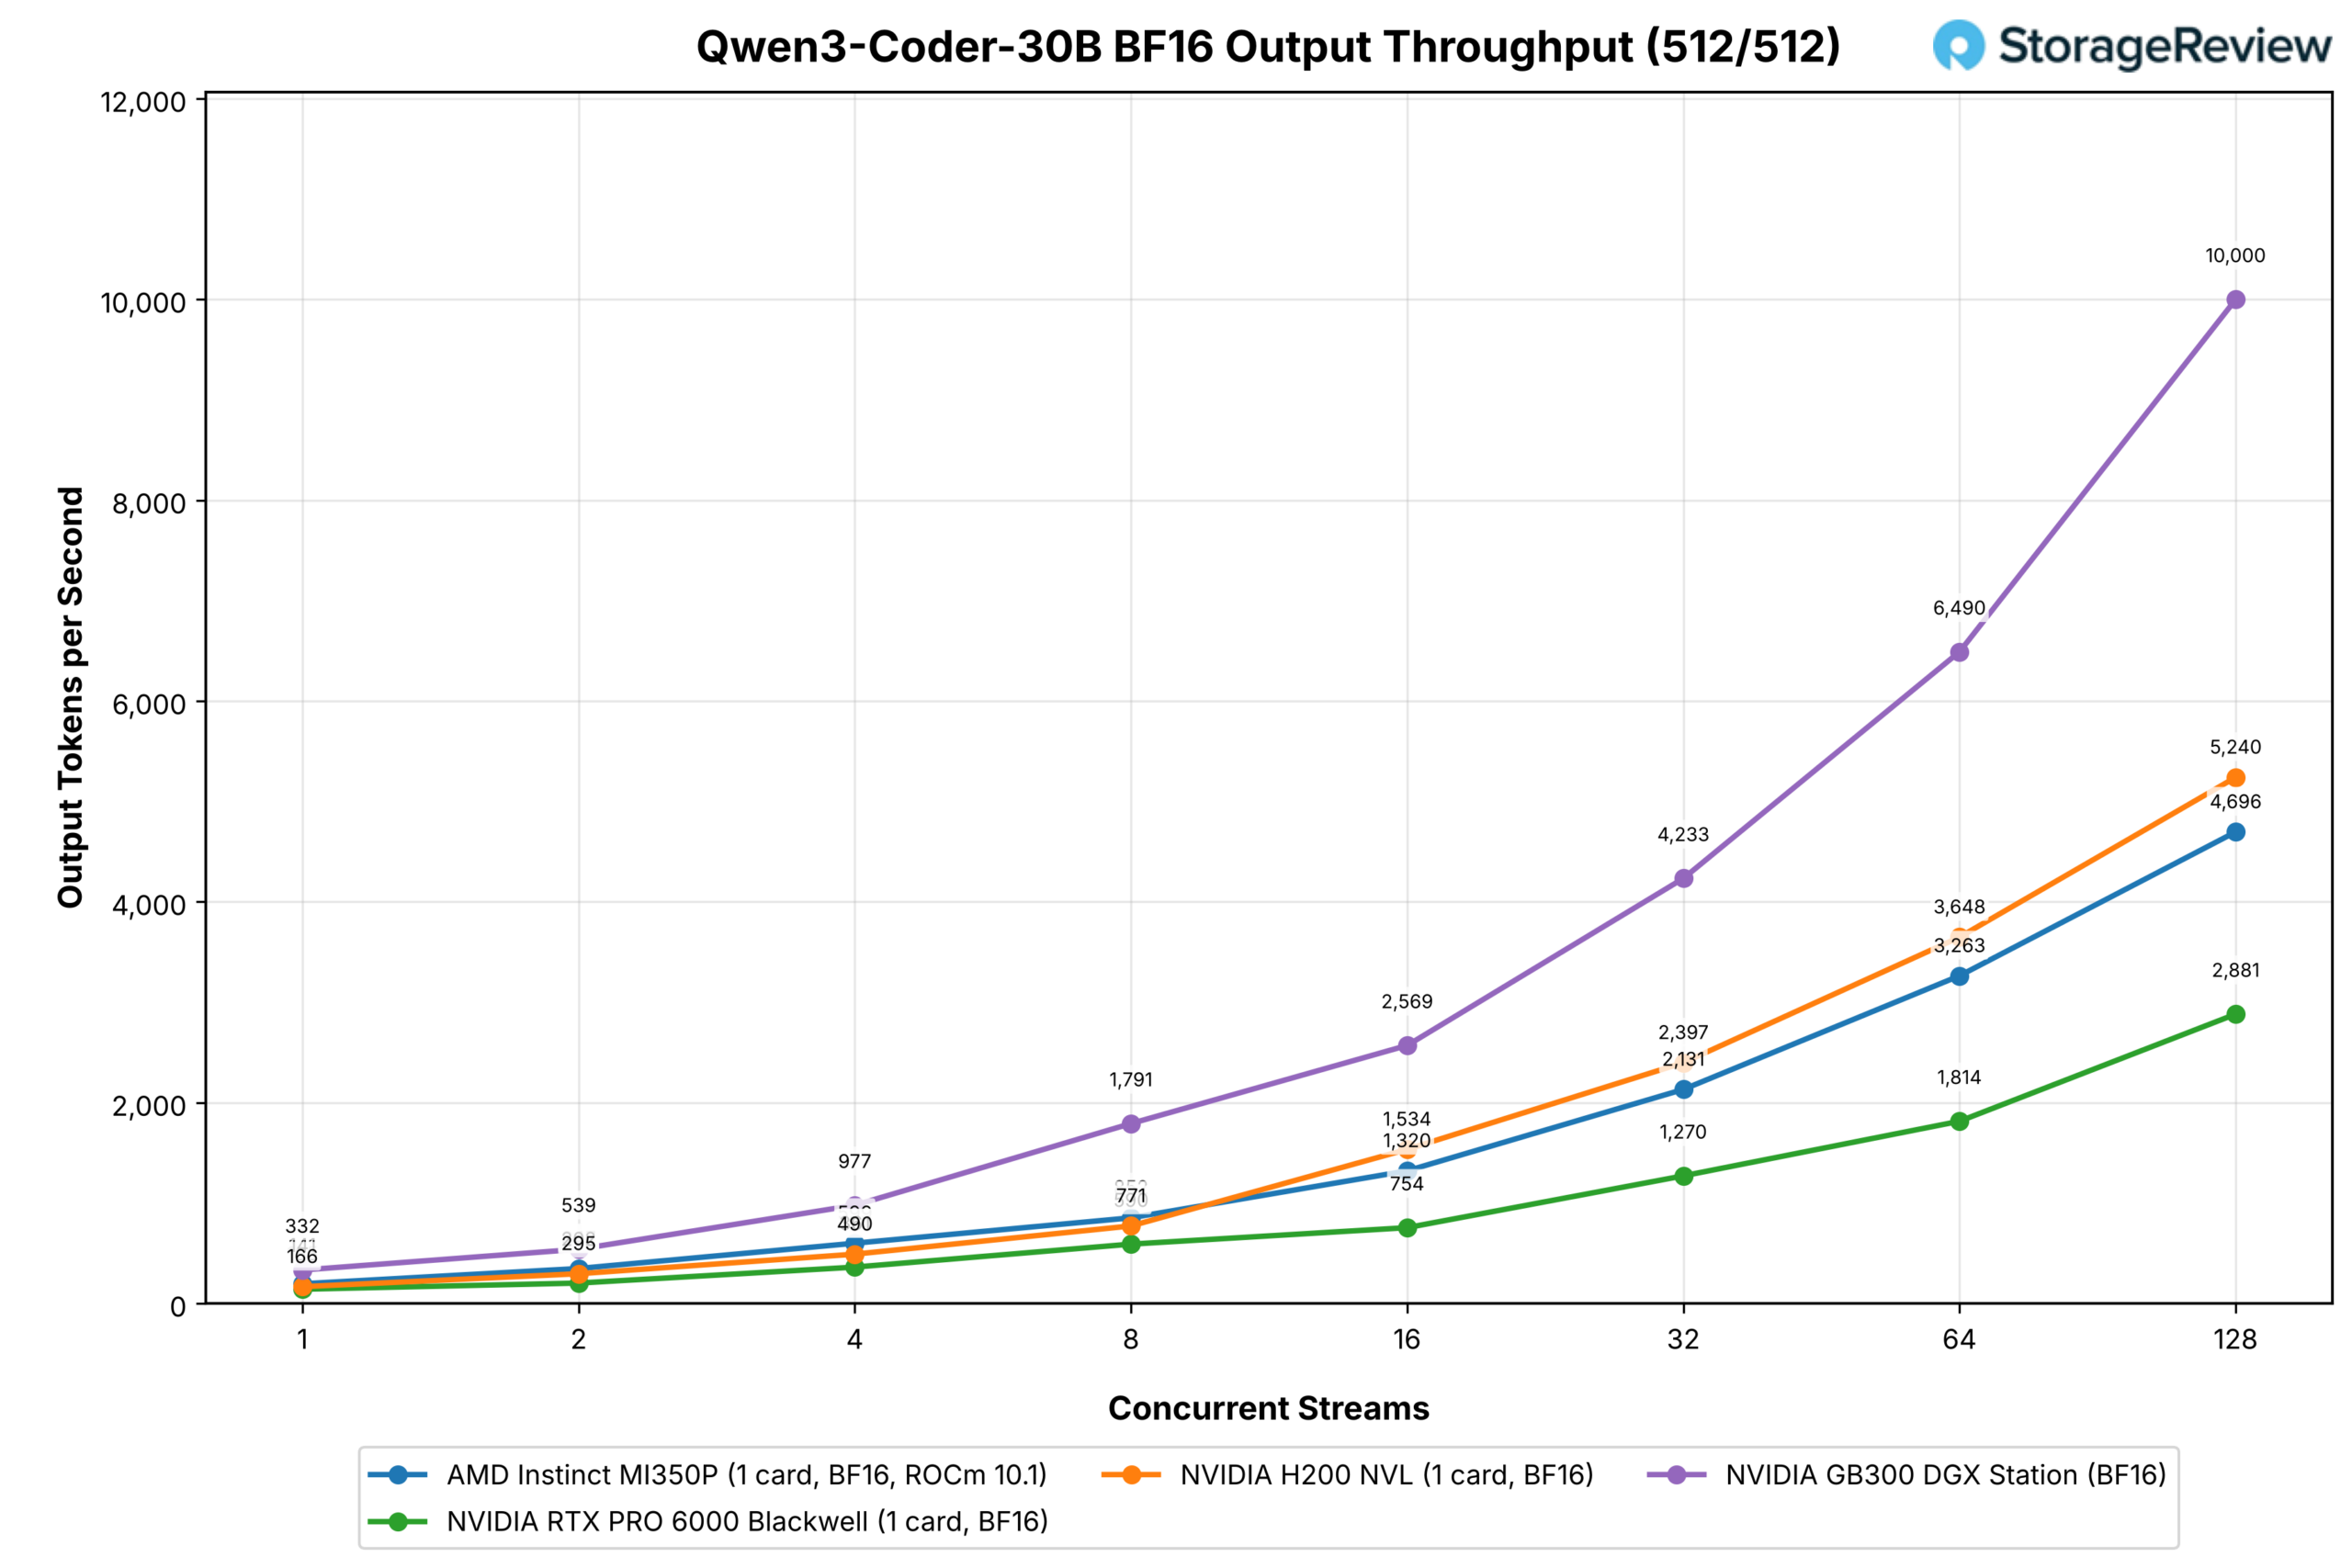
O MoE de 30 bits com 3 bits de parâmetros ativos dá à MI350P uma vantagem sobre a RTX PRO 6000 em todas as operações simultâneas na carga de trabalho de bate-papo, terminando com 6,451 contra 3,995 no FP8 e 4,696 contra 2,881 no BF16 com 128 fluxos, enquanto a H200 obteve 7,459 e 5,240, respectivamente.
Em prompts com muitos pré-preenchimentos, a execução do FP8 lidera apenas até o quarto fluxo e depois fica atrás do RTX PRO 6000 do oitavo ao 128º fluxo, com 759 contra 823 no topo, enquanto o H200 atinge 1,820; a execução do BF16 sobe para 728 no 128º fluxo contra 588 e 1,592.
Mistral Pequeno 3.1 24B
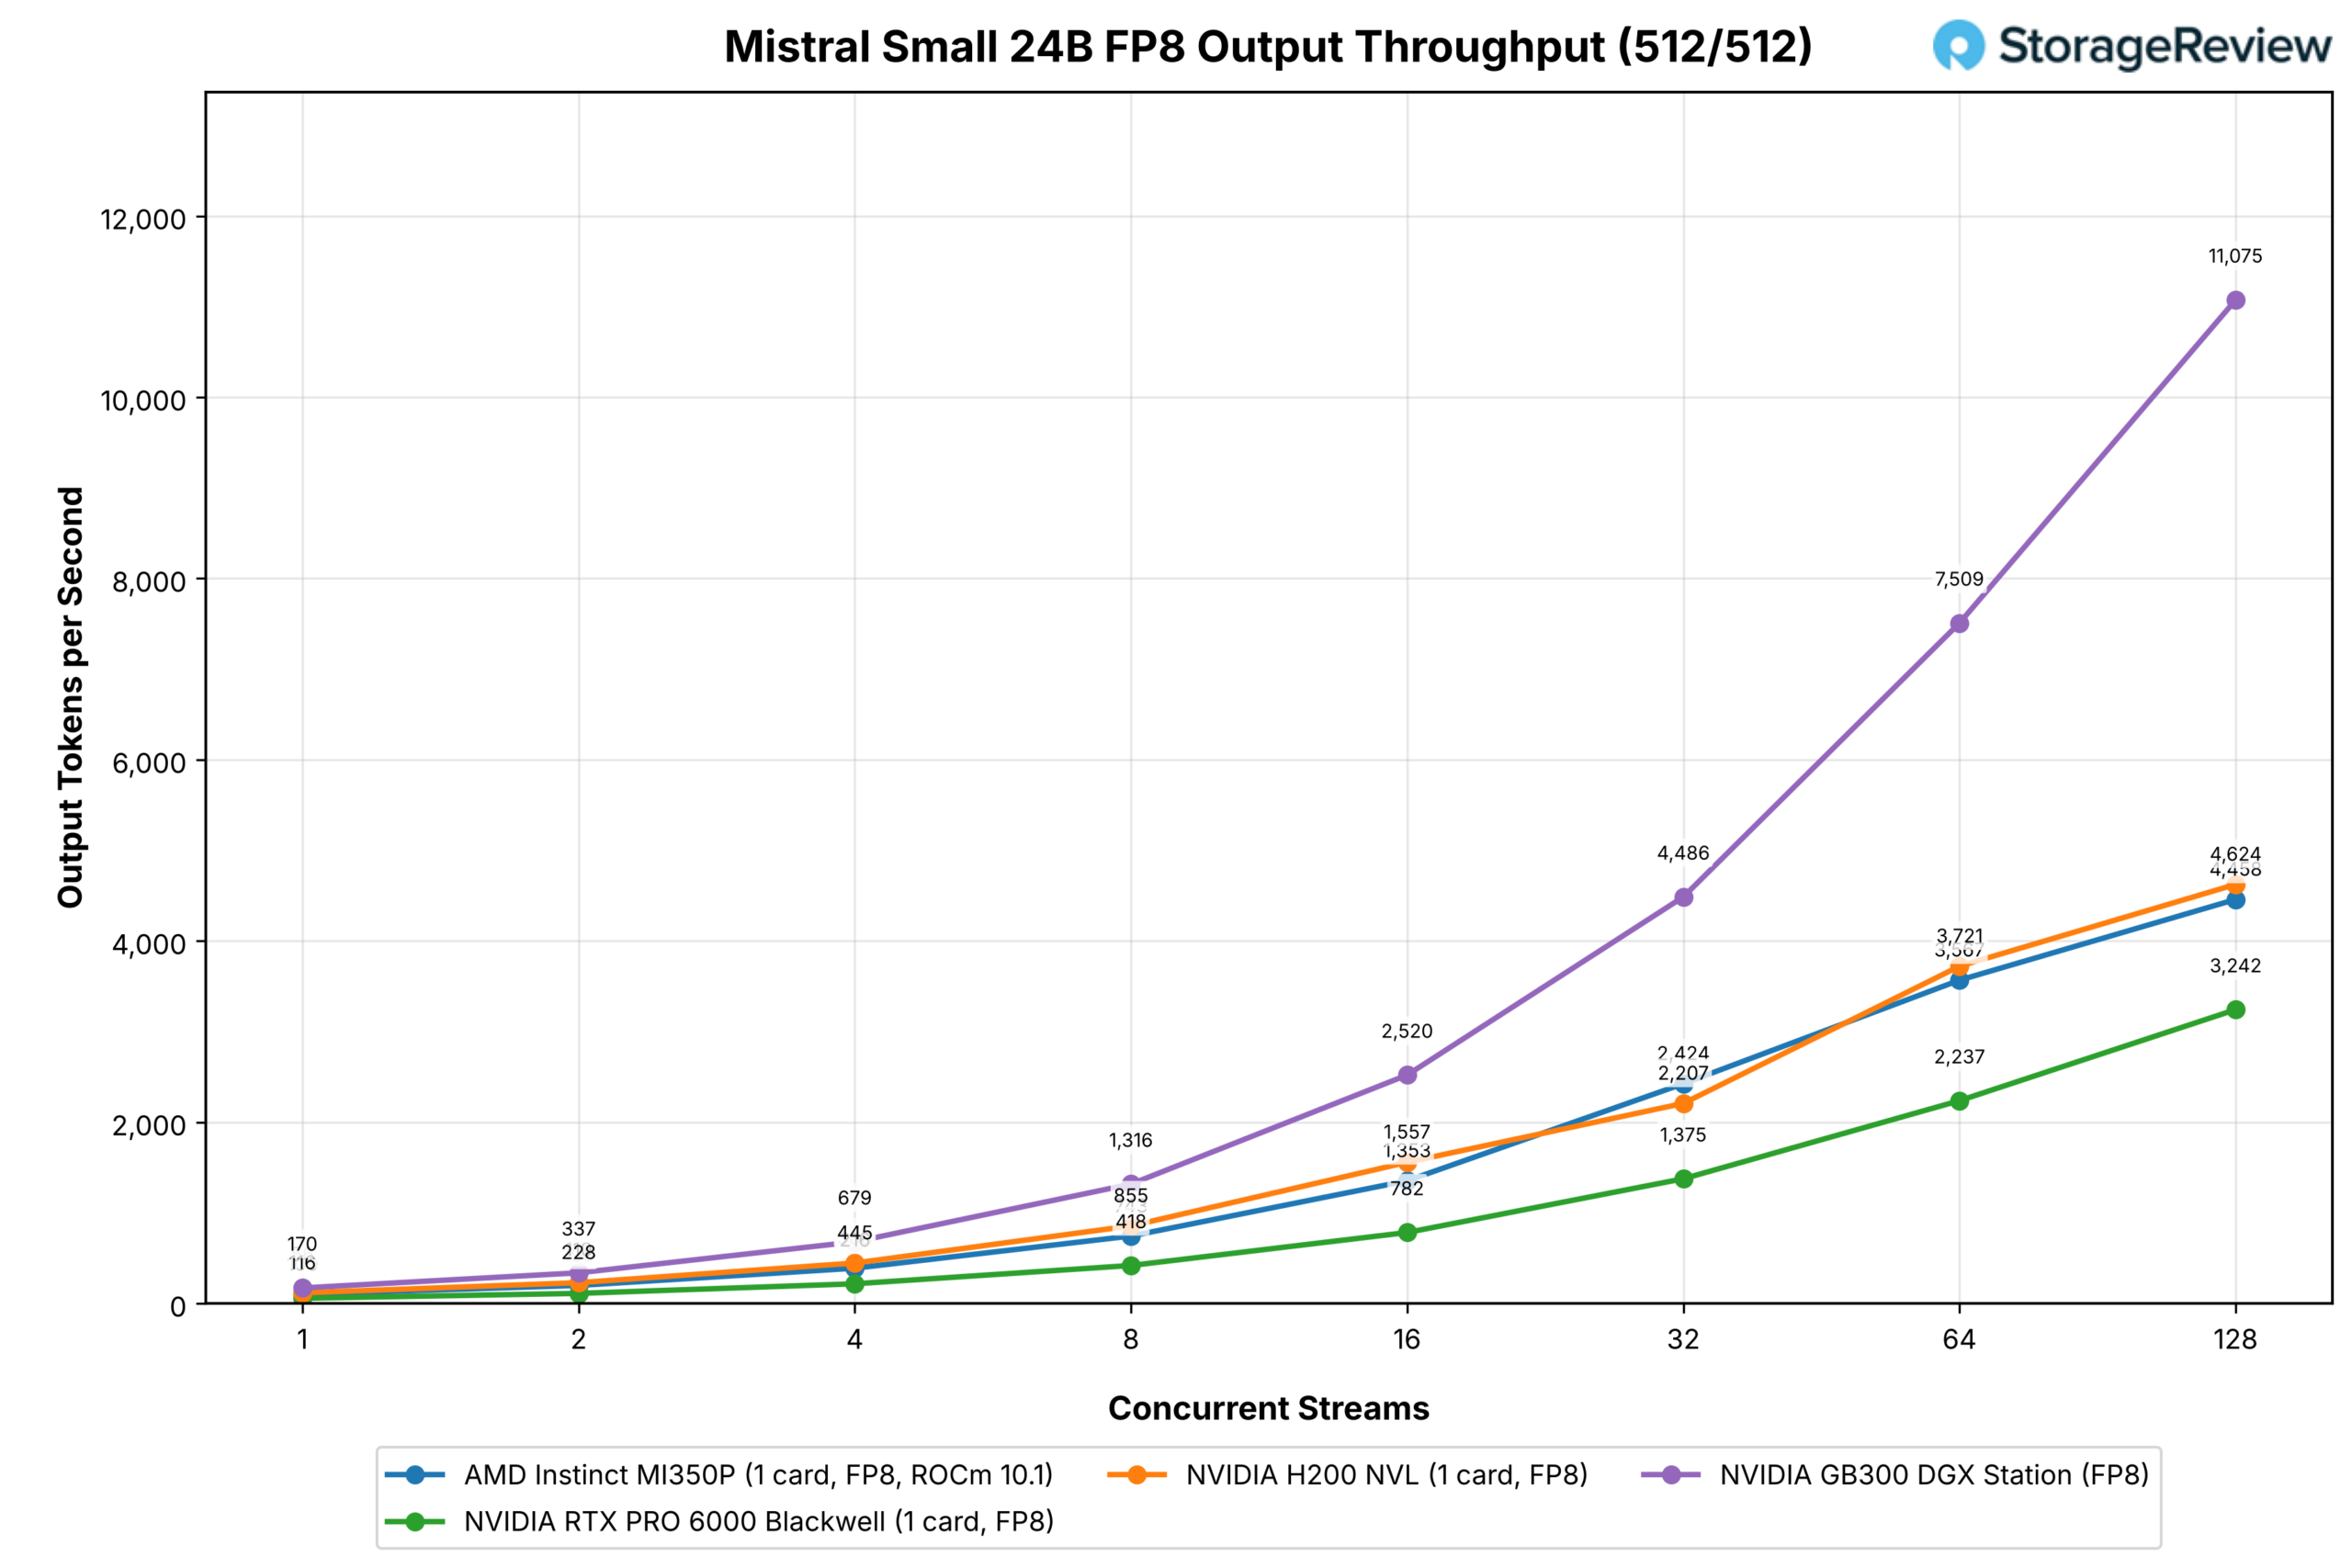
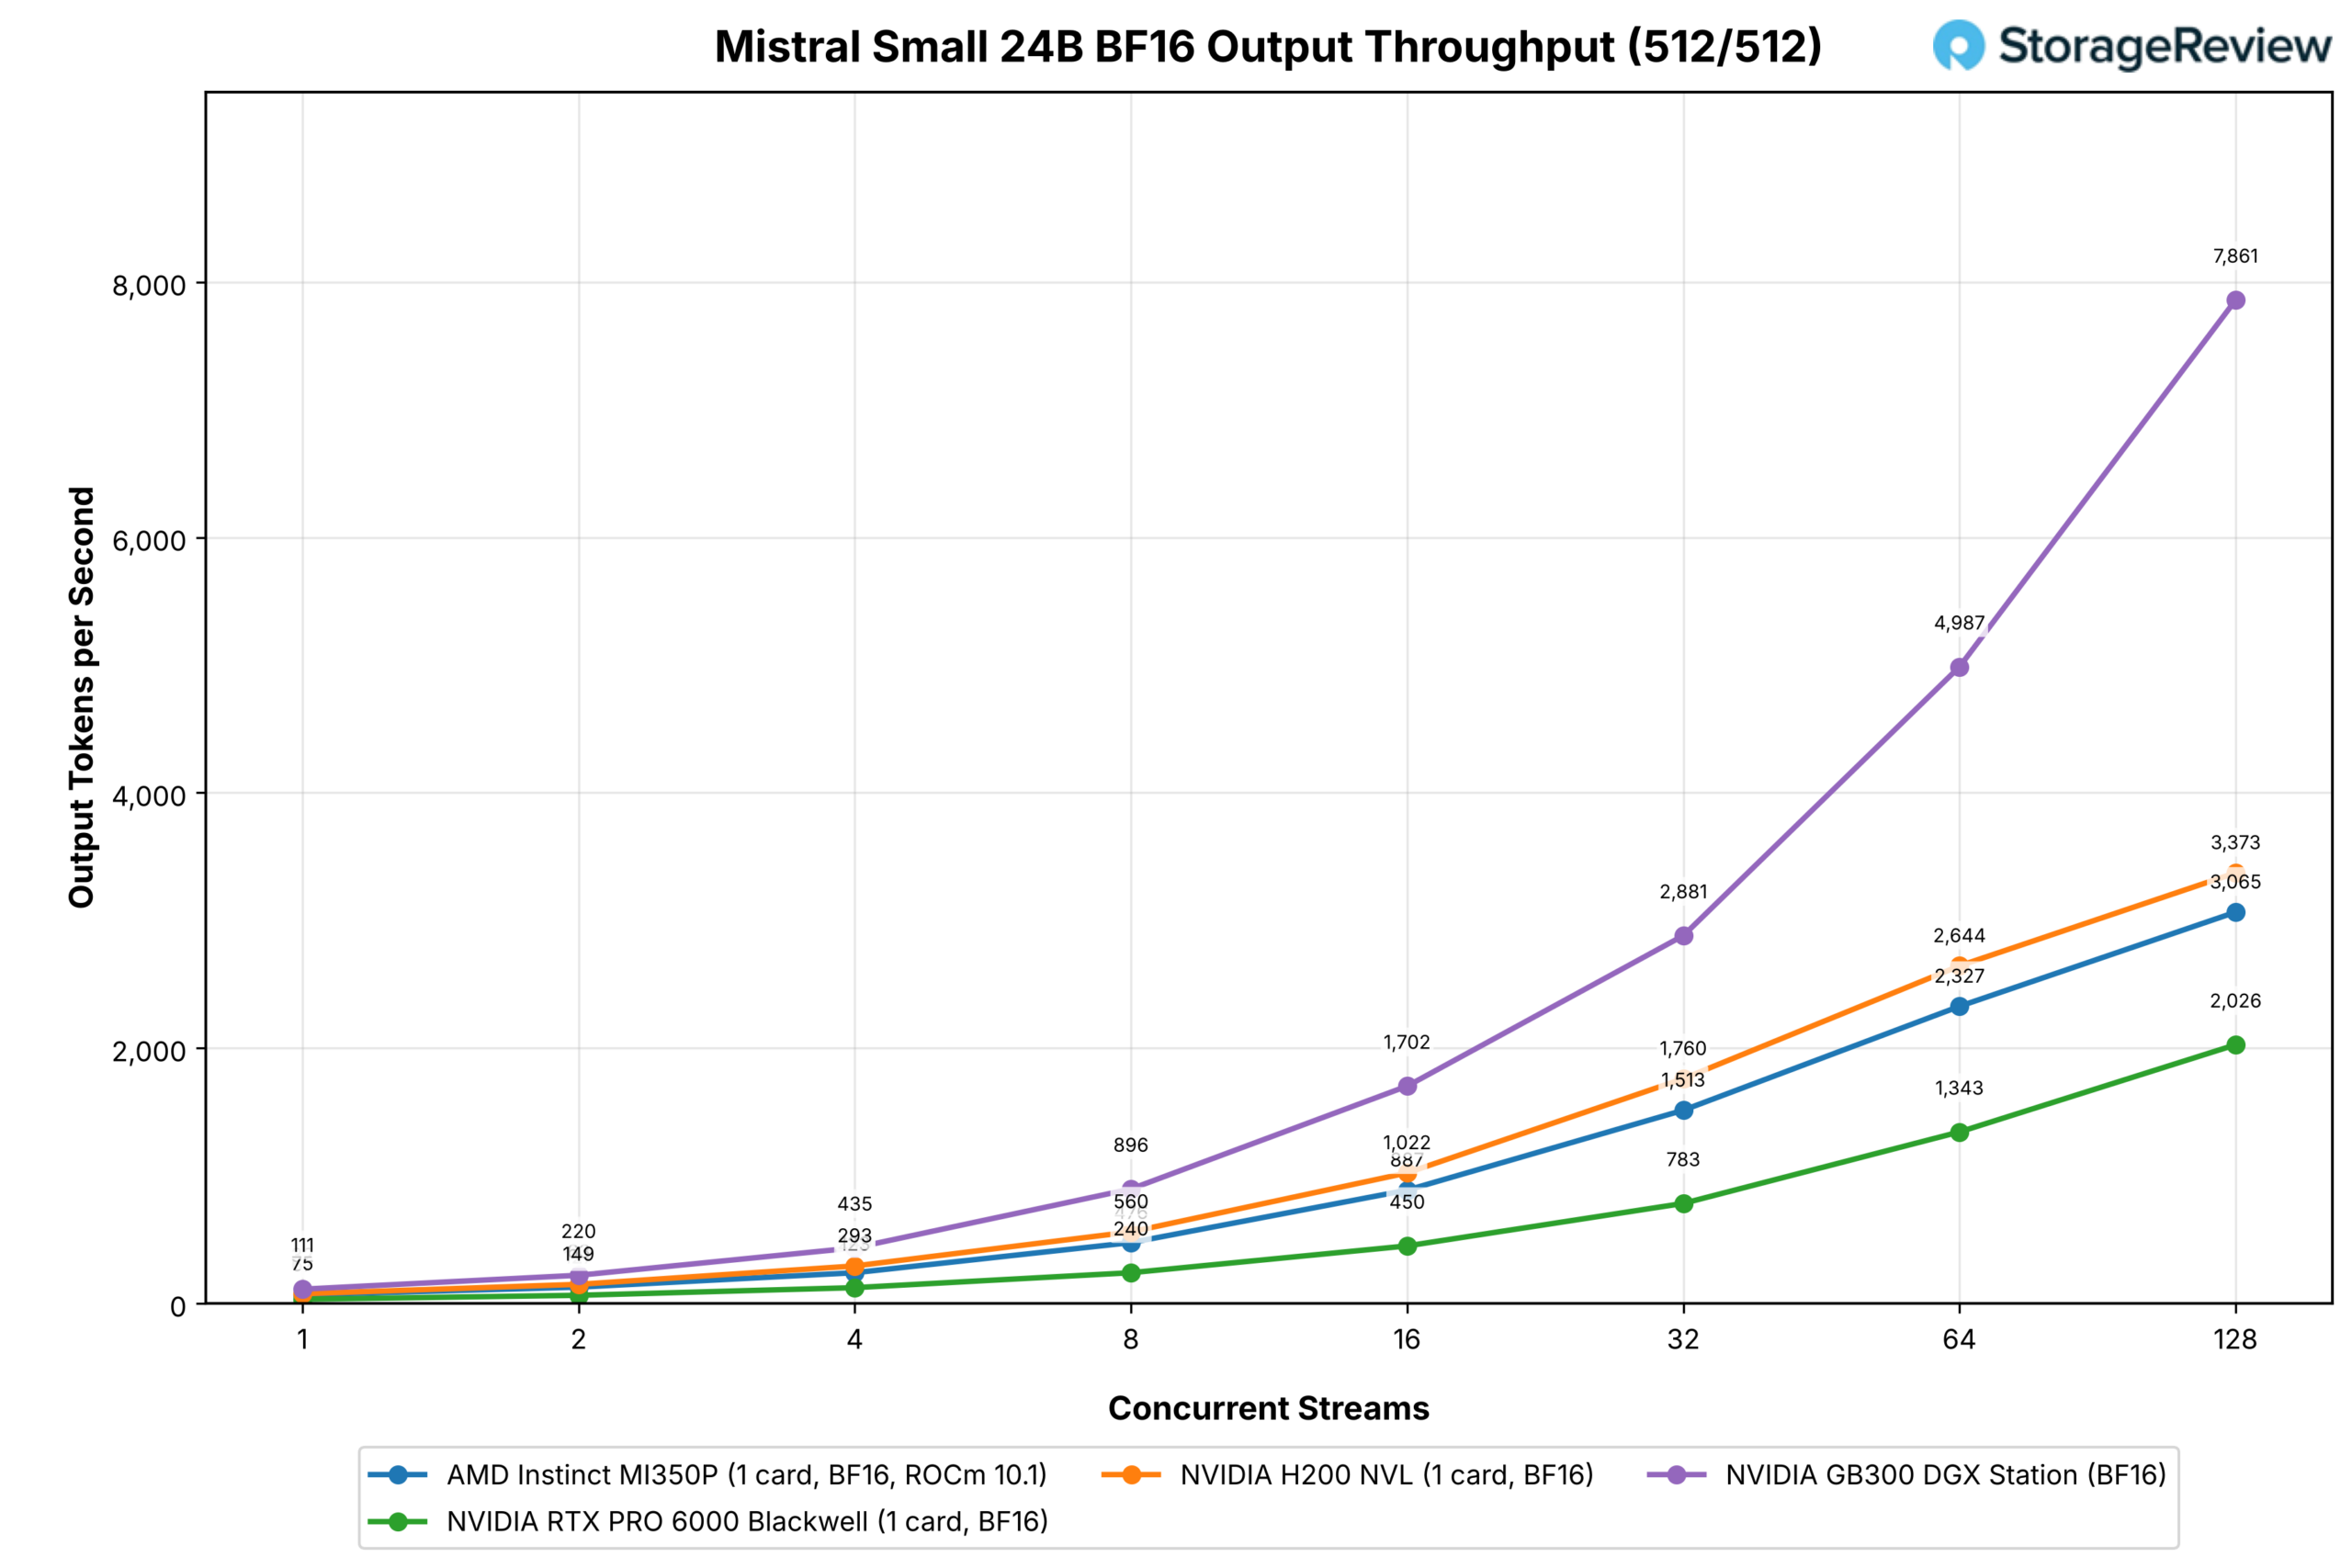
O Mistral Small é o melhor resultado em alta densidade do MI350P contra o RTX PRO 6000: 4,458 contra 3,242 no FP8 e 3,065 contra 2,026 no BF16 com 128 transmissões na carga de trabalho de chat, e com uma única transmissão, o MI350P praticamente dobra o desempenho da placa NVIDIA (100 contra 56 no FP8, 67 contra 32 no BF16).
É também no modelo denso que o MI350P lidera em solicitações com grande número de pré-enchimento, 599 contra 482 no FP8 com 128 fluxos e 425 contra 299 no BF16 com 64, embora o H200 alcance 799 e 632 nos mesmos pontos.
Lhama 3.1 8B
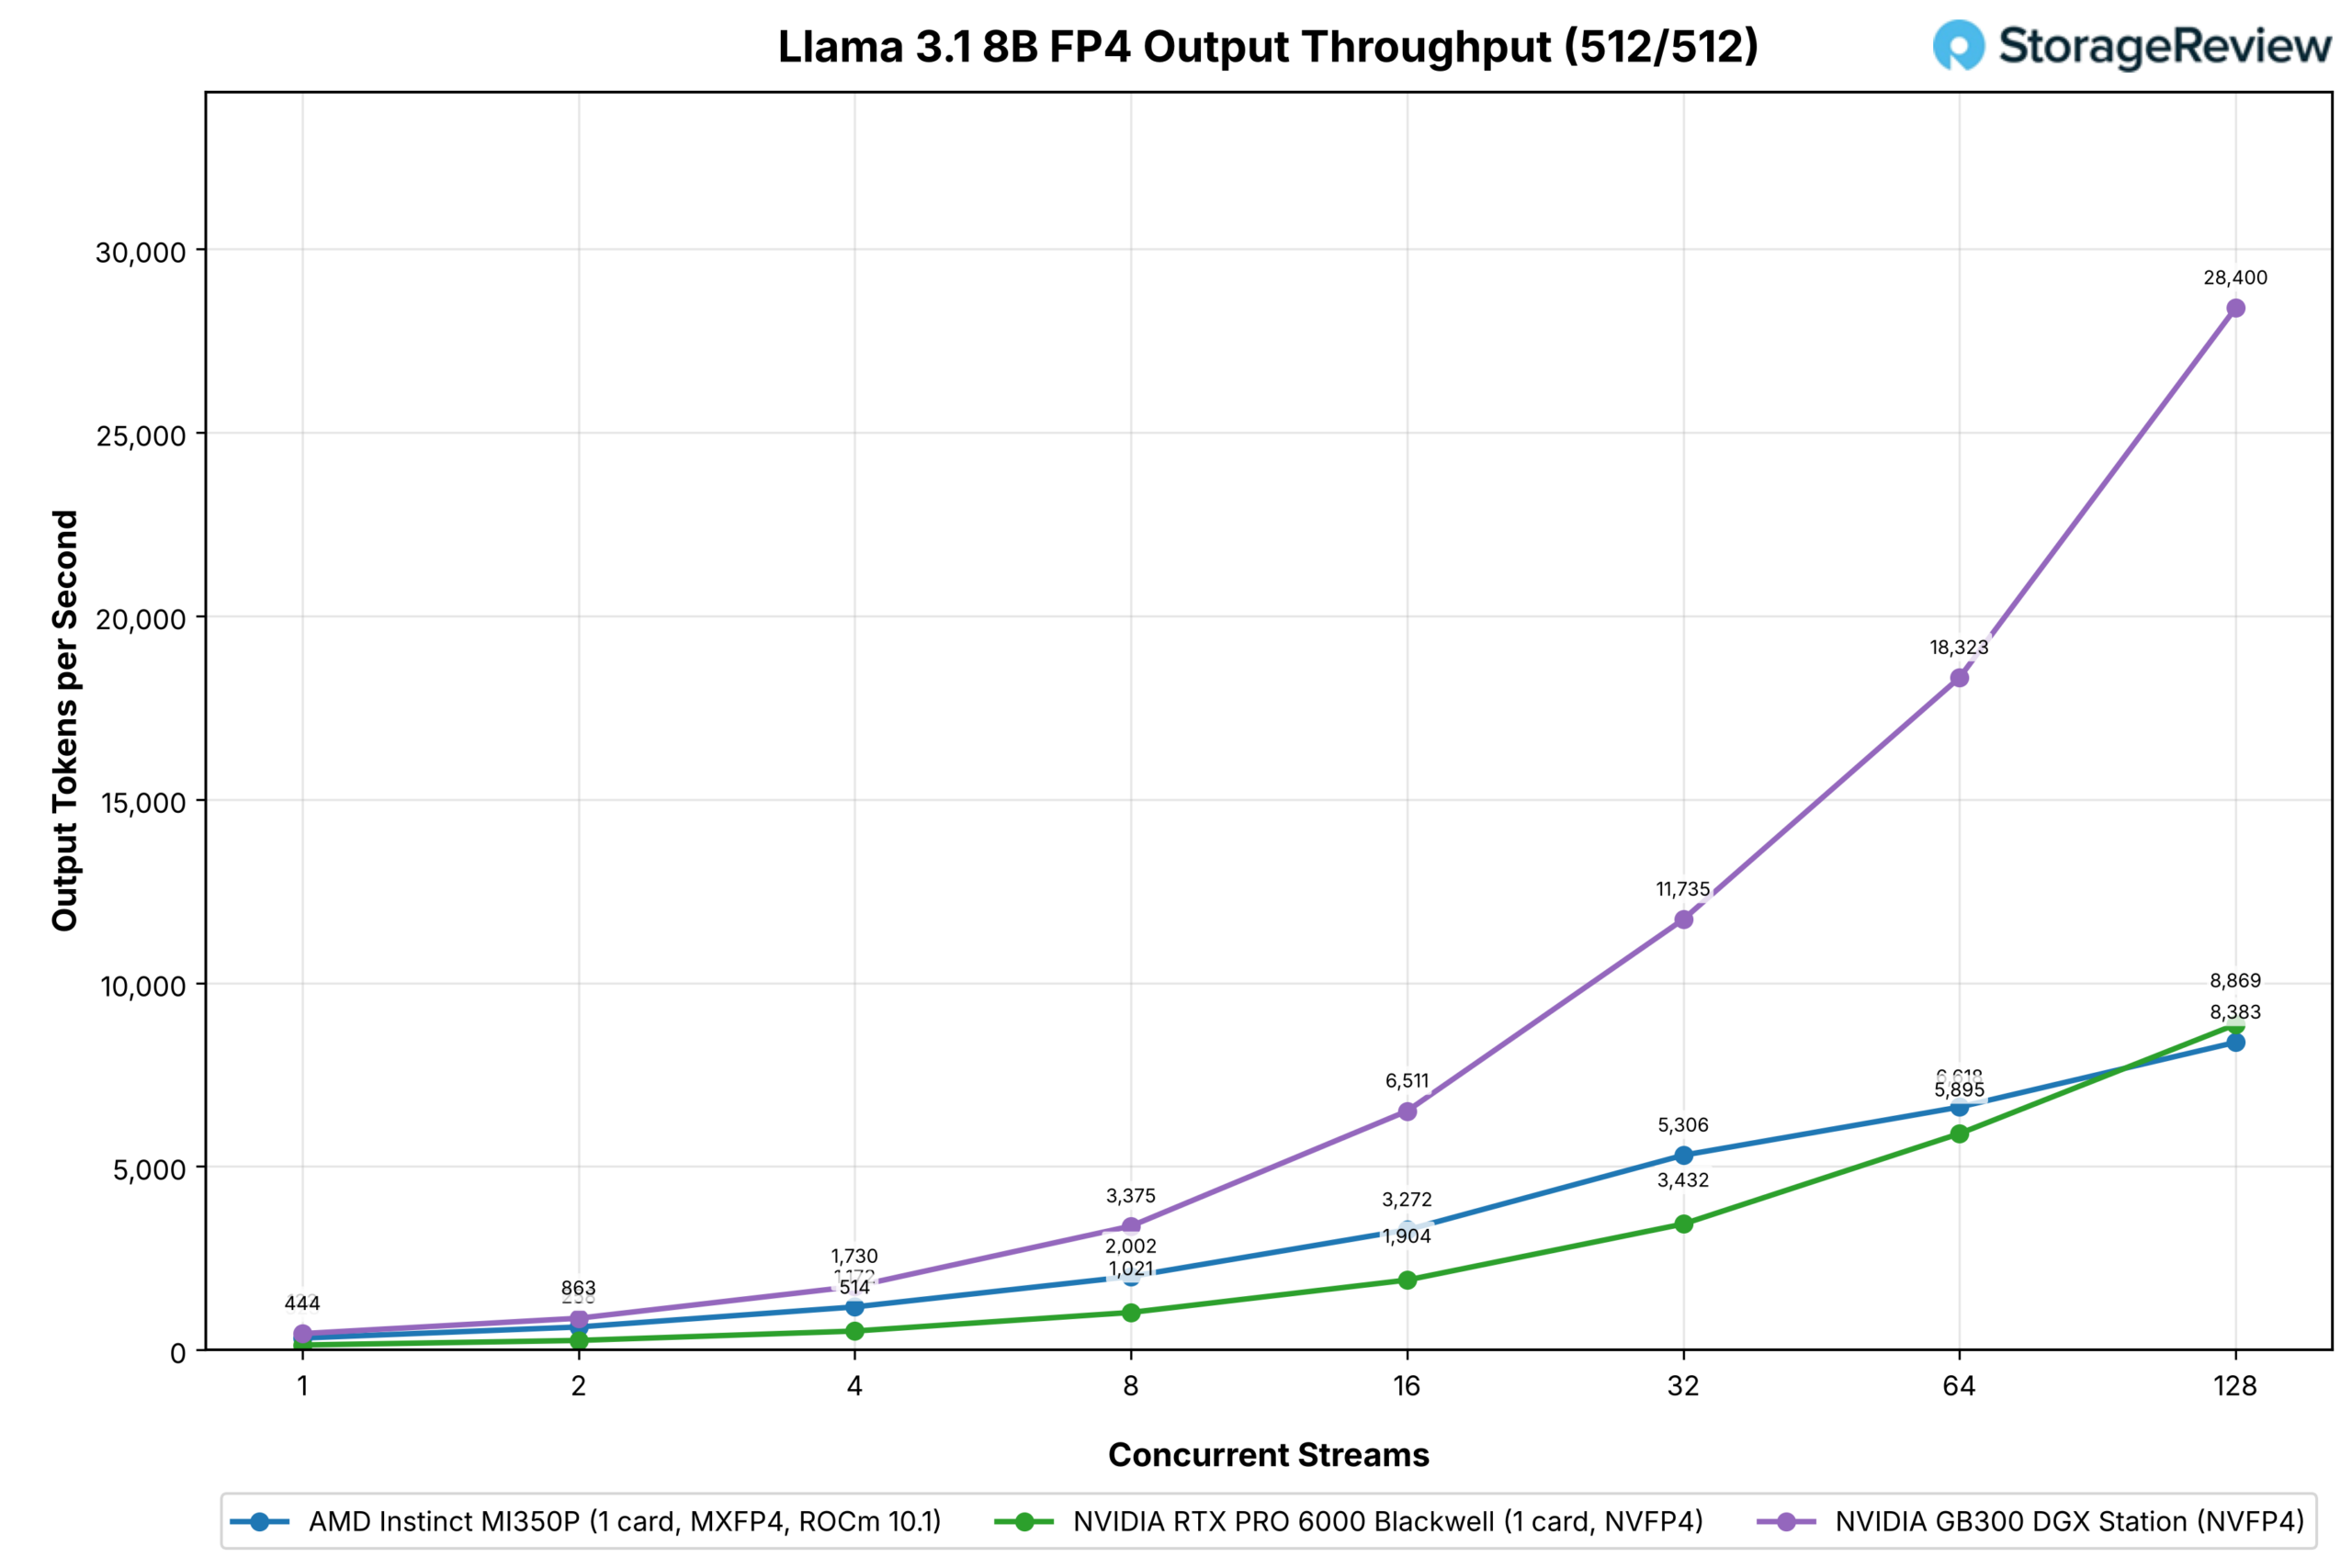
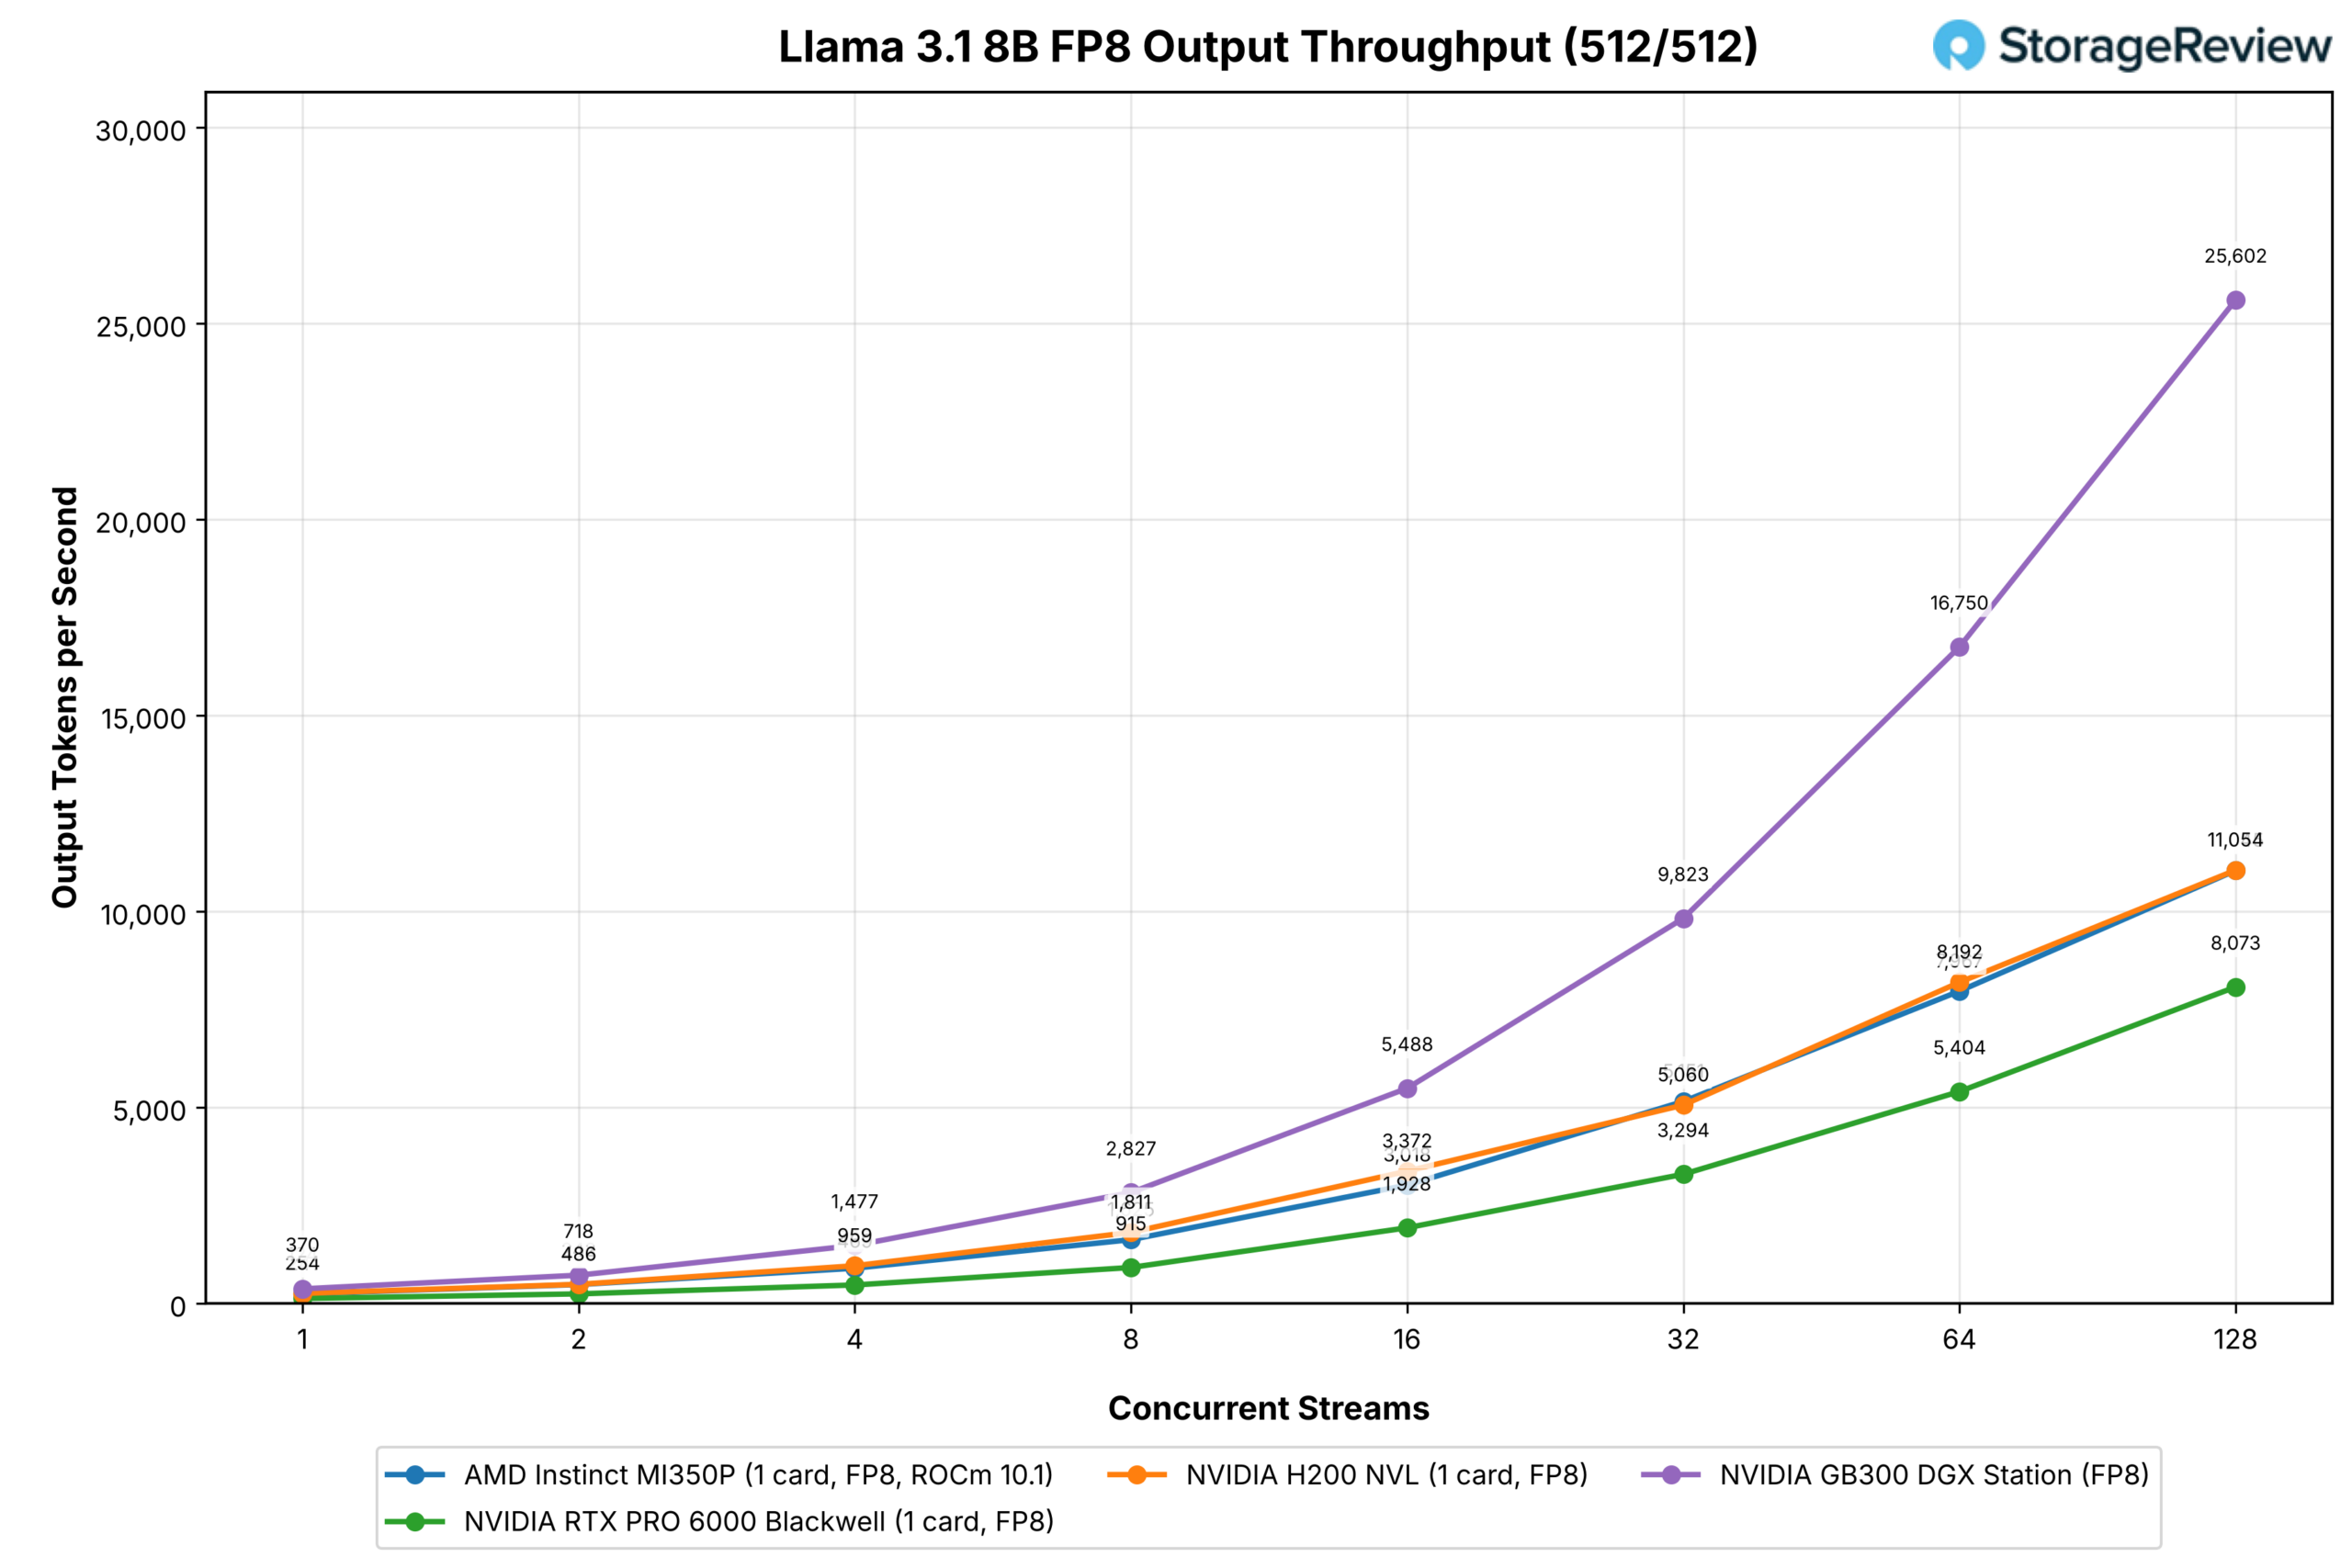
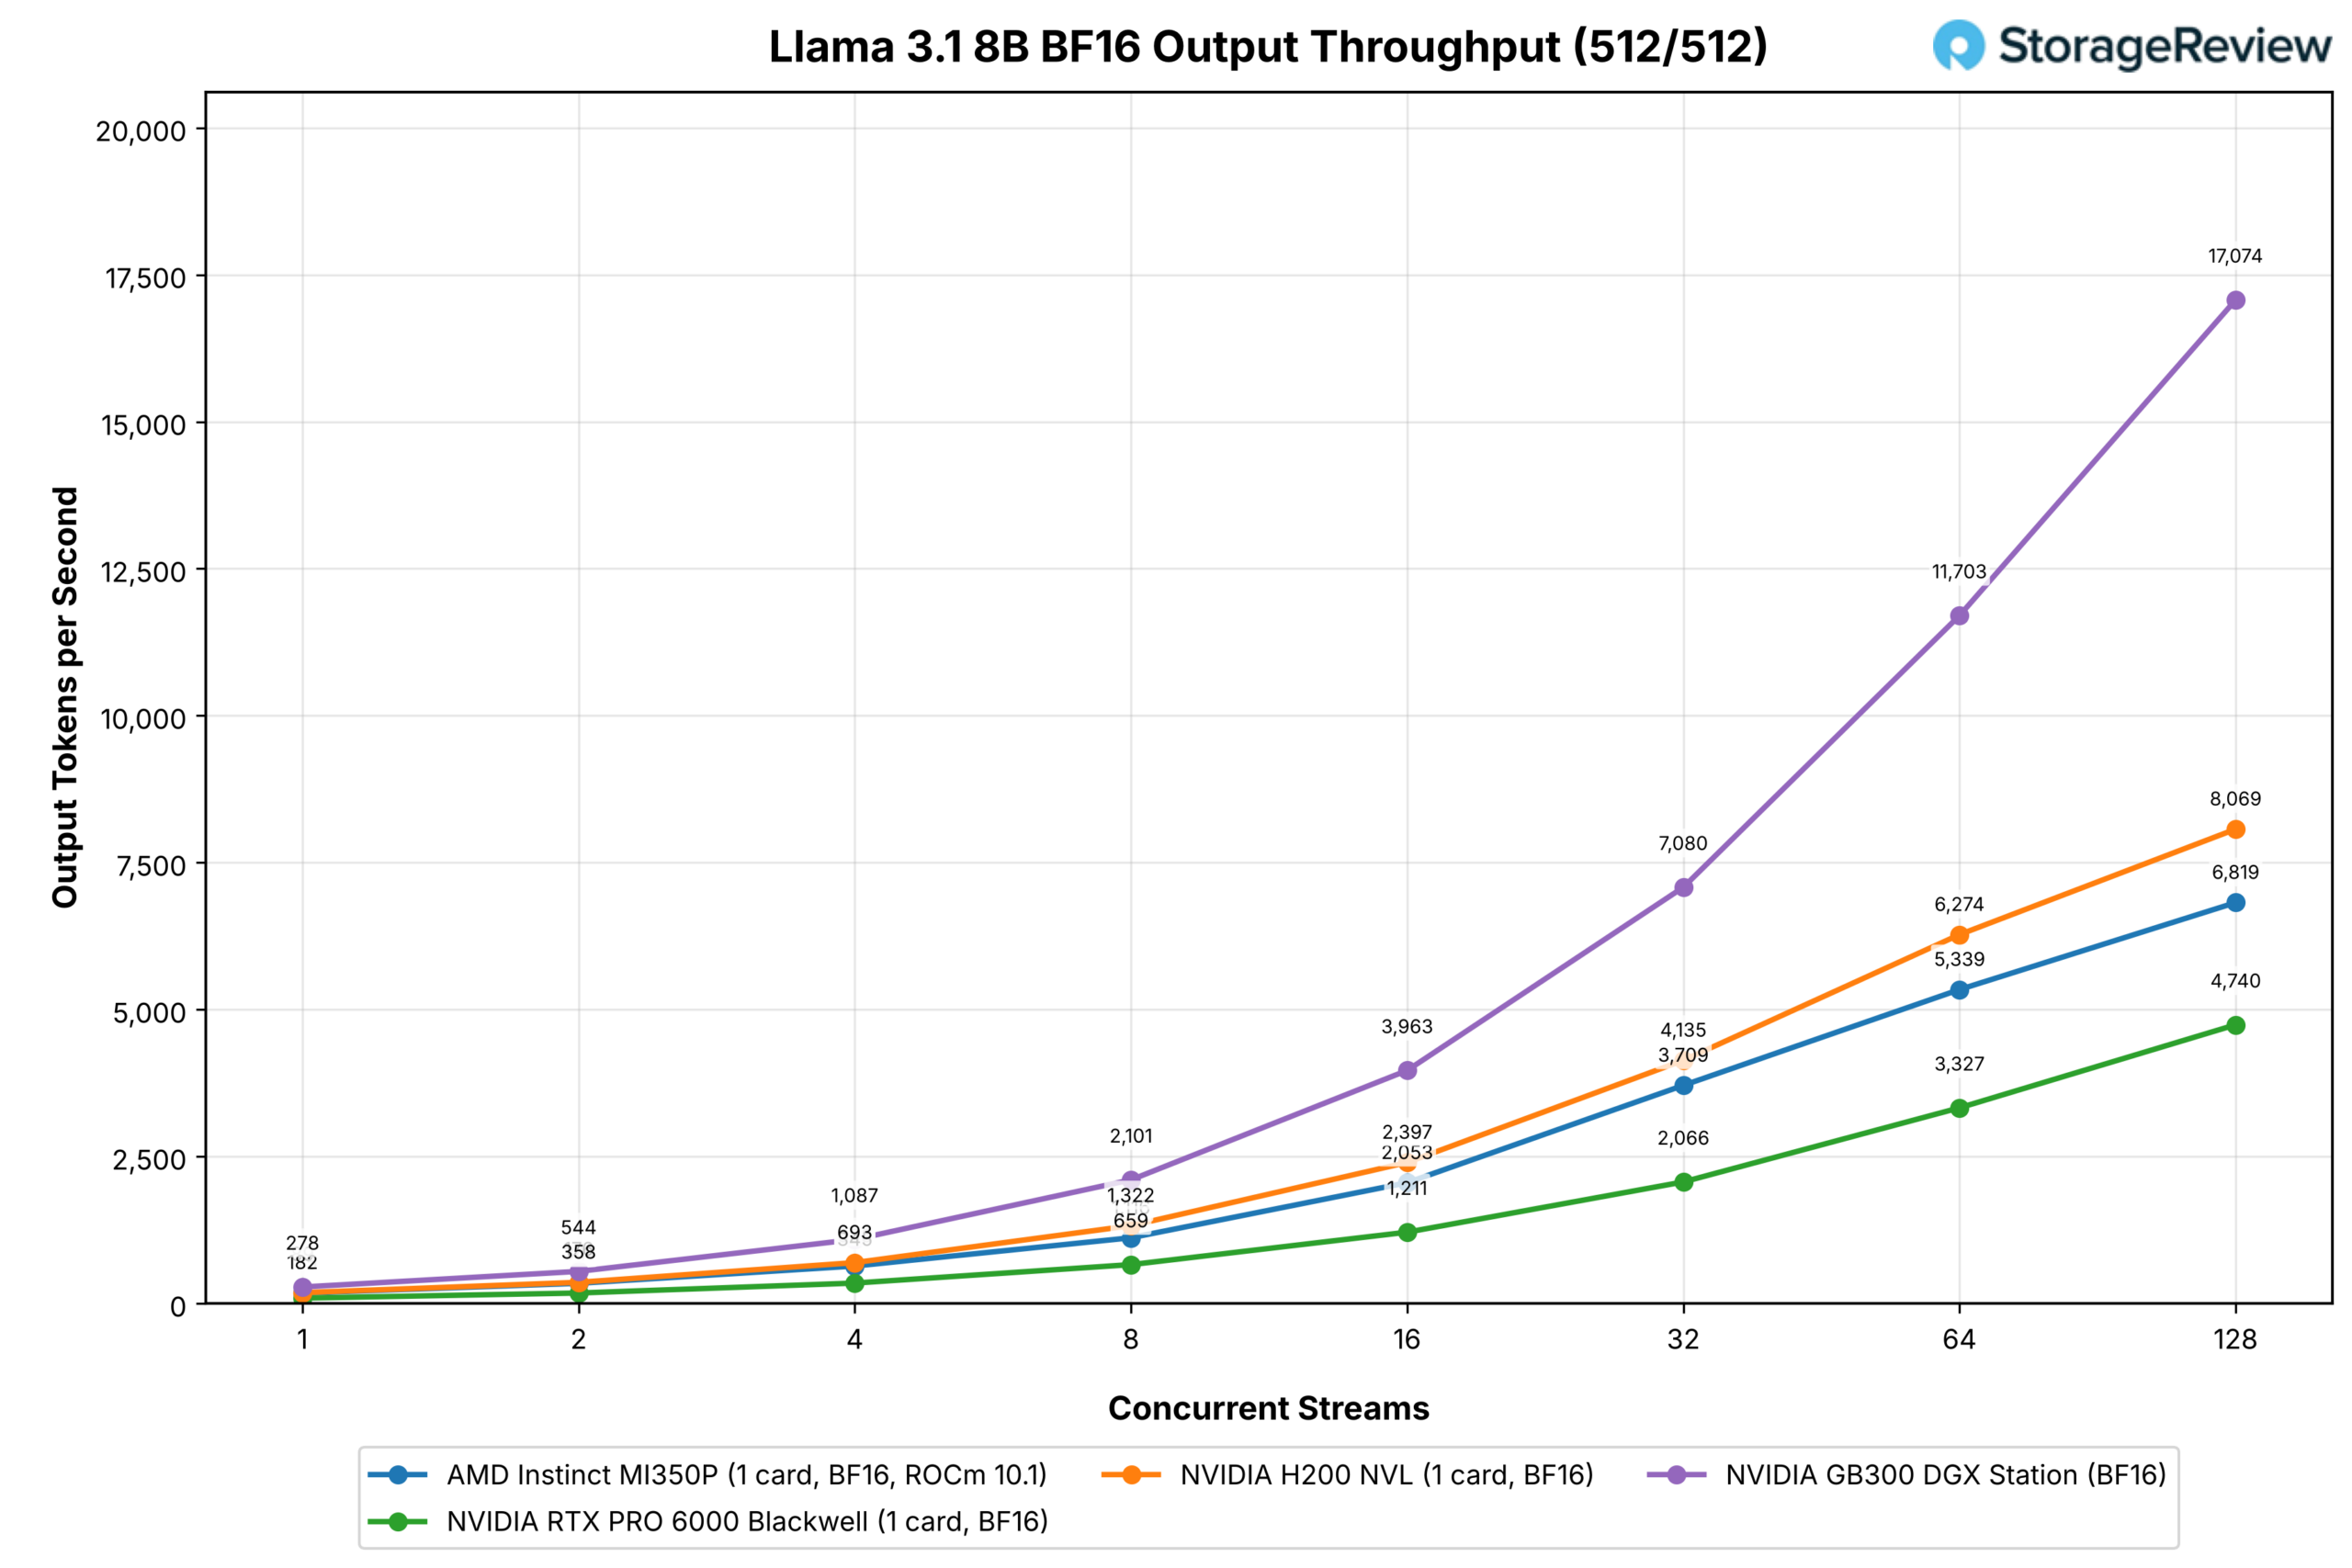
O Llama 3.1 8B está aqui para dar continuidade à nossa cobertura anterior de GPUs. Com 128 fluxos na carga de trabalho de chat, o MI350P entrega 11,045 tokens de saída por segundo no FP8, contra 8,073 do RTX PRO 6000 e 11,054 do H200, um empate com a placa Hopper, e 6,819 no BF16, contra 4,740 e 8,069. A versão MXFP4 da AMD atinge 8,383 com 128 fluxos, 5% atrás da versão NVFP4 da NVIDIA no RTX PRO 6000 (8,869), depois de liderá-la por 12 a 143% em cada contagem de fluxos menor; com um único fluxo, a execução do MXFP4 registra 323 contra 133.
Os testes com uso intensivo de pré-carregamento invertem o resultado: o MI350P FP8 apresenta uma queda de 16 fluxos e termina com 1,211 pontos, contra 1,481 do RTX PRO 6000 e 2,045 do H200, mesmo que o MI350P comece com 90% de vantagem sobre o RTX PRO 6000 em um fluxo, e a versão MXFP4 fique 41% atrás do NVFP4 em 128 fluxos.
Conclusão
A MI350P é a primeira placa Instinct em quatro anos a ser instalada em um servidor padrão e, com 450 W em um gabinete 2U, se destaca como aceleradora PCIe: 144 GB de HBM3E a 4 TB/s, 1,120 TFLOPS de FP8 e 2,228 de FP4 com escala de bloco no MAMF, contra 820 e 1,634 da RTX PRO 6000 Blackwell, e cerca de 2.1 vezes a largura de banda de memória utilizável da placa NVIDIA.

Em comparação com a RTX PRO 6000, a MI350P foi mais rápida em prompts do tamanho de um chat em todos os modelos FP8, BF16 e GPT-OSS, com uma diferença de 35 a 65% em 128 fluxos, onde a largura de banda e a capacidade da HBM3E superaram uma placa GDDR7 de 96 GB, e liderou em ambos os modelos GPT-OSS em todas as contagens de fluxos em ambos os formatos de prompt.
A H200 NVL ainda superou a Hopper nos testes densos FP8 e BF16, por 4 a 18% em 128 fluxos em prompts de chat e por uma margem ainda maior em prompts longos, com 20% mais largura de banda e sem caminho FP4; no GPT-OSS, a MI350P ficou 50% e 78% à frente da placa Hopper. Os modelos maiores apresentam resultados menos consistentes, já que quatro RTX PRO 6000 superam o par MI350P no GLM-5.2 em 16 fluxos, com 384 GB contra 288 GB e mais largura de banda e poder computacional agregados disponíveis.
O MiniMax-M3 apresenta resultados mais próximos: as três configurações mantêm uma diferença de no máximo 10% em oito fluxos de mensagens de chat, o conjunto de quatro placas RTX se destaca em 16 fluxos e o par de MI350P lidera em mensagens longas também em oito fluxos. Por placa, a taxa FP4 medida do MI350P é 36% maior que a do RTX PRO 6000, portanto, a vantagem reside na quantidade de placas. Esses resultados com duas placas foram obtidos com o ROCm 7.2.3 e serão repetidos no ROCm 10.1, juntamente com os testes de 600W.
Ainda não podemos emitir uma opinião definitiva sobre o MI350P sem testá-lo em seu potencial máximo de 600 W, o que planejamos fazer em um PowerEdge XE7745; a Dell suporta até oito MI350Ps de 600 W nesse chassi. Segundo informações da AMD, os 150 W extras representam um aumento de desempenho de cerca de 10%.
A AMD percorreu um longo caminho, e a linha MI350/5X demonstra a capacidade da arquitetura. Utilizamos um servidor MI300X em nosso laboratório para desenvolvimento, e a agilidade do conjunto de softwares ficou evidente na quantidade de testes executados com o vLLM padrão sem problemas.
Com base no que vimos nesta configuração, o MI350P é ideal para compradores que buscam uma alternativa às GPUs da NVIDIA, seja por conta dos prazos de entrega, preços ou para evitar depender de um único fabricante. O suporte da Dell para essa tecnologia na linha PowerEdge oferece a diversidade de silício necessária para que os servidores convencionais atendam a essa necessidade.
Para sermos justos, nosso trabalho aqui está longe de terminar. Embora muitos compradores possam instalar essas placas em servidores 2U, há mais desempenho disponível quando elas são utilizadas em chassis maiores, projetados para placas de 600W. Independentemente de como forem implementadas, esta é uma ótima primeira impressão do retorno da AMD ao mercado de placas de expansão para servidores e, à medida que o conjunto de softwares continua a amadurecer, a MI350P, e o que vier a seguir, tem um futuro promissor. Hoje, para um comprador cujos modelos se enquadram na faixa de 96GB a 144GB, a MI350P é uma das duas placas PCIe que permitem o uso de uma única GPU, e a única acima de 141GB.
Classificação: A AMD Instinct MI350P aparece na seção "Também testadas" da nossa classificação de Melhores GPUs para Empresas , com seus resultados de duas placas na categoria Configurações de Expansão Horizontal.



 Amazon