

A MSI XpertStation WS300 é construída com a mais recente arquitetura DGX Station da NVIDIA, a geração mais poderosa até o momento, colocando um nó Grace Blackwell Ultra GB300 completo ao lado da sua mesa. O número principal é 20 petaFLOPS de computação FP4, fornecidos por uma única GPU Blackwell Ultra conectada a uma CPU Grace de 72 núcleos por meio de uma conexão NVLink-C2C de 900 GB/s. Ambos os processadores utilizam um único pool de memória coerente de 748 GB; 252 GB de HBM3e combinados com 496 GB de LPDDR5X, o suficiente para manter um modelo com um trilhão de parâmetros residente na memória local.
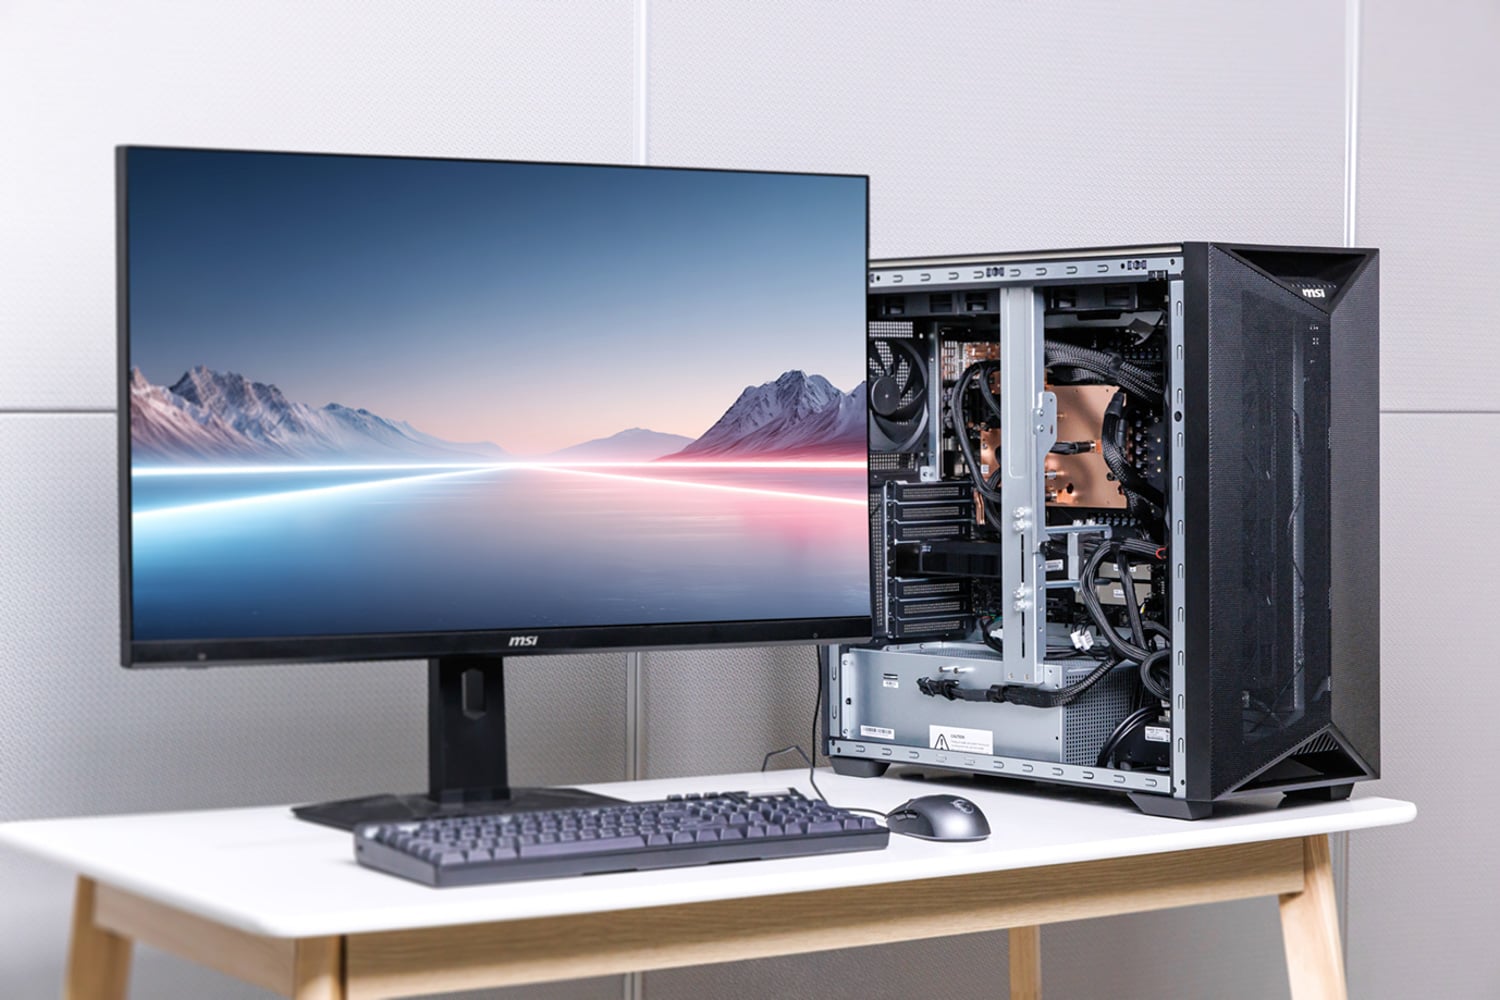
A DGX Station também suporta o agrupamento de várias unidades usando sua placa de rede ConnectX-8 SuperNIC, que expõe duas portas 400GbE para uma taxa de transferência de 800Gb/s. O resultado é uma máquina de nível de data center que pode ser executada em uma casa ou escritório, em vez de um data center tradicional.
Especificações técnicas da estação NVIDIA DGX
A XpertStation WS300 é a implementação da MSI da plataforma GB300 DGX Station da NVIDIA. A NVIDIA fornece a placa-mãe Grace Blackwell Ultra e o ambiente de software, enquanto a MSI fornece o chassi, o sistema de refrigeração líquida, a alimentação, o layout de armazenamento, as E/S externas e o modelo de serviço que transformam a plataforma em um sistema completo para uso em mesas. Como a CPU Grace, a GPU Blackwell Ultra, a interconexão NVLink-C2C e a rede ConnectX-8 são fixas, o diferencial real do fabricante está na eficácia com que o sistema circundante suporta, gerencia e expõe esse hardware. A MSI configurou este sistema com quatro SSDs Micron 4600 Gen5 M.2 de 2 TB para testes. Dois SSDs foram configurados em RAID 1 para armazenamento de inicialização, enquanto os outros dois eram SSDs dedicados para espaço de trabalho temporário ou outros usos.
| Especificação | Detalhes |
|---|---|
| Plataforma | |
| CPU | NVIDIA Grace, Arm Neoverse V2 de 72 núcleos |
| GPU | NVIDIA Blackwell Ultra (B300) |
| Núcleos Tensores | 5th Generation |
| Interconexão CPU-GPU | NVLink-C2C, 900 GB/s bidirecional |
| Memória | |
| Memória coerente | Até 748 GB |
| Memória GPU | Até 252 GB HBM3e |
| Largura de banda da memória da GPU | 7.1 TB / s |
| Memória CPU | Até 496 GB LPDDR5X (4 x SOCAMM) |
| Largura de banda da memória da CPU | 396 GB / s |
| Armazenamento | |
| Unidades de Inicialização | 2 x M.2 2280 PCIe 5.0 x4 NVMe (conectados à CPU), com 2 SSDs Micron 4600 Gen5 de 2 TB em RAID 1. |
| Expansão impulsiona | 2 x M.2 2280 PCIe 5.0 x4 NVMe (conectados ao ConnectX-8), instalados para teste com 2 SSDs Micron 4600 Gen5 de 2 TB. |
| Networking | |
| NIC | NVIDIA ConnectX-8 SuperNIC, 2 x 400G QSFP112 (800 Gb/s agregados) |
| Ethernet | 1 x 10GBase-T RJ45 (Marvell AQC113) |
| Porto de Gestão | 1 x RJ45 1000Base-T (dedicado fora de banda) |
| Sem Fios | Slot M.2 2230 Key-E, PCIe 2.0 x1 (Wi-Fi 6E / Wi-Fi 7, Bluetooth) |
| Expansão | |
| Slots PCIe | 1 x PCIe 5.0 x16 FHFL de largura dupla; 2 x PCIe 5.0 x16 FHFL de largura simples (8 sinais) |
| GPUs adicionais suportadas | NVIDIA RTX PRO 2000 Blackwell, RTX PRO 4000 Blackwell SFF, RTX PRO 6000 Blackwell Workstation / Max-Q |
| Entrada/saída frontal/superior | |
| USB | 2 portas USB 3.2 Gen 2 Tipo A; 2 portas USB 3.2 Gen 2 Tipo C (5V/3A) |
| em áudio | 2 x conectores (saída de linha / microfone) |
| I / O traseiro | |
| USB | 4 portas USB 10Gbps Tipo A; 1 porta Micro-USB COM (console serial) |
| Ecrã | 1 x Mini DisplayPort (vídeo BMC, máx. 1024 x 768, sem DP++) |
| em áudio | 3 x conectores (entrada de linha / saída de linha / microfone) |
| Gestão e segurança | |
| BMC | ASPEED AST2600 com firmware AMI MegaRAC, IPMI 2.0 e Redfish, armazenamento local eMMC |
| Total | TPM 2.0, intrusão no chassi, raiz de confiança de hardware Microchip CEC1736 (ERoT) |
| Resfriamento | |
| Refrigeração Líquida | Módulo de refrigeração líquida com capacidade para 1400W de CPU + GPU, com blocos para GPU, CPU, memória e ConnectX-8. |
| Radiadores / Ventoinhas | 2 radiadores de 360 mm; 1 ventoinha de sistema de 12025 mm |
| Energia | |
| Fonte de alimentação do laboratório | 1 x 1600W ATX, 80 PLUS Platinum (150 x 86 x 210 mm) |
| Entrada AC | 100-114 Vca, 15 A, 47-63 Hz (potência máxima de saída de 1300 W); 115-240 Vca, 15-8 A, 47-63 Hz (potência máxima de saída de 1600 W) |
| Fator de Forma | |
| Dimensões | 245.7 x 529.0 x 570.4 mm (9.67 x 20.83 x 22.46 pol.), L x A x P |
Design e Construção
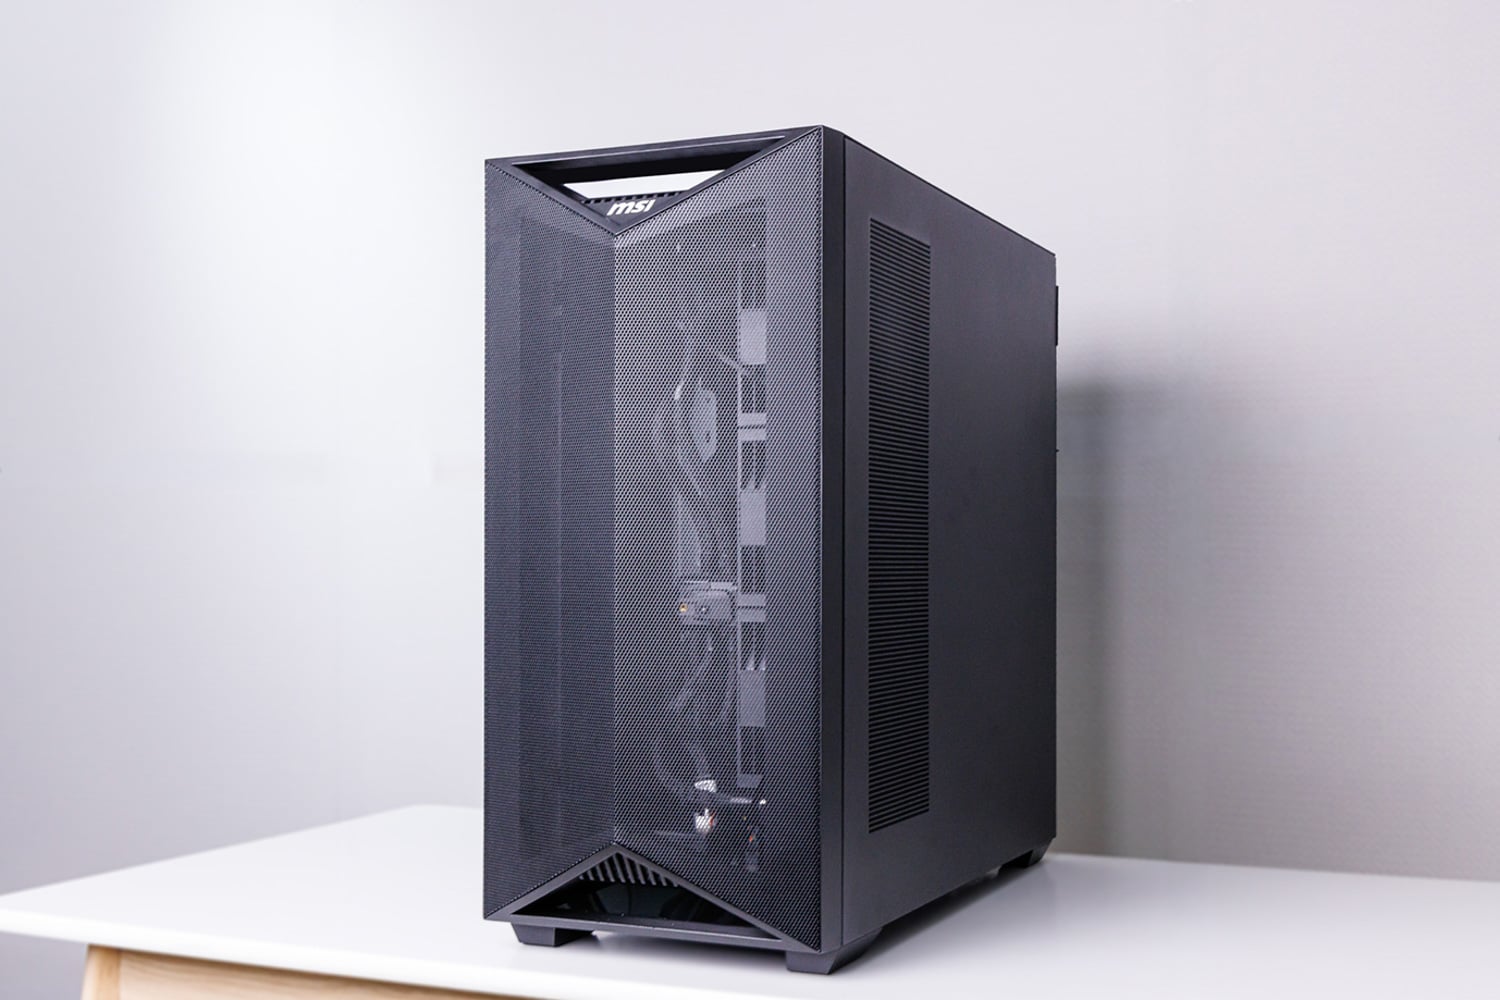
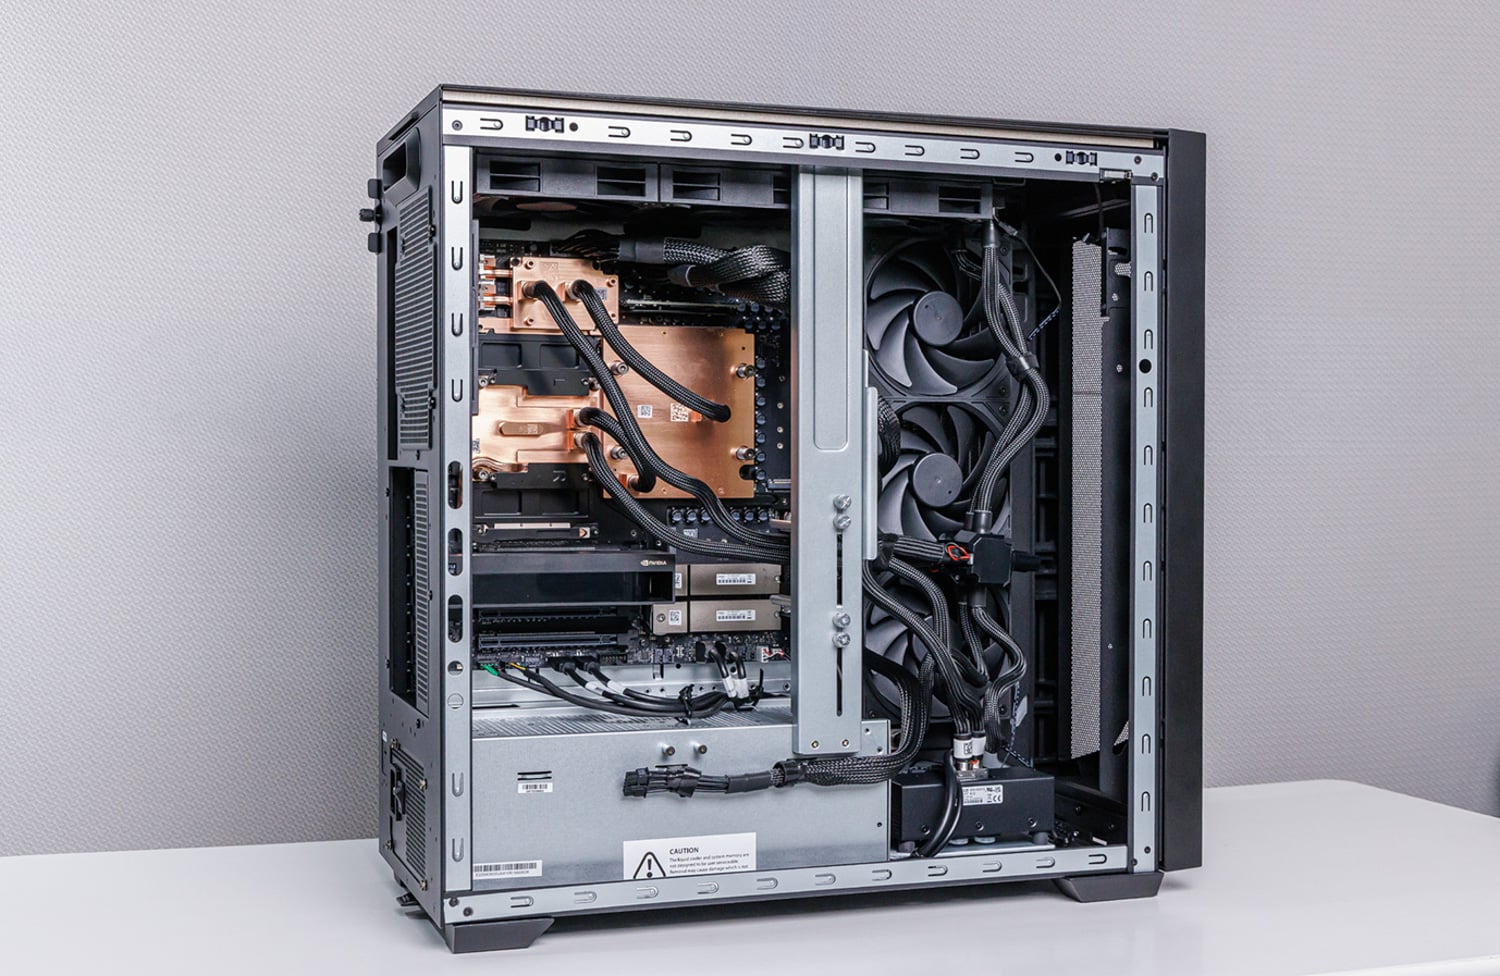
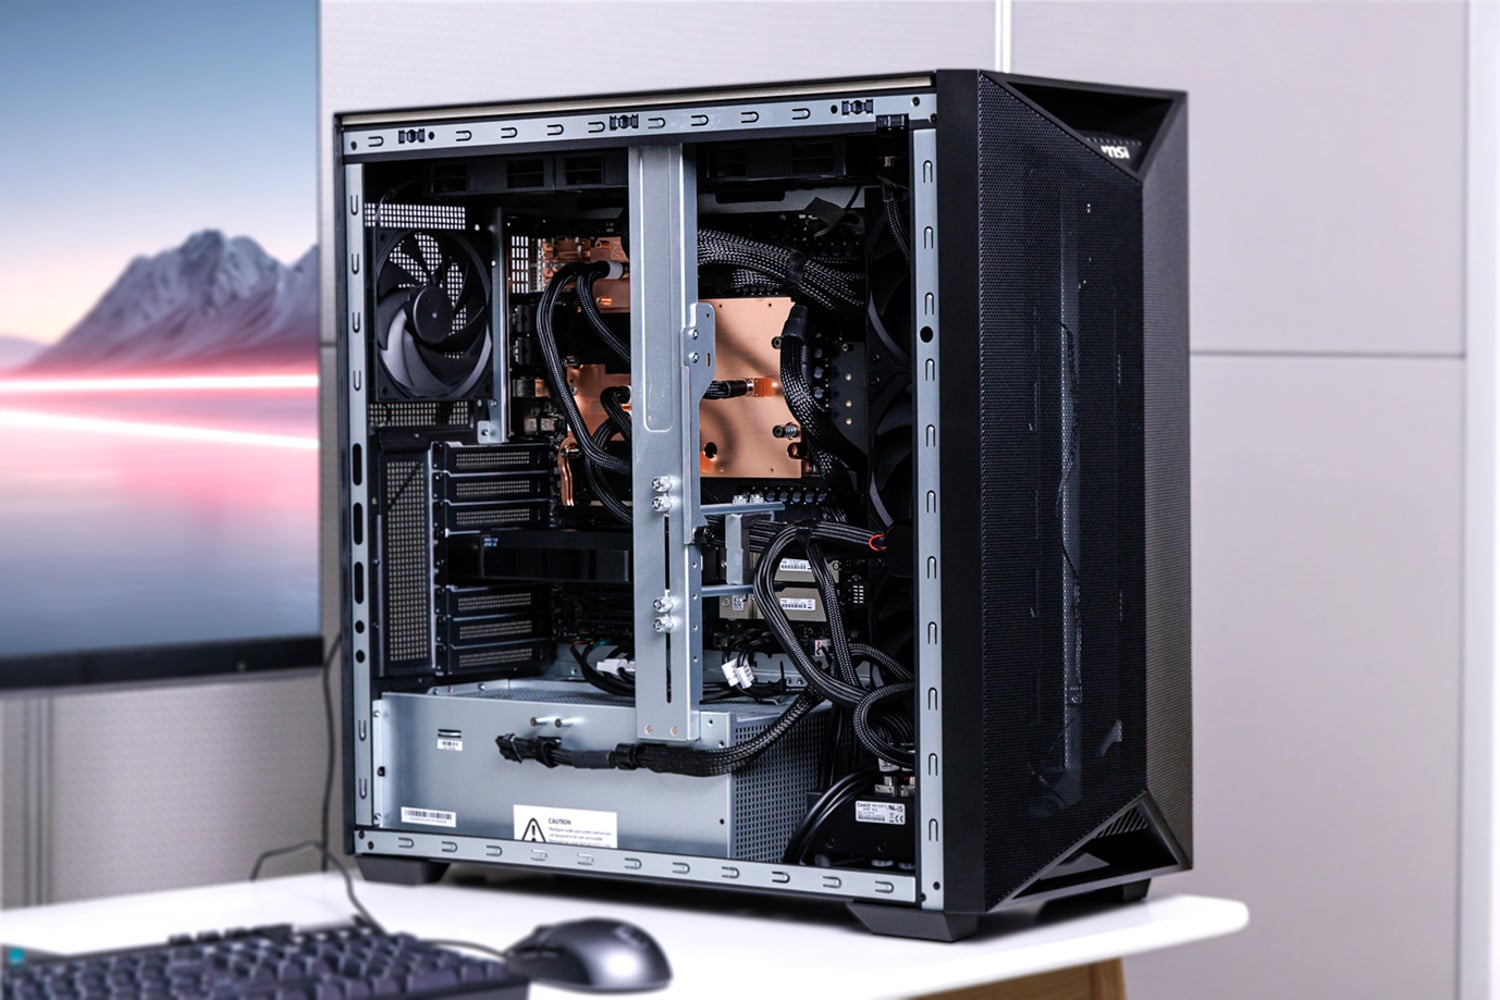
À primeira vista, a XpertStation parece uma estação de trabalho moderna padrão, com um design profissional elegante. Mas, ao remover o painel lateral, as semelhanças terminam aí.
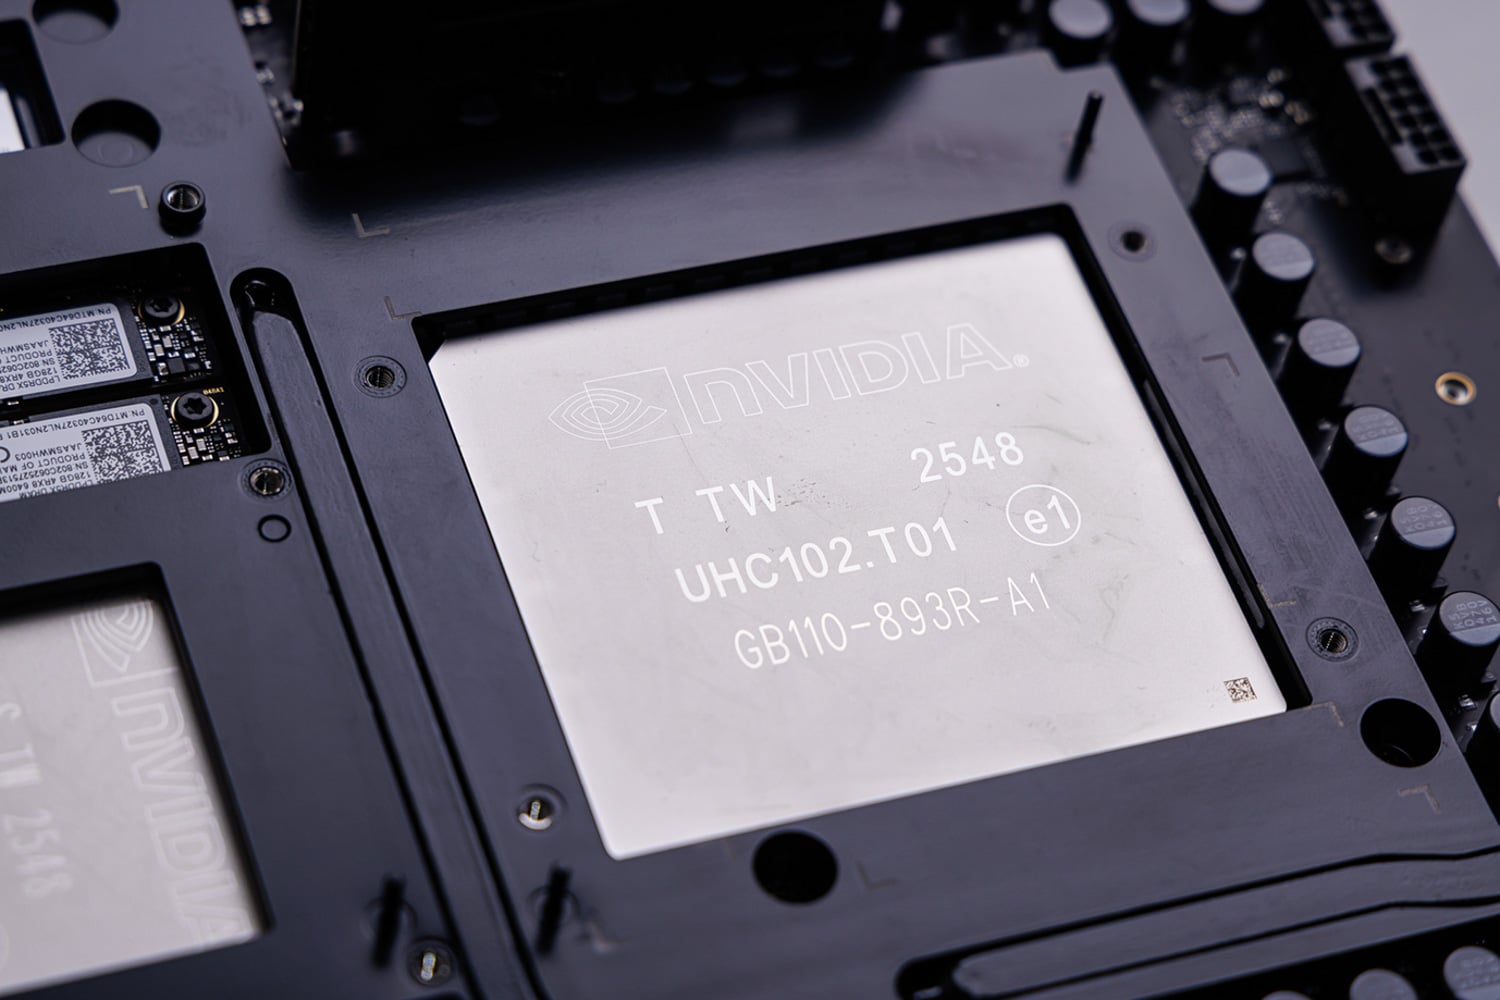
GB300 Grace Blackwell Ultra Desktop Superchip
No centro do WS300 está a nossa estrela principal: a GPU B300 da NVIDIA, construída com base na arquitetura Blackwell Ultra.
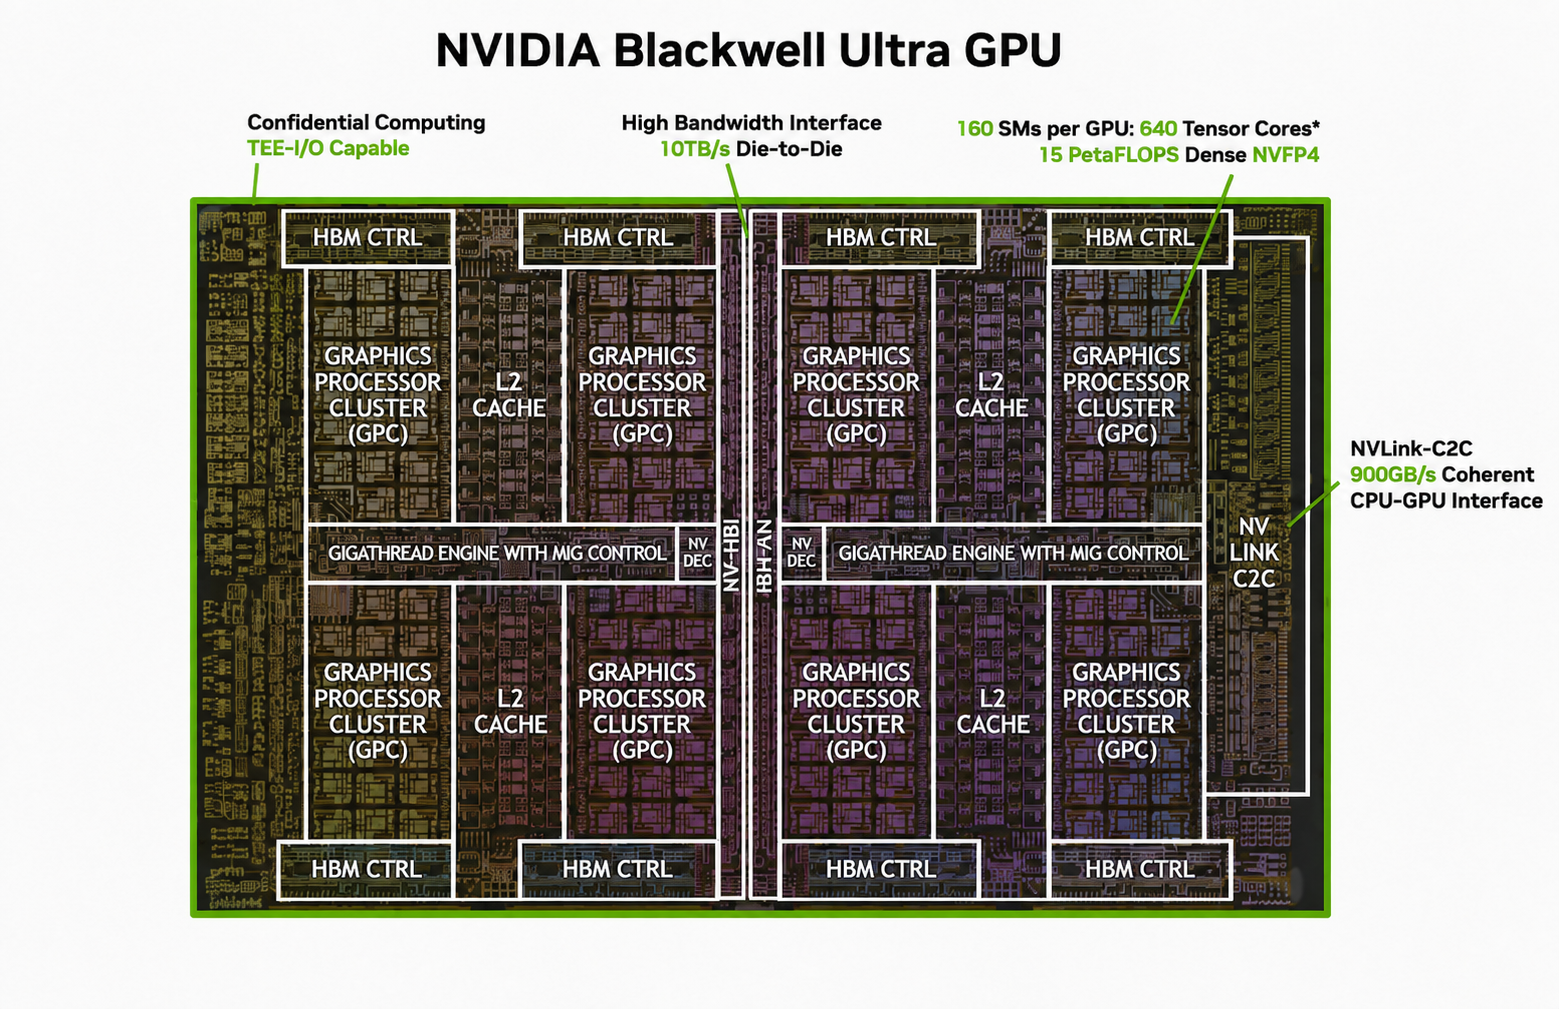
Fonte: NVIDIA, com anotações da StorageReview
A B300 é uma das GPUs mais avançadas disponíveis atualmente, apresentando um design de retículo duplo construído com o processo 4NP da TSMC. Os dois chips são unidos pela interface NV-HBI de 10 TB/s da NVIDIA, permitindo que a GPU opere como um único acelerador CUDA. A B300 usada no DGX Station é baseada no design Blackwell Ultra de 208 bilhões de transistores, com até 160 SMs e 640 Tensor Cores de quinta geração. Ela também possui 252 GB de HBM3e com largura de banda de memória de 7.1 TB/s. Como componente para data centers, a B300 não possui saída de vídeo convencional nem codificadores de hardware NVENC. No entanto, ela inclui sete mecanismos NVDEC e sete decodificadores nvJPEG. A GPU também suporta MIG, permitindo que seja particionada em até sete instâncias isoladas. Em termos de computação, a B300 oferece:
| Precisão | Peak Performance |
|---|---|
| Desempenho de computação B300 | |
| Núcleo Tensor NVFP4 | 20 PFLOPS esparsos / 15 PFLOPS densos |
| FP8 / Núcleo Tensor FP6 | 10 PFLOPS |
| Núcleo tensor INT8 | 330 TOPS |
| Núcleo Tensor FP16 / BF16 | 5 PFLOPS |
| Núcleo tensor TF32 | 2.5 PFLOPS |
| FP32 | 80 TFLOPS |
| FP64 / Núcleo Tensor FP64 | 1.3 TFLOPS |
| As taxas de pico são baseadas na frequência de boost da GPU. As especificações do Tensor Core usam esparsidade, a menos que seja indicado o contrário. | |
A placa-mãe B300 é acompanhada pelo Grace, o primeiro processador da NVIDIA para data centers. Ele utiliza 72 núcleos Arm Neoverse V2, mas o processador em si é um projeto próprio da NVIDIA, incluindo a hierarquia de cache, controladores de memória, E/S do sistema, Scalable Coherency Fabric e interface NVLink-C2C. O Grace expõe 72 núcleos e 72 threads de hardware, com cada núcleo implementando Armv9 com extensões de criptografia e quatro unidades vetoriais SVE2 de 128 bits. O núcleo possui um decodificador de instruções de seis vias capaz de despachar até oito instruções por ciclo de clock, seis ALUs escalares, 64 KB de cache L1 para instruções e dados, e 1 MB de cache L2 privado. Em todo o chip, o processador compartilha 114 MB de cache L3.
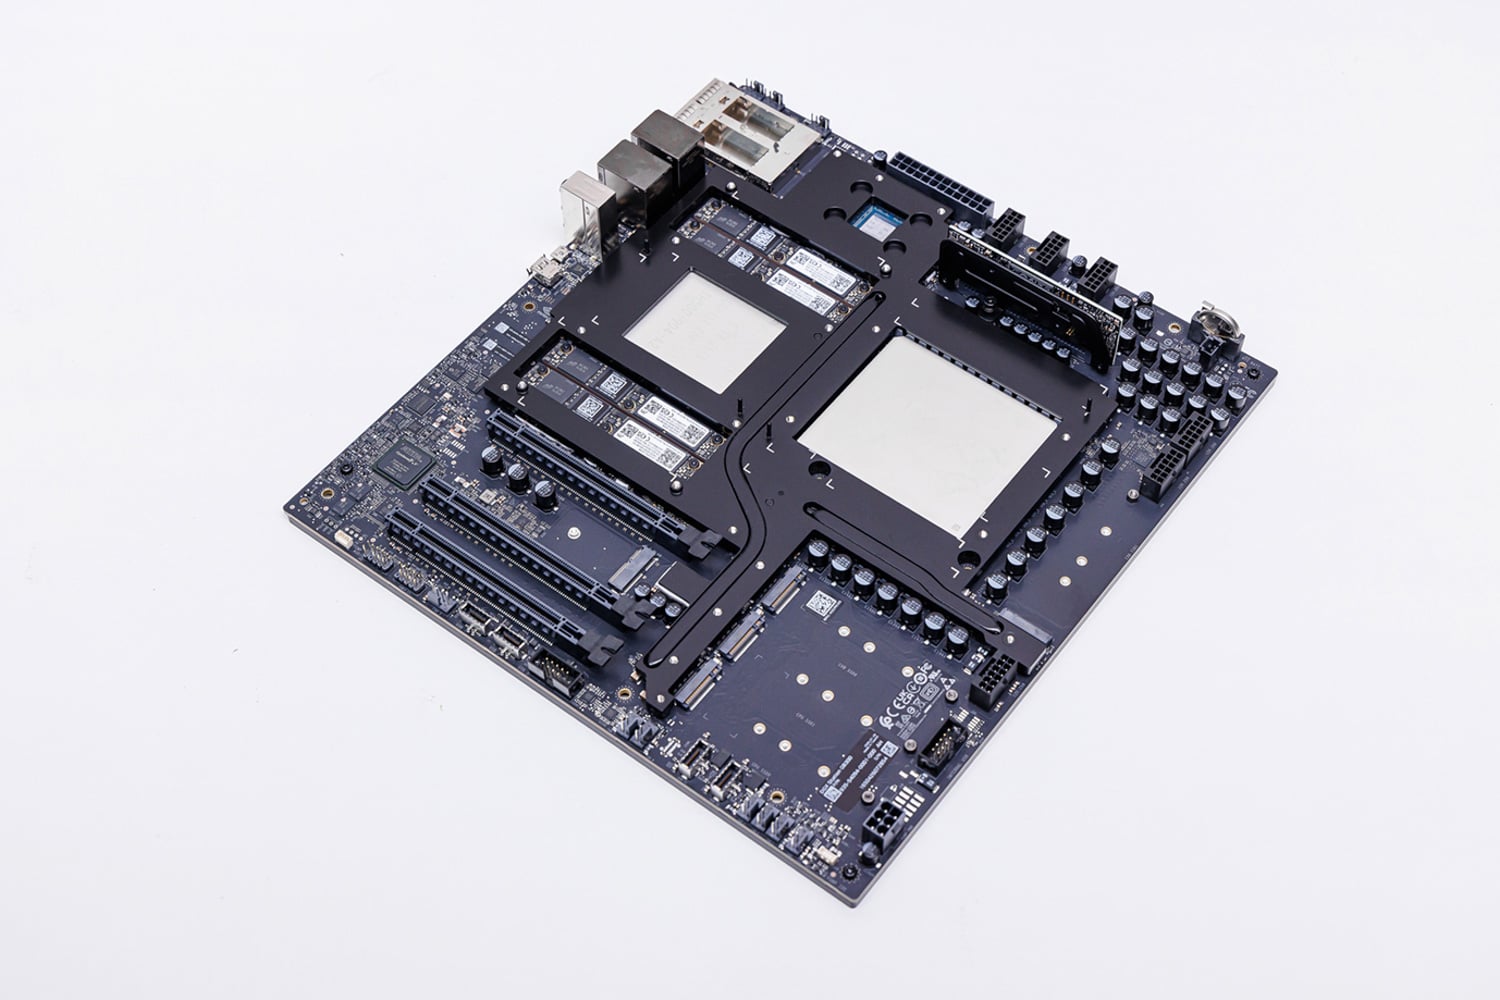
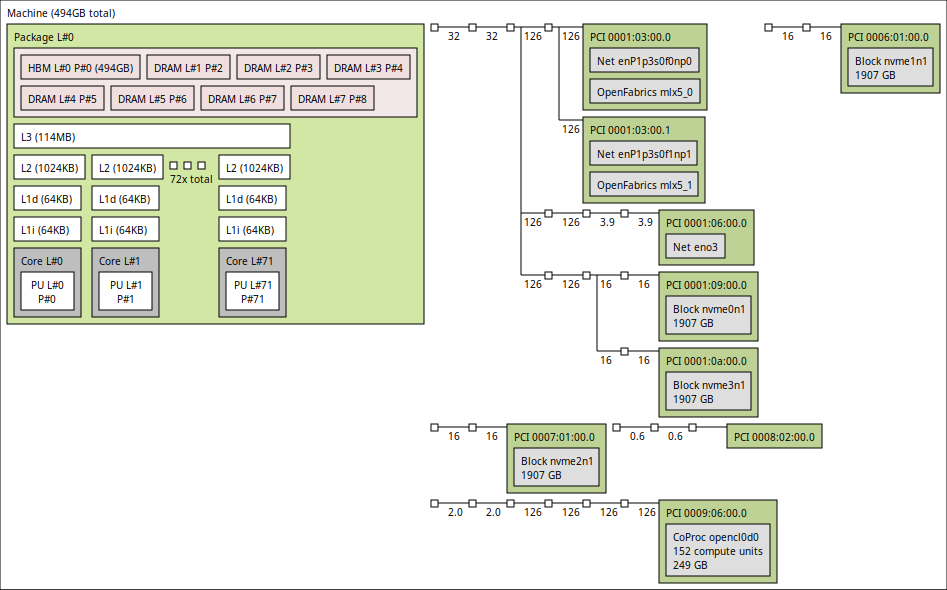
Os núcleos e as fatias de cache L3 são conectados através do Scalable Coherency Fabric da NVIDIA, uma interconexão em malha com largura de banda de bisseção de 3.2 TB/s. A malha também conecta os núcleos da CPU à memória, à E/S do sistema e à interface NVLink-C2C, fornecendo ao Grace a largura de banda de movimentação de dados necessária para manter o B300 alimentado. No WS300, o Grace lida com o trabalho do lado da CPU relacionado ao acelerador: inicialização do kernel da GPU, carregamento de dados, pré-processamento, tokenização e orquestração de modelos. A visualização da topologia abaixo oferece uma visão clara do design de soquete único, com uma CPU Grace de 72 núcleos e os dispositivos da plataforma conectados ao seu redor.
Grace vem equipada com 496 GB de memória LPDDR5X, oferecendo 396 GB/s de largura de banda. Em vez de soldar a memória diretamente à placa-mãe, a DGX Station utiliza quatro módulos SOCAMM. O SOCAMM, ou System-on-Chip Advanced Memory Module (Módulo de Memória Avançada em Sistema em Chip), encapsula a LPDDR5X em um formato compacto e removível. Isso permite que a plataforma mantenha os benefícios de largura de banda e eficiência energética da LPDDR5X, ao mesmo tempo que torna a memória substituível. Um módulo com defeito pode ser substituído sem a necessidade de trocar toda a placa-mãe.
A conexão entre Grace e a placa-mãe B300 é feita pela interface NVLink-C2C da NVIDIA, uma interconexão em nível de pacote que oferece 900 GB/s de largura de banda bidirecional, aproximadamente sete vezes maior que uma conexão PCIe Gen5 x16. A diferença mais importante, porém, reside na coerência de memória. Em uma estação de trabalho convencional, a CPU e a GPU dedicada mantêm espaços de memória separados, com os dados sendo copiados entre elas via PCIe. Com o NVLink-C2C, Grace e a B300 compartilham um espaço de endereçamento coerente, permitindo que cada processador acesse diretamente a memória conectada ao outro.
O resultado é um espaço de endereçamento coerente de 748 GB, e não um bloco de 748 GB de HBM. A B300 possui 252 GB de HBM3e, oferecendo 7.1 TB/s, enquanto a Grace contribui com 496 GB de LPDDR5X a 396 GB/s. Os dados armazenados na memória Grace ainda precisam atravessar o link C2C, portanto, a HBM continua sendo a melhor opção para pesos de modelos, tensores e buffers acessados com frequência. A memória Grace, por sua vez, atua como uma camada de alta capacidade, permitindo que cargas de trabalho que excedam os 252 GB de memória local da B300 permaneçam em um único sistema, em vez de serem distribuídas entre várias GPUs. Mediremos o impacto no desempenho da utilização dessa segunda camada de memória posteriormente na seção de testes.
Topologia do sistema
Saindo do pacote GB300, o diagrama de blocos da MSI mostra como o restante do sistema se conecta ao redor de Grace. A CPU fica no centro da topologia de E/S, com dois slots M.2 PCIe 5.0 x4 conectados diretamente a ela. A MSI utiliza dois SSDs Micron 4600 de 2 TB configurados em RAID 1 para o sistema operacional e o pacote de software NVIDIA. Os três slots de expansão de tamanho normal também são conectados diretamente a Grace, com um link PCIe 5.0 x16 e dois links PCIe 5.0 x8.
A MSI também preparou o chassi para acomodar uma placa de vídeo adicional de grande porte. Um cabo de alimentação 12VHPWR pré-instalado é de fácil acesso na parte frontal do chassi, evitando a necessidade de passar outro cabo pelo sistema. A estrutura metálica vertical que reforça o chassi também incorpora um suporte anti-flacidez para suportar placas RTX PRO longas e pesadas.
Um controlador USB no lado do Grace gerencia as principais portas USB frontais e traseiras do sistema, juntamente com o codec de áudio. O Grace também se conecta ao BMC ASPEED AST2600, que fornece uma porta de gerenciamento 1GbE dedicada, uma saída Mini DisplayPort limitada a 1024 x 768 e um console serial Micro-USB. A Mini DisplayPort destina-se à configuração inicial e à resolução de problemas, não como a saída de vídeo principal do sistema. Quem planeja usar o WS300 como um desktop convencional ainda precisará de uma das placas de vídeo RTX PRO opcionais.
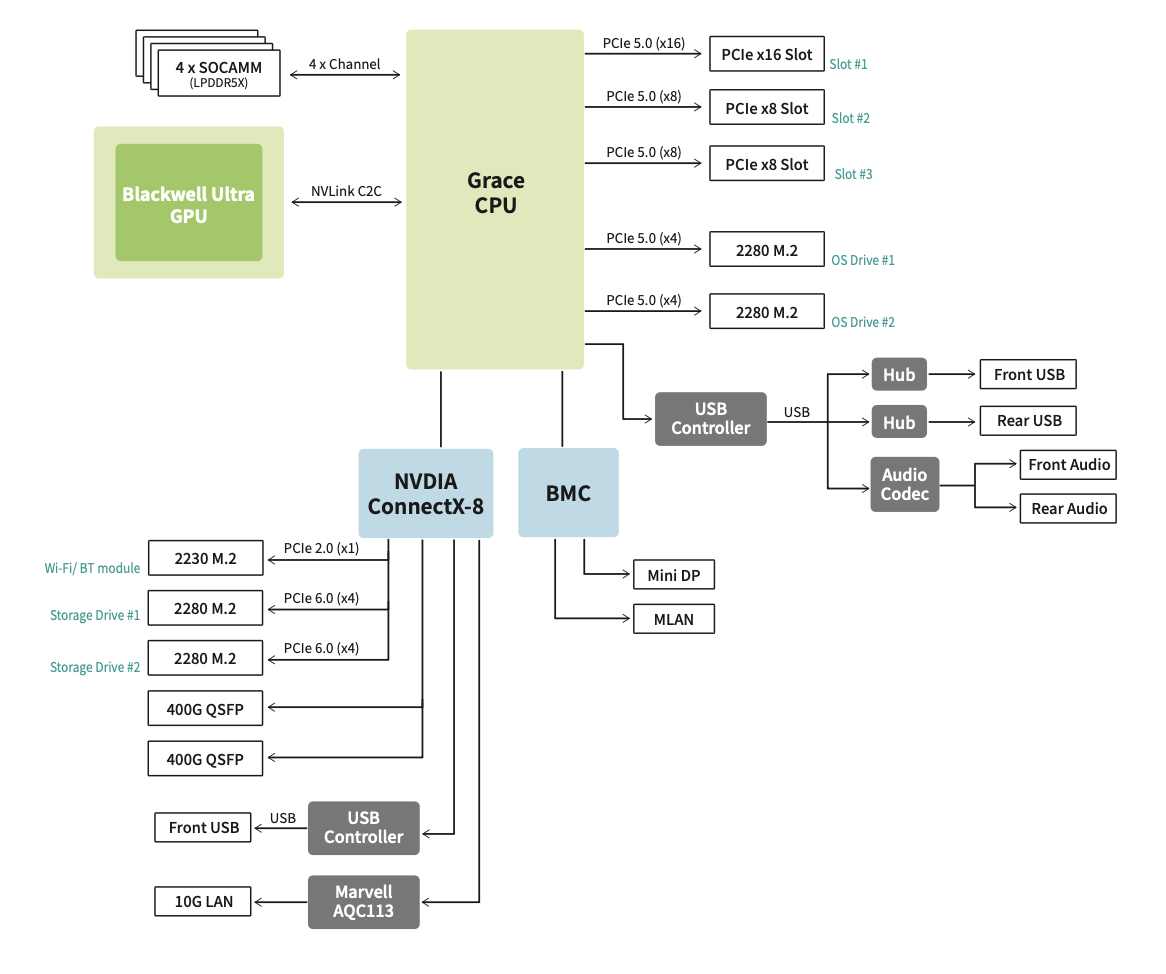
A outra linha principal é a SuperNIC ConnectX-8 da NVIDIA. Sua característica mais visível é o par de portas QSFP112 de 400 GbE no painel traseiro, que oferece até 800 Gb/s de largura de banda de rede agregada. A ConnectX-8 também inclui um switch PCIe integrado com 48 pistas; seu link upstream é compatível com PCIe Gen6, mas as portas downstream que ele expõe aos dispositivos operam em PCIe 5.0, permitindo que a MSI o utilize como um hub de E/S secundário em vez de simplesmente um adaptador de rede.
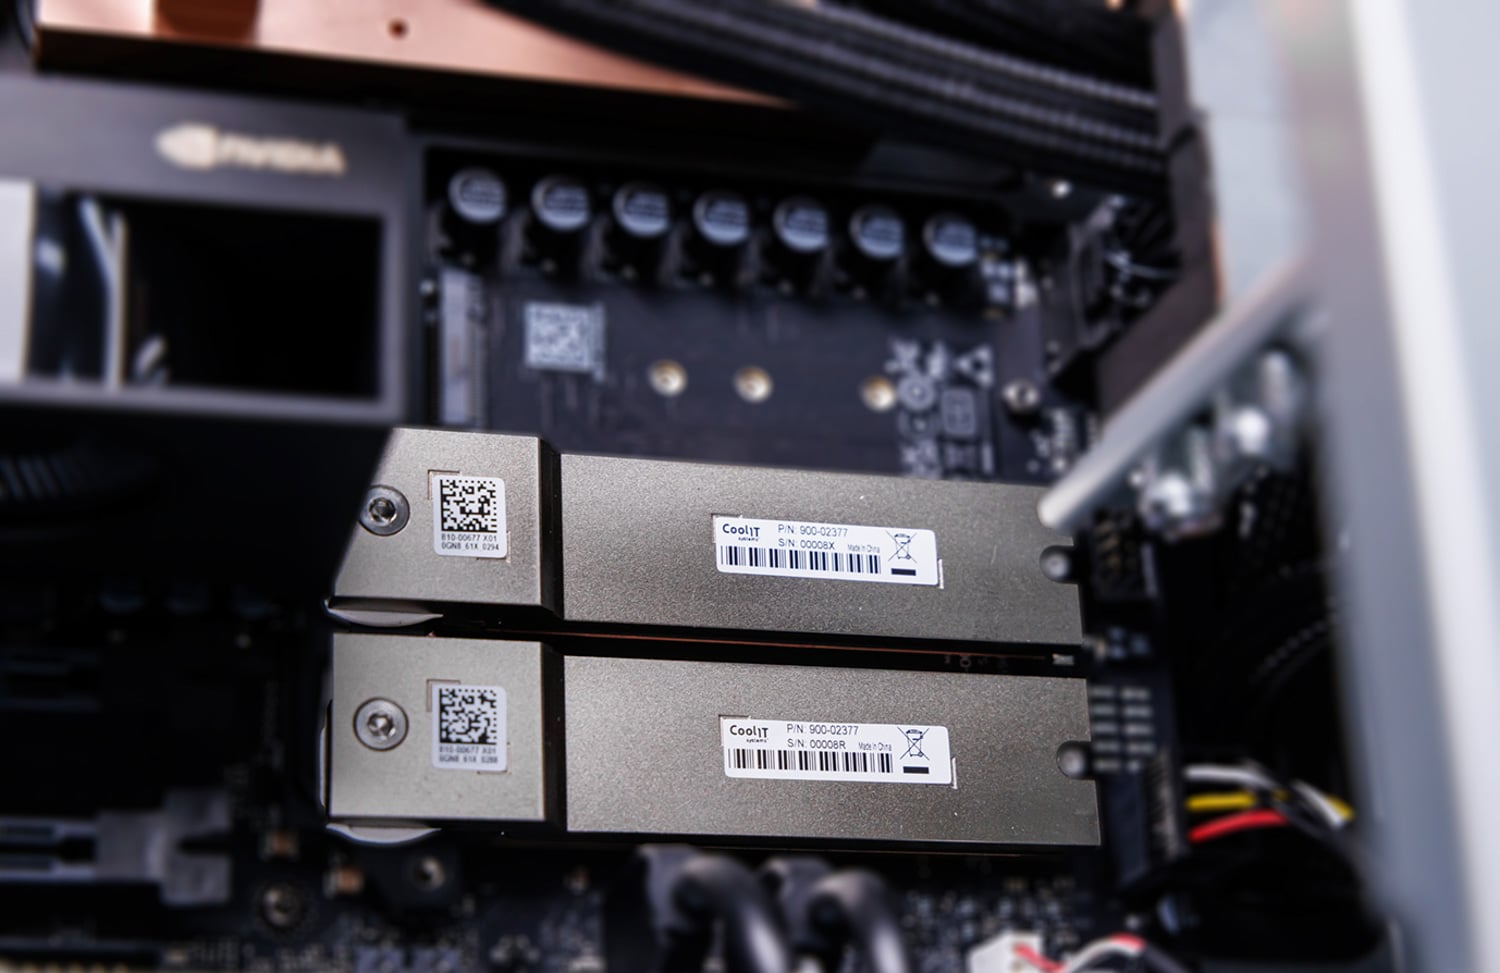
Duas conexões PCIe 5.0 x4 do ConnectX-8 alimentam os slots M.2 2280 restantes, que a MSI deixa livres para expansão. A mesma ramificação também conecta o slot M.2 2230 Wi-Fi e Bluetooth via PCIe 2.0 x1, o controlador Marvell AQC113 para a porta 10GBase-T e um segundo controlador USB que serve como caminho USB adicional no painel frontal.
Energia e refrigeração
A WS300 é alimentada por uma única fonte de alimentação ATX de 1,600 W com certificação 80 PLUS Platinum e entrada C19. Para instalações na América do Norte, a DGX Station requer um circuito dedicado de 20 A para fornecer ao sistema toda a sua capacidade de potência.
A potência nominal de 1,600 W é o limite máximo para todo o sistema. Grace, a placa-mãe B300, o armazenamento, as bombas, as ventoinhas e qualquer placa RTX PRO opcional consomem da mesma fonte de alimentação. Adicionar uma placa de vídeo de alta potência expande as capacidades do WS300, mas não utiliza uma fonte de alimentação diferente. Quando a placa-mãe B300 e a placa RTX estão sob carga, elas precisam compartilhar a energia já disponível, o que pode reduzir o desempenho da GPU B300.
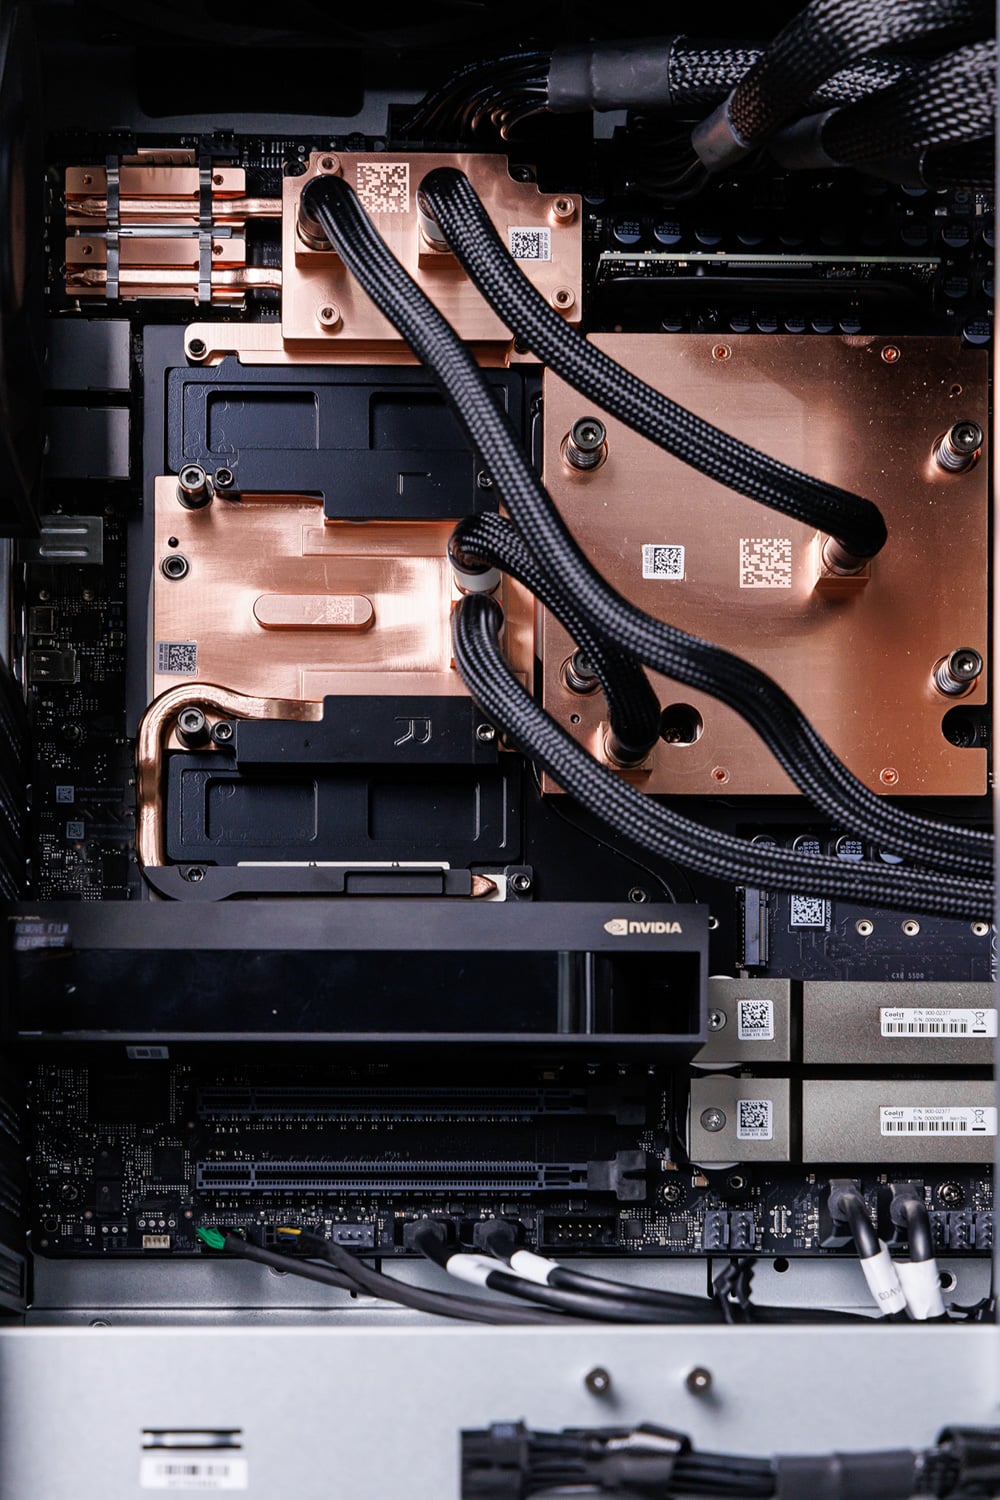
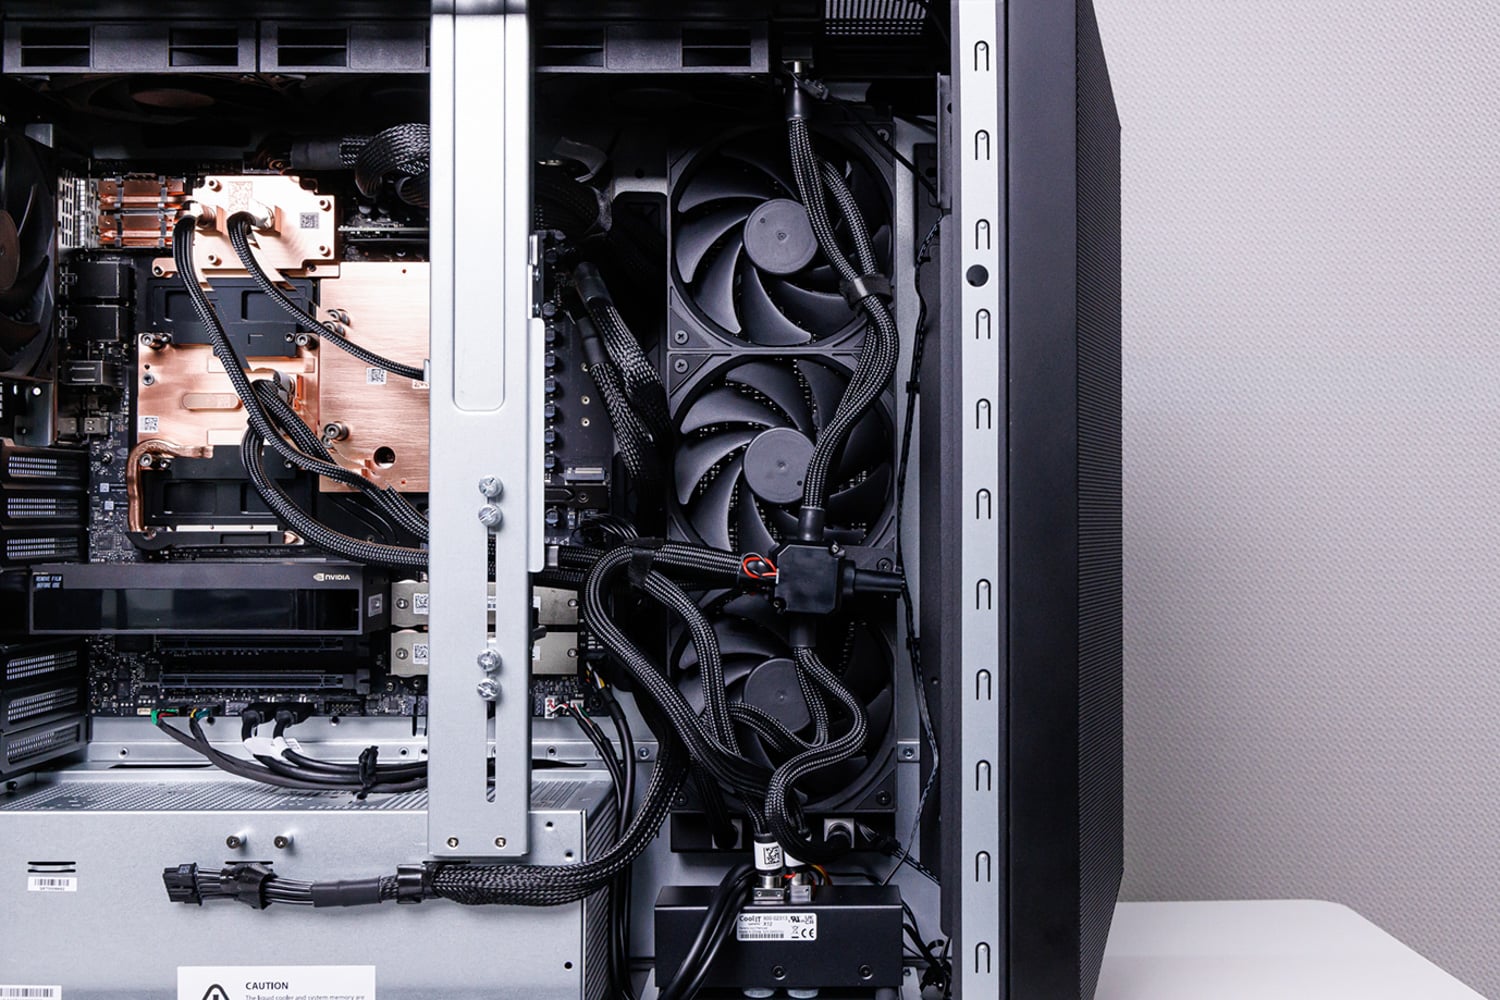
A MSI lida com a carga térmica resultante com um circuito de refrigeração líquida personalizado que abrange a placa-mãe B300, o processador Grace, a memória SOCAMM e o ConnectX-8, incluindo as baias ópticas. O calor é dissipado por dois radiadores de 360 mm, enquanto uma ventoinha de 120 mm movimenta o ar pelo restante do gabinete. A MSI classifica o sistema de refrigeração para até 1,400 W, considerando o processador e a placa de vídeo. Durante nossos testes, a temperatura da placa-mãe B300 atingiu um pico de 71 °C, enquanto o processador nunca ultrapassou os 65 °C, mesmo com o consumo de 1292 W da placa de vídeo.
oscilação de poder
A NVIDIA gerencia esse orçamento compartilhado por meio do serviço vsloshd. Em seu modo dinâmico padrão, o serviço monitora o consumo de energia em tempo real do módulo GB300 e de uma placa RTX PRO opcional, distribuindo a margem disponível entre eles em vez de limitar cada dispositivo a um limite fixo. De acordo com a política atual, a placa RTX tem prioridade; portanto, quando ela precisa de mais energia, o sistema primeiro reduz o limite de energia do GB300 antes de aumentar o limite da RTX. Sem uma placa RTX instalada, todo o orçamento da política permanece disponível para o módulo GB300.
Isso significa que a RTX PRO 6000 opcional não é simplesmente um recurso adicional de desempenho em relação à placa-mãe B300. Quando ambas as GPUs estão em uso, a energia alocada para a placa RTX é consumida diretamente do orçamento da GB300, podendo reduzir os clocks e o desempenho da B300.
A plataforma também inclui um freio de energia de hardware para casos em que o sistema detecta degradação no fornecimento de energia. Observamos isso durante nossos testes práticos, quando conectores de energia soltos fizeram com que o WS300 reduzisse seu limite de energia em vez de desligar ou continuar consumindo energia em potência máxima devido a uma conexão comprometida. A máquina permaneceu online em estado de potência reduzida até que o problema de conexão fosse resolvido.
Conectividade
Antes de prosseguirmos com a análise do chassi, vale a pena dar uma olhada rápida nas portas de E/S frontal e traseira. A parte frontal inclui duas portas USB 3.2 Gen 2 Tipo A, duas portas USB 3.2 Gen 2 Tipo C, conectores separados para saída de áudio e microfone, além dos controles de energia e reinicialização.
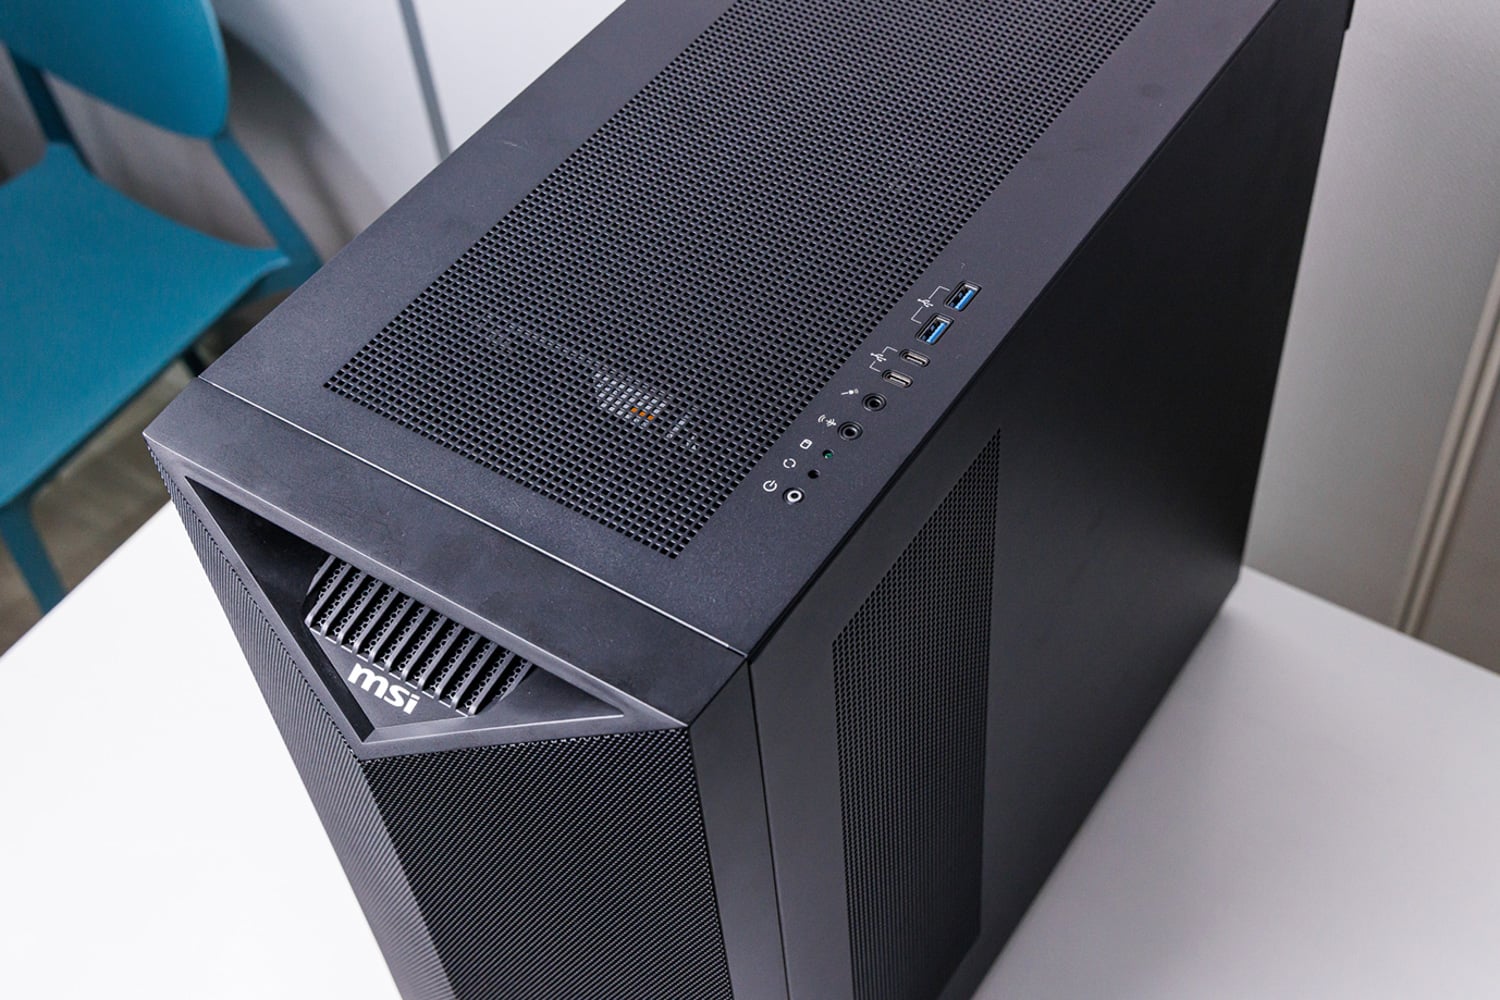
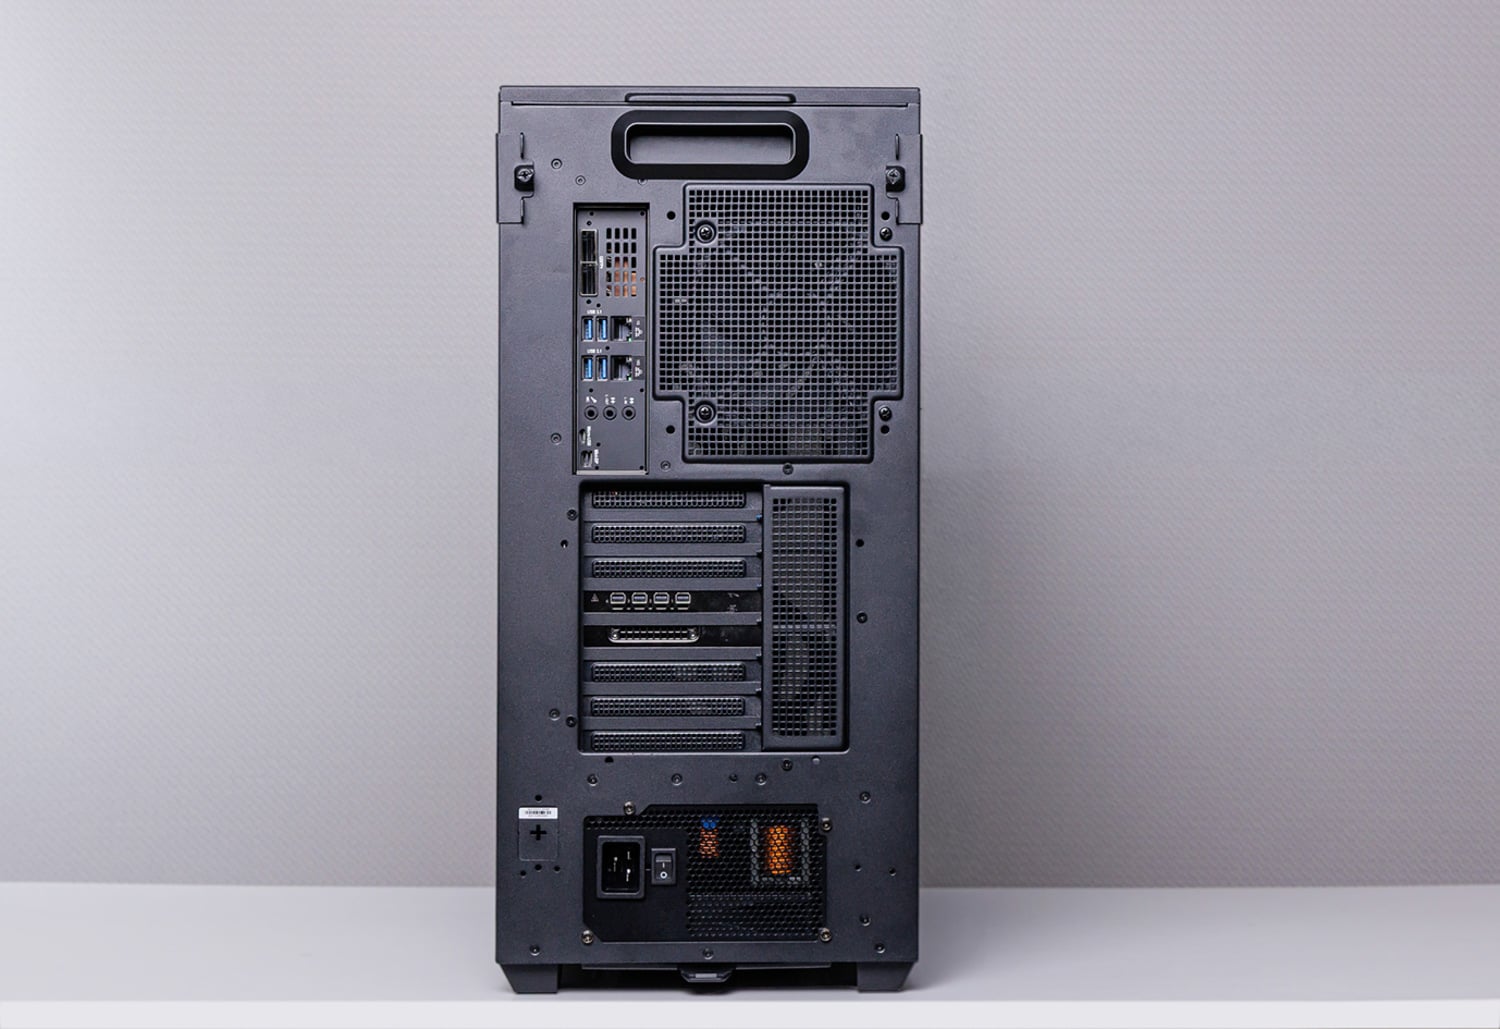
O painel traseiro é dividido entre a conectividade da estação de trabalho e o hardware do servidor subjacente. O ConnectX-8 oferece duas portas QSFP112 de 400 GbE, enquanto uma porta 10GBase-T separada lida com a rede do host e uma porta 1GbE dedicada conecta-se ao BMC. Quatro portas USB Tipo A de 10 Gbps e três conectores de áudio atendem aos periféricos locais. O BMC também disponibiliza um console serial Micro-USB e uma Mini DisplayPort. A entrada de alimentação C19 fica na parte inferior do chassi, e Wi-Fi 6E ou Wi-Fi 7 com Bluetooth podem ser adicionados através do slot M.2 2230 Key-E interno.
Cargas de trabalho do data center na mesa
Até aqui, descrevemos o que é a DGX Station; a pergunta mais útil para os compradores é o que a XpertStation permite que uma equipe faça. O valor da WS300 fica mais claro quando a consideramos uma plataforma de desenvolvimento, e não apenas um sistema de inferência de alta capacidade. Sua GPU B300, CPU Grace, suporte a MIG, placa gráfica RTX PRO opcional e conjunto de software para data center trazem diversos fluxos de trabalho que normalmente dependeriam de hardware compartilhado em cluster para um único nó local.
MIG como ferramenta de desenvolvimento
Imagine executar várias tarefas completamente separadas em uma única GPU simultaneamente, cada uma isolada das outras. É isso que a GPU Multi-Instance (MIG) faz: ela segmenta espacialmente a B300 em até sete fatias ou instâncias de tamanho igual. Cada instância recebe sua própria parcela fixa de SMs, HBM, cache e largura de banda de memória, possui sua própria identidade de dispositivo e aparece para o CUDA como uma GPU separada.
Isso possibilita desenvolver, testar e validar cargas de trabalho com múltiplas GPUs; treinar scripts; e desenvolver para ferramentas como Dynamo, LLM-D, etc.
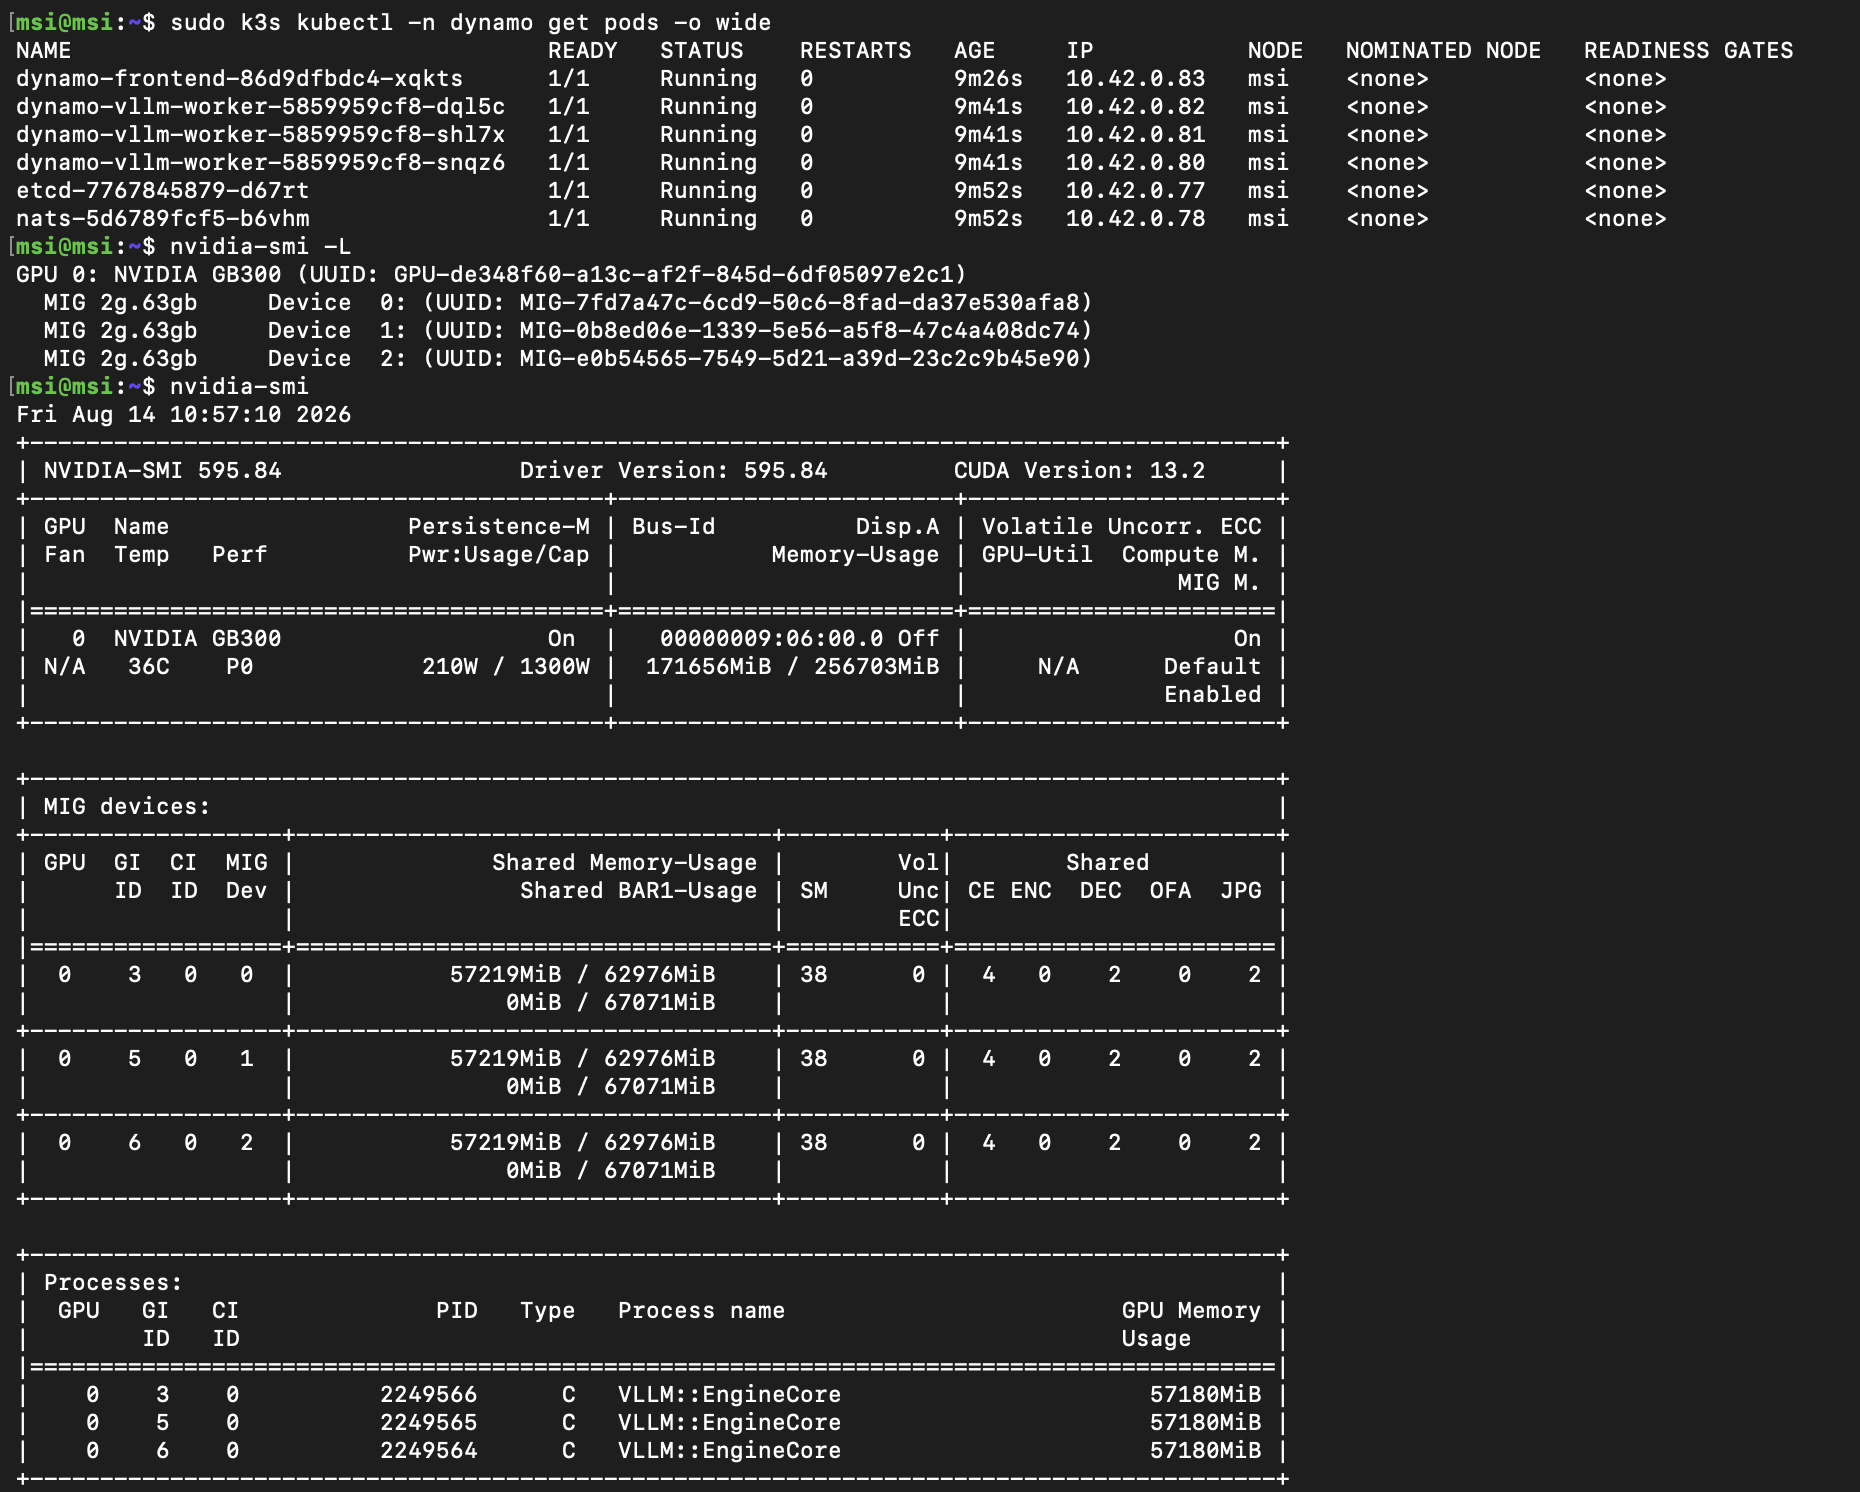
Para nossos testes, configuramos o B300 com 3 instâncias MIG e as utilizamos para inicializar componentes NVIDIA Dynamo em dispositivos separados com visibilidade CUDA. Isso reflete a forma como grande parte de nossas ferramentas de benchmark é desenvolvida: validar se elas se comportam exatamente como esperado significa iterar repetidamente em hardware real. Ter um B300 local que podemos particionar e reconfigurar, sem precisar reservar tempo em um servidor compartilhado e sem o consumo de energia, o calor e o ruído de um rack na sala, elimina uma quantidade surpreendente de sobrecarga desse tipo de trabalho iterativo.
Isaac GR00T e o loop físico da IA
Outro fluxo de trabalho que se adapta particularmente bem à DGX Station é a IA física.
Já testamos esse tipo de fluxo de trabalho antes , mas ele exigia vários sistemas equipados com diferentes classes de GPUs. A DGX Station reúne essas etapas anteriormente separadas em uma única máquina de mesa.
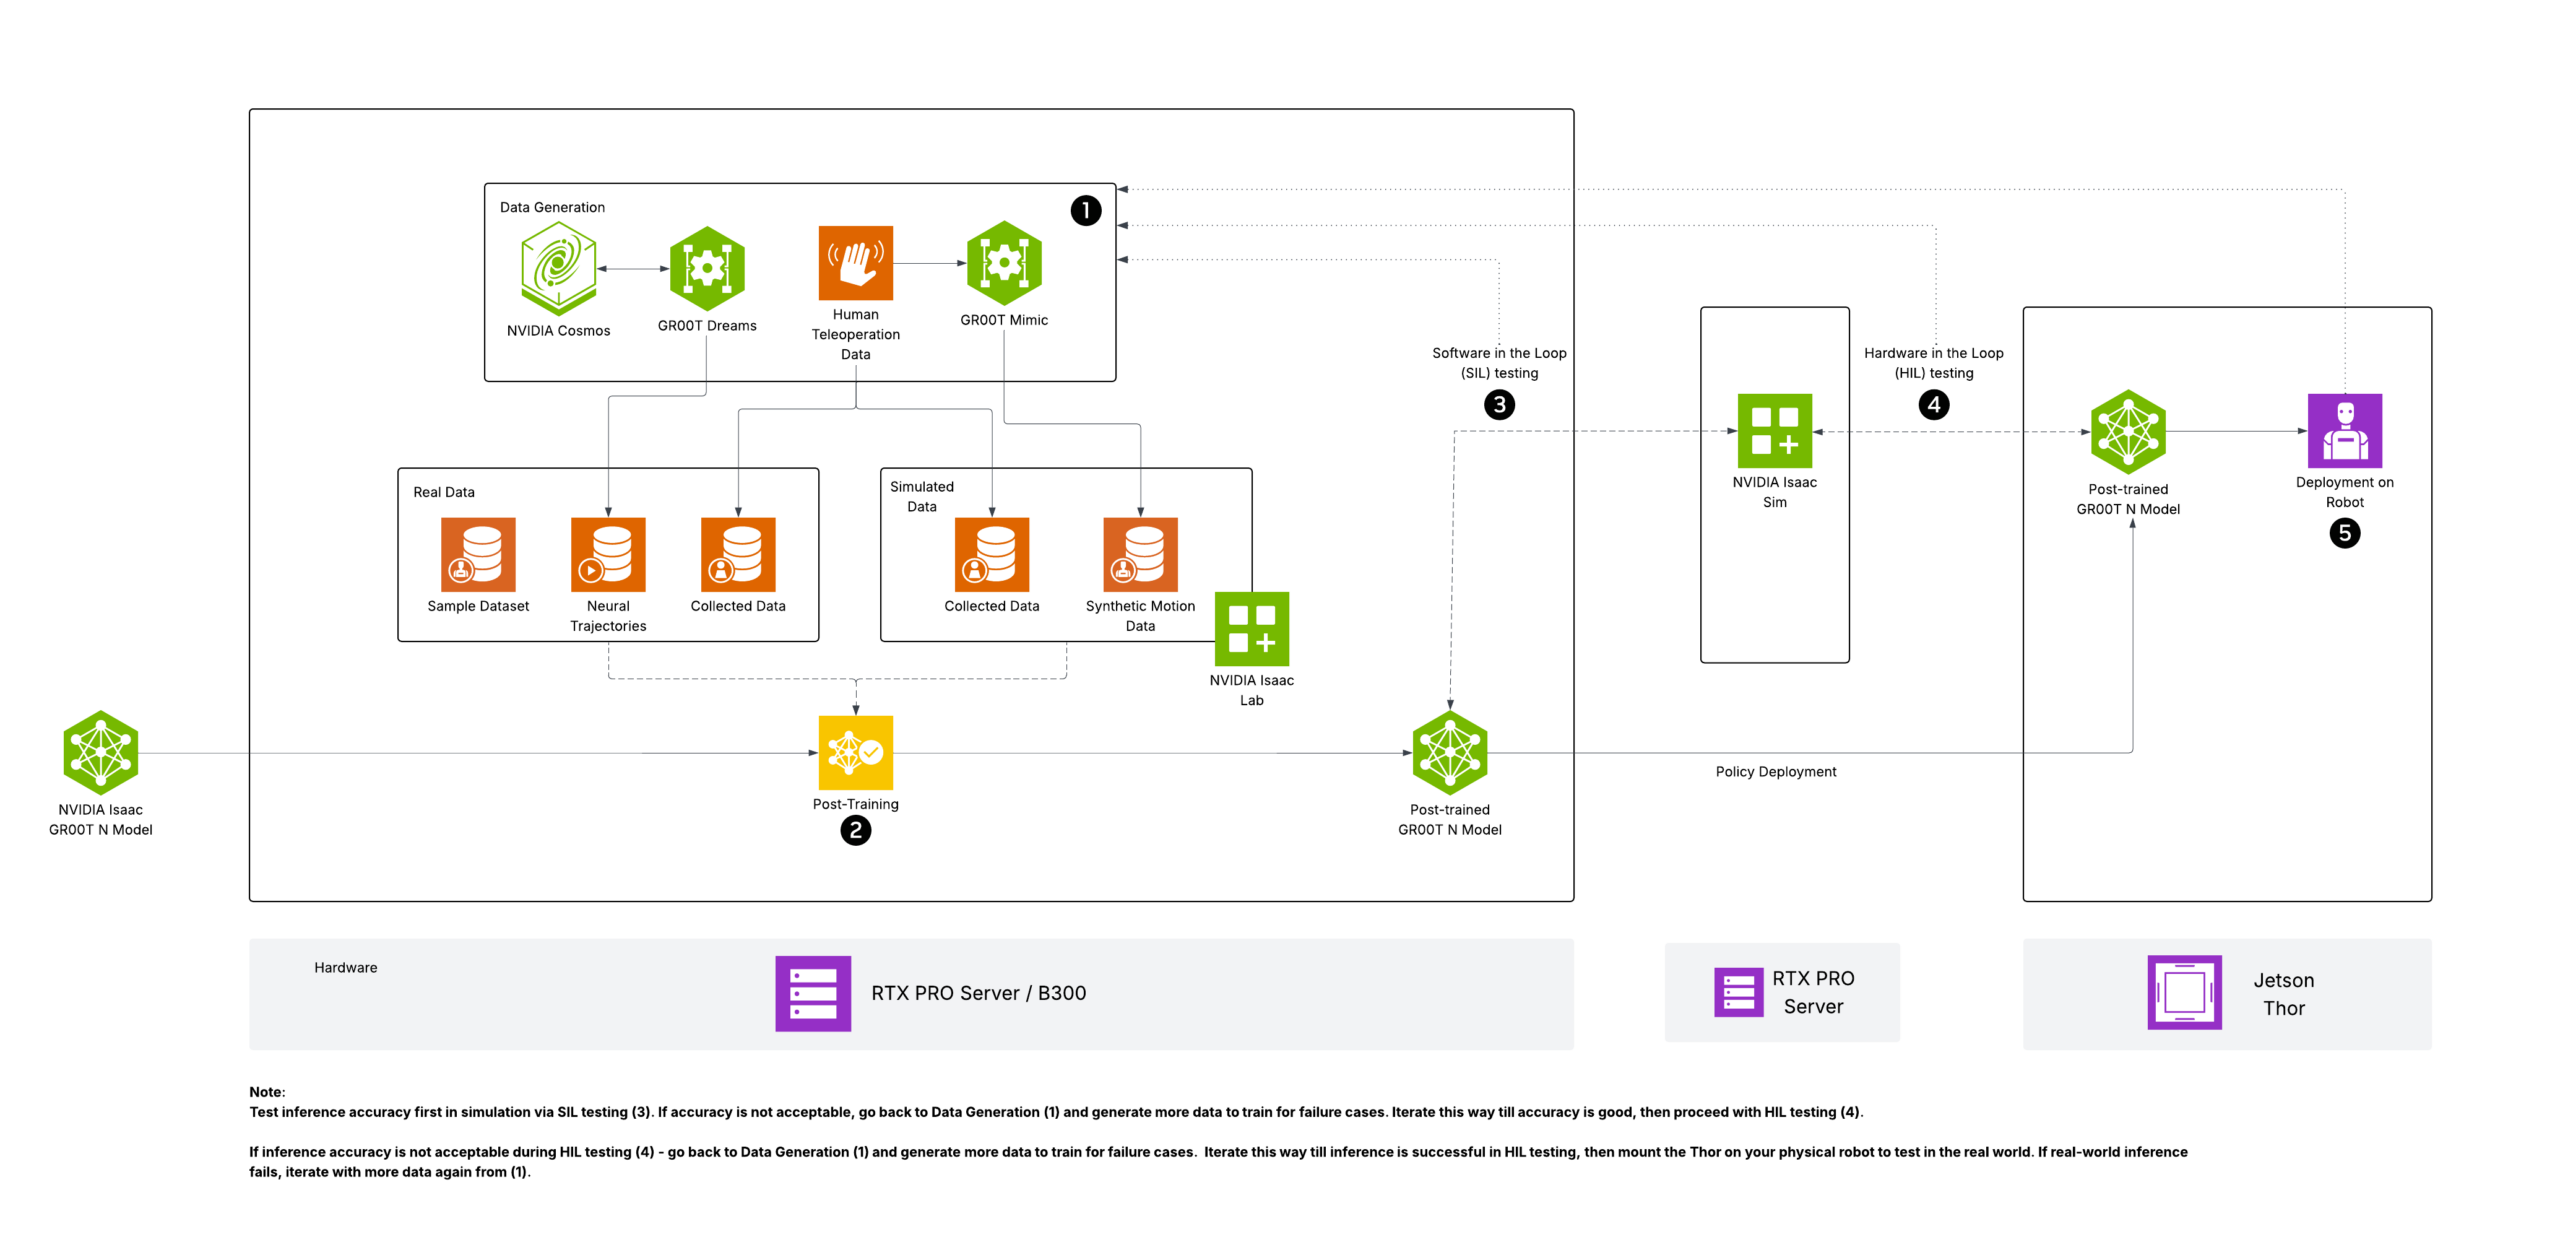
O processo começa com a teleoperação: um operador guia o robô através de uma tarefa para capturar um pequeno conjunto de demonstrações do mundo real. Esses exemplos entram então no fluxo de trabalho do Isaac GR00T. A GPU RTX PRO opcional lida com as demandas gráficas e de traçado de raios do Isaac Sim, enquanto o Isaac Lab e o GR00T-Mimic expandem as demonstrações originais para uma coleção muito maior de trajetórias sintéticas fisicamente plausíveis. Finalmente, o B300 ajusta o modelo GR00T usando o conjunto de dados reais e sintéticos combinados.
Fonte: NVIDIA
Após o ajuste fino, a política resultante pode ser validada em simulação antes de ser implementada no robô para avaliação no mundo real. Isso cria um ciclo de desenvolvimento eficiente: capturar uma demonstração real, reproduzi-la e variá-la em simulação, treinar novamente o modelo e testar a política atualizada no hardware. Para equipes com acesso limitado a robôs, operadores ou janelas de coleta de dados, consolidar a simulação, a geração de dados sintéticos e o treinamento do modelo em um único sistema de mesa pode reduzir significativamente o atrito de cada iteração.
Desenvolvimento do kernel Blackwell Ultra
Sem dúvida, o melhor caso de uso para a DGX Station é a otimização de kernel. Quando uma equipe está escrevendo kernels CUDA ou Triton para Blackwell Ultra, não há substituto para a execução na arquitetura de destino. O WS300 coloca um B300 e 252 GB de HBM3e ao lado do desenvolvedor, possibilitando a criação de perfis de cargas de trabalho reais, a inspeção do comportamento da memória, o ajuste de caminhos do Tensor Core, a fusão de operações e a iteração sem a necessidade de reservar tempo em um servidor com oito GPUs ou em um sistema de rack.
Sistemas maiores ainda são importantes, mas podem ser reservados para tarefas que realmente os exigem: escalonamento NVLink, operações coletivas NCCL, kernels de comunicação, inferência multi-GPU e validação final de throughput. O WS300 lida localmente com as tarefas do kernel de GPU única, mantendo esses sistemas compartilhados dispendiosos disponíveis para testes em escala ampliada. Para uma equipe focada na otimização do Blackwell Ultra, esta é uma das máquinas de desenvolvimento mais diretas que o mercado oferece.
Se a DGX Station tivesse sido lançada juntamente com os primeiros sistemas Blackwell Ultra, suspeitamos que o estoque inicial teria desaparecido quase imediatamente, sendo absorvido por laboratórios de IA, equipes de compiladores, desenvolvedores de mecanismos de inferência e outros grupos que corriam para otimizar softwares para o B300. Mesmo agora, o acesso direto à GPU alvo pode ser o motivo mais evidente para uma organização adquirir uma.
Desempenho
Nota sobre os testes: Os testes foram conduzidos remotamente em um sistema hospedado pela MSI, com o StorageReview controlando todo o ambiente de software durante o período de avaliação. O sistema foi testado sem uma GPU RTX PRO ou qualquer outra placa de expansão PCIe instalada. Isso permitiu que o Superchip GB300 utilizasse toda a capacidade de aceleração disponível do sistema durante os testes.
Máximo FLOPS de Matmul Alcançáveis (MAMF)
Primeiramente, para contextualizar o poder computacional do B300, executamos o MAMF em três sistemas da geração Blackwell. O MAMF (Maximum Achievable Matmul FLOPS) é uma métrica prática de desempenho projetada para medir o pico realista de operações de ponto flutuante por segundo que podem ser alcançadas em aceleradores de aprendizado de máquina durante operações de multiplicação de matrizes, oferecendo uma referência mais precisa do que o pico teórico de FLOPS frequentemente anunciado nas especificações de hardware.
Para este teste, realizamos varreduras em cada um dos 3 sistemas em BF16, FP8 e NVFP4, e relatamos o melhor resultado sustentado (denso) por precisão.
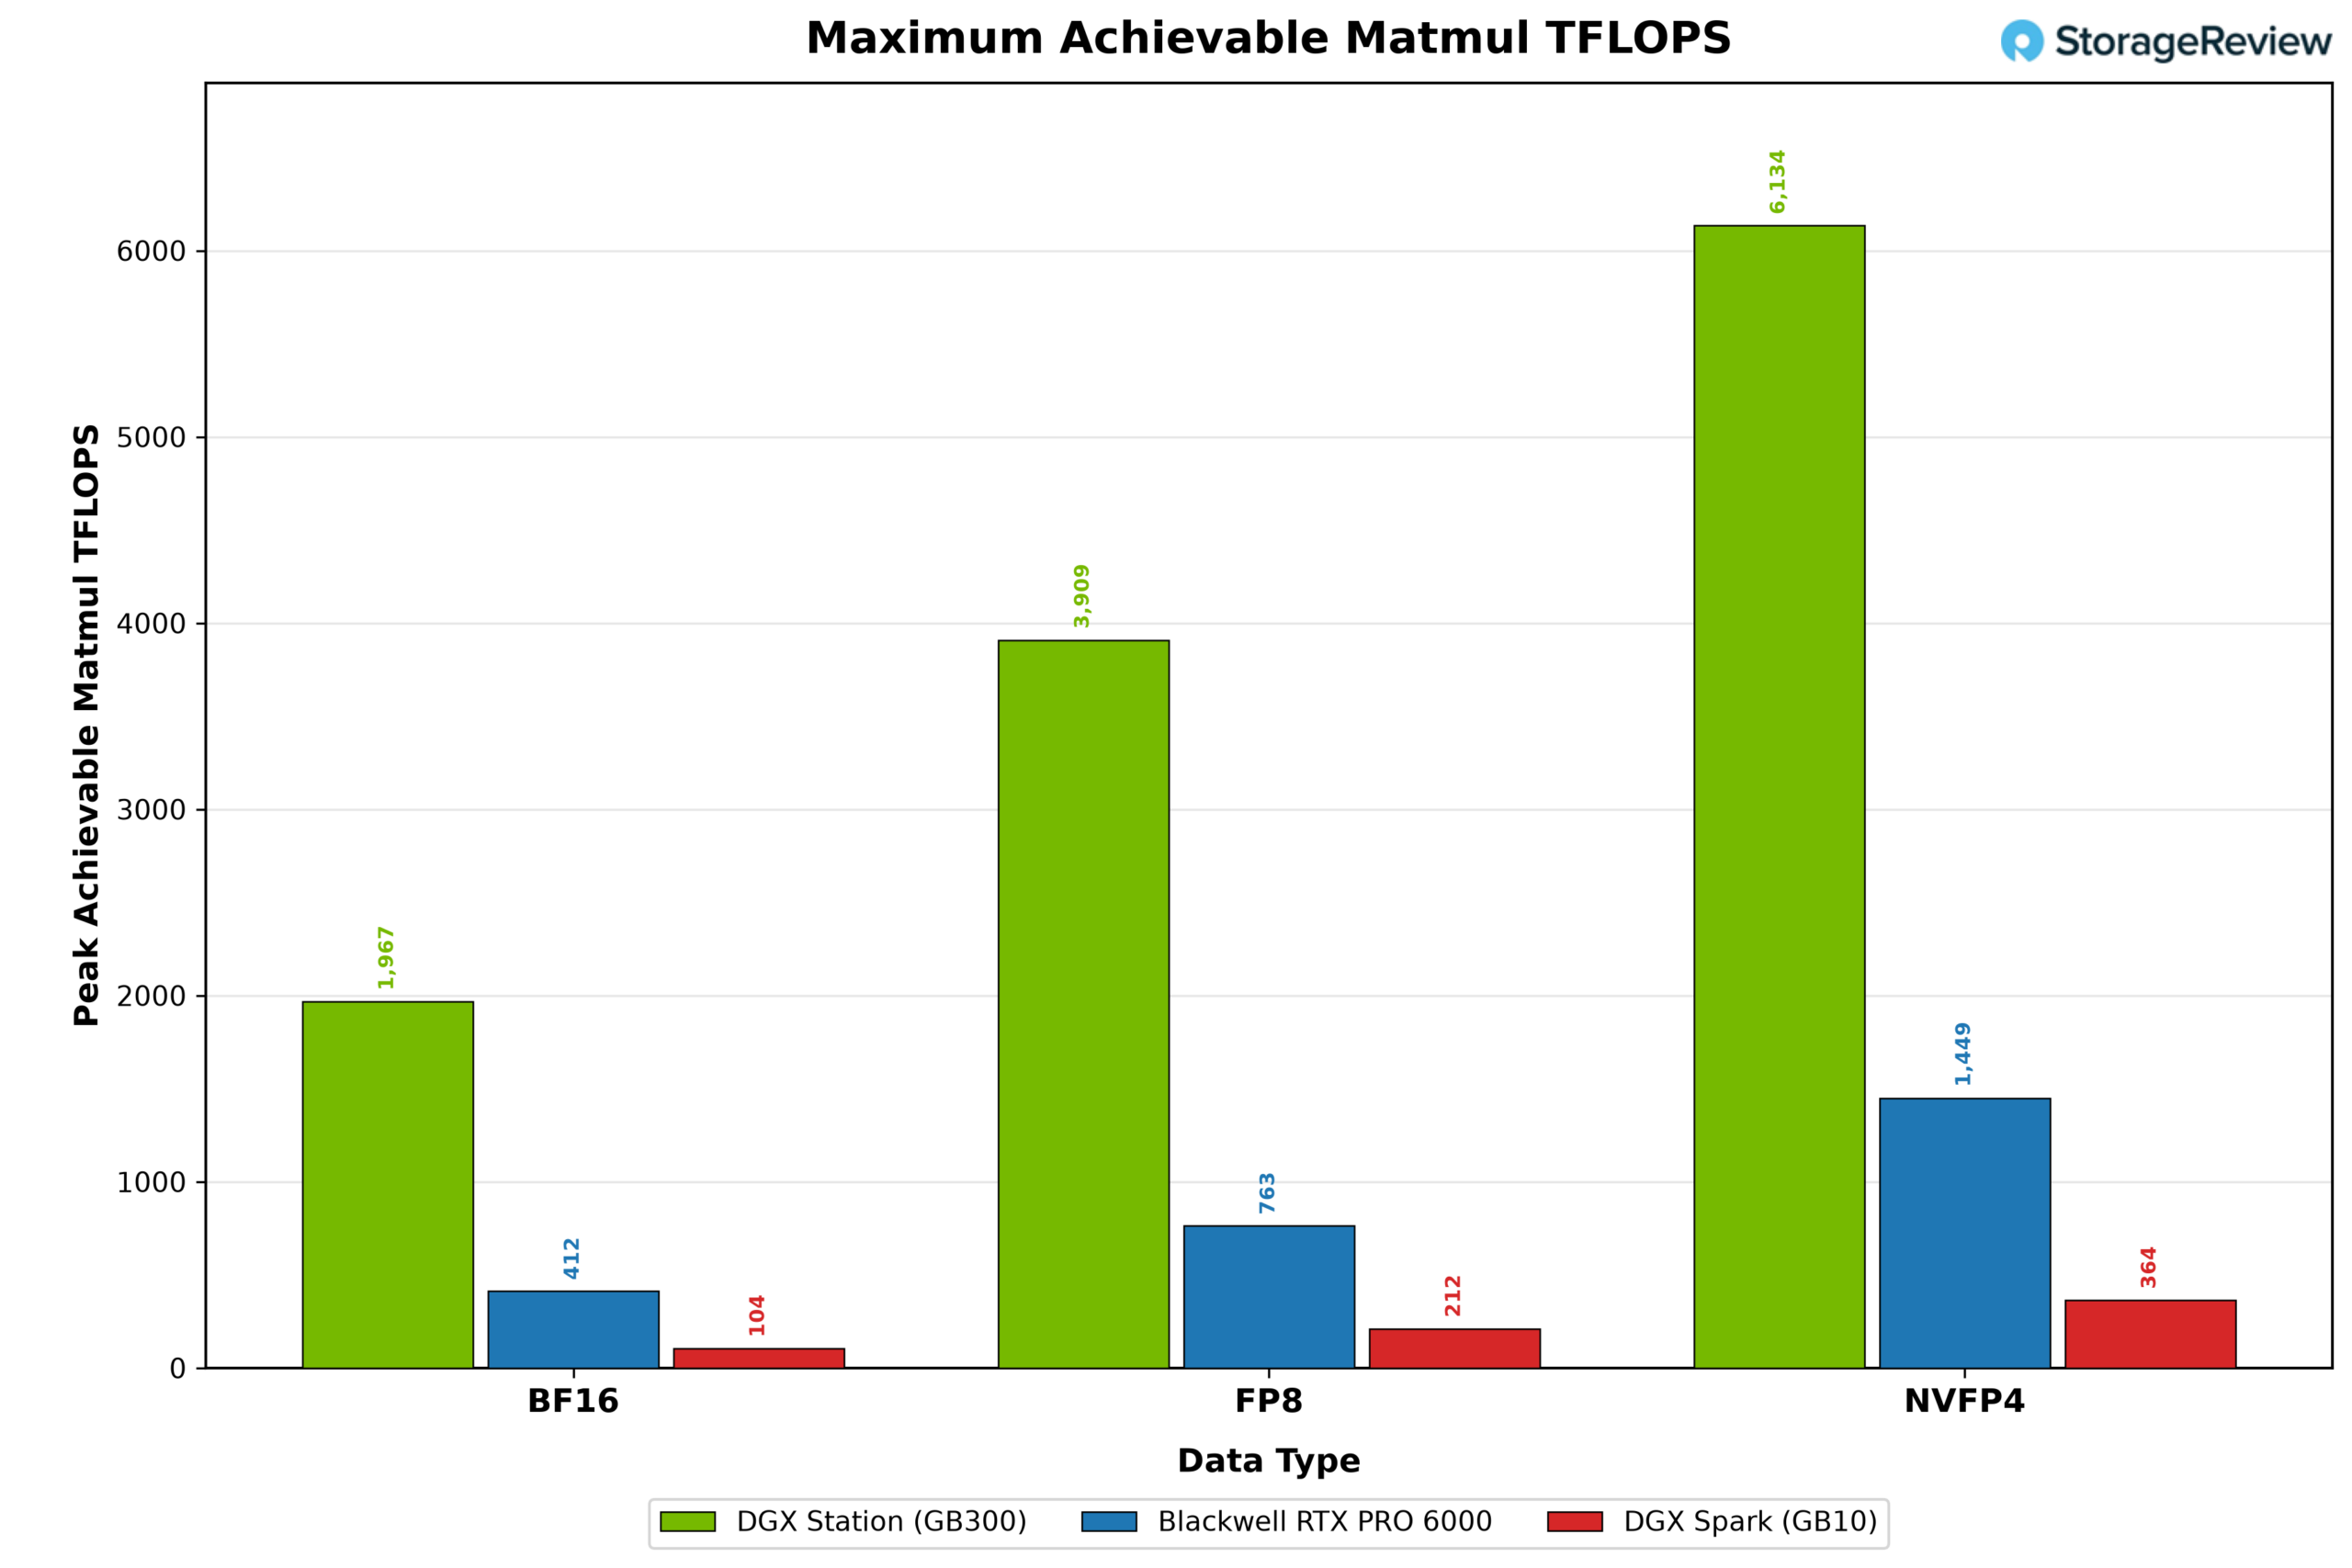
A GB300 lidera em todas as precisões. Em BF16, ela atinge 1,967 TFLOPS contra 412 da RTX PRO 6000 e 104 da DGX Spark . FP8 segue o mesmo padrão: 3,909, 763 e 211. NVFP4 leva a GB300 a 6,134 TFLOPS, com a RTX PRO 6000 em 1,449 e a Spark em 364. As proporções são notavelmente estáveis em todas as três precisões: a GB300 mantém uma vantagem de 4 a 5 vezes sobre a RTX PRO 6000 e de 17 a 19 vezes sobre a Spark, enquanto a RTX PRO 6000 mantém uma vantagem de aproximadamente 4 vezes sobre a Spark.
NVBandwidth
A capacidade de processamento bruto só é útil se o acelerador conseguir manter suas unidades de execução alimentadas com dados. Isso é especialmente importante para inferência de IA, onde a geração de tokens durante a fase de decodificação é frequentemente limitada mais pela largura de banda da memória do que pelos FLOPS disponíveis.
No Superchip GB300, essa hierarquia abrange a HBM3e local do B300, a memória LPDDR5X da Grace e a interconexão NVLink-C2C que as conecta. O utilitário NVBandwidth da NVIDIA testa os diferentes caminhos de cópia entre esses componentes, mostrando tanto a largura de banda disponível dentro da GPU quanto o custo de movimentação de dados entre os domínios de memória da GPU e da CPU.
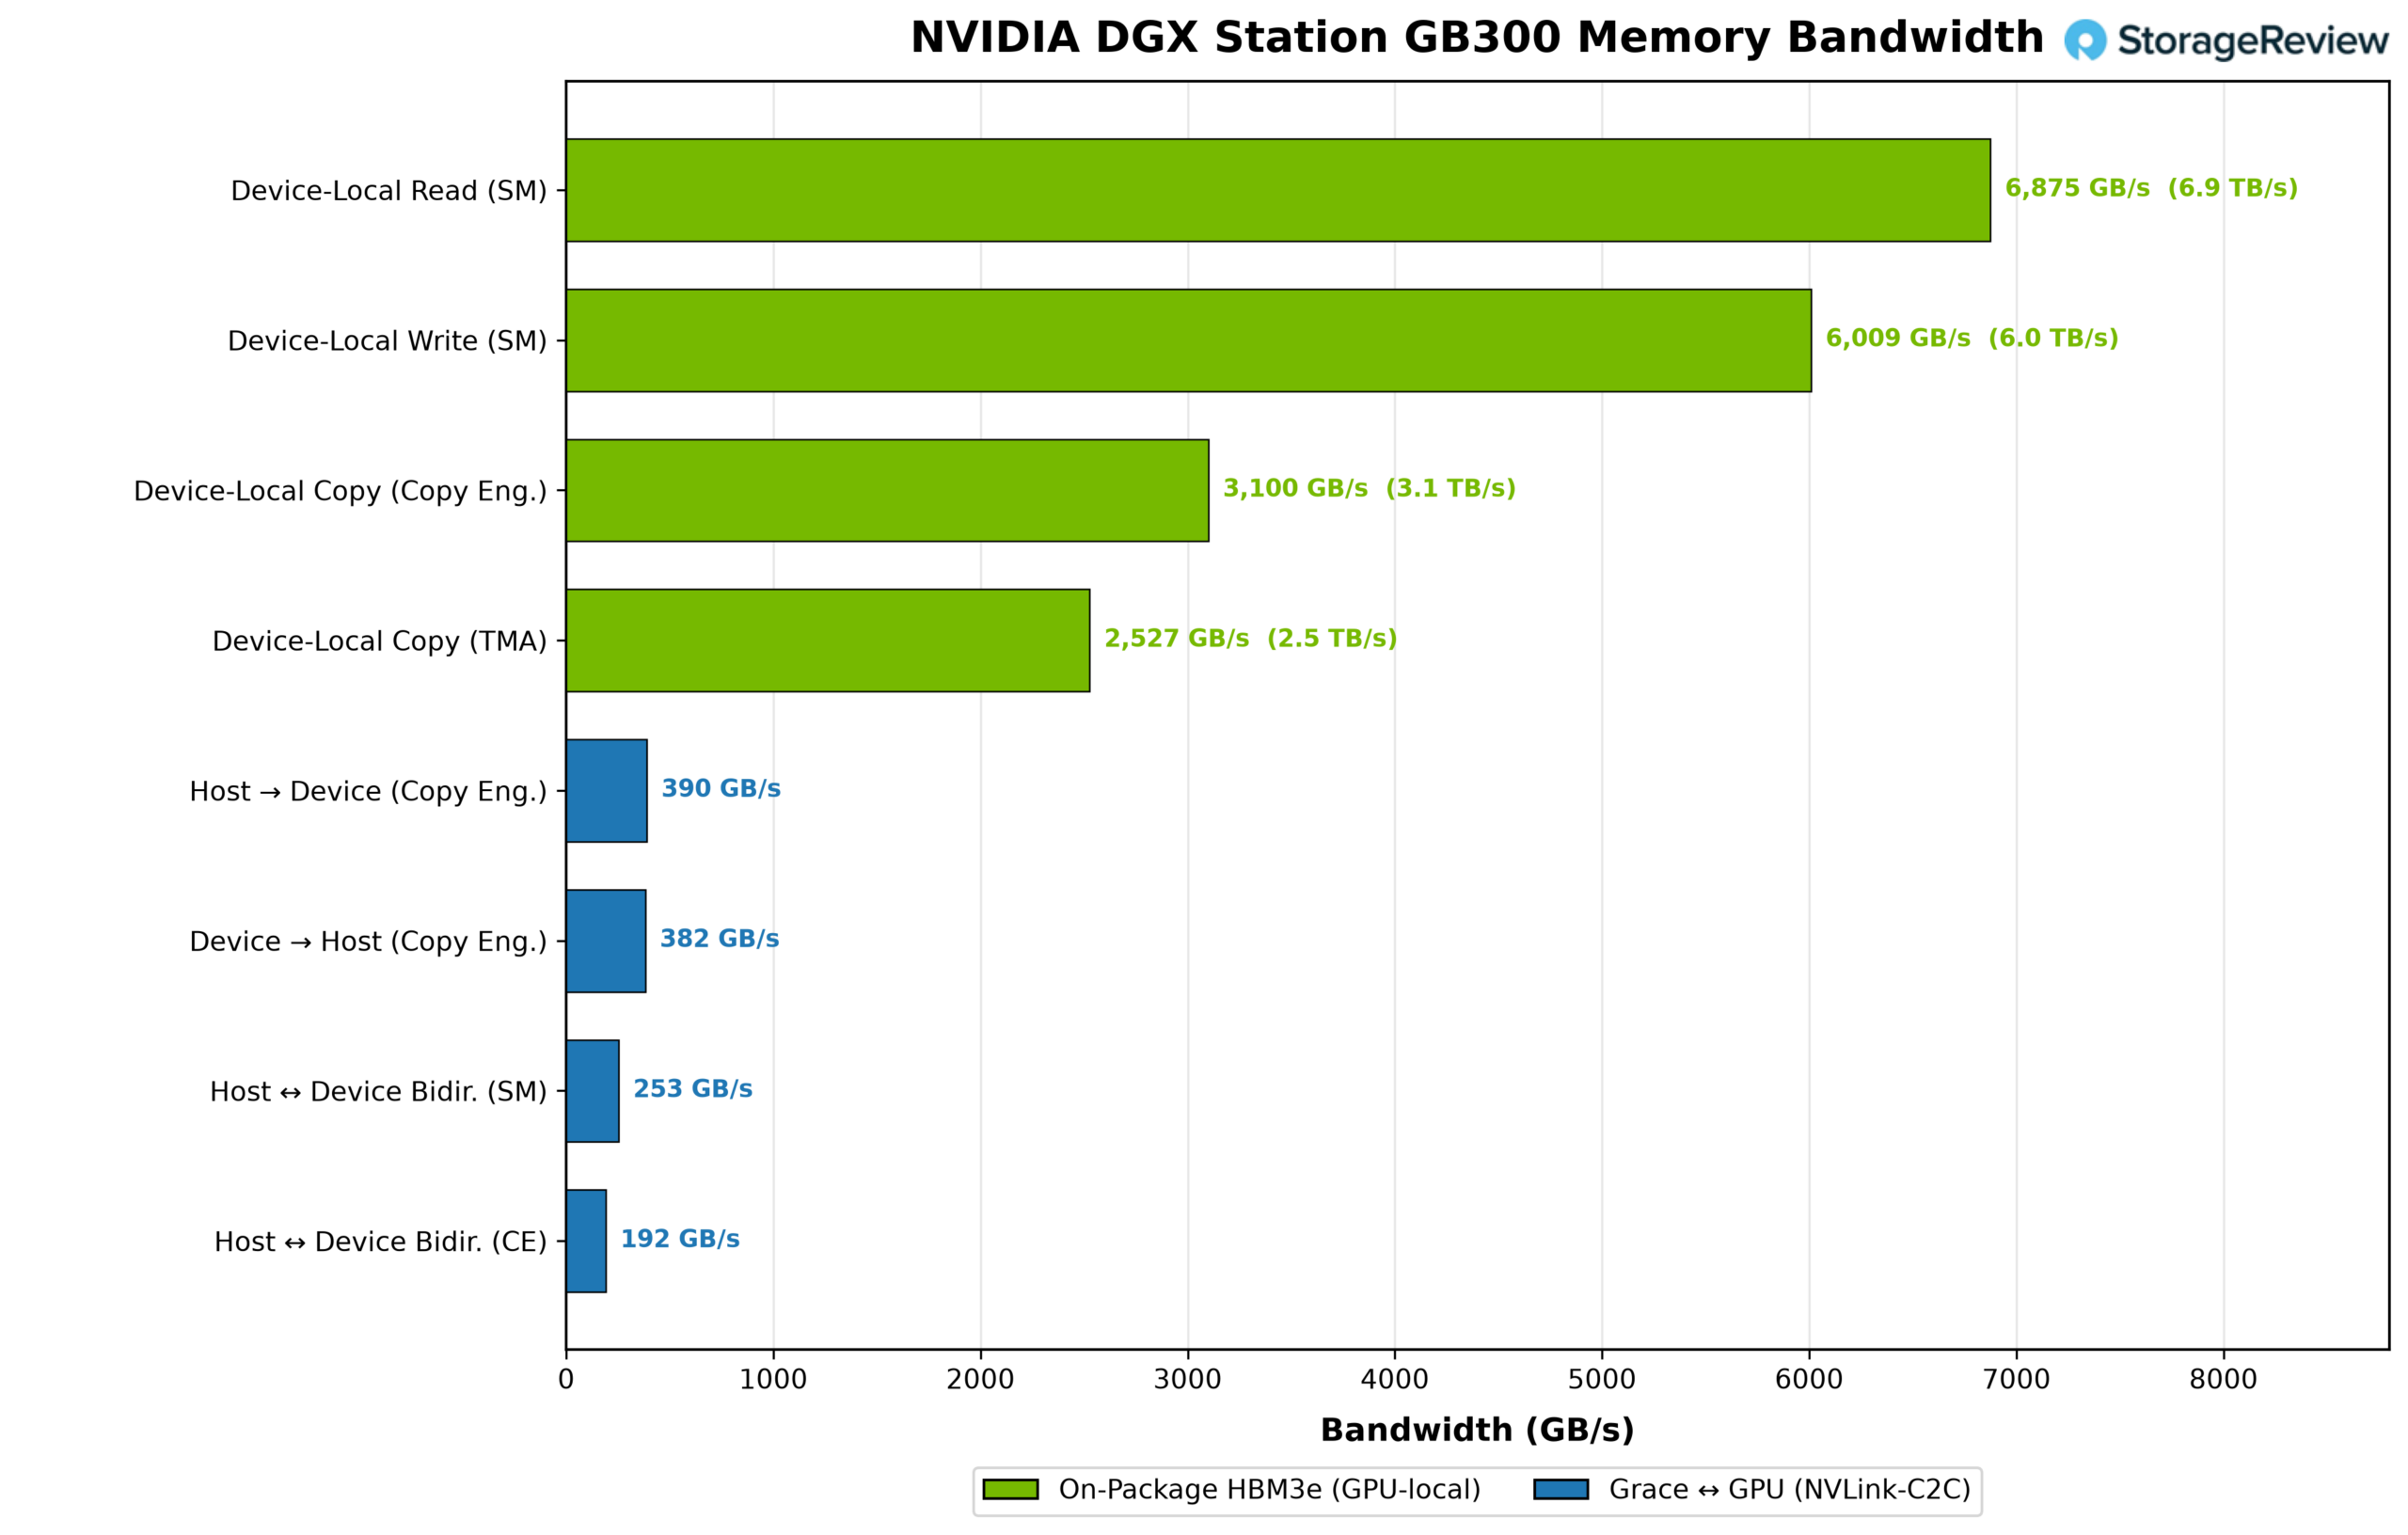
Os quatro primeiros testes medem a movimentação de dados dentro dos 252 GB de HBM3e da B300. As leituras locais do dispositivo atingem 6,875 GB/s, ou aproximadamente 6.9 TB/s, colocando o resultado a poucos pontos percentuais da largura de banda de memória nominal da GPU, de 7.1 TB/s. As gravações locais do dispositivo atingem 6,009 GB/s.
As operações de cópia HBM para HBM são mais lentas porque cada cópia consome largura de banda duas vezes: uma para ler a origem e outra para gravar no destino. Os mecanismos de cópia dedicados atingem 3,100 GB/s, enquanto o Acelerador de Memória Tensor registra 2,527 GB/s.
Os testes restantes utilizam a interface NVLink-C2C e acessam os 496 GB de memória LPDDR5X da Grace. As transferências da memória da Grace para a HBM B300 atingem 390 GB/s, enquanto as transferências na direção oposta alcançam 382 GB/s. Embora o NVLink-C2C forneça até 900 GB/s de largura de banda coerente entre a CPU e a GPU, as transferências medidas são limitadas pela largura de banda de 396 GB/s da memória LPDDR5X da Grace. Transferências bidirecionais expõem ainda mais essa limitação. O tráfego simultâneo atinge 253 GB/s usando cópias baseadas em SM e 192 GB/s através dos mecanismos de cópia.
Inferência
Com os testes de baixo nível concluídos, passamos para a inferência LLM. Aqui, o foco muda dos números de pico para tokens por segundo, tempo até o primeiro token e latência sob carga, o que nos dá uma visão melhor de como o WS300 se comporta como um sistema de servidor.
Comecemos pela principal capacidade do Superchip GB300: atender modelos que ultrapassam o limite de capacidade de 252 GB da HBM3e do B300. É aqui que seu pool de memória coerente de 748 GB se mostra mais importante. Os cinco pontos de verificação progridem de dois modelos que se encaixam confortavelmente na HBM, para um que nominalmente cabe, mas deixa pouco espaço para o cache de tempo de execução e KV, e finalmente para dois que precisam transferir porções substanciais de seus recursos para a memória Grace.
Nota: Quando mencionado, os modelos foram executados com decodificação especulativa para maior taxa de transferência de decodificação, com a quantidade de tokens de aceitação forçada definida como a quantidade de tokens de decodificação especulativa. Os resultados, portanto, mostram o desempenho no melhor cenário; em situações reais de serviço, a taxa de transferência é dinâmica e depende da qualidade dos tokens de decodificação especulativa.
Modelos que se encaixam perfeitamente no HBM
DeepSeek v4 Flash (0731)
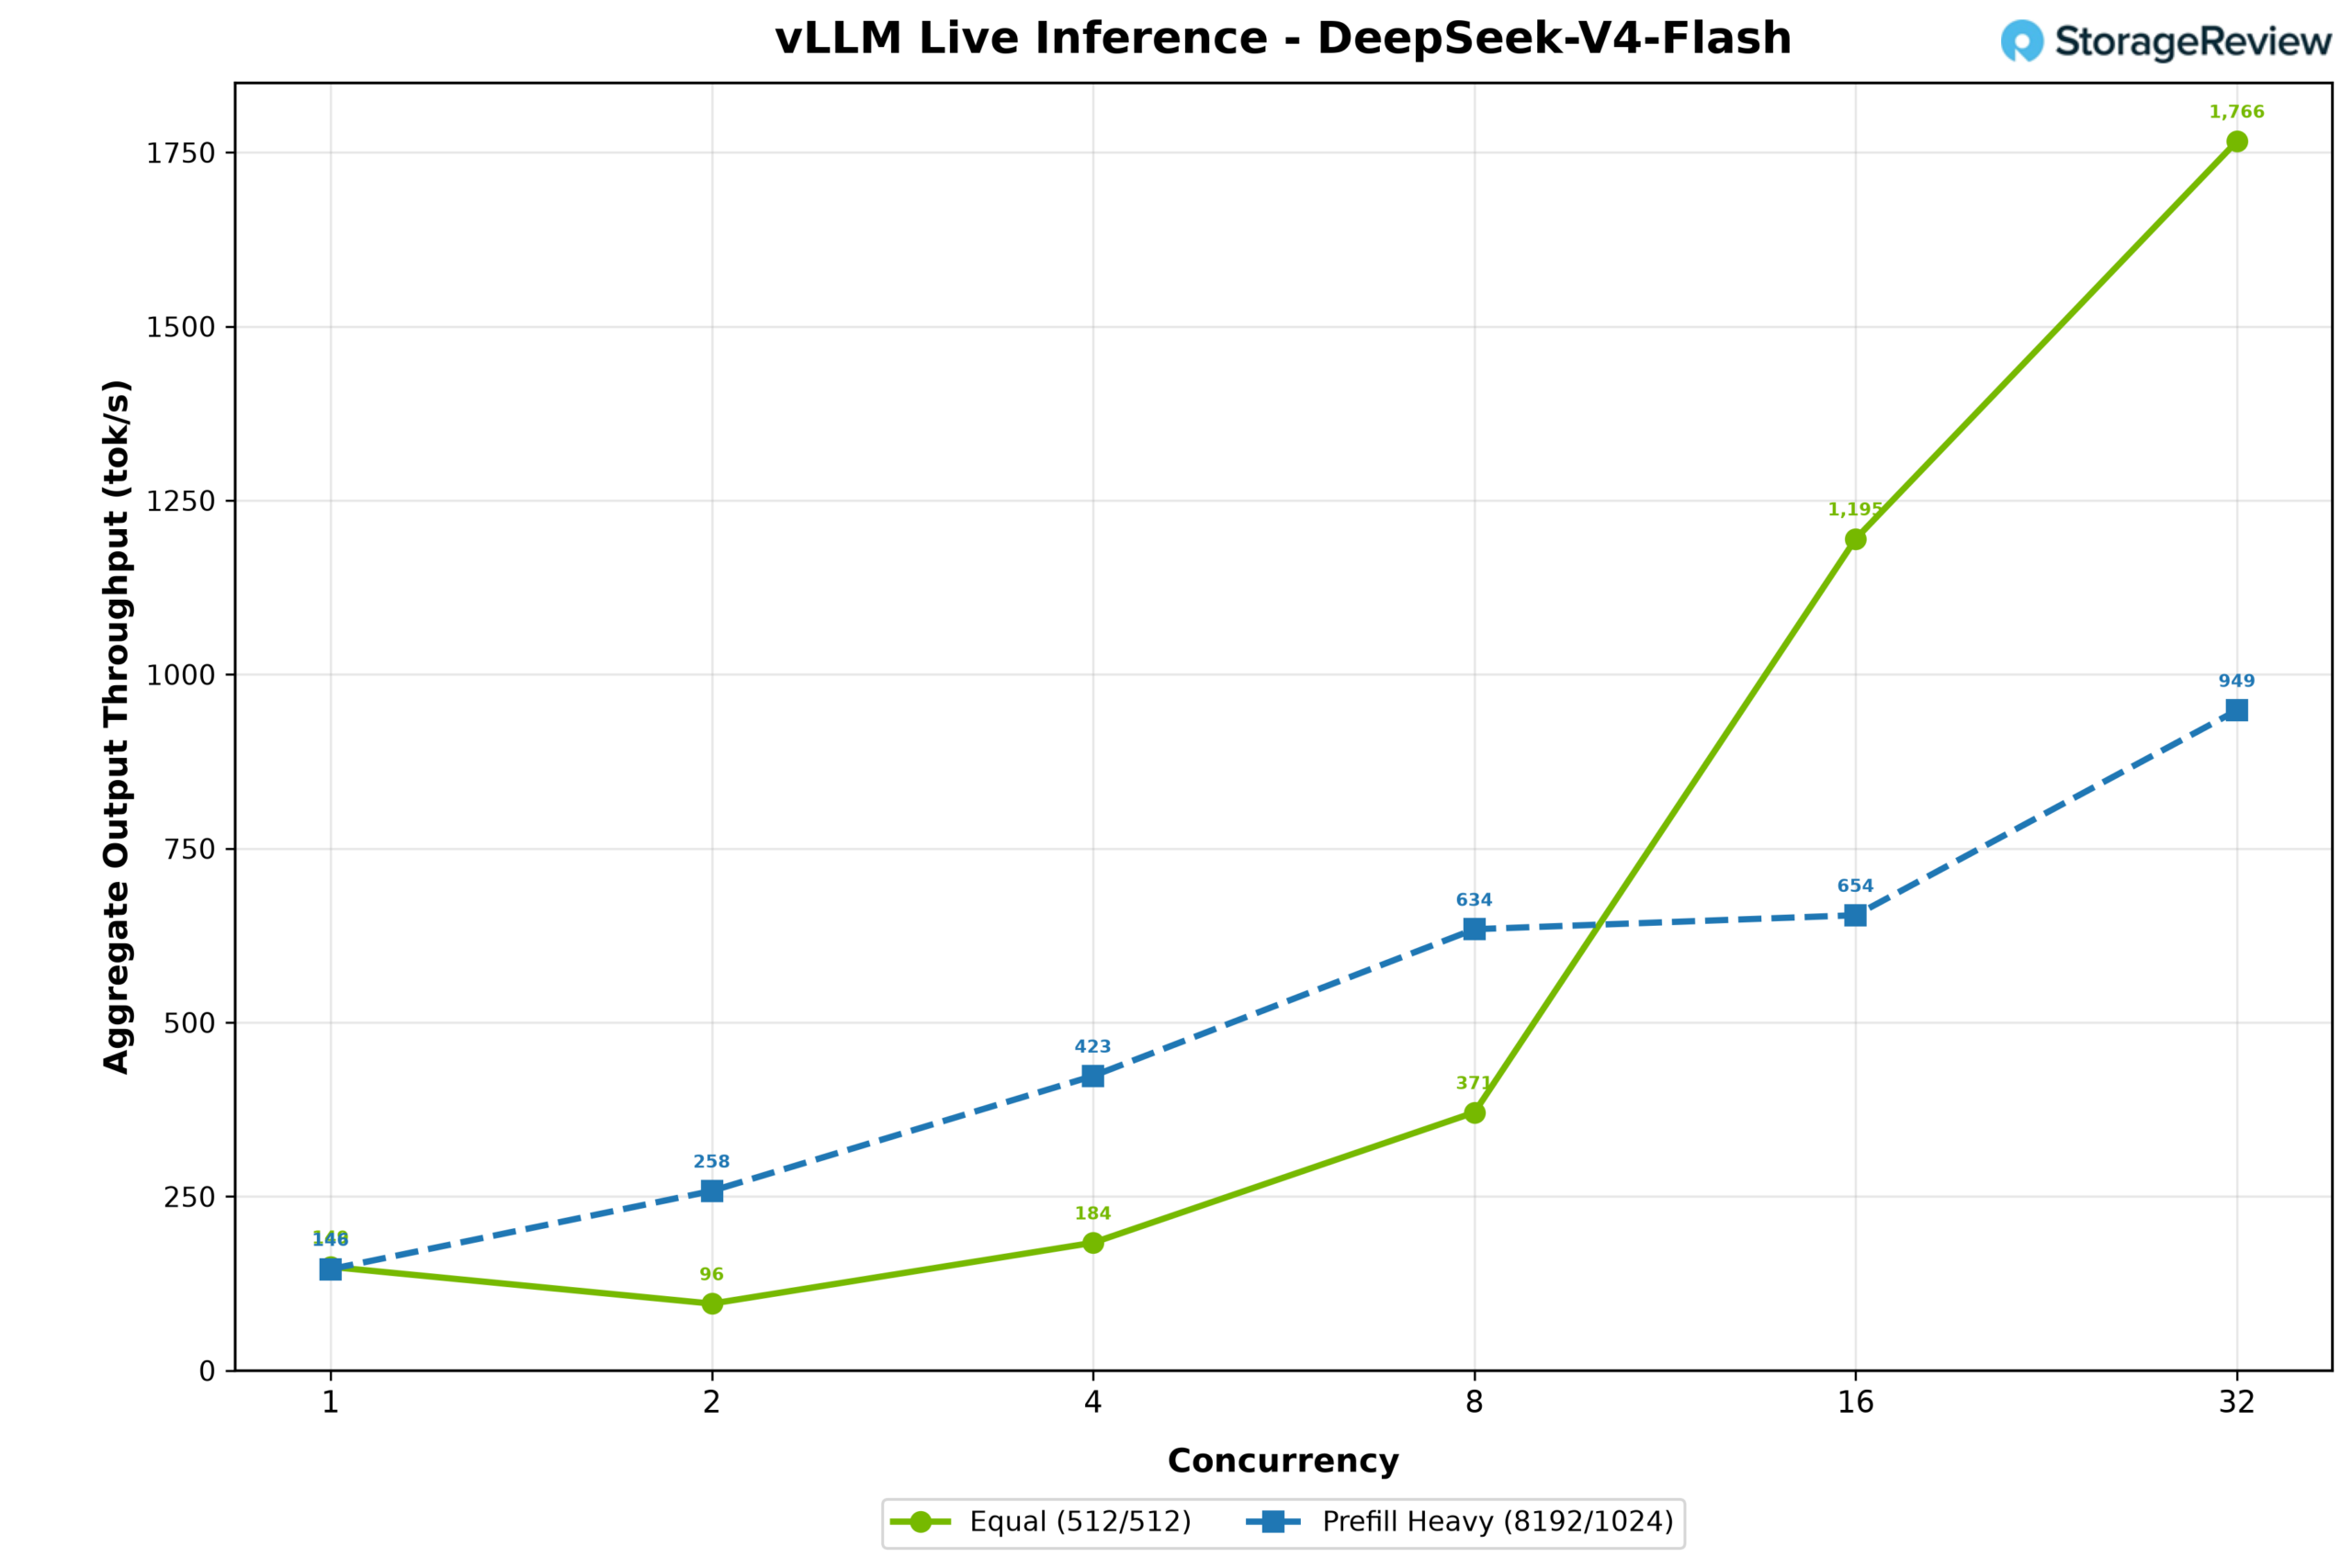
Em primeiro lugar, testamos o extremamente popular DeepSeek v4 Flash (0731), que consome 14+6 GB de memória como um checkpoint FP8 nativo. Este modelo é conhecido por ser muito eficiente e fácil de executar, o que constatamos na DGX Station. Na carga de trabalho 512/512, a taxa de transferência de saída começou em 149 tokens por segundo com concorrência 1, subindo rapidamente para 1,766 com concorrência 32. A carga de trabalho com uso intensivo de pré-preenchimento escalou de 146 para 949 tokens por segundo.
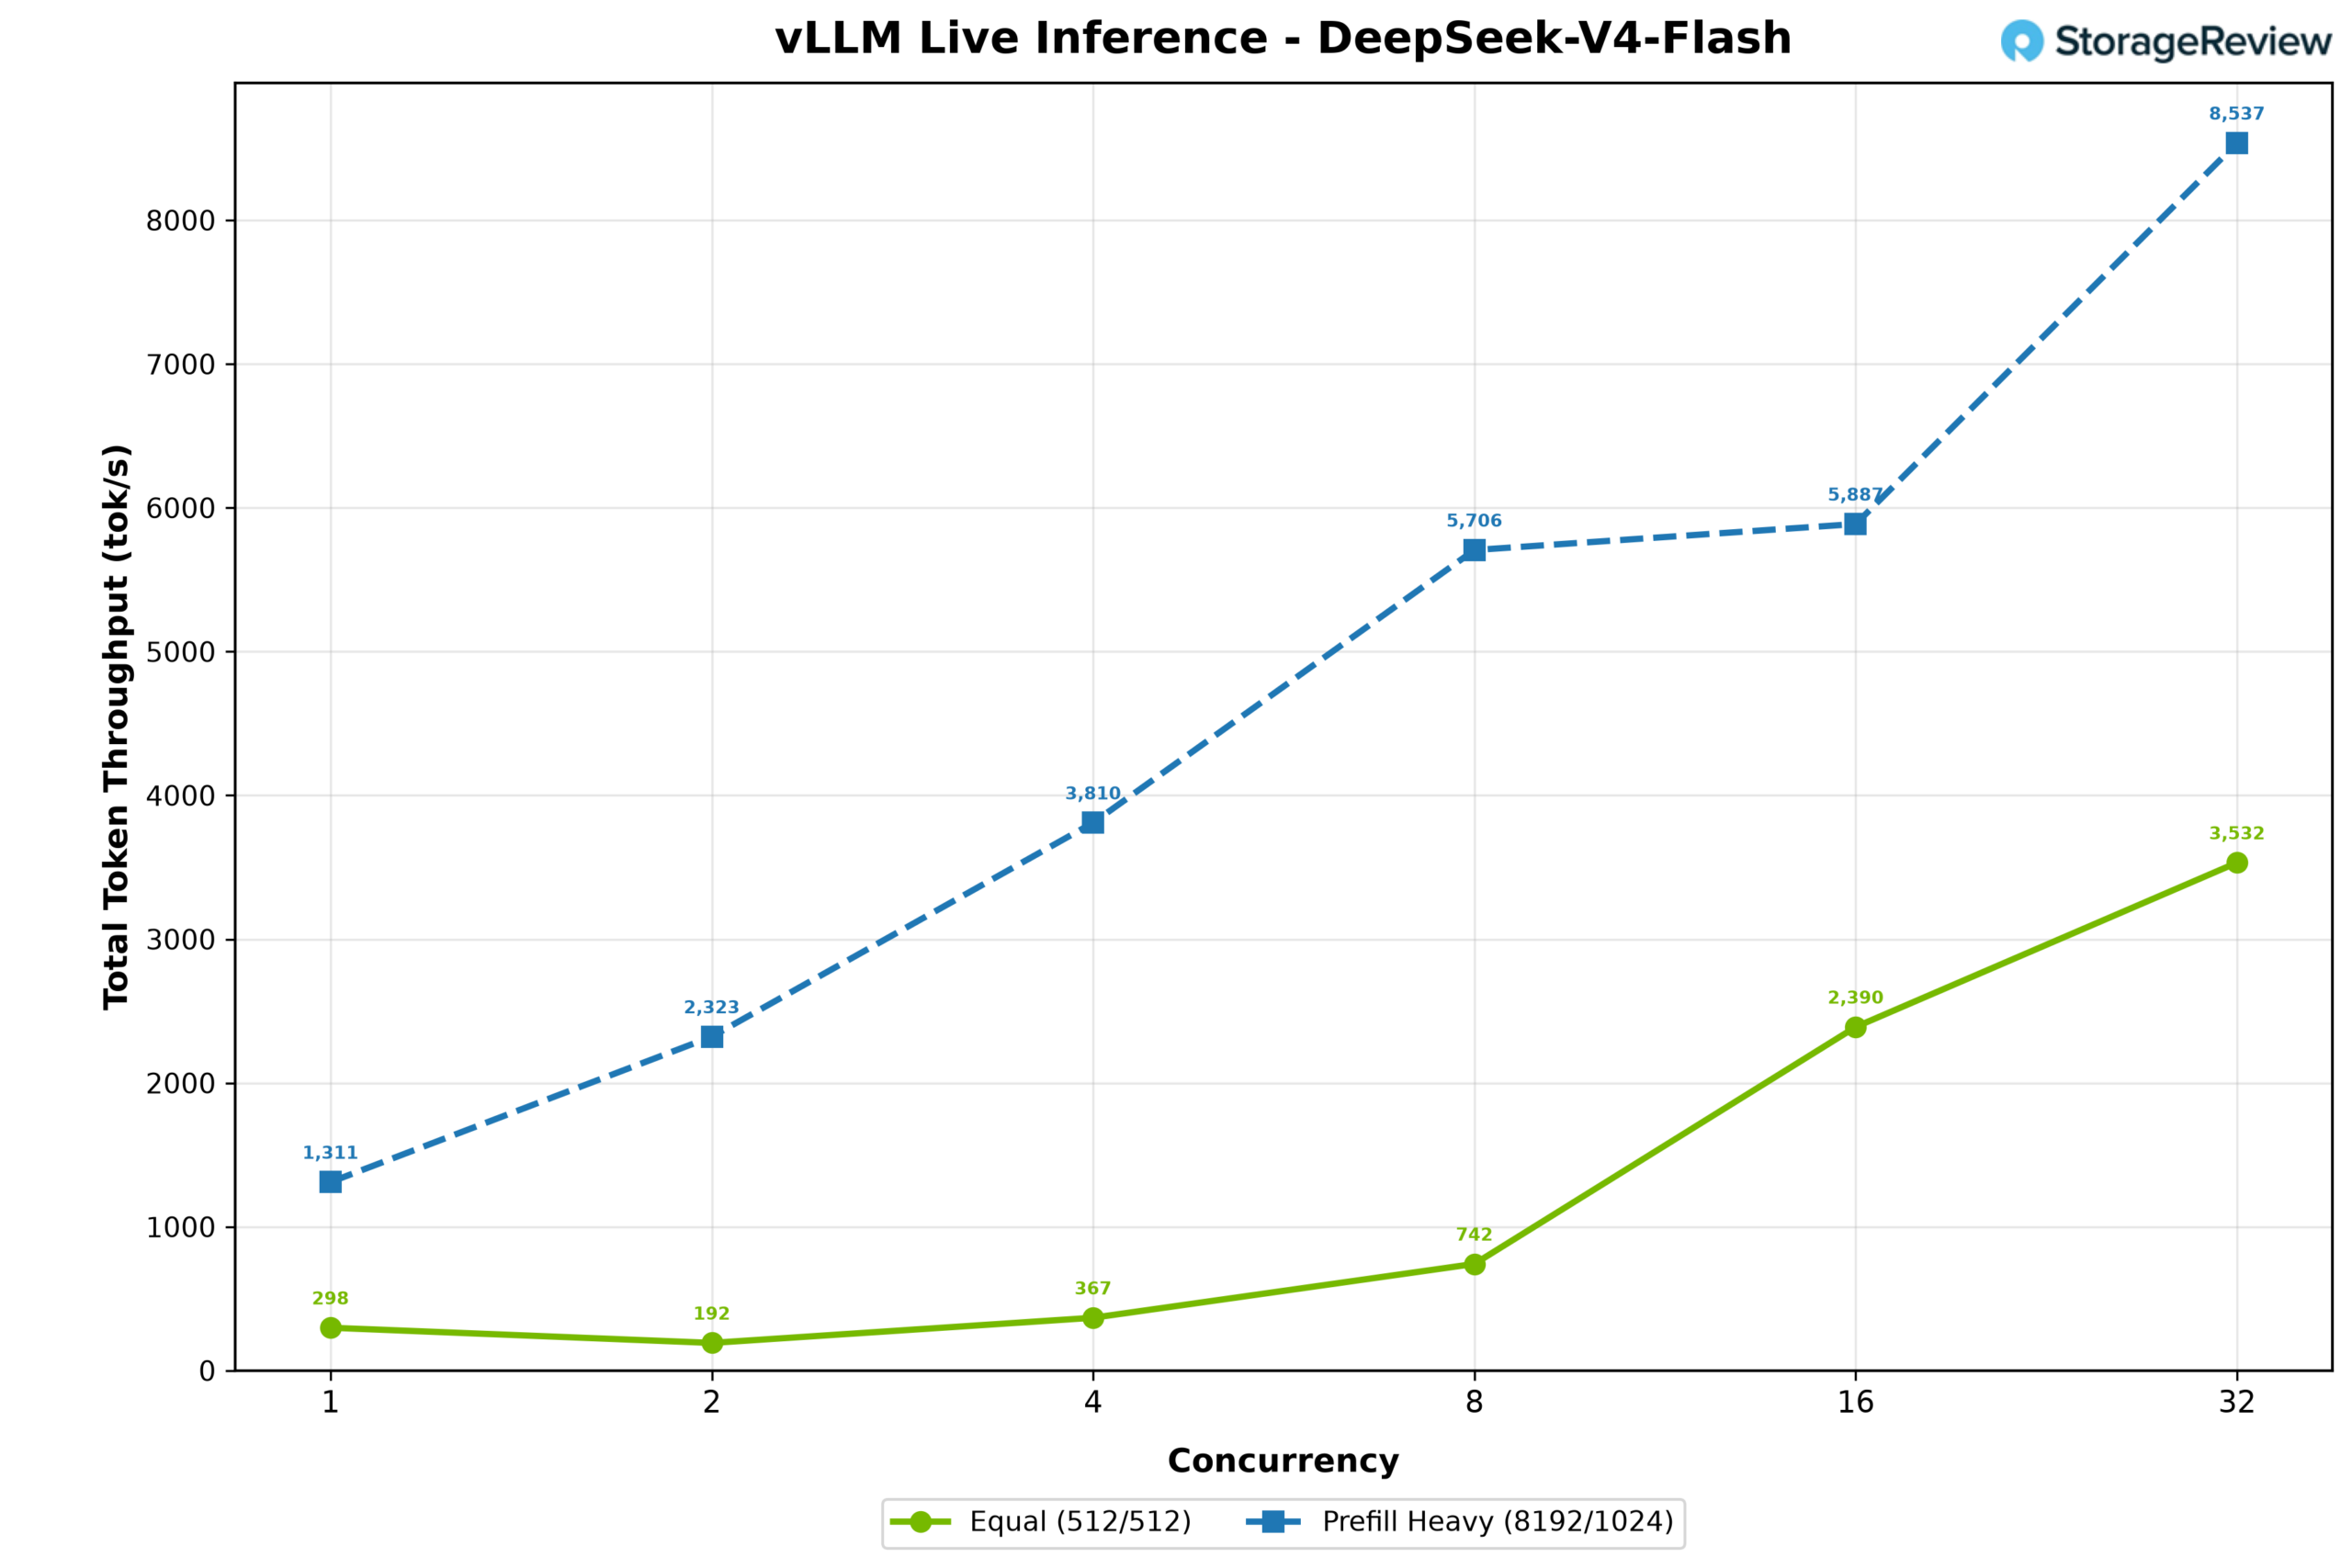
A taxa total de transferência de tokens aumentou em sincronia, com a carga de trabalho 512/512 subindo de 298 para 3,532 tokens por segundo e a carga de trabalho com uso intensivo de pré-preenchimento aumentando de 1,311 para 8,537.
MiniMax M2.7 (NVFP4)
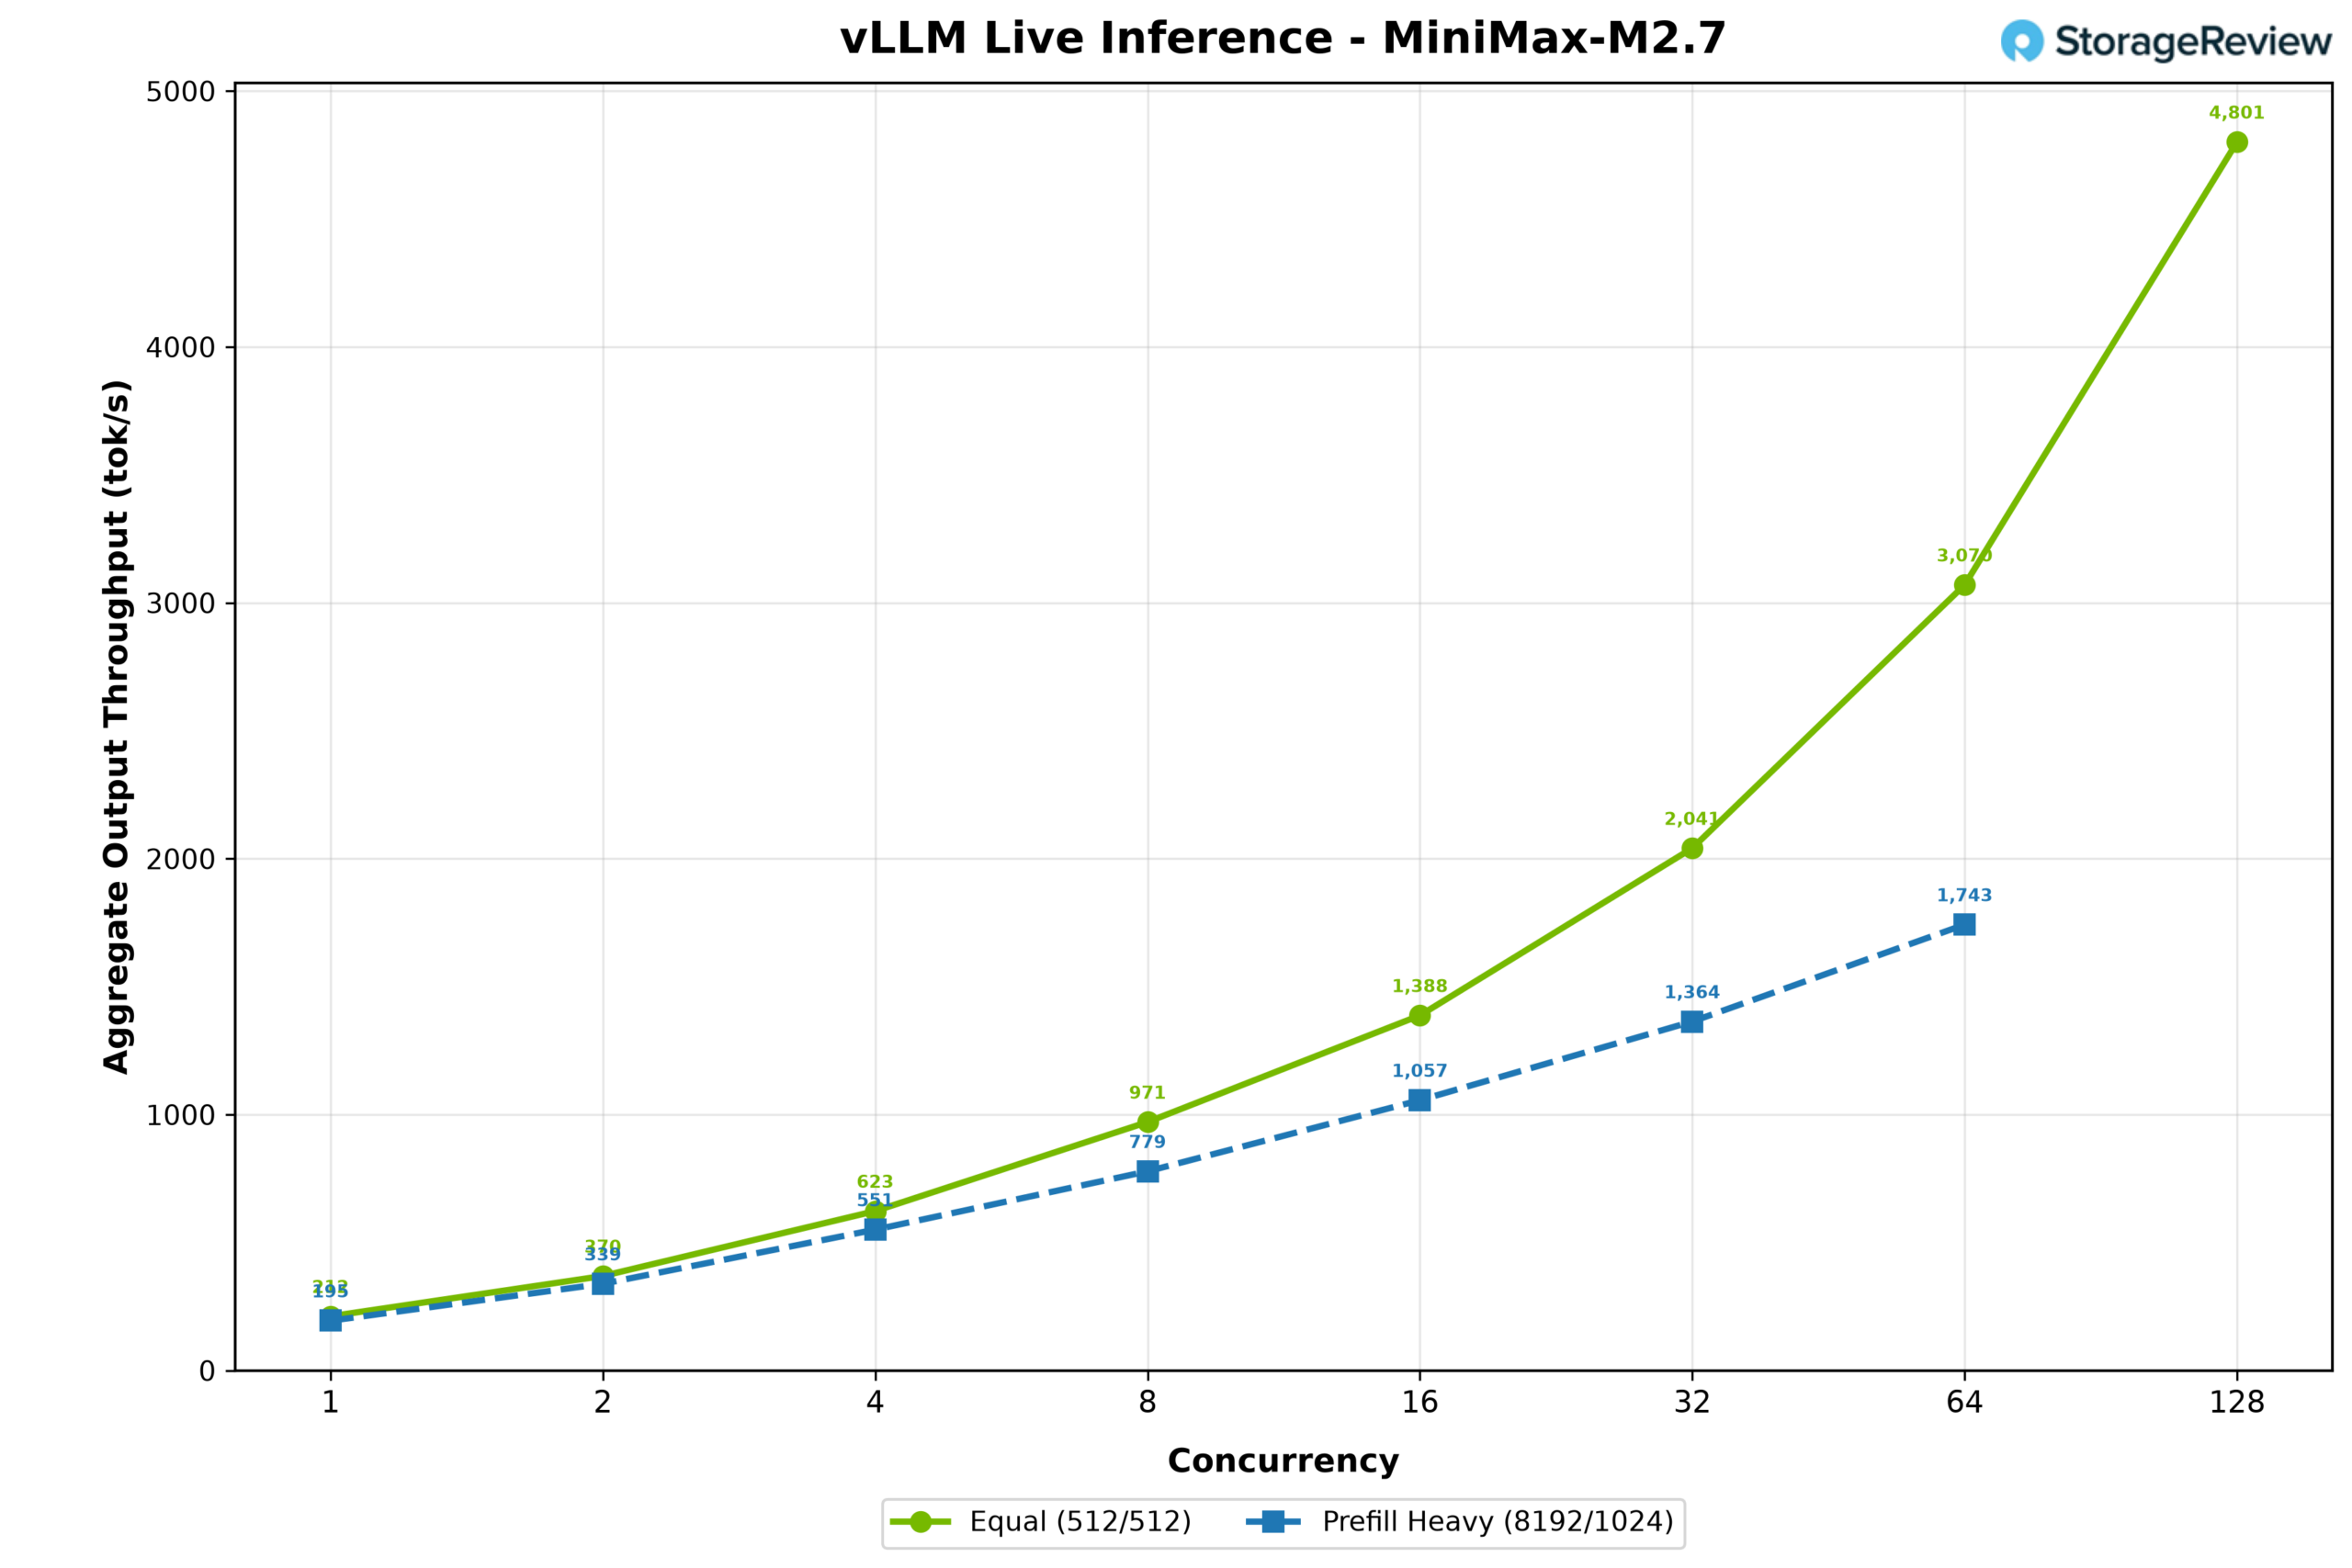
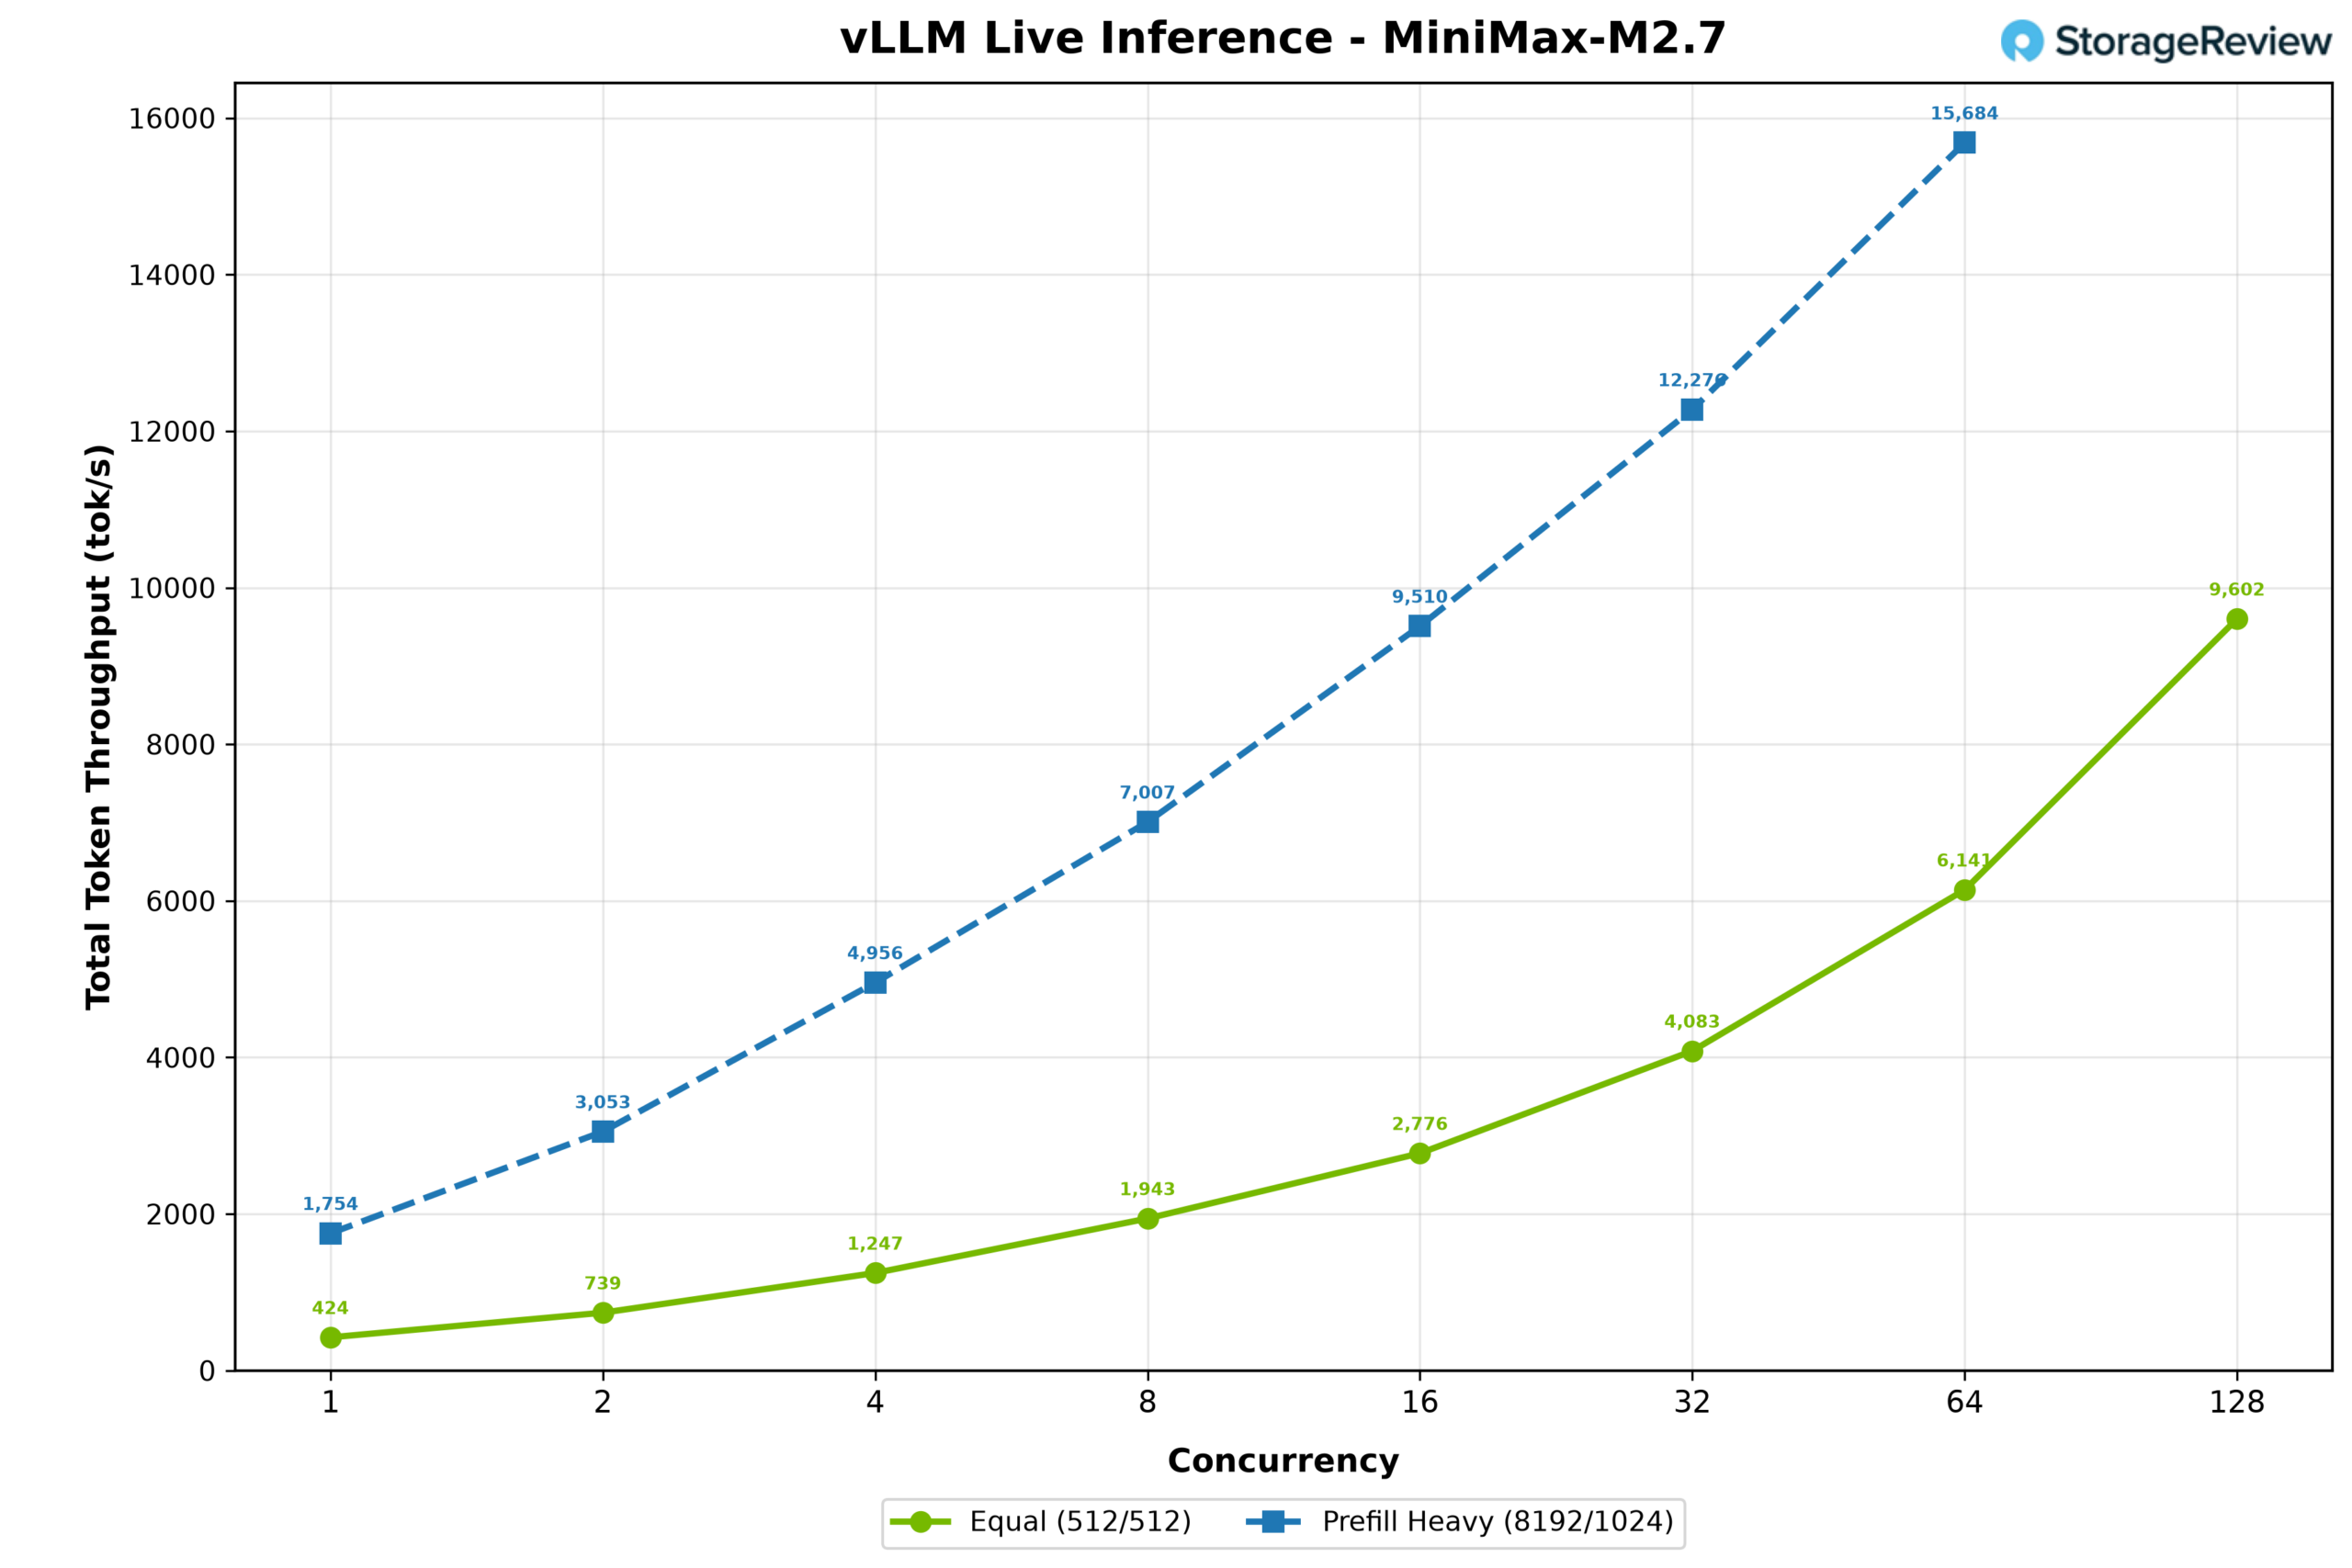
Em seguida, temos o MiniMax M2.7, um dos nossos modelos favoritos, testado usando o NVFP4 quant da NVIDIA, ocupando 125 GB de VRAM. Na carga de trabalho 512/512, a taxa de transferência de saída começou em 193 tokens por segundo com concorrência 1 e escalou rapidamente para 4,801 tokens por segundo com concorrência 128. A carga de trabalho com uso intensivo de pré-preenchimento aumentou de 195 tokens por segundo com concorrência 1 para 1,743 tokens por segundo com concorrência 64. A taxa de transferência total de tokens mostrou a tendência oposta, com a carga de trabalho com uso intensivo de pré-preenchimento subindo de 1,754 para 15,684 tokens por segundo com concorrência 64, enquanto a carga de trabalho 512/512 escalou de 424 para 9,602 tokens por segundo com concorrência 128.
A taxa total de transferência de tokens apresentou a tendência oposta, com a carga de trabalho com uso intensivo de pré-preenchimento subindo de 1,754 para 15,684 tokens por segundo na simultaneidade 64, enquanto a carga de trabalho 512/512 aumentou de 424 para 9,602 tokens por segundo na simultaneidade 128.
Modelos que mal se encaixam no HBM
MiniMax M3 (NVFP4)
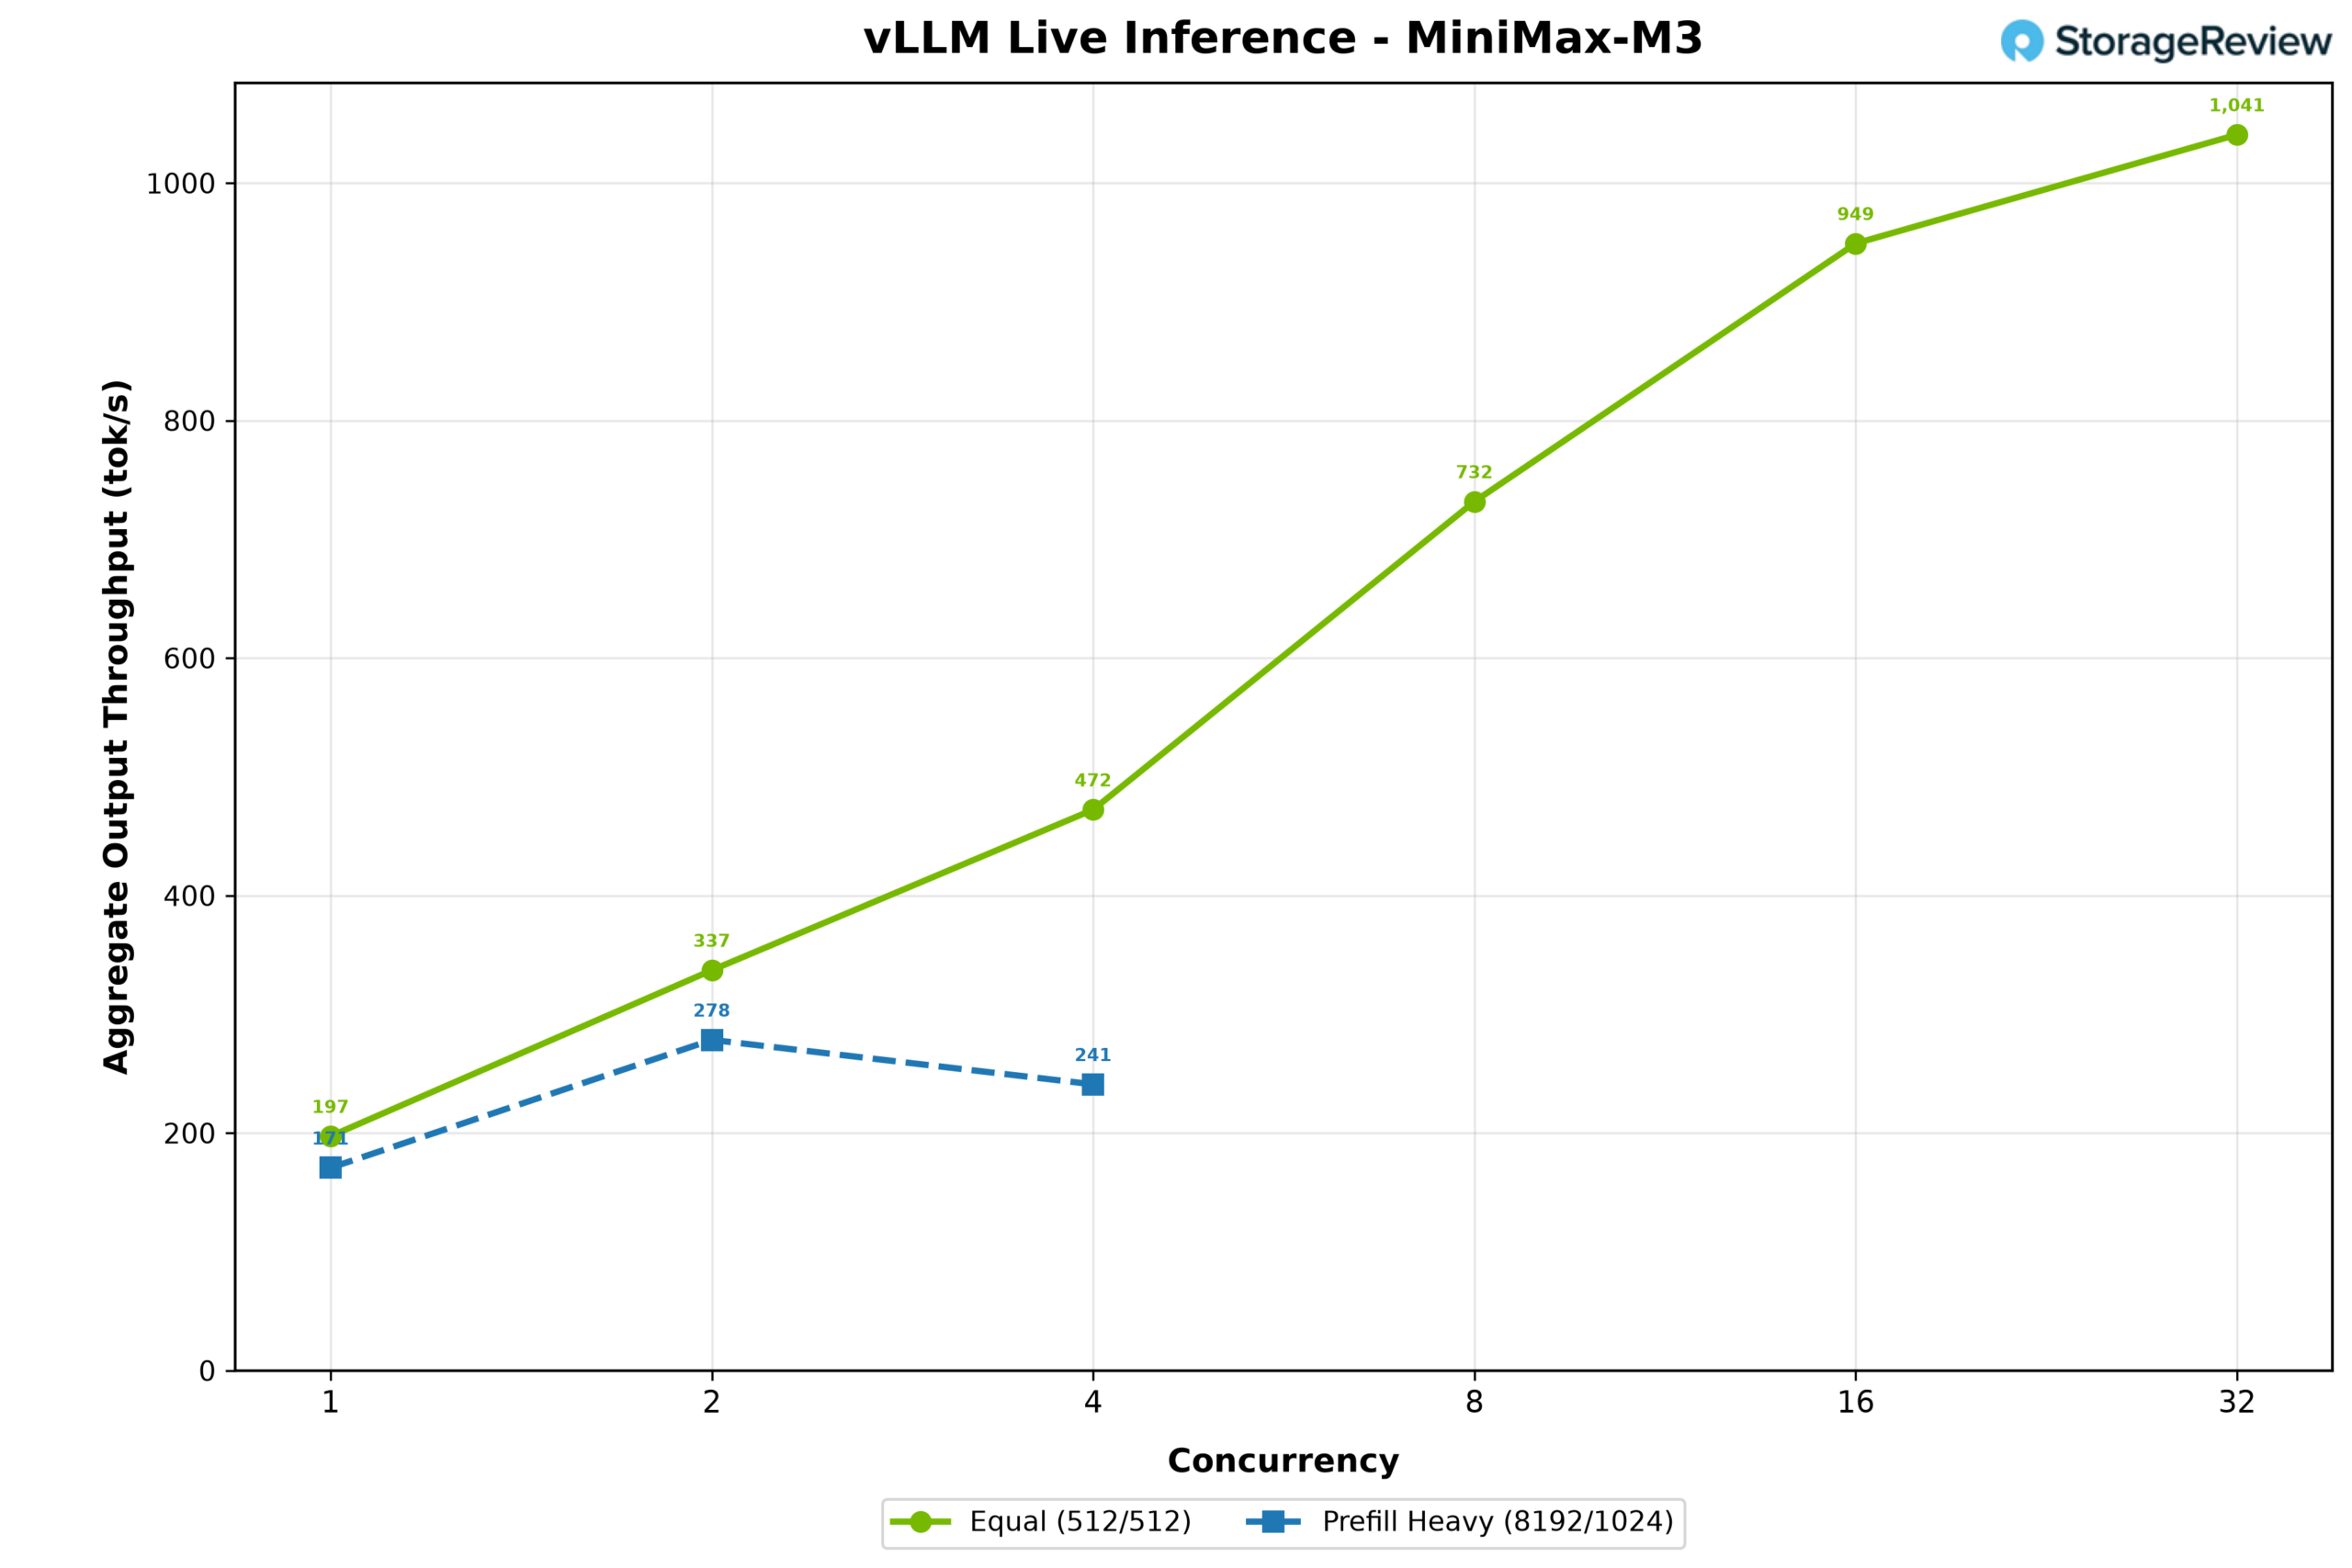
O MiniMax M3 demonstra na prática o que significa "quase no limite". Seu checkpoint NVFP4 de 233 GB é menor que os 252 GB de HBM do B300, mas o modelo ainda precisa de espaço para o runtime e o cache KV. Ele acabou ocupando 223 GB de HBM, com 21 GB de especialistas descarregados para o Grace. A decodificação especulativa EAGLE3-GQA foi usada com um comprimento de aceitação sintético de 3 tokens. Na carga de trabalho 512/512, a taxa de transferência de saída começou em 197 tokens por segundo na concorrência 1 e aumentou de forma constante para 1,041 tokens por segundo na concorrência 32. A carga de trabalho com uso intensivo de pré-preenchimento aumentou de 171 tokens por segundo na concorrência 1 para um pico de 278 na concorrência 2, antes de cair para 241 na concorrência 4.
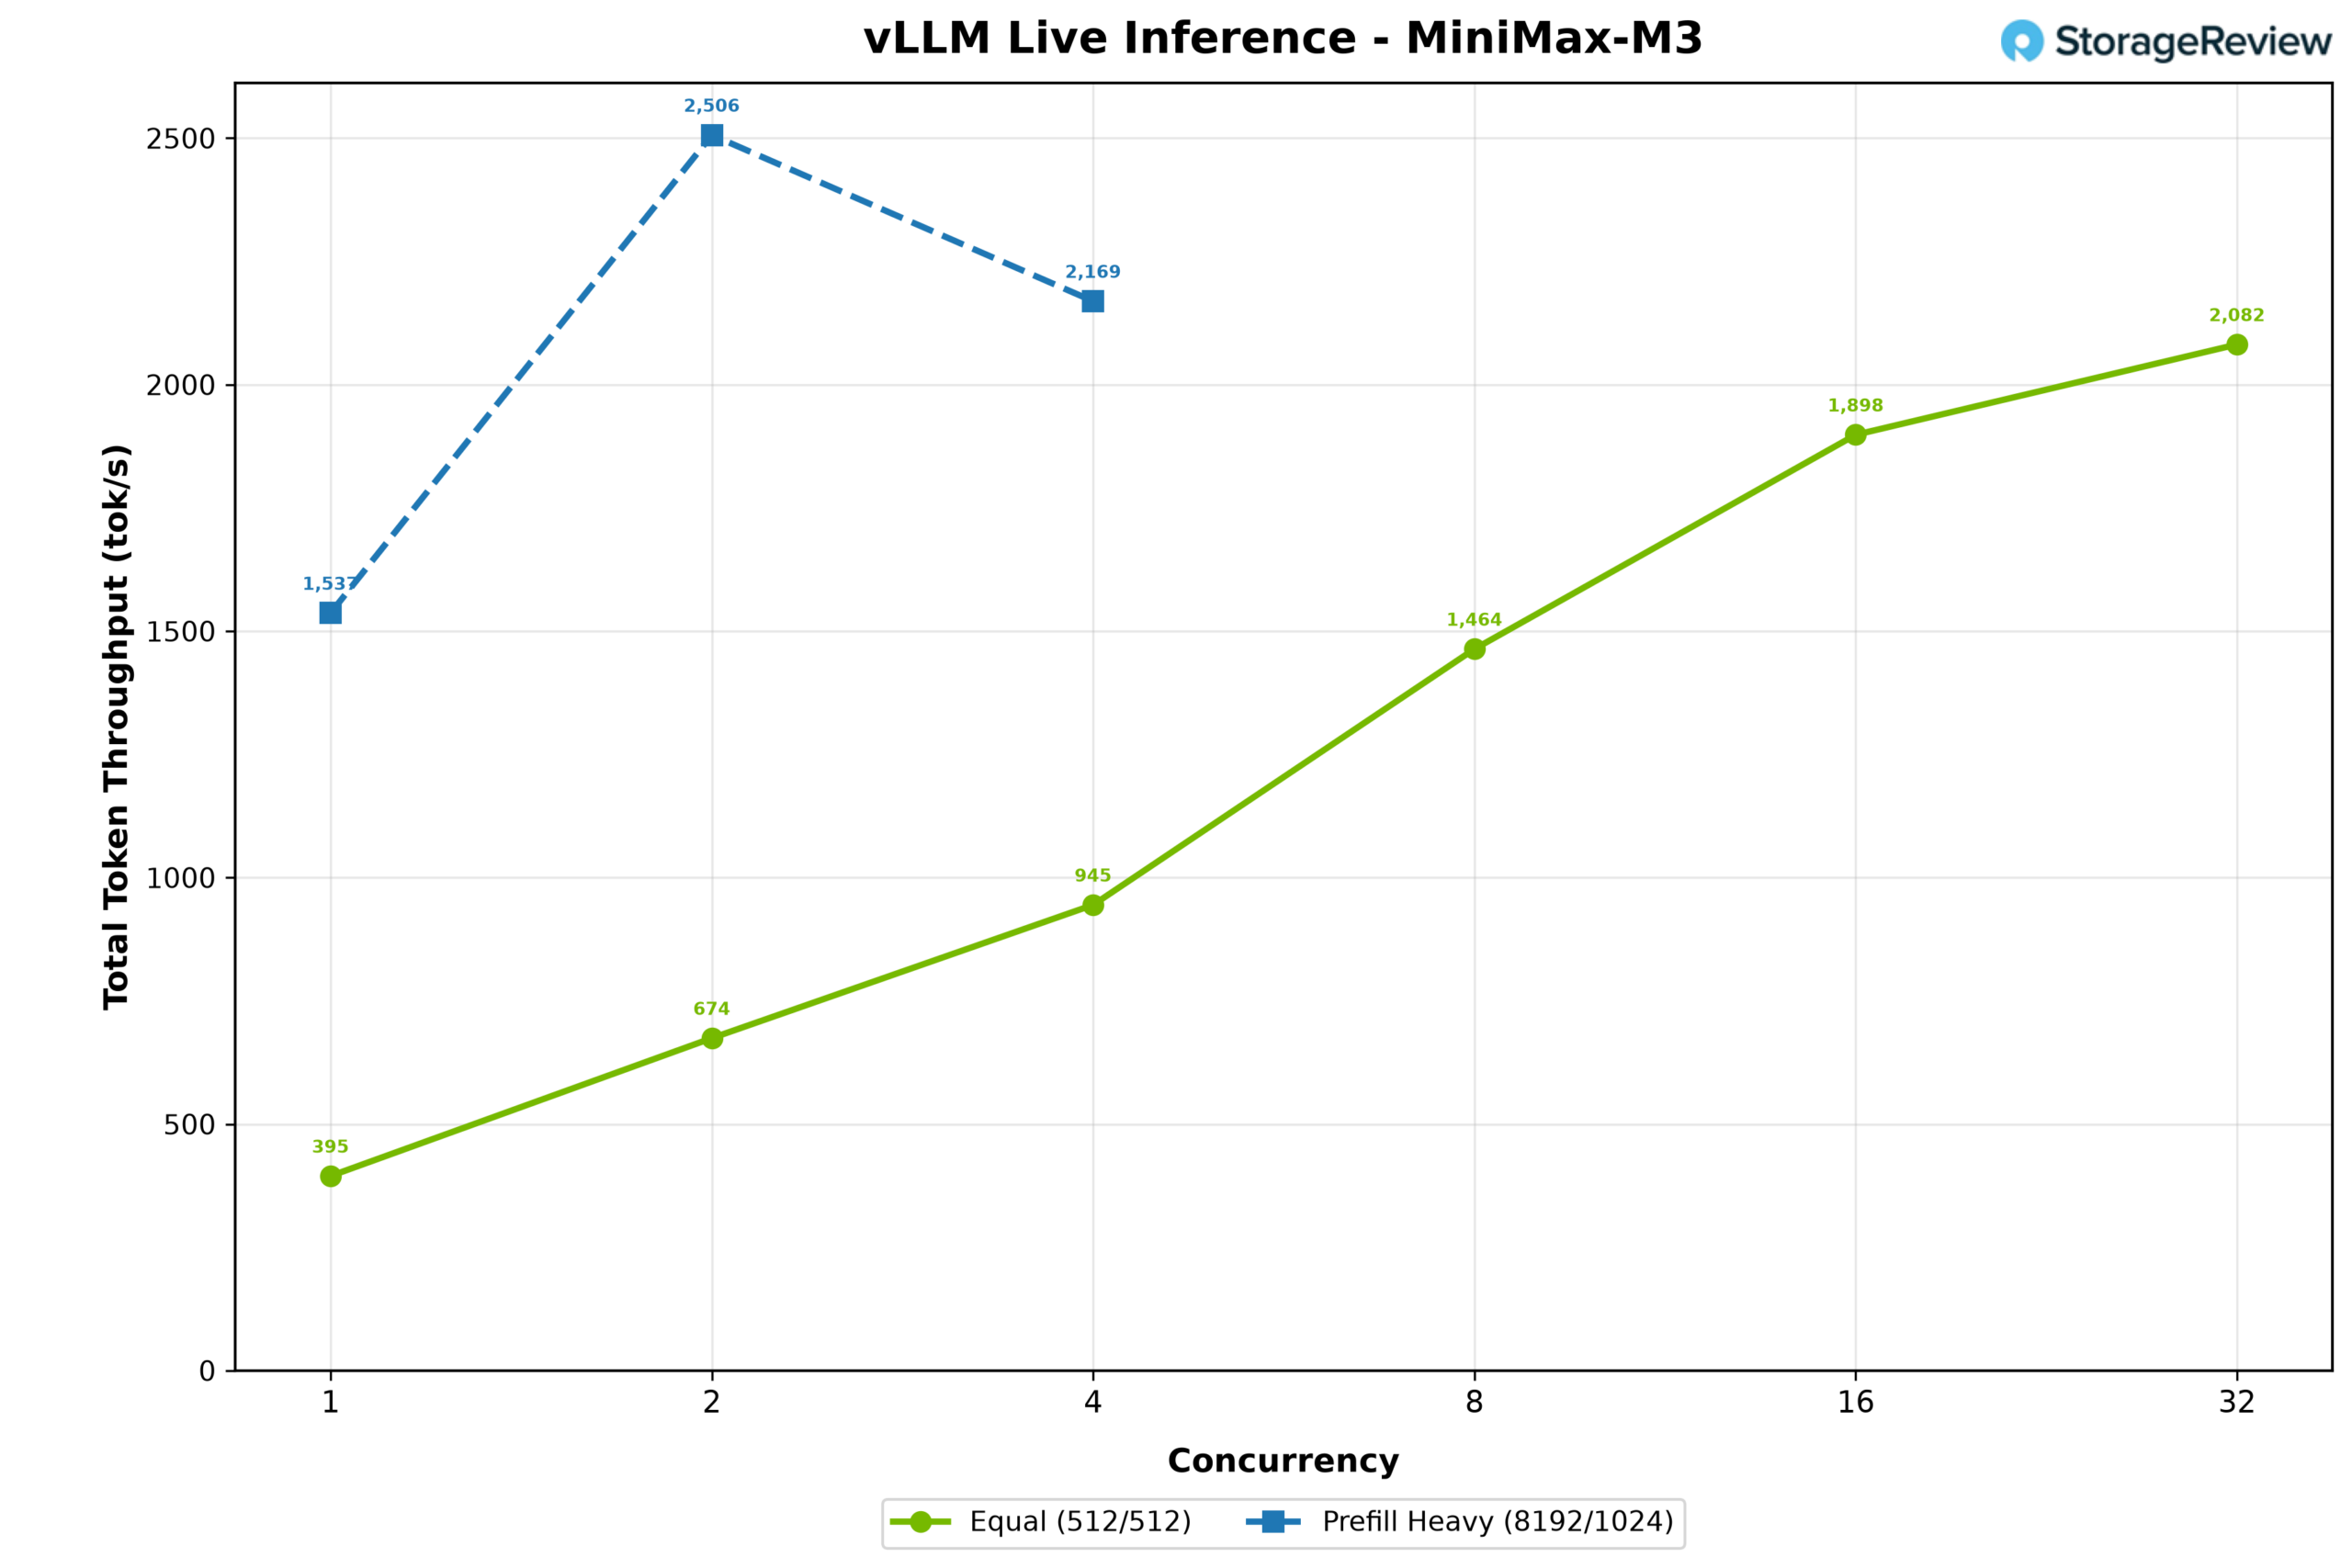
A taxa total de transferência de tokens seguiu um padrão semelhante, com a carga de trabalho 512/512 aumentando de 395 para 2,082 tokens por segundo, enquanto a carga de trabalho com uso intensivo de pré-preenchimento atingiu um pico de 2,506 tokens por segundo na concorrência 2, antes de cair para 2,169 na concorrência 4.
Modelos que não se encaixam no HBM
GLM-5.2 (NVFP4)
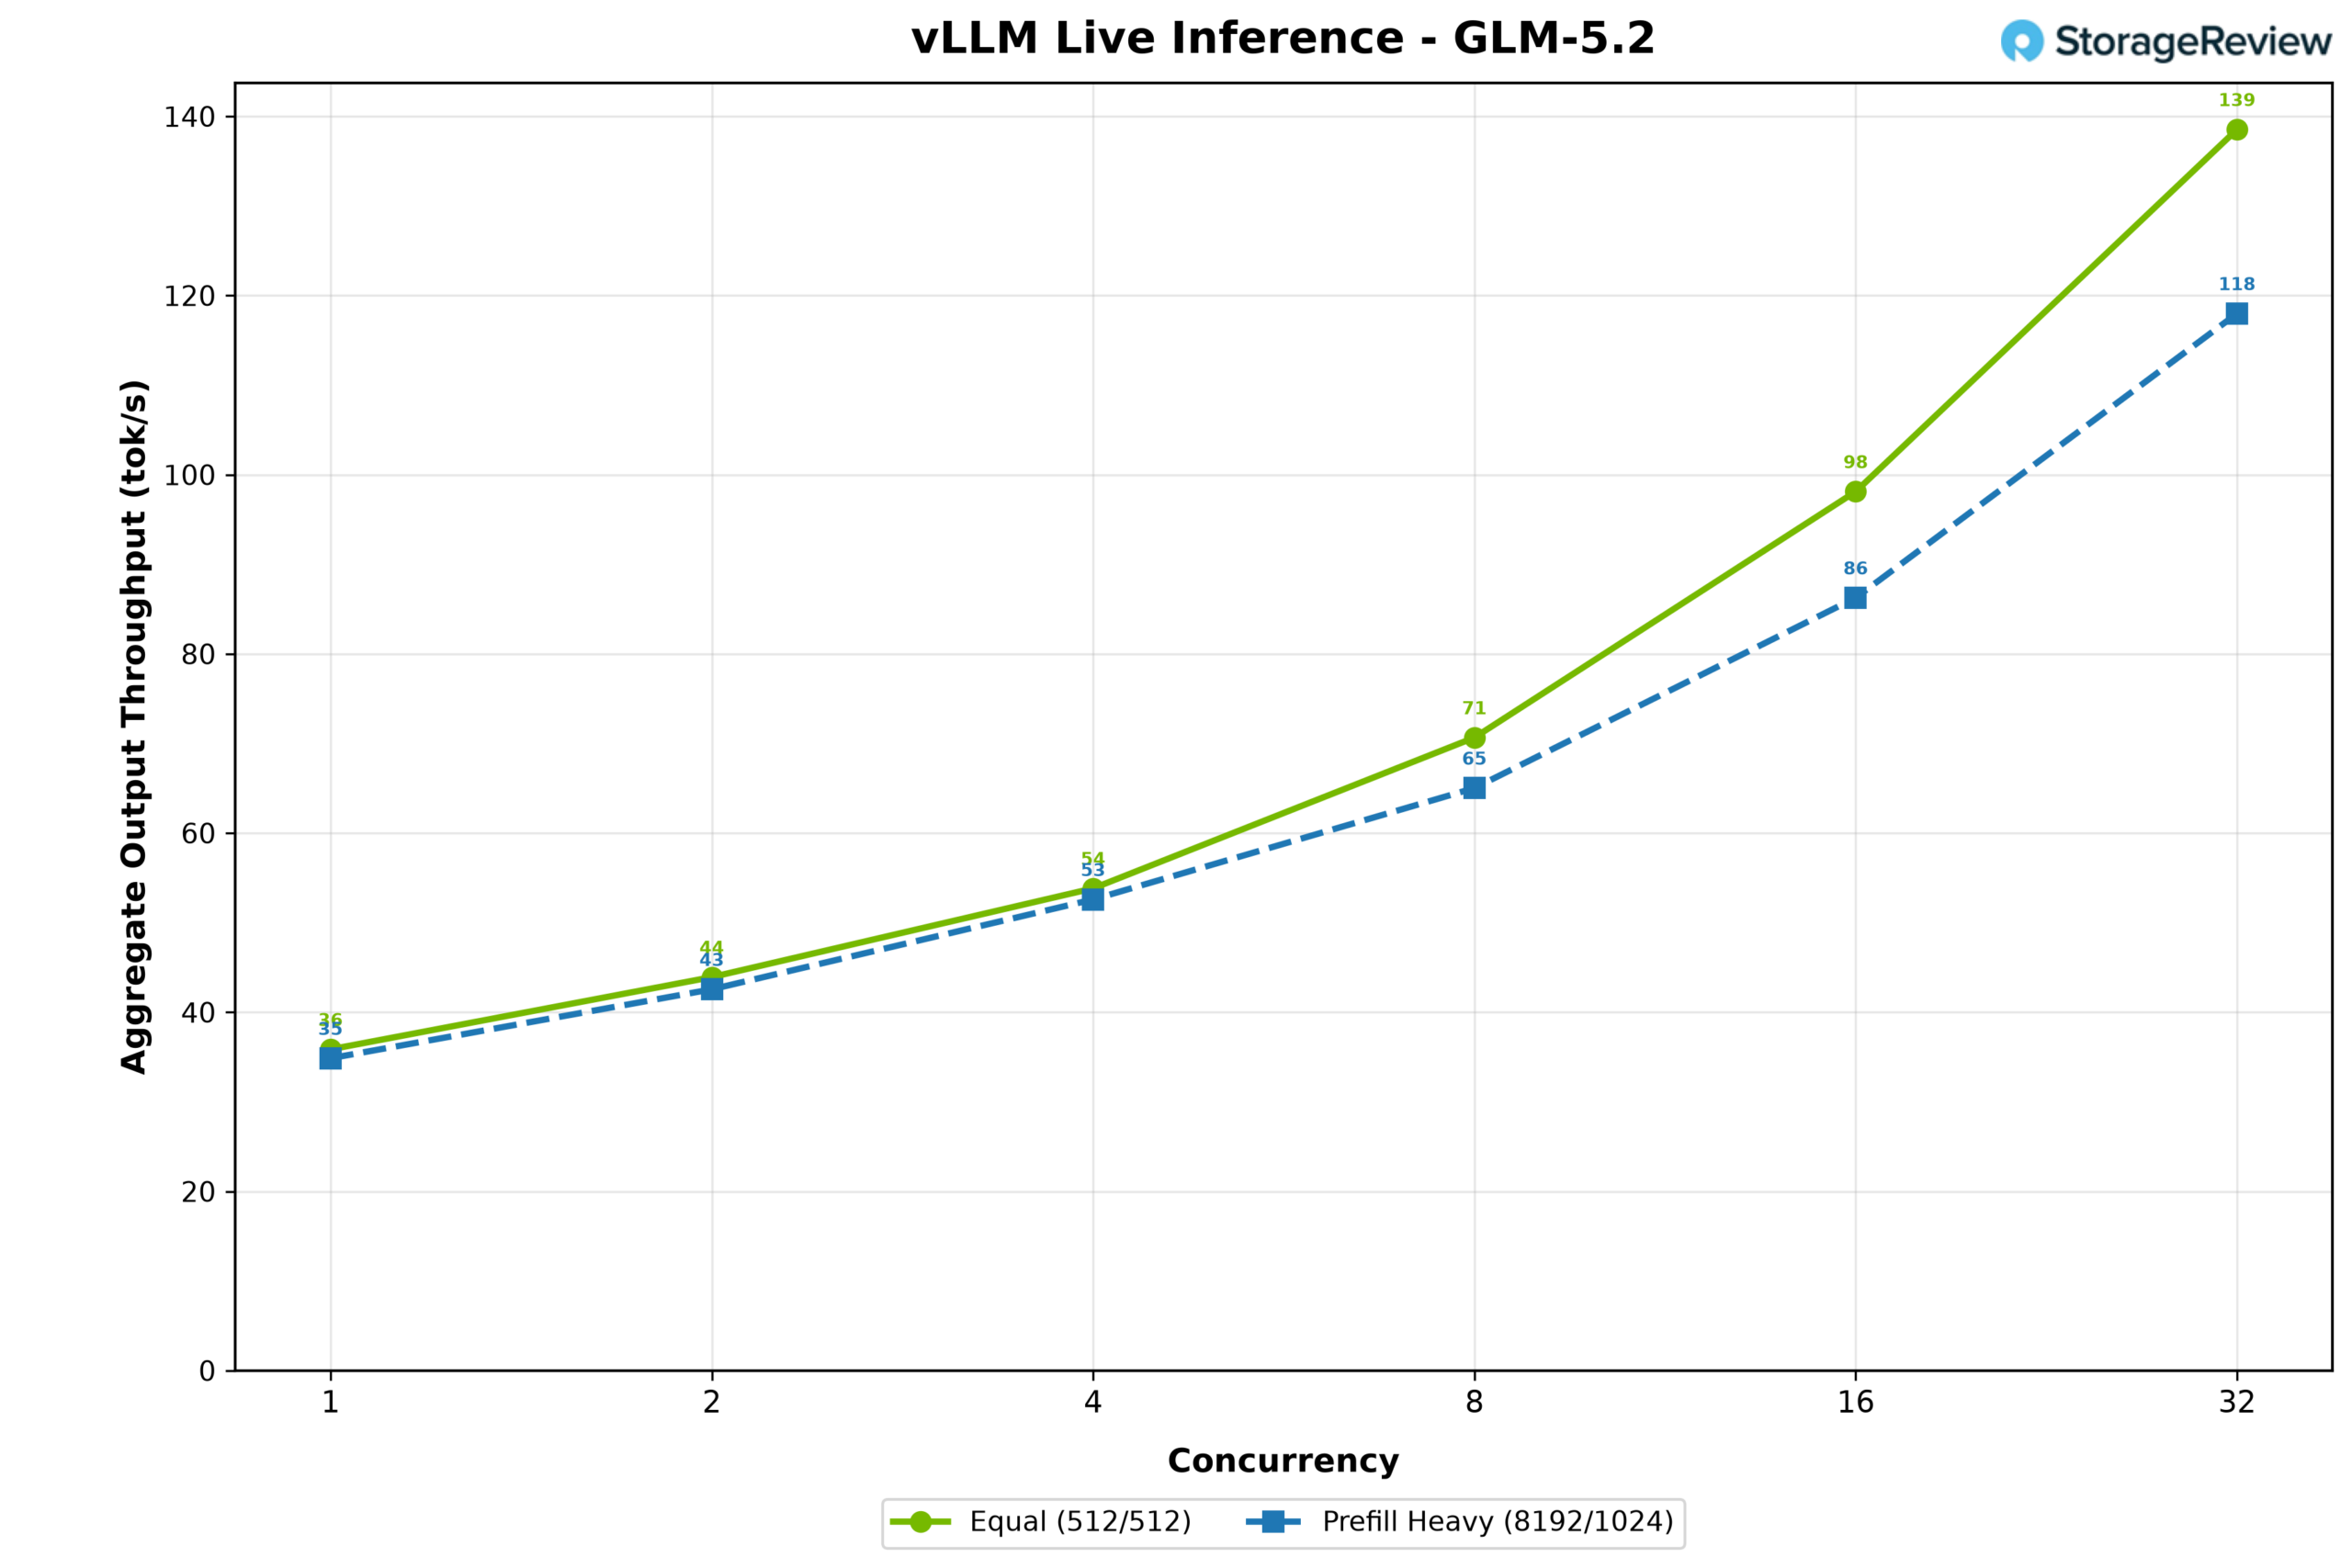
O GLM-5.2 foi testado usando o quantizador NVFP4 da NVIDIA. Seu checkpoint de 433 GB utilizou 218 GB de HBM, com 216 GB de pesos especialistas descarregados para a memória Grace. A decodificação especulativa MTP foi utilizada com um comprimento de aceitação sintético de 3 tokens. A taxa de transferência de saída na carga de trabalho 512/512 aumentou de 36 tokens por segundo na concorrência 1 para 139 na concorrência 32. A carga de trabalho 8,192/1,024 seguiu de perto, aumentando de 35 para 118 tokens por segundo. Os resultados semelhantes entre os dois perfis mostram que a geração permaneceu limitada principalmente pela movimentação dos especialistas descarregados entre a memória Grace e a GPU. A varredura terminou na concorrência 32 porque não havia HBM suficiente disponível para contexto adicional.
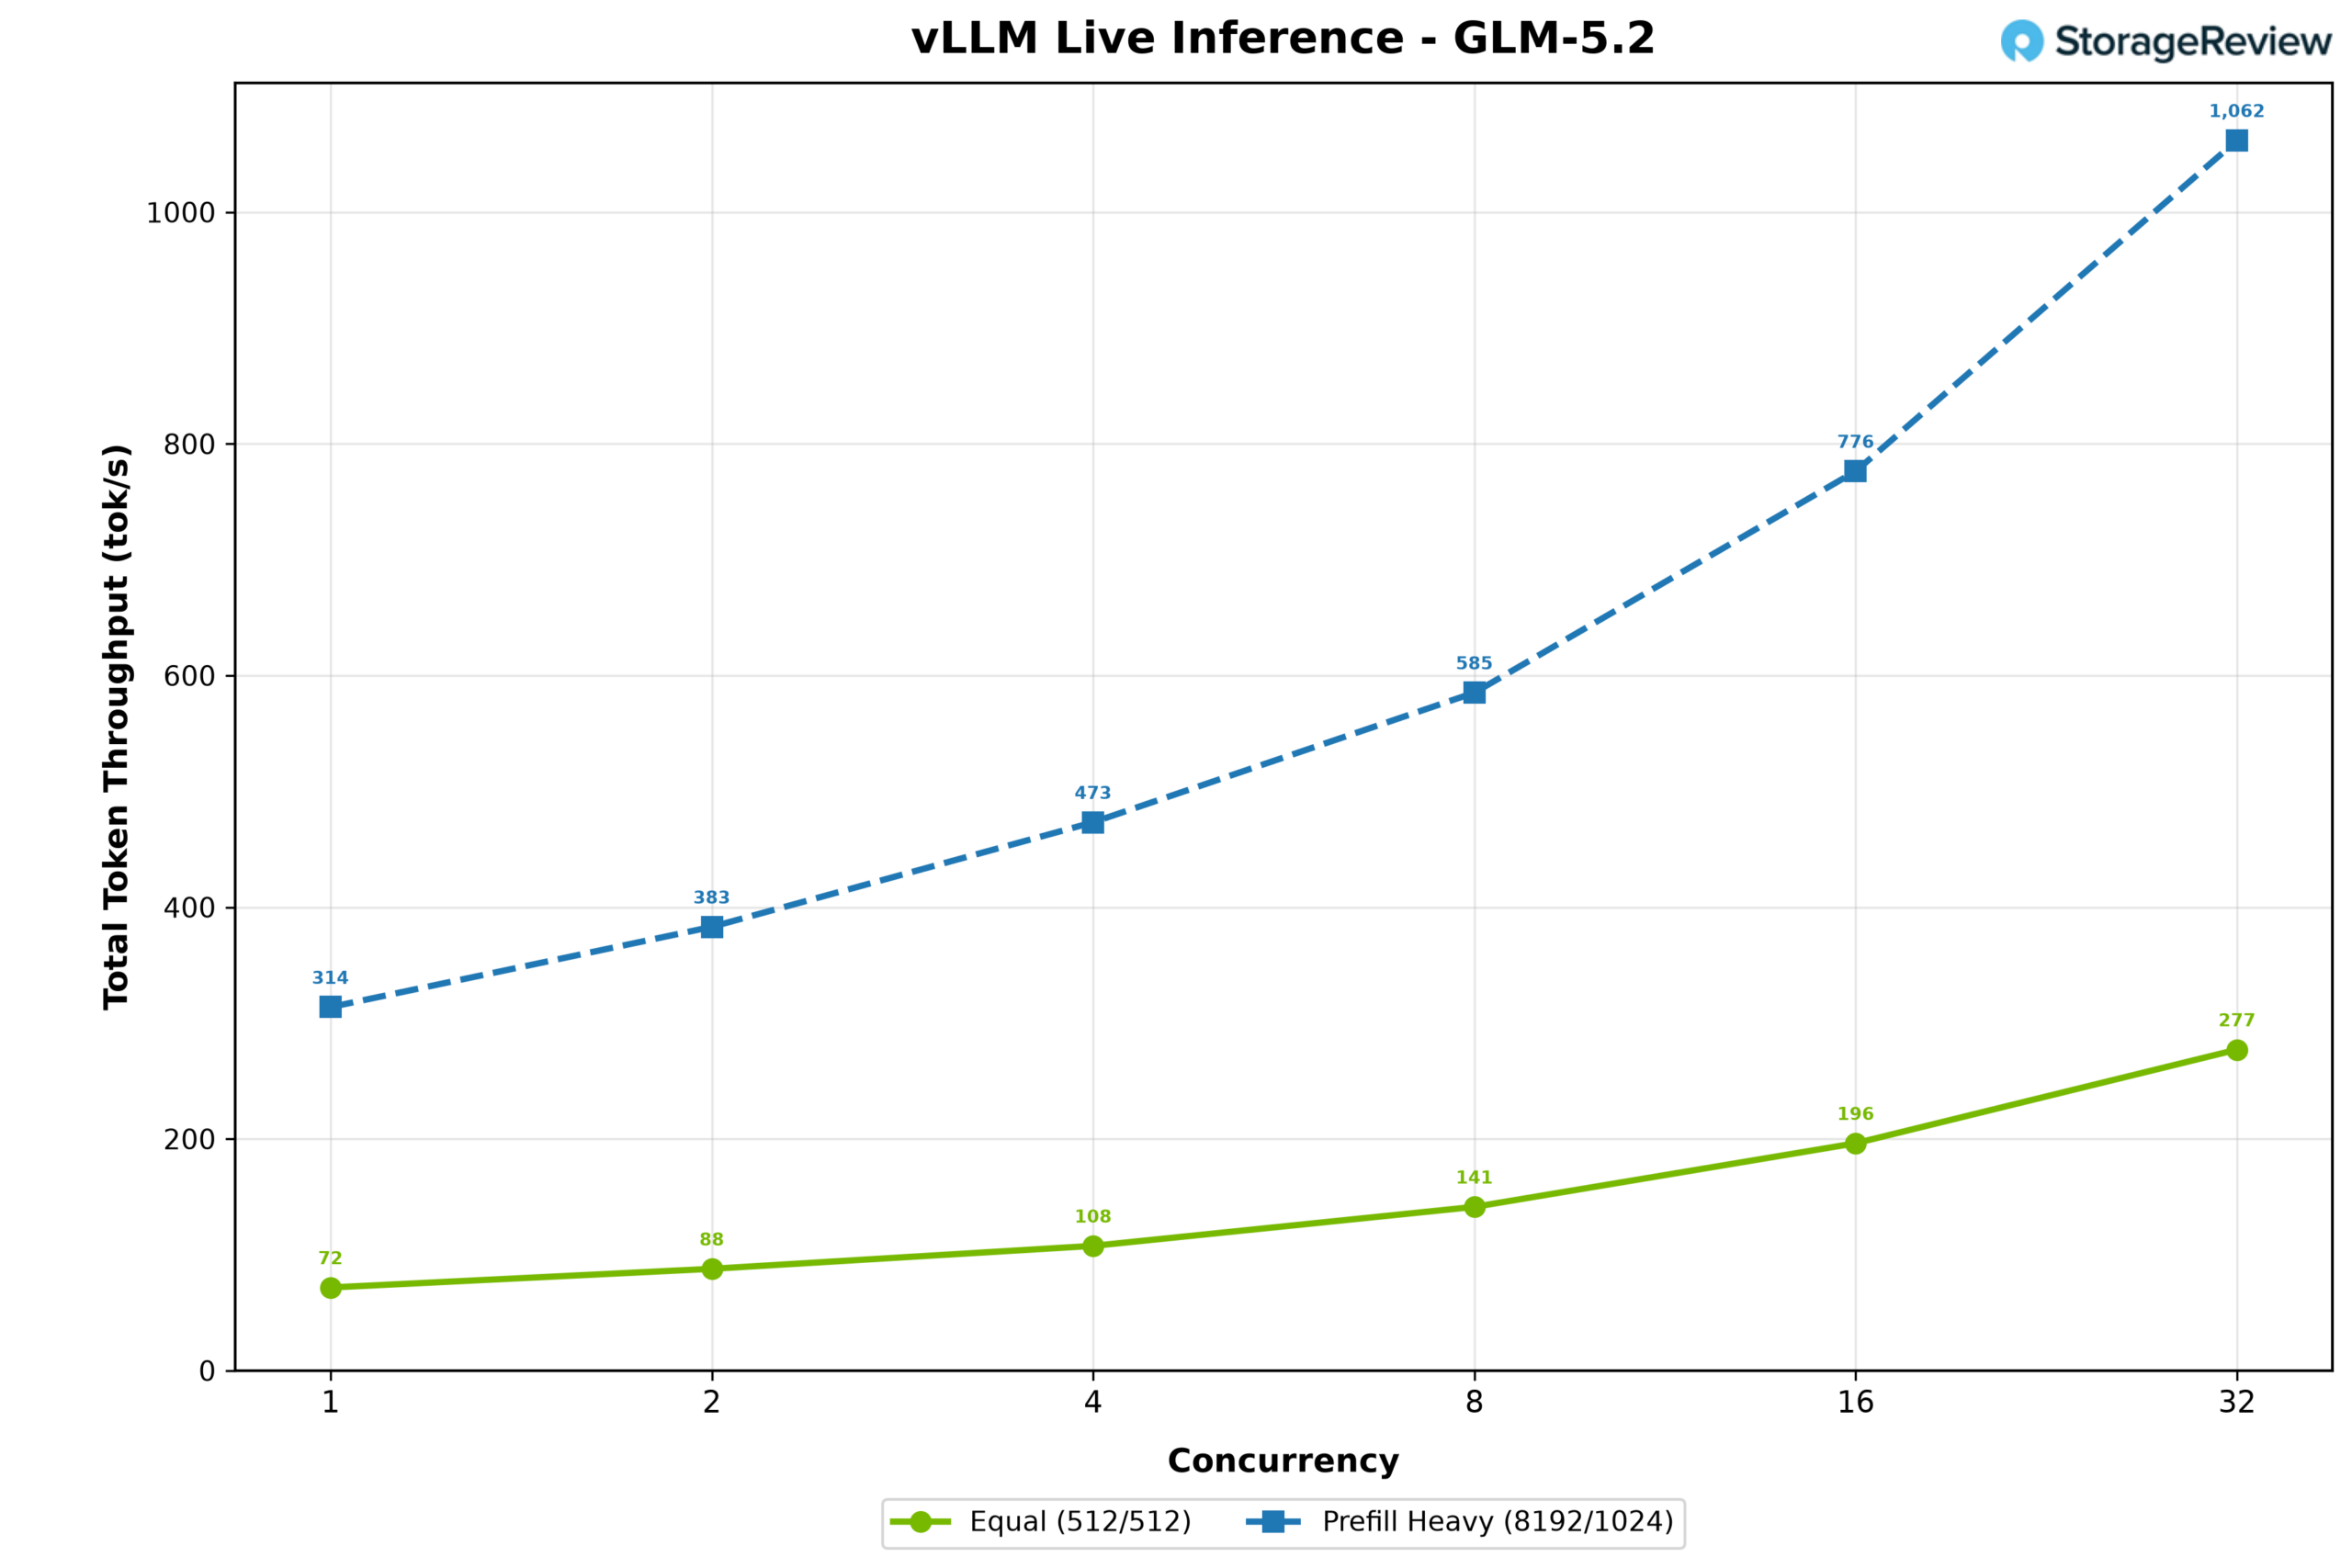
A taxa total de transferência de tokens seguiu o mesmo padrão, com a carga de trabalho 512/512 aumentando de 72 para 277 tokens por segundo e a carga de trabalho com uso intensivo de preenchimento automático subindo de 314 para 1,062; aqui, os prompts mais longos finalmente separam os dois perfis, já que os próprios tokens de preenchimento automático contam para o total.
Nemotron-3-Ultra 550B (NVFP4)
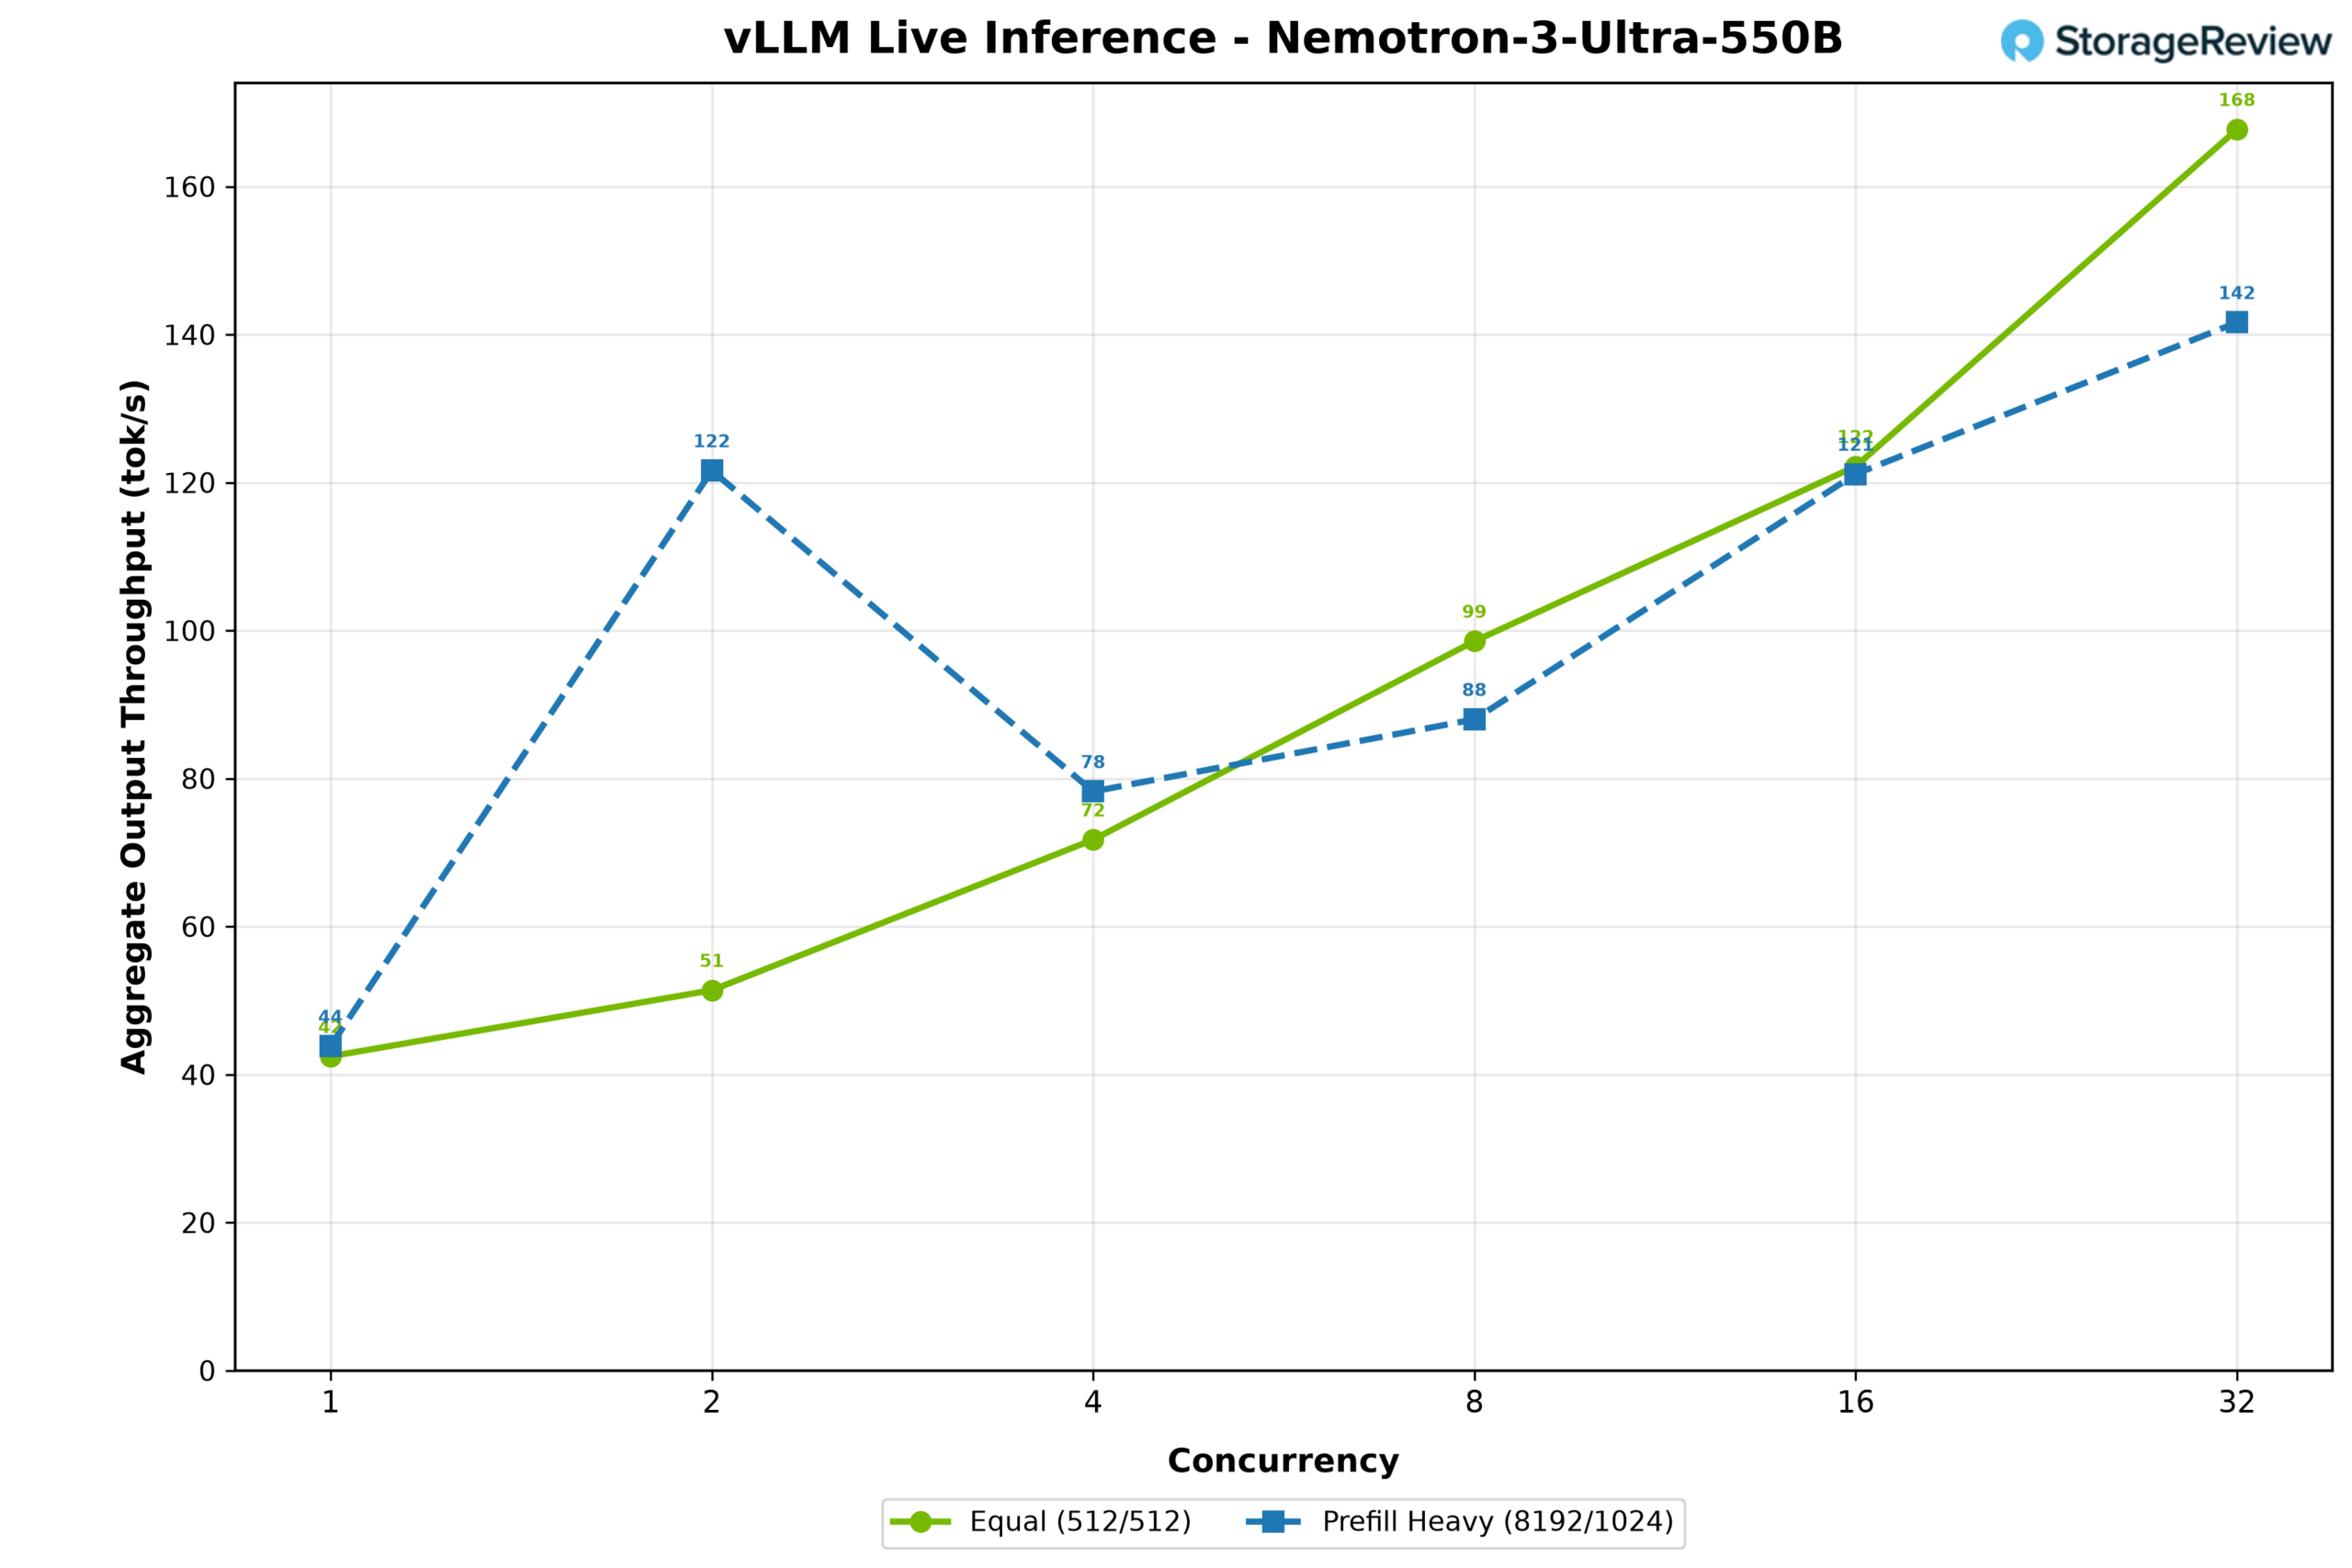
O Nemotron-3-Ultra 550B é o maior modelo que executamos e o que utiliza mais diretamente todo o pool coerente. Trata-se de um modelo híbrido Transformer-Mamba NVFP4 de 307 GB, muito grande para ser usado apenas com a memória HBM, com 114 GB de seus pesos alocados para a memória Grace. A decodificação especulativa MTP foi utilizada com um comprimento de aceitação sintético de 5 tokens. A taxa de transferência de saída na carga de trabalho 512/512 começou em 43 tokens por segundo na concorrência 1 e subiu para 168 na concorrência 32. A carga de trabalho com uso intensivo de pré-preenchimento apresentou um resultado mais interessante: a taxa de transferência subiu de 44 tokens por segundo na concorrência 1 para um pico de 122 na concorrência 2, mas depois caiu para 78 na concorrência 4, à medida que os prompts longos preenchiam o cache KV limitado. Assim como no GLM-5.2, os dois perfis se assemelham bastante, apontando novamente para a migração de especialistas entre o Grace e a GPU como o fator limitante, e não a capacidade computacional. A varredura terminou na concorrência 32 pelo mesmo motivo: não havia memória HBM suficiente disponível para contexto adicional.
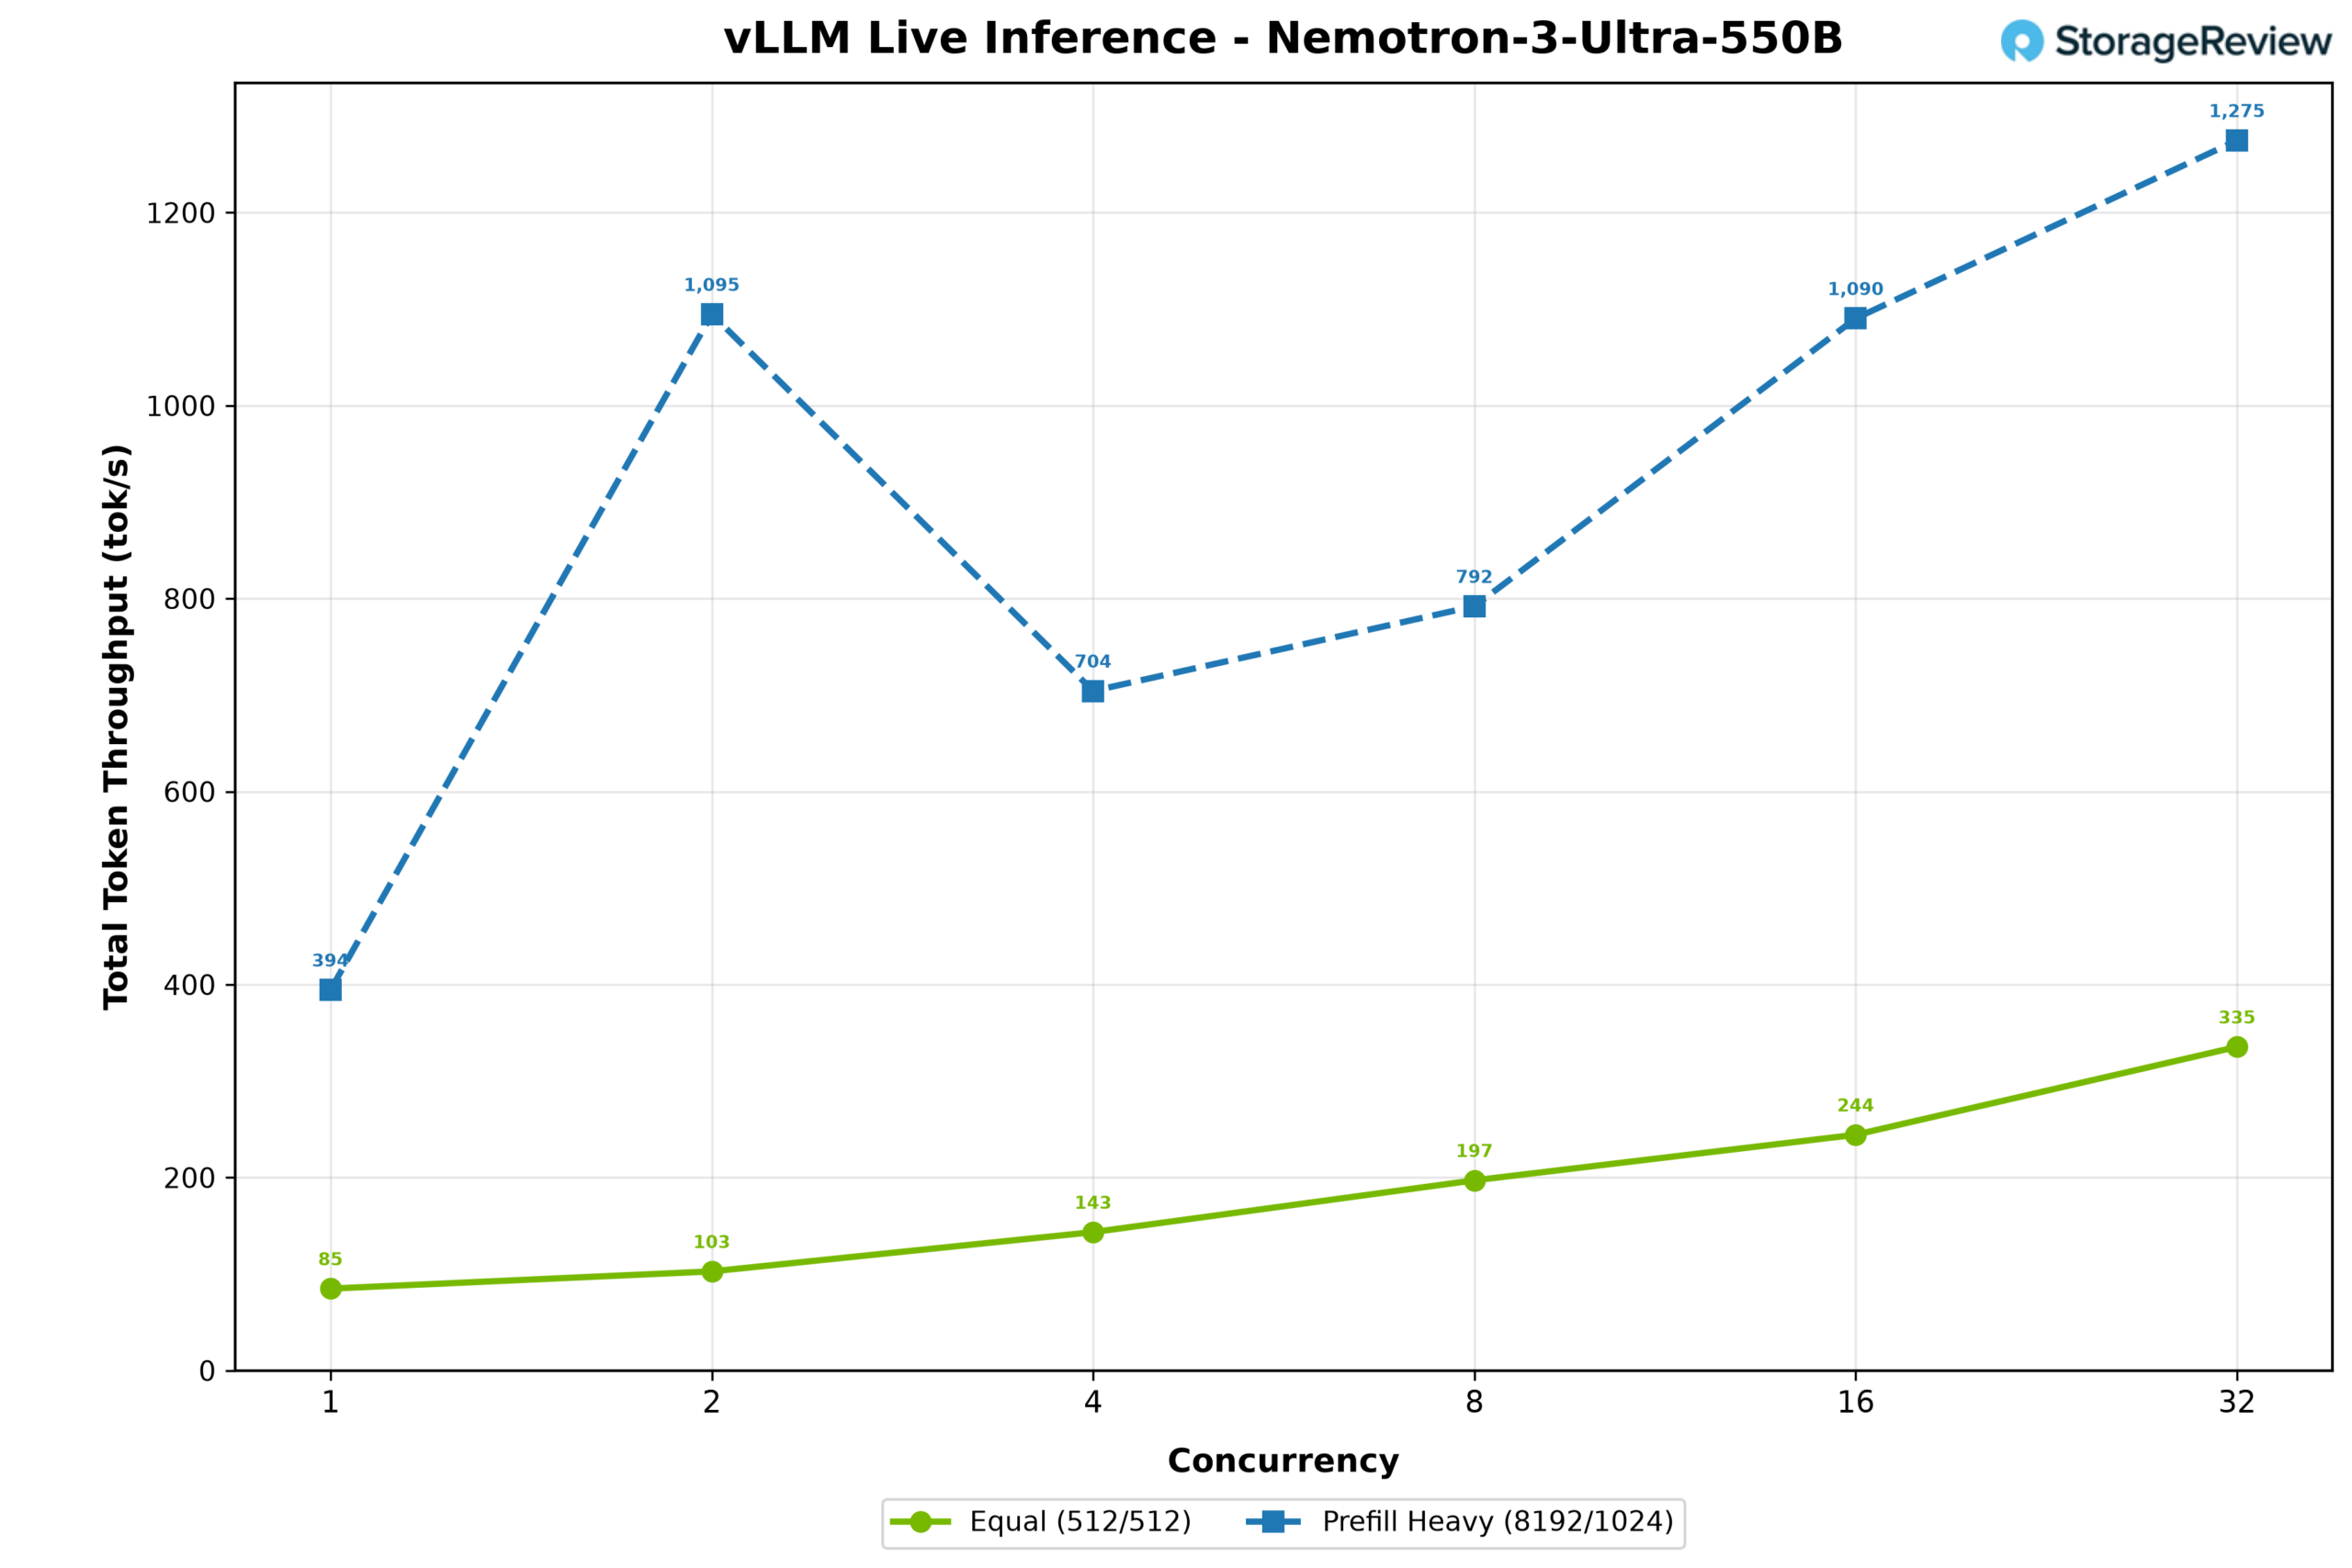
Em seguida, veio a taxa total de transferência de tokens, com a carga de trabalho com grande volume de pré-preenchimento atingindo um pico de 2,506 tokens por segundo na concorrência 2, antes de cair para 2,169 na concorrência 4, enquanto a carga de trabalho 512/512 escalou de 85 para 336 tokens por segundo.
WS300 vs. Blackwell RTX PRO 6000 vs. DGX Spark
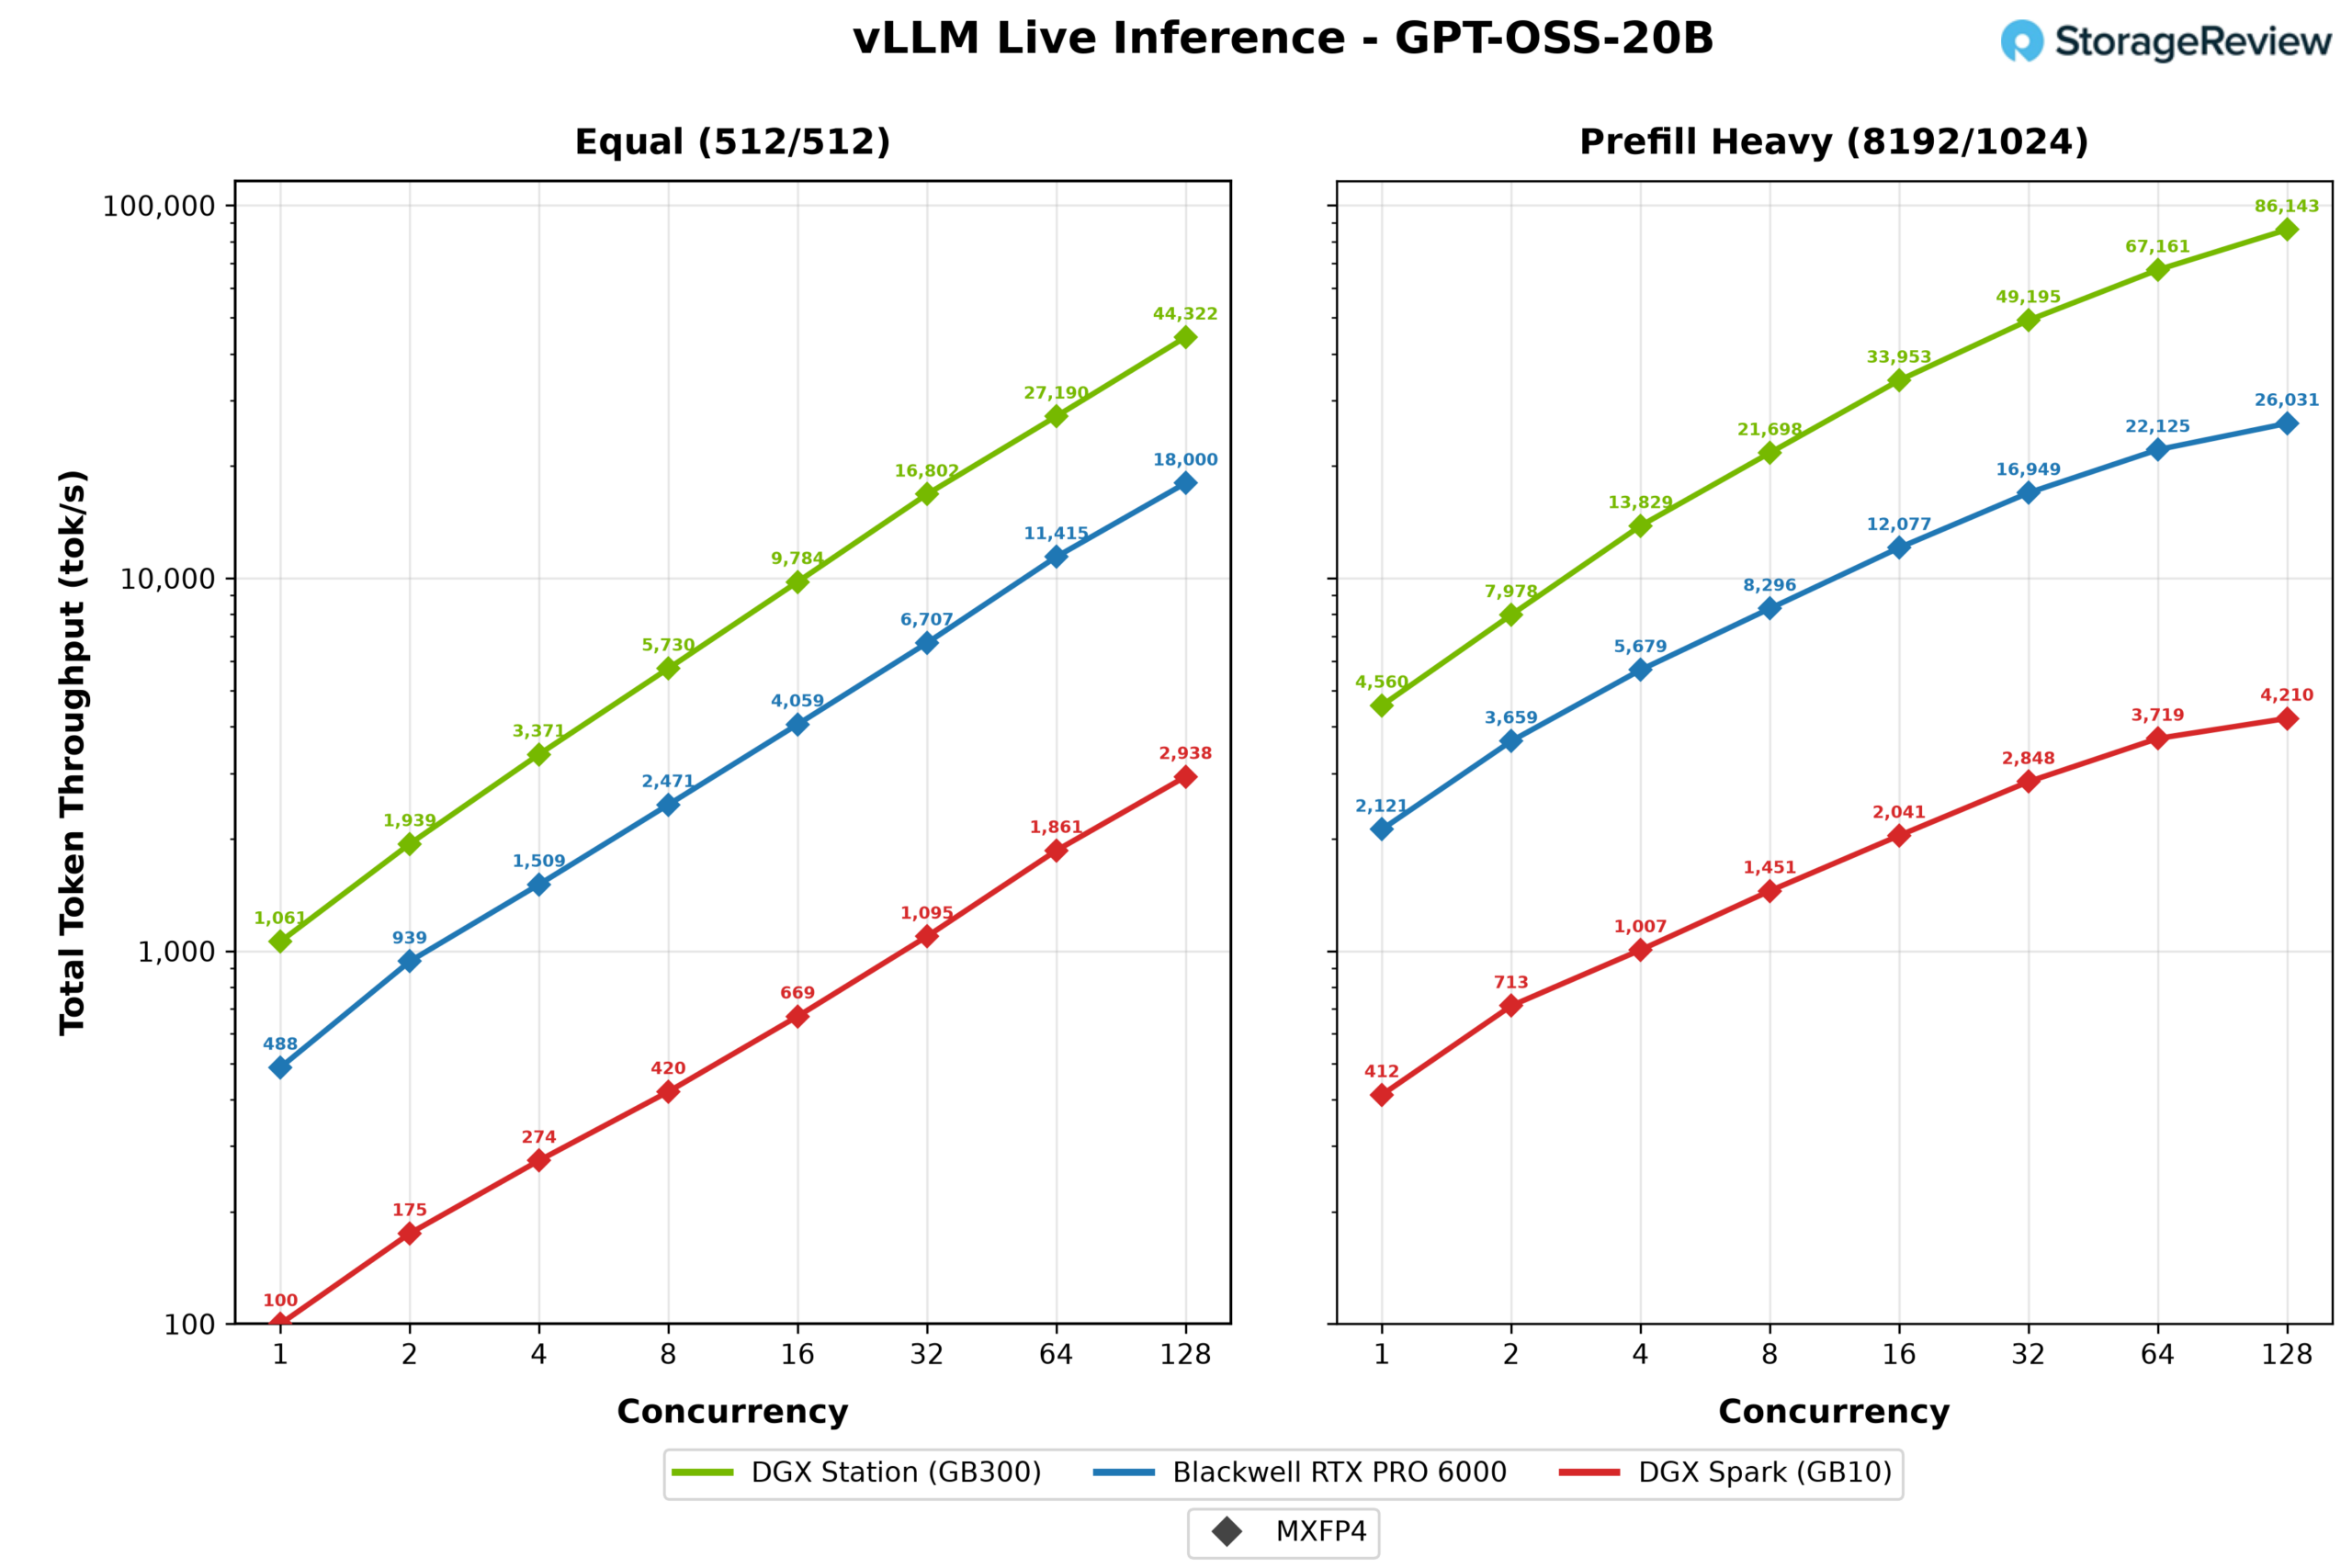
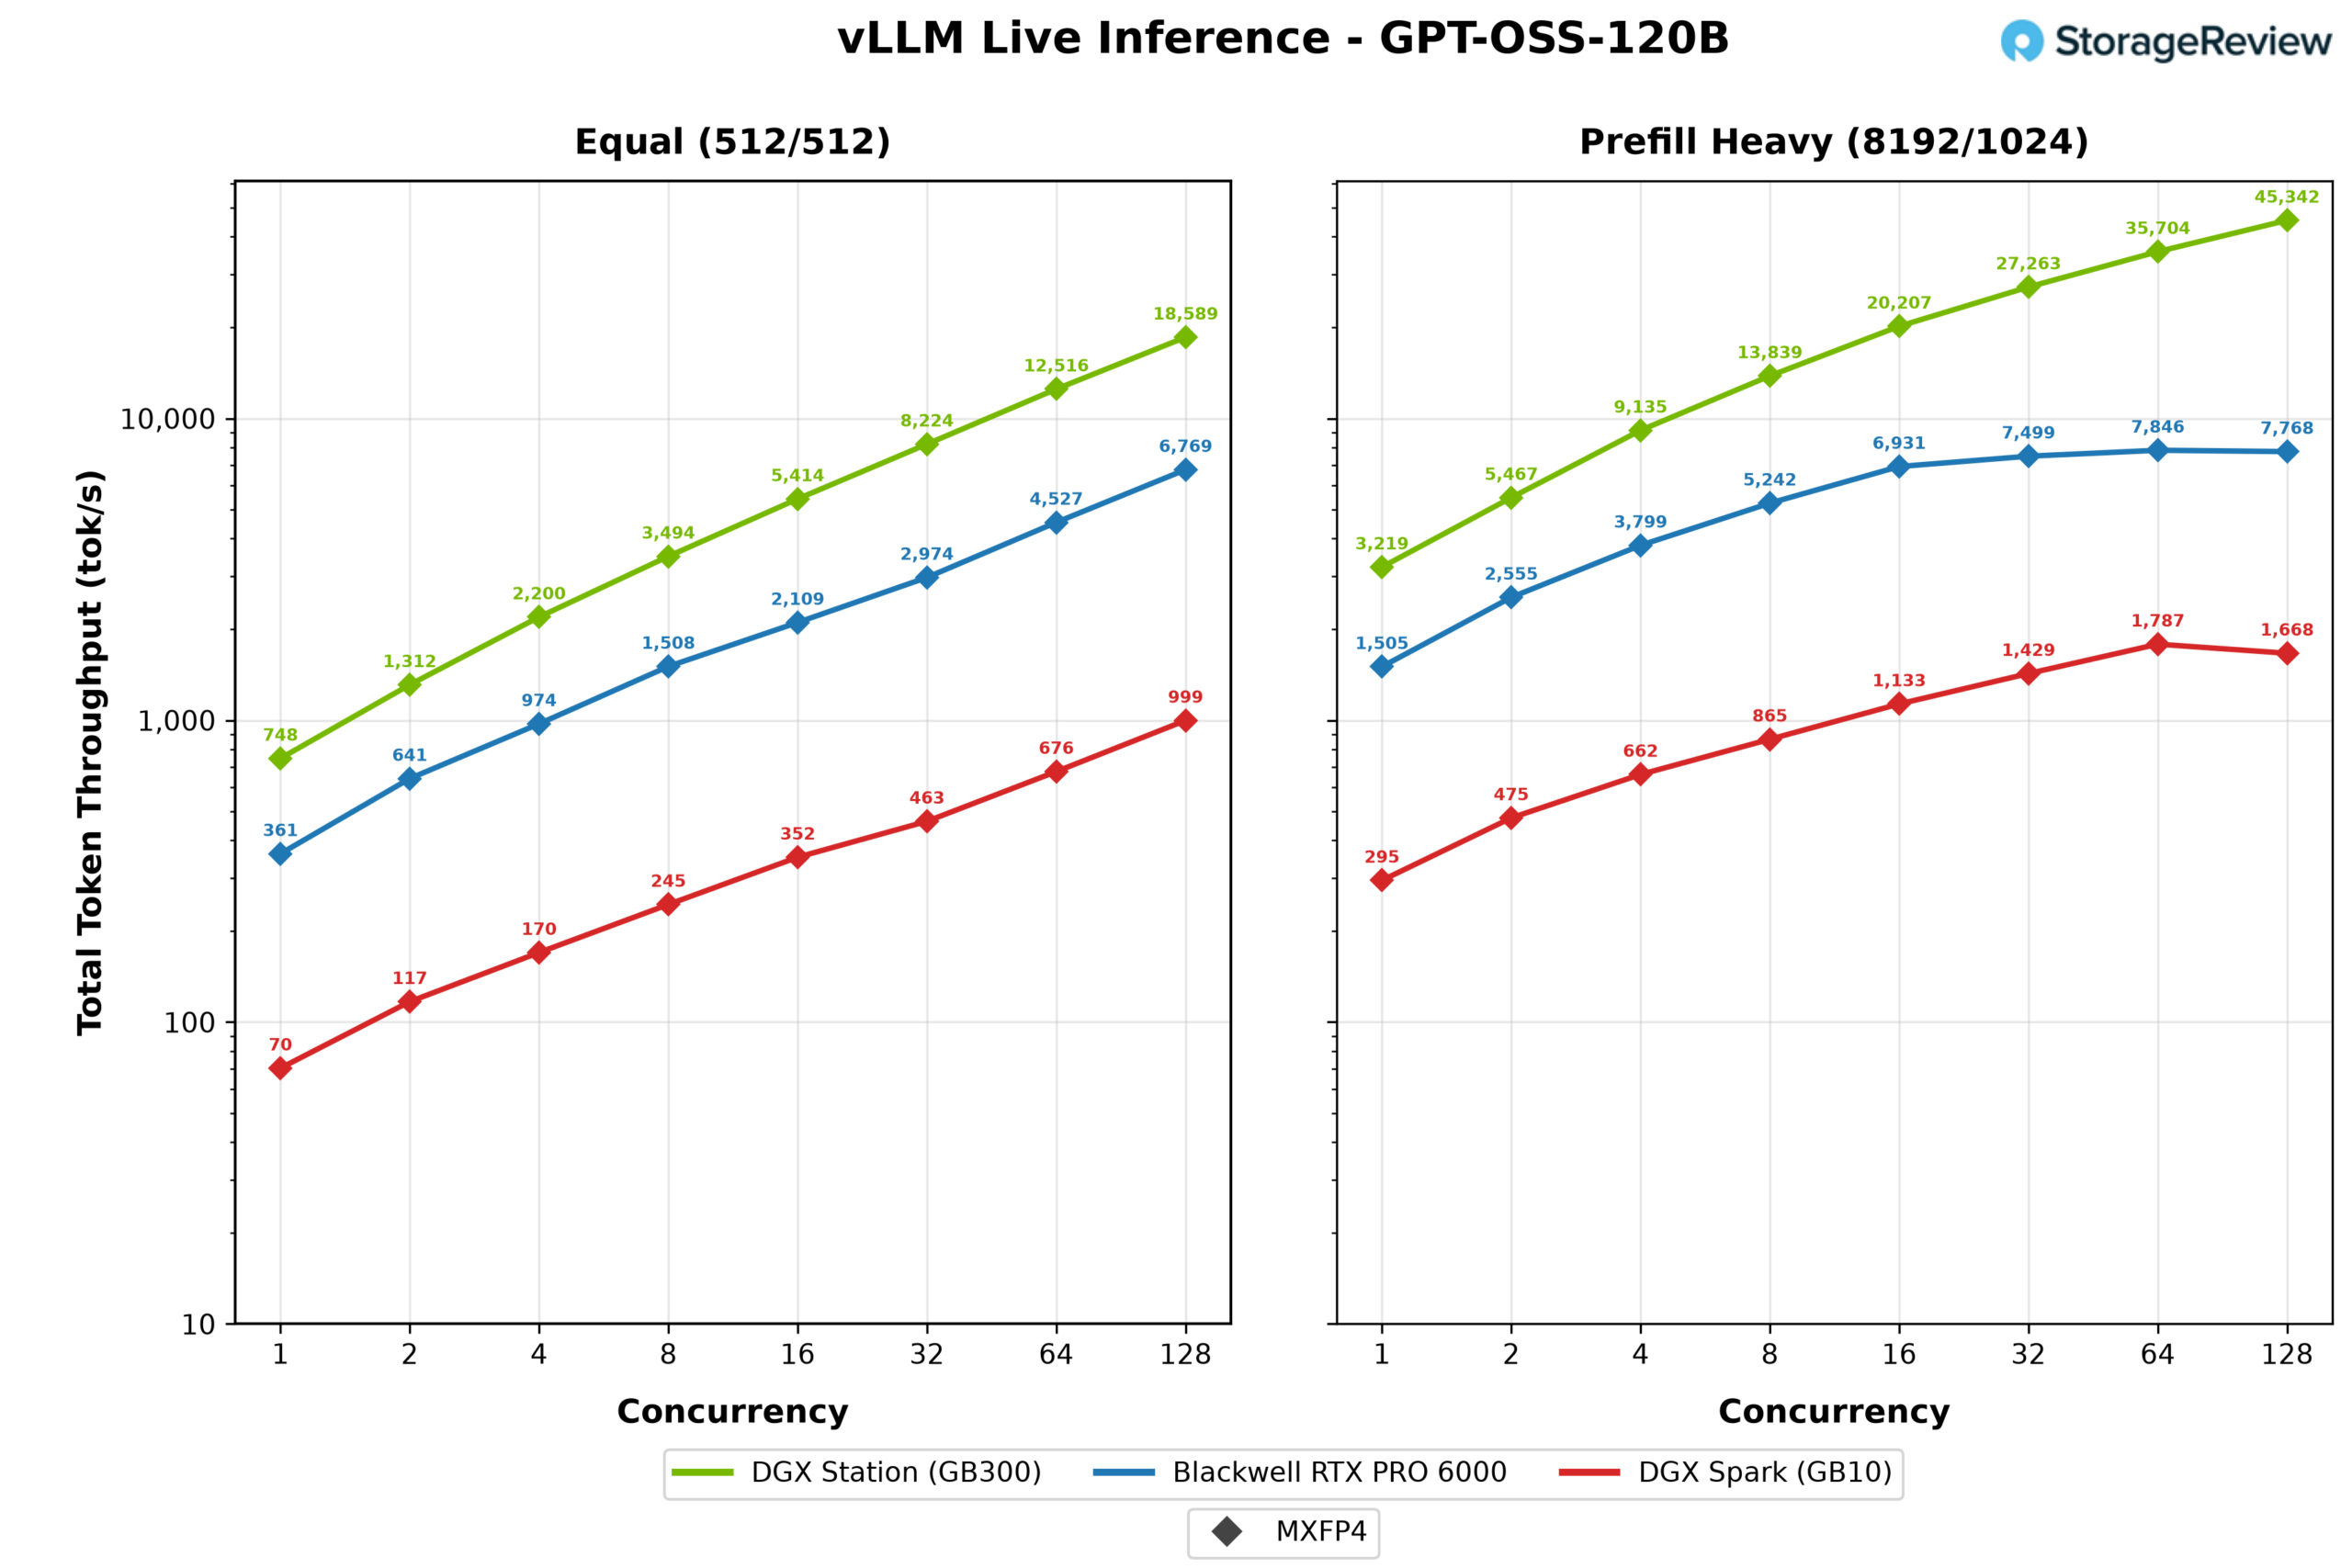
Nesta primeira parte dos nossos testes de inferência, o WS300 é comparado com as outras duas maneiras de ter o Blackwell em cima ou perto de uma mesa: o Blackwell RTX PRO 6000, a placa de workstation de 600W da NVIDIA, presente no Dell Pro Max Tower T2 que analisamos anteriormente, e o DGX Spark baseado no GB10, representado aqui pelo Acer Veriton GN100 . Cada sistema executou as mesmas cargas de trabalho de inferência ao vivo do vLLM em dois cenários: uma carga de trabalho equilibrada com 512 tokens de entrada e 512 de saída, e uma carga de trabalho com preenchimento prévio intensivo, com 8,192 tokens de entrada e 1,024 de saída, em níveis de concorrência de 1 a 128. Apresentamos graficamente a saída agregada e a taxa de transferência total para cada modelo que os três sistemas podem utilizar em comum: GPT-OSS-20B e GPT-OSS-120B em seu MXFP4 nativo, Llama 3.1 8B em BF16, FP8 e NVFP4, e Mistral Small 24B e Qwen3 Coder 30B em BF16 e FP8.
GPT-OSS-20B
O GPT-OSS-20B é o teste mais amigável do conjunto, um checkpoint que se encaixa facilmente nos três sistemas. Com a mesma carga de trabalho, o WS300 escalou sem problemas para 22,161 tokens de saída por segundo com 128 fluxos simultâneos, aproximadamente 2.5 vezes o RTX PRO 6000 com 9,000 e 15 vezes o DGX Spark com 1,469. Os resultados de fluxo único contam a mesma história em menor escala: 530 tokens por segundo na Station, 244 na placa e 50 no Spark.
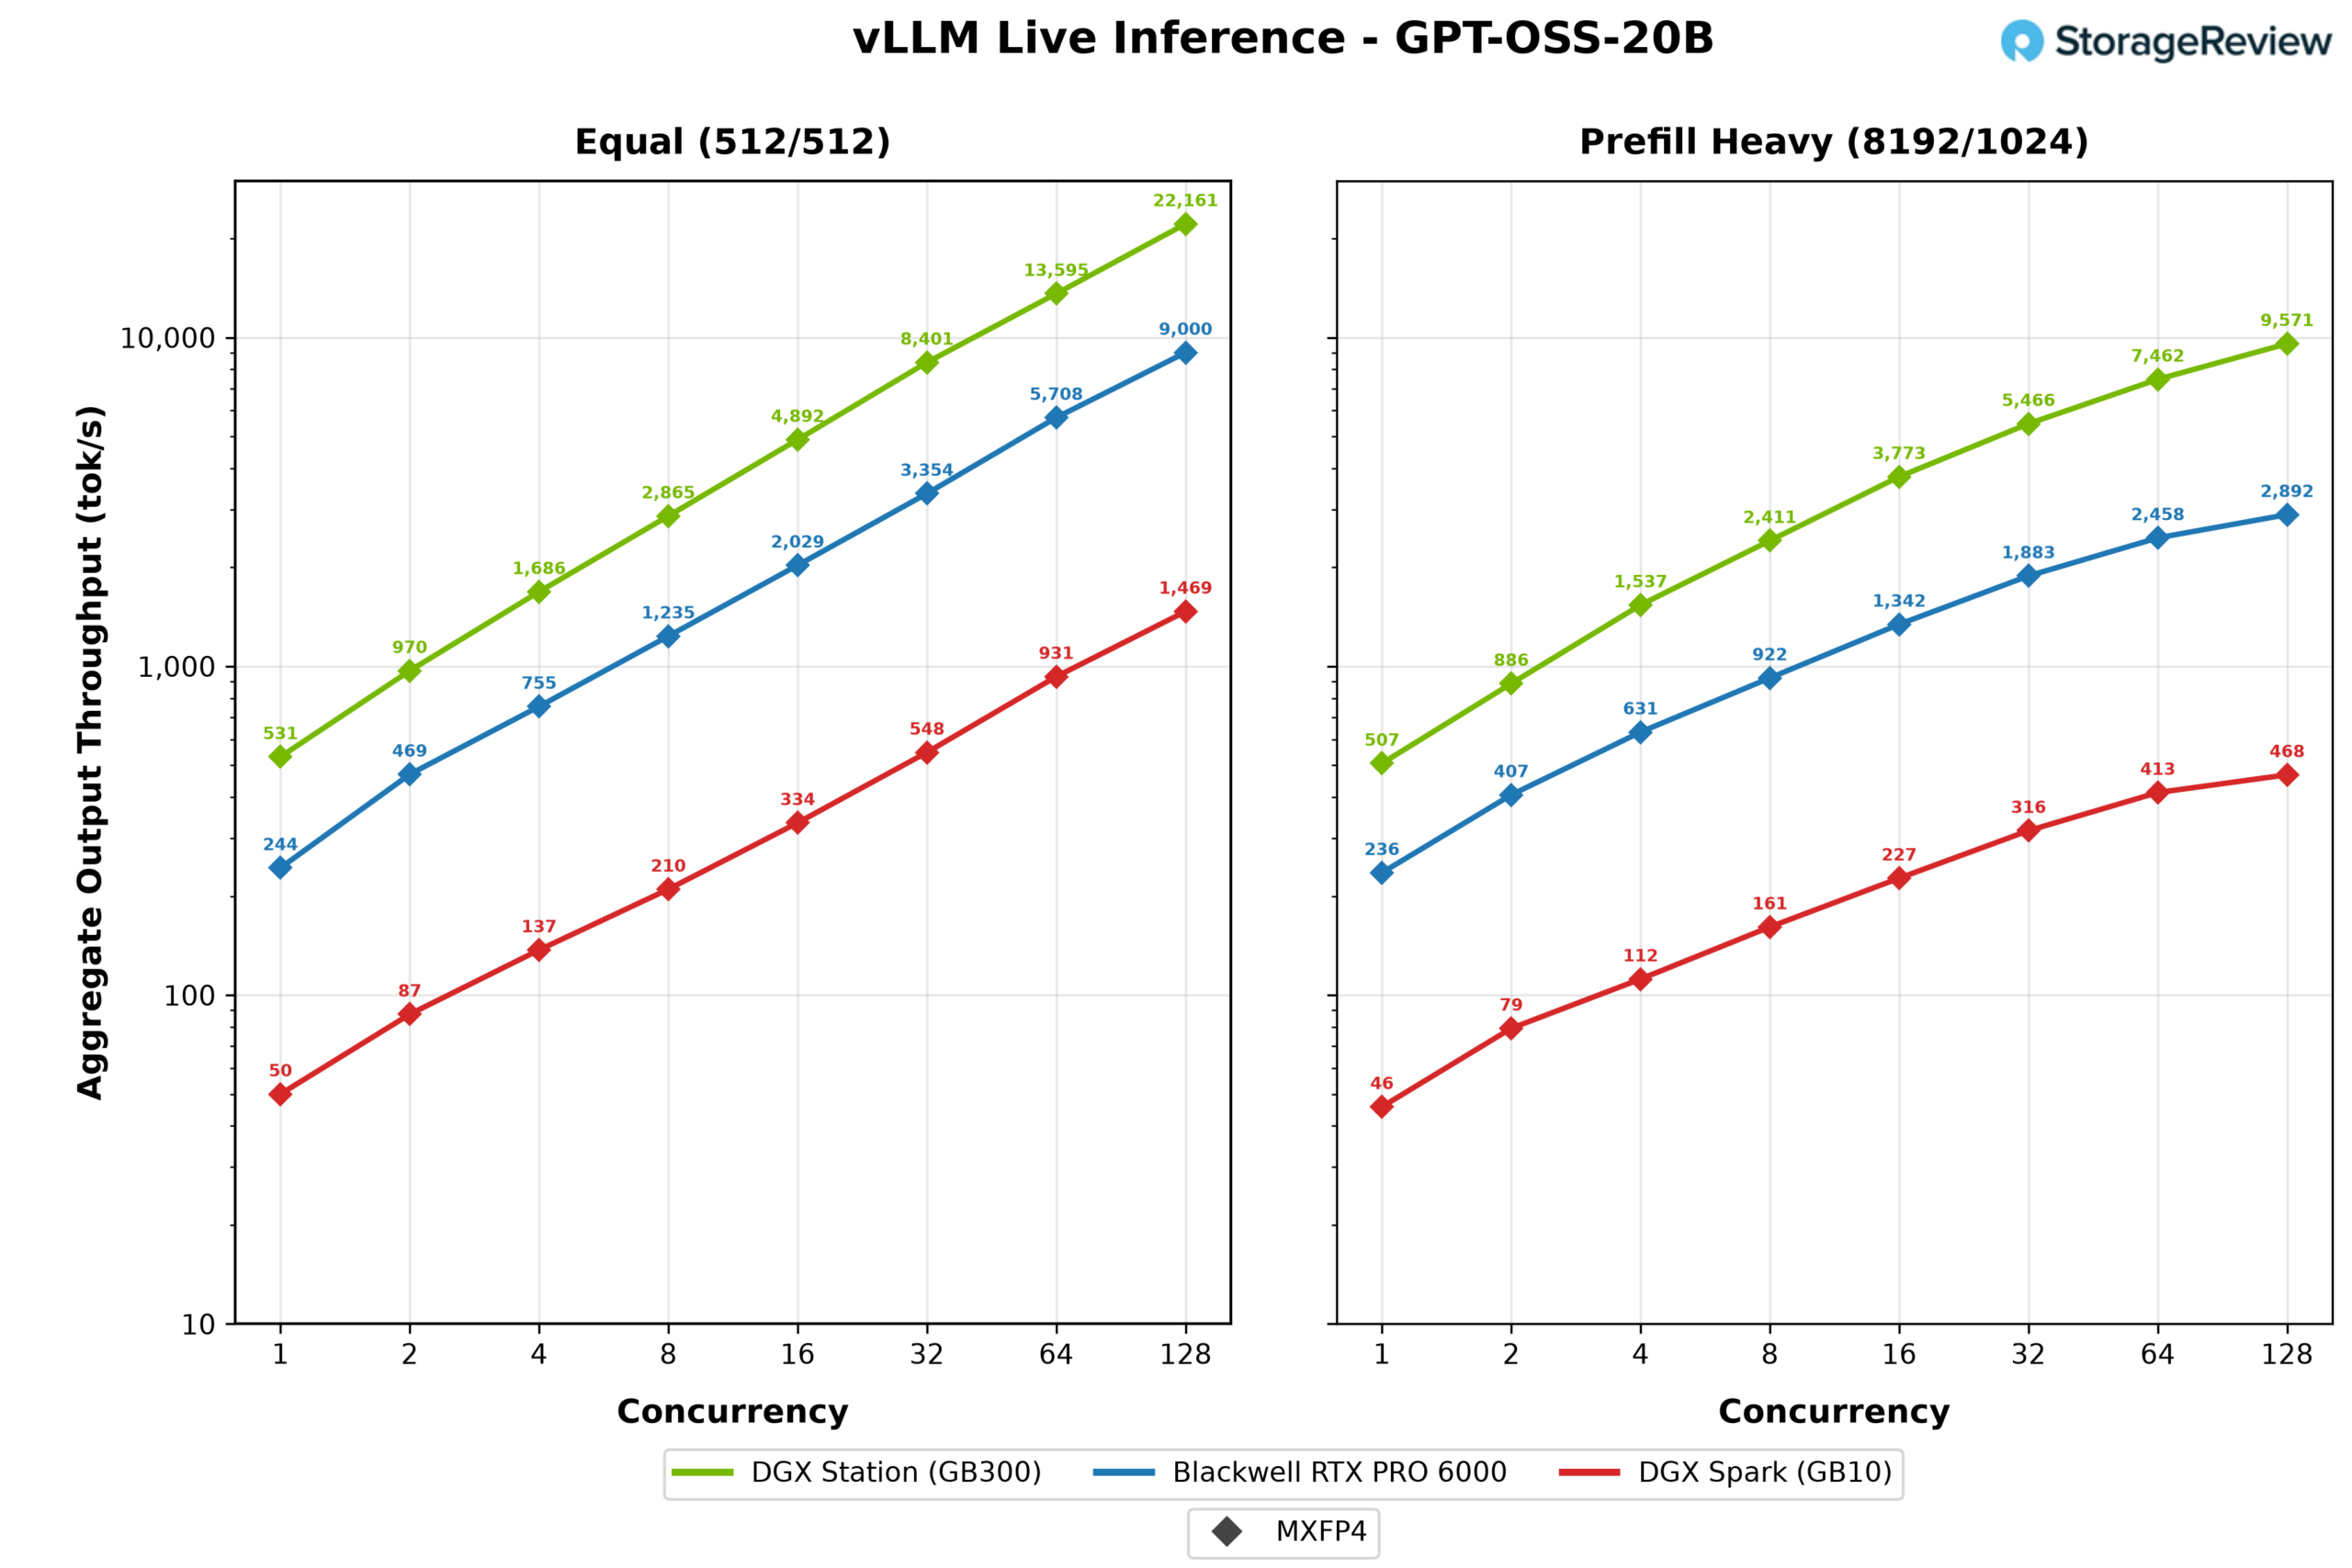
O cenário com uso intensivo de pré-preenchimento diferencia ainda mais os concorrentes. Ao processar 8,192 solicitações de tokens, o WS300 ainda entregou 9,572 tokens de saída por segundo no pico, o que resulta em mais de 86,000 tokens totais por segundo quando o pré-preenchimento é contabilizado, enquanto o RTX PRO 6000 atingiu o pico de 2,892 e o Spark, 468.
GPT-OSS-120B
Ao passar para o GPT-OSS-120B, todos os três sistemas ainda conseguem carregar o modelo, mas a hierarquia de memória começa a importar. O WS300 atingiu um pico de 9,294 tokens de saída por segundo sob a mesma carga de trabalho, 2.7 vezes mais que o RTX PRO 6000, com 3,384, e quase 19 vezes mais que o DGX Spark, com 500.
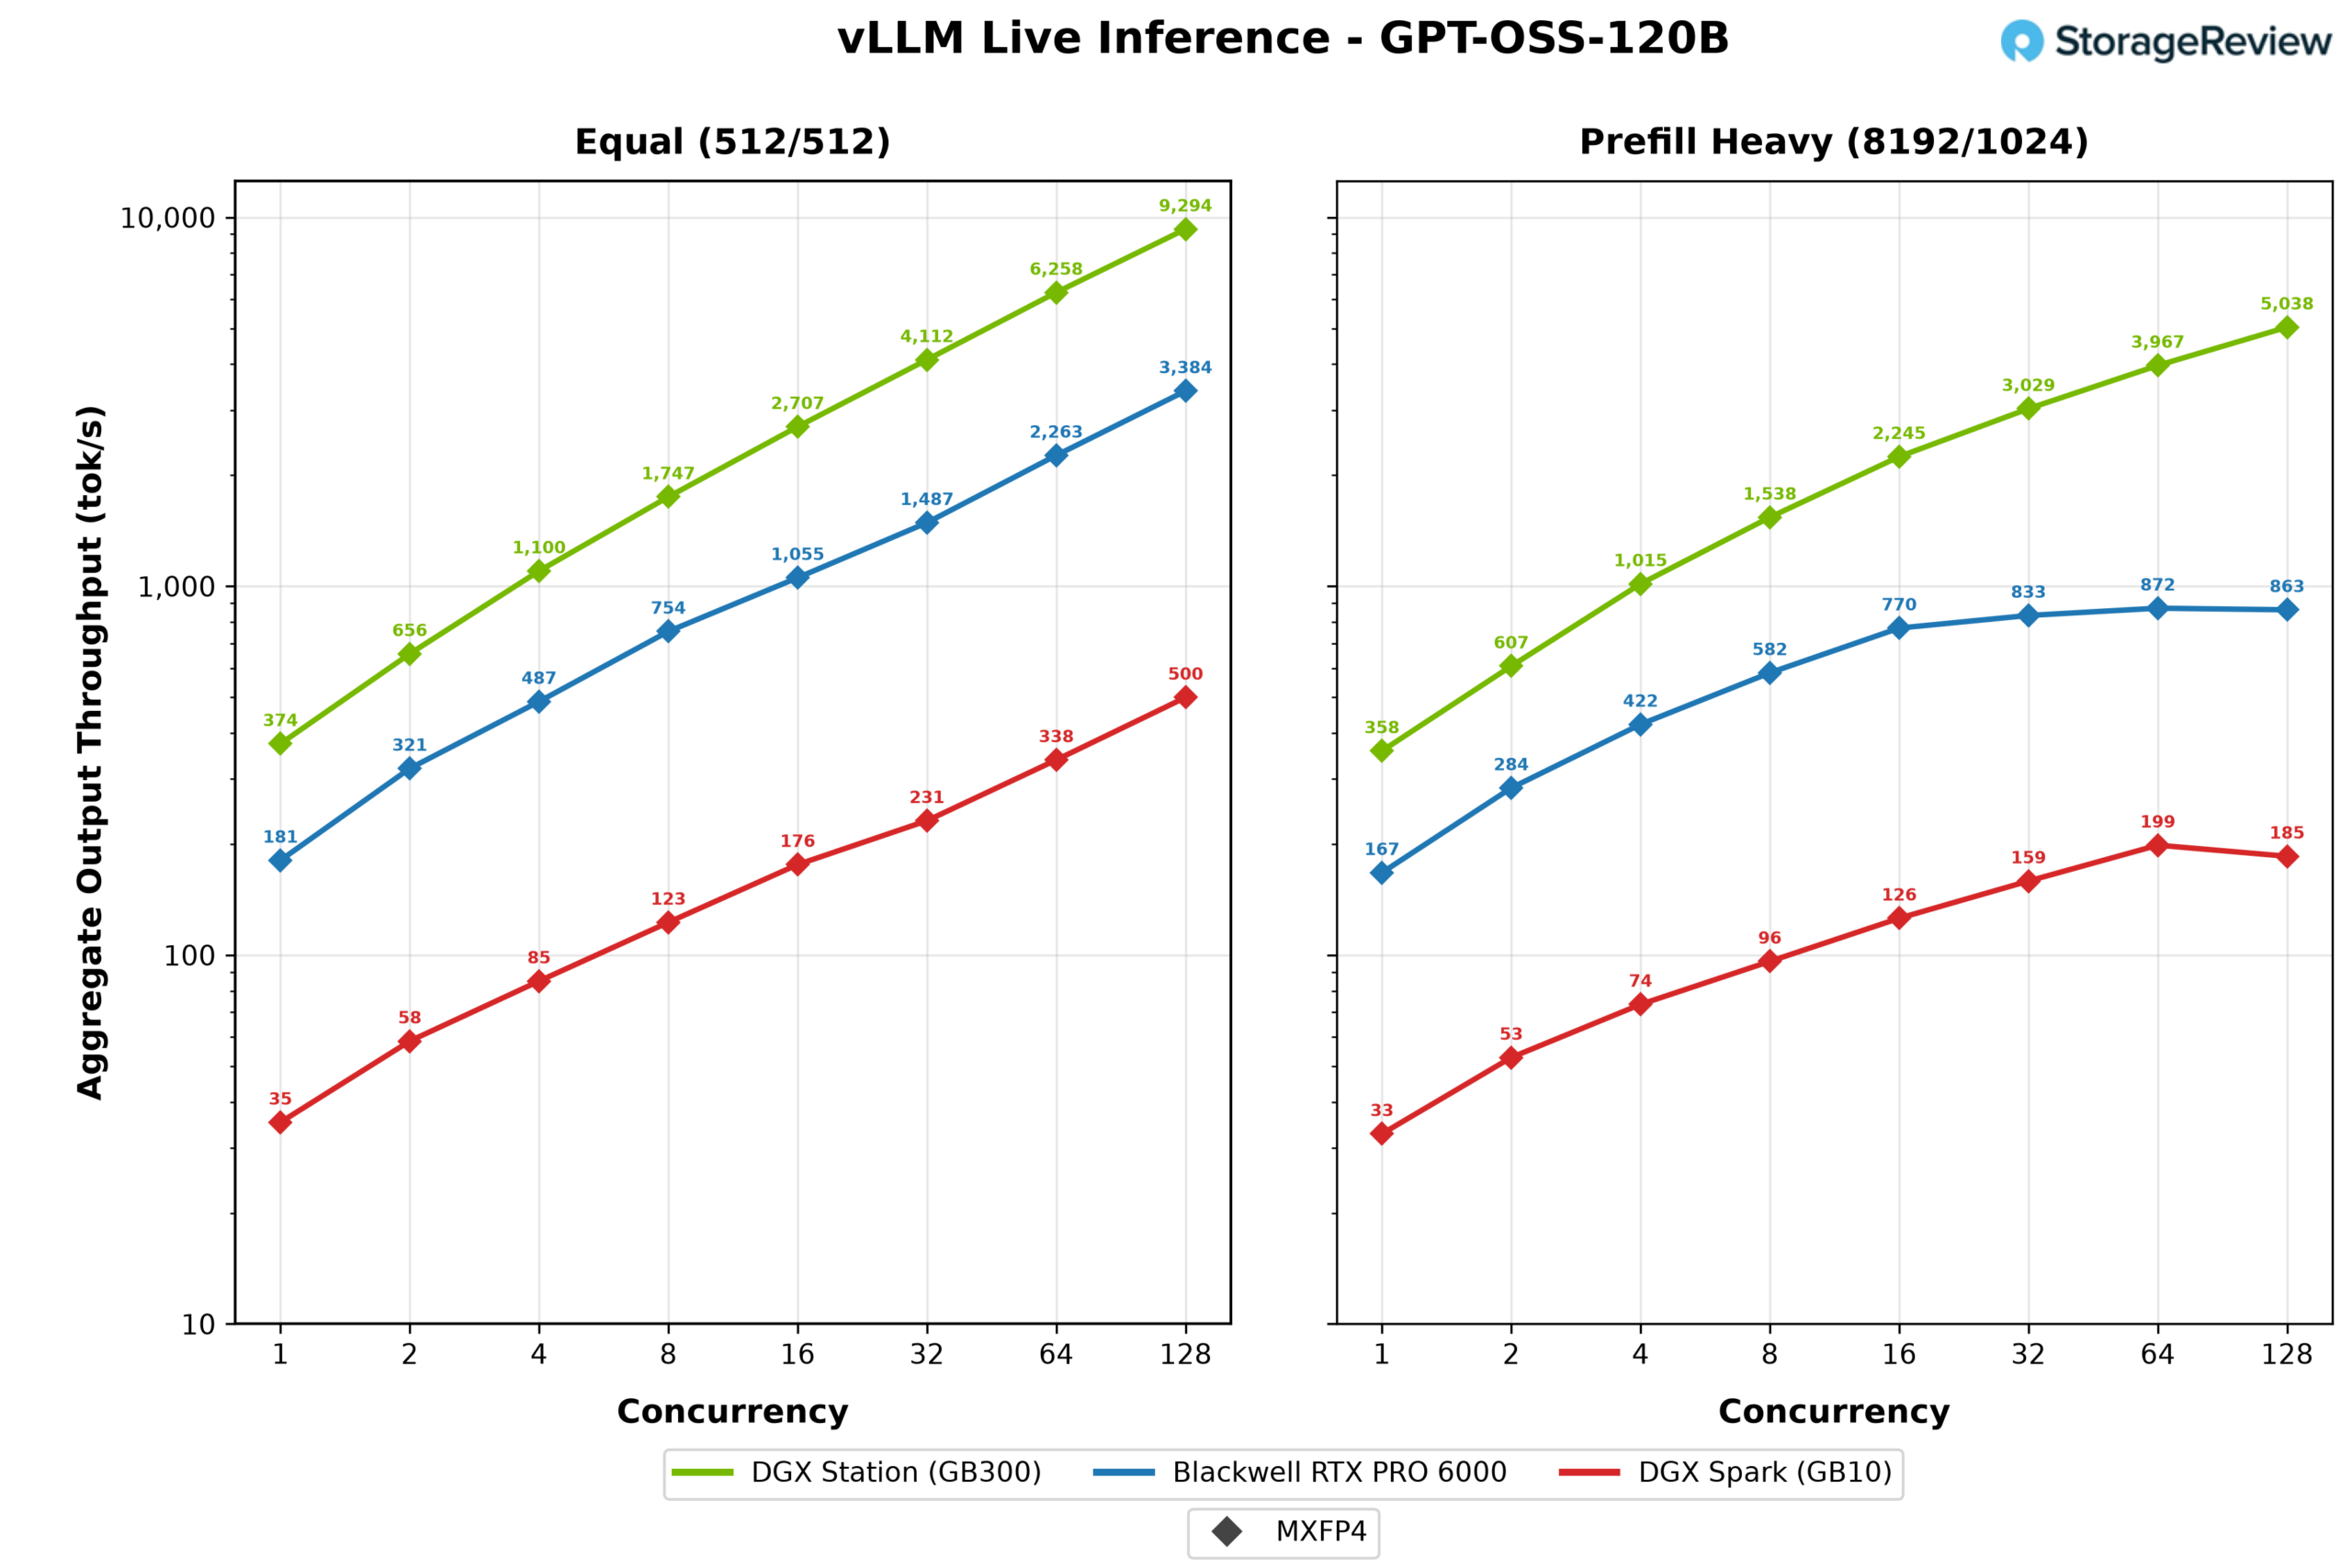
A fase de pré-carregamento intenso é onde os sistemas menores atingem seu limite. A RTX PRO 6000 estabilizou em 872 tokens de saída por segundo com 64 fluxos simultâneos, e o Spark em 199, enquanto o WS300 ainda estava em fase de crescimento com 128 fluxos e terminou com 5,038, uma diferença de quase 6 vezes em relação à placa. Solicitações longas aumentam o cache KV, e os sistemas com menos memória disponível ficam sem espaço para processamento em lote muito antes do que a Station.
Lhama 3.1 8B
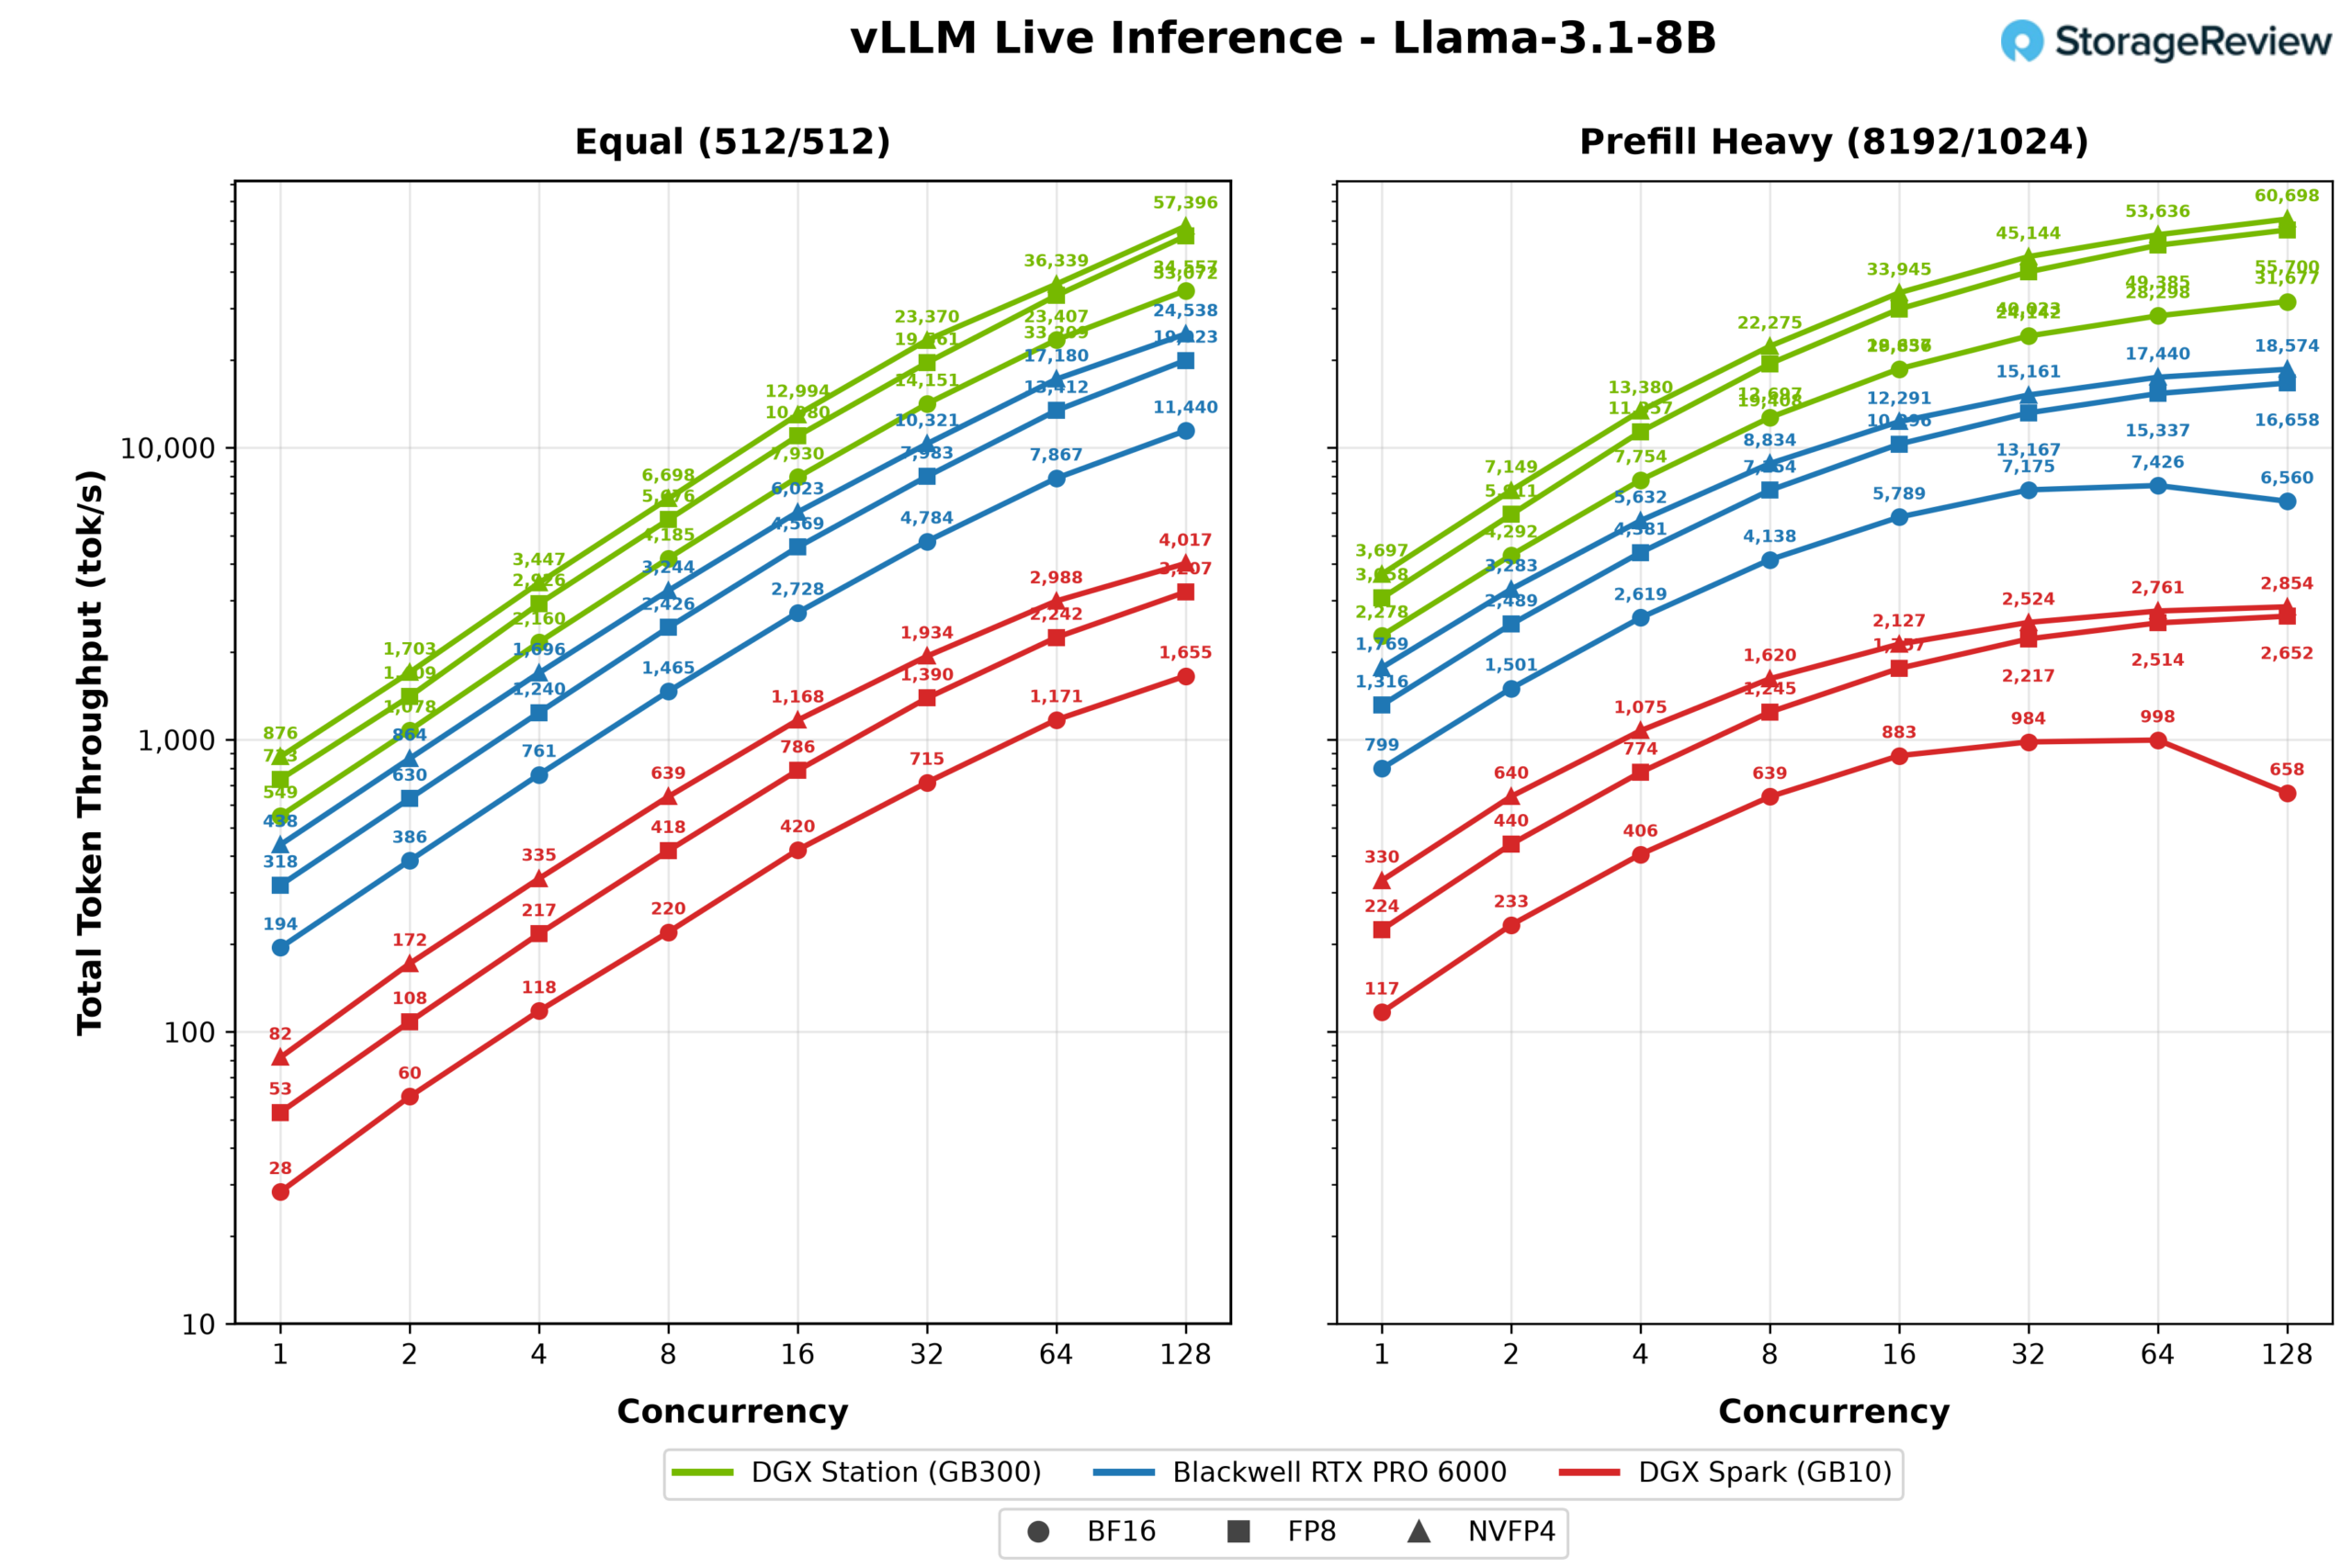
O Llama 3.1 8B é pequeno o suficiente para que pudéssemos executá-lo em BF16, FP8 e NVFP4 em todos os sistemas, o que o torna a maneira mais clara de analisar o ganho de desempenho da quantização em cada máquina. Com 128 fluxos simultâneos sob a mesma carga de trabalho, o WS300 passou de 17,278 tokens de saída por segundo em BF16 para 28,698 em NVFP4, um ganho de 66%. O RTX PRO 6000 obteve um ganho de 114% com a mesma mudança, de 5,720 para 12,269, e o DGX Spark ganhou 143%, de 828 para 2,009. Vale a pena lembrar o padrão: quanto menor a máquina, maior o ganho com a quantização.
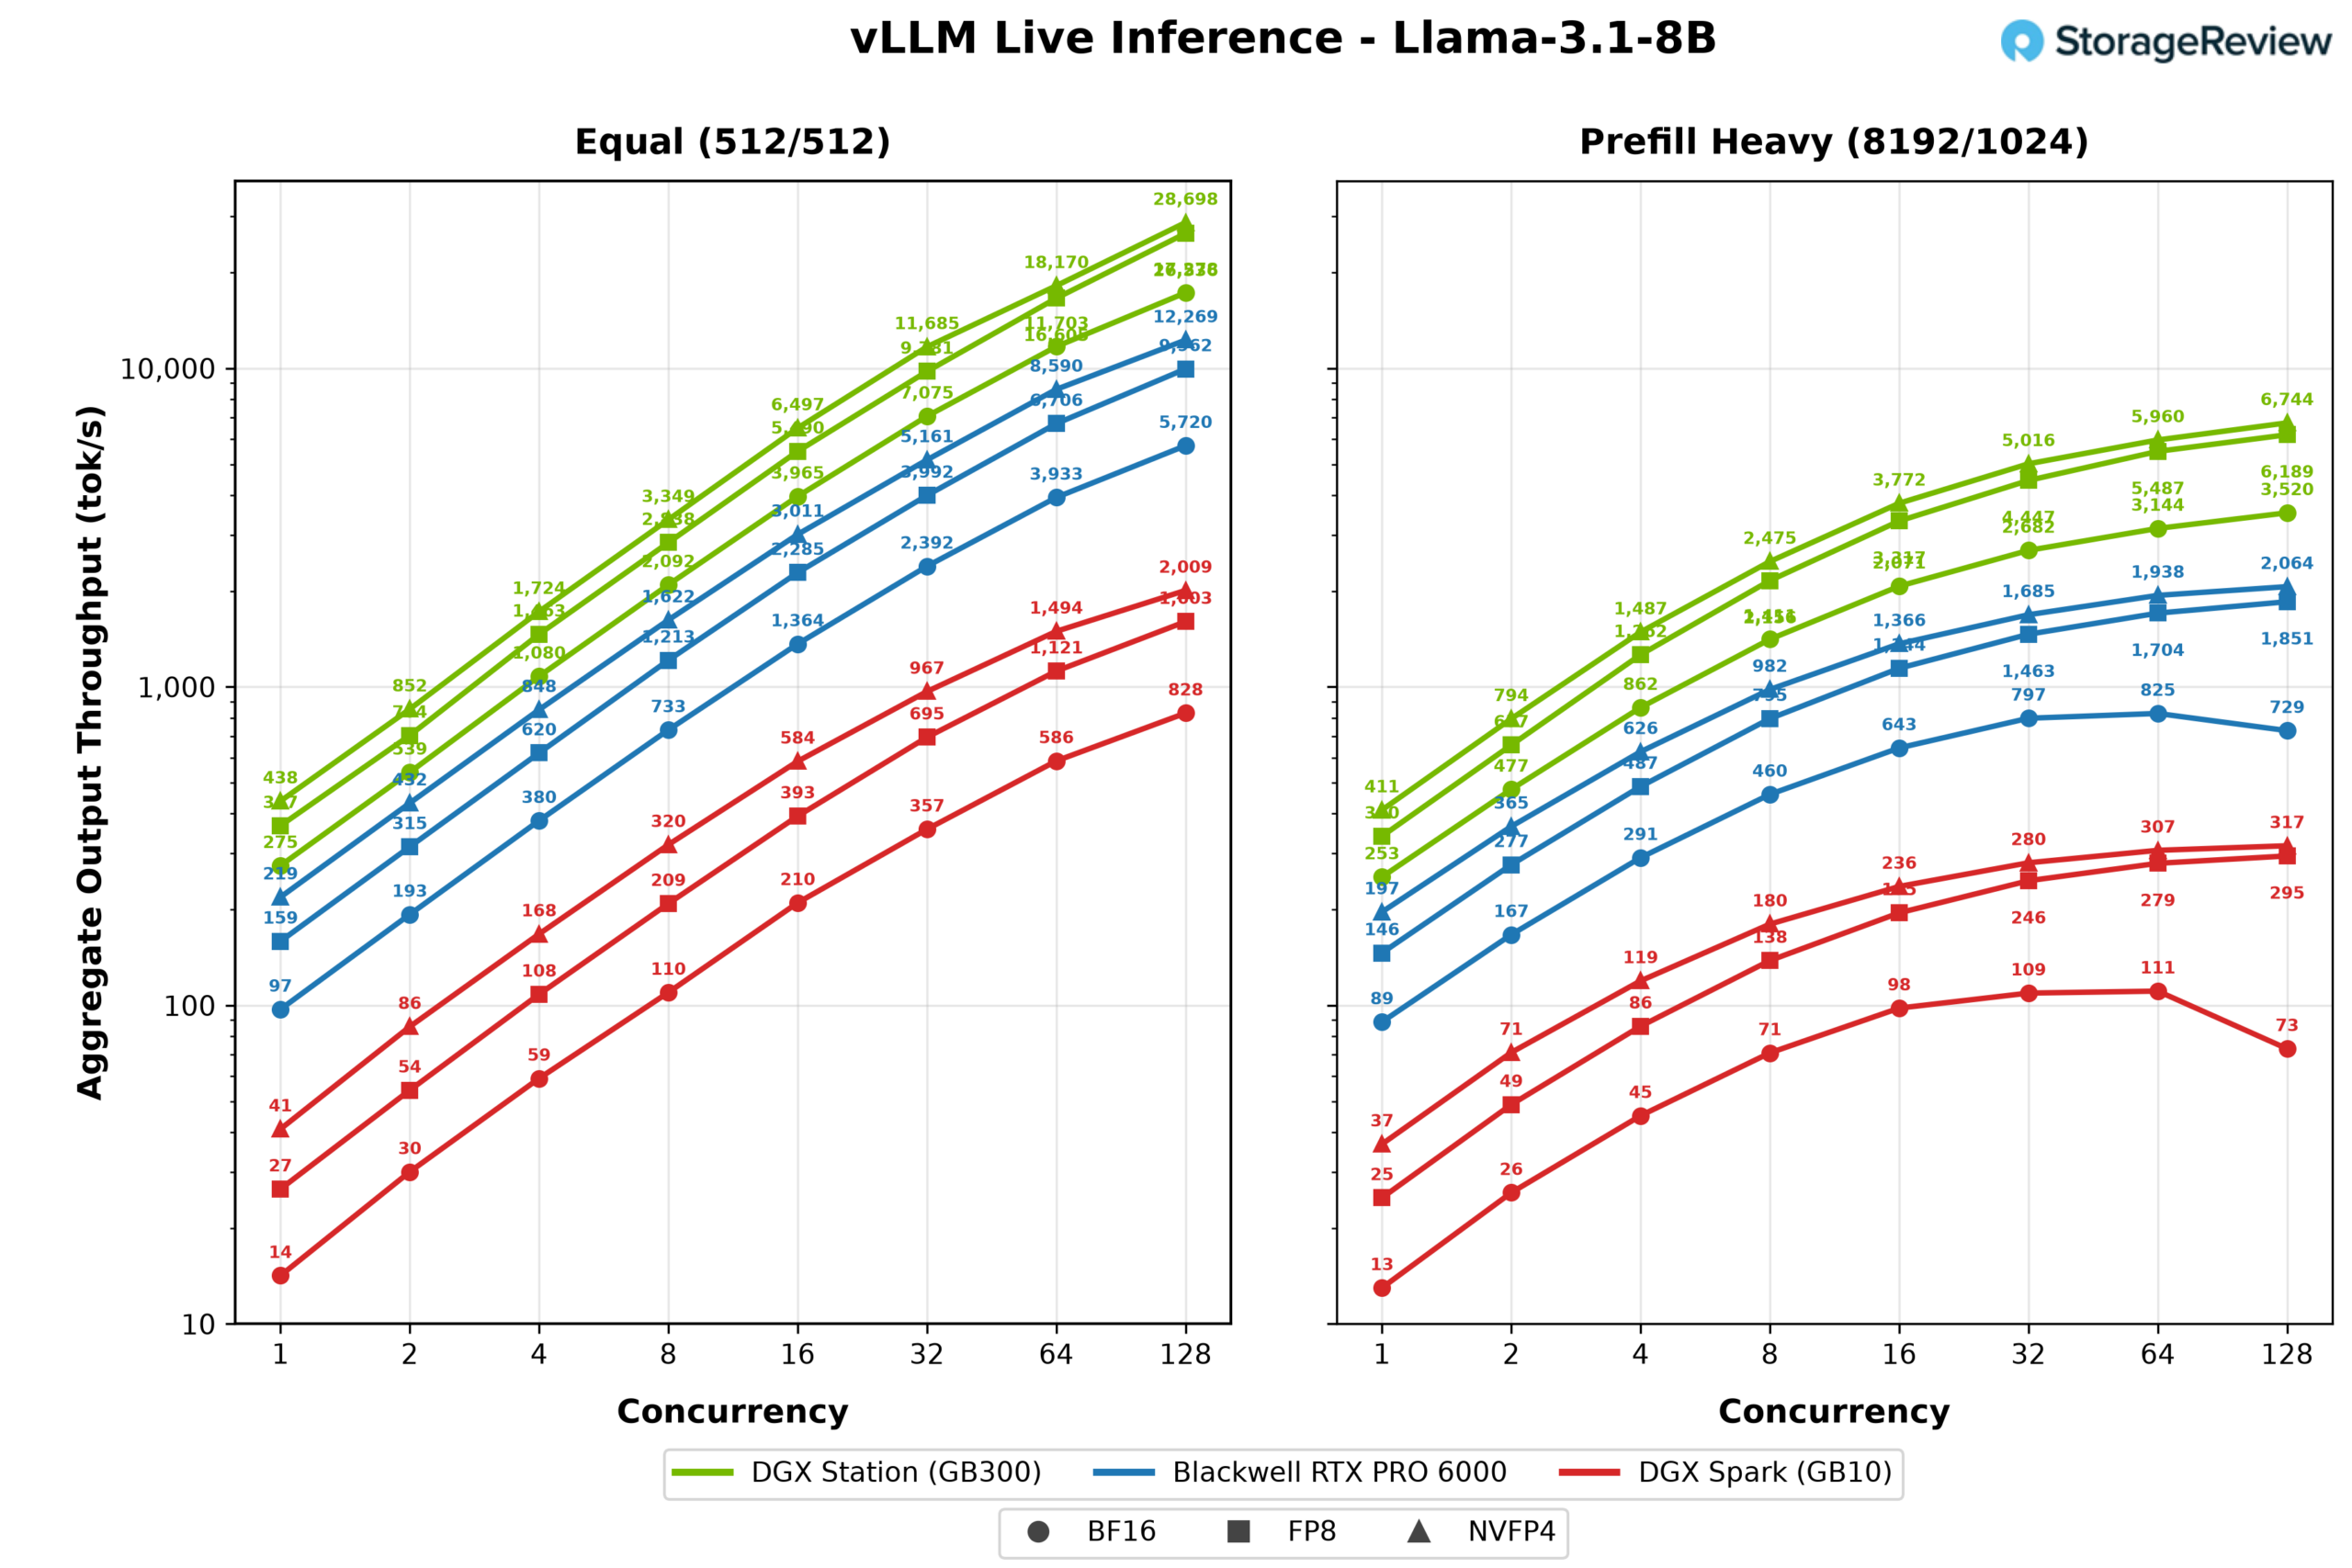
Os resultados com preenchimento prévio comprimem todo o campo, com a execução do NVFP4 do WS300 atingindo um pico de 6,744 tokens de saída por segundo, contra 2,064 para a placa e 317 para o Spark.
Mistral Pequeno 24B
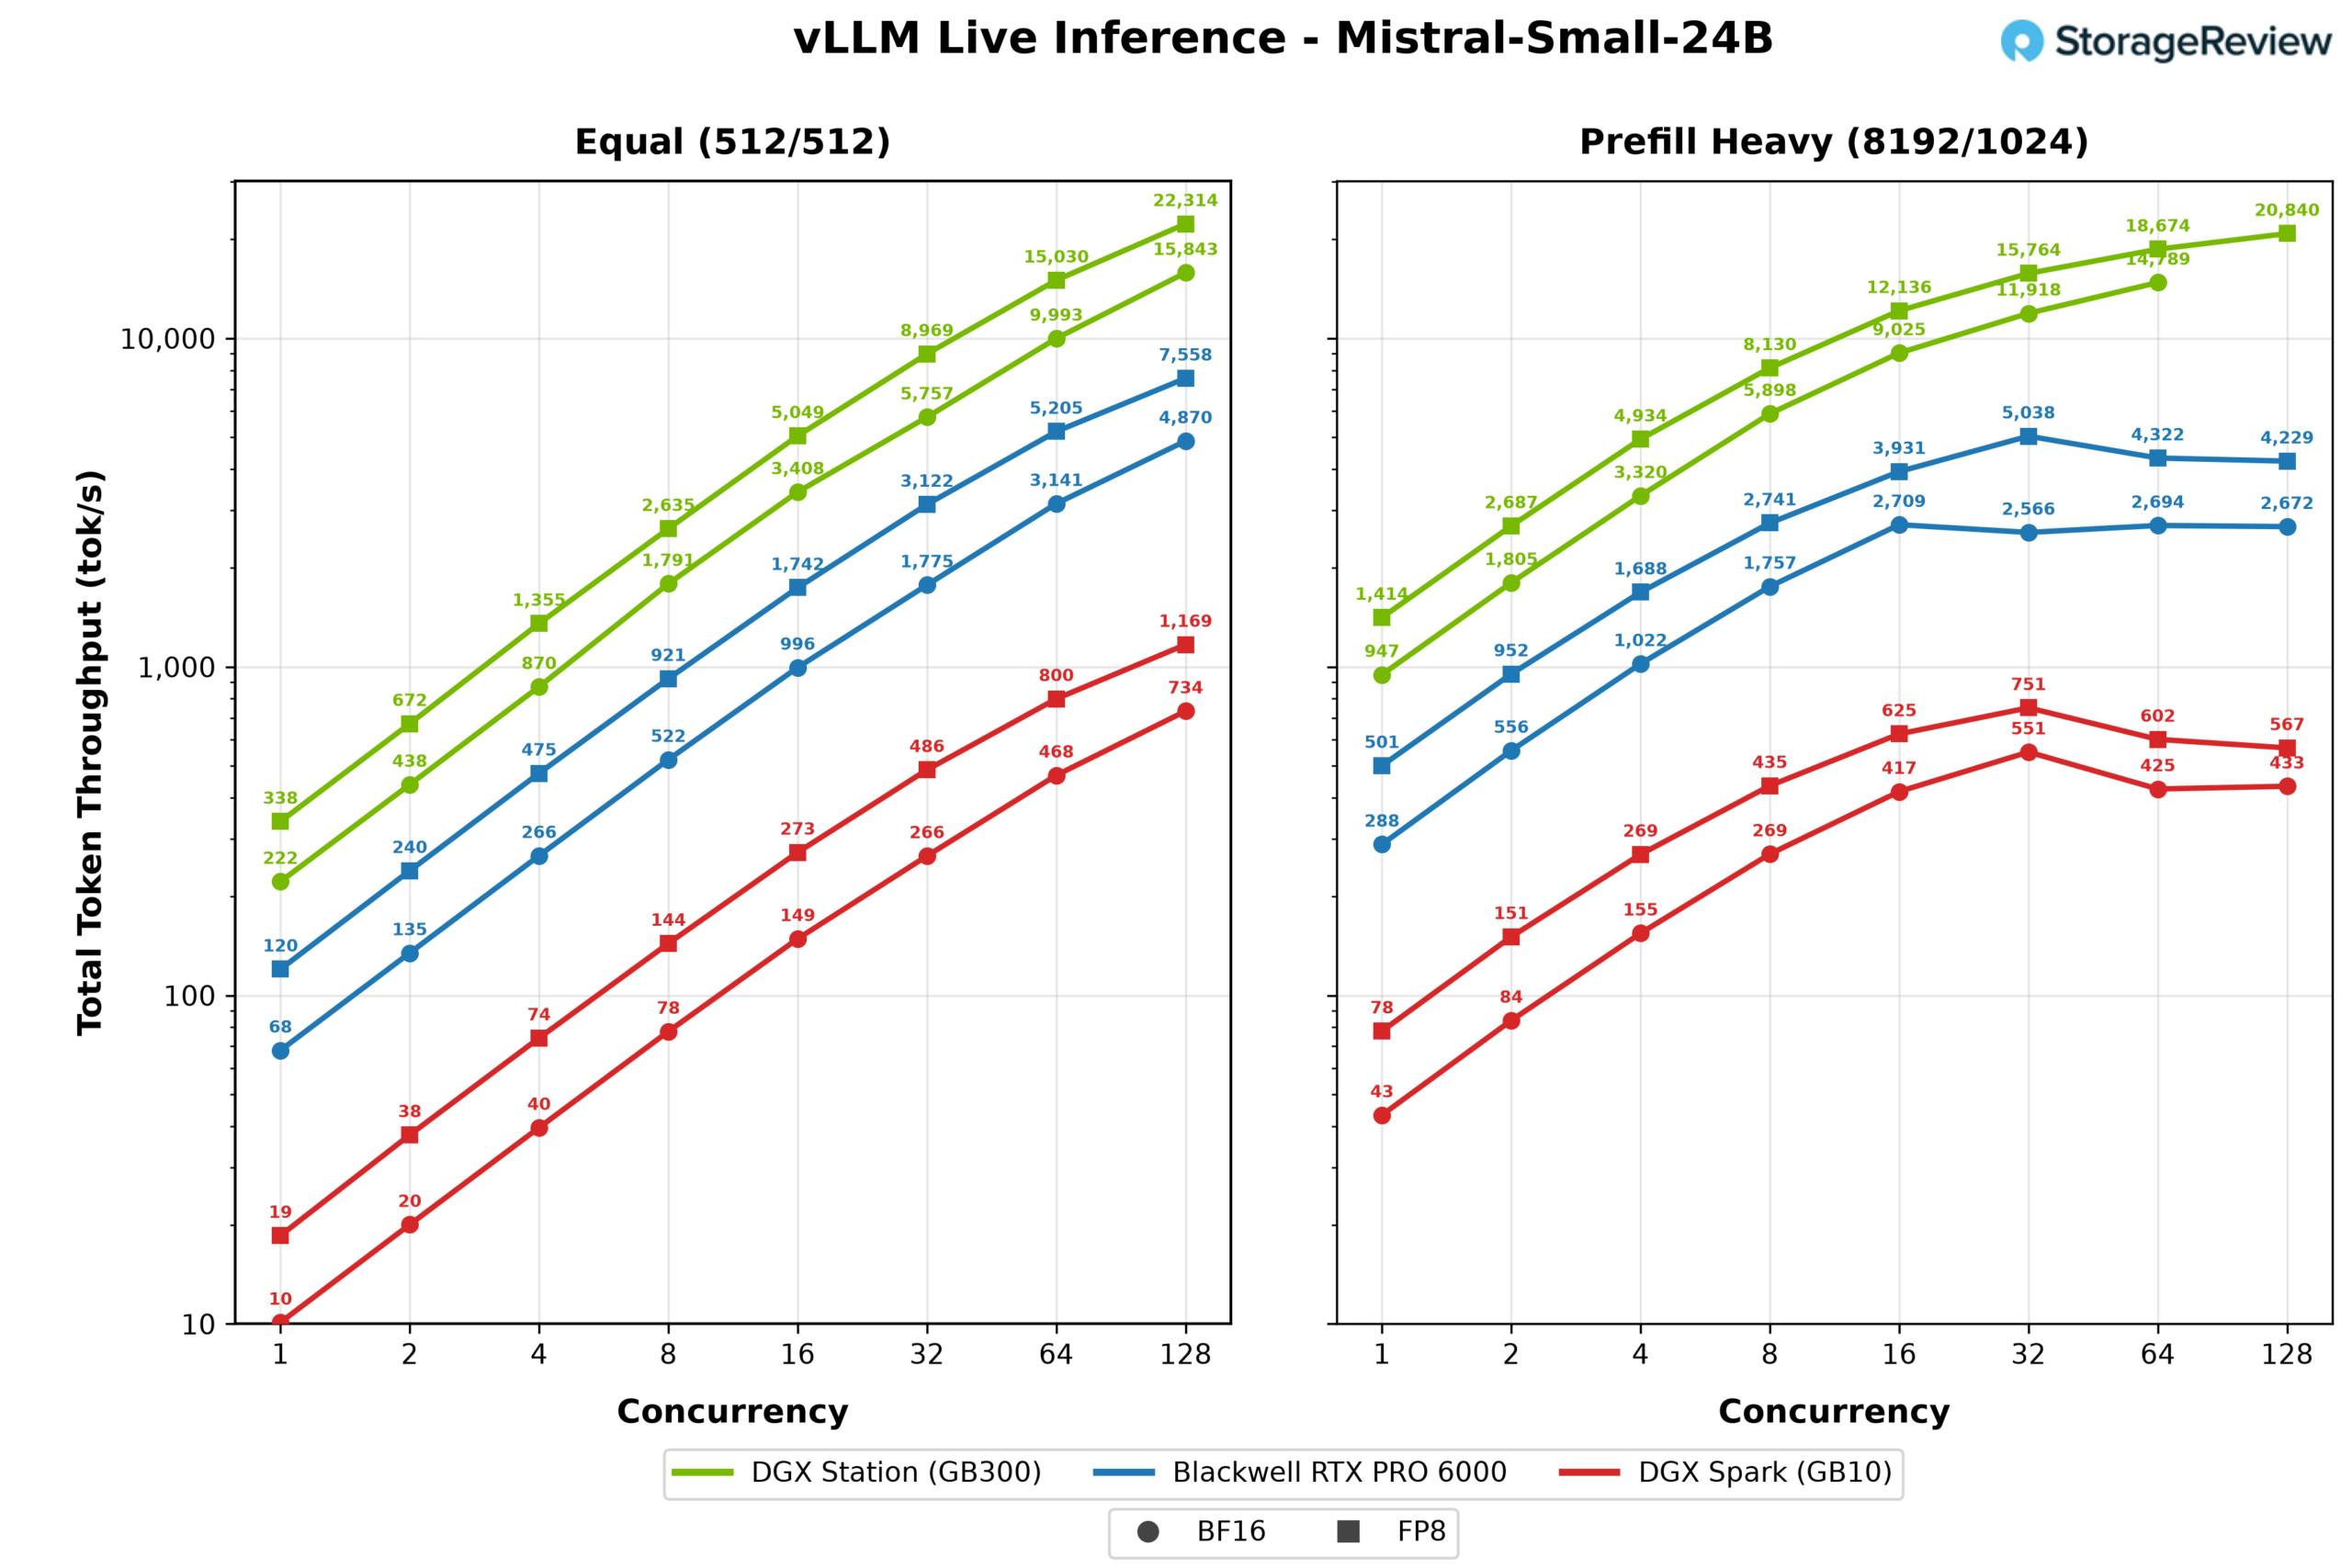
O Mistral Small 24B produziu as maiores lacunas entre os conjuntos. Em FP8, sob a mesma carga de trabalho, o WS300 atingiu um pico de 11,157 tokens de saída por segundo, três vezes mais que o RTX PRO 6000, com 3,779, e 19 vezes mais que o DGX Spark, com 585. Em fluxo único, os 169 tokens por segundo da Station estão muito mais próximos do conforto interativo do que os 9 do Spark.
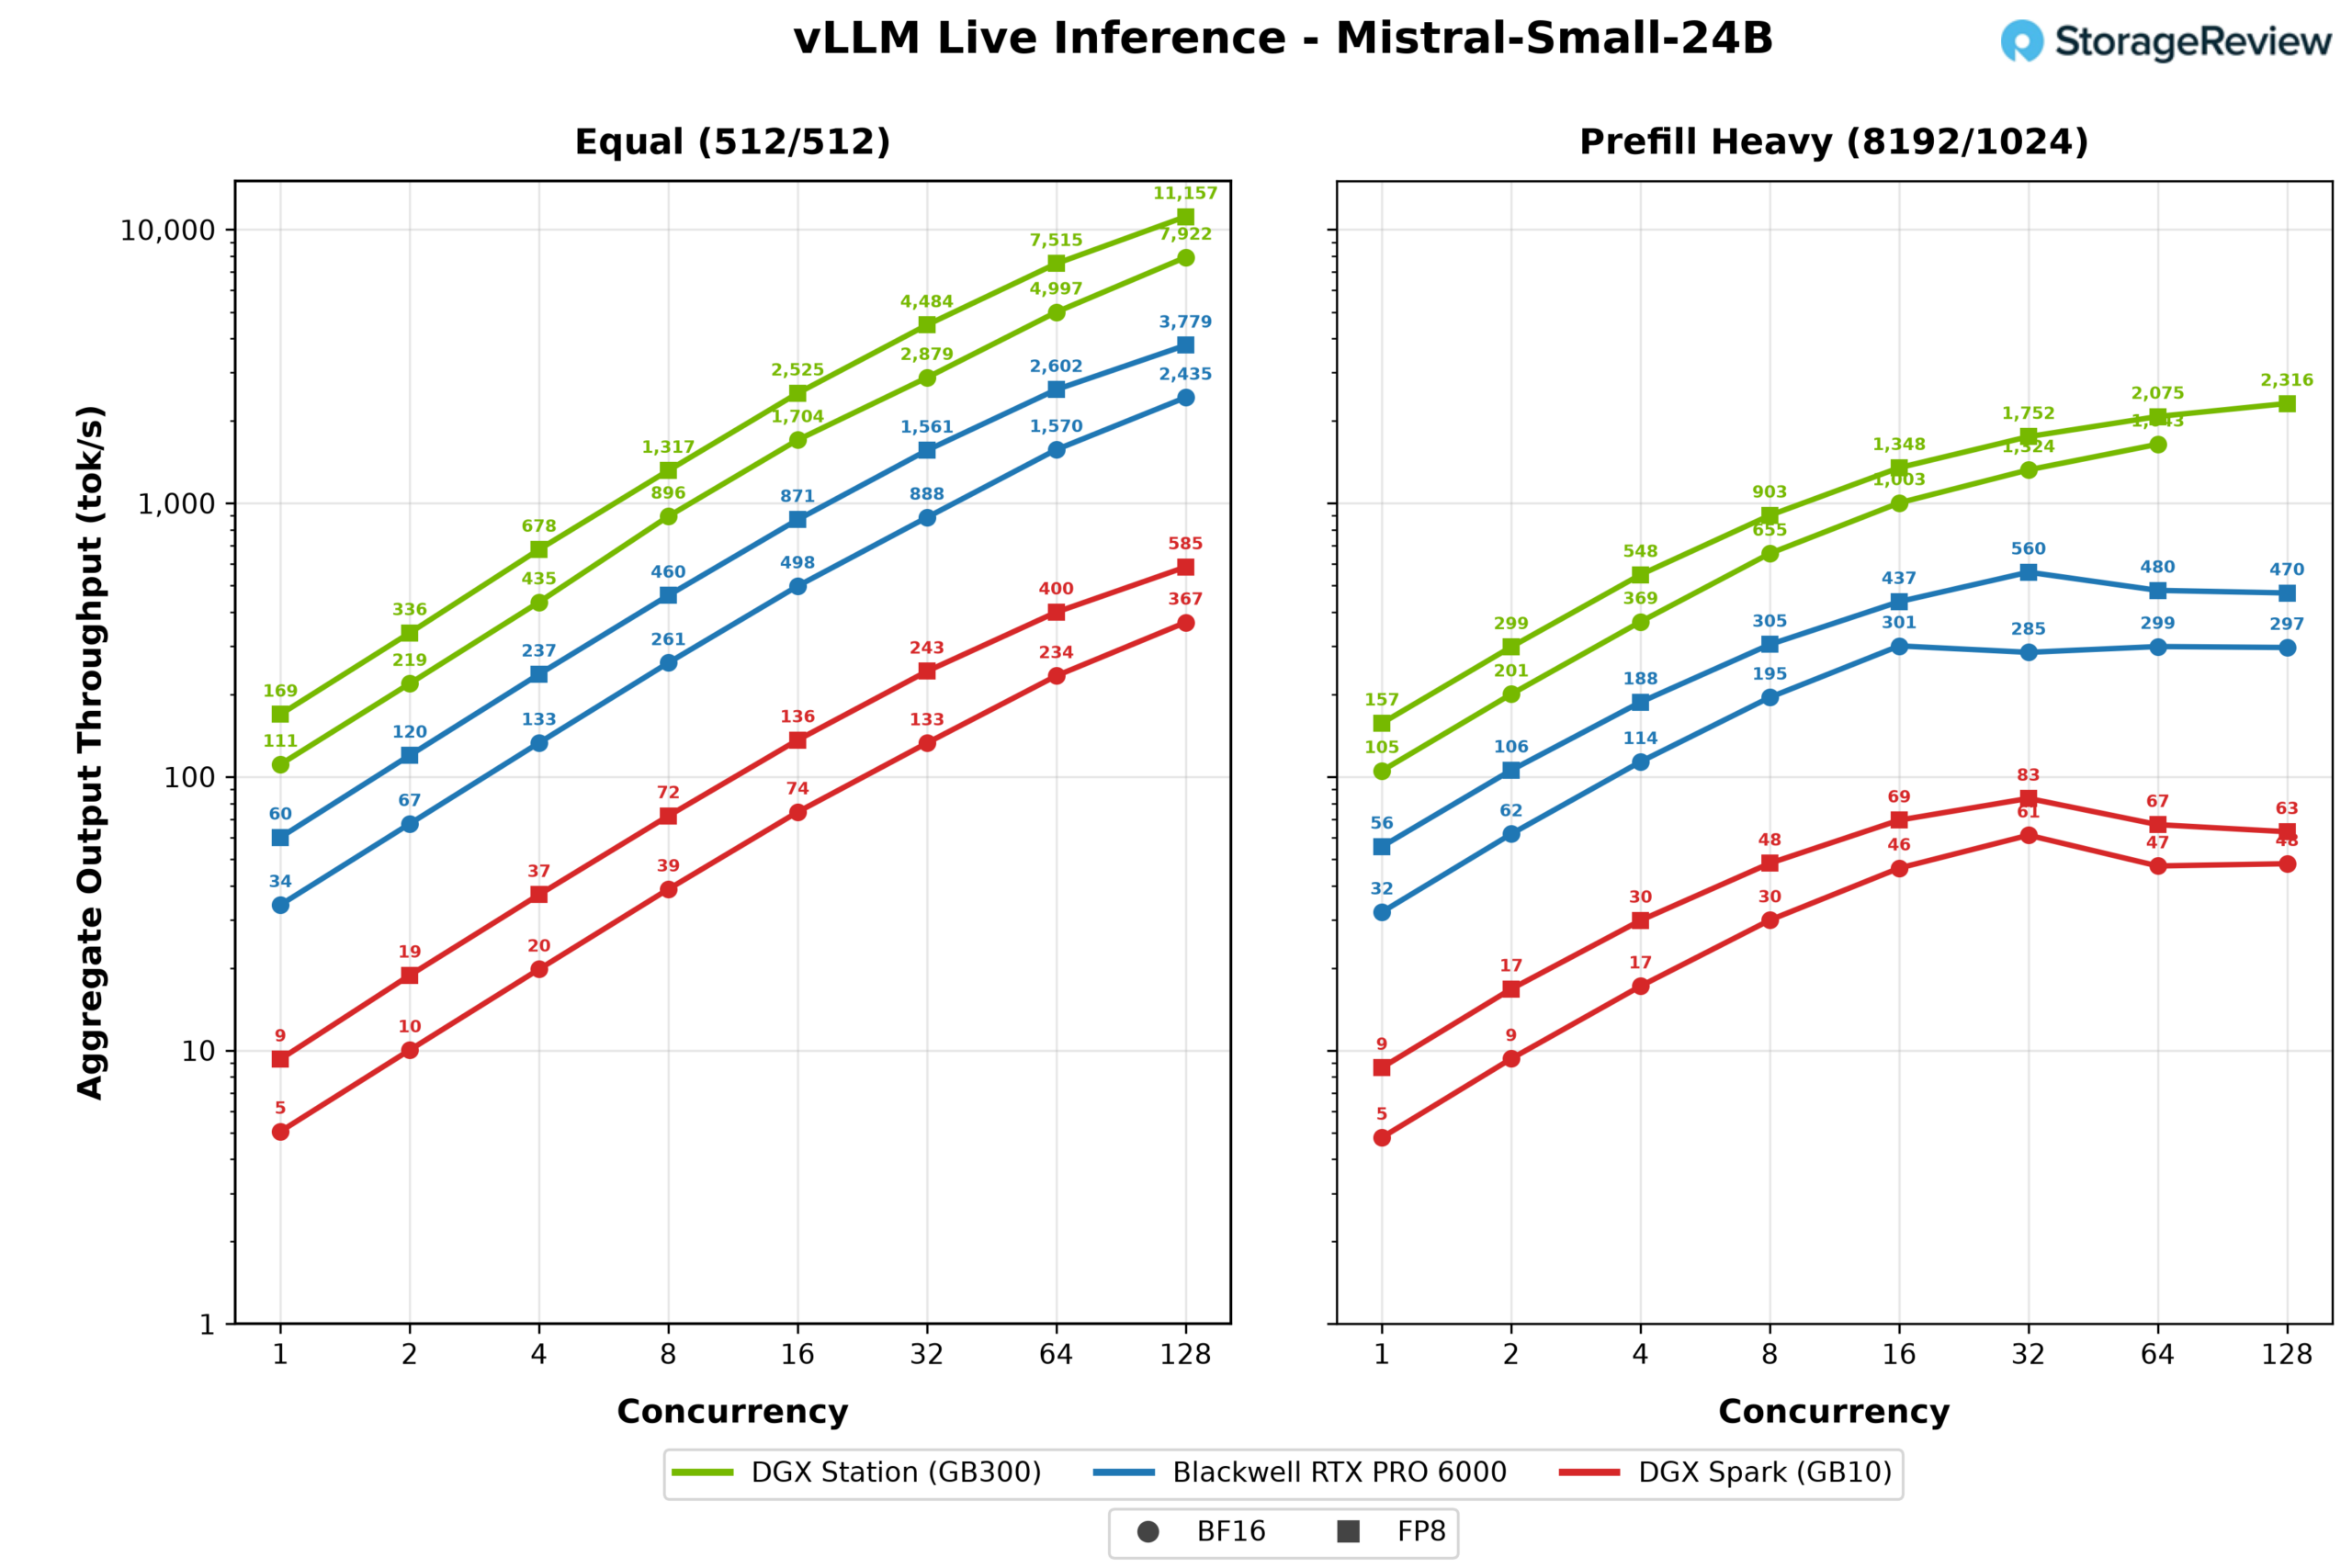
Sob carga pesada de pré-carregamento, a RTX PRO 6000 atingiu um pico de apenas 32 fluxos simultâneos e 560 tokens de saída por segundo antes de reduzir o desempenho, enquanto a WS300 continuou até 2,316 com 128 fluxos.
Codificador Qwen3 30B
O Qwen3 Coder 30B, um modelo misto de especialistas com um pequeno número de parâmetros ativos, é o único teste em que os sistemas menores reduzem a diferença no desempenho em fluxo único. Com uma solicitação simultânea sob a mesma carga de trabalho, a RTX PRO 6000 entregou 208 tokens de saída por segundo, contra 310 da WS300, o resultado mais próximo ao da Station nesta comparação, e até mesmo a Spark conseguiu 55 tokens utilizáveis. O processamento em lote restaura a ordem usual: com 128 fluxos, os 12,425 tokens de saída por segundo da Station em FP8 representam 2.4 vezes o desempenho da placa e quase 16 vezes o da Spark.
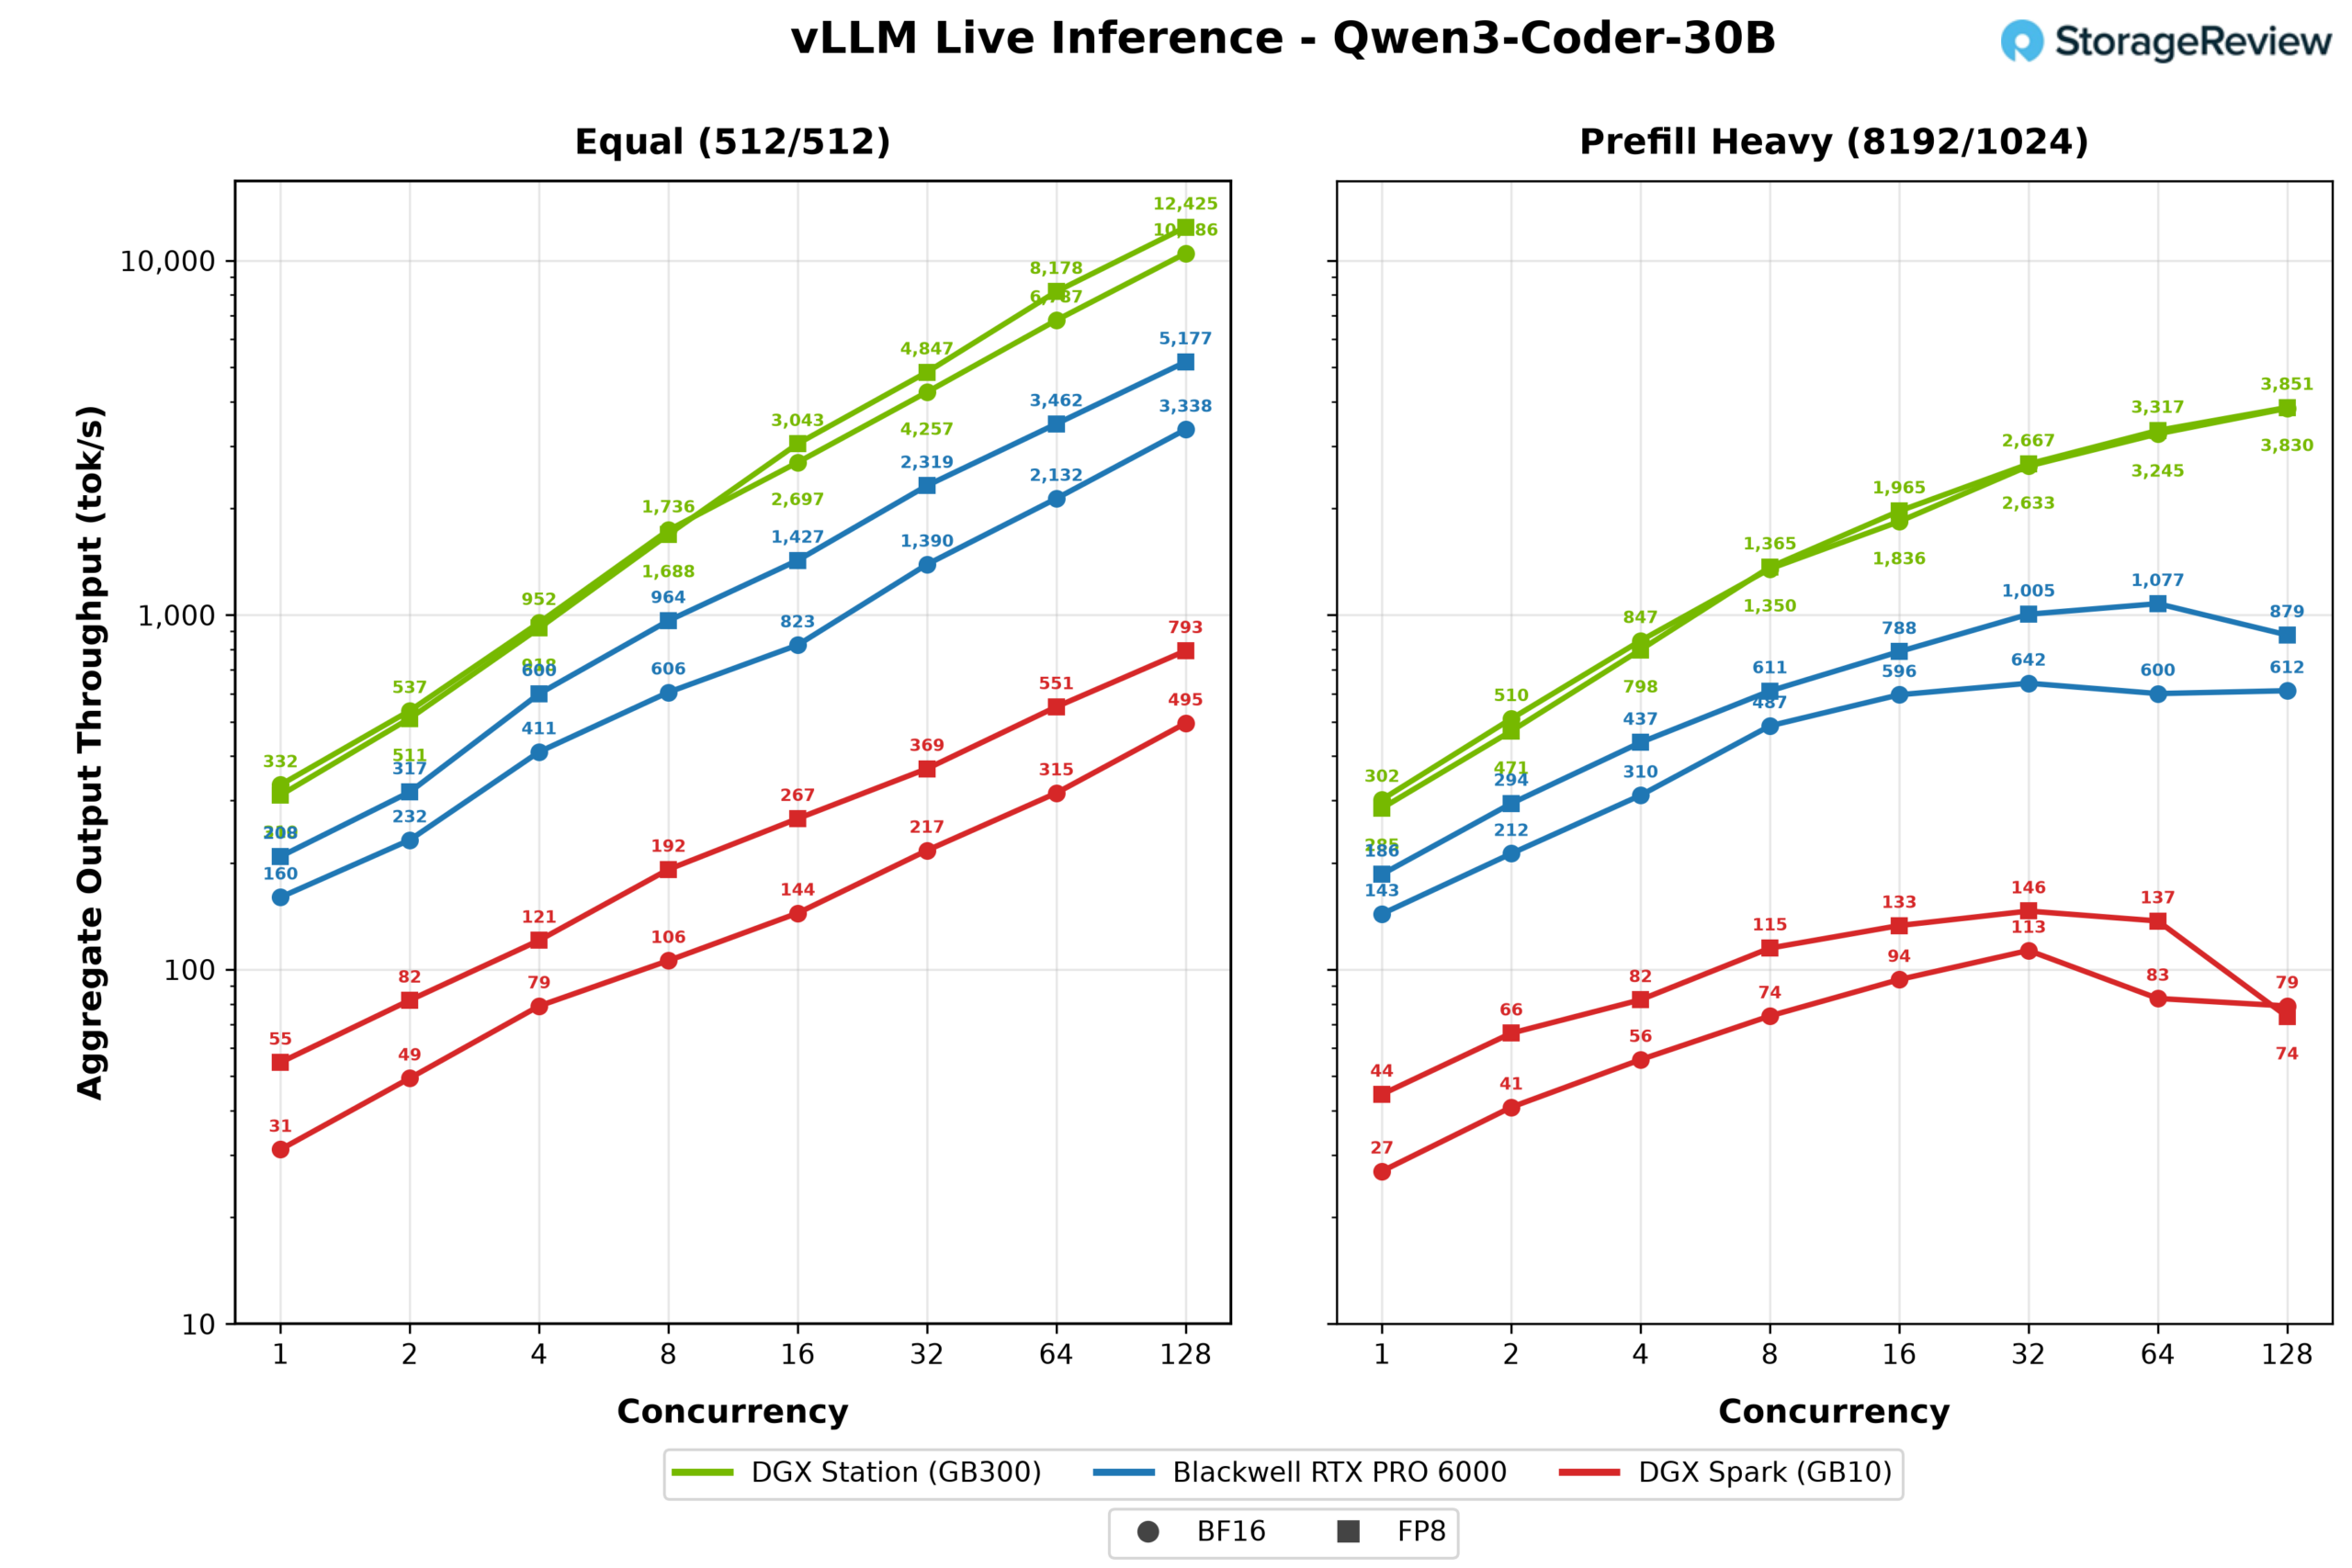
O pré-carregamento intenso seguiu o padrão estabelecido, com o WS300 atingindo 3,851 tokens de saída por segundo, enquanto o cartão atingiu um pico de 1,077 e o Spark, 146.
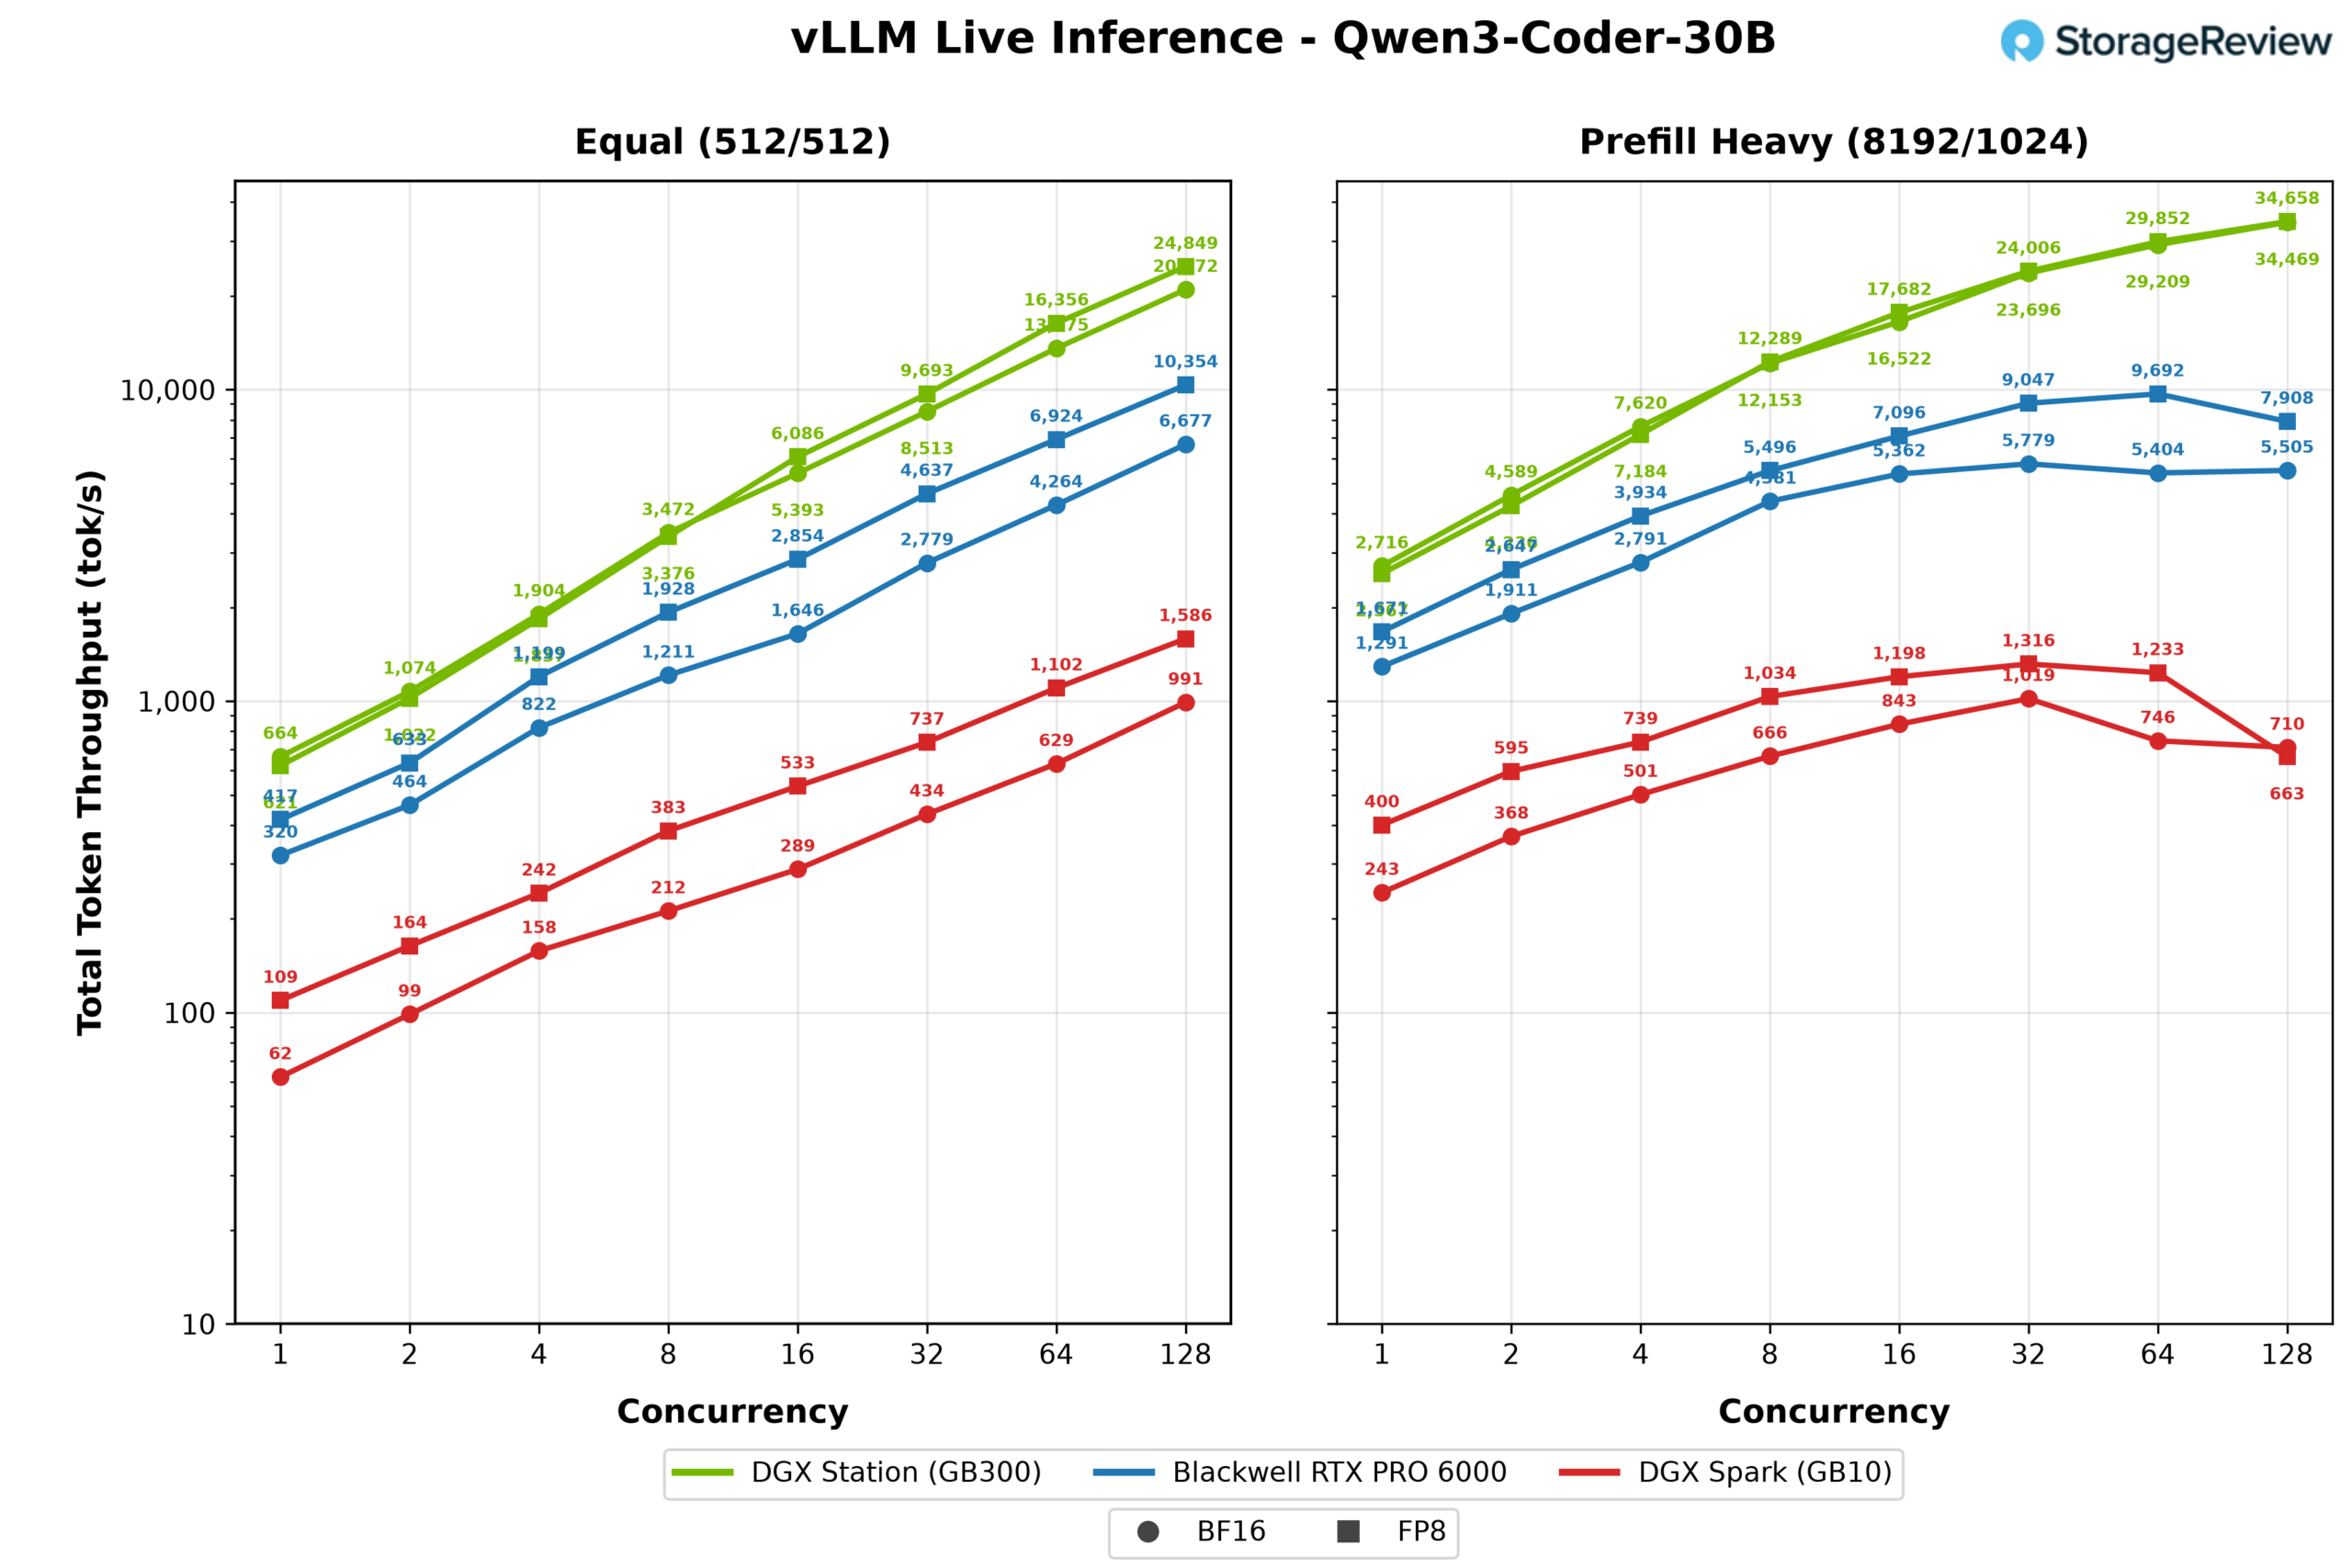
Nos cinco modelos compartilhados, o WS300 apresentou um desempenho entre 2.3 e 3 vezes superior ao do Blackwell RTX PRO 6000 e entre 14 e 19 vezes superior ao do DGX Spark em plena concorrência, com a margem aumentando para cerca de 6 vezes em relação à placa quando prompts longos sobrecarregam o cache KV. Todas as três máquinas executam a mesma pilha CUDA e os mesmos caminhos de quantização; o diferencial do Station é a capacidade de memória e a largura de banda, que se refletem aqui como margem de concorrência e tolerância a contextos longos. Tão importante quanto isso é o que esses gráficos não mostram: nenhum dos modelos de escala avançada nas seções anteriores sequer será carregado nos outros dois sistemas.
GDSIO
As cargas de trabalho modernas de IA dependem da transferência de lotes de dados, pesos de modelos e pontos de verificação do armazenamento para a memória da GPU com rapidez suficiente para manter o acelerador ocupado. O NVIDIA GPUDirect Storage elimina o caminho tradicional de duas cópias, no qual os dados são primeiro lidos de um SSD para a memória do sistema e, em seguida, copiados para a memória da GPU.
A estação GB300 DGX implementa isso de forma diferente de um servidor GPU PCIe convencional. O Micron 4600 usado em nosso teste está conectado ao switch PCIe integrado ao ConnectX-8. O ConnectX-8 se conecta upstream à CPU Grace, enquanto a GPU B300 se conecta ao Grace via NVLink-C2C. O SSD e a GPU não estão sob o mesmo switch PCIe. O tráfego de armazenamento passa pelo switch ConnectX-8, entra no complexo raiz PCIe do Grace, atravessa a malha de coerência do Grace e cruza o NVLink-C2C para alcançar a HBM3e da B300.
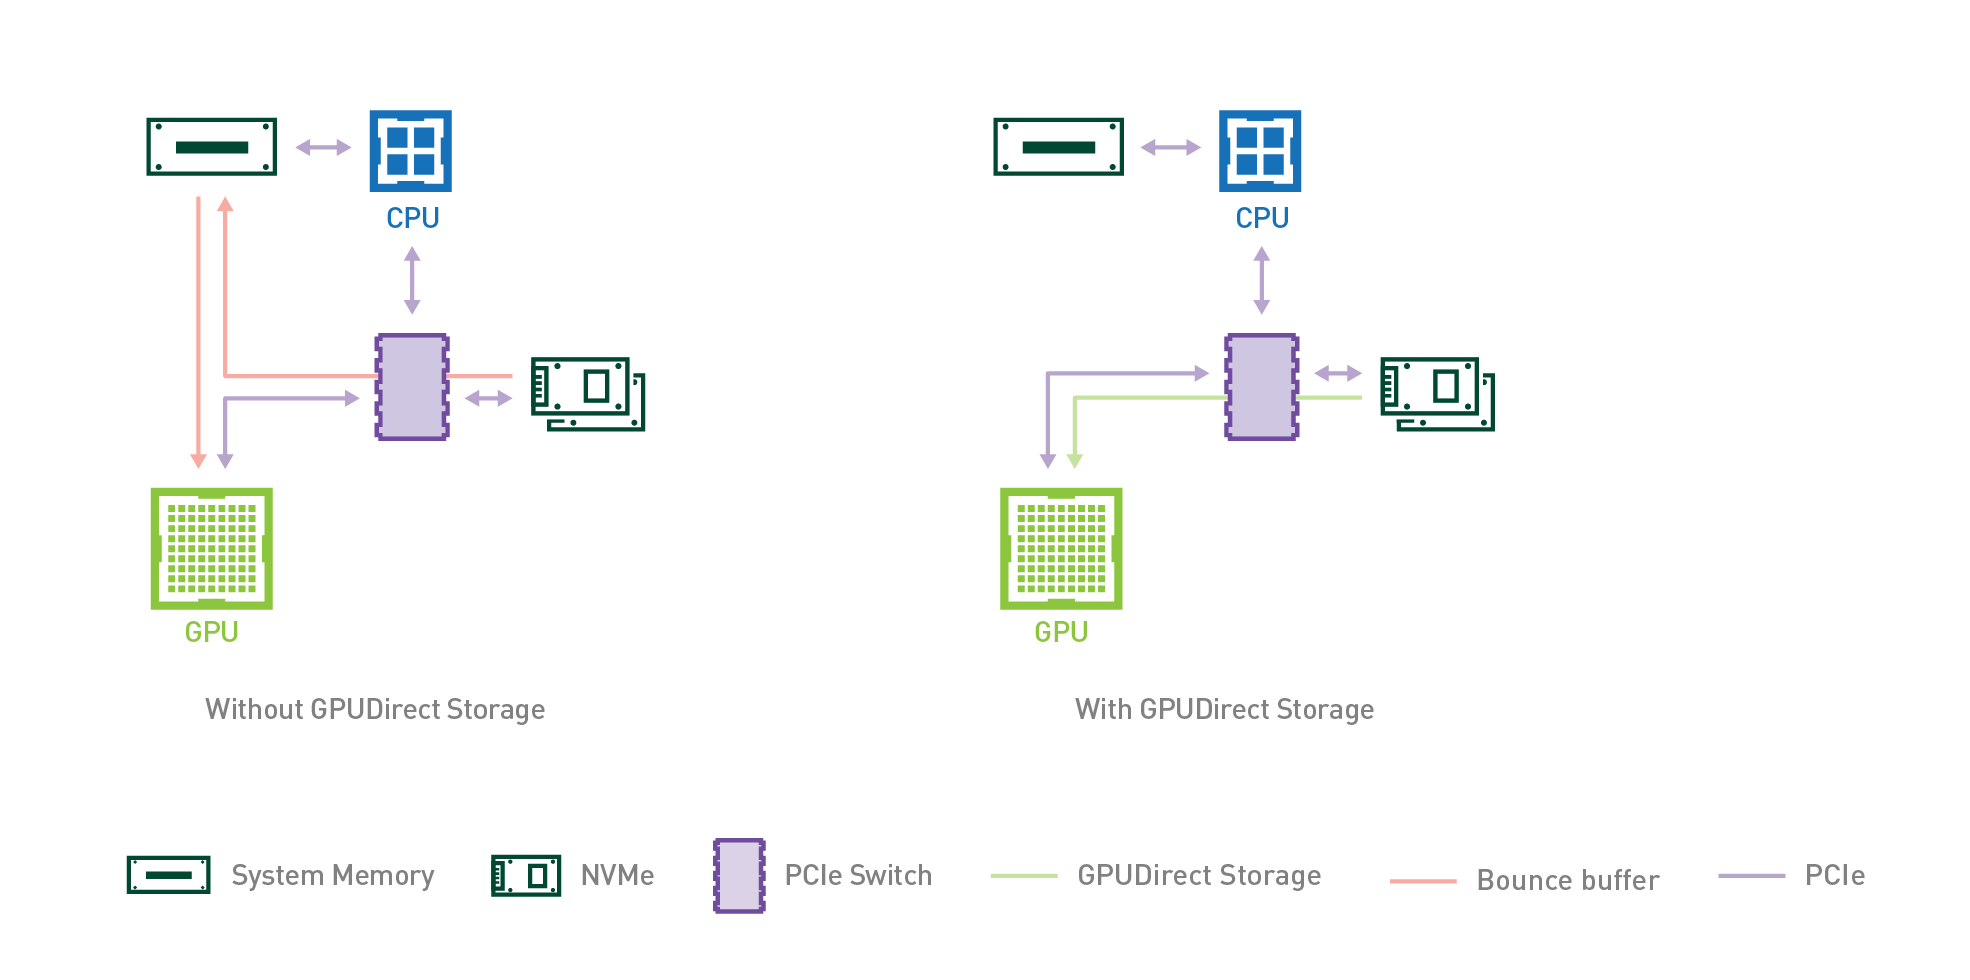
Com o GPUDirect Storage, o cuFile registra um buffer alocado na memória HBM3e do B300 como origem ou destino para operações de E/S de armazenamento. Em uma leitura, o controlador do Micron 4600 usa DMA para colocar dados na HBM3e; em uma gravação, ele recupera os dados da HBM3e. Ambas as operações seguem o caminho Grace e NVLink-C2C descrito acima, sem armazenar a carga útil na memória LPDDR5X do Grace. O Grace ainda gerencia o sistema de arquivos e o plano de controle NVMe, incluindo o envio de comandos e a tradução de endereços, mas não copia os dados. Portanto, o GPUDirect Storage elimina a etapa de armazenamento temporário na memória do sistema, mesmo que o tráfego ainda passe pelo Grace em seu trajeto entre o SSD e a memória B300. Para cargas de trabalho de IA, as leituras sequenciais correspondem ao streaming de conjuntos de dados, carregamento de modelos e restaurações de checkpoints, enquanto as gravações sequenciais correspondem ao salvamento de checkpoints e outras transferências de volta para o armazenamento. Para testar o desempenho do GDSIO, medimos o desempenho do armazenamento utilizando um SSD secundário independente.
Configuração de teste GDSIO
- Armazenamento de inicialização: 2 x Micron 4600 de 2 TB em RAID 1
- Armazenamento secundário: 2 x Micron 4600 de 2 TB
Analisando o desempenho de leitura sequencial do GDSIO, a unidade escala de forma consistente tanto com o número de threads quanto com o tamanho do bloco. Com blocos de 16 KB, a taxa de transferência aumenta de 16 MiB/s com 1 thread para 250 MiB/s com 16 threads, atingindo 2.0 GiB/s com 128 threads. Blocos maiores apresentam um aumento de desempenho muito mais rápido, com blocos de 256 KB atingindo 11.8 GiB/s com 64 threads e um pico de 12.9 GiB/s com 128 threads. Os melhores resultados aparecem com blocos de 512 KB e 1 MB, onde a taxa de transferência atinge o pico de 13.1 GiB/s, com a carga de trabalho de 1 MB alcançando esse nível com apenas 32 threads e mantendo-o com 128 threads.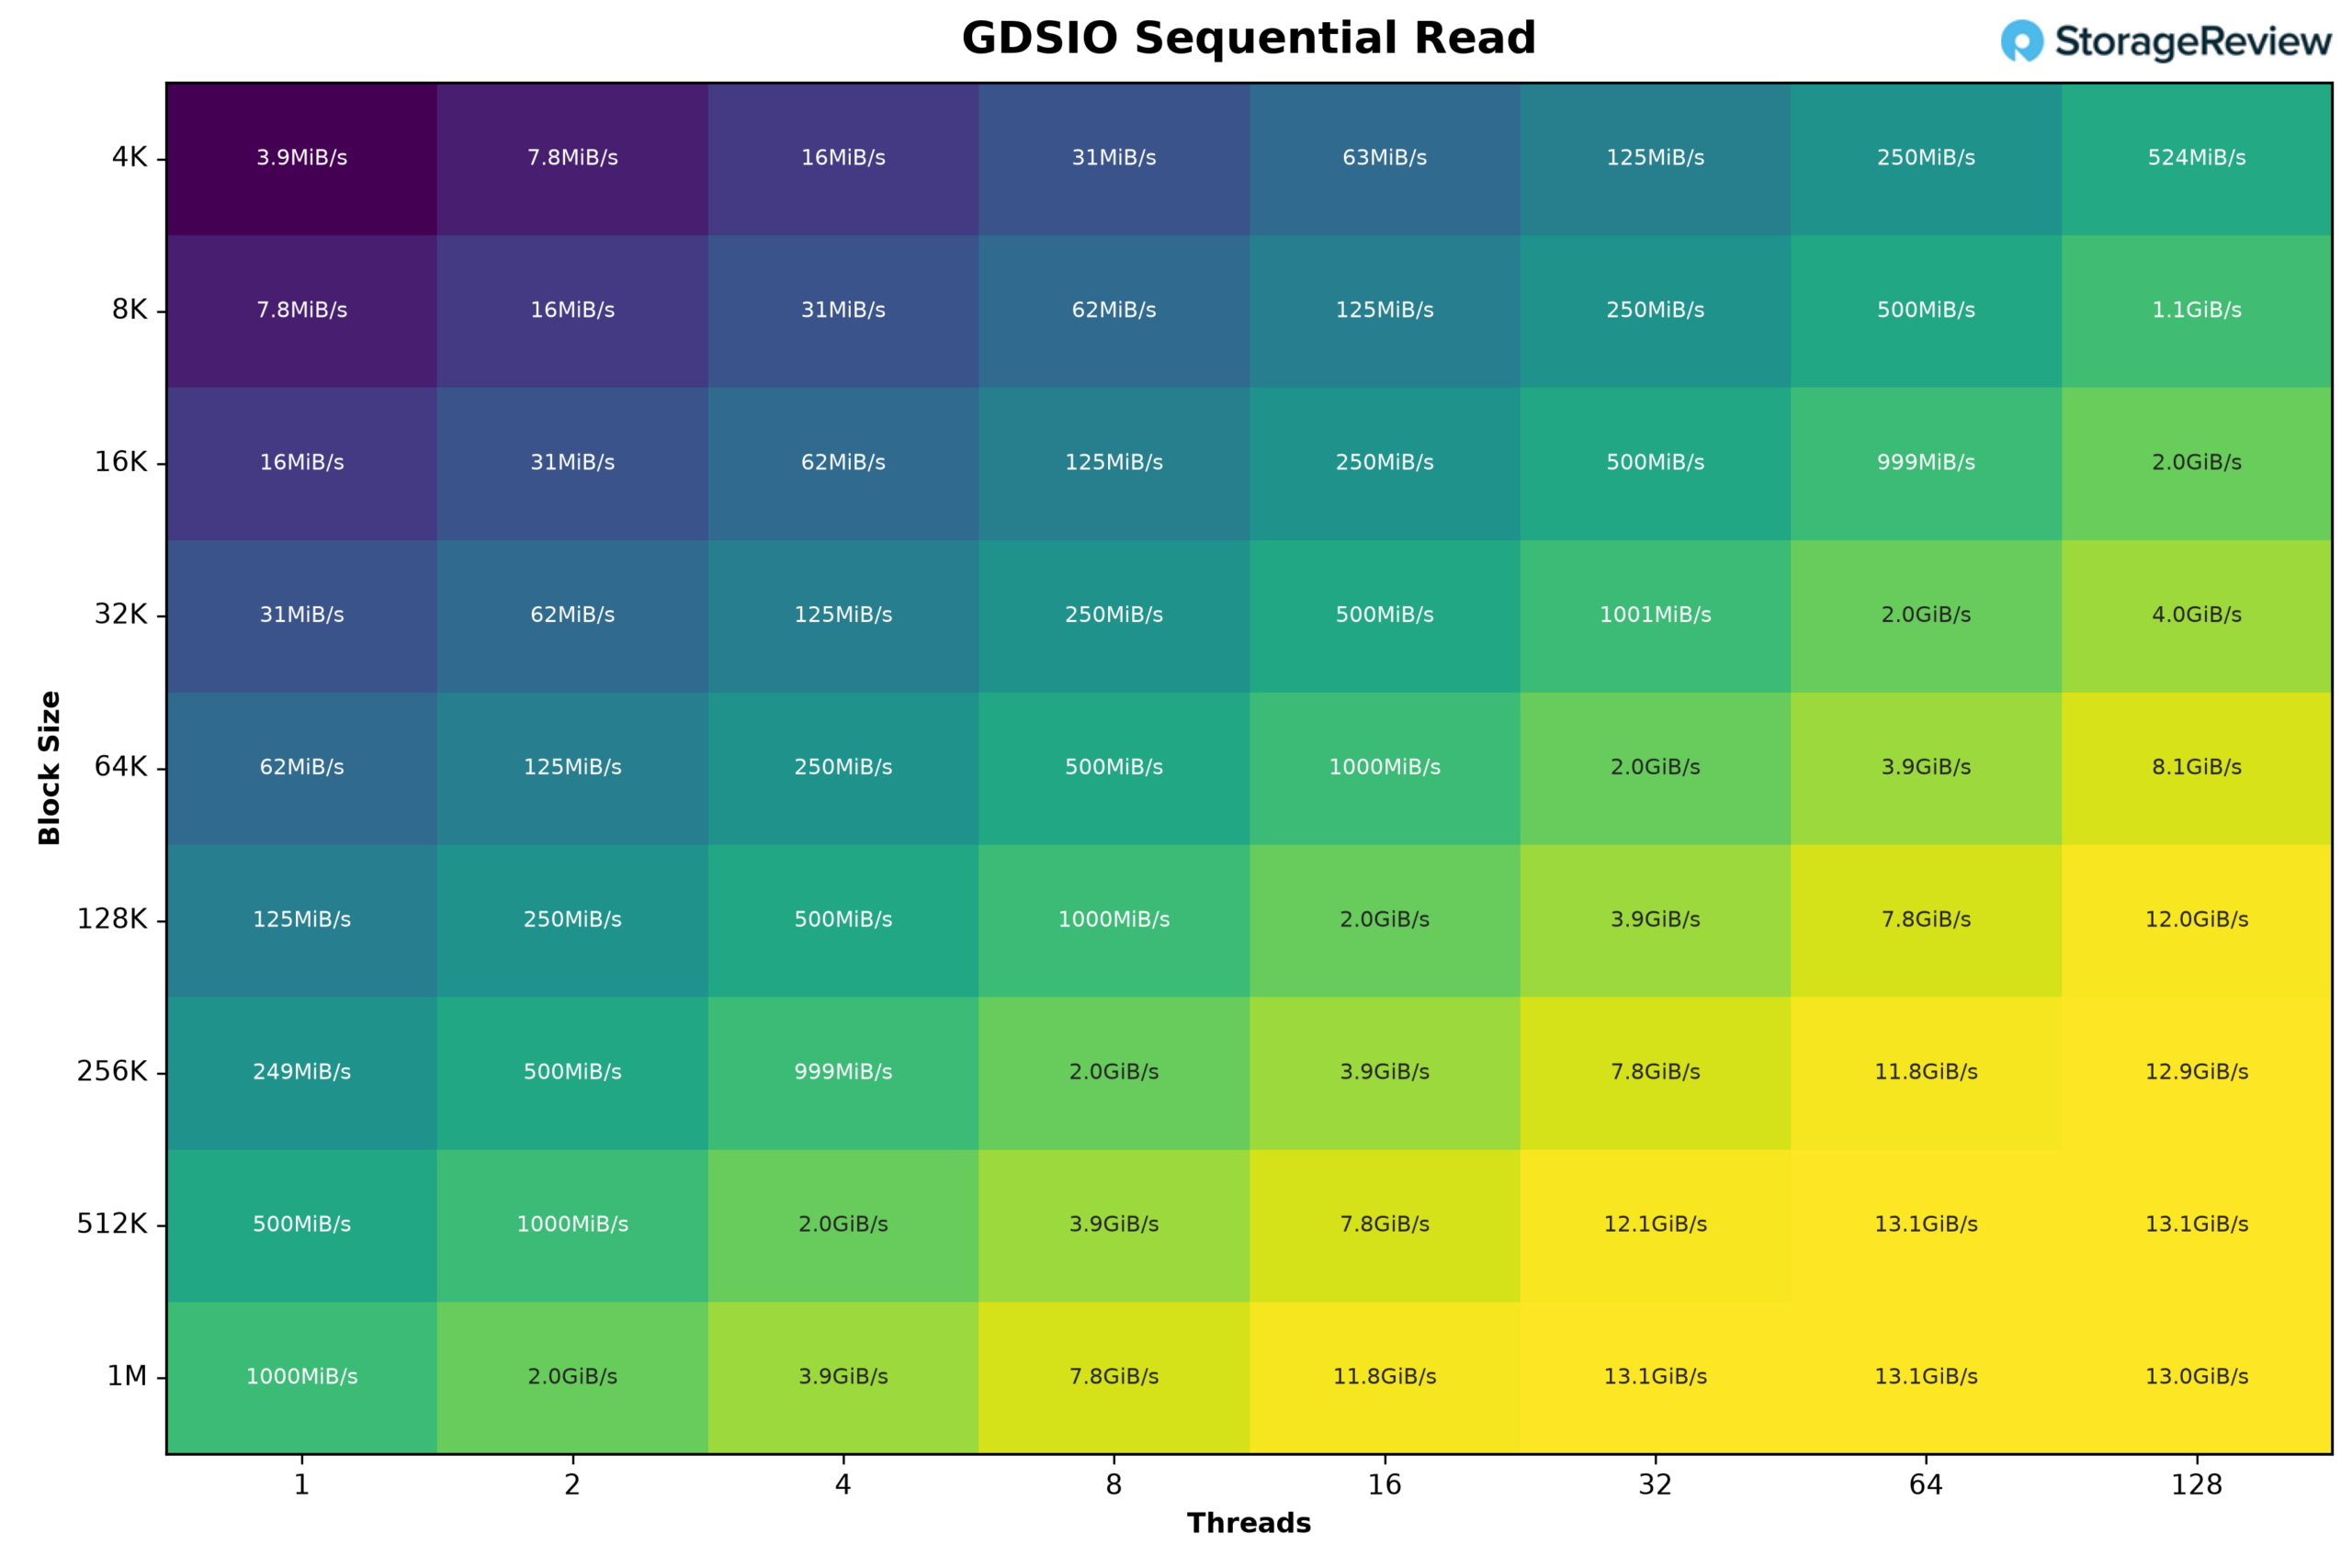
Em relação ao desempenho de gravação sequencial GDSIO, a unidade apresenta escalabilidade consistente tanto em relação ao número de threads quanto ao tamanho do bloco. Com 16 KB, a taxa de transferência aumenta de 16 MiB/s com 1 thread para 250 MiB/s com 16 threads, atingindo 2.0 GiB/s com 128 threads. Blocos maiores apresentam um aumento de desempenho muito mais rápido, com 256 KB atingindo 7.5 GiB/s com 32 threads e 12.0 GiB/s com 64 threads. O melhor resultado vem da carga de trabalho de 1 milhão de blocos, que atinge o limite de 12.0 GiB/s com apenas 16 threads e mantém esse desempenho até 128 threads. 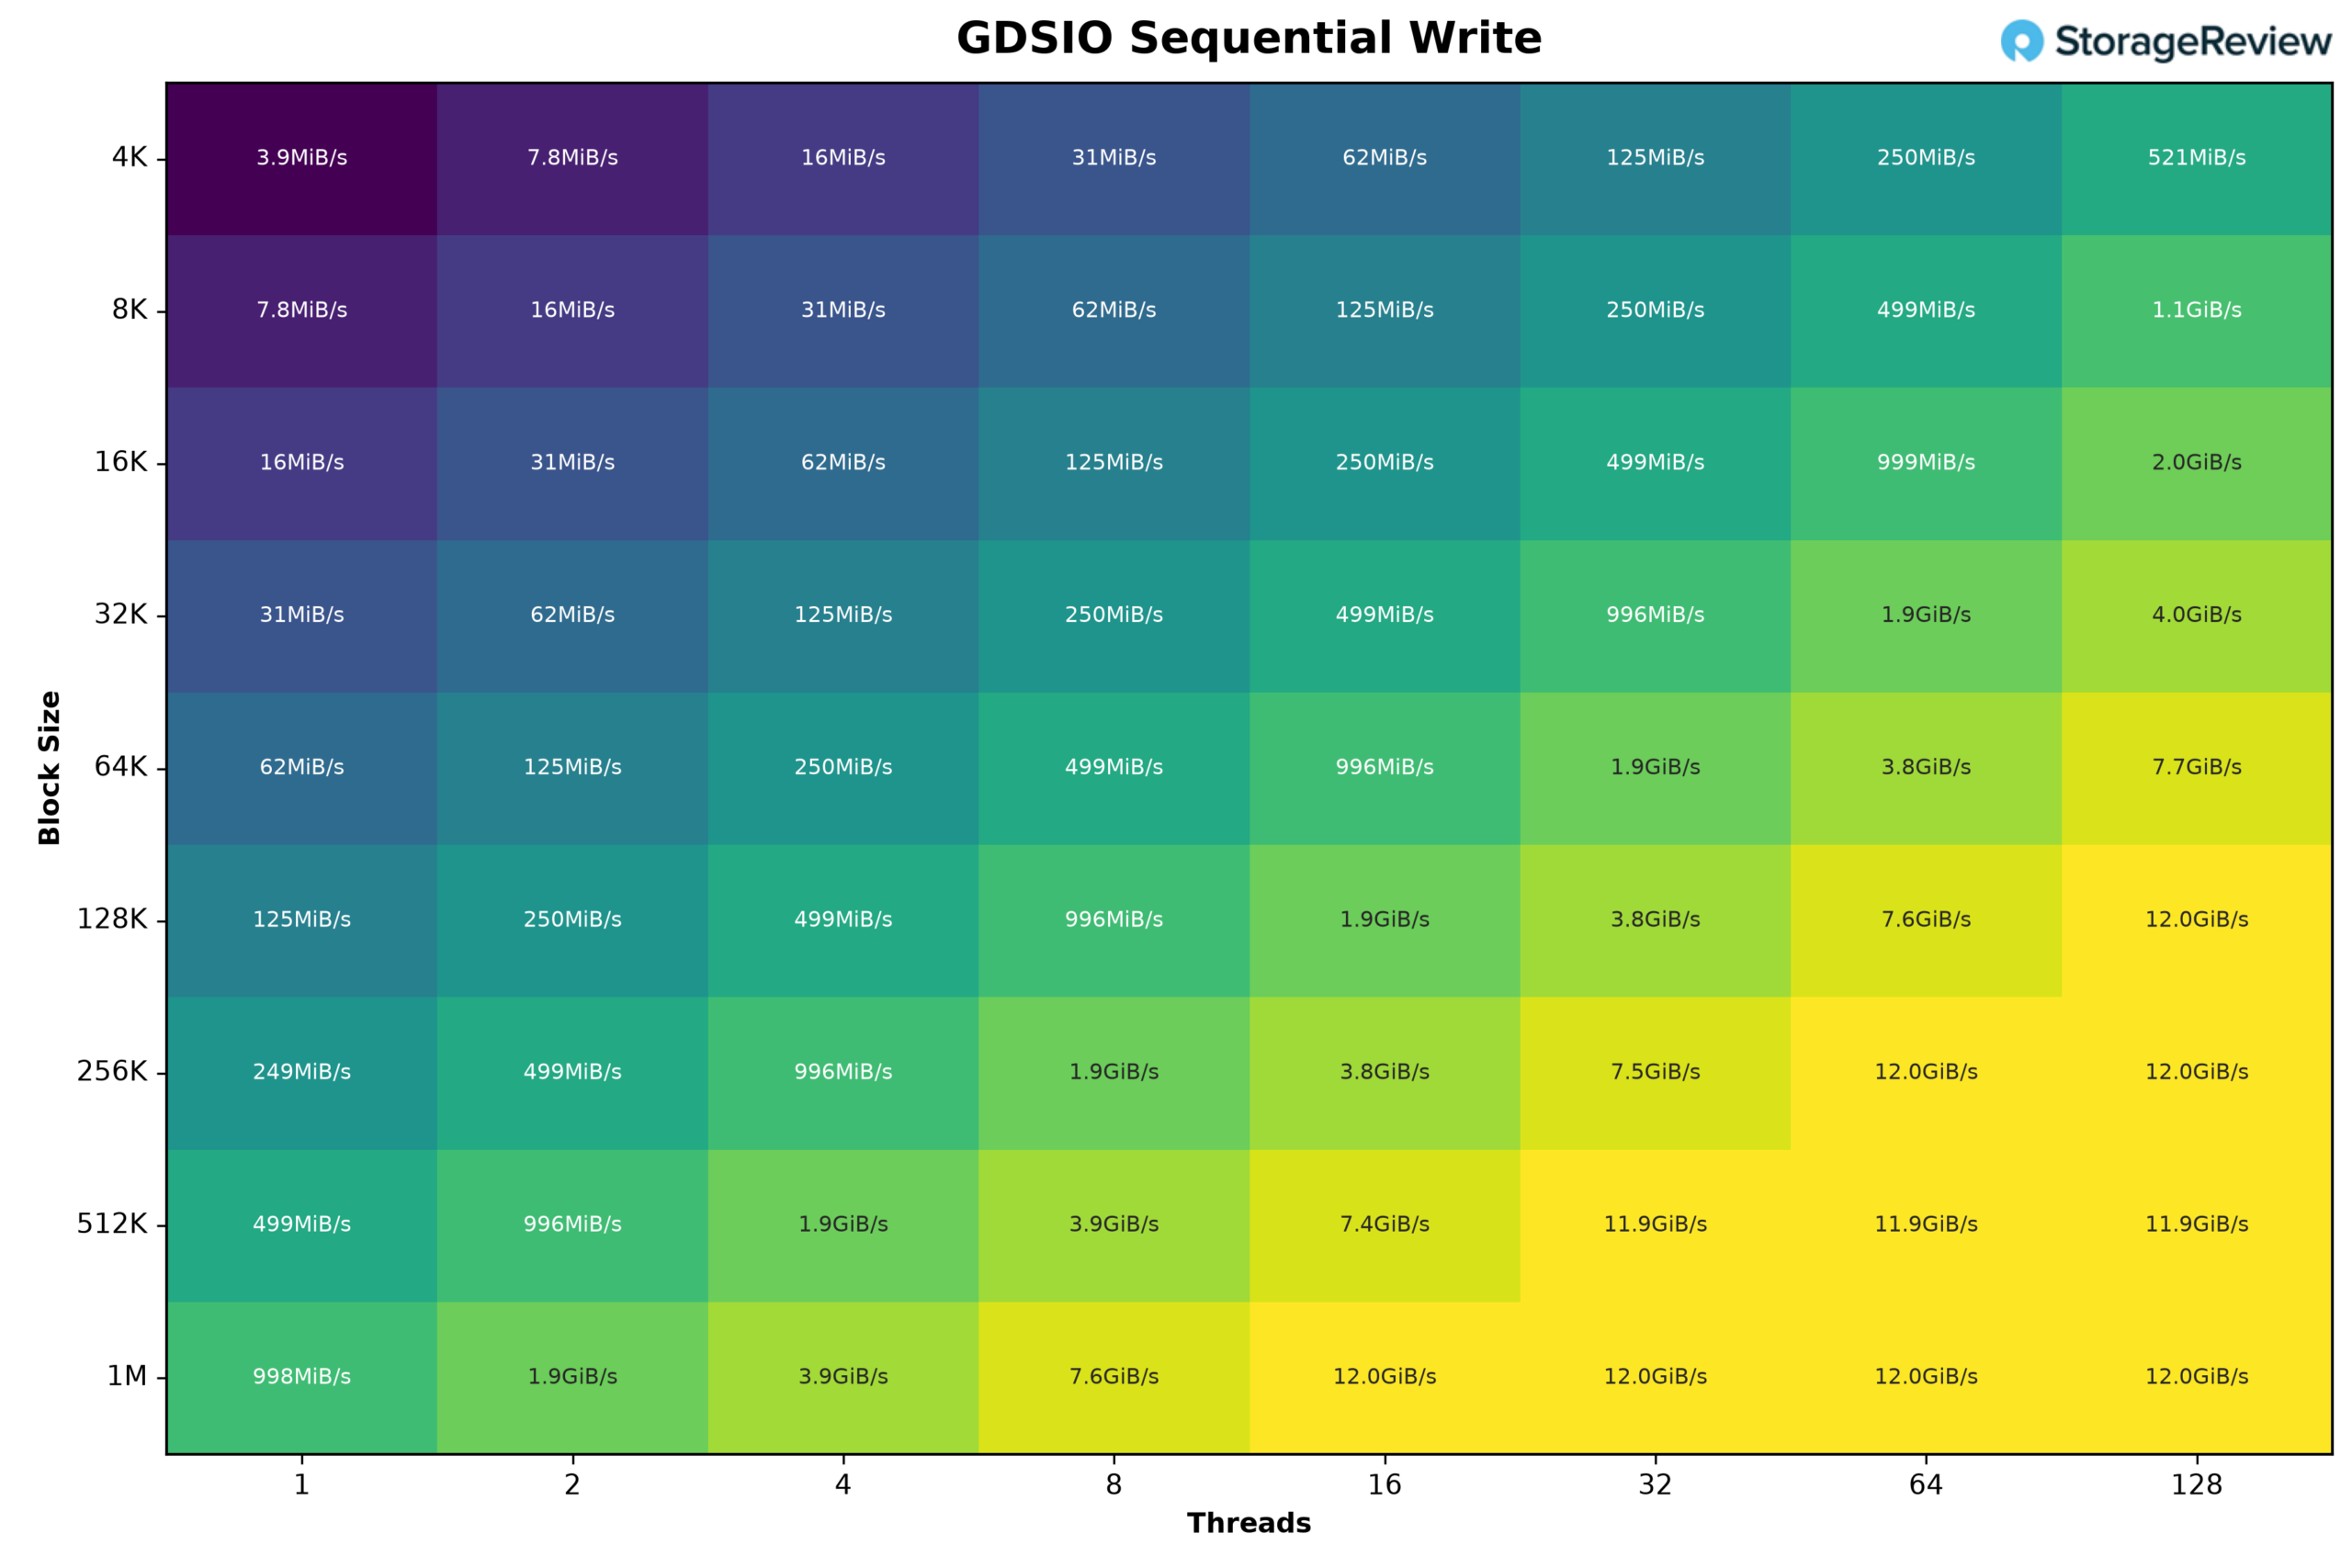
Para quem é indicado o MSI XpertStation WS300?
O WS300 é ideal para organizações que precisam de acesso direto ao Blackwell Ultra, mas não desejam que cada experimento comece com uma reserva de cluster ou uma solicitação na nuvem. Laboratórios de IA, desenvolvedores de mecanismos de inferência, equipes de frameworks e compiladores, grupos de robótica e equipes de IA corporativas podem usá-lo como um nó de desenvolvimento local para os fluxos de trabalho mencionados. O MIG permite que os desenvolvedores testem e desenvolvam para uma configuração com múltiplas GPUs, e o BMC torna o sistema gerenciável remotamente.
Também faz sentido para desenvolvedores de IA experientes que precisam de um sistema pronto para uso imediato. O valor não está apenas na placa-mãe B300, mas sim em toda a plataforma que a acompanha: 252 GB de HBM3e, Grace e 496 GB de LPDDR5X, ConnectX-8, armazenamento de inicialização espelhado, refrigeração líquida, gerenciamento remoto e suporte da MSI, tudo em um único gabinete. As limitações práticas são o host Arm, a necessidade de um circuito dedicado de 20 A e o orçamento compartilhado de 1,600 W quando uma placa de vídeo RTX PRO de grande porte está instalada.
Aproveitar ao máximo o WS300 também depende do software que o acompanha. A NVIDIA oferece uma ampla coleção de manuais e guias de implementação projetados para ajudar as equipes a colocar o sistema online e utilizar seus recursos rapidamente. Exploraremos várias dessas ferramentas em futuras publicações, incluindo o Brev, que pode simplificar o acesso compartilhado à estação de trabalho e melhorar a utilização, evitando que um recurso tão caro fique ocioso.
Quanto ao preço, a MSI não o divulgou, e máquinas desta categoria raramente têm um preço de tabela; trata-se de uma conversa franca com a equipe de vendas, não de um botão de "adicionar ao carrinho". A comparação honesta não é com outras estações de trabalho, mas sim com o que uma equipe de IA já paga: tempo de cluster reservado, compromissos de GPU na nuvem e o custo de cronograma de espera por hardware compartilhado.
Conclusão
A MSI XpertStation WS300 é a estação de trabalho mais poderosa que já analisamos, e um produto raro que amplia as possibilidades de um profissional autônomo. Pontos de verificação de última geração, que normalmente ficam restritos a um cluster, GLM-5.2 com 433 GB de memória e Nemotron-3-Ultra com 550 bilhões de parâmetros, são carregados e disponibilizados em um único dispositivo ao lado da mesa, de forma privada e sempre disponível. Essa é a origem do nosso entusiasmo por este sistema.
A DGX Station é voltada para desenvolvedores: desenvolvedores de kernel que utilizam o Blackwell Ultra, equipes de mecanismos de inferência e frameworks, grupos de robótica que executam o ciclo completo do Isaac e, em geral, usuários frustrados com o agendamento de experimentos em hardware compartilhado. Fora desse nicho, a justificativa para comprar esses sistemas é bastante limitada. O host Arm exclui algumas cadeias de ferramentas; o circuito de 20A é um requisito de instalação em circuitos de 120V; não há saída de vídeo sem uma placa adicional; e uma workstation RTX PRO 6000 custa muito menos, cobrindo o trabalho de um único usuário em modelos que cabem em seus 96GB.
A questão econômica também define o tamanho ideal da implantação. Um WS300 é fácil de justificar considerando o tempo de cluster reservado, e um par por equipe também é justificável. Aumentar o número de servidores deixa de fazer sentido a partir de certo ponto: quando uma organização compra quatro torres GB300, por exemplo, o mesmo valor pode ser investido em um servidor B300 de oito GPUs com mais memória por GPU, particionamento MIG mais denso e NVLink entre cada GPU. O ideal é ter um servidor na mesa de trabalho e talvez dois no laboratório, complementando o investimento no data center.
A NVIDIA fornece a placa-mãe, então a diferenciação entre os fabricantes se resume à implementação, e a execução da MSI nesse quesito é sólida. Um circuito de refrigeração líquida de 1,400 W resfria a B300, a Grace, a SOCAMM e a ConnectX-8, e a plataforma se manteve estável durante todos os testes. Essa análise mais detalhada já foi publicada: nosso estudo aprofundado sobre o desempenho térmico da WS300 combina os dados da placa fria e do radiador da MSI com um teste instrumentado de 2.8 horas, mostrando que o chip se manteve a 60 °C e com um clock estável de 2.07 GHz em carga máxima. O orçamento de energia de 1,600 W é distribuído automaticamente entre os componentes e, quando testamos o freio de energia de hardware com uma conexão comprometida, o processador reduziu a frequência em vez de desligar. Um cabo 12VHPWR pré-cabeado e um suporte anti-flacidez facilitam a expansão da placa de vídeo RTX PRO. Tendo testado a primeira GB300 DGX Station que chegou até nós, podemos afirmar que a XpertStation WS300 estabelece um alto padrão para a plataforma.
O XpertStation WS300 agora ocupa o primeiro lugar como o melhor sistema GB300 em nossa lista de melhores desktops para IA local e é o tema central da discussão sobre memória em nosso guia de RAM, GPU e armazenamento para IA ativa.


 Amazon