

Equinix har utökat sitt partnerskap med NVIDIA och inlett ett nytt samarbete med Together AI för att lansera Equinix Inference Exchange. Plattformen är utformad som en distribuerad AI-inferensarkitektur för företagsdistributioner och syftar till att flytta beräkningsarbetsbelastningar närmare centrala datalager, slutanvändare och operativa applikationer. Initiativet, som tillkännagavs tillsammans med Equinix Fabric One på Equinix Horizon-evenemanget, kombinerar NVIDIAs företagshårdvaruarkitekturer, Together AIs plattform med öppen källkod och Equinix globala sammankopplingsinfrastruktur för att hantera latens, datasuveränitet och flaskhalsar i nätverk.
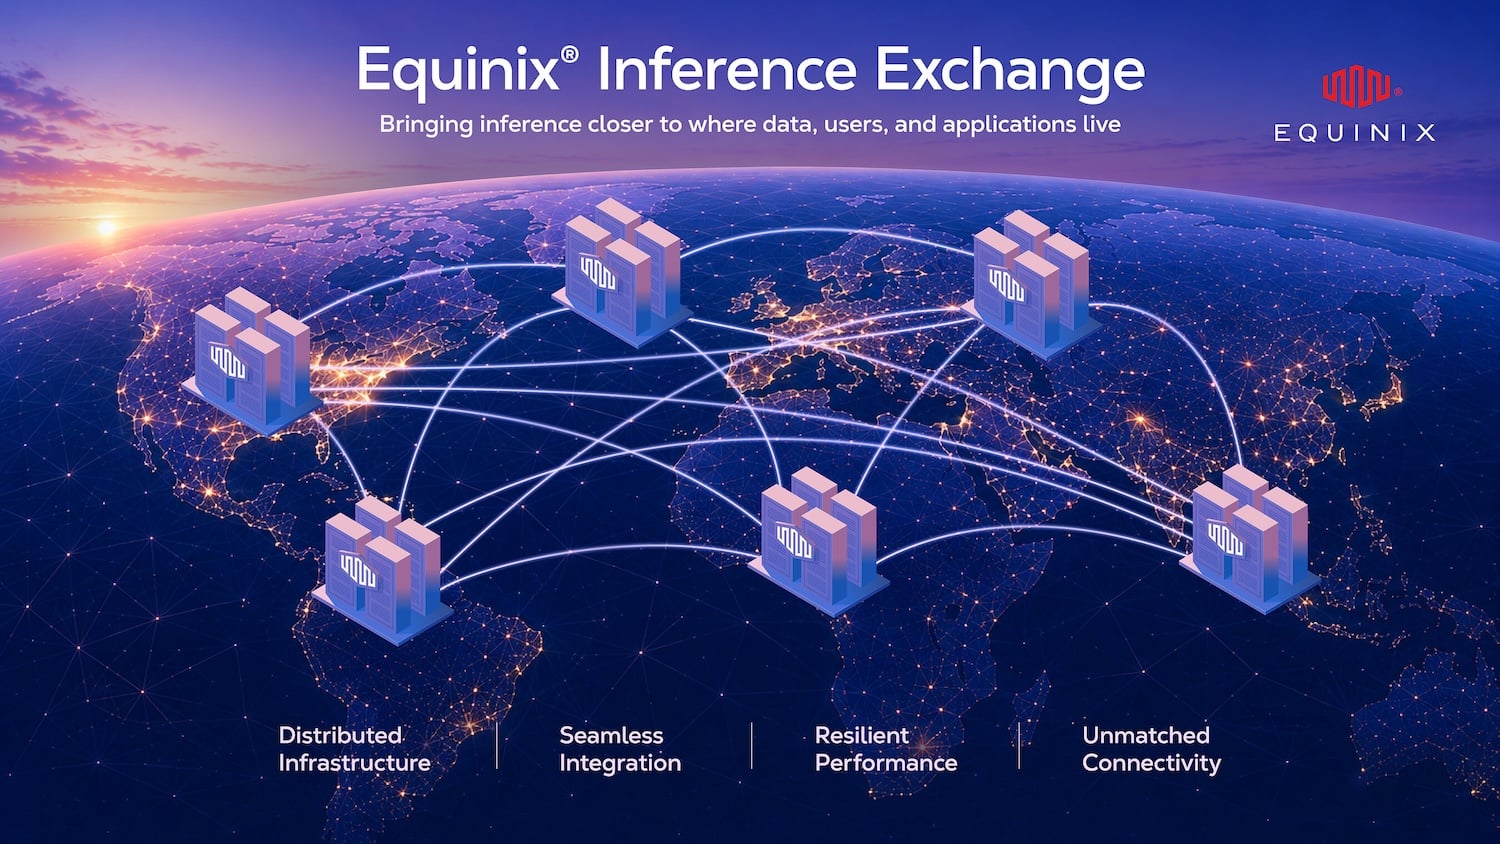
Att ta itu med distribuerad inferens och datagravitation
När företags AI-initiativ övergår från prototypvalidering till högkapacitetsproduktion, dikterar placeringen av inferenser den totala kostnaden, svarslatensen och efterlevnadspositionen. Att flytta modellkörning närmare datakällor minskar kostnaden för att backa data över publika moln samtidigt som det ger deterministiska latensprofiler. Att hantera distribuerad infrastruktur över olika miljöer introducerar dock driftskostnader och nätverkskomplexitet.
Equinix tar itu med detta operativa hinder genom att utnyttja sin närvaro med fler än 280 datacenter i 77 storstadsområden, 230 molnanslutningar och ett nätverk av över 10 500 sammankopplade företag. Med åtta av de tio största leverantörerna av AI-modeller och nio av de tio största AI-molnen redan i drift inom Equinix anläggningar, fungerar plattformen som ett neutralt aggregeringslager för distribuerade AI-pipelines.
Arkitektur och stackintegration
Equinix Inference Exchange-stacken är strukturerad i tre distinkta lager över beräknings-, mjukvaru- och fysisk infrastruktur:
Equinix hanterar den grundläggande fysiska och sammankopplade grunden. Detta inkluderar strömförsörjning, avancerade vätskekylningsfunktioner, drift av anläggningen under två dagar och privat sammankoppling till nätverk, publika moln och SaaS-plattformar via Equinix Fabric.
NVIDIA tillhandahåller beräknings- och referensvalideringslagret och tillhandahåller AI-infrastruktur för företag, konstruerad för hög token-genomströmning och minskade inferenskostnader per fråga.
Tillsammans tillhandahåller AI det inferensbaserade programvarulager som stöder över 200 modeller med öppen källkod. Plattformen stöder både delade multitenant-miljöer för generell beräkningseffektivitet och dedikerade topologier med en enda hyresgäst för arbetsbelastningar som kräver isolerad kapacitet.
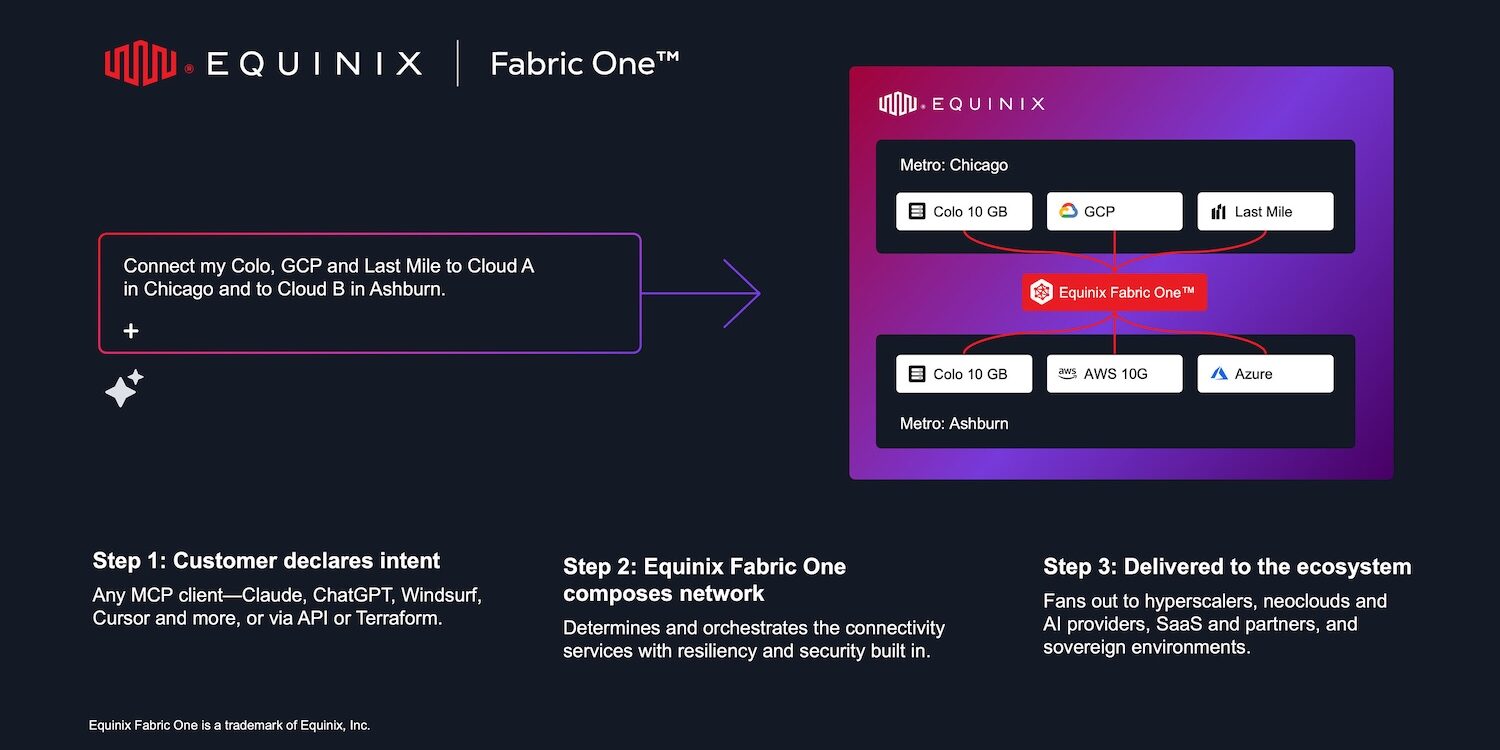
Genom att dirigera trafik över Equinix Fabric minskar plattformen time-to-first-token (TTFT)-mätvärden för regionala användare samtidigt som privata peering-vägar upprättas mellan lokal lagring och modellslutpunkter.
Mål och tillgänglighet för företagsdistribution
Plattformen riktar sig mot tre primära distributionstopologier. För inferens i storstadsregioner kan organisationer köra modeller i lokala storstadshubbar, vilket levererar API-svar med låg latens samtidigt som centraliserad hantering och privata sammankopplingar bibehålls. För migrering av modeller med öppen källkod ger arkitekturen en smidig övergång från slutna, proprietära API:er till grundläggande modeller med öppen källkod, vilket minskar leverantörsinlåsning samtidigt som befintliga nätverksstrukturer utnyttjas. För suverän AI och efterlevnadsmandat gör den distribuerade layouten det möjligt för företag i reglerade sektorer att hålla inferenskörning och databehandling inom specifika geografiska gränser, vilket hjälper till att uppfylla strikta krav på datalagring och styrning.
Ledningen från Equinix, NVIDIA och Together AI noterade att integrationen etablerar en leverantörsneutral, högkapacitets inferensstruktur som balanserar beräkningsprestanda med operativ flexibilitet.
Equinix Inference Exchange är planerad att vara allmänt tillgänglig för företag under första kvartalet 2027.


 Amazon