

Google och AMD har meddelat betydande utvecklingar inom artificiell intelligens. Google introducerade Gemma 3, den senaste generationen av sin AI-modellserie med öppen källkod. Samtidigt tillkännagav AMD integration med Open Platform for Enterprise AI (OPEA) och lanserade sina Instella-språkmodeller.
Googles Gemma 3: Multimodal AI-effektivitet på minimal hårdvara
Utgivningen av Gemma 12 den 3 mars bygger på framgången med Gemma 2. Den nya modellen introducerar multimodala möjligheter, flerspråkigt stöd och förbättrad effektivitet, vilket möjliggör avancerad AI-prestanda även på begränsad hårdvara.
Gemma 3 finns i fyra storlekar: 1B, 4B, 12B och 27B parametrar. Varje variant kommer i både basversioner (förtränade) och instruktionstrimmade versioner. De större modellerna (4B, 12B och 27B) erbjuder multimodal funktionalitet, sömlös bearbetning av text, bilder och korta videor. Googles SigLIP vision-kodare omvandlar visuella indata till tokens som kan tolkas av språkmodellen, vilket gör att Gemma 3 kan svara på bildbaserade frågor, identifiera objekt och läsa inbäddad text.
Gemma 3 utökar också sitt kontextfönster avsevärt och stödjer upp till 128,000 2 tokens jämfört med Gemma 80,000:s 3 140 tokens. Detta gör att modellen kan hantera mer information inom en enda prompt. Dessutom stöder Gemma XNUMX över XNUMX språk, vilket förbättrar den globala tillgängligheten.
LMSYS Chatbot Arena Ranking
Gemma 3 har snabbt framstått som en av de mest framgångsrika AI-modellerna på LMSYS Chatbot Arena , ett riktmärke som utvärderar stora språkmodeller baserade på mänskliga preferenser. Gemma-3-27B uppnådde ett Elo-resultat på 1338, vilket är den nia globalt. Detta placerar den före anmärkningsvärda konkurrenter som DeepSeek-V3 (1318), Llama3-405B (1257), Qwen2.5-72B (1257), Mistral Large och Googles tidigare Gemma 2-modeller.
AMD stärker Enterprise AI med OPEA-integration
AMD tillkännagav sitt stöd för Open Platform for Enterprise AI (OPEA) den 12 mars 2025. Denna integration kopplar samman OPEA GenAI-ramverket med AMD:s ROCm-mjukvarustack, vilket gör det möjligt för företag att effektivt distribuera skalbara generativa AI-applikationer på AMD datacenter GPU:er.
Samarbetet tar itu med viktiga företags AI-utmaningar, inklusive modellintegrationskomplexitet, GPU-resurshantering, säkerhet och arbetsflödesflexibilitet. Som medlem i OPEA:s tekniska styrkommitté samarbetar AMD med branschledare för att möjliggöra komponerbara generativa AI-lösningar som kan implementeras i offentliga och privata molnmiljöer.
OPEA tillhandahåller viktiga AI-applikationskomponenter, inklusive förbyggda arbetsflöden, utvärderingsförmåga, inbäddningsmodeller och vektordatabaser. Dess molnbaserade, mikrotjänstbaserade arkitektur säkerställer sömlös integration genom API-drivna arbetsflöden.
AMD lanserar Instella: helt öppna språkmodeller med 3B-parameter
AMD introducerade också Instella, en familj av helt öppen källkod, språkmodeller med 3 miljarder parametrar utvecklade helt på AMD-hårdvara.
Tekniska innovationer och utbildningsmetod
Instella-modeller använder en autoregressiv transformatorarkitektur endast för text med 36 avkodarlager och 32 uppmärksamhetshuvuden per lager, som stöder sekvenser upp till 4,096 50,000 tokens. Modellerna använder ett ordförråd på cirka XNUMX XNUMX tokens via OLMo-tokenizern.
Efter en pipeline i flera steg skedde utbildning på 128 AMD Instinct MI300X GPU:er över 16 noder. Inledande förträning involverade cirka 4.065 57.575 biljoner tokens från olika datauppsättningar som täcker kodning, akademiker, matematik och allmän kunskap. Ett andra förträningssteg förfinade problemlösningsförmågan med hjälp av ytterligare 8 miljarder tokens från specialiserade benchmarks som MMLU, BBH och GSMXNUMXk.
Efter förträning genomgick Instella övervakad finjustering (SFT) med 8.9 miljarder tokens av utvalda instruktions-svarsdata, vilket förbättrade interaktiva funktioner. En sista fas med Direct Preference Optimization (DPO) anpassade modellen nära till mänskliga preferenser, med hjälp av 760 miljoner tokens av noggrant utvalda data.
Imponerande benchmarkprestanda
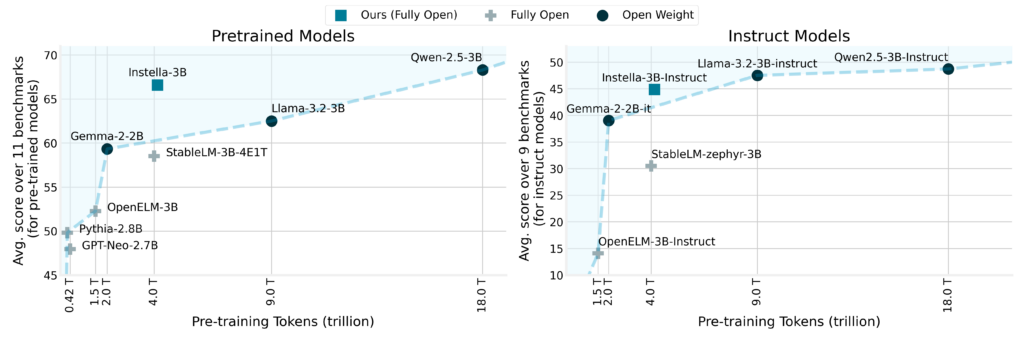
Benchmarkresultaten framhäver Instellas anmärkningsvärda prestandavinster. Modellen överträffade befintliga helt öppna modeller med en genomsnittlig marginal på över 8 %, med imponerande resultat i benchmarks som ARC Challenge (+8.02 %), ARC Easy (+3.51 %), Winograde (+4.7 %), OpenBookQA (+3.88 %), MMLU (+13.12 %) och GSM 8 (+48.98 %).
Till skillnad från ledande modeller med öppen vikt som Llama-3.2-3B och Gemma-2-2B, visade Instella överlägsen eller mycket konkurrenskraftig prestanda över flera uppgifter. Den instruktionstrimmade varianten, Instella-3B-Instruct, visade betydande fördelar jämfört med andra helt öppna instruktionstrimmade modeller med en genomsnittlig prestandaförsprång på över 14 % samtidigt som den presterade konkurrenskraftigt mot ledande öppenviktsinstruktionsjusterade modeller.
Fullständig version med öppen källkod och tillgänglighet
I linje med AMD:s engagemang för principer med öppen källkod har företaget släppt alla artefakter relaterade till Instella-modeller, inklusive modellvikter, detaljerade träningskonfigurationer, datauppsättningar och kod. Denna fullständiga transparens gör det möjligt för AI-gemenskapen att samarbeta, replikera och förnya med dessa modeller.
Slutsats
Dessa tillkännagivanden från Google och AMD satte scenen för ett spännande år framför AI-innovation. Industrins momentum är tydligt med Gemma 3 som omdefinierar multimodal effektivitet och AMD:s Instella-modeller och OPEA-integration som stärker företags-AI. När vi närmar oss NVIDIAs GTC-konferens och förutser ytterligare banbrytande utgåvor, är det uppenbart att denna utveckling bara är början på vad som komma skall.


 Amazon