

IBM fortsätter att utveckla sin Storage Scale System 6000-plattform för att åtgärda ett välkänt problem i moderna datacenter: datasilos som saktar ner AI-initiativ, ökar infrastrukturens komplexitet och strandar värdefull information. Genom att förena data över edge, core och moln genom ett enda globalt namnutrymme och Active File Management (AFM) är Storage Scale System 6000 utformat för att ge organisationer en konsekvent, högpresterande dataplattform som kan mata GPU:er och processorer i stor skala. Resultatet är en lagringsgrund som gör det möjligt för AI-pipelines att starta omedelbart och leverera resultat snabbare, snarare än att vänta på äldre lagringsbegränsningar.
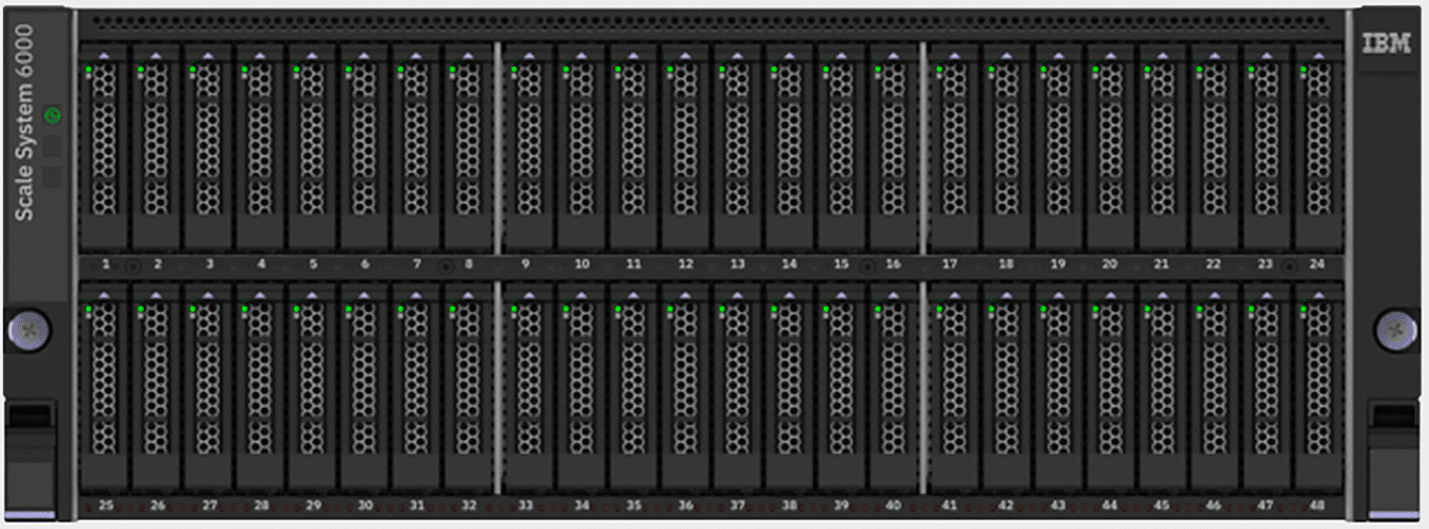
De senaste uppdateringarna fokuserar på två viktiga teman för organisationer idag: att låsa upp mörk data och ta bort flaskhalsar inom AI-inferens och träning. IBM tar itu med dessa prioriteringar med ett nytt all-flash expansionskabinett, stöd för QLC NVMe-media med hög kapacitet och en uppgraderad programvarustack som riktar in sig på både prestanda och effektivitet. Tillsammans positionerar dessa förändringar Storage Scale System 6000 som en tät, skalbar och AI-klar lagringsplattform lämplig för företags-, HPC- och AI-as-a-service-miljöer.
Rackkapacitet tredubblad med högdensitets QLC-flash
Med sina senaste förbättringar har IBM tredubblat den maximala kapaciteten för Storage Scale System 6000 till 47 PB per rack. Denna ökning kommer från stöd för branschstandard QLC NVMe SSD-diskar i konfigurationer på 30 TB, 60 TB och 122 TB. Kunderna får större flexibilitet i att matcha medietyp till arbetsbelastningsbehov, från prestandakänsliga nivåer till kapacitetsorienterade AI-arkiv.
Utökningen av enhetsalternativ är särskilt relevant för AI- och analyspipelines som måste lagra och bearbeta massiva datamängder utan att fragmentera dem över flera silos eller plattformar. Genom att konsolidera kapacitet till ett enda globalt namnområde hjälper Storage Scale System 6000 till att minska hanteringskostnaderna samtidigt som det fortfarande levererar de prestandaegenskaper som krävs för GPU-tunga arbetsbelastningar.
IBM Storage Scale System 7.0.0: Programvaruförbättringar för AI och datatjänster
Lanseringen av IBM Storage Scale System 7.0.0-programvaran introducerar flera viktiga förbättringar för att förbättra effektiviteten, prestandan och motståndskraften inom datahantering i miljöer med blandade arbetsbelastningar.
För det första stöder plattformen nu multiflash-nivåer med branschstandardiserade NVMe TLC- och QLC-flashenheter inom samma system. Denna funktion gör det möjligt för organisationer att anpassa kostnad, prestanda och uthållighet till arbetsbelastningsprofiler. Het eller latenskänslig data kan lagras på TLC-baserade nivåer, medan kallare eller kapacitetsfokuserade datamängder kan lagras på täta QLC-media. Nivåmodellen ger ett mer detaljerat sätt att optimera den totala ägandekostnaden (TCO) samtidigt som förutsägbar prestanda bibehålls.
För det andra har IBM introducerat en dedikerad dataaccelerationsnivå som använder högpresterande NVMe-oF för att mata applikationer i stor skala. Denna nivå kan leverera upp till 340 GB/s dataflöde och upp till 28 miljoner IOPS. Den är konstruerad för hög komprimeringseffektivitet och datadensitet samtidigt som den förbrukar mindre ström per prestandaenhet. För AI- och HPC-team som behöver hålla dyra beräkningar fullt utnyttjade är denna accelerationsnivå särskilt värdefull för att minimera GPU-inaktivitet som orsakas av flaskhalsar i lagring.
För det tredje har ramverket för dataskydd förbättrats med bredare alternativ för raderingskodning, inklusive stöd för 16+2/3P-konfigurationer. Dessa bredare koder förbättrar diskeffektiviteten och den totala lagringsutnyttjandet samtidigt som de ökar prestanda och skrivdataflöde. Resultatet är ett dataskyddssystem som skalar med plattformens ökade kapacitet och dataflöde, snarare än att bli en flaskhals.
Slutligen integreras programvarupaketet med NVIDIA Spectrum-X Ethernet-nätverk för att accelerera arbetsflöden för AI-utbildning. Spectrum-X kan avsevärt minska kontrollpunktstiden under utbildning av AI-grundmodeller, vilket resulterar i kortare utbildningscykler och förbättrat infrastrukturutnyttjande. För storskaliga utbildningsmiljöer är detta ett praktiskt verktyg för att minska tiden till insikt samtidigt som en Ethernet-baserad struktur bibehålls.
Helflash-expansionskabinett
För att möta kraven från arbetsbelastningar som använder massiva datamängder har IBM introducerat IBM Storage Scale System All-Flash Expansion Enclosure. Detta kabinett är optimerat för högpresterande AI-träning, inferens, HPC och andra dataintensiva arbetsbelastningar som kräver både hög dataflöde och stora, sammanhängande datamängder.
Genom att integrera 122 TB QLC NVMe SSD-diskar levererar Storage Scale System 6000 med All-Flash Expansion Enclosure mer än 47 PB högdensitets, kostnadseffektiv flashkapacitet i ett enda 42U-rack. För organisationer som vill bygga AI-fabriker eller storskaliga HPC-kluster ger detta en tydlig väg att konsolidera lagring till ett mindre format utan att offra prestanda.
Kabinettet är också utformat för att integreras med NVIDIA BlueField-3 DPU:er för acceleration i stor skala. Nätverkskort i lösningen kan ge upp till 400 Gb/s högpresterande nätverksdataflöde, tillsammans med NVMe-oF-offload-funktioner för Storage Scale System. Denna avlastning minskar CPU-overhead, vilket gör att fler värdresurser kan riktas mot AI, analys eller HPC-bearbetning istället för lagring och protokollhantering.
Varje expansionskabinett levererar upp till 100 GB/s dataflöde och mer än 3 PB rå flashkapacitet i ett 2U-formfaktor. Denna densitet och prestandaprofil gör den till en stark lösning för miljöer där rackutrymme, strömförsörjning och kylning är hårt begränsade men prestandaförväntningarna inte är förhandlingsbara.
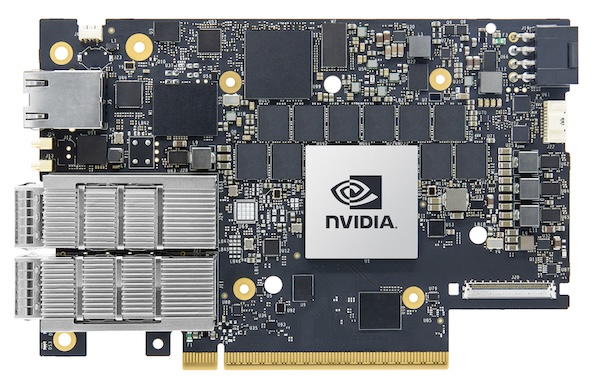
Kabinettet har stöd för upp till fyra NVIDIA BlueField-3 DPU :er och upp till 26 QLC SSD-diskar med dubbla portar . Denna kombination möjliggör hög aggregerad bandbredd, omfattande anslutningsmöjligheter och flexibel skalning av både kapacitet och avlastningsacceleration allt eftersom arbetsbelastningen växer.
Användningsfall för flerbostadshushåll och tjänsteleverantörer
Skalbarheten hos det nya All-Flash-expansionskabinettet anpassas också till större cachekonfigurationer och krav från leverantörer av multitenant-tjänster. IBM Storage Scale System 6000 stöder mycket konfigurerbar multitenancy på kluster-, filsystem- eller filuppsättningsnivå.
För tjänsteleverantörer och stora AI-fabriker tillhandahåller denna design verktygen för att isolera arbetsbelastningar, tillämpa differentierade säkerhetspolicyer och allokera resurser exakt till hyresgäster eller interna affärsenheter. Isolering kan implementeras utan att offra prestanda eller komplicera den operativa modellen.
Oavsett om miljön är en stor superdatorinstallation, ett traditionellt HPC-kluster eller en AI-as-a-service-plattform, är den här arkitekturen byggd för att stödja säkra, skalbara och kostnadseffektiva multitenant-operationer. Olika dataintensiva arbetsbelastningar kan samexistera på samma infrastruktur samtidigt som de uppfyller förväntningar på efterlevnad, prestanda och servicenivå.
Möjliggör AI i stor skala samtidigt som befintliga arbetsbelastningar stöds
IT-infrastrukturteam pressas att skala upp AI-initiativ samtidigt som de fortsätter att stödja befintliga företagsarbetsbelastningar och äldre applikationer. Det förbättrade IBM Storage Scale System 6000 är utformat för att hantera båda kraven med en enda plattform.
Genom att förena data över protokoll, platser och format gör systemet det möjligt för globalt spridda team att samarbeta direkt kring delade data utan att kopiera eller placera dem i separata miljöer. AFM, IBMs globala cachnings- och dataorkestreringslager, kan nu cacha mycket större arbetsmängder av data närmare GPU:erna, tack vare den tredubblade kapaciteten och utökade kabinettalternativen. Denna närhet hjälper till att eliminera datasilos och minskar dataförflyttningskostnader, vilket leder till snabbare och effektivare AI-pipelines.
Istället för att upprätthålla separata lagringssilos för traditionella arbetsbelastningar och AI kan organisationer standardisera Storage Scale System 6000 som ett gemensamt dataplan. Denna metod förenklar driften, stöder ett brett utbud av protokoll och åtkomstmetoder och levererar fortfarande den prestanda som krävs för moderna AI- och HPC-arbetsflöden.
Tillgänglighet
Programvaran IBM Storage Scale System 7.0.0 är planerad att vara tillgänglig den 9 december. Allmän tillgänglighet för det nya IBM Storage Scale System All-Flash Expansion Enclosure är den 12 december.


 Amazon