

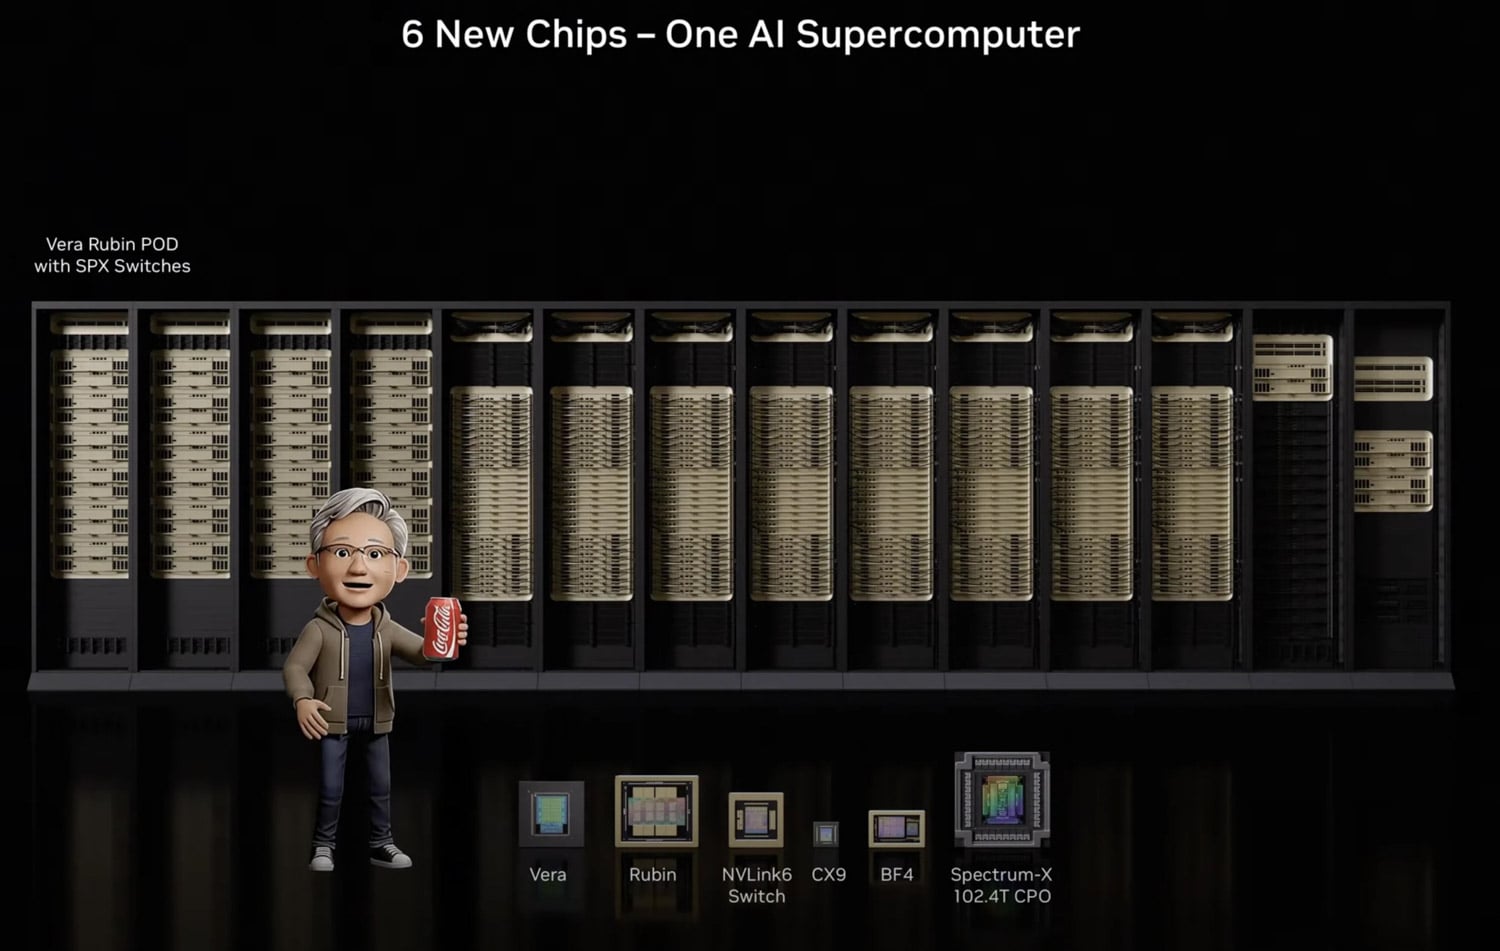
På CES 2026 presenterade NVIDIA Rubin-plattformen, förankrad i racksystemet Vera Rubin NVL72. Detta är NVIDIAs tredje generationens rackarkitektur som kombinerar sex samdesignade chip till ett enda enhetligt system. Plattformen kommer att finnas tillgänglig från partners under andra halvan av 2026, där alla sex chip redan är tillbaka från tillverkning och för närvarande genomgår validering med verkliga arbetsbelastningar.
Vera Rubin NVL72: Sex chip, ett enhetligt system
Vera Rubin NVL72 använder vad NVIDIA kallar "extrem samdesign", där sex distinkta kretsar utvecklas tillsammans för att fungera som ett enhetligt system.
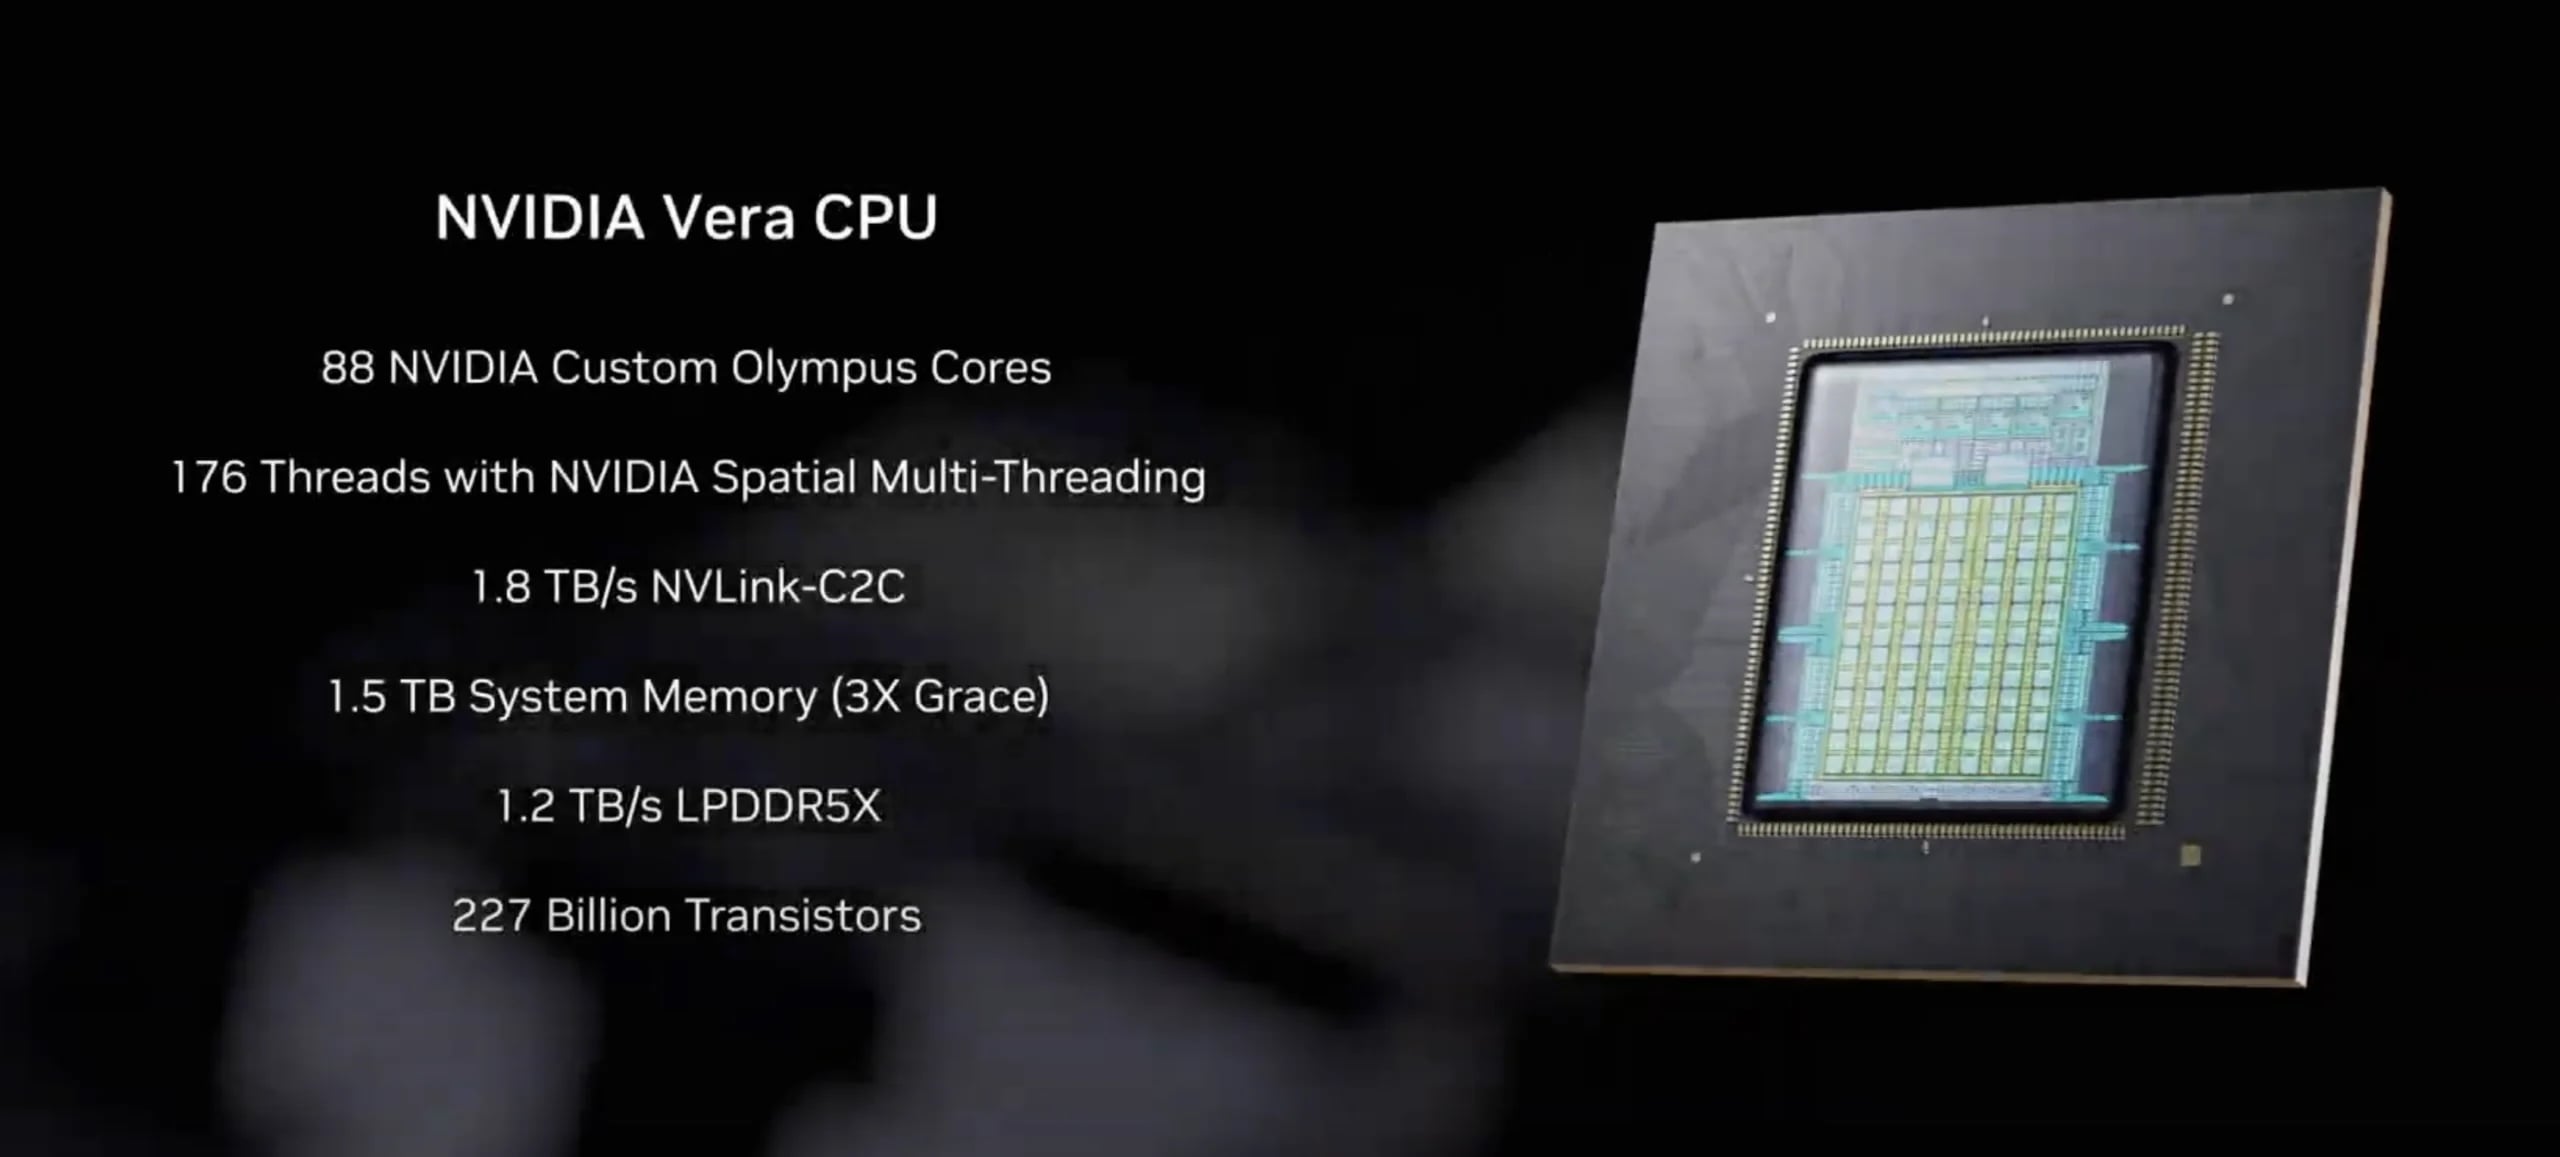
Vera CPU: ARM-kisel designad för AI-fabriker
Det första chippet som visades upp var NVIDIA Vera-processorn, då NVIDIA fortsätter sin investering i anpassad ARM-kisel för AI-arbetsbelastningar. Vera är byggd på 88 anpassade Olympus ARM-kärnor med full Armv9.2-kompatibilitet och är specifikt utformad för dataförflyttning och agentbehandlingskrav i moderna AI-fabriker. Den har NVLink-C2C-anslutning, vilket levererar 1.8 TB/s bandbredd till Rubin GPU:er, vilket fördubblar C2C-bandbredden jämfört med tidigare generationer och kör sju gånger snabbare än PCIe Gen 6. Vera-processorn fördubblar prestandan för databehandling, komprimering och kodkompilering jämfört med föregående generations Grace-processor.
Generationsjämförelse: Blackwell Ultra vs. Vera Rubin NVL72
| Specifikation | GB300 NVL72 (Blackwell Ultra) | VR NVL72 (Vera Rubin) |
|---|---|---|
| Antal GPU | 72 Blackwell Ultra GPU:er | 72 Rubin GPU:er |
| CPU-antal | 36 Grace-processorer | 36 Vera-processorer |
| CPU-kärnor | 72 ARM-kärnor per processor | 88 Olympus ARM-kärnor per processor |
| FP4-inferensprestanda | 1.44 ExaFLOPS | 3.6 ExaFLOPS |
| NVFP4 per GPU (inferens) | 20 PFLOPS | 50 PFLOPS |
| NVFP4 per GPU (träning) | 10 PFLOPS | 35 PFLOPS |
| GPU-minnestyp | HBM3e | HBM4 |
| GPU-minnes bandbredd | ~8 TB/s | ~22 TB/s |
| NVLink-generering | NVLänk 5 | NVLänk 6 |
| NVLink-bandbredd (per GPU) | 1.8 TB / s | 3.6 TB / s |
| Rackskalig NVLink-bandbredd | 130 TB / s | 260 TB / s |
| Skalbart nätverkskort | ConnectX-8 (800 Gb/s) | ConnectX-9 (1.6 TB/s) |
| CPU-GPU Interconnect | NVLink-C2C (900 GB/s) | NVLink-C2C (1.8 TB/s) |
Rubin GPU: Transformer Engines, NVFP4 och HBM4
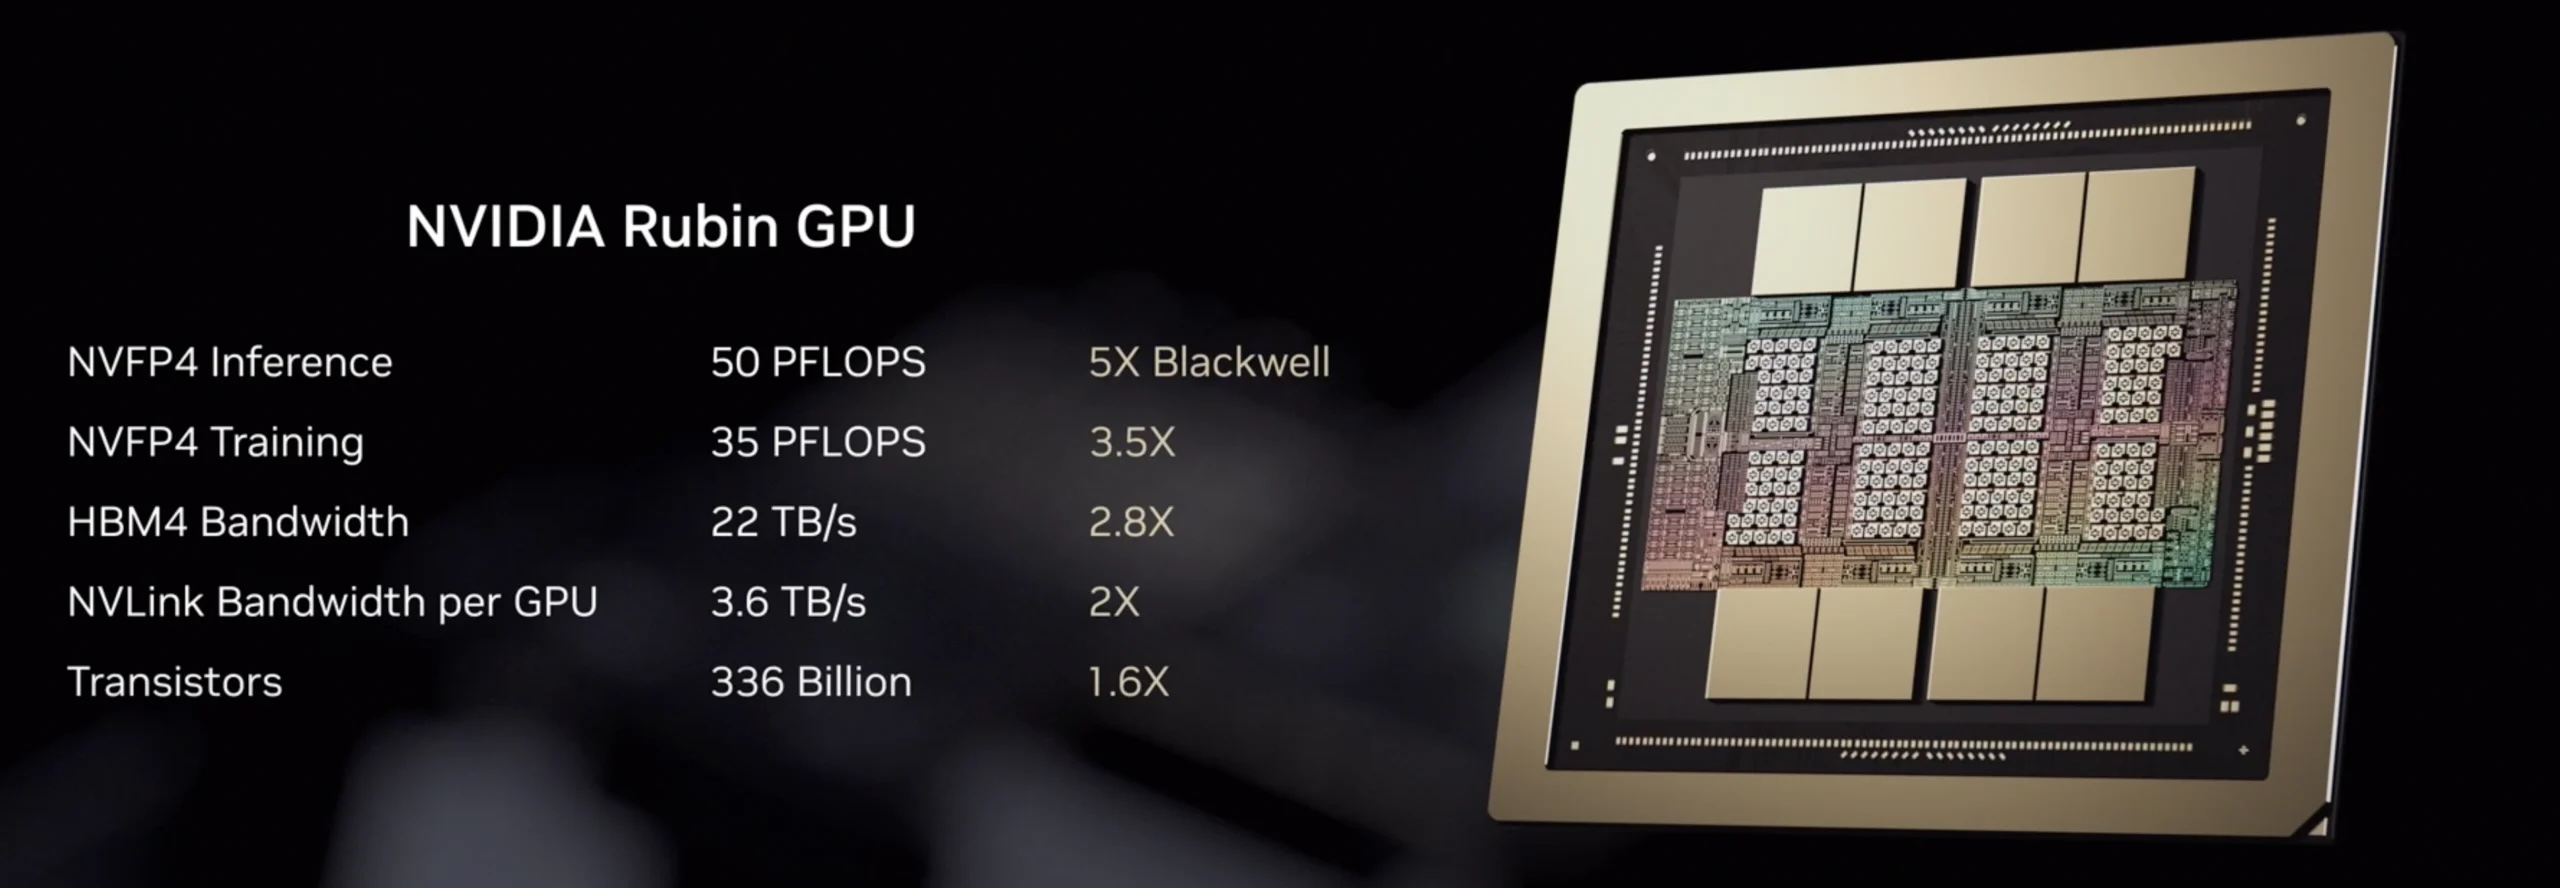
Nästa stjärna i serien var NVIDIA Rubin GPU, som har en tredje generationens Transformer Engine med hårdvaruaccelererad adaptiv komprimering. Denna justerar dynamiskt precisionen över transformatorlager, vilket uppnår högre dataflöde där precisionen kan minskas samtidigt som noggrannheten bibehålls där det är viktigt. Denna NVFP4-implementering levererar 50 petaflops beräkning för inferens (5x Blackwell) och 35 petaflops för träning (3.5x Blackwell). Rubin GPU är den första att integrera HBM4-minne med bandbredd upp till 22 TB/s, ett betydande hopp som åtgärdar den minnesbandbreddsvägg som stora MoE-modeller står inför.
NVLink 6: Rackskalig allt-till-allo-kommunikation
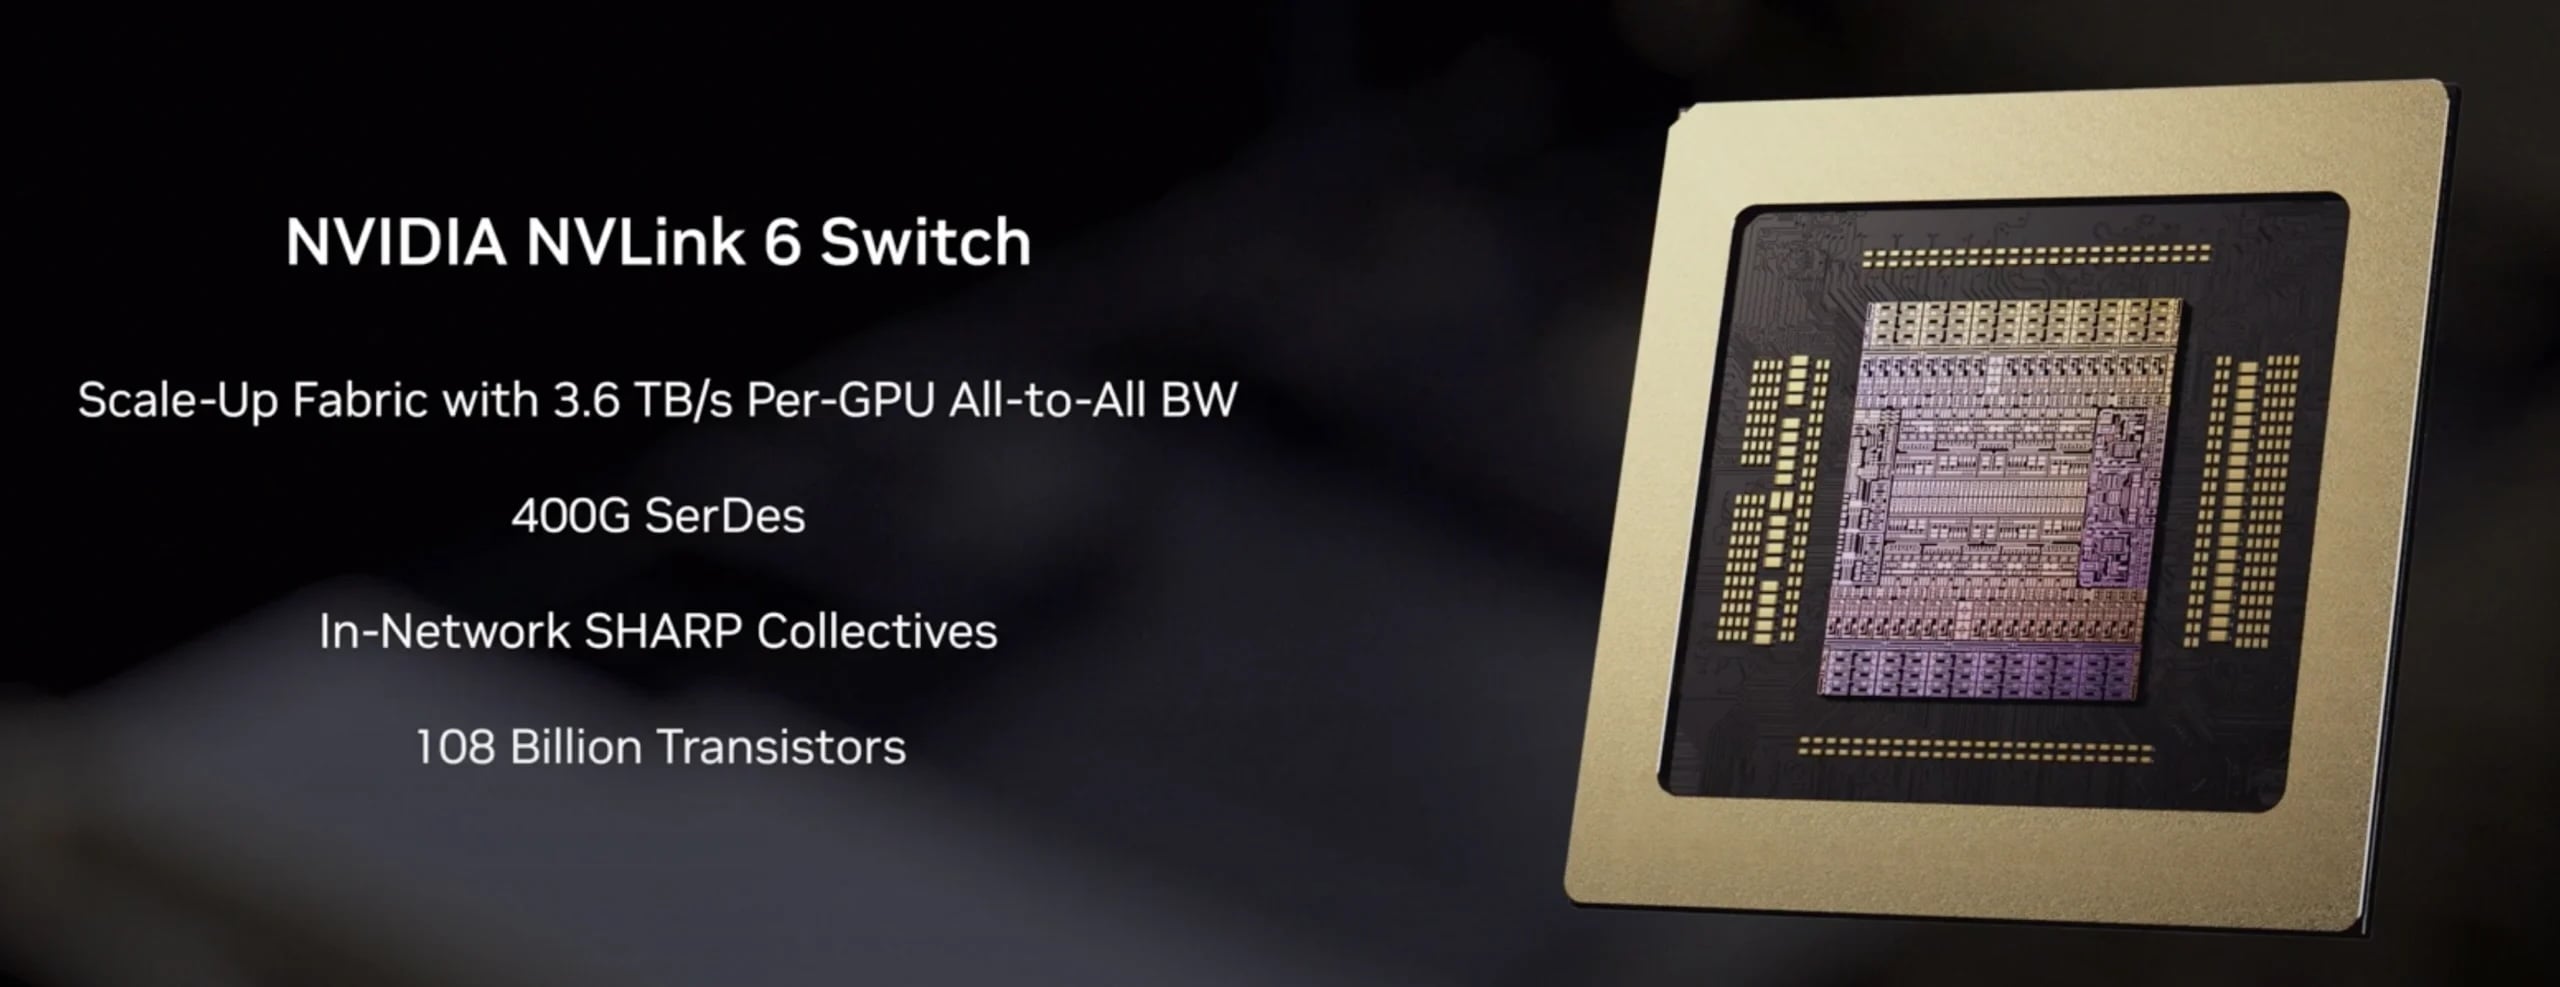
NVIDIA NVLink 6-switchen fördubblar bandbredden per GPU till 3.6 TB/s, där hela racket ger 260 TB/s skalbart nätverk – mer än dubbelt så mycket som det globala internets tvärsnittsbandbredd. Denna skalbara struktur gör det möjligt för varje GPU att kommunicera med alla andra GPU:er samtidigt (ett krav för MoE-expertparallellitet), där alla experter måste dela resultat över hela klustret. Inbyggd beräkning i nätverket accelererar kollektiva operationer och minskar överbelastning, vilket avlastar arbete som annars skulle förbruka GPU-cykler.
ConnectX-9 SuperNIC: Omdefiniera skalbara nätverk
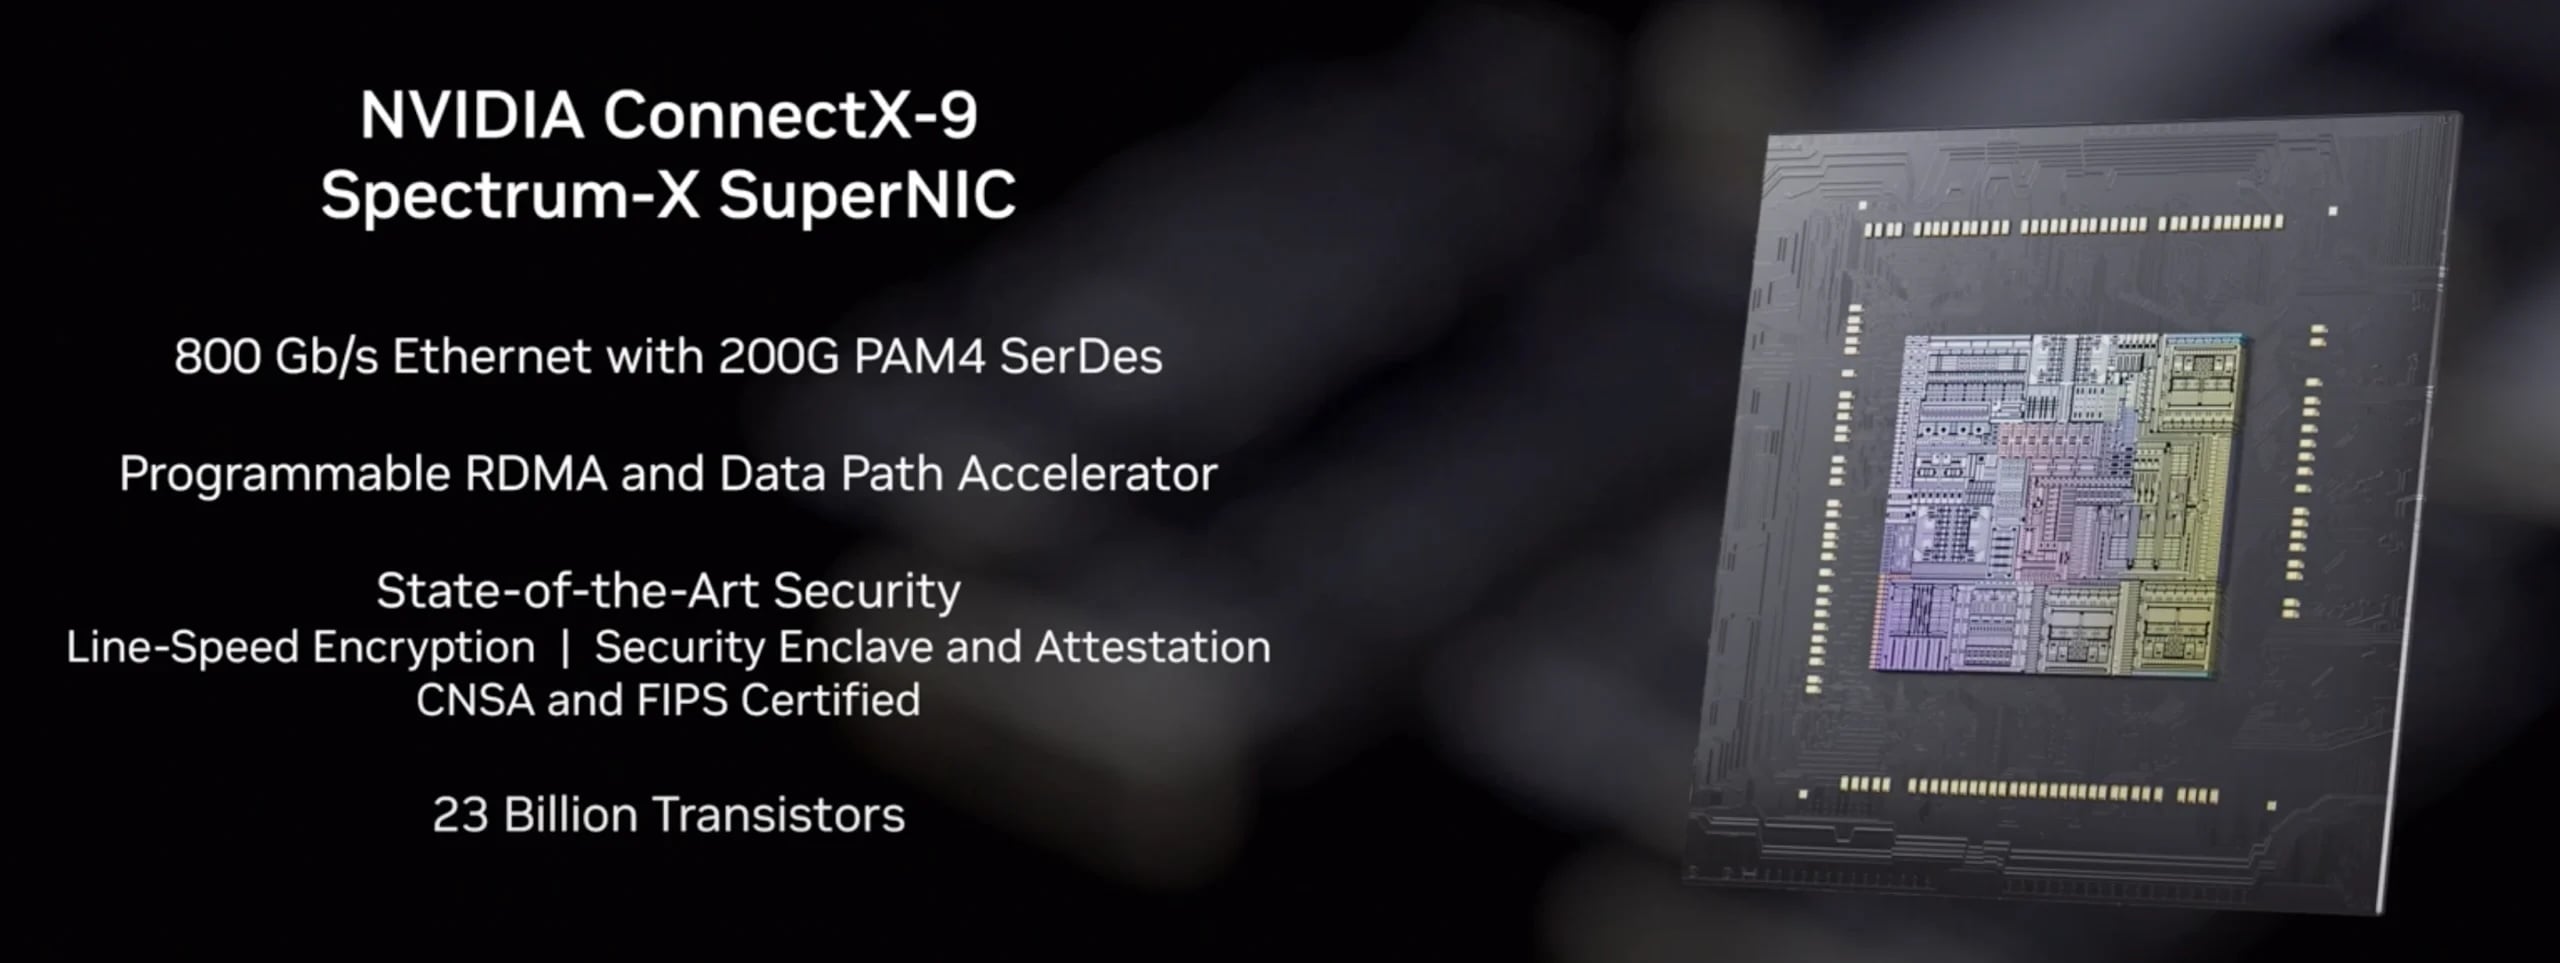
NVIDIA ConnectX-9 SuperNIC hanterar skalbara nätverk och levererar 1.6 TB/s RDMA-bandbredd per GPU för kommunikation utanför racket. ConnectX-9 har utformats tillsammans med Vera-processorn för att maximera effektiviteten i datavägen och introducerar en helt programvarudefinierad, programmerbar och accelererad dataväg som gör det möjligt för AI-labb att implementera anpassade dataförflyttningsalgoritmer optimerade för deras specifika modellarkitekturer.
BlueField-4 DPU och ASTRA säker arkitektur
BlueField-4 är NVIDIAs fjärde generationens databehandlingsenhet och representerar ett fundamentalt nytänkande kring lagring och nätverk för AI-arbetsbelastningar. Den nya DPU:n har en 64-kärnig NVIDIA-processor jämfört med BlueField-3:s 16 ARM Cortex-A78-kärnor, vilket ger 6 gånger högre beräkningsprestanda. Den inkluderar ett medföljande ConnectX-9 SuperNIC jämfört med ConnectX-7 i BlueField-3, vilket fördubblar nätverksbandbredden till 800 Gb/s. GPU-åtkomst till datalagring är dubbelt så snabb som föregående generation. Utöver specifikationsförbättringarna ligger BlueField-4:s betydelse i vad den möjliggör: en ny nivå av AI-inbyggd lagringsinfrastruktur som NVIDIA positionerar som avgörande för agentbaserad AI i stor skala.
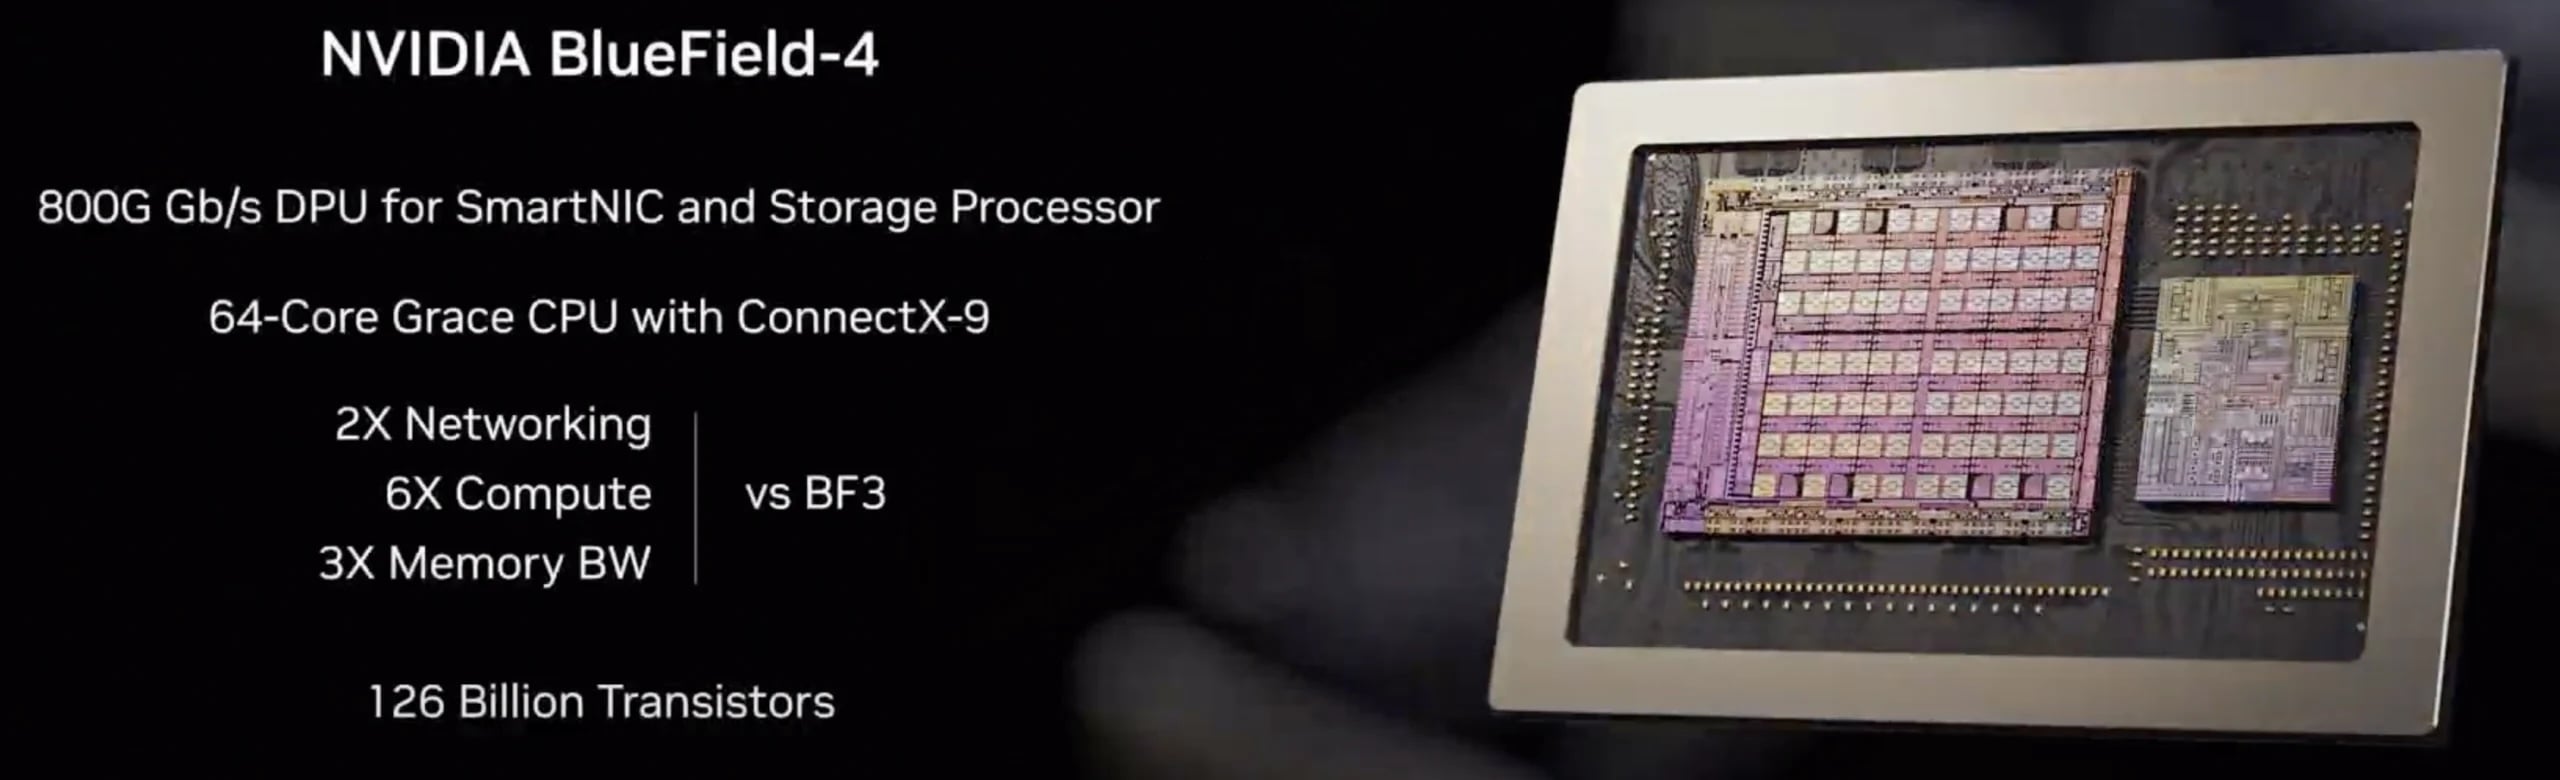
BlueField-4 avlastar nätverk, lagring och säkerhetsbearbetning så att Rubin GPU:er och Vera CPU:er förblir fokuserade på modellkörning. Den är helt integrerad i NVIDIA Enterprise AI Factory-validerad design, med ekosystemstöd från Red Hat, Palo Alto Networks, Fortinet med flera.
BlueField-4 introducerar även ASTRA (Advanced Secure Trusted Resource Architecture). Denna förtroendearkitektur på systemnivå ger en enda kontrollpunkt för säker provisionering, isolering och drift av storskaliga AI-miljöer utan att kompromissa med prestandan.
Konfidentiell databehandling över hela racket
Vera Rubin NVL72 är den första rackplattformen som levererar NVIDIA Confidential Computing över hela systemet. Tredje generationens konfidentiella databehandling upprätthåller datasäkerhet över CPU, GPU och hela NVLink-domänen, med varje buss krypterad under överföring. Detta åtgärdar en växande oro bland företag och AI-labb som kör proprietära modeller på delad infrastruktur: möjligheten att garantera att modeller, träningsdata och inferensarbetsbelastningar förblir skyddade även när de distribueras på tredjepartssystem.
NVIDIA Spectrum-6 Ethernet-switchen driver Nvidias skalbara nätverk. Den är byggd med 200G SerDes-teknik med sampaketerad optik (CPO), vilket uppnår 102 TB/s switchkapacitet och driver öst-västlig trafik över VR NVL72-rack. Övergången till CPO är betydande. Genom att integrera optik direkt med switchkiseln hävdar NVIDIA 10 gånger högre tillförlitlighet, 5 gånger längre drifttid och 5 gånger bättre energieffektivitet jämfört med traditionell pluggbar optik.

Kostnads- och effektivitetsförbättringar för MoE-modeller
NVIDIA uppger att VR NVL72 levererar en sjundedel så låg tokenkostnad för stora Mixture-of-Experts-modellinferenser med samma latens som Blackwell. Den kräver bara en fjärdedel så många GPU:er för att träna samma stora MoE-modell på samma tid. Plattformen uppnår 8 gånger högre inferensberäkning per watt.
Dessa förbättringar åtgärdar kraven hos MoE-modeller, som endast aktiverar en delmängd av sina experter för en given token. Modeller som Kimi K2 Thinking använder 384 experter men aktiverar endast åtta åt gången, vilket kräver massiv all-to-all GPU-kommunikation. VR NVL72:s 260 TB/s skalbara nätverk hanterar detta kommunikationsmönster.
Ett kabelfritt rack designat för storskalig användning
VR NVL72 introducerar en modulär, kabelfri, fläktfri och slangfri fackdesign som endast använder kretskort och kontakter, snarare än intern kablage. Beräkningsfacken ansluts via blindkontakter när de sätts in i racket, vilket eliminerar behovet av manuell kabeldragning. De enda externa anslutningarna är två vätskeinlopps- och utloppsslangar som ansluts till vätskekylblocken.

Tidigare system, som GB300 NVL72, krävde ungefär 100 minuter för att montera ett enda datorfack. Varje kabelanslutning var en potentiell felpunkt, vilket blir betydande vid hundratusentals grafikkort. Kabeldragningen begränsade kylvägarna och förbrukade utrymme, medan fläktar ökade mekanisk komplexitet och ökade bullernivån.
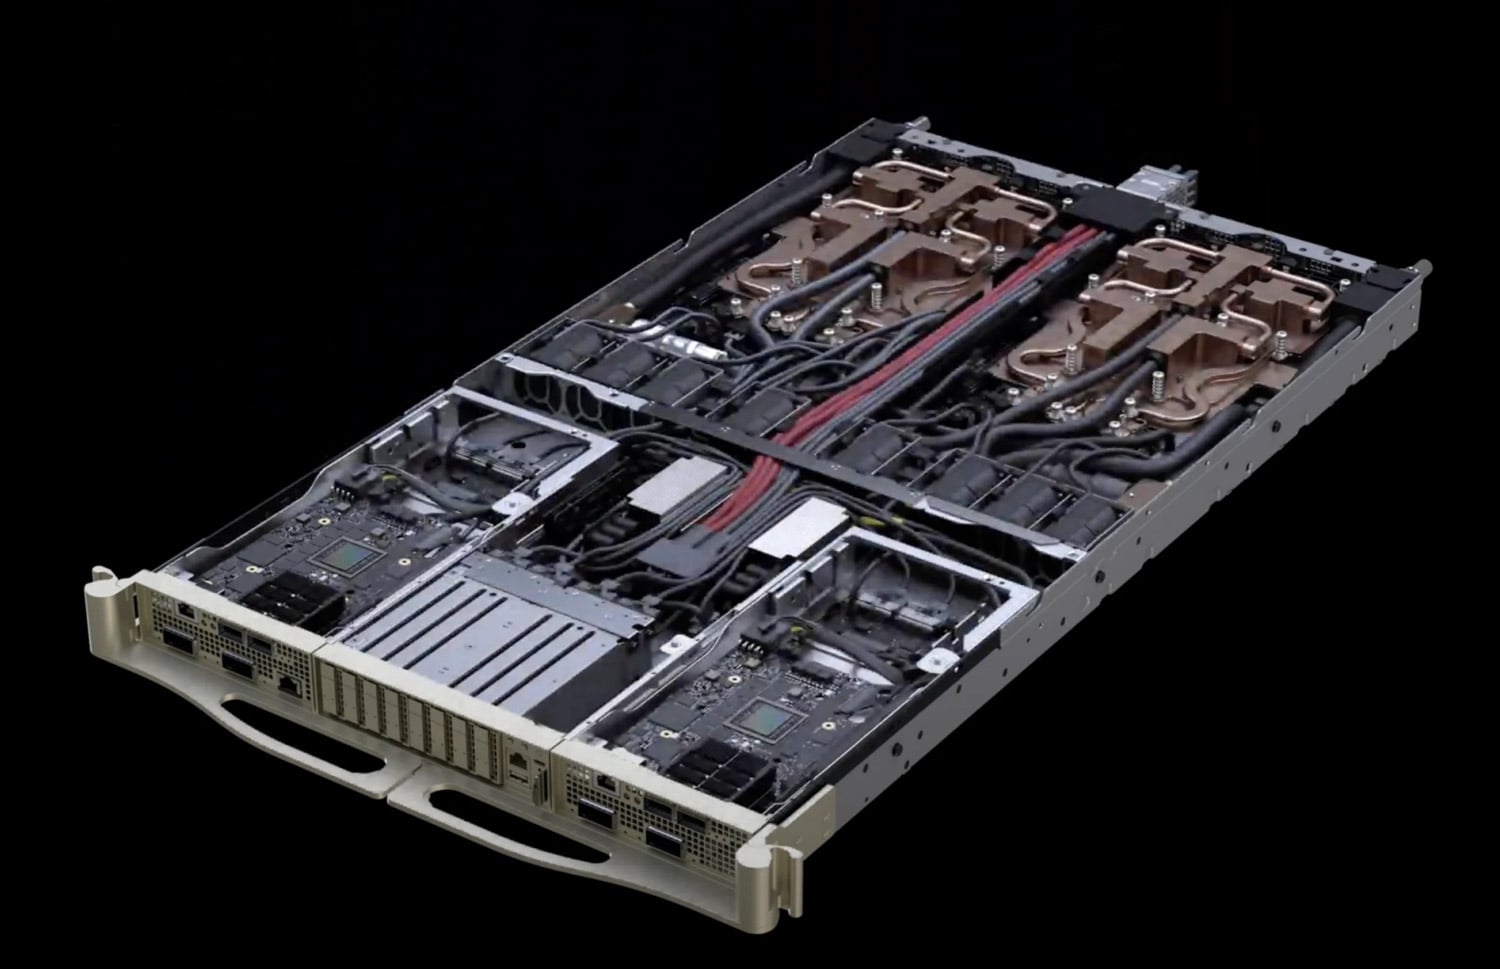
Den nya designen minskar monterings- och servicetiden med 18 gånger. Plattformen har också en andra generationens RAS-motor (Reliability, Availability, Serviceability) som omfattar GPU, CPU och NVLink, vilket ger hälsokontroller i realtid, feltolerans och proaktivt underhåll. NVLink-switchbrickor stöder nu underhåll med noll driftstopp, vilket gör att rack kan förbli i drift medan switchbrickor tas bort eller delvis fylls. Vid en skala av hundratusentals GPU:er leder dessa förbättringar av servicevänligheten direkt till klusterdrifttid och goodput.
Denna arkitektur möjliggör framtida konfigurationer med högre densitet. Detta är också nyckeln till att möjliggöra de tidigare omnämnda Vera Rubin CPX-rackdesignerna som vi behandlade på AI Infra Summit , vilka ytterligare lägger till kontextbearbetnings-GPU:er till samma beräkningssläde i en redan tät design.
Inferenskontextminneslagringsplattform
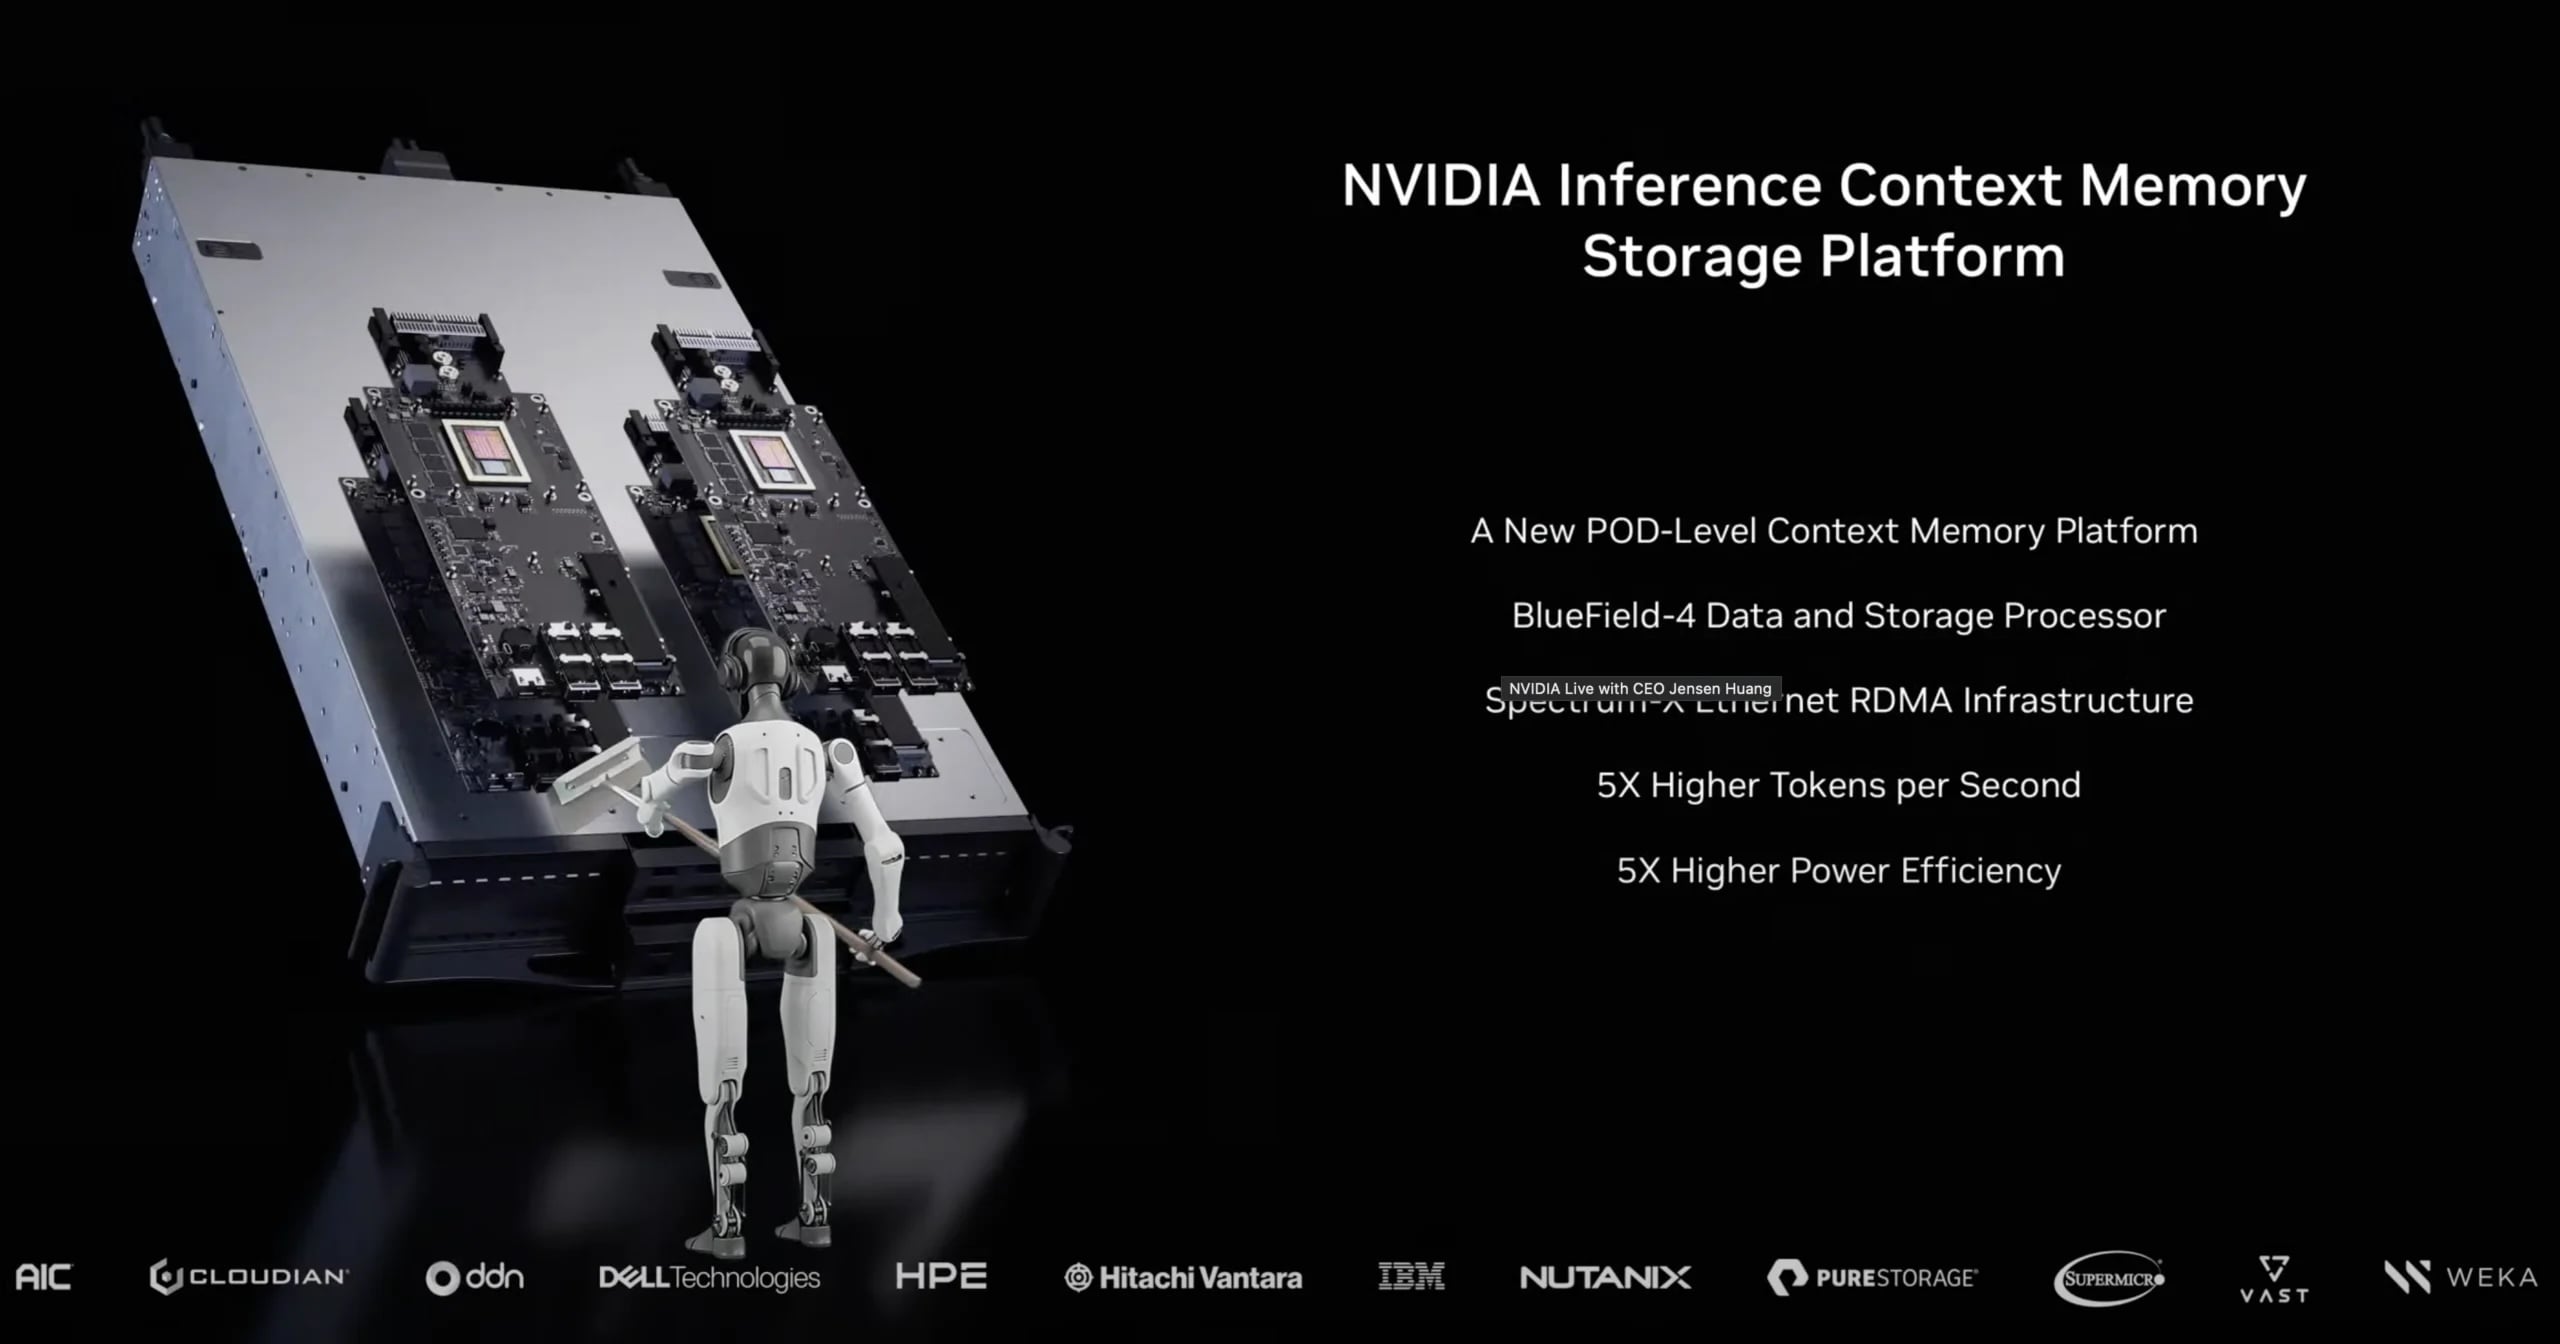
NVIDIA tillkännagav Inference Context Memory Storage Platform på CES 2026, en ny klass av AI-baserad lagringsinfrastruktur byggd specifikt för KV-cache. Plattformen drivs av BlueField-4 och Spectrum-X Ethernet-nätverk. Den levererar upp till 5 gånger fler tokens per sekund än traditionell nätverkslagring som används för inferenskontext, upp till 5 gånger bättre prestanda per total ägandekostnad, upp till 5 gånger bättre energieffektivitet och en 20 gånger förbättring av tid till första token. BlueField-4:s hårdvaruaccelererade KV-cacheplacering eliminerar metadataoverhead och minskar dataförflyttning, medan Spectrum-X Ethernet tillhandahåller högbandbredd och låg latens för RDMA-baserad åtkomst.
Denna plattform adresserar en växande flaskhals inom LLM-inferens: KV-cachehantering. Transformatormodeller använder en uppmärksamhetsmekanism där varje genererad token måste hantera alla tidigare tokens. Utan cachning kräver detta att nyckel- och värdevektorer beräknas om för varje token, vilket resulterar i O(n²)-komplexitet. KV-cachning lagrar dessa förberäknade matriser i minnet för återanvändning, vilket minskar komplexiteten till O(n). Problemet är att KV-cachestorleken växer linjärt med sekvenslängd och batchstorlek. En enda långkontextkonversation kan förbruka gigabyte minne. I miljöer med flera hyresgäster, där tusentals samtidiga förfrågningar hanteras över kontextfönster som sträcker sig till miljontals tokens, blir GPU HBM uttömd. Operatörer måste antingen minska batchstorlekarna, förkorta kontextfönster eller köpa fler GPU:er.
Traditionell nätverkslagring var inte utformad för KV-cacheåtkomstmönster, vilka kräver slumpmässig åtkomst med låg latens till potentiellt terabyte av transient data spridda över många samtidiga sessioner. Inference Context Memory Storage Platform tillhandahåller en dedikerad lagringsnivå som är optimerad för denna arbetsbelastning, och ligger mellan GPU HBM och konventionell lagring. Detta gör det möjligt för AI-fabriker att skala kontextkapacitet oberoende av GPU-beräkning. Vi har tidigare behandlat hur KV-cache-avlastning fungerar med NVIDIA Dynamo med hjälp av en KV Cache-accelerator från Pliops. NVIDIA skalar upp det med NVIDIA Inference Context Memory Storage Platform och kopplar det till deras Dynamo-projekt med öppen källkod. Detta tillhandahåller programvaruramverket som knyter samman de disaggregerade förfyllnings-/avkodningsfaserna, smart routing och nivåindelad lagringsavlastning i denna nya plattform.
Lagringspartners, inklusive VAST Data, NetApp, DDN, Dell Technologies, HPE, Hitachi Vantara, IBM, Nutanix, Pure Storage och WEKA, bygger plattformar med BlueField-4. Dessa kommer att finnas tillgängliga under andra halvan av 2026.
Alpamayo: Resonemangsbaserad fysisk AI för autonoma fordon
NVIDIA presenterade Alpamayo-familjen med öppna AI-modeller, simuleringsverktyg och datamängder utformade för att accelerera säker, resonemangsbaserad utveckling av autonoma fordon (AV). Alpamayo-familjen introducerar tankekedjan, resonemangsbaserade vision-språk-handlingsmodeller som ger människoliknande tänkande till AV-beslutsfattande. Säkerhetssystemet NVIDIA Halo ligger till grund för dessa system.
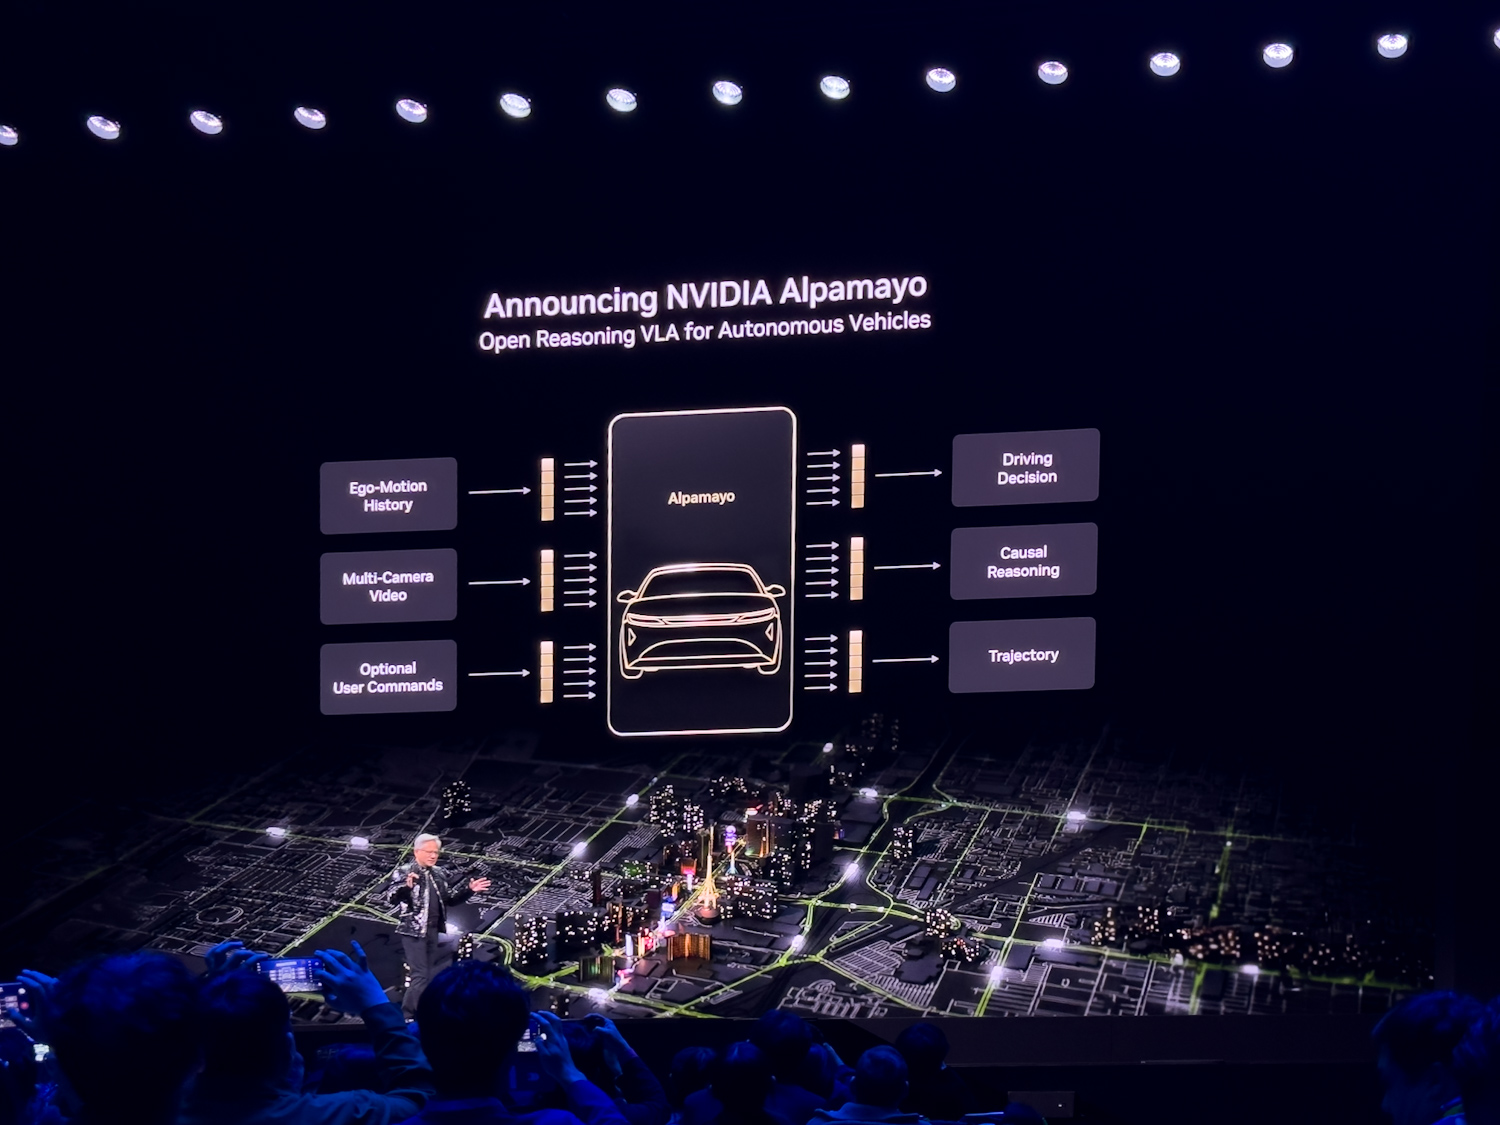
Traditionella AV-arkitekturer separerar perception och planering, vilket kan begränsa skalbarheten när nya eller ovanliga situationer uppstår. Den "långa svansen" av sällsynta, komplexa scenarier är fortfarande en av de svåraste utmaningarna för autonoma system att bemästra på ett säkert sätt. Alpamayo tar itu med detta genom att göra det möjligt för modeller att resonera kring orsak och verkan, och genom att tänka igenom nya scenarier steg för steg för att förbättra körförmågan och förklaringsförmågan.
Istället för att köras direkt i fordonet fungerar Alpamayo-modellerna som storskaliga lärarmodeller som utvecklare kan finjustera och destillera in i grunden för sina kompletta AV-stackar. Utvecklare kan anpassa Alpamayo till mindre runtime-modeller för fordonsutveckling, eller använda det som en grund för AV-utvecklingsverktyg som resonemangsbaserade utvärderare och automatiska märkningssystem.
Alpamayo-modeller, simulering och öppna datamängder
Alpamayo 1 är branschens första VLA-modell för tankekedjan, designad för AV-forskningsgemenskapen, tillgänglig på Hugging Face. Med en arkitektur på 10 miljarder parametrar använder Alpamayo 1 videoingång för att generera banor tillsammans med resonemangsspår, vilket visar logiken bakom varje beslut. Alpamayo 1 tillhandahåller modellvikter och inferensskript med öppen källkod. Framtida modeller i familjen kommer att ha högre parameterantal, mer detaljerade resonemangsfunktioner, större flexibilitet vad gäller in- och utdata samt alternativ för kommersiellt bruk.
AlpaSim är ett helt öppen källkodsramverk för end-to-end-simulering för högkvalitativ AV-utveckling, tillgängligt på GitHub. Det tillhandahåller realistisk sensormodellering, konfigurerbar trafikdynamik och skalbara slutna testmiljöer, vilket möjliggör snabb validering och policyförfining.
Öppna datamängder för fysisk AI innehåller över 1 700 timmar kördata insamlade över en mängd olika geografiska områden och förhållanden, och täcker sällsynta och komplexa verkliga edge-fall som är avgörande för att utveckla resonemangsarkitekturer. Dessa datamängder finns tillgängliga på Hugging Face.
Utvecklare kan finjustera Alpamayo-modellreleaser på proprietär flottdata, integrera dem i NVIDIA DRIVE Hyperion-arkitekturen byggd med NVIDIA DRIVE AGX Thor accelererad beräkning och validera prestanda i simulering före kommersiell driftsättning.
NVIDIA DRIVE, redundanta AV-stackar och Mercedes-Benz CLA
NVIDIA har arbetat med självkörande bilar i åtta år med ett team på flera tusen personer. Företaget byggde hela stacken: chip (dubbla Orin-processorer, nästa generations dubbla Thor-processorer), infrastruktur (Omniverse och Cosmos), modeller (Alpamayo) och applikationslagret. Mercedes-Benz samarbetade med NVIDIA för fem år sedan för att driftsätta denna stack.
Det första fullstack-autonoma fordonet från NVIDIA, Mercedes-Benz CLA, lanseras under första kvartalet 2026 i USA, andra kvartalet i Europa och tredje/fjärde kvartalet i Asien. Euro NCAP gav CLA det högsta betyget för aktiv säkerhet av alla bilar som inlämnades 2025. Varje kodrad och varje chip i systemet är säkerhetscertifierat.

Systemet kör två kompletta AV-stackar parallellt. Alpamayo-stacken använder tankekedjans resonemang och hanterar komplexa körscenarier. En andra klassisk AV-stack under är fullt spårbar och tog sex till sju år att bygga. En policy- och säkerhetsutvärderare bestämmer vilken stack som ska användas baserat på konfidensnivå. Om Alpamayo stöter på ett scenario där det inte är säkert, faller systemet tillbaka till den klassiska stacken. Denna mångfald och redundans i programvaran speglar hur säkerhetskritiska system hanterar hårdvaruredundans.
NVIDIA kommer att fortsätta uppdatera systemet med nya versioner av Alpamayo. Mobilitetspartners, inklusive JLR, Lucid, Uber och Berkeley DeepDrive, använder Alpamayo för utveckling av resonemangsbaserad autonomi på nivå 4.
Nya fysiska AI-modeller och robotikmeddelanden
Vid sidan av sina infrastruktur- och systemmeddelanden använde NVIDIA även CES 2026 för att vidareutveckla sin fysiska AI-strategi genom att släppa nya öppna modeller, ramverk och edge-plattformar för att påskynda robotutvecklingen. Företaget introducerade uppdateringar av sina Cosmos-världsmodeller och GR00T-resonemangsmodeller för robotinlärning, tillsammans med nya verktyg med öppen källkod (inklusive Isaac Lab-Arena) för storskalig robotutvärdering. OSMO är ett edge-to-cloud-orkestreringsramverk utformat för att förenkla utbildningsarbetsflöden över heterogena beräkningsmiljöer.

NVIDIA lyfte fram ett brett branschantagande av sin robotstack, med partners som Boston Dynamics, Caterpillar, LG Electronics och NEURA Robotics, som visade upp nästa generations autonoma maskiner byggda med NVIDIA-teknik. Företaget tillkännagav också ett närmare samarbete med Hugging Face för att integrera NVIDIA Isaac- och GR00T-modellerna i det öppna källkodsramverket LeRobot, vilket ytterligare utökar åtkomsten för den globala robotutvecklarcommunityn.
NVIDIA bekräftade tillgängligheten av den Blackwell-drivna Jetson T4000-modulen, som ger en betydande ökning av AI-beräkning och energieffektivitet för autonoma maskiner och industriell robotik. Tillsammans förstärker dessa tillkännagivanden NVIDIAs strävan att utöka sin fullstack-AI-plattform bortom datacentret, och omfattar simulering, modeller, edge-beräkning och verklig implementering inom robotik och autonoma system.


 Amazon