

Supermicro tillkännagav idag en KV-cachelagringslösning med IBM och NVIDIA som flyttar nyckel-värde-tillståndet bakom långkontextinferens från GPU:n till en delad all-flash-nivå. Paketet kombinerar Supermicro Petascale-lagringsservrar på AMD EPYC 9005-processorer, IBM Storage Scale, NVIDIA Dynamo och NVIDIA Spectrum-X Ethernet, och företagen stöder det med en validerad referensarkitektur som IBM publicerat som en Redbook. Huvudsiffran är en 56-faldig tidsförkortning till första token på 130 000-token-prompter mot en GPU som beräknar om kontexten från grunden.
Varför KV-cache behöver en lagringsnivå
Inferensen sker i två faser: förfyllning omvandlar prompten till tokens och skickar dem genom modellen för att producera mellanliggande nyckel-värde-tillstånd, och avkodning genererar svaret en token i taget mot dessa tillstånd. Genom att behålla KV-tillståndet i en permanent cache kan systemet återanvända det för nästa tur, nästa agentsteg eller nästa begäran som delar samma kontext, och hoppa över omberäkningen.
Agentiska arbetsflöden, kodningsassistenter, långkontextiga RAG och multi-turn-applikationer genererar tillräckligt av detta tillstånd för att snabbt överbelasta GPU- och CPU-minne, vilket är anledningen till att Supermicro, IBM och NVIDIA skapar en nätverkslagringsnivå.
I den här designen hanterar NVIDIA Dynamo cachehierarkin och flyttar block över NIXL; IBM Storage Scale Erasure Code Edition tillhandahåller den delade filnivån; och Petascale-servrarna tillhandahåller flashminnet och PCIe Gen5-banorna bakom det. Supermicro säger att de tre företagen testade stacken på klusternivå under hög samtidighet och med brusig grannnätverkstrafik, och de presenterar resultatet som en nyckelfärdig version med fabriksrackintegration och driftsättning på plats som de säger minskar driftsättningstiden från veckor till dagar.
Den testade konfigurationen
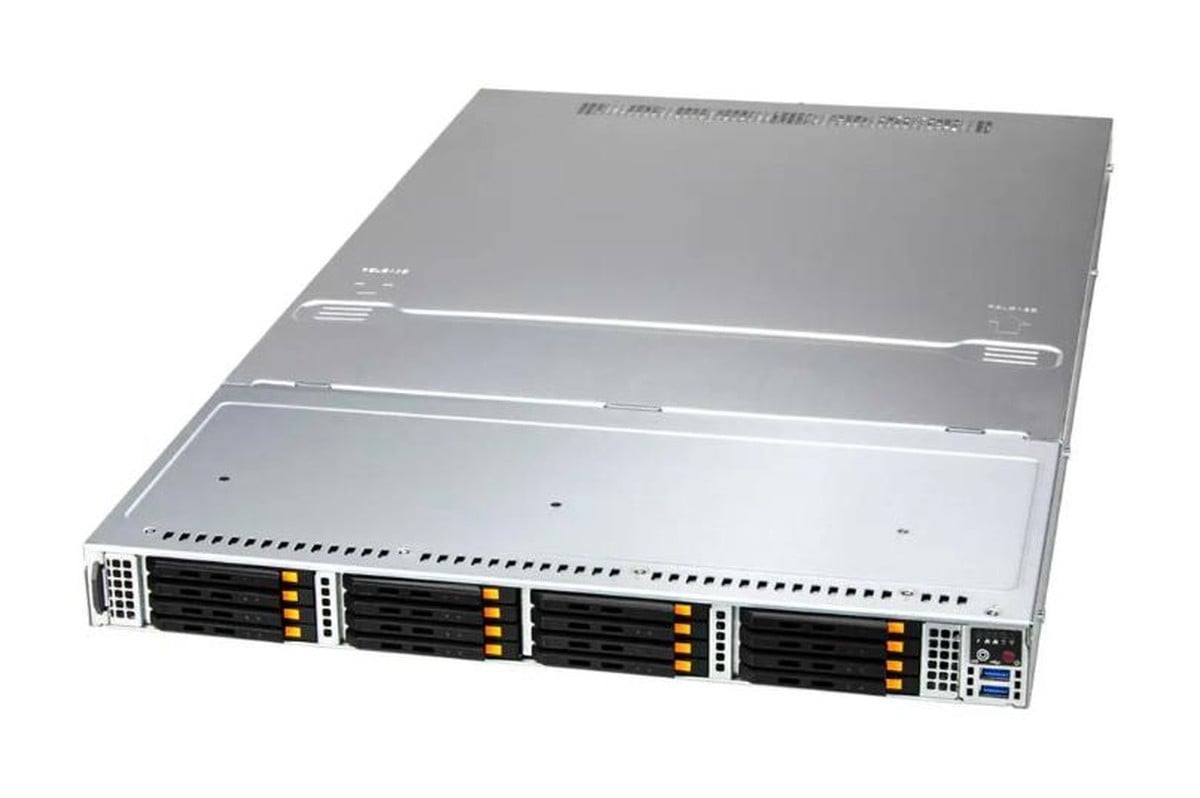
Referensarkitekturen använder åtta Supermicro ASG-1115S-NE316R Petascale-noder, var och en ett 1U-system med en enda AMD EPYC 9535 och 16 Micron 7.68 TB E3.S NVMe-hårddiskar, vilket placerar 122.88 TB rå flashminne i varje nod och cirka 983 TB fördelat på de åtta. Varje nod har en NVIDIA BlueField-3 B3220 med dubbla portar på 200 Gb på klientsidan och en 400 Gb ConnectX-7 för lagringsbackend, med tre Spectrum-X SN5600-switchar i en spine- och leaf-layout och 800 Gb/s upplänkar.
Lagringsnoderna kör RHEL 9.6 och IBM Storage Scale ECE 6.0.0.1 i en 8+2P-raderingskodlayout, och IBM uppskattar läshastigheten för denna nivå med åtta noder till 315 GB/s från tidigare tester.
| Komponent | KV Cache-referensarkitektur (testad) |
|---|---|
| Lagringsnivå | |
| Lagringsnoder | 8x Supermicro ASG-1115S-NE316R (1U, enkel sockel) |
| CPU per nod | AMD EPYC 9535, 128 PCIe Gen5-banor (64 till NVMe, 64 till nätverk) |
| Flash per nod | 16x Micron 7.68 TB E3.S NVMe (122.88 TB rå) |
| Nätverk per nod | NVIDIA BlueField-3 B3220, dubbla portar 200 Gb (klientsidan) NVIDIA ConnectX-7 400 Gb (lagringsbackend) |
| Byta | 3x NVIDIA Spectrum-X SN5600, ryggrad och löv, 800 Gb/s upplänkar |
| Lagringsprogramvara | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Inferensklient | |
| Systemkrav | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| GPU som används för riktmärkena | 1x NVIDIA RTX PRO 6000 Blackwell, 19.6 GiB kvar för KV-cache efter vikter och CUDA-grafer |
| Klientnätverk | 2x NVIDIA BlueField-3 B3140H 400 Gb/s, upp till 80 GB/s klientriktad bandbredd |
| Modell och programvara | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 med NIXL NVIDIA AIPerf-benchmarkklient |
| Cachenivåsättning | Värd- och lokala nivåer inställda på noll; alla 1.4 miljoner cachade tokens serveras från Storage Scale-nivån |
Benchmark-klienten är ett enda Supermicro SYS-212GB-FNR MGX-system, och resultaten kommer från en NVIDIA RTX PRO 6000 Blackwell GPU i den lådan som kör openai/gpt-oss-120b-modellen i MXFP4 under vLLM 0.14.1 och Dynamo 0.9.0.
Efter vikterna och CUDA-graferna fanns 19.6 GiB GPU-minne kvar för KV-cache, tillräckligt för cirka 1.14 miljoner tokens på själva GPU:n. För testerna sattes värdminnet och de lokala nivåerna till noll så att varje cachat block kom tillbaka från Storage Scale, så resultaten mäter lagringsvägen i sig själv, utan hjälp från en blandad hierarki.
56x tid till första token, 22x dataflöde
Utan cache ökade tiden till första token för 120B-modellen från 0.572 sekunder vid 10 000 inmatade tokens till 32.14 sekunder vid 130 000 när GPU:n beräknade om hela kontexten. Med KV-cachen på Storage Scale låg TTFT mellan 0.193 och 0.57 sekunder över samma intervall, vilket är 56x-siffran vid 130 000 tokens och den spread på 0.377 sekunder som Supermicro anger i sitt tillkännagivande. IBM, Supermicro och NVIDIA körde dessa tester, och vi körde eller granskade inte resultaten.
Dataflödestestet skickade 200 förfrågningar över 28 samtidiga anslutningar, hämtade från 100 unika prompter med totalt 24 miljoner tokens och 825 GB KV-cachedata, med cachen som startar tom. Omberäkningsbaslinjen slutade på 0.19 förfrågningar per sekund på 1 048 sekunder; Storage Scale-nivån slutade på 4.26 förfrågningar per sekund på 46.94 sekunder, en 22x vinst som inkluderar kallstartskostnaden för att fylla cachen.
En tredje körning lade till fyra klienter som skickade 200 GB/s orelaterad nätverkstrafik över samma infrastruktur, och den cachade konfigurationen klarade 3.6 förfrågningar per sekund och 55.56 sekunder för de 200 förfrågningarna, ungefär nio sekunder långsammare än den rena körningen och fortfarande 18 gånger baslinjen. IBM tillskriver den lilla belastningen till Spectrum-X-infrastrukturen som isolerar cachetrafiken från bakgrundsbelastningen.
”Agentisk AI och applikationer med långa kontexter är beroende av att återanvända kontext effektivt över många steg, och NVIDIA Dynamo hjälper till att orkestrera distribuerad inferens så att företag kan få mer användbar dataflöde från varje GPU”, säger Shruti Koparkar, produktchef för NVIDIA AI Inferens. ”Genom att para ihop NVIDIA Dynamo och Spectrum-X Ethernet med Supermicro Petascale-lagringsservrar och IBM Storage Scale skapar denna KV-cachelösning en högpresterande delad lagringsnivå som kan minska redundant beräkning, förbättra time-to-first-token och hjälpa kunder att skala motståndskraftiga AI-inferenstjänster.”
Storleksfördelning och vad som inte finns i siffrorna
IBMs storleksguide anger att en fyrnodsversion ska vara 4+2P med 67 procent användbar kapacitet för modeller från 7B till 34B och upp till 64 GPU:er, den testade åttanodsversionen ska vara 8+2P och 80 procent användbar för modeller från 70B till 120B och 100 till 256 GPU:er som behöver 100 till 300 GB/s läsbandbredd, och 16 eller fler noder vid 16+3P och 84 procent användbara för större modeller och 300 eller fler GPU:er vid 300 GB/s och uppåt. Lagringsskala ECE självt skalar från tre lagringsservrar till 256.
Testuppställningen med ett enda GPU är den största nackdelen. Referensarkitekturen är dimensionerad för hundratals GPU:er, men varje resultat i artikeln kommer från ett RTX PRO 6000 mot ett åtta-nodigt, 983TB flash-lager som IBM värderar till 315 GB/s, så lagringssidan var inte i närheten av mättnad, och testerna visar inte hur TTFT håller när ett komplett GPU-kluster hämtar cache samtidigt.
Supermicro har inte publicerat priser eller tillgänglighetsdatum för den paketerade lösningen, och tillkännagivandet ger inga siffror för GPU-användning. Metoden ligger i samma territorium som DDN:s Dynamo-integrerade KV-cacheacceleration på AI400X3M , med skillnaden att denna stack körs på vanliga Supermicro-servrar och Ethernet under IBMs filsystem.
”I takt med att AI-arbetsbelastningar expanderar från träning till inferens, måste företag och neomoln som använder inferensarbetsbelastningar med hög genomströmning, som är karakteristiska för agentisk AI och långkontextuell, multiturn generativ AI, ta bort flaskhalsar för att förbättra GPU-effektiviteten”, säger Charles Liang, VD och koncernchef för Supermicro. ”Vår lösning med IBM och NVIDIA visar tydligt dessa prestandafördelar.”



 Amazon