

Marknaden för AI-infrastruktur rör sig inte i en enda riktning; den delas upp i två distinkta världar. På ena sidan finns gränsöverskridande utbildningskluster, byggda för att utveckla grundmodeller i massiv skala, tätt kopplade till proprietära strukturer och en begränsad uppsättning acceleratorer. Den andra sidan är den snabbt växande verkligheten av företagsinferens, där organisationer distribuerar modeller för att betjäna användare, bearbeta livedata och generera mätbart affärsvärde. Dell PowerEdge XE7740 är utformad specifikt för denna andra värld.
Key Takeaways
- PowerEdge XE7740 är byggd för företagsinferens, med dubbla zoners temperaturreglering, strukturerad PCIe Gen5-topologi och skalbar nätverksanslutning anpassad till verkliga produktionsarbetsbelastningar.
- Systembalans är avsiktlig, en kombination av Xeon 6-kärndensitet, hög minnesbandbredd och PCIe Gen 5 E3.S NVMe för att stödja KV-cacheavlastning och orkestrering.
- Kiselflexibilitet är grundläggande, stödja ett brett utbud av PCIe Gen5-acceleratorer utan att tvinga fram en omdesign av infrastrukturen.
- Plattformen skalas upp smidigt över tid, från partiell GPU-population i ett enda chassi till distribuerad inferens över rack med hjälp av åtta bakre Gen5 x16 dedikerade nätverksplatser.
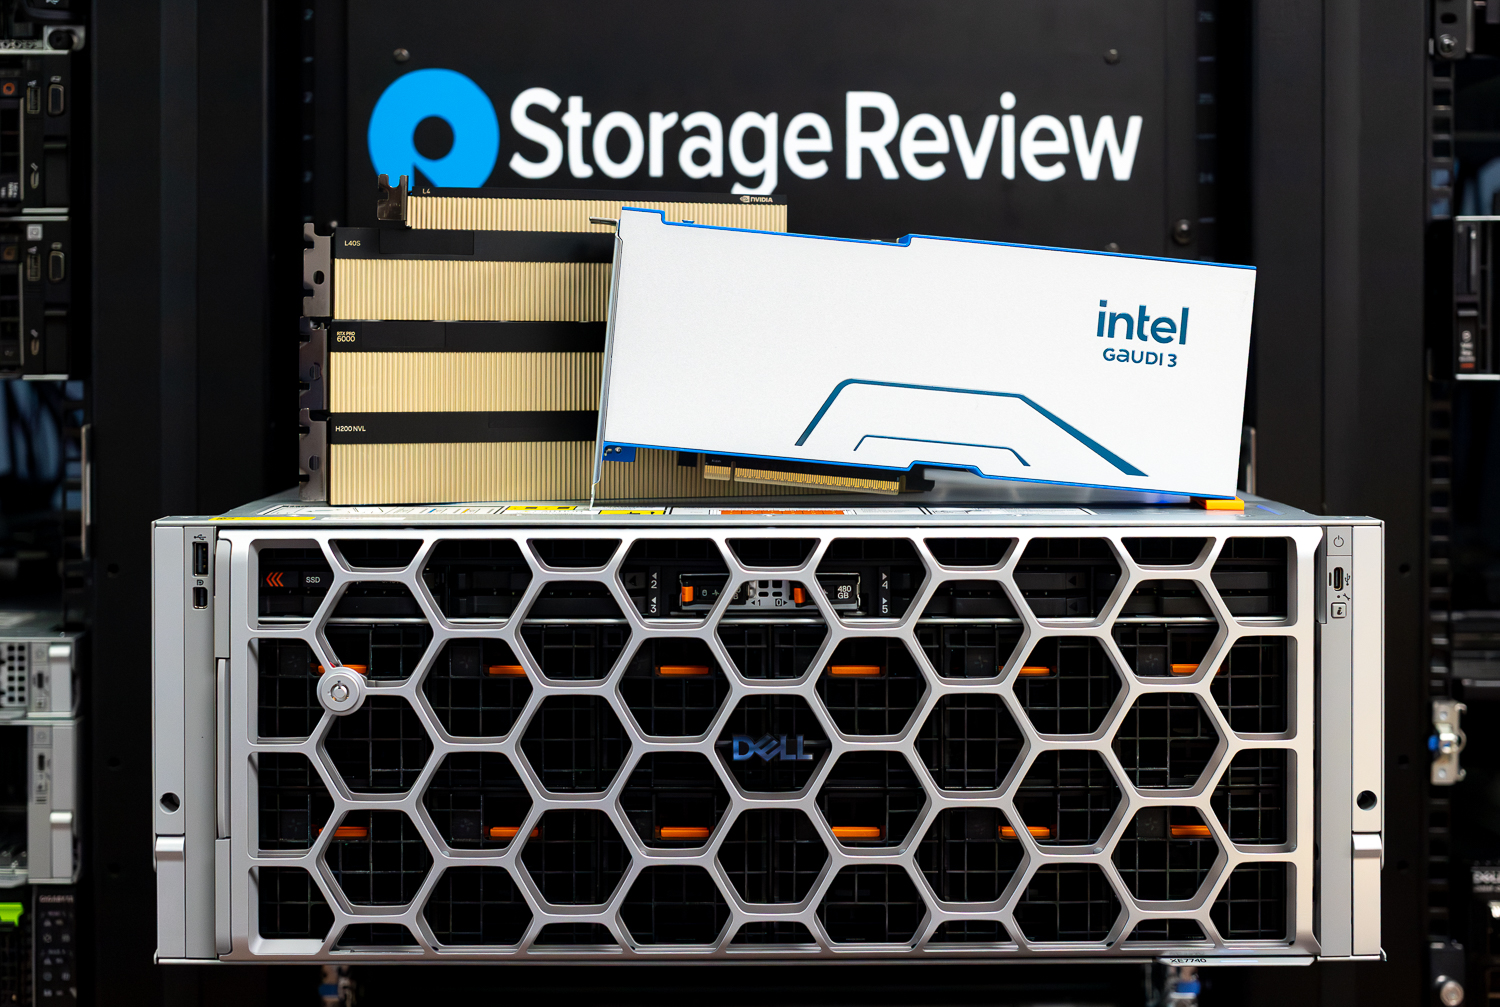
Kärnan i XE7740 ligger i ett engagemang för kiseldiversitet. Istället för att förankra plattformen i en enda acceleratorplan har Dell byggt ett system som anpassar sig till tillgänglighet, kostnad och organisationens beredskap. XE7740 stöder en rad PCIe Gen5-acceleratorer, inklusive NVIDIAs RTX PRO 6000, H100/200, L40S, L4 och A16 GPU:er för organisationer som värdesätter bred ekosystemkompatibilitet, och Intel Gaudi 3 för team som söker en mer kostnadseffektiv och lättillgänglig inferensväg. Gaudi 3-acceleratorer finns tillgängliga idag, vilket gör det möjligt för organisationer att gå från planering till driftsättning utan de upphandlingsförseningar som ofta formar acceleratorstrategin.
I takt med att inferens blir den dominerande AI-arbetsbelastningen spelar tillgänglighet och kostnadsstruktur roll. De flesta företag tränar inte modeller i frontlinjen. De kör inferenspipelines, hanterar medelstora språkmodeller, driver arbetsflöden för generering med hämtningshöjande förstärkning och distribuerar datorseende i produktion. I detta sammanhang positioneras Gaudi 3 som en av de mest prisvärda moderna inferensacceleratorerna på marknaden, och erbjuder en modern arkitektur med högbandbreddsminne och Ethernet-baserad skalbarhet utan kostnadsprofilen för flaggskeppstränings-GPU:er. Inom XE7740 handlar Gaudi 3 mindre om förskjutning och mer om att möjliggöra hållbara inferensdistributioner.
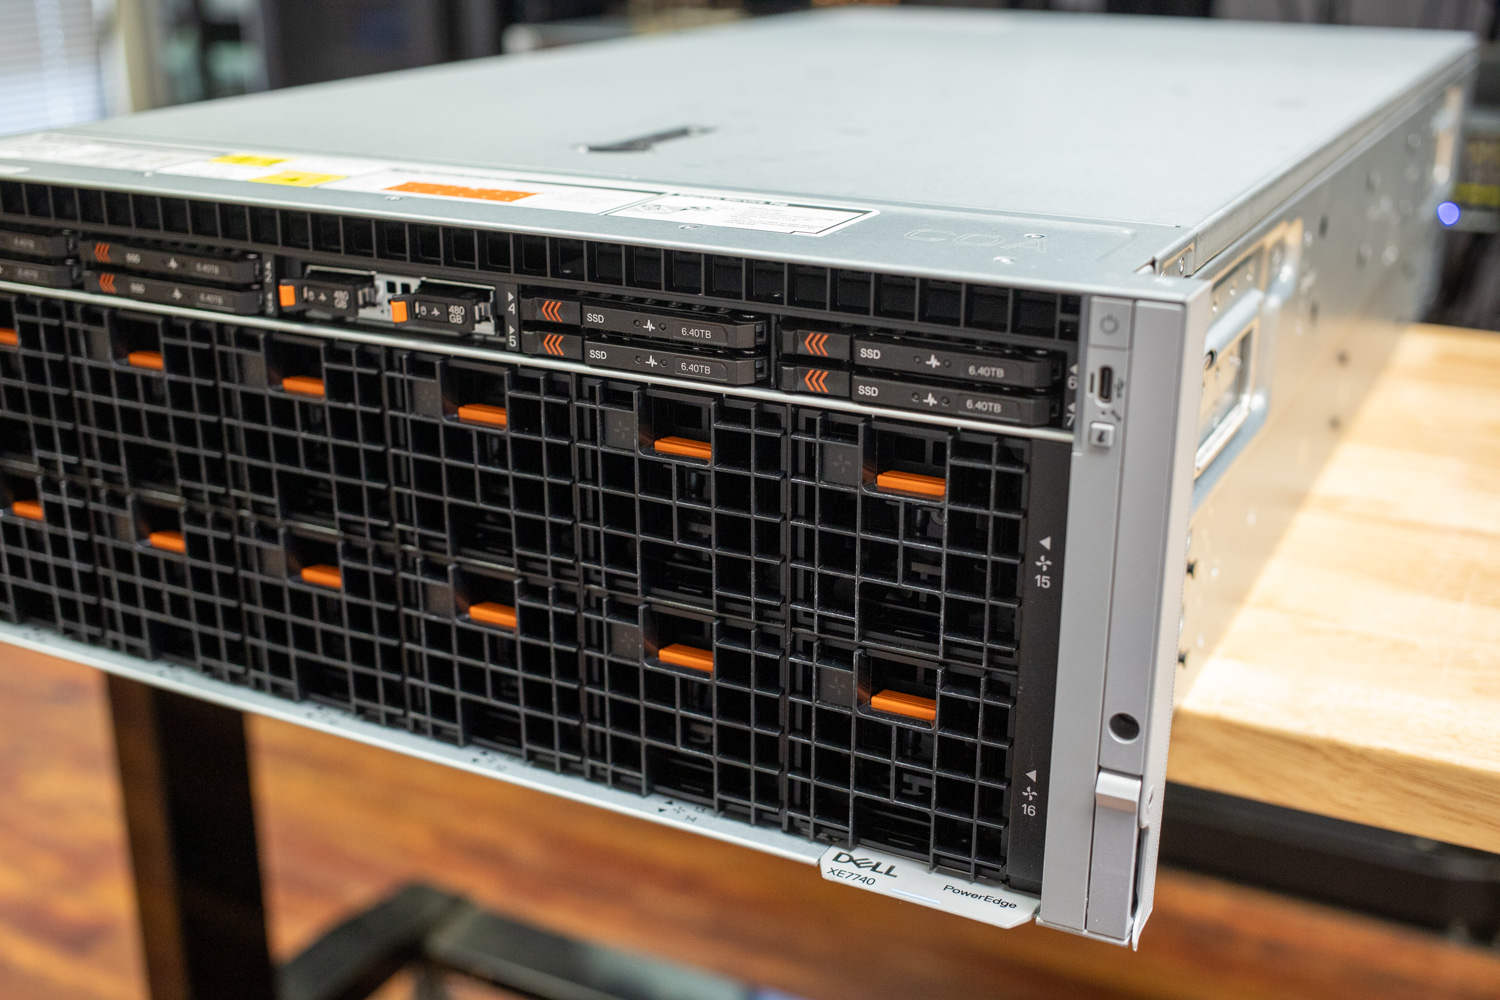
Plattformen kring acceleratorerna är lika medveten. XE7740 är byggd på Intel Xeon 6-processorer, och i inferensfokuserade system förblir processorn en kritisk komponent. Högt antal kärnor och ökad minnesbandbredd ger det utrymme som krävs för schemaläggare, tokenisering, förbehandling och orkestreringsuppgifter som ligger direkt på den kritiska inferensvägen. Frontmonterad E3.S NVMe-lagring stöder ytterligare lokal datastaging och KV-cache-avlastning, vilket minskar acceleratorbelastningen och förbättrar den totala systemets effektivitet. Denna balanserade design återspeglar en förståelse för att inferensprestanda formas av hela systemet, inte enbart av acceleratorer.
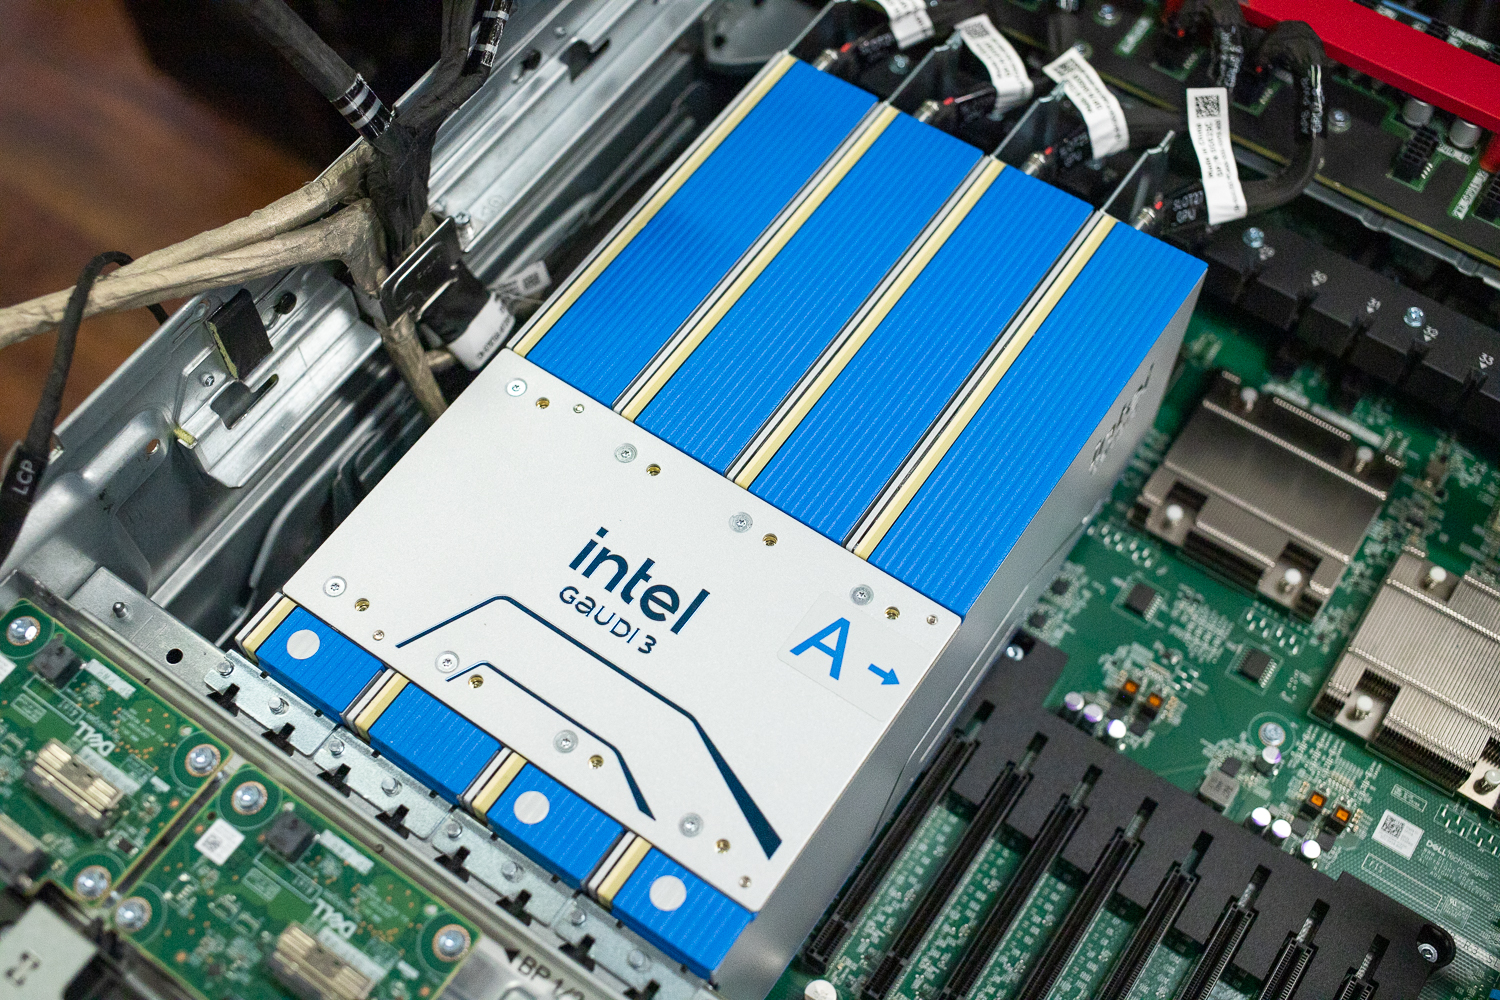
XE7740 är också konstruerad för att skalas smidigt över tid. Organisationer kan börja med en blygsam konfiguration, till exempel två eller fyra acceleratorer, och omedelbart utvinna värde utan att behöva fylla hela chassit. Allt eftersom kraven växer kan samma plattform skalas vertikalt eller övergå till distribuerad inferens. Åtta bakåtvända PCIe Gen5 x16-kortplatser levererar dedikerad bandbredd för höghastighetsnätverk, vilket gör att XE7740 kan fungera som en byggsten för skalbara inferenskluster. Valfritt DPU-stöd utökar denna flexibilitet ytterligare genom att avlasta nätverks- och kommunikationsuppgifter allt eftersom implementeringarna mognar.
Viktiga specifikationer för Dell PowerEdge XE7740
| Specifikation | PowerEdge XE7740 |
|---|---|
| Funktioner hos PowerEdge XE7740 | |
| Processorn | Två Intel® Xeon® 6-seriens processorer, med upp till 86 kärnor per processor |
| spelautomater | |
| PCIe-acceleratorer | 8x PCIe Gen 5 x16 DW-FHFL upp till 600 W, eller
16x PCIe Gen 5 x16 SW-FHFL upp till 75 W |
| PCIe-nätverkskort |
|
| Formfaktor | |
| Formfaktor | 4U rackserver |
| Minne | |
| DIMM-hastighet, maximal kapacitet | Upp till 6400 MT/s, max 4 TB |
| Minnesmodulplatser | 32 DDR5 DIMM-platser Stöder endast registrerade ECC DDR5 RDIMM. |
| lagring | |
| Främre fack | Upp till 8 x EDSFF E3.S Gen5 NVMe (SSD) max 122.88 TB |
| Lagringsstyrare | |
| Intern start | Bootoptimerat lagringsundersystem (BOSS-N1 DC-MHS): HWRAID 1, 2 x M.2
NVMe SSDs |
| Strömförsörjning | |
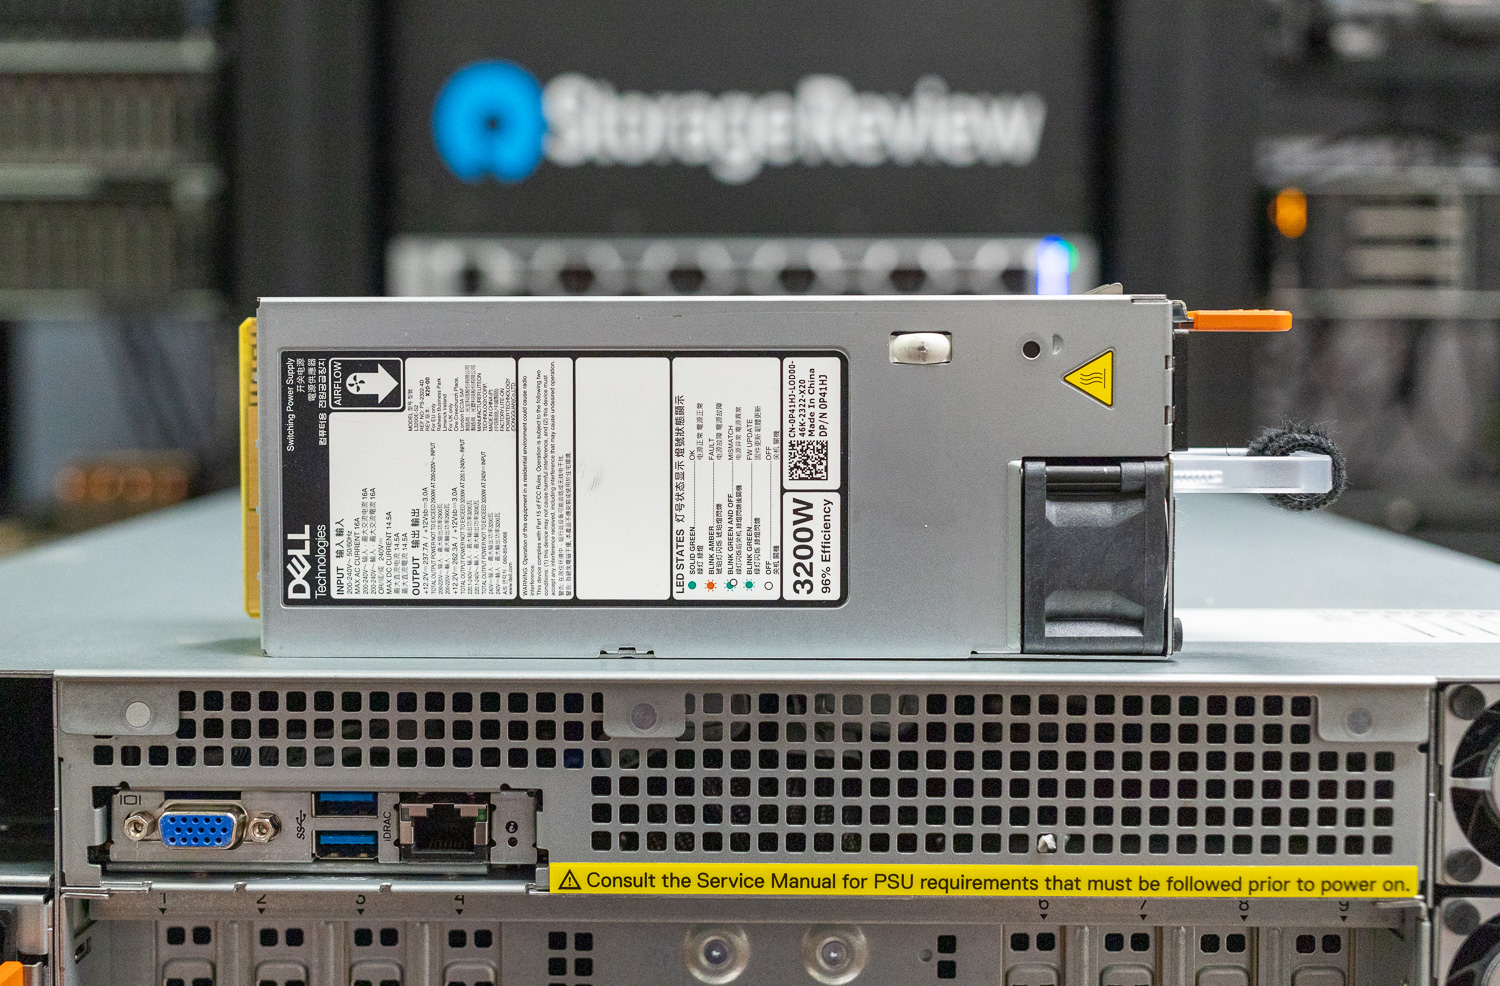
| Strömförsörjning | 3200 W Titanium 200–240 V AC eller 240 V DC, redundant med hot-swap
Multikapacitet för 3200 W nätaggregat:
Multikapacitet för 2400 W nätaggregat:
VARNING: Systemet kräver minst en nätaggregat i CPU-zonen och en nätaggregat i GPU-zonen för att upprätthålla BMC- och standby-ström. Om ingen nätaggregat installeras i GPU-zonen kommer systemet att förbli i vänteläge. För att säkerställa full redundans, installera N+N nätaggregat i varje zon: 1+1 i CPU-zonen och 3+3 i GPU-zonen. Om du tar bort alla nätaggregat från CPU-zonen medan systemet är påslaget kommer det att orsaka en omedelbar avstängning och kan resultera i dataförlust. |
| Kylningsalternativ | |
| Kylningsalternativ | lUFTKYLNING |
| Fläktar | Upp till fyra uppsättningar högpresterande (HPR) platinafläktar (dubbelfläktmodul) installerade i mittfacket
Upp till tolv högpresterande (HPR) platinafläktar installerade på systemets framsida Alla är hot-swap-fläktar |
| Hamnar | |
| Nätverksalternativ | 1 PCIe Gen 5 OCP 3.0-kompatibel I/O (stöds av x8 PCIe-banor) |
| Frontportar | 1 x USB 2.0 Typ-A (valfritt) 1 x Mini-DisplayPort (valfritt) 1 x USB 2.0 Typ-C dubbelt läge (Host/iDRAC Direct-port) |
| Bakre portar | 1 x Dedikerad iDRAC/BMC Direct Ethernet-port 2 x USB 3.1 Typ A-port 1 x VGA- |
| Interna portar | 1 x USB 3.1 Typ-A |
XE7740 Design och konstruktion
Dubbelzonsarkitektur: CPU- och GPU-separation
Ett av de mest utmärkande designvalen i XE7740 är dess fysiska uppdelning i två distinkta temperatur- och kraftzoner. Den övre 1U-sektionen inrymmer CPU-zonen, som består av båda Xeon 6-processorerna, alla 32 DIMM-kortplatser, lagringen och DC-SCM-hanteringsmodulen. CPU-zonen använder fyra uppsättningar högpresterande dubbla fläktmoduler (40×40×56 mm) som levererar 47.4 CFM luftflöde.
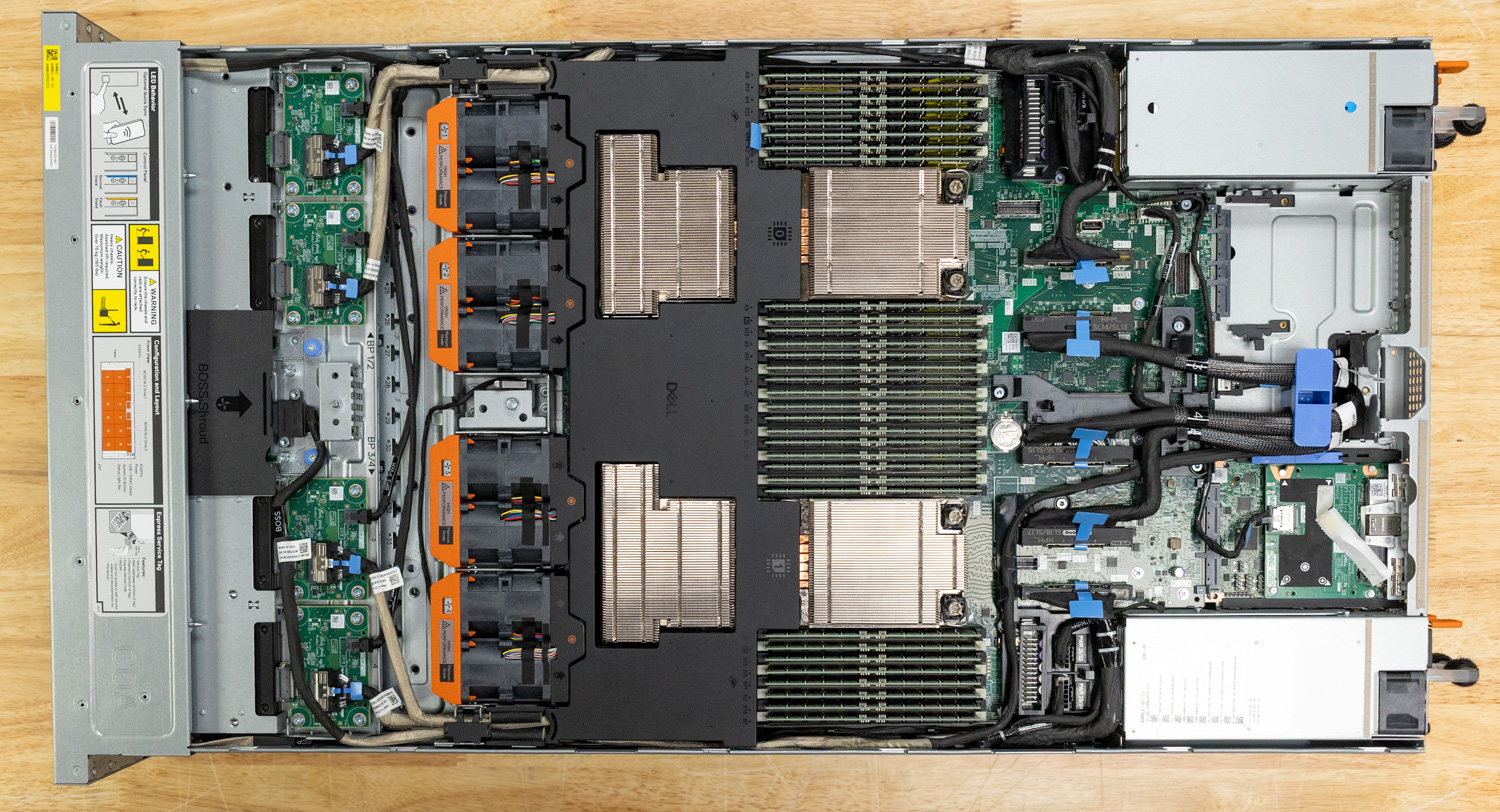
Den nedre 3U-sektionen är GPU-zonen, som innehåller alla acceleratorplatser med egen dedikerad kylinfrastruktur, tillsammans med PCIe-baskortet (PBB), bakåtvända PCIe-expansionsplatser och OCP NIC-anslutning. GPU-zonen använder tolv större högpresterande fläktar (60×60×56 mm) med betydligt högre luftflödeskapacitet upp till 122.2 CFM per fläkt jämfört med CPU-fläktarna. Alla fläktar är hot-swap-bara. Denna kylningsmetod med dubbla zoner innebär att de termiska kraven från acceleratorer med hög TDP (upp till 600 W per kort) inte kompromissar med CPU- och minneskylning, och vice versa, i ett 19-tums standardrack.
Dell har lagt stor vikt vid optimering av luftflödet i XE7740. System med många acceleratorer kräver omfattande interna kablar, inklusive GPU-strömkablar, PCIe-signalkablar mellan HPM-kortet och PBB, samt fläktkortsanslutningar. I XE7740 är dessa kablar dragen längs chassits sidoväggar med hjälp av dedikerade kabelhållarfästen och kabelskyddsaggregat. Varje kabel är byggd till exakt den längd som krävs; det finns inga överflödiga kabelbuntar inuti systemet. Genom att hålla kablarna borta från den centrala luftflödeskanalen bibehåller designen en tydlig luftflödesväg framifrån och bakåt och minimerar impedansen över både CPU- och GPU-kylzonerna.
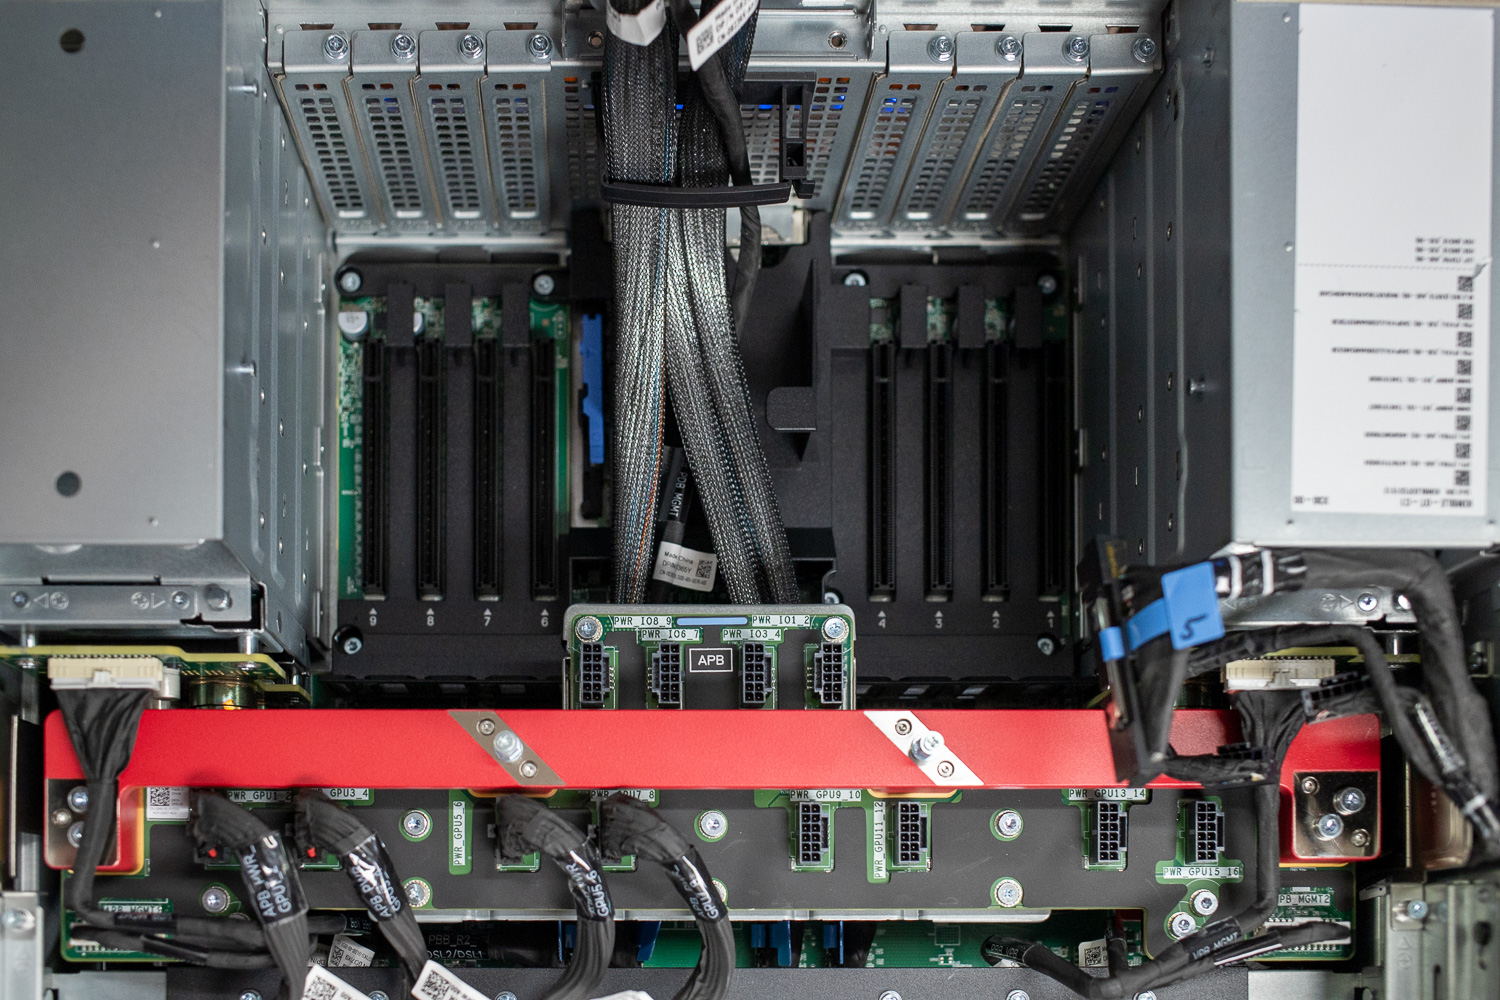
I ett chassi med upp till åtta 600W-acceleratorer kan även små hinder i luftflödesvägen skapa lokala heta punkter och tvinga fläktarna att köras med högre hastigheter – vilket ökar både strömförbrukningen och den akustiska effekten. Dells kabelhanteringsmetod håller mitten av chassit fritt för direkt, obehindrat luftflöde över de komponenter som behöver det mest.
PCIe-switchtopologi och dataflöde
XE7740:s PCIe-undersystem är byggt kring fyra PCIe Gen 5-switchar på PBB (PCIe Base Board), betecknade SW1 till SW4. Dessa switchar utgör ryggraden i systemets I/O-arkitektur och kopplar samman acceleratorer, nätverk och lagring med de två Xeon 6-processorerna i en noggrant organiserad topologi.
De 16 interna GPU-kortplatserna är uppdelade i två bankar med åtta stycken, där varje bank betjänas av ett par PCIe-switchar, var och en ansluten uppströms till en processor. Inom varje bank sammanflätas par av intilliggande GPU-kortplatser med dubbel bredd över de två switcharna. På CPU0-sidan betjänar SW1 GPU-kortplatserna 21 och 25, samt bakre PCIe-kortplatser 8 och 9, medan SW2 betjänar GPU-kortplatserna 23 och 27, samt bakre PCIe-kortplatser 6 och 7. På CPU1-sidan betjänar SW3 GPU-kortplatserna 29 och 33, samt bakre PCIe-kortplatser 3 och 4, medan SW4 betjänar GPU-kortplatserna 31 och 35, samt bakre PCIe-kortplatser 1 och 2.

Varje CPU-domän äger därför fyra acceleratorplatser med dubbel bredd, fyra bakåtvända NIC/I/O-platser och fyra av de åtta framåtvända E3.S NVMe-lagringsfacken. Denna switchtopologi har betydande konsekvenser för dataflödet, särskilt för RDMA-baserad trafik. Eftersom varje switch är värd för både accelerator- och bakre NIC-platser, kan en accelerator och ett nätverkskort på samma switch utföra RDMA-överföringar helt inom switchstrukturen. Data behöver aldrig passera processorns rotkomplex, vilket eliminerar den CPU-studsbuffert som annars skulle krävas när en PCIe-enhet på en rotport kommunicerar med en enhet på en annan. Detta minskar latensen, undviker att förbruka värdefull CPU-minnesbandbredd och frigör CPU-cykler för annat arbete.
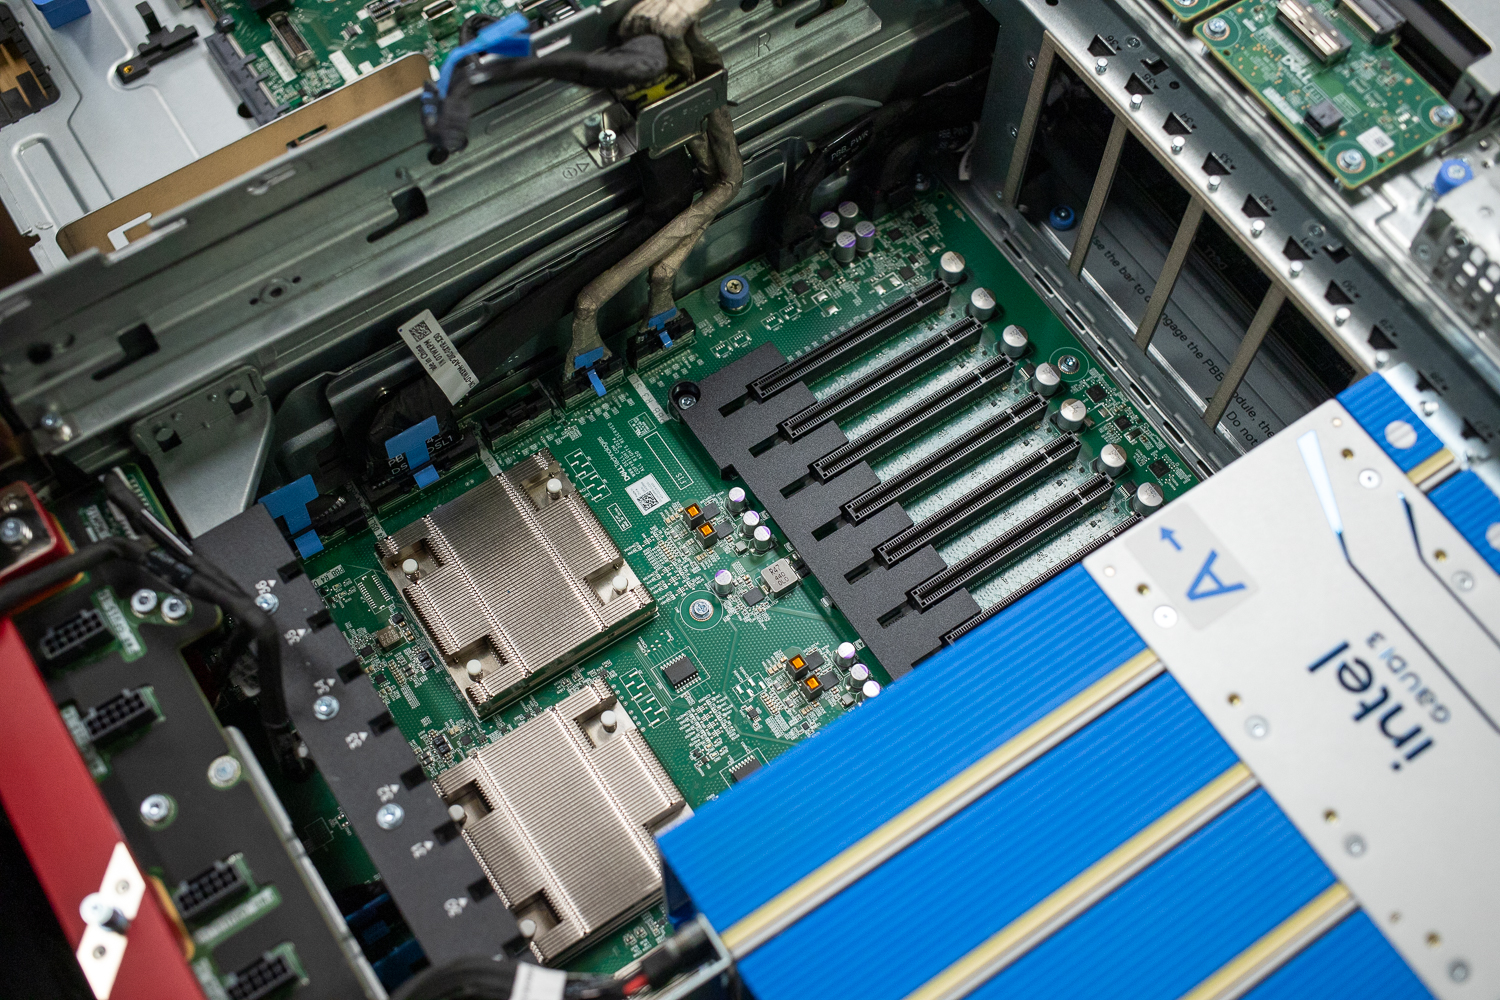
Kommunikation inom en enda processordomän mellan dess två switchar går genom processorrotkomplexet men förblir lokal för den sockeln. Kommunikation mellan processorer måste dock gå via UPI-länkarna mellan de två Xeon 6-processorerna. 6787P tillhandahåller fyra UPI 2.0-länkar med 24 GT/s vardera, vilket erbjuder betydande bandbredd mellan socklarna. Trafik mellan en accelerator på CPU0:s switchbank och ett nätverkskort på CPU1:s switchbank kommer dock att ha högre latens än switch-lokala eller samma-socket-överföringar.
Switcharna själva är inte direkt sammankopplade. All trafik mellan switcharna går genom CPU-rotkomplexet, så det är viktigt att förstå sambandet mellan GPU-platser, NIC-platser, lagring och CPU-socklar. För att förenkla denna komplexitet för organisationer erbjuder Dell validerade och optimerade konfigurationer för populära acceleratorer.
Strömförsörjning med dubbla zoner
XE7740:s strömförsörjning speglar dess termiska arkitektur med en något ovanlig design med två zoner för nätaggregat. Systemet stöder upp till åtta nätaggregat som kan bytas under drift, uppdelade i två zoner: Zon 1 (CPU-zon) rymmer nätaggregat 1 och 2, medan zon 2 (GPU-zon) rymmer nätaggregat 3 till 8.
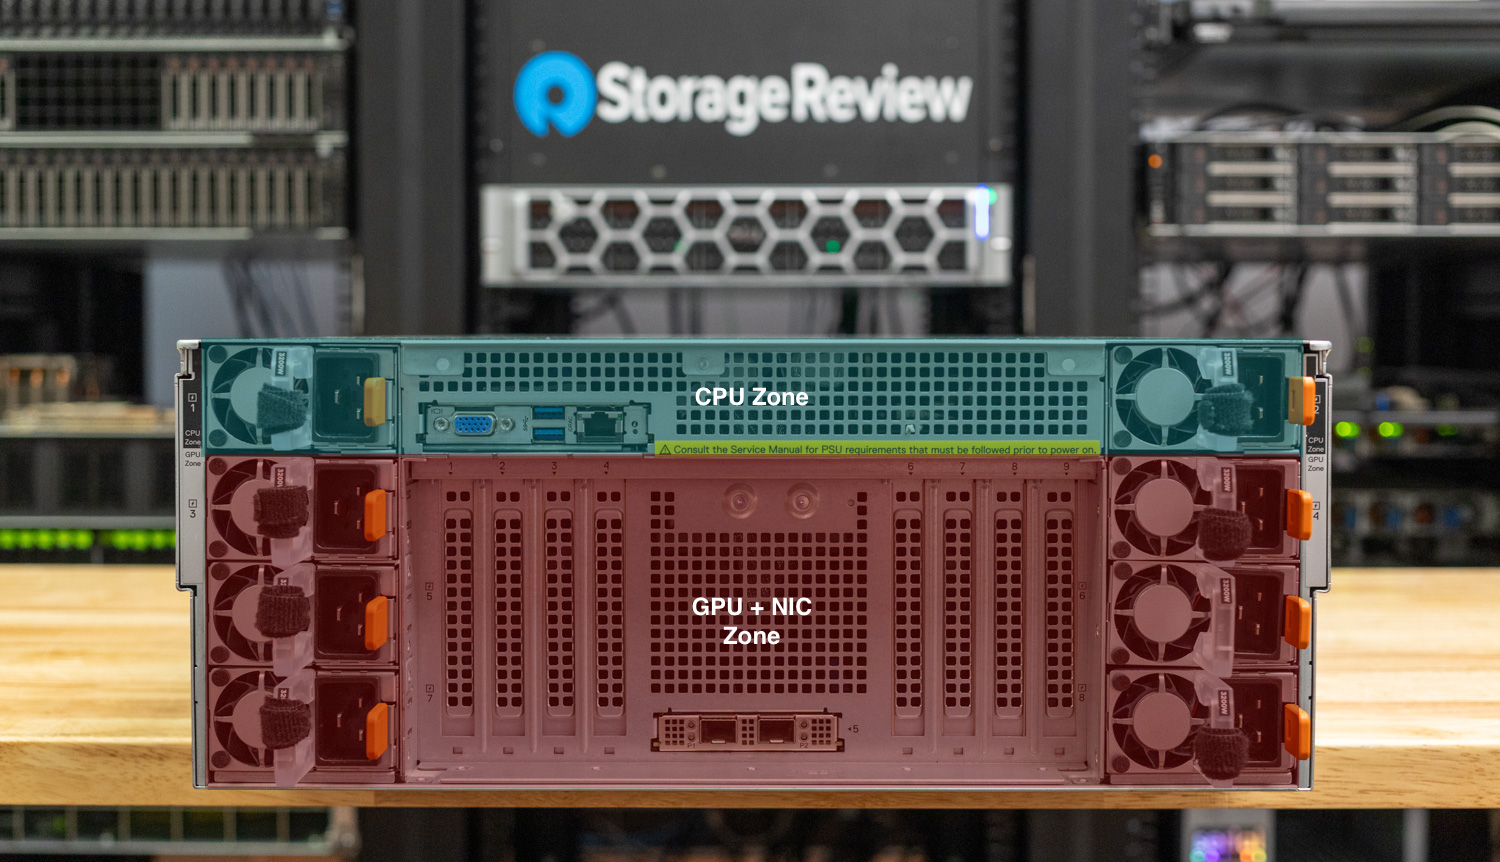
Systemet kräver minst en nätaggregatsenhet i varje zon för att upprätthålla BMC- och standby-strömförsörjning. Om någon av zonerna förlorar nätström medan systemet är igång stängs systemet omedelbart av för att förhindra dataförlust. Zonerna är beroende av varandra för drift, även om de är fysiskt och elektriskt separerade. För fullständig redundans rekommenderar Dell en 1+1-konfiguration i CPU-zonen och en 3+3-konfiguration i GPU-zonen, vilket innebär att alla åtta nätaggregatsfacken bör vara isatta för en fullständigt redundant driftsättning.
Dell AIOps, hantering och företagstillförlitlighet
Dells PowerEdge-plattform har fått ett rykte i branschen för tillförlitlighet och servicevänlighet. Företagskunder lyfter konsekvent fram samma teman: PowerEdge-system är byggda för att hålla, Dells supportorganisation löser problem snabbt och hanteringsverktygen är mogna och välintegrerade. XE7740 fortsätter denna tradition, och Dell har gjort betydande framsteg inom både hårdvaruhantering och säkerhet med denna generation.
iDRAC 10
XE7740 levereras med Dells nästa generations iDRAC 10, en rejäl ansiktslyftning jämfört med den redan kapabla iDRAC 9 som Dells kunder har förlitat sig på i åratal. Implementerad som en Data Center Secure Control Module (DC-SCM) i enlighet med OCP DC-MHS-standarden, är iDRAC 10 inte bara en firmwareuppdatering; den representerar ny hårdvara. Styrenheten har fyra 1 GHz-kärnor med en 64-bitarsarkitektur och 2 GB DDR4-minne (dubbelt så mycket som föregående generation), vilket ger avsevärt förbättrad prestanda och respons för hanteringsåtgärder.
På säkerhetsfronten introducerar iDRAC 10 flera anmärkningsvärda förbättringar. Plattformen har starkare kryptografiskt stöd över hela linjen, inklusive SHA-384- och SHA-512-autentisering och kvantsäker AES-256-kryptering, i takt med att branschen förbereder sig för postkvantkryptografiska hot. En dedikerad integrerad säkerhetsenklav i iDRAC 10-kisel hanterar cybermotståndskraftsfunktioner, inklusive attestering på enhetsnivå och Dells anpassade Root-of-Trust. Denna hårdvarubaserade Root-of-Trust säkerställer att all firmware (BIOS, iDRAC och komponentfirmware) verifieras kryptografiskt före körning, vilket skyddar mot attacker i leveranskedjan och manipulering av firmware.
Säker komponentverifiering validerar att system som levereras från Dells fabrik anländer med exakt de komponenter och konfigurationer som specificerats av kunden, vilket bibehåller integriteten från tillverkning till driftsättning. Den senaste iDRAC 10-firmwaren levererar också ett uppdaterat, modulärt användargränssnitt som förbättrar den dagliga administrativa upplevelsen.
OpenManage Enterprise
För storskalig hantering av maskiner och maskiner erbjuder Dells OpenManage Enterprise centraliserad övervakning, firmwareuppdateringar och konfigurationshantering över hela PowerEdge-distributioner. Ett anmärkningsvärt nytt tillägg för AI-fokuserade distributioner är att OME nu stöder direkt insyn i GPU- och acceleratorstatistik: strömförbrukning, temperatur, användning, felantal med mera, utan att det krävs separata leverantörsspecifika verktyg. För organisationer som hanterar dussintals eller hundratals XE7740-noder i ett inferenskluster är detta enhetliga hanteringsplan en betydande driftsförenkling.
Intel Xeon 6
I hjärtat av XE7740 finns två Intel Xeon 6 6787P-processorer, flaggskeppet i Xeon 6700P-serien. Byggd på Granite Rapids-arkitekturen med Intels 3 nm-teknik, levererar 6787P 86 P-kärnor (172 trådar) per sockel vid en TDP på 350 W, med en basklockfrekvens på 2.0 GHz och en turboklockfrekvens på 3.8 GHz.
Det som gör Granite Rapids särskilt relevant för AI-infrastruktur är dess kombination av högt antal kärnor och dess minnesundersystem. Varje 6787P-processor har åtta DDR5-minneskanaler med upp till 6400 MT/s. Med en XE7740 med dubbla socklar och 32 DIMM-moduler kan systemet konfigureras för upp till 4 TB totalt systemminne.
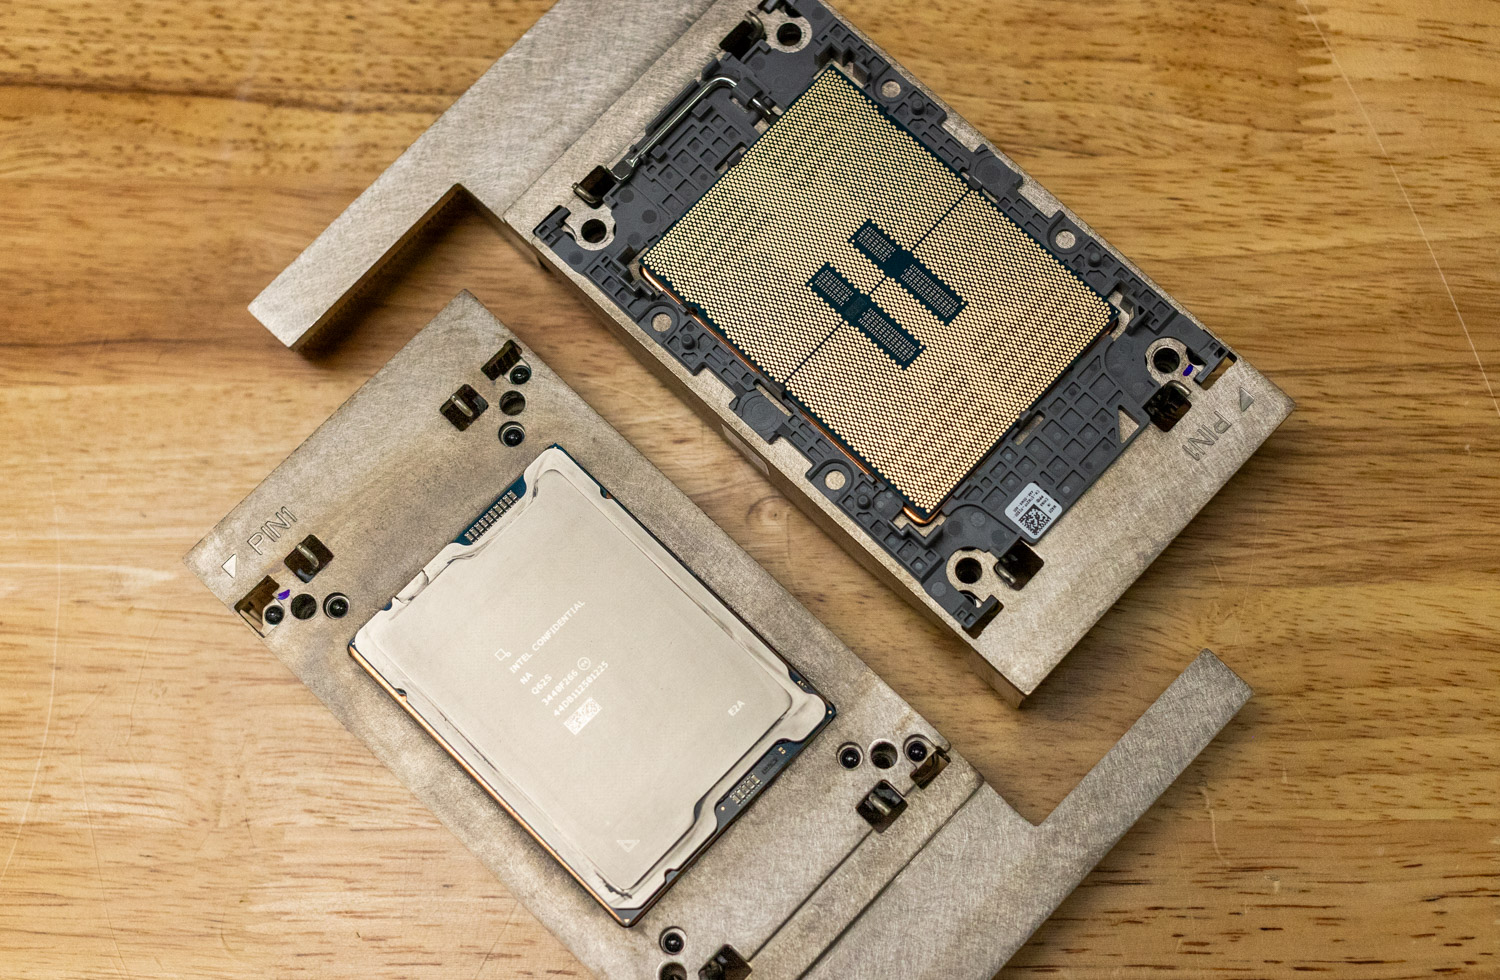
Minneskapacitet och bandbredd är avgörande för AI-arbetsbelastningar, särskilt när man använder KV-cache-offloading. När stora språkmodeller ökar kontextlängden skalas KV-cachen proportionellt och kan förbruka en betydande mängd acceleratorminne. Att avlasta delar av KV-cachen till systemminne eller snabb lagring gör att acceleratorns HBM kan användas mer effektivt för aktiv beräkning, vilket minskar tiden till första token (TTFT) för multi-turn-chattar.
Det är också värt att notera Xeon 6:s AMX-tensorenheter, som hanterar betydande arbete på CPU-sidan. Dessa inkluderar förbehandling, tokenisering och hybridinferensuppgifter som involverar matrisoperationer. Detta blir särskilt användbart med inferensramverk som SGLang, som använder CPU:n för Radix Tree för KV Cache Management och Zero Overhead-schemaläggning.
Intel Gaudi 3 tilläggskort: Konkurrenskraftig inferens i stor skala
Intels Gaudi 3 är företagets flaggskepps-AI-accelerator, lanserad under fjärde kvartalet 2024. Intel positionerar dessa acceleratorer mycket aggressivt snarare än att konkurrera direkt med de allra bästa acceleratorerna för datacenterutbildning. Gaudi 3 riktar sig direkt mot inferenssegmentet.
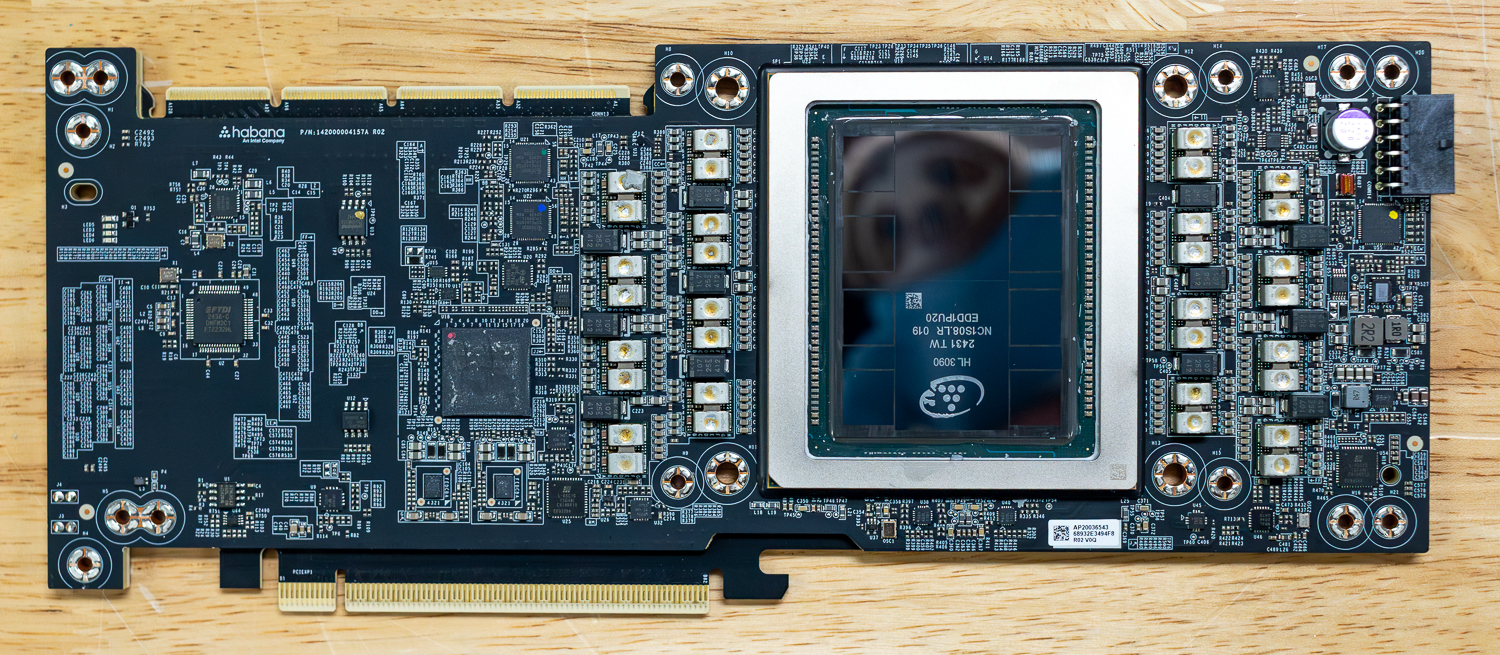
Transformatorbaserad modellinferens i alla populära LLM:er idag är i grunden minnesbunden. Under avkodningsfasen av autoregressiv generering genererar modellen tokens en i taget och läser modellvikterna och KV-cacheposterna för varje producerad token. Flaskhalsen är inte beräkningskapaciteten utan minnesbandbredden, vilket är hur snabbt acceleratorn kan strömma data från HBM till beräkningsmotorerna.
Gaudi 3 har 128 GB HBM2e med 3.7 TB/s minnesbandbredd. Arkitektoniskt sett är Gaudi 3 byggd på TSMC:s 5nm-process och använder en dual-die-chipletdesign: två identiska kiselchips sammanfogade med en högbandbreddskoppling, vilket presenteras som en enda enhet för programvaran. Beräkningsförmågan är organiserad i fyra Deep Learning Cores (DCORE), som var och en innehåller 2 MME, 16 TPC och 24 MB lokal SRAM-cache. De totala 96 MB inbyggda SRAM ger 12.8 TB/s intern bandbredd. Acceleratorn integrerar också 14 dedikerade medieavkodare (H.265, H.264, JPEG, VP9), vilket möjliggör snabb förbehandling av bildkvalitet för multimodala arbetsbelastningar.
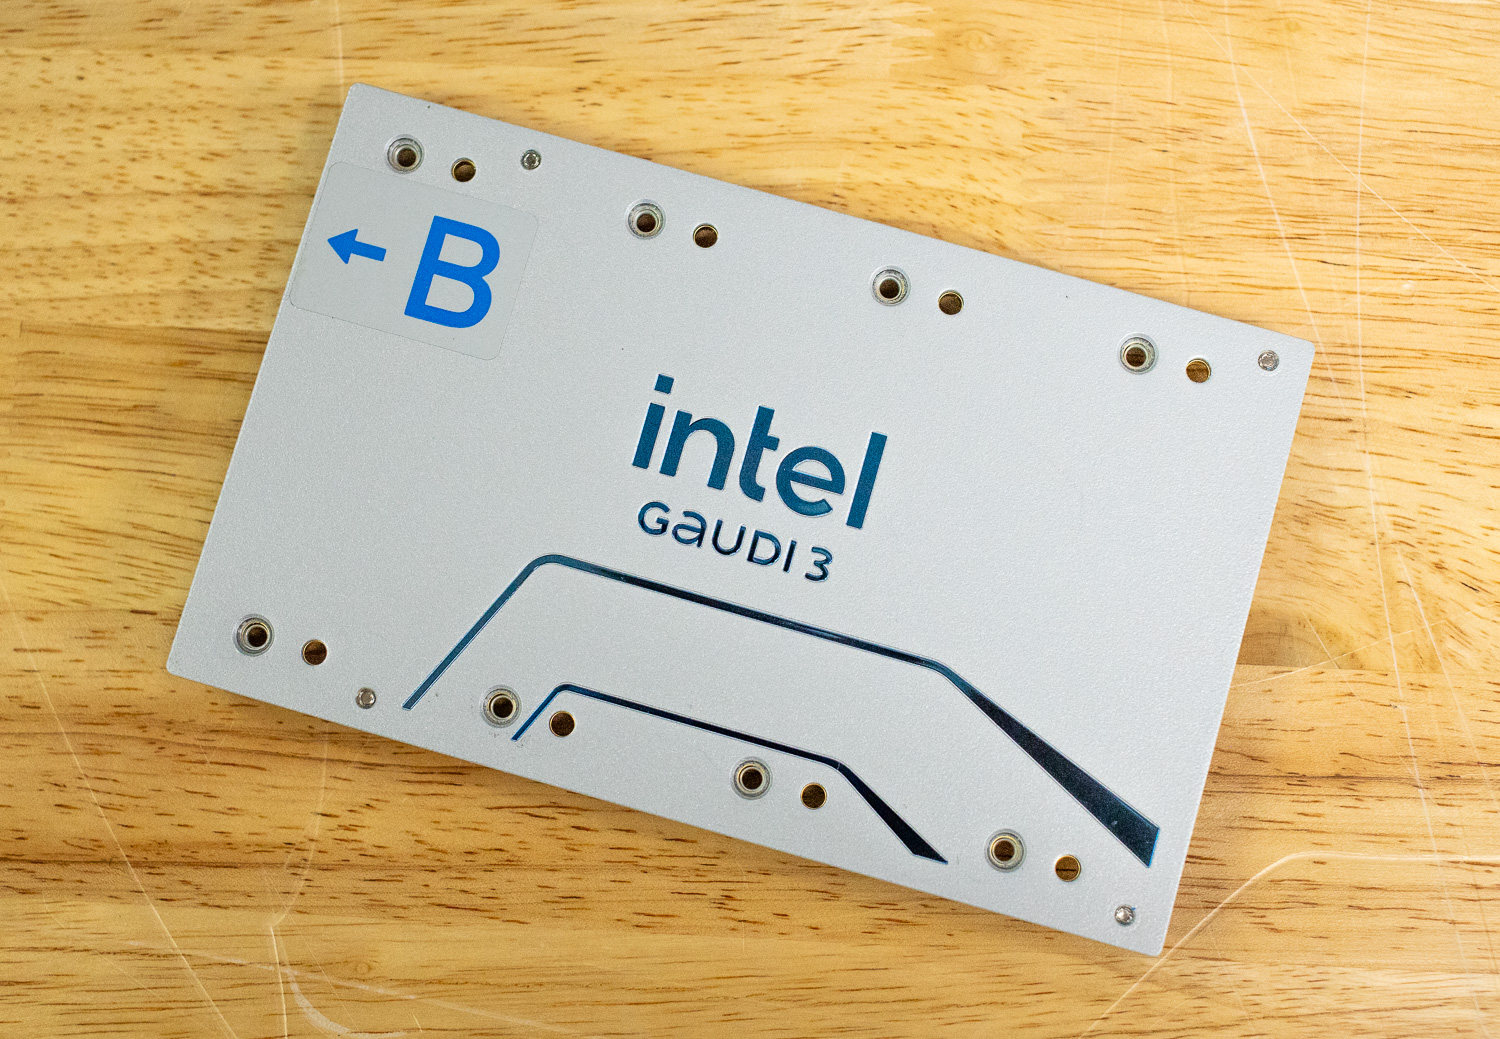
En stor del av de AI-modeller med öppen källkod som släpps idag är antingen nativt FP8-tränade eller hybridmodeller som blandar FP8- (E4M3) och BF16-vikter. Gaudi 3 tillhandahåller nativ FP8-acceleration för dessa över sina 8 matrismultiplikationsmotorer och 64 tensorprocessorkärnor, vilket levererar 1.8 PFlops FP8-beräkning.
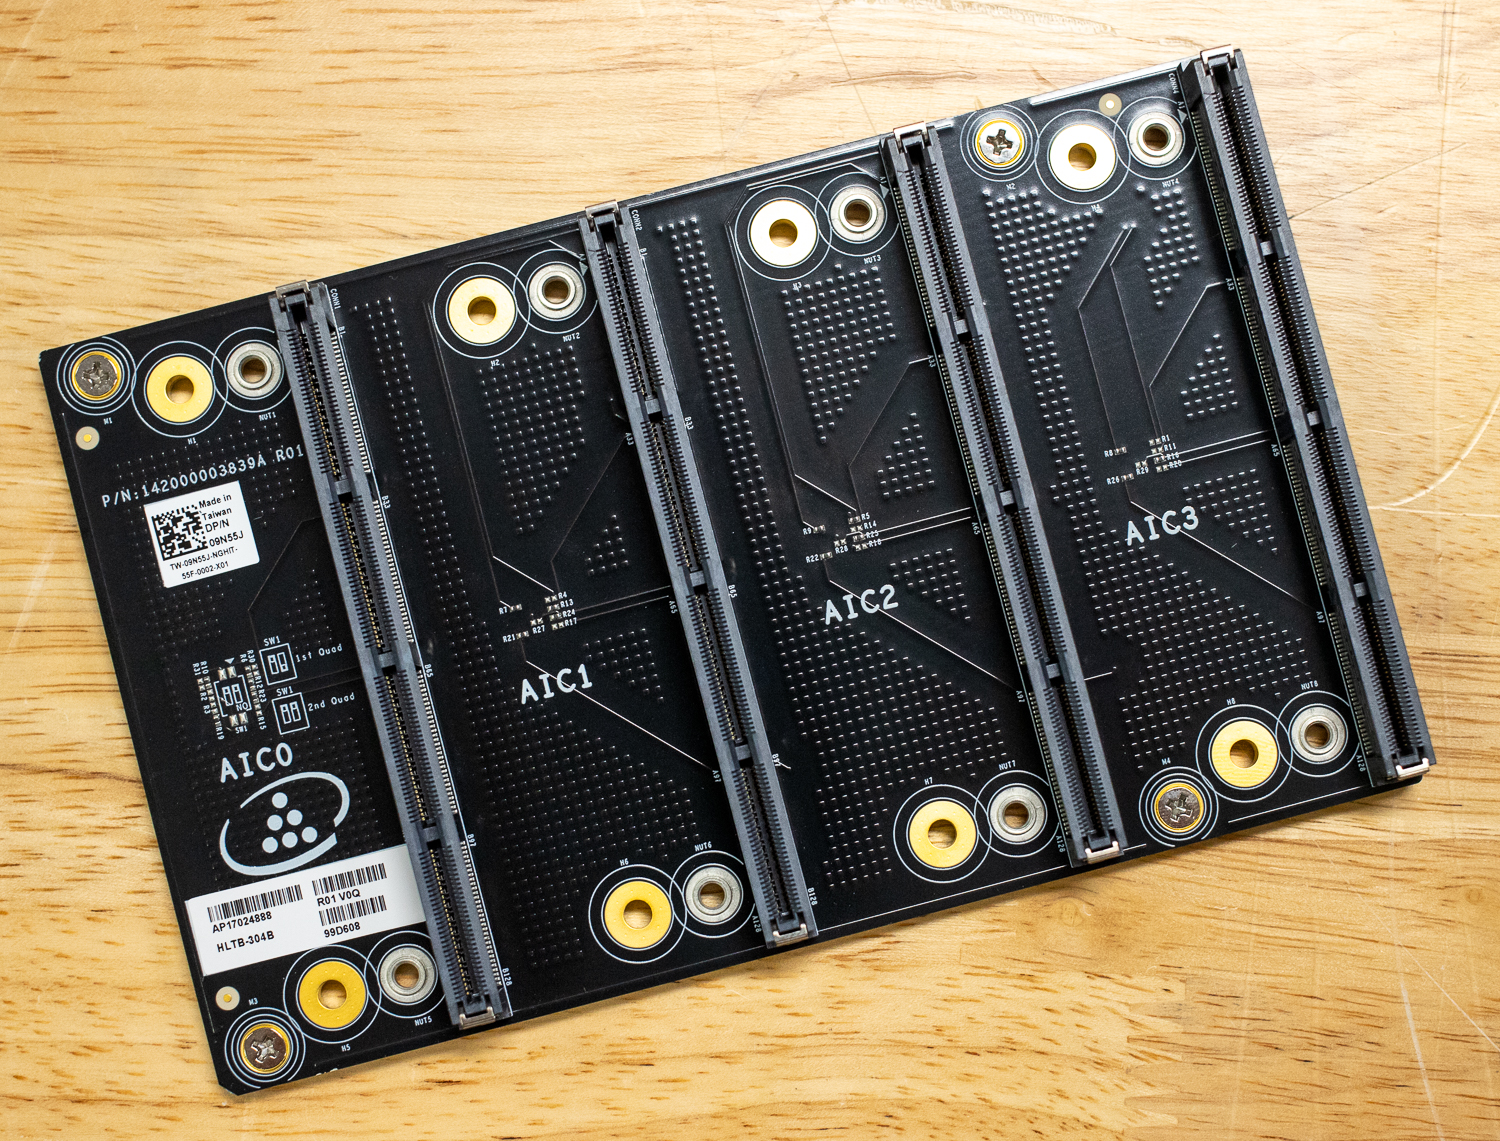
Gaudi 3 integrerar även RDMA över Converged Ethernet (RoCEv2)-nätverk med 24×200 GbE-portar på OAM-versionen, inbyggda direkt i kiseln. Även om PCIe-tilläggskortsvarianten som används i XE7740 inte exponerar alla dessa portar på samma sätt, stöder tilläggskortsvarianterna bryggkoppling av fyra kort för snabbare kommunikation mellan dem.
Prestanda och benchmarks
XE7740-konfigurationsdetaljer:
- 2 x Intel Xeon 6787P-processor (86 kärnor, 2.00 GHz)
- 2 TB DDR5 (32 x 64 GB 5200 MT/s DDR5)
- 4 x Intel Gaudi 3 PCIe AI-acceleratorer med 128 GB HBM
- Ubuntu 24.04.5 Server
vLLM Online-serverprestanda
För att utvärdera inferenskapaciteten hos Dell XE7740, som drivs av Intel Gaudi 3-acceleratorer, jämförde vi vLLM:s online-serverprestanda över en rad populära modeller som spänner över olika arkitekturer, parameterantal och precisionsformat. Varje modell testades över tre arbetsbelastningsprofiler med samtidiga begärandeantal som skalades från 1 till 128.
LLM-inferens består av två distinkta faser. Förfyllningsfasen bearbetar alla indatatokens parallellt innan någon utdatatoken kan genereras, vilket gör den till en beräkningsbunden operation som skalar linjärt med antalet indatatokens. Avkodningsfasen genererar sedan utdatatokens en i taget (autoregressivt), där varje ny token kräver att man läser hela modellvikten från minnet, men utför relativt lite beräkning per token – vilket gör den minnesbandbreddsbunden.
Dessa två faser belastar fundamentalt olika delar av acceleratorn, så vi testar tre arbetsbelastningsprofiler som förändrar balansen mellan dem:
- Lika (1024 input/1024 output tokens) representerar balanserade chattinteraktioner.
- Prefill Heavy (8192 input/1024 output) simulerar hämtningsutökad generering eller långkontextsummering, där systemet måste bearbeta stora inmatningskontexter.
- Decode Heavy (1024 input/8192 output) representerar generering av långformat innehåll där bibehållen minnesbandbredd avgör dataflödet.
Vi fokuserar på två primära mätvärden i det här avsnittet. Total tokengenomströmning, mätt i tokens per sekund, fångar systemets totala serveringkapacitet under belastning. Tid till första token (TTFT) mäter fördröjningen mellan att en begäran skickas och att den första genererade token tas emot. Eftersom modellen måste slutföra hela förfyllningsfasen innan den kan generera den första token är TTFT direkt kopplad till acceleratorns beräkningsgenomströmning. Detta gör scenariot med hög förfyllning (kombinerat med TTFT) till ett särskilt användbart mått för att förstå de råa beräkningsfunktionerna hos Gaudi 3-acceleratorerna, eftersom systemet måste bearbeta alla 8 192 inmatade tokens innan användaren ser något svar.
Omvänt testar det avkodningsintensiva scenariot acceleratorernas minnesbandbredd, eftersom systemet måste upprätthålla hög dataflödeshastighet för tusentals genererade tokens. TTFT är avgörande för interaktiva applikationer där användare väntar på svar innan strömning kan börja. Ett system kan uppnå utmärkt dataflöde under tung batchning men ändå kännas trögt om TTFT stiger för högt, så båda mätvärdena är viktiga för produktionsdistributioner.
En anmärkning om FP8-precisionsresultat: medan Intel Gaudi 3-acceleratorer inkluderar inbyggd FP8-beräkningsacceleration (och FP8 borde i teorin leverera högre dataflöde än BF16), är FP8-prestandasiffrorna i våra riktmärken lägre än deras BF16-motsvarigheter. Detta är inte en hårdvarubegränsning utan snarare ett problem med mjukvarumognad inom Intels förgrening av vLLM. Den version vi testade (vLLM-installationsprogram 2.7.1 på Gaudi Docker 1.22.2) har ännu inte helt optimerat sina FP8-kodvägar. Intel har en ny plugin-baserad version av vLLM som för närvarande är i betafas och som kan åtgärda många av dessa prestandautmaningar.
Llama 3.1 8B Instruktion
Llama 3.1 8B Instruct är en tät transformeringsmodell från Meta, vilket innebär att varje parameter är aktiv för varje genererad token. Med 8 miljarder parametrar är den bland de mer öppna källkodsmodellerna. Modeller i denna storleksklass är populära för vardagliga uppgifter som att sammanfatta korta dokument, skriva e-postmeddelanden och meddelanden, besvara enkla frågor och driva enkla chatbot-interaktioner där hastighet och kostnadseffektivitet är viktigare än djupt resonemang.
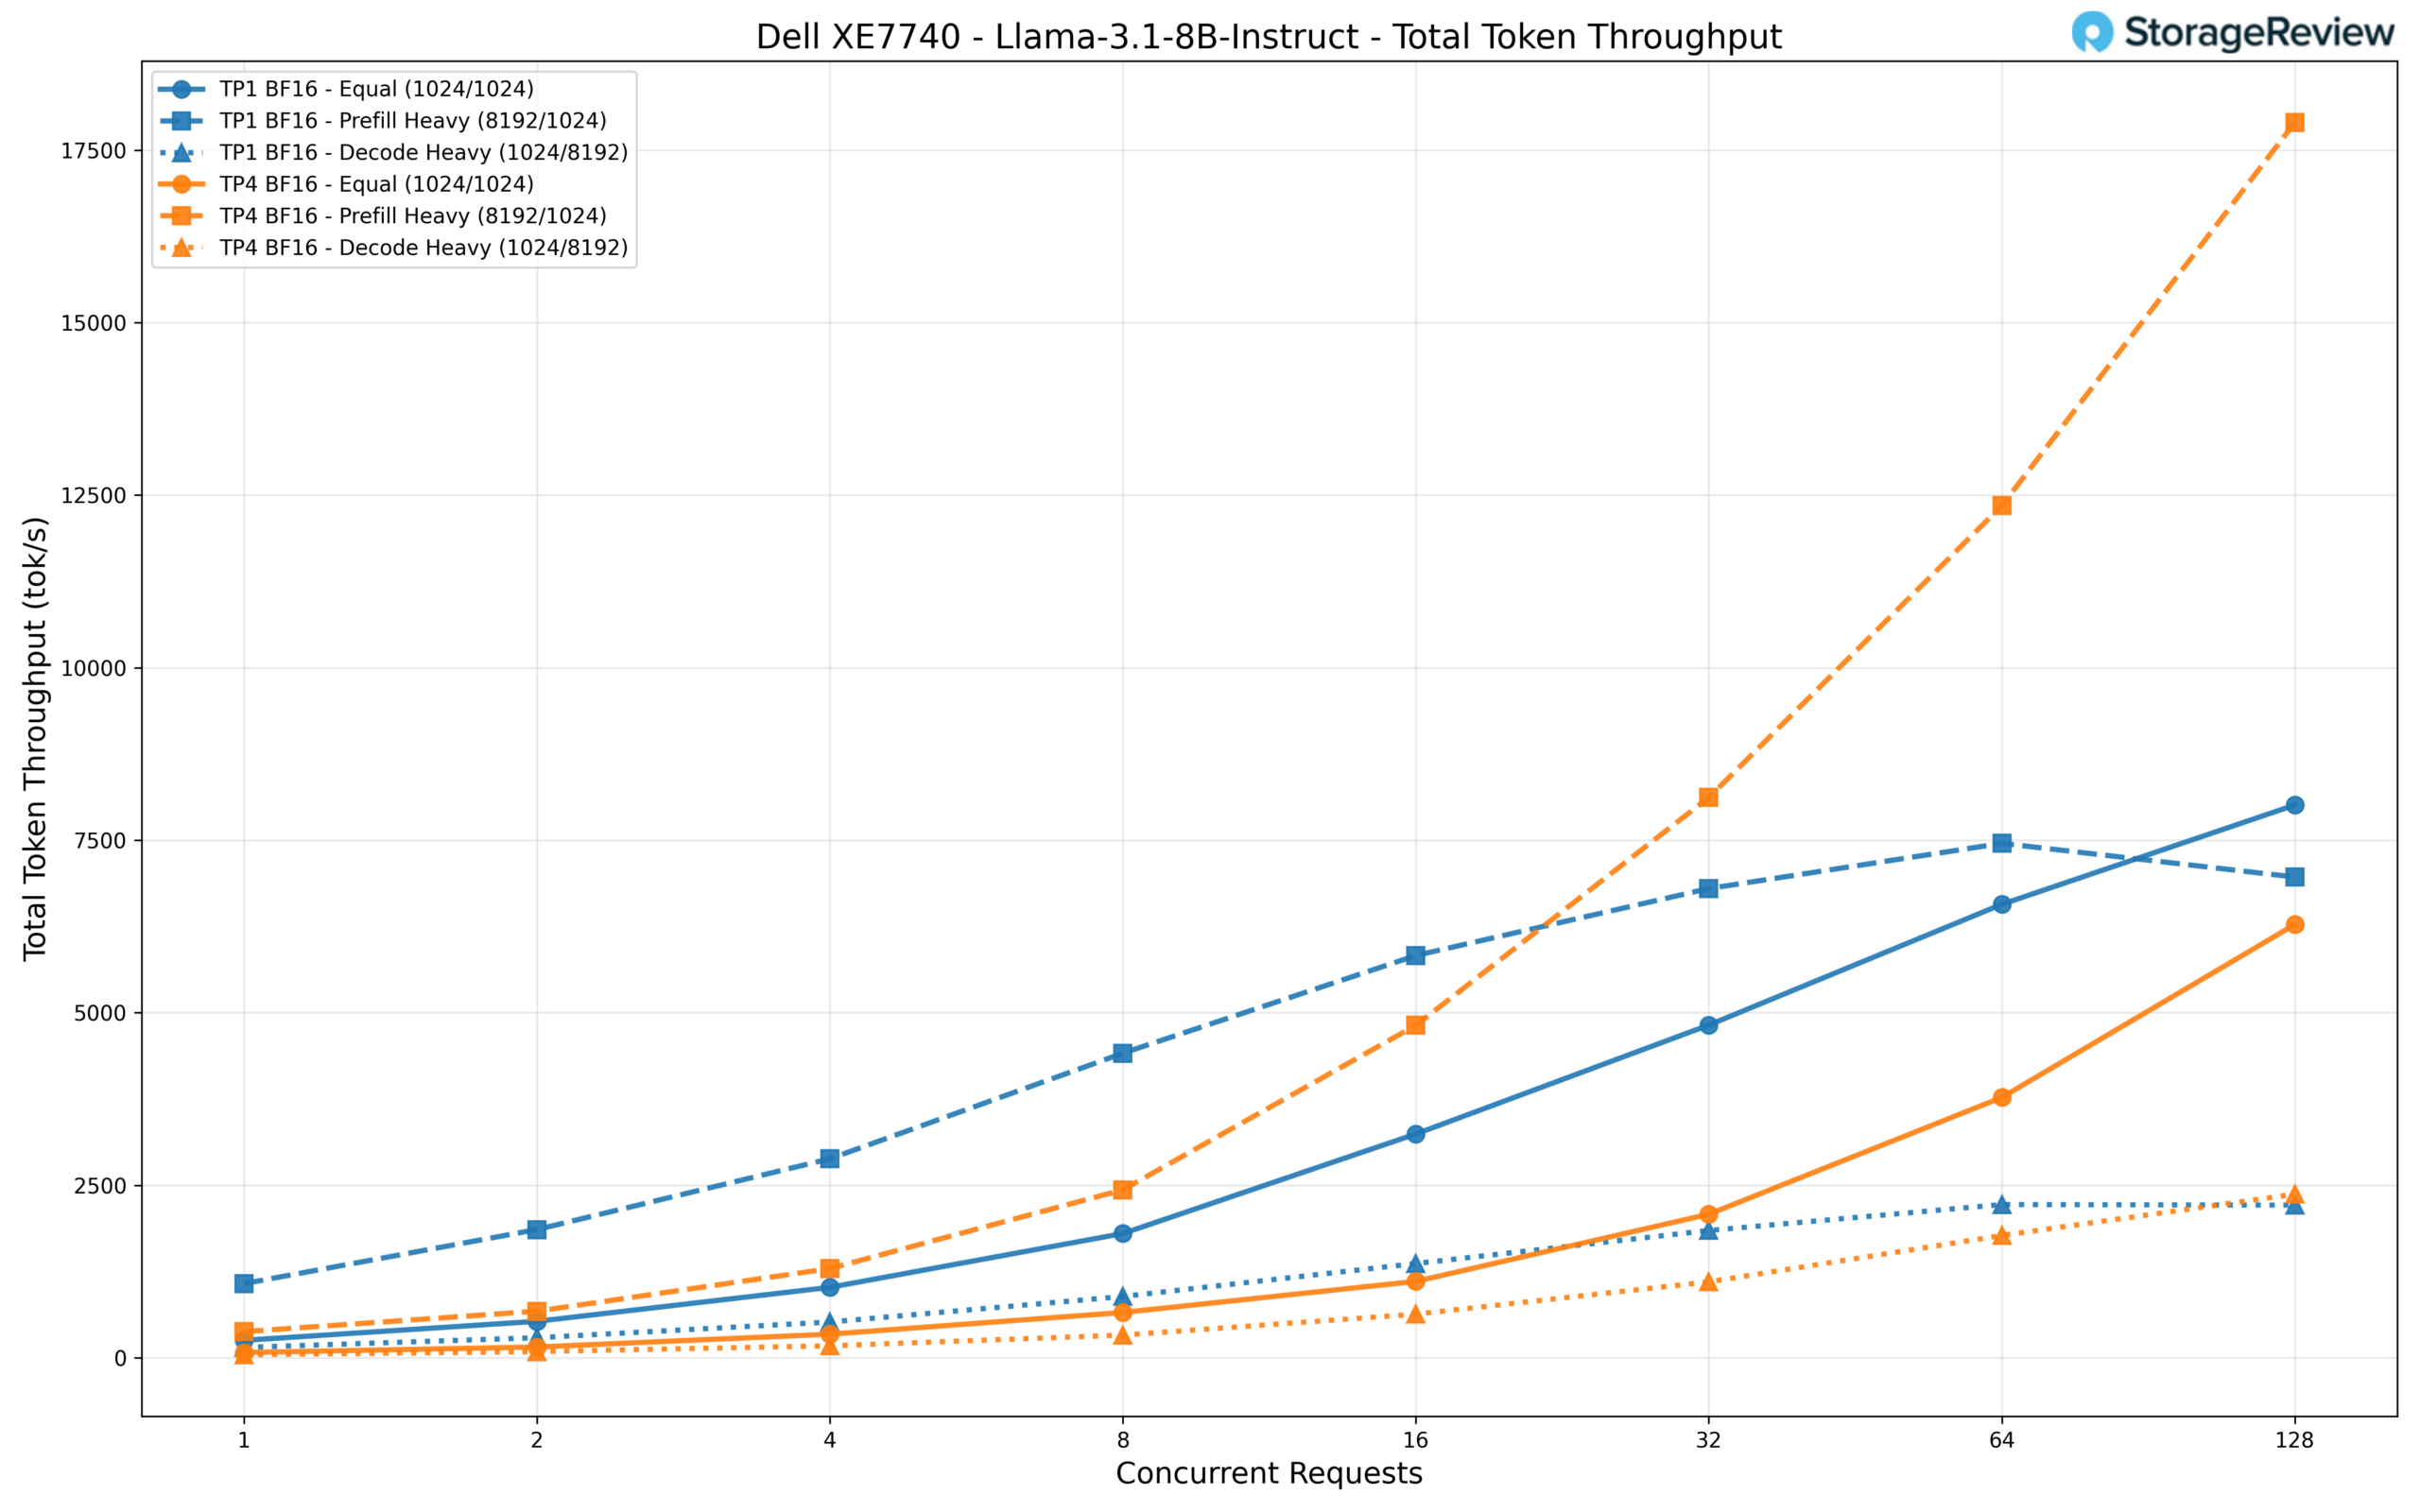
Vi testade den här modellen i både TP1-konfigurationer (enkel accelerator) och TP4-konfigurationer (alla fyra Gaudi 3-acceleratorer). Modellen körs på TP1 och uppnår en total dataflödeshastighet på ungefär 8 000 tok/s vid 128 samtidiga förfrågningar i samma arbetsbelastning, och skalar enkelt från cirka 250 tok/s vid en enda förfrågan. Scenariot med hög förfyllningshastighet visar ett intressant mönster: medan TP1 når en topp på cirka 7 000 tok/s, ökar TP4 till över 17 900 tok/s vid 128 samtidiga förfrågningar, vilket utnyttjar ytterligare acceleratorer för att bearbeta den stora indatakontexten mer effektivt.
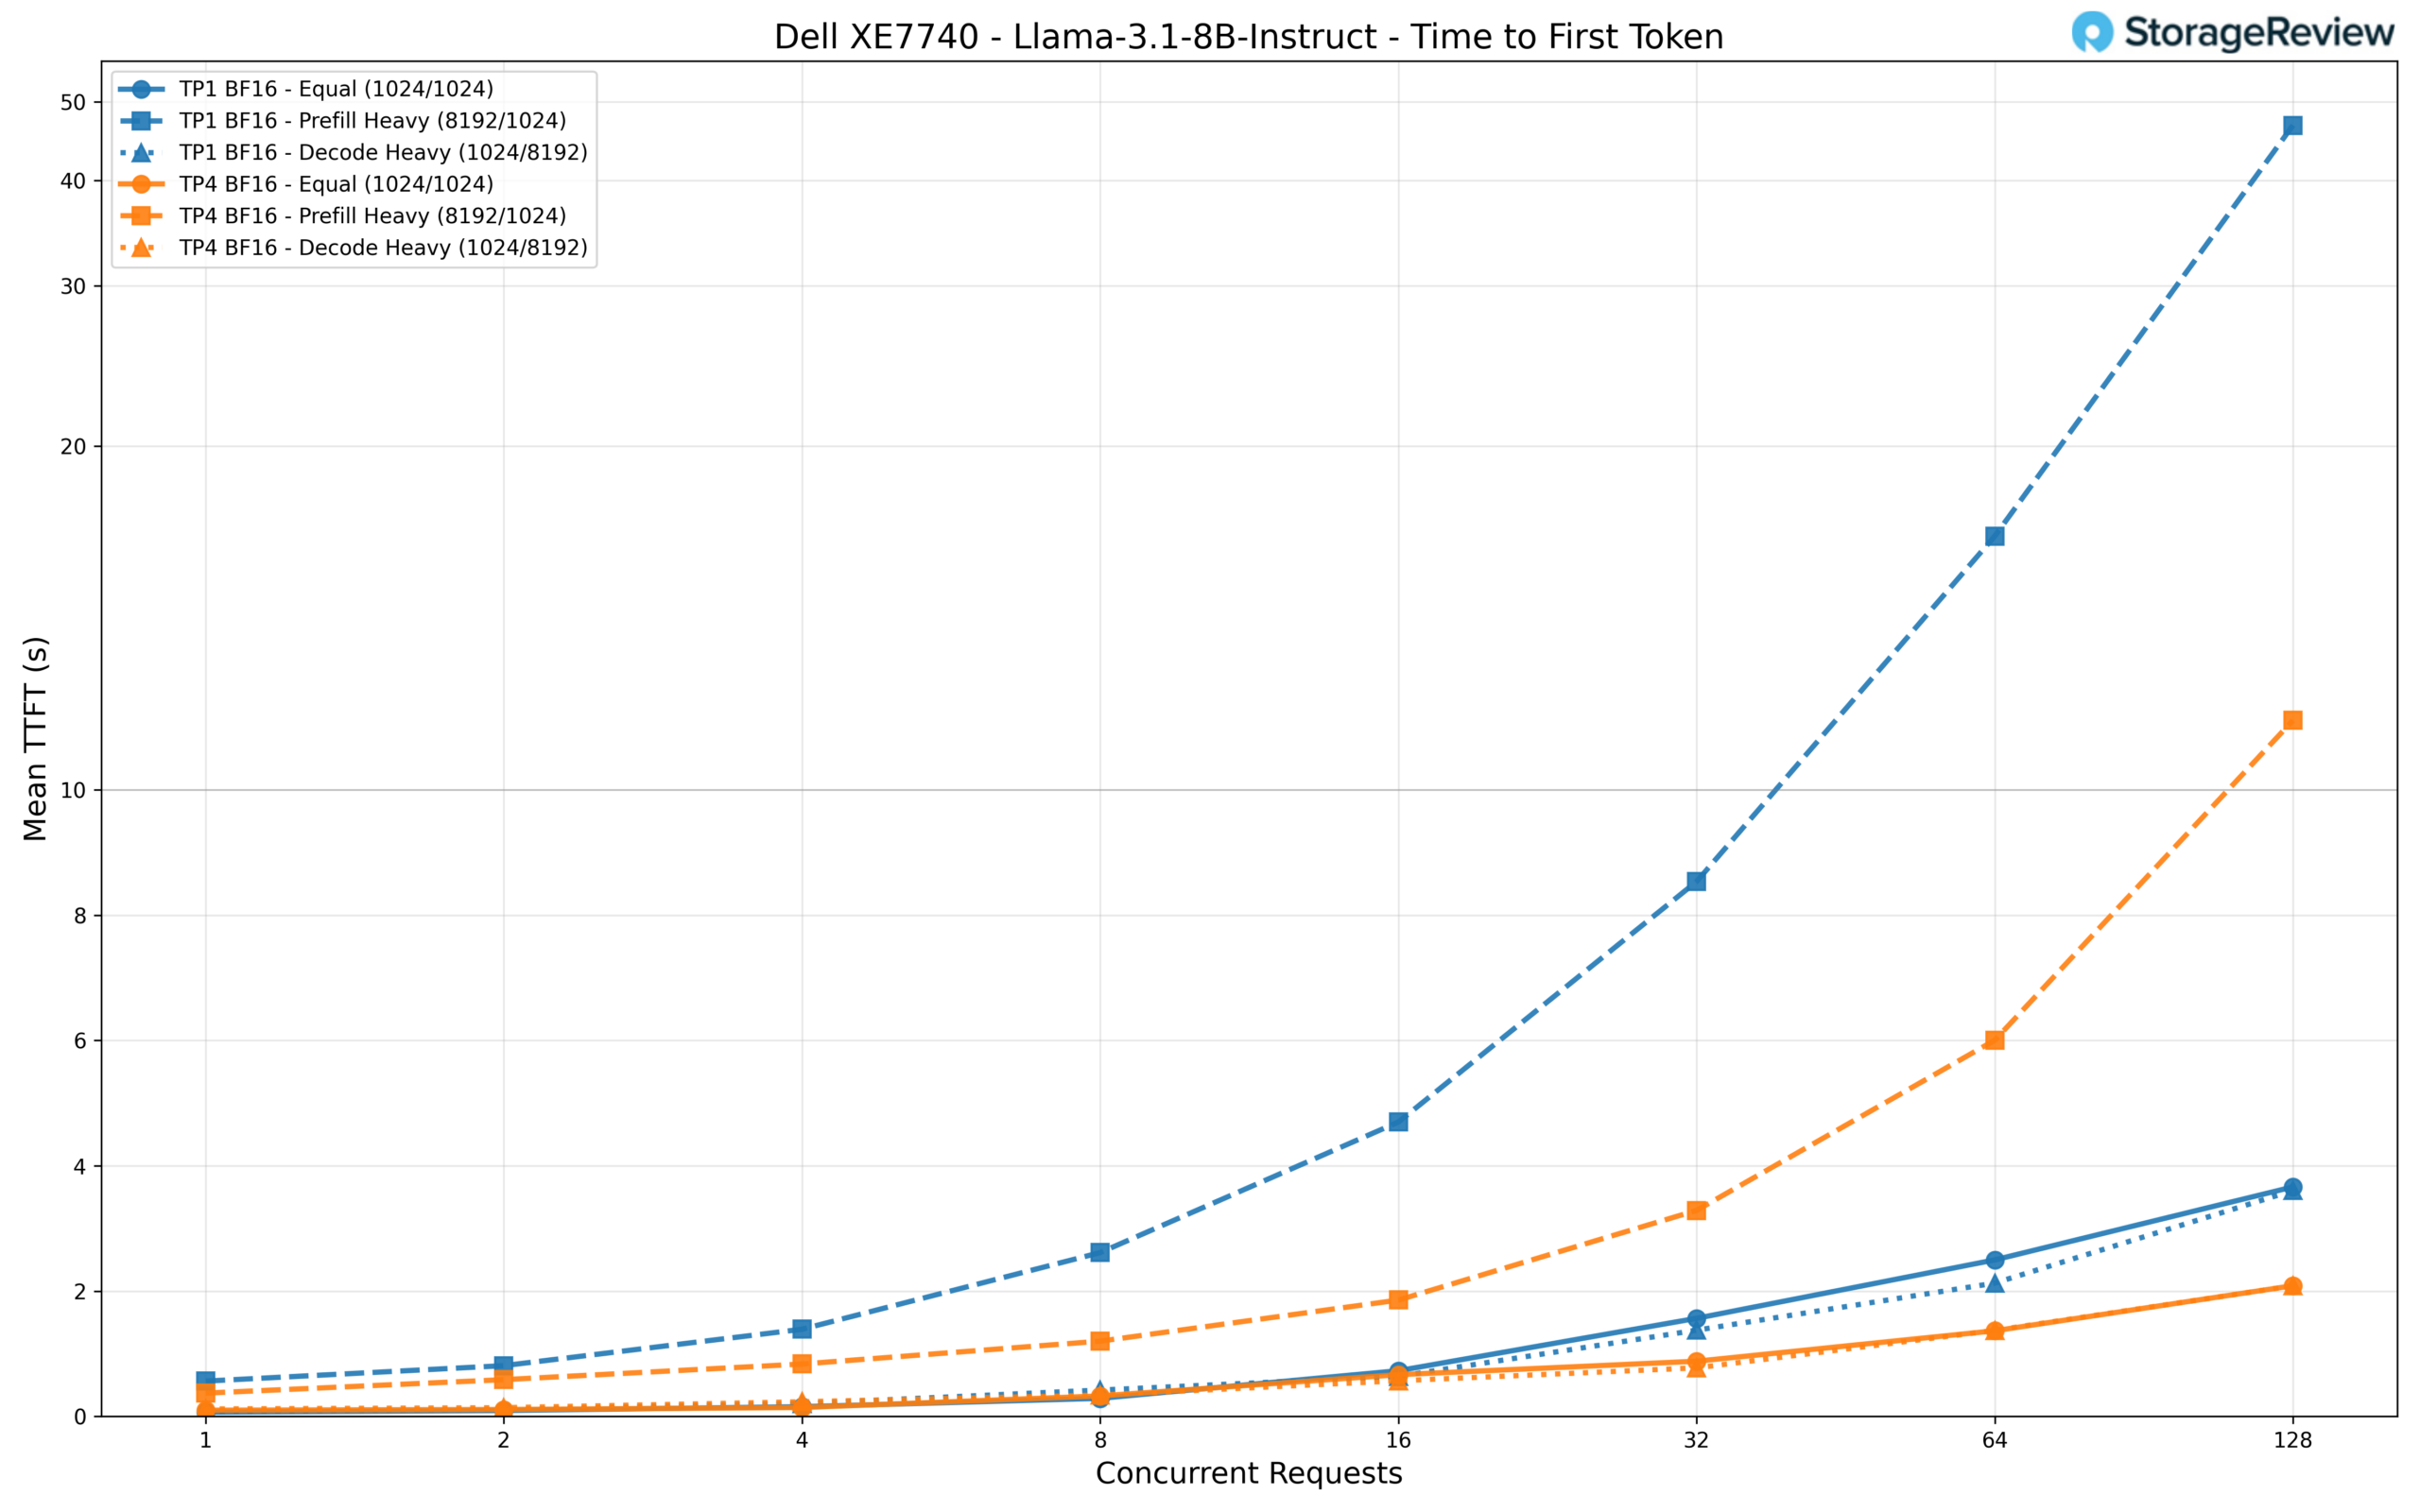
För latens för en enda användare levererar TP1 faktiskt lägre TTFT vid låg samtidighet (67 ms mot 98 ms för TP4), vilket återspeglar kostnaden för att koordinera över fyra acceleratorer för en modell som bekvämt passar på en. Allt eftersom belastningen ökar tar TP4 dock ledningen avsevärt. Vid 128 samtidiga förfrågningar håller TP4 TTFT till cirka 2 sekunder för lika och avkodade arbetsbelastningar, medan TP1 klättrar till 3.7 sekunder respektive 6.6 sekunder. Det är i scenariot med hög förfyllning som skillnaden blir mest dramatisk: TP1 når nästan 47 sekunder TTFT vid 128 förfrågningar, medan TP4 håller den till cirka 11 sekunder.
Llama 3.1 70B Instruktion
Llama 3.1 70B Instruct är den större, tätare modellen i Metas Llama 3.1-familj. Med 70B-parametrar levererar den betydligt bättre instruktioner och flerspråkighet än 8B-varianten. Modeller i denna skala är väl lämpade för mer intensiva agentarbetsbelastningar, såsom kundsupportagenter, forskningsassistenter i flera steg, komplex dokumentanalys och uppgifter som kräver att sammanhängande kontext bibehålls under längre interaktioner.
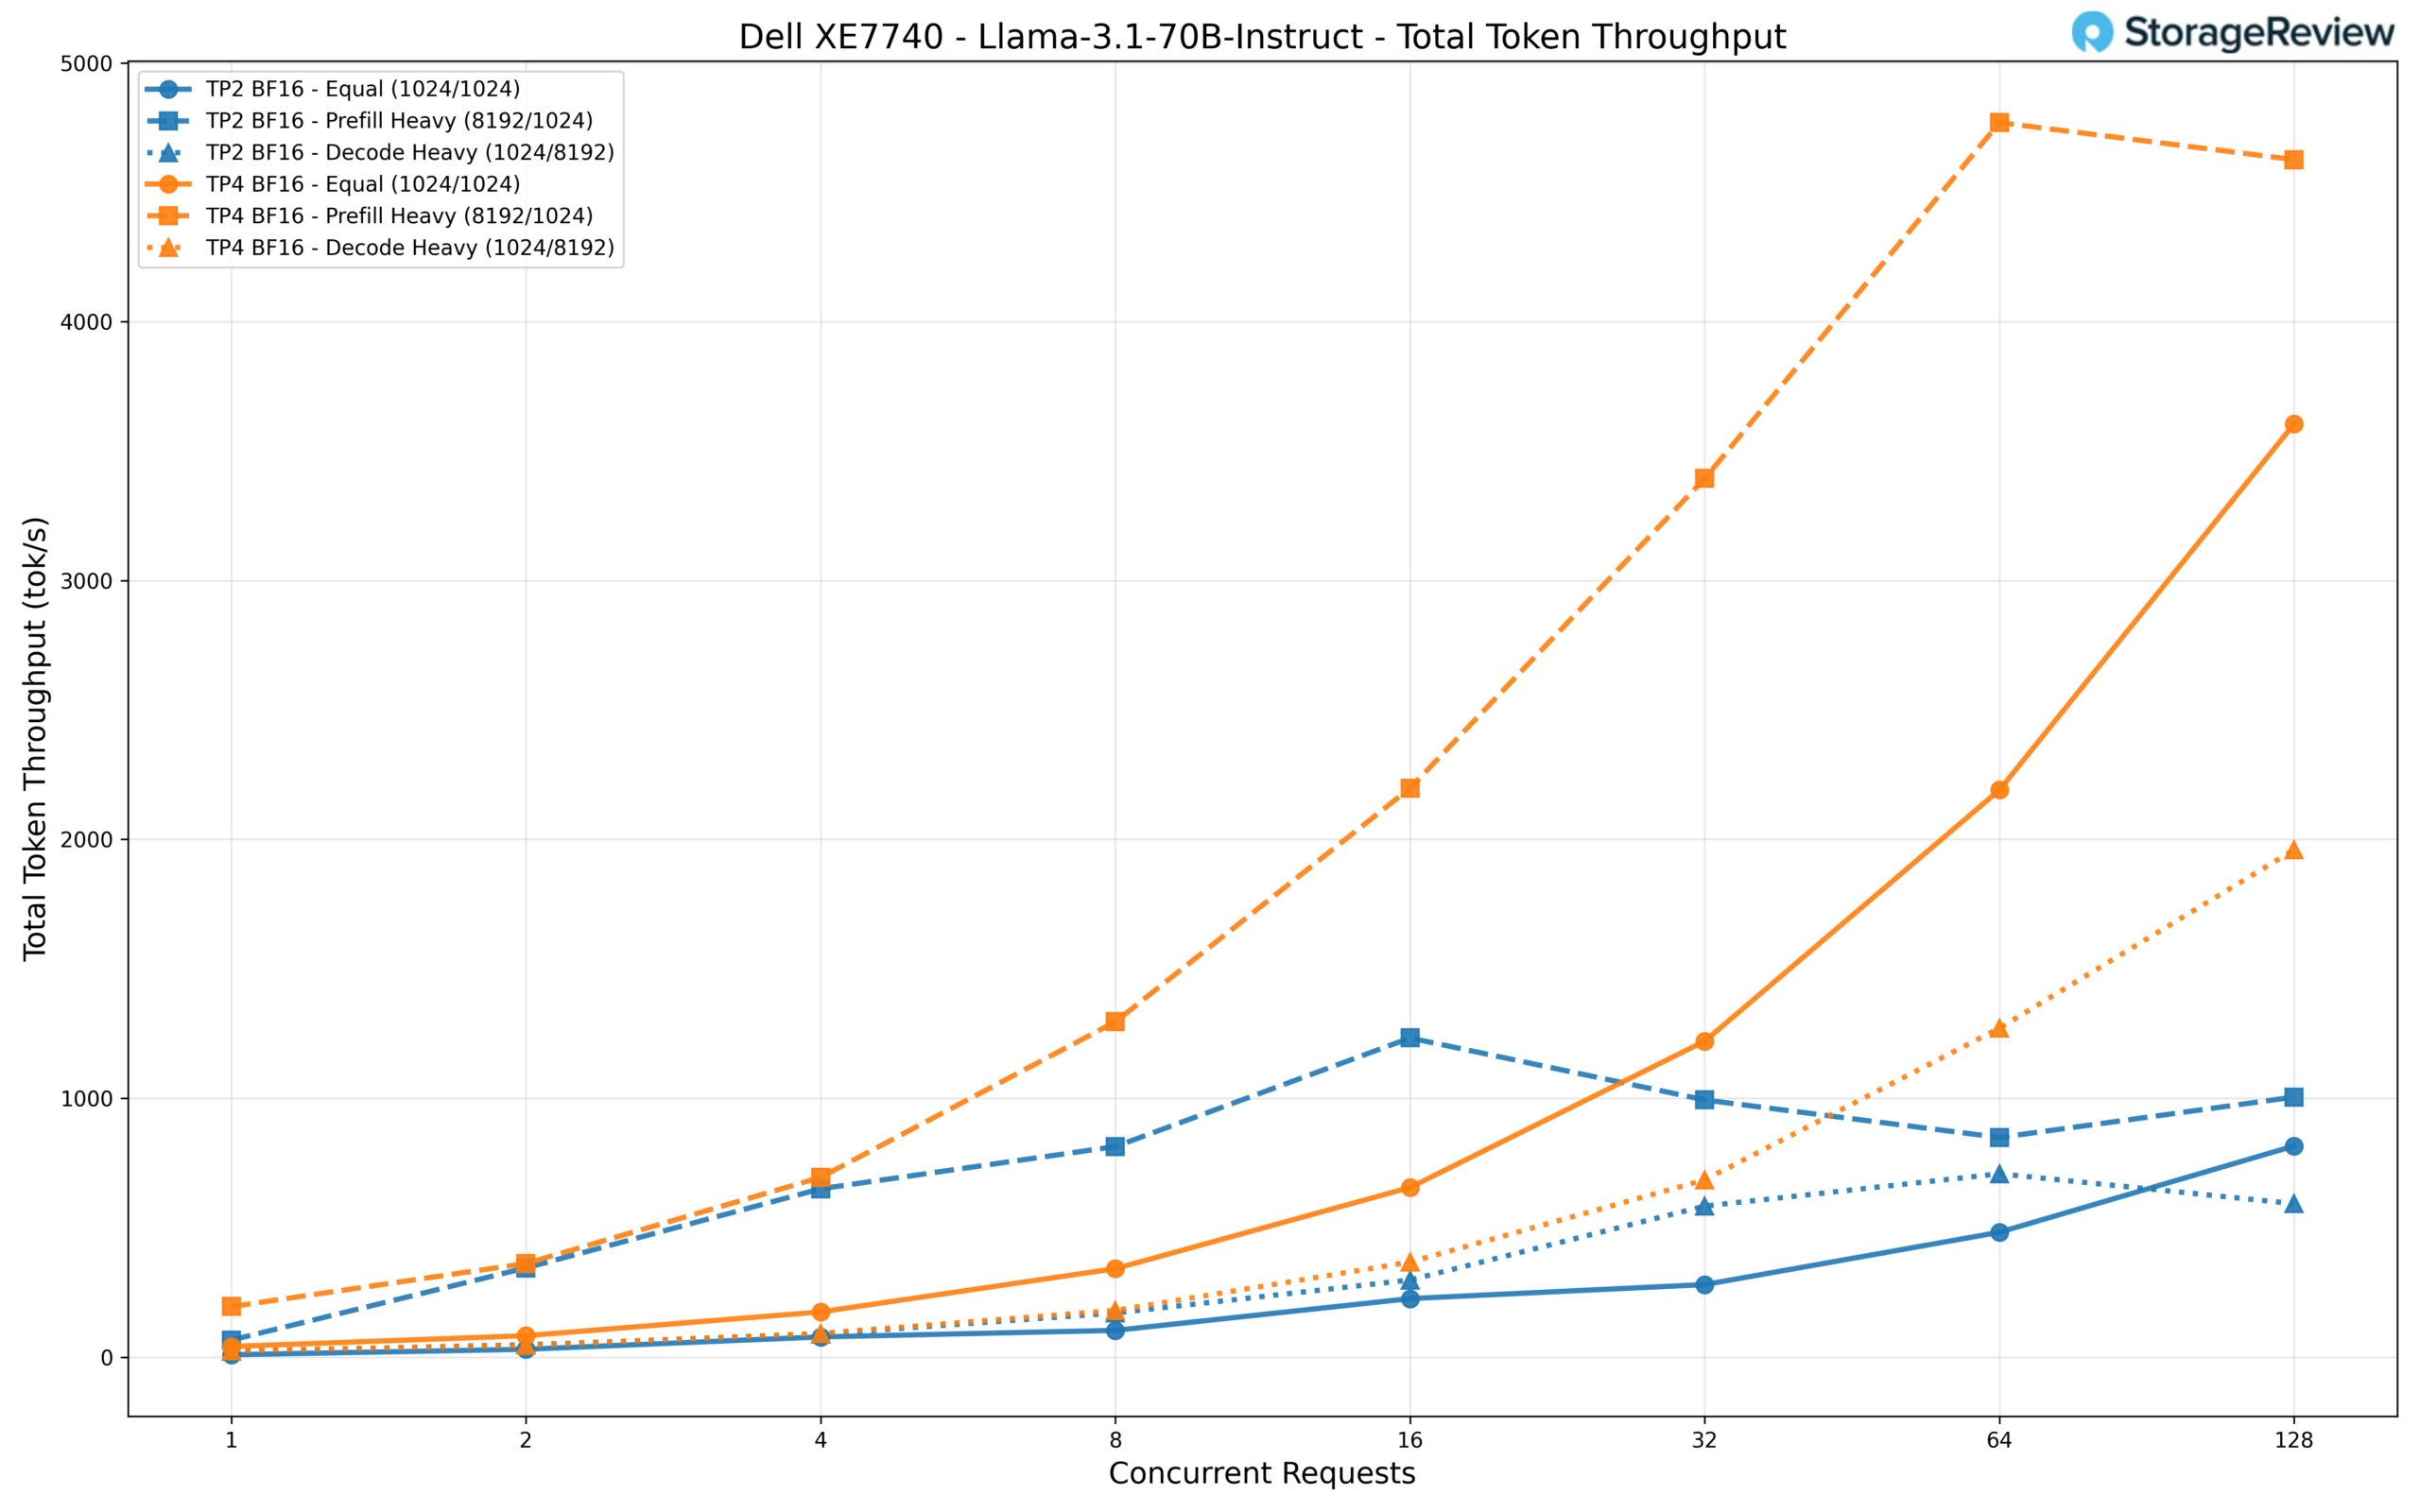
Vi testade den här modellen med TP2- och TP4-konfigurationer. Skillnaden i dataflöde mellan de två är betydande. Vid 128 samtidiga förfrågningar levererar TP4 ungefär 3 600 tok/s i samma arbetsbelastning och når en topp på nära 4 600 tok/s i scenariot med hög förfyllning. Detta är ungefär 4.4x respektive 4.6x dataflödet för TP2, som maximalt når cirka 816 tok/s respektive 1 005 tok/s. Även den avkodningstunga arbetsbelastningen når cirka 1 960 tok/s på TP4, jämfört med 593 tok/s på TP2.
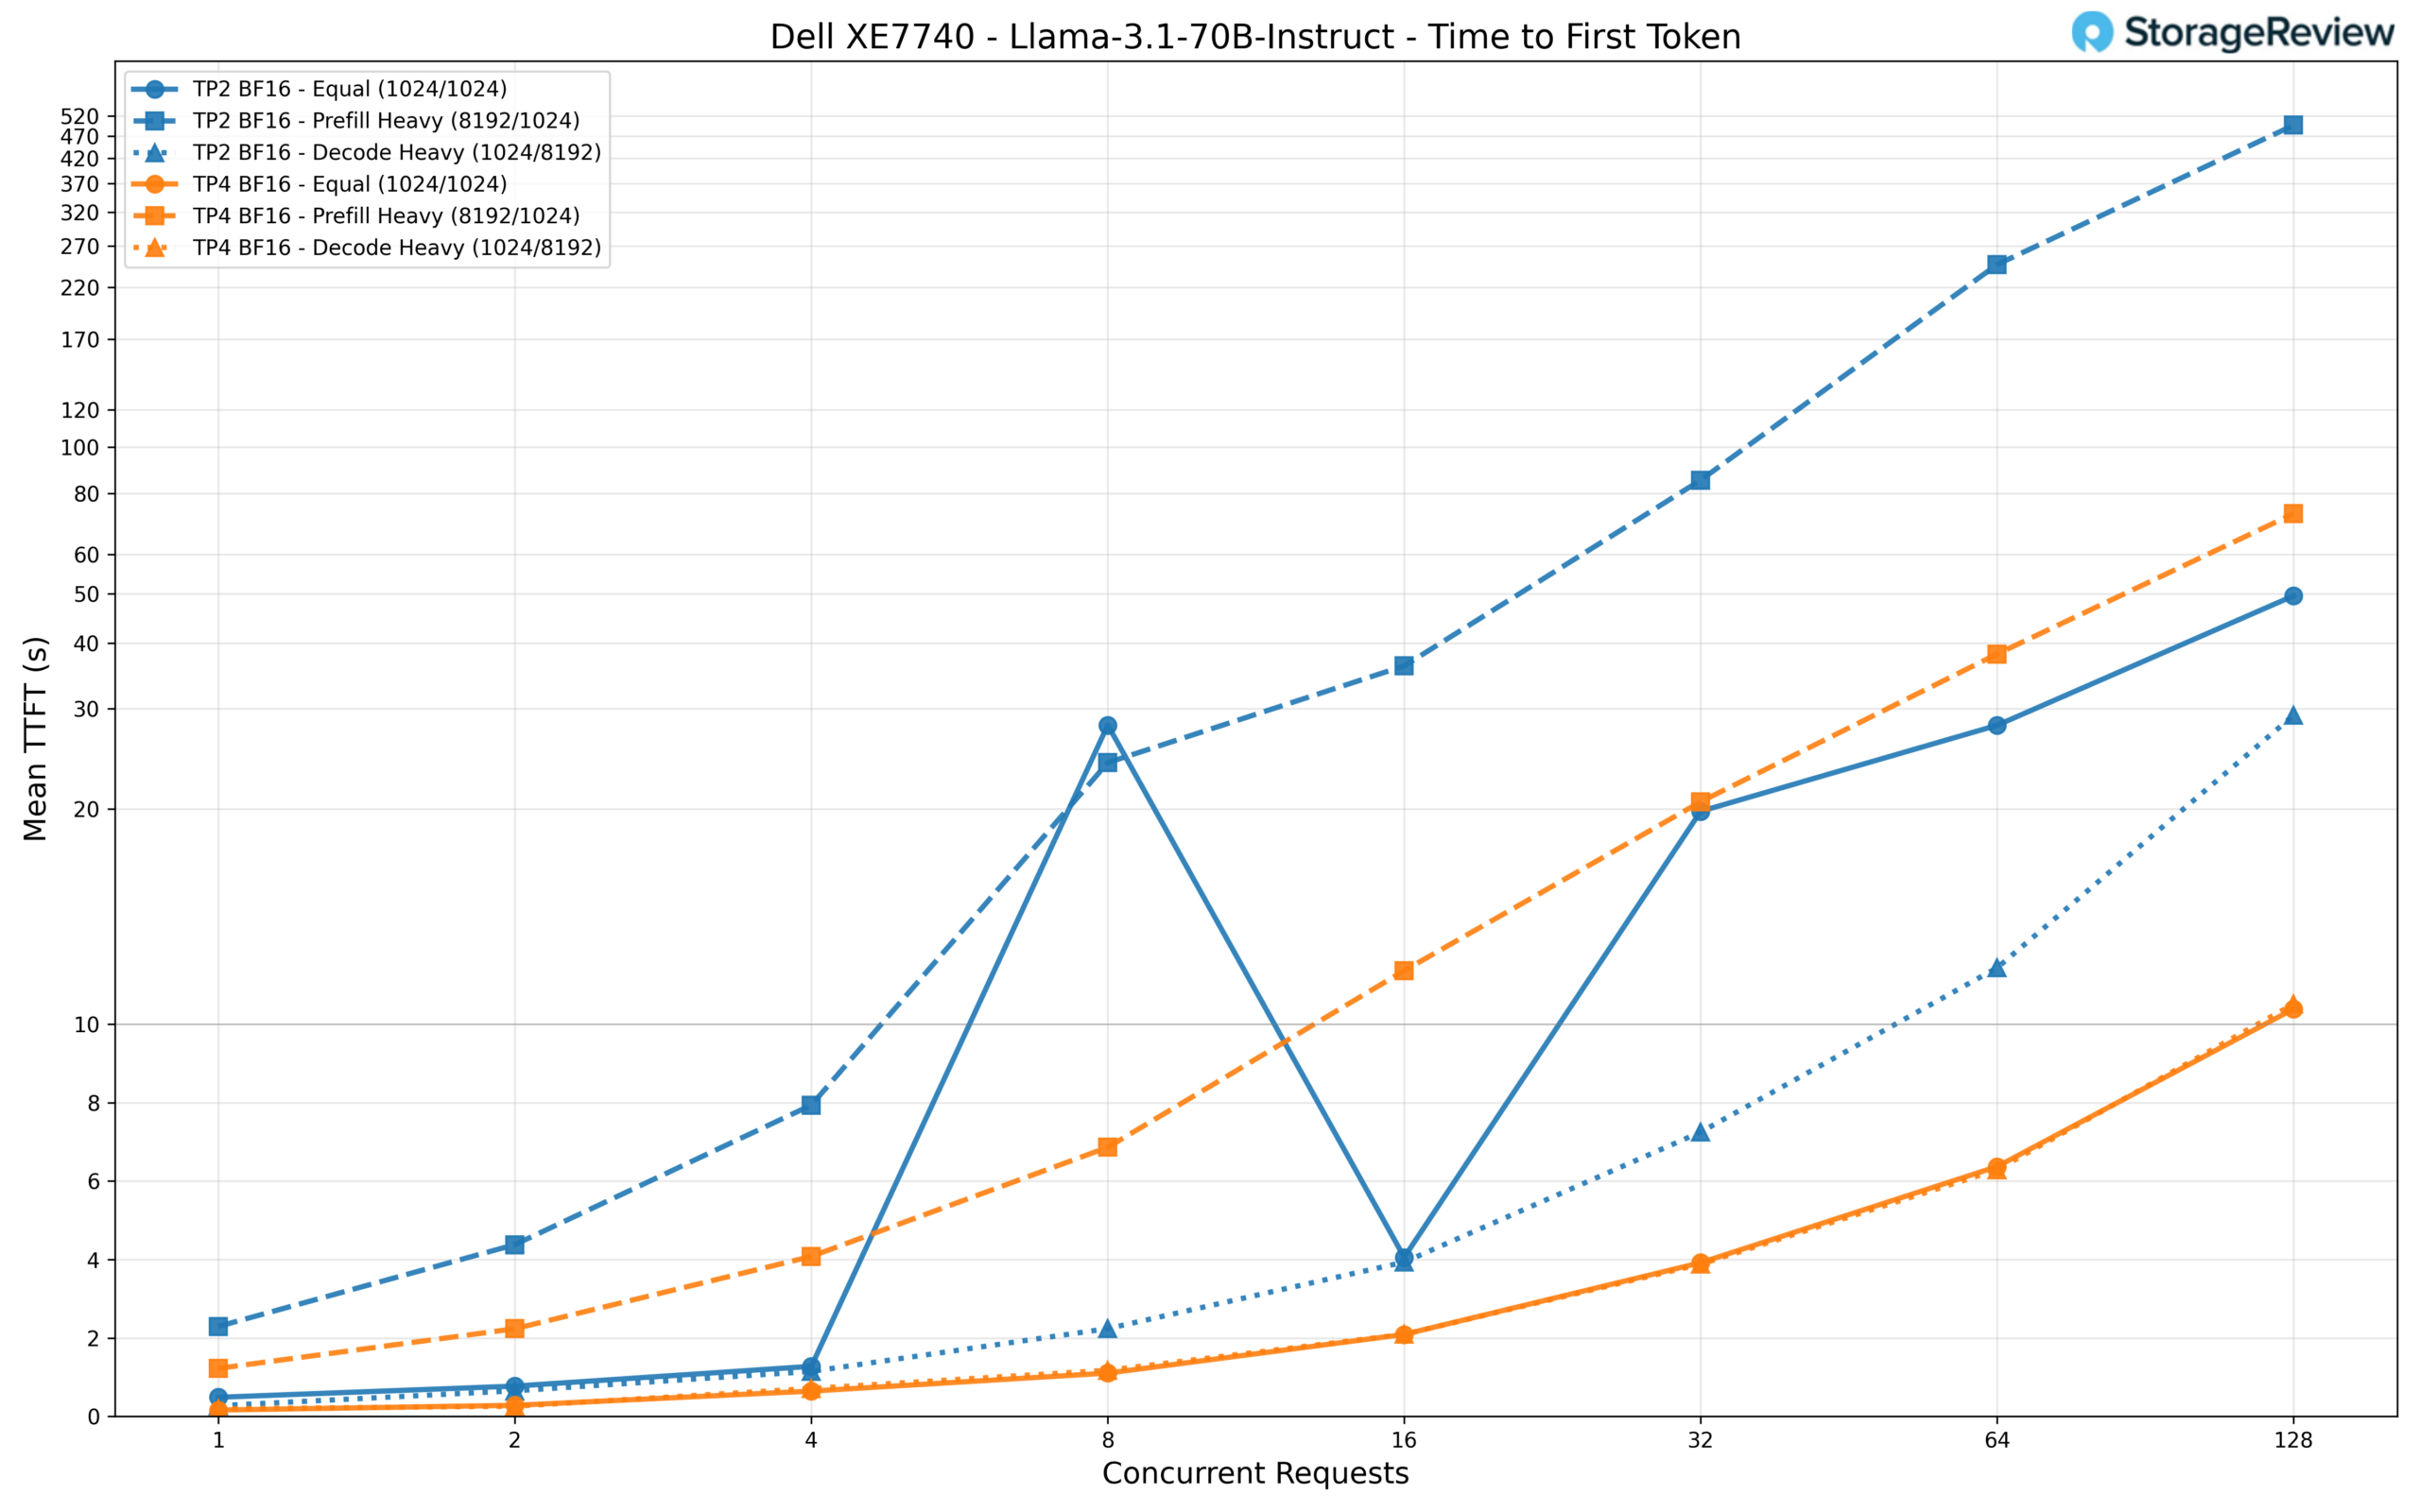
För TTFT kämpar TP2 under belastning med den förfyllningstunga arbetsbelastningen och klättrar till häpnadsväckande 496 sekunder vid 128 samtidiga förfrågningar, vilket gör den i princip oanvändbar för interaktiva applikationer. TP4 sänker detta till cirka 73 sekunder. För lika och avkodande arbetsbelastningar håller TP4 TTFT till ungefär 10 sekunder vid 128 förfrågningar, medan TP2 når 50 respektive 29 sekunder. Vid låg samtidighet levererar TP4 first-token-svar på cirka 160 ms för samma arbetsbelastning, jämfört med 486 ms på TP2.
Qwen3-kodare 30B-A3B Instruktion
Qwen3 Coder 30B-A3B är en av de mest populära kodningsmodellerna för lokala inferensdistributioner och använder en Mixture-of-Experts (MoE)-arkitektur. Till skillnad från täta modeller, där varje parameter deltar i varje framåtriktad pass, dirigerar MoE-modeller varje token genom en liten delmängd av specialiserade expertnätverk. Qwen3 Coder bibehåller en full modellstorlek på 30B parametrar med BF16-precision samtidigt som den endast aktiverar 3B parametrar per genererad token. Detta glesa aktiveringsmönster innebär att modellen kan leverera kvaliteten hos ett mycket större nätverk samtidigt som den bara kräver en bråkdel av beräkningskostnaden per token, vilket gör den extremt effektiv på hårdvara som stöder routing-overhead. För slutanvändare är denna modell väl lämpad för vardaglig kodningshjälp, såsom att generera standardbeskrivningar, slutföra funktioner, förklara kod, skriva enhetstester och hantera rutinmässiga utvecklingsuppgifter som drar nytta av en kodspecialiserad modell utan att kräva tungt resonemang.
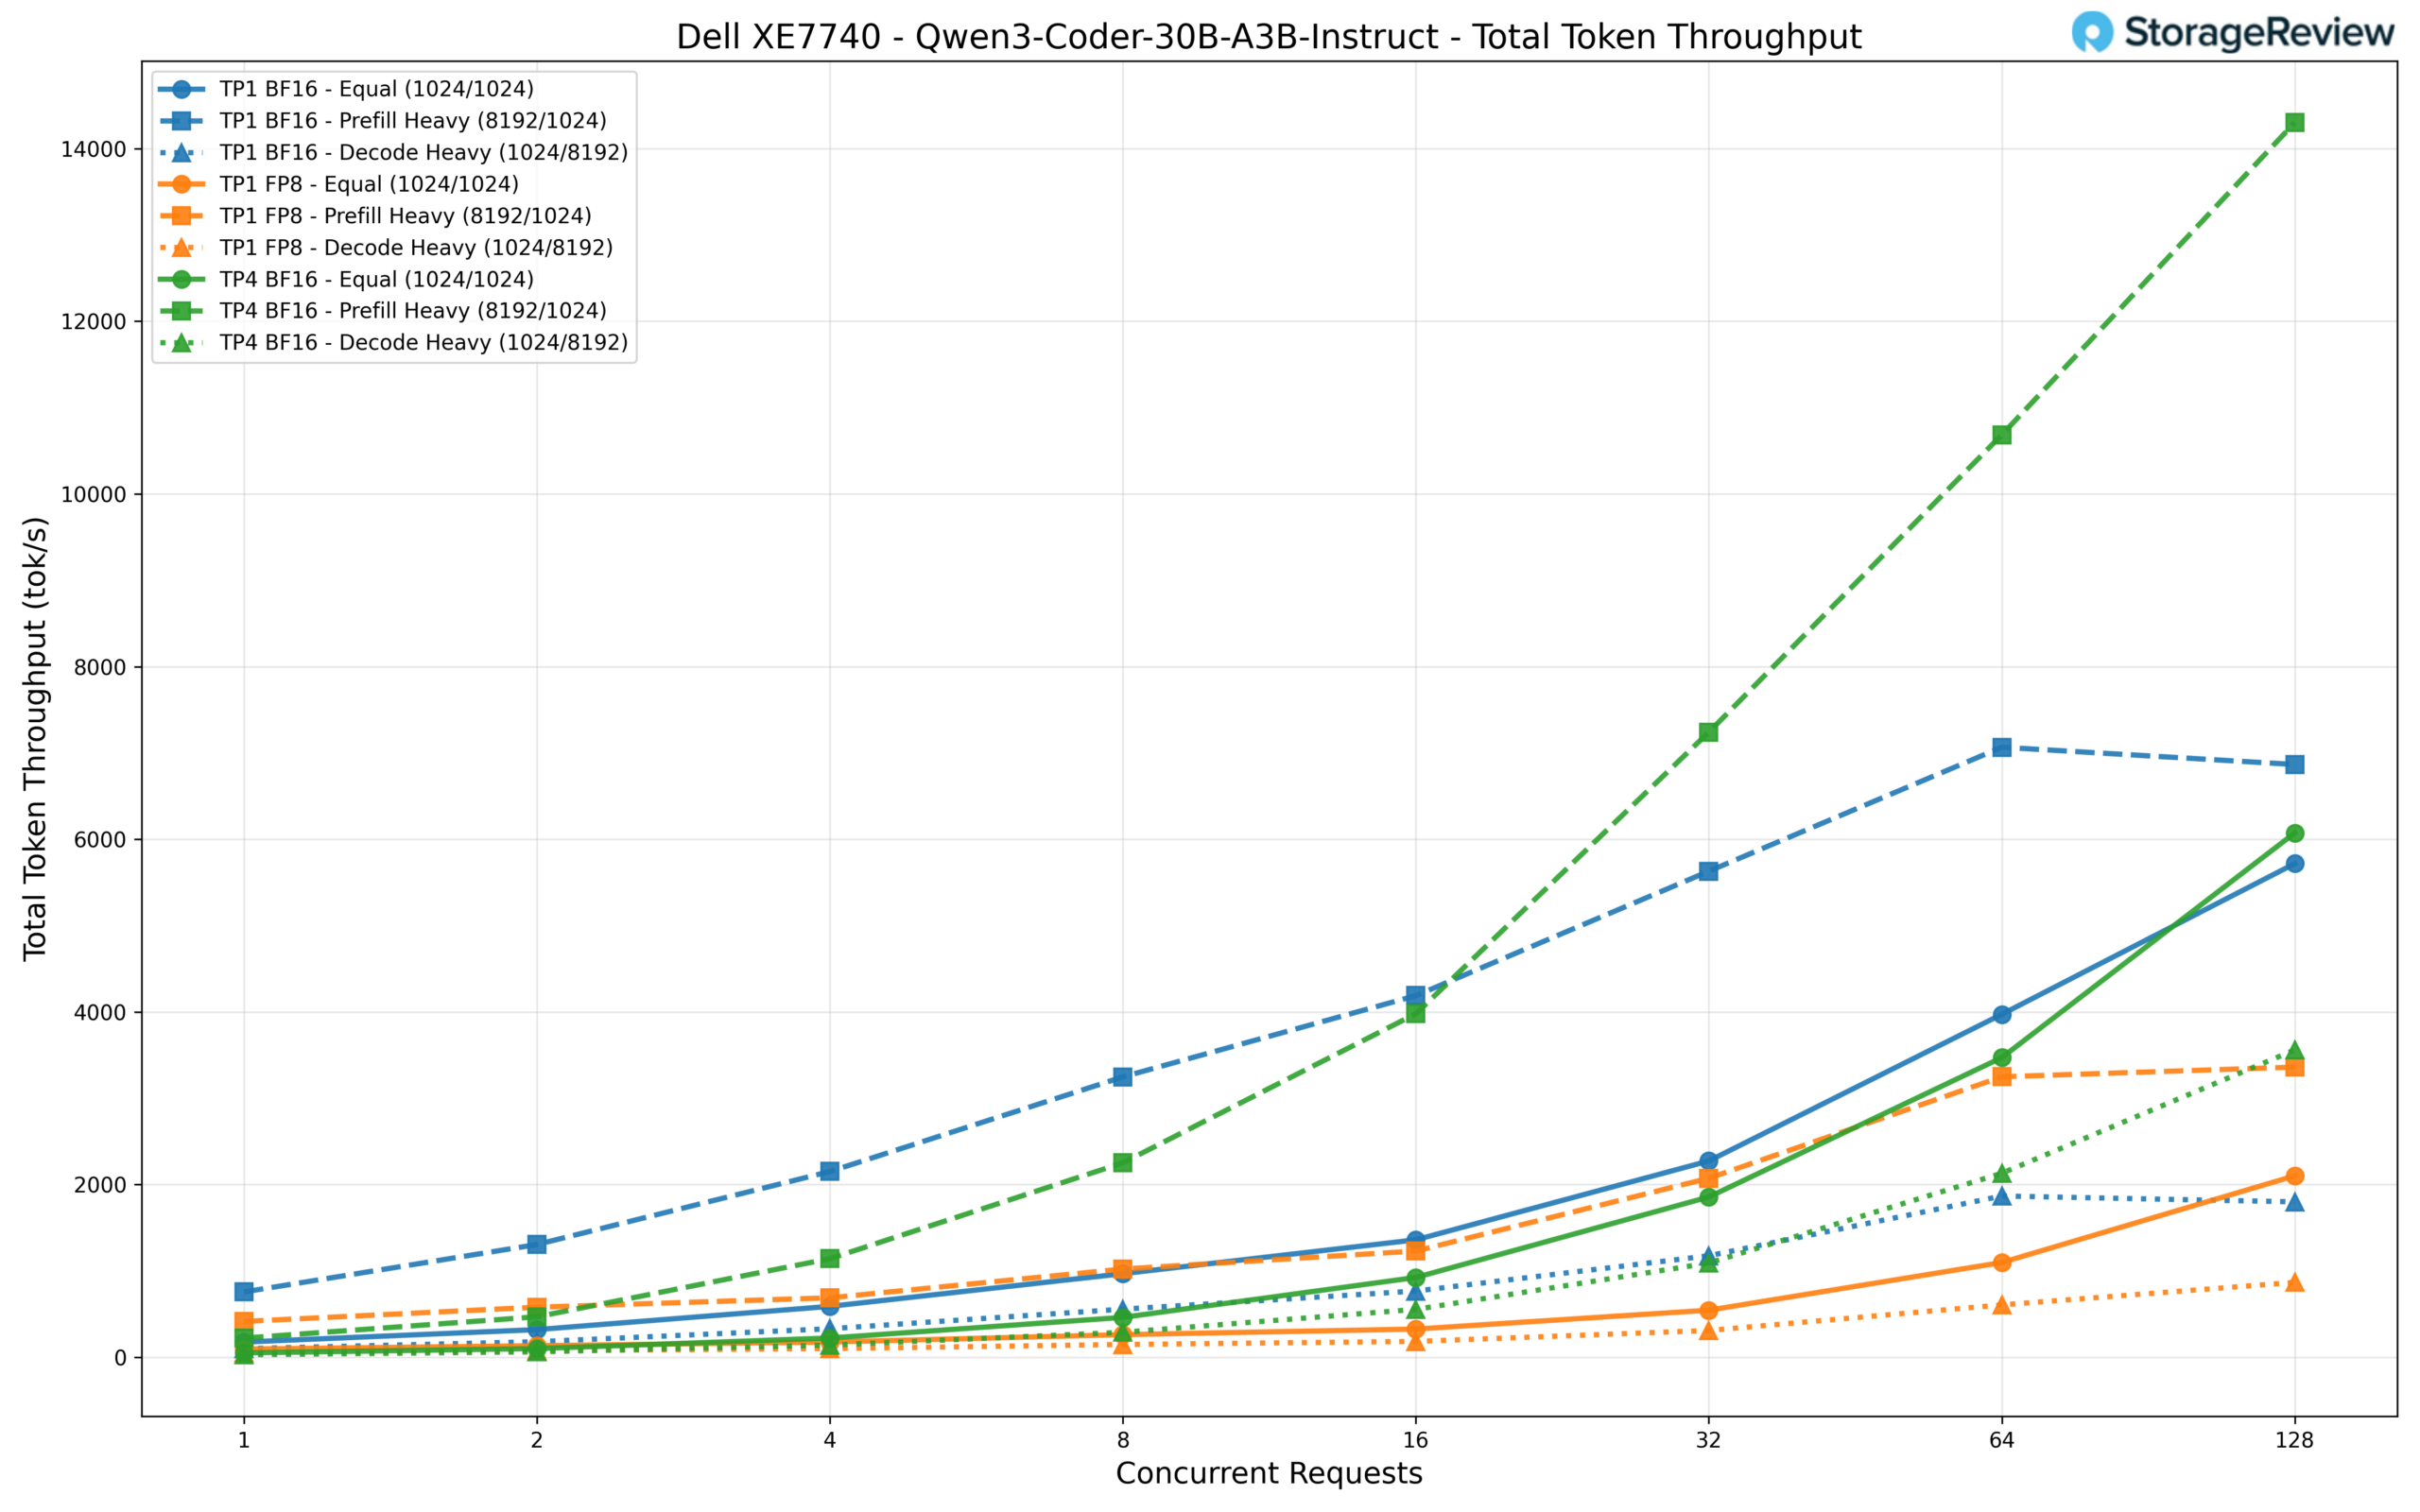
Vi testade tre konfigurationer: TP1 BF16, TP1 FP8 och TP4 BF16. Vid 128 samtidiga förfrågningar leder TP4 BF16 med ungefär 14 300 tok/s i scenariot med hög förfyllningshastighet, den högsta dataflödessiffran vi registrerade för någon modell i vår testsvit. TP1 BF16 följer med cirka 6 900 tok/s i samma scenario, medan TP1 FP8 ligger efter med cirka 3 360 tok/s. I samma arbetsbelastning minskar gapet något med TP4 på 6 073 tok/s, TP1 BF16 på 5 718 tok/s och TP1 FP8 på 2 101 tok/s. Som diskuterats i FP8-noten ovan återspeglar de lägre FP8-siffrorna här det nuvarande tillståndet för Intels vLLM-gaffel snarare än en hårdvaruflaskhals.
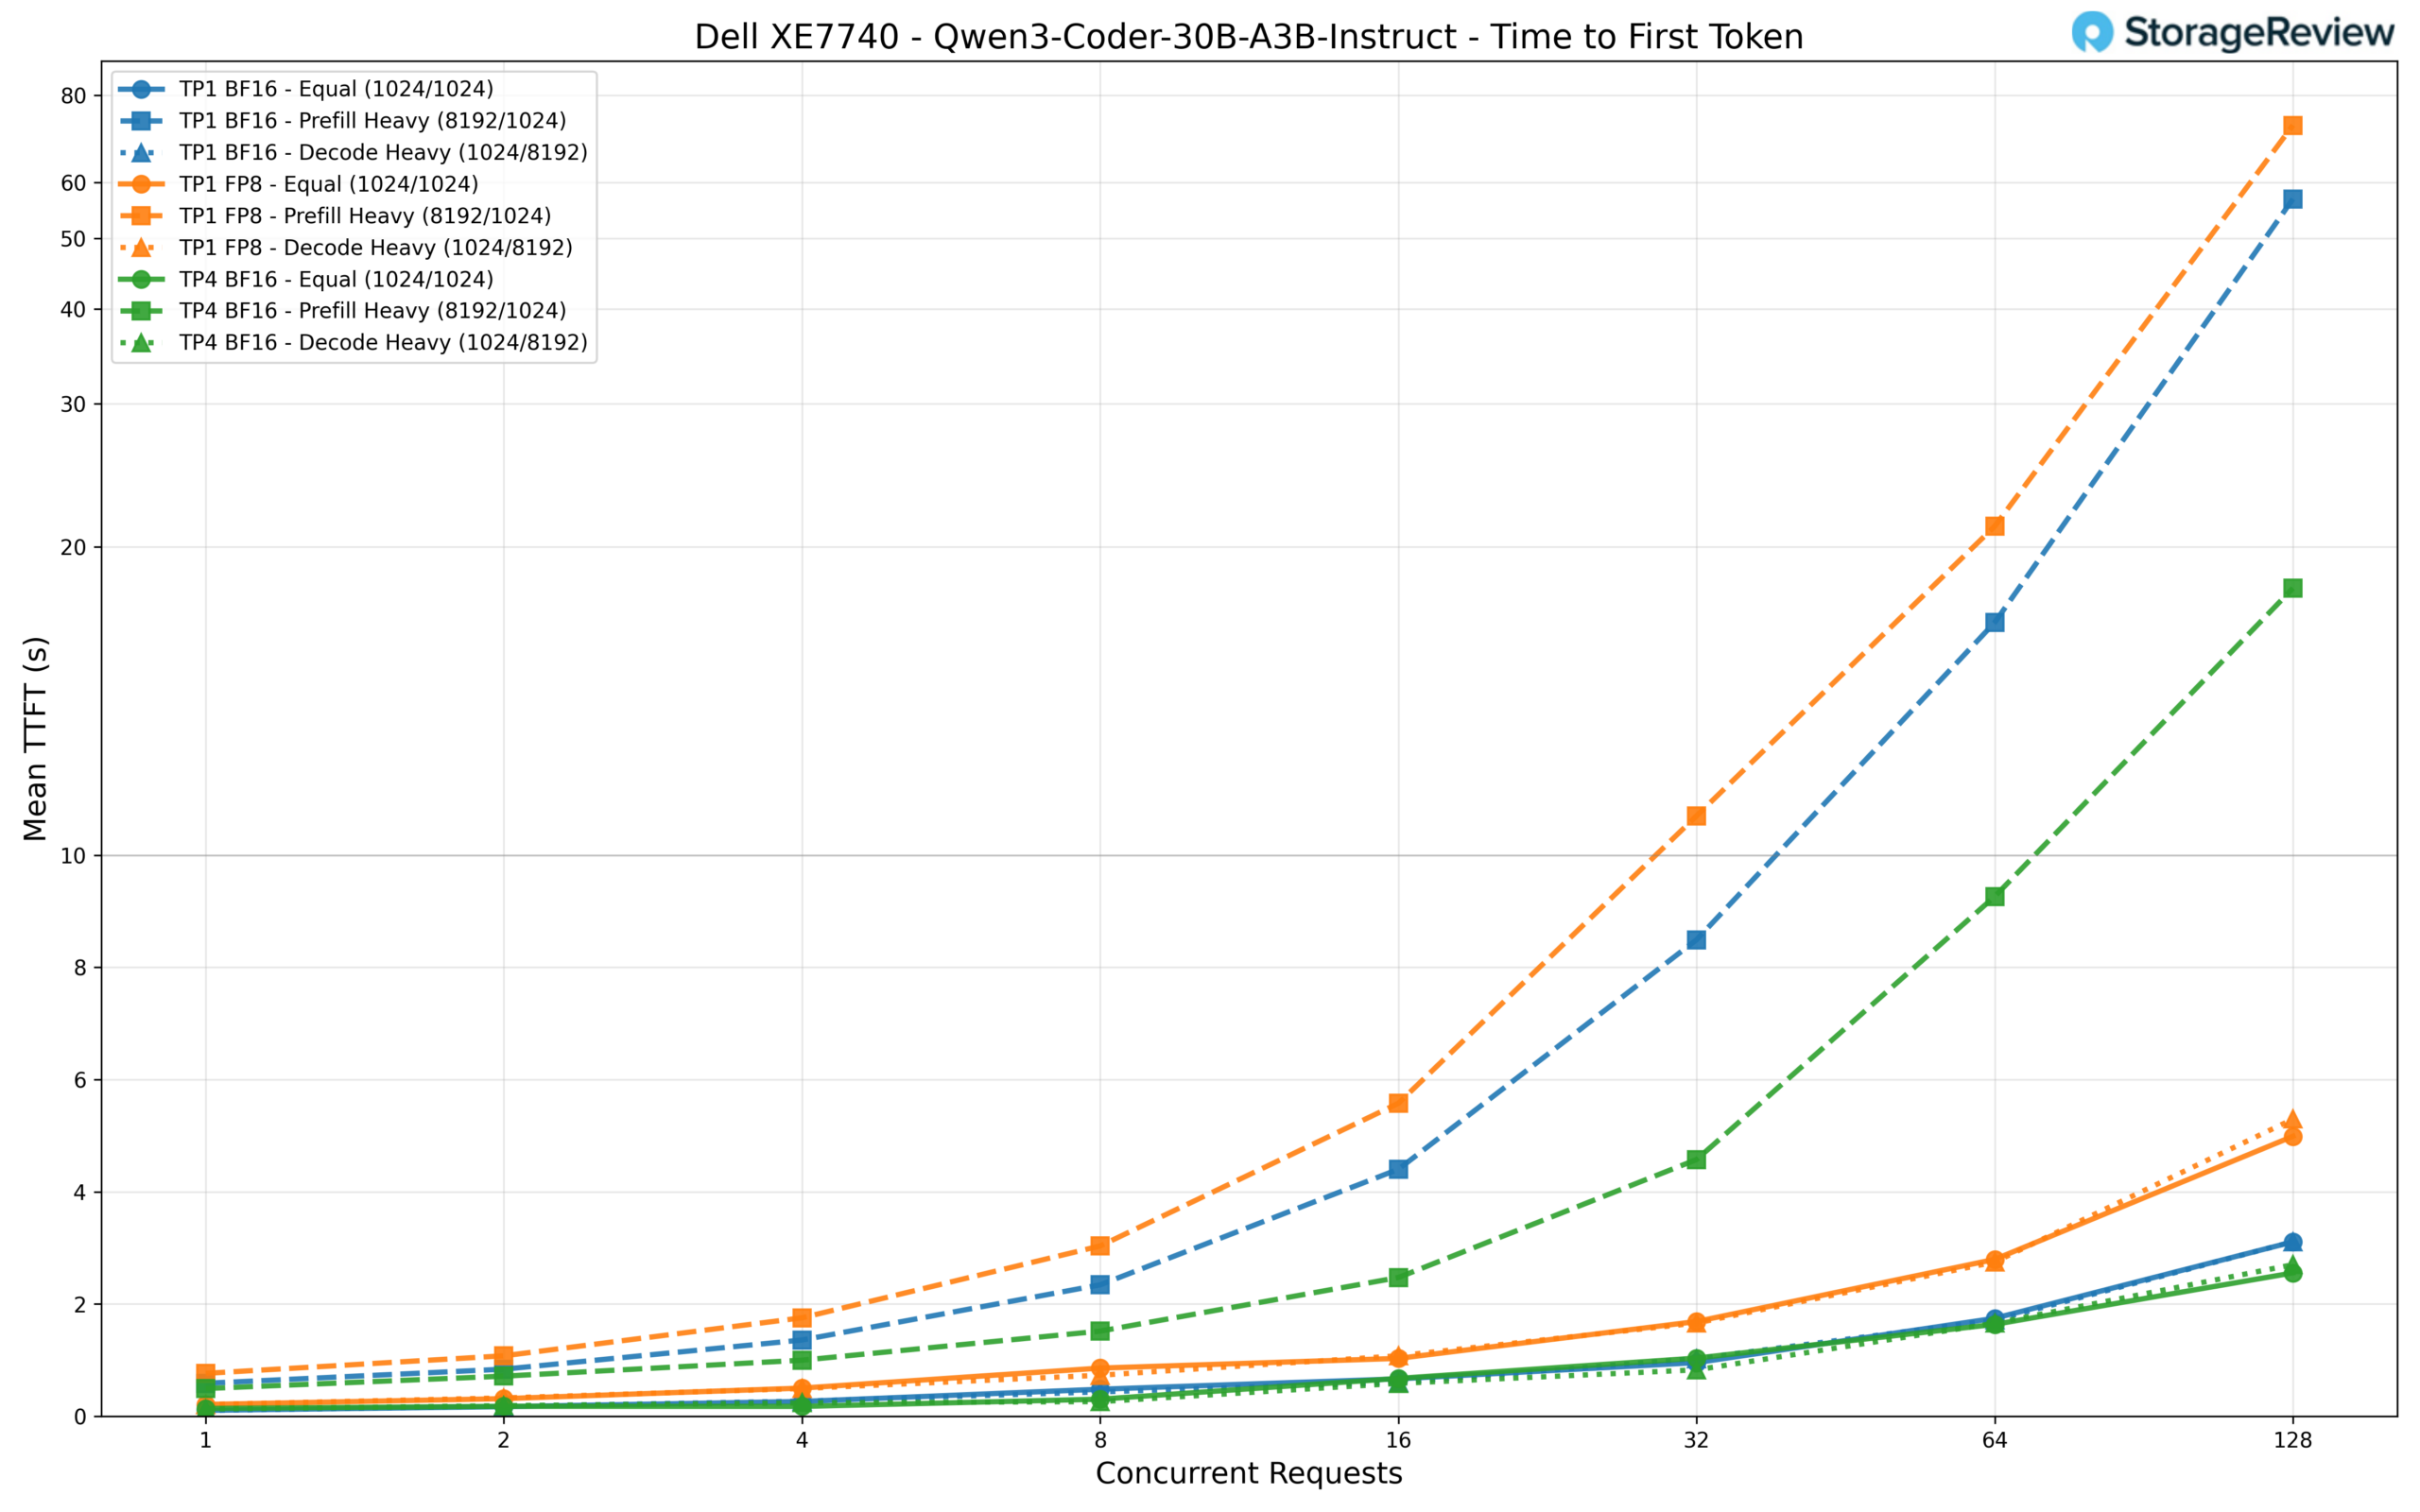
TTFT förblir låg tack vare det sparsamma aktiveringsmönstret. TP4 BF16 levererar en first-token latens på cirka 140 ms vid enanvändarbelastning och håller sig till ungefär 2.6 sekunder vid 128 samtidiga förfrågningar i samma arbetsbelastning. TP1 BF16 är jämförbar vid låg samtidighet (106 ms) men klättrar till 3.1 sekunder under full belastning. Scenariot med hög förfyllning skiljer återigen tydligt konfigurationerna åt: TP4 når cirka 18 sekunder vid 128 förfrågningar, TP1 BF16 når 57 sekunder och TP1 FP8 förlängs till 72 sekunder.
Qwen3 235B-A22B Tänkande
Den största modellen i vår benchmarksvit, Qwen3 235B-A22B Thinking, är en massiv MoE-resonemangsmodell med totalt 235 miljarder parametrar och 22 miljarder aktiva parametrar per token. Utöver sin stora skala inkluderar denna modell inbyggda funktioner för tankekedjan, vilket gör att den kan bryta ner komplexa problem steg för steg innan den kommer fram till ett svar på bekostnad av fler avkodningstokens. Detta gör den särskilt väl lämpad för de mest utmanande uppgifterna: avancerad kodgenerering och felsökning, matematisk problemlösning, flerstegslogiskt resonemang och komplexa, agentiska arbetsflöden där noggrannhet är viktigare än råhastighet. Denna modell kräver TP4 för att köras, och vi testade den med både BF16- och FP8-precision.
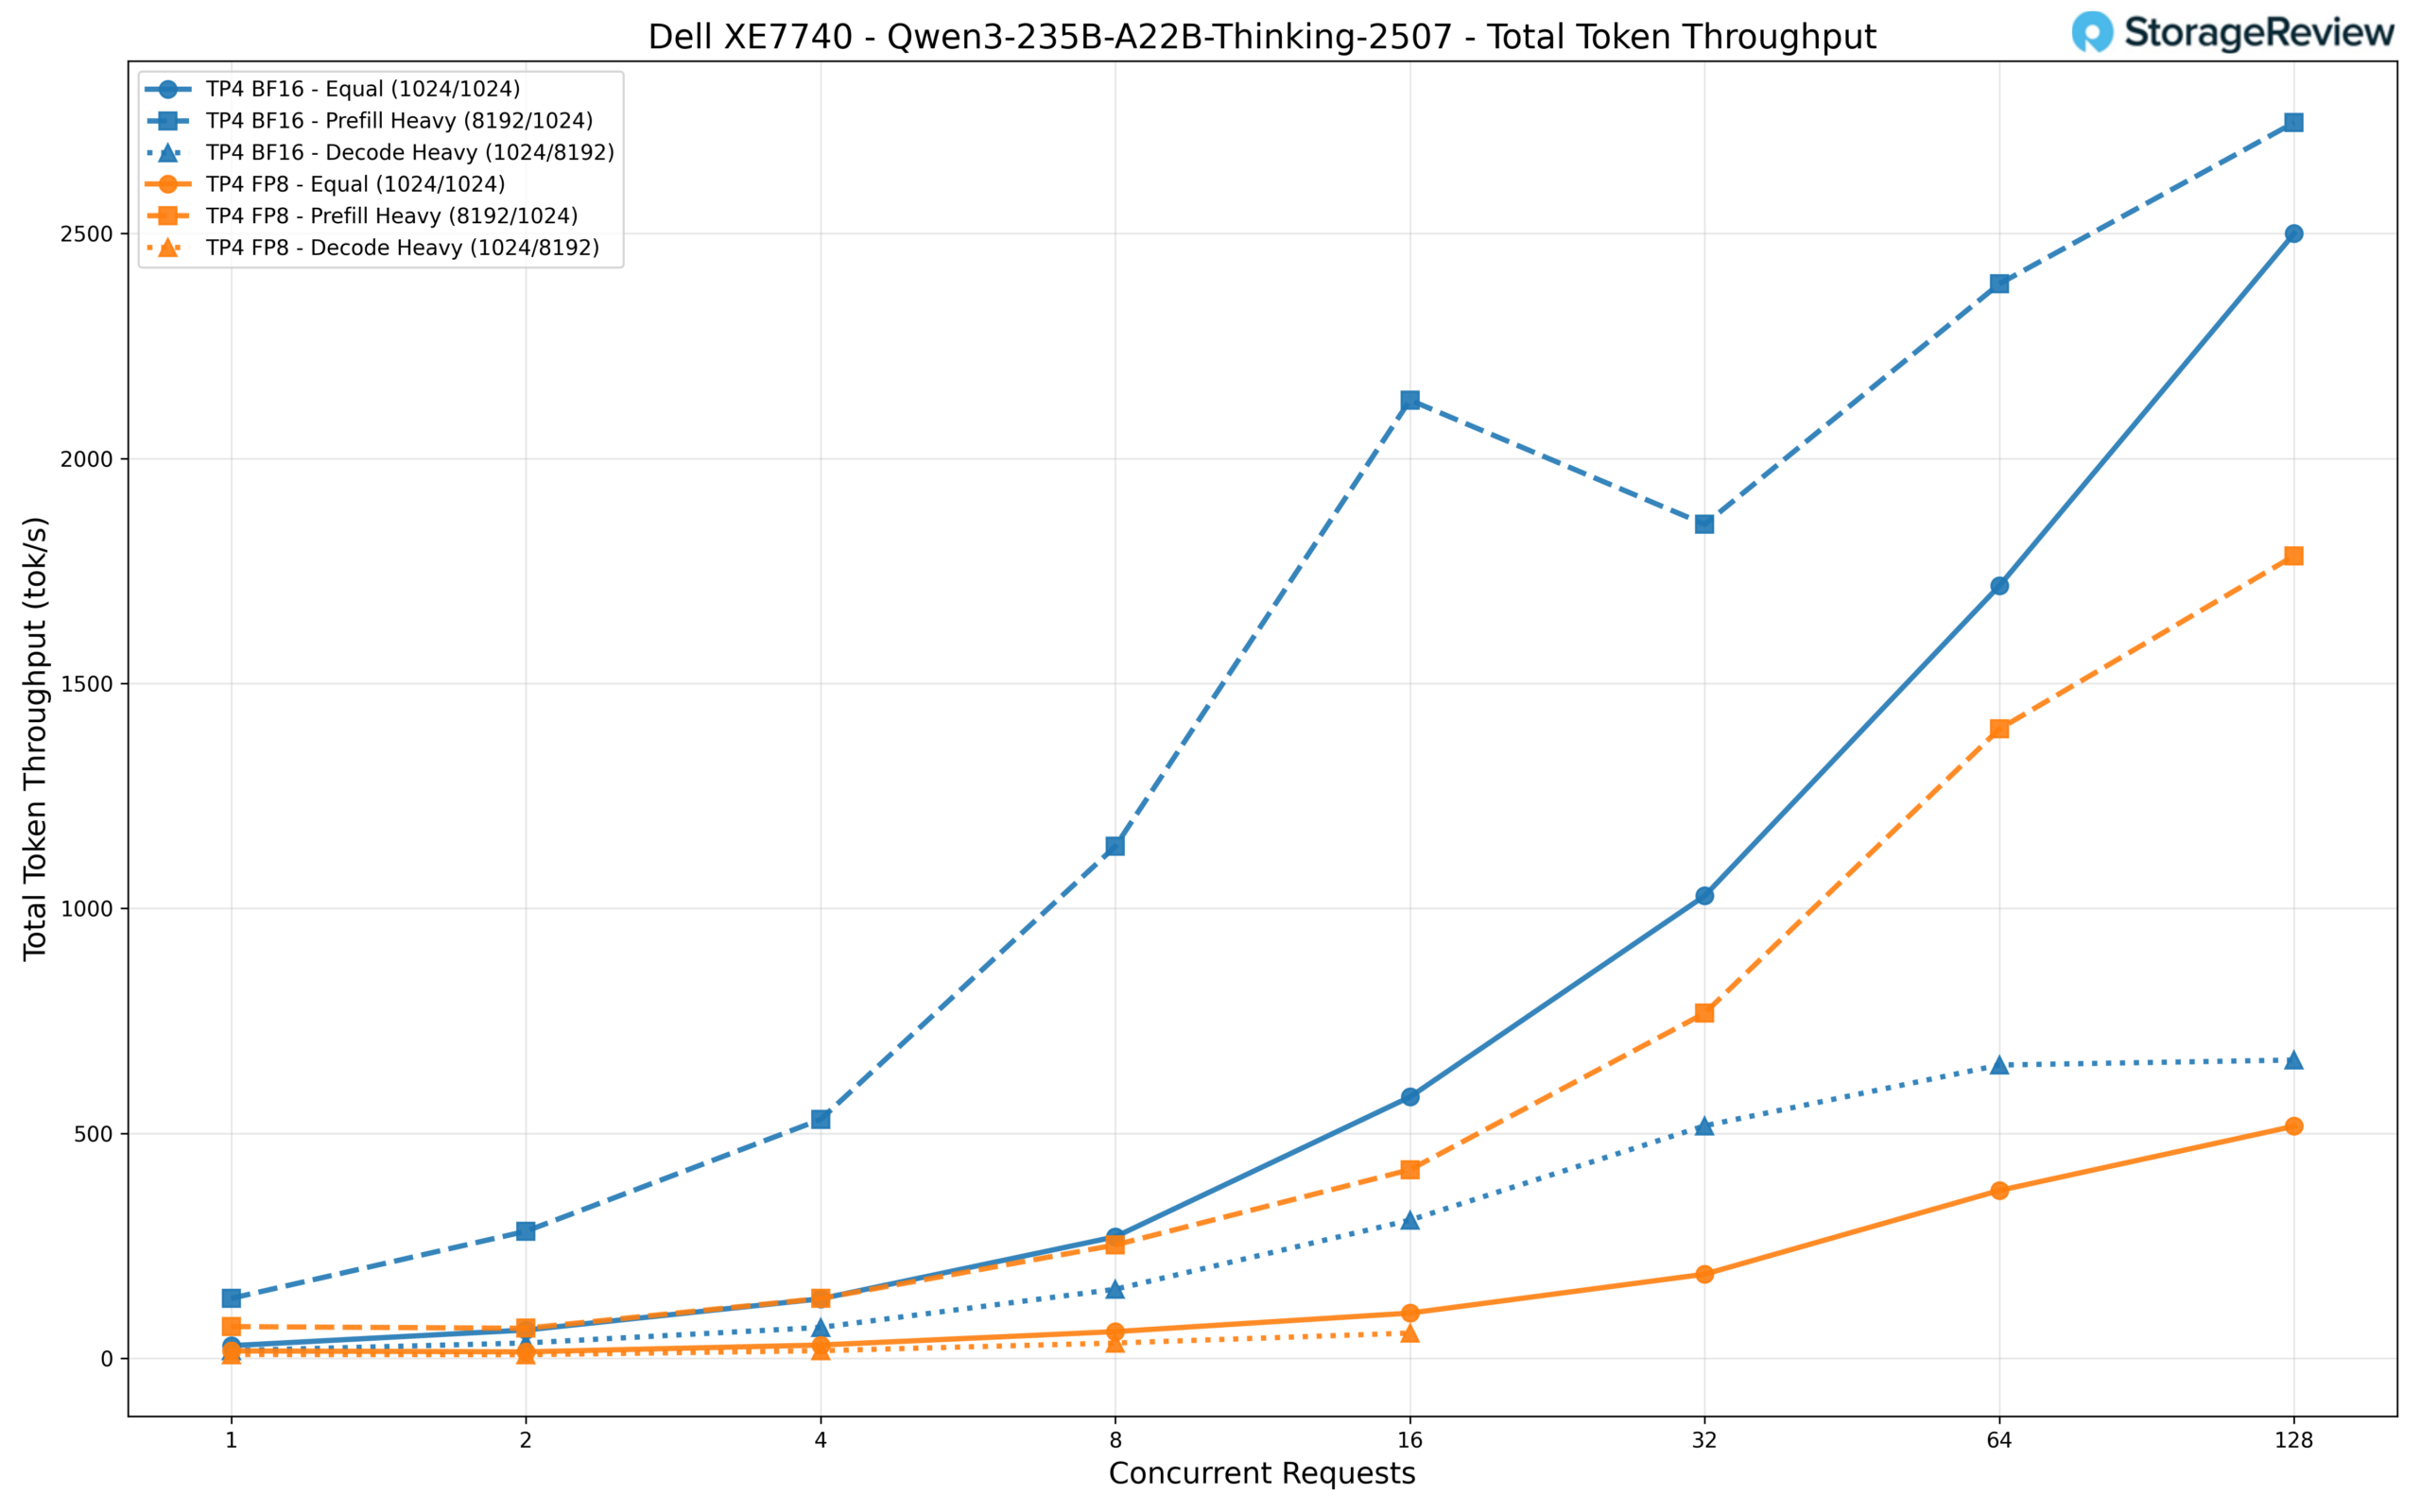
BF16 överträffar FP8 klart överlag. Vid 128 samtidiga förfrågningar når BF16 cirka 2 750 tok/s i den förfyllningstunga arbetsbelastningen och 2 500 tok/s i den lika stora arbetsbelastningen, medan FP8 hanterar cirka 1 784 tok/s respektive 516 tok/s. FP8-varianten upplevde också timeouts i det avkodningstunga scenariot vid högre samtidighetsnivåer (32+ förfrågningar).
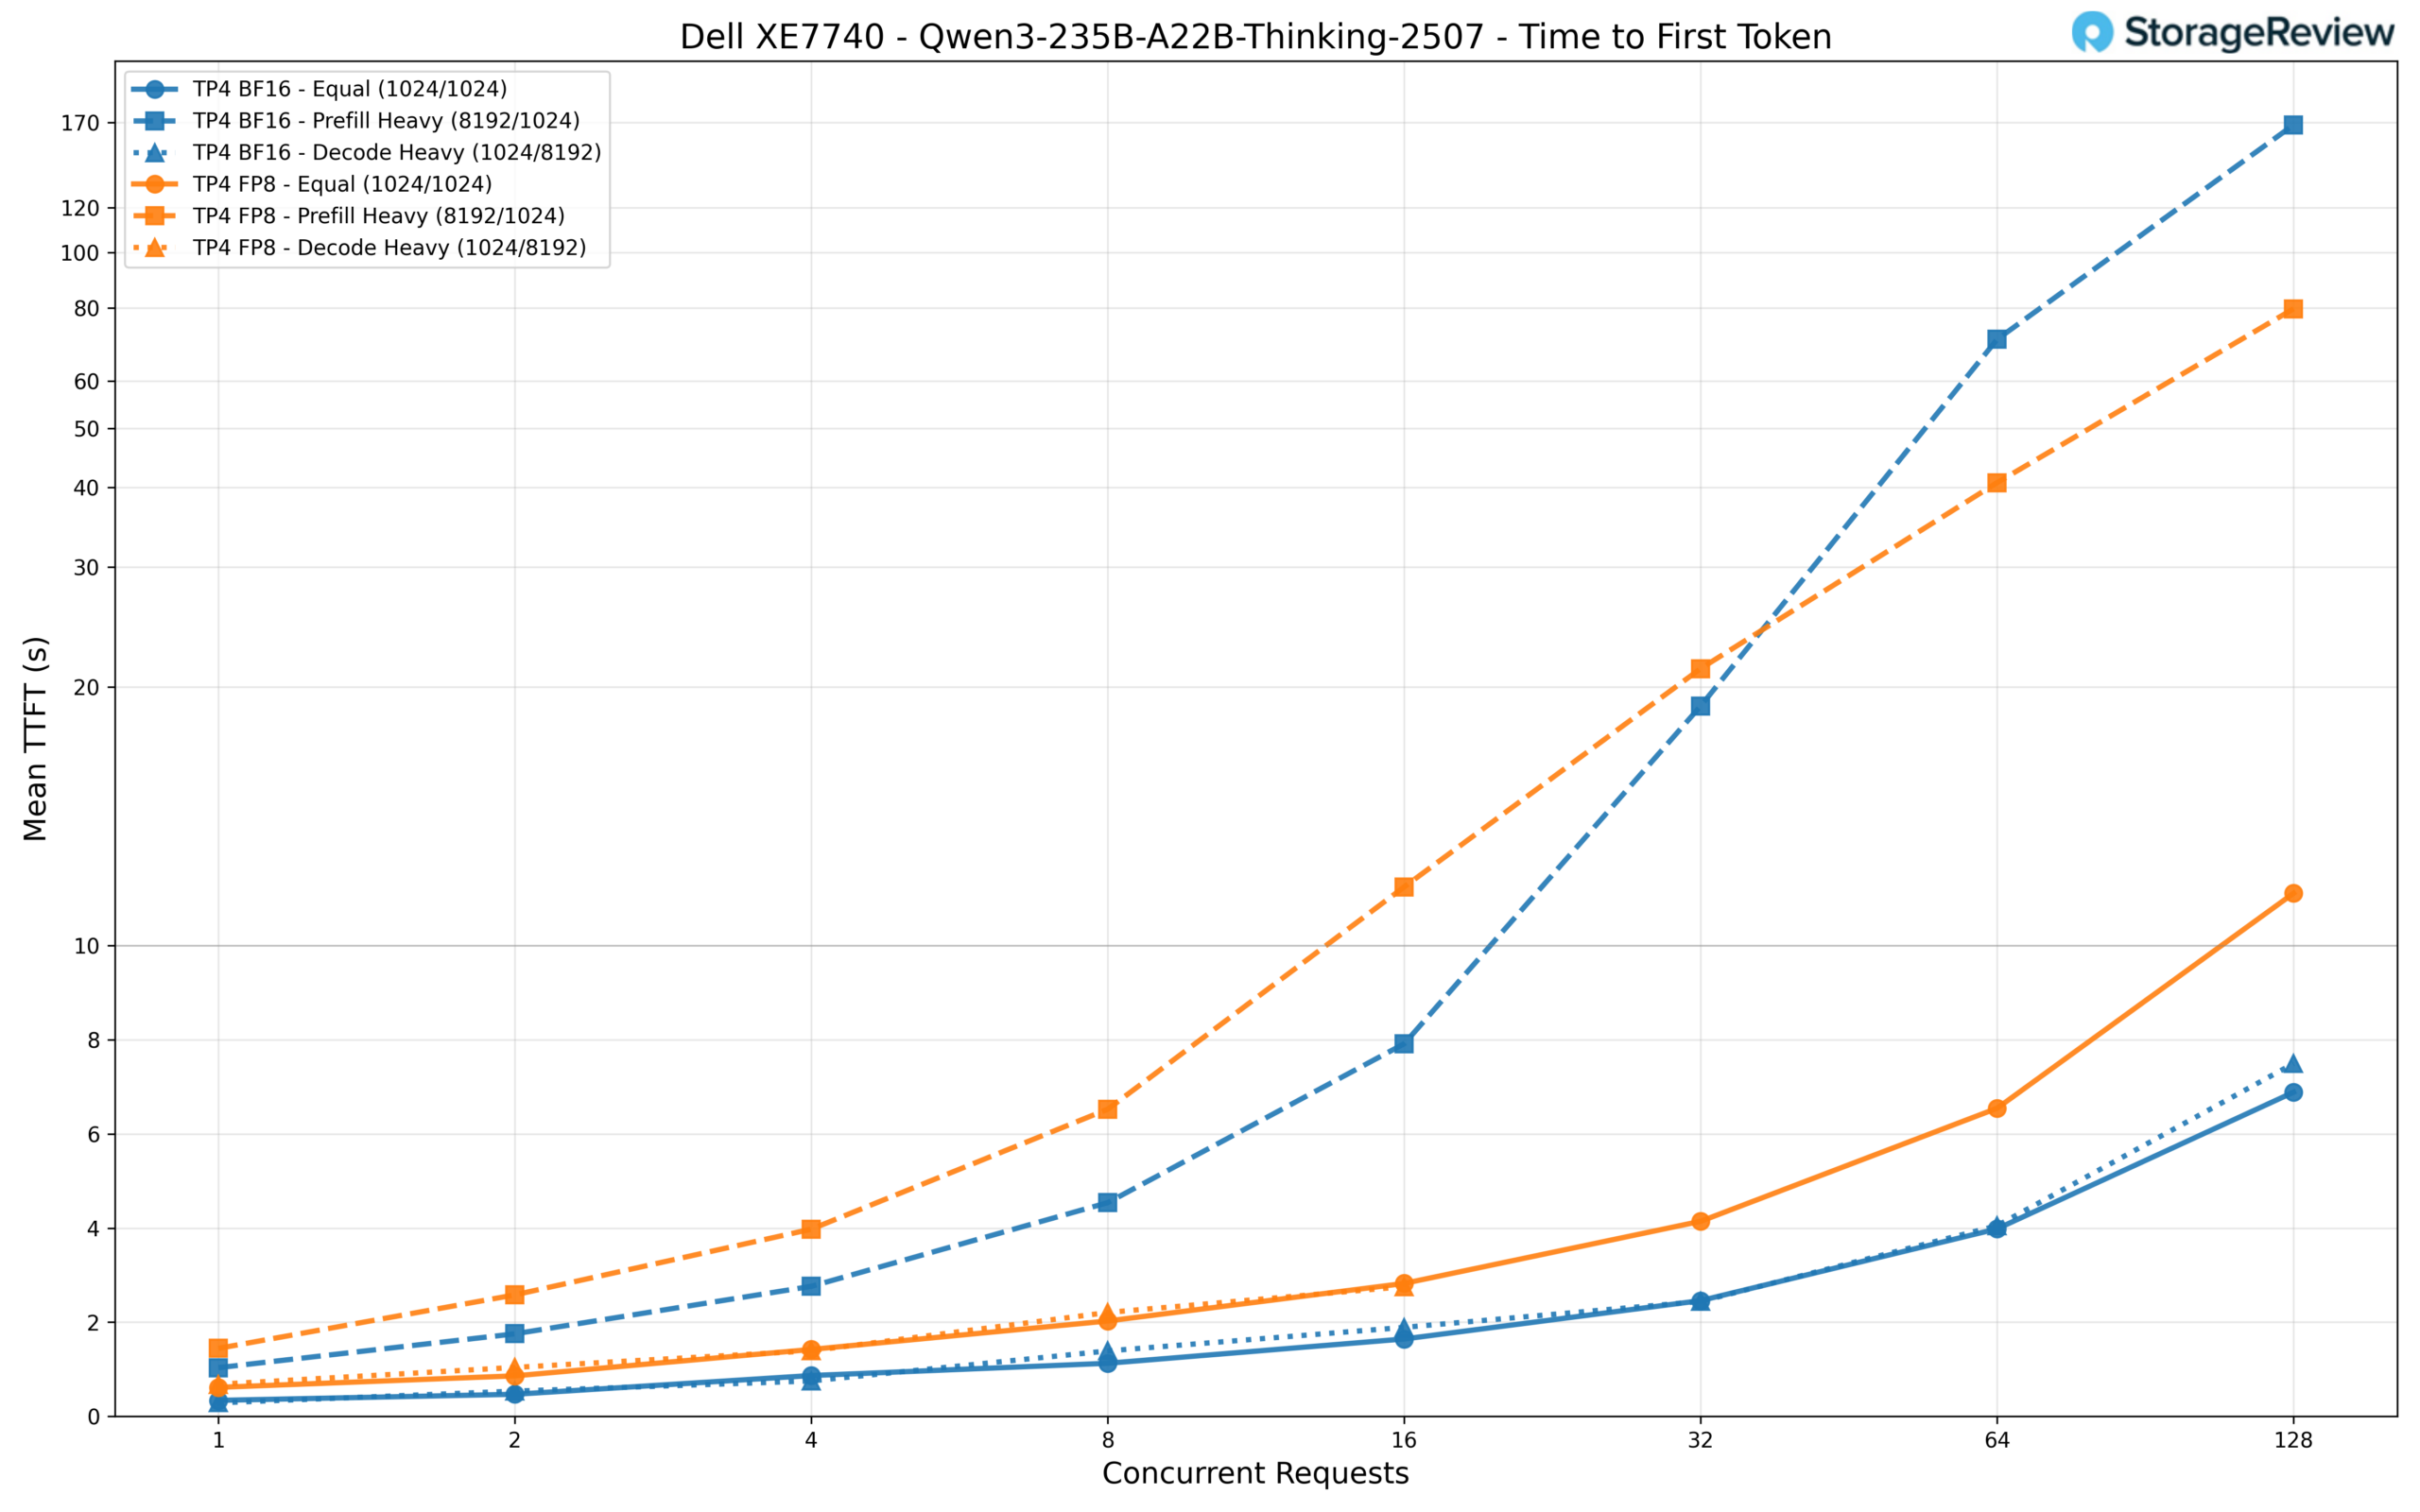
För TTFT börjar BF16 vid cirka 340 ms för en enda lika lång förfrågan och skalar till cirka 6.9 sekunder vid 128 samtidiga förfrågningar. Detta är ganska responsivt för en modell av denna skala. FP8 är ungefär dubbelt så långsammare genomgående, med början vid 615 ms och en tid på cirka 11.2 sekunder vid full belastning. Den förfyllda arbetsbelastningen är det mest krävande scenariot, där BF16 klättrar till 168 sekunder och FP8 till 80 sekunder vid 128 förfrågningar.
Vem är det här för?
Efterfrågan på inferens minskar inte. Oavsett om organisationer distribuerar modeller internt för att accelerera utvecklingsteam, bäddar in AI i kundvändiga produkter eller sätter upp automatiseringspipelines som körs dygnet runt, fortsätter beräkningskraven att öka. Och med den efterfrågan kommer en välbekant flaskhals: upphandling. Ledtiderna för populära acceleratorer kan sträcka sig i månader, vilket stoppar projekt som redan har finansierats och bemannats.
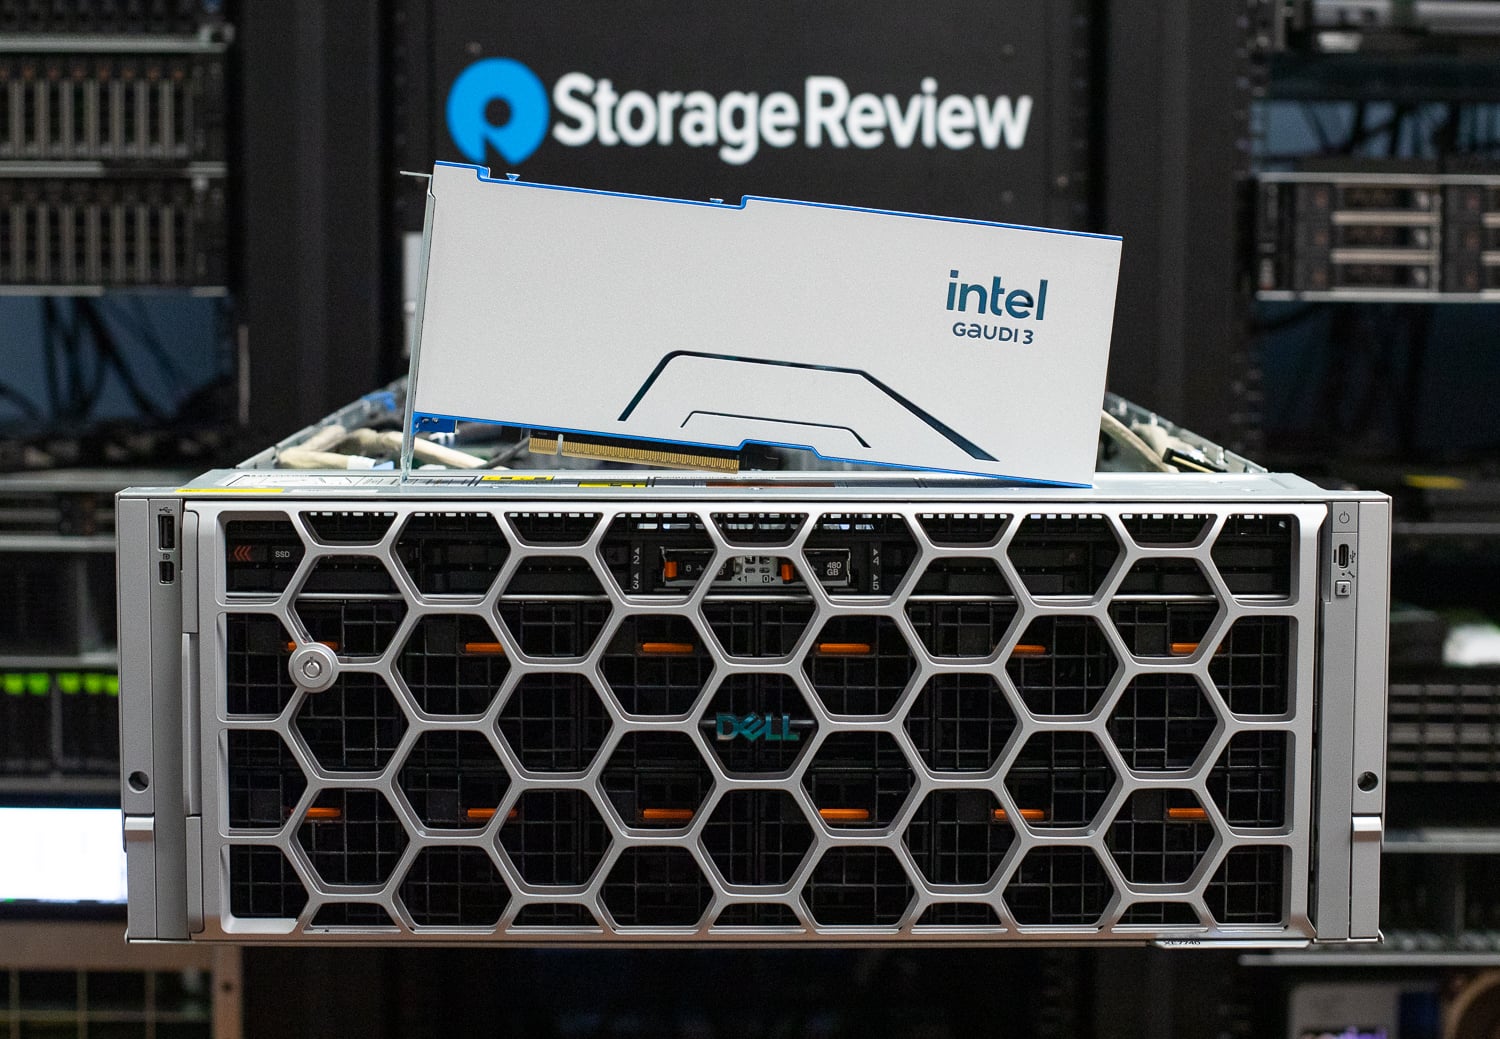
XE7740, konfigurerad med Intel Gaudi 3, adresserar denna begränsning direkt. Gaudi 3-acceleratorer finns tillgängliga nu, och Intel tillhandahåller validerade distributionsmallar så att team kan gå från uppackning till att leverera inferens på några timmar. Dell sänker barriären ytterligare med "try-and-buy"-program som placerar XE7740-system direkt i din miljö, vilket låter dig validera prestanda mot dina faktiska arbetsbelastningar, data och infrastruktur innan du bestämmer dig för en fullständig utrullning. Den kombinationen av omedelbar tillgänglighet, snabb värdeskapande och lågriskutvärdering gör Gaudi 3-konfigurationen särskilt attraktiv för organisationer som behöver inferenskapacitet idag och inte har råd att vänta på allokeringsköer.
Med det sagt är XE7740 inte en plattform med en enda accelerator. Med Dells engagemang för kiseldiversitet kan samma plattform erhållas med en mängd olika alternativ och alla populära acceleratorer på marknaden, och rätt val beror helt på arbetsbelastningen. Videobehandlingspipelines, till exempel, är en naturlig lösning för NVIDIA L4:or, och XE7740 kan utrustas med 16 L4 GPU:er tillsammans med 8 PCIe Gen5 x16 NIC-kortplatser för ett kompromisslöst streaming- och transkodningssystem. Organisationer som kör blandade AI-arbetsbelastningar över olika avdelningar kan standardisera XE7740-chassit och helt enkelt variera acceleratorkonfigurationen för att matcha varje driftsättning, vilket förenklar flotthanteringen samtidigt som beräkningen skräddarsyrs efter uppgiften.
Slutsats
Dell PowerEdge XE7740 är konstruerad för verkligheten av företagsinferens. Dess termiska design med dubbla zoner, strukturerade PCIe-topologi, minnesarkitektur med hög bandbredd och skalbara nätverkskapacitet skapar ett system byggt för hållbara produktionsarbetsbelastningar. Dessa är inte tillfälliga designval; de återspeglar en infrastrukturmodell där inferens körs kontinuerligt, skalas förutsägbart och integreras snyggt i befintliga datacenterverksamheter. I denna utvärdering visar Intel Gaudi 3 att XE7740 levererar inferens idag över täta och minnesbundna arkitekturer, med förutsägbart skalningsbeteende och starkt minnesbundet dataflöde. Programvaruoptimeringar kommer att fortsätta att förbättras, men plattformens arkitektoniska grund är redan sund.
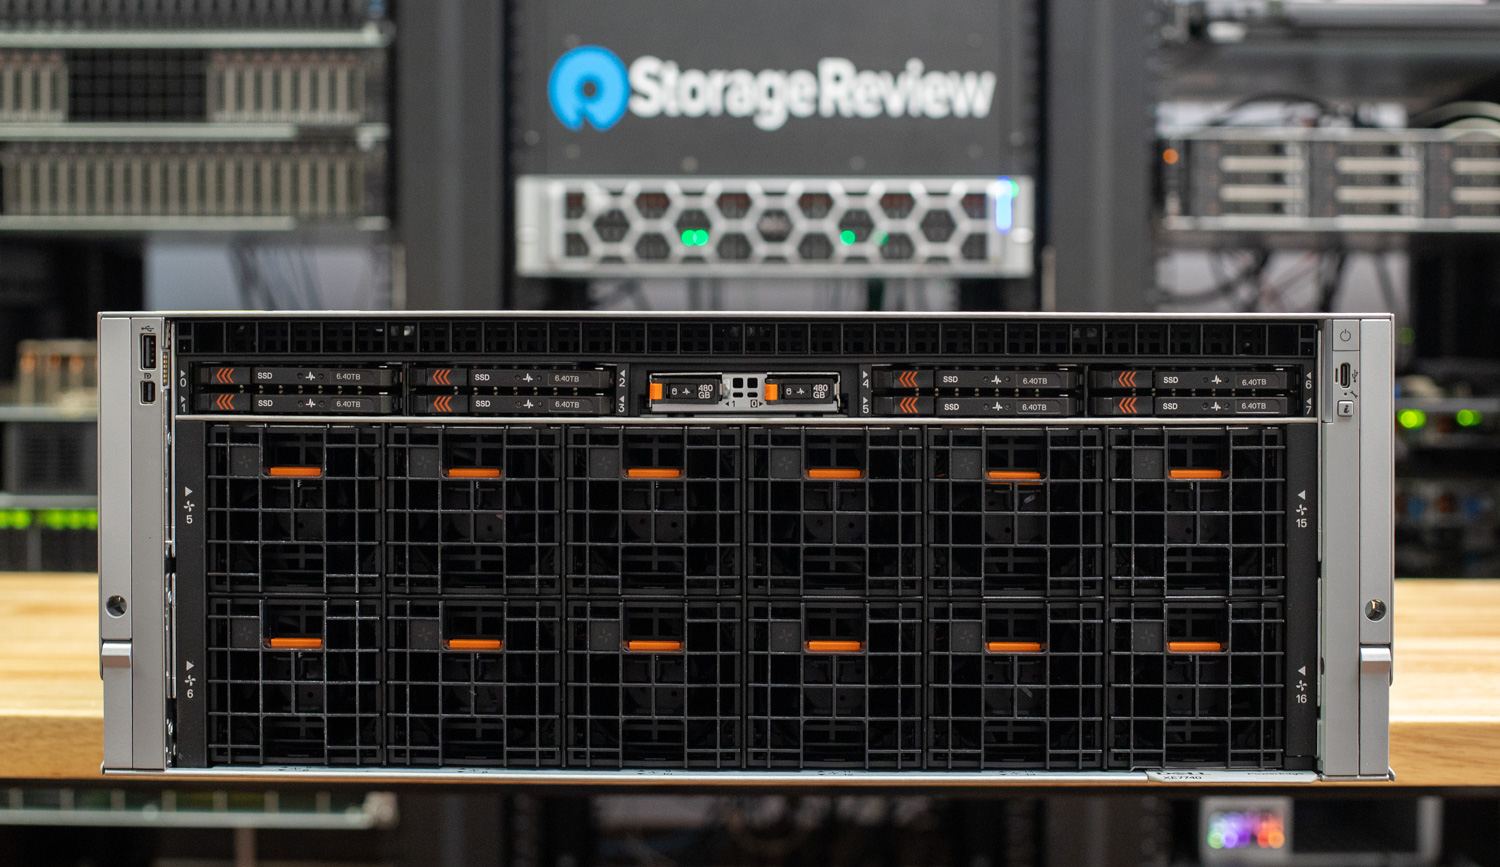
Ännu viktigare är att XE7740 etablerar en hållbar ritning för företags-AI-infrastruktur. Organisationer kan standardisera på ett konsekvent chassi, hanteringsstack och distributionsmodell samtidigt som de utvecklar acceleratorstrategin över tid. I takt med att modeller växer, arbetsbelastningar diversifieras och inferens blir djupare integrerad i affärsverksamheten, kommer behovet av stabil och anpassningsbar infrastruktur bara att öka. PowerEdge XE7740 är positionerad för att möta den utvecklingen. Den levererar den arkitektoniska balansen, operativa mognaden och det expansionsutrymme som krävs för företags-AI när det går från snabb implementering till långsiktig integration.
Den här rapporten är sponsrad av Dell Technologies. Alla åsikter och åsikter som uttrycks i denna rapport är baserade på vår opartiska syn på produkten/de produkter som övervägs.
Leader: The four-card Gaudi 3 configuration in this review appears in the scale-out table on our Bästa företags-GPU:er topplista.


 Amazon