

Med den första lanseringen av NVIDIAs DGX Spark-plattform ser vi nu olika leverantörer paketera GB10 Grace Blackwell-grunden i sina egna kompakta stationära system. Medan kärnkortet och kiseln förblir standardiserade, uppstår skillnader i chassidesign, kylningsbeteende, lagringskonfiguration och övergripande prestanda. I den här recensionen fokuserar vi på GIGABYTEs implementering med AI TOP ATOM.
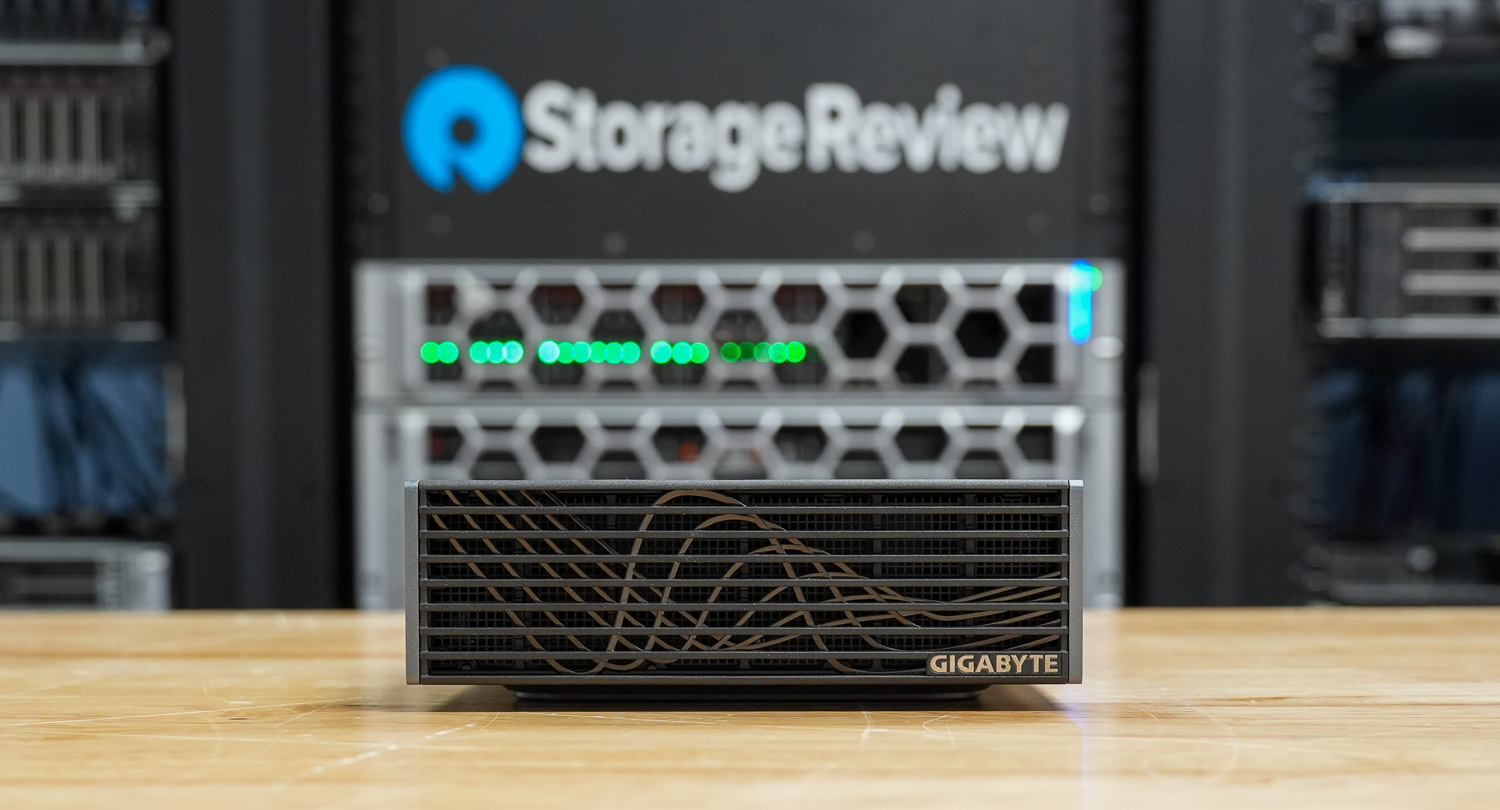
Inuti finns samma GB10 Superchip, som kombinerar ett 20-kärnigt Arm CPU-komplex med Blackwell AI-acceleration och 128 GB enhetligt LPDDR5X-minne. Den grunden stöder upp till 1 petaflop FP4-beräkning och modellerar upp till 200 miljarder parametrar, vilket positionerar den stadigt i arbetsstationsklassens AI-territorium.
AI TOP ATOM är inrymd i ett kompakt 1-liters chassi som mäter 150 x 150 x 50.5 mm och drivs av en extern adapter på 240 W. Även om datorkärnan är identisk med den i andra Spark-system undersöker vi hur GIGABYTEs designval påverkar temperatur, beteende vid ihållande arbetsbelastning, lagringsprestanda och daglig användbarhet.
Lagringsalternativ kan skalas upp till 4 TB Gen5 NVMe, och systemet levereras med NVIDIA DGX OS baserat på Ubuntu, vilket gör det redo för AI-arbetsbelastningar direkt ur lådan. Kort sagt, medan den centrala beräkningshårdvaran förblir identisk med den hos andra Spark-klassade system, beror användarupplevelsen, temperaturen, akustiken och den övergripande presentationen på vad GIGABYTE erbjuder i sin kompakta låda.
I den här recensionen ska vi undersöka hur GIGABYTEs tolkning av Spark-plattformen står sig i jämförelse vad gäller hållbara arbetsbelastningar, kylningsbeteende och daglig användbarhet, och om dess kompakta formfaktor medför några märkbara nackdelar.
| Specifikation | GIGABYTE AI TOP ATOM (GB10) |
|---|---|
| Mått och vikt | |
| Höjd | 2 i |
| Bredd | 5.9 i |
| Djup | 5.9 i |
| Vikt | 2.64 Ib |
| Processorn | |
| Processor Typ | NVIDIA GB10 (Grace Blackwell Superchip) (20 kärnor) |
| Integrerad grafik | NVIDIA Blackwell GPU (integrerad) |
| Minne | |
| Minnestyp | LPDDR5x (enhetligt systemminne) |
| Minneskonfiguration | 128 GB LPDDR5x, enhetligt systemminne |
| minnesbandbredd | 273 GB/s (8533 MT/s) |
| Operativ system | |
| Operativsystem som stöds | NVIDIA DGX OS |
| Externa portar och kortplatser | |
| Nätverksportar | En RJ45 (10 GbE) NVIDIA ConnectX-7 nätverkskort (200G × 2 QSFP) |
| USB-portar | Tre USB 3.2 Gen 2×2 Typ-C (20 Gbps) En USB 3.2 Gen 2×2 Typ-C med PD-ingång |
| Videoport(ar) | En HDMI 2.1a |
| Port för nätadapter | USB Typ-C (PD-IN) |
| Säkerhetsplats | Ingen |
| trådlös | |
| WiFi | WiFi 7 (AW-EM637, 2×2) |
| bluetooth | Bluetooth 5.4 |
| lagring | |
| Lagringsalternativ | Upp till 4 TB Gen5 NVMe (stöd för självkryptering) |
| Strömadapter | |
| Typ | 240 W extern adapter (USB typ-C) |
GIGABYTE AI TOP ATOM Design och Byggnad
GIGABYTE AI TOP ATOM behåller det välbekanta måttet på 150 x 150 mm som vi sett hos dessa Spark-baserade system, med en höjd på 50.5 mm och en vikt på 1.2 kg. Den är tillräckligt kompakt för att få plats på ett skrivbord, men när du lyfter upp den känns den tät och solid. Finishen har ett mörkt, matt utseende, vilket ger den mer av en arbetsstationskänsla.
Istället för ett enkelt platt galler på frontpanelen är hela framsidan täckt med horisontella lameller och ett subtilt vågmönster bakom dem, vilket ger den djup och textur sett från olika vinklar. Det är en kylningsfokuserad design. GIGABYTE-logotypen sitter i det nedre hörnet, och det finns inga framåtriktade dataportar eller ens en strömbrytare, så framsidan förblir ren och luftflödesdriven.
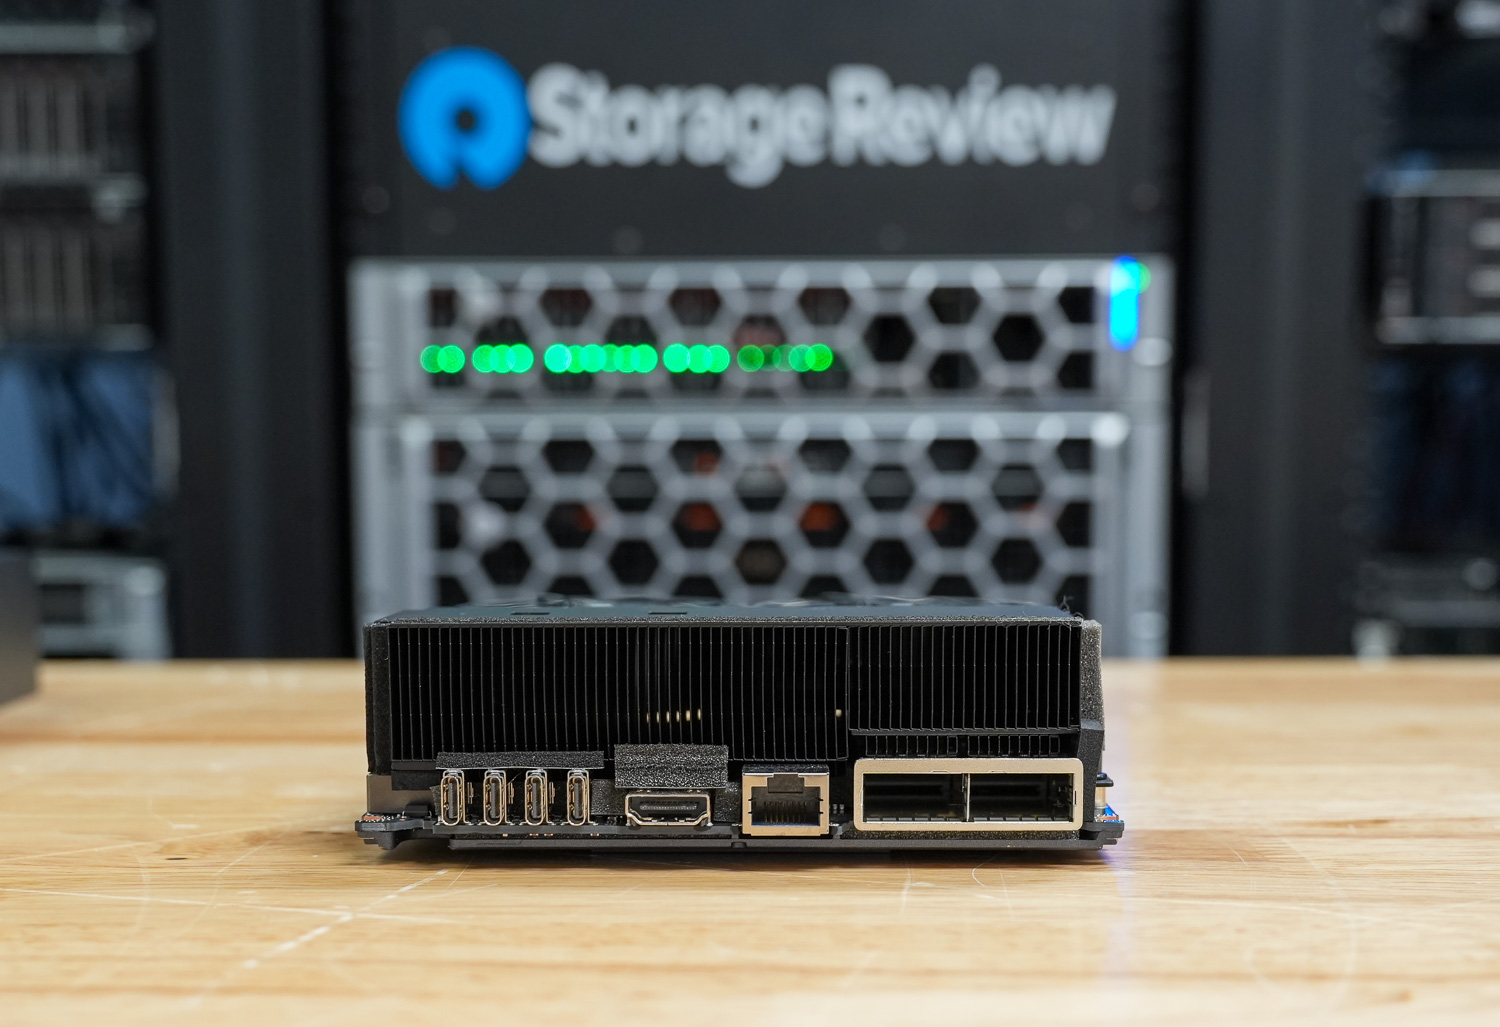
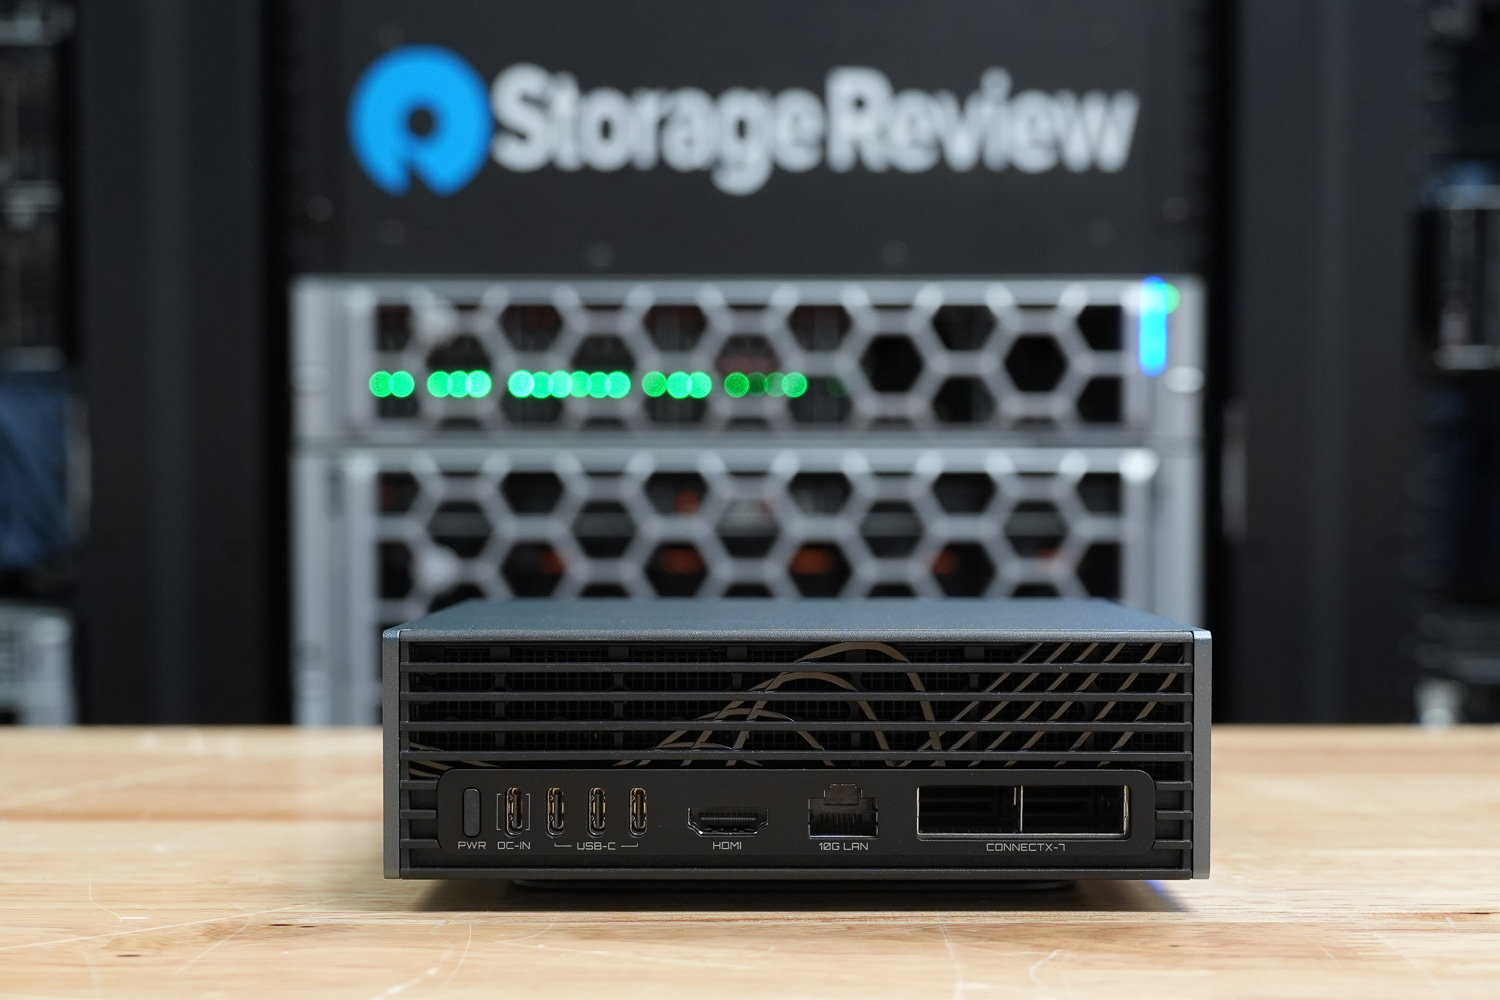
All anslutning finns på bakpanelen. Det finns tre USB 3.2 Gen 2×2 Type-C-portar klassade för upp till 20 Gbps, tillsammans med en fjärde USB Type-C-port dedikerad för strömingång. För skärmutgång inkluderar den en enda HDMI 2.1a-port. Nätverk har en 10 GbE RJ-45-port tillsammans med en NVIDIA ConnectX-7 SmartNIC, som stöder höghastighetsdataöverföringar och länkar flera system om du vill bygga en större installation. Längs sidopanelen har GIGABYTE en Kensington Nano-låsplats.
Inuti körs AI TOP ATOM på NVIDIAs GB10 Grace Blackwell Superchip, som kombinerar en 20-kärnig Arm CPU-konfiguration med integrerad Blackwell-grafik. Den stöds av 128 GB LPDDR5x enhetligt minne på ett 256-bitars gränssnitt, vilket ger upp till 273 GB/s bandbredd. Liksom de andra GB10-systemen delar CPU och GPU samma minnespool, vilket är avgörande för hur dessa maskiner är utformade för att hantera AI-arbetsbelastningar.
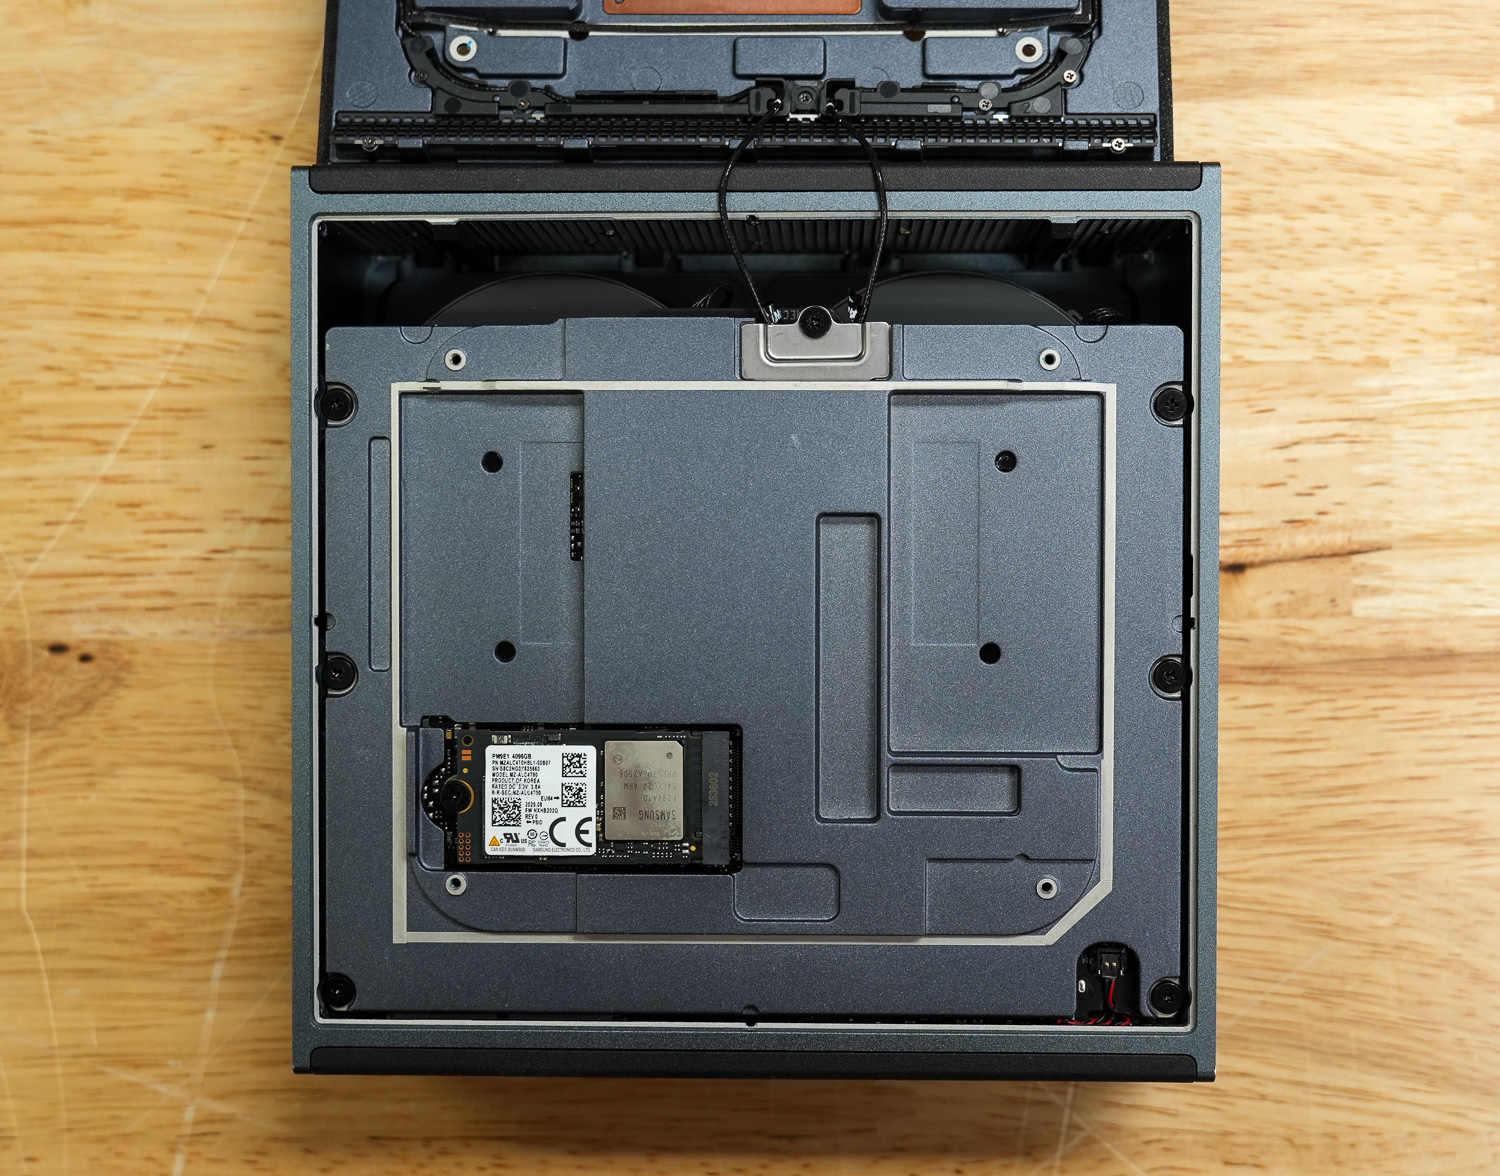
Lagringsstödet går upp till en 4TB Gen5 NVMe SSD, beroende på konfiguration, och strömförsörjningen sker via en extern adapter på 240 W. Trådlös anslutning inkluderar WiFi 7 och Bluetooth 5.4, tillsammans med integrerat 10 GbE-nätverk för trådbunden prestanda.
GIGABYTE AI TOP ATOM-temperaturtestning
För att testa temperaturen hos komponenterna i GIGABYTE AI TOP ATOM jämförde vi dem med Founders Edition och OEM-tillverkare som Asus, Acer och Dell. Vi fördjupade oss i detta i vår artikel om Spark Thermal Testing.
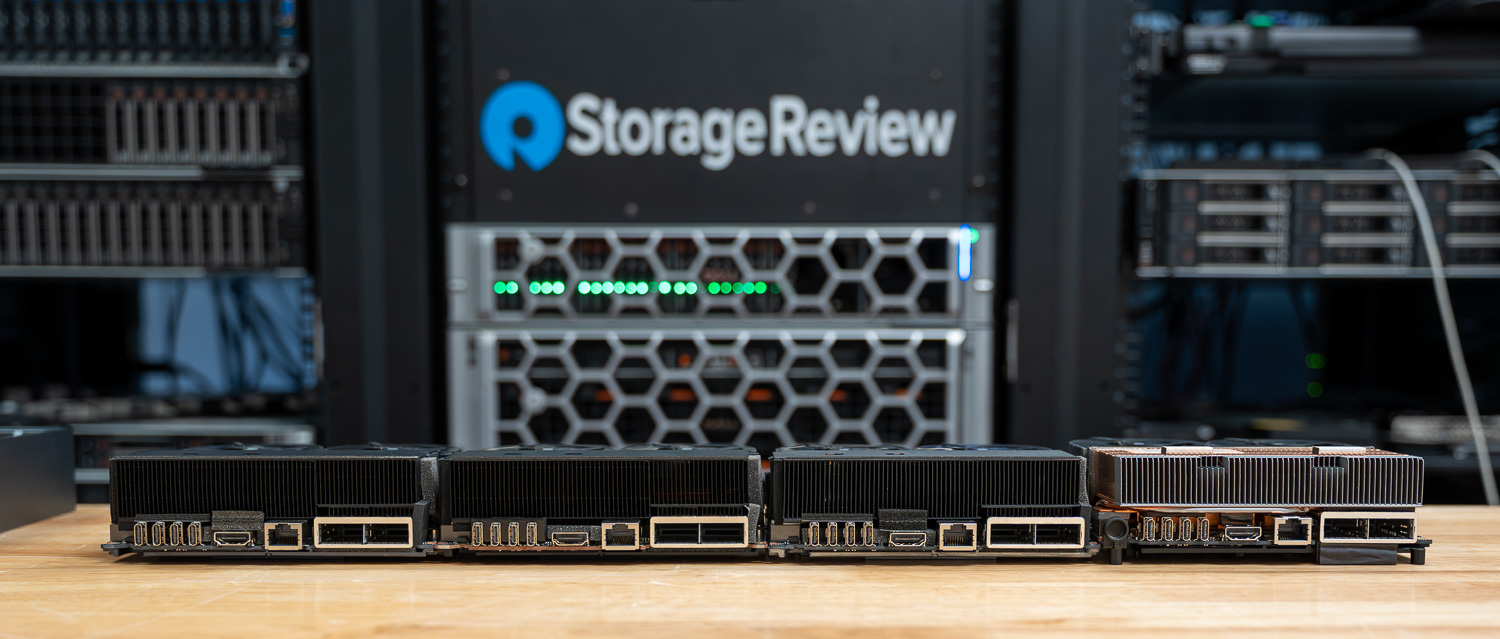
Över hela stacken övervakade vi komponenterna under en given tidsram, med tre steg i arbetsbelastningen, vilket ökade användningen under ungefär en timme. Detta gjorde det möjligt för oss att se enheten vid längre tids användning och olika arbetsbelastningsfaser. Vi övervakade CPU-, GPU-, nätverks-, NVMe-temperaturer och total strömförbrukning.
CPU-temperatur
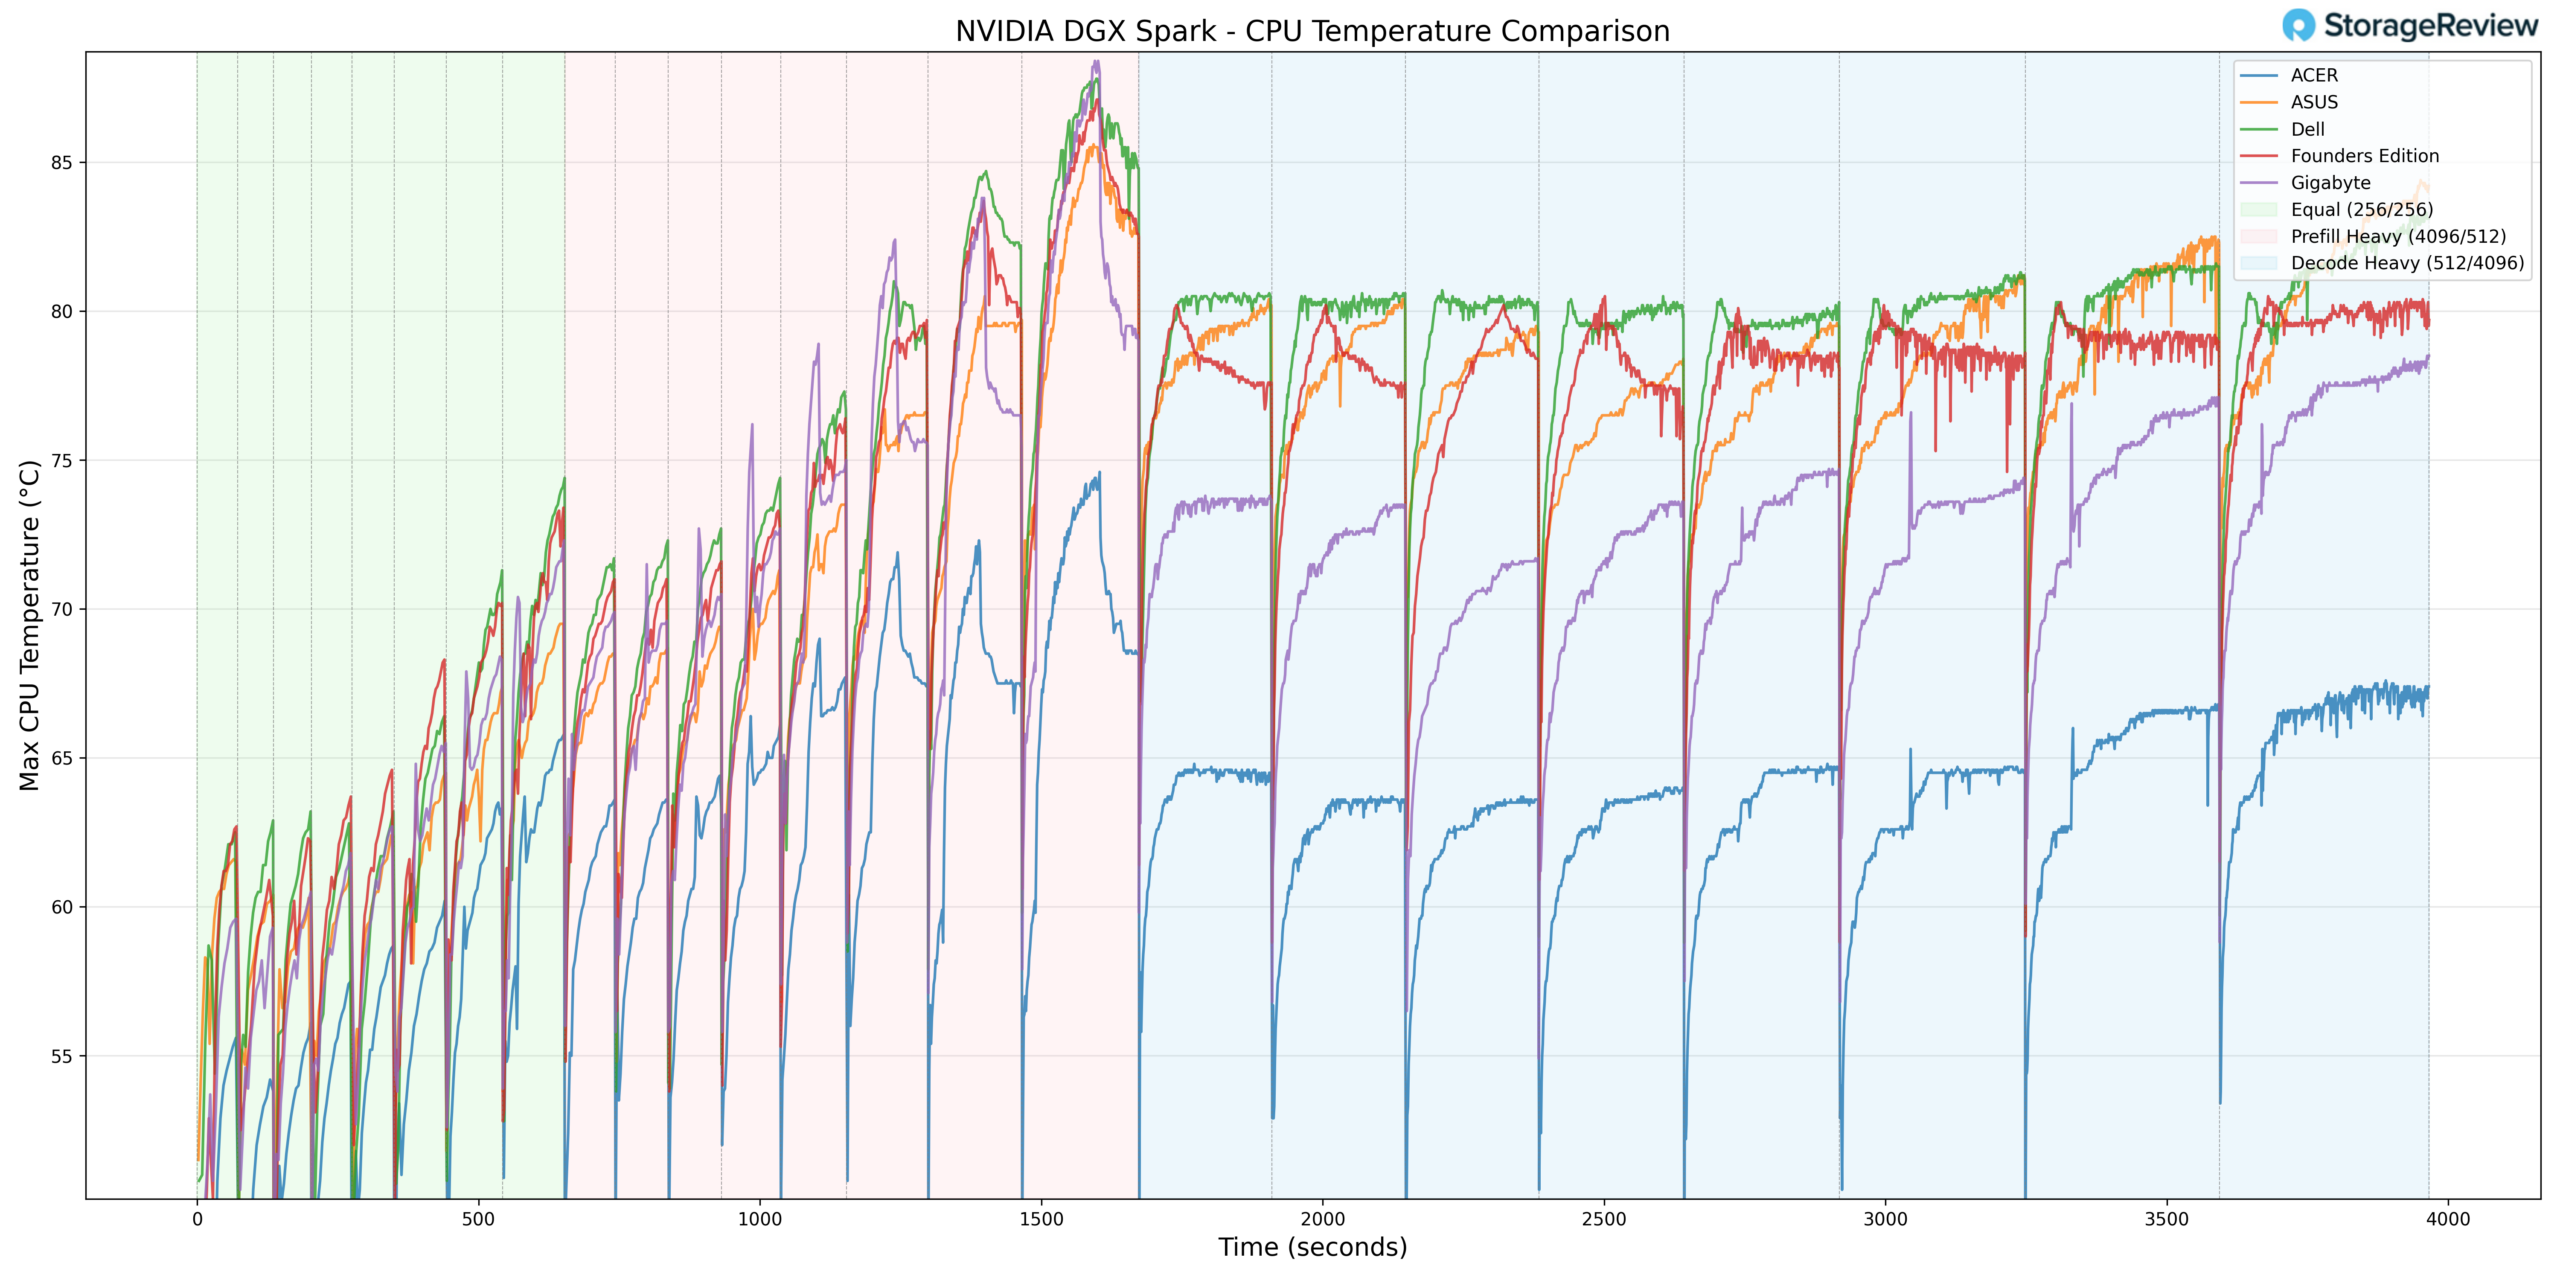
Under CPU-temperaturtester nådde GIGABYTE-systemet en topptemperatur på 90 °C under burst-tunga förfyllningsövergångar. Detta placerar det nära den övre gränsen för observerade CPU-toppar inom jämförelsegruppen under aggressiv arbetsbelastningsökning.
Vid övergången till Equal ISL/OSL och slutligen Decode Heavy-arbetsbelastningar stabiliserades temperaturkurvan snarare än att fortsätta att eskalera. Under ihållande belastning förblev processorn i ett kontrollerat termiskt band, vilket visar att den högre toppen var kopplad till kortvarig rampaktivitet snarare än otillräcklig långsiktig kylkapacitet.
I den nedre delen av temperaturen uppmättes en lägsta temperatur på 38.7 °C under vila eller låg belastning. Denna låga baslinje återspeglar effektiv värmeavledning i vila och indikerar att kyllösningen bibehåller tillräckligt med utrymme utanför burstfaser.
Sammantaget uppvisade GIGABYTE högre CPU-temperaturer vid burst, men bibehöll ett stabilt och ihållande beteende när arbetsbelastningen normaliserades.
GPU temperatur
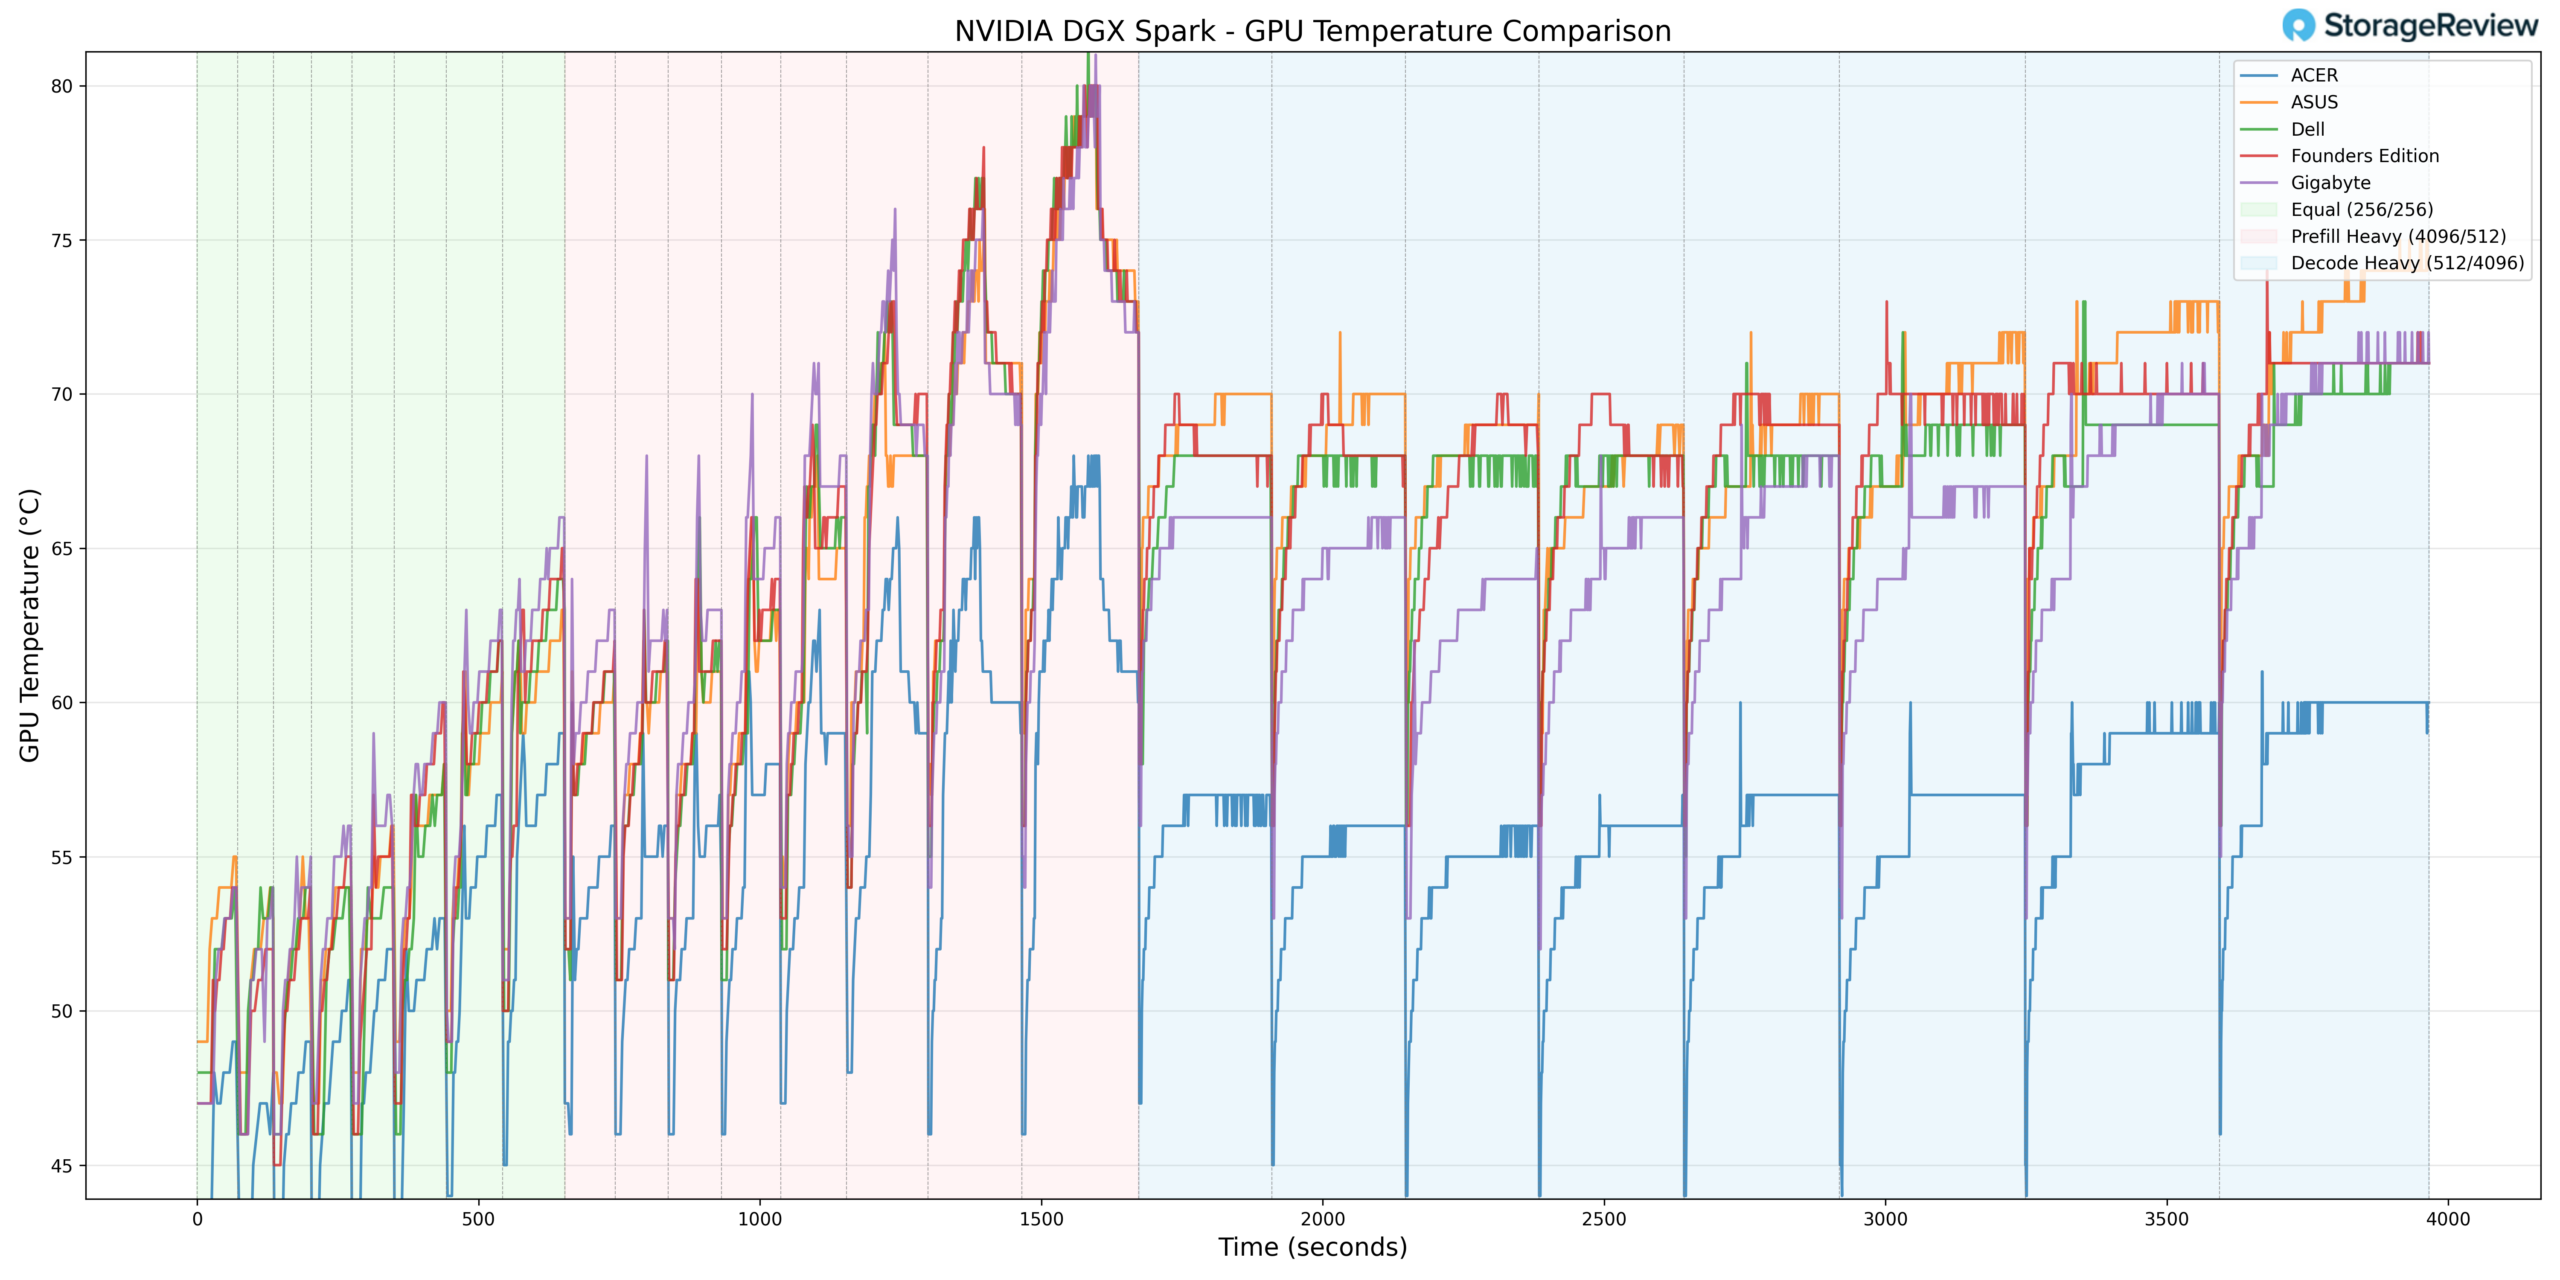
GPU-temperaturen följde ett liknande mönster. Under Prefill Heavy-aktivitet nådde GPU:n en maximal temperatur på 81 °C. Detta placerar den mot den varmare sidan av gruppen under burst-heavy acceleration men fortfarande inom förväntade driftsspecifikationer för GB10-plattformen.
Allt eftersom arbetsbelastningen övergick till faserna Equal ISL/OSL och Decode Heavy, planade GPU-temperaturerna ut snarare än att fortsätta stiga.
Vid tomgång eller låg användning registrerade GPU:n en lägsta temperatur på 37 °C, vilket indikerar en stabil baslinjetemperaturkontroll när systemet inte är under beräkningsstress.
Sammantaget återspeglar GIGABYTEs GPU-beteende aggressiv burst-utnyttjande i kombination med stabila, ihållande temperaturer.
NVMe-temperatur
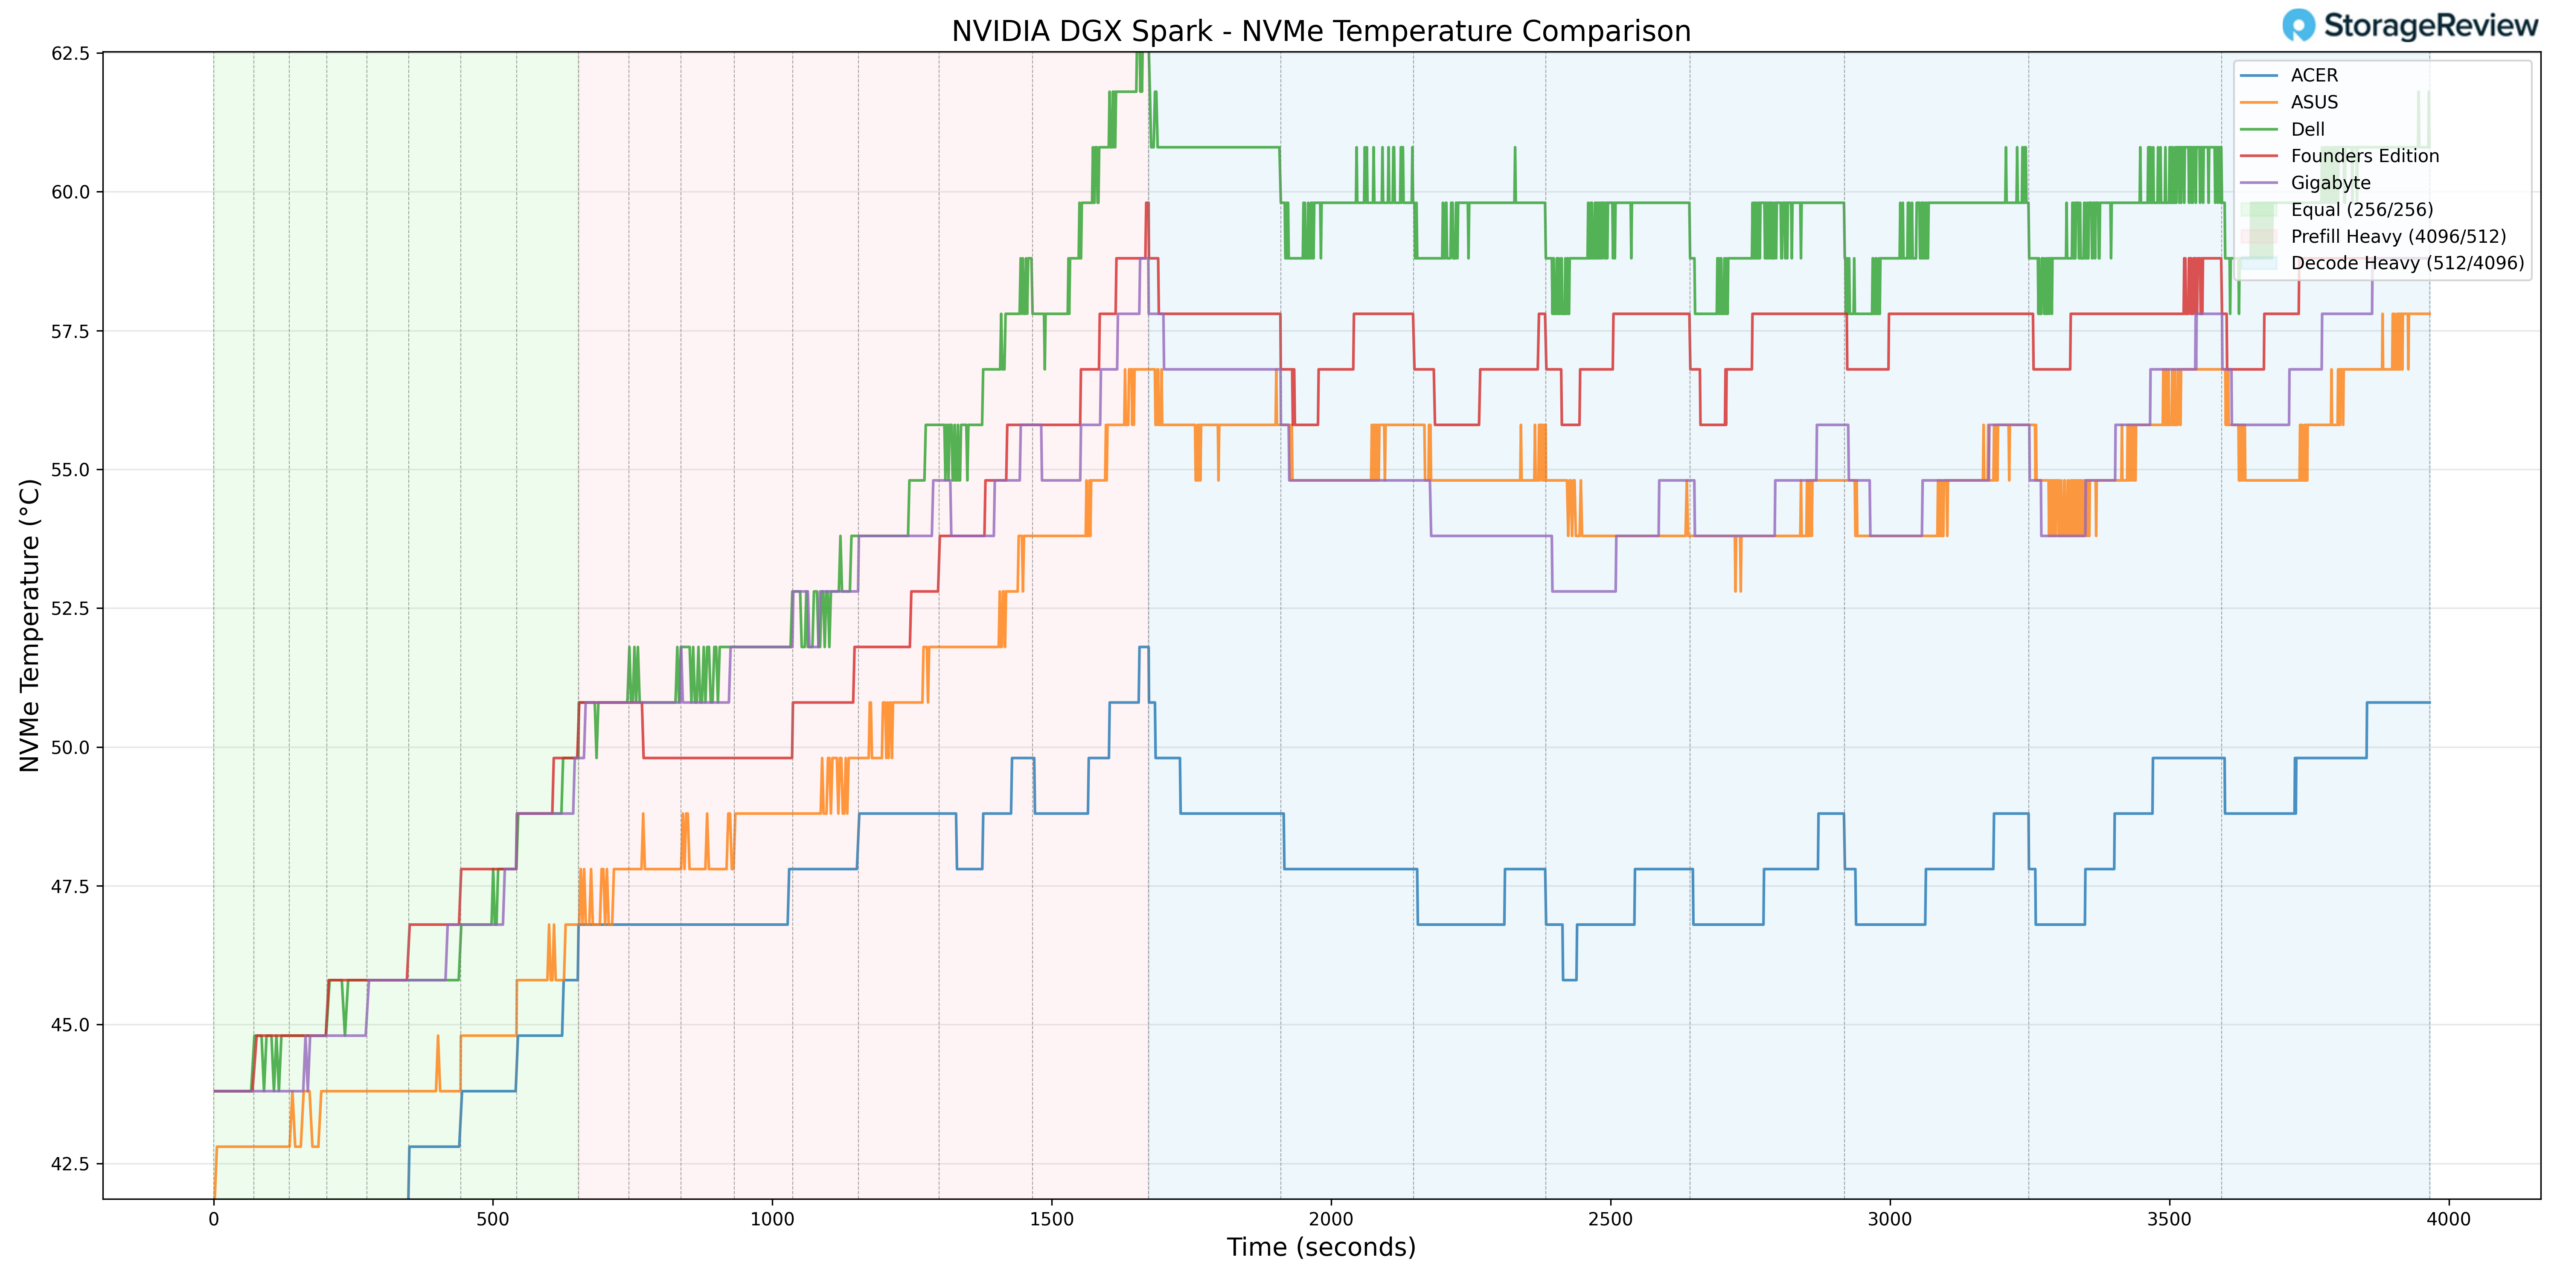
Lagringstemperaturen förblev välkontrollerad under hela testningen. NVMe-enheten registrerade en maximal temperatur på 59.8 °C under krävande driftfaser. Denna topp låg bekvämt under vanliga strypningsgränser, vilket tyder på tillräckligt luftflöde eller gynnsam intern placering av enheten i chassit.
Under lättare arbetsbelastningsfaser sjönk NVMe-enheten till minst 37.8 °C, vilket förstärker att lagringstemperaturen inte begränsas i vila.
Jämfört med vissa kompakta, stationära datorimplementeringar, visar en temperatur under 60 °C under belastning en god temperaturhantering för lagring.
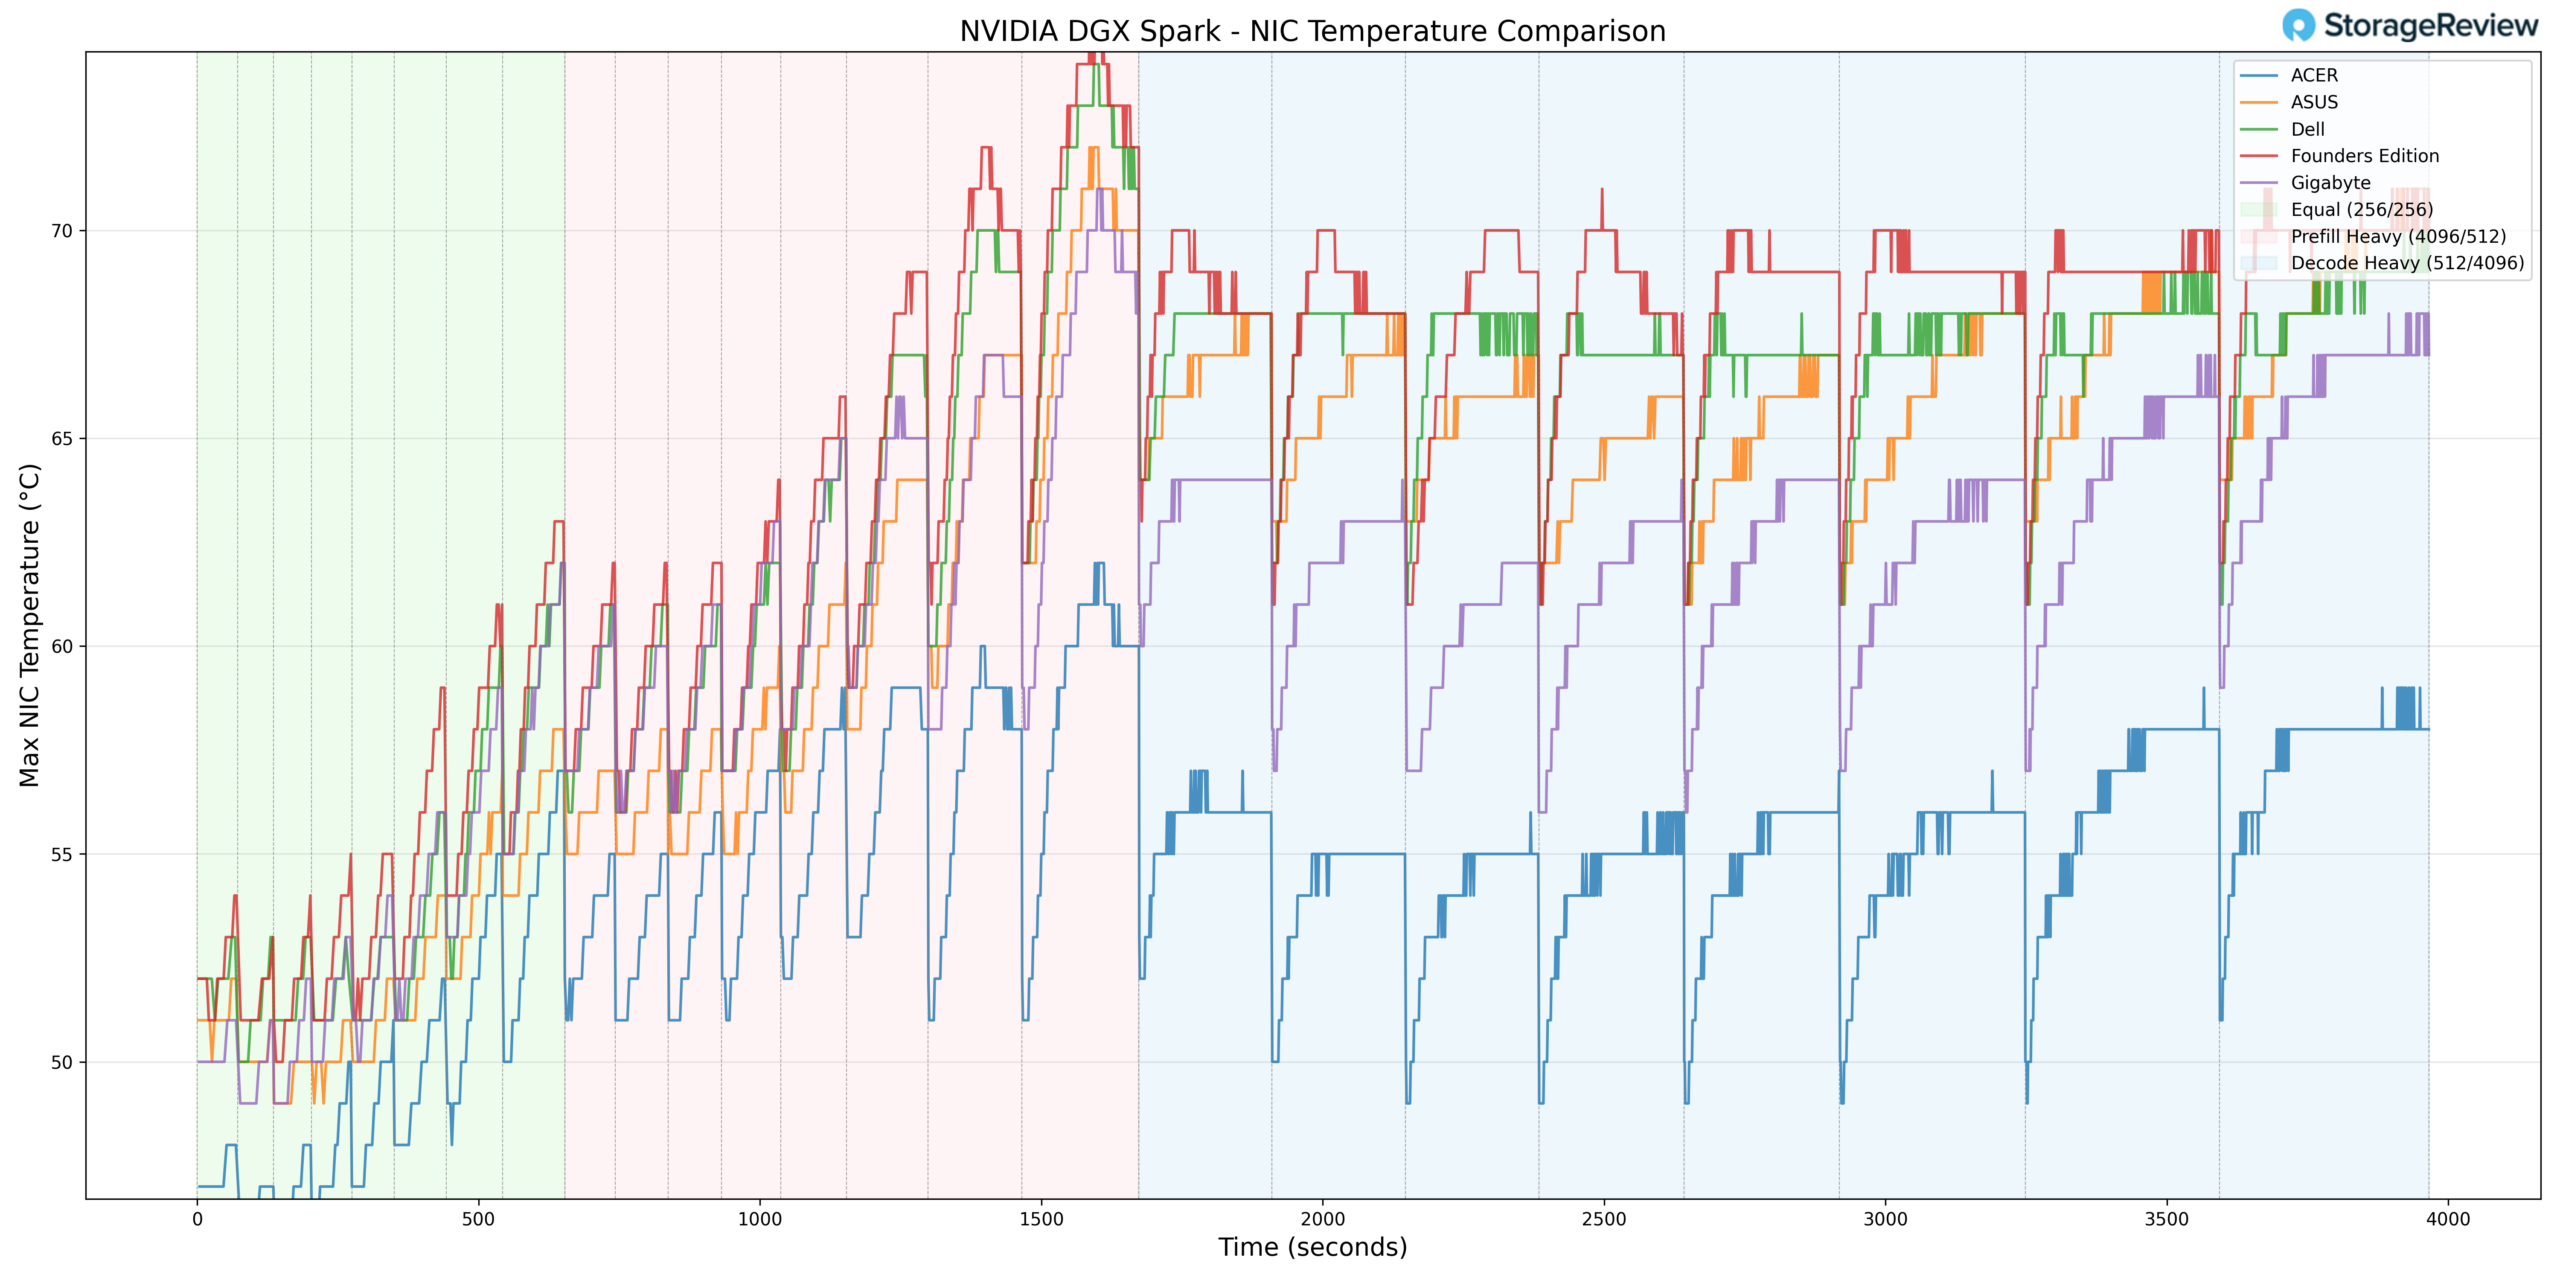
NIC-temperatur
NIC-temperaturerna nådde sin topp vid 72 °C under perioder med tyngre arbetsbelastning, vilket överensstämmer med ökad dataflöde under övergångarna mellan förfyllning och avkodning. Även om detta placerar nätverkskontrollern i den varmare halvan av stacken under maximal aktivitet, förblev temperaturen inom driftstoleranserna och uppvisade inga toppar.
Den lägsta uppmätta NIC-temperaturen var 41 °C, vilket återspeglar normalt baslinjebeteende under lättare faser.
Sammantaget följde nätverkskortet den totala systembelastningen förutsägbart och uppvisade ingen onormal skalning.
GPU-strömförbrukning
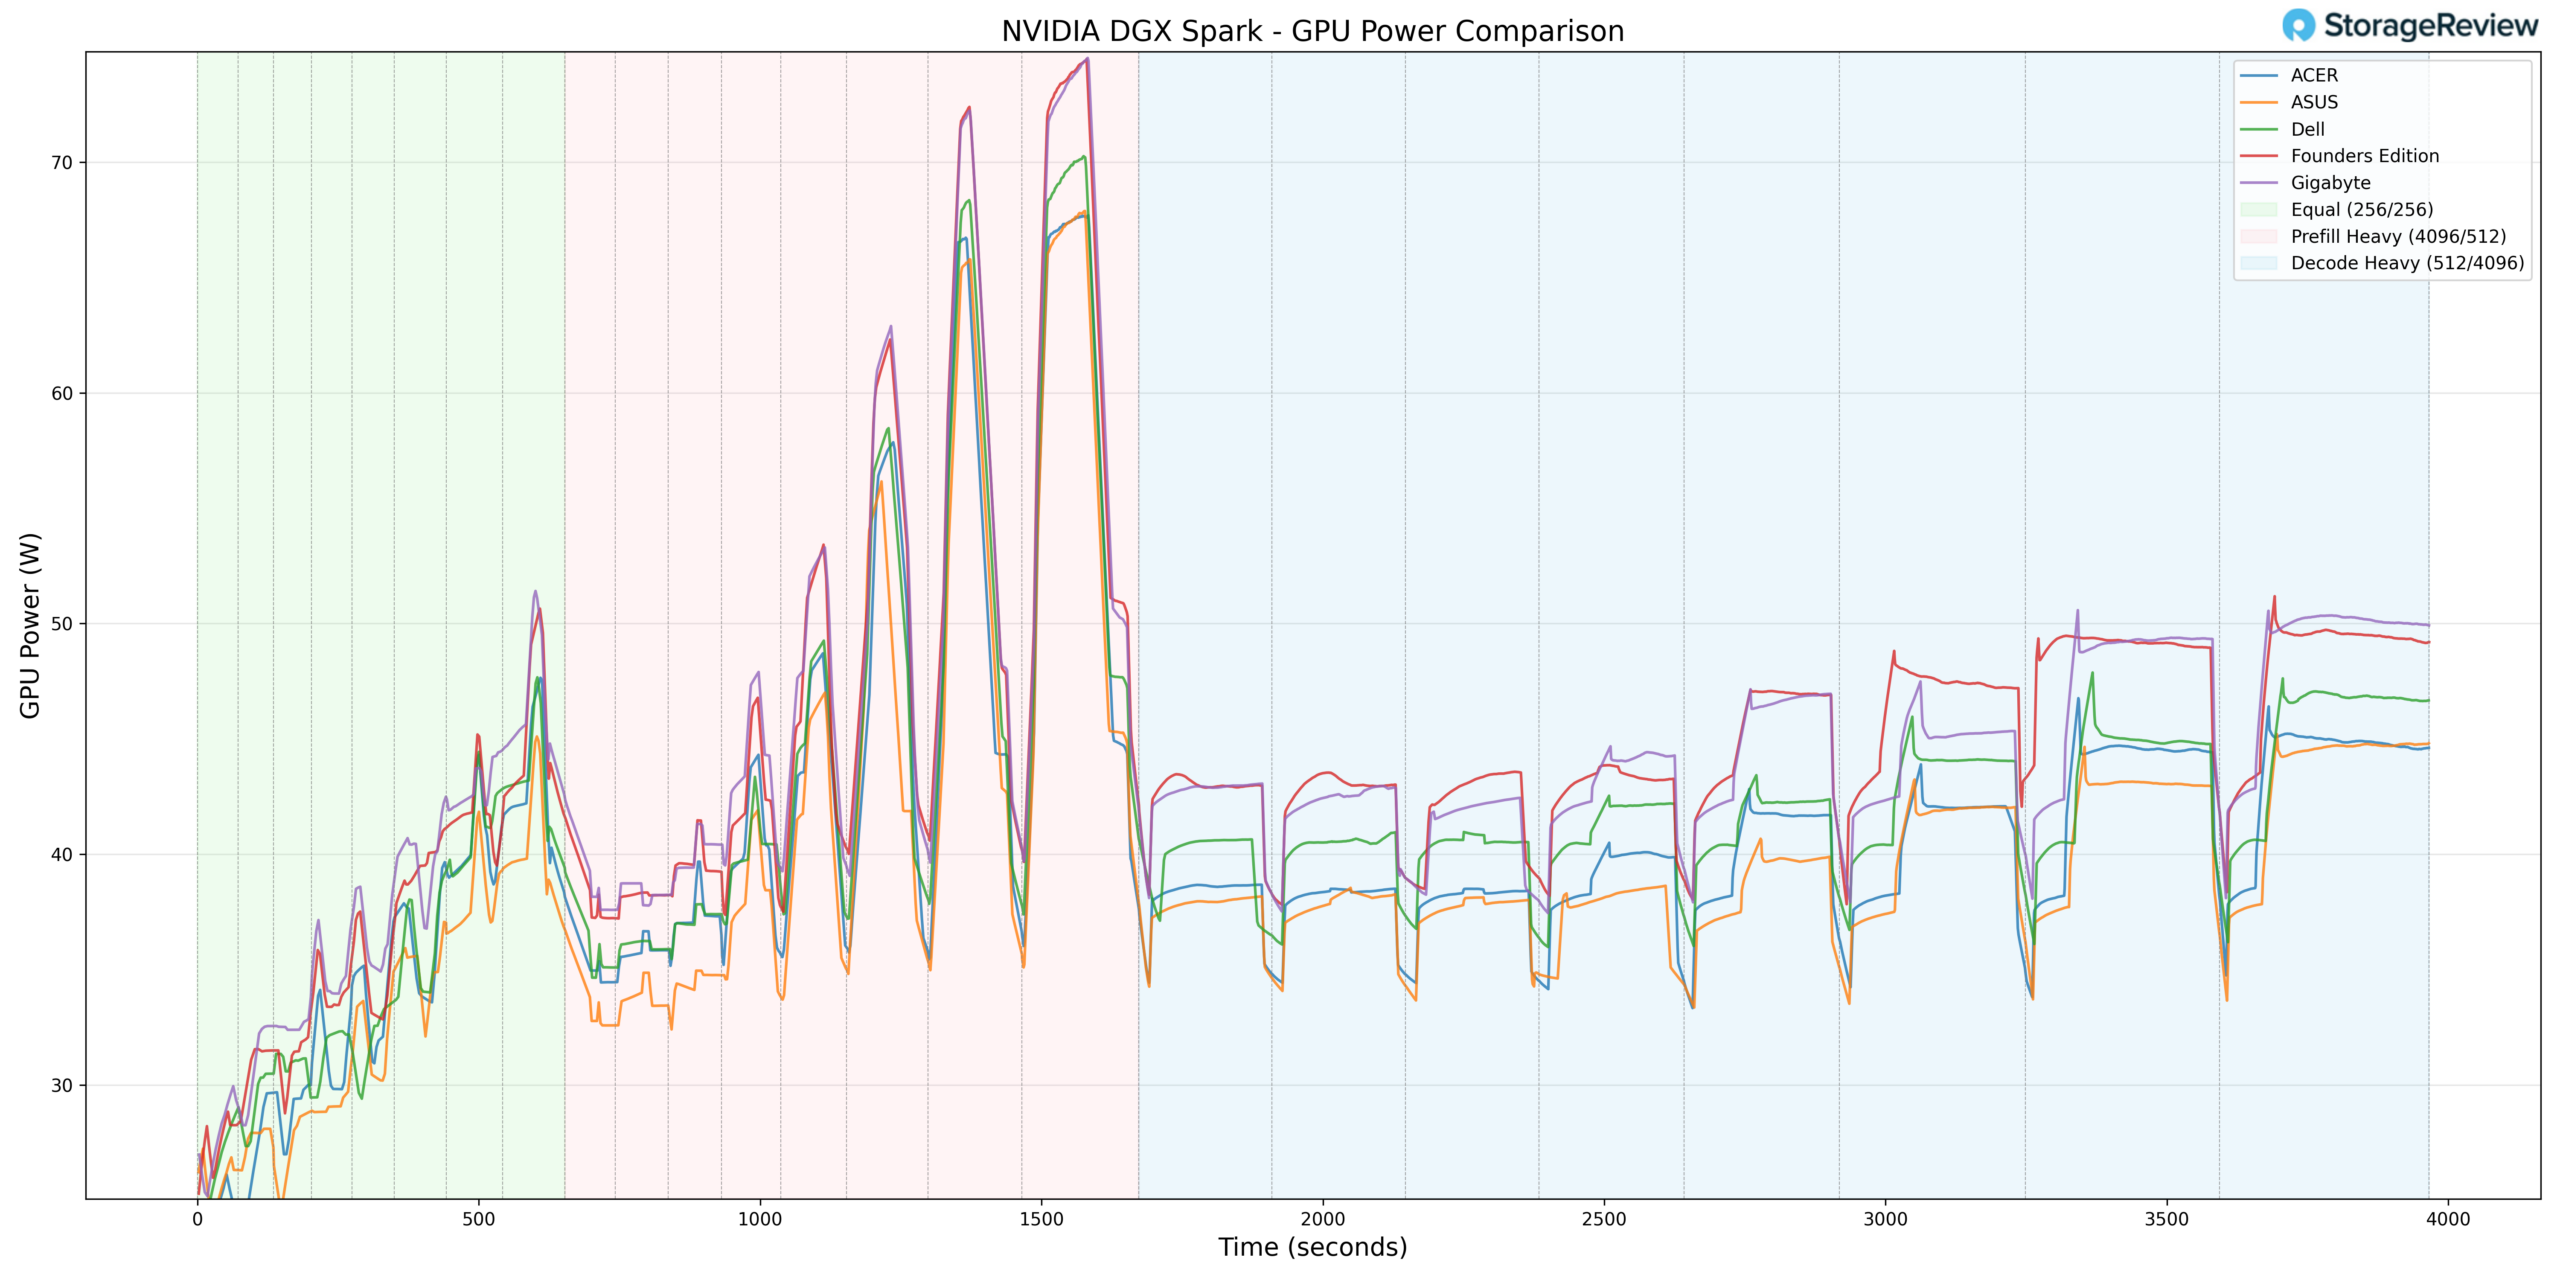
GPU-effektbeteendet hjälper till att kontextualisera de förhöjda burst-temperaturerna. GIGABYTE nådde en maximal GPU-effektförbrukning på 75.54 W under Prefill Heavy-övergångar. Detta placerar den i den övre delen av de observerade effektkurvorna inom de testade GB10-enheterna.
Istället för att artificiellt begränsa GPU-effekten verkar GIGABYTE tillåta burstperioder nära maximum, vilket korrelerar direkt med dess högre topptemperaturbeteende för GPU:n. Allt eftersom arbetsbelastningen övergick i ihållande avkodningsfaser stabiliserades strömförbrukningen därefter.
Ur ett effektperspektiv verkar GIGABYTE-systemet inte vara överdrivet överdrivet. Istället är dess högre topptemperaturer under burstfaser i linje med prestandaorienterade effektallokeringsbeslut snarare än med okontrollerad termisk design.
Termisk sammanfattning
Vid övervakning av CPU, GPU, NVMe och NIC, fungerade GIGABYTE GB10 med konkurrenskraftiga tomgångstemperaturer och högre bursttoppar under övergångar med hög Prefill-belastning. CPU:n nådde 90°C och GPU:n 81°C under toppacceleration, medan NVMe förblev under 60°C och NIC nådde 72°C. GPU:ns effektförbrukning nådde sin topp på 75.54W, vilket indikerar bursts nära maxgränsen.
Under ihållande Decode-arbetsbelastningar stabiliserades temperaturerna utan ytterligare eskalering, vilket tyder på att GIGABYTE, även om de tillåter aggressiv prestanda under korta perioder, bibehåller förutsägbar, kontrollerad temperatur under längre tids drift.
GIGABYTE AI TOP ATOM prestandatestning
För att utvärdera GIGABYTE AI TOP ATOM testade vi Spark-enheter med hjälp av vLLM Online Serving-benchmarket, den mest använda högkapacitetsinferens- och servingsmotorn för stora språkmodeller. vLLM Online Serving-benchmarket simulerar verkliga produktionsarbetsbelastningar genom att skicka samtidiga förfrågningar till en körande vLLM-server, och mäta viktiga mätvärden, inklusive total token-genomströmning (tokens per sekund), tid till första token och tid per utgående token, vid varierande belastningsförhållanden.
Våra tester omfattade en rad olika modeller, från täta arkitekturer till mikroskalningsdatatyper. Den utvärderade prestanda över tre arbetsbelastningsscenarier: Lika ISL/OSL, Förfyllningshög och Avkodningshög. Dessa scenarier representerar distinkta verkliga serveringmönster, från balanserade in- och utmatningsbelastningar till beräkningsintensiv promptbearbetning och generering av minnesbandbreddsbundna tokens.
Utöver GIGABYTE AI TOP ATOM jämförde vi NVIDIA Founders Edition Spark som referenspunkt, tillsammans med OEM-system från Asus, Acer och Dell. Detta gjorde det möjligt för oss att placera GIGABYTEs resultat i det bredare konkurrenslandskapet och förstå var företaget leder, ligger i linje med gänget eller släpar efter mellan olika modeller och arbetsbelastningstyper.
GPT-OSS-120B
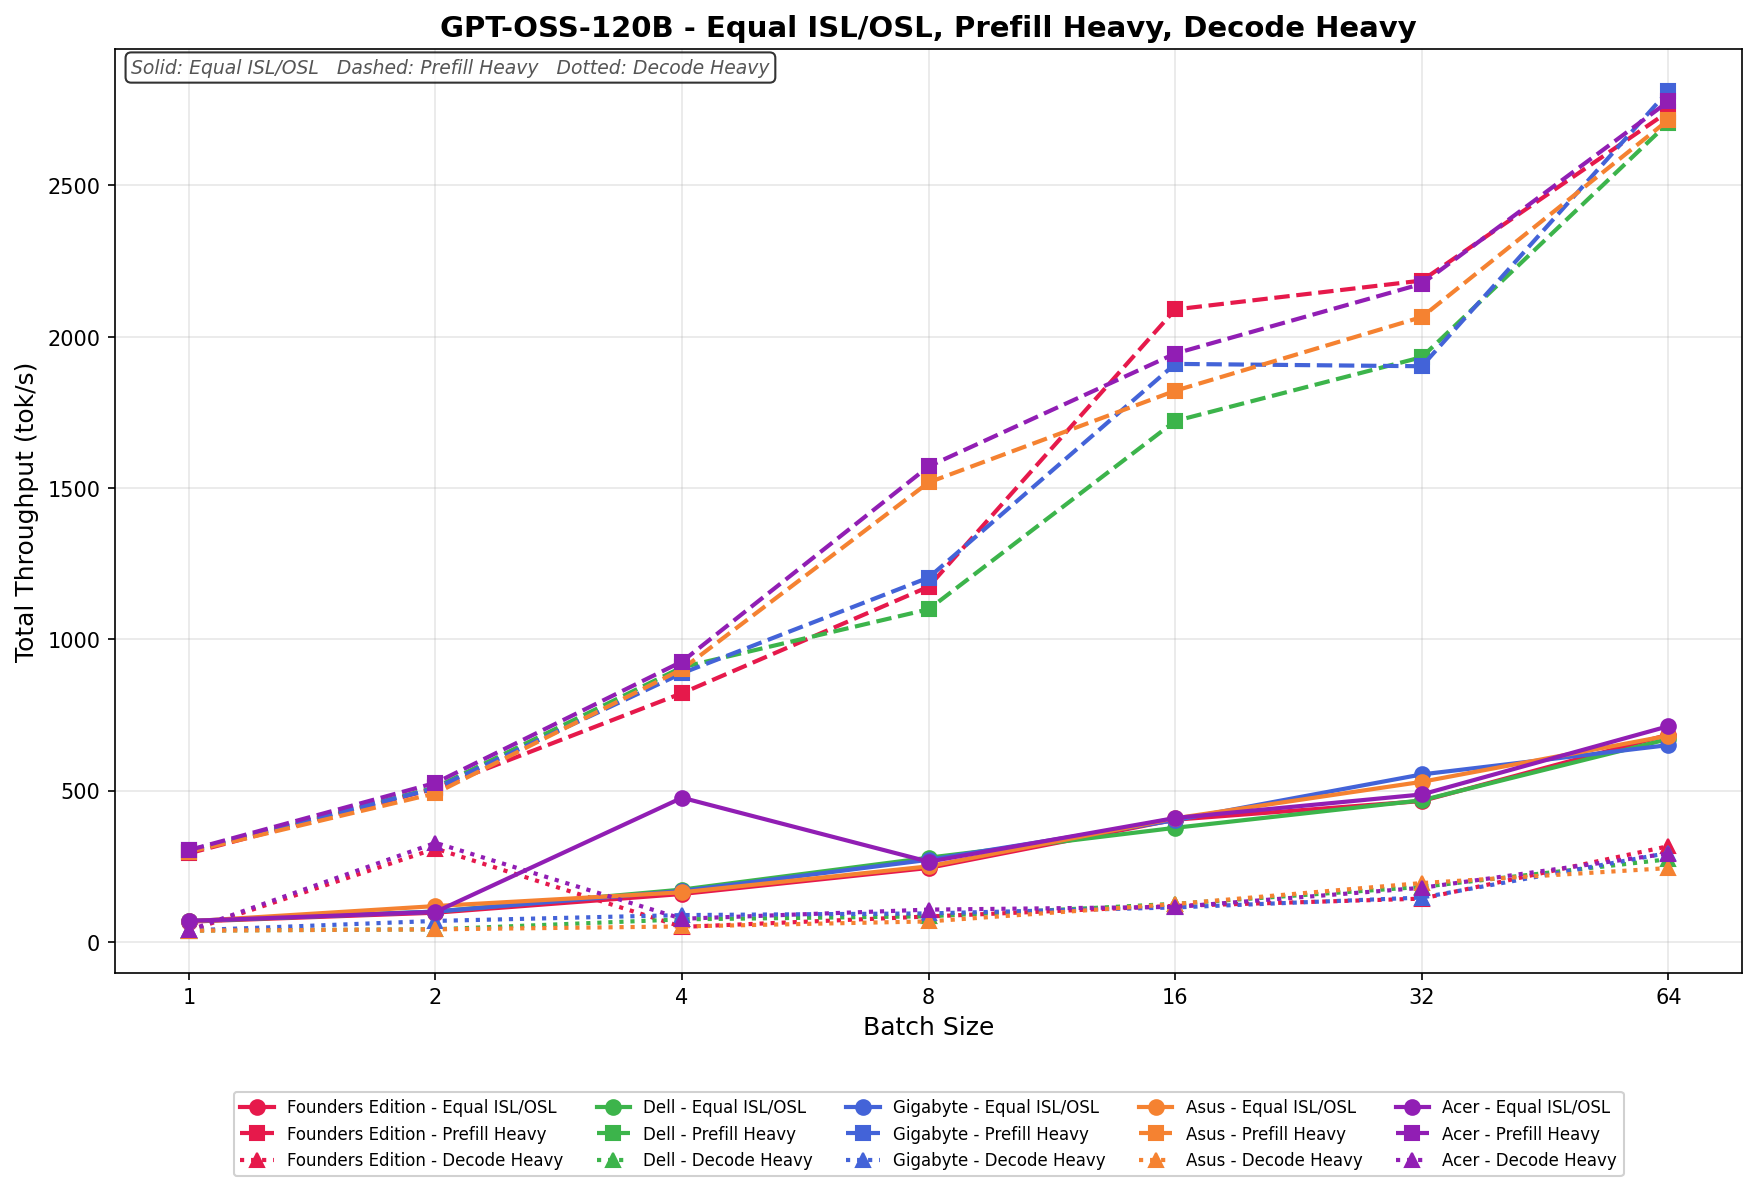
I Equal ISL/OSL skalar GIGABYTE från 60.71 till 649.62 tok/s, och ligger konsekvent i mitten av fältet och ligger nära Dell och Asus vid högre batchstorlekar. Skalningen är stadig och linjär fram till batch 32, med fortsatta vinster vid batch 64, även om den inte riktigt når om topprestörerna i den övre delen.
Prefill Heavy börjar på 304.63 tok/s och klättrar till 2 771,38 tok/s vid batchstorlek 64. Tillväxten är stark fram till batch 16, där GIGABYTE kortvarigt ligger trea från toppnivån, innan de konvergerar med den bredare gruppen vid större batchstorlekar. Den övergripande skalningen är aggressiv och konkurrenskraftig, särskilt i batchstorlekar i mellanklassen.
Decode Heavy varierar från 47.01 till 299.41 tok/s, med gradvis och konsekvent skalning över batch-svepet.
GPT-OSS-20B
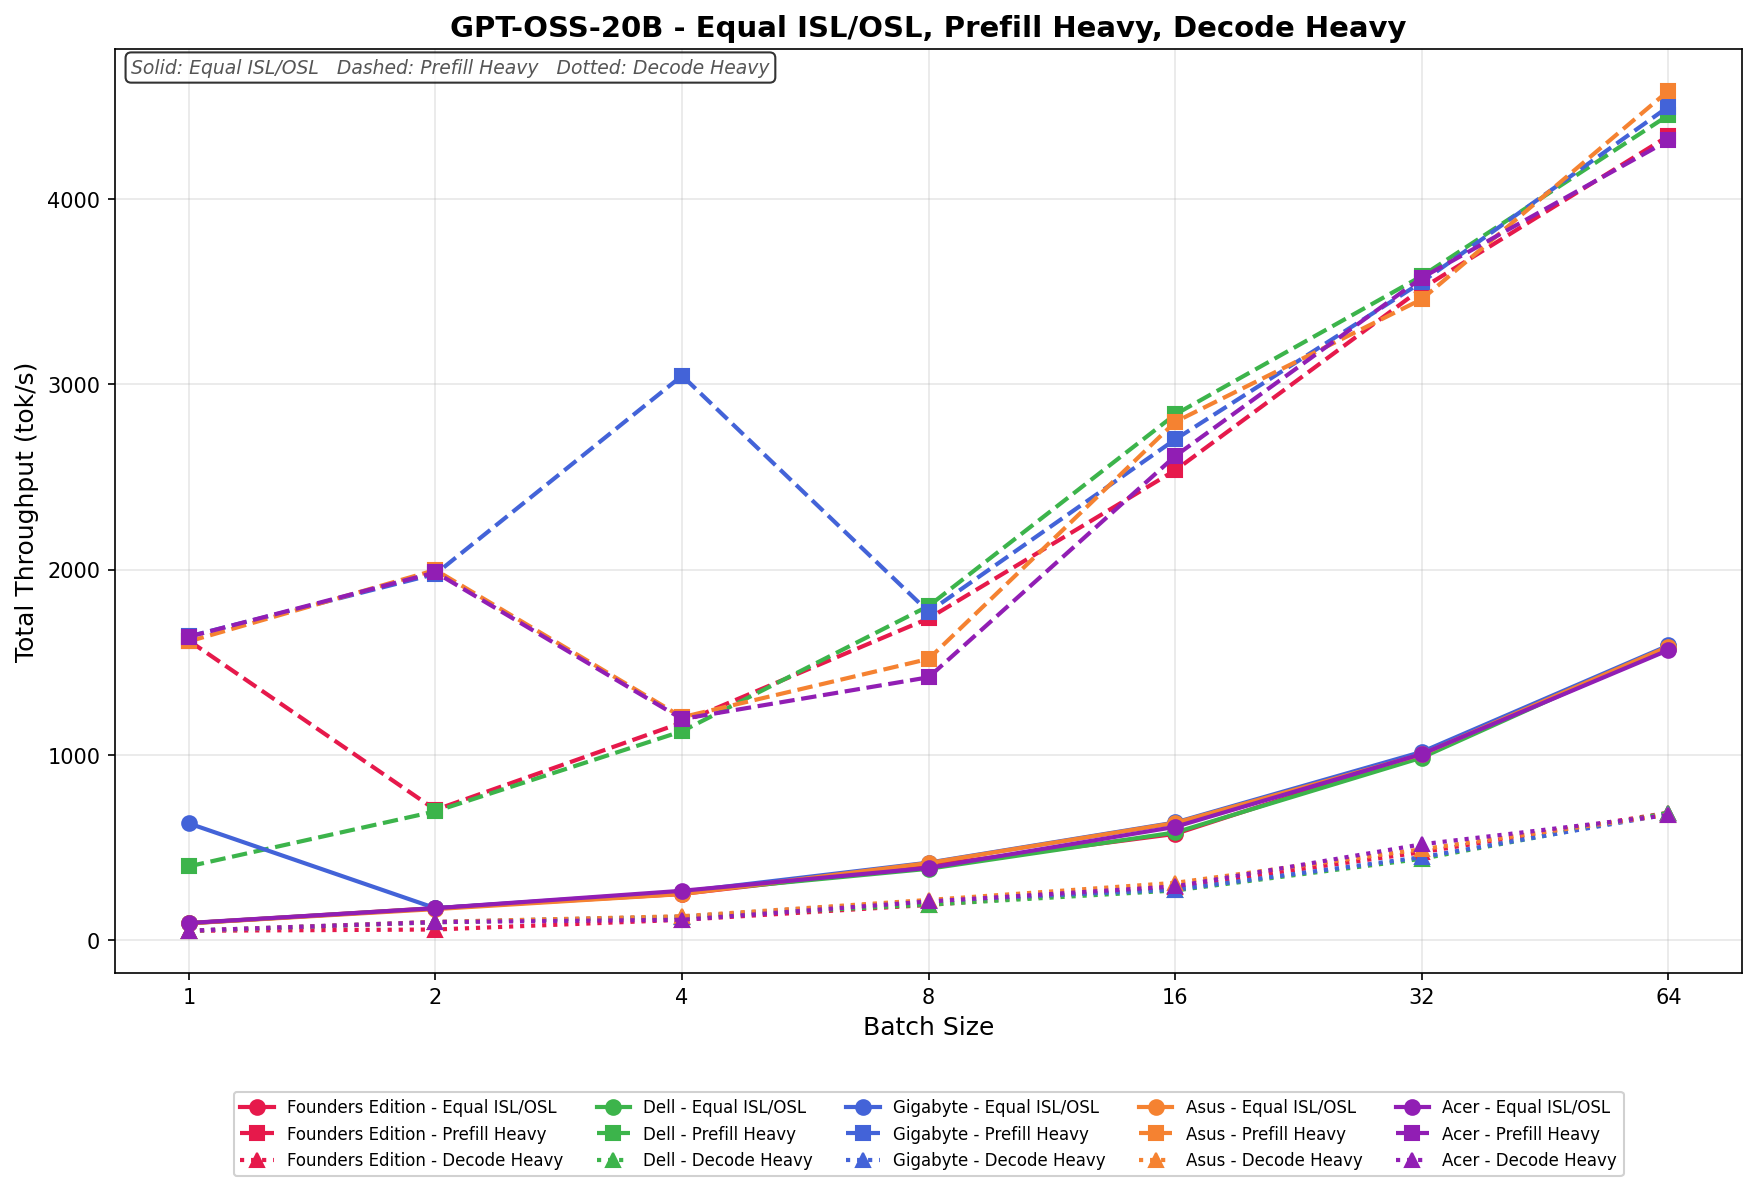
I Equal ISL/OSL skalar GIGABYTE från 641.73 till 1 587,62 tok/s, med en stark start vid batchstorlek 1 innan den sjunker vid batchstorlek 2 och sedan gradvis går vidare genom större batchstorlekar. Från och med batch 8 normaliseras skalningen och följer resten av fältet, och slutar nära toppnivån vid batchstorlek 64.
Förfyllning av tunga enheter börjar vid 1 650,32 tok/s och når sin topp vid 4 401,27 tok/s vid batchstorlek 64. Från och med batch 16 är skalningen konsekvent och konkurrenskraftig, och håller jämna steg med Dell och Asus genom de övre batchstorlekarna.
Decode Heavy varierar från 63.18 till 688.44 tok/s, med ren linjär skalning över svepområdet. Vinsterna är stegvisa men konsekventa, ligger nära de andra plattformarna och återspeglar det mer begränsade skalningsbeteendet som är typiskt för avkodningstunga arbetsbelastningar.
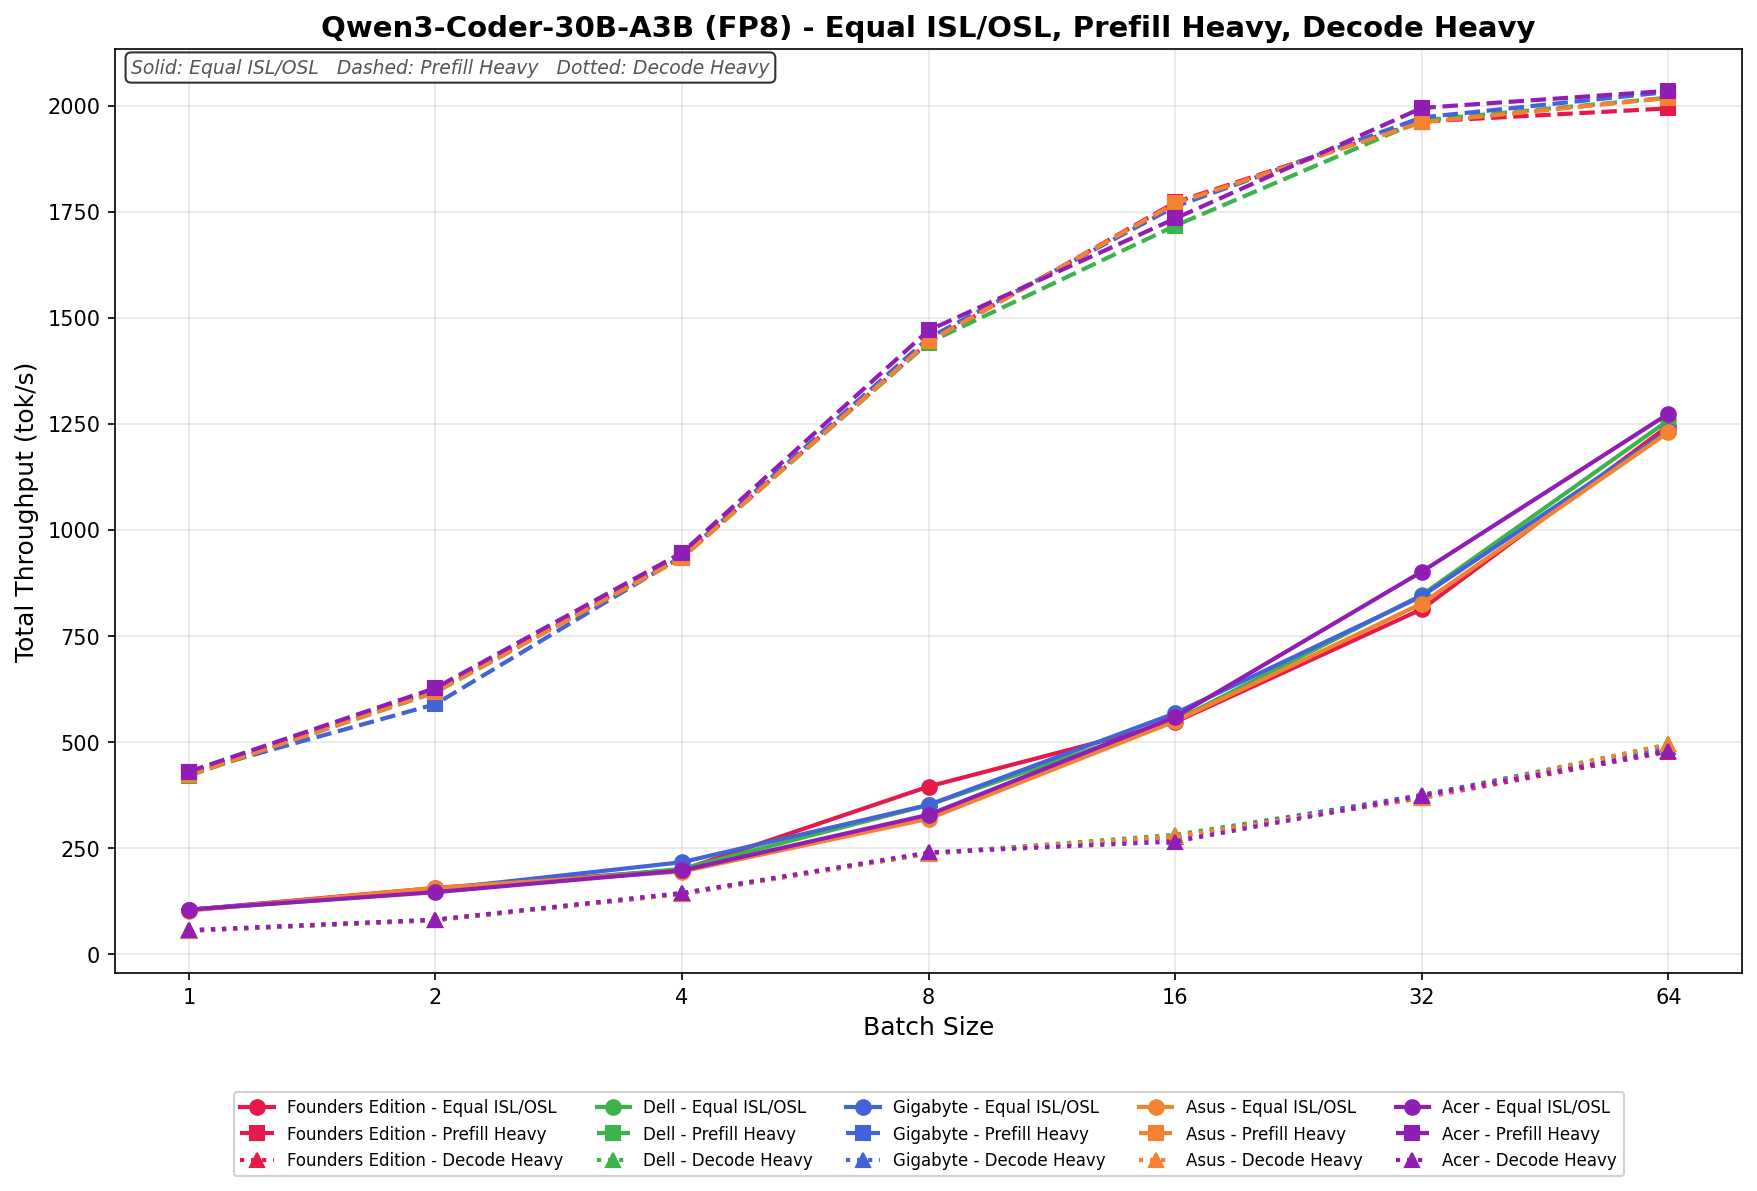
Qwen3-kodare 30B A3B FB8
I Equal ISL/OSL skalar GIGABYTE från 101.27 till 1 251,84 tok/s, vilket visar en stadig linjär progression över hela batchsvepet. Prestandan följer Dells och Asus jämnt fram till batch 16, fortsätter sedan att klättra rent fram till batch 64, och slutar nära den övre nivån utan några märkbara skalningsavvikelser.
Prefill Heavy börjar på 428.66 tok/s och skalas upp till 2 026,94 tok/s när batchstorleken ökar till 64. Tillväxten är jämn och konsekvent över alla batchstorlekar, där GIGABYTE förblir nära grupperat med det bredare fältet.
Decode Heavy varierar från 61.18 till 482.73 tok/s, med förutsägbara, stegvisa vinster allt eftersom batchstorlekarna ökar.
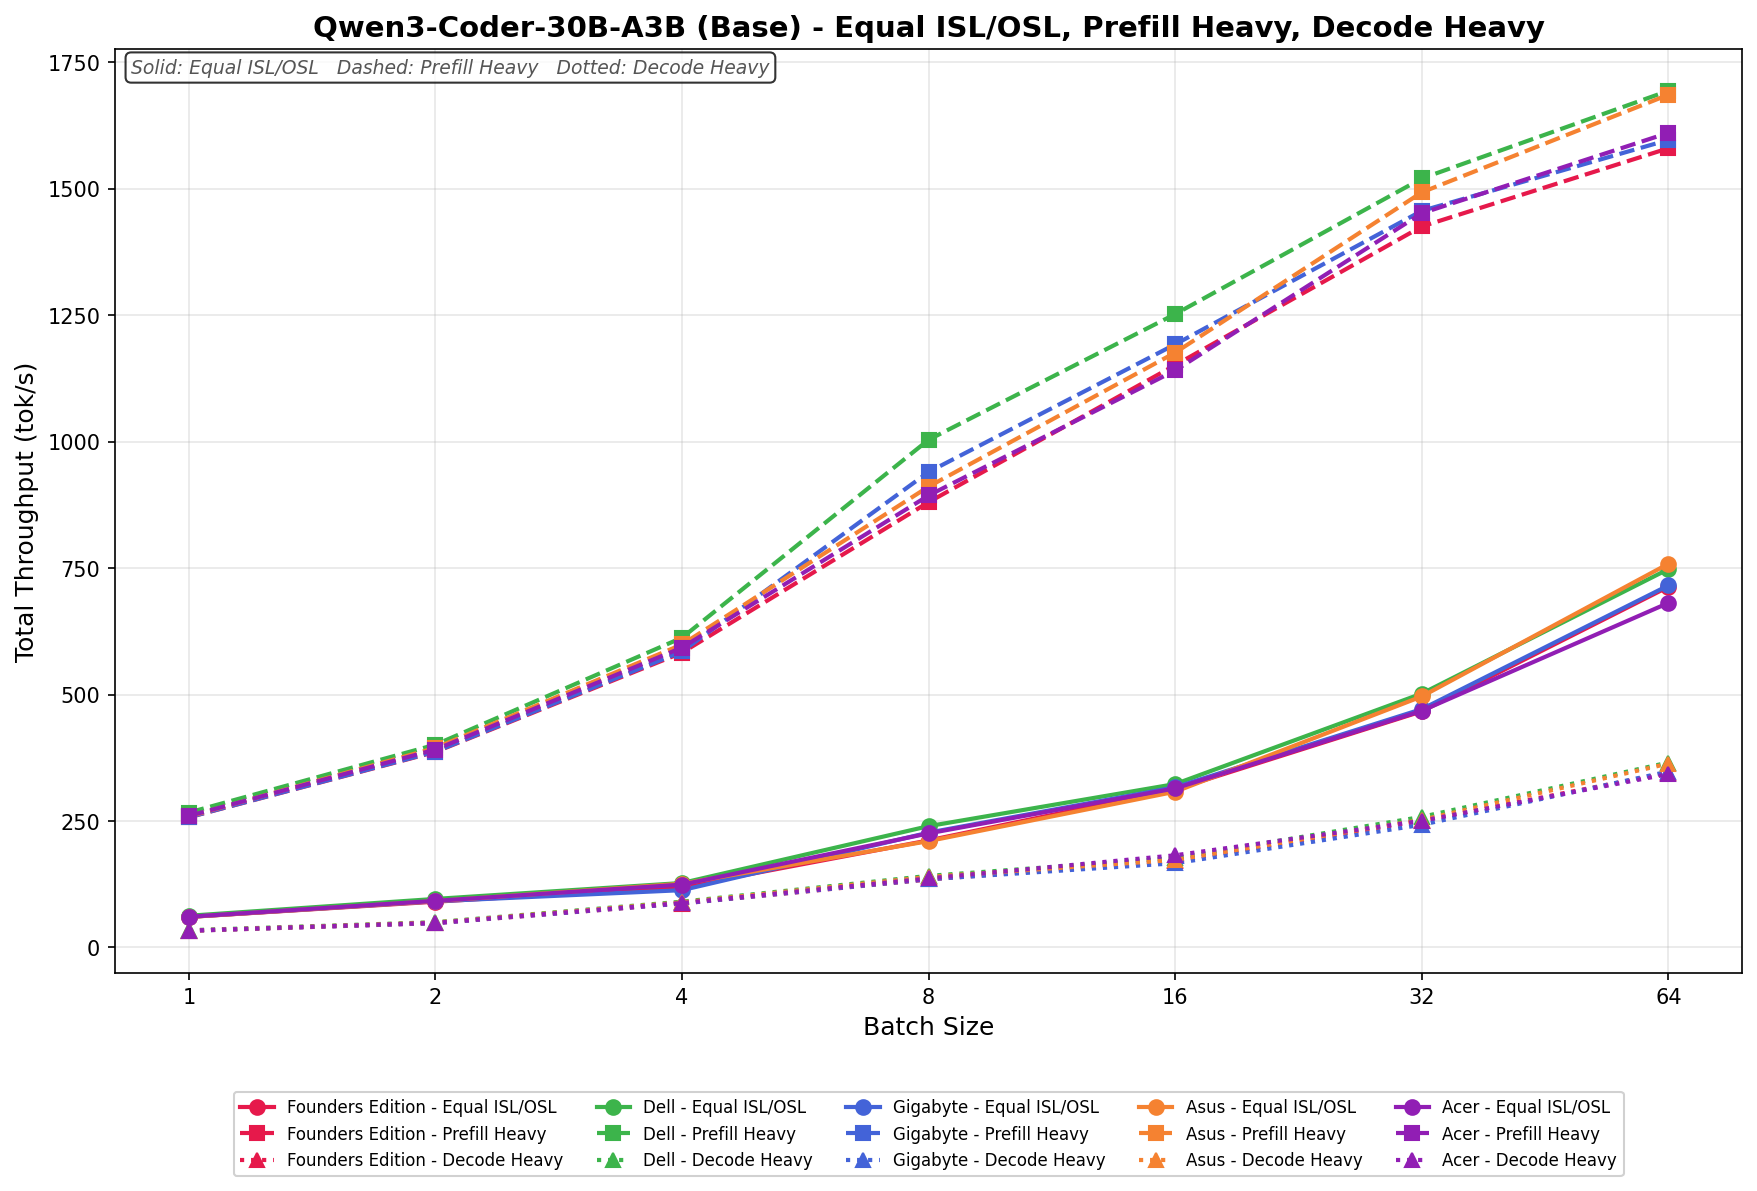
Qwen3-kodare 30B A3B-bas
I Equal ISL/OSL skalar GIGABYTE från 63.42 till 721.08 tok/s och ökar stadigt över hela batchintervallet. Prestandan här följer det bredare fältet fram till batch 16 och fortsätter att skala rent fram till batch 64, och avslutar konkurrenskraftigt utan någon märkbar avvikelse från linjärt beteende.
Prefill Heavy börjar vid 258.11 tok/s och klättrar till 1 603,74 tok/s vid batchstorlek 64.
Decode Heavy varierar från 33.57 till 349.82 tok/s, med stegvis, linjär skalning över svepområdet.
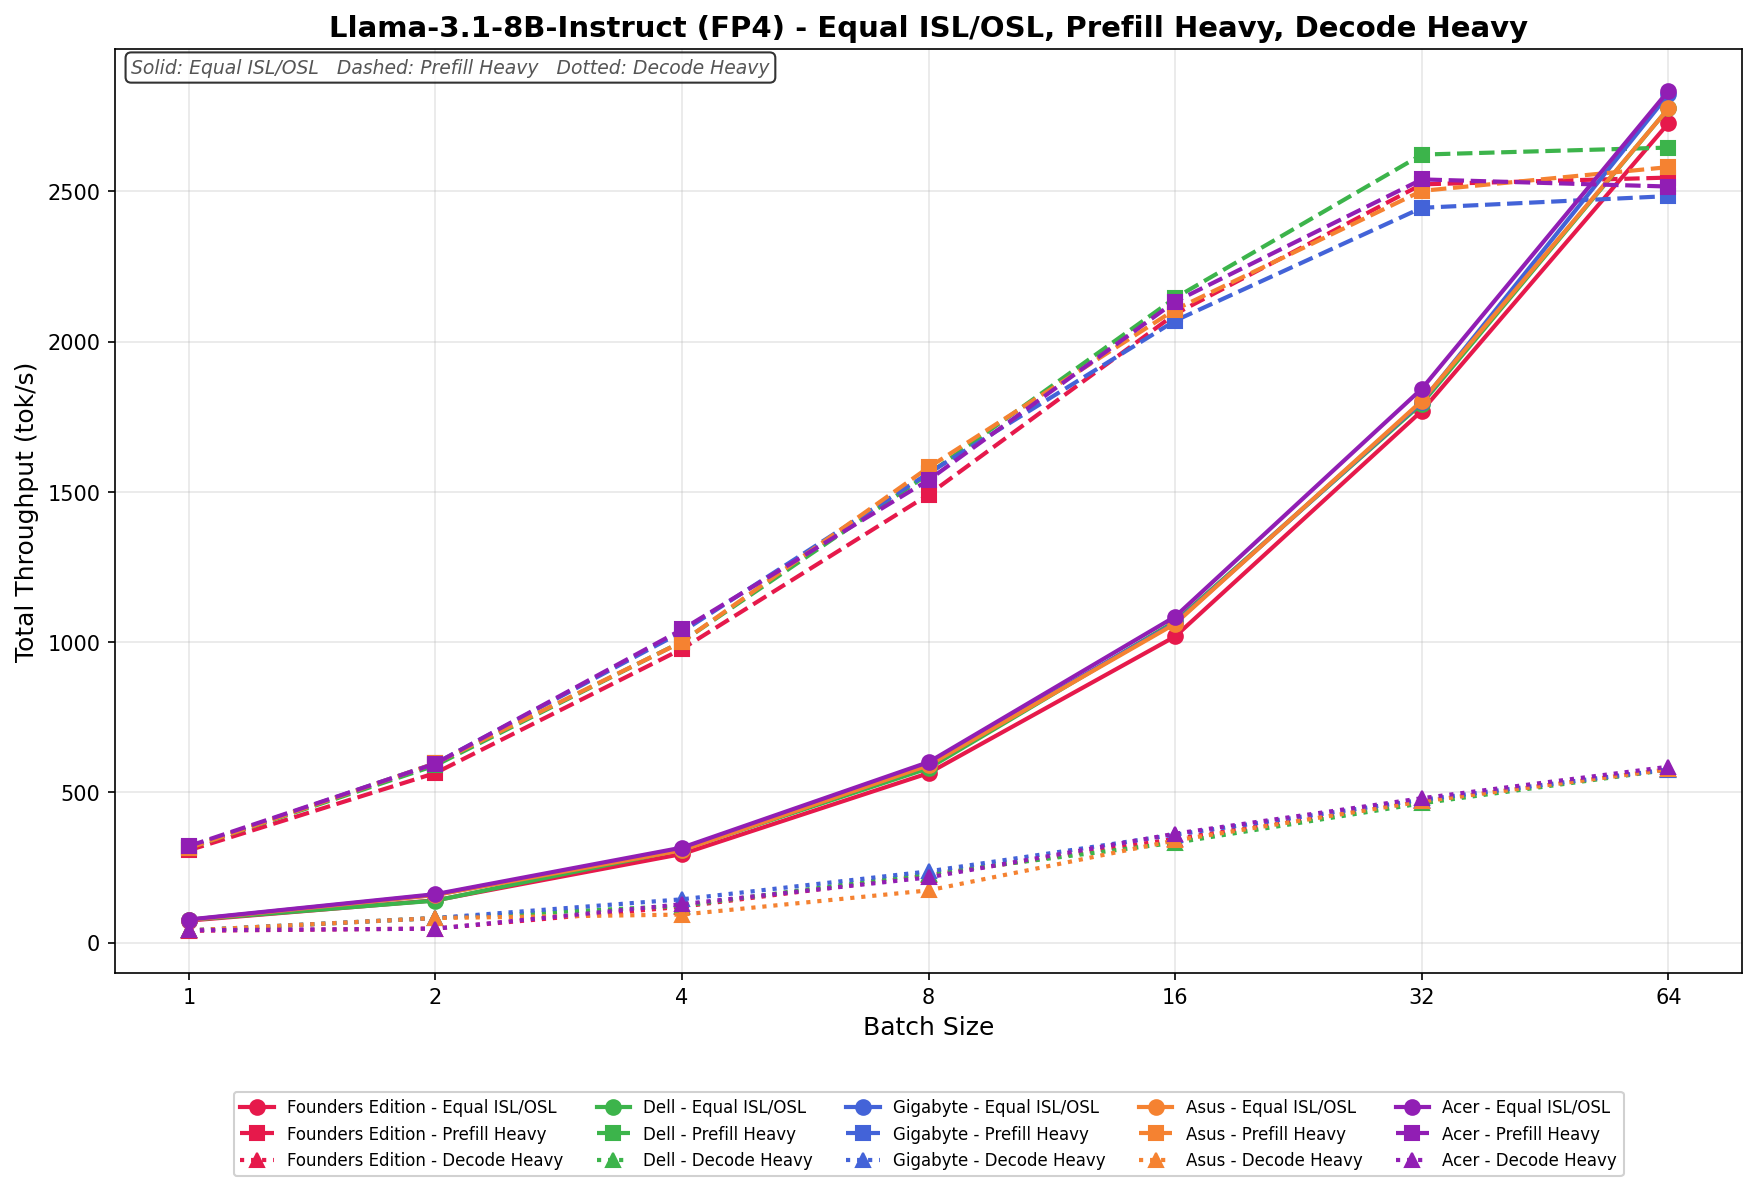
Llama 3.1 8B Instruktion FP4
I Equal ISL/OSL ökar GIGABYTE från 69.84 till 2 756,91 tok/s över batch-svepet. Skalningen är progressiv och välbalanserad fram till batch 32, där dataflödet närmar sig den övre nivån, innan den levererar ett starkt hopp vid batch 64, vilket placerar det bland de ledande systemen på högre samtidighetsnivåer.
Prefill Heavy börjar på 321.67 tok/s och når 2 493,52 tok/s vid batchstorlek 64. Tillväxten är stadig fram till batch 16 och börjar sedan avta något vid högre batchstorlekar i förhållande till den högst presterande, vilket indikerar en solid men inte dominerande effektivitet vid skalning av stora batcher.
Decode Heavy varierar från 48.92 till 575.84 tok/s, med konsekventa stegvisa vinster allt eftersom batchstorleken ökar.
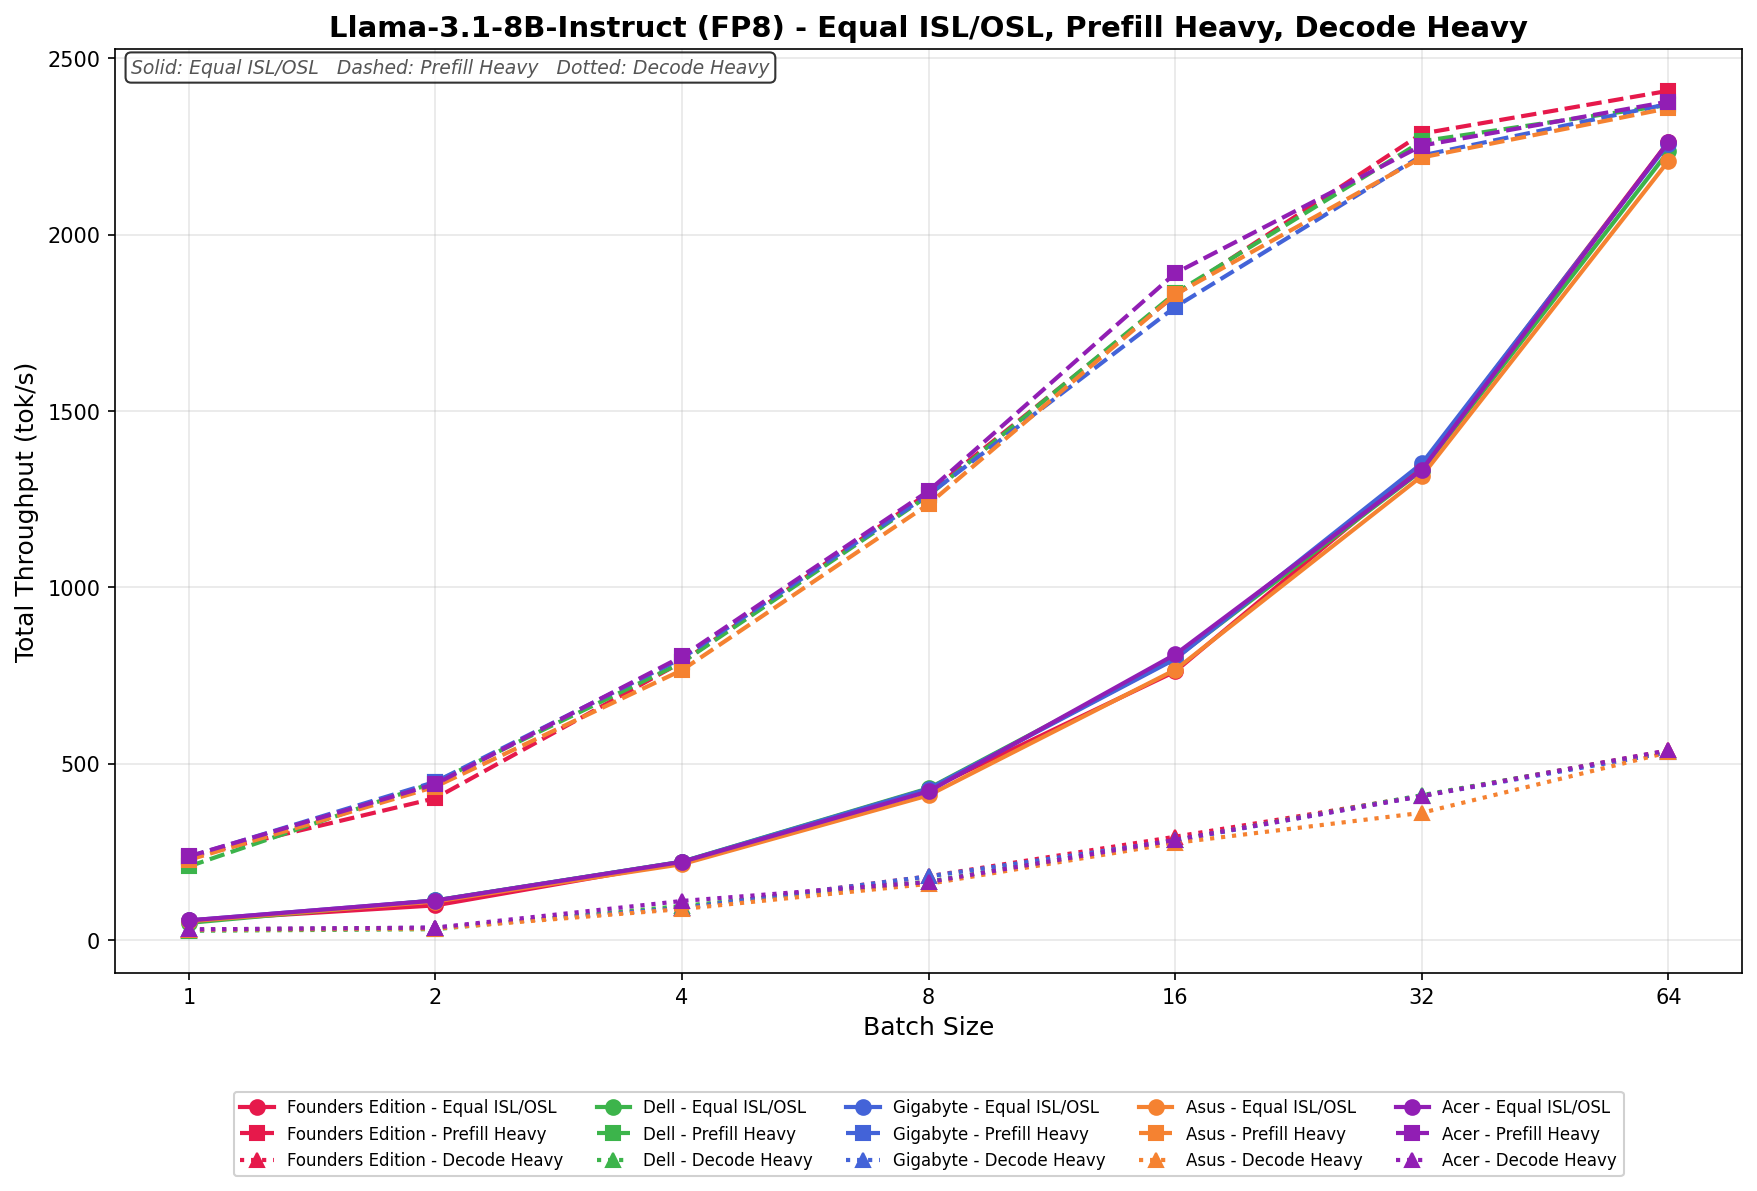
Llama 3.1 8B Instruktion FP8
I Equal ISL/OSL skalar GIGABYTE från 54.12 till 2 314,87 tok/s, och visar jämn, linjär tillväxt fram till batch 32 och en stark satsning vid batch 64 som håller det konkurrenskraftigt på högre samtidighetsnivåer.
Förfyllning av tunga batcher börjar vid 226.43 tok/s och når 2 332,19 tok/s vid batchstorlek 64. Skalningen är konsekvent över hela svepområdet, följer noggrant det bredare fältet och bibehåller en god effektivitet vid större batchstorlekar.
Decode Heavy varierar från 32.88 till 522.41 tok/s, med stadiga stegvisa ökningar allt eftersom batchstorleken ökar. Som förväntat förblir skalningen mer begränsad i förhållande till Equal- och Prefill-arbetsbelastningar.
GPU direkt lagring
Ett av testerna vi utförde på Spark var MagnumIO GPU Direct Storage (GDS)-testet. GDS är en funktion utvecklad av NVIDIA som gör det möjligt för GPU:er att kringgå processorn vid åtkomst till data lagrad på NVMe-enheter eller andra höghastighetslagringsenheter. Istället för att dirigera data genom processorn och systemminnet möjliggör GDS direkt kommunikation mellan GPU:n och lagringsenheten, vilket avsevärt minskar latensen och förbättrar dataflödet.
Gigabyte använder Samsung PM9E1 Gen5 SSD på 4 TB i AI TOP ATOM, vilket hittills är den snabbaste 2242 M.2-disken vi sett på marknaden. Det är samma SSD som vi sett i FE Spark och Acer Veriton GN100.
Hur GPU Direct Storage fungerar
Traditionellt sett, när en GPU bearbetar data som lagras på en NVMe-enhet, måste informationen först passera genom processorn och systemminnet innan den når GPU:n. Denna process skapar flaskhalsar eftersom processorn fungerar som en mellanhand, vilket ökar latensen och förbrukar värdefulla systemresurser. GPU Direct Storage eliminerar denna ineffektivitet genom att göra det möjligt för GPU:n att komma åt data direkt från lagringsenheten via PCIe-bussen. Denna direkta väg minskar dataöverföringskostnaden, vilket möjliggör snabbare och effektivare dataöverföringar.
AI-arbetsbelastningar, särskilt de som involverar djupinlärning, är mycket dataintensiva. Att träna stora neurala nätverk kräver bearbetning av terabyte med data, och varje fördröjning i dataöverföringen kan leda till underutnyttjade GPU:er och längre träningstider. GPU Direct Storage hanterar denna utmaning genom att säkerställa att data levereras till GPU:n så snabbt som möjligt, vilket minimerar vilotiden och maximerar beräkningseffektiviteten.
Dessutom är GDS särskilt fördelaktigt för arbetsbelastningar som involverar streaming av stora datamängder, såsom videobearbetning, naturlig språkbehandling eller realtidsinferens. Genom att minska beroendet av CPU:n påskyndar GDS datarörelsen och frigör CPU-resurser för andra uppgifter, vilket ytterligare förbättrar den övergripande systemets prestanda.
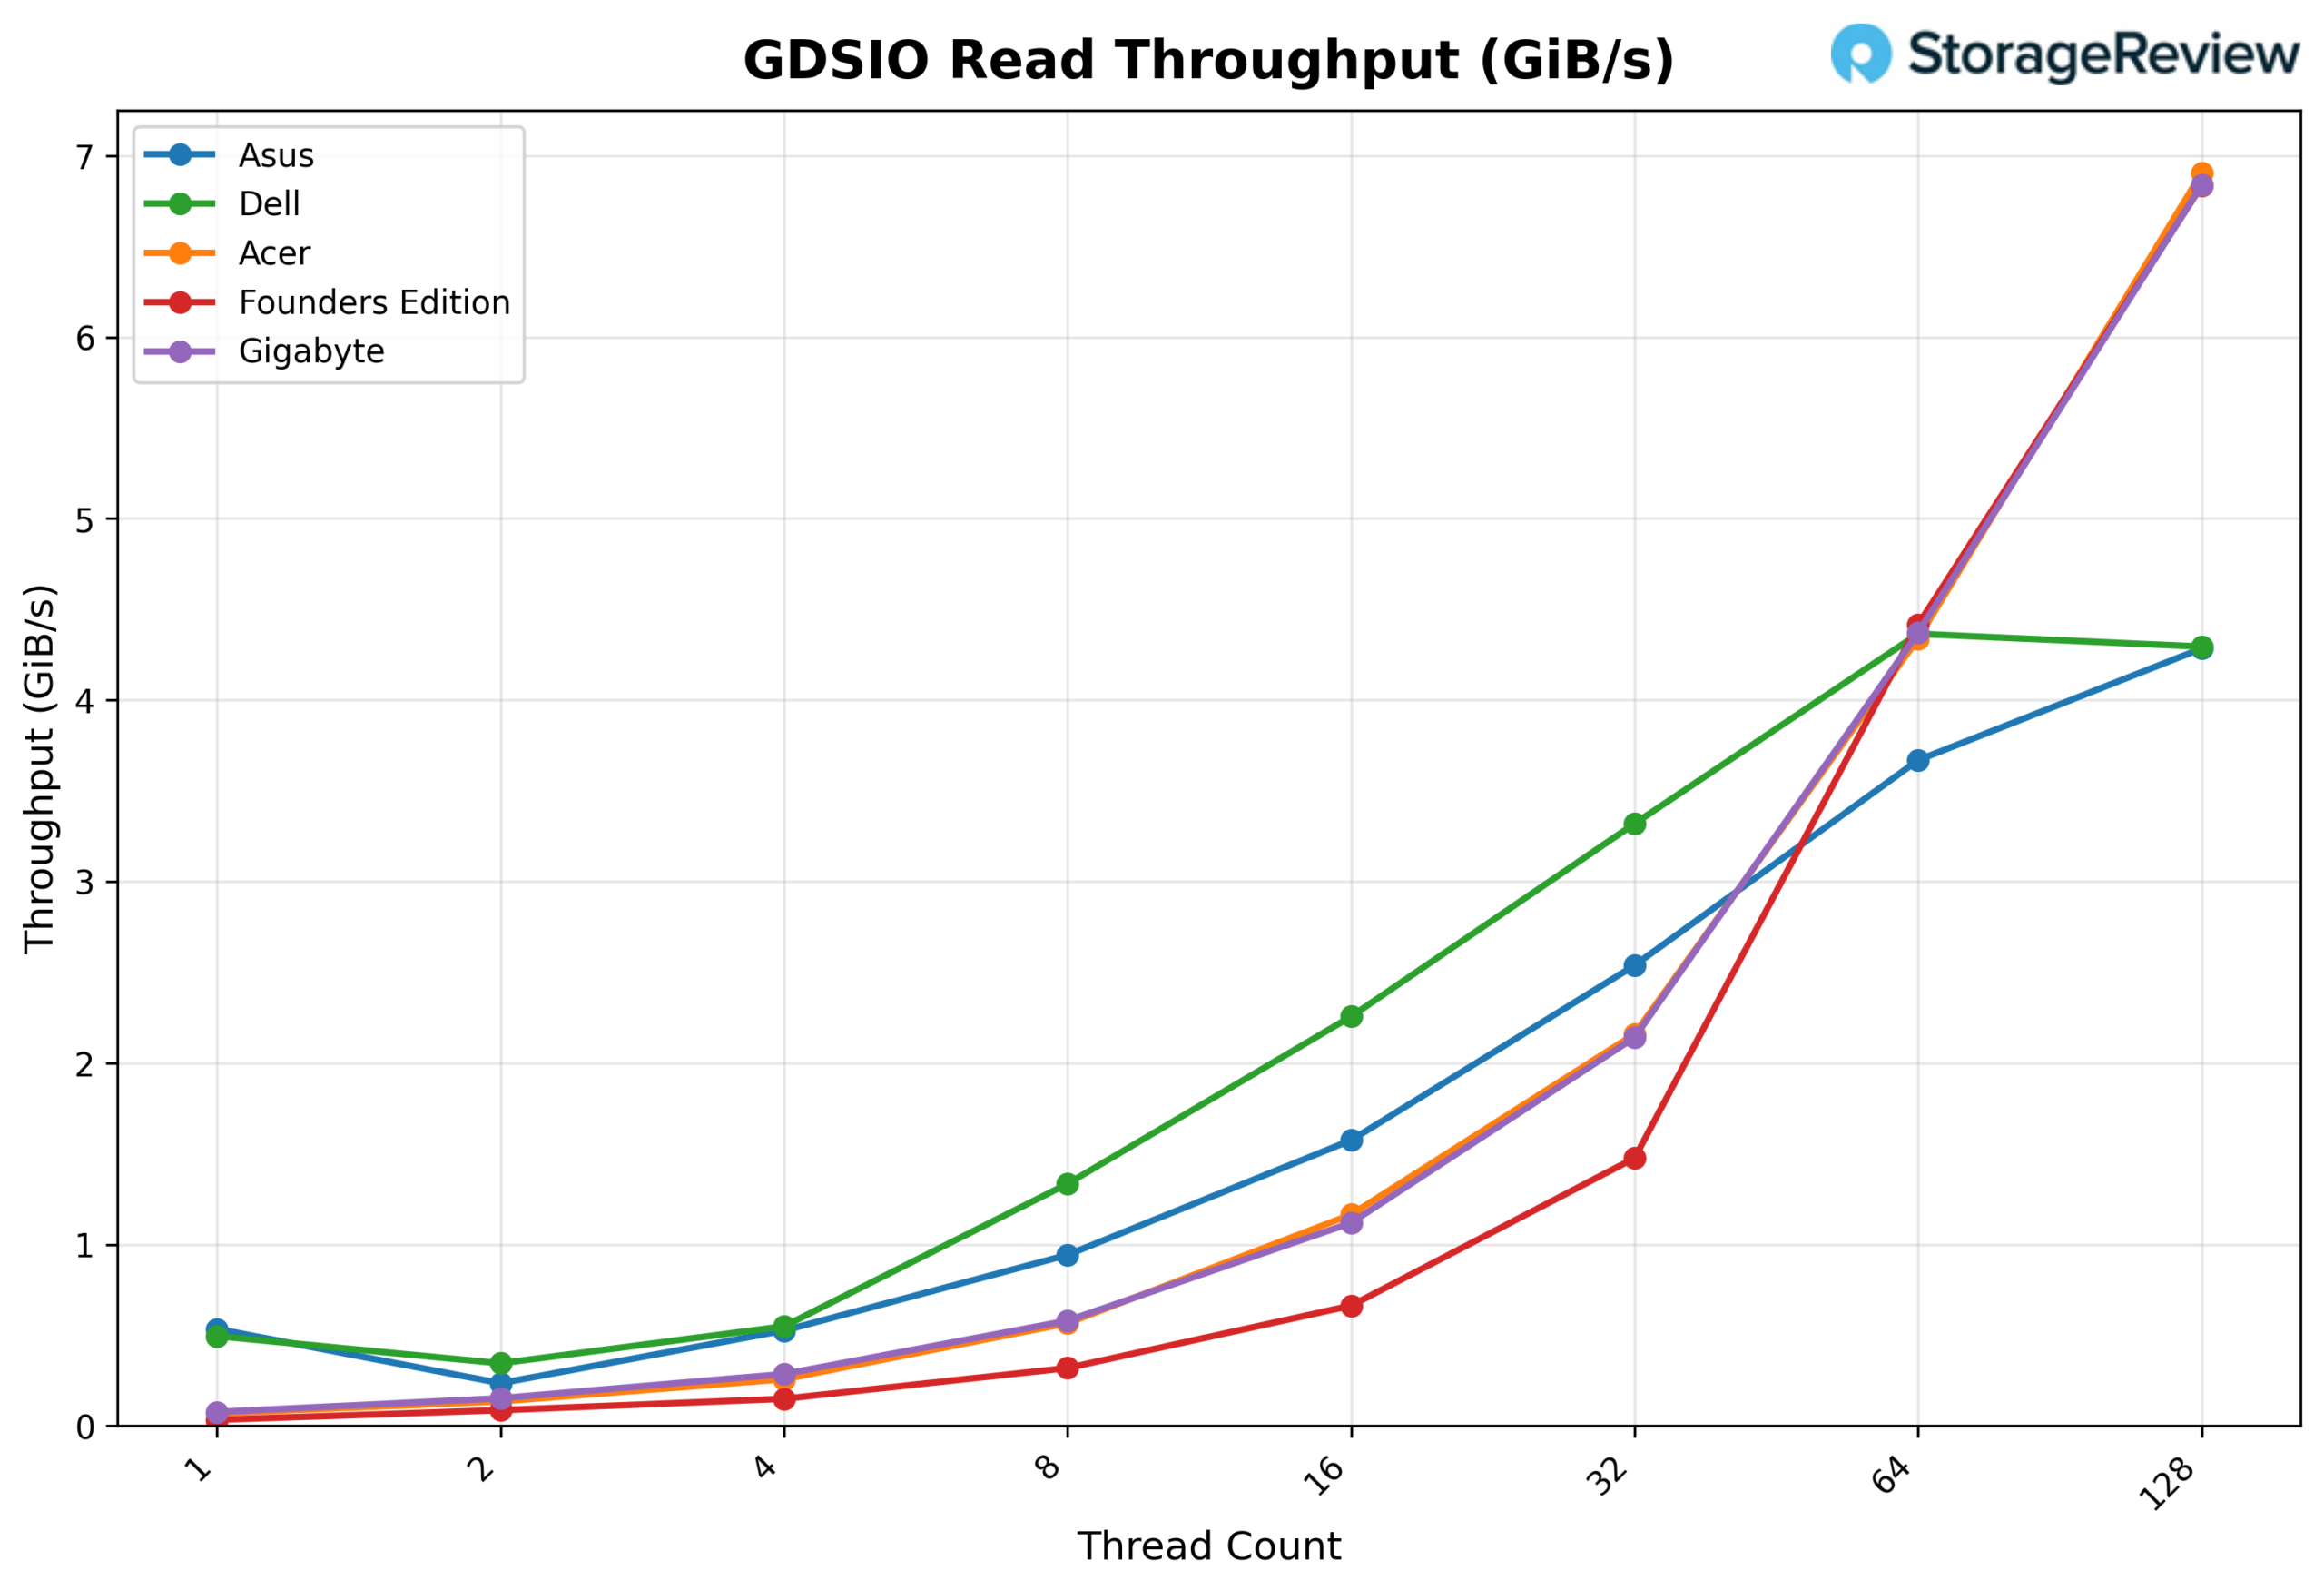
GDSIO-läsdataflöde 16k
Om man tittar på GDSIO Read Throughput 16K börjar GIGABYTE på cirka 0.08 GiB/s vid 1 tråd och klättrar till 0.58 GiB/s vid 8 trådar. Därifrån fortsätter den att skala rent vid 16 trådar (1.12 GiB/s) och 32 trådar (2.14 GiB/s), innan den ökar kraftigt vid 64 trådar till 4.37 GiB/s. Vid 128 trådar fortsätter GIGABYTE att skala till 6.84 GiB/s och visar inga tecken på att plana ut i den övre delen av trådintervallet.
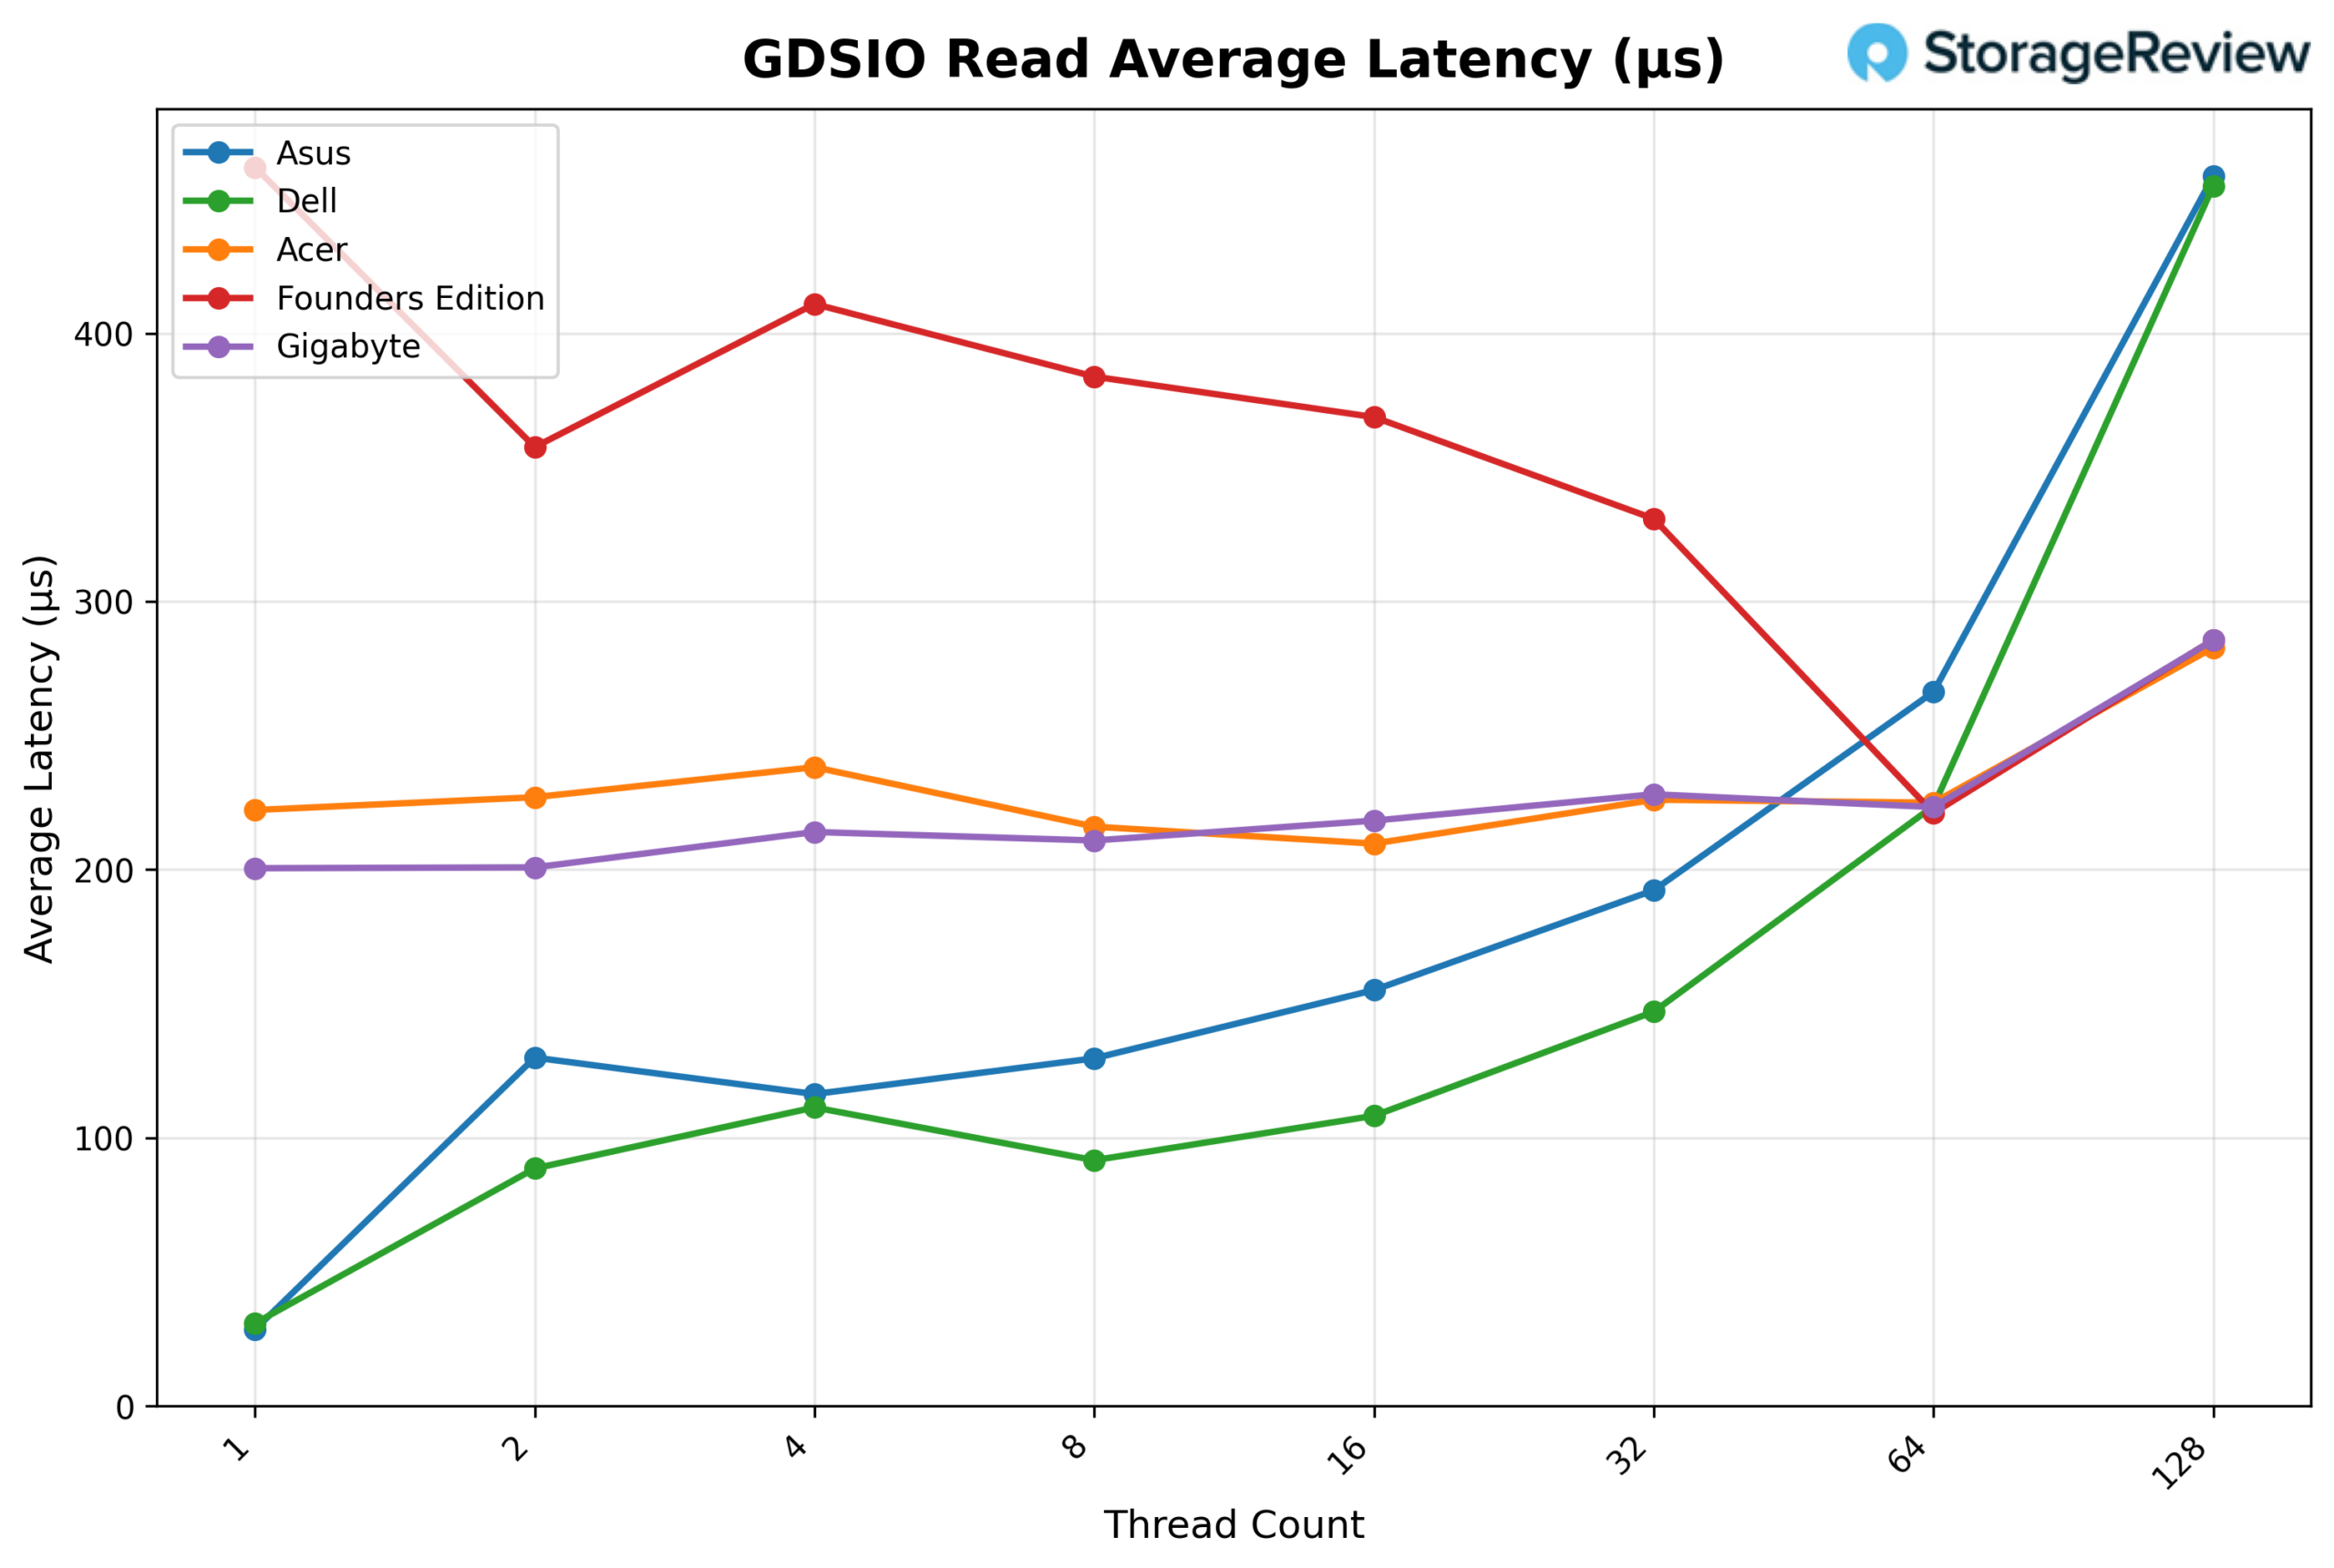
GDSIO-läsning Genomsnittlig latens 16K
Om man tittar på GDSIO Read Average Latency (16K) har GIGABYTE en mycket stabil latens över större delen av kurvan. Den börjar på ungefär 0.201 ms på 1 tråd och ligger tätt grupperad i intervallet ~0.21–0.23 ms från 2 trådar till 64 trådar (t.ex. 0.211 ms vid 8 trådar, 0.218 ms vid 16 trådar, 0.228 ms vid 32 trådar och 0.223 ms vid 64 trådar). Det är först vid 128 trådar som latensen ökar mer märkbart till cirka 0.286 ms, medan dataflödet fortsätter att öka.
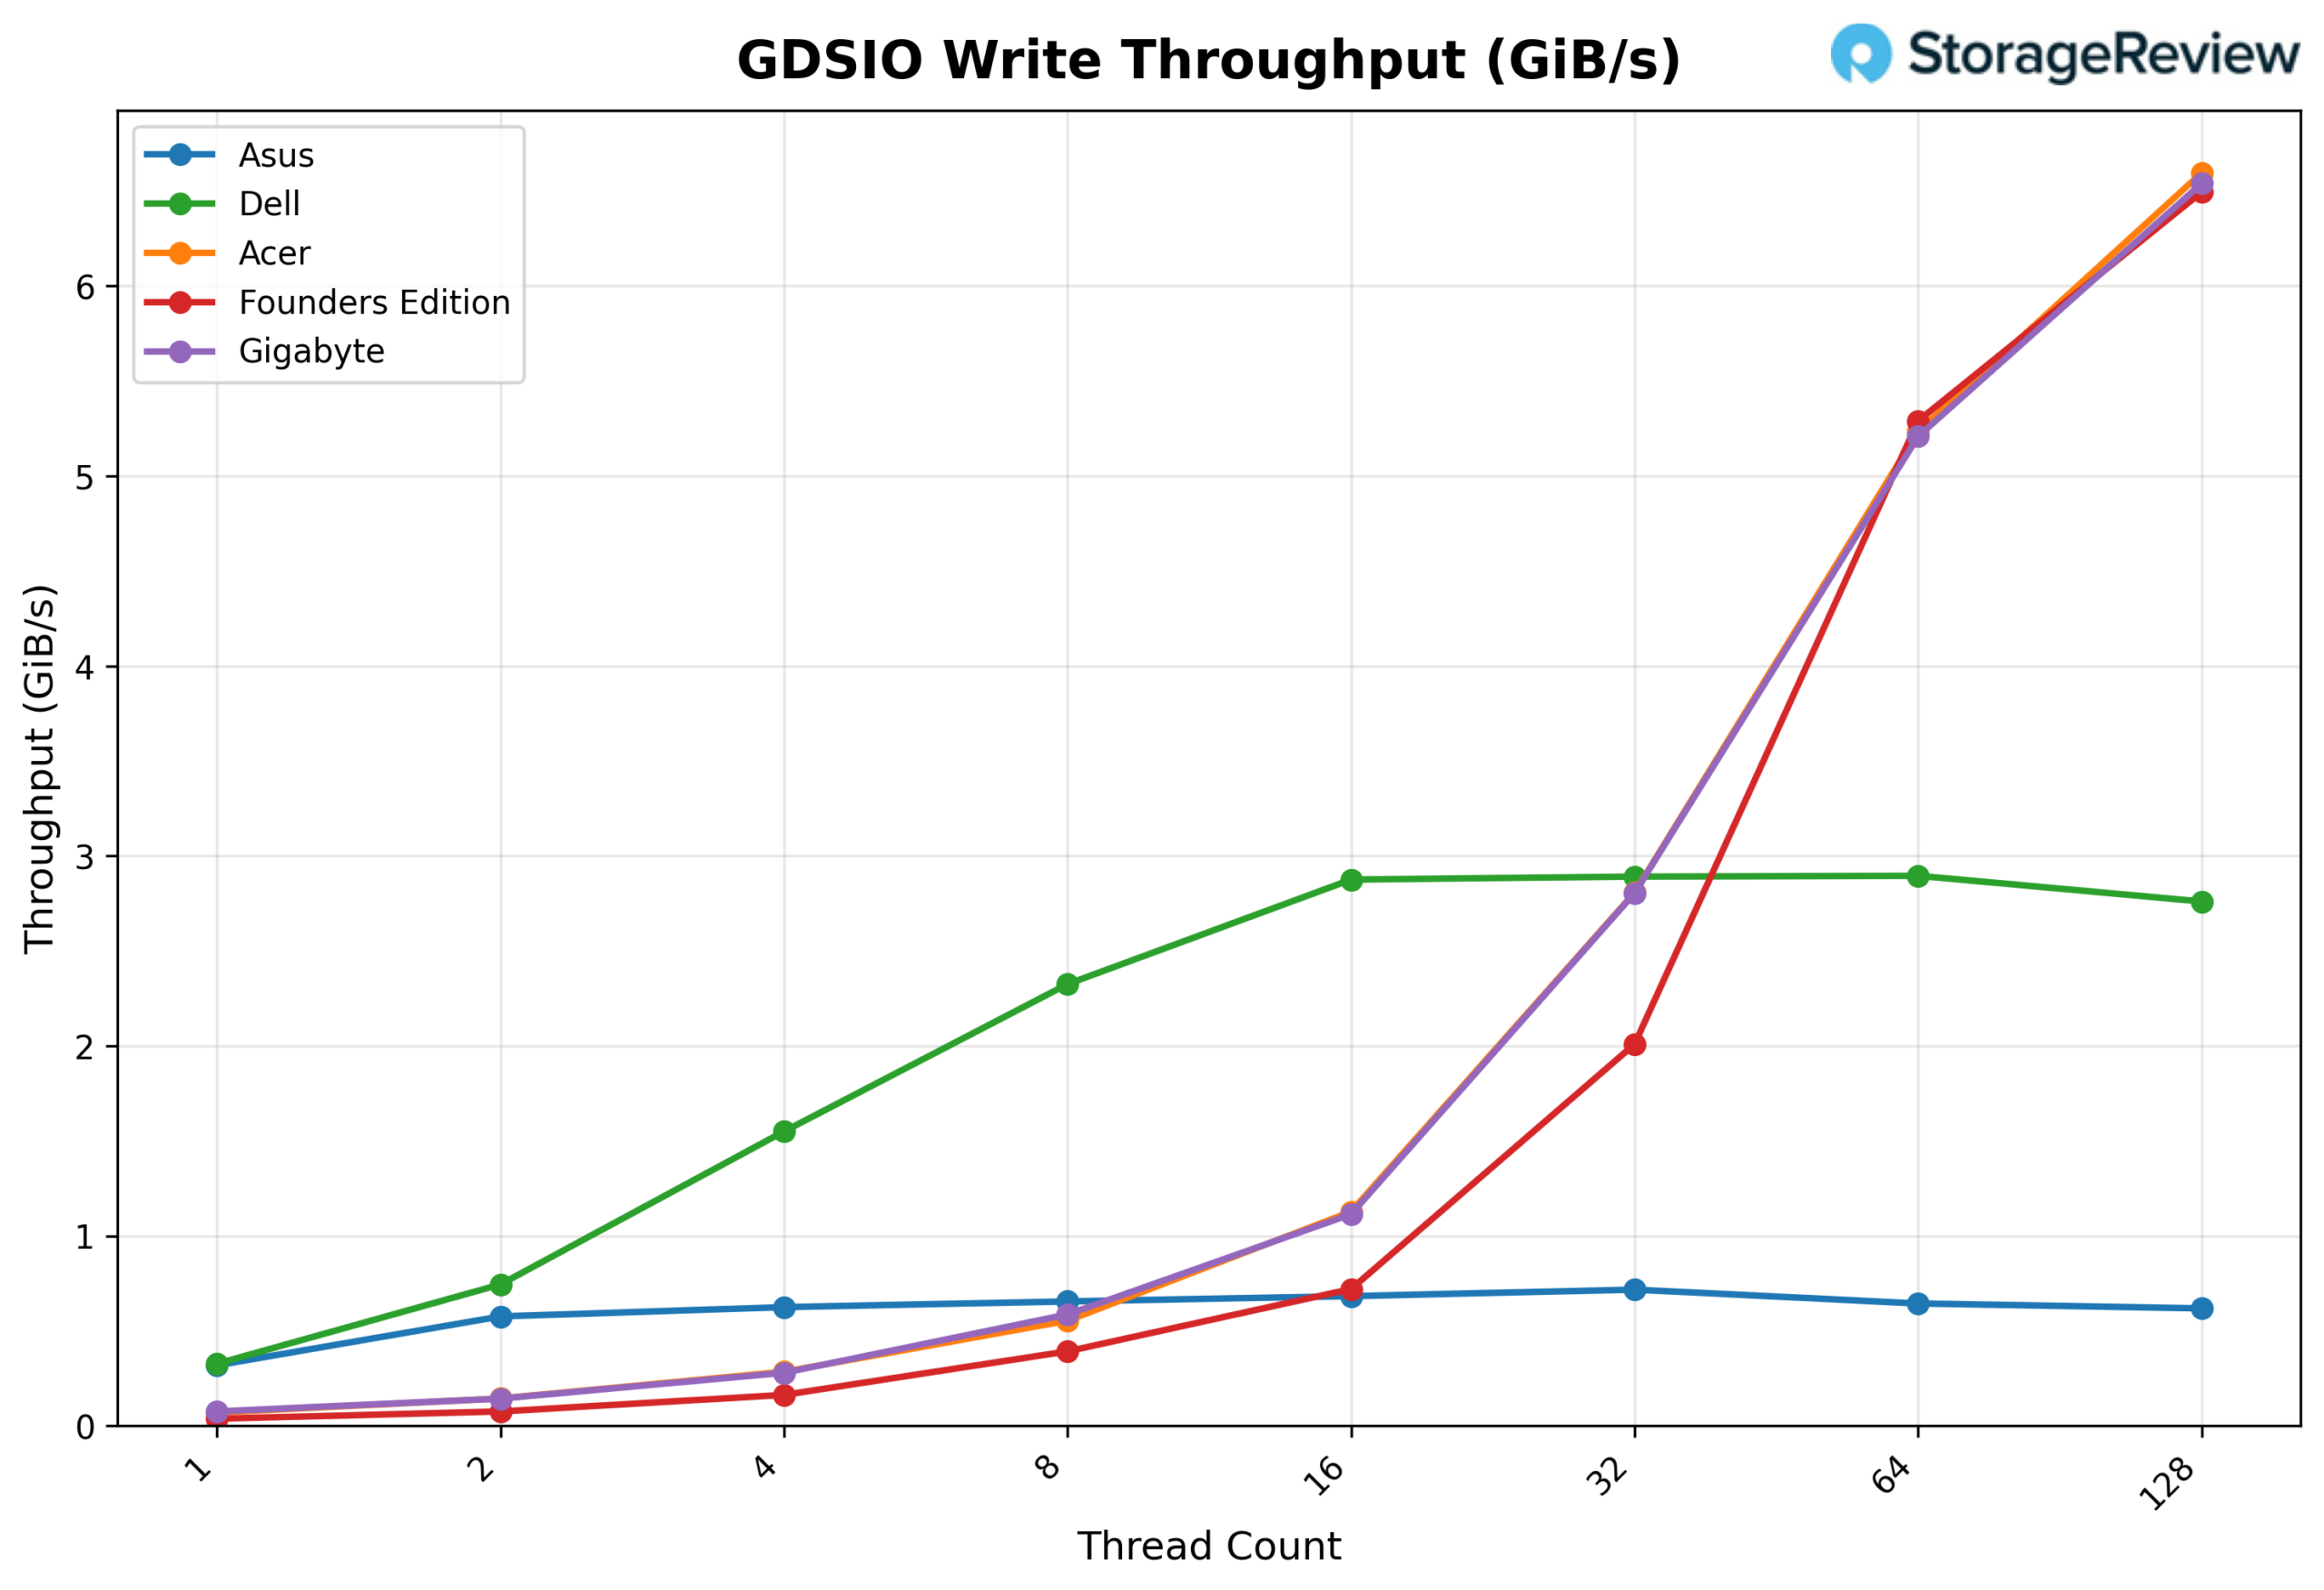
GSDIO-skrivdataflöde 16K
Om man tittar på GDSIO Write Throughput 16K börjar GIGABYTE på cirka 0.08 GiB/s vid 1 tråd, skalar stadigt till 0.14 GiB/s vid 2 trådar och 0.28 GiB/s vid 4 trådar. Prestandan fortsätter att klättra tydligt vid 8 trådar (0.59 GiB/s) och 16 trådar (1.11 GiB/s) innan den ökar mer aggressivt vid 32 trådar (2.80 GiB/s). Skalningen är fortsatt stark vid 64 trådar (5.21 GiB/s) och når sin topp vid 6.54 GiB/s vid 128 trådar, vilket visar fortsatt uppåtgående rörelse utan en tidig platå.
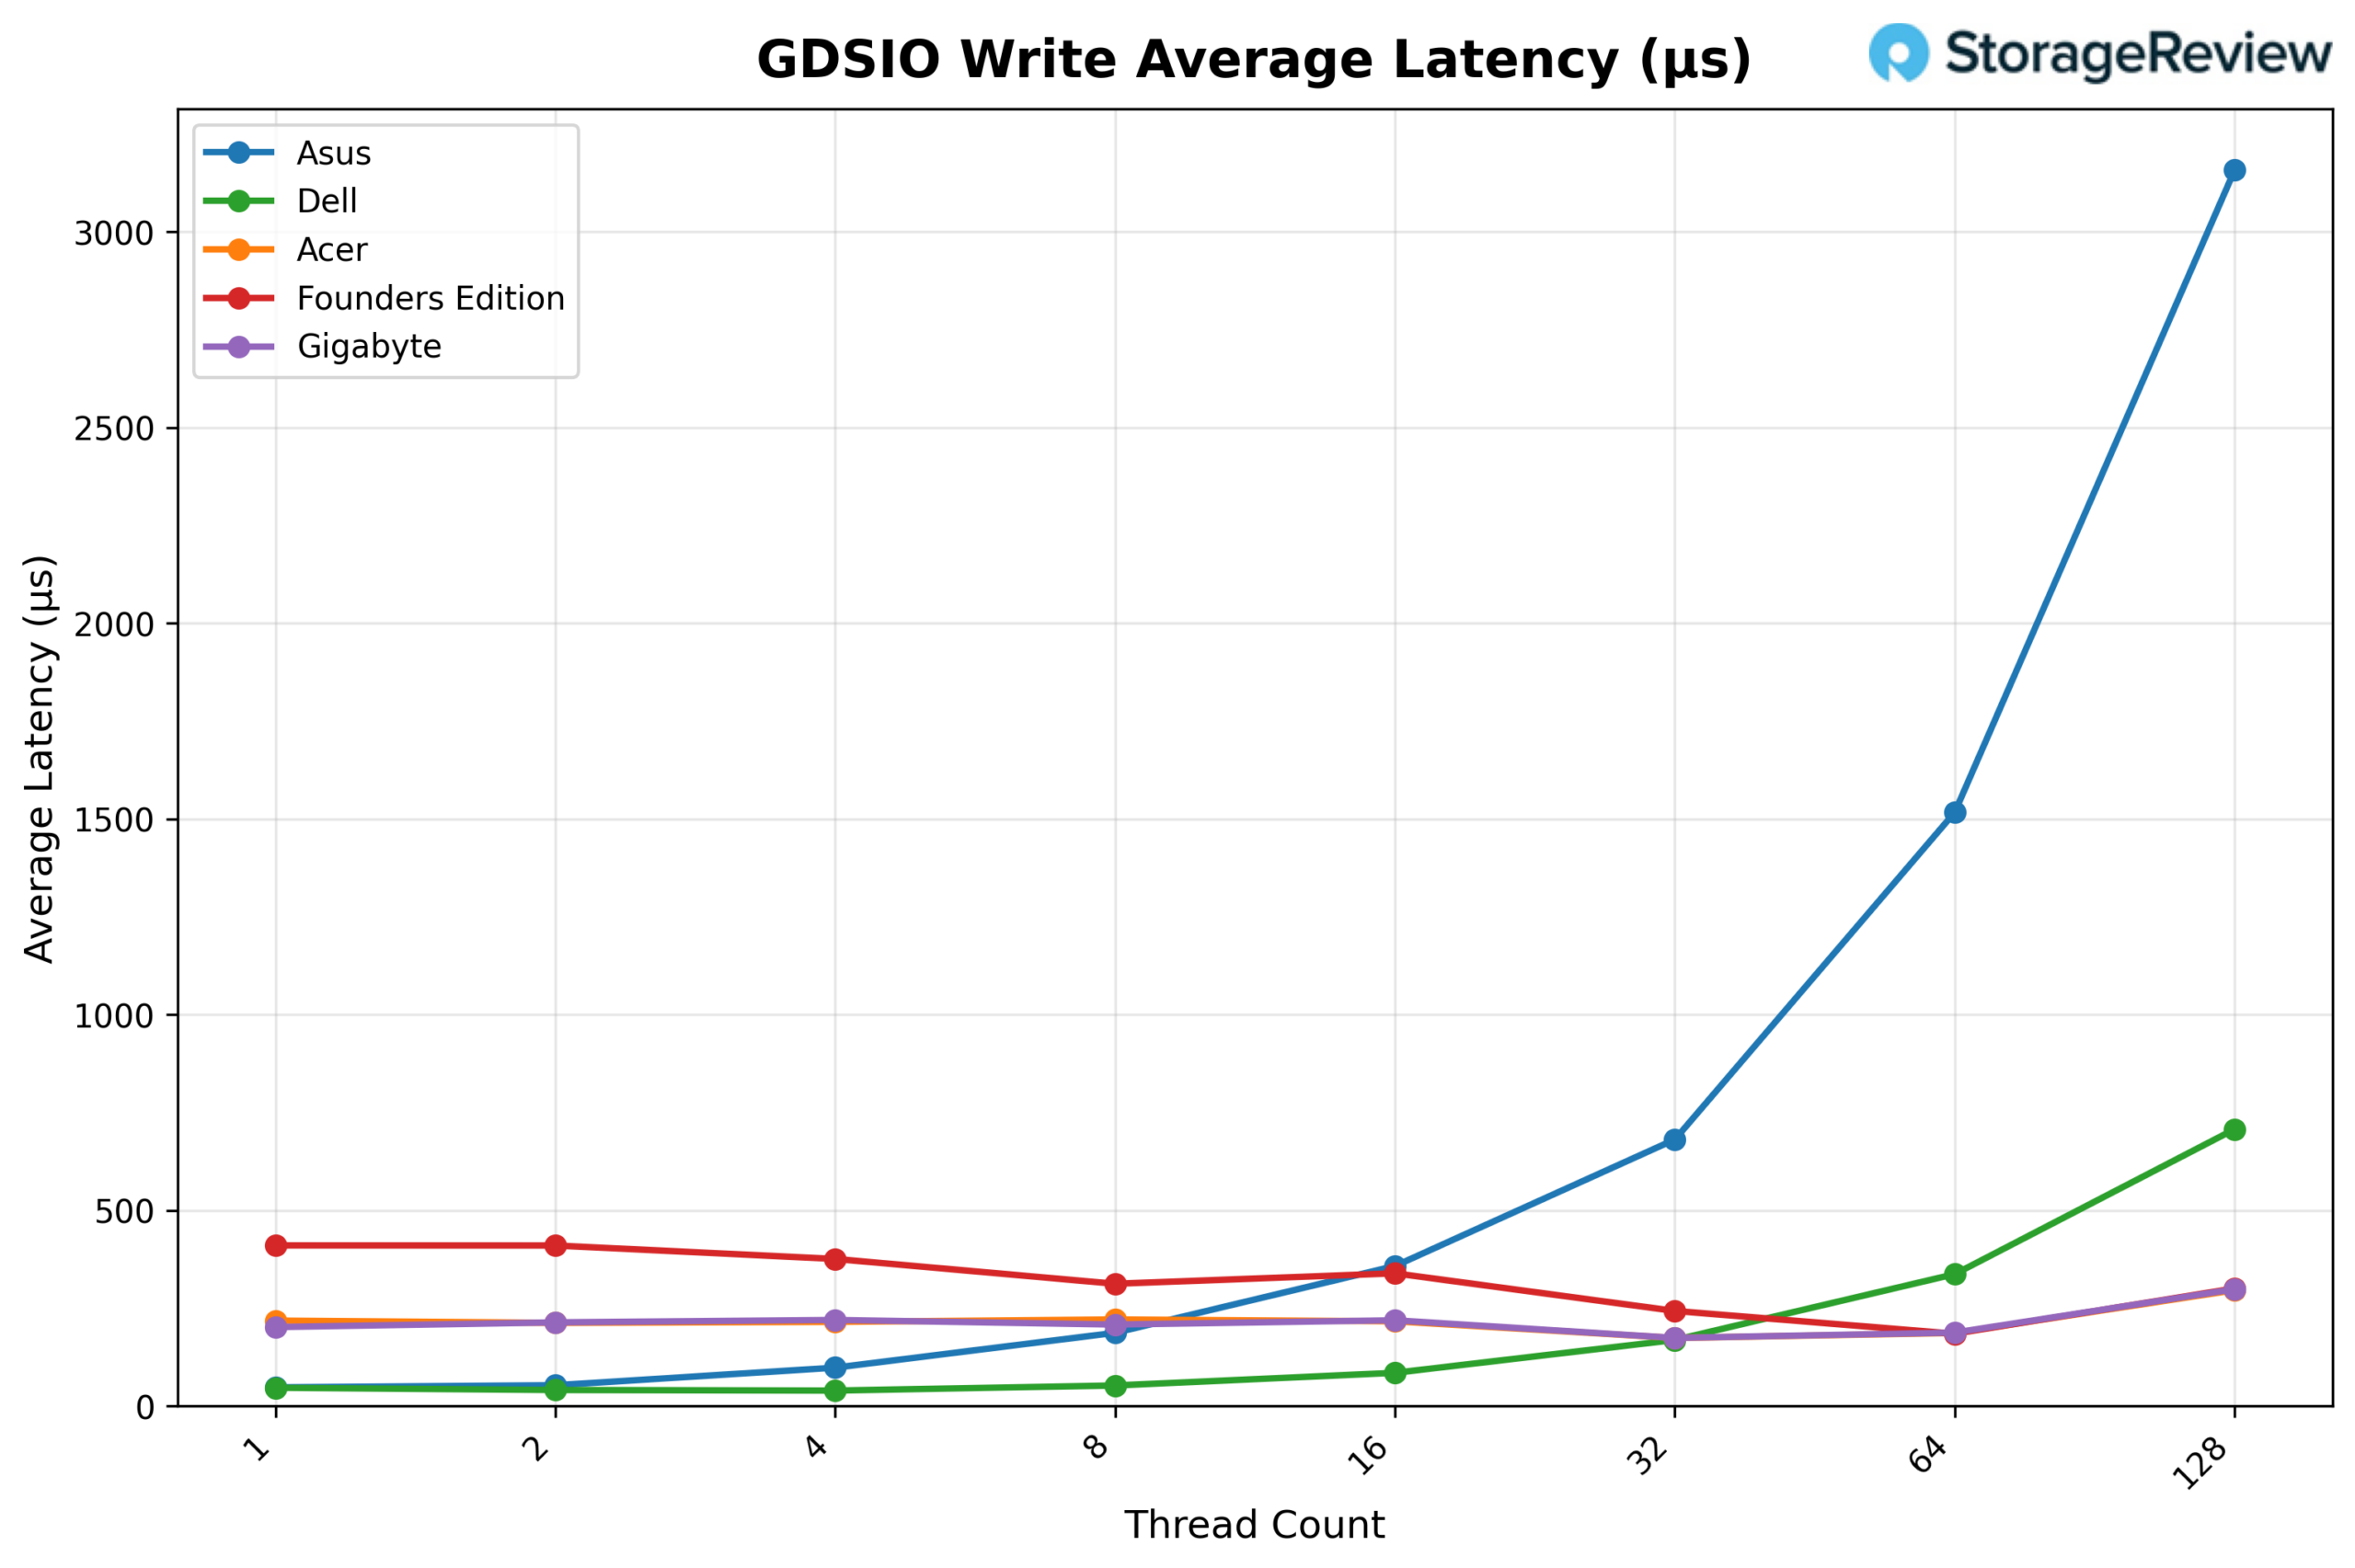
Genomsnittlig skrivlatens för GDSIO 16K
Om man tittar på GDSIO Write Average Latency (16K) upprätthåller GIGABYTE en relativt stabil latens över större delen av kurvan. Den börjar på cirka 0.20 ms vid 1 tråd och ligger kvar i intervallet ~0.21–0.22 ms genom 16 trådar. Vid 32 trådar förbättras latensen något till cirka 0.17 ms, och ökar sedan blygsamt vid 64 trådar (0.19 ms). Det är först vid 128 trådar som latensen ökar märkbart, till ungefär 0.30 ms, vilket motsvarar den högsta dataflödesnivån.
GDSIO-läsdataflöde 1M
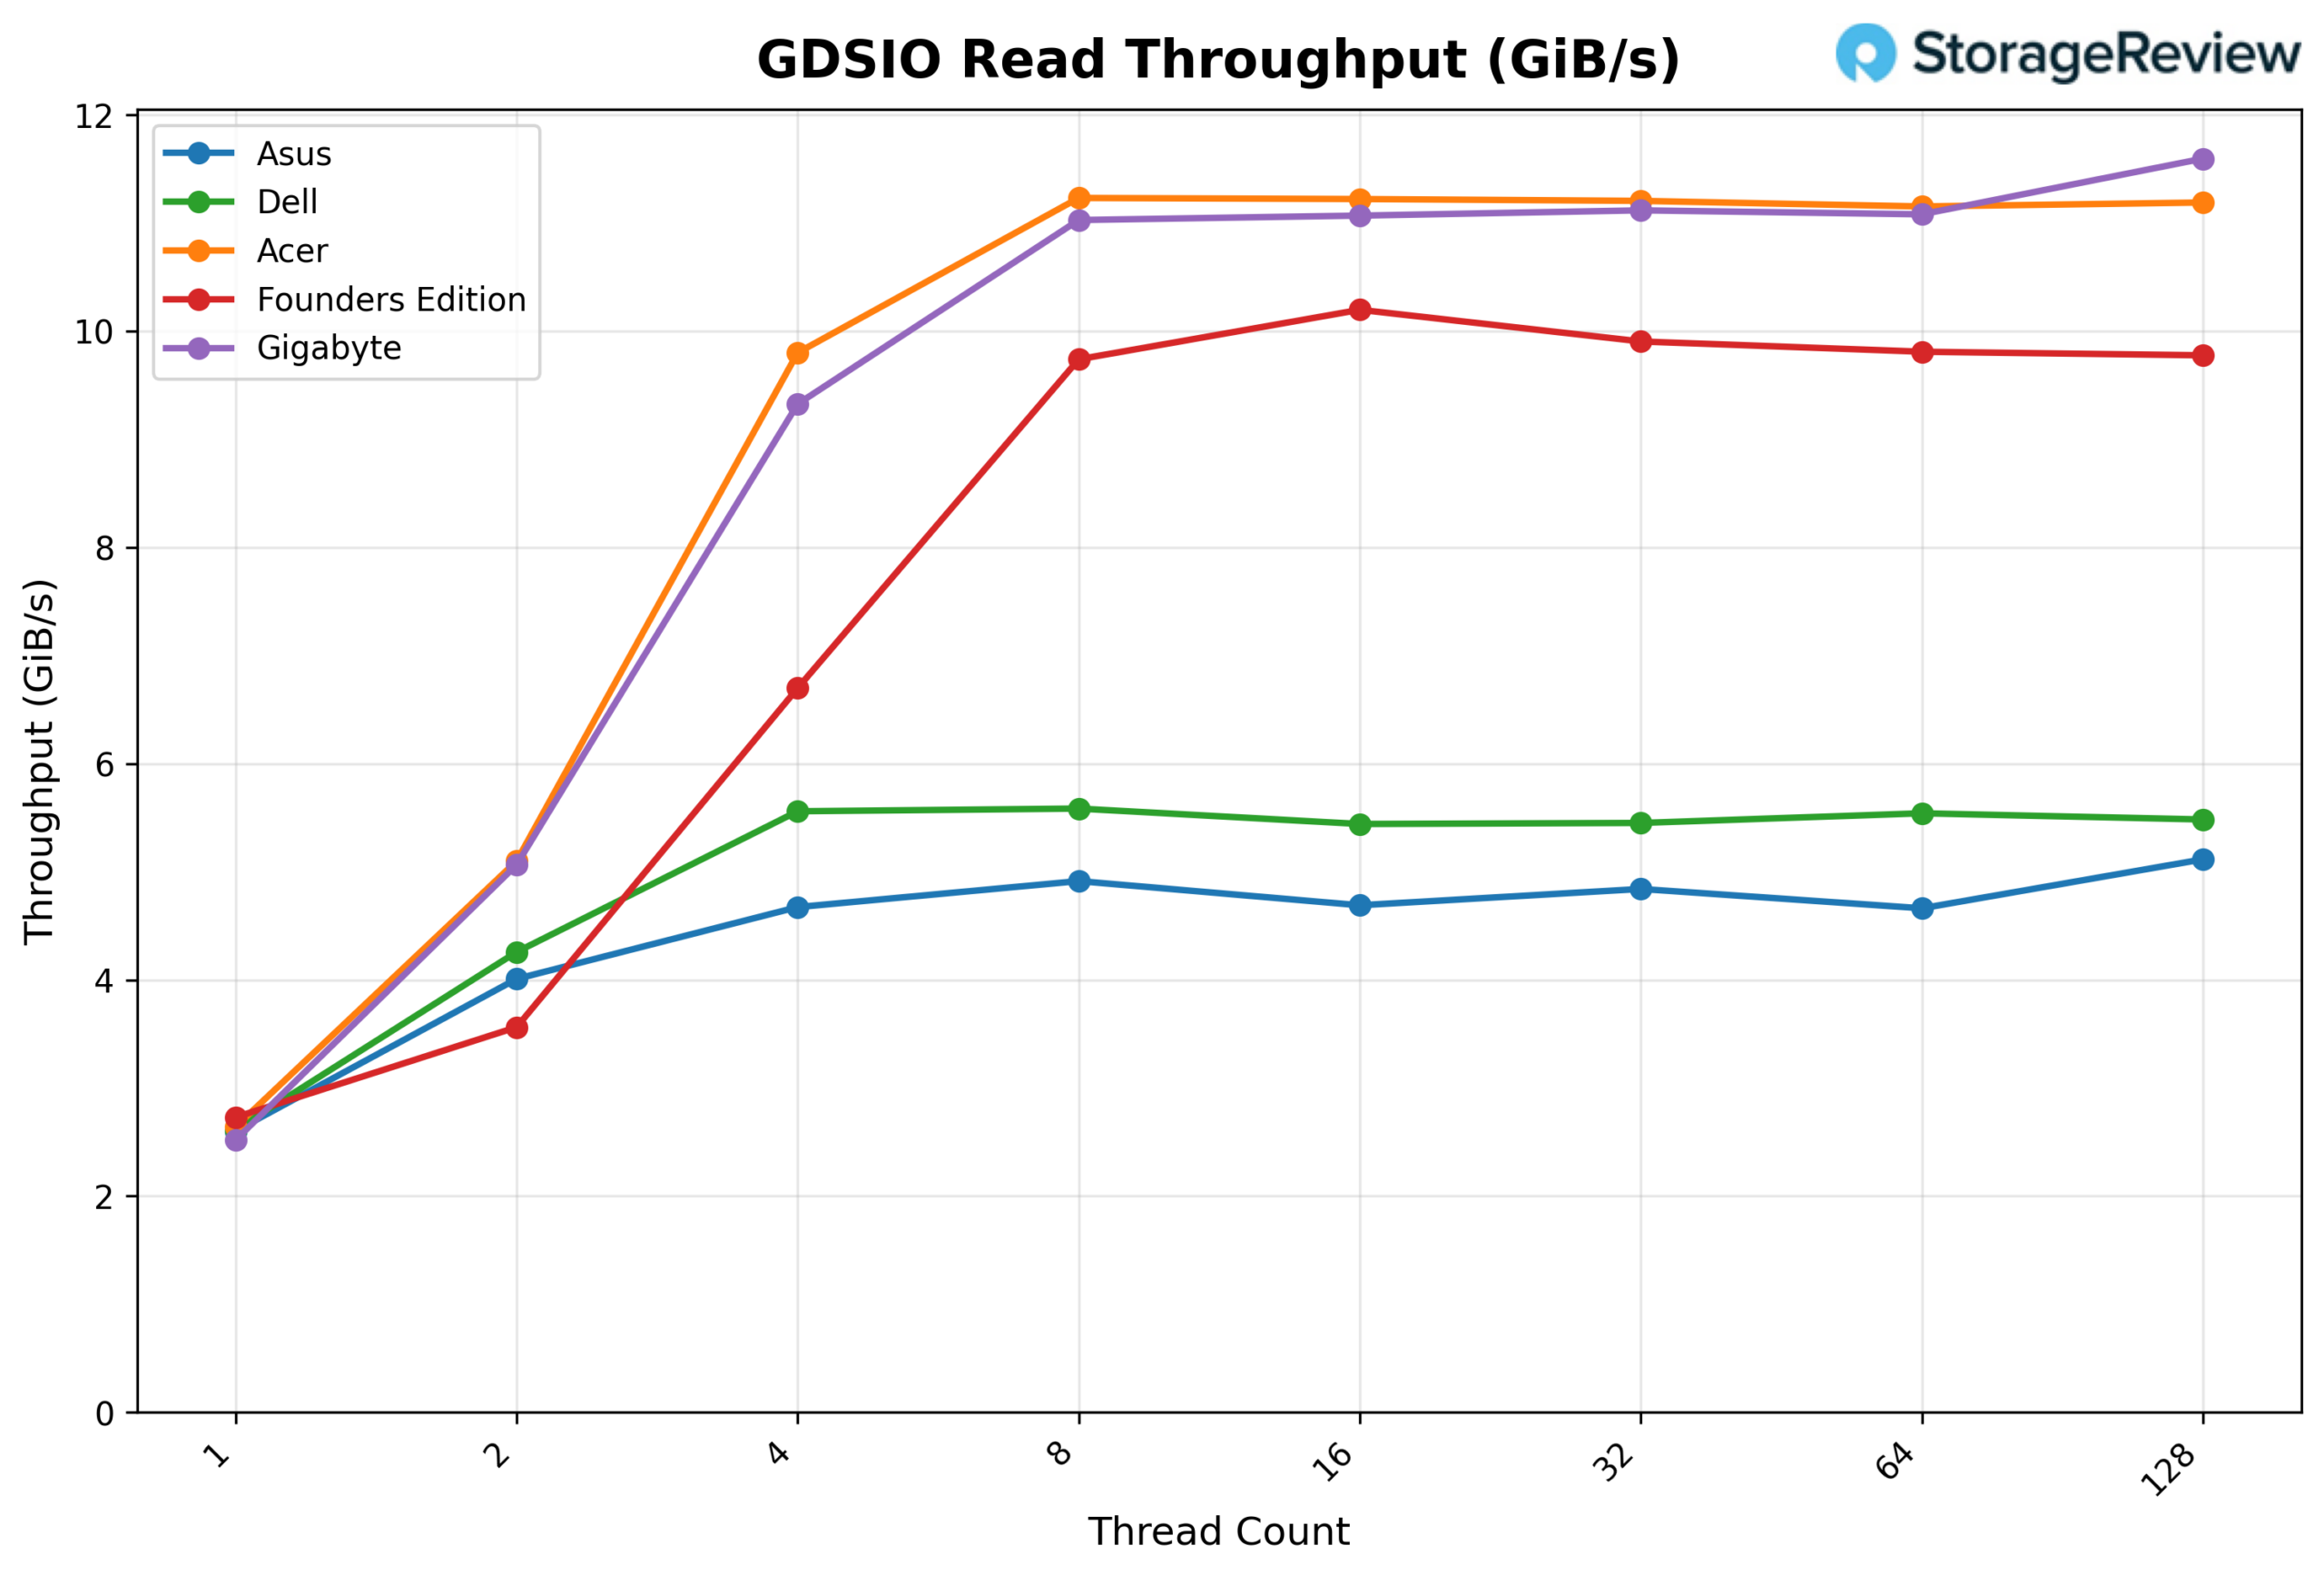
Om man tittar på GDSIO Read Throughput 1M börjar GIGABYTE på 2.52 GiB/s vid 1 tråd och skalar till 5.07 GiB/s vid 2 trådar och 9.33 GiB/s vid 4 trådar. Vid 8 trådar når dataflödet 11.03 GiB/s, varefter plattformen effektivt mättas. Prestandan förblir konstant vid 16 trådar (11.07 GiB/s), 32 trådar (11.12 GiB/s) och 64 trådar (11.08 GiB/s), vilket visar en stabil platå. Vid 128 trådar ökar dataflödet något till 11.60 GiB/s, vilket är det högsta observerade resultatet i svepningen.
Genomsnittlig läsfördröjning för GDSIO 1M
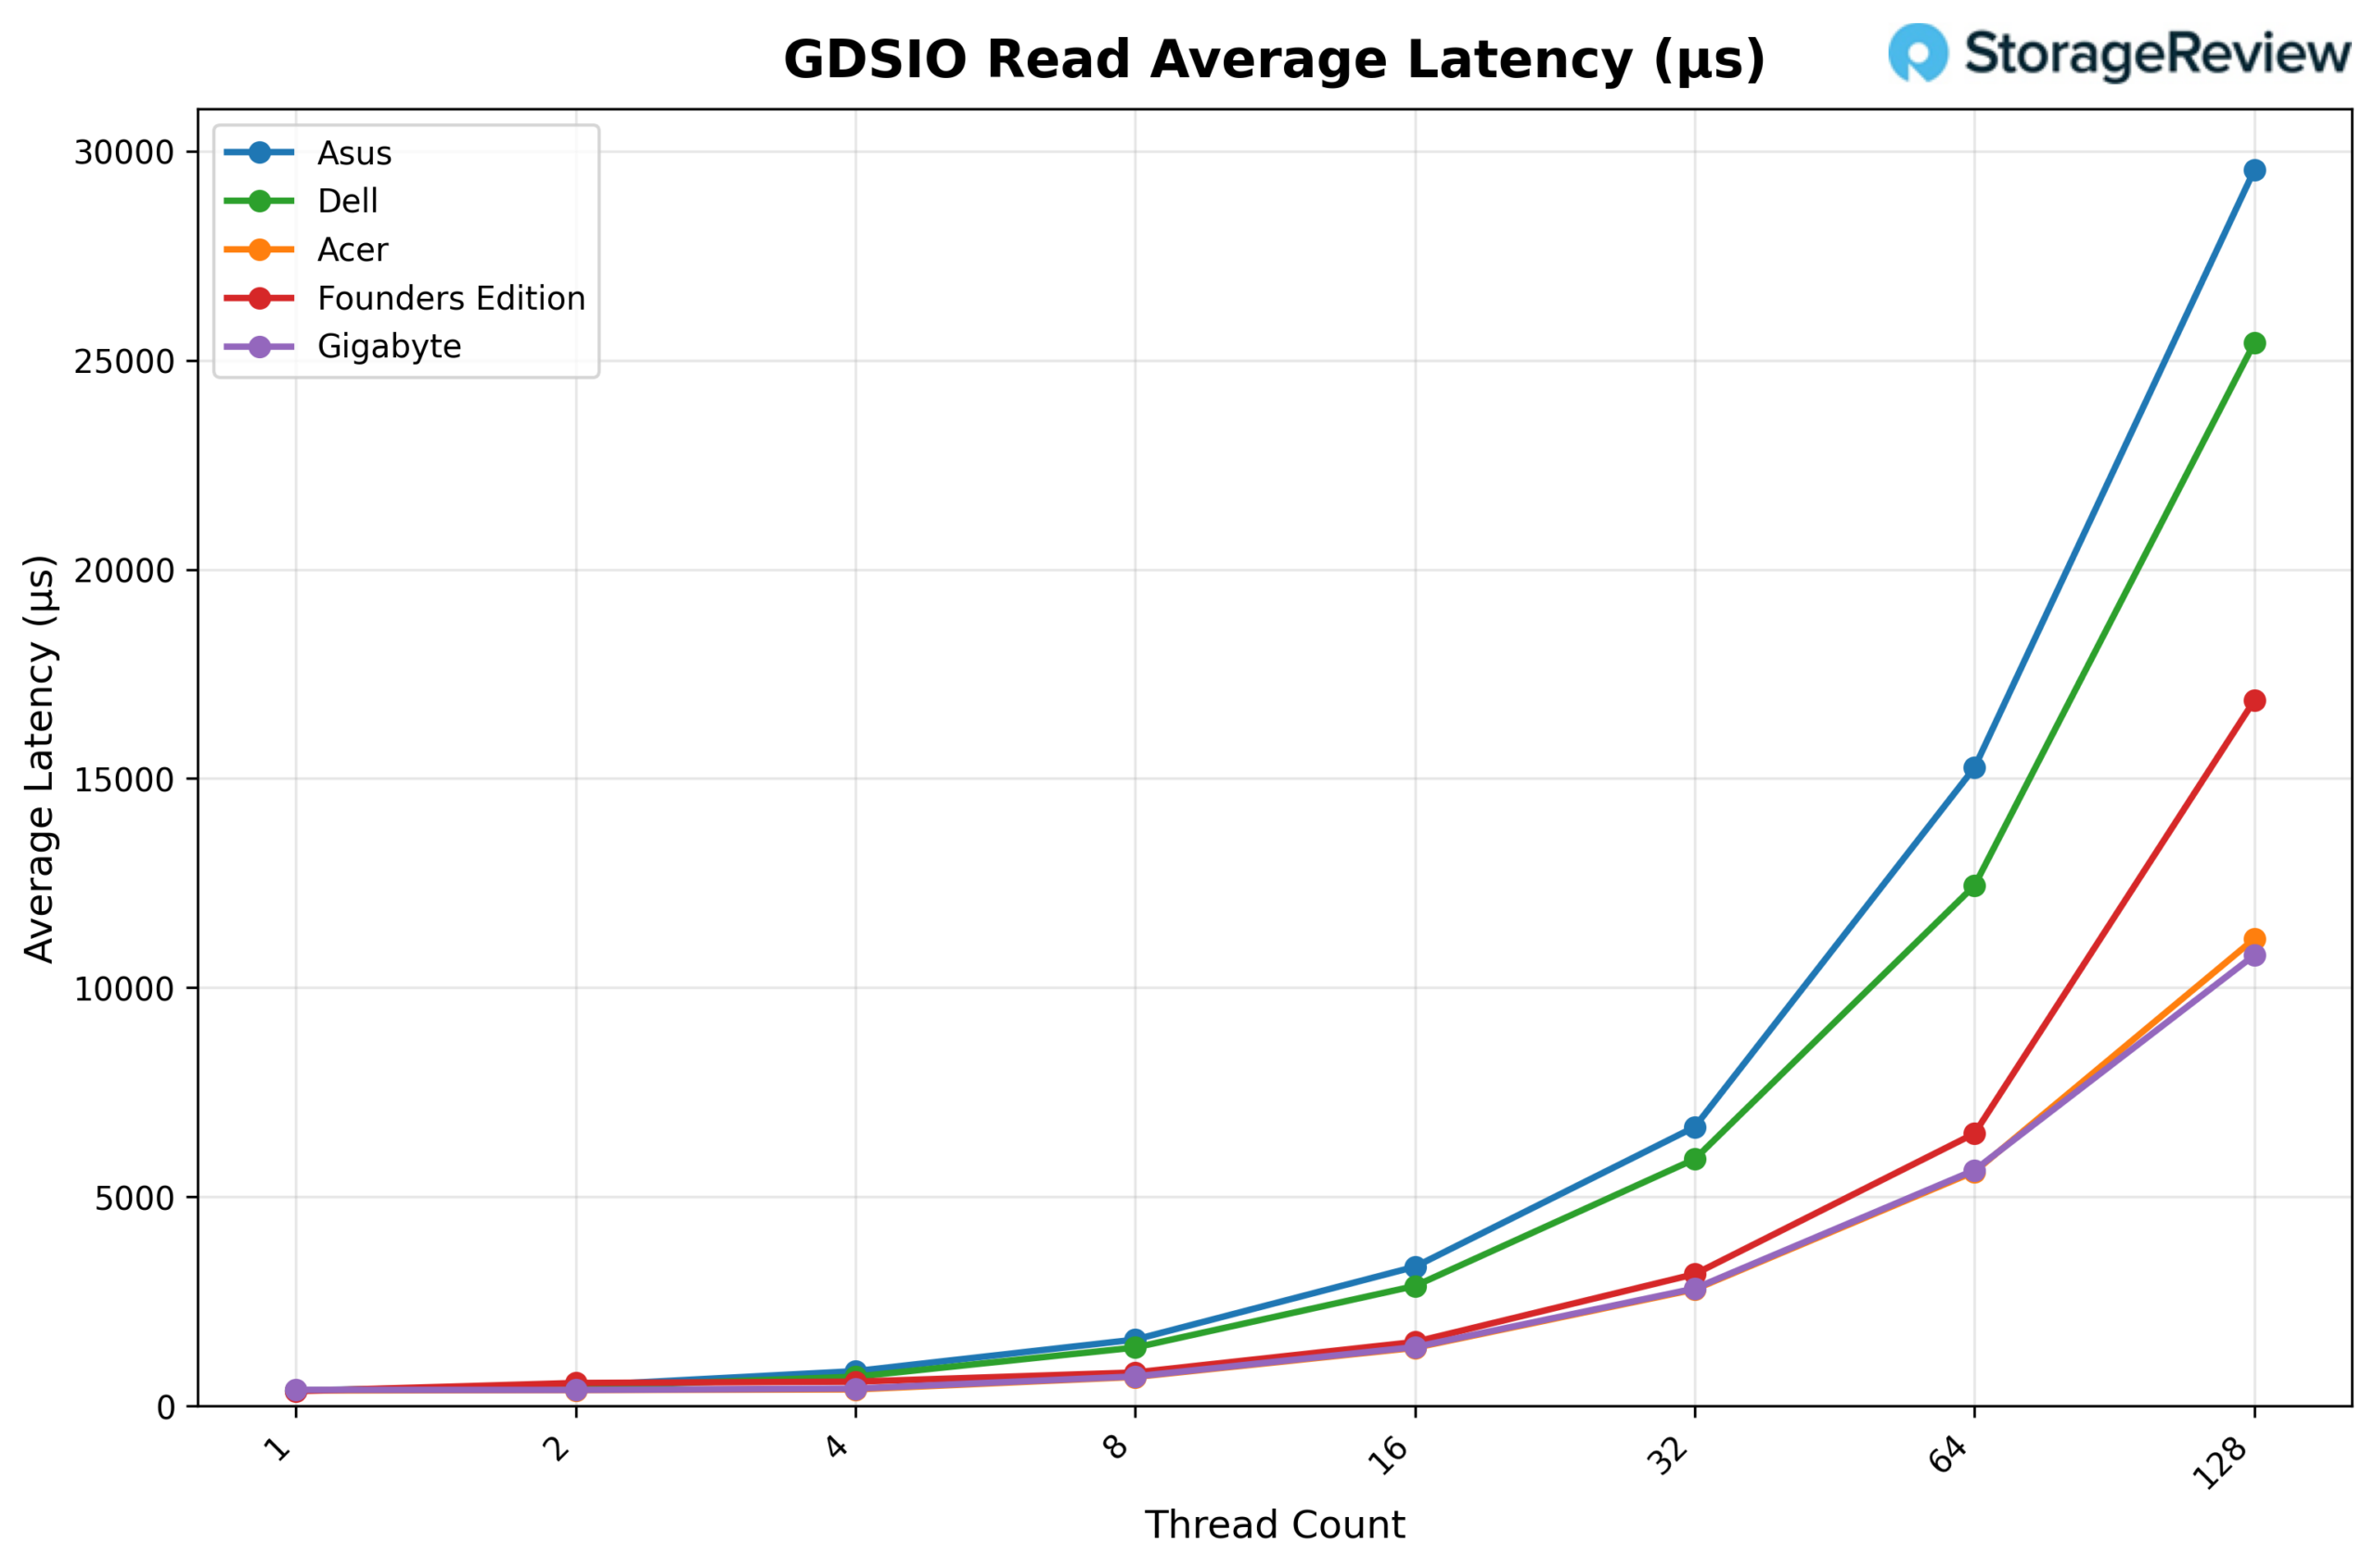
Om man tittar på GDSIO:s genomsnittliga läslatens (1M), börjar GIGABYTE på cirka 0.39 ms vid 1 tråd och förblir likartad vid 2 trådar (0.39 ms) och 4 trådar (0.42 ms). Latensen ökar när samtidigheten ökar och stiger till 0.71 ms vid 8 trådar, 1.41 ms vid 16 trådar och 2.81 ms vid 32 trådar. Den uppåtgående trenden fortsätter vid 64 trådar (5.64 ms) och når 10.78 ms vid 128 trådar, vilket motsvarar toppnivåerna för samtidighet, medan dataflödet i stort sett förblir oförändrat.
GDSIO-skrivgenomströmning 1M
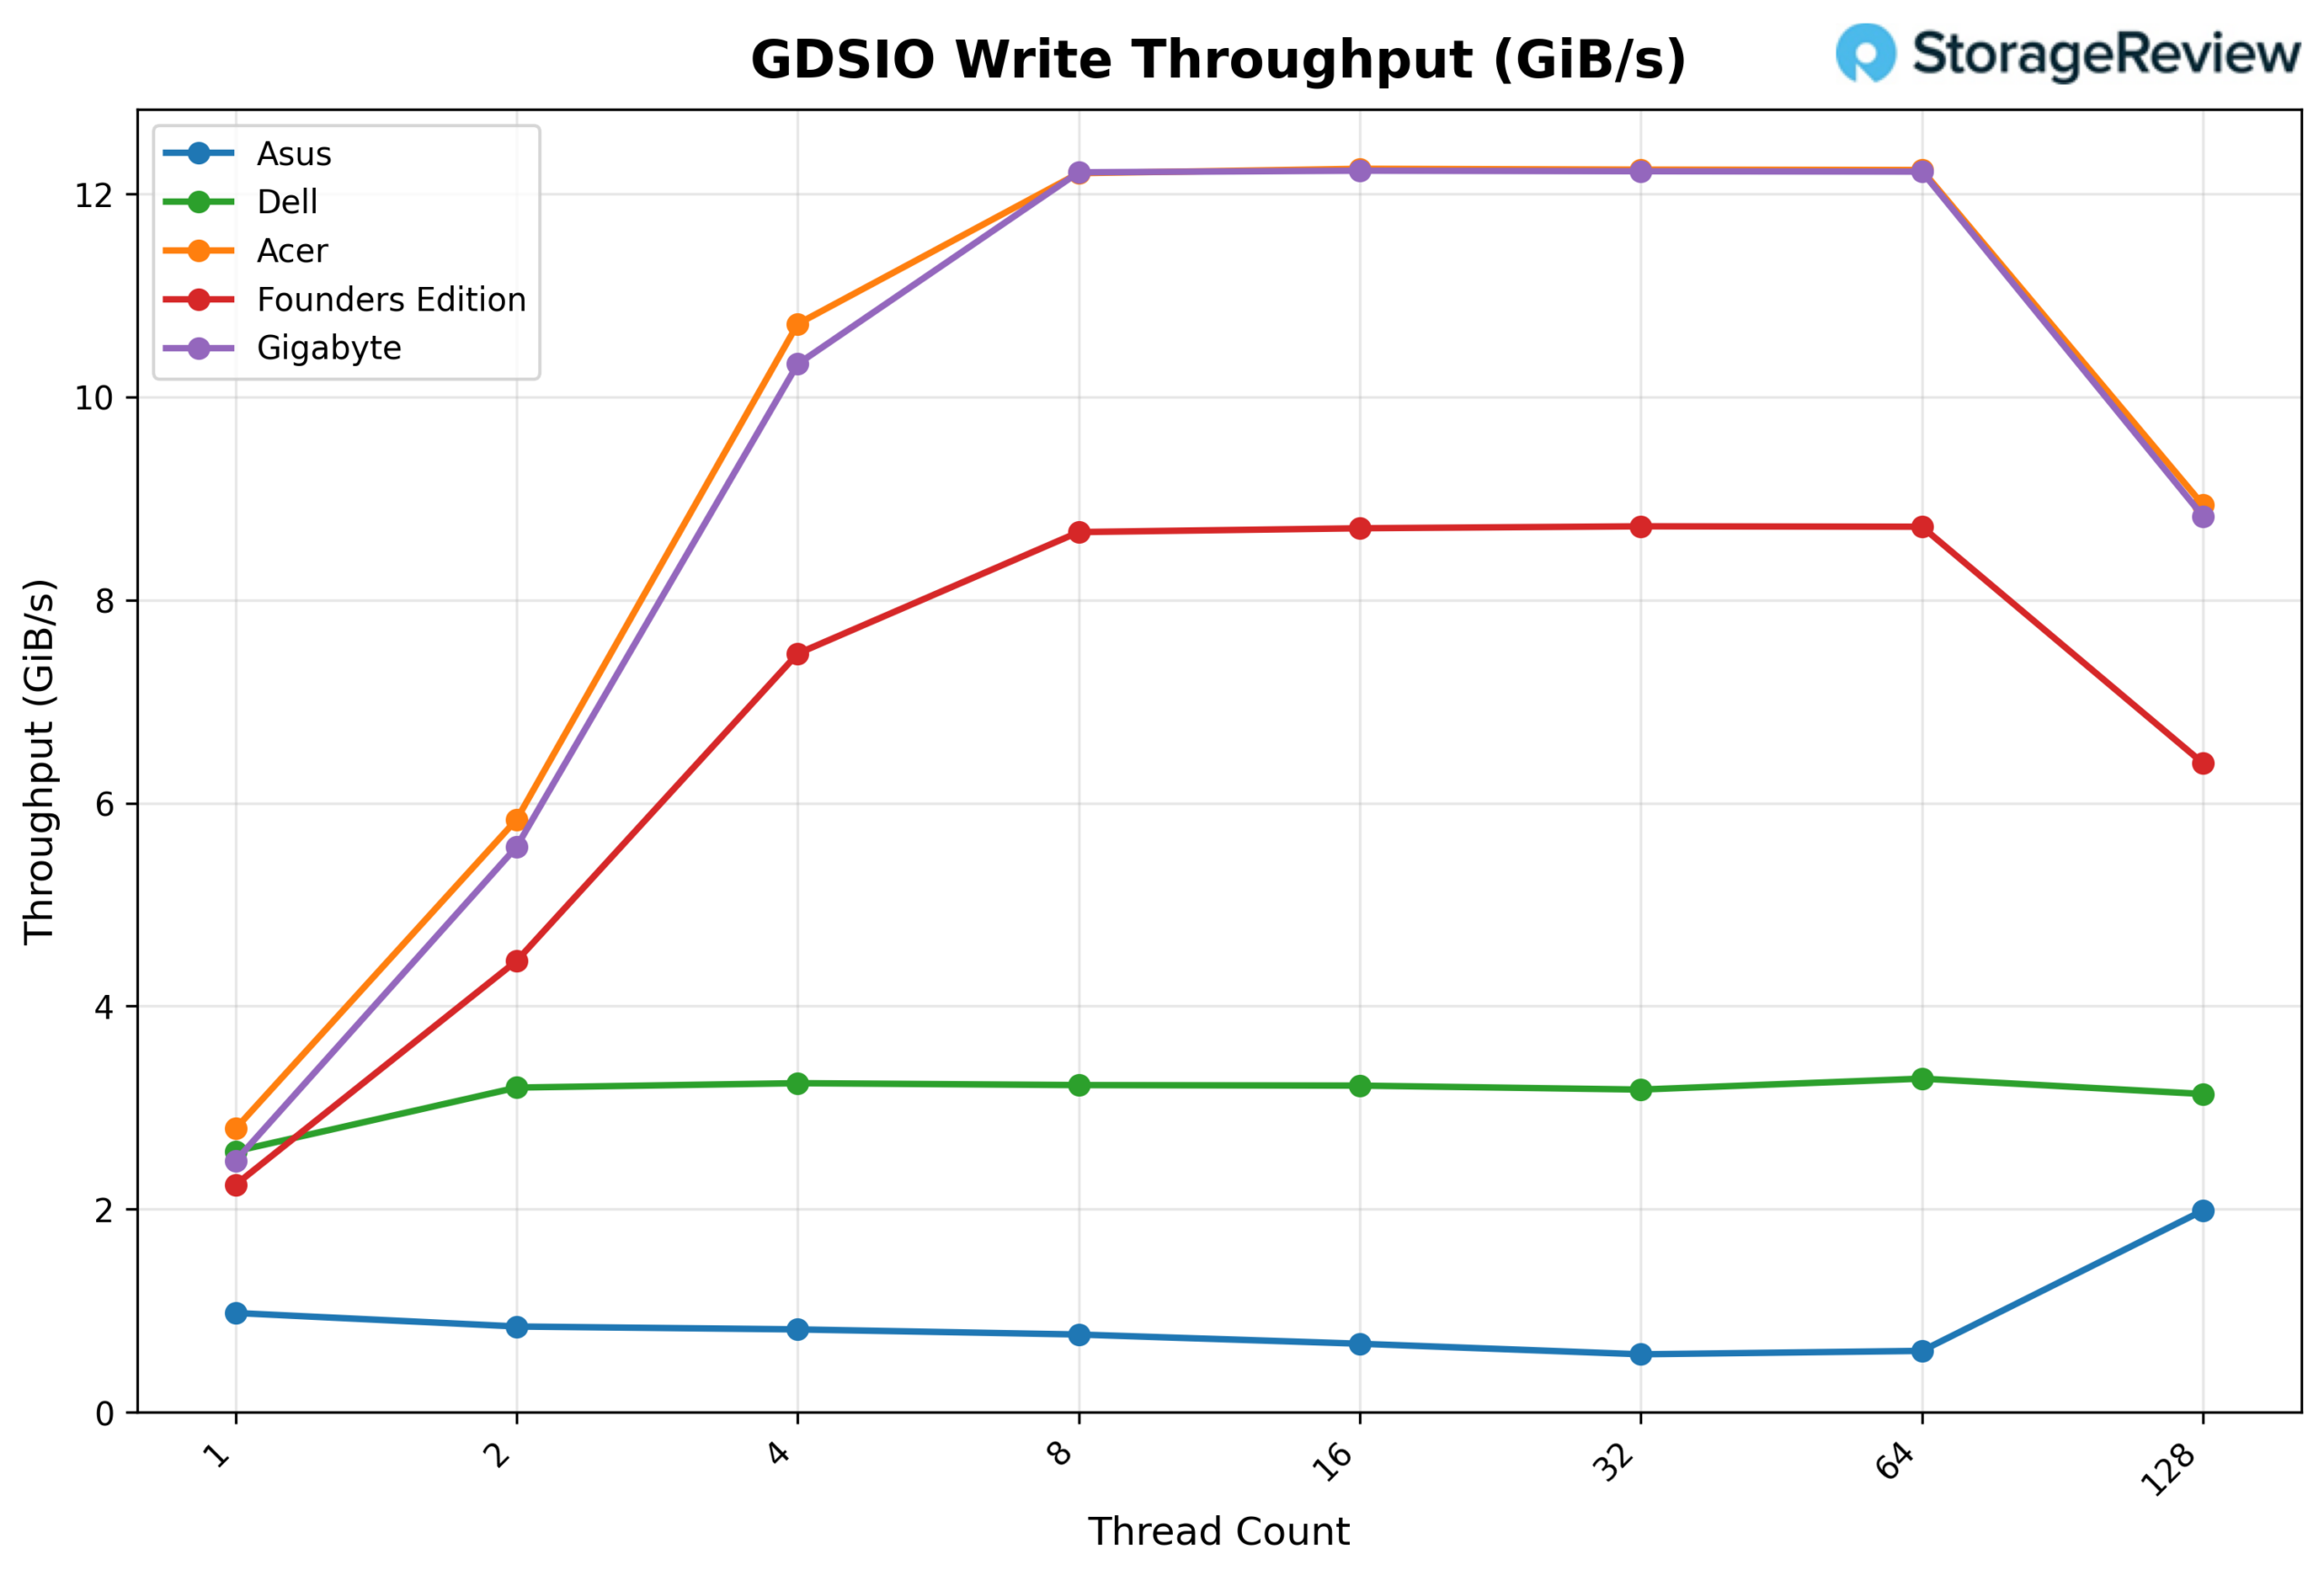
Om man tittar på GDSIO Write Throughput 1M börjar GIGABYTE på 2.48 GiB/s vid 1 tråd och skalar kraftigt till 5.57 GiB/s vid 2 trådar och 10.32 GiB/s vid 4 trådar. Vid 8 trådar når dataflödet 12.21 GiB/s, vilket effektivt mättar plattformen. Prestandan förblir oförändrad vid 16 trådar (12.23 GiB/s), 32 trådar (12.22 GiB/s) och 64 trådar (12.22 GiB/s), vilket indikerar en tidig platå. Vid 128 trådar minskar dataflödet till 8.82 GiB/s, vilket tyder på att systemet har rört sig bortom sitt optimala samtidighetsintervall.
Genomsnittlig skrivlatens för GDSIO 1M
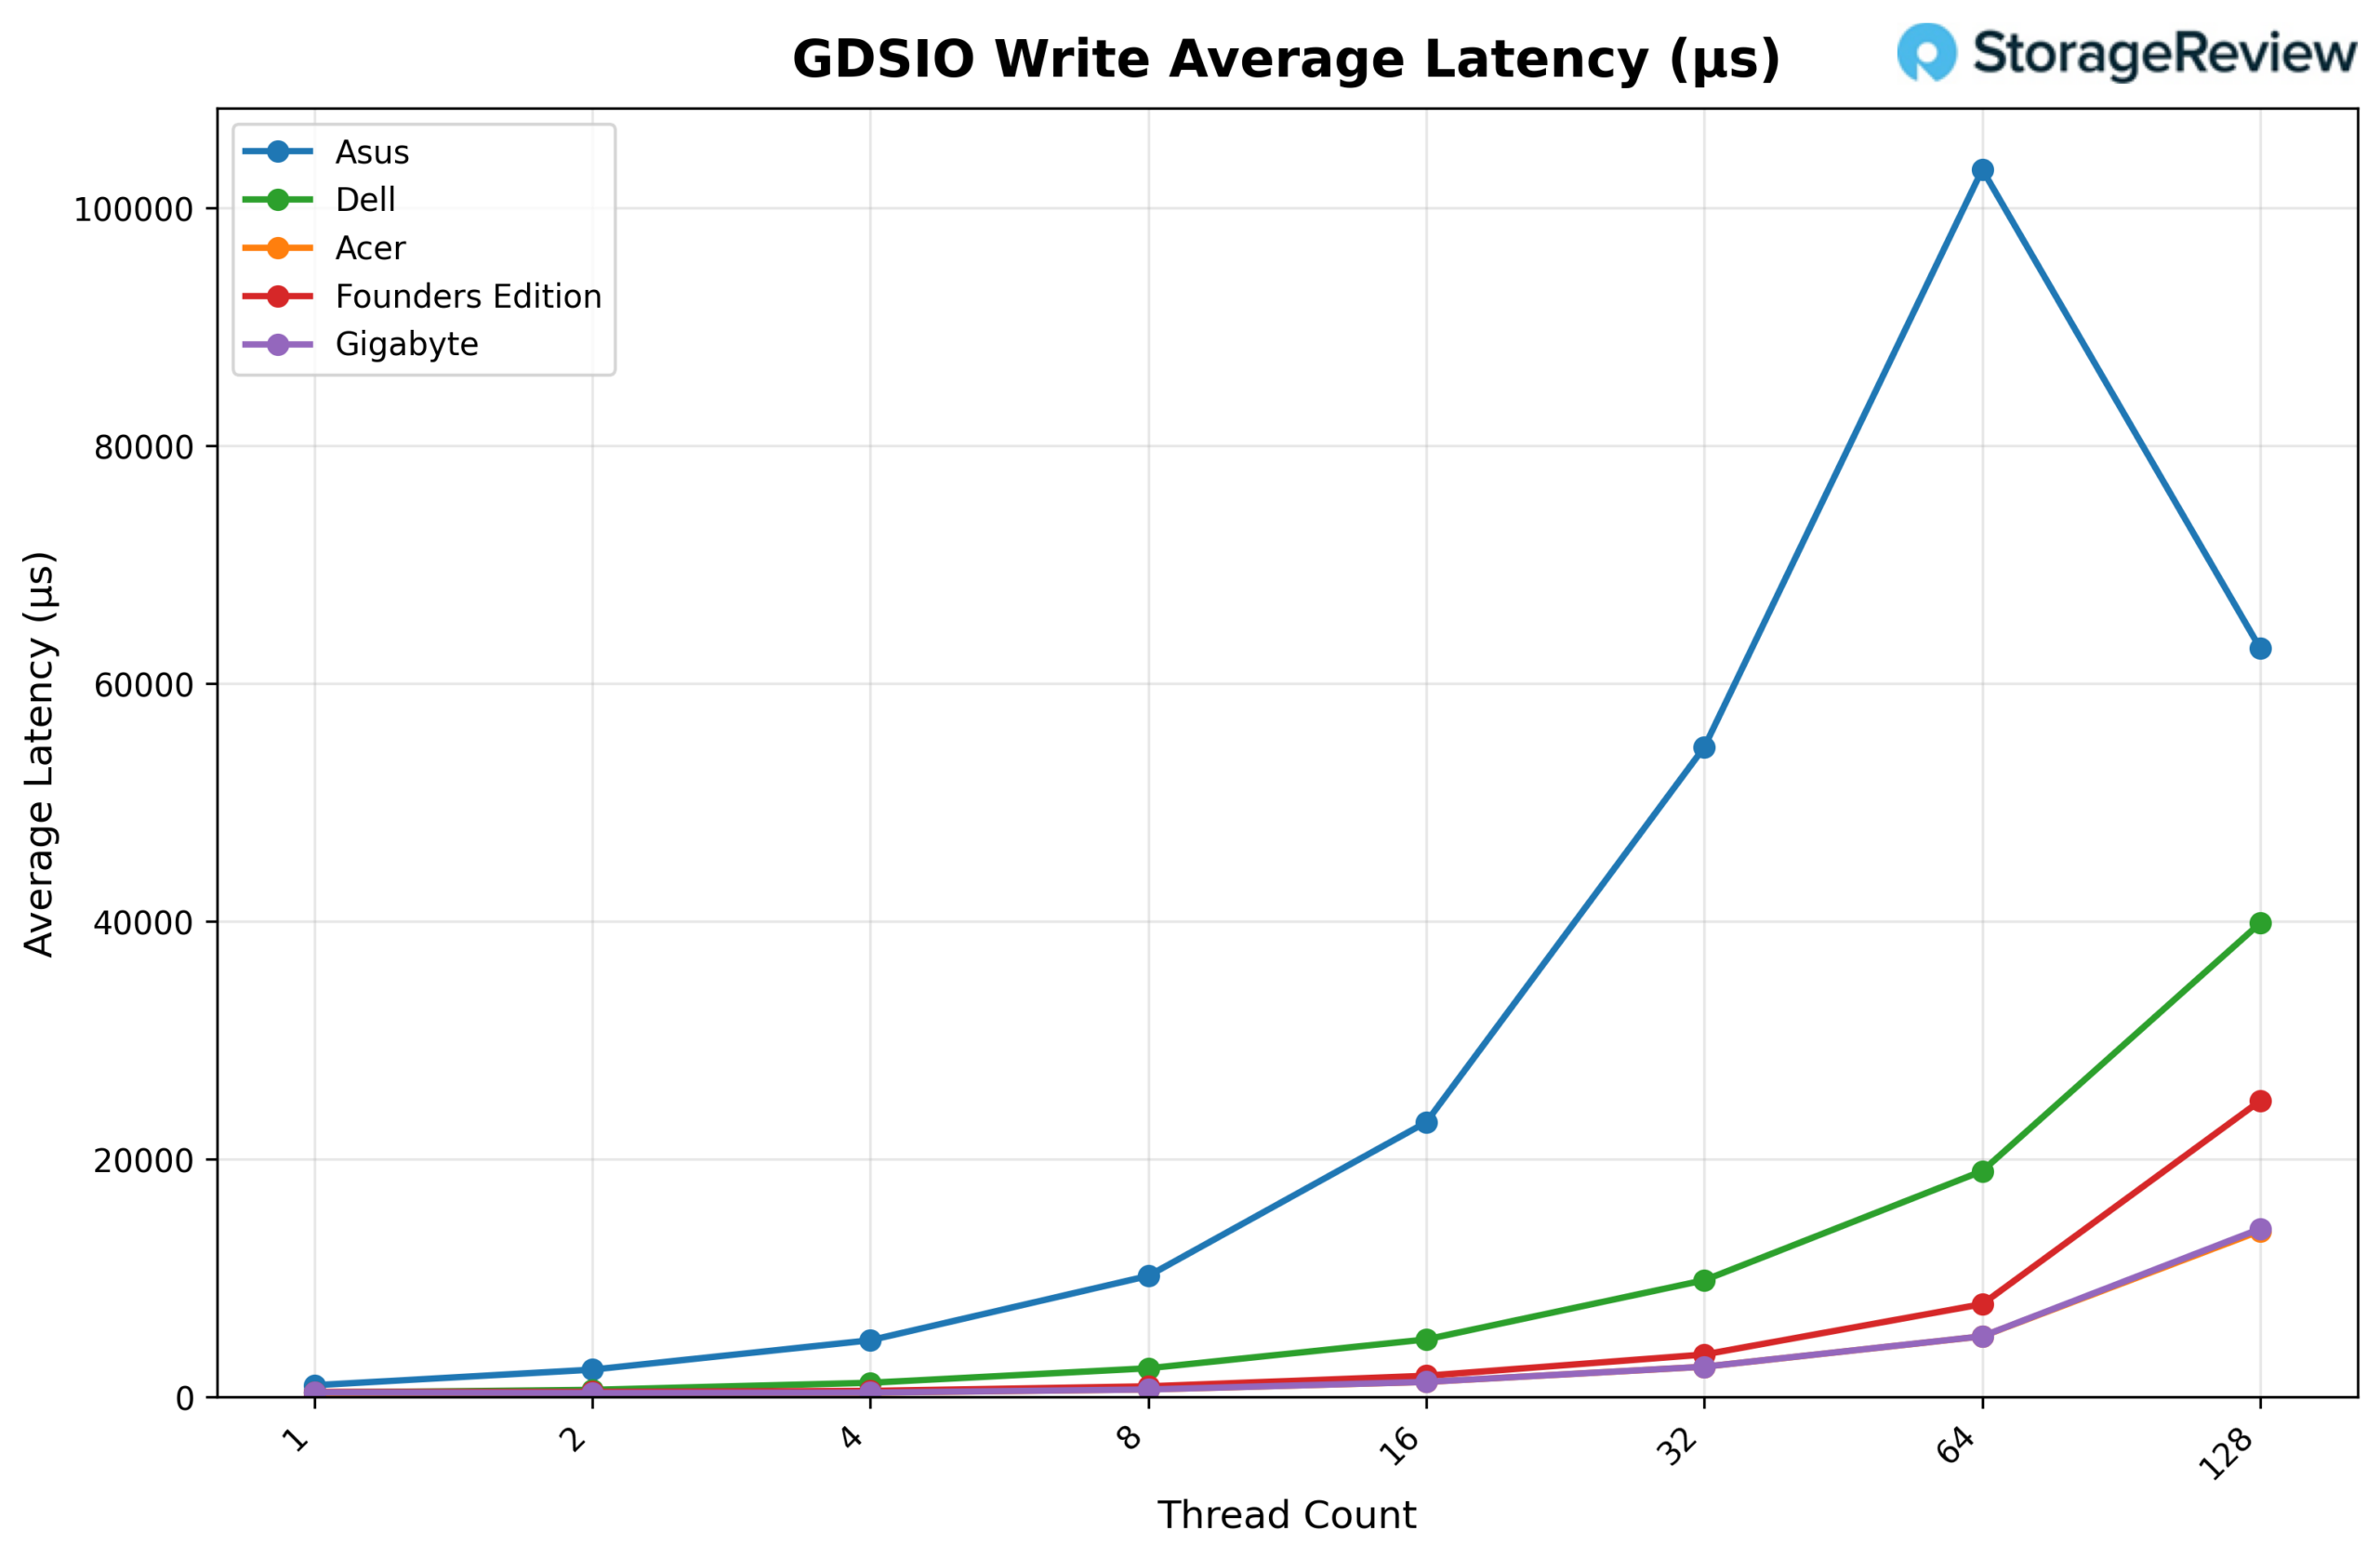
Om man tittar på GDSIO:s genomsnittliga skrivlatens (1M), börjar GIGABYTE på cirka 0.39 ms vid 1 tråd och förblir relativt kort genom 2 trådar (0.35 ms) och 4 trådar (0.38 ms). Latensen ökar mer märkbart vid högre trådantal och stiger till 0.64 ms vid 8 trådar, 1.28 ms vid 16 trådar och 2.56 ms vid 32 trådar. Trenden fortsätter uppåt vid 64 trådar (5.11 ms) innan den ökar markant vid 128 trådar till 14.16 ms, vilket överensstämmer med den observerade minskningen av dataflödet vid den högsta samtidighetsnivån.
Slutsats
GIGABYTE AI TOP ATOM är ytterligare en implementering av NVIDIAs GB10-baserade Spark-plattform, byggd på samma kort och kisel som vi har testat i hela sortimentet. Som förväntat speglar kärnberäkningsprestandan i vLLM nära resten av fältet. På GPT-OSS-, Qwen3-Coder- och Llama 3.1-modellerna förblev skalningsbeteendet förutsägbart, med stark Prefill-genomströmning och stabil Equal- och Decode-prestanda allt eftersom samtidigheten ökade.
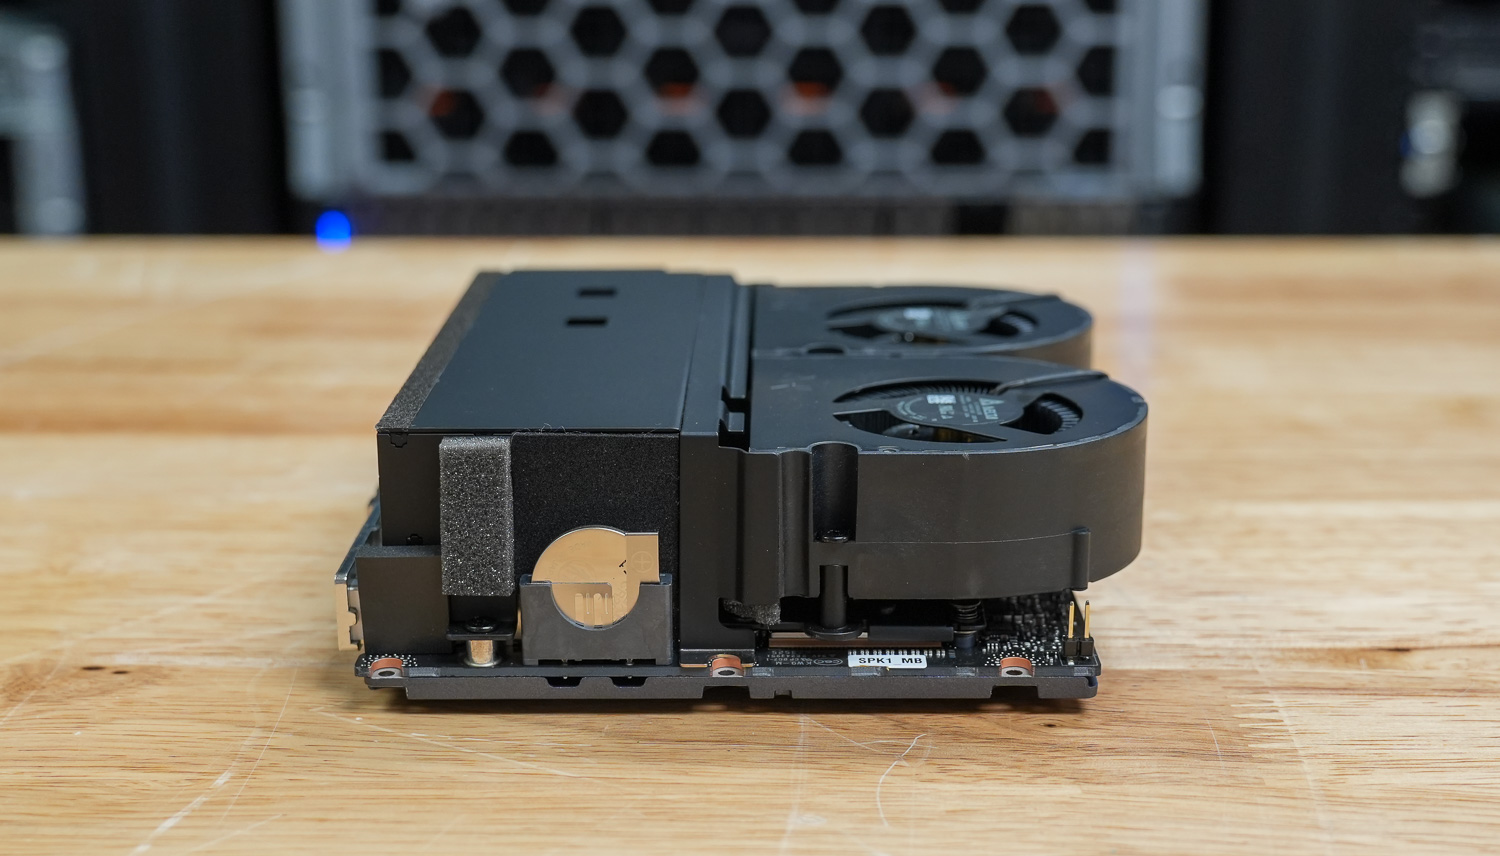
Termiskt tillät GIGABYTE något mer aggressivt burstbeteende. CPU:n nådde en topp på 90°C och GPU:n på 81°C under övergångar med hög förfyllning, med en GPU-effekt på 75.54W. När arbetsbelastningen normaliserades stabiliserades temperaturerna utan tecken på ihållande strypning. I praktiken återspeglar de högre topparna kortvariga strömfördelningsbeslut snarare än instabilitet.
Där den här enheten tydligt skiljer sig åt är inom lagring. Med 4TB Gen5 Samsung PM9E1 levererade GIGABYTE några av de starkaste GDSIO-resultaten i Spark-gruppen. Läs- och skrivhastigheten skalades tydligt över både 16K och 1M arbetsbelastningar, med tidig mättnad vid förväntade samtidighetsnivåer och latensökningar främst vid de högsta trådantalen.
Eftersom alla Spark-system delar samma GB10-grund, förblir skillnaden mellan benchmarks i AI-inferens smal. Valet i verkligheten beror snarare på chassidesign, termiskt beteende i burst-data, lagringskonfiguration och leverantörsanpassning än grundläggande beräkningsskillnader.
Produktsida – GIGABYTE AI TOP ATOM
Topplista: GIGABYTE AI TOP ATOM är en del av testfältet på vår topplista över de bästa stationära datorerna för lokal AI .


 Amazon