

Två saker tenderar att dyka upp först när samtalet kommer in på NVIDIA DGX Spark. Den första är huvudspecifikationen: 128 GB enhetligt minne i en stationär datorlåda för ungefär 4 000 dollar, en siffra som hade verkat osannolik att placera på en ingenjörs skrivbord för bara två år sedan. Den andra är 200 GB nätverksutrymme på baksidan av enheten. Närvaron av en riktig datacenter-klassad struktur på en stationär enhet är det som får folk att luta sig framåt, eftersom det innebär något mer än en snabbare arbetsstation i en enda låda. Det innebär möjligheten att ansluta Sparks och replikera fysiskt, den typ av multinodsinstallation som tidigare uteslutande fanns i ett rack.
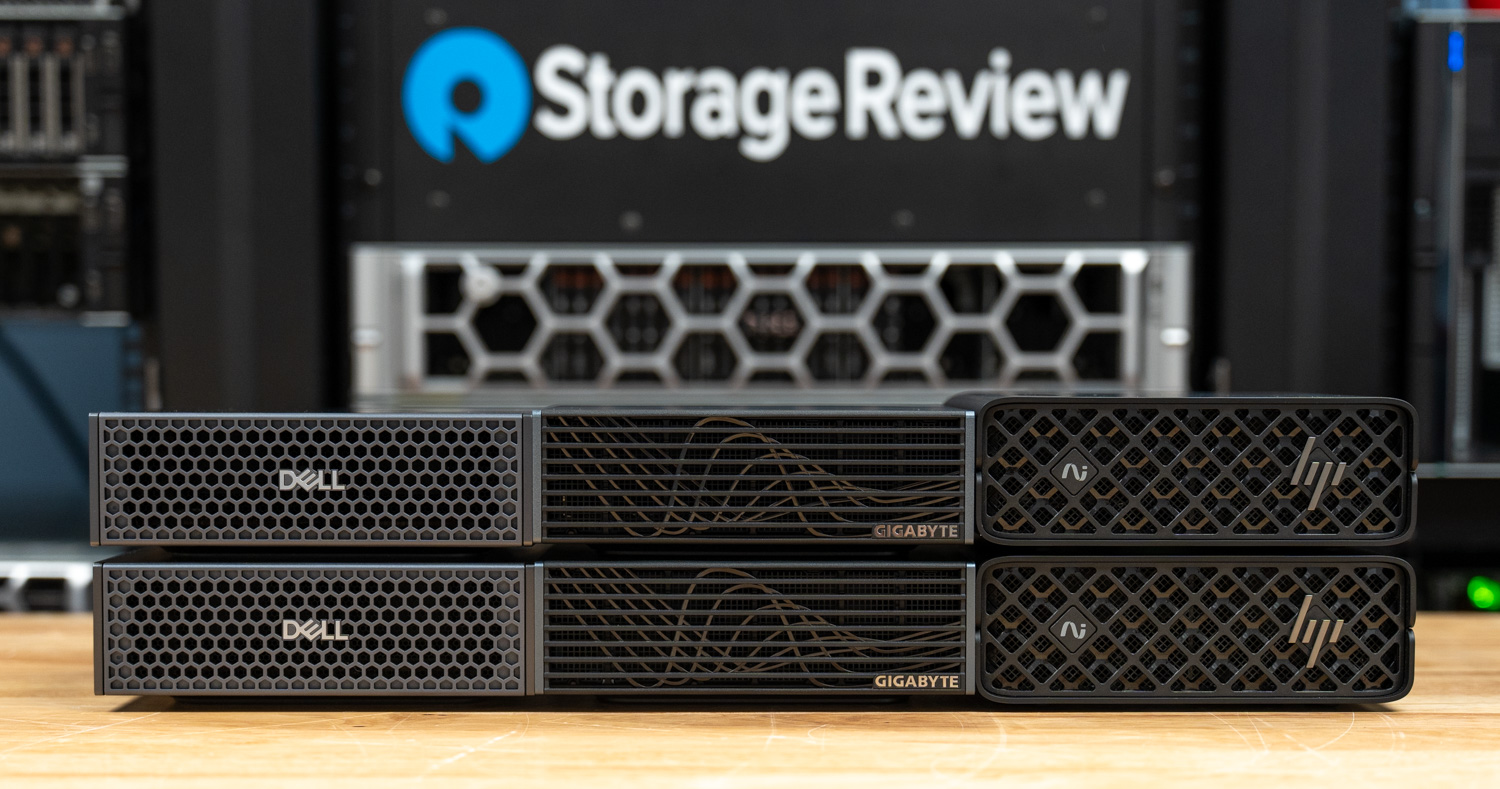
Den här granskningen undersöker den förmågan. Vi jämför distribuerad inferens över alla tre OEM Spark-implementeringar vi har till hands, parade i tvånodskluster anslutna över 200 Gb-strukturen, och sveper över modellvarianter och tre arbetsbelastningsformer. Vi gör också ett medvetet metodologiskt val om hur modellen är uppdelad mellan de två rutorna som avviker från NVIDIAs standardrekommendation, och vi försvarar det med data. Innan något av detta formar dock två delar av kontexten allt som följer: nätverket som möjliggör klustring från första början, och anledningarna till att en person kanske vill eller inte vill använda det.
200 GB-tyget
Vi behandlade nätverksimplementeringen i detalj i vår ursprungliga DGX Spark-recension, men grunderna är värda att upprepa eftersom allt i den här recensionen beror på dem. Baksidan av varje Spark har två QSFP56-burar som drivs av ett integrerat NVIDIA ConnectX-7 SmartNIC. På pappret antyder de två burarna 400 GB aggregerad anslutning, men PCIe är det verkliga taket: ConnectX-7 sitter bakom ett par Gen5 x4-länkar, och plattformen når upp till 200 GB användbar bandbredd, oavsett hur burarna är kopplade. En enda QSFP56-bur ger dig redan hela de 200 Gb som lådan stöder, så den andra porten finns där för topologiflexibilitet snarare än ytterligare dataflöde.
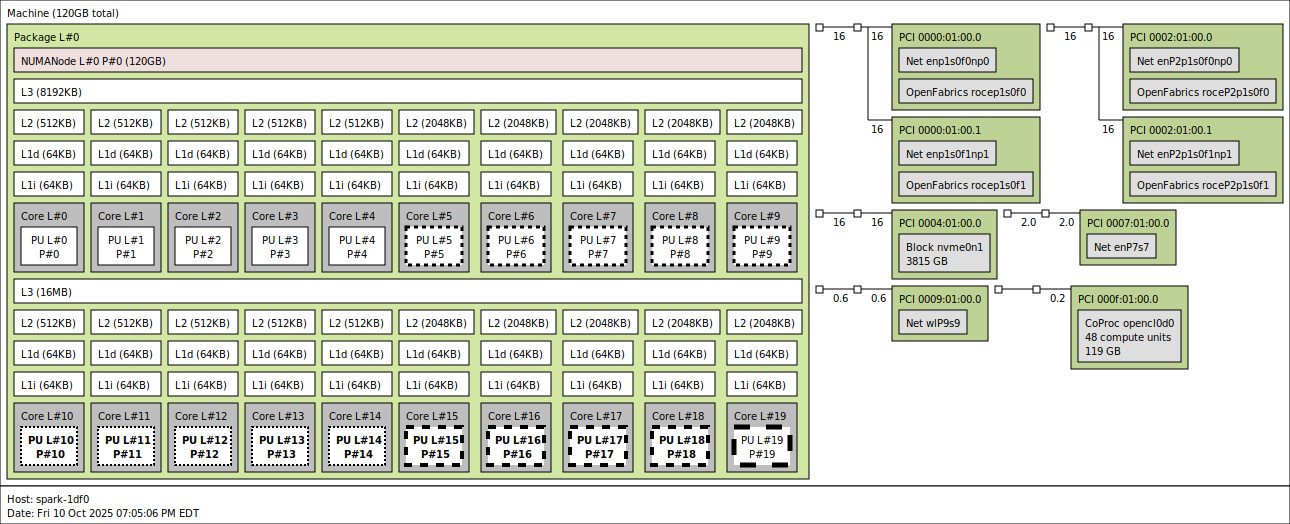
Den flexibiliteten visar sig i tre vanliga konfigurationer. Den enklaste är en enda 200 GB-port som används som en direkt Spark-till-Spark-länk, vilket är vad NVIDIAs validerade tvånodskonfiguration specificerar och vad vi använde för den här recensionen. Den andra är två 100 Gb-portar som skapar en ringliknande topologi mellan Sparks och klustring utan en switch. Den tredje är en split-role-konfiguration där en bur går till en peer Spark för klustring och den andra går till höghastighetslagring över NVMe-oF, vilket är användbart när den fungerande datamängden inte får plats på Sparks interna NVMe.
NVIDIA säljer Spark i tre konfigurationer som direkt kopplas till hur nätverket används. En enda Spark för individuellt skrivbordsarbete, ett validerat två-Spark-kluster direkt anslutet över 200 Gb-strukturen för utsträckta modeller, och, från och med årets GTC, en konfiguration med fyra enheter som NVIDIA demonstrerade offentligt som svar på användarnas efterfrågan att komma förbi gränsen på två noder. Dual-Spark-konfigurationen är den som NVIDIA aktivt marknadsför, den som de flesta läsare faktiskt kommer att driftsätta, och den vi tror representerar den rimliga övre gränsen för produktionsliknande slutsatser på denna hårdvara. Det är också den som denna recension jämför från början till slut.
Varför klustergnistor uppstår från första början
Den uppenbara anledningen till att klustra Sparks är densamma som för alla kluster: en enda 128 GB-box kan inte rymma alla modeller som är viktiga. Att sträcka ut en 120B-parametermodell över två boxar öppnar upp en klass av arbetsbelastningar som annars inte skulle få plats. Det är det huvudsakliga användningsfallet, och det är det som demonstreras mest.
Den mindre uppenbara anledningen, och förmodligen den viktigaste för NVIDIAs faktiska kundbas på den här plattformen, är lärande. NVIDIA positionerar Spark som en ingångspunkt. Deras officiella dokumentation , exempelanteckningsböcker och partnerhandböcker behandlar lådan som ett undervisningsverktyg. De inkluderar förstklassiga guider för allt från att skapa en förbyggd modell bakom ett lokalt chattgränssnitt till att köra en kodningsassistent mot en värdbaserad slutpunkt, till finjustering av små modeller och att bygga kompletta applikationer i PyTorch och JAX. Tanken är att någon som aldrig har skrivit en CUDA-kärna i sitt liv kan komma från noll till ett fungerande AI-arbetsflöde vid sitt skrivbord på en helg, och detsamma gäller ingenjörer inom ett område som inte är ML och som vill ha en fristående sandlåda som de helt kontrollerar. Ett kluster med två Spark utökar den undervisningsytan till ett flernodigt territorium: samma person kan nu också lära sig hur tensorparallellism, pipelineparallellism och kollektiva kommunikationsbibliotek faktiskt beter sig, med ett nätverk som är tillräckligt verkligt för att avslöja verkliga flaskhalsar.
Det som påfallande saknas i NVIDIAs egna positioner är dock påståendet att Spark är avsedd för produktionsinferenshantering. Jensen har talat om samdesign av hårdvara och mjukvara i nästan varje huvudanförande de senaste åren, och principen gäller även här. Varje NVIDIA-plattform är optimerad för en specifik arbetsbelastningsform, och Spark är optimerad för individuell utforskning och inlärning, inte för att hantera trafik. Våra tidigare Spark-recensioner har redan visat att plattformen är starkt begränsad till minnesbandbredd för de flesta inferensuppgifter, och nätverket skärper bara den begränsningen så fort man klustrar. En enda 200 Gb-länk, även om den är imponerande för en stationär dator, är betydligt långsammare än en PCIe Gen5 x16-anslutning inom ett enda chassi, och kollektiva kommunikationsmönster som fungerar smidigt över ett NVLink-bryggat par av datacenter-GPU:er kan inte överföras till en 200 Gb-struktur utan att det medför verkliga latensförluster.
Det är den verkliga anledningen till att NVIDIA begränsade den officiellt stödda konfigurationen till två Sparks så länge, och varför demonstrationen med fyra enheter på GTC var ett svar på användarnas efterfrågan snarare än en organisk produktexpansion. Ingenting hindrar programvarustacken från att köras på fyra eller åtta noder, och flera användare och leverantörer har publicerat resultat från större kluster. Prestandasiffrorna från dessa experiment är i allmänhet inte smickrande: strukturen mellan noder blir den dominerande kostnaden, och den samlade prestandan försämras kraftigt, och dessutom kan dataflödet per användare i slutet av dessa konfigurationer sjunka till intervallet ensiffriga tokens per sekund för alla modeller som är tillräckligt stora för att motivera klustret från första början. Vid den tidpunkten är installationen funktionellt ett inlärningslabb snarare än en serverplattform.
Inget av detta är menat som en avfärdande. Clustering Sparks är ett verkligt utmärkt sätt att utveckla en intuition för distribuerad inferens och träning som annars är låst bakom hundratusentals dollar i datacenterhårdvara, och det pedagogiska värdet av att faktiskt kunna se pipeline-bubblor, helt minska flaskhalsar och parallellitetsavvägningar i ett system du äger är betydande. Vår egen uppföljningsplan var att ta detta vidare genom att träna en liten 1B-parameter- eller sub-1 B-modell från grunden över ett dual-Spark-kluster, med en uppställning vald för att så nära som möjligt spegla de förhållanden under vilka en verklig distribuerad förträningskörning fungerar, så att vi kunde visa exakt var denna klass av kluster är och inte är meningsfull. Det projektet ligger för närvarande på is medan vi arbetar igenom annan täckning som du kanske redan har sett och väntar på att optiken för vår nya 800 Gb labkärnswitch ska komma. Vi räknar med att återkomma till det när labbygget har stabiliserats.
Det följande fokuserar på det användningsfall där dual-Spark-konfigurationen är mest försvarbar: distribuerad inferens av modeller som är tillräckligt stora för att kräva båda boxarna, jämförda med alla tre OEM-implementeringar vi har till hands. Innan vi går in på siffrorna per modell förklarar nästa avsnitt varför vi rapporterar dessa siffror under en pipeline-parallell konfiguration snarare än den tensor-parallella konfiguration som NVIDIAs egen dokumentation tenderar att använda som standard.
Prestandatester
Varför vi rapporterar pipeline parallell, inte Tensor parallell
NVIDIAs publicerade DGX Spark-guider och det mesta av deras referensmaterial förlitar sig på tensorparallelism (TP) för att beskriva hur man skalar en modell över två Spark-boxar. TP delar upp varje matrismultiplikation över båda GPU:erna, så varje lager körs på båda enheterna samtidigt, och de partiella resultaten kombineras genom en all-reduce efter varje attention- och MLP-block. Pipelineparallelism (PP) tar en annan väg: den delar modellen i hälften lager för lager, placerar den första halvan på en box och den andra halvan på den andra, och strömmar sedan aktiveringar mellan dem. Varje begäran flödar fortfarande genom hela modellen, men vid varje given tidpunkt gör bara en box matematiken för en given token medan den andra arbetar på nästa mikrobatch.
Avvägningen handlar om vad som färdas över kabeln. En dubbel-Spark-stack kopplar samman de två systemen via en ConnectX-7 200 GbE-länk, vilket är snabbt för en nätverkslänk men långsamt jämfört med minnesbandbredden inom en enda Spark. TP:s all-reduce-funktion utlöses två gånger per transformatorlager, så en 80-lagersmodell som kör TP=2 genererar 160 cross-box-utbyten för varje enskild token av utdata, där var och en av dessa utbyten blockerar nästa beräkning. PP=2 hanterar bara aktiveringar en gång per token, vid skarven mellan modellens två halvor. På en 200 GbE-länk med icke-trivial latens dominerar den skillnaden allt annat.
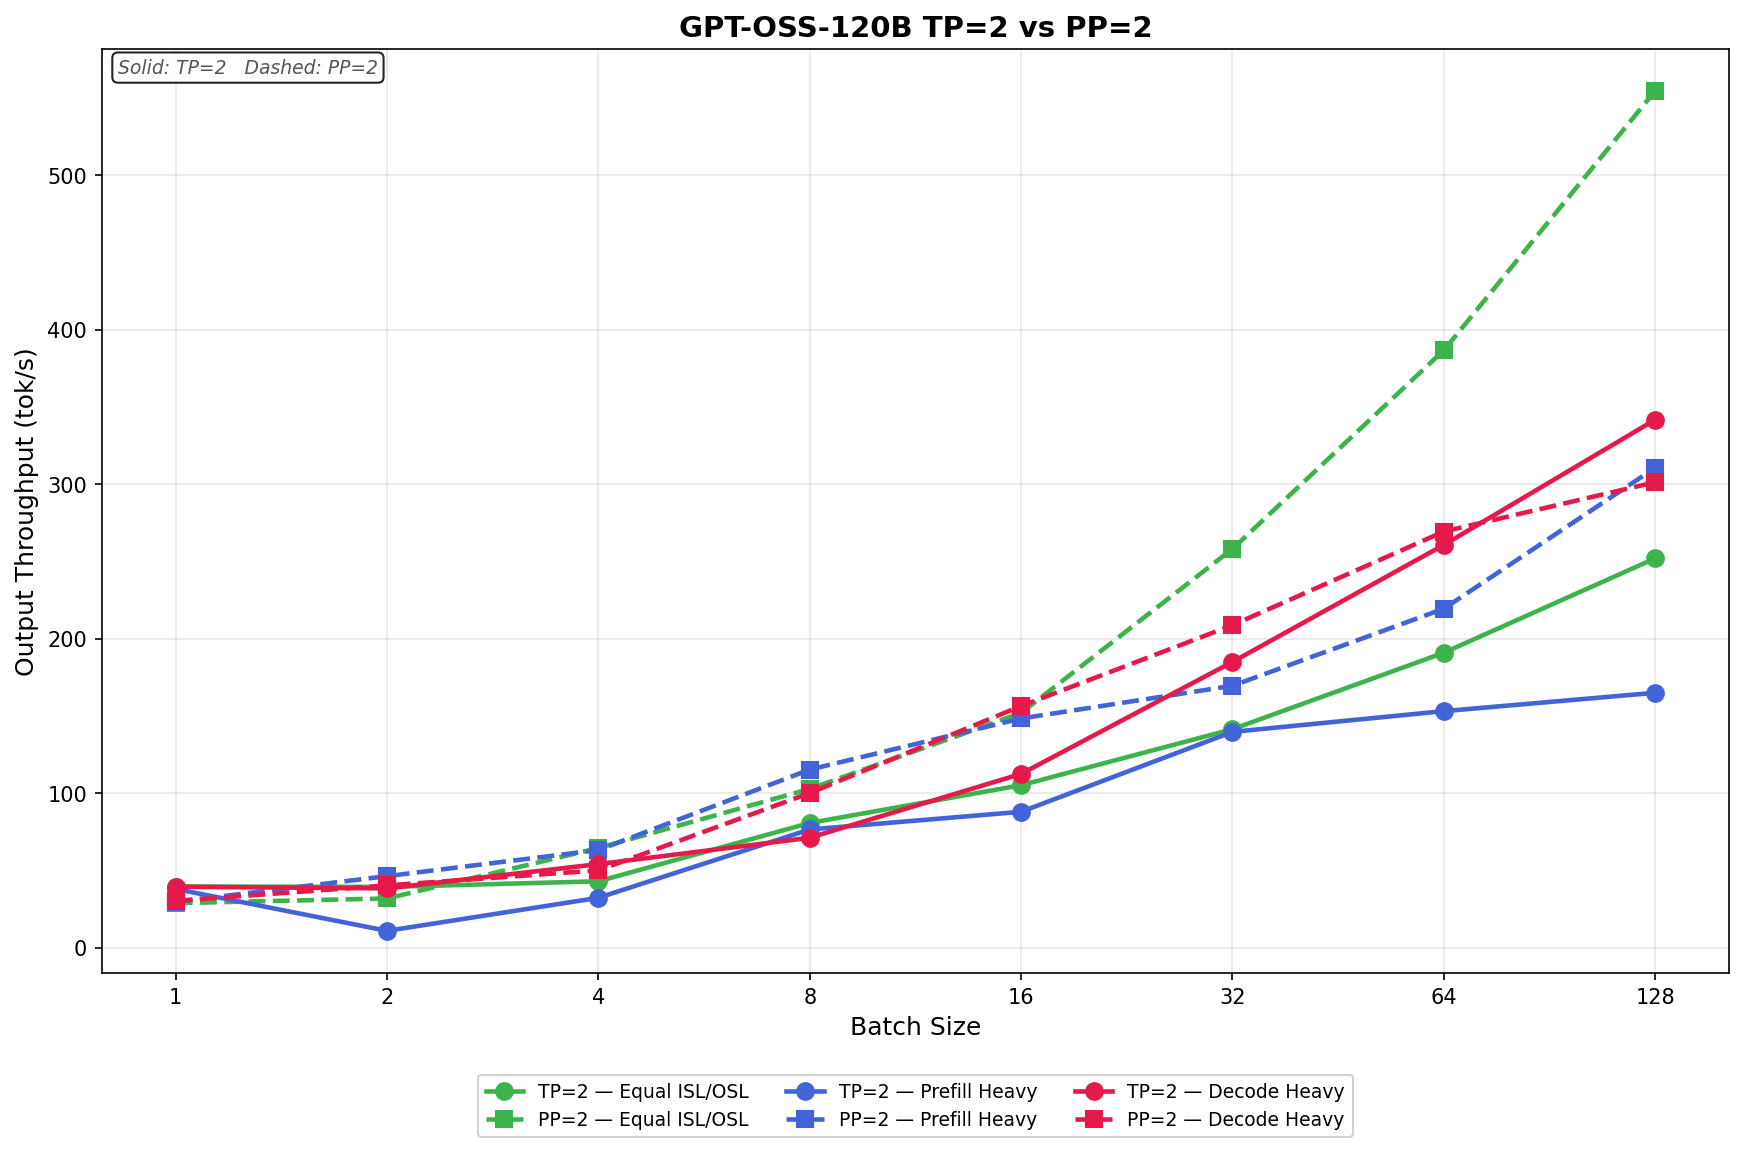
Våra GPT-OSS-120B-mätningar bekräftar detta tydligt. Utanför batchstorlek 1, där arbetsbelastningen är för tunn för att dölja någon av strategiernas overhead, tar PP=2 ledningen och bibehåller den allt eftersom samtidigheten växer. I arbetsbelastningen Equal ISL/OSL når TP=2 252.01 tok/s vid en batchstorlek på 128, medan PP=2 klättrar till 554.69 tok/s på samma hårdvara, en fördel på 2.20x. Prefill Heavy visar samma form, med PP=2 som slutar på 310.63 tok/s jämfört med TP=2 på 164.99 tok/s. Decode Heavy-scenariot är det närmaste av de tre, men PP=2 leder fortfarande från batchstorlek 8 till batchstorlek 64, och ger bara tillbaka en blygsam ledning vid batchstorlek 128, där den långa 8K-utgången förstärker pipeline-bubblakostnaden.
TP=2 har ett smalt fönster där den vinner. Vid batchstorlek 1 i varje scenario ger TP en liten men verklig fördel: 39.55 tok/s vs 28.79 tok/s i Equal, 37.97 vs 29.60 i Prefill Heavy och 39.42 vs 30.28 i Decode Heavy. Med en förfrågan igång finns det ingen andra mikrobatch som håller det inaktiva pipeline-steget sysselsatt, så PP betalar för en tom plats varje steg medan TP får använda båda GPU:erna på den enda token som finns. Det är detta som NVIDIAs TP-riktlinjer är byggda för: interaktiv single-stream-servering där latens på den första och enda förfrågan spelar större roll än aggregerad dataflöde. Om en distribution verkligen är chattliknande, med en användare per box och snäva TTFT-mål, är TP=2 rätt val, och detta överensstämmer också med hur NVIDIA ser på Spark.
För arbetsbelastningar som hanterar infrastruktur i stor skala, med batchinferens och många samtidiga förfrågningar, är pipeline-parallellism bättre lämpad vid skalning över olika boxar, särskilt när strategier som Expert Parallelism inte används. 200 GbE-strukturen kan inte hantera TP:s totala trafik per token utan att lämna beräkningen inaktiv, och när batchstorleken är 4 eller 8 försvinner PP:s bubbelkostnad till stationärströmmen. Det är därför varje nummer per modell i resten av den här artikeln rapporteras med TP=1 och PP=2. Det är den konfiguration som faktiskt representerar vad en dubbel-Spark-distribution kan leverera när den ombeds att utföra verkligt arbete.
Vi valde medvetet GPT-OSS-120B som huvuddiagram för TP vs PP eftersom det visar den största skillnaden. Vi vill dock också visa att detta inte gäller för alla modeller, och att dessa parametrar beror på modellens parametrar. Llama-3.1-8B-Instruct i BF16 berättar en mycket mer konservativ historia. Modellen är tillräckligt liten för att varje lagers beräkning ska vara snabb och TP:s all-reduce-trafik är motsvarande blygsam. Däremot är PP:s koordinationskostnad per steg fast oavsett modellens storlek. Resultatet är att TP=2 har ledningen över nästan hela batch-svepet. I Equal ISL/OSL leder TP=2 från batchstorlek 1 (23.2 vs 13.4 tok/s) till batchstorlek 32 (388.7 vs 349.3 tok/s), och tappar bara toppen vid batchstorlek 64 (524.8 vs 638.2 tok/s) och batchstorlek 128 (679.2 vs 1 047,1 tok/s). Prefill Heavy följer samma mönster, med TP=2 i ledning till batchstorlek 32 innan PP=2 tar över vid 64 och 128. Decode Heavy är den mest avgörande: TP=2 vinner vid varje enskild batchstorlek och slutar på 366.7 tok/s mot 330.5 tok/s för PP=2 vid batchstorlek 128.
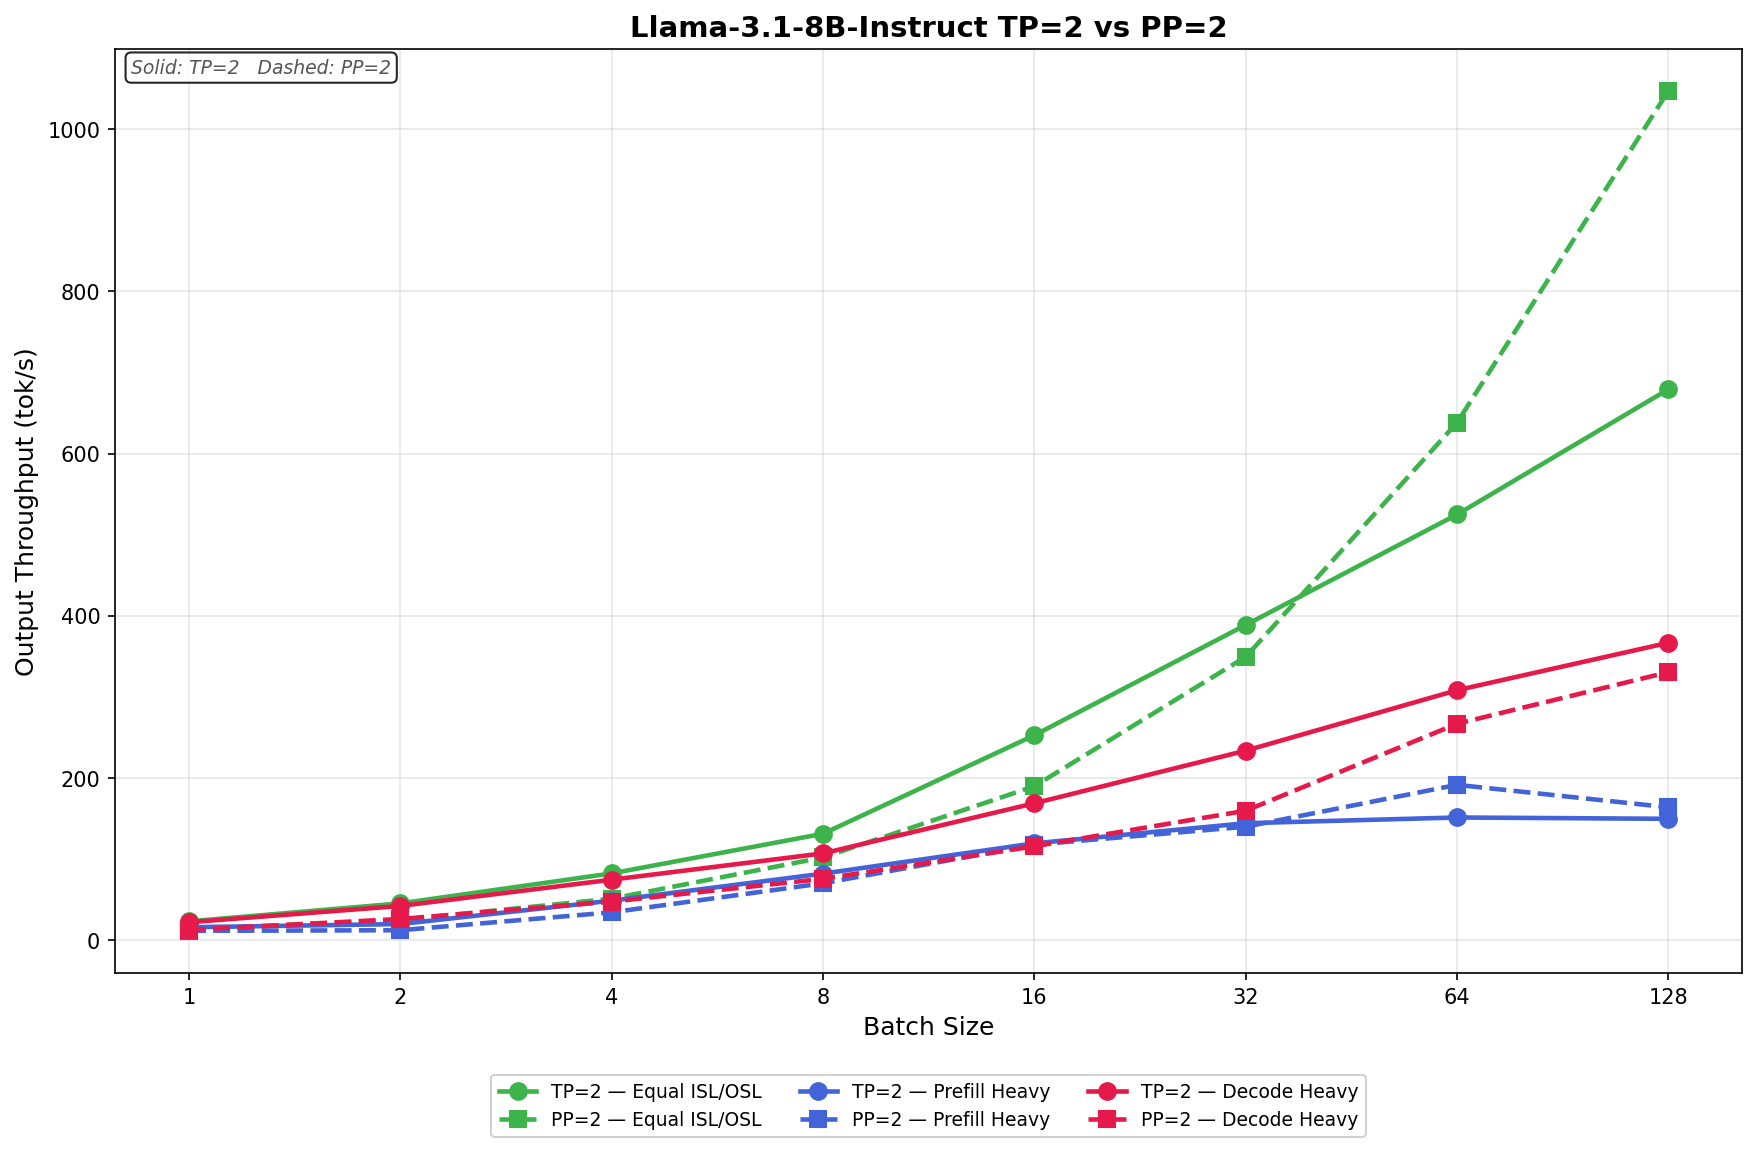
Detta motexempel förstärker, snarare än motsäger, den underliggande mekanismen. PP=2 vinner bara när batchstorlekarna är tillräckligt höga för att fylla pipelinen och amortera bubbelkostnaden helt, och när modellen i sig är tillräckligt liten för att TP:s all-reduce per lager är billig; den övergångspunkten flyttas längre ut. Resultatet för Decode Heavy är också konsekvent: längre utdatasekvenser innebär fler avkodningssteg, fler pipelinebubblor som betalas tillbaka back-to-back och ett mindre fönster för PP att kompensera för skillnaden. Med andra ord, samma fysik som ger PP en 2.20x vinst på GPT-OSS-120B vid batchstorlek 128 förklarar också varför den bara vinner de två bästa batchstorlekarna på en 8B-modell och aldrig vinner den avkodningstunga svepen.
GPT-OSS-120B
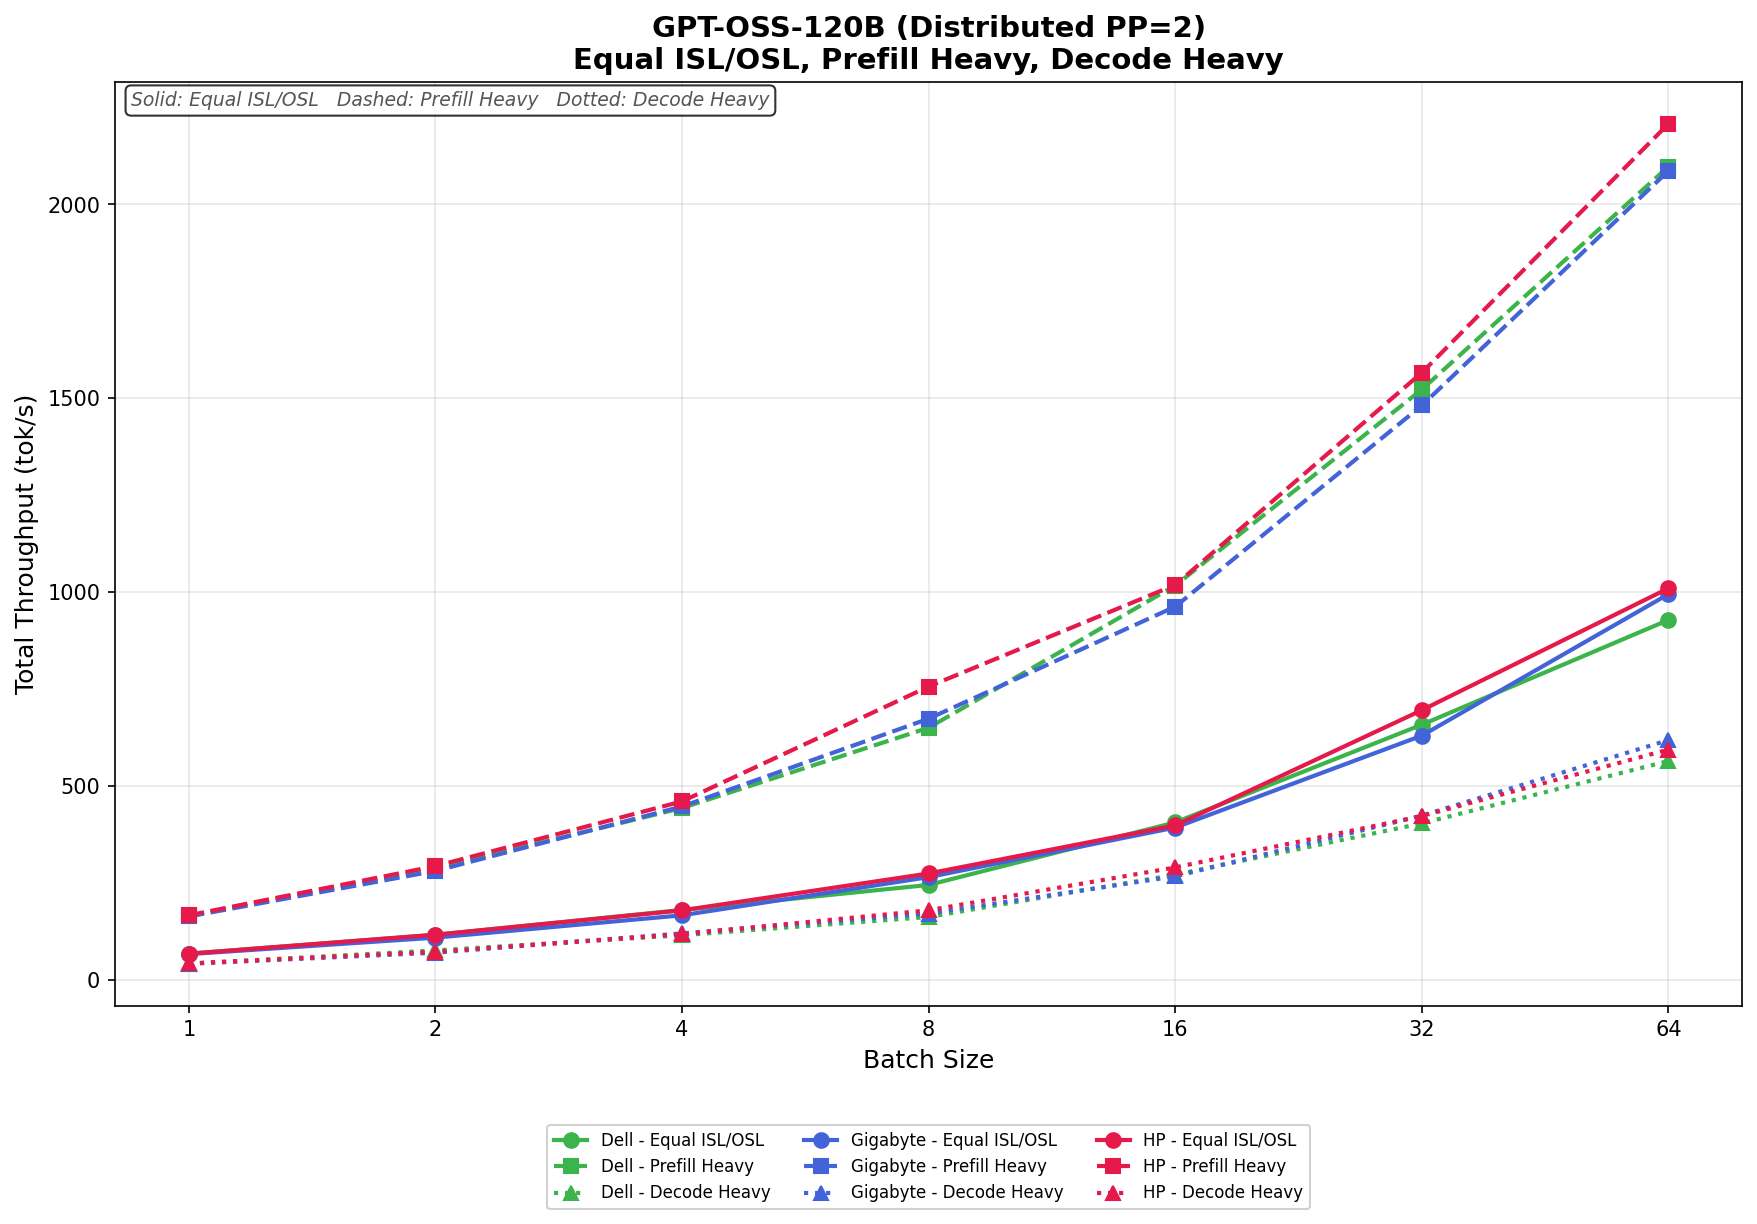
I Equal ISL/OSL börjar Dell på 67.06 tok/s och skalar upp till 927.93 tok/s med en batchstorlek på 64. GIGABYTE börjar något lägre på 65.77 tok/s men avslutar starkare på 994.53 tok/s, medan HP leder gruppen i toppen med 1 009,75 tok/s. Spridningen förblir snäv under större delen av svepet, med HP som drar ledningen från batchstorlek 32 och framåt.
I Prefill Heavy ökar dataflödet mycket mer aggressivt över hela linjen. Dell skalar från 164.42 tok/s till 2 097,80 tok/s, GIGABYTE går från 162.96 tok/s till 2 086,72 tok/s, och HP redovisar det starkaste resultatet, klättrande från 165.95 tok/s till 2 208,16 tok/s. HP leder i nästan alla batchstorlekar, medan Dell och GIGABYTE förblir tätt grupperade, särskilt i batchstorlekarna 32 och 64.
I Decode Heavy är den totala prestandan lägre, som förväntat för avkodningsarbetsbelastningen. Dell varierar från 41.20 tok/s till 563.98 tok/s, GIGABYTE skalar från 40.83 tok/s till 617.96 tok/s, och HP går från 41.63 tok/s till 593.56 tok/s. GIGABYTE har den starkaste finishen med en batchstorlek på 64, medan HP leder i mellanregistret, och Dell ligger nära men ligger något efter vid högre samtidighet.
GPT-OSS-20B
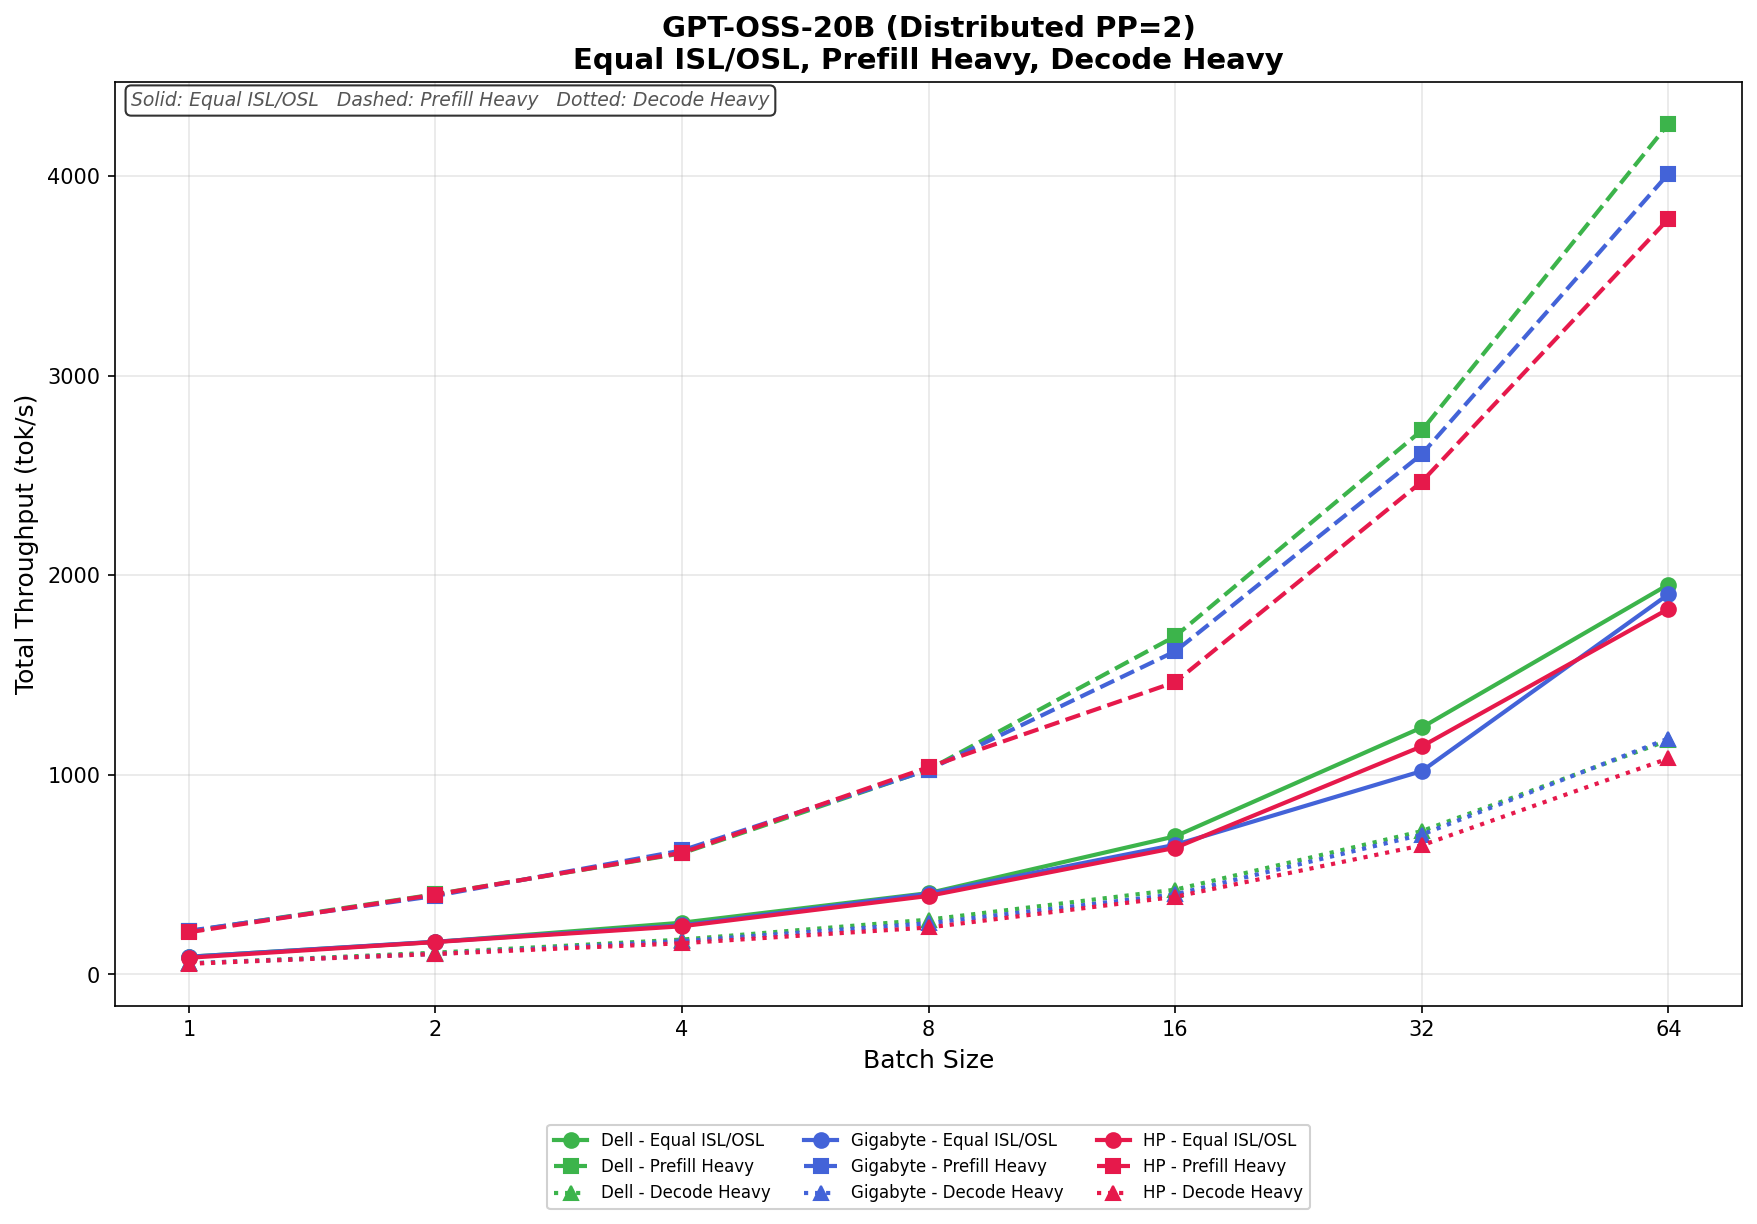
Inom Equal ISL/OSL leder Dell större delen av ökningen, med en skalning från 88.73 tok/s vid batchstorlek 1 till 1 953,55 tok/s vid batchstorlek 64. GIGABYTE följer tätt och ökar från 88.42 tok/s till 1 904,62 tok/s, medan HP varierar från 83.49 tok/s till 1 831,45 tok/s. Dell har den starkaste skalningen i den övre delen totalt sett, särskilt från batchstorlek 16 och framåt.
I Prefill Heavy ökar dataflödet aggressivt över alla tre systemen. Dell levererar det högsta resultatet i detta test, och skalar från 216.05 tok/s till 4 261,96 tok/s vid en batchstorlek på 64. GIGABYTE följer med 4 011,86 tok/s, medan HP når 3 785,25 tok/s. De tre systemen förblir tätt grupperade vid mindre batchstorlekar, men Dell börjar separera sig vid batchstorlek 16 och utökar sin ledning under resten av svepningen.
I Decode Heavy är skalningen mer gradvis men förblir stark över alla plattformar. Dells hastighet varierar från 54.88 tok/s till 1 173,31 tok/s, GIGABYTE skalar från 55.24 tok/s till 1 181,94 tok/s, och HP ökar från 53.20 tok/s till 1 082,23 tok/s. GIGABYTE ligger knappt före Dell vid den högsta batchstorleken, medan HP släpar efter båda systemen vid högre samtidighetsnivåer.
Llama 3.1 8B Instruktionsbas
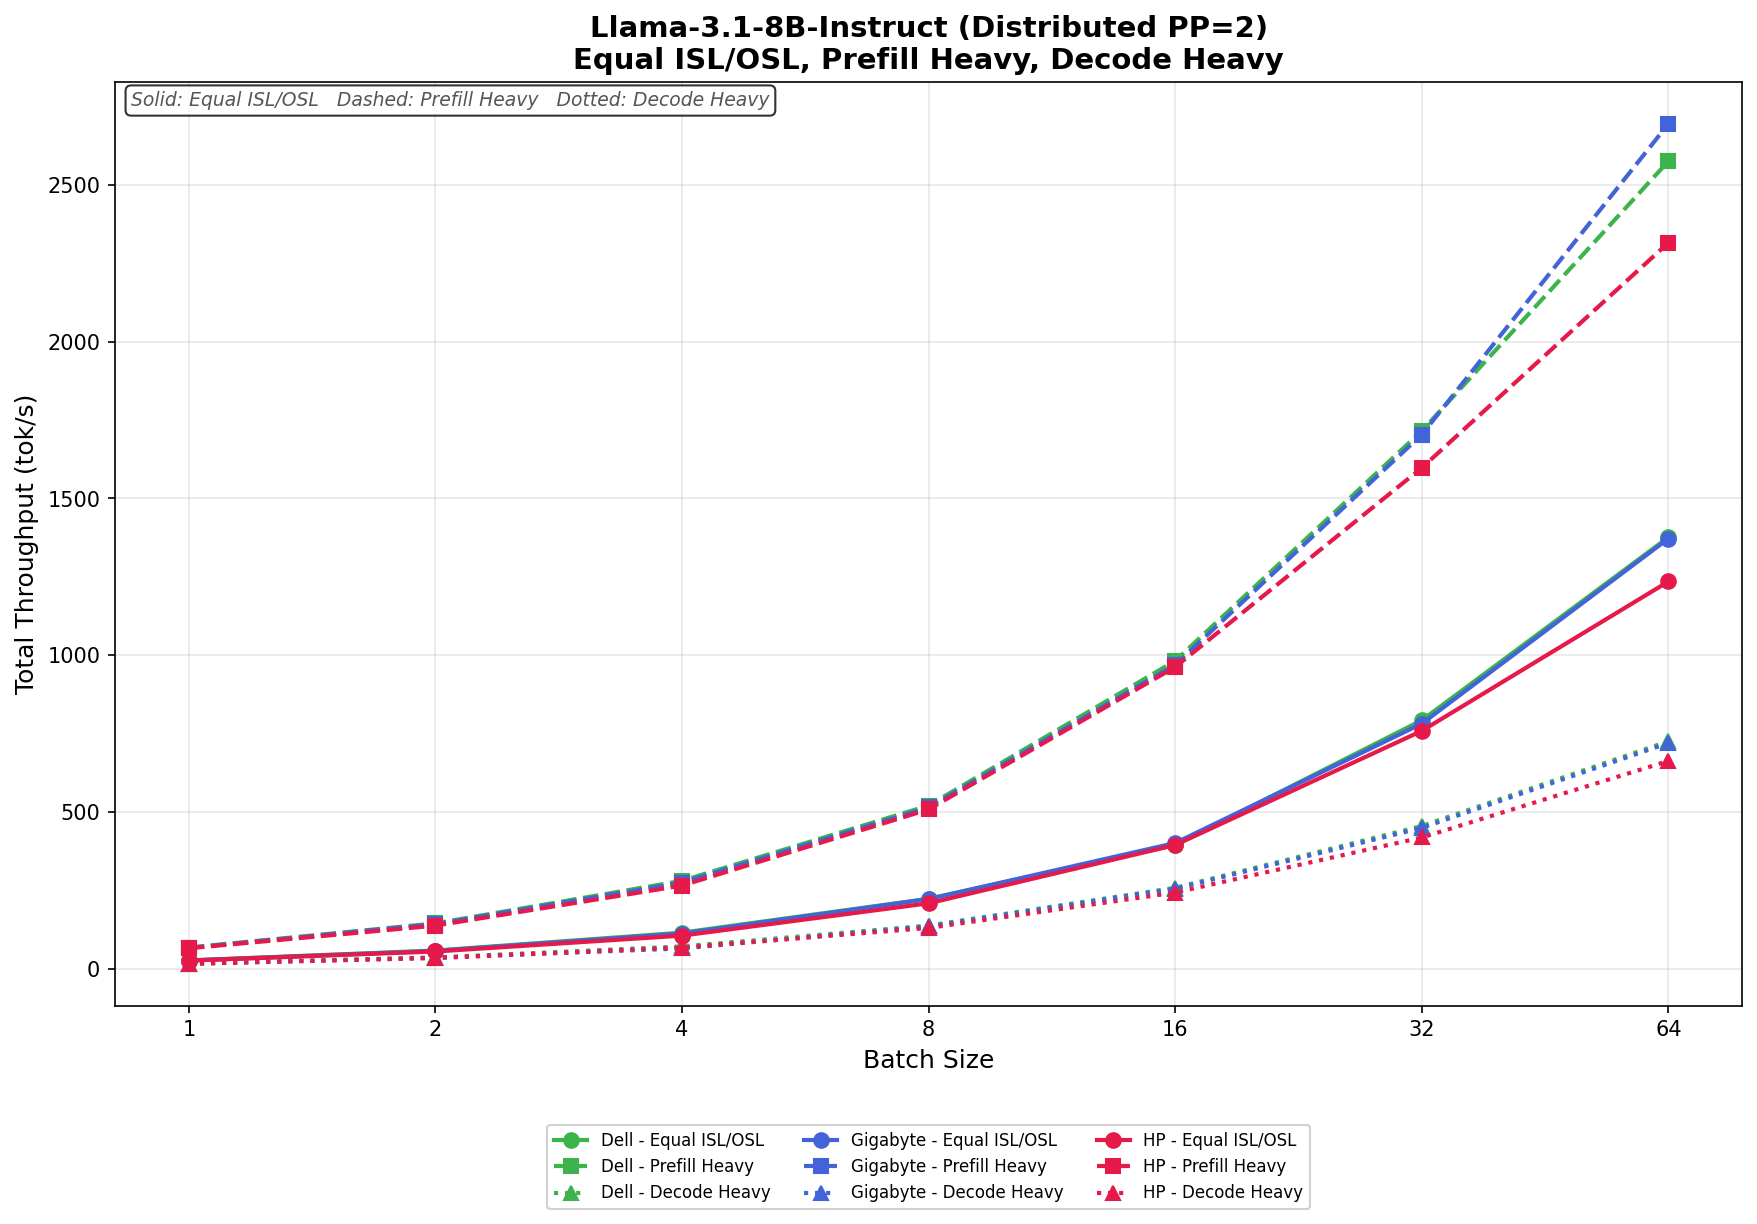
I Equal ISL/OSL skalar Dell från 27.69 tok/s till 1 376,38 tok/s vid batchstorlek 64, strax före GIGABYTE, som varierar från 27.23 tok/s till 1 372,27 tok/s. HP ligger något efter genom hela svepet och skalar från 26.89 tok/s till 1 235,32 tok/s. Alla tre systemen följer mycket nära genom en batchstorlek på 16 innan Dell börjar öppna en liten ledning vid högre samtidighetsnivåer.
I Prefill Heavy ökar genomströmningen aggressivt i takt med att batchstorlekarna ökar. Dell växer från 68.60 tok/s till 2 575,25 tok/s, medan GIGABYTE slutligen redovisar det starkaste resultatet, med en skalning från 67.49 tok/s till 2 694,25 tok/s vid batchstorlek 64. HP når 2 315,15 tok/s, och förblir konkurrenskraftigt men ligger konsekvent bakom Dell och GIGABYTE vid högre batchstorlekar. GIGABYTE tar ledningen i den övre delen, särskilt för batchstorlekar på 64 eller mer.
I Decode Heavy förblir skalningen stabil över hela testintervallet. Dells hastighet varierar från 17.19 tok/s till 726.22 tok/s, GIGABYTEs hastighet skalar från 16.96 tok/s till 720.57 tok/s, och HPs hastighet går från 16.79 tok/s till 663.31 tok/s. Dell och GIGABYTE förblir nästan identiska under större delen av testet, med Dell som har en liten fördel vid de högsta samtidighetsnivåerna. Samtidigt hamnar HP något efter vid större batchstorlekar.
Llama 3.1 8B Instruktion FP4
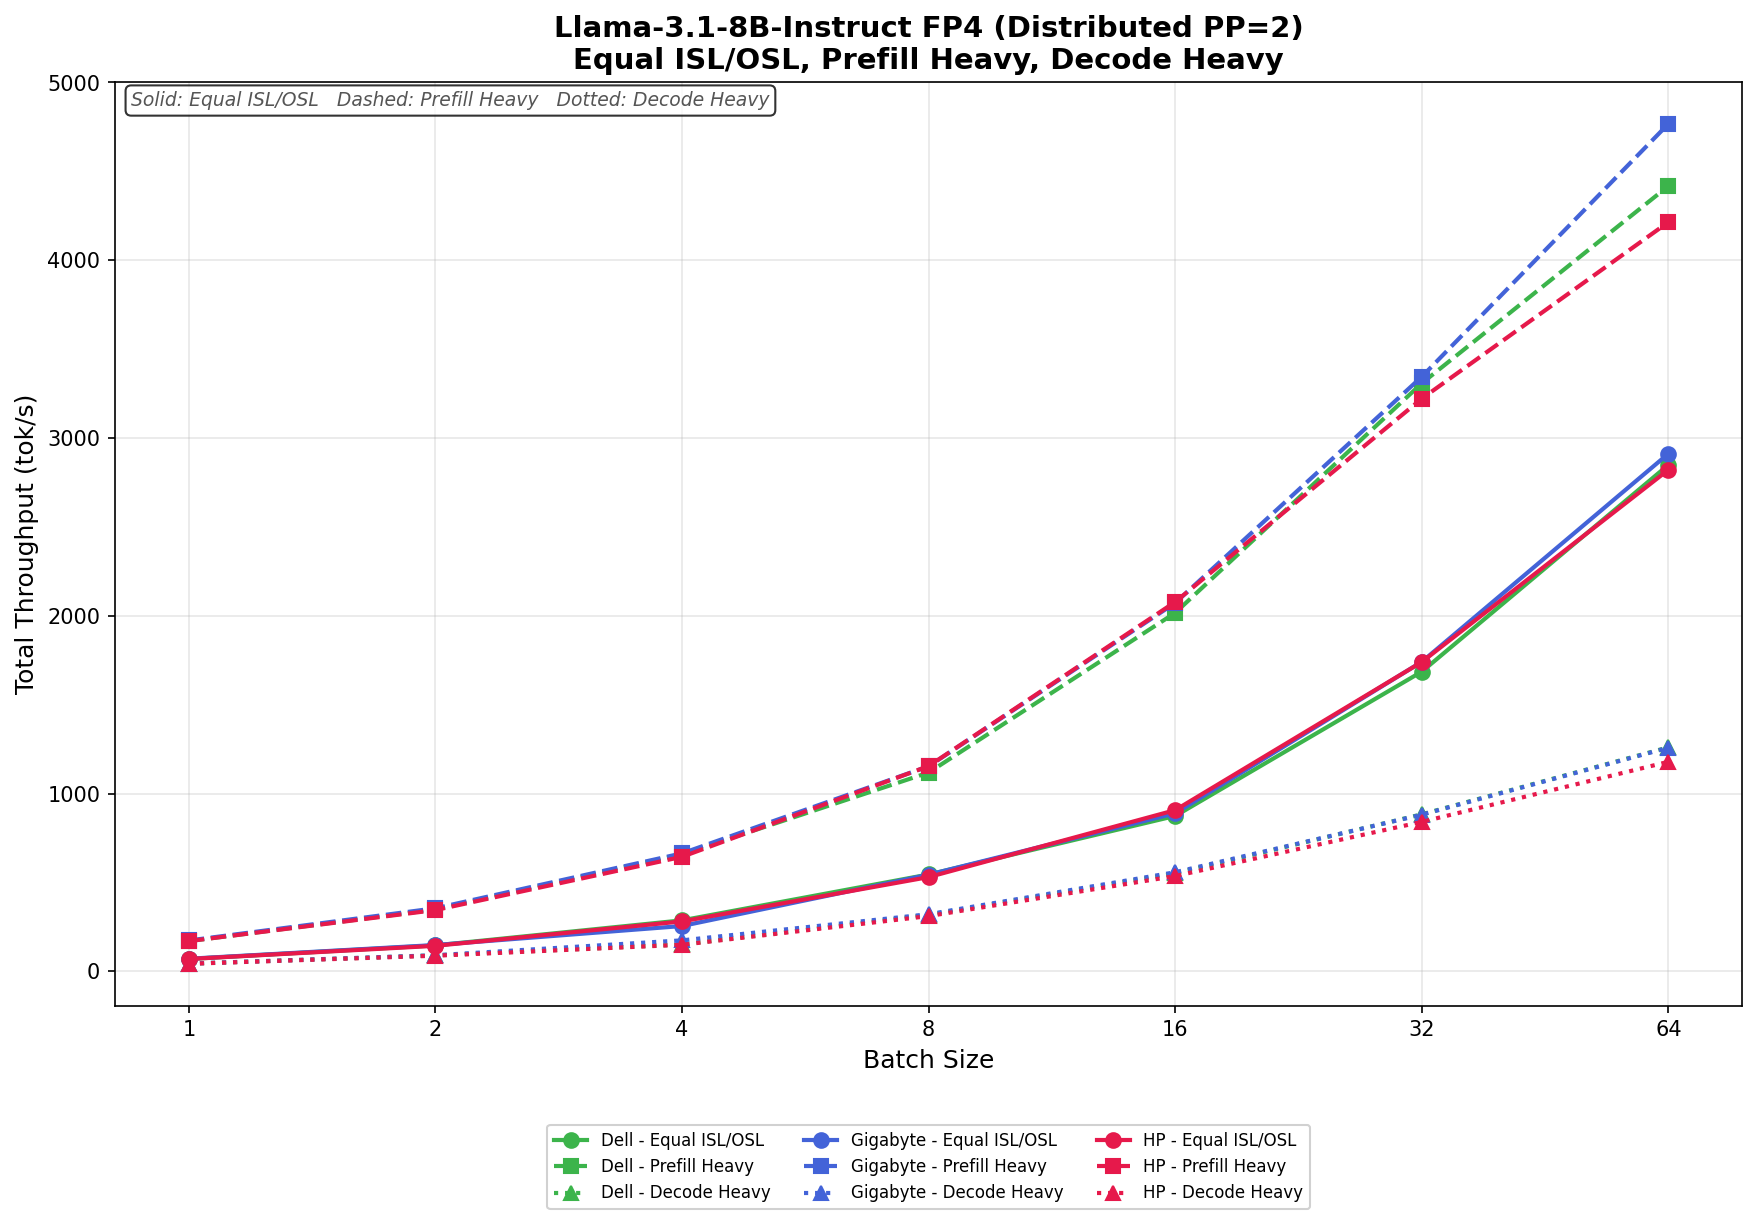
I Equal ISL/OSL skalar Dell från 69.71 tok/s till 2 849,20 tok/s vid batchstorlek 64, medan GIGABYTE ligger något före och växer från 70.92 tok/s till 2 912,03 tok/s. HP förblir konkurrenskraftigt och varierar från 69.52 tok/s till 2 821,50 tok/s. De tre systemen förblir tätt grupperade över hela arbetsbelastningen, med endast en liten separation vid högre samtidighetsnivåer.
I Prefill Heavy blir skalningen mycket mer aggressiv, särskilt vid större batchstorlekar. Dell ökar från 170.09 tok/s till 4 417,65 tok/s, medan GIGABYTE redovisar det starkaste resultatet i gruppen, med en klättring från 173.55 tok/s till 4 767,43 tok/s vid batchstorlek 64. HP skalar från 170.12 tok/s till 4 214,57 tok/s. GIGABYTE börjar separera från fältet efter en batchstorlek på 32, vilket ger den starkaste övre delen av dataflödet på denna arbetsbelastning.
I Decode Heavy ligger alla tre systemen återigen nära varandra under större delen av svepet. Dells hastighet varierar från 43.19 tok/s till 1 260,24 tok/s, GIGABYTEs hastighet skalar från 43.53 tok/s till 1 258,05 tok/s, och HP ökar från 42.54 tok/s till 1 178,74 tok/s. Dell och GIGABYTE utbyter effektivt ledningen beroende på batchstorlek, medan HP ligger något efter båda systemen på de största samtidighetsnivåerna.
Llama 3.1 8B Instruktion FP8
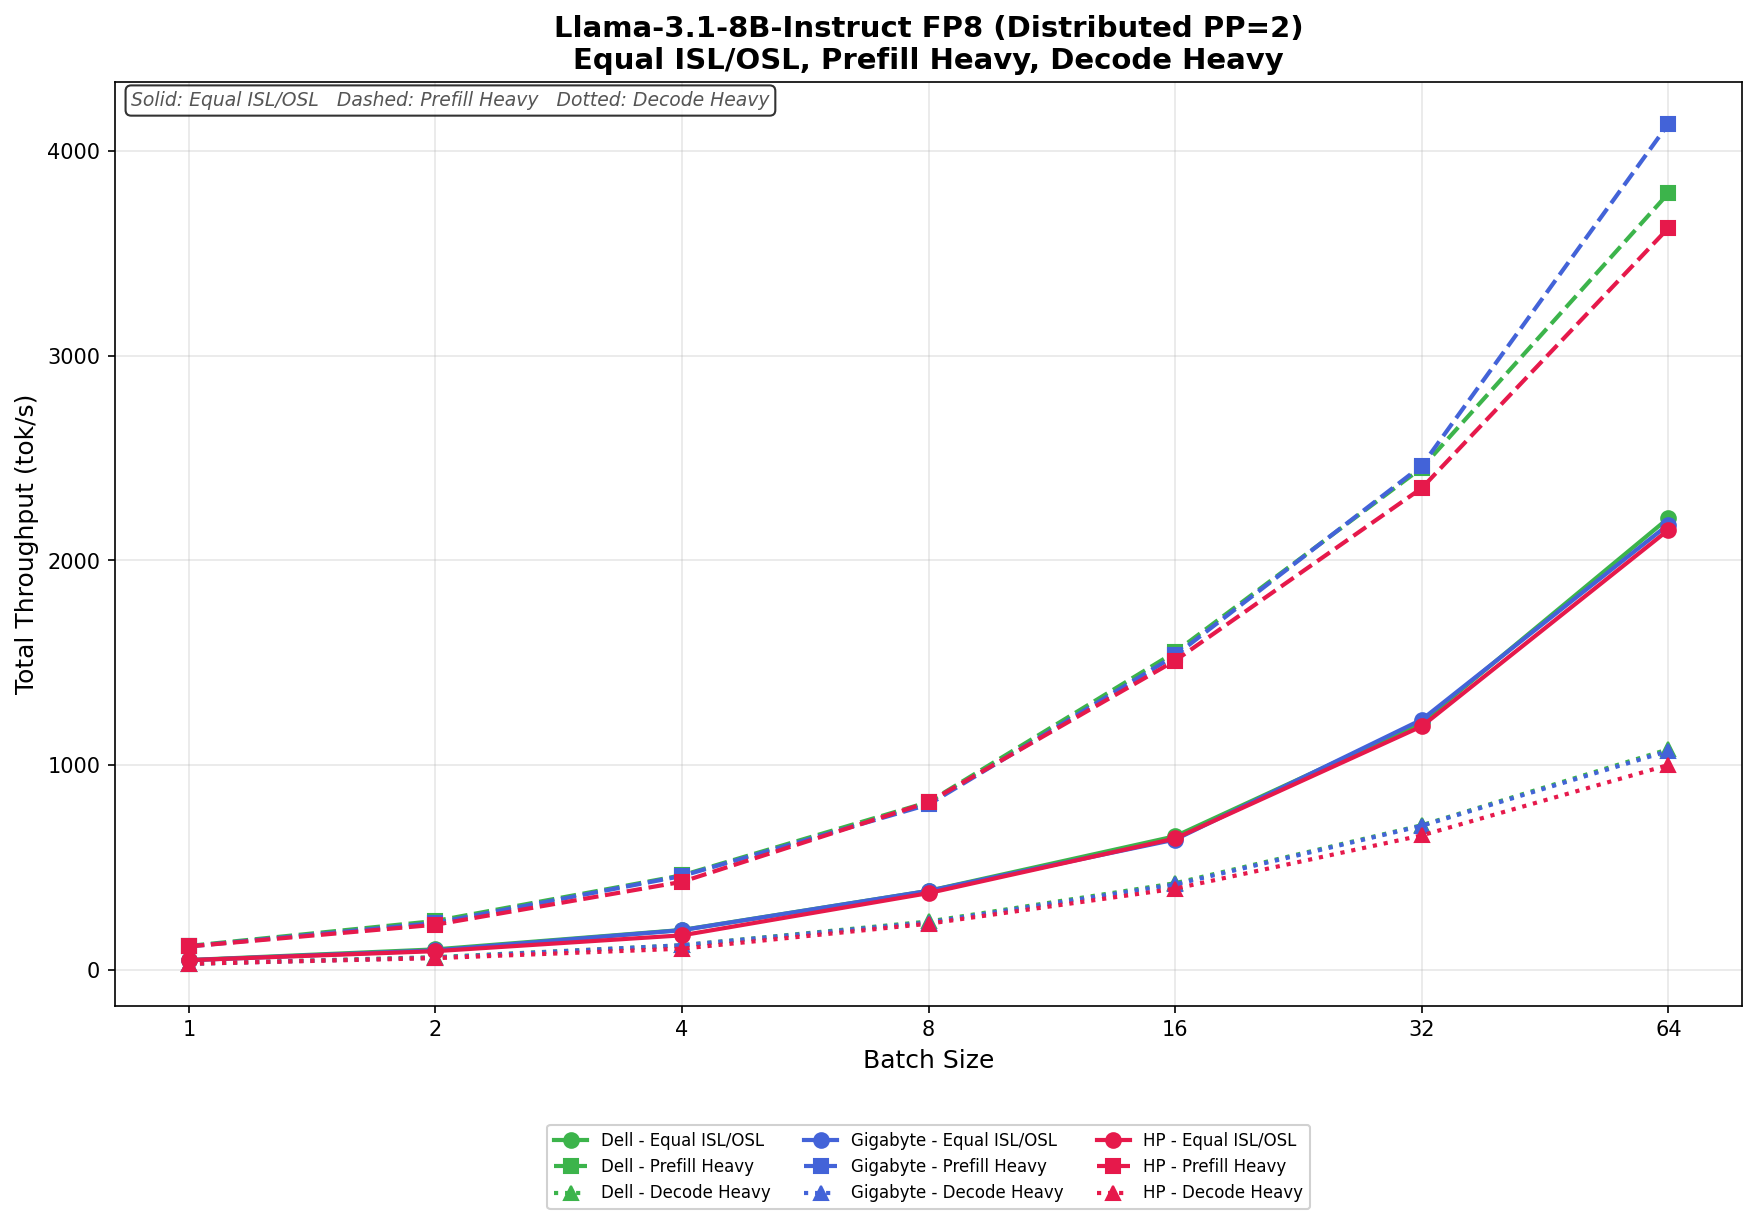
I Equal ISL/OSL skalar Dell från 46.93 tok/s till 2 206,52 tok/s vid batchstorlek 64, medan GIGABYTE varierar från 46.16 tok/s till 2 175,44 tok/s. HP följer tätt efter och ökar från 46.40 tok/s till 2 149,15 tok/s. Den totala spridningen förblir smal under hela testet, där alla tre system bibehåller nästan identiskt skalningsbeteende fram till batchstorlek 32.
I Prefill Heavy ökar genomströmningen mer aggressivt i takt med att samtidigheten ökar. Dell växer från 115.85 tok/s till 3 794,52 tok/s, medan GIGABYTE redovisar det starkaste totalresultatet, med en skalning från 113.34 tok/s till 4 133,76 tok/s vid batchstorlek 64. HP når 3 624,73 tok/s. GIGABYTE börjar etablera en mer uttalad ledning vid högre batchstorlekar, särskilt från batchstorlek 32 och framåt.
I Decode Heavy förblir de tre systemen tätt grupperade vid låga samtidighetsnivåer innan små separationer uppstår vid hög samtidighetsnivå. Dell varierar från 29.11 tok/s till 1 077,07 tok/s, GIGABYTE skalar från 28.64 tok/s till 1 068,92 tok/s, och HP ökar från 28.68 tok/s till 1 000,20 tok/s. Dell behåller en knapp ledning genom större delen av arbetsbelastningen, med GIGABYTE extremt tätt bakom, medan HP släpar något efter vid större batchstorlekar.
Mistral Small 3.1 24B
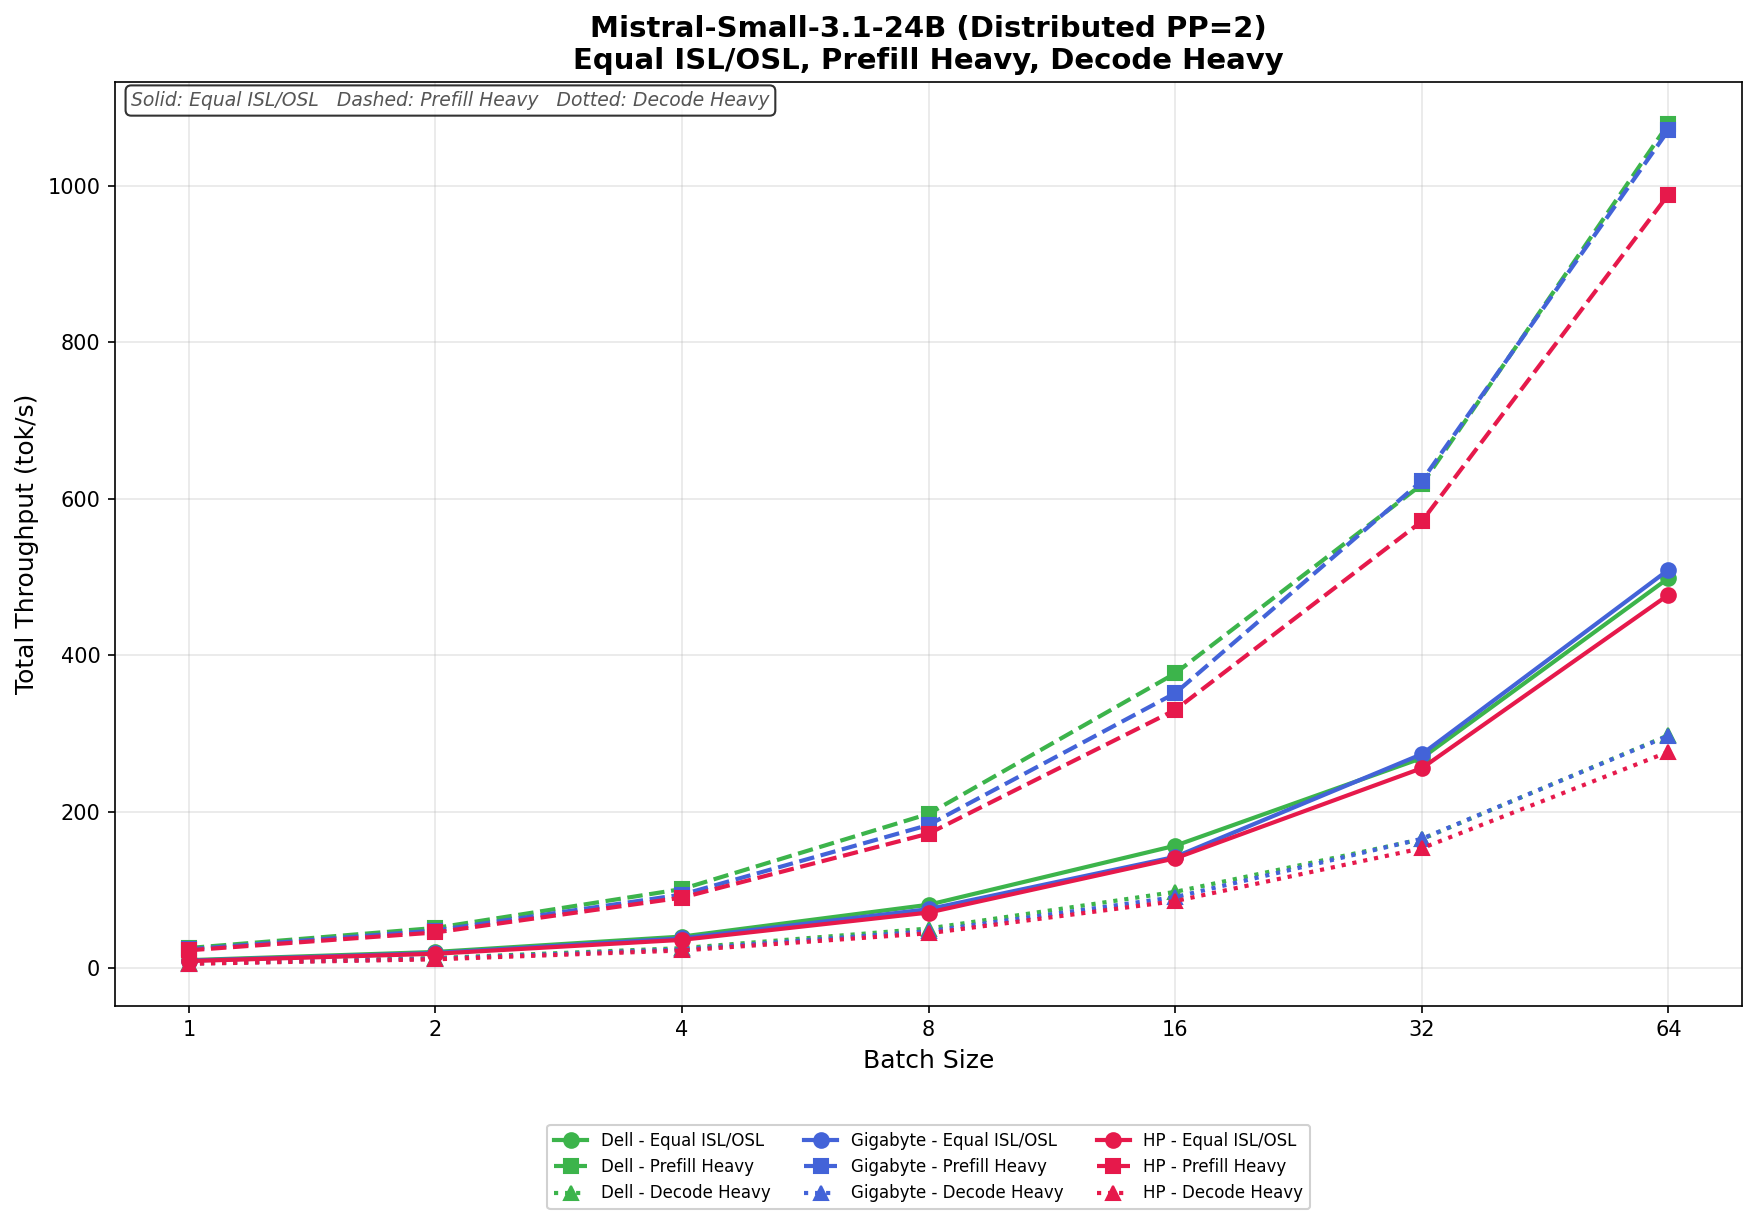
I Equal ISL/OSL skalar Dell från 10.41 tok/s till 498.56 tok/s vid batchstorlek 64, medan GIGABYTE ligger något före i den övre delen, från 9.76 tok/s till 509.18 tok/s. HP ligger blygsamt efter båda systemen, från 9.25 tok/s till 477.25 tok/s. Skillnaden mellan systemen förblir relativt liten under hela arbetsbelastningen, särskilt på lägre och mellanliggande samtidighetsnivåer.
I Prefill Heavy förbättras skalningen avsevärt över alla tre systemen. Dell ökar från 25.91 tok/s till 1 079,19 tok/s, medan GIGABYTE skalar från 24.25 tok/s till 1 071,07 tok/s. HP når 988.82 tok/s med en batchstorlek på 64. Dell och GIGABYTE förblir nästan identiska under större delen av svepet, med Dell som har en liten fördel på den högsta samtidighetsnivån.
I Decode Heavy är dataflödet betydligt lägre totalt sett, vilket förväntas för den avkodningsfokuserade arbetsbelastningen på en större modell. Dell varierar från 6.49 tok/s till 297.82 tok/s, GIGABYTE skalar från 6.10 tok/s till 297.23 tok/s, och HP ökar från 5.77 tok/s till 276.55 tok/s. Dell och GIGABYTE ligger jämnt i testet, medan HP konsekvent halkar något efter båda systemen vid större batchstorlekar.
Qwen3-kodare 30B A3B-bas
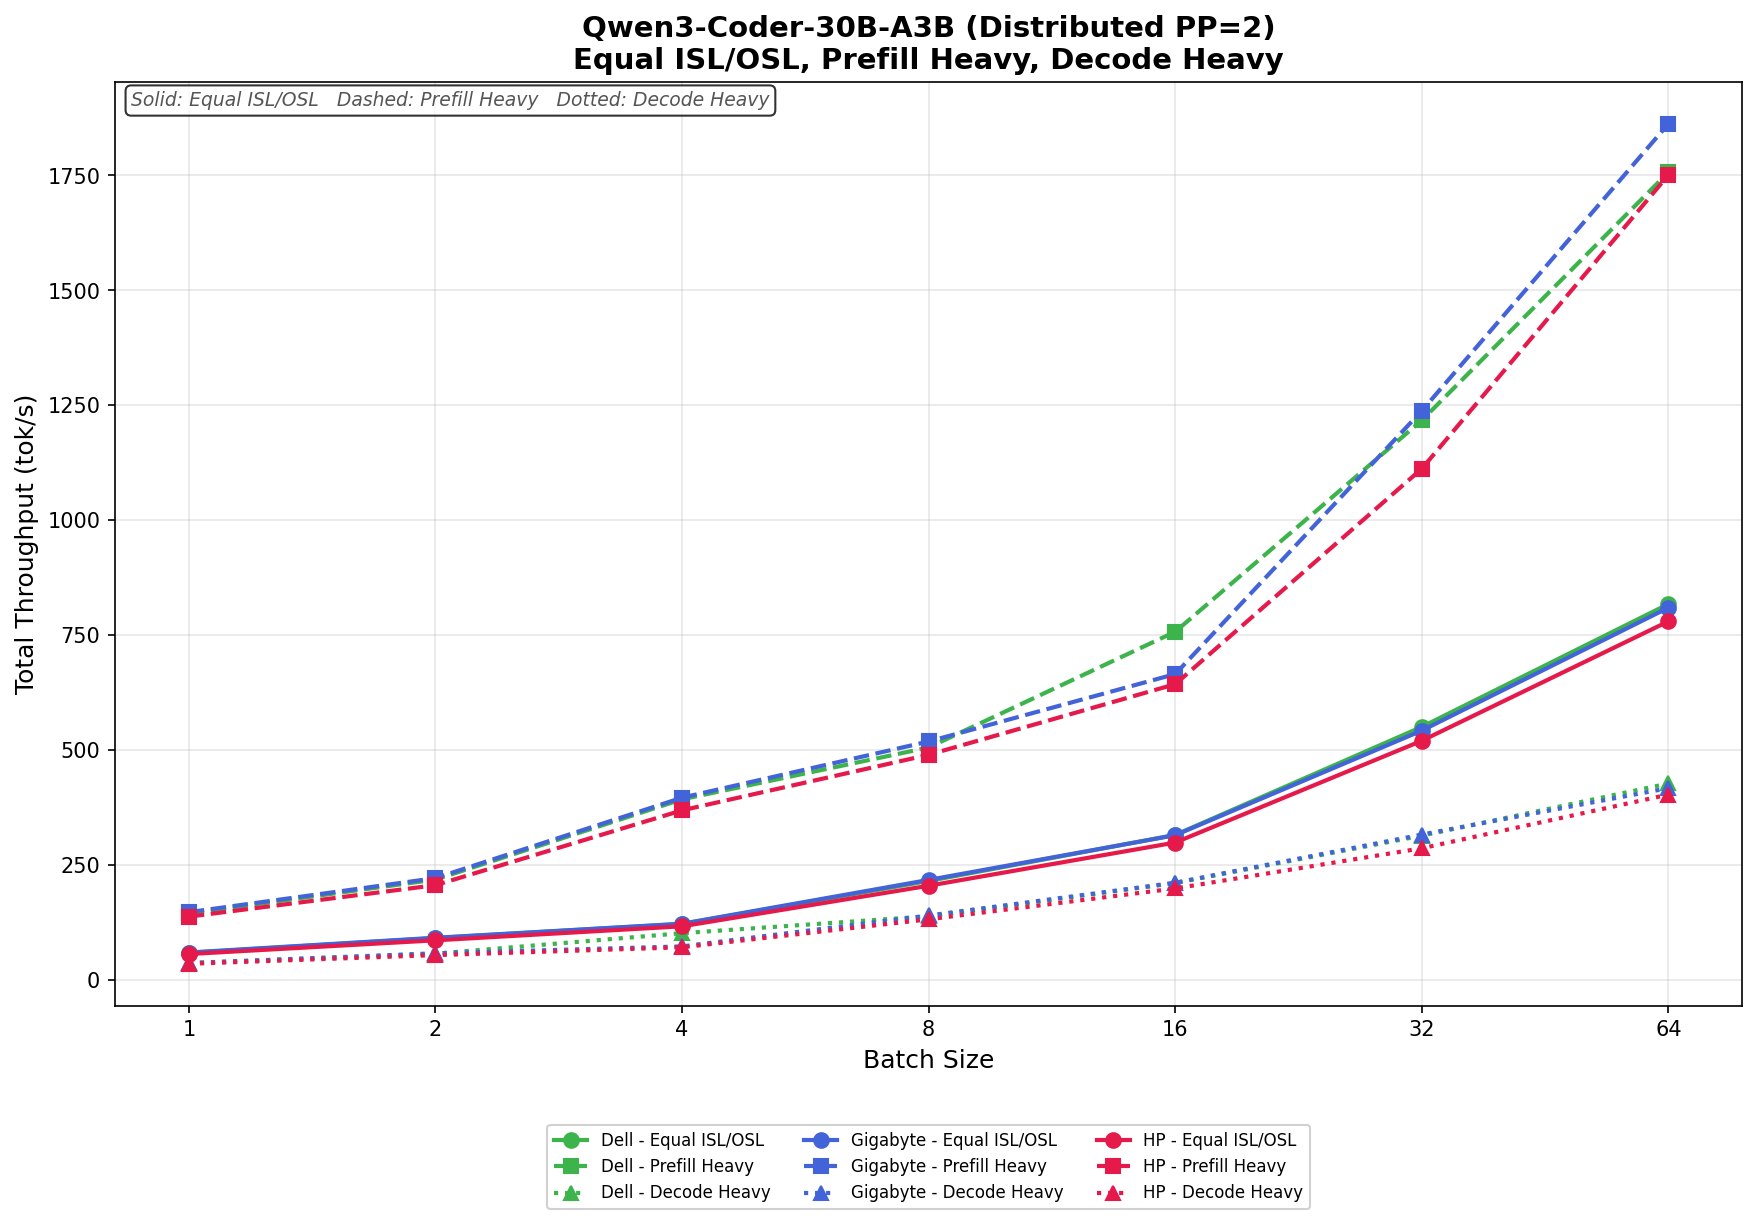
I Equal ISL/OSL skalar Dell från 59.05 tok/s till 817.82 tok/s vid batchstorlek 64, medan GIGABYTE varierar från 59.81 tok/s till 809.88 tok/s. HP ligger något efter båda systemen och ökar från 56.51 tok/s till 780.21 tok/s. Prestandan mellan Dell och GIGABYTE förblir nästan identisk under större delen av svepningen, med endast små skillnader vid högre batchstorlekar.
I Prefill Heavy ökar dataflödet avsevärt i takt med att samtidigheten ökar. Dell växer från 144.81 tok/s till 1 756,99 tok/s, medan GIGABYTE har den starkaste totala skalningen, med en ökning från 147.55 tok/s till 1 862,40 tok/s vid batchstorlek 64. HP når 1 751,17 tok/s och är fortsatt konkurrenskraftigt men något efter de andra två systemen i den övre delen. GIGABYTE etablerar en blygsam ledning runt batchstorlek 32 och utökar den till testets sista steg.
I Decode Heavy förblir de tre systemen återigen nära sammanlänkade under större delen av arbetsbelastningen. Dells hastighet varierar från 36.69 tok/s till 427.48 tok/s, GIGABYTEs hastighet skalar från 36.92 tok/s till 417.42 tok/s, och HP ökar från 35.30 tok/s till 403.32 tok/s. Dell behåller en liten fördel vid de högsta batchstorlekarna, medan HP ligger något efter både Dell och GIGABYTE över den avkodningsfokuserade arbetsbelastningen.
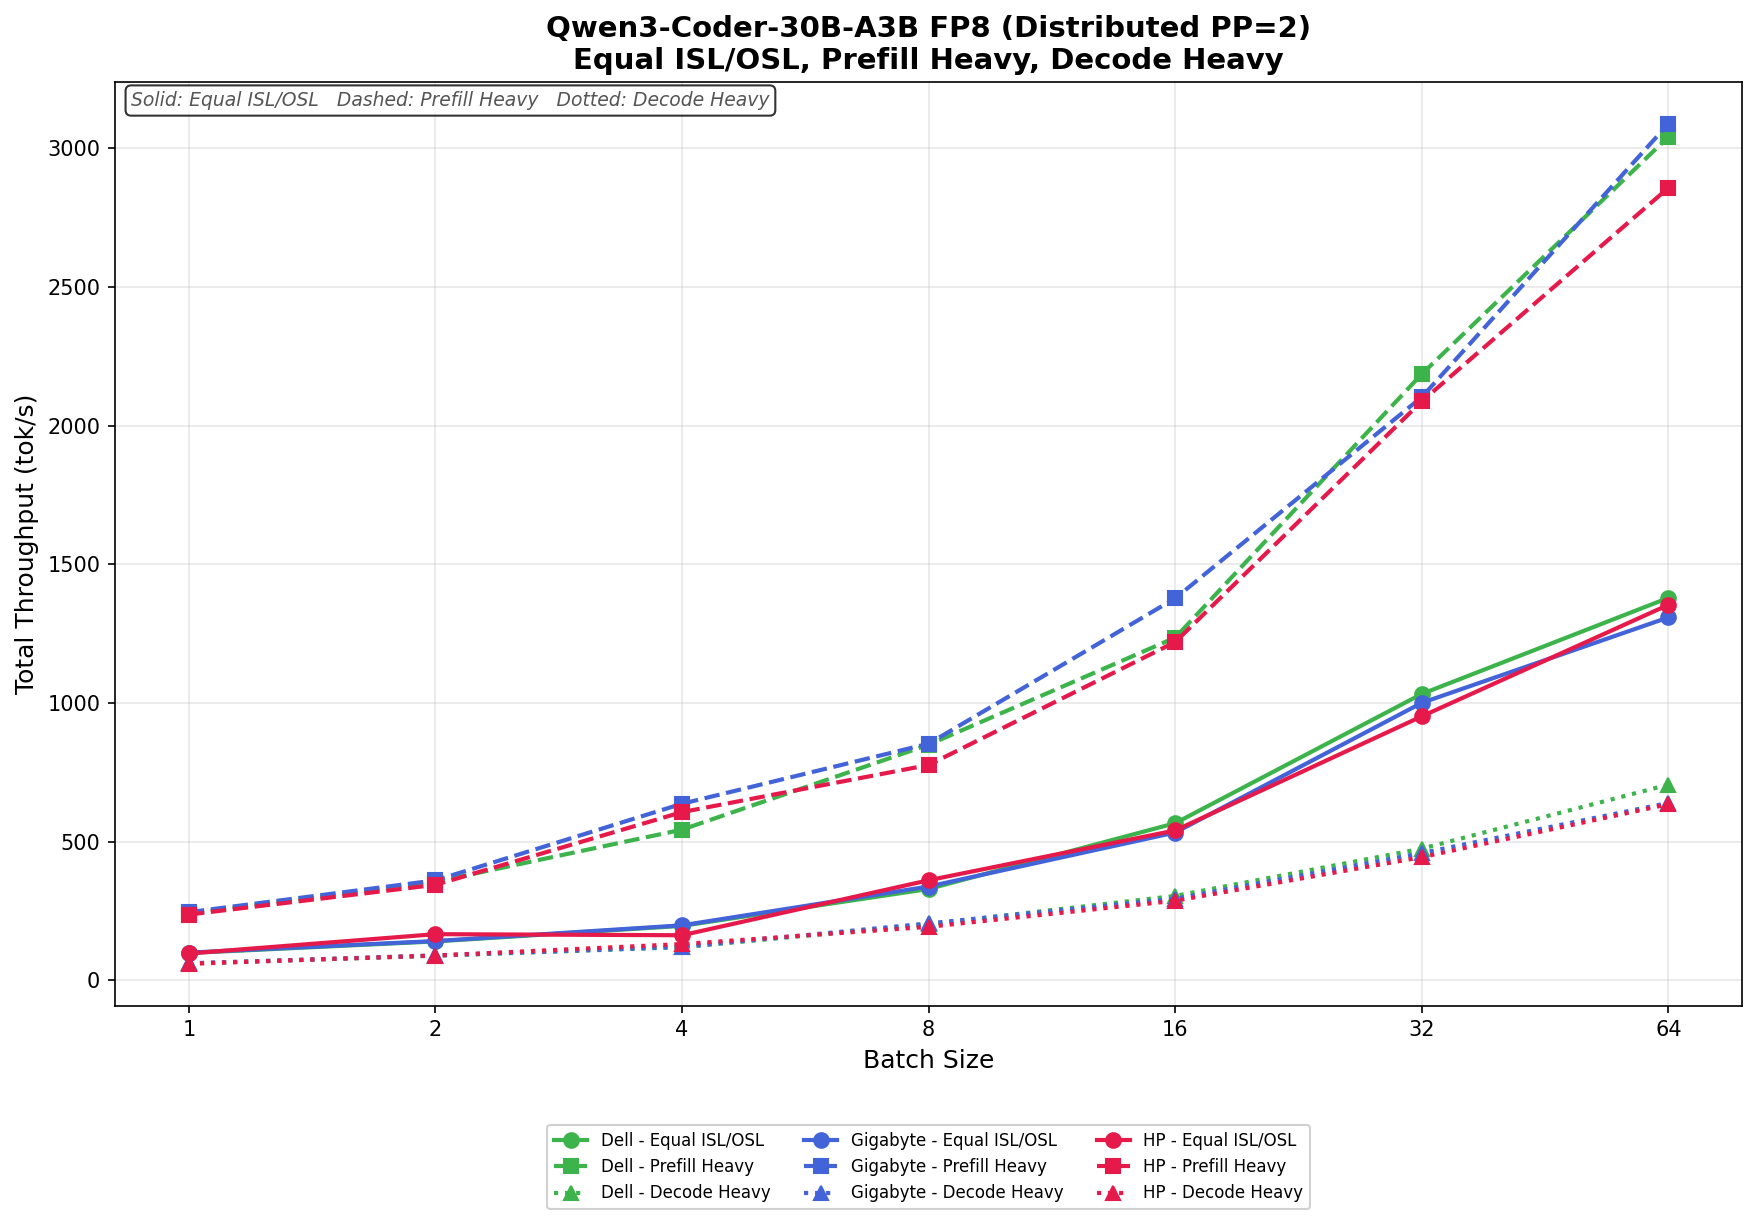
Qwen3-kodare 30B A3B FB8
I Equal ISL/OSL skalar Dell från 98.65 tok/s till 1 379,26 tok/s vid batchstorlek 64, medan GIGABYTE varierar från 100.20 tok/s till 1 308,79 tok/s. HP förblir konkurrenskraftigt hela tiden och ökar från 97.06 tok/s till 1 354,23 tok/s. HP leder kortvarigt vid flera lägre och mellanstora batchstorlekar, även om Dell avslutar med den starkaste totala genomströmningen i den övre delen.
I Prefill Heavy skalar dataflödet aggressivt över alla tre systemen. Dell växer från 240.43 tok/s till 3 041,72 tok/s, medan GIGABYTE redovisar det starkaste totalresultatet, med en skalning från 245.92 tok/s till 3 088,62 tok/s vid batchstorlek 64. HP når 2 857,80 tok/s. GIGABYTE etablerar en märkbar ledning från batchstorlek 4 och bibehåller den under resten av intervallet.
I Decode Heavy har Dell den starkaste skalningen i den övre delen totalt sett. Dell varierar från 60.91 tok/s till 705.77 tok/s, medan GIGABYTE skalar från 61.53 tok/s till 639.80 tok/s, och HP ökar från 59.85 tok/s till 635.25 tok/s. HP leder kortvarigt vid mindre batchstorlekar, men Dell ligger före vid större samtidighetsnivåer och avslutar med den starkaste avkodningskapaciteten i gruppen.
Sammanfattning av toppeffekt för Dual Spark-system
Tabellen nedan sammanfattar den maximala token-utdataflödet som observerades under distribuerad PP=2-testning över Dell-, GIGABYTE- och HP dual-Spark-systemen. Varje värde representerar den högsta uppmätta utdataflödet (tok/s) som uppnåtts för det arbetsbelastningsscenariot vid den testade batchstorleken. Fetmarkerade siffror anger det bäst presterande systemet inom det specifika arbetsbelastningsscenariot.
| Modell | Scenario (BS – 64) | Dells maximala utgång | GIGABYTE Peak Output | HP topputgång |
|---|---|---|---|---|
| GPT-OSS-modeller | ||||
| GPT-OSS-120B | Lika ISL/OSL | 463.97 tok/s | 497.26 tok/s | 504.88 tok/s |
| GPT-OSS-120B | Förfyllning Tung | 419.56 tok/s | 417.34 tok/s | 441.63 tok/s |
| GPT-OSS-120B | Avkoda tung | 451.18 tok/s | 494.37 tok/s | 474.85 tok/s |
| GPT-OSS-20B | Lika ISL/OSL | 976.77 tok/s | 952.31 tok/s | 915.72 tok/s |
| GPT-OSS-20B | Förfyllning Tung | 852.39 tok/s | 802.37 tok/s | 757.05 tok/s |
| GPT-OSS-20B | Avkoda tung | 938.65 tok/s | 945.55 tok/s | 865.78 tok/s |
| Lama-modeller | ||||
| Llama-3.1-8B-instruktion | Lika ISL/OSL | 689.53 tok/s | 687.48 tok/s | 618.87 tok/s |
| Llama-3.1-8B-instruktion | Förfyllning Tung | 515.45 tok/s | 539.27 tok/s | 463.39 tok/s |
| Llama-3.1-8B-instruktion | Avkoda tung | 581.43 tok/s | 576.91 tok/s | 531.07 tok/s |
| Llama-3.1-8B-FP4 | Lika ISL/OSL | 1427.39 tok/s | 1458.86 tok/s | 1413.51 tok/s |
| Llama-3.1-8B-FP4 | Förfyllning Tung | 884.22 tok/s | 954.23 tok/s | 843.57 tok/s |
| Llama-3.1-8B-FP4 | Avkoda tung | 1008.98 tok/s | 1007.23 tok/s | 943.73 tok/s |
| Llama-3.1-8B-FP8 | Lika ISL/OSL | 1105.42 tok/s | 1089.85 tok/s | 1076.68 tok/s |
| Llama-3.1-8B-FP8 | Förfyllning Tung | 759.50 tok/s | 827.40 tok/s | 725.51 tok/s |
| Llama-3.1-8B-FP8 | Avkoda tung | 862.33 tok/s | 855.81 tok/s | 800.78 tok/s |
| Mistral- och Qwen-modellerna | ||||
| Mistral-Small-3.1-24B | Lika ISL/OSL | 249.77 tok/s | 255.09 tok/s | 239.09 tok/s |
| Mistral-Small-3.1-24B | Förfyllning Tung | 216.01 tok/s | 214.38 tok/s | 197.92 tok/s |
| Mistral-Small-3.1-24B | Avkoda tung | 238.44 tok/s | 237.97 tok/s | 221.41 tok/s |
Slutsats
Det mest användbara resultatet från denna testrunda har föga att göra med vilken OEM som kom ut i topp på vilken arbetsbelastning. Över alla modeller och arbetsbelastningsformer vi testade presterade de tre Spark-implementationerna från Dell, GIGABYTE och HP inom ett smalt band. Små ledningar uppstod vid specifika batchstorlekar, men ingen plattform vann direkt, och ingen plattform låg konsekvent efter. Köpare som väljer mellan de tre bör basera sitt beslut på chassidesign, termiskt beteende, garantivillkor och supportrelation snarare än på riktmärkesdelta, som ligger nära den varians mellan körningar som alla stationära datorer producerar under långvarig belastning.
Det mer intressanta resultatet är metodologiskt. På 200 GbE-strukturen som förbinder två Sparks spelar valet mellan tensorparallellism och pipelineparallellism större roll än någon skillnad mellan de tre OEM-tillverkarna, och för batchinferens vid vilken rimlig samtidighet som helst är pipelineparallellism den bättre passformen. TP=2:s helt reducerade trafik per lager överlever inte resan över en ConnectX-7-länk utan att lämna beräkningen inaktiv, och PP=2:s pipelinebubblakostnad amorteras till stationärströmmen så snart batchen fyller pipelinen. NVIDIA:s dokumentation använder TP som standard av en försvarbar anledning: deras primära positionering för Spark är interaktiv enkelströmsservering med tight TTFT, vilket är det enda regimen där TP=2 vinner direkt. I det ögonblick som arbetsbelastningen ser ut att betjäna infrastruktur snarare än ett chattgränssnitt, inverteras kalkylen.
Den inversionen förstärker vad Spark är och inte är. Ett Spark-kluster med två noder är en utvecklings- och inlärningsplattform som låter en enda ingenjör se distribuerat inferensbeteende på första hand i ett nätverk tillräckligt snabbt för att efterlikna en verklig datacenterstruktur, men tillräckligt begränsat för att avslöja de flaskhalsar som produktionsdistributioner arbetar runt i stor skala.
Större Spark-konfigurationer är värda att undersöka på sina egna villkor, med arbetsbelastningar och parallellitetsstrategier som är anpassade till den skalan, och vi har det arbetet på gång. Separat skiftar nästa experiment som ligger i kö efter detta från inferens till träning: en sub-1B-parametermodell tränad från grunden på ett dubbelt Spark-kluster, konfigurerad för att spegla de distribuerade förträningsförhållandena i mycket större system. Det arbetet pausas medan vi väntar på optiken för vår nya 800 Gb labkärnswitch, och vi förväntar oss att publicera den när den nya kärnan är online.


 Amazon