

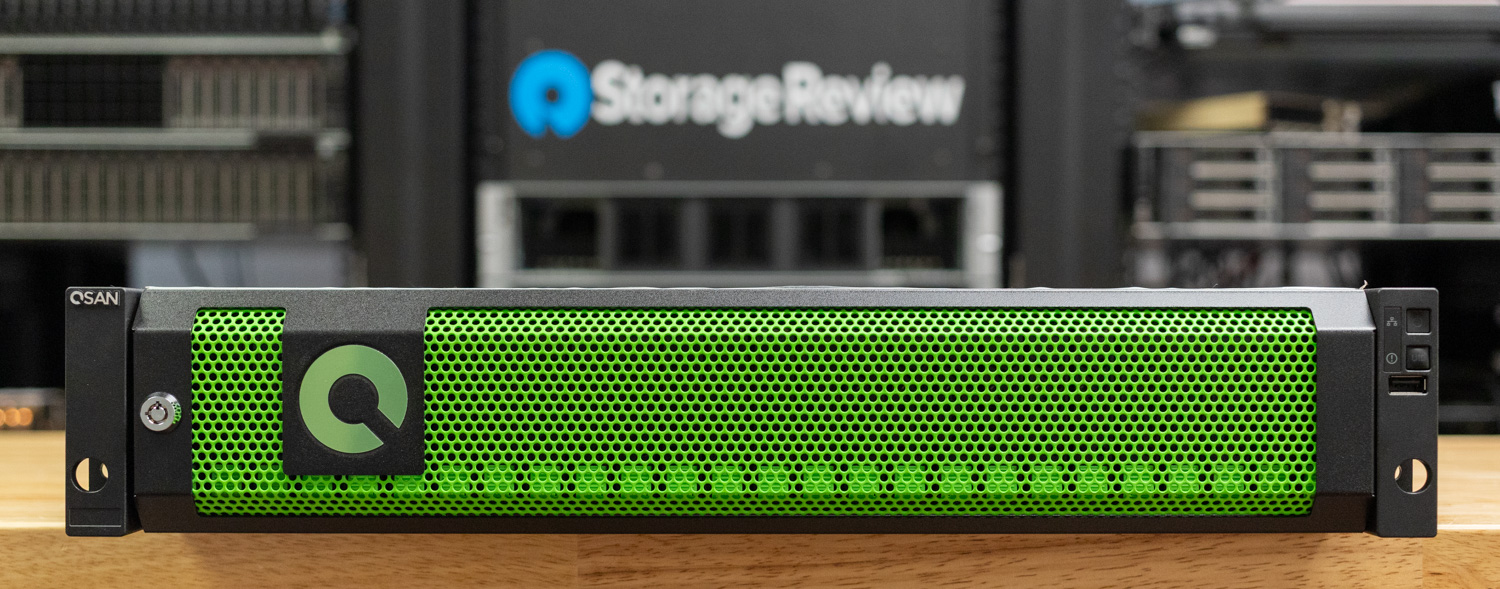
QSAN har byggt lagringslösningar för företag sedan 2004, och den erfarenheten är tydlig i XN4-serien. XN4226D i vårt labb är en 2U, 26-facks, helt NVMe-array med dubbla aktiva styrenheter, vilket ger hög tillgänglighet som enhetlig block- och fillagring. QSM 4-programvaran lägger till de förväntade datatjänsterna, inklusive snapshots, replikeringsalternativ, datareduktion och en enkel hanteringsupplevelse. XN4 är utformad för team som söker NVMe-hastighet utan att kompromissa med flexibilitet i flera protokoll, allt till ett mycket överkomligt pris.
Key Takeaways
- Enhetligt block och fil med riktig HA. Dubbla aktiva styrenheter och QSM 4 ger hög tillgänglighet med en plattform för block och fil.
- NVMe-oF gjort rätt. Fullständig protokollspridning med NVMe-oF över TCP och RDMA tillsammans med iSCSI, Fibre Channel, NFS, SMB, FTP och WebDAV.
- Bevisad genomströmning. Vi mätte upp till 21.21 GB/s vid stora sekventiella läsningar med TCP och 11.14 GB/s vid stora sekventiella skrivningar med RDMA.
- Byggd för moderna rörledningar. 26 helt NVMe-fack i 2U, enkel hantering och I/O-alternativ som skalar till 100–200 GbE för media, övervakningsanalys, VDI, databaser och AI-inferens.
Plattformen stöder NVMe-oF över TCP och RDMA, utöver iSCSI, Fibre Channel, NFS, SMB, FTP och WebDAV. Vi genomförde också en fokuserad NVMe-oF-studie som jämförde beteendet och skalningen hos TCP och RDMA. I våra tester pressade vi enheten till sin gräns med stora sekventiella läsningar, vilket uppnådde en imponerande dataflöde på 21.21 GB/s. Var detta system passar in spelar lika stor roll som råa siffror. XN4226D betjänar blandade miljöer som blandar VMware eller Proxmox för virtuella maskiner, VDI och databasnivåer, samt kreativa filtjänster, AI-inferensnoder som kräver förutsägbara NVMe-sökvägar, mediasäkerhetskopior och inmatning av hög bandbredd för övervaknings- och sensorarbetsbelastningar. QSAN XN4226D är väl lämpad för nästan alla arbetsbelastningar.
QSAN har noterat en betydande tillväxt inom medieproduktion, inklusive livesändningar, uppspelningsalternativ, AI-videoförbättring och OTT/edge-caching, såväl som inom övervakningsvideoanalys, såsom smart city CCTV, avvikelsedetektering och uppspelning i realtid. Dessa arbetsbelastningar stöds idealiskt med 100–200 GbE-dataflöde.
I slutändan är värdet enkelt. Du får enhetlig hög tillgänglighet, NVMe i hela chassit och I/O-alternativ på upp till 100 GbE eller 32 Gb Fibre Channel allt eftersom behoven växer. Prestandan följer vad många nivå-1-arrayer levererar, medan licensiering förblir mer lättillgänglig och protokolltäckningen förblir bred över NVMe-oF, iSCSI, Fibre Channel, SMB och NFS. För företag som siktar på InfiniBand men begränsas av budgeten, erbjuder QSANs Ethernet-metod nära IB-respons på standardutrustning i skala 100 till 200 GbE.
För team som prioriterar resultat i verkliga applikationer gör QSANs långa livslängd, intuitiva programvara och rena hårdvarudesign XN4226D till en trovärdig all-flash-arbetshäst att bygga kring.
QSAN XN4-hårdvara
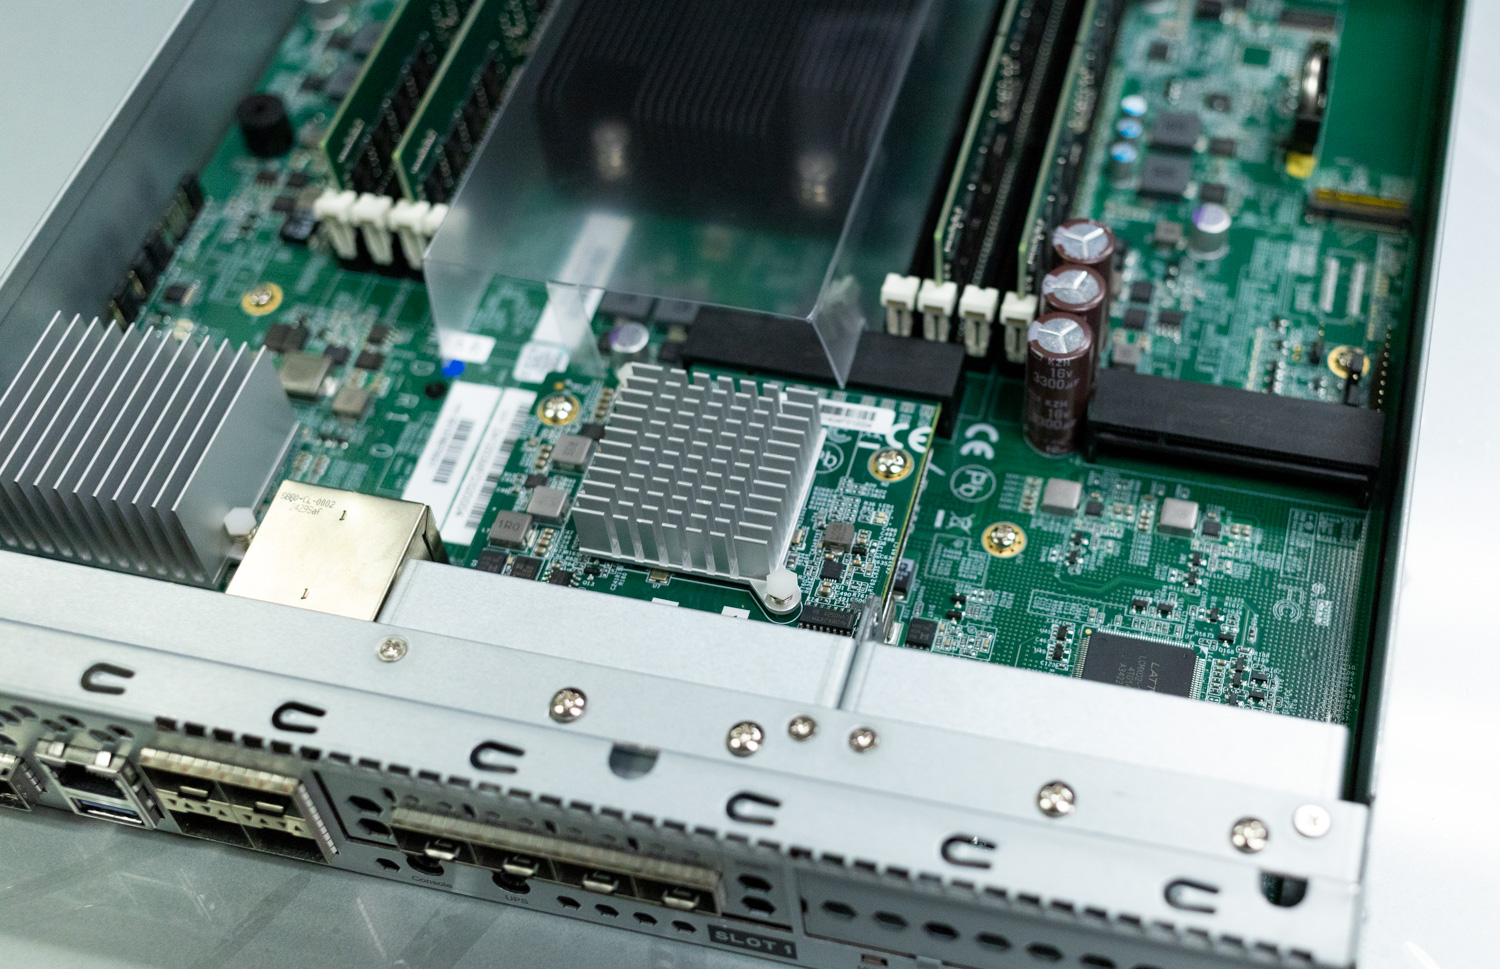
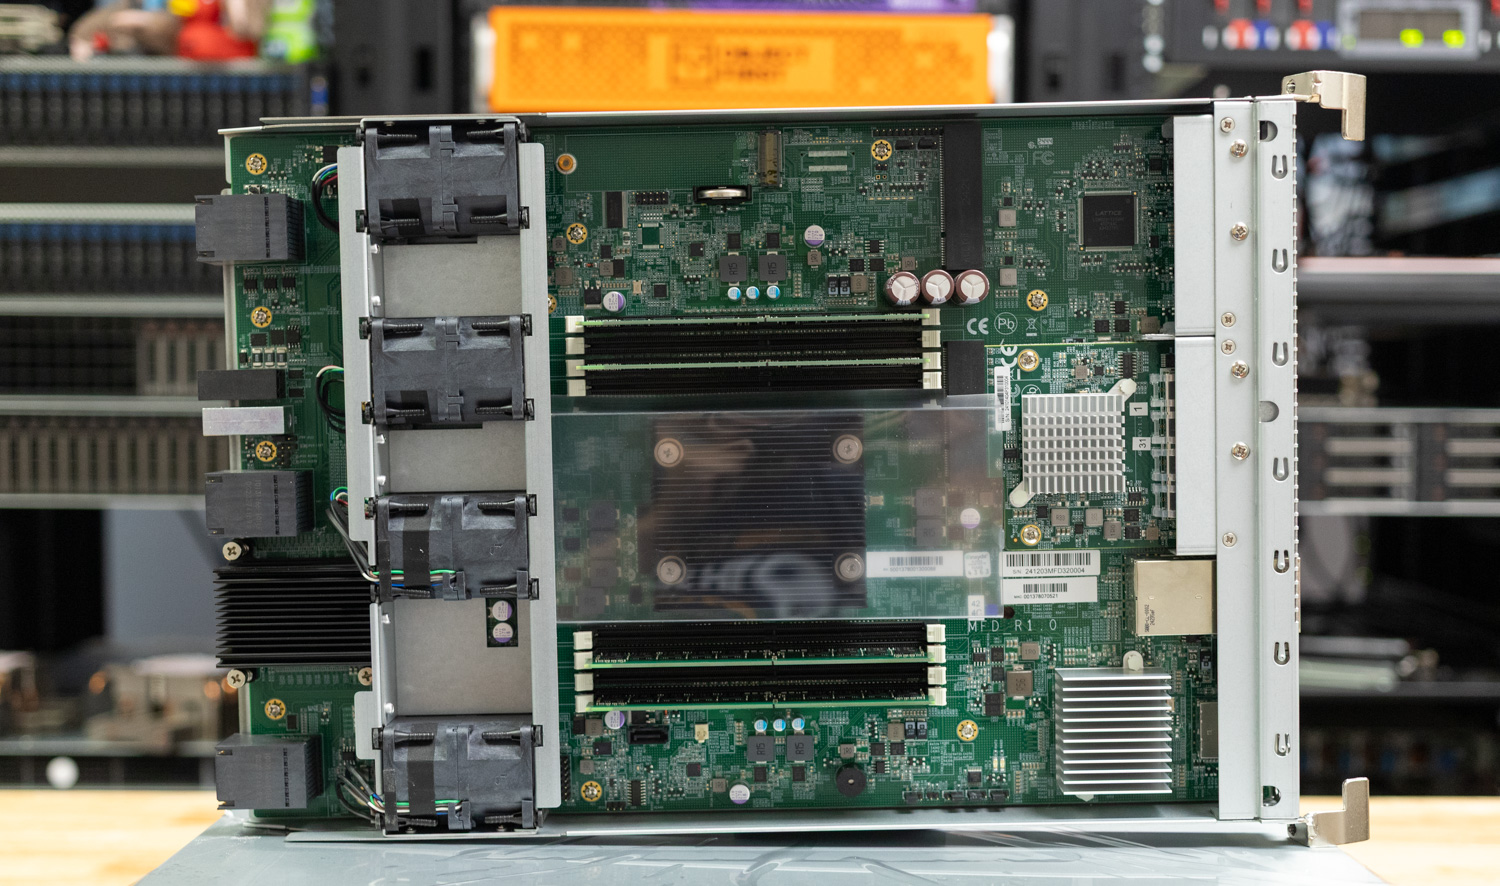
QSAN XN4-seriens lagringsmatriser levereras i ett 2U-rackkompatibla 19-tums serverchassi med 26 fack, 2U, med alternativ för en eller två styrenheter som rymmer 4- eller 8-kärniga Intel Xeon-processorer för att passa redundans- och prestandabehoven hos både de minsta och största verksamheterna. Med alla 26 fack utplacerade kan ett enda chassi i XN4-serien lagra upp till 798 terabyte data på 2.5-tums U.2/U.3 NVMe SSD-diskar. Upp till 20 SAS-anslutna expansionsenheter kan också läggas till, vilket ökar den totala kapaciteten för en array till hela 16 773 petabyte.
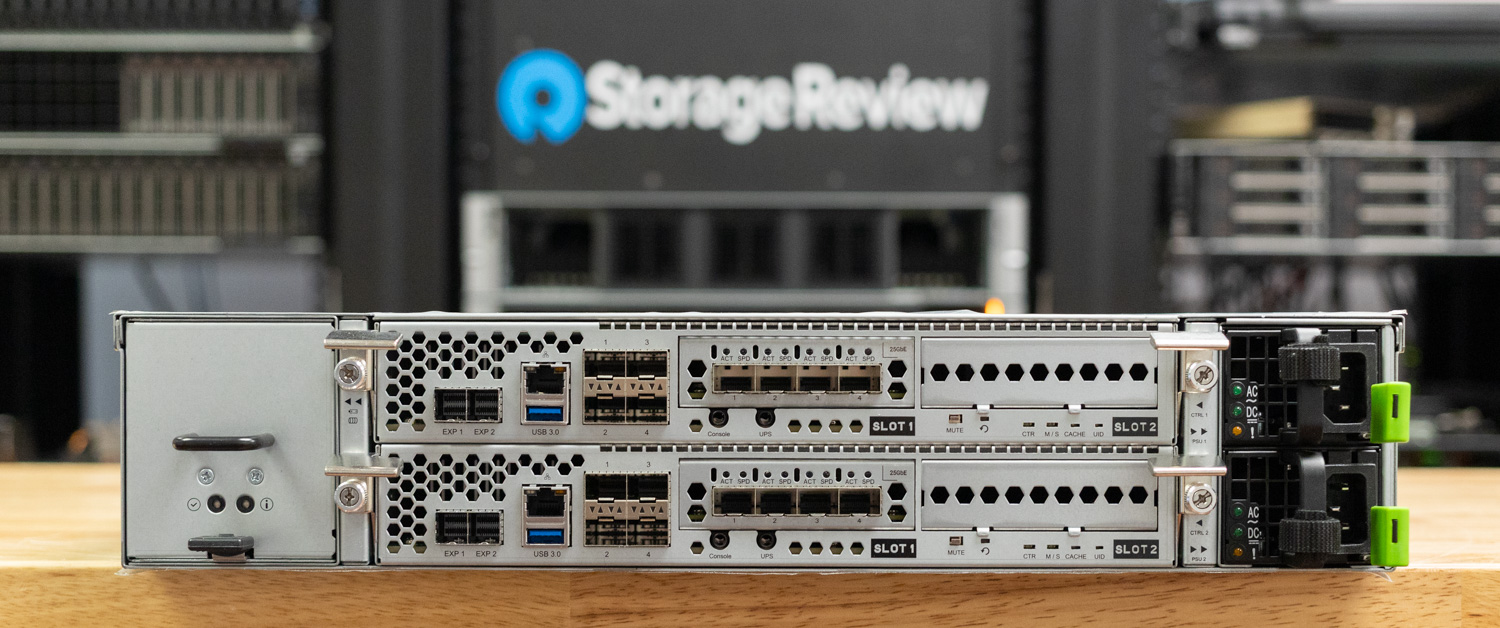
Varje inbyggd styrenhet har en enda 2.5 Gbps RJ45 Ethernet-port, fyra 10 Gbps SFP+-portar och två 12 Gbps SAS-portar. Det finns också uppgraderingsalternativ för 10 Gbps RJ45-, 25 Gbps SFP28- och 100 Gbps QSFP-portar. Stöd för fiberkanal kan också läggas till, med 16 Gbps SFP+- och 32 Gbps SFP28-adaptrar.
Tabellen nedan jämför specifikationerna för lagringssystemen XN4226D-4C och XN4226S-4C. Dessa är 4C-varianterna, utformade med antingen dubbelaktiva eller enkla uppgraderingsbara styrenheter beroende på modell. För driftsättningar som kräver mer processorkraft finns även en 8C-version av dessa system tillgänglig.
| Specifikation | XN4226D-4C | XN4226S-4C |
|---|---|---|
| Modellnamn | XN4226D-4C | XN4226S-4C |
| arkitektur | Dubbelaktiv styrenhet | Enkelt uppgraderingsbar styrenhet |
| CPU | Intel® Xeon® 4-kärnig × 2 | Intel® Xeon® 4-kärnig |
| Minne | ||
| Minnesmodul förinstallerad | 32 GB DDR4 RDIMM | 16 GB DDR4 RDIMM |
| Totalt minnesplatser | 16 | 8 |
| Minne Kan utökas upp till | 2,048GB | 1,024GB |
| lagring | ||
| Enhetsfack | 2.5″-fack × 26 | 2.5″-fack × 26 |
| Maximalt antal körfack med expansionsenhet | 546 | 546 |
| Kompatibel enhetstyp | 2.5″ U.2/U.3 NVMe SSD med dubbla portar 2.5″ SAS SSD (för expansionsenheter) 3.5″ SAS-hårddisk (för expansionsenheter) |
2.5″ U.2/U.3 NVMe SSD med en port 2.5″ SAS SSD (för expansionsenheter) 3.5″ SAS-hårddisk (för expansionsenheter) |
| Drive Interface | U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (för expansionsenheter) |
U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (för expansionsenheter) |
| Maximal intern rå kapacitet | 798TB | 798TB |
| Maximal råkapacitet med expansion | 16,773TB | 16,773TB |
| Hot Swappable Drive | Ja | Ja |
| Anslutningsport | ||
| PCIe-expansion | (Gen 4×8-plats) × 4 | (Gen 4×8-plats) × 2 |
| 2.5 GbE RJ45 LAN-port | 2 (ombord) | 1 (ombord) |
| 10 GbE SFP+ LAN-port | 8 (inbyggda) / 16 (tillval) | 4 (inbyggda) / 8 (tillval) |
| 10 GbE RJ45 LAN-port | 16 (tillval) | 8 (tillval) |
| 25 GbE SFP28 LAN-port | 16 (tillval) | 8 (tillval) |
| 100 GbE QSFP LAN-port | 8 (tillval) | 4 (tillval) |
| 16 Gb SFP+ fiberkanal | 16 (tillval) | 8 (tillval) |
| 32 Gb SFP28 fiberkanal | 16 (tillval) | 8 (tillval) |
| Expansion och extern port | ||
| 12 Gb/s SAS bred port | 4 (ombord) | 2 (ombord) |
| USB-port | 1 (fram) / 2 (bak) | 1 (fram) / 1 (bak) |
| Övrigt | Konsolport × 2, serviceport × 2 | Konsolport × 1, serviceport × 1 |
| Programspecifikation | ||
| Lagring OS | QSM 4 | QSM 4 |
| RAID-typ | 0 / 1 / 5 / 6 / 10 / 50 / 60 / 5EE / 6EE / 50EE / 60EE | |
| Förvaringseffektivitet | Tunn provisionering / Komprimering och deduplicering (tillval) | |
| Mjukvaruacceleration | SSD-cache / Automatisk nivåindelning / RDMA | |
| Dataskydd | Ögonblicksbild / Asynkron / Synkron (tillval) | |
| Backup Service | Rsync / S3-säkerhetskopiering / Molnsäkerhetskopiering / XMirror* / Microsoft 365 e-postsäkerhetskopiering | |
| Säkerhet | SSL / SSH / iSCSI CHAP / ISE & SED / WORM / RBAC / Windows ACL / Antivirus | |
| Stödprotokoll | CIFS / NFS / FTP / WebDAV / iSCSI / FCP / NVMe-oF | |
| Verksamhetsledningen | Webbgränssnitt / Windows AD / LDAP / RESTful API / SES / LCM | |
| Utseende | ||
| Mått (H × B × D) | 88 × 438 × 573mm | 88 × 438 × 573mm |
| Nettovikt | 19.6kg | 16.5kg |
| Bruttovikt | 28.6kg | 25.5kg |
| Övrigt | ||
| Minnesskydd | Cache-to-Flash-modul (inbyggd) | |
| Systemfläkt | 8 st | 4 st |
| Nätaggregat | 850 W × 2 (80 Plus Platinum) | |
| Ineffekt | 100–240 V växelström, 50/60 Hz | |
| Energiförbrukning | 812 W / 2 770 BTU | |
| certifiering | CE / FCC / BSMI | |
| Standard garanti | System: 5 år | Cache-to-Flash-modul: 1 år | |
QSAN XN4-funktioner
XN4-arrayer levereras som standard med de senaste anslutningsprotokollen som krävs för att stödja högpresterande beräkningar och datakrävande AI-modeller, inklusive NVMe over Fabrics (NVMe-oF) som hanteras via TCP och RDMA. Anslutningar via iSCSI, NFS, FCP, CIFS/SMB, FTP och WebDAV är också möjliga, vilket gör att arrayen kan möta block- och fillagringsbehoven hos datacenter med en blandning av äldre och avancerade system.
Fördelarna med NVMe-oF
Medan protokoll som iSCSI, NFS och FCP fortfarande används i stor utsträckning i företagslagringsapplikationer, erbjuder NVMe-oF betydande förbättringar av latensen. NVMe-standarder utformades från grunden för solid state-diskar som är direkt anslutna till ett systems PCIe-buss. Däremot utvecklades äldre protokoll som iSCSI och NFS kring begränsningarna och de långsammare åtkomsttiderna hos traditionella hårddiskar. I nästan alla fall överträffar NVMe-oF-tekniker äldre anslutningsprotokoll, med högre bandbredd och snabbare åtkomsttider. NVMe-oF kan också utnyttja nätverksgränssnitt med RDMA-funktioner (Remote Direct Memory Access), vilket gör att data kan överföras direkt till minnet på en måldator utan att kräva CPU-bearbetning.
Funktioner för datareducering och optimering
Den högpresterande hårdvarustacken i XN4-lagringsarrayen förbättras ytterligare av ett flertal programvarufunktioner som är välkända och uppskattade av lagringsadministratörer. Thin provisioning, komprimering och deduplicering gör det möjligt för företag att maximera sin SAN-kapacitet, medan SSD-cachning och automatisk lagringsnivåer snabbar upp åtkomsttiderna för ofta använda filer och objekt. Enhetens QSM 4-operativsystem gör det också enkelt att testa och återställa ändringar med inbyggda snapshot-verktyg.
Säkerhets- och hanteringsfunktioner
QSAN har tagit hänsyn till sina kunders ständigt föränderliga säkerhets- och hanteringskrav med XN4-serien. XN4 är kompatibel med Instant Secure Erase (ISE) och Self-Encrypting Drives (SED), samt säkerhetsprotokoll som SSL/TLS, autentisering via Role-Based Access Control (RBAC) och stöd för Active Directory/LDAP-servrar. Disksystemet kan hanteras med hjälp av ett HTTPS-webbgränssnitt eller ett RESTful API, vilket möjliggör automatisering genom en mängd olika verktyg, som Ansible eller Terraform.
QSM 4-hantering
QSM 4, operativsystemet för QSAN XN4-serien, gör installation och hantering av lagringsmatrisen enkel för lagringsadministratörer oavsett erfarenhetsnivå. Direktdistribution är enkel: snabb poolgenerering, intuitiv värdtilldelning och lätt hantering via webbgränssnitt och REST API:er – allt utformat för mindre IT-team utan djupgående lagringsexpertis.
Instrumentpanelsskärmen visar systemstatusinformation och de senaste händelserna som loggats av servern.
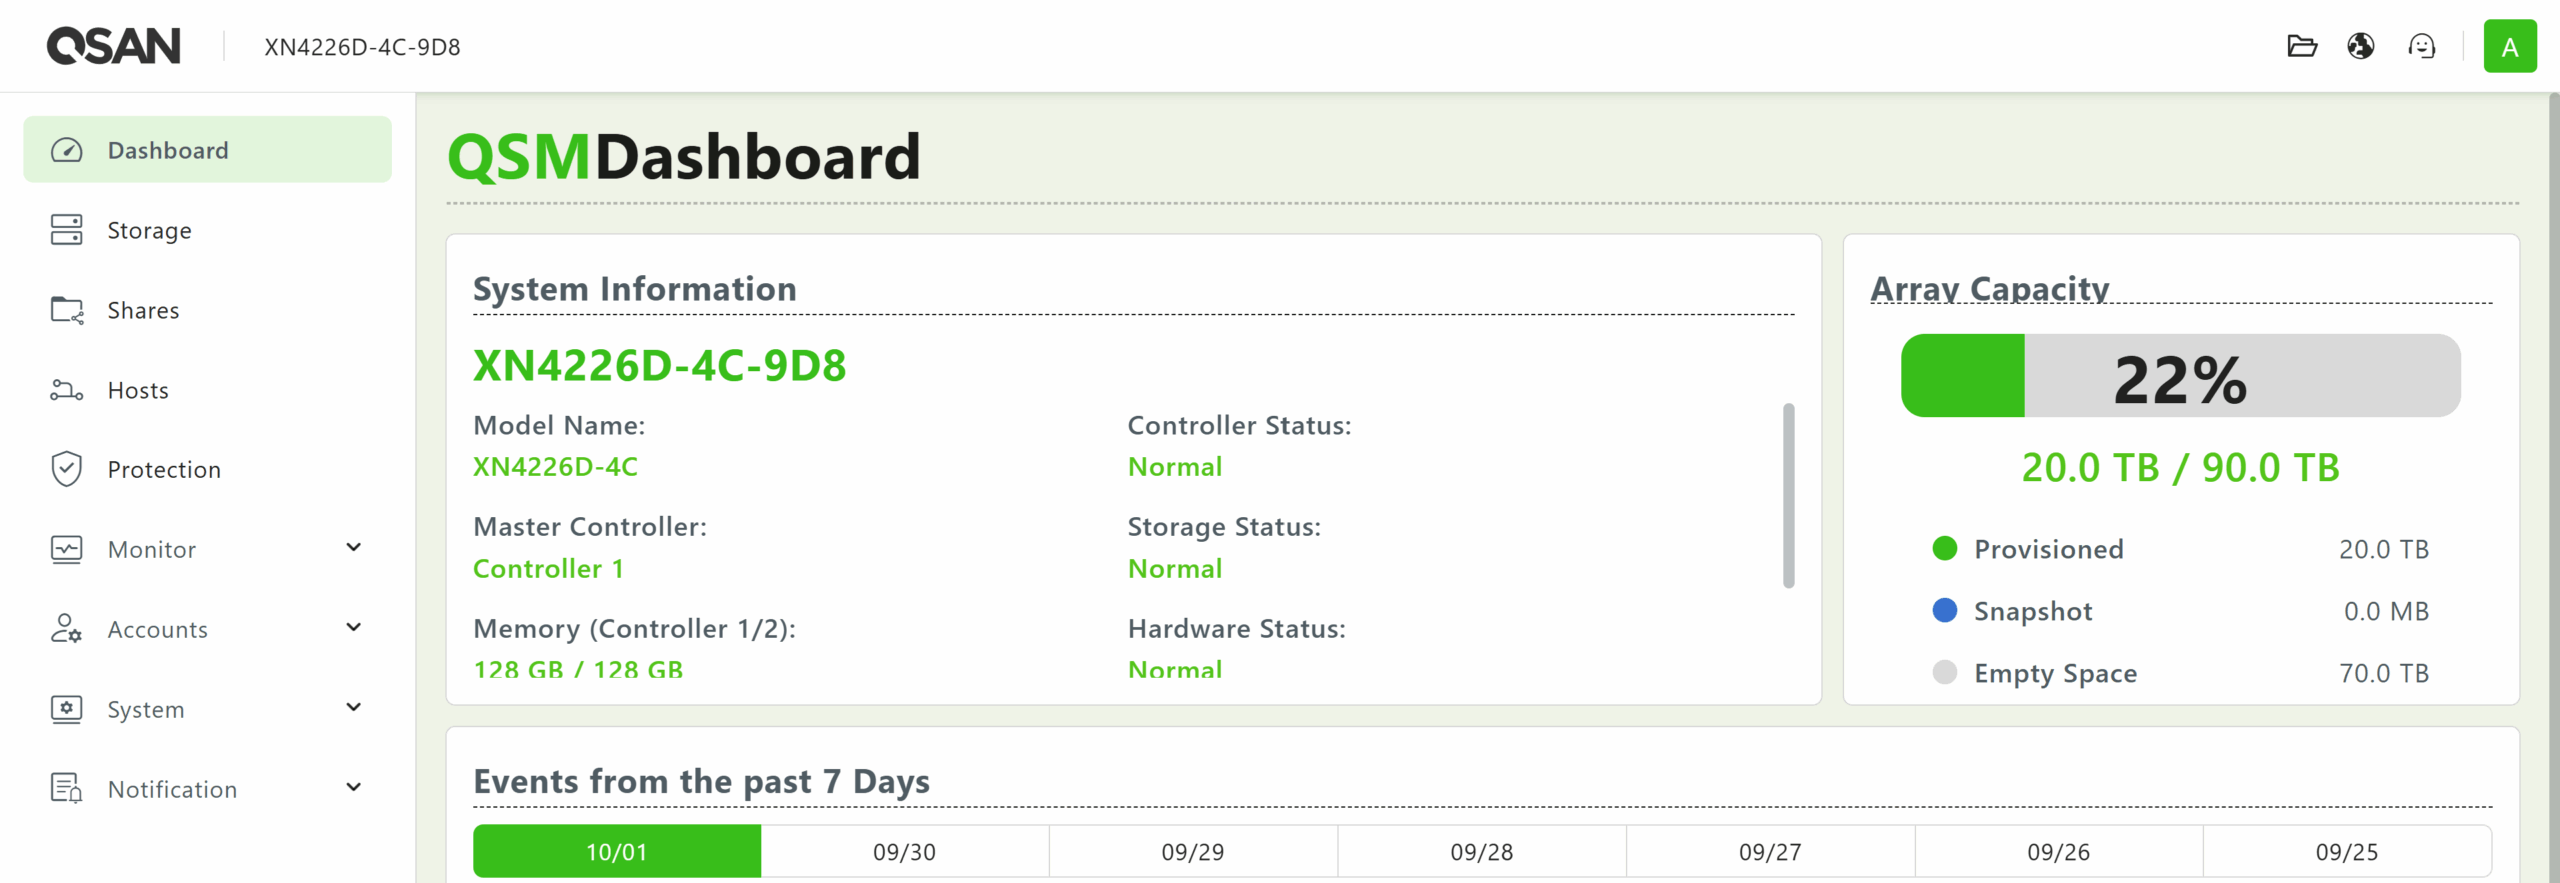
Efter inloggning visas instrumentpanelen, som ger en snabb översikt över SAN-systemets tillstånd. Härifrån kan du hoppa till valfri undermeny från listan i panelen till vänster.
Från menyn Lagring kan administratörer skapa och hantera pooler av enheter och deras tillhörande volymer.
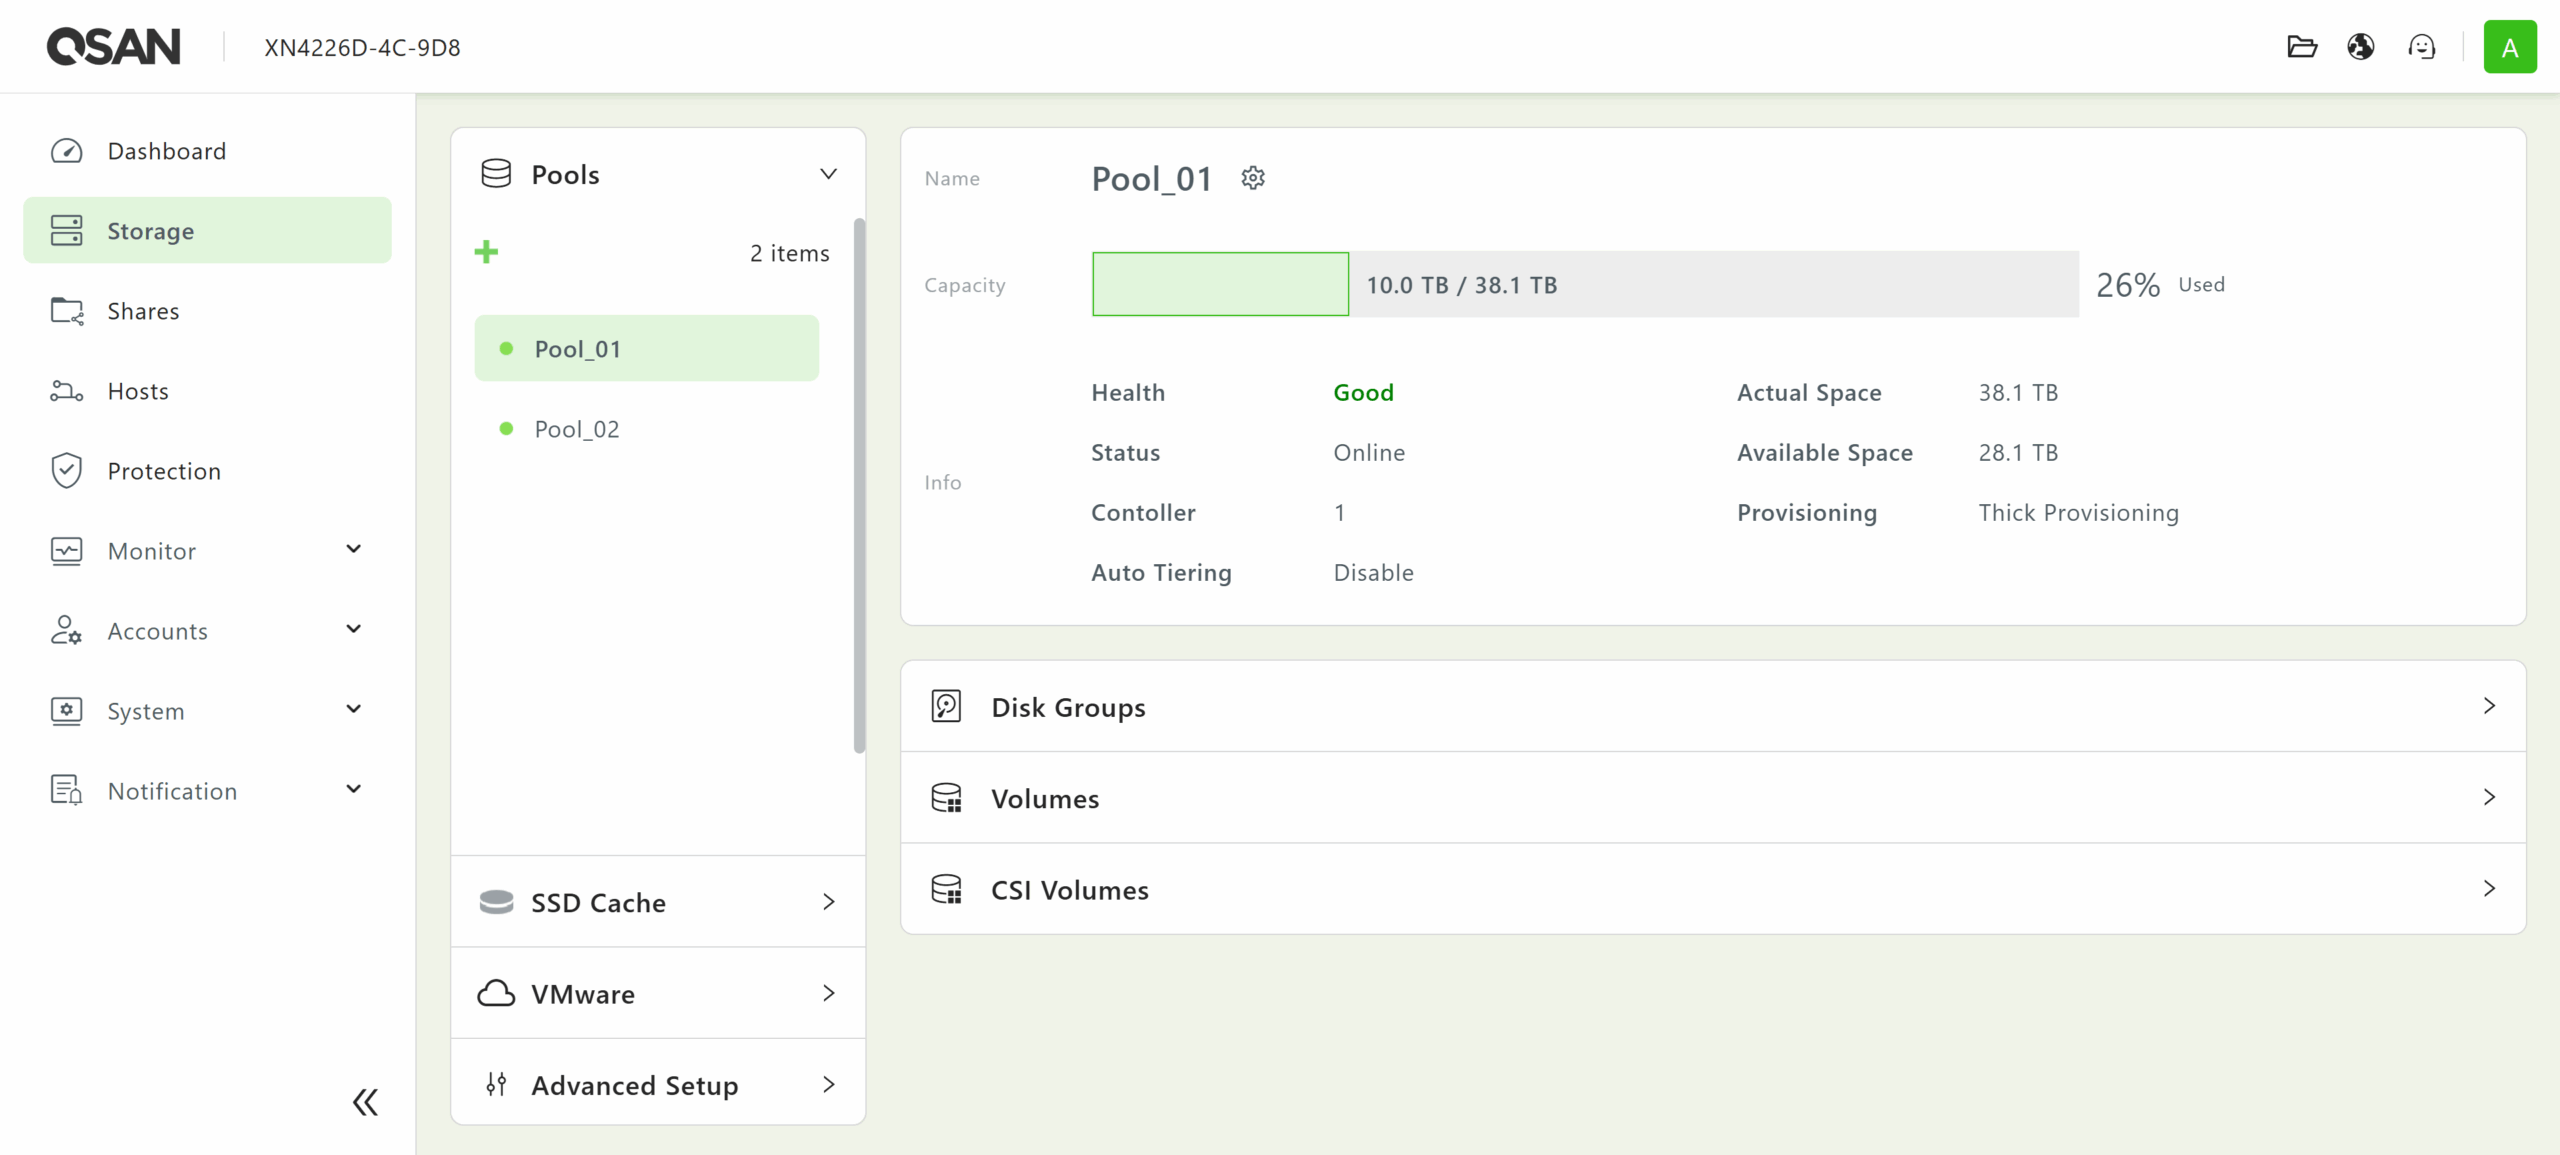
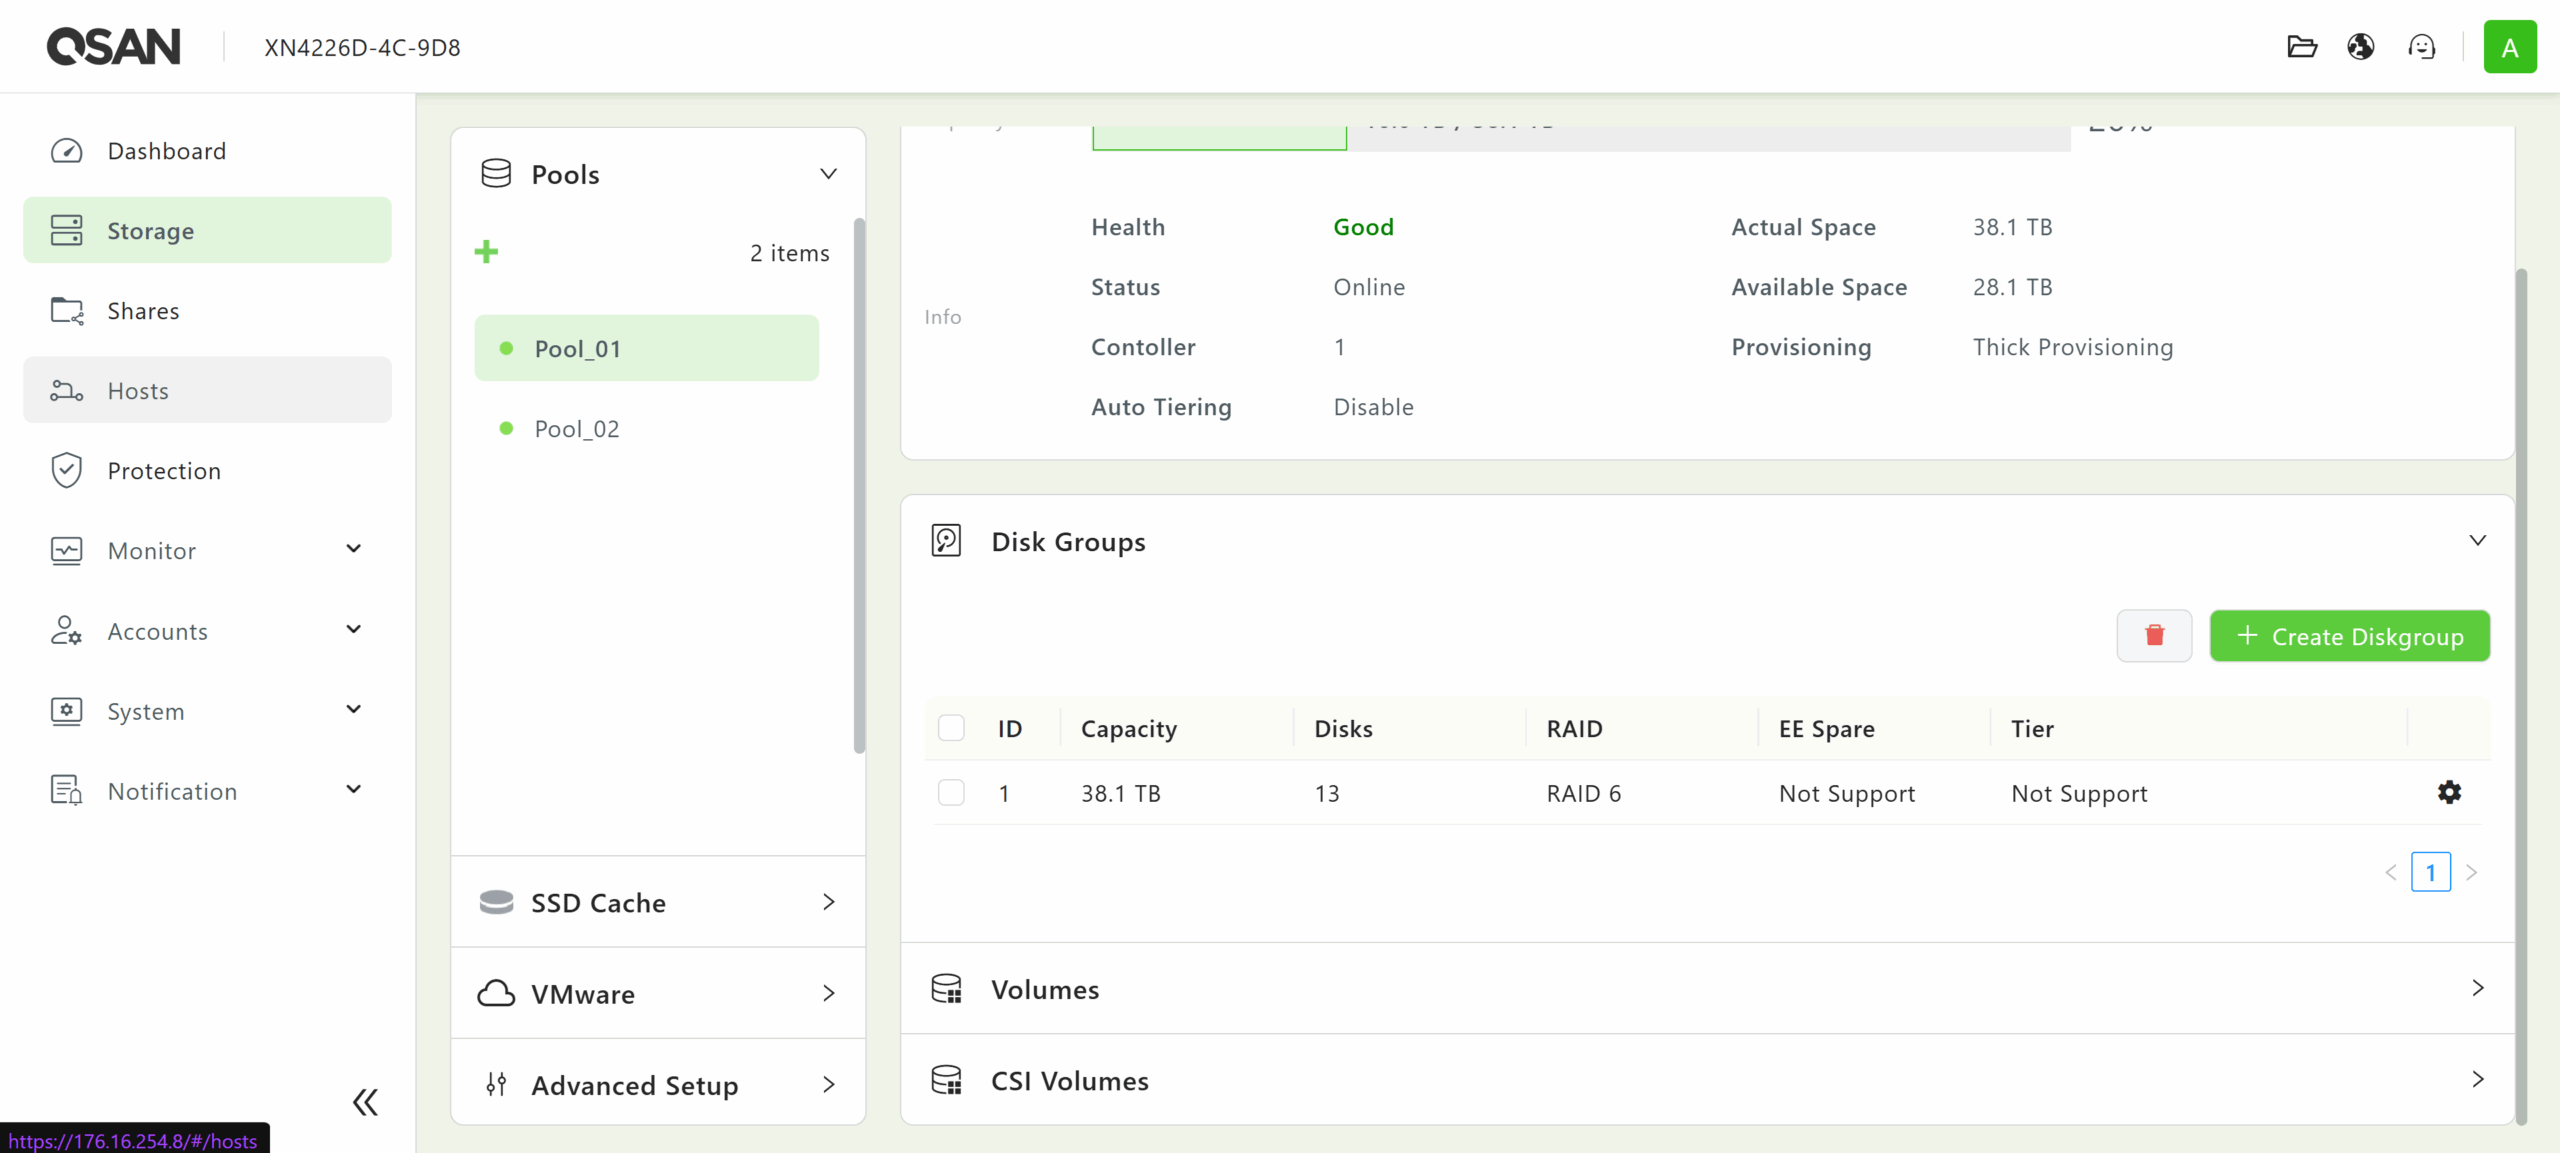
Diskgrupperna som utgör varje pool kan hanteras på fliken Diskgrupper. Den här funktionen stöder olika RAID-nivåer, inklusive 0, 1, 5, 6, 10, 50, 60, 5EE, 6EE, 50EE och 60EE, beroende på antalet enheter som redan har tilldelats.
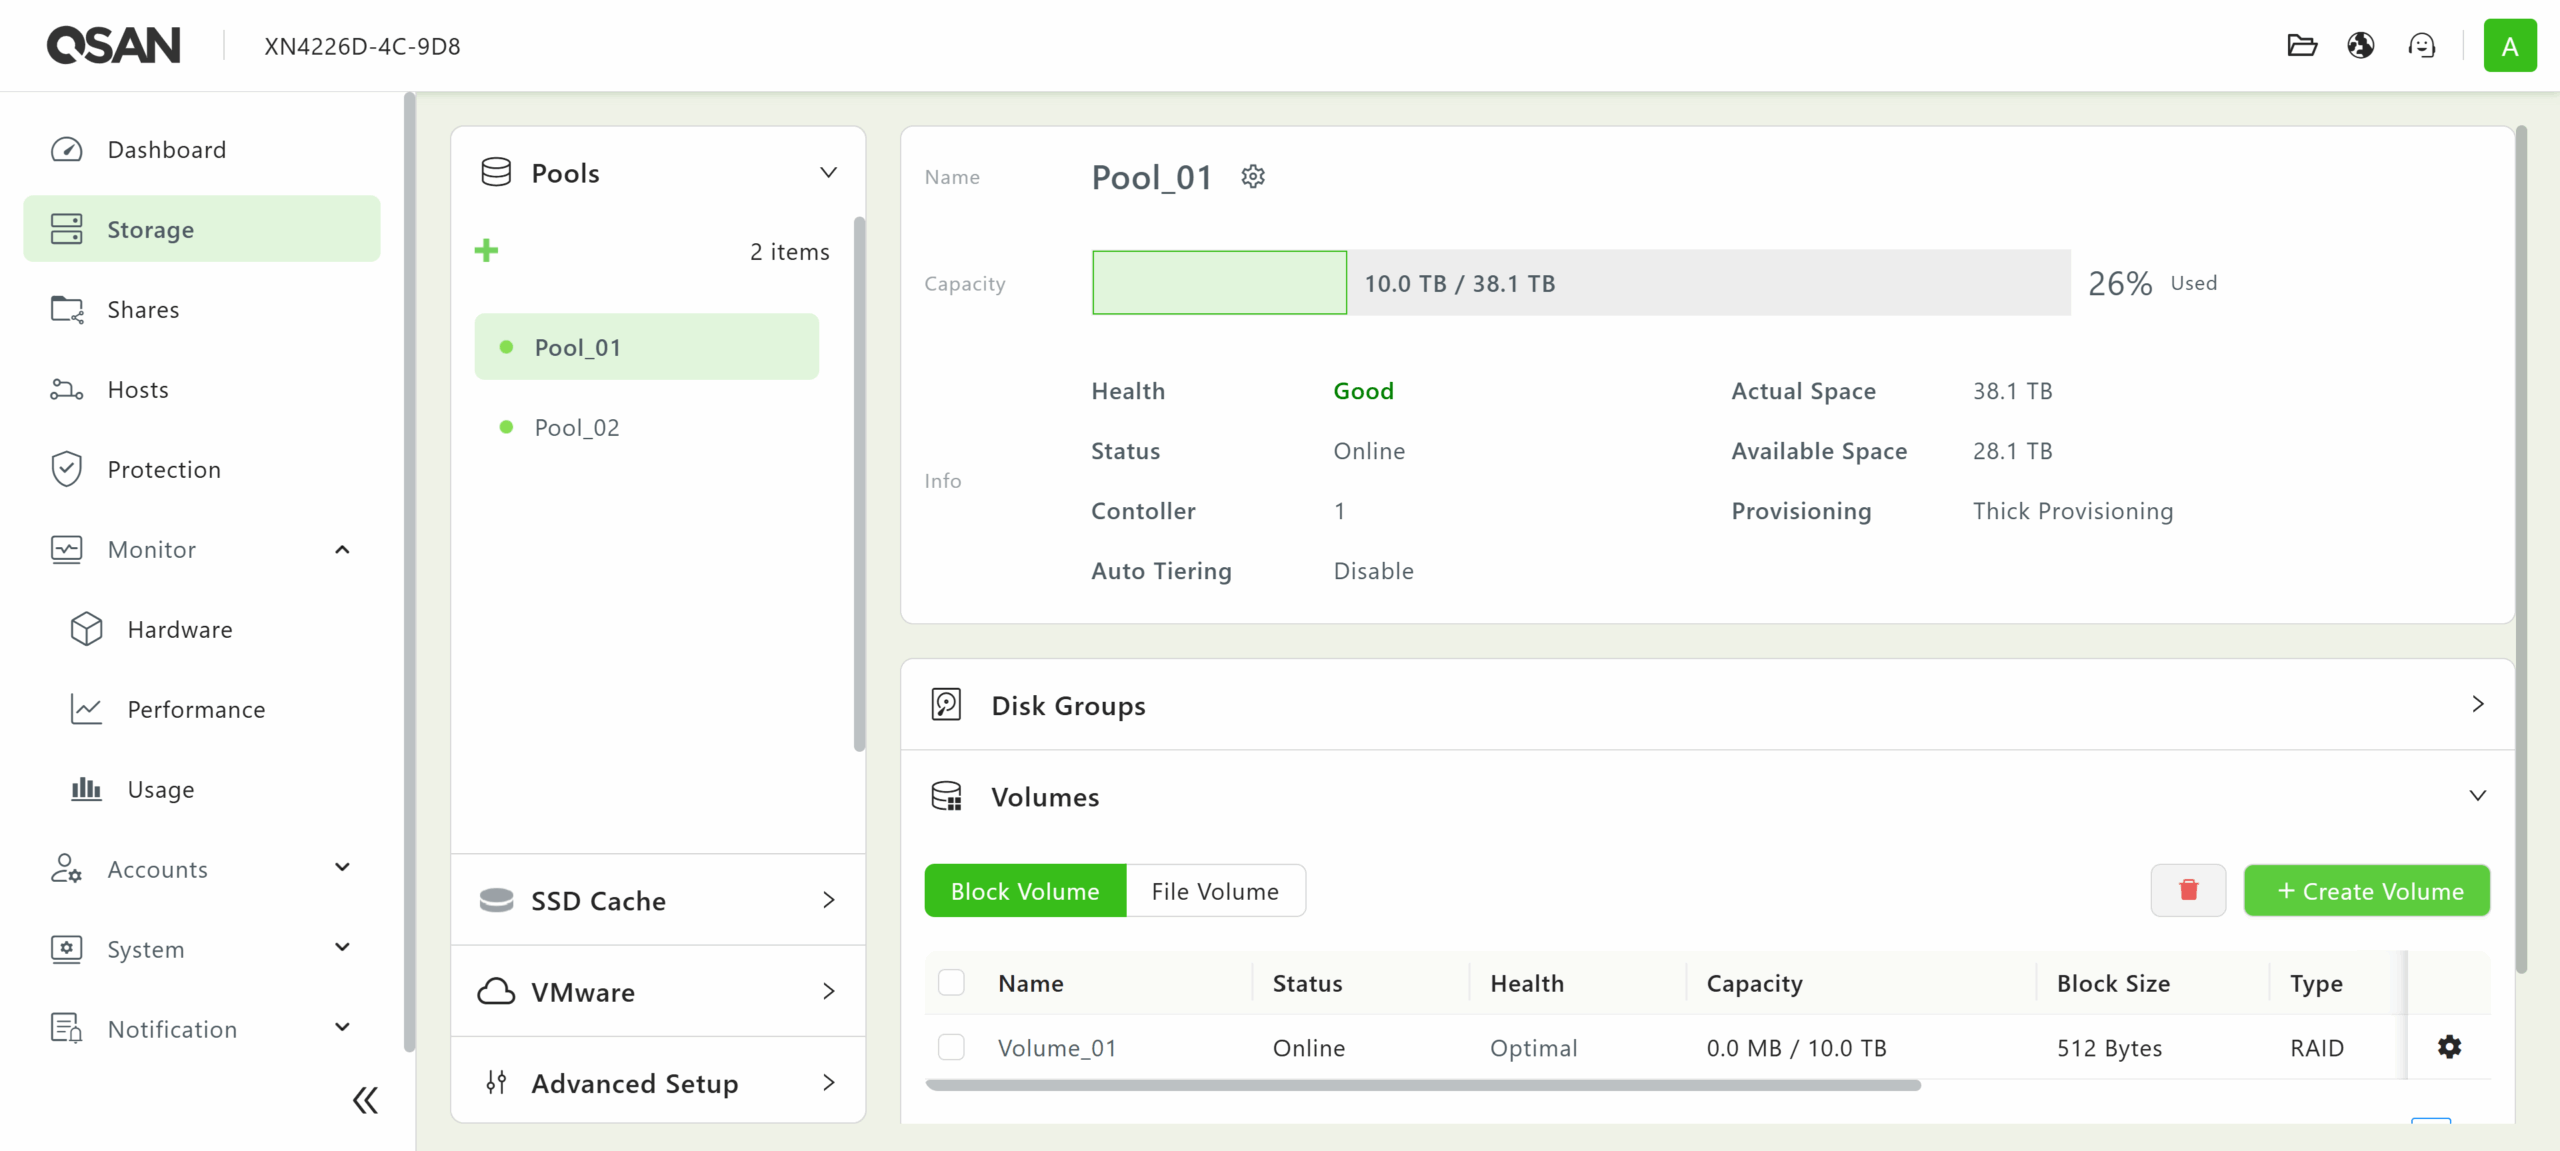
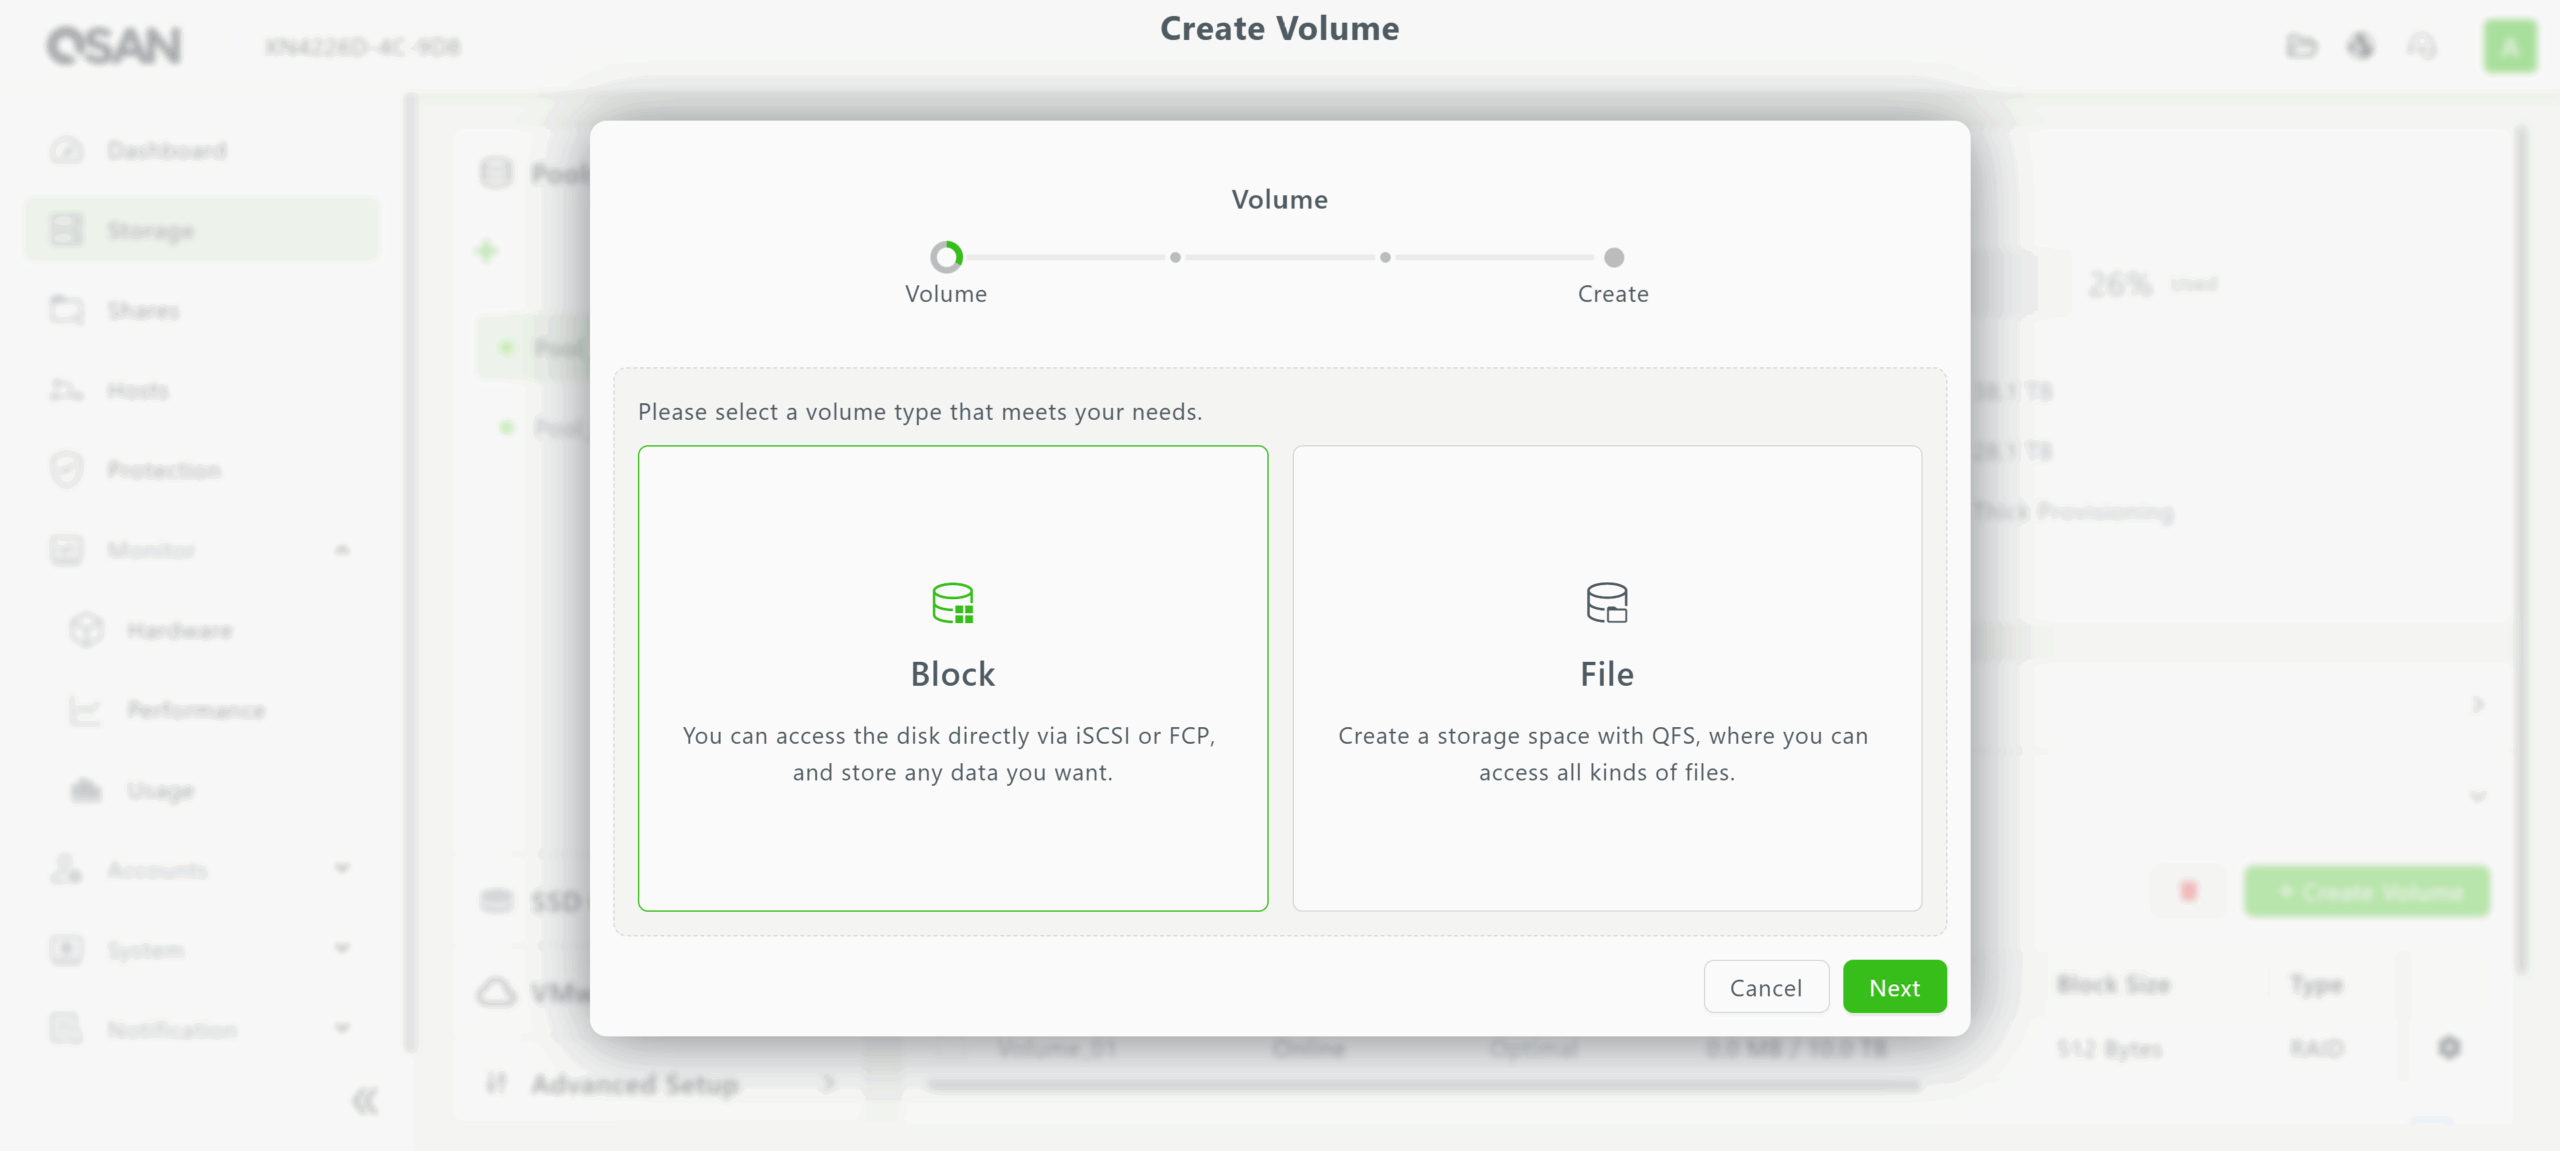
Volymer för block- och fillagringsbehov kan sedan byggas ovanpå pooler. Med hjälp av guiden kan kapaciteten och blockstorlekarna för varje volym ställas in så att de passar de anslutna klienternas behov.
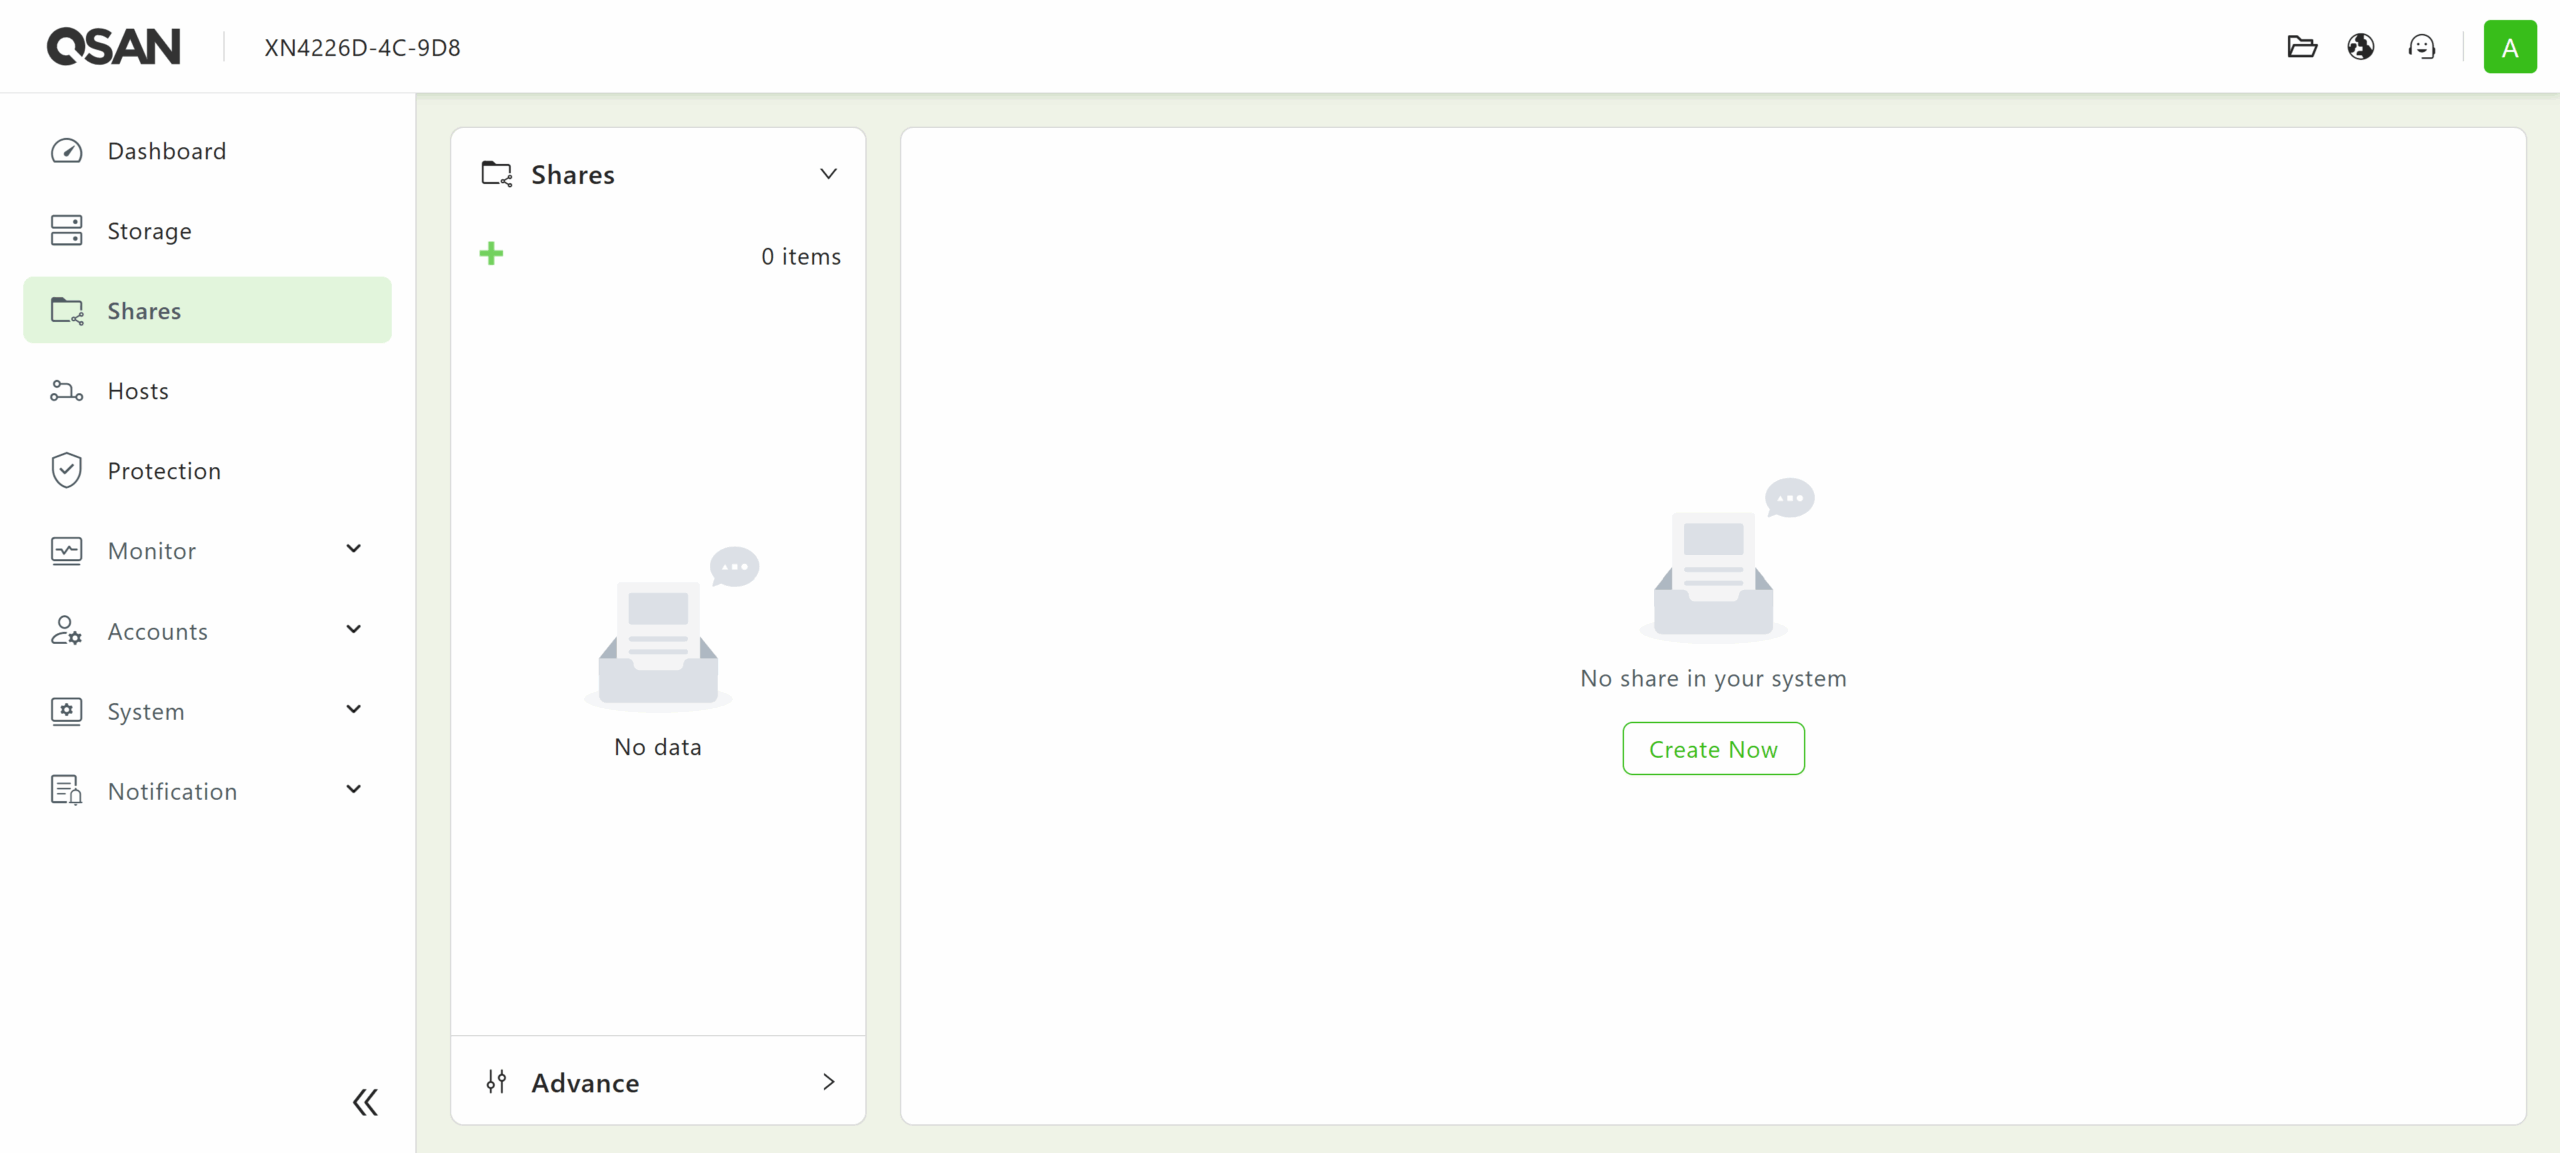
Om du går ner i listan kan du använda menyn Delningar för att skapa ett delningsobjekt ovanpå en filvolym. Delningsprotokoll som stöds inkluderar CIFS (SMB), FTP, NFS och WebDAV.
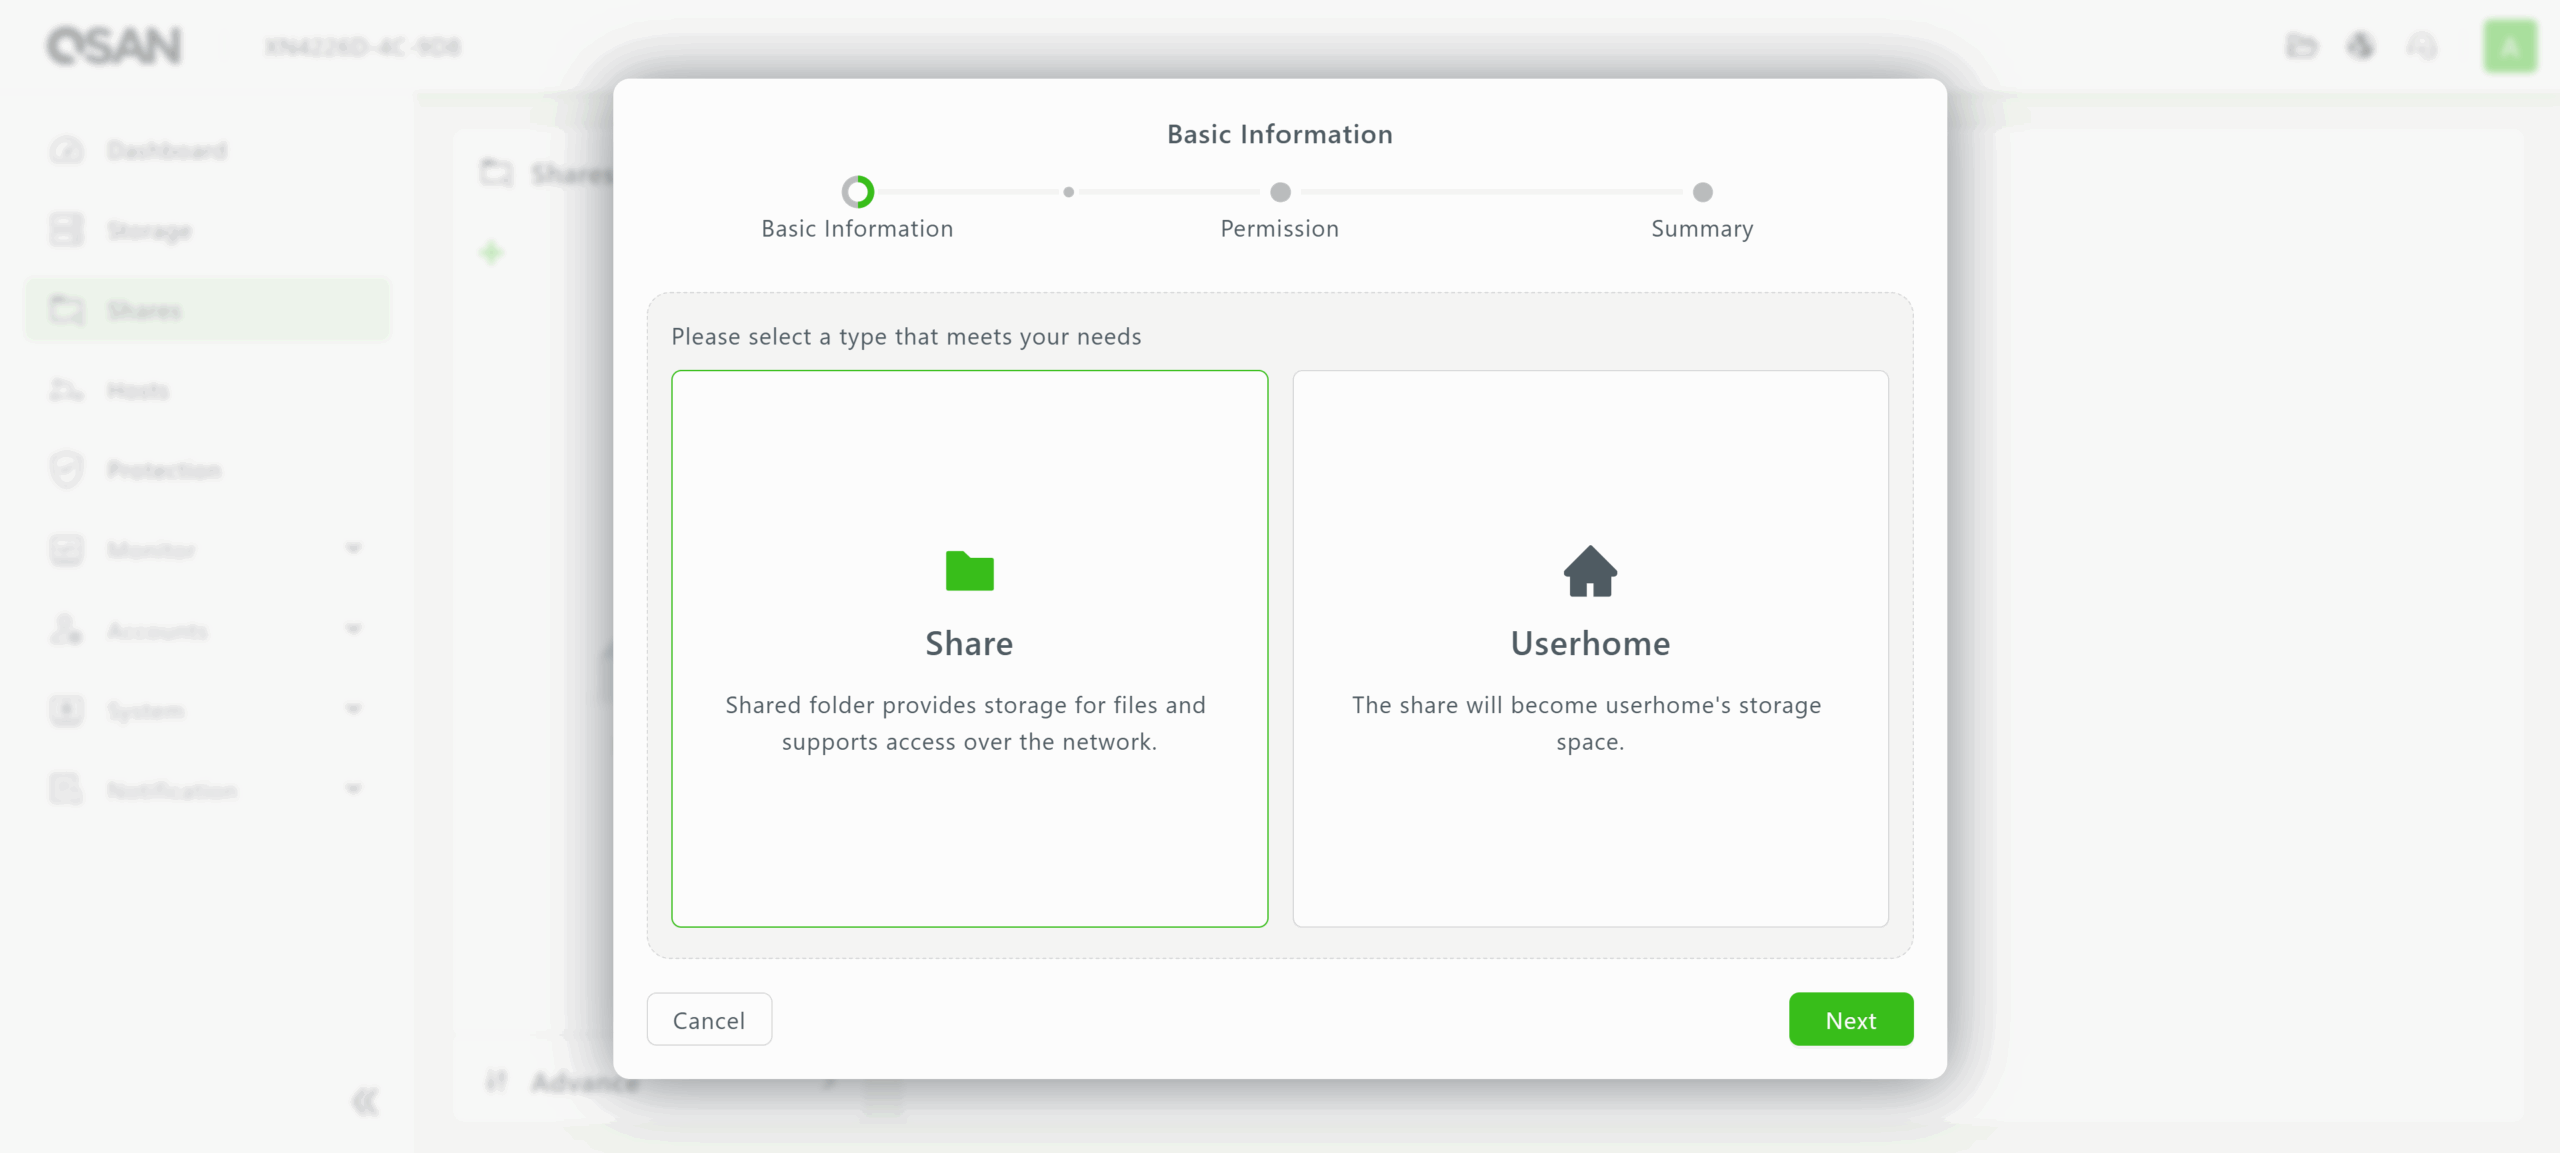
 När du skapar en ny resurs erbjuder QSM 4 två alternativ: en standardnätverksresurs för att vara värd för filer som flera användare kommer att komma åt, och en användarhemresurs, som är utformad för att lagra hemmapappar för användare som bara kan nås individuellt.
När en blockvolym eller filvolym och resurs har skapats måste den tilldelas en IP-adress eller ett värdnamn i menyn Värdar. Värdar är organiserade efter om de motsvarar block- eller fillagring (resurslagring), som visas på skärmdumparna nedan.
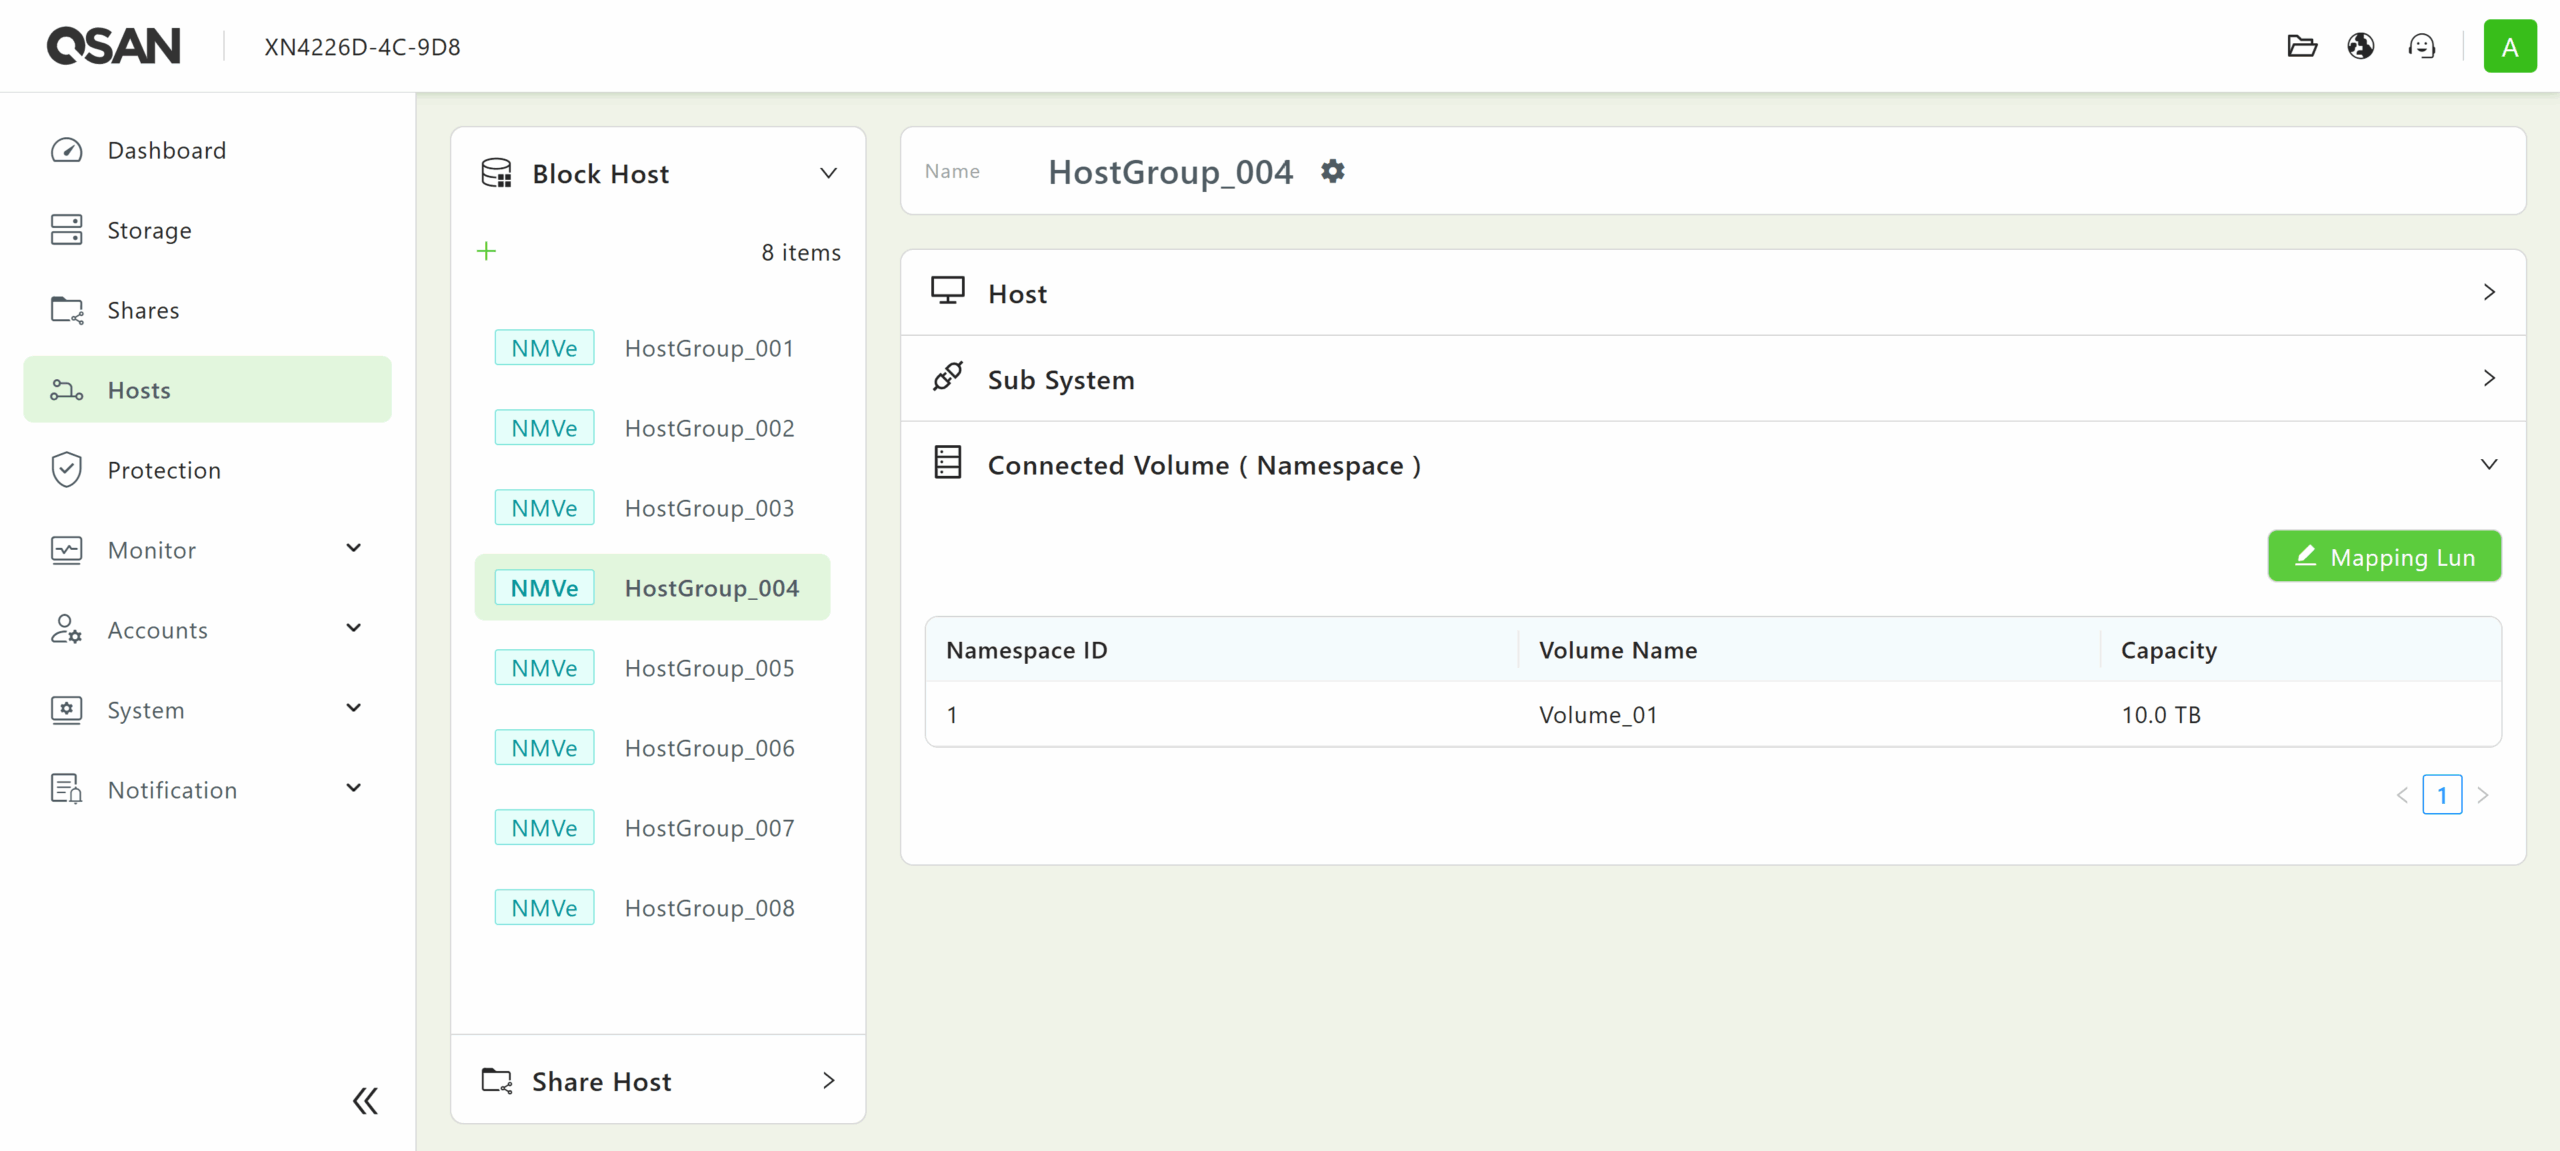
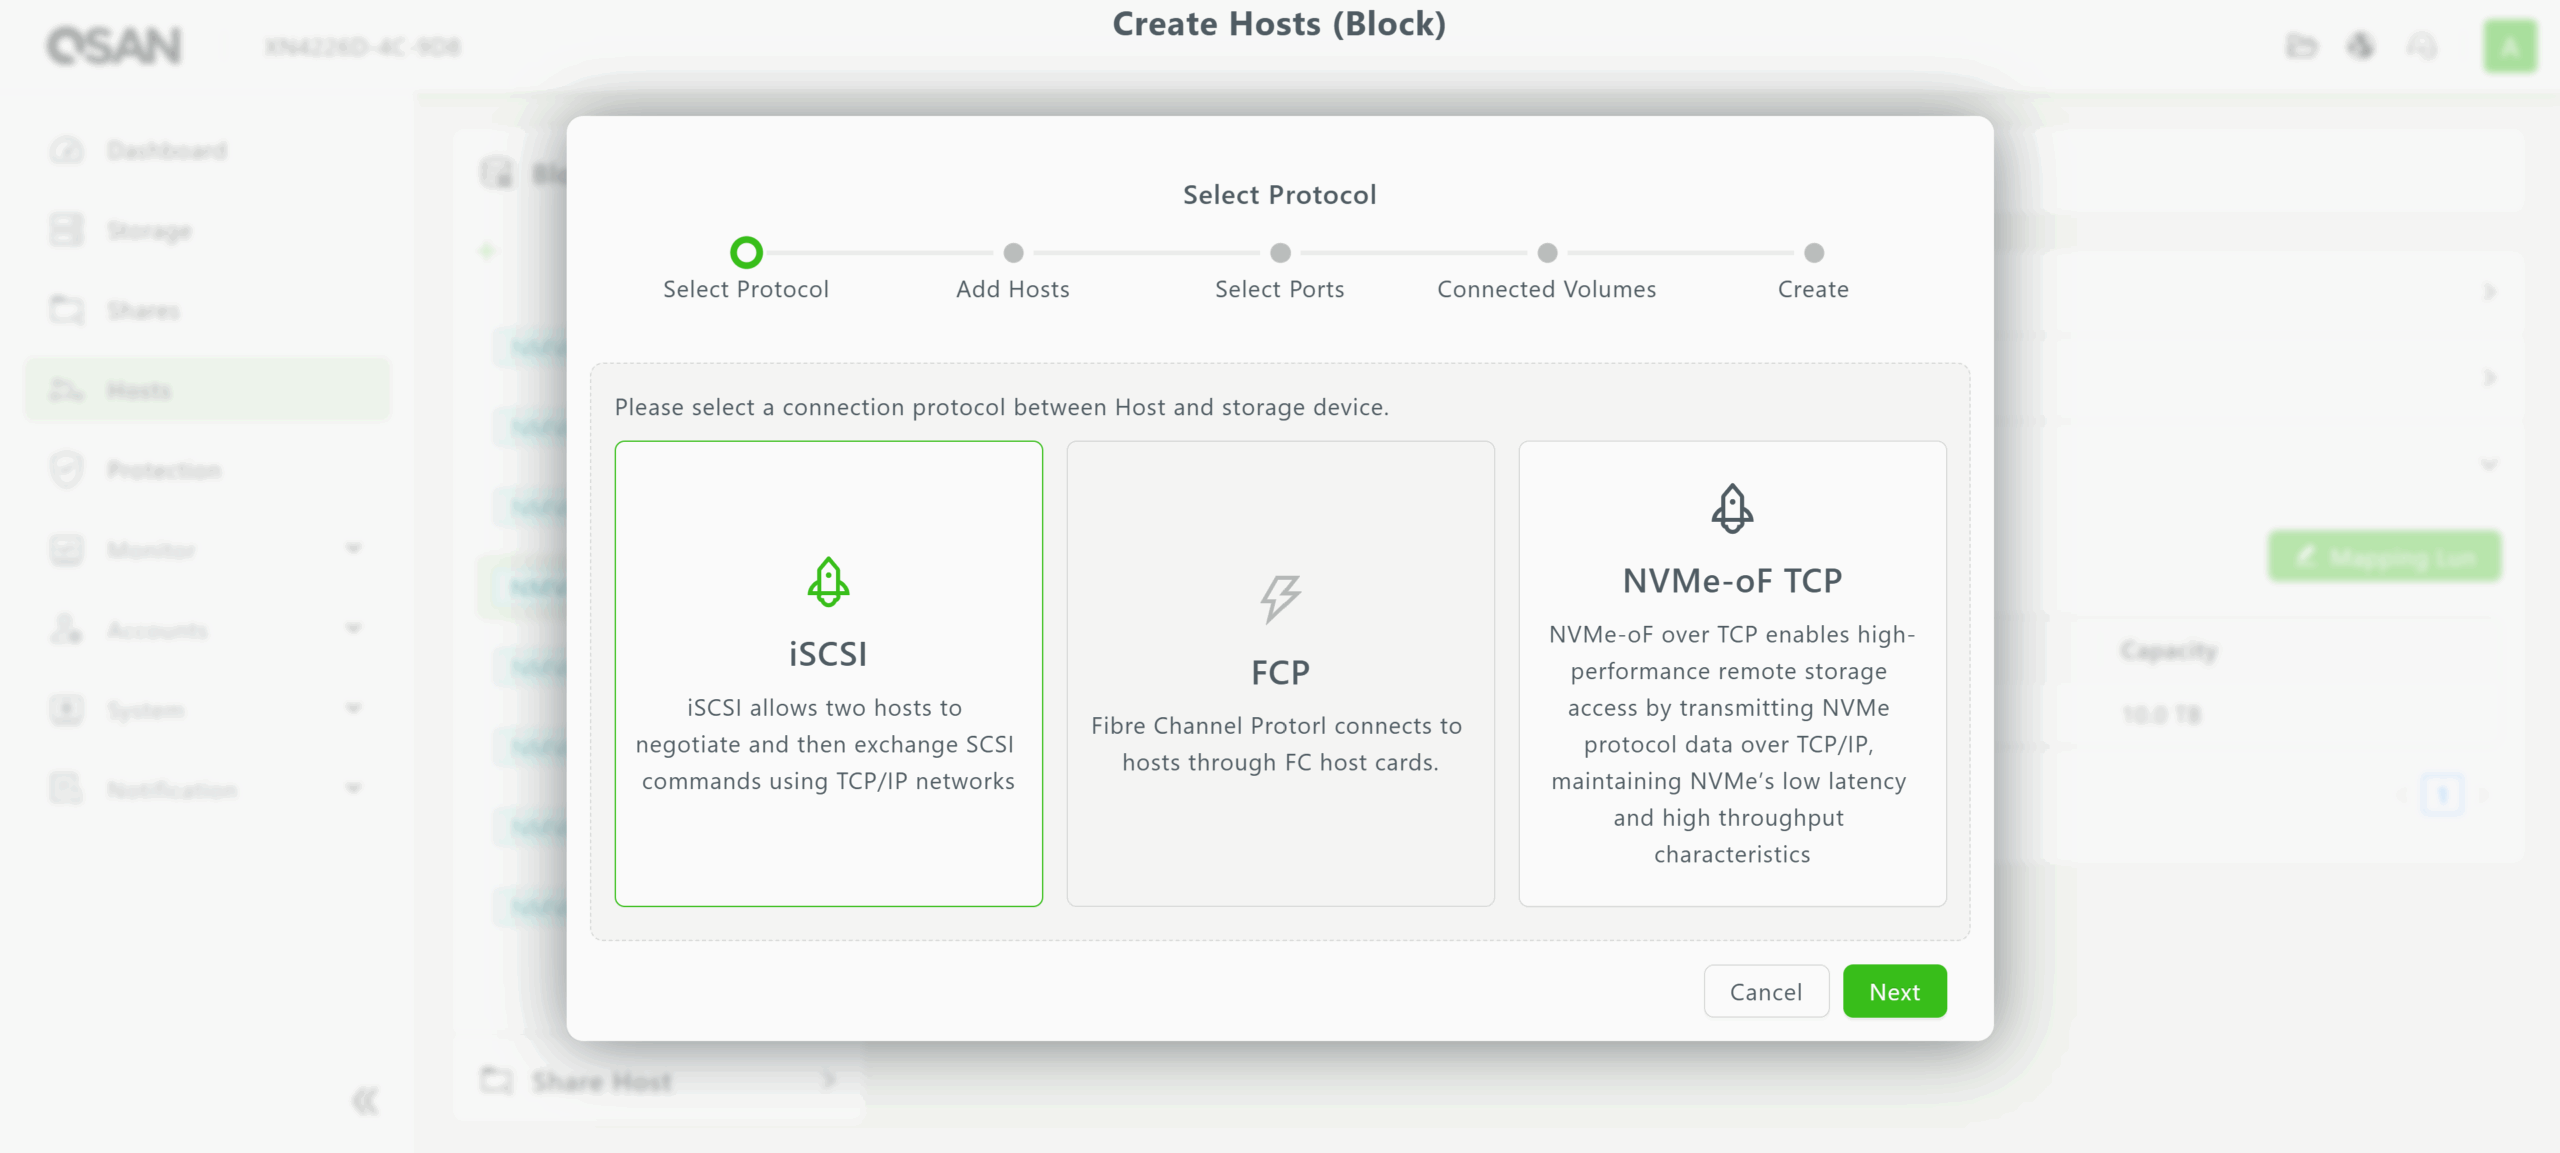
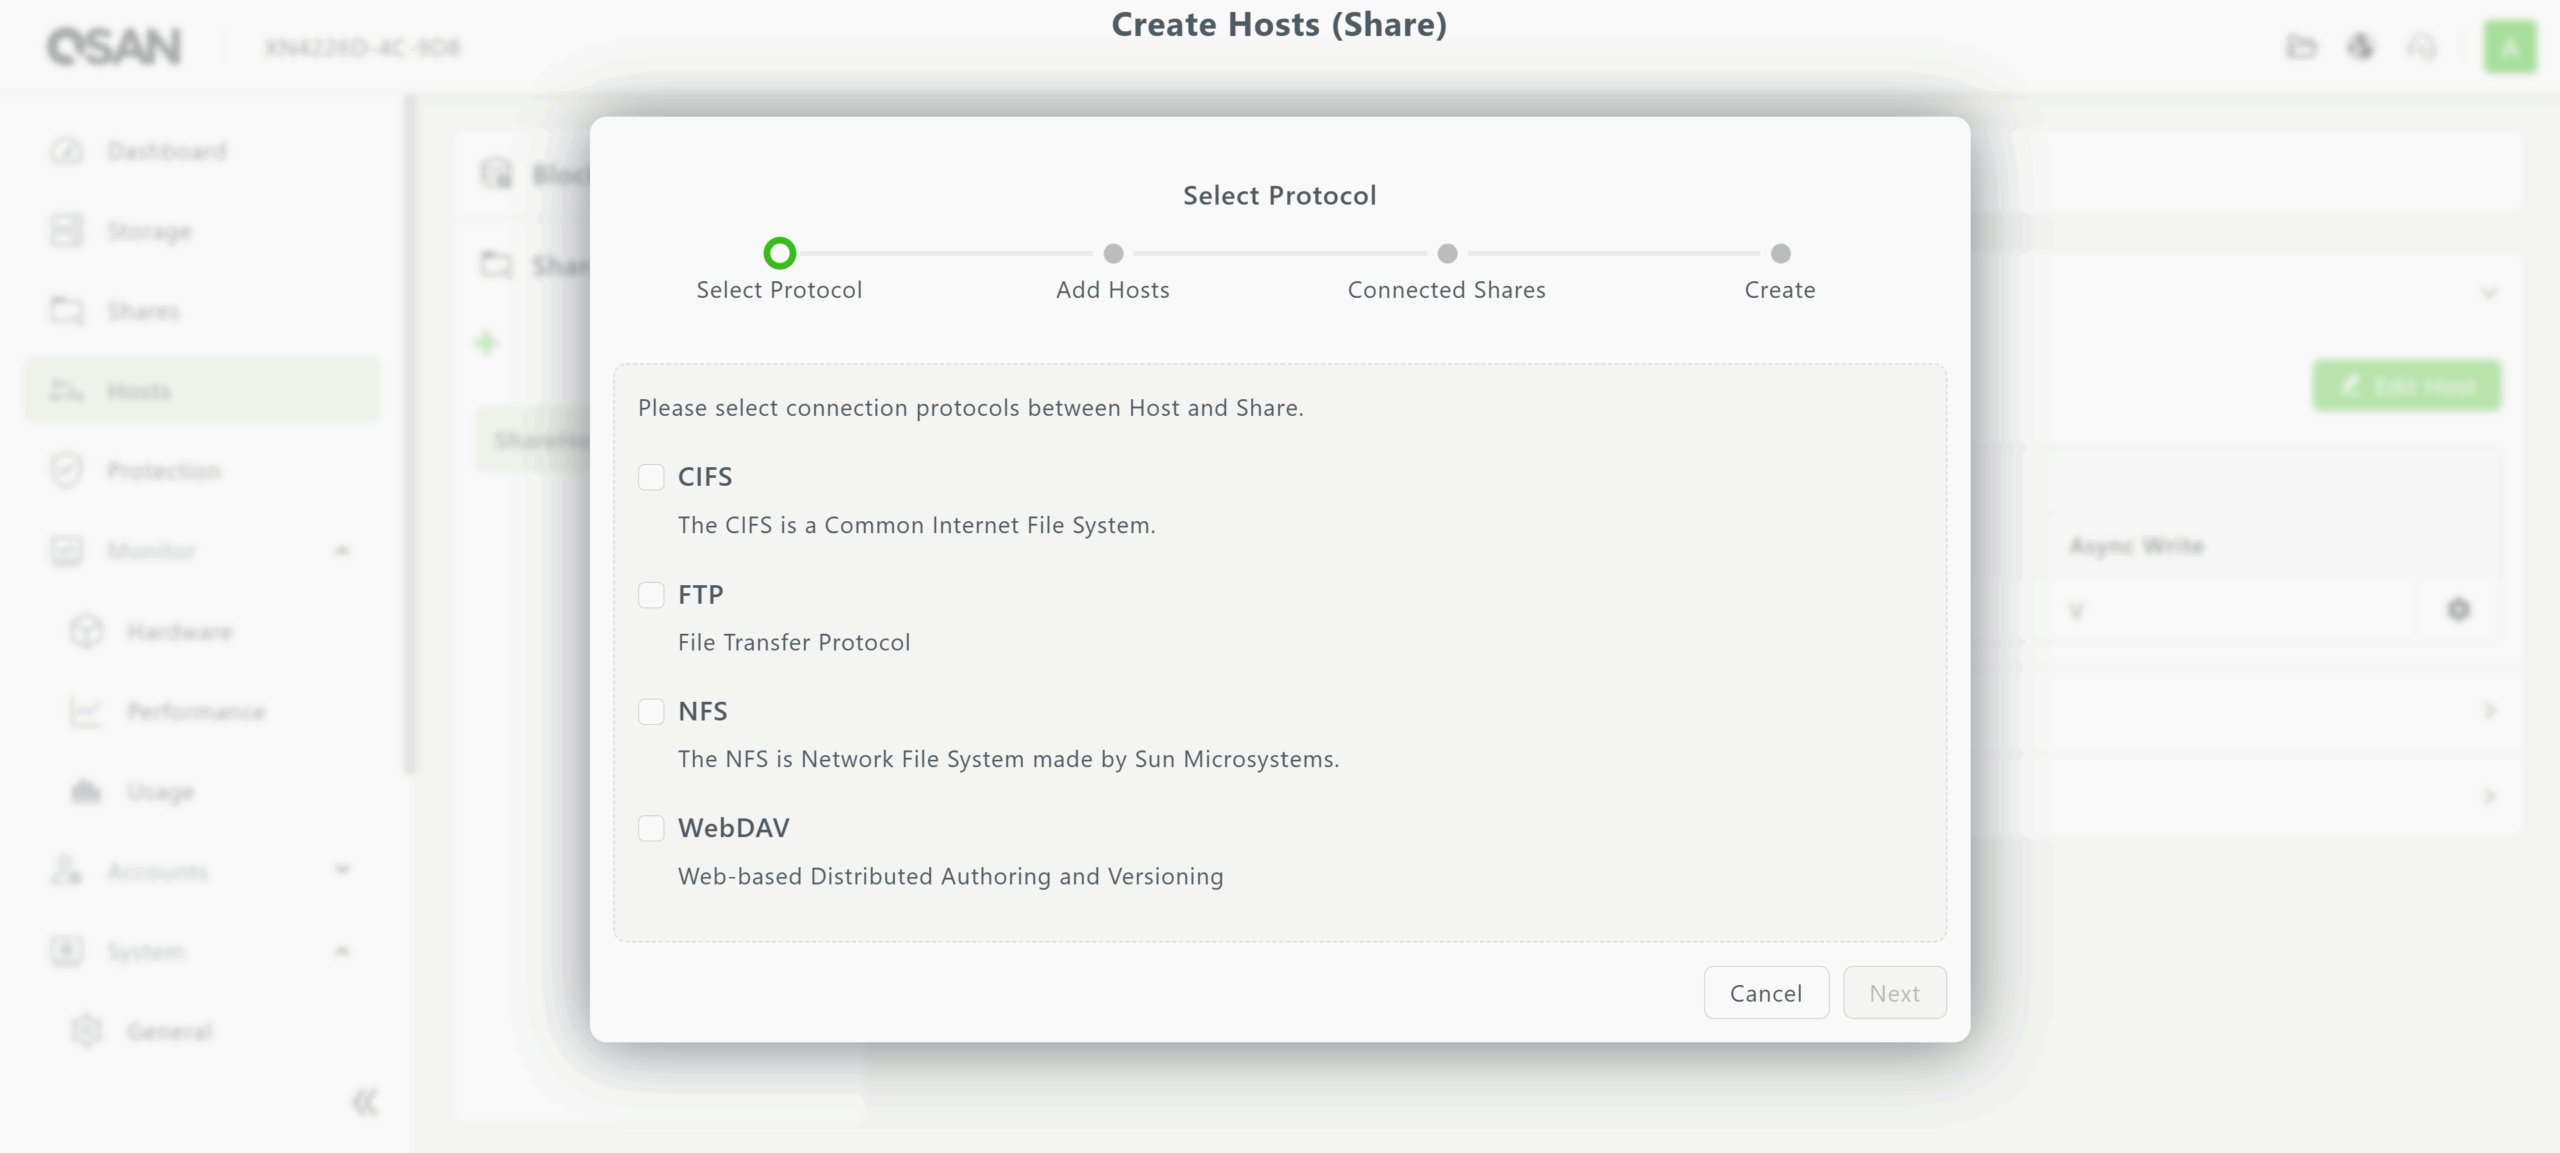
Värdar för blocklagring kan använda iSCSI, FCP eller NVMe-oF över TCP för en volym. Däremot kan värdar för fillagring (delning) stödja flera protokoll samtidigt, vilket erbjuder viktig flexibilitet för datacenter med olika fildelningskrav.
QSM 4 tillhandahåller även grundläggande övervakningsfunktioner i övervakningsmenyn, som visar status för olika hårdvarumoduler och enheter i arrayen, samt statistik för enhets-, lagringspool-, CPU- och minnesanvändning.
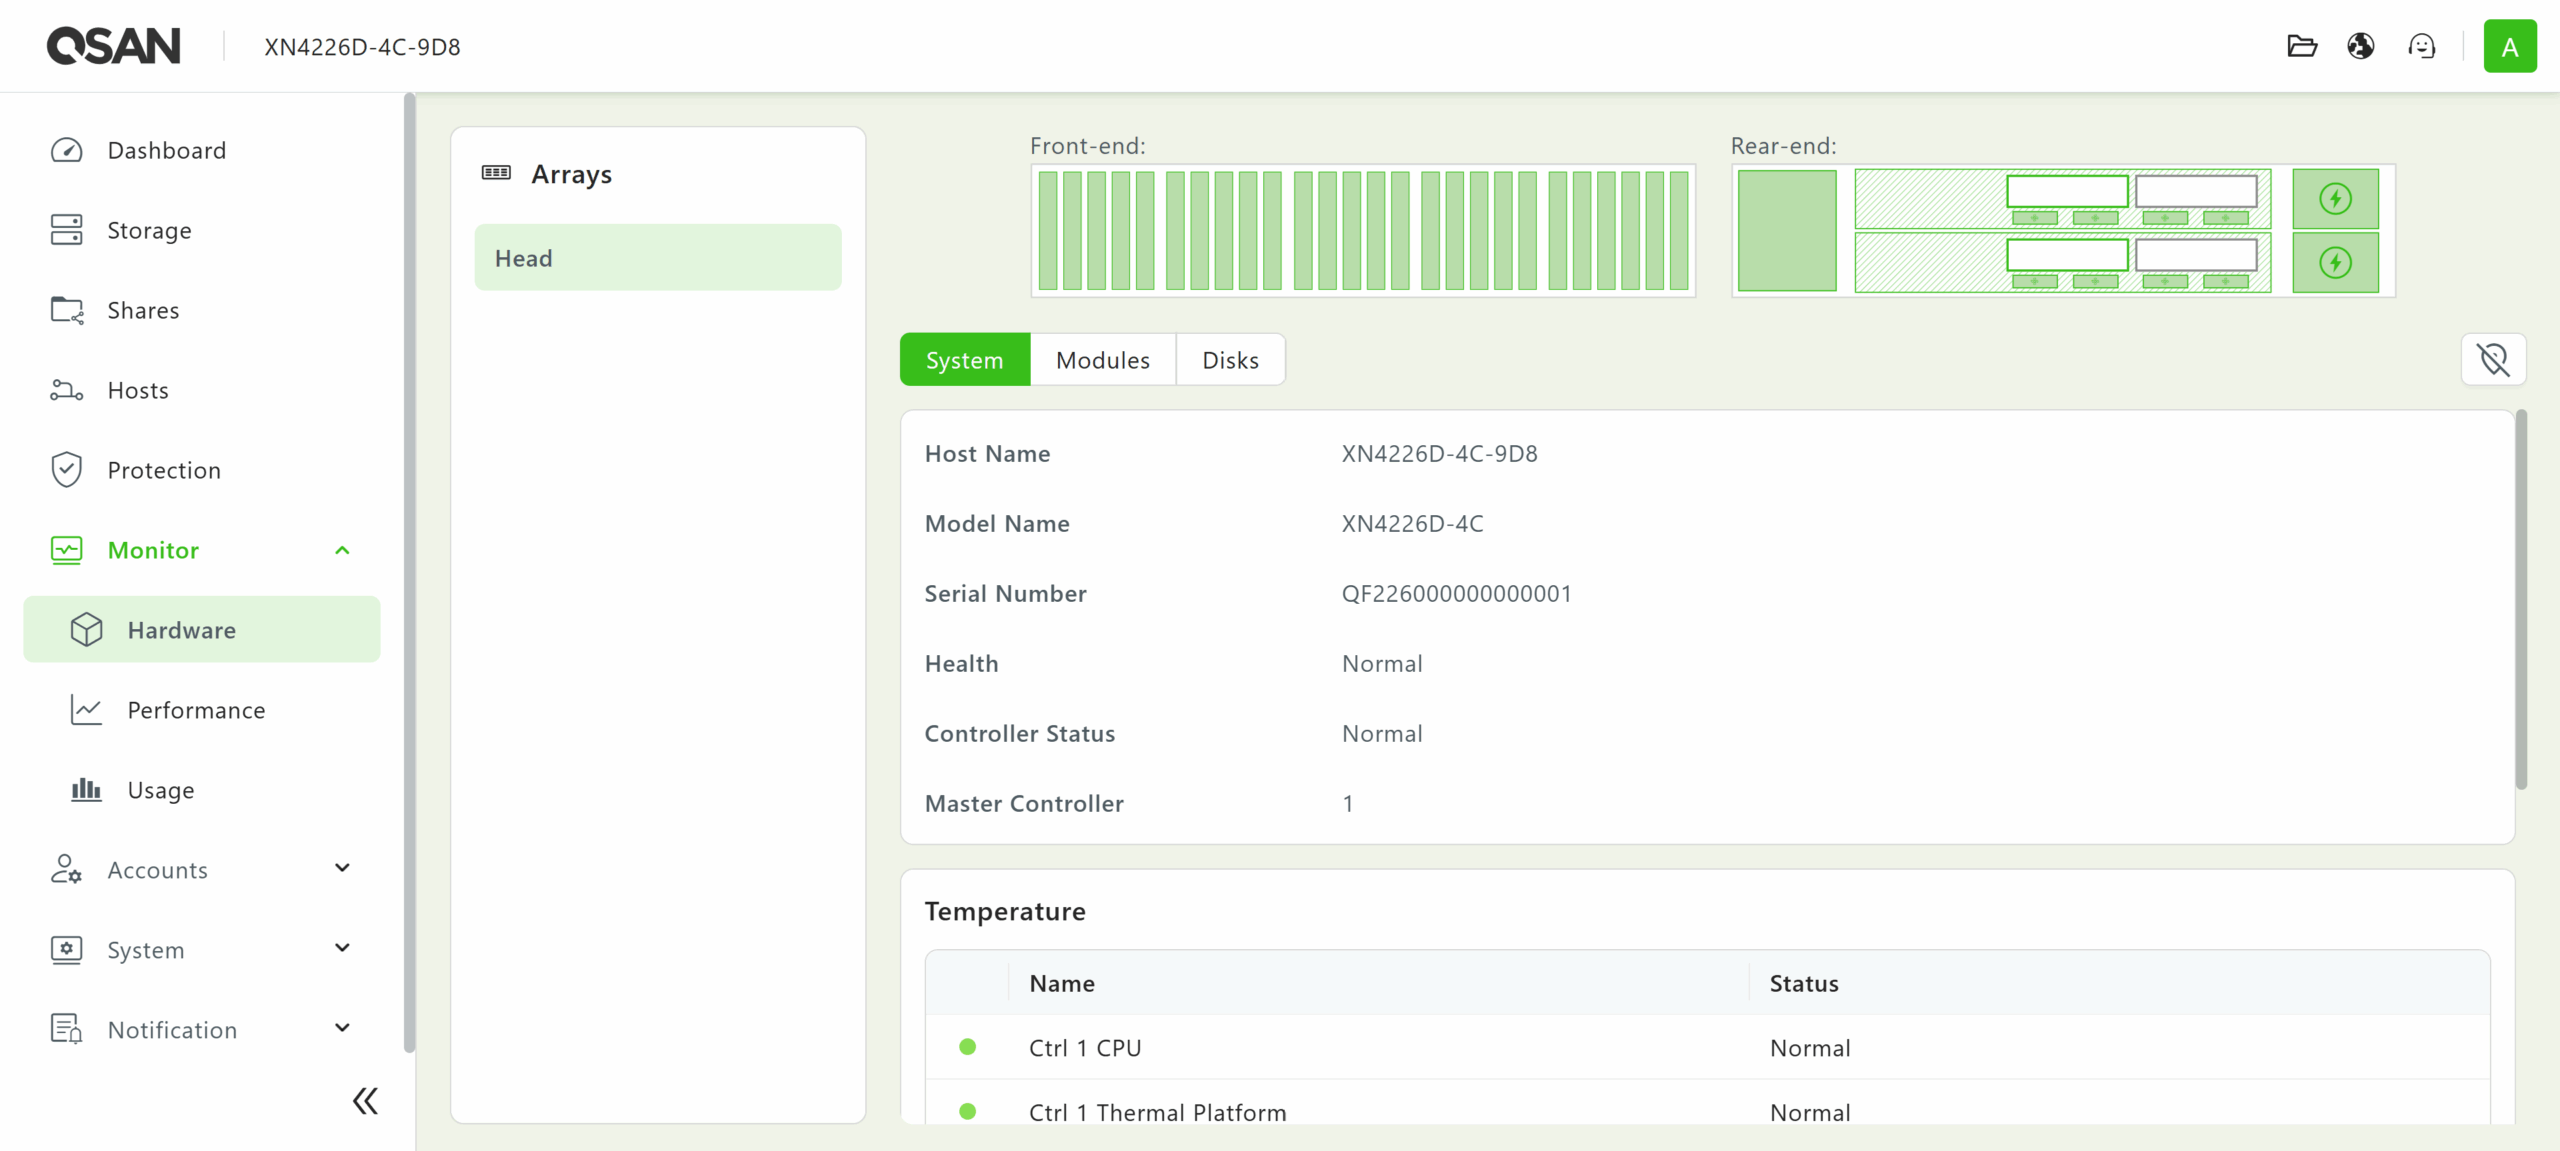
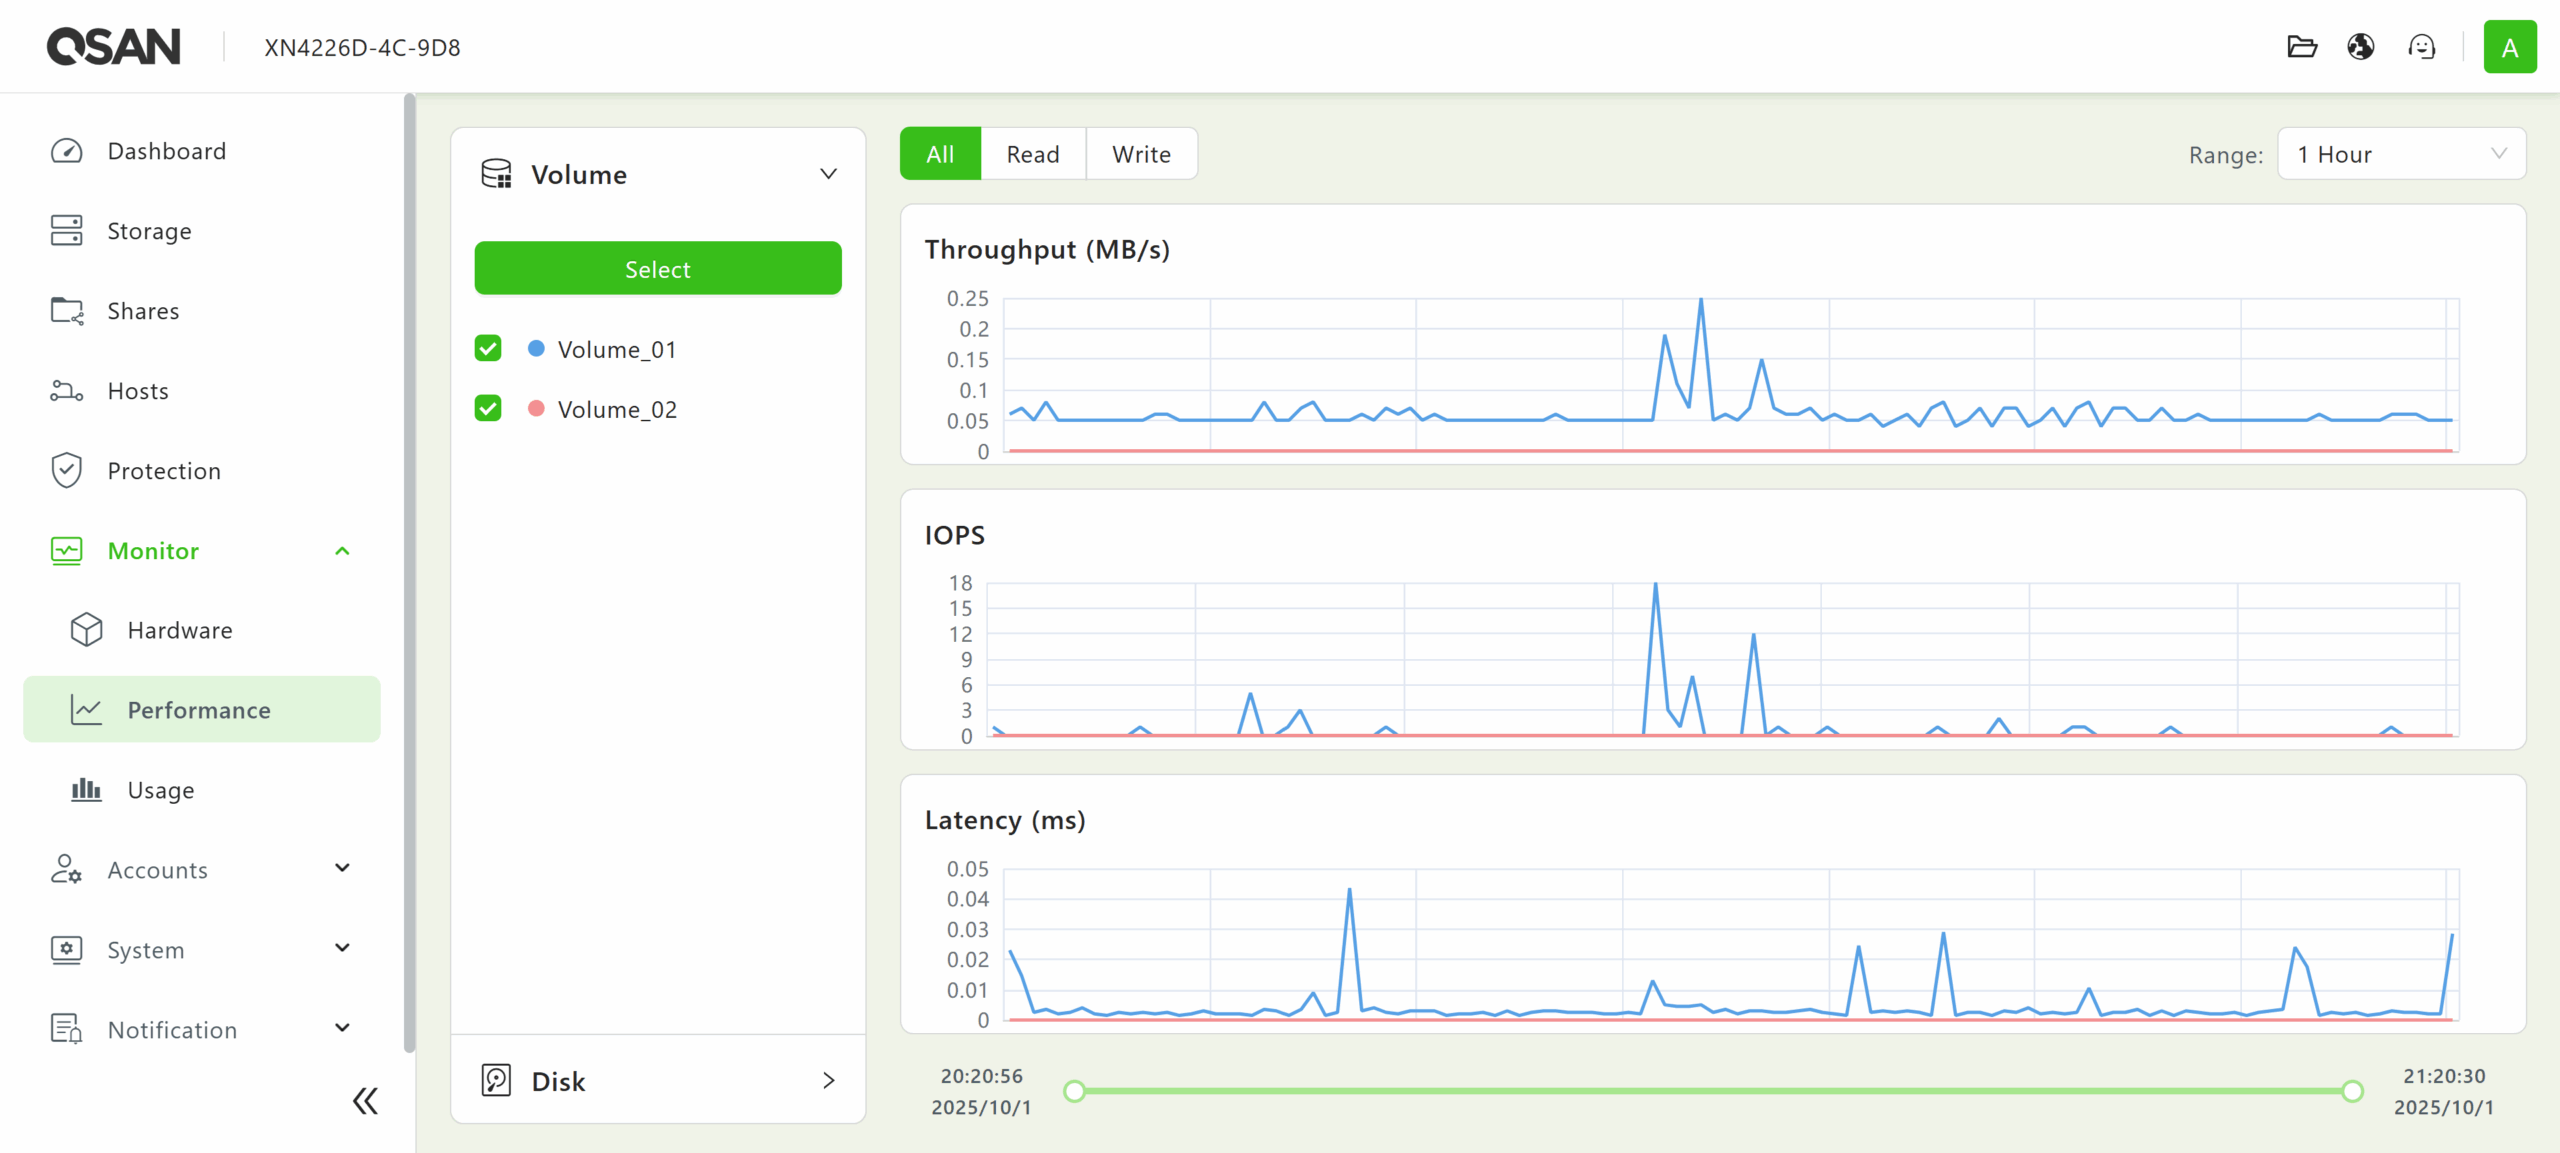
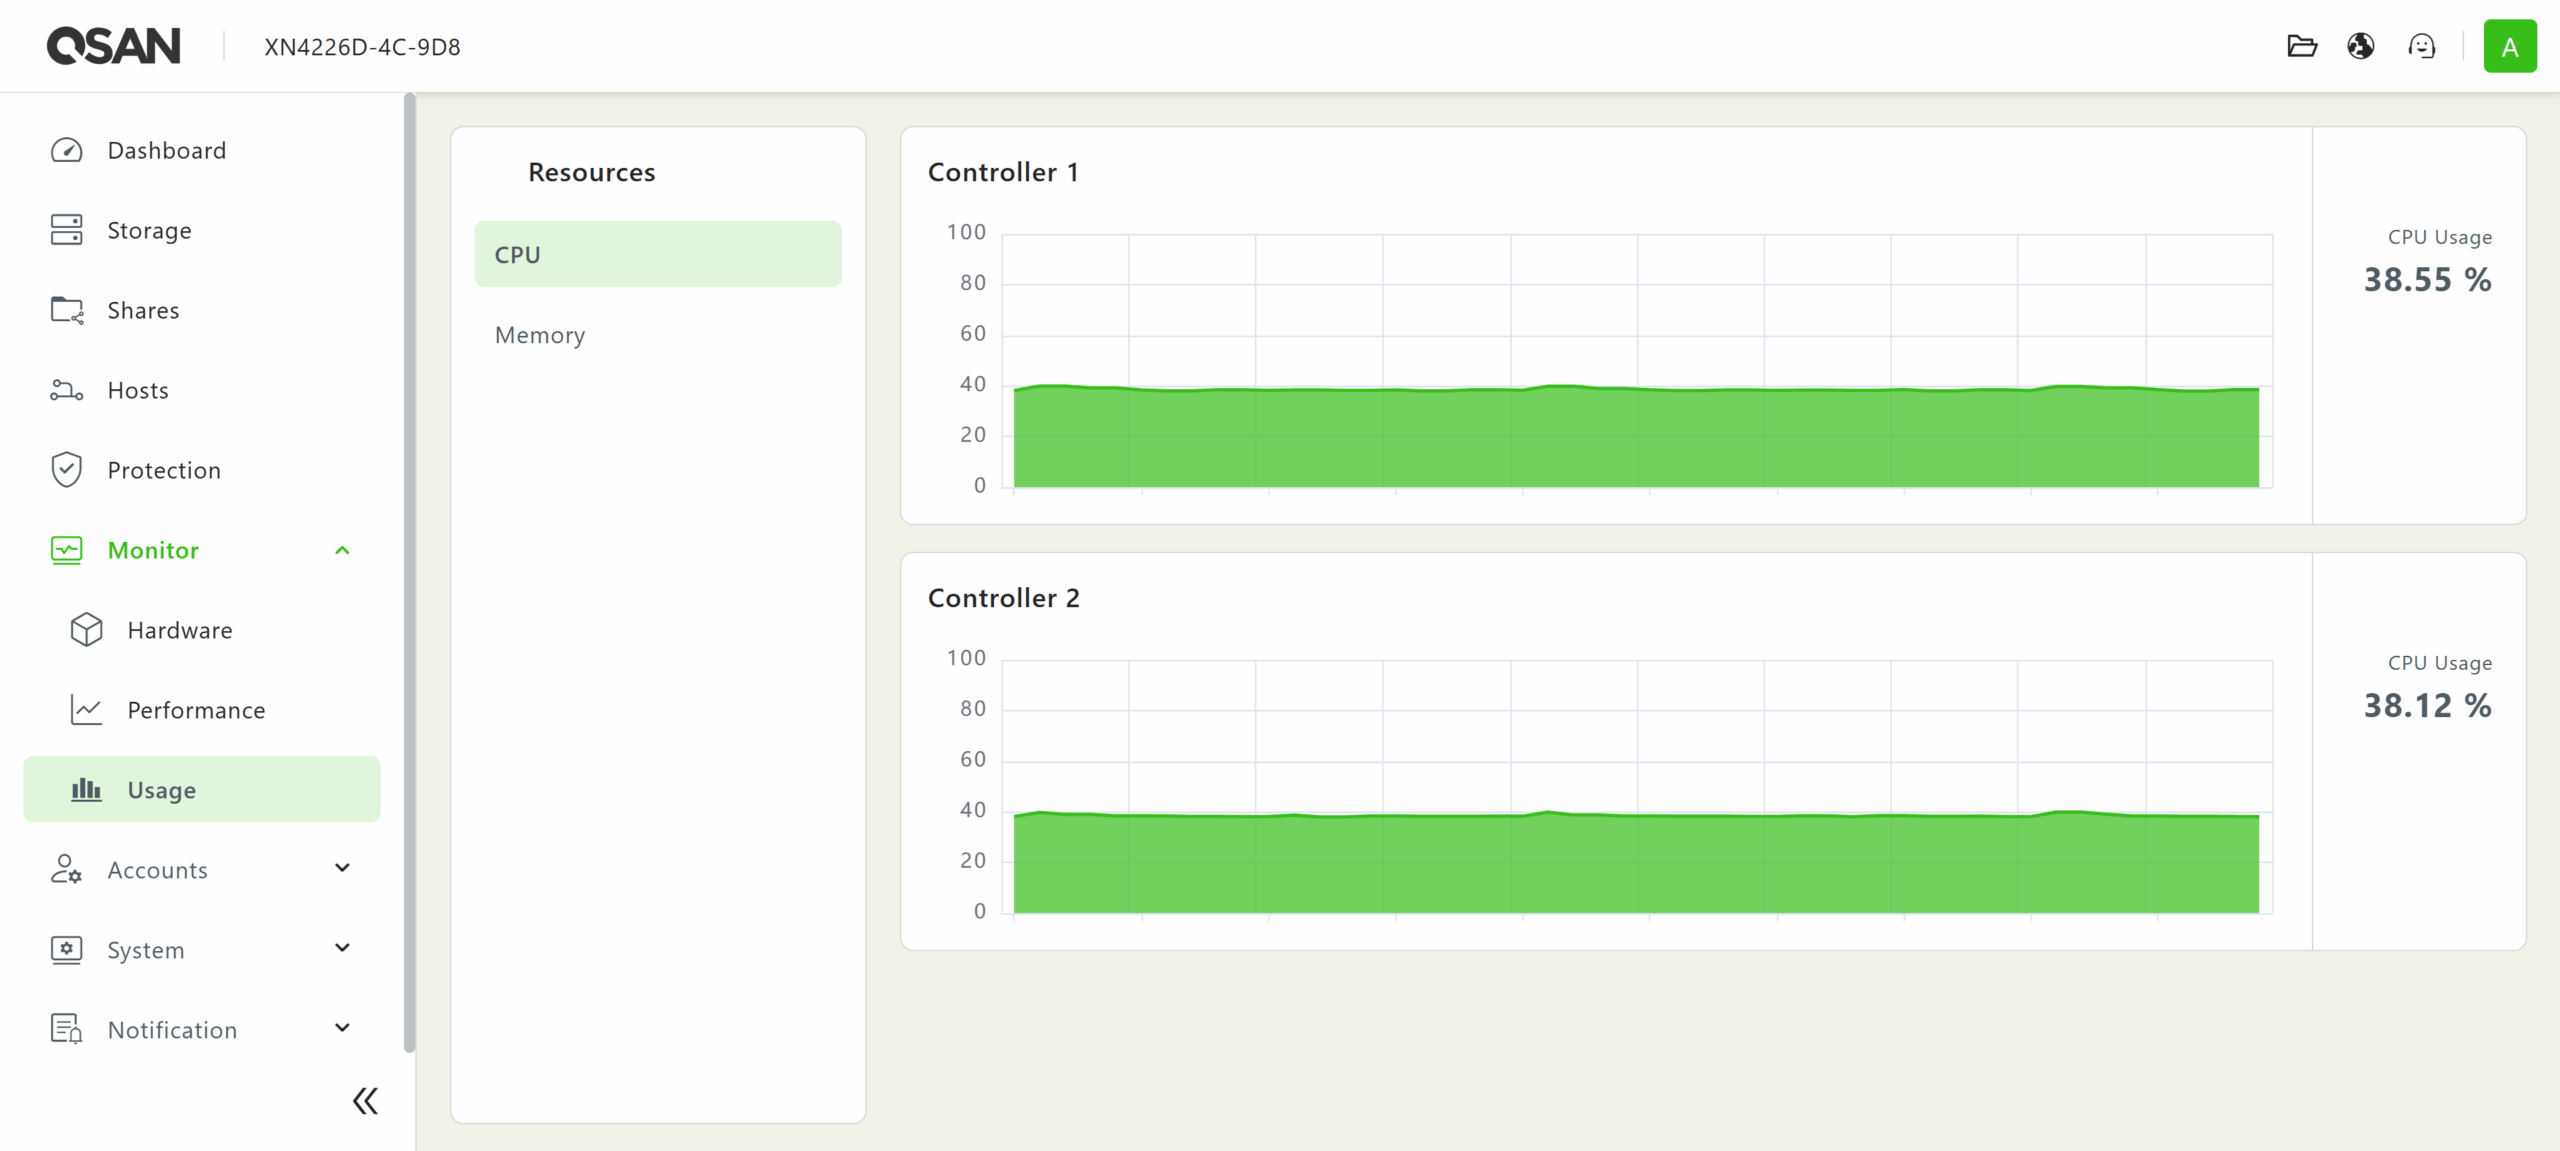
Webbgränssnittet för QSM 4 har även hantering av användare, grupper och domäner under menyn Konton. Det finns också olika SAN-omfattande konfigurationsalternativ tillgängliga i systemmenyn. Loggnings- och varningsfunktioner är tillgängliga från menyn Meddelande. Slutligen finns ikonerna för QSAN-filhanteraren, språkstöd och utloggning/energihantering i menyradens övre högra hörn.
Enkel Proxmox-integration
Proxmox har inbyggt stöd för NVMe over Fabrics (NVMe-oF), vilket möjliggör enkel integration av högpresterande lagringsarrayer i ett kluster. Processen börjar med att provisionera NVMe-oF-mål på ditt lagringssystem. Använd sedan Proxmox-värden för att upptäcka och ansluta till dessa mål. När systemet är anslutet måste du konfigurera det för att säkerställa att dessa anslutningar kvarstår efter omstart.
I vårt exempel utförs identifiering med hjälp av shell-kommandon, som anger IP-adressen och serviceporten för arrayen.
nvme discover -t tcp -a 172.16.16.100 -s 4420
nvme discover -t tcp -a 172.13.13.100 -s 4420
Anslut sedan till de etablerade namnrymderna genom att referera till deras NQN:er.
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev4 -a 172.16.16.100 -s 4420
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev6 -a 172.13.13.100 -s 4420
För att säkerställa att konfigurationen är beständig även efter omstarter kan identifieringsadresserna läggas till i NVMe-identifieringskonfigurationsfilen.
echo "discover -t tcp -a 172.16.16.100 -s 4420" | tee -a /etc/nvme/discovery.conf
echo "discover -t tcp -a 172.13.13.100 -s 4420" | tee -a /etc/nvme/discovery.conf
Slutligen, aktivera automatisk anslutningstjänst så att Proxmox återupprättar NVMe-sessionerna automatiskt vid start.
systemctl enable nvmf-autoconnect.serviceProxmox kan integreras sömlöst med QSAN-lagring, vilket ger NVMe-prestanda med låg latens och hög bandbredd, tillsammans med flexibiliteten hos nätverksanslutna strukturer.
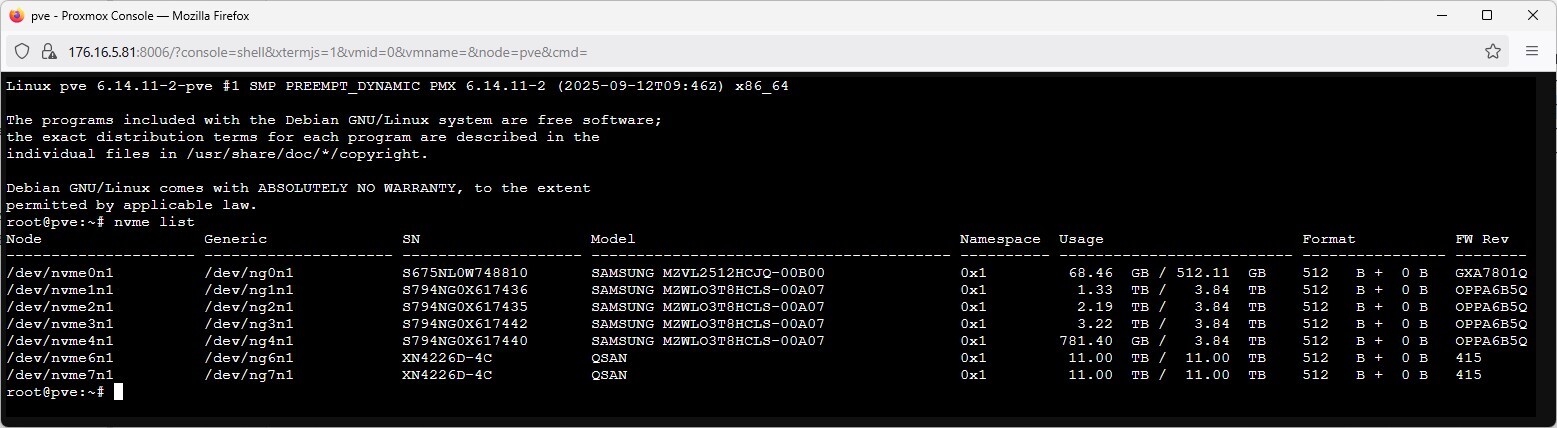
Efter att vi har anslutit vårt QSAN kan vi köra kommandot "nvme list" från Proxmox-skalet för att visa alla NVMe-enheter, där de nyligen tillagda QSAN-volymerna visas som /dev/nvme6n1 och /dev/nvme7n1, var och en med 11 TB lagringsutrymme.
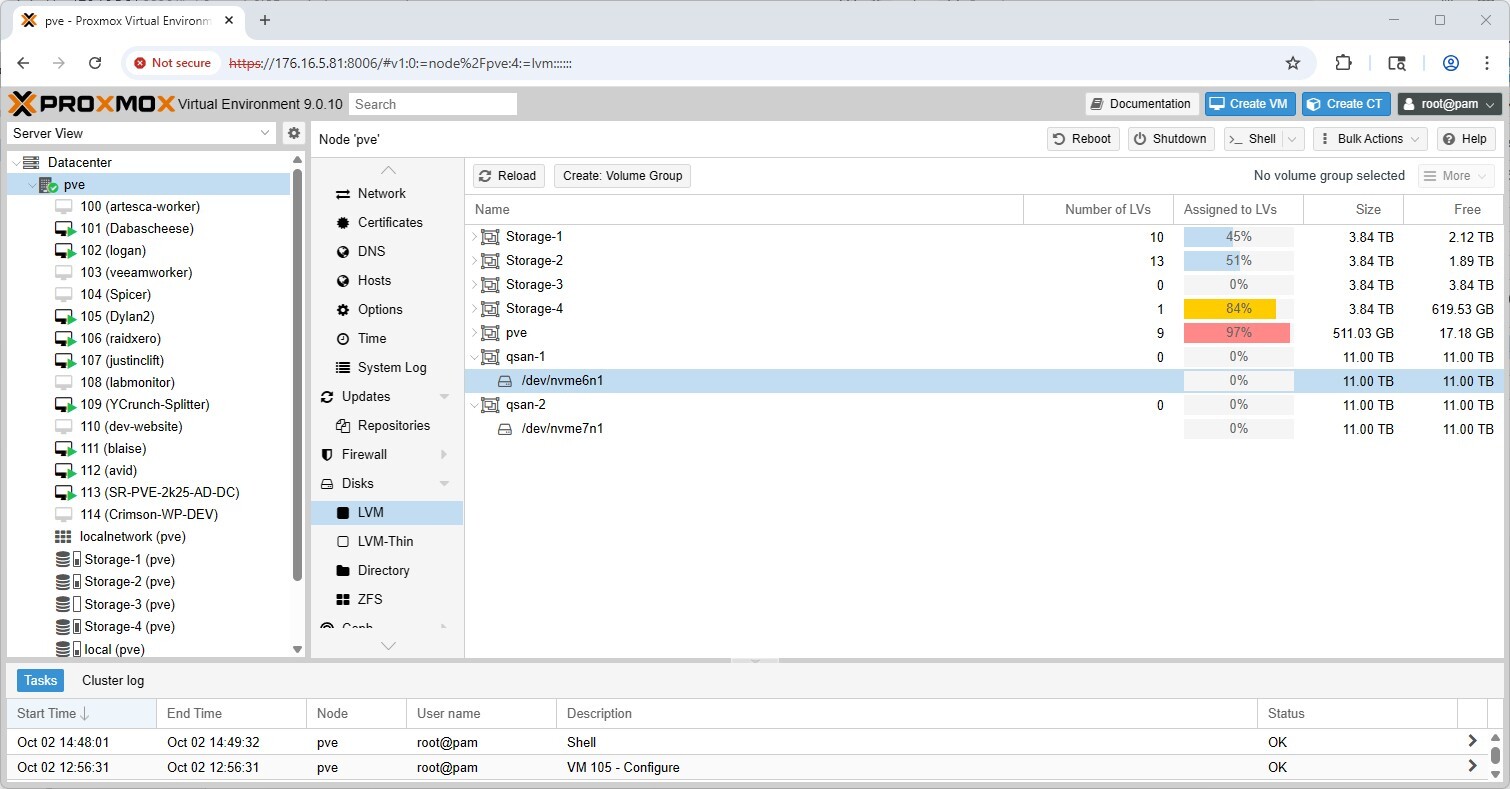
När QSAN-lagringen är synlig i Proxmox GUI kan vi skapa en ny LVM-volymgrupp: pve > Disks > LVM, de två 11TB-enheterna (/dev/nvme6n1 och /dev/nvme7n1) visas och kan initieras som separata volymgrupper (t.ex. qsan-1 och qsan-2) för användning med virtuella maskiner och containrar.
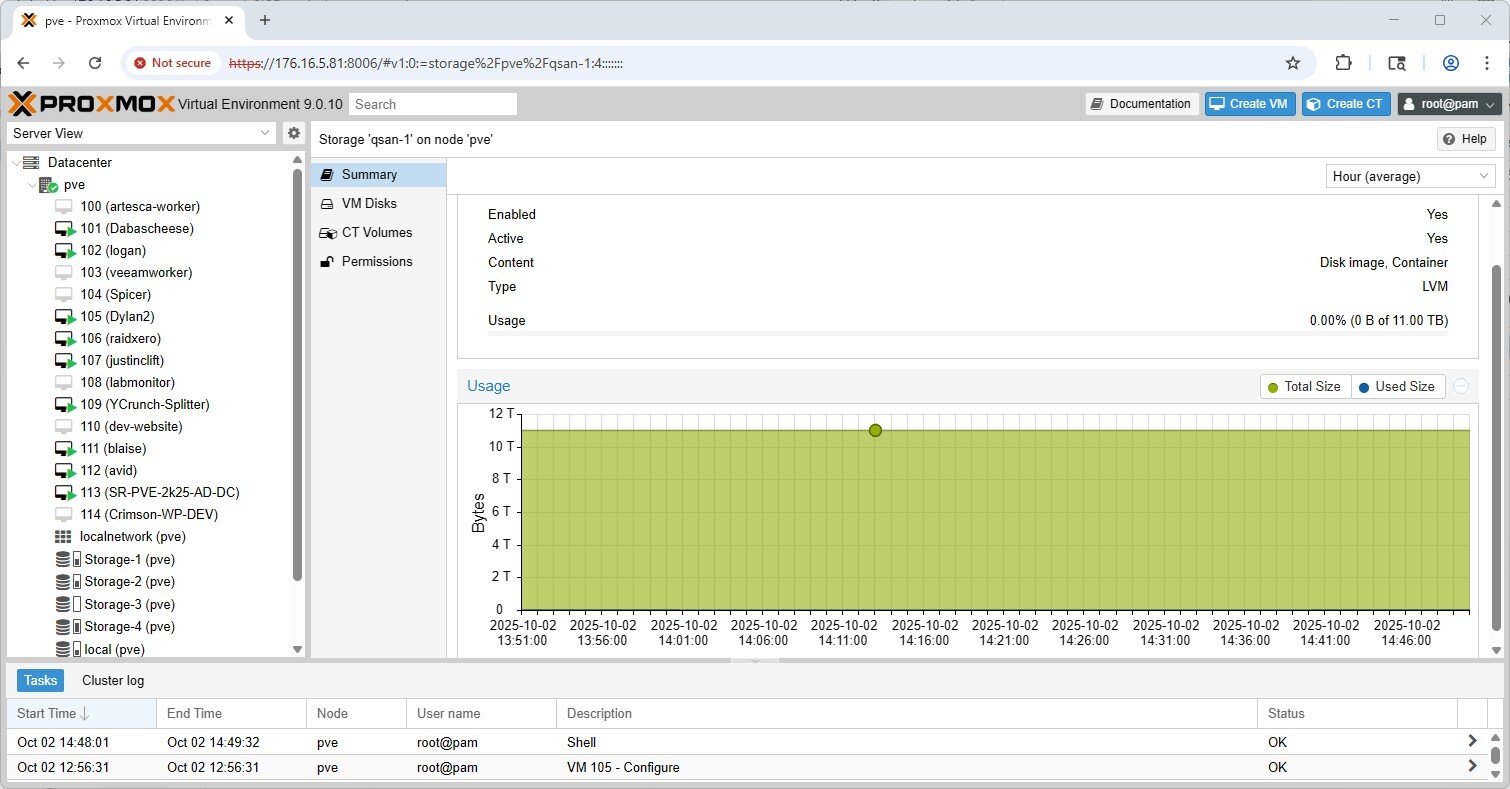
Om du klickar på en av våra nya LVM-pooler (qsan-1) i lagringsfönstret visas att den är online, aktiverad och tillgänglig för användning, med full kapacitet på 11 TB, och redo för etablering av virtuella maskiner och container.
Prestandatester
Vi testade QSAN XN4226D i två miljöer med olika testplattformar. Vår första miljö byggdes kring en Dell PowerEdge R750, utrustad med fyra NVIDIA ConnectX-5 25G nätverkskort med dubbla portar. Vi anslöt QSAN XN4226D direkt till servern med åtta DAC-kablar. Denna installation använde alla tillgängliga nätverksportar på QSAN, vilket gjorde det möjligt för oss att visa upp dess högsta topprestanda.
För FIO-testet använde vi två RAID6-lagringspooler, vilket skapade åtta blockvolymer som var jämnt fördelade över båda kontrollerna. Varje volym tilldelades ett unikt mål, med en enda IP-adress dedicerad till varje volym. Vi mätte både NVMe-oF RDMA och TCP på den här plattformen.
Den andra miljön för GDSIO utnyttjade en Dell PowerEdge R7715, utrustad med två NVIDIA H100 GPU:er och ett fyrports Broadcom 25G NIC. I den här miljön behöll vi samma QSAN-volymlayout, även om vi minskade antalet volymer från åtta till fyra. Med ett fyrports NIC använde vi fyra 25G-anslutningar för att ansluta servern direkt till lagringsmatrisen.
FIO-prestandamåttstock
För att mäta lagringsprestanda för QSAN XN4226D tillämpade vi vanliga branschmått och FIO-verktyget. Varje lagringsenhet genomgår samma testprocess, vilket inkluderar ett förkonditioneringssteg som involverar två fullständiga hårddiskfyllningar med en sekventiell skrivarbetsbelastning, följt av mätning av prestanda i stationärt tillstånd. När varje arbetsbelastningstyp som mäts ändras kör vi ytterligare en förkonditioneringsfyllning med den nya överföringsstorleken.
I det här avsnittet fokuserar vi på följande FIO-riktmärken:
- 1M Sekventiell
- 64K slumpmässigt
- 16K slumpmässigt
- 4K slumpmässigt
1M sekventiell skrivbandbredd
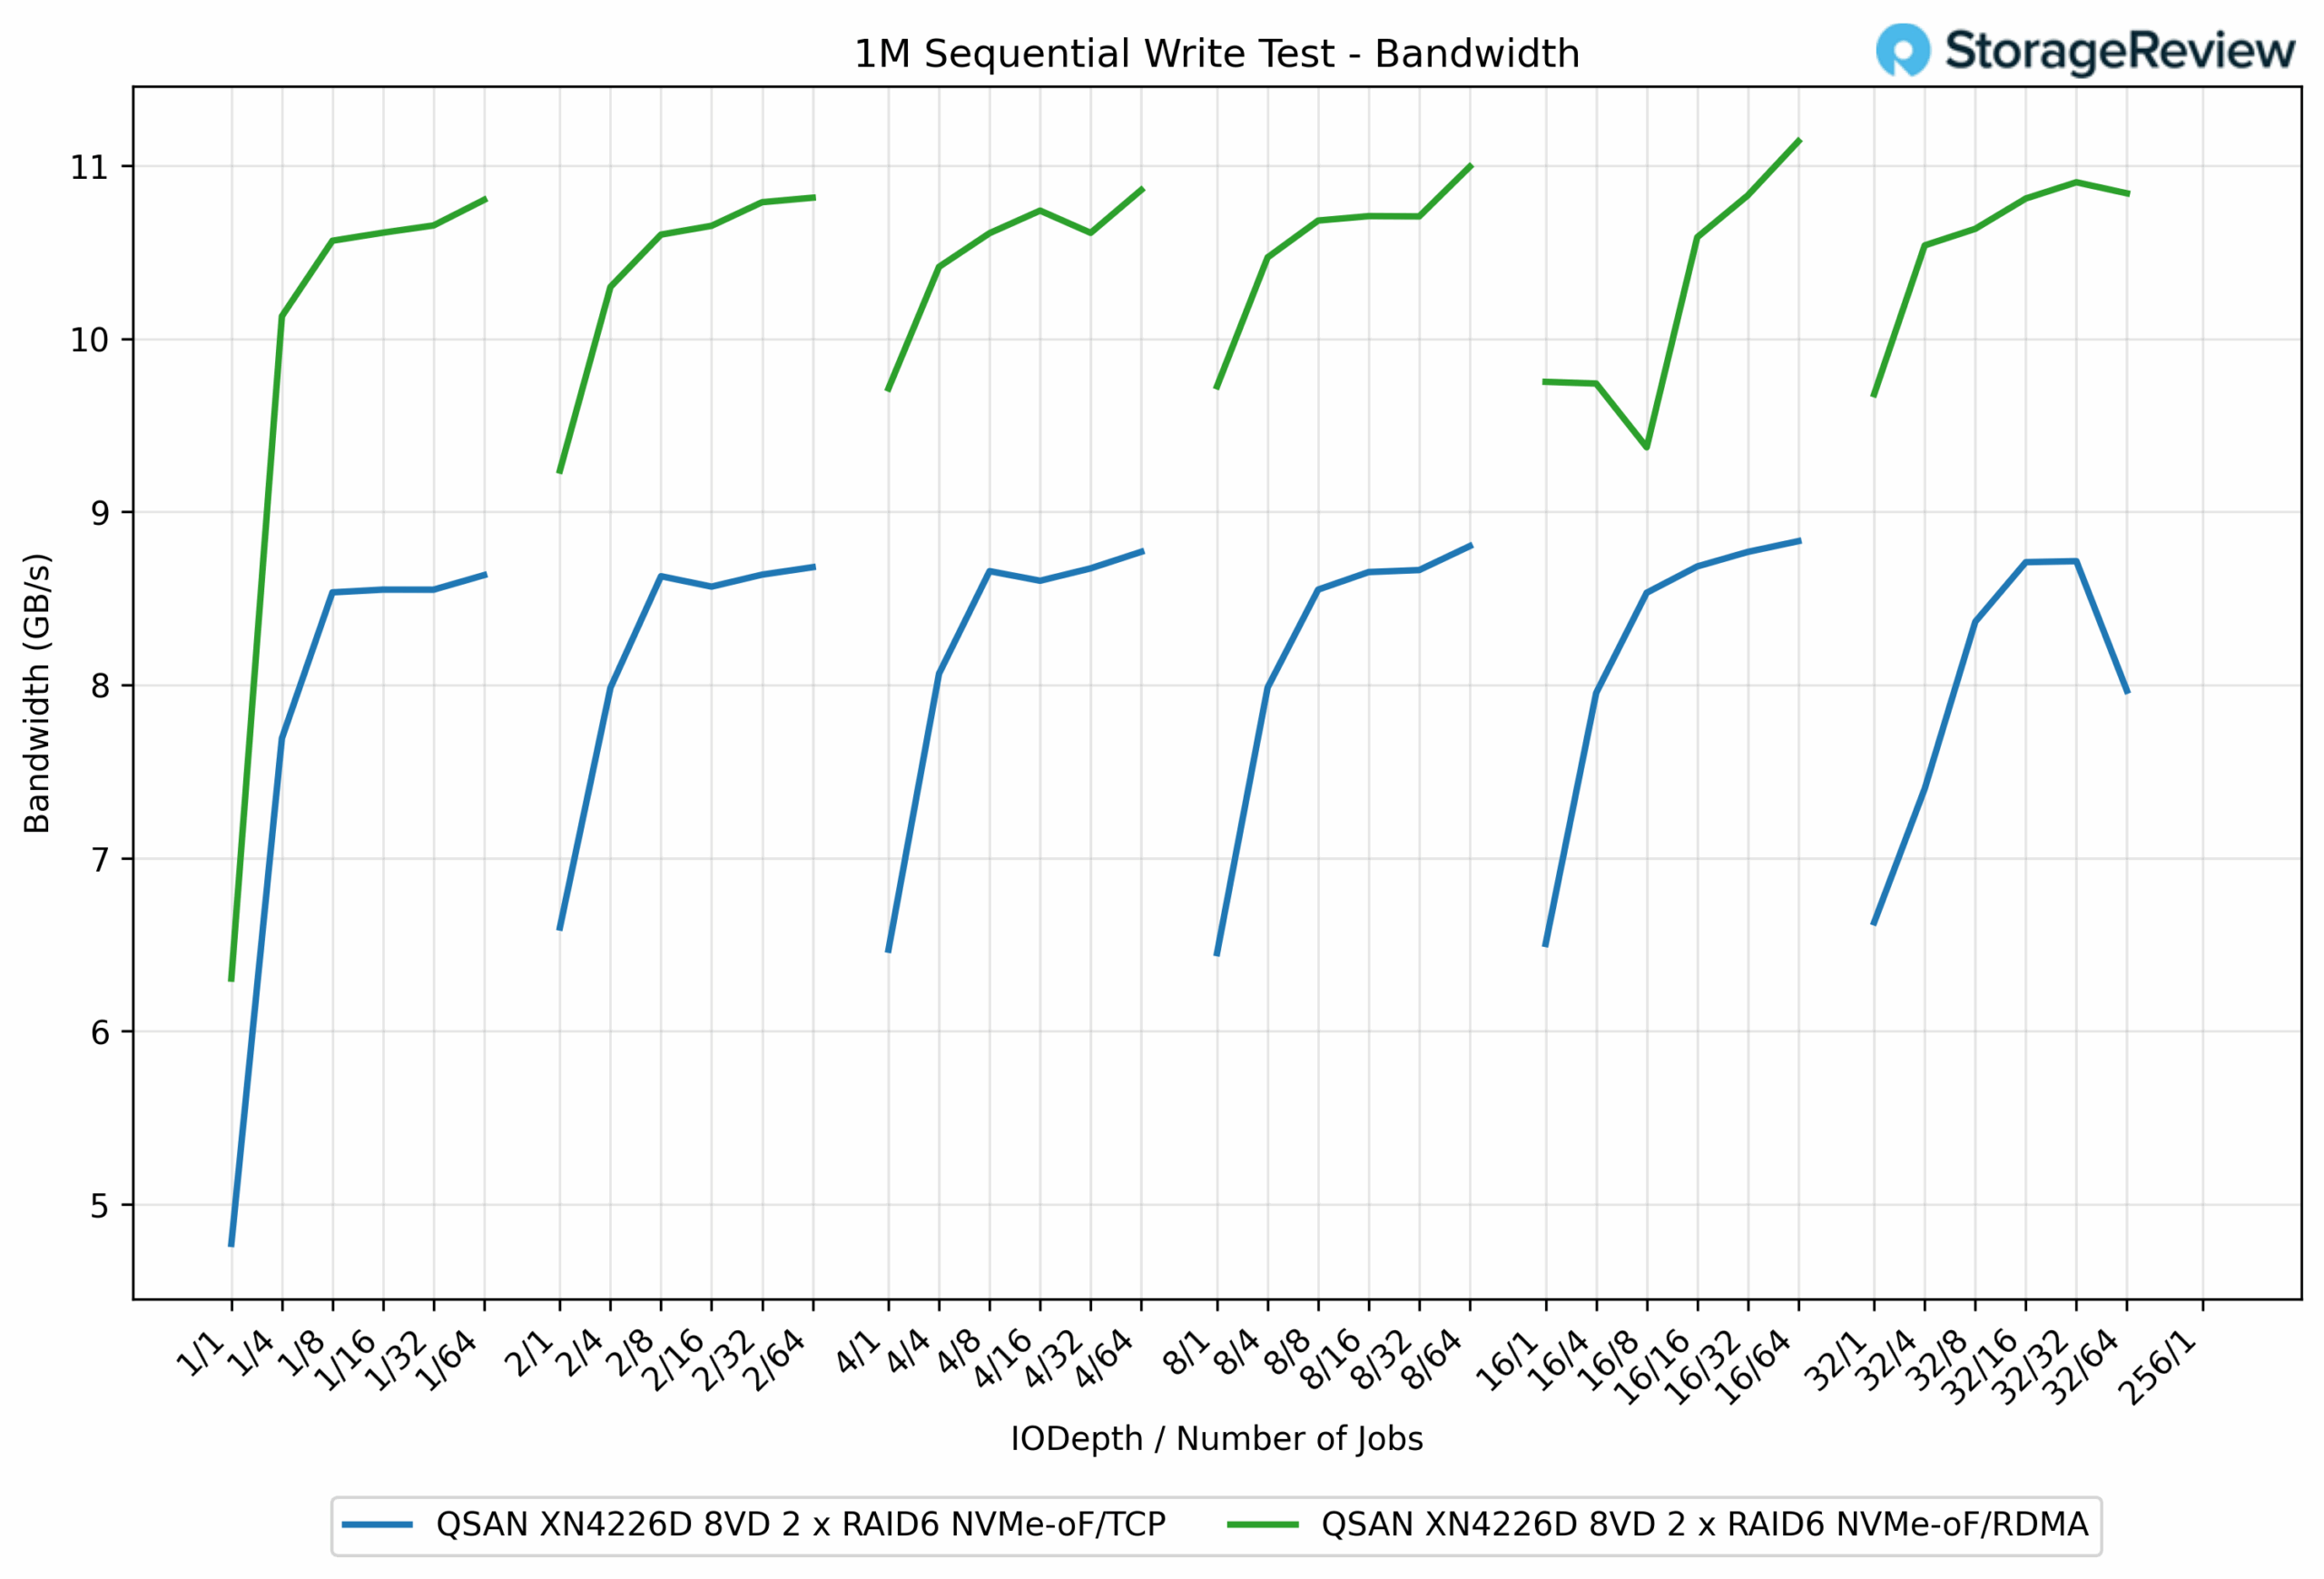
I 1M Sequential Write-testet levererade NVMe över RDMA konsekvent högre bandbredd över nästan alla ködjup och jobbantal jämfört med NVMe över TCP. Som mest uppnådde RDMA 11.14 GB/s, medan TCP nådde 8.83 GB/s, en skillnad på ungefär 26 % till RDMA:s fördel. Även vid lägre ködjup behöll RDMA sin fördel. Till exempel, vid QD1/1-jobbet, publicerade den 6.30 GB/s, vilket överträffade TCP:s 4.77 GB/s med cirka 32 %.
Prestandaskillnaden mellan de två protokollen minskade något i takt med att arbetsbelastningen skalades upp, men RDMA visade fortfarande en tydlig fördel genomgående. TCP låg konsekvent i intervallet 8.5 till 8.8 GB/s över flera testpunkter, medan RDMA ofta pressade sig förbi 10.5 GB/s-gränsen och nådde en topp på drygt 11 GB/s.
1M sekventiell skrivlatens
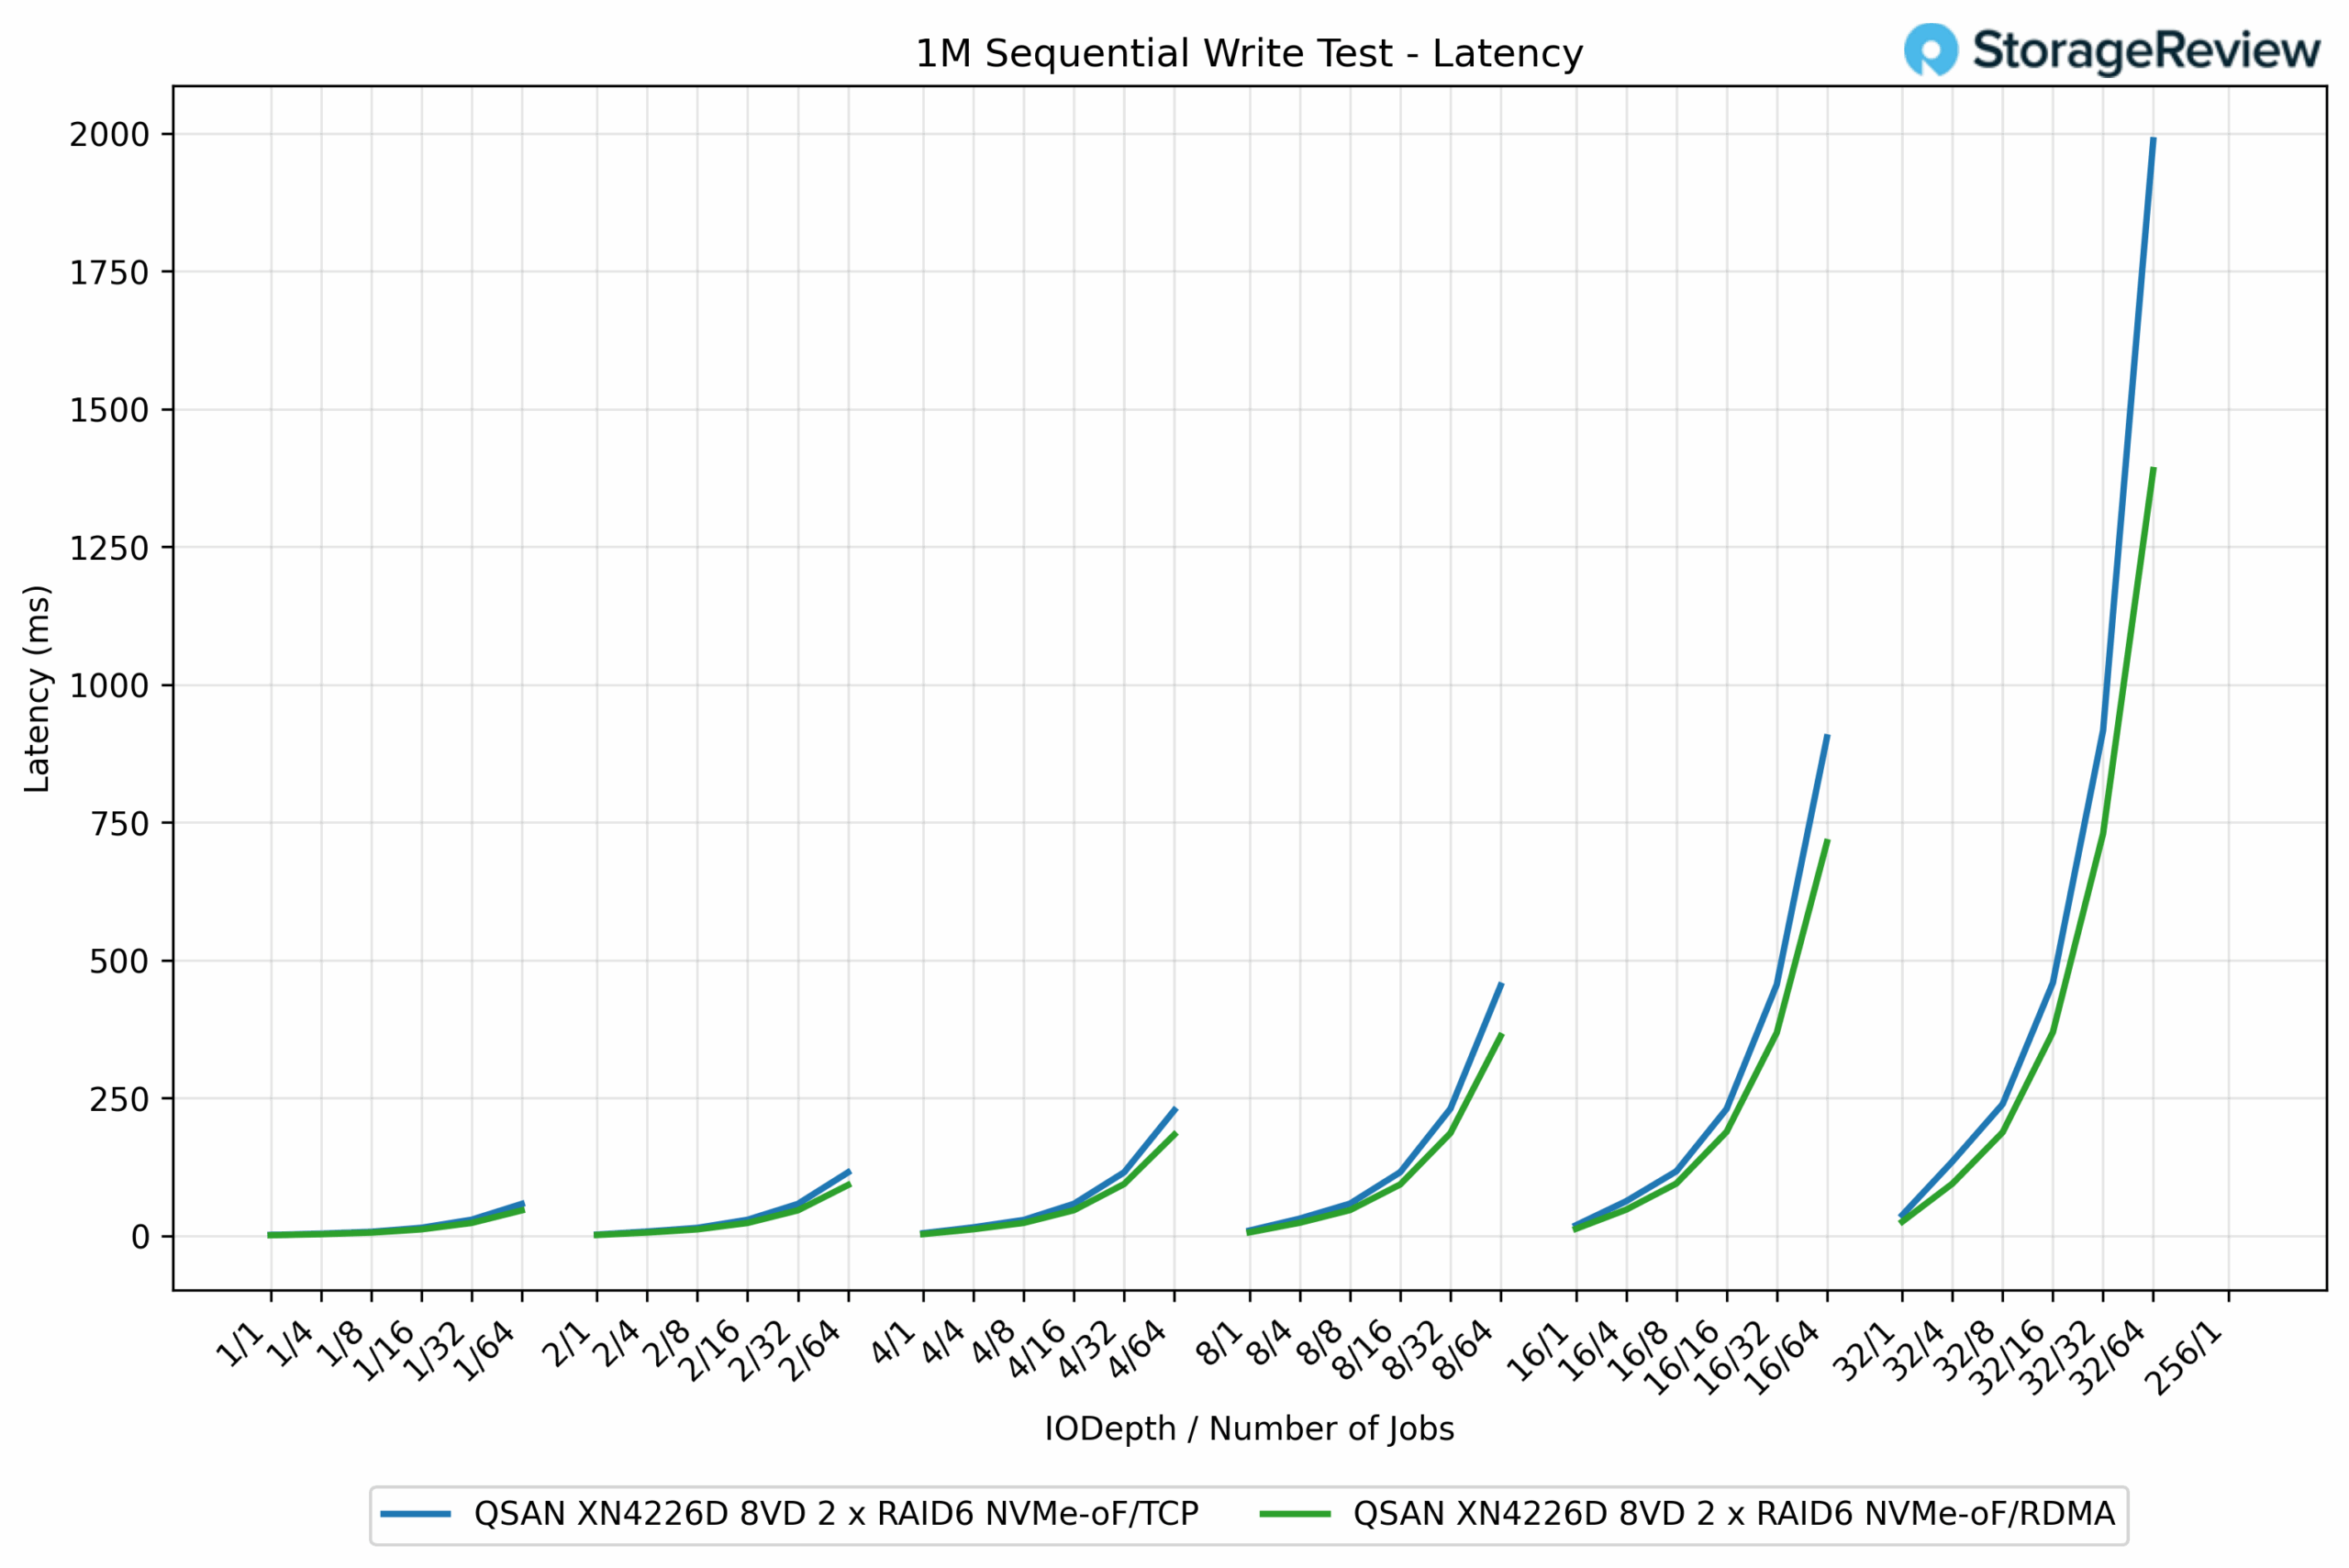
I 1M Sequential Write latency-testet behöll RDMA återigen en tydlig effektivitetsfördel jämfört med TCP över de flesta ködjup och jobbantal. Vid lättare arbetsbelastningar låg de två protokollen nära varandra, båda uppvisade latenser under 5 ms. Men allt eftersom samtidigheten ökade blev skillnaderna tydligare. Till exempel, vid QD16/16-jobb mätte RDMA 368.48 ms, medan TCP uppvisade 455.95 ms, en förbättring på 19 % för RDMA.
Skillnaden blev ännu mer betydande vid extrema skalor. Vid QD256/1-jobbet slutfördes RDMA vid 1 389,16 ms, medan TCP klättrade till 1 987,39 ms, vilket återspeglar en latensreduktion på 43 % till förmån för RDMA. Denna trend belyser RDMAs förmåga att upprätthålla högre dataflöde samtidigt som latensen hålls i schack, särskilt i scenarier med hög belastning.
1M sekventiell läsbandbredd
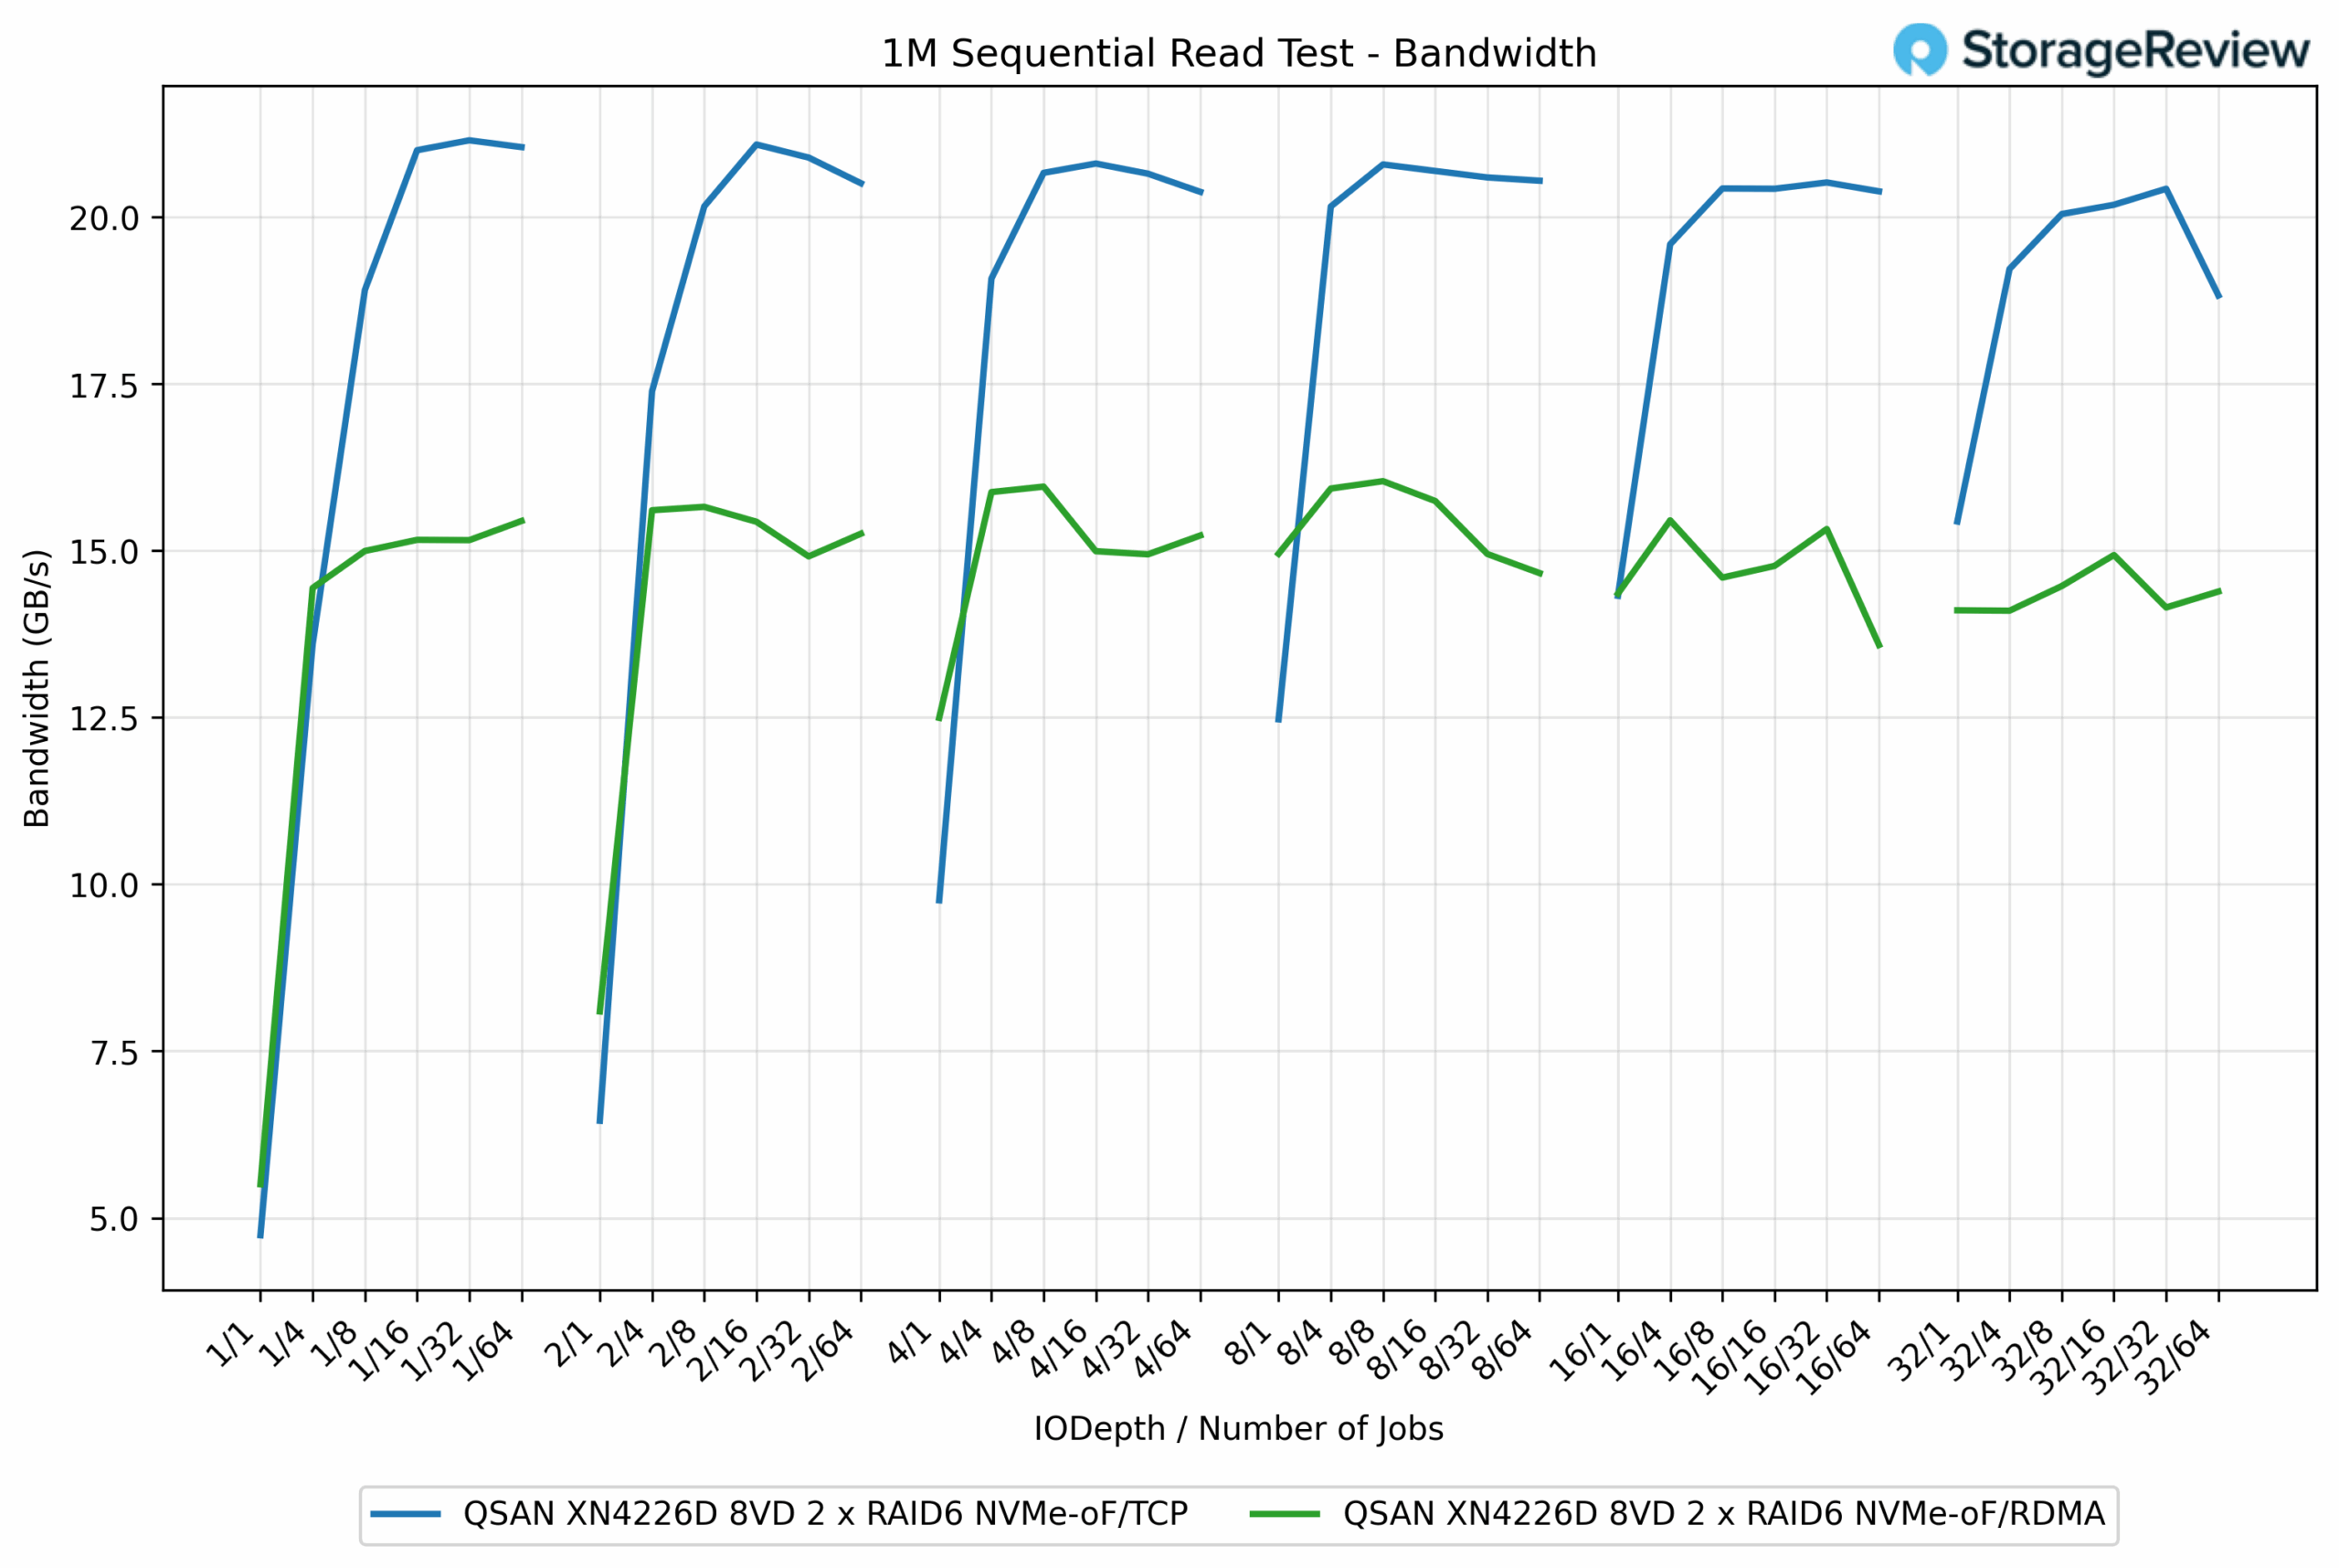
I 1M Sequential Read-testet förändrades prestandadynamiken, där TCP tydligt överträffade RDMA över hela linjen. TCP nådde en topp på 21.21 GB/s, medan RDMA toppade på 15.96 GB/s, en skillnad på ungefär 33 % till TCP:s fördel. Även vid lägre ködjup steg TCP snabbt. Till exempel, vid QD1/4-jobb levererade TCP 18.91 GB/s, jämfört med RDMAs 15.05 GB/s, en skillnad på mer än 25 %.
Fördelen med TCP var konsekvent över nästan alla arbetsbelastningsskalor. När mättnad inträffade bibehöll TCP resultaten i intervallet 20-21 GB/s, medan RDMA planade ut närmare 15 GB/s. Detta indikerar att medan RDMA utmärker sig i skrivtunga och latenskänsliga operationer, uppvisar TCP starkare sekventiell läsbandbreddseffektivitet med den testade RAID6 NVMe-konfigurationen.
1M sekventiell läslatens
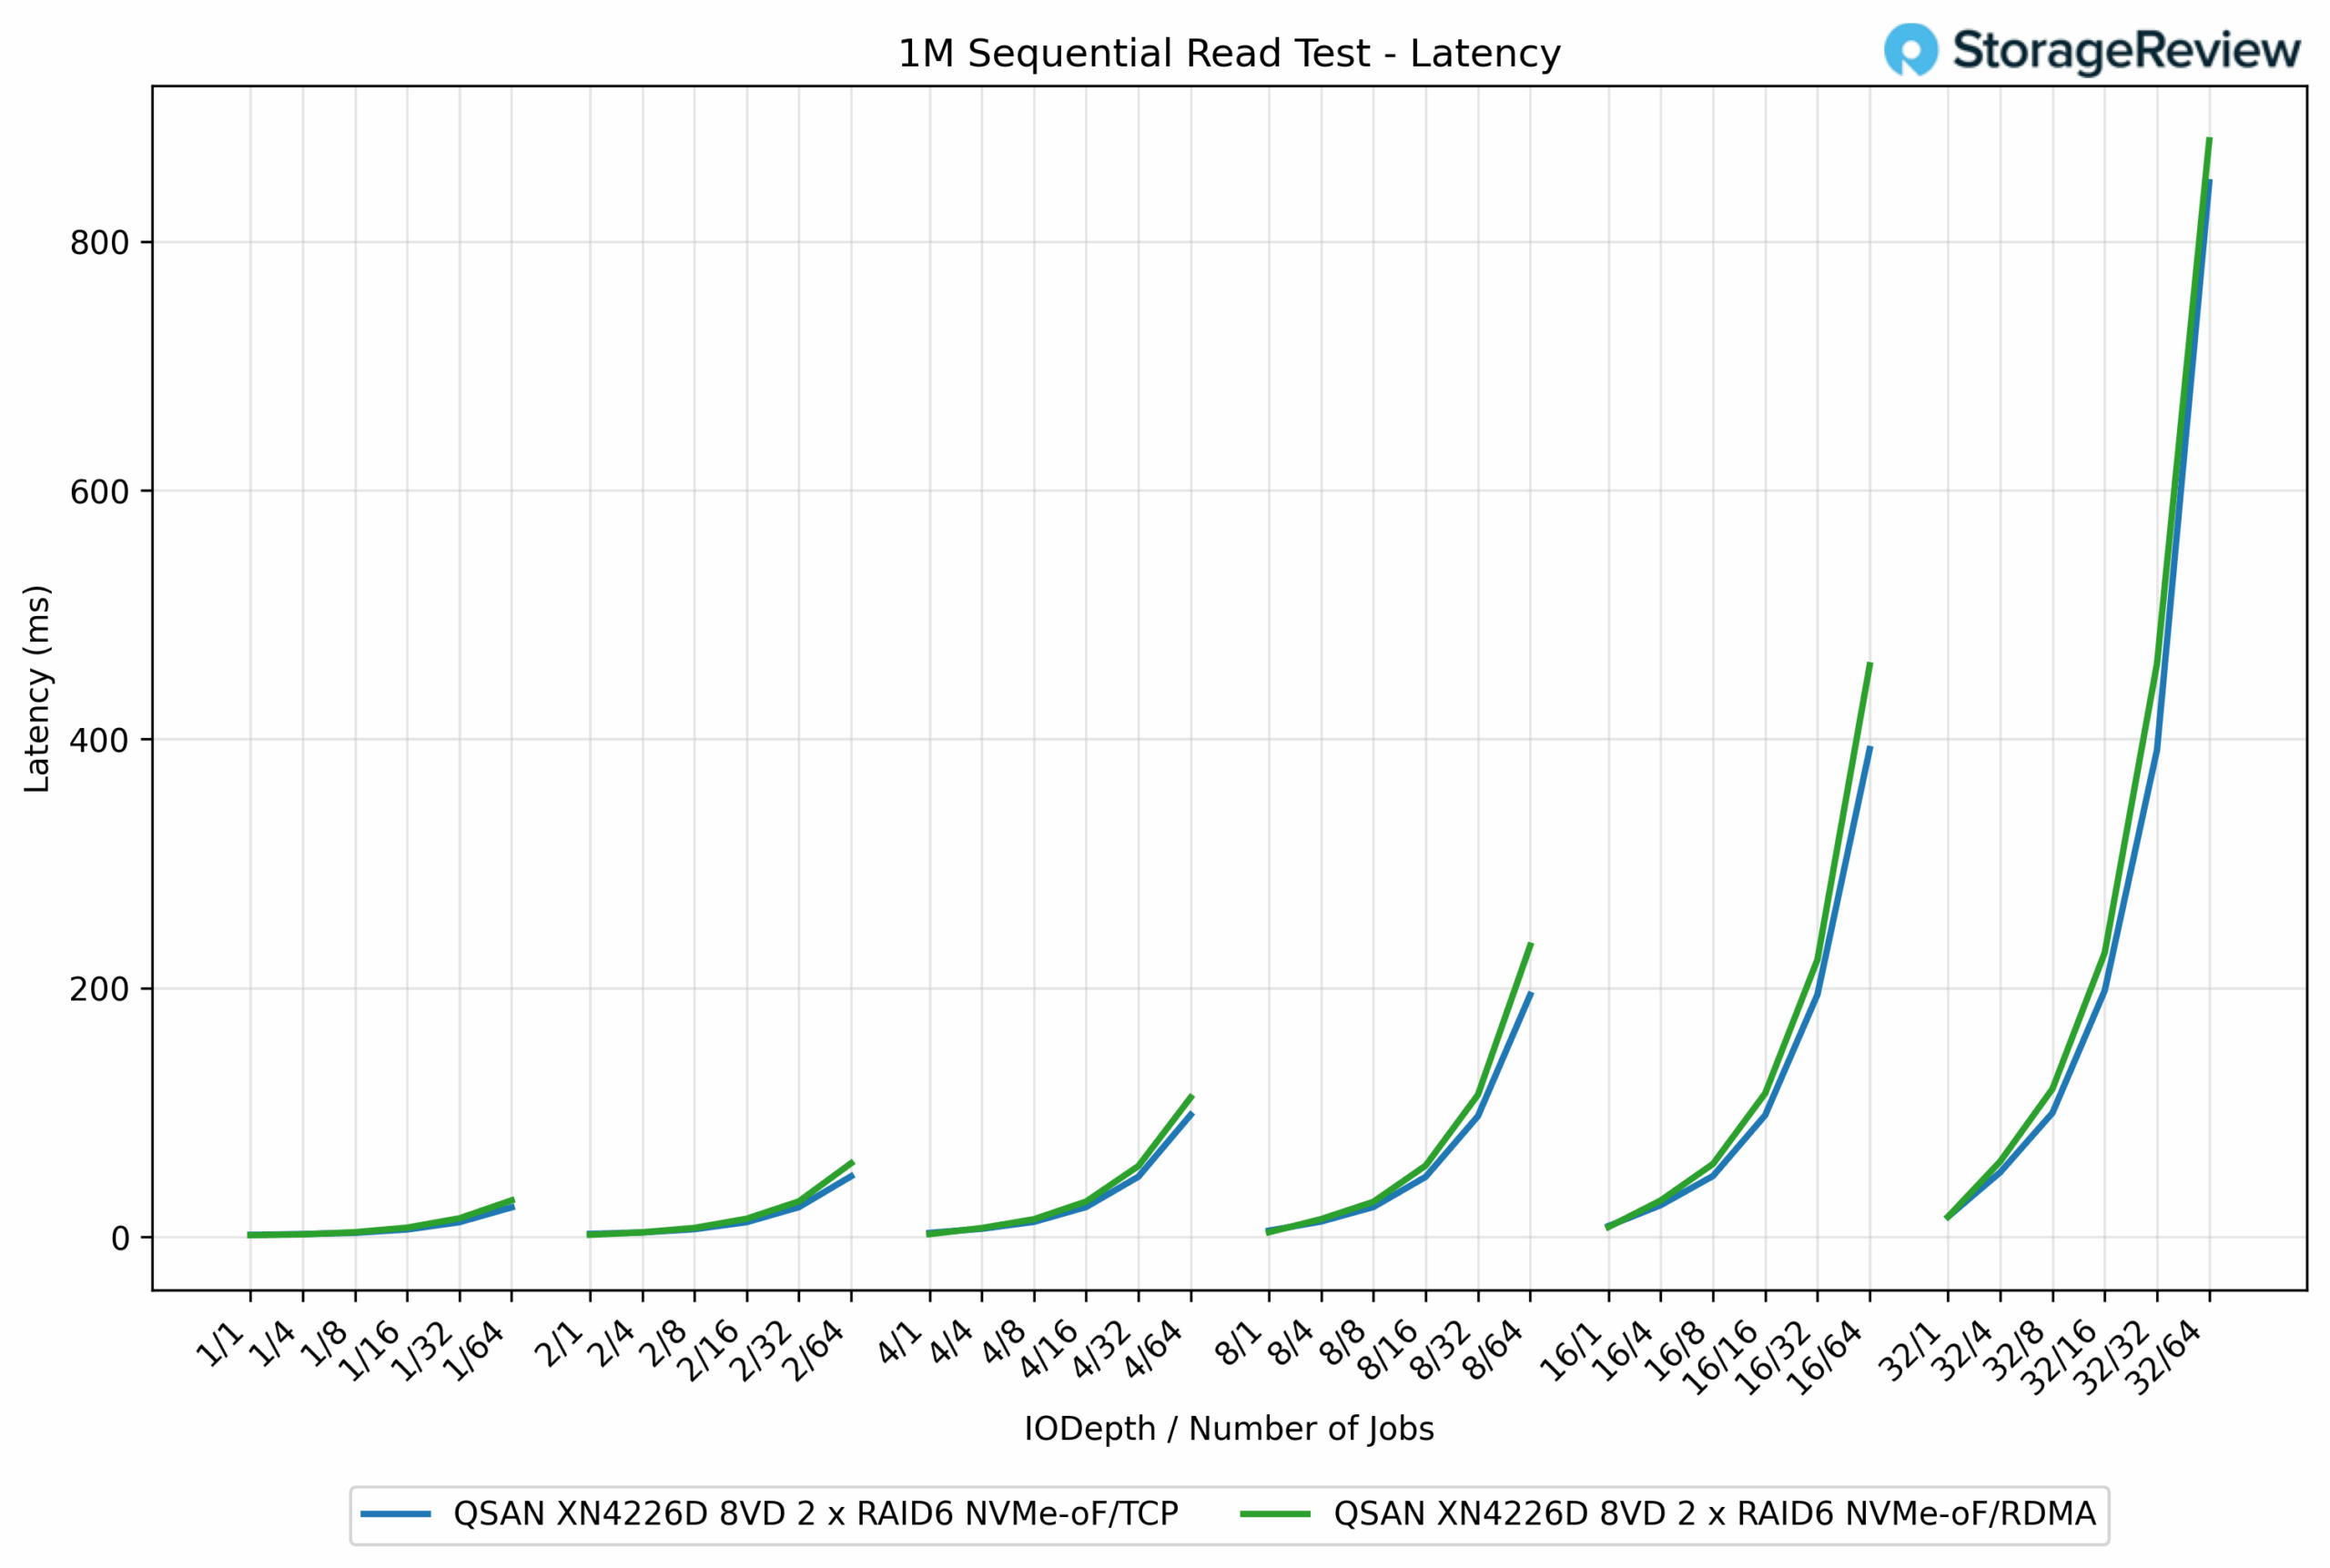
I latenstestet för 1M sekventiell läsning var resultaten närmare varandra mellan de två protokollen, även om RDMA generellt sett hade en liten fördel vid högre ködjup. Vid lättare arbetsbelastningar var latensprofilerna nästan identiska, båda låg under 5 ms tills samtidigheten började öka. Till exempel, vid QD8/64-jobb registrerade TCP 234.09 ms, medan RDMA låg lägre vid 194.54 ms, vilket återspeglar en minskning med 17 %.
Denna trend fortsatte vid tyngre belastningar. Vid QD32/64-jobb mättes RDMA till 847.59 ms, jämfört med TCP:s 881.31 ms, en mindre förbättring på 3.8 % men fortfarande i linje med RDMA:s lägre stackoverhead. Med det sagt skalade båda protokollen i ett liknande mönster, med latens som förutsägbart ökade i takt med att arbetsbelastningen intensifierades.
64k slumpmässiga skriv-IOPS
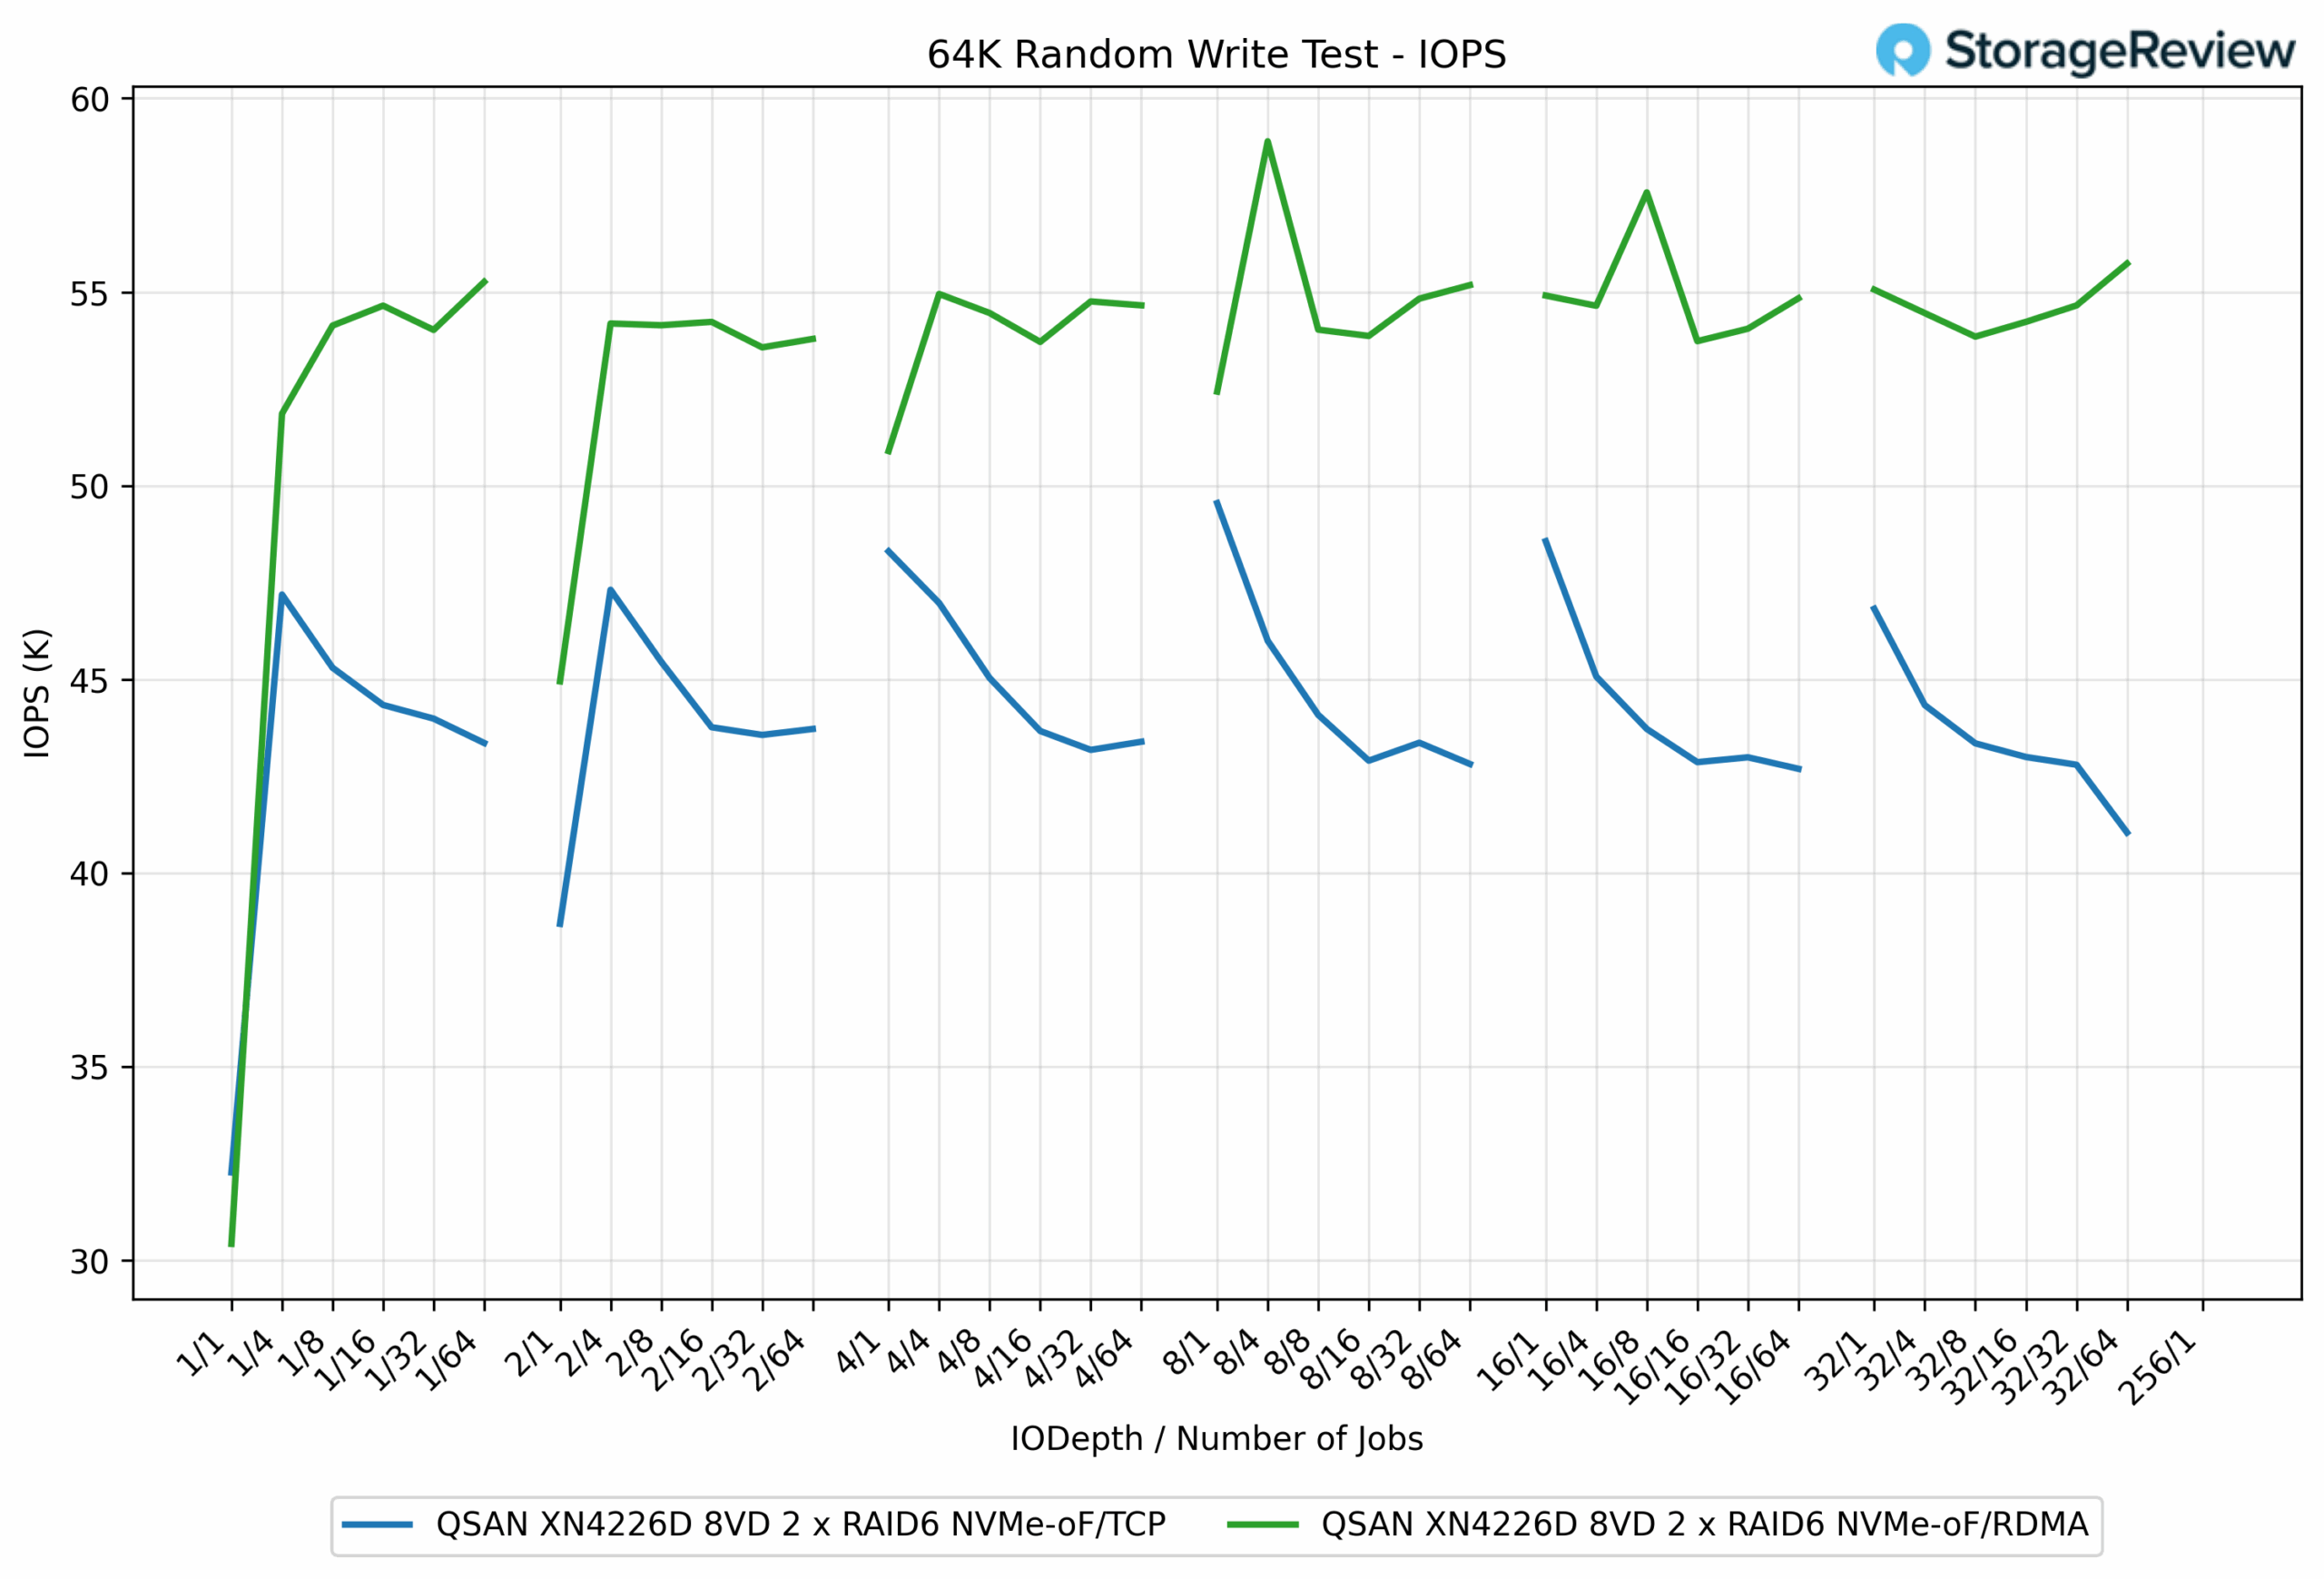
I 64K Random Write-testet levererade RDMA konsekvent högre IOPS än TCP, vilket visar dess effektivitet i hanteringen av parallella slumpmässiga operationer. Som mest nådde RDMA 58.89K IOPS, medan TCP låg efter på 48.57K IOPS, vilket innebär en prestandafördel på 21 %.
Skillnaden mellan de två protokollen fanns kvar under hela testet. Till exempel, vid QD1/16-jobb, publicerade RDMA 54.13 000 IOPS, jämfört med TCP:s 45.30 000 IOPS, en skillnad på nästan 16 %. Allt eftersom arbetsbelastningen skalades upp bibehöll RDMA resultaten i intervallet 53 000 till 55 000 IOPS, medan TCP bibehöll ett intervall på 42 000 till 46 000 IOPS.
64K slumpmässig skrivlatens
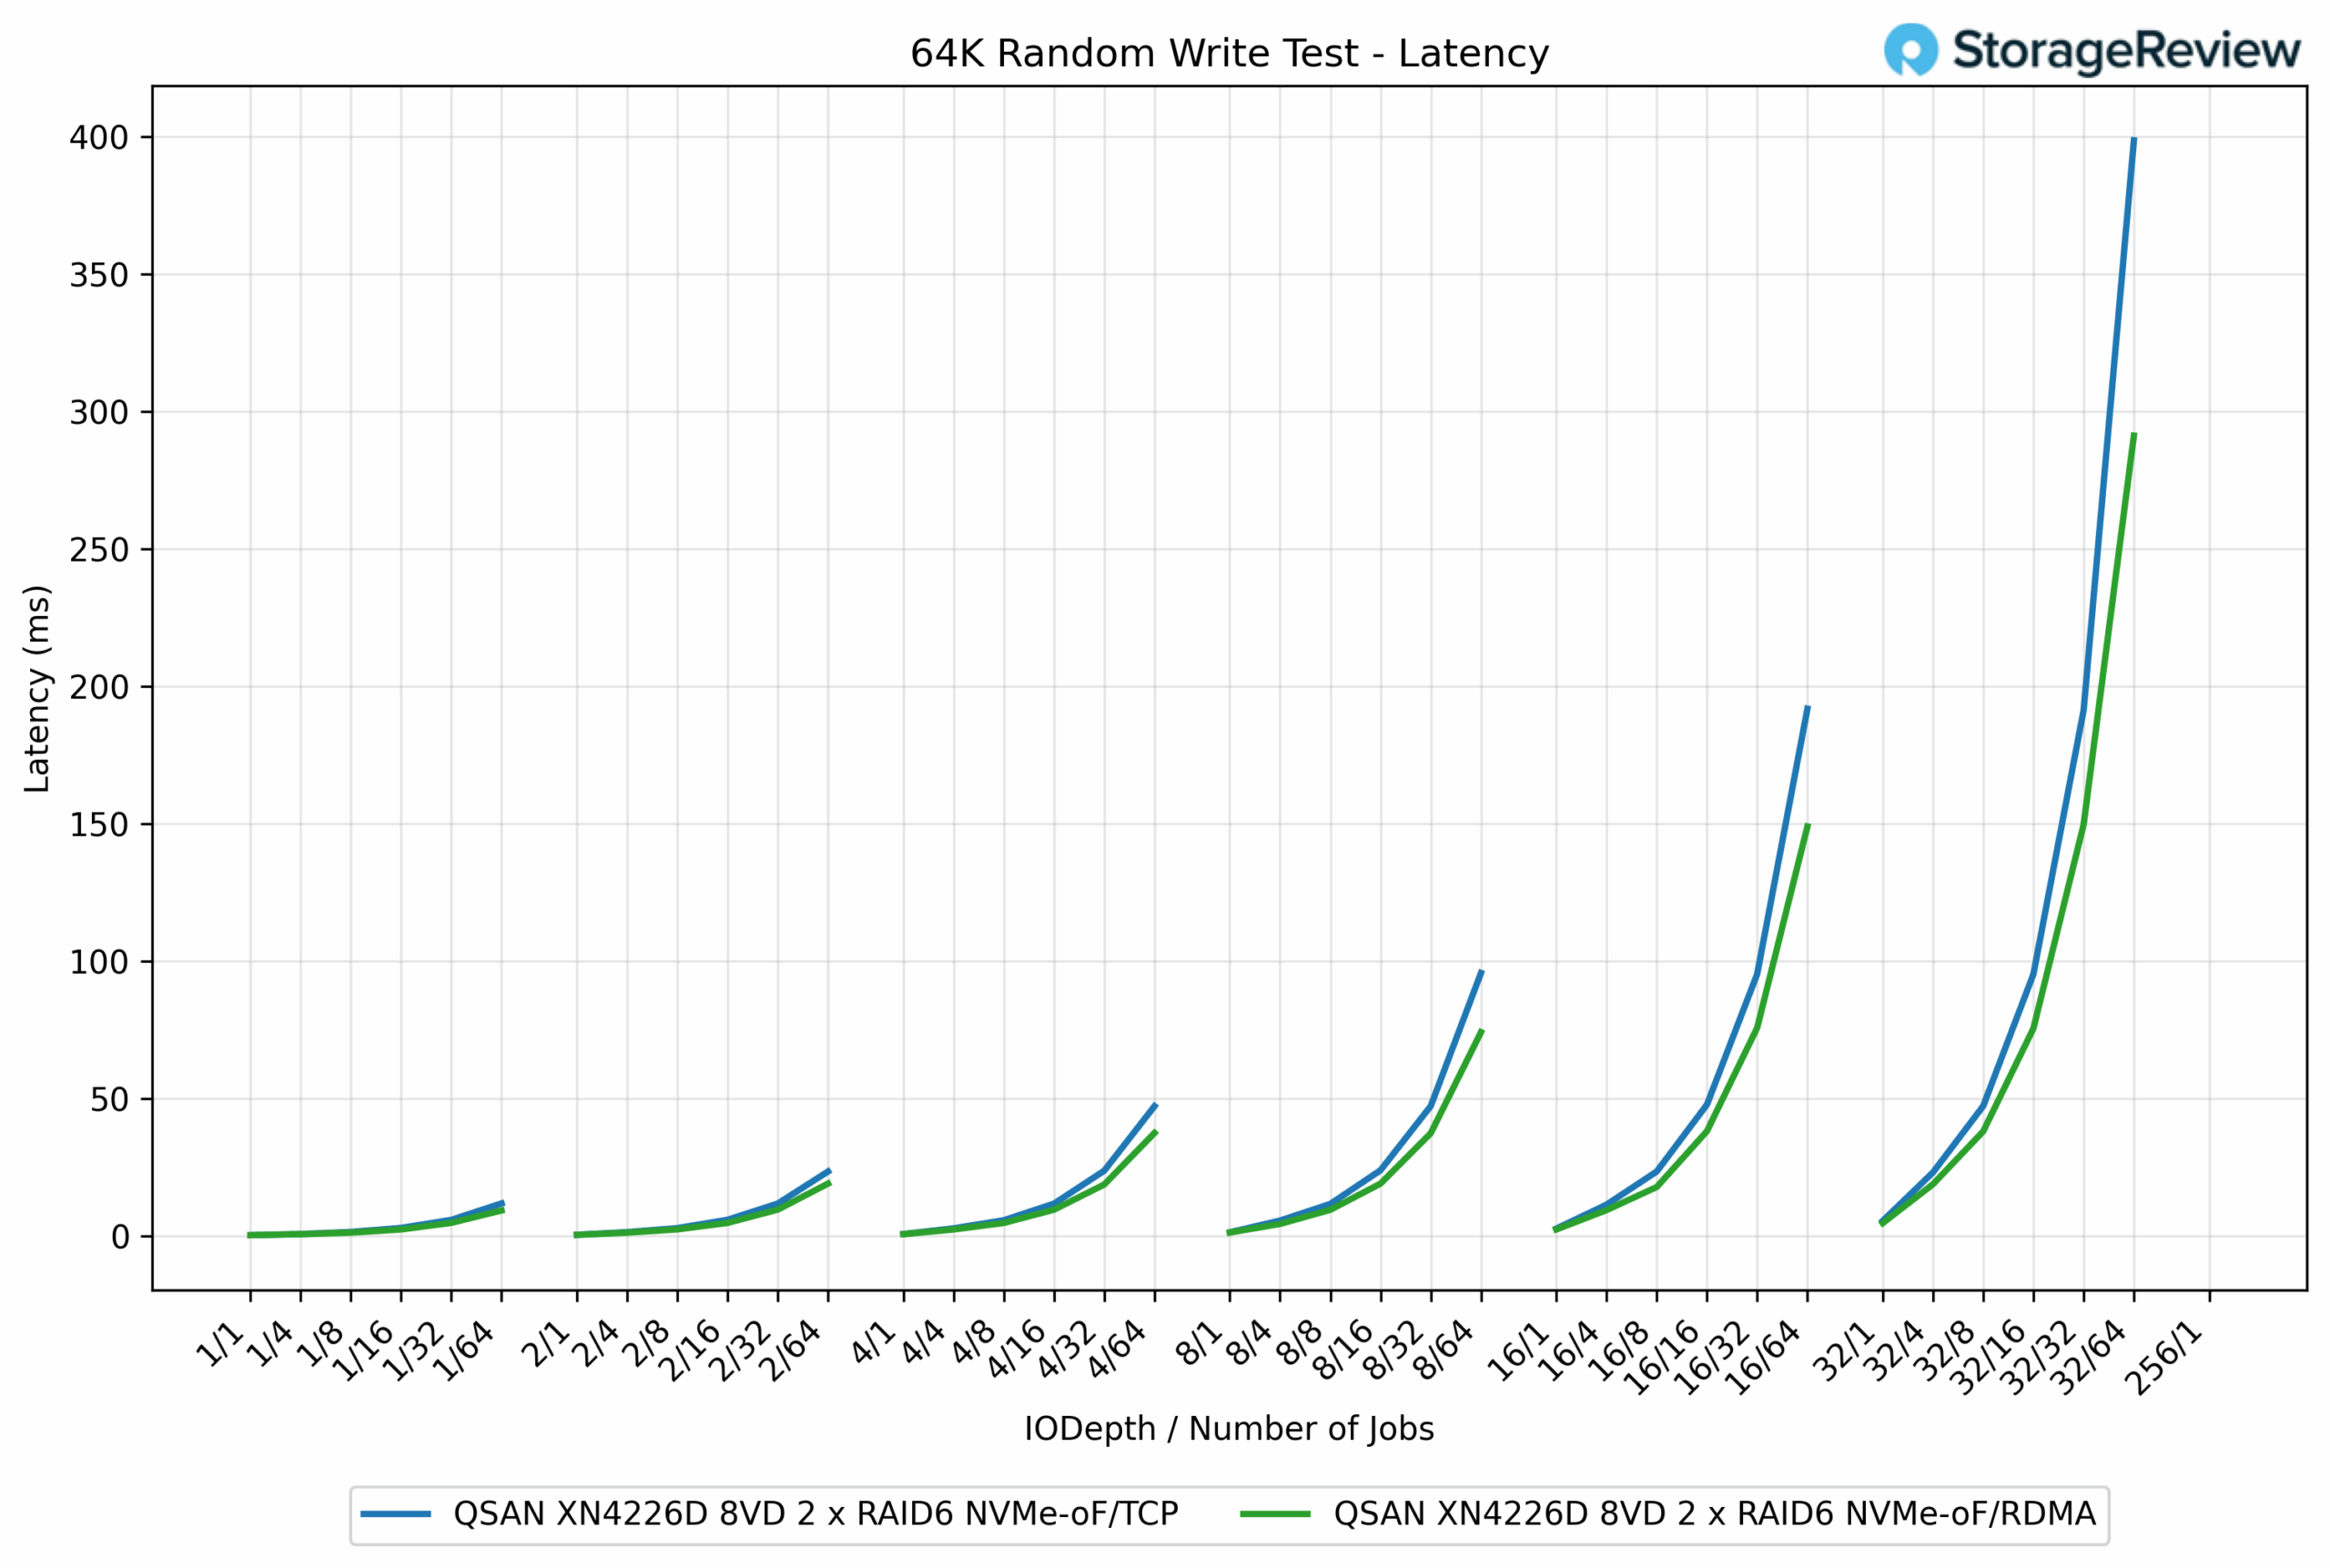
I 64K Random Write-latenstestet uppvisade RDMA återigen lägre svarstider jämfört med TCP, särskilt i takt med att ködjupet och antalet jobb ökade. Vid lägre belastningar presterade båda protokollen nästan identiskt och höll sig under 1 ms. Till exempel, vid QD1/1-jobbet mättes TCP till 0.26 ms, medan RDMA i princip var densamma vid 0.25 ms.
Allt eftersom arbetsbelastningen ökade behöll dock RDMA sin effektivitetsfördel. Vid QD16/64-jobb registrerade RDMA 74.09 ms, jämfört med TCP:s 95.64 ms, en skillnad på ungefär 23 %. Skillnaden ökade ytterligare under maximal belastning vid QD256/1-jobbet, där RDMA registrerade 291.13 ms, medan TCP steg till 398.56 ms, nästan 37 % högre.
64K Random Read IOPS
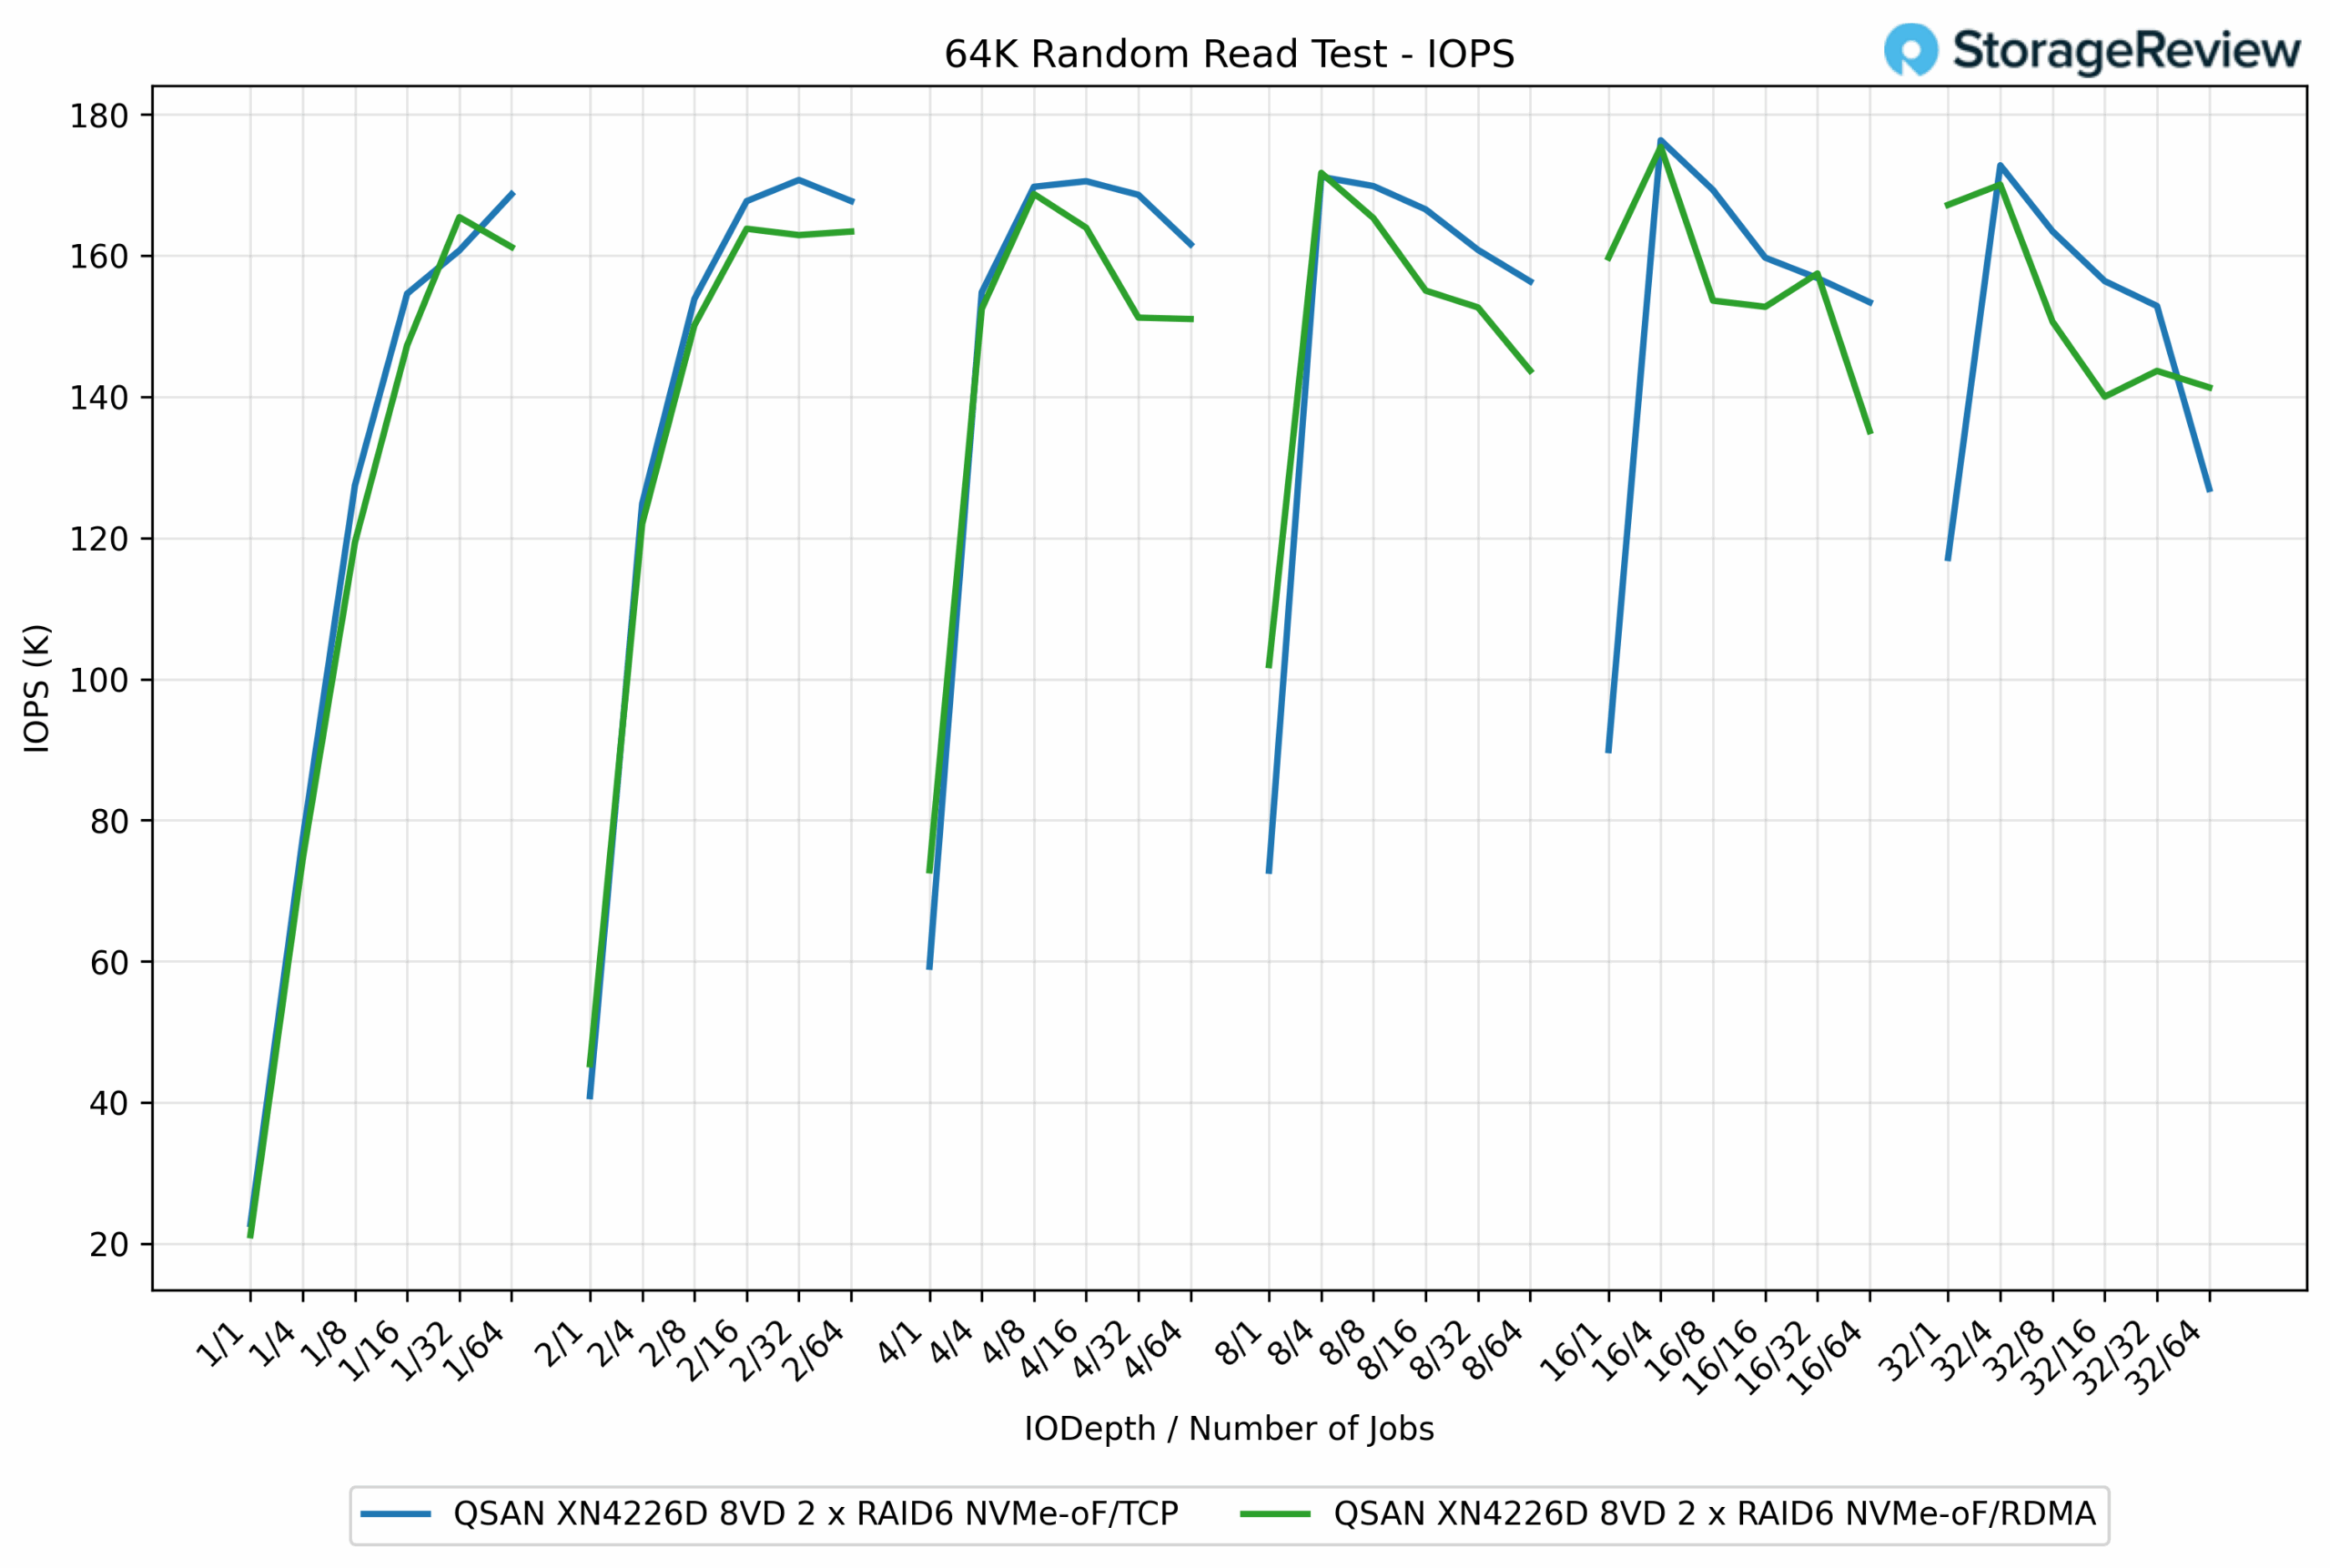
I 64K Random Read-testet levererade TCP och RDMA mycket liknande prestanda totalt sett, med en något förskjutning mellan de två protokollen beroende på arbetsbelastningen. TCP uppnådde en topp på 176.33K IOPS, medan RDMA låg tätt efter med 175.40K IOPS, vilket bara visade en skillnad på 0.5 %.
På måttliga djup förblev resultaten tätt grupperade. Till exempel, vid QD4/16-jobb, publicerade TCP 168.60K IOPS, medan RDMA följde med 163.94K IOPS, en skillnad på mindre än 2.8%. På andra punkter steg RDMA något, såsom vid QD8/1-jobb, där det nådde 171.71K IOPS jämfört med TCP:s 171.15K IOPS, i princip oavgjort.
64K slumpmässig läsfördröjning
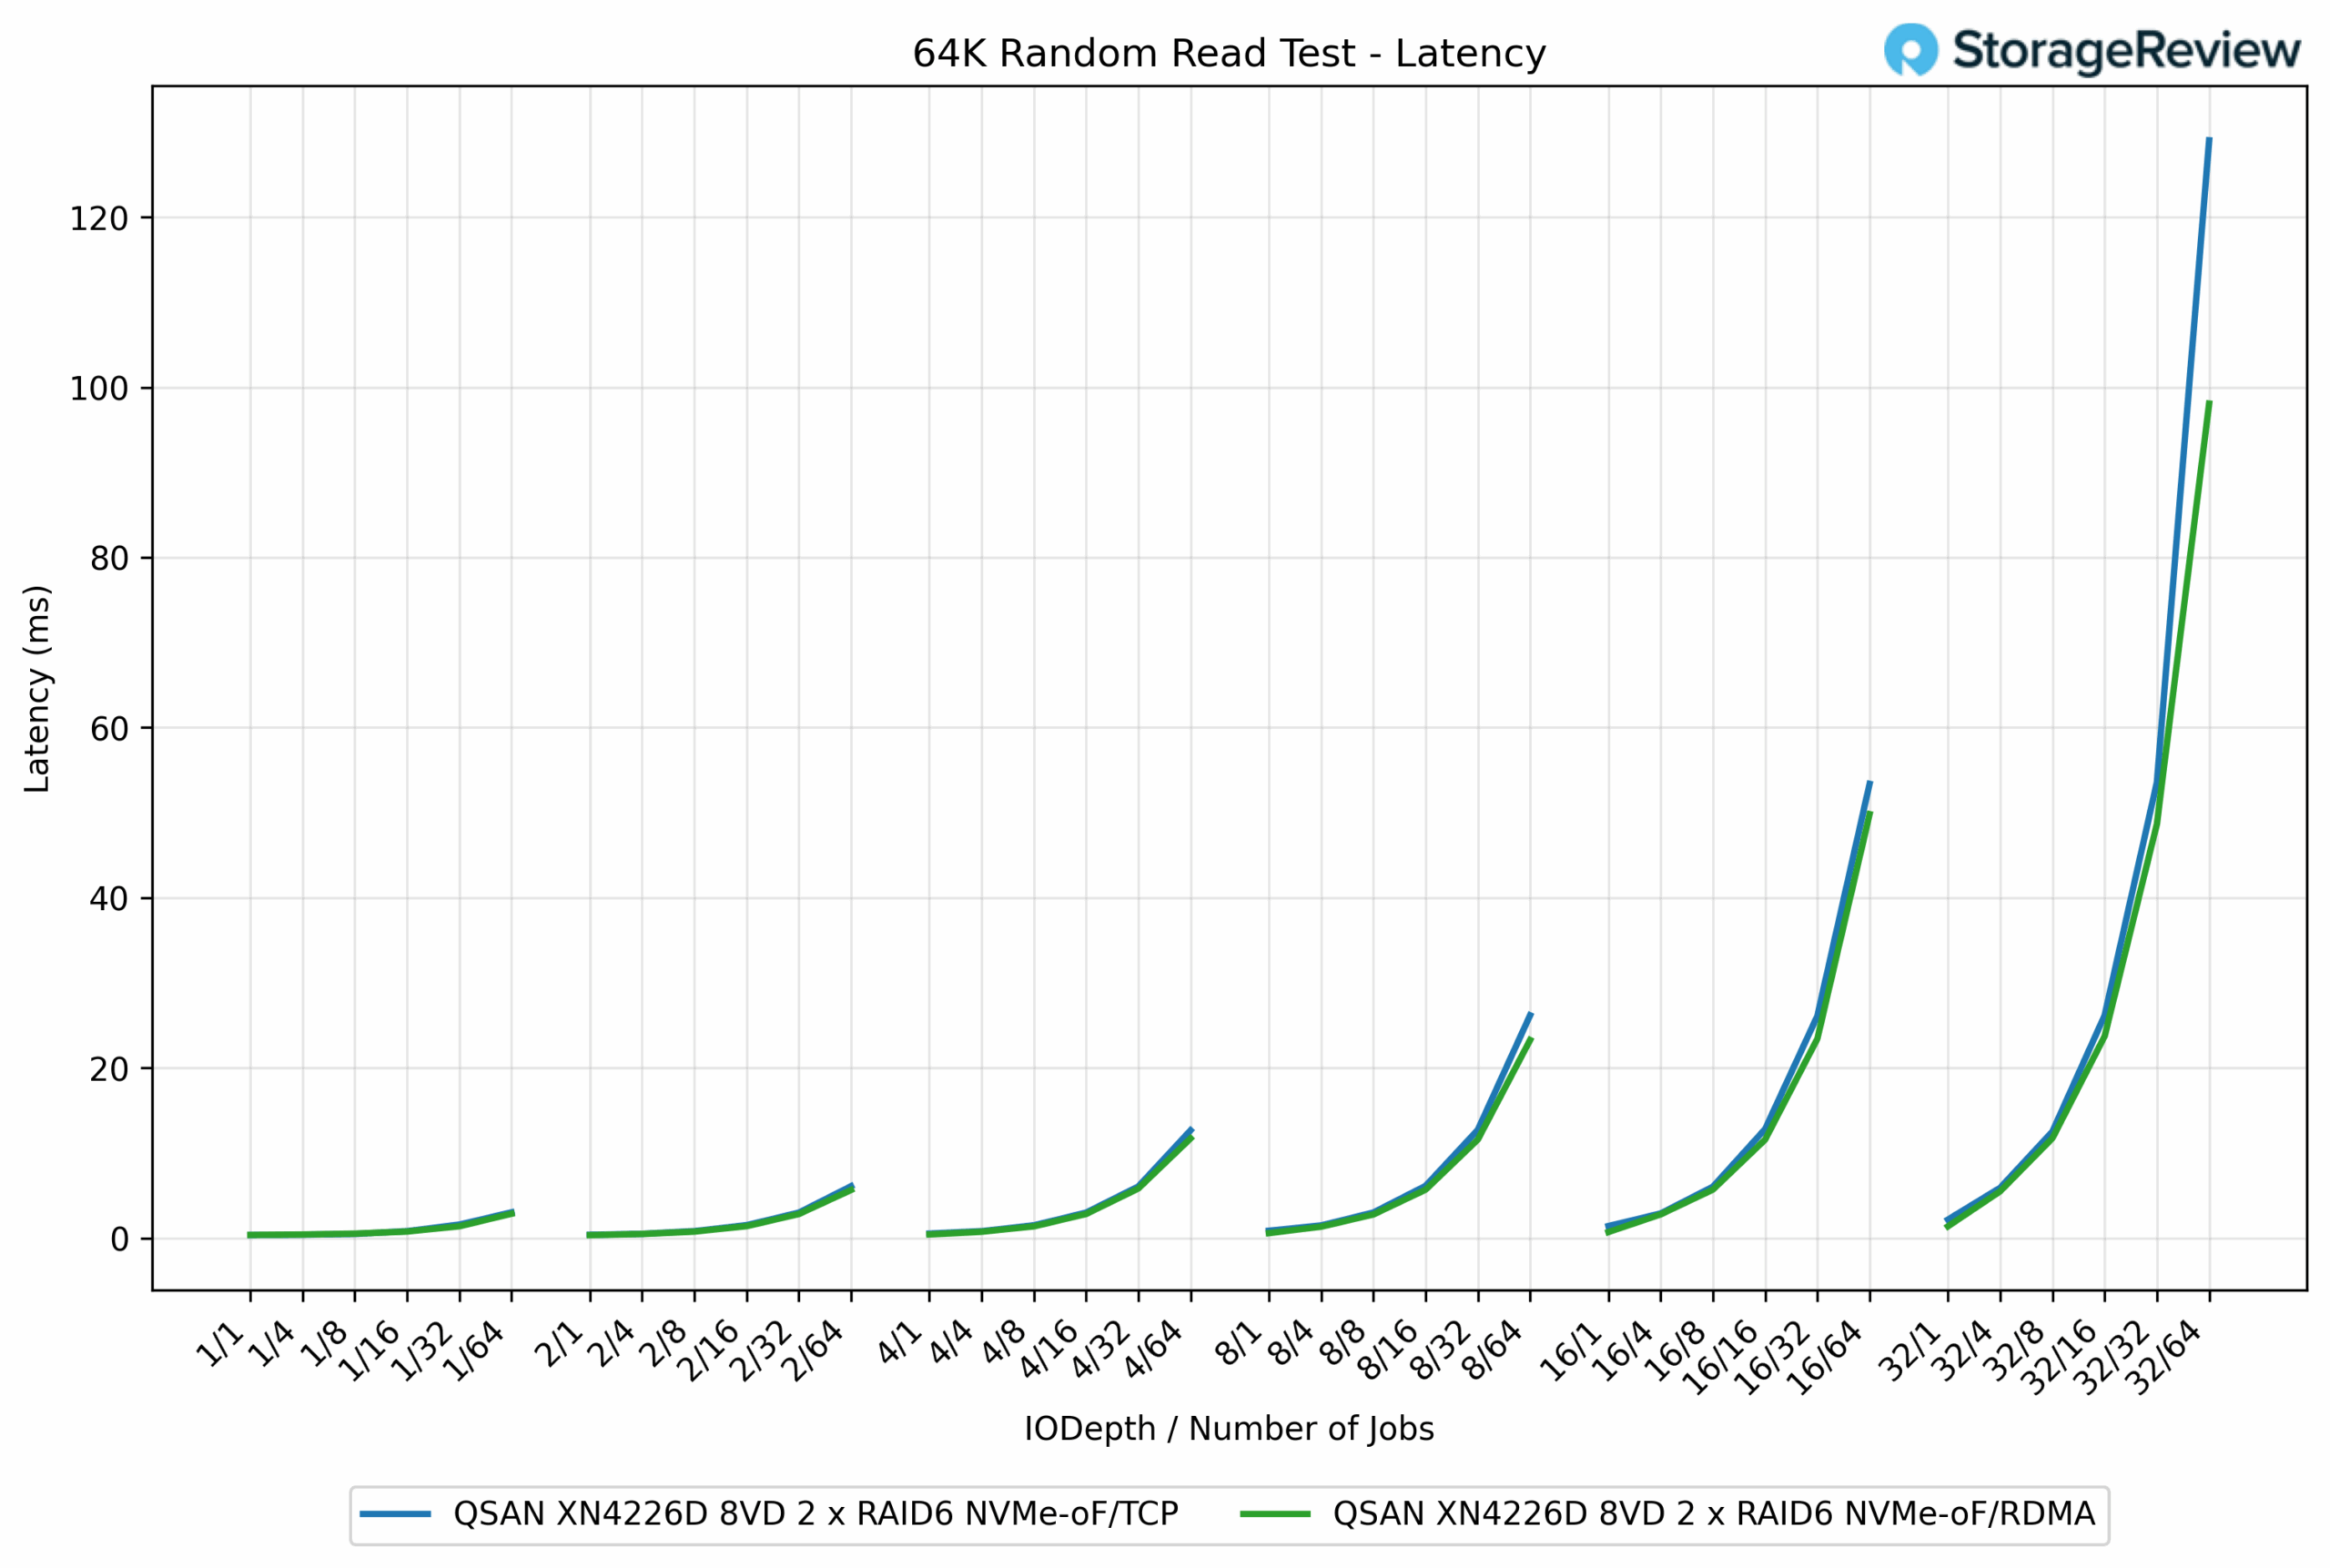
I latenstestet för 64K slumpmässig läsning låg de två protokollen mycket nära varandra, även om RDMA visade en blygsam fördel under högre belastning. Vid lätta arbetsbelastningar levererade både TCP och RDMA latenser under 1 ms, i princip oskiljbara. Till exempel, vid QD1/1-jobbet mättes TCP 0.43 ms jämfört med RDMA:s 0.38 ms.
Allt eftersom samtidigheten ökade blev skillnaden mer märkbar. Vid QD16/64-jobb hade RDMA 23.28 ms, medan TCP registrerade 26.19 ms, en förbättring med 12 %. Spridningen ökade under maximal stress, där RDMA låg på 98.08 ms jämfört med TCP:s 129.02 ms, en minskning med 24 %.
16K Random Write IOPS
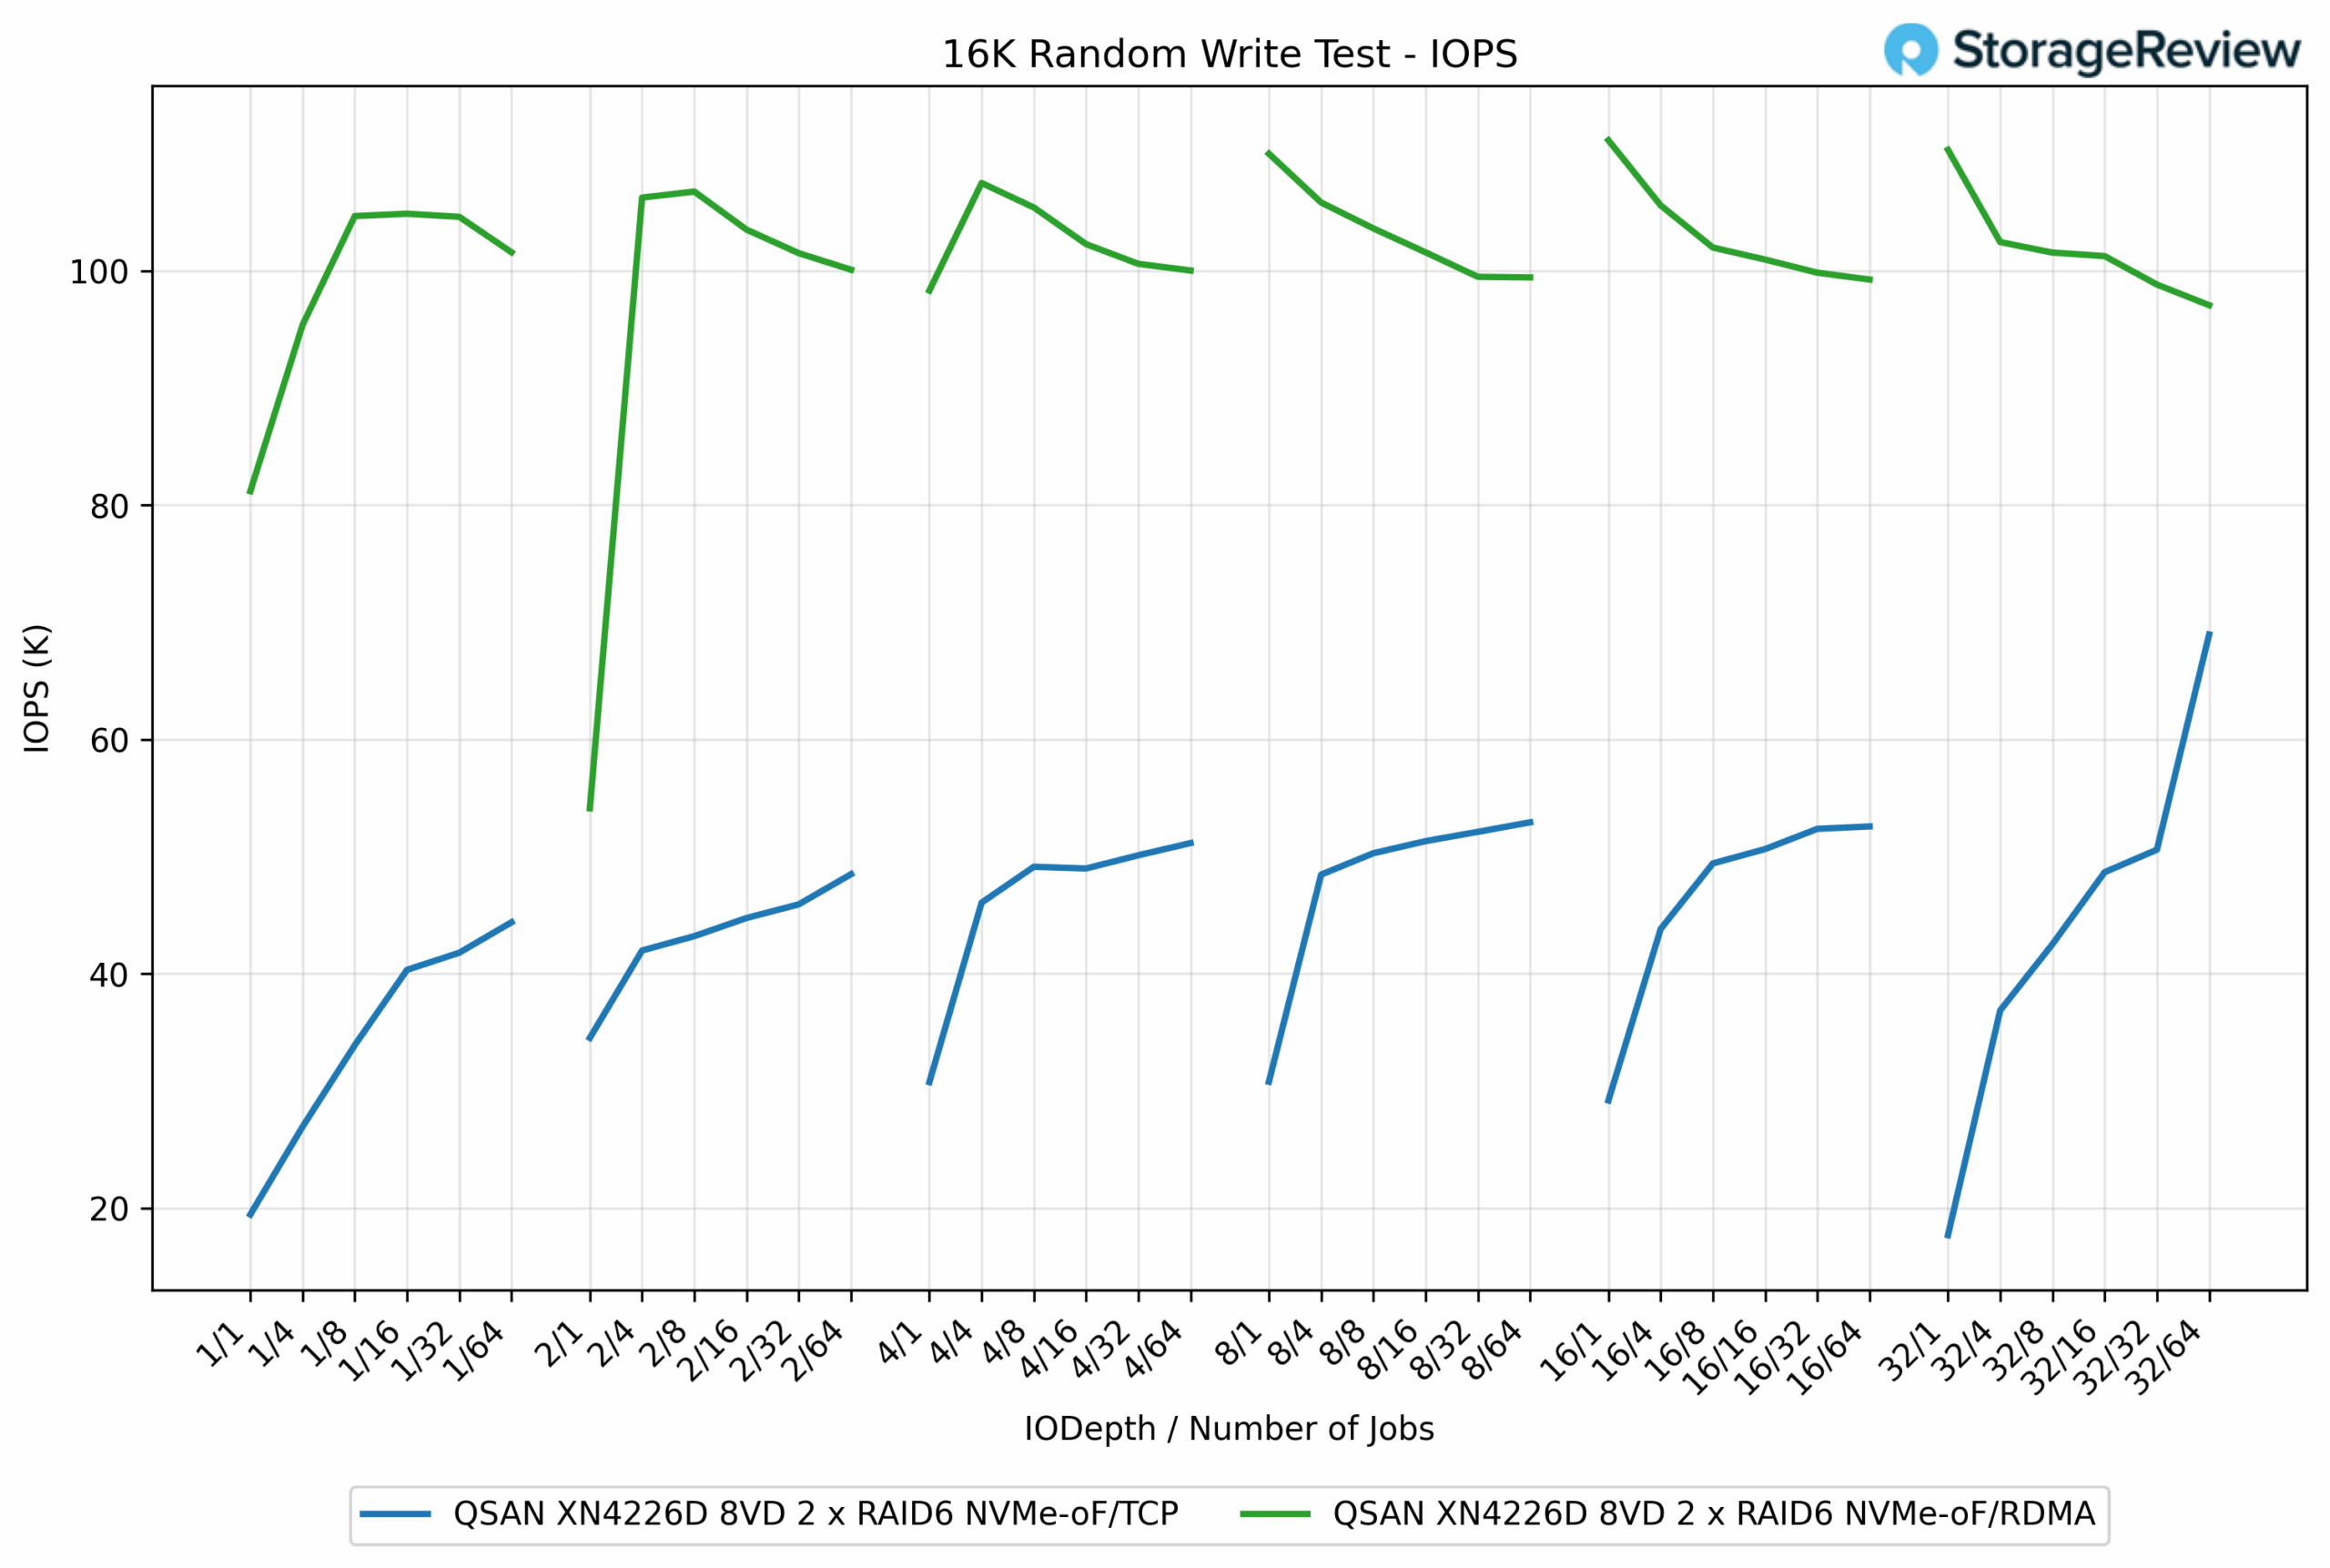
I 16K Random Write-testet var prestandaskillnaden mellan de två protokollen betydande, där RDMA levererade mer än dubbelt så många IOPS som TCP i de flesta fall. RDMA nådde sin topp på 111.13K IOPS, medan TCP nådde sin topp på 68.95K IOPS, vilket återspeglar en fördel på 61 % för RDMA.
Vid lägre ködjup var skillnaden tydlig. Till exempel, vid QD1/16-jobb, mätte RDMA 104.86K IOPS, jämfört med TCP:s 41.78K IOPS, vilket motsvarar en ökning med 151 % till förmån för RDMA. Över hela arbetsbelastningsintervallet bibehöll RDMA konsekvent resultaten i intervallet 100K till 111K IOPS, medan TCP generellt sett låg kvar i intervallet 40K till 50K IOPS, förutom en sen ökning vid maximalt djup.
16K slumpmässig skrivlatens
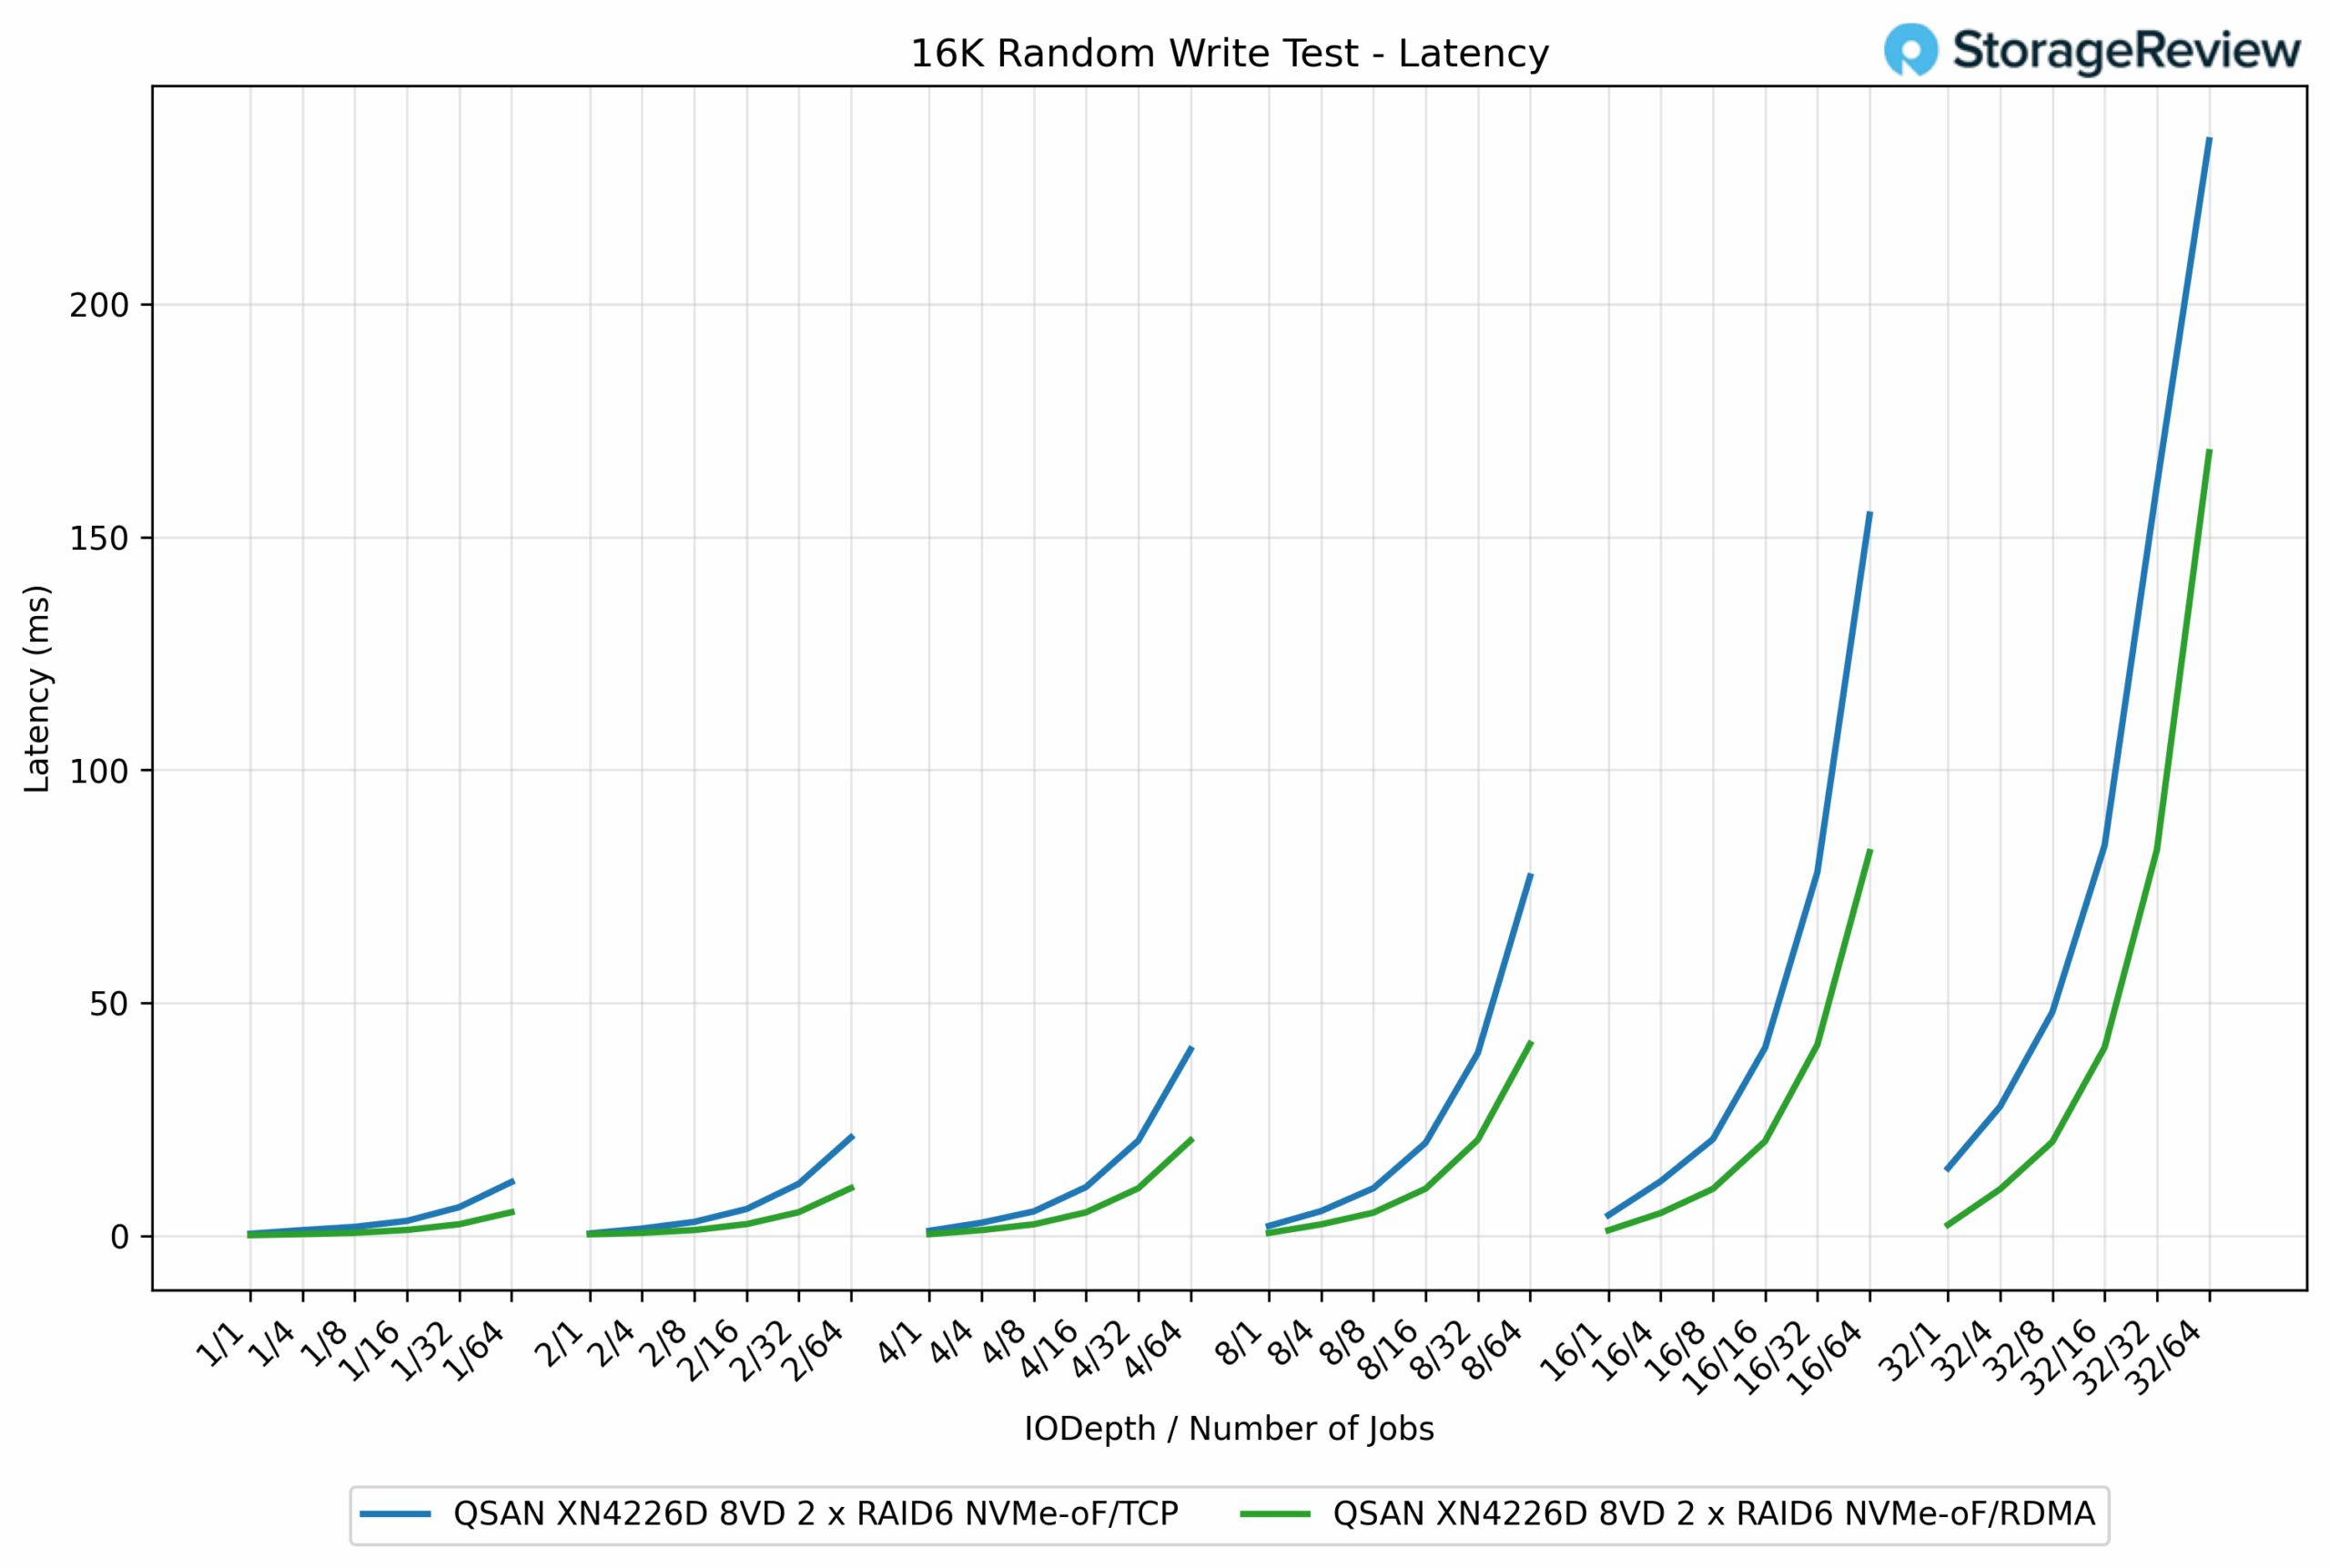
I 16K Random Write-latenstestet behöll RDMA återigen en tydlig fördel jämfört med TCP när arbetsbelastningarna skalades. Vid lättare belastningar var båda protokollen nästan identiska, med svarstider under 2 ms. Till exempel, vid QD1/1-jobbet mättes TCP till 0.40 ms jämfört med RDMA:s 0.41 ms.
Allt eftersom samtidigheten ökade började RDMA separeras. Vid QD16/64-jobb registrerade RDMA 21.15 ms, medan TCP låg på 77.12 ms, en dramatisk minskning med 72 %. Denna fördel kvarstod på de högsta djupen. Vid QD32/64-jobb slutfördes RDMA på 161.13 ms, jämfört med TCP:s 235.17 ms, vilket motsvarar en förbättring med 31 %.
16K Random Read IOPS
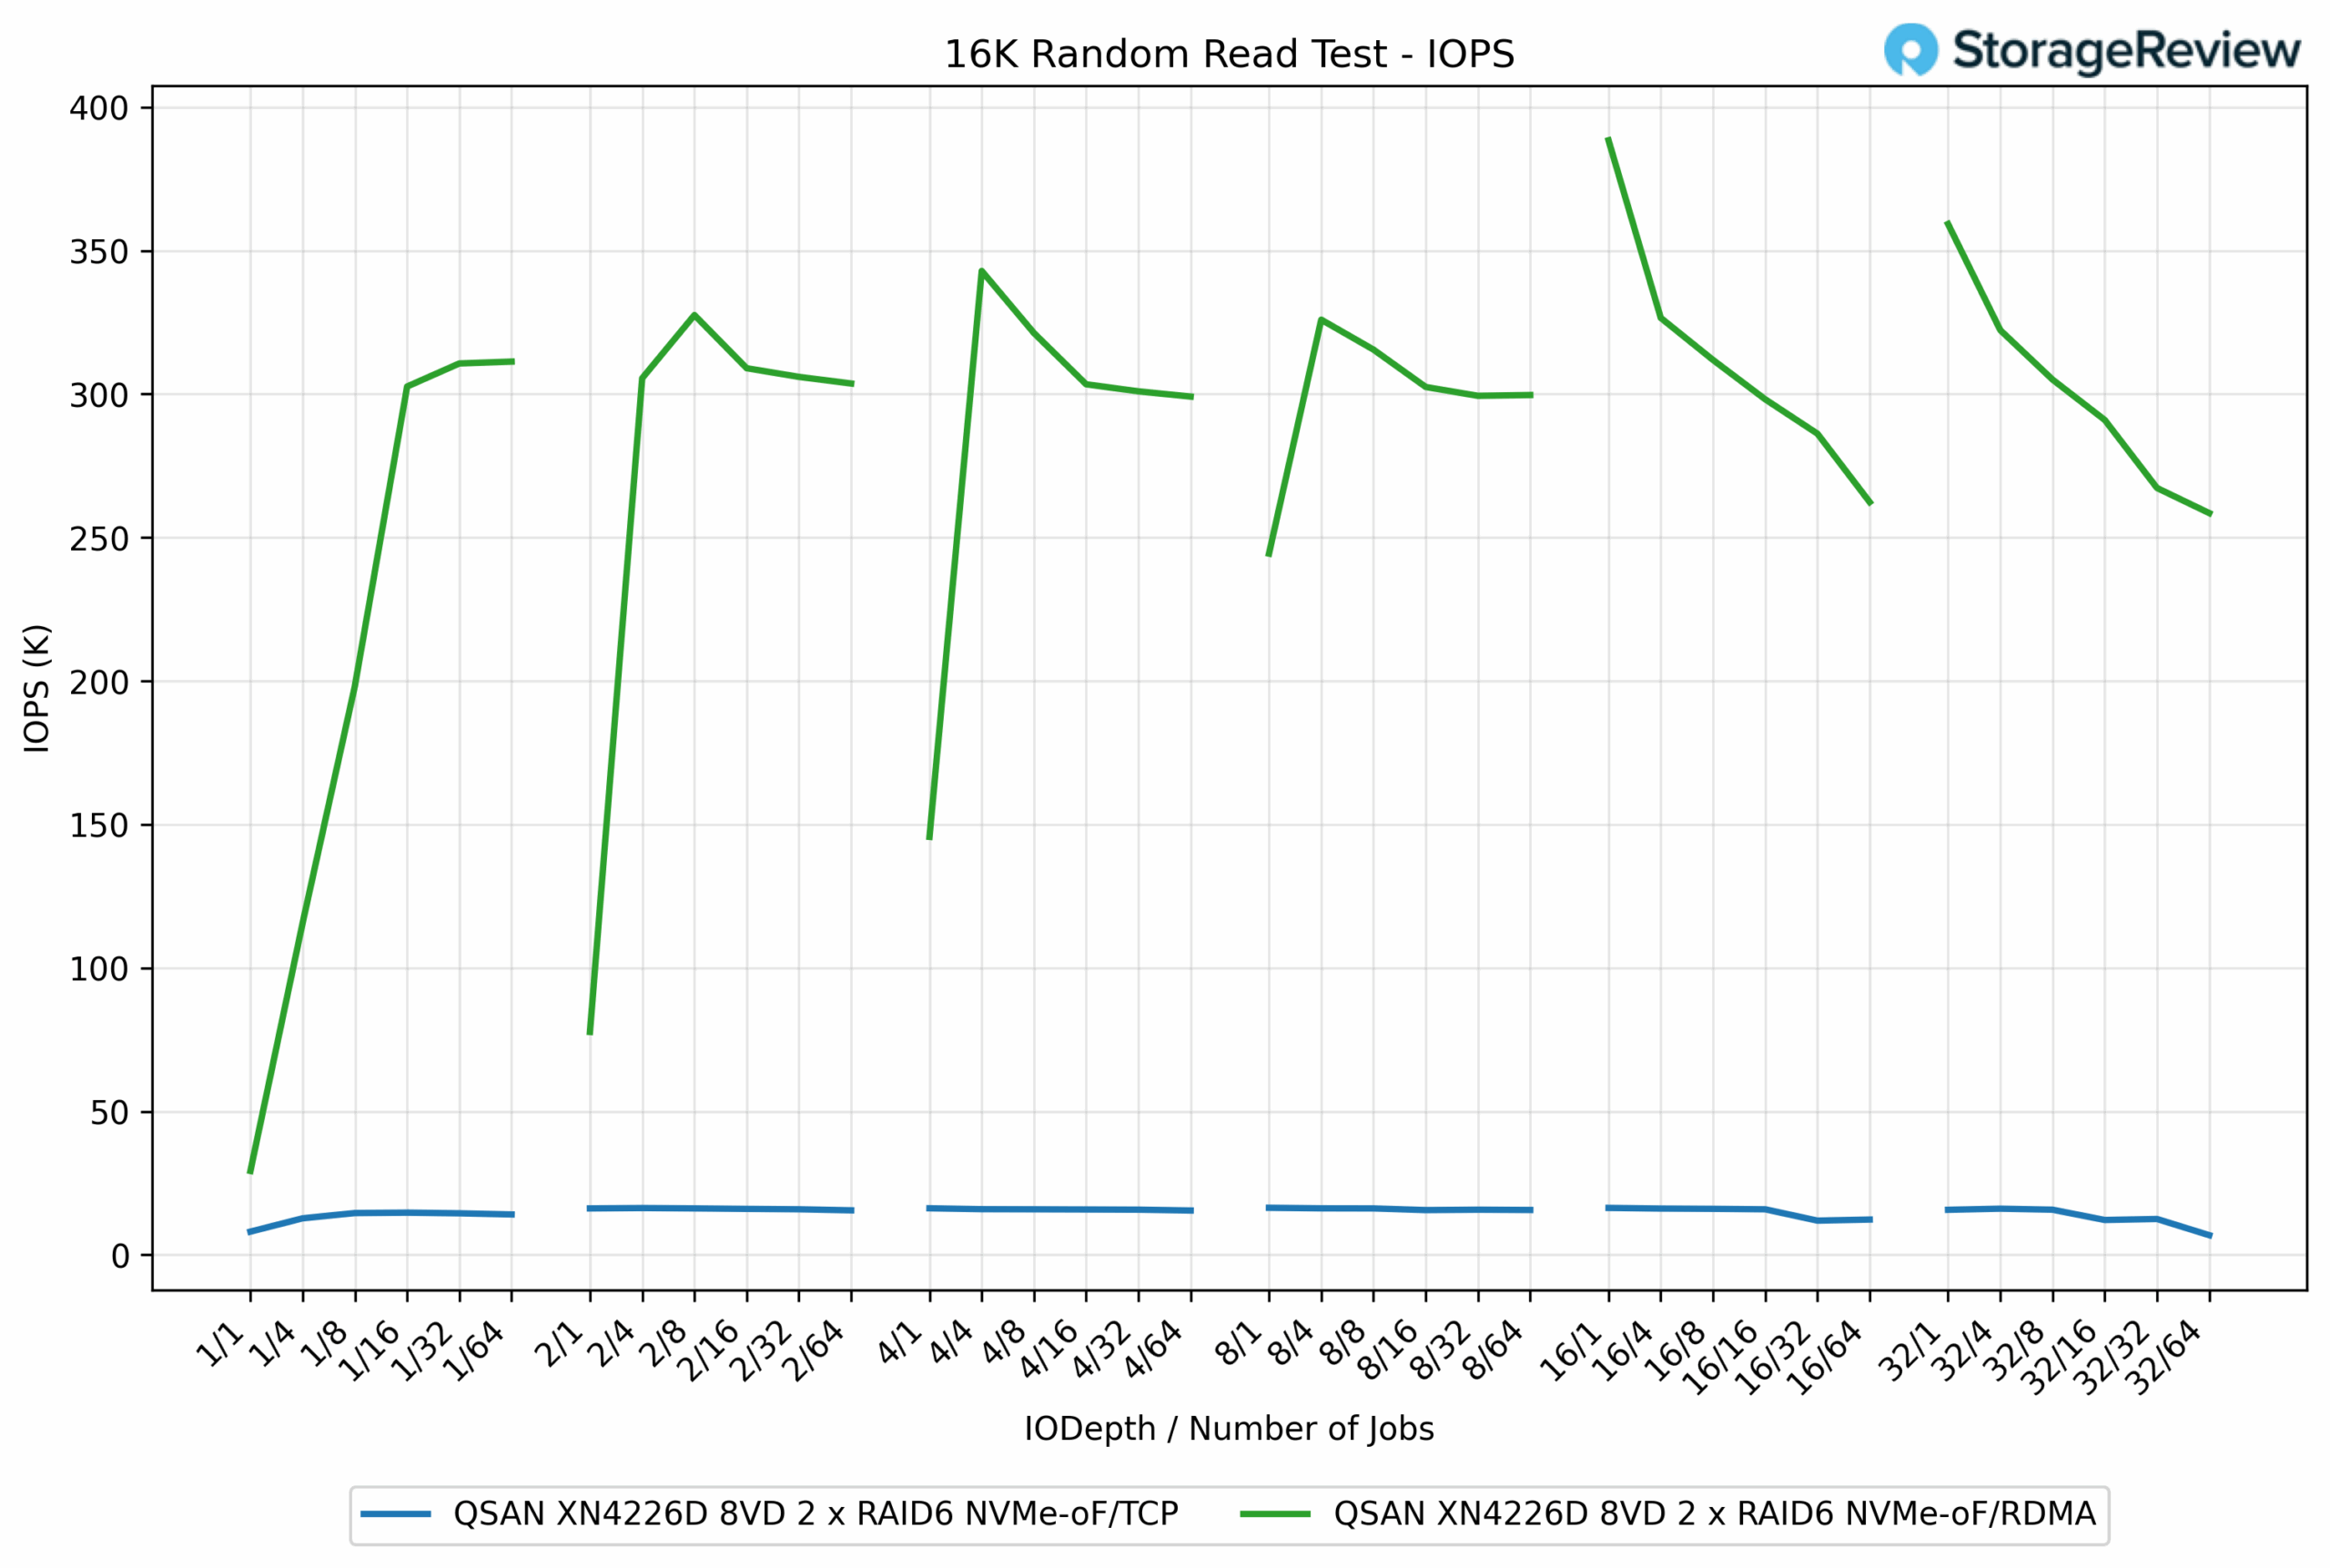
I 16K Random Read-testet överträffade RDMA TCP fullständigt över hela arbetsbelastningsområdet. RDMA uppnådde en topp på 388.44K IOPS, medan TCP toppade på bara 16.42K IOPS, vilket visar en fördel på mer än 23 gånger för RDMA.
Skillnaden var synlig från allra första början. Vid QD1/1-jobbet levererade RDMA 29.27 000 IOPS, medan TCP bara hanterade 8.10 000 IOPS. Allt eftersom samtidigheten ökade skalade RDMA snabbt upp till intervallet 300 000 till 380 000 IOPS, medan TCP låg stabilt runt 15 000 till 16 000 IOPS, även vid högre ködjup.
16K slumpmässig läsningslatens
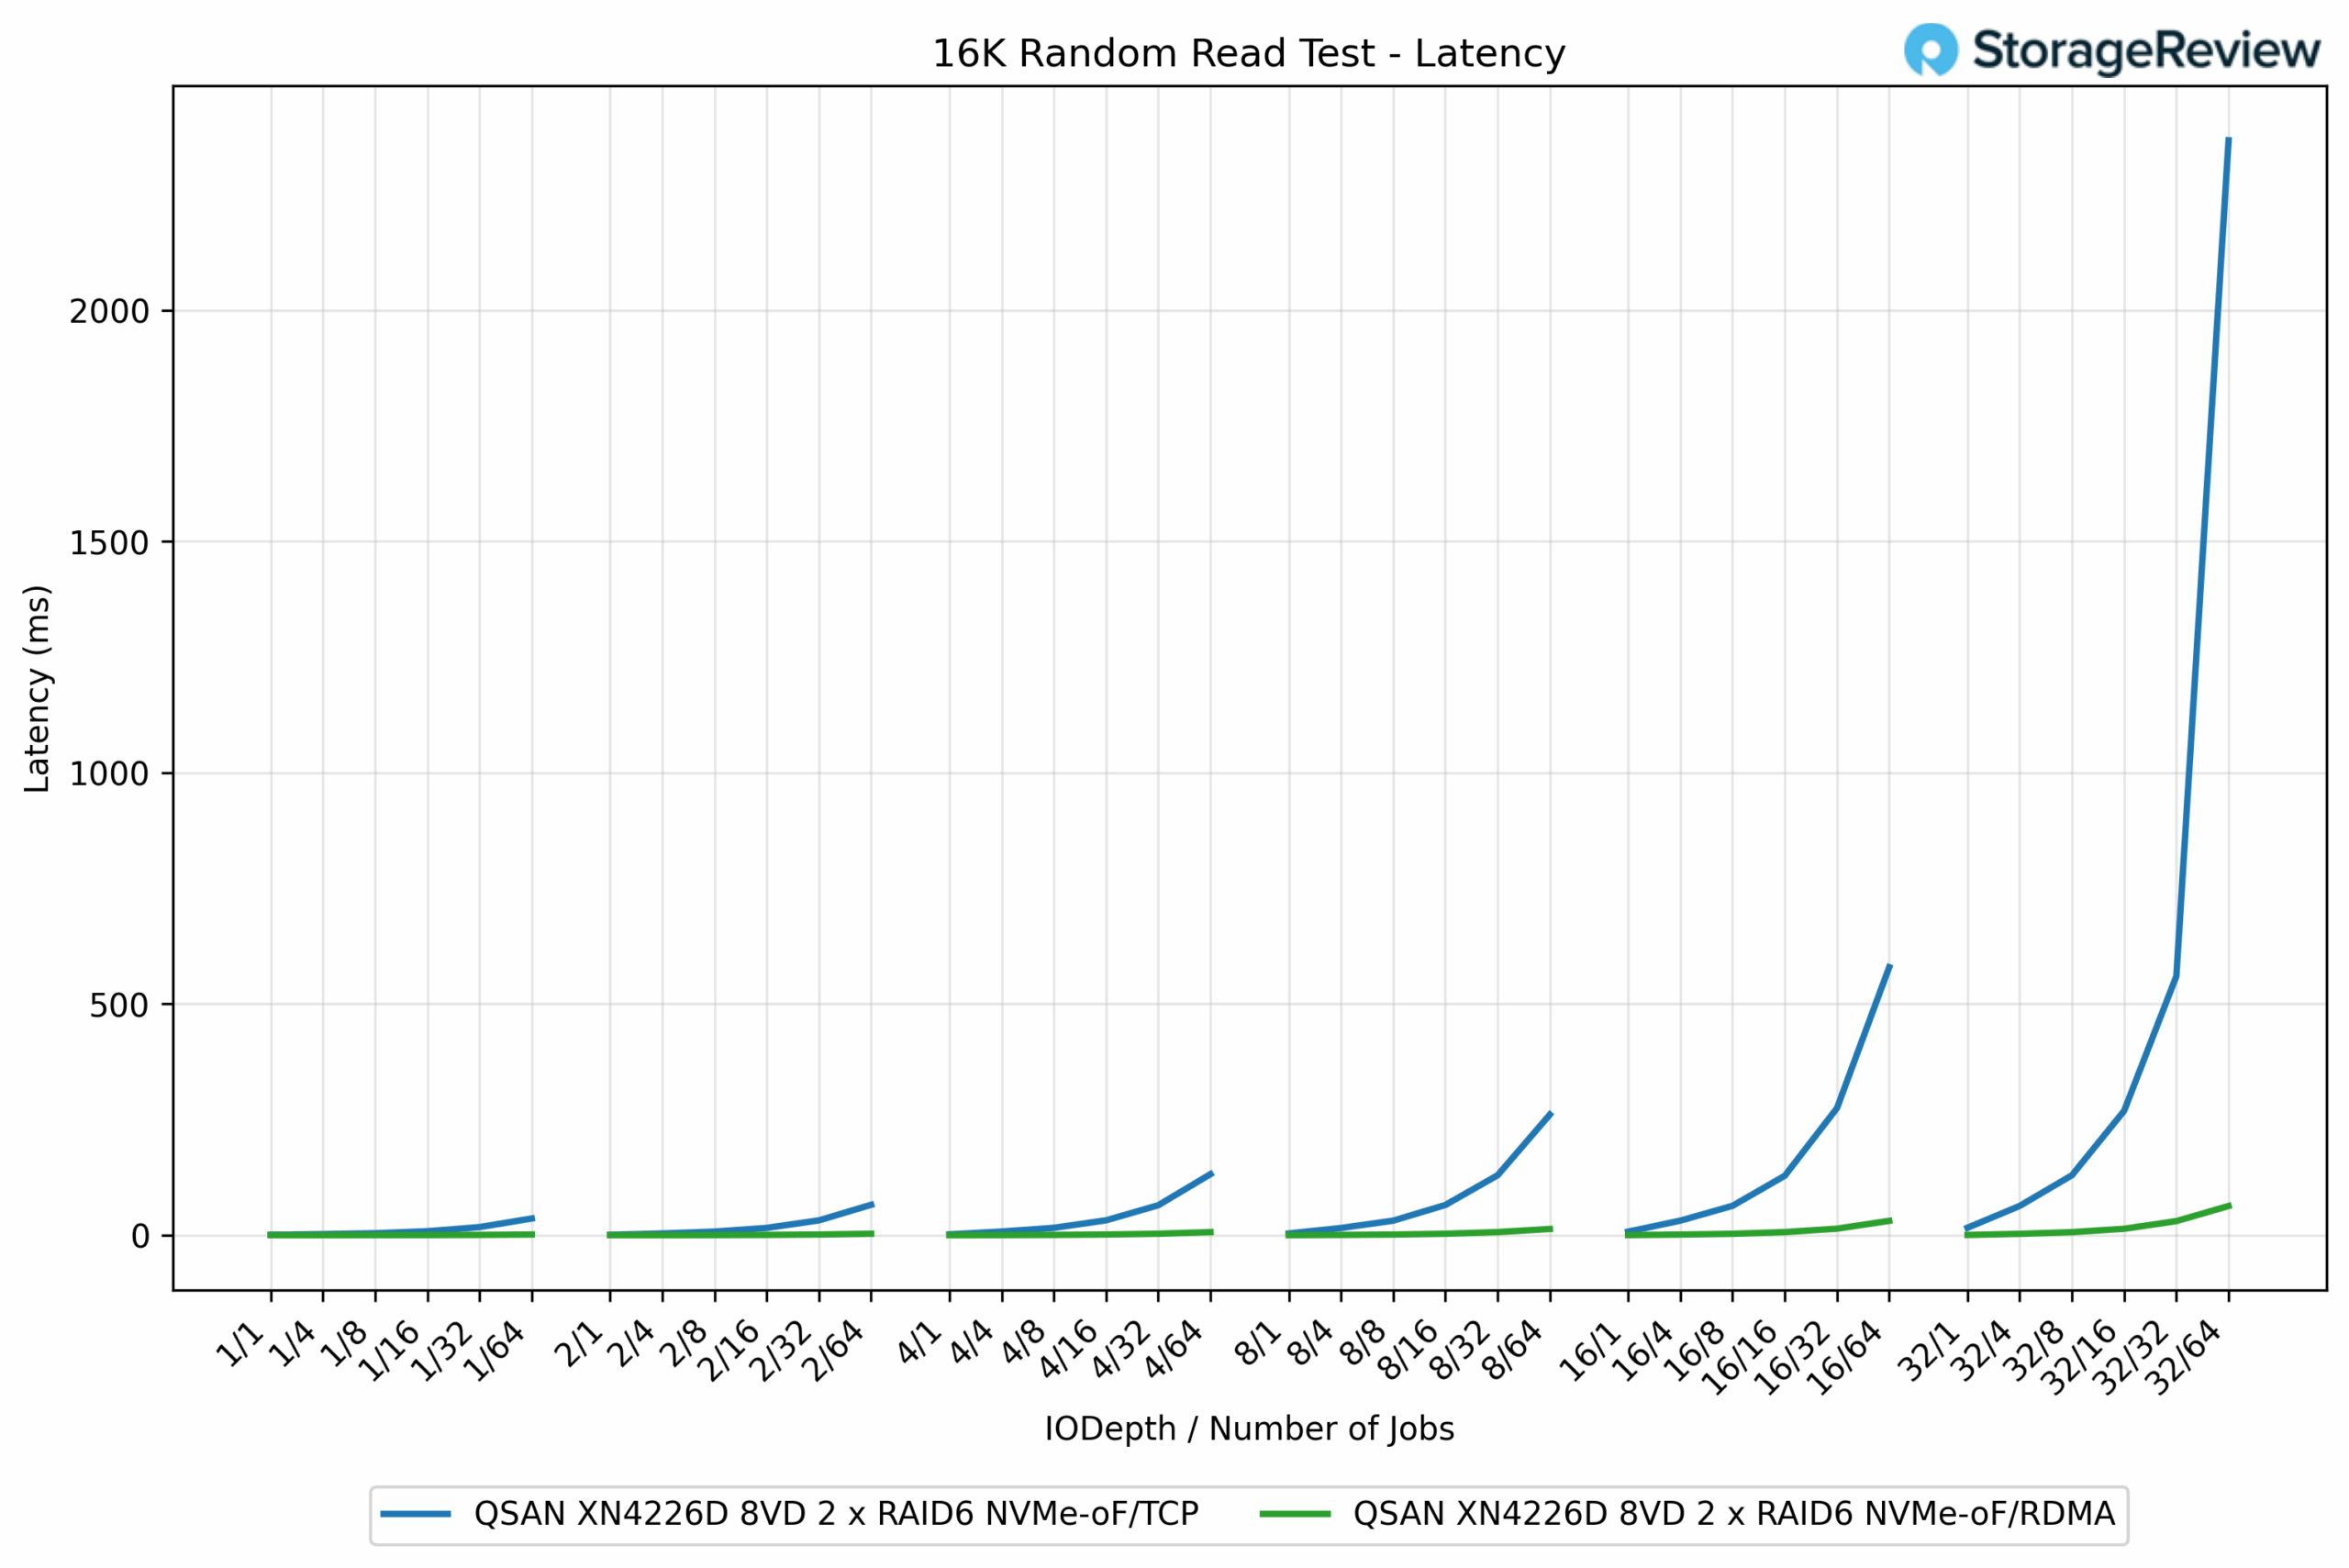
I latenstestet för 16K slumpmässig läsning var skillnaden mellan RDMA och TCP dramatisk, vilket speglade IOPS-resultaten. Vid lätta arbetsbelastningar var de två protokollen nästan identiska, med latenser från 1 till 10 ms.
Allt eftersom arbetsbelastningarna skalades upp höll RDMA latensen väl i schack, medan TCP försämrades avsevärt. Vid Q8/64-jobb mättes RDMA till 13.65 ms, jämfört med TCP:s 260.90 ms, en nästan 19x förbättring. I slutändan slutförde QD32/64-jobb RDMA på 63.28 ms, medan TCP tog 2 366,99 ms, nästan 37 gånger längre.
4K Random Write IOPS
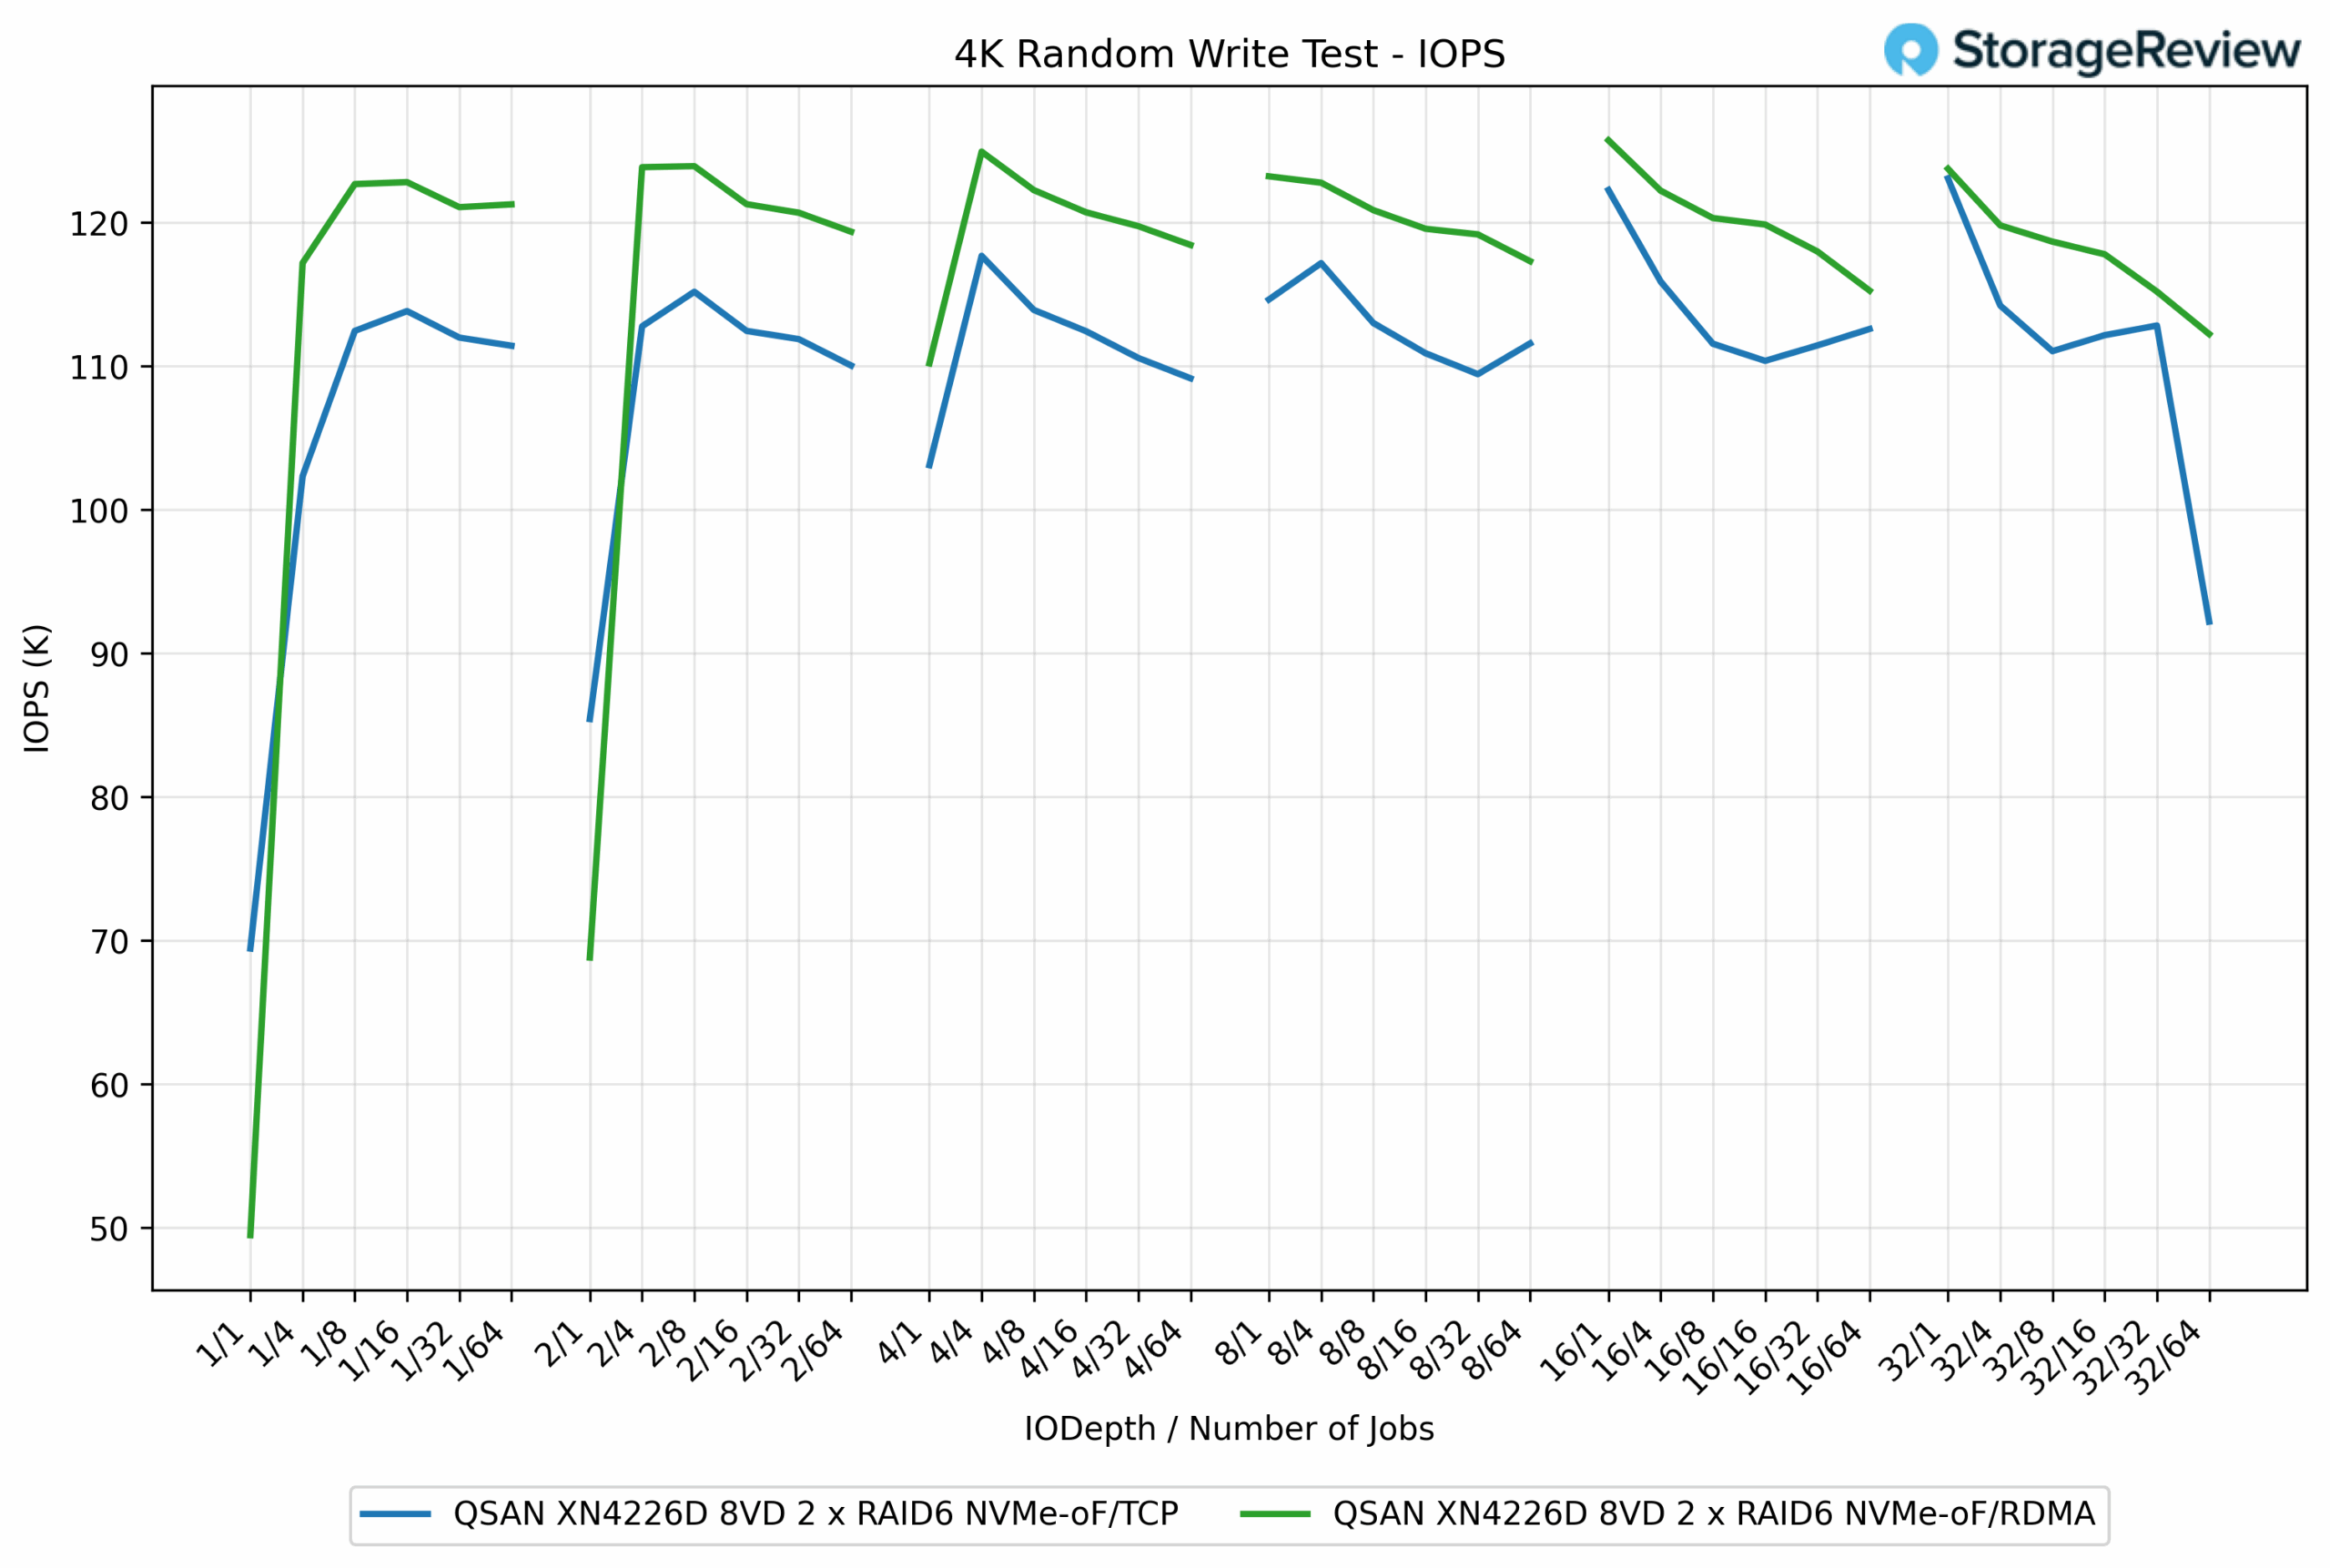
I 4K Random Write-testet överträffade RDMA konsekvent TCP, även om marginalen var mindre jämfört med arbetsbelastningar med större blockstorlekar. RDMA uppnådde en topp på 125.73K IOPS, medan TCP nådde 115.89K IOPS, vilket resulterade i en fördel på cirka 8.5 % för RDMA.
Vid lägre ködjup låg TCP något efter RDMA men levererade fortfarande konkurrenskraftig prestanda. Till exempel, vid QD1/16-jobb uppnådde RDMA 122.82K IOPS, jämfört med TCP:s 111.91K IOPS, en förbättring på nästan 10 %. Över de flesta testpunkter låg RDMA i intervallet 120K till 125K IOPS, medan TCP bibehöll resultaten mellan 110K och 116K IOPS, med en sen nedgång vid QD32/64-jobb till 92.21K IOPS.
4K slumpmässig skrivlatens
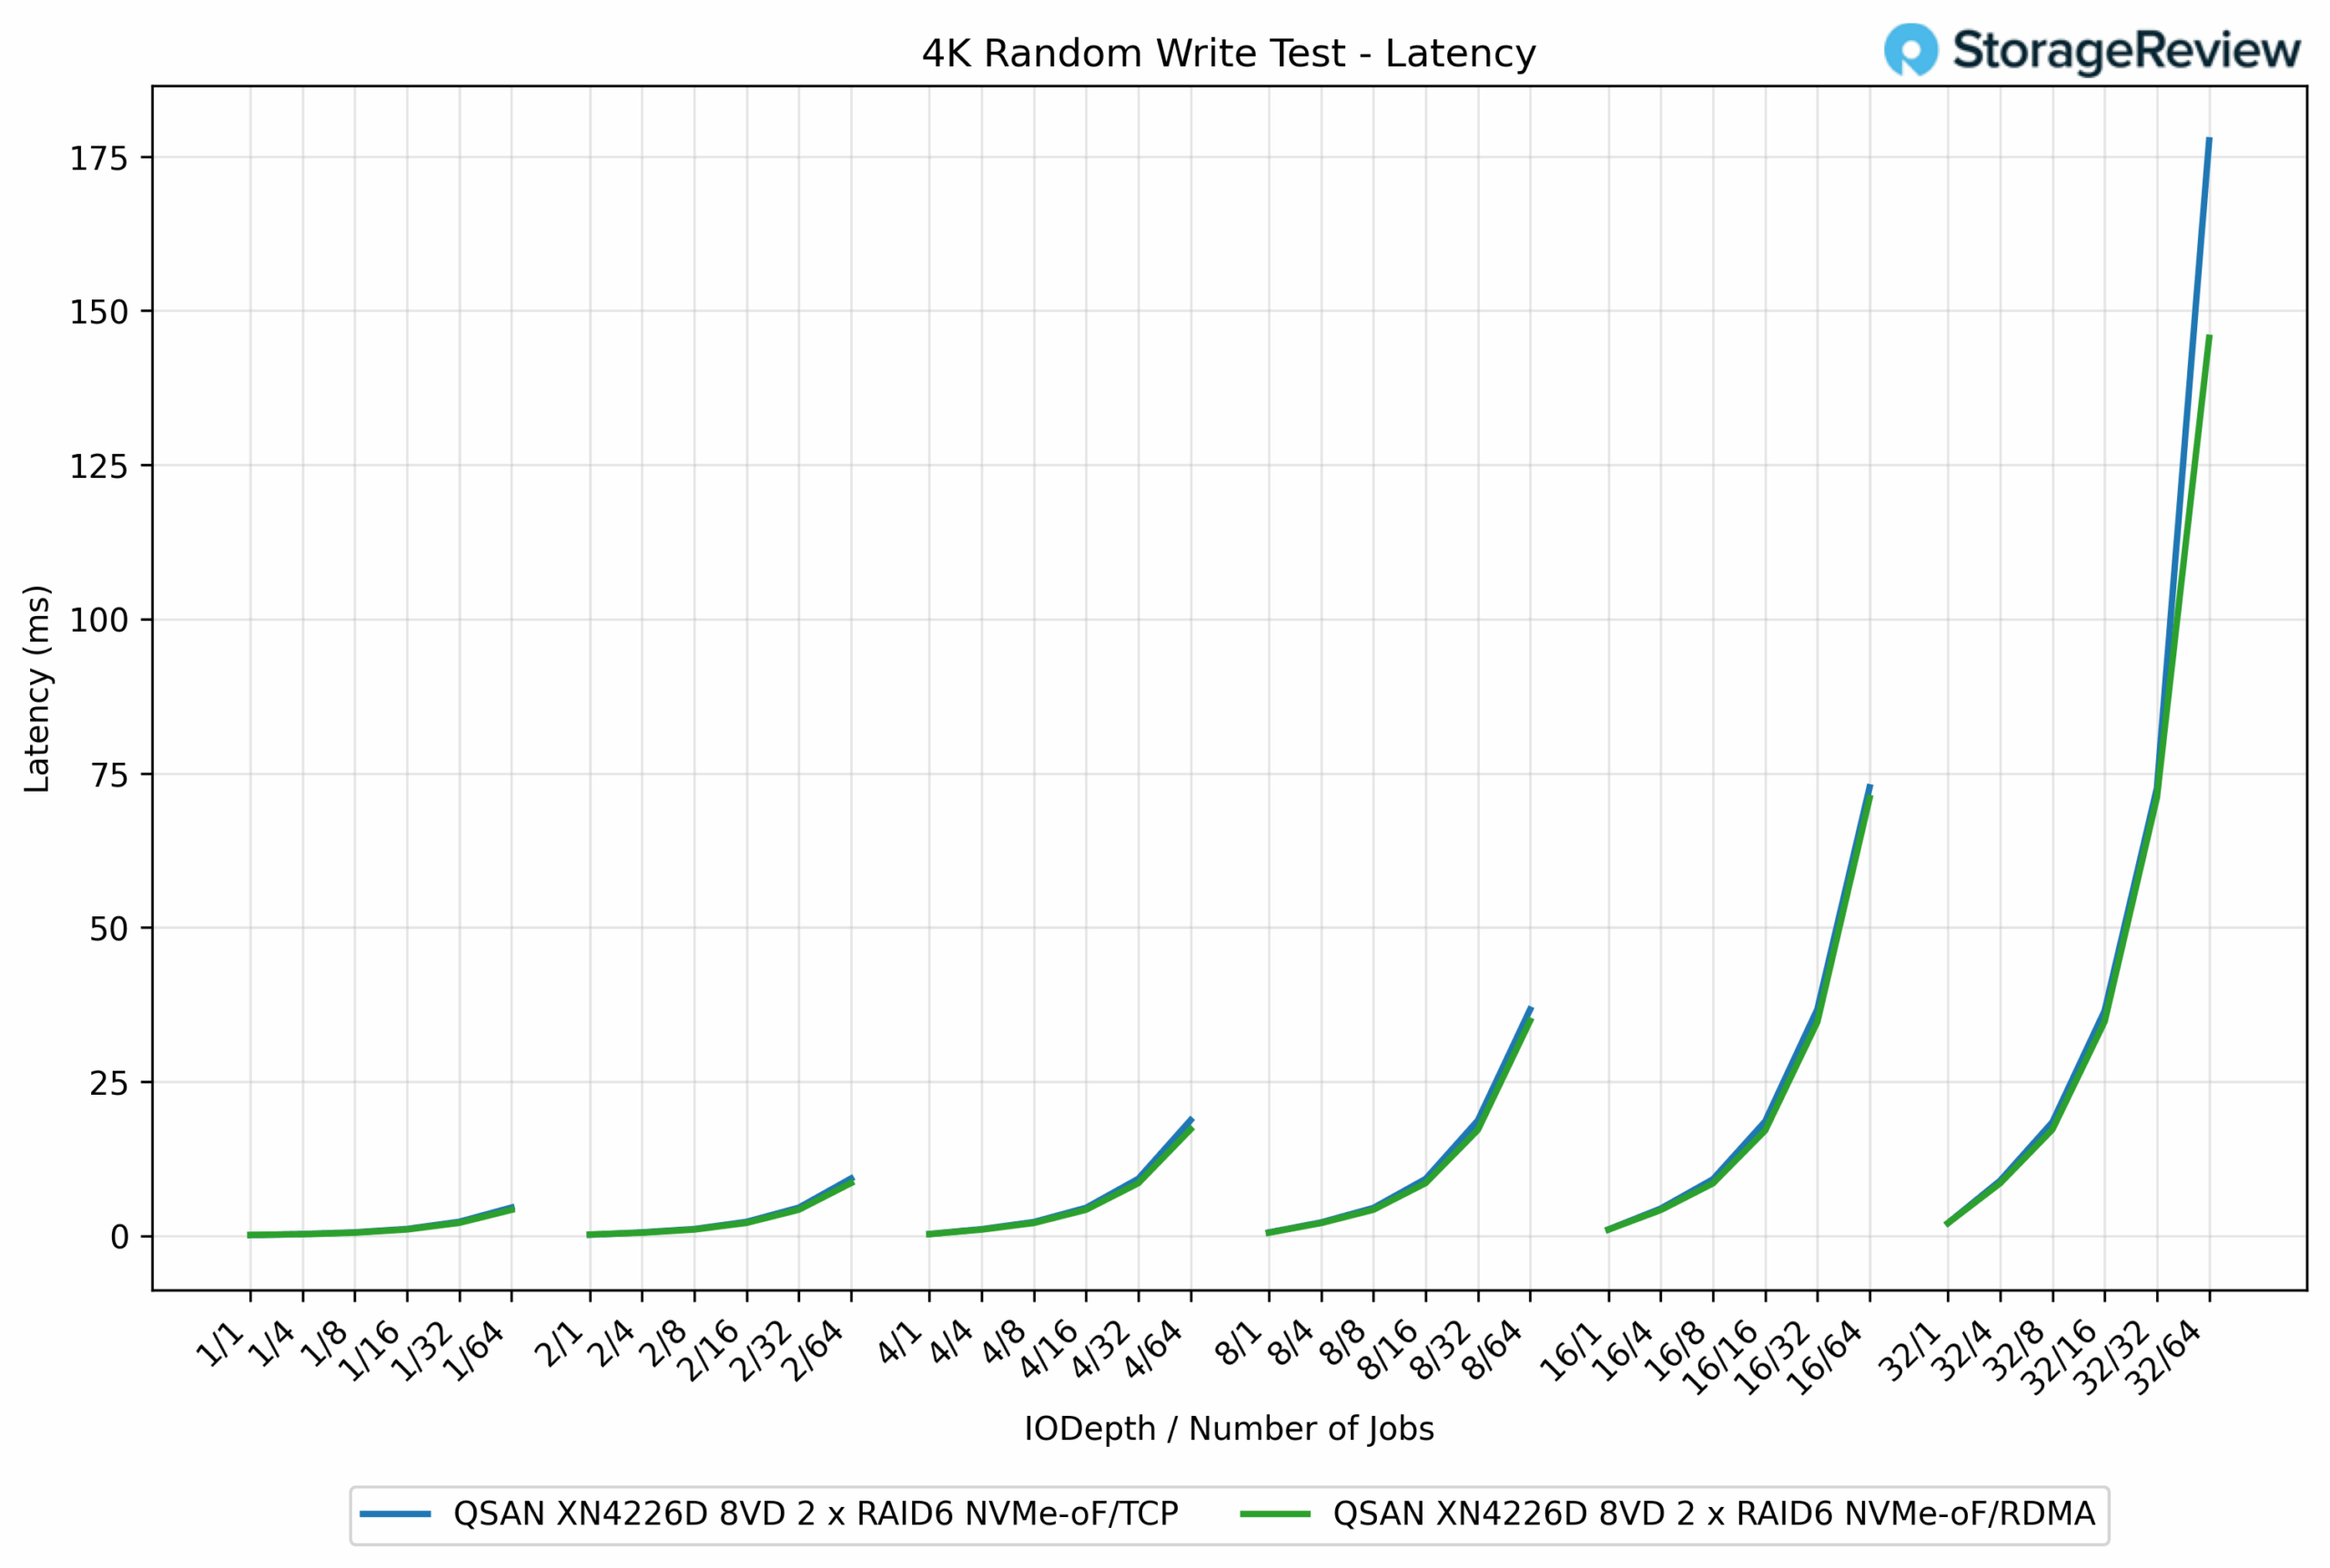
I 4K Random Write-latenstestet visade RDMA konsekvent lägre svarstider än TCP, även om marginalerna var smalare jämfört med de större blockbelastningarna. Vid lättare belastningar var båda protokollen nästan identiska och höll sig under 1 ms. Till exempel, vid QD1/1, mätte TCP 0.16 ms, medan RDMA låg på 0.21 ms.
Allt eftersom samtidigheten ökade blev skillnaderna tydligare. Vid QD16/64-jobb registrerade RDMA 19.36 ms, jämfört med TCP:s 36.20 ms, vilket gav RDMA en 46 % minskning av latensen. Vid maximalt djup slutfördes RDMA vid 145.61 ms, medan TCP steg till 177.62 ms, en förbättring på 22 % för RDMA.
4K Random Read IOPS
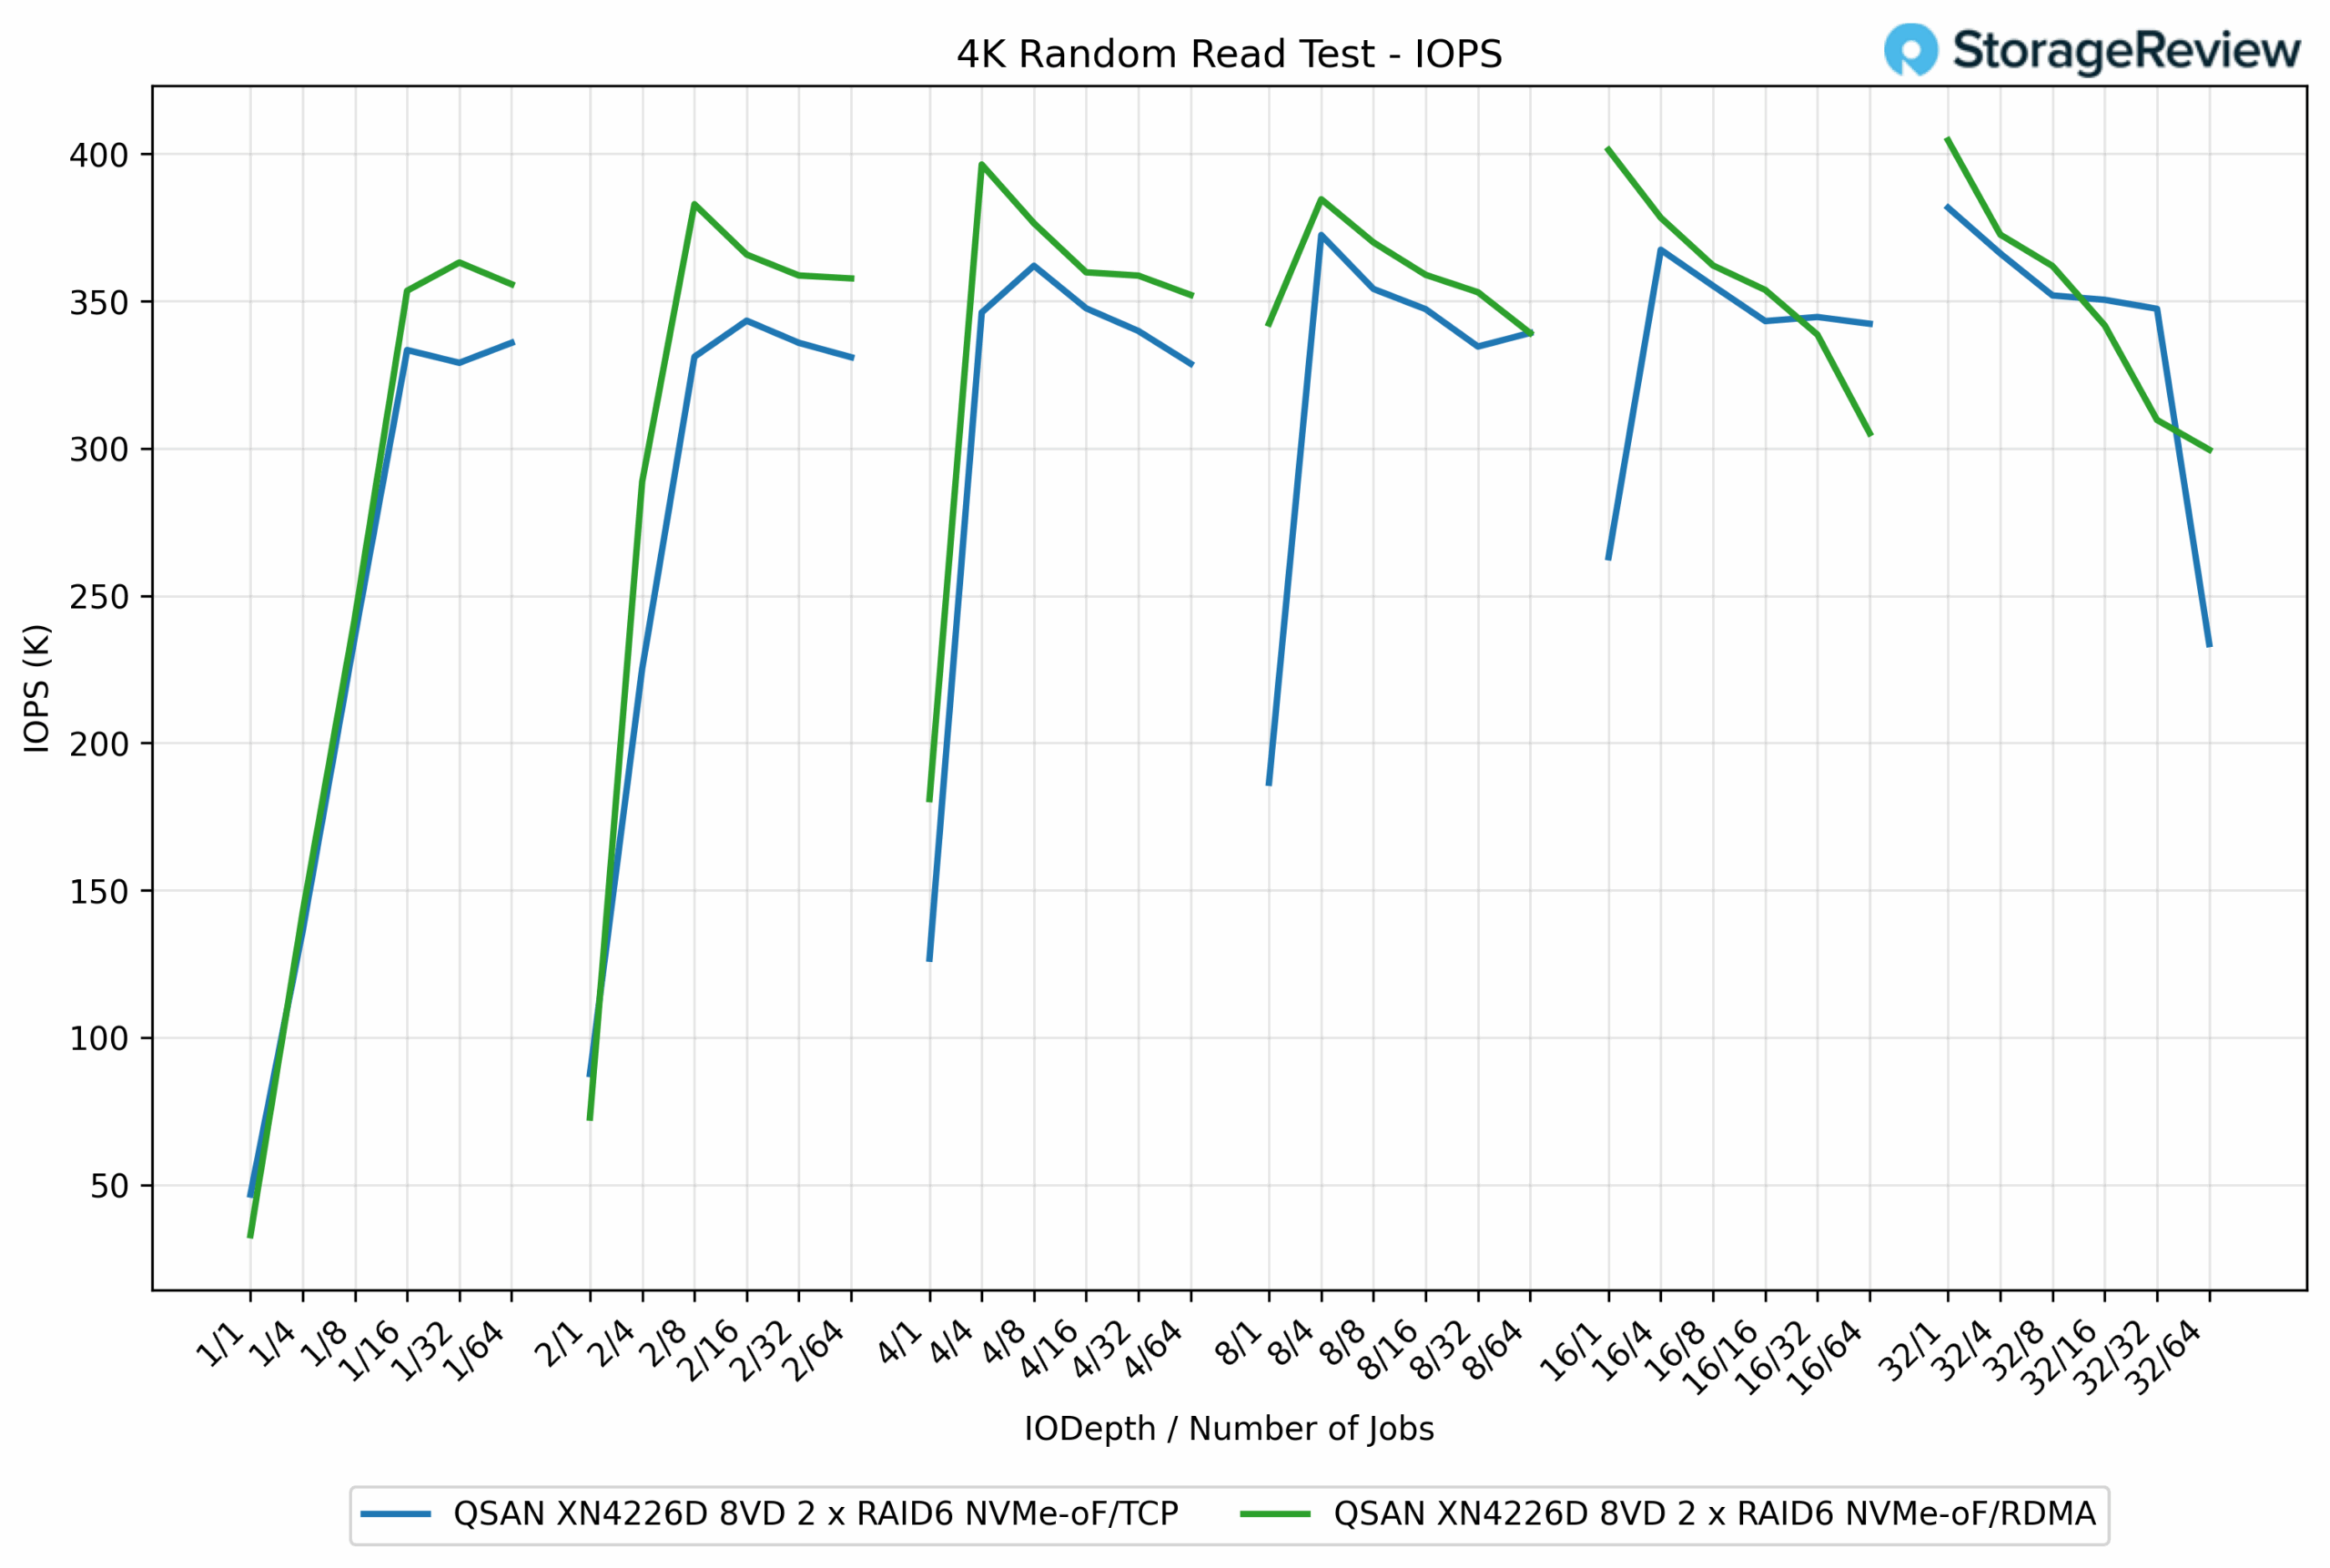
I 4K Random Read-testet levererade båda protokollen stark prestanda, även om RDMA konsekvent hade en liten fördel gentemot TCP. RDMA nådde en topp på 404.64K IOPS, medan TCP toppade på 382.96K IOPS, vilket gav RDMA en fördel på 5.7 %.
På lägre djup var resultaten redan till RDMA:s fördel. Till exempel, vid QD1/16-jobb uppnådde RDMA 353.57K IOPS, jämfört med TCP:s 329.10K IOPS, en skillnad på cirka 7.5 %. Allt eftersom arbetsbelastningarna skalades upp behöll RDMA sin ledning och arbetade vanligtvis i intervallet 360K till 400K IOPS, medan TCP låg närmare 330K till 380K IOPS.
4K slumpmässig läsfördröjning
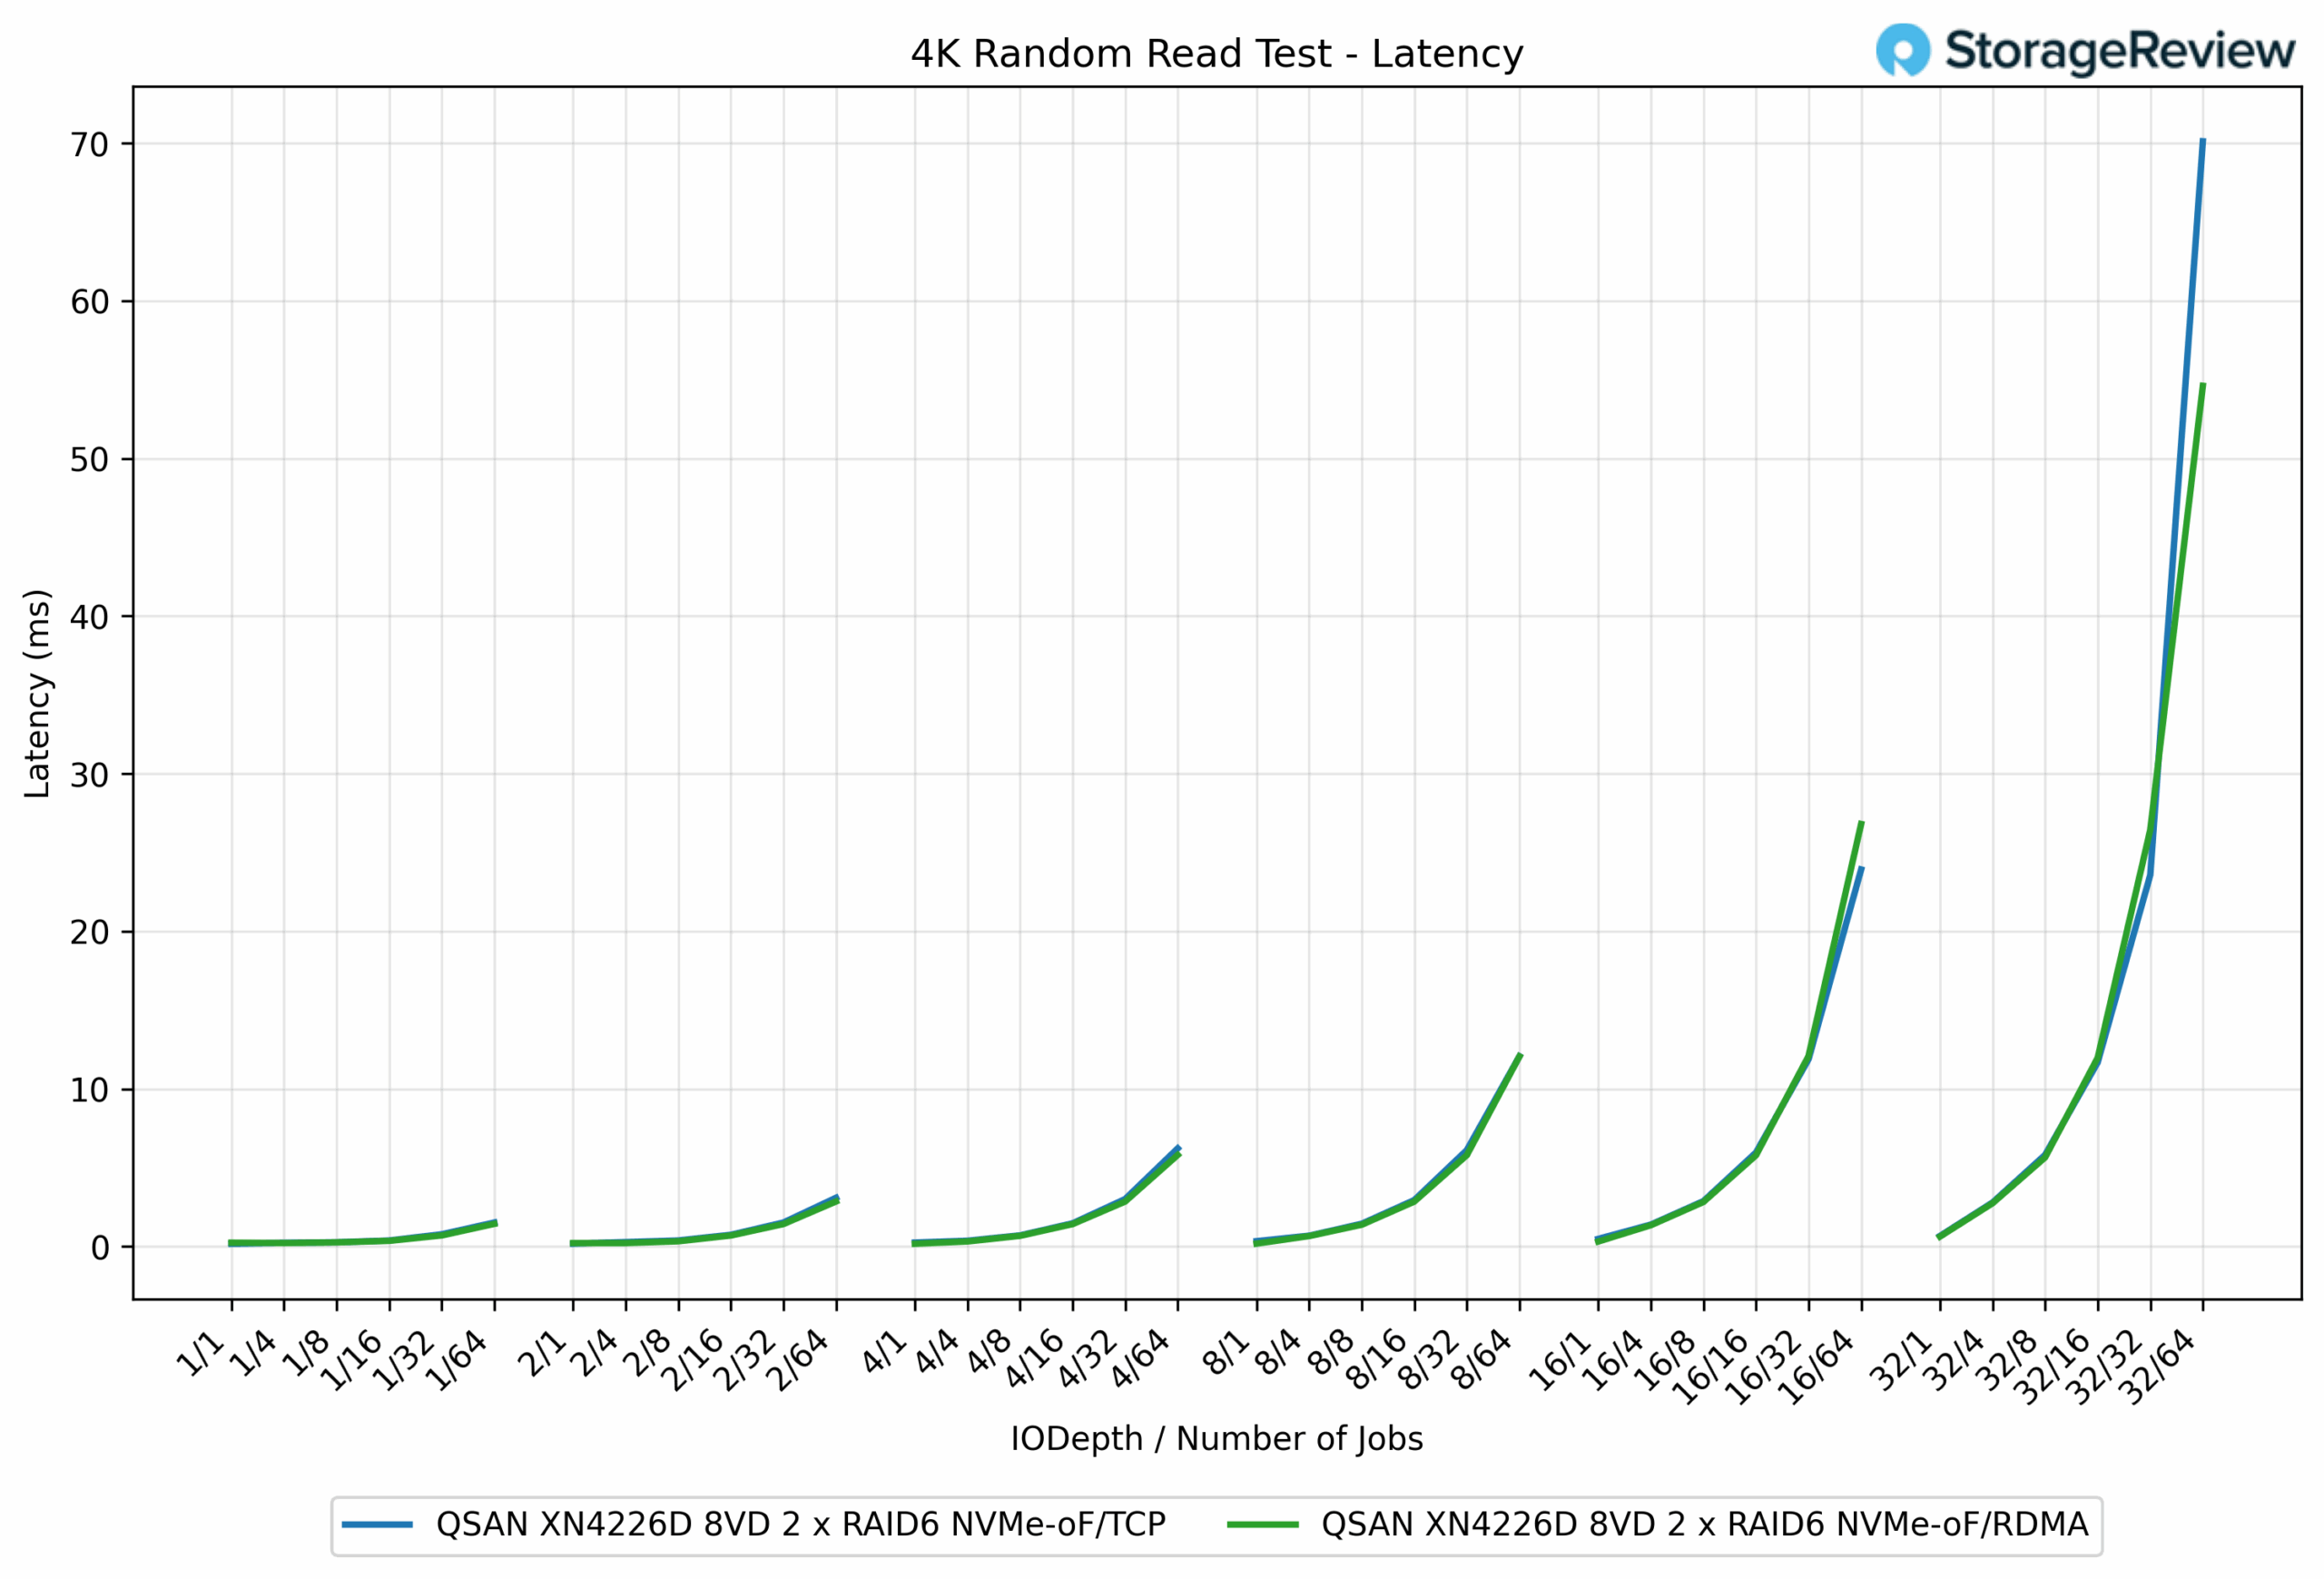
I 4K Random Read-latenstestet visade RDMA en tydlig effektivitetsfördel jämfört med TCP, särskilt i takt med att arbetsbelastningarna ökade i skala. Vid låga ködjup var de två protokollen nästan identiska. Till exempel, vid QD1/1-jobbet registrerade TCP 0.24 ms, medan RDMA låg strax efter med 0.27 ms.
I takt med att samtidigheten ökade, drog RDMA före. Vid QD16/64-jobb mättes RDMA till 23.92 ms, medan TCP låg på 26.81 ms, en förbättring med 10.8 %. Vid den högsta belastningen av QD32/64-jobb slutfördes RDMA på 54.61 ms, medan TCP ökade till 70.12 ms, en minskning av latensen med 22 % för RDMA.
GPUDirect-lagringsprestanda
Ett av testerna vi utförde på den här testbänken var Magnum IO GPUDirect Storage (GDS)-testet. GDS är en funktion utvecklad av NVIDIA som gör det möjligt för GPU:er att kringgå processorn vid åtkomst till data lagrad på NVMe-enheter eller andra höghastighetslagringsenheter. Istället för att dirigera data genom processorn och systemminnet möjliggör GDS direkt kommunikation mellan GPU:n och lagringsenheten, vilket avsevärt minskar latensen och förbättrar dataflödet.
Hur GPUDirect-lagring fungerar
Traditionellt sett, när en GPU bearbetar data som lagras på en NVMe-enhet, måste informationen först passera genom processorn och systemminnet innan den når GPU:n. Denna process skapar flaskhalsar, eftersom processorn blir en mellanhand, vilket ökar latensen och förbrukar värdefulla systemresurser. GPUDirect Storage eliminerar denna ineffektivitet genom att göra det möjligt för GPU:n att komma åt data direkt från lagringsenheten via PCIe-bussen. Denna direkta väg minskar kostnaden i samband med dataförflyttning, vilket möjliggör snabbare och effektivare dataöverföringar.
AI-arbetsbelastningar, särskilt de som involverar djupinlärning, är mycket dataintensiva. Att träna stora neurala nätverk kräver bearbetning av terabyte data, och eventuella fördröjningar i dataöverföringen kan leda till underutnyttjade GPU:er och längre träningstider. GPUDirect Storage hanterar denna utmaning genom att säkerställa att data levereras till GPU:n så snabbt som möjligt, vilket minimerar inaktivitetstid och maximerar beräkningseffektiviteten.
Dessutom är GDS särskilt fördelaktigt för arbetsbelastningar som involverar streaming av stora datamängder, såsom videobearbetning, naturlig språkbehandling eller realtidsinferens. Genom att minska beroendet av CPU:n påskyndar GDS datarörelsen och frigör CPU-resurser för andra uppgifter, vilket ytterligare förbättrar den övergripande systemets prestanda.
Utöver rå bandbredd levererar GPUDirect med NVMe-oF (TCP/RDMA) även I/O med ultralåg latens. Detta säkerställer att GPU:er aldrig svälter på data, vilket gör systemet idealiskt för AI-inferens i realtid, analyspipelines och videouppspelning.
För många praktiska implementeringar innebär detta en användbar dataflödeshastighet på 100–200 GbE, vilket passar perfekt för arbetsbelastningar som AI-inferens (2–4 GPU:er), medieproduktion (sändningsuppspelning, OTT-kantcache), övervakningsvideoanalys och HPC-kontrollpunkter.
Läs genomströmning
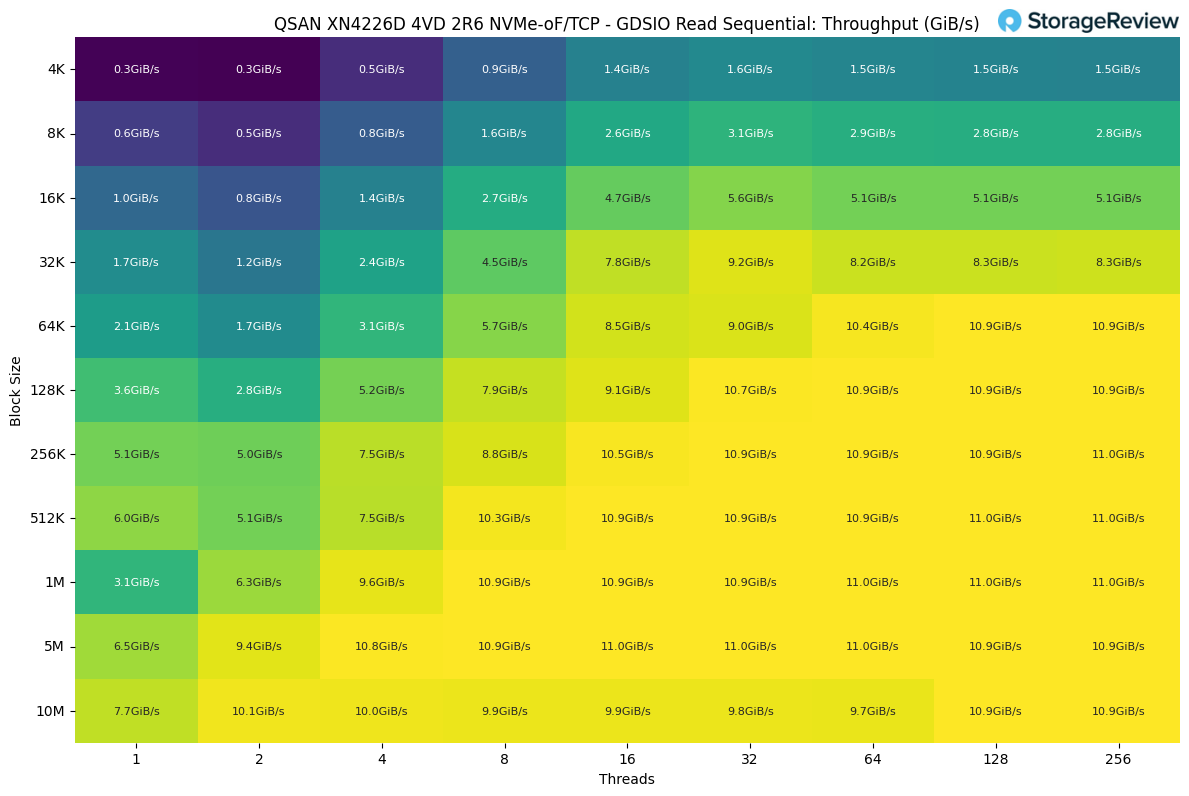
I arbetsbelastningen GDSIO Sequential Read skalades dataflödet stadigt med både blockstorlek och trådantal och nådde maximalt 11.0 GiB/s över flera testpunkter. De högsta resultaten upprätthölls när blockstorlekarna nådde 512K och högre, där dataflödet stabiliserades mellan 10.9 och 11.0 GiB/s, oavsett trådantal.
Vid mindre blockstorlekar började prestandan mycket lägre. Till exempel, med 4K-block, började dataflödet på bara 0.3 GiB/s med en enda tråd och planade ut vid 1.5 GiB/s även vid 256 trådar. Som jämförelse gjorde en ökning av blockstorleken till 64K det möjligt för systemet att skala upp till 10.9 GiB/s, vilket nästan mättade dataflödet med högre trådantal.
Sweet spot verkade ligga runt 128K till 256K block, där dataflödet översteg 10GiB/s med 32 eller fler trådar och förblev konstant över de största blockstorlekarna som testades. Detta visar hur plattformen uppnår full bandbreddsmättnad när blockstorlekarna blir tillräckligt stora, med endast stegvisa vinster utöver 256K.
Läs Latency
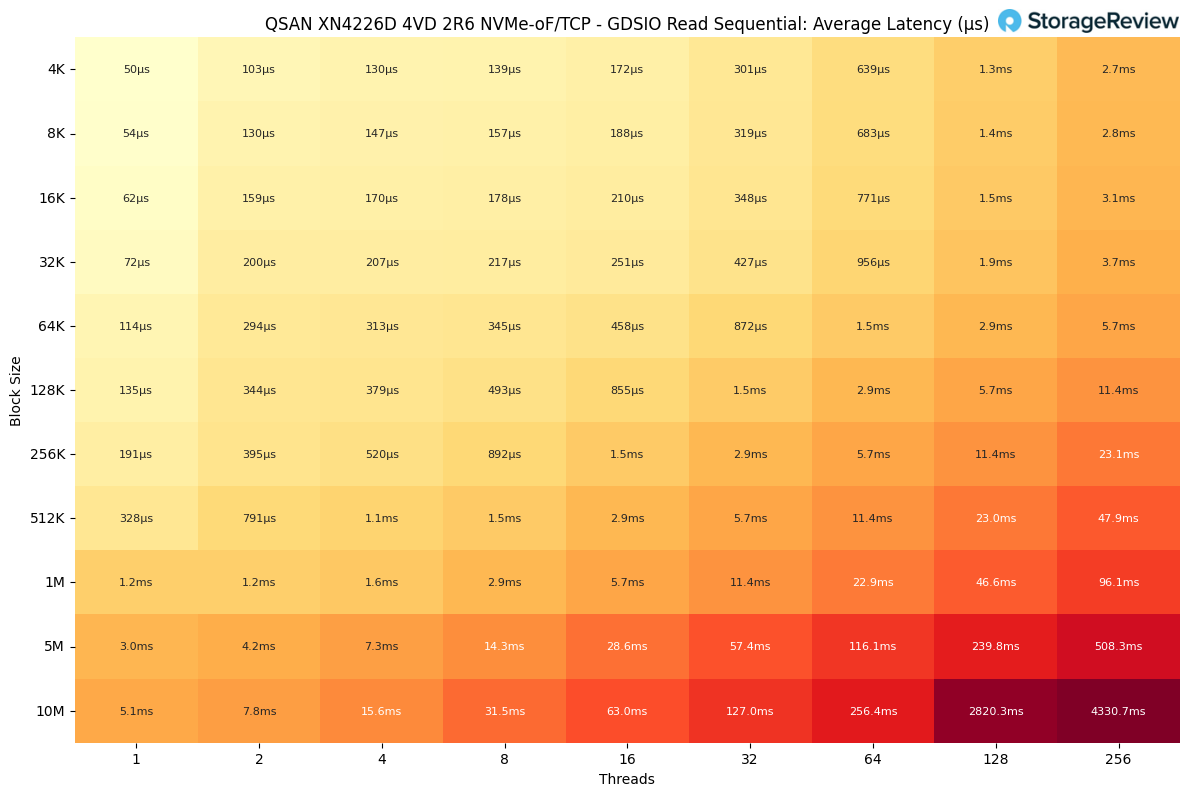
I resultaten från GDSIO Sequential Read-latensen skalades svarstiderna förutsägbart med både blockstorlek och trådantal. Vid de minsta arbetsbelastningarna förblev latensen extremt låg. Till exempel, med 4K-block i en enda tråd, mättes latensen bara 50 µs, och höll sig under 200 µs upp till 32K blockstorlekar med minimal samtidighet.
Allt eftersom trådantalet ökade började latensen öka mer märkbart. Vid 64K-block och 64 trådar nådde latensen 1.5ms, fördubblades till 2.9ms vid 128 trådar och klättrade till 5.7ms vid 256 trådar. Däremot låg mindre blockstorlekar, som 4K och 8K, bara inom intervallet 2.7–2.8ms, även vid maximalt 256 trådar, vilket visade bättre kontroll vid finare granulariteter.
Större blockstorlekar skapade mer dramatiska hopp. Vid 1 miljon block och 256 trådar nådde latensen 96.1 ms, medan 10 miljoner block vid 256 trådar steg till 4.3 sekunder, vilket tydligt visar systemets skalningsgränser under extrema förhållanden.
Skriv genomströmning
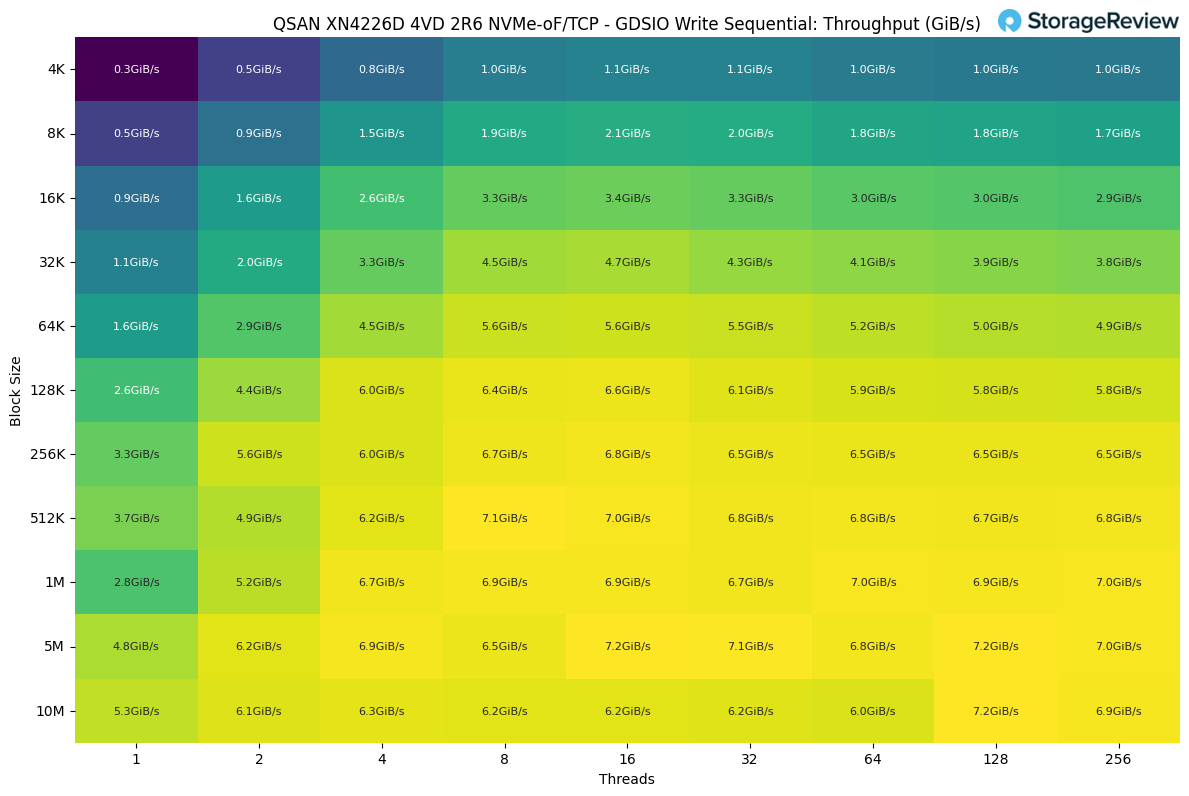
I arbetsbelastningen GDSIO Sequential Write skalades dataflödet med både blockstorlek och trådantal men planade ut långt under läsprestandataket. Systemet uppnådde en topp på 7.2 GiB/s, med större blockstorlekar, såsom 5M och 10M, vid 128 trådar.
Vid de minsta blockstorlekarna var dataflödet blygsamt. Med 4K-block började prestandan på 0.3 GiB/s med en enda tråd och skalades till 1.0 GiB/s med 32 trådar, för att sedan plana ut. Att öka blockstorleken till 64K frigjorde mer bandbredd och nådde 5.6 GiB/s med åtta trådar innan den minskade något vid högre samtidighet.
Den bästa balansen uppstod runt blocken 512K till 1M, där dataflödet varierade från 6.7 till 7.1 GiB/s över olika trådantal, vilket indikerar att systemet nådde mättnad i detta intervall. Utöver den punkten gav ytterligare trådar inte några betydande vinster, och i vissa fall sjönk prestandan faktiskt något på grund av ökad overhead.
Skriv latens
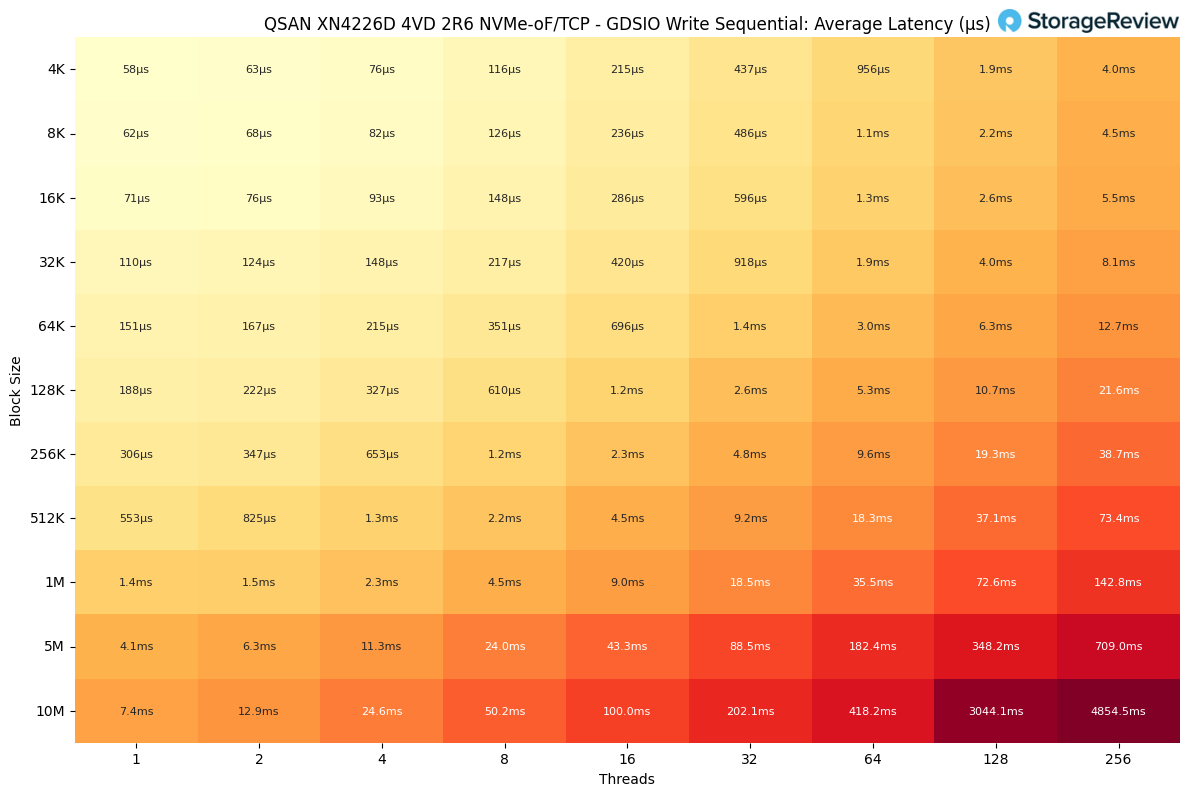
I resultaten från GDSIO Sequential Write-latensen skalades svarstiderna smidigt vid lägre blockstorlekar men ökade kraftigt när både blockstorlek och trådantal ökade.
Vid de minsta arbetsbelastningarna var latensen minimal. Med 4K-block och en enda tråd mättes den genomsnittliga latensen bara 58µs och låg under 200µs genom 16K-block vid upp till fyra trådar. Även med 32K-block och måttlig samtidighet låg latensen under 1ms.
Allt eftersom systemet övergick till större blockstorlekar blev fördröjningarna mer uttalade. Vid 128 000 block och 64 trådar nådde latensen 5.3 ms, vilket fördubblades igen till 10.7 ms vid 128 trådar. Med 512 000 block sträcktes resultaten ytterligare och klättrade till 73.4 ms vid 256 trådar.
De tyngsta fallen, 5M- och 10M-block med 256 trådar, upplevde en dramatisk ökning av latensen till 709ms respektive 4.8 sekunder, vilket avslöjade de övre gränserna för sekventiell skrivskalning.
Avslutande tankar
QSANs XN4226D hamnar precis där många IT-team behöver den. Det är en enhetlig NVMe-plattform med dubbla styrenheter som stöder både moderna och äldre protokoll utan att kräva arkitektoniska förändringar. I våra tester ledde TCP stora sekventiella läsningar med 21.21 GB/s, medan RDMA producerade de starkaste stora sekventiella skrivningarna med 11.14 GB/s och höll latensen lägre allt eftersom samtidigheten skalades. Vid mindre blockstorlekar förbättrade RDMA konsekvent effektiviteten hos slumpmässiga skriv och höll tillbaka beteendet vid svansen. Slutsatsen är enkel. Använd NVMe-oF TCP för bred kompatibilitet och hög läsbandbredd, och använd RDMA när skrivlatens och konsekvens är som viktigast.
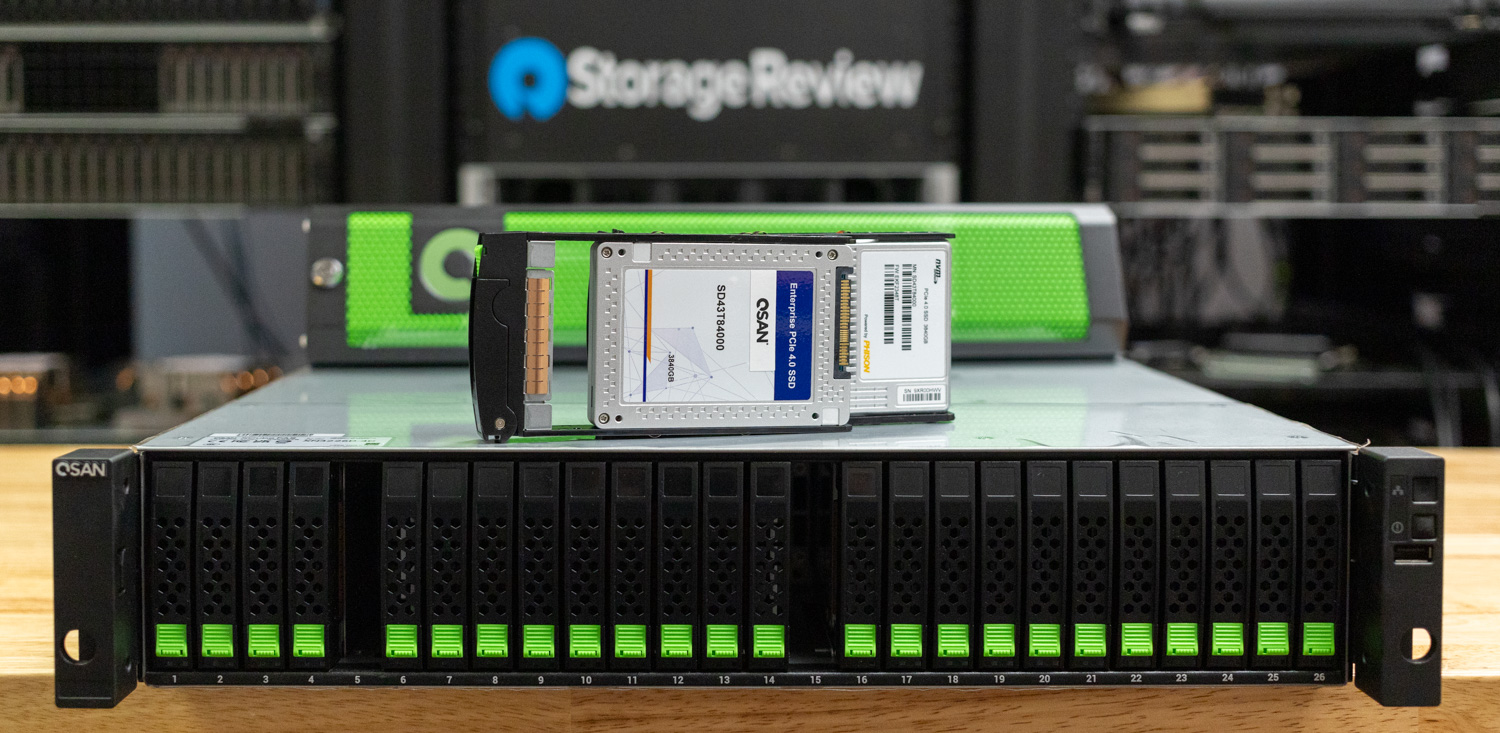
Hårdvarubehovet är praktiskt. Du får 26 frontfack för U.2- eller U.3 NVMe-enheter i ett 2U-chassi, med aktiv hög tillgänglighet och enkel expansion till SAS-hyllor när kapacitet prioriteras framför rå NVMe-hastighet. QSM 4 levererar de förväntade datatjänsterna och ett rent användargränssnitt, tillsammans med ett REST API som underlättar sömlös integration med befintlig automation. Små IT-team bör tycka att QSM 4 är enkelt att konfigurera och hantera. För att validera detta integrerade vi enkelt vårt Proxmox-kluster, vilket ger dessa virtuella maskiner tillgång till höghastighetslagring. För mer avancerade arbetsbelastningar är QSAN väl rustat att leverera på små och medelstora företags AI-behov.
För organisationer som värdesätter förutsägbar prestanda, ren hantering och räckvidd för flera protokoll är XN4226D lätt att rekommendera. Den levererar verkligt NVMe-genomströmningshastighet, stark skrivfördröjning med RDMA och en mjukvaruupplevelse som inte kommer att sakta ner dig. Lägg till det rimliga priset, och denna QSAN-plattform kan förankra blandade miljöer utan drama.


 Amazon