

I augusti delade NVIDIA upp sitt topperbjudande för Blackwell-stationära datorer i två spår för proffs: Workstation och Server. RTX PRO 6000 Workstation-kortet är designat för kreatörer, ingenjörer och AI-utvecklare som behöver maximal beräkningsförmåga och VRAM i ett torn- eller stationärt chassi. RTX PRO 6000 Blackwell Server Edition är designad för rackservrar och headless inferens- eller renderingsnoder i datacentret. Nu när vi har arbetsstationskortet på bänken kan vi fokusera på det för den här recensionen.
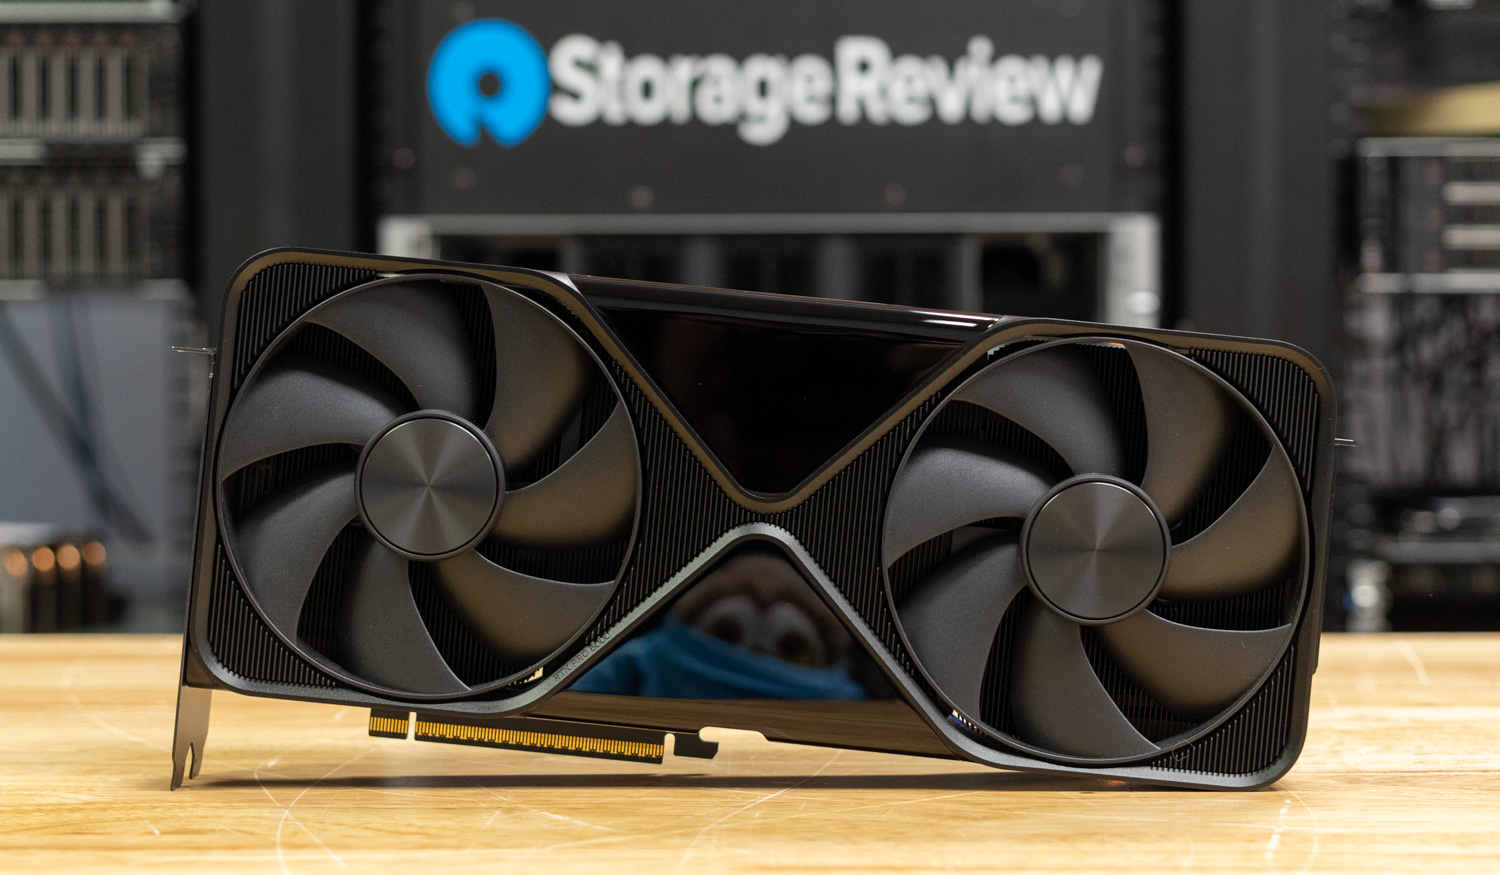
För 8 500 dollar ger RTX PRO 6000 ett fullfjädrat GB202-kort till skrivbordet med 24 064 CUDA-kärnor, 752 femte generationens Tensor-kärnor, 188 fjärde generationens RT-kärnor och 96 GB GDDR7 ECC. Attraktionen är omedelbart uppenbar. Du får minneskapacitet som konsumentkort inte kan matcha, proffsdrivrutiner och en formfaktor med dubbla kortplatser som passar riktiga arbetsstationer utan speciella krav på strömförsörjning eller luftflöde.
NVIDIA positionerar denna GPU för blandade arbetsflöden. Det inkluderar lokal LLM-inferens med lång kontext, rendering av stora scener, komplex simulering och forskningsriggar med flera GPU:er. Praktiska detaljer är viktiga här. Kortet använder ett standard PCIe 5.0 x16-gränssnitt, erbjuder fyra DisplayPort 2.1b-utgångar för visualisering med hög upplösning och hög uppdateringsfrekvens och ger en konfigurerbar TDP på 600 W, vilket gör det möjligt för integratörer att finjustera för optimal temperatur, akustik eller densitet.
Vårt mål är att utvärdera hur den här arbetsstationsversionen presterar i labbet inom AI, rendering och allmän databehandling, och att kvantifiera effekten av 96 GB-poolen på funktionerna hos en enskild stationär nod.
NVIDIA RTX PRO 6000 Workstation vs. Server Edition
RTX PRO 6000-varianterna bygger på samma Blackwell GB202-grund, så den råa matematiska kapaciteten ser bekant ut på pappret. Skillnaden ligger i hur och var de är avsedda att placeras. Arbetsstationskortet vi testar är ett fristående, aktivt kylt kort med dubbla kortplatser, fyra DisplayPort 2.1b-utgångar och studioklassdrivrutiner. Det passar in i en tower- eller skrivbordsarbetsstation, driver lokala paneler och kör ISV-certifierade DCC- och CAD-appar tillsammans med CUDA, TensorRT och cuDNN. Om arbetsflöden blandar interaktivt viewport-arbete, lokal visualisering och AI i datorn, är detta vägen som håller allt i ett chassi med förutsägbar akustik och temperatur.
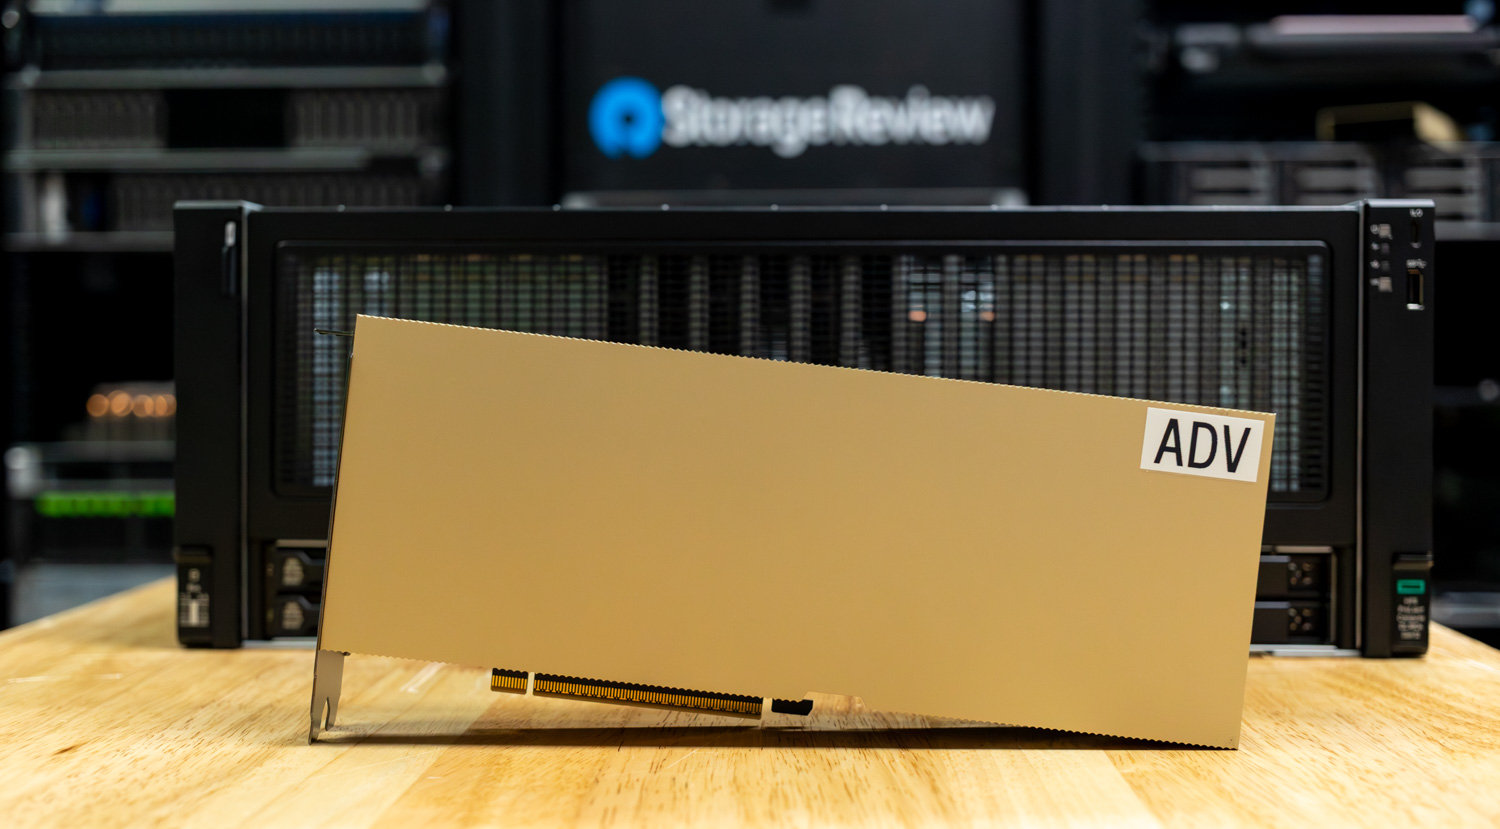
RTX PRO 6000 Blackwell Server Edition är utformad för ett helt annat syfte. Det är en headless, rack-first-konfiguration avsedd för servrar, med front-to-back-luftflöde och fjärrhanteringsfunktioner. Det finns inga aktiva skärmutgångar eftersom jobb schemaläggs över nätverket och resultaten konsumeras på distans. Firmware-, ström- och temperaturprofiler är inställda för dygnet runt-drift under en schemaläggare, vanligtvis i kombination med NVIDIA AI Enterprise, containerorkestrering och hypervisor-passthrough. Kort sagt är arbetsstationsmodellen rätt val när skapare och ingenjörer behöver se och manipulera arbete lokalt samtidigt som de kör stora inferens- eller simuleringsbatchar. Serverversionen är mer meningsfull när man skalar ut identiska noder bakom en kö i ett datacenter, där varje watt, kabel och luftflödesväg måste passa inom en OEM-serviceplan.
NVIDIA RTX PRO 6000 Specifikationer
Tabellen nedan visar specifikationerna för NVIDIA RTX PRO 6000 jämfört med RTX 5090 och den tidigare generationen Ada Lovelace RTX 4090.
| GPU-jämförelse | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 |
| GPU-namn | GB202 | GB202 | AD102 |
| arkitektur | Blackwell 2.0 | Blackwell 2.0 | Ada Lovelace |
| Processstorlek | 5 nm | 5 nm | 5 nm |
| Transistorer | 92,200 miljoner | 92,200 miljoner | 76,300 miljoner |
| Densitet | 122.9 M/mm² | 122.9 M/mm² | 125.3 M/mm² |
| Måttstorlek | 750 mm² | 750 mm² | 609 mm² |
| Spårbredd | Dubbla plats | Dubbla plats | Trippelslot |
| Mått | 304 mm x 137 mm x 40 mm | 304 mm x 137 mm x 48 mm | 304 mm x 137 mm x 61 mm |
| TDP | 600W | 575W | 450W |
| Utgångarna | 4x DisplayPort 2.1b | 1x HDMI 2.1b, 3x DisplayPort 2.1b | 1x HDMI 2.1, 3x DisplayPort 1.4a |
| Strömkontakter | 1x 16-stift | 1x 16-stift | 1x 16-stift |
| Busgränssnitt | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| Basklocka | 1590 MHz | 2017 MHz | 2235 MHz |
| Boost Clock | 2617 MHz | 2407 MHz | 2520 MHz |
| Minnes klocka | 1750 MHz (28 Gbps effektiv) | 2209 MHz (28 Gbps effektiv) | 1313 MHz (21 Gbps effektiv) |
| Minnesstorlek | 96 GB | 32 GB | 24 GB |
| Minnestyp | GDDR7 ECC | GDDR7 | GDDR6X |
| Minnesbuss | 512 bitars | 512 bitars | 384 bitars |
| minnesbandbredd | 1.79 TB / s | 1.79 TB / s | 1.01 TB / s |
| CUDA Cores | 24,064 | 21,760 | 16,384 |
| Tensorkärnor | 752 | 680 | 512 |
| ROPs | 192 | 192 | 176 |
| SM räkning | 188 | 170 | 128 |
| RT Cores | 188 | 170 | 128 |
| L1 Cache | 128 KB (per SM) | 128 KB (per SM) | 128 KB (per SM) |
| L2 Cache | 128 MB | 88 MB | 72 MB |
| Pixelhastighet | 502.5 GPixel/s | 462.1 GPixel/s | 443.5 GPixel/s |
| Texturhastighet | 1,968.0 XNUMX GTexel/s | 1,637 XNUMX GTexel/s | 1,290 XNUMX GTexel/s |
| FP16 (halva) | 126.0 TFLOPS (1:1) | 104.8 TFLOPS (1:1) | 82.58 TFLOPS (1:1) |
| FP32 (flytande) | 126.0 TFLOPS | 104.8 TFLOPS | 82.58 TFLOPS |
| FP64 (dubbel) | 1.968 TFLOPS (1:64) | 1.637 TFLOPS (1:64) | 1,290 1 GFLOPS (64:XNUMX) |
| Startpris (USD) | $8,500 | $1,999 | $1,599 |
Bygg och design
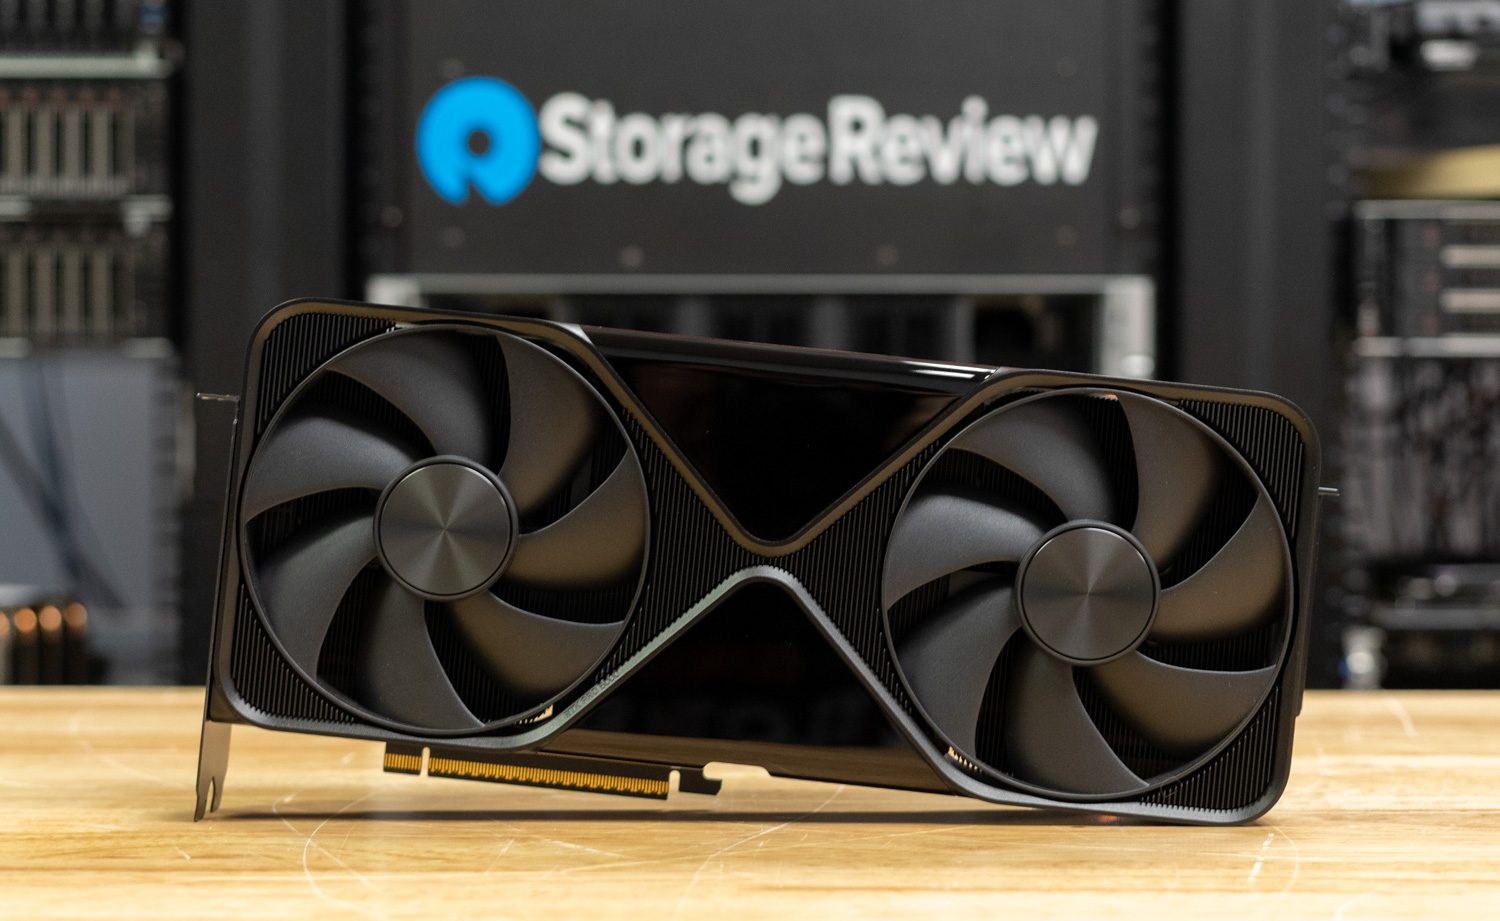
RTX PRO 6000 Workstation GPU bygger vidare på NVIDIAs rena, funktionella design, som ses på RTX 5090 FE, med en industriell mattsvart finish och en dubbelaxiell fläktlayout optimerad för arbetsstationsmiljöer. Varje fläkt är konstruerad för att driva luftflöde genom den fullängds 3D-ångkammaren, vilket hjälper till att upprätthålla termisk jämvikt under långvariga arbetsbelastningar. Med måtten 304 mm × 137 mm × 40 mm passar den bekvämt i en konfiguration med dubbla slots och erbjuder exceptionell prestandatäthet med tanke på dess TDP-värde på 600 W.
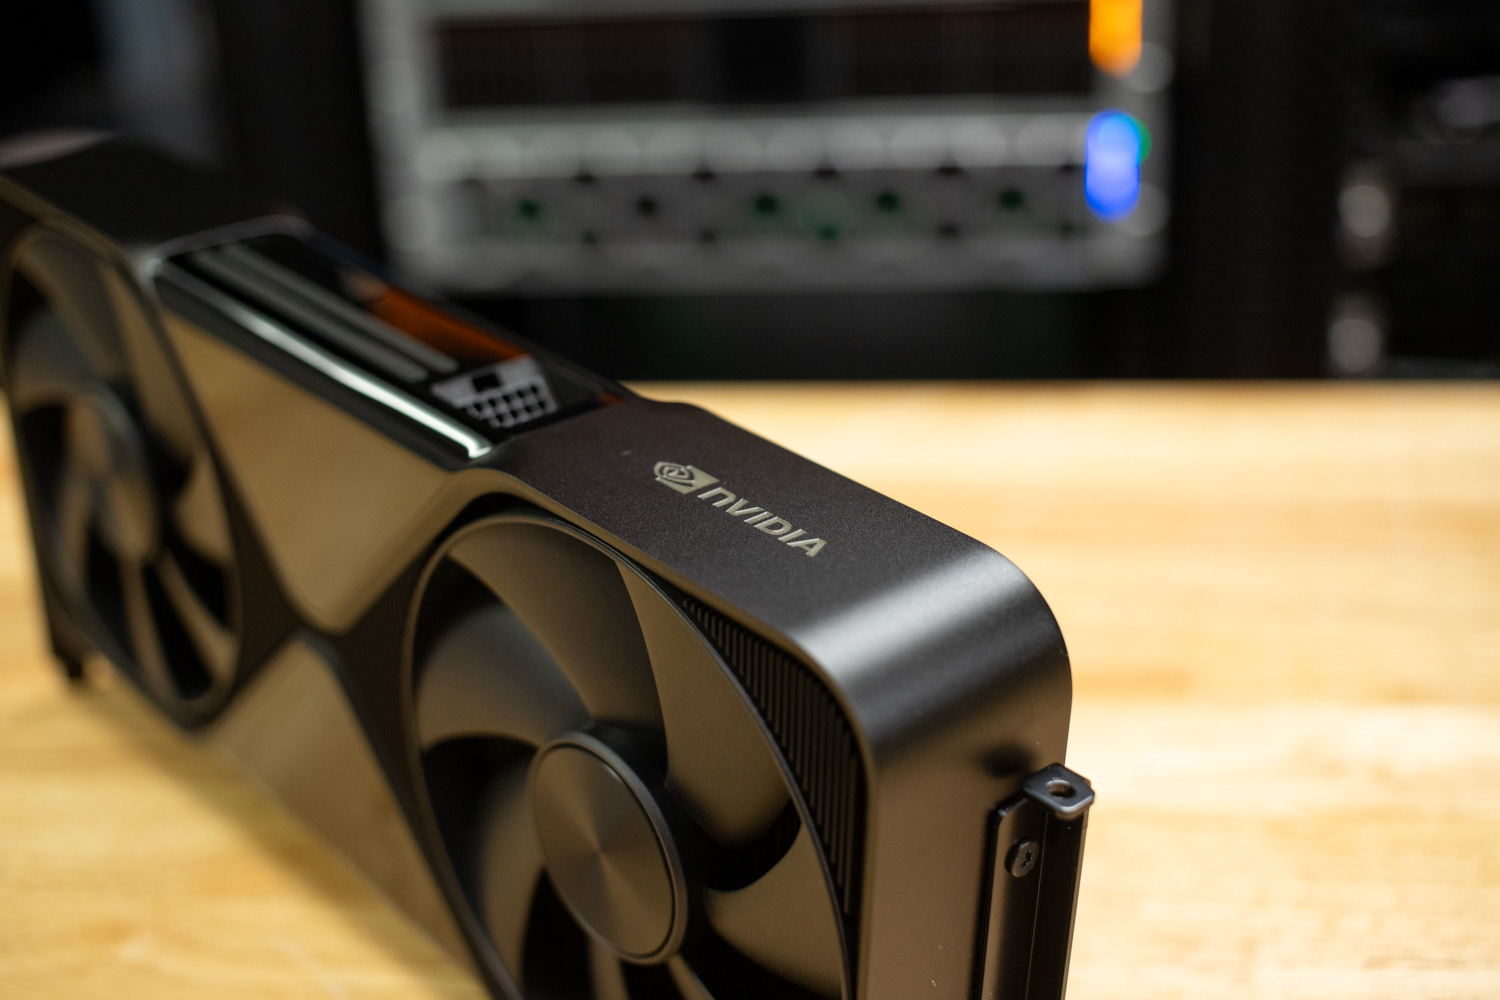
Längs den övre kanten har PRO 6000 en enda 16-pins strömkontakt som levererar den ström som krävs för att stödja dess 96 GB GDDR7-minne och fullständiga Blackwell 2.0-arkitektur. Byggkvaliteten känns premium och styv, med ett aluminiumhölje som effektivt leder luften över flänsstacken. NVIDIAs subtila varumärke kompletterar den professionella estetiken, utan RGB-effekter eller spelföremål, vilket betonar tillförlitlighet och prestanda i termiskt krävande arbetsstationschassin.
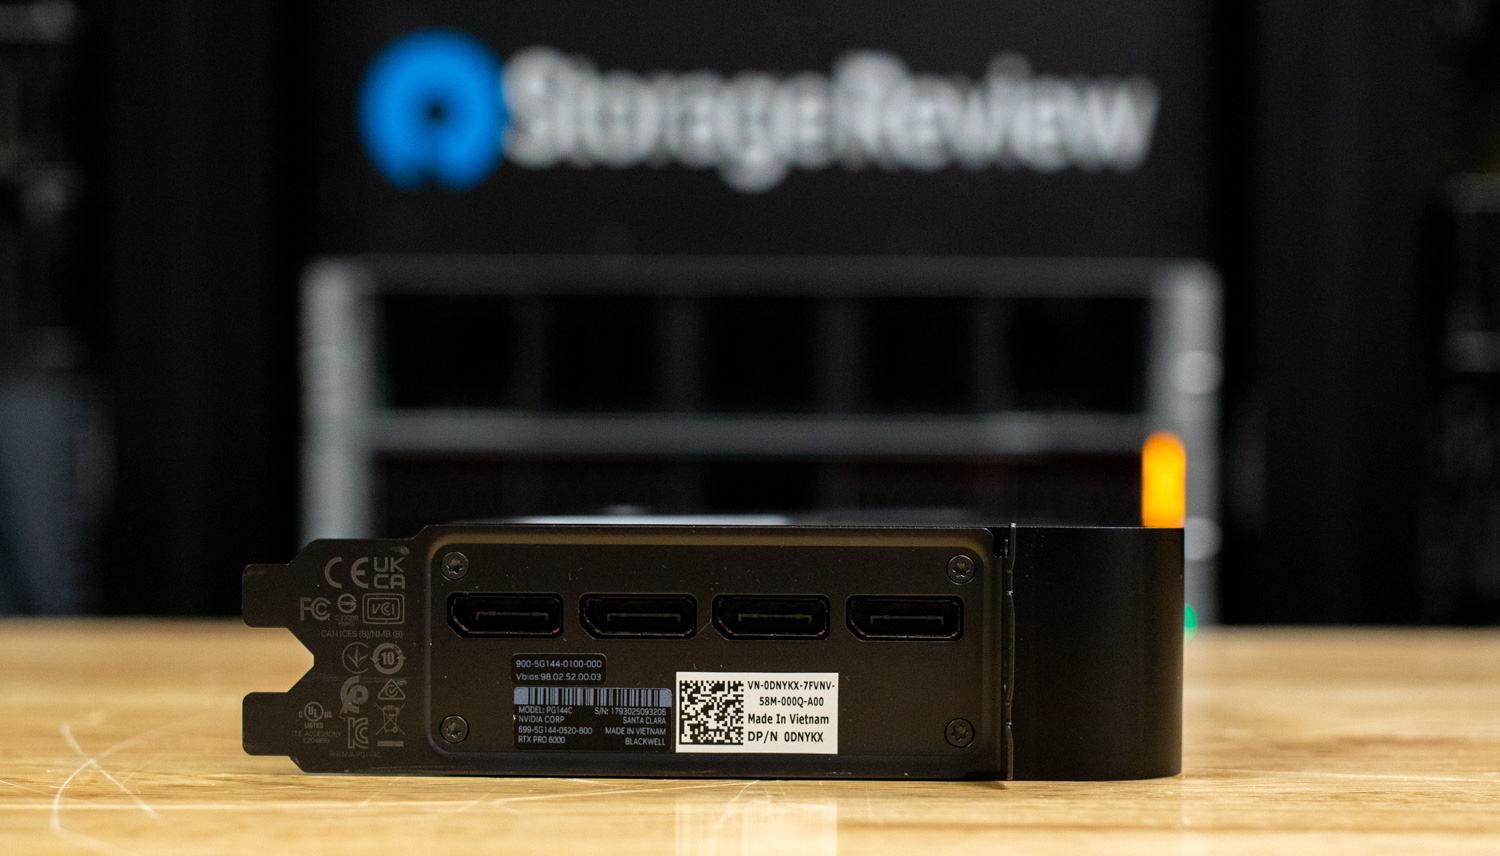
På I/O-sidan tillhandahåller NVIDIA fyra DisplayPort 2.1b-utgångar, vilket säkerställer kompatibilitet med 8K-uppsättningar med flera bildskärmar, färgkorriga HDR-arbetsflöden och avancerade renderingsmiljöer. Användningen av DisplayPort 2.1b över HDMI återspeglar dess professionella inriktning, med förbättrad bandbredd för skärmar med hög uppdateringsfrekvens och hög upplösning.
Prestandatester
För att utvärdera prestandan hos vårt NVIDIA RTX PRO 6000-exemplar jämförde vi det direkt med NVIDIAs flaggskeppsmotsvarigheter för konsumenter, RTX 5090 Founders Edition och RTX 4090 Founders Edition. Testerna utfördes på en blandning av professionella och AI-drivna arbetsbelastningar för att belysa både rå beräkningskraft och prestanda för verkliga applikationer. Bland riktmärkena fanns UL Procyon AI Text Generation, UL Procyon AI Image Generation, LuxMark, Geekbench 6 och V-Ray, vilket gav en balanserad översikt över rendering, inferens och produktivitetsprestanda.
Utöver dessa standardarbetsbelastningar körde vi även riktade tester utformade för att visa upp de 96 GB GDDR7-minnet i RTX PRO 6000, vilket demonstrerade dess fördelar vid hantering av stora modeller, högupplösta datamängder och professionella visualiseringsarbetsbelastningar där kapacitet och hållbar dataflöde är avgörande.
- RTX PRO 6000
- GeForce RTX 5090FE
- GeForce RTX 4090FE
- RTX 6000 ADA
För att fullt ut utnyttja fördelarna med den nya NVIDIA RTX PRO 6000 använde vi vår AMD ThreadRipper-plattform. Systemet, som det är konfigurerat, erbjuder en 64-kärnig processor och en vattenkylningsslinga. Det har gott om underliggande processorkraft för att låta grafikkortet göra sitt arbete utan att begränsas. Den fullständiga systemkonfigurationen listas nedan.
StorageReview AMD ThreadRipper testplattform
- Moderkort: ASUS Pro WS TRX50-SAGE WIFI
- CPU: AMD Ryzen Threadripper 7980X 64-Core
- BAGGE: 32 GB DDR5 4800MT/s
- Förvaring: 2TB Samsung 980 Pro
- OS: Windows 11 Pro för arbetsstationer
UL Procyon: AI Text Generation
Procyon AI Text Generation Benchmark effektiviserar prestandatestning av AI LLM genom att tillhandahålla en koncis och konsekvent utvärderingsmetod. Den möjliggör upprepad testning över flera LLM-modeller samtidigt som komplexiteten hos stora modellstorlekar och variabla faktorer minimeras. Utvecklad med ledande AI-hårdvara optimerar den användningen av lokala AI-acceleratorer för mer tillförlitliga och effektiva prestandabedömningar. Resultaten som mäts nedan testades med TensorRT.
Över alla fyra modelltester ledde NVIDIA RTX PRO 6000 konsekvent fältet. Med början i Phi uppnådde PRO 6000 en totalpoäng på 6 775, vilket överträffade RTX 5090 med 5 749, RTX 4090 med 4 958 och RTX 6000 Ada med 4 508. Dess snabbare tokengenereringshastighet (325.9 tokens/s) och lägre latens (0.182 s till första token) understryker dess responsivitet vid textgenerering i realtid och chattbaserade AI-arbetsbelastningar.
Trenden fortsatte med Mistral, där PRO 6000 noterade 7 346, vilket bibehöll en betydande marginal jämfört med 5090 (6 267), 4090 (5 094) och 6000 Ada (4 255). Dess dataflöde på 271.8 tokens/s visar fördelarna med dess större minnespool på 96 GB och optimerade arbetsstationsinställning för högkontextinferens.
I Llama3 låg PRO 6000 kvar i ledningen med en poäng på 6 501, jämfört med 6 104 för RTX 5090, 4 849 för 4090 och 4 026 för 6000 Ada. Detta belyser NVIDIAs Blackwell-arkitekturs konsekvens, där PRO 6000 bibehåller prestandafördelar allt eftersom transformatorarbetsbelastningar skalas i komplexitet och kontextlängd.
Slutligen, i Llama2, som betonar långvarig kontextinferens och bibehållen prestanda, uppnådde PRO 6000 8 008, medan 5090, 4090 och 6000 Ada låg efter med 6 591, 5 013 respektive 3 957. Även när sekvenslängder och inferenstider ökade, behöll PRO 6000 en tydlig dominans i både hastighet och stabilitet, och slutförde körningar snabbare och med jämnare genomströmning än någon annan testad GPU.
| UL Procyon: AI Text Generation | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 | NVIDIA RTX 6000 Ada |
| Phi totalpoäng | 6,775 | 5,749 | 4,958 | 4,508 |
| Phi-utgångstid till första token | 0.182 s | 0.244 s | 0.255 s | 0.288 s |
| Phi Output Tokens per sekund | 325.855 tok/s | 314.435 tok/s | 244.343 tok/s | 228.359 tok/s |
| Phi total varaktighet | 9.498 s | 10.280 s | 12.872 s | 13.869 s |
| Mistral totalt resultat | 7,346 | 6,267 | 5,094 | 4,255 |
| Mistral-utgångstid till första token | 0.229 s | 0.297 s | 0.322 s | 0.419 s |
| Mistral Output Tokens per sekund | 271.779 tok/s | 255.945 tok/s | 183.266 tok/s | 166.633 tok/s |
| Mistral total varaktighet | 11.493 s | 12.593 s | 17.010 s | 19.092 s |
| Llama3 Totalt resultat | 6,501 | 6,104 | 4,849 | 4,026 |
| Llama3-utgångstid till första token | 0.218 s | 0.234 s | 0.259 s | 0.348 s |
| Llama3 Output Tokens per sekund | 226.407 tok/s | 214.285 tok/s | 150.039 tok/s | 138.620 tok/s |
| Llama3 Total Duration | 13.554 s | 14.304 s | 19.991 s | 22.062 s |
| Llama2 Totalt resultat | 8,008 | 6,591 | 5,013 | 3,957 |
| Llama2-utgångstid till första token | 0.307 s | 0.419 s | 0.500 s | 0.679 s |
| Llama2 Output Tokens per sekund | 145.595 tok/s | 134.502 tok/s | 92.853 tok/s | 78.532 tok/s |
| Llama2 Total Duration | 20.712 s | 23.018 s | 32.448 s | 38.923 s |
UL Procyon: AI-bildgenerering
Procyon AI Image Generation Benchmark tillhandahåller en konsekvent och noggrann metod för att mäta AI-inferensprestanda över olika hårdvaror, från lågenergi-NPU:er till avancerade GPU:er. Den inkluderar tre tester: Stable Diffusion XL (FP16) för avancerade GPU:er, Stable Diffusion 1.5 (FP16) för måttligt kraftfulla GPU:er och Stable Diffusion 1.5 (INT8) för lågenergienheter. Benchmarket använder den optimala inferensmotorn för varje system, vilket säkerställer rättvisa och jämförbara resultat.
Med utgångspunkt i Stable Diffusion 1.5 (FP16) levererade NVIDIA RTX PRO 6000 en imponerande totalpoäng på 8 869, vilket överträffade RTX 5090 med 8 193, RTX 4090 med 5 260 och RTX 6000 Ada med 4 230. PRO 6000 slutförde bildgenereringen på 11.27 sekunder med ett genomsnitt på 0.705 sekunder per bild, vilket gör den snabbast i detta test. Detta visar hur dess arbetsstationsoptimerade finjustering och 96 GB GDDR7-minne möjliggör hållbar, högprecisionsutdata utan att kompromissa med effektiviteten.
I Stable Diffusion 1.5 (INT8)-testet, som mäter prestanda för kvantiserad inferens med låg vikt, presterade alla GPU:er nära. PRO 6000 fick 79 064 poäng, nästan identiskt med RTX 5090:s 79 272, samtidigt som den ledde RTX 4090 (62 160) och RTX 6000 Ada (55 901). Eftersom INT8-arbetsbelastningar är mindre beroende av minnesbandbredd och kapacitet var skillnaderna minimala, men PRO 6000 bibehöll konsekventa resultat med en genomsnittlig genereringstid på 0.395 sekunder per bild.
Stable Diffusion XL (FP16)-testet utmanar GPU:er med längre, mer krävande inferenskörningar som belastar både minne och bibehållen dataflödeshastighet. Här uppnådde PRO 6000 en totalpoäng på 6 991, strax efter RTX 5090:s 7 179, men långt före RTX 4090:s 5 025 och RTX 6000 Adas 3 043. Den bibehöll en total renderingstid på 85.8 sekunder, eller 5.36 sekunder per bild, vilket visar att PRO 6000 hanterar utökade genereringsarbetsbelastningar effektivt och utan avmattningar.
| UL Procyon: AI Image Generation | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 | NVIDIA RTX 6000 Ada |
| Stabil Diffusion 1.5 (FP16) – Totalt resultat | 8,869 | 8,193 | 5,260 | 4,230 |
| Stabil Diffusion 1.5 (FP16) – Total tid | 11.274 s | 12.204 s | 19.011 s | 23.639 s |
| Stabil Diffusion 1.5 (FP16) – Bildgenereringshastighet | 0.705 s/bild | 0.763 s/bild | 1.188 s/bild | 1.477 s/bild |
| Stabil Diffusion 1.5 (INT8) – Totalt resultat | 79,064 | 79,272 | 62,160 | 55,901 |
| Stabil Diffusion 1.5 (INT8) – Total tid | 3.162 s | 3.154 s | 4.022 s | 4.472 s |
| Stable Diffusion 1.5 (INT8) – Bildgenereringshastighet | 0.395 s/bild | 0.394 s/bild | 0.503 s/bild | 0.559 s/bild |
| Stable Diffusion XL (FP16) – Totalt resultat | 6,991 | 7,179 | 5,025 | 3,043 |
| Stabil Diffusion XL (FP16) – Total tid | 85.819 s | 83.573 s | 119.379 s | 197.172 s |
| Stable Diffusion XL (FP16) – Bildgenereringshastighet | 5.364 s/bild | 5.223 s/bild | 7.461 s/bild | 12.323 s/bild |
Blender 4.4
Blender är ett 3D-modelleringsprogram med öppen källkod. Detta benchmark kördes med hjälp av Blender Benchmark-verktyget. Poängen mäts i samplingar per minut, där högre värden indikerar bättre prestanda.
I alla tre scenerna tog NVIDIA RTX PRO 6000 topplaceringen, vilket visade upp fördelarna med sin Blackwell-arkitektur och utökade minneskapacitet. I Monster-scenen fick PRO 6000 7 870,17 samplingar per minut, före RTX 5090 på 7 421,50, medan RTX 4090 och RTX 6000 Ada följde på 5 733,97 respektive 5 632,60.
I Junkshop-scenen fortsatte PRO 6000 sin ledning med 4 158,91 samplingar per minut, jämfört med 3 980,15 för RTX 5090, 2 827,83 för RTX 4090 och 2 663,77 för RTX 6000 Ada. Slutligen, i klassrumsscenen, som tenderar att betona både skuggning och minneseffektivitet, nådde PRO 6000 4 041,11 samplingar per minut, återigen före RTX 5090:s 3 732,63 och överträffade RTX 4090 och RTX 6000 Ada avsevärt med 2 909,35 respektive 2 818,83.
| Blender 4.4 (högre desto bättre) | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 | NVIDIA RTX 6000 Ada |
| Monster | 7,870.17 | 7,421.50 | 5,733.97 | 5,632.60 |
| Junkshop | 4,158.91 | 3,980.15 | 2,827.83 | 2,663.77 |
| Klassrum | 4,041.11 | 3,732.63 | 2,909.35 | 2,818.83 |
Luxmark
Luxmark är ett GPU-riktmärke som använder LuxRender, en öppen källkod för strålspårningsrenderare, för att bedöma ett systems prestanda vid hantering av mycket detaljerade 3D-scener. Detta riktmärke är särskilt relevant för att utvärdera de grafiska renderingsfunktionerna hos servrar och arbetsstationer, särskilt i visuella effekter och arkitektoniska visualiseringstillämpningar, där noggrann ljussimulering är avgörande.
I matscentestet ledde NVIDIA RTX PRO 6000 med en poäng på 24 287, och slog RTX 5090 på 23 141, medan RTX 4090 och RTX 6000 Ada följde med 17 171 respektive 14 873. Detta visar hur PRO 6000 bibehåller smidig strålspårningsprestanda över mycket detaljerad geometri och ljusbelastningar utan stabilitetsförlust eller termisk strypning.
I den mer krävande Hall-scenen, som betonar storskalig geometri och komplex global belysning, säkrade PRO 6000 återigen toppresultatet på 52 588, knappt före RTX 5090:s 51 725, och långt över RTX 4090 (38 887) och RTX 6000 Ada (32 132).
| Luxmark (högre är bättre) | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 | NVIDIA RTX 6000 Ada |
| Matpoäng | 24,287 | 23,141 | 17,171 | 14,873 |
| Hallresultat | 52,588 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6 är ett plattformsoberoende benchmark som mäter systemets övergripande prestanda. Geekbench Browser låter dig jämföra vilket system som helst med det.
I detta test uppnådde NVIDIA RTX PRO 6000 ett GPU OpenCL-resultat på 384 158, vilket överträffade RTX 5090 (374 807), RTX 4090 (333 384) och RTX 6000 Ada (336 882). PRO 6000:s högre resultat återspeglar dess optimerade arbetsstationsdesign, förbättrade minnesbandbredd och professionella drivrutinsstack, vilket tillsammans möjliggör konsekvent prestanda över ett brett spektrum av beräkningstunga arbetsbelastningar.
| Geekbench (högre är bättre) | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 | NVIDIA RTX 6000 Ada |
| GPU OpenCL-poäng | 384,158 | 374,807 | 333,384 | 336,882 |
V-Ray
V -Ray Benchmark mäter renderingsprestanda för processorer, NVIDIA GPU:er eller båda med avancerade V-Ray 6-motorer. Den använder snabba tester och ett enkelt poängsystem för att göra det möjligt för användare att utvärdera och jämföra sina systems renderingskapacitet. Det är ett viktigt verktyg för yrkesverksamma som söker effektiv prestandainsikt.
I våra tester fick NVIDIA RTX PRO 6000 12 128 vpaths, vilket placerar den mellan RTX 5090, som ledde med 14 764, och RTX 4090, som fick 10 847. RTX 6000 Ada låg något efter med 10 766. Medan RTX 5090 behöll en liten ledning i detta GPU-intensiva renderingstest, uppvisade PRO 6000 stark och konsekvent prestanda, vilket förstärkte dess arbetsstationsorienterade finjustering och bibehållna effektivitet under full renderingsbelastning.
| V-Ray (högre är bättre) | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 | NVIDIA RTX 6000 Ada |
| vpaths | 12,128 | 14,764 | 10,847 | 10,766 |
LM Studio flermodellsinferenstest
För den här testomgången använde vi LM Studio för att utvärdera hur NVIDIA RTX PRO 6000 presterar i en rad populära stora språkmodeller, inklusive GPT-OSS 120B, Gemma 3 (4B, 12B och 27B), Llama 3.1 (8B och 70B) och Llama 3.3 70B. Varje modell fick samma instruktion:
"Skriv en akademisk uppsats på 500 ord om sengångarnas historia."
Det primära fokuset i detta test ligger på Tokens per Second (genomströmning) och Total Time (slutförandetid), vilka tillsammans visar hur effektivt RTX PRO 6000 hanterar olika modellstorlekar och komplexiteter under identiska genereringsförhållanden.
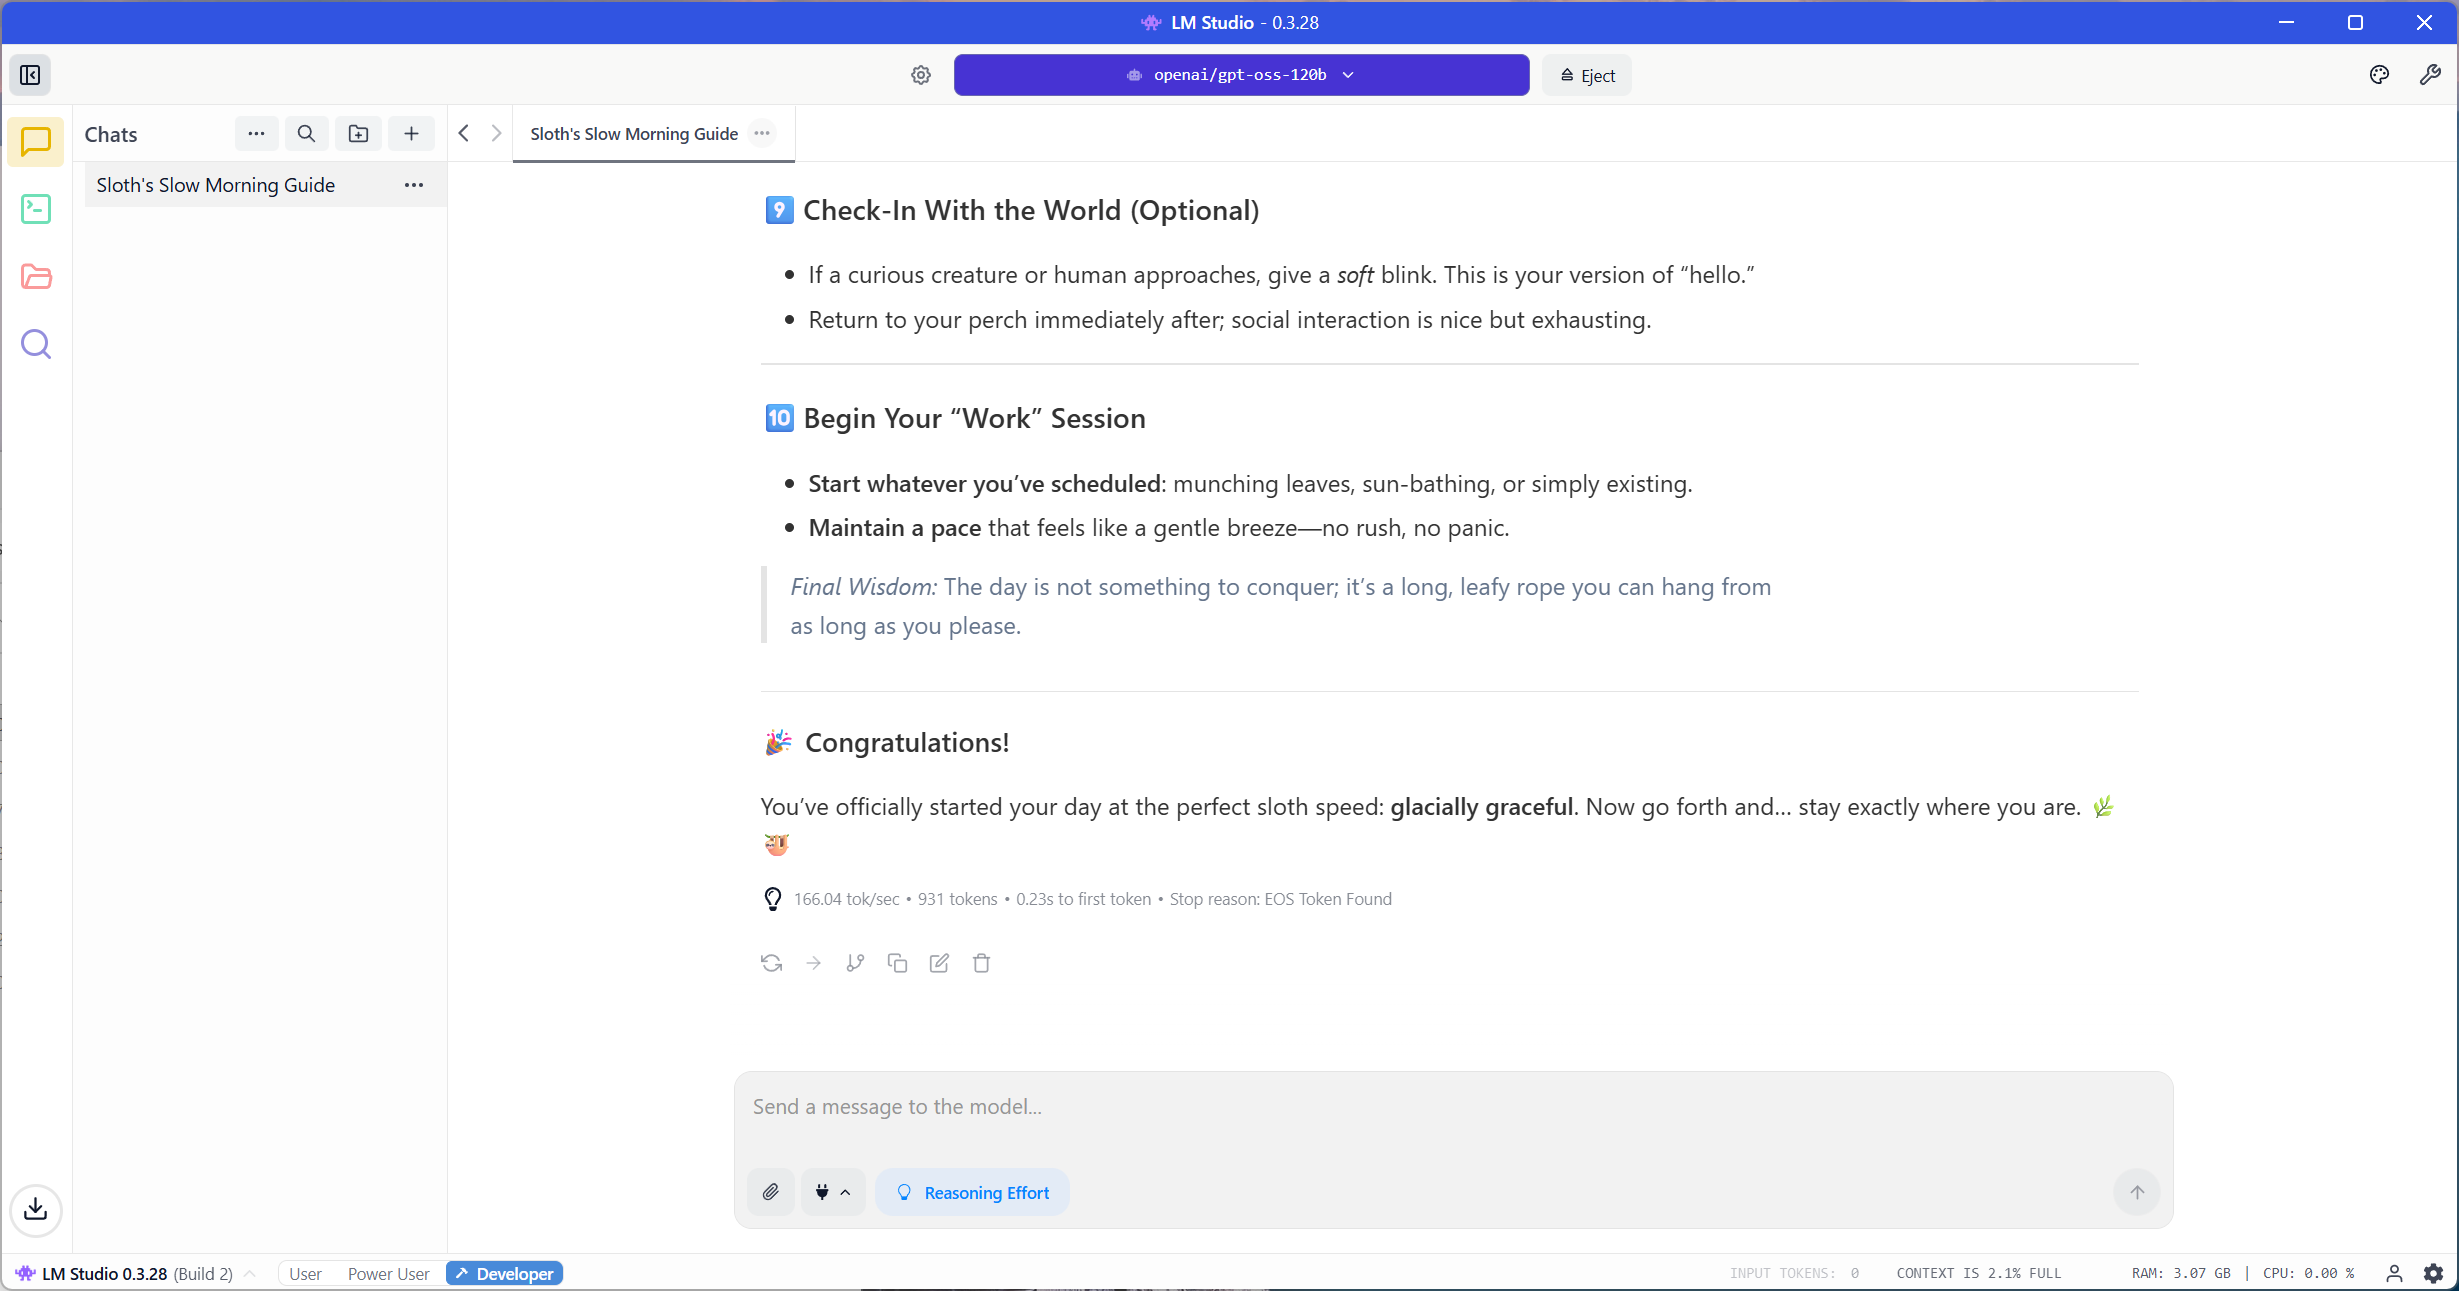
I LM Studios inferenstester uppvisade NVIDIA RTX PRO 6000 utmärkt prestanda och skalbarhet över en mängd olika modellstorlekar, från mindre modeller med 4B-parametrar till massiva konfigurationer i 120B-klassen.
Höjdpunkten i detta test var OpenAI GPT-OSS 120B, där RTX PRO 6000 producerade 163.1 tokens per sekund och slutförde 500-ordsgenereringen på 9.54 sekunder. Detta resultat sticker ut eftersom kort som RTX 5090 inte kan ladda eller exekvera en 120B-modell och ofta inte klarar av att hantera ens 70B-modeller på grund av begränsat VRAM. PRO 6000:s 96 GB GDDR7-minne gör det möjligt att bearbeta dessa enorma modeller lokalt, vilket gör den unikt kapabel bland arbetsstationers GPU:er.
För mindre modeller uppnådde Gemma 3.4 B den högsta datahastigheten och slutförde uppgiften med 226.7 tokens per sekund på 3.51 sekunder. Llama 3.1 8B Instruct följde tätt efter, med 197.1 tokens per sekund och en total tid på 4.17 sekunder. Dessa körningar visar PRO 6000:s starka effektivitet och snabba respons i mellanstora inferensarbetsbelastningar.
I den högre änden hade modellerna Llama 3.1 70B Instruct och Llama 3.3 70B i genomsnitt cirka 31.8 tokens per sekund med totala genereringstider på 27.2 sekunder och 25.3 sekunder, vilket visade en konsekvent utdata trots sin stora storlek.
Sammantaget levererar RTX PRO 6000 enastående stabilitet, dataflöde och kapacitet vid körning av storskaliga modeller. Dess minneskapacitet på 96 GB gör att den kan hantera arbetsbelastningar som överstiger gränserna för konsument-GPU:er, vilket gör den till ett utmärkt val för utvecklare, forskare och yrkesverksamma som behöver pålitlig lokal prestanda för avancerad AI och generativ modellutveckling.
| LM Studio (Modell inferensresultat) | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| Modellnamn | Tokens / Sek | Tid till första token (er) | Total tid (s) | Prompt-tokens | Förutspådda tokens | Totala tokens | |||
| OpenAI GPT-OSS 120B | 163.15 | 0.193 | 9.543 | 81 | 1,557 | 1,638 | |||
| Gemma 3 4B | 226.73 | 0.113 | 3.51 | 25 | 796 | 821 | |||
| Gemma 3 12B | 117.15 | 0.068 | 8.06 | 25 | 944 | 969 | |||
| Gemma 3 27B | 68.06 | 0.221 | 12.048 | 25 | 820 | 845 | |||
| Meta Llama 3.1 8B Instruktion | 197.07 | 0.062 | 4.171 | 49 | 822 | 871 | |||
| Meta Llama 3.1 70B Instruktion | 31.84 | 0.159 | 27.227 | 49 | 867 | 916 | |||
| Meta Lama 3.3 70B | 31.74 | 0.323 | 25.329 | 49 | 804 | 853 | |||
NVIDIA RTX PRO 6000 strömförbrukning
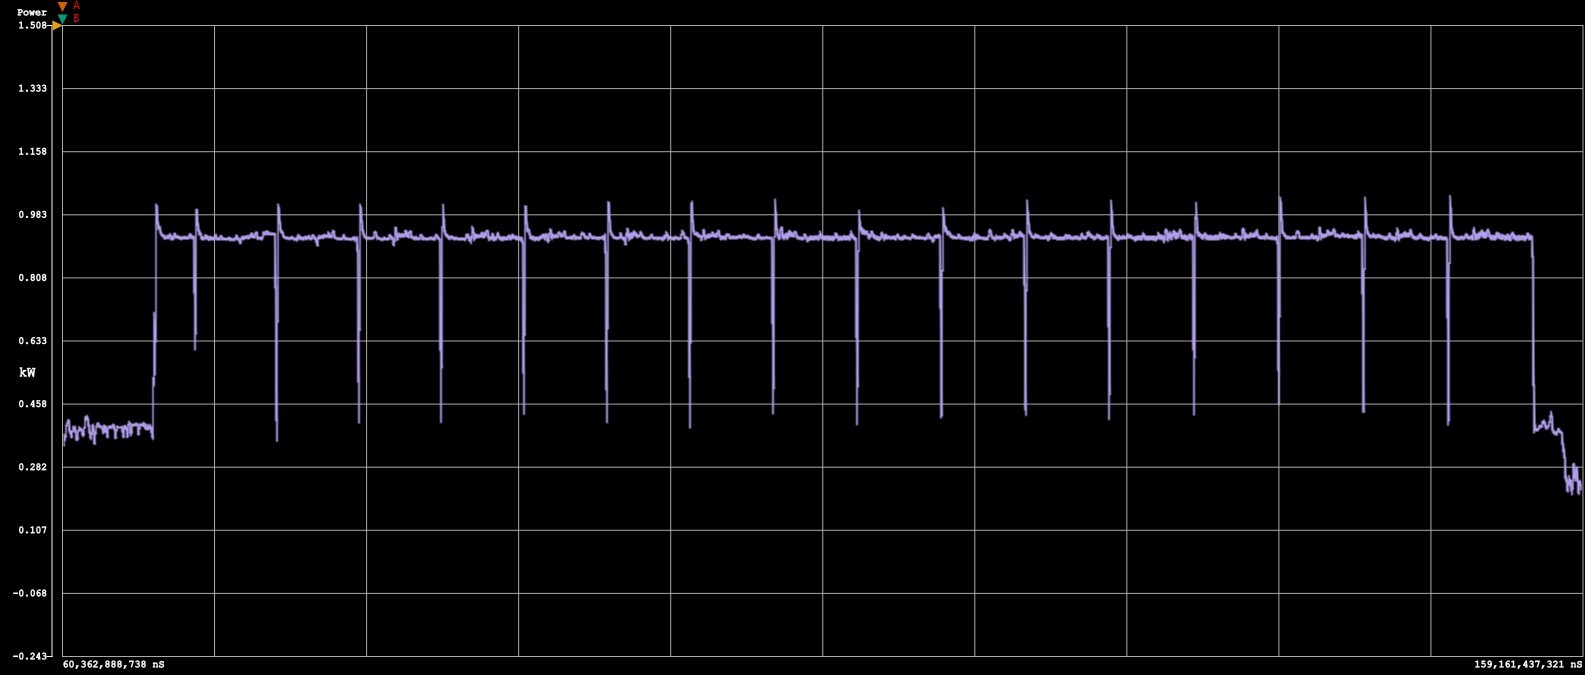
För att utvärdera den verkliga effektiviteten hos AI-arbetsbelastningar använde vi UL Procyon AI Image Generation-riktmärket, specifikt Stable Diffusion XL FP16-testet. Detta test fokuserar på intervallet mellan den andra och sista genererade bilden, och registrerar tiden det tar att slutföra intervallet, maximal och ihållande strömförbrukning samt systemets viloläge efter slutförandet.
Under våra tester bibehöll RTX PRO 6000 en genomsnittlig systemförbrukning på 918.5 W under ihållande belastning, med en topp på 1 036,3 W, och en strömförbrukning vid tomgång på 152.3 W när arbetsbelastningen var klar. Hela testintervallet varade i 5.3 sekunder och förbrukade totalt 1.35 Wh energi. Dessa resultat visar utmärkt effekt-till-prestanda-effektivitet för en GPU i arbetsstationsklass, vilket håller förbrukningen välkontrollerad samtidigt som hög effekt bibehålls under längre inferensarbetsbelastningar.
Jämfört med andra grafikkort ligger RTX PRO 6000 nära RTX 4090 i total energiförbrukning samtidigt som den bibehåller en snabbare slutförandetid, och den överträffar RTX 6000 Ada avsevärt i både energieffektivitet och hastighet. Intressant nog uppvisar de nya Blackwell-korten, som delar GB202-chippet, mycket liknande effektivitetsegenskaper under denna arbetsbelastning, med endast mindre skillnader i total energiförbrukning, troligen på grund av PRO 6000:s högre TDP. Detta indikerar att NVIDIAs senaste generation fortsätter att förfina prestandan per watt snarare än att drastiskt förändra den.
| Stabil Diffusion XL FP16 Bildeffekt som används (lägre är bättre) | NVIDIA RTX PRO 6000 | NVIDIA RTX-5090 | NVIDIA RTX-4090 | NVIDIA RTX 6000 Ada |
| Ström förbrukad | 1.35Wh | 1.16Wh | 1.35Wh | 1.76Wh |
| Testets varaktighet | 5.3s | 5.1s | 7.3s | 12.6s |
Slutsats
NVIDIA RTX PRO 6000 är, sammantaget, den mest kapabla arbetsstations-GPU:n som finns tillgänglig för professionella arbetsflöden, och levererar prestanda i datacenterklass i ett skrivbordsformat. Med ett detaljhandelspris på cirka 8 500 dollar vid testtillfället riktar den sig till team som kräver tillförlitlighet, hög beräkningstäthet och en massiv ECC-minnespool för produktionsarbete. Med 24 064 CUDA-kärnor, 752 Tensor-kärnor, 96 GB GDDR7 ECC och Blackwell-arkitektur hanterar den arbetsbelastningar som överskrider de praktiska gränserna för konsumentkort som GeForce RTX 5090 eller 4090. Enskilda prestandatester kan visa att ett konsumentkort överträffar det i rå hastighet, men som helhet sett till kapacitet, stabilitet, drivrutiner och ISV-stöd är RTX PRO 6000 den starkare lösningen för professionell användning.
För AI och ML är 96 GB-poolen huvudprioriteten. Den möjliggör långvarig kontextinferens och mycket stora kontrollpunkter lokalt, vilket vi demonstrerade genom att köra modeller i klasserna 70B till 120B samtidigt som vi bibehåller starka tokens per sekund. Rendering och simulering drar också nytta av den större L2-cachen och minnesbandbredden, vilket ger förutsägbar och hållbar prestanda i Blender, V-Ray och LuxMark under längre belastningar.
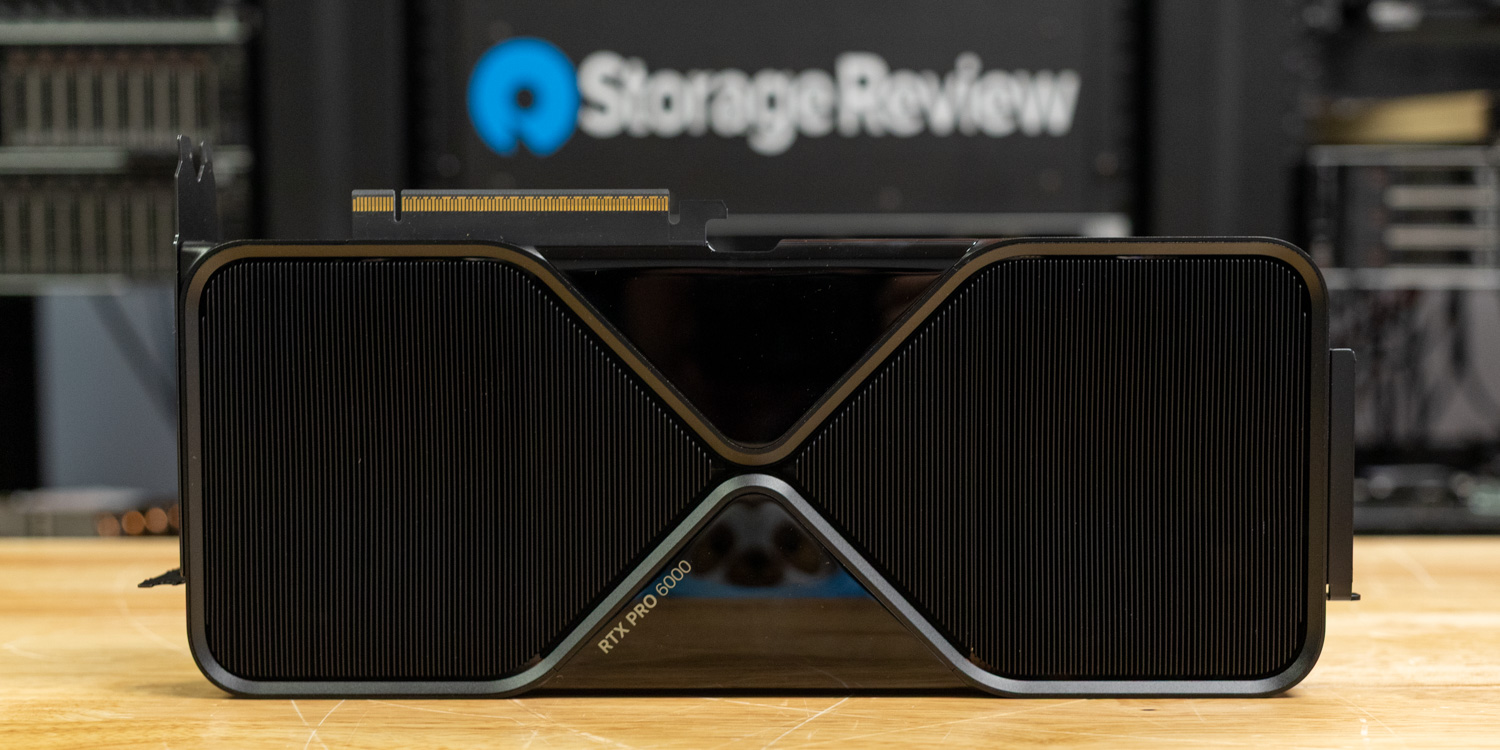
Kortet passar riktiga arbetsstationer. Det har en äkta dubbla slot-design med ett PCIe 5.0 x16-gränssnitt, fyra DisplayPort 2.1b-utgångar och en enda 16-pins strömingång. Planera för ett nätaggregat och chassiluftflöde av hög kvalitet för att stödja 600W-kortets strömförsörjning. Multi-GPU är också enkelt, med OEM- och ISV-stöd för 2 till 8 GPU:er över AI-, renderings- och beräkningsstackar.
Om ditt arbete involverar långa kontextuella LLM:er, mycket stora scener eller högprecisionssimulering på en enda nod, rättfärdigar RTX PRO 6000 sin premiumkvalitet med kapacitet och konsekvens som andra kort inte kan matcha.
Nvidia RTX PRO 6000 produktsida
Topplista: RTX PRO 6000 Blackwell Server Edition har bästa Enterprise Inference GPU på vår topplista över bästa Enterprise GPU: er, där Workstation Edition-data från detta kort står för serverdelen.


 Amazon