

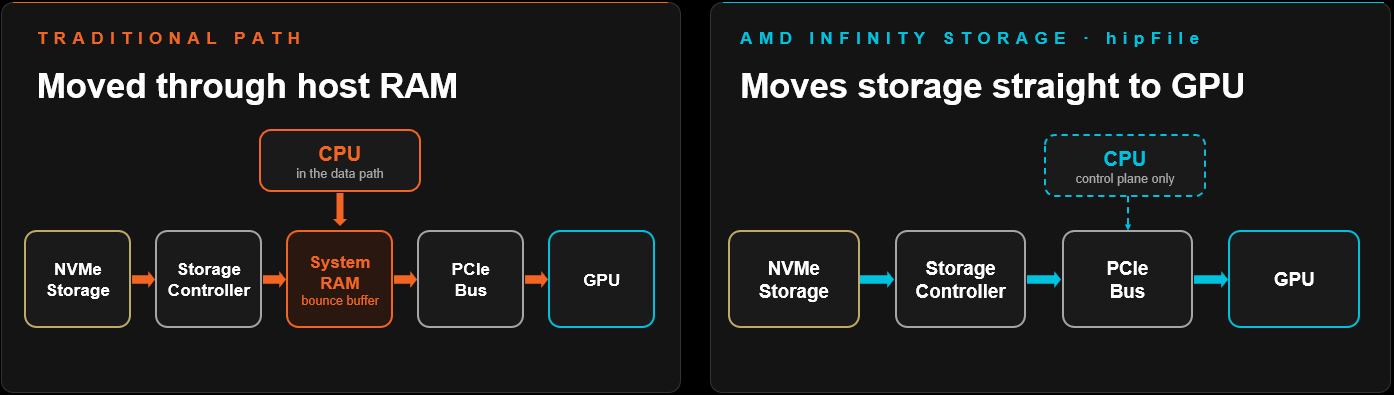
10 月 5 日發布的 AMD ROCm 10.1 著重優化了儲存和 GPU 之間的資料傳輸路徑。檢查點檔案、鍵值快取和模型權重如今經常超出加速器記憶體的容量,而當這種情況發生時,資料傳輸所花費的時間將比計算本身更能決定迭代時間。此版本擴展了 AMD Infinity Storage(ROCm 7.14 中引入的直接儲存堆疊),將儲存存取整合到 HIP 運行時中,並添加了支援 NUMA 的主機內存,從而使資料無需經過 CPU 內存即可直接到達 GPU。
直接GPU儲存管線和NUMA感知內存
AMD Infinity Storage 內部的 hipFILE 函式庫新增了非同步快速路徑後端。讀寫請求直接在 HIP 流上運行,無需傳統路徑所需的宿主機記憶體暫存步驟。 AMD 表示,這可以降低檢查點引擎和鍵值快取卸載的延遲,同時保持頻寬穩定。發布說明中明確指出了相關呼叫:hipFileReadAsync() 和 hipFileWriteAsync() 現在支援快速路徑。
批次 I/O API 一次提交多個檔案請求,並將它們指派到內部工作執行緒池中,這樣在訓練作業拉取大型資料集時,儲存佇列就會保持滿載運轉。遙測資料也會隨之成長:hipFileGetStatsL1、L2 和 L3 傳回的 I/O 統計資料會逐步變得更加詳細,這些計數器會提供給 ROCm 分析器,以便操作員判斷管道的瓶頸是運算能力、記憶體還是資料傳輸。
在雙路主機上,如果緩衝區分配在錯誤的插槽上,每次資料傳輸都會產生插槽間效能損失。 ROCm 10.1 擴展了 HIP 虛擬記憶體管理 API,新增了 hipMemLocationTypeHostNuma 和 hipMemLocationTypeHostNumaCurrent 接口,使得主機記憶體可以透過完整的創建、預留、映射和拆除生命週期放置在特定的 NUMA 節點上。諸如 RCCL 之類的庫可以在此基礎上建立 NUMA 本地的零拷貝通訊緩衝區,從而避免主機到設備的流量經過插槽互連。
ROCm CLI v1.0.0 和 AI 代理工作流程
ROCm CLI 版本 v1.0.0 正式發布,作為適用於 Linux、Windows 和 WSL2 的獨立二進位文件,它能夠安裝、配置和運行 AMD GPU 上的本地 AI 工作負載。此版本能夠偵測 vLLM 所需的 flash-attn 和 amd-aiter wheel 文件,支援更新後的ROCm 10軟體包佈局,並新增了一個標誌,用於在腳本化或 CI 環境中進行完全非互動式安裝。全螢幕 TUI 控制面板會在模型服務旁邊顯示即時 GPU 遙測數據,並提供一個本地聊天窗口,用於檢查端點是否響應。
AMD Skills 是 Claude Code 和 Codex 等程式設計代理程式的整合軟體包,現在又新增了兩個元件。 quark-install 用於安裝與 PyTorch 版本相符的 AMD Quark,而 quark-torch-llm-ptq 則用於在 PyTorch 和 Hugging Face LLM 上運行訓練後量化,支援的方案包括 FP8 和 INT4。
分析和遙測現代化
ROCprofiler-SDK 新增了核心重播功能(測試版)。 GPU 硬體每次調度僅暴露有限數量的效能計數器,因此以往收集完整的計數器集意味著需要為每個計數器組重新執行一次整個應用程式。內核重播功能會就地重新執行每個調度,並在每次執行之間重置 GPU 內存,從而在一次運行中收集完整的計數器集。此 SDK 還允許在 PyTorch Kineto 和 Triton Proton 的運行過程中隨時啟動和停止效能分析,並提供了一個 PC 採樣代理技能,引導程式碼助手使用 rocprofv3 進行 PC 採樣以查找計算停滯點。
ROCm 計算分析器的屋頂線報告現在是一個互動式 HTML 頁面,工程師可以隔離單一內核,並在不同快取等級之間切換算術強度軸。 PC 採樣報告按內核生成,細化到單一指令的採樣和停頓計數,新增的指南涵蓋了 vLLM 分析。 ROCm 系統分析器新增了 Gorgon Point 1、2 和 3 APU(gfx1150、gfx1152 和 gfx1153)的 Linux 追蹤功能,ROCm Optiq 現在可以將 rocprofv3 分析結果與系統分析器追蹤結果和計算分析器分析結果一起視覺化。
AMD SMI (amd-smi) 取代了 ROCm SMI,後者已從本次發布的標準構建中移除。它支援 Linux 和 Windows 系統上的 AMD GPU、CPU 和 APU,涵蓋裸機和虛擬化環境,並提供命令列介面 (CLI)、C 庫 (amd_smi_lib) 以及 Python、Go 和 Rust 綁定。容器感知功能擴展到 containerd、CRI-O、Podman、LXC 和 LXD,包括 Kubernetes Pod,因此叢集管理員可以將 GPU 進程和利用率與運行它們的容器進行匹配。
核心編譯器更新、函式庫和運行時支持
工具鏈從 LLVM 23 升級到 LLVM 24,clang_major 巨集現在會報告版本號為 24,任何鎖定編譯器版本或連結到 libLLVM 的使用者在升級前都應該檢查此設定。增量建置速度會因快取裝置程式碼連結時優化建立的分割區而加快,因此未變更的分割區會在下次建置時重複使用。
可組合核心加快了 Radeon GPU 的注意力處理速度,並為其調度器添加了更多量化矩陣乘法類型。 MIGraphX 將其後端編譯器從 rocMLIR 替換為 rocMLIRTriton,AMD 表示這可以提高推理效能,並通常縮短模型編譯時間,同時保持編譯器與上游 Triton 的同步。 rocSPARSE 直接對以 ELLPACK (ELL) 格式儲存的矩陣進行三角求解,無需事先進行轉換步驟。
hipThreads 是 ROCm Core SDK 執行緒庫中的新增元件,它將標準的 C++ 執行緒概念引入到 Linux 和 Windows 平台上的 AMD GPU。其目的是在不完全重寫為 HIP 核心和同步原語的情況下,加速現有 CPU 執行緒程式碼在 GPU 上的運作。
適用於 Linux 的 Windows 子系統 2 (WSL2) 進入技術預覽階段,標準 Linux 軟體套件將安裝在用戶端中,GPU 半虛擬化功能會將工作交給 Windows 主機驅動程式。預覽版支援 .deb 軟體包和 Python wheel 包,但不支援 RPM 包,且 WSL2 內部的效能分析、偵錯和 KFD 依賴工具目前尚無法使用。在虛擬化方面,KVM SR-IOV 現在支援 Ubuntu 26.04 LTS 作為主機和客戶機,並搭配 AMD GIM 虛擬化驅動程式 9.3.0.K 版本。
支援的硬體清單新增了 Radeon AI PRO R9600,以及 Instinct MI355X、MI350X 和 MI350P、MI300 和 MI200 系列、Radeon AI PRO R9700 系列的其餘部分和 Ryzen AI 處理器。


 Amazon