

AMD 宣布推出業界首款完全可編程的 AI 網路介面卡 (NIC) Pensando Pollara 400。此創新解決方案旨在加速 AI 工作負載,與正在開發的超級乙太網路聯盟 (UEC) 標準相容,並經過最佳化以增強資料中心的 GPU 到 GPU 通訊。 Pollara 400 AI NIC 代表著在為 AI/ML 工作負載、生成式 AI 和大型語言模型構建可擴展、高效能基礎設施方面邁出了重大飛躍。
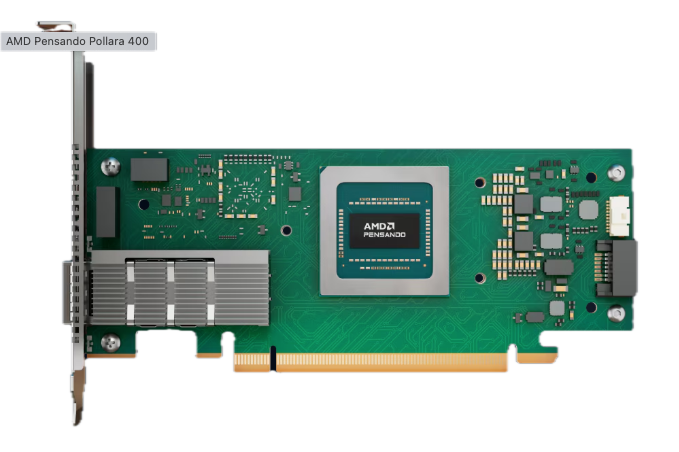
隨著人工智慧的發展,組織面臨著開發類似運算基礎架構的挑戰,這些基礎設施可提供最佳效能並提供適應未來需求的靈活性。這一演進的關鍵因素是有效擴展節點內 GPU 通訊網路。 AMD 致力於保留客戶的選擇權並在不犧牲效能的情況下降低總體擁有成本 (TCO),這一點在 Pollara 400 AI NIC 中得到了充分體現。該解決方案使組織能夠創建面向未來的人工智慧基礎設施,同時保持與開放生態系統的兼容性。
利用進階網路加速人工智慧工作負載
最大限度地提高 AI 叢集效能是雲端服務供應商、超大規模企業和企業的首要任務。然而,許多組織將網路視為限制 GPU 利用率的瓶頸。雖然資料傳輸速度至關重要,但只有當網路經過最佳化以滿足現代 AI 工作負載的需求時,它才有益。
| 規格 | 信息 |
|---|---|
| 最大帶寬 | 400 Gbps |
| 外形 | 半高半長(HHHL) |
| 主機接口 | PCIe Gen5.0 x16 |
| 以太網接口 | QSFP112(NRZ/PAM4 串列器/解串器) |
| 乙太網路速度 | 25/50/100/200/400 Gbps |
| 乙太網路配置 | 最多支援4個連接埠: 1 x 400克 2 x 200克 4 x 100克 4 x 50克 4 x 25克 |
| 管理 | 基於 SMBus 的 MCTP |
Pensando Pollara 400 AI NIC 透過提供智慧負載平衡、擁塞管理、快速故障轉移和損失復原來解決這些挑戰。這些功能可確保充分利用網路和運算資源,從而實現更高的正常運作時間、更快的作業完成速度和更高的可靠性。隨著 AI 工作負載的複雜性和規模不斷增加,Pollara 400 AI NIC 提供了消除瓶頸和釋放 AI 基礎設施全部潛力所需的工具。
面向未來的可程式解決方案
Pollara 400 AI NIC 採用 AMD 的 P4 架構,提供完全可編程的硬體管道,具有無與倫比的靈活性。這種可程式性使客戶能夠適應新標準(例如 UEC 制定的標準),或建立為其特定工作負載設計的自訂傳輸協定。與需要新一代硬體來支援新興功能的傳統硬體不同,Pollara 400 使組織能夠升級其 AI 基礎設施,而無需等待硬體更新。
Pollara 400 的主要特性包括支援多種傳輸協議,例如 RoCEv2、UEC RDMA 和其他乙太網路協議,確保與各種工作負載相容。智慧型資料包噴灑、亂序資料包處理和選擇性重傳等進階功能可優化頻寬利用率並減少延遲,這對於訓練和部署大型 AI 模型至關重要。路徑感知擁塞控制和快速故障偵測可確保近線速率效能並最大限度地減少 GPU 空閒時間,即使在瞬時擁塞或網路故障期間也是如此。
開放生態系優勢
AMD 的開放生態系統方法確保了與供應商無關的兼容性,使組織能夠建立滿足當前需求同時可擴展和可編程以滿足未來需求的 AI 基礎設施。該策略無需昂貴的基於單元的大型緩衝交換結構,從而降低了資本支出 (CapEx),同時確保了高效能。
Pensando Pollara 400 AI NIC 已在全球一些最大的橫向擴展資料中心得到驗證。雲端服務供應商 (CSP) 之所以選擇該解決方案,是因為它具有可程式化、高頻寬、低延遲和廣泛功能集的獨特組合。透過在開放生態系統中實現可擴展的基礎設施,AMD 可協助企業確保其 AI 環境的未來發展,同時提供即時的效能優勢。


 Amazon