

在巴黎舉行的 RAISE 高峰會上,DDN 重點介紹了其與歐洲主權混合雲供應商 Nebul 的持續合作,旨在提升大規模 AI 推理部署的效率。這項上周宣布的合作項目結合了 Nebul 的推理平台、DDN 的 Infinia 資料智慧架構以及 NVIDIA 的加速運算技術,以解決日益嚴峻的生產級 AI 瓶頸:推理過程中資料遷移帶來的成本和效能問題。
DDN圍繞著關鍵生產指標展開工作,包括GPU利用率、令牌吞吐量、單令牌成本和延遲。其前提是,模型訓練決定了AI資產的價值,而推理則決定了其營運和商業回報。隨著智能體AI、檢索增強生成和高並發推理的日益普及,儲存和資料基礎設施將直接影響加速器的利用率和回應時間。
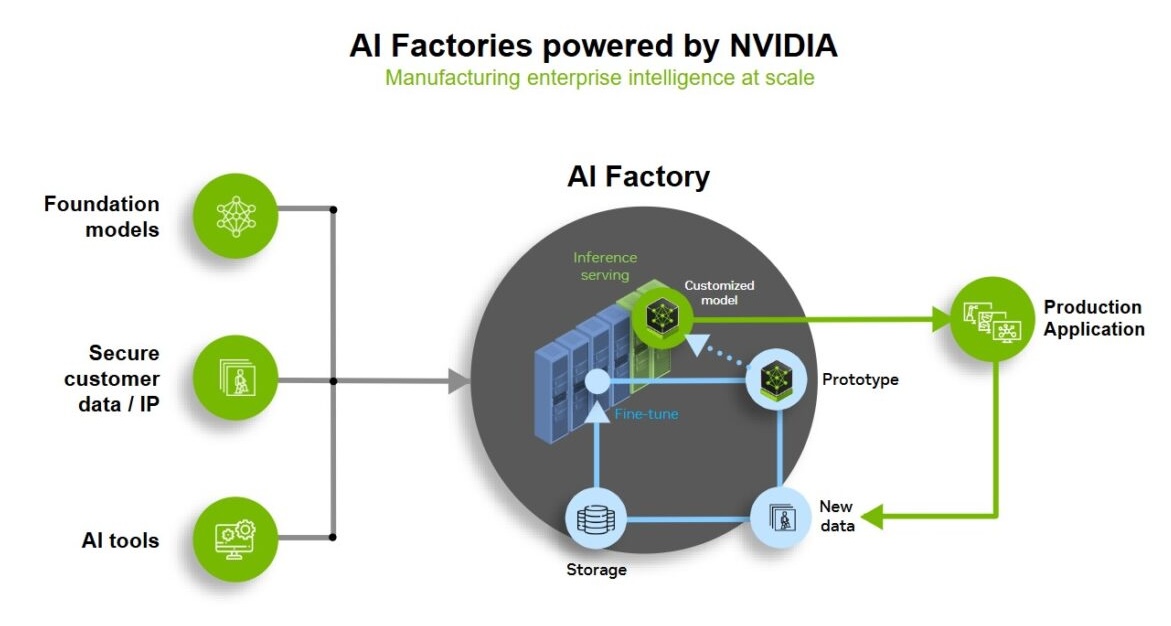
這項工作目前仍處於概念驗證階段,DDN 將迄今為止的成果描述為令人鼓舞的早期數據。兩家公司報告稱,啟用鍵值快取後,首次令牌生成時間得到了顯著縮短,並且已完成基於 RoCE 的基礎設施驗證。隨著他們在 Infinia 平台中發現更多最佳化機會,基準測試將在更長的推理序列長度上繼續進行。該計畫還擴展到與 NVIDIA 合作,共同開發基準測試方法、進行可擴展性驗證並撰寫未來的技術出版物。
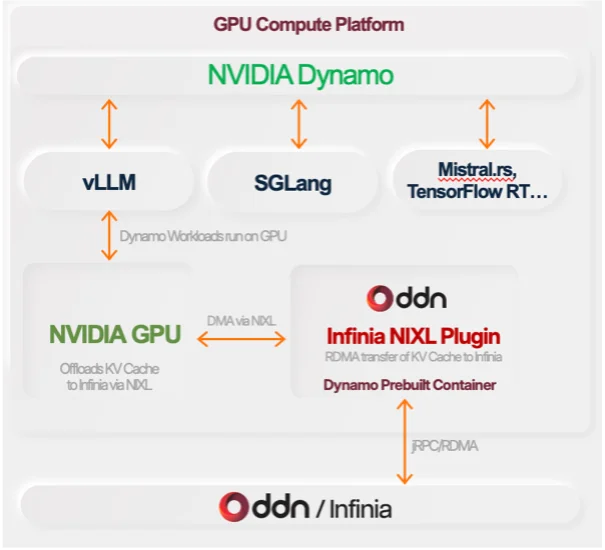
本平台採用分散式鍵值快取服務、GPU原生資料移動、資料編排與高效能儲存架構。鍵值快取加速對於推理特別重要,因為它能夠保存並快速檢索先前計算的注意力狀態,從而減少重複計算並降低資料傳輸延遲,避免GPU閒置。
DDN、Nebul 和 NVIDIA 的領導層標誌著業界重心從 GPU 購買轉向營運效率,重點在於最大化已部署加速器的價值。 DDN 執行長 Alex Bouzari 和 Nebul 執行長 Arnold Juffer 都強調,雖然模型規模一直是過去的首要任務,但當前的挑戰在於推理經濟性,以及如何透過降低代幣成本來使生產級 AI 在商業上可行。 NVIDIA 雲端基礎設施副總裁 Rod Evans 補充道,隨著企業向大規模智能體工作負載轉型,衡量基礎設施成功與否的標準越來越是 GPU 利用率和延遲,而不是原始運算能力。
DDN認為,人工智慧基礎設施必須超越傳統的儲存操作,並積極參與人工智慧的執行。該公司表示,其平台在全球支援超過一百萬個GPU,用戶涵蓋超大規模資料中心、雲端服務供應商、企業、政府機構和研究機構。
對於基礎設施團隊而言,相關的生產指標越來越多地包括:
- GPU利用率衡量昂貴的加速器在推理過程中保持活躍的有效程度。
- 每個代幣的成本將基礎設施效率與模型產出成本連結起來。
- 每瓦代幣數量衡量輸出效率與功耗的關係。
- 到達第一個代幣的時間這會影響使用者對互動式人工智慧應用的感知響應能力。
- 投入生產所需時間反映了將人工智慧服務從測試階段過渡到生產階段所需的營運工作量。 可擴充部署。
隨著推理成為人工智慧的主要運行工作負載,以低、可預測的延遲向 GPU 提供快取的上下文和企業資料的能力對於維持利用率和控製成本將變得越來越重要。


 Amazon