

戴爾科技集團宣布對其人工智慧資料平台進行重大更新,這是戴爾人工智慧工廠 (Dell AI Factory) 計畫的一部分。這些改進旨在幫助企業將分散、孤立的數據轉化為快速、可重複的人工智慧成果。隨著人工智慧的普及,企業資料量不斷成長,企業需要集安全性、靈活性和可擴展效能於一體的架構。戴爾的方案以建立統一、開放和模組化的基礎為中心,該基礎能夠連接孤立的資料孤島,同時支援訓練、微調、檢索增強生成 (RAG) 和推理等高階工作負載。
釋放孤立資料對 AI 工作負載的價值
戴爾人工智慧資料平台的架構將資料儲存與處理分離,消除了效能和管理瓶頸。這種分離使得不同的團隊(例如資料科學家、DevOps 工程師和 IT 管理員)能夠在多個人工智慧工作流程中使用相同的資料平台,而無需每次都重新建構基礎架構。該平台還與 NVIDIA 人工智慧數據平台參考設計直接集成,為企業提供跨戴爾和 NVIDIA 技術的優化互通性和加速性能。
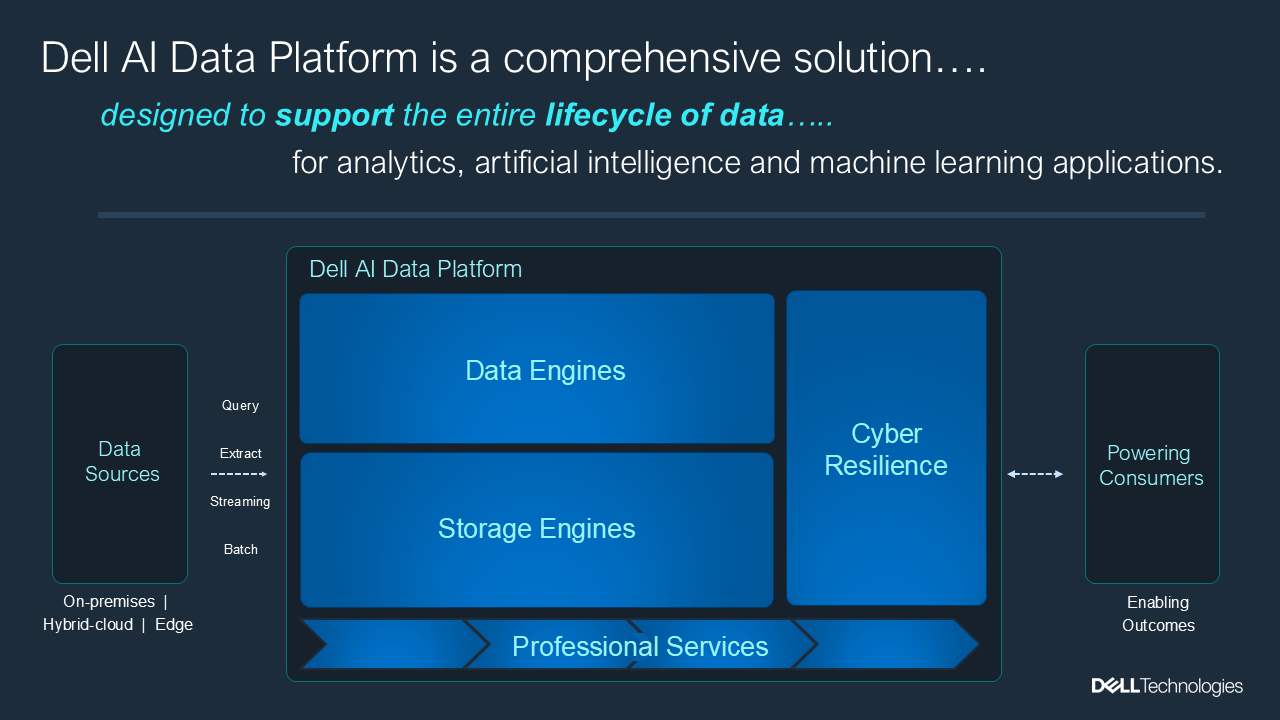
戴爾平台圍繞著四大關鍵支柱構建:用於資料放置和移動的儲存引擎、用於即時洞察的資料引擎、內建網路彈性以及智慧資料管理服務。這些組件共同為尋求大規模實施人工智慧的企業創建了一個靈活、可擴展且安全的基礎。
適用於現代 AI 管道的高性能儲存引擎
戴爾人工智慧資料平台的核心建構於 PowerScale 和 ObjectScale 儲存系列之上。這兩款產品均已增強,可提供更快的資料吞吐量、更高的安全性以及對多協定存取的支持,這些功能對於訓練、微調、推理和 RAG 管道至關重要,因為在這些管道中,延遲和資料局部性會直接影響模型的準確性和迭代速度。
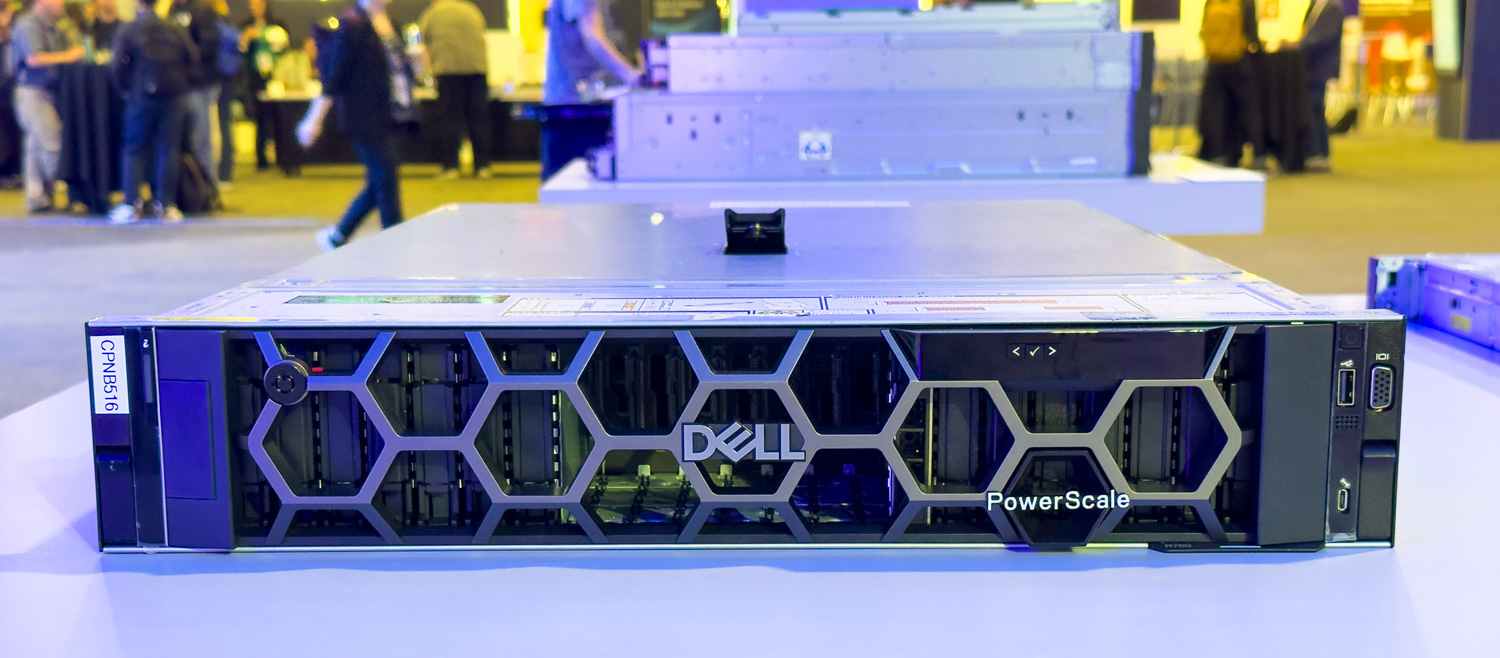
戴爾 PowerScale 兼具 NAS 的易用性和現代 AI 架構所需的大規模平行處理能力。最新更新與包括 GB200 和GB300 NVL72在內的全新 NVIDIA 平台緊密整合,並與現有應用堆疊無縫相容。這種協同確保運行 GPU 密集型工作負載的企業能夠線性擴展,同時保持效能穩定。獲得 NVIDIA 雲端合作夥伴認證的 PowerScale F710 便是最好的例證,它在單一系統中支援超過 16,000 個 GPU,同時佔用的機架空間卻減少了五倍,從而顯著提高了資料中心的密度和資源效率。
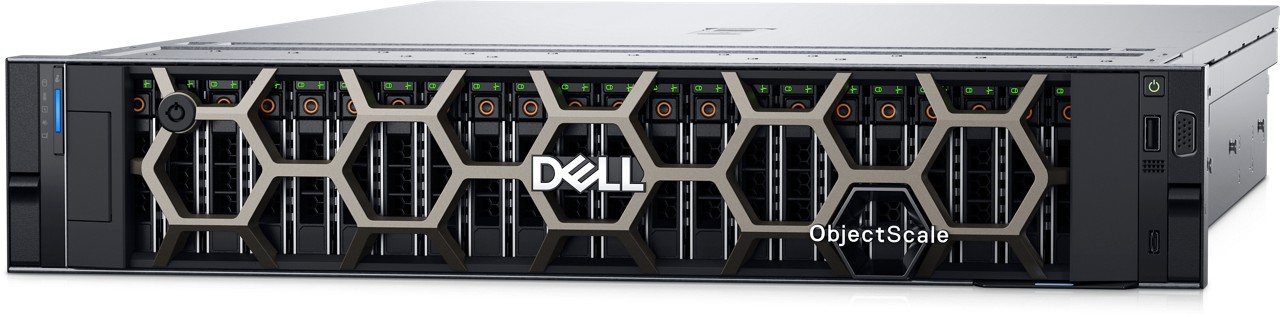
作為 PowerScale 的補充,Dell ObjectScale 提供與 S3 相容的高效能物件存儲,專為大規模 AI 資料工作負載而建置。客戶可以將其部署為專用設備,也可以部署為 Dell PowerEdge 伺服器上的軟體定義堆疊。效能基準測試表明,ObjectScale 現在的運行速度比上一代全快閃配置快八倍,這直接提升了資料密集型 AI 訓練和分析工作流程的效能。
戴爾也將在即將發布的技術預覽版中推出基於 RDMA 的 S3,其效能顯著提升:與傳統 S3 協定相比,吞吐量提升高達 230%,延遲降低 80%,CPU 使用率降低 98%。這些改進有助於減少資料移動開銷,釋放系統資源用於 GPU 處理和推理。此外,增強的 AWS S3 整合、儲存桶級壓縮和小物件效能調優功能,可將 10KB 物件操作的吞吐量提升高達 19%,延遲降低 18%,這對於人工智慧和邊緣應用中常見的高流失率小檔案環境至關重要。
用於即時 AI 啟動的智慧數據引擎
戴爾人工智慧數據平台的數據引擎旨在使原始數據立即用於人工智慧、分析和決策。這些引擎由戴爾與 NVIDIA、Elastic 和 Starburst 等合作夥伴共同開發,將資料搜尋、分析和語義理解整合到統一的操作層。
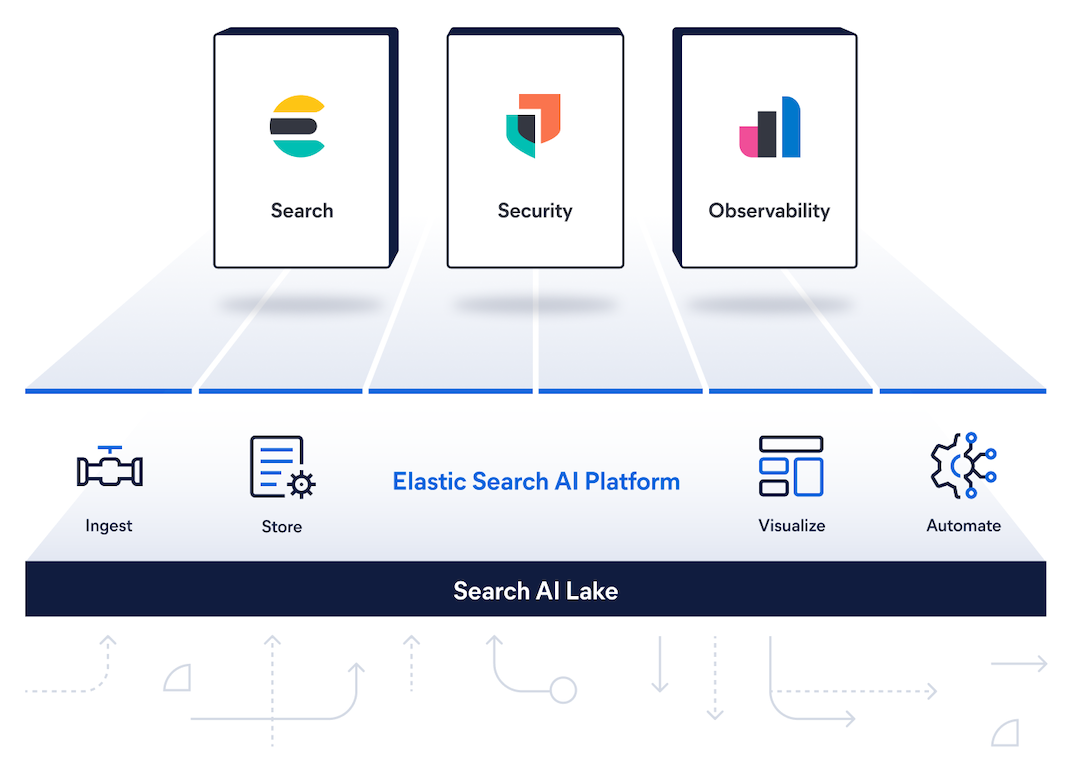
全新資料搜尋引擎由 Elastic 提供支持,可在企業資料來源之間提供自然語言搜尋。使用者可以對話式查詢資料集,非常適合 RAG、語意搜尋和生成式 AI 用例。該引擎與 MetadataIQ 集成,增強了檔案層級感知能力,透過元資料標記和發現功能在 PowerScale 和 ObjectScale 上索引數十億個檔案。此功能使開發人員能夠使用 LangChain 等工具建立更具創新性的 RAG 應用程序,這些工具可以有效地更新和檢索新數據或已更改的數據,從而最大限度地降低索引成本並維護準確的向量資料庫。
基於 Starburst 建構的資料分析引擎進一步擴展了這項功能,支援跨電子表格、資料庫、雲端倉庫和湖倉進行聯合查詢,無需資料遷移。全新的代理層利用大型語言模型 (LLM) 實現核心資料管理任務的自動化,包括文件產生、洞察生成和 SQL 增強。透過將 AI 直接嵌入資料庫工作流程,企業可以更快地從原始資料攝取轉換為可執行的輸出。
一個重要的新增功能是用於資料分析引擎的 MCP 伺服器,它引入了多智能體協調功能,並為 AI 應用程式開發提供原生支援。團隊可以同時運行生成式 AI 和資料分析工作流程,同時保持模型治理和沿襲追蹤——這對於受監管或大規模企業環境至關重要。此外,統一的向量儲存存取功能允許在 Iceberg、戴爾資料搜尋引擎、PostgreSQL + PGVector 和其他儲存庫之間無縫運行 RAG 和 AI 搜尋功能。
戴爾和 NVIDIA 的 GPU 加速向量搜索
戴爾將 AI 資料平台與NVIDIA cuVS集成,為企業級向量搜尋帶來 GPU 加速。這項技術進步使企業能夠以卓越的效能和可擴展性執行混合關鍵字和向量搜尋。透過 GPU 加速,查詢運行速度更快,相似度評分更高,並且可以在符合企業治理標準的安全本地環境中即時處理大型向量儲存。
這款 GPU 加速的混合搜尋連接了戴爾的儲存和資料引擎,縮小了儲存基礎架構與 AI 推理之間的差距。透過 cuVS 和戴爾的託管基礎架構,IT 團隊可以獲得一個針對速度和安全性進行最佳化的交鑰匙高效能搜尋解決方案,能夠支援最新的企業級 LLM 和多模式工作負載。
更大的圖景:企業 AI 的統一平台
擴展的戴爾AI數據平台彰顯了戴爾科技集團向AI原生基礎架構環境的持續轉型。透過與NVIDIA、Elastic和Starburst等合作夥伴的開放式協作,戴爾整合了其伺服器、儲存和資料引擎,將自己定位為現代AI和分析的全端解決方案提供商,而非儲存供應商。


 Amazon