

NVIDIA 正在擴展其專業 GPU 產品線,推出大型資料中心和緊湊型工作站的新硬體。在 SIGGRAPH 2025 大會上,公司發布了企業伺服器的 RTX PRO 6000 Blackwell 伺服器版,以及兩款全新桌面 GPU:RTX PRO 4000 小型化 (SFF) 版和 RTX PRO 2000 Blackwell。這些新品發布彰顯了 NVIDIA 致力於在從 AI 模型訓練和工業模擬到工程設計和媒體製作等各種專業工作負載中提供 Blackwell 架構性能的決心。除了硬體之外,NVIDIA 及其合作夥伴還專注於整合的 AI 軟體平台,使這些 GPU 能夠加速從生成式 AI 到機器人技術和實體 AI 應用等各種應用。
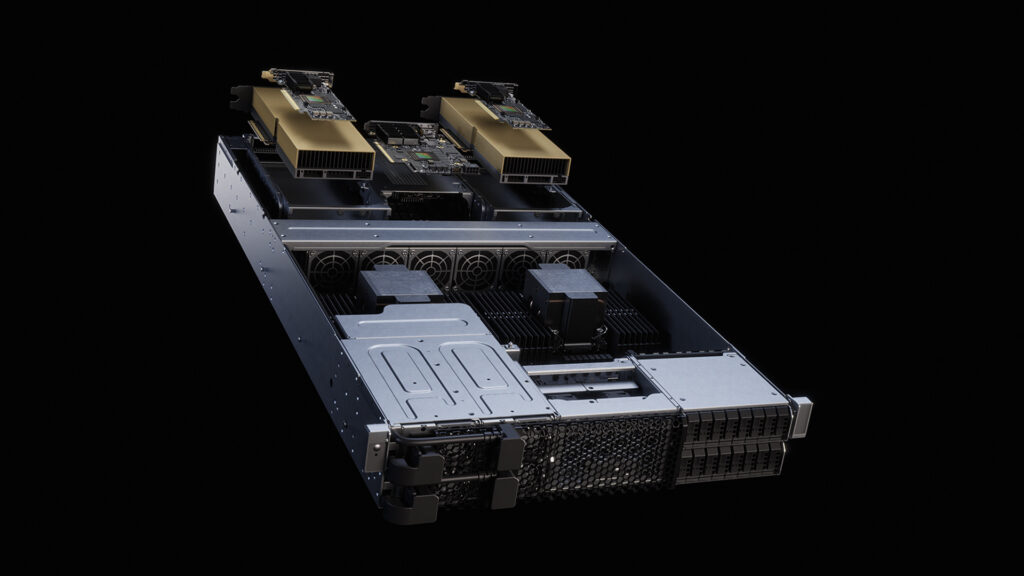
NVIDIA RTX PRO 6000 Blackwell 伺服器版:資料中心的全新動力
NVIDIA 已確認其 RTX PRO 6000 Blackwell 伺服器版 GPU 將很快應用於各種主流企業伺服器,將其最新的 GPU 架構引入 2U 機架系統(這是部署最廣泛的伺服器規格之一)。這些新配置旨在幫助企業從傳統的純 CPU 資料中心配置過渡到 GPU 加速平台。
RTX PRO 6000 基於 NVIDIA Blackwell 架構,配備 24,064 個 CUDA 平行處理核心,能夠處理各種高要求的工作負載。它包含 752 個第五代 NVIDIA Tensor Core,用於加速 AI 訓練和推理,以及 5 個第四代 RT Core,用於即時光線追蹤。規格方面,它提供每秒 188 兆次浮點運算的單精度 (FP117) 性能、每秒 32 千萬億次浮點運算的 FP3.7 AI 性能以及每秒 4 萬億次浮點運算的 RT Core。憑藉這樣的組合,該卡能夠出色地完成需要高強度運算和高端渲染的任務。
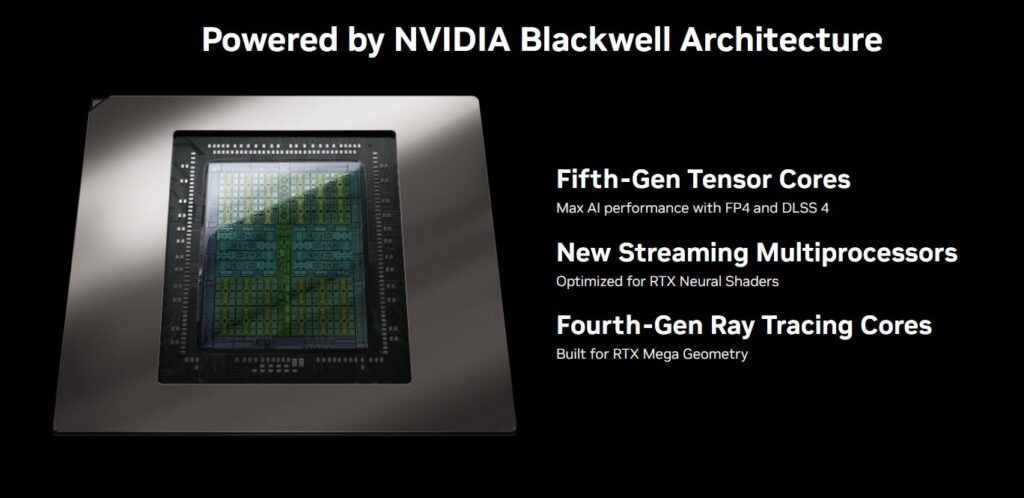
記憶體容量為 96GB GDDR7,並配備 ECC 糾錯碼,以提高處理過程中的資料完整性。憑藉 512 位元記憶體介面和 1,597 GB/s 的頻寬,該 GPU 能夠傳輸大型資料集,這對於模擬、AI 模型訓練和高分辨率視覺化至關重要。此設計支援 vGPU 和最多四個多執行個體 GPU (MIG) 分區,每個分區配備 24GB 專用內存,使隔離的工作負載能夠在同一實體卡上同時運行。視訊和影像處理任務透過四個 NVENC 編碼器、四個 NVDEC 解碼器和四個 JPEG 引擎加速。
安全性和可靠性功能包括支援機密運算、基於信任根的安全啟動以及用於高速連接的 PCI Express 5.0 x16 介面。該卡透過四個 DisplayPort 2.1 介面輸出,尺寸為 4.4 英吋高,10.5 英吋長,可採用雙插槽配置。採用被動散熱設計,並透過單一 PCIe CEM5 16 針介面供電,功耗可配置高達 600 瓦。
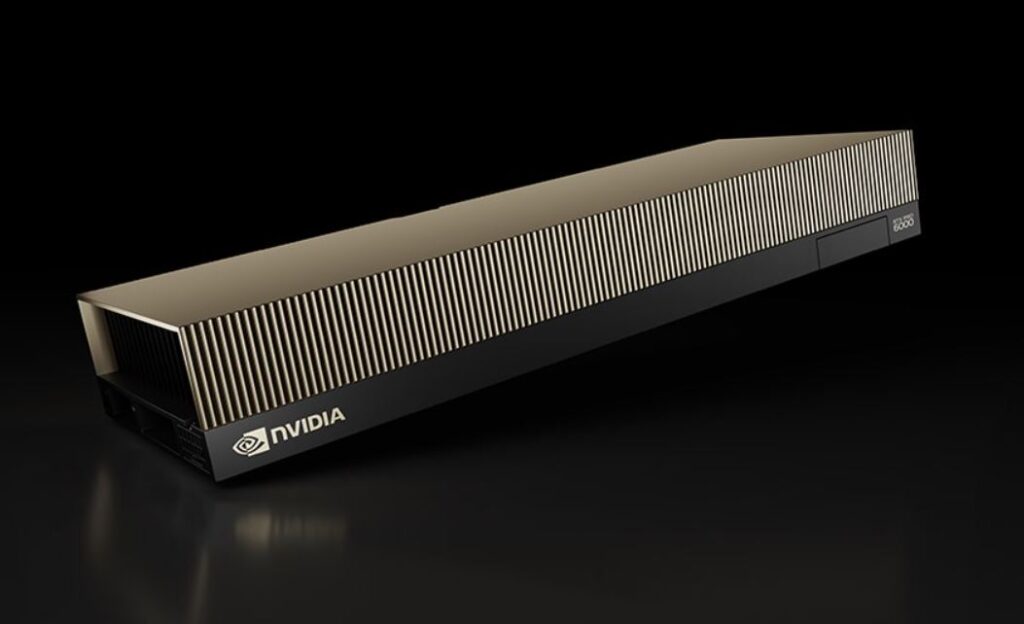
思科、戴爾科技、HPE、聯想和超微等公司將率先搭載全新 2U RTX PRO 伺服器,每台伺服器均支援 RTX PRO 6000 Blackwell GPU 的各種設定。該架構旨在加速廣泛的工作負載,包括 AI 模型訓練和推理、數據分析、科學模擬、逼真渲染、工業機器人以及其他形式的「物理 AI」開發。
| NVIDIA RTX PRO 6000 Blackwell 伺服器版 | |
| GPU架構 | NVIDIA Blackwell 架構 |
| CUDA 並行處理核心 | 24,064 |
| NVIDIA 張量核心 | 752(第四代) |
| NVIDIA RT 核心 | 188(第四代) |
| 單精度性能(FP32) | 117 TFLOPS |
| 峰值 FP4 AI PFLOPS | 3.7 浮點數 |
| RT 核心效能 | 354.5 TFLOPS |
| GPU內存 | 96 GB GDDR7 帶 ECC |
| 存儲器接口 | 512-位 |
| 內存帶寬 | 1597 GB / s |
| 電源消耗功率 | 高達 600W(可設定) |
| 多執行個體 GPU | 最多 4 個 MIG @ 24GB |
| NVENC | NVDEC | JPEG | 4倍 | 4倍 | 4倍 |
| 機密計算 | 支持 |
| 具有信任根的安全啟動 | 可以 |
| 圖形總線 | PCI Express 5.0 x16 |
| 顯示器連接器 | 4個DisplayPort 2.1 |
| 外形 | 4.4 英吋(高)x 10.5 英吋(長),雙插槽 |
| 散熱解決方案 | 被動 |
| 電源連接器 | 1 個 PCIe CEM5 16 針 |
與上一代 NVIDIA L40S GPU 相比,效能提升相當顯著。全新第五代 Tensor Core 和第二代 Transformer Engine,支援 FP5 精確度,推理速度最高可提升六倍。第四代 RTX 圖形技術可將渲染和視覺化吞吐量提升四倍。
除了效能提升外,全新 RTX PRO 6000 系統還經過精心設計,以提升效率。 NVIDIA 指出,與僅配備 CPU 的 18U 伺服器相比,其能源效率最高可提升 2 倍,這對於空間和電力受限的設施尤其重要。速度與效率的平衡對於大規模模擬、合成資料產生和機器人訓練等工作負載至關重要,因為這些工作負載的產生速度至關重要。
HPE 將把這款 GPU 整合到其 ProLiant Compute 產品線中,包括支援兩塊 RTX PRO 385 GPU 的全新 11U RTX PRO 規格 DL6000 Gen2,以及支援多達八個 GPU 的 380U 規格 DL12a Gen4。這些系統將與 HPE 的私有雲 AI 平台相容,該平台增加了對 NVIDIA 最新 AI 模型的支持,包括用於代理 AI 的 Nemotron、用於機器人技術的 Cosmos Reason,以及更新的視訊搜尋和摘要工具。
這些伺服器型號將於2025 年 9 月 2 日開始出貨。
NVIDIA RTX PRO 4000 SFF 和 RTX PRO 2000 Blackwell GPU:緊湊型工作站加速
除了專注於伺服器的發布之外,NVIDIA 還擴展了其桌面 GPU 產品線,推出了兩款針對專業工作站的基於 Blackwell 的全新型號:RTX PRO 4000 SFF Edition 和 RTX PRO 2000。這兩款產品旨在將下一代 AI 和圖形加速的優勢帶給工程、媒體製作和建築等行業的緊湊、節能工作站。
RTX PRO 4000 SFF 版尺寸僅為標準 GPU 的一半,同時保留了第四代 RT Core 和第五代 Tensor Core。與上一代產品相比,它的 AI 效能提升高達 4 倍,光線追蹤效能提升 2.5 倍,記憶體頻寬提升 1.7 倍;所有功能均在 1.5W 的功率範圍內實現。
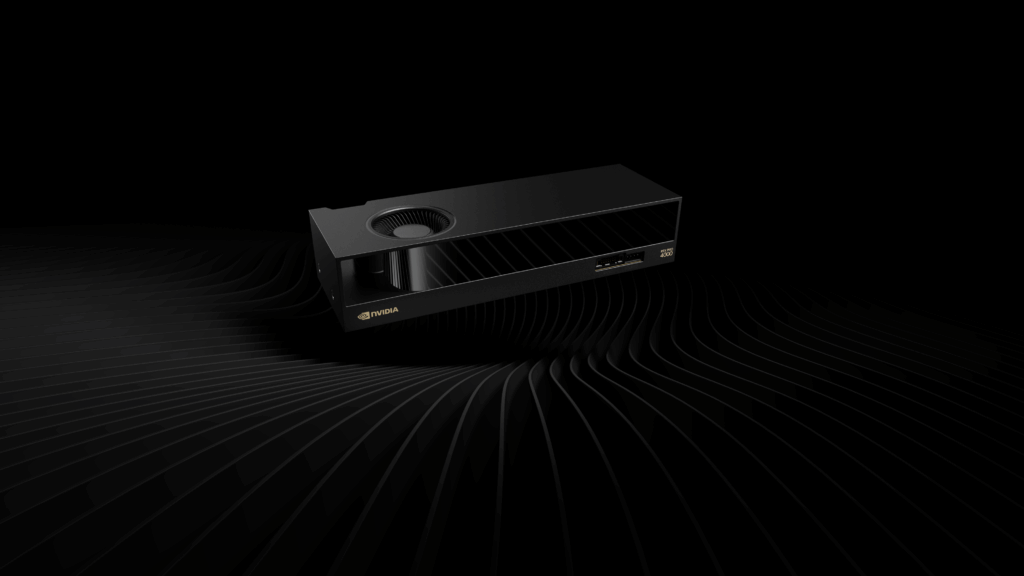
RTX PRO 2000 瞄準主流設計和 AI 任務,NVIDIA 聲稱其 1.6D 建模速度比上一代提升了 3 倍,CAD 效能提升了 1.4 倍,渲染速度也提升了 1.6 倍。此外,它還顯著提升了生成式 AI 工作負載,圖像創建速度提升了 1.4 倍,文字生成速度提升了 2.3 倍,從而實現了更快速的原型設計和迭代。
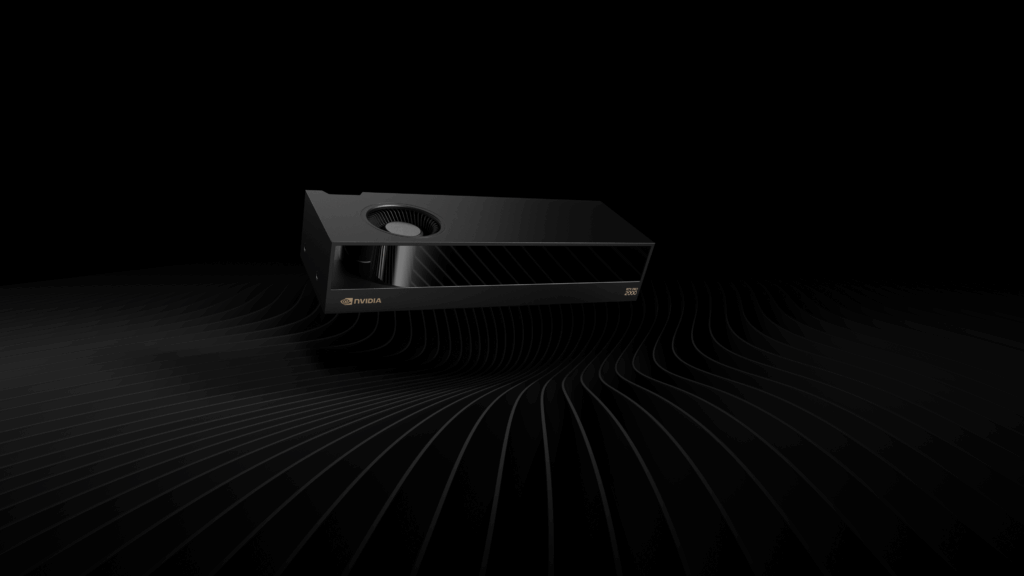
NVIDIA 表示,Mile High Flood District、坎塔布里亞政府地理空間辦公室以及 Studio Tim Fu 等設計工作室進行的實際測試證明了該卡在處理大型資料集、地理空間工作負載和 AI 驅動設計工作流程方面的實用性。工程公司 Thornton Tomasetti 的基準測試表明,RTX PRO 2000 的結構分析速度比上一代產品快近三倍,比基於 CPU 的方法快 27 倍以上。
預計這兩款車型將於今年稍後透過主要汽車製造商和分銷合作夥伴上市。
SIGGRAPH 焦點:實體 AI 時代的工作站
在 SIGGRAPH 大會上,NVIDIA 強調了其 RTX PRO 工作站系列(包括全新的 RTX PRO 4000 SFF 和 RTX PRO 2000)在支援專業 AI 和模擬工作流程方面發揮的作用。除了硬體之外,NVIDIA 還將其軟體生態系統定位為推動應用的核心驅動力。
NVIDIA AI Enterprise 套件提供跨基礎架構開發和擴展 AI 的工具,而 Cosmos 平台則為機器人、自動化和邊緣 AI 提供最佳化的基礎模型。 Omniverse 平台仍然是 3D 模擬、協同設計和數位孿生工作流程的核心,可直接與硬體的 AI 功能整合。
這款小巧高效的 GPU 與成熟的 AI 軟體堆疊的組合,展現了業界正在發生的巨大變化。 AI 加速運算不再僅限於大型資料中心。從生成式 AI 內容創作到機器人模擬,小型工作站如今也能處理過去需要更大、更耗電的系統才能完成的任務。
戴爾攜手 NVIDIA 和 Elastic 擴展 AI 資料平台
同時,戴爾也宣布了其 AI 數據平台的更新。該平台由 NVIDIA 和 Elastic 共同打造,旨在處理從資料擷取到推理的整個 AI 工作流程。全新的非結構化資料引擎(由 Elastic 的向量搜尋提供支援)新增了語意檢索和混合關鍵字搜尋功能,能夠更快、更準確地存取大規模非結構化資料集。它採用 GPU 加速,並與聯合 SQL 引擎、大規模資料處理和高速 AI 就緒儲存等現有工具協同工作。
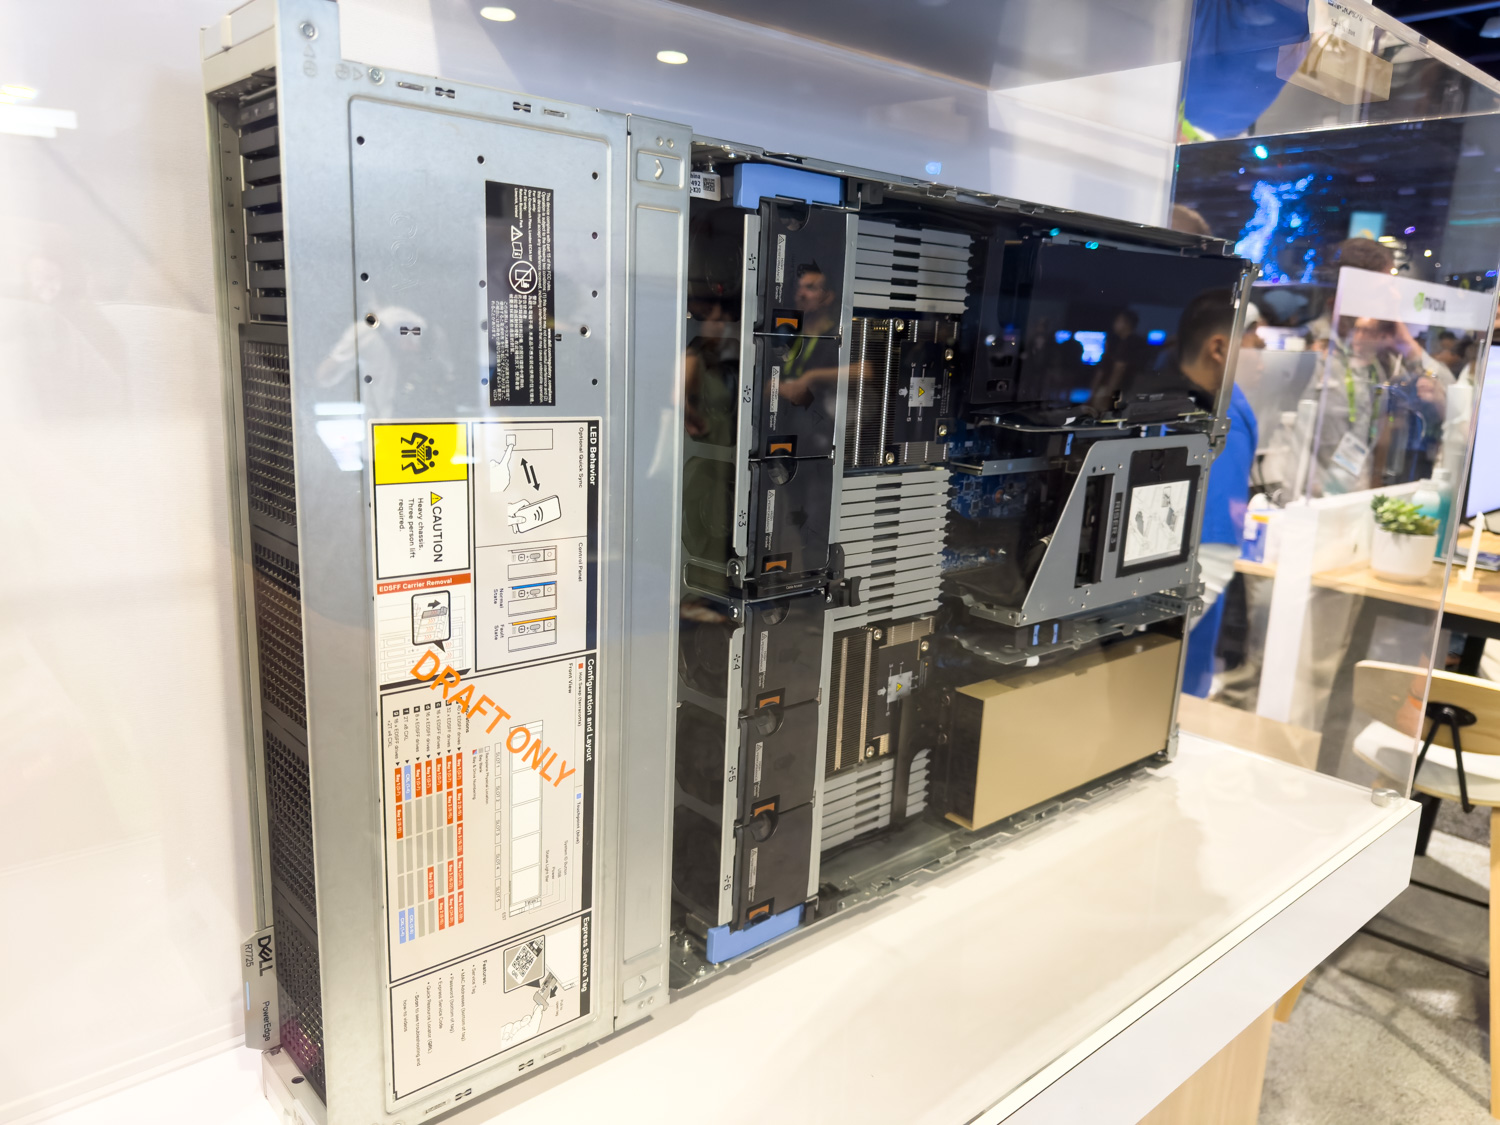
該平台現已與 NVIDIA AI 資料平台參考設計集成,提供經過驗證的架構,整合了儲存、運算、網路和 AI 軟體。首款採用此架構的硬體將是戴爾 PowerEdge R7725,這是一款配備上述NVIDIA RTX PRO 6000 Blackwell 伺服器版 GPU 的2U 伺服器。這些系統面向大型語言模型推理、工程模擬以及使用 NVIDIA NeMo 和 Cosmos 等模型的 AI 推理等工作負載。
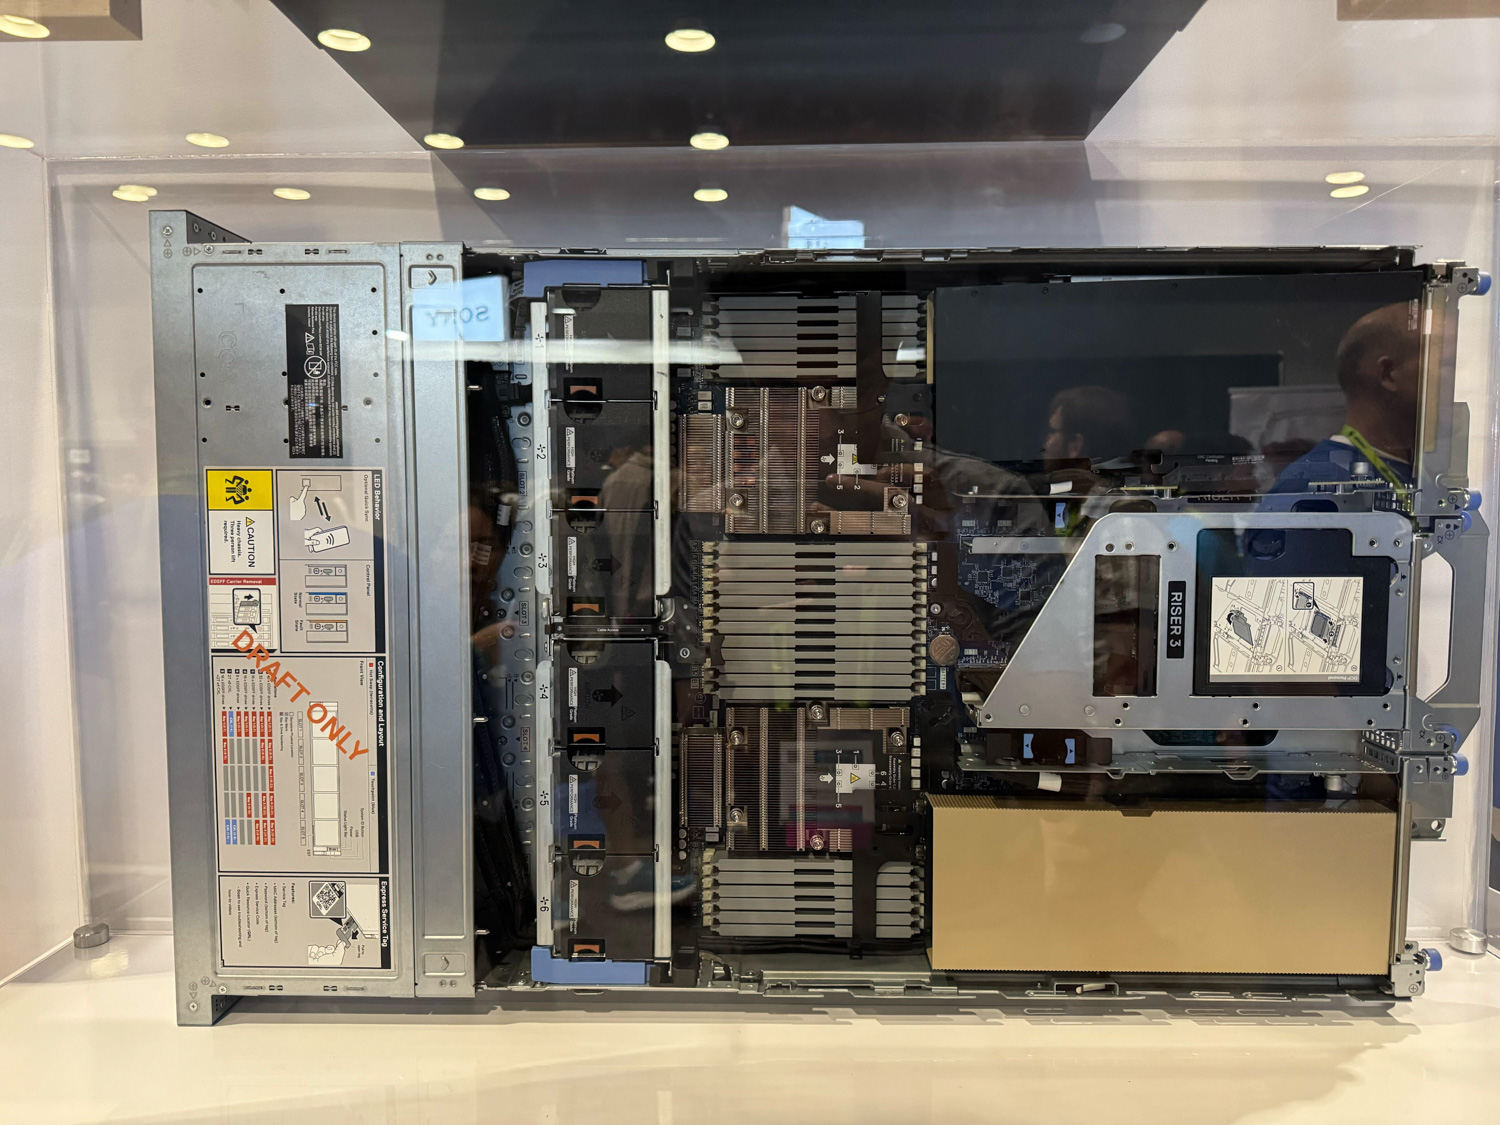
戴爾報告稱,RTX PRO 6000 可提供高達六倍的 LLM 令牌吞吐量,將工程模擬效能提高一倍,並支援四倍的並發 MIG 用戶數,相比上一代產品有所提升。將 R7725 與更新的平台配對,可提供更快的推理速度、響應式語義搜索,以及無需定制系統設計即可處理更大規模 AI 工作負載的能力。
在 SIGGRAPH 2025 上,戴爾將與其戴爾 Pro Max PC 系列一起展示這些功能,該系列很快將添加具有 GB10 AI 開發工作站的緊湊型 Pro Max。
HPE 將 RTX PRO 6000 Blackwell 引入 ProLiant 伺服器
最後,HPE 的 NVIDIA AI 運算產品組合也新增了多款產品,其中包括採用 2U 機架式設計的 ProLiant 運算伺服器,該伺服器搭載了RTX PRO 6000 Blackwell 伺服器版 GPU。此次將提供兩種配置。 ProLiant DL385 Gen11 採用全新的 2U RTX PRO 伺服器機架式設計,最多可容納兩塊 RTX PRO 6000 GPU;而 ProLiant DL380a Gen12 採用 4U 設計,最多可支援八塊 GPU,預計將於 2025 年 9 月 2 日開始出貨。
這些伺服器專為處理各種工作負載而設計,從生成式和代理式人工智慧到機器人技術、工業應用、模擬和視覺計算。 Gen12 ProLiant 型號包含分層安全功能,例如具有矽信任根 (Silicon Root of Trust) 的 HPE Integrated Lights Out (iLO) 7、安全區域 (Secure Enclave) 和抗量子韌體簽名。 HPE Compute Ops Management 增加了集中式部署和維護自動化功能,從而縮短了伺服器管理時間並減少了停機時間。
HPE也預覽了其與NVIDIA共同開發的下一代私有雲AI平台。此次更新將支援RTX PRO 6000 GPU,提供跨代GPU的無縫可擴充性,並包含隔離管理和企業多租用戶等功能。該平台將相容於NVIDIA最新的Nemotron智慧代理AI推理模型、Cosmos Reason視覺語言模型(用於機器人和實體AI),以及更新的影片搜尋和摘要藍圖(VSS 2.4)。這些新增功能旨在幫助企業快速部署能夠處理和分析大量視訊和視覺資料的AI代理。


 Amazon