

卡內基梅隆大學的研究人員發布了一項專注於 SSD 現場可靠性的研究,該研究的標題為“現場閃存故障的大規模研究”。 這項研究是在四年的時間裡使用 Facebook 的數據中心進行的,運行時間達數百萬小時。 該研究著眼於錯誤是如何表現出來的,旨在幫助其他人開發新穎的閃存可靠性解決方案。
正如我們在 StorageReview 上一段時間以來所說的那樣,閃存提供了多項性能優勢、密度優勢和更低的功耗,最大的缺點是成本。 雖然許多 SSD 聲稱具有良好的使用壽命和可靠性,但直到現在還沒有任何重大的現場研究。
雖然沒有提到特定的供應商和特定的驅動器,但 Facebook 在他們的熱數據層中使用了很多,該研究確實記錄了使用 SSD 的平台類型(這被定義為系統中使用的設備容量的組合,所使用的 PCIe 技術,以及系統中 SSD 的數量),這些都是標籤平台 AF。 這些平台容量從720GB到3.2TB不等,有兩代PCIe(版本1和2),有的使用一個SSD,有的使用兩個,運行時間從半年到兩年多不等。
研究人員使用寄存器來跟踪類似於 SMART 數據的 SSD 操作。 每小時收集一次原始值,將其解析為可以整理到 Hive 表中的形式,然後一組機器使用 MapReduce 作業對存儲在 Hive 中的數據執行並行聚合。 由此,研究人員能夠監控誤碼率、SSD 故障率和錯誤計數、不同 SSD 之間的相關性(特別是在具有多個 SSD 的平台中)以及內部和外部因素的作用。
研究得出的結論包括:
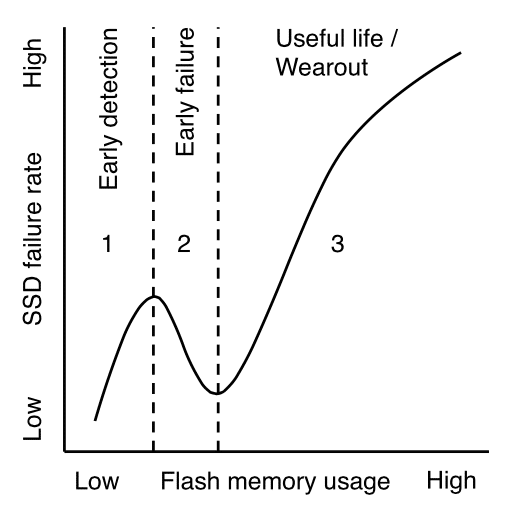
- SSD 在其生命週期中會經歷幾個不同的故障期——早期檢測、早期故障、使用壽命和磨損,這與寫入閃存芯片的數據量相對應。
- 讀取乾擾錯誤的影響並不是所檢查的 SSD 中的主要錯誤來源。
- 跨 SSD 物理地址空間的稀疏數據佈局(例如,非連續分配的數據)導致 SSD 故障率高; 密集的數據佈局(例如,連續數據)在某些情況下也會對可靠性產生負面影響,這可能是由於對抗性訪問模式。
- 更高的溫度會導致故障率增加,但對於未採用節流技術的 SSD 來說,這種情況最為明顯。
- 由於系統級緩沖和減少磨損技術,系統軟件報告要寫入的數據量可能會誇大實際寫入閃存芯片的數據量。
雖然這項研究沒有說明一種驅動器或一種驅動器比另一種更好,但它仍然是一個有趣的觀察,看看 SSD 在大量使用的情況下在現實世界中的表現如何。 這項研究為未來研究 SSD 的使用以及可以使 SSD 更可靠或使用壽命更長的新技術打開了大門。
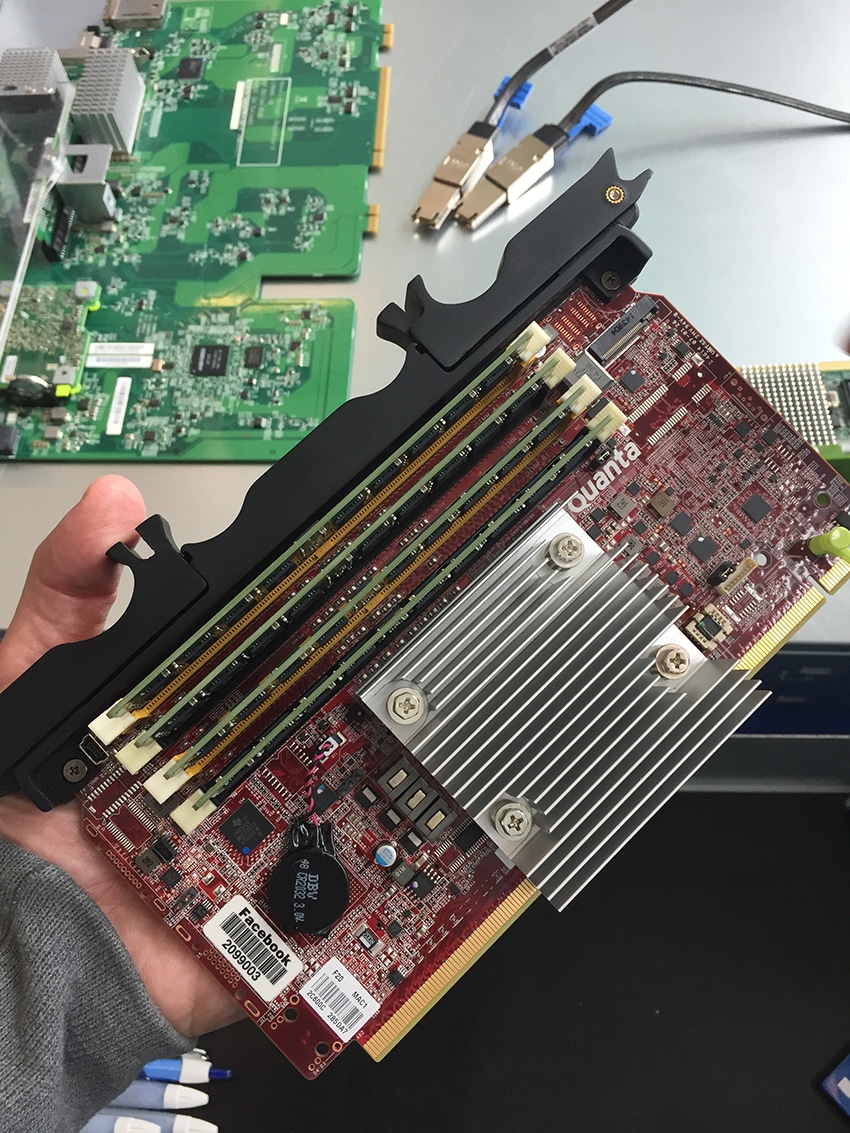
Facebook一直在不斷改進其伺服器設計,以適應卡內基美隆大學研究等數據點。他們最近發布的Yosemite平台就是一個恰當的例子,它展示了Facebook如何利用非傳統外形尺寸的Flash技術(至少在資料中心領域),以在高度重視總體擁有成本(TCO)的情況下獲得最佳效能。


 Amazon