

在聖荷西舉辦的 Advancing AI 大會上,AMD 發布了最新一代 GPU Instinct MI350 系列,並公佈了未來 AI 加速器平台的宏偉藍圖。 MI4 系列基於先進的 CDNA350 架構,可望大幅提升效能,以應對高要求的 AI 工作負載。此次發布也預覽了未來的 Instinct 系列產品,彰顯了 AMD 致力於 AI 硬體持續創新的承諾。
AMD Instinct MI350 系列
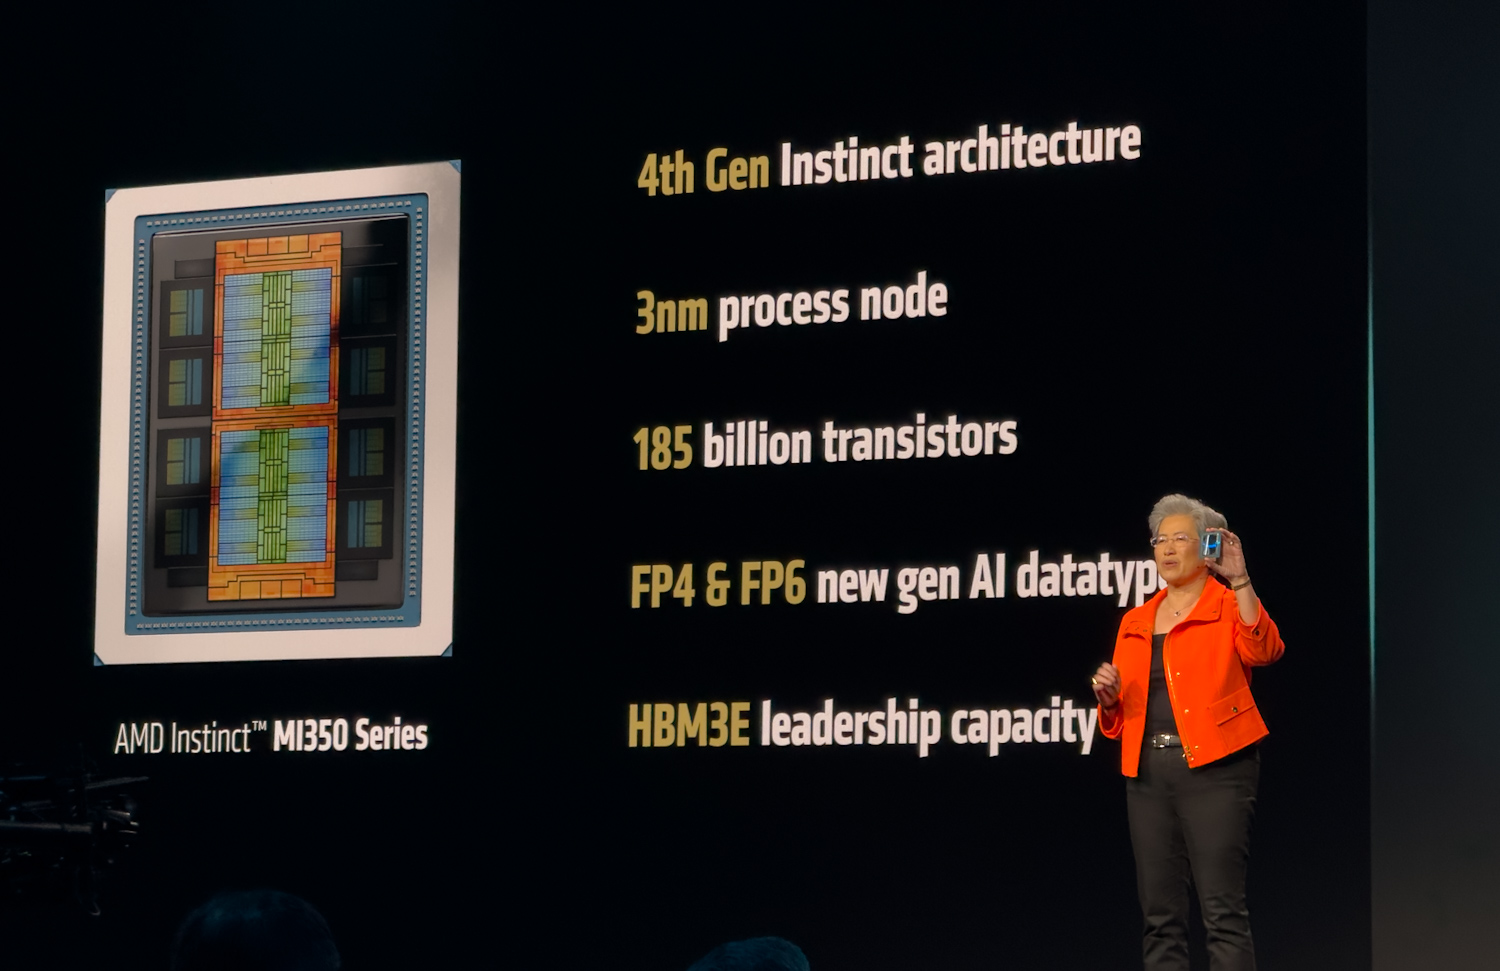
採用全新 CDNA4 架構的AMD Instinct MI350 系列顯示卡,代表著人工智慧運算領域的重大飛躍。 CDNA4 架構專為人工智慧工作負載而設計,引入了增強型矩陣引擎、對新型資料格式的支持,並在能源效率方面實現了顯著提升。
先進封裝與晶片架構:MI350 的基礎
MI350 系列基於 AMD 先進的 3D 小晶片封裝技術,在 MI300 系列的基礎上進行了改進,並進行了關鍵的改進。
晶片設計與製造
此 GPU 套件的核心是八個加速器運算晶片 (XCD),即主要的運算引擎。這些 XCD 採用先進的 3nm Node 3+ 節點製程製造,是 MI5 系列所採用的 300nm 製程的升級版,顯著提升了能源效率。每個 XCD 包含四個著色器引擎,每個引擎包含八個活躍的 CDNA4 計算單元,最終每個 XCD 包含 32 個計算單元 (CU),加速器總共包含 256 個計算單元 (CU)。

與 XCD 互補的是兩個 IO 晶片 (IOD),比 MI300 系列的四個 IOD 有所減少。這些 IOD 採用 6nm 級製程製造,可處理記憶體存取、I/O 操作和晶片間通訊。這款精簡的雙 IOD 設計,結合更寬的內部互連,在降低功耗的同時,保持了頻寬目標。
物理整合與邏輯統一
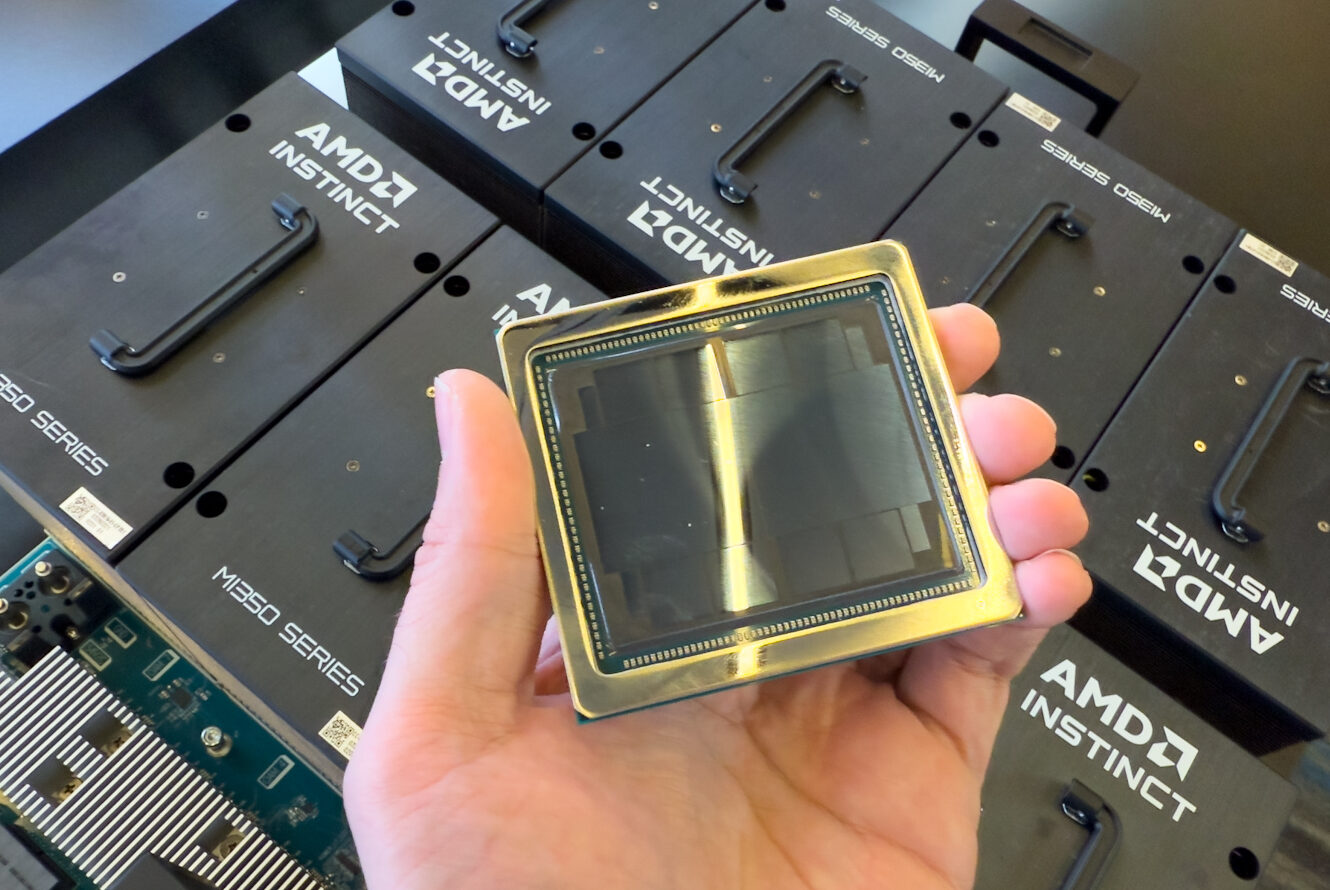
物理組裝包括將 XCD 和 HBM3E 記憶體堆疊安裝在晶圓上晶片 (COOS) 中介層上。設計的一個關鍵點在於 XCD 與其下方 IOD 的混合鍵結。這種 3D 混合鍵合技術在運算和 I/O 晶片之間創建了極其密集、高頻寬的互連,遠遠超越了傳統的 2.5D 結構,這對於高效地向高功耗的 XCD 提供資料至關重要。此外,這種先進的 3D 整合有助於減少 GPU 的整體佔用空間,從而提高製造良率和運作可靠性。
儘管晶片組結構複雜,MI350 在邏輯上可充當單一統一的 GPU。每個 XCD 構成一個加速器運算複合體,配備全域資源,包括指令處理器和 4MB 二級快取。
增強型記憶體子系統
為了充分支援強大的 CDNA4 核心,MI350 系列配備了大幅升級的記憶體子系統。它配備了八個 HBM3E 記憶體堆疊,每個 GPU 的總容量高達 288GB。每個 36 GB 的堆疊由 12 個 24Gbit 裝置組成,以每針 3Gbps 的 HBM8E 引腳速度運作。
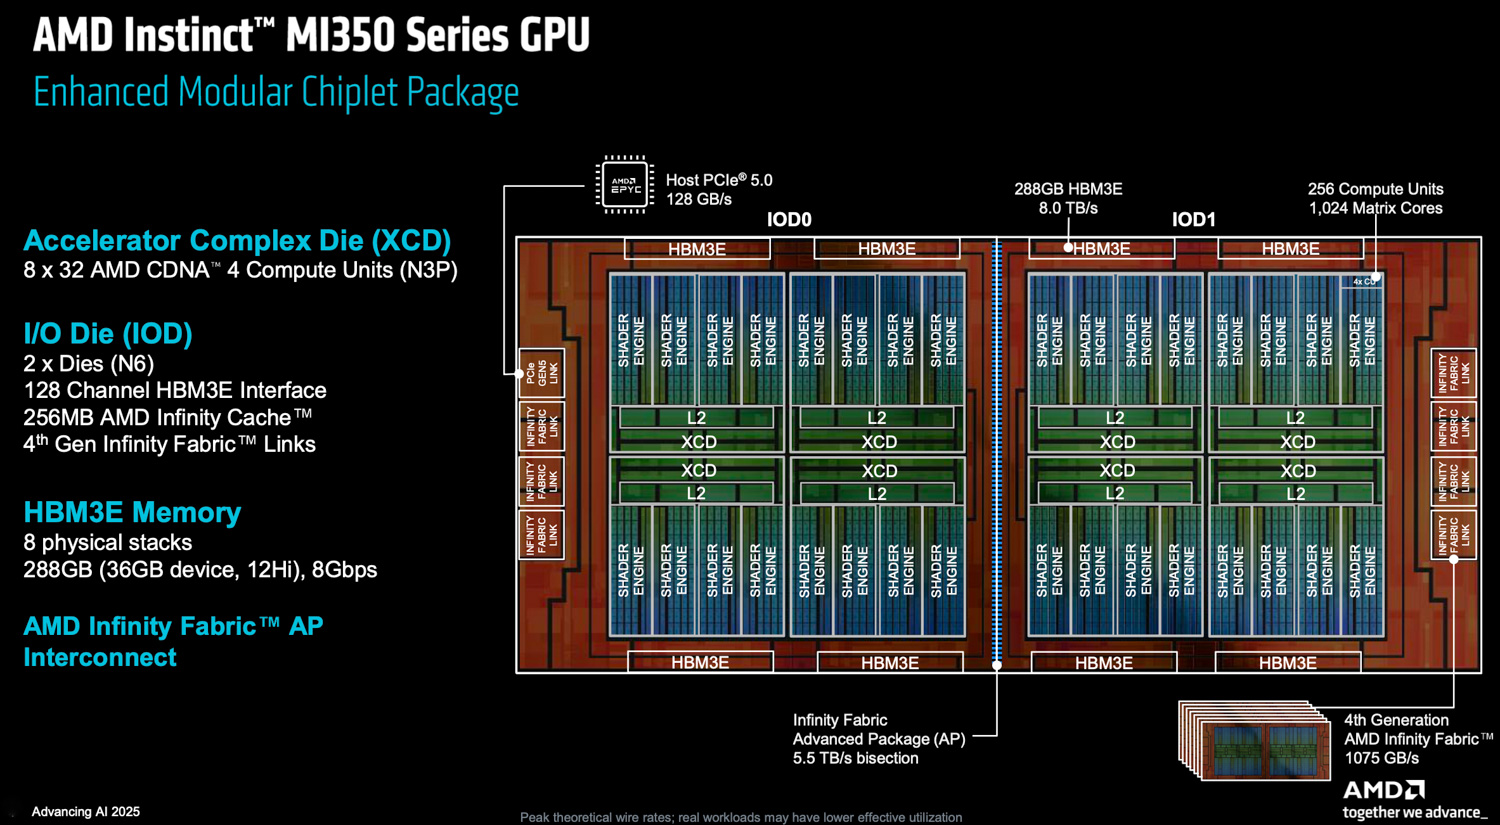
該架構還保留了 AMD 的 Infinity Cache,這是位於 HBM 和 Infinity Fabric/L2 快取之間的關鍵記憶體側快取。該快取包含 128 個通道,每個通道支援 2MB 緩存,GPU 總共擁有 256MB 的快取。為了在低功耗下提高頻寬傳輸效率,AMD 加寬了 IOD 內的晶片網路匯流排,並降低了工作電壓。這項優化降低了每位元功耗,使 MI350 系列的每瓦記憶體頻寬比其前代產品 MI1.3 系列高出約 300 倍。
此外,為了有效管理高達 288GB 的實體內存,類似於 CPU 轉換後備緩衝區 (TLB) 的通用轉換快取 (UTC) 得到了顯著增強。 MI350 系列在 UTC L1 和 L2 中引入了更精細的頁面大小控制,並提升了容量。這些改進提升了 TLB 的覆蓋範圍,並提高了虛擬記憶體管理的效率。
Infinity Fabric 增強功能
AMD 的 Infinity Fabric 技術仍然是 MI350 可擴充性和 GPU 間通訊效能的核心。連接兩個 IOD 的 Infinity Fabric AP 連結的雙向頻寬已大幅提升至 5.5TB/s,從而促進了 GPU 兩部分之間的高效資料傳輸。
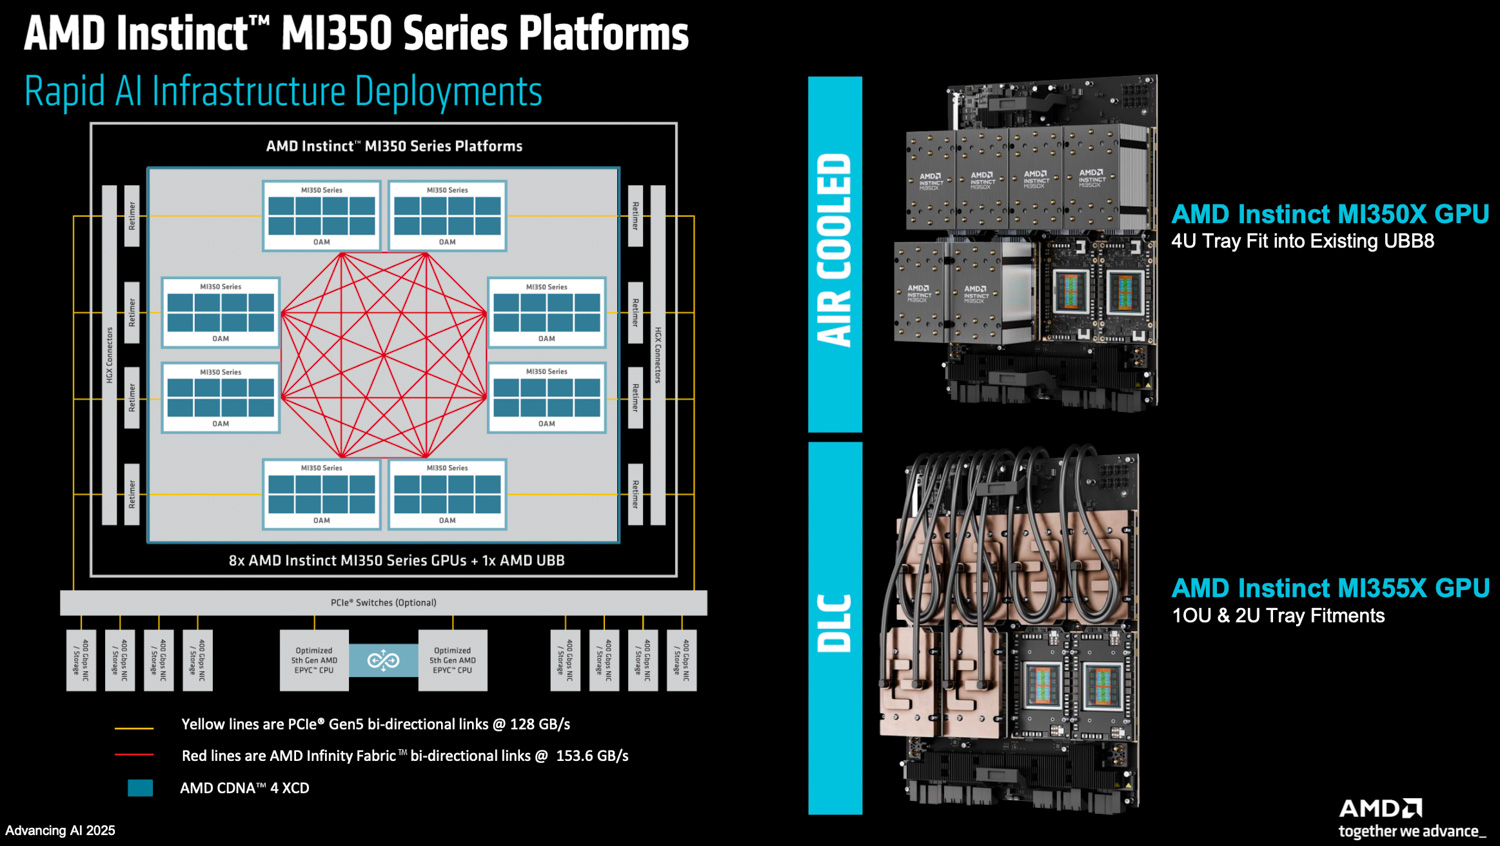
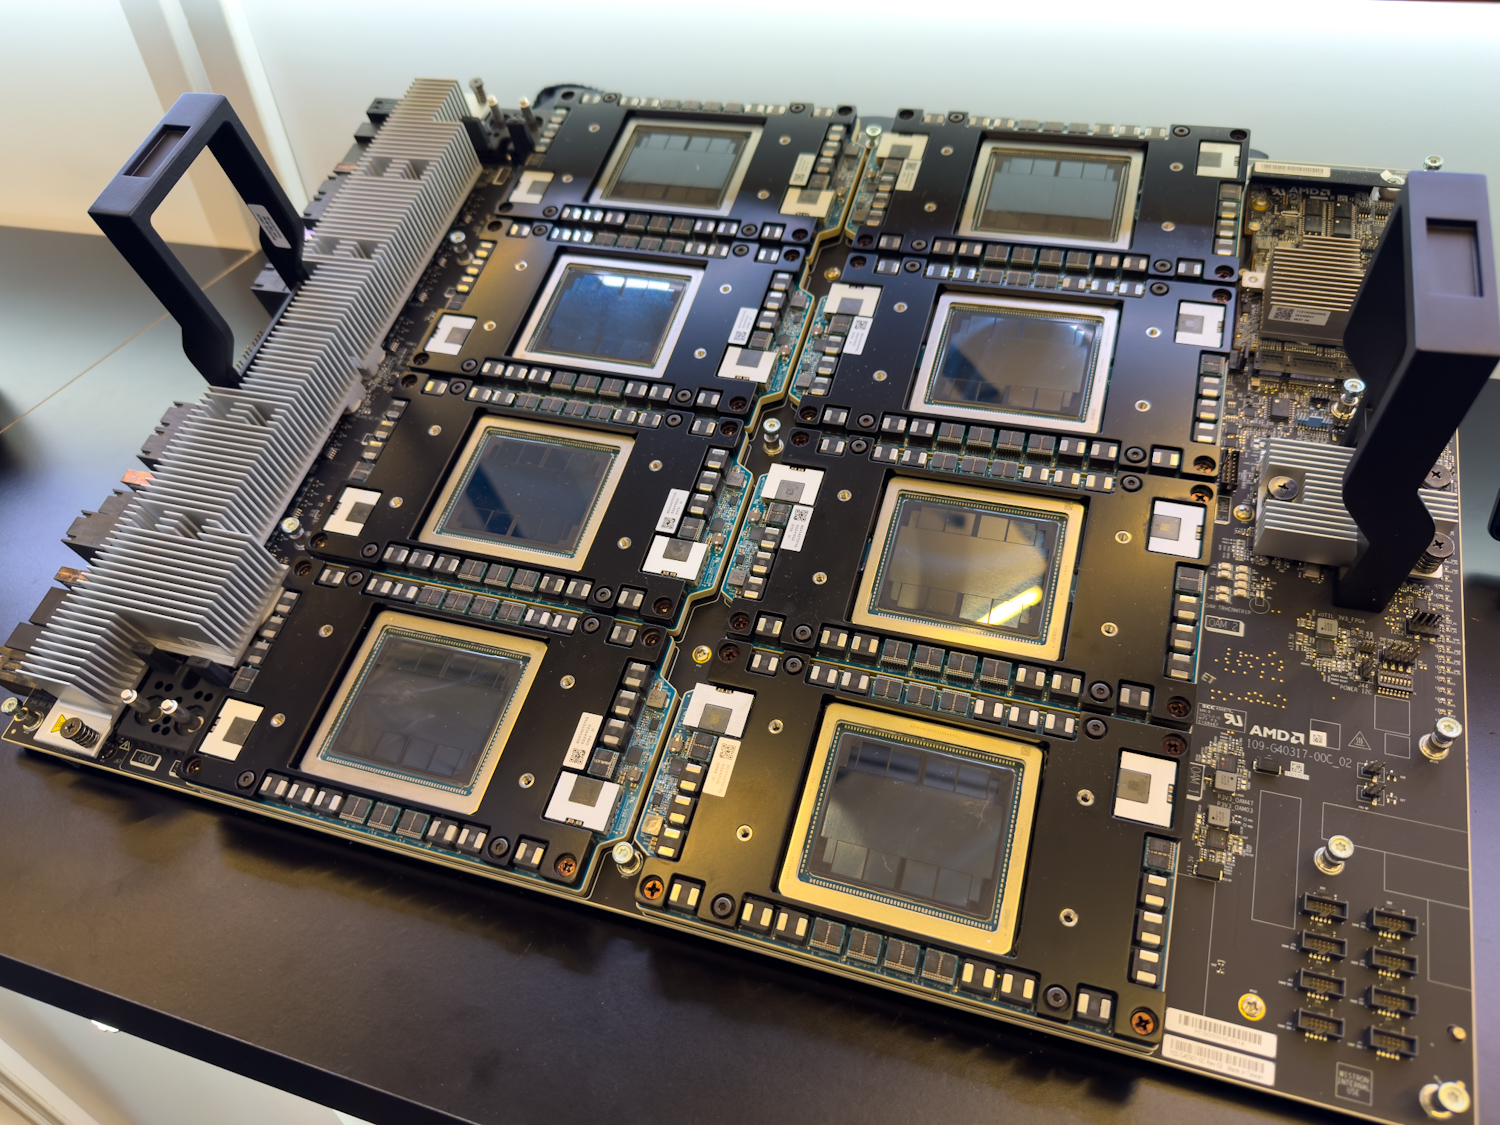
對於外部通信,每個 MI350 GPU 都配備七個 Infinity Fabric 鏈路,可在 8-GPU UBB 2.0 平台等配置中實現 GPU 之間的直接連接。這些鏈路的運行速度為每針 38.4Gbps。在 8-GPU OAM 設定中,此配置在每個連結的每個方向上提供約 153.6 GB/s 的對分頻寬。 AMD 也改進了這些外部鏈路上的資料打包和壓縮技術,以提高有效傳輸頻寬。在內部,Infinity Fabric 確保所有 XCD 都能跨兩個 IOD 對整個 HBM3E 內存空間進行完整、細粒度的交叉訪問,從而將內存作為單一、扁平、統一的資源呈現給計算單元。
CDNA4 運算核心架構
MI350 處理能力的核心是CDNA4 運算單元,它經過了針對人工智慧的重大重新架構。
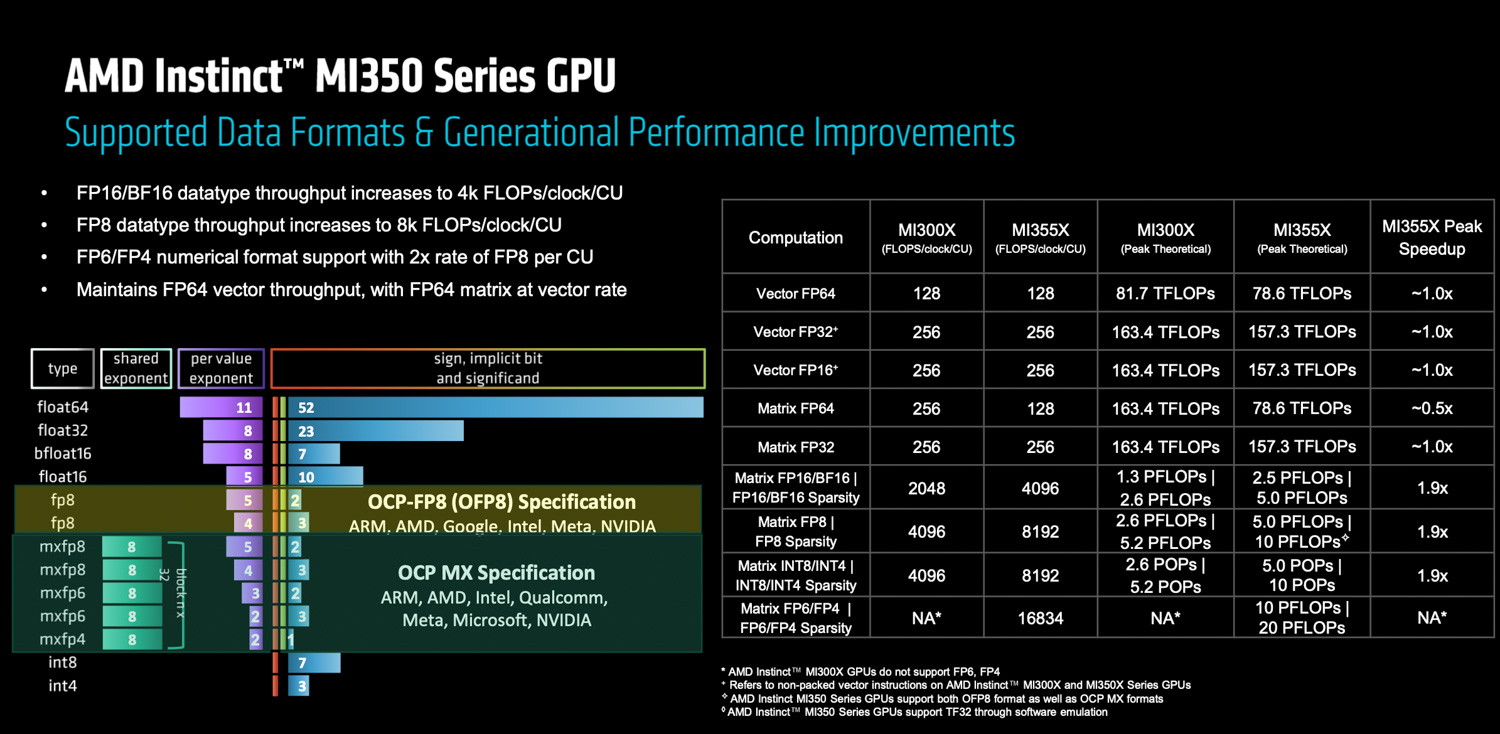
矩陣數學運算能力大幅提升:與 MI350 相比,MI2 運算單元 (CU) 的 16 位元(BF16、FP16)和 8 位元(FP8、INT8)運算吞吐量分別提升了 300 倍。 MI350 系列還引入了對 OCP MX 指定微尺度格式(特別是 FP6 和 FP4)的硬體支持,這些格式與 FP8 成比例擴展。值得注意的是,AMD 的實施使 FP6 能夠以與 FP4 相同的計算速率運作。這項策略決策使 AMD 在 FP6 這一新興格式(具有 AI 訓練潛力)中佔據領先地位。此外,還增加了一個新的向量算術邏輯單元 (ALU),支援 2 位元運算,並能夠將 BF16 結果累積到 FP32 中,從而提高某些低精度向量運算的吞吐量。
為了支援這些增強的張量吞吐量,每個計算單元的本地資料共享 (LDS) 大小已增加,並且新功能增強了從全域記憶體載入資料到 LDS 的頻寬。考慮到 Softmax 和注意力機制等運算中的潛在瓶頸,超越函數的吞吐量也與張量核心的改進同步提升。
其他一些架構增強功能也有助於提高效能和靈活性:
- 硬體支援的隨機舍入:透過注入熵來減輕從 FP32 向下轉換為低精度格式時的偏差。
- 邏輯運算子 3 (LUT3) 指令:為程式設計師提供更大的彈性來實現自訂三輸入邏輯運算。
- 新的最小最大運算子:使程式設計師能夠在比較期間控制 NaN 傳播,讓他們可以傳播 NaN 值或選擇非 NaN 浮點數,有助於實現強大的 AI 資料管理。
雖然 AI 是 MI350 系列的重點,但它仍然支援向量和矩陣單元中的 64 位元浮點 (FP64) 運算。然而,與 MI300 的一個關鍵差異在於,在 MI350 上,矩陣 FP64 運算的運作速率與向量 FP64 單元相同,實際上是 MI64 FP300 矩陣速率的一半。
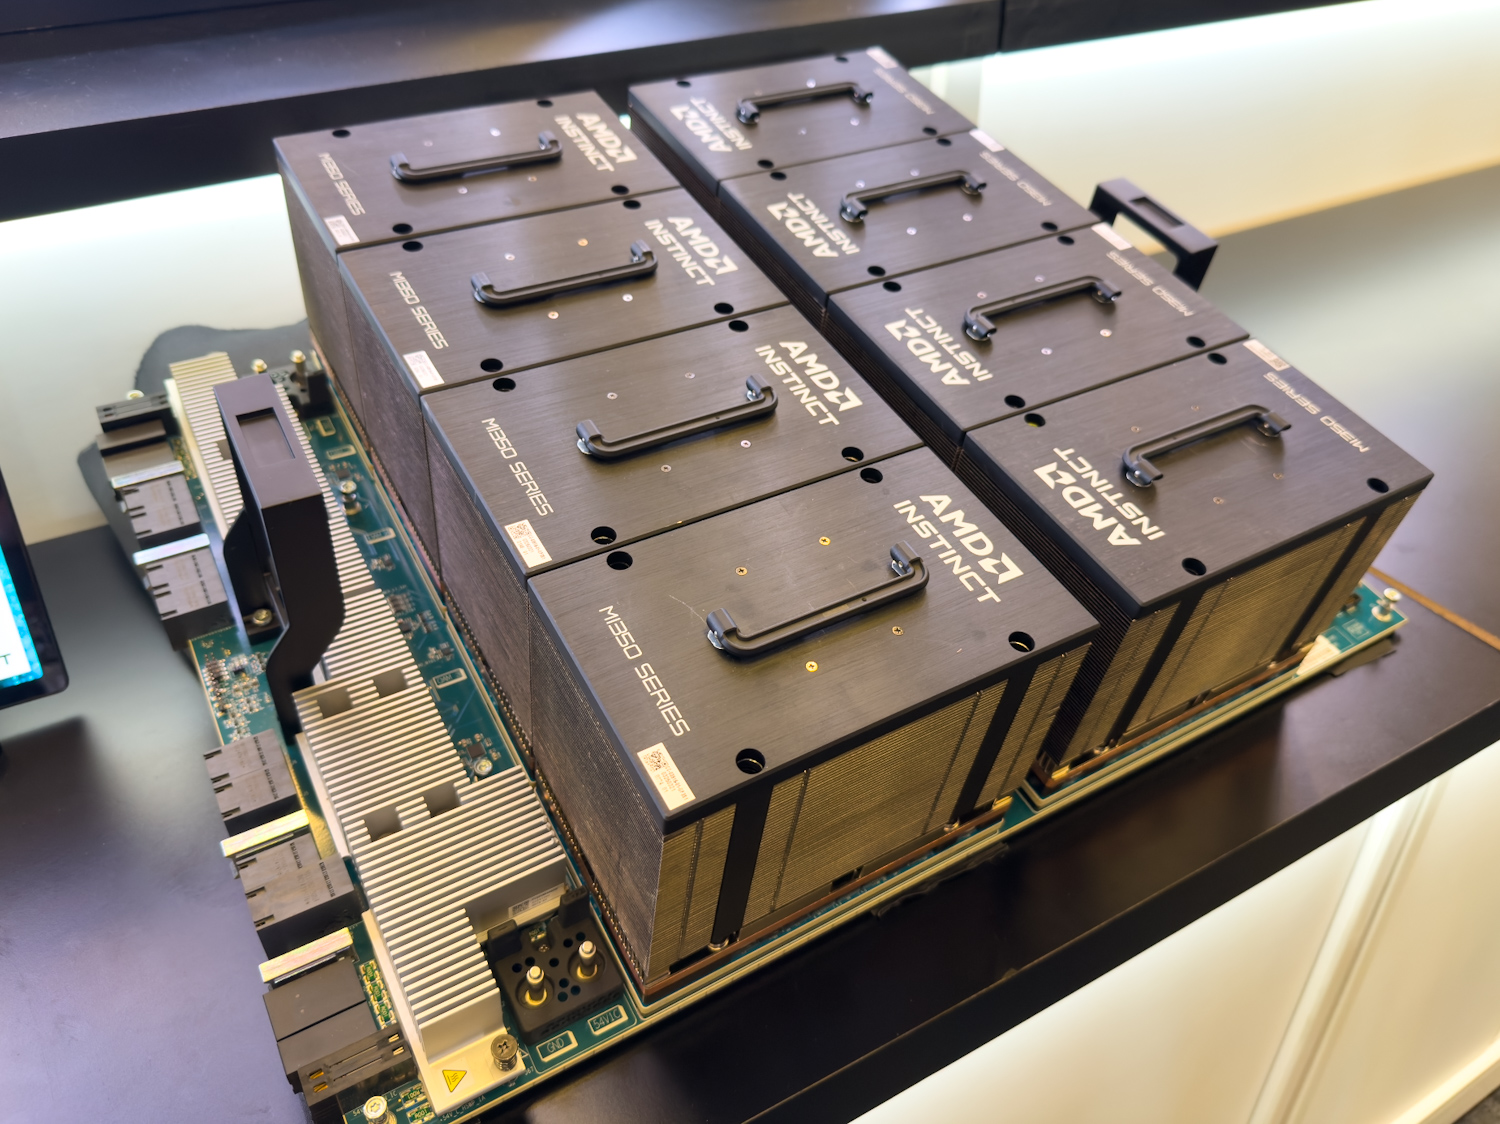
最後,更高的 HBM3E 頻寬和略微減少的 CU 數量(MI256X/350X 為 355 個,而 MI304X 為 300 個)相結合,意味著 MI350 系列中的每個 CU 都能從每個時鐘週期更高的全域記憶體頻寬中受益。這對於加速 GEMM(通用矩陣乘法)密集型運算和頻寬受限的向量運算至關重要。
靈活分區:NPS 和計算分區
AMD MI350 系列具有增強的分區功能,可高度靈活地分配其大量資源,以最大限度地提高不同工作負載的利用率和效率。
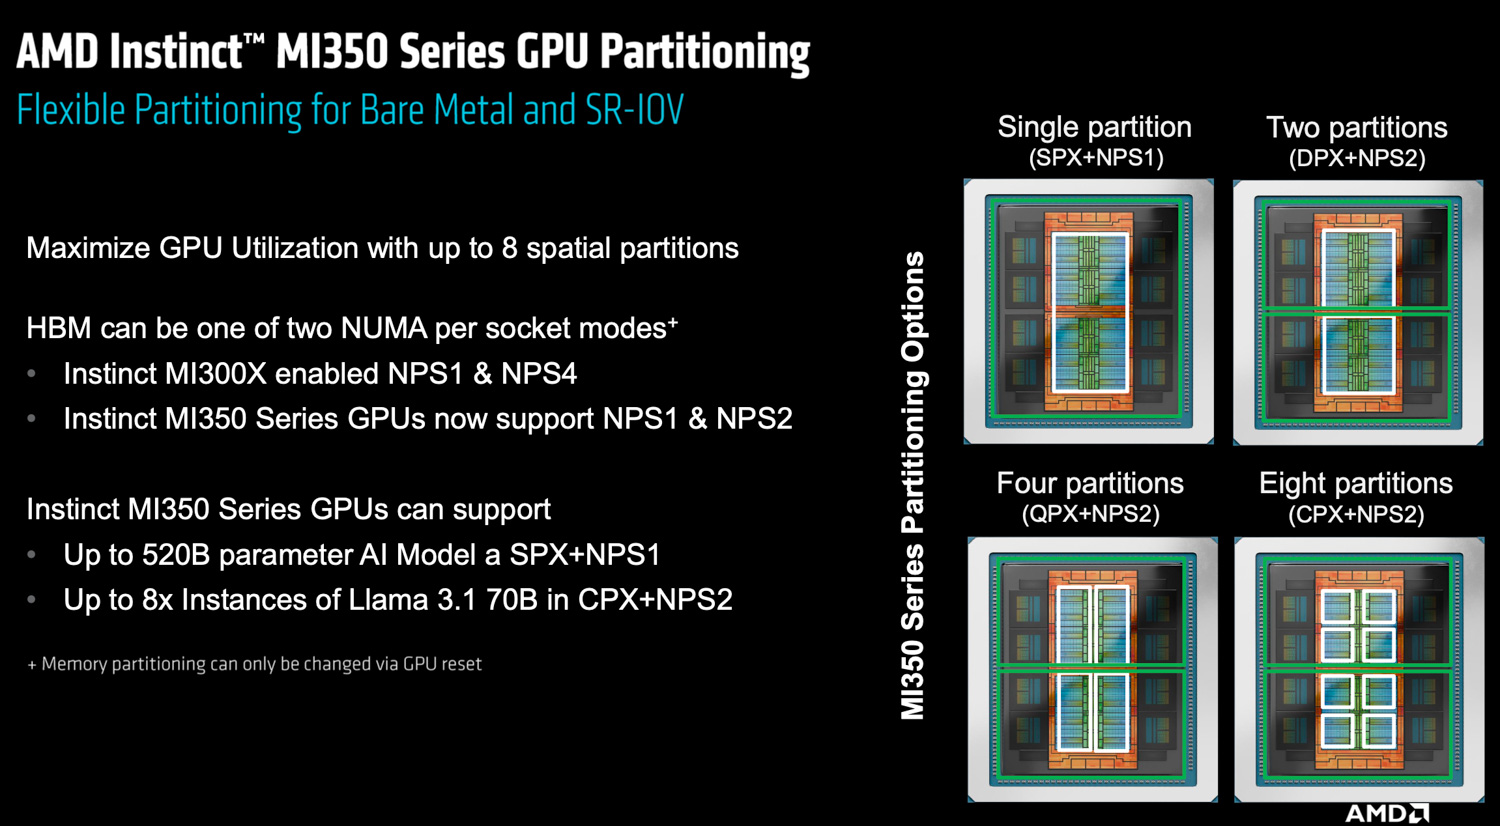
對於記憶體管理,MI350 提供兩種主要的 NUMA(非統一記憶體存取)模式:
- NPS1:透過在所有八個 HBM 堆疊上交錯資料訪問,將整個 288GB HBM3E 記憶體視為單一統一的 NUMA 域。
- NPS2:將記憶體劃分為兩個獨立的 NUMA 域,每個域對應兩個 IOD 中的一個及其關聯的四個 HBM 堆疊。在 NPS2 模式下,每個 IOD 內的記憶體存取保持細粒度交錯,而跨 IOD 的記憶體存取則變為粗粒度。此模式,尤其是與計算分區結合使用時,可以實現空間局部性的最佳化。
值得注意的是,AMD 選擇不支援 MI4 上的 NPS350 模式(該模式在 MI300 上可用)。這項決定源自於新架構中兩個 IOD 內部的記憶體耦合更加緊密,這削弱了進一步記憶體細分帶來的潛在效能優勢。
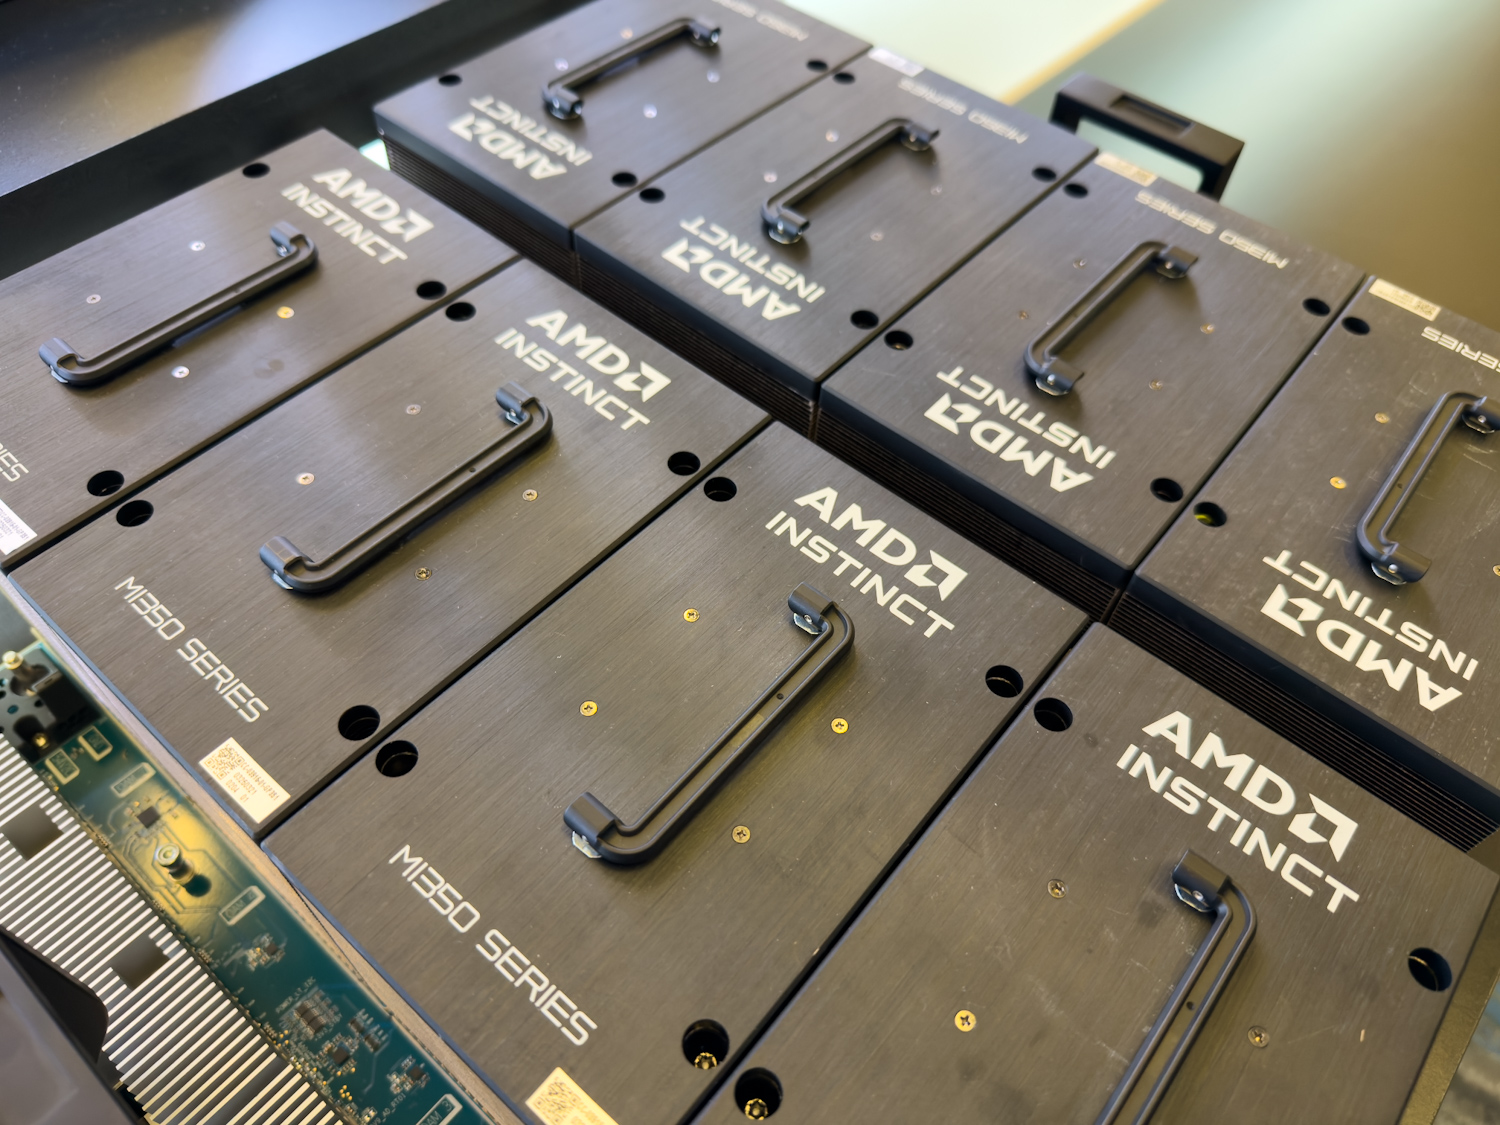
在運算方面,GPU 可以配置為以多種模式運作:
- SPX(單一分區執行):GPU 作為單一、強大的引擎運行,通常與 NPS1 記憶體模式一起使用。
- DPX、QPX、OPX(雙、四、八分區執行):GPU 可分別分為兩個、四個甚至八個獨立的計算分區。
這些計算分區可以與 NPS1 或 NPS2 記憶體配置配對,但限制條件是計算分區的粒度必須至少與記憶體分區一樣細或更細(例如,SPX 模式與 NPS2 記憶體分區不相容)。
這些多功能分區選項在裸機部署和 SR-IOV(單根 I/O 虛擬化)中均受支持,使其成為虛擬化多租戶環境的理想選擇。例如,在雲端或資料中心環境中,單一 MI350 GPU 可以進行邏輯分段,以同時為多個使用者或應用程式提供服務。每個租戶都會獲得專用的記憶體和運算資源,從而確保服務品質和安全性,這對於不同虛擬機器需要獨立存取 GPU 硬體的場景尤其重要。
MI350X 與 MI355X:針對不同部署量身定制
MI350 系列有兩種主要型號,可滿足不同的部署需求和熱範圍:
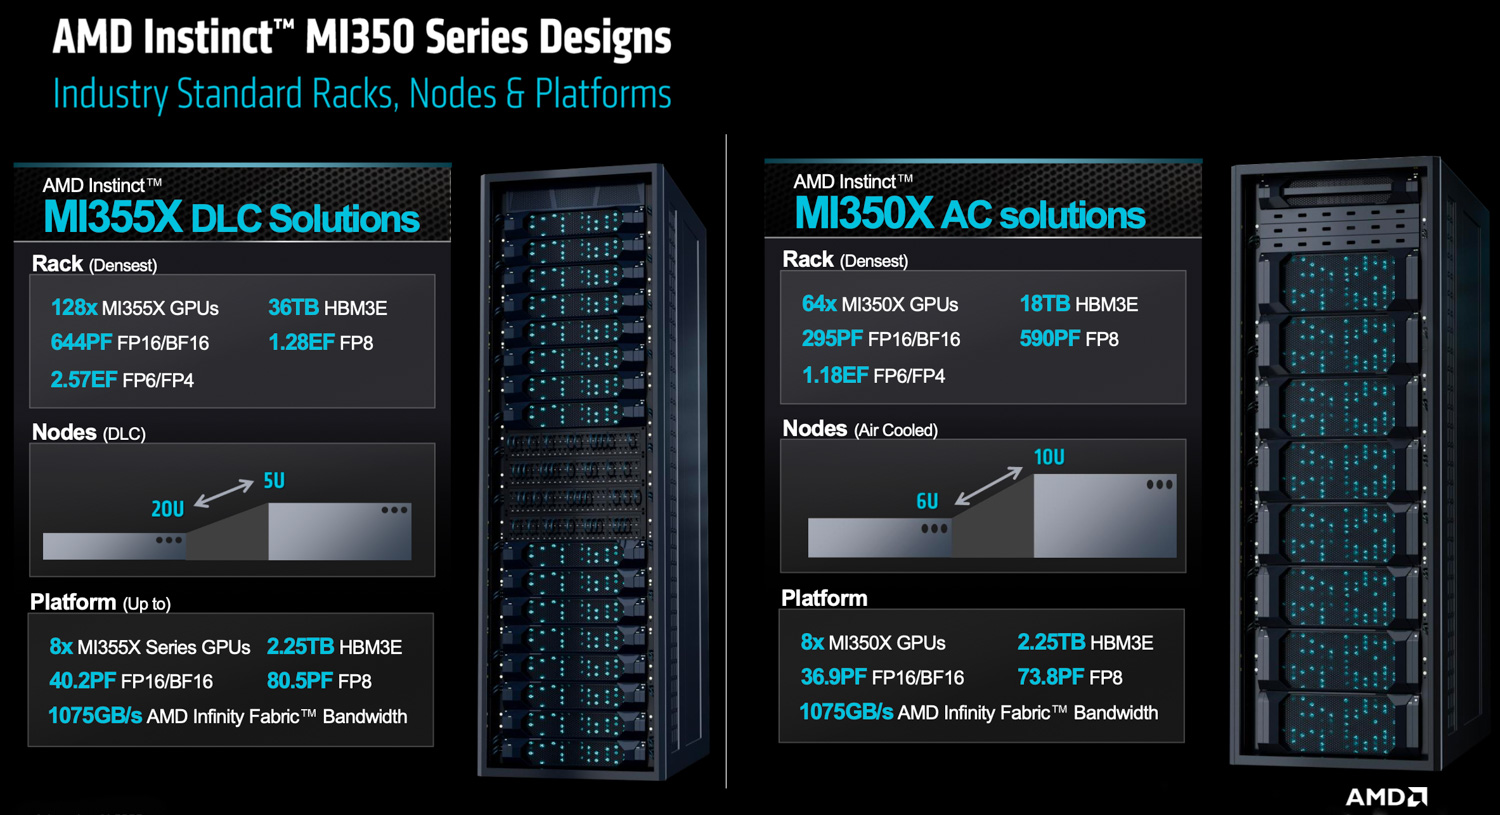
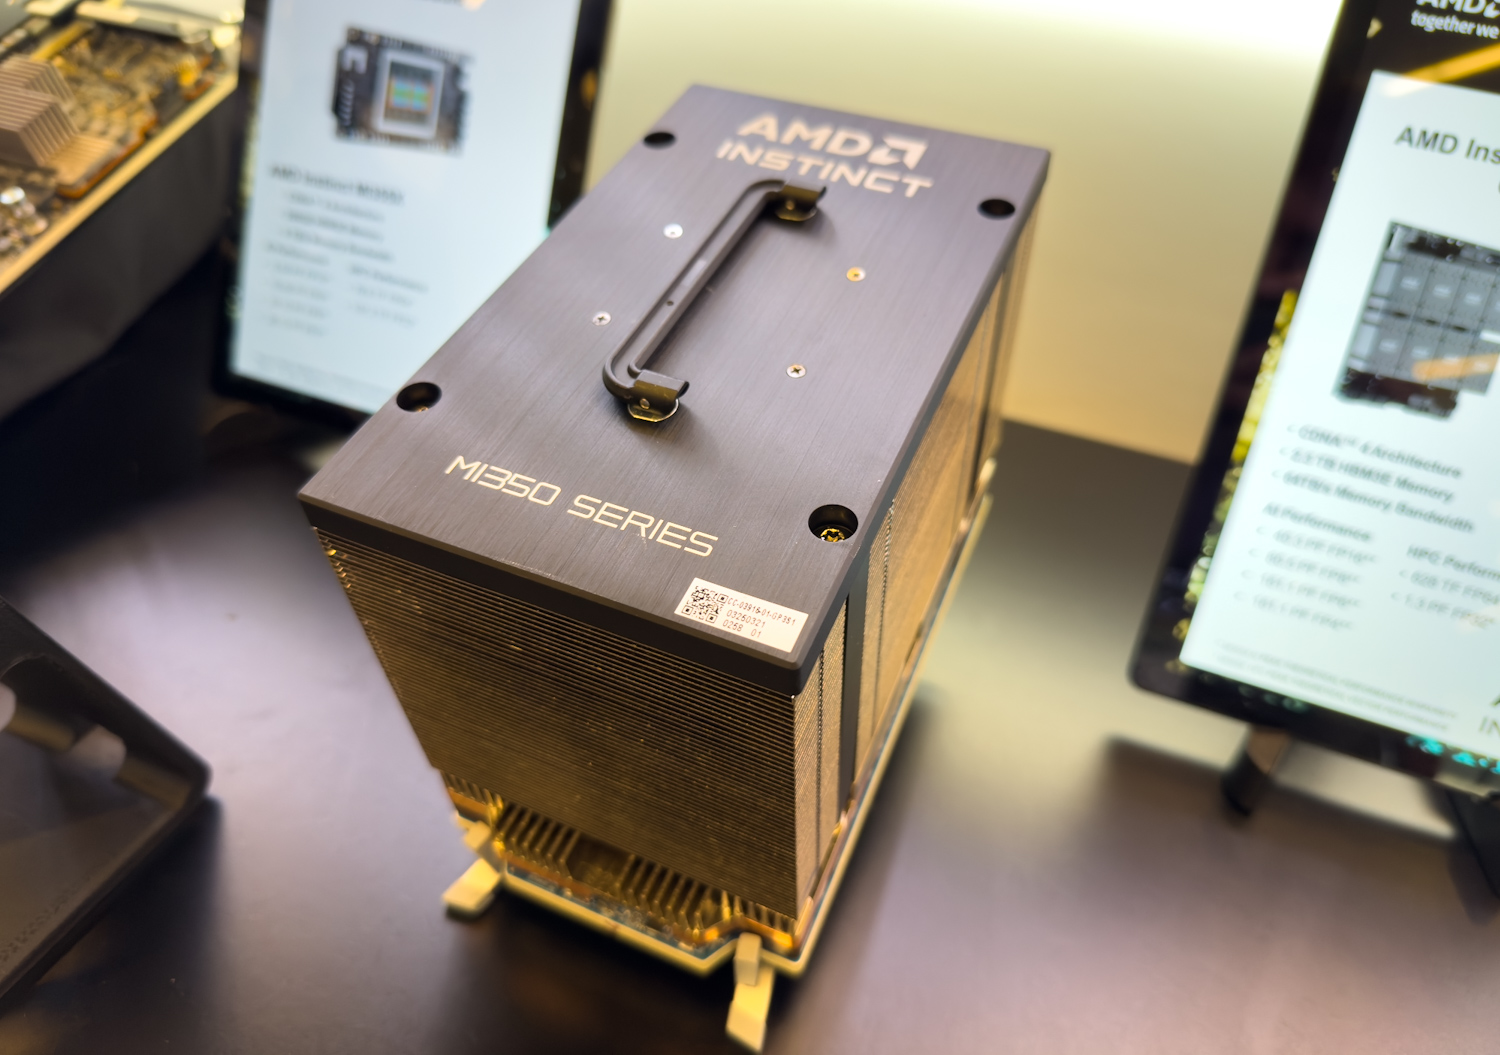
- MI350X:此型號專為降低功耗而設計,熱設計功率 (TDP) 高達 XNUMX 千瓦。它支援風冷部署,在現有資料中心基礎設施中提供更廣泛的相容性。
- MI355X:MI1.4X 的系統功率高達 355 千瓦 TDP,主要針對液冷部署,因此能夠提供最佳效能。
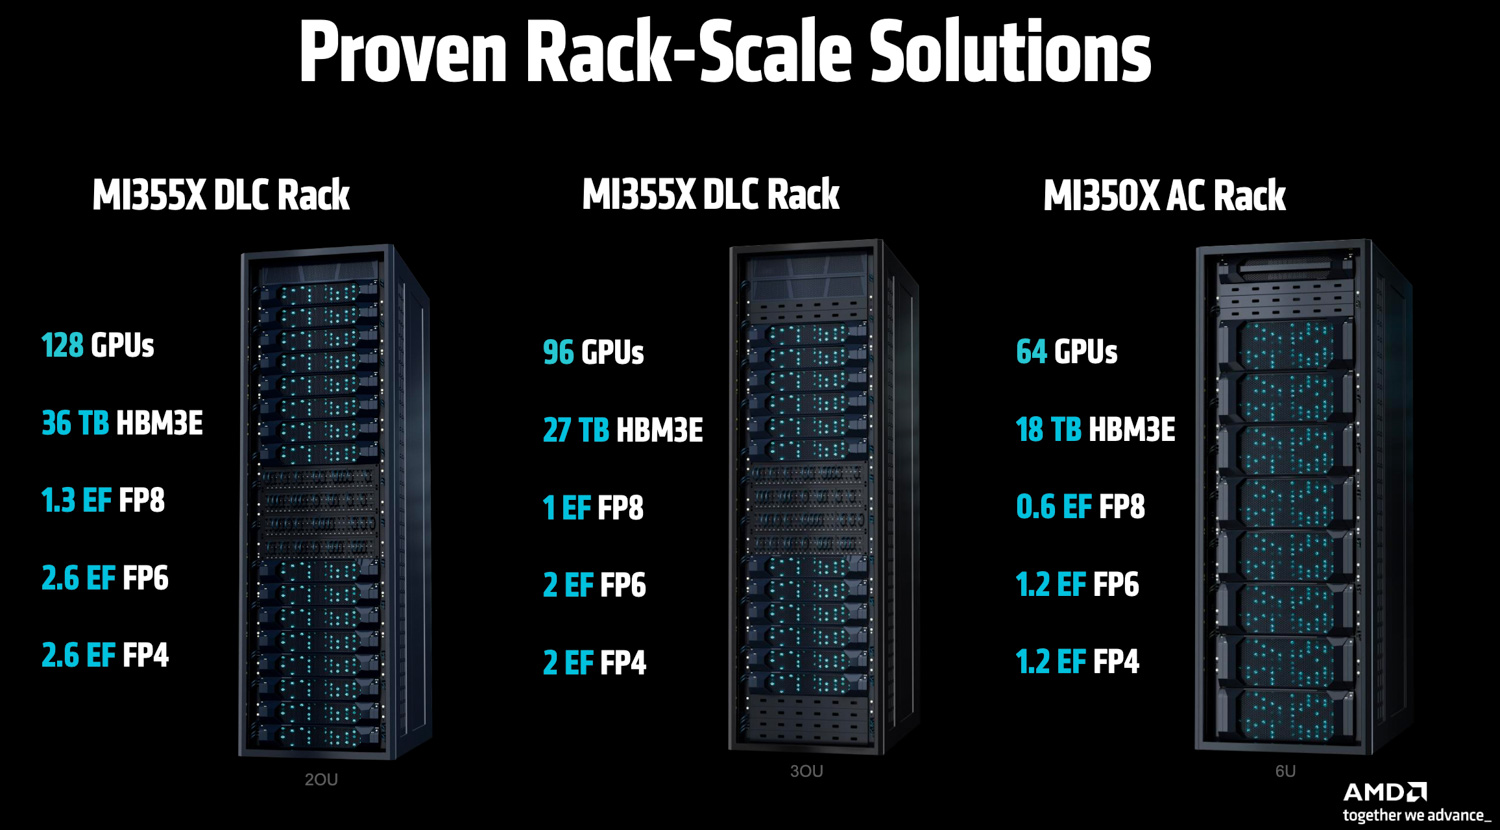
雖然兩種型號都基於相同的基礎硬體構建,但 MI355X 更高的運行功率範圍可實現更高的持續時脈頻率。與 MI20X 相比,這意味著在實際端對端工作負載下,其效能提升約 350%。 MIXNUMXX 提供三種經過驗證的機架配置。
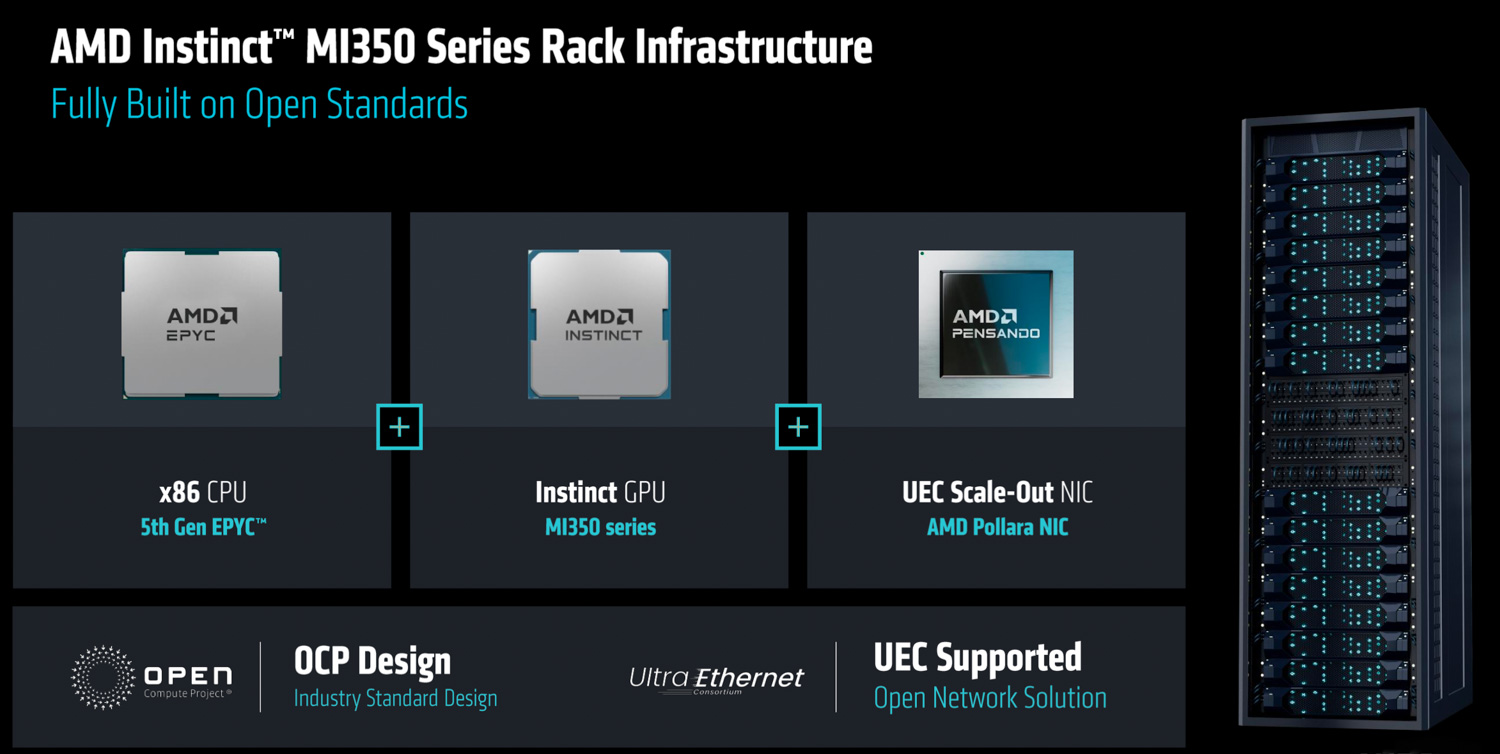
AMD Pensando Pollara 網絡
除了全新 GPU 之外,AMD 還深入介紹了其 Pollara 網路解決方案,展示了其顯著的架構改進,旨在滿足大規模人工智慧系統日益增長的需求。 Pollara 400 AI NIC 基於 AMD 收購 Pensando 的技術構建,為 AI 網路結構帶來了全新水平的可編程性和智慧化。

Pollara 創新的核心在於其可程式架構。與固定功能硬體不同,Pollara NIC 採用 P4 可程式 MPU 核心。這種設計至關重要,因為 AI 網路需求瞬息萬變,新的協定、傳輸機制和遙測需求層出不窮。可程式性使 Pollara NIC 能夠透過軟體更新進行調整,從而允許部署自訂流量管理方案、新型負載平衡演算法和客製化的擁塞控制機制,而無需更換硬體。這種靈活性對於面向未來的 AI 資料中心以及快速反應不斷變化的工作負載特性至關重要。
為了解決常見的網路瓶頸問題,Pollara 引入了多播技術。對於 GPU 到 GPU 的通信,來自單一連接的資料可以同時分發到多個實體網路鏈路上。這種方法透過避免任何單一路徑上的擁塞,提高了整體網路利用率和吞吐量。 NIC 本身負責管理這種分發的複雜性,包括對可能亂序到達目的地的資料包進行重新排序。
透過選擇性確認重傳,網路效率得以提升。在傳統網路中,遺失單一資料包就可能觸發大量資料的重傳。 Pollara 採用了一種更精確的方法,僅重傳遺失的資料包。這顯著減少了網路上的冗餘數據,從而提高了有效頻寬。 Pollara網路解決方案還針對各種網路環境(包括存在丟包的網路)進行了最佳化,確保其穩健運作。它整合了複雜、可編程且路徑感知的擁塞控制功能。這項功能降低了對完全無損網路架構的依賴,而這種架構在現代 AI 叢集所需的大規模部署和維護方面可能既複雜又昂貴。

AMD 也是超級乙太網路聯盟 (UEC) 的積極參與者,為其標準做出貢獻並實施。 UEC 旨在定義針對 AI 優化的下一代以太網,重點關注高效的負載平衡、增強的可靠性以及 AI 特定的擁塞控制。遵守這些開放標準有助於促進互通性並培育更廣泛的生態系統。
最後,Pollara 技術旨在與 AMD 更廣泛的平台協同運行,從而實現 CPU、GPU 和 NIC 組件之間的協同創新。這包括集體操作卸載等功能,其中 NIC 負責處理特定的網路密集型通訊任務(無需 GPU 運算)。這釋放了 GPU 資源,使其能夠用於主要處理任務。
ROCm 7:高階人工智慧的開放軟體生態系統
這些硬體創新的基礎是 ROCm 7 的發布,它是 AMD 開放軟體平台的最新演進,旨在最大限度地提高效能和可訪問性。 AMD 計劃於今日發佈公開預覽版,並於 7 月正式發布。 AMD 報告稱,ROCm 3 在現有硬體上的推理和訓練性能相比上一代產品均實現了驚人的 3.5 倍至 XNUMX 倍的提升。
面向企業客戶,AMD 推出了 ROCm AI Enterprise,這是一款全面的套件,提供叢集管理、MLOps 和用於大規模部署的應用程式建置工具。同時,AMD 也透過全新的開發者雲端平台為個人開發者提供存取權限,並提供免費 GPU 積分,以鼓勵開發者進行實驗。 ROCm 7 的可訪問性得到了進一步提升,正式擴展了對客戶端設備的支持,包括運行 Windows 的筆記型電腦和工作站,確保開發者能夠在整個 AMD 生態系統中無縫構建和測試 AI 應用程式。
前方的路
AMD 致力於快速的年度創新週期,其產品路線圖已超越其 MI350 系列。

AMD 正在開發 MI2026 系列,目標是在 400 年推出,該系列將成為代號為 Helios 的全整合式機架式解決方案的核心。該平台專為訓練尖端 AI 模型和管理大規模分散式推理任務而設計。 Helios 系統將是一個整合的 AMD 平台,整合代號為 Venice 的未來 EPYC CPU、Instinct MI400 GPU 以及下一代 Pensando 網絡,特別是 Vulcano 800G AI NIC。全面的 ROCm 軟體堆疊,包括用於自動部署和管理的專用 Fabric Manager,也將成為此解決方案的一部分。 Helios 機架強調開放式標準,將符合 OCP 規範。它將利用超級乙太網路 (UEC) 實現機架間網路的橫向擴展,並引入超級加速器鏈路 (UAL 1.0) 來擴展單一機架內的通訊。

Instinct MI400 GPU 專為超大規模 AI 應用打造。初步規格顯示其性能卓越,包括每秒 40 千萬億次浮點運算 (FP4) 和每秒 20 千萬億次浮點運算 (FP8)。預計每塊 GPU 將配備 432 GB 的 HBM 內存,提供約 20 TB/s 的 HBM 內存頻寬,並提供每秒 300 GB 的橫向擴展頻寬。作為 GPU 的補充,Vulcano 800G AI NIC 將支援 UEC,並支援 UAL 和 PCIe Gen6,UAL 可提供兩倍於 PCIe Gen6 的頻寬。與上一代 Polara 相比,這款 NIC 預計將為每塊 GPU 提供高達八倍的橫向擴展頻寬。 AMD 為 Helios 機架解決方案設定了雄心勃勃的性能目標,預計其在最先進的前沿型號上提供的 AI 性能將比 MI355 提升十倍。面對 2026 年的 Vera Rubin,Helios 的目標是提供具有競爭力的原始 FLOPS、增加 50% 的 HBM 容量、增加 50% 的 HBM 記憶體頻寬以及增加高達 50% 的橫向擴展頻寬。
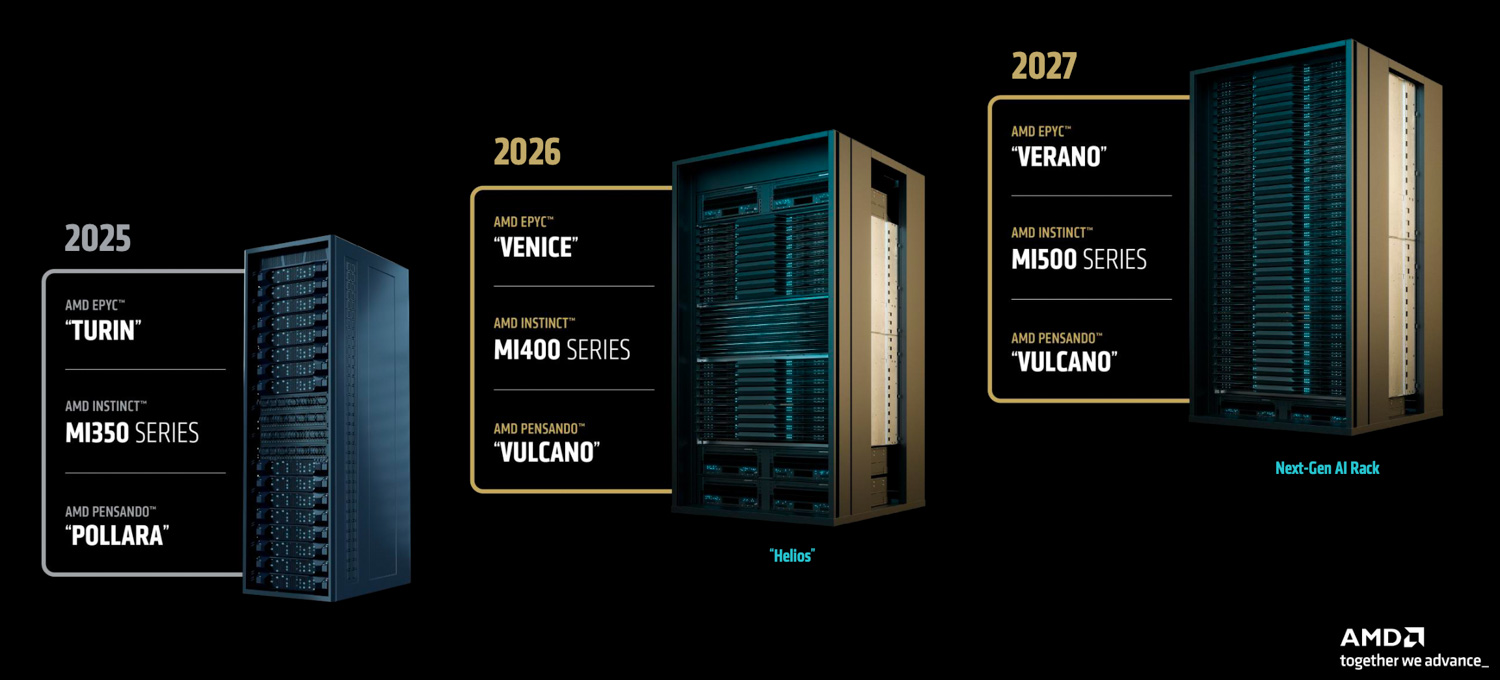
AMD 的路線圖進一步延伸,MI500 系列的開發工作已在順利進行,後續機架級架構的開發計畫將於 2027 年及以後推出。這些未來平台將整合 MI500 系列、代號為 Verano 的新一代 EPYC CPU 以及 Pensando 網路技術的進一步發展。不過,此次發布會並未透露更多資訊。


 Amazon