

在2026年GTC大會上,IBM和NVIDIA宣布大幅擴展雙方長達十餘年的合作關係,並專注於推動人工智慧從試點階段走向全面生產。此次合作旨在解決企業人工智慧應用流程中的幾個關鍵瓶頸,包括GPU原生資料分析、智慧文件處理以及受監管環境的基礎架構。雙方的合作目標是提供一套統一的資料基礎架構、硬體和諮詢服務,幫助企業管理分散的資料並滿足合規性要求。
IBM董事長兼執行長Arvind Krishna指出,企業人工智慧的下一階段取決於資料、基礎設施和編排的緊密整合。他表示,此次合作旨在為企業提供必要的組件,使其能夠從實驗階段過渡到實際營運部署階段。 NVIDIA創辦人兼執行長黃仁勳強調,透過將CUDA加速整合到資料層,兩家公司正致力於將傳統的資料處理轉變為即時智慧引擎。
利用cuDF和Presto加速結構化資料分析
此次公告的主要技術重點是將 NVIDIA cuDF 庫與 IBM watsonx.data 中的 Presto SQL 引擎整合。這種開源整合能夠對海量資料集進行 GPU 加速查詢執行,從而顯著降低從結構化資料中提取資訊所需的時間和成本。
這些公司在生產環境中,利用雀巢的訂單到收款資料倉儲驗證了這種方法。該倉庫在全球範圍內處理 44 個表中的 TB 級資料。在傳統的 CPU 基礎架構上,單次資料刷新需要 15 分鐘,並且每天只能刷新幾次。透過遷移到 GPU 加速的 watsonx.data 引擎,雀巢報告指出查詢運行時間縮短至 3 分鐘。這相當於性價比提升了 30 倍,成本降低了 83%。雀巢首席資訊和數位長 Chris Wright 表示,這項功能透過提供近乎即時的營運數據,能夠幫助製造和倉儲部門更快地做出決策。
利用 Docling 和 Nemotron 解鎖非結構化數據
為了應對資料被困於非結構化格式(例如 SharePoint 網站和 CMS 系統)的挑戰,IBM 和 NVIDIA 共同推出了一項解決方案,該方案利用了 IBM Docling 和 NVIDIA Nemotron 開放模型。 Docling 旨在將複雜文件標準化並轉換為 AI 可用的格式,同時保持對原始檔案的可追溯性。

與 NVIDIA Nemotron 模型搭配使用時,此系統可加速多模態內容的攝取。早期測試表明,與現有開源模型相比,其吞吐量顯著提高。此方案旨在幫助企業建立可信任的 AI 資料基礎,使內部知識庫更易於存取和標準化,從而支援自動化推理。

GPU優化基礎設施和主權人工智慧
此次合作也深入儲存和基礎設施層面。 NVIDIA 選擇 IBM Storage Scale System 6000 為其 GPU 原生高階分析引擎提供 10 PB 的高效能儲存。 Storage Scale 6000 已通過 NVIDIA DGX 平台的認證和驗證,它將 IBM 的平行吞吐量能力與 NVIDIA 的 GPU 資料管道結合,從而消除 I/O 瓶頸。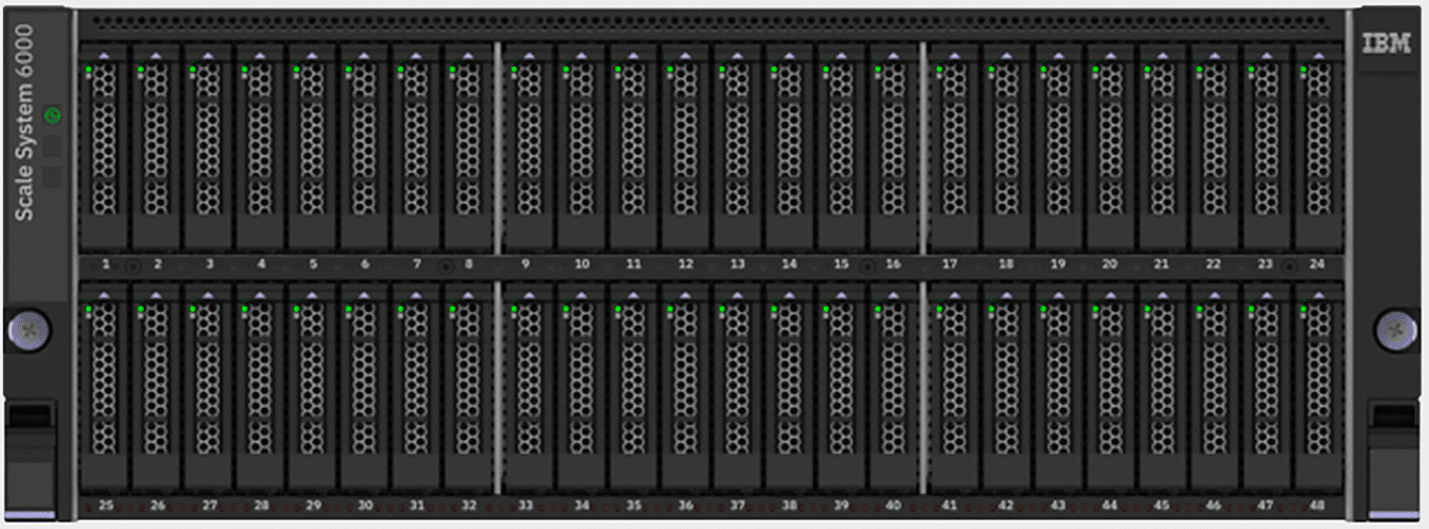
對於那些對資料駐留和監管要求有嚴格限制的組織而言,他們正在探索將 IBM Sovereign Core 與 NVIDIA 基礎架構整合。這項計畫旨在使 GPU 密集型 AI 工作負載能夠在特定區域邊界內完全運行,從而確保在不犧牲運算效能的前提下滿足治理和合規標準。
利用 Blackwell 和 Red Hat 擴展 AI 技術棧
IBM宣布計劃於2026年第二季初在IBM雲端平台引進NVIDIA Blackwell Ultra GPU。這些資源將主要用於大規模模型訓練和高吞吐量推理。 Blackwell架構也將與NVIDIA和VPC伺服器一起整合到Red Hat AI Factory中,從而提供企業級的資料駐留控制。

此外,IBM諮詢將透過IBM諮詢優勢平台提供基於NVIDIA技術的Red Hat AI Factory解決方案。此舉旨在簡化資料準備、模型建立和部署流程。透過整合這些技術,IBM和NVIDIA力求為企業提供更順暢的途徑,使其能夠在各種技術環境下擴展AI應用,同時保持可控性和效能。


 Amazon