

Meta概述了其Meta訓練和推理加速器(MTIA)計畫的快速發展。該公司介紹了在兩年左右的時間內開發的四代晶片。這些晶片解決了Meta認為對全球人工智慧至關重要的關鍵基礎設施問題:無需依賴漫長的晶片開發週期,即可低成本地快速適應不斷演進的模型架構。 MTIA是Meta更廣泛的晶片策略的一部分,Meta重申了與博通公司在晶片開發方面的合作。
據 Meta 公司稱,其已在生產環境中部署了數十萬台 MTIA 設備,並整合了多個內部模型。驗證工作包括測試 Llama 等大型語言模型。該公司先前已在 ISCA 研究論文中發布了前兩代 MTIA(MTIA 100 和 MTIA 200)的技術細節。目前,該公司正在透過 MTIA 300、400、450 和 500 擴展平台功能。這些新組件將覆蓋範圍從排序和推薦 (R&R) 推理擴展到 R&R 訓練,並日益擴展到通用 GenAI 工作負載,尤其是推理,相關部署正在進行中或計劃於 2026 年和 2027 年進行。
迭代作為一種設計原則
節奏是關鍵。 Meta 認為,MTIA 晶片的演進速度比傳統晶片開發更快,後者從設計到量產可能需要兩年時間。 Meta 基於開源 RISC-V 架構來建構 MTIA 晶片,並由台積電 (TSMC) 負責製造。其解決方案是採用迭代式模組化設計方法。每一代產品都基於可重複使用的晶片組,並根據運營商和服務領域的最新洞察進行微調。該公司還強調了晶片之外的重用性的重要性。 MTIA 400、450 和 500 共用相同的機箱、機架和網路基礎設施。這使得快速升級成為可能,從而縮短了從晶片準備就緒到資料中心部署的時間。
MTIA 300:矽谷內建的網路與社群
MTIA 300 是新路線圖的基礎。它最初針對 R&R 訓練進行了優化,這是在 GenAI 興起之前 Meta 的主要工作負載。該架構包含內建網路晶片、用於高效集體通訊的專用訊息引擎以及近記憶體運算,以減輕集體操作的負載。雖然最初專注於 R&R,但這些溝通組件在後續版本中也支持 GenAI 的訓練和推理效率。
在模組層面,Meta 將 MTIA 300 描述為多晶片組設計,包含一個運算晶片組、兩個網路晶片組和多個 HBM 堆疊。計算模組以處理單元 (PE) 網格的形式排列,並配備額外的 PE 以提高良率。每個 PE 包含兩個 RISC-V 向量內核、一個用於矩陣運算的點積引擎、一個用於激活和逐元素運算的專用功能單元、一個用於累加和 PE 間通信的歸約引擎,以及一個用於本地數據傳輸的 DMA 引擎。
MTIA 400:向具有競爭力的吞吐量宣稱的GenAI轉型
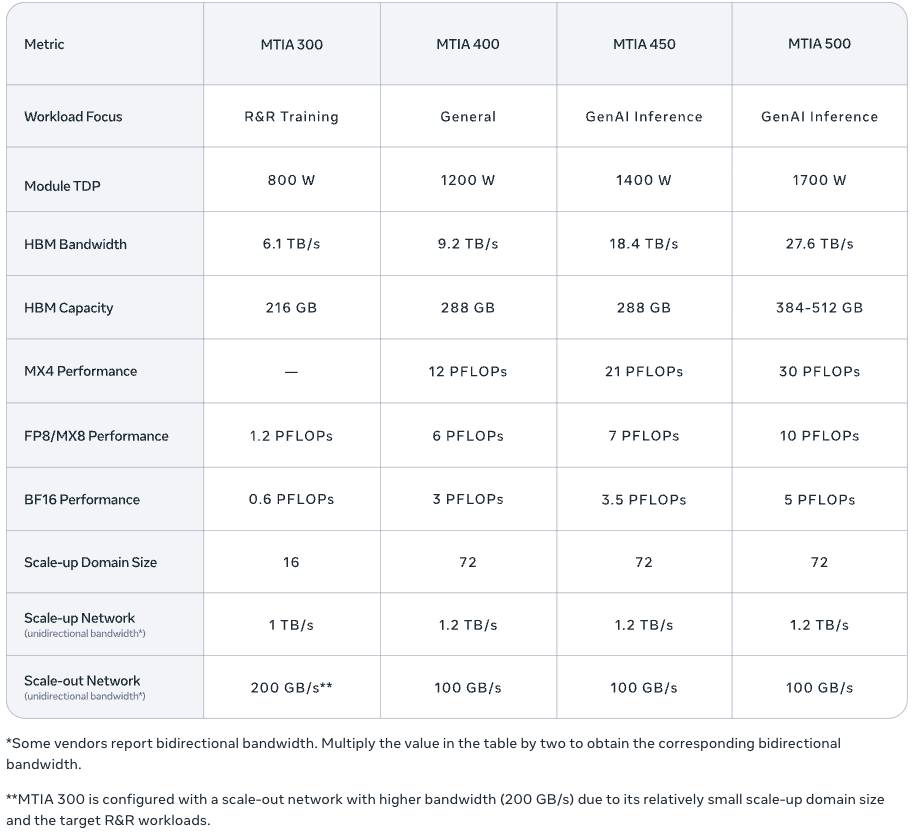
MTIA 400 是 MTIA 300 的升級版,旨在更好地支援 GenAI,同時保持其可重複使用性。 Meta 將 MTIA 400 描述為重大升級,其 FP8 FLOPS 效能比 MTIA 300 提升了 400%,HBM 頻寬提升了 51%。在架構方面,MTIA 400 集成了兩個計算晶片,提高了計算密度,並增加了對改進的 MX8 和 MX4 低精度格式的支持,Meta 認為這對於高效的 GenAI 推理至關重要。

系統設計仍然是重點。 Meta 描述了一種機架級部署方案,其中 72 台 MTIA 400 設備透過交換式背板連接,形成一個可擴展的單一域。為了實現靈活部署,Meta 提到了空氣輔助液冷 (AALC) 機架,以加快現有資料中心的部署速度。該公司還指出,該平台可以支援液冷解決方案。
MTIA 450:GenAI推理優化始於記憶體頻寬
MTIA 450 是 MTIA 400 的改進版本,專注於推理,旨在滿足日益增長的 GenAI 推理需求。 Meta 發現 HBM 頻寬是限制推理效能的主要因素,並將頻寬從 MTIA 400 提升至 MTIA 450 的兩倍。該公司還報告稱,MX4 的 FLOPS 性能提升了 75%,從而改善了混合專家計算,並採用了硬體加速來減少注意力機制和前饋操作中的常見瓶頸,尤其是在 Softmax 和 FlashAttention 的行為方面。
Meta強調其在資料類型方面的工作是其成功的關鍵因素。 MTIA 450超越了FP8和MX8,實現了MX4吞吐量,速度是FP16/BF16的六倍。此晶片支援混合低精度計算,無需軟體轉換。它針對資料類型進行了客製化創新,旨在以最小的面積影響,在提高浮點運算性能的同時,保持模型品質。 MTIA 450計劃於2027年初大規模部署。
MTIA 500:更大的頻寬、更大的容量、更精細的晶片分解
MTIA 500 繼續專注於推理效能,並在記憶體和計算方面進行了進一步改進。 Meta 指出,MTIA 500 的 HBM 頻寬比 MTIA 450 提升了 50%,HBM 容量提升了高達 80%,MX4 浮點運算效能提升了 43%。晶片組設計也進行了改進,採用了 2×2 的小型運算晶片組配置,周圍環繞著多個 HBM 堆疊和兩個網路晶片組。此外,它還包含一個用於透過 PCIe 連接到主機 CPU 和橫向擴充網路卡的系統級晶片 (SoC) 晶片組。 Meta 也提到,為了解決推理瓶頸問題,MTIA 500 增加了硬體加速功能並更改了資料類型。
MTIA 500計劃於2027年大規模部署。
輕鬆採用
Meta 致力於讓 MTIA 易於上手,強調使用業界標準工具而非專用框架。該公司稱 MTIA 是 PyTorch 原生框架,可與 PyTorch 2.x 編譯流程無縫協作,並支援 eager 模式和圖模式兩種執行方式。在圖模式下,開發者可以使用 `torch.compile` 和 `torch.export` 來最佳化圖,而無需重寫 MTIA 特有的模型,從而實現跨 GPU 和 MTIA 的平行部署。
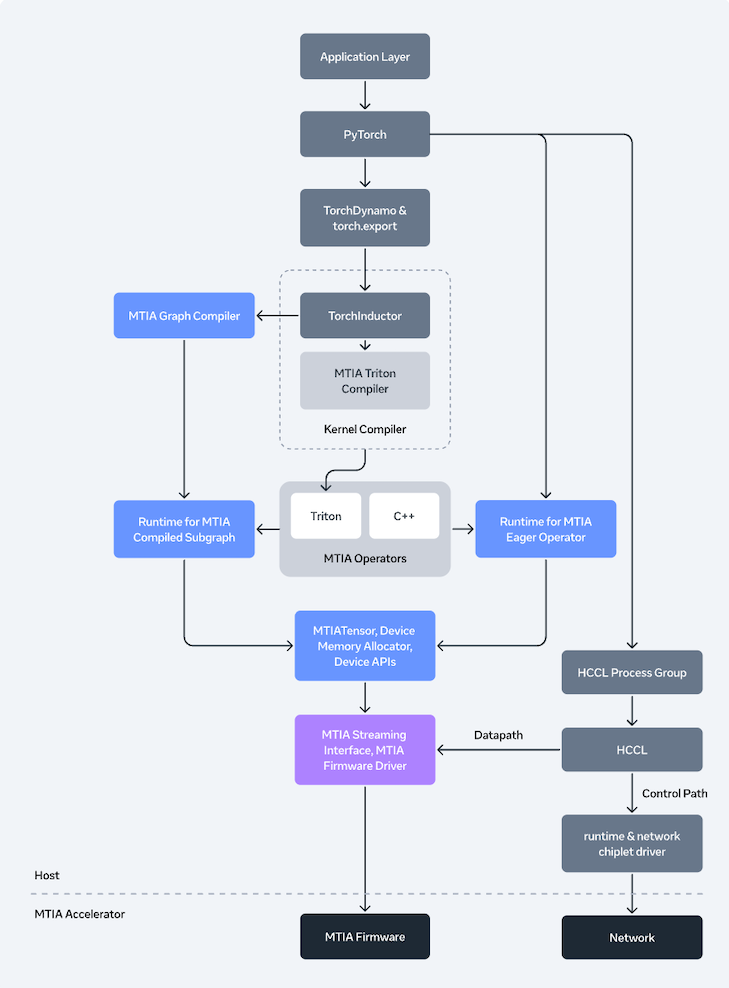
Meta詳細介紹了基於Torch FX IR和TorchInductor建構的MTIA編譯器堆疊。底層使用了Triton、MLIR和LLVM,以及MTIA特有的最佳化,包括核心融合的改進和對效能關鍵部分的擴展。自動調優是其關鍵特性,可用於選擇不同的編譯策略。
為了實現分散式執行,Meta 推出了 Hoot 集體通訊庫 (HCCL)。該函式庫類似於 GPU 集體通訊協定棧,但針對 MTIA 的內建網路晶片和訊息引擎進行了最佳化。它利用近記憶體計算來加速歸約操作。 Meta 還支援計算集體融合以降低延遲,並擁有一個旨在管理資料路徑和減少主機開銷的傳輸協定堆疊。
在運行時,Meta 展示了一個裝置運行時環境,該環境能夠管理記憶體、調度以及在即時模式和圖形模式下的協調。它還引入了一個基於 Rust 的用戶空間驅動程序,從而擺脫了傳統的 Linux 核心驅動程式。韌體採用裸機 Rust 編寫,強調低延遲和安全性。
Meta 介紹了其 GenAI 服務中如何利用插件系統整合 vLLM。該系統將 FlashAttention 和融合 LayerNorm 等關鍵算子替換為 MTIA 特有的核心。此外,它還透過自訂的 torch.compile 後端啟用圖模式。 Meta 也提到了一些用於管理大型 MTIA 部署的工具,包括跨主機和裝置的監控、效能分析、調試和可觀測性。
下一步是什麼
Meta 更新後的 MTIA 路線圖強調了 GenAI 推理的經濟性,並將 HBM 頻寬和低精度格式列為關鍵因素。如果 Meta 能夠按計劃完成部署,MTIA 450 和 500 將成為首批大規模測試,以確定基於快速晶片迭代和標準化軟體的推理優先加速器策略,在提供 GenAI 服務方面,能否保持相對於主流 GPU 平台的優勢。


 Amazon