

NVIDIA宣布了兩項旨在進軍高效能運算和人工智慧領域的重大舉措:收購了Slurm工作負載管理器背後的公司SchedMD,以及推出多智能體人工智慧的Nemotron 3系列開放模型、資料和工具。這兩項措施將進一步鞏固NVIDIA在高效能運算、生成式人工智慧和企業級人工智慧基礎設施領域的地位,同時持續秉持開放、廠商中立軟體的理念。
Slurm 和 SchedMD:加強開放、廠商中立的高效能運算調度
SchedMD 是 Slurm 的主要開發者,Slurm 是目前應用最廣泛的開源高效能運算 (HPC) 和人工智慧 (AI) 叢集工作負載管理器之一。 Slurm 用於在大規模叢集中對運行緊密耦合並行工作負載的運算資源進行排隊、調度和分配。隨著叢集規模和模型複雜性的增加,高效的調度對於維持資源利用率和吞吐量至關重要。
Slurm 在高效能運算 (HPC) 領域的應用十分廣泛。在 TOP500 榜單的前 10 名和前 100 名系統中,超過一半都使用了 Slurm,這主要得益於其可擴展性、高吞吐量以及對複雜策略管理的支援。對於人工智慧 (AI) 工作負載,Slurm 已成為基礎模型開發者和 AI 建構者在 GPU 加速系統上協調大規模模型訓練和推理的關鍵基礎設施組件。
收購完成後,NVIDIA計劃繼續開發和發行Slurm,並將其作為開源、廠商中立的軟體發布。該公司表示,Slurm將繼續面向更廣泛的高效能運算(HPC)和人工智慧(AI)社區,並繼續支援各種硬體和軟體平台上的異質環境。 NVIDIA與SchedMD已合作十餘年,此次正式收購旨在加速雙方的合作路線圖,而非策略轉型。
SchedMD管理層認為這筆交易是對Slurm在高效能運算和人工智慧領域核心地位的認可。該公司指出,NVIDIA在加速運算方面的專業知識將有助於Slurm滿足未來人工智慧和超級運算的需求,同時保持其開源模式和社群參與度。
客戶影響和平台支持
對於 SchedMD 的現有客戶,NVIDIA 計劃繼續提供 Slurm 支援、培訓和開發服務。目前,Slurm 的部署涵蓋雲端服務供應商、製造商、人工智慧公司和研究機構,涉及自動駕駛、醫療保健和生命科學、能源、金融服務、政府和一般製造業等多個行業。
NVIDIA 也希望加快 SchedMD 對新系統和架構的存取。對於採用 NVIDIA 加速運算平台的客戶而言,這意味著新一代 GPU 和系統配置的支援速度將更快。同時,NVIDIA 重申 Slurm 將繼續支援各種異質環境,使混合廠商叢集能夠採用新的 Slurm 功能,而無需局限於單一硬體堆疊。
NVIDIA 和 SchedMD 的共同努力被視為加強高效能運算和人工智慧領域開源軟體生態系統的更廣泛計畫的一部分,旨在促進各行業和部署規模的創新。
Nemotron 3:針對多智能體、智能體的開放式 MoE 模型
同時,NVIDIA 推出了Nemotron 3 系列,這是一個開放的生態系統,包含模型、資料集和函式庫,用於建立透明且高效的智慧體 AI 系統。隨著企業從單模型聊天機器人轉向更複雜的多智能體架構,他們面臨著許多挑戰,例如智能體之間的通訊開銷、長時間工作流程中的上下文漂移以及不斷攀升的推理成本。此外,企業對透明度的需求也日益增長,以便更好地理解和信任嵌入關鍵業務流程中的 AI 系統。
Nemotron 3 採用混合潛在專家混合 (MoE) 架構來滿足這些需求,該架構專為大規模多智能體工作負載而設計。這些模型旨在支援智能體的協作行為、專業技能和高效的任務路由,同時保持可預測的效能和成本特性。
英偉達創辦人兼執行長黃仁勳強調,開放式創新對人工智慧的發展至關重要。他著重指出,Nemotron 將前沿人工智慧轉化為一個易於使用的平台,提升透明度和效率,從而支援大規模智能體的開發。
歐洲、韓國及其他地區的國家和地區人工智慧計畫已開始將Nemotron視為開放式、在地化人工智慧開發的基礎。包括埃森哲、Cadence、CrowdStrike、Cursor、德勤、Palantir、Perplexity等在內的早期採用者,正在將Nemotron模型融入到涵蓋製造業、網路安全、軟體工程、媒體和通訊等領域的工作流程中。
型號系列:Nano、Super 和 Ultra
Nemotron 3 由三個主要的 MoE 模型層級組成,每個層級都針對不同類型的工作負載:
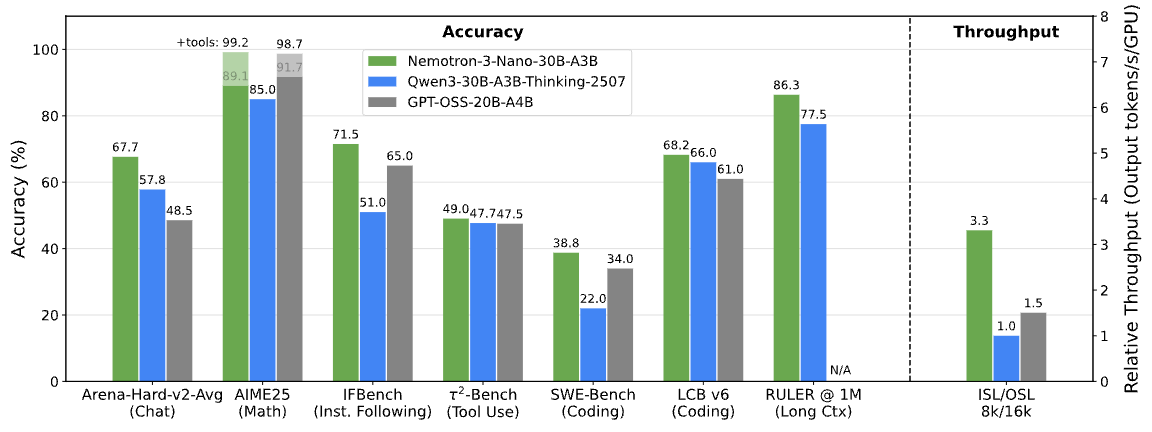
- 納米 這是一個小型模型,大約有30億個參數, 激活 每個代幣最多可包含 3 億個參數。 對於 高效推理。它是 適宜 對於任務 LIKe 偵錯, 摘要,人工智慧 管道以及資訊檢索,其中低延遲和 成本 是 至關重要的。 其 混合式 MoE 設計可提供比 Nemotron 2 Nano 高達 4 倍的令牌吞吐量,並將推理成本降低高達 60%,從而降低整體推理成本。Nemotron 3 Nano 擁有 1 萬個令牌的上下文視窗。 維持s 更多州 長 工作流程,提高準確性並連接遠端上下文。 獨立基準對其進行排名 它是最開放、最高效的模式之一。 類與 最佳 準確度 窺視s.
- Super 是一款高精度推理模型,擁有約 10 億個參數,每個 token 最多可包含 100 億個活躍參數。它專為多智能體應用而設計,在這些應用中,多個智能體協作以在低延遲要求下實現複雜目標。 Super 適用於推理深度、工具使用和智慧體間協作需要擴展,但又不希望像大型模型那樣產生高昂成本的場景。
- Ultra 是頂級模型,它作為一個大型推理引擎,擁有約 50 億個參數,每個 token 最多可激活 500 億個參數。它專為要求最苛刻的 AI 工作流程而設計,包括深度研究、策略規劃以及需要在超長上下文中進行高品質推理的複雜決策支援系統。
Nemotron 3 Super 和 Ultra 使用 NVIDIA 的 4 位元 NVFP4 格式在 Blackwell 架構上進行訓練。這種訓練格式顯著降低了記憶體佔用,提高了訓練吞吐量,同時保持了與更高精度格式相當的精度。對於企業和服務提供者而言,這使得他們能夠在現有基礎設施上訓練更大的模型,或減少特定規模所需的硬體資源。
透過這種分層式系列,開發人員可以根據特定的工作負載和成本目標來匹配模型大小和功能,從數十個代理擴展到幾百個代理,同時在複雜的多步驟工作流程中保持更快、更準確的長期推理。
路由、代幣經濟學和混合模型策略
隨著多智能體系統的日益成熟,許多組織開始採用混合模型策略。 Frontier 的專有模型用於處理最複雜的推理任務,而高效且可自訂的開放模型則用於處理常規或特定領域的工作負載。 Nemotron 3 正是專為這種基於路由的架構而設計的。
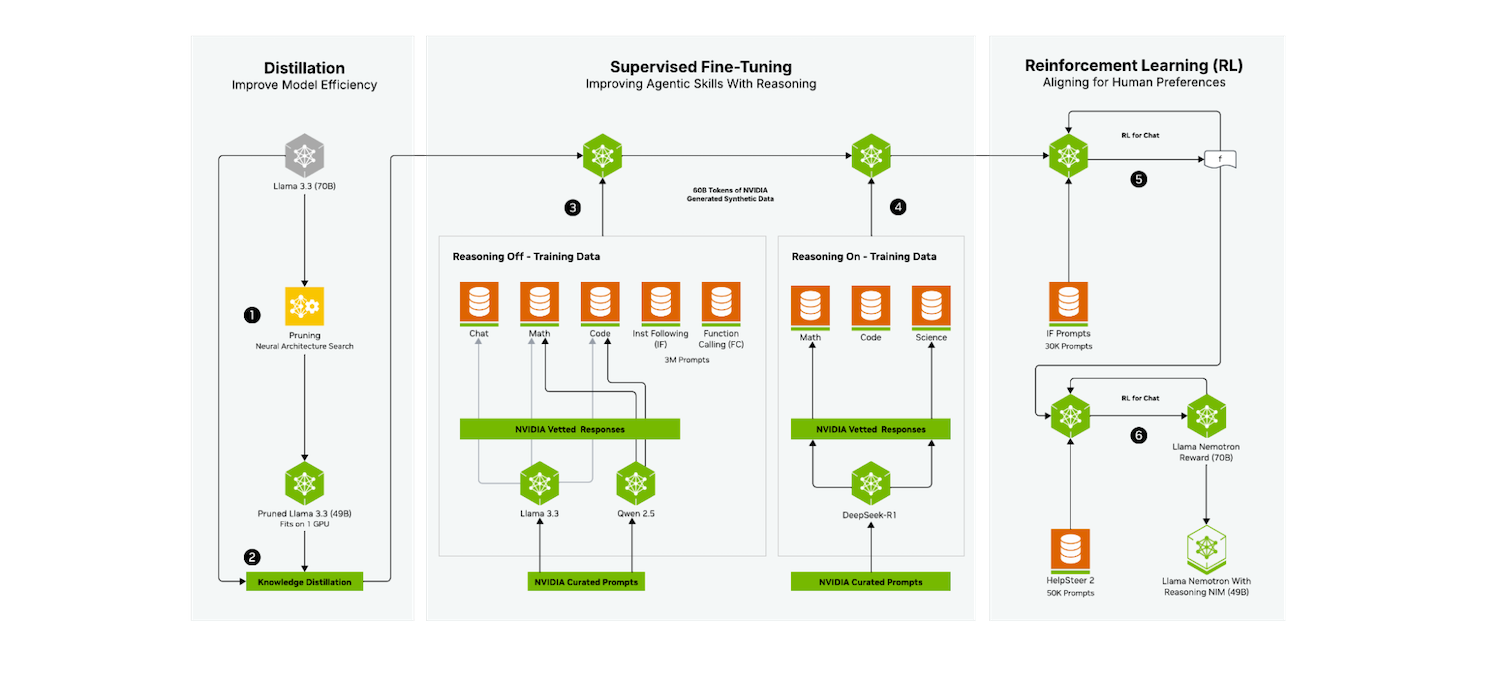
在典型的架構中,代理路由器即時分析任務。它將任務分派給經過精細調優的 Nemotron 模型(例如 Nemotron 3 Ultra),或在專有模型能夠提供獨特價值時將其分派給專有模型。這種方法透過為最苛刻的場景預留昂貴的前沿容量,並利用 Nemotron 處理高吞吐量、高效率的工作負載,從而優化代幣經濟。
建構 AI 助理和代理平台的合作夥伴表示,這種路由策略使他們能夠提供更高的響應速度和更好的成本控制,同時保持靈活性,以便隨著時間的推移整合不同的模型提供者和訓練策略。
開放資料、函式庫和安全工具
除了模型本身之外,NVIDIA 還發布了大量開放資源,以支援自訂代理程式的開發:
訓練與強化學習資料集
NVIDIA 提供 3 兆個 Nemotron 資料集,用於前期學習、後期學習和強化學習。這些資料集包含豐富的範例,涵蓋推理、編碼和多步驟工作流程,可用於訓練或微調特定領域的智慧體。 Nemotron 智能體安全資料集提供真實世界的遙測數據,團隊可利用這些數據評估和提升複雜自主系統的安全性。
NeMo Gym 和 NeMo RL
為了簡化強化學習和訓練後處理,NVIDIA 發布了 NeMo Gym 和 NeMo RL 這兩個開源函式庫。它們提供與 Nemotron 模型相容的訓練環境和訓練後處理基礎架構,並且可以擴展或適合其他架構。 NeMo Evaluator 則用於評估模型在各種基準測試和用例中的安全性和效能。
所有這些工具和資料集都可以在 GitHub 和 Hugging Face 上找到,方便團隊將其整合到現有的 MLOps 管線和訓練工作流程中。像 Prime Intellect 和 Unsloth 這樣的生態系統參與者已經將 NeMo Gym 訓練環境整合到他們的平台中,以簡化企業用戶的強化學習流程。
Nemotron 3 模型還相容於流行的推理和部署框架,包括 LM Studio、llama.cpp、SGLang 和 vLLM,這使得進行本地實驗和部署到各種環境變得更加容易。
庫存情況
Nemotron 3 Nano 現已透過以下列出的多個分銷管道發售。
模型中心和推理提供者:Nemotron 3 Nano 模型可透過 Hugging Face 以及Baseten、DeepInfra、Fireworks、FriendliAI、OpenRouter 和 Together AI 等推理提供者取得。這些服務使團隊能夠快速評估模型並將其整合到現有應用程式中。
企業平台: Nemotron 模型正整合到企業級 AI 和資料平台中,包括 Couchbase、DataRobot、H2O.ai、JFrog、Lambda 和 UiPath。這使得客戶能夠將 Nemotron 驅動的功能直接嵌入到他們的資料、編排和自動化堆疊中。
公有雲和 NIM 微服務:對於公有雲用戶,Nemotron 3 Nano 將透過 Amazon Bedrock 在 AWS 上提供,用於無伺服器推理,並且還將在 Google Cloud、CoreWeave、Crusoe、Microsoft Foundry、Nebius、Nscale 和 Yotta 上提供。
Nemotron 3 Nano 也可作為 NVIDIA NIM 微服務提供,以便在 NVIDIA 加速的基礎架構上進行安全、可擴展的部署,使企業能夠更好地控制隱私、資料本地性和效能。
Nemotron 3 Super 和 Ultra 預計將於 2026 年上半年上市,這將使各組織有時間在 Nano 層進行標準化,以滿足早期代理用例的需求,並隨著需求的增長計劃未來遷移到更大的模型。


 Amazon