

LPU(語言處理單元)是由 Groq 公司設計和建構的客製化 AI 推理加速器。 Groq 由前Google工程師 Jonathan Ross 於 2016 年創立,他也是 TPU 的最初發明者之一。 Groq 花費數年時間從零開始開發了一種確定性的軟體定義處理器架構。與依賴動態硬體調度和多層級快取層次結構的 GPU 不同,LPU 採用了一種截然不同的方法:它消除了所有被動式硬體元件,並將整個控制平面置於編譯器中,從而實現了精確到時脈週期的完全可預測執行。
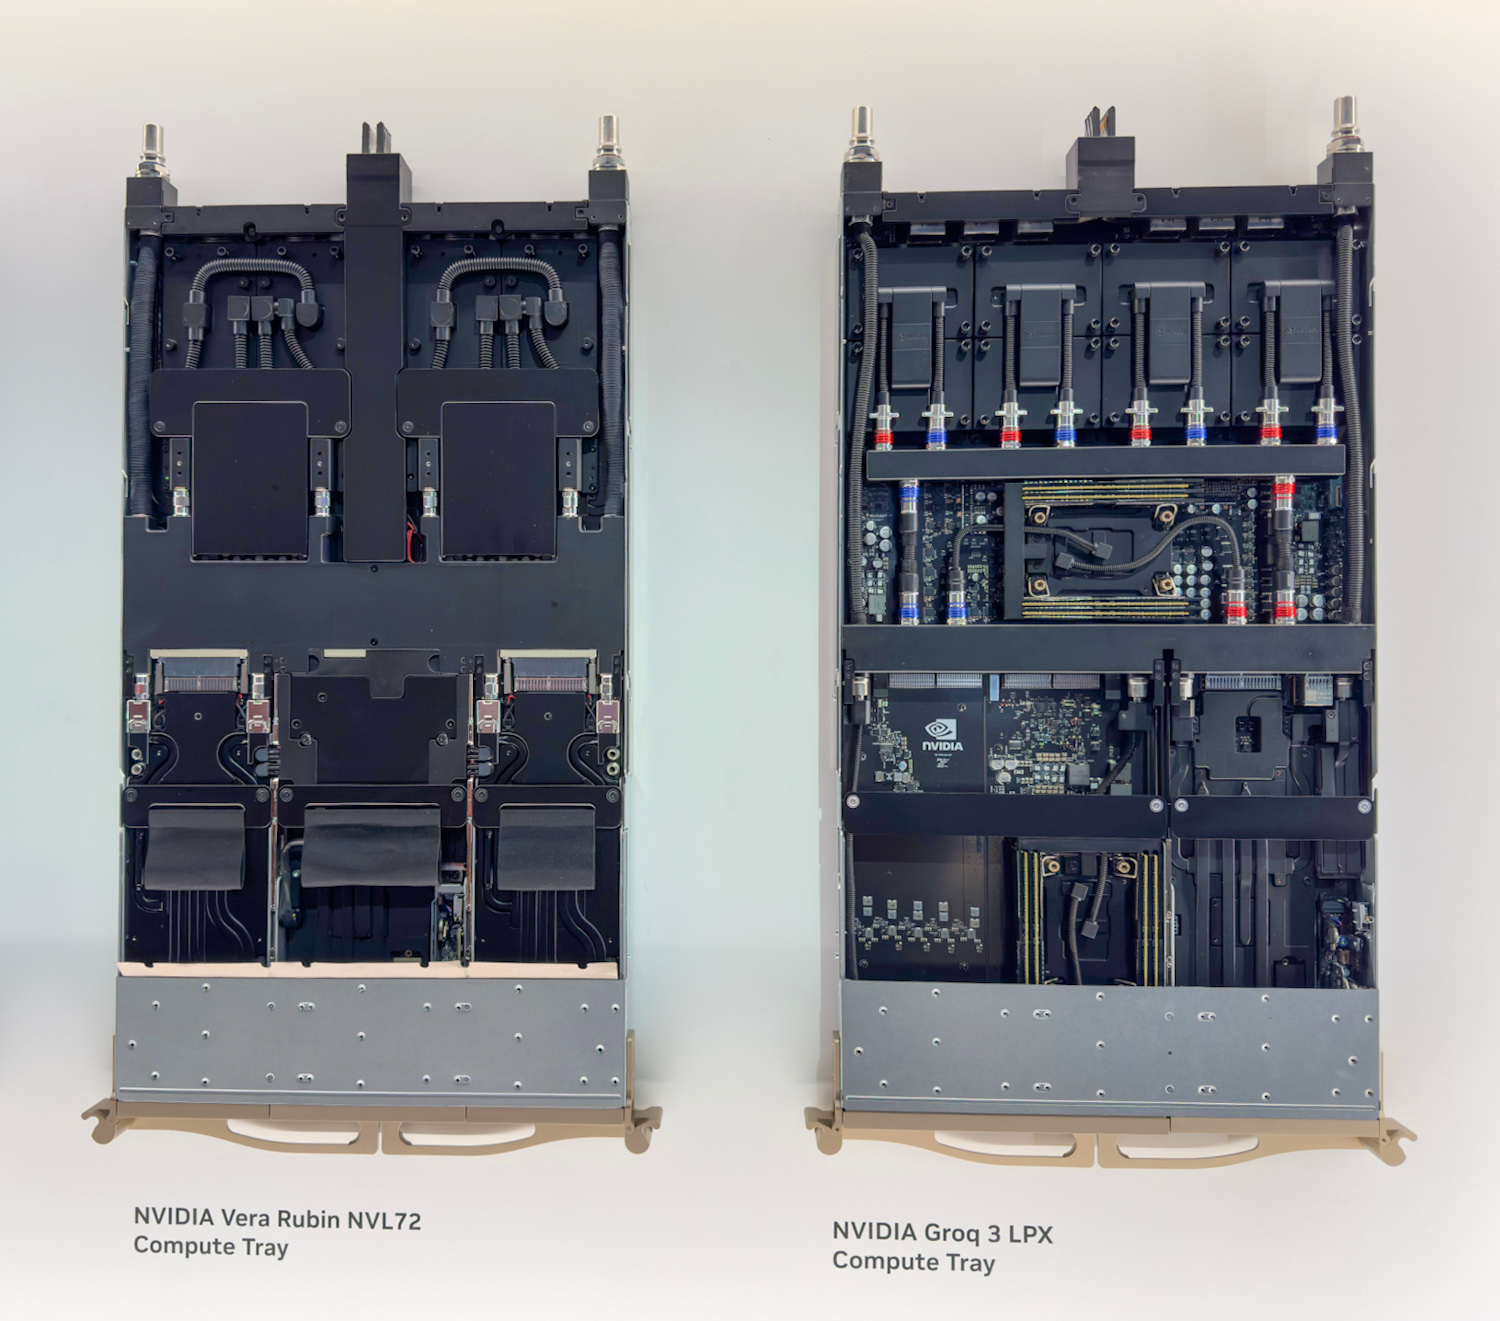
去年12月,NVIDIA收購了Groq,將LPU架構納入旗下。這項收購在業界引起了廣泛關注,並立即引發了人們對NVIDIA將如何將Groq的技術整合到其資料中心生態系統中的猜測。這些問題最終在GTC 2026大會上得到了解答。 NVIDIA在會上發布了Groq 3 LPX,作為Vera Rubin平台的第七款晶片,它將256個LPU加速器與Vera Rubin NVL72整合在一個機架級系統中。
CPX發生了什麼事?
去年在人工智慧基礎設施高峰會上,NVIDIA 也發布了 CPX 機架,並推出了幾種配置,旨在加速長上下文推理查詢。在我們最初報告該訊息後,我們對 CPX 的實際功能產生了一些疑問。乍一看,儘管其架構概念很有趣,但除了可能對注意力機制進行額外加速之外,CPX 似乎並沒有提供任何實質性的功能,而這些功能與 Rubin GPU 本身並沒有太大區別。隨後,NVIDIA 收購了 Groq,這引發了人們對 NVIDIA 將如何將 Groq 的 LPU 技術整合到更廣泛的 Vera Rubin 平台中的猜測。
在2026年GTC大會上,NVIDIA發布了LPX,澄清了先前的種種疑慮。從目前展示的內容來看,CPX機架的概念已經演變成Groq 3 LPX機架,原CPX專注於情境處理的架構被基於Groq晶片建構的全新解碼加速架構所取代。 LPX機架採用全液冷設計,基於MGX架構,將於2026年下半年上市,與Vera Rubin的全面推廣同步進行。 NVIDIA聲稱,這款新產品每兆瓦的推理吞吐量可提升高達35倍,並且在處理兆參數模型時,可帶來高達10倍的額外收益機會。
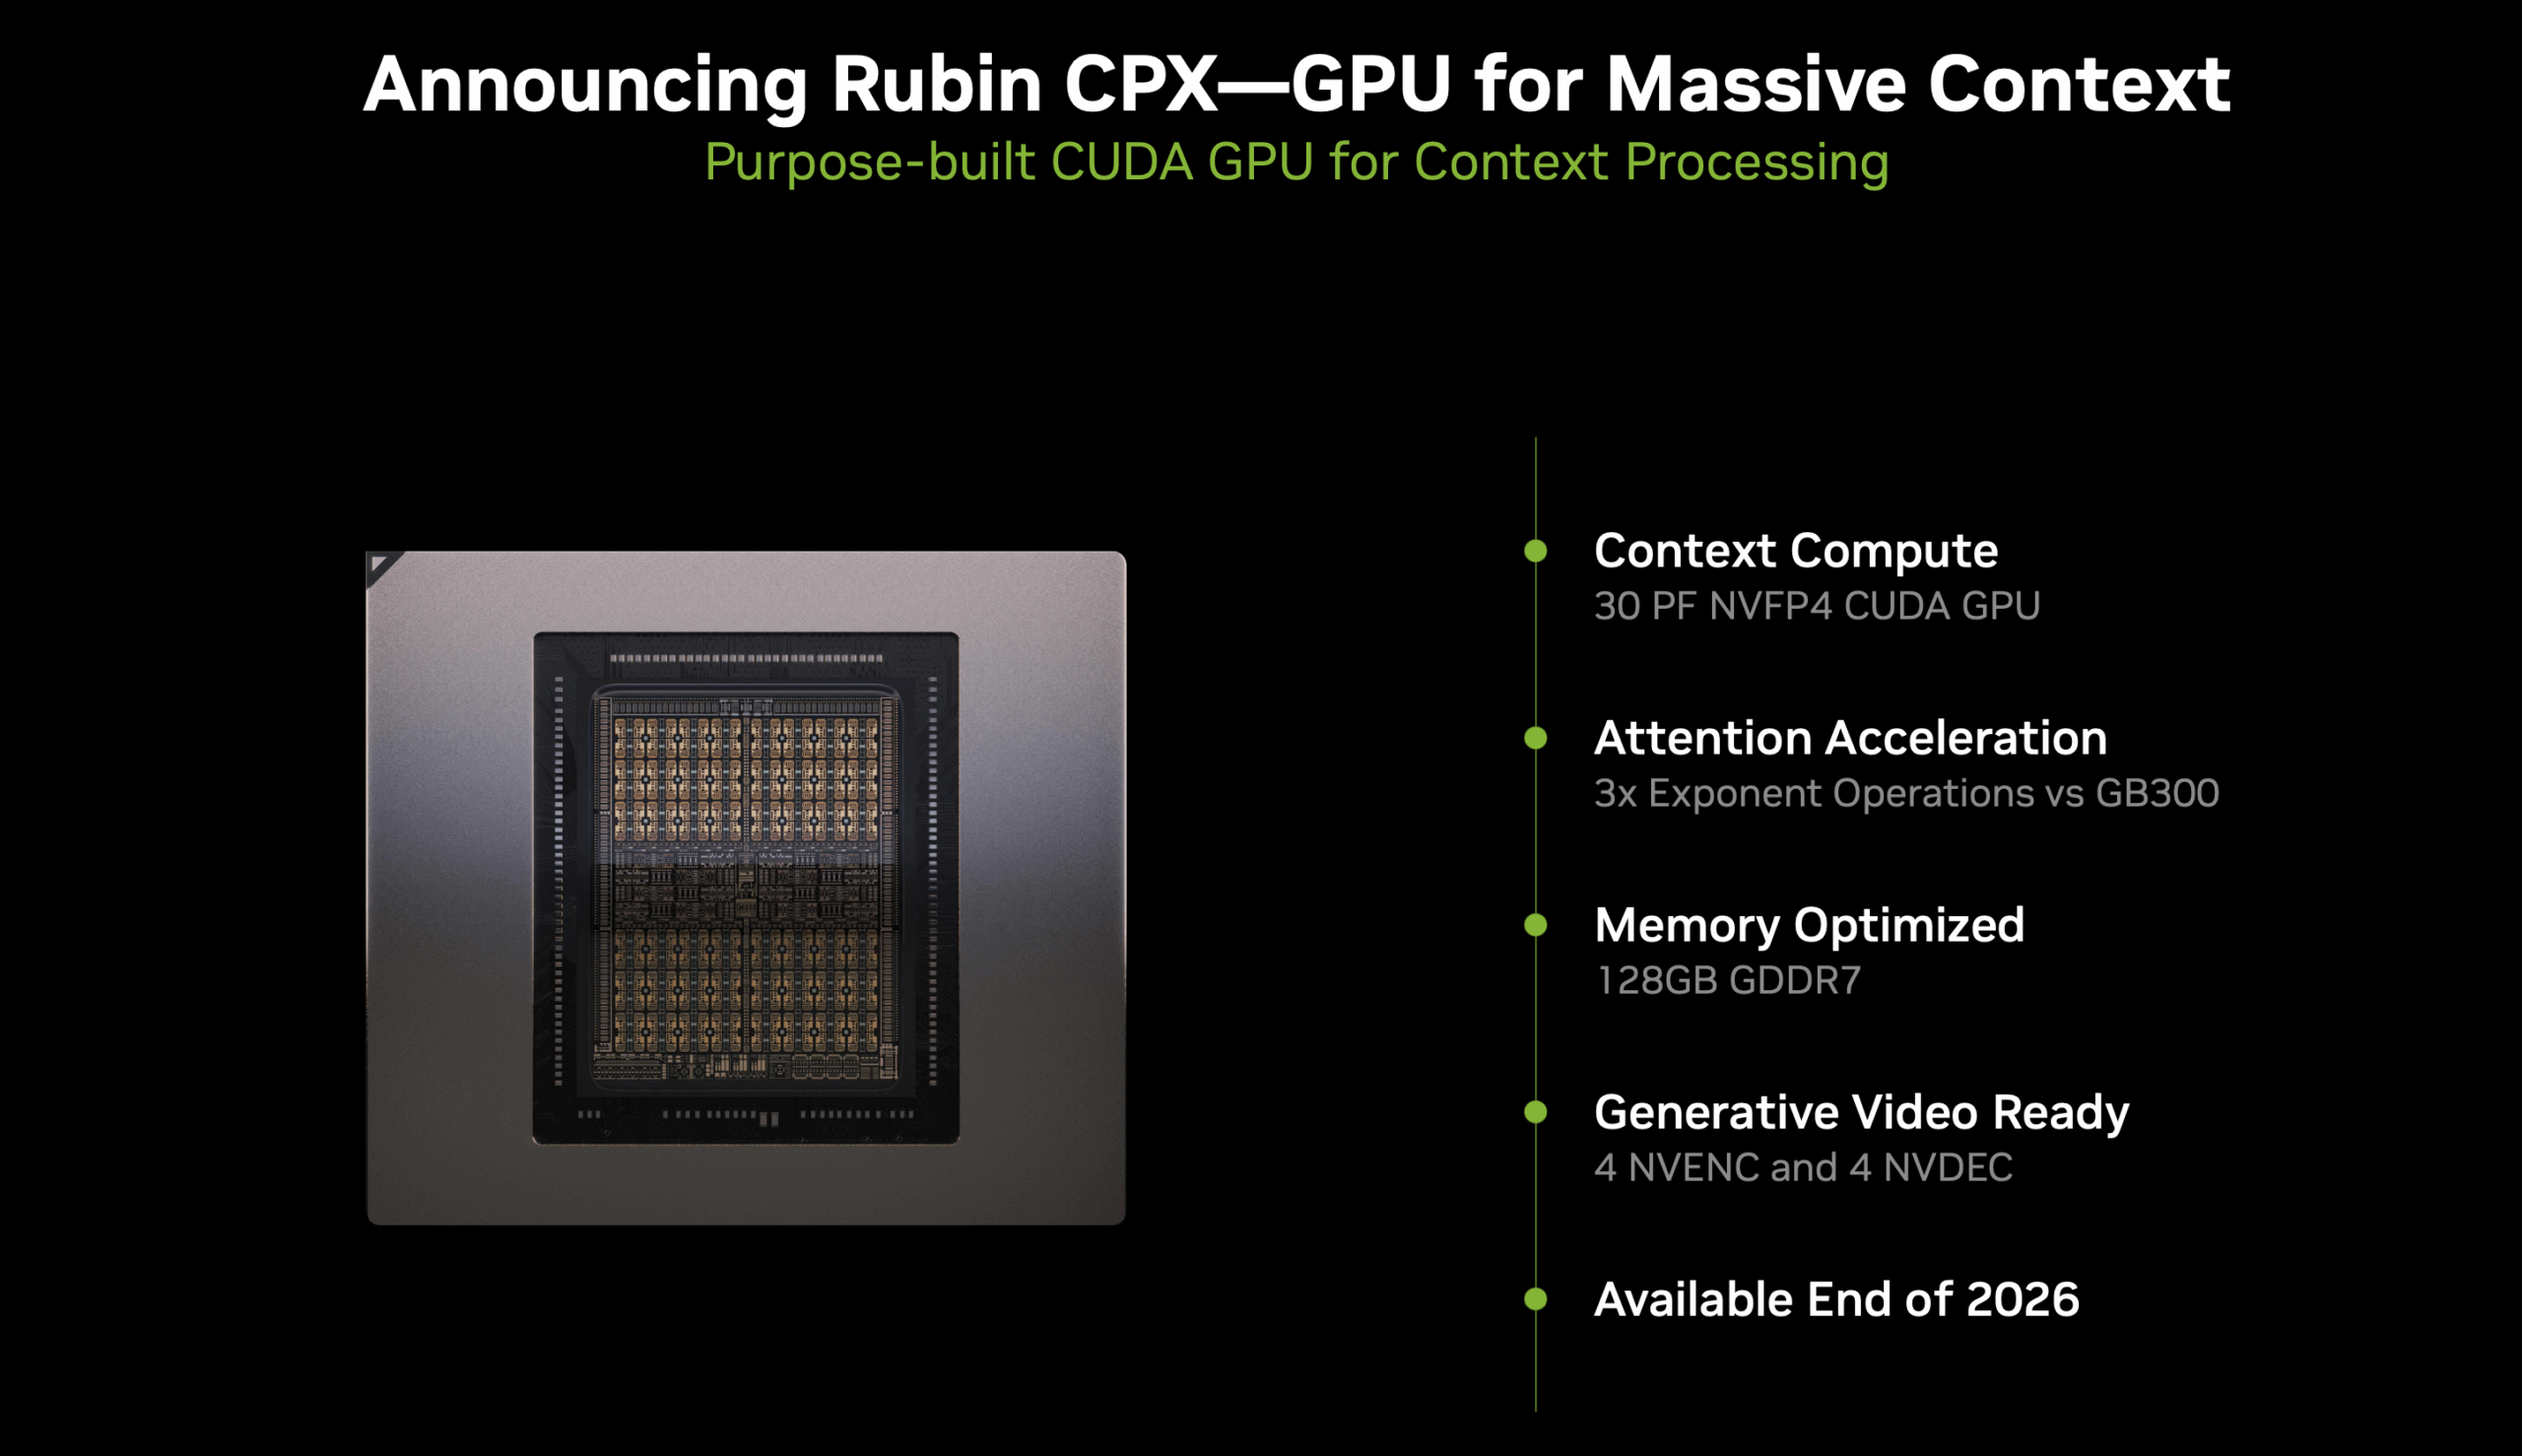
但更重要的是,NVIDIA 確認 LPU 作為加速器運行在 Vera 和 NVL72 平台上的現有 CUDA 堆疊中,能夠以透明的方式按令牌卸載計算任務。在 GTC 問答環節,NVIDIA 將 LPU 描述為“解碼模型加速器”,並解釋說他們將與人工智慧實驗室和前沿模型建構者緊密合作,部署萬億參數模型,以實現下一代高端模型服務。
CPX 問題解決了,接下來自然會問:NVIDIA 圍繞 LPU 建構的整個機架級系統究竟是什麼?
什麼是LPU?
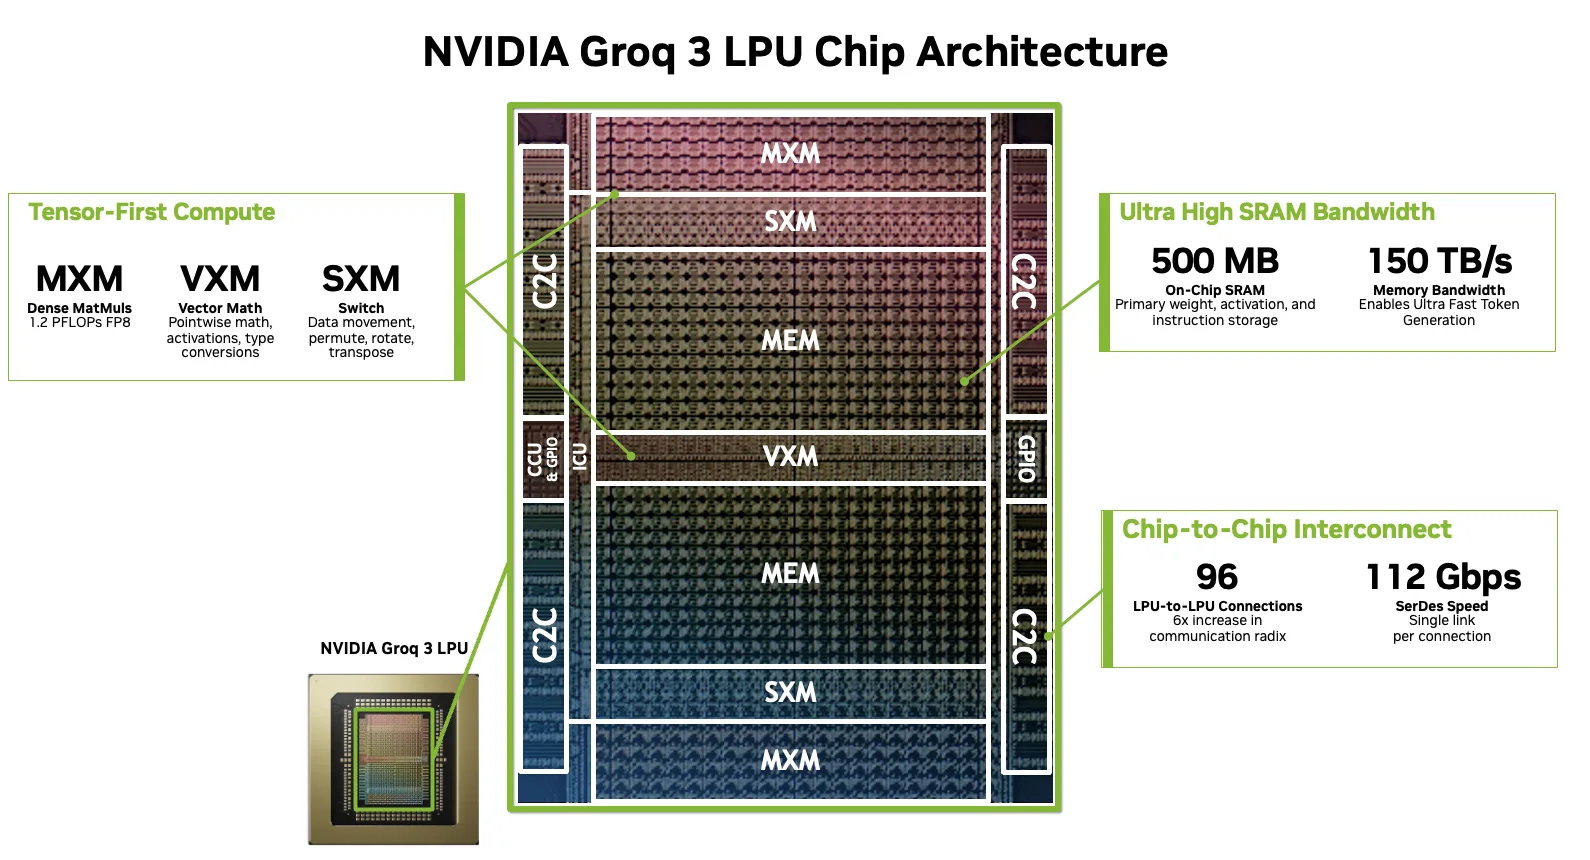
LPU 的核心是一個非常大的向量處理器。其計算和通訊的基本單元是一個 320 元素的向量,其中 INT8 為 320 位元組,FP16 為 640 位元組。晶片上的所有操作,無論是算術運算、記憶體存取、資料重塑或晶片間資料傳輸,都基於這些固定大小的向量。
資料來源:Nvidia
此架構由一個基礎建構模組構成:一個 SIMD 功能單元和一個輕量級指令分發單元。 Groq 將其視為一個基類,並將其細分為四種不同的類型,每種類型都針對特定類別的操作進行了最佳化:
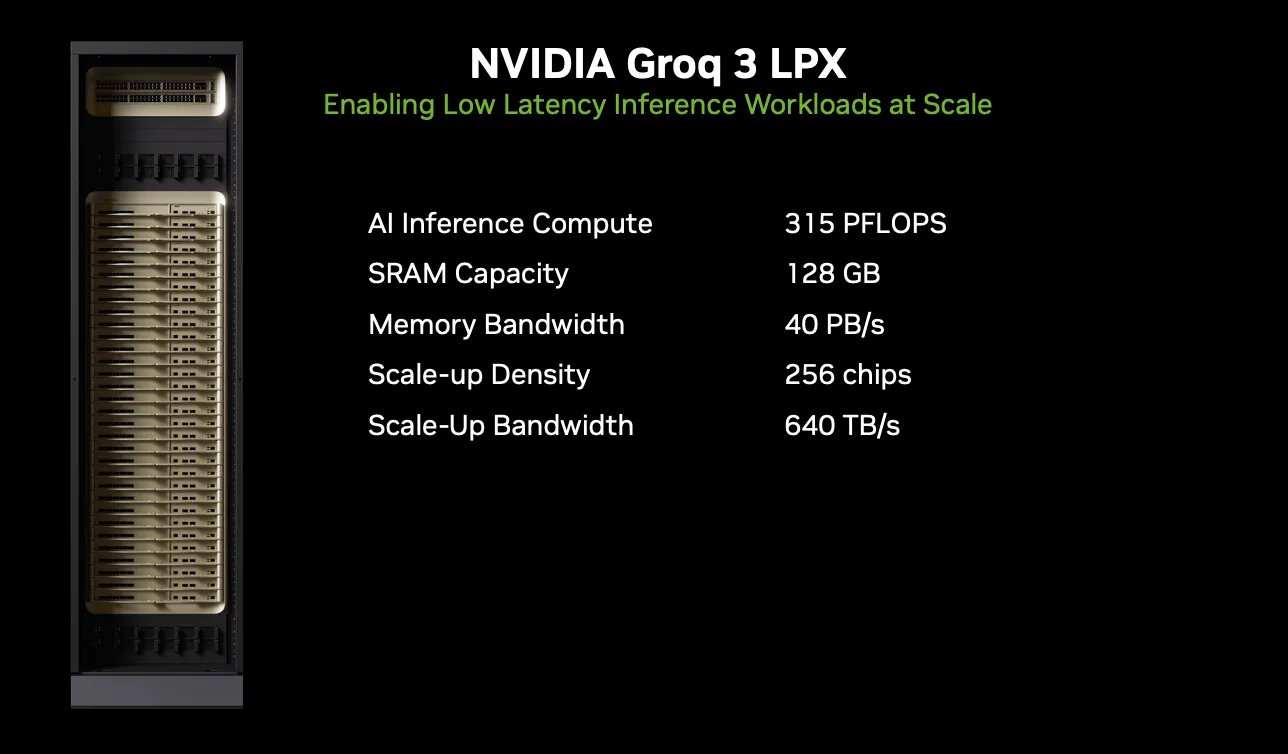
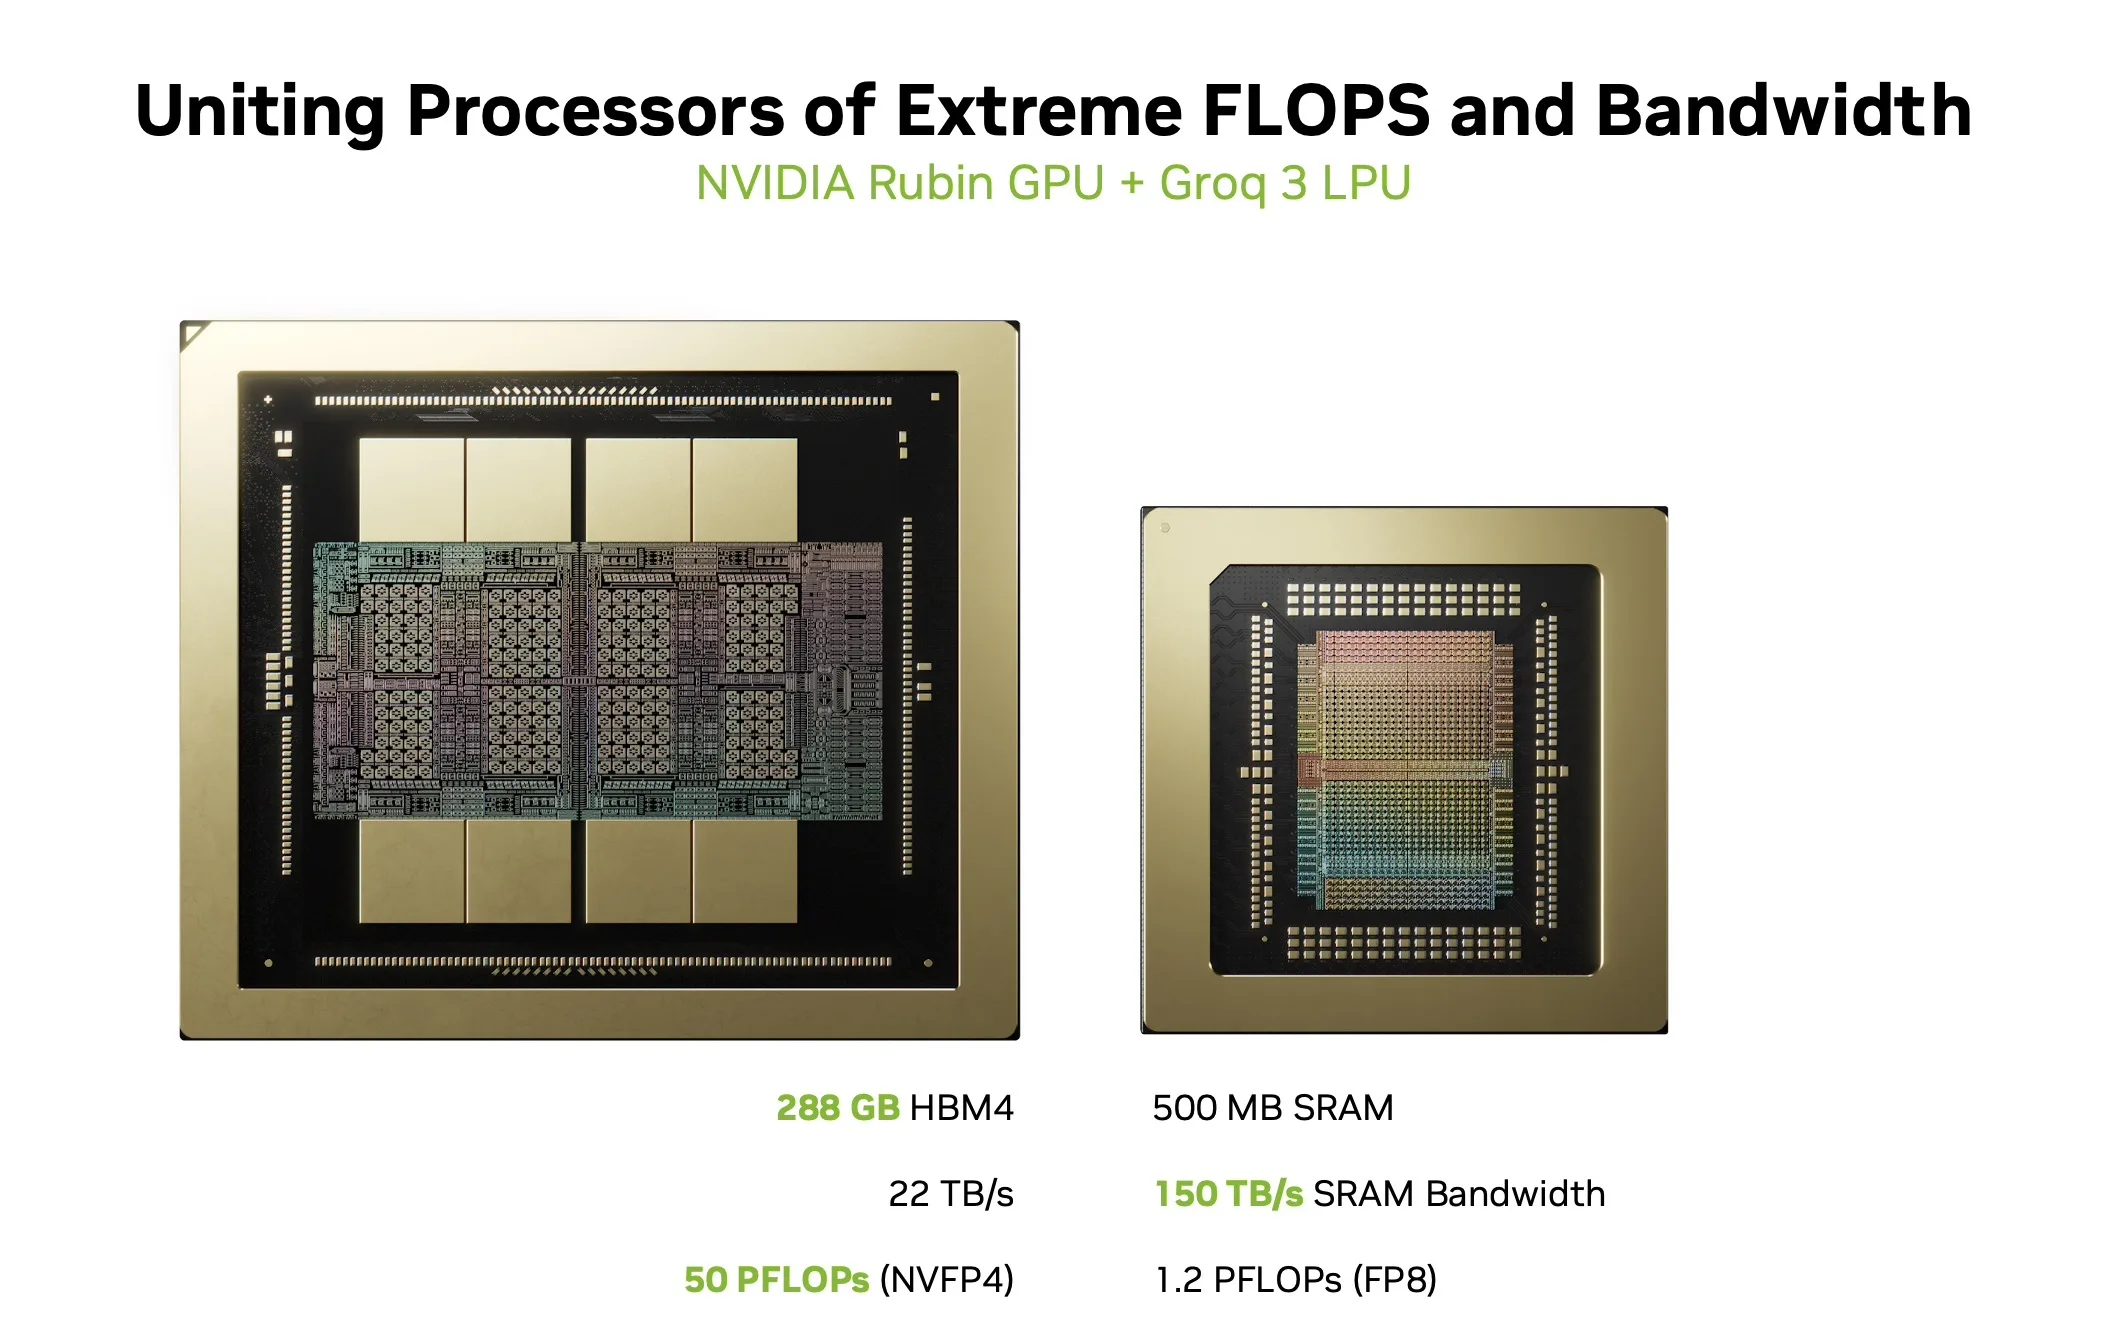
矩陣執行模組 (MXM):作為主要的計算主力,為矩陣向量和矩陣矩陣運算提供密集的乘加能力。 NVIDIA LPX 機架中的 8 個 Groq 3 LP30 晶片,每個晶片可提供 1.2 PFLOPS 的 FP8 運算能力,每個 LPX 機架總共可提供 9.6 PFLOPS 的 FP8 運算能力。
向量執行模組 (VXM):處理逐點算術運算、邏輯運算、類型轉換和激活函數。 VXM 包含一個 ALU 數組,編譯器會自動將這些 ALU 連結起來,在一次編譯過程中形成複合運算(例如,先進行歸約運算,然後進行偏置加法運算,接著進行啟動運算,最後進行型別運算)。
切換執行模組(SXM):執行結構化資料移動,包括向量的排列、旋轉、分佈和轉置。
儲存單元 (MEM):一種扁平化的、SRAM 優先的儲存架構,沒有快取、沒有層次結構,也沒有快取未命中的概念。 Groq 3 LP30 提供 500 MB 的片上 SRAM,頻寬為 150 TB/s。編譯器直接定址實體儲存位置,在程式執行過程中始終掌握所有資料的精確位置。
晶片水平方向上印製了多種功能單元。指令從上到下流向中間,資料流從東到西流動,與各個功能單元相交以執行操作。
一維互連、流暫存器和確定性
流暫存器和一維互連
LPU 上各功能單元之間的通訊透過串流暫存器實現,這是一種設計簡潔的一維互連方式。通訊路徑分為兩條,一條向東,一條向西,每個流暫存器代表一次傳輸。資料在每個時脈週期內精確地傳輸一次,這意味著編譯器可以根據兩個功能單元在晶片佈局上的物理位置,透過簡單的加減運算來推斷它們之間的傳輸時間。
互連內部沒有隊列,也沒有爭用機制。這使得調度問題從複雜的二維裝箱問題簡化為更易於處理的一維問題。 Groq的首席架構師 Igor Arsovski 對此做了最好的詮釋:編譯器能夠精確地知道 10 個時鐘週期後資料的位置,因為它正好位於 10 跳之外。不存在任何歧義、猜測,也沒有任何硬體進行獨立的路由決策。
確定性
LPU 的顯著特徵是確定性。與傳統處理器不同,傳統處理器的動態調度、快取行為和記憶體存取爭用會引入執行時間差異,而 LPU 的執行沒有差異,每個功能單元都同步運作。
這種確定性是透過移除硬體互鎖等機制並將所有決策過程移至編譯器來實現的;硬體只需執行最終產生的調度方案。這種方法的其他優點包括:所有操作的延遲完全相同,甚至功耗在任何時刻都是可預測的。
確定性也透過 Groq 的 TruePoint 技術延伸到數值領域。此技術透過確保運算順序,利用 320 元素融合點積(僅需一次捨去)即可從 FP16 輸入獲得 FP32 等級的精度。關於數值確定性為何對 LLM 推理至關重要,以及為何非確定性硬體在不同運行中會產生細微差異的輸出,Thinking Lab 的白皮書《克服 LLM 推理中的非確定性》對此進行了深入探討。本文並非重點討論這些內容,但對數值精度影響感興趣的讀者可以在文末連結的 Groq TruePoint 技術文件中找到相關分析。
LPU 的連接方式:RealScale、組裝線和機架拓撲
資料流水線:資料如何流動
從最簡單的層面來說,LPU 之間的資料傳輸就像一條裝配線。當系統編譯模型時,編譯器會將模型劃分為多個階段,並將每個階段對應到一組 LPU 晶片上。每組晶片將所需的權重參數儲存在本機片上 SRAM 中。在推理過程中,晶片組之間傳輸的唯一資料是來自前一階段的中間啟動輸出。資料像產品沿著傳送帶移動一樣在晶片間流動,每個工作站執行其分配的計算並將結果傳遞給下一個工作站。這與 GPU 有著本質上的區別,GPU 的每個運算階段都需要從片外 HBM 記憶體中檢索完整的權重集並將結果寫回。而在 LPU 上,權重已經駐留在每個工作站的 SRAM 中;只有啟動張量會移動。
關於 C2C 連結的說明:RealScale,而非 NVIDIA C2C
在深入探討拓樸結構細節之前,有必要先澄清一個可能造成混淆的地方。 LPX 系統中使用的晶片間 (C2C) 連結是 Groq 的 RealScale C2C 互連技術。這與 NVIDIA 生態系中其他產品使用的 NVIDIA C2C 技術不同。這兩種技術在架構上截然不同:
- NVIDIA C2C 是一種快取一致性互連技術,旨在連接緊密耦合模組中的兩種不同類型的晶片,例如 CPU 到 GPU 的連接。它採用具有高速 SerDes 的一致性協議,專為單一封裝或模組內的異質晶片間通訊而設計。
- Groq RealScale C2C 是一種軟體調度、確定性的點對點互連協定。網路鏈路由編譯器明確地進行流控制,並像 MXM 或 VXM 計算單元一樣作為一級功能單元進行調度。它不涉及硬體仲裁或自適應路由,封包也不攜帶來源位址或目標位址頭部。鏈路相位對齊,如同晶片間高頻寬、固定延遲的線路。準同步協定能夠確定性地處理晶片間的自然時鐘漂移,從而為編譯器提供整個網路的單一公共時間域。
LPX機架中的所有C2C連接,無論是在托盤內、透過主幹網路跨托盤連接,或是透過前面板連接埠在機架間連接,都採用RealScale技術。這是Groq自初代GroqNode以來一直使用的基本互連技術,鏈路速度有所提升(從每通道30 Gbps提升至112 Gbps),但架構保持不變。
註:下一節對連接性的解釋是基於我們對架構的理解,該理解依據是 Groq 的文檔(鏈接在文末)、NVIDIA 的博客文章以及我們在 GTC 展位上獲得的機架說明:
- LPX機架單元所使用的C2C連結是Groq的技術,與NVIDIA其他機架級系統所使用的C2C連結不同。
- 每個LPX機架單元前端的4個C2C連結用於連接同一層相鄰的機架單元。
- 在機架內部,LPU 之間實現全對全通訊。
- LPX機架中的處理器是x86架構的。
托盤內連接
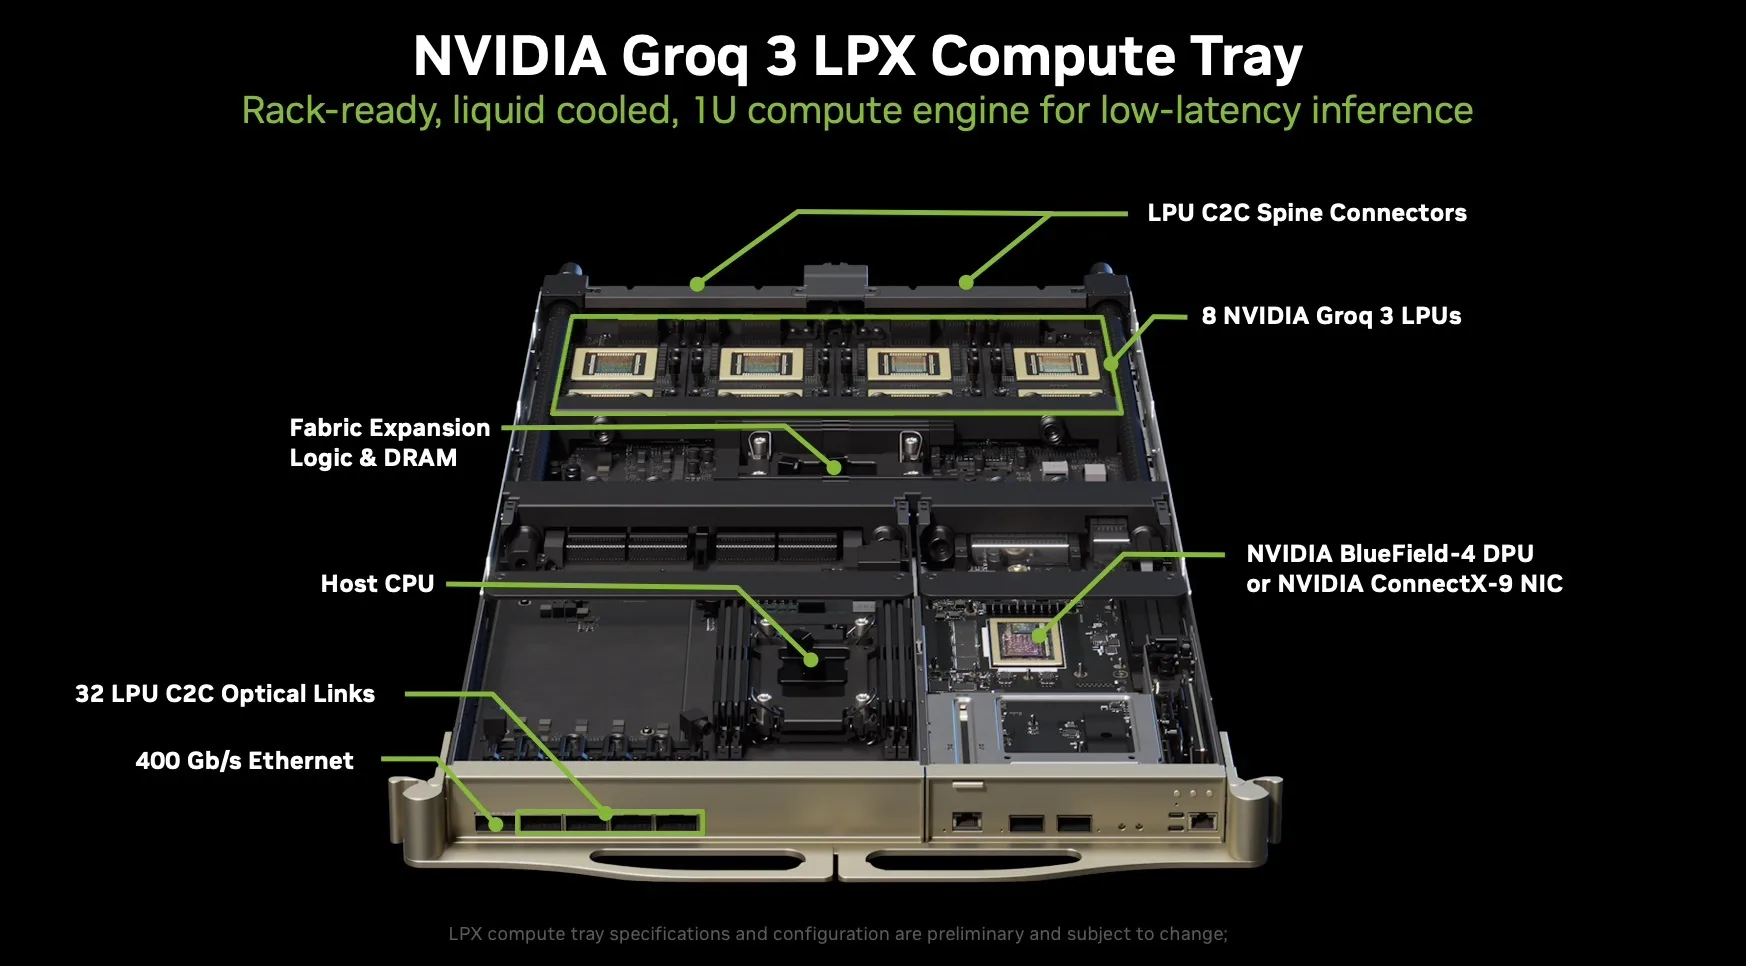
從最初的 GroqNode 到 NVIDIA Groq 3 LPX,Groq 網路拓撲的基本建置模組並沒有改變。每個 1U 計算托架都包含恰好八個 LP30 晶片,它們以完全互連圖(全對全)的形式緊密連接,其中每個晶片都可以以相同的速率與其他每個晶片直接通信。
資料來源:Nvidia
每個 LP30 晶片擁有 96 條 C2C 鏈路,每條鏈路的運行速度為 112 Gbps,每個晶片可提供 2.5 TB/s 的雙向頻寬。在一個包含 8 個晶片的完整網路中,每個晶片有 7 個相鄰晶片。一個托架內唯一的晶片間連接數量為 C(8,2) = 28。每個晶片的 96 條連結中,一部分專用於這些托架內的全連接,其餘連結則路由至背板(用於機架主幹)和前面板(用於機架間連接)。 NVIDIA 公佈的規格書顯示,每個托架的總擴展頻寬為 20 TB/s,這代表了托架內頻寬和主幹頻寬的總和。我們可以驗證這一點:每個托架共有 8 個晶片 × 96 條連結 = 768 條連結。減去 32 條前面板機架間通道後,剩餘 736 個連結可用於擴充。單連結速度為 112 Gbps,則總速度為 736 × 112 Gbps = 82,432 Gbps,約合單向 10.3 TB/s,雙向速度約為 20.6 TB/s。這與 NVIDIA 宣稱的每托架 20 TB/s 的速度基本吻合。
這8晶片全連接組構成了蜻蜓網路拓樸的「本地組」。初代GroqChip 1每張卡有11條C2C鏈路,每條鏈路每通道30 Gbps(每條鏈路4條通道),每張卡總頻寬為330 GB/s。 Groq 3 LP30的96條鏈路,每條鏈路頻寬高達112 Gbps,在保持相同拓撲結構的同時,實現了單晶片I/O頻寬的巨大飛躍。
機架內連接
在單一 LPX 機架內,32 個計算托架(共 256 個晶片)透過背板上的四個 ETL 主幹互連。這些主幹承載托架間的 RealScale C2C 流量,從而建構機架級縱向擴展域。整個機架的總縱向擴展頻寬為 640 TB/s(32 個托架 × 每個托架 20 TB/s)。四個主幹分配到每個主幹上,每個主幹承載約 160 TB/s 的雙向頻寬。
機架間連接
每個 1U 計算托架的前面板都提供四個 QSFP C2C 端口,總共提供 32 個通道(每個端口 8 條通道)用於機架間通訊。這些連接埠以對稱模式連接到相鄰機架:兩個連接埠(16 條通道)連接到左側相鄰機架,兩個連接埠(16 條通道)連接到右側相鄰機架。每個 U 位置都連接到相鄰機架中對應的 U 位置(機架 A 的第一個 U 連接到機架 B 的第一個 U,第二個 U 連接到機架 B 的第二個 U,依此類推)。
資料來源:Nvidia
每個托盤每通道頻寬為 112 Gbps,因此每個托盤的 32 條機架間通道可提供 32 × 112 Gbps = 3,584 Gbps 的機架間頻寬,即每個托盤每個方向約 448 GB/s。整個機架的 32 個托盤共提供 32 × 32 = 1,024 條機架間通道。這相當於 1,024 × 112 Gbps = 114,688 Gbps,即每個相鄰機架每個方向約 14.3 TB/s 的頻寬(左右各佔約 7.2 TB/s)。
這種機架間頻寬的設計使其比機架內頻寬更為稀疏。在機架內部,640 TB/s 的擴展域透過主幹網路提供密集的、全連接可及性。機架間,前面板連結提供蜻蜓拓樸結構中較稀疏的全局連結。這與最初的 GroqRack 架構模式相同,其中每個晶片的四個外部 C2C 鏈路連接本地組(節點),形成網路直徑較小的多機架系統(在 264 晶片部署中最多三跳)。
整合:相同的架構,4倍的密度
最初的四機架 GroqRack 部署方案包含 264 個 GroqChip 處理器。單一 LPX 機架將 256 個 LP30 晶片整合到一個 MGX ETL 機架中,晶片密度約為原來的四倍,並採用液冷和無電纜背板設計。 8 晶片全連接本地組、蜻蜓拓樸結構和軟體調度路由模式都得以完整保留。 Groq 的基本網路技術並未改變,只是進行了擴展。
對於 SRAM 容量超過單一機架(256 個晶片共 128 GB)的型號,可以透過前面板的 C2C 連接埠互連多個 LPX 機架或多排機架,從而進一步延長生產線。下一節將詳細介紹這對於實際型號尺寸的影響。
為什麼需要 FFN 層?了解 NVIDIA 正在卸載什麼
為什麼解碼服務越來越難提供?
在深入探討NVIDIA將哪些任務卸載到LPX以及原因之前,了解NVIDIA所指出的促成這項架構決策的更廣泛趨勢至關重要。 AI推理並非單一的、統一的工作負載。在單一請求中,預填階段(接收提示訊息並建立鍵值快取)和解碼階段(逐一產生令牌)對硬體的要求截然不同,而且這些要求會隨著批次大小、上下文長度和模型結構的變化而變化。
隨著模型產生更長的推理輸出和多步驟的思維鏈,每個請求中越來越多的時間會流向順序解碼階段。同時,諸如前綴快取之類的技術透過在請求間重複使用共享的提示狀態來降低預填充的成本,這反而使解碼的相對成本更加突出。上下文視窗也成長到數十萬個令牌,給注意力運算期間的記憶體頻寬帶來了越來越大的壓力。在智能體工作流程中,延遲會在多次模型呼叫、工具互動和驗證循環中累積。這些累積效應導致解碼延遲日益成為用戶感受到的瓶頸,而僅針對最大總吞吐量優化的硬體並不總是最適合需要為每個請求快速、可預測地產生令牌的工作負載。
此外,正如Anthropic 的快速模式版本所顯示的那樣,更低的延遲和更高的代幣吞吐量確實能帶來更高的收入,Anthropic 的快速推理服務的成本是普通請求的 6 倍。
透過此次 LPX 的發布,我們了解到 NVIDIA 希望將最大的解碼瓶頸——前饋網路 (FFN) 層——轉移到 LPU 上。為了理解為何 FFN 層是目標,並體會其意義之重大,我們分析了目前最受歡迎的開源模型的 FFN 參數數量。
FFN層是什麼?為什麼它們佔據主導地位?
每個Transformer層都包含兩個主要模組:注意力模組和前饋神經網路(FFN)模組。注意力模組允許每個詞元查看並混合序列中其他詞元的資訊。 FFN模組則獨立地處理每個詞元:它將詞元的表示投影到更高維度的空間,應用非線性變換,然後再投影回低維空間。你可以把它想像成模型的知識庫,其中儲存著事實關聯和學習到的變換。
MoE(混合專家)架構已成為當今領先的開源大型語言模型中的主導架構:DeepSeek R1、Kimi K2、Qwen3-235B、GLM-5、MiniMax M2.5 和 OpenAI 的 GPT-OSS 120B。
在這些 MoE 模型中,FFN 模組會被複製成數百個較小的獨立副本,稱為專家,而注意力機制則保持共享。一個輕量級的學習路由函數會動態地選擇一小部分專家,並根據每個 token 的值進行啟動。最終得到的模型雖然儲存了龐大的參數總數,但每個 token 只激活其中一小部分,從而在不增加相應計算成本的情況下,獲得了規模效應帶來的質量提升。
然而,正如您所意識到的,這帶來了另一個挑戰:FFN 層佔據了模型的大部分權重。特別是對於 MoE 模型,這甚至可以占到模型權重的 90%。
DeepSeek R1 內部構造:一個實際範例
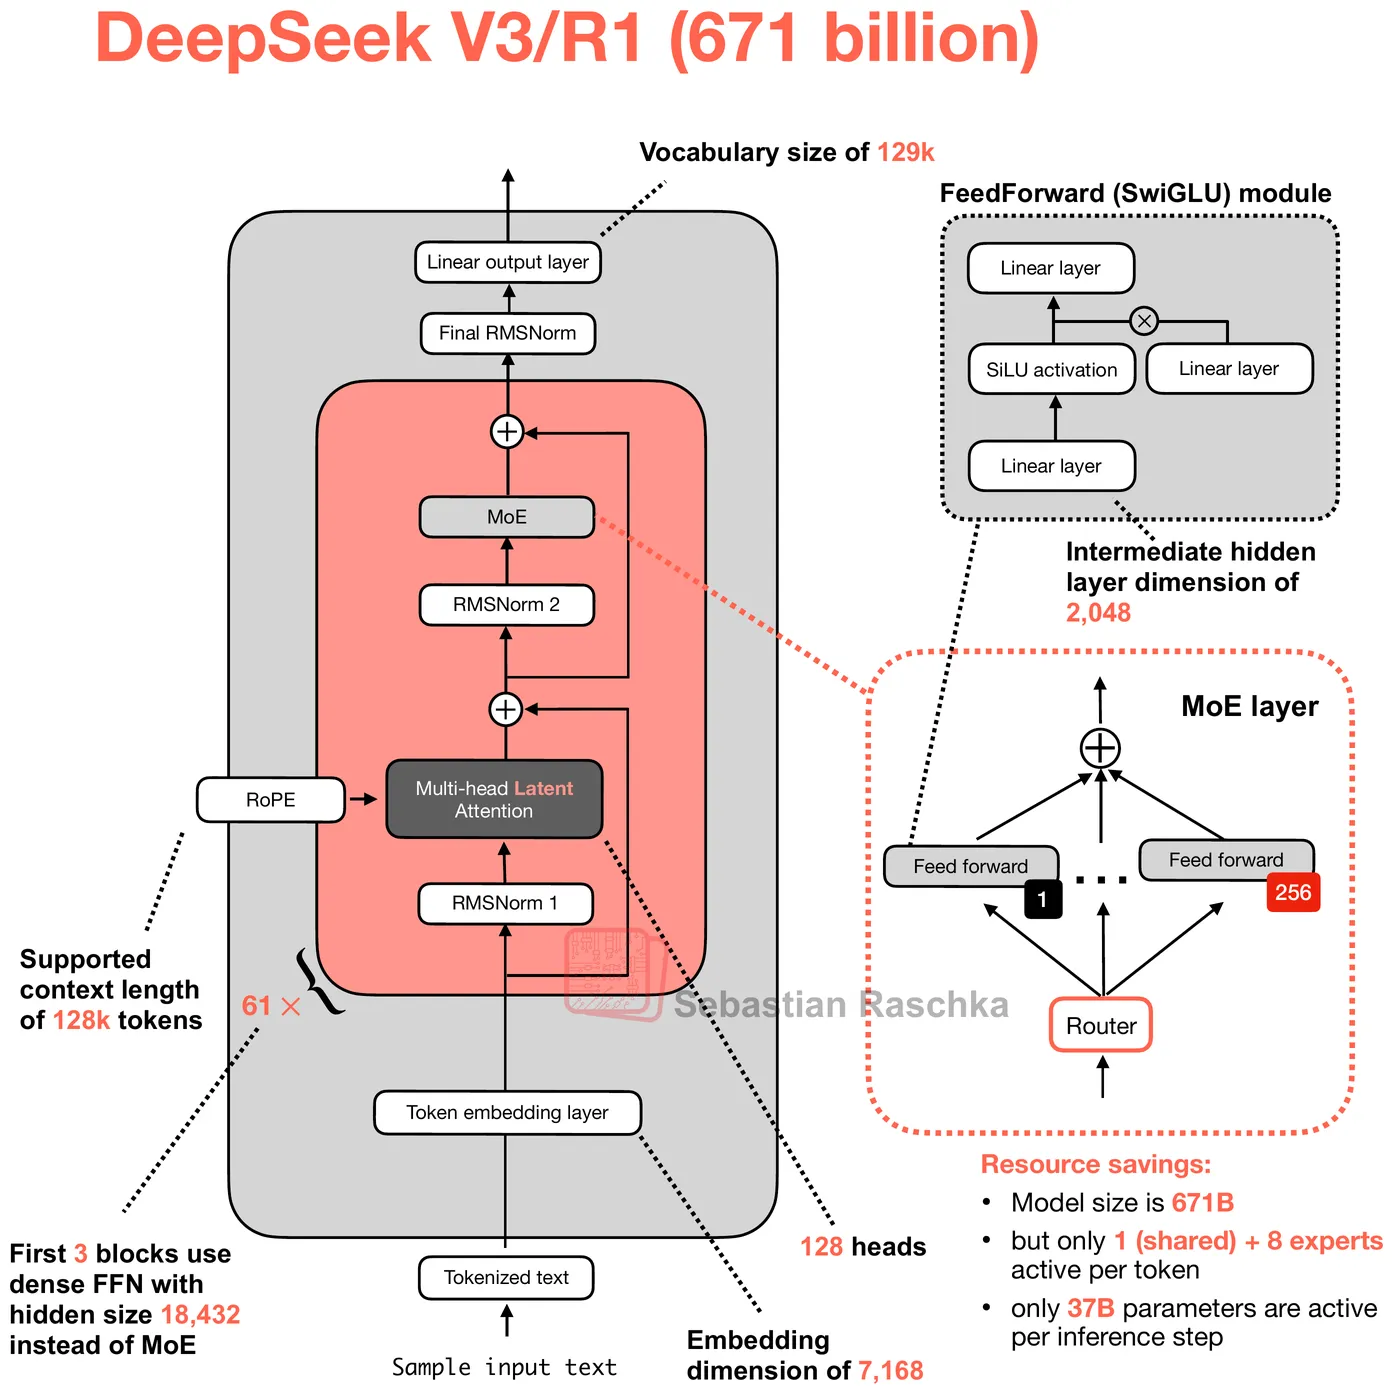
為了方便說明,我們放大來看 DeepSeek R1。此模型有 61 個 Transformer 層,隱藏維度 (H) 為 7,168。前 3 層使用標準的密集前饋神經網路 (FFN),其餘 58 層使用 MoE(外加 1 個帶有自身專家的 MTP 層,總共 59 個 MoE 層)。現代 LLM 使用一種名為 SwiGLU 的變體,它使用三個權重矩陣而不是兩個。前向傳播計算 w2(SiLU(w1(x)) ⊙ w3(x)),其中 w1(門控投影)和 w3(上投影)都將隱藏維度從 H 擴展到中間大小 I,而 w2(下投影)將其壓縮回去。 ⊙ 表示門控路徑和非門控路徑之間的元素級乘法。這些矩陣都沒有偏置項,因此每個 SwiGLU FFN 區塊恰好包含 3 × H × I 個參數。
來源:塞巴斯蒂安·拉什卡
對於 DeepSeek R1 的密集層(前三層),中間維度為 18,432,因此每層有 3 × 7,168 × 18,432 = 396.4 億個參數。對於 MoE 層,256 個路由專家中的每一個都是一個完整的 SwiGLU 區塊,其中間維度較小,為 2,048,因此每個專家有 3 × 7,168 × 2,048 = 4,400 萬個參數。乘以 256 個專家,每層僅路由專家就有 11.27 億個參數。此外,每個 MoE 層還有一個共享專家(相同的 4,400 萬參數的 SwiGLU 區塊,始終對每個 token 激活)、一個路由門(形狀為 [256, 7168] = 180 萬個參數的線性投影)以及一個包含 256 個 FP32 值的小型偏置負載,用於路由期間的小型偏置負載。
完整的 FFN 模型大約有 669.1 億個參數。採用 FP8 E4M3 格式(每個權重 1 位元組),這相當於大約 623.1 GB 的 FFN 資料。這佔模型在磁碟上估計總大小的 97.7%。剩餘的約 2.3% 是注意力權重、嵌入、輸出頭、層範數和 FP8 尺度元資料。
解碼分解
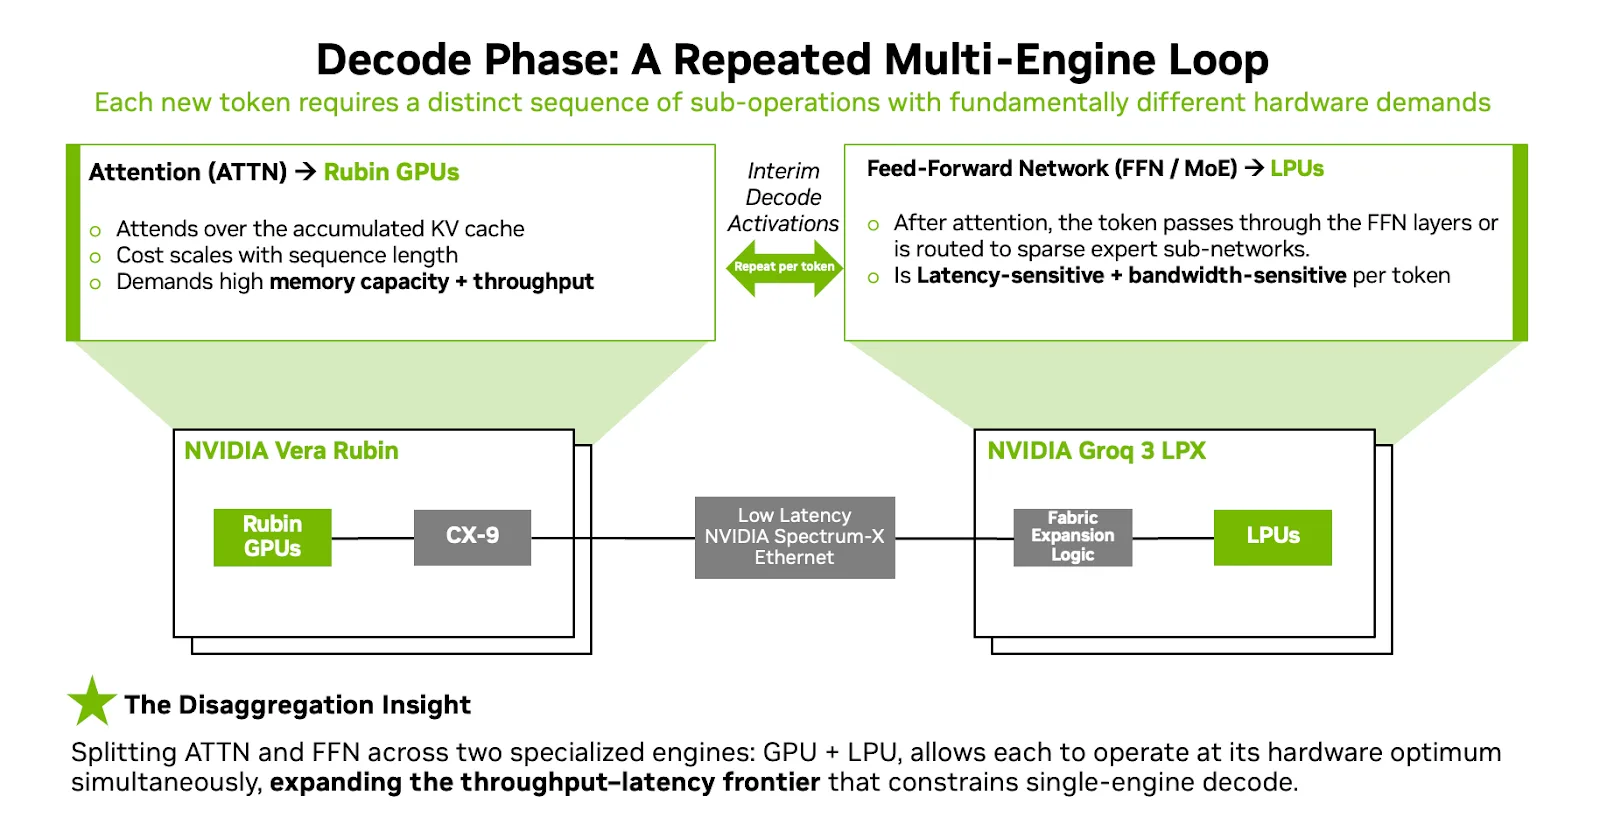
NVIDIA 現在將解碼階段不再視為單一操作,而是視為一個重複的逐詞循環,其中不同的部分會分別考驗不同的硬體瓶頸。預填充階段主要涉及接收大量輸入和建構鍵值緩存,這種工作負載受益於密集並行計算和大容量記憶體。 Vera Rubin NVL72 能夠有效率地處理這些任務,尤其適用於提示資訊量龐大且變化極大的長上下文工作負載。
資料來源:Nvidia
解碼過程有所不同。對於每個新詞元,系統必須對整個累積的鍵值快取執行注意力機制,然後對注意力輸出執行 FFN/MoE 計算。在 NVIDIA 的注意力-FFN 解耦 (AFD) 架構中,這兩個步驟被分配到兩個引擎。 Rubin GPU 負責解碼注意力:從 HBM 讀取鍵值緩存,計算注意力分數,並產生中間激活值。該激活張量(NVIDIA 稱之為「中間張量狀態」)隨後被傳遞給 LPX,LPX 以極高的頻寬和確定性的延遲運行 FFN 或 MoE 專家計算,然後將結果返回給 GPU 以繼續生成詞元。
每個令牌都會進行這種交接。 GPU 與 LPU 之間交換的啟動張量相對於權重資料而言很小,而這正是 LPU 近乎零開銷網路優勢的體現。這種分配方式充分發揮了每個處理器的核心優勢:GPU 提供 HBM 容量和靈活的執行能力,以支援在大型鍵值快取上實現可變長度注意力機制;而 LPU 提供 SRAM 頻寬和確定性調度能力,以支援頻寬受限、靜態可調度的 FFN 權重。
資料來源:Nvidia
這裡有一個微妙但重要的擴展特性值得一提。隨著上下文長度的增長,注意力機制的計算和記憶體需求也會隨之增長:鍵值快取會隨著上下文數量的增加而線性擴展,並且每個新的解碼步驟都必須存取整個快取。然而,前饋神經網路(FFN)的運算和記憶體需求卻不會隨著上下文長度的增長而增長。 FFN 的權重矩陣(在 SwiGLU 中為 w1、w2 和 w3)是模型架構的固定常數。無論上下文是 1,000 個詞元還是 1,000,000 萬個詞元,它們的大小都相同,每個詞元都會獨立地經過這些權重矩陣。這意味著在 AFD 架構中,隨著上下文視窗的不斷增長,GPU 端會承擔不斷增加的成本(用於 KV 快取的更多 HBM,以及用於注意力機制的更多計算),而 LPX 端則完全保持不變。服務於模型 FFN 所需的 LPX 機架數量完全由模型的架構決定,而不是由服務配置的上下文長度決定。這巧妙地解決了長期以來純SRAM加速器面臨的最大挑戰之一:不斷增長的上下文需求最終會超過片上固定的記憶體容量。在AFD分離架構中,情境相關的工作保留在具有可擴展HBM的硬體上,而LPU則只處理那些自然適合儲存在固定SRAM中的上下文無關工作。
NVIDIA Dynamo 讓異質解碼得以運作
要讓這種雙引擎循環在生產環境中正常運行,需要的不僅僅是硬體。 NVIDIA 的 Dynamo 編排層才是異質解碼得以實現的關鍵。 Dynamo 負責協調 GPU 和 LPU 後端之間的解耦服務,處理 AFD 所需的每個令牌的分類、路由和啟動傳輸。
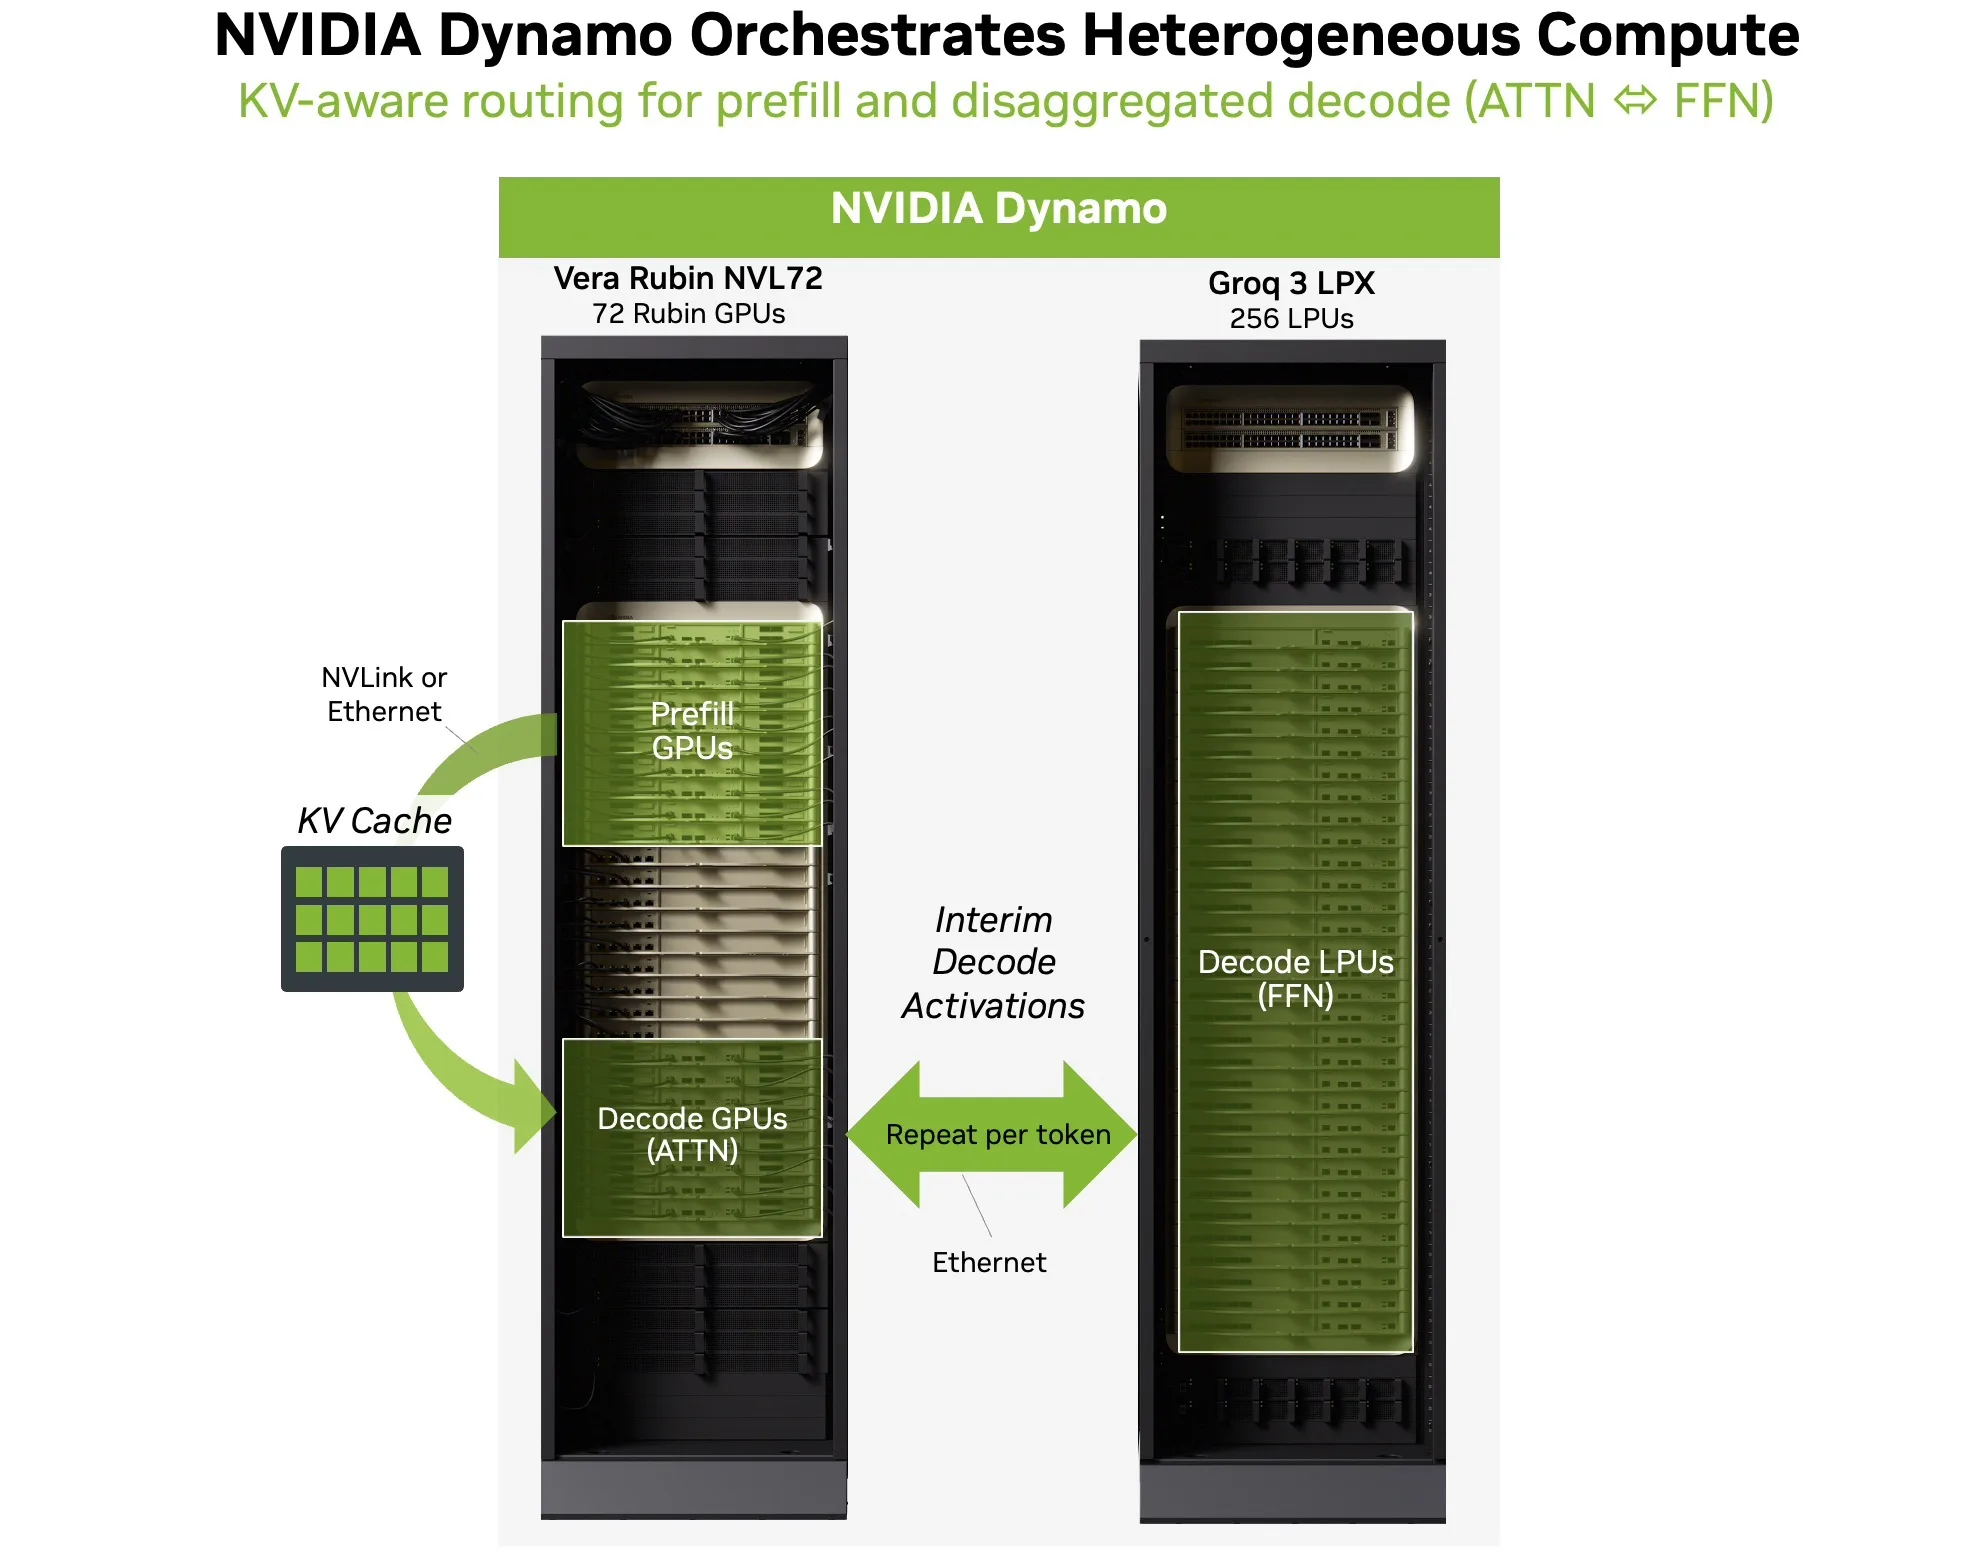
資料來源:Nvidia
在實際應用中,Dynamo 將預填資料路由到 GPU 工作節點來處理輸入並建立鍵值快取。在解碼過程中,Dynamo 會協調 AFD 迴圈:GPU 對累積的鍵值快取進行注意力機制處理,中間啟動訊息會交給 LPU 執行 FFN/MoE 指令,輸出回傳給 GPU 繼續產生令牌。最終形成一個統一的服務路徑,而不是兩個不相連的系統。
Dynamo 還提供鍵值感知路由(確保請求到達已駐留相關鍵值快取的工作節點)、延遲目標驅動調度(避免互動式會話長時間排隊)以及低開銷傳輸管理。這些功能至關重要,因為在實際生產環境中,面對可變上下文長度、混合請求類型和突發並發等複雜情況,編排層能夠保持尾延遲穩定,防止跨租戶抖動影響用戶體驗。
FFN 尺寸適用於所有主流開源模型和 LPX 尺寸
現在我們已經了解了LPX的工作原理以及它試圖解決的問題,接下來讓我們看看它對硬體的要求。
我們使用Huggingface 上提供的config.json和model.safetensors.index.json計算了流行模型的參數數量和磁碟上的 FFN 大小。
| 型號 | FFN 參數 | FFN 大小(磁碟上) | FFN% | D型 | 專家 |
|---|---|---|---|---|---|
| DeepSeek R1 和 DeepSeek V3.2 | 669.1B | GB 623.1 | FP8 | 256 | |
| 基米 K2 | 1.02T | GB 948.0 | FP8 | 384 | |
| 基米 K2.5 | 1.02T | GB 474.0 | INT4 | 384 | |
| MiniMax M2.5 | 224.7B | GB 209.3 | FP8 | 256 | |
| OpenAI GPT-OSS 120B | 114.7B | GB 53.4 | MXFP4 | 128 | |
| GLM 5 | 738.1B | GB 1,374.8 | BF16 | 256 | |
| Qwen3 235B-A22B | 227.2B | GB 423.1 | BF16 | 128 |
此模式證實了我們先前的探索:在本次分析的所有模型中,前饋神經網路(FFN)參數佔磁碟總模型大小的95%到99%。 Kimi K2是最極端的例子,每層384個路由專家,使得FFN參數超過1兆個,幾乎佔總參數的99%。即使是資料集中最小的模型,OpenAI的GPT-OSS 120B(128個專家儲存在MXFP4格式中),其FFN參數也佔總參數的95.4%。磁碟佔用空間從GPT-OSS 120B的53 GB(得益於4位元量化)到GLM 5的近1.4 TB(儲存在BF16格式中,未進行量化)不等。
這些數據有助於我們了解 LPX 的容量。單一 LPX 機架包含 256 個晶片,總共提供 128 GB 的 SRAM。對於像 OpenAI 的 GPT-OSS 120B 這樣佔用 53 GB FFN 記憶體的模型,其 FFN 權重可以輕鬆裝入單一機架,並且還有剩餘空間。 DeepSeek R1 佔用 623 GB 內存,大約需要五個 LPX 機架;而 GLM 5 佔用 1.4 TB 內存(採用 BF16 編碼),則需要十個以上的機架(不過,如果量化為 FP8,則所需空間將減少近一半)。這正是機架間前面板 C2C 連接埠的必要性所在:它們允許將多個 LPX 機架串聯起來,從而擴展生產線以容納更大的模型。
利用 LPX 加速推測性解碼
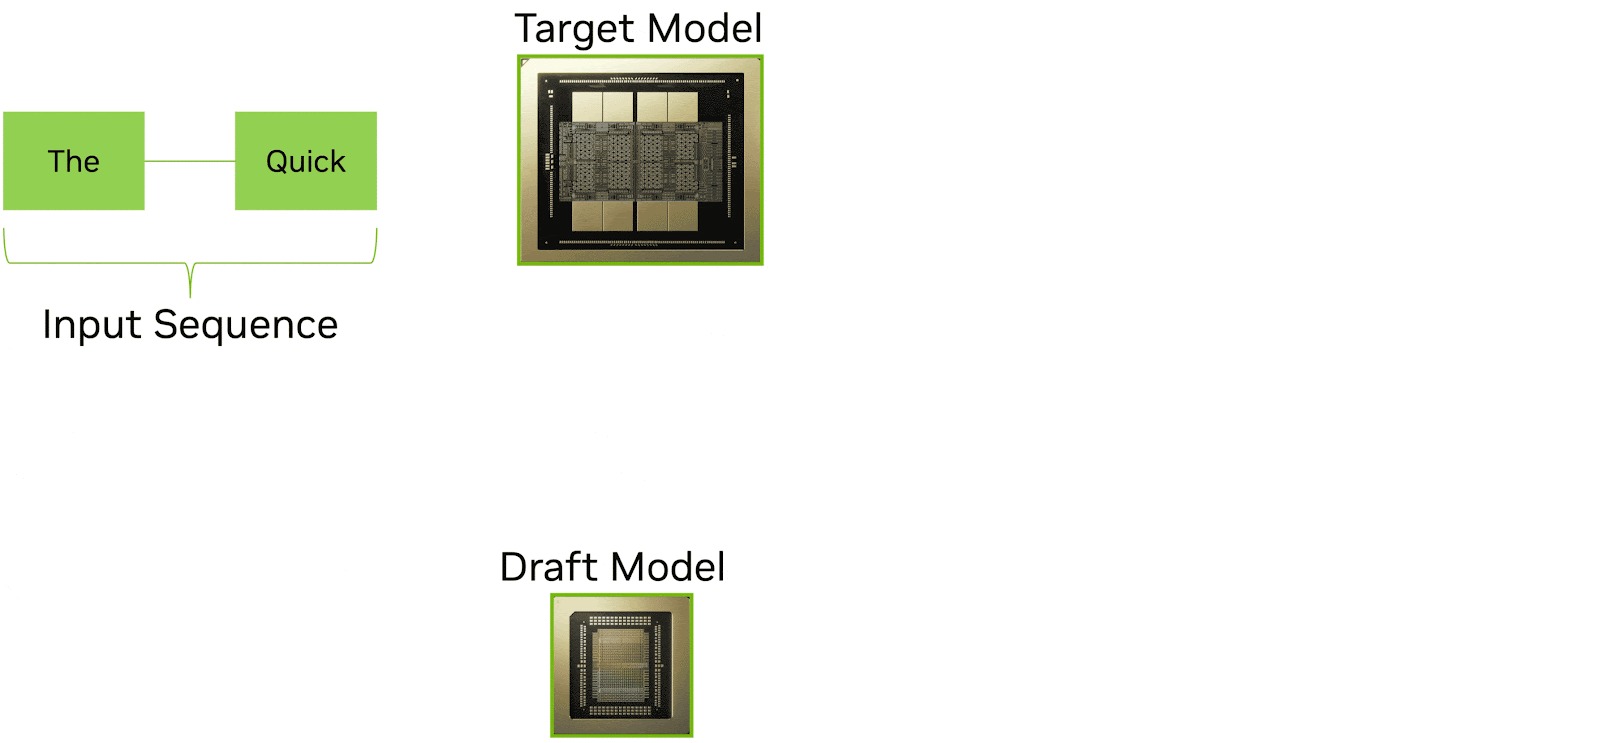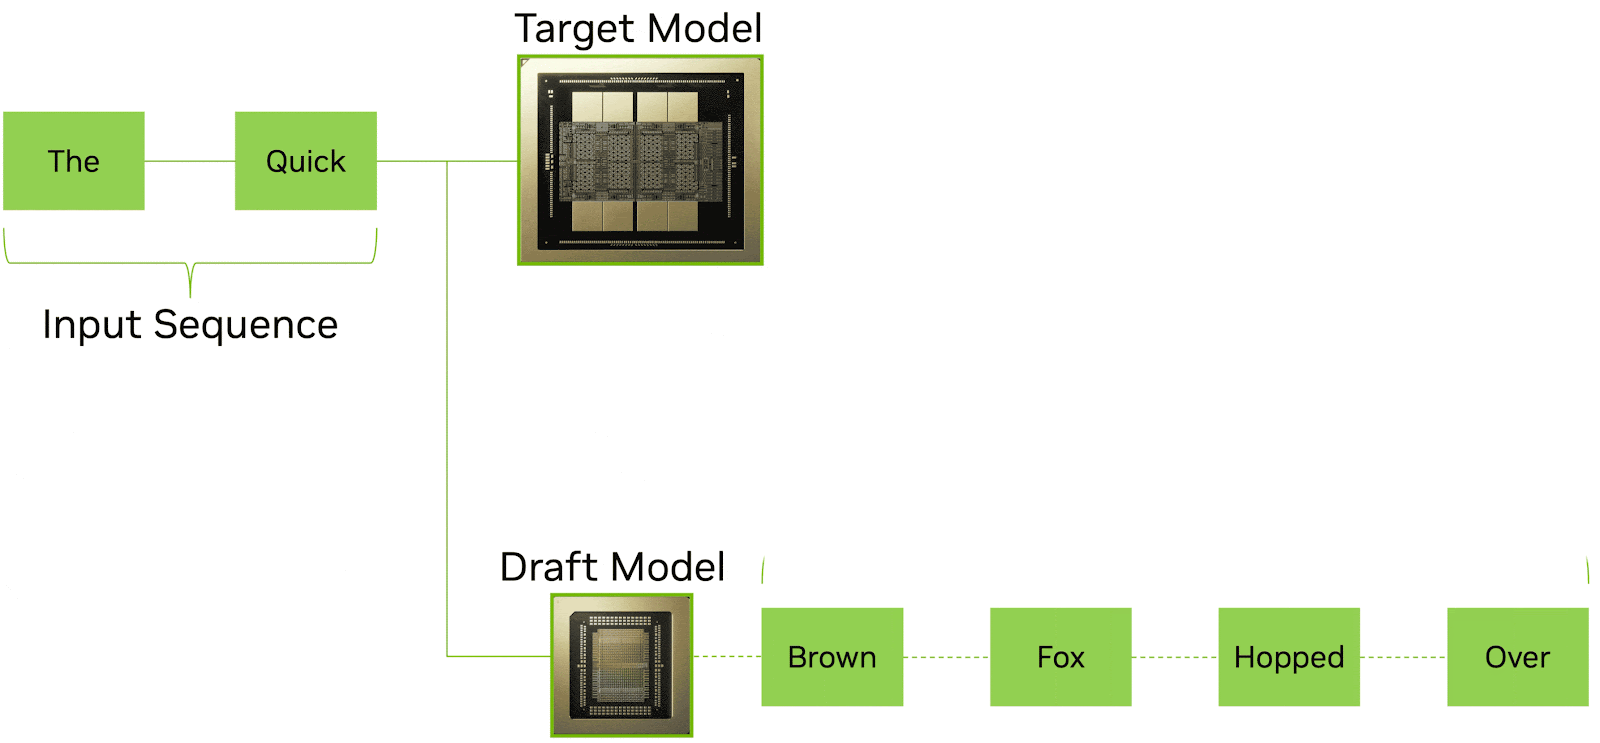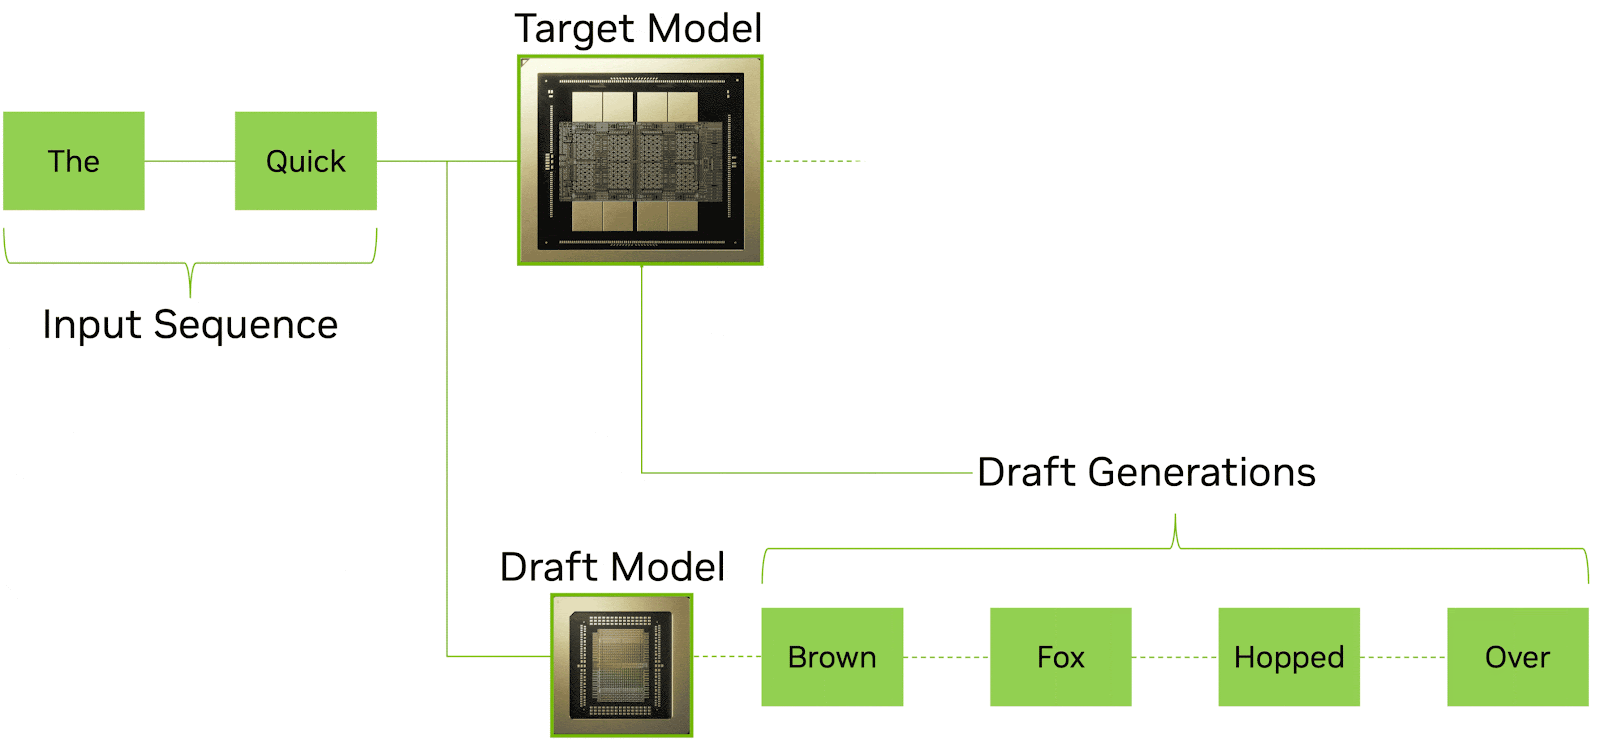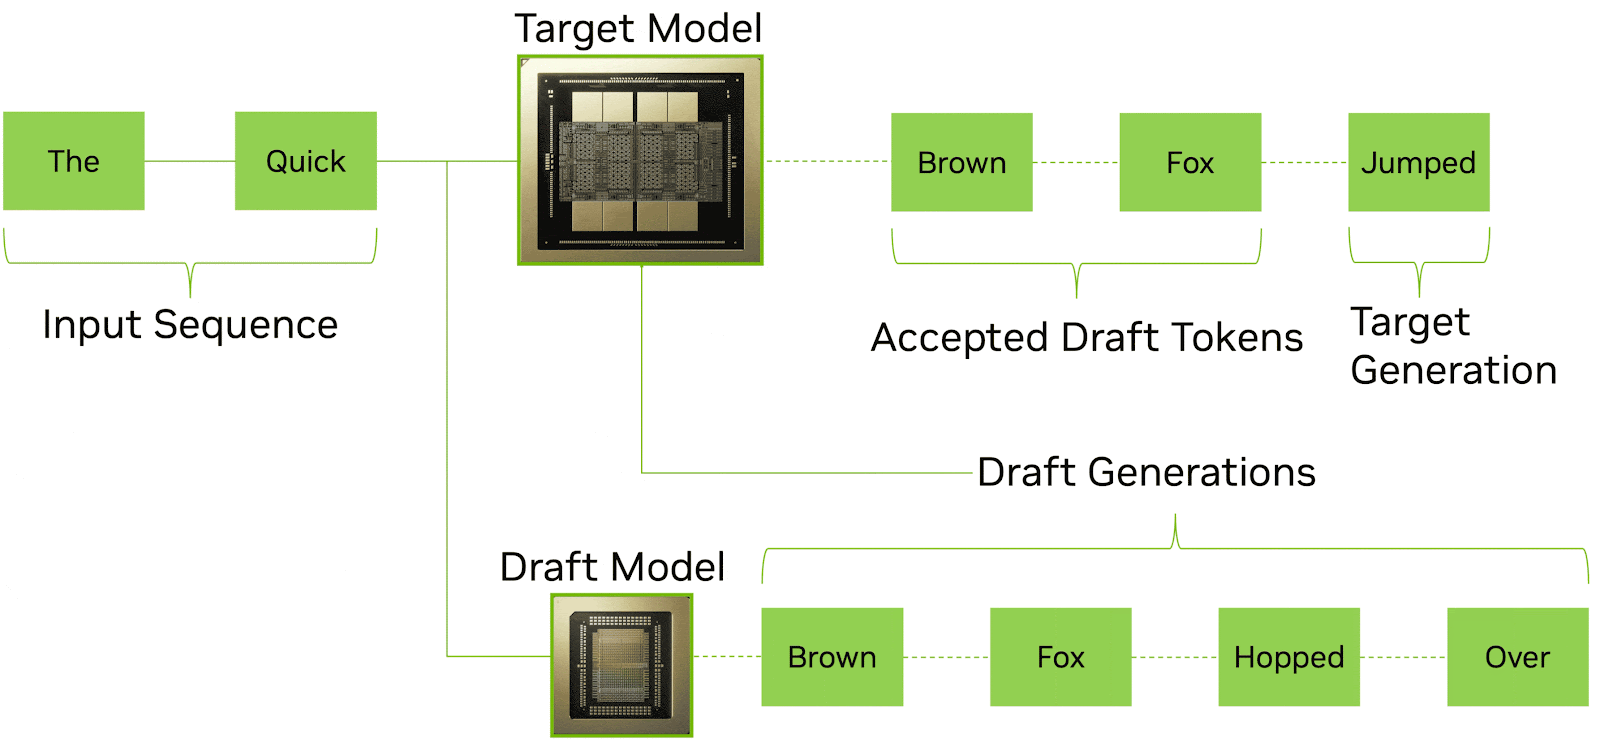
除了 AFD 解碼循環之外,NVIDIA 還確定了 LPX 的第二個主要用途:作為推測性解碼中的草稿生成引擎。
推測解碼是降低 LLM 推理延遲的日益重要的技術。其原理很簡單:一個更小、更快的草稿模型預先產生多個候選詞元,而一個更大的目標模型並行地驗證並接受這些候選詞元。當草稿模型的預測正確時(對於常規文本來說,預測通常是正確的),可以在單一驗證步驟中一次提交多個詞元。最終結果是每秒有效詞元數顯著提高,最終用戶感知到的延遲也更低。
資料來源:Nvidia
挑戰在於,推測性解碼要求草稿模型運行速度極快。草稿模型產生候選解的每一毫秒,驗證器就需要等待一毫秒。在傳統的純GPU架構中,草稿模型和目標模型會爭用相同的硬體資源,而草稿模型的速度也受到與其他所有元件相同的HBM頻寬限制。
LPX 非常適合此用途。其確定性執行模型和 LP30 的超高晶片上 SRAM 頻寬,能夠實現快速且可預測的草稿令牌產生。較小的草稿模型可以輕鬆裝入單個 LPX 托架或少量托架的 SRAM 中,而確定性調度則確保草稿生成以一致且可預測的速度運行,避免了因速度波動而導致的與驗證器流水線集成困難。
在這種配置下,系統將兩個處理器配對,發揮互補作用:LPX 利用其低延遲架構快速生成草稿令牌,而 Rubin GPU 則利用其高吞吐量運算能力和大容量 HBM 高效地驗證和最終確定令牌。這種分離使得推測性解碼能夠在異質處理器上運行,而無需兩個模型共享單一 GPU,與同構配置相比,這有可能提高草稿速度和驗證吞吐量。
NVIDIA 已將推測性解碼與 AFD 一起列為 LPX 的關鍵工作負載,這表明他們認為這是該系統價值主張的重要組成部分。隨著前沿模型的不斷發展和推理鏈的延長,在專用硬體上並行生成和驗證令牌的能力可能成為保持交互響應能力的重要手段。
總結:極致的軟硬體協同設計
NVIDIA Vera Rubin平台和LPX最突出的特點之一,就是每個組件的精準定位。在消費領域,我們經常會遇到一些產品,它們試圖解決一些根本不存在的問題,而這些產品背後的公司對客戶的需求缺乏深刻的理解。 NVIDIA的策略則截然不同。他們顯然對推理流程中的問題有著極其細緻的理解,並針對流程的每個環節進行最佳化,以幫助客戶最大限度地提高硬體效益。
注意力/FFN分離並非行銷概念,而是針對兆參數MoE模型服務瓶頸問題的直接因應措施。決定專門卸載FFN(而非注意力),並將CPX機架升級為LPX機架,體現了對哪些操作受頻寬限制、哪些受容量限制、哪些可靜態調度、哪些可動態調度以及哪種處理器架構最適合每種操作的精準理解。 Dynamo編排層、透明的CUDA整合以及無線MGX機架設計,都顯示工程團隊已對整個部署生命週期進行了周全的考慮。
LPX 和 NVIDIA 的新一代產品仍有許多未知之處。其中一個懸而未決的問題是,「Fabric Expansion Logic and DRAM」的用途是什麼?它使用了哪種矽晶片?許多人已經注意到 x86 插槽,考慮到去年對英特爾的投資以及散熱器固定設計,很可能使用的是英特爾處理器,但具體是哪一款仍然是個謎。
LPX部署初期將重點放在模型建構者和服務供應商,而非全面覆蓋。其在生產流量模式下的實際效能,包括可變上下文長度、混合請求類型和突發並發等情況,以及能效表現,仍需進行獨立驗證。我們期待獲得這些系統的存取權限,以便進行獨立測試。
參考資料來源:
Groq:Groq LPU 採用 AI 推理技術,可實現更高的能源效率…
Aleksa Gordić – 人工智慧頓悟:Groq LPU 的工作原理是什麼? (特邀矽谷負責人 Igor Arsovski!)


 Amazon