

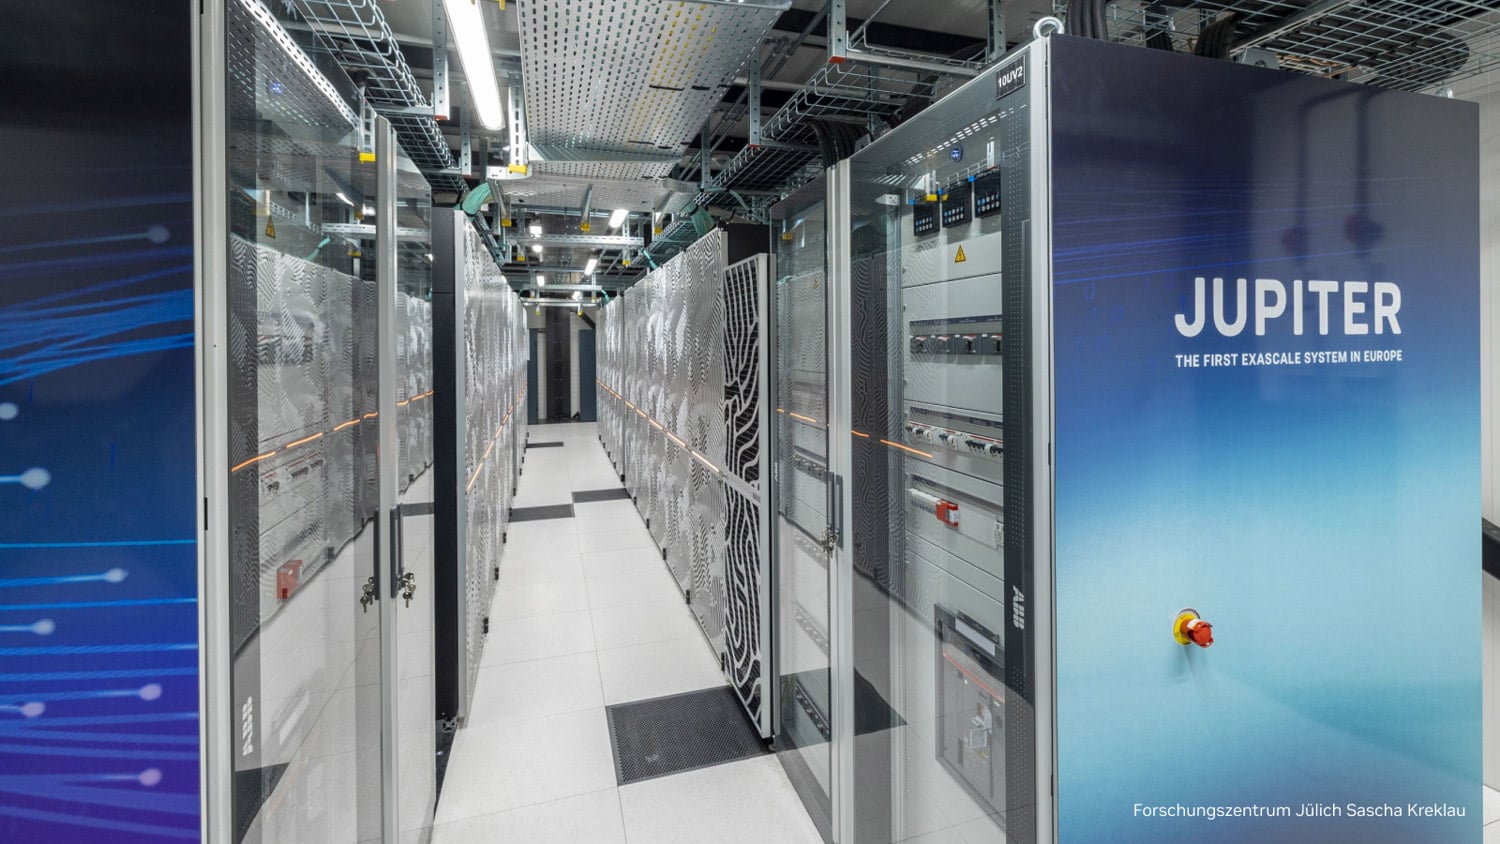
NVIDIA 利用位於於利希超級運算中心的歐洲首台百億億次級超級電腦JUPITER ,使用 8,192 個 GH200 GPU ,對一個容錯量子處理器進行了 104 量子位元的模擬。此次模擬在 GTC 柏林大會前夕發布,模擬了「魔態培養」過程——一種在實際硬體噪音條件下產生容錯電腦在邏輯運算過程中所需的非克利福德態的方法。 NVIDIA 稱這是迄今為止規模最大的容錯量子處理器綜合模擬,並表示魔態培養所需的量子位元數量比以往的方法減少了 90%,但該公司並未詳細說明這一差異的具體數值。
104量子比特容錯模型在真實雜訊下的適用性
先前於利希研究所的工作在理想無雜訊條件下模擬了50個量子比特,而本模擬則保留了雜訊。 104個實體量子位元涵蓋了整個協議中的數據和輔助量子位元。協定首先使用距離為3的色碼,從魔態開始,然後透過標誌測量來捕捉有害錯誤,將其擴展為距離為7的混合色碼和表面碼,最後進行進一步的糾錯和讀出。雜訊模型不僅考慮了隨機的位元和相位翻轉,還包括可以累積和乾涉的相干相位誤差。此外,選定的量子點還攜帶第三個能階,因此模擬能夠捕捉到計算態的洩漏。
該狀態是一個完整的狀態向量,沒有使用任何克利福德捷徑來處理準備魔法狀態的非克利福德操作。編碼後的寄存器為 45 位,約 35.2 兆個複振幅,在雙精度下佔用 512 TiB 的分佈式 GPU 內存,或在 8,192 個 GPU 上每個 GPU 佔用 64 GiB 內存,並且還留有通信和分析所需的空間。
NVIDIA 的模擬器在保留依賴關係和測量統計資料的前提下重新排列操作順序,在測量和釋放量子位元時重複使用儲存空間,並將三能階位點打包到二進位儲存中,使得五個位點(243 個基態)可以裝入 10 位元。在小規模情況下,獨立的張量網路計算結果與狀態向量計算結果的匹配度約為兆分之一。
GB200 NVL72 和 cuQuantum Stack 的開發
NVIDIA 加速量子研究中心的 GB200 NVL72 系統作為開發平台。研究人員將測試規模從四個 GPU 擴展到數百個,並將結果與 JUPITER 進行了比較,並在分配全部 8,192 個 GPU 資源之前,研究了計算量增加對精度的影響。 NVIDIA 表示,此舉將原本需要一週的模擬工作縮短到了幾天。此運行使用 cuQuantum 的 cuStateVec 庫進行狀態向量演化,並利用 cuBLASMp 和 cuSOLVERMp 對儲存狀態的特定分區進行分解,以便將近似方法與完整的參考狀態進行比較。培養電路透過CUDA-Q 的容錯邏輯層實現。
於利希研究中心(Forschungszentrum Jülich)於利希超級計算中心主任克里斯蒂爾·米歇爾森(Kristel Michielsen)表示:“歐洲對JUPITER的投資使研究人員能夠探索以前無法觸及的問題。” 英偉達(NVIDIA)為此項目設定的目標是將觀察到錯誤的硬體與邏輯連接成本聯繫起來。目前,該運行尚未公佈任何邏輯錯誤率、保真度或運行時間數據。


 Amazon