

華碩 Ascent GX10 沿用了基於 NVIDIA GB10 超級晶片的核心架構,搭載 Arm v9.2-A CPU 複合體、整合 Blackwell 顯示卡和 128GB 統一 LPDDR5x 記憶體。 NVIDIA 官方標稱該平台擁有高達 1 petaFLOP 的 FP4 AI 運算能力,支援高達 200 億參數的模型微調。 CPU 和 GPU 透過 NVLink-C2C 進行通信,從而實現系統內一致的記憶體存取。
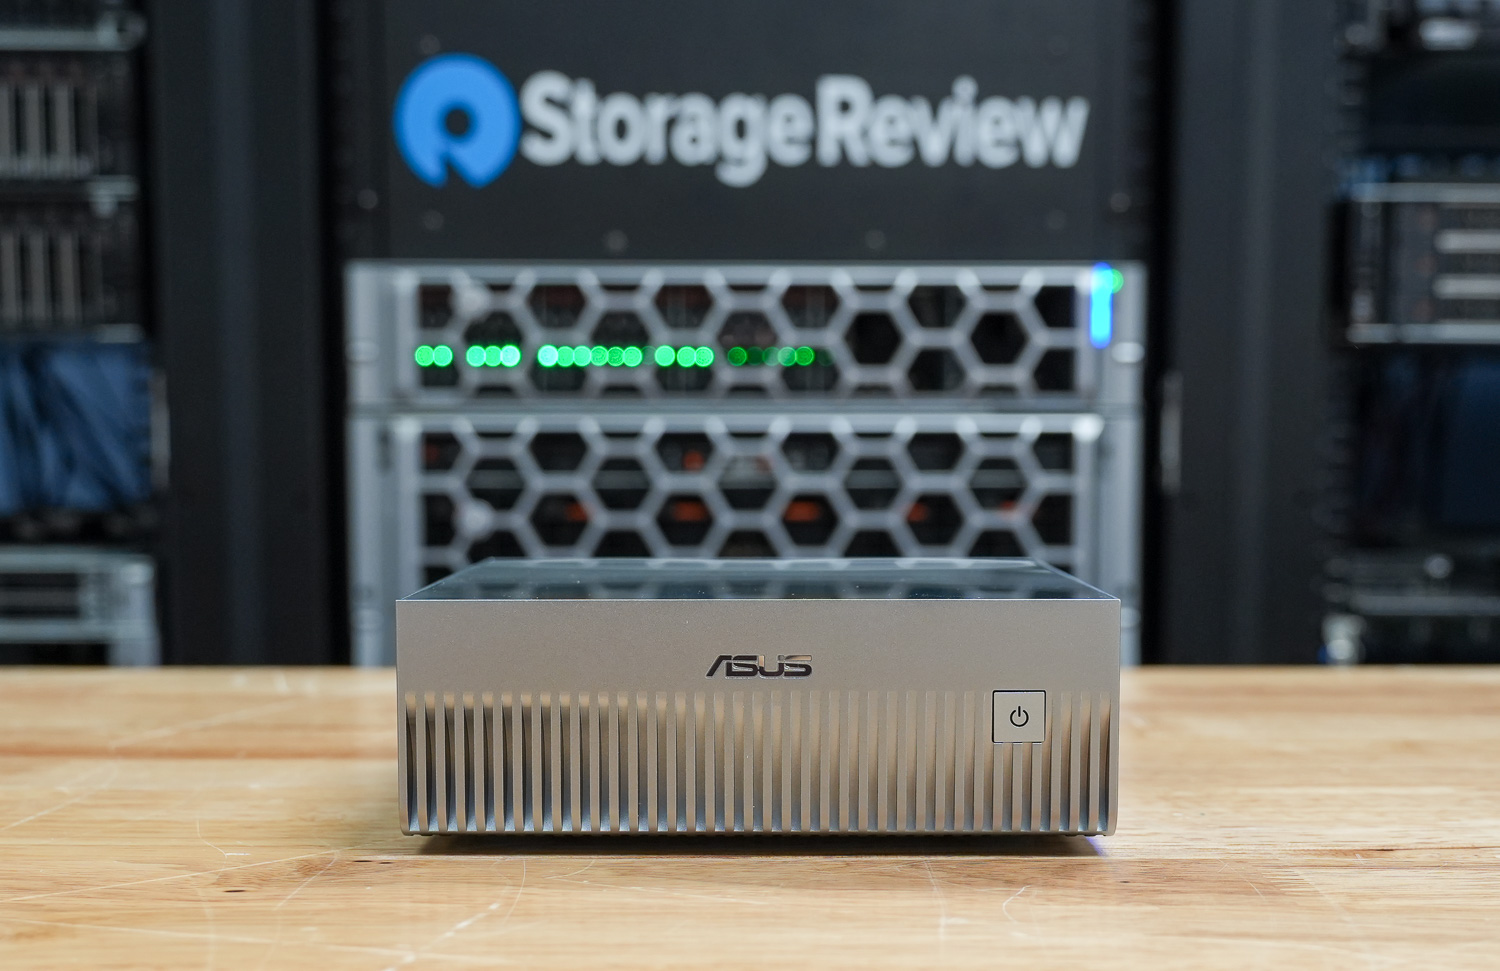
華碩將這些硬體封裝在一個緊湊、時尚的150 x 150 x 51毫米機殼內,重量為1.48公斤(比戴爾和技嘉的同類產品略高略重),並採用星空灰配色。與其他同類產品一樣,它也使用240瓦外置電源適配器供電。
儲存選項包括 1TB 和 2TB PCIe 4.0 NVMe 配置,以及 4TB PCIe 5.0 NVMe 版本。網路方面,配備 10G 乙太網路介面和整合式 NVIDIA ConnectX-7 智慧網路卡,並透過 AW-EM637 模組支援 WiFi 7 和藍牙 5.4。後置介接包括三個支援 DisplayPort 2.1 替代模式的 USB 3.2 Gen 2×2 Type-C 介面、一個支援 180W PD 輸入的 USB Type-C 介面、HDMI 2.1 介面、10G 乙太網路介面、ConnectX-7 介面以及 Kensington 安全性鎖槽。
讓我們看看華碩在 GB10 平台上如何整合散熱、儲存和連接功能,與其他廠商相比如何,以及在持續工作負載下其效能是否有可衡量的差異。
ASUS Ascent GX10 規格參數
| 規格 | 華碩 Ascent GX10 (GB10) |
|---|---|
| 尺寸和重量 | |
| 高度 | 2在 |
| 信號寬度 | 5.9在 |
| 深度 | 5.9在 |
| 重量 | 3.26磅 |
| 處理器 | |
| 處理器類型 | NVIDIA GB10(Grace Blackwell Superchip)(20 核心) |
| 集成顯卡 | NVIDIA Blackwell GPU(整合式顯示卡) |
| 記憶體應用 | |
| 內存類型 | LPDDR5x(統一系統記憶體) |
| 內存配置 | 128 GB LPDDR5x 統一系統內存 |
| 內存帶寬 | 273 GB/s (8533 MT/s) |
| 操作系統 | |
| 支持的操作系統 | NVIDIA DGX 作業系統 |
| 外部連接埠和插槽 | |
| 網絡端口 | 一個 RJ45 (10GbE) NVIDIA ConnectX-7 網路卡(200G × 2 QSFP) |
| USB端口 | 三個 USB 3.2 Gen 2×2 Type-C (20Gbps) 一個支援PD的USB 3.2 Gen 2×2 Type-C接口 |
| 視訊連接埠 | 一個 HDMI 2.1a 接口 |
| 電源適配器端口 | USB Type-C(PD 輸入) |
| 安全槽 | 肯辛頓鎖一號 |
| 無線應用 | |
| WiFi | WiFi 7(AW-EM637,2×2) |
| 藍牙 | 藍牙5.4 |
| 儲存 | |
| 儲存選項 | M.2 NVMe PCIe 5.0:4TB M.2 NVMe PCIe 4.0:1TB / 2TB |
| 電源適配器 | |
| 類型 | 240W 外置轉接器(USB Type-C) |
ASUS Ascent GX10 的設計與構造
華碩 Ascent GX10 延續了我們在其他基於 Spark 平台的系統上常見的緊湊型設計,尺寸為 150 x 150 毫米,高度為 51 毫米,重量為 1.48 公斤。機殼採用亮灰色塗裝,看起來更像是一款時尚的桌上設備,而非實驗室級的參考級產品。
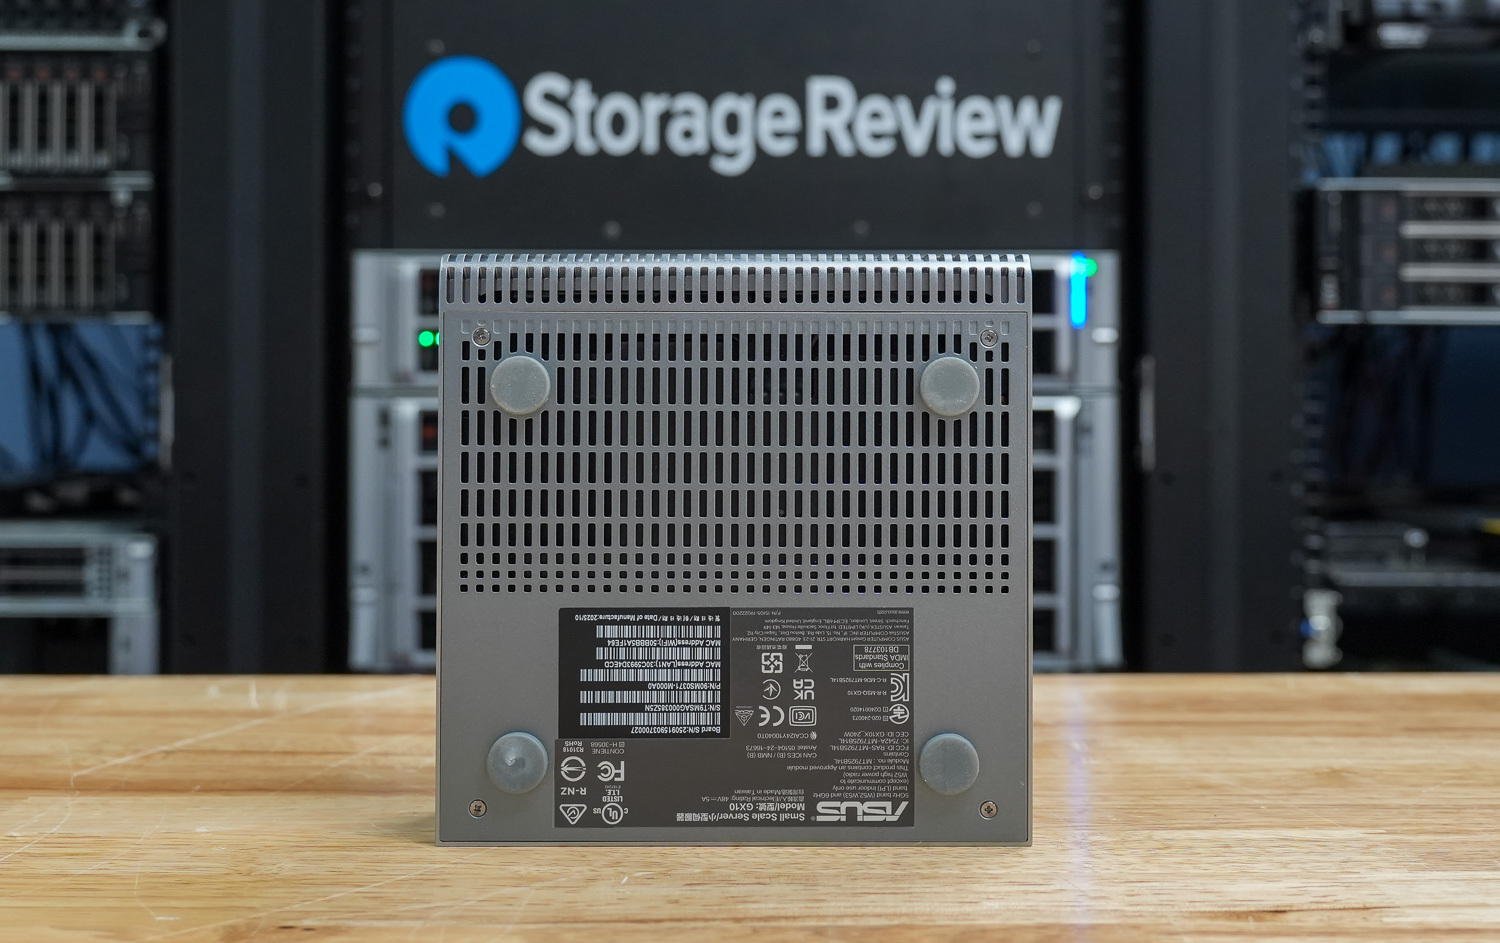
正面最引人注目的是排列緊密的垂直通風口,貫穿整個機身寬度,其間點綴著小巧的華碩標誌和一個與通風口融為一體的方形電源按鈕。這款產品的獨特之處還在於,華碩將電源指示燈整合到了電源按鈕中。雖然這一點可能有點奇怪,但許多GB10系統根本沒有電源指示燈。
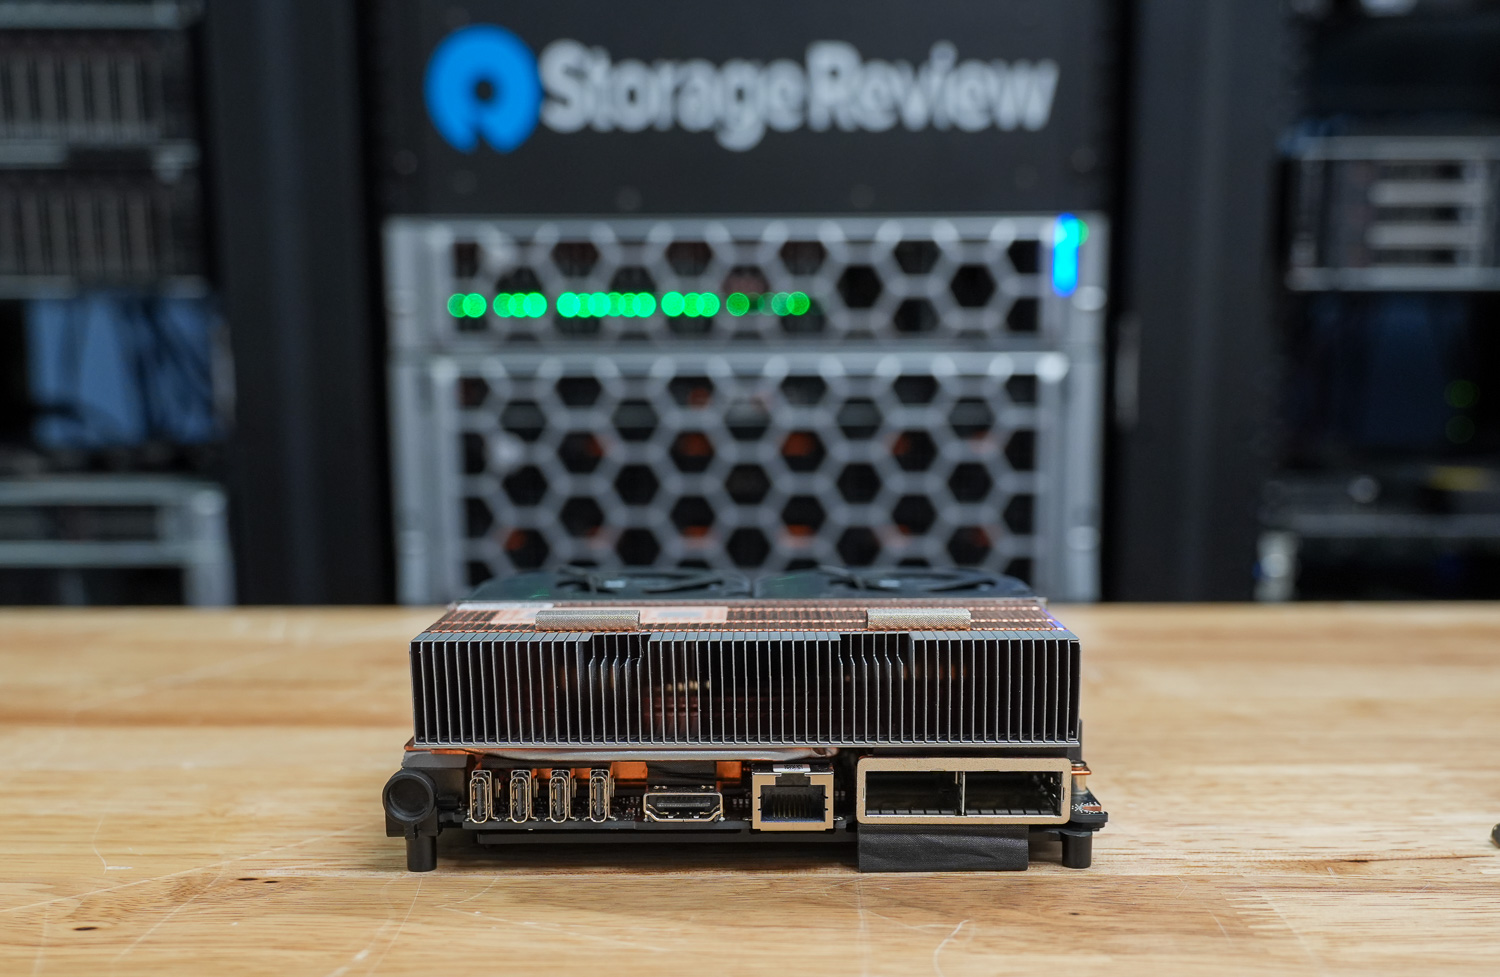
所有主要介面都位於機身背面,華碩充分利用了可用空間。三個 USB 3.2 Gen 2×2 Type-C 介面支援 20Gbps 傳輸速度,並支援 DisplayPort Alter Mode;此外,還有一個專用於供電的 USB Type-C 接口,支援最高 180W 的 PD 3.1 EPR 供電。顯示輸出方面,它配備了一個 HDMI 2.1 介面。
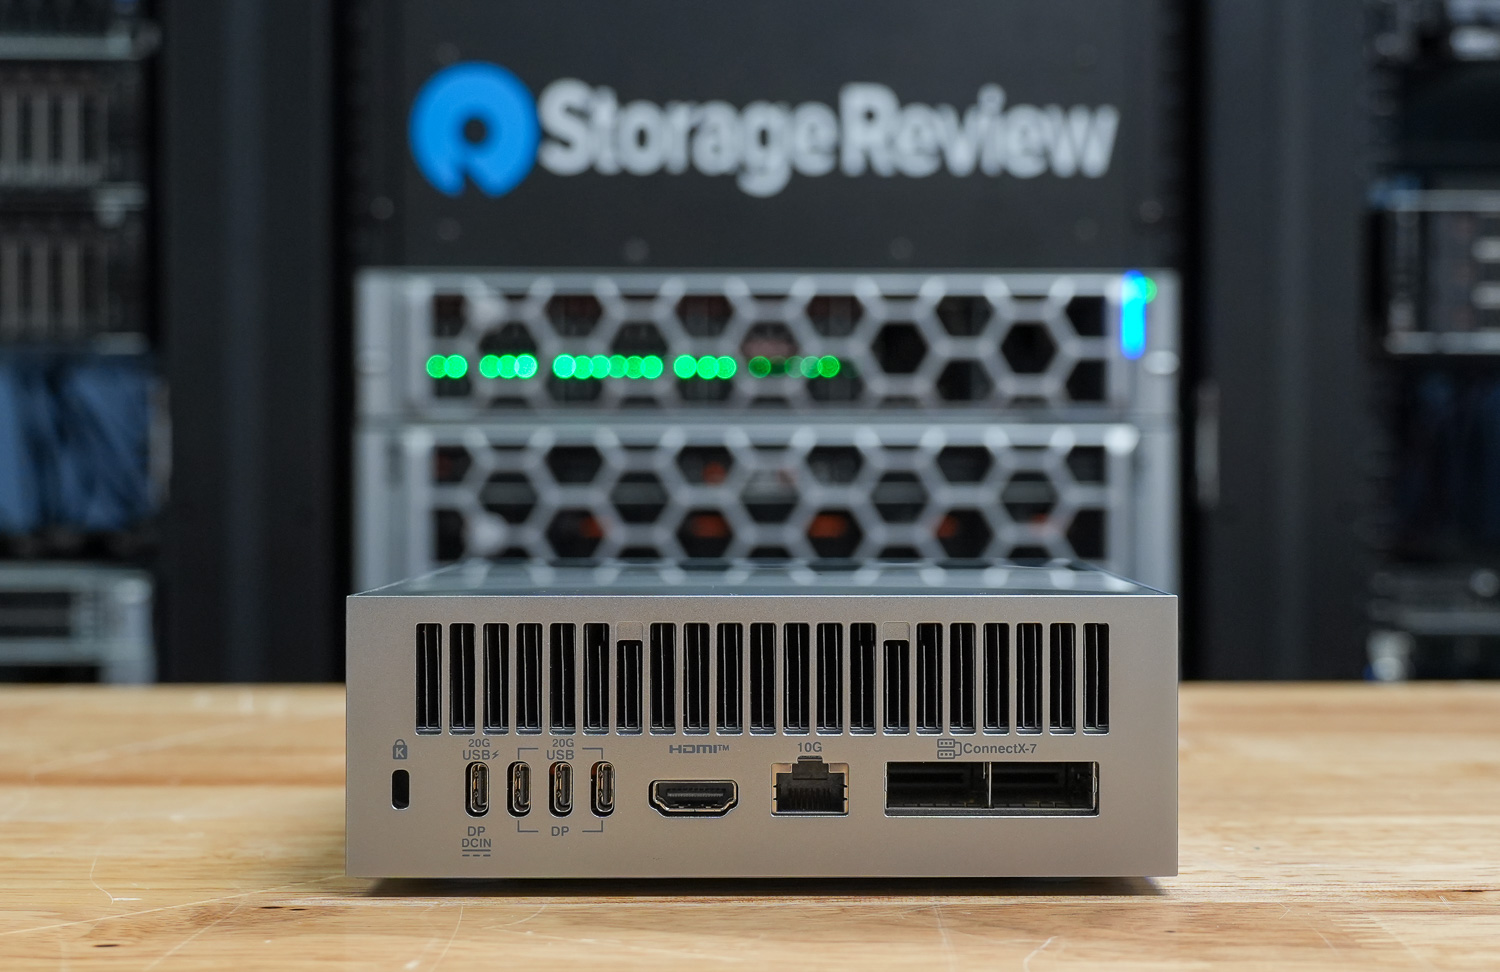
網路選項包括一個 10G LAN 連接埠和一個 NVIDIA ConnectX-7 網路卡,可實現高頻寬資料傳輸並連接多個系統。它還配備了常見的 Kensington 安全鎖槽。
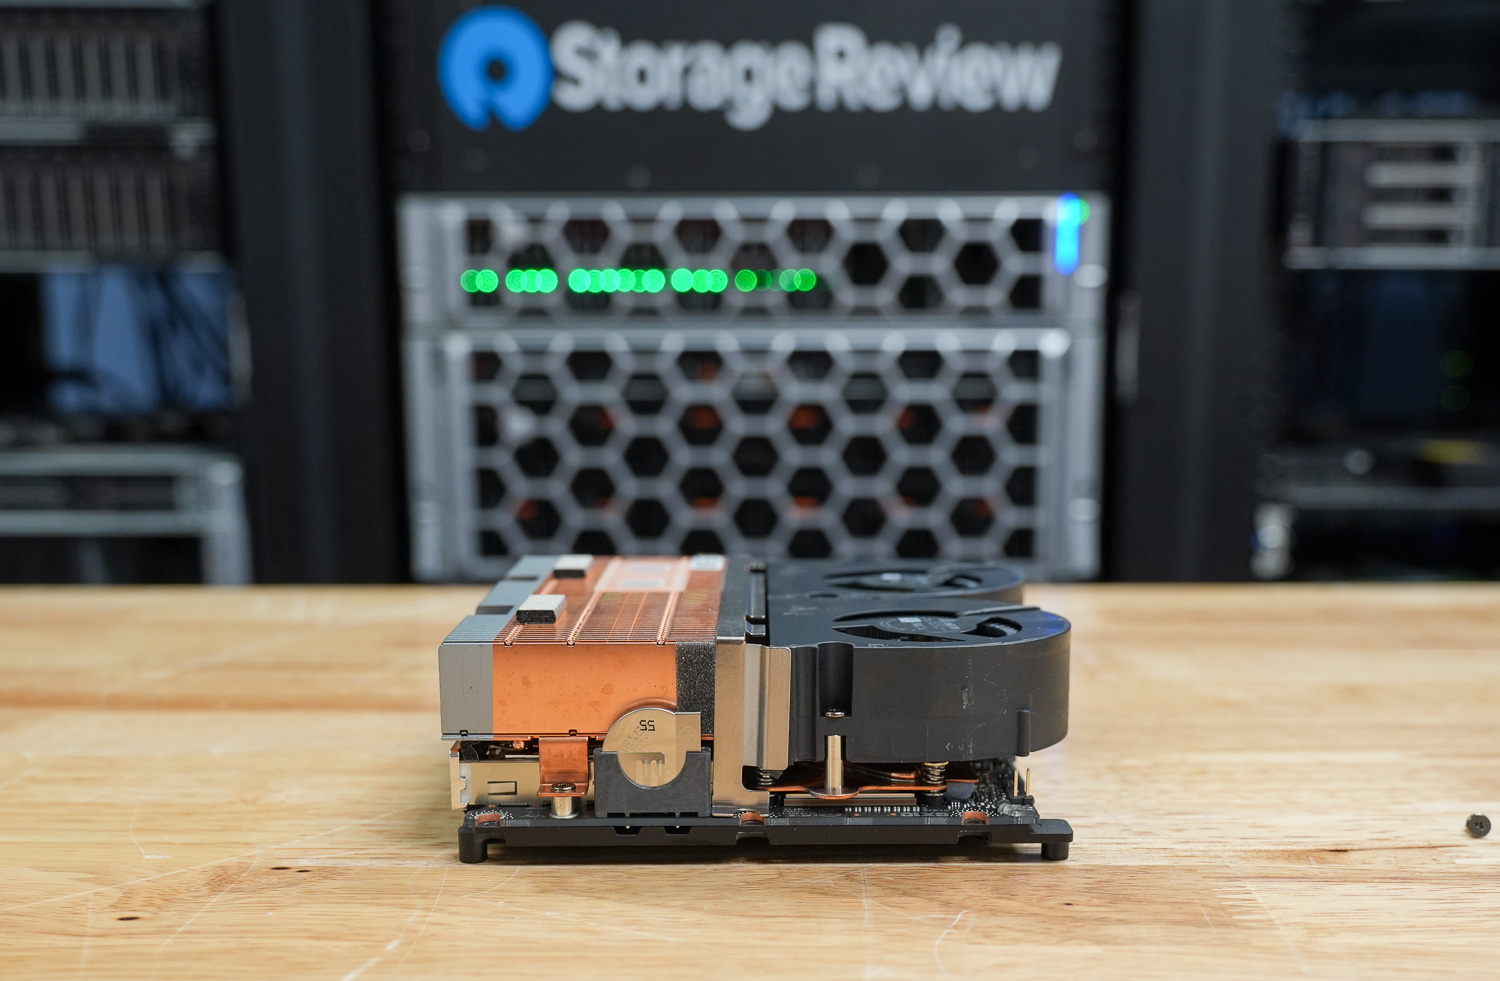
GX10 內部搭載 NVIDIA GB10 Grace Blackwell 超級晶片,由 Arm v9.2-A CPU 和整合 Blackwell 顯示卡組成。它配備 128 GB LPDDR5x 統一內存,因此 CPU 和 GPU 共享同一內存池,而不是在不同的內存域中工作。這種配置對於這些系統所針對的 AI 工作負載至關重要。
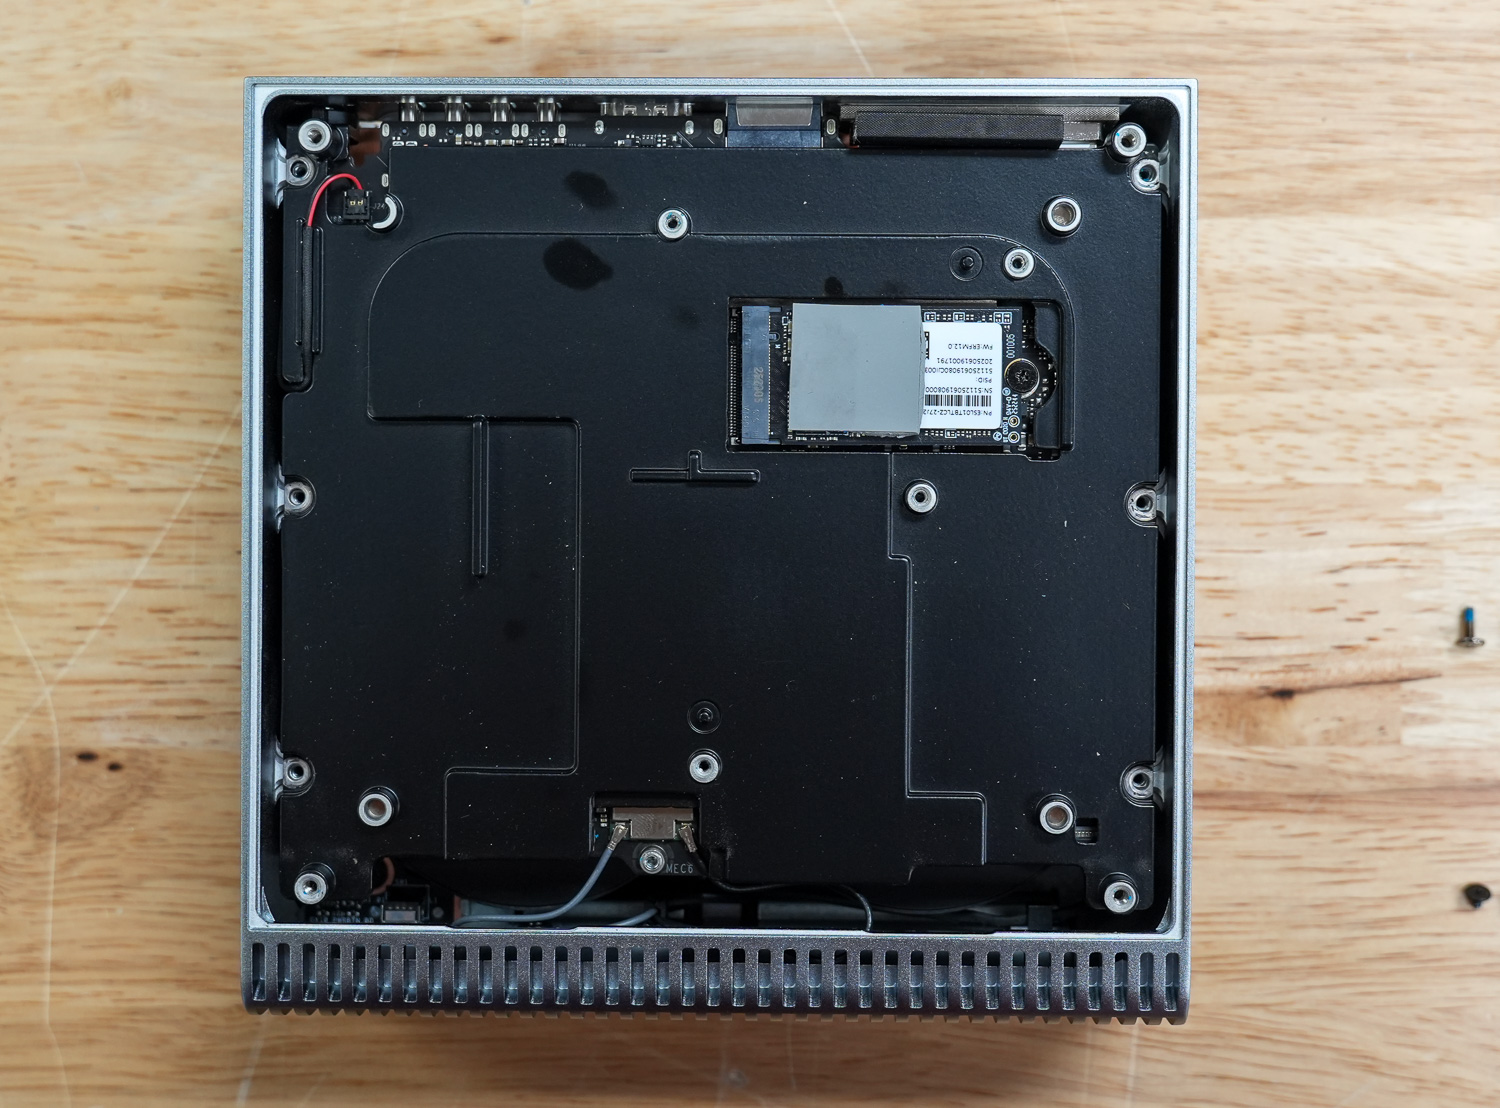
儲存方面,該裝置配備 M.2 2242 NVMe 插槽,可選配 1TB 和 2TB PCIe 4.0 固態硬碟,最高可達 4TB PCIe 5.0 配置。電源供應器方面,採用 USB-C PD 3.1 EPR 轉接器供電,額定功率最高可達 240W,裝置實際功耗最高可達 180W。同時,無線連接方面,該設備配備 Wi-Fi 7 模組和藍牙 5.4,並整合 10G 乙太網路接口,支援有線網路連接。
華碩Ascent GX10 熱測試
為了測試華碩 Ascent GX10 內部組件的散熱性能,我們將其與 Founders Edition 版本以及戴爾、宏碁和技嘉等 OEM 廠商的產品進行了比較。我們在Spark 散熱測驗論文中對此進行了更深入的探討。
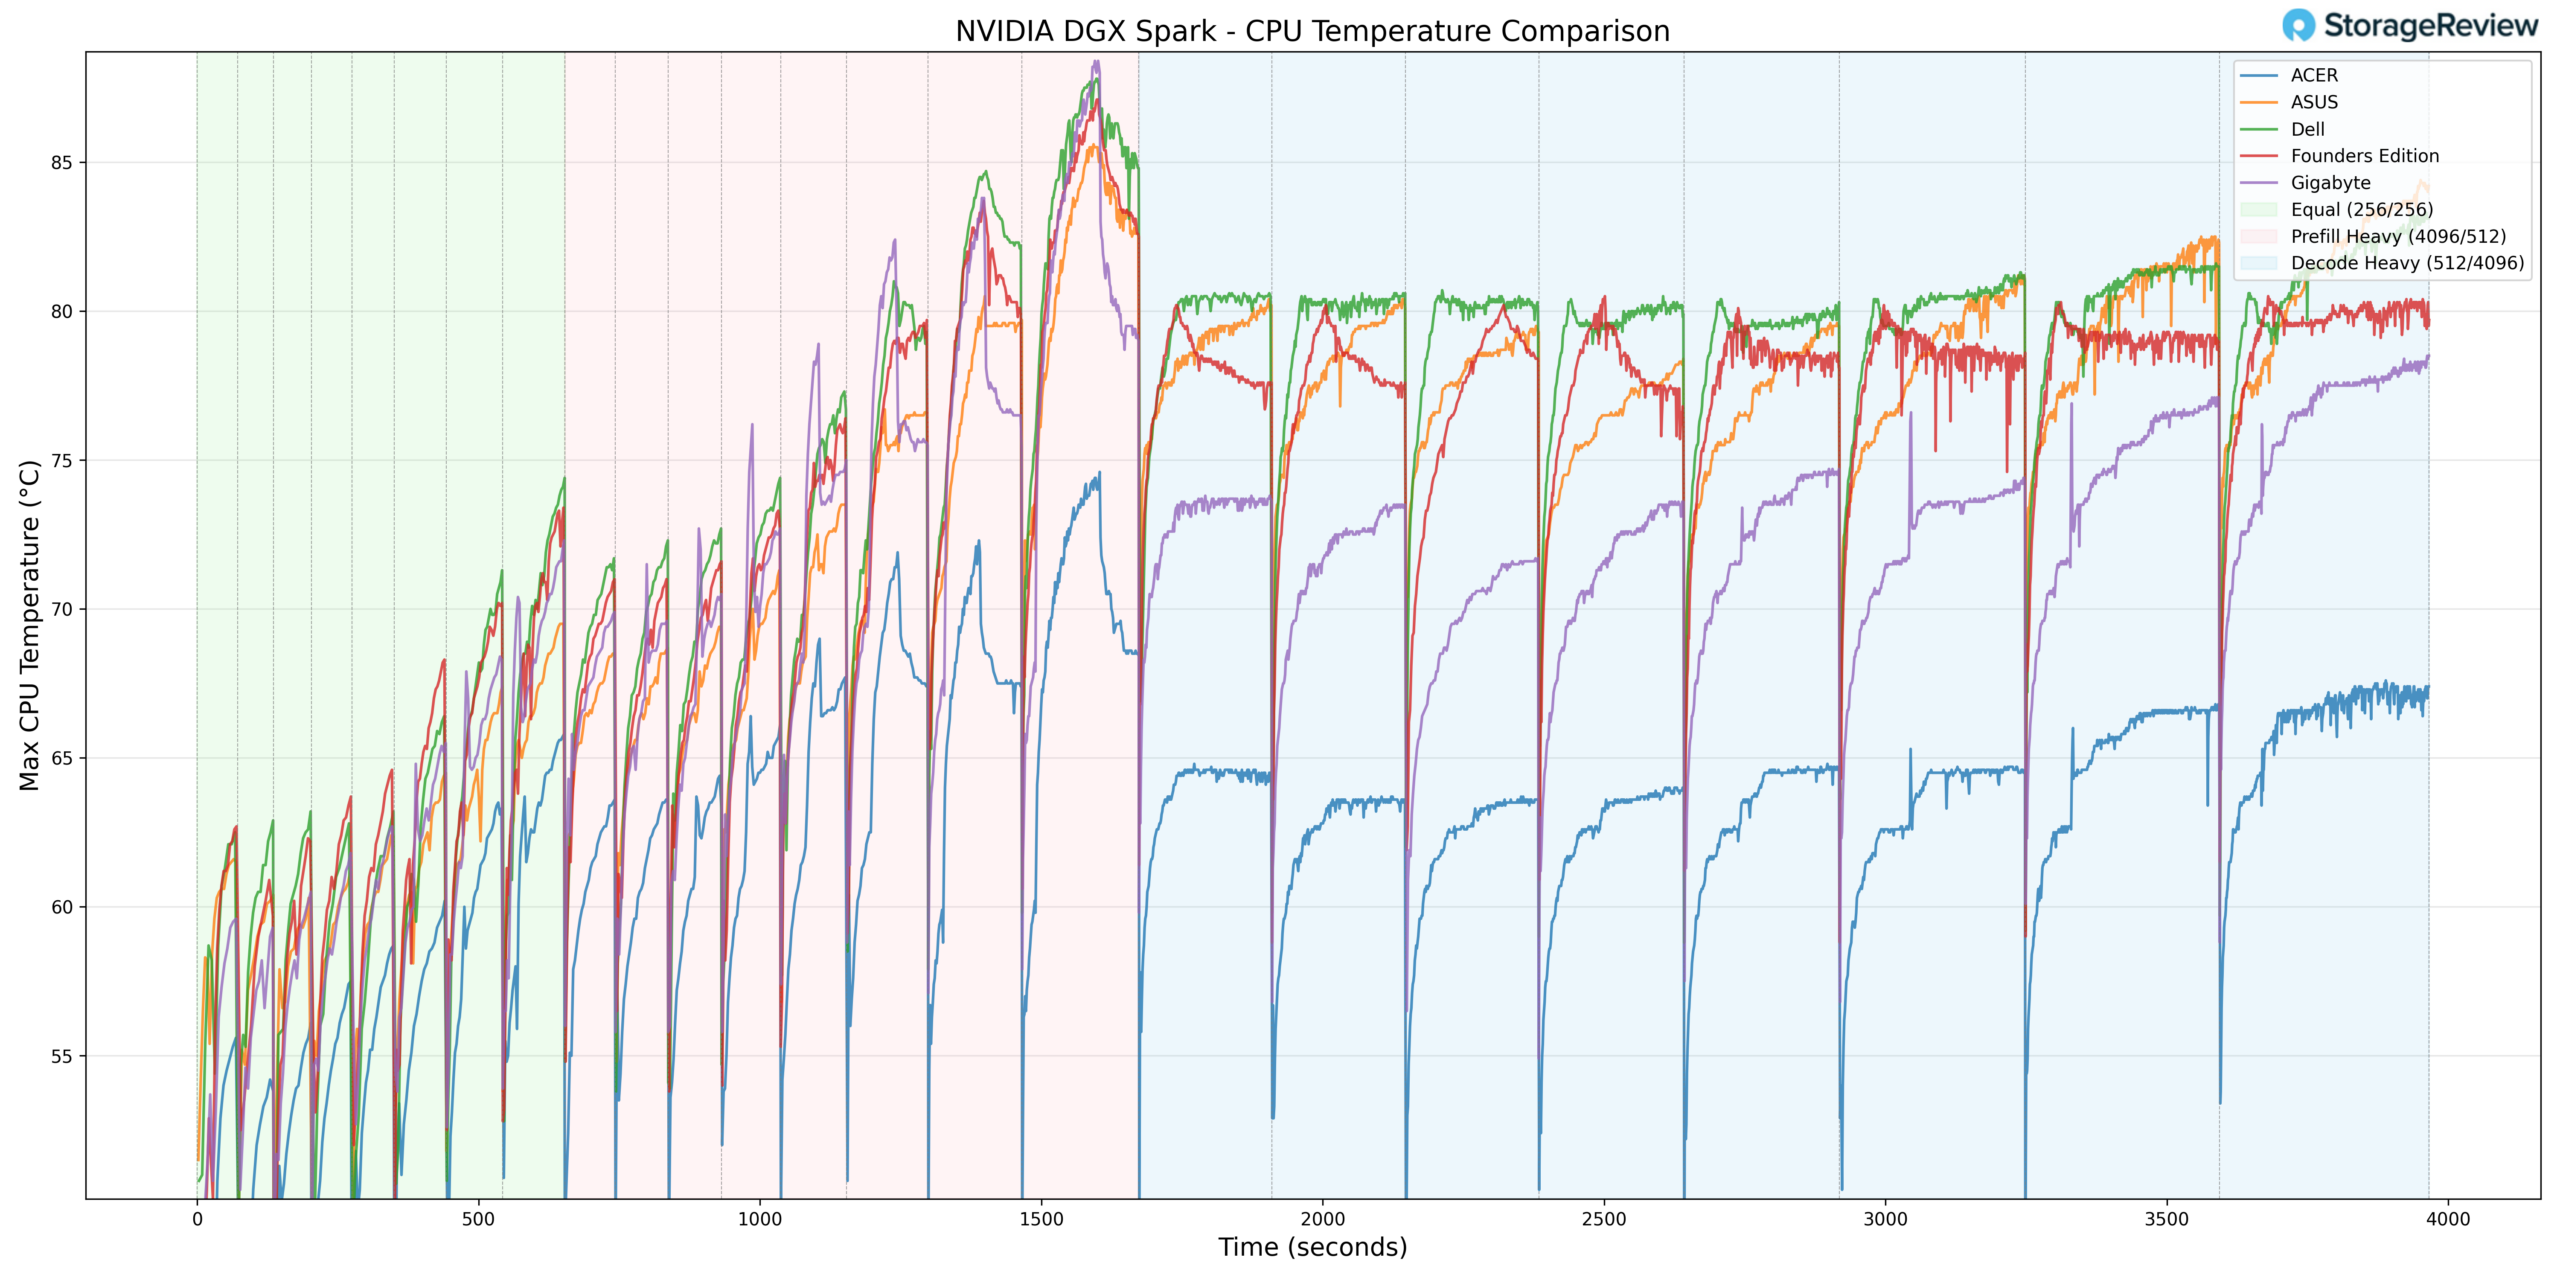
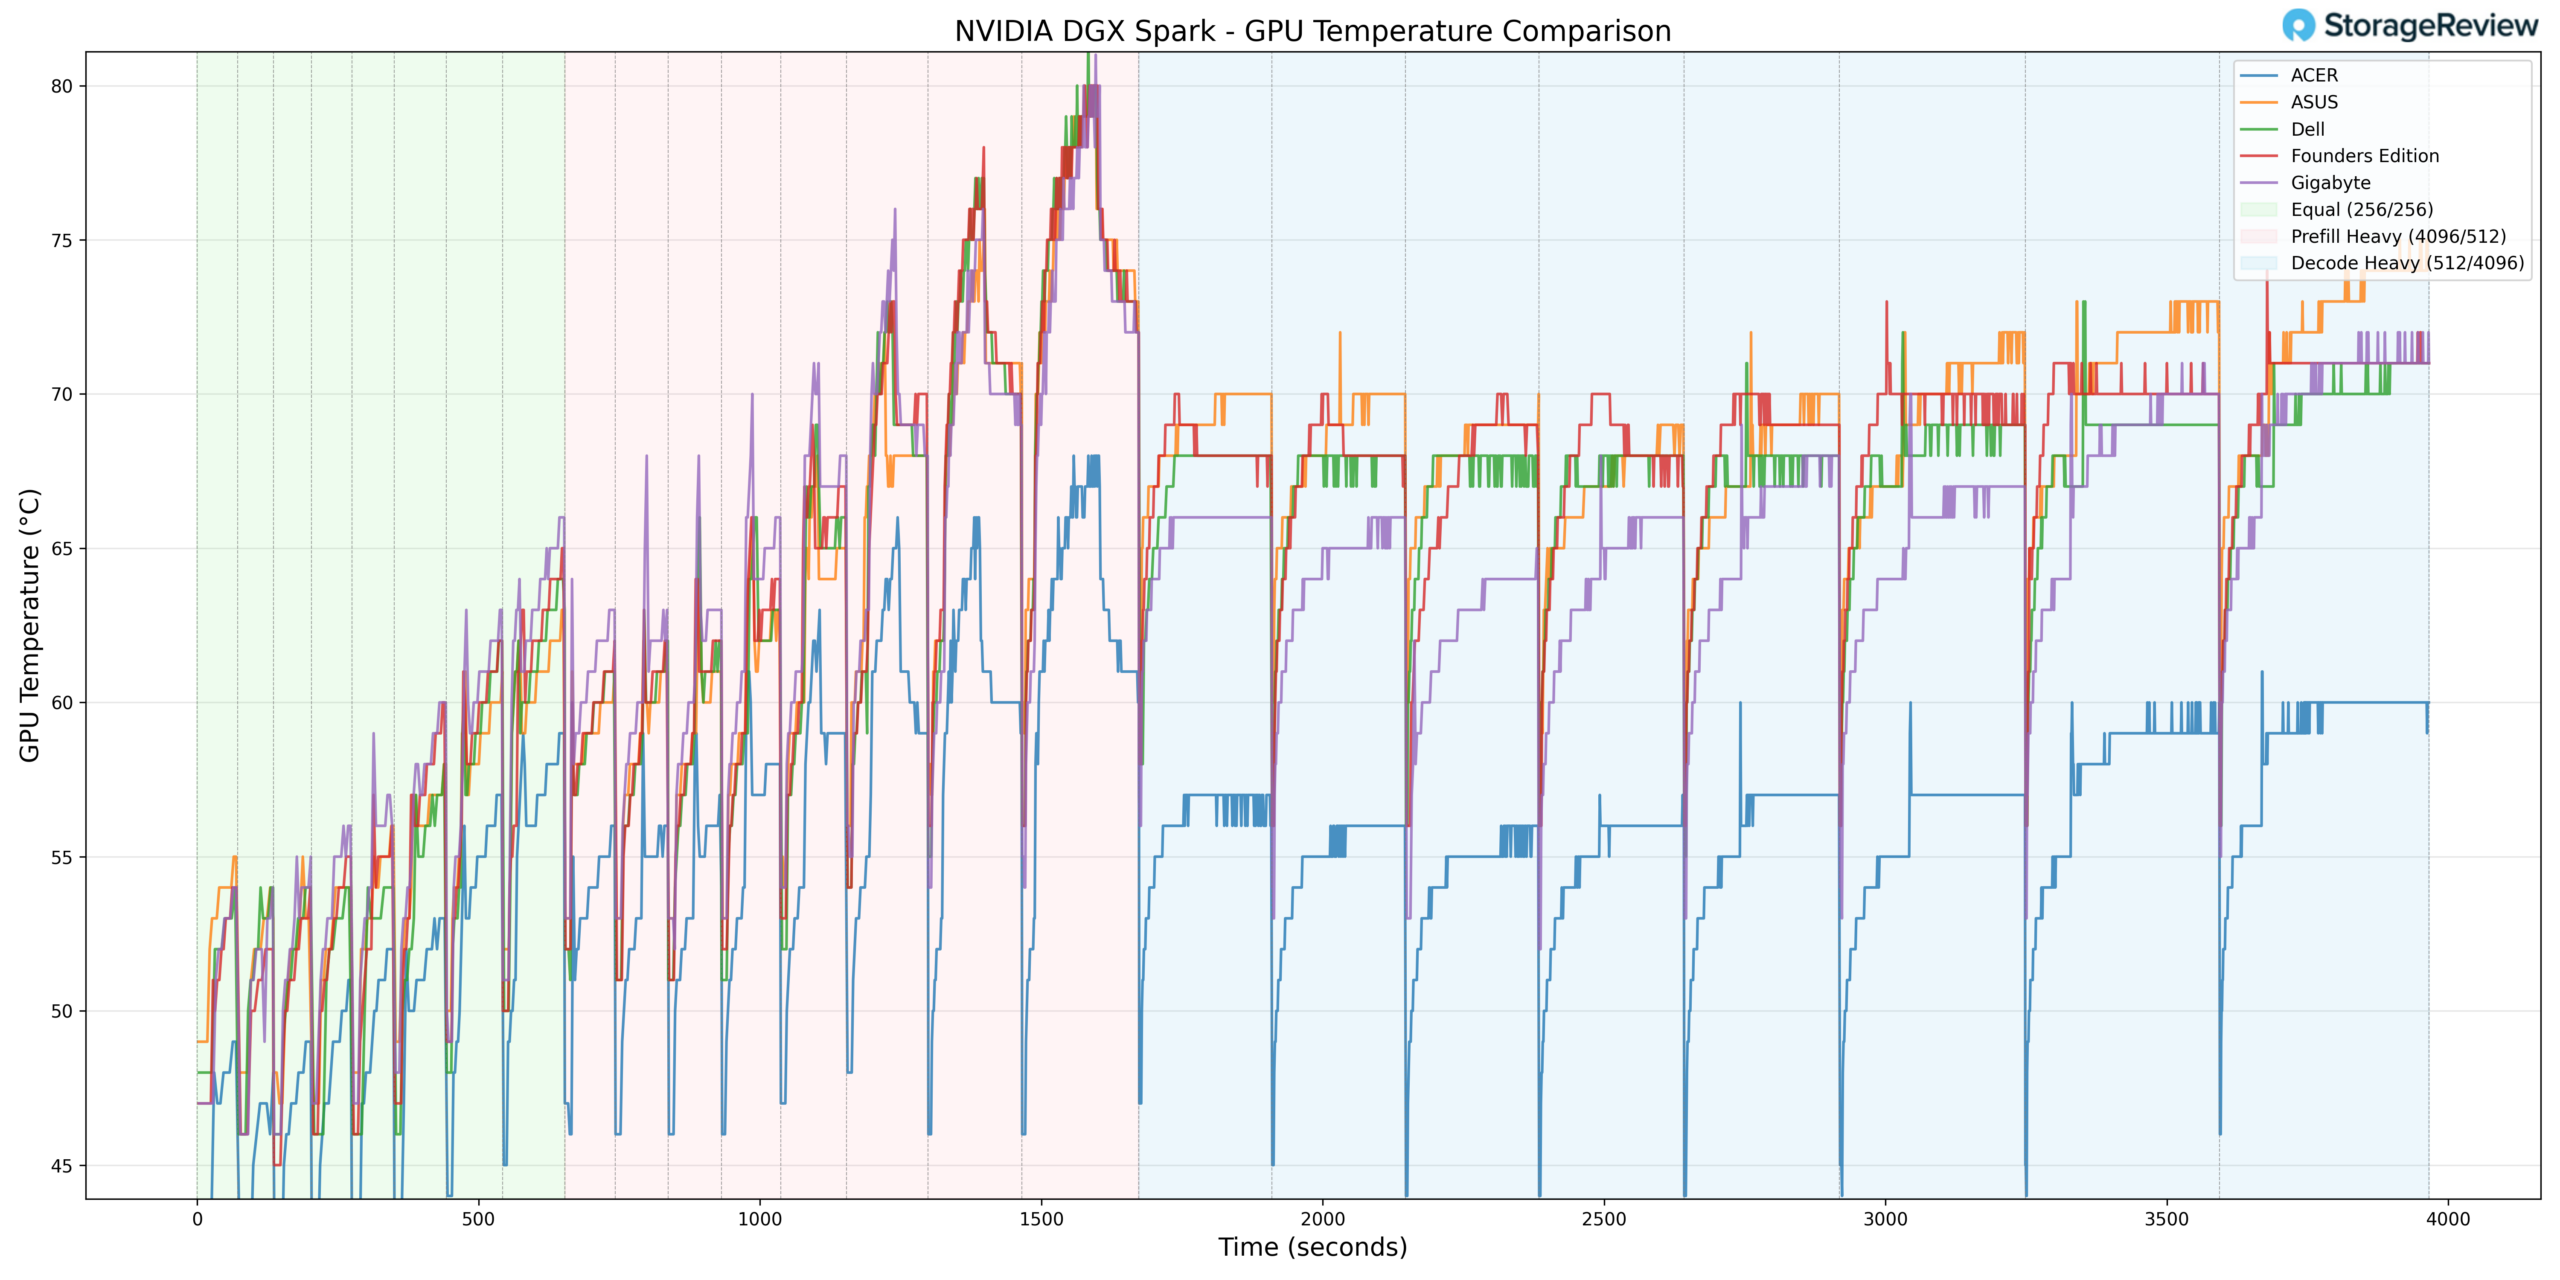
我們對整個技術堆疊進行了監控,在給定的時間段內,工作負載分為三個階段,利用率在大約一小時內逐步提升。這使我們能夠觀察設備在長時間內以及不同工作負載階段的使用情況。我們監控了 CPU、GPU、網路、NVMe 的溫度以及總功耗。
CPU溫度
在CPU散熱測試中,華碩系統在預填充重負載階段的最高溫度達到了87.3°C。這使得華碩在高負載突發轉換階段的性能處於對比產品的中上水平,但略低於其他產品的最高峰值。
隨著工作負載從均衡ISL/OSL過渡到繁重解碼,CPU溫度趨於穩定,並未持續攀升。持續的解碼活動始終保持在可控的溫度範圍內,顯示87.3°C的峰值與短時負載上升活動相關,而非長時間的熱飽和。
在低負載情況下,CPU 的最低溫度為 38.8°C。此基準溫度反映了系統在非高計算壓力下有效的散熱性能。
整體而言,華碩展現了較高但可控的CPU尖峰溫度,以及穩定的持續負載效能。
GPU溫度
GPU 溫度表現也呈現類似趨勢。在預填充重加速測試期間,GPU 最高溫度達到 82°C。這使得華碩顯示卡在尖峰加速工況下的溫度略高於部分競爭對手,但仍在 GB10 平台的預期運作範圍內。
隨著活動轉移到 ISL/OSL 相等和解碼密集型階段,GPU 溫度趨於穩定。
在較輕的階段,GPU 記錄到的最低溫度為 38°C,顯示其空閒時的熱特性與堆疊的其他部分一致。
綜合來看,華碩在確保GPU峰值利用率的同時,還能維持可預測的持續散熱。
NVMe溫度
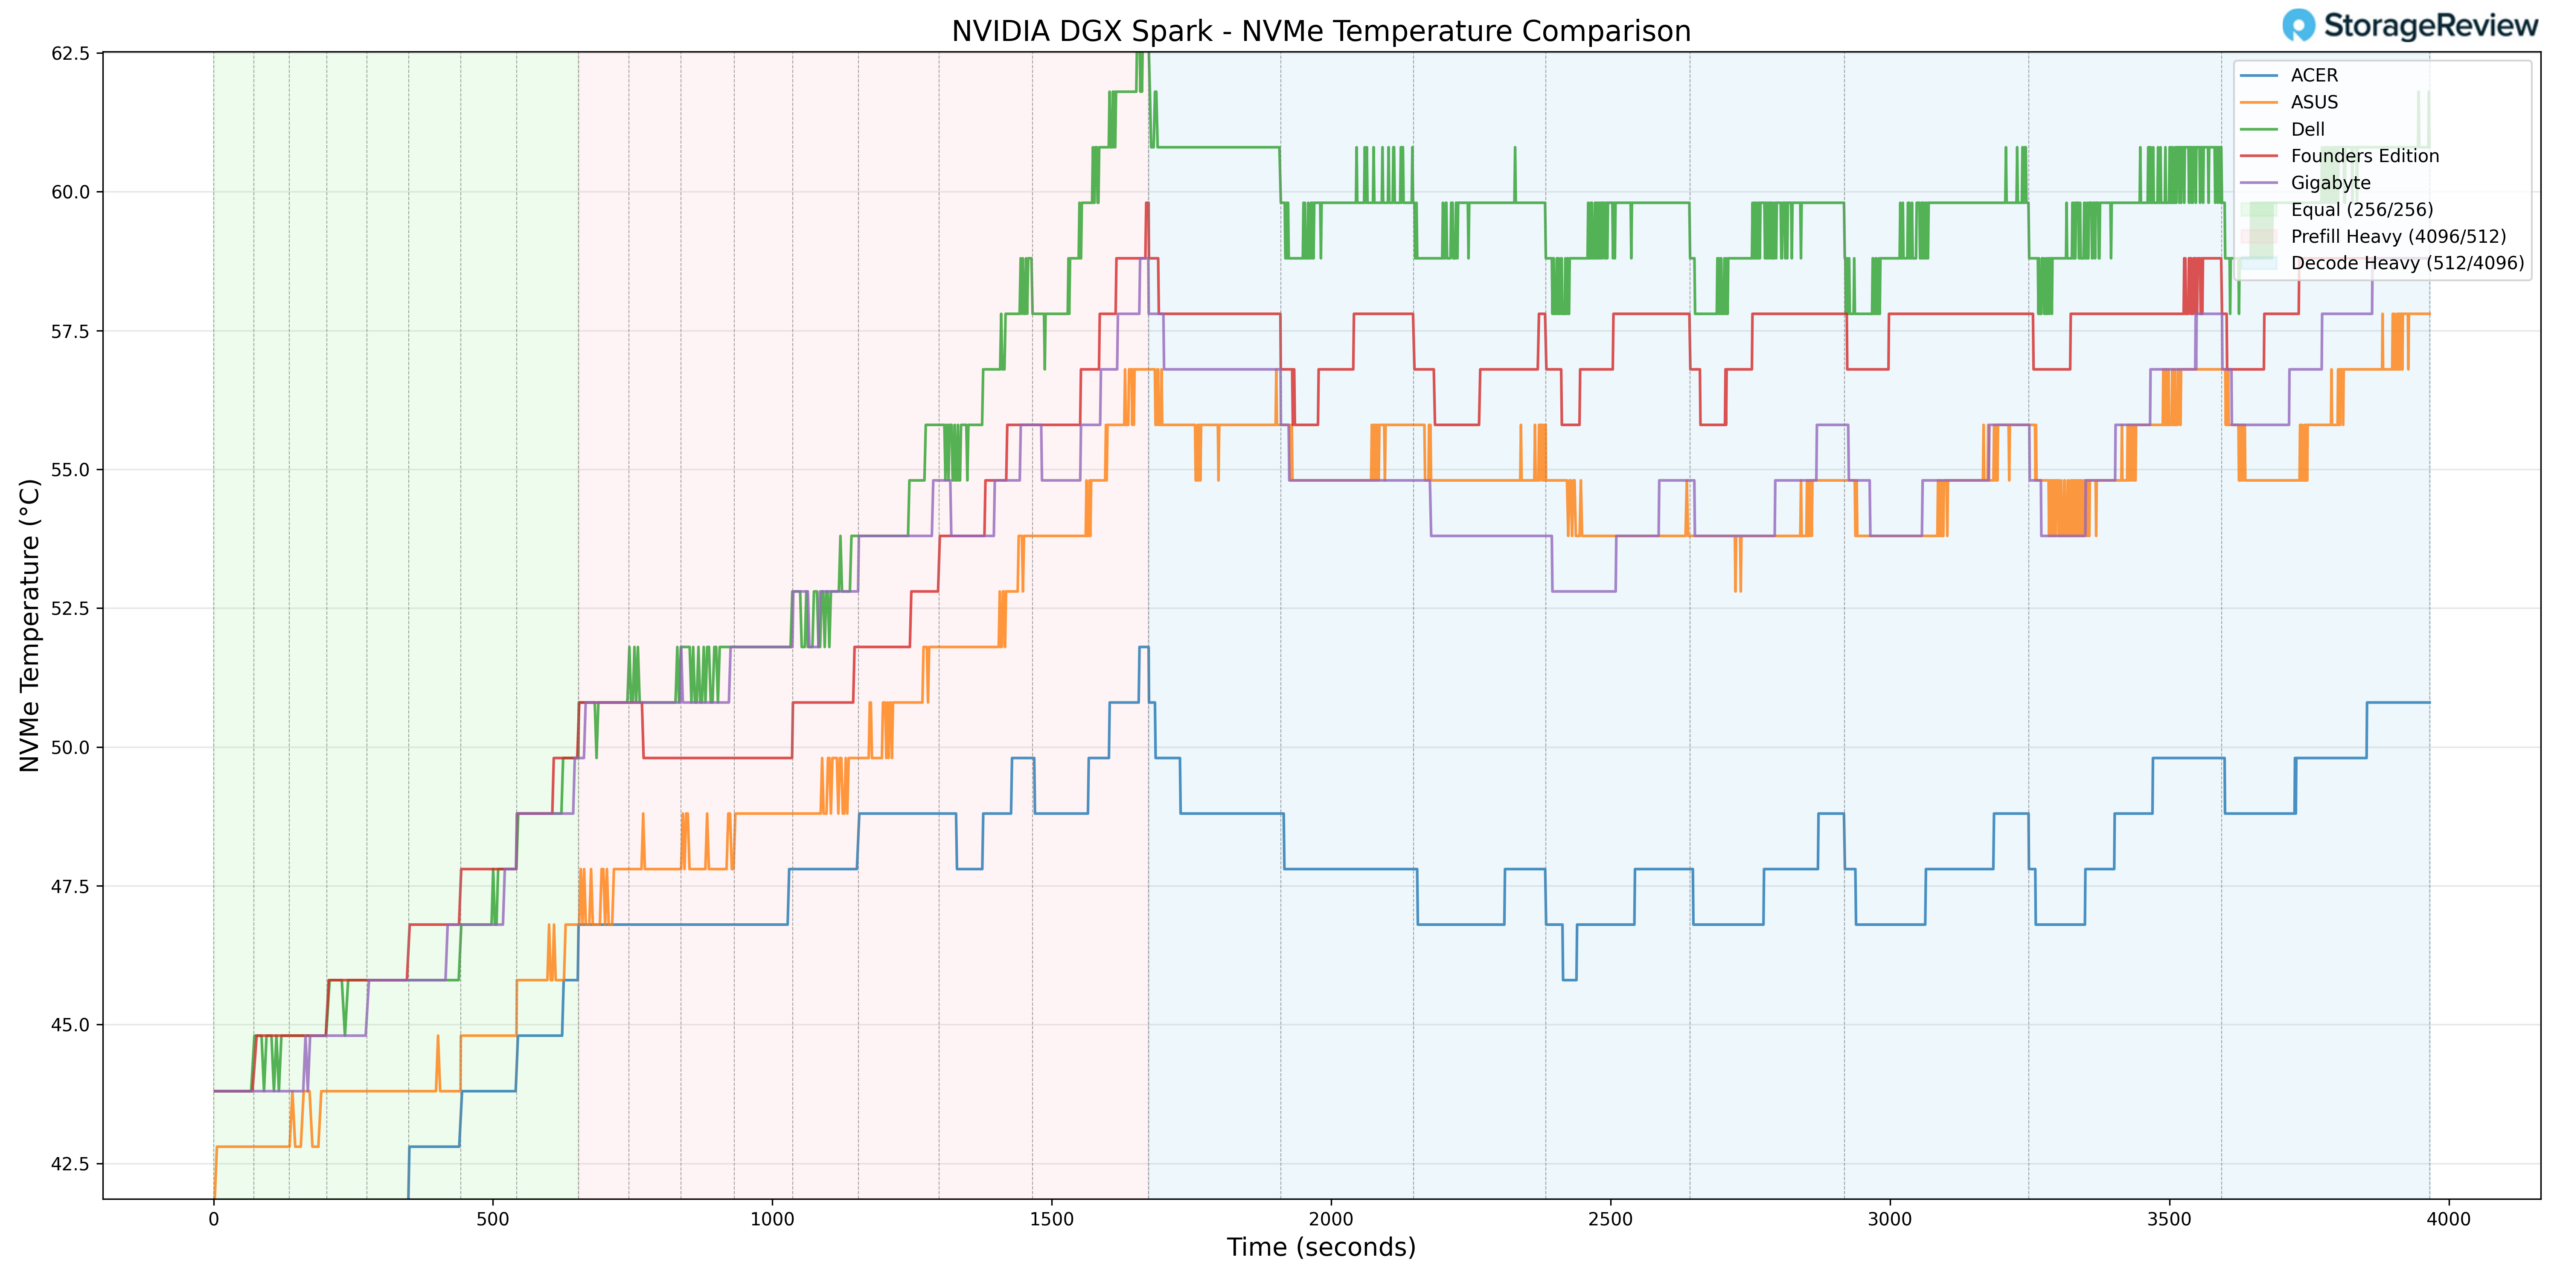
儲存設備的散熱控制良好。在負載較高的情況下,NVMe 固態硬碟的最高溫度僅為 56.8°C,遠低於常見的降頻閾值。這表明機箱內部儲存子系統周圍的氣流或散熱設計非常有效。
在較輕的階段,NVMe 溫度降至最低 37.8°C,與其他系統的空閒溫度非常接近,這進一步證實了儲存裝置在靜止狀態下不受熱限制。
總體而言,華碩在負載下保持了較溫和的 NVMe 散熱性能。
NIC 溫度
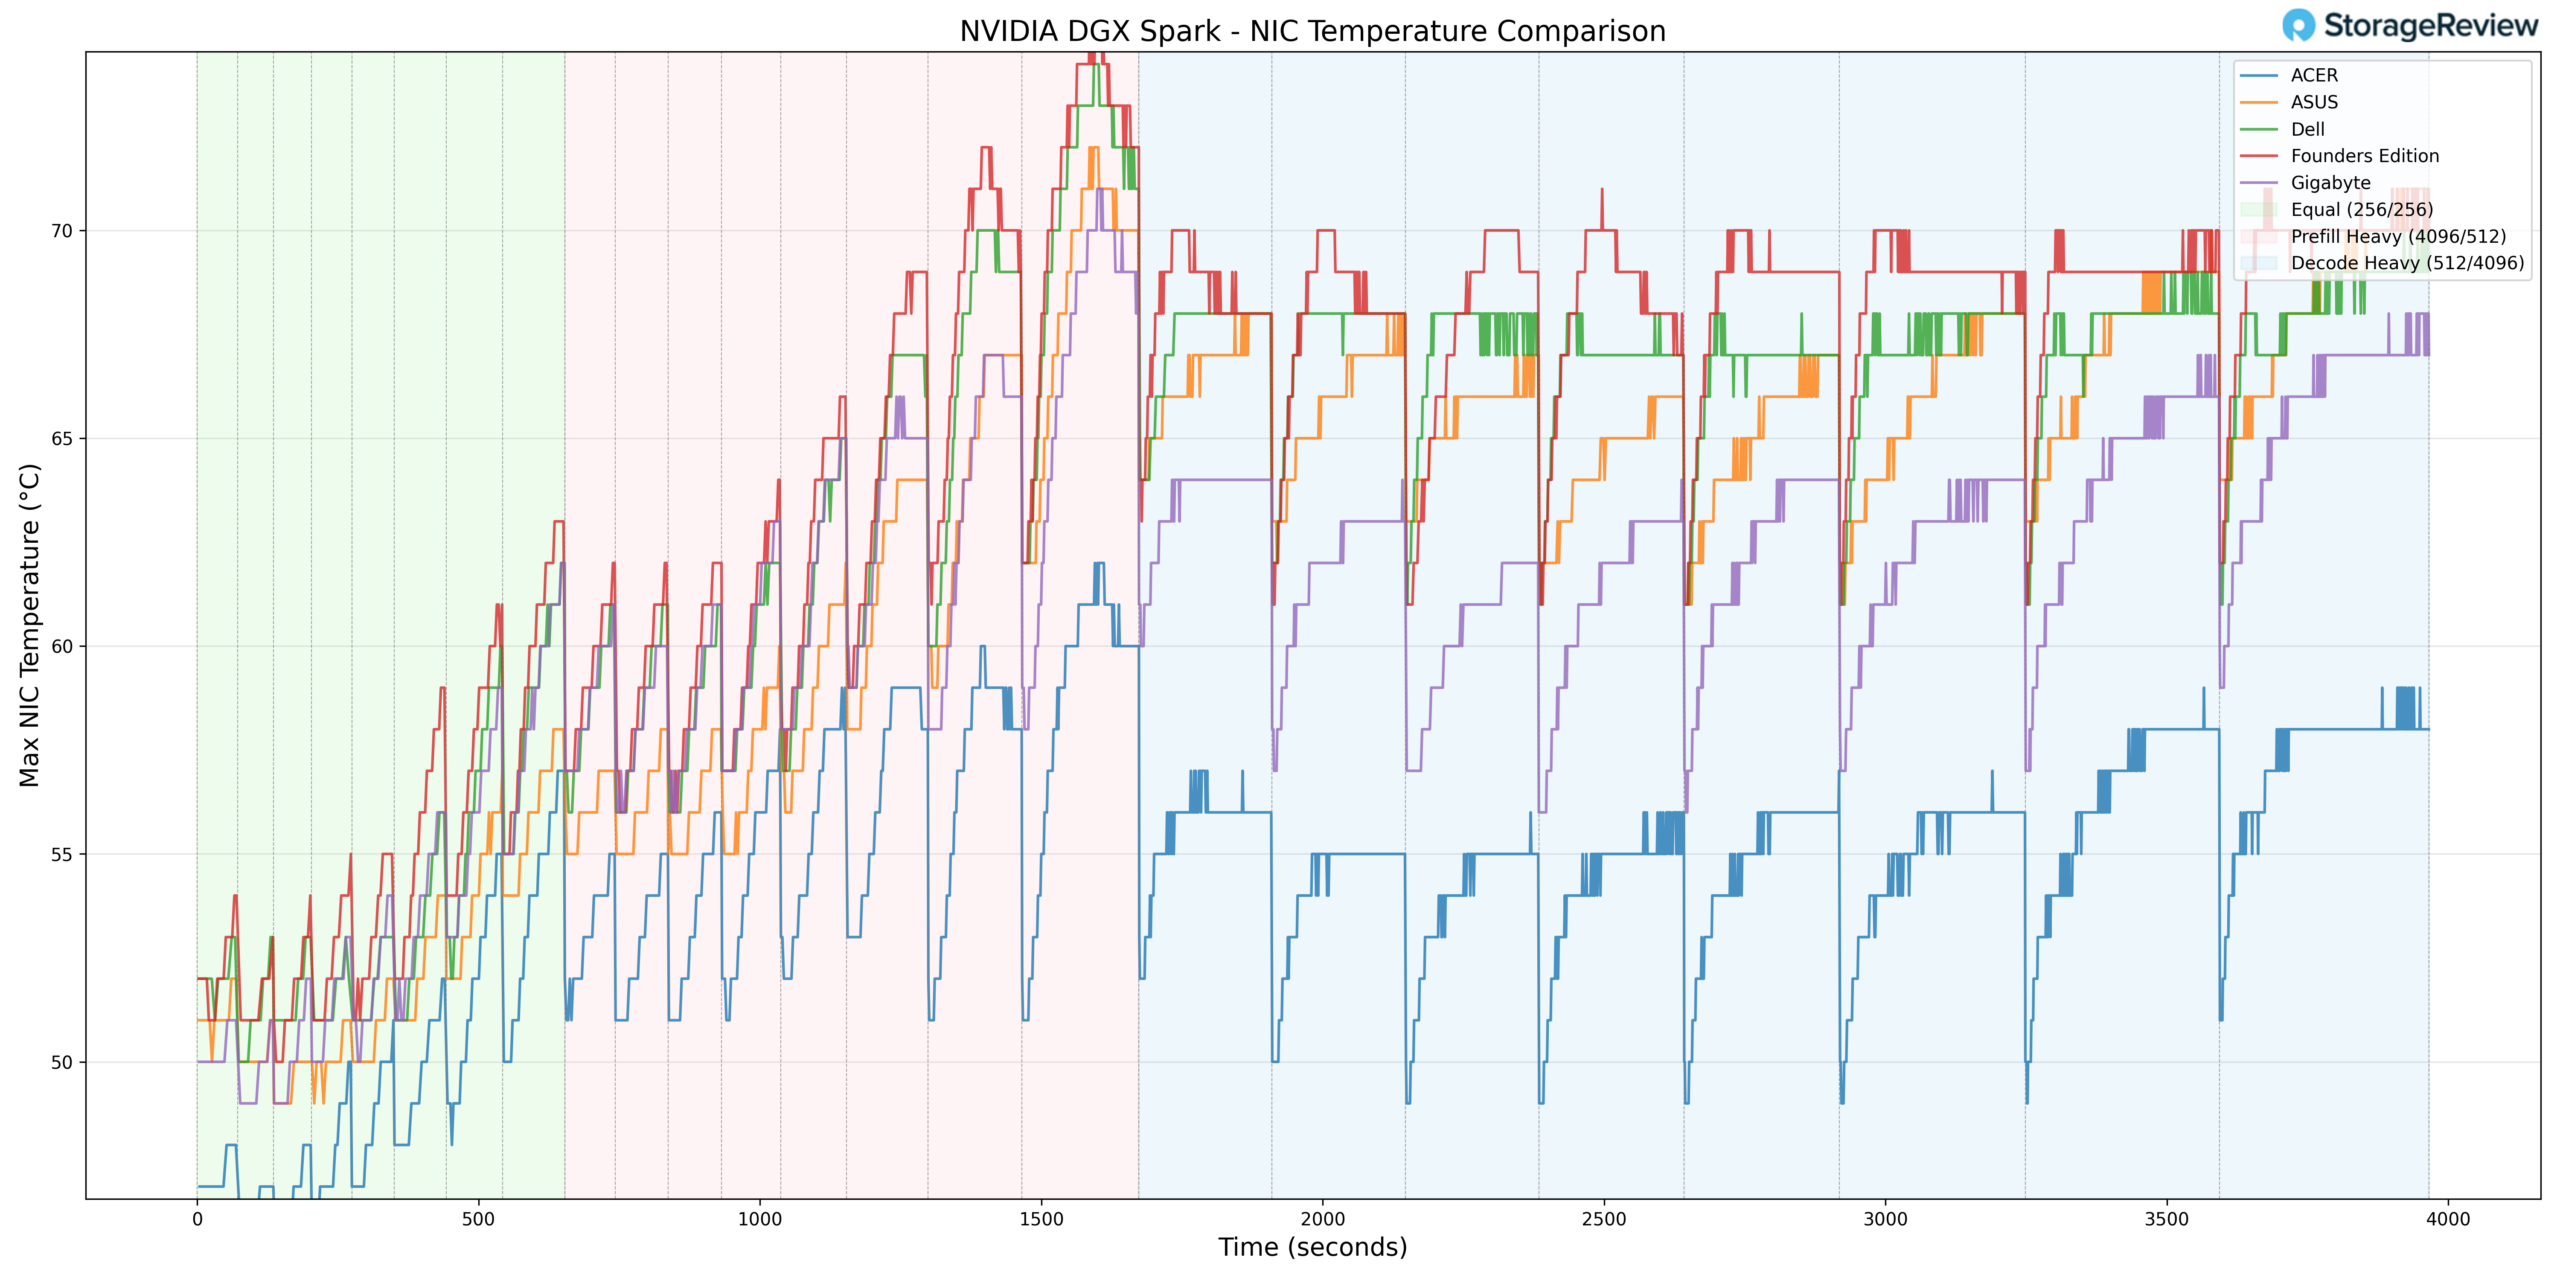
在網路活動高峰期,網卡溫度最高達到 73°C。這使得華碩網卡在網路吞吐量峰值時處於溫度較高的位置,但仍在正常運作的容差範圍內。
在負載較輕的情況下,記錄到的最低 NIC 溫度為 41°C,反映了預期的基線行為。
網卡的熱膨脹與系統負載成正比,沒有異常波動。
GPU功耗
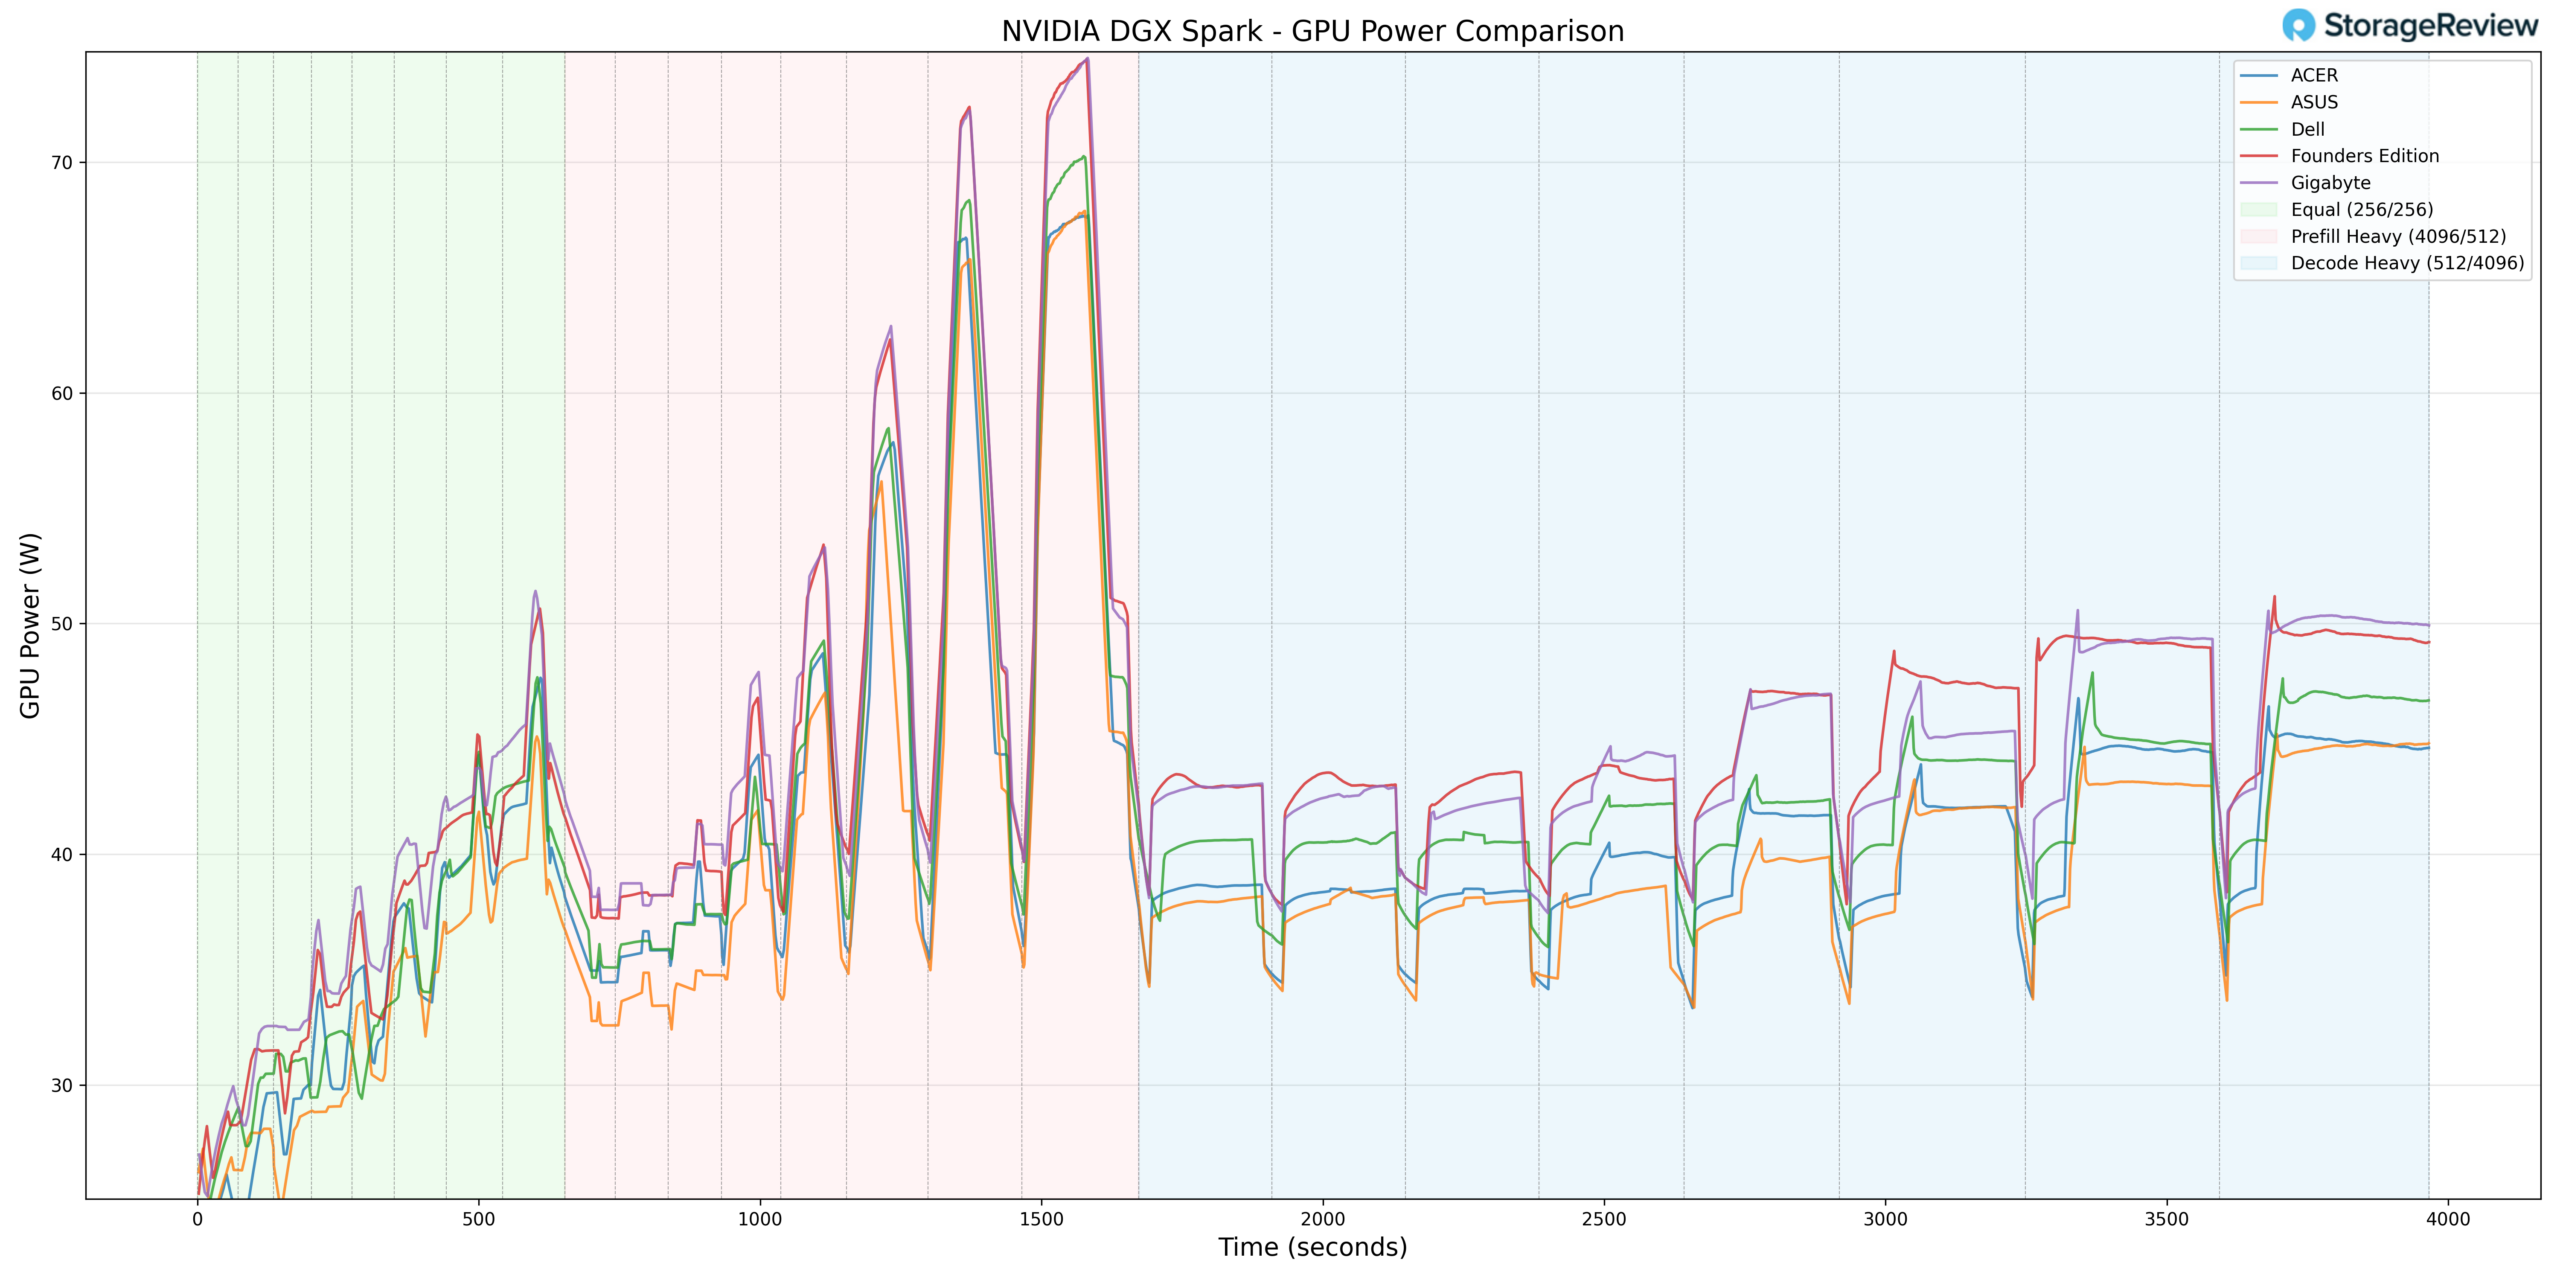
在預填充重度轉換期間,GPU 功耗峰值達到 69.77W。與同組其他一些功耗上限較高的方案相比,華碩這款產品的功耗略低於實際觀測到的最大功耗水準。
這種功耗特性有助於解釋系統均衡的散熱性能。雖然GPU溫度在峰值負載階段達到了82°C,但相對於功耗最高的系統而言,其峰值功耗分配略低,這表明華碩並沒有將GPU的功耗推至測試系統的最高水準。
在持續解碼工作負載期間,功耗會隨著工作負載需求而穩定下來,這反映了一致且可預測的電源管理。
熱力總結
在對 CPU、GPU、NVMe 和網路卡進行全面監控後,華碩 GB10 展現出可控的突發溫度和極具競爭力的持續負載穩定性。在預填充密集型任務切換期間,CPU 最高溫度為 87.3°C,GPU 最高溫度為 82°C,而 NVMe 溫度保持在 57°C 以下,網卡最高溫度為 73°C。 GPU 最高功耗為 69.77W,略低於同類產品中觀察到的最高功耗。
整體而言,華碩的散熱設計均衡,既能達到強勁的尖峰效能,又能維持穩定的持續效能和適中的功耗分配。
ASUS Ascent GX10 效能測試
為了評估華碩 Ascent GX10,我們使用 vLLM Online Serving 基準測試對 Spark 單元進行了測試。 vLLM Online Serving 基準測試是目前應用最廣泛的大型語言模式高吞吐量推理和服務引擎。此基準測試透過向運行中的 vLLM 伺服器發送並發請求來模擬真實生產環境中的工作負載,並測量關鍵指標,包括總令牌吞吐量(每秒令牌數)、首令牌到達時間和每個輸出令牌的產生時間,並考察不同負載條件下的效能。
我們的測試涵蓋了從密集架構到微擴展資料類型的各種模型。測試評估了三種工作負載場景下的效能:均衡 ISL/OSL、預填密集型和解碼密集型。這些場景代表了不同的實際服務模式,從均衡的輸入輸出負載到計算密集型的提示符號處理和記憶體頻寬受限的令牌產生。
除了華碩 Ascent GX10 之外,我們還以 NVIDIA Founders Edition Spark 作為參考基準,同時測試了戴爾、宏碁和技嘉的 OEM 系統。這使我們能夠將華碩的測試結果置於更廣泛的競爭格局中,並了解其在不同型號和工作負載類型下處於領先地位、與競爭對手持平還是落後。
GPT-OSS-120B
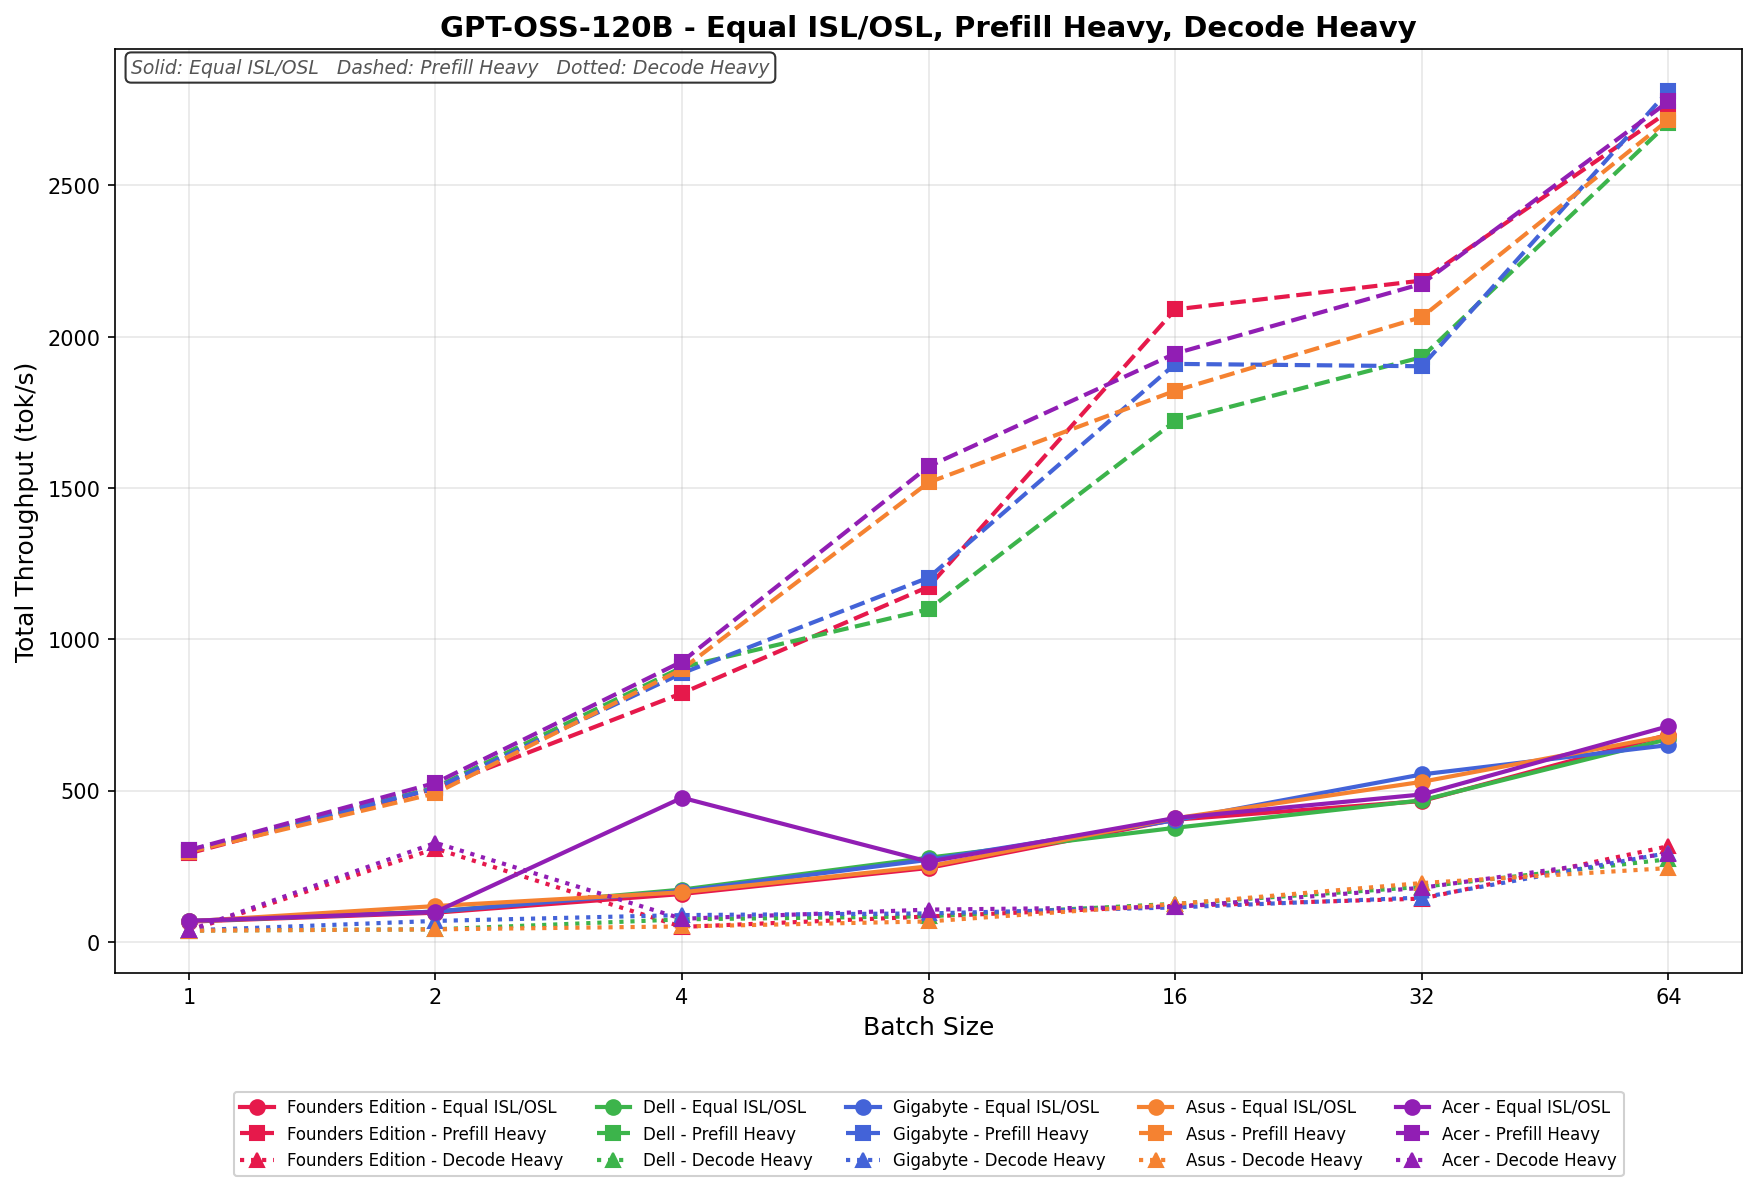
在 ISL/OSL 相等的測試條件下,華碩 Spark 的吞吐量從批次 1 的 70 tok/s 提升至批次 64 的 680 tok/s。在整個批次範圍內,吞吐量的提升穩定且呈線性,每次批次翻倍後都能獲得持續的提升。沒有出現明顯的峰值或停滯,吞吐量從批次 4 開始穩步增長,在中高批次規模下與更廣泛的 OEM 廠商保持高度一致。
預填充重型生產線的初始產能為 290 tok/s,到第 64 批時攀升至 2,700 tok/s。在第 8 批次之前,產能成長迅猛,超過 1,500 tok/s,並在第 16 批次和第 32 批次繼續保持平穩增長。曲線保持平滑,沒有迴歸點,展現出強大的大量生產效率和穩定的高產能表現。
解碼重任務的吞吐量從批次 1 的 45 tok/s 到批次 64 的 260 tok/s 不等。批次較小時,批次 1 和批次 2 之間的吞吐量波動較小,但從批次 4 開始吞吐量趨於穩定,並持續增長至批次 16。批次 32 到批次 64 的吞吐量提升顯著,反映了在高並發性下解碼效率的提高。
總體而言,華碩在所有三種工作負載類型上都與更廣泛的 Spark 生態系統保持著非常緊密的聯繫。
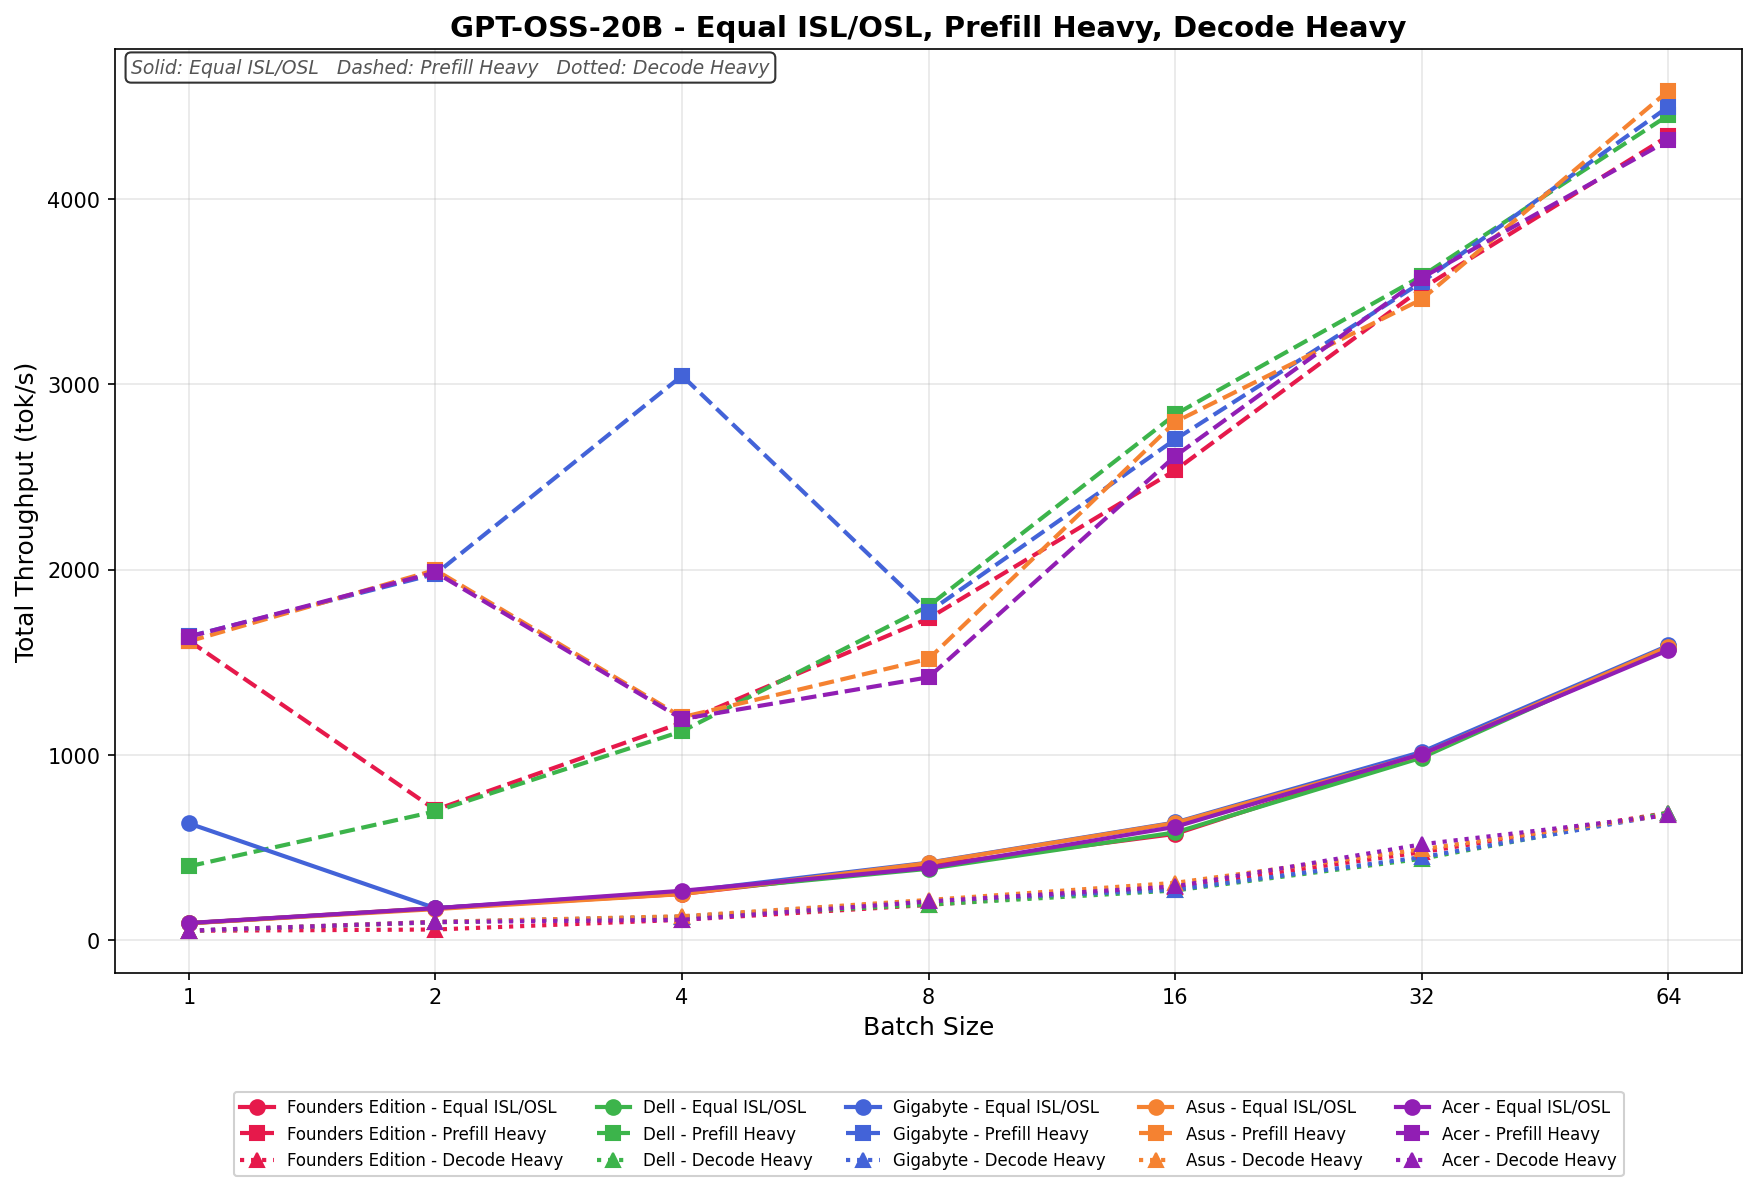
GPT-OSS-20B
在 ISL/OSL 相等的測試環境下,華碩 Spark 處理器的處理能力從批次 1 的 90 tok/s 提升至批次 64 的 1,600 tok/s。吞吐量在整個測試過程中穩步提升,尤其從批次 8 開始呈現非常平滑的線性增長。每次批次翻倍後,效能提升都保持穩定,曲線也未出現任何不穩定或效能下降的情況。
預填充重型設備在第一批次的處理速度為 1,650 tok/s,第二批次上升至 2,000 tok/s,然後在第四批次有所下降,之後再次強勁增長。從第八批次開始,處理速度持續攀升,到第 64 批達到 4,550 tok/s。
解碼重任務的處理速度從第 1 批的 60 tok/s 到第 64 批的 700 tok/s 不等。整個處理過程中,處理速度的提升是漸進且穩定的,每次批數翻倍後都會有可預測的提升。最顯著的成長發生在第 16 批到第 64 批之間,吞吐量穩定提升,沒有出現高峰或低谷。
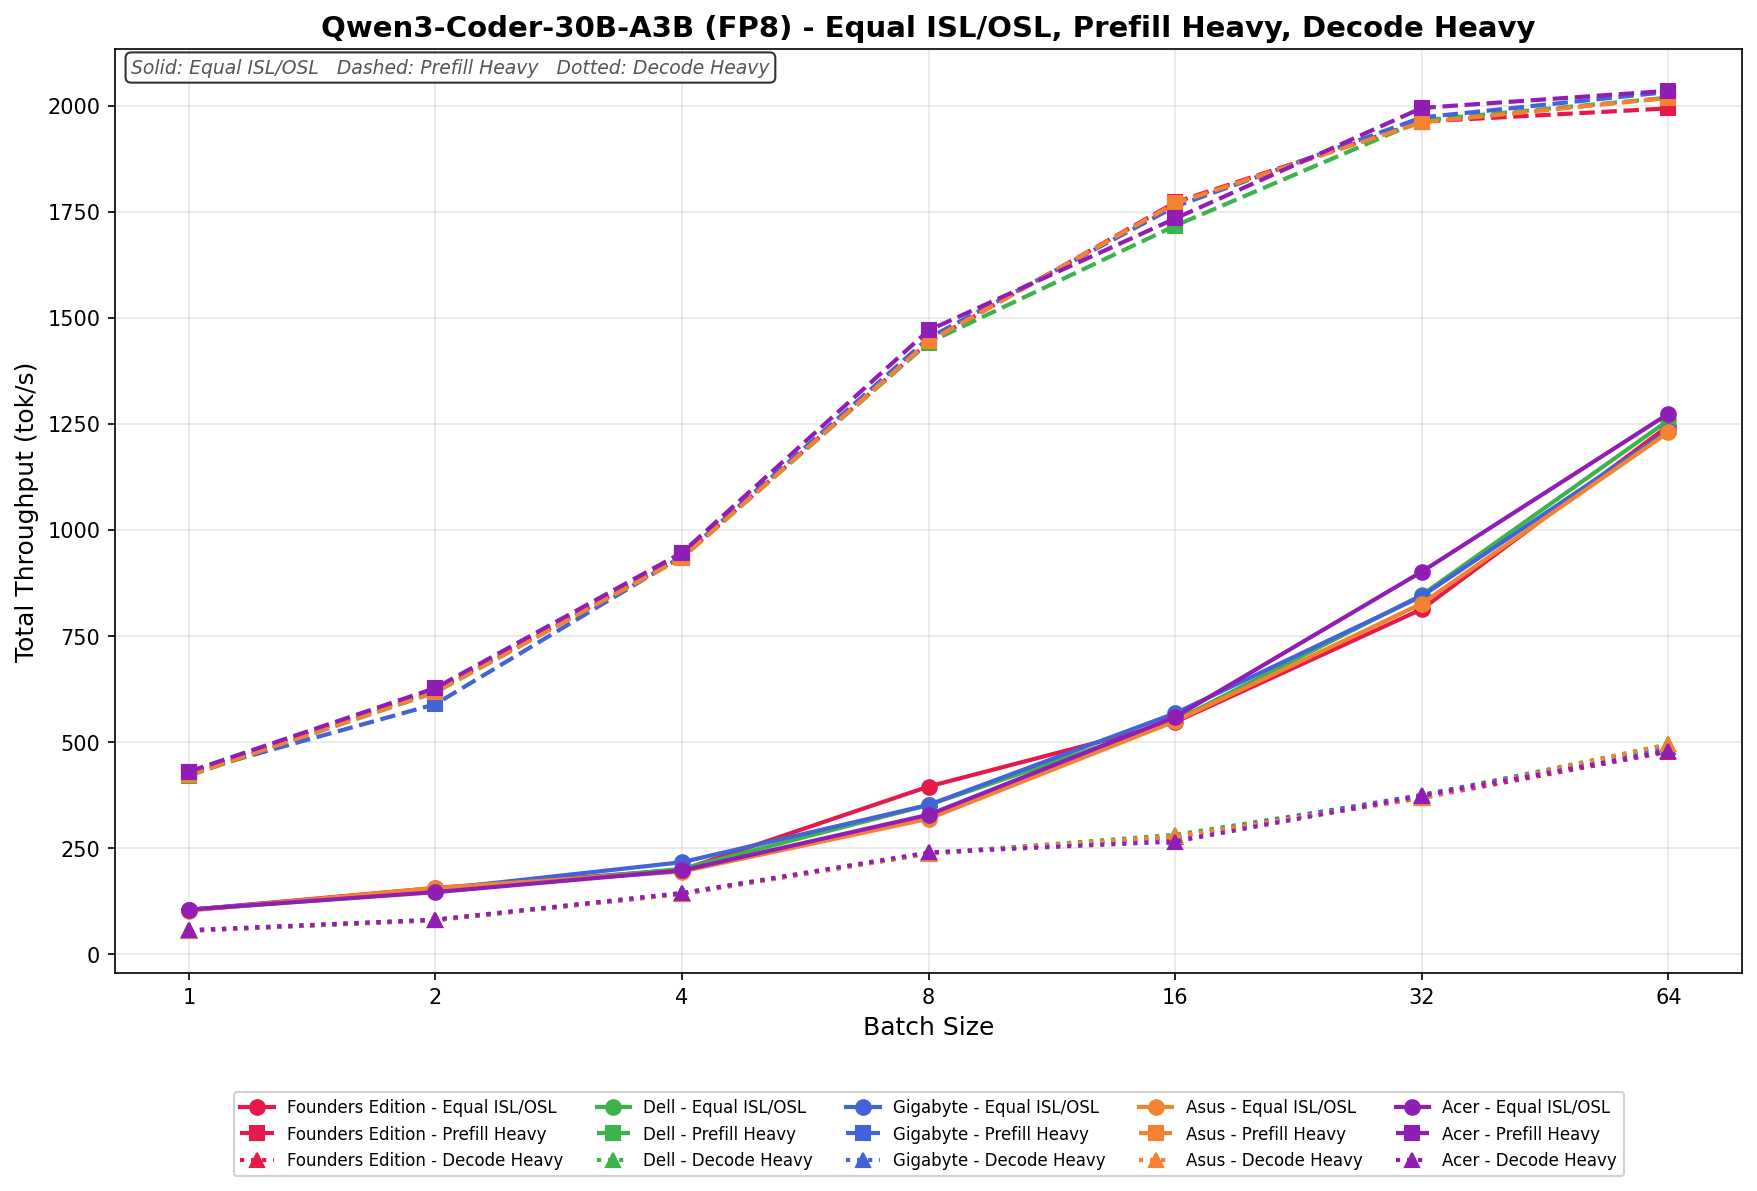
Qwen3 程式設計師 30B A3B FB8
在 ISL/OSL 相等的情況下,華碩 Spark 的處理能力從第 1 批的 100 tok/s 提升到第 64 批的 1,230 tok/s。吞吐量在整個掃描過程中穩定成長,從第 4 批開始呈現乾淨的線性成長。
預填充重型設備的初始處理速度為 420 tok/s,到第 64 批時提升至 2,000 tok/s。在整個批次處理過程中,處理速度的提昇平滑且高度可預測。最大的提升發生在第 4 批到第 8 批之間,處理速度從大約 940 tok/s 躍升至 1,450 tok/s。
解碼重任務的處理速度從批次 1 的 60 tok/s 到批次 64 的 490 tok/s 不等。處理速度的提升是漸進且穩定的,沒有任何下降或異常情況。吞吐量隨著批次翻倍而按預期增長,從批次 16 開始提升最為顯著,這反映了在高並發情況下解碼處理效率的提高。
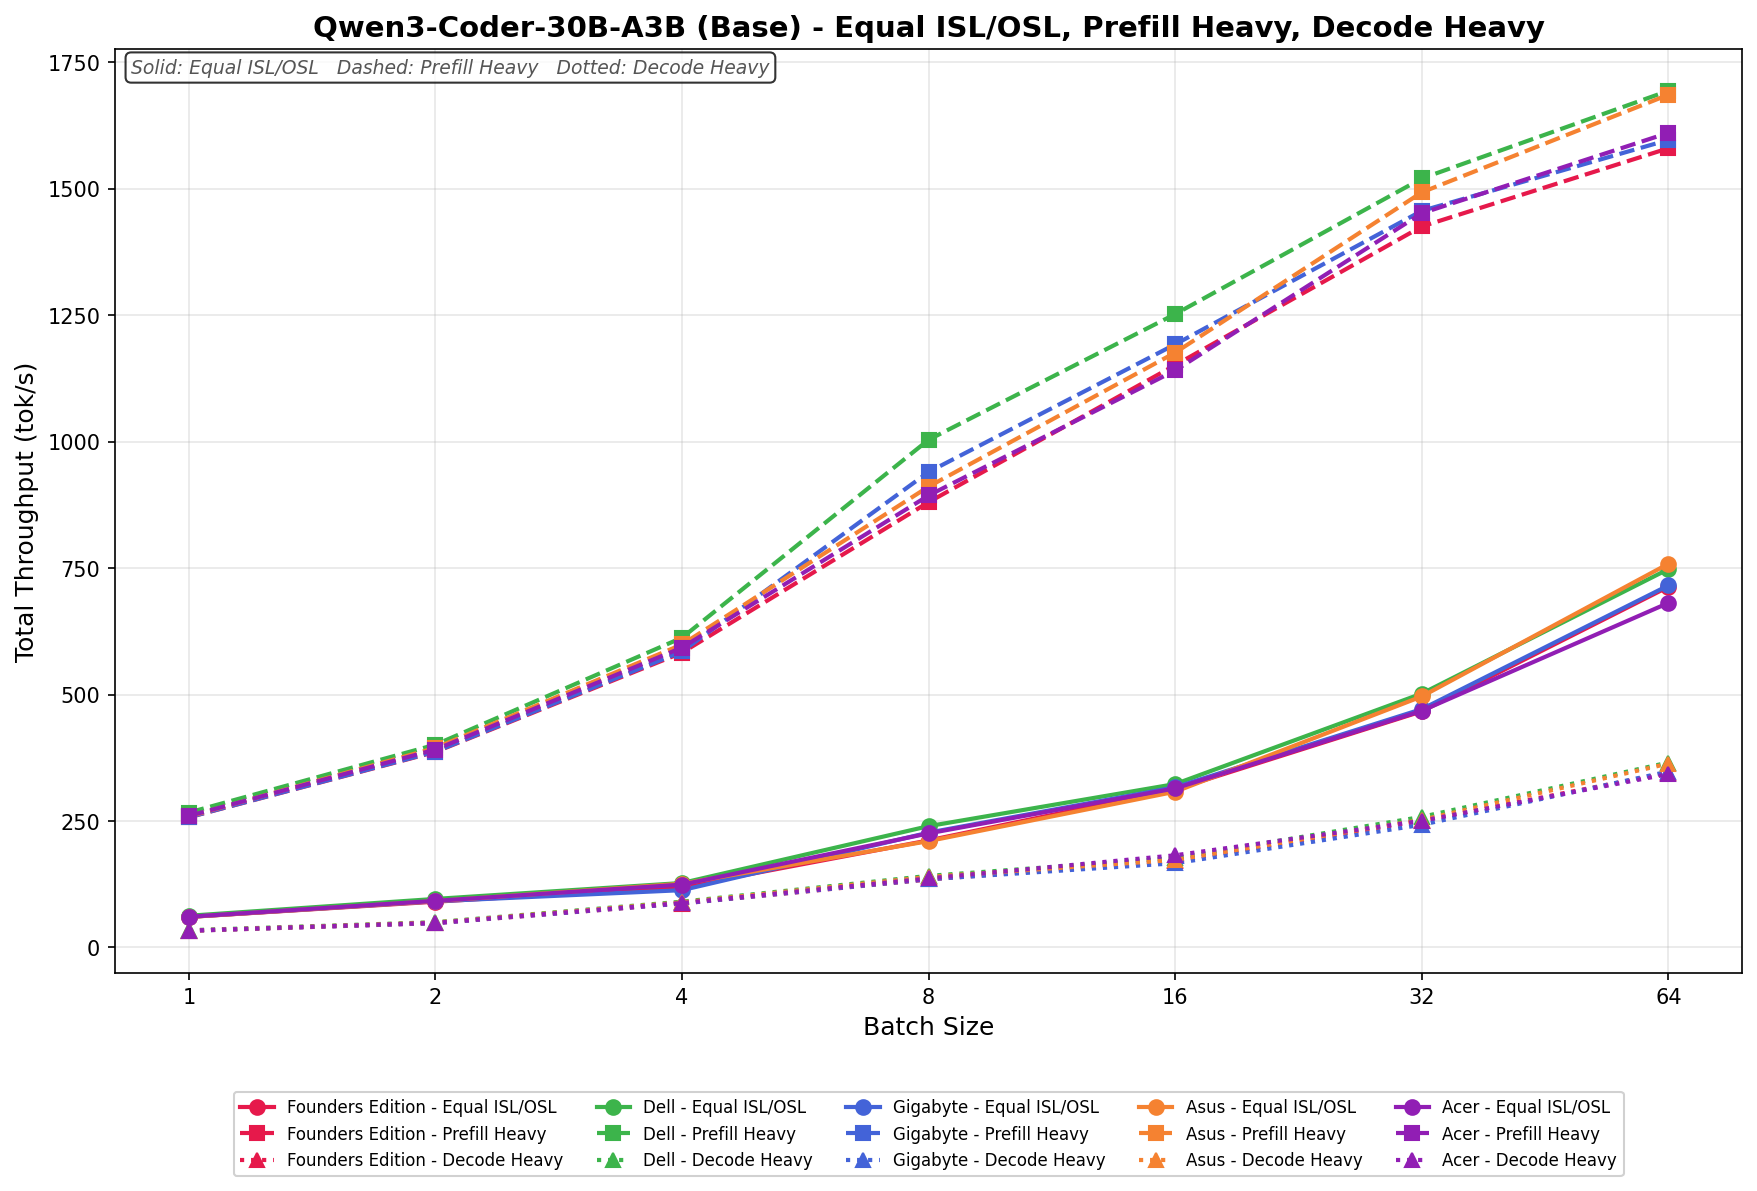
Qwen3 編碼器 30B A3B 基地
在 Equal ISL/OSL 測試中,ASUS Spark 的吞吐量從批次 1 的 60 tok/s 提升到批次 64 的 750 tok/s。吞吐量在整個測試過程中穩步提升,從批次 8 開始,吞吐量的線性提升尤為顯著。
預填重型任務的處理速度從 260 tok/s 開始,到第 64 批時提升至 1,680 tok/s。在整個批次掃描過程中,處理速度的提昇平穩且漸進。最顯著的加速發生在第 4 批次到第 8 批次之間,處理速度從大約 600 tok/s 躍升至 900 tok/s。
解碼重資料的速度範圍從批次 1 時的 30 tok/s 到批次 64 時的 360 tok/s。擴展是漸進且一致的,在較低的批次大小下沒有不規則的行為。
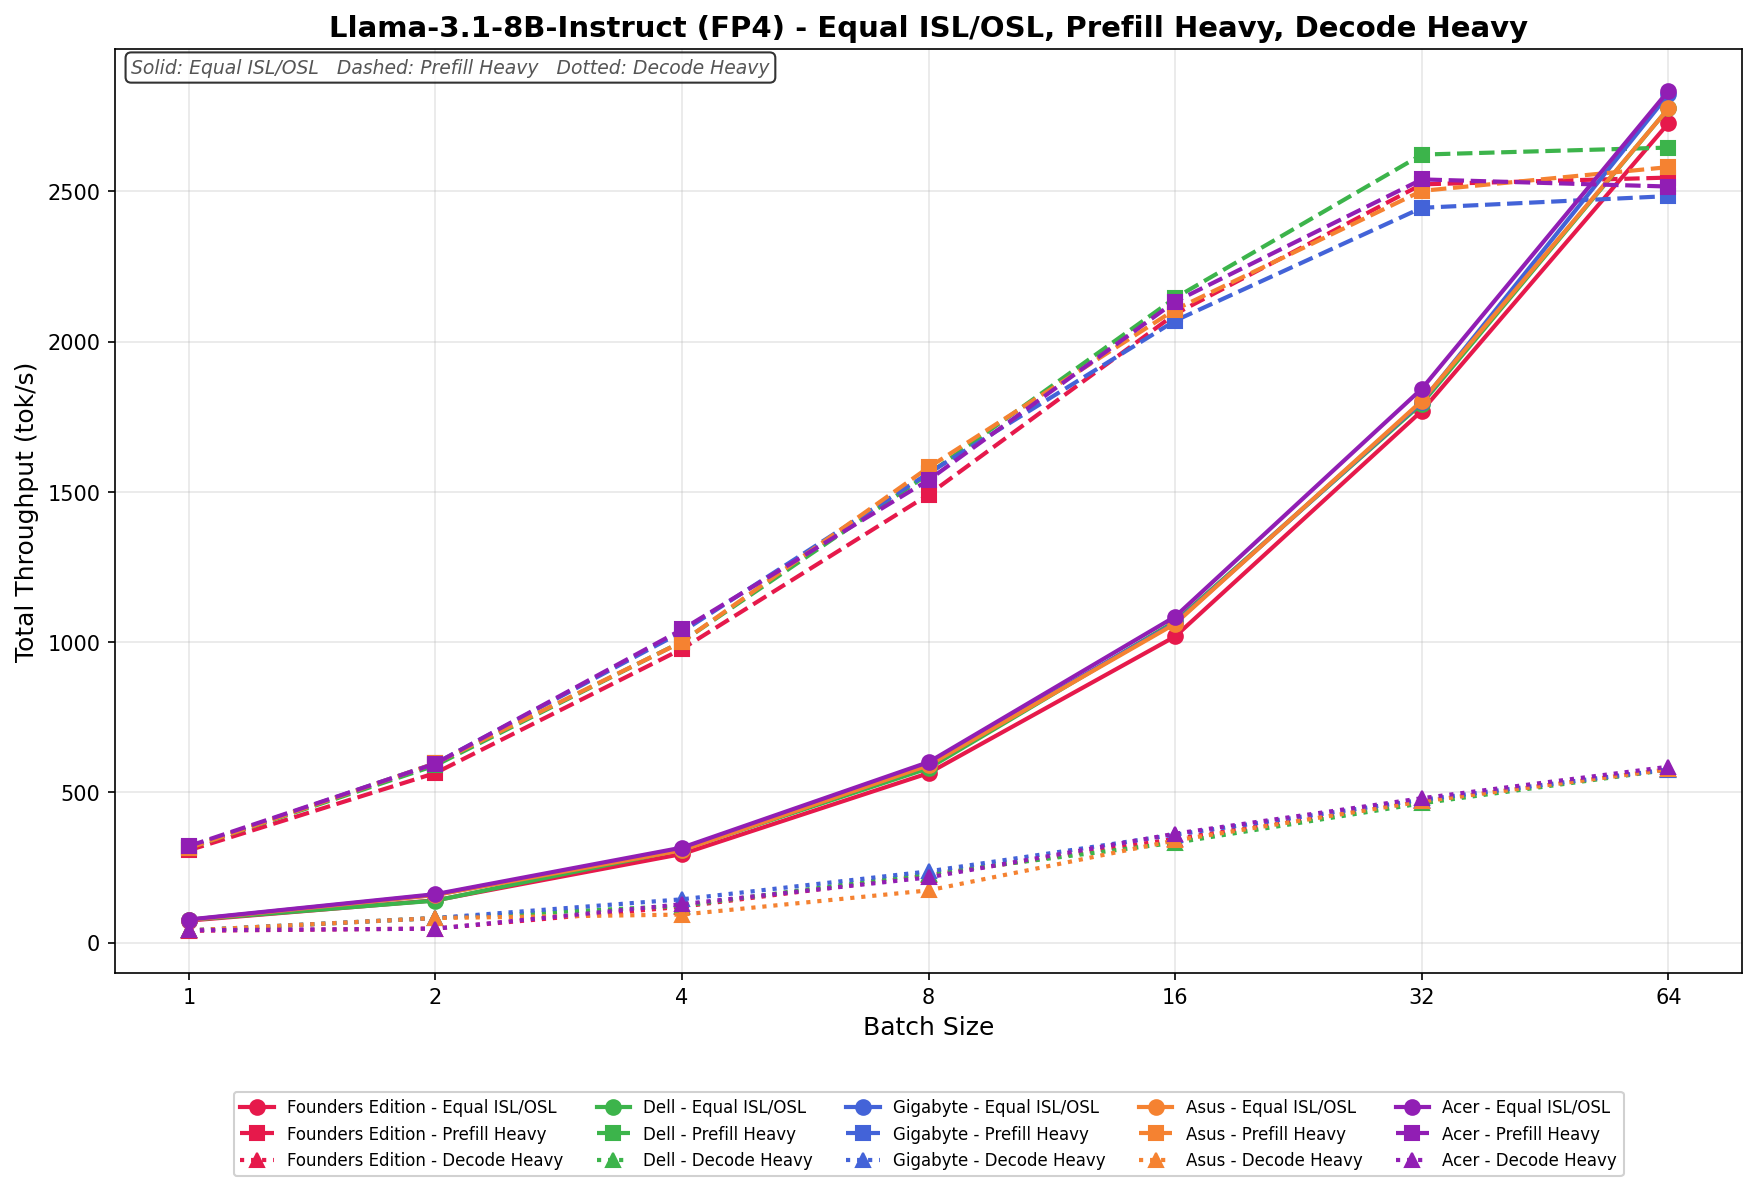
Llama 3.1 8B 指令 FP4
在 Equal ISL/OSL 測試中,ASUS Spark 的處理速度從第 1 批處理的 70 tok/s 提升到第 64 批處理的 2,750 tok/s。在整個測試過程中,處理速度穩步提升,尤其是在第 16 批處理之後,隨著並發性的增加,處理速度得到了顯著提升。
Prefill Heavy 從 300 tok/s 開始,到第 64 批時上升到 2,550 tok/s。擴展過程乾淨俐落且線性,每次翻倍都有穩定的成長,並且在更高的批次大小下沒有不穩定。
解碼重任務的吞吐量在整個批次掃描過程中介於 40 tok/s 到 580 tok/s 之間。吞吐量逐漸且可預測地增加,最大增益出現在第 16 個批次之後。
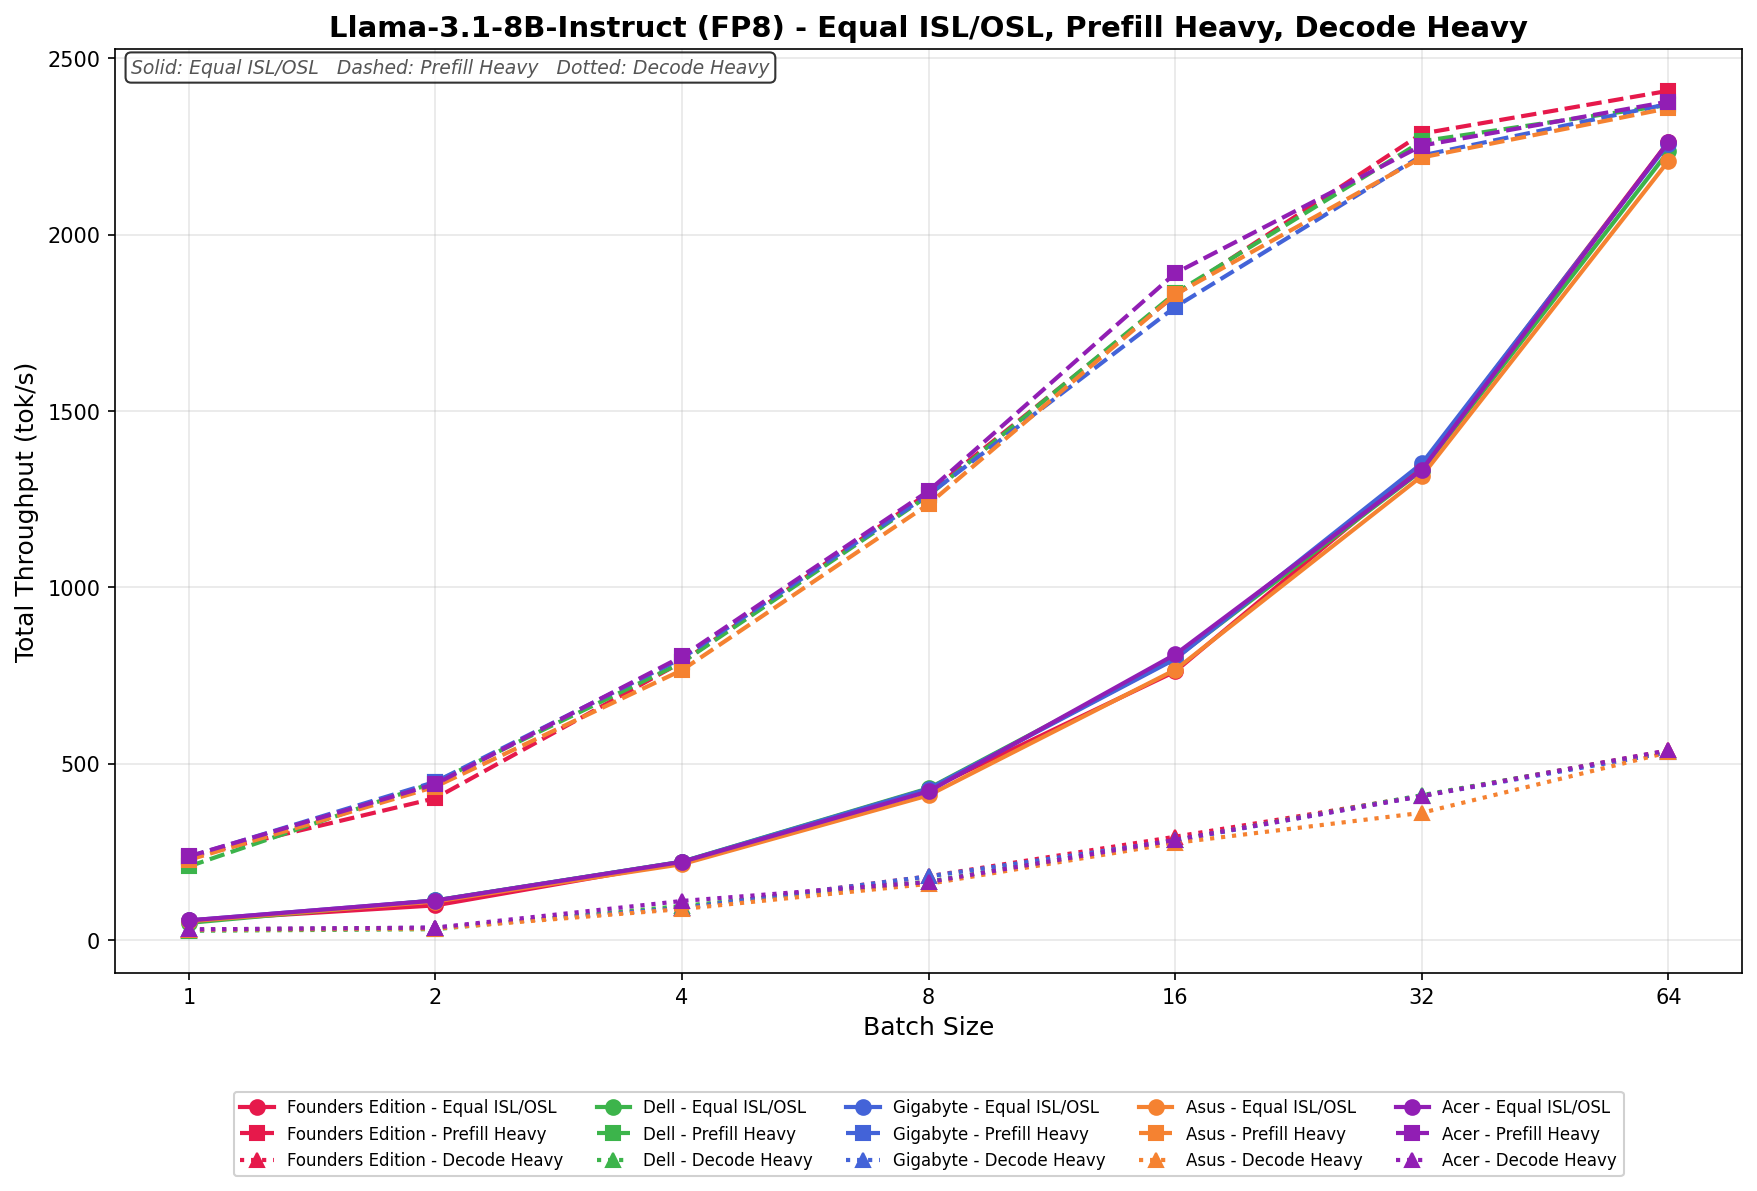
Llama 3.1 8B 指令 FP8
在 Equal ISL/OSL 下,ASUS Spark 的處理速度從批次 1 的 50 tok/s 提升到批次 64 的 2,200 tok/s。成長平穩且線性,隨著並發性的增加,批次 16 之後速度顯著提升。
預填充重型從 220 tok/s 開始,到第 64 批時上升到 2,350 tok/s。整個掃描過程中擴展乾淨且一致,每次翻倍都有可預測的增益,並且高批次行為穩定。
解碼重型資料的速度範圍為 30 tok/s 至 530 tok/s。吞吐量隨著批次大小的增加而逐漸提高,從第 16 個批次開始,吞吐量的提升最為顯著。
GPU直接儲存
我們在 Spark 上進行的測試之一是 MagnumIO GPU 直接儲存 (GDS) 測試。 GDS 是 NVIDIA 開發的功能,可讓 GPU 在存取儲存在 NVMe 磁碟機或其他高速儲存裝置上的資料時繞過 CPU。 GDS 無需透過 CPU 和系統記憶體路由數據,而是支援 GPU 和儲存設備之間的直接通信,從而顯著降低延遲並提高數據吞吐量。
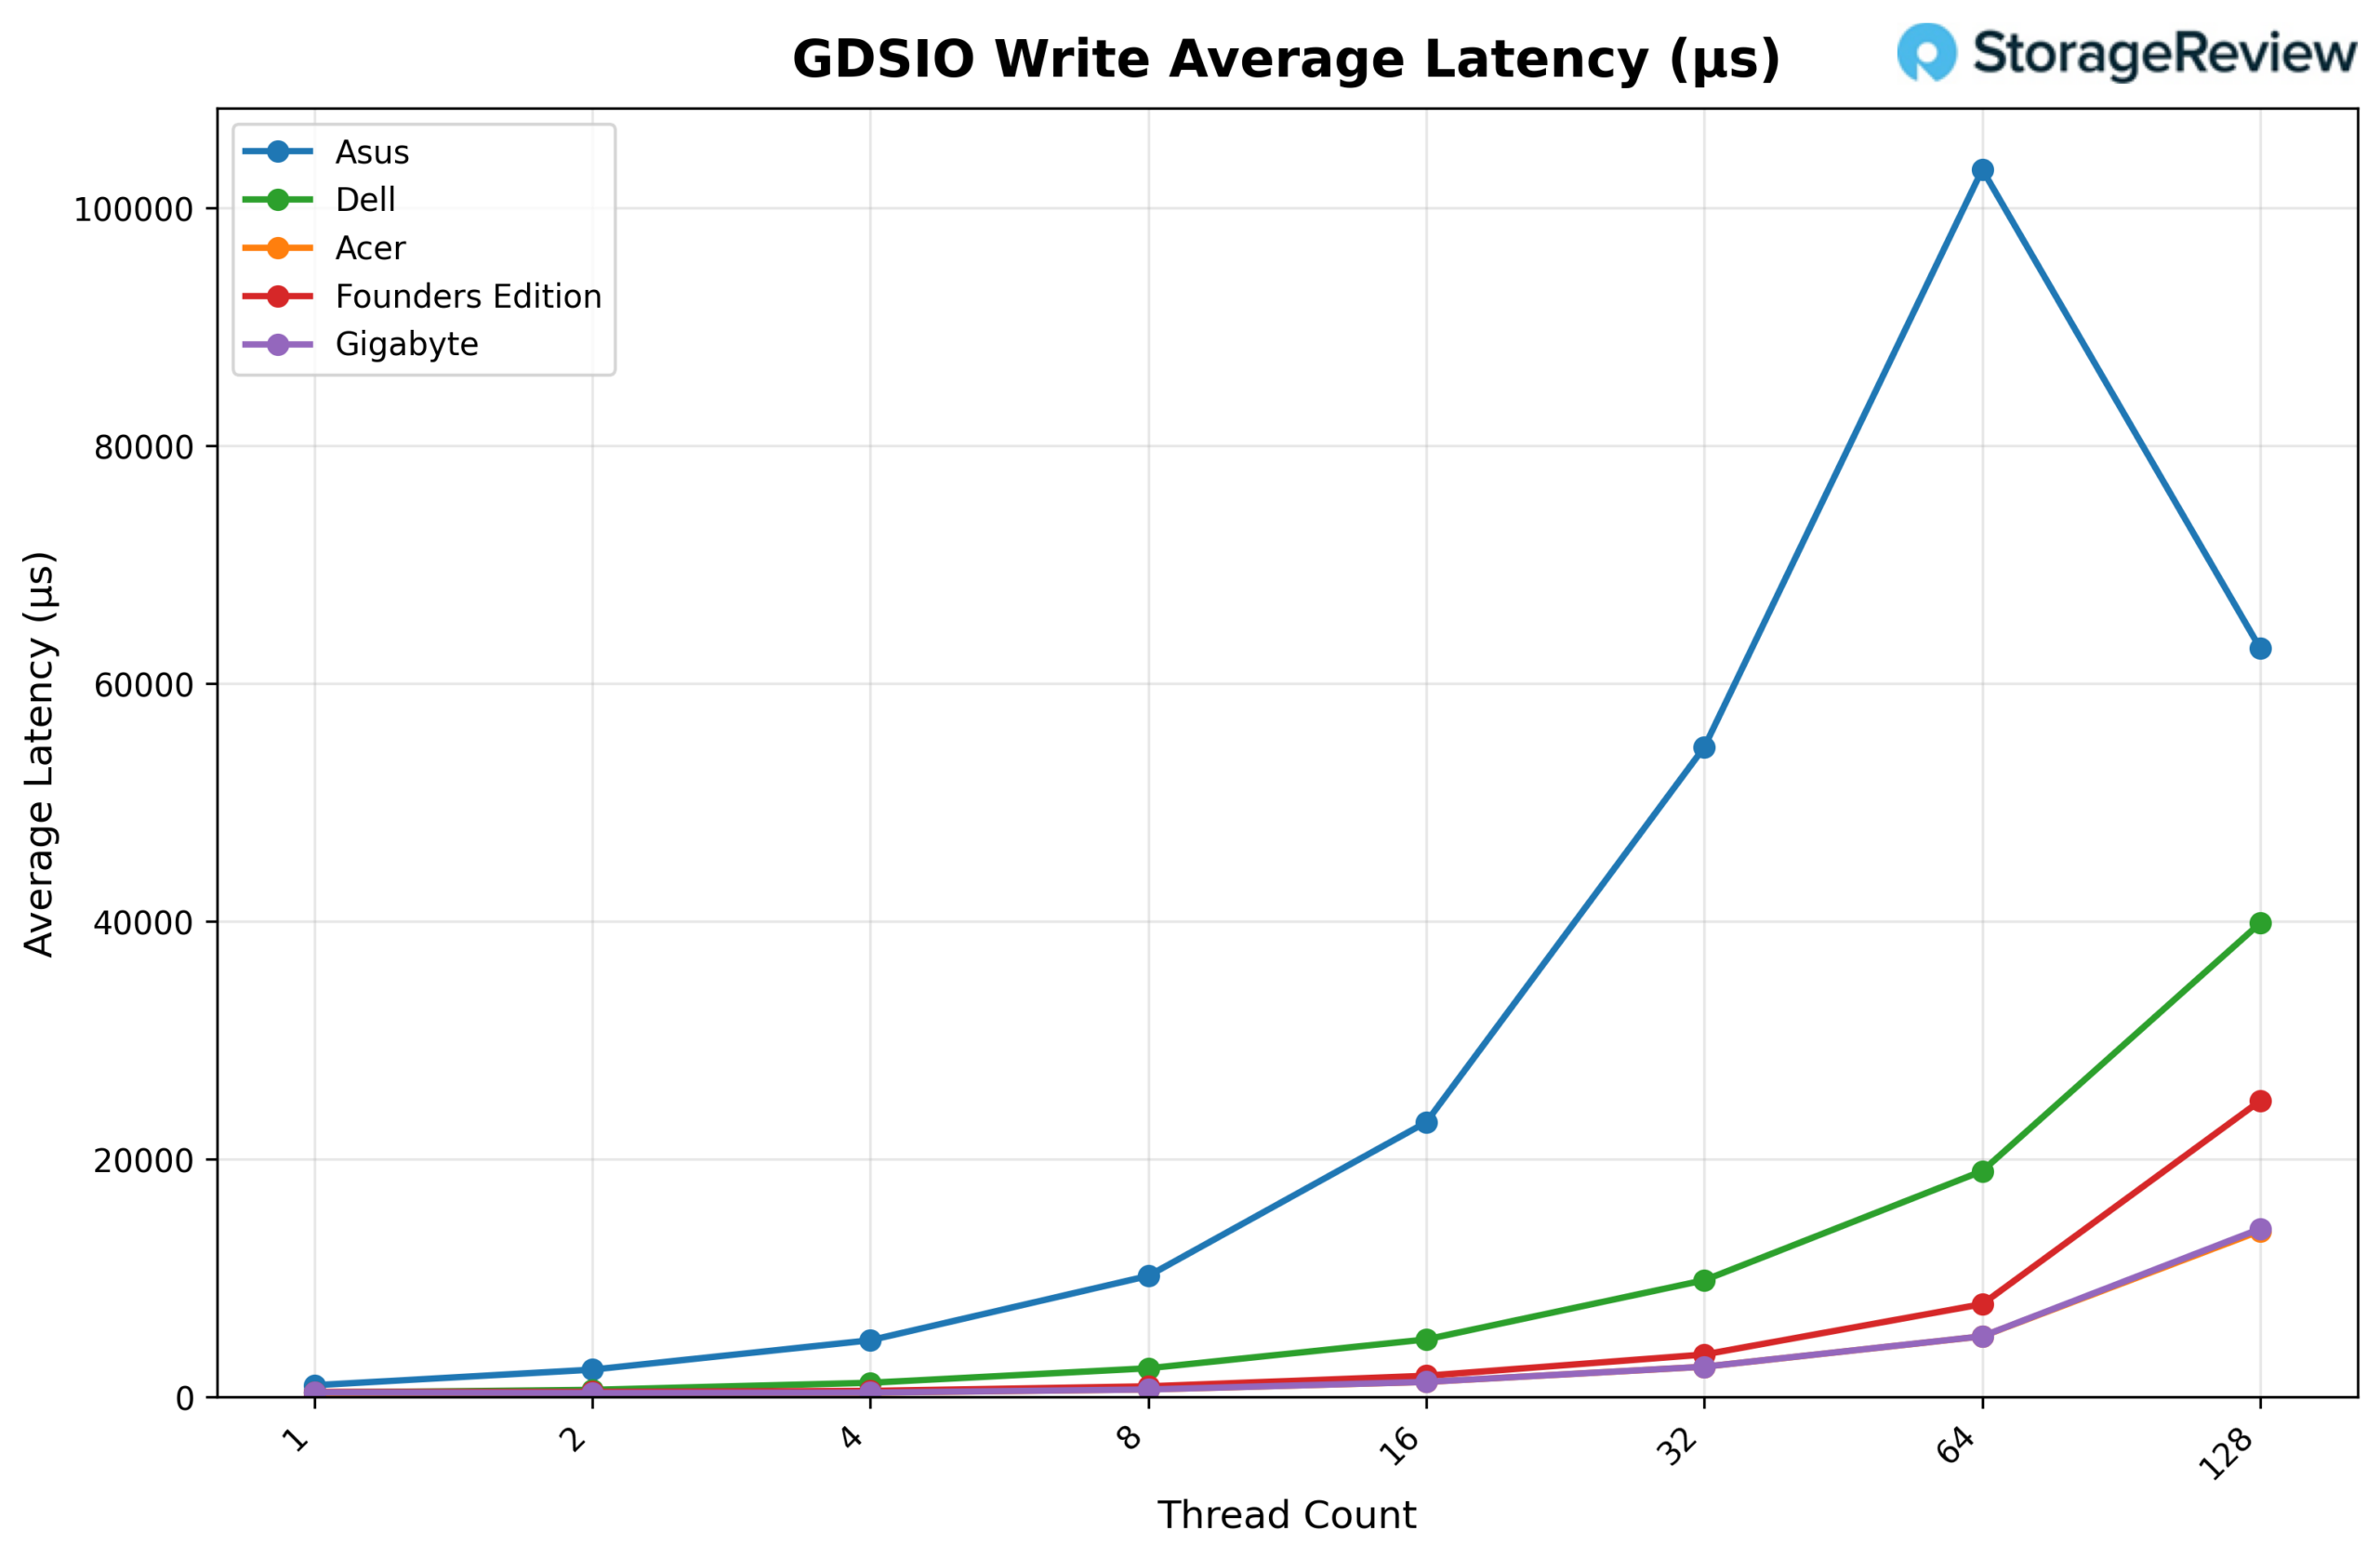
ASUS Ascent GX10 內部使用了 Phison ESL04TBTLCZ 1TB Gen4 SSD。這是我們目前測試過的唯一一款 1TB GB10 平台,但就我們所見,這款 SSD 除了是 PCIe Gen4 之外,寫入速度也是最慢的。
GPU 直接儲存的工作原理
傳統上,當GPU處理儲存在NVMe磁碟機上的資料時,資料必須先經過CPU和系統記憶體才能到達GPU。由於CPU充當中間人,這個過程會造成效能瓶頸,增加延遲並消耗寶貴的系統資源。 GPU直接儲存(GPU Direct Storage)透過允許GPU直接透過PCIe匯流排存取儲存裝置中的數據,消除了這種低效率。這種直接路徑減少了資料傳輸的開銷,從而實現了更快、更有效率的資料傳輸。
人工智慧工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理 TB 級的數據,資料傳輸中的任何延遲都可能導致 GPU 利用率不足和訓練時間更長。 GPU 直接儲存透過確保資料盡快傳輸到 GPU、最大限度地減少空閒時間並最大限度地提高運算效率來解決這一挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
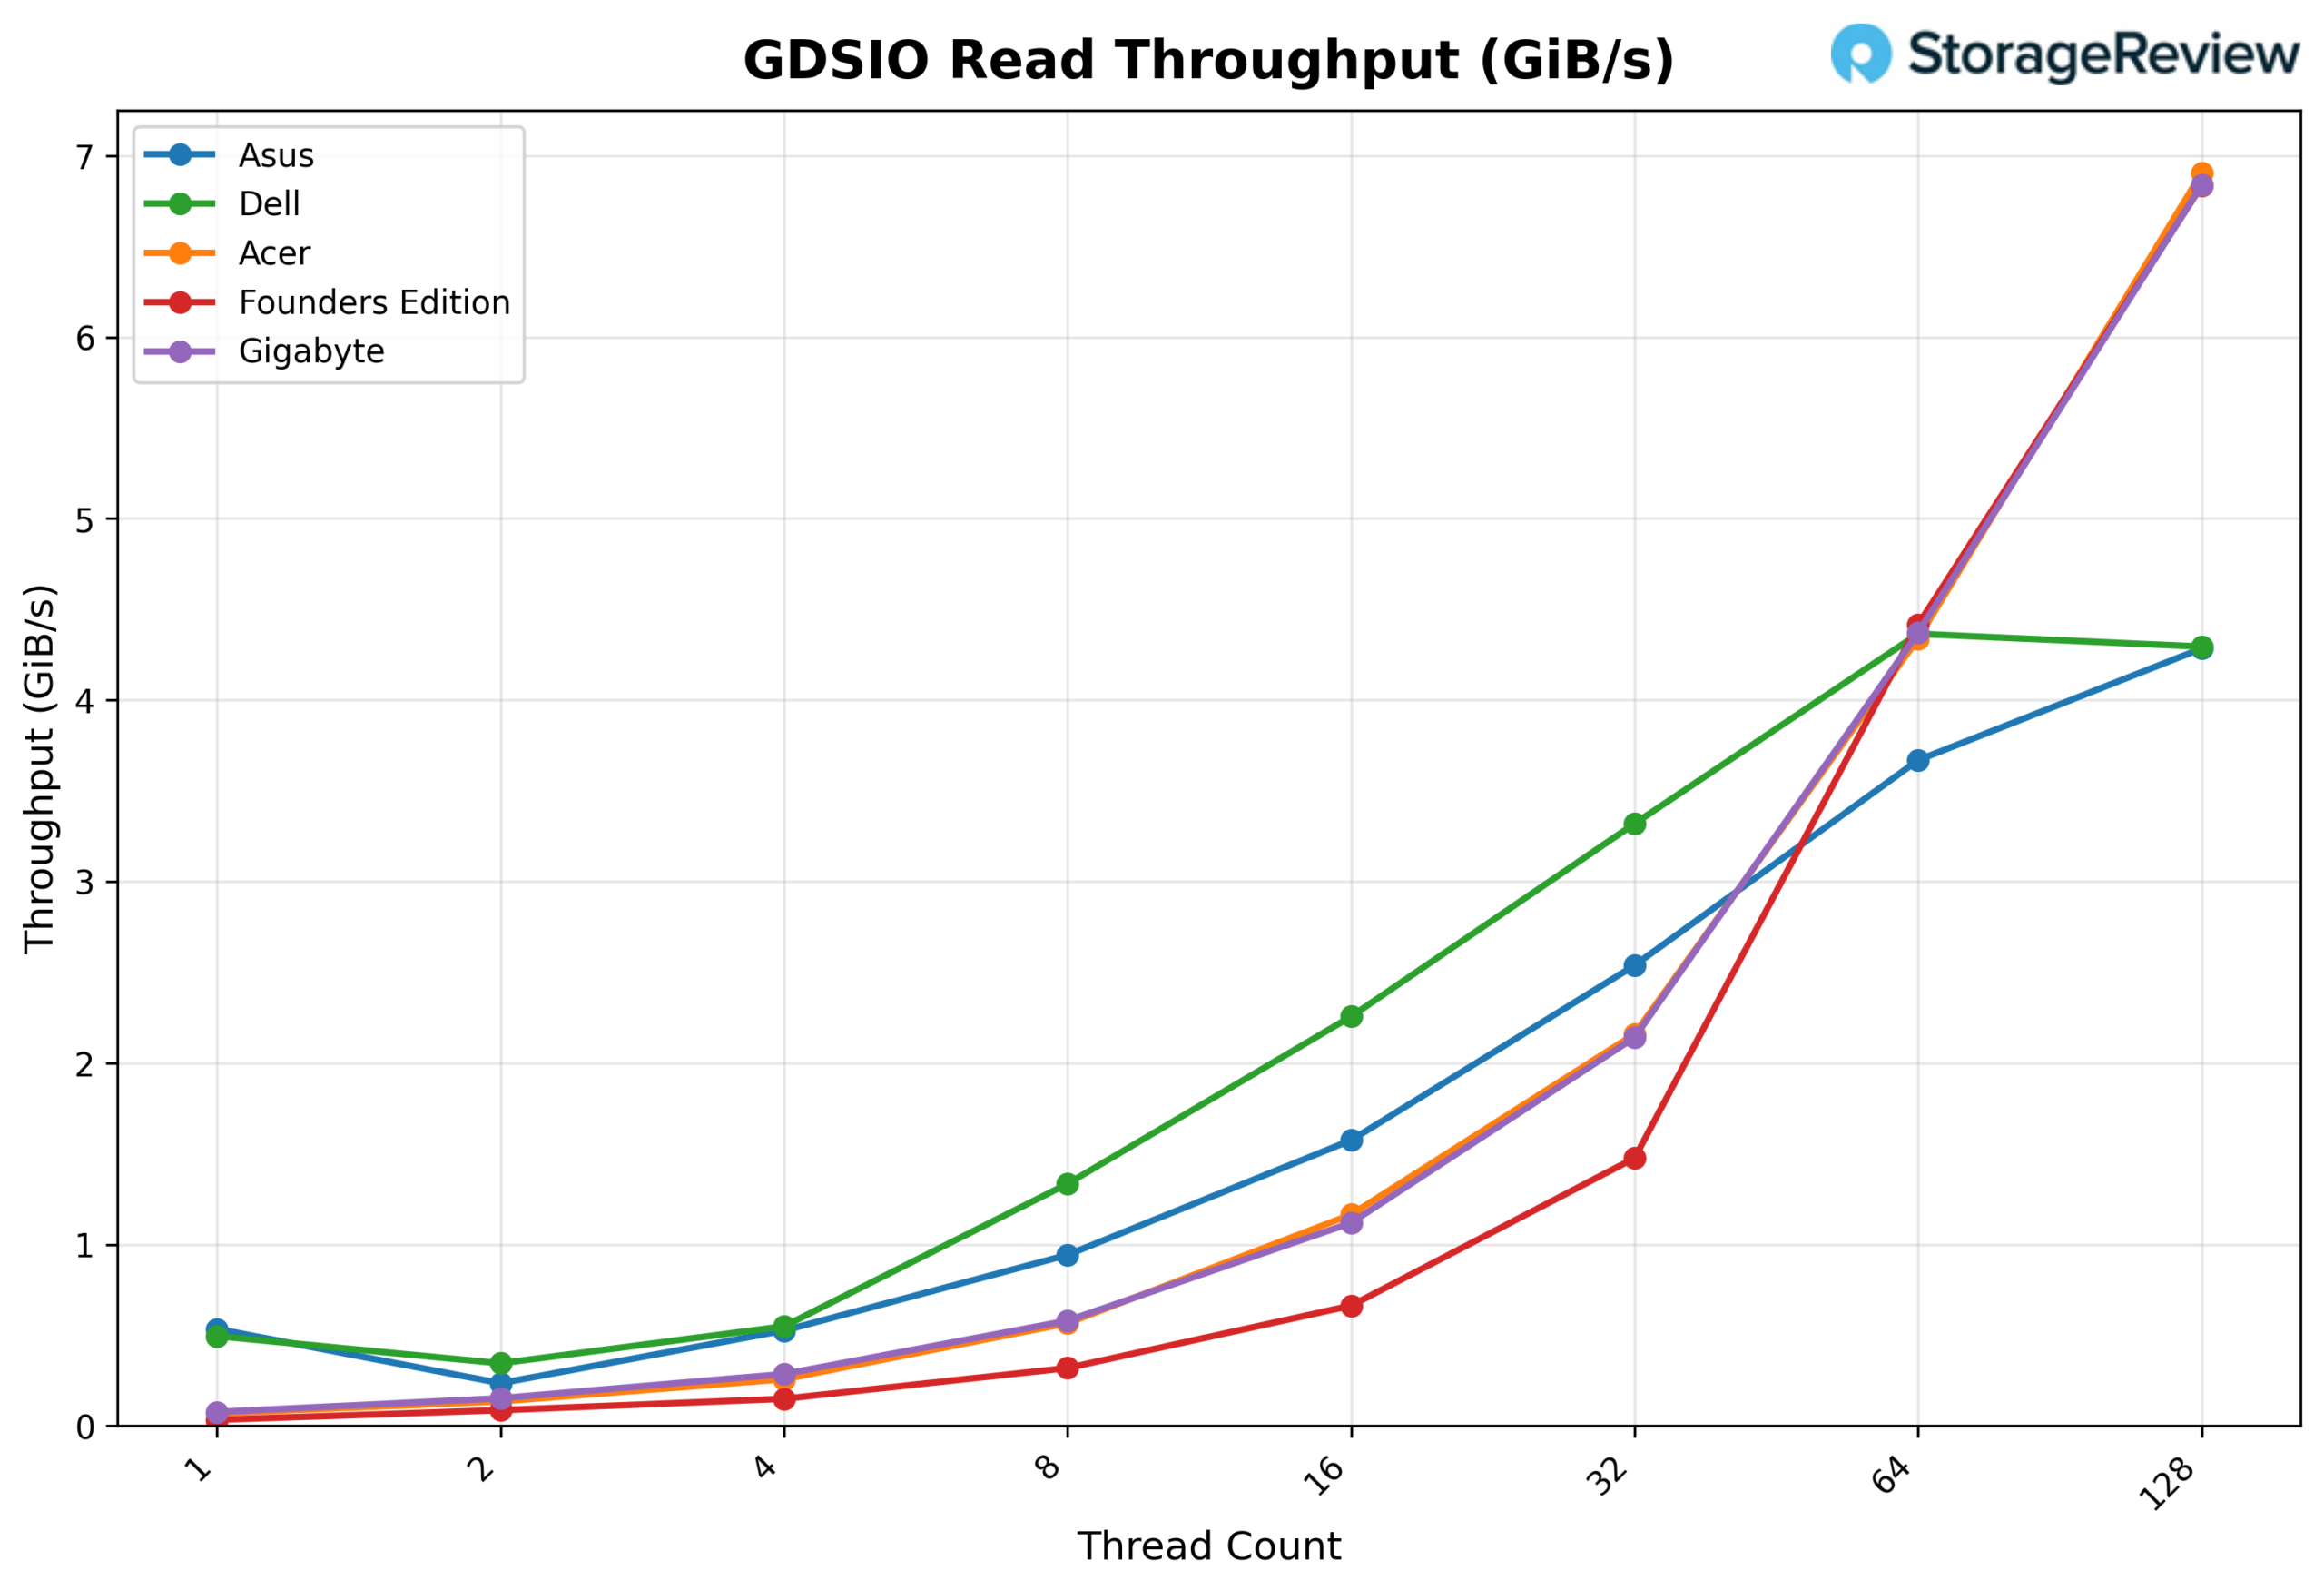
GDSIO 讀取吞吐量 16k
從 GDSIO 16K 讀取吞吐量測試來看,華碩主機板在單執行緒時初始吞吐量為 0.53 GiB/s,但低執行緒時波動較大,雙執行緒時為 0.23 GiB/s,四執行緒時回升至 0.52 GiB/s。吞吐量在八線程(0.94 GiB/s)和十六線程(1.57 GiB/s)時恢復穩定增長,並在三十二線程時顯著提升至 2.54 GiB/s。六十四線程時吞吐量依然強勁(3.67 GiB/s),並在十二線程時達到峰值 4.28 GiB/s,呈現持續上升趨勢,沒有出現早期停滯。
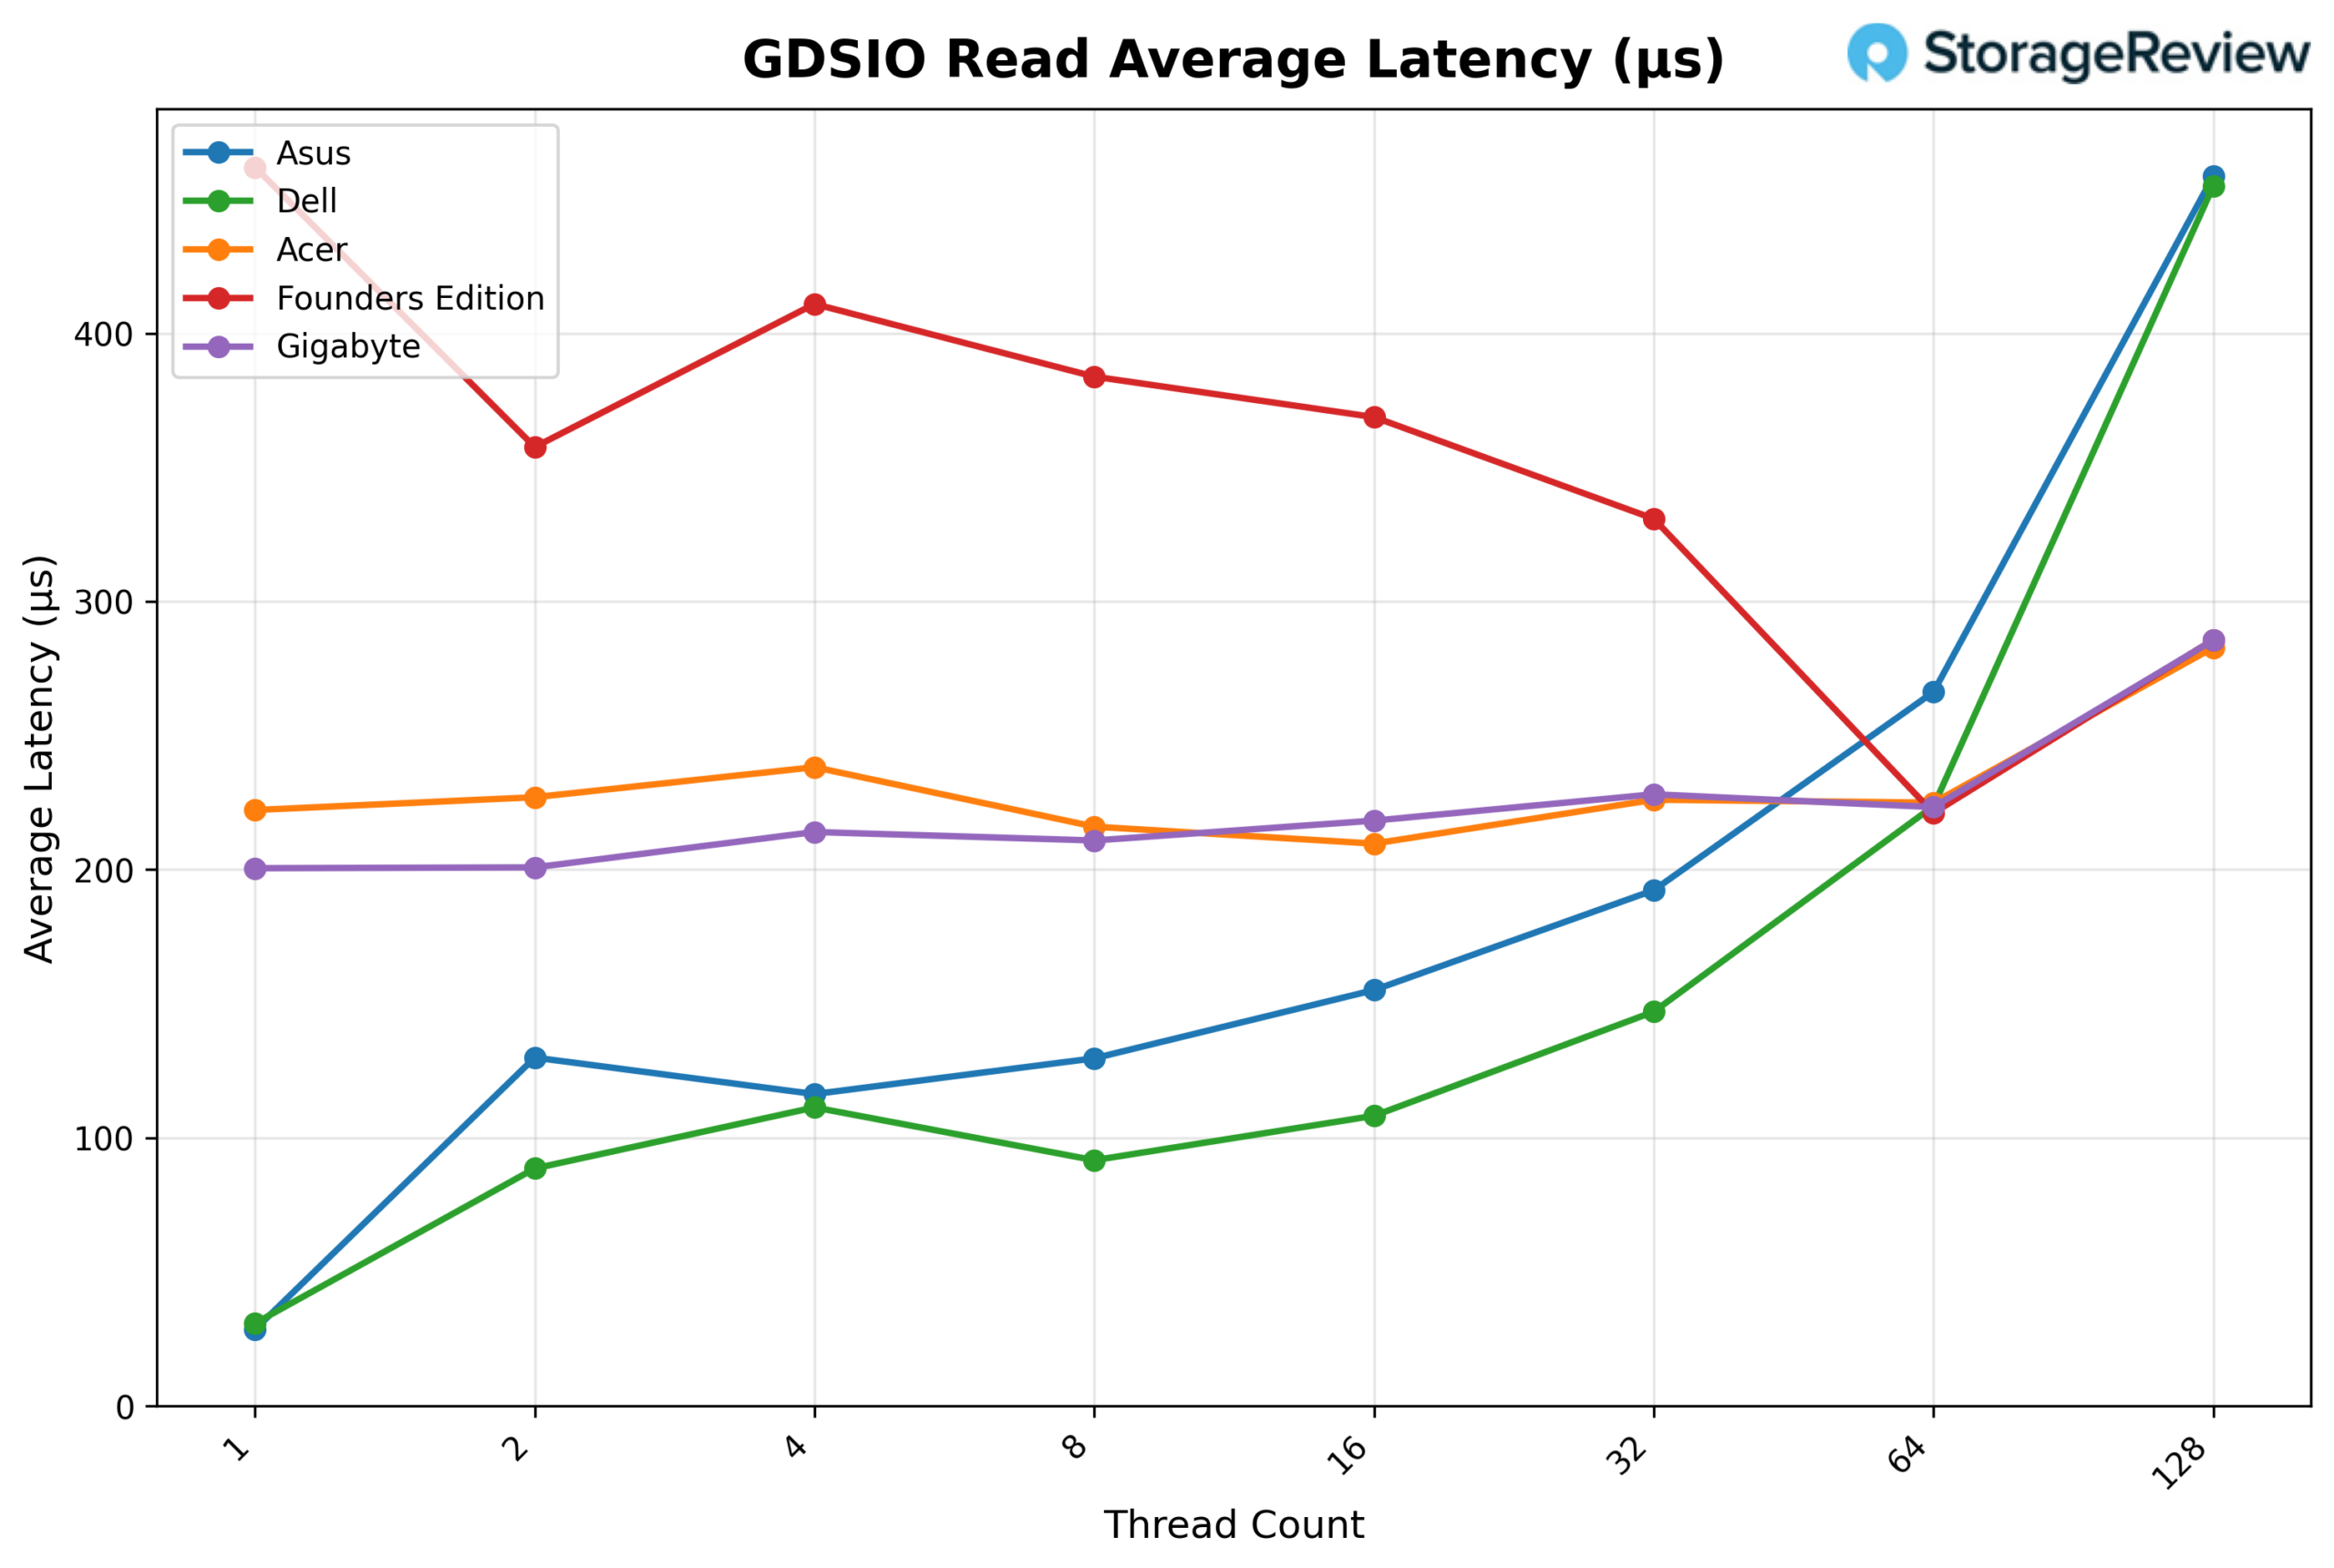
GDSIO 讀取平均延遲 16K
從 GDSIO 讀取平均延遲 (16K) 來看,華碩主機板在單執行緒時延遲約為 0.03 毫秒,在雙執行緒 (0.13 毫秒) 和四執行緒 (0.12 毫秒) 時也保持較低水準。延遲在八線程 (0.13 毫秒) 和十六線程 (0.16 毫秒) 時略有上升,然後在三十二線程 (0.19 毫秒) 和六十四線程 (0.27 毫秒) 時進一步升高。在 128 個執行緒時,延遲達到 0.46 毫秒,在整個測試過程中保持相對較低,這與吞吐量持續提升的特性一致。
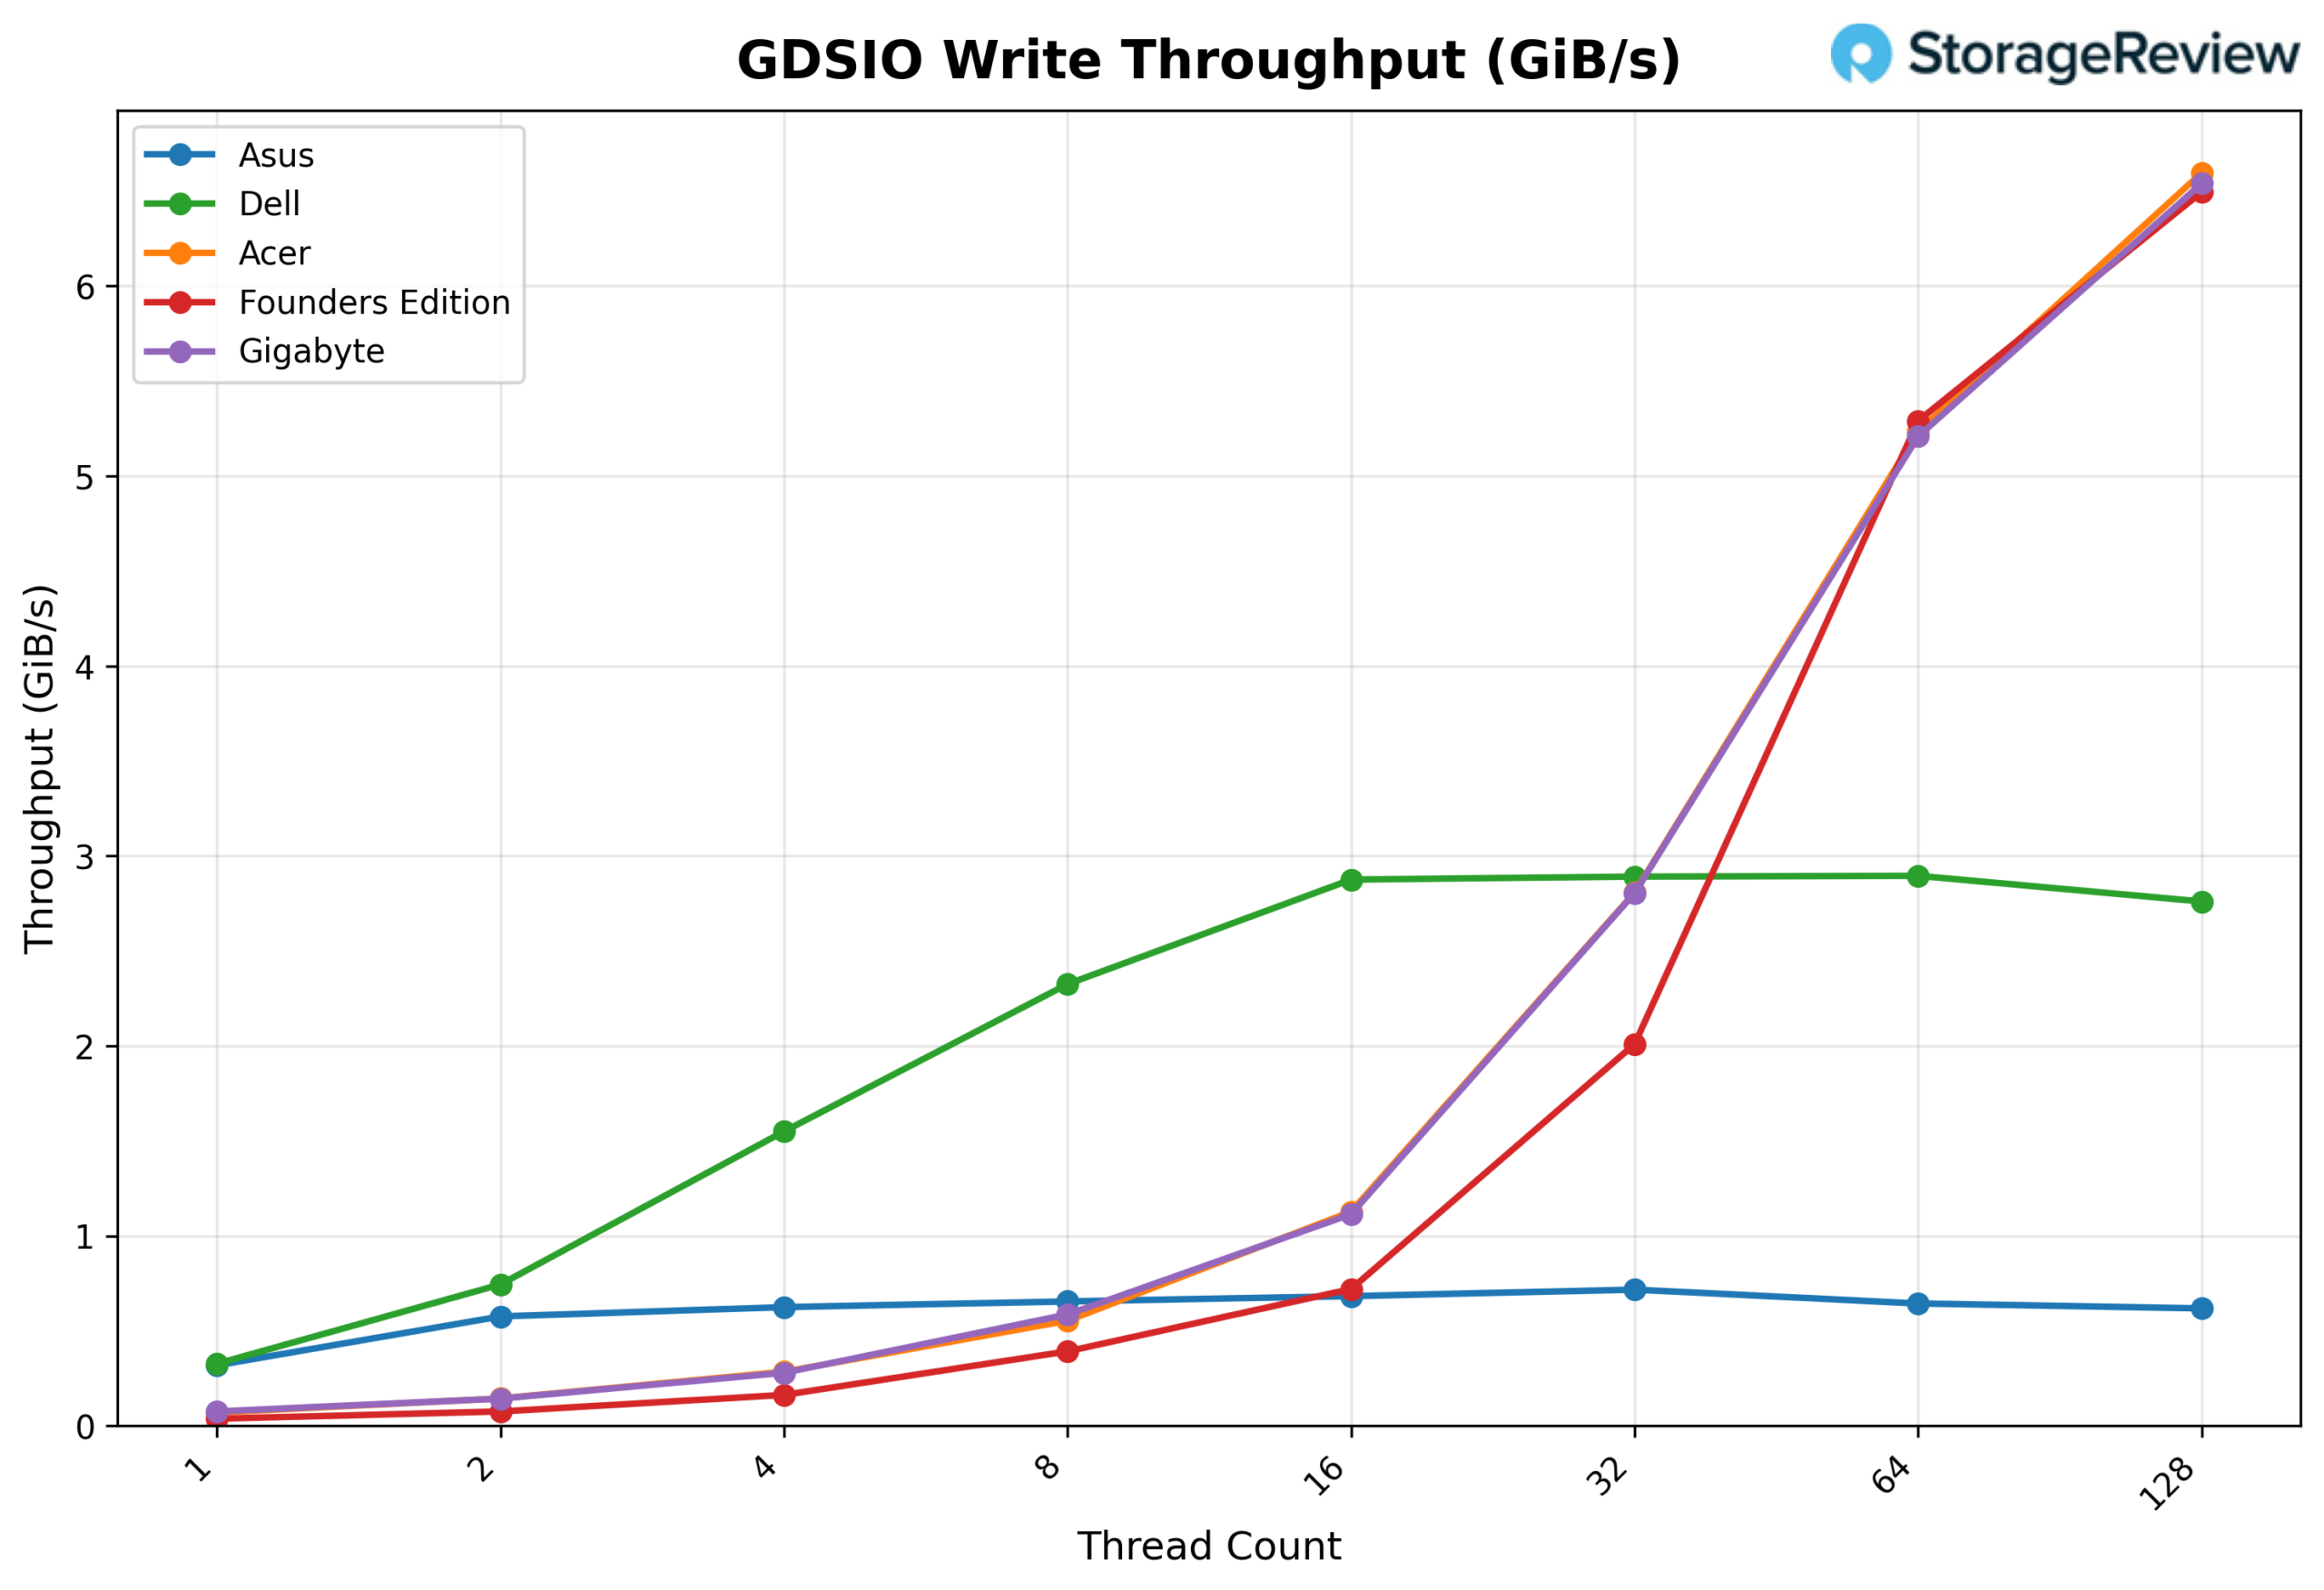
GSDIO 寫入吞吐量 16K
從 GDSIO 16K 寫入吞吐量測試來看,華碩主機板在單執行緒下初始吞吐量為 0.32 GiB/s,雙執行緒下提升至 0.58 GiB/s,四執行緒下為 0.62 GiB/s。效能在 8 個執行緒(0.65 GiB/s)和 16 個執行緒(0.68 GiB/s)時繼續提升,並在 32 個執行緒時達到一個較為溫和的峰值(0.72 GiB/s)。在 64 個線程(0.64 GiB/s)和 128 個線程(0.62 GiB/s)時吞吐量略有下降,表明該平台在達到線程數上限之前就已經達到了寫入效能的飽和點。
GDSIO 寫入平均延遲 16K
從 GDSIO 寫入平均延遲(16K)來看,華碩主機板在單執行緒時延遲約為 0.05 毫秒,在雙執行緒(0.05 毫秒)和四個執行緒(0.10 毫秒)時仍保持極低水準。延遲在八線程(0.19 毫秒)和十六線程(0.36 毫秒)時略有上升,然後在三十二線程(0.68 毫秒)和六十四線程(1.52 毫秒)時顯著增加。在 128 個線程時,延遲達到 3.16 毫秒,與 100 萬線程的結果相比仍然相對較低,但其上升趨勢與在高線程數下觀察到的吞吐量平台期相吻合。
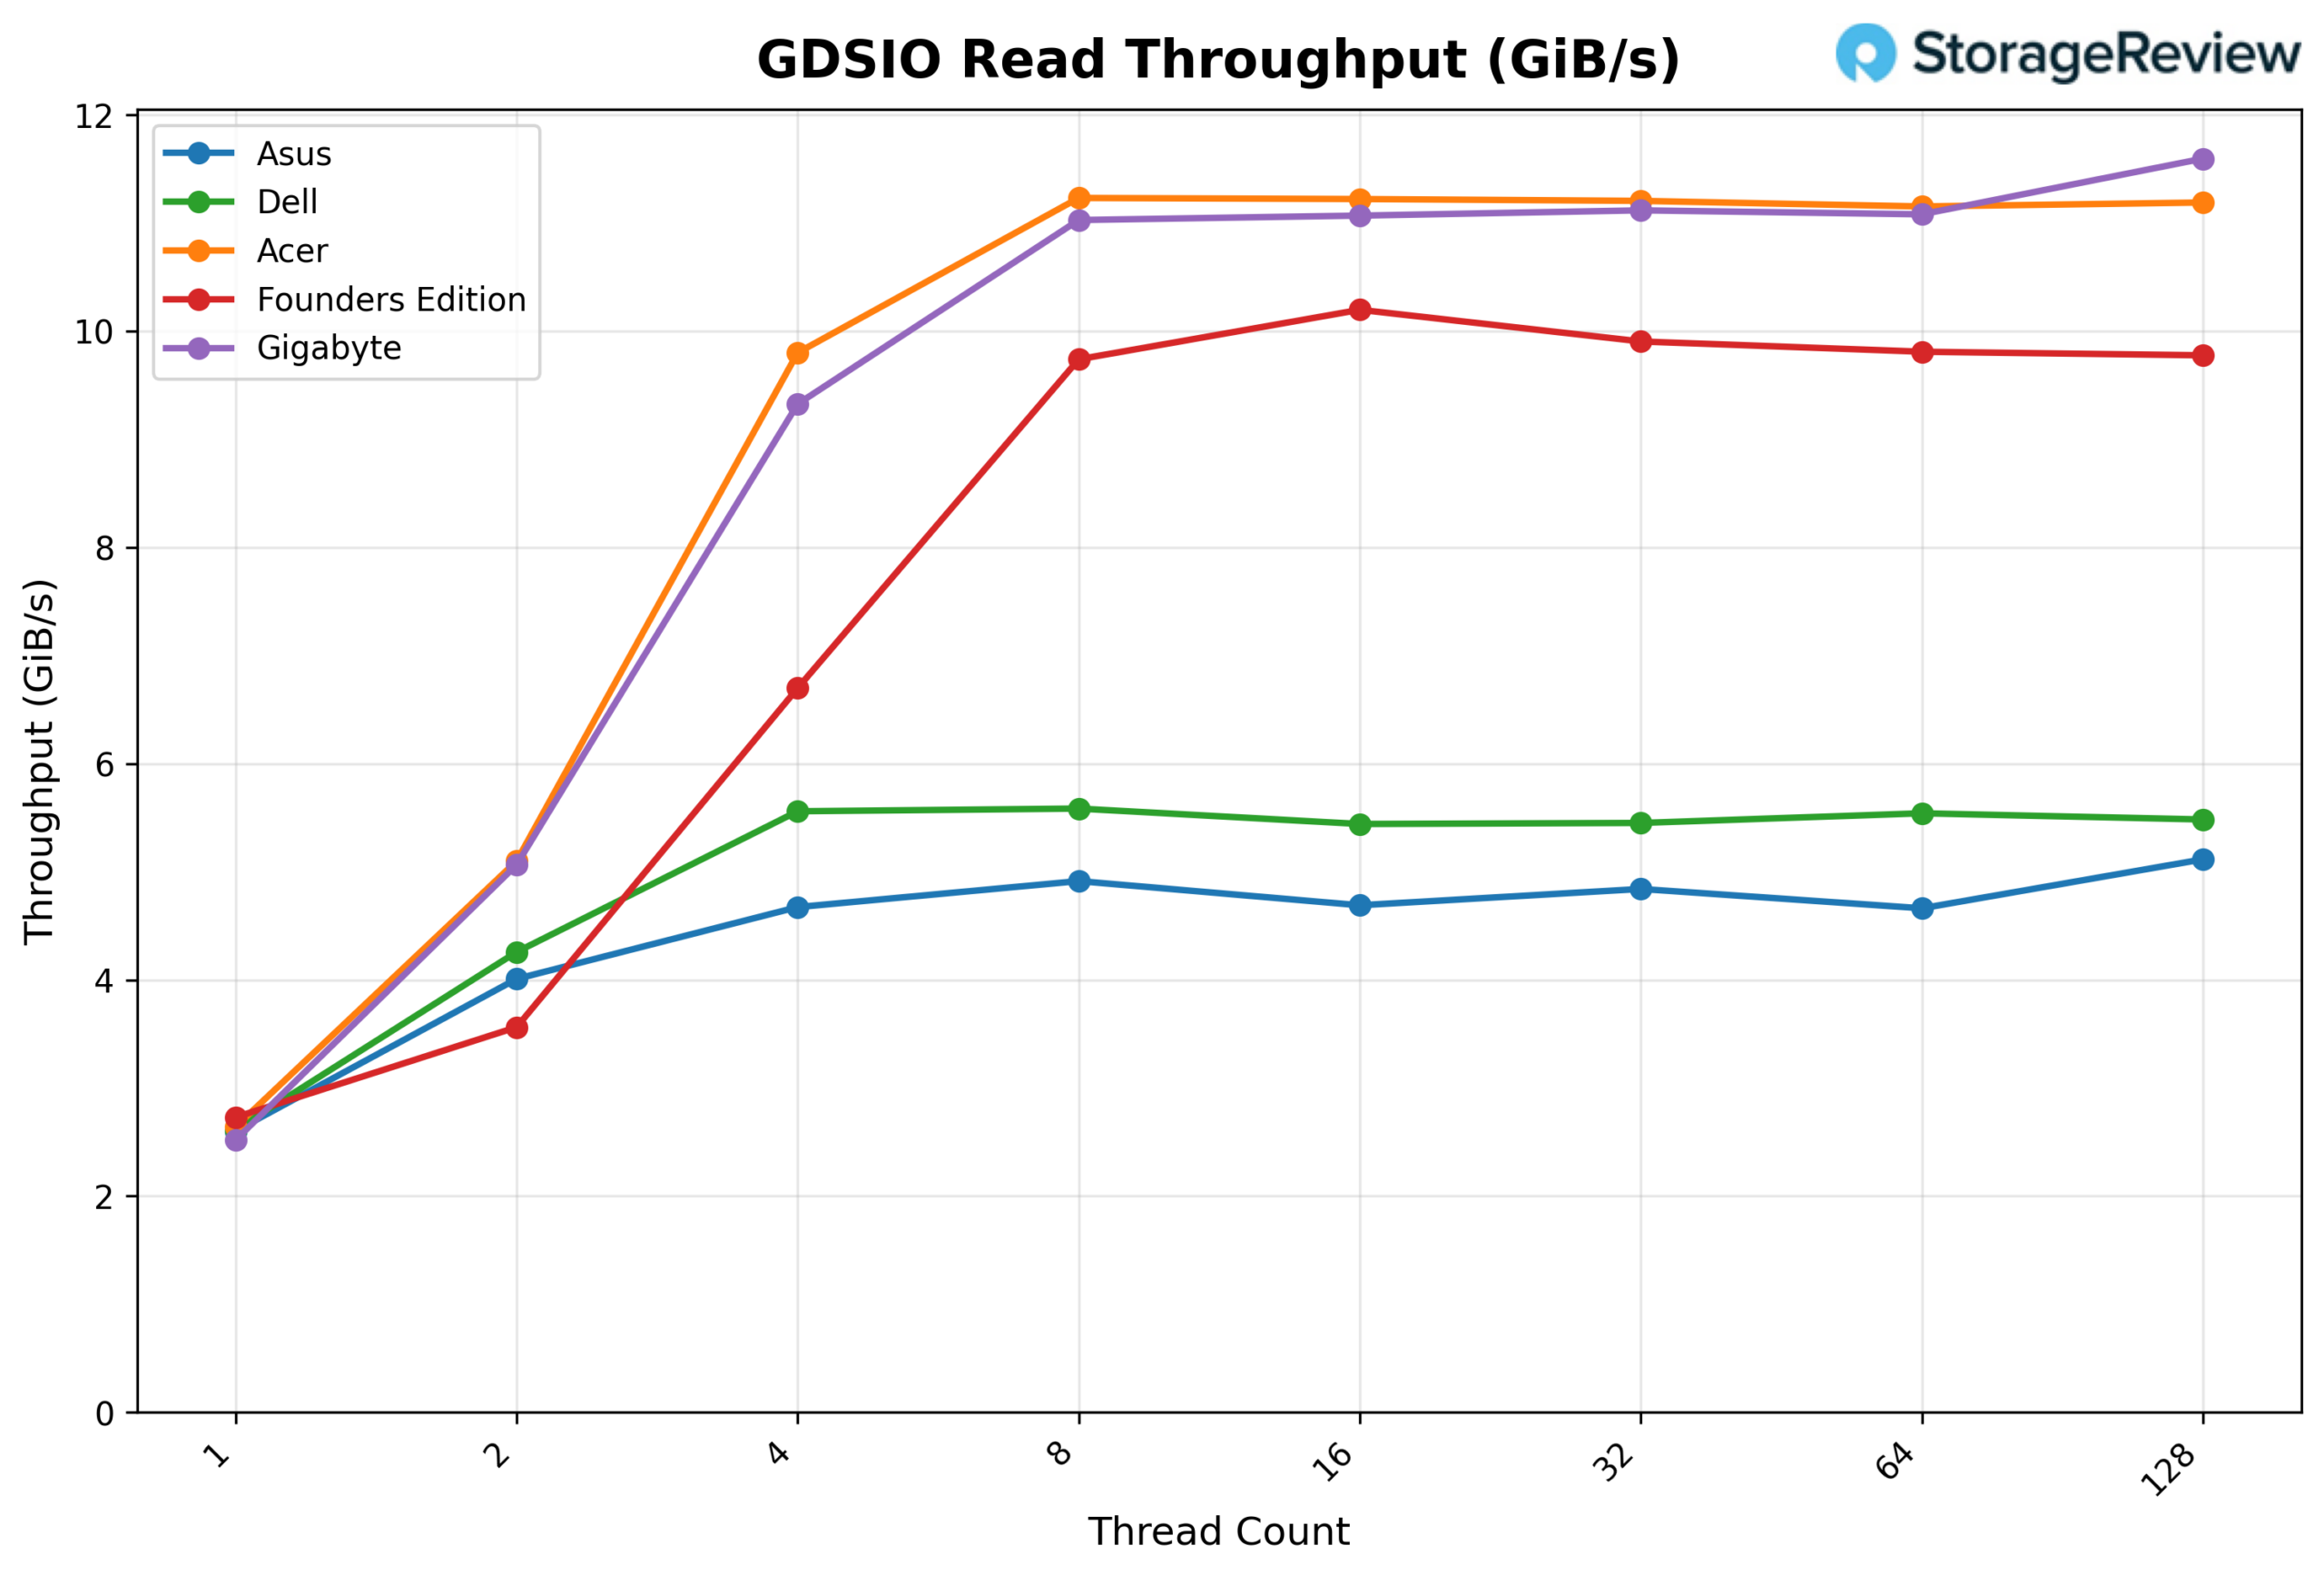
GDSIO 讀取吞吐量 1M
在 GDSIO 讀取吞吐量 1M 測試中,華碩主機板在單執行緒下初始吞吐量為 2.60 GiB/s,雙執行緒下迅速躍升至 4.01 GiB/s。效能在四線程(4.67 GiB/s)和八線程(4.91 GiB/s)下繼續提升,之後平台性能基本上達到飽和。在 16 執行緒(4.69 GiB/s)、32 執行緒(4.84 GiB/s)和 64 執行緒(4.66 GiB/s)下,吞吐量保持穩定,呈現平穩狀態。在 128 執行緒下,吞吐量達到 5.12 GiB/s,為本次測試中的最高值。
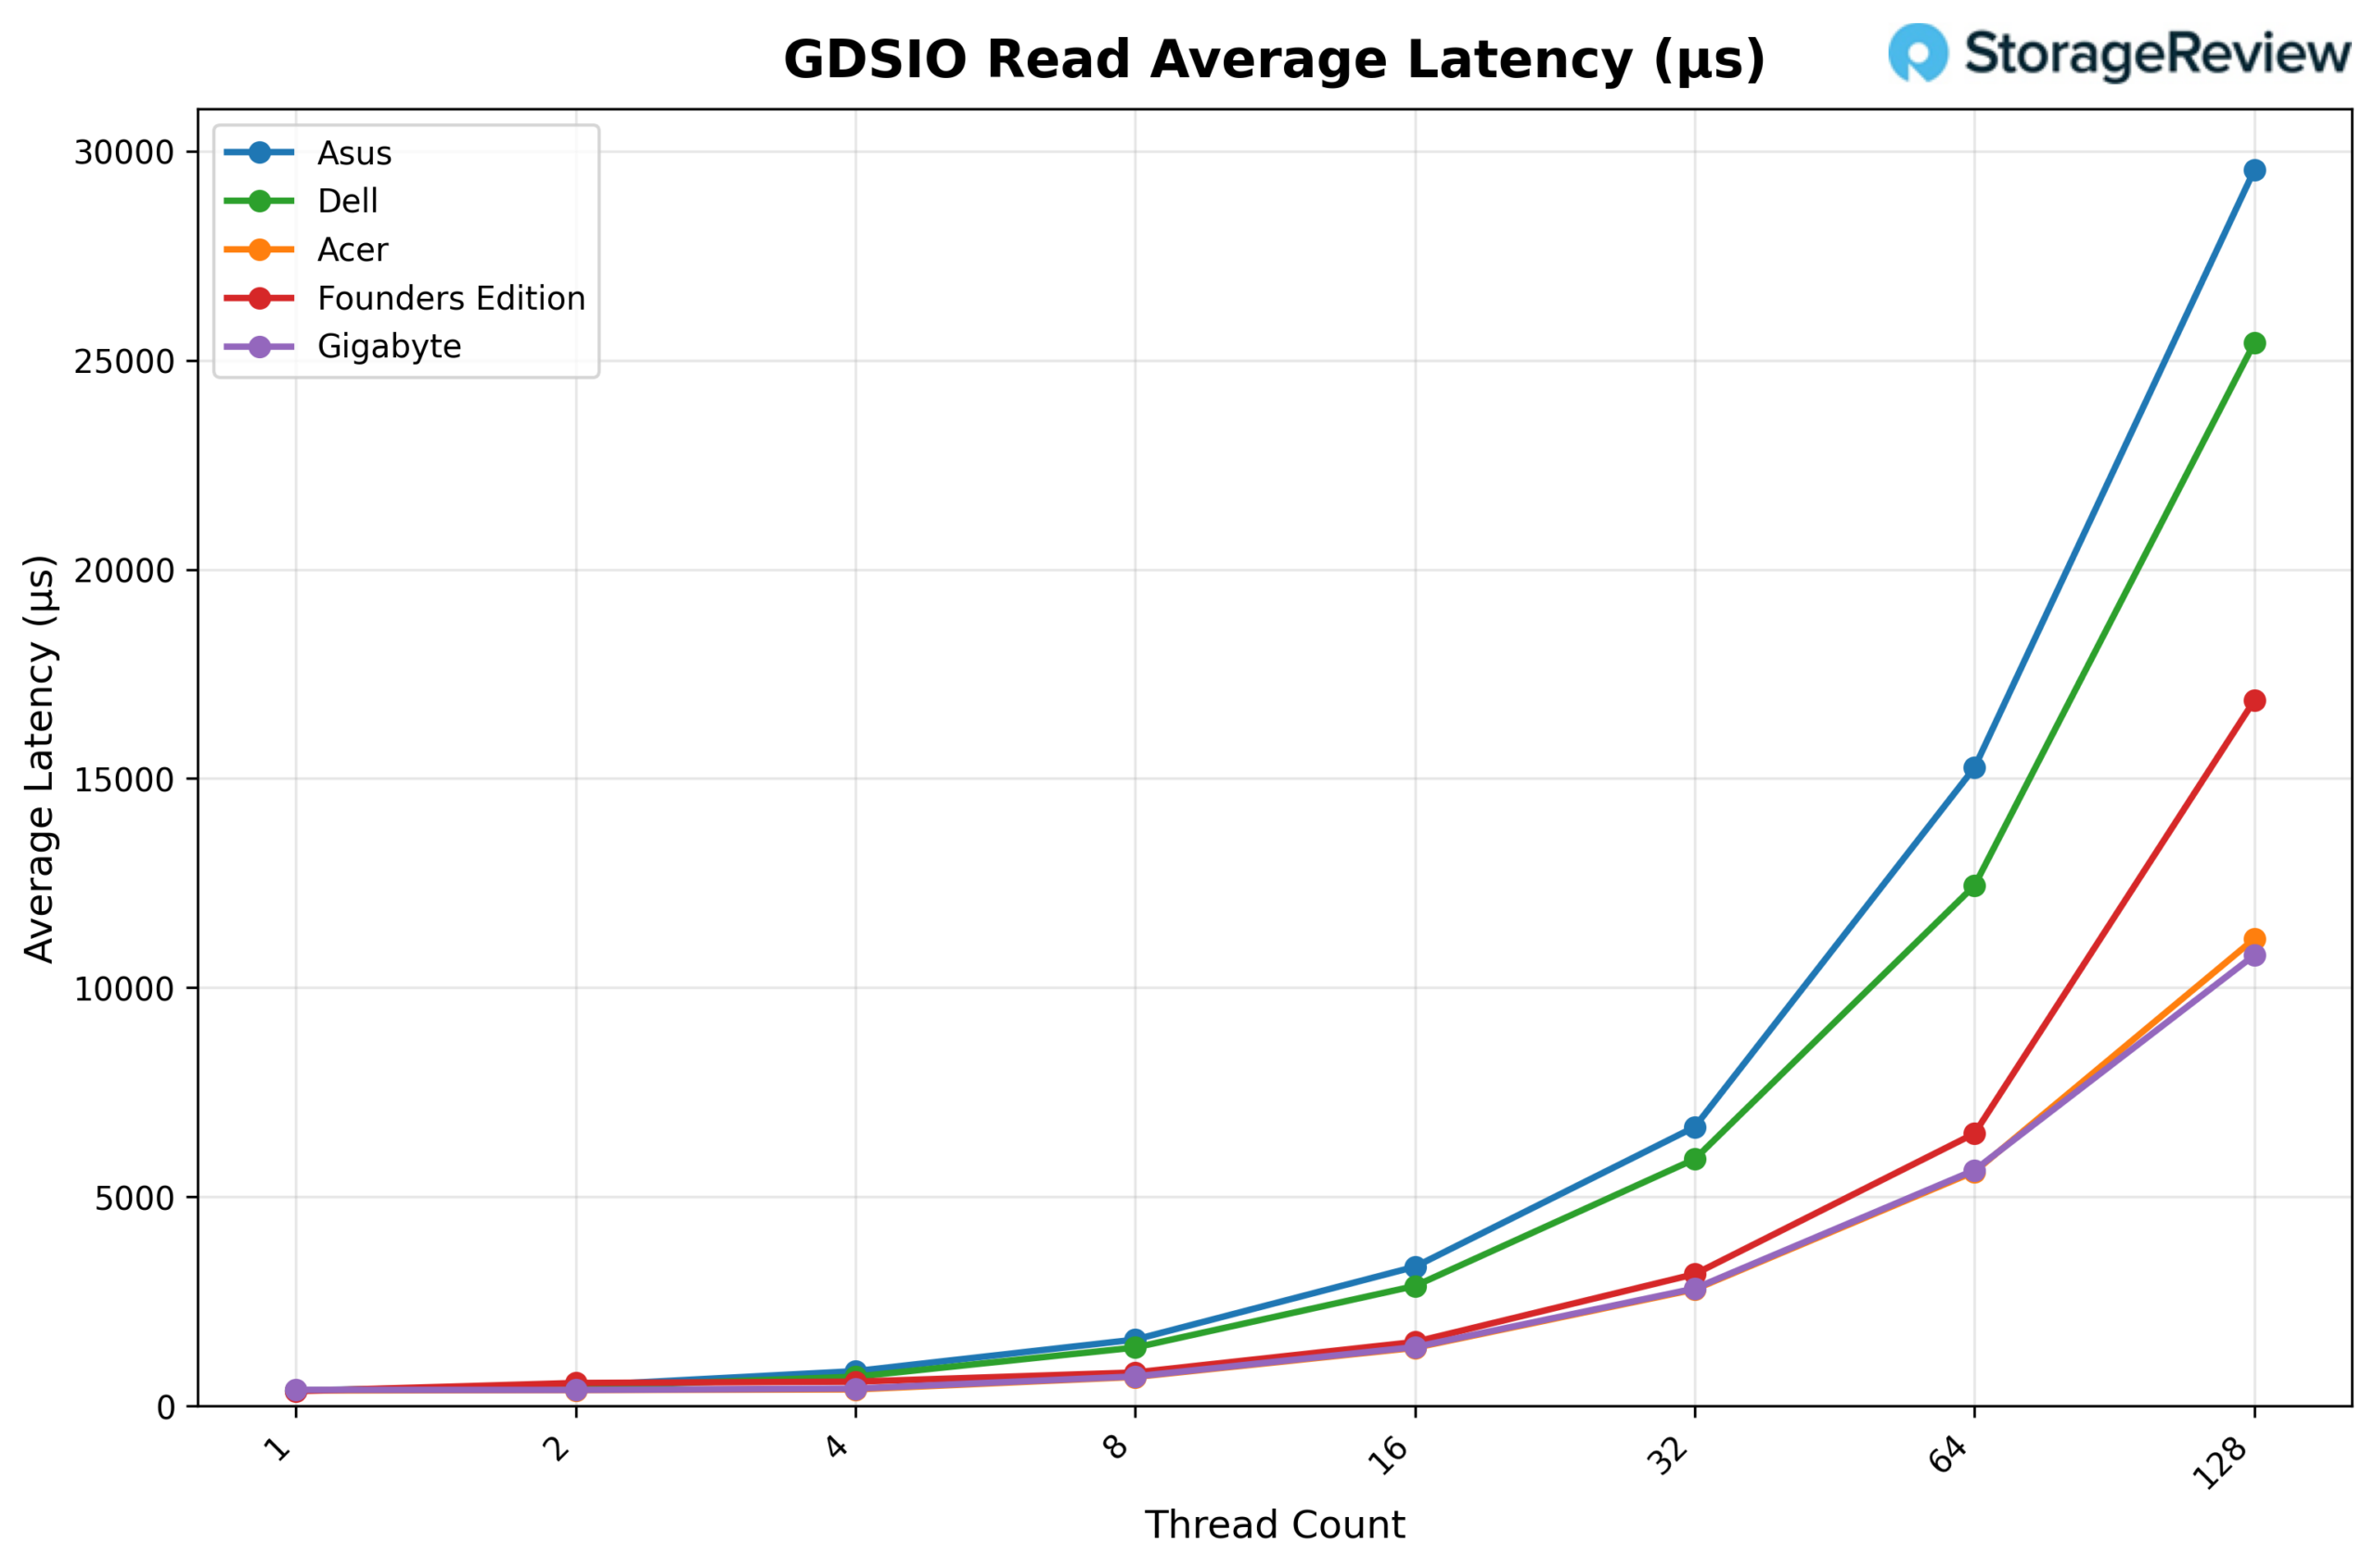
GDSIO 讀取平均延遲 1M
從 GDSIO 讀取平均延遲(1M)來看,華碩顯示卡在單執行緒時延遲約為 0.38 毫秒,在雙執行緒(0.49 毫秒)和四執行緒(0.84 毫秒)時也保持較低水準。延遲隨著同時數量的增加而增加,在 8 個執行緒時上升至 1.59 毫秒,16 個執行緒時上升至 3.33 毫秒,32 個執行緒時上升至 6.67 毫秒。延遲繼續上升,在 64 個線程時達到 15.26 毫秒,並在 128 個線程時達到 29.54 毫秒,這與峰值並發量相對應,而吞吐量基本上保持穩定。
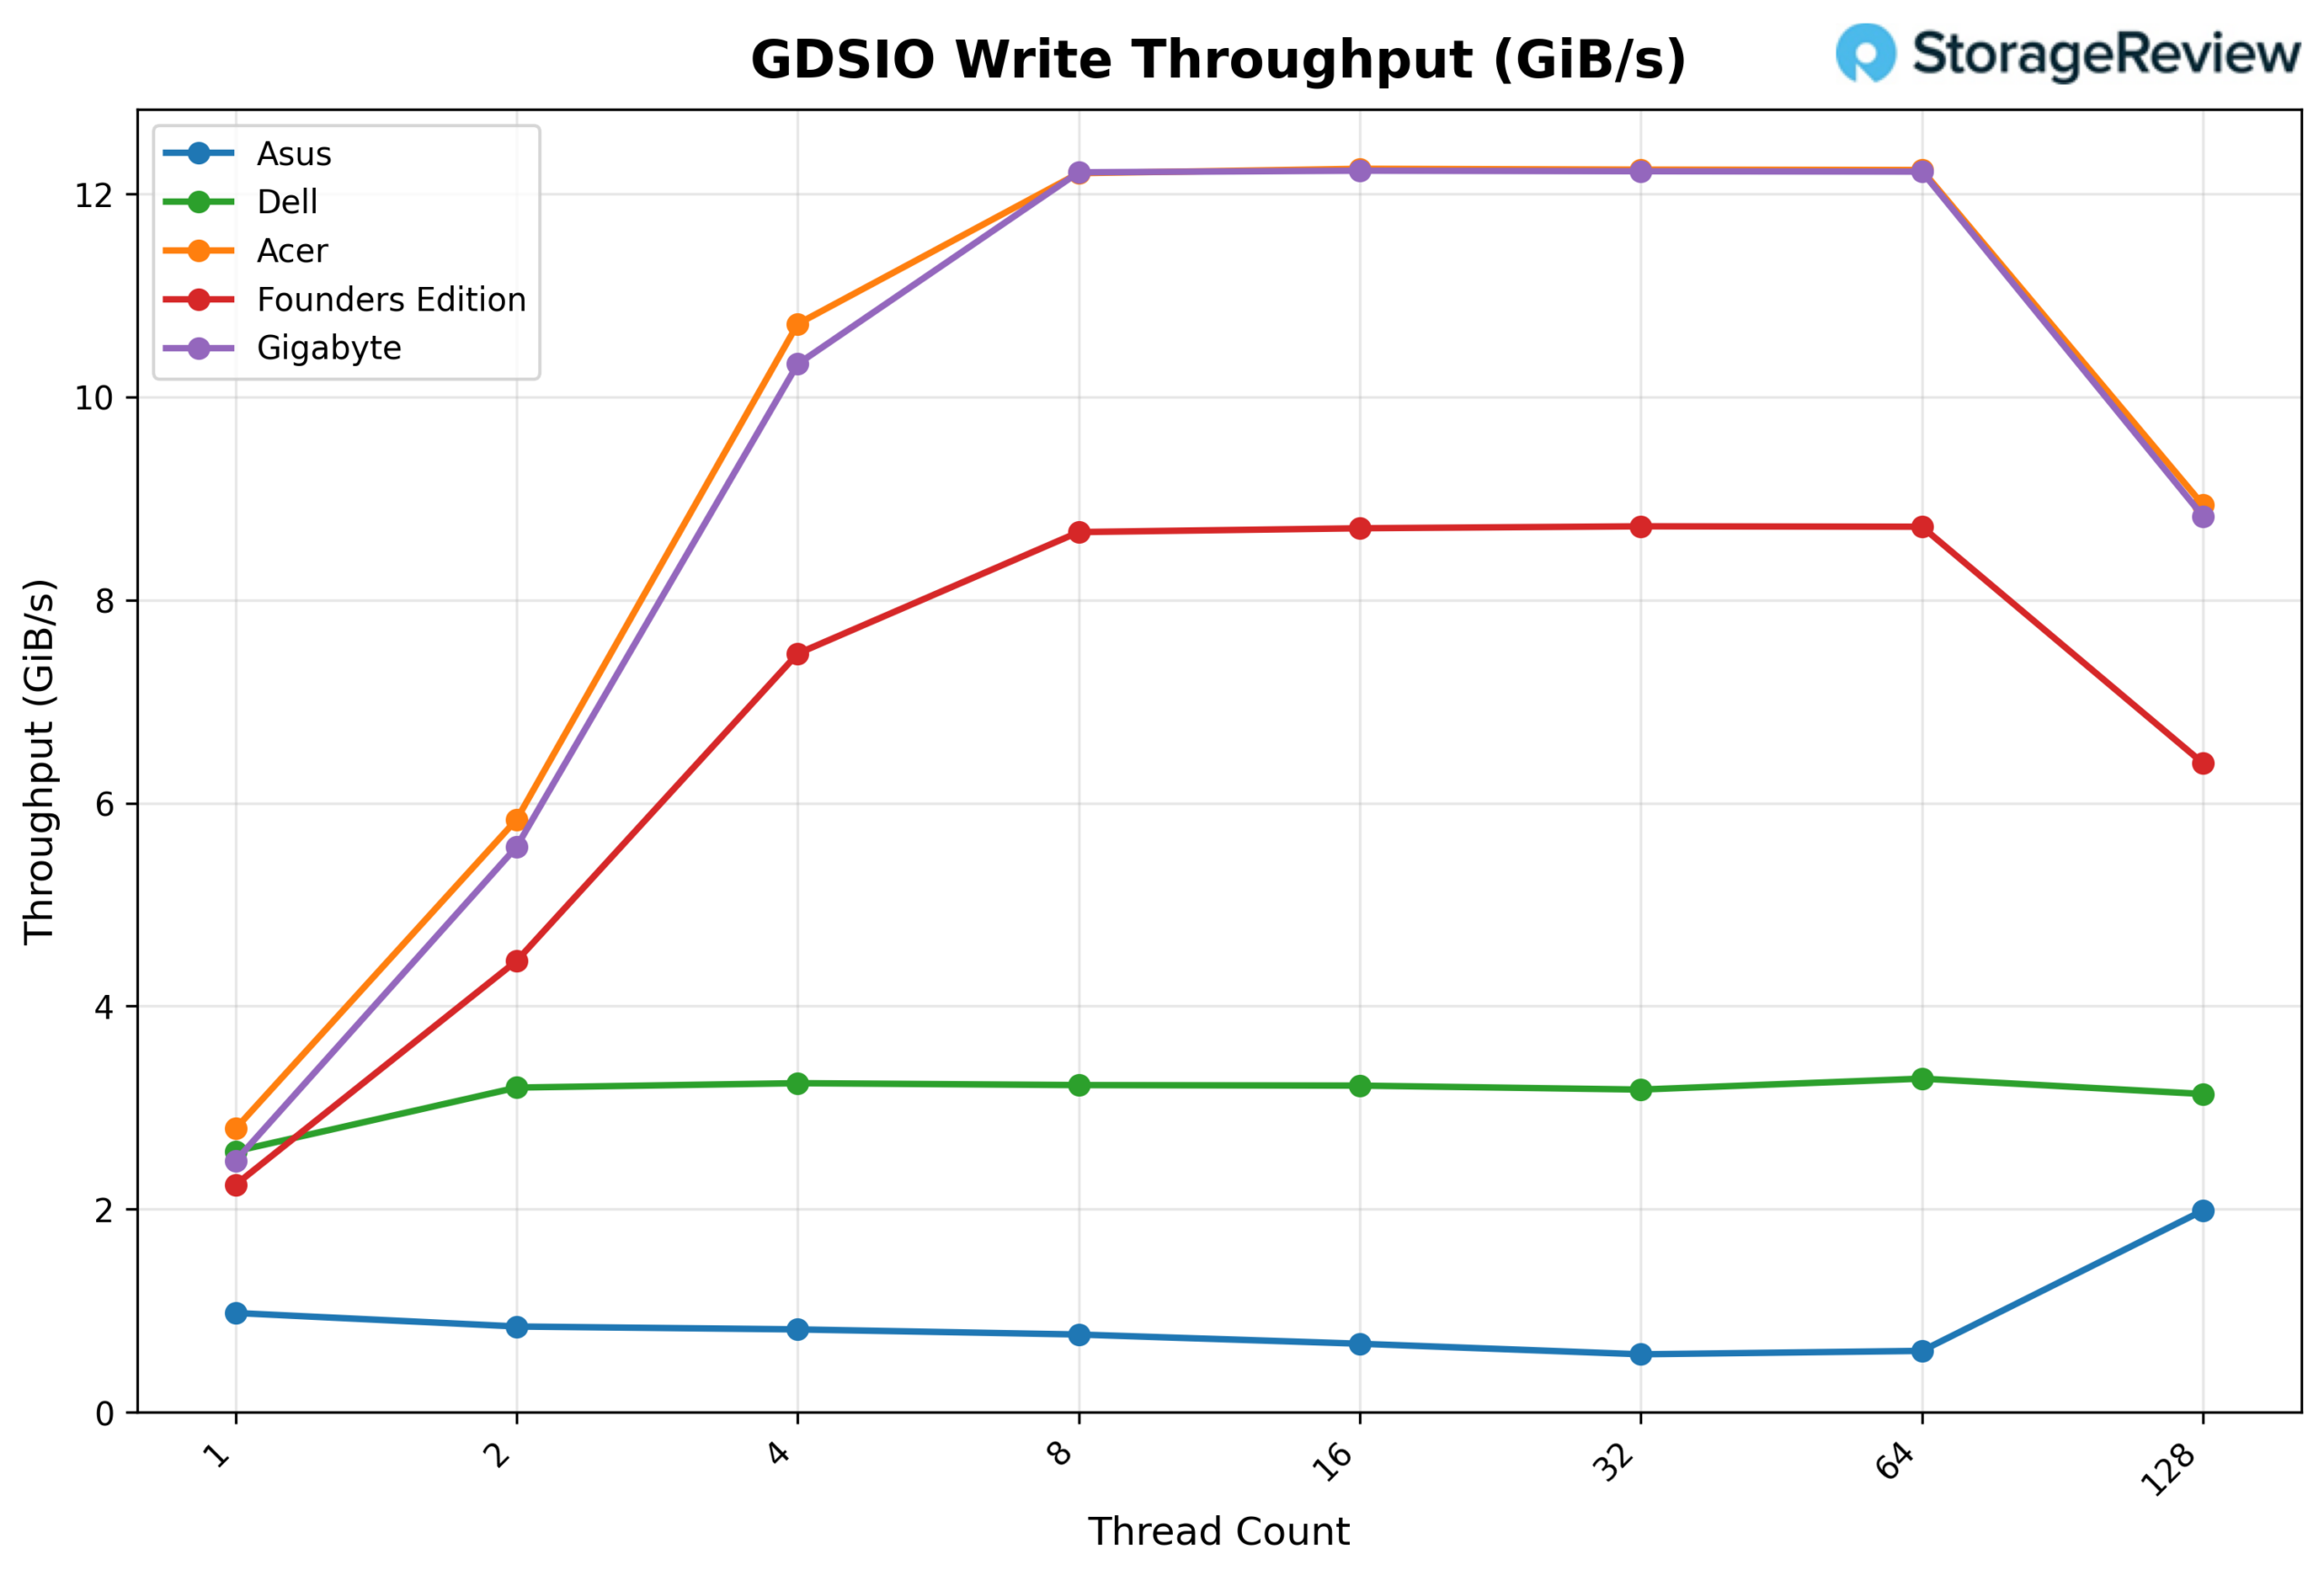
GDSIO 寫入吞吐量 1M
從 GDSIO 寫入吞吐量 1M 測試結果來看,華碩主機板在 1 線程時為 0.98 GiB/s,隨後在 2 個線程(0.85 GiB/s)和 4 個線程(0.82 GiB/s)時下降,在 8 個線程(0.77 GiB/s)和 16 線程時繼續下降。在 32 執行緒時效能進一步降低(0.57 GiB/s),然後在 64 執行緒時略有回升(0.61 GiB/s)。在 128 個執行緒時,吞吐量上升至 1.99 GiB/s,但整體寫入效能的提升趨勢表明,在整個測試過程中都存在明顯的執行緒爭用。
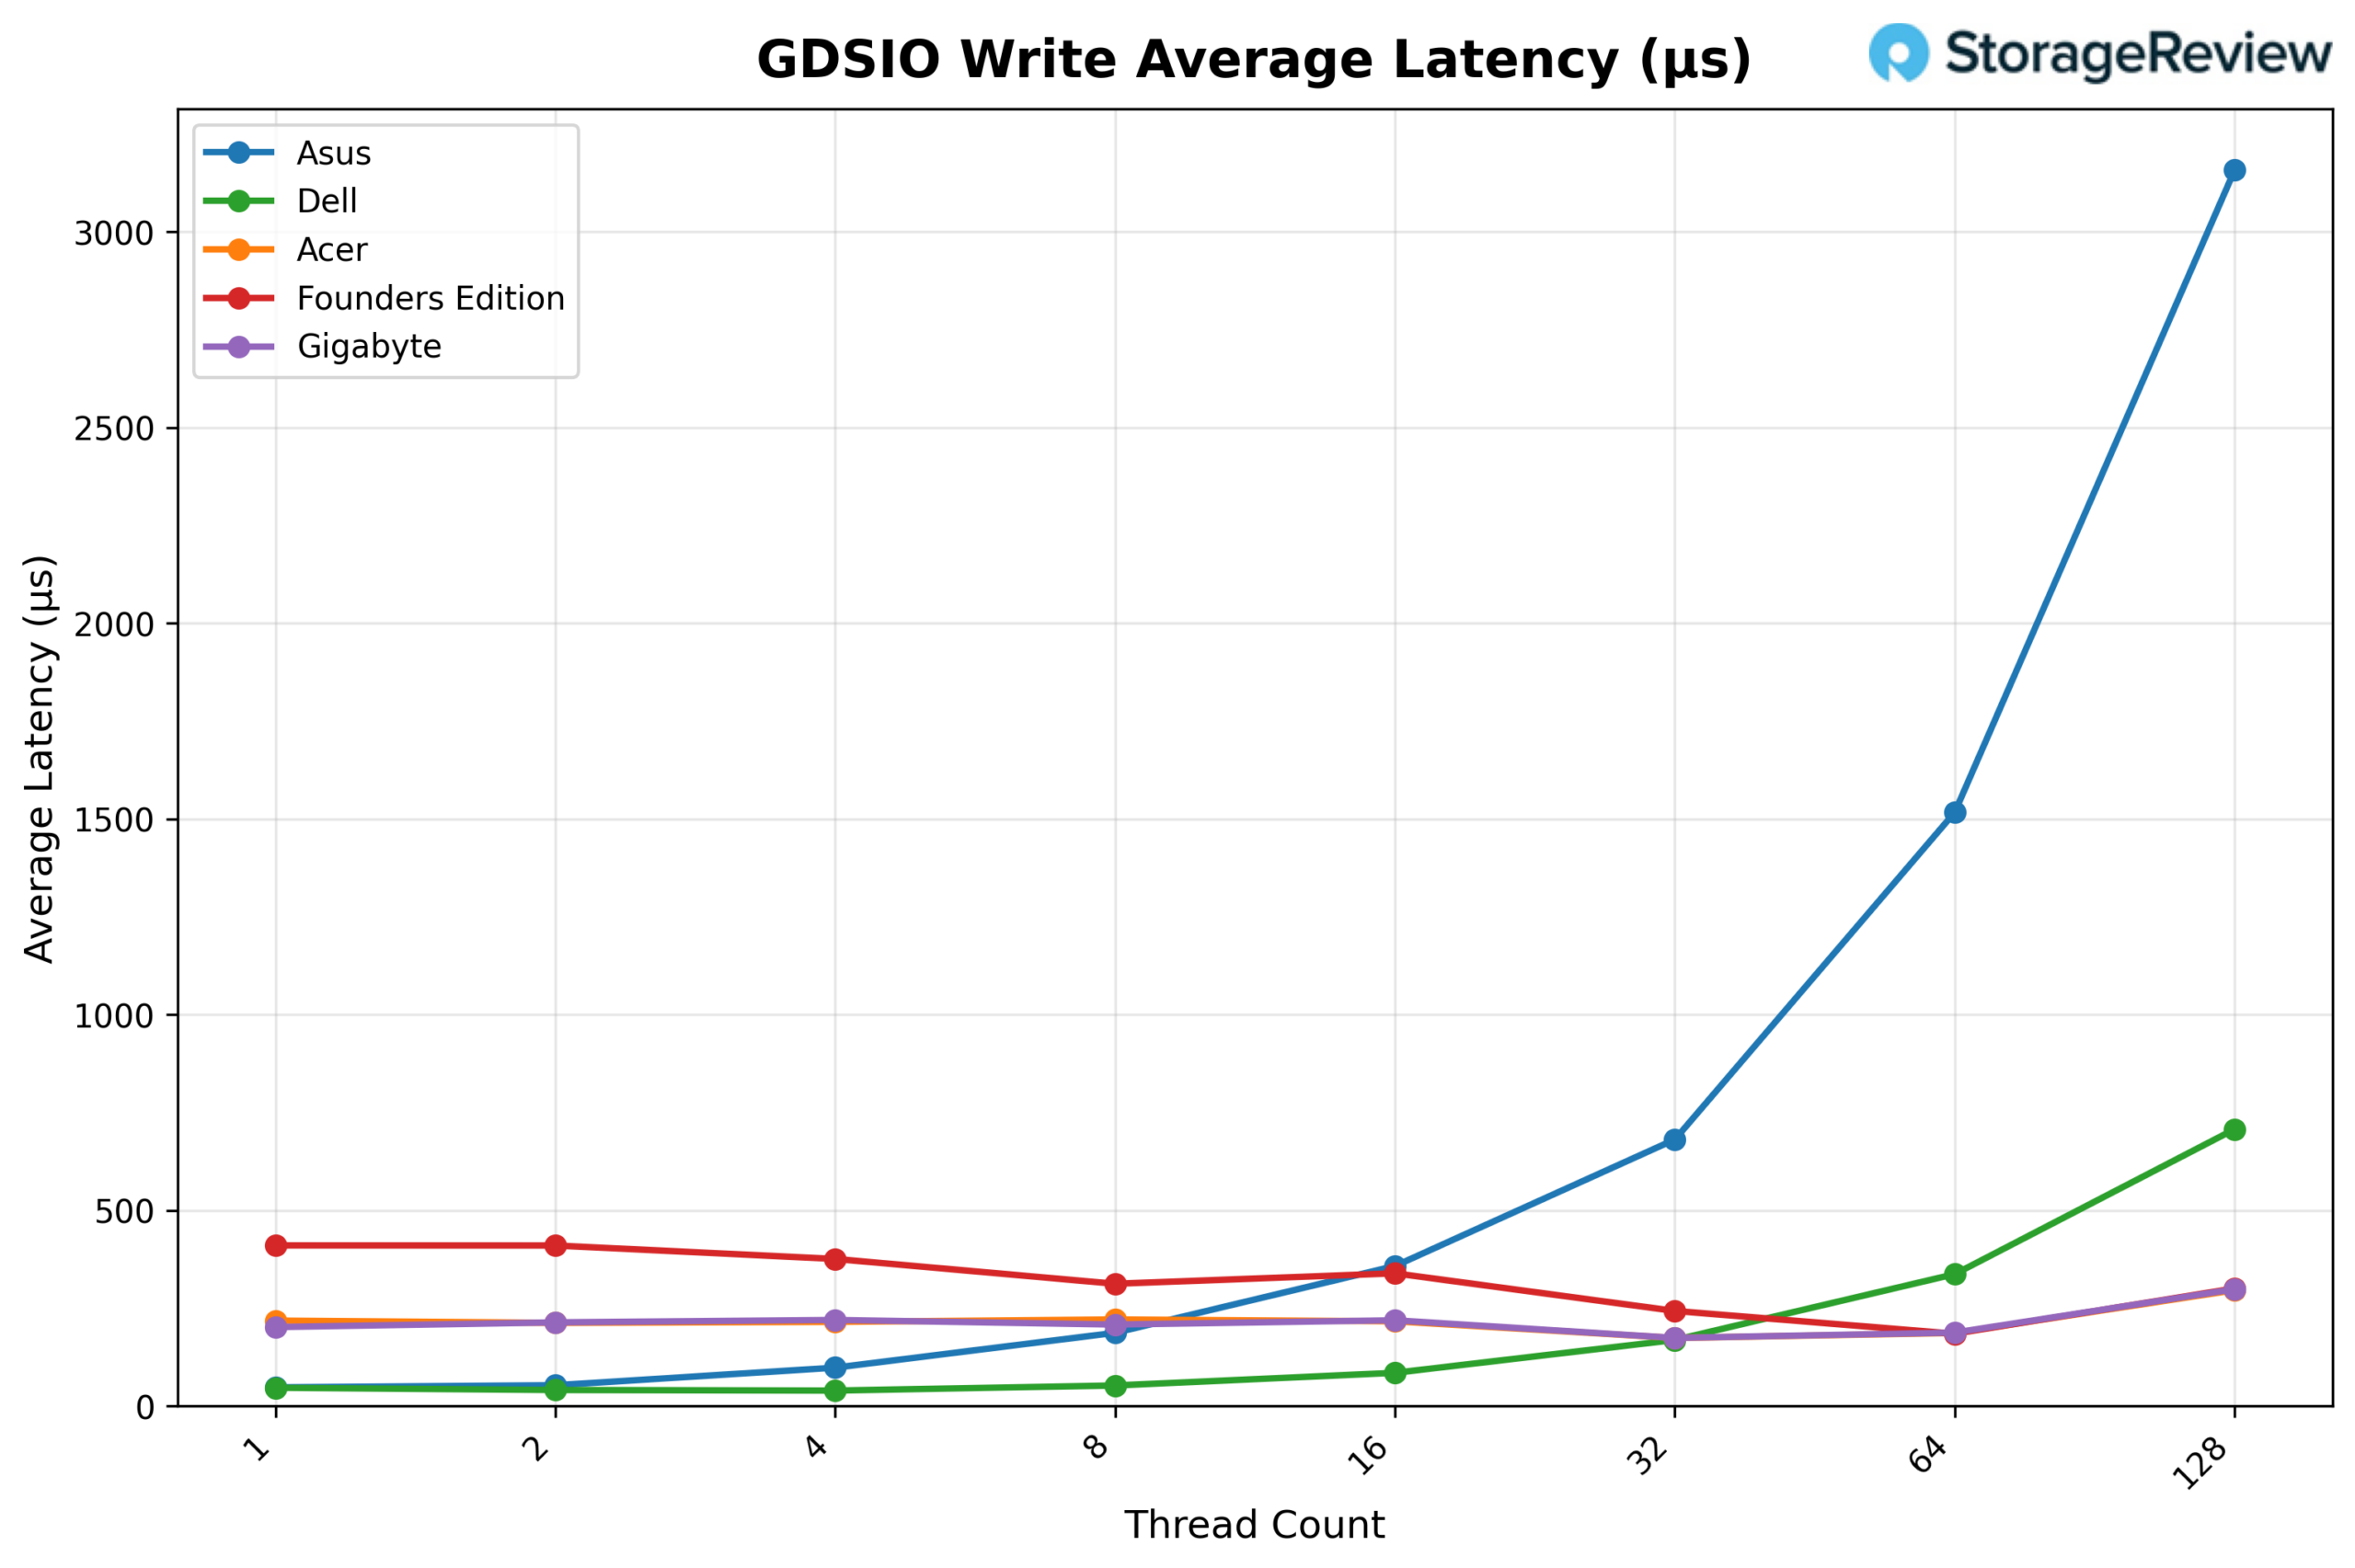
GDSIO 寫入平均延遲 1M
從 GDSIO 寫入平均延遲(1M)來看,華碩主機板在單執行緒時延遲約 1.00 毫秒,雙執行緒時上升至 2.31 毫秒,四執行緒時上升至 4.78 毫秒。隨著並發數的增加,延遲急劇上升,在 8 個執行緒時達到 10.19 毫秒,16 個執行緒時達到 23.12 毫秒,32 個執行緒時達到 54.67 毫秒。在 64 個執行緒時,延遲繼續快速上升(103.25 毫秒),之後回落至 128 個執行緒時的 62.97 毫秒,這與在最大並發數下觀察到的部分吞吐量恢復現象相符。
結語
華碩 Ascent GX10 是基於 NVIDIA GB10 架構的 Spark 平台的又一力作,它採用與我們測試過的同類產品相同的底層電路板和晶片。這意味著其核心計算性能基本一致。在 vLLM 測試中,GX10 在 GPT-OSS、Qwen3-Coder 和 Llama 3.1 等多種 Spark 系統模型上的表現都非常接近。其擴展性能也保持了可預測性,在處理大量預填充任務時吞吐量強勁,並且在大批量處理時性能穩步提升。
在運作階段,GX10 的溫度在同組產品中偏高,CPU 最高溫度達到 87.3°C,GPU 最高溫度達到 82°C,之後在持續高負載下趨於穩定。 NVMe 固態硬碟和網卡的溫度均在預期範圍內,顯示機殼的散熱性能良好,即使其峰值溫度並非同組產品中最低的。
GPU Direct Storage 是效能差異最顯著的一點,這主要受內建的 1TB Gen4 SSD 的影響。讀取效能雖然能夠滿足需求,但排名靠後;寫入吞吐量在峰值並發時延遲較高,且較早達到瓶頸。如果換用更好的 SSD,效能會有顯著提升。
由於所有 Spark 系統都採用相同的電路板和 GB10 超級晶片,因此效能差異微乎其微。實際上,最終的選擇取決於儲存配置、散熱、實體設計以及廠商的契合度,而非原始的運算能力。
排行榜:華碩 Ascent GX10 已入選我們「最佳本地 AI 桌上型電腦」排行榜。


 Amazon