

隨著NVIDIA DGX Spark平台的首次發布,我們現在看到不同的廠商將基於GB10 Grace Blackwell的平台封裝到各自的緊湊型桌上型電腦系統中。雖然核心主機板和晶片保持標準化,但在機箱設計、散熱方案、儲存配置和整體效能方面卻出現了差異。這次評測,我們將聚焦在技嘉搭載AI TOP ATOM處理器的版本。
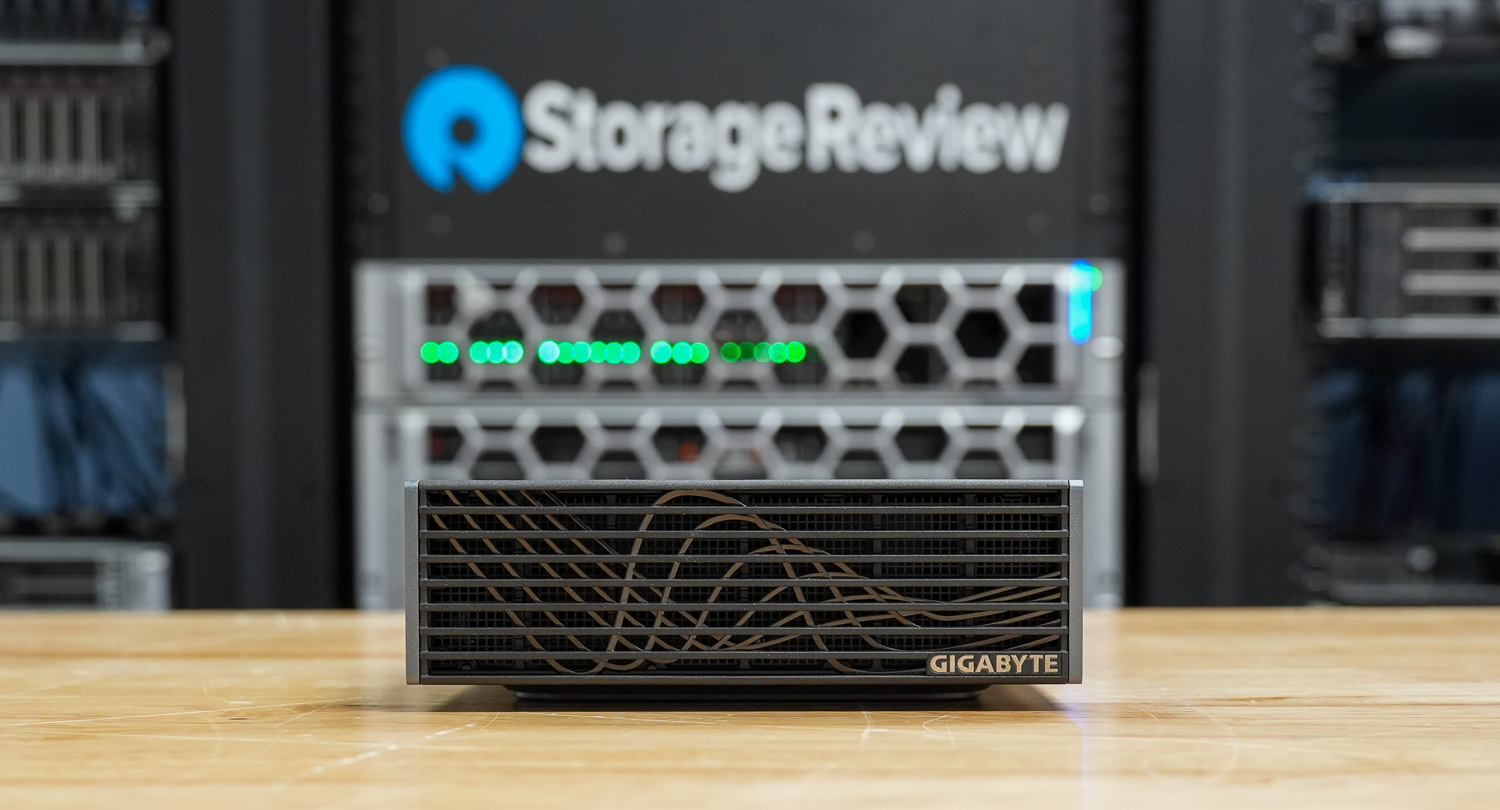
內部搭載了相同的GB10超級晶片,配備20核心Arm CPU複合體、Blackwell AI加速處理器和128GB統一LPDDR5X記憶體。該架構支援高達1 petaflop的FP4運算能力,並可建模高達200億個參數,使其穩居工作站級AI產品之列。
AI TOP ATOM 採用緊湊的 1 公升機箱,尺寸為 150 x 150 x 50.5 毫米,並由 240W 外接式電源轉接器供電。雖然其運算核心與其他 Spark 系統相同,但我們將深入探討技嘉的設計選擇如何影響其散熱、持續工作負載效能、儲存效能以及日常使用體驗。
儲存選項可擴充至 4TB 第五代 NVMe 固態硬碟,系統預先安裝基於 Ubuntu 的 NVIDIA DGX 作業系統,開箱即可應對 AI 工作負載。簡而言之,雖然核心運算硬體與其他 Spark 系列系統相同,但使用者體驗、散熱、噪音和整體外觀都取決於技嘉在這款緊湊型機殼中所提供的配置。
在本評測中,我們將檢視技嘉的 Spark 平台在持續工作負載、散熱性能和日常使用性方面的表現,以及其緊湊的外形尺寸是否會帶來任何明顯的妥協。
| 規格 | 技嘉 AI TOP ATOM (GB10) |
|---|---|
| 尺寸和重量 | |
| 高度 | 2在 |
| 信號寬度 | 5.9在 |
| 深度 | 5.9在 |
| 重量 | 2.64磅 |
| 處理器 | |
| 處理器類型 | NVIDIA GB10(Grace Blackwell Superchip)(20 核心) |
| 集成顯卡 | NVIDIA Blackwell GPU(整合式顯示卡) |
| 記憶體應用 | |
| 內存類型 | LPDDR5x(統一系統記憶體) |
| 內存配置 | 128 GB LPDDR5x 統一系統內存 |
| 內存帶寬 | 273 GB/s (8533 MT/s) |
| 操作系統 | |
| 支持的操作系統 | NVIDIA DGX 作業系統 |
| 外部連接埠和插槽 | |
| 網絡端口 | 一個 RJ45 (10GbE) NVIDIA ConnectX-7 網路卡(200G × 2 QSFP) |
| USB端口 | 三個 USB 3.2 Gen 2×2 Type-C (20Gbps) 一個支援PD的USB 3.2 Gen 2×2 Type-C接口 |
| 視訊連接埠 | 一個 HDMI 2.1a 接口 |
| 電源適配器端口 | USB Type-C(PD 輸入) |
| 安全槽 | 無 |
| 無線應用 | |
| WiFi | WiFi 7(AW-EM637,2×2) |
| 藍牙 | 藍牙5.4 |
| 儲存 | |
| 儲存選項 | 最高支援 4 TB Gen5 NVMe(支援自加密) |
| 電源適配器 | |
| 類型 | 240W 外置轉接器(USB Type-C) |
技嘉 AI TOP ATOM 設計製造
技嘉 AI TOP ATOM 延續了 Spark 系列系統一貫的 150 x 150 毫米尺寸,高度為 50.5 毫米,重量為 1.2 公斤。它足夠小巧,可以放在桌面上,但拿在手中卻感覺厚實穩重。其表面採用深色霧面處理,更添工作站的質感。
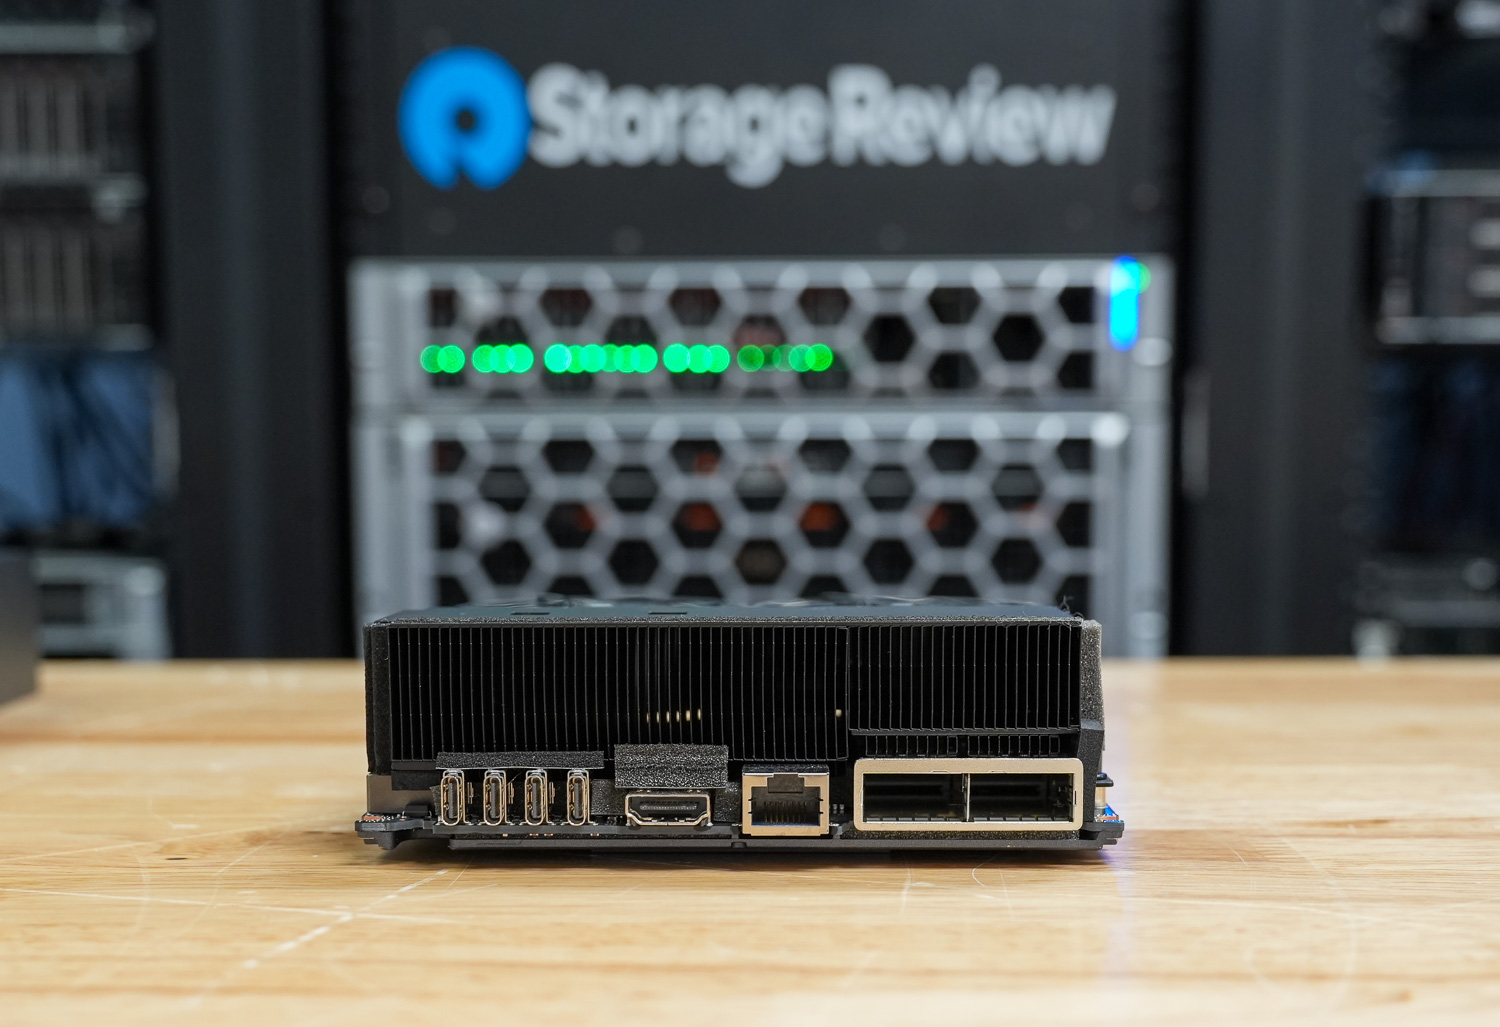
這款筆記型電腦的前面板並非採用簡單的平面格柵,而是由水平條狀散熱格柵和其後微妙的波浪紋理構成,從不同角度觀看時,都能呈現出豐富的層次感和質感。這是一款以散熱為核心的設計。技嘉的標誌位於面板的下角,正面沒有數據接口,甚至連電源按鈕也沒有,因此面板保持簡潔,並專注於空氣流通。
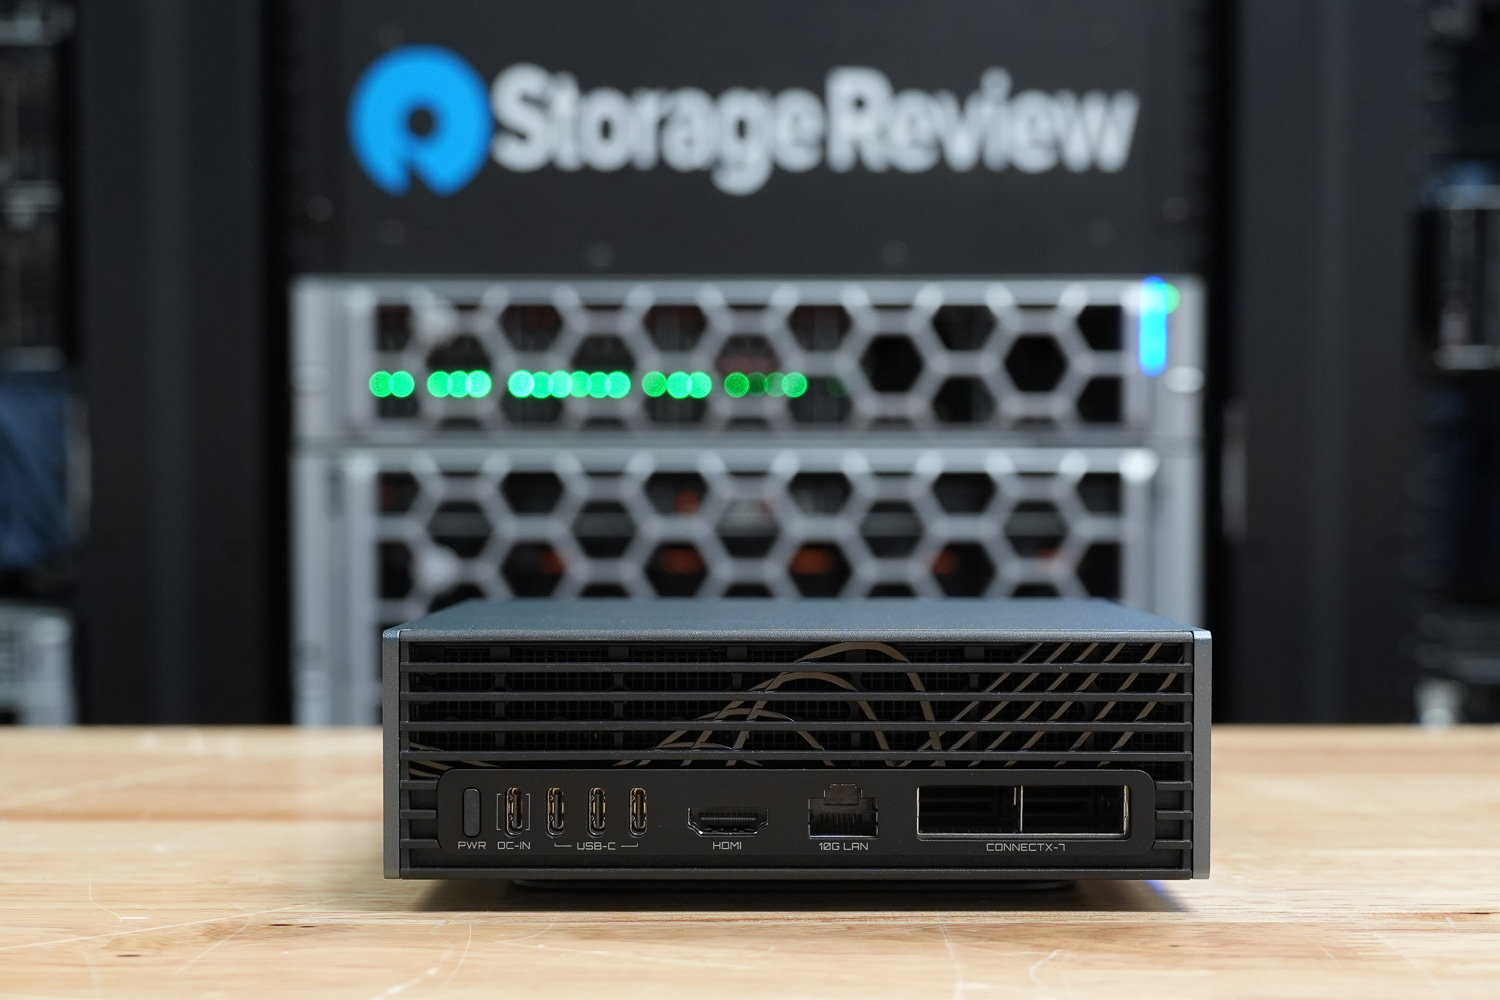
所有介面均位於後面板。它配備三個 USB 3.2 Gen 2×2 Type-C 接口,傳輸速度高達 20Gbps,此外還有一個專用於供電的 USB Type-C 接口。顯示輸出方面,它配備一個 HDMI 2.1a 介面。網路方面,它配備 10GbE RJ-45 介面以及 NVIDIA ConnectX-7 智慧網卡,支援高速資料傳輸,並可用於連接多個系統,方便您建置更大型的網路環境。技嘉還在側面板上配備了一個 Kensington Nano 安全鎖槽。
AI TOP ATOM 內部搭載 NVIDIA GB10 Grace Blackwell 超級晶片,採用 20 核心 Arm CPU 配置和整合 Blackwell 顯示卡。它配備 128 GB LPDDR5x 統一內存,採用 256 位元接口,可提供高達 273 GB/s 的頻寬。與其他 GB10 系統一樣,CPU 和 GPU 共享相同記憶體池,這對於這些機器處理 AI 工作負載的設計至關重要。
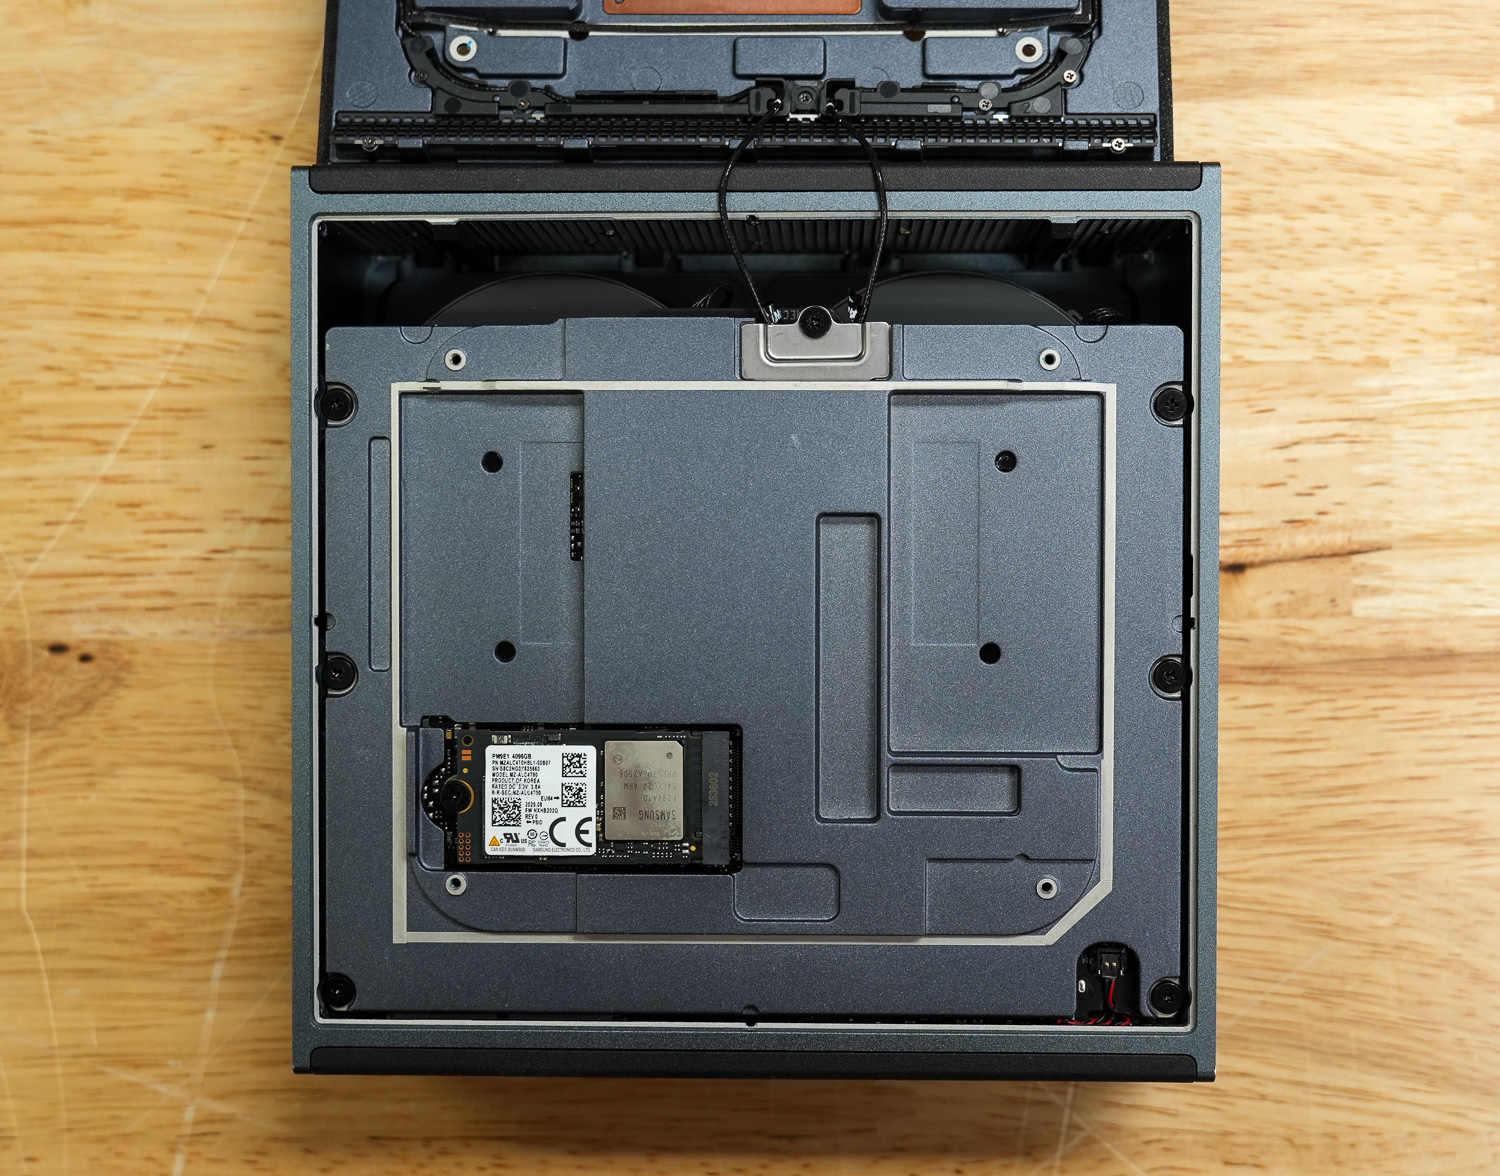
儲存方面,最高支援 4TB Gen5 NVMe SSD(視配置而定),電源由 240W 外接式轉接器提供。無線連接方面,支援 WiFi 7 和藍牙 5.4,同時還整合了 10GbE 網路卡,可提供有線連接效能。
技嘉 AI TOP ATOM 散熱測試
為了測試技嘉 AI TOP ATOM 主機板內部組件的散熱性能,我們將其與公版主機板以及華碩、宏碁和戴爾等 OEM 廠商的產品進行了比較。我們在Spark 散熱測驗論文中對此進行了更深入的探討。
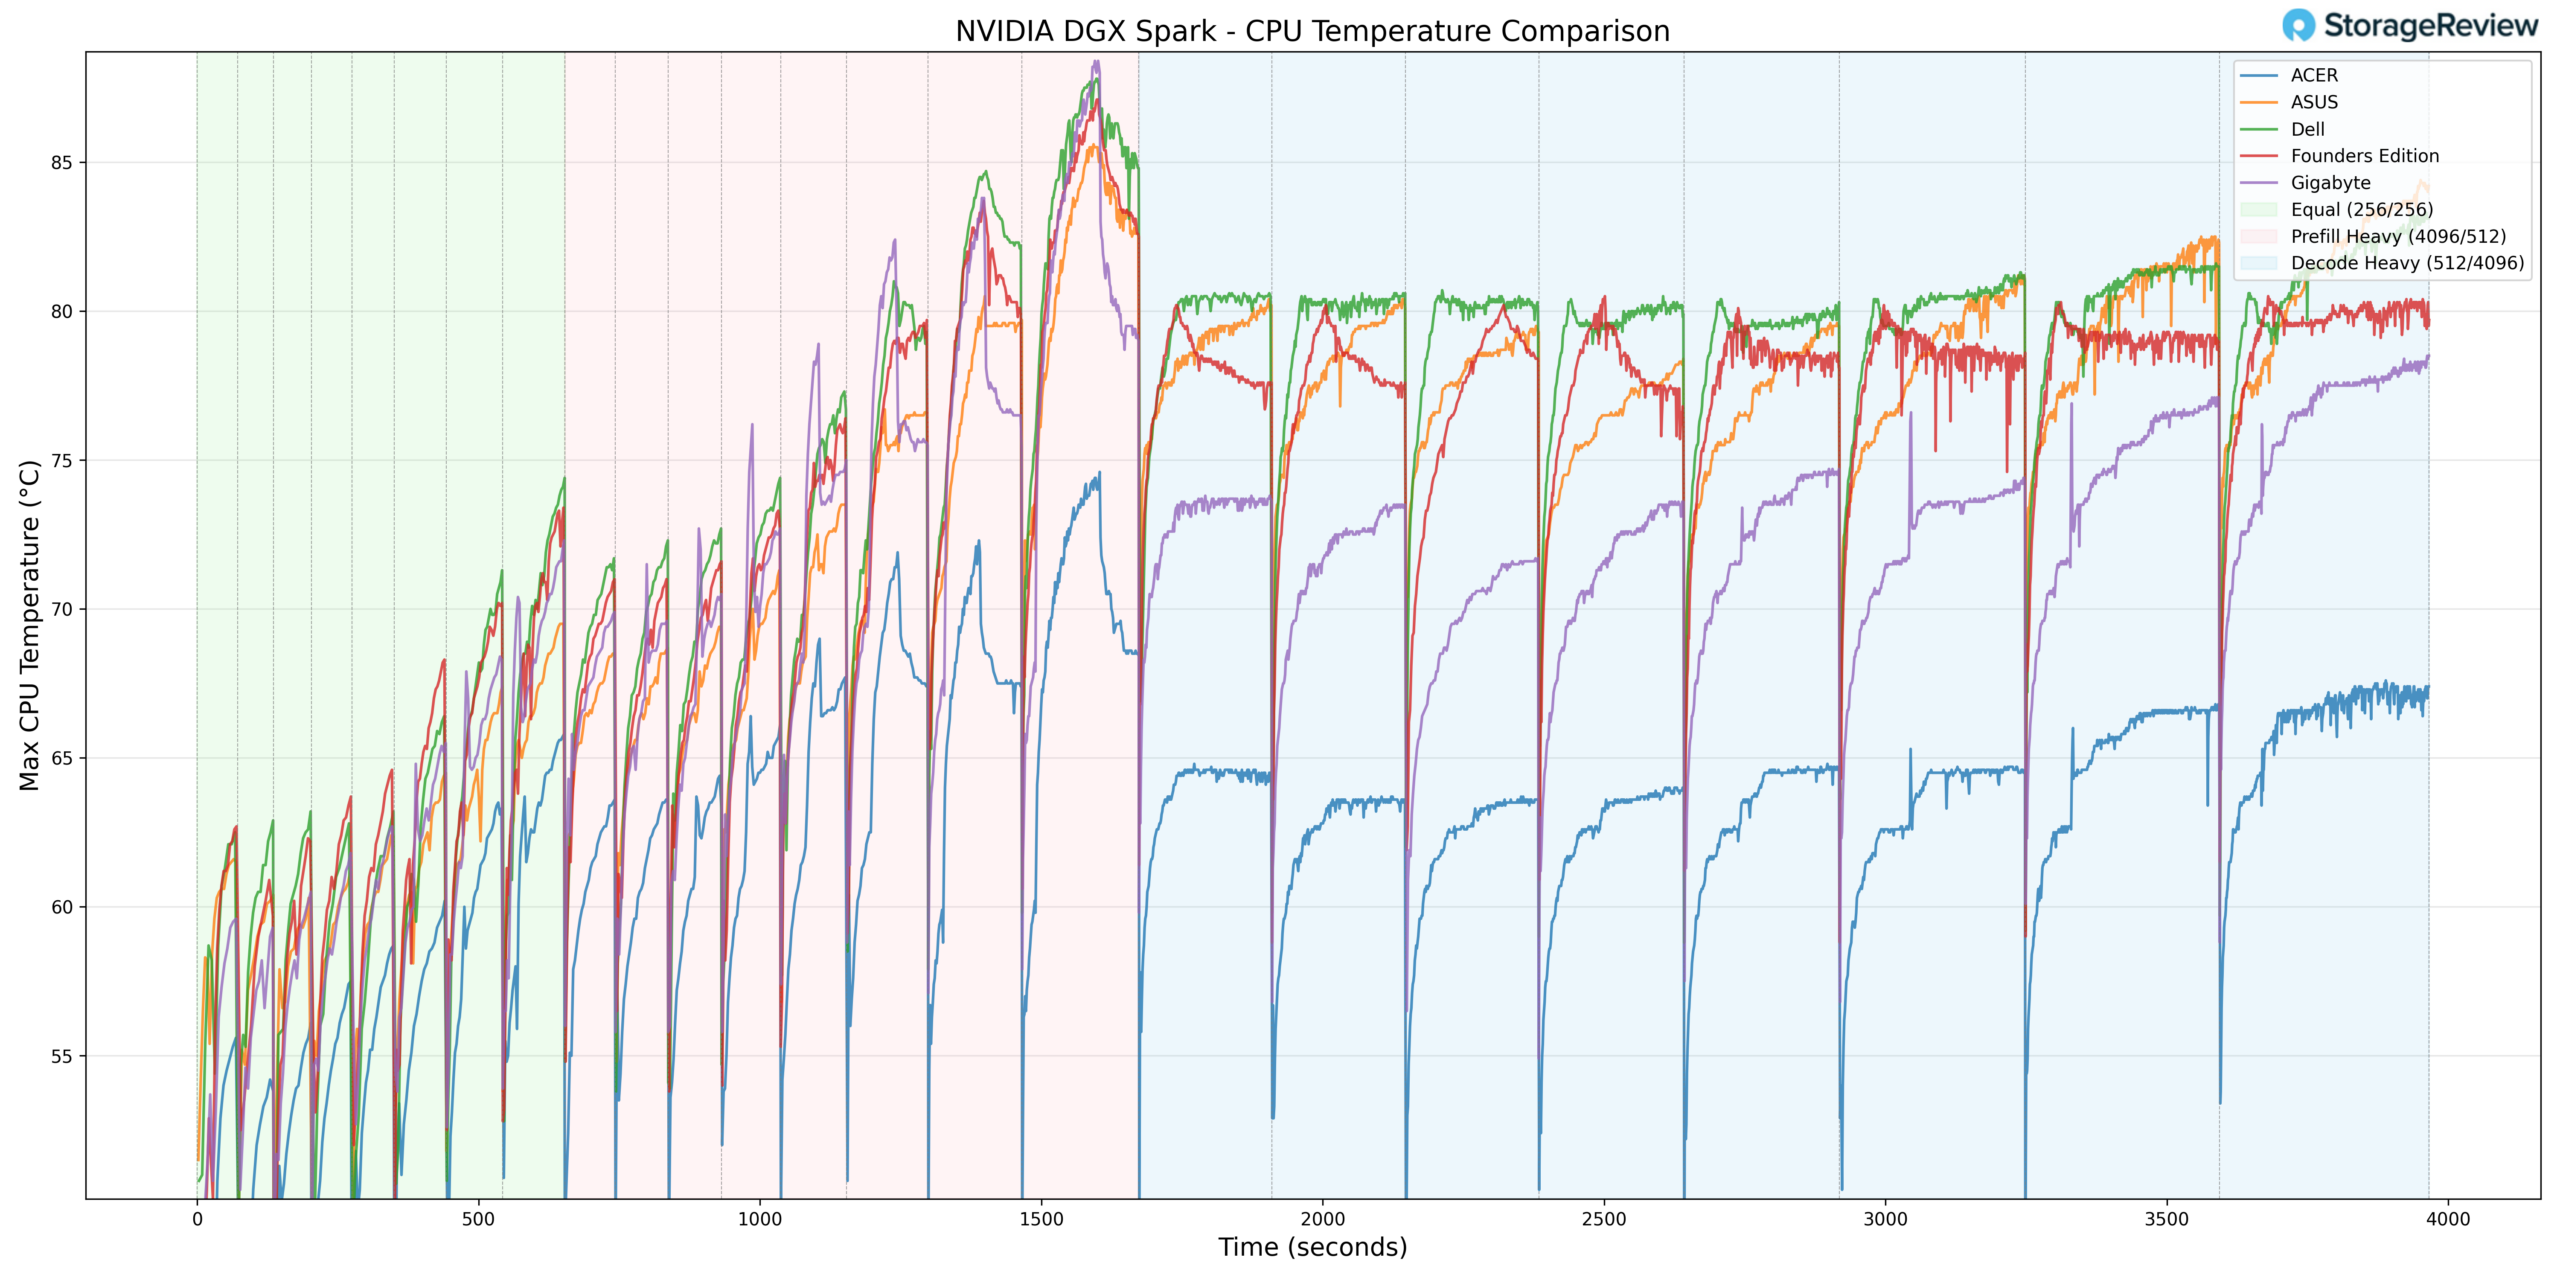
我們對整個堆疊中的各個組件在給定的時間段內進行了監控,工作負載分為三個階段,利用率在大約一小時內逐步提升。這使我們能夠觀察設備在長時間使用和不同工作負載階段的效能。我們監控了 CPU、GPU、網路、NVMe 的溫度以及總功耗。
CPU溫度
在CPU熱測試中,技嘉系統在突發性高負載預填充轉換期間最高溫度達到90°C。這使其在對比組中接近高負載運行時觀察到的CPU峰值溫度上限。
當負載過渡到均衡的 ISL/OSL 模式,最終進入解碼密集型工作負載時,溫度曲線趨於穩定,不再持續攀升。在持續負載下,CPU 溫度保持在可控範圍內,這表明較高的峰值溫度與短時負載上升有關,而非長期散熱能力不足。
在低負載情況下,CPU在空閒或輕負載條件下的最低溫度為38.7°C。這一較低的基準溫度反映了其在空閒狀態下的高效散熱,並表明該散熱方案在非高峰時段也能保持足夠的散熱餘裕。
整體而言,技嘉處理器的突發CPU溫度較高,但一旦工作負載恢復正常,就能維持穩定的持續效能。
GPU溫度
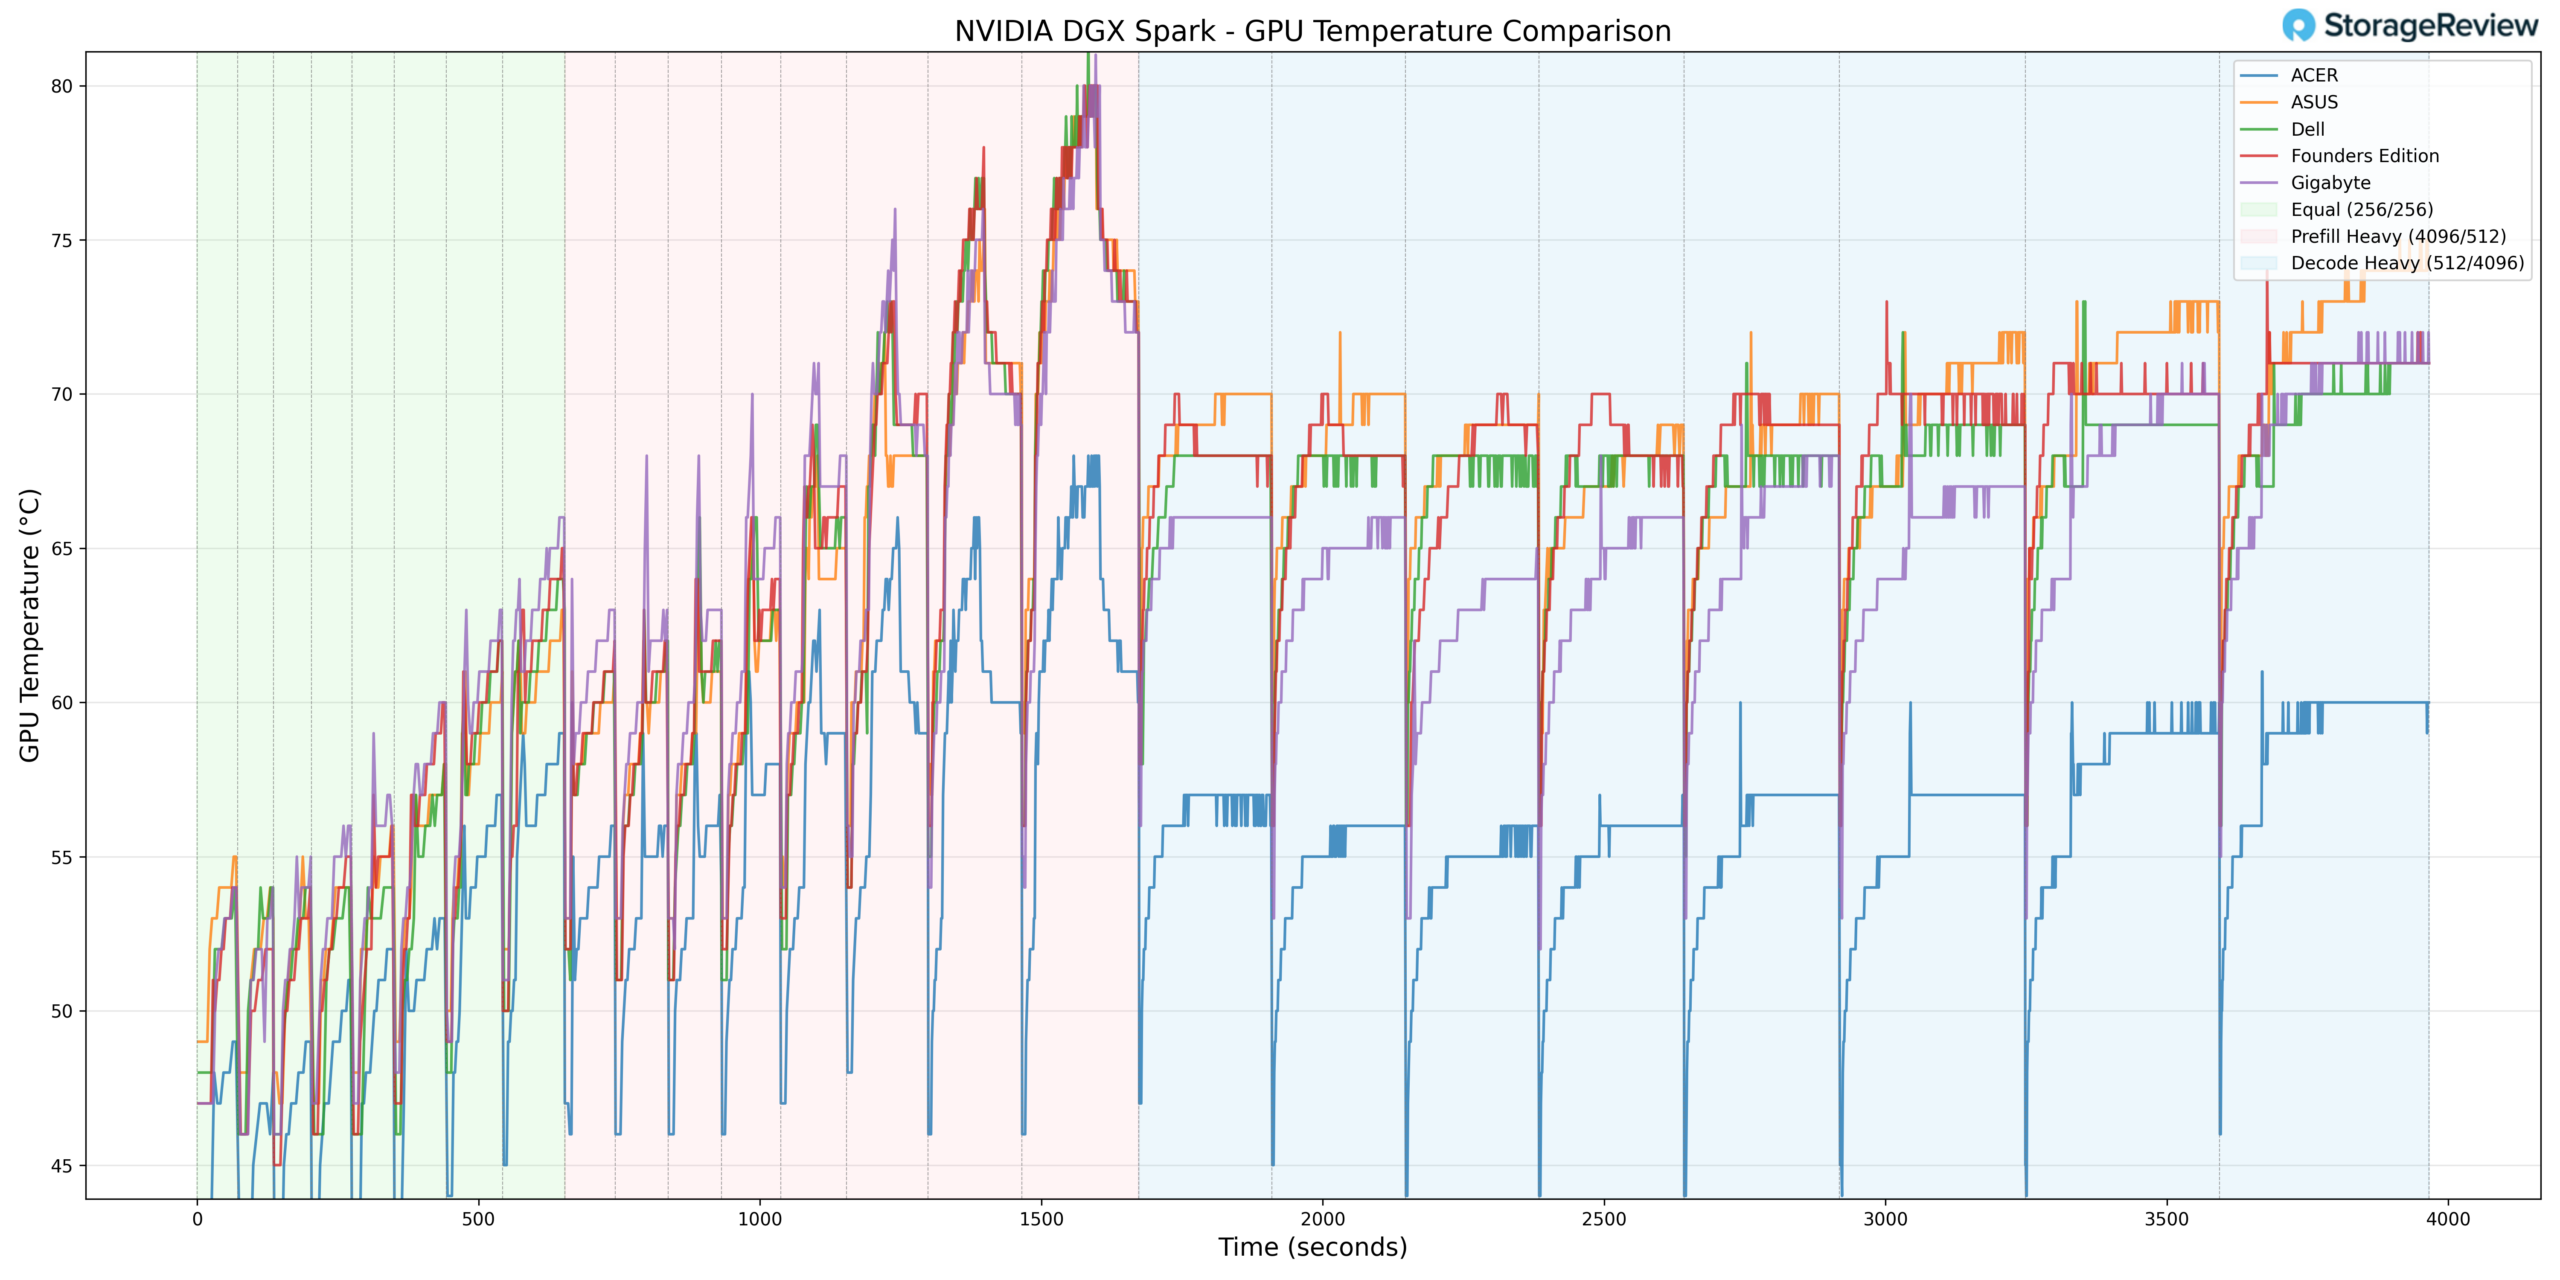
GPU 的溫度變化趨勢類似。在預填充重負載運轉時,GPU 最高溫度達到 81°C。這使其在突發重加速期間的溫度偏高,但仍在 GB10 平台的預期運作規格範圍內。
隨著工作負載過渡到 ISL/OSL 相等和解碼密集型階段,GPU 溫度趨於穩定,而不是繼續攀升。
在空閒或低利用率情況下,GPU 記錄的最低溫度為 37°C,表示當系統沒有承受計算壓力時,其基準熱控制良好。
綜合來看,技嘉的GPU性能體現了積極的突發利用率和穩定的持續散熱。
NVMe溫度
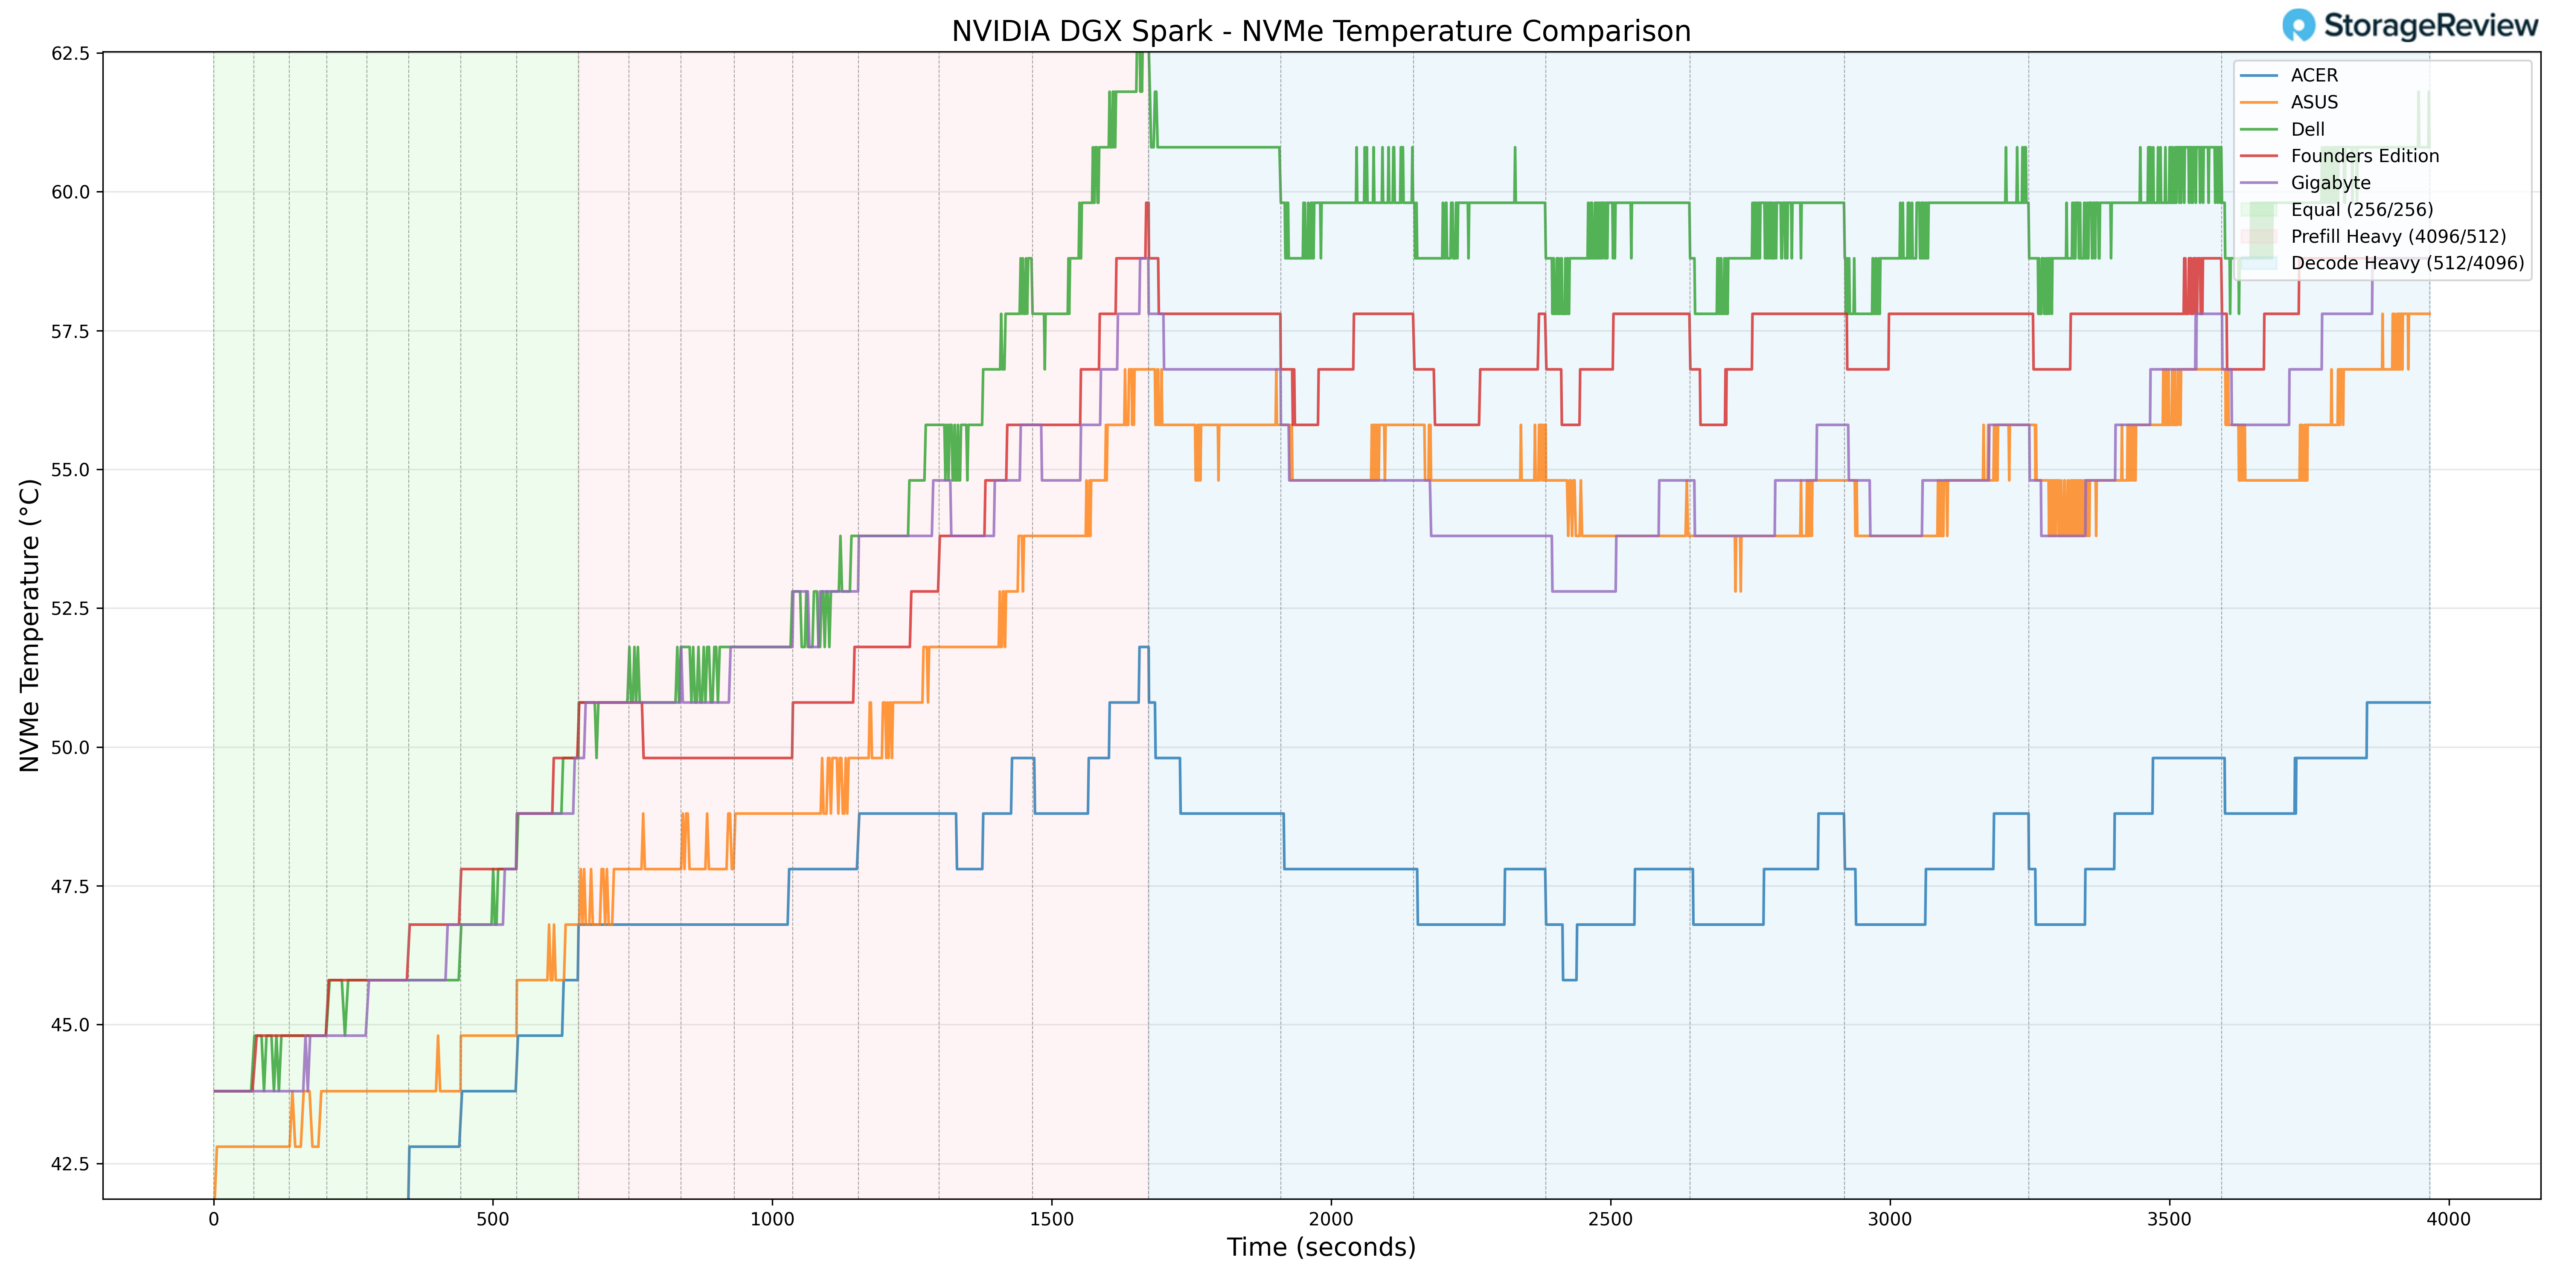
測試過程中,儲存設備的溫度控制始終良好。 NVMe 固態硬碟在高負載運作階段的最高溫度為 59.8°C。此峰值溫度遠低於常見的降頻閾值,表示機殼內部氣流充足或硬碟擺放位置合理。
在負載較輕的階段,NVMe 驅動器的最低溫度降至 37.8°C,這進一步證實了儲存散熱在靜止狀態下不受限制。
與一些緊湊型桌面應用相比,在負載下保持在 60°C 以下反映了良好的儲存散熱管理。
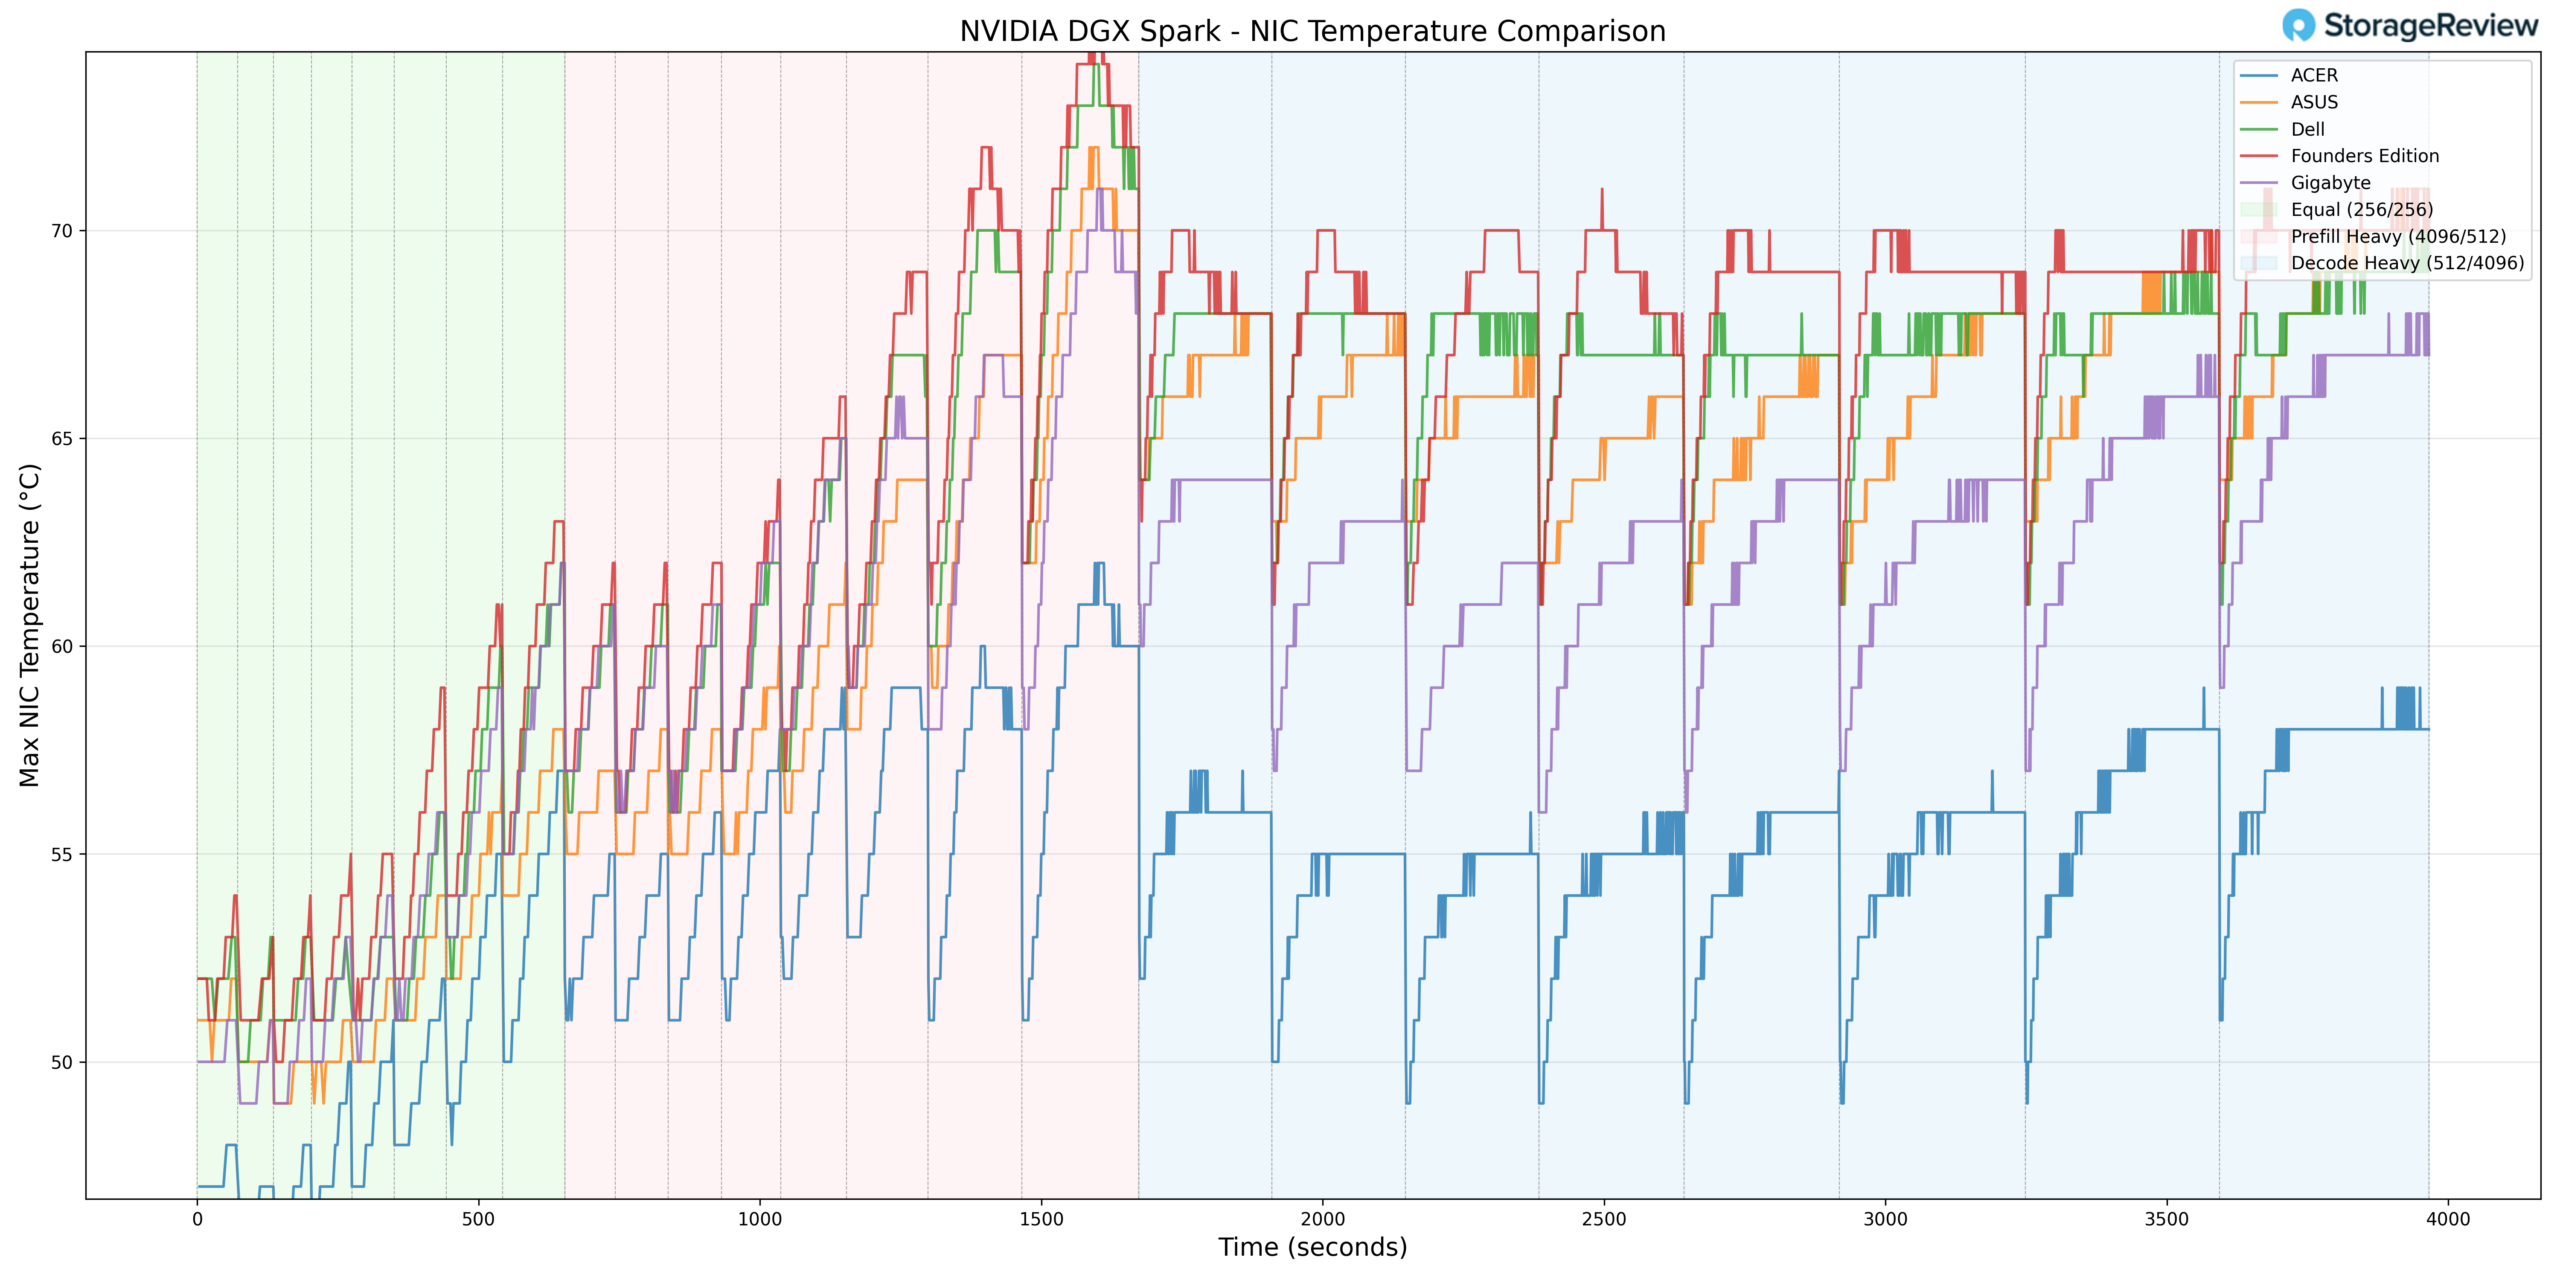
NIC 溫度
在高負載階段,網路卡溫度峰值達到 72°C,這與預填充和解碼轉換期間的高吞吐量相吻合。雖然這使得網路控制器在高峰活動期間位於堆疊中溫度較高的一側,但溫度始終保持在運行容差範圍內,並未出現溫度尖峰。
記錄到的最低 NIC 溫度為 41°C,反映了光照較淺階段的正常基線行為。
整體而言,網卡效能與系統整體負載呈現可預測的趨勢,並沒有出現異常的擴展性。
GPU功耗
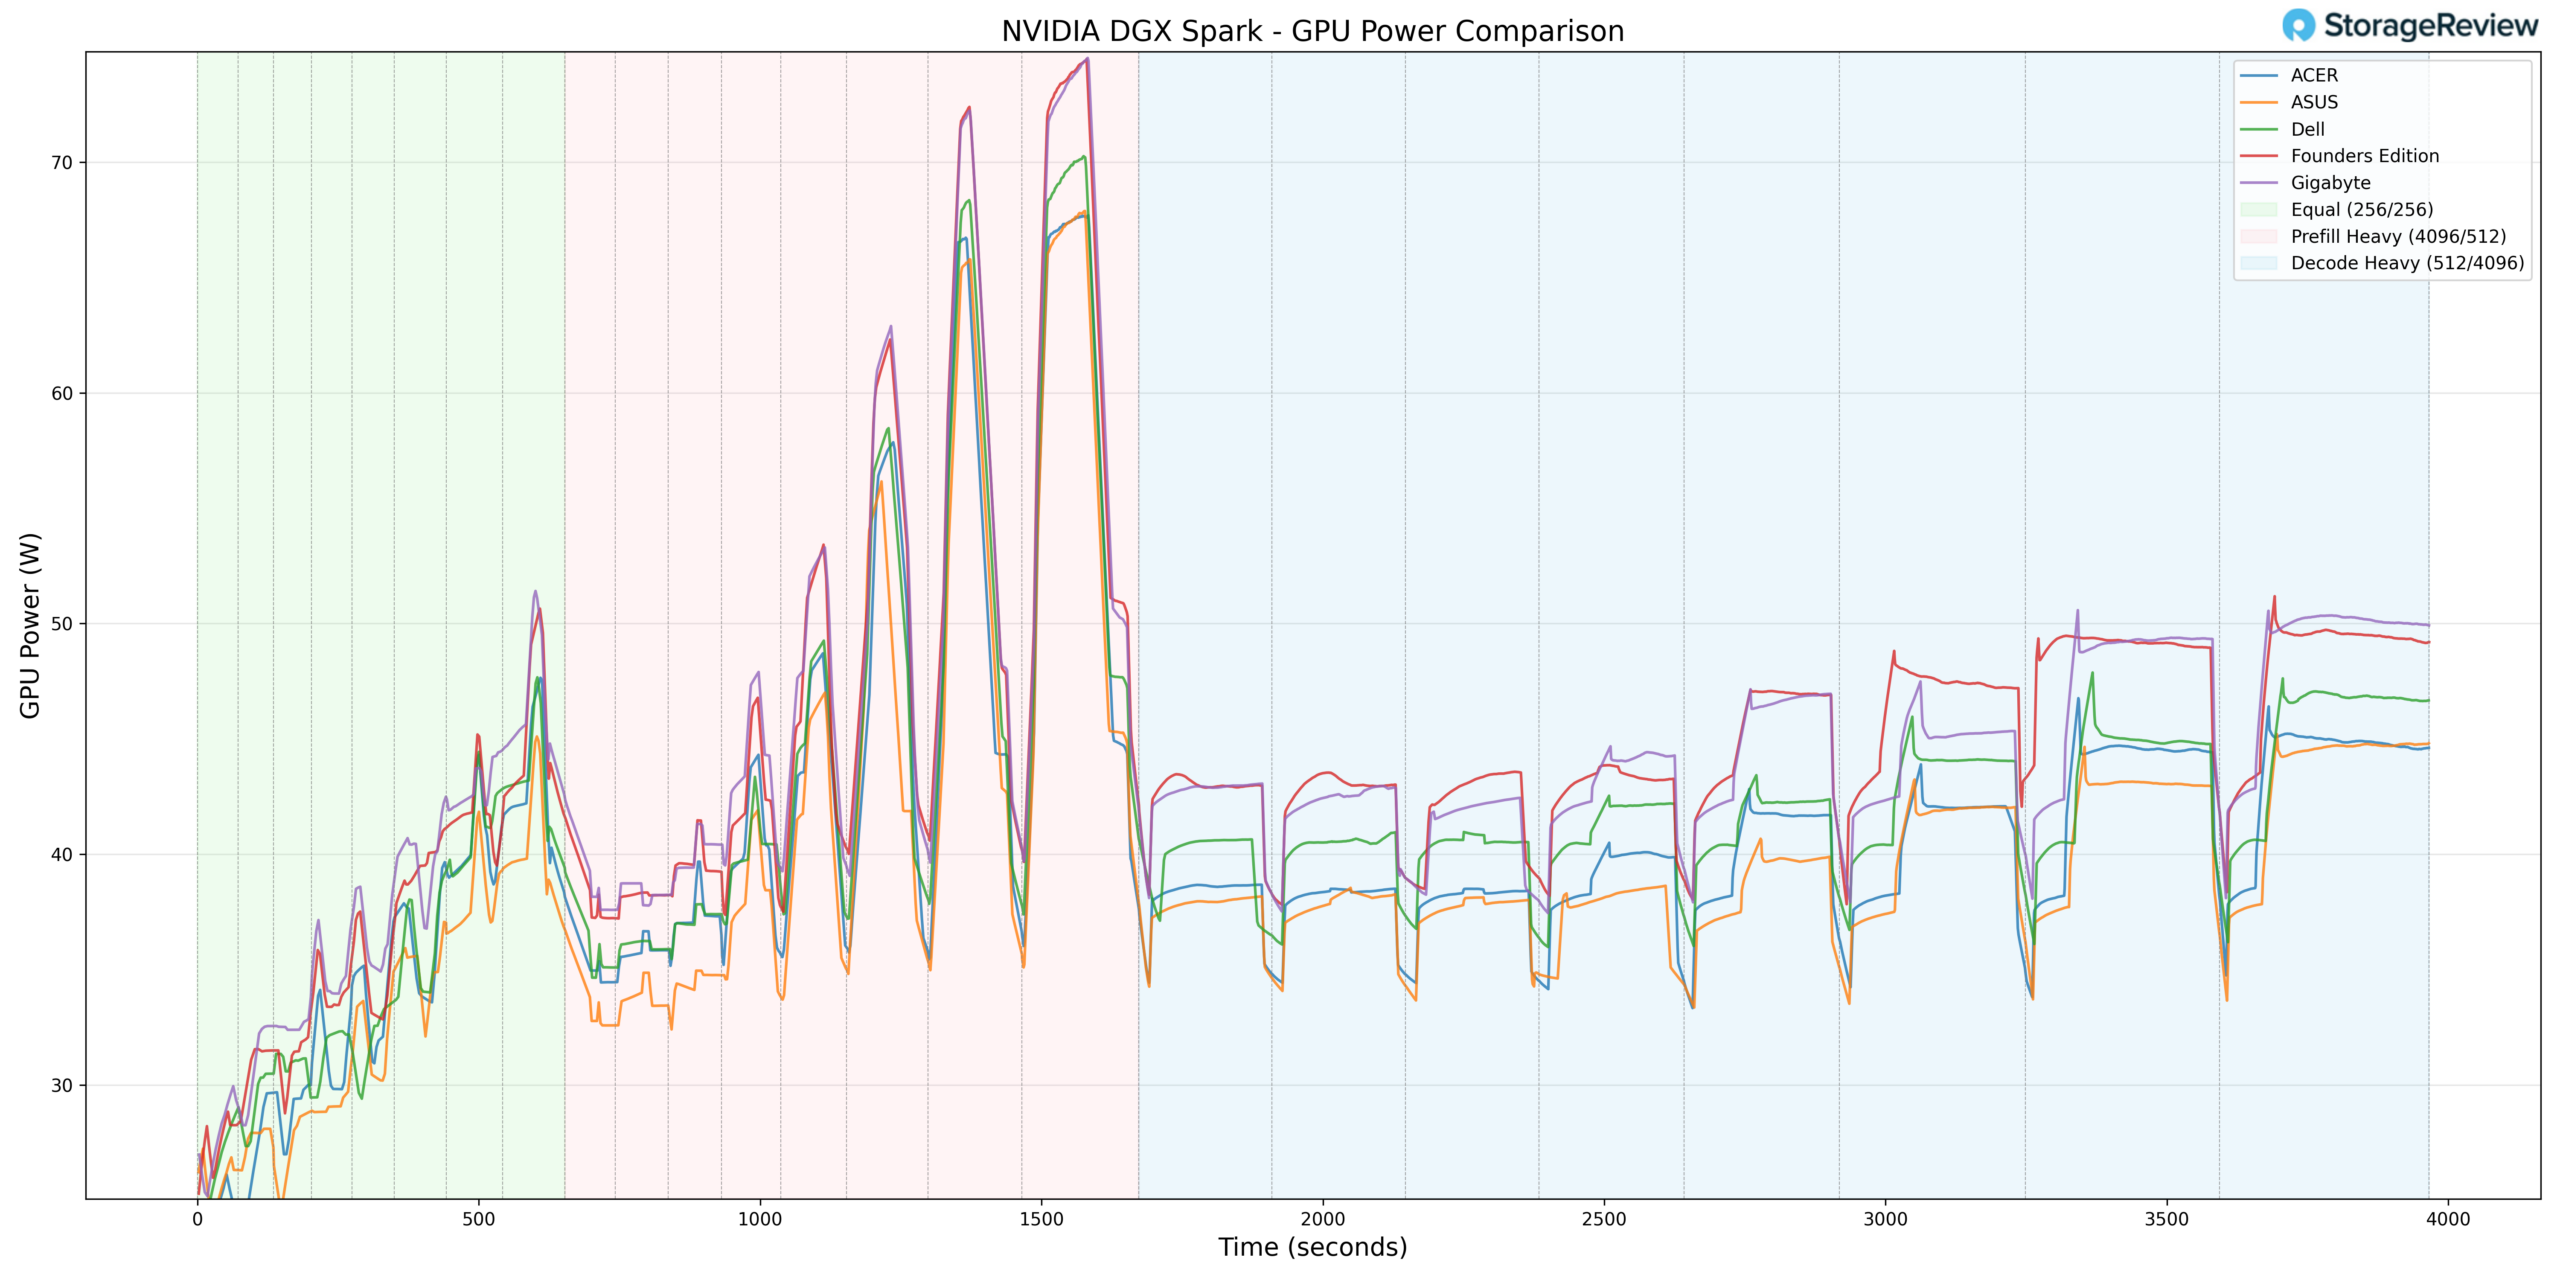
GPU 功耗表現有助於理解峰值溫度升高的原因。技嘉在預填充重度切換期間,GPU 峰值功耗達到了 75.54W。這使其處於所測試 GB10 機型中觀察到的功耗範圍的上限。
技嘉似乎沒有人為限制GPU功耗,而是允許GPU在接近峰值功耗時出現峰值,這與GPU較高的峰值溫度直接相關。隨著工作負載進入持續解碼階段,功耗也隨之趨於穩定。
從功耗角度來看,技嘉的這套系統似乎並沒有過度驅動。相反,其在突發模式下較高的峰值溫度,是出於性能優先的功耗分配考慮,而非散熱設計失控所致。
熱力總結
在對 CPU、GPU、NVMe 和網路卡進行全面監控後發現,技嘉 GB10 的待機溫度表現出色,並且在預填充密集型任務切換期間,峰值溫度更高。在峰值加速下,CPU 溫度達到 90°C,GPU 溫度達到 81°C,而 NVMe 溫度保持在 60°C 以下,網卡溫度達到 72°C。 GPU 功耗峰值達到 75.54W,顯示其峰值功耗接近上限。
在持續解碼工作負載下,溫度趨於穩定,沒有進一步升高,這表明技嘉雖然允許短時間內實現高負載性能,但在長時間運行期間仍能保持可預測、可控的散熱。
技嘉 AI TOP ATOM 效能測試
為了評估技嘉AI TOP ATOM,我們使用vLLM Online Serving基準測試對Spark單元進行了測試。 vLLM Online Serving基準測試是目前應用最廣泛的大型語言模式高吞吐量推理和服務引擎。此基準測試透過向運行中的vLLM伺服器發送並發請求來模擬真實生產環境中的工作負載,並測量關鍵指標,包括總令牌吞吐量(每秒令牌數)、首令牌到達時間和每個輸出令牌的產生時間,並考察不同負載條件下的效能。
我們的測試涵蓋了從密集架構到微擴展資料類型的各種模型。測試評估了三種工作負載場景下的效能:均衡 ISL/OSL、預填密集型和解碼密集型。這些場景代表了不同的實際服務模式,從均衡的輸入輸出負載到計算密集型的提示符號處理和記憶體頻寬受限的令牌產生。
除了技嘉 AI TOP ATOM 處理器之外,我們還以 NVIDIA Founders Edition Spark 作為參考基準,並比較了華碩、宏碁和戴爾等 OEM 廠商的系統。這使我們能夠將技嘉的測試結果置於更廣泛的競爭格局中,並了解其在不同型號和工作負載類型下處於領先地位、與競爭對手持平還是落後。
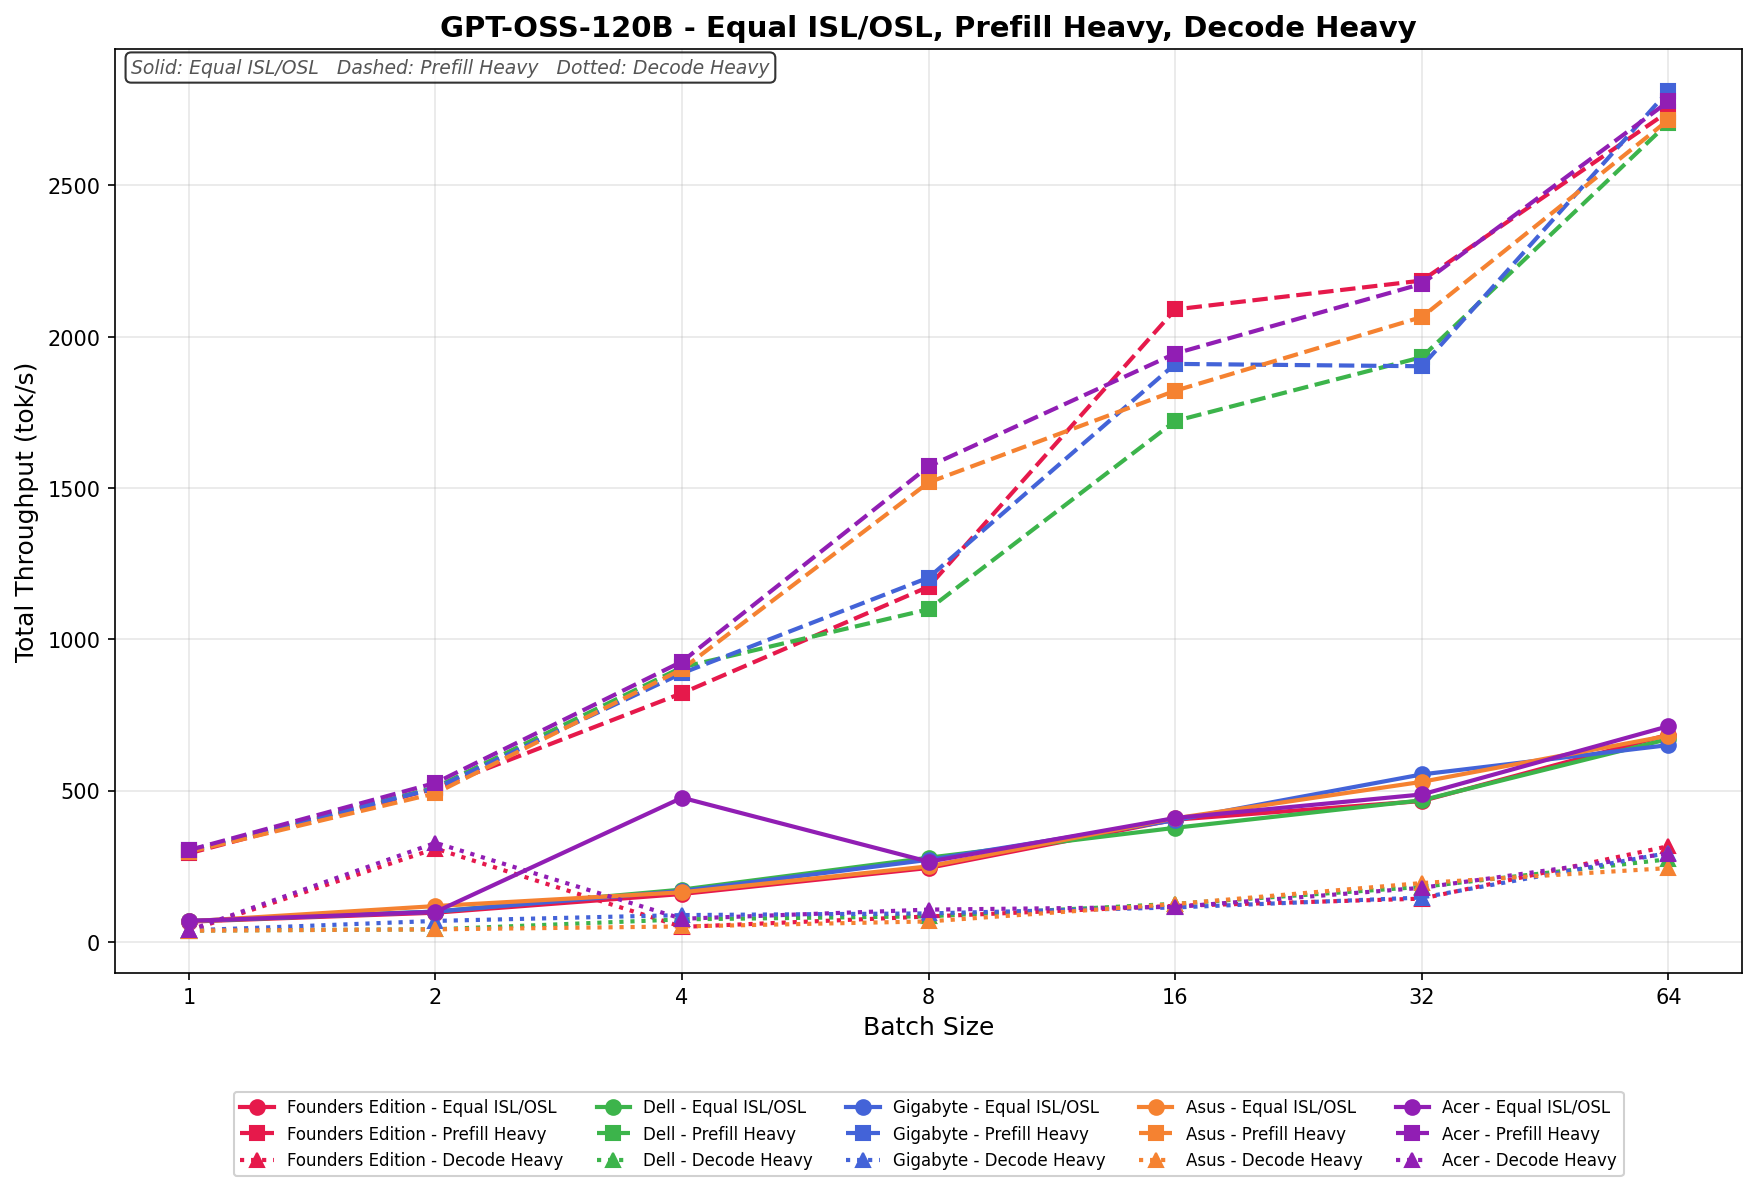
GPT-OSS-120B
在 ISL/OSL 相等的測試中,技嘉的晶片性能從 60.71 到 649.62 tok/s 提升,始終處於行業中游水平,在大批量生產時與戴爾和華碩的性能較為接近。在第 32 批之前,性能提升穩定且呈線性增長,並在第 64 批繼續提升,但最終未能超越高端廠商的領先水平。
預先填充重型晶片的初始速度為 304.63 tok/s,到批次大小 64 時攀升至 2,771.38 tok/s。成長勢頭強勁,直至第 16 批次,技嘉一度位列第三,之後隨著批次大小的增加而與其他廠商趨於一致。整體而言,技嘉的晶片擴展能力強勁且極具競爭力,尤其是在中等批次大小範圍內。
解碼重任務的速度範圍為 47.01 至 299.41 tok/s,在整個批次掃描過程中,速度逐漸且穩定地提升。
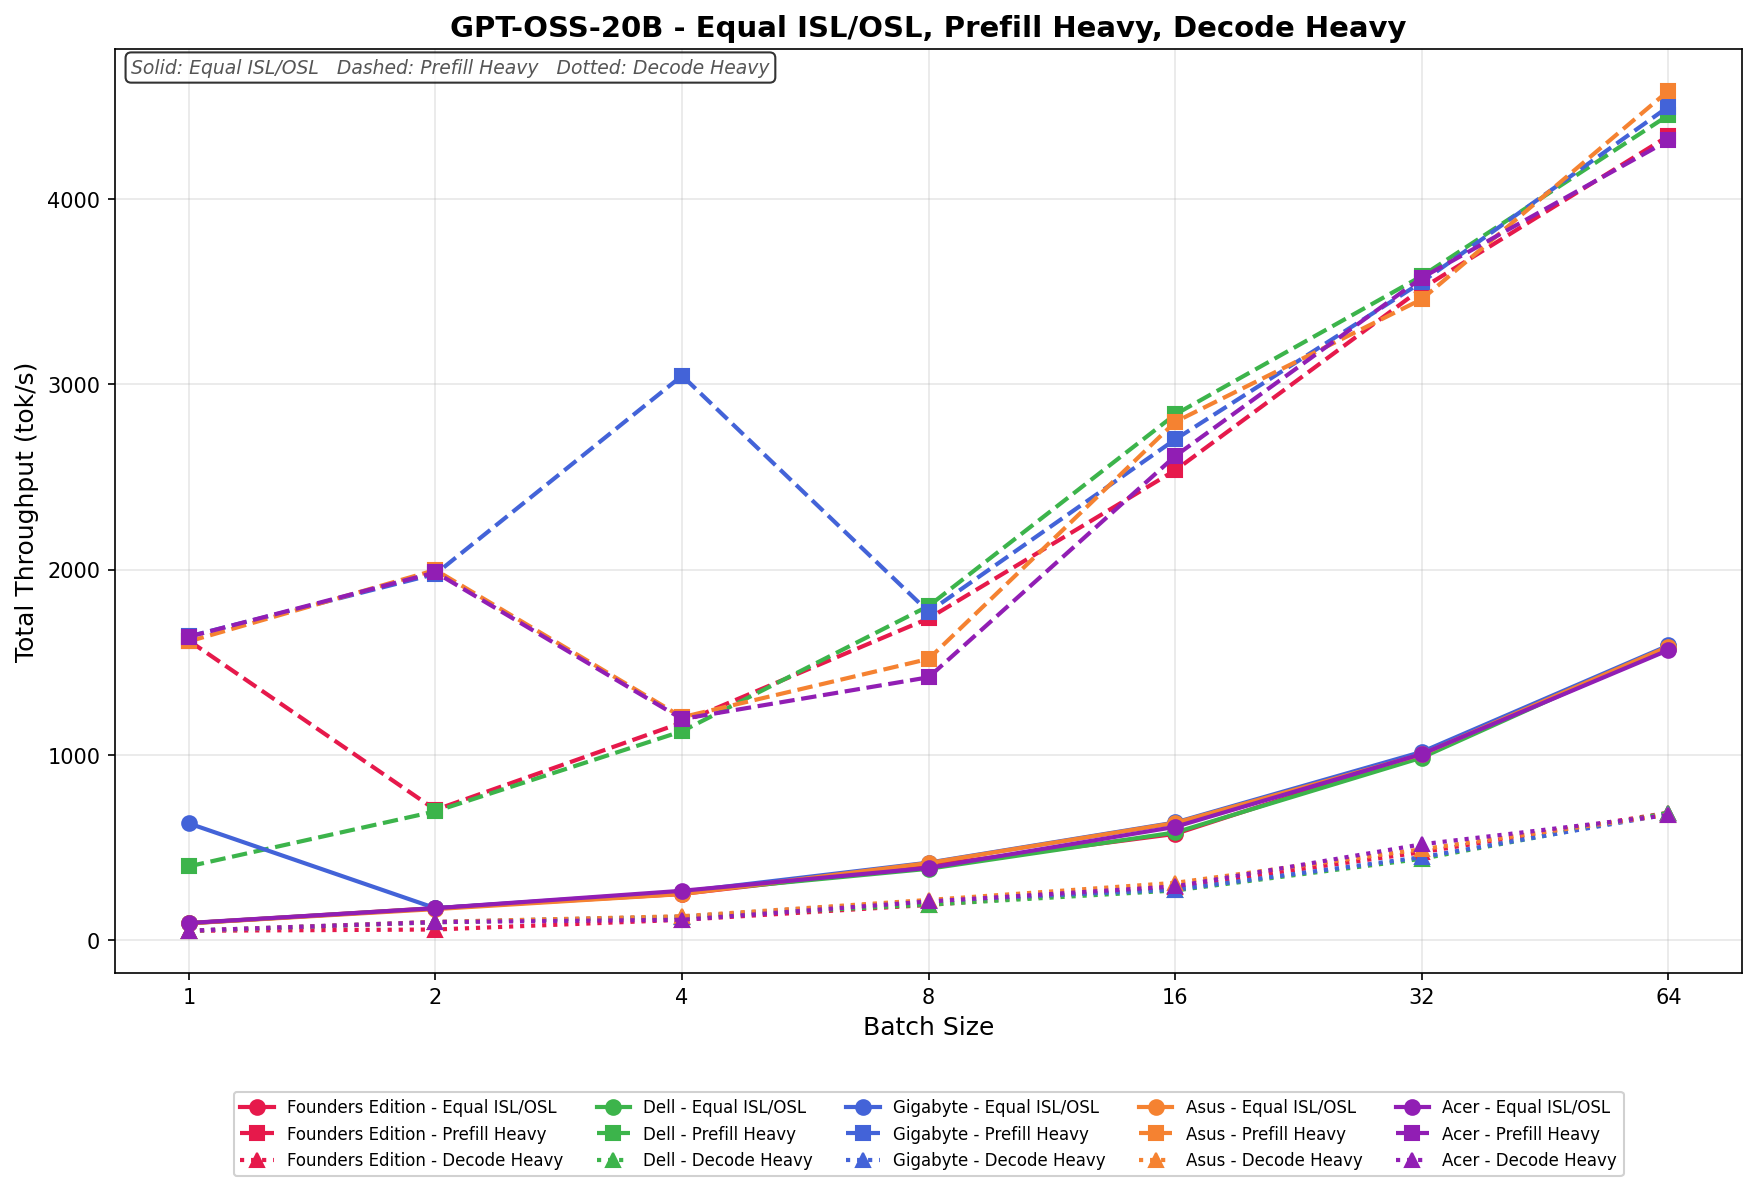
GPT-OSS-20B
在等效ISL/OSL測試中,技嘉的性能從641.73 tok/s提升至1,587.62 tok/s,在批次大小為1時表現強勁,在批次大小為2時略有下降,之後隨著批量大小的增加而穩步提升。從批次大小為8開始,效能提升趨於正常,與同類產品表現基本一致,並在批次大小為64時接近頂尖水準。
預先填充重型印表機的列印速度從 1,650.32 tok/s 開始,在批次大小為 64 時達到峰值 4,401.27 tok/s。從第 16 批次開始,列印速度持續穩定且具有競爭力,在較大的批次大小下與戴爾和華碩保持同步。
解碼密集型任務的處理速度範圍為 63.18 至 688.44 tok/s,在整個測試範圍內呈現良好的線性擴展性。效能提升雖小但穩定,與其他平台的效能表現高度一致,並反映了解碼密集型工作負載典型的較為受限的擴充特性。
Qwen3 程式設計師 30B A3B FB8
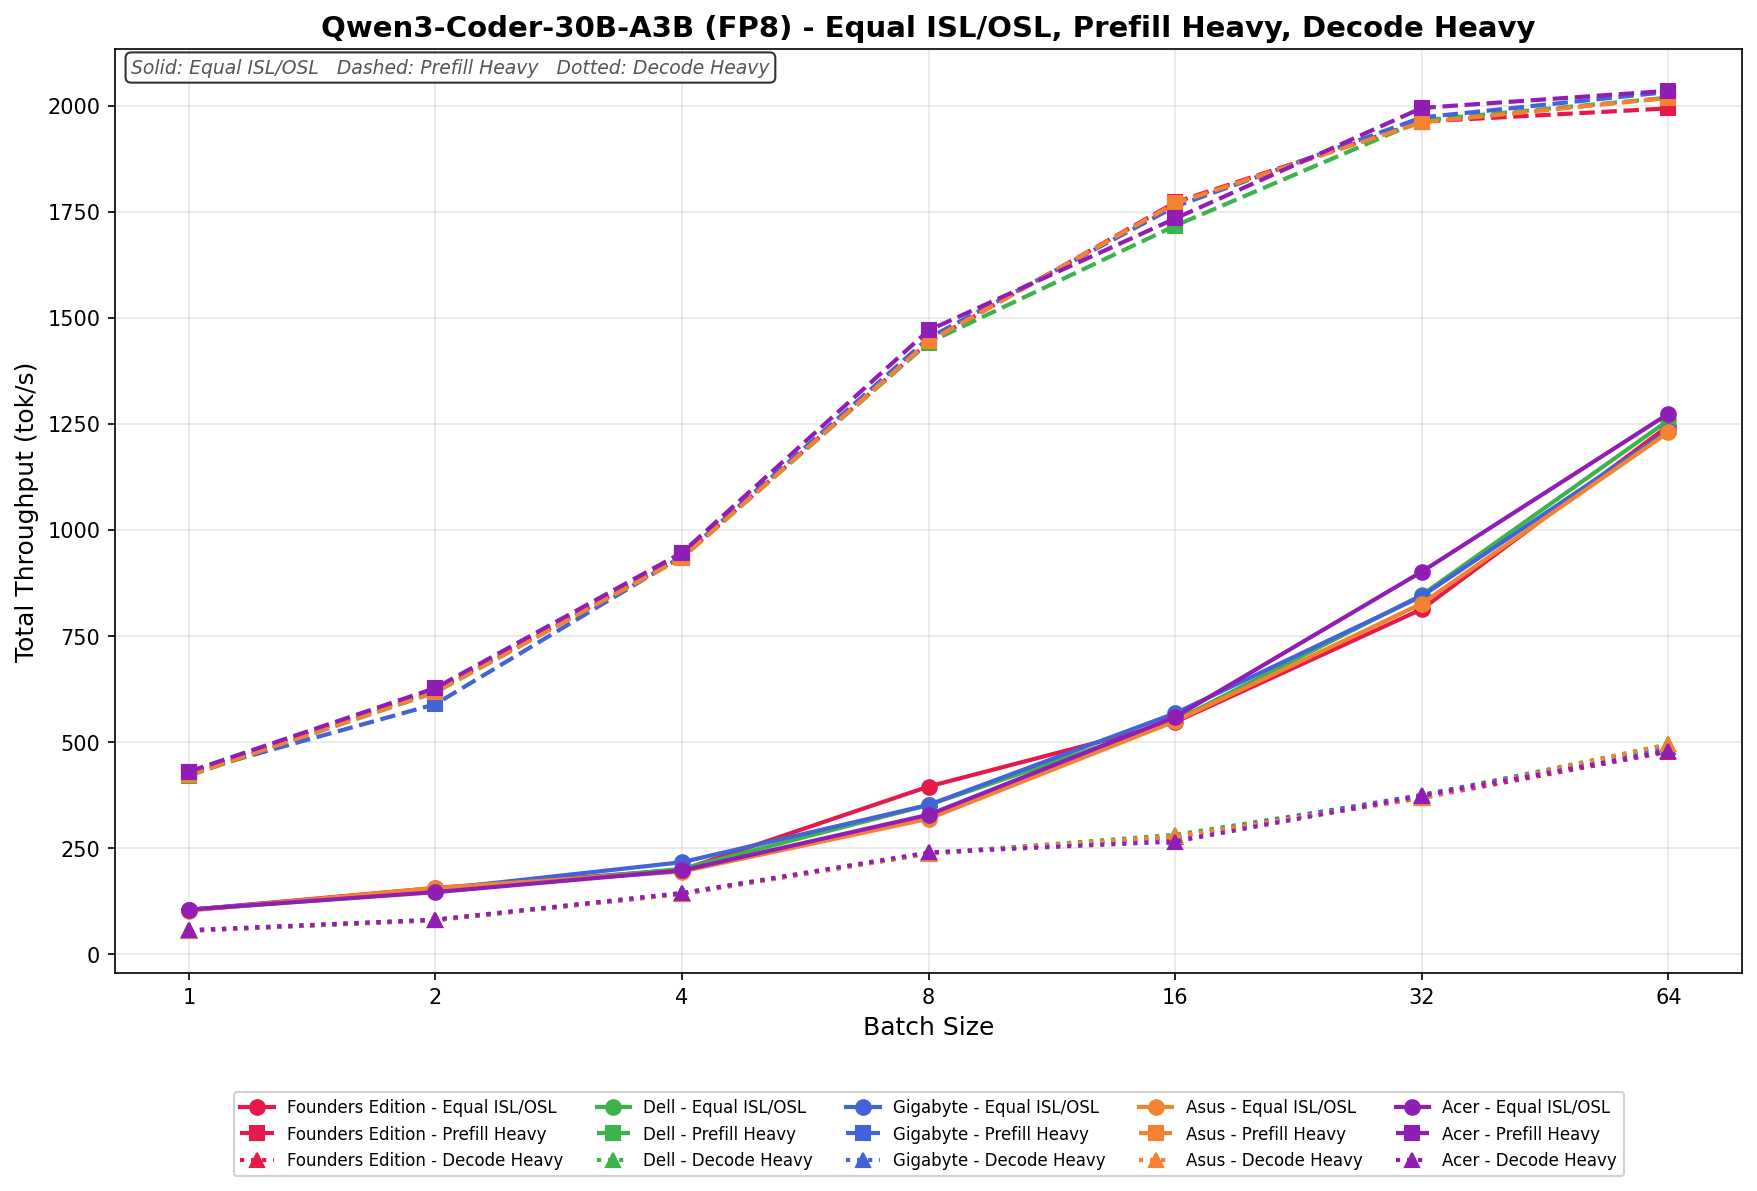
在 ISL/OSL 相等的測試中,技嘉的讀寫速度從 101.27 tok/s 提升至 1,251.84 tok/s,在整個批次測試過程中呈現穩定的線性增長。在第 16 個批次之前,其性能與戴爾和華碩的產品基本一致,之後在第 64 個批次之前持續穩步提升,最終接近頂級水平,且未出現任何明顯的性能提升異常。
預填充重型設備從 428.66 tok/s 開始,隨著批次大小增加到 64,速度提升至 2,026.94 tok/s。所有批次大小的成長都平穩一致,技嘉始終與更廣泛的領域保持緊密聯繫。
解碼重任務的速度範圍為 61.18 至 482.73 tok/s,隨著批次大小的增加,速度會有可預測的逐步提升。
Qwen3 編碼器 30B A3B 基地
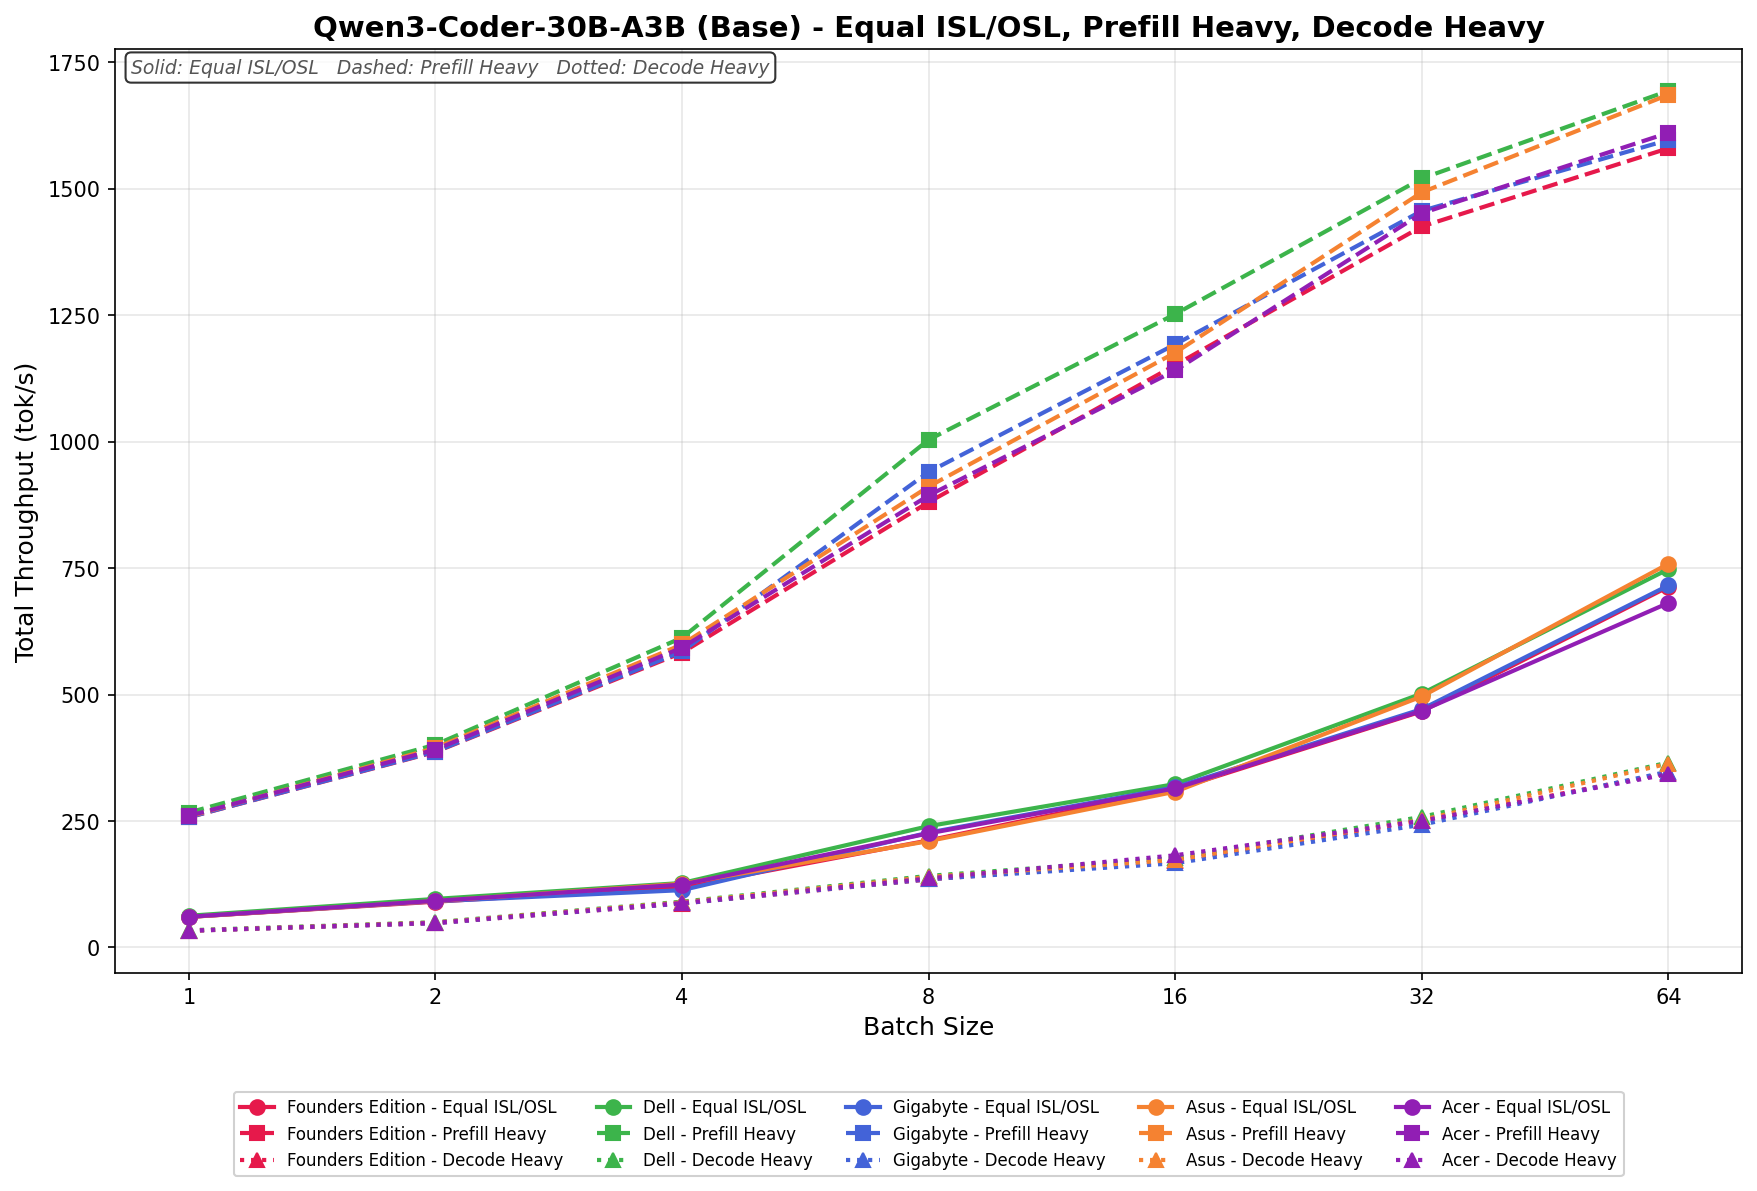
在等效ISL/OSL測試中,技嘉的幀速率從63.42 tok/s提升至721.08 tok/s,並在整個批次範圍內穩步提升。在第16批次之前,其性能與行業平均水平基本一致,並在第64批次之前保持了良好的性能提升,最終以具有競爭力的成績收尾,且未出現任何明顯的線性偏差。
預填充重型從 258.11 tok/s 開始,到批次大小 64 時攀升至 1,603.74 tok/s。
解碼重取樣率範圍為 33.57 至 349.82 tok/s,掃描過程中呈現線性遞增縮放。
Llama 3.1 8B 指令 FP4
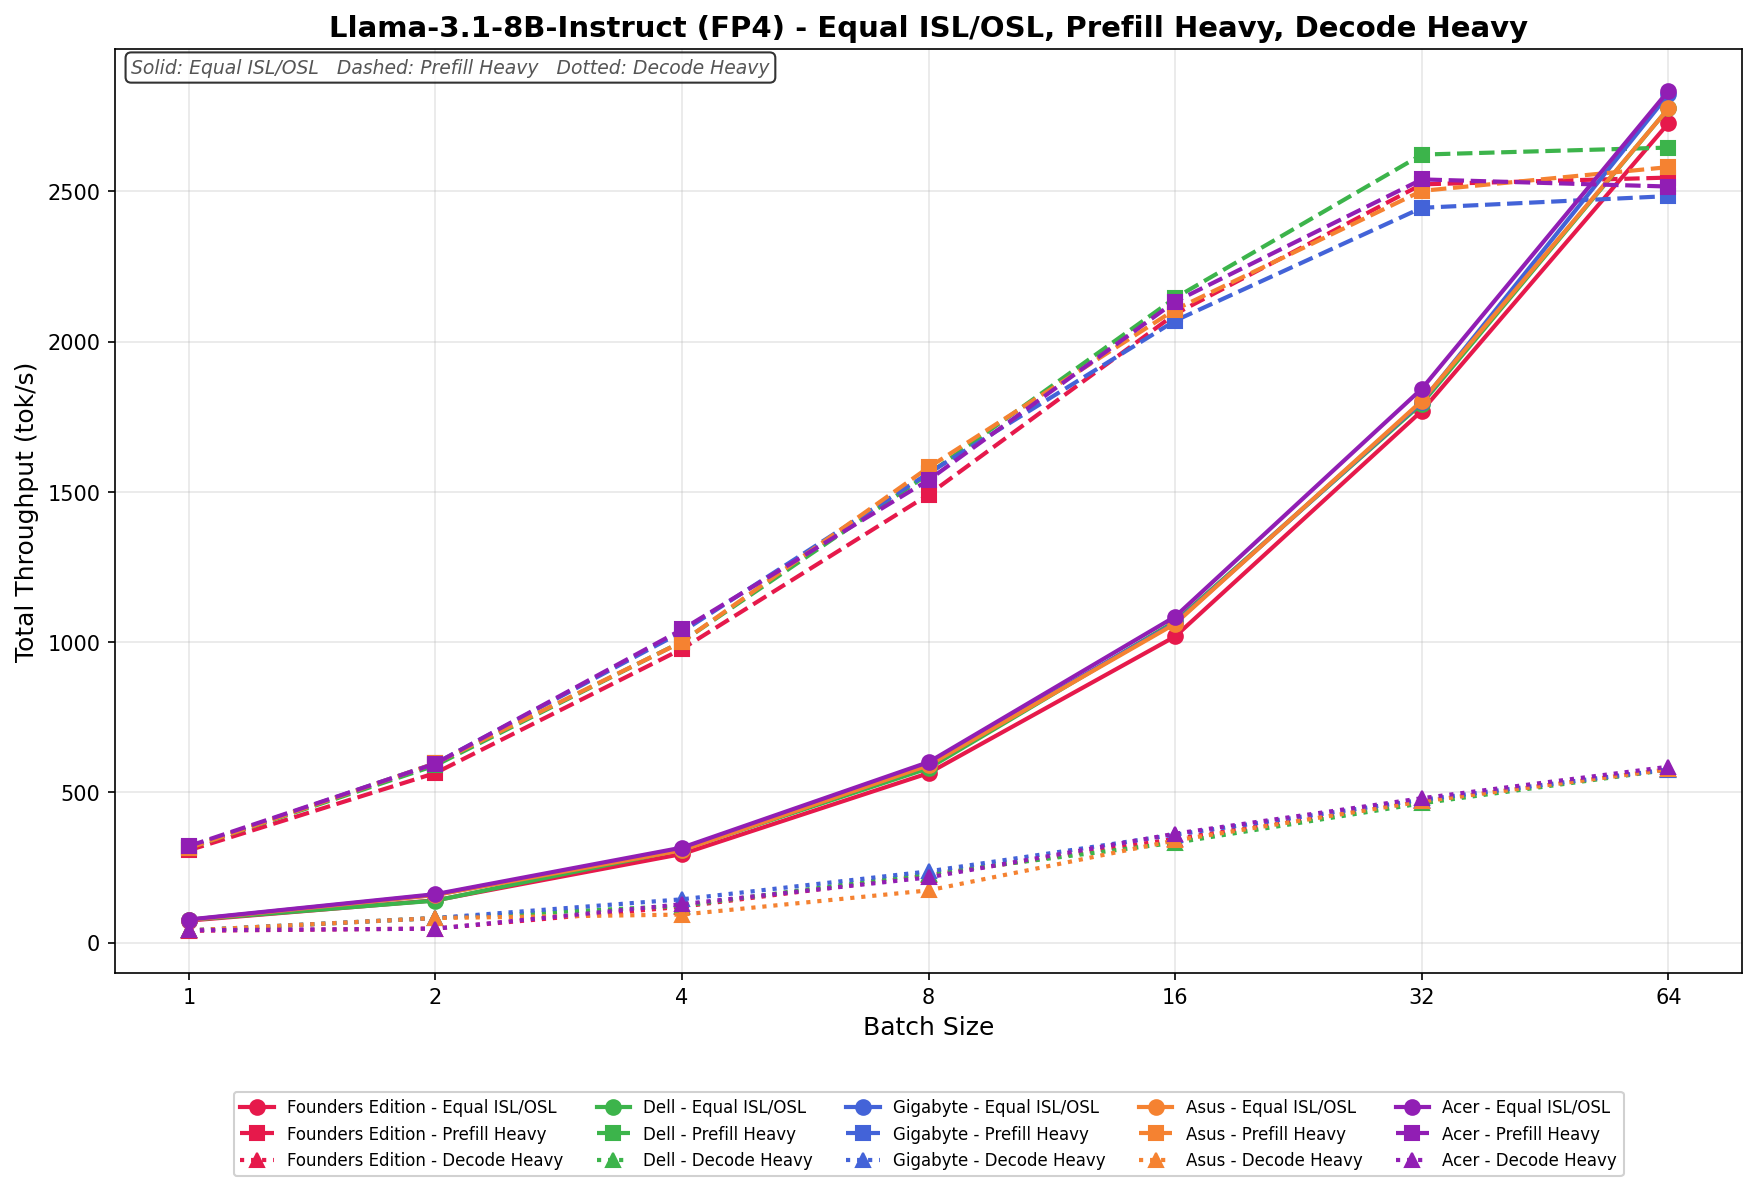
在 ISL/OSL 相等的測試環境中,技嘉的吞吐量從 69.84 tok/s 提升至 2,756.91 tok/s。在第 32 個批次之前,吞吐量呈現漸進且均衡的提升,接近頂級水平;而在第 64 個批次時,吞吐量再次大幅提升,使其在高並發級別下躋身領先系統之列。
Prefill Heavy 的初始速度為 321.67 tok/s,到批次大小 64 時達到 2,493.52 tok/s。成長一直持續到第 16 批次,然後相對於表現最佳的批次,在更高的批次大小下開始略有下降,這表明其大批量擴展效率穩健但不占主導地位。
解碼重任務的速度範圍為 48.92 至 575.84 tok/s,隨著批次大小的增加,速度穩定提升。
Llama 3.1 8B 指令 FP8
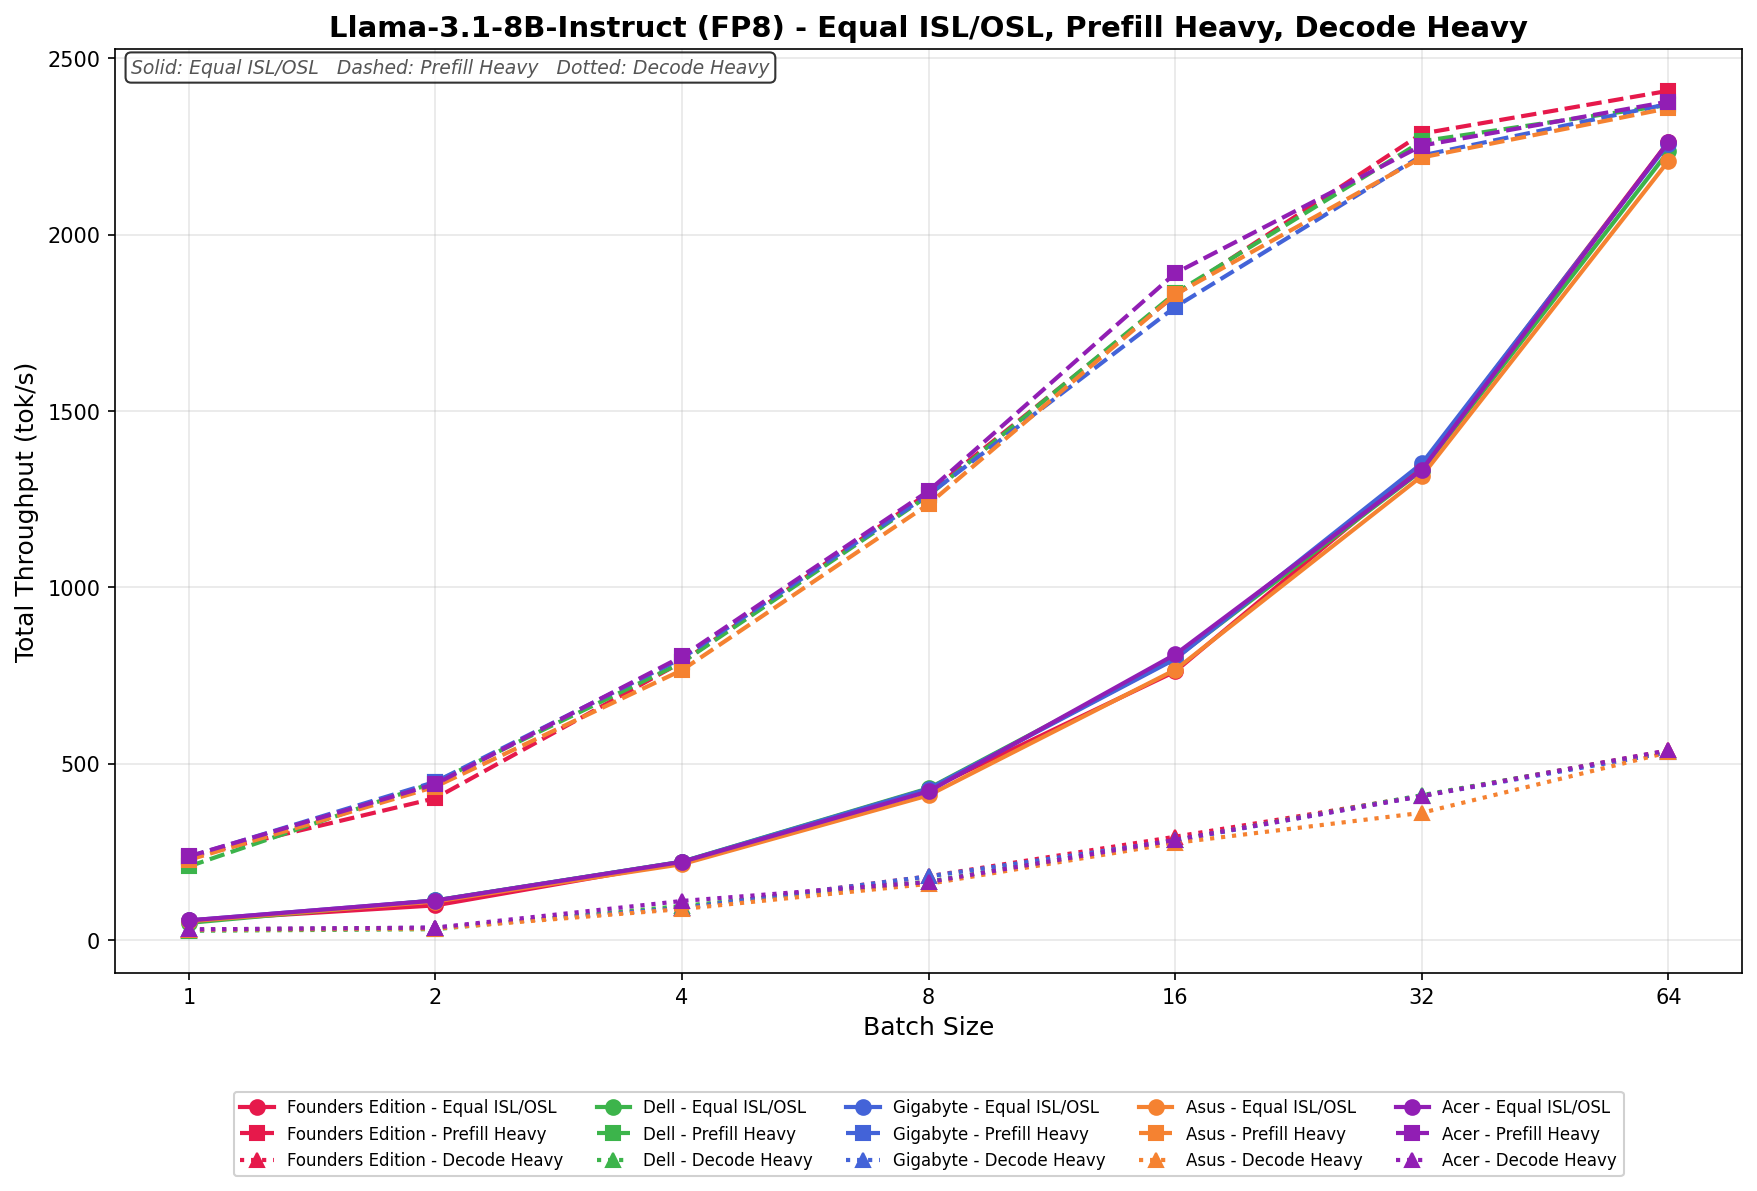
在 Equal ISL/OSL 測試中,技嘉的吞吐量從 54.12 提升至 2,314.87 tok/s,在第 32 批次中呈現平滑的線性增長,並在第 64 批次中強勁提升,使其在高並發水平下保持競爭力。
預填充重型從 226.43 tok/s 開始,到批次大小 64 時達到 2,332.19 tok/s。在整個掃描過程中,規模化保持一致,與更廣泛的領域密切相關,並在更大的批次大小下保持良好的效率。
Decode Heavy 的效能範圍為 32.88 至 522.41 tok/s,隨著批次規模的增加,效能穩定提升。如預期,與 Equal 和 Prefill 工作負載相比,其擴展性仍較為有限。
GPU直接儲存
我們在 Spark 上進行的測試之一是 MagnumIO GPU 直接儲存 (GDS) 測試。 GDS 是 NVIDIA 開發的功能,可讓 GPU 在存取儲存在 NVMe 磁碟機或其他高速儲存裝置上的資料時繞過 CPU。 GDS 無需透過 CPU 和系統記憶體路由數據,而是支援 GPU 和儲存設備之間的直接通信,從而顯著降低延遲並提高數據吞吐量。
技嘉在AI TOP ATOM主機板中使用了4TB三星PM9E1 Gen5固態硬碟,這是我們目前在市場上見過的速度最快的2242 M.2固態硬碟。這款固態硬碟也曾用於FE Spark和宏碁Veriton GN100筆記型電腦。
GPU 直接儲存的工作原理
傳統上,當GPU處理儲存在NVMe磁碟機上的資料時,資料必須先經過CPU和系統記憶體才能到達GPU。由於CPU充當中間人,這個過程會造成效能瓶頸,增加延遲並消耗寶貴的系統資源。 GPU直接儲存(GPU Direct Storage)透過允許GPU直接透過PCIe匯流排存取儲存裝置中的數據,消除了這種低效率。這種直接路徑減少了資料傳輸的開銷,從而實現了更快、更有效率的資料傳輸。
人工智慧工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理 TB 級的數據,資料傳輸中的任何延遲都可能導致 GPU 利用率不足和訓練時間更長。 GPU 直接儲存透過確保資料盡快傳輸到 GPU、最大限度地減少空閒時間並最大限度地提高運算效率來解決這一挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
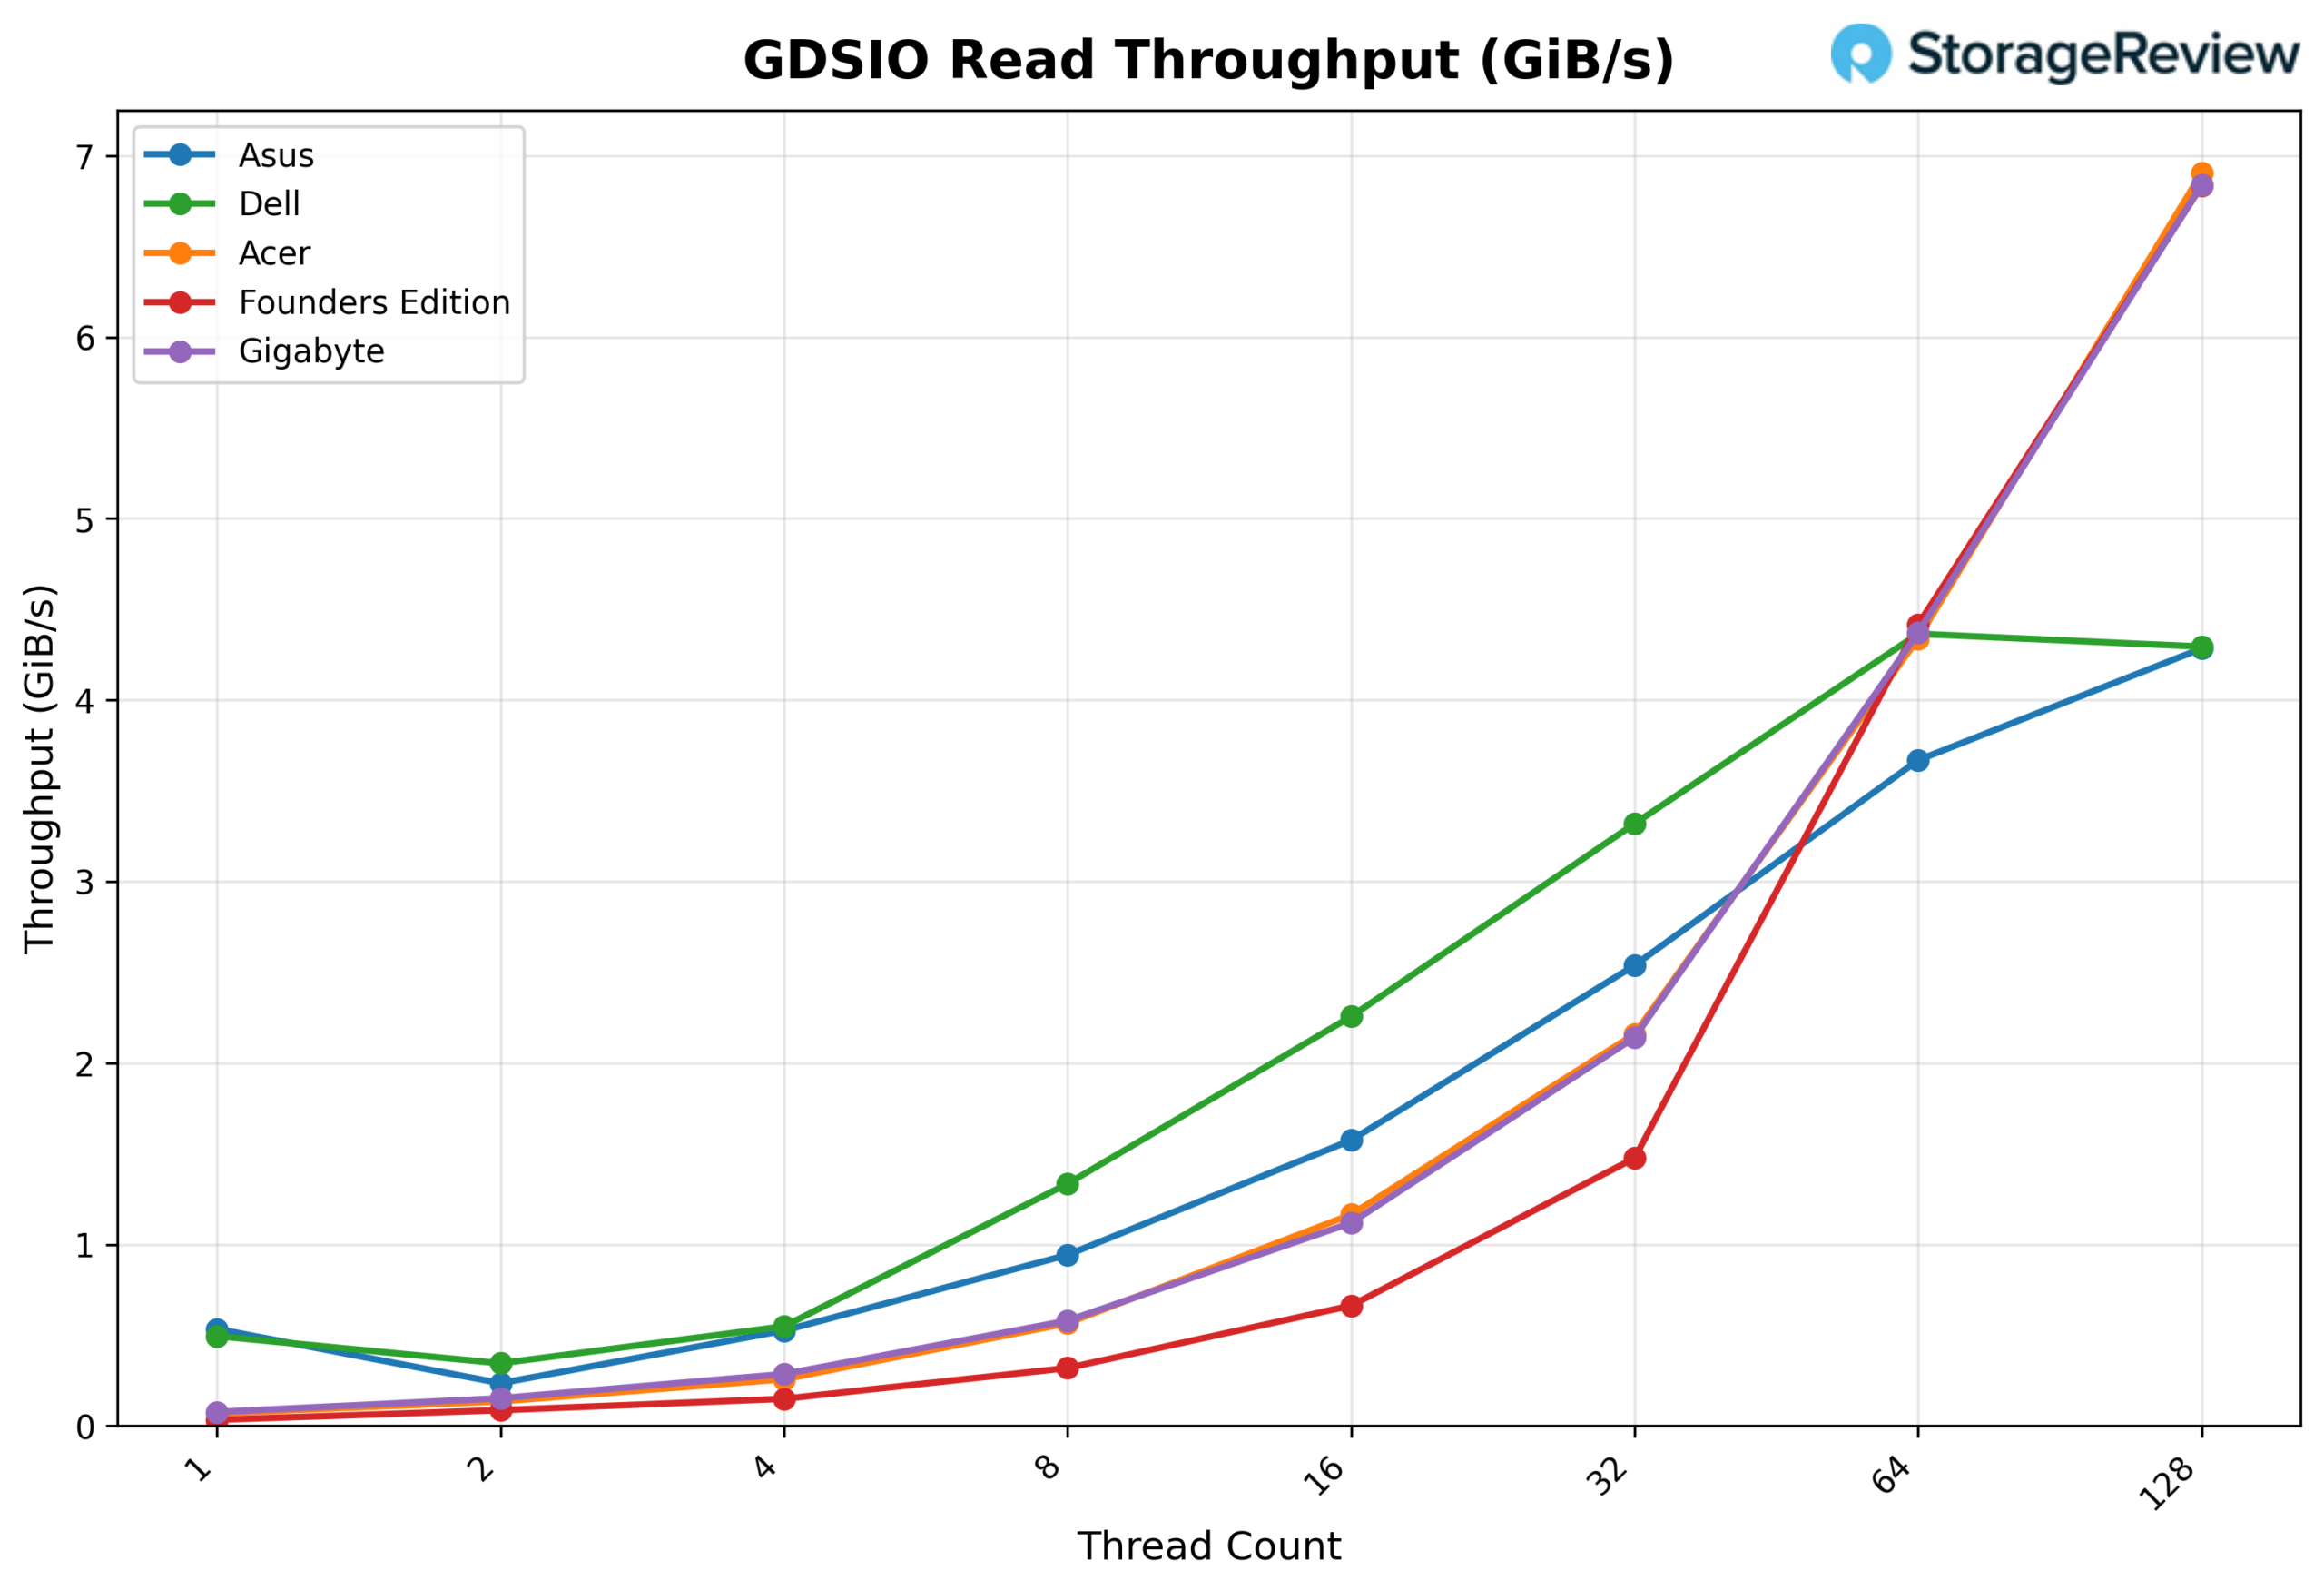
GDSIO 讀取吞吐量 16k
從 GDSIO 讀取吞吐量 16K 測試結果來看,技嘉顯示卡在單執行緒時約為 0.08 GiB/s,8 執行緒時提升至 0.58 GiB/s。之後,在 16 個線程(1.12 GiB/s)和 32 個線程(2.14 GiB/s)時,性能繼續平穩提升,並在 64 個線程時急劇躍升至 4.37 GiB/s。在 128 執行緒時,技嘉顯示卡的效能依然保持強勁,達到 6.84 GiB/s,在執行緒數上限附近沒有出現效能瓶頸。
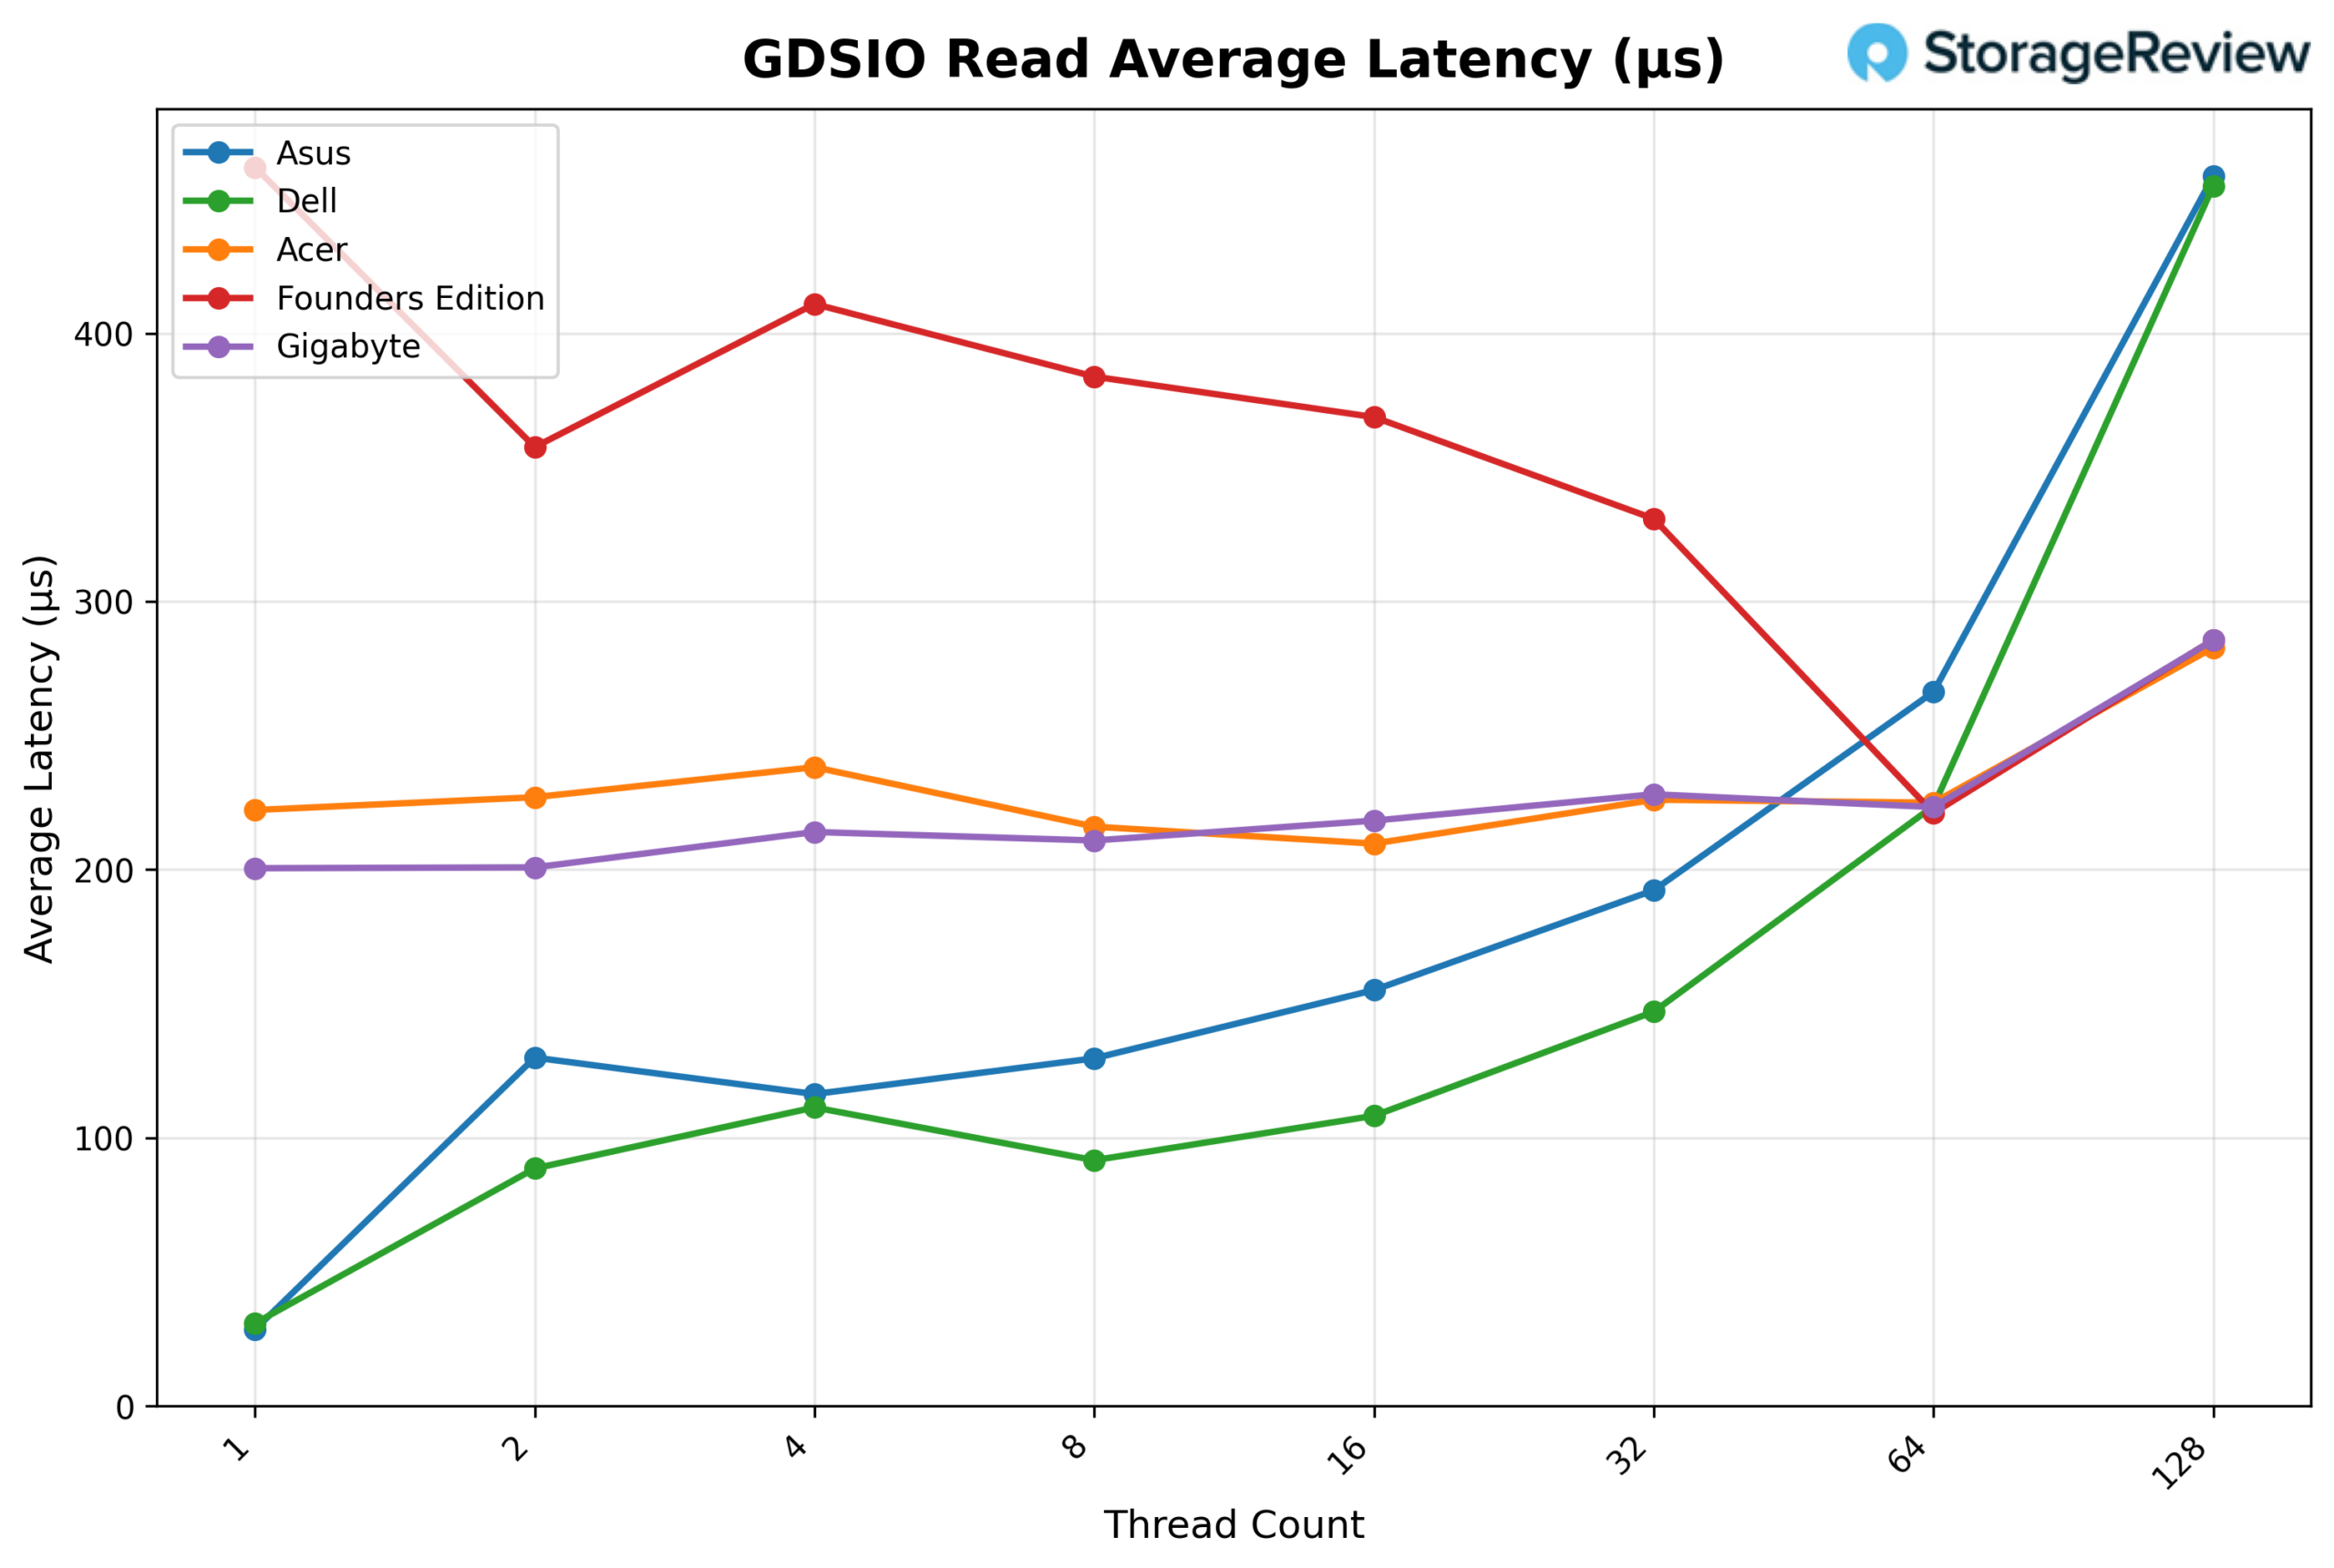
GDSIO 讀取平均延遲 16K
從 GDSIO 讀取平均延遲 (16K) 來看,技嘉顯卡在大部分測試區間內保持了非常穩定的延遲。在單執行緒情況下,延遲約為 0.201 毫秒,並且在 2 執行緒到 64 執行緒範圍內都保持在 0.21 毫秒到 0.23 毫秒的範圍內(例如,8 執行緒時為 0.211 毫秒,16 執行緒時為 0.218 毫秒,32 執行緒時為 0.211 毫秒,16 執行緒時為 0.218 毫秒,32 執行緒時為 0.211 毫秒,16 執行緒時為 0.218 毫秒,32 執行緒時為 0.21 毫秒,16 執行緒時為 0.218 毫秒,32 執行緒時為 0.28 毫秒時為 23 毫秒)。只有在 128 個執行緒時,延遲才明顯上升到約 0.286 毫秒,而吞吐量則繼續增加。
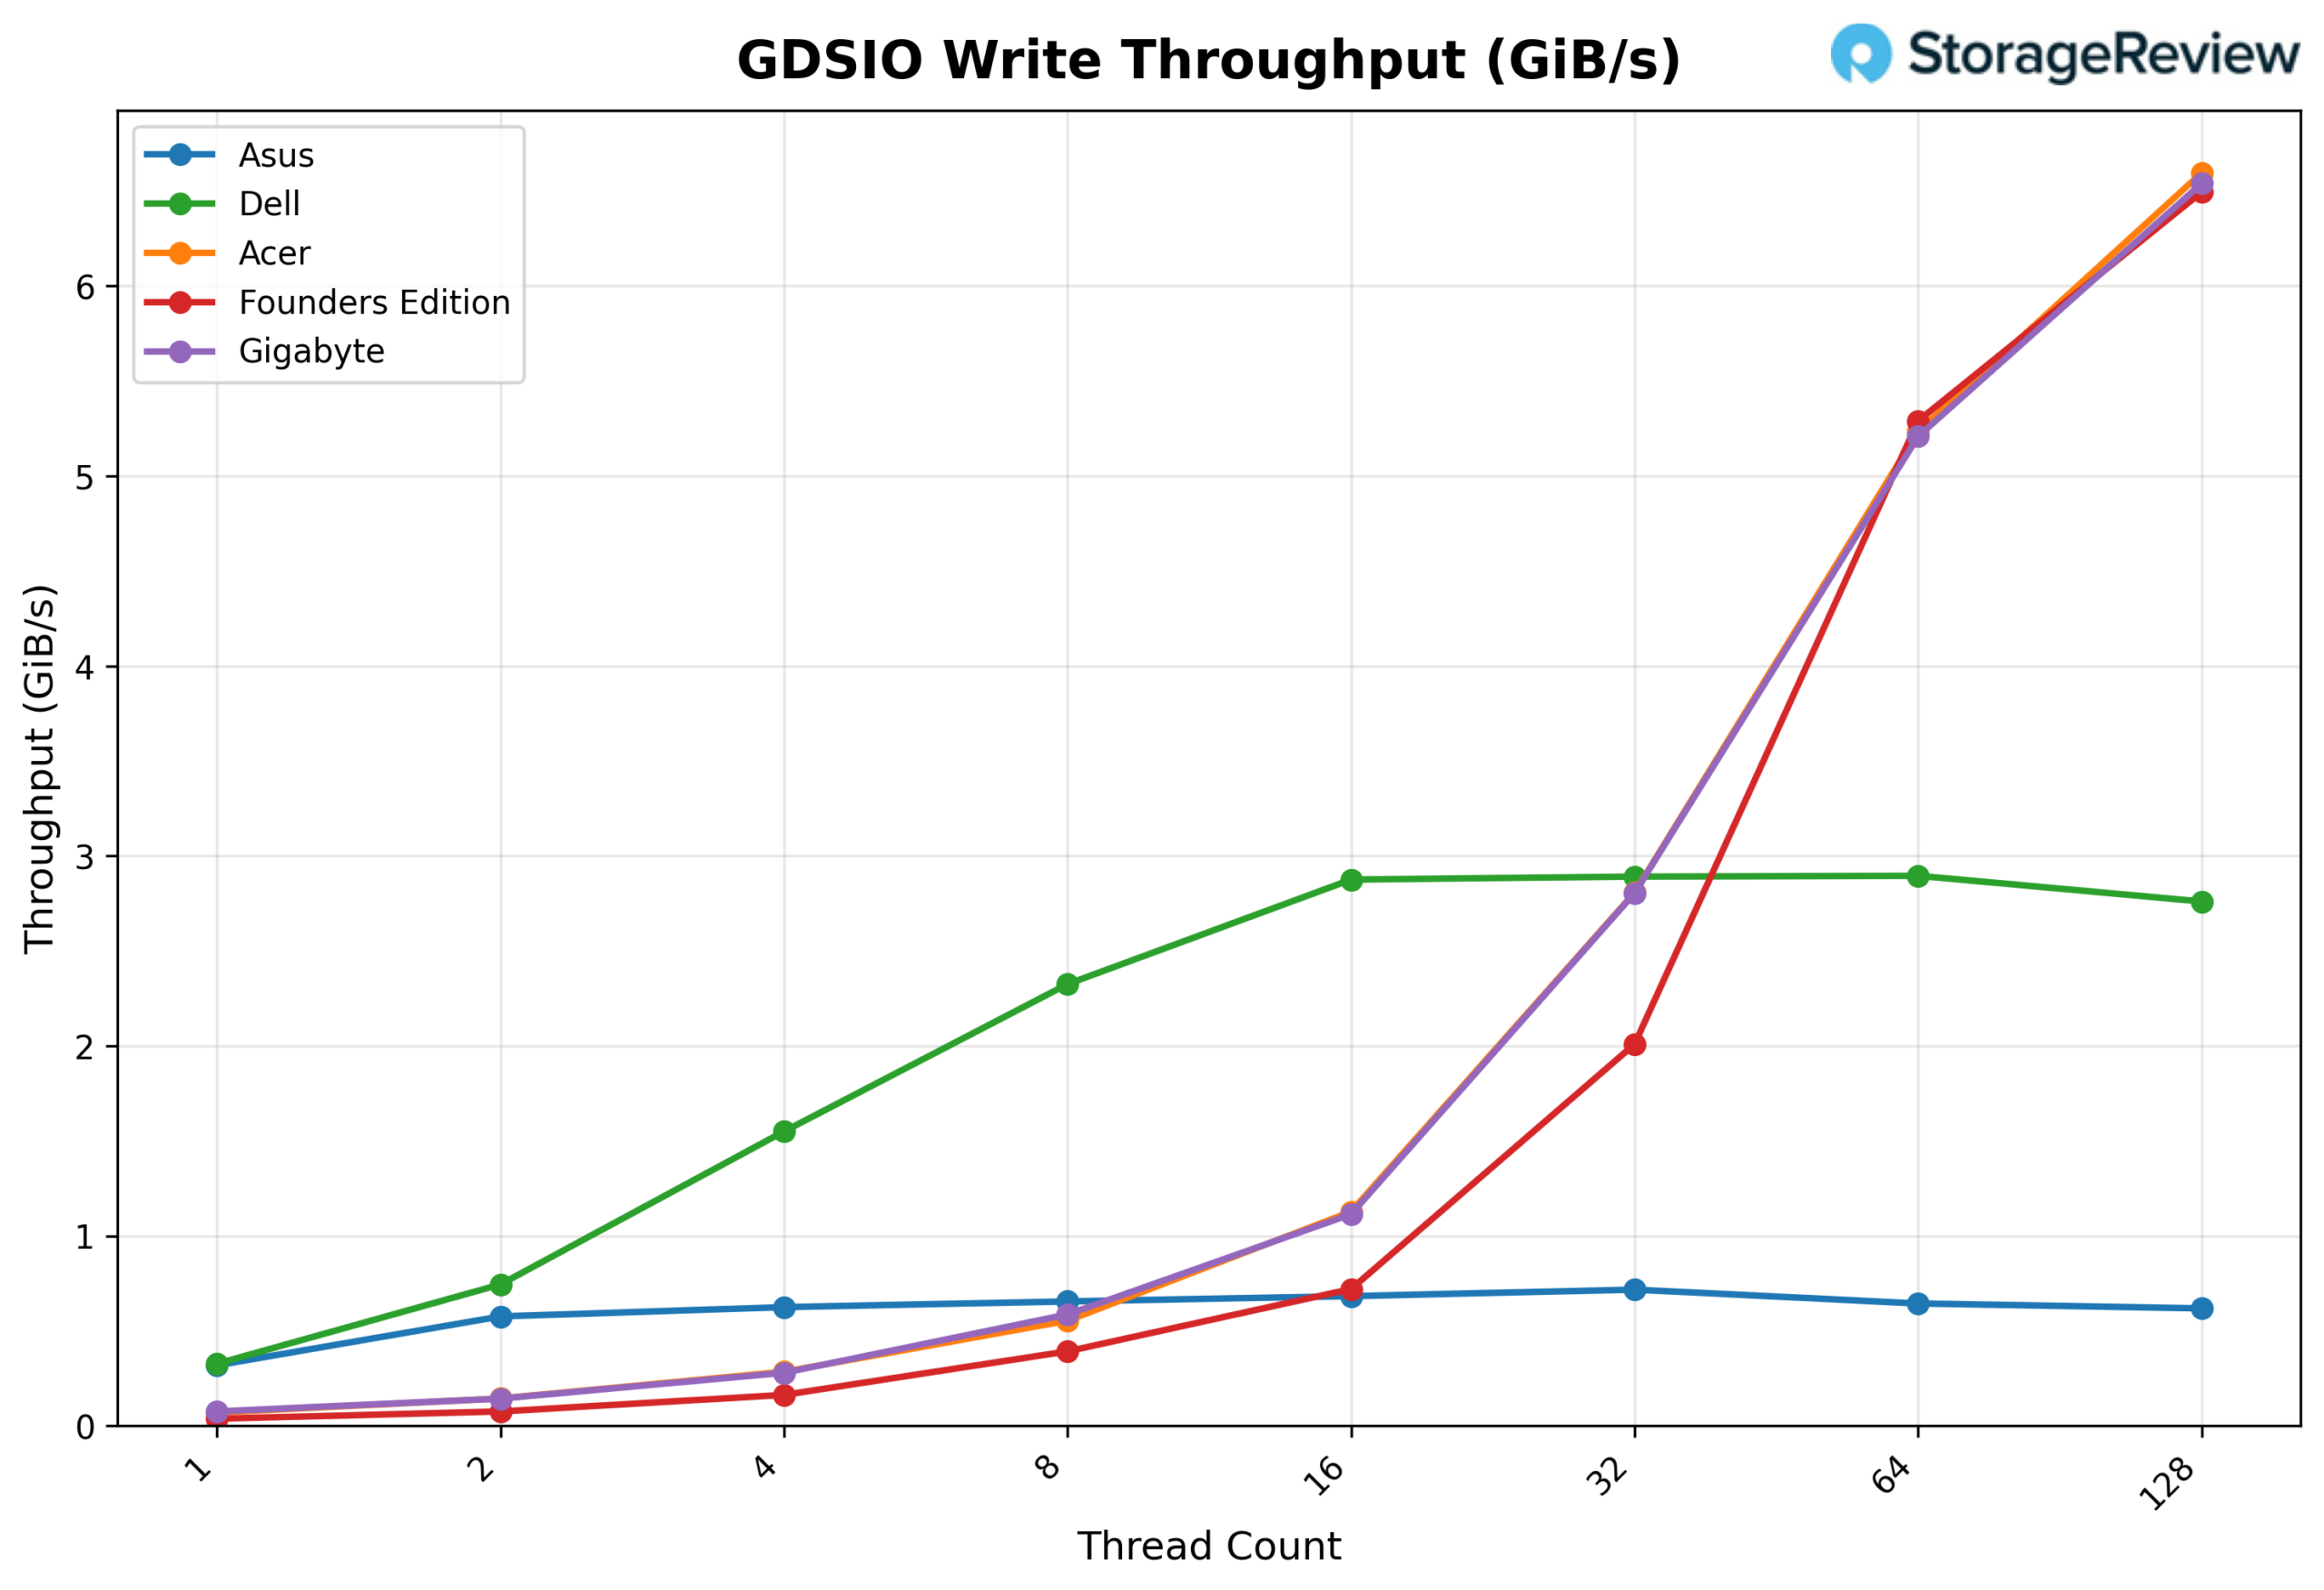
GSDIO 寫入吞吐量 16K
從 GDSIO 16K 寫入吞吐量測試來看,技嘉這款顯示卡在單線程時初始速度約為 0.08 GiB/s,隨後穩步提升至雙線程的 0.14 GiB/s 和四線程的 0.28 GiB/s。在 8 執行緒(0.59 GiB/s)和 16 執行緒(1.11 GiB/s)時,效能繼續平緩提升,並在 32 執行緒時達到更顯著的提升(2.80 GiB/s)。在 64 個線程時,性能依然強勁(5.21 GiB/s),並在 128 個線程時達到峰值 6.54 GiB/s,展現出持續上升的趨勢,沒有出現早期停滯期。
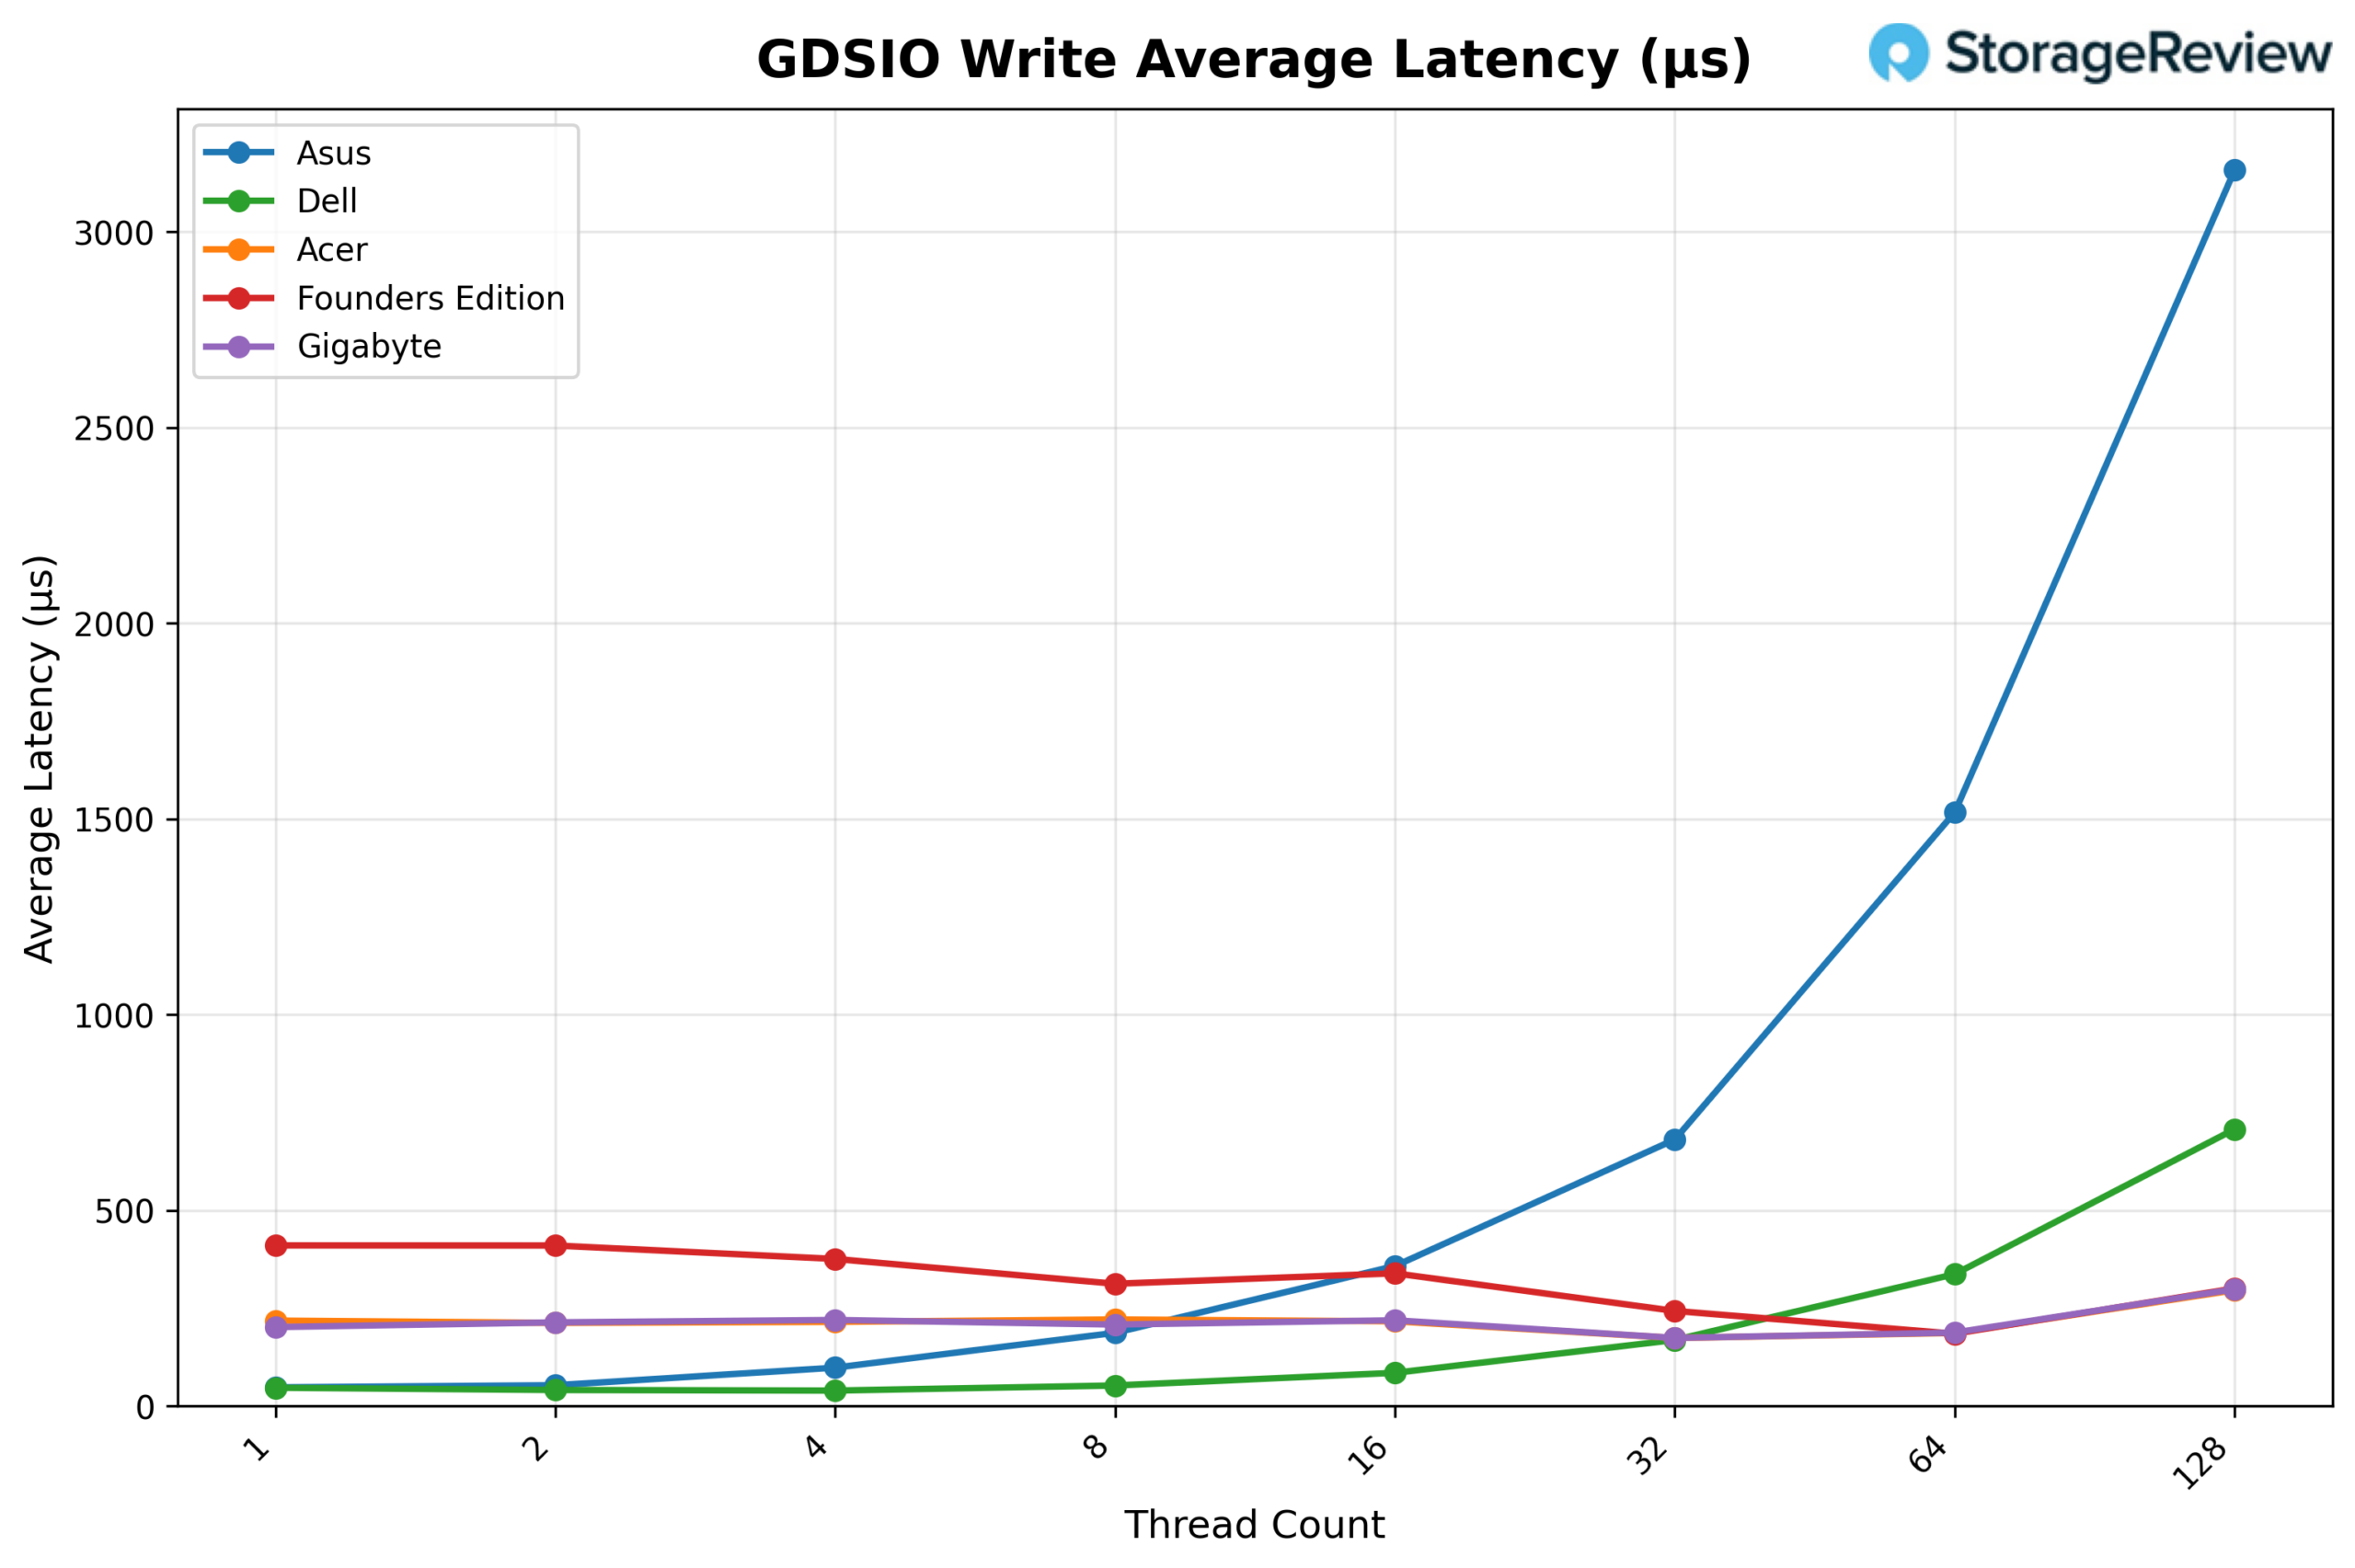
GDSIO 寫入平均延遲 16K
從 GDSIO 寫入平均延遲 (16K) 來看,技嘉在大部分測試階段都保持了相對穩定的延遲。在單執行緒時,延遲約為 0.20 毫秒,在 16 個執行緒時保持在 0.21-0.22 毫秒左右。 32 執行緒時,延遲略微改善至約 0.17 毫秒,然後在 64 執行緒時略有上升(0.19 毫秒)。只有在 128 個執行緒時,延遲才顯著增加,達到約 0.30 毫秒,這與最高的吞吐量水準相對應。
GDSIO 讀取吞吐量 1M
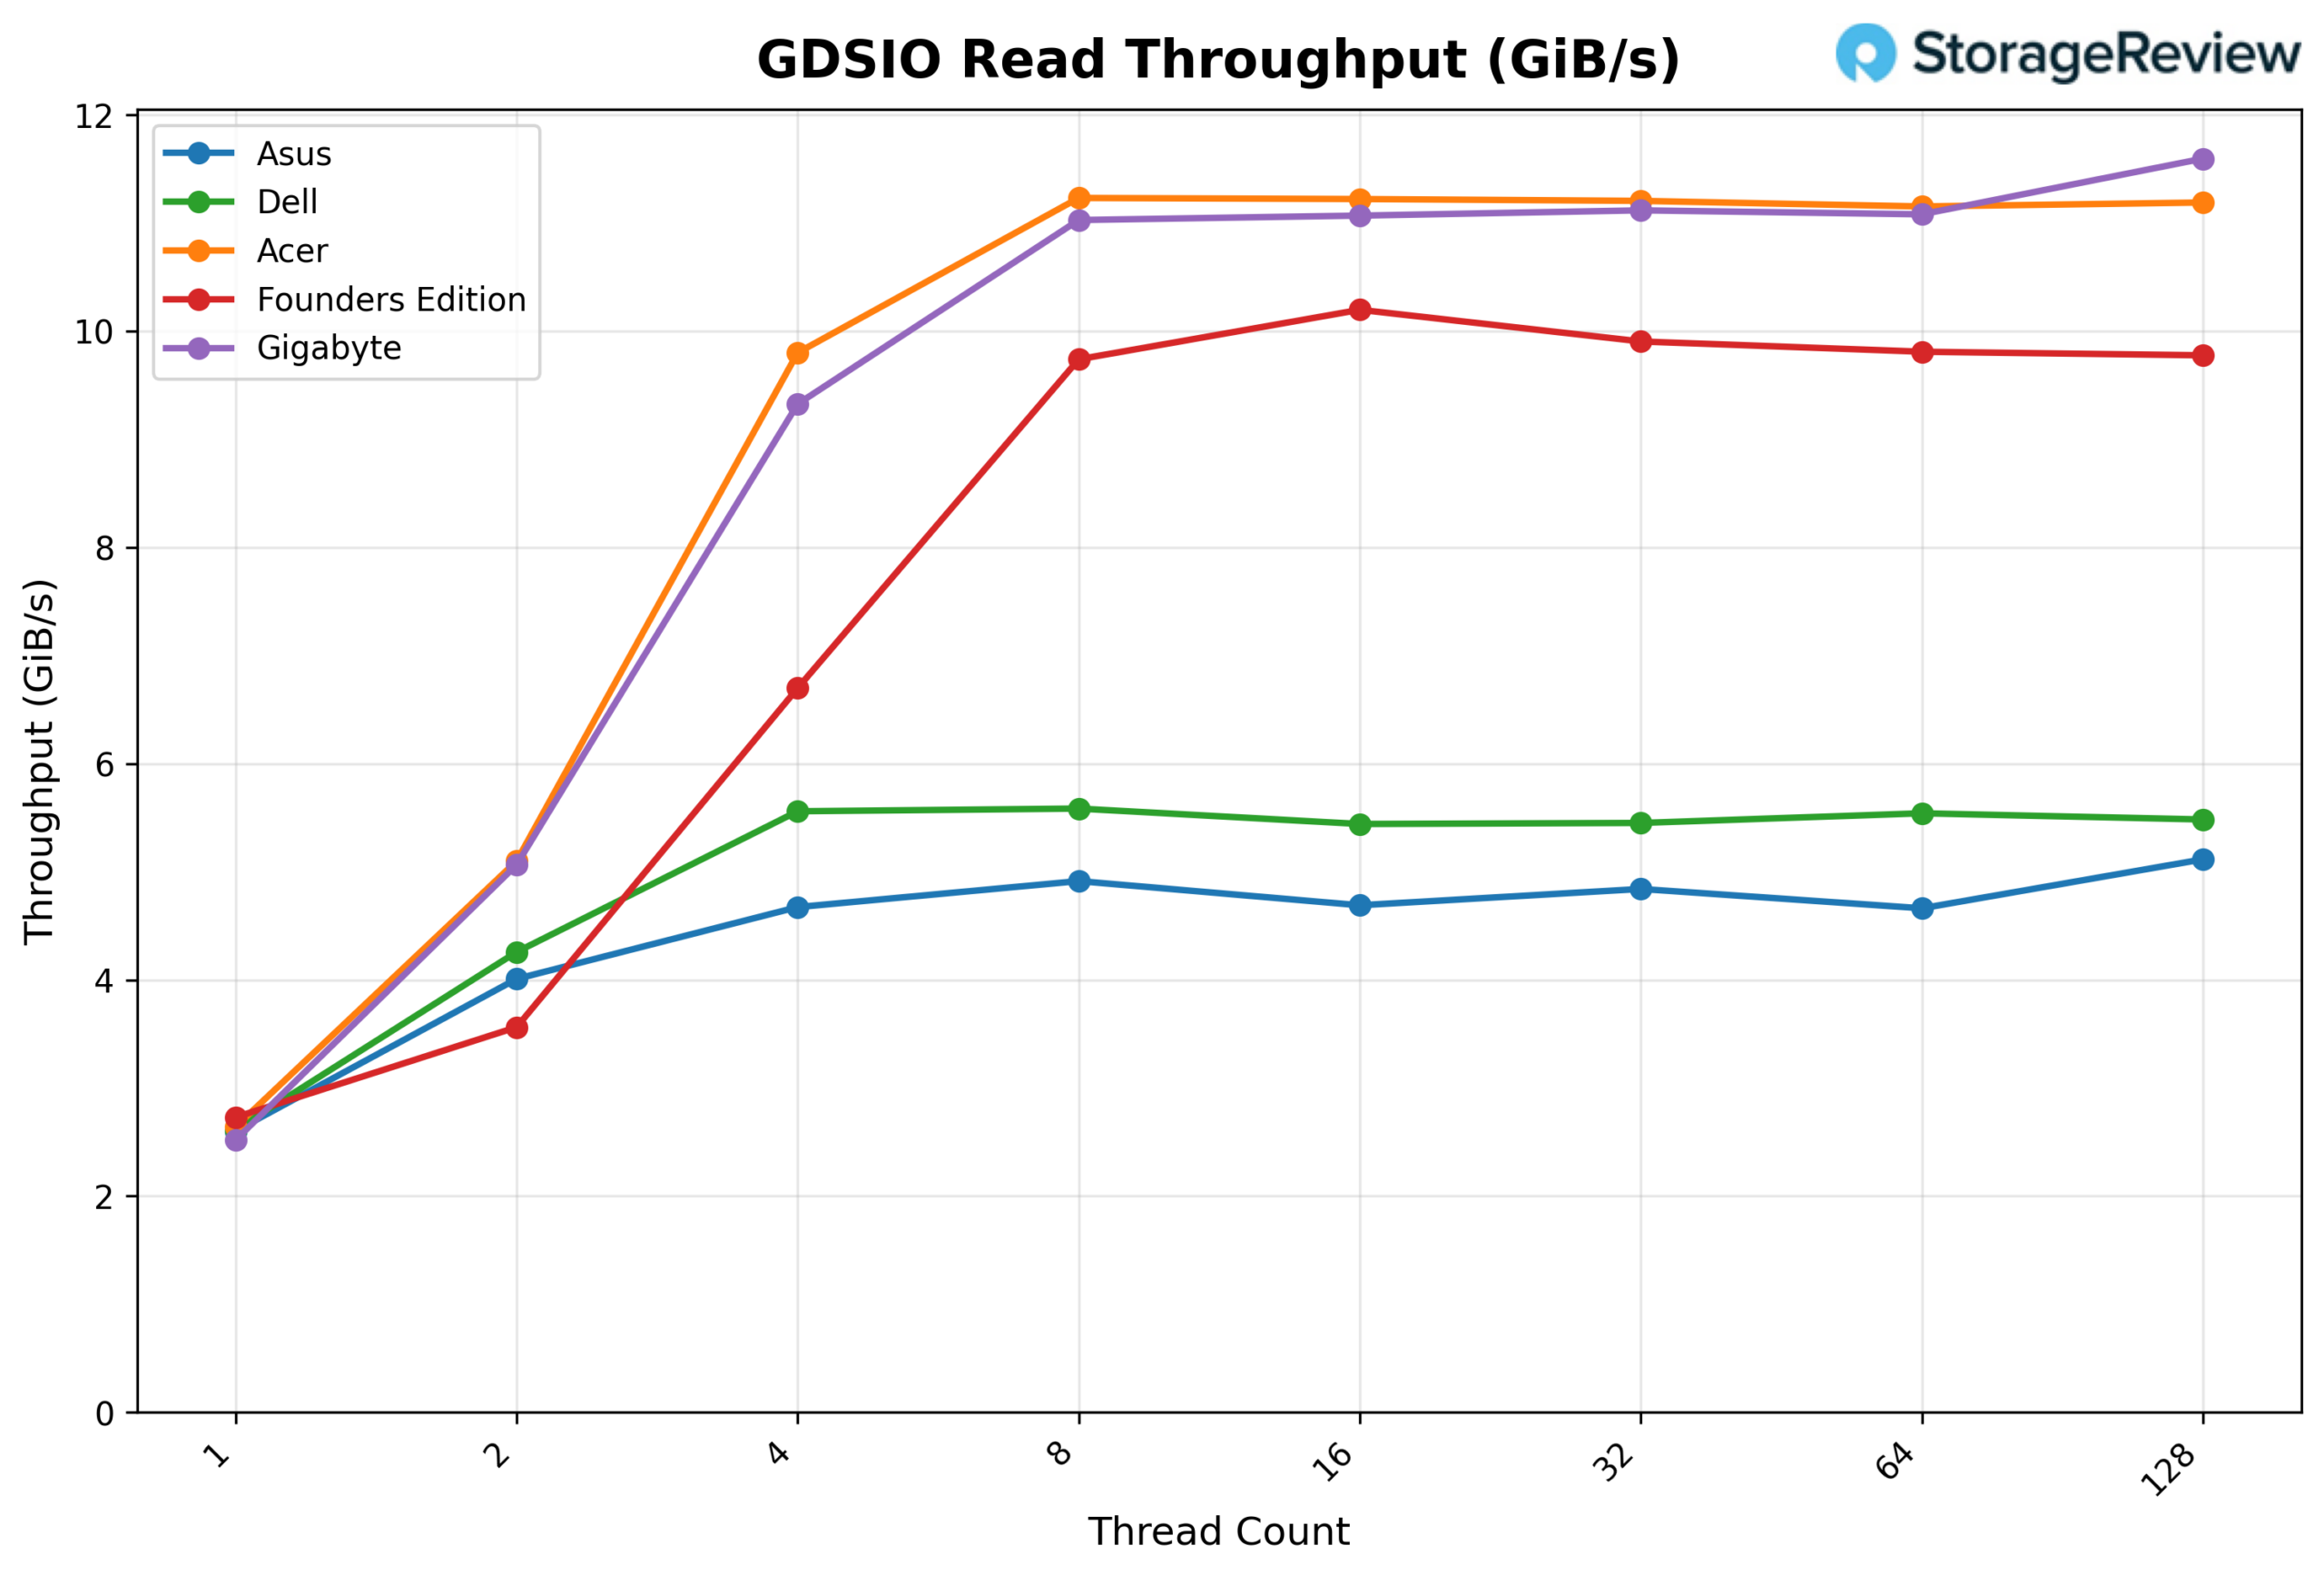
在 GDSIO 讀取吞吐量 1M 測試中,技嘉平台在單線程下初始吞吐量為 2.52 GiB/s,雙線程下提升至 5.07 GiB/s,四線程下達到 9.33 GiB/s。八線程時吞吐量達到 11.03 GiB/s,之後平台效能基本上達到飽和。在 16 執行緒(11.07 GiB/s)、32 執行緒(11.12 GiB/s)和 64 執行緒(11.08 GiB/s)下,效能保持穩定,呈現平穩狀態。在 128 執行緒時,吞吐量略微提升至 11.60 GiB/s,這是本次測試中觀察到的最高值。
GDSIO 讀取平均延遲 1M
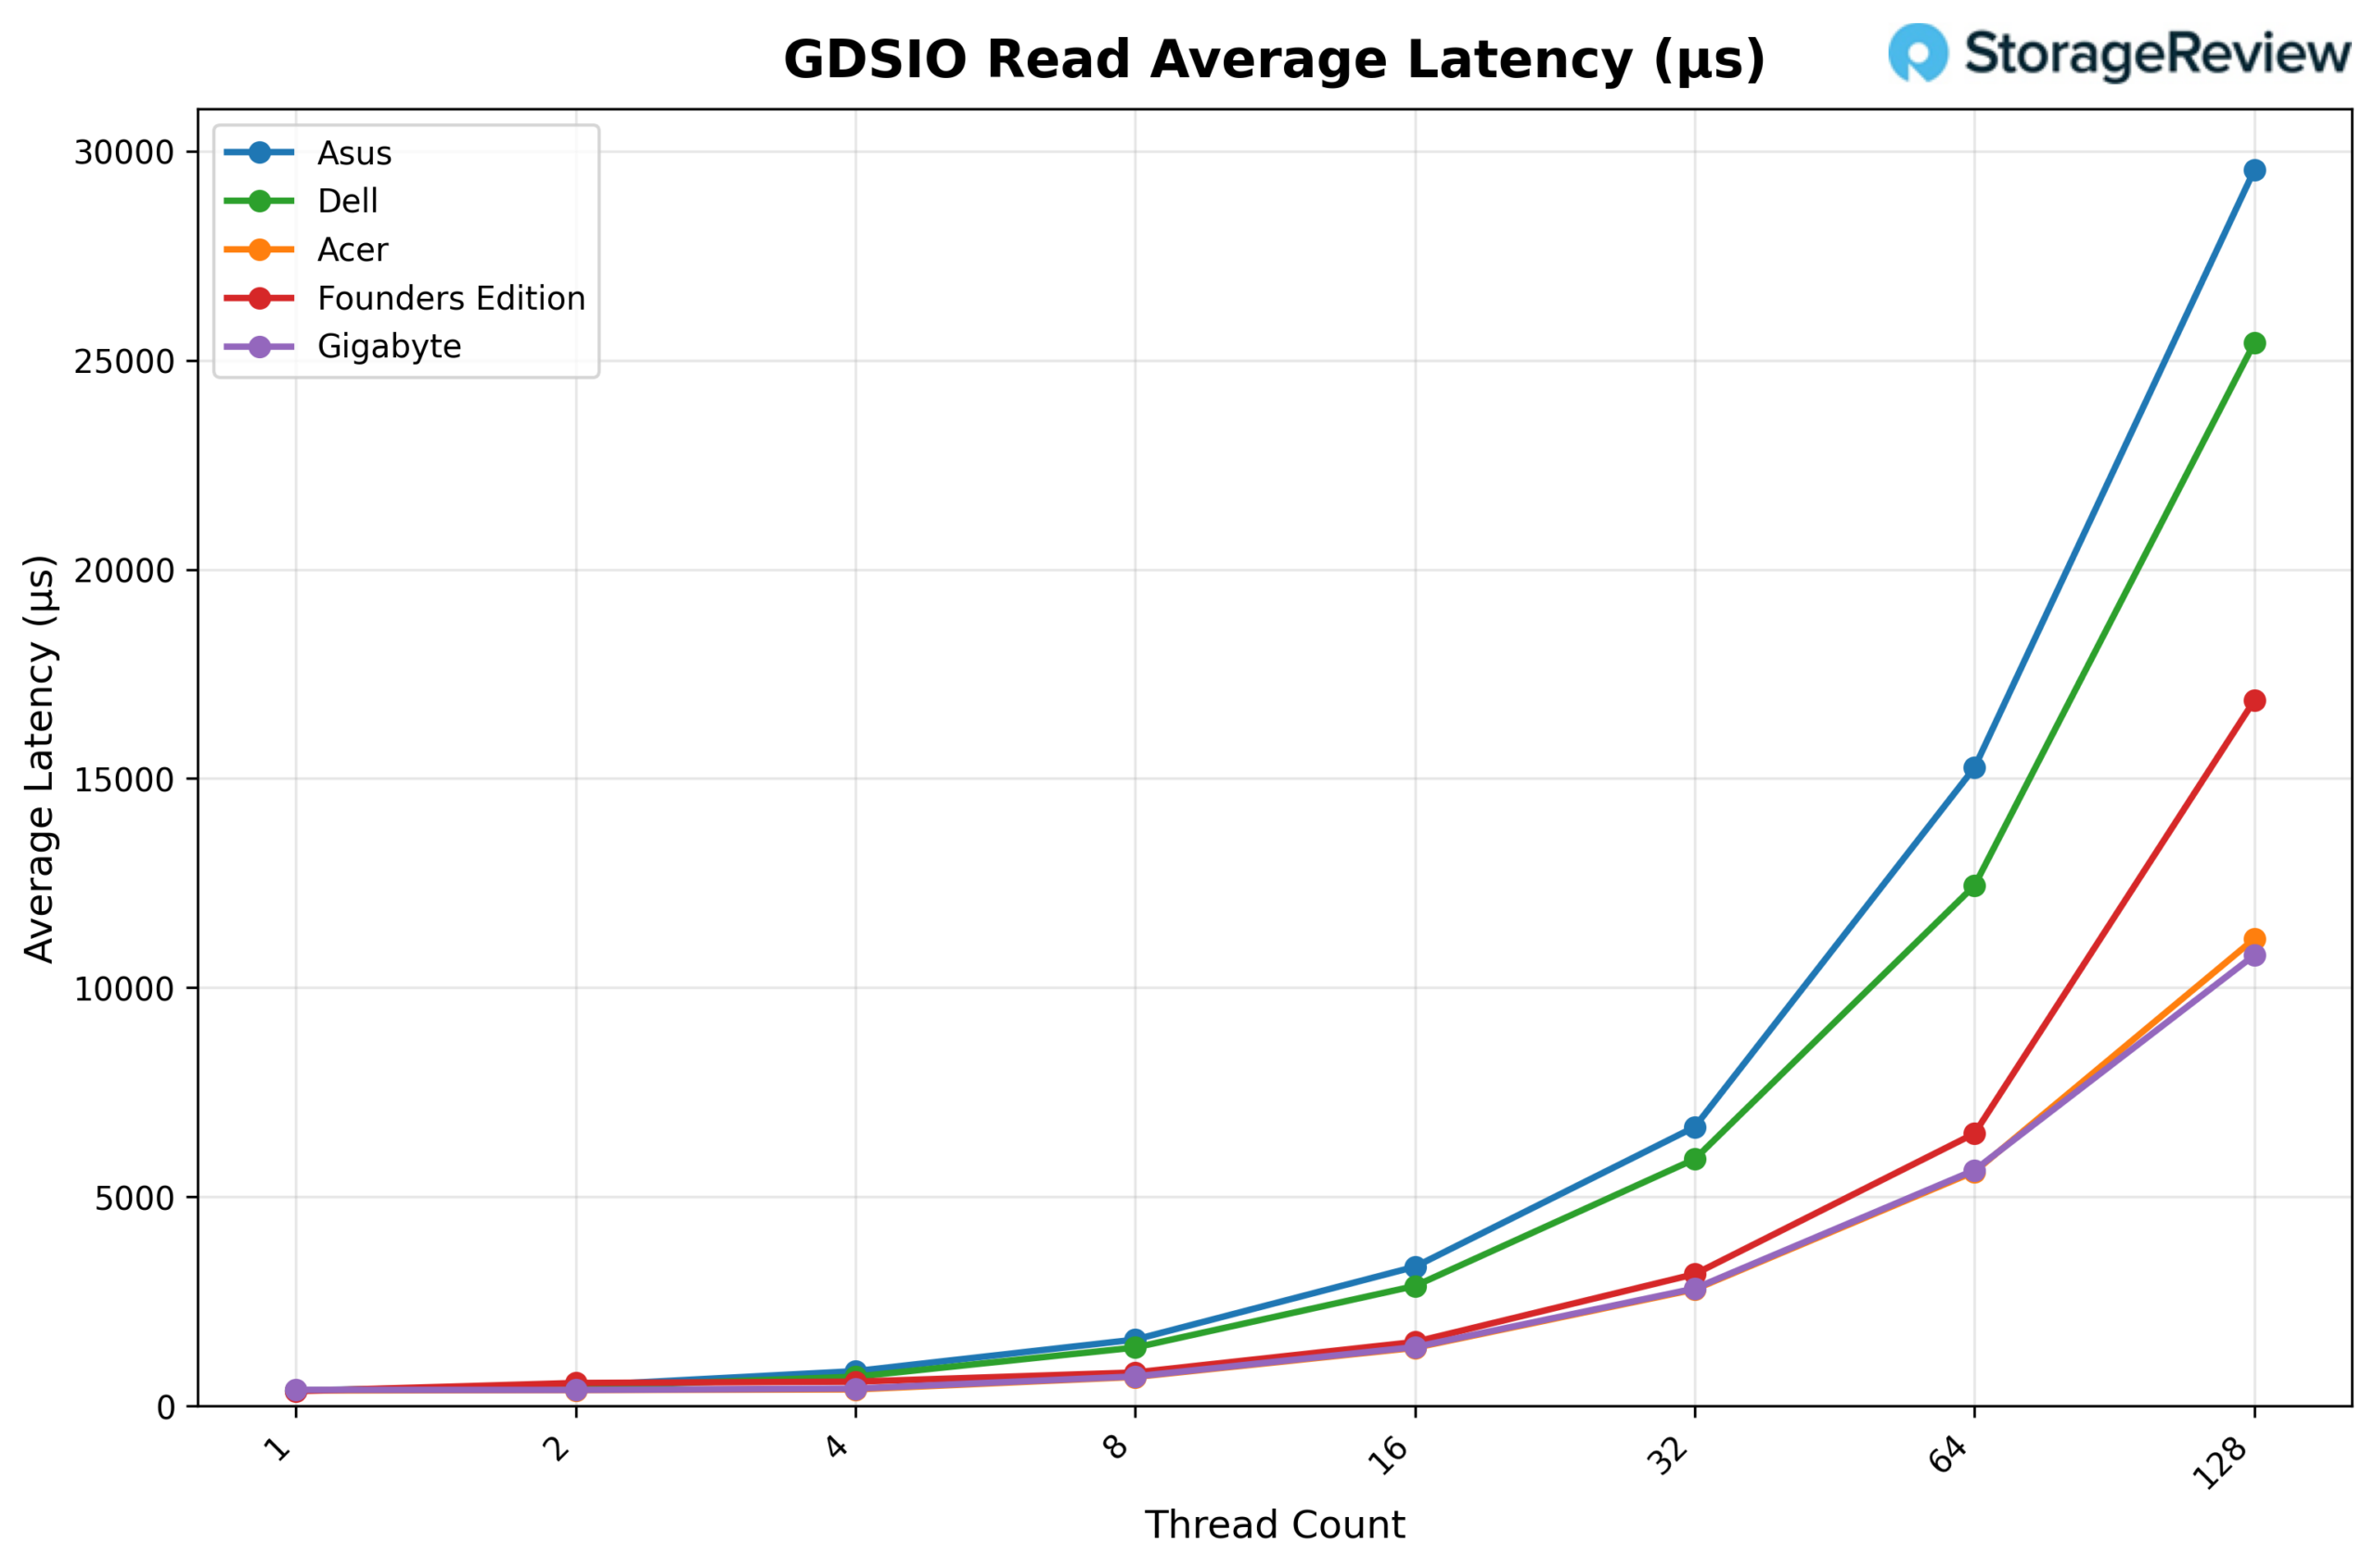
從 GDSIO 讀取平均延遲(1M)來看,技嘉顯示卡在單執行緒時延遲約為 0.39 毫秒,在雙執行緒(0.39 毫秒)和四個執行緒(0.42 毫秒)時也保持相似水準。隨著並發數的增加,延遲也隨之增加,在 8 執行緒時上升至 0.71 毫秒,16 執行緒時上升至 1.41 毫秒,32 執行緒時上升至 2.81 毫秒。在 64 執行緒時,延遲繼續上升至 5.64 毫秒,並在 128 執行緒時達到 10.78 毫秒,這與峰值並發數相對應,而吞吐量基本上保持穩定。
GDSIO 寫入吞吐量 1M
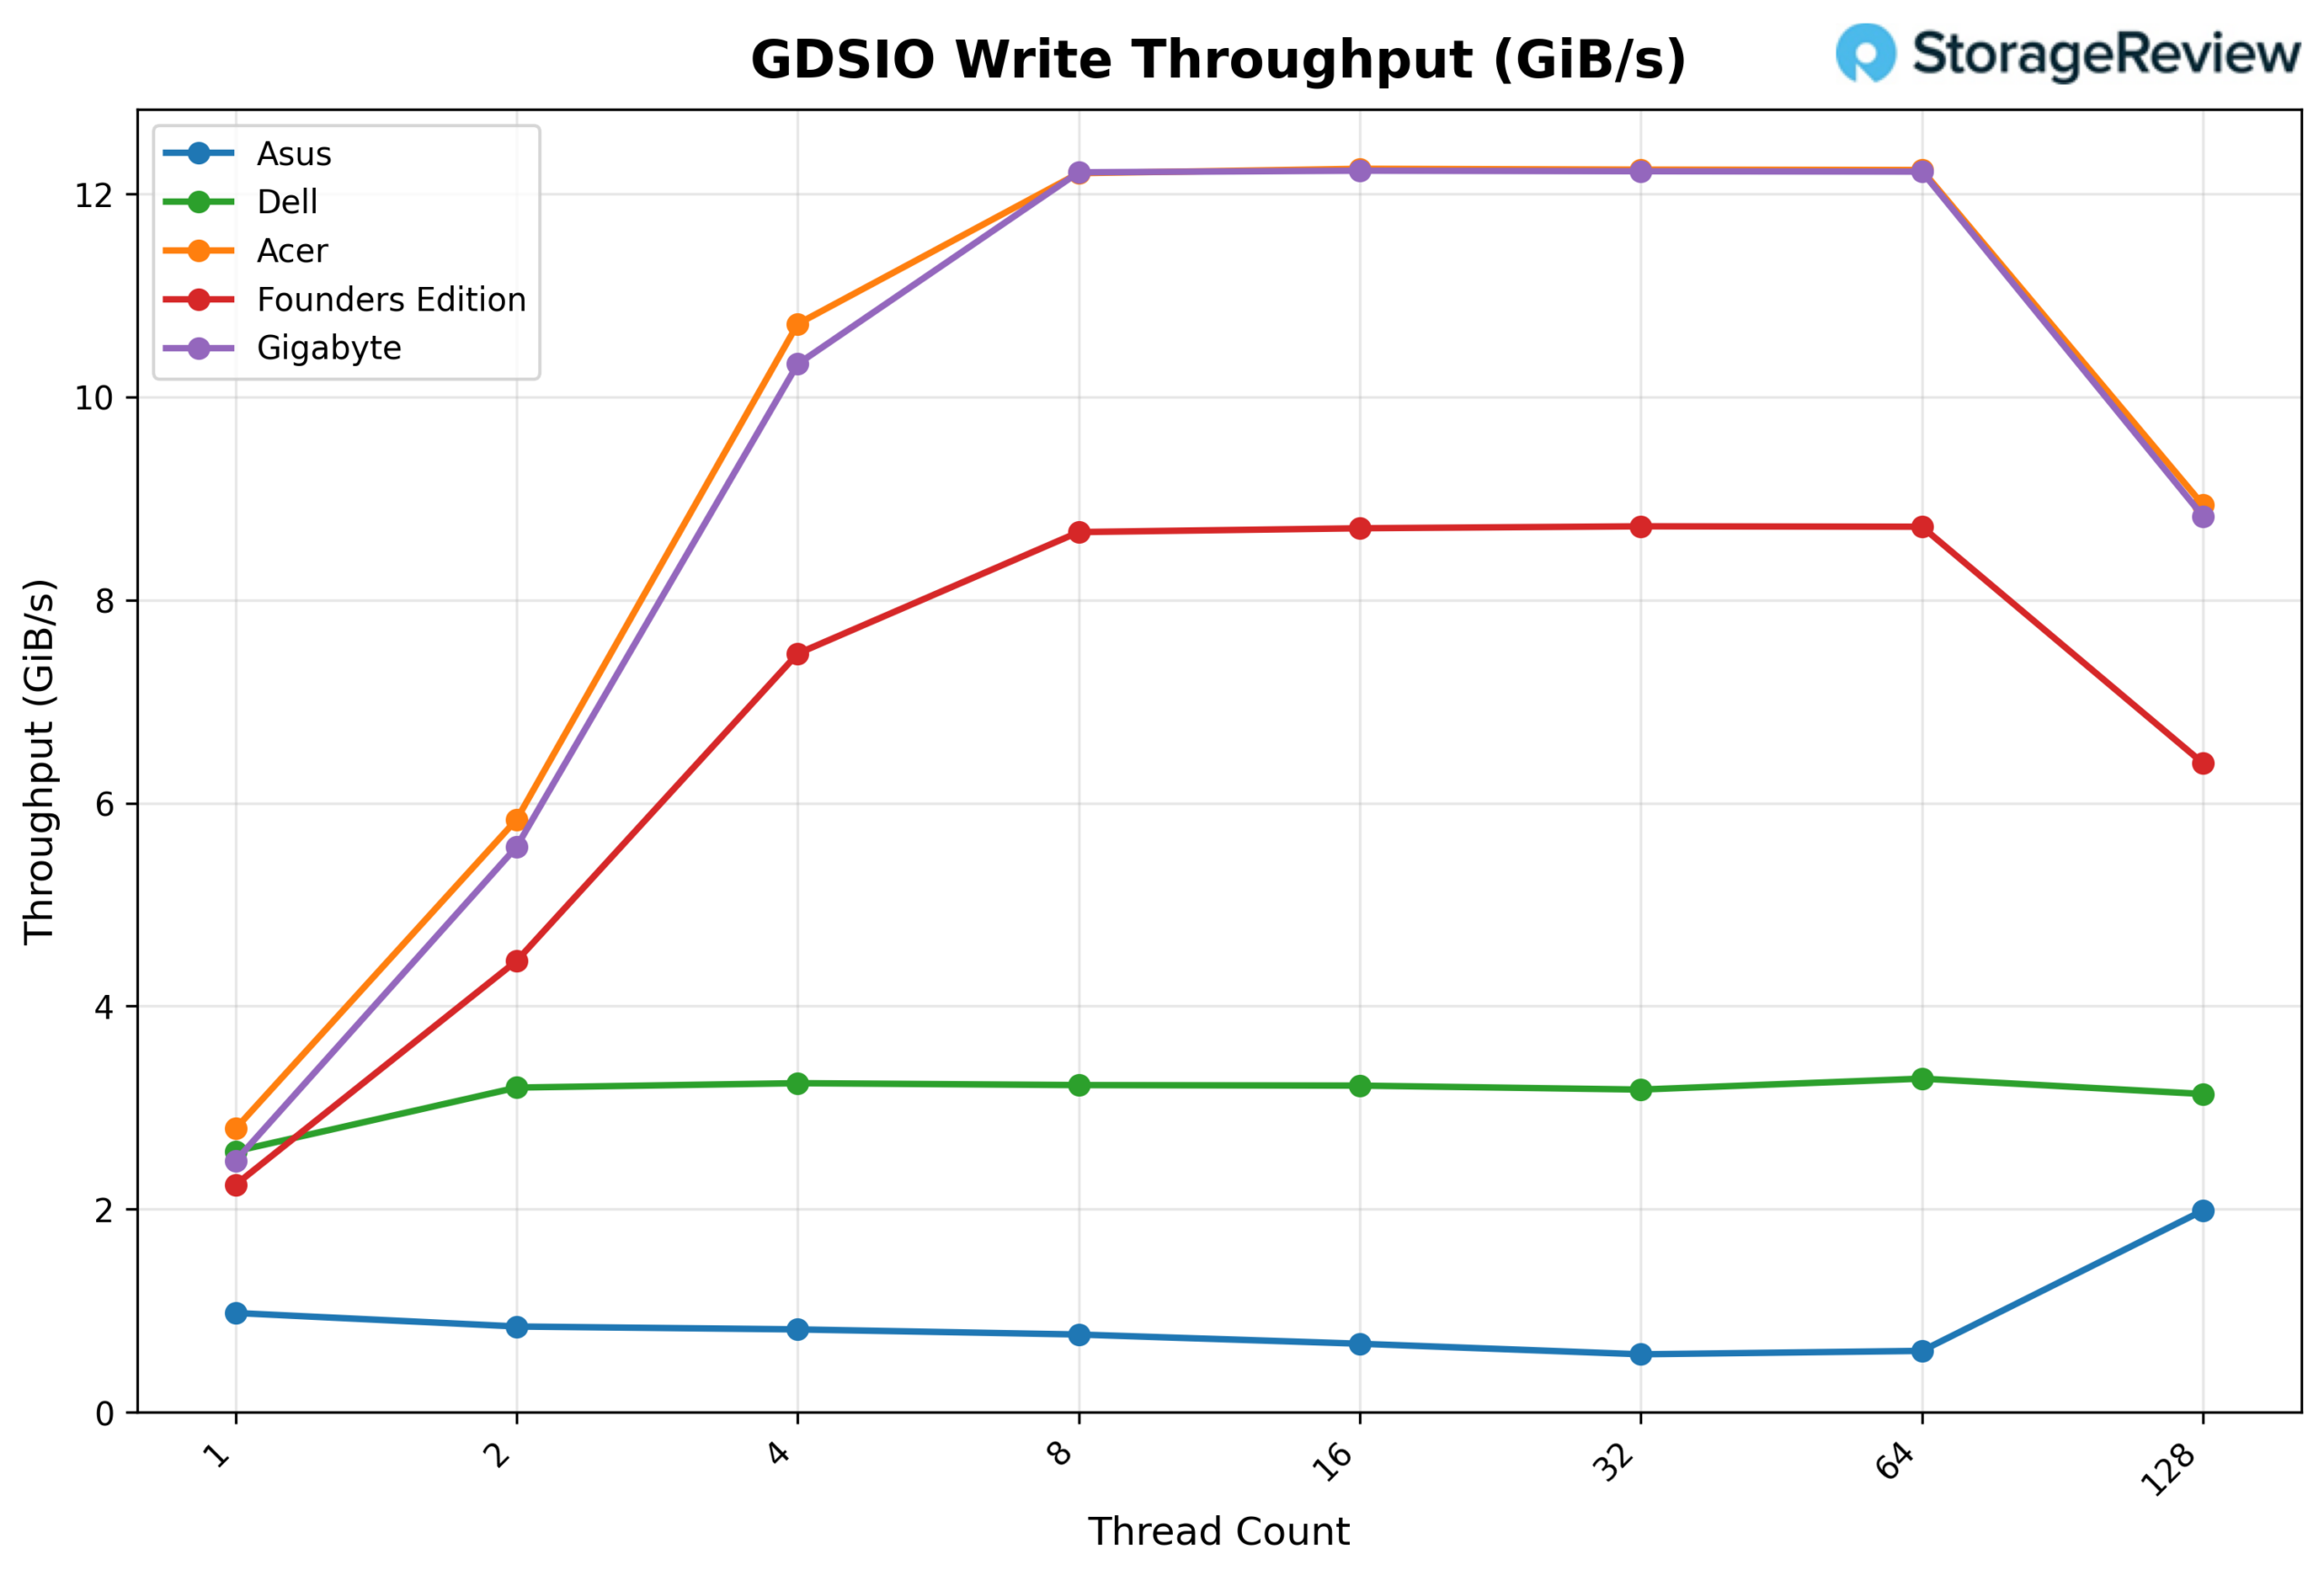
從 GDSIO 寫入吞吐量 1M 測試結果來看,技嘉這款主機板在單線程下吞吐量為 2.48 GiB/s,隨後迅速提升至雙線程的 5.57 GiB/s 和四線程的 10.32 GiB/s。當執行緒數達到 8 時,吞吐量達到 12.21 GiB/s,基本上達到平台極限。在 16 執行緒(12.23 GiB/s)、32 執行緒(12.22 GiB/s)和 64 執行緒(12.22 GiB/s)下,效能基本上保持不變,表示效能已接近飽和。當執行緒數達到 128 時,吞吐量下降至 8.82 GiB/s,表示系統已超出其最佳並發範圍。
GDSIO 寫入平均延遲 1M
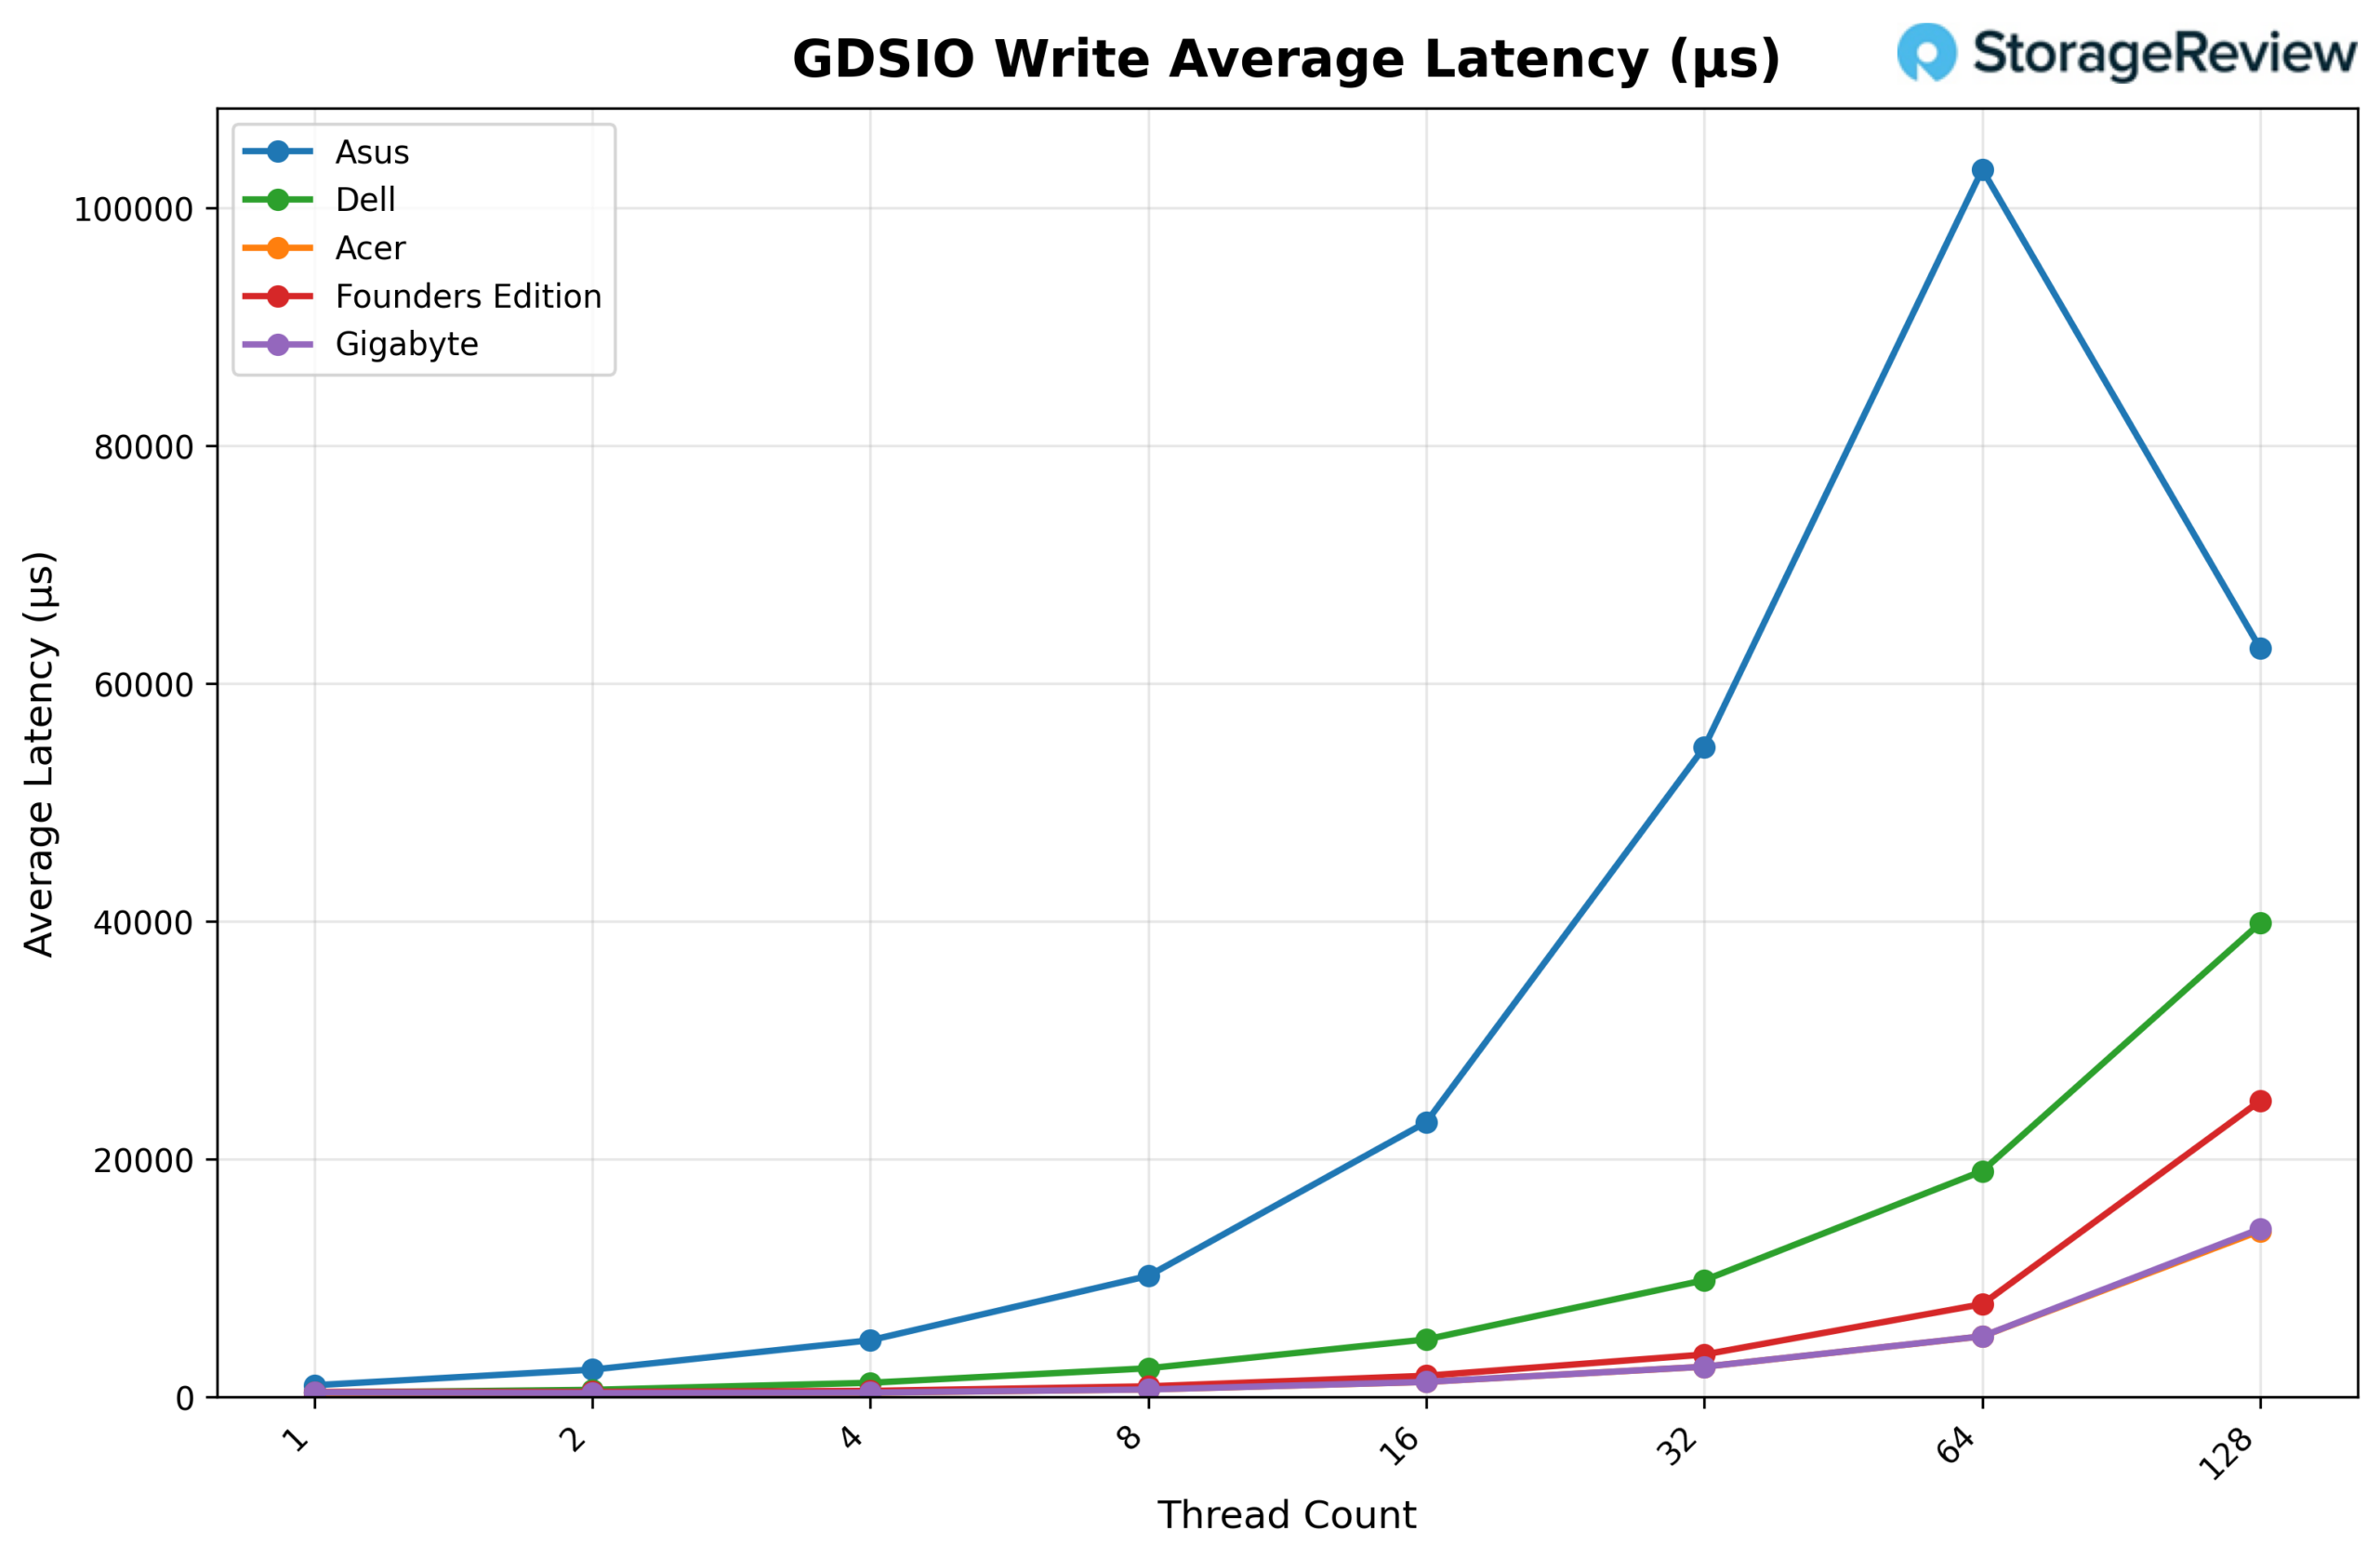
從 GDSIO 寫入平均延遲(1M)來看,技嘉顯示卡在單執行緒時延遲約為 0.39 毫秒,在雙執行緒(0.35 毫秒)和四個執行緒(0.38 毫秒)時也保持相對較低的延遲。隨著執行緒數的增加,延遲明顯上升,在 8 個執行緒時達到 0.64 毫秒,16 個執行緒時達到 1.28 毫秒,32 個執行緒時達到 2.56 毫秒。延遲在 64 線程時繼續上升(5.11 毫秒),並在 128 線程時急劇上升至 14.16 毫秒,這與觀察到的最高並發級別下的吞吐量下降相吻合。
結語
技嘉 AI TOP ATOM 是 NVIDIA 基於 GB10 的 Spark 平台的又一力作,它採用與我們測試過的其他 Spark 產品相同的電路板和晶片。如預期,其在 vLLM 測試中的核心運算效能與同類產品基本一致。在 GPT-OSS、Qwen3-Coder 和 Llama 3.1 測試模型中,其擴展性能表現依然可預測,隨著並發量的增加,預填充吞吐量保持強勁,Equal 和 Decode 性能也保持穩定。
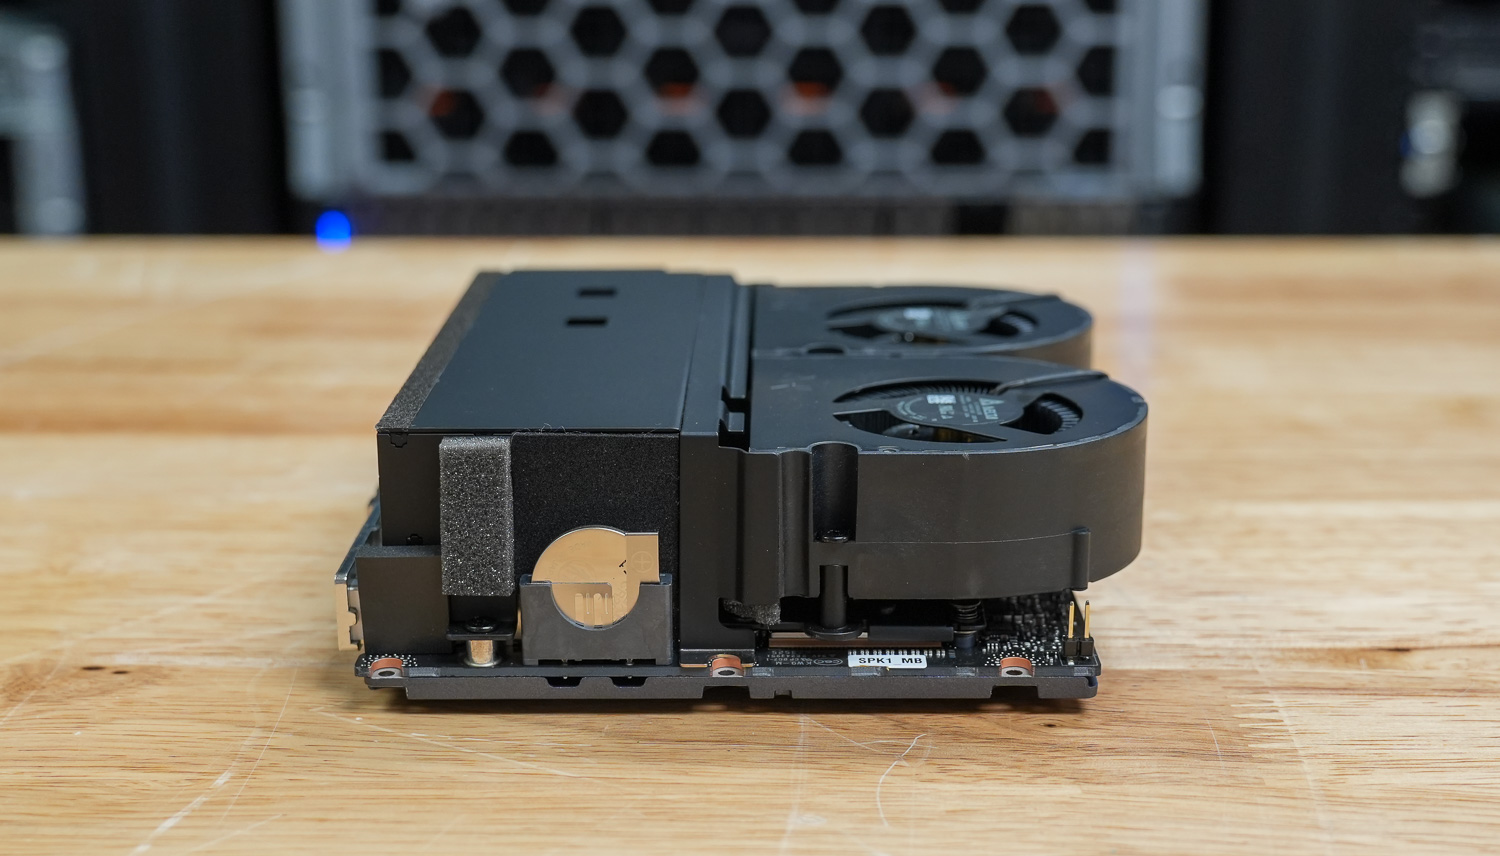
在散熱方面,技嘉允許處理器在峰值功耗下運作更激進。在預填充密集型任務切換期間,CPU 溫度峰值達到 90°C,GPU 溫度峰值達到 81°C,GPU 功耗最高達到 75.54W。一旦工作負載恢復正常,溫度便趨於穩定,沒有持續降頻的跡象。實際上,較高的峰值溫度反映的是短時功率分配策略,而非系統不穩定。
這款設備最顯著的優勢在於儲存方面。技嘉採用 4TB 第五代三星 PM9E1 固態硬碟,在 Spark 測試組中取得了頂尖的 GDSIO 效能。讀寫吞吐量在 16K 和 1M 的工作負載下均表現出色,在預期並發水準下早期達到飽和,延遲增加主要出現在線程數最高的時候。
由於所有 Spark 系統都基於相同的 GB10 架構,因此在 AI 推理方面的基準測試差異仍然很小。實際應用中的選擇主要取決於機箱設計、突發散熱性能、儲存配置以及廠商匹配度,而非基本的運算能力差異。
排行榜:技嘉 AI TOP ATOM 已入選我們「最佳本地 AI 桌上型電腦」排行榜。


 Amazon