

基於 NVIDIA GB10 的桌面 AI 系統只有一個任務,而且它們出色地完成了這項任務:將 128GB 的統一內存和 1 petaflop 的計算能力放在離用戶足夠近的桌面上,實現即時迭代。但它們缺少的是與組織現有儲存的連接。每個 DGX Spark 和 OEM 版本都配備一個短的 M.2 插槽,這限制了本地容量約為 4TB,並將機器上的所有資料集、模型和檢查點都置於資料中心的治理、存取控制、備份和稽核追蹤之外。如果這種情況發生在實驗室、部門或園區,就會產生數十個孤立的 4TB 資料孤島,每個孤島都儲存著相同模型和資料集的副本,而每個孤島的安全性都取決於它所放置的桌面。
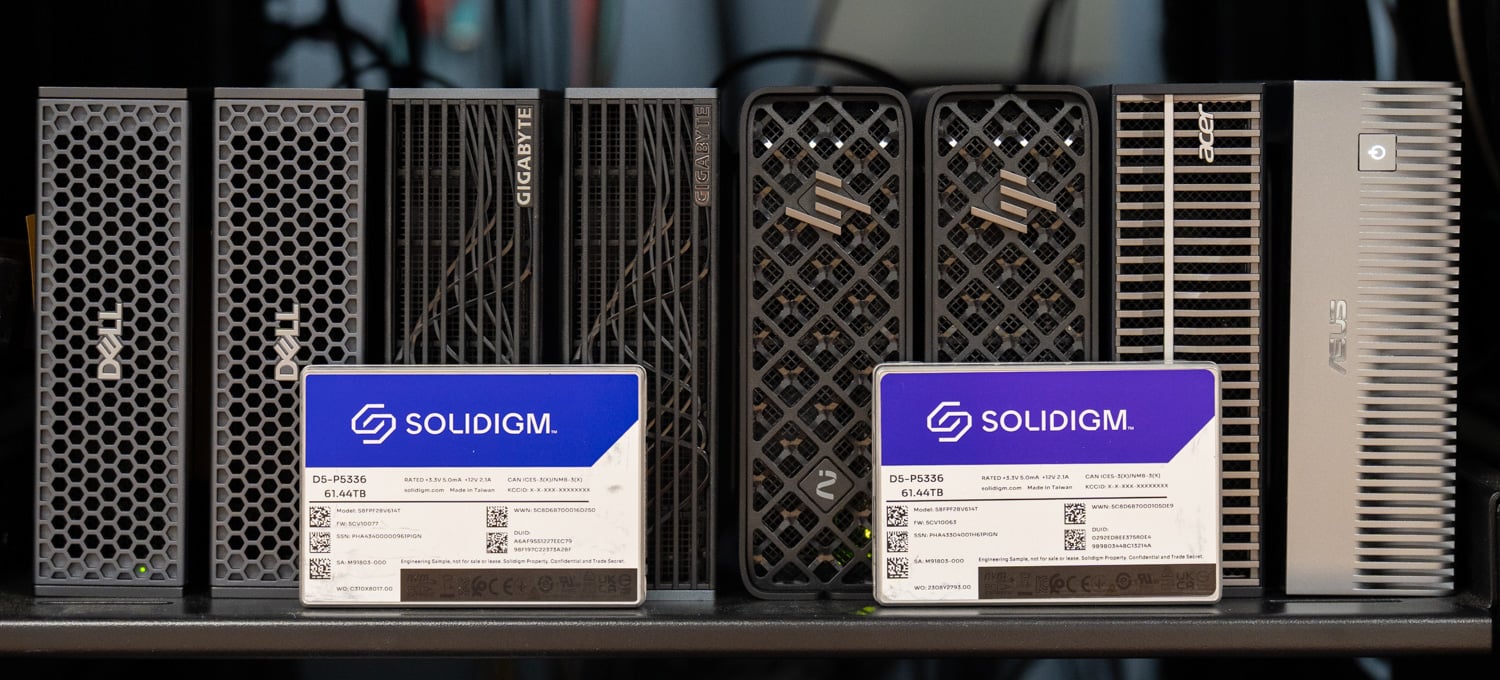
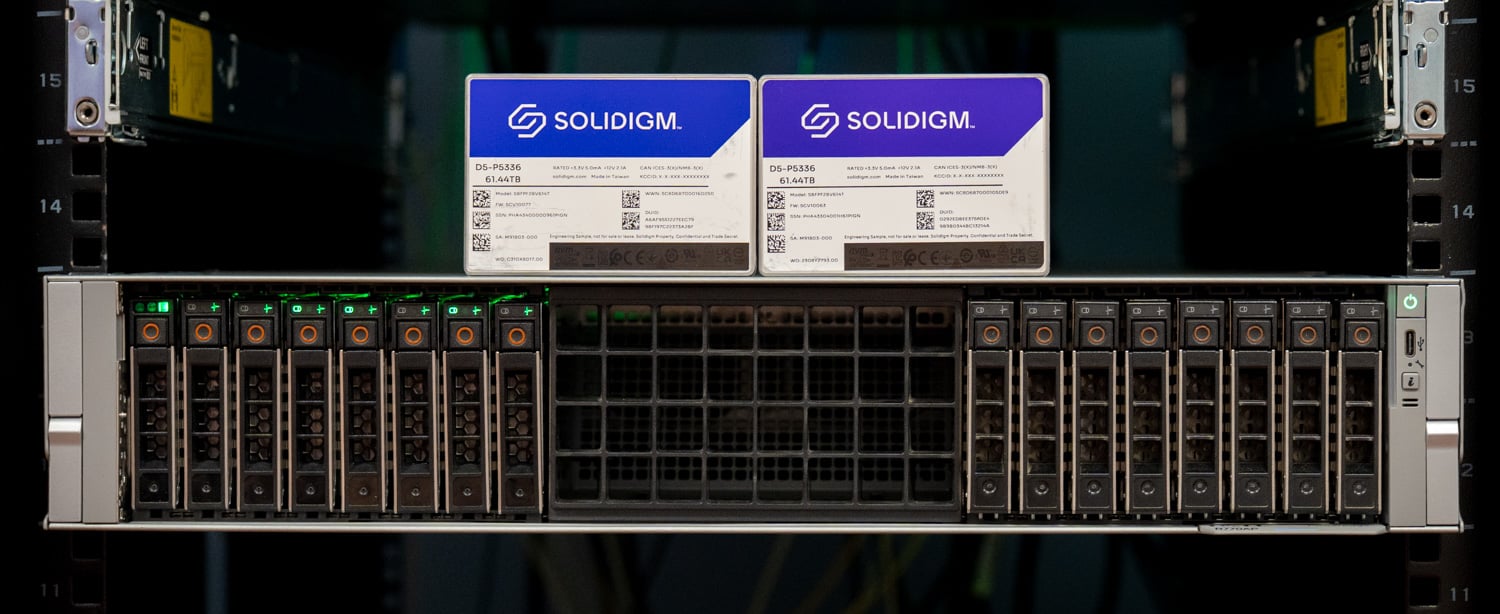
這個項目將儲存問題重新帶回資料中心。我們用一台戴爾 PowerEdge R770AP 伺服器搭建了一個 DGX Spark 共享儲存主機,配備了八塊 Solidigm D5-P5336 QLC SSD 固態硬碟(採用 Graid SupremeRAID RAID 5 陣列)、博通 400GbE 網卡以及 Tuxera Fusion 儲存服務(Duxera Fusion) 100GbE 埠。每個 Spark 儲存裝置都透過一條線路掛載同一個受控的、奇偶校驗保護的儲存池;每個模型和資料集的單一副本供所有裝置使用,工作站無需超出其自帶的儲存空間,而且 Spark 儲存裝置本身可以放置在陣列旁的機架中,便於安全維護、散熱和共用。這個方案的關鍵在於資料儲存的位置,任何配備高速網卡的 NVMe 伺服器都可以勝任這項工作。俄勒岡州立大學正在探索一個用於人工智慧學習的大規模 Spark 實驗室,並希望讓學生能夠存取數十 TB 的研究資料集。在我們設計建造方案時,大學與我們分享了他們的想法。對於如此大規模的數據,共享儲存是適合本次評估的方法。
關鍵要點
- 一個陣列,八個 Spark,無需客戶端軟體: 來自五個 OEM 廠商的八個 DGX Spark 設備,透過 Graid SupremeRAID 和 Tuxera Fusion 後面的單一 Solidigm D5-P5336 QLC 陣列,利用它們已有的 100GbE 端口,在標準的 Ubuntu 系統上透過一行掛載命令,掛載 NFS/RDMA 共用。
- 託管模型的載入方式與本機模型相同: 一台 Spark 從共享陣列加載 78GB Qwen3.5-122B-A10B-NVFP4 模型耗時 269.6 秒,比同一台 Spark 從其內部 NVMe 加載所需時間 239.6 秒縮短了 13%。八台 Spark 同時載入相同單一副本,完成時間為 232.8 到 326.5 秒。
- 每張辦公桌上放一份,就能取代一個資料筒: 模型和資料集儲存在受管控且具備奇偶校驗保護的資料中心儲存上,取代了工作站上每台 4TB M.2 固態硬碟上的副本,從而提高了儲存利用率,減少了資料複製,而且 Spark 無需升級儲存或佔用桌面空間。對於像俄勒岡州立大學正在探索的那種大型人工智慧學習實驗室(其研究資料集高達數十 TB),這種方法在我們評估中最適合其用例。
- 硬碟容量決定了效能上限,而網路還有提升空間: 八個 Spark 裝置同時讀取資料時,八盤位元 RAID 5 陣列的讀寫速度接近 25GiB/s,約 214Gb/s,這佔用了主機中兩塊 Broadcom BCM57608 網路卡 800Gb/s 頻寬的 27%。單一 Spark 設備從此陣列讀取資料的速度為 10.8GiB/s,與我們在 GB10 系統中測得最快的內建 M.2 介面速度相當。
- 治理源於協議: 帶有 RDMA 的 NFS 將每個使用者的資料夾、共用資料集和託管模型放在一個命名空間中,並帶有 Active Directory、Kerberos 和 LDAP 鉤子,這使得資料能夠在 Spark 移入機架的同時保持在資料中心的控制之下。
每張辦公桌上都擺放一個人工智慧島的問題
DGX Spark及其來自戴爾、技嘉、惠普、宏碁和華碩的OEM版本均採用GB10平台,儲存容量上限也相同。在我們最初的DGX Spark評測中,儲存容量是該平台最明顯的瓶頸。其內建插槽僅支援短版M.2固態硬碟,因此標配的8TB 2280規格固態硬碟無法安裝。我們在8月評測的Luisuantech GP Spark解決了這個問題,它透過一個四盤位M.2外接硬碟盒連接到一個100GbE網口,對於一台桌面上的Spark來說,這是一個簡潔的解決方案;而在實驗室規模下,則相當於每張桌面上都配備了一個更大的儲存模組。
容量問題只佔一半;另一半在於資料一旦到達桌上型電腦後會發生什麼事。一個78GB的模型被下載到Spark伺服器上,IT人員根本看不到這個副本。一個研究資料集被暫存在本地快閃記憶體上,這意味著它不受備份計劃、存取策略和機構審計的約束。實驗室裡的十台Spark伺服器意味著十份相同的權重資料副本,佔用了780GB的快閃記憶體空間,而這些空間原本可以用於其他用途;同時,資料集也可能隨著機器被帶出十個不同的位置。隨著設備數量的增加,問題會變得更加嚴重,無論是GB10系統或任何桌上型AI基礎設施。每個管理過大量筆記型電腦的組織都了解這種模式,而當時的解決方案也是一樣的:將資料保存在資料中心的共用儲存上,讓終端設備僅作為終端設備使用。
值得慶幸的是,NVIDIA 在 Spark 的設計中預留了足夠的連接埠來實現這一點。每個 Spark 單元都整合了 ConnectX-7 晶片,並配備兩個 QSFP56 插槽,透過一對 PCIe Gen5 x4 連結提供高達 200Gb 的可用頻寬。在我們的DGX Spark 叢集評測中,我們介紹了一種角色分離配置,其中一個插槽連接到對等 Spark 單元,另一個用於儲存。本專案為每個 Spark 單元使用 100GbE 儲存插槽,第二個插槽則可用於叢集或其他擴充頻寬。在 100GbE 頻寬下,每個 Spark 單元到儲存主機的理論頻寬約為 12.5GB/s,這超過了大多數此類系統內建 M.2 插槽提供的頻寬。
一旦資料儲存在連結的另一端,Spark 的角色就改變了。它變成了一個計算端點,配備啟動盤和本地緩存盤,容量不再是按工作站單獨購買的。模型或資料集只需寫入一次,即可被所有客戶端讀取,因此儲存利用率提高,副本數量減少。資料保護轉移到伺服器機箱內的奇偶校驗保護陣列,存取控制、靜態加密、備份和稽核等功能也與其它功能一樣,在現有系統中運作。由於 Spark 現在只需要電源和 100GbE 鏈路,因此完全沒有必要放在桌面上。將其安裝在儲存主機旁的機架上,可降低溫度、減少噪音、增強實體安全性,並隨時供其他使用者使用。
儲存主機
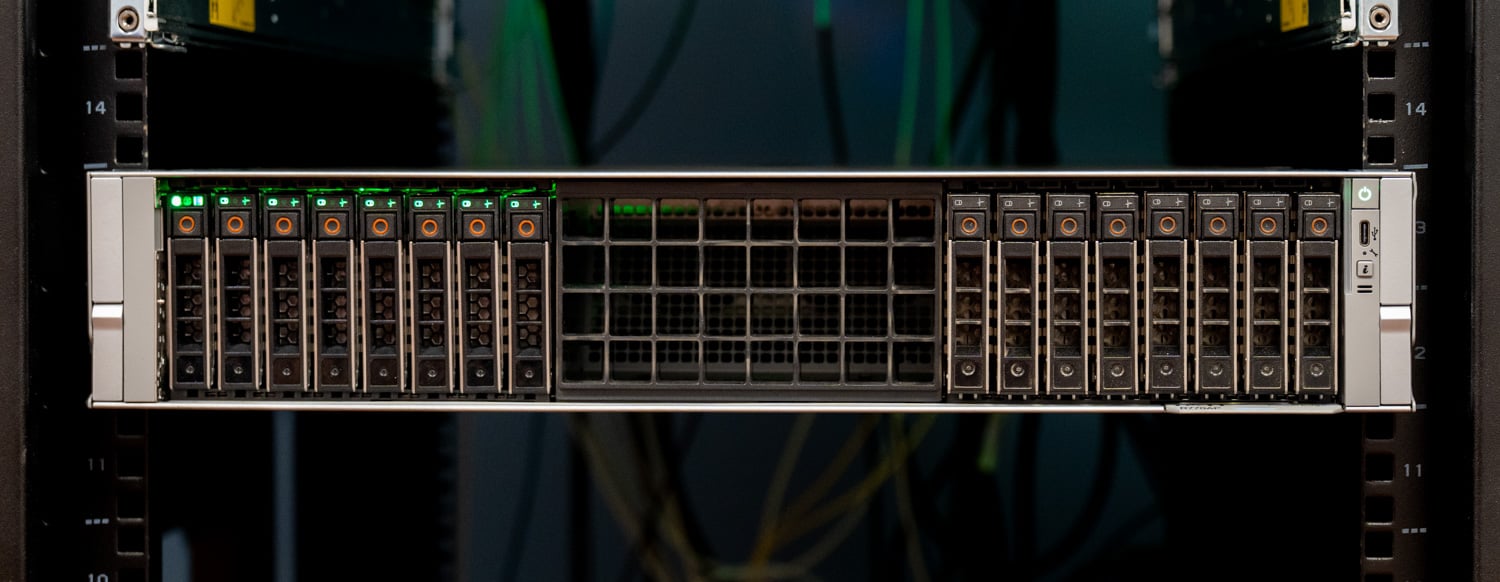
儲存主機是戴爾 PowerEdge R770AP,也就是我們今年稍早評測過的那款 2U Xeon 6 平台。之所以選擇它,是因為計畫開始時實驗室裡正好有一台空著的。任何配備高速網卡和小型 GPU 的 NVMe 伺服器都可以勝任這項工作,R770AP 就是其中一個選擇,儘管配置略高。我們的這台伺服器搭載了兩顆 Xeon 6 6978P 處理器,24 個 DIMM 插槽共 1.5TB DDR5 內存,使用了其兩組 8 個 Gen5 NVMe 硬碟位中的一組,並將硬碟和 Graid GPU 連接到 CPU 0,兩個 400GbE 網卡連接到 CPU 1。伺服器運行的是 Ubuntu 24.04 作業系統。
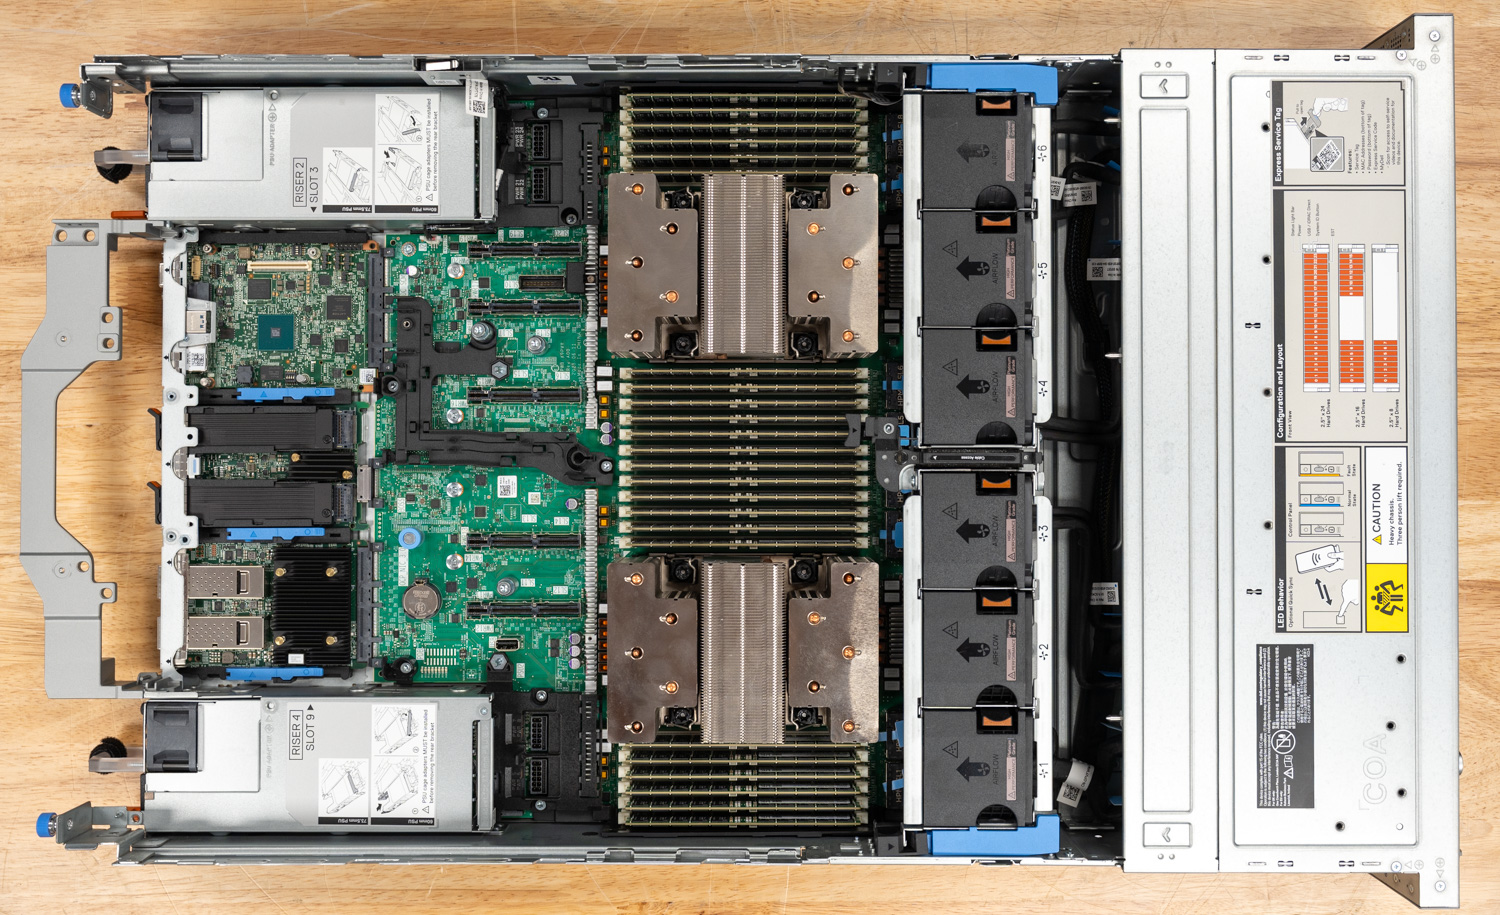
| 元件 | 儲存主機配置 |
|---|---|
| 伺服器 | 戴爾 PowerEdge R770AP,2U,16 個 2.5 吋 Gen5 NVMe 硬碟位 |
| 中央處理器 | 2 個 Intel Xeon 6 6978P 處理器 |
| 記憶體應用 | 1.5TB DDR5 (24x 64GB) |
| 儲存 | 8 個 Solidigm D5-P5336 61.44TB U.2 PCIe 4.0 QLC(491.52TB 原始) |
| 的RAID | Graid SupremeRAID,所有八個硬碟均採用 RAID 5 模式,CPU 0 搭載 NVIDIA RTX A2000 GPU。 |
| 文件系統 | SupremeRAID 虛擬磁碟機上的 XFS |
| 文件服務器 | Tuxera Fusion(Fusion NFS,私人預覽版),基於 RDMA 的 NFS 4.1(連接埠 20049 上的 RPC-RDMA),使用者模式 |
| 網路相關 | 2 個 Broadcom BCM57608 (Thor 2) 單端口 400GbE 網卡,PCIe Gen5 x16 接口,位於 CPU 1 上,支援 RoCEv2。 |
| 軸體 | 戴爾 PowerSwitch Z9864F-ON,64 個 800GbE OSFP112 端口,企業級 SONiC |
| 客戶連結 | 800G 光纖端口分接成 8 個 100GbE 端口,每個 Spark 設備使用一條鏈路,每個存儲網卡連接四個 Spark 設備,分別位於不同的 VLAN 上。 |
| 客戶 | 2 台戴爾 Pro Max(配備 GB10 處理器)、2 台技嘉 AI TOP Atom 處理器、2 台惠普 ZGX Nano G1n 處理器、1 台宏碁 Veriton GN100 處理器、1 台華碩 Ascent GX10 處理器 |
| OS | Ubuntu的LTS 24.04 |
為什麼選擇QLC,以及為什麼選擇D5-P5336
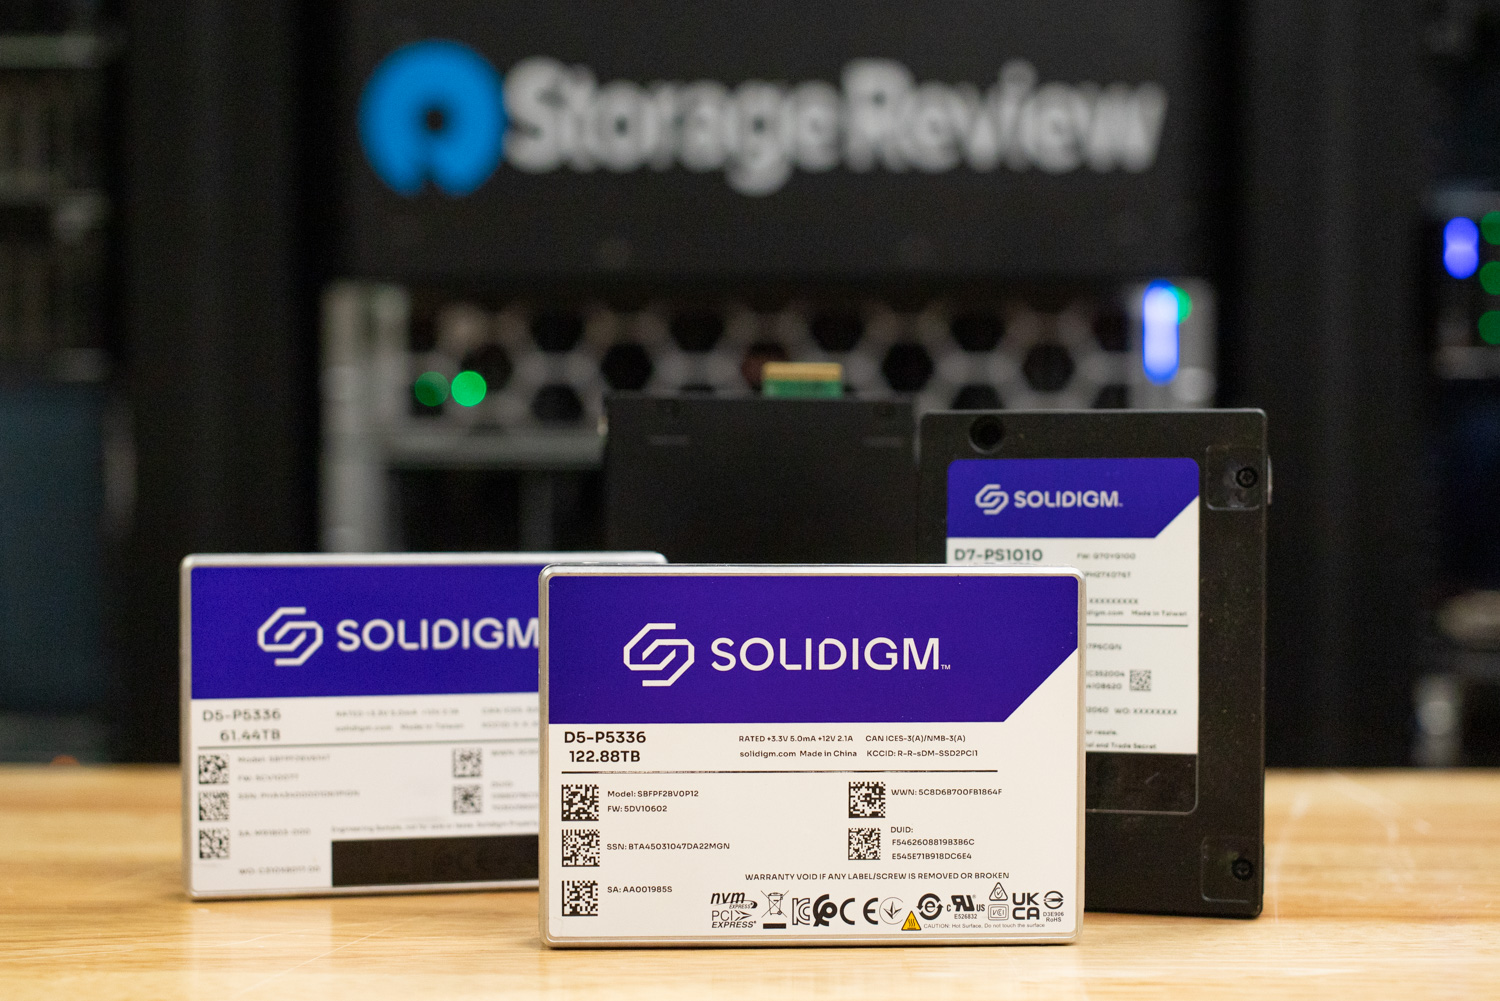
在與俄勒岡州立大學討論Spark實驗室概念時,容量是首要考慮因素,因為涉及的研究資料集非常龐大。這台伺服器的任務是儲存一屋子Spark程式可能需要的所有數據,並以可供多個客戶端同時讀取的形式提供這些數據。這是一個讀取密集、大塊、高容量的應用場景,而這正是QLC快閃記憶體的強項。 D5 -P5336系列容量從7.68TB到122.88TB不等;這裡使用的61.44TB U.2固態硬碟,經Solidigm公司評測,順序讀取速度高達7,000MB/s,順序寫入速度高達3,000MB/s,4K隨機讀取IOPS高達1.005萬,耐久性高達65.2PBW(相當於五年內每天寫入0.58次),採用192層QLC3單元,並配備 16K,並配備192層QLC單元。
八塊 61.44TB 的硬碟佔據了 R770AP 前面板一半的硬碟位,而實際生產環境中,使用者可以選擇該系列中任意容量的硬碟,並根據需要選擇任意數量的硬碟位。即便如此,八支硬碟組成 RAID 5 陣列也能提供約 430TB 的可用空間,並具備單碟容錯能力。這比 Spark 的 M.2 插槽容量高出 100 多倍,足以滿足一個部門的模型庫、學生共享的資料集以及每個用戶的主目錄的需求。如果將剩餘的八個硬碟位也裝滿,容量就能翻倍,而無需更改網路設計。本文稍後將展示硬碟容量擴充的優勢。
對於這種工作負載而言,16KB 的間接單元至關重要,因為 Solidigm 更大的間接單元雖然提高了儲存密度和成本,但卻犧牲了小隨機寫入的效率。而對於用於儲存模型和資料集的共享儲存來說,小隨機寫入只是少數情況。模型載入是大量的順序讀取操作。資料集串流也是大量的順序讀取操作。檢查點和學生文件只需寫入一次,即可頻繁讀取。由此產生的分工對於 Spark 實驗室來說是合適的:共享的 QLC 陣列儲存所有被多個進程讀取的數據,而 Spark 自身的 M.2 介面則處理單一進程寫入的臨時數據和交換數據。
GPU 上的 RAID:Graid SupremeRAID
在八塊第四代 NVMe 硬碟上建置 RAID,每塊硬碟的讀取速度均為 7,000MB/s,此時傳統硬體 RAID 卡就會成為瓶頸,因為每個位元組都必須透過卡的 PCIe 插槽傳輸。軟體 RAID 則面臨不同的資源挑戰。 Graid SupremeRAID 將奇偶校驗計算卸載到 GPU 上,並將資料傳輸路徑保持在主機 PCIe 通道上,因此我們在SupremeRAID AE 測試中使用 16 塊硬碟時,速度可以擴展到 180GB/s 以上。在本測試中,我們使用 NVIDIA RTX A2000(小型工作站 GPU)來執行 SupremeRAID。
八塊 D5-P5336 硬碟在交付給 Graid 之前,均經過安全擦除並按順序填充,然後配置成一個 RAID 5 陣列。產生的虛擬硬碟採用 XFS 檔案系統格式化,並由 Tuxera 提供服務。 RAID 5 非常適合這種共享場景:即使一塊硬碟發生故障,陣列也能保持在線;重建過程不會中斷用戶資料;容量損失僅為八分之一的硬碟。對於更注重重建視窗保護而非容量的生產環境部署,RAID 6 或 RAID 10 也是合理的選擇,而 SupremeRAID 同時支援這兩個層級。
網路架構:博通 400GbE 和 800G 核心網
此網路架構的儲存端由R770AP中的兩塊博通BCM57608 Thor 2網路卡組成,每塊網路卡都是單一連接埠400GbE網路卡,採用PCIe Gen5 x16介面。博通將BCM57608定位為業界功耗最低的400G網卡,其功能特性也使其非常適合該架構:支援RoCEv2增強型DCQCN擁塞控制、自適應路由、基於矽信任根的安全啟動以及內聯kTLS加密卸載。 RoCEv2在該設計中透過RDMA傳輸NFS數據,擁塞控制功能可防止多個客戶端同時拉取資料時相互幹擾。在建造過程中,bnxt_en驅動程式報告稱,在持續負載下,400G連接埠上的光模組溫度達到了70℃的警告閾值。我們透過對R770AP的風扇轉速進行小幅調整解決了這個問題,之後網路卡運作正常。
兩塊網路卡都連接到我們實驗室的 800G 核心交換器Dell PowerSwitch Z9864F-ON上,該交換器運行企業級 SONiC 協定。 Z9864F-ON 提供 64 個 800GbE OSFP112 端口,並可將其中任意端口擴展為 2 個 400G、4 個 200G 或 8 個 100G。其中一塊 800G 光模組擴展為 8 個 100G 端口,將八個 Spark 儲存設備分別連接到同一交換機,該交換機也負責終止兩個 400G 儲存鏈路。每塊 400G 網路卡位於獨立的 VLAN 中,服務四個 Spark 儲存設備,因此儲存主機提供兩個 RDMA 目標,負載按設計均勻分配到這兩個目標上。實際上,這是一個全速率拓撲:一側有 8x100G 的客戶端頻寬,另一側有 2x400G 的儲存頻寬,中間有一個容量為 102.4Tbps 的交換器。
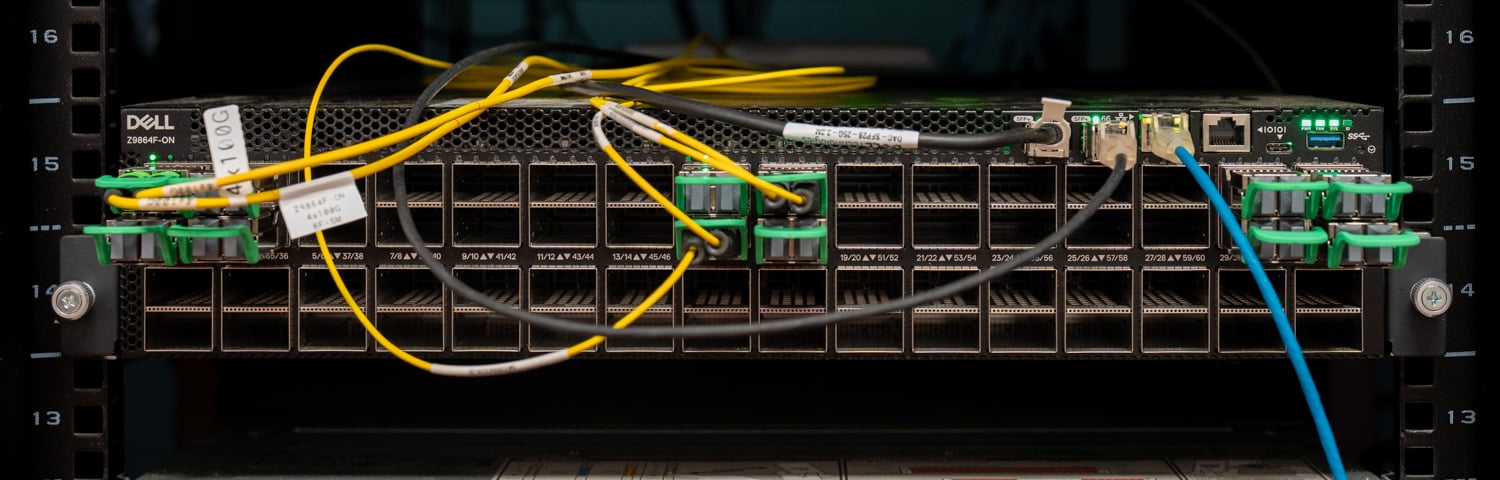
在任何儲存軟體存取網路之前,我們對網路架構進行了驗證。 R770AP 與另一台主機之間透過 400G 連結進行的伺服器間測試顯示,雙向傳輸速率均達到線速;來自 Spark 的 RDMA 流量也證實了 100G 分支連接埠能夠全速運作。 Tuxera 的工程師配置好 NFS 共享後,我們使用 iperf3 對 Spark 到各自網卡的傳輸進行了測試,結果顯示四個平行資料流能夠穩定傳輸 99Gbps 的數據,且無重傳。
為什麼選擇 NFS,以及為什麼選擇 Tuxera
Graid 提供了一種高速區塊設備,儲存主機可以將 Spark 用作 NVMe-oF 區塊目標或檔案共用。我們在 GP Spark 評測中測試了區塊路徑,它對單一客戶端運作良好。但對於擁有多個 Spark 的實驗室來說,我們需要不同的方案。塊卷是一對一的;每個使用者都需要一個 LUN,一旦兩個使用者想要存取相同的資料集,就需要進行複製,而這正是我們整個設計旨在解決的問題。 NFS 位於維恩圖的中心:單一命名空間可容納共享資料集、託管模型和每個使用者的資料夾。每個 Spark 掛載點都使用 Ubuntu 中已有的 NFS 用戶端,大學在 Spark 實驗室上部署的 Kubernetes 和 Slurm 工具也都支援 NFS。
Fusion NFS是 Tuxera Fusion 的 NFS 部分,Tuxera Fusion 是一款多協定檔案伺服器,在單一使用者模式多執行緒核心上支援 SMB 和 NFS;我們最早在2024 年與 Solidigm 和 Tuxera 合作的媒體工作流程專案中接觸到了 Fusion SMB。 Tuxera聲稱,在單一 200GbE 連線上使用 RDMA 時,其傳輸速度最高可達 22.7GB/s,高於核心 NFSD 和 Ganesha(根據 Tuxera 自身的測試)。本產品支援 NFS 4.1、主動-主動橫向擴展叢集、透明故障轉移以及 Active Directory、Kerberos 和 LDAP 整合。最後一點是治理機制:控制使用者登入 Spark 的相同目錄也控制他們對共享資源的存取權限。需要注意的是,本文中提到的所有 Tuxera 資料都存在一個前提條件:我們執行的版本是 Fusion NFS 的內部預覽版,Tuxera 表示該版本尚未針對效能進行全面最佳化,且該軟體尚未正式上市。正式版計劃於 2026 年 11 月 SC'26 之後發布。
Tuxera 在 R770AP 上安裝了 Fusion,使用 XFS 格式化了 Graid 卷,並在標準連接埠上設定了 NFS,在 20049 連接埠上配置了 RPC-RDMA,由於本專案僅使用 NFS,因此未配置 SMB 監聽器。初始線程配置為四個協定線程,每個協定線程包含八個線程,分別用於傳輸發送和接收、VFS 資料以及 VFS 元數據,Tuxera 將其描述為調優的起點。實驗室版本刻意省略了目錄服務;大學部署將在其基礎上疊加自己的身分服務。在 Spark 端,掛載共用只需一條指令:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
這一行程式碼就包含了全部的客戶端集成,無需驅動程式、啟動器配置,也無需在 Spark 上安裝任何廠商軟體。明天,另一個使用者登入另一個 Spark 實例,運行同樣的程式碼,就能看到相同的檔案。
配置驗證:八個 Spark 演算法運行於同一資料集
在進行任何模型建置工作之前,我們對每個 Spark 實例分別進行了健全性檢查:使用 16 個作業,佇列深度為 16,對陣列上各自的資料夾進行 10.0 萬次順序 fio 讀取。這八個實例的讀取速度在 100 到 11.2 GiB/s 之間,每個實例都達到了 100GbE 連結的飽和狀態。然後,我們進行了一次全面測試,以驗證所有八個實例都能勝任各自的負載。每次測試都保持 16 個線程,隊列深度為 16,並將它們分別分配到 1、2、4 和 8 個 Spark 實例上,進行 100 萬次順序讀取、64 萬次隨機讀取、16 萬次順序讀取和 4 萬次隨機讀取的工作負載測試,包括讀寫操作和直接 I/O,每次測試持續 60 秒。每個 Spark 實例都寫入陣列上各自的資料夾,每個儲存網路卡對應四個資料夾,整個堆疊中沒有任何 QoS 設定。在所有八個Spark節點同時載入的情況下,每個節點的100萬次順序讀取效能在3.09至3.13GiB/s之間,64萬次隨機讀取效能在6,648至6,779 IOPS之間,4千次隨機寫入效能在2,136至2,155 IOPS之間。測試涵蓋了五個OEM廠商的資源,分佈在兩個VLAN上,且未強制執行公平性策略。每個Spark節點都已接入陣列,並獲得了均衡的資源分配,配置已準備就緒,可以應對重要的工作負載。
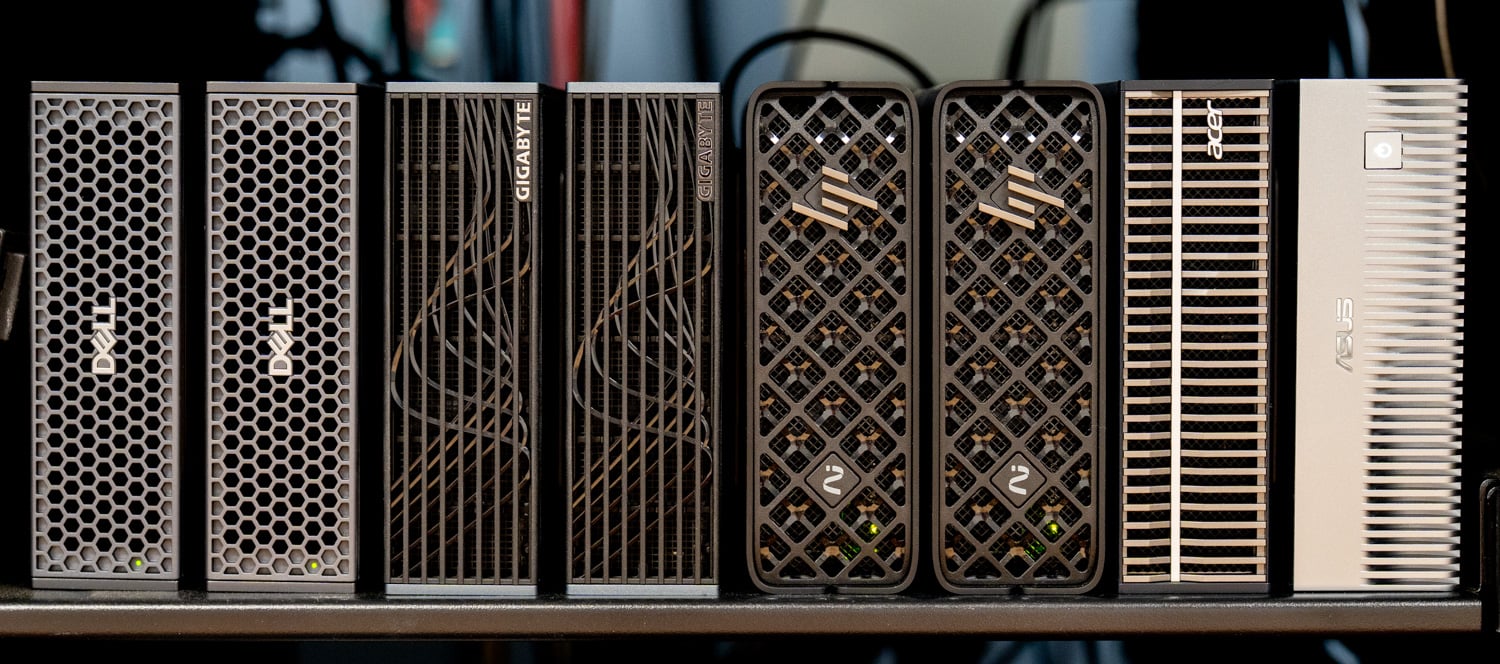
| Spark(八個客戶端,每個客戶端 2 個執行緒 x QD16) | 儲存網路卡 | 1M順序讀取 | 64K 隨機讀取 IOPS | 4K 隨機讀取 IOPS | 4K隨機寫入IOPS |
|---|---|---|---|---|---|
| 戴爾 Pro Max 附 GB10 (1) | 1 | 3,176MiB/秒 | 6,648 | 10,000 | 2,150 |
| 技嘉 AI TOP ATOM (1) | 1 | 3,195MiB/秒 | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201MiB/秒 | 6,696 | 10,100 | 2,136 |
| 宏碁 Veriton GN100 | 1 | 3,194MiB/秒 | 6,670 | 10,100 | 2,149 |
| 戴爾 Pro Max 附 GB10 (2) | 2 | 3,184MiB/秒 | 6,694 | 10,200 | 2,155 |
| 技嘉 AI TOP ATOM (2) | 2 | 3,187MiB/秒 | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189MiB/秒 | 6,678 | 10,100 | 2,151 |
| 華碩Ascent GX10 | 2 | 3,163MiB/秒 | 6,734 | 10,300 | 2,145 |
主機配置:兩張網路卡,並留有足夠的餘裕
同樣的測試也能解答實驗室或企業在購買前必須解決的問題:效能上限在哪裡?以及主機的哪個部分決定了效能上限?下面的四個面板展示了在固定負載從一個 Spark 擴展到八個的情況下,所有四種工作負載的讀取吞吐量;寫入吞吐量將在下文的文字和表格中進行介紹。
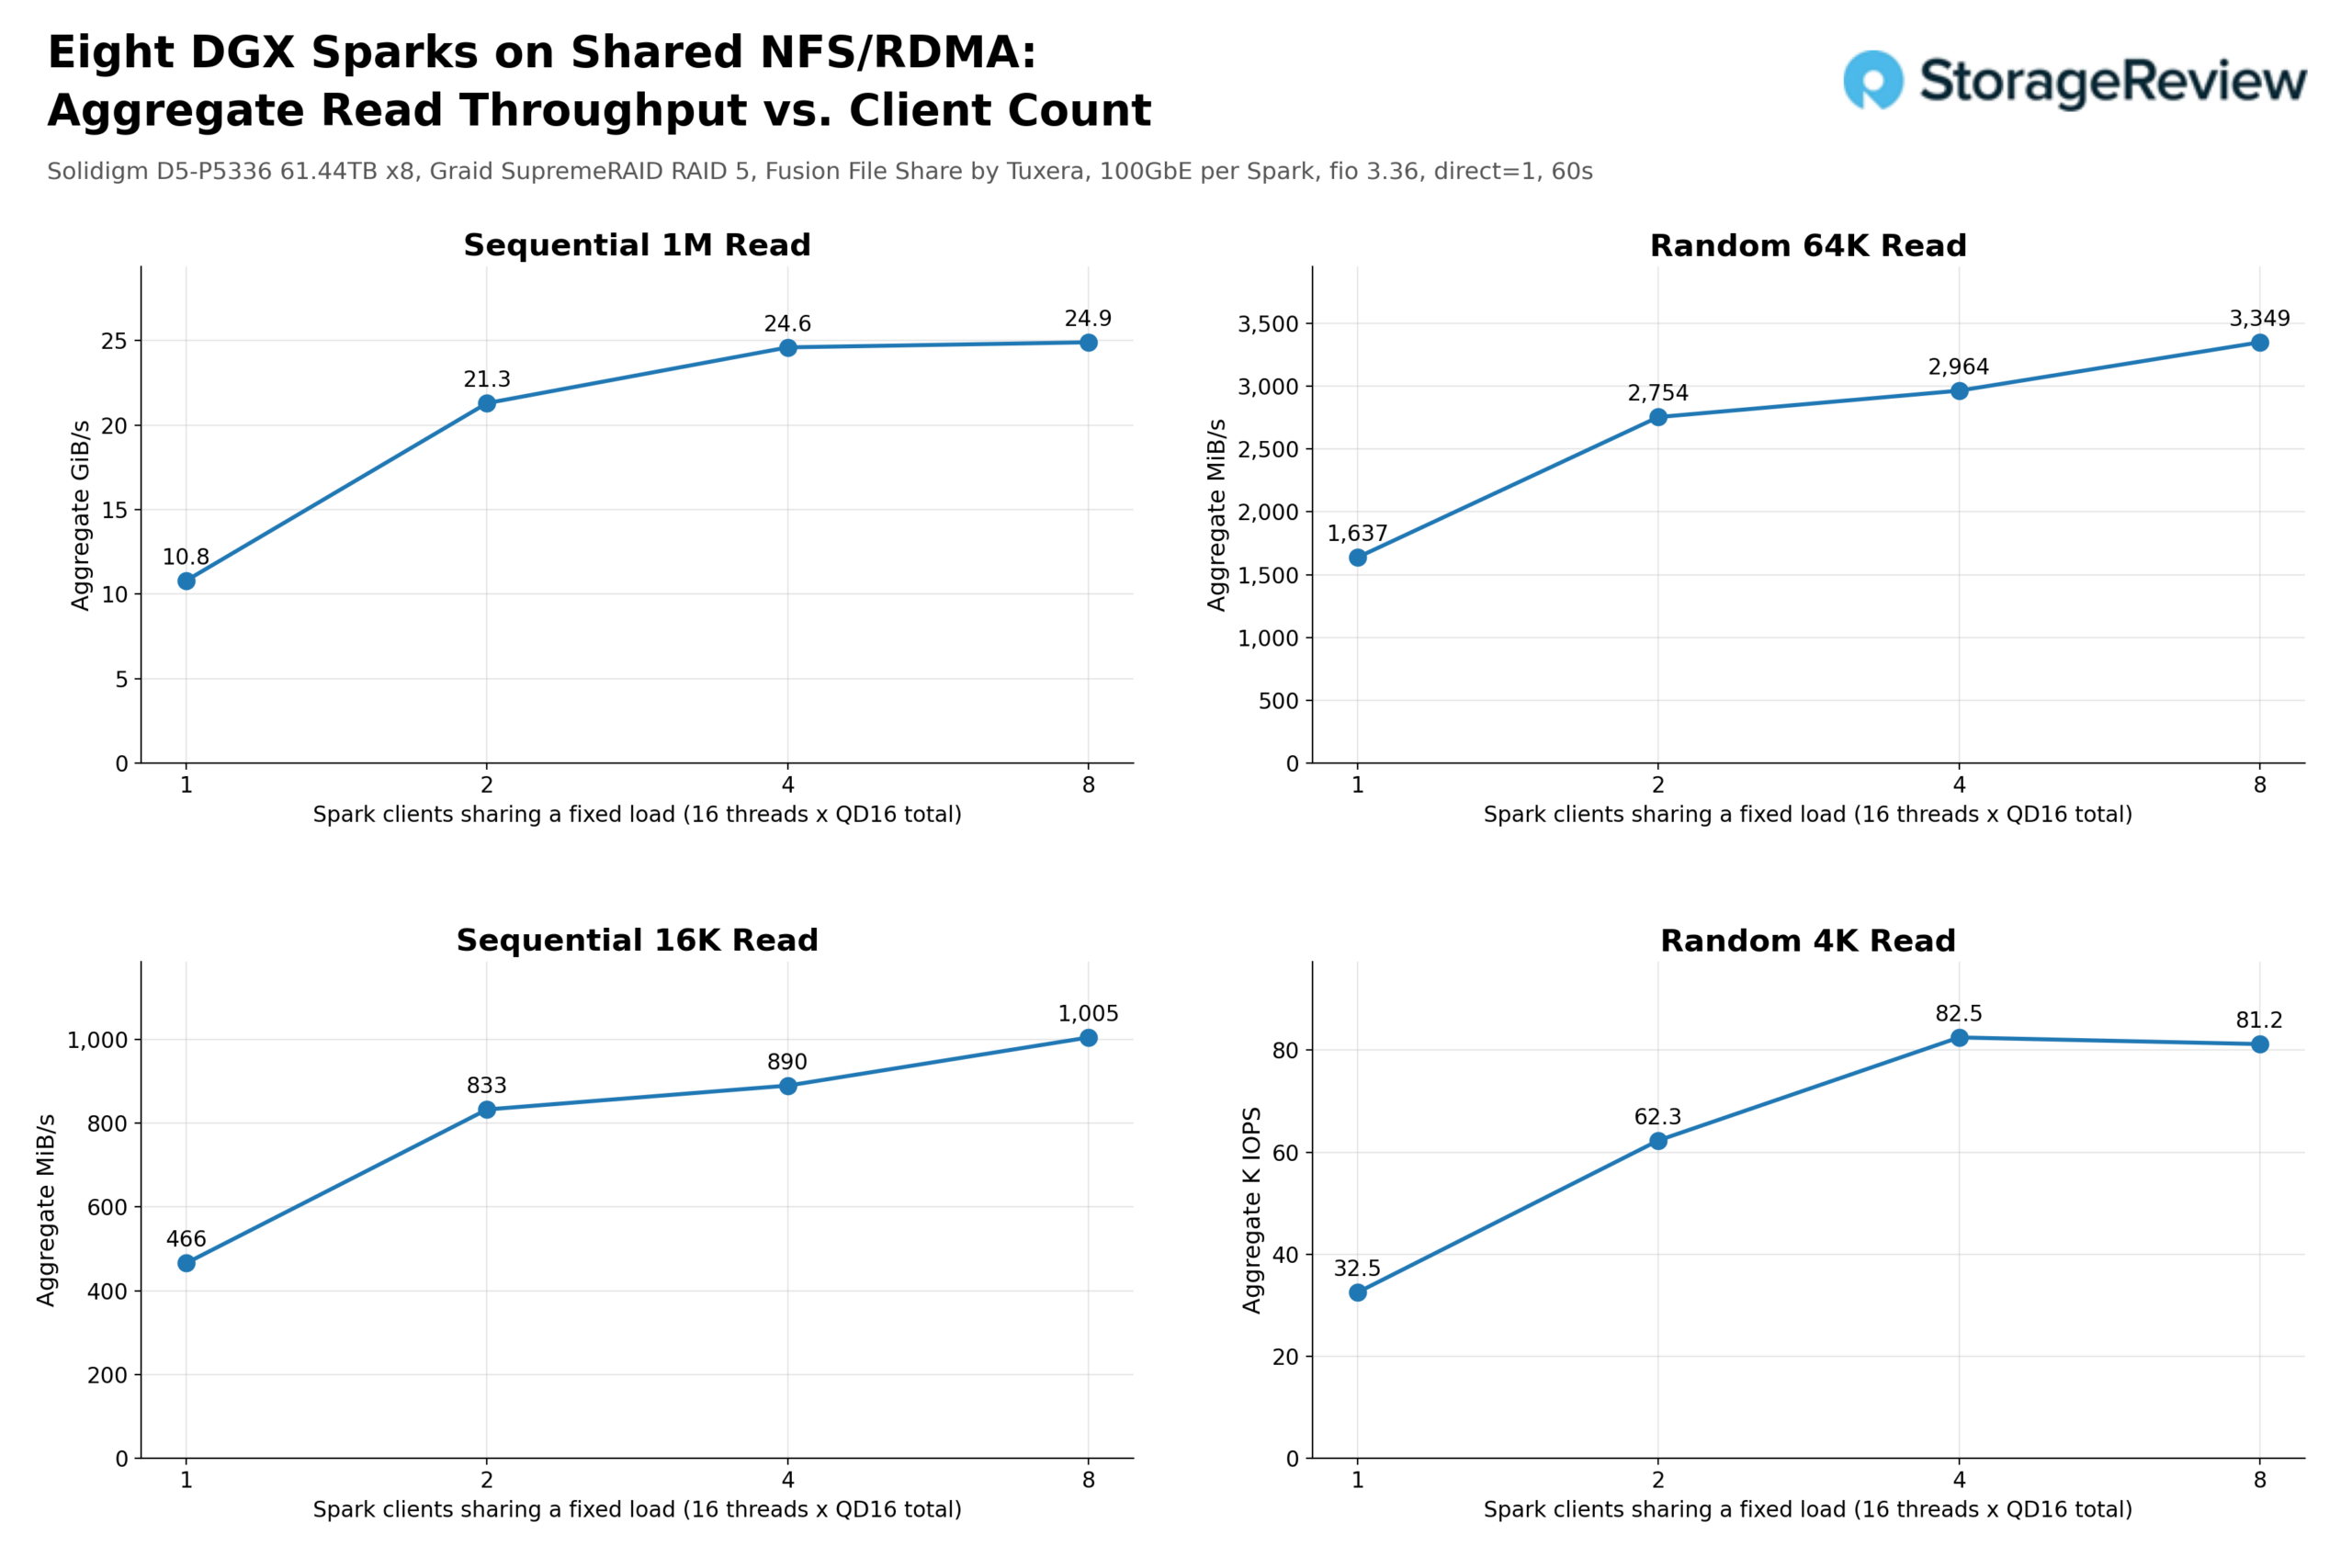
聚合 1M 順序讀取速度從單一 Spark 上的 10.8GiB/s 提升至兩台 Spark 上的 21.3GiB/s、四台 Spark 上的 24.6GiB/s 以及八台 Spark 上的 24.9GiB/s。換算成網路頻寬,分別為 93Gb/s、183Gb/s、212Gb/s 和 214Gb/s,而兩塊 Broadcom 400GbE 網路卡的總頻寬為 800Gb/s。因此,在滿載運行八個客戶端的情況下,該陣列使用了主機 27% 的網路容量。接近 25GiB/s 的峰值速度屬於八盤 RAID 5 QLC 陣列;網卡、交換器以及 Spark 本身的 100GbE 連結從未成為瓶頸。
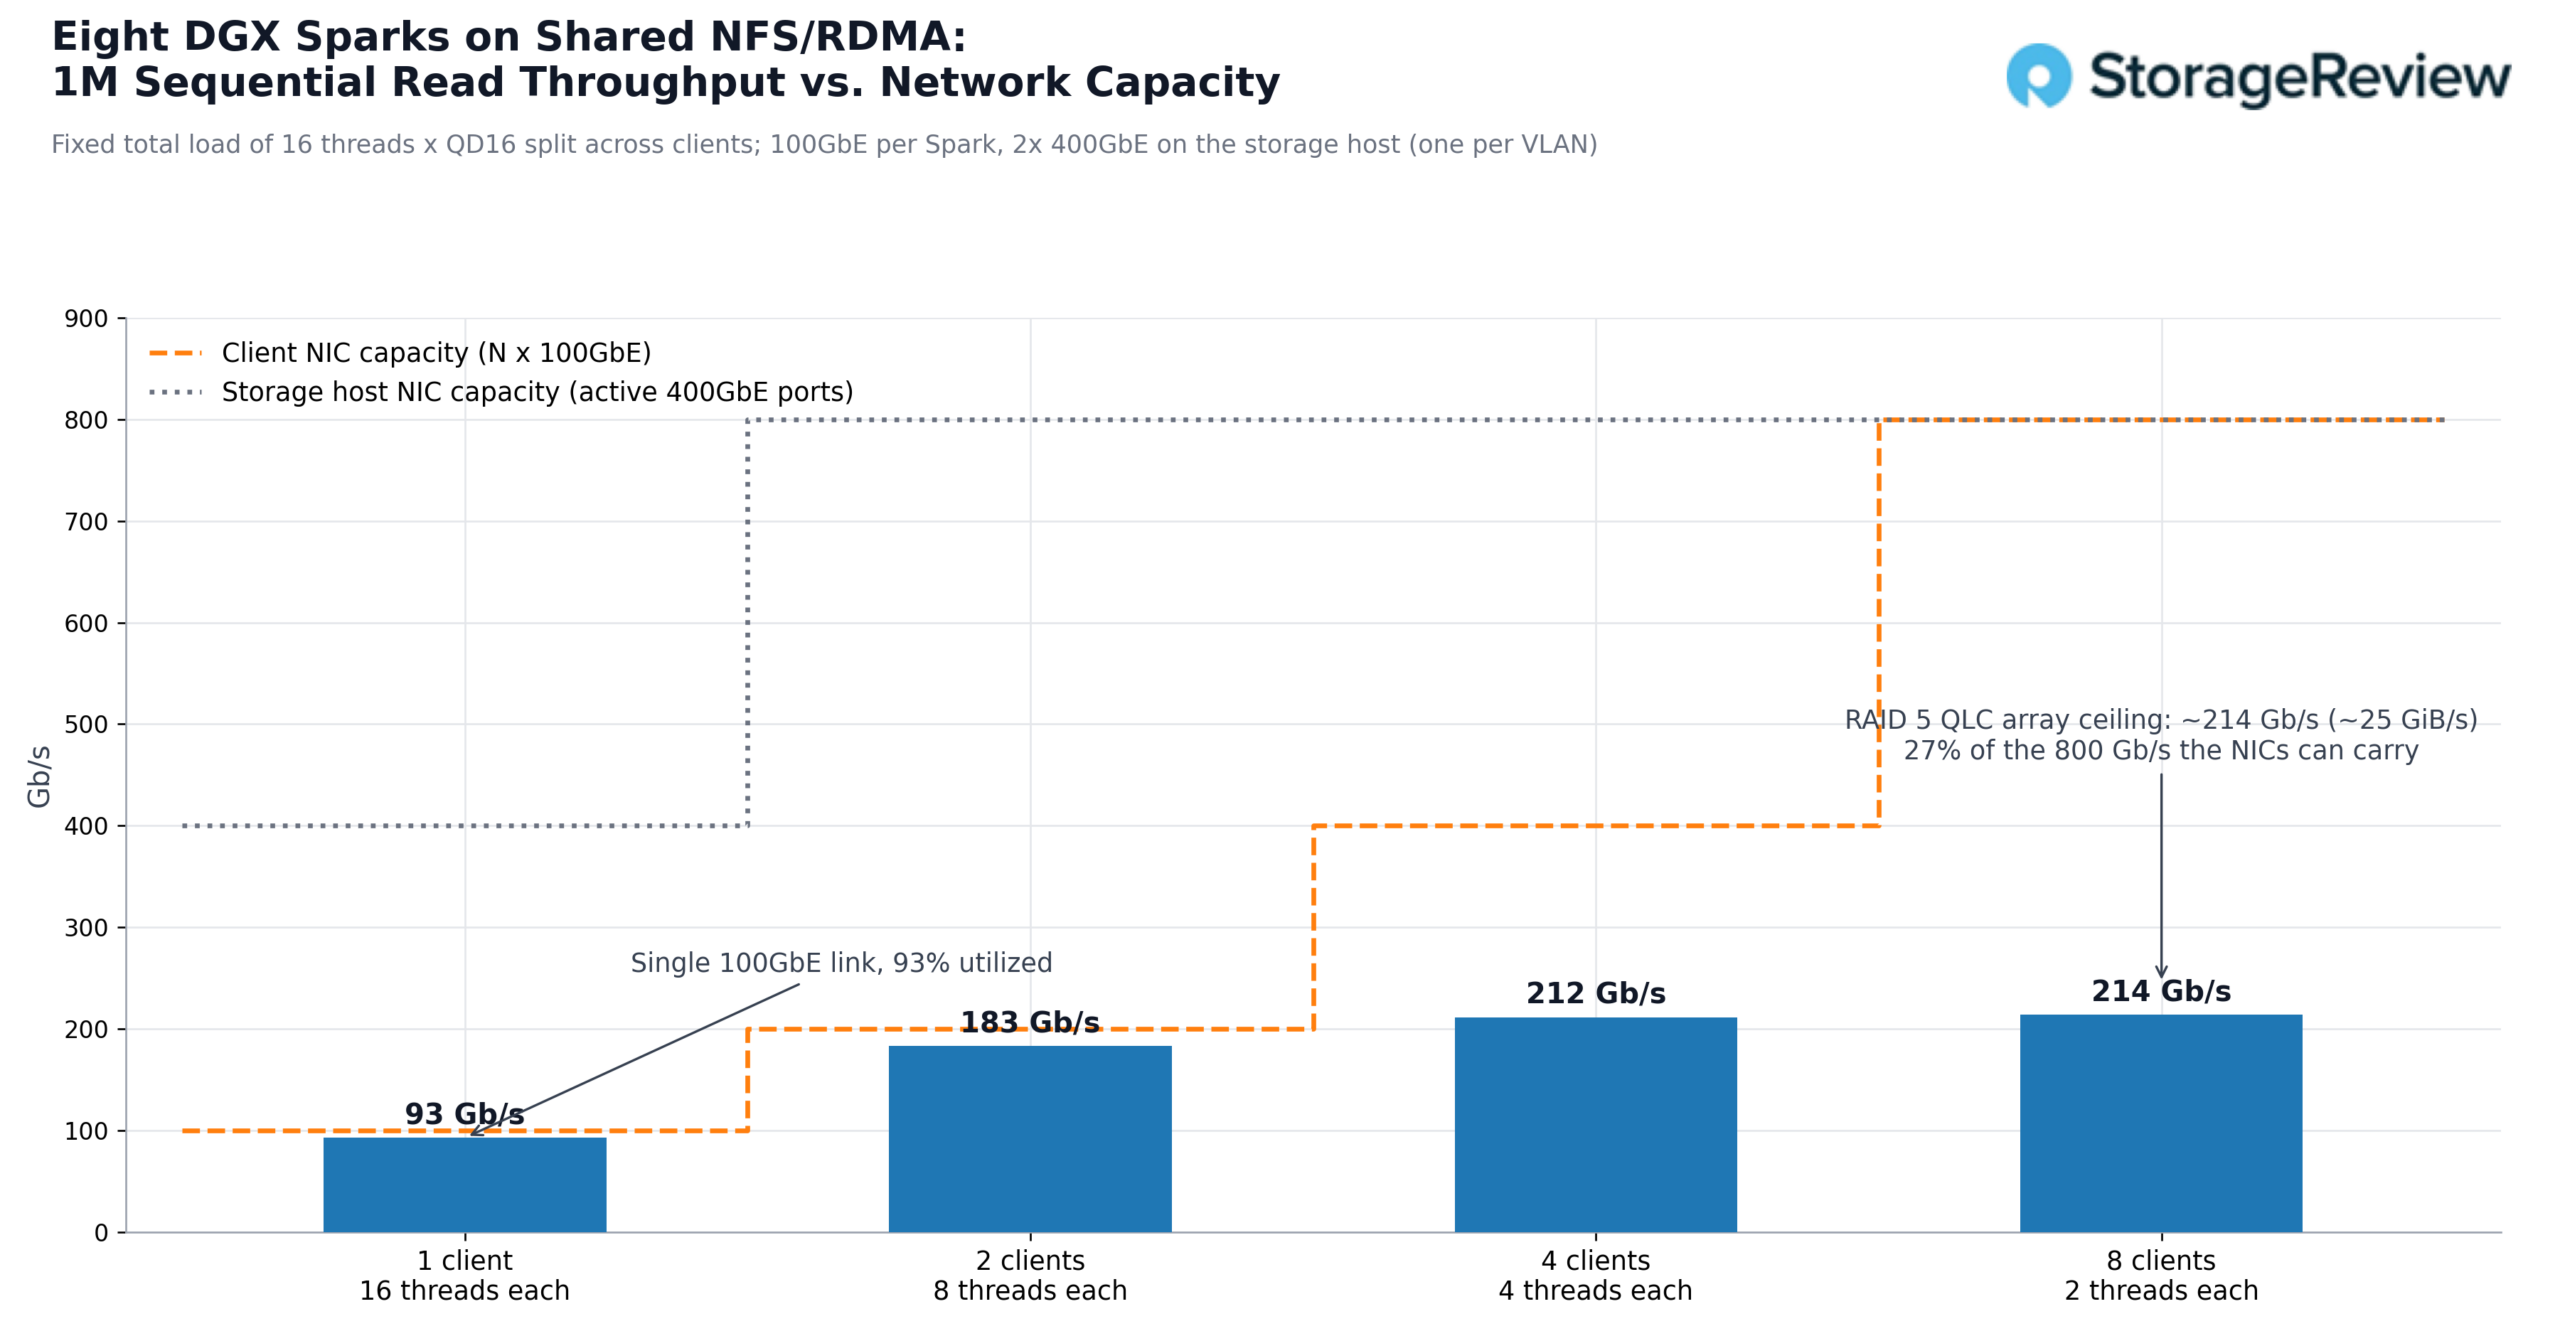
兩塊伺服器端網卡已經能夠以線速覆蓋八塊 Spark 硬碟,並且也能覆蓋 R770AP 中的另外八個硬碟位元:無論是作為第二個陣列還是擴展 RAID 集,硬碟數量翻倍都能在相同的兩個連接埠後提供更大的讀取頻寬,並且還有剩餘頻寬。 I/O 效能也是如此。 4K 隨機讀取的效能從單一客戶端的 32.5K IOPS 提升到四個或更多客戶端時穩定的約 81K IOPS,隨著每個客戶端佇列深度的減小,每次 I/O 操作的延遲從 7.9 毫秒降至 3.1 毫秒;64K 隨機讀取的效能從 1,637 MiB/s 1,637 349 MiB/s,在這兩種情況下,網路頻寬都遠未達到極限。
另一個重要的比較是與 Spark 自身儲存的比較。在我們單獨評測 GB10 時,使用 GDSIO 從內建 M.2 介面讀取 1M 位元組數據,Acer Veriton GN100 和 GIGABYTE AI TOP ATOM 的讀取速度最高接近 11.2GiB/s。配備 GB10 的 Dell Pro Max 和 HP ZGX Nano G1n 的讀取速度約為 5.5GiB/s,而 ASUS Ascent GX10 的讀取速度則接近 5GiB/s。相較之下,Luisuantech GP Spark 的外接 NVMe-oF 固態硬碟透過相同的 100GbE 連接埠實現了 9.5Gb/s 的讀取速度。 Spark 從共享的 QLC 陣列讀取資料的速度為 10.8GiB/s,與該組中速度最快的內建硬碟相當,並且大約是速度最慢的內建硬碟的兩倍(透過單一網路線讀取),而其他所有 Spark 都能讀取這些資料。由於測試工具不同:內建硬碟使用 GDSIO,而 Spark 透過 NFS 使用 fio,因此這是速度範圍的比較。
完整的測試結果如下所示,其中包含了每種客戶端數量下所有四種工作負載的匯總資料。每行讀取操作數都會隨著客戶端數量的增加而增加,直到陣列達到容量上限;而每行寫入操作數則保持不變,無論 Spark 用戶端數量是 1 還是 8,因為 RAID 5 奇偶校驗路徑都會將陣列的寫入上限固定,而與共享該陣列的客戶端數量無關。對於一個旨在被多個客戶端讀取並在資料擷取時寫入一次的共用陣列來說,這正是該設計的目標場景。
| 總計(共 16 個執行緒) | 1 Spark | 2 火花 | 4 火花 | 8 火花 |
|---|---|---|---|---|
| 1M順序讀取 | 10.8GiB/秒 | 21.3GiB/秒 | 24.6GiB/秒 | 24.9GiB/秒 |
| 1M順序寫入 | 2.4GiB/秒 | 2.4GiB/秒 | 2.4GiB/秒 | 2.4GiB/秒 |
| 64K 隨機讀取 | 1,637MiB/秒 | 2,754MiB/秒 | 2,964MiB/秒 | 3,349MiB/秒 |
| 64K 隨機寫入 | 722MiB/秒 | 719MiB/秒 | 723MiB/秒 | 703MiB/秒 |
| 16K 順序讀取 | 466MiB/秒 | 833MiB/秒 | 890MiB/秒 | 1,005MiB/秒 |
| 16K 順序寫入 | 57MiB/秒 | 60MiB/秒 | 62MiB/秒 | 28MiB/秒 |
| 4K 隨機讀取 | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K 隨機寫入 | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
共享儲存上的託管模型
fio 掃描結果證明陣列和網路完全能夠勝任。接下來對用例至關重要的測試是,位於共享陣列上的模型載入速度是否與位於 Spark 自身 NVMe 上的模型載入速度相同,因為整個設計依賴於這種工作流程:集中託管的單一副本,可供任何使用者載入。我們選擇了 NVFP4 中的 Qwen3.5-122B-A10B 模型,這是一個擁有 122 億參數的混合專家模型,佔用 78GB 磁碟空間,可以載入到單一 Spark 的 128GB 統一記憶體中。我們測量了從啟動推理伺服器到伺服器報告運行正常所需的時間,以及該時間段內的平均儲存頻寬,並分別在三種場景下進行測試:單一 Spark 從其內部 NVMe 載入;同一個 Spark 透過 NFS/RDMA 從共用陣列載入;以及所有八個 Spark 同時從陣列載入同一個副本。
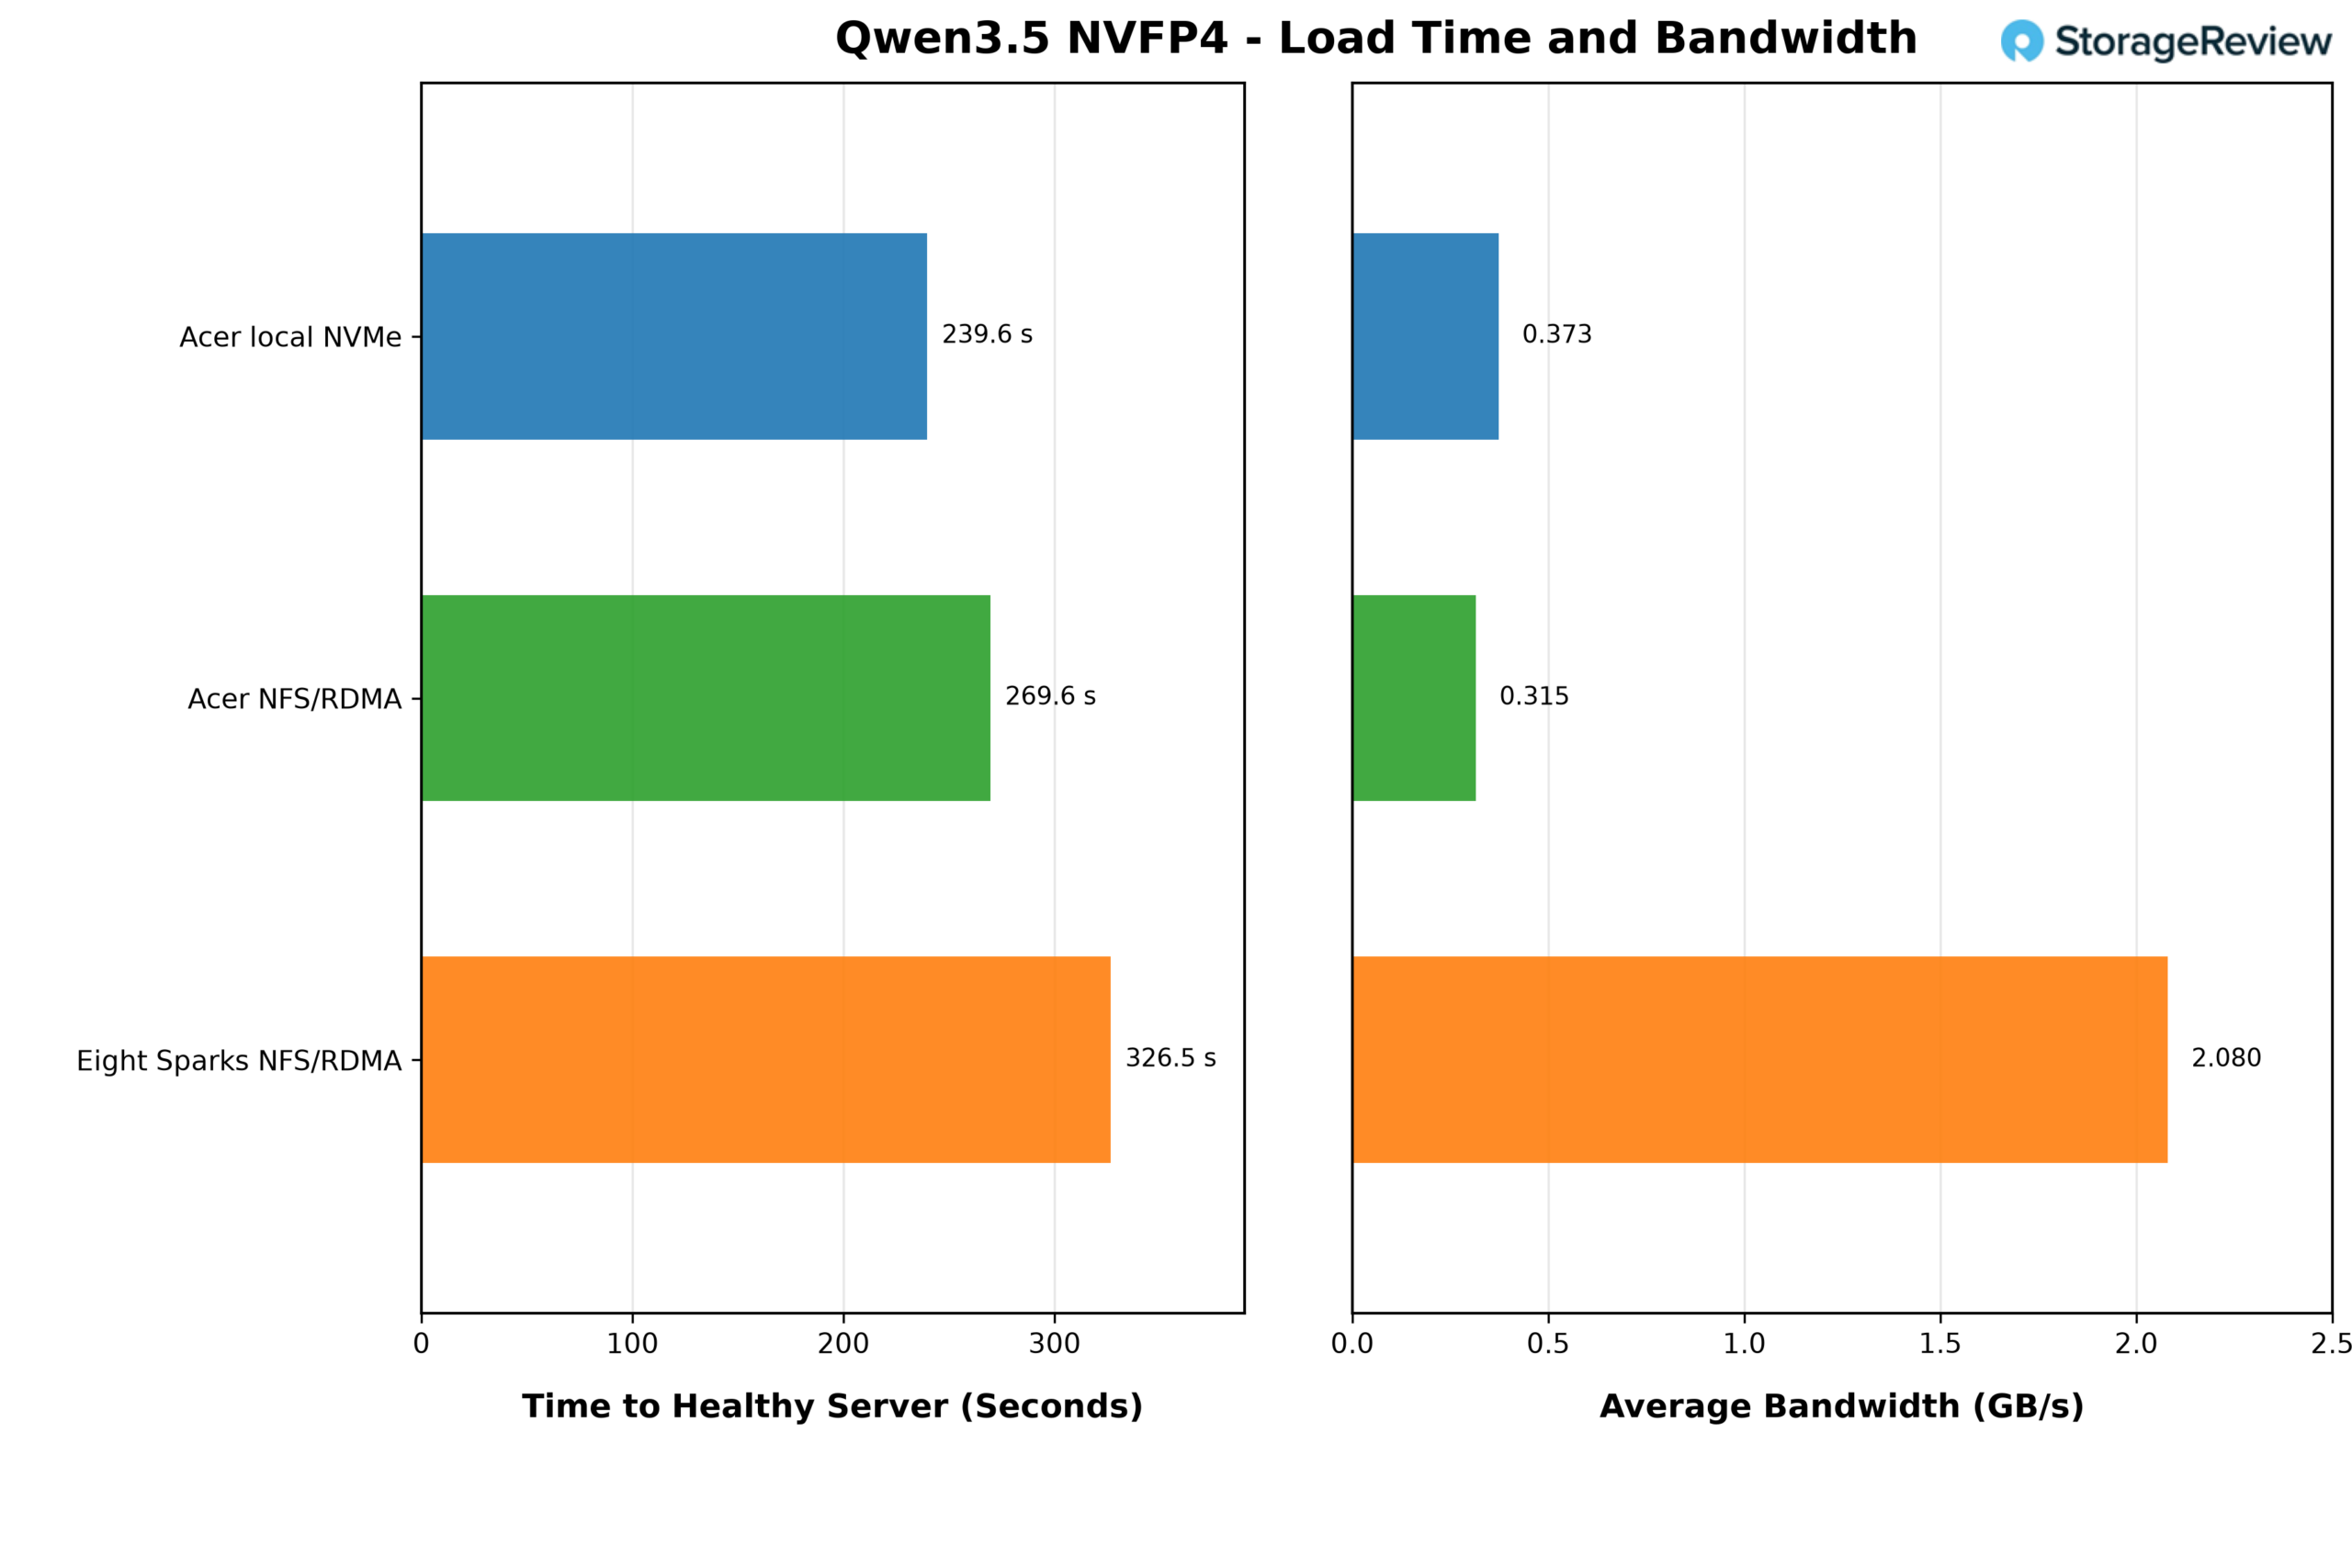
從內部 NVMe 存儲,Acer Veriton GN100 以平均 0.373GB/s 的速度,耗時 239.6 秒完成伺服器的健康狀態載入。而從透過 NFS/RDMA 共享的陣列加載,同樣的 Spark 模型耗時 269.6 秒,速度為 0.315GB/s,比前者慢了約 30 秒,即 13%。平均值表明,在四分鐘內加載 78GB 的數據,Spark 模型加載在兩種情況下都不受存儲限制。 GB10 自身對權重的處理決定了載入速度,而儲存則在大部分時間內處於等待狀態。
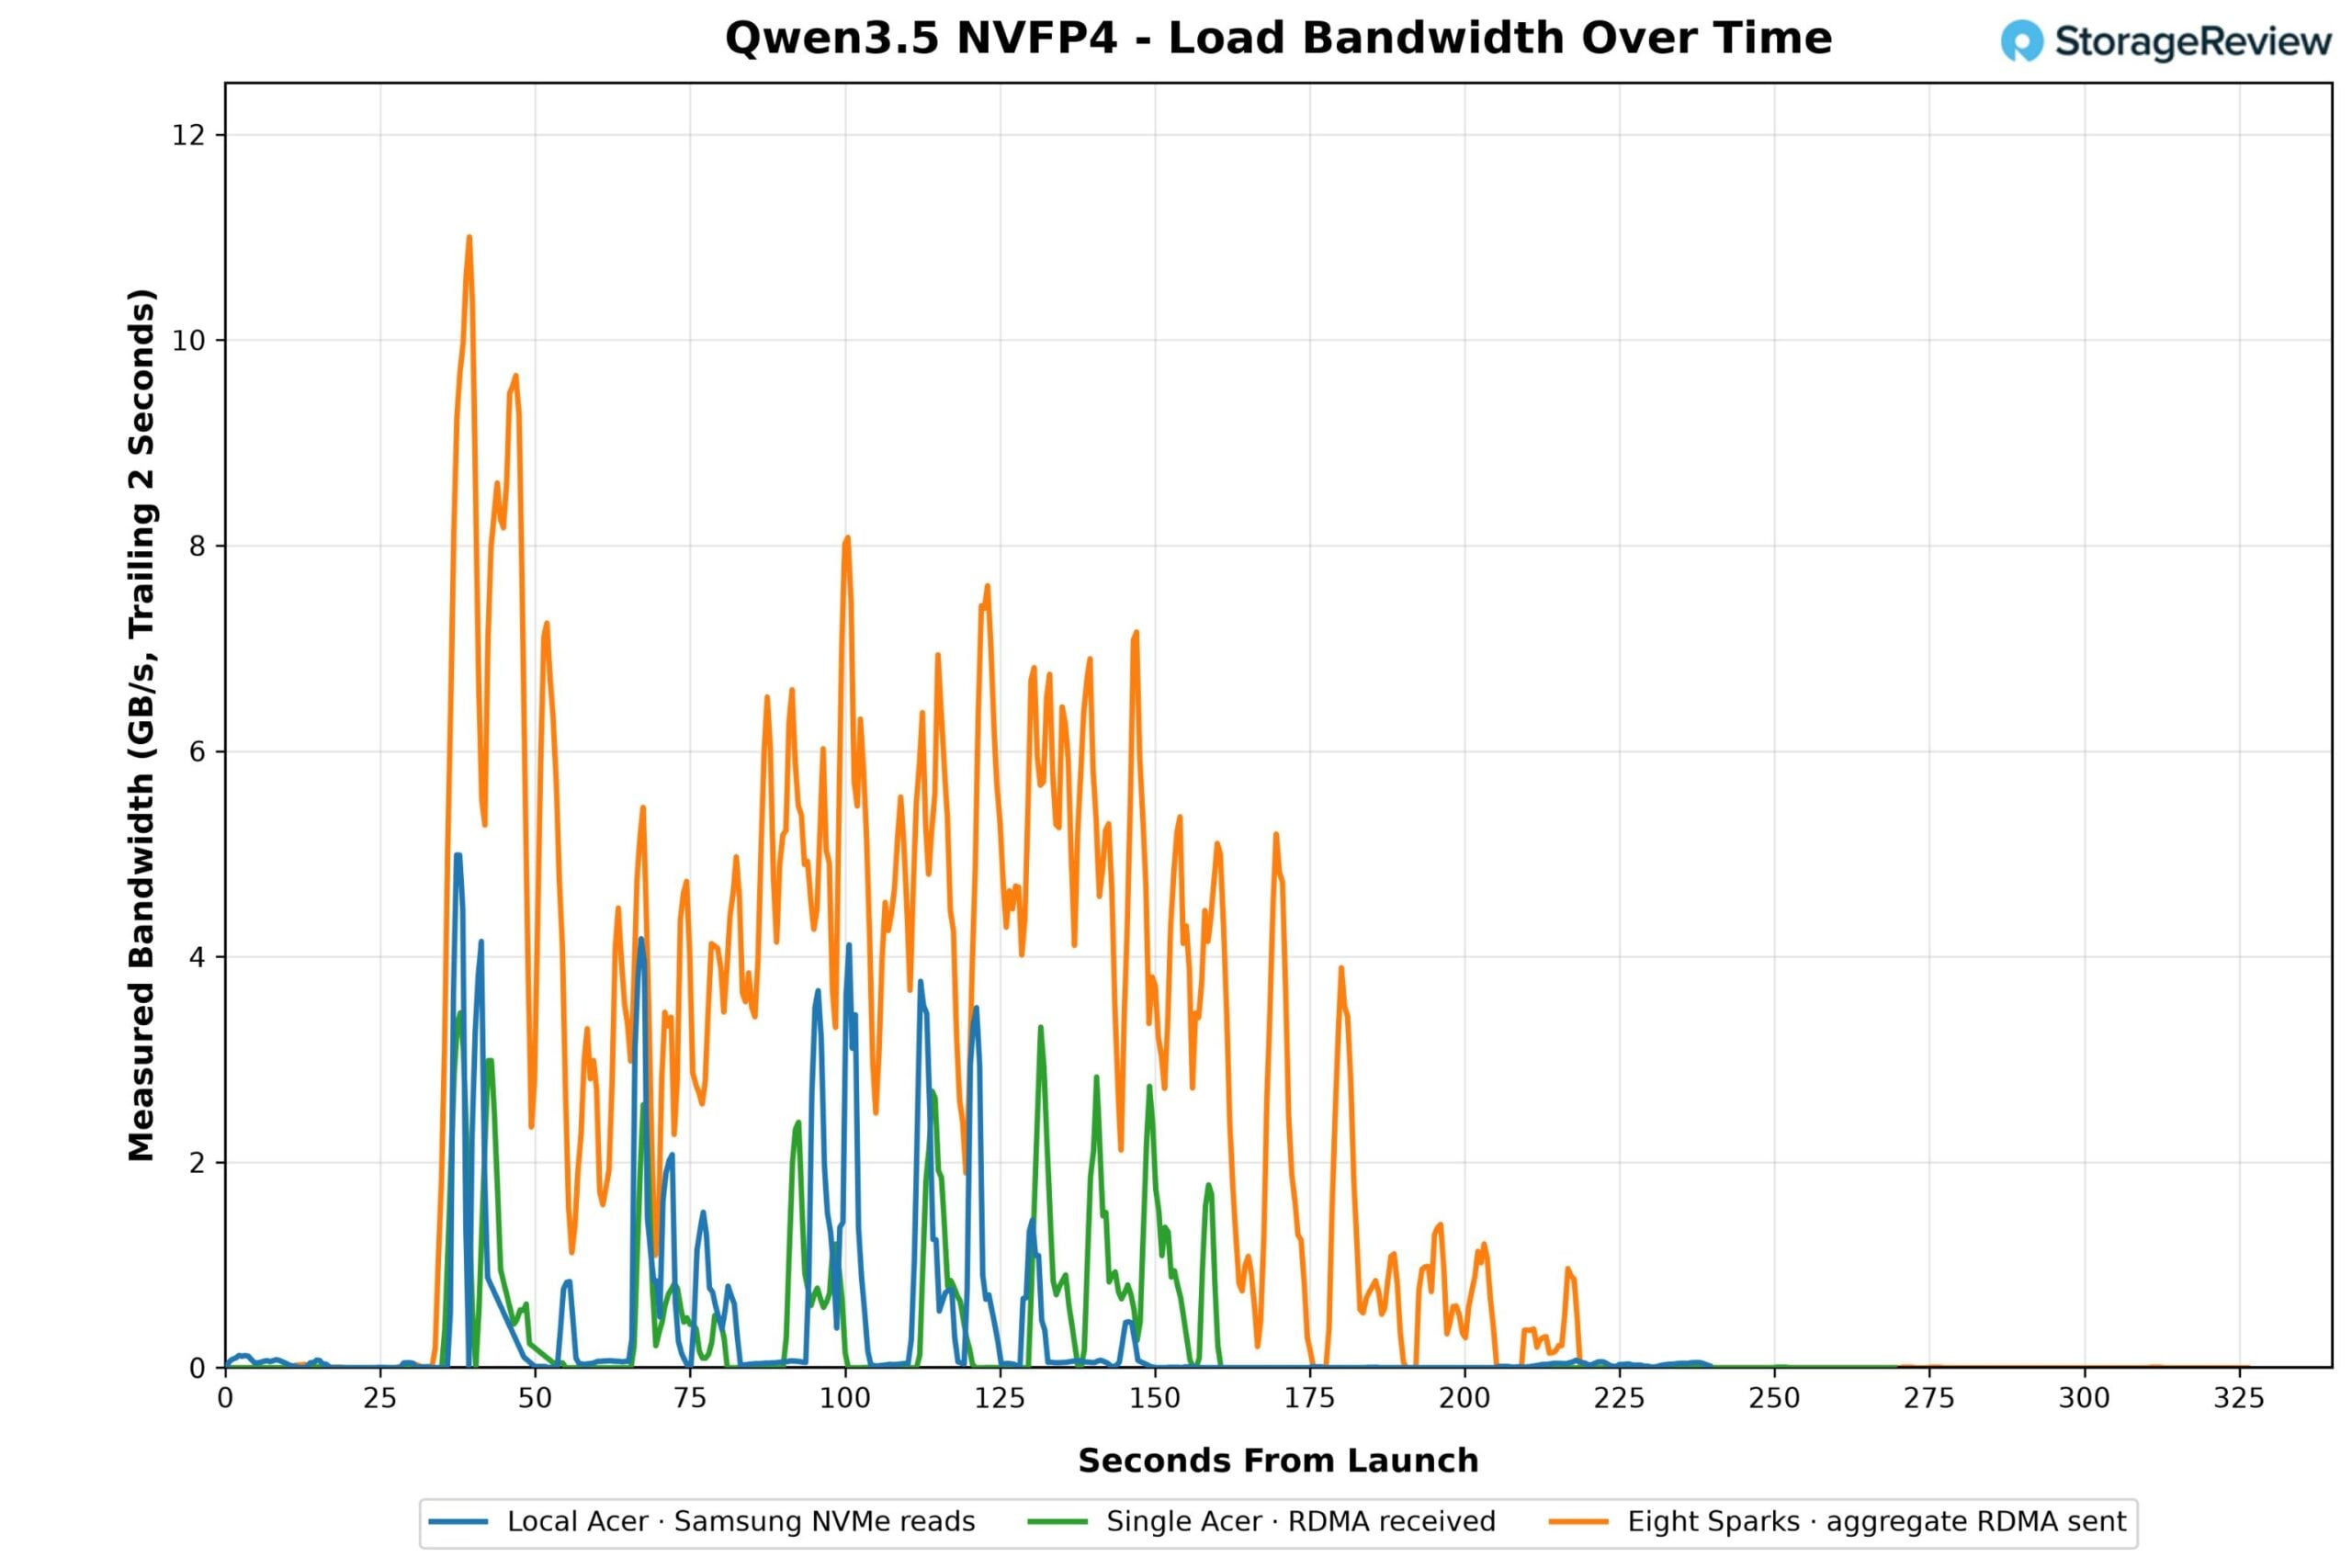
頻寬追蹤顯示了這種模式:本地 NVMe 讀取以突發形式出現,峰值接近 5GB/s,但突發之間間隔較長;單一 NFS 用戶端也顯示相同的突發形狀,但峰值略低。八個 Spark 的聚合曲線顯示了陣列在並發需求下的效能。當所有八個 Spark 同時讀取相同的 78GB 資料時,陣列在第一分鐘內達到了 11GB/s 的聚合峰值,然後在接下來的兩分鐘內穩定在 4 到 8GB/s 之間,期間 Spark 處理其權重,整個時間段內的平均速度為 2.08GB/s。與 fio 掃描顯示的 25GiB/s 的陣列容量相比,八個 Spark 同時載入模型僅使用了可用容量的一小部分。
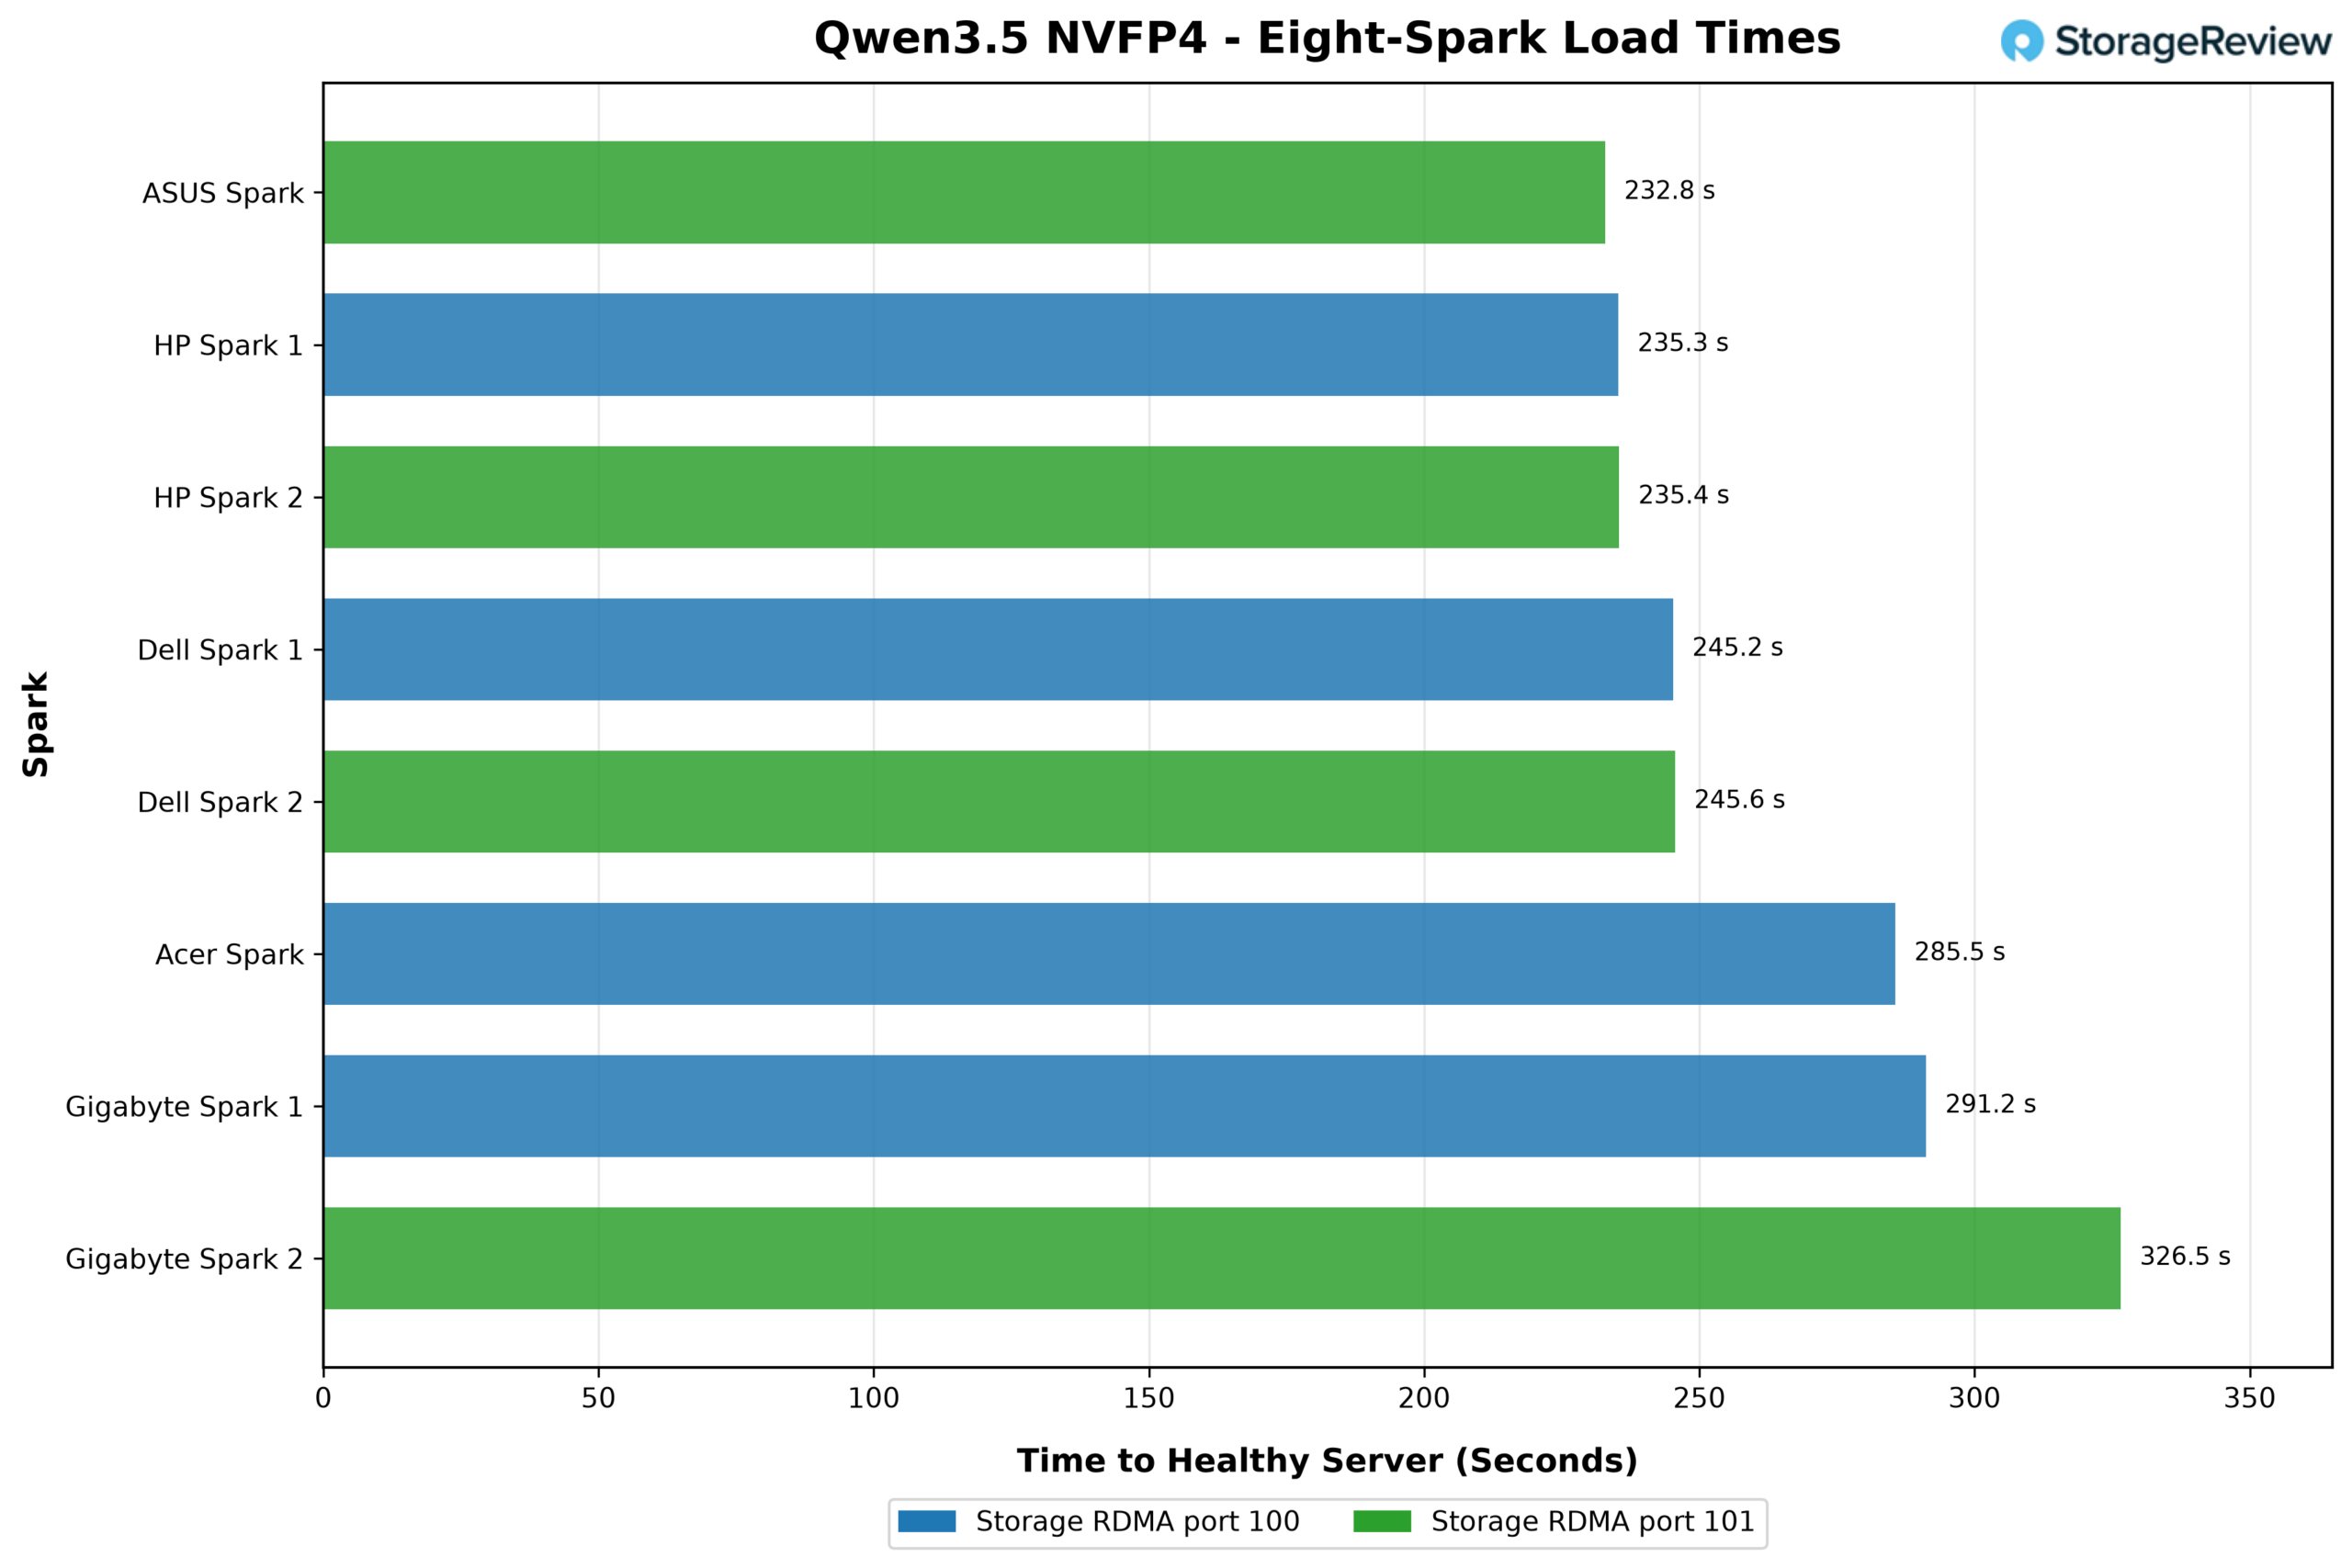
在八組測試中,各單元的加載時間從華碩 Ascent GX10 的 232.8 秒到技嘉 AI TOP ATOM 單元的 326.5 秒不等,兩台惠普 ZGX Nano G1n 系統的加載時間分別為 235.3 秒和 235.4 秒,兩台載爾 45 秒單元的裝載時間分別為 250 秒和 235.4 秒,兩台裝置的時間載 45 秒的時間245.6 秒。八台 Spark 設備同時從共享陣列加載數據,其中五台的性能優於單台 Spark 設備透過 NFS/RDMA 單獨加載,三台的性能優於本地 NVMe 加載。這種差異並非廠商差異所致;由於協定堆疊中沒有 QoS,每次測試中等待陣列加載的設備都會有所不同,而且每張存儲網卡上的兩台設備在測試結果的快慢兩端分佈均勻。
對於實驗室而言,其結果是可以在數組上保留每個模型的副本,任何 Spark 或每個 Spark 加載它所需的時間與加載本地副本所需的時間大致相同,無需下載步驟,不佔用本地容量,也無需在桌面上保存權重副本。
俄勒岡州立大學用例
俄勒岡州立大學地球、海洋與大氣科學學院一直是我們在人工智慧基礎設施建設方面的長期合作夥伴,從科考船上的即時海洋研究到與 Metrum AI 合作的人工智慧輔助學術評估,雙方都有過合作。俄勒岡州立大學研究與學術計算主任 Chris Sullivan 和他的架構師 Thomas Olson 正在探索一個可擴展至 100 個單元的大型 Spark 人工智慧學習實驗室,他們對儲存的思考在兩個方面為我們的設計提供了參考。
首先,儲存必須獨立於 Spark 設備。俄亥俄州立大學曾考慮在 Spark 設備上部署檔案系統,但最終放棄了這種方案,因為在教室環境中,新增或移除單一節點都會中斷所有人的儲存服務。而採用中央陣列,任何 Spark 設備都可以掛載該陣列,這意味著可以添加、移除、重裝系統或將 Spark 設備交給其他學生,而不會影響其他學生的資料。其次,儲存必須能夠跟隨用戶移動。我們將俄亥俄州立大學的要求描述為增強版的 AI 檔案共享,學生可以在系統之間移動時儲存持久性資訊。使用 NFS,每位學生對應一個資料夾;登入任何 Spark 設備,掛載共用資料夾,即可存取學生的工作內容。
正是因為資料集的存在,俄亥俄州立大學(OSU)才認為這比對使用者主目錄伺服器更為重要。地球、海洋與大氣科學學院希望將其數十TB的海洋和大氣研究數據提供給學生用於自己的研究。桌面儲存無法滿足這一需求:一個4TB的M.2插槽甚至無法容納如此龐大的數據集,即使實驗室裡擺滿了外接硬碟盒,也意味著每個桌面都需要購買並儲存一份數據,並且還要不斷更新,這對於任何部門來說都是難以承受的。在我們評估後發現,將資料集中一次儲存並透過100GbE網路掛載才是最符合要求的方案。同一陣列也儲存著模型庫,因此學生可以直接執行Qwen、Llama或其他任何模型,無需下載。同樣的原理也適用於企業將桌面人工智慧系統部署為開發人員工作站的情況:透過高速網路傳輸生產資料集,讓系統直接在本地進行處理,這樣就無需為了滿足桌面機器的讀取需求而搭建第二個資料湖。資料保留在資料中心內,並受到現有存取控制、加密和備份機制的保護,而Spark在遷移出資料中心時,不會儲存任何重要資訊。
結語
桌上型AI硬體功能強大,但不擅長融入企業的資料體系。每個GB10系統都只有一個M.2插槽,這正好暴露了這一點:用戶所需的數據最終都會被複製到本地閃存上,IT人員無法察覺,數據也缺乏保護,並且每個需要相同數據的用戶都會遇到同樣的問題。對於單一Spark設備來說,外部本地儲存盒是一個合理的解決方案。但對於實驗室、部門或企業來說,如果部署數十台設備,每個擁有獨立資料的桌面就如同一個資料孤島。而解決方案其實是資料中心多年前就已採用的:將所有容量置於高速網路之後,集中管理,然後共享。 Spark設備本身就具備高速網路連線功能;這個專案展示了為資料提供儲存位置後會發生什麼,也證明了Spark設備本身就應該放在機架上。
一台戴爾伺服器中的八塊 Solidigm D5-P5336 QLC 固態硬碟組成 RAID 5 陣列,為八台 Spark 裝置提供單一的奇偶校驗保護資料集。兩架博通 400GbE 網路卡和一台配備 800G 分線器的戴爾 Z9864F-ON 路由器,為每台 Spark 裝置提供 100GbE 網路連線。 Tuxera 的 Fusion NFS over RDMA 技術使得在預設的 Ubuntu 系統上只需一行命令即可掛載該網絡,並可透過目錄服務鉤子實現存取控制。在所有八台設備上施加固定負載的情況下,陣列實現了 24.9GiB/s 的總順序讀取速度(均勻分配,未啟用 QoS)。其中一台 Spark 設備就達到了 10.8GiB/s 的鏈路飽和速度,與我們測試過的任何 GB10 系統中性能最佳的內建硬碟速度相當;該速度峰值僅使用了兩塊伺服器端網卡 27% 的頻寬,因此該網路的容量足以支援比這台伺服器負載更高的裝置。模型測試證實了工作流程:一個 78GB 的模型在共享陣列上託管一次,在單個 Spark 上的加載速度比本地 NVMe 快 13%,在八個 Spark 上同時加載,其中五個 Spark 的完成速度比單個 NFS 運行更快。
QLC快閃記憶體之所以能實現這種經濟效益,是因為工作負載對容量和讀取操作都非常密集,而這正是D5-P5336的優勢所在。一台伺服器就能儲存一百台Spark伺服器本地都無法承載的數據,而且所有資料都只有一個副本,所有副本都由資料中心統一管理。俄勒岡州立大學擁有生產級研究存儲,用於處理那些刻不容緩的工作。克里斯·沙利文和托馬斯·奧爾森正在探索的概念是該大學目前尚不具備的教育儲存層級:一個由伺服器和少量大容量硬碟組成的、可容納一個或多個機架Spark伺服器的受控共享儲存池,可以將數十TB的真實海洋學和大氣數據放在大型人工智慧學習實驗室的前端,而該實驗室的Spark伺服器就運行在同一架構上運行在同一架構上。
本報告由 Solidigm 贊助。 本報告中表達的所有觀點和意見均基於我們對所考慮產品的公正看法。
本文提及的商業產品僅供參考,並不代表俄勒岡州立大學的認可。



 Amazon