

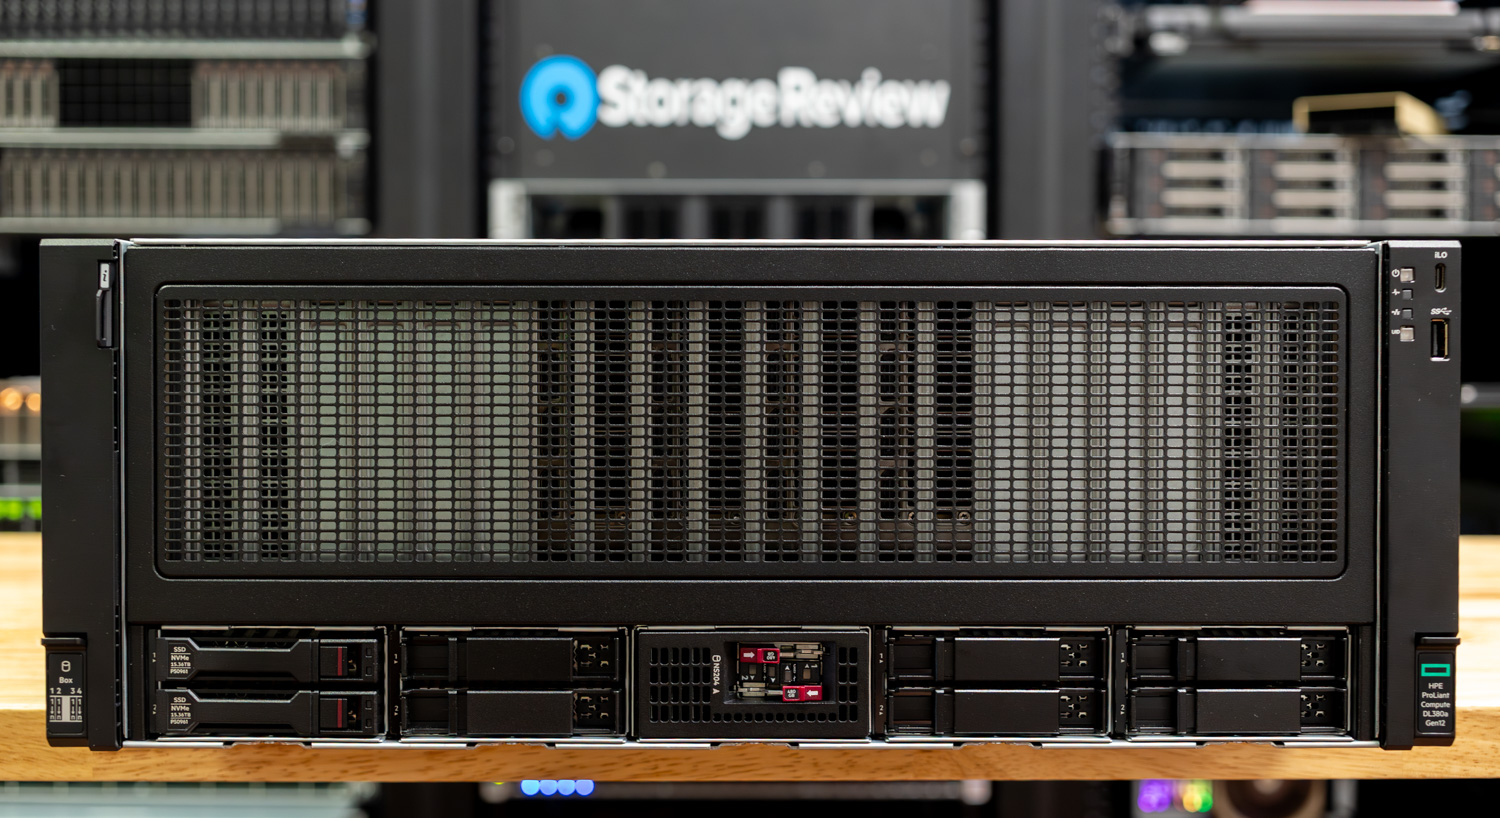
HPE ProLiant Compute DL380a Gen12 伺服器針對主流企業級 AI 團隊,旨在滿足他們無需改變機架配置即可實現高密度運算的需求。這款 4U 風冷機殼可輕鬆安裝,支援多達八個雙寬 GPU,並提供全 PCIe Gen5 插槽。它可配置雙路 Intel Xeon 6 CPU(每路最高 144 核心)、32 個 DIMM 插槽,支援 4TB DDR5 內存,以及 16 個 E3.S NVMe 硬碟位,以實現高吞吐量和高容量。其目標非常明確:在不採用液冷散熱的情況下,實現大規模的生產級推理和精細化調優。
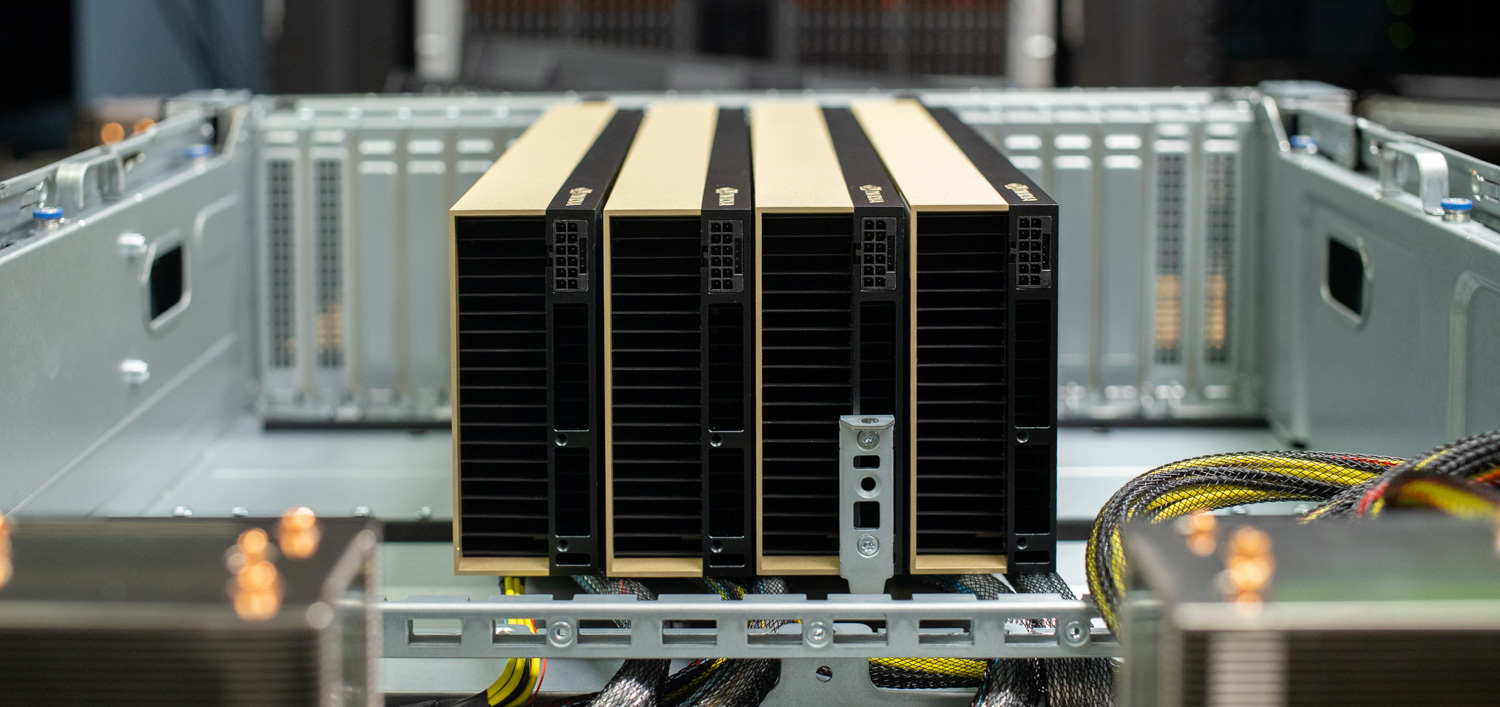
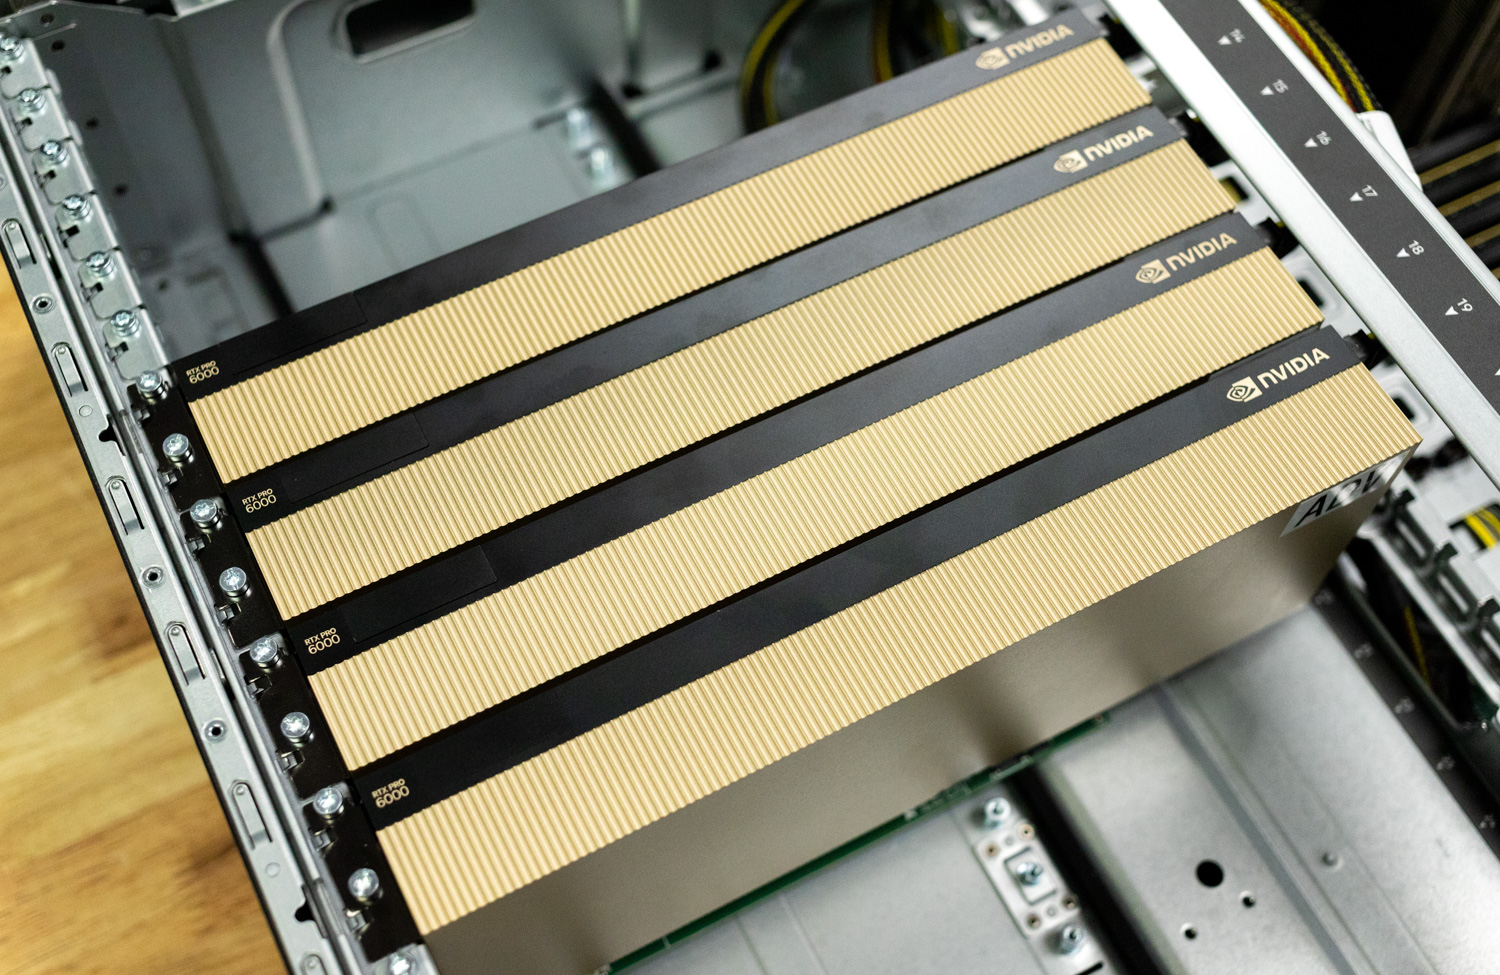
在加速器方面,HPE 驗證了涵蓋 NVIDIA H200 NVL、H100 NVL、L40S、L20、L4 和 RTX PRO 6000 Blackwell 伺服器版的廣泛產品線,並提供支援更高功耗組件的電源選項。本次評測我們將聚焦在 RTX PRO 6000 伺服器版,它完美契合企業級 AI 的實際需求。每張顯示卡配備 96GB ECC GDDR7 記憶體、PCIe Gen5 x16 插槽、支援 FP4 運算的 Tensor 核心,以及 600W 的耗電量,可在風冷機架中運作。我們的測試平台配備了四張顯示卡,這對於高吞吐量推理和針對性微調來說是一個合理的起點,並且還留有擴展空間。
HPE 為該平台配備了至關重要的運維組件。 iLO 7 可處理帶外設定、健康狀況和電源控制,其核心是矽信任根(Silicon Root of Trust),這是一個用於確保韌體完整性的安全隔離區,支援 4096 位元 RSA 加密,並配備可拆卸的 DC-MHS iLO 模組,從而加強供應鏈驗證。此外,該伺服器還可與 HPE 私有雲 AI 框架集成,實現多團隊治理和大規模可重複部署。
HPE ProLiant Compute DL380a Gen12 – 技術規格
| 項目類別 | 規格 |
|---|---|
| 處理器類型 | HPE ProLiant Compute DL380a Gen12 |
| 處理器系列 | 第四代英特爾® 至強® 可擴充處理器 |
| 可用處理器核心數 | 根據處理器不同,核心數在 64 到 144 之間。 |
| 處理器數量 | 2 |
| 處理器速度 | 高達 2.4 GHz,取決於處理器 |
| 最大內存 | 4 TB RDIMM(每個處理器 2 TB) |
| 內存插槽 | 32個DIMM插槽 |
| 內存類型 | HPE DDR5 智慧內存 |
| 內存保護 | RAS:進階 ECC、線上備用、鏡像、組合通道(鎖定步進)功能、HPE 快速容錯記憶體 (ADDDC) |
| 驅動支援 | SFF NVMe 和 EDSFF |
| 安全性 | 可選配鎖定面板、入侵偵測功能和嵌入式 HPE TPM 2.0 |
| 基建管理 | HPE iLO 標準版(含智慧型設定功能,嵌入式)、HPE OneView 標準版(需下載)• 可選:HPE iLO Advanced 和 HPE OneView Advanced(需要許可證) |
| 電源 | 最多支援 8 個 M-CRPS。系統主機板採用單路 1+1 冗餘設計。 GPU 採用雙路 2+1 冗餘設計。 |
| 擴展插槽 | 6 |
| 系統風扇 | 內含 4 個雙轉子風扇和 8 個單轉子熱插拔風扇 |
| 外形尺寸 | 4U機架 |
| 保固 | 3/3/3:伺服器保修 |
HPE ProLiant DL380a Gen12 設計與建造
HPE ProLiant Compute DL380a Gen12 是一款 4U 雙路機架式伺服器,專為高效能、可擴展部署而設計。其尺寸為 6.88 x 17.63 x 31.60 英寸,結合了強大的 CPU 和 GPU 運算能力以及高效的風冷散熱,即使在高負載下也能可靠運作。
根據配置不同,機殼重量在 82.7 磅到 137.8 磅之間,支援高容量組件、冗餘電源,並可輕鬆從正面進行維護。其設計著重於效能、可擴展性和強大的散熱管理,使其非常適合企業和資料中心環境。
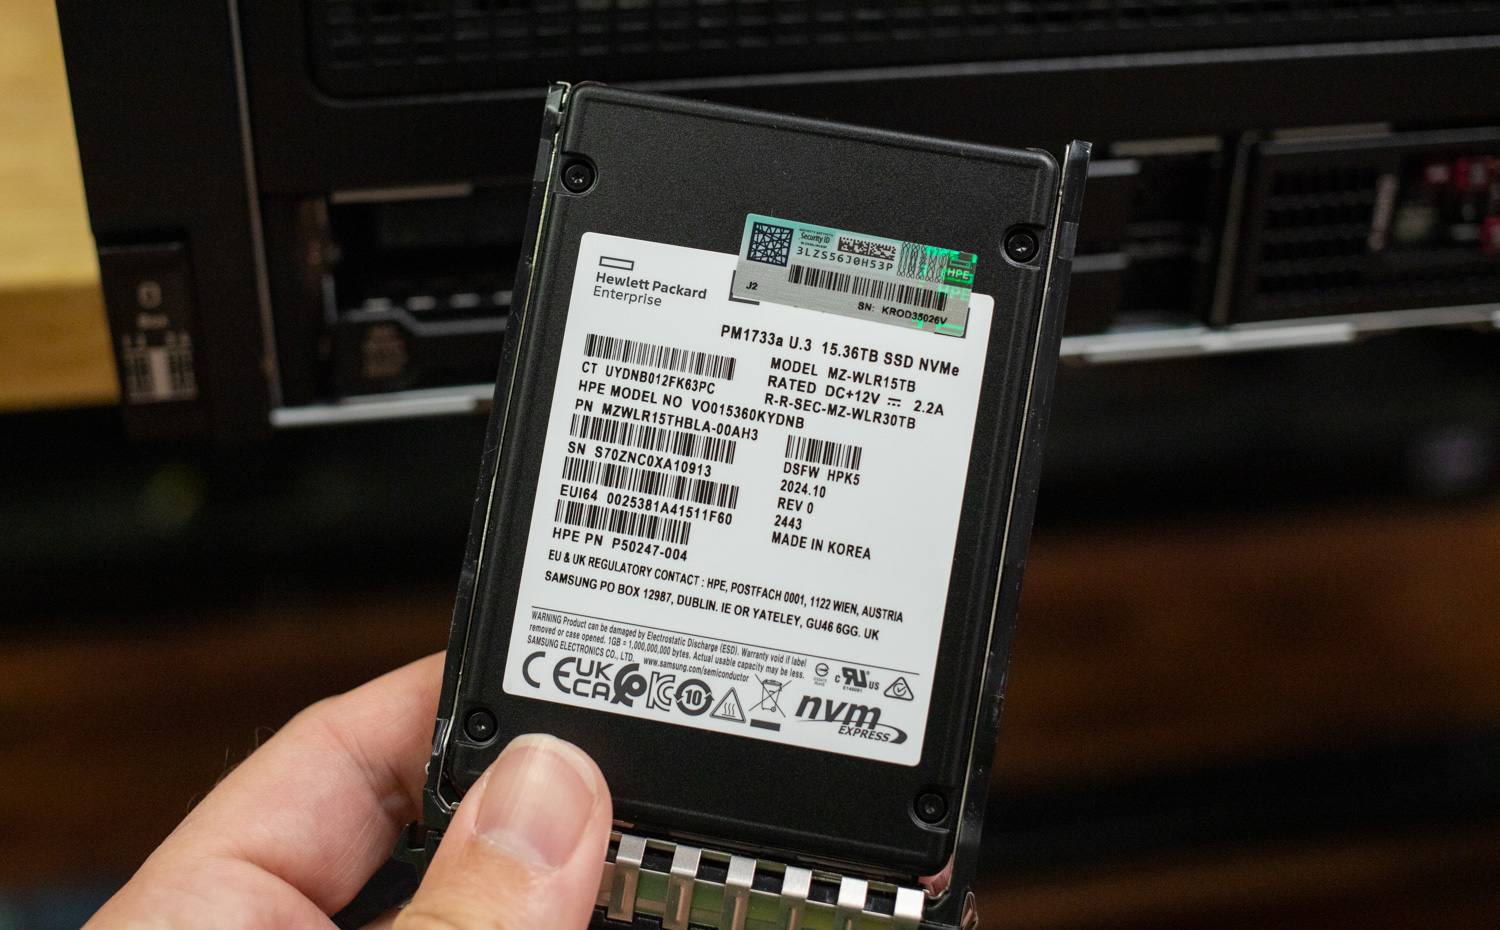
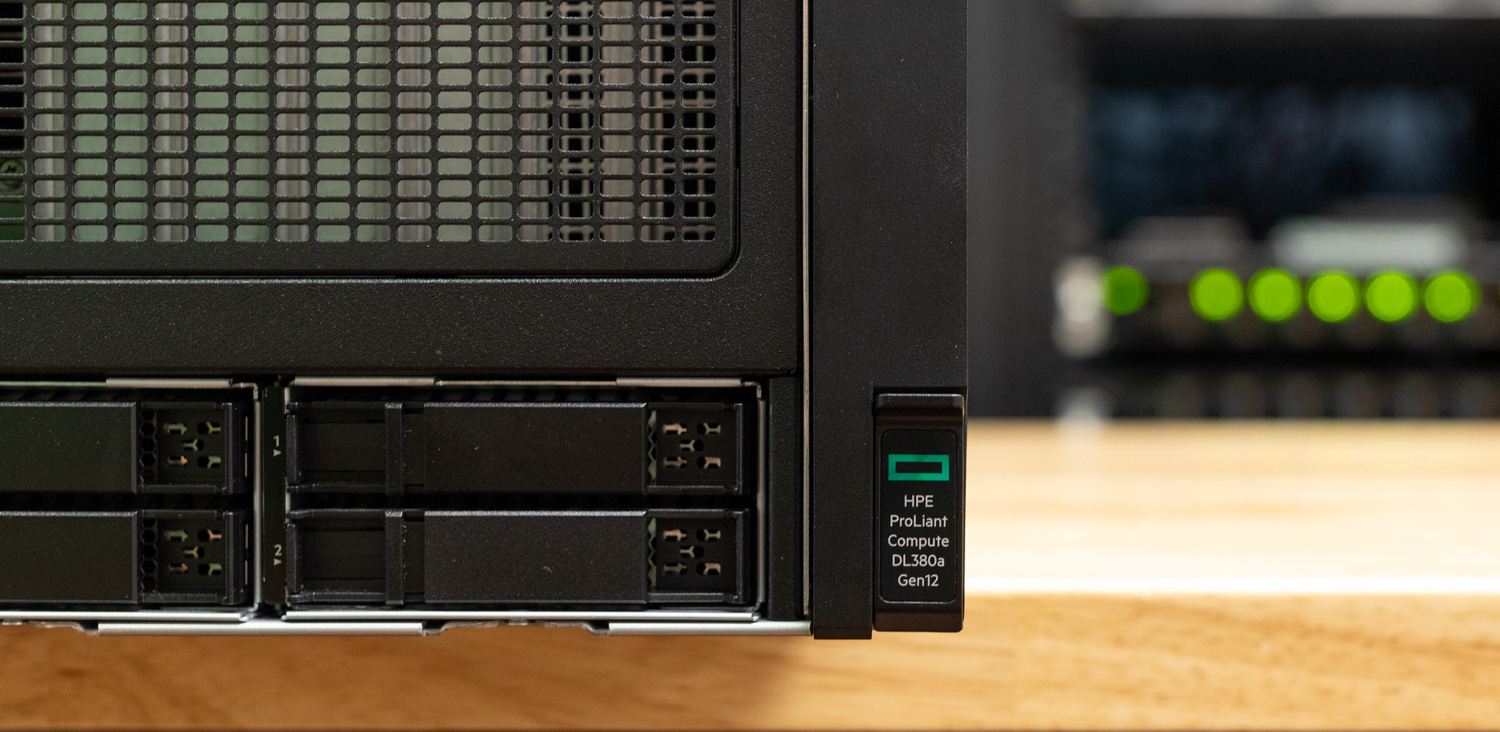 儲存方面,HPE ProLiant DL380a Gen12 伺服器提供 4 碟位和 8 磁碟位兩種配置,並可選擇 SFF 或 EDSFF 規格。我們評測的這台伺服器配備了 HPE DL380a Gen12 NS204i-u 前置硬碟籠套件,支援兩個 NVMe M.2 熱插拔啟動設備。機殼還包含八個 2.5 吋硬碟位,並安裝了兩個 HPE 品牌的 U.3 SSD,總容量為 15.36 TB。 HPE 提供多種前置硬碟選項,可靈活擴展以滿足不同的部署需求。
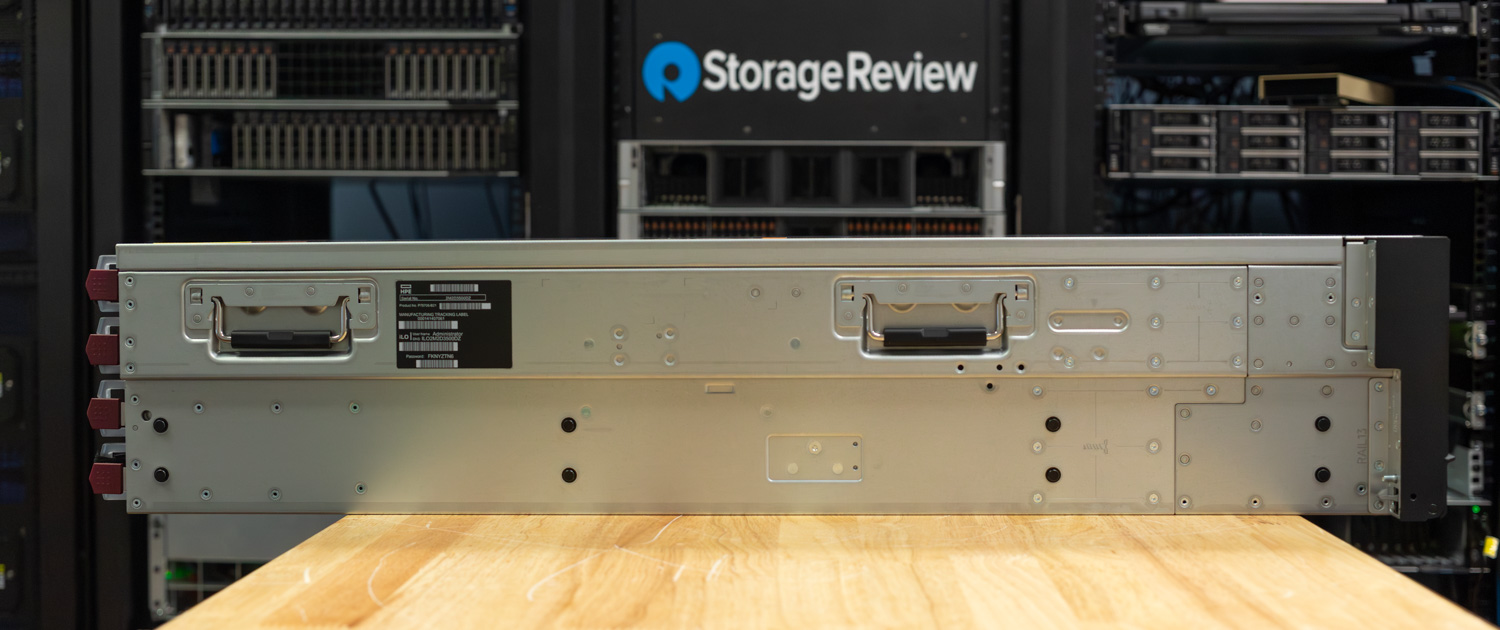
該設備兩側各有兩個把手,方便搬運,因此至少需要兩人才能安全地進行機架安裝。它採用 2U 導軌套件,配備伸縮式導軌,無需完全拆卸機架即可實現順暢的安裝和機架內維護。
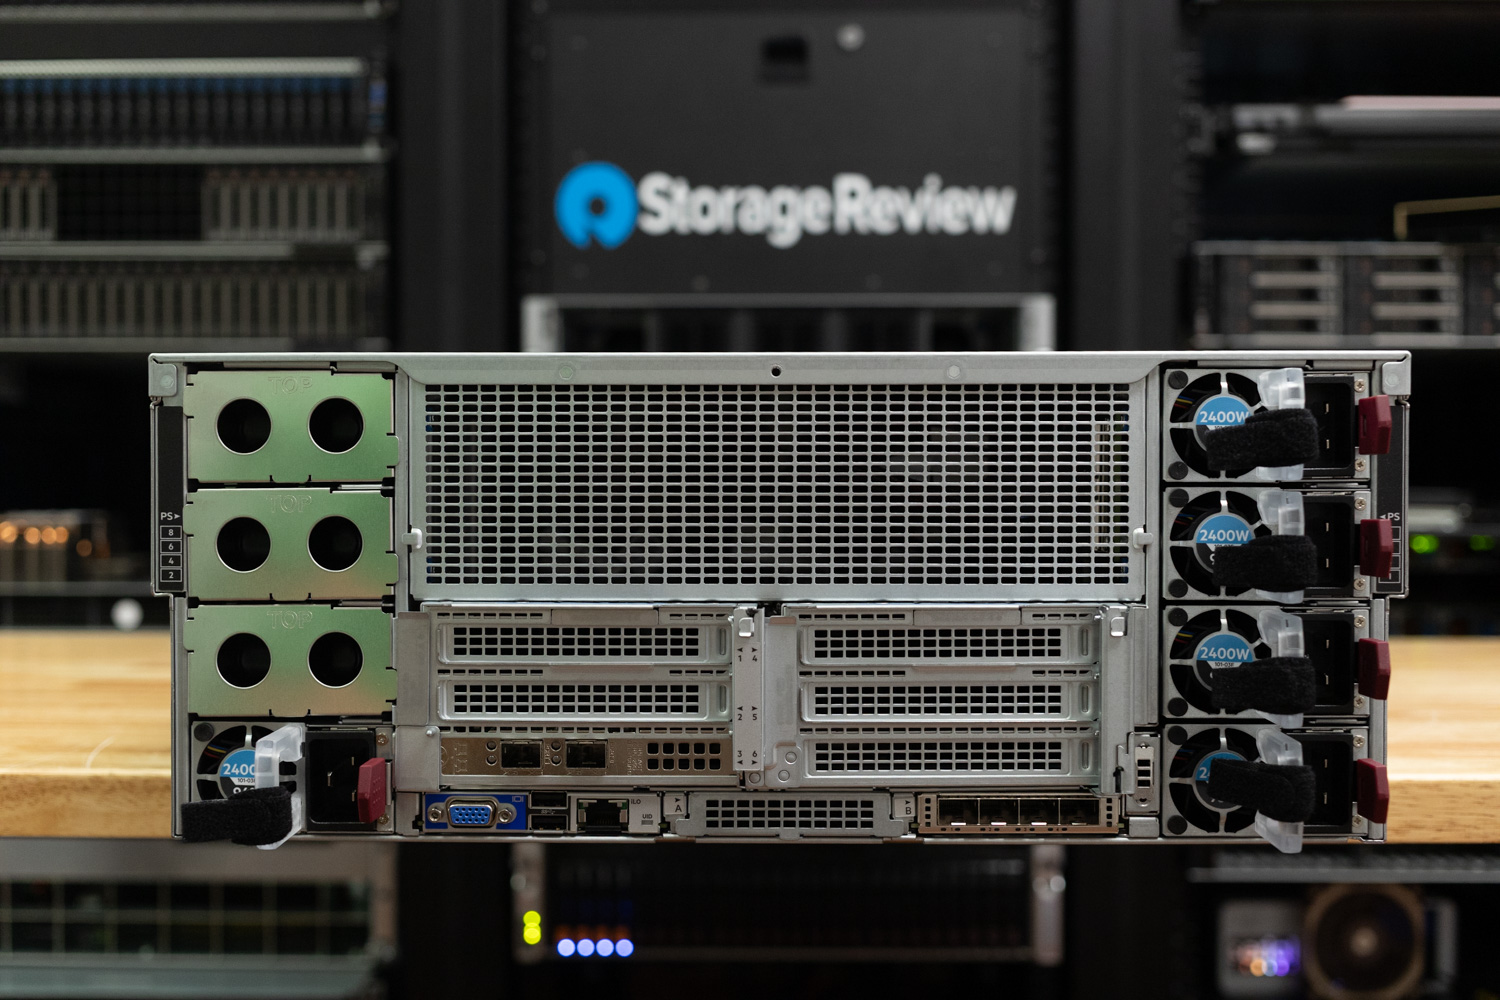
 HPE ProLiant DL380a Gen12 伺服器的背面佈局合理,重點在於優化氣流、擴展性和易維護性。該系統支援最多八個 MCRPS 電源(1-8 號插槽),並整合通風牆,確保在高負載下也能保持最佳散熱效果。擴充性方面,該系統擁有豐富的插槽,配備多個 PCIe Gen5 x16 插槽(1-6 號插槽),可相容於預設和可選的專用擴充卡,以及用於靈活配置網路適配器的 OCP 插槽 A 和 B。
連接方面,包括一個專用的 iLO 網路連接埠、多個 USB 3.2 Gen 1 連接埠和一個用於本地管理的 VGA 連接埠。需要注意的是,插槽 1 僅在安裝了 HPE DL380a Gen12 4EDSFF NVD 直連接纜 (P74716-B21) 後可用,且不能與 SFF NVMe 硬碟一起使用;而插槽 4 在配備 4 個或 8 個 DW GPU 的配置中不受支援。
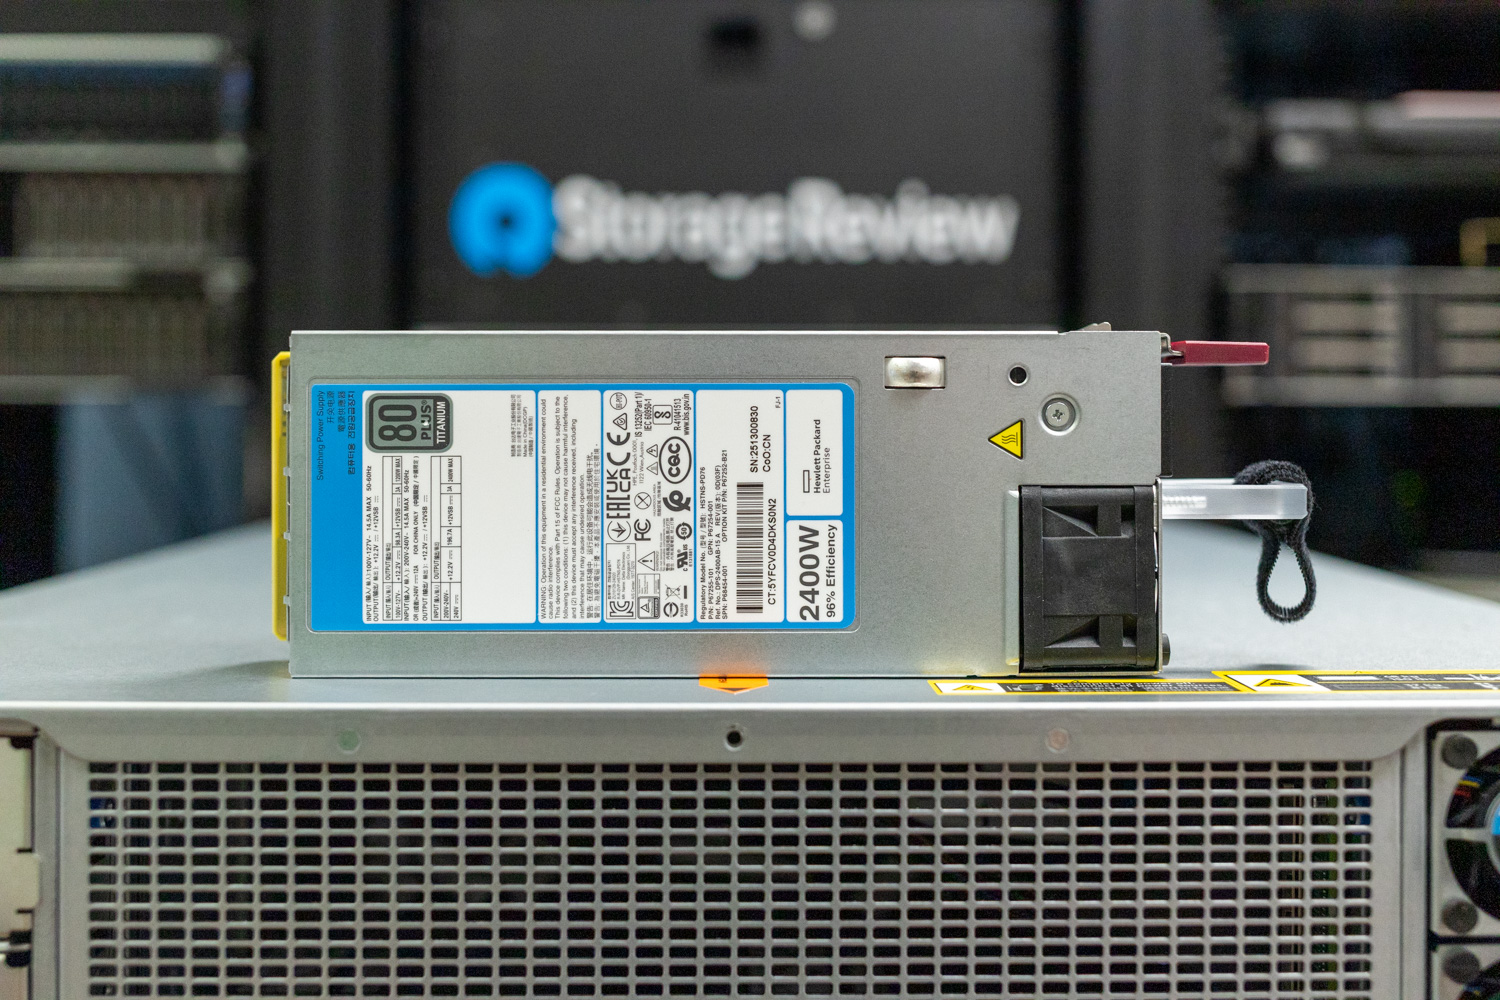
HPE ProLiant DL380a Gen12 伺服器採用模組化 M-CRPS 鈦金熱插拔電源套件供電,支援的型號包括 1500W (P67244-B21)、2400W (P67252-B21) 和 3200W (P67248-B21)。該系統最多支援八個電源,實現 N+1 冗餘,即使某個電源模組發生故障也能確保系統持續運作。根據 GPU 配置的不同,電源需求和分配也會有所不同。我們評測的這台伺服器配備了五個 2400W 的 M-CRPS 電源,足以支援系統四個 600W TDP 的 GPU,同時保持可靠的冗餘性。
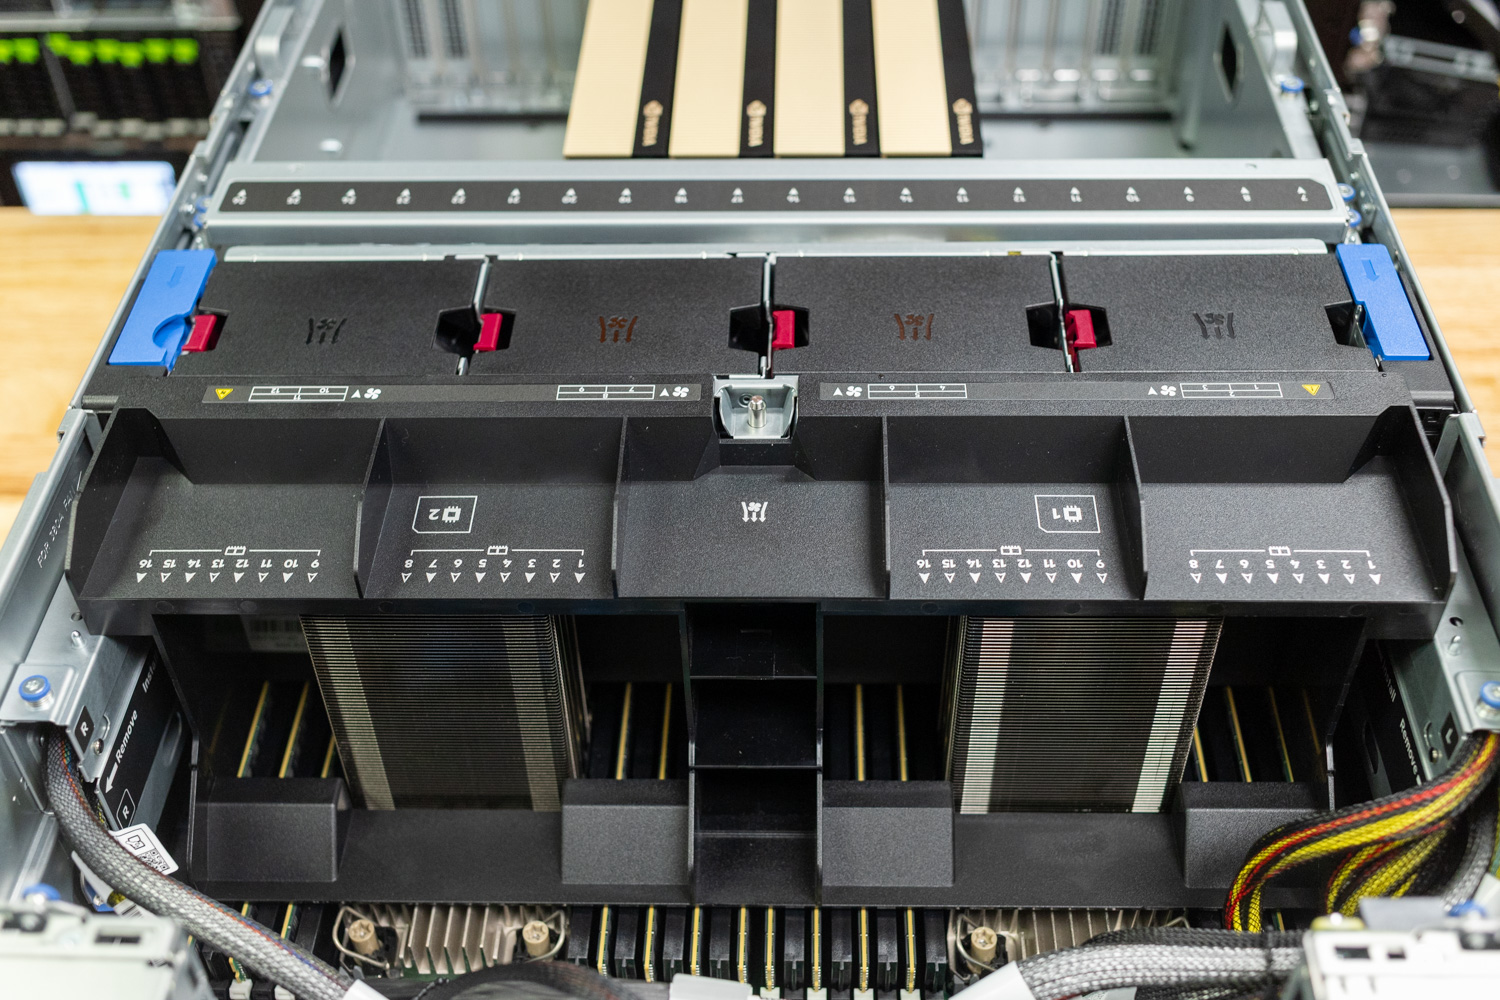
 從頂部俯視 HPE ProLiant DL380a Gen12 伺服器內部,可以明顯看出 HPE 在設計這款機殼時採用了 GPU 優先散熱策略,將 GPU 置於系統前端,以確保其獲得直接、暢通無阻的氣流。散熱系統配備了四個熱插拔風扇組件,每個組件包含一個 92x56mm 雙轉子風扇和兩個 40x28mm 單轉子風扇。較小的風扇將氣流集中吹向 CPU 和記憶體模組,確保較低層組件的高效散熱。相較之下,較大的雙轉子風扇則專門用於將大風量直接吹向 GPU 陣列。這種均衡的設計確保了計算組件和加速器組件的最佳散熱效果,即使在持續的高負載下也能保持穩定運作。
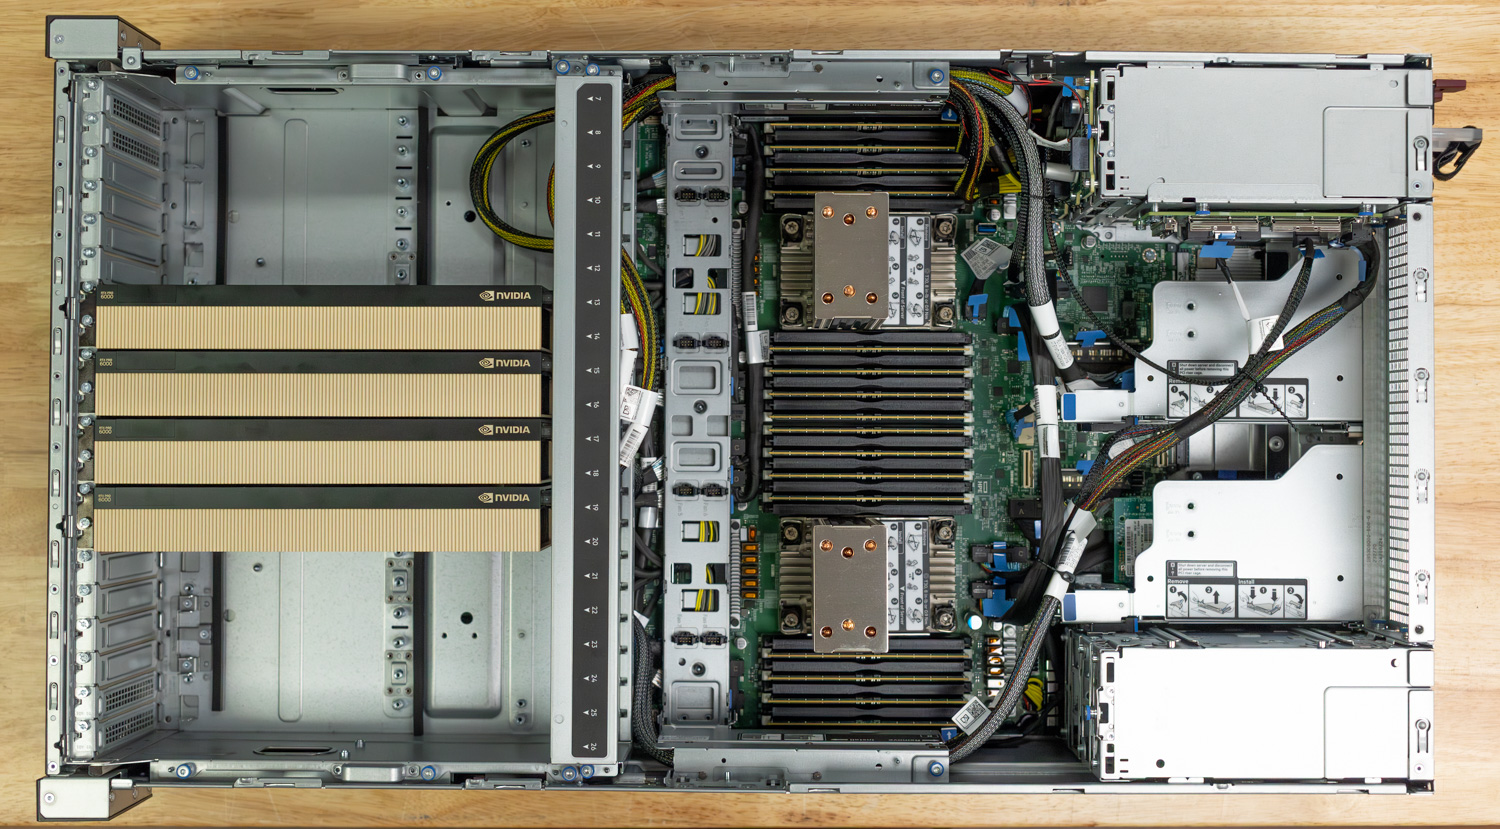
經過檢查GPU配置,我們的設備預先安裝了四個PCIe 5.0 GPU接口,每個GPU都整齊地安裝在前置GPU籠內。該系統配置了NVIDIA RTX PRO 6000 GPU(Blackwell伺服器版,96GB),這是NVIDIA全新專業級產品線的一部分,專為AI、渲染和運算工作負載而最佳化。根據配置的不同,DL380a Gen12可以支援4或8個雙寬GPU,或最多16個單寬加速器,為各種企業和AI部署提供了靈活性。
該平台支援的GPU包括:
- NVIDIA RTX PRO 6000 伺服器版 (96GB)
- NVIDIA H200 NVL(141GB)
- NVIDIA H100 NVL(94GB)
- NVIDIA L40S (48GB)
- NVIDIA L20(48GB)
- NVIDIA L4(24GB)
這款靈活的GPU佈局,搭配高頻寬的PCIe Gen5通道,確保DL380a Gen12能夠輕鬆應對密集型推理任務和大規模AI訓練環境。深入機殼內部,安裝散熱罩後,我們可以看到HPE在氣流管理上精心設計的方案。散熱罩採用精密模壓的擋板設計,能夠有效率地引導氣流經CPU、記憶體模組和VRM,確保整個系統均勻散熱。
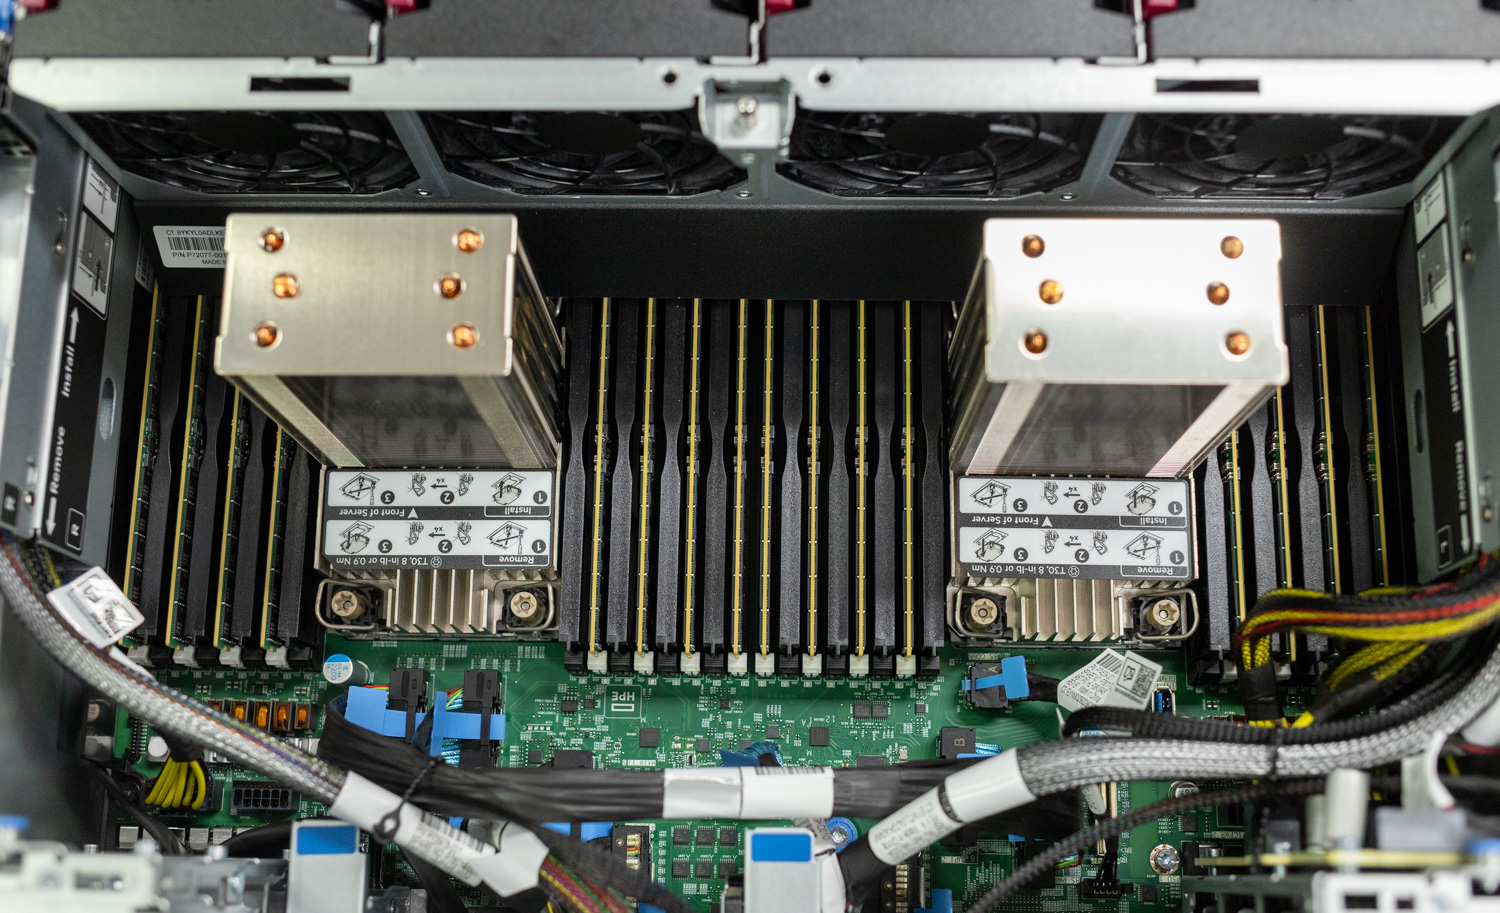
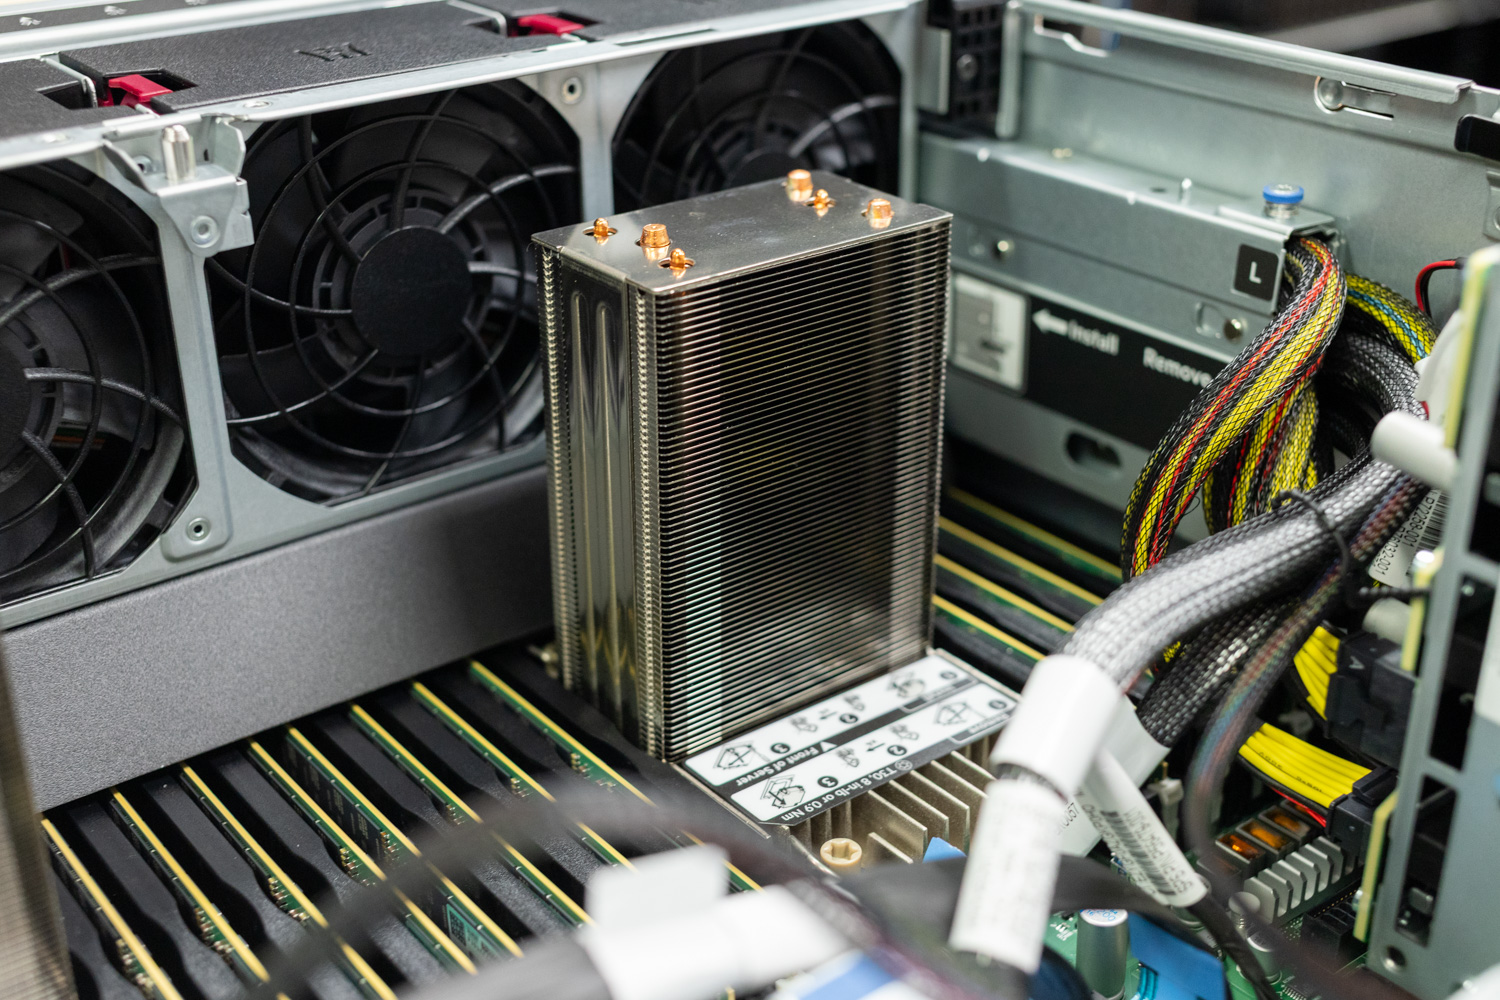
 從CPU散熱器來看,HPE在設計DL380a Gen12時充分考慮了散熱平衡。每顆Xeon 6處理器都配備了高密度、高散熱片,旨在應對CPU自身的熱量輸出以及位於機殼前方的GPU產生的額外熱量。這種設計確保即使在高負載混合工作負載下也能維持穩定的散熱性能,避免GPU排氣導致CPU周圍環境溫度升高。當安裝高功耗GPU時,更高的散熱片結合HPE的前後氣流設計,能夠提供足夠的散熱面積和效率,有效應對額外的熱負荷。
國際勞工組織第七屆大會概述
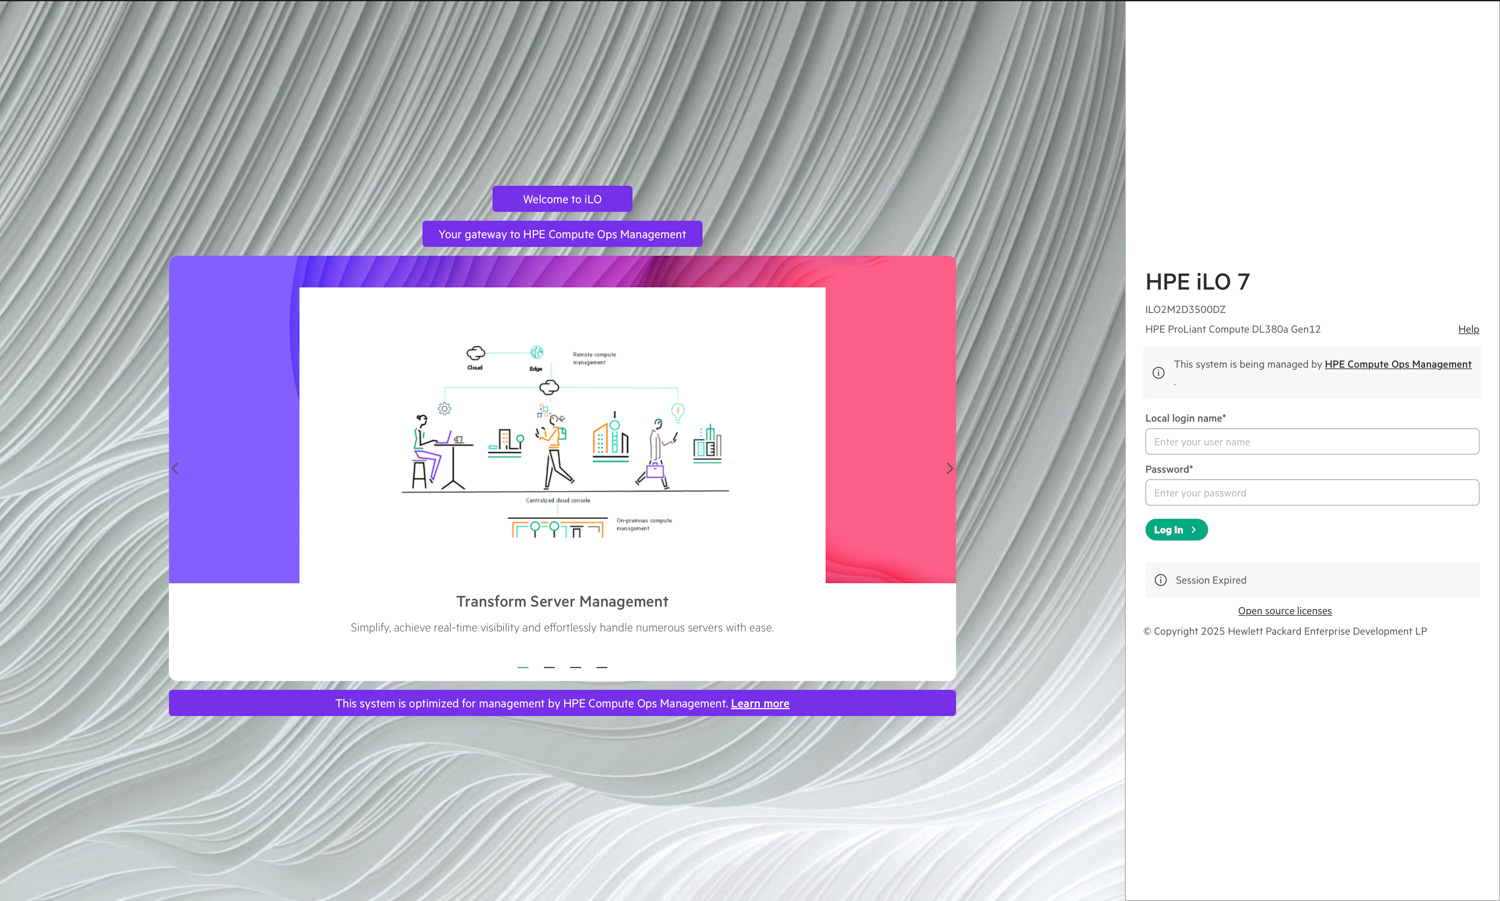
如前所述,該系統包含一個專用的 iLO 端口,可提供帶外管理功能,實現對伺服器的全面控制和監控。此設備配備全新的 HPE iLO 7 介面,為管理員提供煥然一新的介面和增強的功能,並與 HPE Compute Ops Management 集成,從而簡化配置、監控和生命週期管理。以下是我們範例係統中全新的 HPE iLO 7 登入介面。
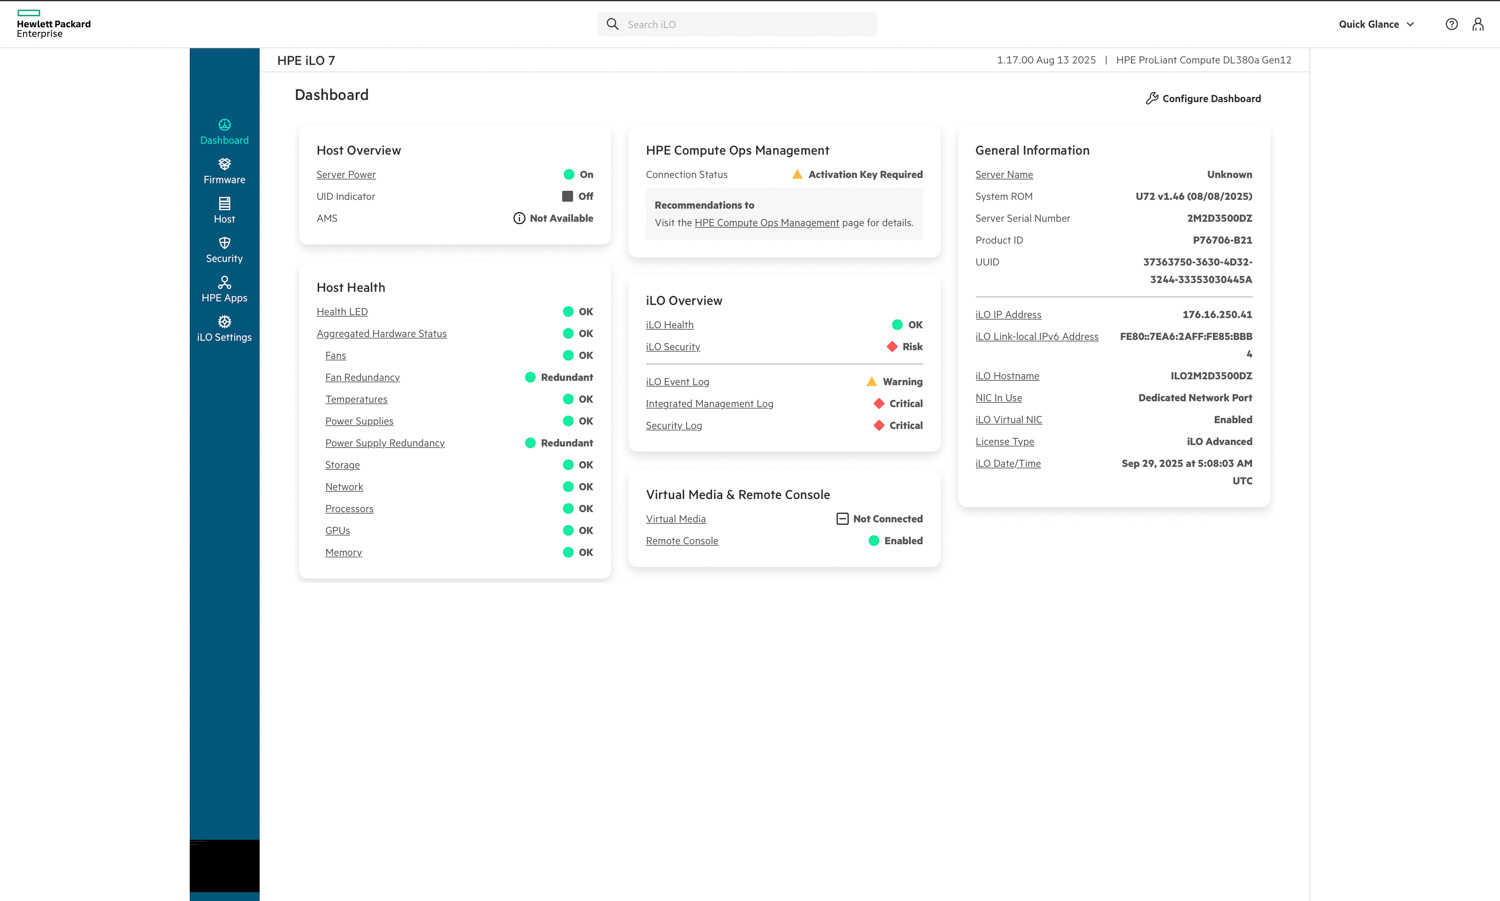
首先來看控制面板,我們可以看到 HPE iLO 7 採用了現代化的介面,能夠直觀地顯示系統狀態和關鍵運作狀況指標。主面板概述了主機電源狀態、運作狀況以及與 HPE Compute Ops Management 的連線狀態。右側則顯示了 iLO IP 位址、主機名稱和許可證類型等常規系統訊息,方便使用者快速查閱。
儀錶板將風扇冗餘、電源健康狀況和溫度讀數等關鍵指標整合到一個清晰的顏色編碼佈局中,使用戶能夠一目了然地評估伺服器狀況。此外,使用者還可以直接從主頁存取虛擬媒體和遠端控制台,無需額外導航即可簡化常見的遠端管理任務。
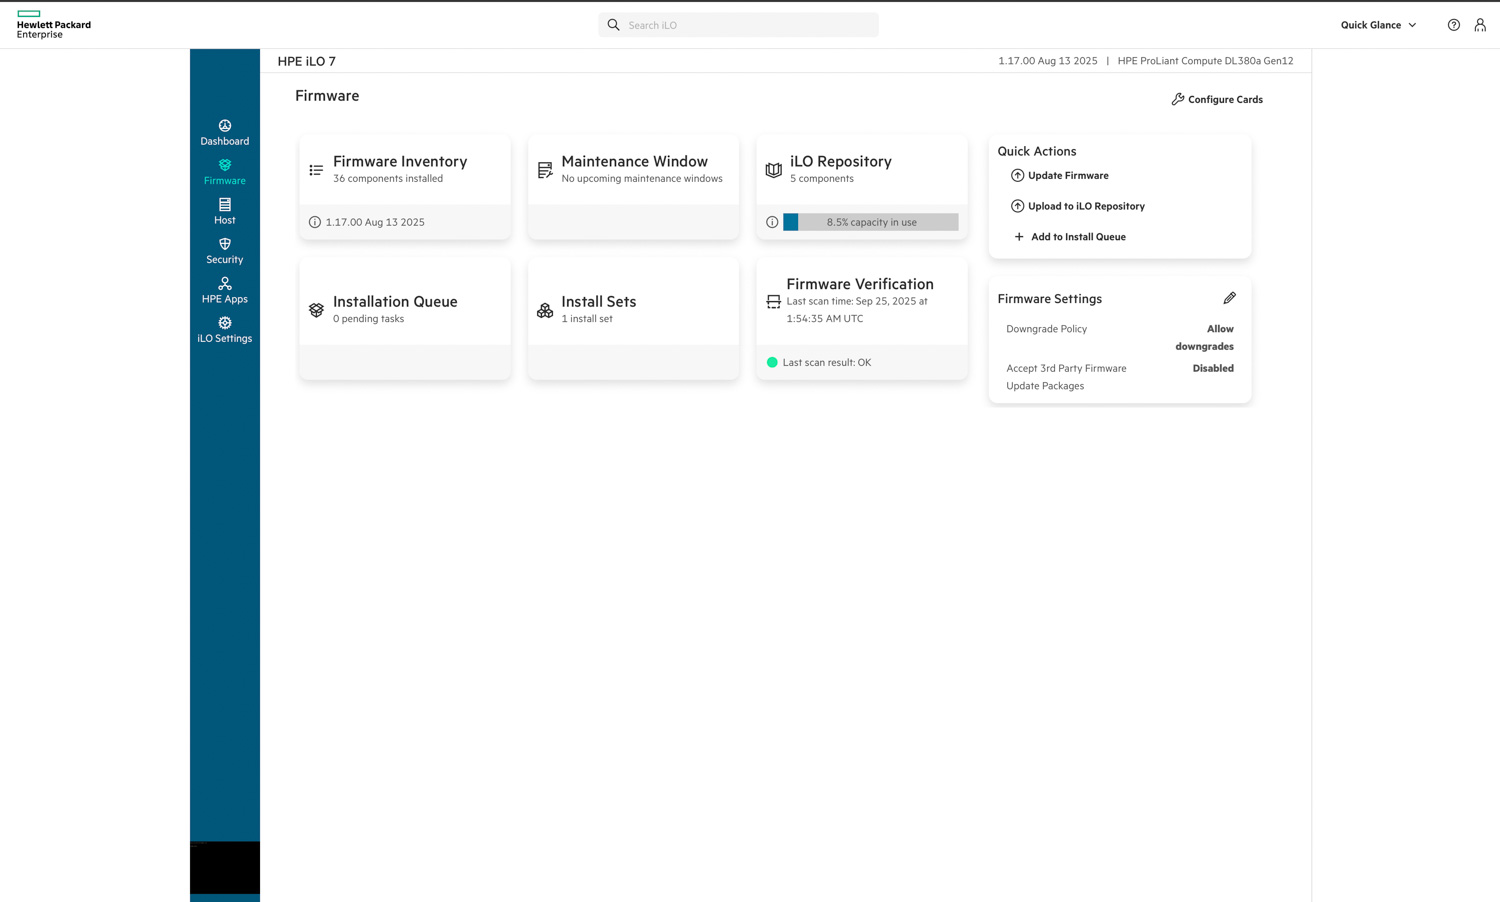
在「韌體」標籤中,HPE iLO 7 以清晰有序的方式展示了所有元件和更新管理任務。介面採用卡片式佈局,方便使用者瀏覽韌體清單、活動安裝佇列和驗證結果。管理員可以快速啟動更新、將軟體包上傳到 iLO 儲存庫,或建立安裝集以進行大量部署。
韌體驗證和儲存庫管理功能已直接整合到此視圖中,使用戶能夠確認韌體完整性並保持元件間的版本一致性。右側的「快速操作」功能表簡化了諸如更新韌體或上傳新檔案等基本任務。 「韌體設定」卡提供了對降級策略和第三方軟體包接受情況的控制。
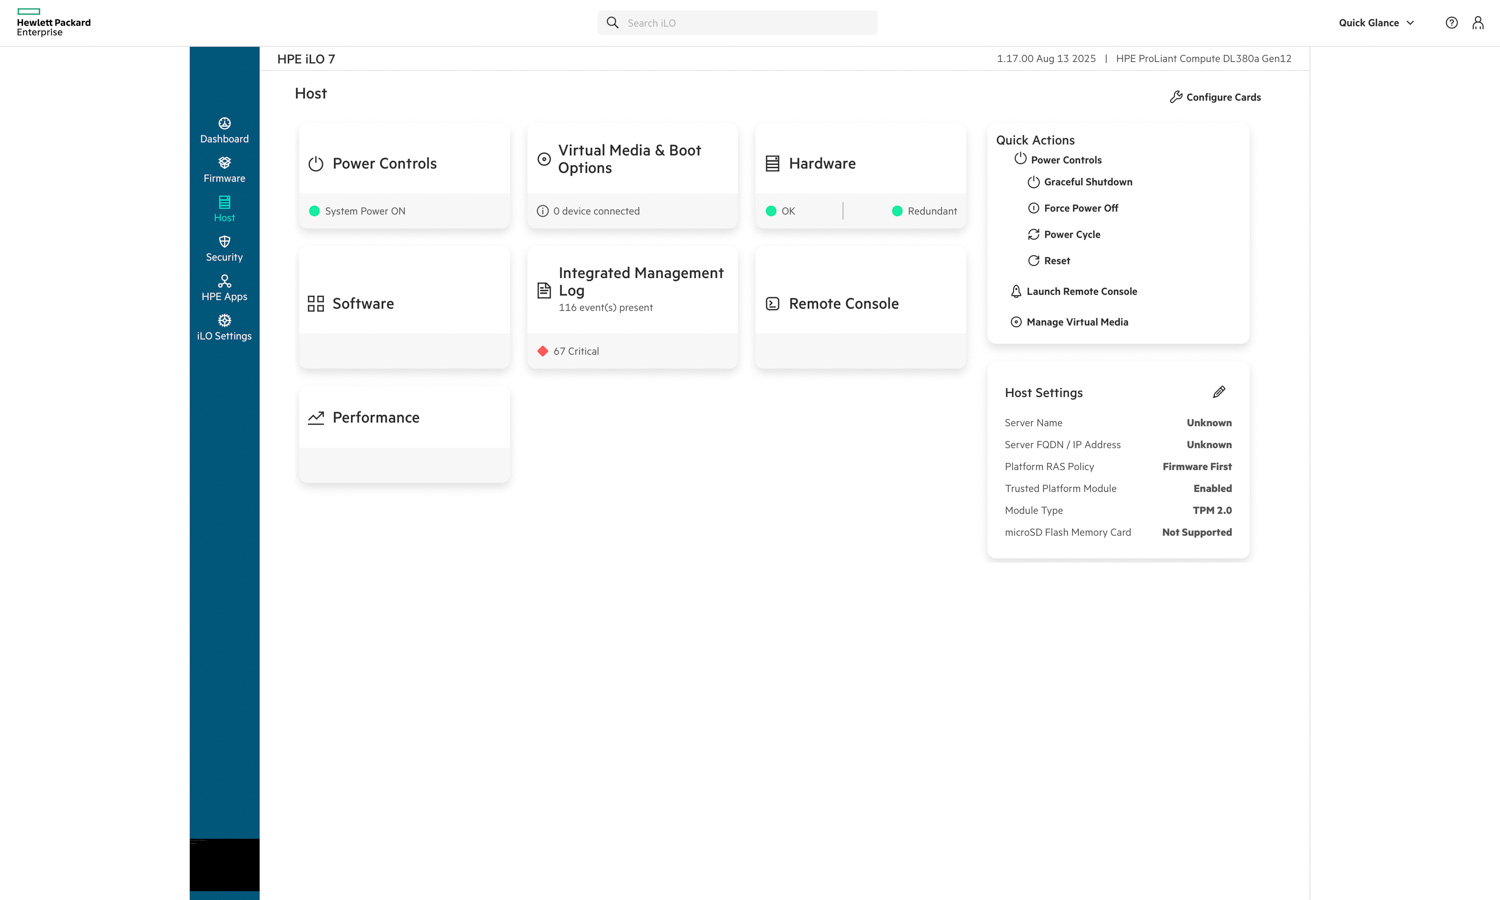
在主機部分,HPE iLO 7 提供對關鍵伺服器管理功能的快速訪問,包括電源控制、虛擬媒體、硬體健康狀況和系統效能。管理員可以查看即時硬體冗餘狀態、存取整合管理日誌,或直接從此介面啟動遠端控制台。該佈局還包含諸如優雅關機、電源循環和重置等快捷操作,從而無需物理訪問即可對系統進行完全遠端控制。
右側面板顯示主機設置,包括 TPM 狀態、平台策略配置和硬體模組資訊。總而言之,本部分重點介紹了 iLO 7 作為集中式控制中心的功能,使管理員能夠在單一視圖中安全地管理電源、監控事件並保持運作監督。
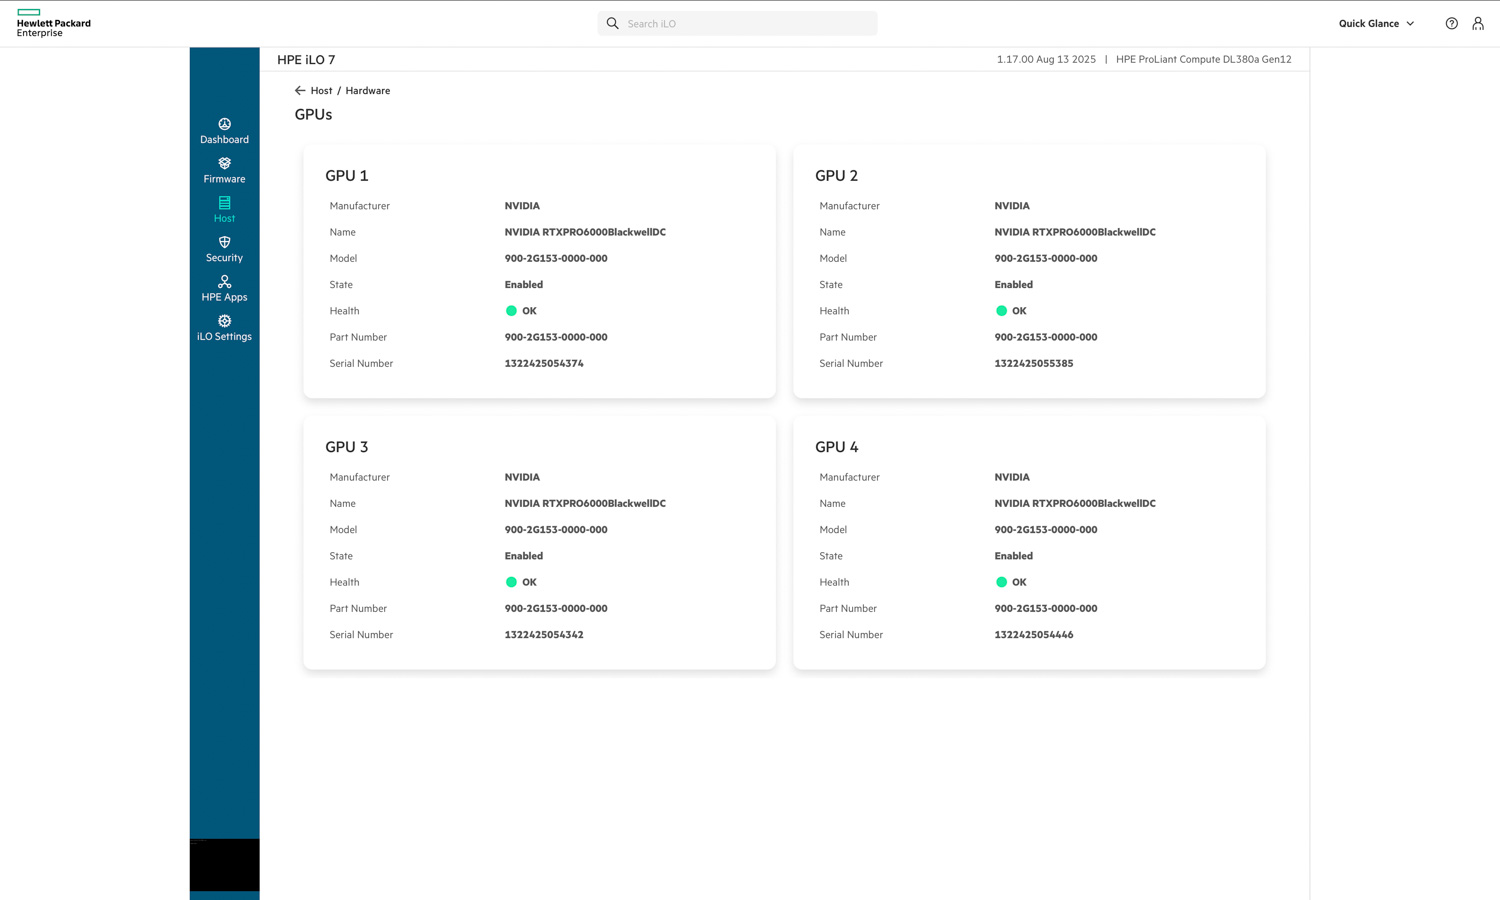
 在「主機」>「硬體」視圖中,我們可以看到系統中安裝的GPU。如前所述,該設備配備了四塊NVIDIA RTX PRO 6000 Blackwell GPU,每塊GPU均顯示已啟用且運作正常。 iLO 7提供詳細的硬體信息,包括型號、部件號和序號,使管理員能夠一目了然地驗證組件的運行狀況。
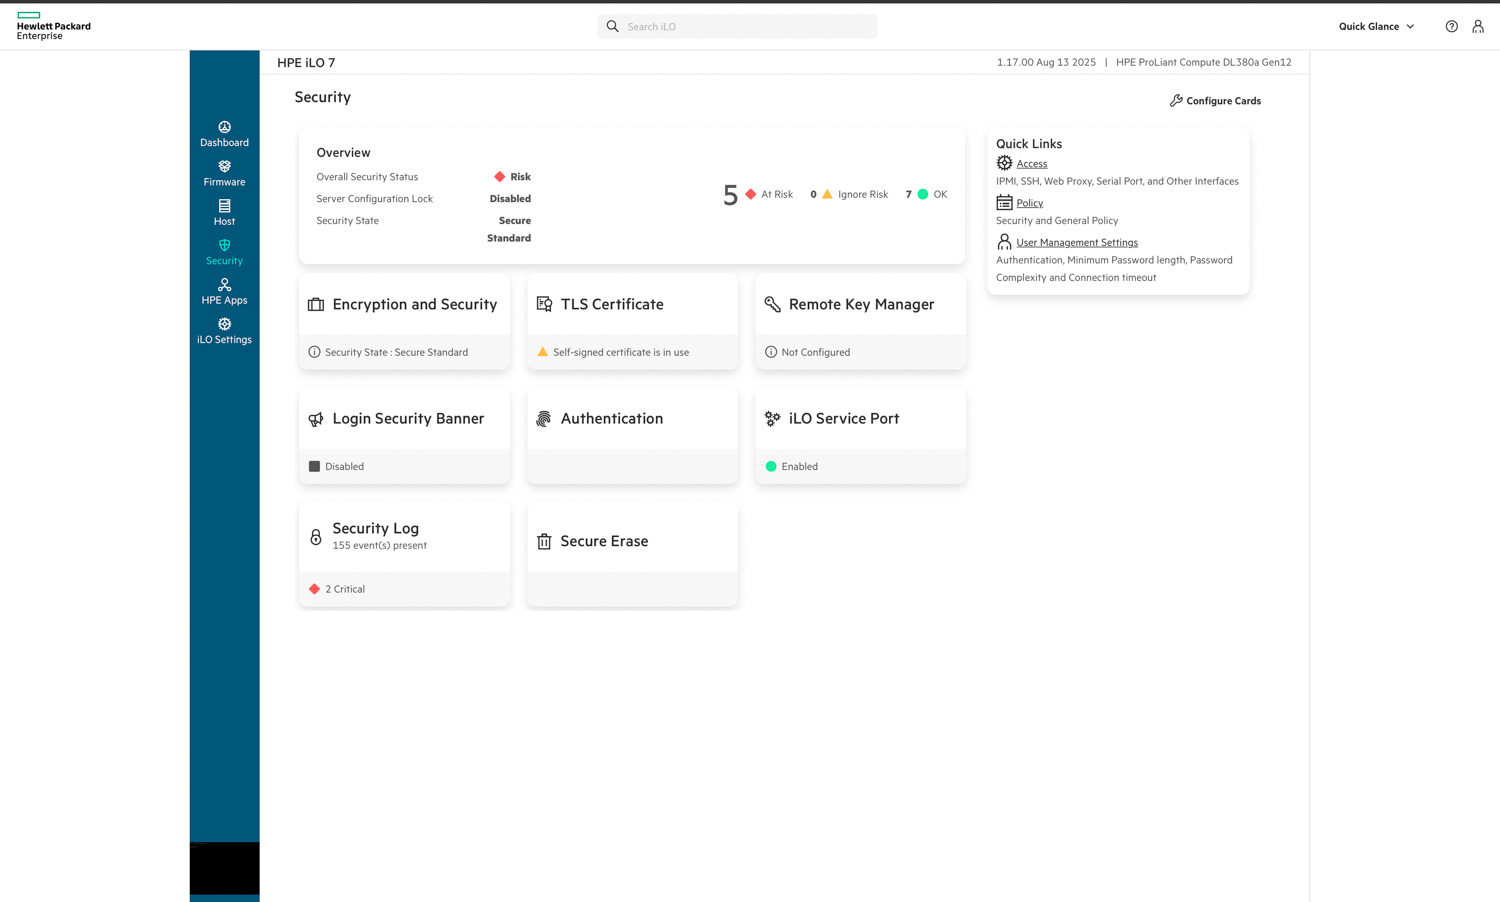
在「安全性」標籤中,HPE iLO 7 整合了所有與系統保護和存取管理相關的關鍵控制項。概覽面板提供了整體安全狀態的進階視圖,突顯風險等級、設定鎖定和憑證狀態。管理員可以在此管理加密設定、身份驗證方法和 TLS 證書,以及設定安全擦除和遠端金鑰管理。
此介面清楚標示出需要關注的區域,例如自簽名憑證或未配置的金鑰管理,同時在適用情況下確認安全運作。安全日誌、使用者管理策略和存取控制均可輕鬆存取,使管理員能夠直接從 iLO 環境全面了解系統的安全狀況。
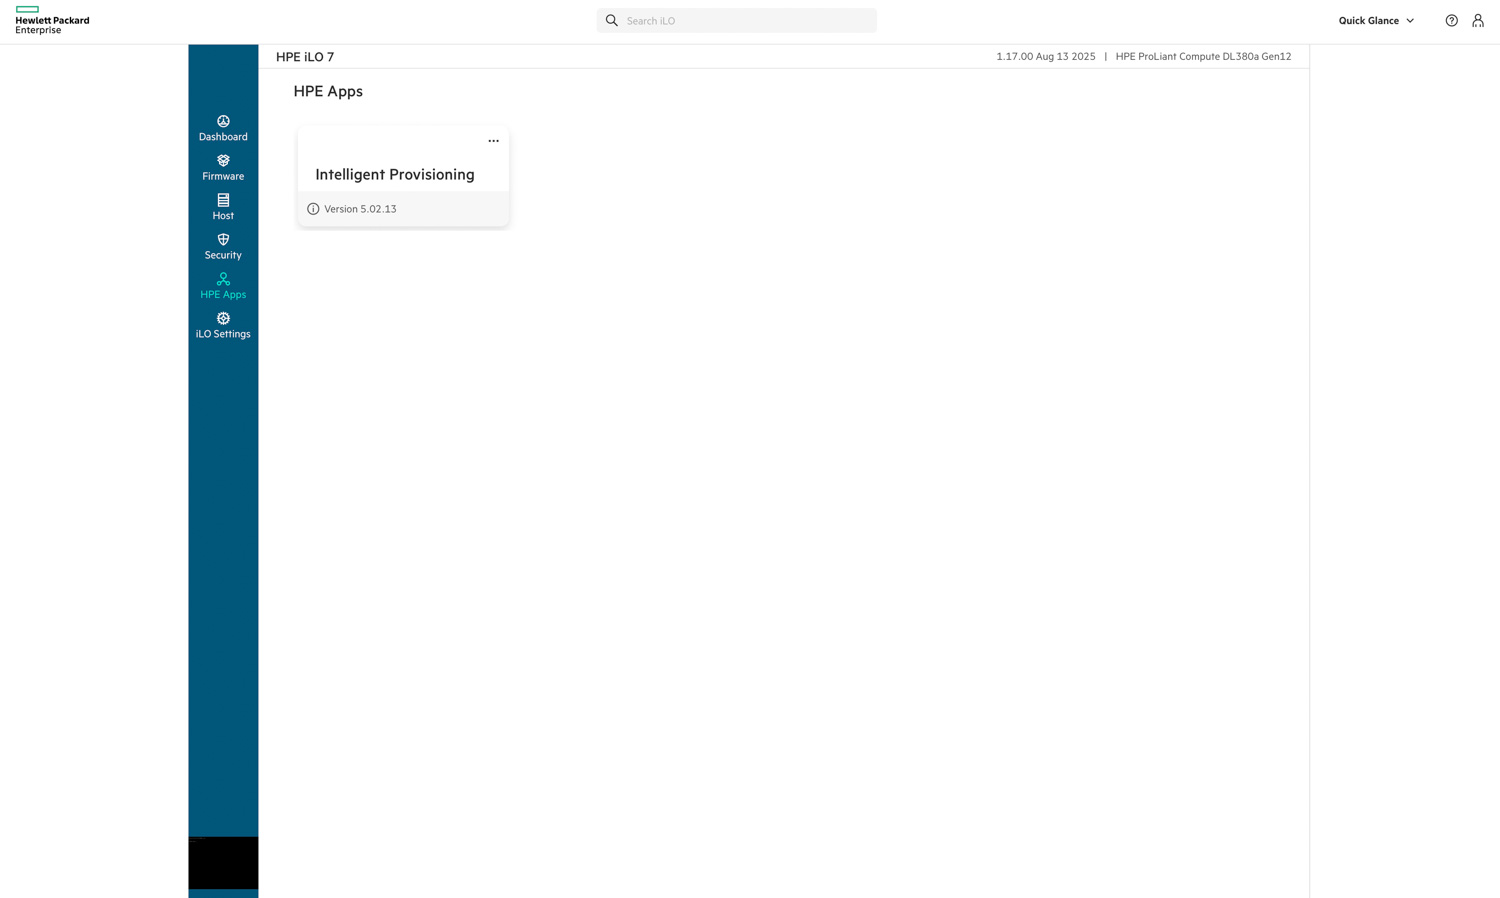
在 HPE Apps 標籤下,iLO 7 提供對整合工具的訪問,這些工具可增強伺服器部署和生命週期管理。管理員可以從此視圖啟動智慧型配置 (Intelligent Provisioning),這是一個內建實用程序,旨在簡化作業系統安裝、韌體更新和系統配置,而無需外部媒體。
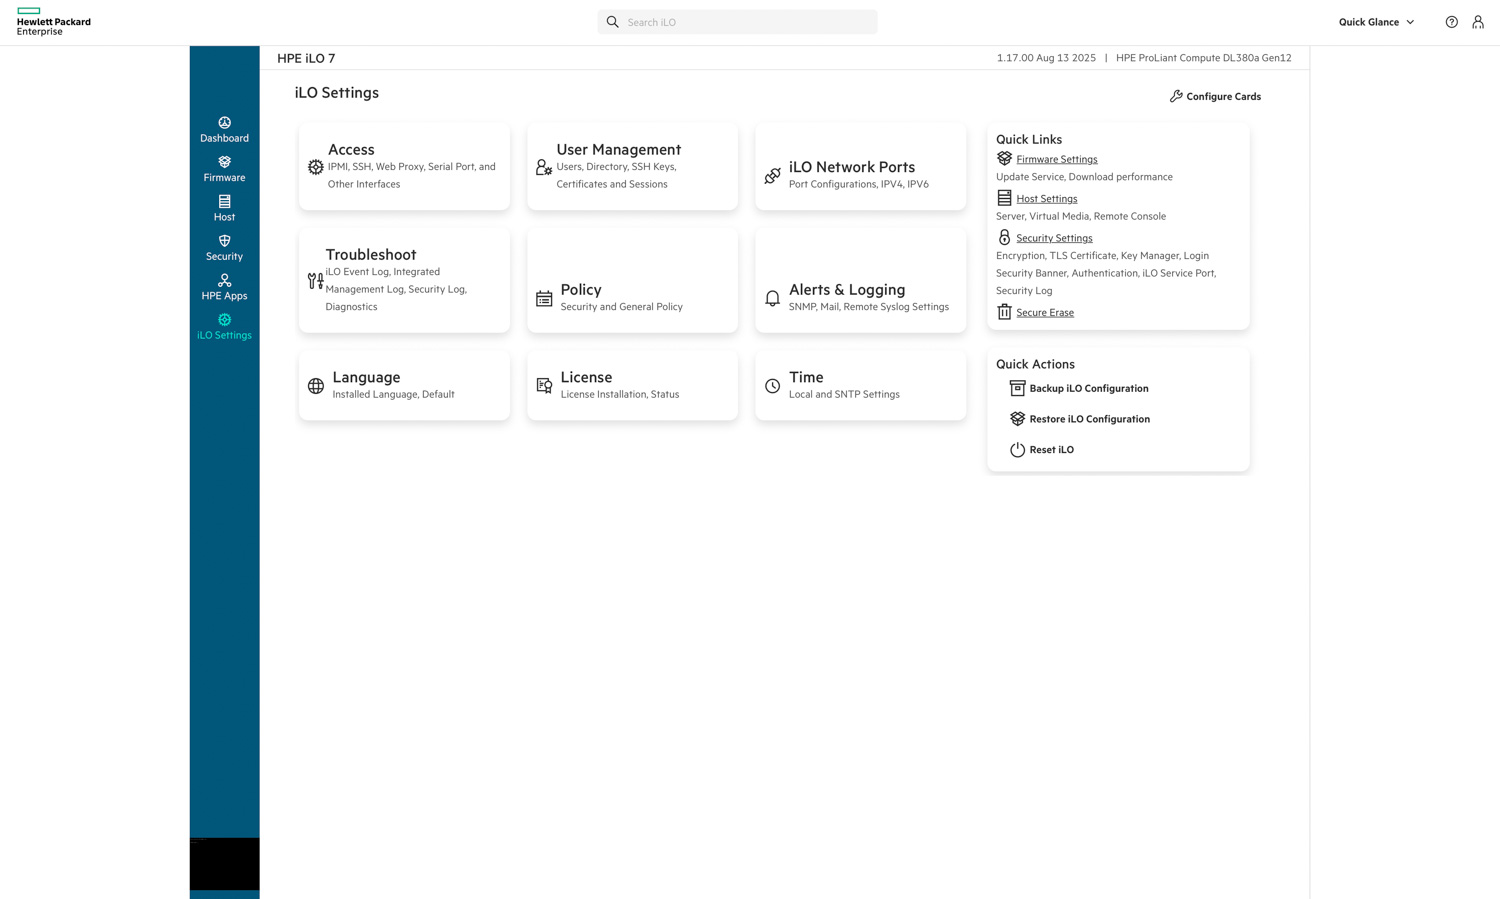
iLO 設定標籤集中了用於管理 iLO 介面的所有配置和管理選項。管理員可以在此控制使用者存取權限、網路連接埠配置、身份驗證方法和日誌記錄行為。此選單還包含故障排除、策略實施、許可證管理和時間同步等選項。
備份或還原 iLO 設定以及執行重置等快速操作均可方便地在右側找到,從而簡化維護任務。此佈局與 iLO 7 現代化的卡片式介面相呼應,提供了一種簡潔有序的方式,可從單一集中位置管理安全性、連接性和運行參數。
性能測試
為了評估 DL380a Gen12 的實際效能,我們進行了一系列全面的效能測試,涵蓋了人工智慧推理和通用計算工作負載。這些測試包括針對大型語言模型 (LLM) 的 vLLM 線上服務基準測試,以及用於測量 CPU 吞吐量、記憶體頻寬、Web 服務效率和加密效能的 Phoronix 測試套件基準測試。
系統配置
- 中央處理器: 2 個 Intel Xeon 6527P CPU
- 內存: 16 x HPE 64GB 2Rx4 PC5-3400B-R 智慧套件
- GPU: 4 x NVIDIA RTX PRO 6000 (96GB)
- 貯存: 2 x 15.63TB PM1733a U.3
vLLM 線上服務 – LLM 推理效能
vLLM 是目前最受歡迎的 LLM 高吞吐量推理和服務引擎。 vLLM 線上服務基準測試是一種效能評估工具,用於衡量該推理引擎在並發請求下的實際服務能力。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境的工作負載,並可配置請求速率、輸入/輸出長度和並發客戶端數量等參數。此基準測試測量關鍵指標,包括吞吐量(tok/s)、首令牌到達時間和每個輸出令牌的處理時間,幫助使用者了解 vLLM 在不同負載條件下的效能。
我們測試了涵蓋不同規模和量化方法的三個代表性模型的推理性能,評估了 HPE ProLiant DL380a Gen12 的四個 NVIDIA RTX PRO 6000 GPU 如何處理生產推理工作負載。
密集模型性能
密集模型代表了傳統的LLM架構,其中所有參數和激活函數都在推理過程中被激活。我們評估了兩種密集模型配置:Llama-2-70b-chat-hf和Llama-3.2-90B-Vision-Instruct。
Llama-2-70B-聊天效能
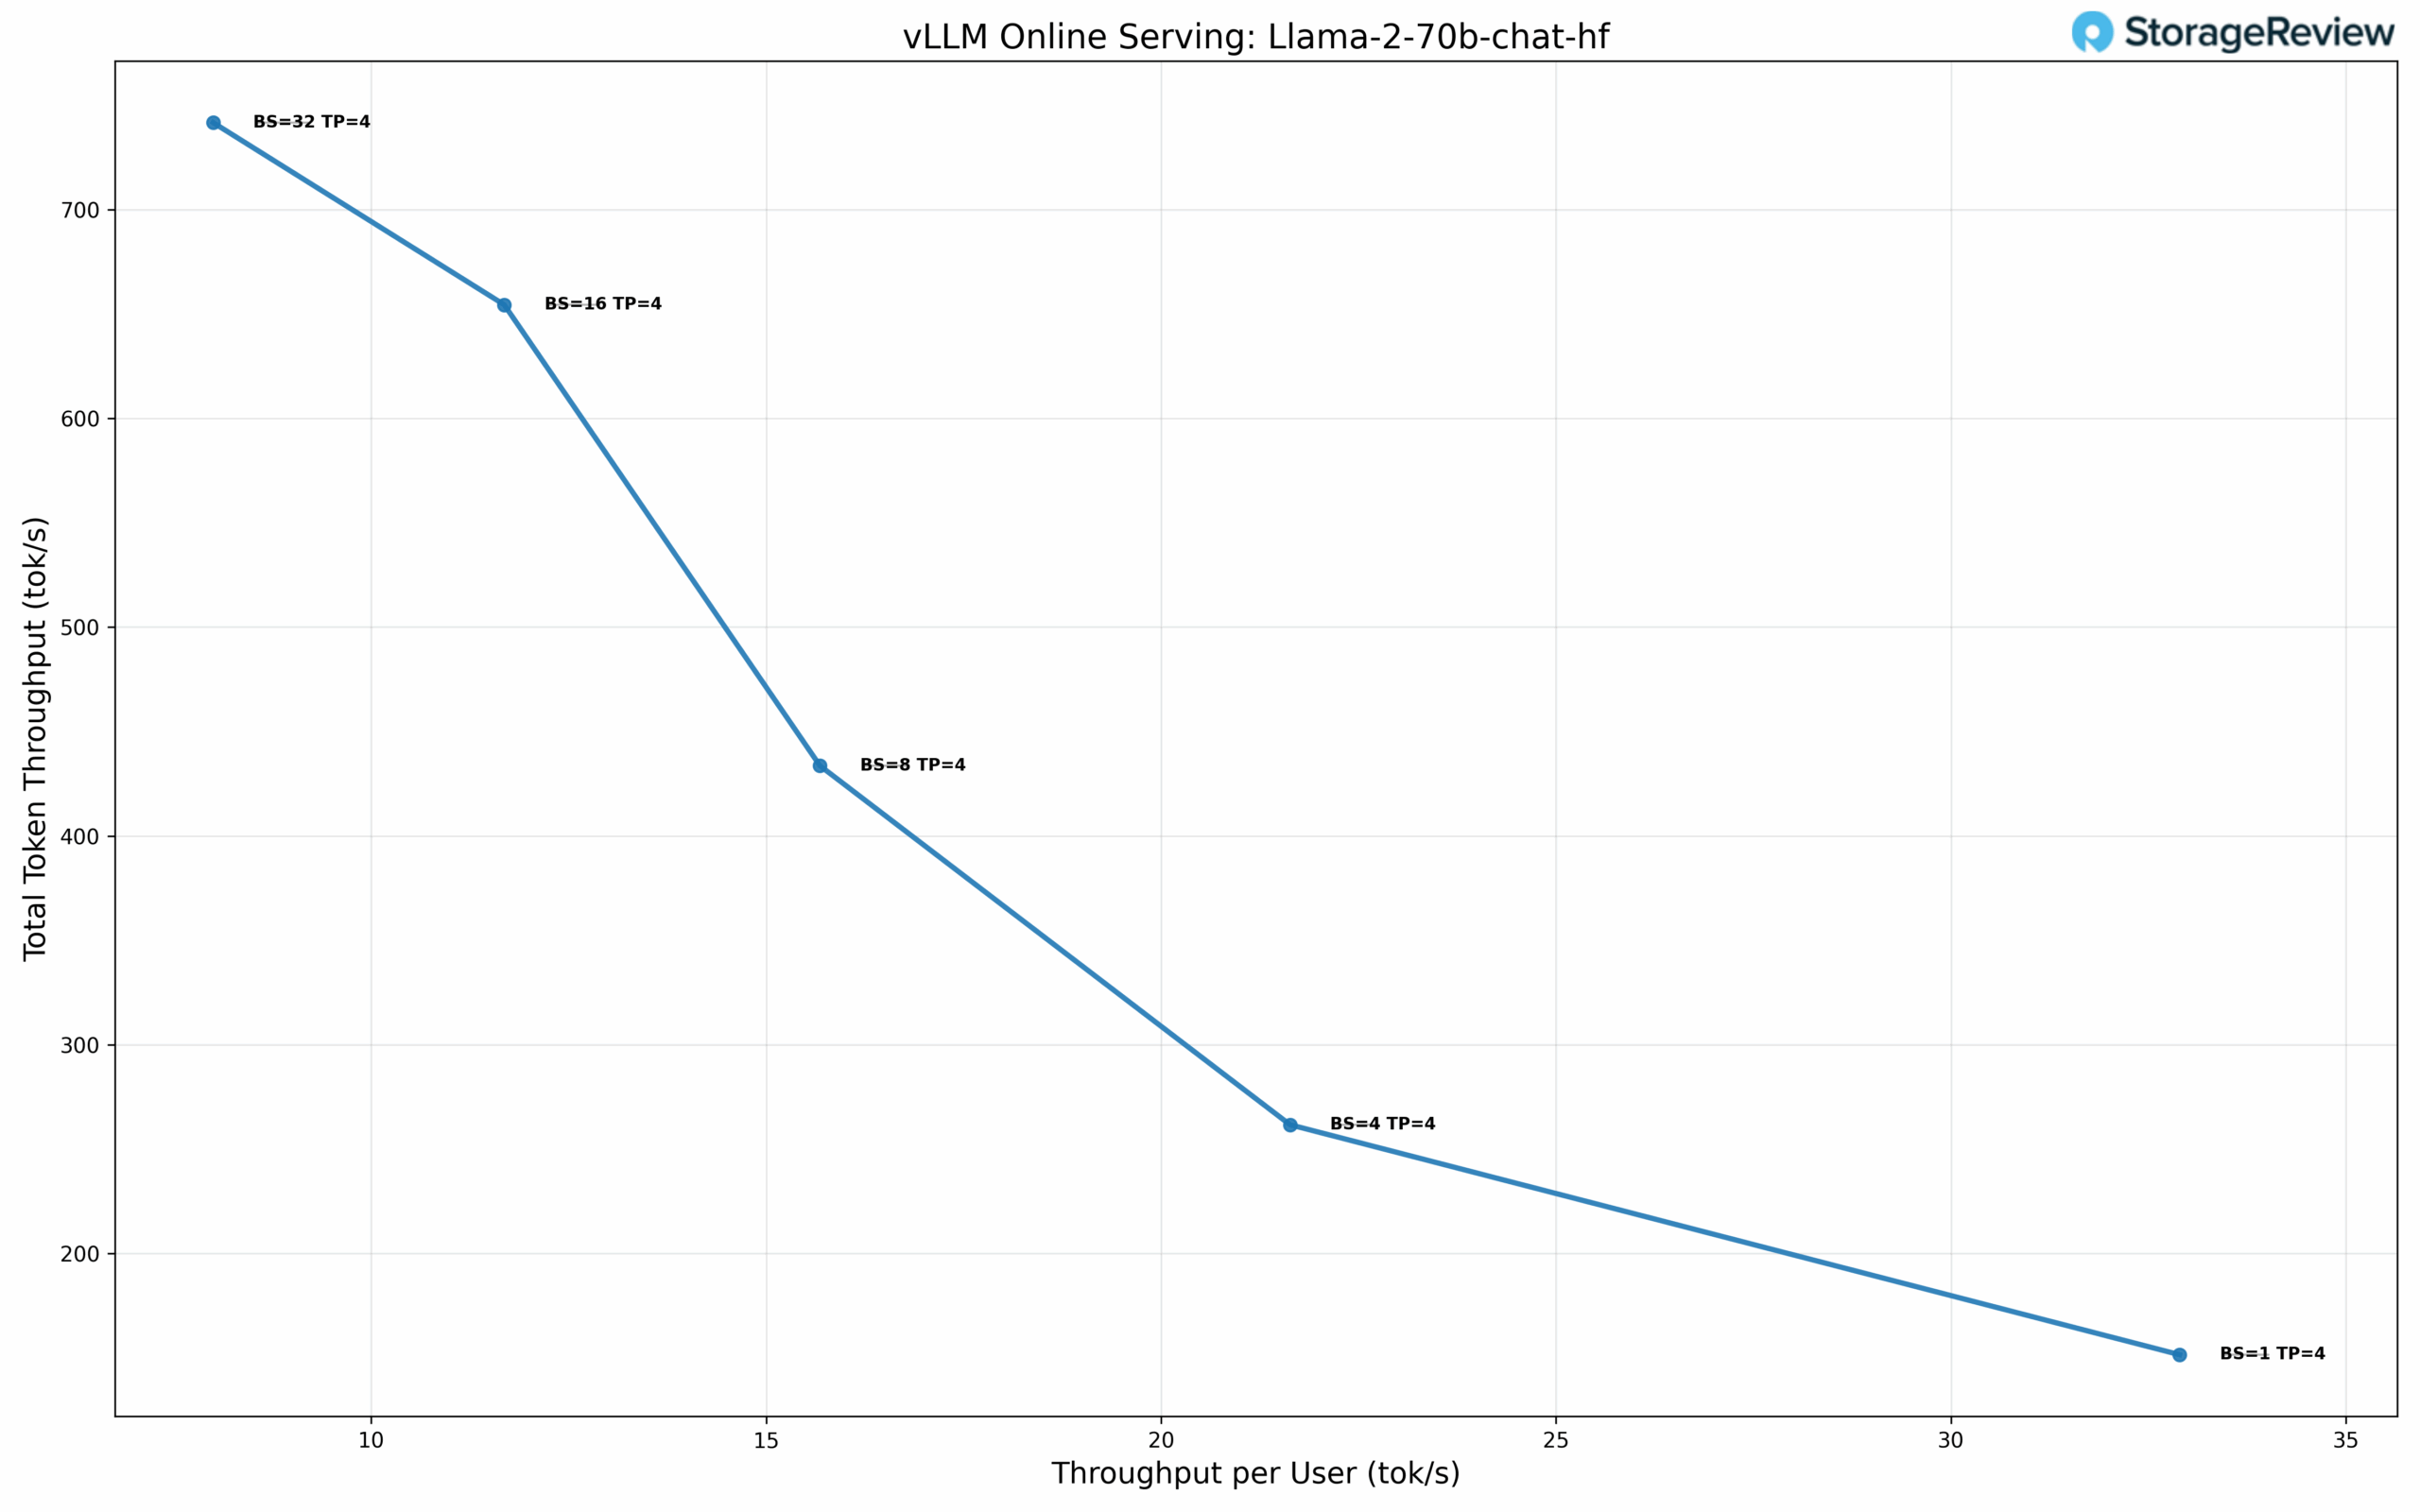
在單一使用者並發(BS=1)且TP=4的情況下,此模型每個使用者可實現32.89 tok/s的吞吐量,TPOT為30.18毫秒。當BS=8時,每個用戶的效能達到15.68 tok/s,總吞吐量為433.62 tok/s,TPOT為35.98毫秒。擴展到BS=32時,總吞吐量達到741.62 tok/s,同時保持每個用戶8.00 tok/s的吞吐量,TPOT為43.44毫秒。
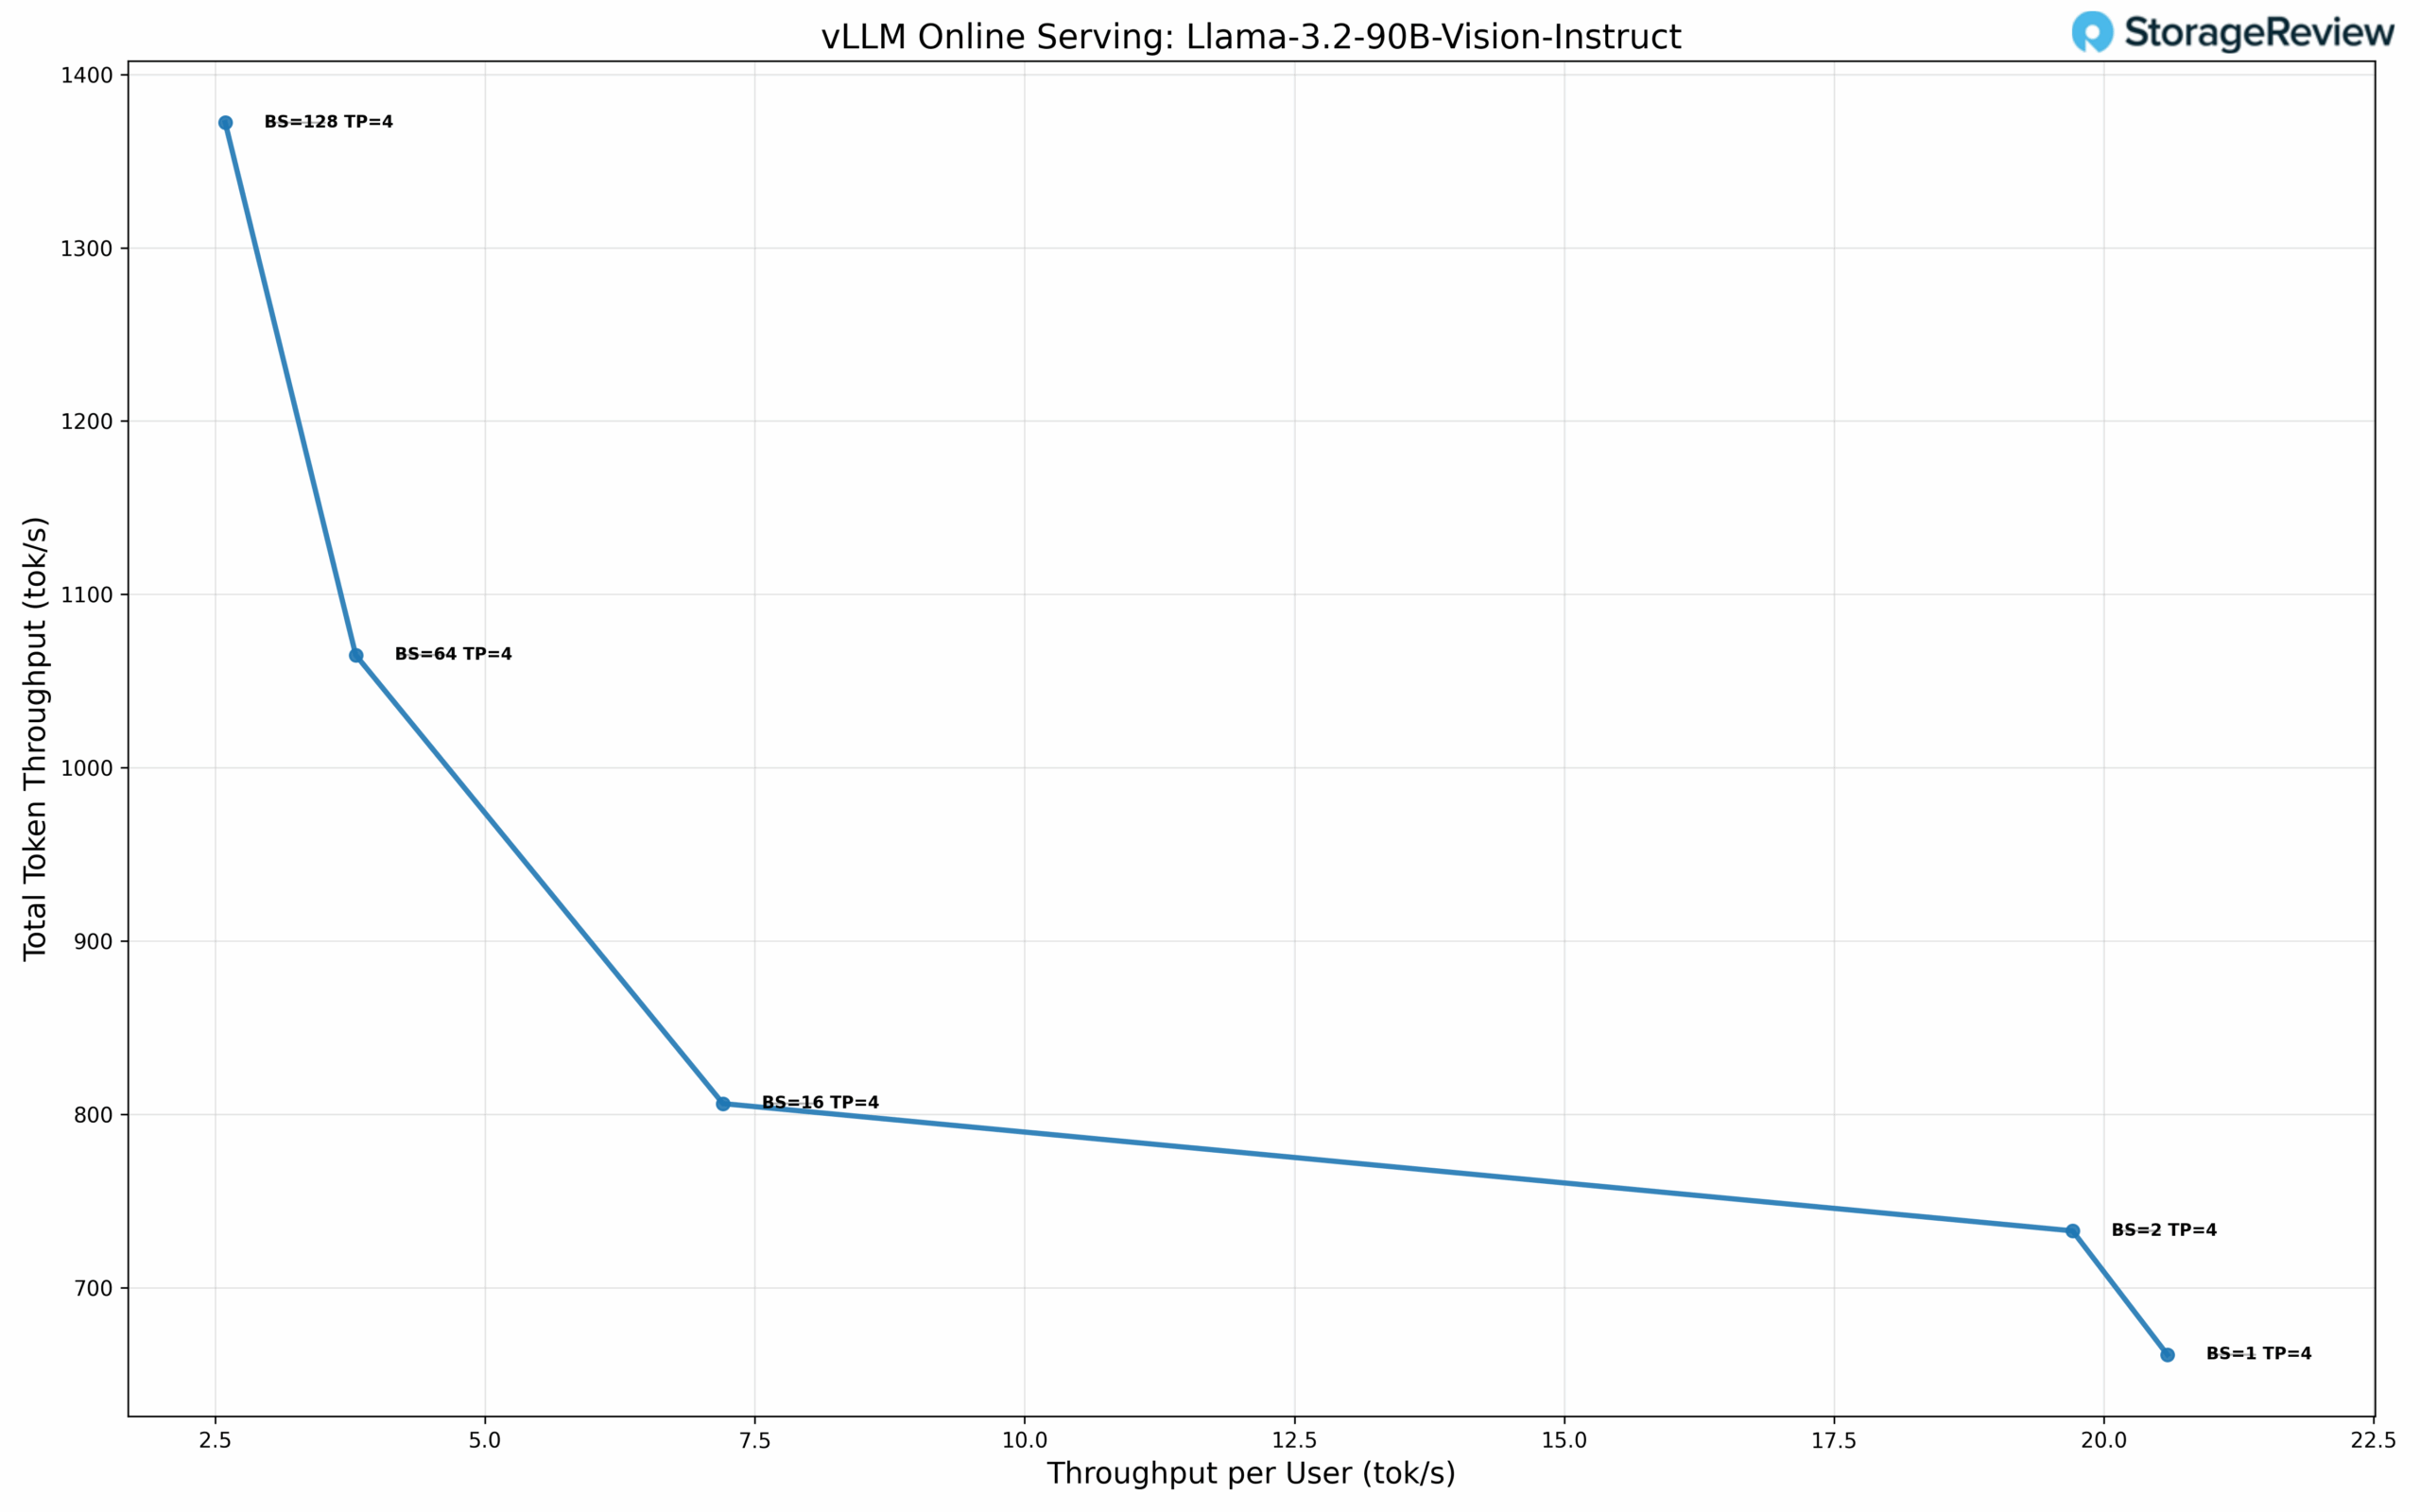
Llama-3.2-90B-Vision-Instruct Performance
當 BS=1 且 TP=4 時,此模型可為每位使用者提供 20.59 tok/s 的吞吐量,TPOT 為 38.27 ms。當 BS=16 時,效能提升至每位使用者 7.20 tok/s,總吞吐量為 806.14 tok/s,TPOT 為 54.98 ms。當 BS=128 時,總吞吐量達到最大值 1372.21 tok/s,每位使用者可提供 2.59 tok/s 的吞吐量,TPOT 為 122.75 ms。
微擴展資料類型效能
微尺度量化是一種先進的量化方法,它對小塊權重應用精細的縮放因子,而不是對大參數組進行均勻量化。 NVIDIA 的 NVFP4 格式透過分割浮點表示來實現這項技術,其中每個包含 8 到 32 個值的微尺度區塊共享一個公共指數作為縮放因子。這種精細化的方法在保持數值精度的同時實現了 4 位元表示,從而維持了 Transformer 架構所需的動態範圍。此格式與 NVIDIA RTX PRO 6000 上的 Tensor Core 架構集成,可在矩陣運算期間實現高效的混合精度計算和即時解壓縮。
GPT-OSS-120B 效能
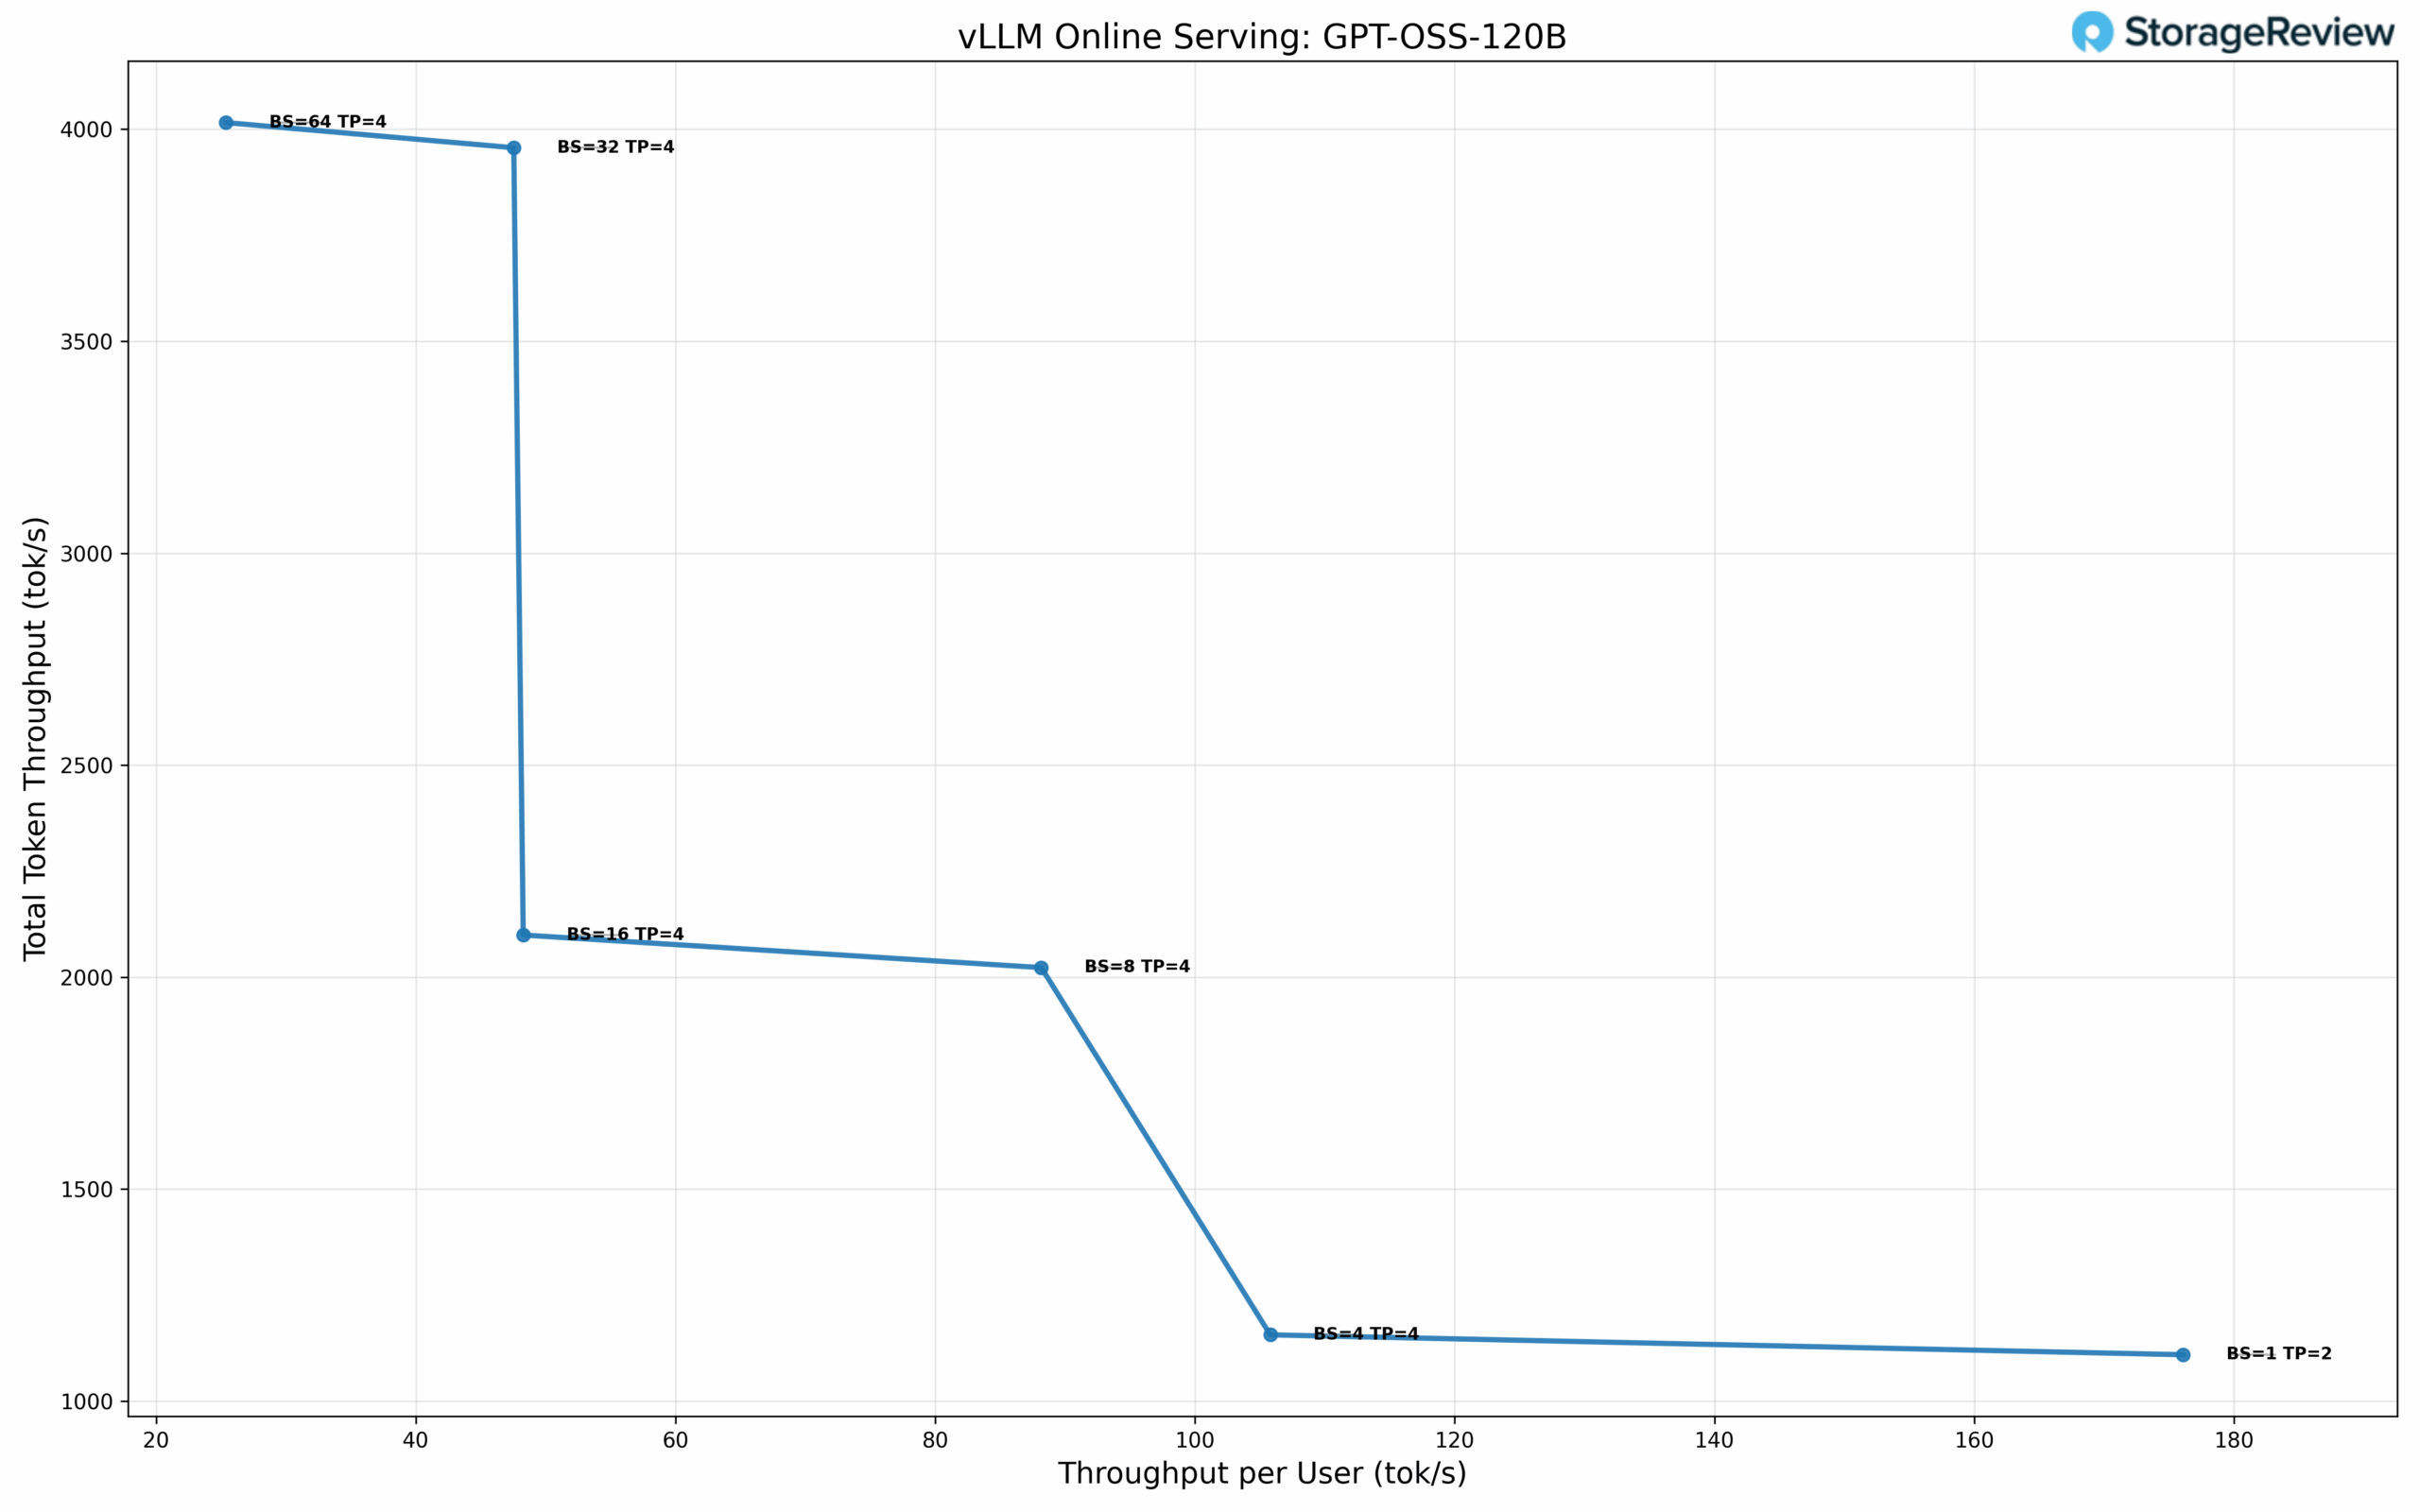
我們使用 NVFP4 量化對 OpenAI 的 GPT-OSS-120B 模型進行了評估。在單一使用者並發且 TP=2 的情況下,該模型實現了每個用戶 176.09 tok/s 的吞吐量,TPOT 為 5.46 ms,這是我們測試套件中延遲最低的。在 BS=4 且 TP=4 的情況下,效能達到每個用戶 105.79 tok/s 的吞吐量,總吞吐量為 1155.94 tok/s,TPOT 為 7.79 ms。在 BS=32 且 TP=4 的情況下,吞吐量擴展至每個用戶 47.54 tok/s 和總吞吐量 3956.44 tok/s,TPOT 為 13.86 ms。在 BS=64 時,實現了 4015.77 tok/s 的最大總吞吐量,每個用戶 25.38 tok/s,TPOT 為 14.78 ms。
Phoronix 基準測試
Phoronix 測試套件是一個開源的自動化基準測試平台,透過 OpenBenchmarking.org 支援超過 450 種測試設定檔和 100 多個測試套件。它能夠處理從安裝依賴項到運行測試和收集結果的所有步驟,使其成為效能比較、硬體驗證和持續整合的理想選擇。我們將重點放在以下測試:Stream 測試、7-Zip 測試、Linux 核心建置測試、Apache 測試和 OpenSSL 測試。
串流記憶體頻寬
在衡量原始記憶體吞吐量的 Stream 基準測試中,HPE DL380a Gen12 取得了令人矚目的 542 GB/s 的成績,展現了該平台在持續負載下維持高數據傳輸速率的能力。如此高的頻寬使得該系統在資料建模、模擬和 AI 推理等工作負載中特別高效,這些工作負載需要將大型資料集在記憶體和運算資源之間快速傳輸。
7-Zip 壓縮
7-Zip 壓縮測試測得 305 k MIPs 的成績,凸顯了該系統在計算密集型壓縮和解壓縮操作方面強大的多執行緒效率。這些結果使得 DL380a Gen12 非常適合需要頻繁進行資料打包、歸檔任務或備份工作流程且依賴穩定可靠 CPU 效能的環境。
核心編譯
在編譯完整的 Linux 核心(allmodconfig)時,DL380a Gen12 僅用時 316 秒。此基準測試結果反映了系統輕鬆處理並行化、程式碼密集工作負載的能力。更快的編譯效能可直接轉換為更短的建置時間和更快的迭代速度,這對於在大規模軟體或 CI/CD 環境中工作的開發人員來說至關重要。
Apache的Web服務器
在Web服務效能方面,DL380a Gen12在Apache基準測試中持續實現了每秒94,348個請求的處理能力。此結果展現了其均衡的I/O處理能力和強大的快取效率,能夠滿足企業級Web應用、虛擬化前端或內部服務託管所需的吞吐量和回應速度。
OpenSSL 驗證
加密效能同樣出色,DL380a Gen12 在 OpenSSL 測試中每秒可驗證 803 億次運算。這充分展現了該系統大規模管理加密、身份驗證和安全通訊工作負載的能力。
| Phoronix 基準測試 | HPE ProLiant DL380a Gen 12(2x Intel Xeon 6527P) |
| 資訊 | 542,720.7 MB /秒 |
| 7-郵編 | 304,907 MIP/秒 |
| 內核編譯(allmod) | 316.166秒 |
| Apache(每秒請求數) | 94,347.52 盧比/秒 |
| OpenSSL的 | 每秒 803,597,895,087 次驗證 |
結語
HPE ProLiant DL380a Gen12 伺服器是專為主流企業級 AI 市場打造的實用且效能均衡的 AI 伺服器之一。其 4U 風冷設計提供強大的運算密度,配備雙路 Xeon 6 CPU,支援多達 8 個雙寬或 16 個單寬 GPU,以及 16 個 E3.S NVMe 硬碟位,同時保持了可靠性和便捷的維護性。 HPE 在氣流和散熱平衡方面的工程設計確保了伺服器在高負載下也能保持穩定的效能,證明了即使在傳統的風冷環境下,先進的 AI 加速也能蓬勃發展。
iLO 7 的加入顯著提升了管理效能,這對 HPE 等一級伺服器供應商而言是一項巨大的優勢。現代化的介面、與 HPE Compute Ops Management 的整合以及詳盡的硬體遙測數據,使得遠端管理更加直觀和高效。儀錶板、韌體、主機、安全性、應用程式和設定等各個部分,都體現了 HPE 向更簡潔、更雲端整合的體驗轉型,同時又不犧牲企業團隊賴以生存的本地控制能力。
在效能測試中,該伺服器表現出色。四支 RTX PRO 6000 GPU 在密集型和微尺度 LLM 模型上均實現了令人印象深刻的吞吐量,其 vLLM 服務性能甚至可以媲美液冷系統。 Phoronix 的 CPU 基準測試進一步凸顯了其均衡的效能:記憶體頻寬超過 540 GB/s,Apache 請求速率達到 94k RPS,OpenSSL 驗證速度超過每秒 800 億次,展現了其在 AI 和通用運算方面的強大實力。
HPE 的設計目標很明確:利用風冷技術,在現有機架和電源基礎設施內實現高密度、生產就緒的 AI 性能。對於尋求可靠、安全且易於管理的風冷運算解決方案的資料中心團隊而言,DL380a Gen12 是一款功能強大、面向未來的解決方案,能夠滿足日益增長的主流 AI 市場的需求。


 Amazon