

許多企業在未來一年內最重要的AI基礎設施決策並非GPU投資,而是資料庫升級。 Oracle AI Database 26ai是Oracle正引導其19c用戶群升級的長期支援版本。 26ai將向量搜尋與事務處理整合在同一個引擎中。當向量索引位於資料庫中時,區塊陣列及其背後的SAN架構就成為了AI基礎設施,除了處理事務之外,還承載著檢索流量。
人工智慧底層資料庫發生了變化。
Oracle 基於此理念建構了 26ai:原生 VECTOR 資料類型、SQL 向量搜尋函數、透過 ONNX 實現的資料庫內模型執行,以及用於自然語言查詢的 SELECT AI,所有這些都整合在一個 LTS 版本中,該公司列舉了超過 300 項新功能。實際上,DBA 可以產生嵌入向量,將其儲存在與其描述的行旁邊,並在同一事務範圍內執行與訂單查找相同的相似性搜尋。無需運行單獨的向量存儲,無需維護同步管道,也無需在審計追蹤之外保留受監管資料的第二個副本。
IBM引用IDC的數據指出這一趨勢:「整合向量資料庫顯然是儲存和查詢向量嵌入的首選平台,因為企業更傾向於為智能體人工智慧建立統一、可控的環境。」 IBM和博通的客戶希望在建立新資料庫之前,先擴展他們已有的、值得信賴的資料庫。
Oracle並非孤軍奮戰。 DB-Engines 2026年10月發布的流行度排名列出了排名前四的關係型和多模型資料庫引擎:Oracle、MySQL、Microsoft SQL Server和PostgreSQL,這四家都已原生或透過pgvector等擴充程式添加了向量類型或向量搜尋功能。 IBM之所以選擇Oracle作為其驗證工作的起點,主要是因為Oracle的市場領導地位,不過本文提到的儲存優勢也適用於其他資料庫引擎。

即使引入人工智慧,將區塊儲存保留在本地的理由依然不變:使人工智慧部署發揮作用的數據,例如患者記錄、索賠、訂單和交易記錄,都不能外傳。將其複製到專用人工智慧平台意味著要支付兩次儲存費用,同時還要接受副本與生產叢集資料不一致的風險,並失去使原始資料具有法律效力的治理控制。將檢索操作保留在資料庫內部可以避免這三點。如今,用於執行亞毫秒行查找的數組,還能同時為臨床醫生提供向量相似性掃描服務,並作為備份流使用。
IBM 儲存和博通光纖通道 (FC) 團隊著手驗證這種混合工作負載場景,並圍繞 IBM FlashSystem 上的 Oracle AI Database 26ai、博通Brocade Gen 8 SAN 光纖通道網路和Emulex 64G SecureHBA建置了一個環境。然後,他們著手解決基礎架構團隊提出的問題:當一個向量工作負載在其旁邊啟動時,交易延遲會受到什麼影響?光纖通道網路速度對向量搜尋吞吐量的影響是什麼?嵌入式資料會消耗多少容量?針對 RMAN 備份卷的勒索軟體偵測的有效性如何?以及在沒有分區票據的情況下向 SAN 新增主機需要滿足哪些要求?
資料已經儲存在區塊儲存中,現在人工智慧開始使用它了。
這並不意味著所有 AI 工作負載都應該使用區塊儲存。企業仍然會為非結構化資料(例如文件、圖像、影片、訓練集和模型檢查點)保留文件和物件數組,這些資料從未儲存在資料庫中,而且可能永遠不會。在接下來的醫療保健演示中,IBM 將原始 X 光影像保存在物件儲存中,而僅將嵌入和病例元資料儲存在 Oracle 中。改變的是數組的負載,現在數組可以同時承載多個具有截然不同 I/O 特性的工作負載。
關係型儲存層是最為人所知的:每秒數百萬次隨機的 4KB 到 16KB I/O 操作,行查找和提交需要在微秒級完成,重做、撤銷和檢查點流量帶來的高並發寫入,以及由於面向用戶的應用程式正在等待,因此尾延遲保持可預測性。 Oracle 的備份公用程式 RMAN 則相反:它是一個順序流,需要預留足夠的時間才能在視窗期內完成,而不會幹擾先前的工作負載。兩者都已被充分理解,IBM 的陣列也針對它們進行了最佳化。
向量層更難描述,因為龐大的向量嵌入表會讓向量搜尋看起來像是一項頻寬密集型工作負載:一次大規模的順序掃描。 IBM 對 Oracle 26ai 向量路徑的描述更接近 OLTP。索引中的每次跳轉都是一次約 4KB 的隨機讀取;查詢路徑受 IOPS 限制且對延遲敏感,且讀取操作占主導地位,因為寫入作業位於單獨的資料攝取和索引建置階段。
頻寬在突發性操作中至關重要,例如建立索引或重新嵌入語料庫時,而這些突發操作往往規模相當大。這種劃分是混合 I/O 問題的核心:在查詢路徑上,向量工作負載與事務爭奪相同的佇列,使得隔離成為服務品質的關鍵問題。如同本文後面 32G 與 64G 的比較結果所示,突發階段正是網路頻寬達到極限的時候。
已驗證的架構
IBM 和博通在博通位於科羅拉多州的 AI 實驗室中建立了一個用於驗證的環境。儲存系統採用 IBM FlashSystem 9000 系列陣列,運行 IBM Storage Virtualize 9.1.3,配備 24 個 FlashCore 模組,並透過 64G 光纖通道連接埠連接到兩台博科 Gen 8 G820 SAN 交換器。資料庫主機是一台雙路 Intel Xeon 6767P 伺服器,配備兩個 2 埠 Emulex LPe38102 64G SecureHBA 卡,運行基於 ASM 的 Oracle AI Database 26ai,儲存路徑中未使用 GPU;IBM Storage Insights 系統監控該陣列。

我們僅在該主機上運行了結構和容量測試結果、32G 與 64G 向量搜尋對比以及使用 VectorDBBench 對 BioASQ 1M 資料集進行的空間佔用測量。此配置也支援應用程式工作負載。一台配備兩顆 Xeon Platinum 8470 處理器和八塊 NVIDIA H100 80GB GPU 的 Supermicro 821GE-TNHR 伺服器運行著醫療保健應用程式及其語言模型。軟體堆疊包含 Oracle 的資料庫內 ONNX 嵌入、Ollama Serving Llama 3 和 NVIDIA cuVS。兩台伺服器之間透過 Broadcom Tomahawk 5 交換器和 Thor 2 400GbE 網路卡連接。 I/O QoS、多租戶、勒索軟體偵測和醫療保健演示均在此環境中運行。

據 IBM 稱,FlashSystem 系列(5300和 5600、7300 和 7600 以及 9500 和 9600)運行相同的 Storage Virtualize 軟體,並且本文演示的功能,包括 I/O 節流、自動分區、勒索 AI上以相同的方式運行於這些陣列中的任何一個,程式碼層級也相同。效能和密度會因型號和 FlashCore 模組的代數而異,因此本文中的每個資料都屬於其所測試的系統。
透過 I/O QoS 確保最佳 OLTP 和向量工作負載效能
IBM 和 Broadcom 首先要解答的問題,也是所有 DBA 在生產陣列上部署向量工作負載時都會問到的問題:核心事務會發生什麼變化? IBM 在 FlashSystem 9000 系列陣列上進行了兩次演示,採用了卷級 I/O 節流技術,即 IBM 所謂的 I/O QoS 機制。資料庫分佈在 30 個磁碟區:15 個磁碟區用於 OLTP 表空間(ORCL16 到 ORCL30),使用 Swingbench Order Entry 工具,支援 192 個使用者;另外 15 個磁碟區用於向量表(ORCL31 到 ORCL45),使用 200 個執行緒的合成器前 500 個相似度,並使用 Storights 個相似度的合成 50 個相似度對每個卷組進行圖表分析。
單獨運行 OLTP 時,每個 OLTP 磁碟區的運算速度穩定在 20,500 次/秒。向量產生器啟動後,向量卷的運算速度在一分鐘內攀升至約 73,000 次/秒,而 OLTP 卷的運算速度則下降至約 13,000 次/秒,降幅達 37%,而事務處理方面沒有任何變化。向量搜尋路徑採用與事務相同的區塊大小進行 4KB 的隨機讀取,因此它會存取相同的佇列,並讀取數組中提供的任何資料。

每個向量卷的 IOPS 上限為 45,000,一行 mkthrottle 在命令列介面 (CLI) 中,將向量磁碟區的效能限制提升到極限,並將 OLTP 效能恢復到約 17,000 次操作/秒。取消限制後,效能恢復正常,向量運作結束後,OLTP 效能回升至 20,500 次操作/秒。儀表板也顯示了相同的總體情況:1.28 萬 IOPS 未受限制,比限制值低約 950,000 萬,這與每個卷的速率乘以 30 個卷的速率相差無幾。

第二個演示是 IBM 預期在生產環境中部署的配置:首先設定上限,每個向量磁碟區 45,000 IOPS,每個 OLTP 磁碟區 20,000 IOPS,然後同時啟動兩個工作負載。向量卷以上限運行,OLTP 卷穩定在約 12,200 ops/s 並在整個運行過程中保持穩定,陣列在 25% CPU 使用率下,以 377 微秒的延遲和 6.9GB/s 的吞吐量實現了 870,000 IOPS(800,000 讀取,70,000 入寫入)。 OLTP 的上限高於工作負載的需求,因此從未啟用;設定上限是為了防止任何一方的負載過高而導致另一方負載不足。
在測試過程中,Swingbench 的 192 位用戶每分鐘約進行 1.19 萬筆交易,約 19,500 TPS。生成器經過調優以達到飽和交易量,因此其單次查詢延遲並非應用程式基準。在 30 分鐘的運行中,它完成了 35,672 次查詢,平均每秒執行 19.8 次,中位數延遲約為 10 秒,p99 為 14.3 秒(應用程式超時時間為 15 秒);共有 99 次查詢(0.28%)逾時,但交易並未受到影響。


FlashSystem 節流是指無論主機或路徑如何,都會在陣列層面強制執行的磁碟區上限,除了 IOPS 限制外,還可以選擇限制頻寬;它會限制相鄰磁碟區的資源,而不會預留任何資源。此上限用於容量規劃:15 個 45,000 IOPS 的向量卷,總共有 675,000 IOPS 的向量資源餘裕,這足以滿足該陣列中 OLTP 卷的需求。不同的陣列或組合可能會略有不同。將向量上限設為交易延遲較低的水平,向量工作負載將獲得超出上限的所有資源。
對即時 Oracle 磁碟區進行勒索軟體偵測
Sophos 2024 年對 2,974 家遭受勒索軟體攻擊的組織進行的調查發現,94% 的組織發現攻擊者攻擊了其備份,攻擊成功率達 57%,且成功後的恢復成本中位數是未攻擊時的八倍。 IBM 基於相同的假設構建了測試,優先攻擊備份,其次攻擊生產環境,並將攻擊目標鎖定在 RMAN 備份上,而未觸及資料庫磁碟區。 RMAN 將其備份集寫入 FlashSystem 卷,然後對這些磁碟區執行勒索軟體模擬器,並讓陣列自行偵測攻擊,過程中未部署任何主機代理程式。
偵測在驅動器內部進行:FCM4 和 FCM5 FlashCore 模組在每次寫入操作落地時計算熵和壓縮率,以及區塊大小、位址和重寫模式,並每兩秒將每個磁碟區的摘要資訊傳遞給 Storage Virtualize(版本 8.6.3 或更高版本,FCM 韌體版本 4.1 或更高版本)內部的推理。該模型會在 FlashSystem GUI 和 IBM Storage Insights Pro 中發出警報,並將警報轉發到 Storage Defender 或 SIEM,並且該模型本身即可進行修補,因此重新訓練的模型可以作為小型安全更新發布,無需韌體升級。
由於分析是在模組上運行的,即使主機遭到入侵,它也能繼續工作。加密輸出具有高熵值,並且會停止壓縮,無論攻擊者是更改檔案副檔名、僅加密每隔一個資料區塊,還是降低加密速率以躲避終端代理,統計資訊都會反映出這一點。
在驗證過程中,RMAN 透過 16 個平行通道寫入備份,每個備份集的大小上限為 150GB。資料庫位於每個 ASM 磁碟組的 15 個 200GB 磁碟上,分別用於儲存 OLTP 和向量資料。 IBM 對此備份目標執行了攻擊,警報在 60 秒內到達 Storage Insights,這符合 IBM 為該功能發布的偵測視窗。 Storage Insights 標記了卷組中的所有 31 個卷,因為一個卷的警報會將整個卷組標記為威脅。
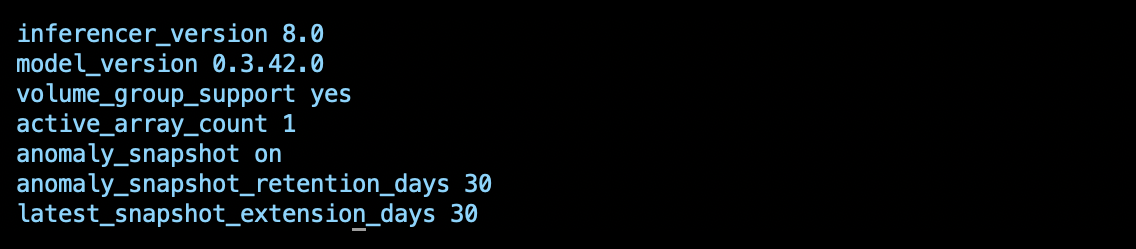
回應是安全副本,陣列無需操作符即可處理:FlashSystem 在威脅出現時立即對受影響的磁碟區組建立了一個不可變快照,並同時延長了上次已知良好快照的保留時間。 lsanomalydetection 陣列輸出顯示了背後的配置:推理引擎 8.0,模型 0.3.42.0,啟用異常快照,新快照保留 30 天,並在上一個正常快照的基礎上增加了 30 天。儲存虛擬化也會標記可疑快照,以防止任何人從中恢復數據,從而保留加密開始之前的乾淨復原點。
此光纖通道網路也具備安全層。博通在博科第八代產品中內建了後量子加密技術,Emulex SecureHBA 可對主機和光纖通道網路之間傳輸的資料進行加密,而FCIA 的新 FC-SP-3 標準則為整個光纖通道網路設定了量子就緒的安全基線。
無需分區許可即可實現 SAN 擴充:使用 Broadcom 目標驅動分區的 IBM FlashSystem 自動分區
將主機新增至光纖通道 SAN 通常需要提交工單並由兩個團隊協作:伺服器管理員收集 HBA 的 WWPN,SAN 管理員手動在兩個光纖通道網路上建立區域,儲存管理員將主機對應到正確的目標連接埠。一個錯誤的 WWPN 會導致新建立的 Oracle RAC 節點缺少路徑。而自動區域分割功能則將這項工作轉移到了陣列端:FlashSystem 直接與光纖通道網路通信,識別發起方的 WWPN,選擇目標端口,並自動建立區域,無需任何人登入交換器。

此功能基於博科目標驅動分割區 (TDZ) 技術,並已在 FlashSystem 軟體 9.1.2 版本中推出。它需要執行 Fabric OS 9.1.1 或更高版本的博科交換機,並且交換器管理員需要在面向 FlashSystem 目標連接埠的交換器連接埠上啟用 TDZ。啟用 TDZ 是 SAN 團隊唯一需要執行的步驟,在此之前,自動分割功能不會對連接埠執行任何操作。之後,FlashSystem 會建置對等區域,允許主機發起程式存取目標端口,但彼此之間無法訪問,並使用可預測的 IBM_SV_ 名稱來標記這些區域為陣列管理區域。
設定從光纖通道連接埠視圖開始,該視圖現在顯示每個連接埠連接的交換器、連接埠是否支援 AutoZone 功能以及其連接是否對稱(即每個節點上相同的連接埠 ID 都連接到相同光纖通道網路)。拓撲視圖以顏色映射這些訊息,只有綠色的連接埠(表示已啟動、支援 AutoZone 且連接對稱)才支援 AutoZone。即使連接埠支援 AutoZone,非對稱連接埠也不會顯示,因為 GUI 會警告這可能會影響冗餘和故障轉移。

主機建立從「未配置主機」清單開始,該清單透過 FDMI 填充,FDMI 會將每個 HBA 的主機名稱、作業系統和連接埠報告給交換矩陣。在 IBM 的演練中,「新增主機」對話方塊打開,其中已包含伺服器名稱、作業系統以及尚未分配任何區域的主機的兩個 HBA 連接埠;管理員選擇了一個啟用 AutoZone 的連接埠集(該連接埠集定義了主機可以存取的目標連接埠),然後按一下「新增」。 FlashSystem 將目標連接埠與主機啟動器配對,將區域推送到兩個交換機,主機隨即上線,並在兩個交換矩陣上建立了四條路徑。

對於 Oracle 而言,IBM 將 AutoZoning 定位為用於添加 RAC 節點和更換 HBA 的功能,因為該功能會追蹤主機或儲存連接的變化並調整區域定義以與之匹配,因此更換 HBA 後無需手動重新劃分區域。當主機需要存取第二個陣列以進行儲存分區遷移或基於策略的高可用性 (PBHA) 時,同樣的自動化功能也適用。 SAN 團隊仍然控制哪些目標連接埠參與其中,因為在啟用 TDZ 之前,連接埠上不會發生任何操作。因此,新增主機不再需要等待區域變更。
營運範圍:PBHA、電網遷移、多租戶和部署
基於政策的高可用性 (PBHA) 可在城域範圍內同步複製兩個 FlashSystem 陣列之間的儲存分區,並在兩個站點啟用雙活主機存取。 IBM 表示,此功能旨在實現零復原點目標 (RPO),並確保正確叢集化的 Oracle 部署能夠順利度過儲存故障轉移,避免資料遺失。當故障站點恢復後,資料將重新同步,工作負載將自動遷移,不會造成任何中斷。
FlashSystem Grid 功能可將多達 32 個 FlashSystem 陣列聯合到一個管理視圖下,儲存分區遷移功能可將分區及其磁碟區、磁碟區組和主機從一個陣列遷移到另一個陣列,而無需應用程式停機。對於 Oracle 資料庫,IBM 建議進行硬體更新,在韌體更新前清空系統,並在嵌入集增長時將向量分區遷移到容量更大的系統。系統每次透過光纖通道或高速乙太網路遷移一個分區;主機可以透過光纖通道、iSCSI 或 NVMe/TCP 連接,已配置為 PBHA 的分區不符合遷移條件。
Storage Insights 部署顧問負責同一網格的規劃。它會根據工作負載的容量、成長率、I/O 特性和延遲目標,對網格中的每個系統進行評分,並在配置任何資源之前確定最合適的方案,並在發現 CPU 或 IOPS 不平衡時建議遷移方案。遷移和部署均使用 Storage Insights Pro,每個網格系統都註冊到同一個 Storage Insights 租用戶。

多租戶架構允許資料庫管理員團隊和人工智慧團隊共享同一網格,而無需共享管理權限。在 IBM 的示範中,管理員在同一陣列上建立了兩個租用戶(Tenant_Scale 和 Tenant_oracle_ai),並分別指派了一個系統、一個具有租用戶角色的使用者群組和一個初始使用者。然後,他們為每個租用戶建立了一個儲存分區,每個分區都包含獨立的磁碟區組、磁碟區和主機映射。圖形使用者介面 (GUI) 會在新分區建立後立即提示配置複製。以 Tenant_Scale 使用者身分登入後,GUI 僅顯示該租用戶的分區和資源,不顯示 Tenant_oracle_ai 的任何內容;從 Tenant_oracle_ai 端進行相同的檢查也得到了相同的結果。
光纖通道網路優勢:向量搜尋下的 32G 與 64G 光纖通道對比
IBM 和 Broadcom 在本次測試中刻意改變的唯一變數是光纖通道網路。他們使用相同的陣列、主機和 Emulex LPe38102 SecureHBA,針對 BioASQ 1M 資料集(來自生物醫學問答語料庫的一百萬個 1,024 維向量)運行了兩次 VectorDBBench 測試:一次使用兩個 HBA 連接埠的 32G 頻寬,另一次使用 64G 連接寬頻,並進行相同的 Gcade其他所有組件,從 16 個 ASM 捲到 4GB SGA,均保持不變,因此兩次測試的差異僅在於光纖通道的產生方式。

此基準測試的搜尋階段為唯讀掃描:Oracle 的 IVF_FLAT 索引會將每個查詢路由到一組分區並進行完整讀取,對於 1,024 維的 FLOAT32 向量,這是一個頻寬密集型工作負載。在兩個 32G 連接埠上,主機端讀取速度穩定在 6.3GB/s,與該連接埠的線速持平,搜尋曲線在 20 個執行緒下達到每秒 43.7 次查詢。在兩個 64G 連接埠上,同一台主機讀取速度為 12.5GB/s,並在 80 個執行緒下持續擴展至每秒 85.0 次查詢,在相同儲存條件下吞吐量提升了 95%。

延遲揭示了 64G 架構的另一面:在單執行緒情況下,兩個光纖通道的延遲相差不到 8%,分別為 0.107 秒和 0.099 秒,因為單一查詢不會填滿任何一個管道。然而,從五個執行緒開始,32G 架構的延遲就開始出現排隊現象:平均延遲每增加一個執行緒就翻一番,而當執行緒數達到 80 個時,p99 值達到 4.08 秒,而 64G 架構僅為 1.14 秒。飽和的光纖通道架構不會發生故障;它會將每個查詢排隊,而這種等待表現為尾延遲。

載入階段也發生了變化;在 32G 交換器上導入一百萬個向量耗時 94.1 秒,在 64G 交換器上耗時 84.5 秒;IVF_FLAT 索引建置耗時 139.6 秒,而 64G 交換器上耗時 108.4 秒,在總交換時間較慢的載入器上耗時 108.4 秒,在總時間較慢的載入器上耗時 108.4 秒,在總時間較慢的載入器上耗時 208.4 秒,在總交換時間長秒延長至 233.7 秒。兩次運轉的召回率和 NDCG 值相差不到 0.1%(32G 交換器上分別為 83.81% 和 84.42%,64G 交換器上分別為 83.95% 和 84.56%),因此交換器架構的升級確實影響了響應速度。對於自部署以來一直使用 32G 交換器的資料庫而言,HBA 和交換器的升級顯然是提升效能的絕佳機會。
制定向量容量增長計劃
向量搜尋在改變效能之前,會先改變容量計算方式。嵌入是來源資料區塊的固定寬度數值副本,對於文字而言,該副本通常比它所描述的資料塊更大:一段 1,000 位元組的文字在資料庫中新增一行來儲存之前,會變成一個 1,024 維的 FLOAT32 向量,大小為 4,096 位元組。研究團隊將這種現象稱為向量儲存放大,並在與織物比較相同的 BioASQ 1M 資料集上進行了測量。
這百萬個向量背後的原始文字大小為 0.90GB。在 Oracle 26ai 中,它變成了一個 7.67GB 的向量表,其中包括約 0.3GB 的行開銷。 IVF_FLAT 索引在此基礎上又增加了 8.57GB,因為它保留了每個向量的第二個群集副本以及大約 4MB 的質心資料。在 SAN 上,持久化佔用空間為 16.24GB,是原始文字大小的 18 倍。這還不包括 Oracle 所需的運作空間:索引建置期間的 15 到 23GB 臨時空間,以及資料擷取期間的 4 到 8GB 撤銷空間和約 15GB 重做空間。

倍增係數隨嵌入模型而變化:博通公司採用相同的方法進行外推,得出 768 維 Cohere v3 模型(也經過測量)的倍增係數為源模型的 4.8 倍,384 維 MiniLM 模型為 9.6 倍,4,096 維 Mistral 模型為 32.5 倍。區塊大小與寬度同樣重要,因為在長段落上使用寬向量的放大倍率小於在短段落上使用相同向量的放大倍率,而且量化索引會縮小索引份額。
這些並非FlashSystem或Oracle特有的。資料放大發生在資料庫內部,在陣列接收到任何位元組之前。每個平台上的每個向量索引都包含向量的副本,因此,在向量項目獲得批准之日,它就應該與GPU一起納入容量預算。陣列決定的是它可以容納多少成長:IBM第五代FlashCore模組的單模組容量高達105.6TB,在最大的FlashSystem型號上,2U機箱內可提供3.3PB的原始容量,根據IBM的數據,有效容量為11.8PB。因此,向量層可以原地擴展數年,而無需移動分區。
IBM針對醫療保健應用的容量規劃模型與影像的處理方式相反:100GB的X光片在資料庫中大約只佔用2GB的空間,因為資料庫中只儲存嵌入和病例元資料。文字的處理則更為耗費空間:100GB的臨床文本分塊後佔用860GB到1.2TB的空間,其中大部分是HNSW索引。容量規劃的輸入是分塊數量和模型寬度;來源語料庫的大小並不具有參考價值。根據IBM的經驗,嵌入的壓縮率也低於行數據,嵌入的壓縮率僅為1.2倍到2倍,而關係型數據的壓縮率則為2倍到4倍,因此FlashCore模組的數據縮減只能減少增長,而且每次重新嵌入都需要再次使用臨時空間。
IBM 的實用原則是先測量後再決定。使用生產環境中的嵌入模型和分塊設置,載入 1% 到 5% 的真實語料庫,測量每個向量的實際位元組數,然後線性擴展,並在模型、維度數量或分塊策略發生變化時重複此過程。
端到端人工智慧推理:醫療保健應用
IBM 為此驗證開發了一款名為 RAD-AI 的放射學和胃腸病學輔助應用程式。這是一個具有生產級需求的範例應用程序,本文示範了它在與先前章節中測量相同的陣列和架構上的完整推理流程。臨床醫生輸入患者的年齡、性別和主訴,上傳胸部 X 光片或內視鏡影像,即可收到一份根據存檔中最相似的既往病例生成的結構化報告。
此檔案包含來自 NIH ChestX-ray14 資料集的 112,120 張胸部 X 光片,以及來自 HyperKvasir 的超過 10,000 張胃腸道內視鏡影像,其中包括 367 個完整內視鏡影片的逐幀向量,涵蓋超過 172,000 個預嵌入病例。每張影像都透過執行在 Oracle AI Database 26ai 內部的 ONNX 執行時間環境中的 CLIP ViT-L/14 模型,產生一個 768 維向量,因此嵌入操作與包含該向量的行資料位於同一事務中。原始影像儲存在物件儲存中;向量和病例元資料則儲存在 Oracle 資料庫中。

在查詢時,Oracle 會在整個存檔中運行基於餘弦距離的近似最近鄰搜索,並返回最接近的病例及其原始發現、診斷和結果。檢索到的資料集作為 Llama 3 的上下文,由運行在 Supermicro 伺服器上的 H100 GPU 之一上的 Ollama 提供服務,用於產生報告:包括臨床優先順序、發現摘要、分級鑑別診斷和建議措施,並在其下方列出匹配的病例。內視鏡檢查遵循相同的流程,並添加臨床註釋;對於視頻,該流程會逐幀嵌入,以便追蹤病變在胃腸道中的位置。
此應用程式針對相同 FlashSystem 磁碟區執行兩種工作負載。事務性工作負載涵蓋登入、報告儲存、稽核日誌記錄和會話;向量工作負載對嵌入表和病例元資料執行高扇出隨機讀取,與 I/O QoS 演示中的生成器設定檔相符。 IBM 的部署設定了前面所述的捲限流,因此批量重新嵌入作業不會減慢臨床醫生輸入病例的速度,並且上面顯示的勒索軟體檢測和分區遷移也適用於這些卷,無需任何更改。

資源消耗最大的步驟是建立歸檔檔案。 IBM 透過使用相同的模型和相同的 VECTOR(768, FLOAT32) 目標,對包含 112,120 張胸部 X 光片的完整資料集進行了兩次嵌入,以此來衡量其效能。當 ONNX 模型運行在主機 CPU 上的資料庫內時,流程能夠以每秒 3.41 張影像的速度進行嵌入,每次嵌入耗時 0.272 秒,處理完整資料集耗時 9.1 小時。將模型遷移到第二台伺服器上的 Oracle 私有 AI 服務容器後,吞吐量提升至每秒 8.55 張映像(每次嵌入耗時 0.097 秒),相同的資料擷取過程僅需 3.6 小時即可完成。

兩次運行的預處理時間(每張影像約 0.019 秒)和 Oracle 插入時間(不到 1 毫秒)完全相同,因此 2.5 倍的效能提升完全來自於模型的執行位置。私人 AI 服務嵌入服務運行在 CPU ONNX 運行時上,因此該伺服器上的 H100 顯示卡並未參與此測試;效能提升來自於將模型從資料庫主機移除,而 GPU 在管線中的份額則體現在接下來要介紹的索引建置部分。
IBM 在科羅拉多州的實驗室測量了這些數據;我們並未運行或審核該測試。實際結論是,首次嵌入歸檔檔案以及每次模型變更後的重新嵌入都是耗時數小時的批次作業,而後續的檢索操作則是一個耗時數毫秒的 CPU 和儲存作業。
同一個容器也負責索引建置。 Oracle 26ai 可以將 HNSW 建置傳送到容器的向量索引服務,該服務使用 GPU 上的 NVIDIA cuVS 建立鄰居圖,然後將完成的索引傳回給資料庫。之後,搜尋操作無需 GPU 參與即可運作。在 IBM 的記錄中,基準 HNSW 建置(32 個鄰居,efConstruction 200)在資料庫中耗時 8.47 秒,卸載後僅需 2.26 秒,耗時縮短了 3.7 倍。此運行使用了一個小型演示表,因此證實了該路徑在此配置下有效;我們仍需測量臨床規模下的數據。
該應用程式示範了本文核心的分工理念。 GPU 伺服器託管語言模型,並在歸檔建置或重建期間提供嵌入和索引服務。資料庫儲存向量及其所描述的記錄,而陣列和 Fabric 則處理檢索讀取和事務。檢索路徑中的任何步驟均不使用外部 API,患者資料也從未離開資料中心。
IBM 選擇醫療保健產業作為驗證此概念的垂直領域,但該模式並非僅限於此。將 X 光片存檔替換為理賠記錄、維護記錄或產品目錄,三個相同的要素依然適用:向量儲存在與其描述的記錄旁邊,在 GPU 伺服器上產生數據,以及在同一個陣列上進行檢索和交易處理。任何對已有數據進行推理的行業都將採用相同的架構。
接下來是什麼
驗證工作在相同的硬體上繼續進行:第二階段將推理引擎的鍵值快取從GPU記憶體遷移到同一光纖通道架構上的FlashSystem,從而使長上下文模型能夠存取更多的工作集;本系列的下一篇文章將詳細介紹這項工作。 IBM也正在建立內容感知刷新管道,利用IBM Storage Scale AFM和Kafka將新文件即時匯入資料庫內的ONNX向量化流程,使向量索引能夠追蹤其來源,而無需批次重新嵌入。 IBM還計劃將相同的儲存驗證擴展到其他已新增向量搜尋功能的多模型資料庫。
第二階段也讓安全層對新資料發揮作用。當鍵值快取遷移到快閃記憶體系統時,醫療保健模型的工作上下文(包括病患病史)與向量索引和交易記錄一樣,都透過相同的光纖通道連結傳輸。 Emulex SecureHBA 在主機和光纖通道網路之間傳輸資料時進行加密,而 Brocade Gen 8 的後量子加密技術則會覆蓋交換器端。每個階段都會增加光纖通道網路的工作負載,但不會增加資料以明文形式傳輸的路徑。
排行榜: IBM 在我們最佳儲存陣列頁面上的簡介現在涵蓋了 FlashSystem 區塊儲存以及 Storage Scale。
本報告由博通贊助。本報告中所表達的所有觀點和意見均基於我們對所考慮產品的公正看法。



 Amazon