

英特爾的 Battlematrix 專案為易於使用的 AI 基礎設施提供了極具吸引力的解決方案,它透過多 GPU 設計,將大容量 GPU 記憶體帶入工作站機殼。該平台以代號為 Battlemage Arc Pro B60 的專業 GPU 為核心,旨在幫助企業在本地部署大型語言模型,而無需承擔雲端訂閱費用或資料隱私方面的擔憂。 Battlematrix 在單一系統中整合了八塊 GPU,最高可提供 192GB 的顯存,使其成為 AI 推理工作負載中比其他專業 GPU 生態系統更具成本效益的選擇。
在Instagram上查看此帖子
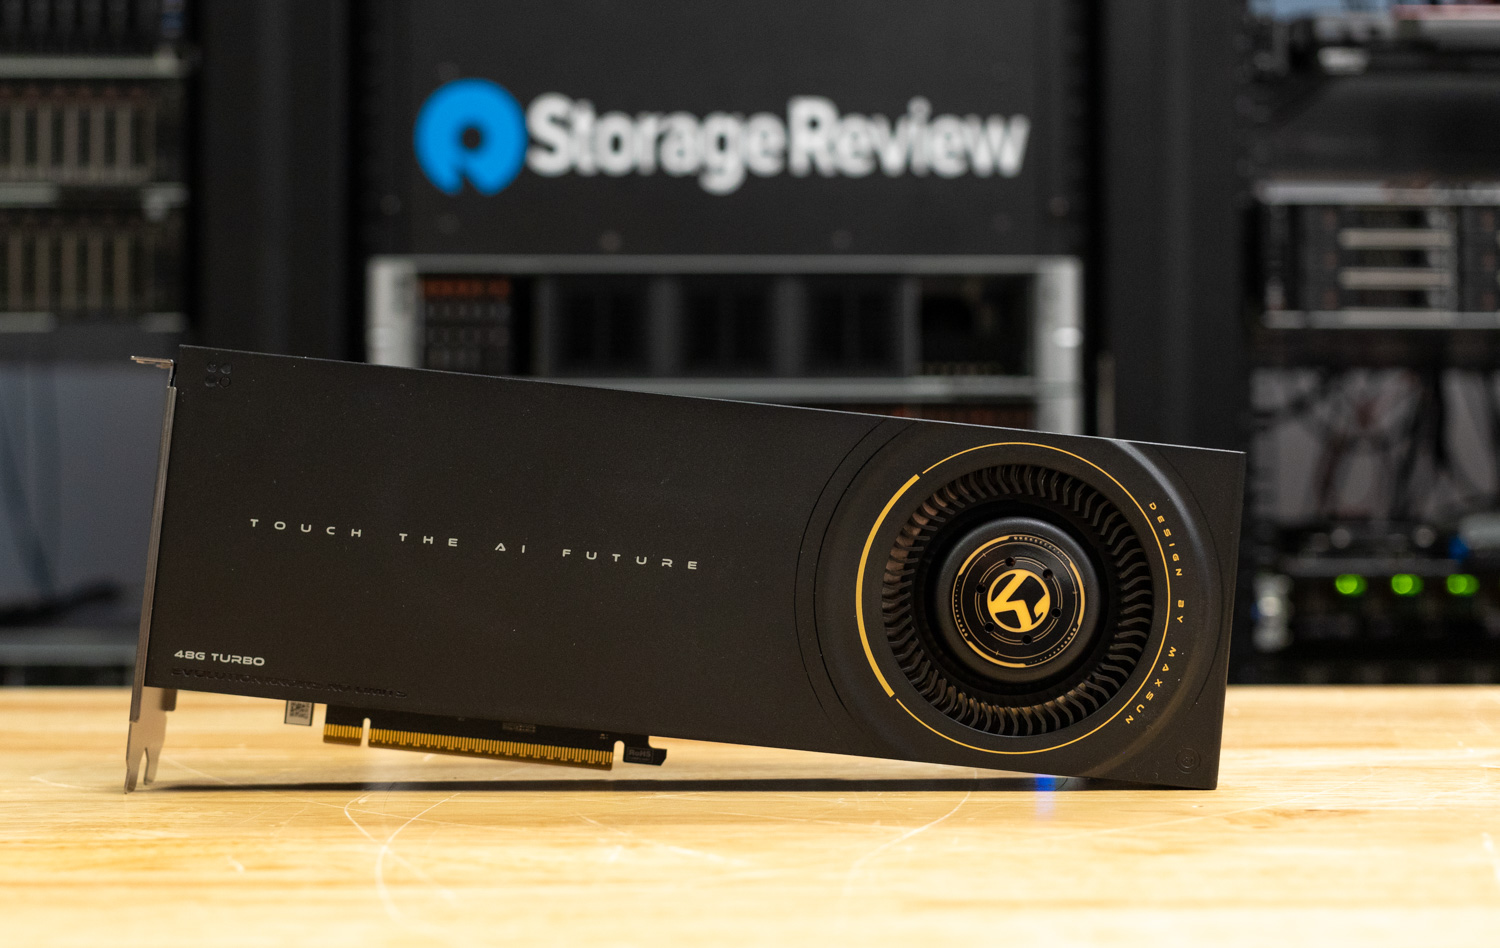
Battlematrix 與傳統工作站配置的區別在於英特爾的雙 GPU 卡設計,它將兩塊完整的 B60 GPU 整合在一塊 PCB 板上,需要 PCIe 通道分叉支援。這種高密度優化方案使得原本需要伺服器主機板才能實現的配置成為可能,而 Arc Pro B60 每塊 GPU 配備 24GB GDDR6 顯存,使其尤其適合內存密集型變形金剛模型。早期測試顯示出其巨大的潛力,但軟體優化仍落後於硬體效能。
揭露聲明
測試使用了早期軟體和驅動程式版本,包括英特爾 LLM Scaler 的開發分支。此外,我們的測試平台採用的是 AMD EPYC 處理器,而非英特爾的 Xeon 平台。英特爾將 Battlematrix 定位為基於 Xeon 6 處理器的全英特爾解決方案,因此採用英特爾 CPU 的生產系統效能可能高於我們的測試結果。讀者應將這些結果視為初步結果,並理解軟體成熟度和平台優化將在 2026 年內持續提升。
規範和架構
| 規格 | 詳情 |
|---|---|
| 產品集合 | 英特爾® Arc™ Pro B 系列顯示卡 |
| 代碼名稱 | 戰鬥法師 |
| GPU架構 | Xe2(台積電 N5) |
| Xe-顏色 | 20 |
| 渲染切片 | 5 |
| 光線追踪單元 | 20 |
| XMX發動機 | 160 |
| Xe向量引擎 | 160 |
| 圖形時鐘 | 2400 MHz |
| 圖形時鐘(LP 模式) | 2000 MHz |
| GPU FP32 效能 | 12.28 TFLOPS |
| GPU峰值TOPS(INT8) | 197 |
| 主板總功耗 (TBP) | 200W¯¯ |
| 記憶體應用 | 24 GB GDDR6 |
| 存儲器接口 | 192-位 |
| 內存帶寬 | 456 GB / s |
| 記憶體速度 | 19 Gbps |
| PCIe 接口 | PCIe 5.0 x8 |
| 支援的顯示器 | 4 |
| 圖形輸出 | HDMI 2.1 | HDMI 2.1 DP2.1(UHBR 13.5)| DP2.1(UHBR 10) |
| 最大解析度(HDMI) | 7680 x 4320 @ 120Hz |
| 最大解析度(DP) | 7680 x 4320 @ 60Hz |
| HDMI可變刷新率 | 可以 |
| VESA自適應同步 | 可以 |
| H.264 / H.265 / AV1 編碼/解碼 | 可以 |
| 光線追蹤支持 | 可以 |
| 一個API支援 | 可以 |
| OpenVINO 支持 | 可以 |
| 英特爾 IPEX 支持 | 可以 |
| Intel XeSS 支援 | 可以 |
这 英特爾 Arc Pro B60 它與專注於遊戲的晶片共享相同的矽晶片基礎。 英特爾Arc B580兩者均採用台積電5nm製程製造的相同晶片。這款272平方毫米的晶片包含19.6億個晶體管,整合20個Xe2核心,官方宣稱每個GPU可提供12.28 TFLOPS的FP32運算效能和197 TOPS的INT8 AI效能。關鍵差異在於內存配置:B580配備12GB GDDR6內存,而B60的內存容量則翻倍至24GB。
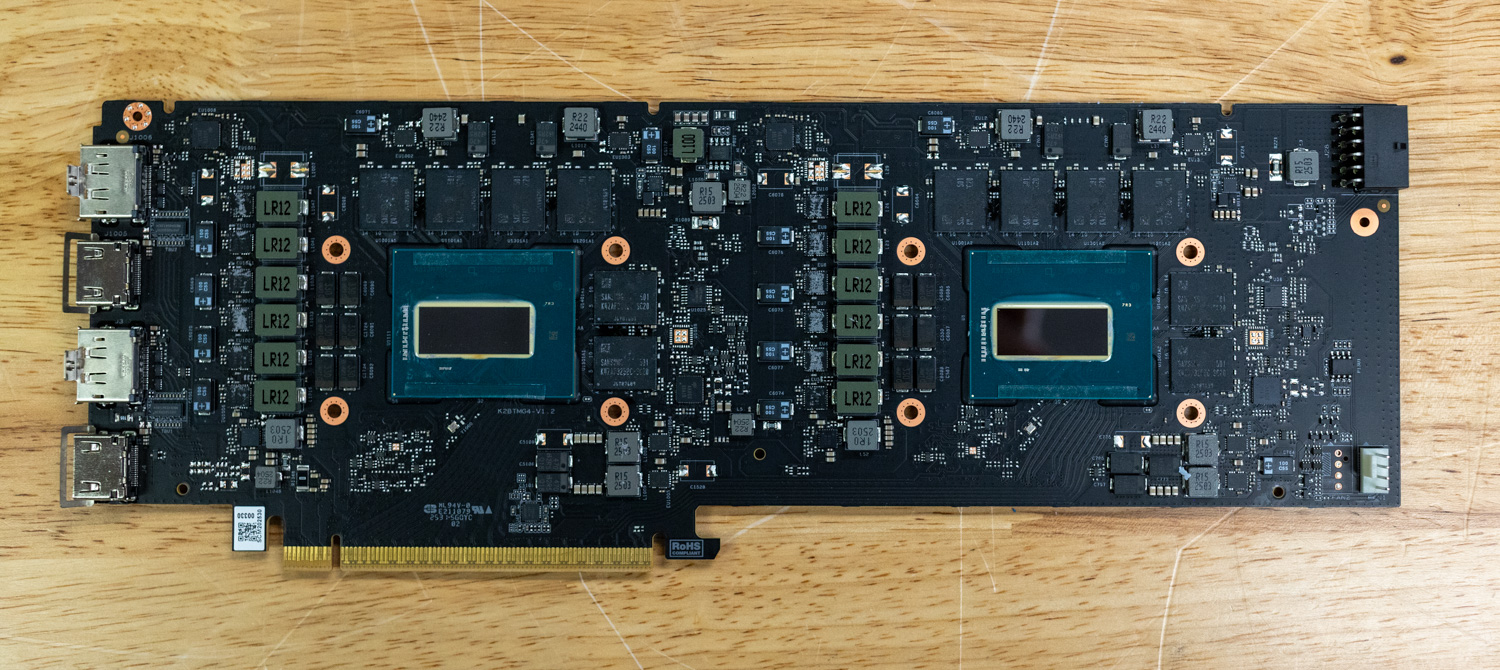
每顆 B60 GPU 的運作頻率為 2,400MHz,採用 192 位元記憶體接口,每顆 GPU 可提供 456GB/s 的頻寬。架構每顆 GPU 配備 160 個 XMX(Xe 矩陣擴展)AI 引擎,專為加速 AI 推理中的矩陣運算而設計。
雙GPU設計和PCIe分叉
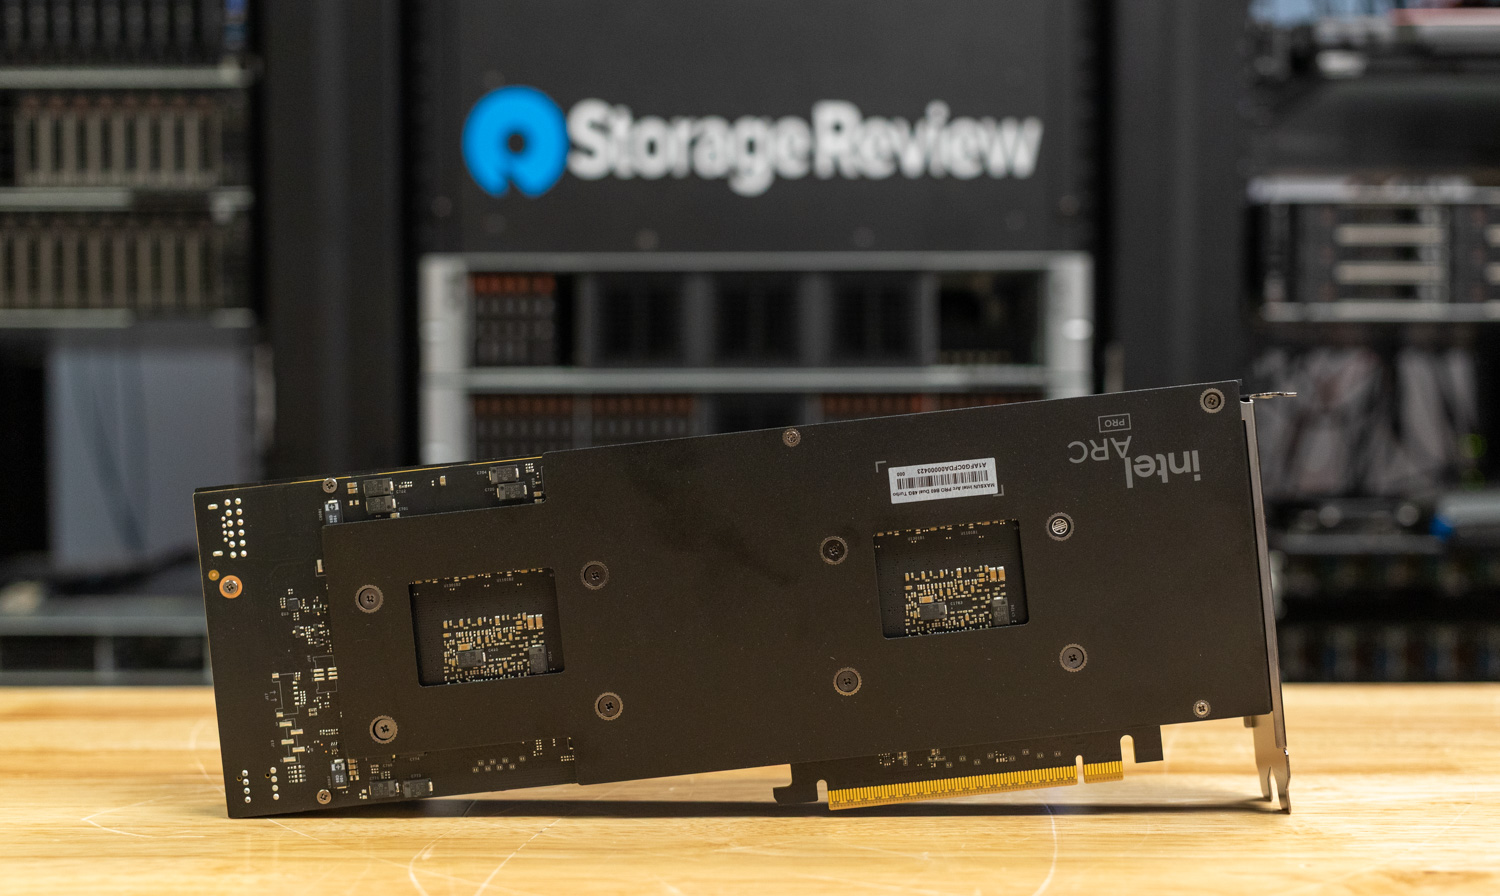
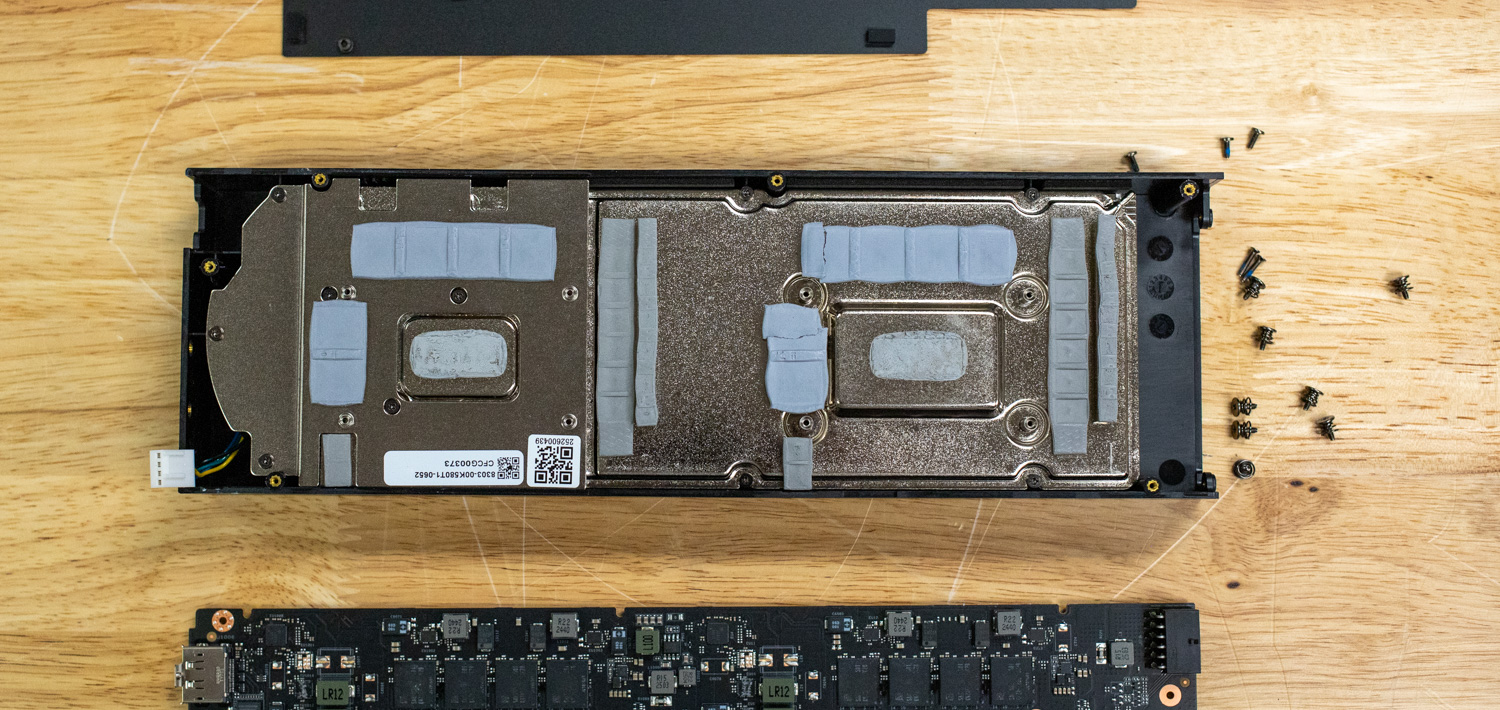
Maxsun Arc Pro B60 Dual 48G Turbo 顯示卡體現了英特爾的高密度設計策略:兩個完整的 GPU 整合在一個雙槽顯示卡上,並透過 PCIe 5.0 x8 介面獨立連接。與傳統的雙 GPU 設計(透過橋接晶片使其協同工作)不同,B60 的每顆 GPU 都作為獨立設備對系統運行,因此需要主機板支援 PCIe x8/x8 分叉。一個 x16 插槽在電氣上被分割為兩個 x8 連接,每個 GPU 都獲得獨立的頻寬。
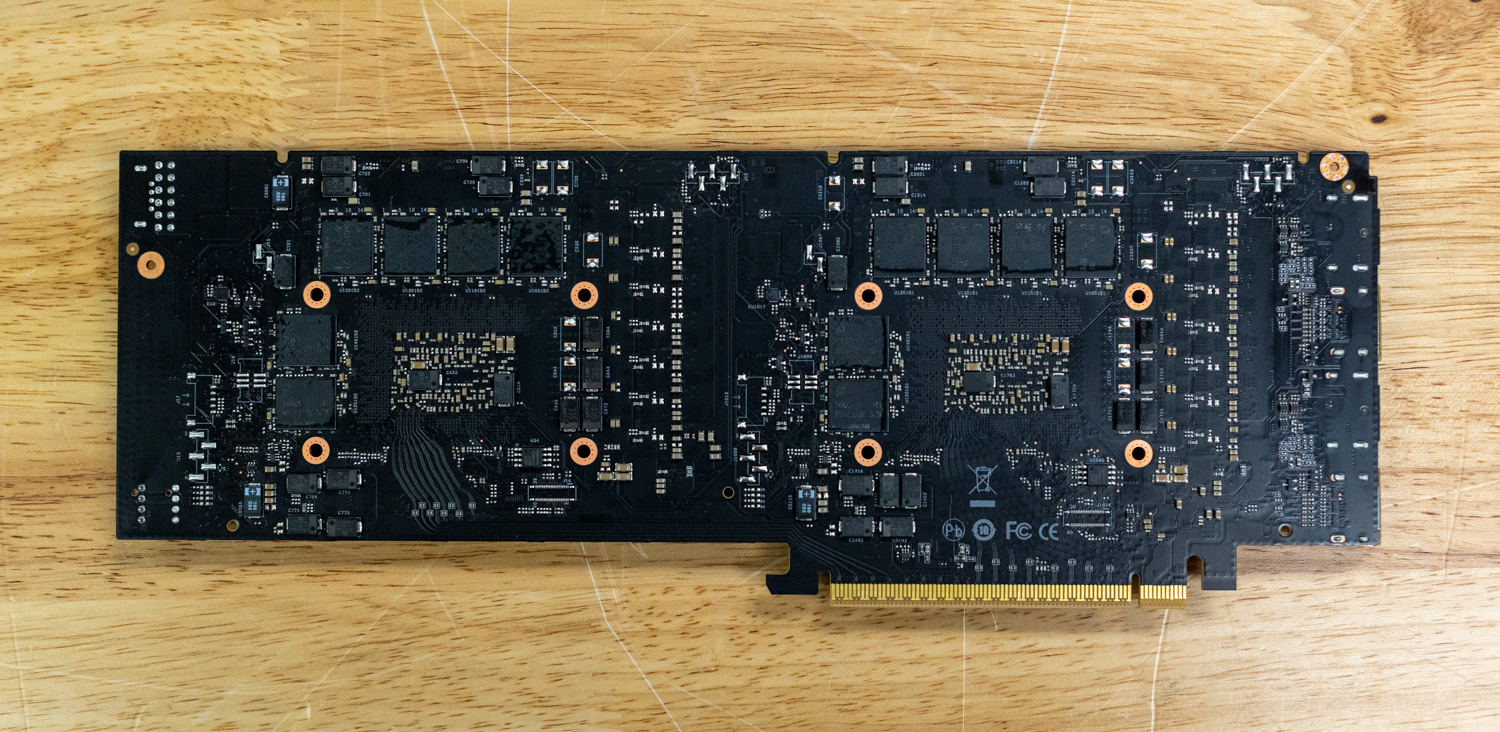
PCIe 5.0 x8 為每張 GPU 提供 128GB/s 的雙向頻寬,與 PCIe 4.0 x16 相當。雙卡配置長度為 300 毫米,佔用兩個插槽,採用渦輪式散熱,並透過一個額定功率為 600W 的 12V-2×6 連接器消耗400W 的總板載功率。
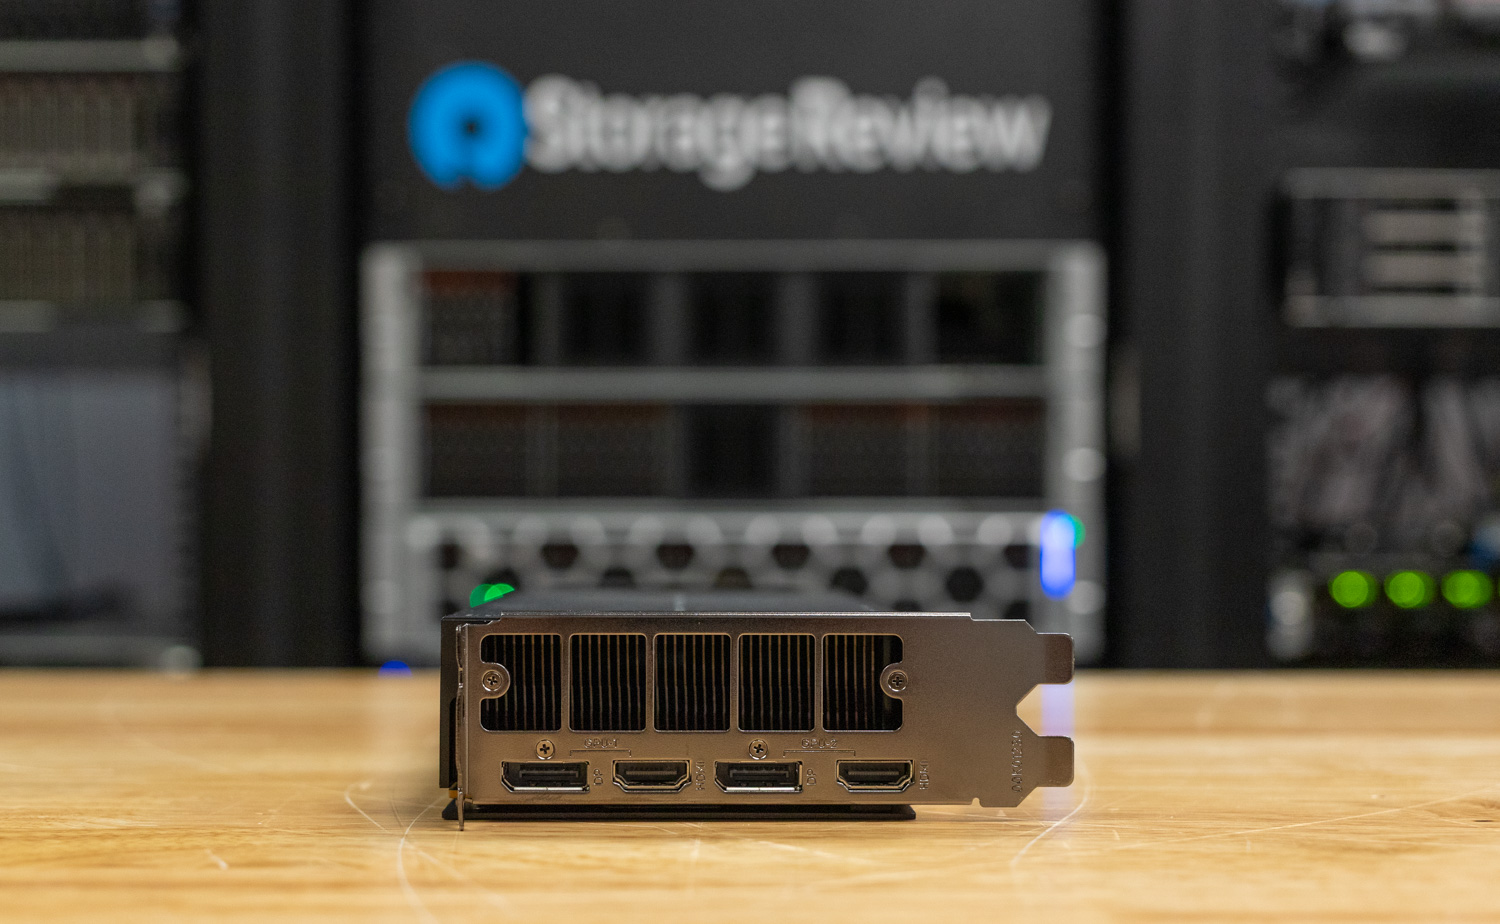
每張雙卡提供四個顯示輸出接口:兩個 DisplayPort 2.1 UHBR20 接口和兩個 HDMI 2.1a 接口,每個 GPU 配備一組接口,從而為虛擬桌面環境或多用戶系統提供獨立的視頻輸出配置。需要注意的是,每個 GPU 在同一時間只能使用兩個顯示輸出介面中的一個。
在Instagram上查看此帖子
八GPU戰鬥矩陣配置
英特爾的 BattleMatrix 參考規格支援在工作站機箱內安裝多達八個 Arc Pro B60 GPU ,這可以透過使用四張雙 GPU 顯示卡來實現。此配置可提供以下效能:
- 系統總記憶體容量為 192GB (8 × 24GB)
- 1,280 台 XMX AI 引擎
- 1,576 INT8 頂級 聚合計算
- 3.6TB/秒 組合記憶體頻寬
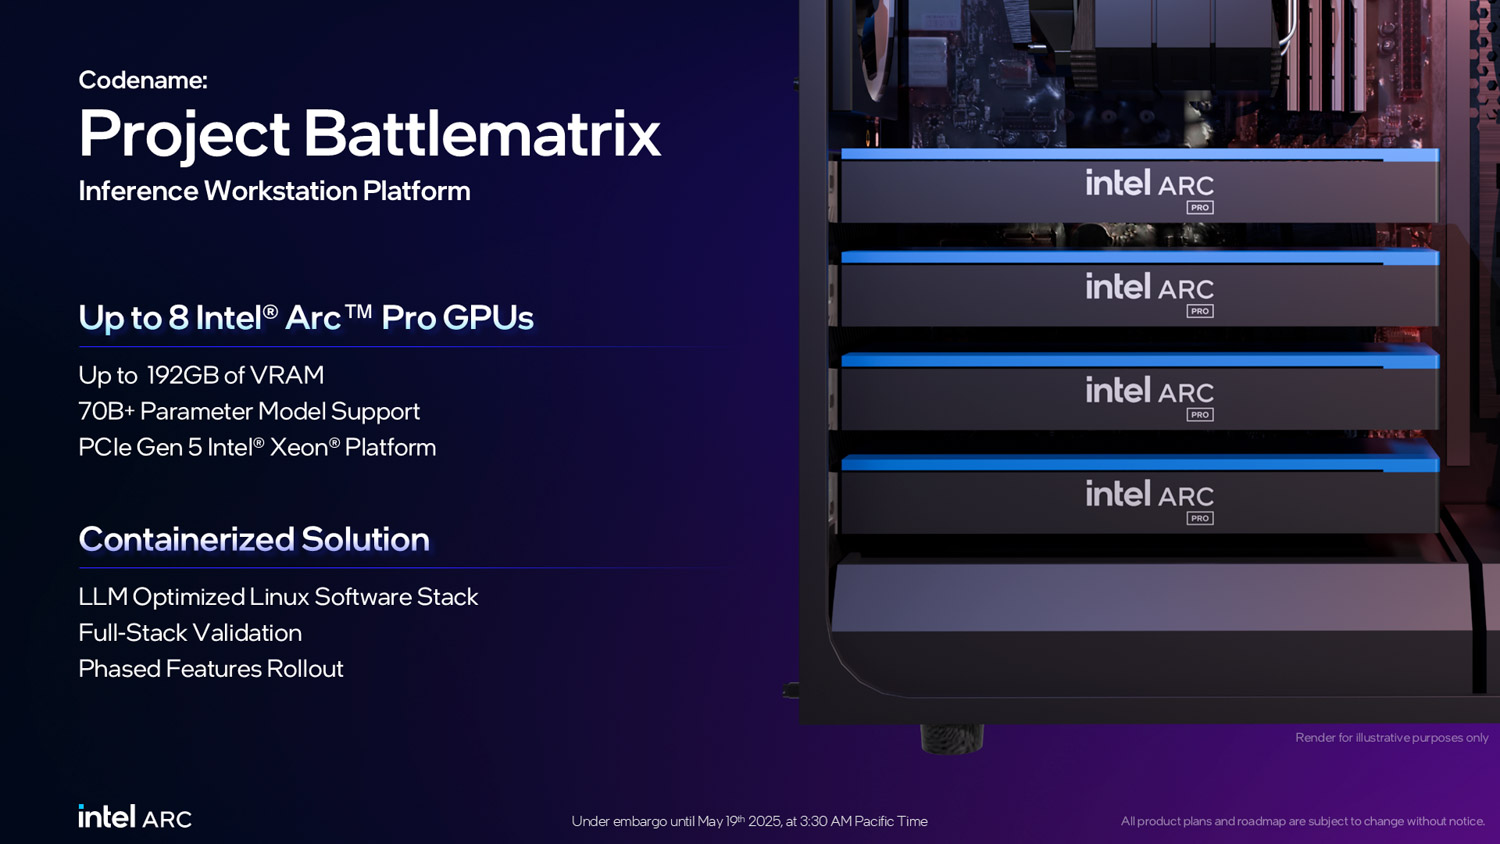
該平台需要配備四個支援 PCIe 5.0 x16 插槽的主機板,而 Battlematrix 規格還將包括一個 Xeon 6 處理器;然而,目前尚無關於 Battlematrix 配置的其他資訊。
用例和價值主張
目標受眾
英特爾的「戰鬥矩陣計畫」(Project Battlematrix)面向三大市場領域:需要本地部署基礎設施的人工智慧開發團隊、使用敏感程式碼庫實施人工智慧輔助工作流程的軟體工程組織,以及尋求經濟高效的雲端推理服務替代方案的組織。該平台的核心價值在於資料主權和整體擁有成本優勢,優於多年期雲端訂閱服務。
私有人工智慧和代理開發
Battlematrix 平台的主要優勢在於支援大型語言模型的開發工作流程,這些模型需要廣泛的上下文視窗和大量的參數。
建構智能體的開發團隊尤其受益於充足的記憶體空間。 RAG 智能體實作通常同時在 GPU 記憶體中維護多個元件:基礎語言模型、用於向量搜尋的嵌入模型和重排序模型。此外,智能體工作流程執行多步驟推理、工具使用和自我糾錯,並透過迭代產生大量的上下文視窗。一個分析大型程式碼庫的編碼智能體在其運作生命週期內可能會累積超過 100 萬個標記。
未來VDI與虛擬化遊戲
英特爾的路線圖包括在 Arc Pro B60 GPU 上啟用 SR-IOV(單根 I/O 虛擬化)支持,從而將該硬體轉變為多用戶圖形平台。 SR-IOV 允許將實體 GPU 細分為多個虛擬 GPU,每個虛擬 GPU 都可以分配給獨立的虛擬機,並擁有直接的硬體存取權和隔離的記憶體空間。
這項功能解鎖了無需授權許可的虛擬桌面基礎架構 (VDI) 方案,其中單個配備八 GPU 的 Battlematrix 系統即可支援數十個並髮用戶,並為 CAD 應用、視訊編輯或中等規模的遊戲提供專用 GPU 加速。傳統的 VDI 解決方案除了硬體成本外,還需要支付昂貴的授權費用,這通常意味著需要更昂貴的專業級或資料中心級 GPU。英特爾致力於提供無需授權許可的虛擬化技術,從而消除了這筆營運成本。
定價與價值主張
英特爾宣布 Arc Pro B60 的單卡售價約為 600 美元。對於初期測試和開發,單卡或雙卡配置(售價 600 至 1,200 美元)提供了較親民的入門選擇。一張配備 48GB 記憶體的雙 GPU 顯示卡足以滿足量化模型的需求,並能涵蓋大部分受歡迎的開源 LLM 應用。
我們測試的這款 Maxsun Dual Arc Pro B60 雙 48G Turbo 配置,直接從 Maxsun 購買售價為 1,200 美元,與英特爾最初的報價一致。不過,近期記憶體價格的波動可能會影響最終售價。
入門價格,超值之選
單卡和雙卡配置為小型團隊、獨立開發者和家庭實驗室用戶提供了極具吸引力的經濟方案。 24GB GPU 顯存版本售價 600 美元,48GB 版本售價 1,200 美元,該平台的價格遠低於通常至少貴一倍的專業級 GPU 產品。
對於那些正在探索人工智慧整合但又不想投入企業預算的組織來說,這種價值主張尤其具有吸引力。
vLLM 線上服務基準效能
vLLM 是目前最受歡迎的 LLM 高吞吐量推理和服務引擎。 vLLM 線上服務基準測試是一種效能評估工具,用於衡量並發請求下的實際服務效能。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境中的工作負載,並可配置請求速率、輸入/輸出長度和並發客戶端數量等參數。此基準測試可測量關鍵指標,包括吞吐量(每秒令牌數)、首令牌時間 (TTFT) 和每個輸出令牌的時間 (TPOT),可協助使用者了解 vLLM 在不同負載條件下的效能。
測試平台:
- 服務器: Supermicro AS-4125GS-TNRT
- 處理器: AMD 霄龍 9374F
- 記憶體:512B 三星 4800 MT/s DDR5
- GPU:4x Maxsun MS-Intel ARC Pro B60 雙 48G Turbo
量化支持與局限性
這些GPU在低精度推理方面應該表現出色,針對INT4量化可以獲得最佳性能。然而,由於我們測試的是英特爾LLM Scaler的早期開發版本,只有最初使用MXFP4微縮放格式訓練的GPT OSS模型能夠正常運作。其他量化格式,包括標準的INT4、FP8和AWQ,都無法啟動。這項限制極大地限制了我們對這些GPU的全面測試,但我們預期隨著軟體堆疊的成熟,對量化的支援範圍會更廣。
我們使用兩種配置測試了大多數模型:完整的八GPU Battlematrix 配置和將模型載入到記憶體所需的最小GPU數量。這種對比揭示了一些有趣的擴展特性,尤其是在較低批次大小下通訊開銷方面。
微擴展資料類型
微尺度量化是一種先進的量化方法,它對小塊權重應用精細的縮放因子,而不是對大塊參數進行均勻量化。 MXFP4 格式使用分塊浮點表示來實現這項技術,其中每個微尺度塊共享一個公共指數作為縮放因子,從而在保持數值精度的同時達到 4 位元精度。 MXFP4 資料類型的一個關鍵優勢在於,將模型量化為 INT4 不會像從 BF16 等更高精度格式量化那樣嚴重降低響應品質。由於 B60 本身不支援 MXFP4,因此 GPT OSS 模型在 B60 上運行時使用 INT4 量化。
OpenAI GPT-OSS 20B
20B 參數模型清楚地展示了通訊開銷現象。在批次大小為 1 時,單一 GPU 的吞吐量為每用戶 49.22 tok/s,而分佈在所有八個 GPU 上時僅為 22.83 tok/s。單 GPU 配置的效能比八 GPU 配置高出兩倍以上。然而,八 GPU 配置在高並發情況下表現出色,在批次大小為 16 時實現了 511.99 tok/s 的總吞吐量。
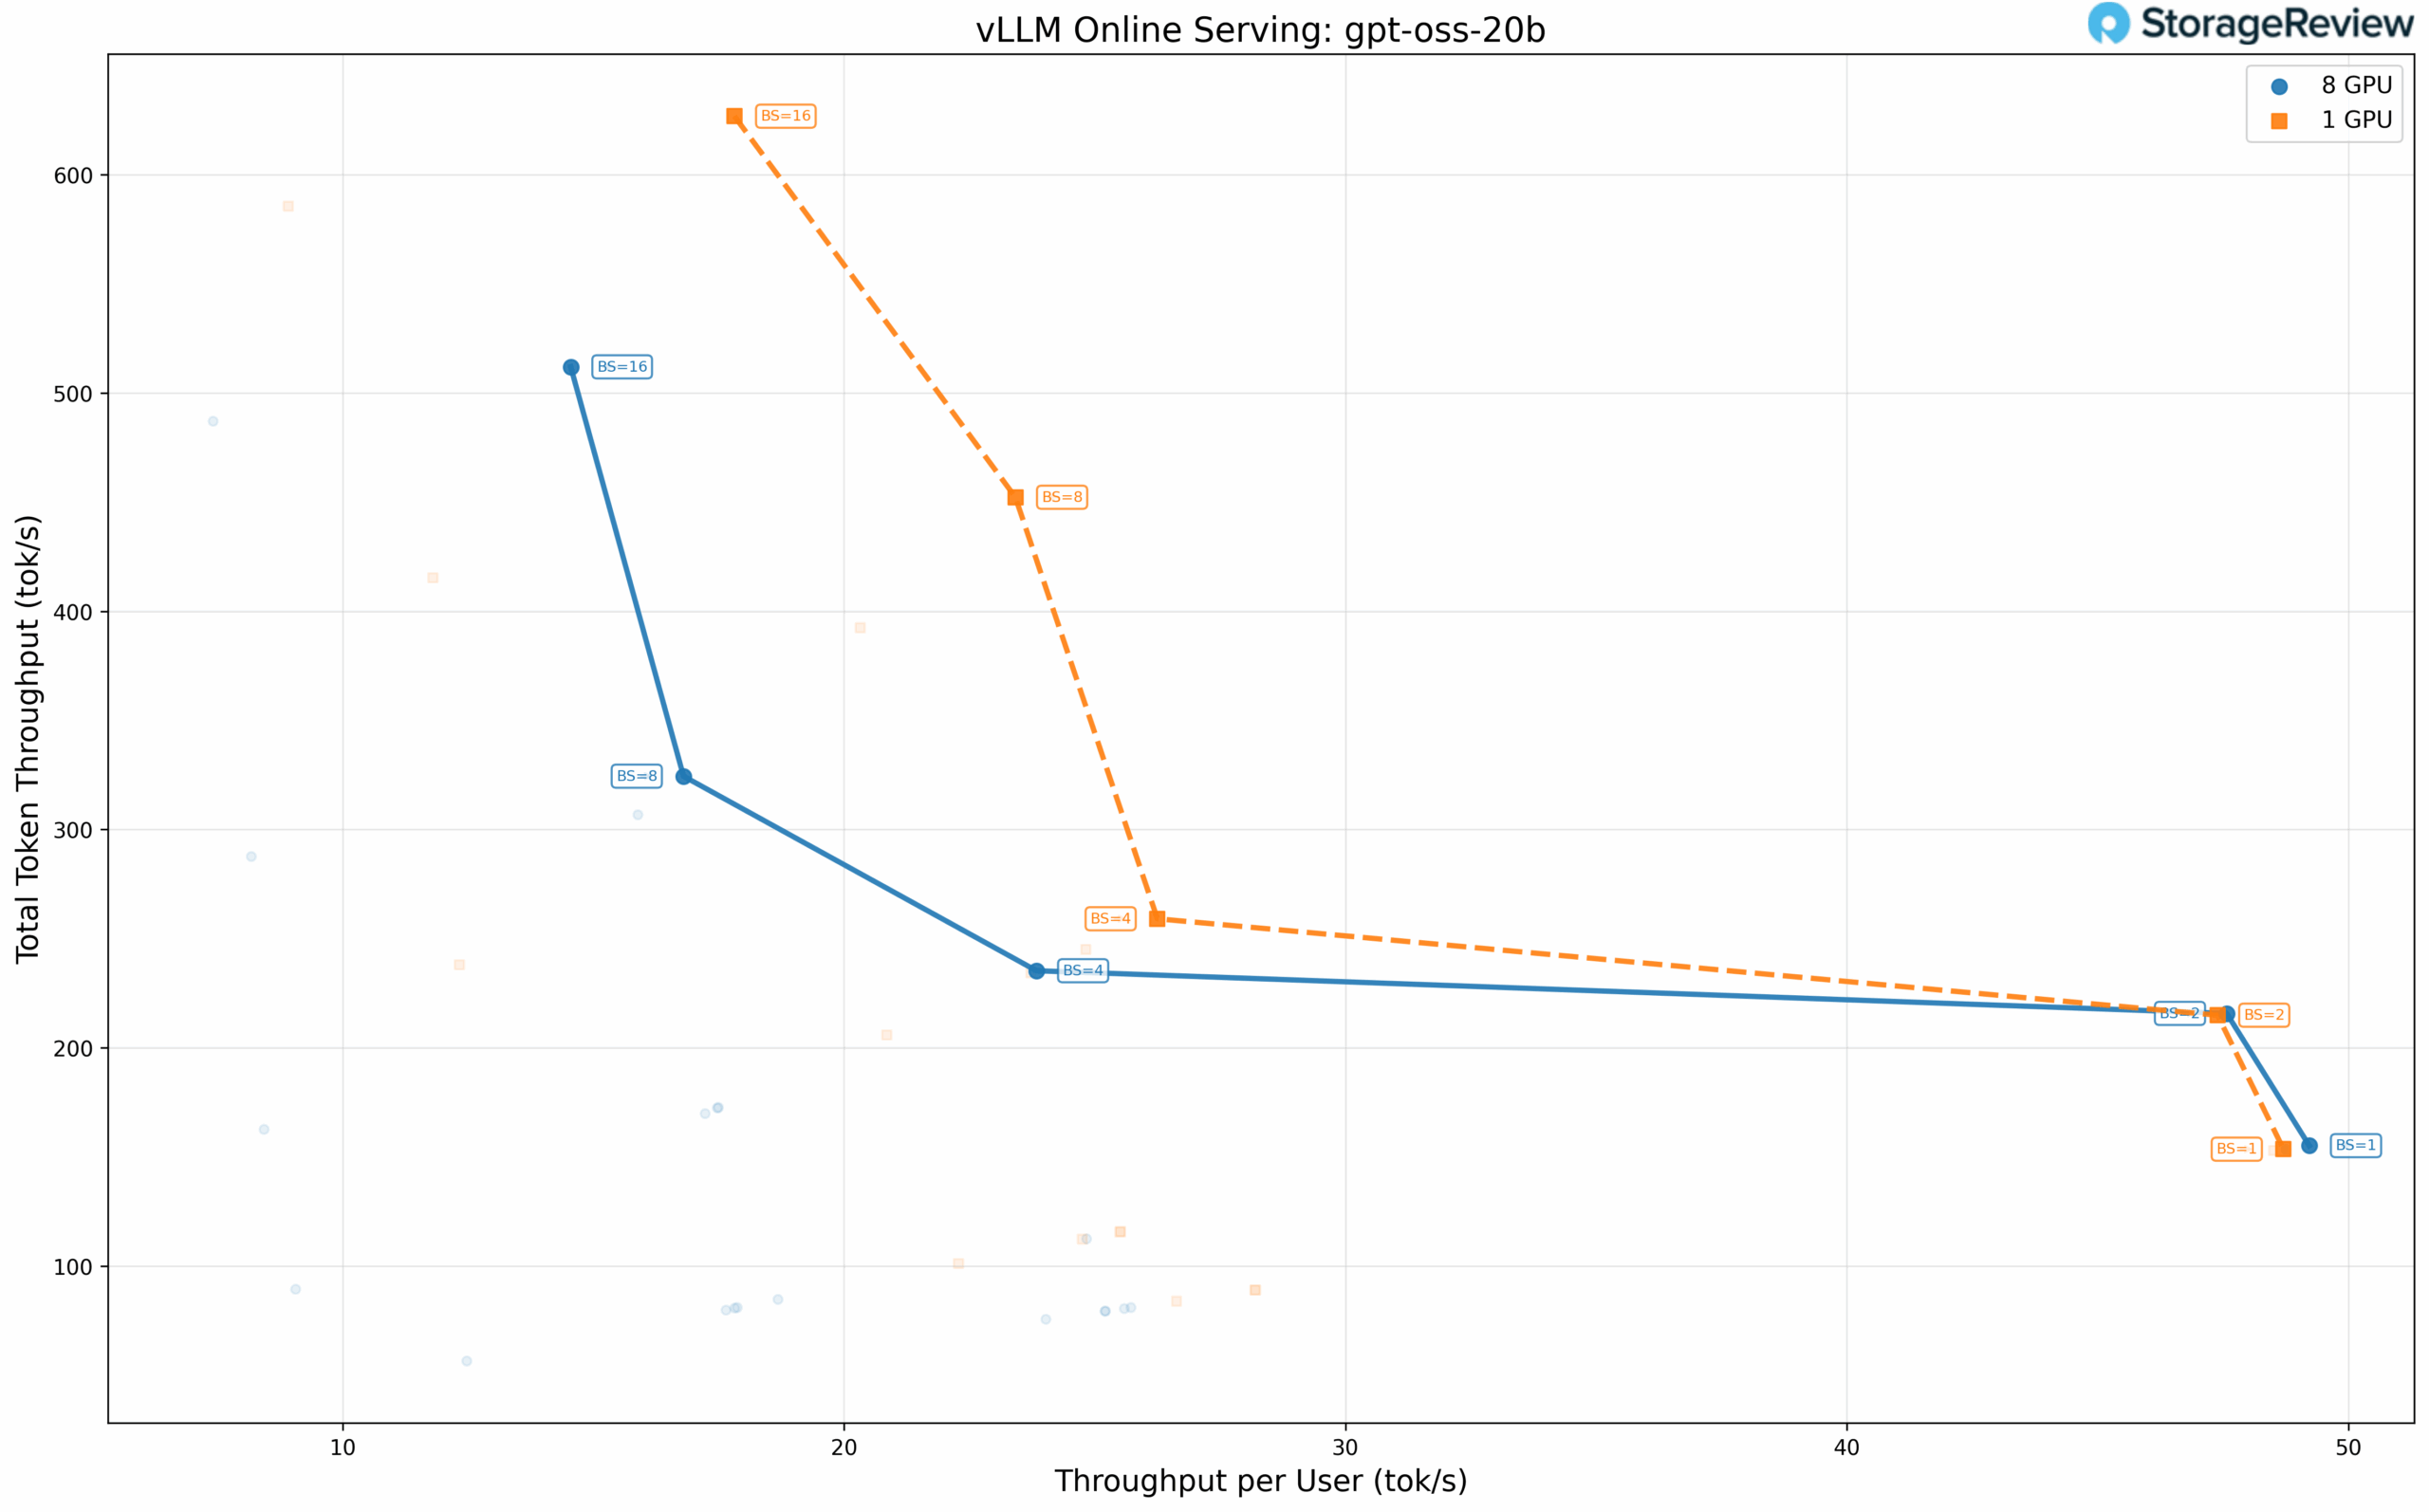 實際上,在批次大小為 16 時,最低 GPU 配置的總吞吐量反而更高:TP=4 時為 626.84 tok/s,而 TP=8 時為 511.99 tok/s。這一反直覺的結果表明,對於能夠在較少 GPU 上輕鬆運行的模型和上下文長度,增加硬體會增加通訊開銷,而不會帶來相應的效能提升。
OpenAI GPT-OSS 120B
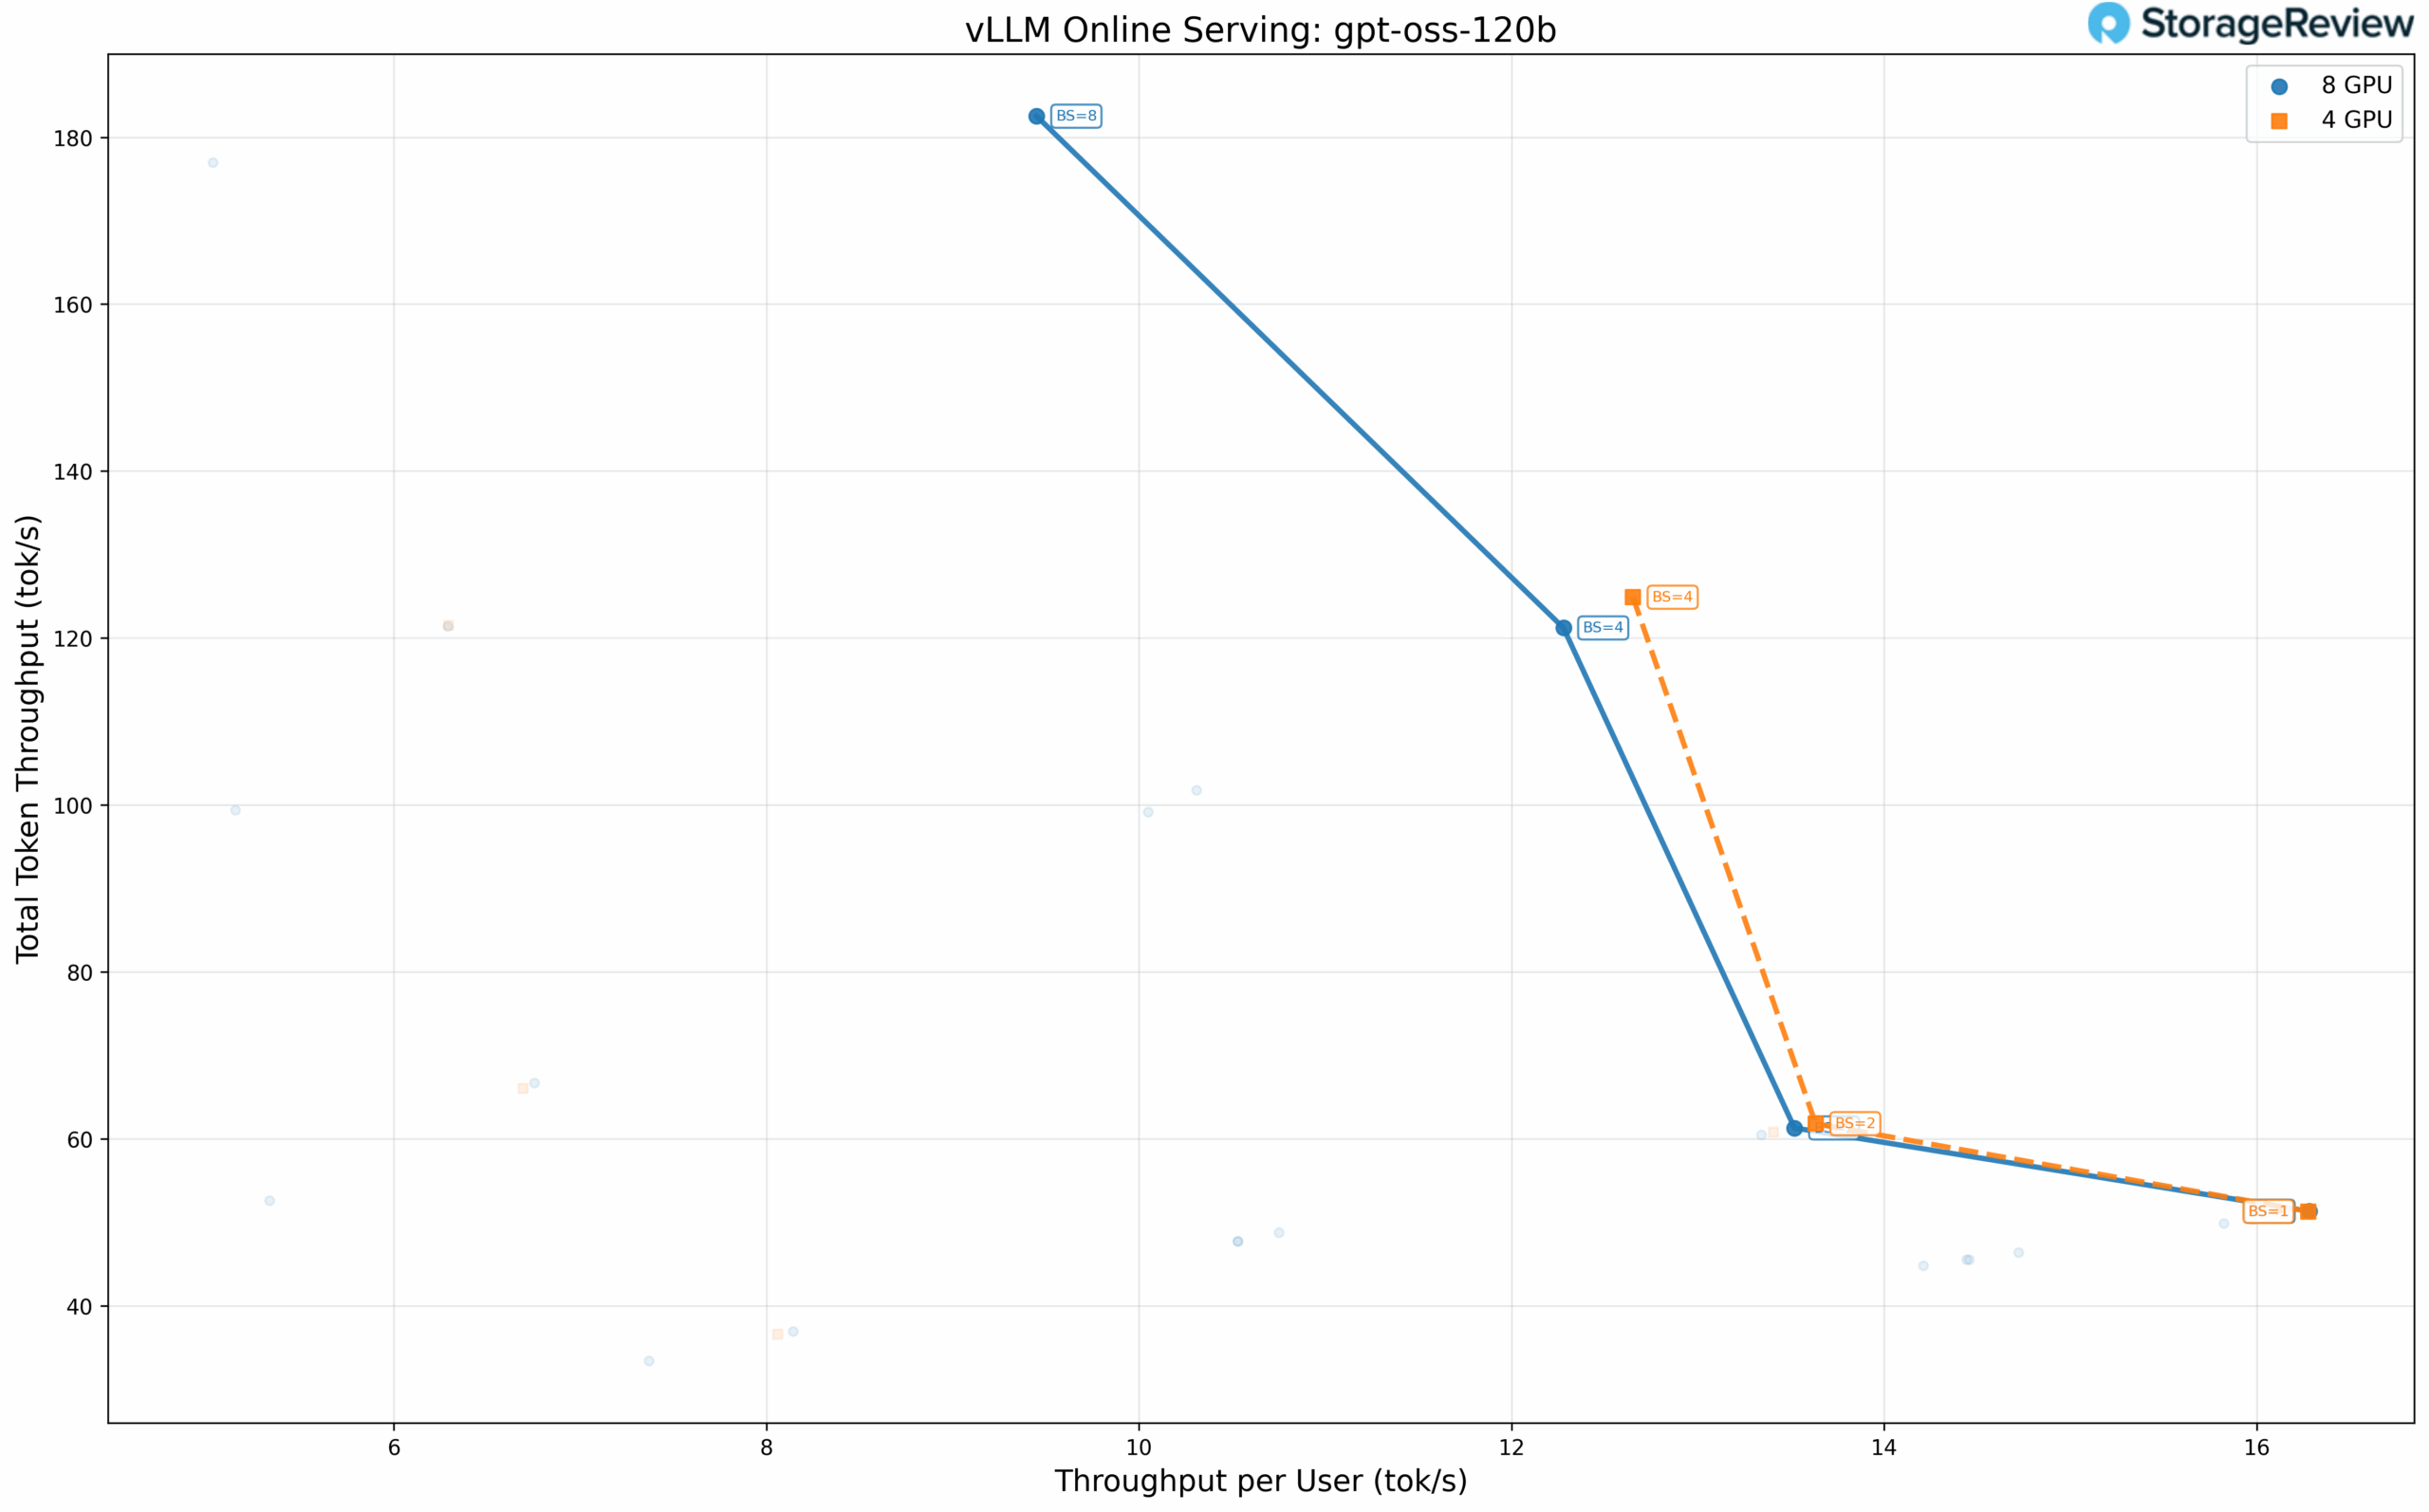
更大的 120B 型號至少需要 4 個 GPU,因此無法進行單 GPU 對比。四 GPU 和八 GPU 配置的效能更為接近,在批次大小為 1 時,每個使用者的吞吐量幾乎相同(均為 16.28 tok/s)。八 GPU 配置透過資料並行化,在大批處理大小下提供了適度的效能提升。
專家組合:Qwen3 程式設計師 30B-A3B
稀疏 MoE 架構在推理過程中僅會啟動部分參數,同時保持大量的參數數量。 Qwen3 Coder 30B-A3B 從其完整的 3 億參數池中為每個 token 啟動約 30 億個參數,因此常用於本地編碼輔助部署。
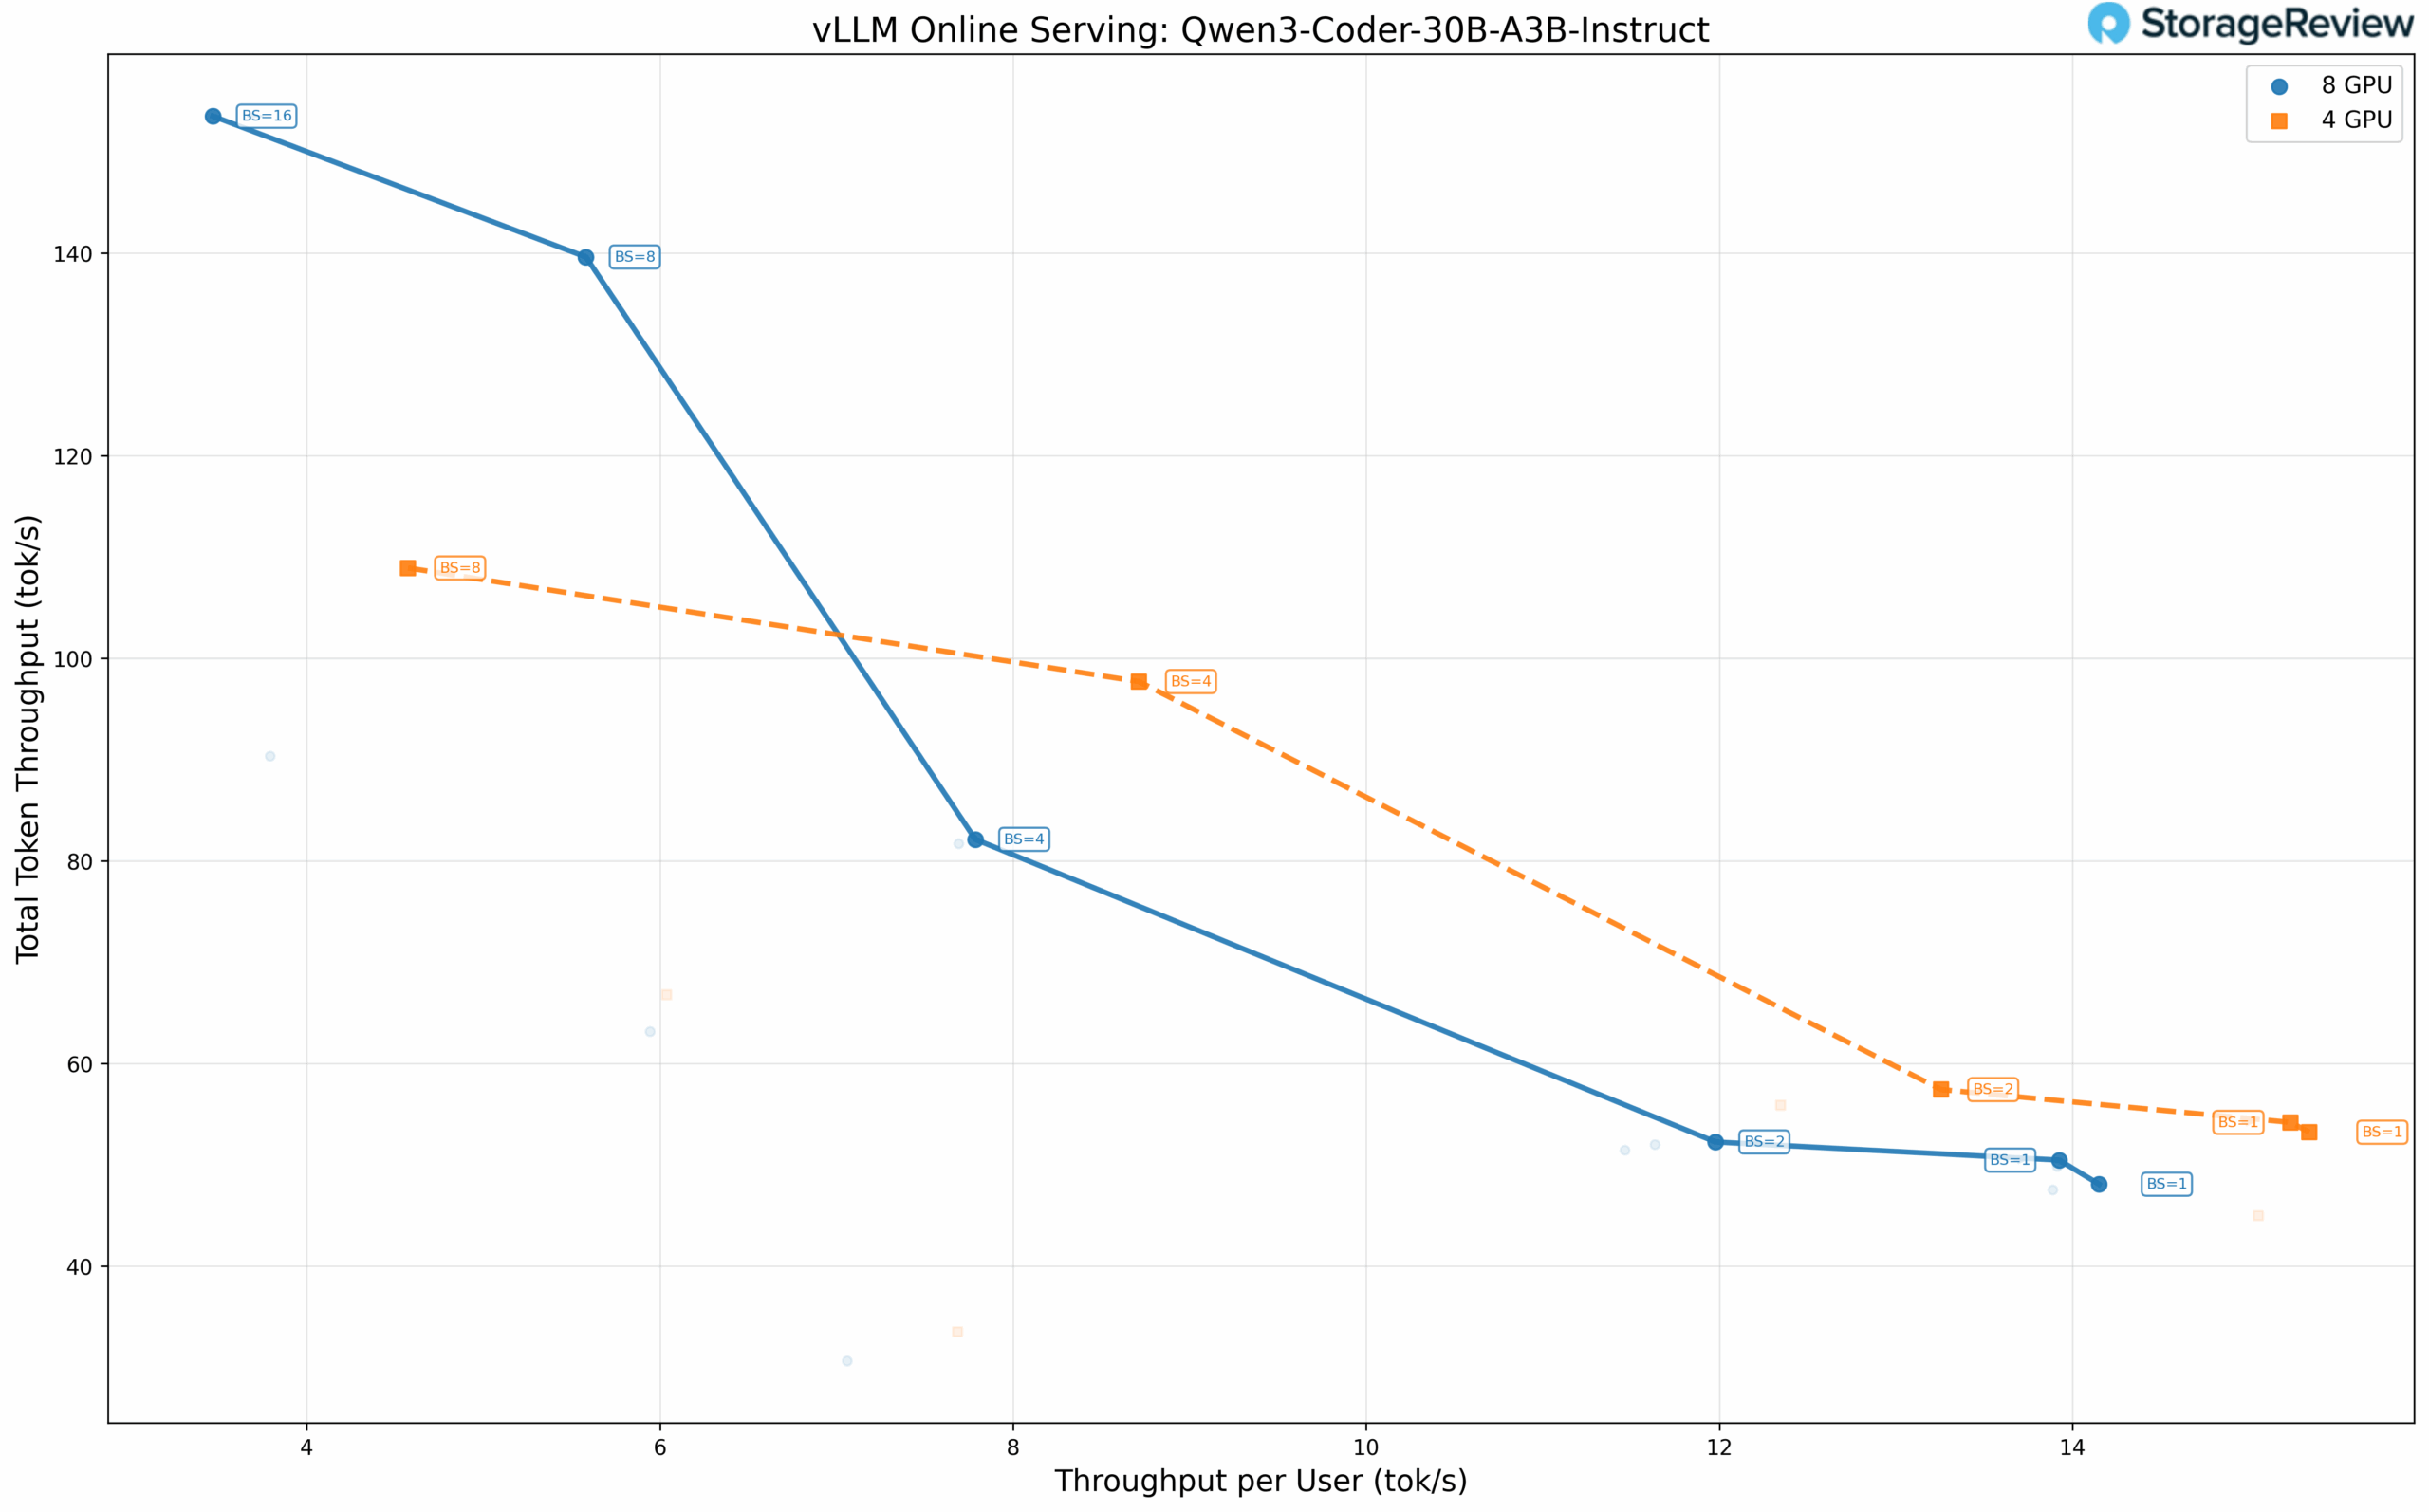
在 BF16 精度下進行測試,四 GPU 配置再次展現了在較小批次大小下的優勢。批次大小為 1 時,TP=4 時單一使用者吞吐量達到 15.34 tok/s,而 TP=8 時為 14.15 tok/s。
密集模型
密集模型遵循傳統的LLM架構,在推理過程中使用所有參數和活化值,因此比稀疏模型需要更多的運算資源。在我們的測試期間,由於INT4量化功能無法正常運作,這些模型以BF16精度運作。
駱駝 3.1 8B 指導
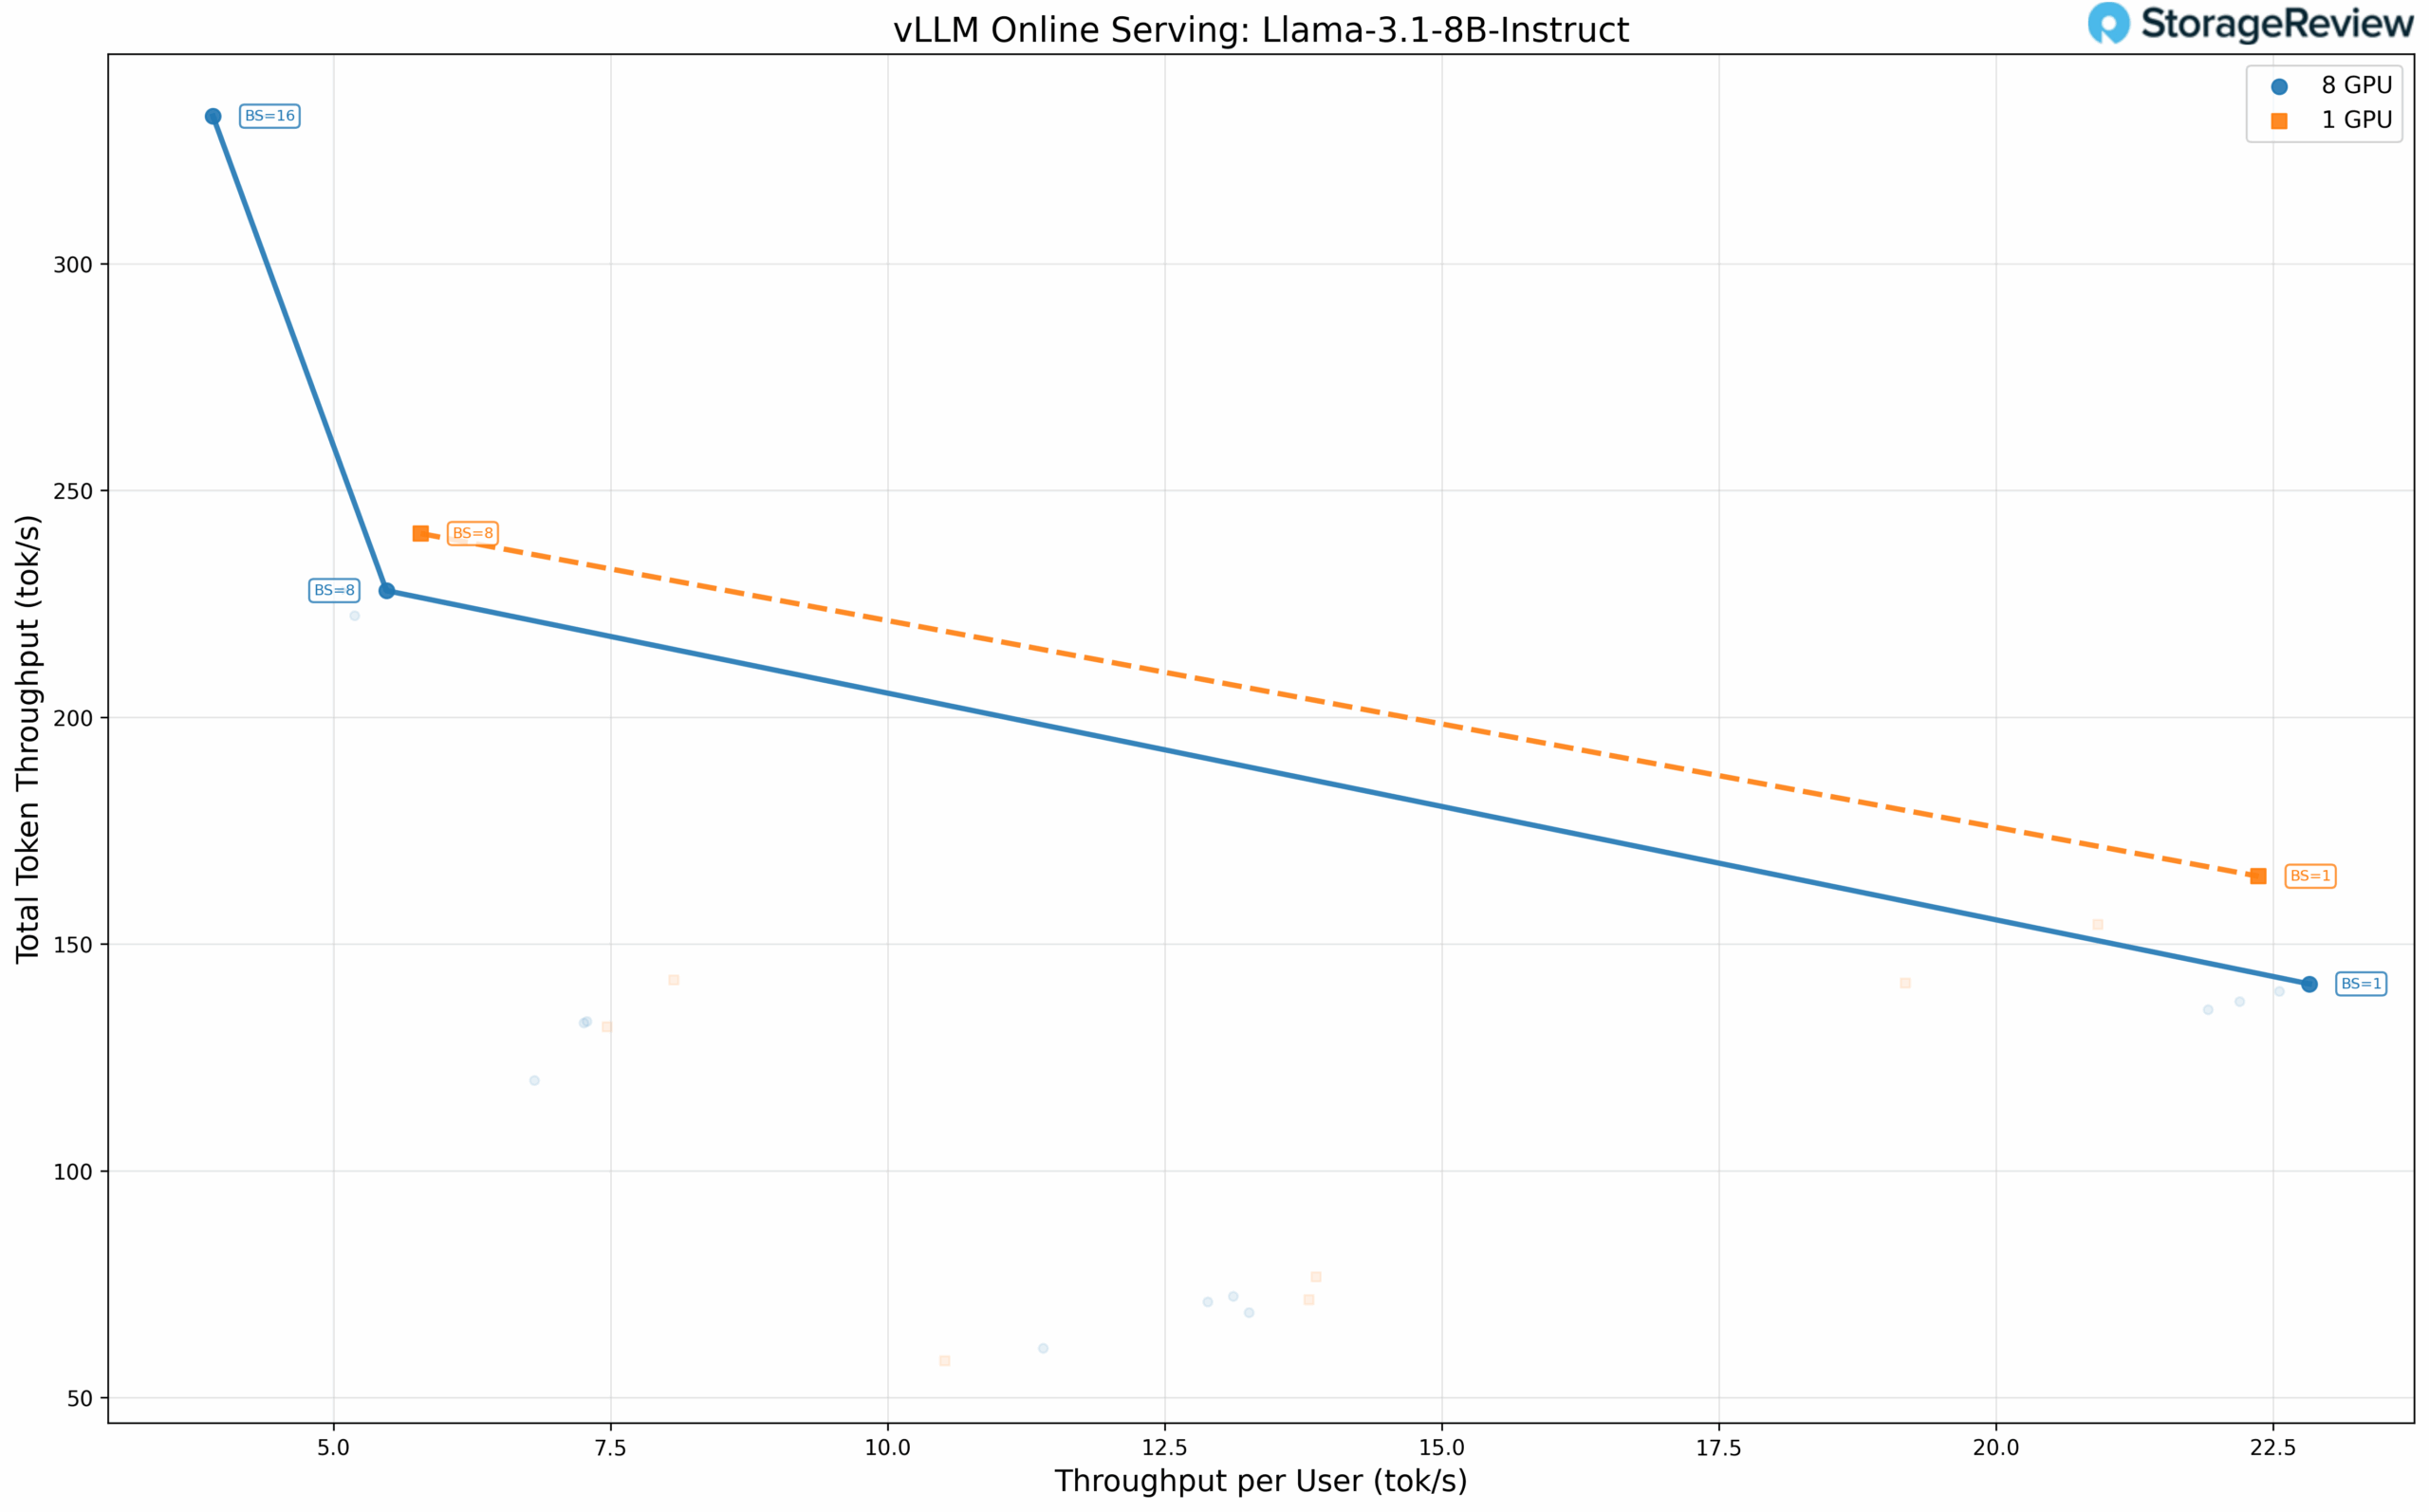
緊湊型 8B 模型可輕鬆安裝在單一 GPU 上,但我們測試了多種配置以表徵其擴充性能。結果證實了這個規律:在批次大小為 8 時,四個 GPU 的總吞吐量為 240.48 tok/s,而八個 GPU 的總吞吐量為 227.90 tok/s。批次大小為 1 時,每位使用者的吞吐量幾乎相同(分別為 22.37 tok/s 和 22.83 tok/s)。
Mistral Small 3.1 24B 指令
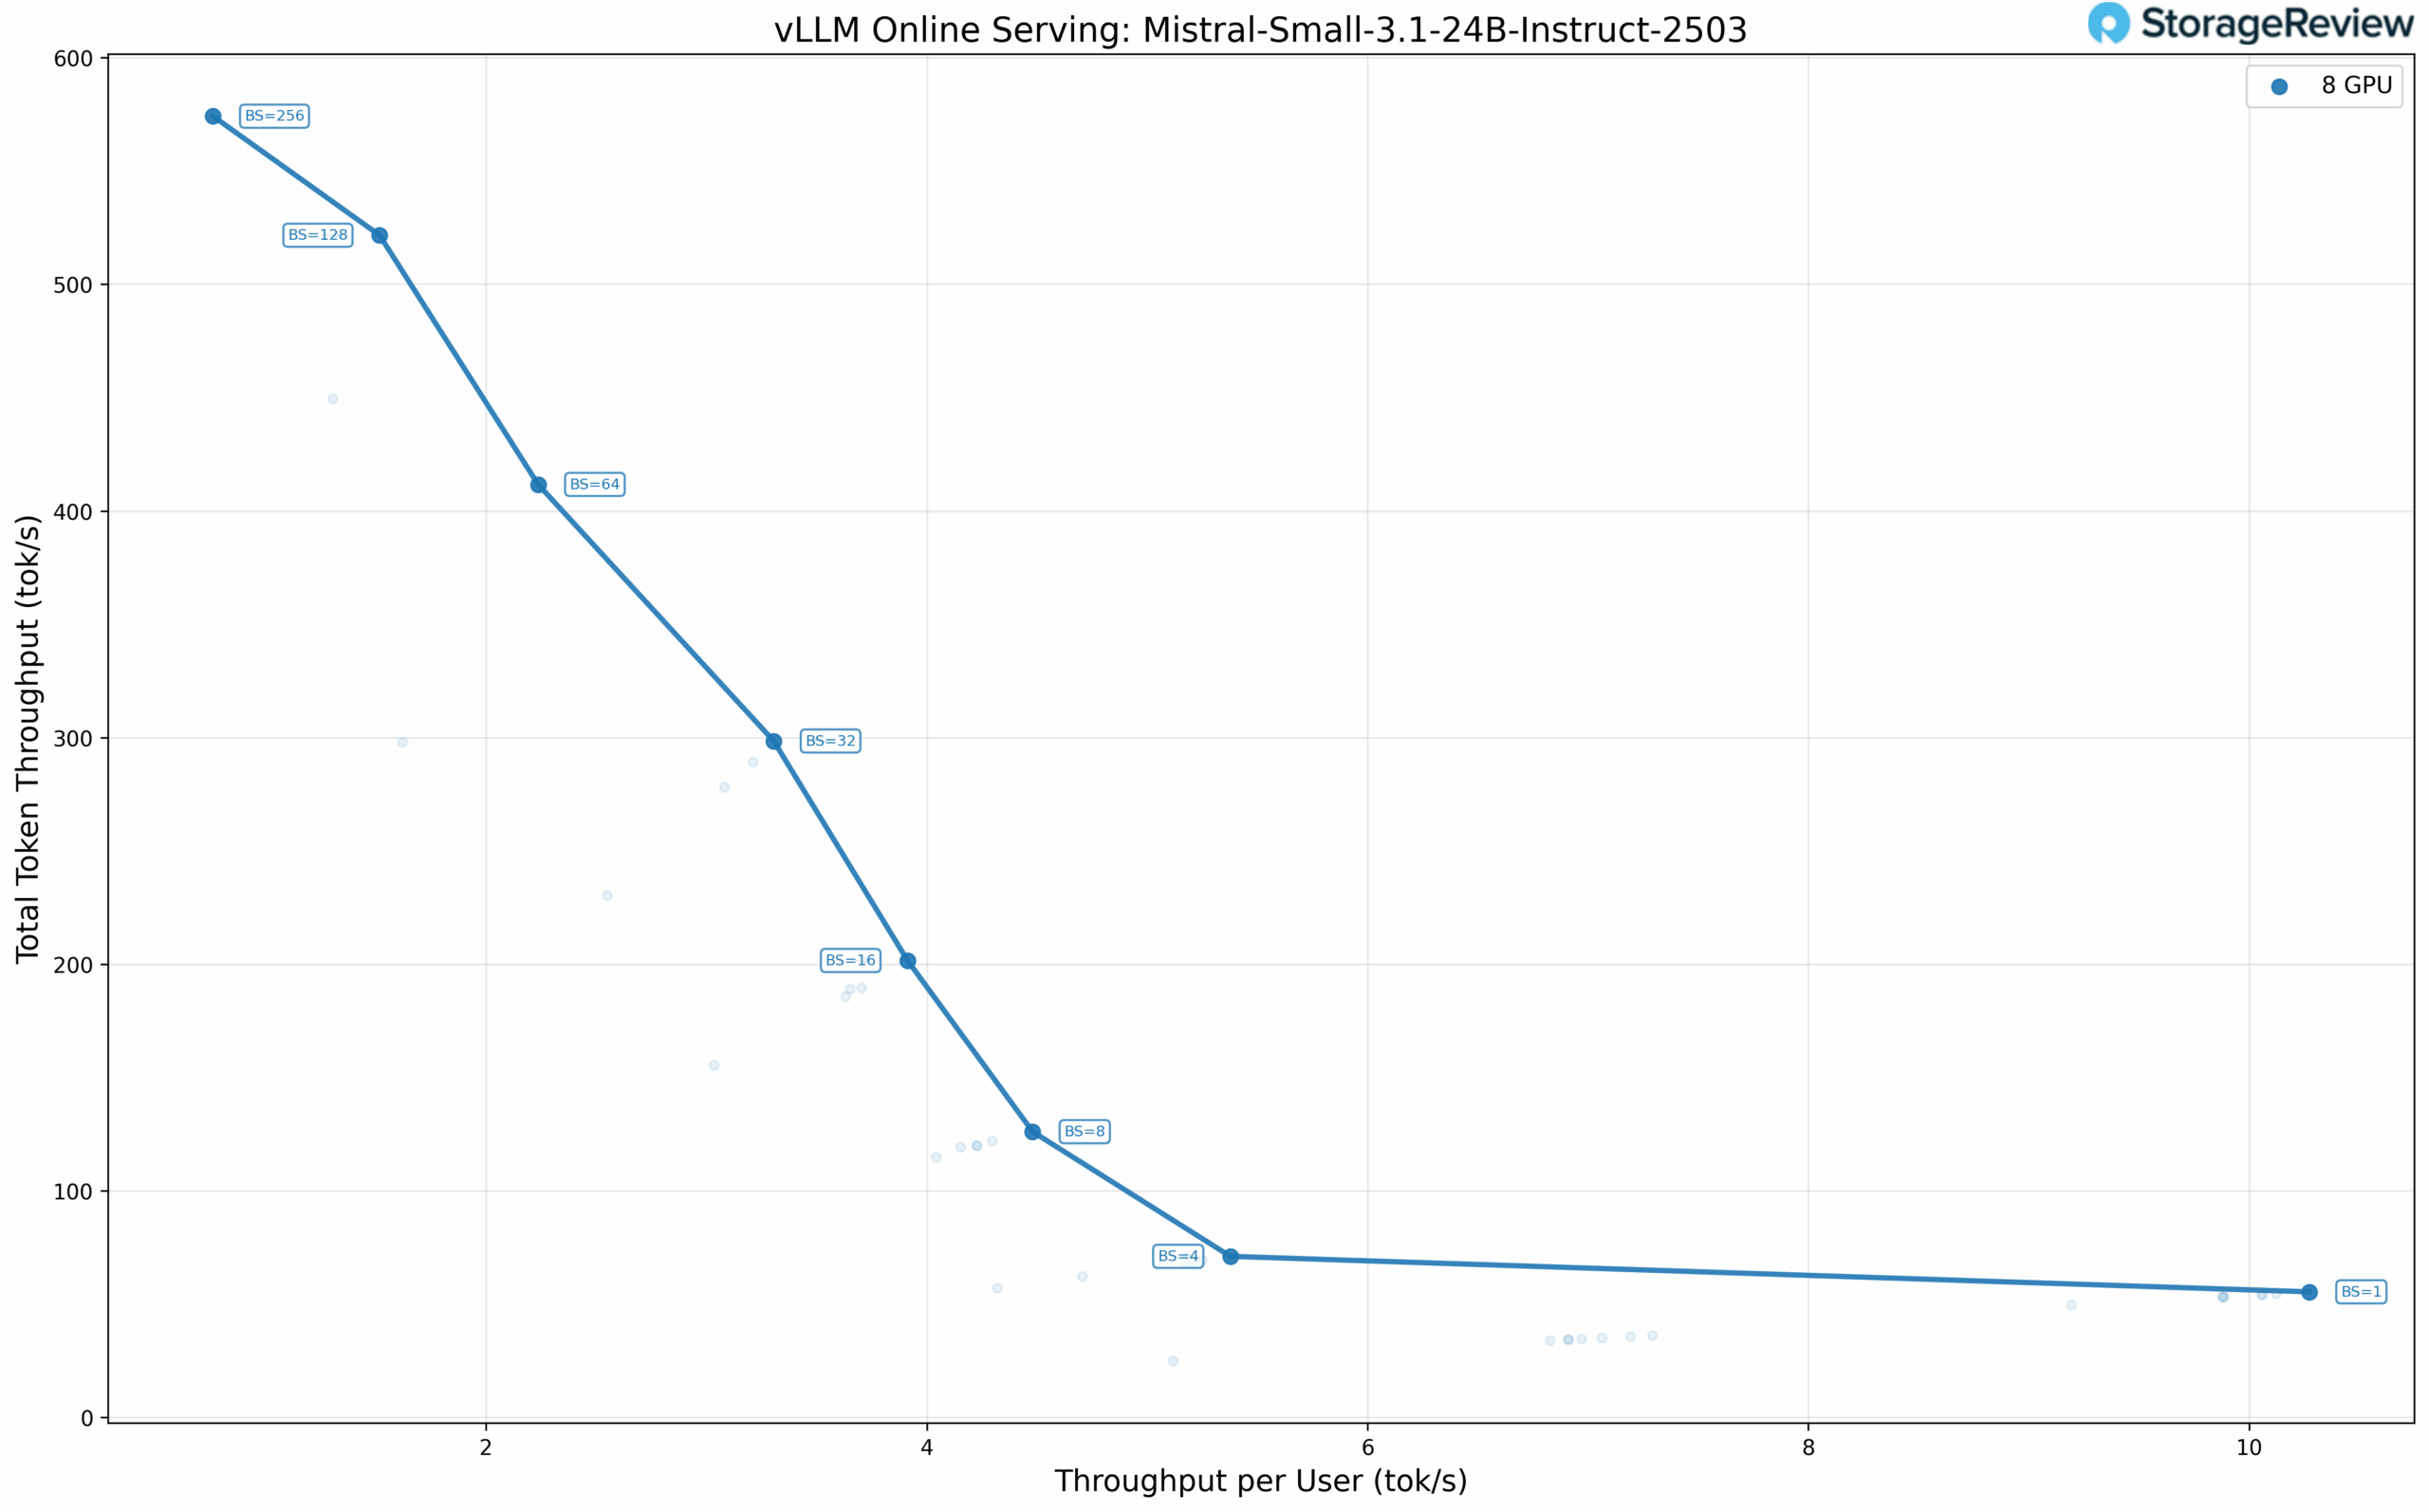
24B 參數的 Mistral 模型代表了更苛刻的工作負載。在 BF16 精度下,該模型在高批次大小下實現了強大的吞吐量擴展性,在所有八個 GPU 上,批次大小為 256 時吞吐量達到了 574.16 tok/s。
發現
所有測試模型都呈現一致的模式:在低批次大小下,使用我們 256 個輸入/輸出令牌的配置時,使用滿足模型擬合所需的最小 GPU 數量,比使用全部八個 GPU 進行分配,能提供更好的單一使用者效能。即使在 PCIe 5.0 速度下,透過 PCIe 進行的 GPU 間通訊開銷也會引入延遲,這種延遲超過了單用戶或低並行場景下並行化帶來的優勢。
這項發現對部署規劃具有實際意義。運行單一使用者編碼助理或低並發代理工作流程的組織可以使用較小的 GPU 配置,即可獲得可接受的效能。完整的八 GPU Battlematrix 配置最適用於批量推理工作負載、合成資料生成或高並發服務場景,在這些場景中,總吞吐量比單次請求延遲更為重要,尤其是在使用需要更多記憶體的大型模型時。
使用 Arc Pro B60s 的經驗
在我們進行的有限測試中,整個過程非常順利。顯示卡的啟動和運作都很簡單,而設定支援 Battlemage 的 vLLM 開發分支 LLM-Scaler 也同樣簡單。然而,該軟體仍處於早期開發階段。測試開始時,我們無法取得任何 GPU 統計數據,而且除了張量並行之外,我們嘗試了其他平行策略,例如專家並行或管線並行,但都無法實現跨多個系統的擴展。不過,考慮到該軟體堆疊仍處於預發布階段,這些限制也在意料之中。
在我們最初發布的 YouTube 短片之後,散熱問題引發了廣泛的討論,許多評論者擔心顯示卡在我們的開放式測試平台上可能會過熱。由於缺乏溫度監測設備,我們最終將顯示卡移至伺服器機箱中,以確保足夠的空氣流通。我們計劃在完整的評測中測試工作站配置下的散熱性能,因為正如英特爾上方宣傳圖所示,最終的 Battlematrix 版本是將這些顯示卡緊密堆疊在工作站機箱中的。
就外形尺寸而言,這些顯示卡比標準工作站顯示卡略長,這可能會造成機箱相容性問題。不過,它們可以輕鬆安裝在伺服器機箱中,因為大多數伺服器機箱在顯示卡前端都預留了額外的空間用於安裝支撐支架。
未來測試計劃
我們計劃在B60s正式發布並全面上市後,重新審視英特爾Battlematrix並進行更全面的評測。我們將透過在各種模型和部署配置下進行額外的vLLM測試來評估LLM推理性能。雖然本次預覽中未展示,但我們觀察到,這些GPU在目前的軟體狀態下,預填操作的效能優於解碼操作。完整的評測將深入研究預填密集型和解碼密集型推理工作負載,以詳細描述此效能表現。
家庭實驗室社群對這些GPU在最熱門的家庭實驗室工作負載之一——媒體伺服器——上的應用表現出了濃厚的興趣。我們計劃在Discord伺服器上與成員們一起測試Plex和Jellyfin等應用程式。專業工作負載也在我們的考慮範圍之內,例如SolidWorks和Autodesk,用於CAD效能測試。此外,我們也計劃使用Proxmox和SR-IOV技術部署一個多用戶VDI伺服器,供Discord成員評估並發桌面密度和雲端遊戲效能。
結語
英特爾 Arc Pro B60 Battlematrix 是一款令人振奮的平台,它以工作站的價格提供了高容量 GPU 記憶體。雙 GPU 卡設計解決了密度限制問題,每個 GPU 分配 24GB 記憶體以滿足 LLM 推理工作負載的需求,而其定價結構則使其成為現有專業 GPU 生態系統的有力替代方案。對於那些優先考慮資料主權和成本效益而非極致效能的企業而言,該平台值得考慮。
軟體成熟度仍是主要限制因素。英特爾透過LLM Scaler對框架優化進行投入,並持續改進驅動程序,表明其致力於維持Arc系列GPU的卓越價值。
目前尚不清楚八GPU的戰鬥矩陣配置與NVIDIA DGX Spark的卓越性能相比,究竟會有多受歡迎。真正值得關注的或許是單卡和雙卡配置,它們600-1,200美元的入門價格將大幅降低私有AI基礎設施探索的門檻。
隨著驅動程式更新和軟體框架的日益成熟,我們將繼續擴大測試範圍。如果您想親自體驗這些功能,歡迎加入我們的Discord 伺服器,我們在那裡提供了一個 B60 存取權限受限的社群伺服器。


 Amazon