

Supermicro 的 JumpStart 計畫採用了截然不同的硬體評估方法。它並非在共享實驗室環境中進行簡短的腳本演示,而是為符合條件的客戶提供免費、限時的裸機訪問權限,讓他們能夠使用一系列真實的生產伺服器。從搭載 Intel Xeon 6 處理器的全新 X14 平台,到配備第五代 AMD EPYC 處理器和大型 HGX GPU 配置的 H14 系統,客戶可以預訂系統,遠端登錄,並像使用自己的機架上的硬體一樣運行自己的工作負載。
快速、明智地做出平台決策,其商業價值便顯而易見。建立一個切實可行的 AI 或高效能運算概念驗證通常意味著等待評估硬體、與多家供應商協調,並寄望於測試配置與計畫部署的配置足夠接近。 JumpStart 消除了這些障礙。團隊無需佔用內部實驗室資源或將大量伺服器運送到全國各地,即可驗證效能、檢查軟體相容性、探索功耗和散熱特性並比較架構。對於大多數組織而言,只需集中一週時間進行正確的配置,就足以確認平台是否符合自身需求,或在做出最終承諾之前將其排除在外。
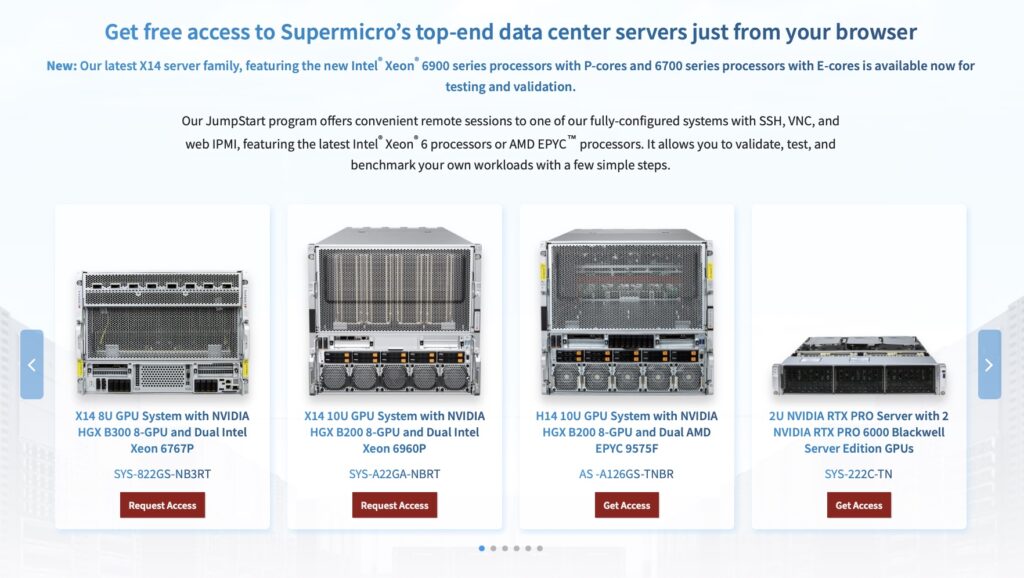
Supermicro JumpStart 啟動頁面
JumpStart 的吸引力不僅在於其線上系統的數量,更在於 Supermicro 願意公開的技術深度。熱門選擇包括搭載 Intel Xeon 6 和 NVIDIA 加速器的 X14 GPU 伺服器、針對密集型 CPU 運算最佳化的搭載第五代 AMD EPYC 處理器的 H14 平台,以及結合了現代 CPU 和全 NVMe 後端的儲存專用系統。在高階產品方面,Supermicro 已提供用於 AI 訓練和推理的 HGX B200 和 B300 級系統,並利用 JumpStart 平台,在簽署保密協議 (NDA) 的前提下,提前展示尚未廣泛上市的下一代平台。我們尚未看到其他任何 OEM 廠商如此積極地將產品正式發布前的基礎設施轉化為結構化、可重複的遠端實驗室體驗。
大多數廠商的展示環境僅限於引導式解決方案實驗室或功能有限的產品沙箱。這些環境雖然有助於學習管理工具和編排工作流程,但很少提供頂級伺服器的根存取權限,也不允許使用者自由安裝和運行自己的技術堆疊。 JumpStart 更像是遠端資料中心的備用機架。預訂特定係統後,您可以在預訂期間透過 SSH、VNC 和 IPMI 取得完全控制權,Supermicro 在下一位客戶使用前擦除並重建環境。實際上,這與其說是行銷演示,不如說是在一個運作良好的遠端實驗室中進行的一次簡短而專注的互動。
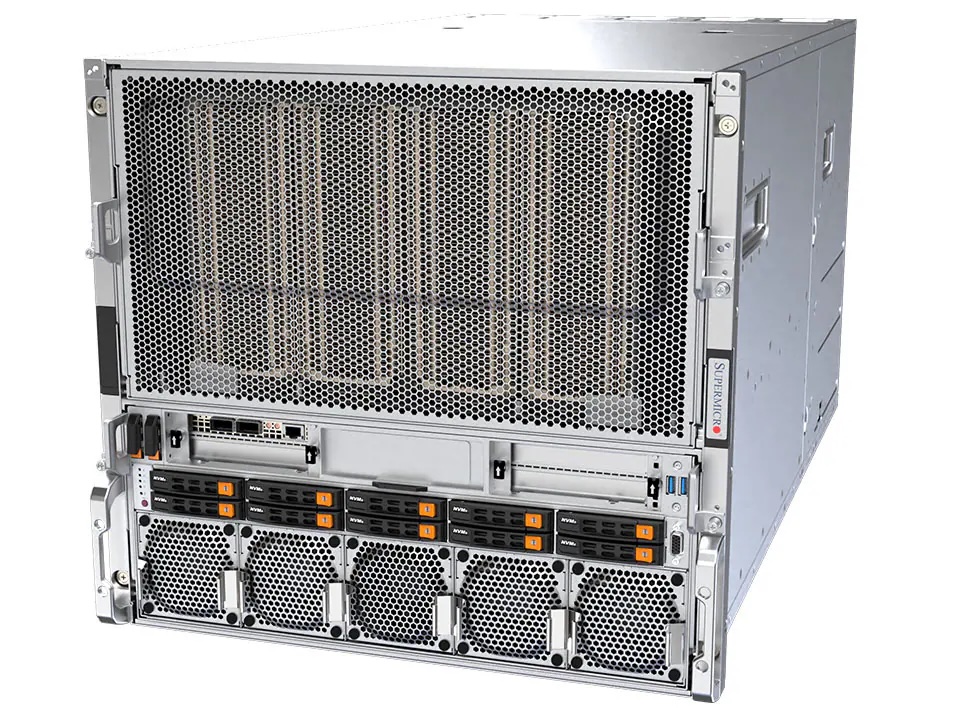
Supermicro JumpStart X14 B200 系統
為了進行本次分析,Supermicro 向 StorageReview 提供了與客戶實際體驗完全相同的 JumpStart 存取權。我們安排了一段時間使用一台X14 10U GPU 伺服器,該伺服器配備了 NVIDIA HGX B200 八 GPU 主機板和兩顆第六代英特爾至強鉑金 6960P 處理器。伺服器配置了 3TB DDR5-6400 ECC 內存、M.2 和 U.2 NVMe SSD 混合用於本地存儲,以及八塊 B200 GPU,每塊 GPU 配備 180GB HBM3e 顯存。在一周的時間裡,我們利用該平台對 AI 工作負載和系統運行情況進行了抽查,重點關注實際買家在部署新一代基礎設施之前最想了解的問題。
我們在Supermicro JumpStart專案的一周
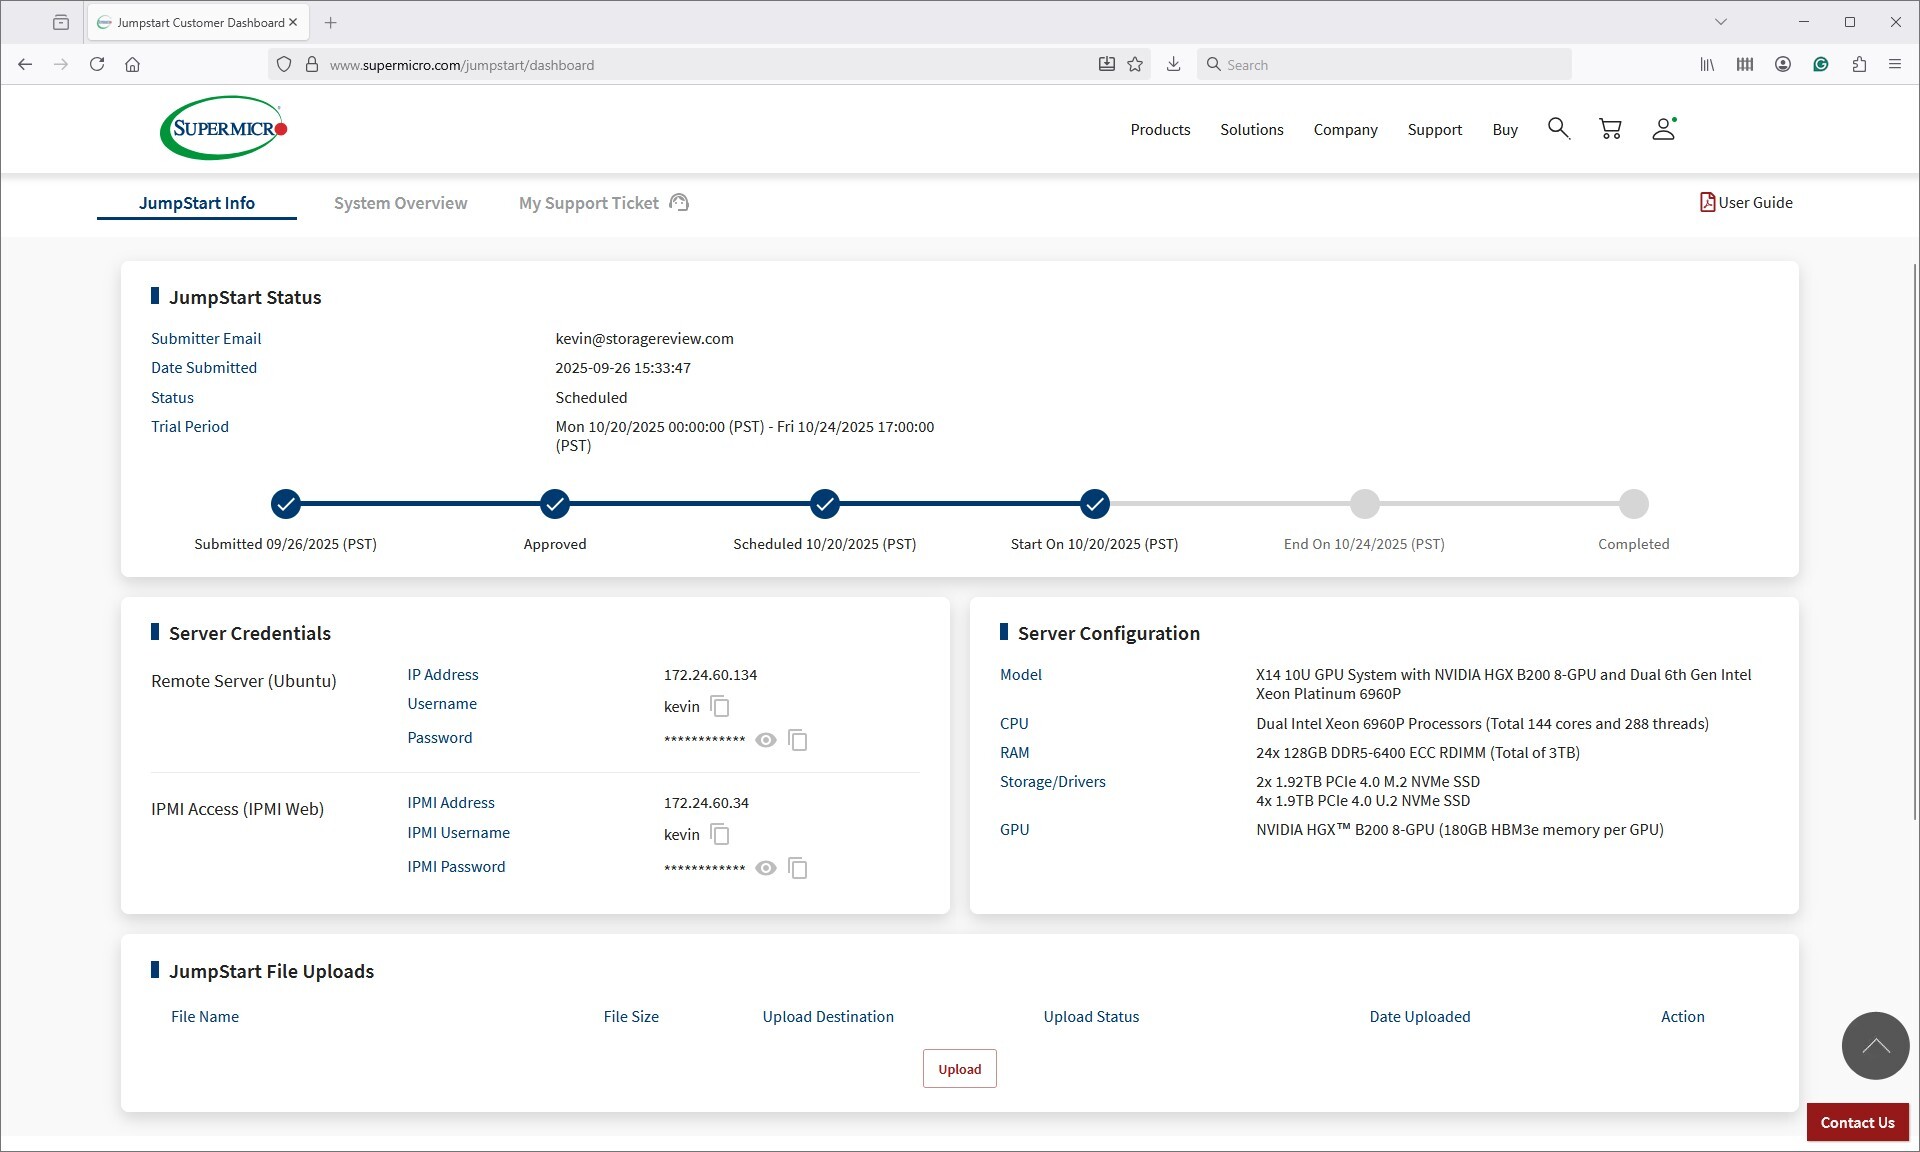
預約窗口開放後,JumpStart 入口網站就成了我們測試的中心樞紐。如下所示的初始儀錶板清楚地展示了預約時間表,並提供了所有必要的啟動信息,包括遠端 Ubuntu 環境的 SSH 憑證和完整的 IPMI 存取權。由於這兩個介面都能立即使用,我們可以在幾分鐘內開始驗證系統,而無需等待配置或技術支援介入。
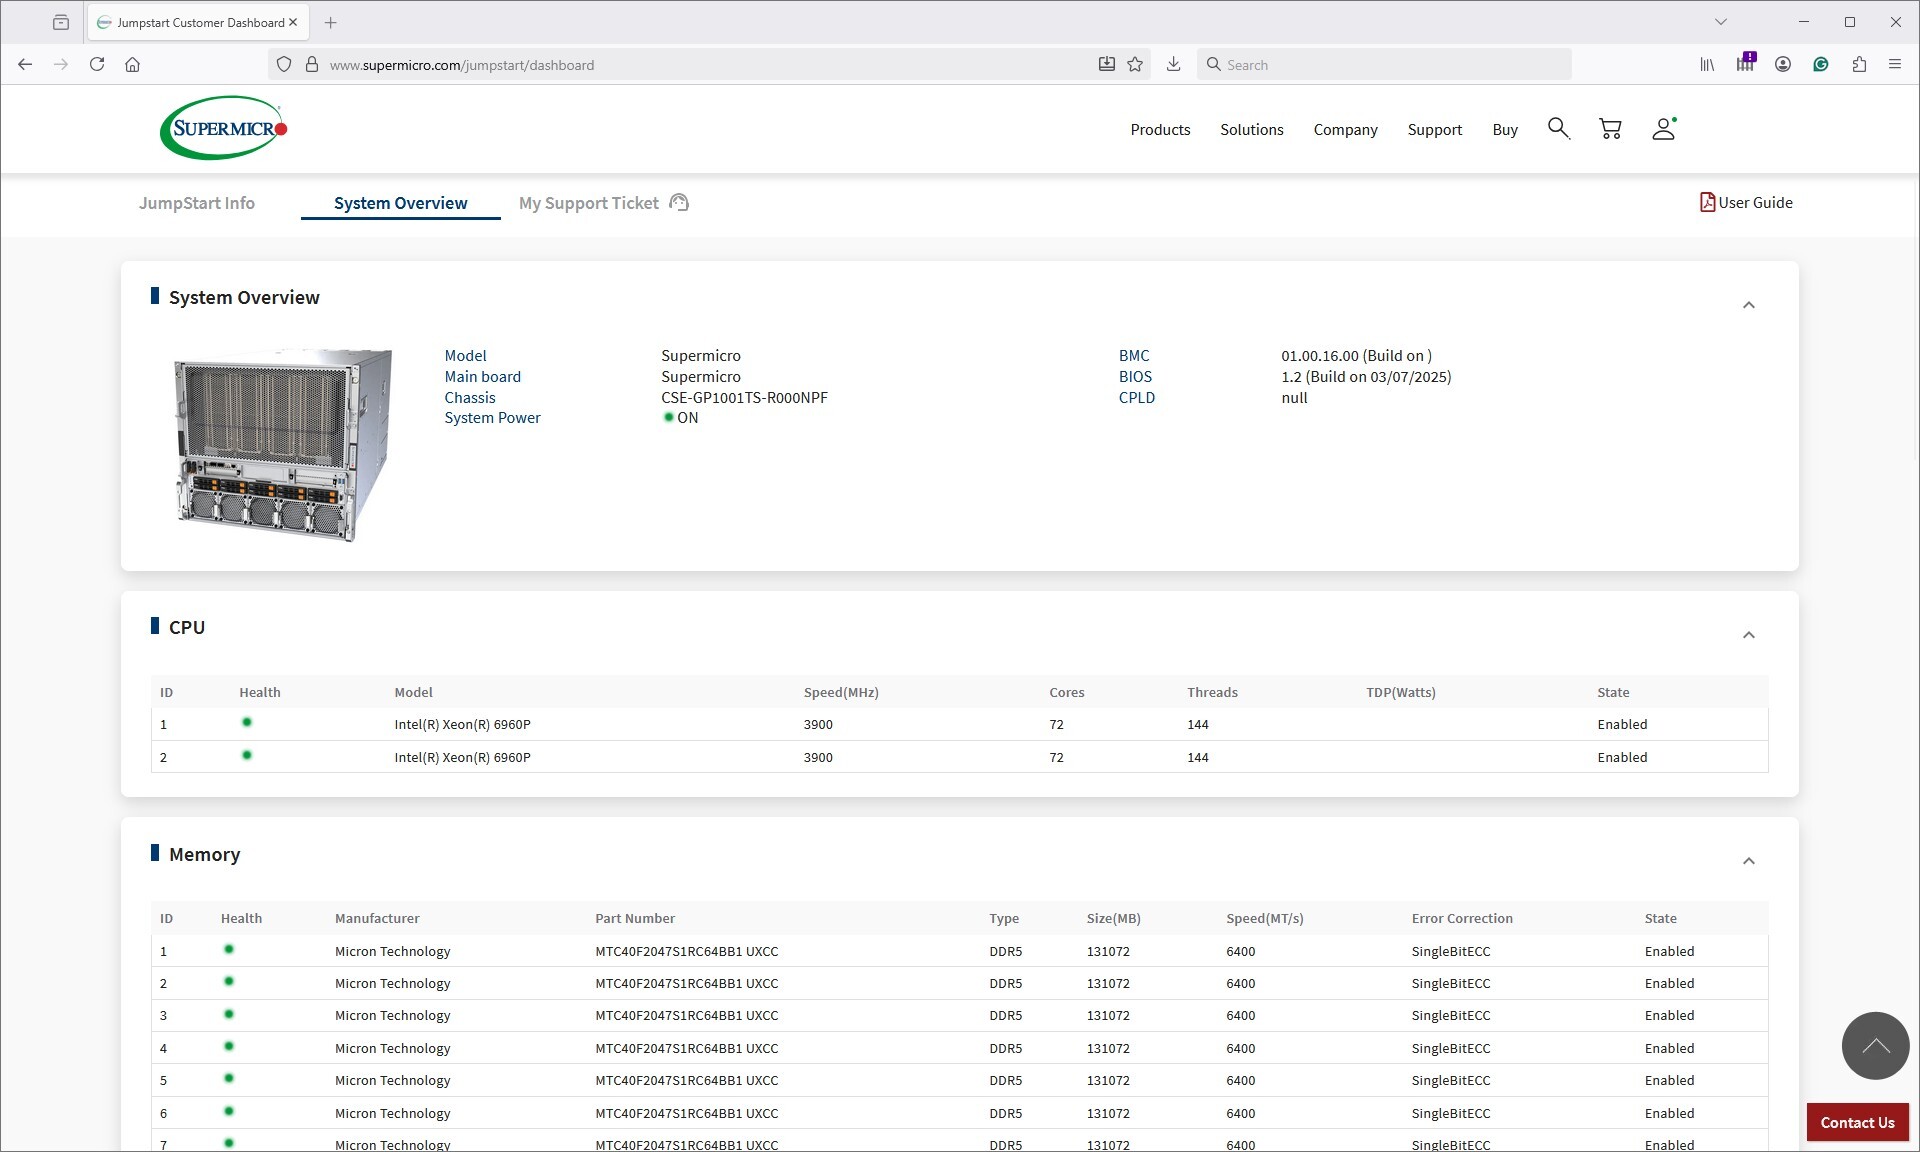
我們工作流程的第一步是確認硬體已準備就緒。透過入口網站的「系統概覽」頁面(見下方截圖),我們驗證了機箱已通電、兩個 CPU 均已被偵測到、記憶體已完全配置,並且 BMC 顯示系統運作狀況良好。這種快速檢查已成為我們實驗室評估的標準流程,而透過入口網站進行遠端查看則簡化了此流程。
系統驗證完畢後,我們開始實際操作。測試資產的檔案上傳直接透過 JumpStart 介面完成,省略了以往在遠端平台上建置資料集的繁瑣步驟。之後,我們透過 SSH 連線進行工作負載部署,並在需要底層存取權或觀察啟動行為時使用 IPMI 遠端控制台。
整個測試週的工作流程與我們在實驗室操作設備非常相似。我們可以快速啟動、停止和迭代工作負載,在需要時重新啟動平台,並在無需Supermicro技術支援的情況下監控硬體運作狀況。作業系統層級的存取權限和完全帶外控制相結合,使得測試環境可預測且高效,尤其適合短週期測試。
預訂結束後,系統會自動回收並重置,順利完成整個專案。這種可預測的流程讓我們能夠專注於測試而非後勤保障,並確保我們充分利用了有限的存取視窗。
GPUDirect儲存效能
我們在Supermicro X14平台上進行的一項測試是Magnum IO GPUDirect Storage (GDS)測試。 GDS是NVIDIA開發的一項功能,它允許GPU在存取儲存在NVMe磁碟機或其他高速儲存裝置上的資料時繞過CPU。 GDS無需透過CPU和系統記憶體路由數據,而是實現GPU與儲存設備之間的直接通信,從而顯著降低延遲並提高數據吞吐量。
GPUDirect 儲存的工作原理
傳統上,當GPU處理儲存在NVMe磁碟機上的資料時,資料必須先經過CPU和系統記憶體才能到達GPU。這個過程會造成瓶頸,因為CPU充當了中間人,增加了延遲並消耗了寶貴的系統資源。 GPUDirect Storage透過允許GPU直接透過PCIe匯流排存取儲存裝置中的數據,消除了這種低效率。這種直接路徑減少了資料傳輸開銷,從而實現了更快、更有效率的資料傳輸。
AI 工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理數 TB 的數據,任何資料傳輸延遲都可能導致 GPU 無法充分利用並延長訓練時間。 GPUDirect Storage 透過確保資料盡快傳輸到 GPU,最大限度地減少空閒時間並最大限度地提高運算效率,解決了這項挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
除了原始頻寬之外,搭載 NVMe-oF (TCP/RDMA) 的 GPUDirect 還能提供超低延遲 I/O。這確保 GPU 永遠不會缺少數據,使該系統成為即時 AI 推理、分析管道和視訊回放的理想選擇。
GDSIO讀取順序吞吐量
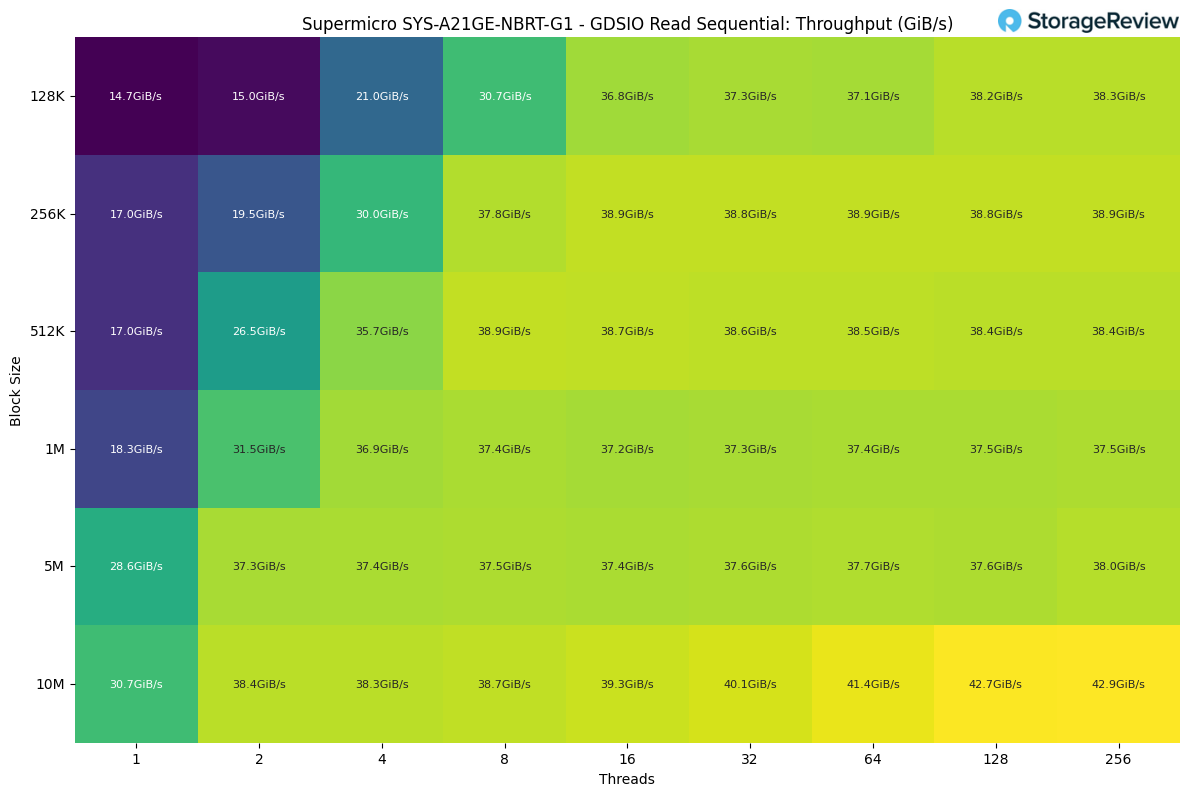
在B200平台上進行GDSIO順序讀取測試時,初始負載較低,單執行緒吞吐量約為14至15GiB/s,具體數值取決於資料區塊大小。隨著執行緒數和資料塊大小的增加,效能迅速提升。當執行緒數增加到2個和4個時,吞吐量更是達到了20至36GiB/s,充分展現了系統在引入並行處理後優異的擴展性。
真正的加速發生在執行緒數達到八個或更多時,此時大多數工作負載的效能都穩定在 30 GiB/s 以上。較大的資料塊受益最大,5MB 和 10MB 的資料塊在所有執行緒數下都能持續提供強勁的效能。
在 256 個執行緒、10M 區塊大小下,吞吐量最終達到約 43GiB/s 的最大值,代表了我們在本次測試中觀察到的最高持續順序讀取速率。
GDSIO 讀取順序延遲
在延遲方面,工作負載初期反應非常迅速,單執行緒讀取較小資料區塊的延遲在 0.06–0.1 毫秒範圍內。隨著線程數的增加,延遲逐漸增大,在大多數工作負載下,即使達到 8 個線程,延遲也保持在 1 毫秒以下。
當執行緒數超過 16 個時,隨著儲存路徑逐漸飽和,更大的資料區塊大小開始將延遲推至毫秒級。最高延遲出現在測試末尾,此時 10M 的資料區塊大小和 256 個執行緒的延遲峰值略高於 1.2 秒(約 1200 毫秒),這反映了旨在使系統不堪重負的最壞情況負載。

GDSIO 寫入順序吞吐量
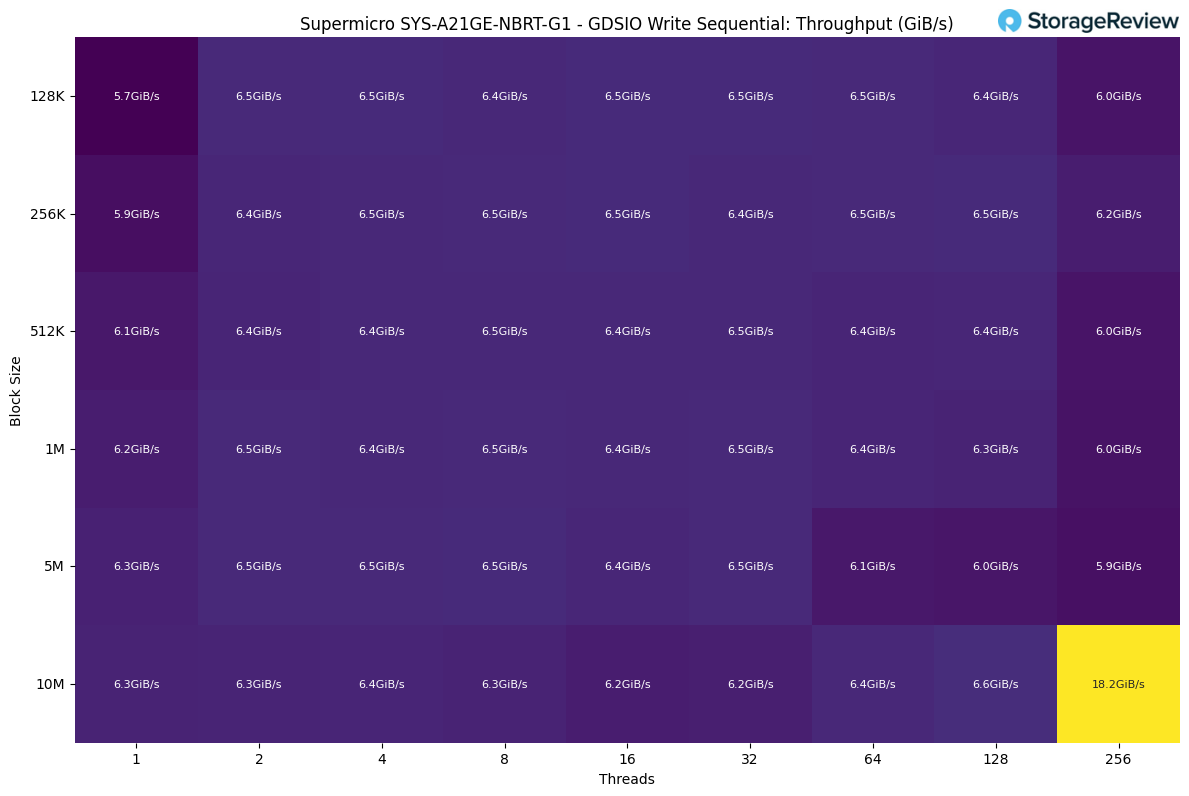
與讀取相比,順序寫入的效能波動要小得多。工作負載很快就穩定下來,大多數執行緒和區塊大小組合的效能都穩定在 6.3–6.5 GiB/s 左右。這表明寫入路徑很早就達到了一個穩定的上限,這可能與儲存媒體和緩衝有關,而不是 GPU 或 PCIe 的限制。
增加線程數並沒有產生顯著影響,吞吐量在 2 到 128 個線程之間基本保持不變。唯一突出的結果出現在最後階段,在 256 個執行緒下,10M 的資料區塊大小峰值達到了 18.2GiB/s,這表明當系統能夠充分利用深度佇列和寫入聚合時,效能會有短暫的優勢。
GDSIO 寫入順序延遲
寫入延遲起初相對較低,單執行緒工作負載在較小資料區塊大小下約為 0.15–0.5 毫秒。隨著執行緒數的增加,寫入延遲的成長速度遠超讀取延遲,四執行緒時達到 1–4 毫秒,八執行緒時達到 4–9 毫秒。
當執行緒數達到 32 個且資料區塊大小增大時,延遲急劇增加,5M 和 10M 的資料區塊延遲躍升至 170-350 毫秒。最極端的情況是 256 個執行緒使用 10M 的資料區塊,延遲峰值接近 3 秒(約 2900 毫秒),這清楚地表明在高並行負載下,寫入路徑很快就會飽和。

GDSIO隨機讀取吞吐量
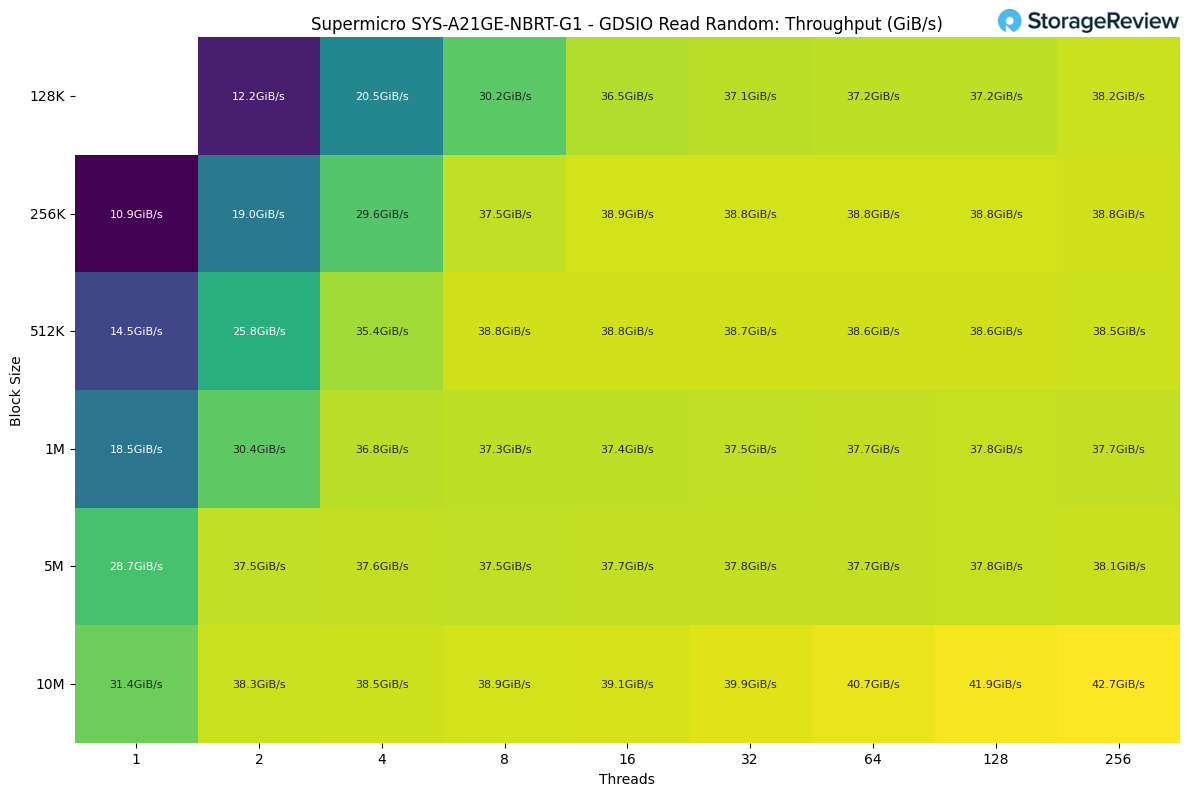
對於隨機讀取任務,工作負載迅速提升。單執行緒效能約為 11–31GiB/s,具體數值取決於資料區塊大小,較大的資料區塊能立即受益於更高的頻寬。當線程數增加到兩個線程和四個線程時,吞吐量攀升至 20–36GiB/s,展現出早期就非常強的擴展性。
從 8 個執行緒開始,系統效能穩定在 30GiB/s 以上的高位,與我們在順序讀取測試中觀察到的結果非常相似。最高結果是在 10M 區塊大小和 256 個執行緒的情況下獲得的,峰值約為 42.7GiB/s。
GDSIO隨機讀取延遲
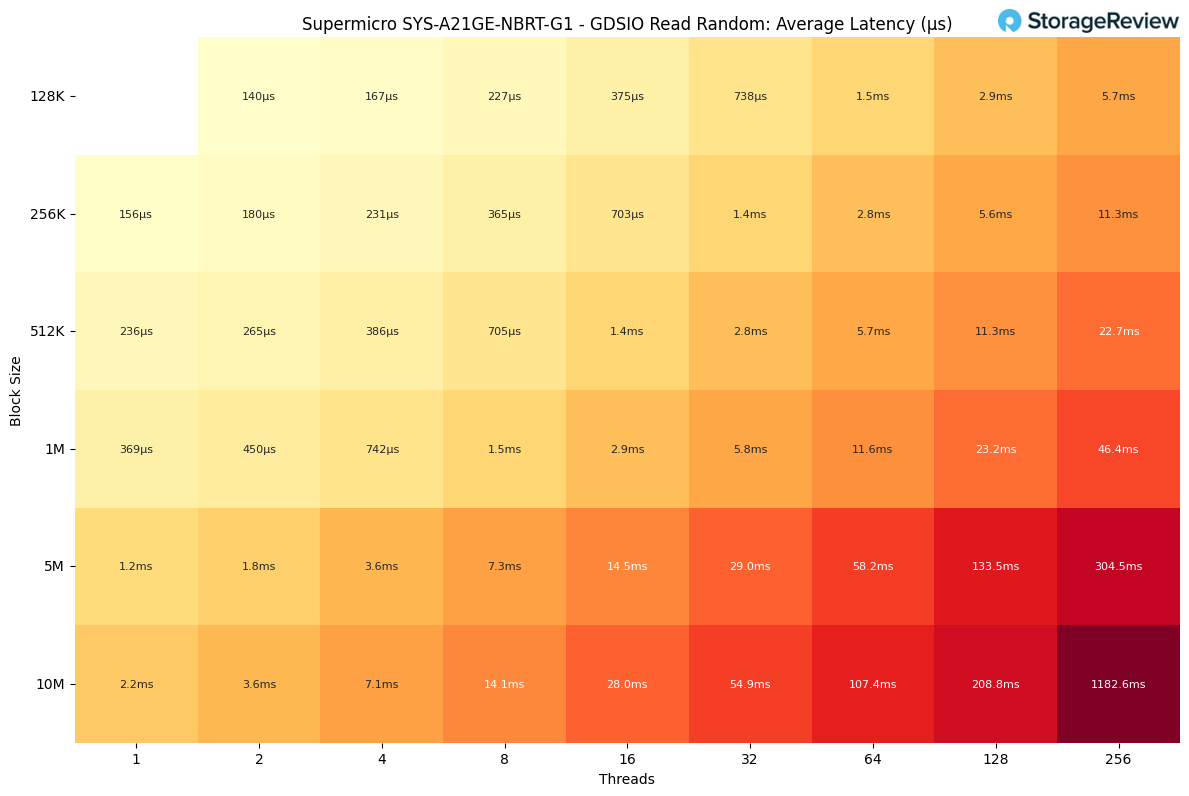
隨機讀取延遲一開始非常低,單執行緒工作負載在較小資料區塊大小下約為 0.15–0.4 毫秒。隨著執行緒數的增加,延遲逐漸上升,在 4 個執行緒時保持在 1 毫秒以下,到 8 個執行緒時達到約 1–3 毫秒。
一旦我們將執行緒數增加到 32 個,資料區塊大小也增大,延遲就急劇上升,5M 和 10M 的資料傳輸延遲就達到了 30-55 毫秒。最極端的情況出現在 256 個執行緒、資料區塊大小為 10M 時,此時延遲峰值略高於 1.1 秒(約 1180 毫秒)。
GDSIO 隨機寫入吞吐量
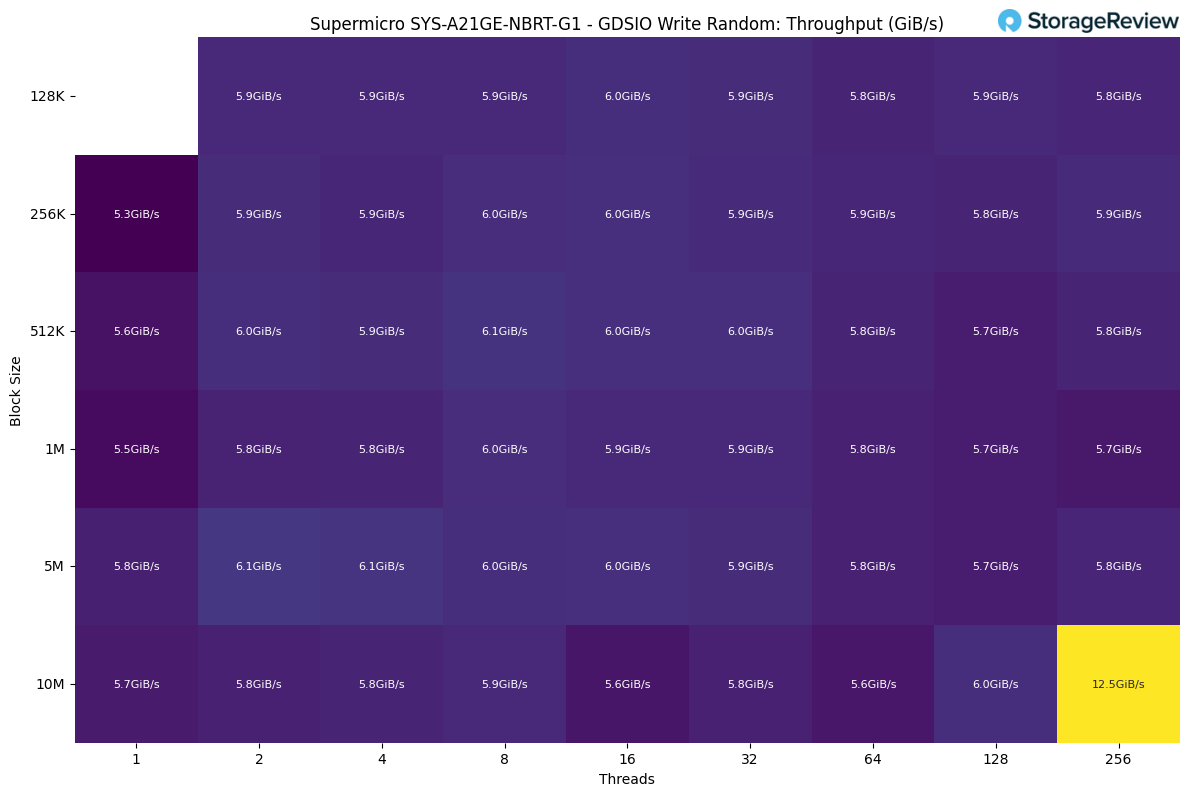
隨機寫入效能總體上非常穩定,大多數區塊大小和執行緒數下的效能都穩定在 5.8–6.1GiB/s 左右。工作負載幾乎立即達到這個水平,隨著執行緒數的增加,效能擴展性很差,表明寫入路徑很早就達到了極限。
唯一值得注意的異常值出現在測試的最後,在 256 個執行緒下,10M 區塊大小短暫地飆升至 12.5GiB/s,這可能是由於在高並行負載下,深度佇列和寫入聚合所致。
GDSIO隨機寫入延遲
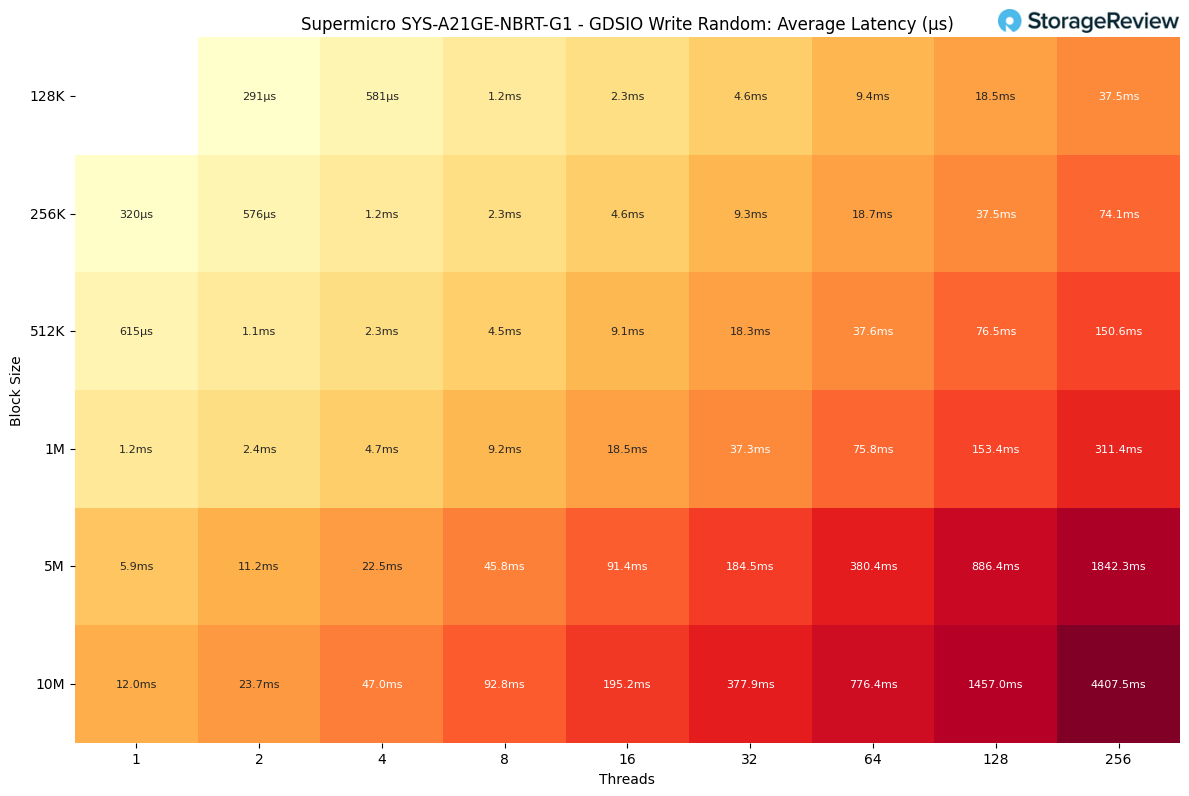
隨機寫入延遲初始值相對較低,單執行緒效能在較小資料區塊大小下約為 0.6–1.2 毫秒,最大資料區塊傳輸時約為 5–12 毫秒。隨著並發數的增加,延遲迅速增加,8 個執行緒時達到 4–9 毫秒,32 個執行緒時達到 18–38 毫秒。
超過這個點後,寫入路徑就飽和了。在 64 個執行緒的情況下,更大的資料區塊大小會導致延遲飆升至 150–380 毫秒,而繼續擴展則會使延遲急劇增加。最糟糕的情況是 256 個執行緒下使用 10M 的資料區塊大小,延遲最高約 4.4 秒。
vLLM 線上服務 – LLM 推理效能
vLLM 是目前最受歡迎的 LLM 高吞吐量推理和服務引擎。 vLLM 線上服務基準測試是一種效能評估工具,用於衡量該推理引擎在並發請求下的實際服務能力。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境的工作負載,並可配置請求速率、輸入/輸出長度和並發客戶端數量等參數。此基準測試會測量關鍵指標,包括吞吐量(每秒令牌數)、首令牌時間 (TTF) 和單次輸出令牌時間 (TPOT),幫助使用者了解 vLLM 在不同負載條件下的效能。
我們測試了涵蓋各種架構、參數規模和量化策略的一系列模型的推理效能,以評估不同並發配置下的吞吐量。
密集模型性能
密集模型遵循傳統的LLM架構,在推理過程中所有參數和激活函數都會被調用,因此其計算量比稀疏模型更大。為了全面評估不同模型規模和量化策略下的性能特徵,我們對Llama 3.1 8B系列中的多種密集模型配置進行了基準測試。
我們的測試套件包含 Meta Llama 3.1 8B 模型在三種精確度格式下的評估:預設配置,以及使用 NVIDIA NVFP4 格式的 FP8 和 FP4 量化版本。需要注意的是,vLLM 目前使用 Marlin 核心來處理 NVFP4 量化模型,因此在這些基準測試中尚未完全發揮該量化格式的效能優勢。未來針對原生 NVFP4 張量核心操作的 vLLM 最佳化可能會帶來進一步的效能提升。這種模型選擇策略能夠實現直接的效能比較,同時隔離漸進式量化對推理吞吐量的影響。
Llama 3.1 8B 性能
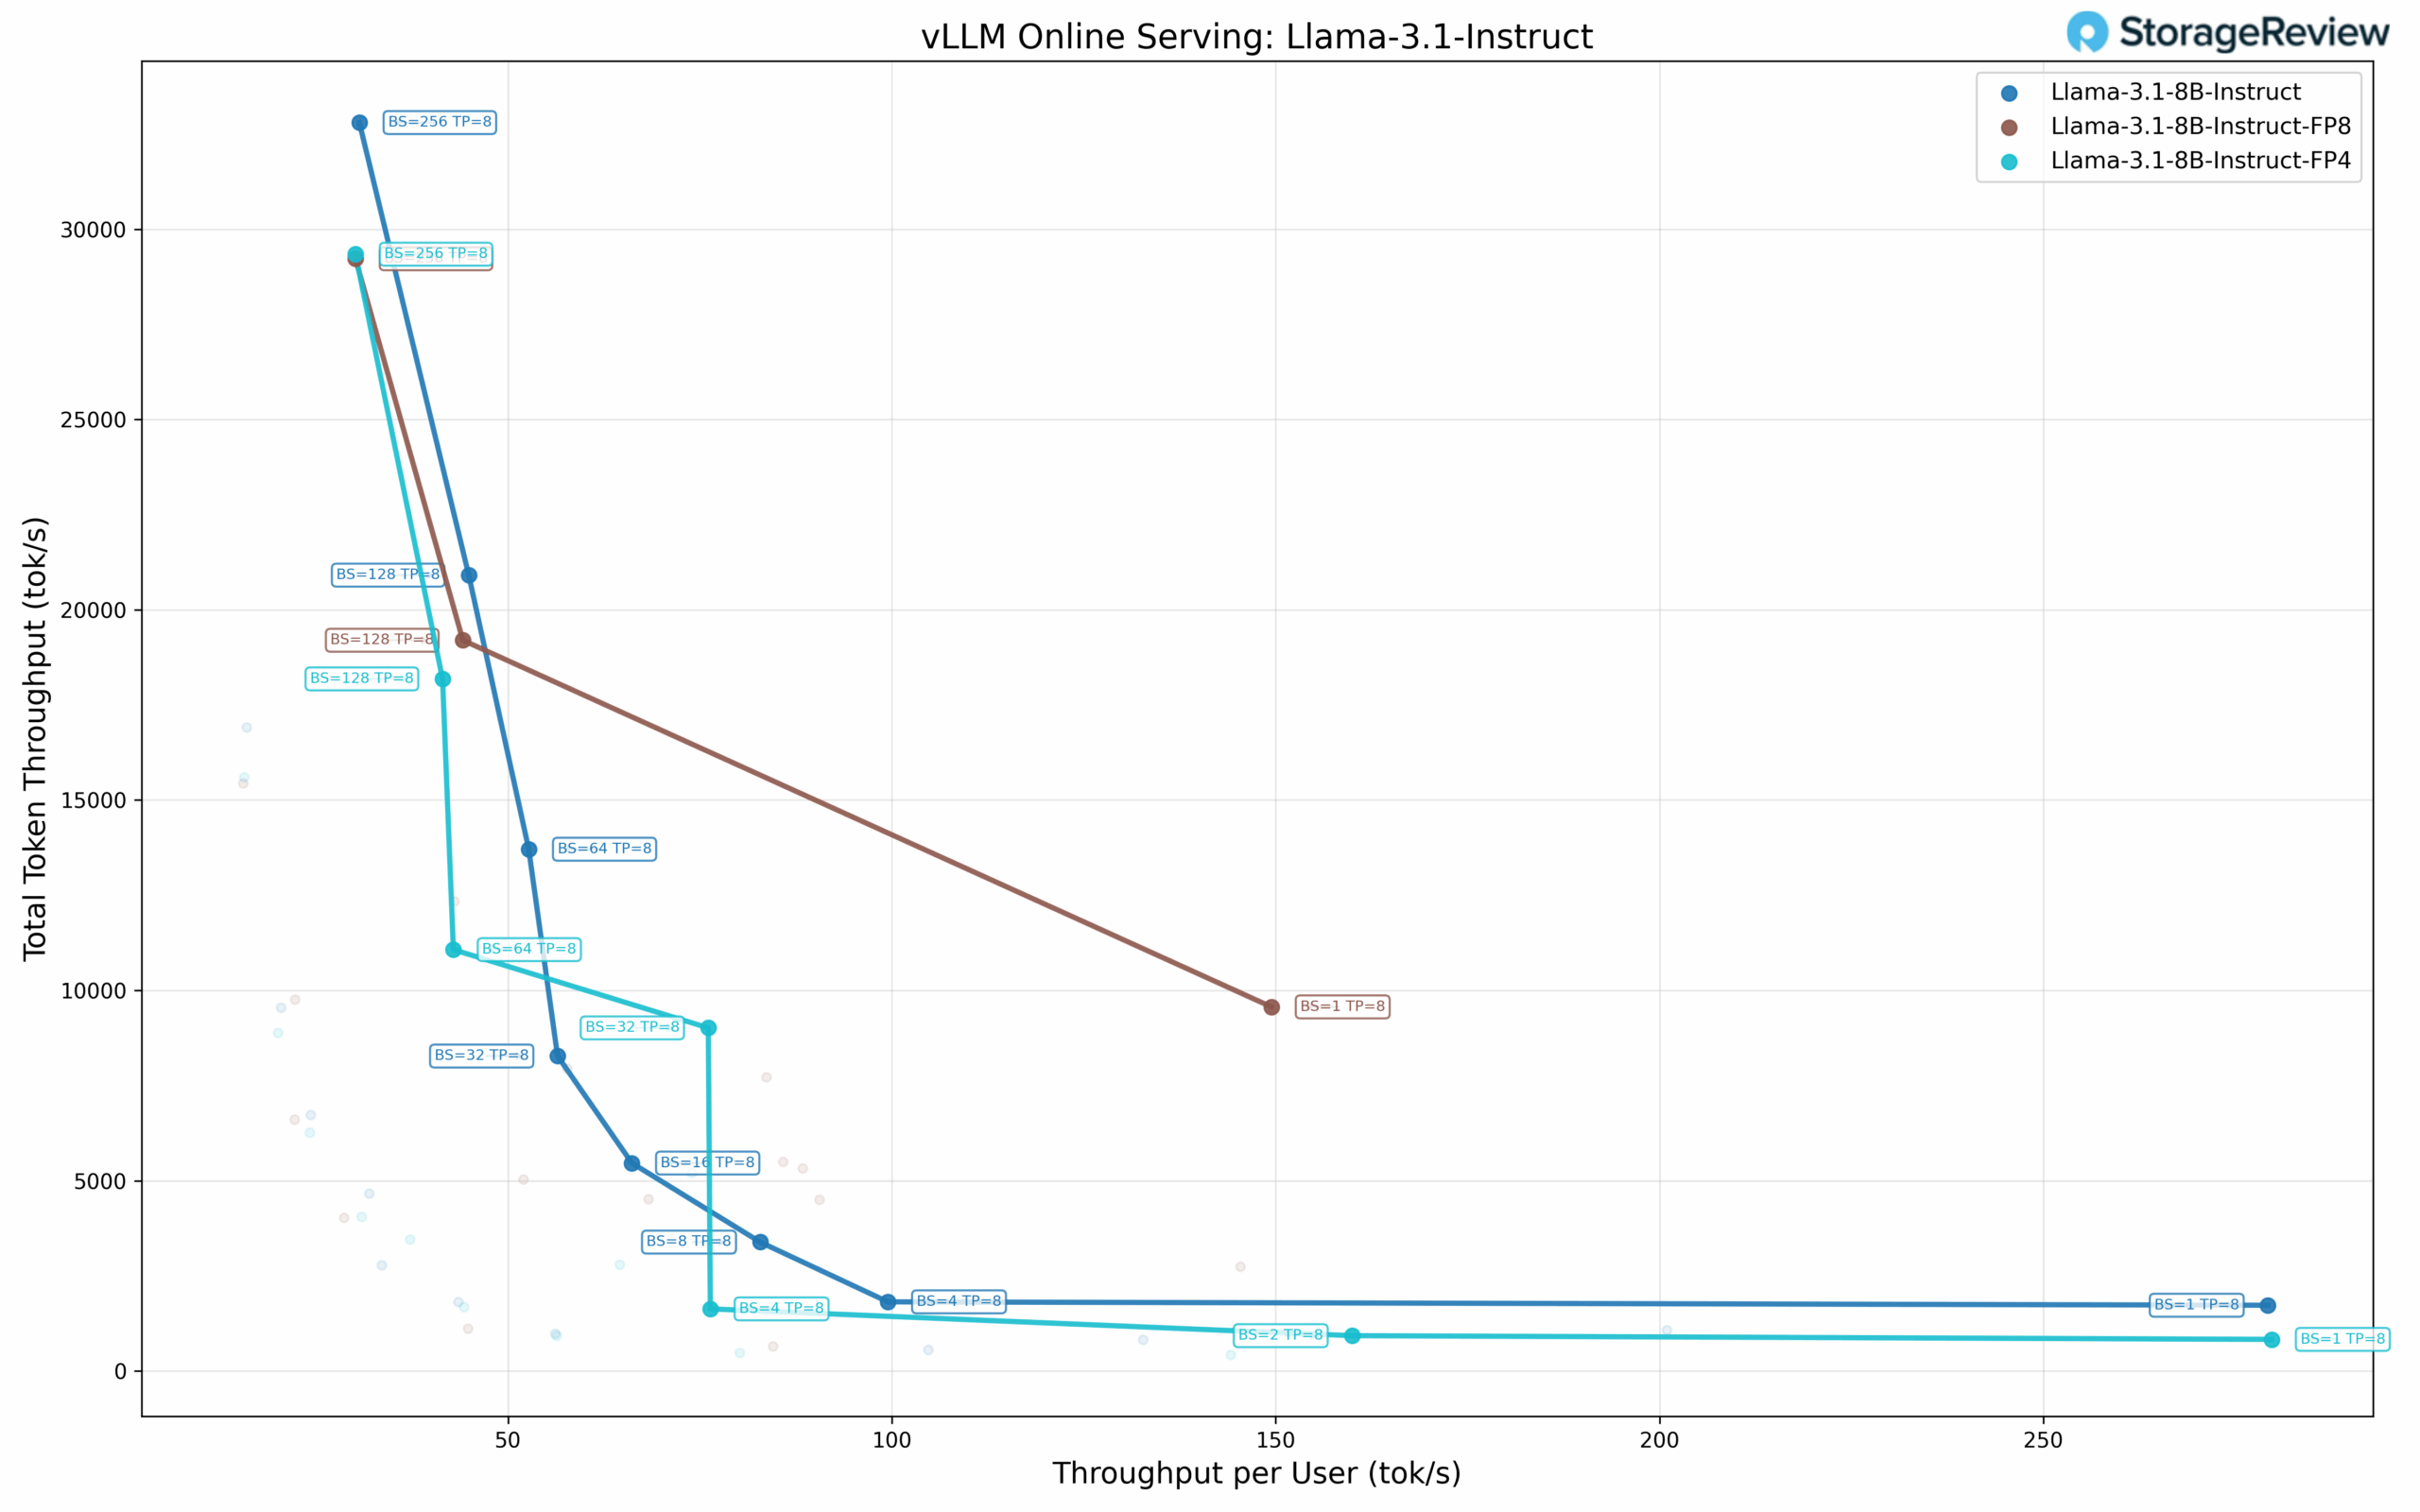
Llama 3.1 8B 在標準精度下展現出以下並發等級的擴展特性。在單一使用者並發(BS=1)時,此模型每個使用者吞吐量為 279.27 tok/s,總吞吐量為 1,727.62 tok/s,TPOT 為 3.37 ms。隨著批次大小的增加,每個用戶的吞吐量下降,而總吞吐量上升。當 BS=8 時,模型每個使用者吞吐量達到 82.85 tok/s,總吞吐量為 3,386.48 tok/s,TPOT 為 3.28 ms。效能持續提升,直至 BS=32(每個用戶 56.46 tok/s,總吞吐量 8,274.66 tok/s)和 BS=64(每個用戶 52.70 tok/s,總吞吐量 13,707.66 tok/s)。
此模型在 BS=256 時達到最大總吞吐量,為 32,797.67 tok/s,平均每個用戶吞吐量為 30.64 tok/s,TPOT 為 16.13 ms。與單一用戶效能相比,總吞吐量提高了 19 倍。在 BS=64 時,TPOT 值保持在 3-4 ms 範圍內,而在 BS=256 時增加到 16.13 ms。
Llama 3.1 8B FP8 效能
FP8量化變體展現出不同的特性。當BS=1時,每位使用者的吞吐量為149.46 tok/s,總吞吐量為9,565.20 tok/s,TPOT為3.44 ms。帕累托前沿分析揭示了三個最適解(BS=1、BS=128、BS=256)。
在 BS=128 時,此模型每位使用者可提供 44.12 tok/s 的吞吐量,總吞吐量為 19,198.40 tok/s,耗時 11.04 毫秒。
TPOT。最大總吞吐量出現在 BS=256 時,總吞吐量為 29,219.67 tok/s,每用戶 30.13 tok/s,TPOT 為 13.26 ms。 FP8 變體的最大總吞吐量低於標準精度(29.2K tok/s 對比 32.8K tok/s)。
Llama 3.1 8B FP4 效能
FP4 量化配置顯示下列結果。在單一使用者並發 (BS=1) 時,每位使用者可達到 279.73 tok/s,總吞吐量為 830.46 tok/s,TPOT 為 3.43 ms。
FP4 模型顯示了七個帕累托前沿點。當 BS=2 時,每個使用者吞吐量為 159.95 tok/s,總吞吐量為 928.60 tok/s,TPOT 為 3.43 ms。效能持續提升,BS=4 時每個使用者吞吐量為 76.36 tok/s,總吞吐量為 1,631.69 tok/s,BS=32 時每個使用者吞吐量為 76.09 tok/s,總吞吐量為 9,014.29 tok/s。此模型在 BS=256 時達到最大總吞吐量,為 29,340.89 tok/s,每個使用者吞吐量為 30.13 tok/s,TPOT 為 16.18 ms。
稀疏模型效能
稀疏模型,特別是專家混合模型(MoE)架構,是一種新興的高效擴展語言模型的方法。這些架構在保持較高總參數數量的同時,每個詞元僅激活一部分參數,從而有可能提高每個激活參數的性能。
我們評估了兩種 MoE 架構:DeepSeek-R1(一種專注推理的模型)和 Qwen3 Coder 30B-A3B(專用於程式碼產生的稀疏架構)。 DeepSeek-R1 是最受歡迎的側重推理的模型,與傳統語言模型相比,它展現出顯著的表現特徵。 Qwen3 Coder 模型保留了 3 億個參數,但每個產生的標記僅啟動 30 億個參數。我們對 Qwen3 Coder 進行了基準測試,分別測試了其在標準語言和 FP8 量化語言環境下的效能,以了解不同量化策略下的效能特徵。
DeepSeek-R1 性能
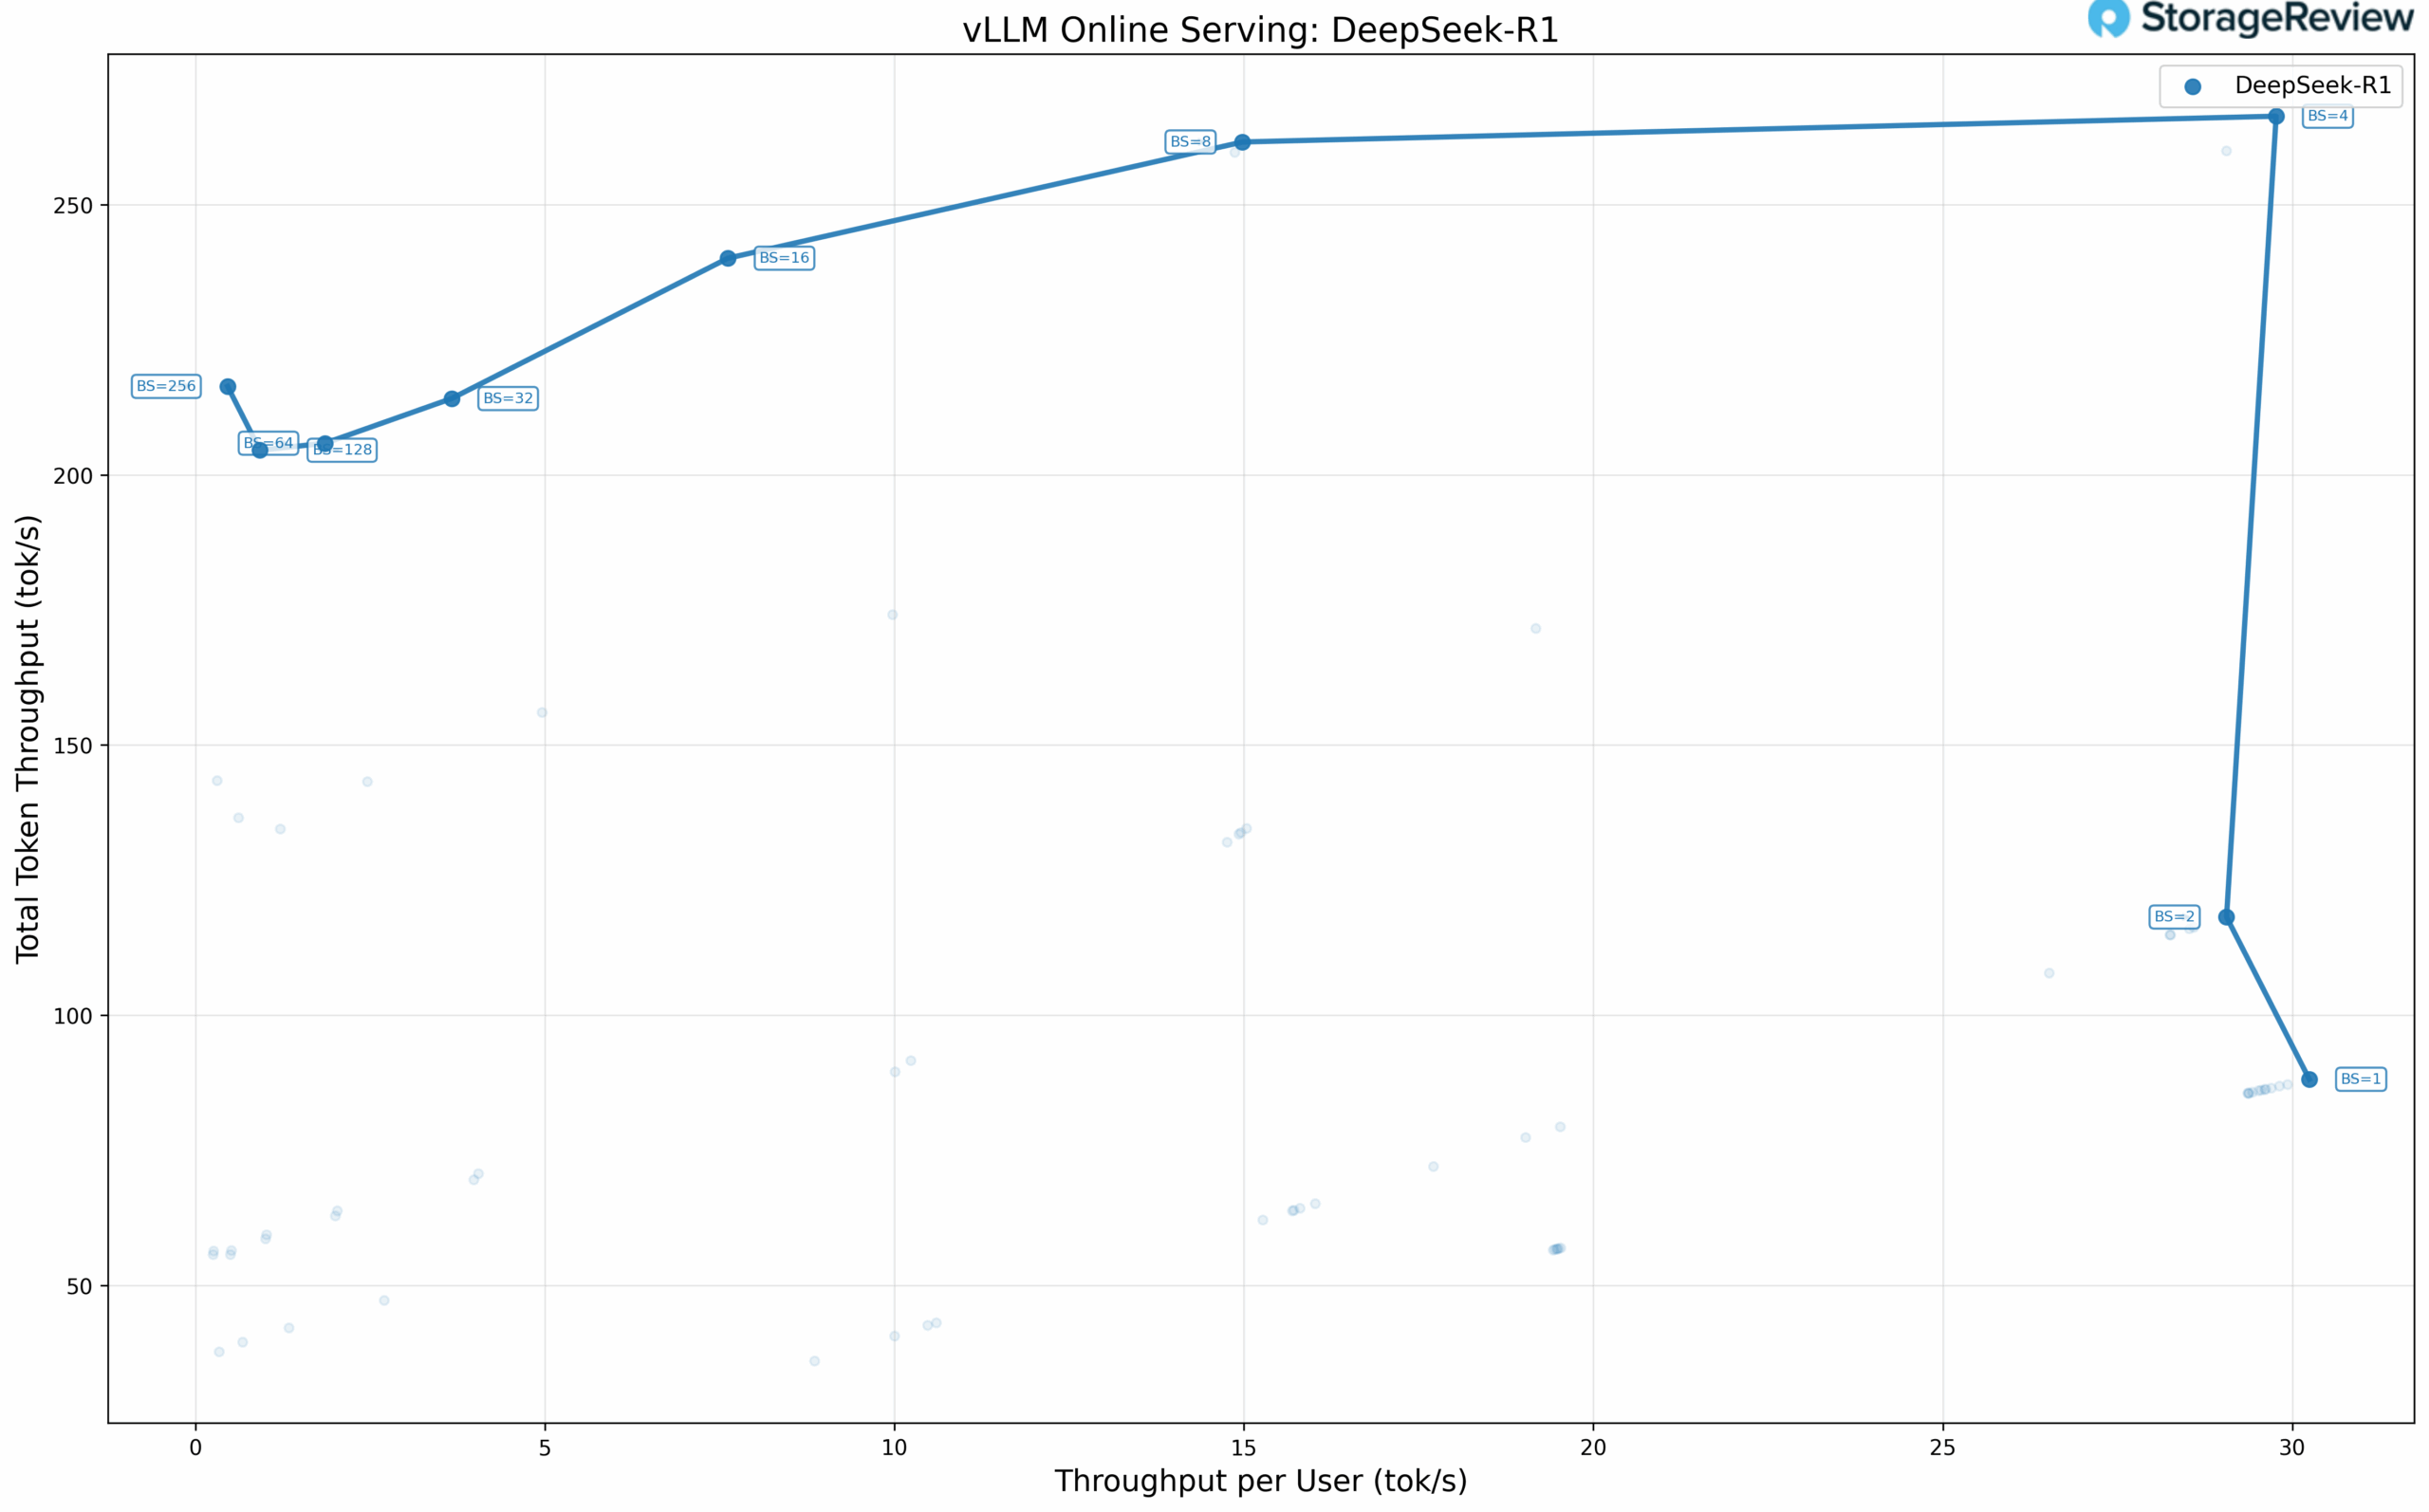
DeepSeek-R1 模型在不同批次大小下展現有趣的擴展性。在單一使用者並發(BS=1)時,此模型每位使用者可達到 30.24 tok/s 的處理速度,總吞吐量為 88.13 tok/s,TPOT 為 29.85 ms。當批次大小擴展至 BS=4 時,每位使用者的效能提升至 29.77 tok/s,總吞吐量達到 266.40 tok/s,TPOT 為 32.04 ms,這是所有配置下所能達到的最大總吞吐量。
DeepSeek-R1 的效能在批次大小 (BS) 超過 4 後趨於穩定。當 BS=8 時,每位使用者的吞吐量急遽下降至 14.98 tok/s,並且隨著批次大小的增加,吞吐量持續下降,在 BS=256 時僅為每個使用者 0.46 tok/s。在 BS=4 到 BS=256 的範圍內,總吞吐量保持在 200 到 260 tok/s 之間相對穩定,這是因為模型無法在單一節點上擴展以應對更多的並發請求,導致延遲增加而吞吐量沒有顯著提升。值得注意的是,B200 DGX 是少數能夠運行這種大規模模型的單一伺服器解決方案之一。
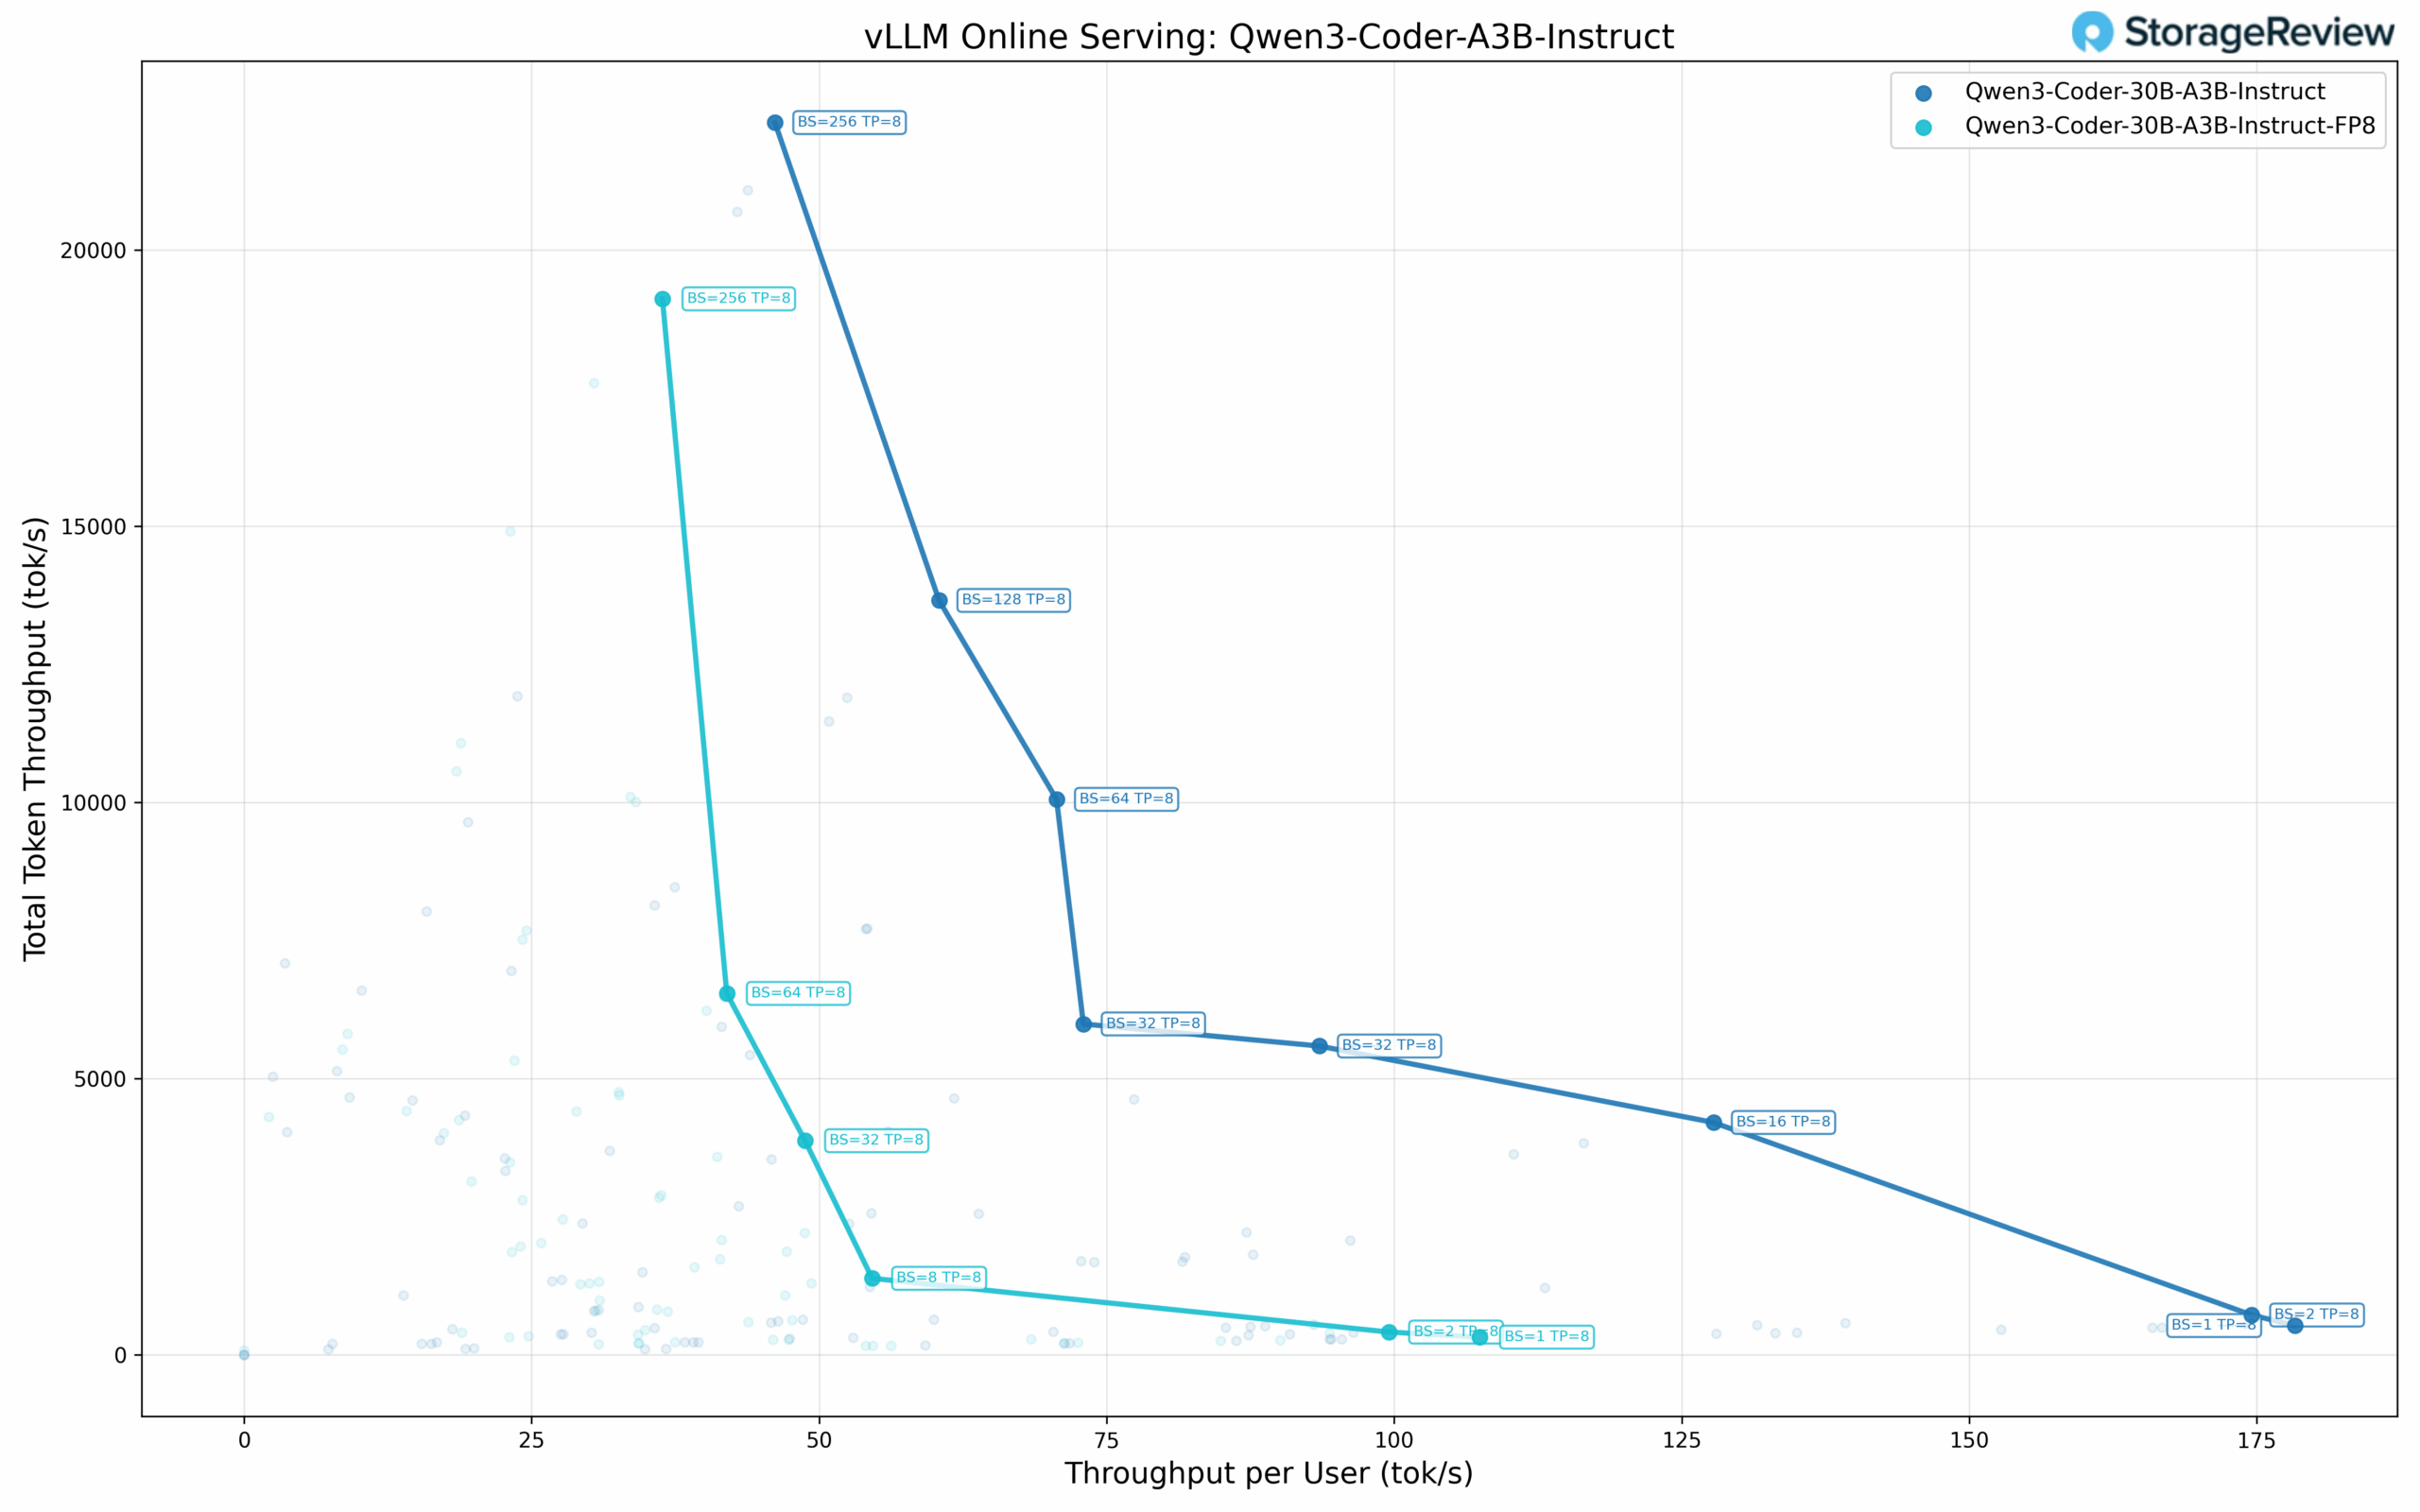
Qwen3 Coder 30B-A3B 性能
標準精度的 Qwen3 編碼器在不同並發等級的性能表現如下。在單一使用者並發(BS=1)時,此模型每個使用者的吞吐量為 178.30 tok/s,總吞吐量為 527.25 tok/s,TPOT 為 5.46 ms。當 BS=2 時,每位使用者的效能提升至 174.56 tok/s,總吞吐量達到 718.70 tok/s,TPOT 為 5.60 ms。隨著批次大小的增加,每個用戶的吞吐量下降,而總吞吐量則持續增長:當 BS=16 時,每個用戶的吞吐量為 127.76 tok/s,總吞吐量為 4,204.40 tok/s,TPOT 為 6.93 ms。
此模型在 BS=256 時達到最大總吞吐量,總吞吐量為 22,305.88 tok/s,平均每個用戶吞吐量為 46.16 tok/s,TPOT 為 17.64 ms。帕累托前緣包含八個不同的點,其中 BS=32 處有一個重複的點(總吞吐量為 72.97 tok/s,平均每個用戶吞吐量為 93.50 tok/s,可能代表不同的配置)。在 BS=64 之前,TPOT 值保持在 5-9 ms 的範圍內。
Qwen3 Coder 30B-A3B FP8 效能
FP8 量化變體展現以下性能特徵。在單一用戶並發(BS=1)下,其每用戶吞吐量為 107.46 tok/s,總吞吐量為 317.75 tok/s,TPOT 為 9.16 ms。在 BS=2 時,此模型每用戶吞吐量為 99.55 tok/s,總吞吐量為 409.87 tok/s,TPOT 為 9.86 ms。
擴展到更高的批次大小:批次大小為 8 時,每個使用者吞吐量為 54.60 tok/s,總吞吐量為 1,383.13 tok/s,TPOT 為 10.24 ms;當批次大小為 32 時,每個使用者吞吐量為 48.78 tok/s,總吞吐量為 3274. 3078 至k/s,總吞吐量為 3175.最大總吞吐量出現在批次大小為 256 時,總吞吐量為 19,114.86 tok/s,每個用戶吞吐量為 36.38 tok/s,TPOT 為 20.00 ms。這大約相當於標準精度最大吞吐量的 86%。
微擴展資料類型效能
微尺度化是一種先進的量化方法,它將細粒度的縮放因子應用於小塊權重,而不是對大型參數組進行統一量化。 NVIDIA 的 NVFP4 格式透過分塊浮點表示實現了這項技術,其中每個包含 8-32 個值的微尺度區塊共享一個公共指數作為縮放因子。這種精細方法在實現 4 位元表示的同時保留了數值精度,從而保持了 Transformer 架構所需的動態範圍。此格式與 NVIDIA 的 Tensor Core 架構集成,可在矩陣運算過程中實現高效的混合精度計算和動態解壓縮。
我們使用 NVFP4 量化方法,在兩種參數尺度下評估了 OpenAI 的 GPT OSS 模型:20B 版本和更大的 120B 版本。這些基準測試展示了微尺度量化方法在不同模型規模下的表現表現。
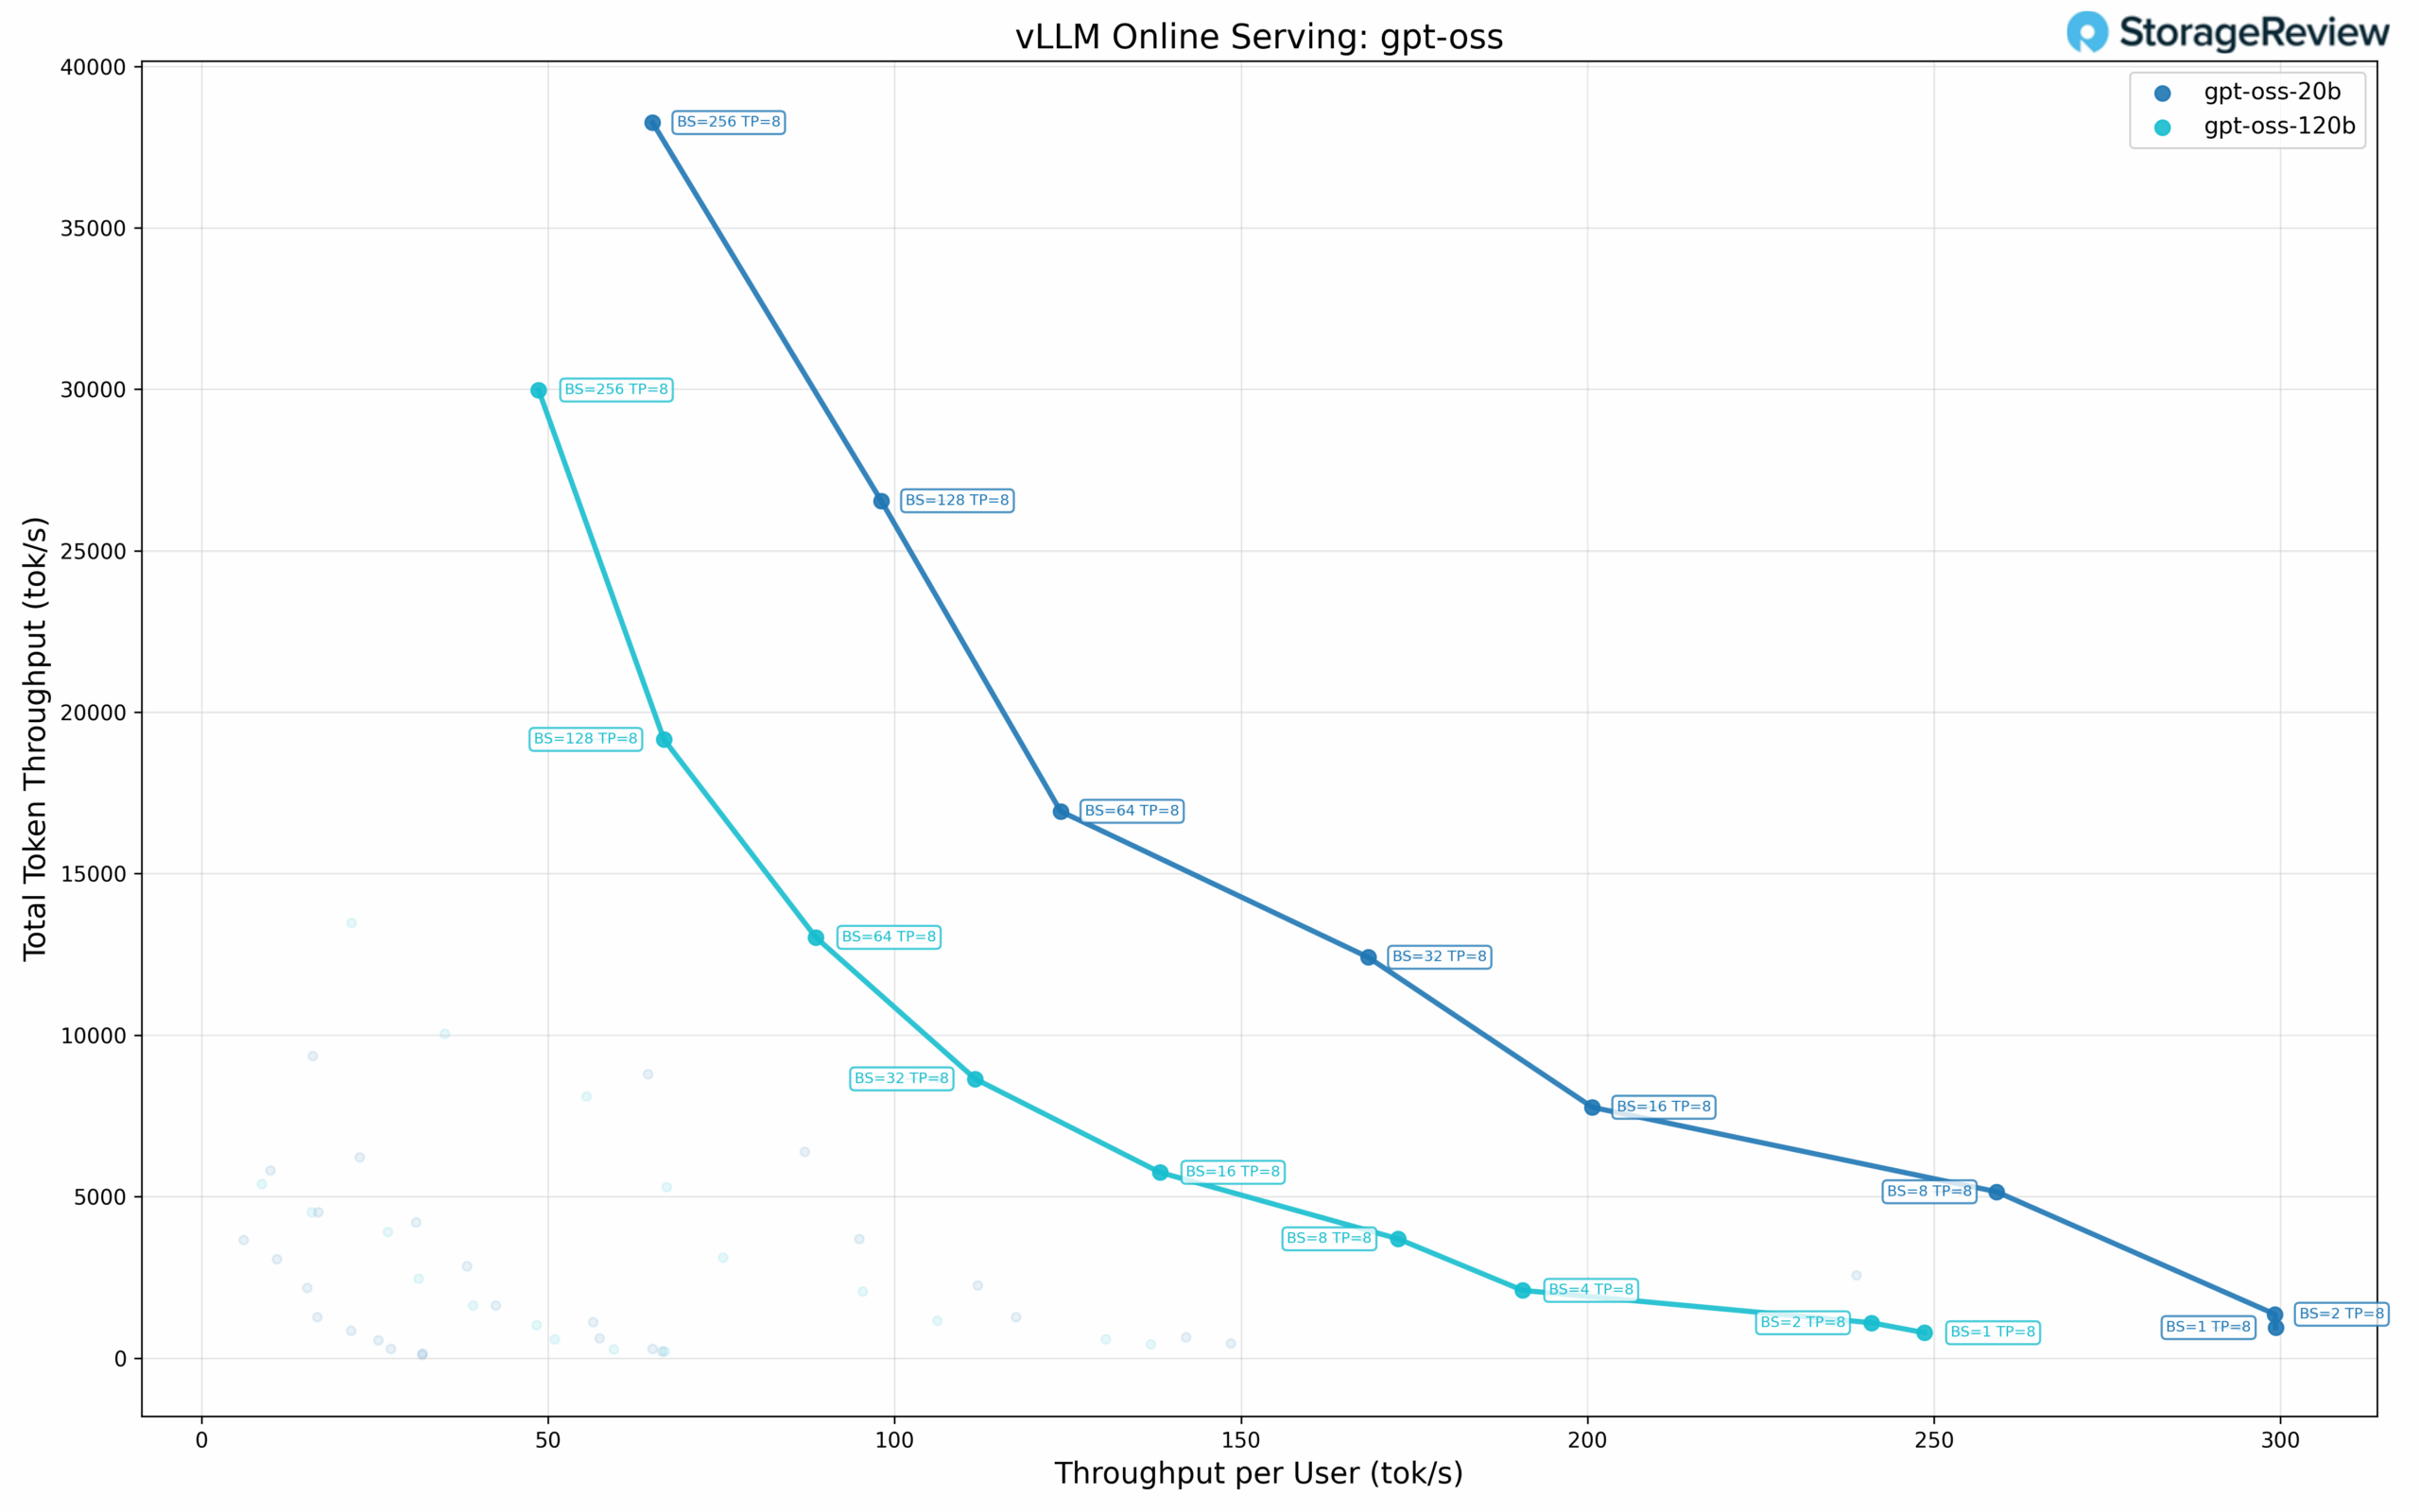
GPT-OSS-20B 效能
20B 參數模型在不同批次大小下實現了以下效能。在單一使用者並發 (BS=1) 時,每個使用者吞吐量為 299.28 tok/s,總吞吐量為 943.43 tok/s,TPOT 為 3.23 ms。在 BS=2 時,模型保持每個使用者 299.19 tok/s 的吞吐量,總吞吐量為 1,356.87 tok/s,TPOT 為 3.19 ms。
擴展到更高的批次大小:批次大小為 8 時,每個使用者的處理速度為 259.02 tok/s,總處理速度為 5,149.59 tok/s,TPOT 為 3.42 ms;批次大小為 16 時,每個使用者的處理速度為 200.69 tok/OTs, 3.77 ms。模型繼續擴展,批次大小達到 32(每個用戶 168.34 tok/s,總處理速度為 12,411.72 tok/s)和 64(每個用戶 123.96 tok/s,總處理速度為 16,931.47 tok/s)。
當 BS=256 時,總吞吐量達到 38,258.50 tok/s,平均每個用戶吞吐量為 65.08 tok/s,TPOT 為 9.39 ms。與單一用戶效能相比,總吞吐量提高了 40.5 倍。在 BS=32 時,TPOT 值保持在 3-5 ms 範圍內。帕累托前緣包含八個不同的點。
GPT-OSS-120B 效能
儘管參數數量增加,更大的 120B 參數模型仍保持了以下性能。在單一使用者並發 (BS=1) 時,每位使用者的吞吐量為 248.62 tok/s,總吞吐量為 783.73 tok/s,TPOT 為 3.89 ms。在 BS=2 時,此模型每位使用者的吞吐量為 240.99 tok/s,總吞吐量為 1,092.91 tok/s,TPOT 為 3.99 ms。
隨著批次大小的增加,效能持續提升:批次大小為 4 時,每位使用者的處理速度為 190.63 tok/s,總處理速度為 2,096.73 tok/s,TPOT 為 4.22 ms;批次大小為 8 時,每位使用者的處理速度為 172.66 to 4.54 ms。批次大小依序增加至 16(每個用戶 138.28 tok/s,總處理速度為 5,751.41 tok/s)、32(每個用戶 111.63 tok/s,總處理速度為 8,646.05 tok/s)和 3,692.10 tok/s,總處理速度為 88.64 tok/s)和 64(每個用戶 to 13,027.97. tok/s)均顯示出吞吐量的持續成長。
此模型在 BS=256 時達到最大總吞吐量,為 29,976.99 tok/s,平均每個使用者吞吐量為 48.64 tok/s,TPOT 為 12.53 ms。與單一用戶效能相比,總吞吐量提高了 38.2 倍。最大總吞吐量約為 20B 模型峰值的 78%。帕累托前緣包含九個不同的點,是所有測試模型中最多的。
意料之外的量化模型性能
量化模型的結果出乎意料,值得進一步研究。在某些情況下,NVFP4 和 FP8 量化版本的模型並未達到預期的效能提升,與對應的原生精度版本相比並無顯著差異。例如,Llama 3.1 8B FP4 模型在 BS=1 時的總吞吐量僅為 830.46 tok/s,而標準精度版本則為 1,727.62 tok/s,儘管二者的用戶吞吐量相近。在更高的批次大小下,雖然量化模型的吞吐量接近標準精度版本(BS=256 時為 29.2K-29.3K tok/s,而標準精度版本為 32.8K tok/s),但總體結果表明,vLLM 的當前實現可能並未針對 Blackwell 進行充分優化。
我們計劃對 vLLM 進行更多測試,並將其與 TensorRT-LLM 進行比較,以了解最終用戶目前可以期待的效能。
Supermicro JumpStart 改變了 AI PoC 的遊戲規則
Supermicro 的 JumpStart 專案兌現了其承諾:真正、不受限制地使用生產級硬件,無需承擔傳統概念驗證 (PoC) 的物流、運輸延誤或實驗室開銷。我們在 X14 HGX B200 平台上的 JumpStart 體驗週啟動迅速,運行流暢,讓我們能夠以與在自家機架上使用相同方式評估其性能。
對於那些需要快速制定 AI 基礎設施決策的組織而言,這種平台存取方式可以將數週的規劃時間縮短至數天。無論目標是驗證 GPU 吞吐量、儲存行為、模型效能,還是僅僅確認堆疊相容性,JumpStart 都能以最小的阻力助您獲得答案。這是一種以信心為導向的硬體評估方法,我們希望看到更多供應商採用這種方法。



 Amazon