

Micron 3610 SSD 旨在滿足主流運算不斷變化的需求,並被廣泛認為是首批採用 QLC NAND 快閃記憶體的 PCIe Gen5 用戶端 SSD 之一。透過將 Micron 最新的第九代 (G9) QLC 快閃記憶體與無 DRAM 的低功耗設計相結合,3610 旨在彌合筆記型電腦的能源效率與現代 Gen5 介面所期望的突發性能之間的差距。此 SSD 提供 1TB 至 4TB 的容量選擇以及多種 M.2 外形尺寸,本次評測將重點放在 2TB 2280 單面型號上,以檢驗其在實際測試中的表現。
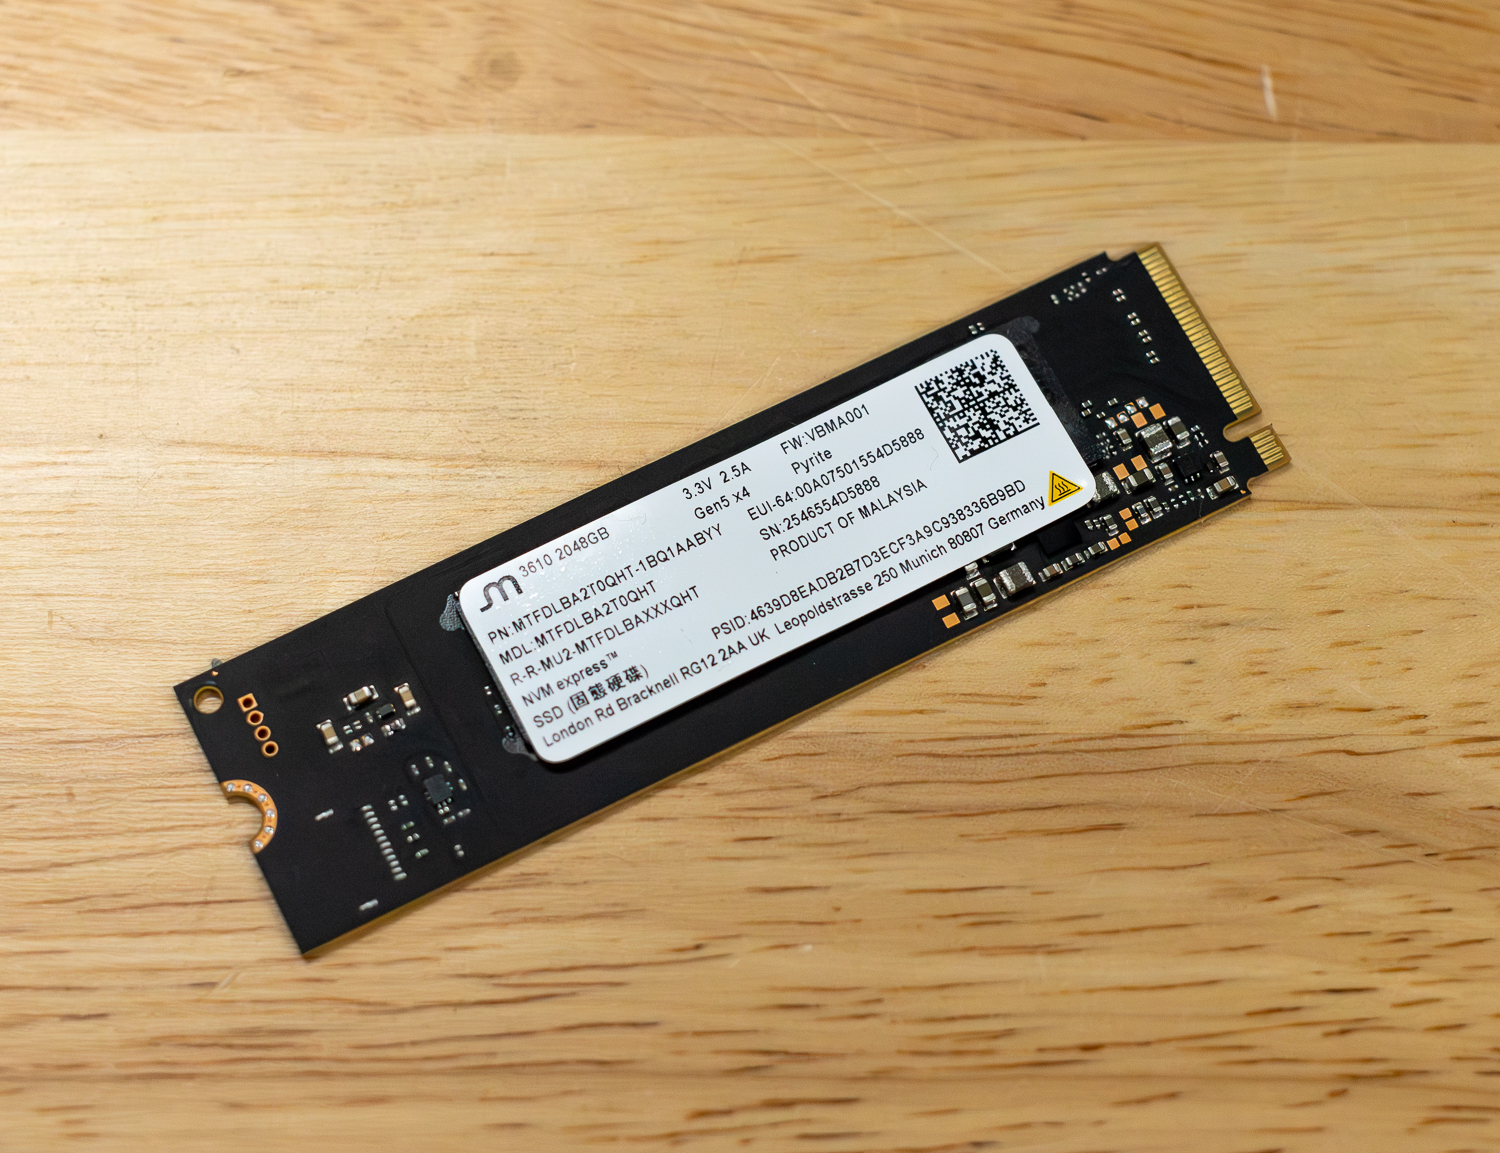
效能規格顯示,所有容量的順序讀取速度均高達驚人的 11,000 MB/s,2TB 和 4TB 型號的寫入速度也達到了 9,300 MB/s。隨機 IOPS 也得到了大幅提升,讀取速度最高可達 1,500K,寫入速度最高可達 1,600K。儘管性能如此強勁,這款硬碟依然注重筆記型電腦應用的能效,其每瓦性能比之前的 Gen4 TLC 解決方案提升了高達 43%。
Micron 3610 的特性與市場定位
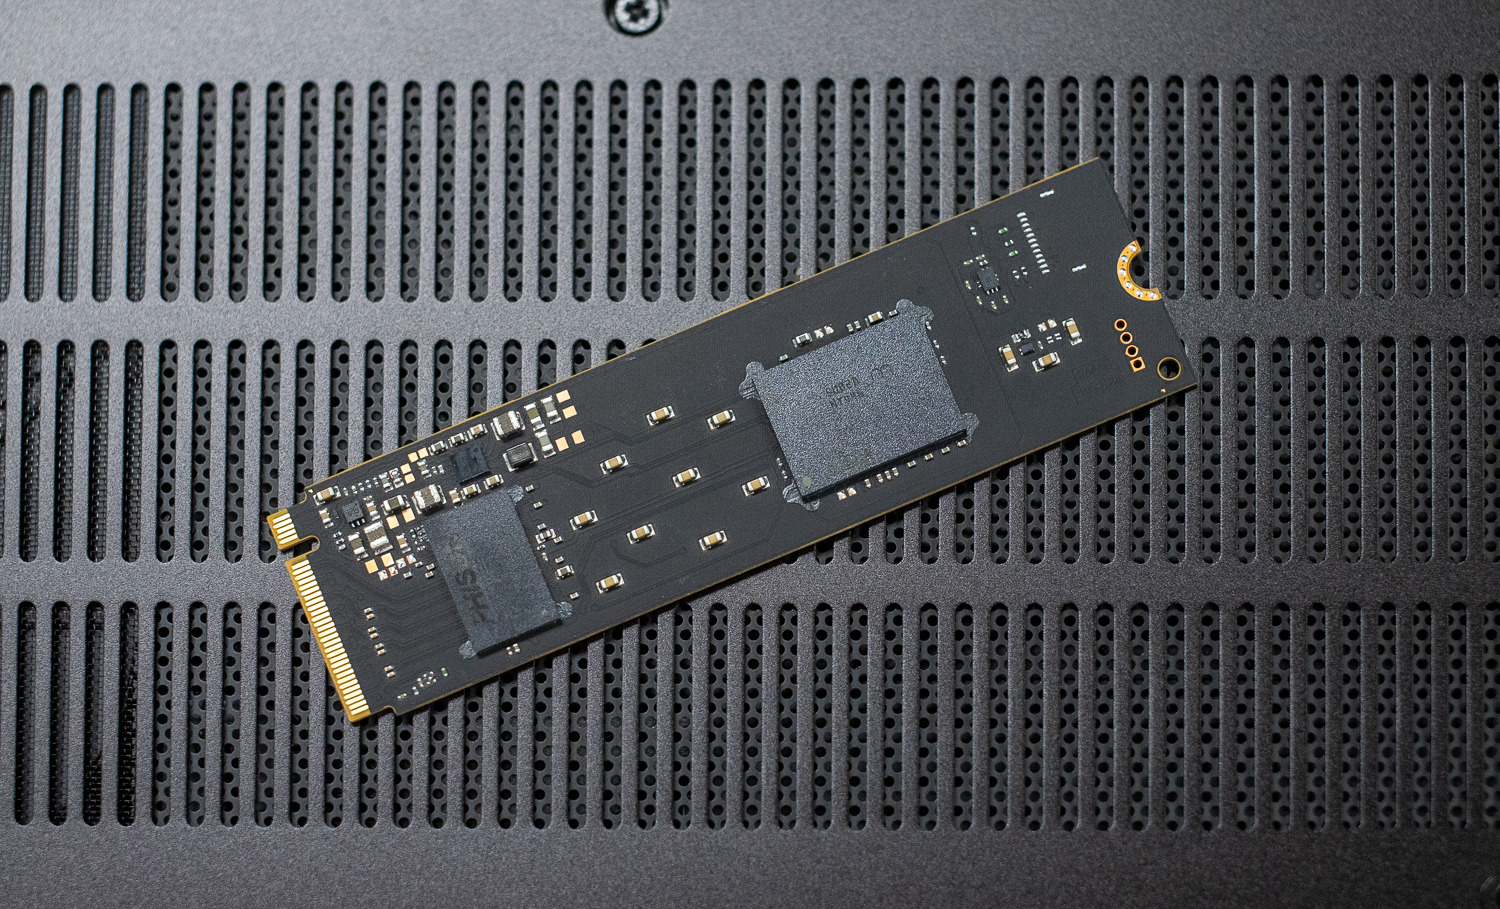
美光在其3610晶片上採用了G9 QLC NAND快閃記憶體和群聯E31主控晶片,並搭載了業界首款2TB QLC NAND快閃記憶體晶片。這種高密度設計使其能夠在小尺寸晶片中實現高容量,同時ONFI 5.0介面支援高達3.6 GT/s的內部讀寫速度。透過採用無DRAM架構並使用主機記憶體緩衝區(HMB),美光有效降低了晶片的物理尺寸和功耗,使其成為輕薄筆記型電腦的理想之選,同時又能提供工作站級別的突發讀寫速度。
QLC快閃記憶體的耐用性評級非常出色,1TB型號的寫入壽命為400 TBW,4TB型號則高達1600 TBW。此外,此硬碟也非常注重安全性,採用了DICE(裝置識別碼組合引擎)和DOE(資料物件交換)協議,以確保韌體的完整性。
從市場定位來看,Micron 3610 是一款顛覆性的產品。它直接與入門級第五代固態硬碟和高階第四代 TLC 固態硬碟競爭,為那些更注重突發速度和現代介面支持,而非持續高強度寫入耐久性或低延遲日常任務的用戶提供了一個極具吸引力的選擇。
| 規格 | 1TB | 2TB | 4TB |
|---|---|---|---|
| 基本資訊 | |||
| 項目類別 | 主流桌上型電腦和筆記型電腦 | ||
| 型號 | 美光 3610 固態硬盤 | ||
| 外形尺寸 | M.2(22mm x 30mm、22mm x 42mm、22mm x 80mm) | ||
| 介面 | PCIe Gen5,NVMe 2.0d | ||
| 性能 | |||
| 順序讀取速度(MB/s) | 11,000 | 11,000 | 11,000 |
| 順序寫入(MB/s) | 7,200 | 9,300 | 9,300 |
| 隨機讀取(KIOPS) | 850 | 1,500 | 1,500 |
| 隨機寫入(KIOPS) | 1,500 | 1,600 | 1,600 |
| 讀取延遲(典型值)(微秒) | 50 | 50 | 50 |
| 寫入延遲(典型值)(微秒) | 12 | 12 | 12 |
| 可靠性和耐久性 | |||
| 耐力(TBW) | 400 | 800 | 1600 |
| MTTF(百萬小時) | 2 | 2 | 2 |
| 電源消耗功率 | |||
| 睡眠/PS4功耗(毫瓦) | <2.5 | <2.5 | <2.5 |
| 空閒功耗(毫瓦) | <150 | <150 | <150 |
| 讀取功耗(毫瓦) | <6,500 | <6,500 | <6,500 |
| 高級功能 | |||
| 功能列表 | 美光 G9 QLC NAND 基於硬件的 AES 256 位加密 斷電保護(靜態數據) 主機控制的熱管理(HCTM) 效能增強型美光AWT 透過 SMBus 實現熱智能 基本管理指令(BMC) 韌體啟動無需重置 清理區塊和加密擦除 掉電信號支持 TCG 蛋白石 2.02,TCG 黃鐵礦 2.01,DOE,DICE Micron Storage 執行 SSD 管理工具 |
||
峰值合成性能
FIO 測試是一款靈活強大的基準測試工具,用於衡量儲存設備(包括 SSD 和 HDD)的效能。它會評估頻寬、IOPS 和延遲等指標,並分析不同工作負載(例如順序和隨機讀取/寫入操作)下的效能。此測試有助於評估儲存系統的峰值效能,因此可用於比較不同的設備或配置。我們測量了該測試的峰值突發性能,並將兩個 SSD 的工作負載限制在 10GB 以內。
在FIO綜合基準測試中,Micron 3610與其他QLC固態硬碟相比,展現出非常獨特的效能表現。大多數硬碟優先考慮讀取速度,而3610的順序寫入效能實際上優於讀取效能。
3610 的順序讀取速度(6,839 MB/s)在 QLC 固態硬碟中最低,落後於 Crucial P510(8,835 MB/s)和 PNY CS2150(10,400 MB/s)。然而,其順序寫入速度(9,673 MB/s)顯著高於 Micron 2600(6,612 MB/s)和 Crucial P310(6,376 MB/s)。此外,它在 4K 隨機寫入方面也表現出色(1.871 萬 IOPS),超越了所有其他 QLC 競爭對手,包括 PNY CS2150 和 Crucial P310。
| FIO 測試(MB/s/IOPS 越高越好) | 順序 128K 讀取 (1T/64Q) | 順序 128K 寫入 (1T/64Q) | 隨機 4K 讀取 (16T/32Q) | 隨機4K寫入(16T/32Q) |
|---|---|---|---|---|
| 閃迪 SN8100 | 15,000 MB/s(平均延遲 0.56ms) | 14,100 MB/s(平均延遲 0.59ms) | 2.312M IOPS(平均延遲 0.22ms) | 2.144M IOPS(平均延遲 0.24ms) |
| 金士頓FURY Renegade G5 | 14,600 MB/s(平均延遲 0.57ms) | 14,100 MB/s(平均延遲 0.59ms) | 2.028M IOPS(平均延遲 0.25ms) | 2.028M IOPS(平均延遲 0.25ms) |
| 三星9100 Pro | 14,600 MB/s(平均延遲 0.57ms) | 13,300 MB/s(平均延遲 0.63ms) | 2.734M IOPS(平均延遲 0.18ms) | 2.734M IOPS(平均延遲 0.19ms) |
| SK海力士白金P51 | 14,500 MB/s(平均延遲 0.58ms) | 13,500 MB/s(平均延遲 0.62ms) | 2.369M IOPS(平均延遲 0.22ms) | 2.669M IOPS(平均延遲 0.19ms) |
| 關鍵T705 | 14,400 MB/s(平均延遲 0.58ms) | 12,300 MB/s(平均延遲 0.68ms) | 1.585M IOPS(平均延遲 0.32ms) | 2.703M IOPS(平均延遲 0.19ms) |
| 十銣科技 GE Pro 2TB | 13,900 MB/s(平均延遲 0.60ms) | 12,800 MB/s(平均延遲 0.65ms) | 2.585M IOPS(平均延遲 0.23ms) | 1.818M IOPS(平均延遲 0.28ms) |
| Lexar Professional NM1090 PRO | 13,800GB/s(平均延遲 0.61ms) | 13,600 MB/s(平均延遲 0.62ms) | 2.251M IOPS(平均延遲 0.23ms) | 1.818M IOPS(平均延遲 0.28ms) |
| 十銣科技 GC Pro 2TB | 13,600 MB/s(平均延遲 0.62ms) | 12,700 MB/s(平均延遲 0.66ms) | 2.110M IOPS(平均延遲 0.24ms) | 1.686M IOPS(平均延遲 0.28ms) |
| PNY CS2150 | 10,400GB/s(平均延遲 0.80ms) | 8,801MB/s(平均延遲 0.95ms) | 1.379M IOPS(平均延遲 0.371ms) | 1.623 IOPS(平均延遲 0.32 毫秒) |
| 關鍵 P510 | 8,835 MiB/s(平均延遲 0.90 毫秒) | 9,961 MB/s(平均延遲 0.80 毫秒) | 1.163M IOPS(平均延遲 0.44ms) | 1.196M IOPS(平均延遲 0.51ms) |
| 美光 3610 2TB | 6,839 MB/s(平均延遲 1.23ms) | 9,673 MB/s(平均延遲 0.87ms) | 1.523M IOPS(平均延遲 0.34ms) | 1.871M IOPS(平均延遲 0.27ms) |
| 三星990 Pro | 7,483 MB/s(平均延遲 1.12ms) | 7,197 MB/s(平均延遲 1.16ms) | 1.400M IOPS(平均延遲 0.36ms) | 1.403M IOPS(平均延遲 0.36ms) |
| 關鍵 P310 2TB | 7,197 MB/s(平均延遲 1.16ms) | 6,376 MB/s(平均延遲 1.31ms) | 1.163M IOPS(平均延遲 0.44ms) | 1.196M IOPS(平均延遲 0.43ms) |
| WD SN850X 2TB | 6,632 MB/s(平均延遲 0.76ms) | 7,235 MB/s(平均延遲 0.92ms) | 1.2M IOPS(平均延遲 0.43ms) | 825K IOPS(平均延遲 0.62ms) |
| 美光 2600 2TB | 5,702 MB/s(平均延遲 1.47ms) | 6,612 MB/s(平均延遲 1.27ms) | 1.11M IOPS(平均延遲 0.46ms) | 1.36M IOPS(平均延遲 0.38ms) |
法學碩士 (LLM) 平均載入時間
平均 LLM 載入時間測試評估了三種不同 LLM 的載入時間:DeepSeek R1 7B、Meta Llama 3.2 11B 和 DeepSeek R1 32B。每個模型測試 10 次,並計算平均載入時間。此測試衡量硬碟將大型語言模型 (LLM) 快速載入記憶體的能力。 LLM 載入時間對於人工智慧相關任務至關重要,尤其是在即時推理和處理大型資料集時。更快的載入速度使模型能夠更快地處理數據,從而提高人工智慧的反應速度並減少等待時間。
在將大型語言模型載入記憶體方面,Micron 3610 在 QLC 固態硬碟中排名墊底。由於 LLM 載入是一項讀取密集型任務,3610 較低的順序讀取速度上限成為了瓶頸。對於 DeepSeek R1 32 位元型號,3610 需要 5.57 秒,比 PNY CS2150(4.89 秒)慢了將近一秒。在所有三個型號(7 位、11 位和 32 位)中,3610 的性能始終落後於 Crucial P510 和 Micron 2600,因此對於需要頻繁地在顯存中讀寫大型 AI 模型的用戶來說,它不太合適。
| 法學碩士平均加載時間(越低越好) | DeepSeek R1 7B | Meta Llama 3.2 11B 視覺 | DeepSeek R1 32B |
|---|---|---|---|
| SK海力士白金P51 | 2.5481s | 3.5809s | 4.1790s |
| 閃迪 SN8100 | 2.5702s | 3.5856s | 4.2870s |
| 三星 9100 Pro 4TB | 2.6173s | 3.6017s | 4.3735s |
| PNY CS2150 | 2.8107s | 3.6820s | 4.8962s |
| 英睿達 T705 2TB | 2.8758s | 3.6312s | 5.1080s |
| 三星 990 Pro 2TB | 2.8758s | 3.6312s | 5.1080s |
| 關鍵 P510 1TB | 2.8817s | 3.6631s | 5.0594s |
| 十銣科技 GE Pro 2TB | 2.9092s | 3.9136s | 4.8974s |
| 十銣科技 GC Pro 2TB | 2.9379s | 3.9267s | 4.8188s |
| WD SN850X 2TB | 3.0082s | 3.6543s | 5.4844s |
| 金士頓FURY Renegade G5 | 3.1843s | 4.8009s | 4.6523s |
| 關鍵 P310 2TB | 3.1889s | 3.7083s | 5.4844s |
| Lexar Professional NM1090 PRO | 3.2135s | 4.9504s | 7.2108s |
| 美光 2600 2TB | 3.3178s | 3.9174s | 5.9060s |
| 美光 3610 2TB | 3.5348s | 5.3853s | 5.5731s |
3DMark 直接存儲
3DMark DirectStorage 功能測試評估 Microsoft 的 DirectStorage 如何最佳化 PCIe SSD 上的遊戲資產載入。透過減少 CPU 開銷並提高資料傳輸速度,DirectStorage 可以縮短載入時間,尤其是與 GDeflate 壓縮和 Windows 11 的 BypassIO 結合使用時。此測試隔離儲存效能,以突出啟用 DirectStorage 時潛在的頻寬改進。
Micron 3610 在 DirectStorage 場景下表現出色。儘管其綜合讀取速度較低,但它處理壓縮遊戲資源的能力卻出乎意料地好。在儲存到顯存 (GDeflate) 測試中,3610 達到了 20.29 GB/s 的速度,超過了 Crucial P510 (19.63 GB/s) 和 PNY CS2150 (19.49 GB/s)。它在該類別中顯著優於 Micron 2600 (14.11 GB/s) 和 Crucial P310 (14.81 GB/s),這表明其控制器或韌體針對 DirectStorage 的高頻寬、多請求特性進行了更好的最佳化。
| 3DMark 直接存儲,(GB/s,越高越好) | 儲存至 VRAM(GDeflate 壓縮) | 儲存至 VRAM(DirectStorage 開啟,未壓縮) | 儲存到 VRAM(DirectStorage 關閉,未壓縮) | 儲存到 RAM(DirectStorage 開啟,未壓縮) | 儲存到 RAM(DirectStorage 關閉,未壓縮) | GDeflate 解壓縮頻寬 |
|---|---|---|---|---|---|---|
| SK海力士白金P51 | 26.32 | 11.20 | 7.75 | 12.85 | 9.46 | 64.68 |
| 閃迪 SN8100 | 26.11 | 12.94 | 7.63 | 12.94 | 9.78 | 64.51 |
| 英睿達 T705 2TB | 25.75 | 10.71 | 8.79 | 12.03 | 8.83 | 66.36 |
| 十銣科技 GE Pro 2TB | 24.70 | 10.19 | 7.49 | 11.33 | 9.35 | 65.05 |
| Lexar Professional NM1090 PRO | 24.03 | 11.23 | 7.57 | 12.18 | 8.72 | 63.15 |
| 三星 9100 Pro 4TB | 23.77 | 11.26 | 8.92 | 11.62 | 9.48 | 66.61 |
| 金士頓FURY Renegade G5 | 23.29 | 10.03 | 7.44 | 11.81 | 9.63 | 65.79 |
| 十銣科技 GC Pro 2TB | 22.94 | 9.46 | 7.13 | 10.71 | 8.14 | 63.80 |
| 美光 3610 2TB | 20.29 | 9.42 | 6.94 | 7.93 | 8.48 | 65.46 |
| 關鍵 P510 1TB | 19.63 | 8.33 | 6.92 | 9.06 | 7.49 | 66.22 |
| PNY CS2150 | 19.49 | 8.60 | 6.98 | 9.22 | 7.70 | 62.43 |
| WD SN850X 2TB | 15.28 | 11.11 | 8.93 | 6.78 | 6.27 | 64.96 |
| 關鍵 P310 2TB | 14.81 | 10.75 | 8.56 | 6.46 | 5.87 | 65.43 |
| 三星 990 Pro 2TB | 14.18 | 11.28 | 8.84 | 6.57 | 6.20 | 65.71 |
| 美光 2600 2TB | 14.11 | 5.93 | 5.27 | 6.34 | 5.50 | 64.09 |
PCMark 10 儲存基準測試
PCMark 10 儲存基準測試使用基於應用程式的追蹤資料來評估實際儲存效能。它測試系統和數據驅動器,測量頻寬、存取時間和負載下的一致性。這些基準測試提供了超越綜合測試的實用見解,使用戶能夠有效地比較現代儲存解決方案。
在實際應用測試中,Micron 3610 的表現難以與 QLC 系列的其他產品相提並論。其得分僅 5,635 分,是本次測試中表現最低的 QLC 固態硬碟。它落後於 Micron 2600(5,885 分),與 Crucial P310(6,436 分)相比差距顯著。這表明,對於啟動 Windows、運行應用程式或傳輸小檔案等日常任務,3610 的延遲和開銷會導致其響應速度遠遜於同類產品。
| PCMark 10 數據驅動器(越高越好) | 總體得分 |
|---|---|
| 英睿達 T705 2TB | 8,783 |
| SK海力士白金P51 | 8,665 |
| 閃迪 SN8100 | 8,644 |
| Lexar Professional NM1090 PRO | 8,247 |
| 金士頓FURY Renegade G5 | 8,062 |
| 十銣科技 GC Pro 2TB | 7,648 |
| 三星 9100 Pro 4TB | 7,552 |
| 三星 990 Pro 2TB | 7,173 |
| 十銣科技 GE Pro 2TB | 6,957 |
| 關鍵 P310 2TB | 6,436 |
| PNY CS2150 | 6,070 |
| 美光 2600 2TB | 5,885 |
| 美光 3610 2TB | 5,635 |
| WD SN850X 2TB | 4,988 |
BlackMagic 磁盤速度測試
BlackMagic 磁碟速度測試會對硬碟的讀寫速度進行基準測試,以評估其效能,尤其適用於影片編輯任務。它可以幫助用戶確保其儲存速度足以應對高解析度內容,例如 4K 或 8K 影片。
在 BlackMagic 的測試中,我們看到了 4 位元 NAND 快閃記憶體的優缺點。雖然大多數 TLC 固態硬碟的寫入速度都能達到 9,000 MB/s 以上,但 QLC 型號卻排名墊底,不過其中有一個令人意外的例子。儘管是 QLC 閃存,它的寫入速度卻達到了 8,519 MB/s,在這項特定的突發寫入測試中甚至超過了三星 990 Pro 和西部數據 SN850X 等 TLC 競爭對手。這很可能是因為美光採用了積極的 SLC 快取技術。
| BlackMagic 磁碟速度(MB/s,越高越好) | 讀取 MB/s | 寫入 MB/s |
|---|---|---|
| 閃迪 SN8100 | 10,005.2 | 10,581.0 |
| 金士頓FURY Renegade G5 | 9,665.0 | 10,831.0 |
| 三星 9100 Pro 4TB | 9,542.3 | 9,907.9 |
| SK海力士白金P51 | 9,241.0 | 9,109.0 |
| Lexar Professional NM1090 PRO | 9,149.2 | 10,466.6 |
| 英睿達 T705 2TB | 8,464.2 | 10,256.4 |
| 關鍵 P510 1TB | 7,853.9 | 7,939.6 |
| 十銣科技 GE Pro 2TB | 6933.6 | 8700.6 |
| PNY CS2150 | 6,625.5 | 7,299.5 |
| 十銣科技 GC Pro 2TB | 6,476.8 | 7,796.8 |
| WD SN850X 2TB | 5,862.6 | 5,894.8 |
| 美光 3610 2TB | 5,834,9 | 8,519.1 |
| 三星 990 Pro 2TB | 5,769.5 | 5,842.9 |
| 關鍵 P310 2TB | 5,282.4 | 5,458.9 |
| 美光 2600 2TB | 4,663.3 | 5,607.4 |
GPU直接儲存
我們在這個測試台上進行的測試之一是 Magnum IO GPU 直接儲存 (GDS) 測試。 GDS 是 NVIDIA 開發的功能,可讓 GPU 在存取儲存在 NVMe 磁碟機或其他高速儲存裝置上的資料時繞過 CPU。 GDS 不再透過 CPU 和系統記憶體來路由數據,而是實現了 GPU 和儲存設備之間的直接通信,從而顯著減少了延遲並提高了數據吞吐量。
GPU 直接儲存的工作原理
傳統上,當GPU處理儲存在NVMe磁碟機上的資料時,資料必須先經過CPU和系統記憶體才能到達GPU。由於CPU充當中間人,這個過程會造成效能瓶頸,增加延遲並消耗寶貴的系統資源。 GPU直接儲存(GPU Direct Storage)透過允許GPU直接透過PCIe匯流排存取儲存裝置中的數據,消除了這種低效率。這種直接路徑減少了資料傳輸的開銷,從而實現了更快、更有效率的資料傳輸。
人工智慧工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理 TB 級的數據,資料傳輸中的任何延遲都可能導致 GPU 利用率不足和訓練時間更長。 GPU 直接儲存透過確保資料盡快傳輸到 GPU、最大限度地減少空閒時間並最大限度地提高運算效率來解決這一挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
分析GPU直接儲存(GDS)效能時,資料才真正變得“勁爆”,尤其是Micron 3610在QLC效能方面開始顯露疲態的地方。雖然GDS旨在繞過CPU,直接將資料傳輸給GPU以降低延遲,但3610的16K區塊平均寫入速度卻驟降至可憐的307.7 MiB/s,與第五代TLC固態硬碟1.5–2.4 GiB/s的速度相比,這是一個顯著的下降。這種效能斷崖式下跌本質上就是「QLC稅」的體現:該硬碟的無DRAM架構,加上QLC NAND快閃記憶體本身速度較慢的特性,使其在處理小塊隨機寫入時舉步維艱,導致其在直接從GPU處理微小資料區塊時出現明顯的「卡頓」。矛盾的是,Crucial P310 和 Micron 2600 這兩款較早的第四代 QLC 設計,在 16K 塊大小下卻表現出更高的穩定性,速度可達 2.1–2.2 GiB/s。這表明,對於涉及大量小檔案的 AI 或遊戲工作負載而言,更成熟的第四代 QLC 架構實際上比 3610 中採用的早期「以速度為導向」的第五代 QLC 實現方案更加穩定可靠。
| GDSIO 圖表(16K、128K、1M 區塊大小平均值) | (16K 區塊大小 128 IO 深度)平均讀取 | (16K 區塊大小 128 IO 深度)平均寫入 | (128K 區塊大小 128 IO 深度)平均讀取 | (128K 區塊大小 128 IO 深度)平均寫入 | (1M 區塊大小 128 IO 深度)平均讀取 | (1M 區塊大小 128 IO 深度)平均寫入 |
|---|---|---|---|---|---|---|
| 金士頓FURY Renegade G5 | 3.7 GiB/秒(0.526毫秒)IOPS:242.1K | 2.4 GiB/秒(0.824毫秒)IOPS:154.7K | 5.9 GiB/秒(2.704毫秒)IOPS:48.5K | 5.8 GiB/秒(0.564毫秒)IOPS:47.3K | 6.5 GiB/秒(19.356毫秒)IOPS:6.6K | 6.3 GiB/秒(19.690毫秒)IOPS:6.5K |
| Lexar Professional NM1090 PRO | 3.6 GiB/秒(0.533毫秒)IOPS:238.7K | 2.3 GiB/秒(0.845毫秒)IOPS:150.8K | 5.9 GiB/秒(2.639毫秒)IOPS:48.4K | 4.2 GiB/秒(3.714毫秒)IOPS:34.4K | 6.5 GiB/秒(19.274毫秒)IOPS:6.6K | 6.2 GiB/秒(20.127毫秒)IOPS:6.4K |
| 閃迪 SN8100 | 3.4 GiB/秒(0.564毫秒)IOPS:225.9K | 2.1 GiB/秒(0.907毫秒)IOPS:140.6K | 5.9 GiB/秒(2.626毫秒)IOPS:48.7K | 5.8 GiB/秒(2.668毫秒)IOPS:47.9K | 6.5 GiB/秒(19.264毫秒)IOPS:6.6K | 5.9 GiB/秒(21.063毫秒)IOPS:6.1K |
| 三星 9100 Pro 4TB | 3.4 GiB/秒(0.565毫秒)IOPS:226.4K | 2.3 GiB/秒(0.839毫秒)IOPS:161.7K | 5.2 GiB/秒(3.001毫秒)IOPS:44.9K | 5.9 GiB/秒(2.662毫秒)IOPS:47.3K | 6.3 GiB/秒(19.877毫秒)IOPS:6.4K | 6.1 GiB/秒(20.579毫秒)IOPS:6.2K |
| 英睿達 T705 2TB | 3.3 GiB/秒(0.587毫秒)IOPS:217.0K | 2.3 GiB/秒(0.836毫秒)IOPS:152.6K | 5.5 GiB/秒(2.863毫秒)IOPS:44.7K | 5.6 GiB/秒(2.799毫秒)IOPS:45.7K | 6.0 GiB/秒(20.738毫秒)IOPS:6.2K | 6.0 GiB/秒(20.855毫秒)IOPS:6.1K |
| SK海力士白金P51 | 3.1 GiB/秒(0.634毫秒)IOPS:200.9K | 1.5 GiB/秒(1.314毫秒)IOPS:97.2K | 5.6 GiB/秒(2.781毫秒)IOPS:46.0K | 3.9 GiB/秒(4.014毫秒)IOPS:31.9K | 6.2 GiB/秒(20.126毫秒)IOPS:6.4K | 4.2 GiB/秒(29.576毫秒)IOPS:4.3K |
| 關鍵 P310 2TB | 3.1 GiB/秒(0.627毫秒)IOPS:203.2K | 2.2 GiB/秒(0.902毫秒)IOPS:141.4K | 4.1 GiB/秒(3.845毫秒)IOPS:33.3K | 3.9 GiB/秒(3.992毫秒)IOPS:32.0K | 4.4 GiB/秒(28.462毫秒)IOPS:4.5K | 4.1 GiB/秒(30.964毫秒)IOPS:4.2K |
| 美光 2600 2TB | 3.1 GiB/秒(0.629毫秒)IOPS:202.4K | 2.1 GiB/秒(0.906毫秒)IOPS:140.8K | 4.0 GiB/秒(3.889毫秒)IOPS:32.9K | 3.9 GiB/秒(3.960毫秒)IOPS:32.3K | 4.4 GiB/秒(28.535毫秒)IOPS:4.5K | 4.2 GiB/秒(30.053毫秒)IOPS:4.3K |
| 三星 990 Pro 2TB | 2.7 GiB/秒(0.731毫秒)IOPS:174.4K | 2.2 GiB/秒(0.903毫秒)IOPS:141.2K | 4.0 GiB/秒(3.944毫秒)IOPS:32.4K | 4.1 GiB/秒(3.849毫秒)IOPS:33.2K | 3.9 GiB/秒(32.415毫秒)IOPS:3.9K | 4.2 GiB/秒(29.520毫秒)IOPS:4.3K |
| PNY CS2150 | 2.5 GiB/秒(0.779毫秒)IOPS:163.5K | 1.8 GiB/秒 1.107毫秒)IOPS:115.3K | 4.5 GiB/秒(3.473毫秒)IOPS:36.8K | 4.7 GiB/秒(3.357毫秒)IOPS:38.1K | 4.6 GiB/秒(27.157毫秒)IOPS:174.4K | 4.9 GiB/秒(25.682毫秒)IOPS:5.0K |
| 關鍵 P510 | 2.3 GiB/秒(0.837毫秒)IOPS:152.2K | 2.3 GiB/秒(0.842毫秒)IOPS:151.5K | 4.5 GiB/秒(3.450毫秒)IOPS:37.1K | 4.8 GiB/秒(3.262毫秒)IOPS:39.2K | 4.8 GiB/秒(26.218毫秒)IOPS:4.9K | 5.0 GiB/秒(25.121毫秒)IOPS:5.1K |
| 西數SN850X | 2.3 GiB/秒(0.736毫秒)IOPS:173.2K | 2.0 GiB/秒(0.989毫秒)IOPS:129.0K | 4.1 GiB/秒(3.878毫秒)IOPS:33.3K | 4.0 GiB/秒(3.958毫秒)IOPS:33.0K | 4.4 GiB/秒(30.501毫秒)IOPS:4.5K | 4.1 GiB/秒(30.782毫秒)IOPS:4.2K |
| 西數SN850X | 2.3 GiB/秒(0.736毫秒)IOPS:173.2K | 2.0 GiB/秒(0.989毫秒)IOPS:129.0K | 4.1 GiB/秒(3.878毫秒)IOPS:33.3K | 4.0 GiB/秒(3.958毫秒)IOPS:33.0K | 4.4 GiB/秒(30.501毫秒)IOPS:4.5K | 4.1 GiB/秒(30.782毫秒)IOPS:4.2K |
| 美光 3610 2TB | 2.2 GiB/秒(0.884毫秒)IOPS:144.3K | 307.7 MiB/s (6.5ms) IOPS:19.7K | 2.9 GiB/秒(5.4毫秒)IOPS:23.7K | 2.1 GiB/秒(7.6毫秒)IOPS:16.8K | 3.8 GiB/秒(33.1毫秒)IOPS:3.9K | 4.9 GiB/秒(25.5毫秒)IOPS:5.0K |
| 十銣科技 GE PRO 2TB | 0.8 GiB/秒(2.464毫秒)IOPS:51.8K | 1.0 GiB/秒(1.913毫秒)IOPS:68.8K | 2.8 GiB/秒(5.627毫秒)IOPS:22.7K | 2.1 GiB/秒(7.309毫秒)IOPS:17.5K | 4.2 GiB/秒(29.599毫秒)IOPS:4.3K | 2.7 GiB/秒(49.915毫秒)IOPS:2.7K |
| 十銣科技 GC PRO 2TB | 0.8 GiB/秒(2.589毫秒)IOPS:49.3K | 1.0 GiB/秒(1.899毫秒)IOPS:67.3K | 2.7 GiB/秒(5.860毫秒)IOPS:21.8K | 2.4 GiB/秒(6.636毫秒)IOPS:19.3K | 3.7 GiB/秒(34.007毫秒)IOPS:3.8K | 3.7 GiB/秒(33.414毫秒)IOPS:3.8K |
結語
Micron 3610 的發布標誌著 QLC NAND 快閃記憶體進入 PCIe Gen5 用戶端領域邁出了重要一步,但其效能特點顯然較為特殊。它擁有令人印象深刻的突發寫入速度,並在 DirectStorage 工作負載中表現出色,因此非常適合注重能源效率和成本的現代遊戲系統和輕薄筆記型電腦。
然而,在這些場景之外,其優缺點就顯而易見了。讀取密集型工作負載(例如 AI 模型載入)會暴露出其較低的順序讀寫上限,而小塊 GPU Direct Storage 寫入則揭示了無 DRAM 的第五代 QLC 設計的限制。在更廣泛的應用測試中,它的響應速度甚至落後於更早的第四代 QLC 固態硬碟。
Micron 3610 既不是性能領先的產品,也不是對成熟的 TLC 或 Gen4 QLC 快閃記憶體的通用升級選擇。相反,它服務於一個特定的目標:在高效的封裝尺寸下提供強大的突發性能和現代平台相容性。對於了解這些限制的買家來說,如果價格符合預期,那麼它就值得考慮。


 Amazon