

L40S 填補了資料中心 GPU 生態系統中的關鍵空白。雖然像 Nvidia H100 這樣的專注於計算的 AI 訓練 GPU 優先考慮原始性能,而完全忽略了圖形加速,但傳統的專業視覺化卡通常缺乏現代推理工作負載和新興 AI 驅動圖形應用程式所需的 AI 運算能力。這種定位使其對於合成資料生成、多模態 AI 開發以及計算和圖形性能都至關重要的 Omniverse 應用尤為重要。
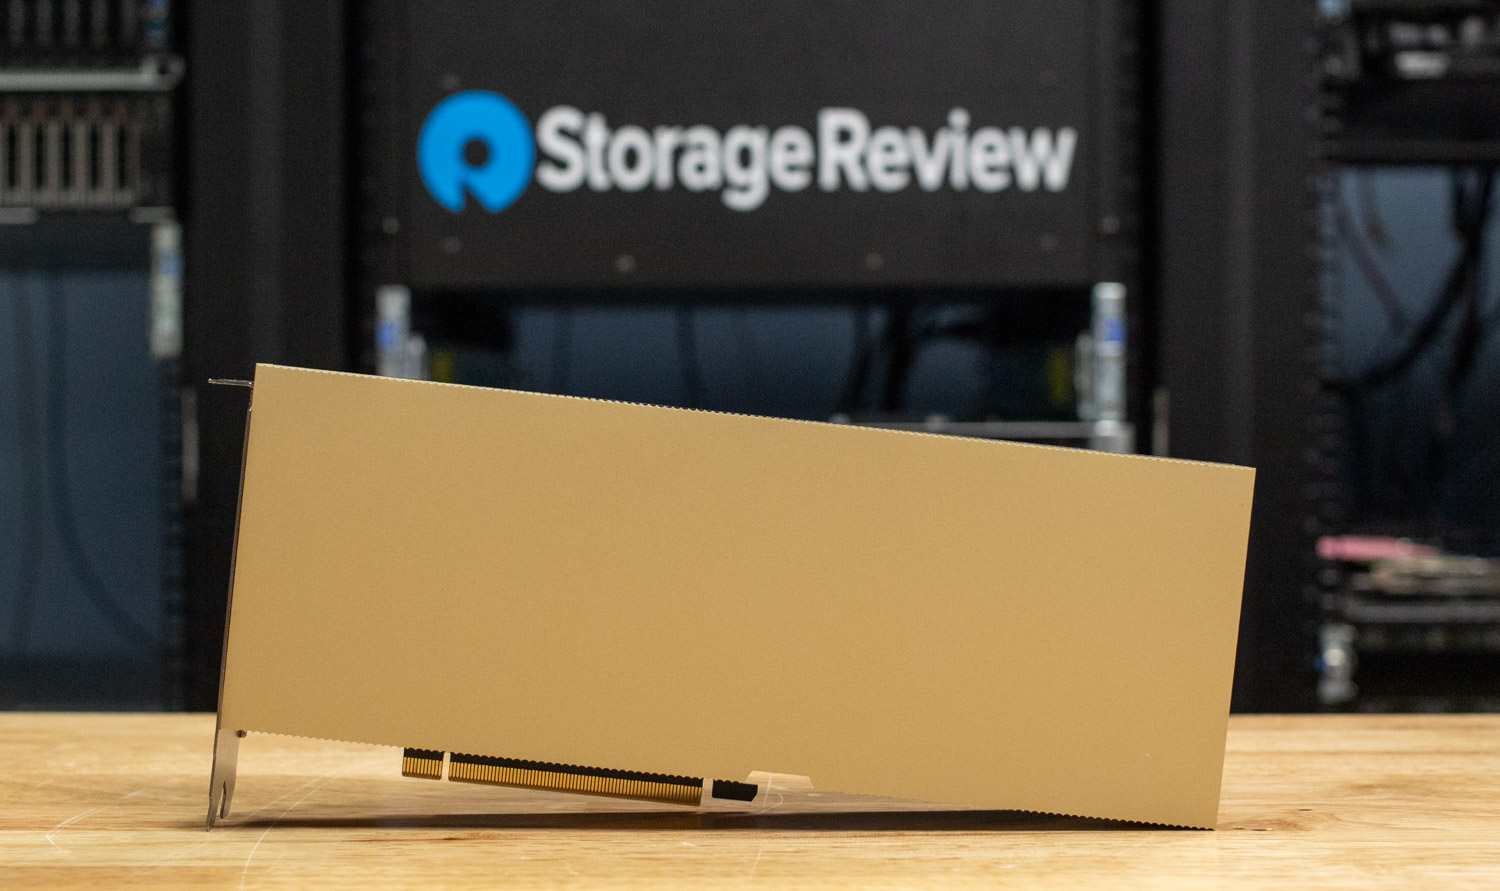
NVIDIA L40S 規格
| 規格 | L40 | L40S | H100 80G PCIe |
| GPU架構 | 艾達洛夫萊斯 | 艾達洛夫萊斯 | 料斗 |
| GPU 芯片 | AD102 | AD102 | GH100 |
| CUDA核心 | 18,176 | 18,176 | 14,592 |
| 張量核心 | 568(第四代) | 568(第四代) | 456 |
| RT核心 | 142(第三代) | 142(第三代) | - |
| GPU內存 | 48GB GDDR6 帶 ECC | 48GB GDDR6 帶 ECC | 80GB HBM2e |
| 內存帶寬 | 864 GB / s | 864 GB / s | 2 TB / s |
| 存儲器接口 | 384-位 | 384-位 | 5120-位 |
| 最大功耗 | 300W | 350W | 350W |
| 外形 | 4.4 英吋高 x 10.5 英吋長:雙槽 | 4.4 英吋高 x 10.5 英吋長:雙槽 | 4.4 英吋高 x 10.5 英吋長:雙槽 |
| 散熱解決方案 | 被動 | 被動 | 被動 |
| 顯示器連接器 | 4 個顯示端口 1.4a | 4 個顯示端口 1.4a | - |
| PCIe 接口 | Gen4 x16 | Gen4 x16 | Gen5 x16 |
| 電源連接器 | 16針 | 16針 | 16針 |
| vGPU 支持 | 可以 | 可以 | 沒有 |
| 多執行個體 GPU (MiG) | 沒有 | 沒有 | 可以 |
| NVLink 支持 | 沒有 | 沒有 | 沒有 |
性能指標
| 公制 | L40 性能 | L40S 效能 | H100 性能 |
| FP32 性能 | 90.5 TFLOPS | 91.6 TFLOPS | 51.2 TFLOPS |
| TF32 張量核心 | 362.1 TFLOPS | 366 TFLOPS | 756 TFLOPS |
| FP16 張量核心 | 724 TFLOPS | 733 TFLOPS | 1513 TFLOPS |
| FP8 張量核心 | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TFLOPS |
| 峰值 INT8 張量 TOPS | 1,448 TFLOPS | 1,466 TFLOPS | 3026 TOPS |
| RT 核心效能 | 209 TFLOPS | 212 TFLOPS | - |
(性能數字具有稀疏性)
NVIDIA L40S 與 H100
仔細查看規格,便能發現 NVIDIA L40S 和 H100 背後獨特的設計理念。 L40S 基於 Ada Lovelace 架構構建,使用與 NVIDIA 高階工作站顯示卡相同的 AD102 晶片。這項傳承使其擁有多達 18,176 個 CUDA 核心,從而實現了卓越的單精度 FP32 性能,這是傳統圖形渲染和科學計算的基石。相較之下,H100 的 Hopper 架構和 GH100 晶片則專為 AI 和 HPC 工作負載而設計。
最顯著的差異在於核心配置。 L40S 包含 142 個第三代 RT Core 和 568 個第四代 Tensor Core。 RT Core 是用於加速光線追蹤的專用硬件,而 H100 則完全沒有這項功能,這使得 L40S 擁有獨特的照片級真實感渲染能力。雖然 H100 的 Tensor Core 數量較少,但它們速度更快、更先進,並針對 FP8 等新型 AI 資料格式進行了最佳化,使其在原始 AI 性能方面遙遙領先。
這種權衡在記憶體子系統上也反映得很明顯。 H100 採用 80GB 高成本 HBM2e 內存,提供驚人的 2 TB/s 頻寬。這對於在大規模 AI 模型訓練和推理過程中確保 SM 的正常運作至關重要。 L40S 採用更傳統的 48GB GDDR6 內存,提供 864 GB/s 的頻寬。雖然不到 H100 的一半,但這仍然是一個相當大的容量,完全足以加載大型 3D 場景、高解析度紋理以及用於推理的大型 AI 模型。
最後,功能集概述了它們的預期用途。 L40S 配備四個 DisplayPort 1.4a 輸出和強大的 vGPU 支持,使其成為虛擬化工作站、渲染農場和雲端遊戲部署的理想選擇。 H100 不具備任何顯示輸出或 vGPU 功能,而是提供多實例 GPU (MiG) 技術,該技術允許將其劃分為多個較小的獨立 GPU 實例,以同時處理多個運算密集型工作負載。 L350S 和 PCIe H40 共享雙插槽、被動散熱設計和 100W 功率範圍,使其能夠在各種行業標準伺服器中靈活部署。
將 L40S 與 NVIDIA 的旗艦產品 H100 進行比較,它們在目標用途上的差異顯而易見。 H100 在同代 GPU 中,在原始 AI 訓練性能方面無可爭議地處於領先地位,但這種比較僅僅展現了部分情況。值得注意的是,L40 也屬於 NVIDIA 產品線,其 TDP 為 300W,而 L40S 的功率範圍為 350W,因此在提供類似性能的同時,功耗也更低。
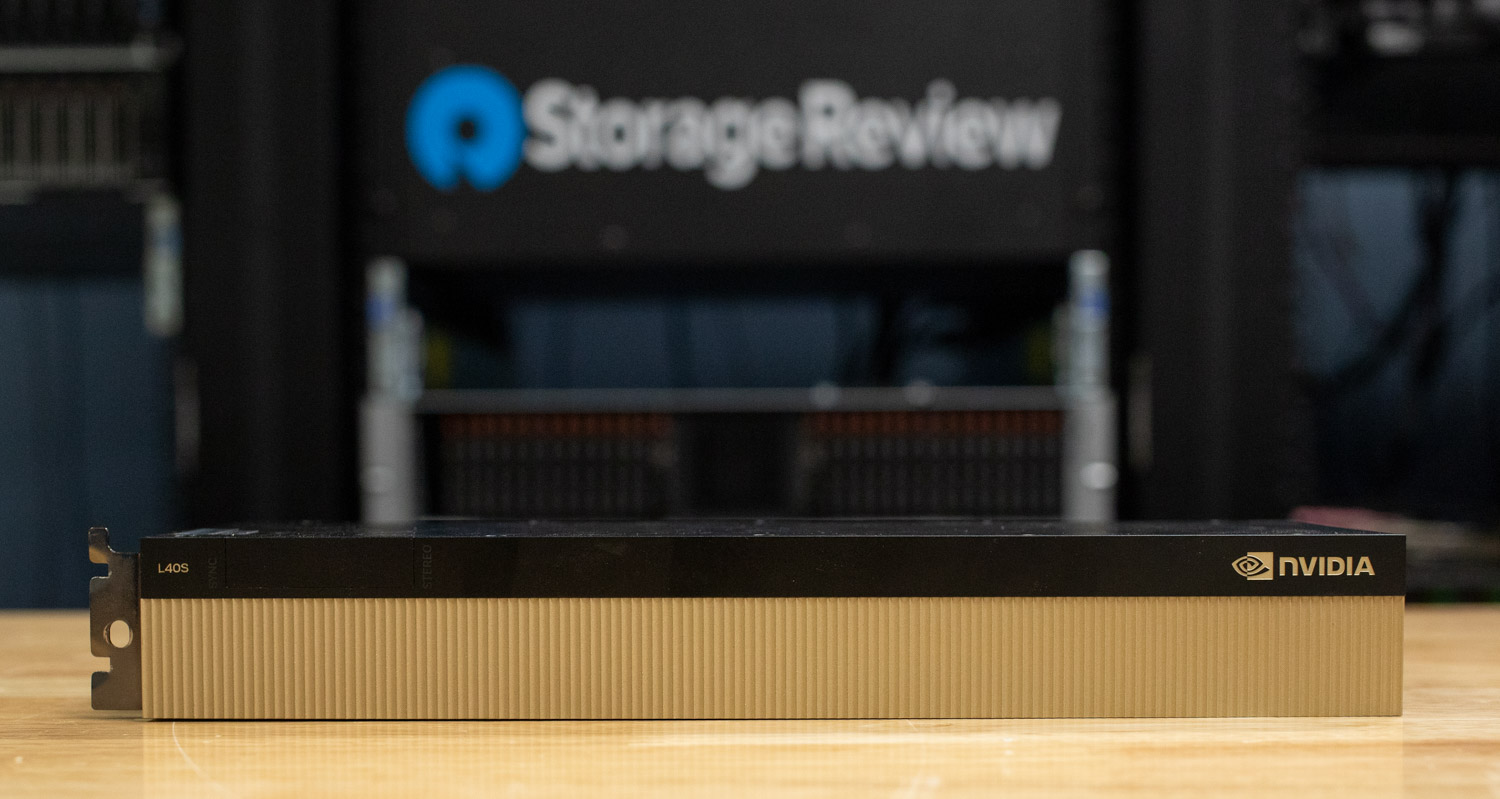
我們這次評測的 H100 是最初搭載 HBM80e 顯存的 2GB PCIe 版本。此後,NVIDIA 陸續擴展了該系列產品,推出了 H100 NVL 等版本。 H80 NVL 是最初 94GB PCIe 型號的替代品,提供 400GB 顯存和更高的 100W TDP,同時增加了對雙 GPU 配置的 NVLink 支援。 H8 系列也擴充了 200 GPU SXM 配置,以及更新的 HXNUMX,它共享相同的 GPU 晶片,但在 PCIe 和 SXM 規格下均能提供增強的效能。
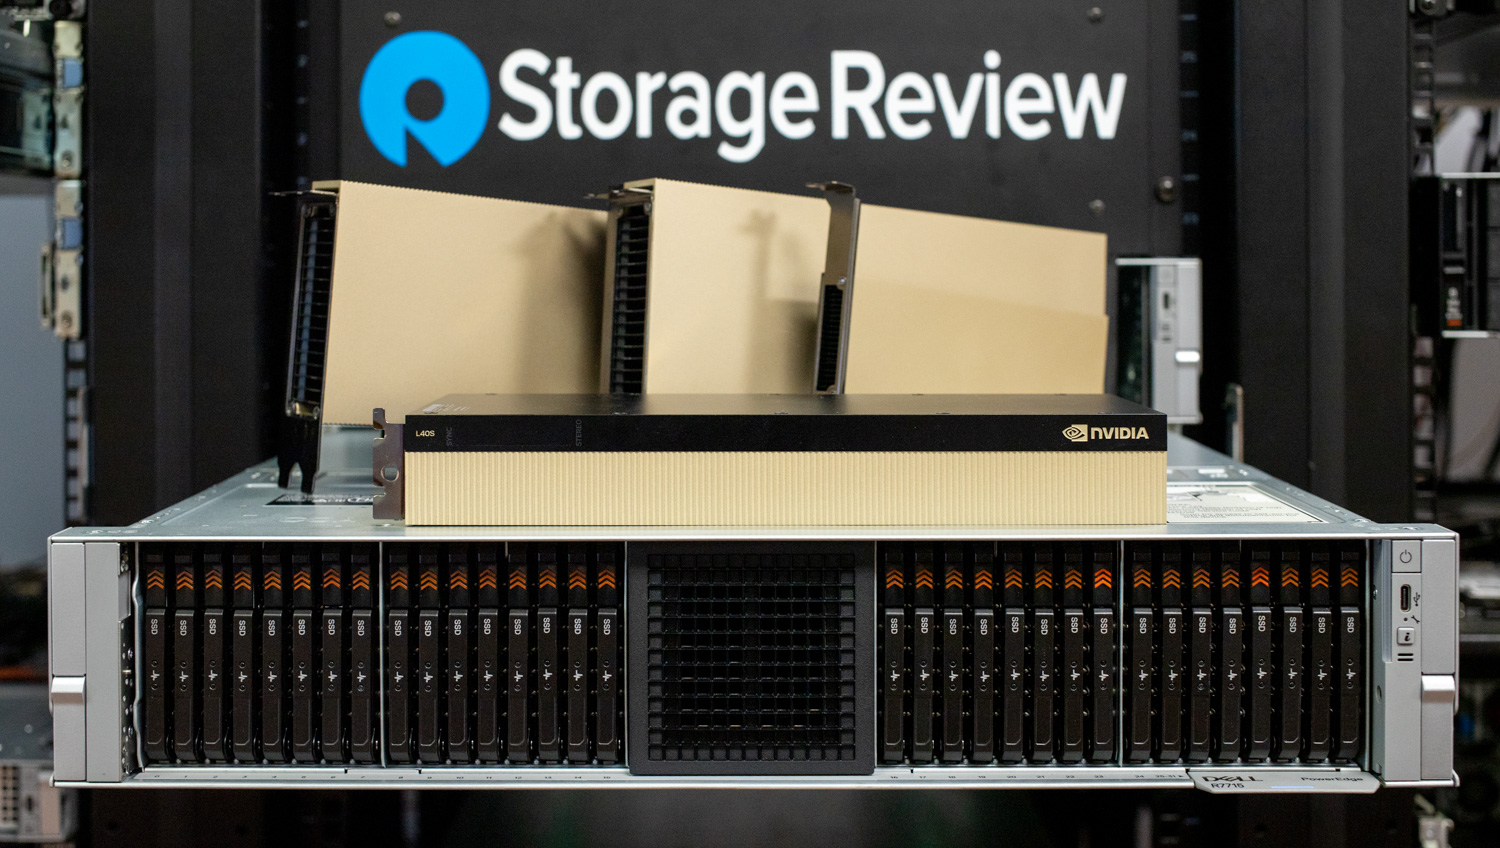
L40S 和 H100 之間的差異凸顯了資料中心 GPU 設計上的策略差異。 H100 是一款專注於運算的顯示卡,專為 AI 和高效能運算工作負載最佳化。其目標是大規模 AI 訓練,其中最大化計算吞吐量是首要目標。從海量的 HBM2e 顯存頻寬到專用的 Tensor Core,其設計的各個方面都專為最嚴苛的神經網路訓練場景而設計。
相較之下,L40S 是一款通用 GPU,專為多功能性而設計,不僅支援 AI 推理,還支援圖形密集型工作負載和 NVIDIA vGPU 部署。雖然 L100S 是一款功能強大且經濟高效的 AI 推理解決方案,但它的真正優勢在於支援各種圖形密集型應用程序,而 HXNUMX 則並非如此。
圖形密集型工作負載和專業應用程式
L40S 在眾多需要強大運算能力和進階渲染能力的圖形密集型領域中表現出色。在 3D 渲染和動畫領域,工作室依靠 L40S 進行複雜的場景渲染,其 RT Core 可加速光線追蹤運算,而這在純運算型 GPU 上是無法實現的。影視製作公司利用這些功能進行即時預視覺化,使導演和攝影師能夠在拍攝過程中看到逼真的 CGI 場景渲染效果,從而大幅縮短後製時間並降低成本。
建築和工程公司利用 L40S 進行即時建築視覺化和產品設計,客戶可以在實際施工開始前瀏覽逼真的建築效果圖或檢查詳細的產品原型。此顯示卡的專業圖形處理能力也使其成為 CAD 工作站的理想選擇,工程師既需要強大的運算能力來執行複雜的模擬,也需要強大的圖形加速功能來實現流暢、高保真的視口效能。
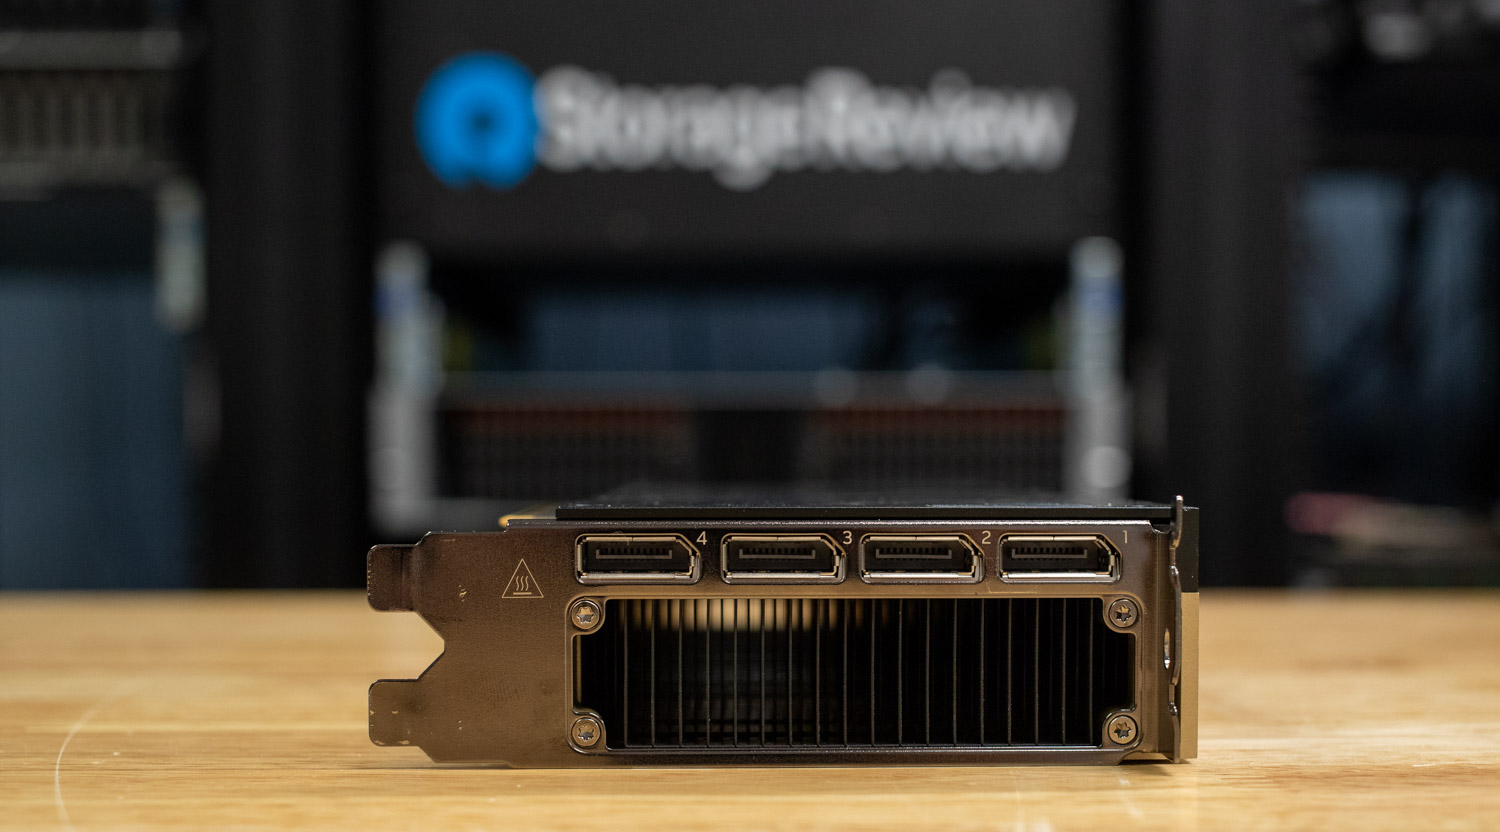
在媒體和娛樂領域,L40S 為渲染農場提供支持,用於處理最終品質的動畫幀。同時,其 vGPU 功能支援基於雲端的創意工作流程,使藝術家可以遠端存取強大的圖形工作站。影片編輯和後製機構使用 L40S 進行即時效果處理、調色和合成工作流程,這些工作流程需要圖形加速和大量計算資源。
虛擬桌面基礎架構 (VDI) 市場是另一個關鍵的應用領域,L40S 的 vGPU 技術可支援多位使用者共享 GPU 資源,進而建構圖形加速的虛擬桌面。這使得企業環境中也能使用專業的圖形功能,而無需為每個使用者分配單獨的 GPU。
基於物理的人工智慧訓練的演變
更重要的是,L40S 提供了 H100 完全缺乏的功能。關鍵區別在於 L40S 擁有 142 個第三代 RT 核心,可實現即時光線追蹤和照片級渲染。 H100 沒有 RT 核心,無法進行圖形加速,而 L40S 的 RT 核心使其成為需要 AI 計算和高級圖形處理能力的應用的理想之選。
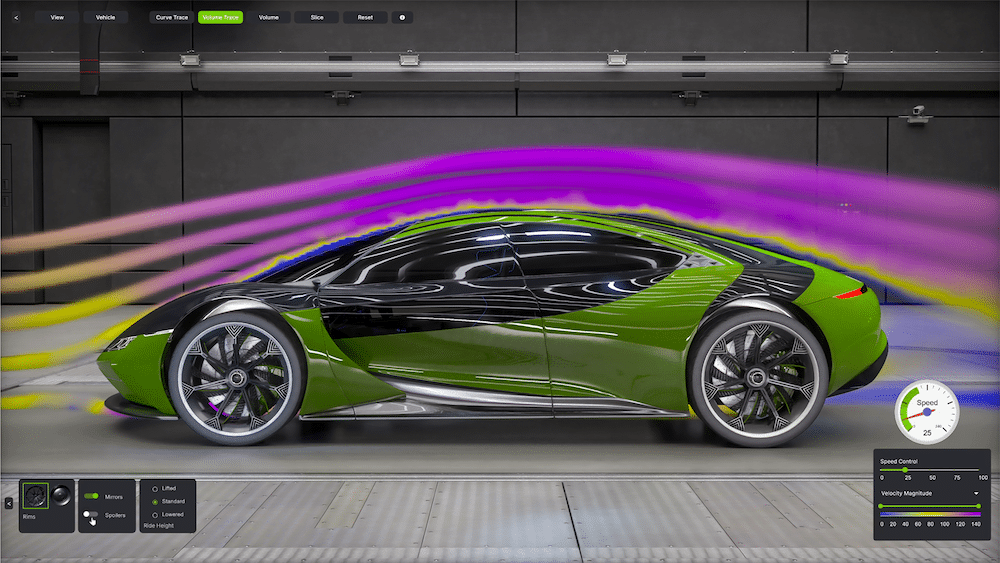
資料來源:Nvidia
隨著我們見證人工智慧生成的 3D 建模、數位孿生模擬和通用場景描述 (OpenUSD) 工作流程的日益普及,這種差異變得越來越重要。人工智慧的下一個前沿領域不僅僅是訓練更大的語言模型;而是開發能夠理解物理、空間關係和現實世界互動的世界模型。這種演進需要我們在訓練資料產生方式上進行根本性的轉變。
雖然訓練傳統 AI 模型在很大程度上依賴 NVIDIA 的旗艦運算 GPU,但訓練下一代基於實體的世界模型則需要不同的方法。這些先進的 AI 系統需要大量的訓練數據,這些數據不僅要捕捉視覺訊息,還要捕捉物理屬性、光照行為、材料相互作用和空間關係。像 L40S 這樣的 GPU 對於大規模訓練資料產生至關重要,其 RT 核心能夠創建物理上精確的合成環境,為訓練更複雜的 AI 模型奠定基礎。
這種由專用 RT Cores 提供支援的高級圖形渲染功能正是使 L40S 成為 NVIDIA Omniverse 平台和更廣泛的基於物理的 AI 開發生態系統的理想引擎的原因。
Omniverse
Omniverse是一個包含 API、SDK 和服務的開發平台,可讓開發者基於通用場景描述 (OpenUSD) 建立應用程式和工作流程。它旨在創建和連接物理上精確的即時 3D 虛擬世界。這透過將 NVIDIA 的 RTX 技術(用於實現逼真的光線追蹤渲染)直接整合到工業和機器人模擬工作流程中來實現。 L40S 憑藉其強大的 RT Core,為驅動這些高要求的 RTX 渲染工作負載提供了必要的硬體加速,使開發者能夠以驚人的真實感模擬光照、材質和物理效果。
Omniverse 不僅僅是一個視覺化工具,更是一個開發下一代實體 AI 的平台。透過創造這些逼真的虛擬世界(或稱為「數位孿生」),開發者可以在安全的虛擬環境中模擬複雜的工業設施、測試整個機器人隊伍,並在實際部署之前驗證自動駕駛汽車。至關重要的是,這些高保真模擬成為產生大量基於物理的合成資料的基礎;而這些資料是訓練在專注於運算的 GPU 上運行的強大 AI 模型的關鍵資源。
機器人合成操作運動生成
NVIDIA Isaac GR00T合成操作運動生成藍圖為機器人訓練提供了一個框架,展示了 L40S 的 RT Core 如何利用最少的人類演示資料創建大型資料集。這個工作流程解決了機器人開發的一個關鍵挑戰:收集足夠的高品質機器人操作任務訓練資料既耗時又昂貴。
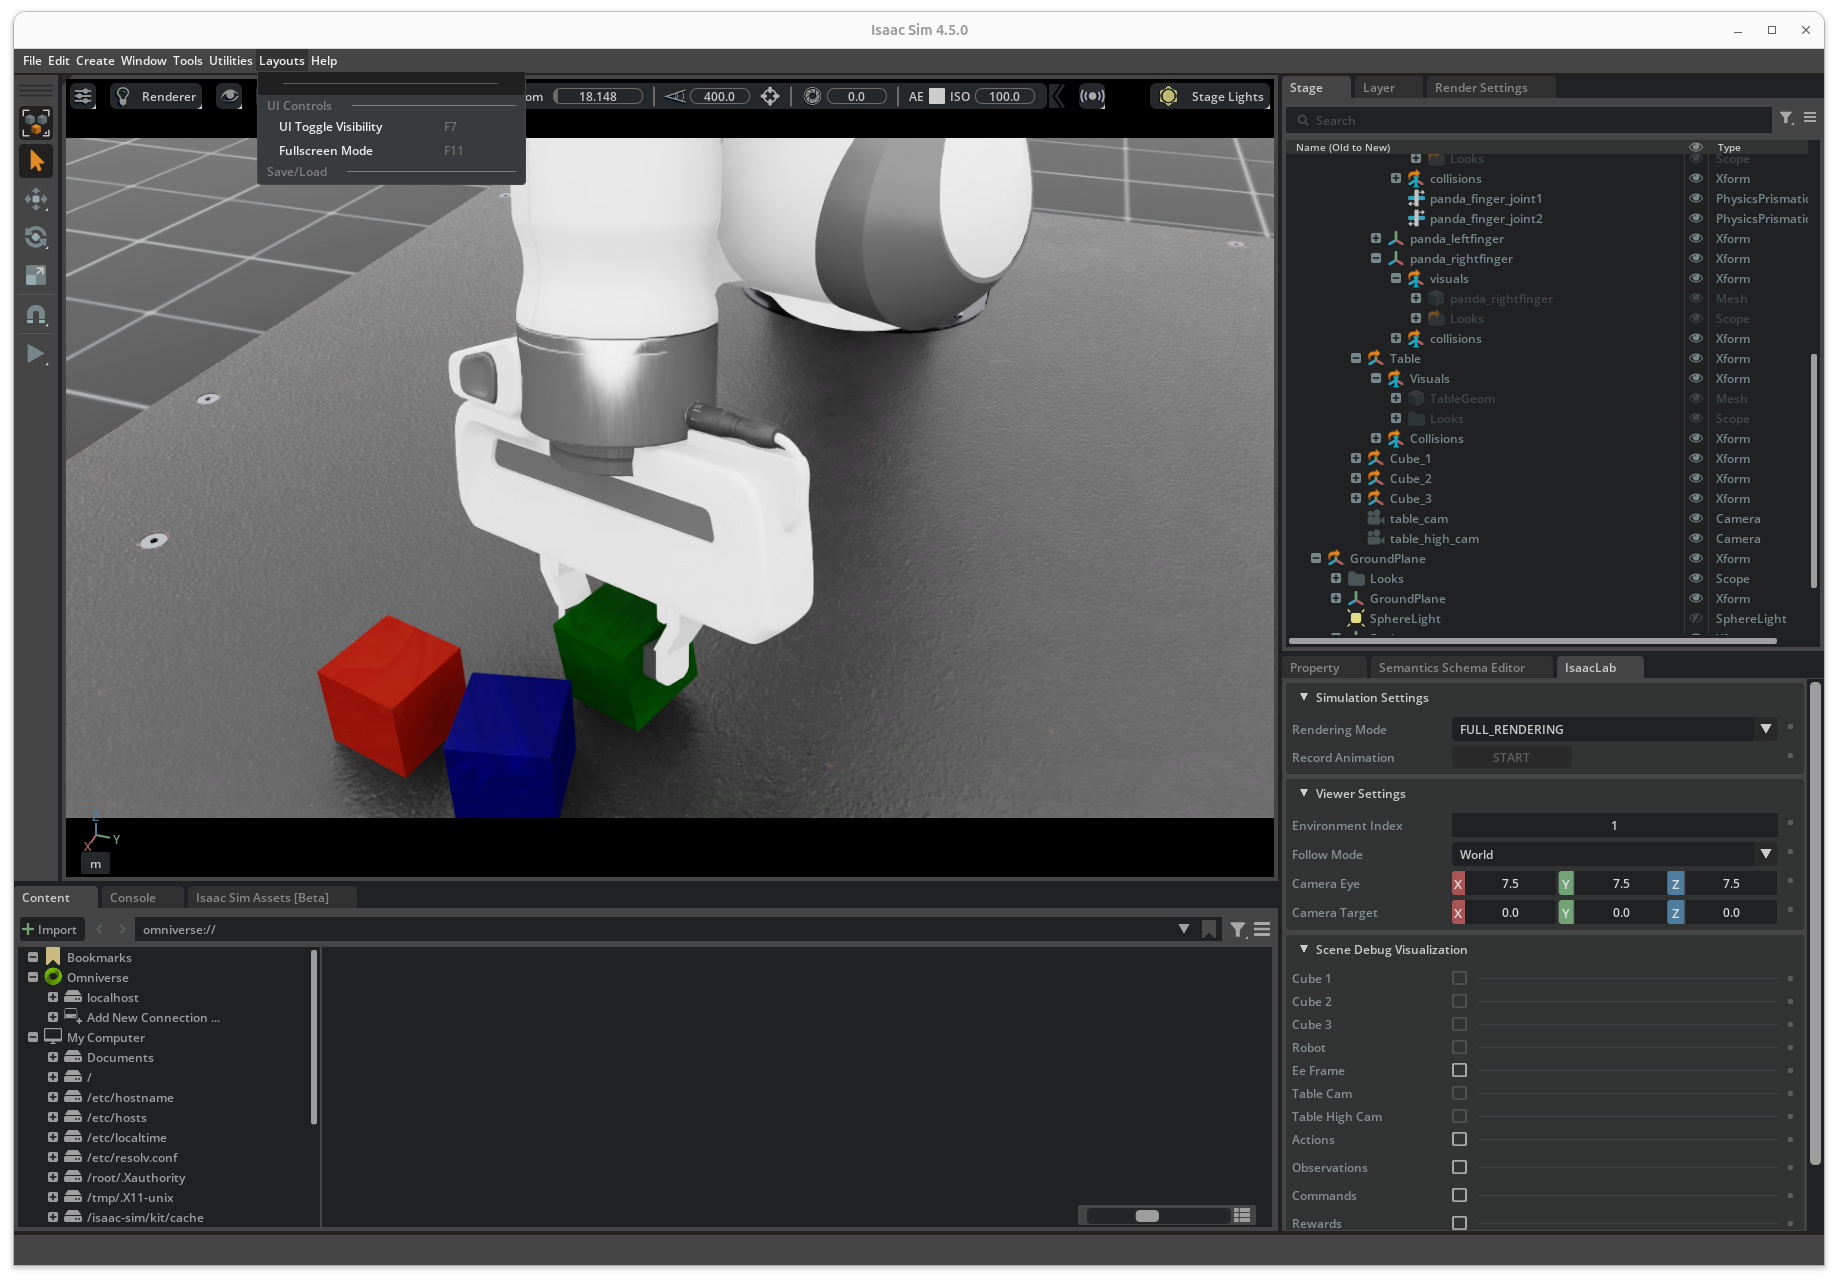
傳統的機器人訓練嚴重依賴監督學習或模仿學習,即機器人透過觀察和模仿人類專家的演示來獲得新技能。然而,創建完美的演示極具挑戰性,而在現實世界中收集大量高品質的資料集既繁瑣又耗時,成本高昂。一位經過專業訓練的人類操作員通常需要大約一分鐘才能錄製一次高品質的演示,由於需要大量的人力投入和潛在的錯誤,這個過程難以擴展。
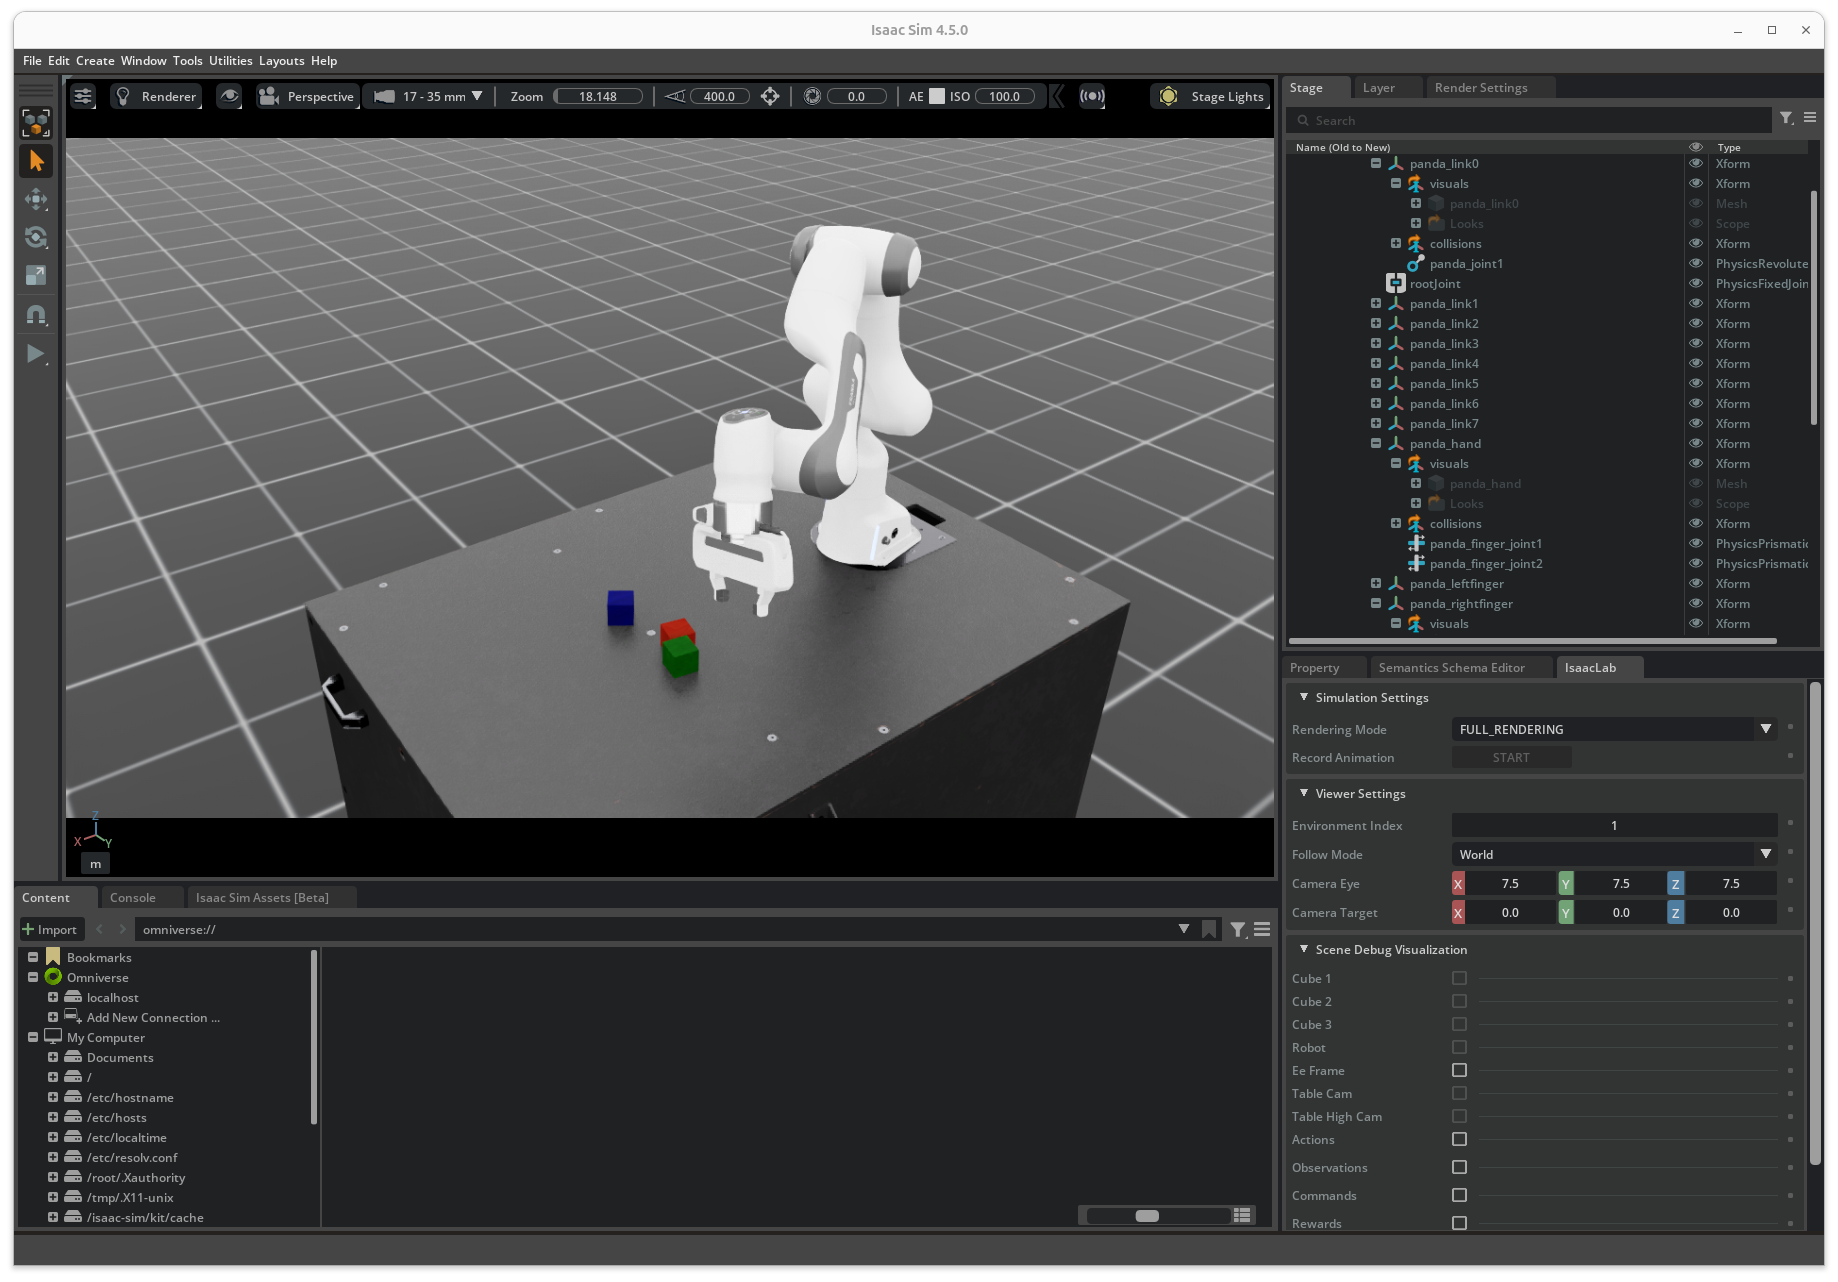
Isaac GR00T 藍圖透過利用物理精確模擬產生的合成資料來加速資料收集過程,從而應對了這項挑戰。組織只需幾個小時的人工演示,就能收集到倍增的數據。
Isaac GR00T藍圖由三個關鍵組件構成,它們協同工作以創建一個全面的合成資料生成流程:
- GR00T-Teleop 使熟練的人類操作員能夠使用 Apple Vision Pro 等空間運算設備控制虛擬機器人。該系統允許操作員在逼真的虛擬環境中示範複雜的操作任務,不僅捕捉運動軌跡,還能捕捉環境背景和物件互動。 Apple Vision Pro 將手部追蹤資料傳輸到 Isaac Lab,後者同時將機器人環境的沉浸式視圖傳回設備,從而實現對機器人的直覺式互動式控制。
- GR00T-模仿者 該組件將記錄的演示數據,利用先進的模擬技術,將其擴展為更大的合成數據集。該組件使用記錄的演示數據作為輸入,在 Isaac Lab 中產生額外的合成運動軌跡,支援單臂和雙手人形機器人的操作。該過程包括註釋演示資料中的關鍵點,並使用插值來確保合成軌蹟的平滑性和上下文相關性。
- GR00T-Gen 利用 NVIDIA Omniverse 和 Cosmos 平台,透過 3D 升級和領域隨機化來擴展合成資料集。此組件透過隨機化場景中的背景、光照和其他變數來增加多樣性。它透過 NVIDIA Cosmos Transfer 增強生成的影像,實現照片級真實感,從而縮小模擬與現實之間的差距。
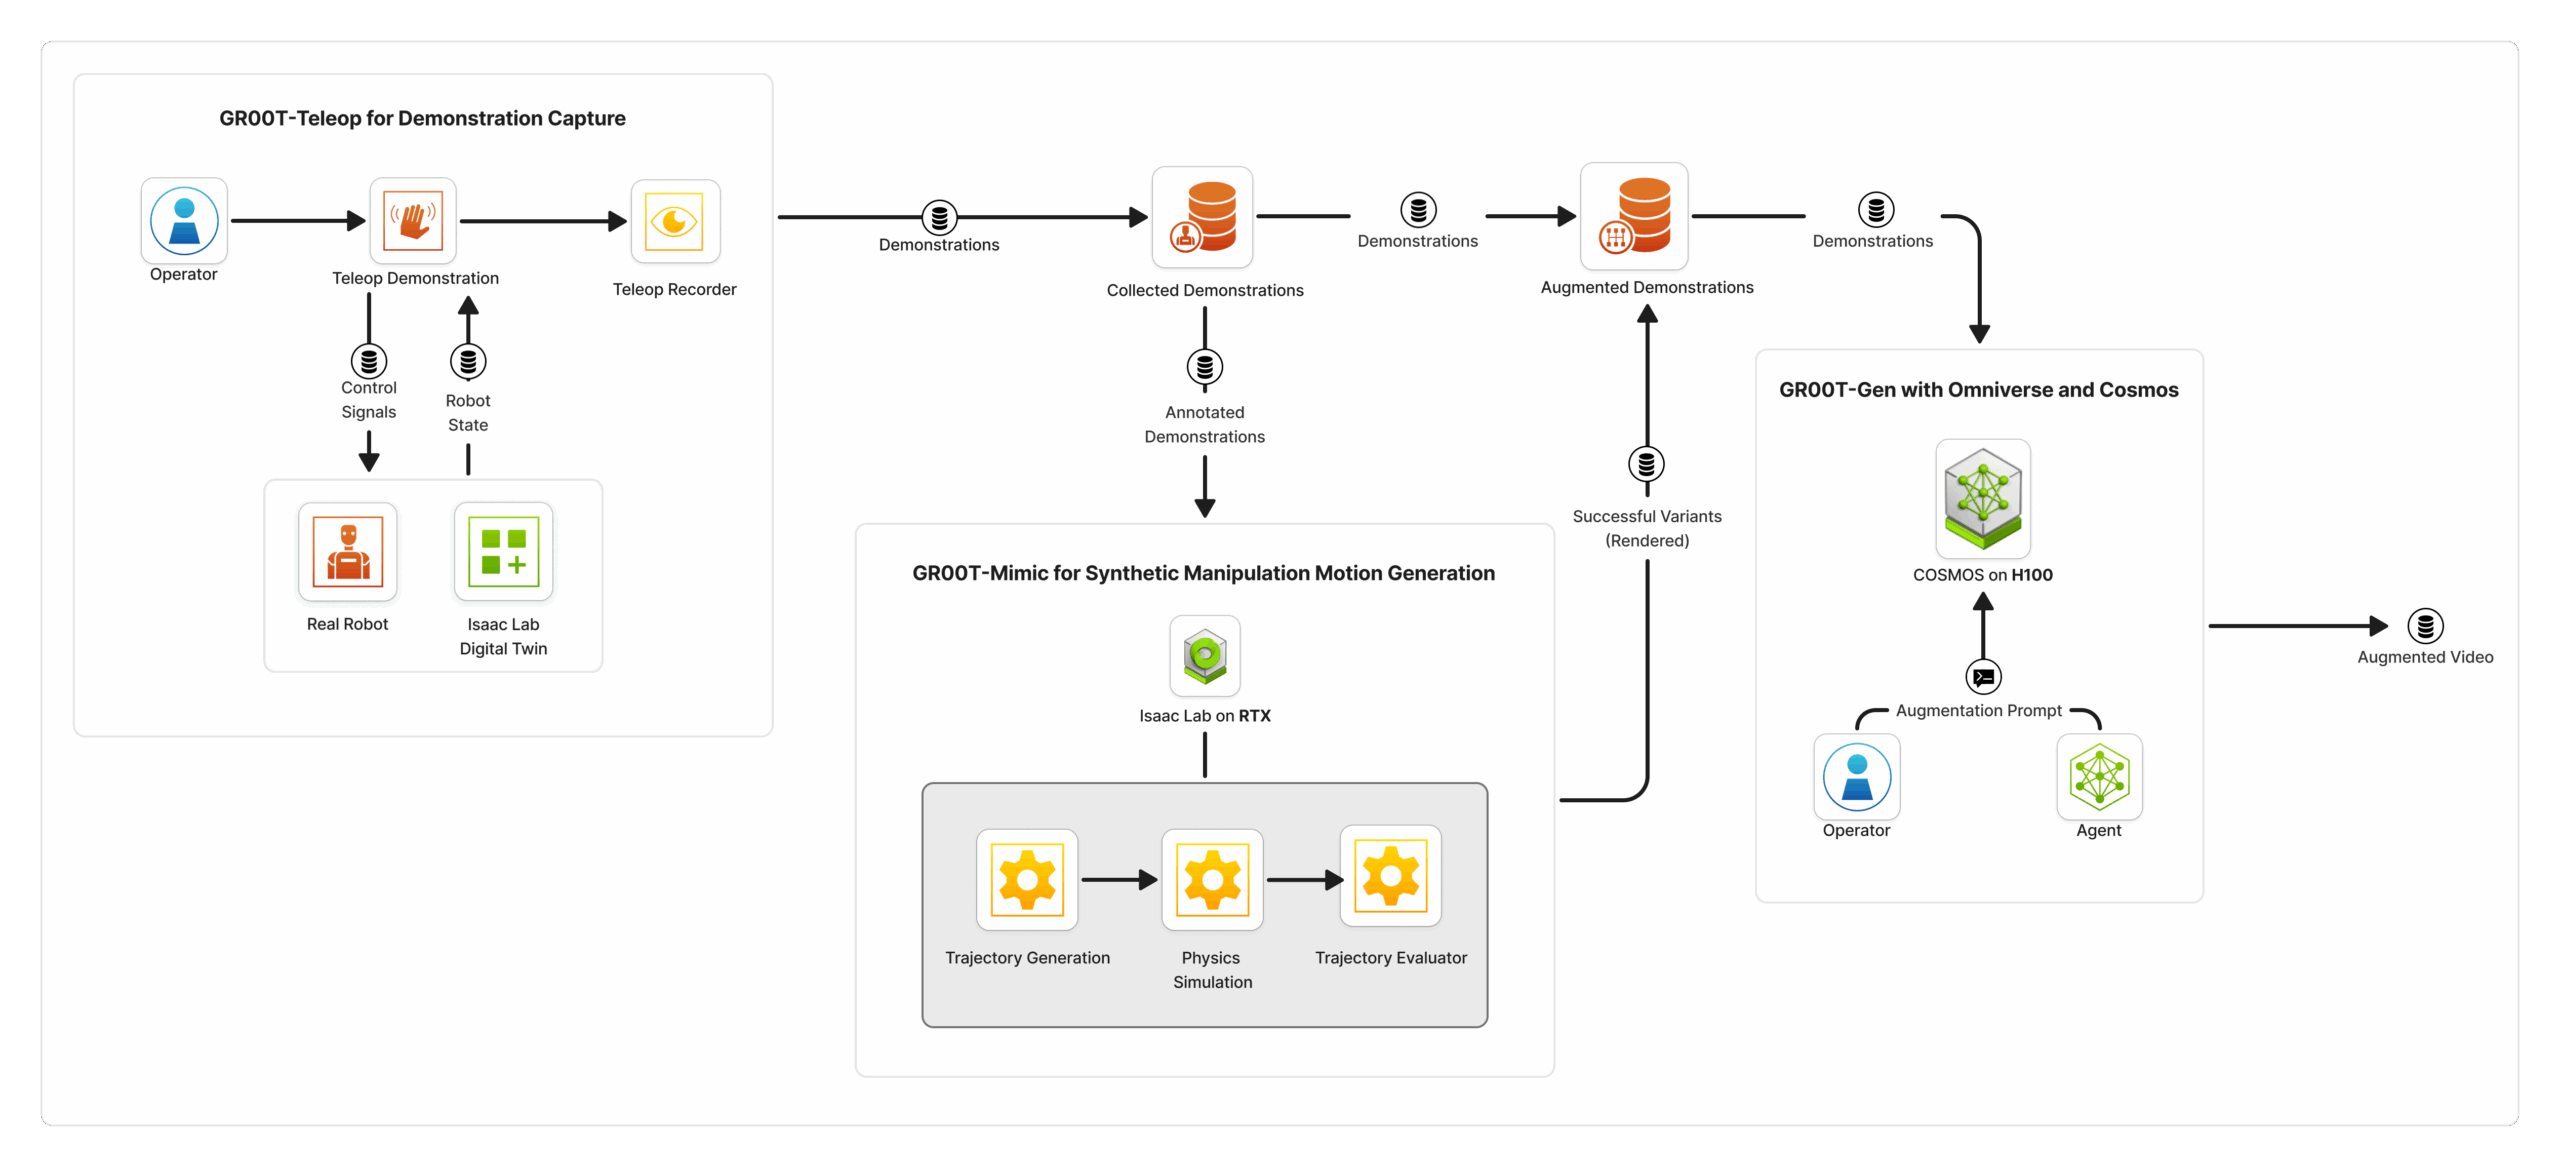
這條管線完美展現了現代資料中心 GPU 各自專屬的互補功能。 L40S 配備專用的 RT 核心,扮演著世界建構器的角色。它在資料生成的初始階段至關重要,負責處理基於物理的渲染、即時光線追蹤和領域隨機化,從而創建逼真且多樣化的虛擬環境。
這個高傳真虛擬世界隨後成為下一代科技的畫布。生成式人工智慧模型(例如NVIDIA Cosmos中的模型)在 H100 等以計算為中心的 GPU 上運行,以產生最終的訓練資料。 H100 利用 L40S 建構的逼真環境,產生數百萬個動態的、具有物理感知能力的場景。
AI推理效能基準
L40S 等顯示卡的另一個受歡迎用例是經濟高效的推理。為了評估 L40S 與 H100 在實際 AI 推理能力方面的比較,我們使用 vLLM 對 LLM 性能進行了基準測試,該 vLLM 在 BF14 上運行 Nvidia 的 Open Reasoning Nemotron 16B 參數模型,最大令牌長度為 32K。
vLLM 基準測試結果
H100 展現出明顯的效能領先優勢,吞吐量比 L4.2S 高出約 40 倍。這一優勢直接源自於 H100 翻倍的 Tensor Core 效能和超過兩倍的記憶體頻寬(2 TB/s vs 864 GB/s)。
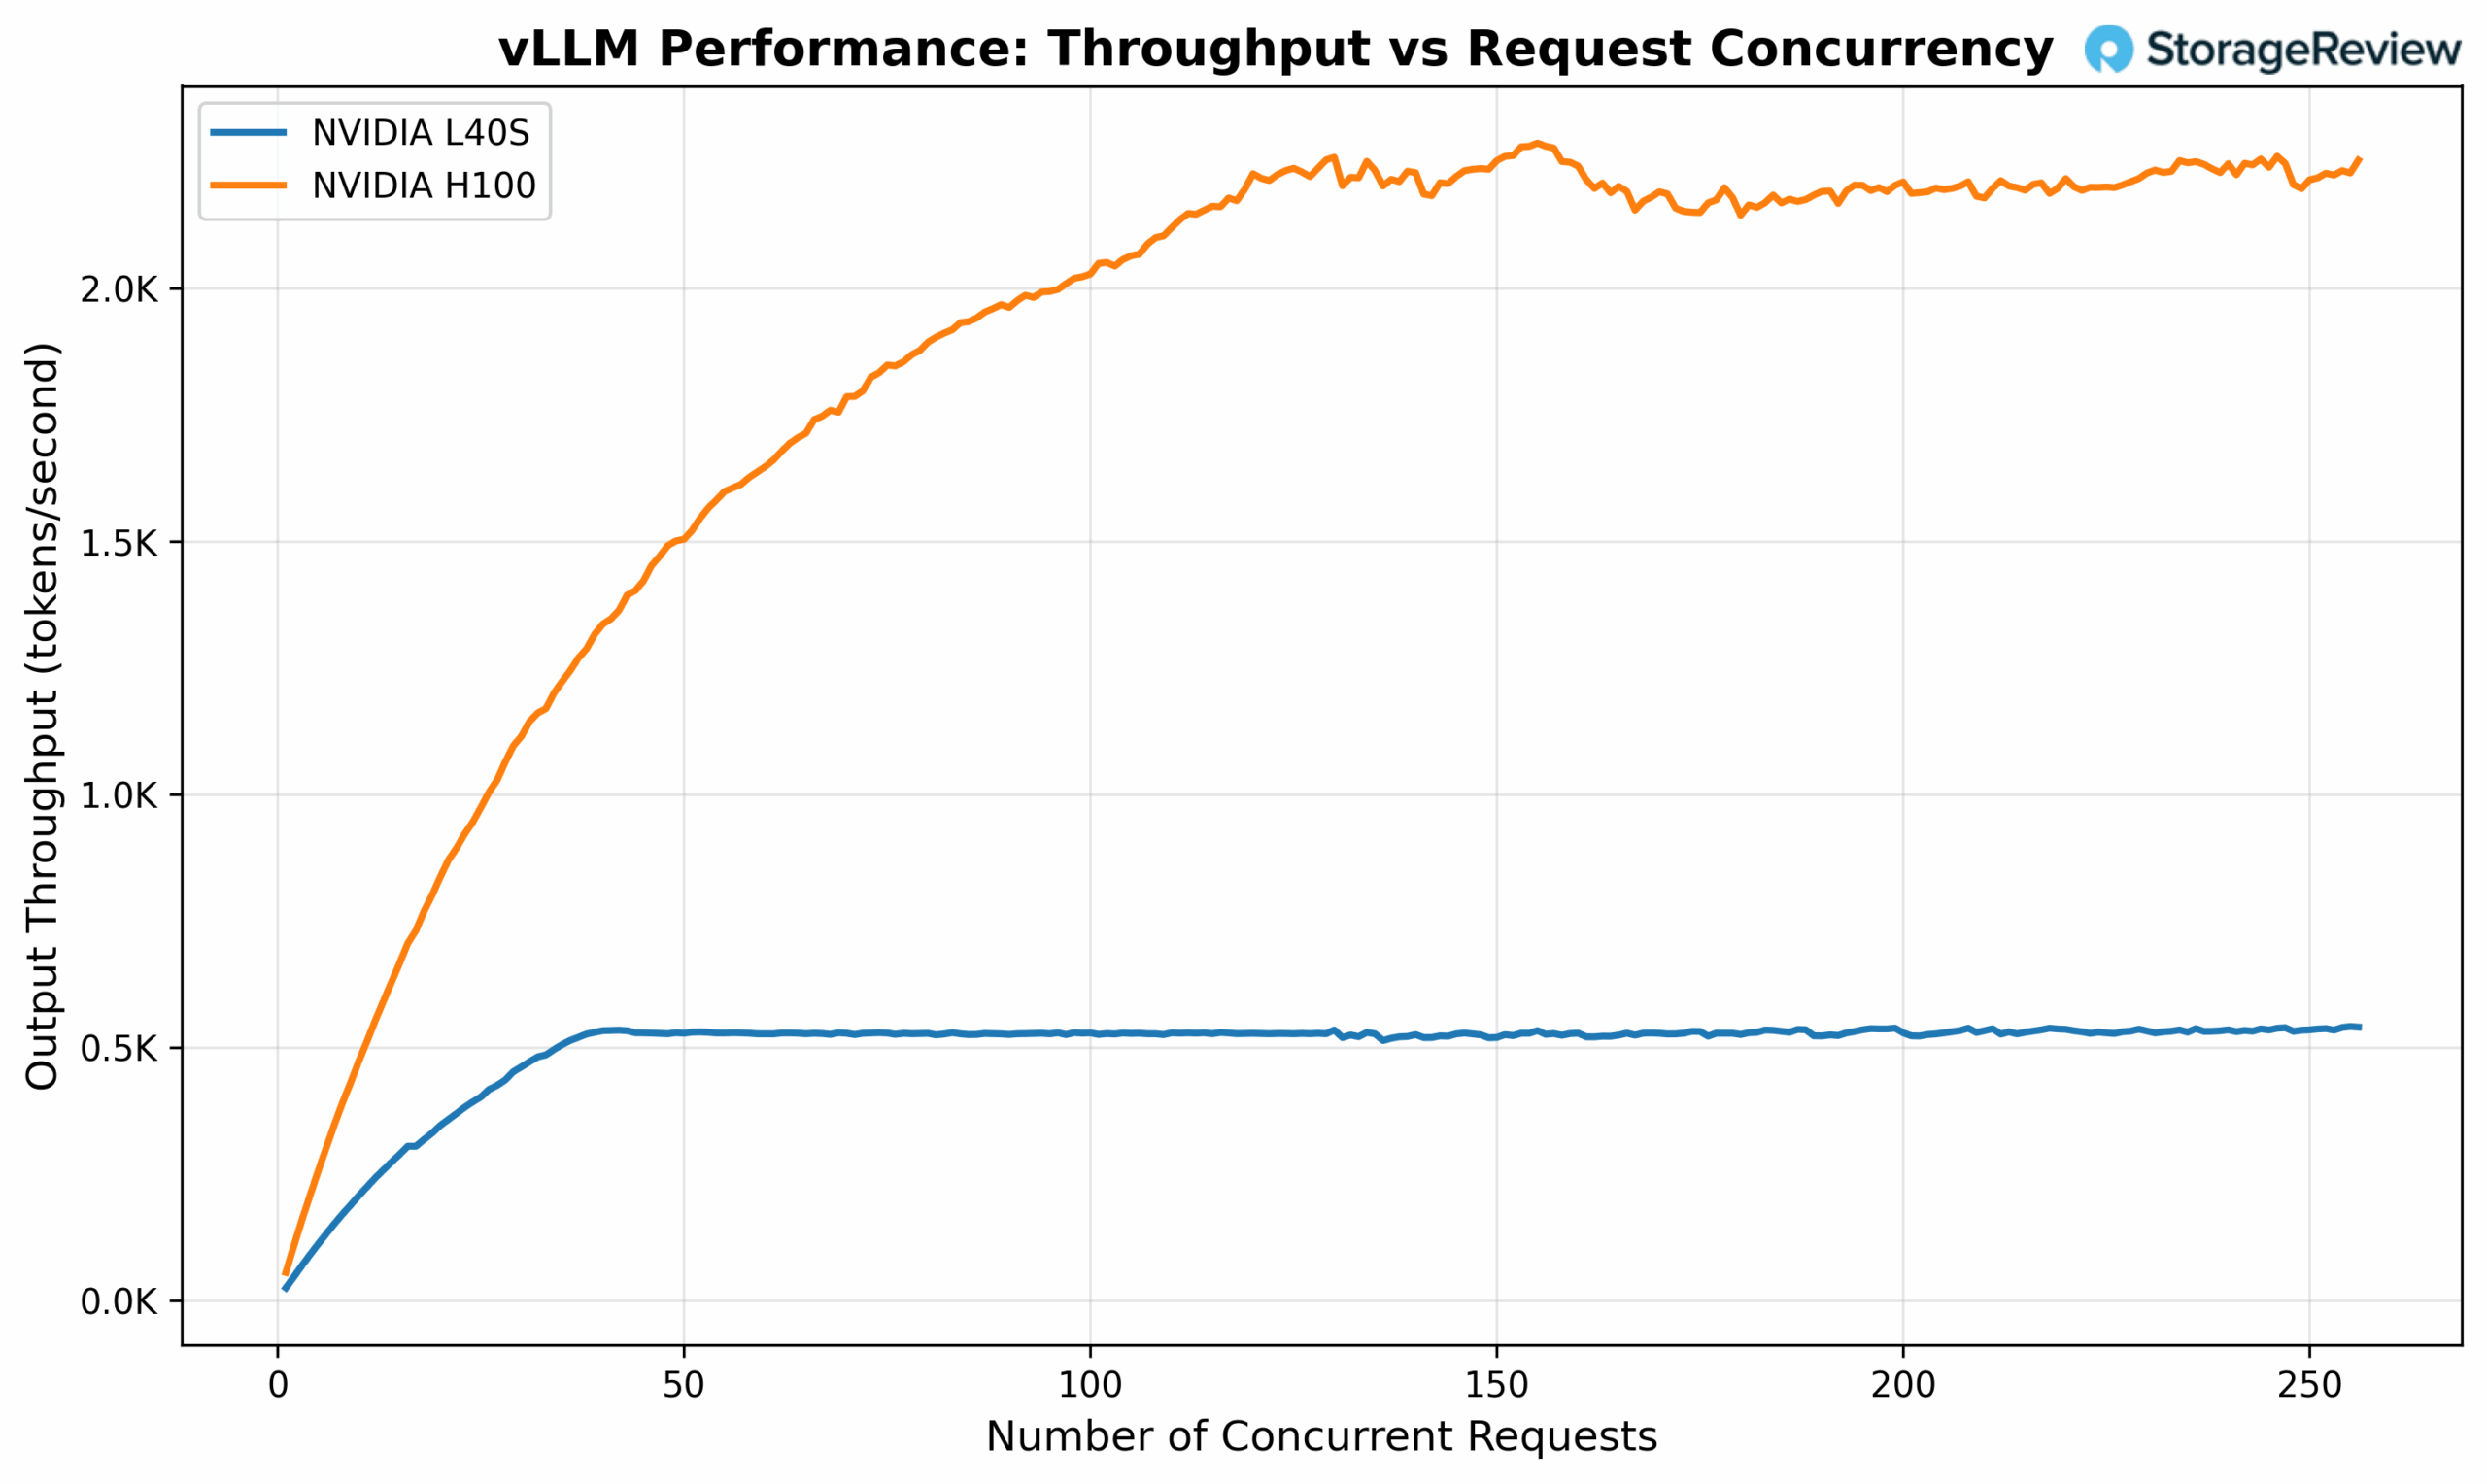
然而,性價比卻截然不同。 L40S 的價格通常不到 H100 的三分之一,這使得它對於許多推理工作負載而言更具成本效益。對於運行推理服務且對絕對峰值效能要求不高的組織而言,L40S 通常會提供更優的總體擁有成本。
雙擊線性效能部分,我們可以看到 L40S 提供了非常可接受的效能水平,能夠以 ~16ms TPOT(每個輸出代幣的時間)SLO 處理 52 個並發請求。
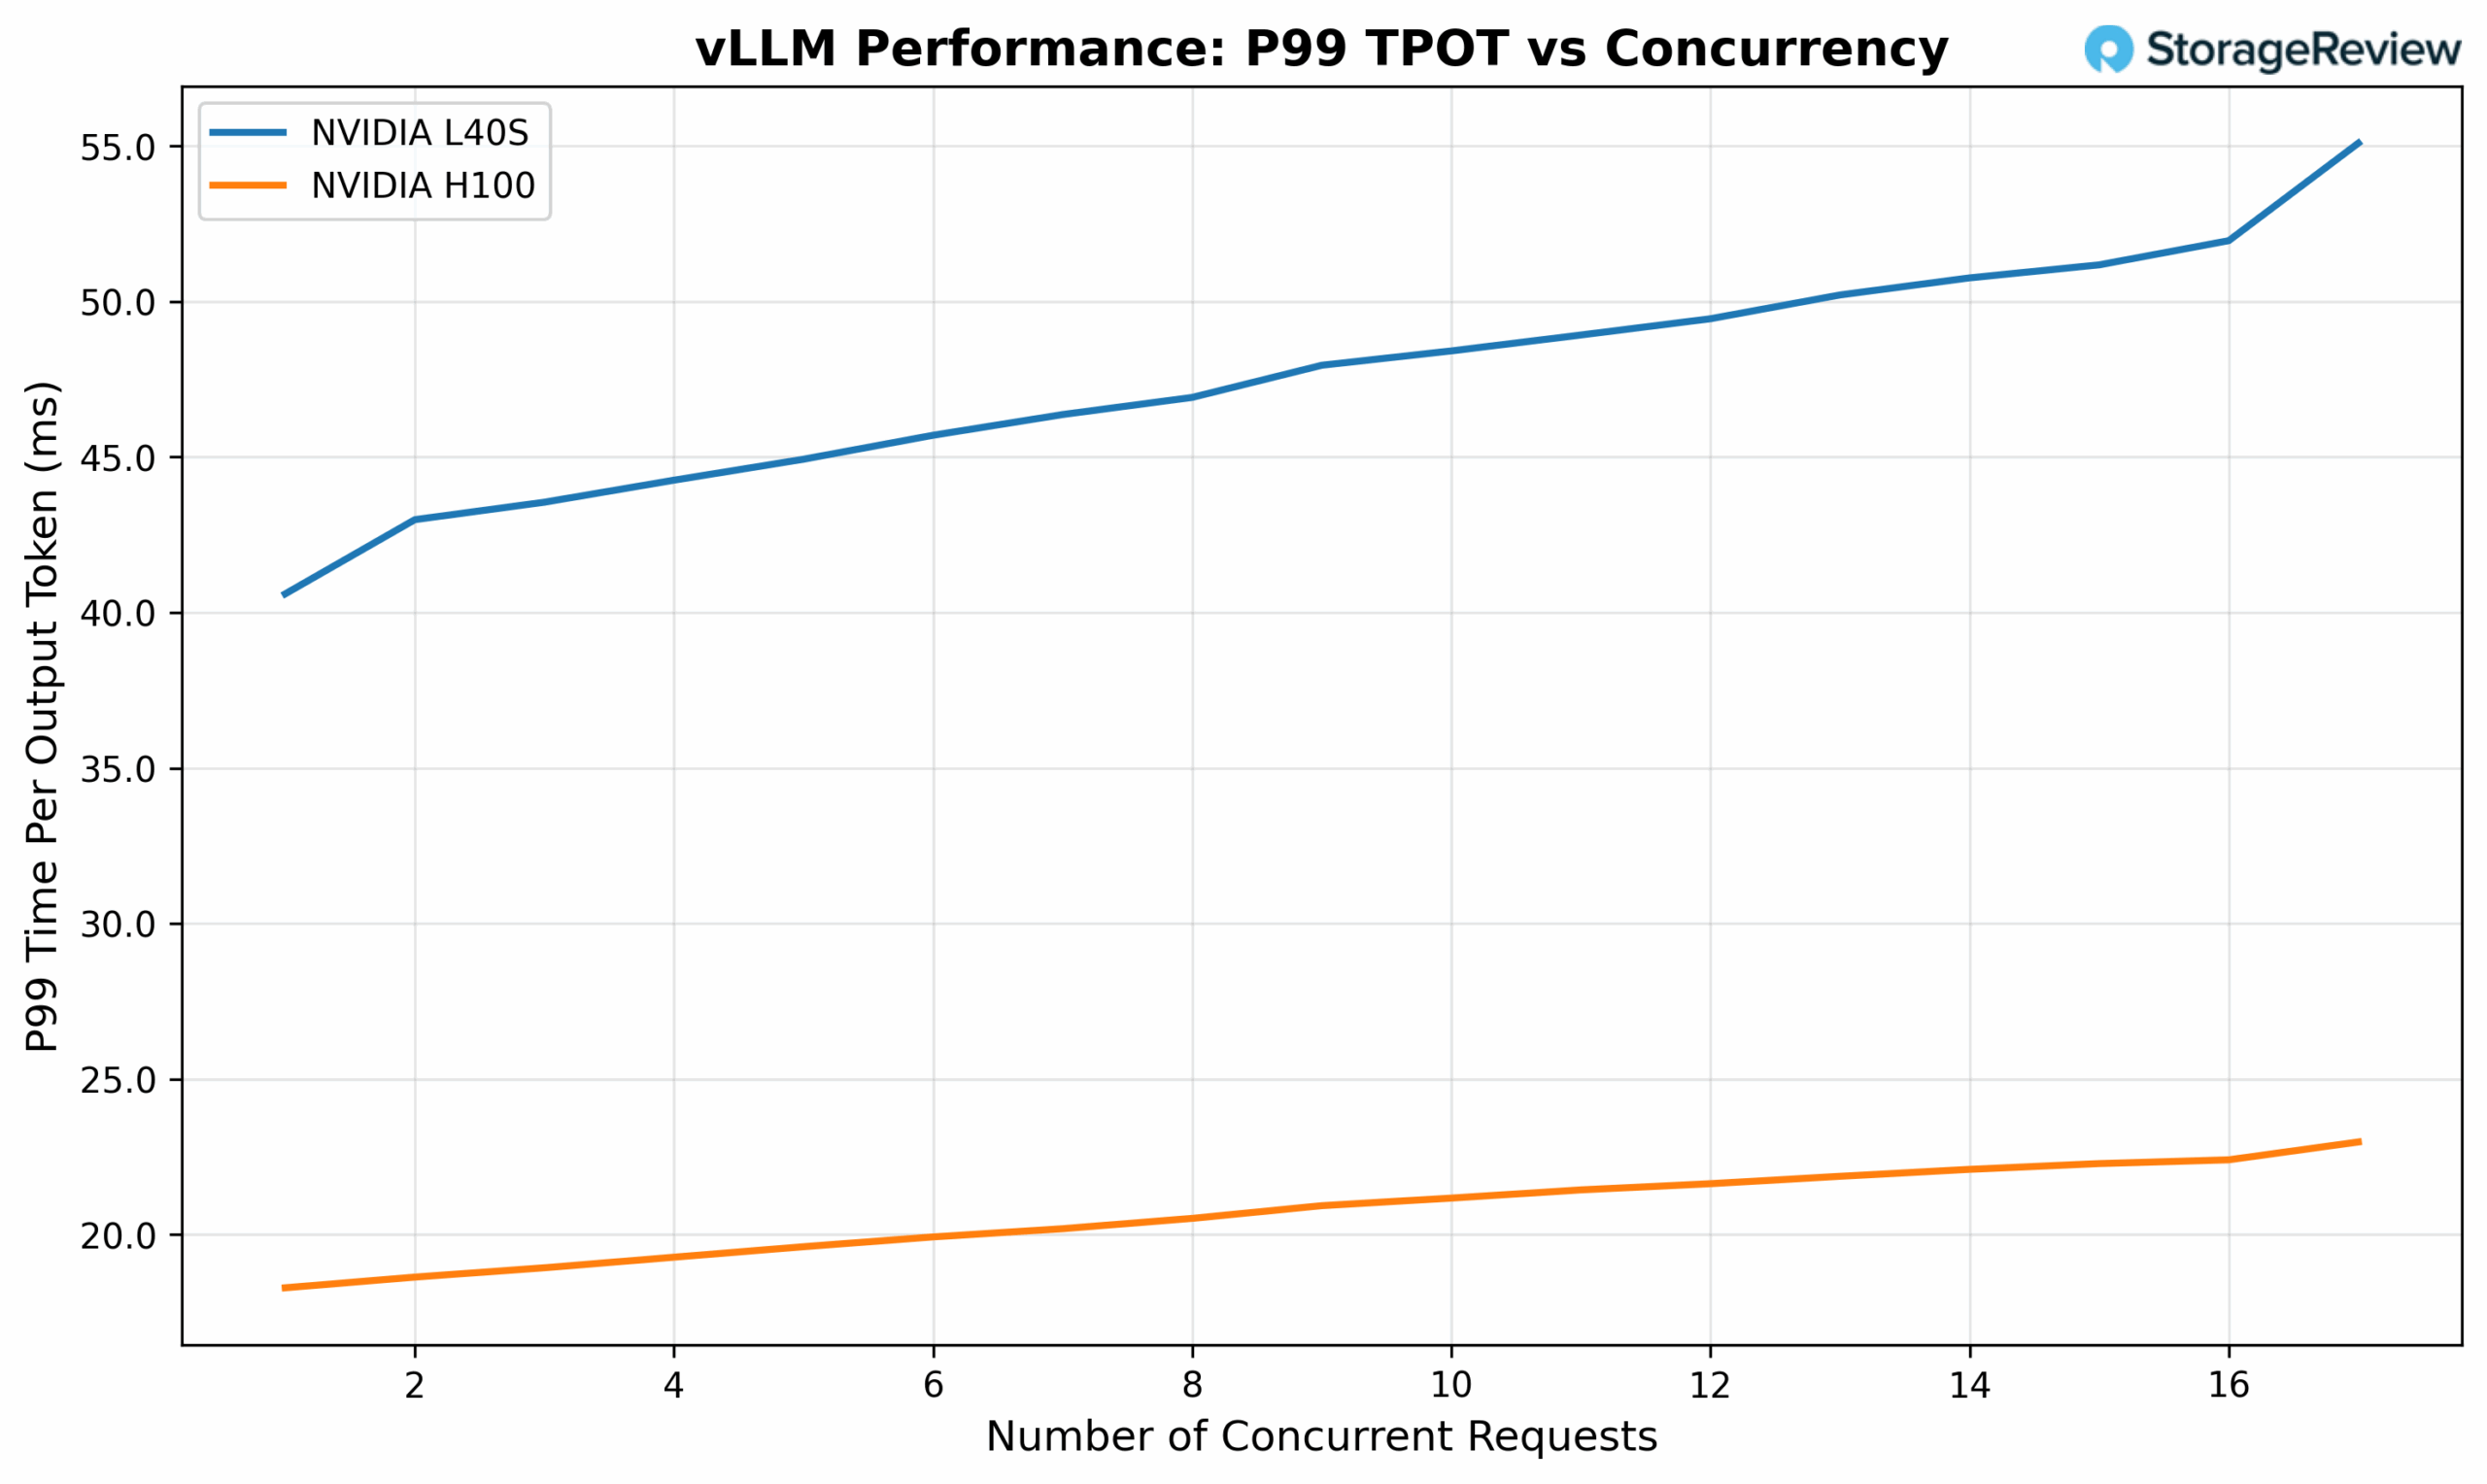
需要注意的一個重要因素是,AI 推理,尤其是文字生成的解碼階段,本質上是一項記憶體頻寬密集型操作。在推理過程中,模型必須反覆存取儲存在 GPU 記憶體中的權重來產生每個新的 token,這使得記憶體吞吐量成為關鍵的效能瓶頸。這項特性解釋了為什麼 H100 憑藉其卓越的記憶體頻寬和增強的 Tensor Core 效能,自然而然地實現了更高的推理吞吐量。
然而,對於同時需要AI推理和圖形加速的部署場景,例如具有AI增強效果的即時渲染、具有AI功能的互動式應用程序,L40S成為唯一可行的選擇。
結語
NVIDIA L40S 和最新的 Blackwell RTX Pro 6000 繼任者作為策略性定位的 GPU,旨在滿足現代資料中心不斷變化的需求,在這些資料中心中,AI 運算和進階圖形功能日益融合。雖然 H100 和 B200 級 GPU 仍然是純 AI 訓練和推理工作負載領域無可爭議的領導者,但 L40S 作為一款通用 GPU,開闢了一個獨特而有價值的細分市場,彌合了以計算為中心的 AI 卡與傳統專業可視化解決方案之間的差距。
L40S 的獨特價值主張在同時需要 AI 推理能力和圖形加速的場景中體現得淋漓盡致。其 142 個第三代 RT 核心,能夠支援 H100 等純運算 GPU 無法實現的應用,從專業工作流程中的即時光線追踪,到用於下一代 AI 訓練的逼真合成資料生成。這種雙重能力使其成為數位孿生開發、基於物理的 AI 訓練以及不斷發展的 Omniverse 生態系統等新興應用不可或缺的利器。
從經濟角度來看,L40S 對於那些不需要 H100 那樣極致 AI 性能的企業來說,具有極高的價值。 L100S 的成本約為 H40 的三分之一,卻能提供出色的推理效能,同時提供圖形功能,為資料中心部署帶來極大的靈活性。對於許多企業而言,這種兼具成本效益和多功能性的選擇,使得 L40S 成為比投資單獨的 AI 和圖形解決方案更實用的選擇。


 Amazon