

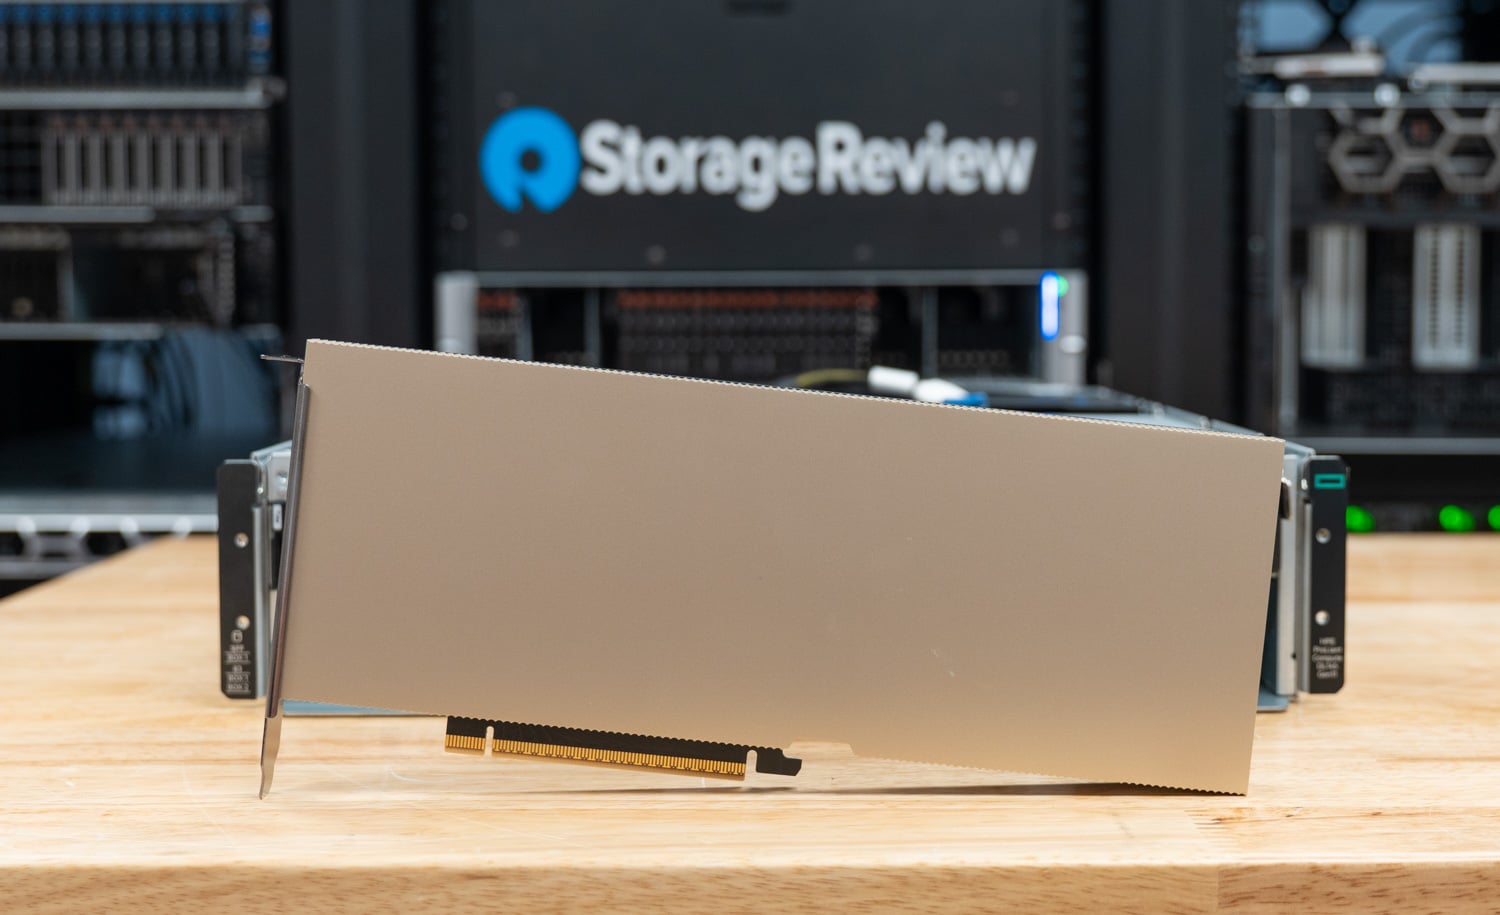
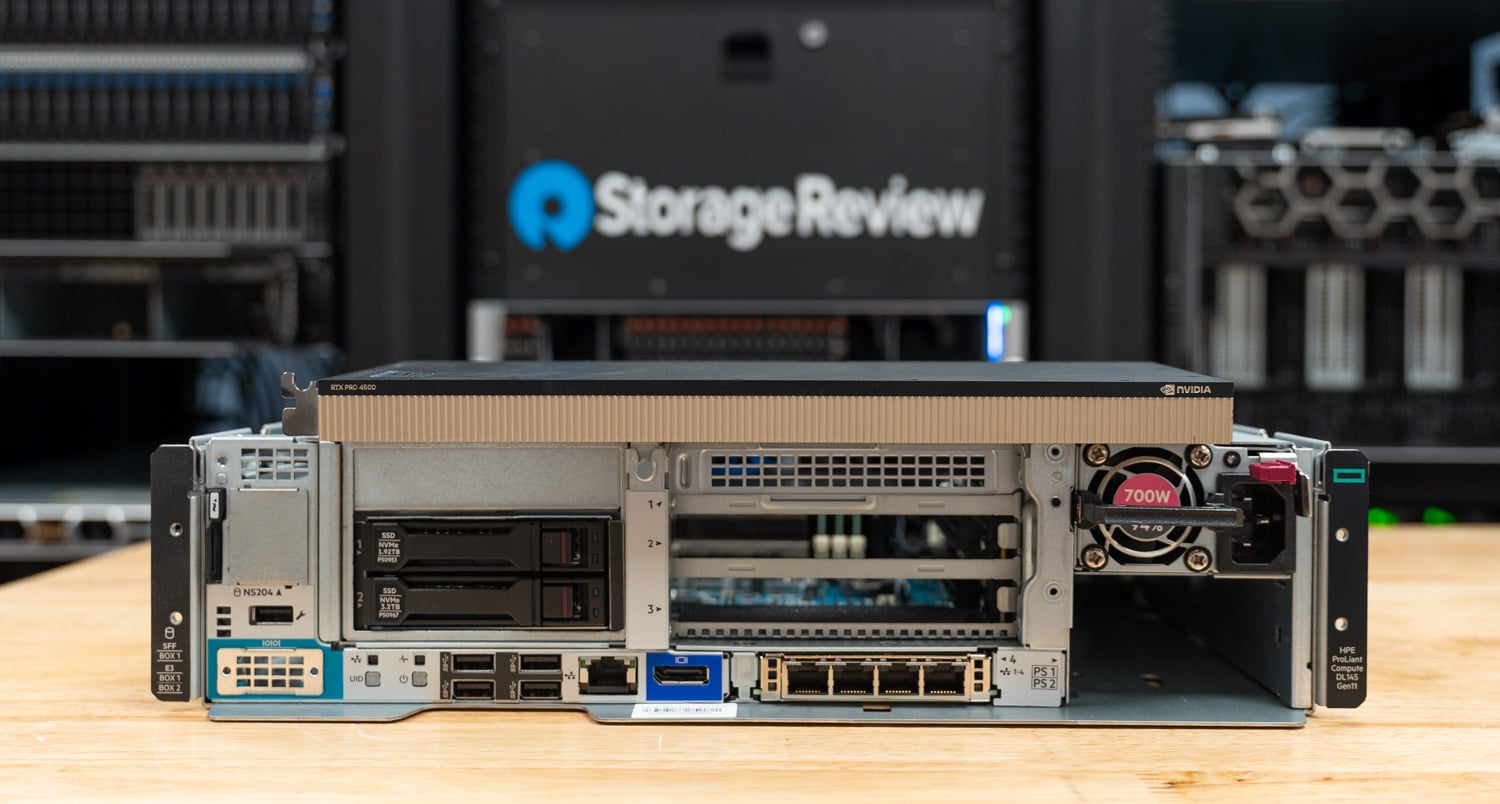
NVIDIA RTX PRO 4500 Blackwell 伺服器版是 NVIDIA 專為替代資料中心外伺服器中的 L4 快取而設計的顯示卡:單槽設計,支援 PCIe Gen5,被動散熱,功耗 165W,配備 32GB GDDR7 顯存,並擁有完整的 Blackwell 功耗功能集,包括 4FP TenFP 功能集。 HPE 為我們提供了一台 ProLiant DL145 Gen11 伺服器,這是一款短深度邊緣伺服器,HPE 將其與這款 GPU 搭配用於其 Nemotron 邊緣解決方案。我們在同一機箱中,分別對 RTX PRO 4500 和 L4 快取進行了相同的 vLLM 服務測試。這篇 RTX PRO 4500 邊緣版評測正是圍繞著這一對比:對於已經在邊緣伺服器上運行 L4 快取的網站而言,更換為 RTX PRO 4500 後,在令牌數量、延遲和功耗方面會有怎樣的變化。
在兩台小型 BF16 模型上,以實際並發情況測試,RTX PRO 4500 的輸出吞吐量是 L4 快取的 2.7 倍,即使在 L4 快取已經進入佇列的情況下,也能將首令牌延遲保持在 1 秒以內,但同時也使 DL145 伺服器的整體功耗從約 196W 伺服器的整體功耗從約 196W。以 GPU 功耗計算,效能提升了 1.3 到 1.4 倍。對於每張顯示卡而言,這意味著並發聊天會話數量從 32 到 64 個增加到 256 個。每台 DL145 伺服器最多可容納三個 L4 緩存,而三個 L4 快取同時處理 32 個會話的吞吐量接近一張 RTX 4500 的吞吐量,因此,RTX 4500 在伺服器層面的優勢主要體現在單一用戶速度、低延遲、單一 32GB 記憶體池以及 FP4 效能上。
本文將針對邊緣伺服器,在 Metrum AI® 基準測試平台上,比較測試了 RTX PRO 4500 Server Edition 與其前代產品在 24GB 和 32GB 記憶體配置下的效能。 RTX PRO 4500 Server Edition 也值得與 NVIDIA 的其他推理顯示卡進行更廣泛的對比,我們正在進行相關測試,並將在另一篇文章中發布。本次比較主要著重於 L4 快取效能,我們新增了一個 RTX PRO 6000 Blackwell 資料集,僅用於展示在 26B 顯存配置下,NVFP4 在更大記憶體顯示卡上的效能表現。 RTX PRO 6000 不支援 HPE 邊緣伺服器。
關鍵要點
- 同一伺服器上 L4 的 2.7 倍: 在 Qwen3.5-4B 和 Gemma 4 E4B 的 18 種輸入和輸出組合中,RTX PRO 4500 在 8 到 32 個並發請求時,每秒輸出令牌數的中位數是 L4 的 2.7 倍;在 256 個並發請求時,中位數是 L3.2 的 3.0 倍。兩張卡都安裝在同一台 HPE ProLiant DL145 Gen11 伺服器上。
- 延遲是更大的差距: 4500 產生每個令牌的時間為 12 至 15 毫秒,而 L4 為 35 至 40 毫秒;在 256 個並發請求的情況下,其首次產生令牌的平均時間保持在 264 毫秒至 650 毫秒之間,而 L4 則分別攀升至 9 秒和 39 秒。
- 牆面功率增加 105 瓦,代幣數量增加 2.7 倍: DL145 在 L4 上運行時功耗約為 196W,在 4500 上運行時功耗約為 301W(32 個並發實例)。 Qwen3.5-4B 的每系統瓦輸出令牌數從 2.7 增加到 5.1,Gemma 4 E4B 的每系統瓦輸出令牌數從 2.9 增加到 5.6。
- 每位使用者在聊天提示模式下最多可進行 256 次會話: 將輸出除以並發數,在 256 個並發會話的情況下,對於 256 個 Token 或更長的答案,4500 仍然能夠為每個用戶提供每秒 11 到 22 個 Token 的輸出,而 L4 的輸出已降至每秒 3.7 到 8.7 個 Token。在大多數題型中,當會話數在 32 到 256 之間時,L4 的輸出低於每秒 10 個 Token 的下限;而在預先填充較多的 1,024/32 題型中,其輸出則在每秒 8 到 16 個 Token 之間;4500 的答案則高於 1,024 個版本,達到 256 個 Token 之間。的提示題型除外。
- 32GB 和 FP4 開啟了一個 L4 無法原生運作的模型類別: 在配備 FP8 KV 快取的 NVFP4 架構 Gemma 4 26B-A4B 處理器上,RTX 4500 在 32 個並發任務下,功耗為 165W,每秒可輸出 1,613 個輸出令牌,約為 RTX PRO 6000 Blackwell 在工作站上可輸出 8 個輸出令牌,約為 RTX PRO 32 Blackwell 在工作站上效能的一半266 到 471W)。在 256 個並發任務下,兩者的差距擴大到約 2.5 倍。
RTX PRO 4500 伺服器版是為什麼而設計的?
NVIDIA 在 GTC 2026 大會上發布了 RTX PRO 4500 Blackwell 伺服器版,作為其 RTX PRO 伺服器系列的入門級產品,也是 L4 的繼任者。它與 RTX PRO 4500 Blackwell 工作站顯示卡同名,兩者共享晶片和 10,496 個 CUDA 核心,但它們是不同的產品。伺服器版取消了顯示輸出和風扇,將板載功耗控制在 165W,並增加了資料中心功能集:支援最多兩個 16GB 顯存實例的 MIG、機密運算、第三個 NVENC 和 NVDEC 編碼器,以及 vGPU 支援。 NVIDIA 標稱其顯存速度為 800GB/s,FP4 Tensor 峰值效能為 1.6 PFLOPS(稀疏化),並將該顯示卡描述為“面向企業級 AI 的節能型 Blackwell GPU”,目標用戶為“主流資料中心和邊緣伺服器”。我們在HPE GTC 2026 的報告中對此進行了詳細介紹。
NVIDIA 也改變了顯卡的外形尺寸:我們 2024 年評測的 L4顯卡是半高半長、72W 的規格,配備 24GB GDDR6 顯存,讀寫速度為 300GB/s;而 RTX PRO 4500 服務器版則是全高全長的單槽顯卡,功耗為 165W,因此它仍然佔用一個插槽,但需要使用全長轉接卡和16 針電源線。 DL145 Gen11 的標準插槽是全高半長的規格,HPE 為我們提供的樣機配備了全長轉接卡和電源線。從紙面參數來看,4500 的顯存頻寬是 L4 的 2.7 倍,顯存容量增加了 33%,FP8 Tensor 峰值效能是 L4 的 1.7 倍,功耗是 L4 的 2.3 倍,此外還增加了 L4 所沒有的 FP4 通道。
| 規格 | RTX PRO 4500 Blackwell 伺服器版 | 英偉達 L4 |
|---|---|---|
| 平台概述 | ||
| 卓越的建築 | 布萊克韋爾 | 艾達洛夫萊斯 |
| CUDA 核心 | 10,496 | 7,424 |
| 記憶體應用 | 32GB GDDR7 帶 ECC | 24GB GDDR6 |
| 內存帶寬 | 800GB /秒 | 300GB /秒 |
| 效能(NVIDIA 峰值數據,考慮稀疏性) | ||
| FP32 | 51 TFLOPS | 30.3 TFLOPS |
| FP8 張量 | 811 TFLOPS | 485 TFLOPS |
| FP4 張量 | 1.6 浮點數 | 不支持 |
| 功率和外形尺寸 | ||
| 板電源 | 165W | 72W |
| 外形尺寸 | 單槽、全高、全長、被動式 | 單槽,半高,半長,被動式 |
| 電源連接器 | 1 個 PCIe CEM5 16 針 | 插槽動力 |
| 介面 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| 產品特性 | ||
| MIG | 最多 2 個實例,每個實例 16GB | 沒有 |
| NVENC/NVDEC | 3 / 3 | 2 / 4 |
| 機密計算 | 能 | 沒有 |
邊緣伺服器:HPE ProLiant DL145 Gen11
HPE 將 DL145 Gen11 定位為沒有伺服器機房的場所的理想選擇。其針對 DL145 和 NVIDIA Nemotron 的解決方案簡介中提到,這是一款可壁掛安裝、近乎靜音的伺服器,工作溫度範圍為 -5°C 至 55°C,適用於通風不良、多塵以及溫度較高或較低的場所。此外,它還配備了 iLO 和 Compute Ops Management 功能,可輕鬆部署數百個僅有電源和乙太網路介面的場所。 HPE 建議零售、醫療保健、金融、製造和能源行業作為目標行業,並列出了本次評測所考察的工作負載:小型語言模型、RAG 和本地運行的向量搜索,從而確保對延遲敏感且受監管的數據始終保留在本地。我們曾在DL145 Gen11發佈時對其進行過評測,因此本文不再贅述其平台特性。
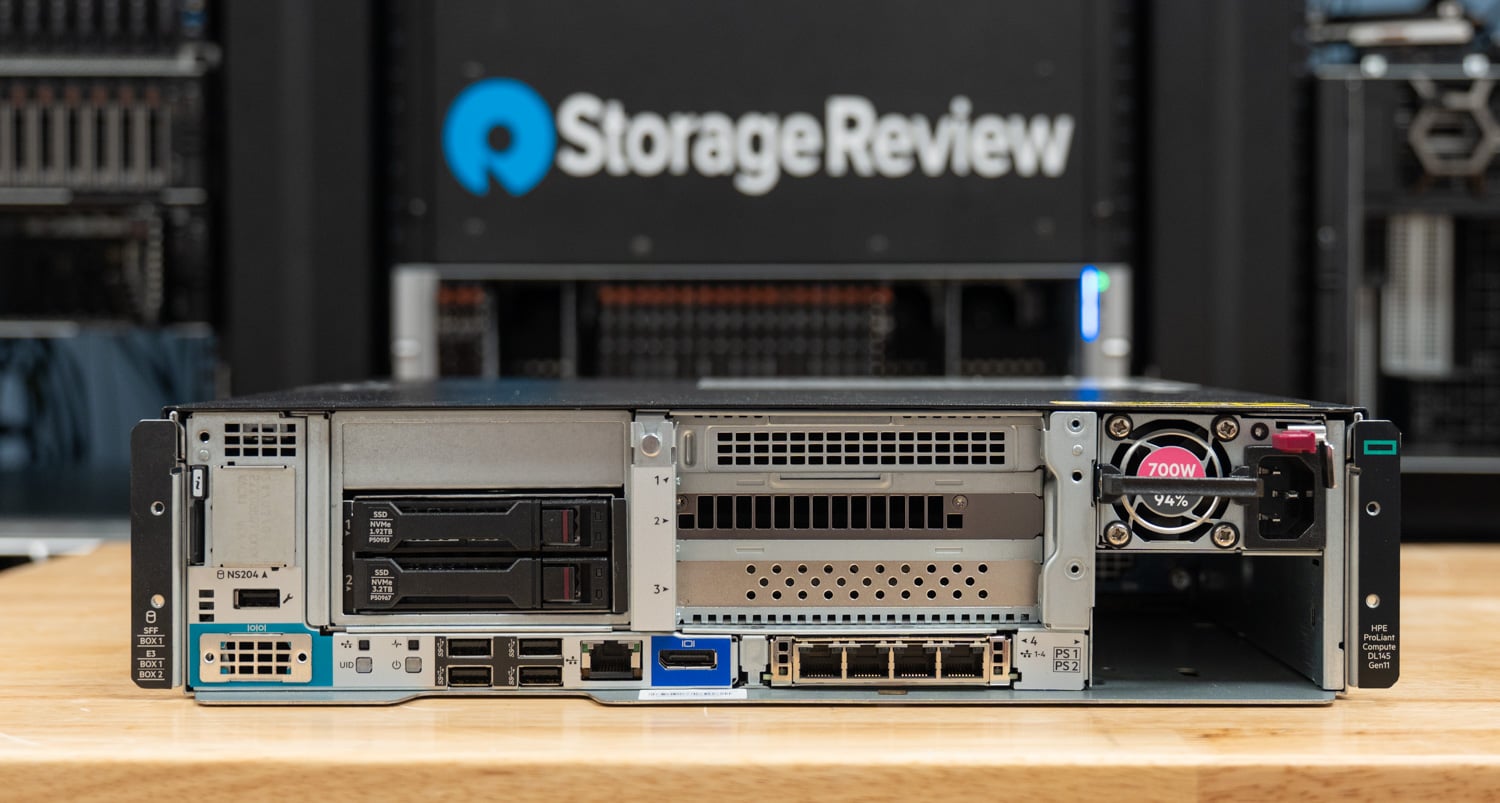
HPE 送測的這台伺服器配置了一顆 AMD EPYC 8534P 處理器(64 核心 128 執行緒 Siena 版本),96GB DDR5-4800 記憶體(六條 16GB DIMM 插槽),以及一個安裝在全長轉接卡上的 RTX PRO 4500 Blackwell 伺服器版本。機殼配備了一個雙碟位 U.3 背板;我們收到的這台伺服器僅配備了 SATA 介面的背板線纜,因此我們使用了一塊安裝在 PCIe 硬碟托架上的 6.4TB Solidigm D7-P5620 NVMe SSD 啟動,但這並不影響 GPU 的測試結果。 L4 快取的對比測試使用了完全相同的伺服器配置。 4500 是 HPE 為其 Nemotron 邊緣運算解決方案在該平台上提供的顯示卡;L4 則是過去兩年內 DL145 伺服器使用者目前很可能在該插槽中使用的顯示卡。
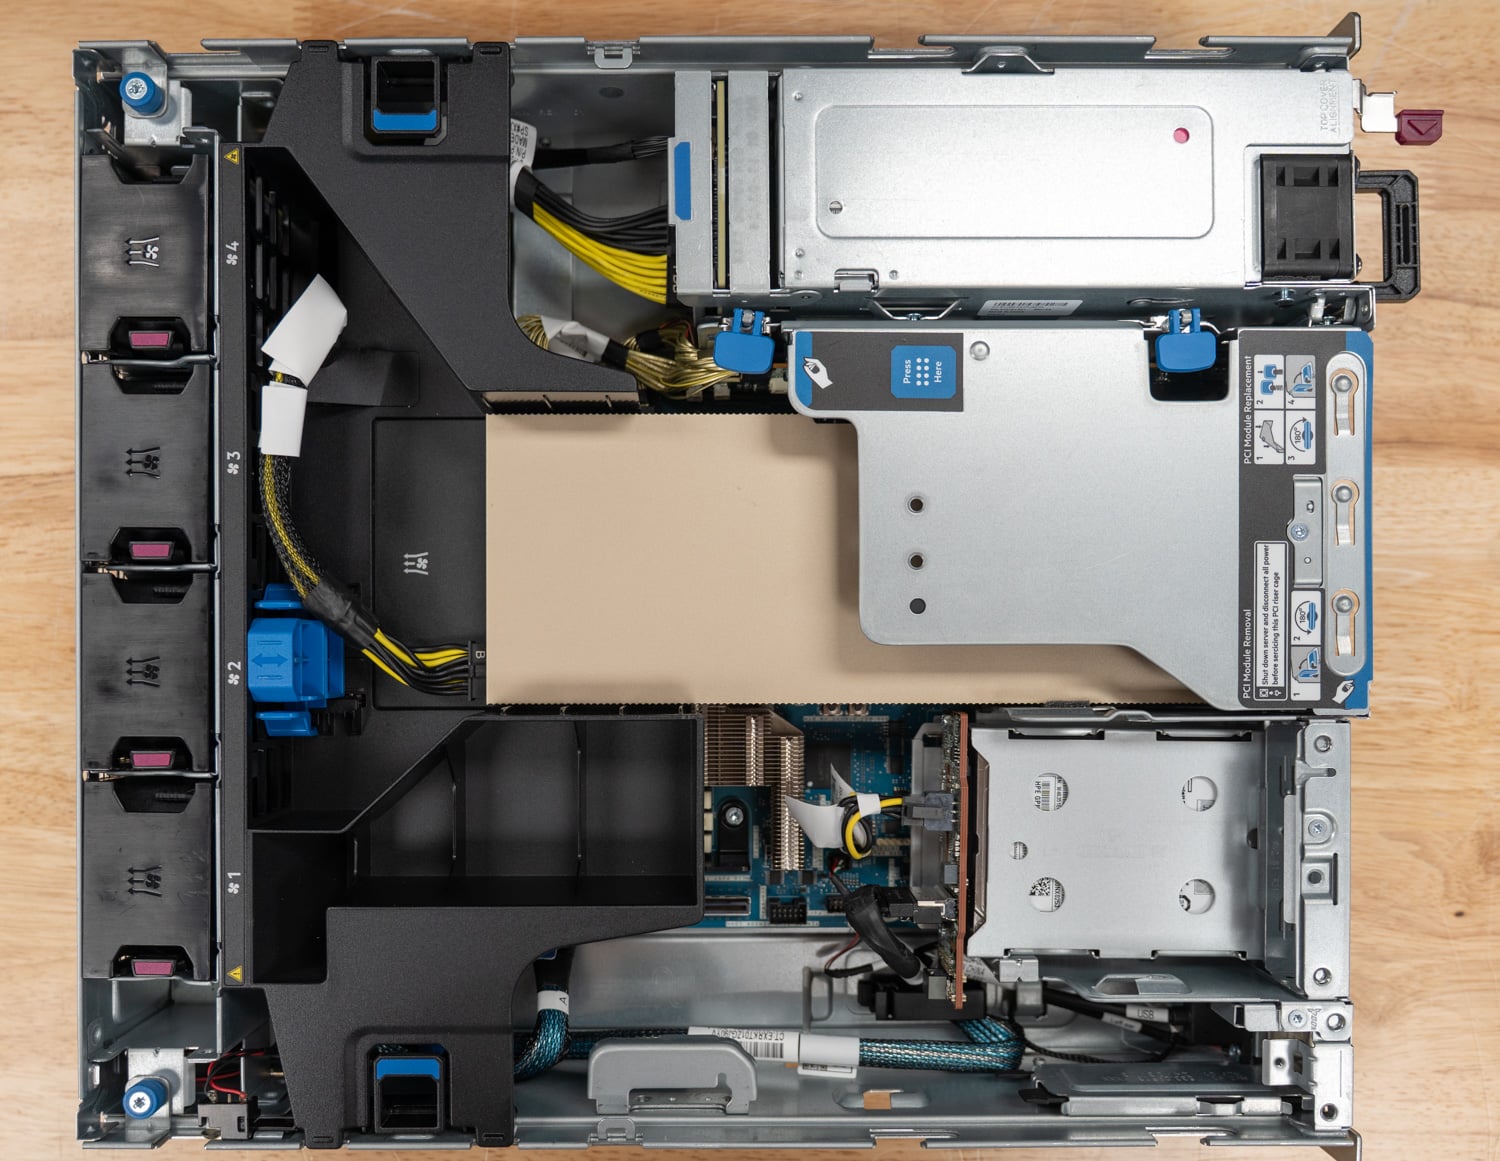
以下分析還參考了另外兩個平台數據:DL145 透過 iLO 報告整機功耗,而基準測試平台在每次運行中都會記錄整機功耗以及 GPU 板載功耗,因此我們可以比較牆插功耗和顯示卡功耗。此外,伺服器的風道設計也確保了兩張被動散熱顯示卡的溫度均在極限範圍內:在 2U 短深度機箱中,4500 在最長運轉時間內平均 GPU 溫度最高達到 84°C,L4 最高達到 86°C,兩者均在持續滿功率推理負載下運行。
我們如何測試
本次評測中的所有推理資料均由Metrum AI Bench Platform (版本 3.9.2,運行文件中記錄的版本號為 Metrum Insights)收集,該平台運行 vLLM 0.24.0 作為服務引擎。 Bench Platform 針對每個系統執行一系列固定場景,記錄每個場景的吞吐量、延遲百分位數、GPU 遙測資料和主機功耗,並將結果匯出為每個作業的單一資料集。我們之前曾報道 Metrum AI 與俄勒岡州立大學的合作,戴爾也曾使用同一平台發布其 R770AP 技術簡報;這是我們首次使用該平台進行端到端的 GPU 對比測試。 Metrum AI 的工程師和我們的實驗室共同運行了這些作業,Bench Platform 負責資料收集,而我們的團隊則負責設定硬體、模型和測試問題。
Metrum AI 也發布了一款開源配套工具Metrum AI Bench CLI,讀者可以使用它在自己的系統上運行相同類型的測試。 Metrum AI 是註冊商標,Metrum AI Bench CLI 和 Metrum AI Bench Platform 是 Metrum AI, Inc. 的商標。使用 Metrum AI Bench 並不代表 Metrum AI 對其內容的認可。
網格包含九種提示形狀:輸入標記數分別為 32、256 和 1,024,最大輸出標記數分別為 32、256 和 1,024 的所有組合,每次運行的並發請求數分別為 1、8、16、32 和 256,每個模型每個 GPU 運行 45 個場景。 L4 的 Gemma 4 運行還包括 64 和 128 個並發請求,這對於找到其效能上限非常有用。每個場景在並發請求數為 1 到 32 時,每個串流發送 15 個請求;在並發請求數為 256 時,發送 1,280 個請求。 4500 的 Gemma 4 E4B 作業運行了三次;重複運行之間的場景間差異小於 2%,我們報告其中位數。 L4 和 4500 BF16 作業以及兩個 Gemma 4 26B 作業(每張卡上一個)共計運行了 378 次場景,其中在一次 4500 場景的重複運行中出現了一次請求失敗,我們提及此事只是為了披露信息。
本次測試涵蓋三種型號:Qwen3.5-4B 和 Gemma 4 E4B,兩者均在 BF16 環境下運行,並配備 BF16 KV 快取。 L4 和 4500 都能運行這兩種模型,它們的大小也與目前 24GB 顯示卡上緣部署實際運行的模型大小相當。 Gemma 4 26B-A4B 是一個 26B 的混合專家模型,擁有約 4 億個活躍參數,僅在 4500 上以 NVFP4 模式運行,並配備 FP8 KV 快取。測試以搭載 RTX PRO 6000 Blackwell 工作站版(600W)的Dell Pro Max Tower T2工作站為參考。 L4 本身不具備 FP4 運算能力,且在 BF16 環境下無法運行此模型,因此未參與這部分測試。
關於圖表解讀的三點說明:吞吐量曲線圖的起始並發請求數為 8。單請求場景的持續時間較短(15 個請求,每個請求僅幾秒鐘),因此在 4500 顯示卡上,每個單一使用者 Qwen 場景的第一個請求(其首令牌延遲為 37 至 39 秒)會影響執行的吞吐量資料。所以,對於單一使用者場景,我們報告的是每個令牌的延遲和回應時間,這兩個資料不受影響。 GPU 功耗是取樣平均值,因此我們只計算運行時間足夠長、平均值趨於穩定的每瓦令牌數,這在實際應用中意味著至少 16 個並發請求。當並發請求數達到 256 個且提示訊息較長時,兩張顯示卡的 KV 快取都會耗盡,vLLM 會將請求排隊;這些點仍然是真實的吞吐量數據,但該負載下的首令牌延遲描述的是一個隊列,因此我們將 32 個並發請求視為對延遲敏感的應用場景的工作範圍。
Qwen3.5-4B
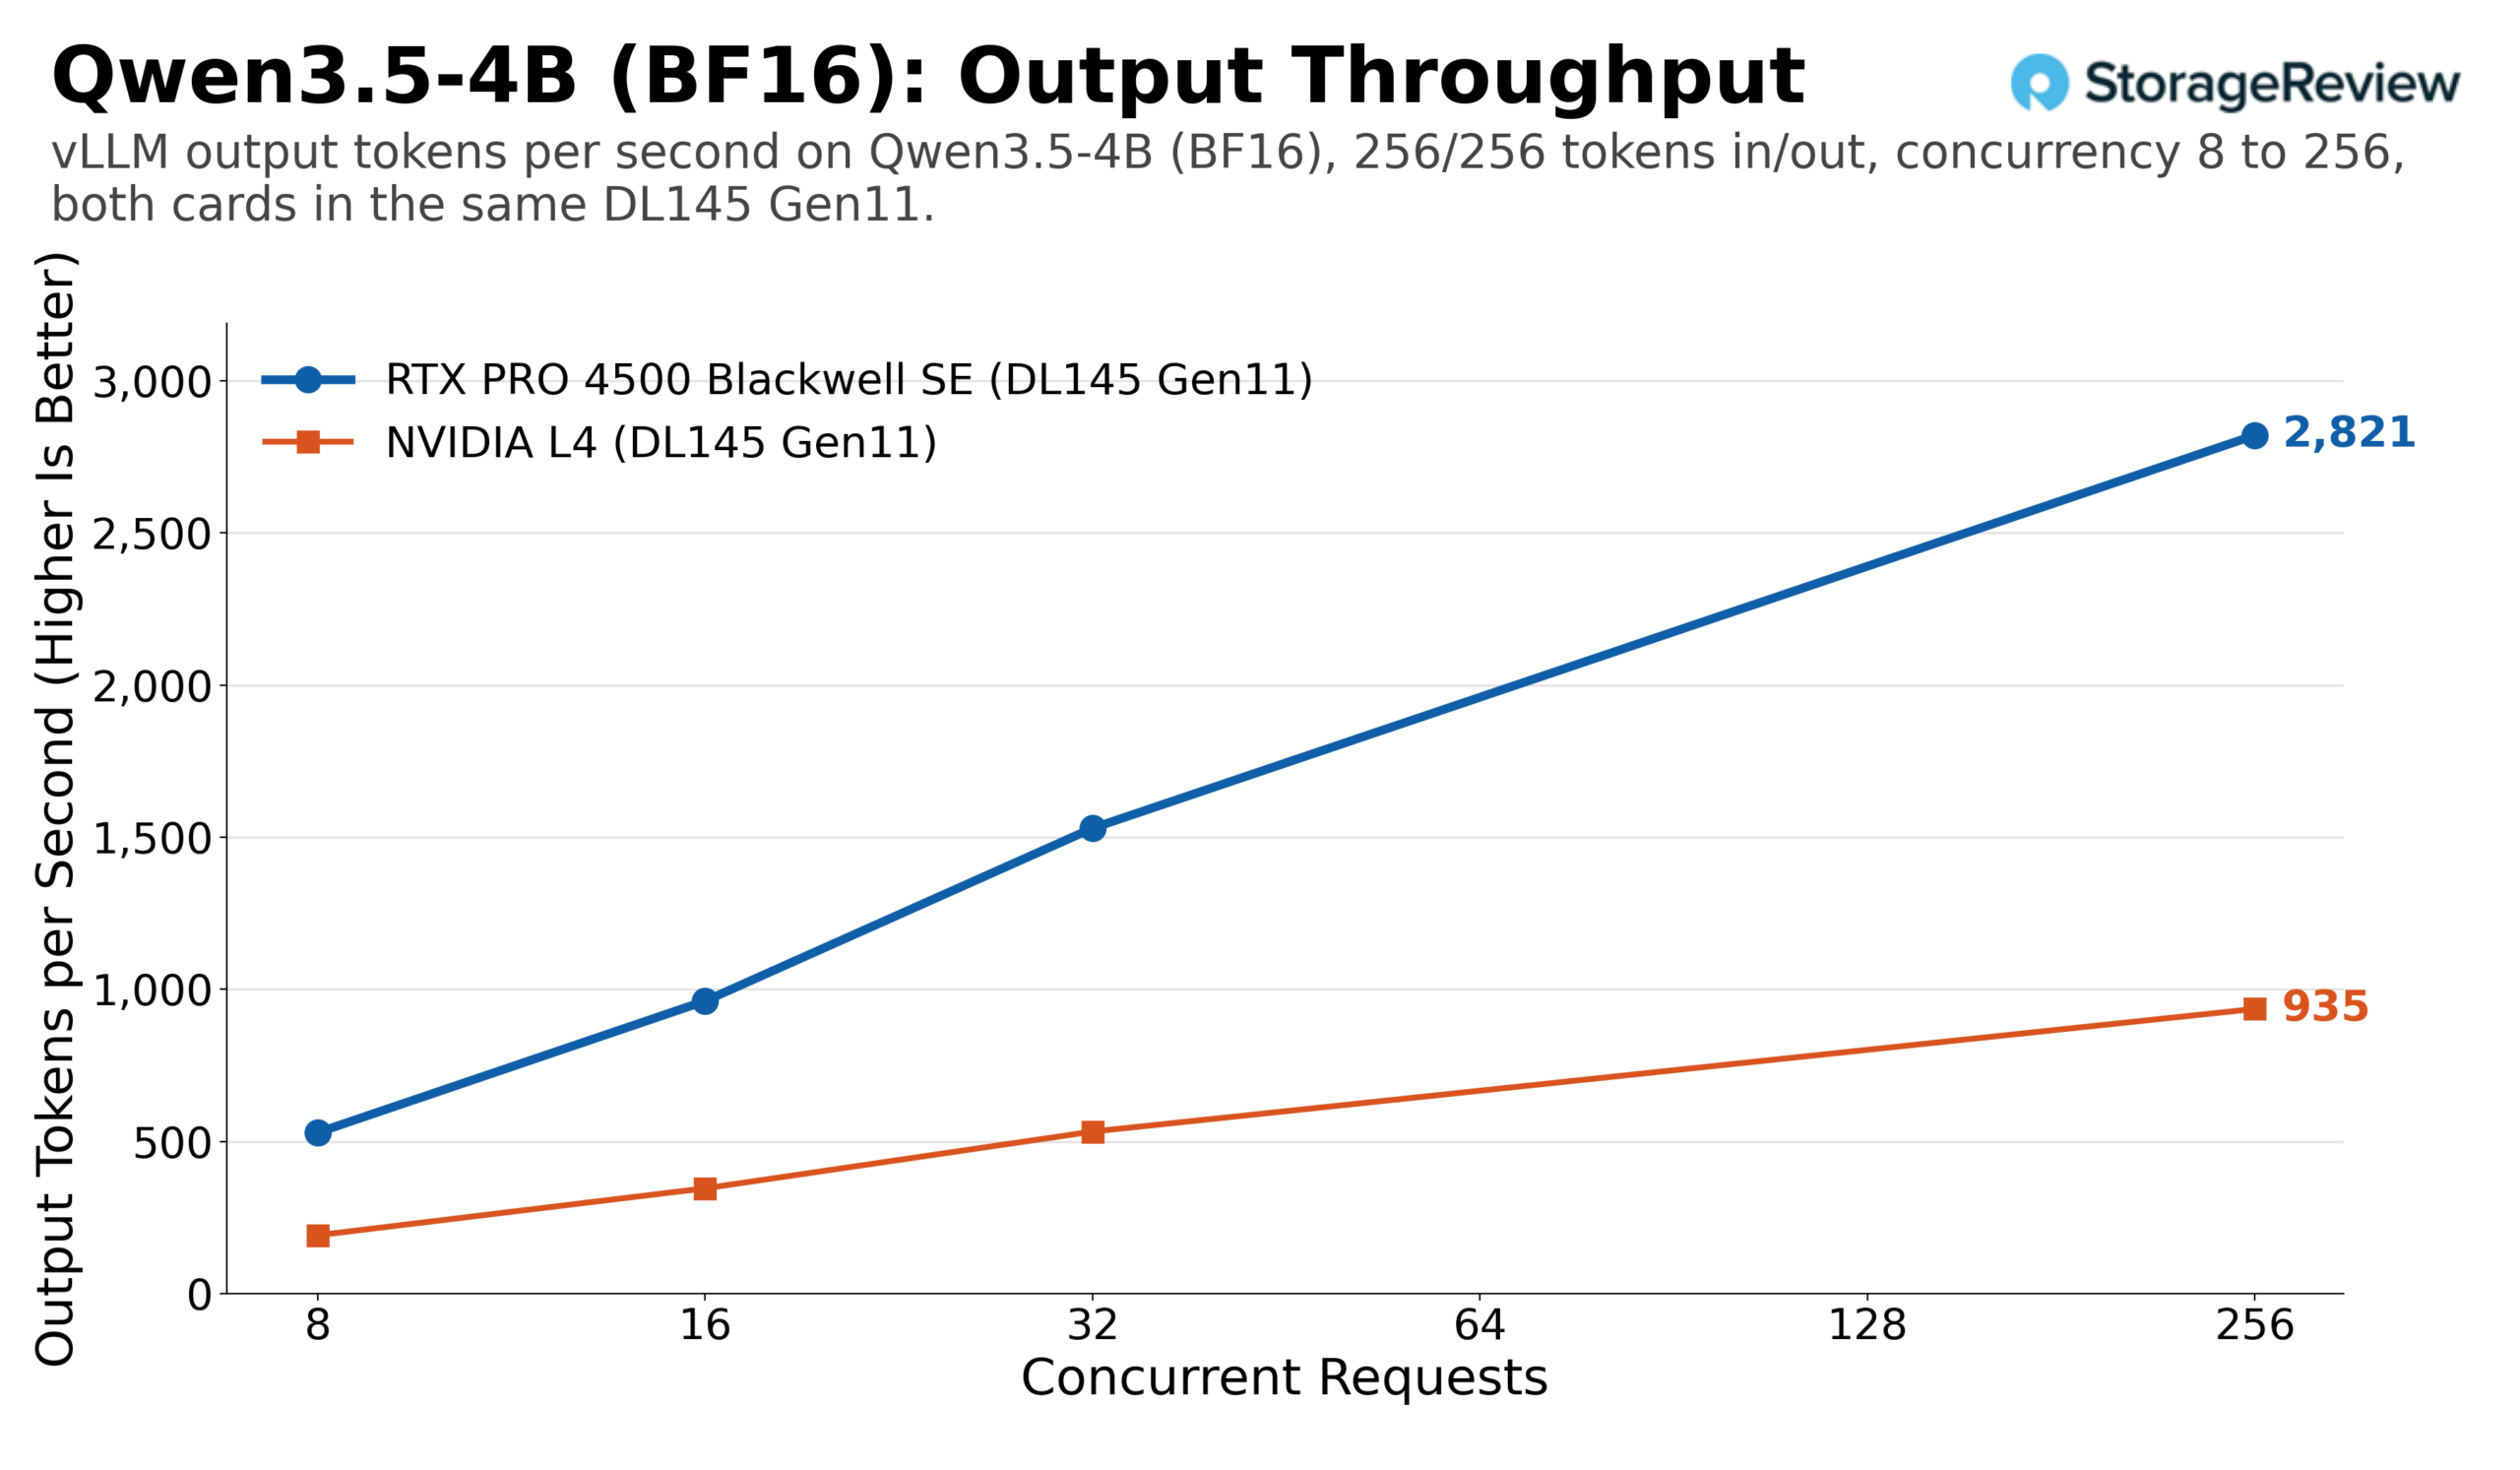
下圖清楚地展示了 Qwen3.5 和 4B 的對比:在 8 到 256 個並發請求的各種提示形狀下,兩張卡片每秒輸出的 token 數量。所有九個面板的曲線形狀都相同,4500 在 8 個並發請求時約為 L4 的 2.5 到 2.8 倍,在 32 個並發請求時速度略有提升,並在 256 個並發請求時達到 2.4 到 3.2 倍。
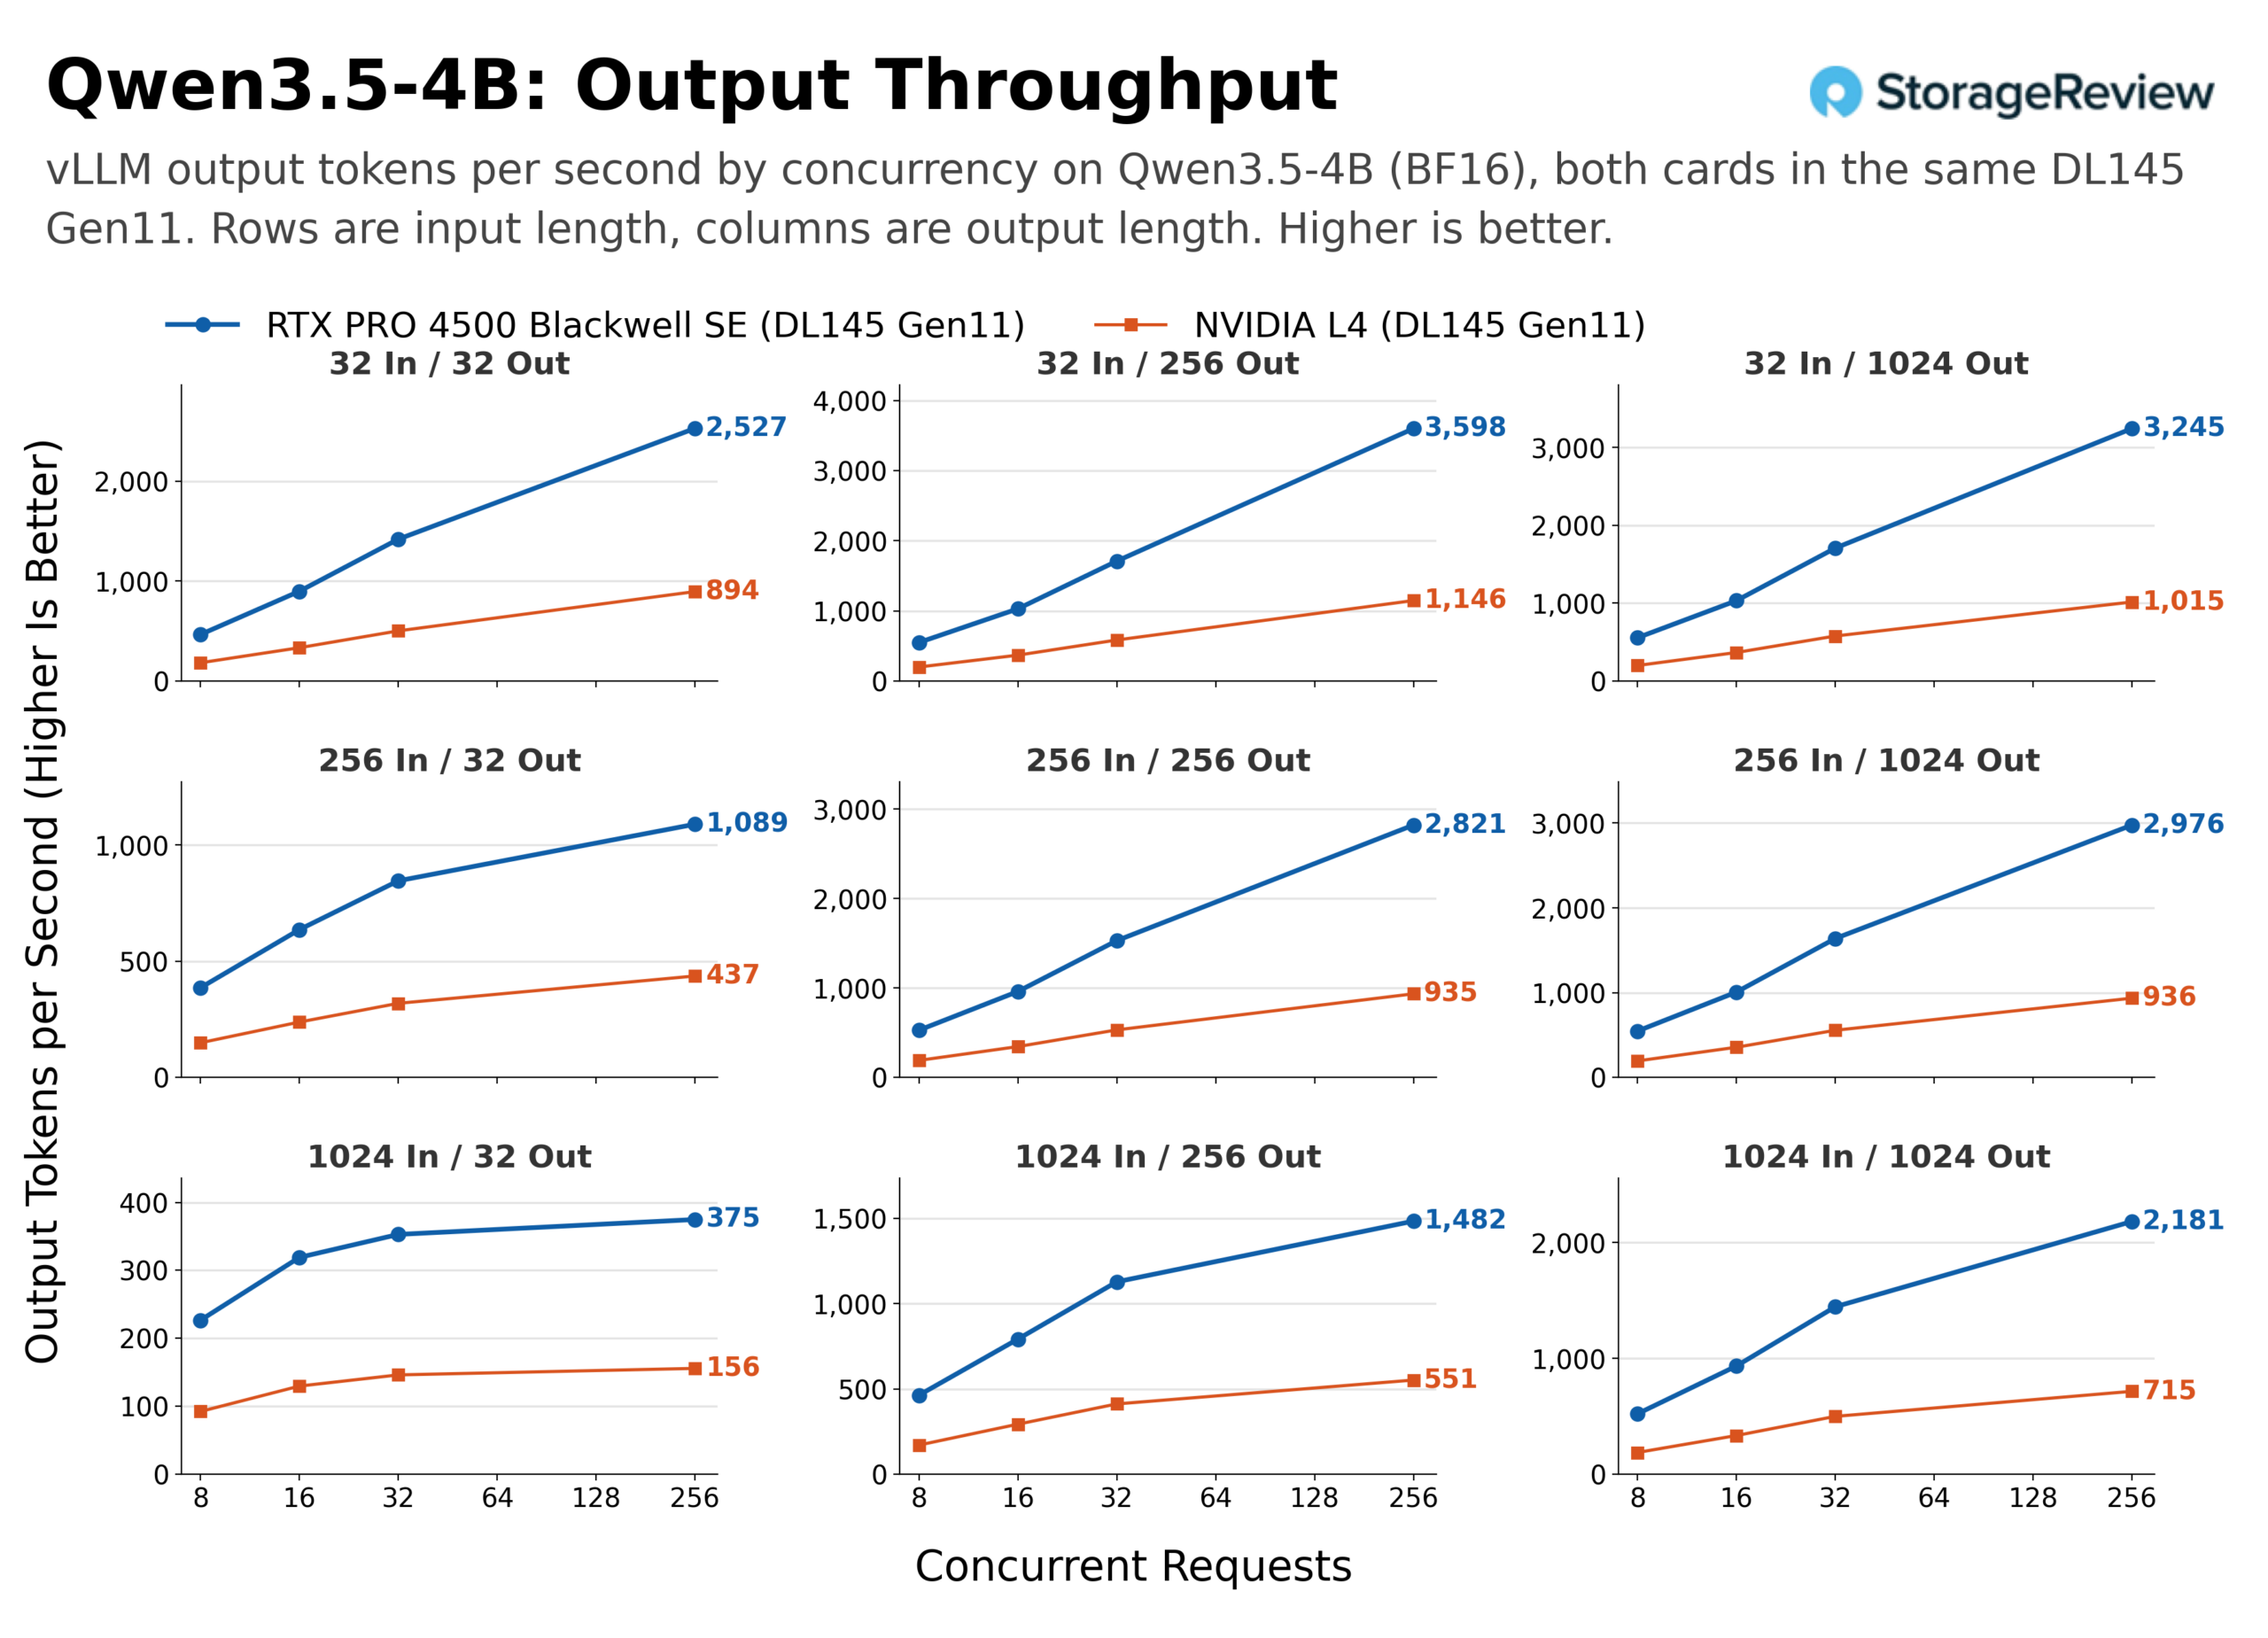
以 256 進 256 出的組合作為聊天規模的參考:在 8 個並發的情況下,L4 每秒產生 192 個輸出令牌,而 4500 每秒產生 529 個(2.76 倍);在 32 個並發的情況下,L4 每秒產生 532 個輸出,而每秒產生 185 185 18 時產生 532 個輸出,而每秒產生 18 58 258 256 個同時發生的情況下,L4 每秒產生 935 個輸出令牌,而 4500 每秒產生 2,821 個(3.02 倍)。最長的組合(每個方向 1,024 個令牌)幾乎完全符合上述情況:在 32 個並發的情況下,L4 每秒產生 499 個輸出令牌,而 4500 每秒產生 1,445 個;在 256 個並發的情況下,L4 每秒產生 715 個令牌,而產生 4500 18 個令牌。整個網格中差距最小的是預填充密集型的 1,024 進 32 出的組合,在這種情況下,從 8 個並發開始,4500 的性能就穩定地保持著 2.4 倍的優勢,因為這種工作負載幾乎完全是即時處理,並且兩張卡從一開始就都處於計算密集型狀態。 Qwen3.5-4B 在兩張牌上都以這種形態穩定上升。 BF16 網格中 16 個同時出現的下跌是 4500 運行的 Gemma 4 E4B,位於 1,024/32,這在所有三個重複中都出現過;我們尚未確定原因。
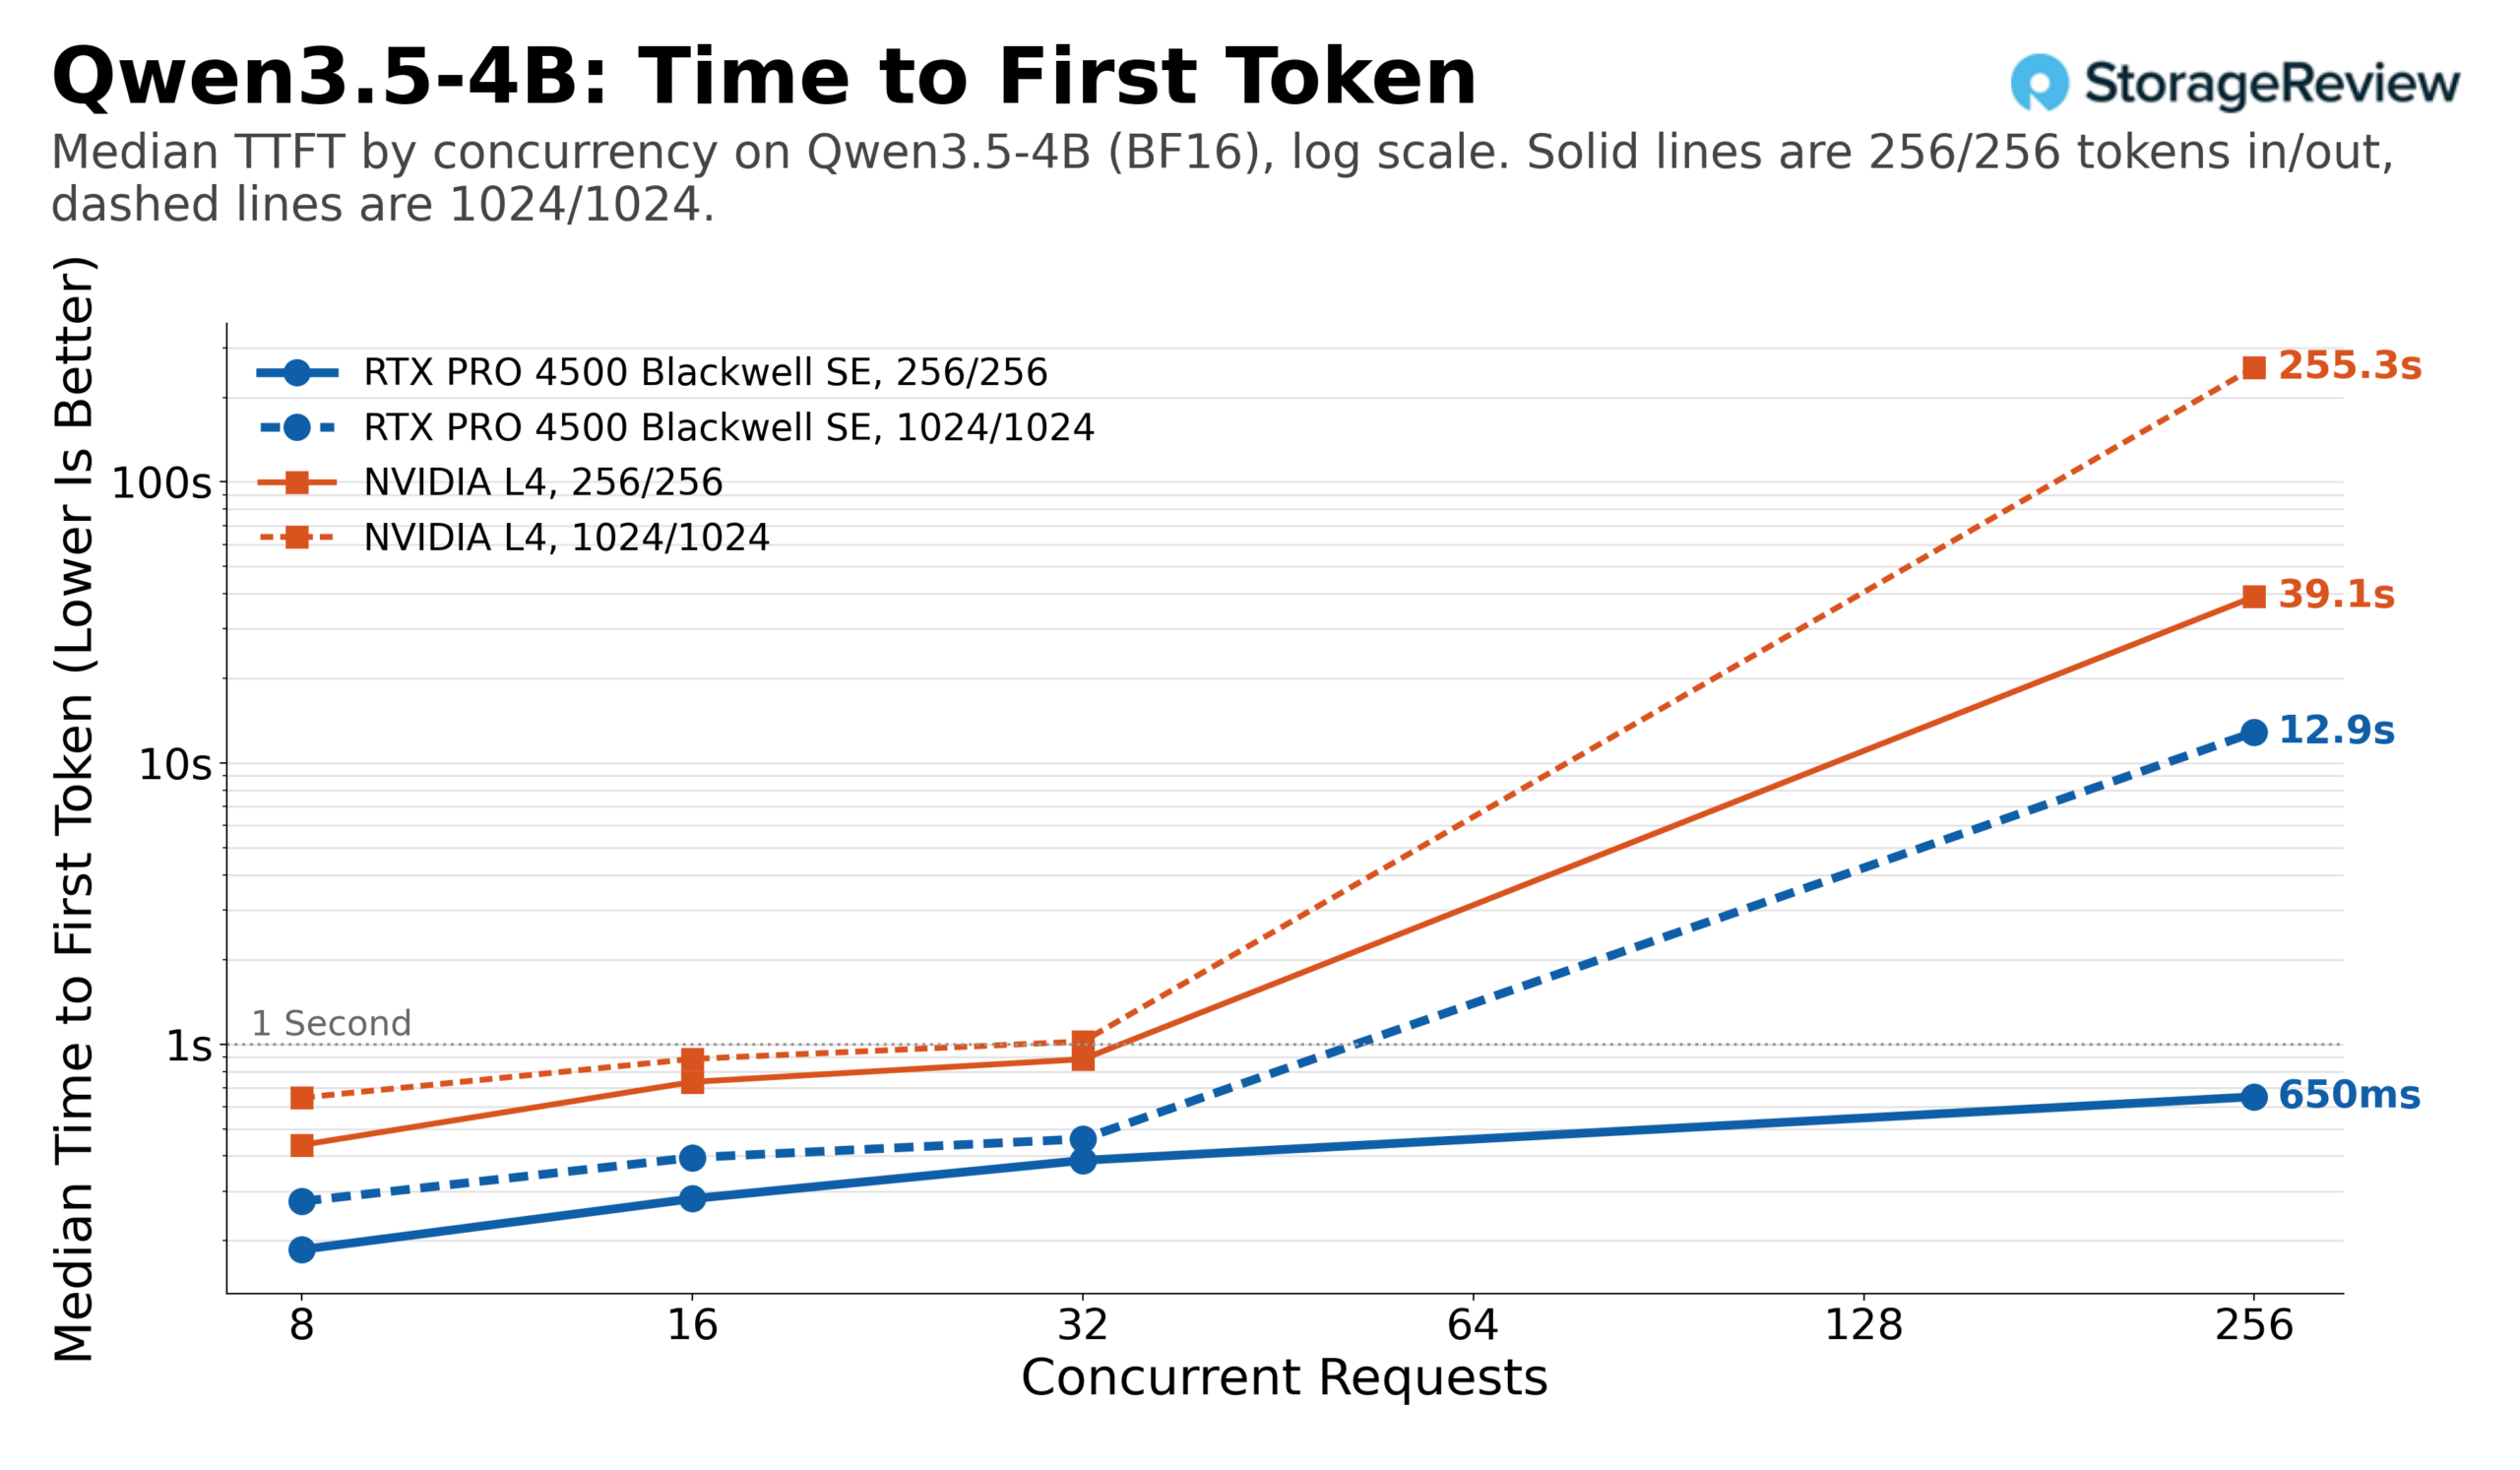
對於單一使用者而言,吞吐量比率低估了差異,因為使用者實際感受到的是單字出現的快慢。在 256/256 的文字格式下,4500 處理器產生每個詞元的平均時間為 12.4 毫秒,L4 處理器為 35.0 毫秒,因此,256 個詞元的反應在 4500 處理器上大約需要 3.2 秒,在 L4 處理器上大約需要 9.0 秒。如果每個方向都產生 1,024 個字元,則耗時分別為 13.1 秒和 36.6 秒。對於該單一用戶,在較短的提示音下,4500 處理器的首詞延遲為 43 毫秒,L4 處理器為 81 毫秒;在較長的提示音下,4500 處理器的首詞延遲為 99 毫秒,L4 處理器為 219 毫秒。
在負載較高的情況下,延遲差距進一步擴大:在 256/256 的並發場景下,32 個並發請求時,L4 的首令牌中位數為 884 毫秒,而 4500 的首令牌中位數為 386 毫秒。在 256 個並發請求時,L4 的首令牌中位數達到 39 秒,而 4500 則保持在 650 毫秒。在 1,024/1,024 的並發場景下,L4 在 32 個並發請求時就已經超過 1 秒(1,022 毫秒),在 256 個並發請求時達到 255 秒,這意味著請求在 vLLM 的隊列中等待了 4 分鐘,直到鍵值緩存釋放。 4500 在該場景下僅在 256 個並發請求時才超過 1 秒,為 12.9 秒。在下圖中,L4 的首令牌中位數在 32 到 256 之間超出了圖表範圍;而 4500 在較短的並發場景下始終保持在 1 秒以內。
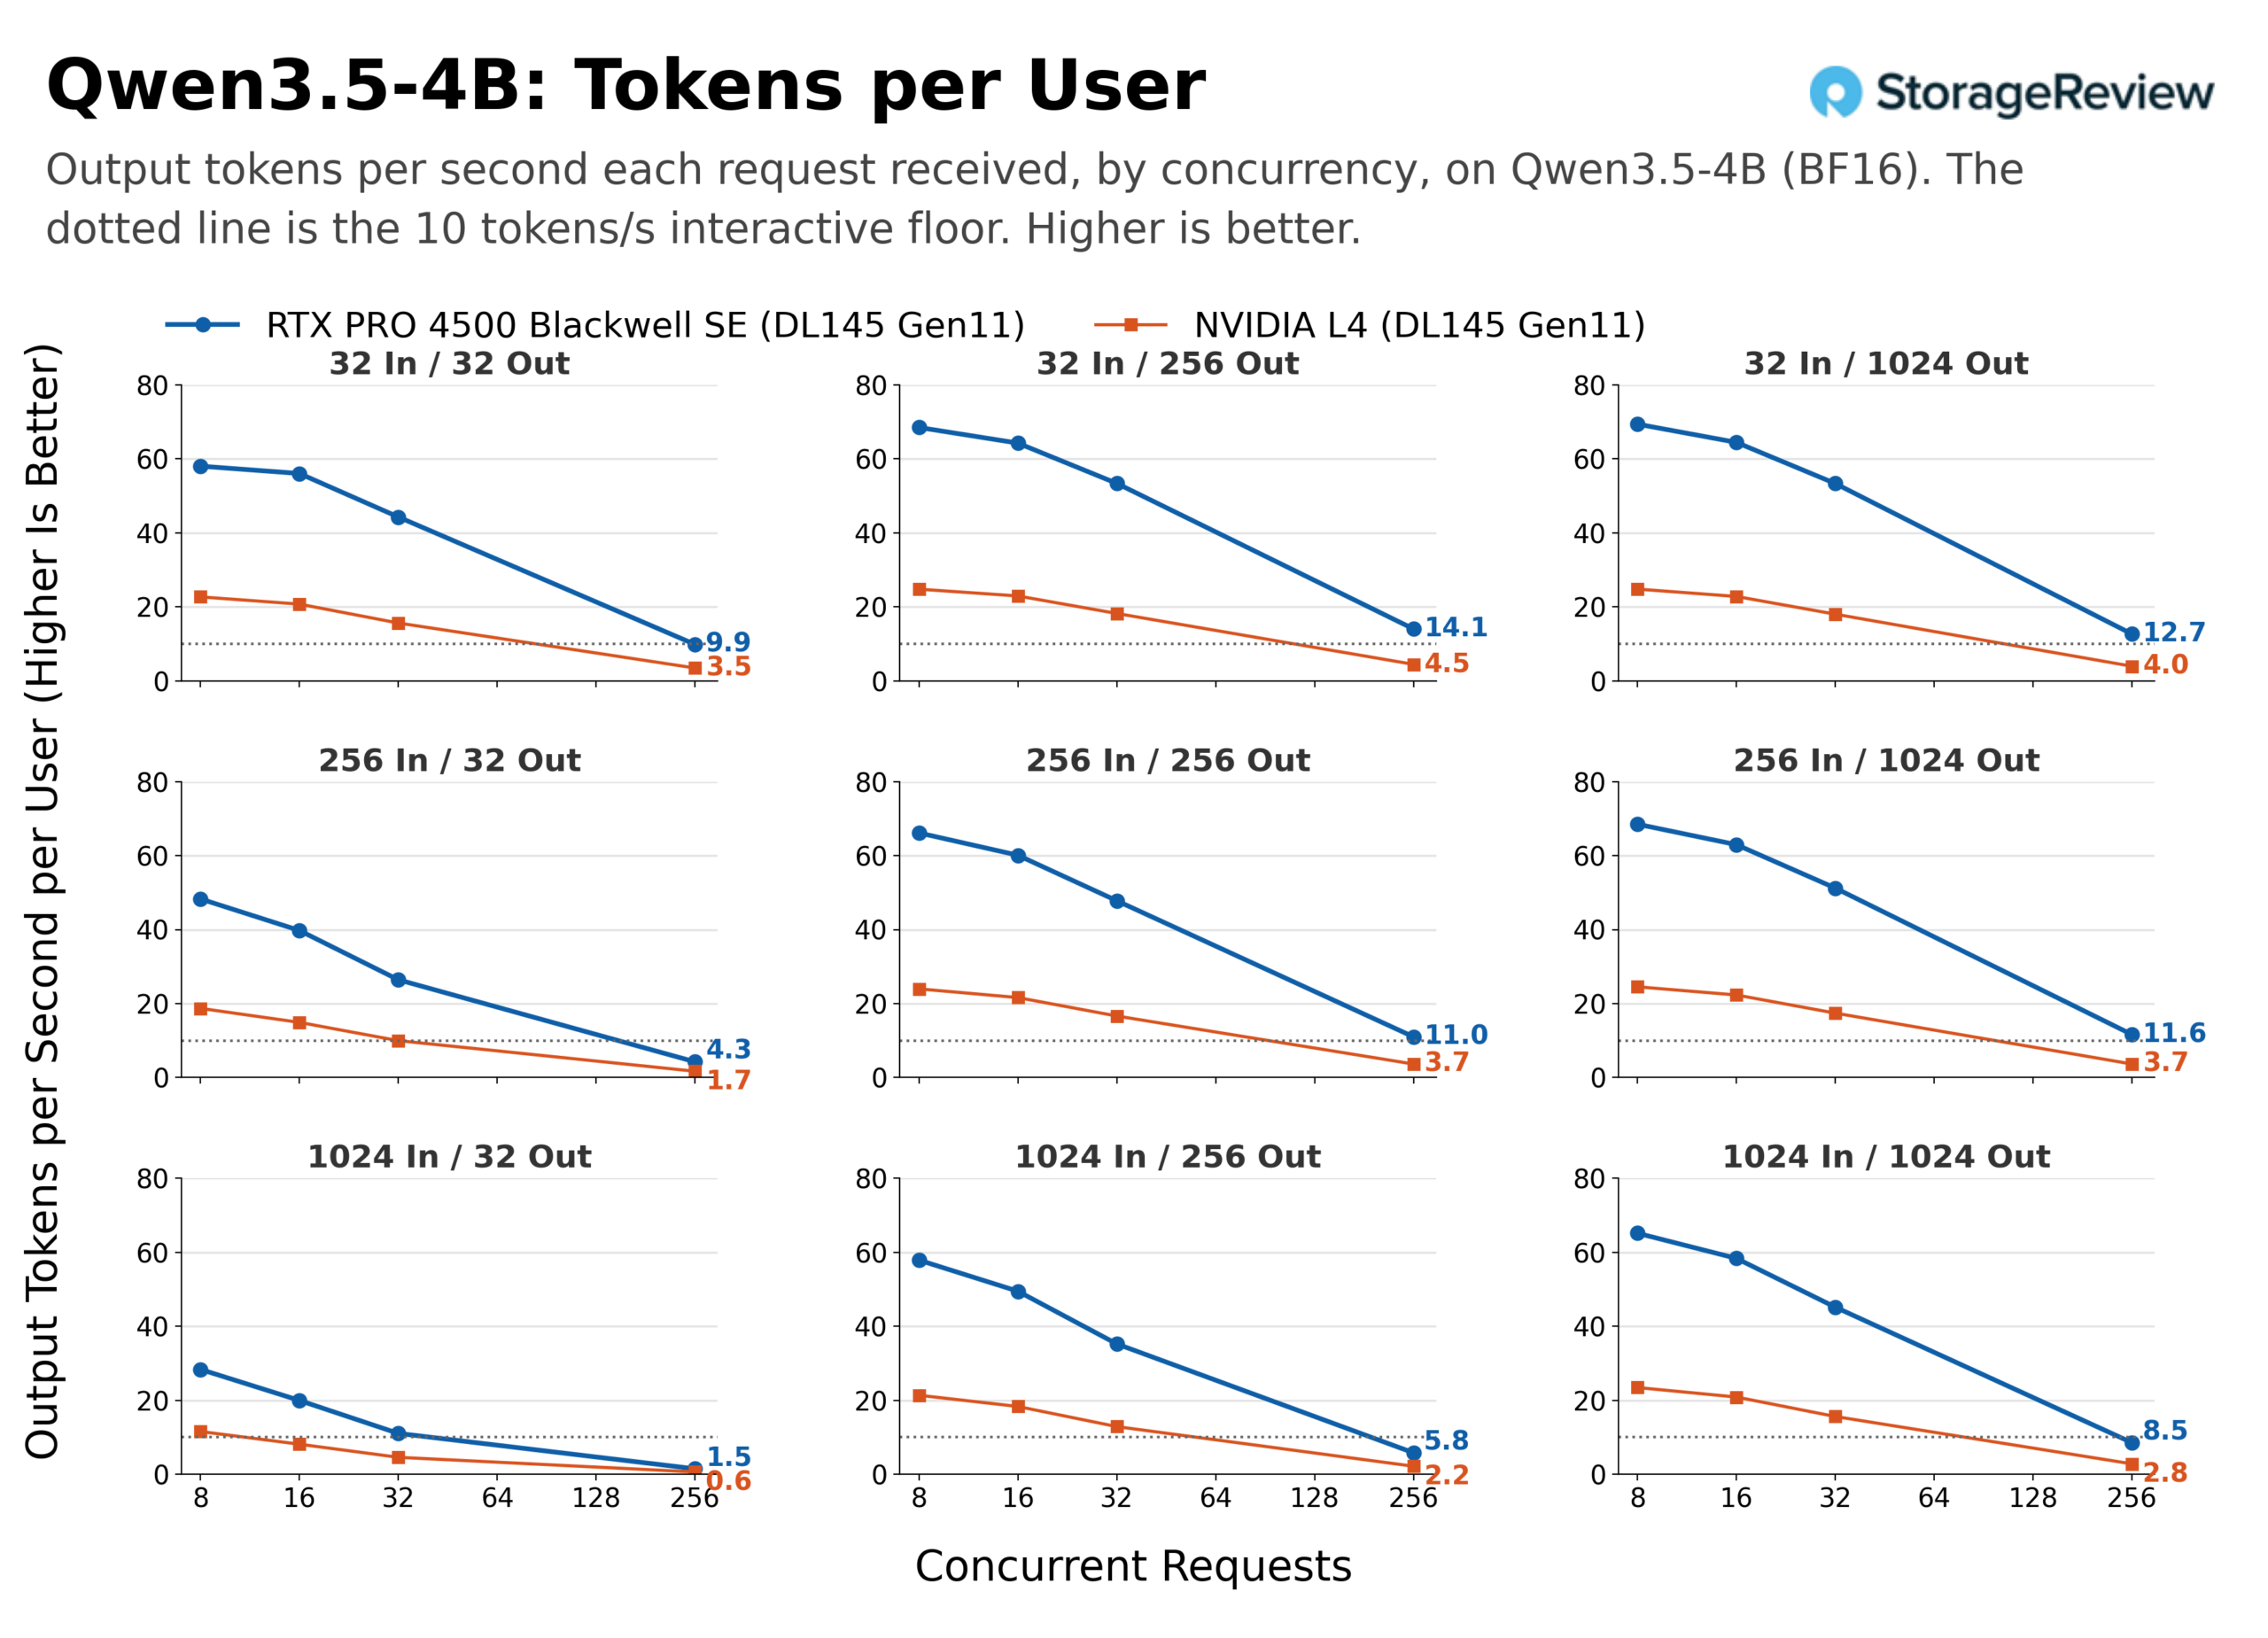
另一種解讀相同資料的方法是按使用者計算:每秒輸出令牌數除以並發請求數,即佇列中每個使用者所看到的速率。下圖網格中針對每種形狀繪製了該速率,並以每秒 10 個令牌作為互動使用的通用閾值。在 32 個同時請求的情況下,4500 型伺服器在除 1,024 進 32 出之外的每種形狀上,每個用戶每秒可獲得 44 到 53 個令牌,而在該形狀上,該速率為 11 個令牌;L4 型伺服器的速率為 10 到 18 個令牌,在該形狀上已降至 4.6 個令牌上已降至 4.6 個令牌。在 256 個同時輸入時,4500 在四種聊天形狀的組合中保持在最低限度之上(32/256 時為 14.1,32/1,024 時為 12.7,256/256 時為 11.0,256/1,024 時為 11.63)個標記的提示和簡答題形狀中低於最低限度,在 1,024/32 時降至 1.5,此時幾乎所有工作都是預先填充的。在 256 個並發輸入時,L4 在所有形狀中都低於最低限度,介於 0.6 和 4.5 之間。 32 和 256 之間沒有進行任何測試,因此每條線與虛線最低限度相交的點位於這兩個並發輸入之間;圖表顯示,L4 的交叉點在所有形態上都遠早於 256,而 4500 的交叉點在聊天形態上位於 256 或接近 256。
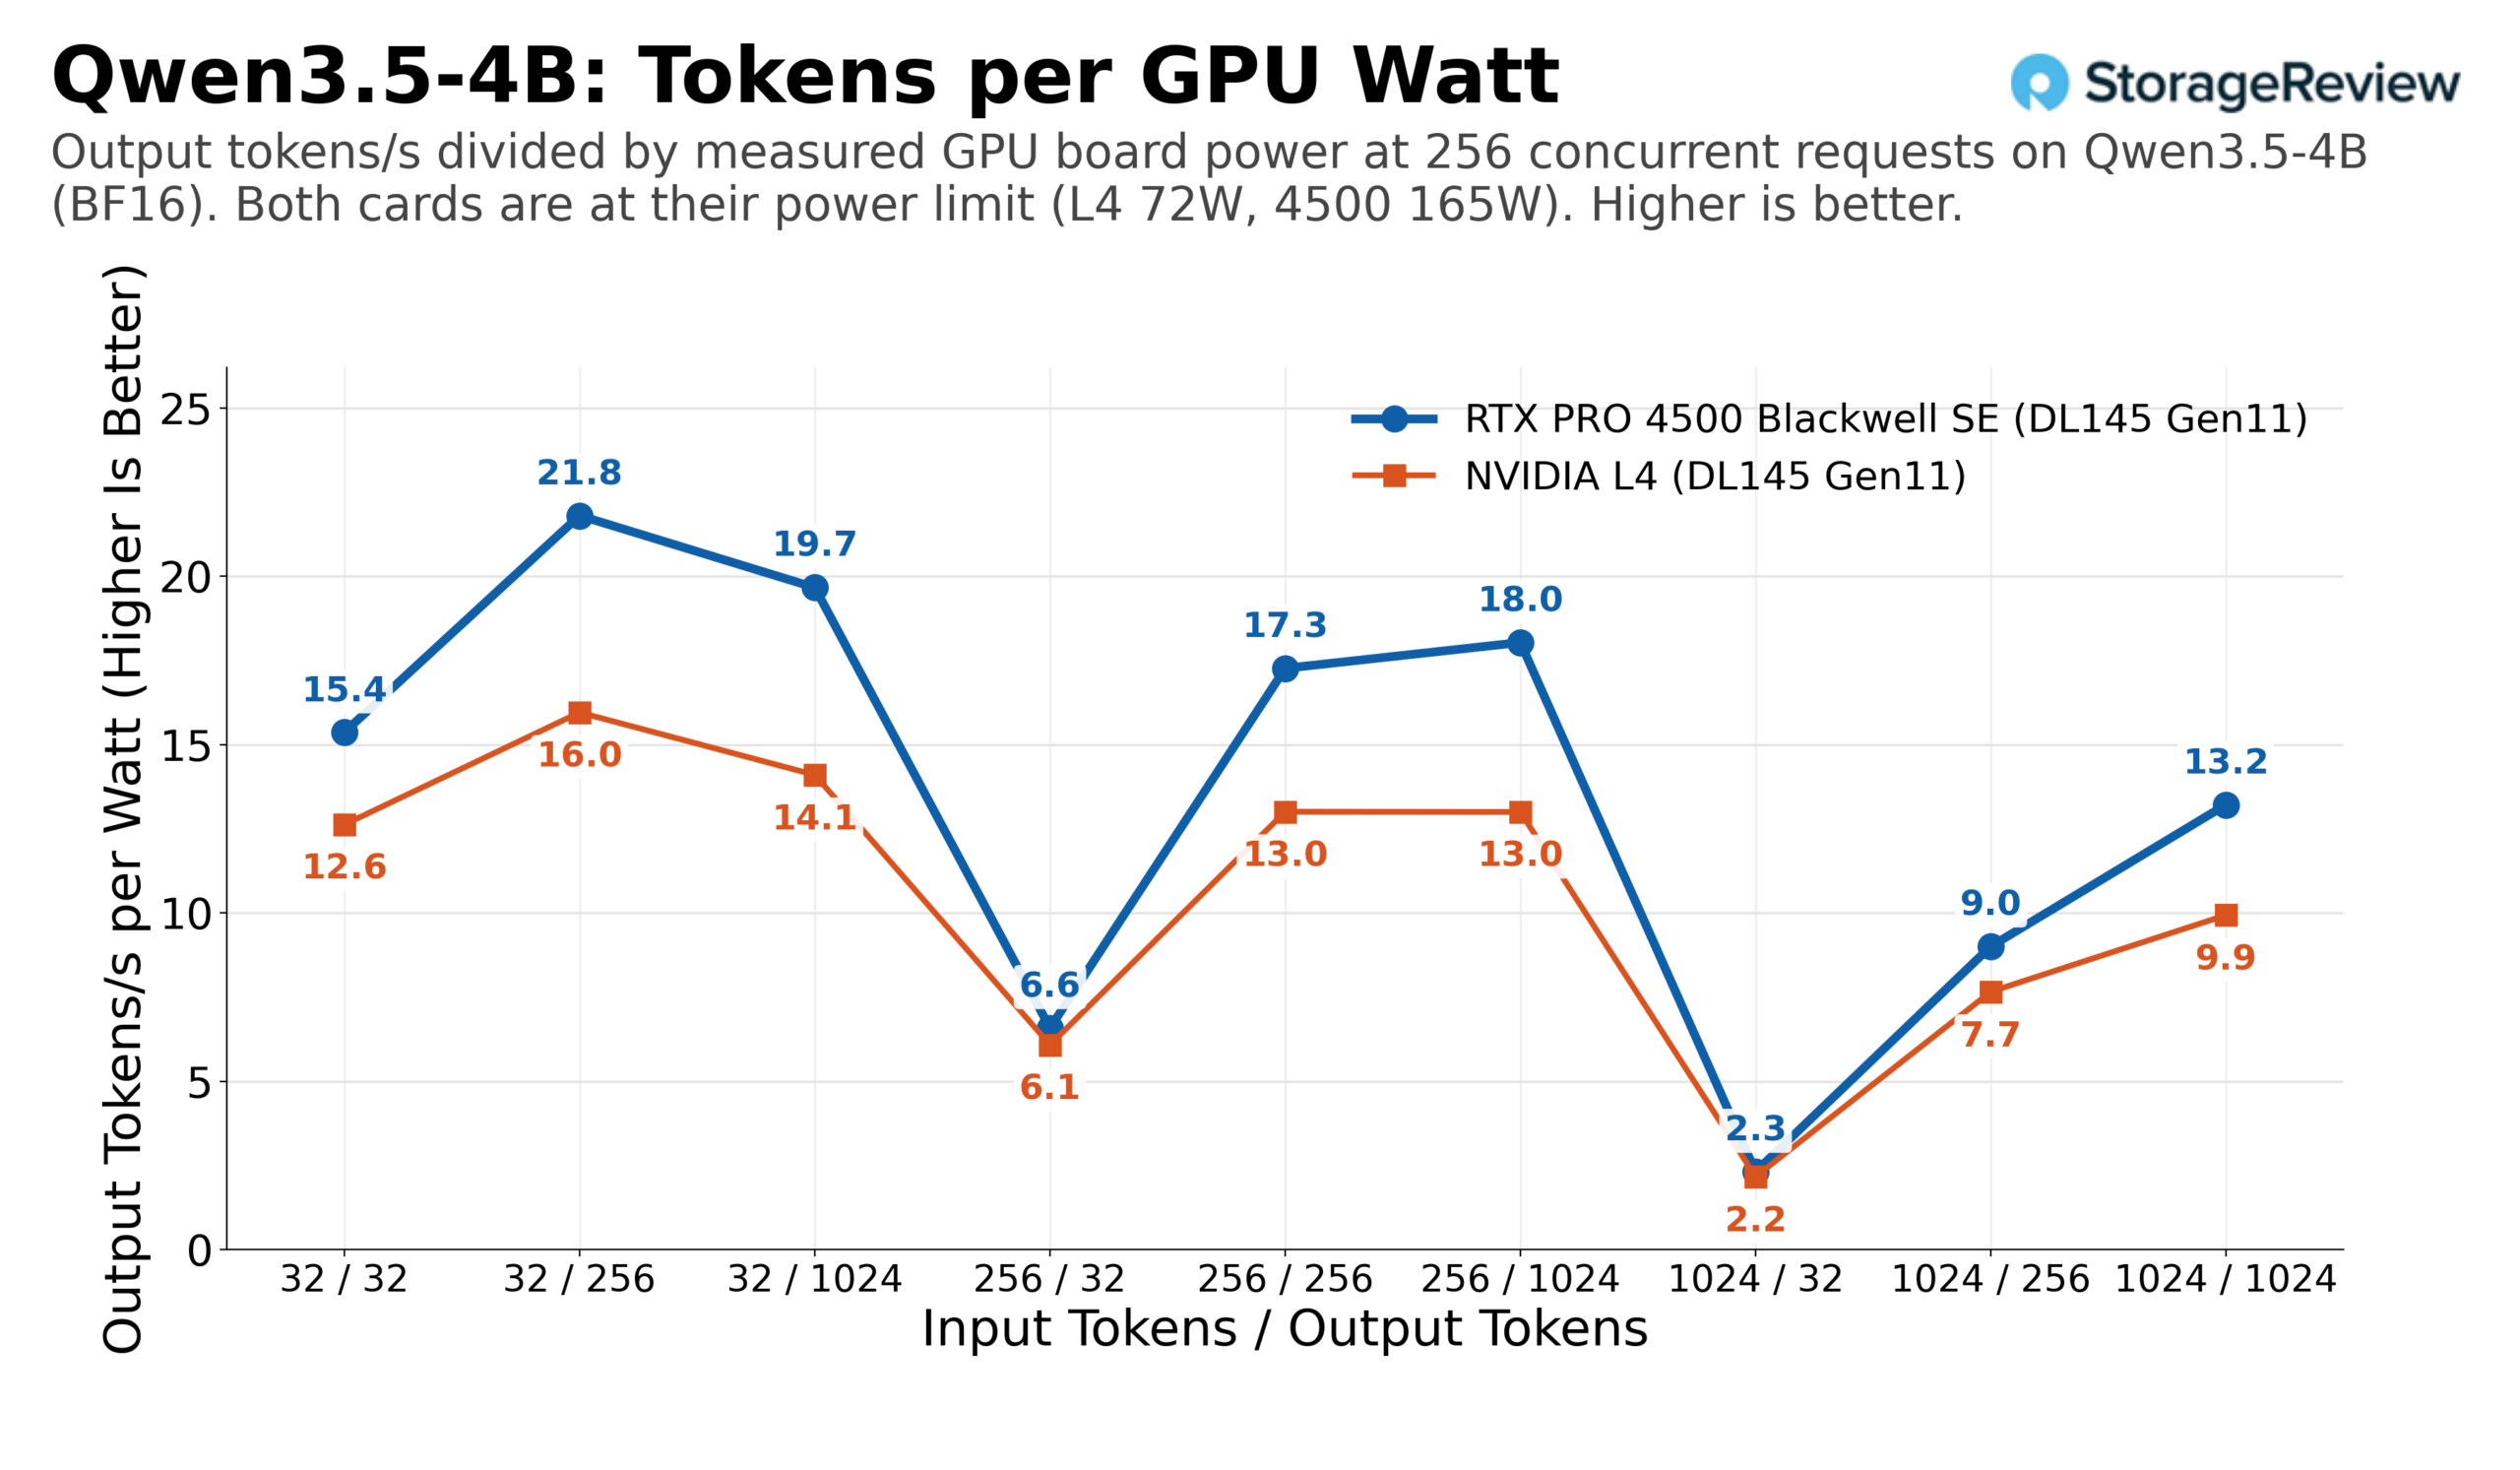
在大多數同時配置(16 個同時任務以上)下,兩張顯示卡的功耗都接近或達到主機板功耗上限,L4 為 72W,4500 為 165W。在輸出功率較低的配置下,功耗則較低,例如在 Qwen3.5-4B 32/32 模式下,4500 在 32 個並發任務下的功耗為 125W,因此每 GPU 瓦特的令牌數與吞吐量密切相關。在 256 個並發任務下,4500 在九種配置下的每瓦特輸出令牌數中位數是 L4 的 1.33 倍,從預填充限制的 1,024/32 模式的 1.07 倍到 256/1,024 模式的 1.39 倍。乘以 2.3 倍的功耗差異,即可得出 3 倍的吞吐量優勢,其中 1.33 倍來自 Blackwell 更高的每瓦特效能,而 2.3 倍則來自 4500 更高的功耗。
Gemma 4 E4B
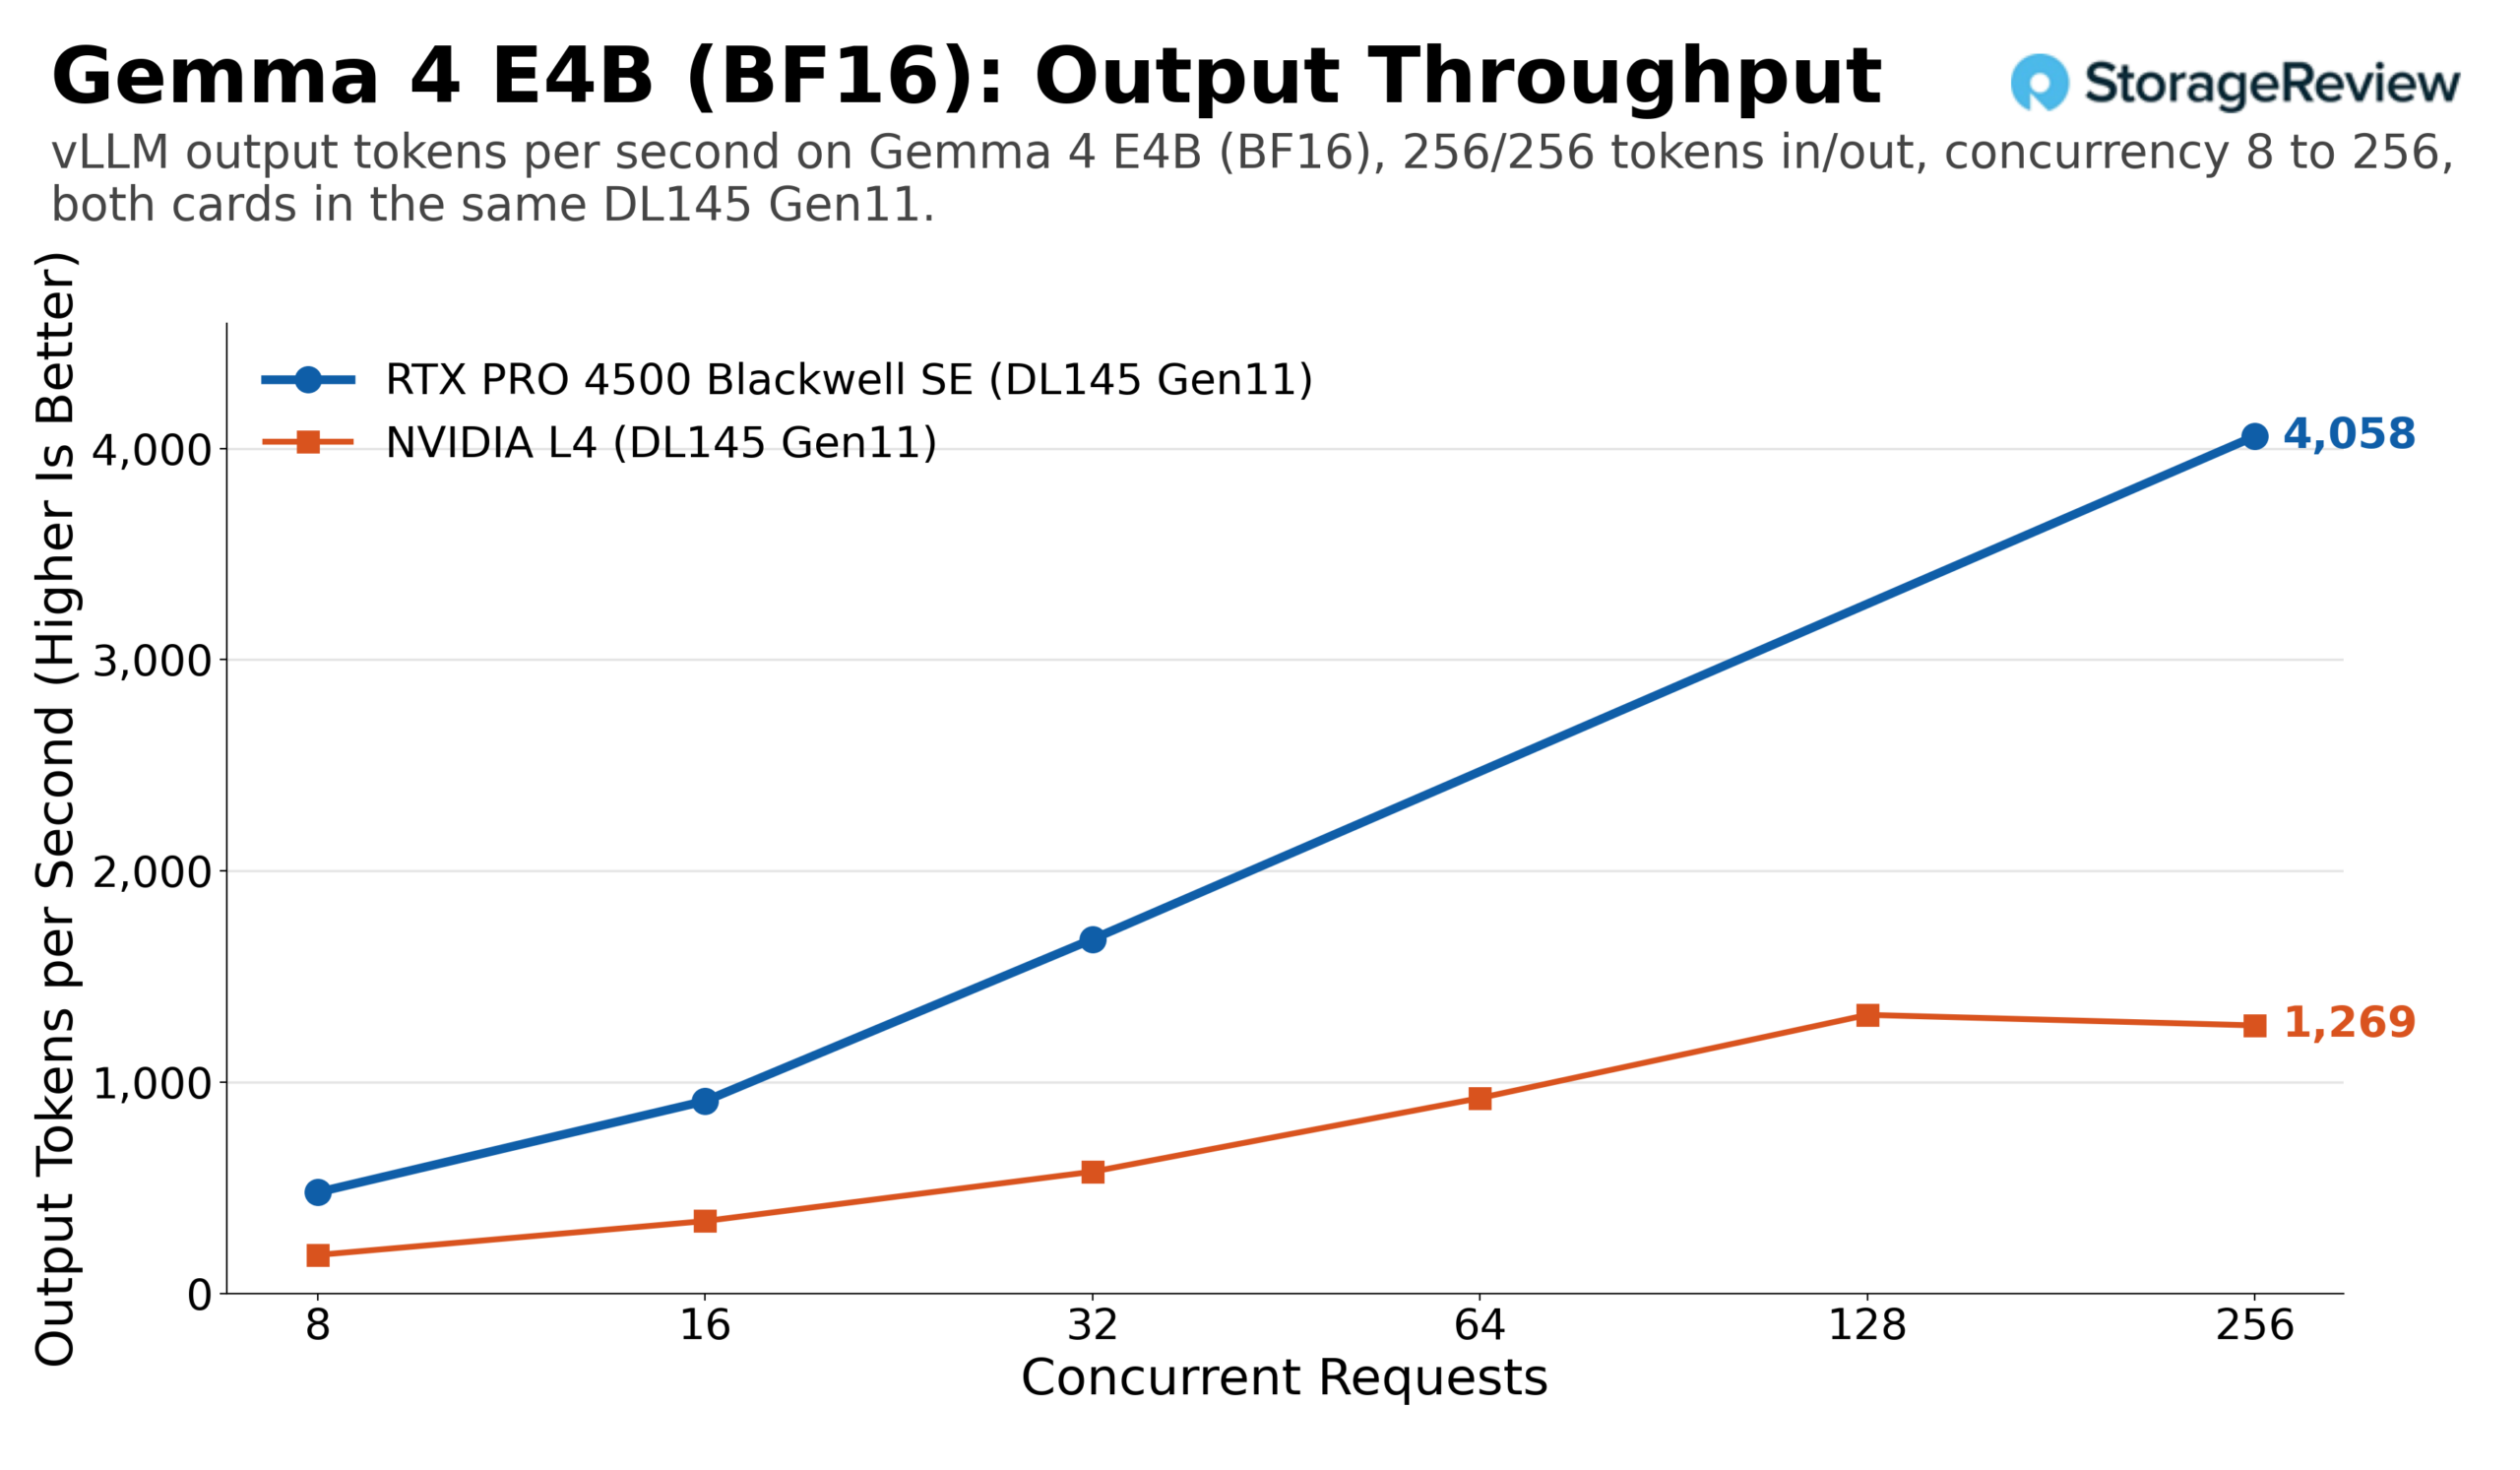
Gemma 4 E4B 是 Google Gemma 4 系列中效能較小的成員,其中的 E 代表有效 4B 參數。它在兩張顯示卡上的表現都與 Qwen3.5-4B 類似,但在性能高峰期略有提升。在 8 到 32 個並發任務的情況下,平均吞吐量倍數為 2.67 倍(範圍為 2.31 倍到 3.07 倍);在 256 個並發任務的情況下,吞吐量倍數為 3.20 倍。當並發任務數達到 1,024/1,024 時,由於 L4 快取深度接近其鍵值快取上限,因此吞吐量倍數達到了 3.82 倍。
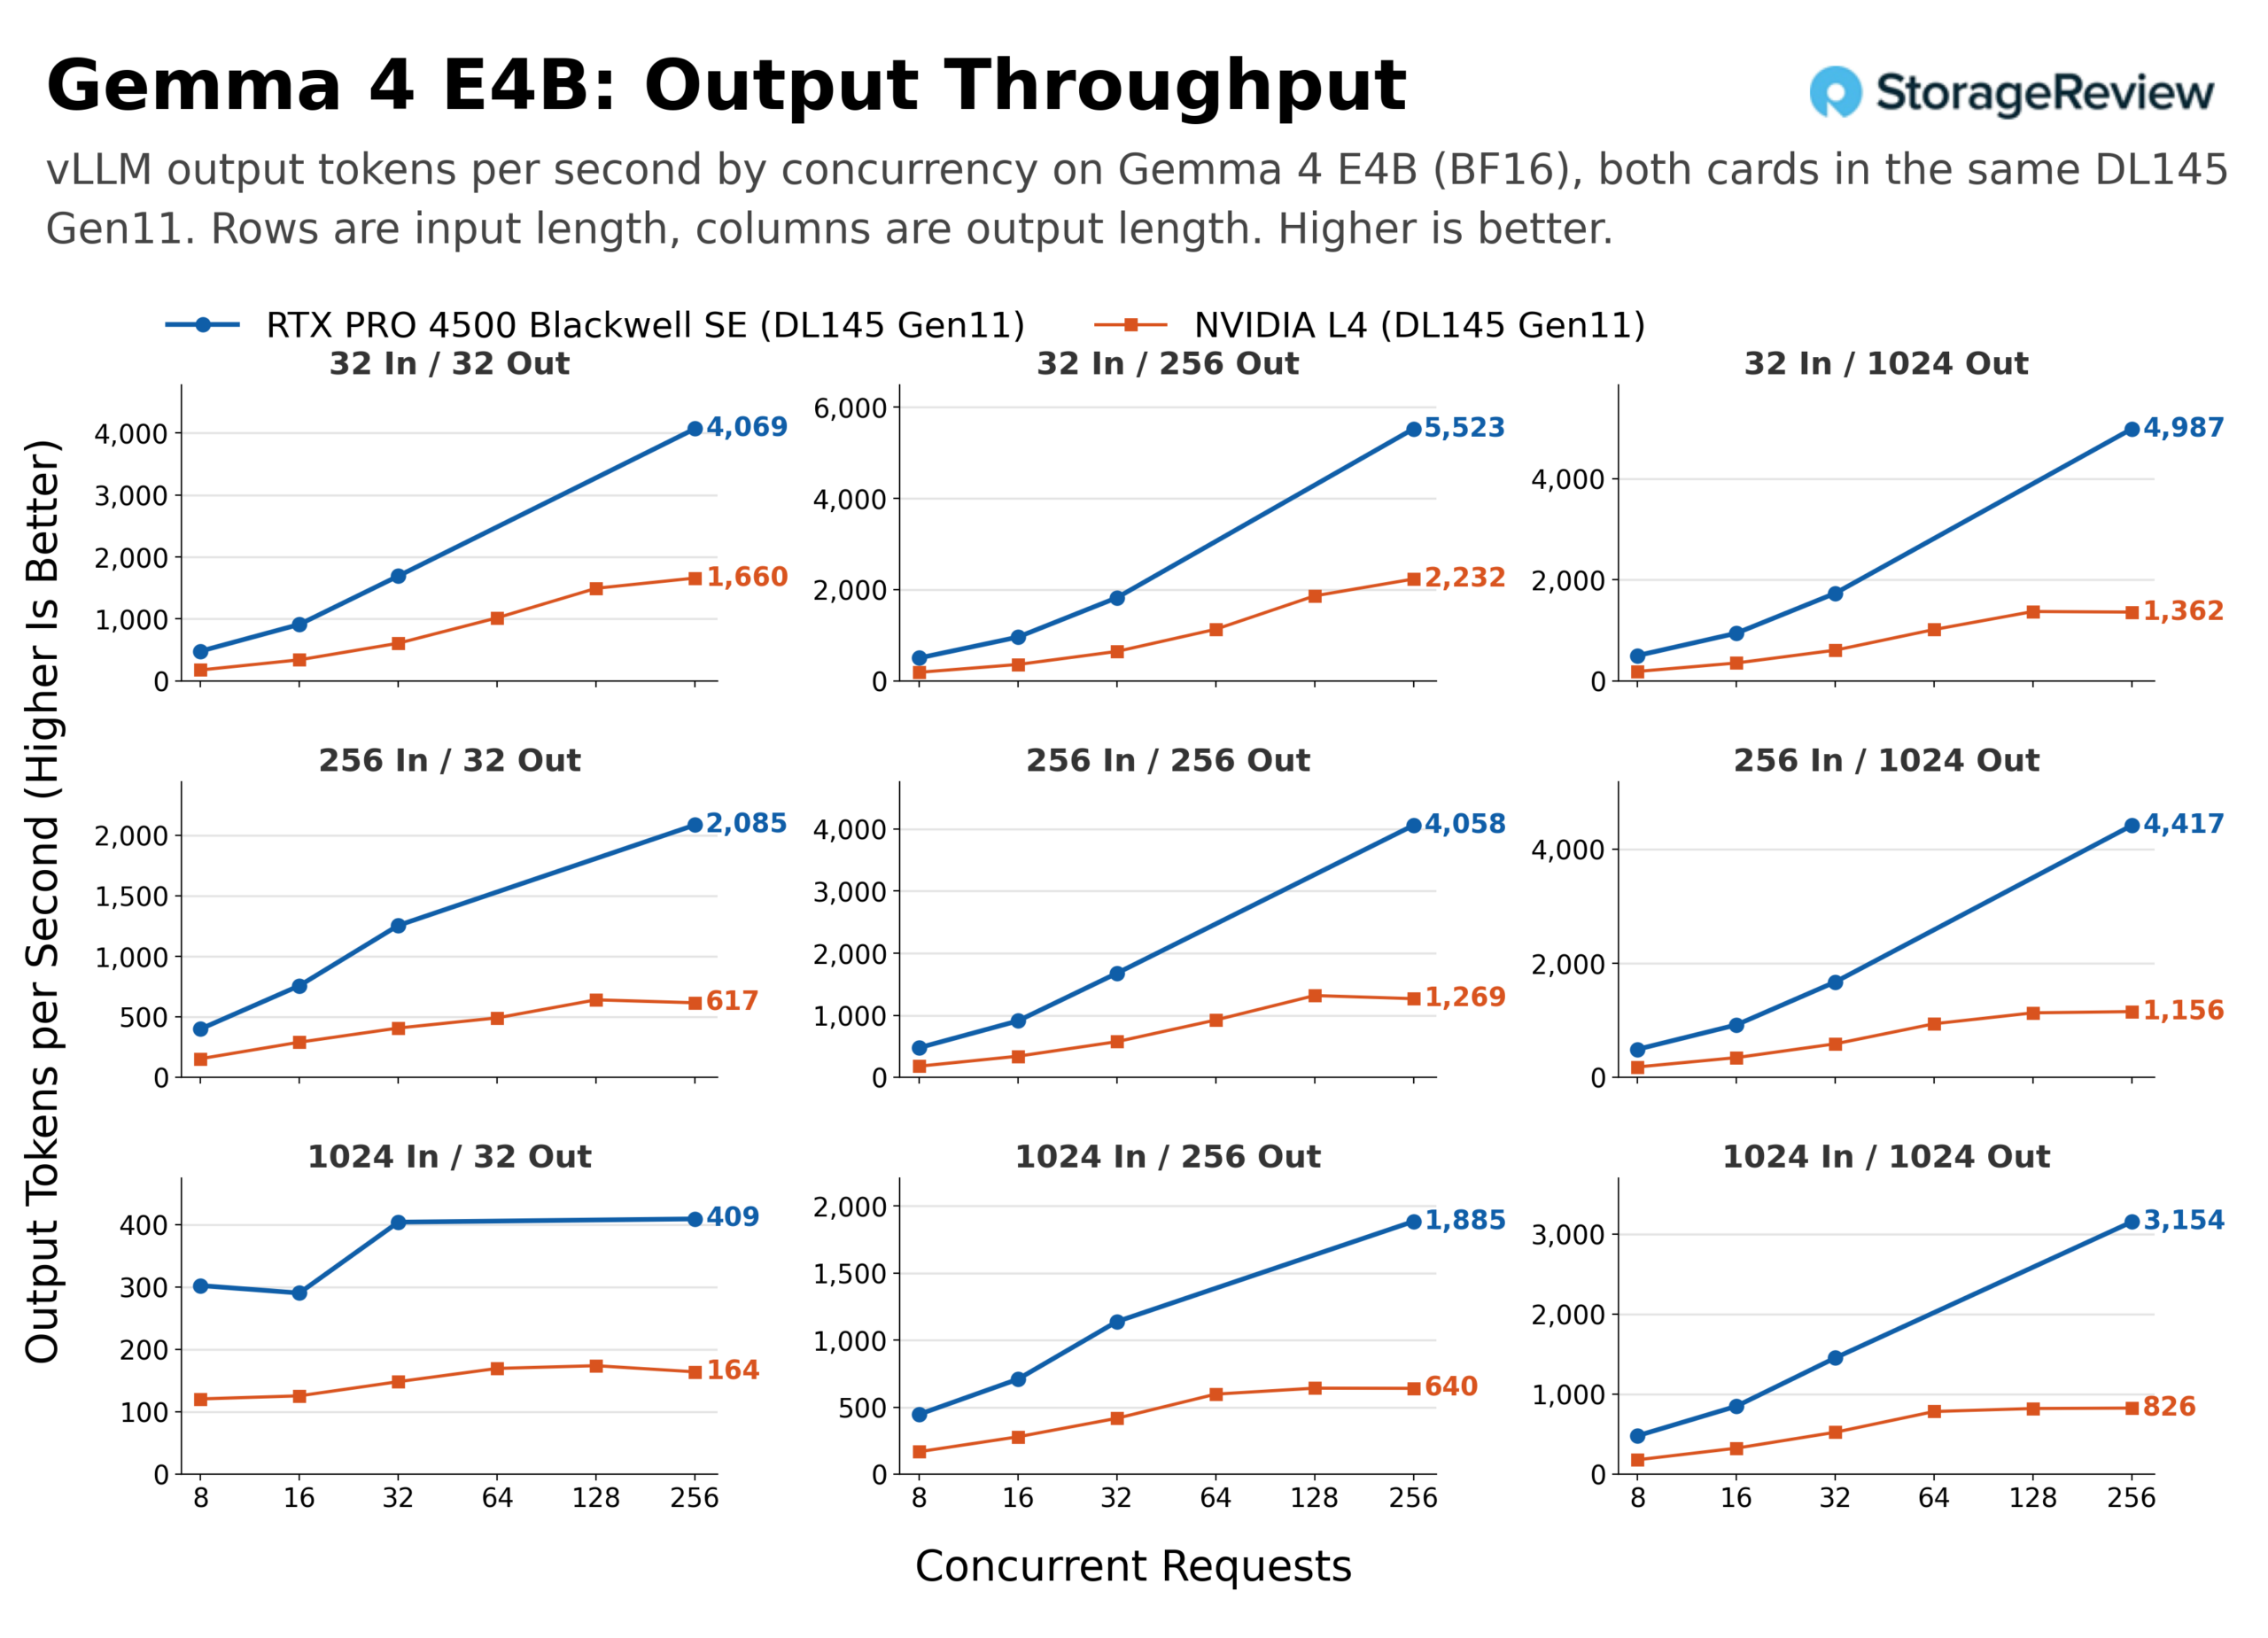
在 256/256 的並發場景下,L4 在 8 個並發會話時每秒產生 183 個輸出令牌,32 個並發會話時每秒產生 577 個輸出令牌,256 個並發會話時每秒產生 1,269 個輸出令牌;4500 則分別為 479、1,678 和 4040 個令牌。在 1,024/1,024 的並發場景下,L4 的並發場景分別為 180、524 和 826 個輸出令牌,而 4500 則分別為 480、1,454 和 3,154 個輸出令牌。 4500 在 256 個並發會話下的效能是 L4 的 3.8 倍,原因可以從 L4 的效能曲線看出:從 32 個並發會話增加到 256 個並發會話時,L4 每秒僅增加了 302 個輸出令牌,因為它沒有足夠的記憶體來添加會話時,L4 每秒僅增加了 302 個輸出令牌,因為它沒有足夠的記憶體來添加會話。
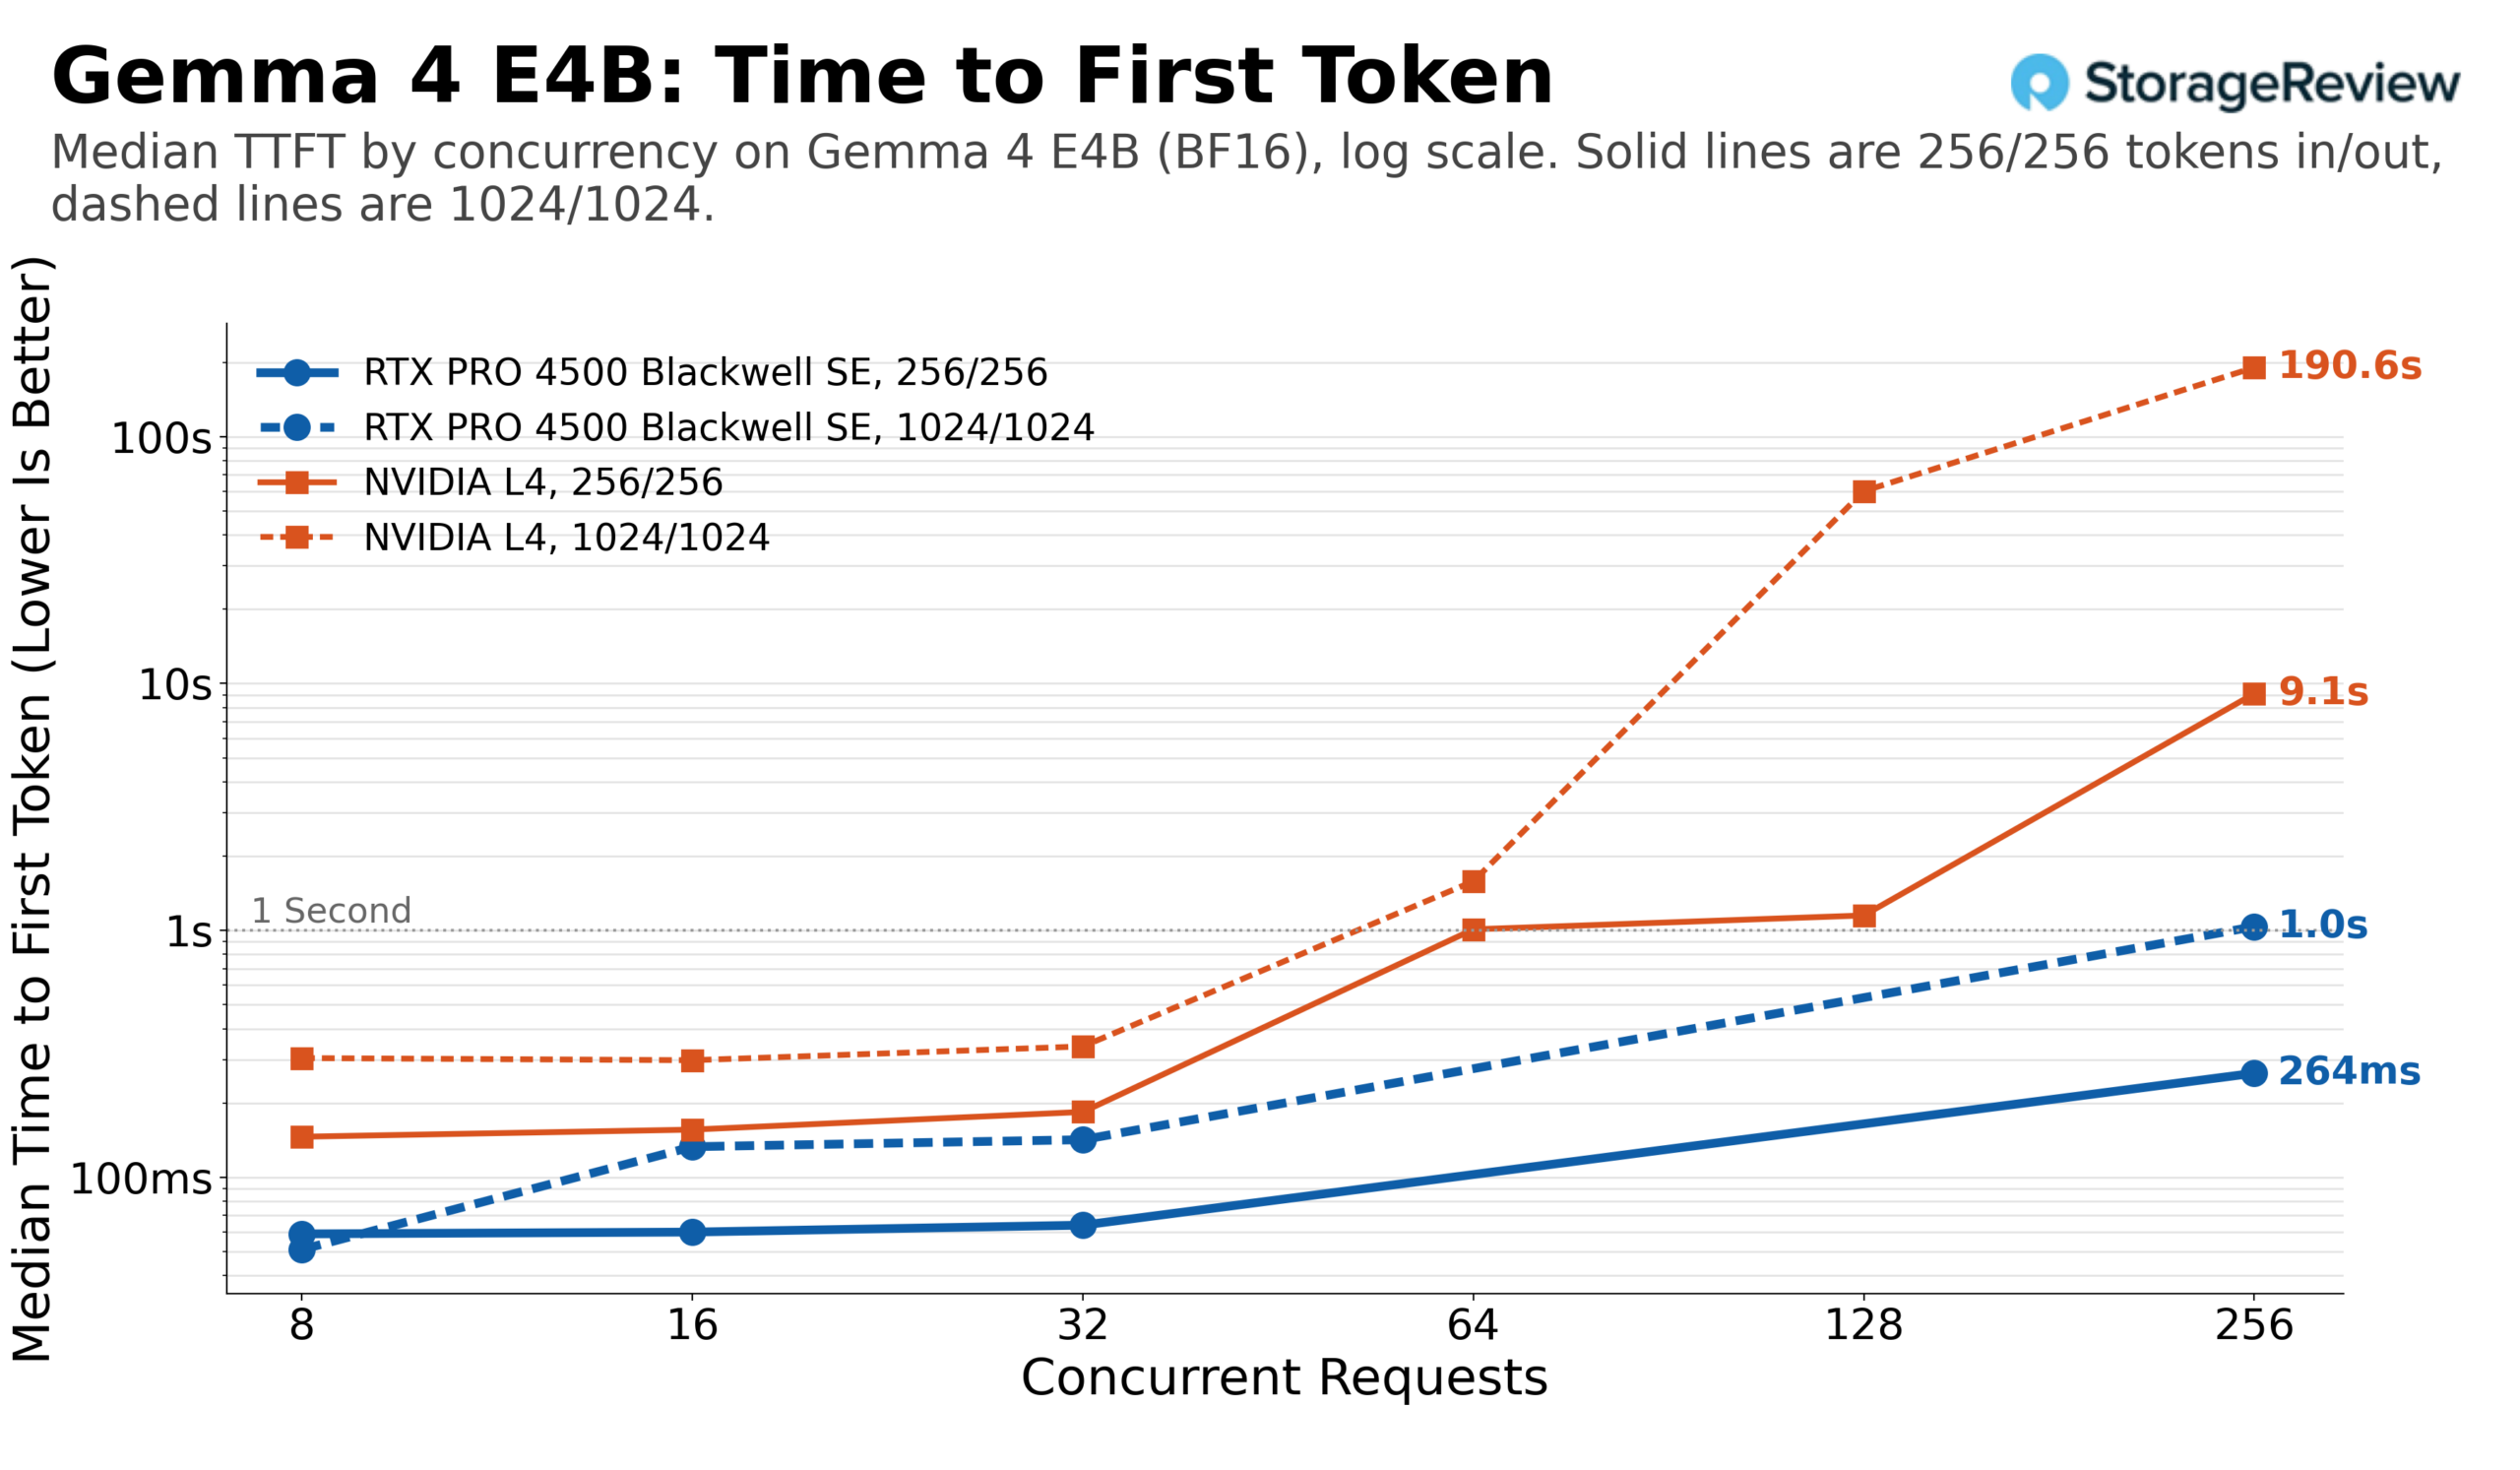
由於 L4 的 Gemma 4 作業同時包含 64 和 128 個並發線程,因此該模型準確地展示了 L4 的效能瓶頸所在。在 256/256 的線程形狀上,其首次令牌到達時間的中位數在 32 個並發線程時為 184 毫秒,在 64 個並發線程時略超過 1 秒,在 256 個並發線程時為 9.1 秒。在 1,024/1,024 的線程形狀上,其首次令牌到達時間的中位數在 32 個並發線程時為 339 毫秒,在 64 個並發線程時超過 1 秒,在 128 個並發線程時為 60 秒,在 256 個並發線程時為 191 秒。 4500 在較短的線程形狀上,在 32 個並發線程時保持在 64 毫秒,在 256 個並發線程時保持在 264 毫秒;在較長的線程形狀上,其首次令牌到達時間的中位數在 32 個並發線程時為 142 毫秒,僅在 256 個並發線程時為 142 毫秒,僅在 256 個並發線程時為 136 毫秒。因此,對於 Gemma 4 E4B 在聊天長度提示下,此伺服器中的 L4 是一張 32 到 64 個會話的卡,而 4500 是一張 256 個會話的卡,並且延遲還有餘量。
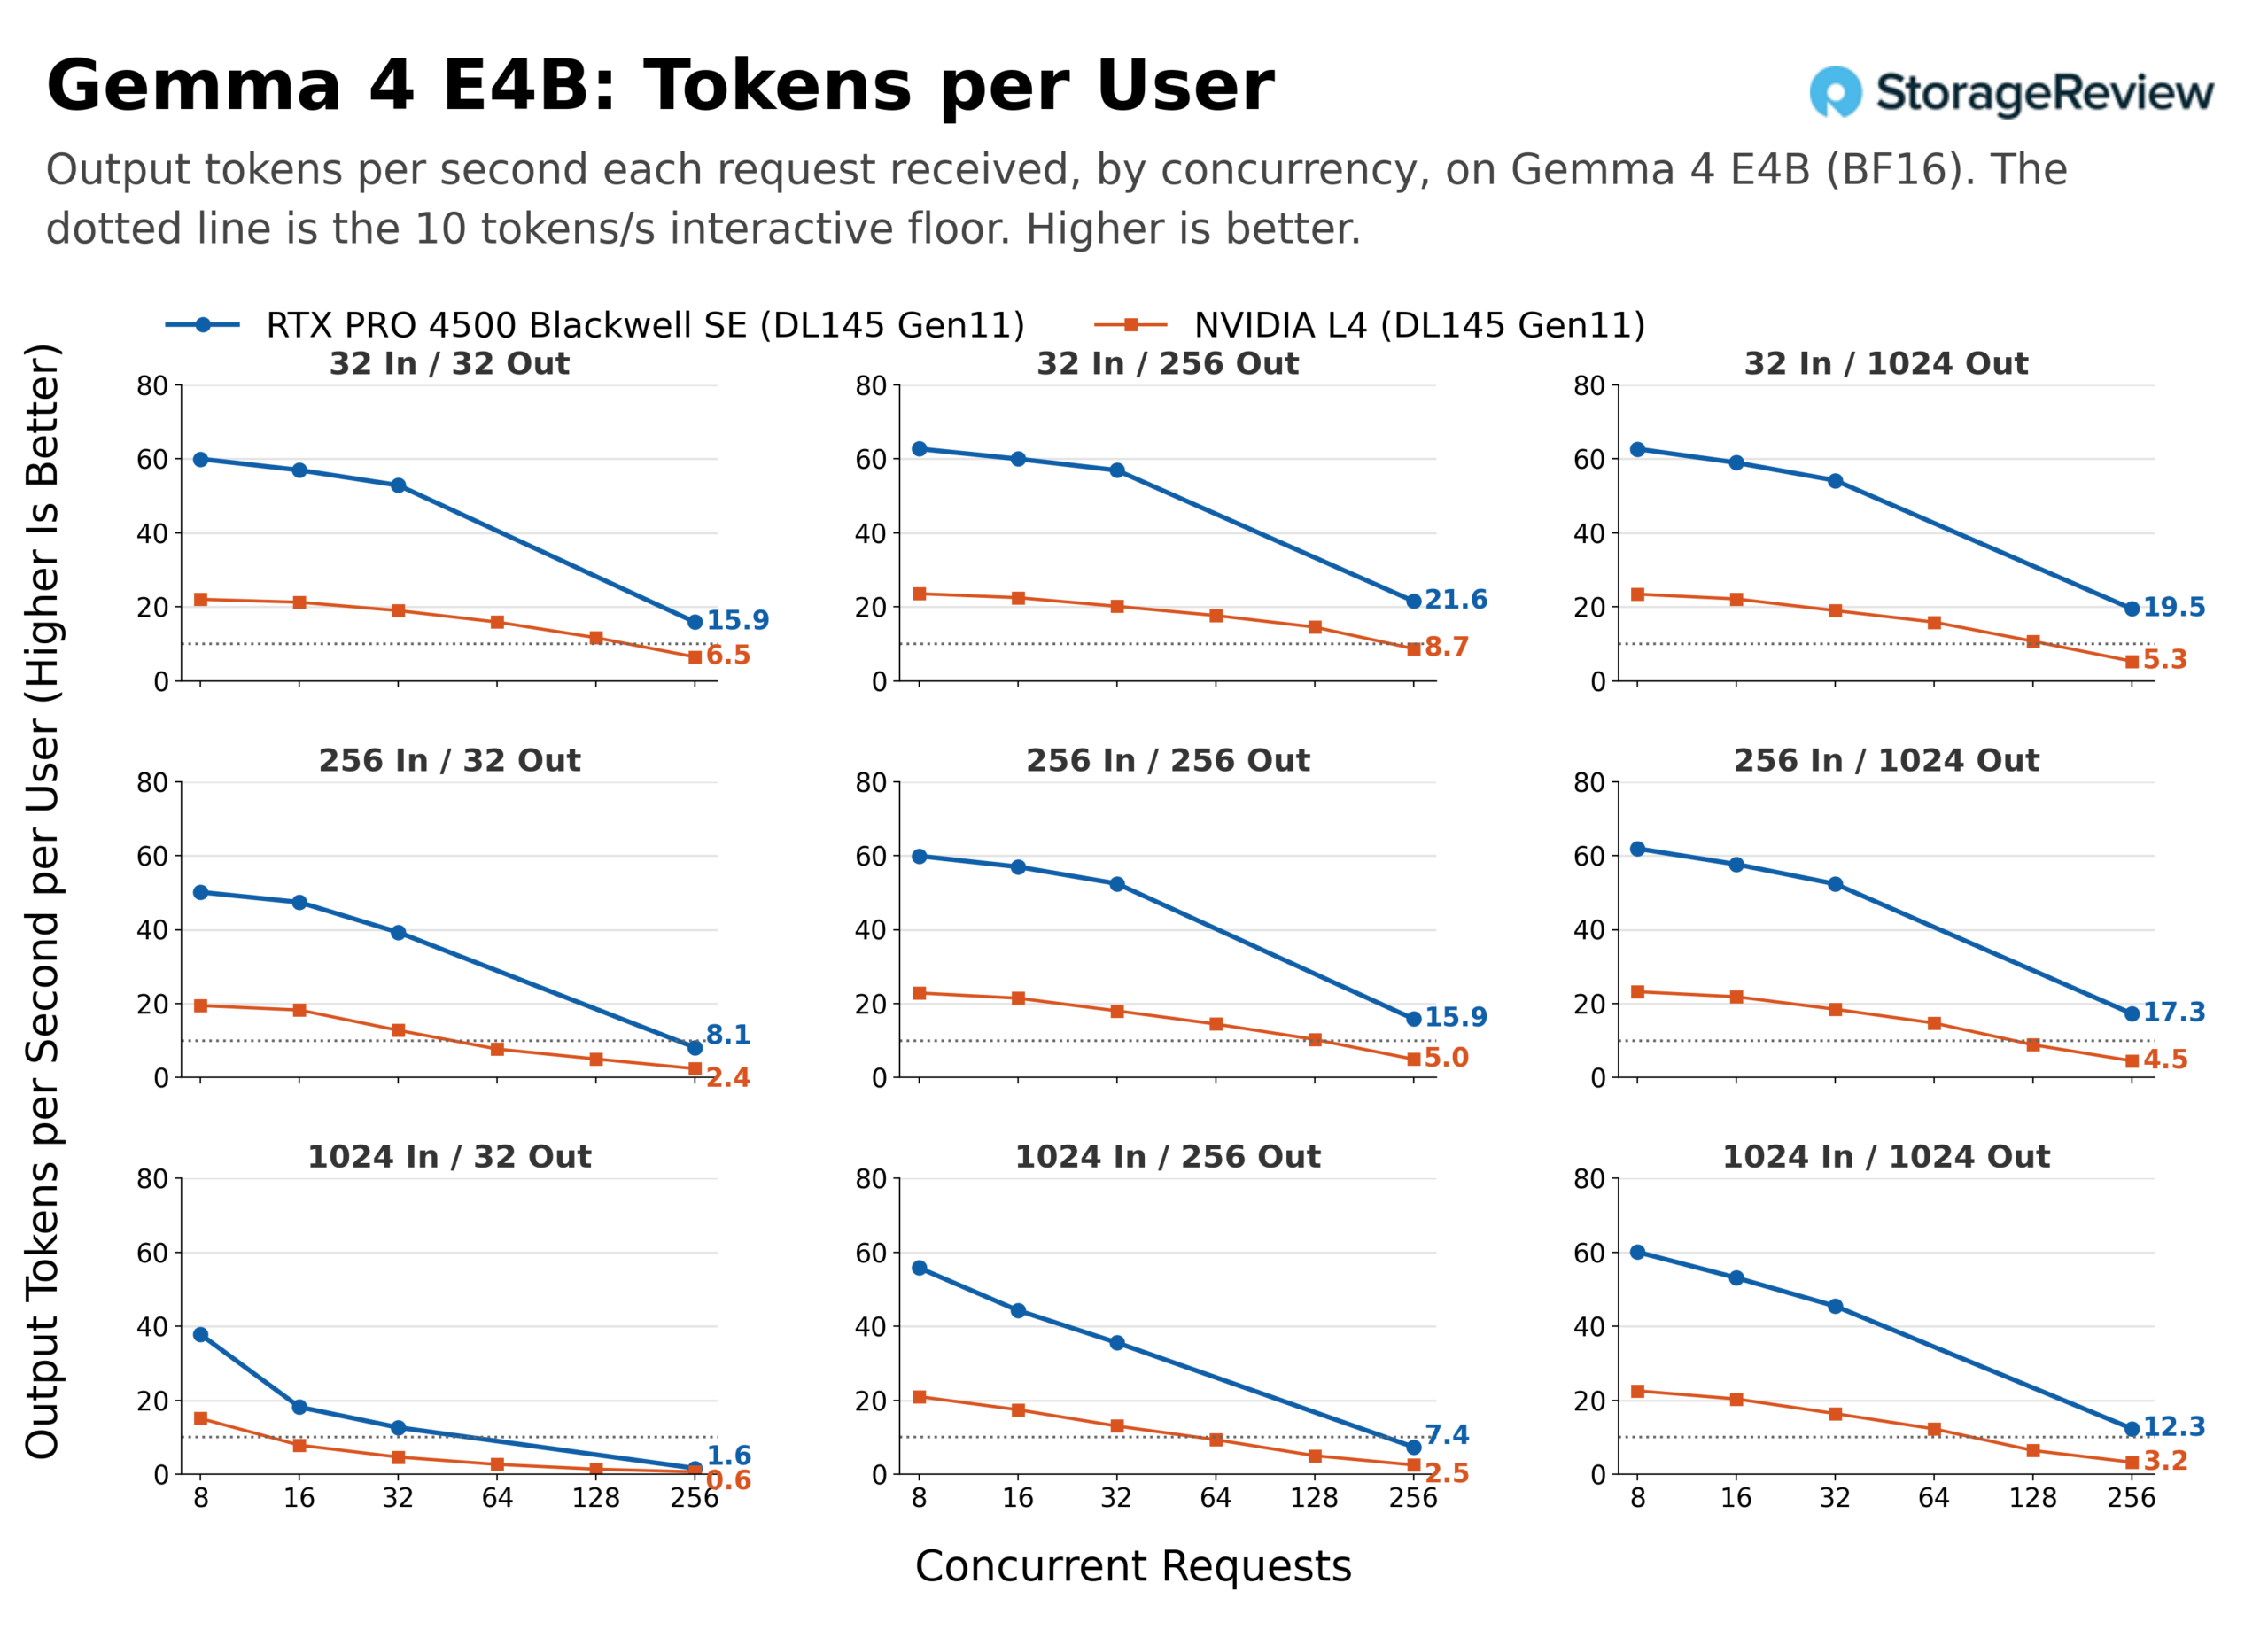
在使用者視圖中,L4 的 64 和 128 個點已填充,顯示了其效能下降的位置。在 256/256 的圖形上,L4 在 32 個並髮用戶時,每個用戶每秒可處理 18.0 個令牌;在 64 個並髮用戶時,每個用戶每秒可處理 14.5 個令牌;在 128 個並發用戶時,每個用戶每秒可處理 10.3 個令牌;在 256 個令牌時,每個用戶每秒可處理 5 個令牌。因此,在該圖形上,其效能在 128 到 256 個並髮用戶之間下降了每秒 10 個令牌。在 256/1,024 的圖形上,其效能在 128 個並髮用戶時為 8.9 個並髮用戶;而在簡答題和 1,024 個並髮用戶的情況下,其性能在 64 個並髮用戶時低於最低限值(在 256/32 時為 7.7 個並髮用戶時低於最低限值(在 256/32 時為 7.7 個並發用戶時為 254在 32 個並髮用戶的聊天形狀中,4500 的每用戶平均為 52 至 57 個字符,並且在九種形狀中的六種形狀中仍然高於最低值 256(在 32 和 256 個輸入形狀中,除 256/32 之外,為 15.9 至 21.6,在 1,024/32 12.3),僅在三種簡答題和長提示形狀中低於最低值(在 256/32 中為 8.1,在 1,024/256 中為 7.4,在 1,024/32 中為 1.6)。
在256並發場景下,Gemma 4 E4B演算法使4500的L4快取性能平均提升至1.39倍,其中在256/1,024場景下提升幅度最大,達到1.68倍;在其他L4緩存因鍵值緩存不足而無法充分利用的長負載場景下,提升幅度也達到1.6倍或更高;而在32/32場景下,由於工作負載過106倍,僅顯著提升在256/256場景下,4500的每瓦輸出令牌數為24.6,而4500為17.7。
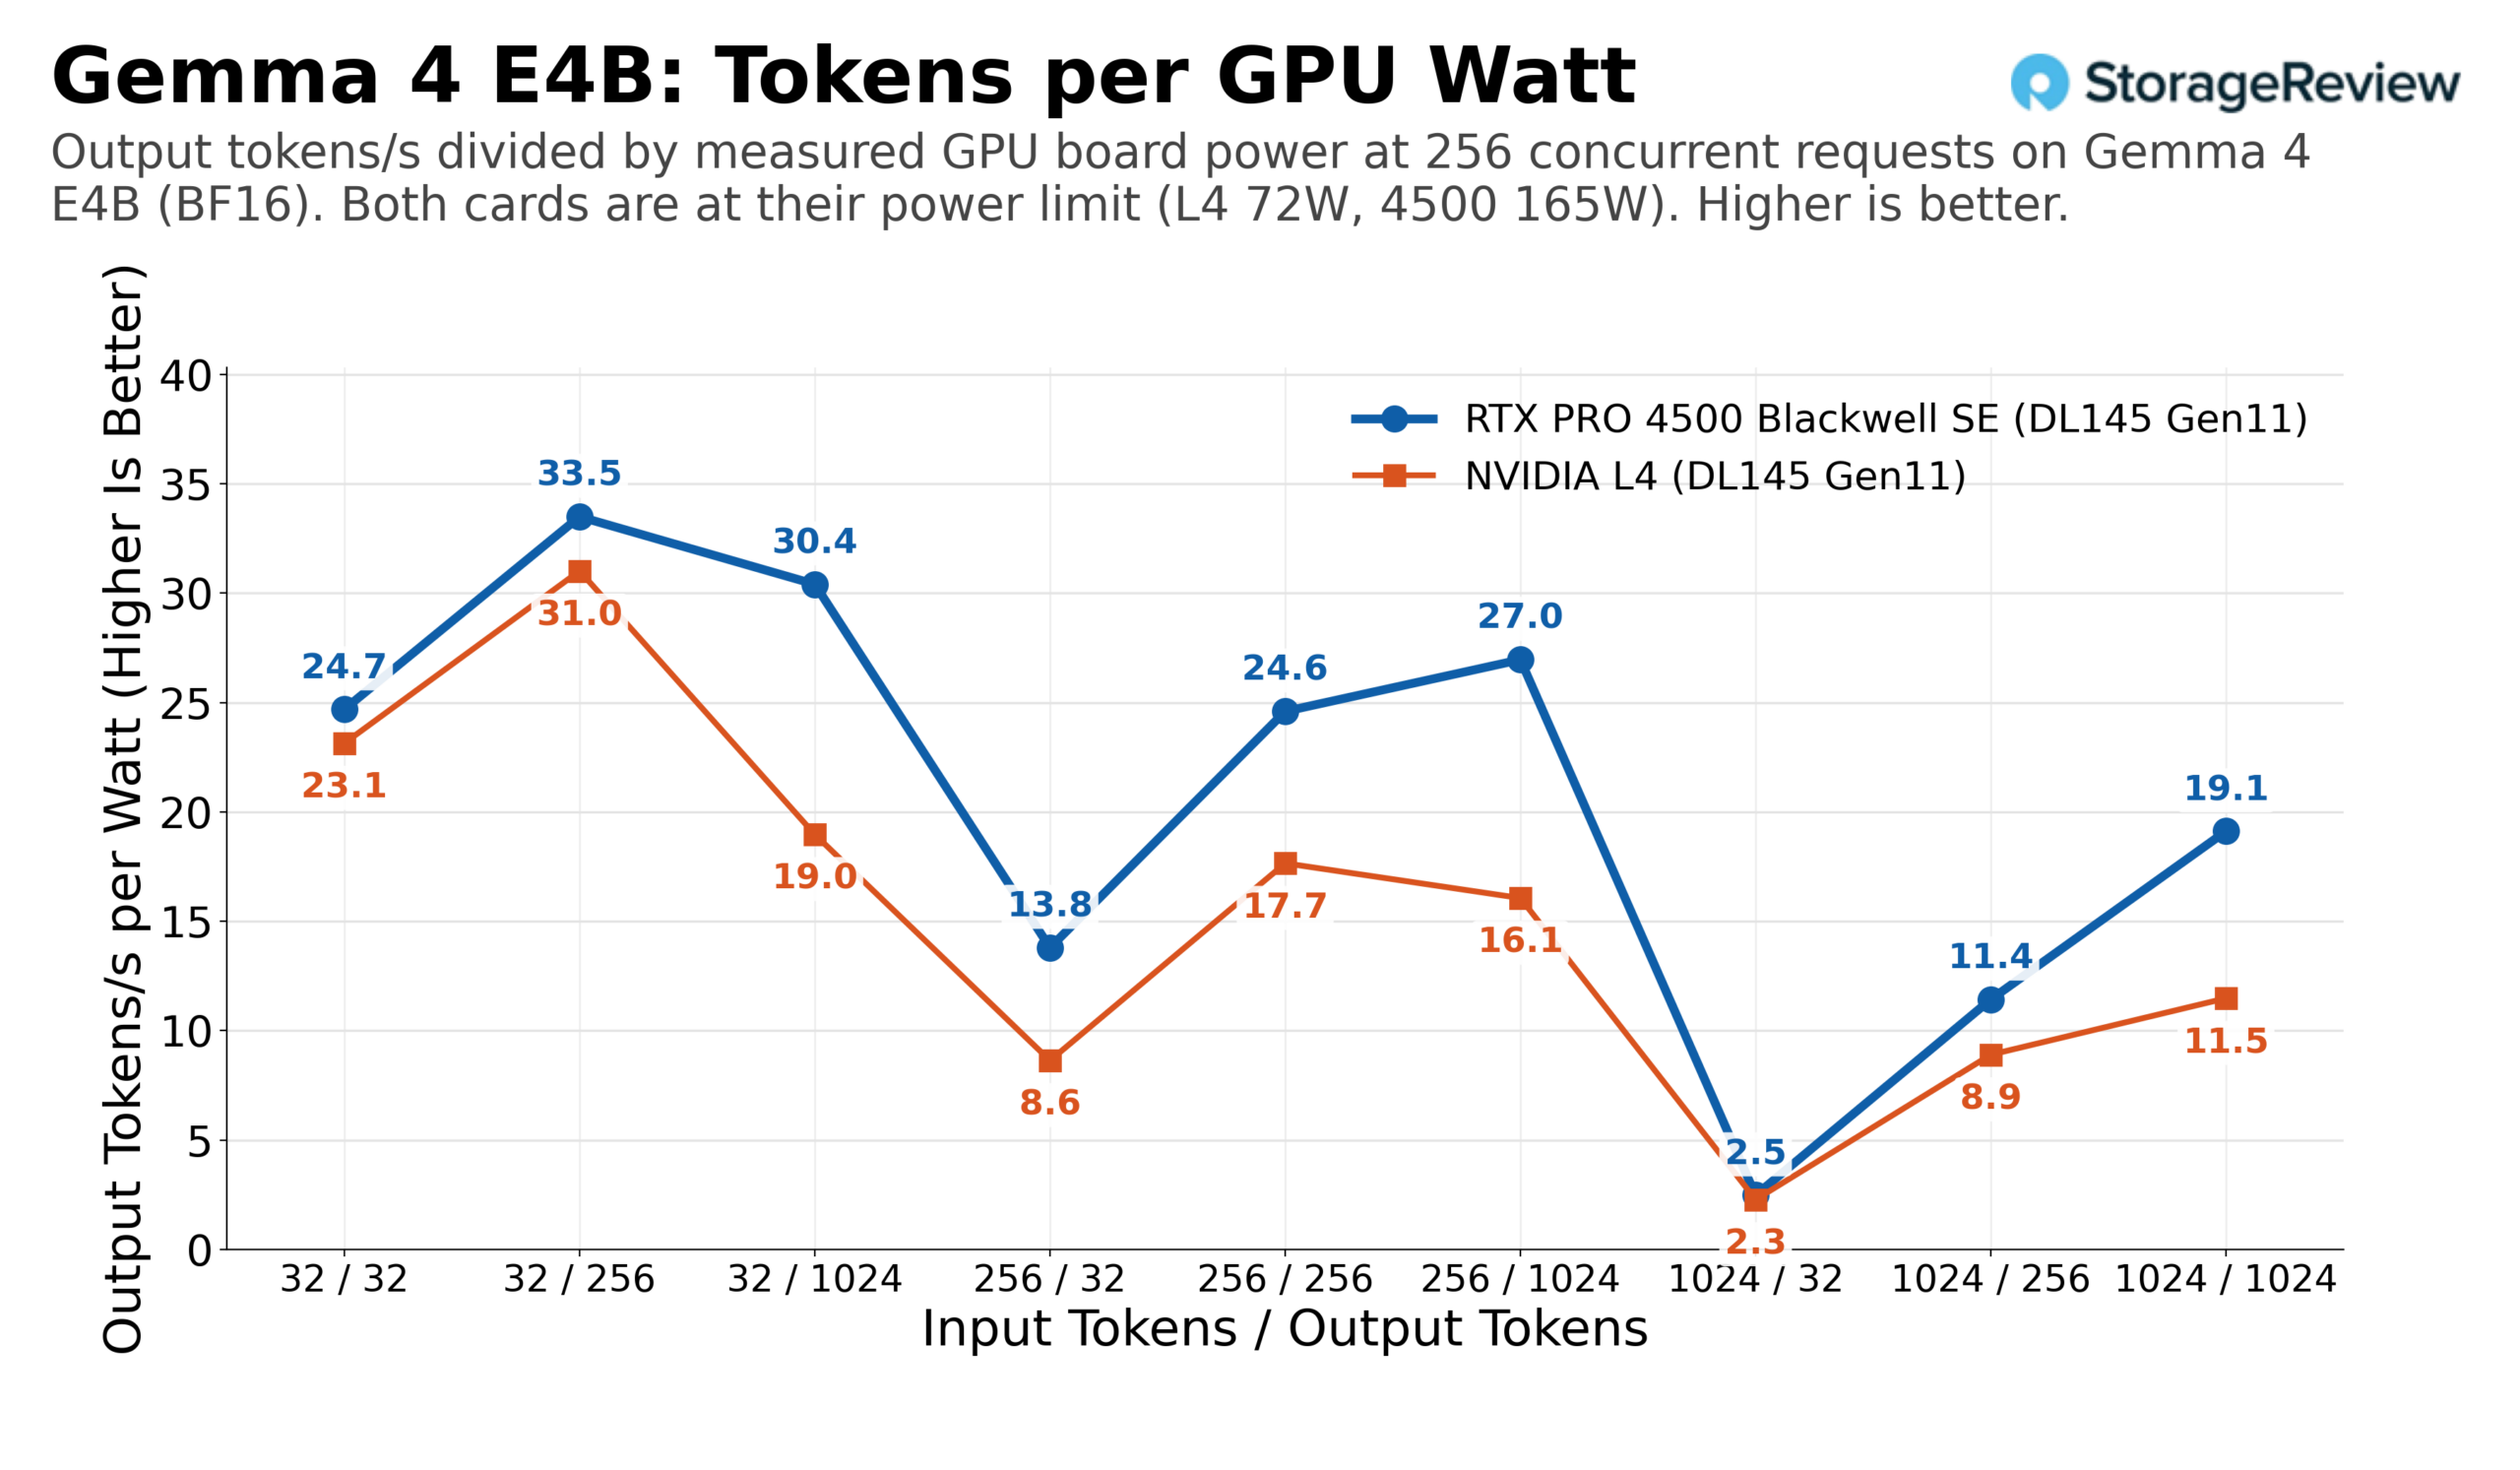
單一使用者的單令牌延遲與 Qwen 的延遲相符:在 4500 上,256/256 時每個令牌的延遲為 14.1 毫秒,而 L4 上為 39.1 毫秒;在 1,024/1,024 時,每個令牌的延遲為 14.6 毫秒,而 L.8 上為 39.8 上為 39.8 毫秒。因此,在 4500 上處理 1,024 個令牌的回應大約需要 15 秒,而在 L4 上則需要 41 秒。
牆上的電源
邊緣站點通常電力資源有限,因此我們在每次運行中都透過 DL145 的 iLO 追蹤了整台伺服器的功耗。在輕負載下,單一用戶運作時,GPU 功耗在 43 到 65W 之間,無論安裝哪張顯示卡,伺服器功耗約為 160W。在 256/256 的並發模式下,伺服器同時運行 32 個進程時,使用 L4 顯示卡的功耗中位數為 196W,使用 RTX PRO 4500 顯示卡的功耗中位數為 301W,這兩個中位數在兩款 BF16 型號上都保持一致;我們記錄到使用的最大功耗為 L4050 2050250 時為 450250250250 5顯示卡時為 308W。因此,升級顯示卡在負載下的功耗約為 105W,這與兩張顯示卡額定功率 93W 的差距接近,再加上一些轉換損耗和額外的風扇散熱。
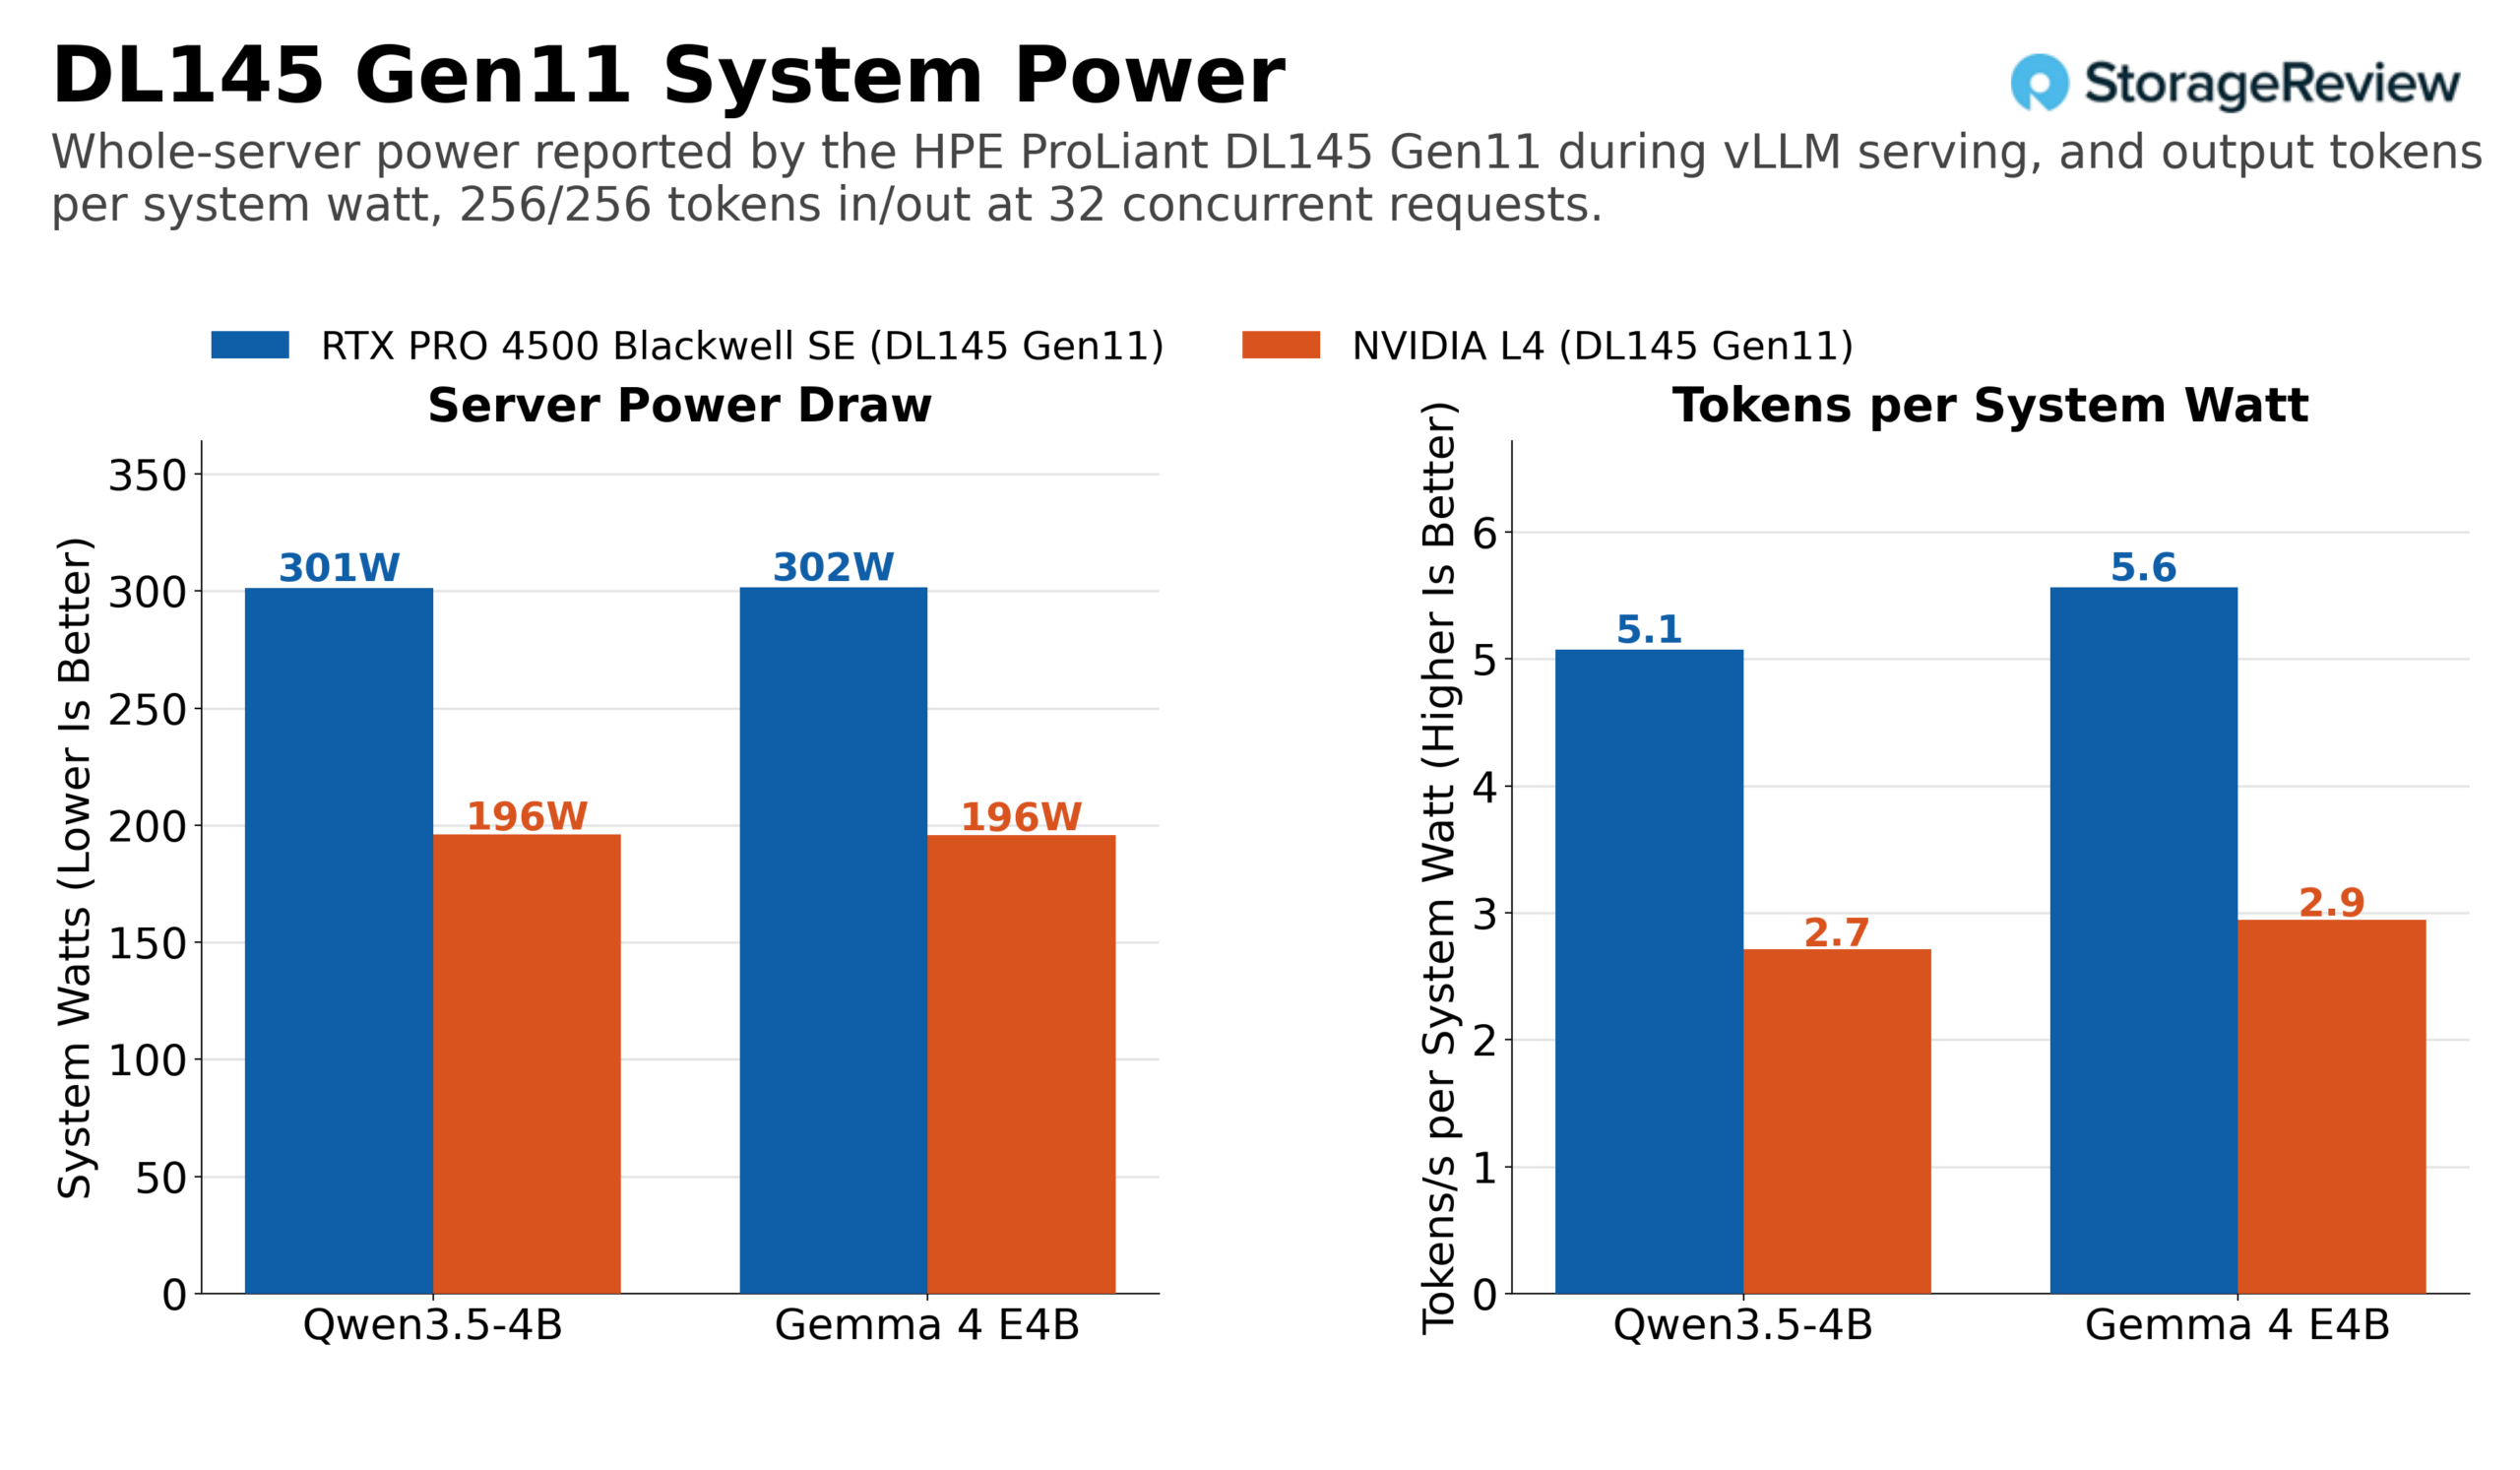
在 256/256 顯存位寬下,32 個並發實例的情況下,伺服器在 Qwen3.5-4B 平台上使用 L4 顯示卡時,每瓦系統每秒可產生 2.7 個輸出令牌;使用 4500 顯示卡時,則為 5.1 個;在 Gemma 4 E4B 平台上,分別為 2.9 個平台上,分別為 5.6 個平台。系統級效率提升大於顯示卡級效率提升,因為 DL145 的大部分功耗都是固定成本:無論 GPU 每秒產生 532 個令牌還是 1,529 個令牌,CPU、記憶體、風扇和儲存的功耗都大致相同。對於付費用戶而言,透過交換器獲得的每瓦輸出令牌數已經是顯示卡級的 1.9 倍,而顯示卡級僅為 1.3 倍。對於以站點功率預算規劃的伺服器叢集而言,這才是需要重點考慮的因素。
32GB 和 NVFP4 有什麼用?
以上所有工作L4都能完成,只是速度較慢。 4500的另一個優點在於L4無法原生支援的模型類別:Gemma 4 26B-A4B(NVFP4格式),這是一個260億位的混合專家模型,每個標記大約有40億個活躍參數,使用FP8鍵值快取。在BF16下,該模型的權重就超過24GB;而NVFP4格式的權重可以裝入4500的32GB內存,並且還有空間容納一個可用的鍵值緩存,Blackwell FP4張量核心可以原生運行這種格式。 vLLM可以透過僅權重核心將NVFP4權重載入到L4的Ada架構上,4位權重大約14GB,可以裝入24GB內存,但L4沒有原生FP4計算能力,所以我們沒有在L4上運行它。為了進行規模對比,我們在戴爾 Pro Max Tower T2 桌上型電腦中,使用 RTX PRO 6000 Blackwell 工作站版(96GB、600W 顯示卡)運行了相同的作業。這是不同的主機和不同層級的顯示卡,我們將其包含在內只是為了給 4500 的資料提供一個參考點。
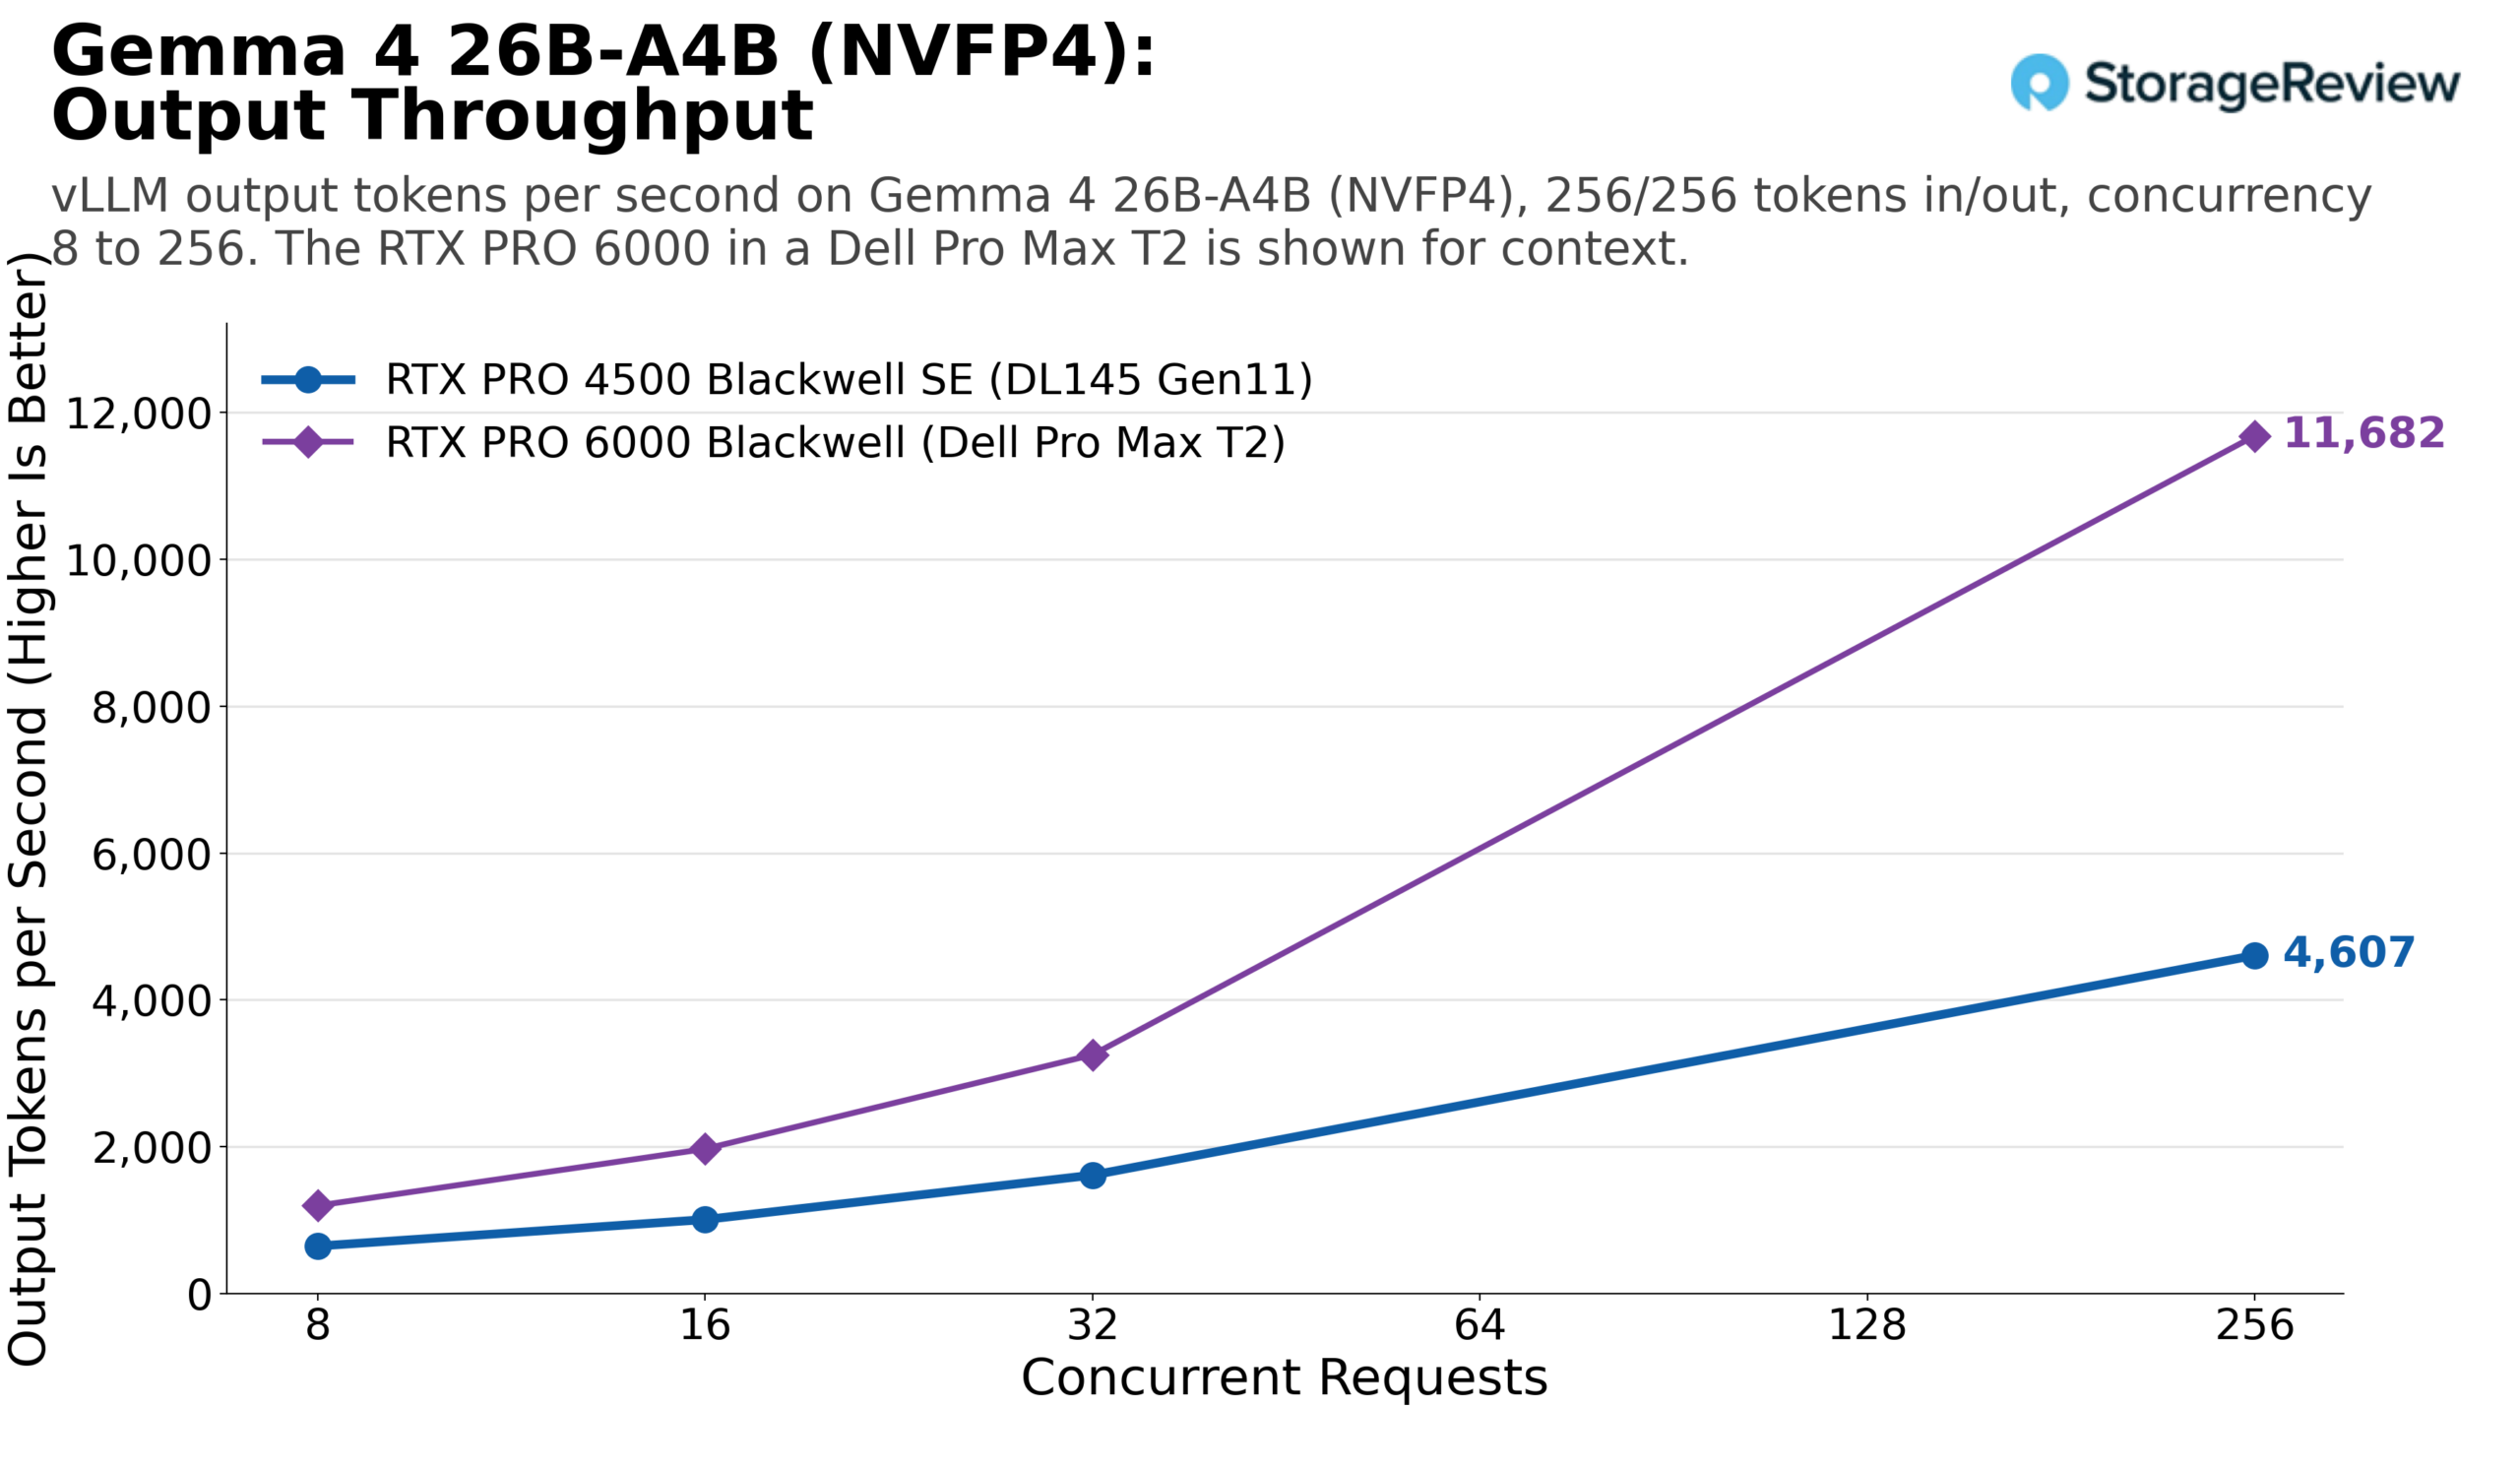
在 256/256 的配置下,RTX 4500 在 8 個並發執行緒時每秒產生 647 個輸出令牌,32 個並發執行緒時每秒產生 1,613 個輸出令牌,256 個並發執行緒時每秒產生 4,607 個輸出令牌;RTX PRO 6000 的對應輸出分別為 198,325 個輸出令牌;RTX PRO 6000 的對應輸出分別為 198、325 196在 8 到 32 個並發線程的情況下,除了預先填充的 1,024/32 配置外,RTX 4500 在所有配置下的性能都達到了 RTX 6000 的 48% 到 55%。在 1024/32 配置下,RTX 4500 在 32 個同時執行緒時的效能降至 RTX 6000 的 29%,功耗為 165W,而 RTX 6000 在上述配置下的功耗為 266W 到 471W。在 256 個並發線程的情況下,隨著 32GB 記憶體的填充,RTX 4500 的效能降至 23% 到 42%。
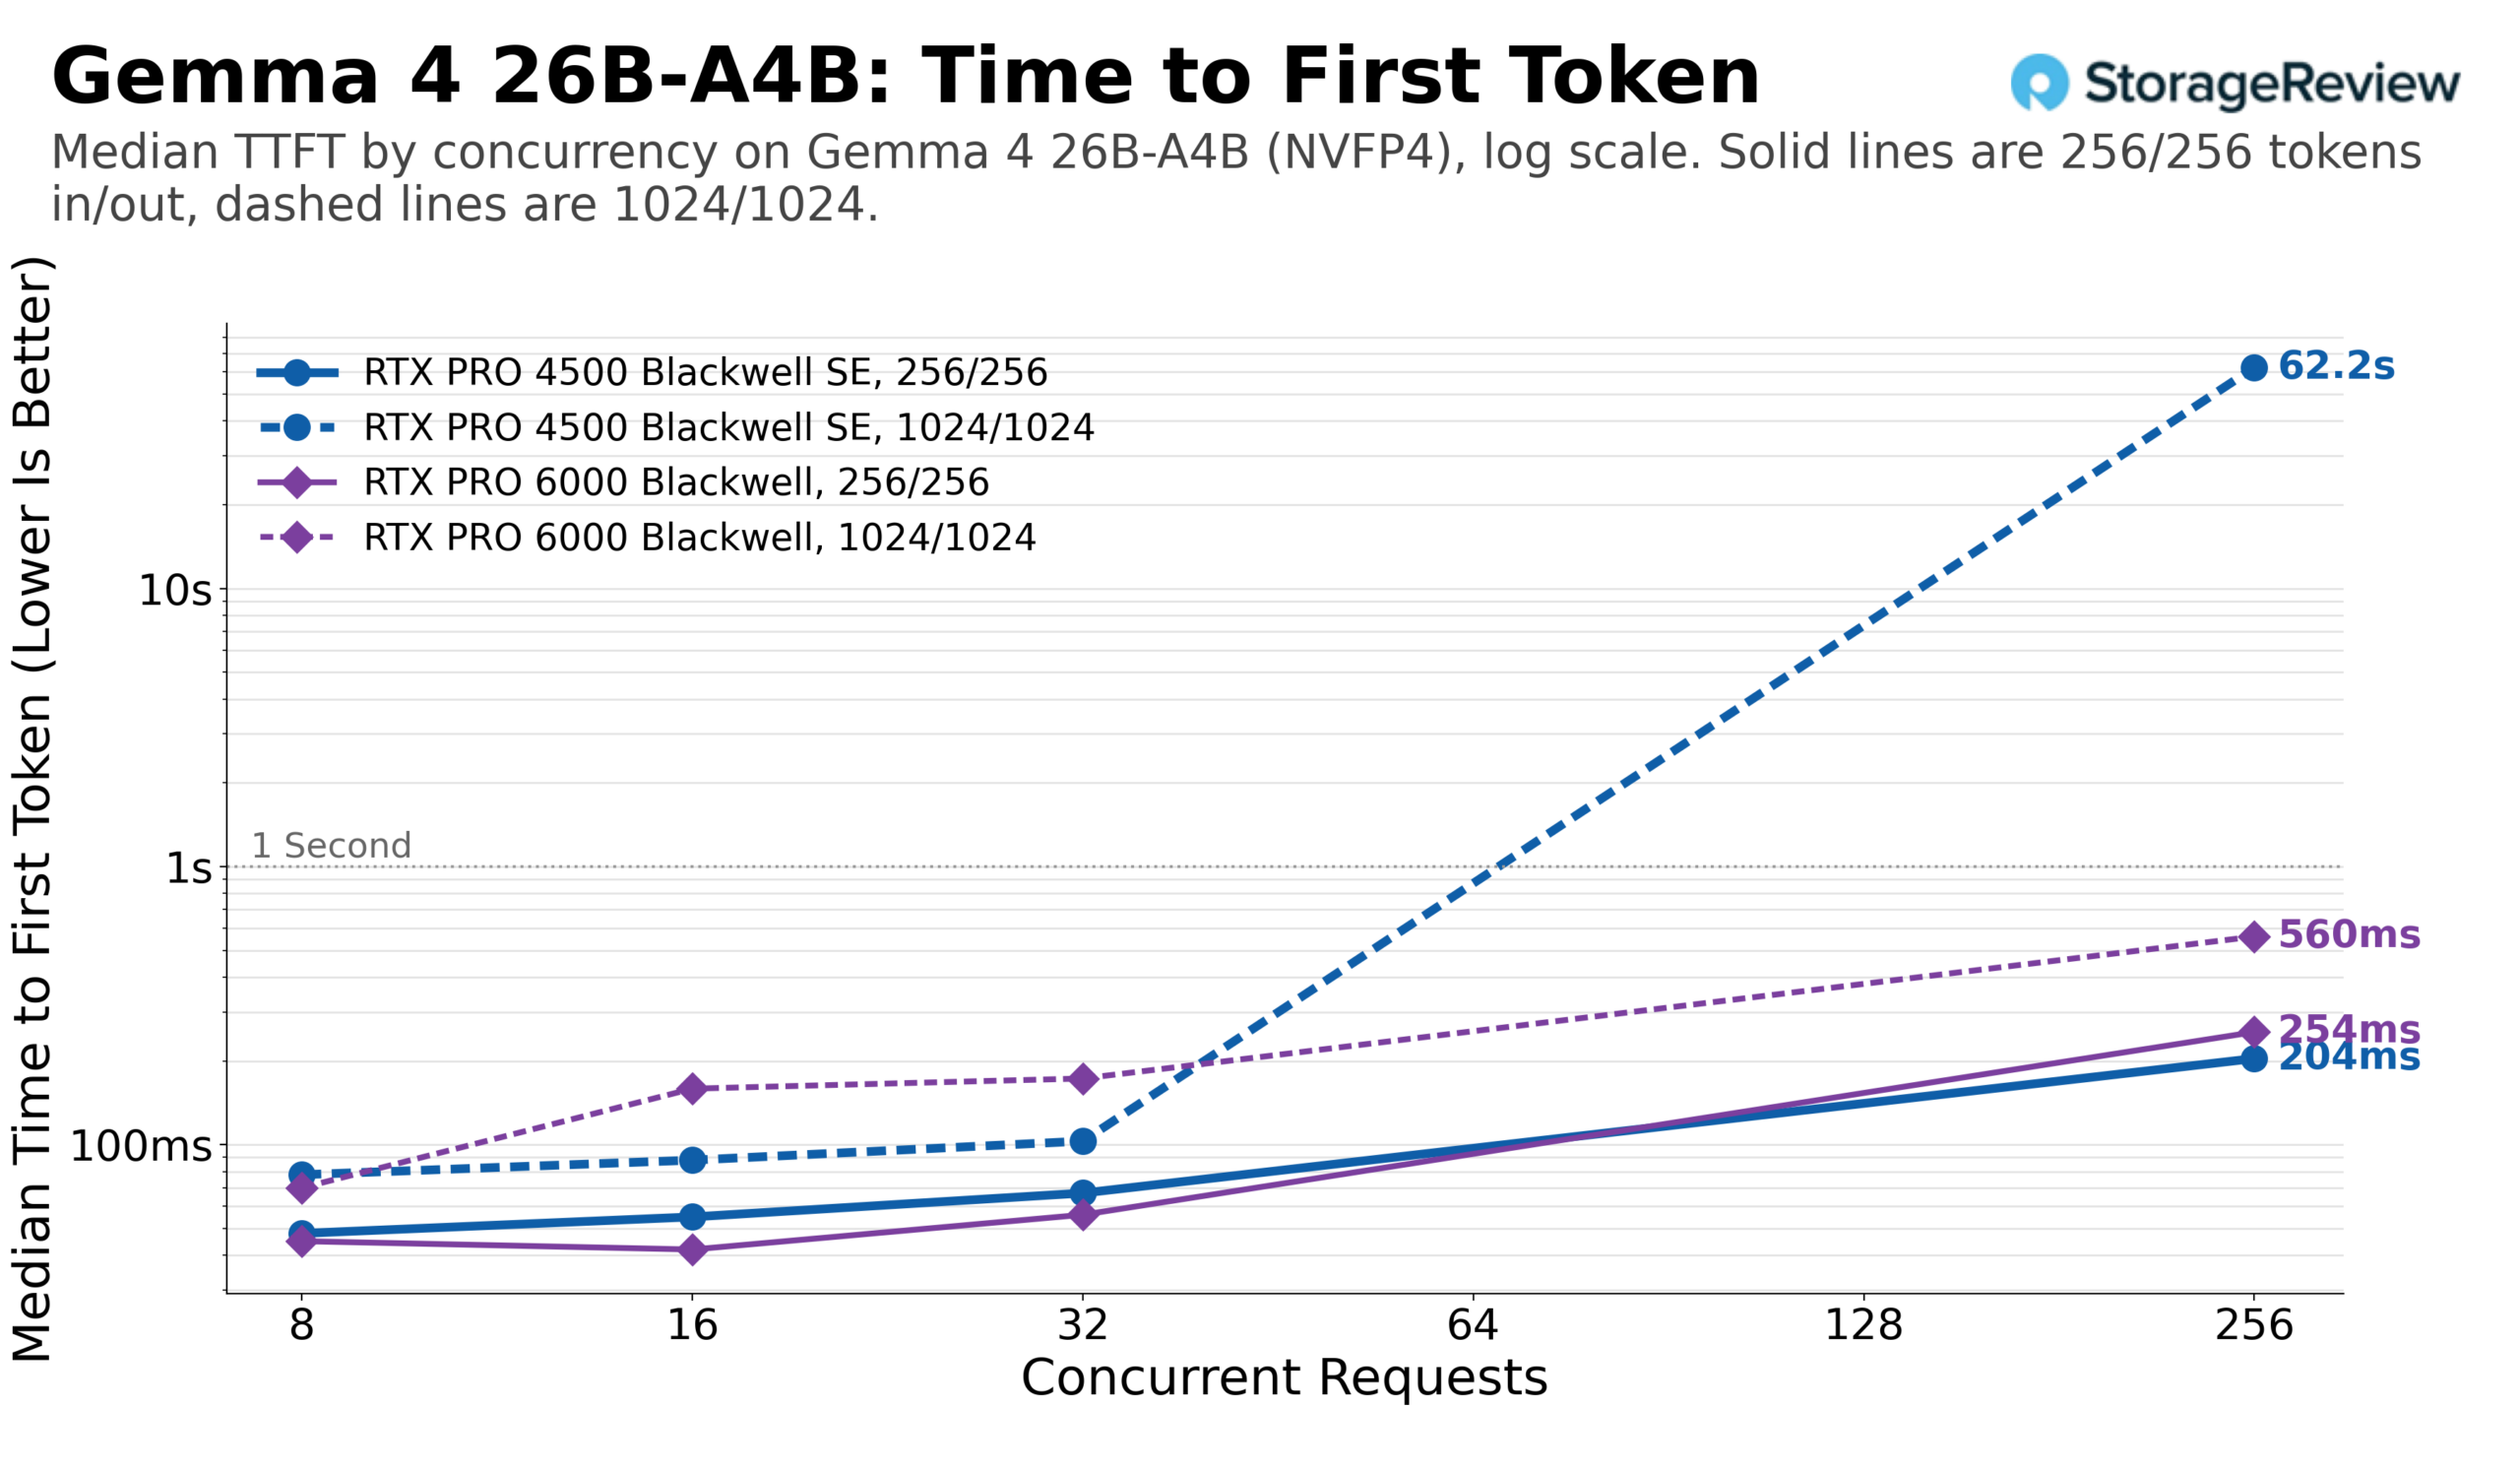
首令牌延遲與 BF16 模型的結果一致:在 32 個並發會話的情況下,4500 在 256/256 內存佈局下的中位數為 67 毫秒,在 1,024/1,024 內存佈局下的中位數為 103 毫秒,與 6000 的延遲僅幾十毫秒; 204 毫秒。在 256 個同時會話的情況下,4500 的排隊時間為 62 秒,而記憶體是其三倍的 6000 的排隊時間為 560 毫秒。對於 26 億 MoE 模型,4500 在長上下文中相當於 32 個會話,在聊天長度下相當於 256 個會話,並且它在 L4 所不具備的 FP4 硬體上運行該模型。
DL145顯示卡在為4500系列伺服器的26B型號供電時,最大功耗為306W,而4B型號的峰值功耗為308W,因為該顯示卡本身的功耗均為165W。如果選擇功率為300W的26B級顯示卡(安裝在邊緣機殼內),則可實現效能升級,且耗電量並不比小型顯示卡更高。
結語
NVIDIA 官方宣稱 RTX PRO 4500 Blackwell 伺服器版的效能是 L4 的 5 倍以上,這項數據是基於 FP4 和 NIM 協定。在同一台 DL145 Gen11 伺服器上,我們進行了 BF16 的同等配置比較測試。在兩個小型模型上,RTX PRO 4500 在正常工作並發狀態下的輸出吞吐量是 L4 的 2.7 倍,在飽和狀態下更是達到了 L4 的 3.0 倍到 3.2 倍。對於單一用戶,RTX PRO 4500 的令牌產生速度是 L4 的 2.8 倍,並且在 L4 需要排隊數十秒的情況下,RTX PRO 4500 的首令牌延遲也保持在 1 秒以內。在大多數配置下,L4 能夠保證每個使用者每秒輸出 10 個令牌,並支援 32 到 256 個會話;而在預先填充資料較多的 1,024/32 配置下,會話數僅為 8 個;而 RTX PRO 4500 在聊天長度的提示訊息下,能夠支援 256 個會話。 4500 也為 NVFP4 中的 Gemma 4 26B-A4B 提供服務,而 L4 無法原生運作該型號。
該晶片在牆插上的功耗為 105W,整個伺服器滿載運行時的功耗約為 196W 至 301W,顯示卡功耗是主機板功耗的 2.3 倍。以 GPU 為基準,4500 的單輸出代幣效率為 L4 的 1.3 至 1.4 倍;以牆插功耗為基準(系統其餘功耗皆由牆插消耗),效率約為 L4 的 1.9 倍。對於按伺服器功耗預算進行配置的網站來說,4500 能更好地利用現有功耗;而對於按插槽配置的網站來說,一台 4500 的吞吐量相當於三台 L4(每台伺服器支援 32 個會話),並且每用戶的快取生成速度快 2.8 倍,只需一個 32GB 的快取池即可滿足需求。
評測開頭提到的範圍限制依然有效,因為本次評測僅針對三款小型邊緣伺服器中的一款顯示卡與其前代產品進行對比,而RTX PRO 4500 Server Edition在L40S、RTX PRO 6000 Server Edition以及其他現有推理產品線中的定位,則是另一個值得探討的問題,我們將在後續文章中進行更深入的分析。對於擁有L4伺服器的DL145用戶而言,答案是:只要機箱配備全長轉接卡和16針電源接口,4500顯示卡就是該平台的理想升級之選。此外,HPE將這款顯示卡與這款伺服器搭配用於Nemotron邊緣運算,也與硬體的實際效能完美契合。
DL145 Gen11 本身出現在我們邊緣部分。 最佳伺服器 排行榜上,這結果現在成為了邊緣推理故事的基石。
排行榜: RTX PRO 4500 Blackwell 伺服器版是我們評測過的最佳單槽 GPU。 最佳企業級GPU leaderboard, and the L4 holds Best Slot-Powered Card for 1U and Edge.


 Amazon