

Open WebUI 將聊天、模型管理、文件管理、網頁搜尋、工具呼叫、圖像支援、知識庫特徵和 API 存取整合到一個本地 AI 介面中。本次評測我們將重點放在 Windows 桌面版本,並使用了與先前1 月份 v0.8.6 版本測試相同的硬體和模型文件,以便在相似的條件下比較兩個版本。
這是我們「最佳本地LLM工具排行榜」中的第二個條目,我們將在對榜單上的平台進行測試的過程中,添加來自相同測試硬體的可重複性能結果。
Open WebUI 是一個開源的、可自架的 AI 平台,旨在為本地和遠端 AI 模型提供一個基於瀏覽器的介面,其外觀和功能與人們已經熟悉的商業 AI 聊天服務非常相似。它可以連接到不同的推理後端和 OpenAI 相容服務,而我們測試的桌面應用程式可以透過其捆綁的 llama.cpp 環境在本地運行 GGUF 模型。這使得它的功能遠超基本的本機聊天應用程序,尤其是在啟用工具、模型預設、網路搜尋、檔案和 API 存取等功能之後。
為了進行測試,我們沿用了先前評測 Jan v0.8.6 時所使用的HP Z4 Rack G5工作站、NVIDIA RTX 5000 Ada Generation GPU 和兩個 Jan GGUF 模型。我們保留了 8,192 個詞元的上下文、2,048 個批次大小、100 個 GPU 層以及與測試文字運行相同的採樣值,同時還體驗了 Open WebUI 的模型預設、多模態輸入、DDGS 網路搜尋、URL 取得和本地 API 等功能。
讓 Open WebUI 正常運作所花費的時間比我們預期的要長得多,而且大部分時間都花在了本地 llama.cpp 和 CUDA 的配置上,之後我們才開始進行正常的模型測試。最終我們成功實現了所有功能,但在此過程中,我們遇到了預設運行時下載損壞、CUDA 檔案缺失、上下文分配過大以及內建工具系統的一些問題。
測試系統
為了方便比較不同應用程式的模型結果,我們保持了 1 月測試的系統配置不變,同時也記錄了本次 Open WebUI 運行所使用的桌面、伺服器、Python 和 llama.cpp 版本。
| 元件 | 型號 |
| 操作系統 | Windows 11 Pro for Workstations |
| 中央處理器 | 英特爾至強W5-2465X,16核 |
| 記憶體應用 | 128GB |
| GPU | NVIDIA RTX 5000 Ada 一代 |
| 顯存 | 32,760 MiB (31.99GB) |
| NVIDIA驅動程序 | 597.06 |
| CUDA 相容性 | 13.2 由 nvidia-smi 報告 |
| Open WebUI 桌面/伺服器 | v0.0.20 / v0.12.2 |
| Python / llama.cpp | 3.12.13 / b11612,CUDA 12.4 |
安裝 Open WebUI Desktop
Windows桌面安裝程式首先會顯示一個環境設定介面,您可以在此介面本機安裝llama.cpp,啟用“開啟終端機”,並在“進階”選項下變更安裝位置。我們停用了“開啟終端機”,啟用了llama.cpp,保留了Windows使用者設定檔下的預設資料夾,然後繼續進行本機安裝。
安裝完軟體包和捆綁的 Python 環境後,Open WebUI 會提示我們選擇連接,然後開啟本機瀏覽器風格的介面。全新安裝後,Open WebUI 會顯示為可用連接,隨後會顯示「建立管理員帳戶」螢幕,該螢幕會在主聊天視窗開啟之前建立第一個本機管理員帳戶。
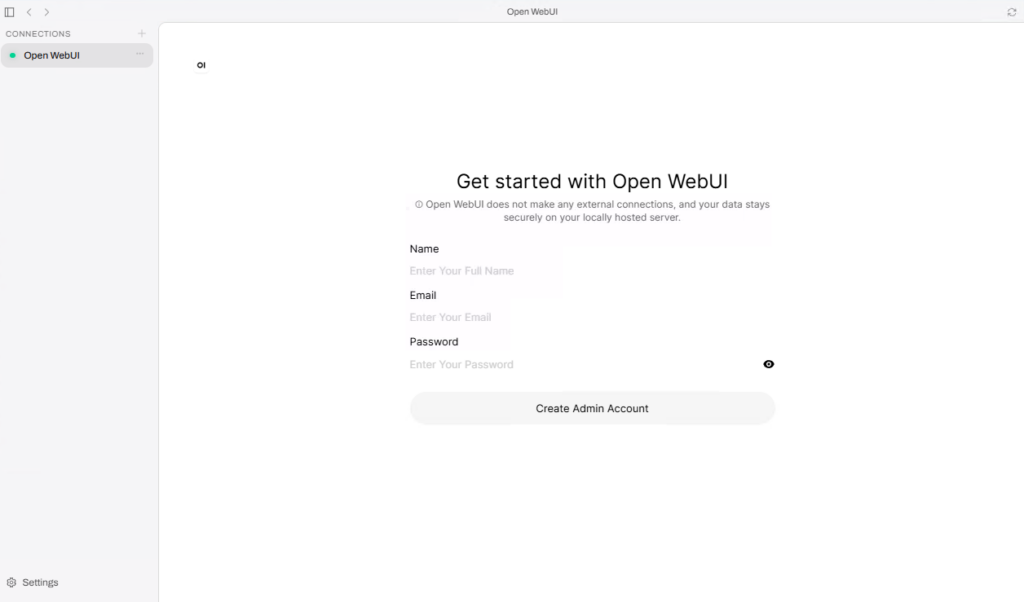
全新本機安裝 Open WebUI 後,在開啟主聊天介面之前會要求輸入第一個管理員帳號。
一開始可能會讓人困惑的一個細節是,Open WebUI Desktop 和本機 Open WebUI 伺服器使用不同的版本號。我們最終的設定方案是 Desktop v0.0.20 和 Open WebUI 伺服器 v0.12.2,伺服器運行在捆綁的 Python 3.12.13 環境中,並使用 Windows 使用者的漫遊設定檔。
新增模型並配置 llama.cpp
桌面應用程式將模型檔案與推理運行時分離,因此「模型」頁面管理本地 GGUF,而「推理運行時」控制 llama.cpp。我們複製了先前測試中使用的 Jan V3.5 4B Q4_K_XL 和 Jan V2 VL High Q4_K_M 文件,以及 V2 多模態投影文件,運行時啟動後,這兩個模型都出現在選擇器中。
第一個運行時問題出現在我們嘗試安裝 llama.cpp 時。將版本欄位設為最新版本,並選擇 CUDA 12.4,導致安裝幾乎立即失敗。查看桌面日誌發現,Open WebUI 將最新版本解析為 llama.cpp v0.6.0,並嘗試下載該版本下不存在的 Windows CUDA 歸檔文件,因此我們將版本鎖定到 b11612 並重試。
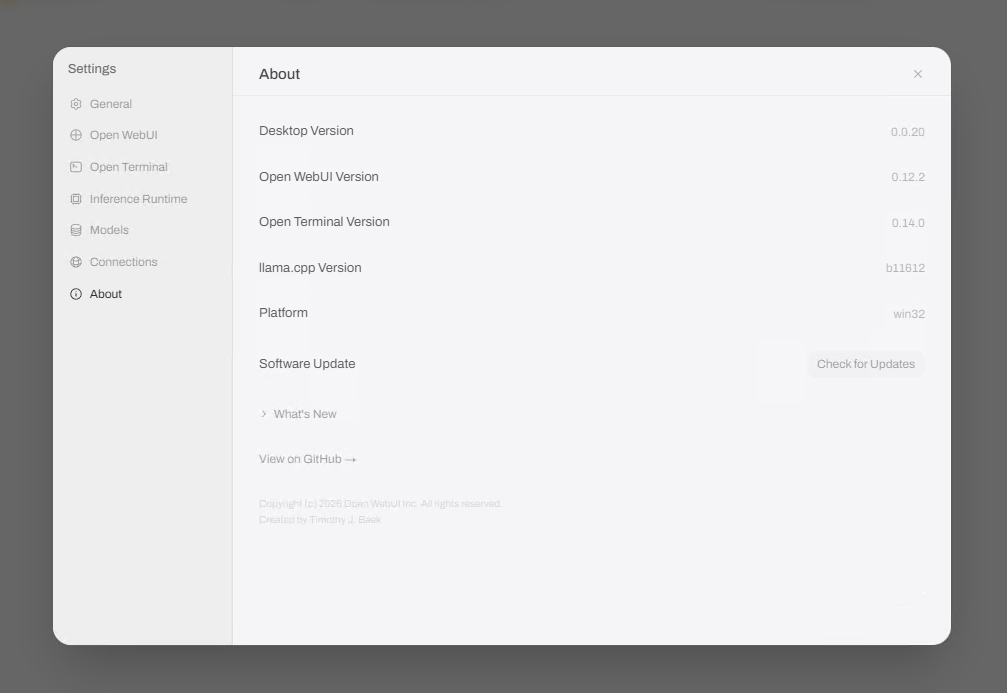
「關於」頁面列出了測試期間使用的各個桌面版、Open WebUI 版、Open Terminal 版和 llama.cpp 版。
這樣就解決了第一個問題,但 llama.cpp 仍然無法啟動,因為單獨的 CUDA 運行時 DLL 套件沒有隨主壓縮套件一起下載。我們手動將官方 CUDA 12.4 套件中的 cudart64_12.dll、cublas64_12.dll 和 cublasLt64_12.dll 加入 b11612 目錄,之後 llama-server 在 18881 連接埠正常啟動,模型也出現在聊天介面中。
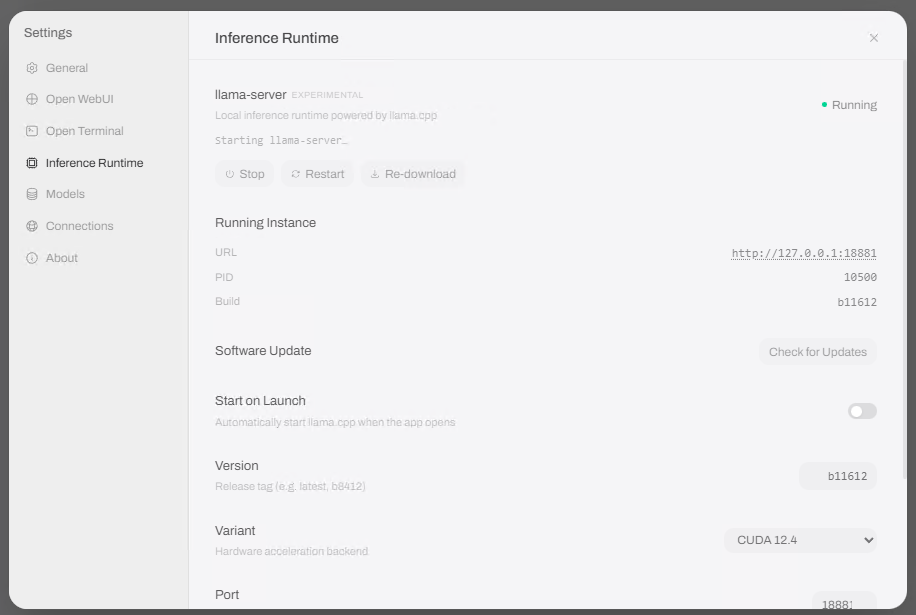
在鎖定建置版本 b11612 並新增所需的 CUDA 執行時間 DLL 後,llama.cpp 在本機連接埠 18881 上執行。
模型設定與 GPU 使用狀況
Open WebUI 將其模型設定分散在桌面應用程式和主 Web 介面中,因此初次嘗試變更設定時需要一些學習時間。桌面端涵蓋 GGUF 檔案和 llama.cpp 運行時,而主介面則新增了每個聊天的參數、工作區模型預設、功能、內建工具、Web 搜尋選項和伺服器管理。
在我們測量的文字運行中,llama.cpp 使用了 8,192 個字元的上下文、2,048 的批次大小和 100 個 GPU 層,並透過 `--no-cache-prompt` 禁用了提示緩存,因此重複使用相同的基準測試提示仍然可以產生真實的預填充測量結果。運行時日誌也證實,Open WebUI 將配置的 GPU 層數以 `--n-gpu-layers 100` 的形式傳遞給了每個模型流程。
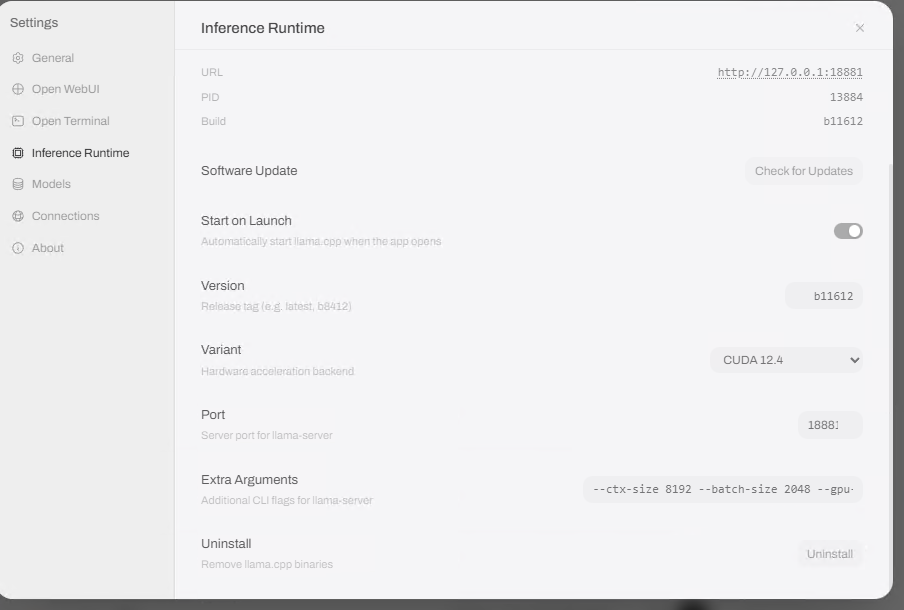
我們測量的運行使用了 8,192 個令牌的上下文、2,048 個批次大小、100 個 GPU 層,並停用了提示快取。
Open WebUI聊天預設設定與Jan的值在每個欄位中都不匹配,因此我們在每次測量運行前都更改了相關控制項。溫度維持在0.8,最高K值維持在40,最高P值從0.9變成0.95,最低P值從0變成0.05,頻率懲罰從1.1變成0,存在懲罰維持在0,重複上次N值維持在64,重複懲罰設定為1.0。
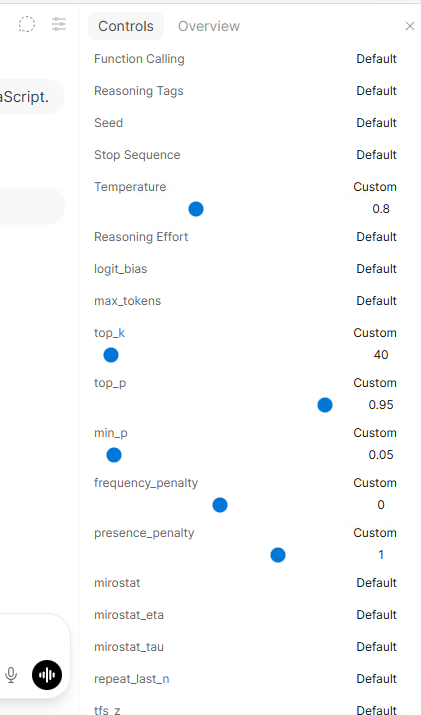
在每次測量文字運行之前,我們都將 Open WebUI 中的 1 月份採樣值進行了匹配。
我們最終為兩個基準測試模型都創建了專用的工作區預設,並關閉了它們的內建工具。之所以這樣做,是因為我們發現,普通的 Open WebUI 模型會話甚至在我們發出提示之前,就會附加大量工具指令,從而添加了足夠的工具上下文,導致 V2 請求超過了我們 8,192 個令牌的限制。
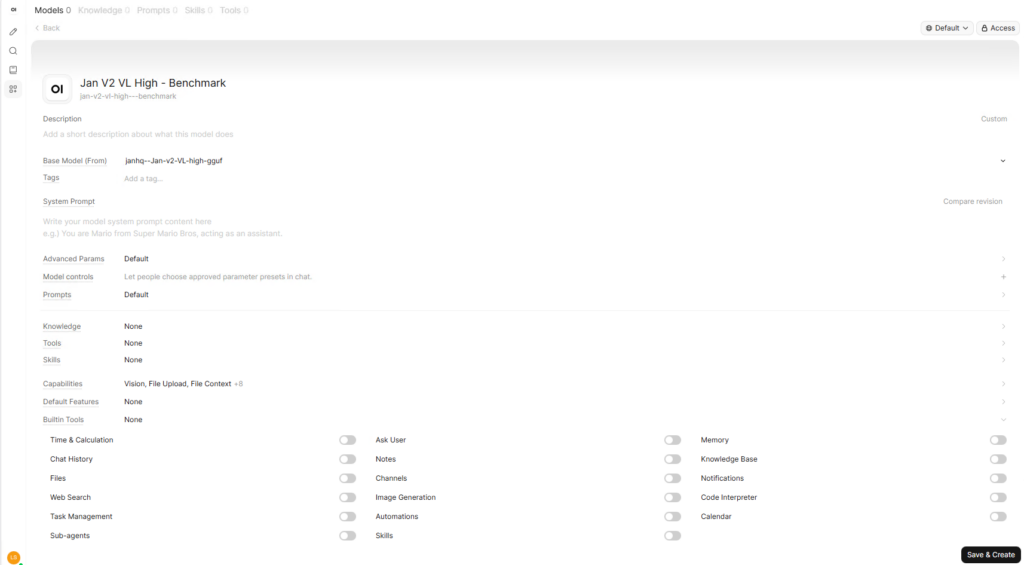
專用的工作區預設可讓我們停用內建工具,同時保持底層 GGUF 不變。
本地發電性能
基準測試提示與 1 月的運行結果完全相同:
請向首次搭建 NAS 的使用者解釋 RAID 5 和 RAID 6。用大約 400 字,列出它們各自的主要優點和缺點。
我們停用了網路搜尋功能,將載入每個模型後的第一個回應作為預熱結果丟棄,然後記錄每個模型的三次全新聊天運行。
| 型號 | 量化 | 中位數解碼 | 中位數輸出 | 中位數總時間 |
| Jan V3.5 4B | Q4_K_XL | 115.32 噸/秒 | 520令牌 | 4.78小號 |
| 一月 V2 VL 高 | Q4_K_M | 75.06 噸/秒 | 1,612令牌 | 21.81小號 |
1 月 V3.5 4B 的解碼速率中位數為 115.32 個字元/秒,輸出詞元中位數為 520 個,總生成時間中位數為 4.78 秒。 1 月 V2 VL High 的解碼速率達到 75.06 個字元/秒,輸出詞元中位數為 1,612 個,總生成時間中位數為 21.81 秒,其較長的推理輸出是造成時間差異的主要原因。
與我們在同一工作站上使用 Jan v0.8.6 的測試結果相比,Open WebUI 在 V3.5 4B 版本下速度慢了約 6.2%,在 V2 VL High 版本下速度慢了約 8.5%。 Jan 的測試結果分別為每秒 123 個和 82 個 tokens,但由於應用程式使用了不同的 llama.cpp 構建版本,因此該比較反映的是我們測試的完整軟體配置的性能,而非 llama.cpp 本身的性能。
本地聊天和工作區預設
完成運行時設定後,實際的聊天體驗就流暢多了,工作區預設很快就成為我們最常用的功能之一。每個預設都可以指向同一個 GGUF,同時擁有各自的功能、內建工具、系統提示、知識庫選項和進階參數,這樣我們就可以在不重複建立模型的情況下,分別配置基準測試和網路搜尋。
預設系統也幫助我們解決了基準測試設定中一個比較奇怪的故障。當我們使用 Jan V2 VL High 作為原始模型時,Open WebUI 在 RAID 測試期間會自動嘗試呼叫 query_knowledge_files,並且該請求超出了我們設定的 8,192 個令牌的上下文限制。建立一個基準測試預設並將內建工具設為「無」後,實際的生成提示符數量減少到 41 個令牌,從而避免了額外的工具呼叫幹擾測試。
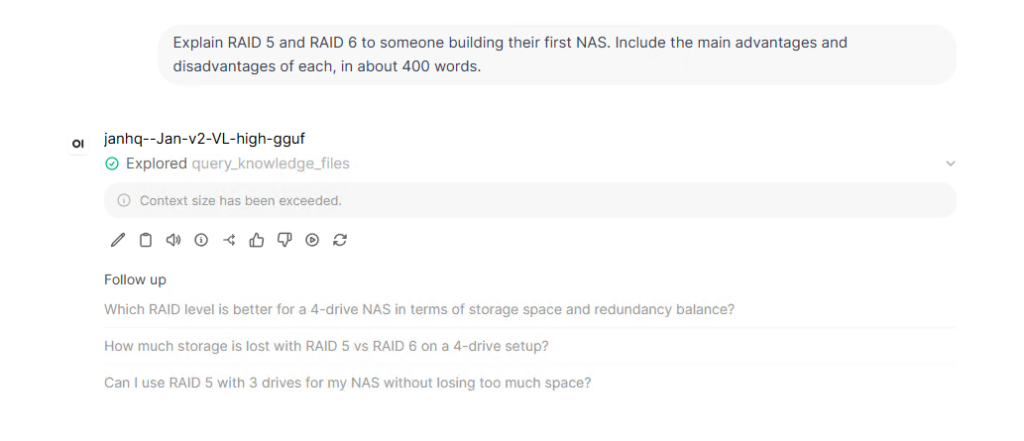
在 Open WebUI 新增內建知識檔案工具呼叫後,原始 V2 模型超過了 8,192 個標記的上下文。
對於日常使用,同樣的預設系統也可以反向使用:一個本地模型可以啟用網頁搜尋、文件存取或其他工具,而另一個預設模型則保持精簡,僅用於純聊天。這種方法在本次評測中效果很好,因為它將基準測試模型與網頁搜尋模型完全分離,而無需建立另一個 GGUF 副本。
多模式輸入
Jan V2 VL High 自動偵測到了其多模態投影文件,因此我們沿用了 Jan 評測中的 nvidia-smi 截圖,並要求獲取影像中顯示的確切 GPU 型號、驅動程式、總顯存、當前使用率、GPU 溫度和功耗。該模型正確傳回了所有請求的值。
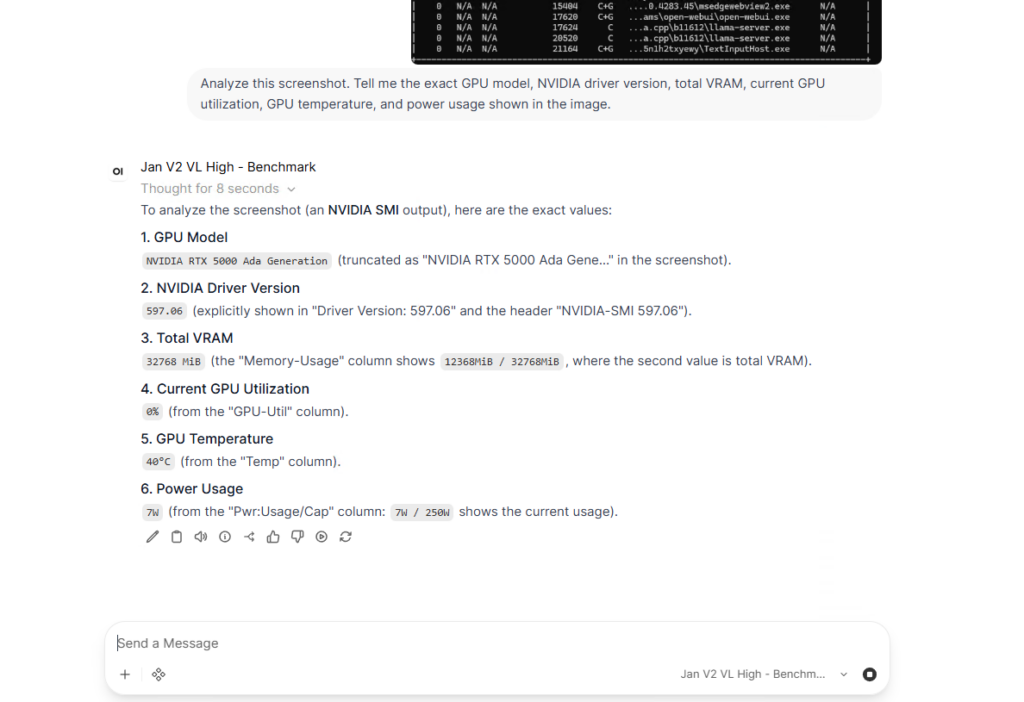
Jan V2 VL High 從 nvidia-smi 螢幕截圖中正確識別了請求的 GPU、驅動程式、VRAM、利用率、溫度和功耗值。
回應顯示 NVIDIA RTX 5000 Ada 代顯示卡,驅動程式版本 597.06,總顯存 32,760 MiB,利用率 0%,溫度 40 攝氏度,功耗 7 瓦/250 瓦。這些讀數與螢幕截圖相符,顯示 Open WebUI 順利通過了我們的定性多模態測試。
站內搜索
網路搜尋在管理員設定中擁有獨立的版塊,可以控制搜尋提供者、結果數量、URL載入、SSL行為以及其他檢索選項。我們選擇DDGS是因為它不需要額外的API金鑰,並且我們建立了一個單獨的Jan V3.5 4B預設,其中啟用了網路搜尋和所需的內建工具存取權。
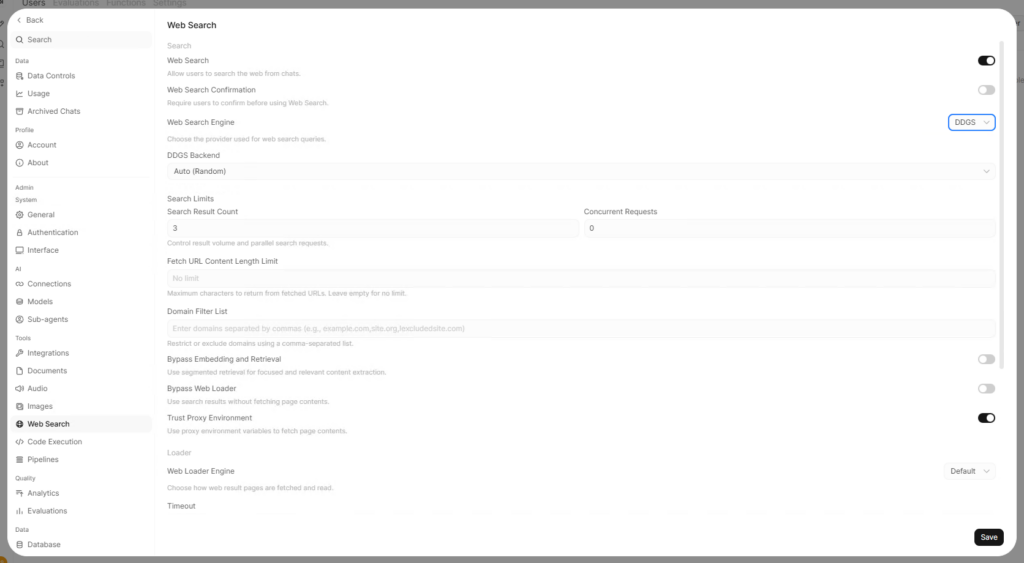
我們啟用了網路搜尋功能,並選擇 DDGS 作為本地搜尋測試的提供者。
我們的首次運行暴露了將小型本地模型與多個工具步驟結合使用的限制之一。 V3.5 成功呼叫了 search_web 並找到了 Open WebUI 的 GitHub 發布頁面,但它並未開啟搜尋結果,而是回退到其舊的內部知識。結果錯誤地顯示 2026 年 10 月 15 日是未來的日期,儘管搜尋本身已經找到了正確的頁面。
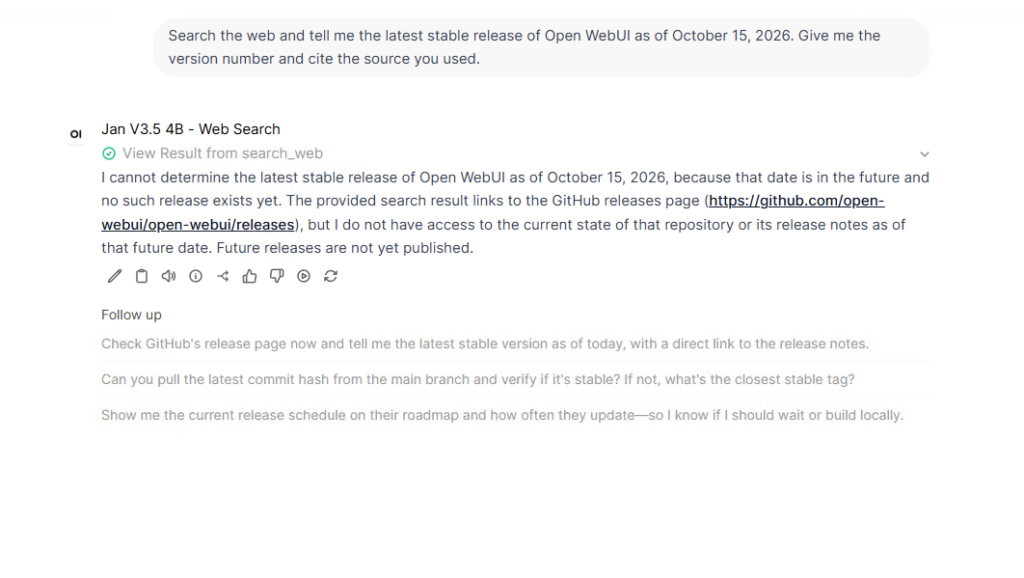
DDGS 傳回了 Open WebUI GitHub 發布頁面,但 4B 模型在回應之前沒有取得該頁面。
我們再次嘗試,這次明確指示模型在搜尋後使用 fetch_url,兩個工具都成功運行了。然而,取得的 GitHub 頁面將請求長度增加到了 17,689 個 token,遠遠超過了我們設定的 8,192 個 token 的上下文限制。將「取得 URL 內容長度限制」設定為 8,000 個字元後,請求長度恢復正常,下一次運行正確地識別出了 Open WebUI v0.12.2,並將其 GitHub 發布頁面作為其來源。
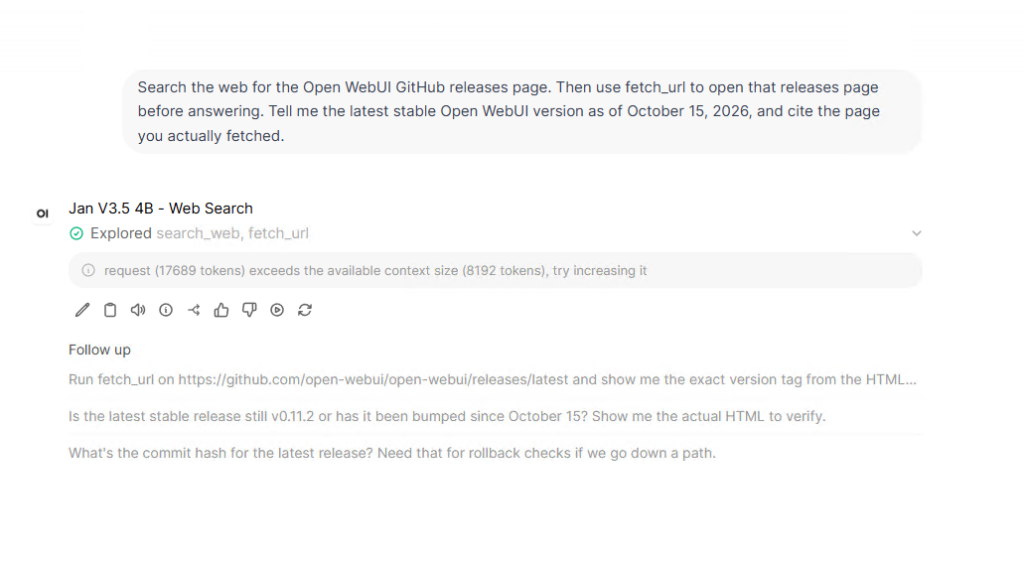
第一次 fetch_url 嘗試成長到 17,689 個 token,超過了我們 8,192 個 token 的上下文視窗。
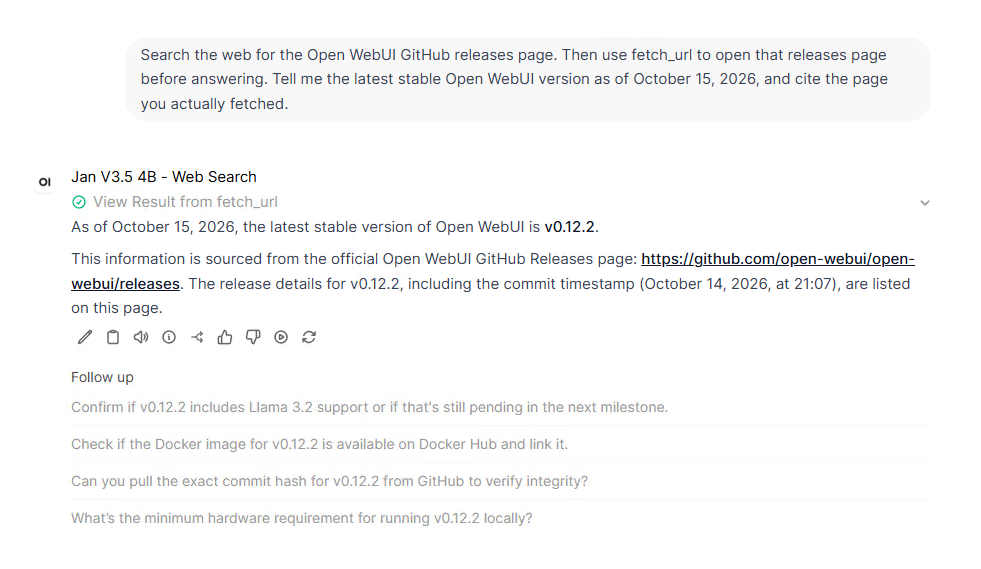
在限制獲取的 URL 內容後,模型正確地從 GitHub 發布頁面報告了 Open WebUI v0.12.2。
本地接口
在完成了網頁搜尋的測試之後,API 測試就容易多了。我們啟用了 API 金鑰,並透過 PowerShell 查詢了 http://127.0.0.1:8080/api/models,結果傳回了原始的 GGUF 模型以及我們建立的所有三個工作區預設。這也證實了這些預設可以透過本地伺服器訪問,而不僅限於聊天介面。
隨後,我們使用 Jan V3.5 4B 基準測試預設向 /api/chat/completions 發送了一個 POST 請求,Open WebUI 傳回了正確的 RAID 5 與 RAID 6 對比結果。 PowerShell 在控制台輸出中將一個 Unicode 短橫線顯示為亂碼,但產生的回應本身沒有問題。
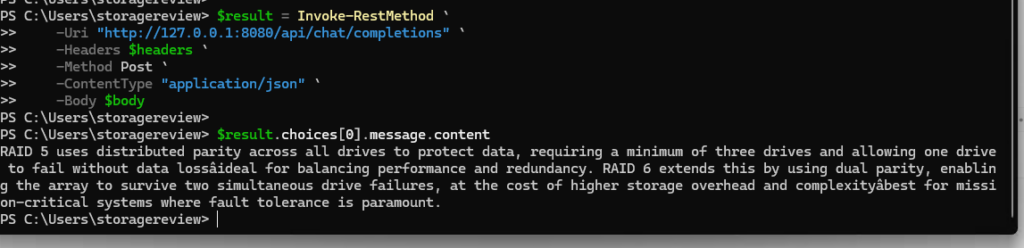
經過驗證的本機 API 透過 Jan V3.5 4B 基準預設成功完成了聊天。
什麼地方出了錯
我們在安裝過程中遇到了不少問題,因此有必要在此總結其中最主要的問題,特別是對於計劃使用 Windows 桌面版本並進行本地 CUDA 推理的用戶而言。預設的最新 llama.cpp 安裝失敗,我們必須鎖定版本 b11612,而且在本機伺服器啟動之前,還需要將單獨的 CUDA 執行時間 DLL 檔案複製到 llama.cpp 目錄中。
全新安裝後,由於移除了我們先前使用的執行時間參數,導致了另一個問題。如果沒有 `--ctx-size 8192` 參數,llama.cpp 會回退到各個伺服器插槽中模型本身非常大的原生上下文值,其中 V2 VL High 每個插槽達到 169,984 個令牌,V3.5 達到 192,000 個令牌。顯存使用量接近 RTX 5000 Ada 的 32GB 上限,遠端桌面會話明顯變慢,直到我們恢復了 8,192 個令牌的上下文。
其他問題則源自於 Open WebUI 的工具系統。內建工具新增的上下文資訊過多,導致 V2 版本的原始測試無法通過;而 Web 搜尋功能則需要明確的抓取步驟,且 URL 長度必須限制在 8,000 個字元以內,V3.5 版本才能完成完整的搜尋和抓取請求。我們最終利用應用程式的設定和日誌逐一解決了這些問題,但與一月份在同一台工作站上的設定相比,讓 Open WebUI 做好可重複測試的準備工作耗時要長得多。
結語
測試結束時,Open WebUI 已經涵蓋了我們在這一輪測試中想要嘗試的所有內容,包括本地文本生成、多模態圖像讀取、DDGS 搜尋、URL 獲取、自訂模型預設和身份驗證 API 存取。
在同一工作站上,Jan 的文字產生效能略低於 Open WebUI。 Jan V3.5 4B 的文字產生速度為 115.32 個令牌/秒,Jan V2 VL High 為 75.06 個令牌/秒,而 Jan v0.8.6 的相應速度分別為 123 個令牌/秒和 82 個令牌/秒。效能差異相對較小,但安裝時間差異卻大得多,因為我們的 Open WebUI Windows 安裝需要手動設定 llama.cpp 和 CUDA,才能進行可重複的測試。
對於希望使用單一本機介面管理模型、工具、搜尋、檔案、預設和 API 工作流程的使用者來說,Open WebUI 可以在精簡的基準測試設定檔、支援 Web 的預設和 API 呼叫之間重複使用同一個 GGUF,而無需建立重複的模型檔案。我們的 Windows 桌面配置比 Jan 的配置需要更多的手動操作,包括固定 llama.cpp 檔案、新增缺少的 CUDA DLL 以及在重新安裝後恢復執行時間參數,但配置完成後,它支援從同一安裝環境中執行更廣泛的本機模型工作流程。
這些結果與 1 月份的數據一起進入了我們最佳本地 LLM 工具排行榜,我們將保持相同的工作站、模型和提示,以便處理清單中的其餘部分。


 Amazon