

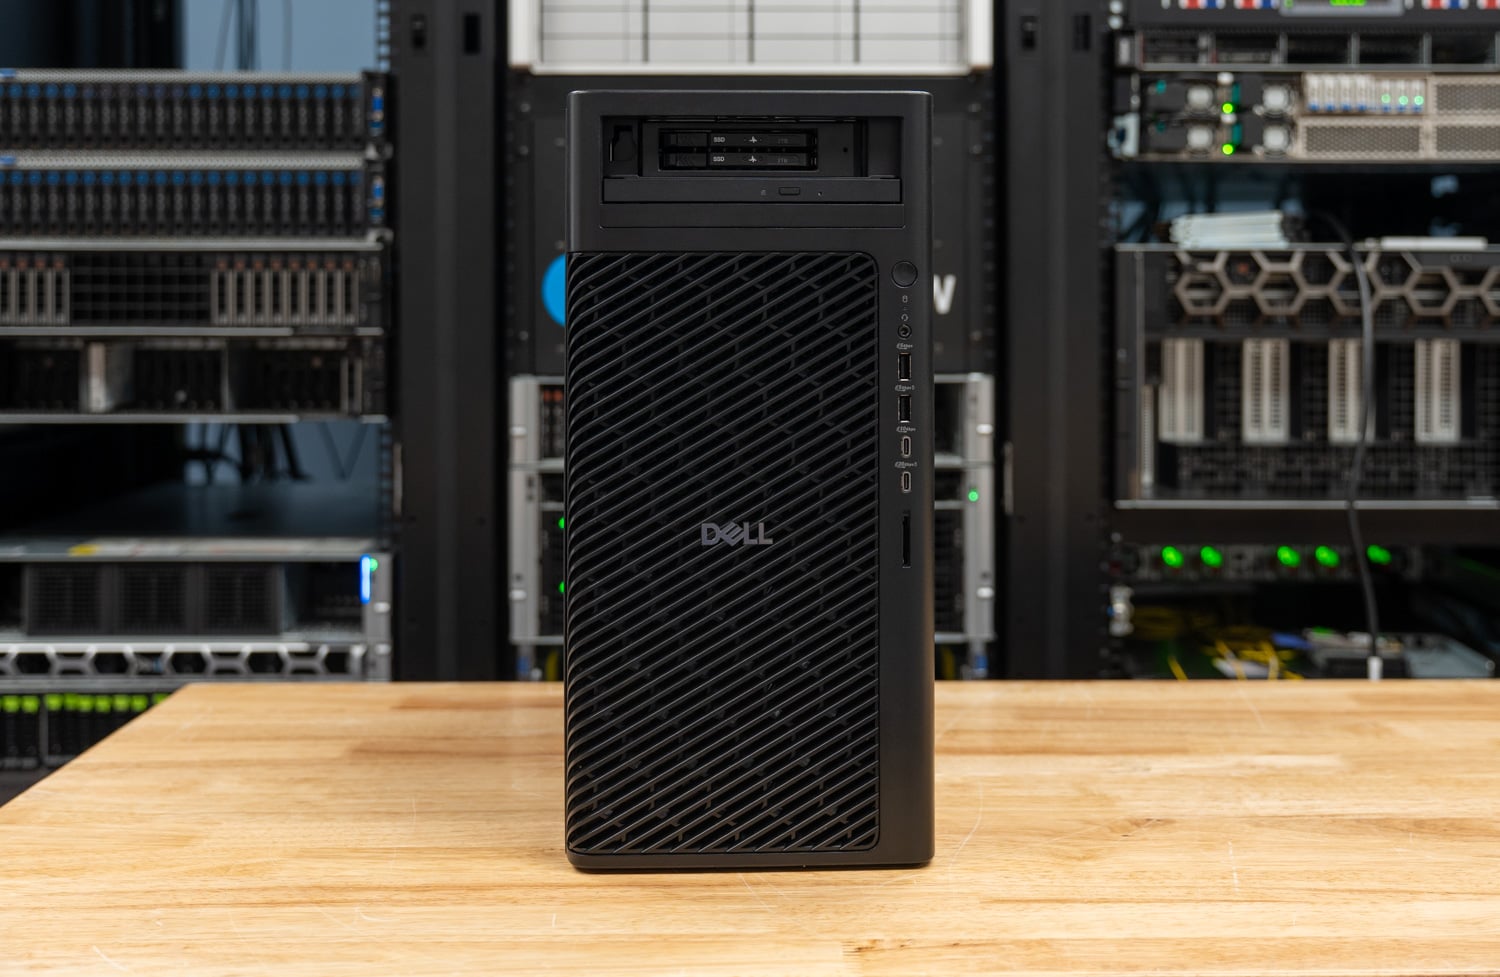
戴爾Pro Precision 9 T2是去年我們評測過的單GPU塔式機戴爾Pro Max Tower T2的Xeon版本,此次更新同時帶來了兩項變化:一是更名,戴爾將其工作站產品線重新歸入Precision品牌;二是採用全新平台,在相同的32升機箱內,用英特爾處理器 696996996999963 48Kore 48Kore 48Kore 48Kore 48Kore處理器取代了Kore 6996K。我們評測的這台機器配備了24核心Xeon 658X處理器、128GB DDR5-6400 RDIMM ECC記憶體、300W RTX PRO 6000 Blackwell Max-Q顯示卡,以及兩塊2TB E3.S Gen5硬碟,它們以條帶化方式安裝在前面板的FlexBay擴充槽中。在戴爾官網上,配置相同的機器售價約為28,300美元。
我們採用矩陣式測試方法:Pro Precision 9 T2 先用標配的 Max-Q 顯示卡運行完整測試套件,再用從 Pro Max Tower T2 中取出的 600W RTX PRO 6000 Blackwell 顯示卡運行,基於 Core 架構的 T2 也同時運行了這兩張顯示卡。因此,以下所有結果均包含四列,每兩列分別代表一個變數:CPU 平台或 GPU 的功耗限制。測試套件與上週RTX Spark 筆記型電腦的測試套件相同,但在此基礎上增加了一些新內容。
Xeon處理器提升了吞吐量,但增加了延遲。 Pro Precision 9 T2在Cinebench 2026多核心測試中得分12,322,而Core T2得分為8,856;LLVM建構耗時140.2秒,Core T2耗時182.5秒;STREAM Triad讀取速度為122,233MB/s,Core T2讀取速度為33,003MB/s;其單核Cinebench得分454.1,低於285K的564.4;Speedometer得分36.8,低於46.3。這款600W顯示卡在兩種塔式機殼中,LLM解碼效能提升約7%至20%,即時處理與擴散效能提升約20%至39%;而在Xeon塔式機殼中,它會使CPU全核心效能降低4%至5%。
關鍵要點
- Xeon 6 是一款採用單路塔式設計的吞吐量平台: 在 Cinebench 2026 多核心測試中得分為 12,322,比同機箱的 Core Ultra 9 285K 高出 39%;在 7-Zip 測試中達到 289.6 GIPS,而 Core Ultra 9 285K 為 174.8;DGEMM 性能為 11638 GFL8, Ultra 98;DGEMM 性能為 18638, 18998;D DDR5-6400 記憶體頻寬是 Core Ultra 9 285K 的 3.7 倍。
- 285K 仍然擁有單線程速度優勢: Xeon 在 Cinebench 單核測試中落後 20%,在 Speedometer 測試中落後 21%,在單線程 Python 測試中落後 20% 到 31%,核心到核心的延遲為 56.2 ns,而後者為 38.1 ns。
- GPU決定AI的運作結果,而這張600W的顯示卡則透過接收指令來取得電量: MLPerf Llama 3.1 8B 使用 Max-Q 顯示卡每秒產生 230.9 個令牌,使用 600W 顯示卡每秒產生 252.8 個令牌,而首次產生令牌的時間從 0.082 秒降至 0.059 秒,Qwen-Image 20B 1 102 秒降至 0.059 秒,Qwen-Image 20B 1 1024 秒,而 20B2012 秒,而 20B2012 秒,而 20B2012 秒顯示卡則為 26.1 秒。
- 600W顯示卡會使Xeon處理器的CPU工作負載增加4%到5%: Cinebench 多核心效能從 12,322 下降到 11,705,30 分鐘持續循環效能從 12,328 下降到 11,764,穩態時脈頻率從 4,274MHz 下降到 4,178MHz;同樣的交換對 Core T2 沒有任何影響。
- E3.S 在 FlexBay 中,由 VROC by Graid 塗裝: 前置硬碟可容納兩塊 E3.S Gen5 固態硬碟,這在我們實驗室的塔式工作站中尚屬首次。戴爾的 RAID 0 啟動選項利用 Graid Technology 的 VROC 技術,將這兩塊硬碟組成一個 4,097GB 的磁碟區。此磁碟區的順序讀取速度為 9,332MB/s,4K 隨機讀取峰值 IOPS 為 840.1K,相較之下,Core T2 中單塊 Gen5 M.2 固態硬碟的 IOPS 為 1.78 萬。
從 Pro Max 到 Pro Precision
戴爾原計劃在2025年初停用Precision系列名稱,屆時所有工作站都將更名為Dell Pro Max,但現在他們又重新啟用了Precision。 10月7日,戴爾將GB10和GB300桌上工作站的名稱從Dell Pro Max改為Dell Pro Precision,戴爾官網(Dell.com)也將Pro Precision 9 T2與新款T4和T6塔式機一同列在同一品牌下。 Pro Max系列仍用於基於酷睿處理器的機型,因此我們去年評測的酷睿Ultra塔式機仍然以Dell Pro Max Tower T2的名稱銷售,而本文評測的至強塔式機則是Dell Pro Precision 9 T2,型號為PW9T2260。
T4 和 T6 機型在更名後也同樣升級到了 Xeon 6 處理器,戴爾根據擴充性對這三款塔式機進行了定位。 Pro Precision 9 T4 (PW9T4260) 搭載了與 T4 相同的處理器列表,最高可選配 86 核的 Xeon 698X,並增加了 16 個 DIMM 插槽,支援在所有八個記憶體通道上安裝高達 4TB 的 DDR5-6400 記憶體。它可搭載一塊 600W 的 RTX PRO 6000 顯示卡,或在 1500W 電源下安裝兩塊 Max-Q 顯示卡,也可選配 2400W 的機殼。
Pro Precision 9 T6 (PW9T6260) 是該系列的頂級產品,擁有六個插槽、2400W 電源,可容納兩張 600W RTX PRO 6000 系列顯示卡、三張 Max-Q 系列顯示卡,或最多五張 RTX PRO 5000 系列顯示卡。 T2 則是該系列中單 GPU、四通道的入門級產品。
命名准確性至關重要,因為這兩款塔式機箱外觀完全相同,都採用相同的 32 昇機箱(尺寸為 387 x 187.7 x 438 毫米)、相同的邊框和前置 FlexBay 擴展槽,並且在戴爾配置器中也提供相同的 RTX PRO 6000 Blackwell 顯卡選項,因此區別在於主板。 Pro Max Tower T2 搭載 24 核心 Core Ultra 9 285K 處理器,配備四個 DIMM 插槽的無緩衝 DDR5 記憶體;而 Pro Precision 9 T2 則採用英特爾面向工作站的 Xeon 6 處理器,即我們在六月份 250 月評測過的Granite Rapids-WSWS,該平台配備更多 ECC 記憶體評估

戴爾Pro Precision 9 T2提供六款至強6處理器可選,從150W的12核至強634到我們評測的這款250W的24核至強658X,從634升級到658X需要額外支付1,560美元。至強658X擁有24個核心和48個線程,基礎頻率為3.0GHz,睿頻可達4.9GHz,配備144MB L3緩存,是285K(36MB)的三倍,並且支援AVX-512和AMX指令集,而285K則不支援。該晶片支援8個DDR5-6400通道和128條Gen5記憶體通道;T2機型配備四個DIMM記憶體插槽和五個擴充插槽,而更大的T4和T6機型則提供剩餘的插槽。
| 系統平台 | 戴爾專業版 Precision 9 T2(測試機型) | 戴爾 Pro Max Tower T2(測試機型) |
|---|---|---|
| 處理器 | 英特爾至強 658X 處理器,24 核心/48 線程,主頻 3.0 至 4.9GHz,144MB 三級緩存,250W | 英特爾酷睿Ultra 9 285K處理器,24核心/24執行緒(8個平行執行緒+16個平行執行緒),最高主頻5.7GHz,36MB三級緩存,125W |
| 指令集 | AVX-512,AMX | AVX2(無 AVX-512)、英特爾 AI Boost NPU |
| 記憶體應用 | 4 x 32GB DDR5-6400 RDIMM ECC(四通道;最大支援 1TB) | 4 x 32GB DDR5-4400 ECC UDIMM |
| 擴展 | Gen5 x16、Gen5 x4、Gen4 x16、兩個 Gen4 x8(其中一個 x4 為電氣設備) | Gen5 x16,Gen4 x4 一台,Gen3 x4 兩台 |
| 已測試的啟動存儲 | 前置 FlexBay 插槽配備 2 塊 2TB E3.S Gen5 NVMe 固態硬碟,組成 RAID 0 陣列(採用 Graid Technology 的 VROC 技術),總容量 4,097GB | 2TB SK 海力士 PCB01 M.2 Gen5(單盤) |
| 內部 M.2 | 3 個 M.2 2280 Gen5 接口 | 1 個 Gen5 和 2 個 Gen4 M.2 接口 |
| 電源 | 標準功率750瓦;可選功率500瓦或1500瓦(測試功率為1500瓦) | 360瓦、500瓦或1500瓦(80 Plus白金認證) |
| 經測試的圖形 | RTX PRO 6000 Blackwell Max-Q (300W) 出廠配置;也測試了 600W 的顯示卡。 | RTX PRO 6000 Blackwell (600W) 出廠配置;Max-Q 版本也進行了測試。 |
| 機殼 | 尺寸:387 x 187.7 x 438毫米,重量:11.6至21.8公斤 | 尺寸:387 x 187.7 x 438毫米,重量:8.17至23公斤 |
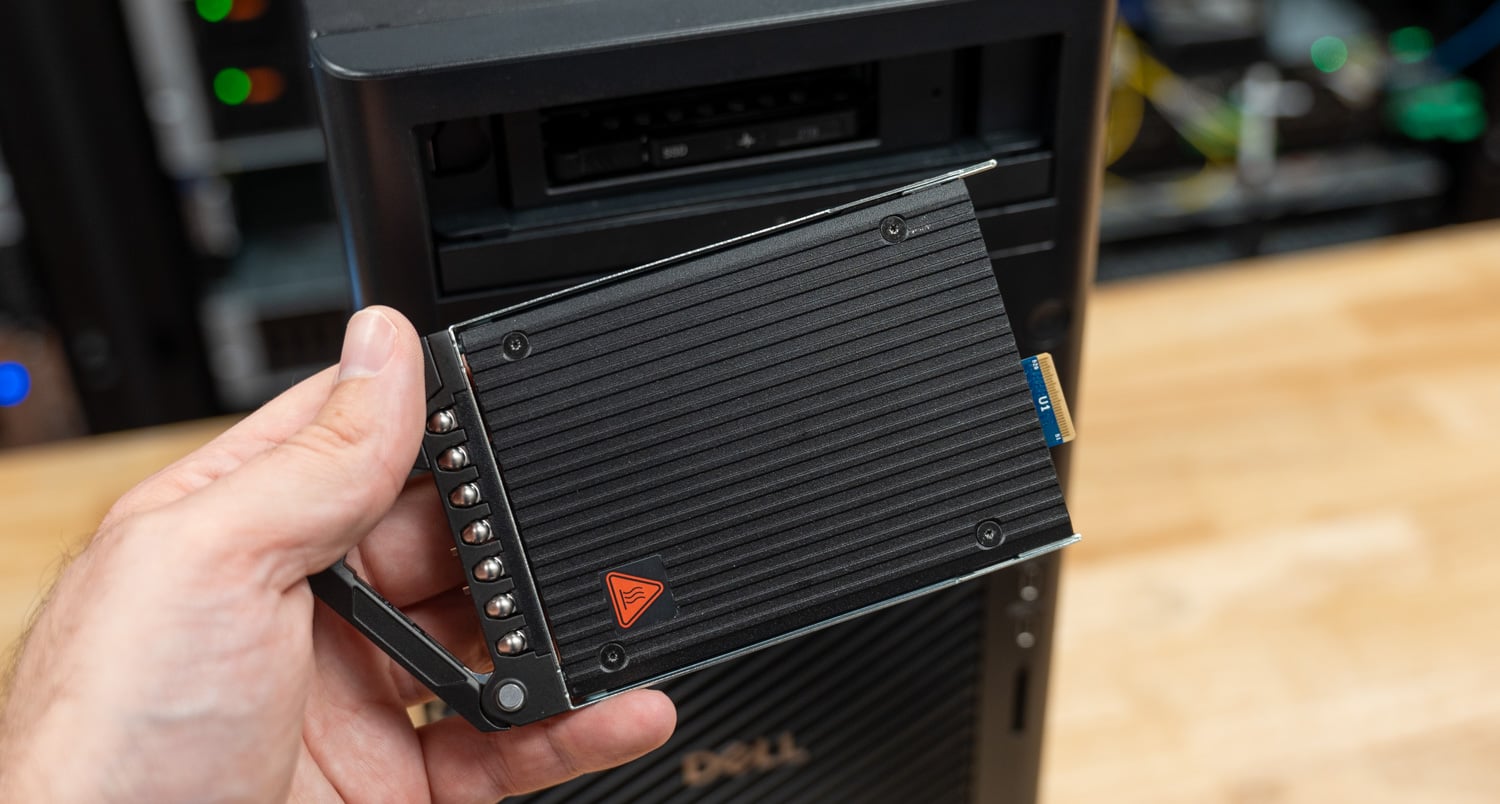
Core T2 從單一 M.2 固態硬碟啟動,而我們的 Pro Precision 9 T2 則配備了戴爾的 FlexBay NVMe 啟動配置:前面板後方有兩個支援熱插拔的 E3.S Gen5 固態硬碟,透過 RAID 0 啟動選項組成一個 4,097GB 的捲。 E3.S 是我們一直向塔式機箱廠商提出的企業級規格,因為它將容量上限遠遠超過了 M.2,而且無需打開機箱即可從正面取出硬碟。 RAID 層採用的是Graid Technology 的 VROC 技術,該技術源自英特爾的 VROC,Graid 去年接管了這項技術並在台北電腦展上重新發布。這是我們實驗室首款搭載此技術的工作站。

600W顯示卡需要額外的空間,而Max-Q顯示卡則不需要。我們收到的這台機器出廠時,顯示卡旁的插槽裡插著一塊Intel E810-XXV雙埠25GbE網卡,要安裝600W的RTX PRO 6000顯示卡,就必須先把網卡拆下來;因為顯示卡的散熱器會佔用相鄰插槽的空間以及電源。如果買家想要購買全功率顯示卡和高速網卡,應該在下單前規劃好插槽佈局,而且1500W的電源是唯一合理的搭配;我們這台機器選配了1500W電源,比標配的750W電源貴了40美元。
構建和設計
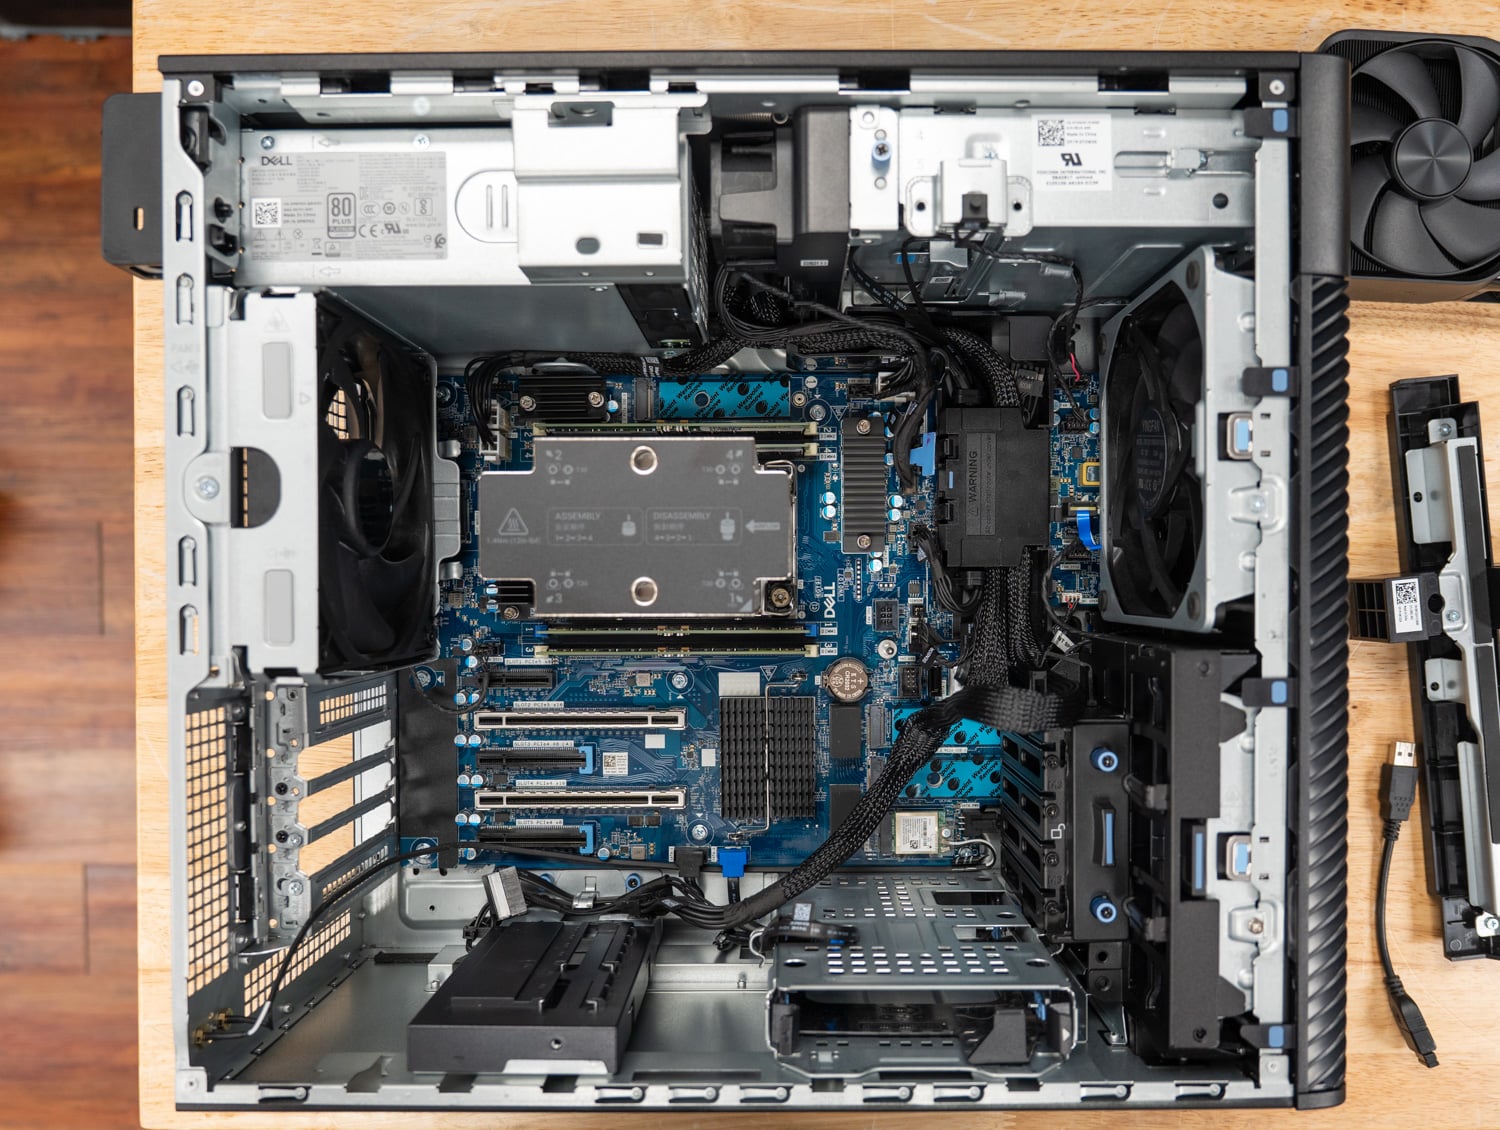
Pro Precision 9 T2 採用與 Pro Max 版本相同的免工具塔式機箱,配備全高網狀前格柵用於進氣,側面板採用側邊卡扣和固定式手擰螺絲,FlexBay 擴展塢和可選的超薄光驅動位於下部邊框後方。戴爾官方標稱機殼空重 11.6 公斤,配置後最大可達 21.8 公斤。我們評測的這台機器配備了 1500W 電源供應器、658X 散熱器和雙槽顯示卡,重量接近上限。

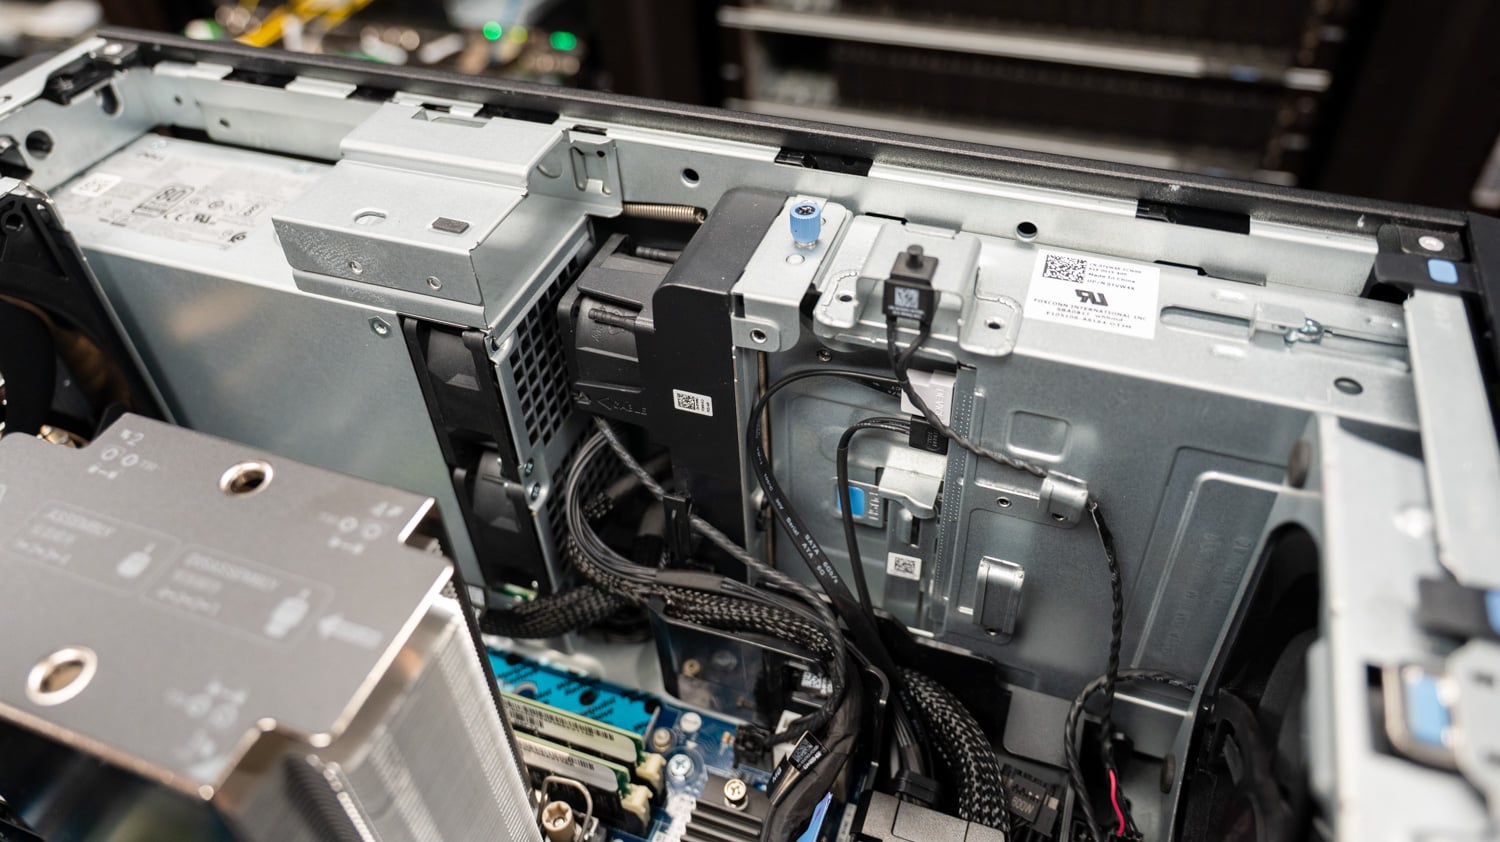
機殼內部設計以氣流為核心,戴爾能精準地引導氣流流向所需之處。大型散熱罩不僅能有效冷卻記憶體條,還能將CPU產生的熱空氣直接排出機箱,其內部整合了一個風扇。打開機殼後,可以看到散熱罩是如何融入機殼結構的:它的下緣擱置在顯示卡支架上,並與側蓋緊密貼合。
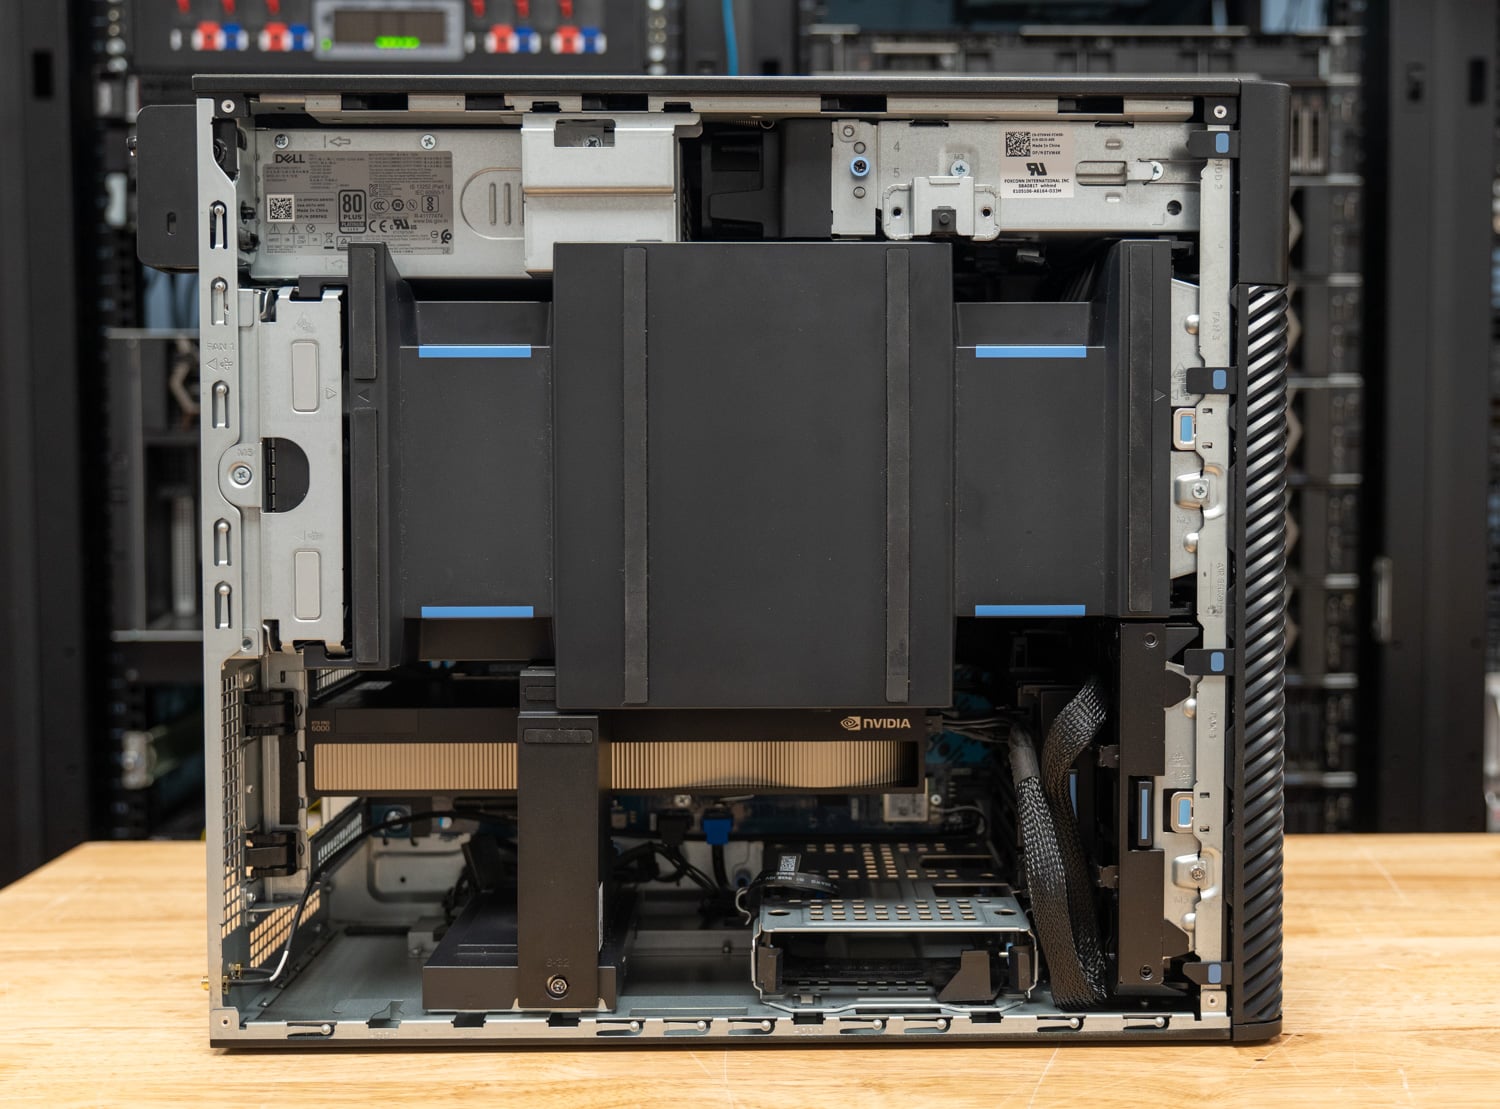
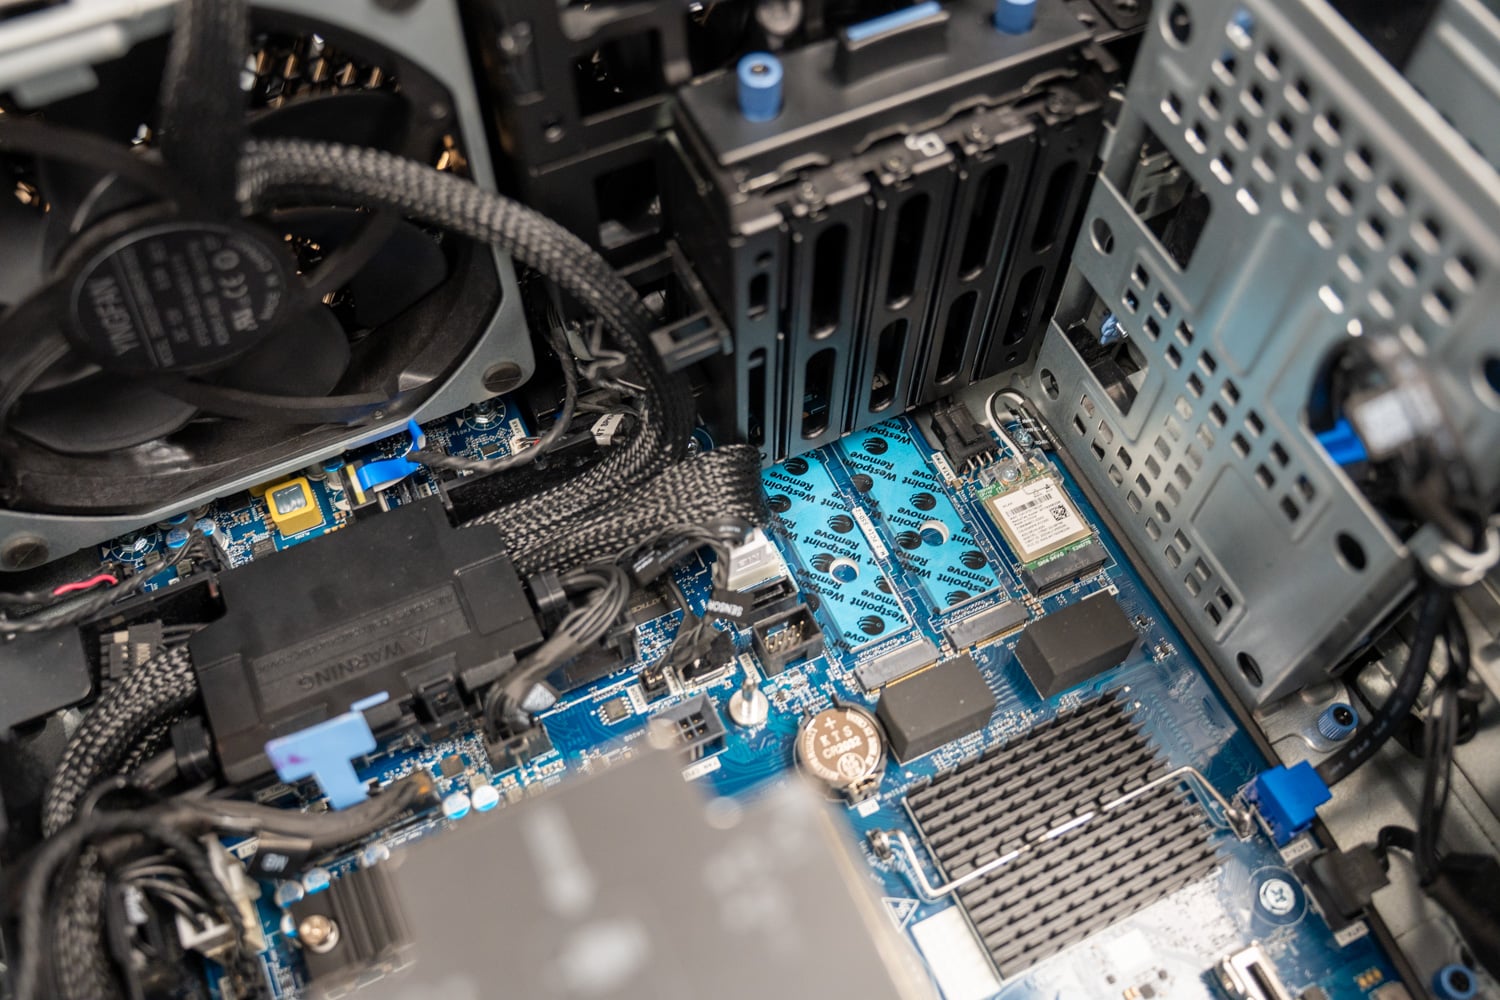
內部佈局與Pro Max塔式機箱相同:處理器和四個DIMM內存插槽位於擴展區域上方,Gen5 x16插槽中的GPU由一個固定支架支撐,電源安裝在機箱後部,並配有方便免工具拆卸的把手。五個插槽均為全高插槽:插槽2為Gen5 x16 GPU插槽,插槽1為Gen5 x4插槽,其餘三個為Gen4插槽,其中一個為x16插槽,兩個為開放式x8插槽,可用於安裝網路卡、記憶卡或第二塊GPU。三個內建M.2 2280 Gen5插槽和兩個3.5吋SATA硬碟位位於前置E3.S擴充槽的後方。
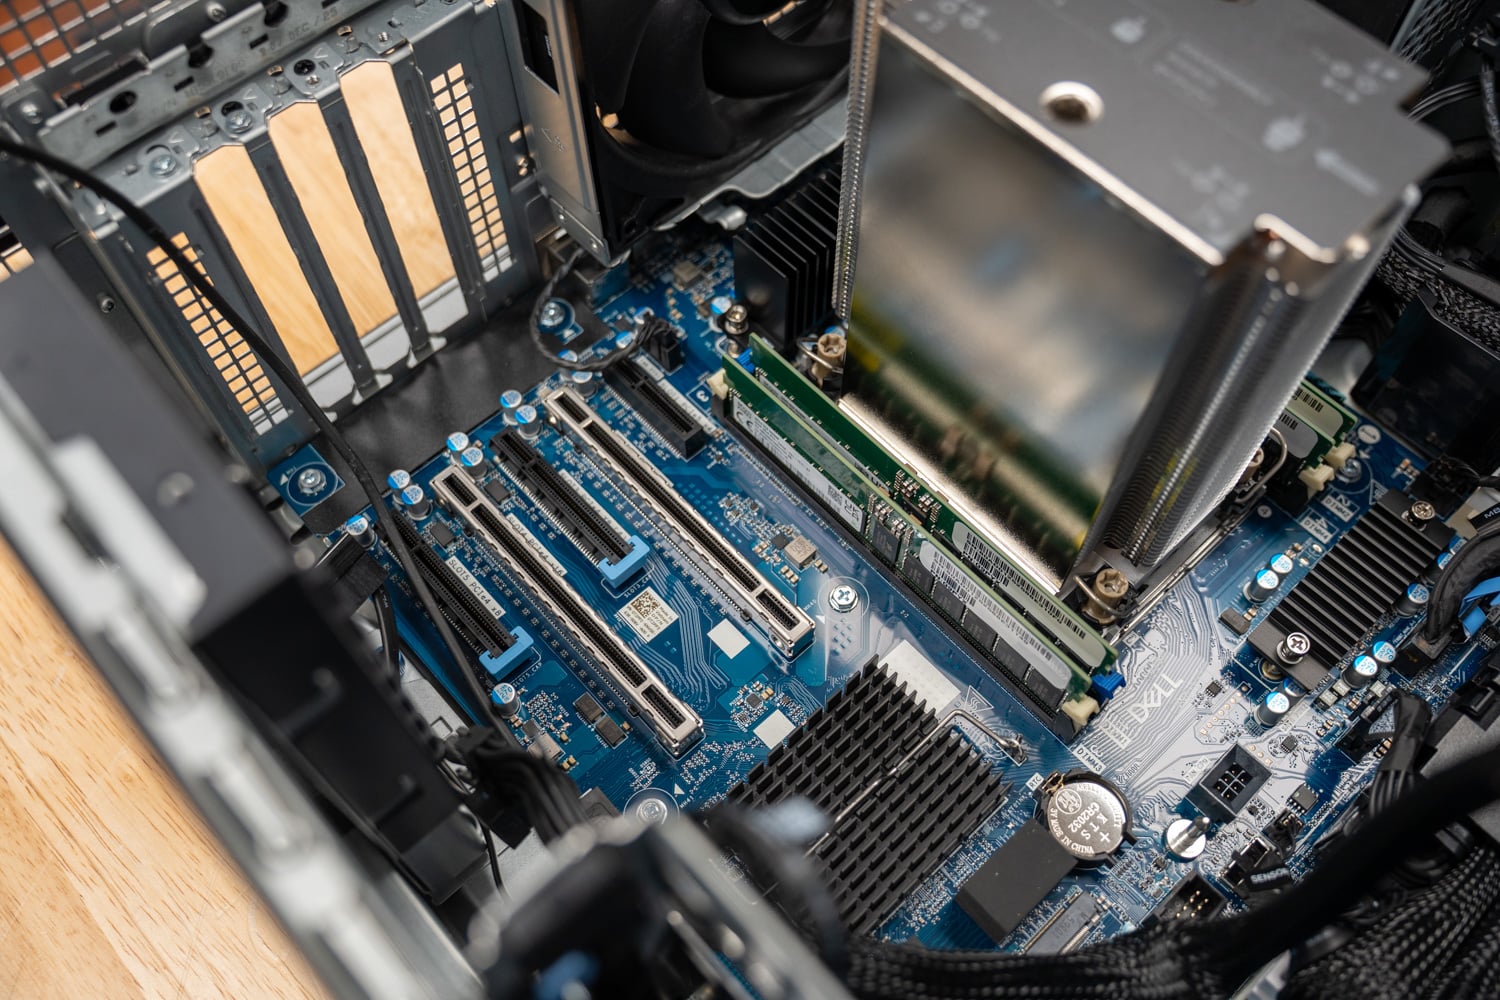
前置I/O接口包括一個耳機插孔、一個支援PowerShare的20Gbps USB-C接口、一個10Gbps USB-C接口、兩個USB-A接口以及一個可選的SD卡槽。後置接口包括音訊線路輸出、一個20Gbps和一個10Gbps USB-C接口、兩個支援SmartPower的USB 2.0接口、兩個5Gbps USB-A接口、一個千兆以太網接口、一個可選的模組插槽(可安裝5GbE網卡或兩個額外的USB-A接口)以及一個可選的傳統串口。我們評測的這台機器在內部M.2 2230插槽中加裝了聯發科MT7925 Wi-Fi 7網卡,並在其600W顯示卡上加裝了英特爾E810-XXV 25GbE網卡。

戴爾 Pro Precision 9 T2 規格
| 規格 | 戴爾 Pro Precision 9 T2 (PW9T2260) |
|---|---|
| 平台概述 | |
| 處理器選項 | 英特爾至強 634(12 核,150W)、636(12 核,170W)、638(16 核,180W)、654(18 核,200W)、656(20 核,210W)、658X 24 核/ 經測試的 Xeon 658X |
| 記憶體應用 | DDR5 RDIMM ECC,5600 或 6400 MT/s,四個插槽,最大支援 1TB (4 x 256GB) 經測試,記憶體容量為 128GB (4 x 32GB) DDR5-6400。 |
| 圖形選項 | NVIDIA RTX A400、A1000、RTX PRO 2000/4000/4500/5000/6000 Blackwell (600W)/6000 Blackwell Max-Q (300W)、A800 Active;AMD Radeon Pro W7400;部分設定卡支援雙路設定和部分設定卡支援雙路設定和部分設定卡支援 測試顯示卡:RTX PRO 6000 Blackwell Max-Q 工作站版,96GB GDDR7 |
| 儲存 | 前置 FlexBay:最多可安裝兩塊 E3.S / NVMe 硬碟,外加一個可選的超薄光碟機位,或一個 3.5 吋 SATA 硬碟位 內部:3 個 M.2 2280 Gen5 NVMe 插槽,2 個 3.5 吋 SATA 插槽 RAID:Intel VMD with VROC by Graid Technology(RAID 0 啟動,內部 RAID 0) 測試結果:2塊2TB E3.S Gen5 NVMe固態硬碟組成RAID 0陣列(4,097GB) |
| 擴展 | 插槽 1:Gen5 x4;插槽 2:Gen5 x16;插槽 3:Gen4 x8(x4 電氣規格,開放式);插槽 4:Gen4 x16;插槽 5:Gen4 x8(開放式);M.2 2230 Wi-Fi 插槽 |
| 的I / O | |
| 前端口 | 1 個支援 PowerShare 的 20Gbps USB-C 連接埠、1 個 10Gbps USB-C 連接埠、1 個支援 PowerShare 的 5Gbps USB-A 介面、1 個 5Gbps USB-A 介面、耳機插孔、選購 SD 卡槽 |
| 後端口 | 1 個 USB-C 20Gbps 介面、1 個 USB-C 10Gbps 介面、2 個 USB 2.0(支援 SmartPower)、2 個 USB-A 5Gbps 介面、音訊線路輸出介面、1 個 RJ45 千兆乙太網路介面、選購 5GbE 或 USB-A 模組、選購串口 |
| 網路測試 | 英特爾 E810-XXV DA2 雙埠 25GbE SFP28(為 600W GPU 運作已移除);聯發科 MT7925 Wi-Fi 7,藍牙 5.4 |
| 力量和體能 | |
| 電源 | 標準功率750瓦;可選功率500瓦或1500瓦;測試功率為1500瓦。 |
| 尺寸 | 387 x 187.7 x 438毫米(15.23 x 7.38 x 17.24英寸) |
| 重量 | 最小重量 11.6 公斤(25.57 磅),最大重量 21.8 公斤(48.06 磅) |
| 操作系統 | Windows 11 專業工作站版(經測試)或 Ubuntu Linux 24.04 LTS |
| 管理和安全 | 英特爾博銳技術、TPM 2.0、機殼入侵開關、可上鎖面板選項、Kensington 鎖槽 |
| 價格 | Dell.com 基本配置售價 3,978 美元(Xeon 634、16GB 記憶體、RTX A400 顯示卡、256GB 記憶體、750W 電源);測試配置售價約 28,300 美元(Xeon 658X、128GB DDR5-6400 記憶體、RTX1 60002 128GB DDR5-6400 記憶體、RTX1 60002 128GB 單元格 RA 0 陣列、1500W 電源供應器、25GbE 乙太網路、Wi-Fi 7),以上價格為戴爾官網 2026 年 10 月 19 日公佈的價格。 |
這個價格有兩個需要注意的地方。戴爾官網的配置器將FlexBay硬碟列為2TB M.2 2280 Gen5模組,單價1,700美元,而我們測試的這台機器配備的是E3.S硬碟。我們已經詢問戴爾,E3.S硬碟何時會在網路上架。戴爾也坦言,很少有商用工作站會以網路價格出售,所以28,300美元的價格應該被視為上限,批量購買和合約價格通常會低於這個上限。記憶體和顯示卡加起來就佔了19,090美元,而顯示卡的價格無論選擇300W還是600W的顯示卡都一樣。
戴爾將這款評樣機的測試價格定為 31,700 美元,該價格在我們定價的配置基礎上增加了 E810-XXV 25GbE 適配器、Wi-Fi 7、光碟機和三年 ProSupport 服務。
測試設定和方法
本次評測中的所有結果均來自我們編寫的 Windows 用戶端基準測試套件 sr-client 1.2,該套件使用戴爾出廠 Windows 鏡像、戴爾驅動程式以及 NVIDIA 驅動程式 596.71,並執行完整配置。所有四種配置均採用相同的設定:Windows 電源模式設定為“最佳效能”,所有睡眠和顯示器關閉計時器均已停用,Windows 防火牆和 UAC 提示已關閉,VBS 和記憶體完整性功能保持原廠預設值。每個結果均為多次執行的中位數,如果測試結果的偏差超過 2%,則該套件會重新執行測試才會接受該結果。
以下四種配置均為兩台主機及兩塊GPU。 Pro Precision 9 T2 使用其 Max-Q 顯示卡運行了全套測試,之後又使用我們 Pro Max Tower T2 中的 600W RTX PRO 6000 Blackwell 顯示卡再次運行測試。 Pro Max Tower T2 則依序運行了這兩個顯示卡,因此同一台主機內不同 GPU 列之間的差異僅在於顯示卡型號,而同一 GPU 下不同主機列之間的差異僅在於平台。 Core T2 的硬碟是其標配的單塊 2TB Gen5 M.2 固態硬碟,而 Xeon T2 的硬碟是其雙硬碟 E3.S 條帶,因此儲存和模型載入行比較的是它們各自的配置。
| 型號 | 中央處理器 | 記憶體應用 | GPU | 啟動磁碟 | 作業系統和電源模式 |
|---|---|---|---|---|---|
| 戴爾 Pro Precision 9 T2 (PW9T2260),Max-Q | 英特爾至強 658X,24 核/48 線程,250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q 工作站版,300W,96GB | 2 x 2TB E3.S Gen5 NVMe,VROC RAID0(4,097GB 啟動磁碟區) | Windows 11 專業工作站版 25H2,最佳效能 |
| 戴爾 Pro Precision 9 T2 (PW9T2260),600W | 英特爾至強 658X,24 核/48 線程,250W | 128GB DDR5-6400 RDIMM ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell 工作站版,600W,96GB | 2 x 2TB E3.S Gen5 NVMe,VROC RAID0(4,097GB 啟動磁碟區) | Windows 11 專業工作站版 25H2,最佳效能 |
| 戴爾 Pro Max Tower T2 (FCT2250),Max-Q | 英特爾酷睿Ultra 9 285K處理器,24核心/24線程,125瓦 | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q 工作站版,300W,96GB | SK海力士PCB01 2TB,第五代 x4 | Windows 11 專業版 26H2,最佳效能 |
| 戴爾 Pro Max Tower T2 (FCT2250),600W | 英特爾酷睿Ultra 9 285K處理器,24核心/24線程,125瓦 | 128GB DDR5-4400 ECC (4 x 32GB) | NVIDIA RTX PRO 6000 Blackwell 工作站版,600W,96GB | SK海力士PCB01 2TB,第五代 x4 | Windows 11 專業版 26H2,最佳效能 |
這裡首次展示了多項測試,首先是LLM服務測試,它運行llama-server,使用四個模型,並逐步增加並發請求數,從單個請求到GPU內存所能容納的最大請求數,並報告總吞吐量、單用戶吞吐量、首令牌到達時間以及每個輸出令牌的生成時間。影像產生測試使用FLUX.2 klein 4B、Z-Image Turbo 6B和Qwen-Image 20B三種模型,分別以Q4_0、Q8_0和BF16權重渲染1024×1024像素的影像,並使用PSNR和SSIM對量化後的輸出結果進行基準評分(以BF16為基準),從而評估保真度為基準度評分(以BF16和保真度評分為基準度評分),從而評估保真度(以BF16和保真度為基準評分),從而評估保真度(以BF16和保真度為基準評分),從而評估保真度(以BF16和保真度為基準評分)。編碼代理測試現在運行在Crush平台上,而用戶旁代理測試則採用了改進的方法,將瀏覽器基準測試限制在三個完整的運行週期內。
表格中反覆出現三個標籤,以「N/A」開頭,表示該測試不適用於該硬體:例如,285K 的 SMT 單核心測試(該處理器不具備 SMT 功能),以及 Xeon 的 OpenBLAS 頂級核心類別測試(該處理器擁有 24 個核心,屬於同一類別)。 「Partial」表示測試套件接受的結果,並附有說明,通常是指在編碼代理層級中,三次運行中有一次測試失敗。由於兩台桌上型電腦均未將 CPU 或 GPU 溫度暴露給測試套件的感測器,因此本次評測報告的是每次測試的平均 CPU 時脈頻率,而非溫度表。
本地人工智慧效能
所有配置均配備 96GB GDDR7 顯存,模型容量毋庸置疑,我們本地 AI 測試套件的每個層級都可以在所有四款顯示卡上運行。因此,測試結果會根據 GPU 功耗限製而出現差異:當測試受限於顯存頻寬時,Max-Q 顯示卡和 600W 顯示卡的效能相近;而當測試受限於運算能力時,600W 顯示卡則更勝一籌。 CPU 平台的影響通常很小,但即便有影響,其影響方向也值得關注。
MLPerf 用戶端 v2.0
MLPerf 用戶端運行 Llama 3.1 8B 和 Phi-4-mini,涵蓋五個提示類別,並報告首次令牌到達時間和之後的令牌產生率(以各類別幾何平均值表示),所有配置均使用基於 CUDA 的 llama.cpp 作為引擎。代理場景運行 Llama 3.1 8B,分別作為數據分析代理和軟體工程代理,在多個回合中調用工具。

| MLPerf 用戶端 v2.0 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Llama 3.1 8B,首次到達令牌的時間,幾何平均值(秒,越低越好) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B,令牌速率,幾何平均值(令牌/秒) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini,首次令牌到達時間,幾何平均值(秒,越低越好) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini,代幣率,幾何平均值(代幣/秒) | 345.9 | 379.0 | 351.0 | 374.3 |
| 數據分析代理,端到端(s,數值越低越好) | 17.5 | 15.7 | 16.2 | 14.4 |
| 數據分析代理,代幣速率(tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWE Agent,端對端(s,數值越低越好) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWE 代理,代幣速率(tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
Max-Q顯示卡在Xeon塔式機上運行Llama 3.1 8B測試,每秒生成230.9個令牌,在Core塔式機上運行230.0個令牌;在Phi-4-mini測試中,每秒產生345.9個令牌,在Core塔式機上執行351.0個令牌,兩者的任務使用相同的。 600W顯示卡在Xeon塔式機上將每秒生成令牌的數量分別提升至252.8個和379.0個,提升約9%;同時,Llama測試中第一個令牌的生成時間從0.082秒縮短至0.059秒,縮短了28%。由於快速處理受運算能力限制,解碼受頻寬限制,且兩張顯示卡共享相同顯存,因此功耗限制在第一個令牌的生成時間上比在後續令牌的產生時間上更為明顯。
在代理場景中,CPU平台的優勢得以體現。資料分析代理程式在配備Max-Q顯示卡的Core T2上耗時16.2秒,在Xeon T2上耗時17.5秒;軟體工程師代理程式的耗時分別為14.6秒和16.2秒,其中Xeon的工具呼叫階段分別比Core T2慢約1.5秒。兩者的令牌生成率相差不到1%,因此差異在於模型呼叫之間CPU上運行的工具,285K的更快核心能夠更快完成這些任務。
模型加載
此測試使用 Ollama 對本地模型進行計時,從硬碟讀取到產生第一個令牌,分別在冷態(檔案快取已清空)和熱態(檔案已在記憶體中)下進行。測試結果會報告冷態載入期間的硬碟讀取速度、權重到達 GPU 記憶體的時間,以及負載效率指標,該指標將負載期間的讀取速度與硬碟 1MB 的順序讀取上限進行比較。在 96GB 顯存的情況下,所有三個層級的磁碟都運作:gpt-oss:20b 佔用 12.8GB,Qwen3.6-35B-A3B 佔用 21.1GB,gpt-oss:120b 佔用 60.9GB。

| 模型載入(記憶體映射開啟) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| gpt-oss:20b,冷加載到第一個標記(s,數值越小越好) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b,熱加載到第一個標記(s,數值越小越好) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b,到達 GPU 內存,冷啟動(s,數值越低越好) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B,冷加載到第一個令牌(s,數值越小越好) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B,熱加載到第一個令牌(s,數值越小越好) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b,冷加載到第一個標記(s,數值越小越好) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b,熱加載到第一個標記(s,數值越小越好) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b,冷載期間的讀取吞吐量(MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b,到達 GPU 內存,冷啟動(s,數值越低越好) | 11.33 | 11.57 | 7.74 | 7.63 |
| 從 gpt-oss:20b 交換後載入 gpt-oss:120b(s,數值越低越好) | 14.30 | 13.97 | 11.89 | 11.93 |
| 磁碟機容量上限,磁碟速度 1MB 順序讀取 (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
Core T2 在所有模型的載入速度上都更快,這主要歸功於其硬碟。 gpt-oss:120b 在 Core T2 上冷啟動僅需 28.54 秒即可完成首次資料寫入,而 Xeon T2 則需要 32.06 秒;61GB 的權重資料到達 GPU 記憶體也僅需 7.74 秒,而 Xeon T2 則需要 11.33 秒。單塊 PCB01 的讀寫速度達到了 11,633MB/s,接近其 11,563MB/s 的 DiskSpd 上限;而 E3.S 條帶的讀寫速度為 9,875MB/s,接近其自身 11,306MB/s 的上限。 RAID 磁碟區讀取大塊資料的速度幾乎與單一硬碟一樣快,但在 Ollama 的記憶體對映載入路徑下無法保持如此高的速度。
熱載入會將差距縮小到一兩秒,因為檔案已經載入到系統記憶體中,剩下的只是傳送到顯存以及 llama.cpp 的設定:在 Xeon T2 上,gpt-oss:120b 的載入時間為 27.18 秒,而 Xeon T2 為 25.58 秒;在載入時間為 7.18 秒,而 Xeon T2 為 25.58 秒; 6.60 秒。正如預期的那樣,GPU 的功耗限制對載入時間沒有明顯影響。
編碼代理
Crush 是一個終端編碼代理,它驅動由 Ollama 服務的本地模型完成一個固定代碼庫中的編碼任務,最多需要三輪才能通過代碼庫中的 11 個測試;我們報告了三次運行的平均耗時、成功次數以及生成率。耗時取決於模型決定使用的工具呼叫次數和令牌數量,而這些數量每次運行都會有所不同,因此生成率是更清晰的硬體比較指標。用戶旁代理測試同時運行代理程式和 Speedometer,並報告它們彼此之間的速度影響。

| 粉碎編碼代理 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| S 級,gpt-oss:20b,64K 上下文 | ||||
| 牆面停留時間,中位數(秒,數值越低越好) | 55.1 | 99.8 | 57.2 | 43.2 |
| 成功次數(共 3 次) | 3 | 2 | 3 | 2 |
| 生成速率(tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| M級,Qwen3.6-35B-A3B,64K上下文 | ||||
| 牆面停留時間,中位數(秒,數值越低越好) | 35.2 | 27.0 | 86.7 | 32.1 |
| 成功次數(共 3 次) | 3 | 3 | 3 | 3 |
| 生成速率(tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| L級,Qwen3.6-35B-A3B,128K上下文 | ||||
| 牆面停留時間,中位數(秒,數值越低越好) | 38.1 | 30.6 | 74.1 | 58.8 |
| 成功次數(共 3 次) | 3 | 3 | 3 | 3 |
| 生成速率(tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Tier W,gpt-oss:120b,128K 上下文 | ||||
| 牆面停留時間,中位數(秒,數值越低越好) | 49.1 | 37.9 | 56.6 | 30.8 |
| 成功次數(共 3 次) | 3 | 3 | 3 | 3 |
| 生成速率(tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| 用戶旁邊的代理商(gpt-oss:20b 和 Speedometer 一起) | ||||
| 代理人旁邊的速度表(分數) | 36.6 | 36.7 | 43.2 | 45.2 |
| 速度表減速(x,數值越低越好) | 1.005 | 1.011 | 1.053 | 1.044 |
| 除了速度表之外的代理程式生成速率(tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| 代理減速(x,數值越低越好) | 1.006 | 1.009 | 1.023 | 0.998 |
所有配置均使用 gpt-oss:120b(套件中最大的模型)完成了 W 層任務的全部三次運行,在 Xeon 塔式機上每秒生成 160.9 至 177.1 個令牌,在 Core 塔式機上每秒生成 158.5 至 174.4 個令牌,其中 600W 顯示卡在兩種配置下已提升了 10% 的 10%。 Qwen3.6 任務在所有配置下也全部通過,每秒產生 223 至 253 個令牌。 gpt-oss:20b 模型表現不佳:在四種配置中的兩種配置下,其 S 層任務在三次運行中均失敗一次,其 128K 上下文的 M 層任務(未顯示)在所有配置下均至少失敗一次,這種模型行為不受硬體影響。
在配備獨立顯示卡和 24 個空閒核心的塔式機上同時執行代理程式和瀏覽器基準測試幾乎不消耗任何資源。運行代理程式後,Xeon T2 的 Speedometer 速度降低了 1.005 倍,Core T2 降低了 1.053 倍,而代理程式的產生速率在所有情況下都變化不到 2%。 Xeon T2 在運行代理程式的同時,其 Speedometer 得分為 36.6,低於 Core T2 的 43.2,原因與它單獨運行代理程式時得分較低的原因相同:285K 的單核速度較低。
檢索增強生成
我們的 RAG 測驗使用 nomic-embed-text 嵌入了 20,963 段 SQuAD v1.1 文本,針對 2,000 個問題分別提取出前五段文本,並使用 Phi-4-mini 對其中 400 段文本進行解答,計算其與參考答案的完全匹配度和 F1 值。由於模型規模較小,因此該測試能夠評估整個流程,包括 GPU 階段之間的 CPU 端向量搜尋。

| 抹布 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 攝取牆壁時間,20,963 次(秒,越低越好) | 128.5 | 125.5 | 108.1 | 103.0 |
| 嵌入率(tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| 檢索查詢時間,p50(毫秒,數值越低越好) | 30.6 | 27.2 | 23.4 | 18.7 |
| 答案,Phi-4-mini 首次令牌到達時間,p50(秒,越低越好) | 0.099 | 0.087 | 0.089 | 0.083 |
| 回答,快速處理(tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| 答案,生成速率(tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| 問題回答,p50(s,越低越好) | 0.152 | 0.133 | 0.130 | 0.120 |
| 召回率@5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| 答案 F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
在這一流程中,Core T2 的速度更快。它攝取語料庫僅需 108.1 秒,而配備相同 Max-Q 顯示卡的 Xeon T2 則需要 128.5 秒;檢索時間中位數為 23.4 毫秒,而 Xeon T2 為 30.6 毫秒;回答問題僅需 0.130 秒,而 Xeon T2 為 0.15 毫秒;回答問題僅需 0.130 秒,而 Xeon T2 為 0.152 秒。嵌入和檢索都存在 CPU 密集階段,而 285K 在這些階段表現更佳。這款 600W 顯示卡讓兩個平台上的提示處理速度都提升了 25% 到 30%,Xeon T2 的提示處理速度從每秒 20,318 個字元提升至每秒 26,549 個字元。所有四種配置的準確率都相同,這與相同模型在 0 溫度下的預期結果一致。
法學碩士在職
服務測試使用 llama-server 運行 Ministral 3 3B 和 8B(4,096 個提示符,1,024 個輸出符)、Qwen3.8 27B 以及 gpt-oss 120B(8,192 個提示符),在權重計算後,分配盡可能多的上限位以適應 GPU 上限,然後達到記憶體數字。我們報告總吞吐量(提示符和輸出符的總和)、輸出吞吐量、首次獲取符的時間以及每個輸出符的耗時(取中位數)。在 96GB 的顯示卡上,gpt-oss 120B 佔用 64 個插槽,並配備 22.5GiB 的鍵值快取;Qwen3.8 27B 佔用 8 個插槽;而兩個 Ministral 模型在其各自的上下文中佔用 4 個插槽位元。

| llama-server,gpt-oss 120B,8,192 個令牌提示符,1,024 個令牌輸出 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 1. 並發:輸出吞吐量(tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 個同時使用者:首次到達令牌的時間,中位數(毫秒,數值越低越好) | 1,241 | 918 | 1,238 | 923 |
| 1 個同時:每個輸出令牌的耗時,中位數(毫秒,數值越低越好) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 個並發:總吞吐量(tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 個並髮用戶:每個用戶的輸出(tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 個同時使用者:首次到達令牌的時間,中位數(毫秒,數值越低越好) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 個並發:總吞吐量(tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 個並髮用戶:每個用戶的輸出(tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 個同時使用者:首次到達令牌的時間,中位數(毫秒,數值越低越好) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 個同時:每個輸出令牌的耗時,中位數(毫秒,數值越低越好) | 163.0 | 141.3 | 152.7 | 126.3 |
單一使用者在 Max-Q 卡上以每秒 160.6 個令牌的速度獲取 gpt-oss 120B 數據,在 600W 卡上則為每秒 182.7 個令牌,第一個令牌在 8,192 個令牌的提示符後分別耗時 1,241 毫秒和 918 毫秒。在 Max-Q 卡上載入 64 個同時請求後,總吞吐量提升至每秒 3,296 個令牌,在 600W 卡上提升至每秒 3,805 個令牌,但代價是每個使用者每秒分別損失 5.7 個令牌和 6.6 個令牌,第一個令牌的到達時間分別延長至 4.3 秒和 3.5 秒。並發請求數在 4 到 32 個之間趨於平緩,並在 64 個並發請求時再次躍升,此時批量處理最終抵消了較長的提示符時間。

| llama-server,在滿足最高並發要求的情況下輸出吞吐量(tok/s) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Ministral 3 3B 推理,4 並發 | 562.5 | 600.4 | 576.8 | 625.3 |
| Ministral 3 8B 推理,4 並發 | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B,8 個併發 | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B,64 個並發進程 | 366.3 | 422.8 | 392.3 | 468.9 |
| 單次請求輸出吞吐量(tok/s) | ||||
| 部長3 3B 推理 | 232.1 | 241.8 | 232.1 | 246.0 |
| 部長3 8B 推理 | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
在Max-Q平台上,對於單一使用者而言,高密度Qwen3.8 27B模型速度最慢,每秒僅能處理54.0個令牌,因為每個令牌都會存取全部270億個參數。而混合專家模型gpt-oss 120B雖然磁碟佔用空間是前者的四倍,但運行速度卻快了3倍。 600W顯示卡的優勢在高密度模型上最為顯著,在8個並發請求的情況下領先24%,而在Ministral 3B模型上優勢最小,約為7%。除了64個請求的gpt-oss場景外,兩款顯示卡在其他所有場景下的效能差距都在3%左右。在gpt-oss場景下,無論使用哪款顯示卡,Core T2都領先7%到11%,因此伺服器在該批次大小下的CPU端工作更傾向於速度更快的核心。
影像產生
影像產生測試使用三種擴散模型和三種權重精度渲染 1024×1024 的影像,並報告每個影像的渲染時間、去噪率以及權重佔用的 GPU 記憶體。此外,該測試還使用相同的種子在 BF16 精度下渲染影像,並使用 PSNR 和 SSIM 對 Q4_0 和 Q8_0 的輸出結果進行評分,從而量化量化對影像品質的影響。

| 影像生成,1024×1024 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| FLUX.2 klein 4B,4 步 | ||||
| Q8_0:每張影像的耗時(越低越好) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0:每分鐘影像數 | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16:每張影像的耗時(越低越好) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B,8 步 | ||||
| Q8_0:每張影像的耗時(越低越好) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0:每分鐘影像數 | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16:每張影像的耗時(越低越好) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B,20 步 | ||||
| Q4_0:每張影像的耗時(越低越好) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0:每張影像的耗時(越低越好) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16:每張影像的耗時(越低越好) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0:每分鐘影像數 | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16:權重的GPU記憶體(GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
擴散運算受運算能力限制,600W 顯示卡充分證明了這一點:在 Max-Q 伺服器上,Qwen-Image 20B 在 Q8_0 模式下每張影像的處理時間為 26.1 秒,而在 Xeon 塔式機上的 600W 映像卡上則為 19.7 秒則為 33% 提升了速度; 32%,FLUX.2 klein 的速度提升了 21%。 CPU 平台在這裡無關緊要,除了伺服器啟動之外,兩台塔式機在每項的效能指標上都相差不到 1%;在伺服器啟動時,Xeon T2 的 RAID 磁碟區載入權重需要幾秒鐘的時間。
| 與 BF16(相同種子)相比的量化保真度 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| PSNR(dB,越高越好)/ SSIM(越高越好) | ||||
| FLUX.2 klein 4B,Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 klein 4B,Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B,Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B,Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Image 20B,Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Image 20B,Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
由於輸出取決於權重而非硬件,因此四個配置的保真度行完全相同。 Q8_0 能夠以 0.938 至 0.987 的 SSIM 值和 28 至 36 dB 的 PSNR 值重現 BF16 影像,而 Q4_0 的 SSIM 值降至 0.75 至 0.79,PSNR 值降至 18 至 22 dB,情況截然不同。在 96GB 的記憶卡上,沒有理由運行低於 Q8_0 的模型;Qwen-Image 的 BF16 權重大小為 45.3GiB,並且在所有三個模型上渲染 BF16 的速度都與 Q8_0 相當或略快,因為 Q8_0 路徑需要花費時間進行反量化。
CPU性能
這兩款處理器在我們的CPU測試套件中呈現出涇渭分明的分界線。在需要使用所有核心的測試中,Xeon 658X 在大多數測試中都領先27%到150%,而且向量範圍越廣、記憶體流量越大,其優勢就越明顯。而在僅使用一個或幾個線程的測試中,Core Ultra 9 285K 憑藉其5.7GHz的P核心,相對於擁有更高緩存和內存延遲的4.9GHz Xeon核心,領先13%到31%。 600W GPU對Xeon全核心效能的影響在每個表格中都有體現,並在時脈頻率部分進行了總結。
Cinebench 2026 和持續負載
Cinebench 2026 使用 Maxon 的 Redshift 引擎在 CPU 上渲染場景,並分別測試單核心、SMT 單核心(一個實體核心上執行兩個執行緒)和多核心的吞吐量。隨後,我們進行一個持續循環測試,重複多核心運行約 30 分鐘,並將穩定狀態與第一次運行進行比較。

| Cinebench 2026(分數越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 單核 | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT單核 | 599.1 | 601.0 | 不適用(無SMT) | 不適用(無SMT) |
| 多核心 | 12,322 | 11,705 | 8,856 | 8,838 |
| 持續循環,第一次 | 12,201 | 11,731 | 8,717 | 8,788 |
| 持續循環,穩態 | 12,328 | 11,764 | 8,825 | 8,844 |
| 穩態/首次通過 | 1.010 | 1.003 | 1.012 | 1.006 |
| 持續循環,穩態 CPU 時脈頻率(MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
安裝 Max-Q 顯示卡後,658X 的多核心跑分達到 12,322 分,比 285K 的 8,856 分高出 39%,並在 30 分鐘的循環測試中保持 12,328 分的穩定成績,比第一次測試高出 1%。單核跑分的情況則相反:285K 的得分為 564.4 分,而 Xeon 的得分為 454.1 分;Xeon 的單核雙線程跑分達到 599.1 分,才超過了 285K 的單線程跑分。
換上 600W 顯示卡後,Xeon 的多核心跑分降至 11,705,穩態跑分降至 11,764,下降了 5%,穩態頻率也從 4,274MHz 降至 4,178MHz。 Core T2 的跑分和穩態頻率則沒有變化,分別為 8,856 和 8,838。由於測試套件沒有記錄兩台主機上的 CPU 或 GPU 溫度,我們無法判斷 250W 處理器的性能下降是由於 600W 顯示卡的散熱問題,還是由於兩者共享電源預算,我們只能確定,在機箱中使用更大功率的顯卡後,其在所有全核測試中的性能都下降了 4% 到 5%。
7-ZIP
7-Zip 內建的基準測試報告 LZMA 壓縮和解壓縮的吞吐量,單位為每秒千兆指令數 (GSI/s),分別在每個執行緒上測試一次,以及在單一核心上測試一次。 LZMA 依賴整數吞吐量、分支預測以及快取和記憶體延遲,因此它更重視核心數量和快速記憶體路徑,而不是向量寬度。

| 7-Zip(GIPS,數值越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 所有貼文 | ||||
| 總額 | 289.6 | 288.9 | 174.8 | 175.7 |
| 壓縮 | 276.4 | 273.5 | 151.5 | 151.9 |
| 解壓縮 | 303.0 | 304.4 | 198.1 | 199.4 |
| 一條線 | ||||
| 總額 | 8.74 | 8.05 | 10.82 | 10.83 |
| 壓縮 | 8.66 | 7.80 | 9.31 | 9.31 |
| 解壓縮 | 8.83 | 8.30 | 12.33 | 12.34 |
在 48 個執行緒的情況下,Xeon 的 GIPS 為 289.6,而 285K 在 24 個執行緒的情況下為 174.8,領先 66%,壓縮效能領先 82%,解壓縮效能領先 53%。在單執行緒情況下,285K 的 GIPS 為 10.82,而 Xeon 為 8.74。當 Xeon 塔式機配備 600W 顯示卡時,差距進一步擴大到 8.05,這與該配置的較低時脈頻率相符。
Blender、HandBrake 和 LLVM
Blender 4.5 使用 Cycles 渲染器在 CPU 上渲染 Monster、Junkshop 和 Classroom 場景。 HandBrake 使用 x265(HEVC,中等預設,品質 22)和 SVT-AV1(預設 8,品質 30)對 60 秒的 4K60 視訊片段進行軟體編碼。 LLVM 測試使用 Clang 和 Ninja 編譯完整的 LLVM 21.1.4 程式碼樹,這是測試套件中最耗時的全核心工作負載。

| 測試 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Blender 4.5 Monster(採樣/分鐘,越高越好) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop(樣本/分鐘) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 課堂(樣本/分鐘) | 187.2 | 169.2 | 132.5 | 132.3 |
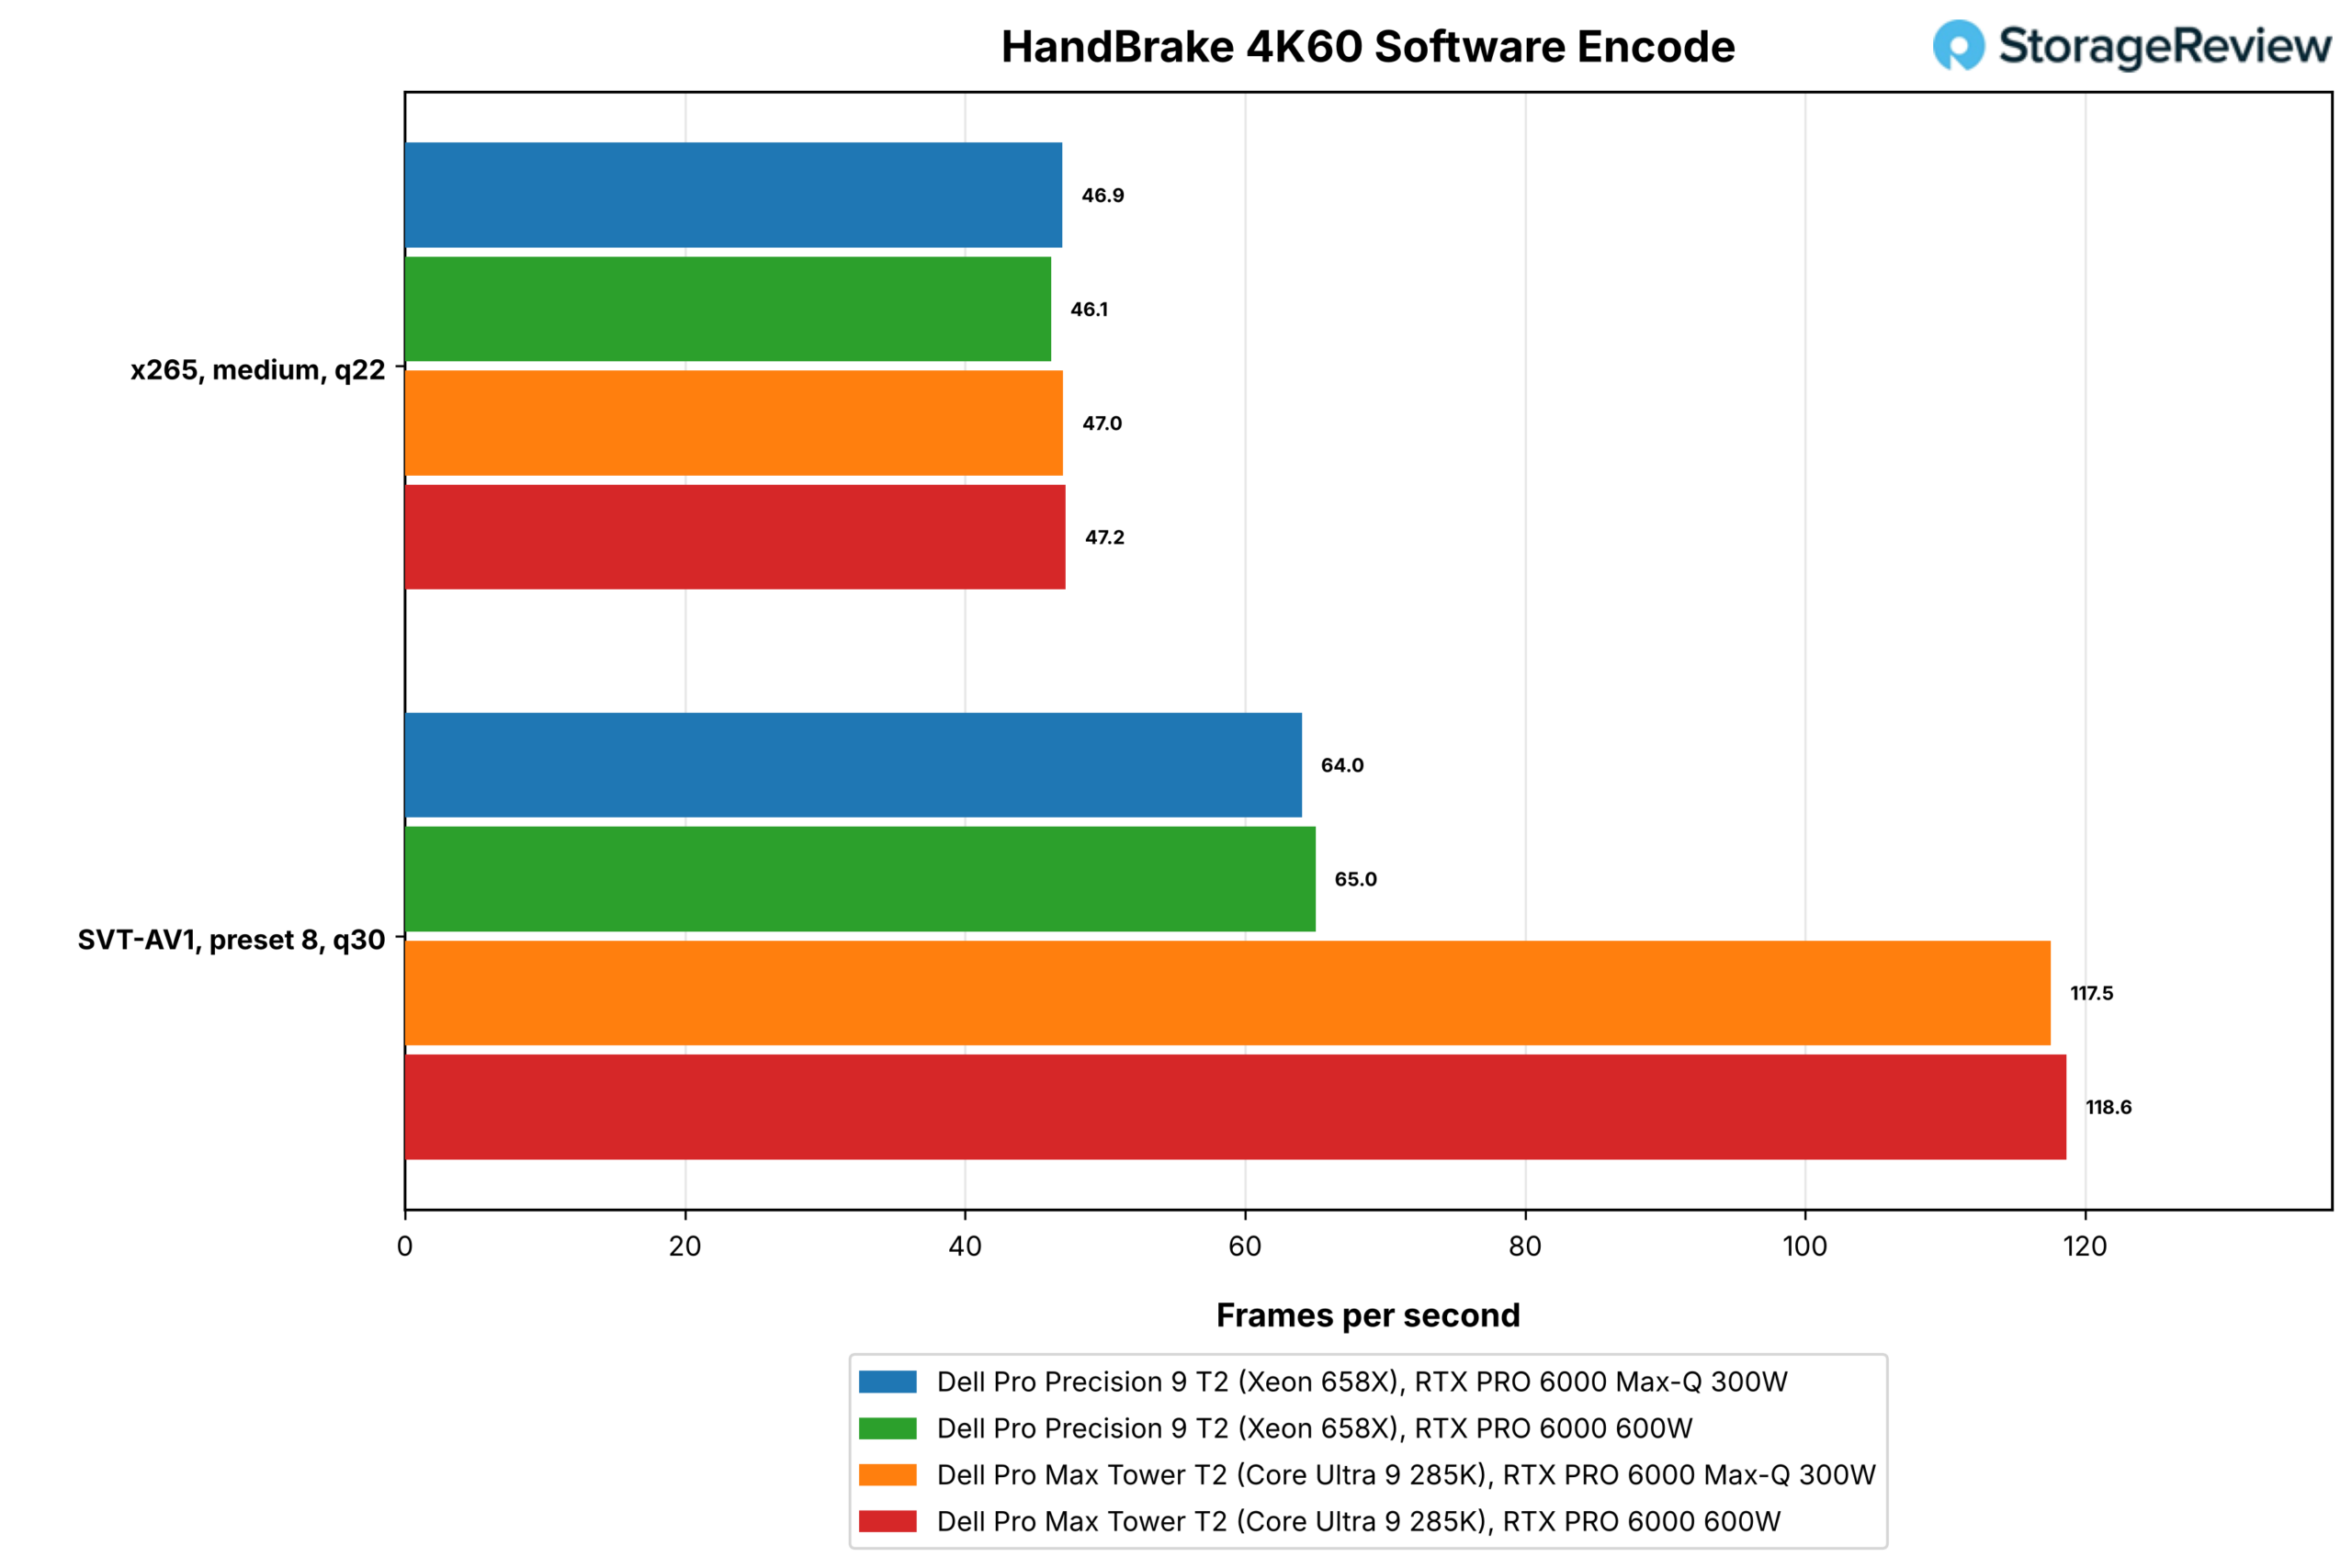
| HandBrake x265,中等畫質,q22(幀率越高越好) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1,預設 8,q30(幀/秒) | 64.0 | 65.0 | 117.5 | 118.6 |
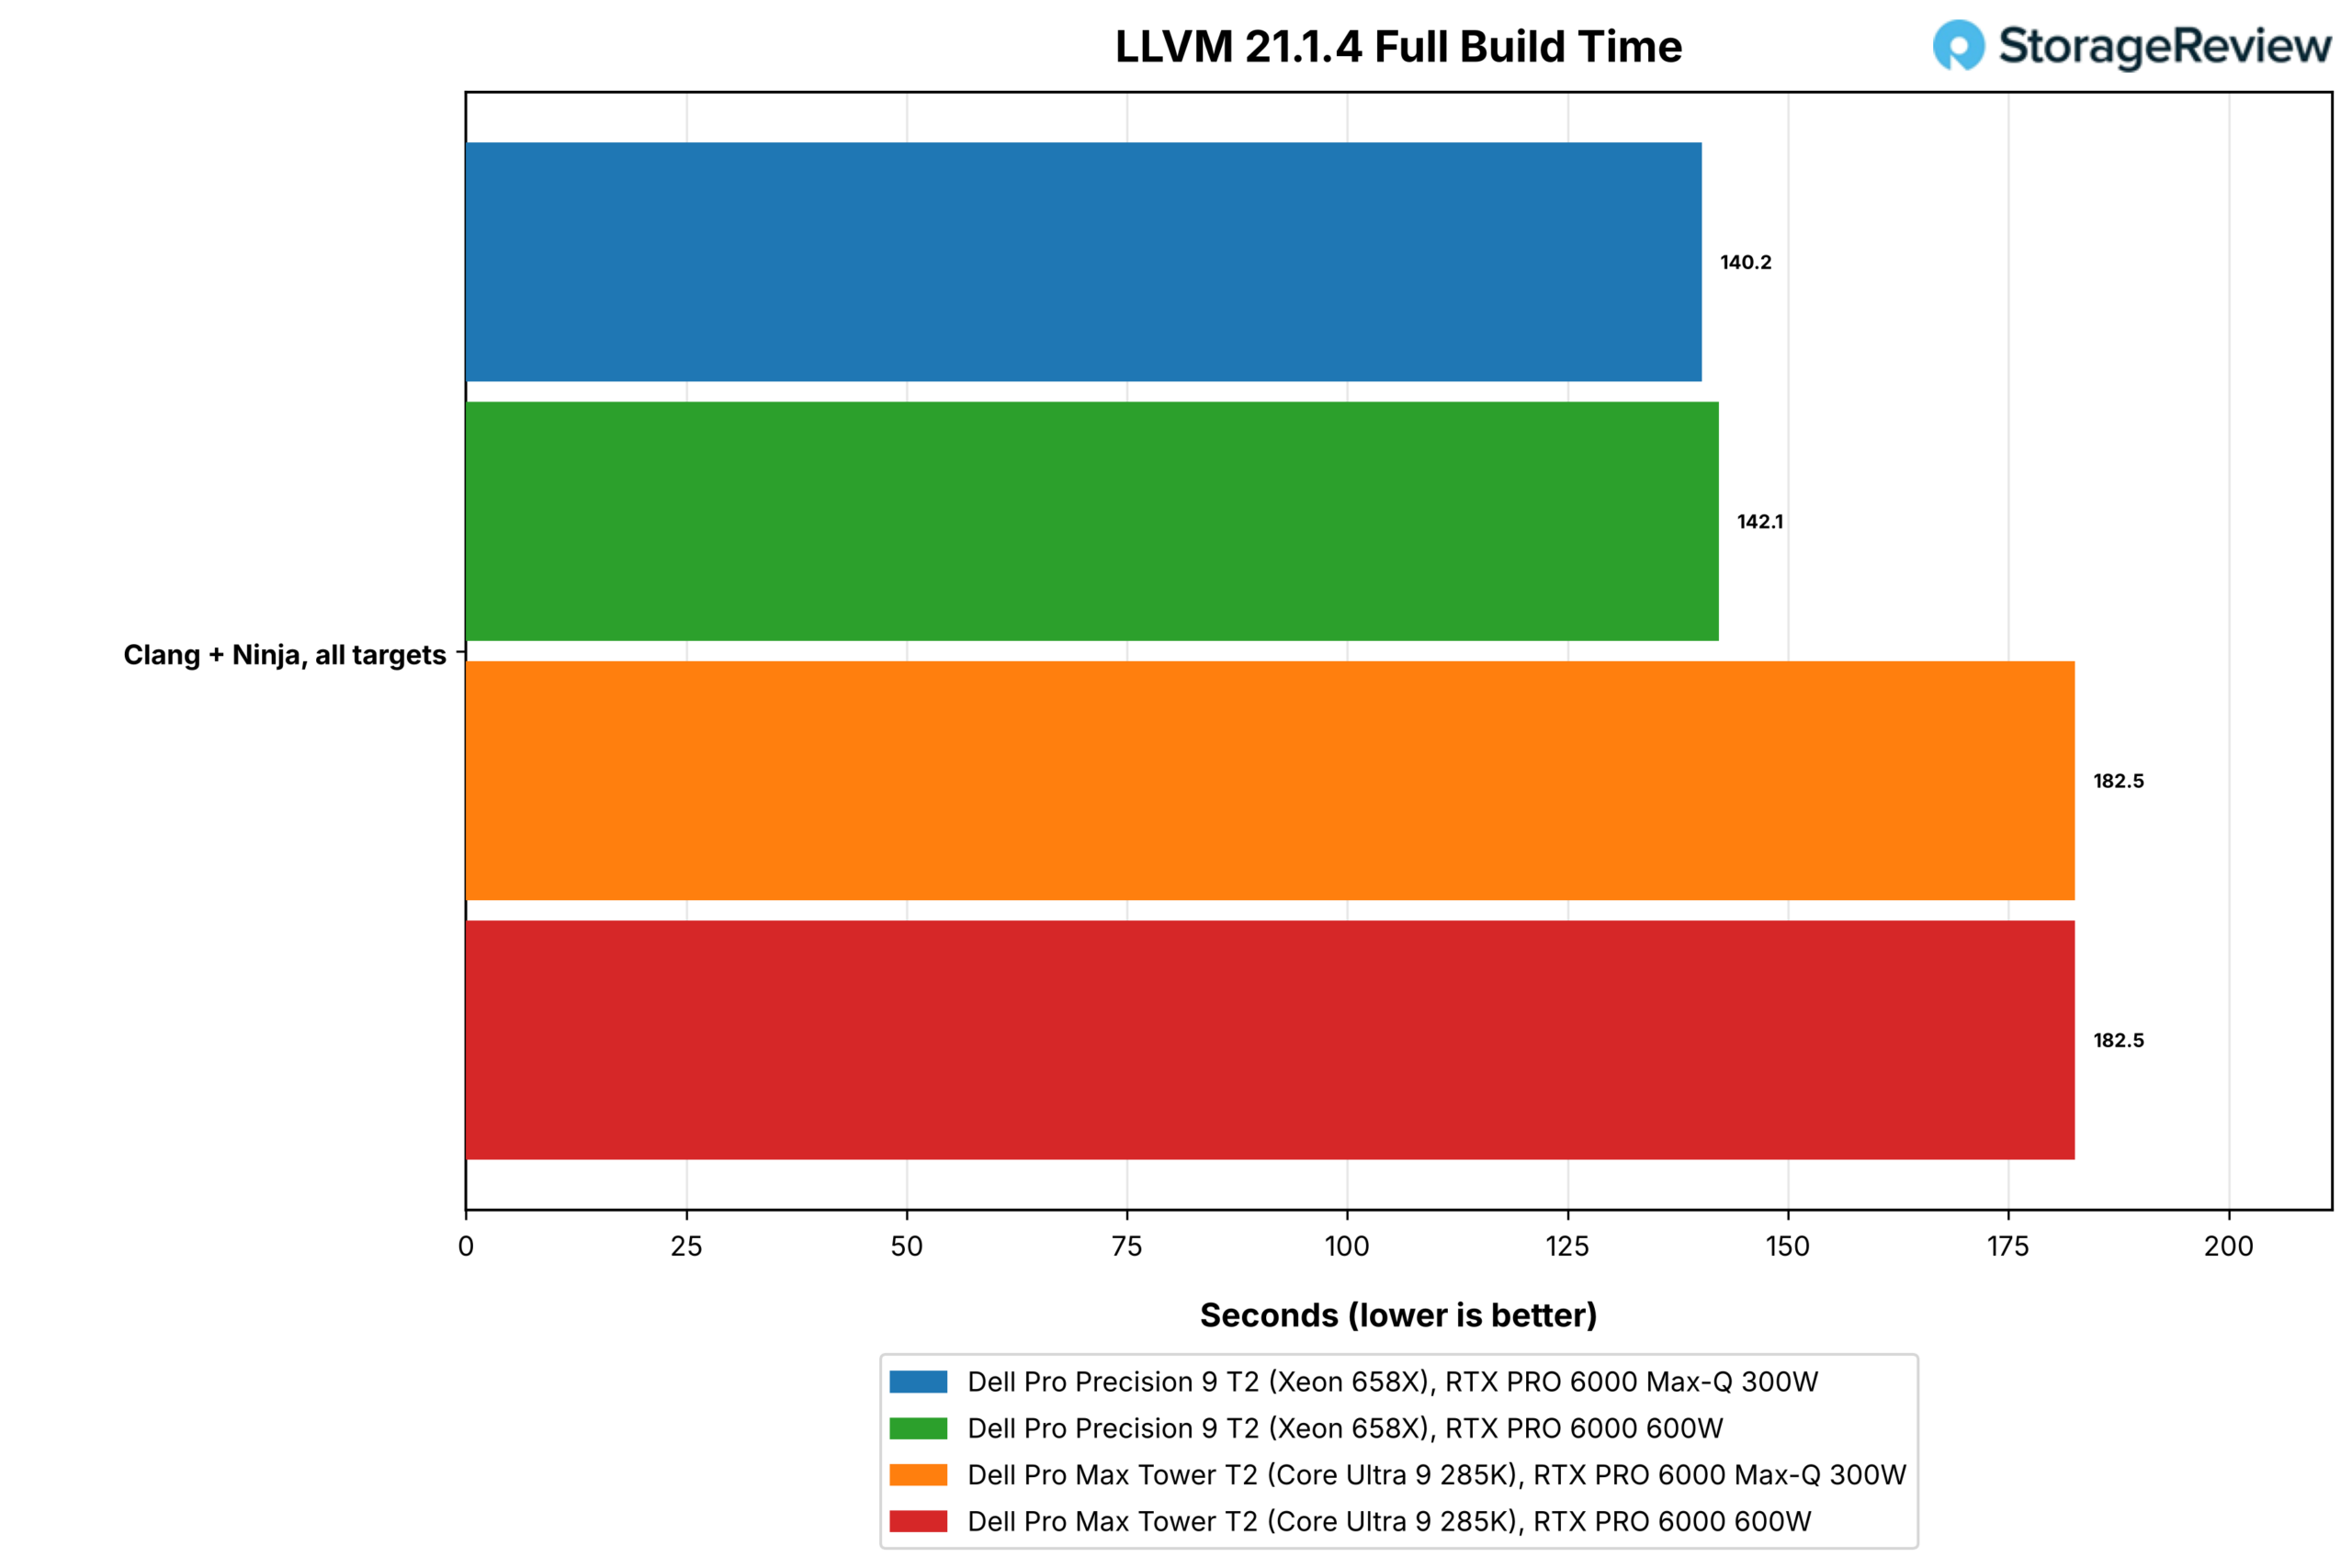
| LLVM 21.1.4 版本(版本編號越低越好) | 140.2 | 142.1 | 182.5 | 182.5 |
在渲染 Monster 模型時,Xeon 處理器每分鐘採樣數達到 366.2,而 285K 處理器僅為 259.6,領先 41%,且在所有三個場景中差距均在兩個百分點以內。此外,Xeon 處理器建置 LLVM 僅需 140.2 秒,而 285K 處理器則需要 182.5 秒,Xeon 處理器因此節省了 23% 的時間。然而,在安裝 600W 顯示卡後,Xeon 處理器的 Blender 得分下降了 7% 到 10%,這是該顯示卡在所有 CPU 測試套件中造成的最高損失。
HandBrake 依編碼器線路劃分:x265 在中等預設下,Xeon 的運行幀率為 46.9 fps,285K 的運行幀率為 47.0 fps,兩者持平;而 SVT-AV1 在預設 8 下,Xeon 的運行幀率為 64.0 fps,而 285K 的運行幀率 fps。
我們花了一個下午研究這個問題,結果是逐線程計算得出的。在這個預設設定下,編碼器的並行度最高達到 6 級,在 Xeon 處理器上大約佔用了九個邏輯處理器的資源;強制使用 AVX2 核心代替 AVX-512 核心並沒有改變幀率(幀率從 63.9 fps 提升到 63.8 fps),而將每個實體核心的執行數限制在 2% 12%),而將每個物理數位和 2% 12%(p 2%),而將每個物理數 2% 1.7% 12%),而將每個物理數為 2%),反而降低了數個物理數 2% 12%(p 2%),而將每個物理數 2% 12%(p 2%),而將每個物理數 2% 12%(p 2%),反而將每個物理數 2% 12% 12%(p 2%)降至 2%),而將每個物理數為 2%(p 2%),而將每個物理數為 2%),反而降低了 2% 1. SMT 調度都不是問題所在。剩下的問題在於 Xeon 核心本身以及核心之間的網路拓撲結構,管線編碼器在每一幀中都會感受到這種拓撲結構的影響,因為它需要等待不同階段之間的交接。
Stockfish、primesieve、Python 和瀏覽器
Stockfish 內建的基準測試工具以每秒百萬個節點為單位報告國際象棋搜尋速度。 primesieve 統計所有執行緒上小於 10^12 的質數,以及單一執行緒上小於 10^11 的質數。 PyPerformance 執行三個 CPython 基準測試(go、nbody 和 regex_compile),並綁定到一個高效能核心上。 Speedometer 3.1 則用於測量 Microsoft Edge 瀏覽器中 Web 應用程式的回應速度。
| 測試 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Stockfish 基準測試,所有執行緒(Mnps,數值越高越好) | 40.87 | 39.17 | 30.10 | 30.63 |
| Stockfish 工作台,單線程(Mnps,數值越高越好) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12,所有線程(s,越低越好) | 7.69 | 7.51 | 6.77 | 6.84 |
| primesieve 1e11,單線程(s,越低越好) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance 的值為(毫秒,數值越低越好) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody(毫秒,數值越低越好) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance 正規表示式編譯(毫秒,數值越低越好) | 88.6 | 90.5 | 61.1 | 61.2 |
| Speedometer 3.1,Edge(評分,越高越好) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish 在 48 執行緒測試中,Xeon 處理器的 Mnps 為 40.87,而 285K 處理器為 30.10。在單執行緒測試中,285K 處理器以 1.99 秒的成績領先 Xeon 處理器的 1.65 秒。在所有執行緒測試中,primesieve 是 285K 處理器唯一勝出的,耗時 6.77 秒,而 Xeon 處理器為 7.69 秒。這是因為 primesieve 的篩選方法可以放入緩存,並且其性能隨時鐘頻率和核心數的增加而提升。所有單執行緒測試中,285K 處理器都領先 13% 到 31%:PyPerformance 測試耗時 64.8 毫秒,而 Xeon 處理器為 91.4 毫秒;regex_compile 測試耗時 61.1 毫秒,而 Xeon 處理器為 88.6 毫秒;Speedometer 46.3 毫秒;Speedometer 36.8 毫秒。
瀏覽器效能指標才是買家在桌面上實際感受到的。雖然36.8的Speedometer得分在絕對值上仍然很快,但它比同機箱的Core塔式機慢了五分之一,任何選擇Xeon處理器是為了追求高吞吐量的用戶都應該預料到,這台機器的交互性能會比Core Ultra台式機慢一些。
GROMACS、OpenBLAS 和內存
GROMACS 在 16 個核心上執行 benchMEM 分子動力學算例,採用四種不同的執行緒佈局,並報告最佳佈局下每天的模擬時間(以奈秒為單位)。我們的 OpenBLAS 測試在所有核心上運行 HPL 風格的雙精度 LU 分解求解(三種問題規模)和 DGEMM 矩陣乘法運算,並在 285K 處理器上僅使用其八個 P 核心再次進行測試;Xeon 的 24 個核心屬於同一類別,因此這些行不適用。 STREAM 測量持續記憶體頻寬,延遲行測量單次記憶體存取和核心間延遲。

| 測驗(分數越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| GROMACS benchMEM,最佳佈局(ns/天) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000,所有核心 (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000,所有核心 (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000,所有核心 (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000,僅限 P 核心(GFLOPS) | 不適用(一門核心課程) | 不適用(一門核心課程) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000,所有核心(GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000,僅限 P 核心(GFLOPS) | 不適用(一門核心課程) | 不適用(一門核心課程) | 565.3 | 566.5 |
AVX-512指令集、144MB三級快取和四通道DDR5-6400記憶體的組合優勢在此得以體現。 DGEMM演算法在Xeon處理器上達到了1,638 GFLOPS,而285K處理器僅為768 GFLOPS。在N=40000的LU求解任務中(該任務需要透過記憶體傳輸11.9GB的資料),Xeon處理器的運算速度達到了1,659 GFLOPS,而285K處理器僅為668 GFLOPS,是Core平台的2.5倍。 3K處理器的效能在N=20000到N=40000的範圍內幾乎沒有提升,因為此時其頻寬已達到瓶頸,而Xeon處理器的效能則持續提升。在16核心GROMACS測試中,Xeon處理器的效能比Core處理器高出27%,達到47.39 ns/day。

| 測試 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 串流複製(MB/s,速度越高越好) | 106,698 | 106,512 | 39,477 | 39,426 |
| 流規模(MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| 流添加(MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM Triad (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| 記憶體延遲,1GiB 緩衝區,4KiB 頁(奈秒,數值越低越好) | 148.3 | 147.8 | 135.2 | 135.4 |
| 核心間延遲,所有核心對的平均值(ns,數值越低越好) | 56.2 | 56.0 | 38.1 | 38.2 |
| 核心間延遲,最小值(奈秒) | 4.6 | 4.6 | 18.6 | 18.6 |
| 核心間延遲,最大值(奈秒) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad 測試在 Xeon T2 上的速度為 122,233MB/s,在 Core T2 的速度為 33,003MB/s,頻寬是後者的 3.7 倍。 Xeon T2 使用四通道 DDR5-6400 RDIMM 內存,而 Core T2 使用的是四通道 DDR5-4400 UDIMM 內存,但該平台的內存容量無法滿足其需求。代價是延遲:Xeon 的記憶體延遲為 148.3 ns,而 Core T2 為 135.2 ns;Xeon 的核心間平均延遲為 56.2 ns,而 Core T2 為 38.1 ns。 Xeon 的最小延遲為 4.6 ns,對應於同一核心上兩個 SMT 子執行緒之間的通訊;最大延遲為 65.7 ns,對應於跨 SMT 網狀結構的通訊。
電競與遊戲設備
SuperTuxKart 1.5 在 1080p 全螢幕模式下,以最高預設設定關閉垂直同步運行其內建基準測試,並報告平均幀率和穩定幀率。在此解析度下,GPU 效能綽綽有餘,因此測試結果與 CPU 效能相符,且該測試可以代表許多具有相同限制的專業視窗。由於這些系統無法完成編碼測試中的 NVENC 轉換,因此省略了該測試結果。

| SuperTuxKart 1.5,1080p 超高畫質,垂直同步關閉(幀數越高越好) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 中等 | 304.6 | 323.2 | 359.1 | 383.5 |
| 典型 | 304 | 322 | 354 | 376 |
| 穩定 | 161 | 174 | 122 | 135 |
Core T2搭配Max-Q顯示卡時平均幀率為359.1 fps,而Xeon T2為304.6 fps,單線程效能差距再次顯現。 Xeon平台則擁有更高的穩定幀率,達到161 fps,而Core T2為122 fps,且幀率波動更少。 600W顯示卡使兩款平台的平均幀率均提升了約6%。
負載下的時鐘
兩台主機均未透過測試套件的感測器路徑報告 CPU 或 GPU 溫度,因此我們通常發布的溫度表在此處被替換為每次測試期間的平均 CPU 頻率,該數值可以解釋 600W 顯示卡對 Xeon 處理器的影響。安裝 Max-Q 顯示卡後,658X 在 30 分鐘持續循環測試中保持 4,269MHz 的頻率,在較短的全核測試中保持 4,040 至 4,480MHz 的頻率。在機箱中安裝 600W 顯示卡後,大多數測試的頻率都降低了,最多降低了 300MHz,並且所有測試的得分也都降低了。
| 測試期間的平均 CPU 時脈頻率(MHz) | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| 持續循環 | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-ZIP | 4,414 | 4,307 | 4,854 | 4,837 |
| 魚乾 | 4,291 | 3,995 | 4,749 | 4,741 |
| 混合器 | 4,258 | 4,253 | 4,582 | 4,552 |
| HandBrake | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVM 建構 | 4,202 | 4,258 | 4,582 | 4,585 |
| GROMACS | 4,288 | 4,290 | 4,664 | 4,694 |
| OpenBLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| 流 | 4,321 | 4,326 | 4,687 | 4,676 |
| 質篩 | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerf 用戶端 | 4,191 | 4,138 | 3,814 | 3,686 |
| 編碼代理 | 4,134 | 4,100 | 4,239 | 4,213 |
| 法學碩士服務 | 4,261 | 4,169 | 4,229 | 4,209 |
| 圖像生成 | 4,044 | 4,008 | 3,702 | 3,837 |
| 抹布 | 4,178 | 4,197 | 4,172 | 4,108 |
| 超級卡丁車 | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish 的頻率從 4,291MHz 降至 3,995MHz,primesieve 的頻率從 4,291MHz 降至 3,995MHz,primesieve 的頻率從 4,441MHz 降至 4,268MHz,7-Zip 的頻率從 4,414MHz 降至 4,307MHz,持續循環的頻率從 4,269MHz,無論 258MHz,而 25125258MHz,哪張卡片降至 252在所有全核測試中的運作頻率都相差不到 20MHz。
平均時脈頻率並不能完全解釋這個問題。 Cinebench 和 Blender 的平均頻率與 Max-Q 配置下的頻率相差不到 10MHz,但仍損失了 5% 到 10% 的性能,這表明存在一些短時波動,而每次測試的平均值掩蓋了這些波動。 658X 的功耗最高可達 250W,600W 的顯示卡功耗也為 600W,兩者的散熱都透過同一個前置進氣口排入 32 公升的散熱器;究竟是處理器的散熱餘裕還是平台的功率上限限制了效能,這個問題需要我們下次使用外部電源和溫度進行測試才能解決。目前,對於執行全核心 CPU 任務的使用者來說,應該知道 Max-Q 配置在 CPU 方面速度更快。
存儲性能
我們的儲存測試使用 fio 的四個角落分別對啟動盤進行 5GB 和 25GB 的讀寫測試,測試內容包括檔案系統以及原始設備,此處報告的是 25GB 的測試結果。在 Core T2 上,啟動盤是一塊 2TB 的 SK 海力士 PCB01 Gen5 x4 硬碟;在 Pro Precision 9 T2 上,啟動盤是 FlexBay 中的兩塊 E3.S Gen5 硬碟,透過 Graid Technology 的 VROC 技術條帶化成 4,097GB 的 RAID 0 卷。所有四個配置的 BitLocker 均已關閉,因此檔案系統行測量的是 NTFS 檔案系統和 RAID 層,而非加密資料。


| fio,25GB 佔用空間,QD32 | Pro Precision 9 T2,Max-Q 300W | Pro Precision 9 T2,600W | Pro Max Tower T2,Max-Q 300W | Pro Max Tower T2,600W |
|---|---|---|---|---|
| 順序讀取 128K,檔案系統 (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| 順序讀取 128K,原始設備 (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| 順序寫入 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1MB 預填讀取,QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| 隨機讀取 4K,檔案系統,峰值(IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| 隨機讀取 4K,原始設備,峰值(IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| 隨機寫入 4K,峰值(IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| 原始/檔案系統隨機讀取 | 1.32x | 1.31x | 1.29x | 1.31x |
| 隨機讀取 4K,4 個任務,p99 延遲(微秒,越低越好) | 506 | 485 | 183 | 185 |
| 隨機讀取 4K,16 個任務,p99.99 延遲(微秒,越低越好) | 15,270 | 23,462 | 676 | 676 |
| 隨機寫入 4K,4 個任務,p99 延遲(微秒,越低越好) | 610 | 594 | 228 | 228 |
| 驅動器溫度,最高(攝氏) | 不適用(位於 RAID 之後) | 不適用(位於 RAID 之後) | 50 | 57 |
條帶化的速度並不比單塊硬碟快,在處理小塊資料時更是遠遠落後。兩塊 E3.S 硬盤通過 NTFS 文件系統順序讀取速度為 9,332MB/s,從原始卷讀取速度為 10,782MB/s,而 PCB01 的讀取速度分別為 11,377MB/s 和 11,186MB/s;寫入速度為 6,507MB/s,而 PCB01 的寫入速度為 7,401MB/s。在 4K 隨機讀取測試中,條帶化硬碟透過檔案系統讀取的峰值 IOPS 為 840.1K,原始磁碟區讀取的峰值 IOPS 為 1.11M,而單塊硬碟的峰值 IOPS 分別為 1.78M 和 2.30M;隨機寫入速度為 557.5K,而單塊的速度則寫入硬碟的速度為 557.5K。兩者的原始磁碟區與檔案系統的讀寫速度比約為 1.3 倍,因此 NTFS 檔案系統在兩者上的成本相同;差異在於兩種路徑下都存在 VROC 層。
尾延遲如下:在 16 個作業的情況下,最慢的 0.01% 隨機讀取操作在磁碟區上耗時 15.3 毫秒,而單一硬碟僅需 0.68 毫秒;4 個作業的 p99 讀取延遲分別為 506 微秒和 183 微秒。跨兩塊 NVMe 裝置的軟體 RAID 會為每次 I/O 操作增加一次 CPU 跳轉,fio CPU 讀數也證實了這一點,順序執行時卷的 CPU 使用率達到 80%,而 Core T2 的 CPU 使用率僅為 40%。此外,該磁碟區還隱藏了硬碟的 SMART 數據,因此測試套件無法記錄其溫度。
以上這些都無法說明FlexBay是個錯誤的選擇。它為T2提供了前置可維護、支援熱插拔的硬碟,其尺寸可擴展至M.2無法企及的容量,而且使用兩塊硬碟創建4TB啟動卷也十分便捷。但這確實意味著,對於那些工作負載主要為小塊隨機I/O、本地資料庫或大量快取的模型目錄的用戶來說,他們應該考慮使用一塊不帶條帶化的E3.S硬碟,或者使用內建的M.2插槽。 Core T2的測試結果表明,在這種機殼下,一塊Gen5硬碟在M.2插槽中的表現與E3.S硬碟相當。
結語
戴爾 Pro Precision 9 T2 其實是搭載工作站處理器的 Pro Max Tower T2,評測數據顯示,這正是買家所期待的。在同樣的 32 公升機箱內,Xeon 658X 處理器在 Cinebench 多核心吞吐量方面提升了 39%,記憶體頻寬提升了 3.7 倍,DGEMM 記憶體速率翻倍,並配備了 24 核心 48 執行緒處理器,支援 AVX-512 和 AMX 指令組,以及 ECC 1,最高記憶體可擴展記憶體集,可擴展記憶體集,可擴充至 12MX 指令,以及 ECC 1,最高記憶體。在單執行緒任務(從 PrimeSieve 到 Python)方面,效能提升了 13% 到 31%,對於那些整天在顯示器或終端機前工作的用戶來說,這一點尤其明顯。
本評測旨在幫助買家了解GPU的選擇。 Max-Q版和600W版RTX PRO 6000顯示卡共享96GB顯存,解碼速度相差7%到20%。 600W版顯示卡的優點在於處理速度更快,首幀反應時間縮短了三分之一甚至更多,以及影像擴散速度更快,影像渲染速度提升了20%到34%。
在至強塔式機中,600W 的顯示卡會使處理器在全核心運行時的效能降低 4% 到 5%,並且需要佔用旁邊的插槽,在我們測試的這台機器上,這意味著需要移除 25GbE 網路卡。對於一台主要運行 CPU 渲染、模擬以及本地模型的塔式機來說,戴爾提供的 Max-Q 顯示卡是一個較為均衡的選擇;而對於一台需要為團隊提供模型或全天渲染圖像的塔式機來說,600W 的顯示卡則值得佔用一個插槽並搭配 1500W 的電源。
FlexBay 中的 E3.S 硬碟是我們多年來一直夢寐以求的塔式機殼規格;Graid Technology 的 VROC 控制器是 RAID 陣列的理想搭檔。在小隨機 I/O 效能方面,它比 Core T2 中的單一 M.2 硬碟速度慢,4K 讀寫速度也慢了大約一半。如果使用者不需要 RAID 啟動卷,可以考慮使用單一 E3.S 硬碟或內部 M.2 插槽。
另一方面,隨著 E3.S SSD 容量突破 60TB,擁有極端資料使用情境的使用者得以進入一個全新的世界,而在此之前,這意味著需要使用外部機箱或安裝共用儲存卷,而閃存價格是實際的限制因素。
在戴爾官網(Dell.com)上,Pro Precision 9 T2 的配置價格約為 28,300 美元,這還不包括大多數企業用戶看到的批量折扣。相比之下,配置相同的 Pro Max Tower T2 價格高出約 4,500 美元:配備 285K 處理器、128GB DDR5-4400 ECC 記憶體、RTX PRO 6000 顯示卡、2TB Gen5 硬碟和 1500W 電源供應器的 Pro Max Tower T2 售價約為 23,800 美元。兩款塔式機殼的顯示卡和記憶體配置價格相差不到 900 美元。第二個 FlexBay 硬碟位的價格差為 1,700 美元,其餘價格則取決於 Xeon 平台。
它買來的是一款單路塔式機,在全核負載下表現得像一台小型伺服器,佔地面積卻與桌上型電腦相同,這就是 Precision 名稱回歸的原因。
排行榜:戴爾 Pro Precision 9 T2 在我們的最佳桌上型工作站排行榜上榮獲最佳綜合桌上型工作站稱號,其 RTX PRO 6000 的效能也出現在我們的最佳企業級 GPU排行榜上。



 Amazon