

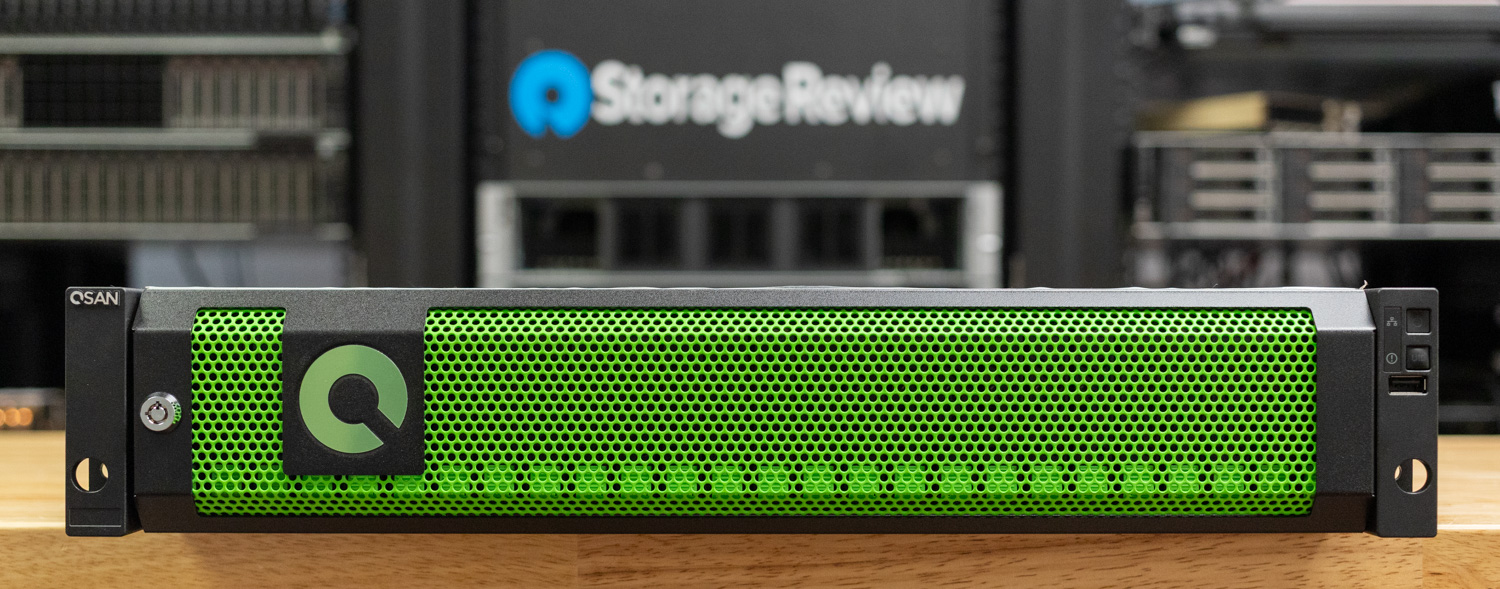
QSAN 自 2004 年以來一直致力於建立企業儲存解決方案,而 XN4 系列正是其經驗的體現。我們實驗室中的 XN4226D 是一款 2U、26 盤位、全 NVMe 陣列,配備雙主動控制器,可提供統一的區塊和檔案儲存的高可用性。 QSM 4 軟體增加了所需的資料服務,包括快照、複製選項、資料縮減和直覺的管理體驗。 XN4 專為追求 NVMe 速度且不犧牲多協議彈性的團隊而設計,價格也非常實惠。
關鍵要點
- 具有真正 HA 的統一區塊和檔案。 雙主動控制器和 QSM 4 透過一個平台為區塊和檔案提供高可用性。
- NVMe-oF 做得對。 完整的協定透過 TCP 和 RDMA 與 NVMe-oF 以及 iSCSI、光纖通道、NFS、SMB、FTP 和 WebDAV 一起傳播。
- 已證實的吞吐量。 我們測量了 TCP 的大型順序讀取速度高達 21.21 GB/s,以及 RDMA 的大型順序寫入速度高達 11.14 GB/s。
- 專為現代管道而建。 2U 中有 26 個全 NVMe 托架,管理簡單,I/O 選項可擴展至 100–200GbE,用於媒體、監控分析、VDI、資料庫和 AI 推理。
該平台支援基於 TCP 和 RDMA 的 NVMe-oF,以及 iSCSI、光纖通道、NFS、SMB、FTP 和 WebDAV。我們也完成了 NVMe-oF 專案研究,比較了 TCP 和 RDMA 的行為和擴展性。在測試中,我們透過大量順序讀取將設備推向極限,實現了令人印象深刻的 21.21 GB/s 吞吐量。此系統的適用場景與原始資料同樣重要。 XN4226D 適用於混合環境,可將 VMware 或 Proxmox 與虛擬機器、虛擬桌面基礎架構 (VDI) 和資料庫層結合,以及創意檔案服務、需要可預測 NVMe 路徑的 AI 推理節點、媒體備份以及用於監控和感測器工作負載的高頻寬資料擷取。 QSAN XN4226D 幾乎適用於所有工作負載。
QSAN 注意到媒體製作(包括直播、重播選項、AI 視訊增強和 OTT/邊緣快取)以及監控視訊分析(例如智慧城市閉路電視監控、異常檢測和即時重播)均取得了顯著增長。理想情況下,100-200GbE 的吞吐量能夠支援這些工作負載。
最終,其價值顯而易見。您可以獲得統一的高可用性、覆蓋整個機箱的 NVMe,以及隨著需求增長而高達 100GbE 或 32Gb 光纖通道的 I/O 選擇。性能與許多一級陣列相當,同時許可仍然更易於獲取,並且協議覆蓋範圍仍然廣泛,涵蓋 NVMe-oF、iSCSI、光纖通道、SMB 和 NFS。對於那些關注 InfiniBand 但預算受限的企業來說,QSAN 的乙太網路方案在 100 至 200GbE 規模的標準設備上提供接近 IB 的響應速度。
對於優先考慮實際應用結果的團隊來說,QSAN 的長壽命、直覺的軟體和簡潔的硬體設計使 XN4226D 成為可靠的全快閃主力。
QSAN XN4 硬體
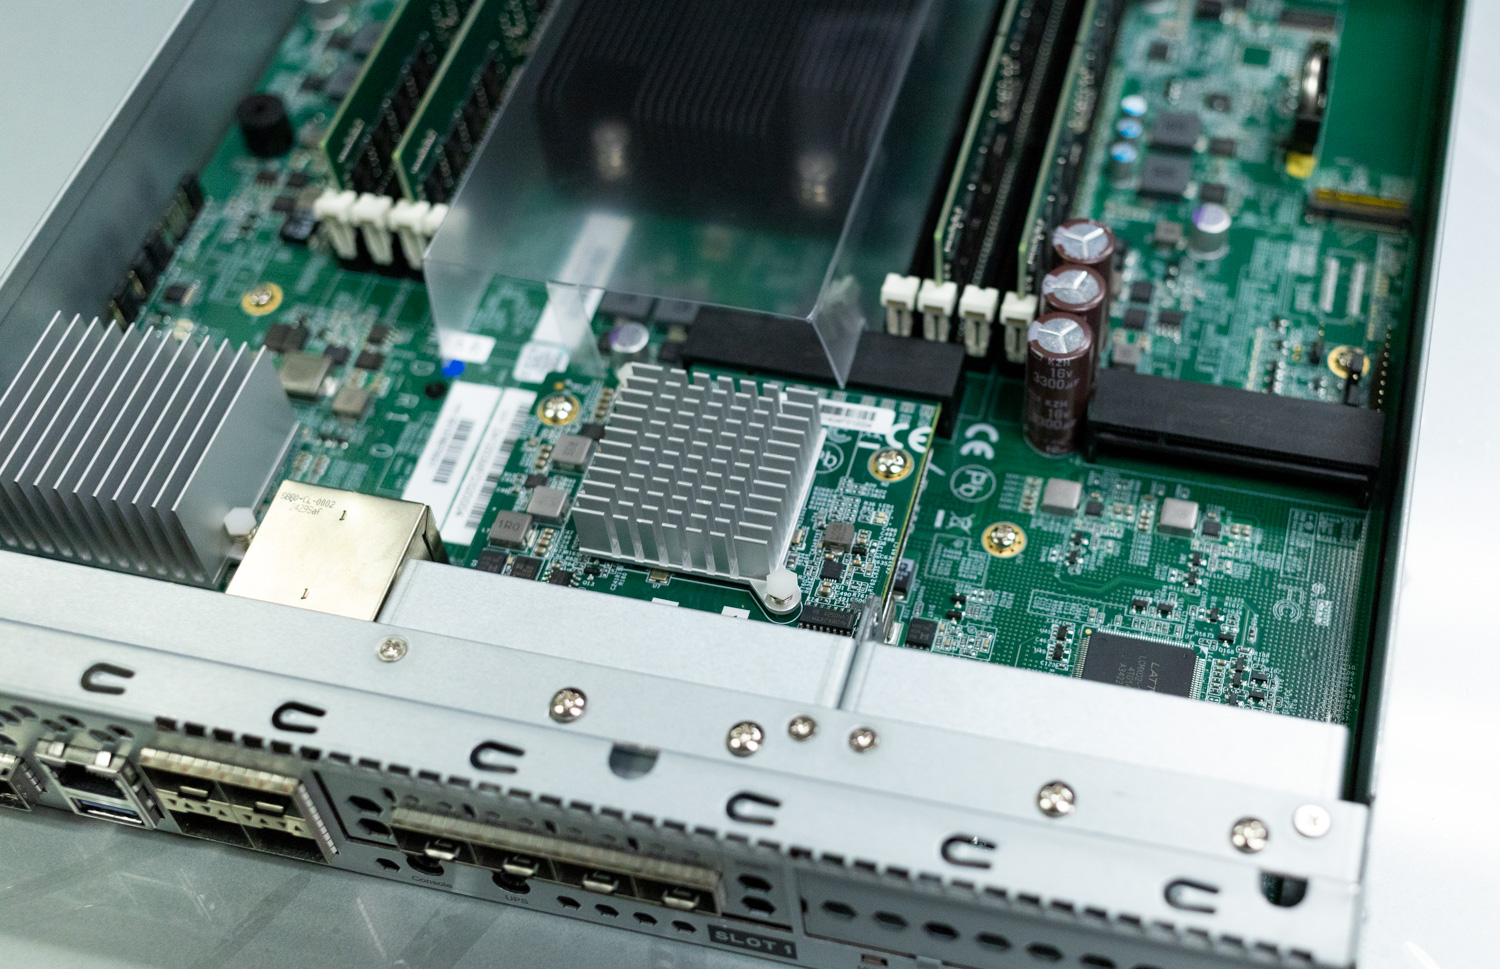
QSAN XN4 系列儲存陣列採用 26 托架、2U、19 吋機架式伺服器機箱,提供單控制器或雙控制器選項,搭載 4 核心或 8 核心英特爾至強 CPU,可滿足各種規模運作的冗餘和效能需求。在 26 個托架全部安裝完畢的情況下,單一 XN4 系列機殼可在 2.5 吋 U.2/U.3 NVMe 固態硬碟上儲存高達 798 TB 的資料。此外,還可以增加多達 20 個 SAS 連接的擴充單元,將陣列的總容量提升至 16.773 PB。
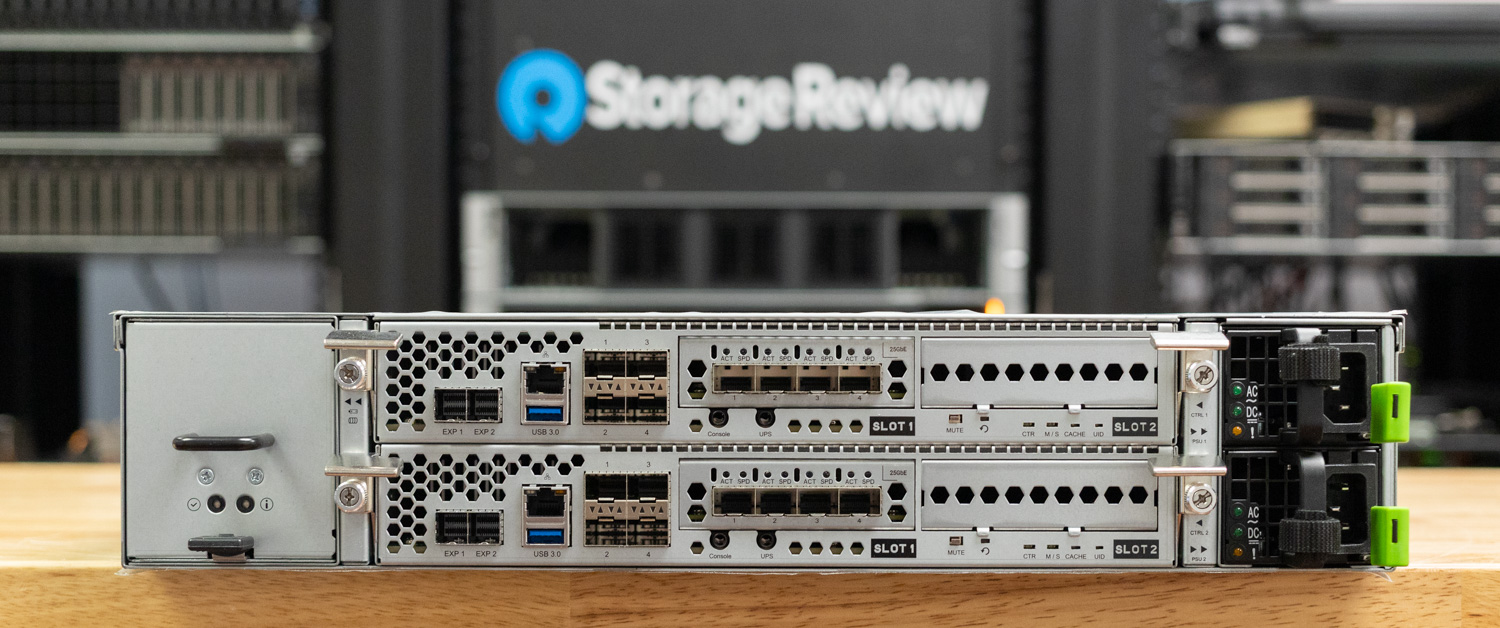
每個板載控制器配備一個 2.5 Gbps RJ45 乙太網路連接埠、四個 10 Gbps SFP+ 連接埠和兩個 12 Gbps SAS 寬連接埠。此外,還提供 10Gbps RJ45、25Gbps SFP28 和 100Gbps QSFP 連接埠的升級選項。此外,還可以添加光纖通道支持,配備 16Gbps SFP+ 和 32Gbps SFP28 適配器。
下表比較了 XN4226D-4C 和 XN4226S-4C 儲存系統的規格。它們是 4C 版本,根據型號設計為雙活控制器或可升級的單控制器。對於需要更高處理能力的部署,我們也提供 8C 版本。
| 規格 | XN4226D-4C | XN4226S-4C |
|---|---|---|
| 型號名稱 | XN4226D-4C | XN4226S-4C |
| 卓越的建築 | 雙活控制器 | 單一可升級控制器 |
| 中央處理器 | Intel® Xeon® 四核心處理器 × 2 | 英特爾® 至強® 四核心 |
| 記憶體應用 | ||
| 預裝內存模塊 | 32GB DDR4 RDIMM | 16GB DDR4 RDIMM |
| 內存插槽總數 | 16 | 8 |
| 內存可擴展至 | 2,048GB | 1,024GB |
| 儲存 | ||
| 驅動器托架 | 2.5吋插槽×26 | 2.5吋插槽×26 |
| 帶擴展單元的最大驅動器托架 | 546 | 546 |
| 兼容驅動器類型 | 2.5吋雙埠 U.2 / U.3 NVMe SSD 2.5 吋 SAS SSD(用於擴充單元) 3.5吋SAS HDD(用於擴充單元) |
2.5吋單埠U.2/U.3 NVMe SSD 2.5 吋 SAS SSD(用於擴充單元) 3.5吋SAS HDD(用於擴充單元) |
| 驅動接口 | U.2 NVMe(PCIe 第四代) SAS 12 Gb/s(用於擴充單元) |
U.2 NVMe(PCIe 第四代) SAS 12 Gb/s(用於擴充單元) |
| 最大內部原始容量 | 798TB | 798TB |
| 最大原容量及擴充 | 16,773TB | 16,773TB |
| 熱插拔驅動器 | 可以 | 可以 |
| 連接端口 | ||
| PCIe 擴展 | (Gen 4×8 插槽)× 4 | (Gen 4×8 插槽)× 2 |
| 2.5 GbE RJ45 LAN 端口 | 2(船上) | 1(船上) |
| 10 GbE SFP+ LAN 連接埠 | 8(板載)/ 16(選配) | 4(板載)/ 8(選配) |
| 10 GbE RJ45 LAN 端口 | 16(可選) | 8(可選) |
| 25 GbE SFP28 LAN 連接埠 | 16(可選) | 8(可選) |
| 100 GbE QSFP LAN 連接埠 | 8(可選) | 4(可選) |
| 16 Gb SFP+ 光纖通道 | 16(可選) | 8(可選) |
| 32 Gb SFP28 光纖通道 | 16(可選) | 8(可選) |
| 擴展和外部端口 | ||
| 12 Gb/s SAS 寬端口 | 4(船上) | 2(船上) |
| USB端口 | 1(前)/2(後) | 1(前)/1(後) |
| 其他 | Console口×2,Service口×2 | Console口×1,Service口×1 |
| 軟件規格 | ||
| 存儲操作系統 | QSM 4 | QSM 4 |
| RAID 類型 | 0 / 1 / 5 / 6 / 10 / 50 / 60 / 5EE / 6EE / 50EE / 60EE | |
| 存儲效率 | 精簡配置/壓縮和重複資料刪除(選項) | |
| 軟件加速 | SSD 快取 / 自動分層 / RDMA | |
| 資料保護 | 快照/非同步/同步(選項) | |
| 備份服務 | Rsync / S3 備份 / 雲端備份 / XMirror* / Microsoft 365 電子郵件備份 | |
| 安全性 | SSL / SSH / iSCSI CHAP / ISE 和 SED / WORM / RBAC / Windows ACL / 防毒 | |
| 支持協議 | CIFS / NFS / FTP / WebDAV / iSCSI / FCP / NVMe-oF | |
| 管理 | Web UI / Windows AD / LDAP / RESTful API / SES / LCM | |
| 外觀 | ||
| 尺寸(高×寬×深) | 88×438×573mm | 88×438×573mm |
| 淨重 | 19.6kg | 16.5kg |
| 毛重 | 28.6kg | 25.5kg |
| 其他 | ||
| 記憶保護 | 快取到快閃記憶體模組(內建) | |
| 系統風扇 | 8個 | 4個 |
| 供電單元 | 850 瓦 × 2(80 Plus 白金認證) | |
| 電源輸入 | 100 – 240 VAC,50/60 Hz | |
| 電源消耗功率 | 812 瓦 / 2,770 英熱單位 | |
| 證書 | CE/FCC/BSMI | |
| 標準保修 | 系統:5年|快取到快閃記憶體模組:1年 | |
QSAN XN4 功能
XN4 陣列標配支援高效能運算和高資料量 AI 模型所需的最新連接協議,包括透過 TCP 和 RDMA 服務的 NVMe over Fabrics (NVMe-oF)。此外,它還支援透過 iSCSI、NFS、FCP、CIFS/SMB、FTP 和 WebDAV 進行連接,使該陣列能夠滿足混合使用傳統和前沿系統的資料中心的區塊儲存和檔案儲存需求。
NVMe-oF的優勢
雖然 iSCSI、NFS 和 FCP 等協定仍在企業儲存應用中廣泛使用,但 NVMe-oF 顯著降低了延遲。 NVMe 標準從一開始就是為直接連接到系統 PCIe 匯流排的固態硬碟設計的。相較之下,iSCSI 和 NFS 等舊協定是圍繞傳統硬碟的局限性和較慢的存取時間而開發的。幾乎在所有情況下,NVMe-oF 技術都優於舊連接協議,具有更高的頻寬和更快的存取時間。 NVMe-oF 還可以利用具有遠端直接記憶體存取 (RDMA) 功能的網路接口,使資料能夠直接傳輸到目標電腦的記憶體中,而無需 CPU 處理。
數據縮減和優化功能
XN4 儲存陣列的高效能硬體堆疊透過眾多深受儲存管理員認可和讚賞的軟體功能進一步增強。精簡配置、壓縮和重複資料刪除功能使企業能夠最大限度地利用其 SAN 容量,而 SSD 快取和自動儲存分層功能則可加快常用檔案和物件的存取速度。該裝置的 QSM 4 作業系統還支援使用內建快照工具輕鬆測試和回滾變更。
安全和管理功能
QSAN 的 XN4 系列充分考慮了客戶不斷變化的安全和管理需求。 XN4 相容於即時安全性擦除 (ISE) 和自加密硬碟 (SED),以及 SSL/TLS 等安全協定、基於角色的存取控制 (RBAC) 驗證以及對 Active Directory/LDAP 伺服器的支援。此陣列可使用 HTTPS Web UI 或 RESTful API 進行管理,並透過 Ansible 或 Terraform 等多種工具自動化。
QSM 4 管理
QSAN XN4 系列的作業系統 QSM 4 讓各種經驗等級的儲存管理員都能輕鬆設定和管理儲存陣列。開箱即用的部署非常簡單:快速建立池、直覺的主機分配以及透過 Web UI 和 REST API 進行的輕量級管理——所有這些都專為無需深厚儲存專業知識的小型 IT 團隊而設計。
儀表板螢幕顯示系統狀態資訊和伺服器記錄的最近事件。
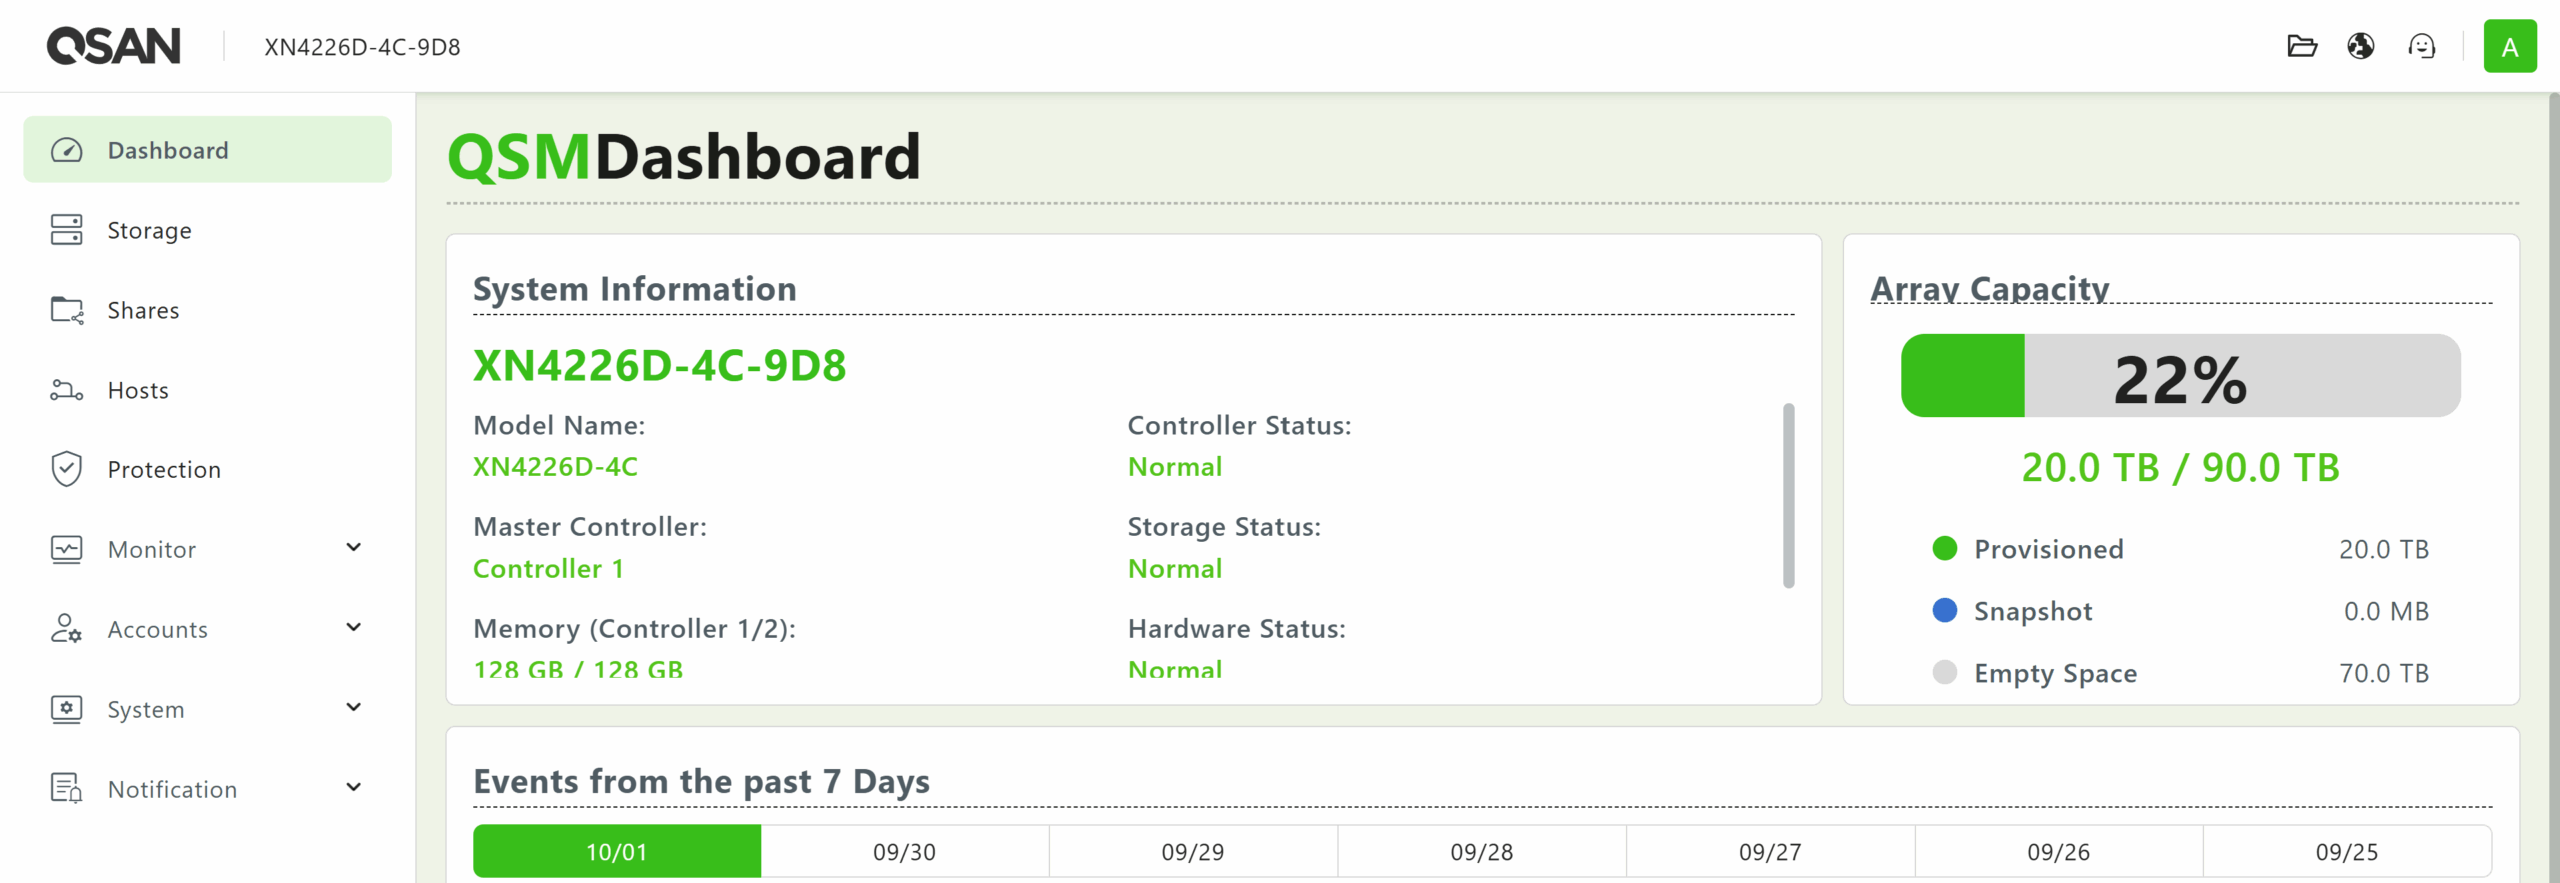
登入後,用戶將看到「儀表板」螢幕,該螢幕提供 SAN 健康狀況的快速概覽。從這裡,您可以跳到左側面板清單中的任何子選單。
從儲存功能表中,管理員可以建立和管理磁碟機池及其相關磁碟區。
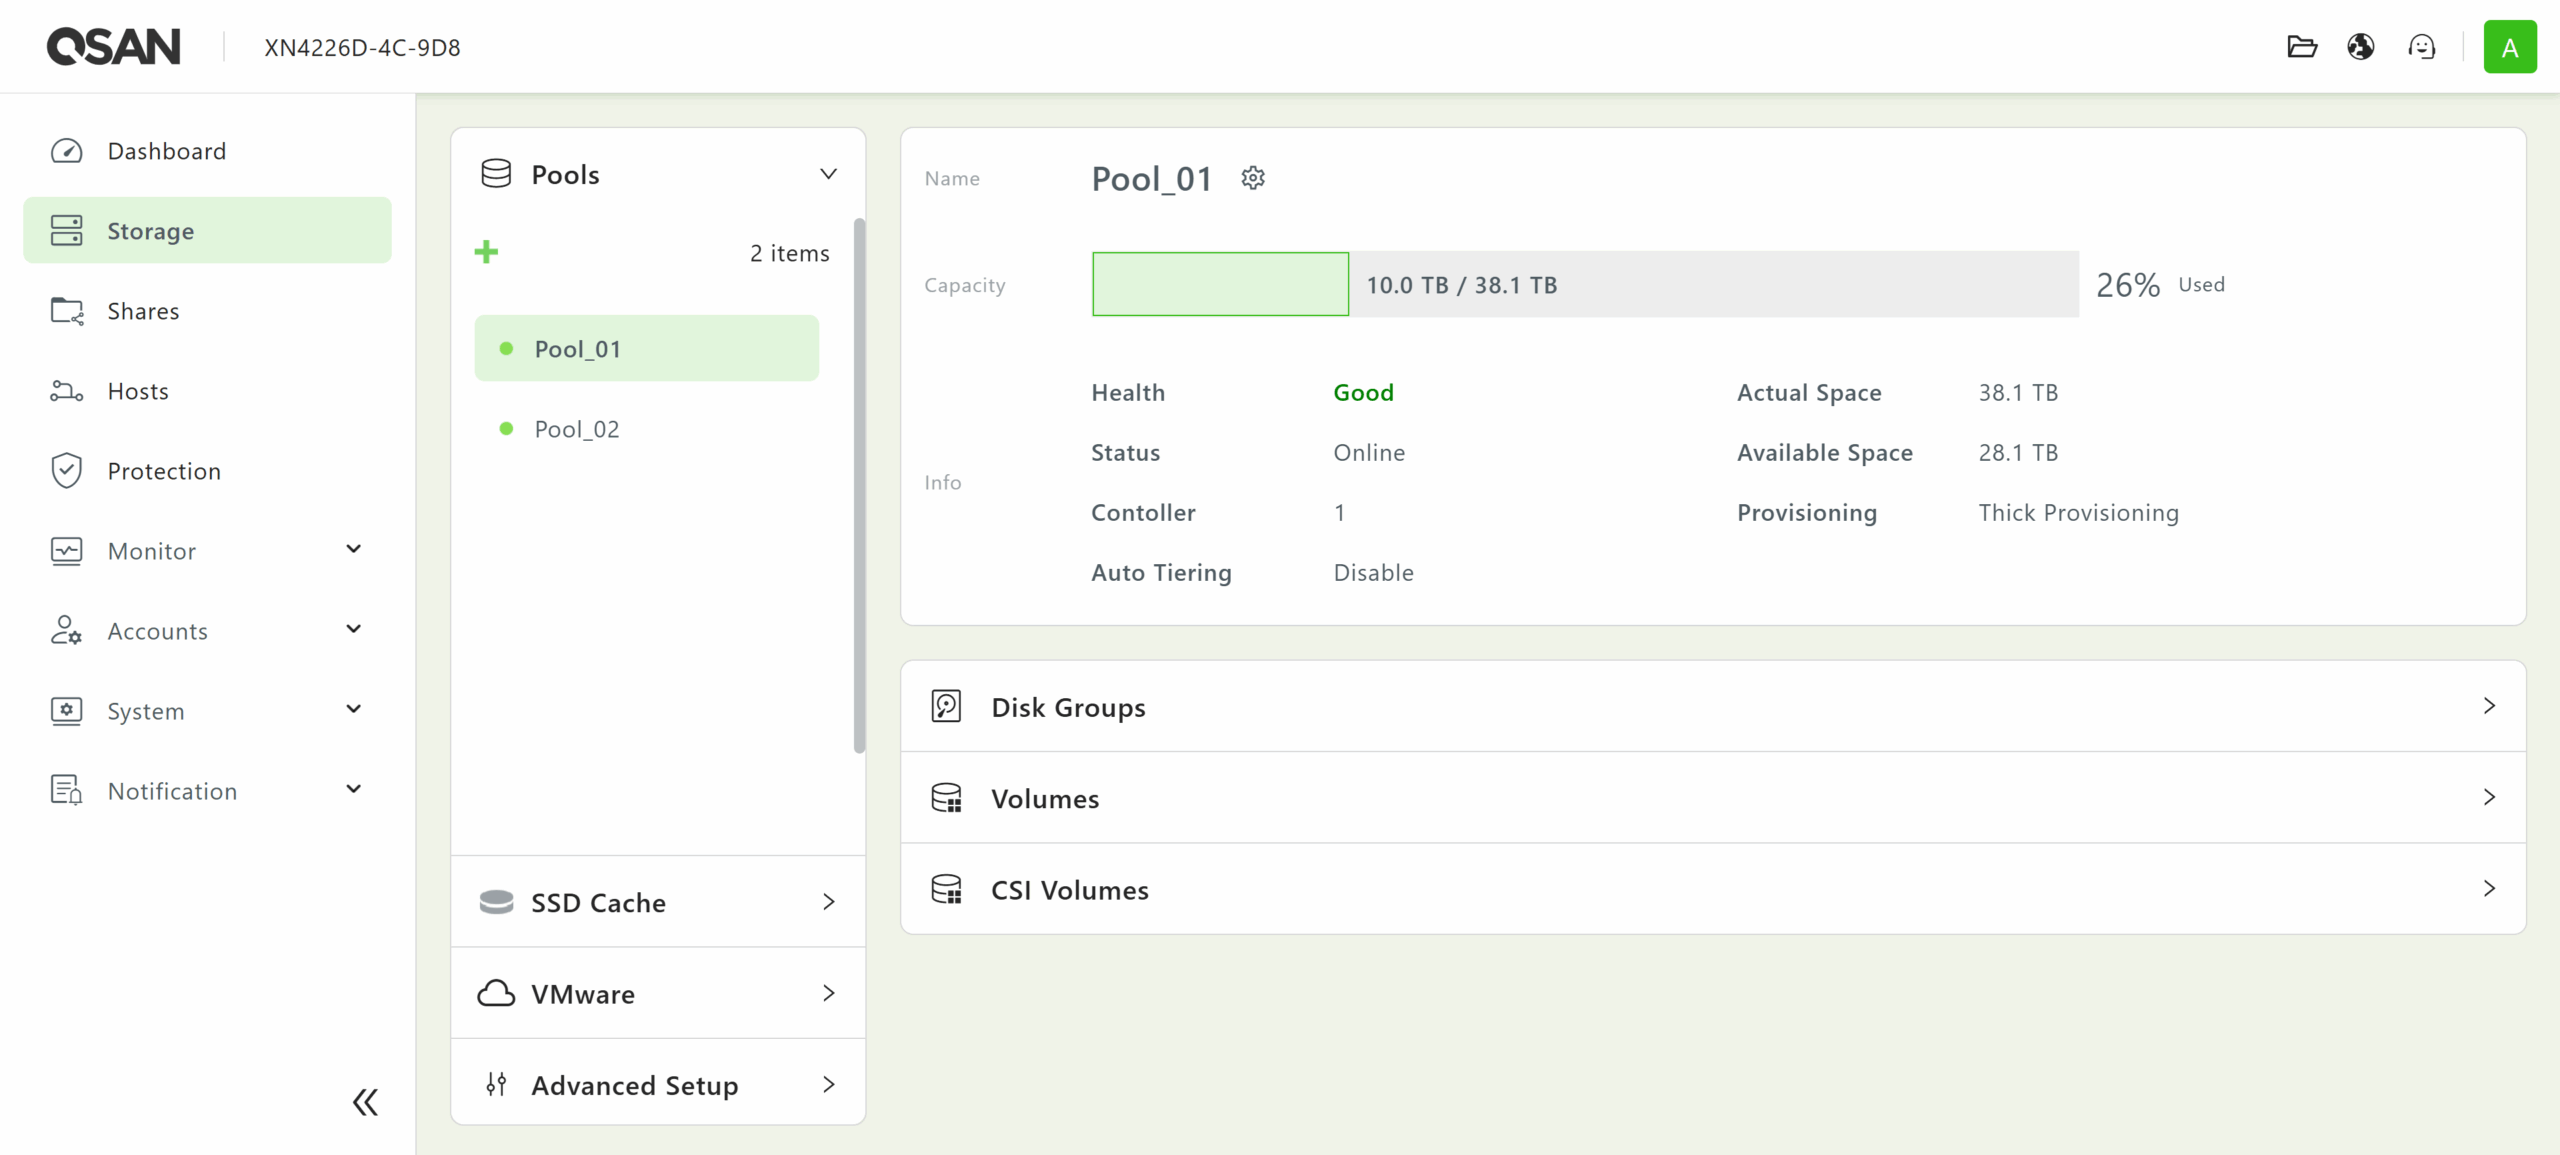
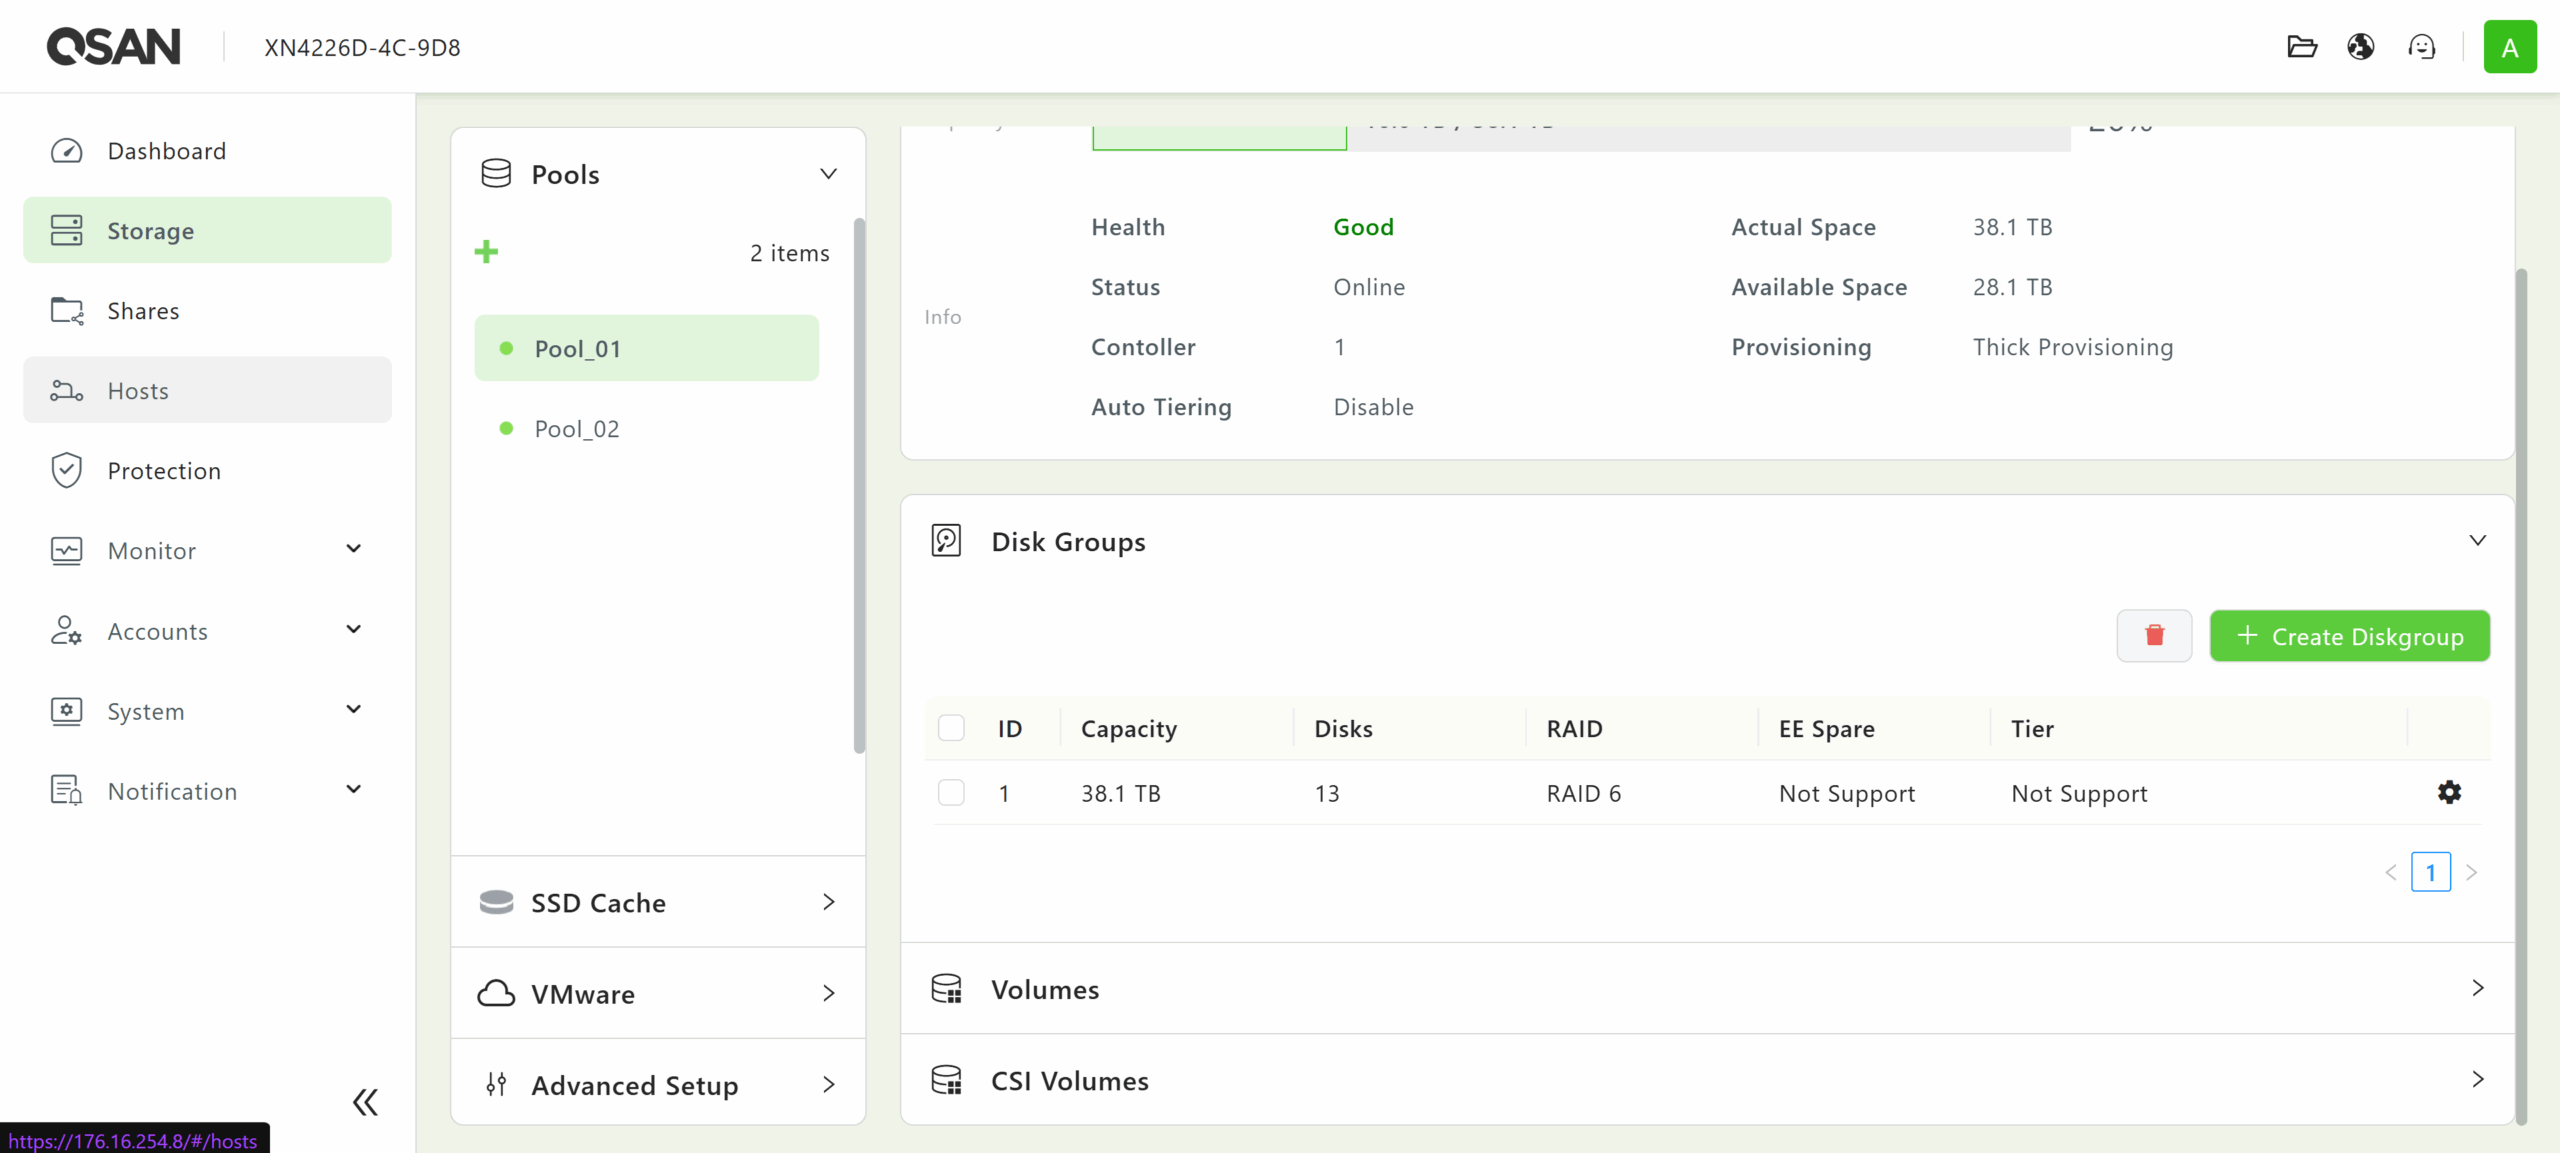
您可以在「磁碟組」標籤中管理構成每個池的磁碟組。此功能支援各種 RAID 級別,包括 0、1、5、6、10、50、60、5EE、6EE、50EE 和 60EE,具體取決於已分配的磁碟機數量。
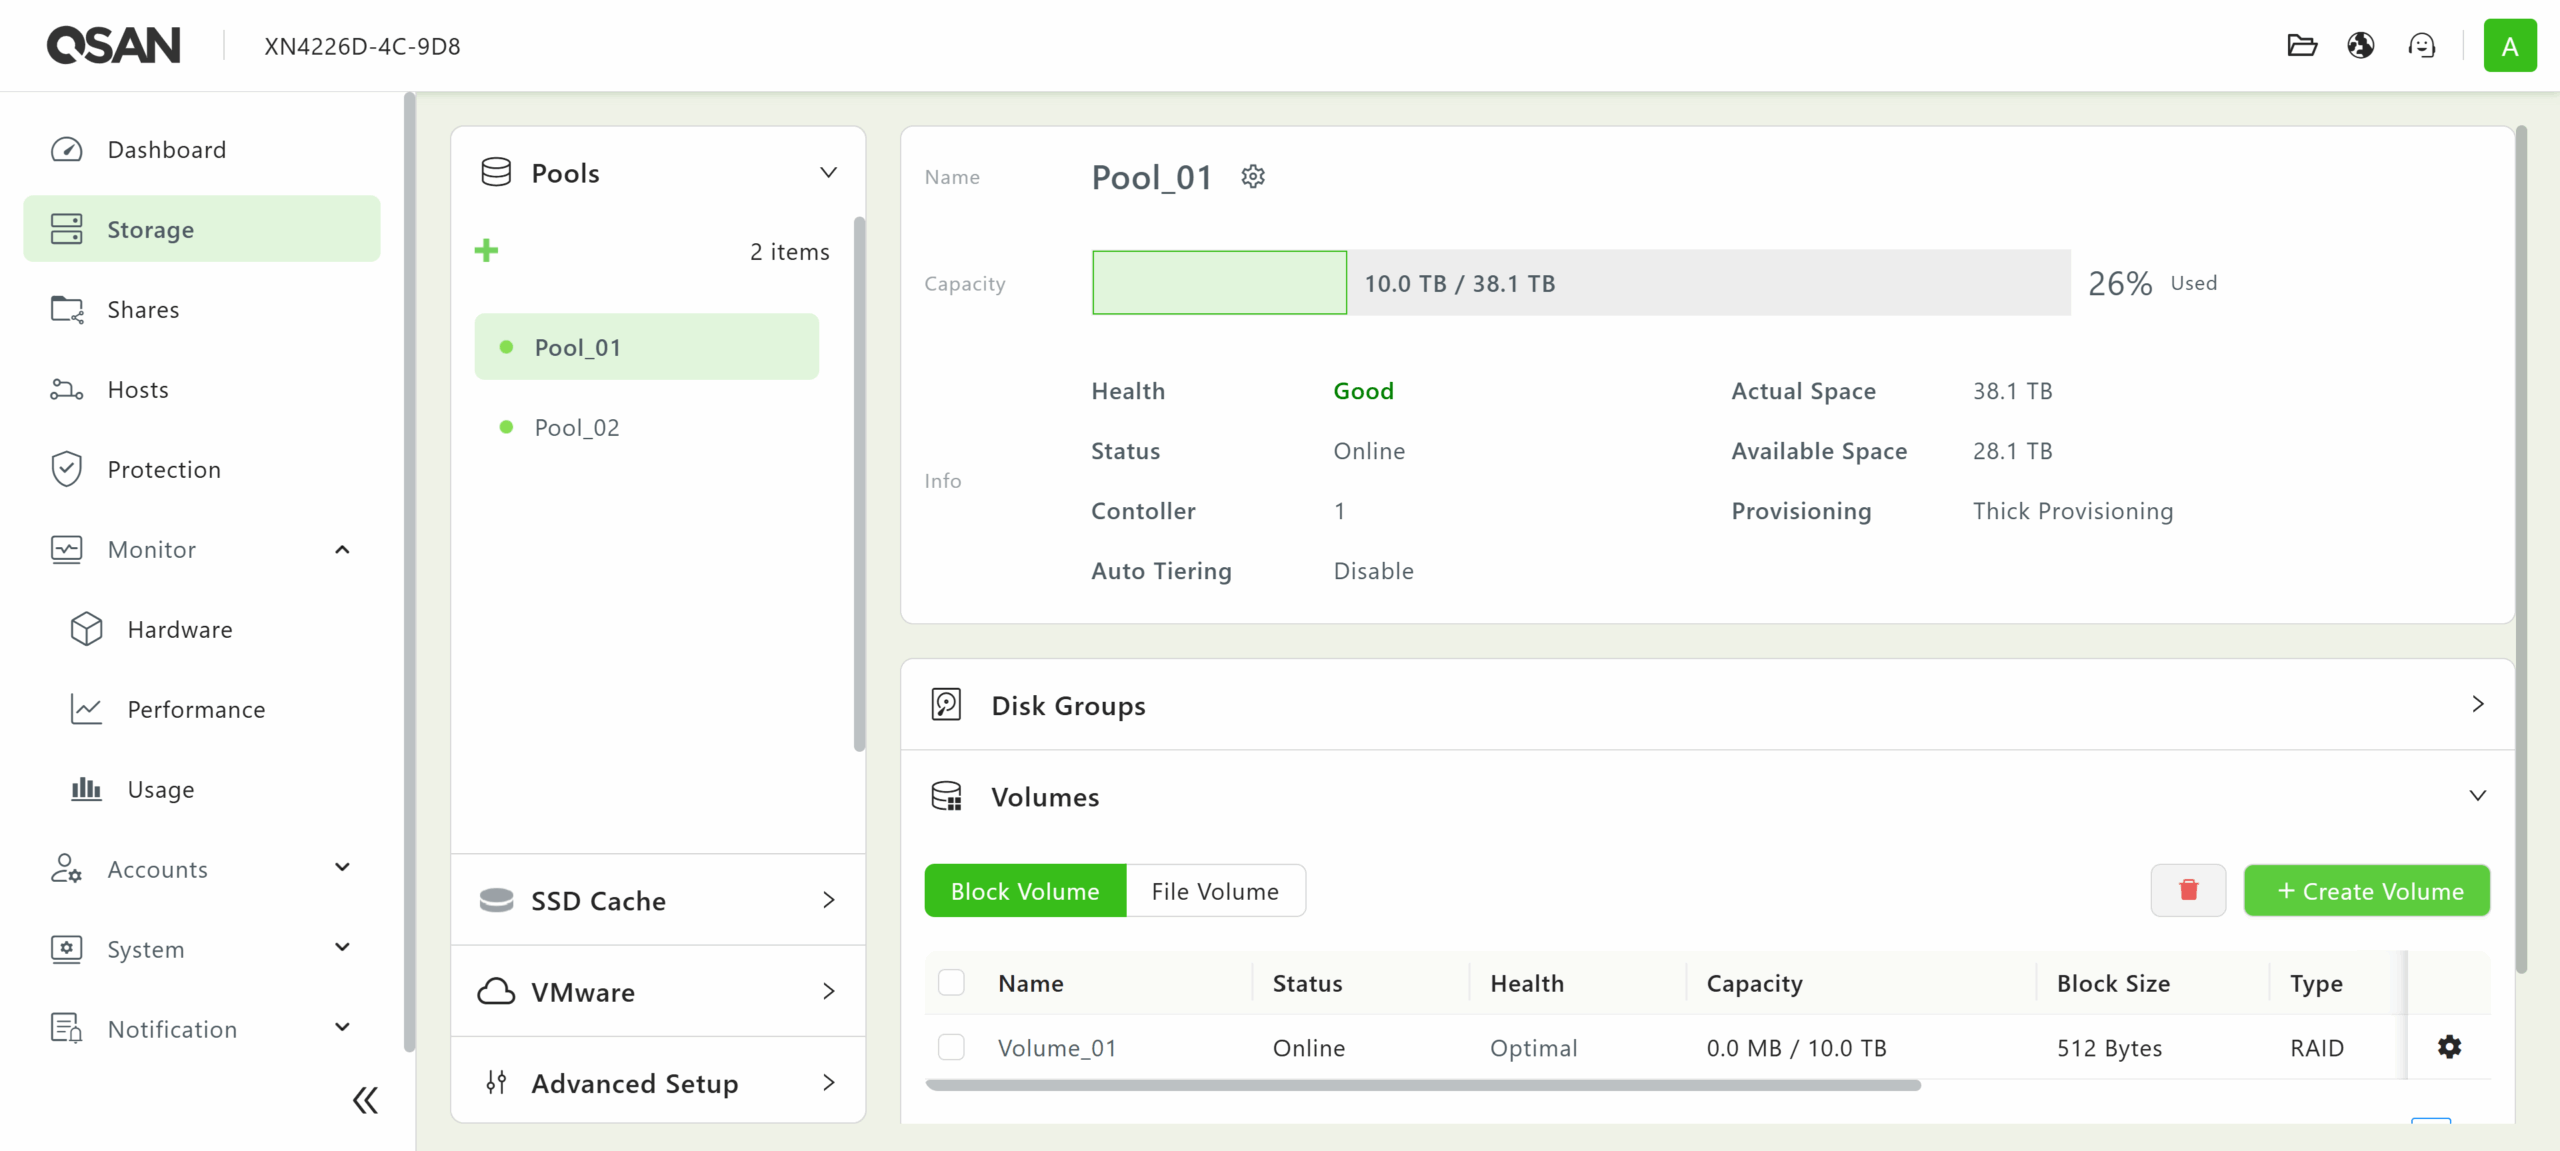
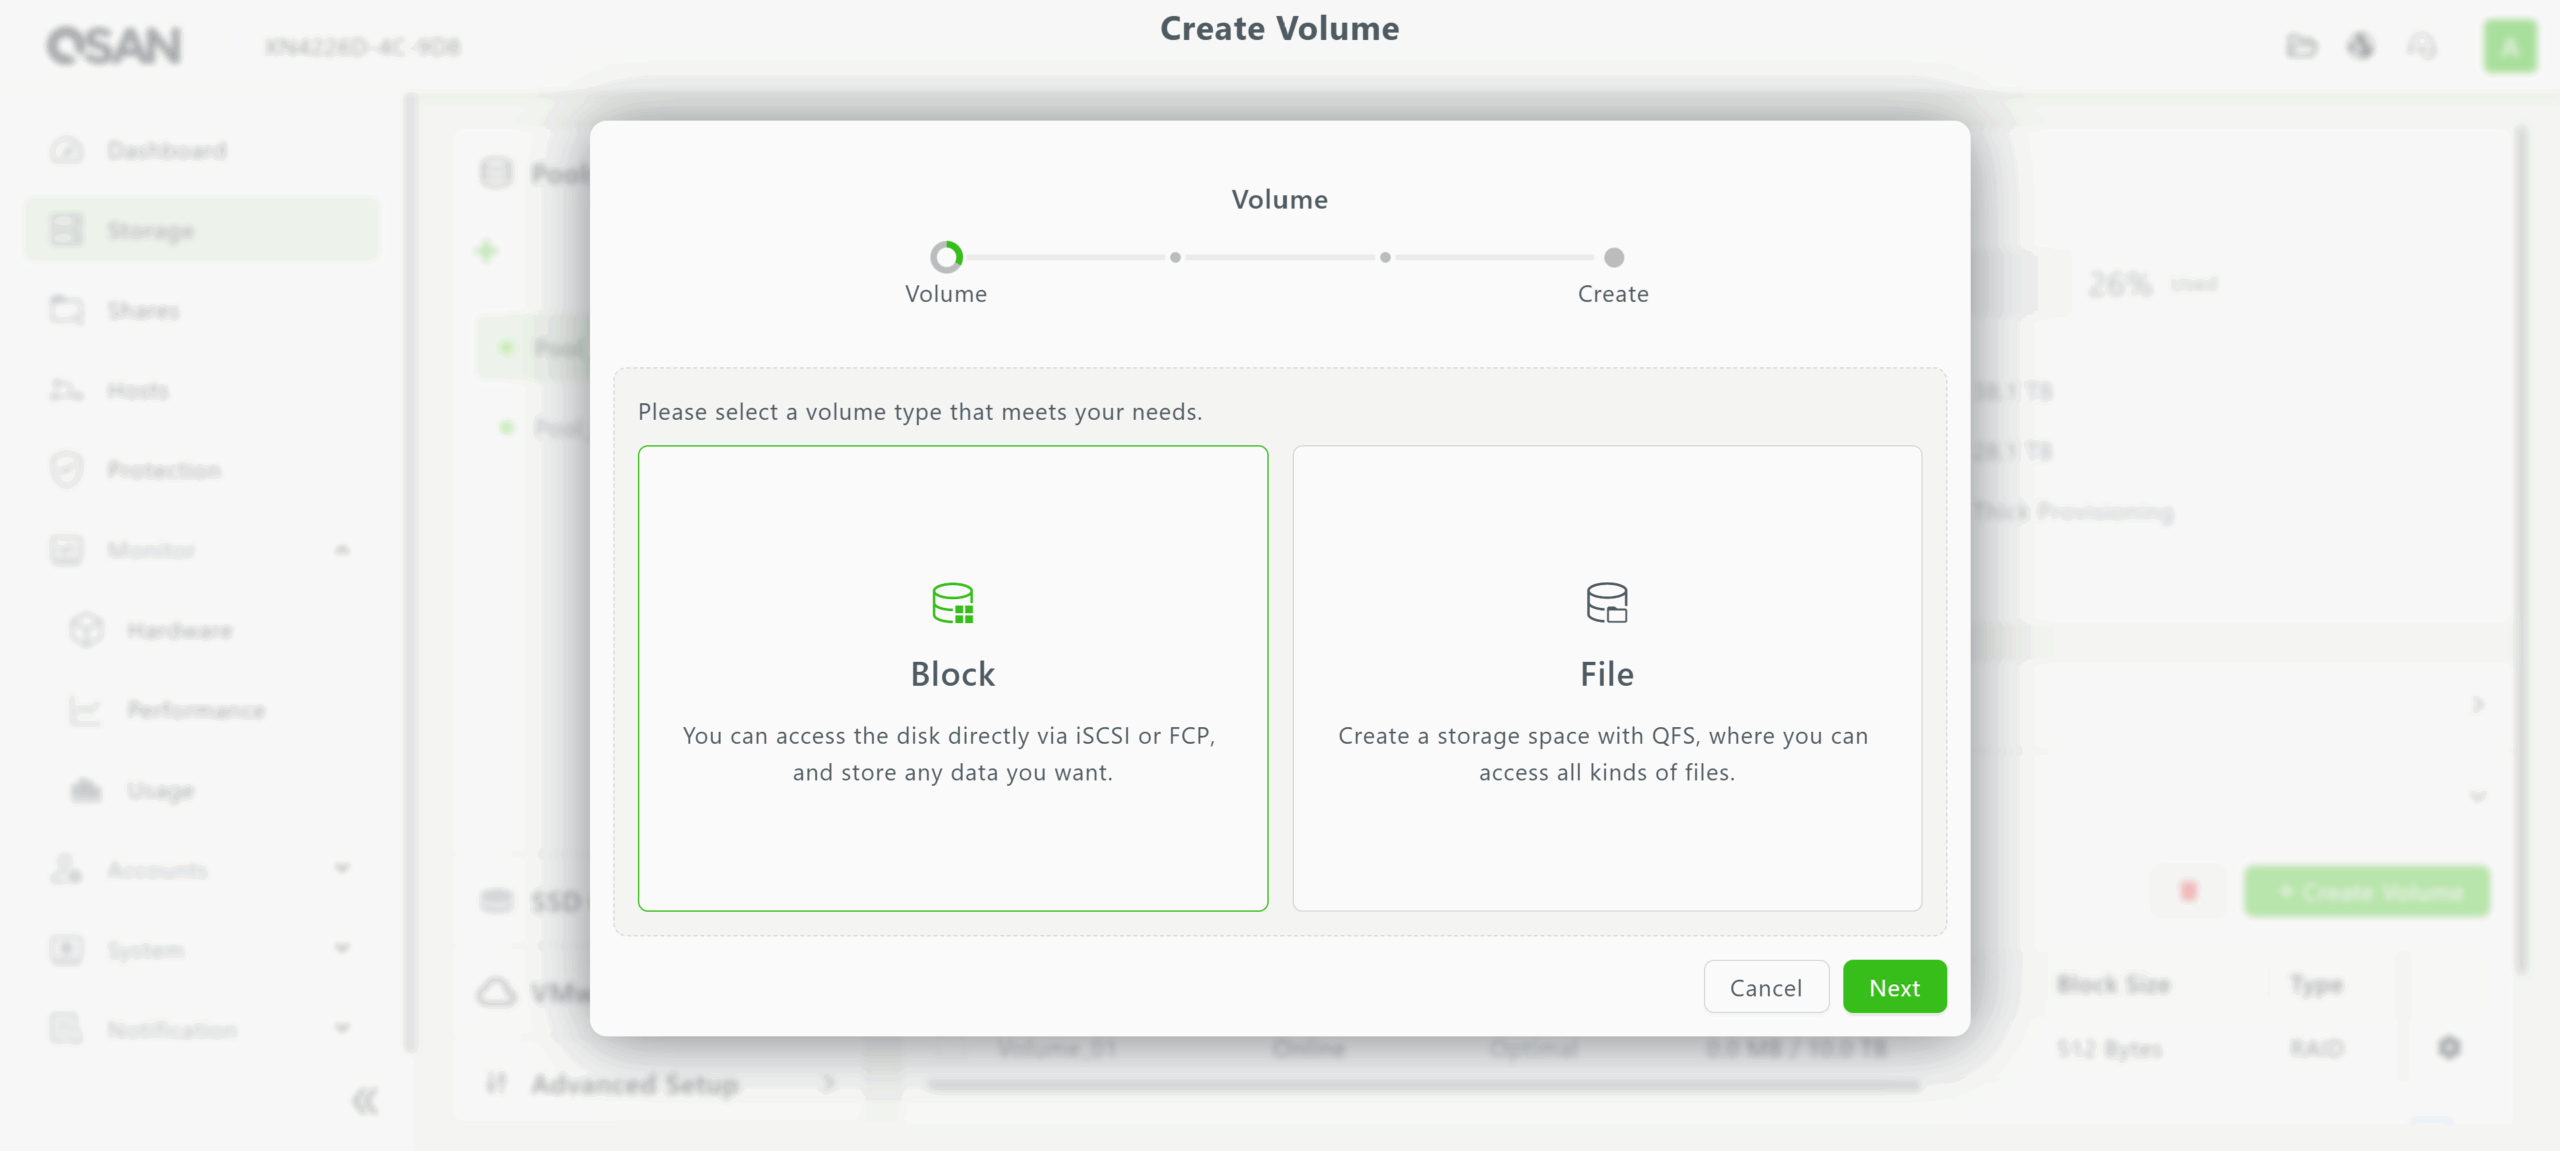
然後,可以在池之上建立用於區塊和文件儲存需求的磁碟區。使用嚮導,可以設定每個磁碟區的容量和區塊大小,以滿足連接客戶端的需求。
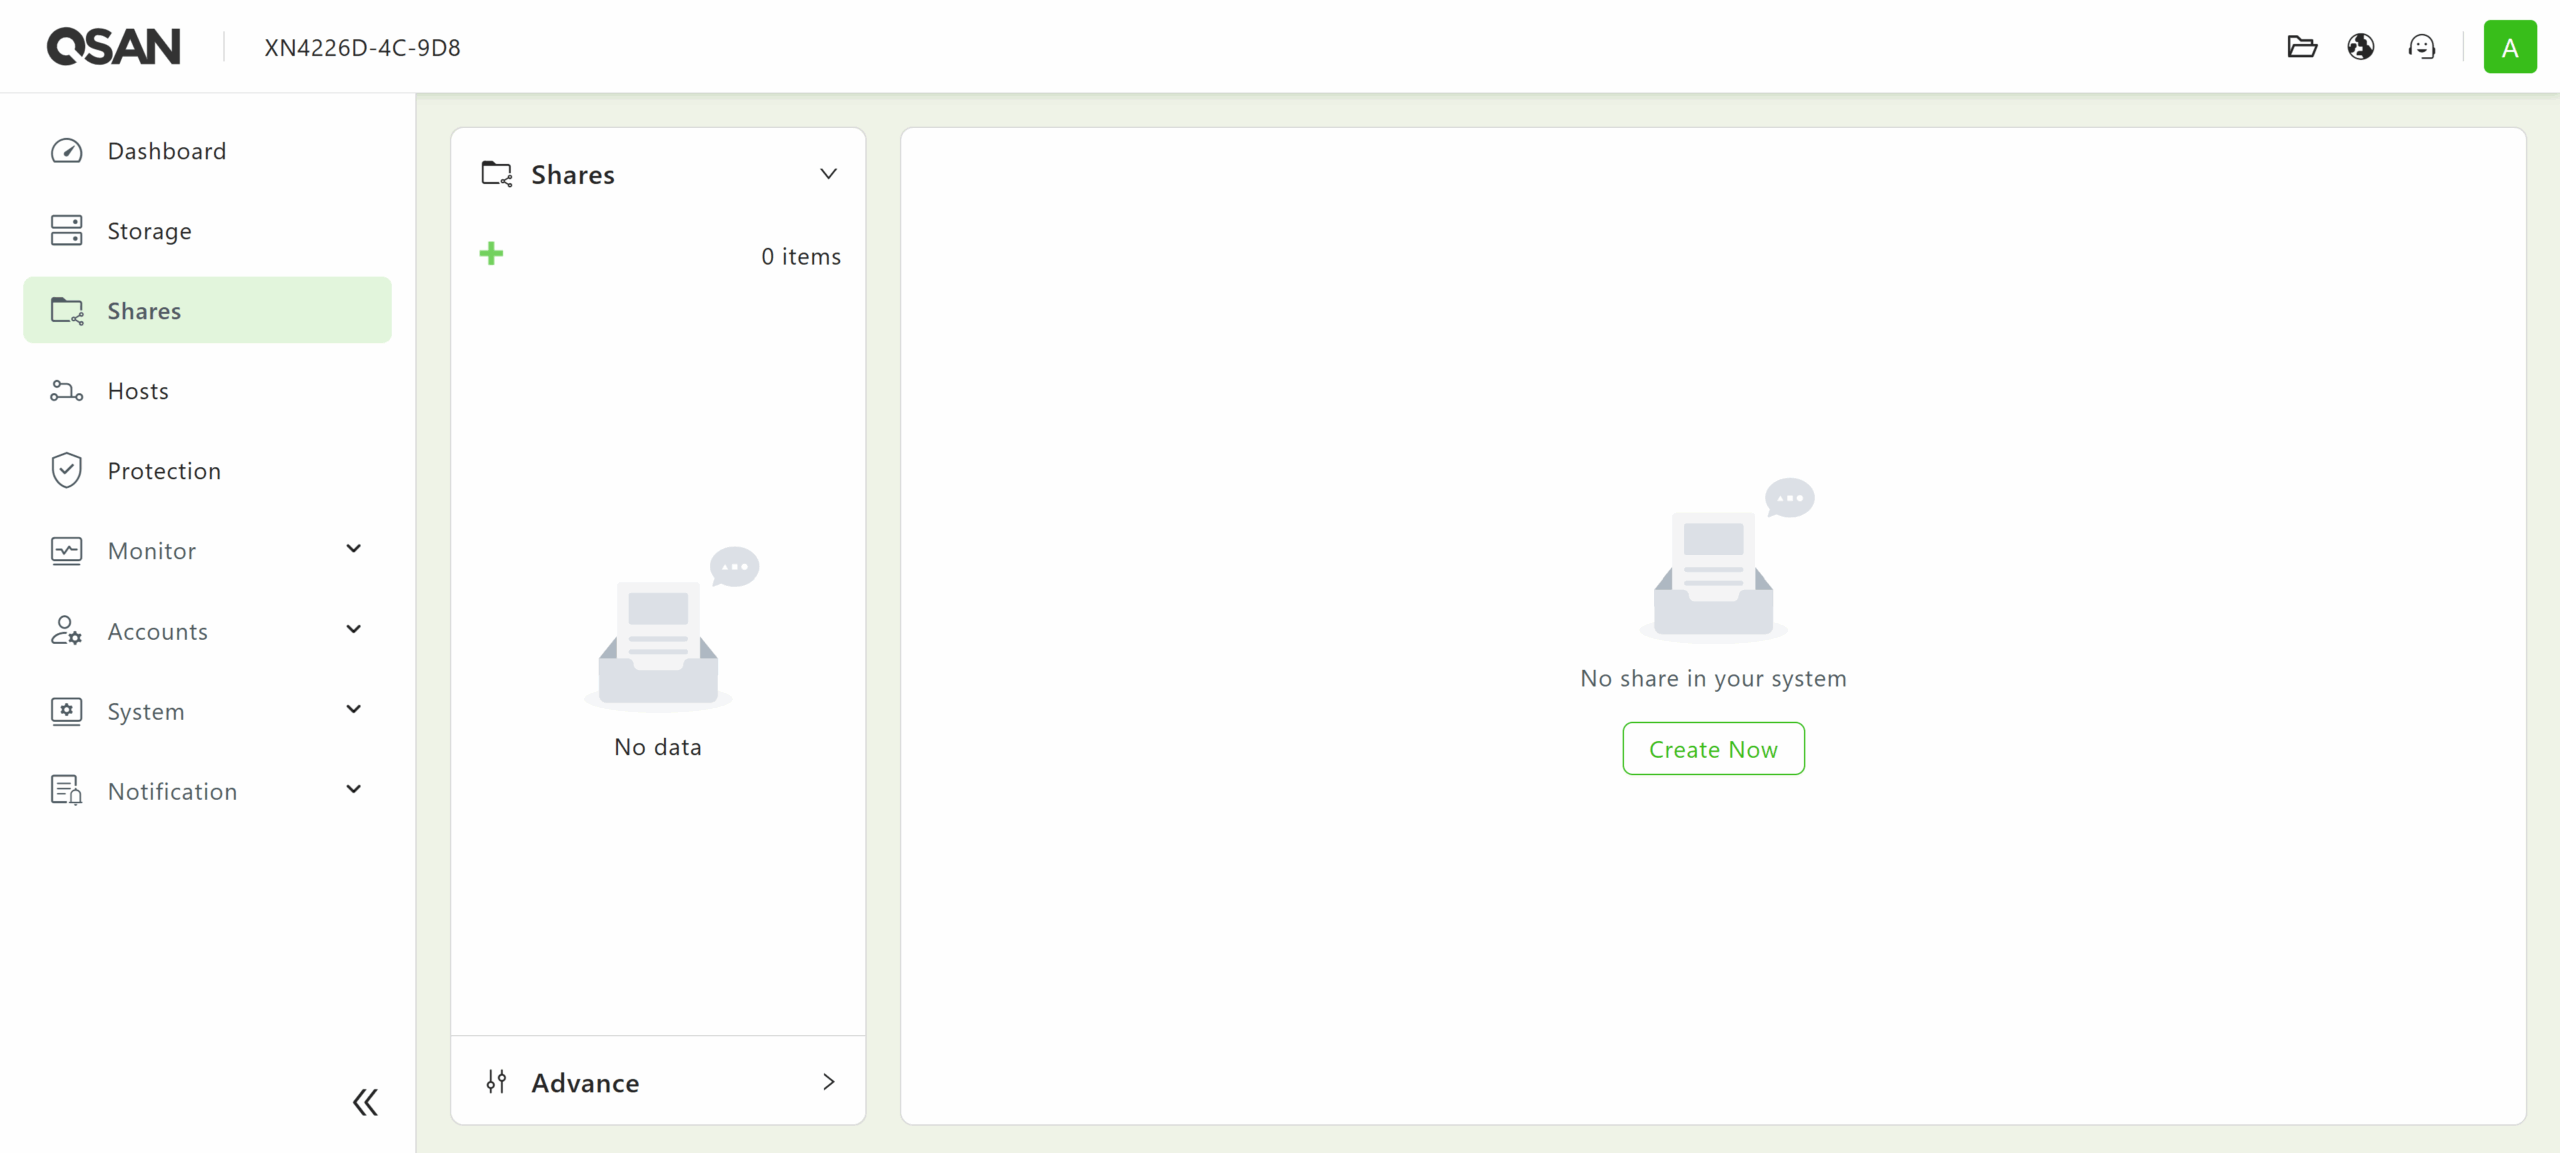
向下移動列表,「共用」選單可用於在檔案磁碟區上建立共用物件。支援的共享協定包括 CIFS (SMB)、FTP、NFS 和 WebDAV。
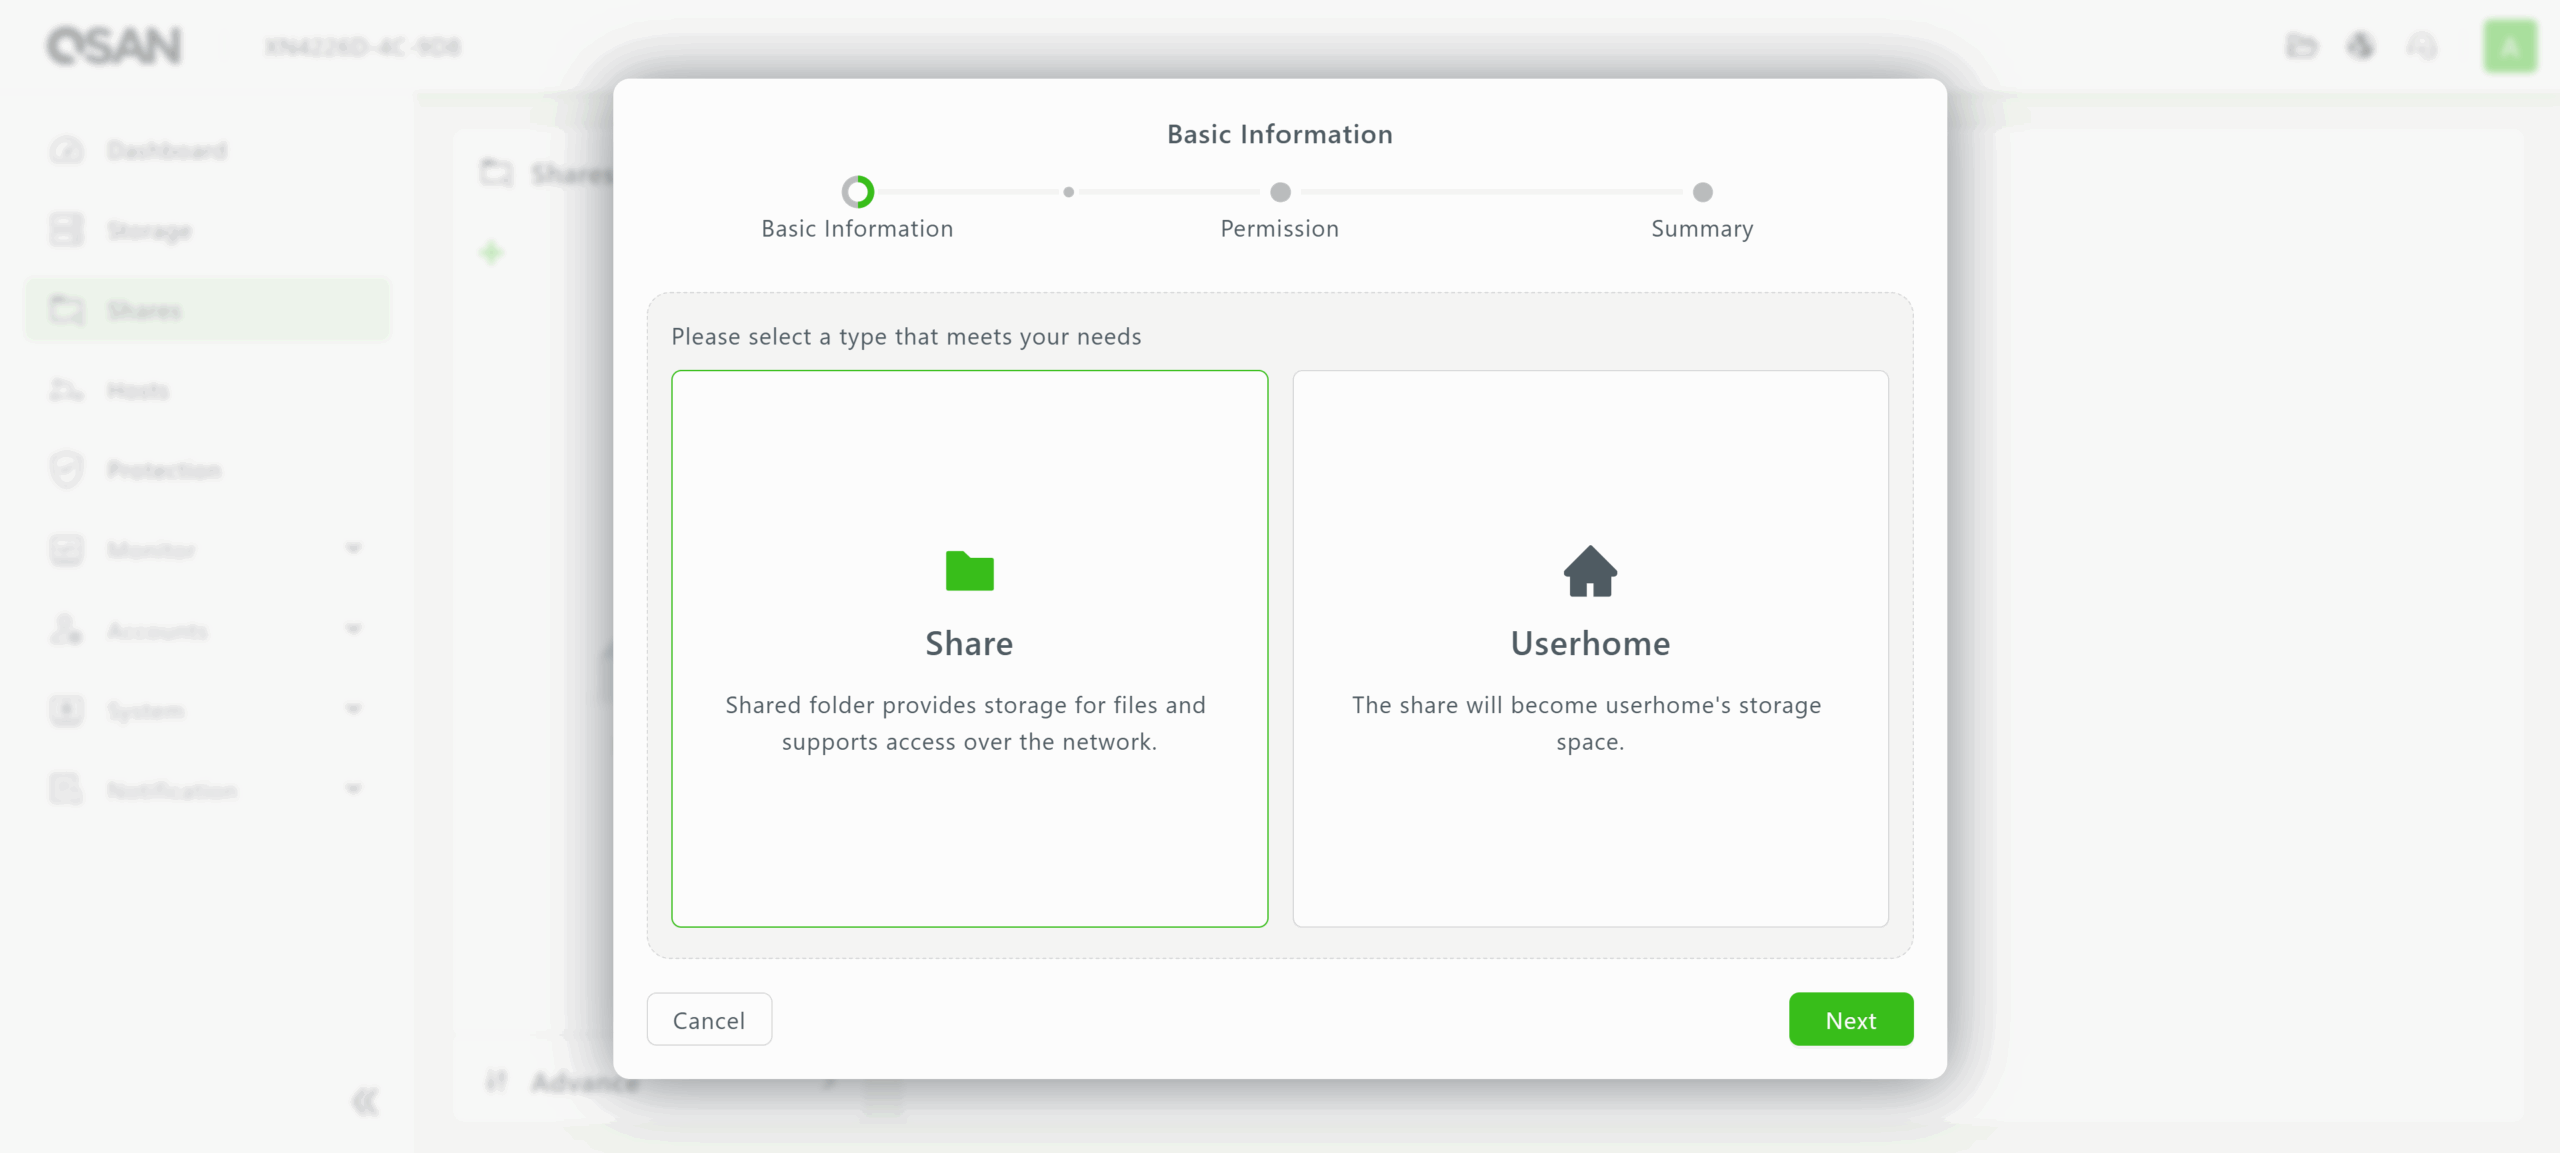
 建立新共用時,QSM 4 提供兩個選項:用於託管多個使用者存取的檔案的標準網路共用,以及用於保存只能單獨存取的使用者主資料夾的使用者主共用。
建立區塊磁碟區或檔案磁碟區和共用後,必須在「主機」選單中為其指派 IP 位址或主機名稱。主機根據其對應的是區塊儲存還是檔案(共享)儲存進行組織,如下面的螢幕截圖所示。
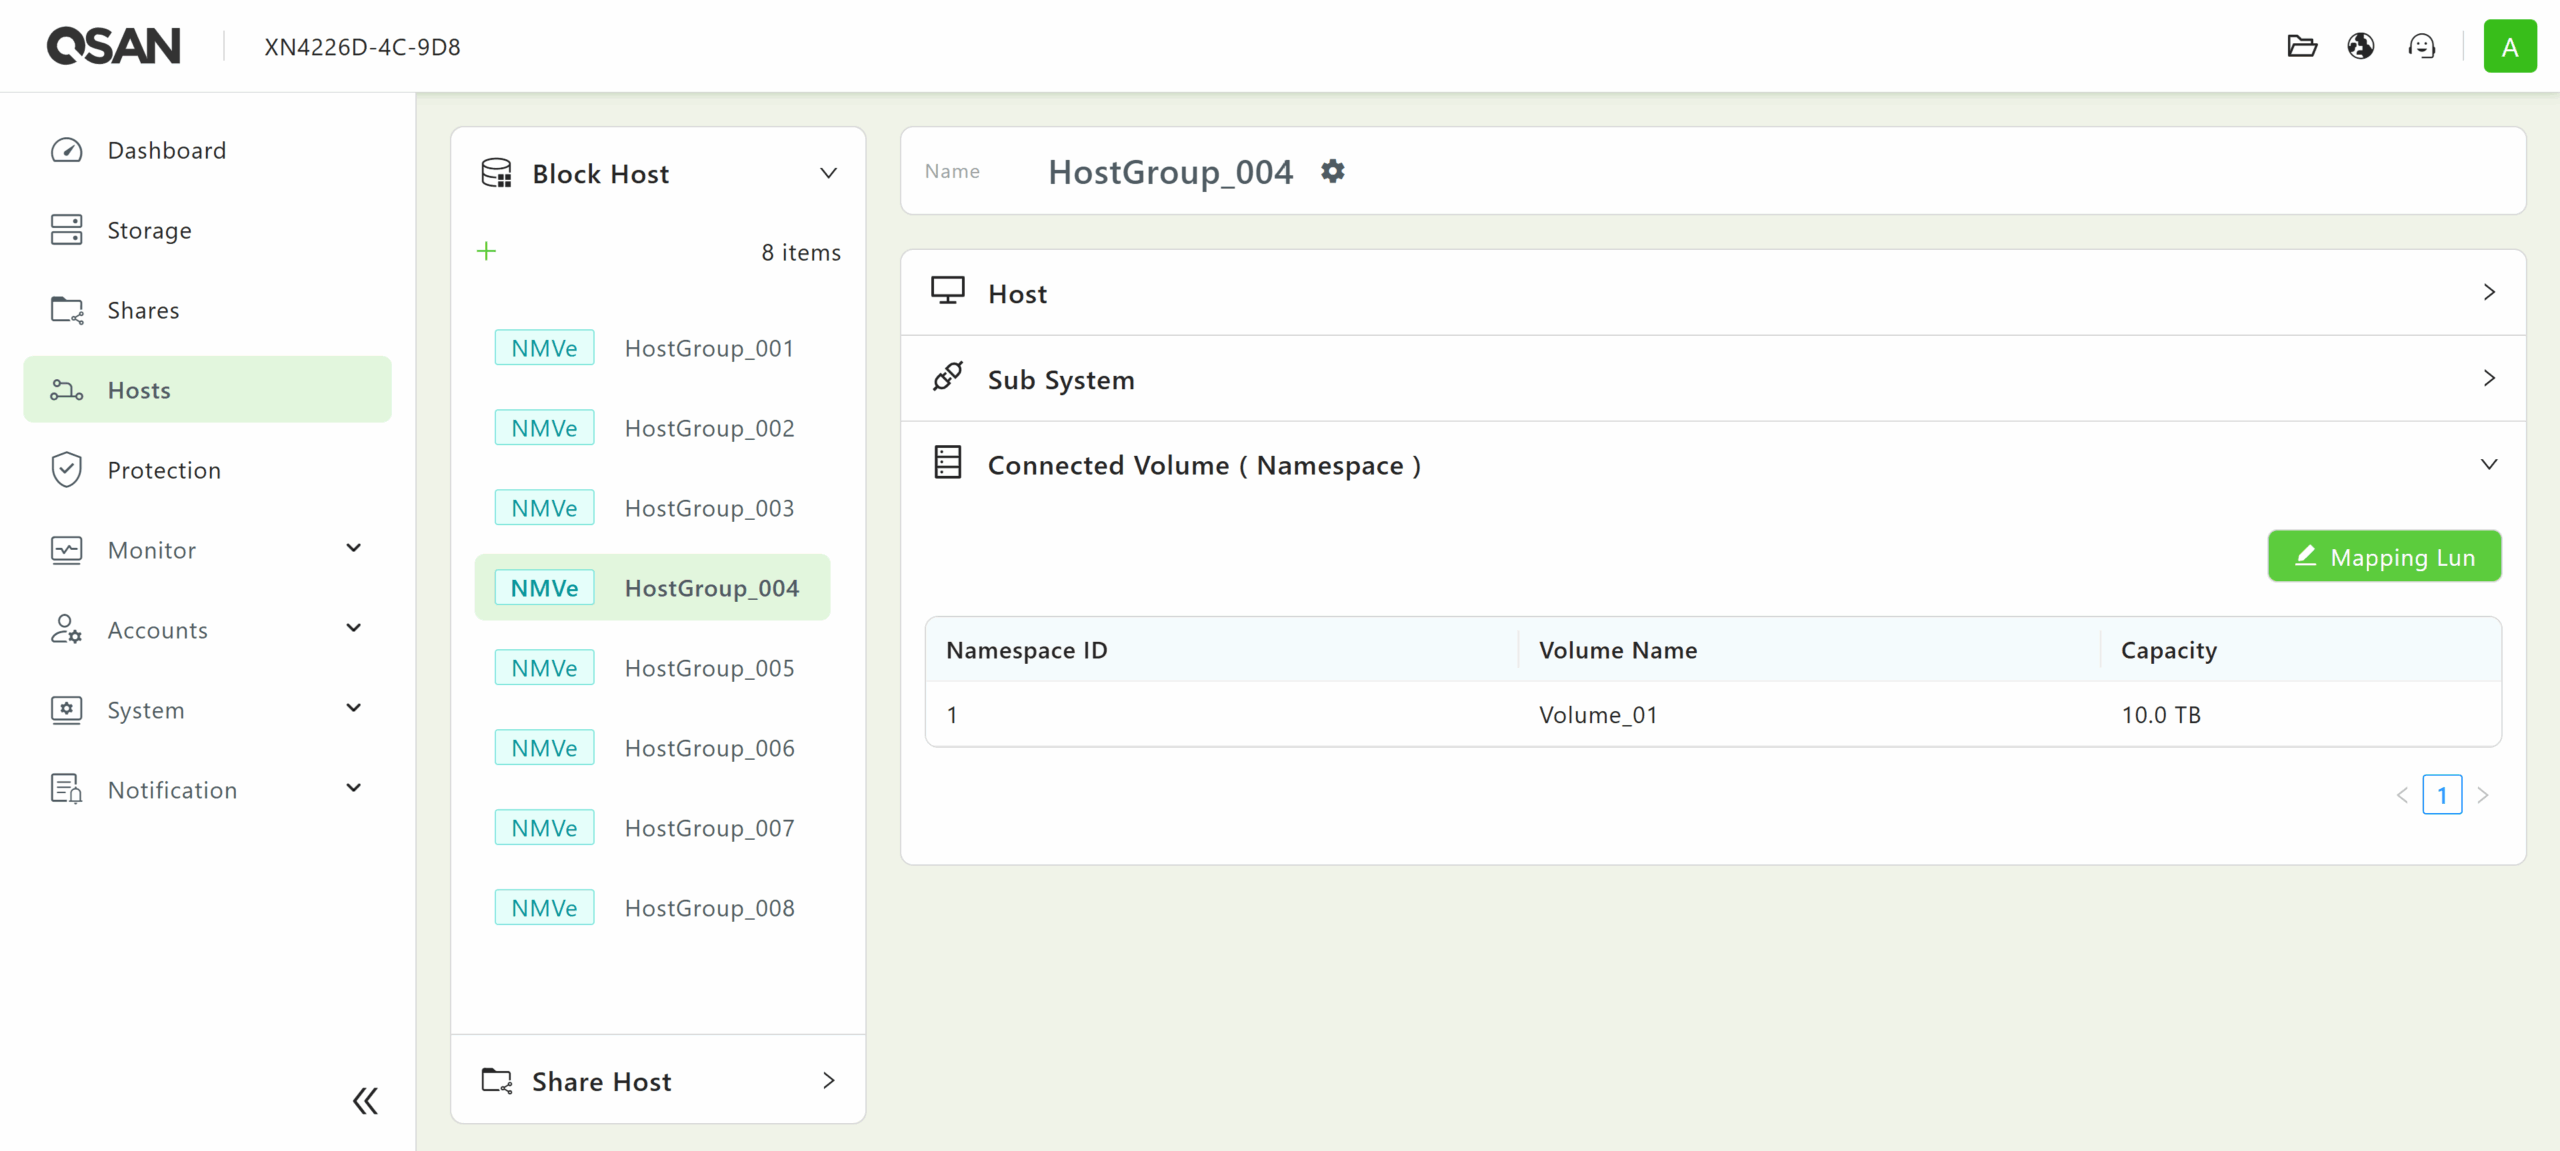
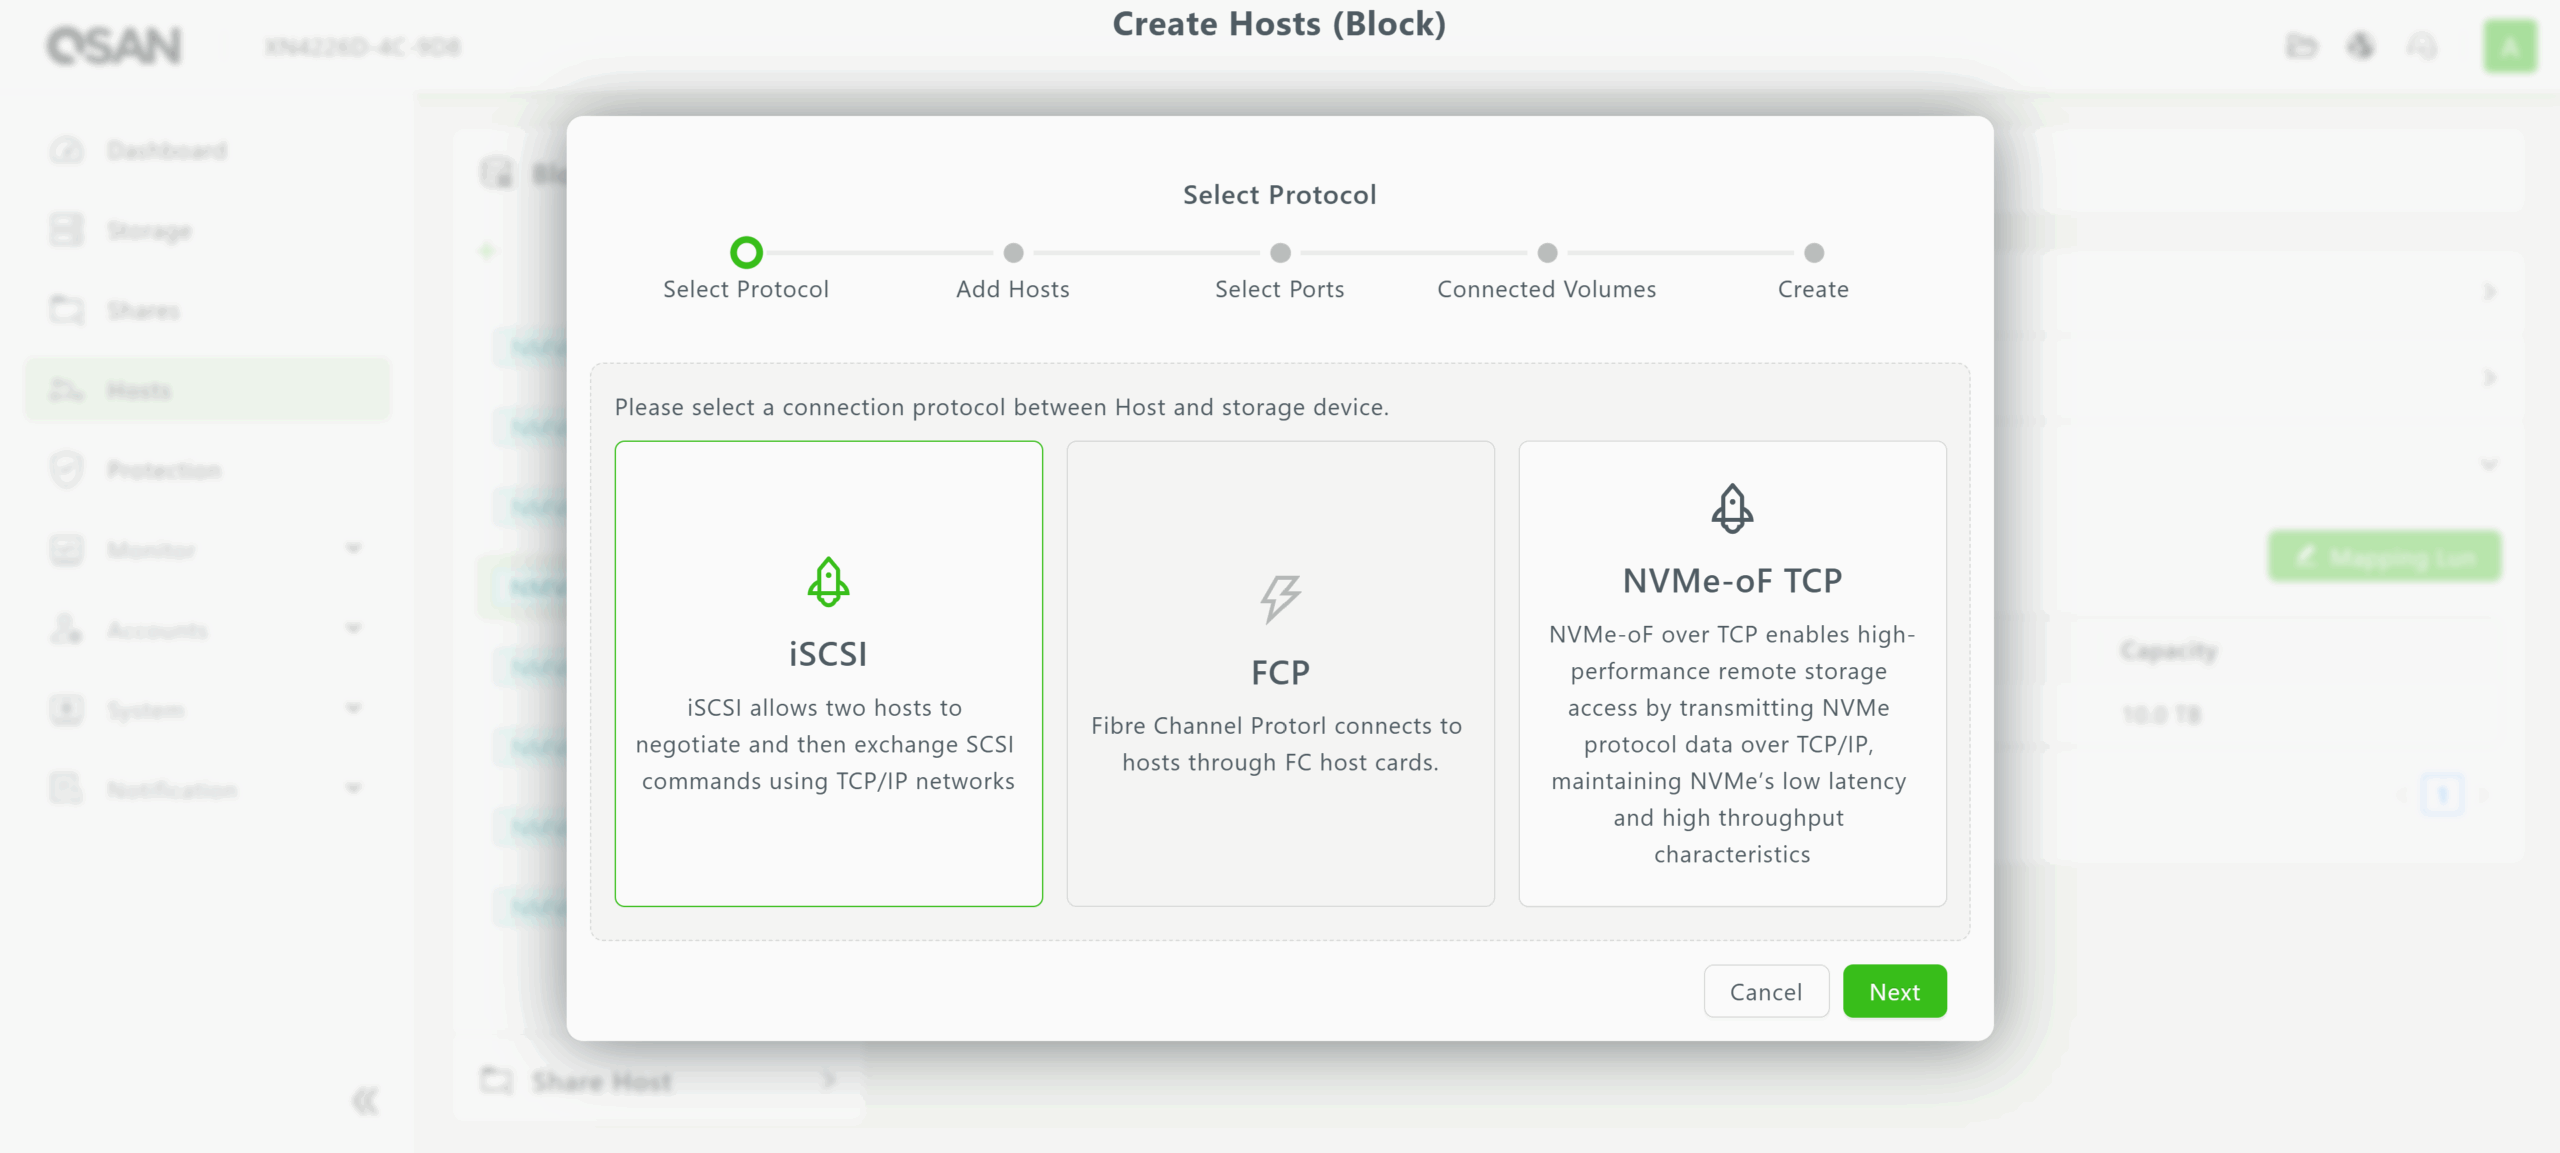
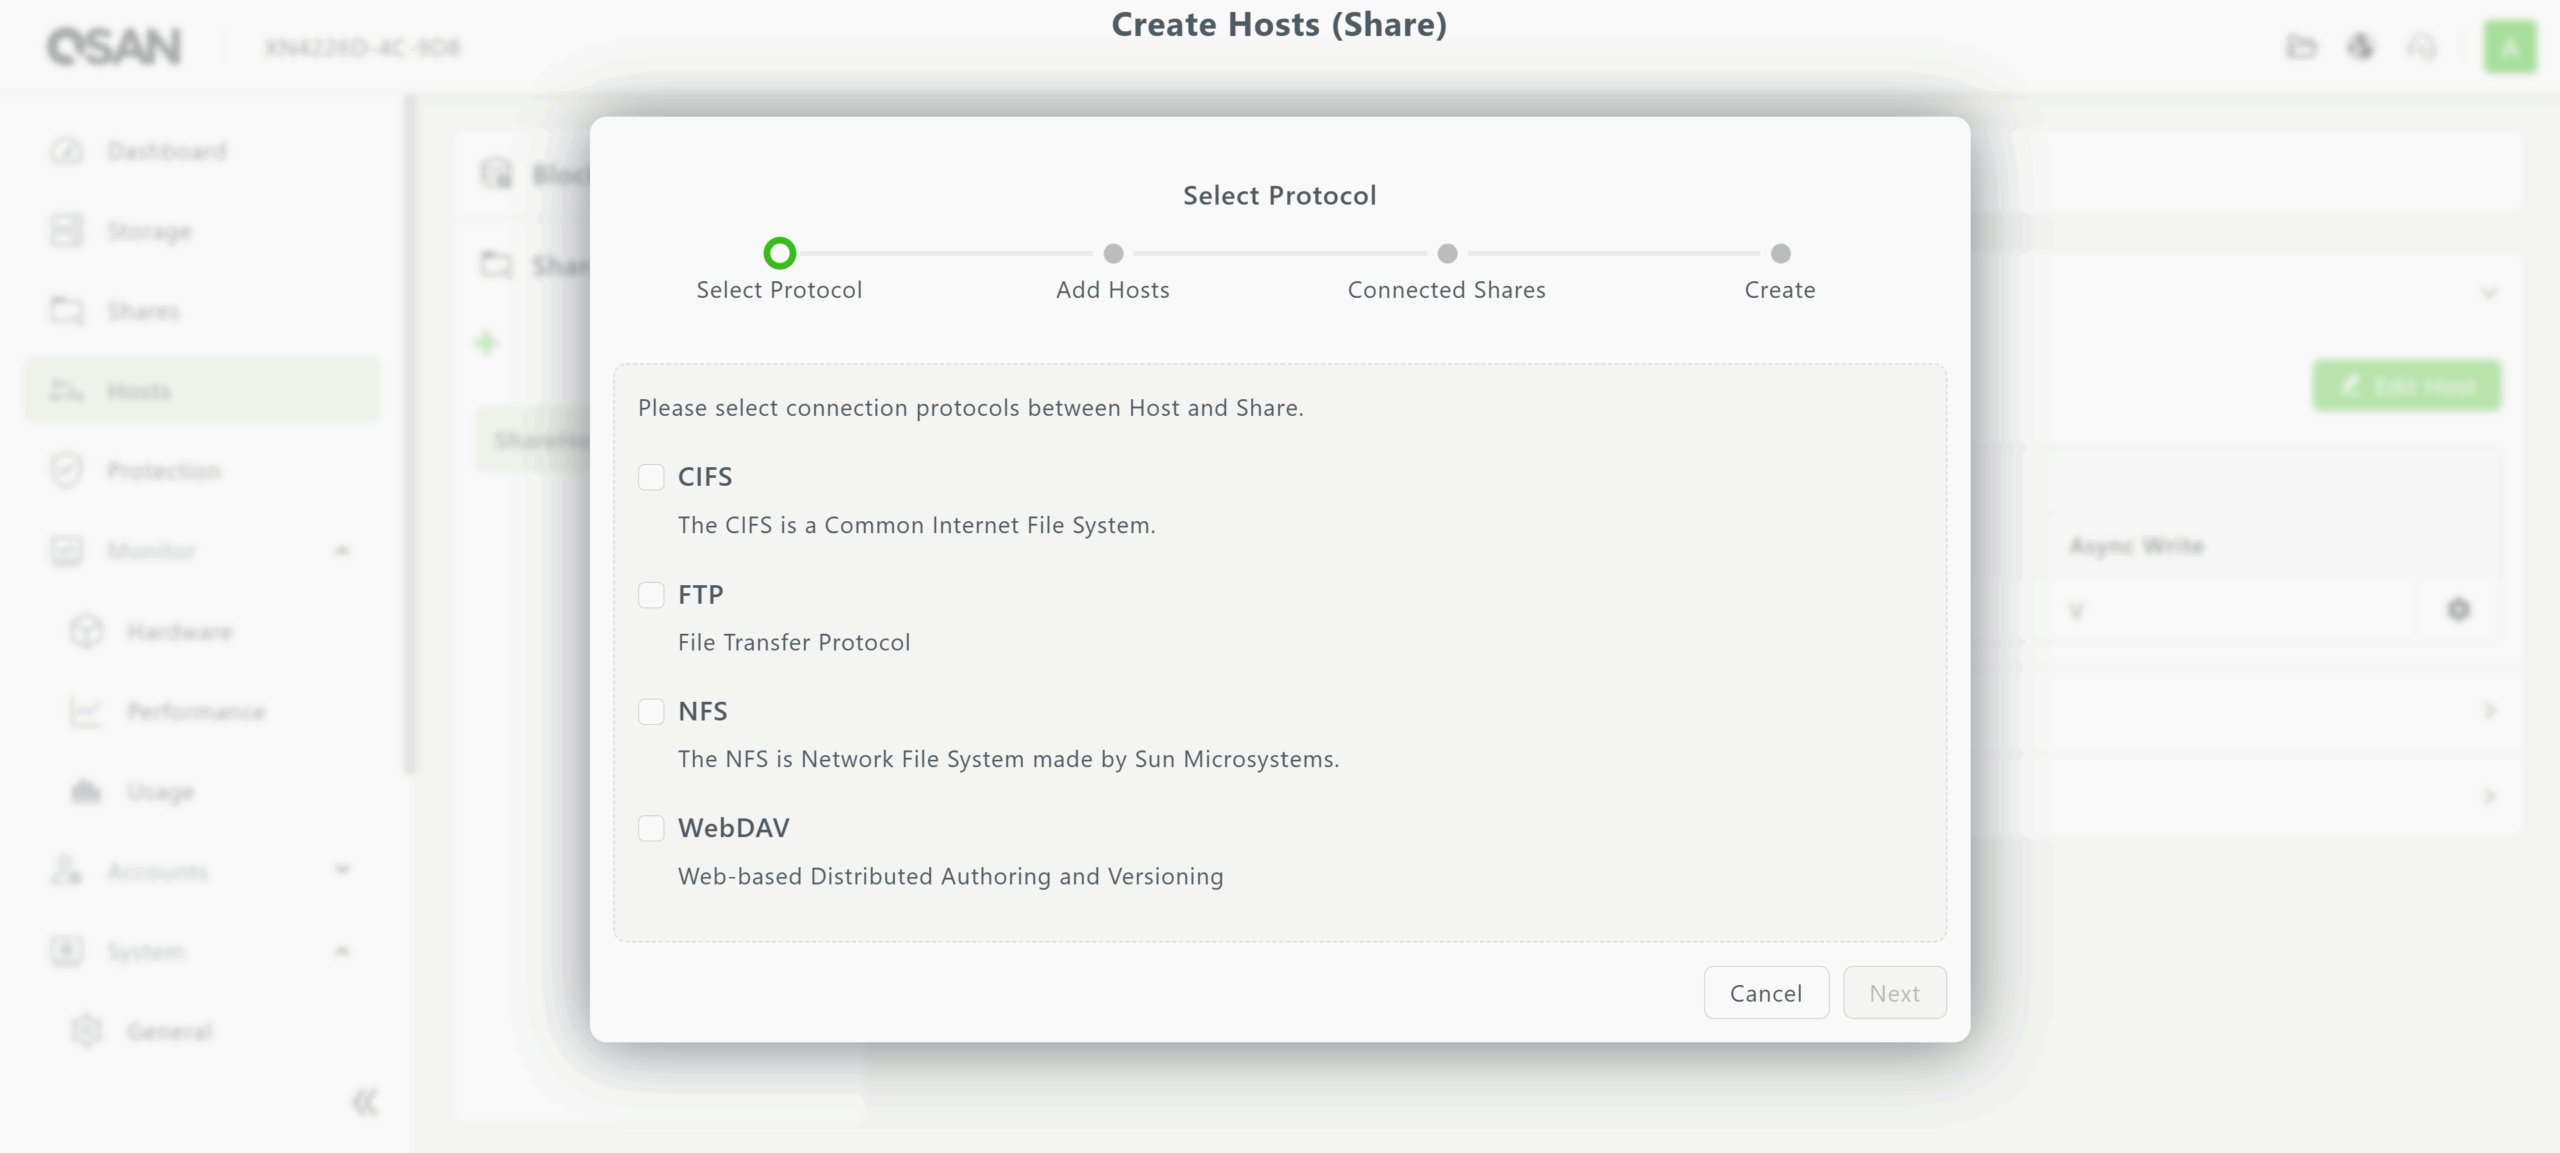
區塊儲存主機可以使用 iSCSI、FCP 或 NVMe-oF over TCP 協定來處理磁碟區。相較之下,文件(共享)儲存主機可以同時支援多種協議,為具有多樣化文件共享需求的資料中心提供必要的靈活性。
QSM 4 在監控選單中也提供了基本的監控功能,顯示陣列內各種硬體模組和驅動器的狀態,以及驅動器、儲存池、CPU 和記憶體使用情況的統計資料。
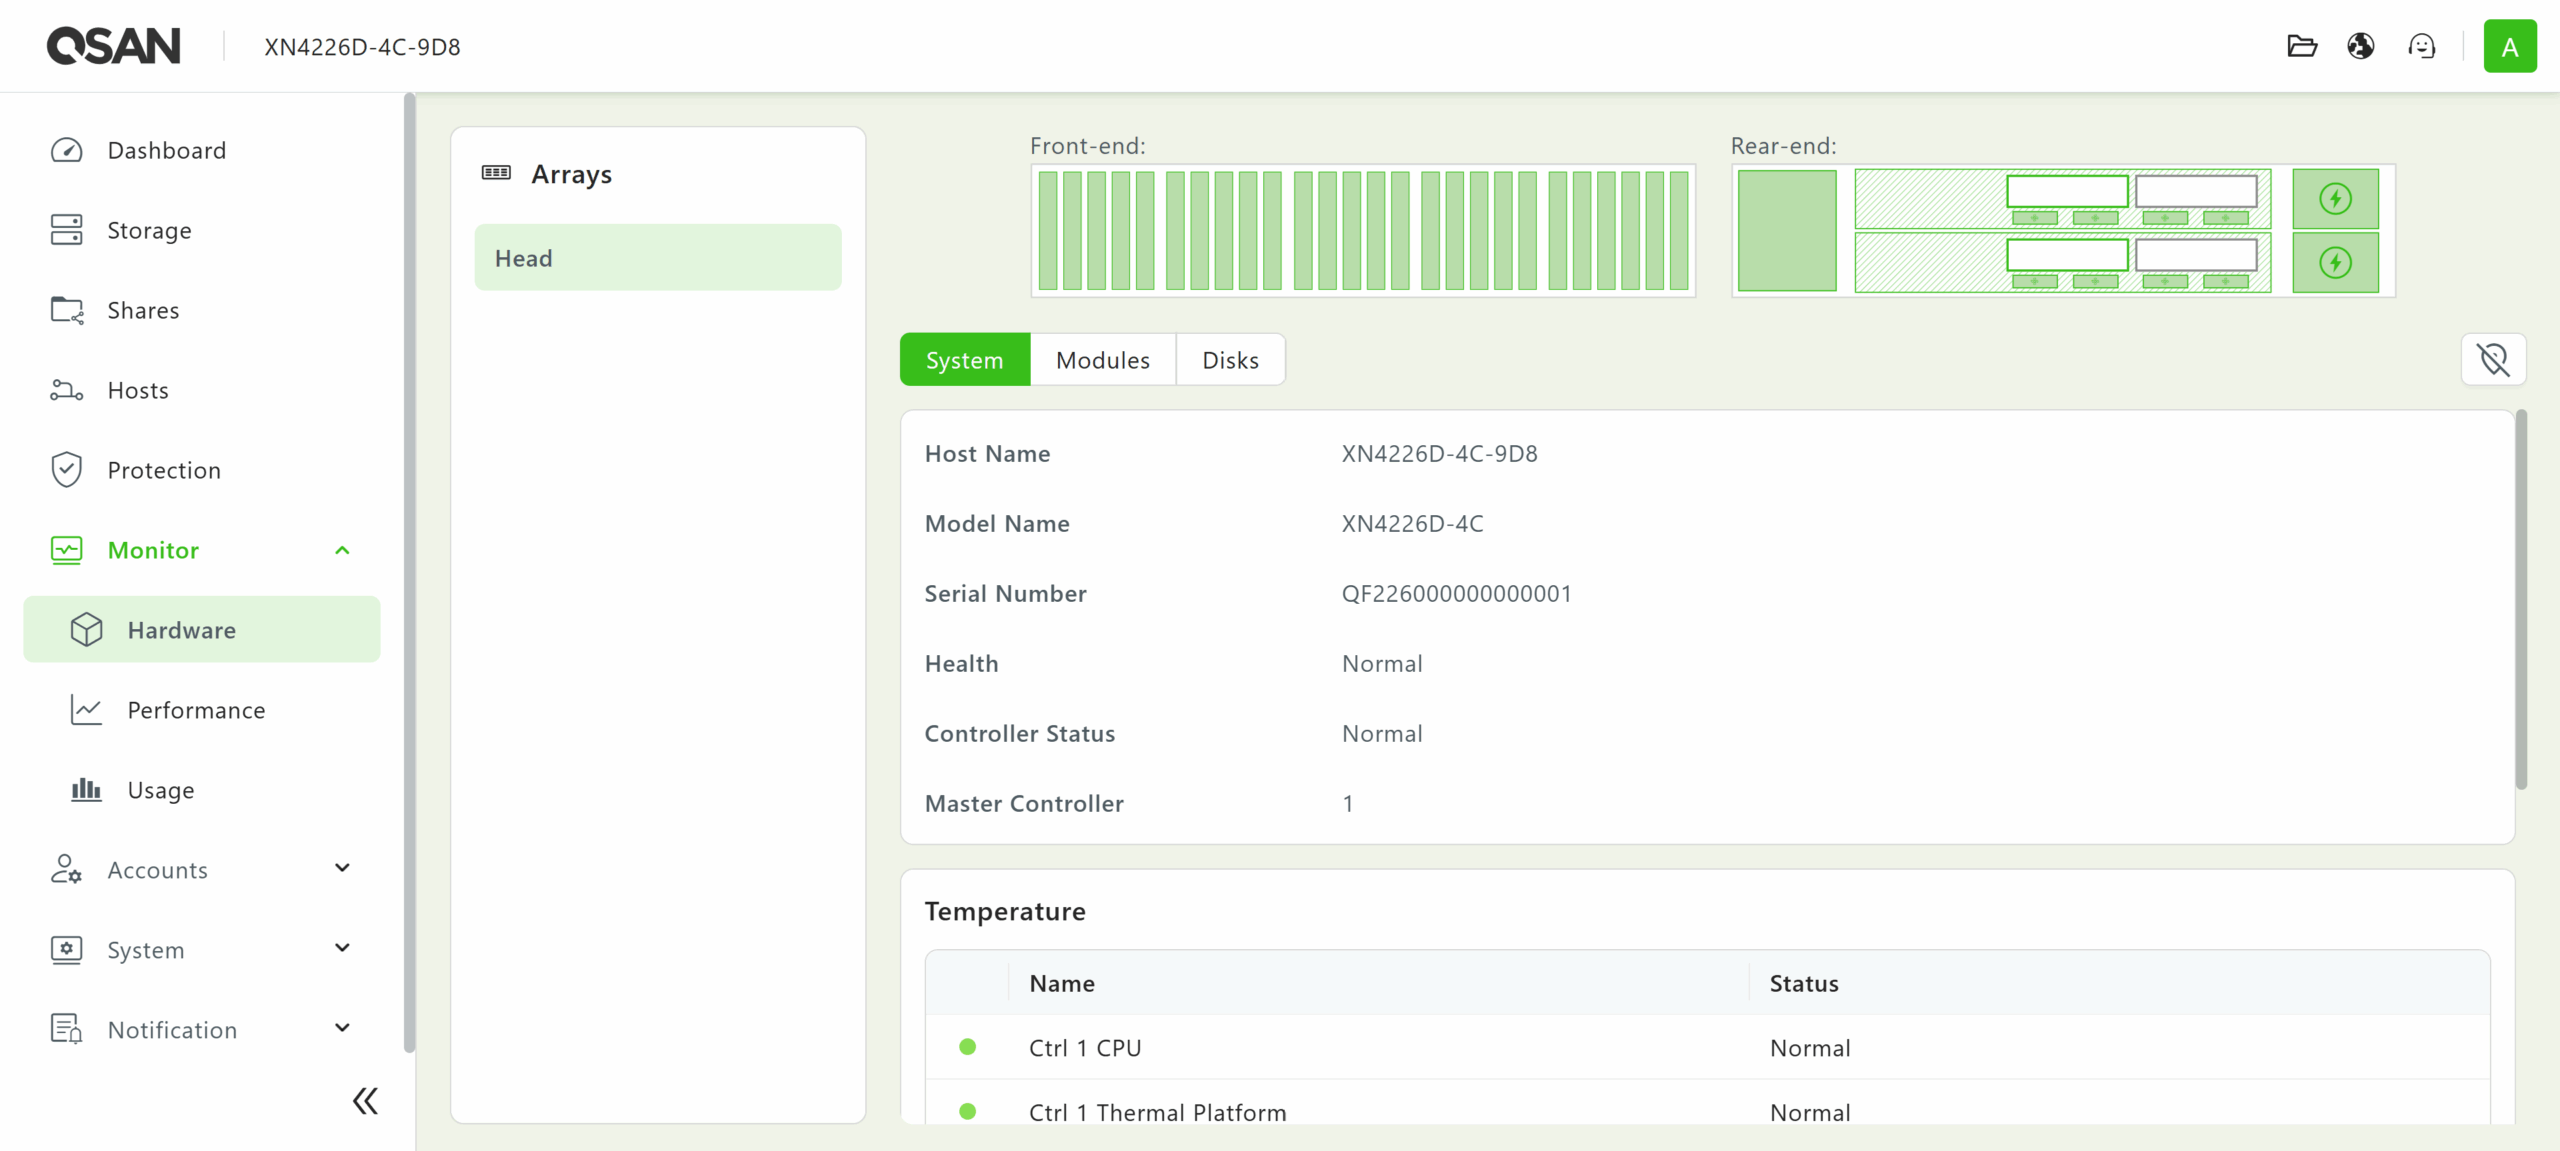
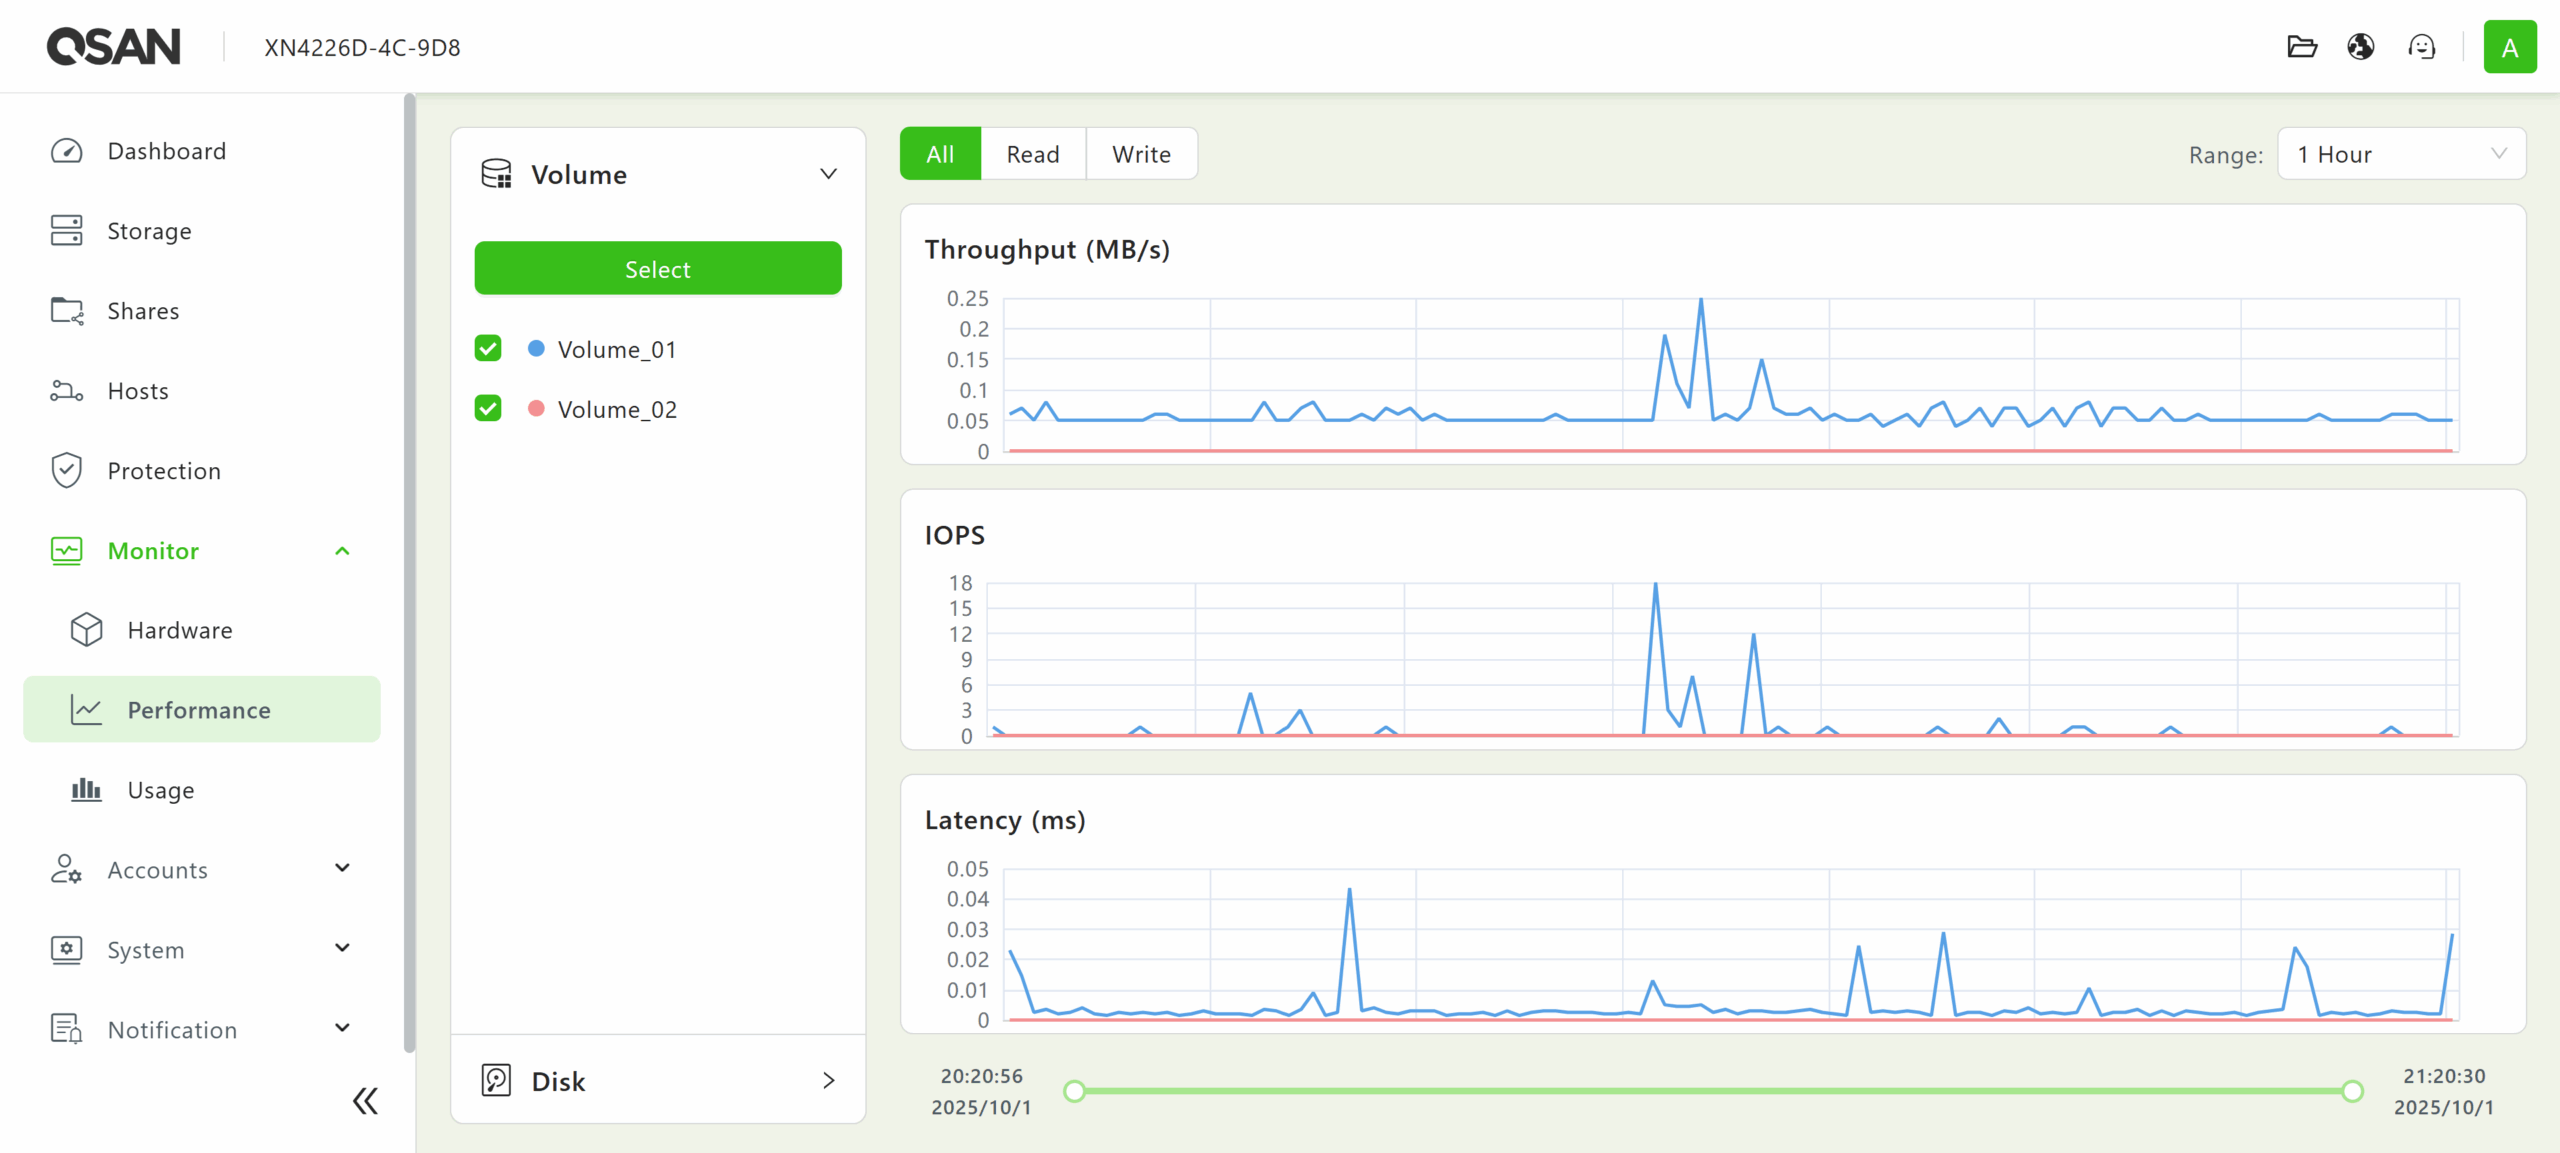
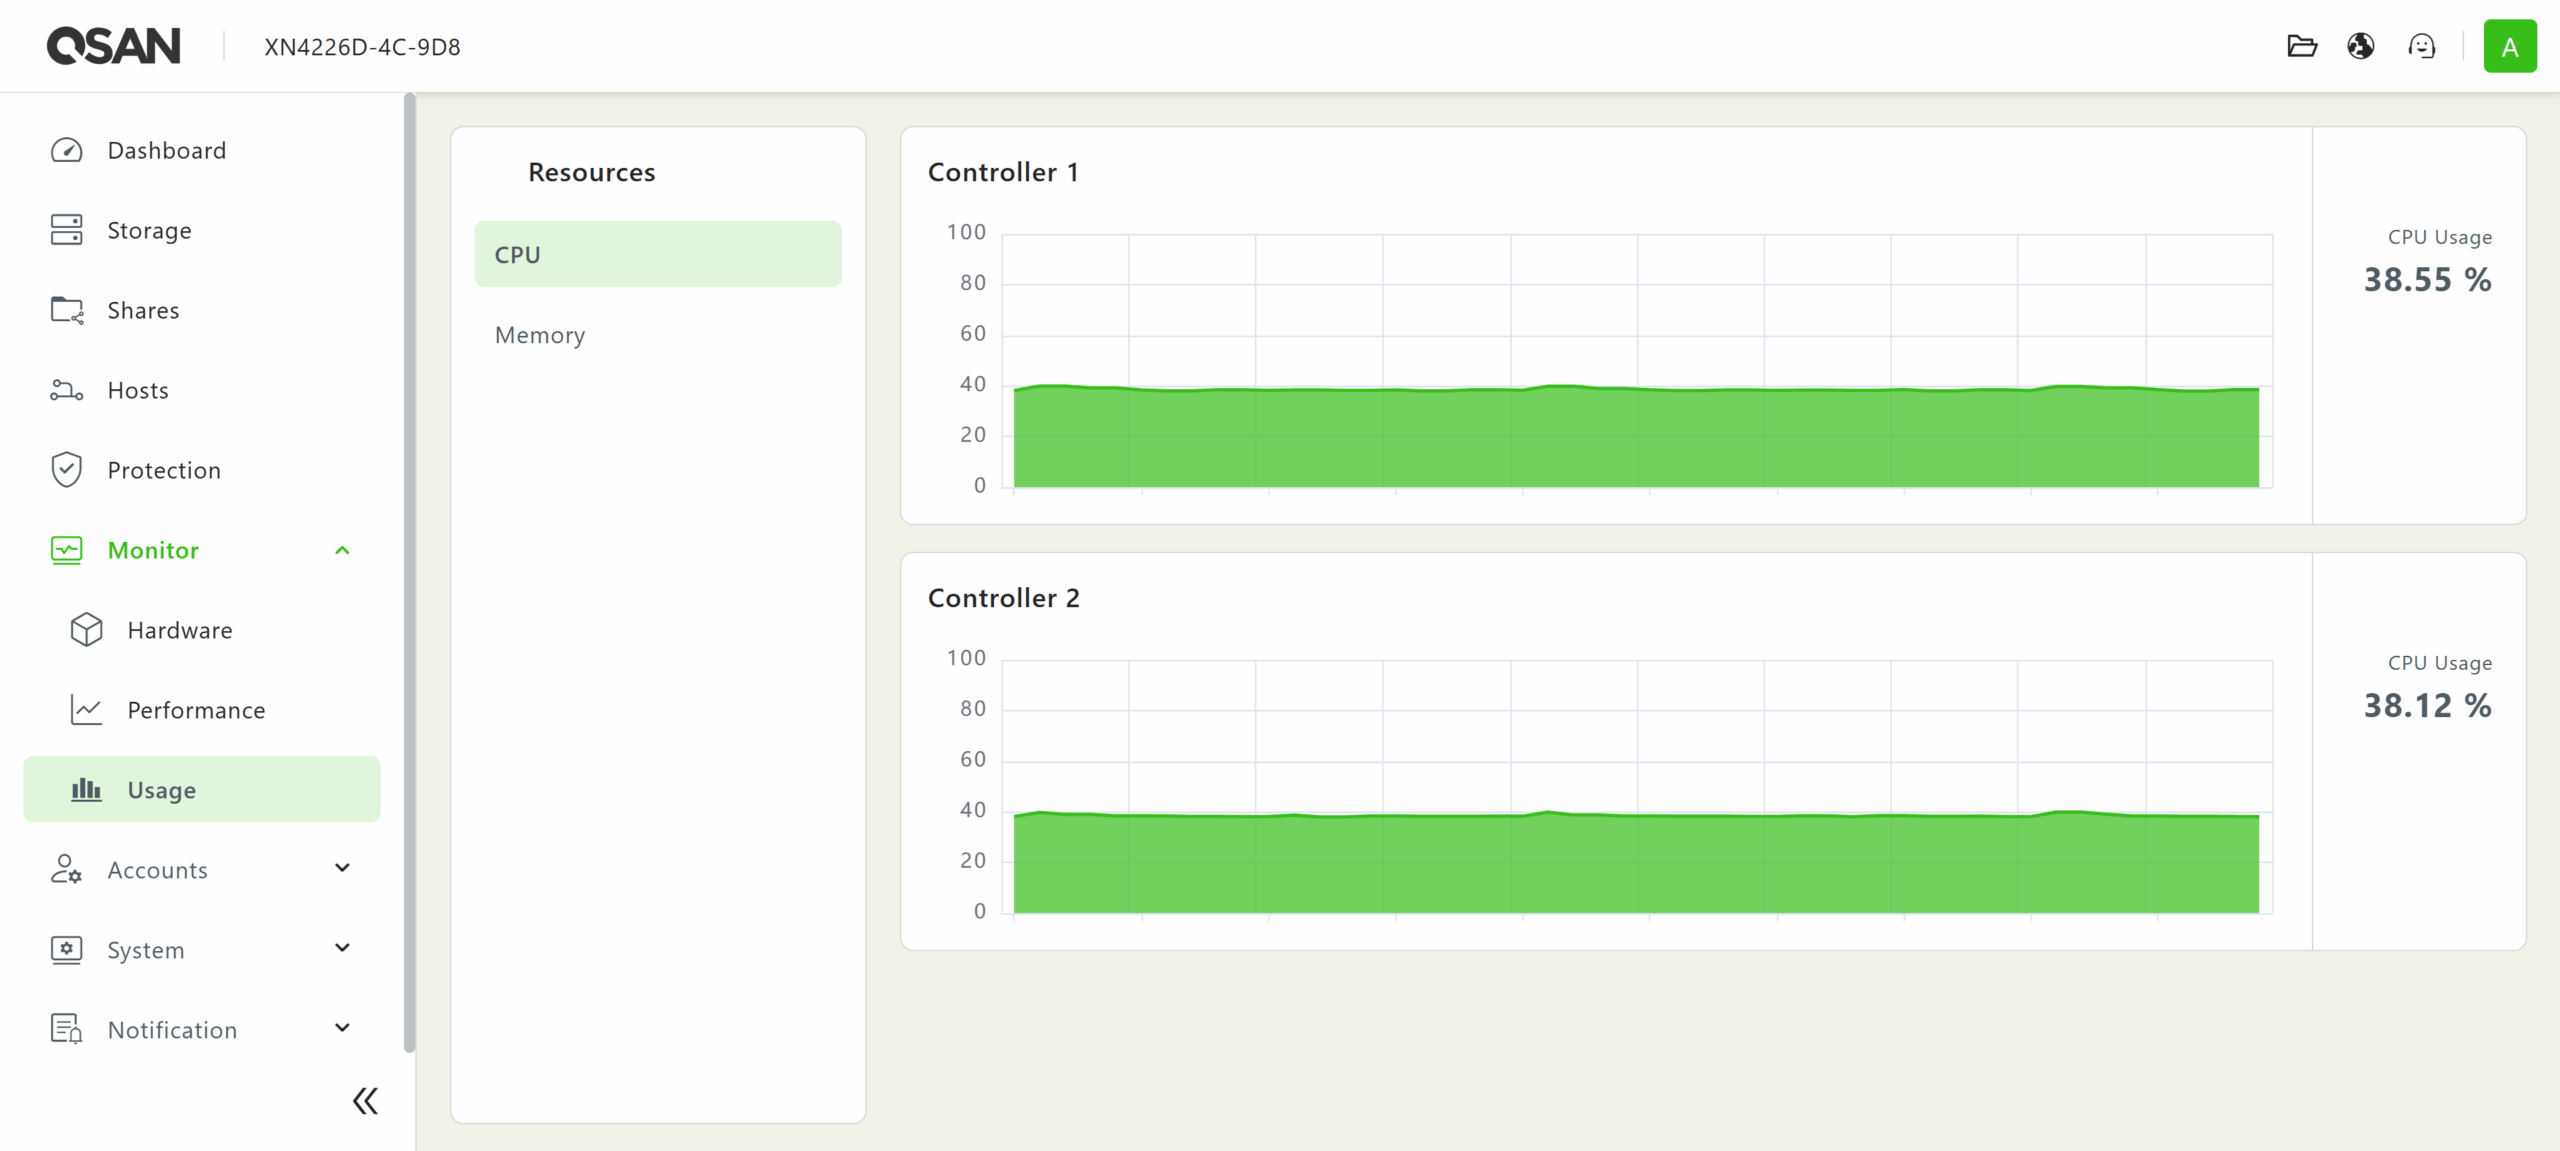
QSM 4 網頁使用者介面 (Web UI) 的「帳戶」選單下還提供了使用者、群組和網域管理功能。 “系統”選單中也提供各種 SAN 範圍的配置選項。 “通知”功能表可存取日誌記錄和警報功能。最後,您可以在功能表列的右上角找到 QSAN 文件管理器、語言支援和登出/電源管理圖示。
簡單的 Proxmox 集成
Proxmox 原生支援 NVMe over Fabrics (NVMe-oF),可輕鬆將高效能儲存陣列整合到叢集中。流程首先在儲存系統上配置 NVMe-oF 目標。然後,使用 Proxmox 主機發現並連接這些目標。連接後,您需要配置系統以確保這些連接在重新啟動後仍然有效。
在我們的範例中,使用 shell 命令執行發現,該命令指定陣列的 IP 位址和服務連接埠。
nvme discover -t tcp -a 172.16.16.100 -s 4420
nvme discover -t tcp -a 172.13.13.100 -s 4420
接下來,透過引用其 NQN 連接到已配置的命名空間。
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev4 -a 172.16.16.100 -s 4420
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev6 -a 172.13.13.100 -s 4420
為了確保設定在重新啟動後仍然有效,可以將發現位址附加到 NVMe 發現設定檔中。
echo "discover -t tcp -a 172.16.16.100 -s 4420" | tee -a /etc/nvme/discovery.conf
echo "discover -t tcp -a 172.13.13.100 -s 4420" | tee -a /etc/nvme/discovery.conf
最後,啟用自動連線服務,以便 Proxmox 在啟動時自動重新建立 NVMe 會話。
systemctl enable nvmf-autoconnect.serviceProxmox 可與 QSAN 儲存無縫集成,提供 NVMe 的低延遲、高頻寬效能以及網路結構的靈活性。
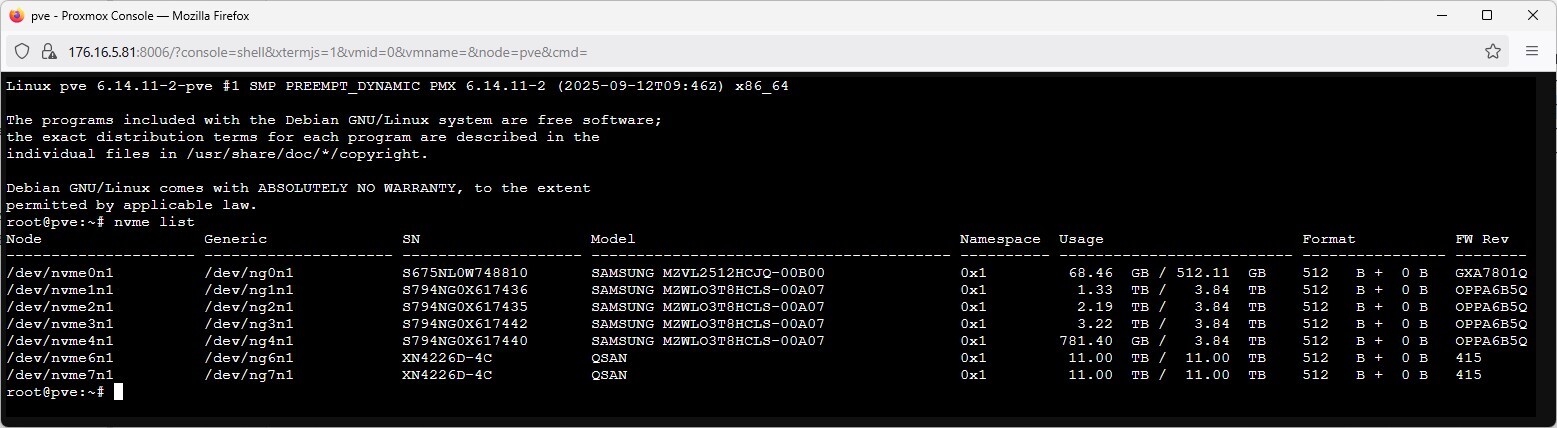
連接我們的 QSAN 後,我們可以從 Proxmox shell 發出「nvme list」命令來顯示所有 NVMe 設備,其中新新增的 QSAN 磁碟區顯示為 /dev/nvme6n1 和 /dev/nvme7n1,每個都有 11TB 的儲存空間。
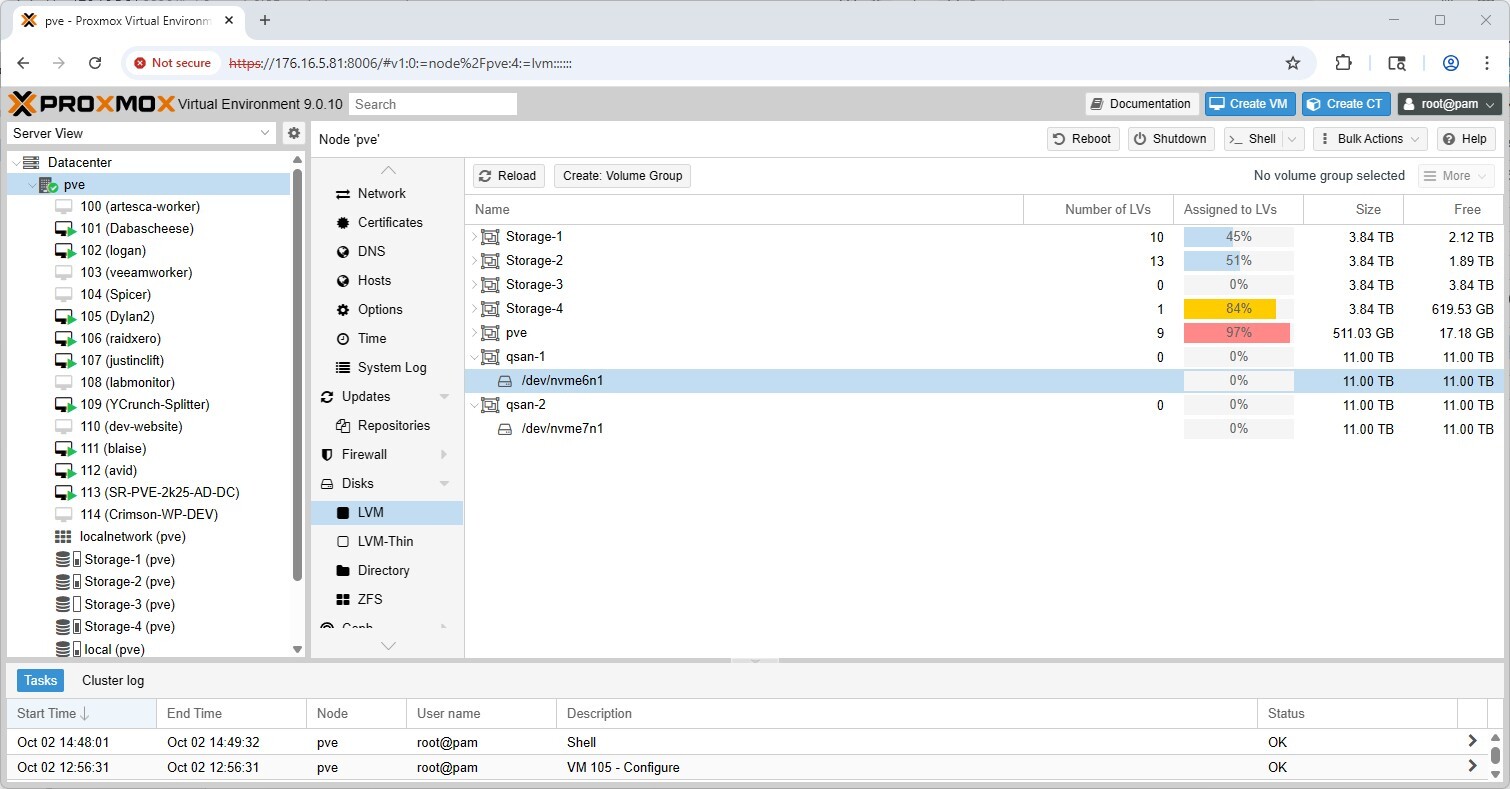
一旦 QSAN 儲存在 Proxmox GUI 中可見,我們就可以建立一個新的 LVM 磁碟區組:pve > 磁碟 > LVM,兩個 11TB 裝置(/dev/nvme6n1 和 /dev/nvme7n1)就會出現,並且可以初始化為單獨的磁碟區組(例如,qsan-1 和 qsan-2)以供使用。
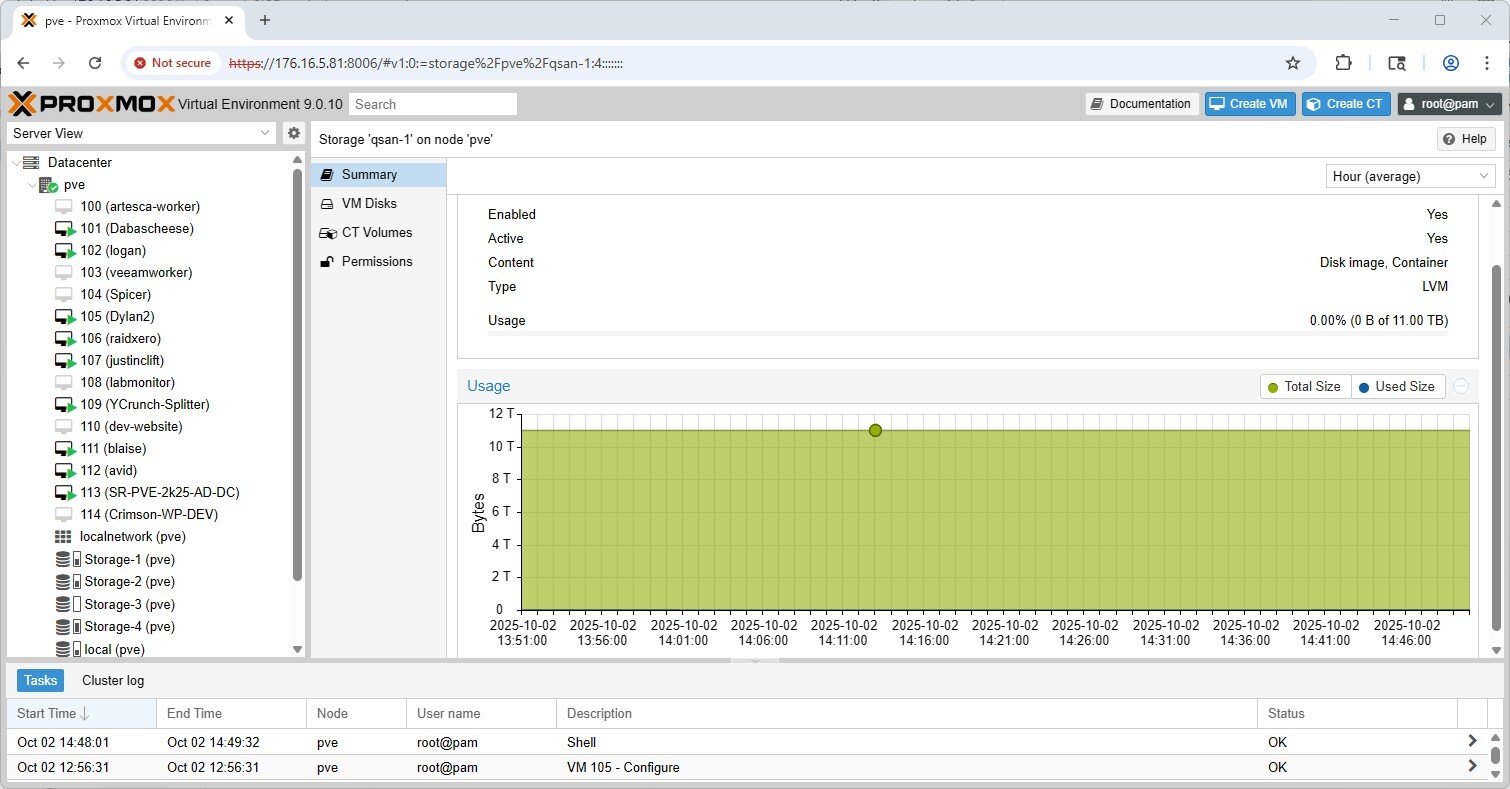
按一下儲存窗格中的一個新的 LVM 池 (qsan-1) 表示它處於線上狀態、已啟用且可供使用,具有完整的 11TB 容量,並可用於 VM 和容器配置。
性能測試
我們在兩個環境中測試了 QSAN XN4226D,並利用了不同的測試平台。第一個環境基於 Dell PowerEdge R750 構建,配備 4 個 NVIDIA ConnectX-5 雙端口 25G 網路卡。我們使用八條 DAC 線纜將 QSAN XN4226D 直接連接到該伺服器。此設定充分利用了 QSAN 上所有可用的網路端口,從而能夠展現其最高的峰值效能。
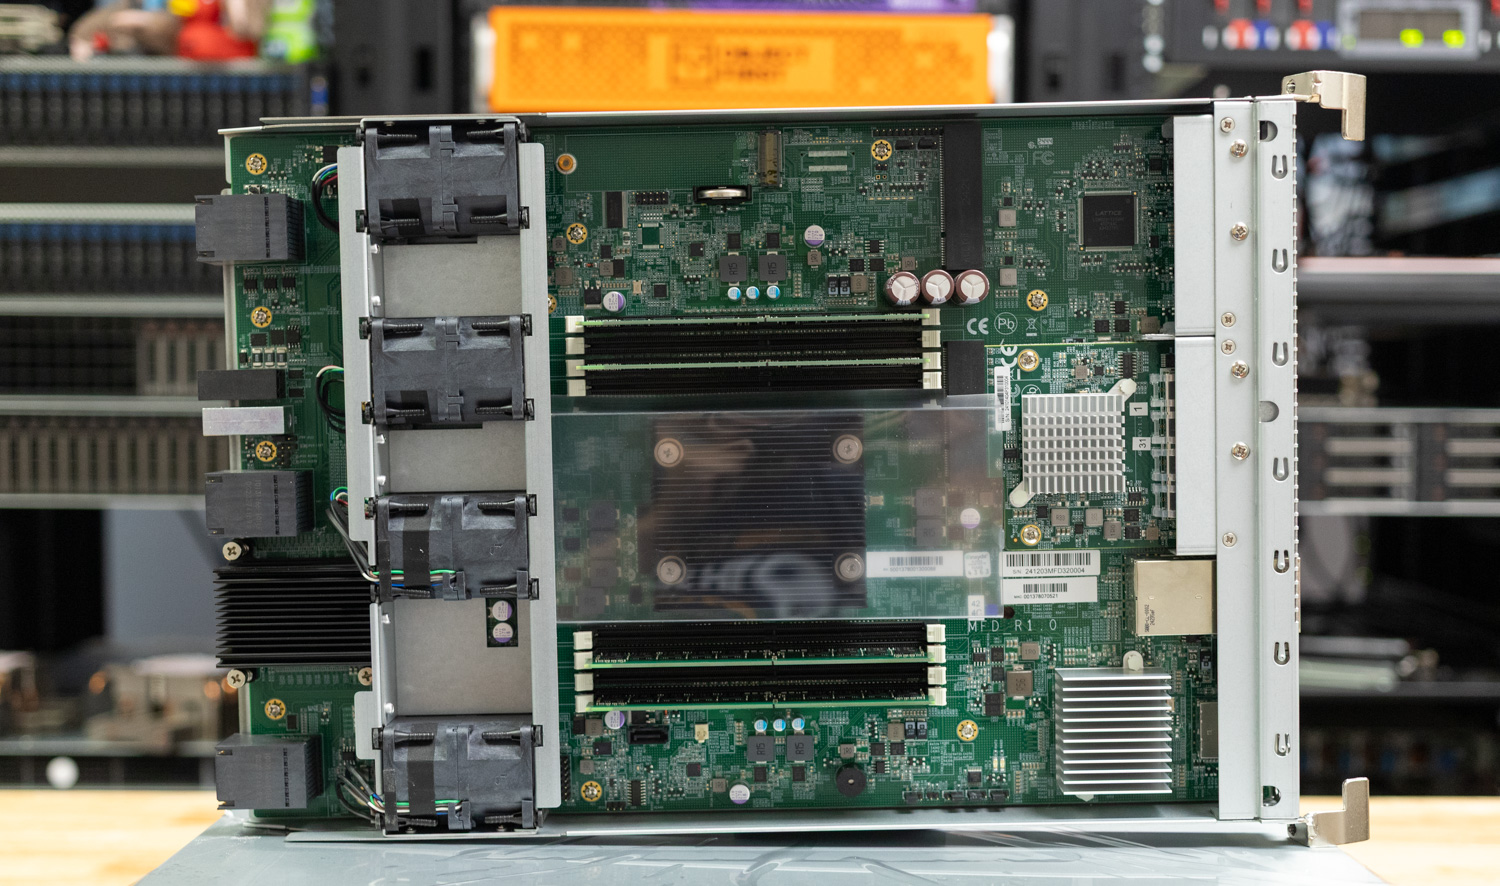
對於 FIO 測試,我們使用了兩個 RAID6 儲存池,建立了八個區塊磁碟區,並均勻分佈在兩個控制器上。每個磁碟區都分配給一個唯一的目標,並為每個磁碟區分配一個 IP 位址。我們在此平台上測量了 NVMe-oF RDMA 和 TCP。
GDSIO 的第二個環境採用了配備兩塊 NVIDIA H100 GPU 和四埠 Broadcom 25G 網路卡的 Dell PowerEdge R7715。在這個環境中,我們保留了相同的 QSAN 卷佈局,但將捲數量從八個減少到了四個。使用四埠網路卡,我們使用四個 25G 連線將伺服器直接連接到儲存陣列。
FIO性能基準
為了測量 QSAN XN4226D 的儲存效能,我們採用了業界通用指標並利用了 FIO 工具。每個儲存設備都經過相同的測試流程,其中包括一個預處理步驟,即兩次以順序寫入工作負載填充整個驅動器,然後測量穩態效能。隨著被測工作負載類型的變化,我們會再次運行一次以新傳輸大小填充的預處理填充。
在本節中,我們將重點放在以下 FIO 基準:
- 1M 順序
- 64K隨機
- 16K隨機
- 4K隨機
1M 順序寫入頻寬
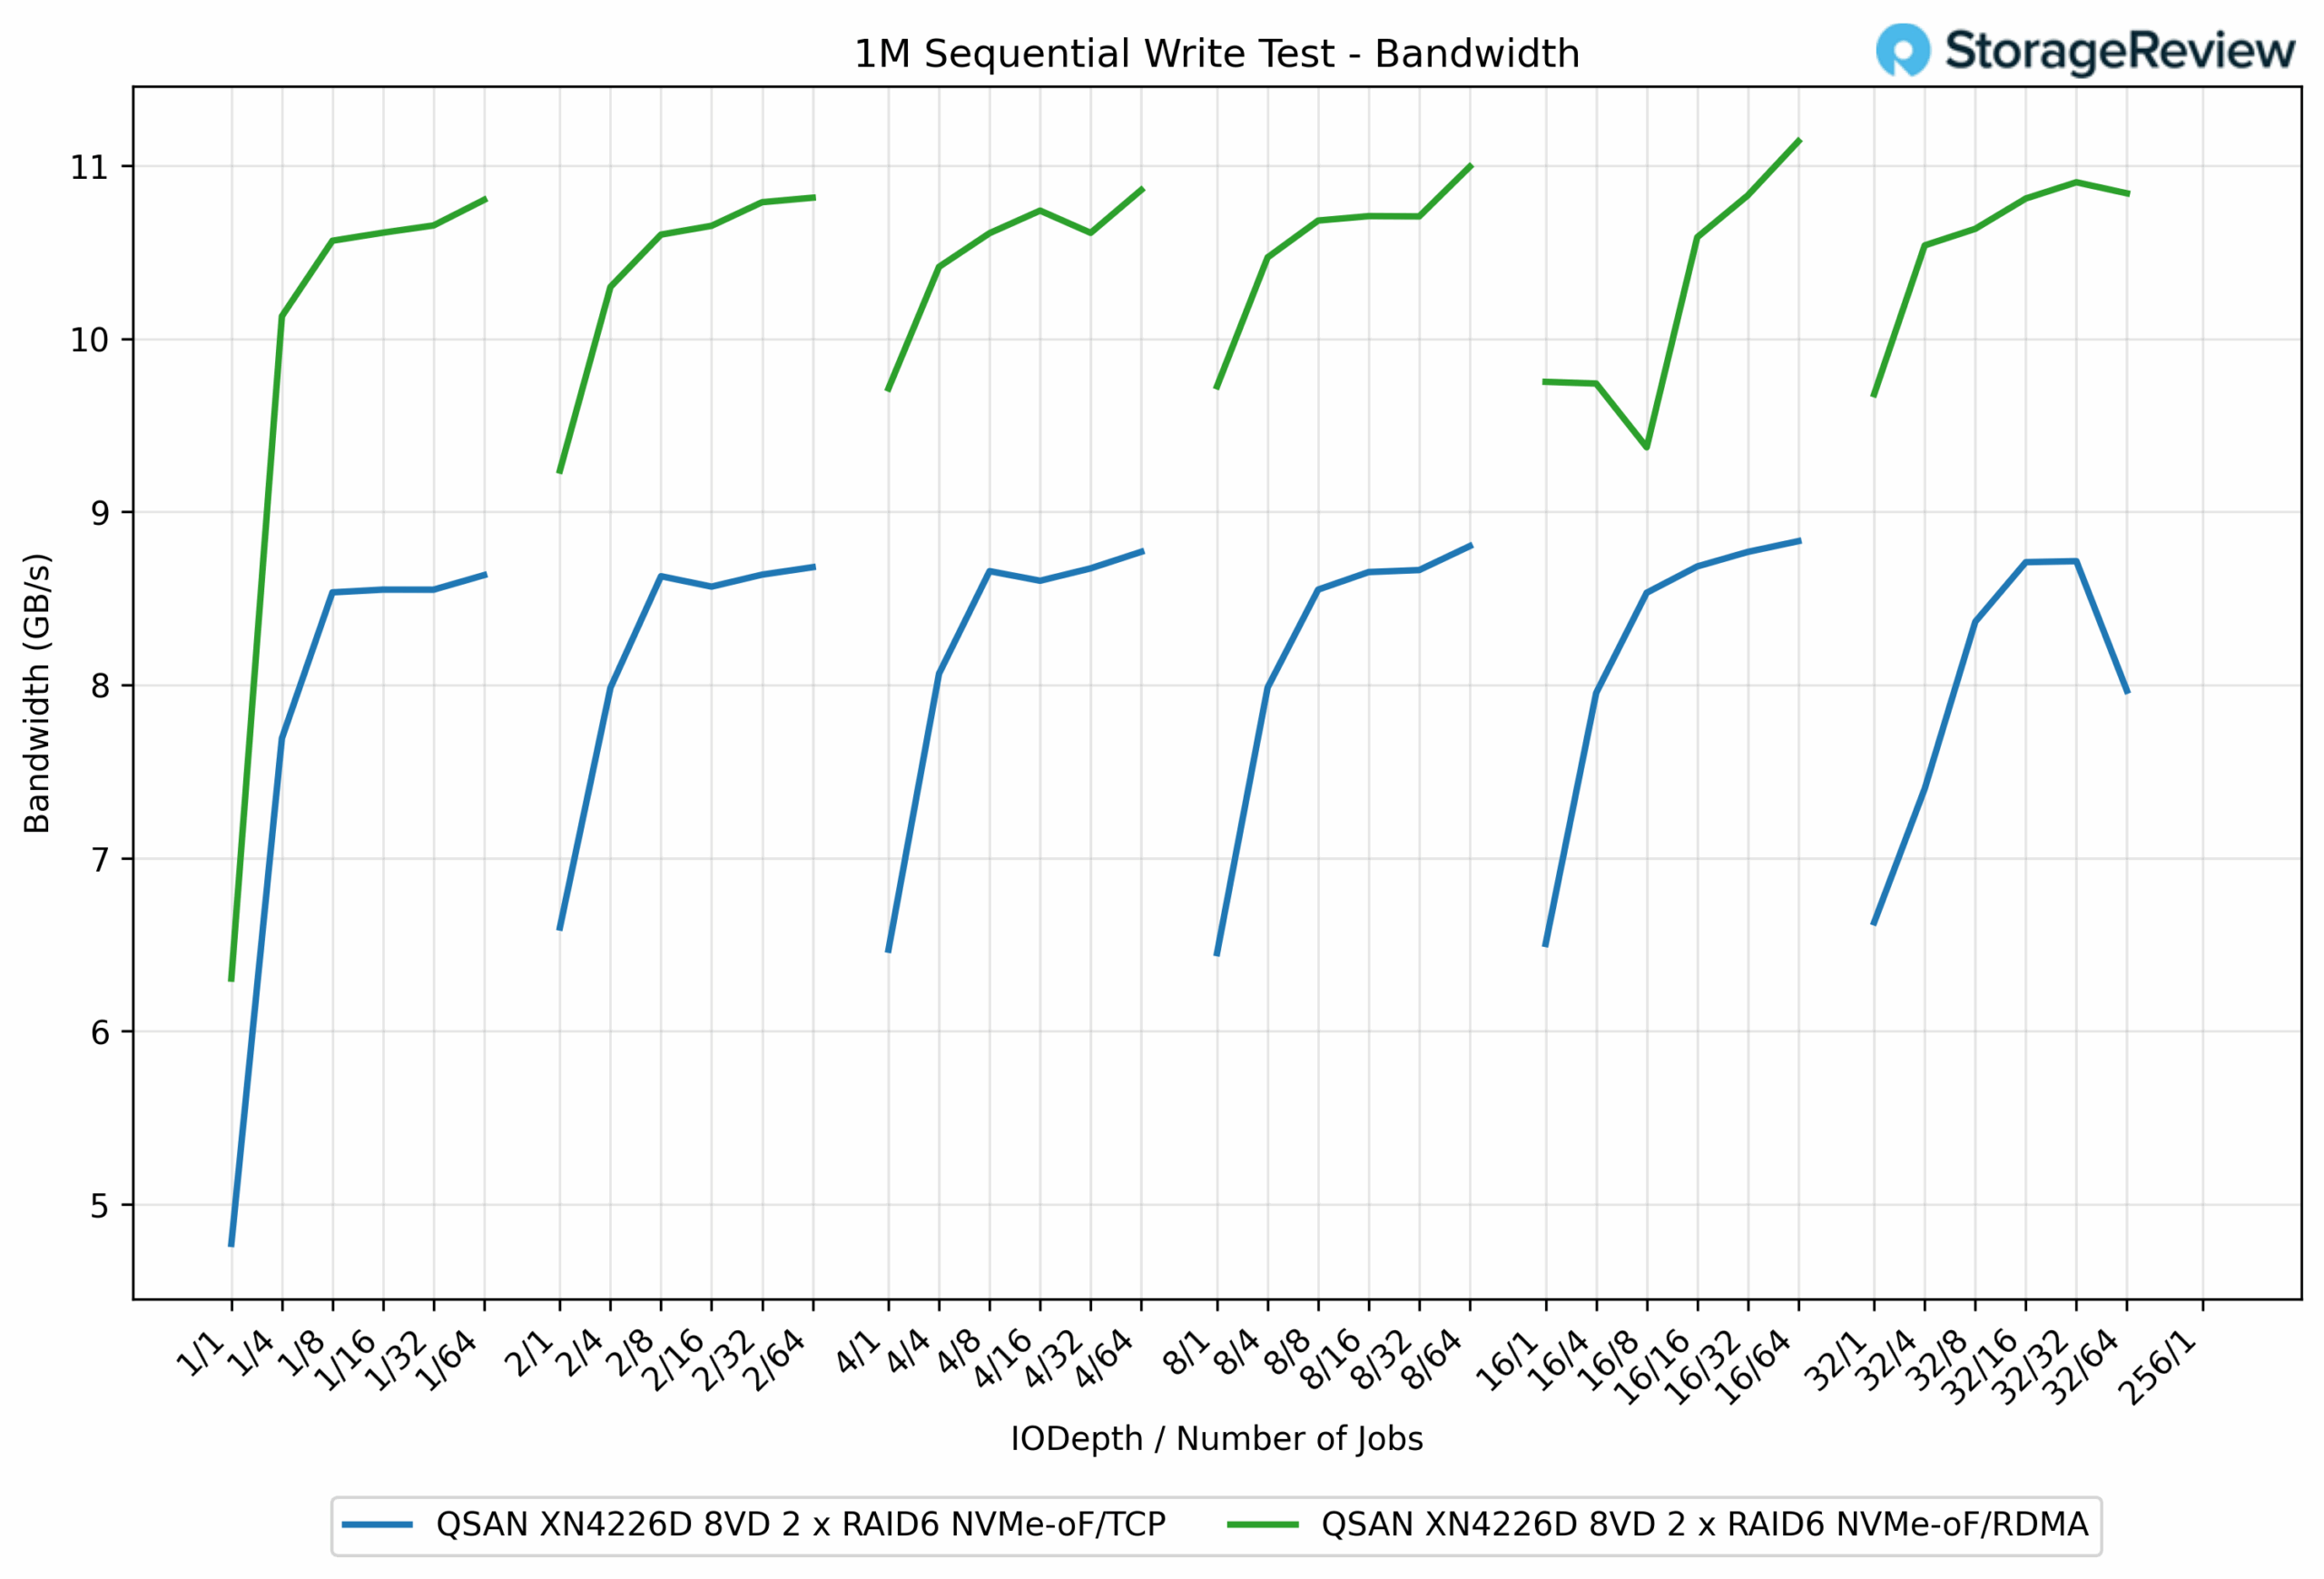
在 1M 順序寫入測試中,NVMe over RDMA 在幾乎所有佇列深度和作業數量下始終比 NVMe over TCP 提供更高的頻寬。峰值時,RDMA 達到 11.14GB/s,而 TCP 最高達到 8.83GB/s,兩者相差約 26%。即使在較低的佇列深度下,RDMA 也保持了優勢。例如,在 QD1/1 作業中,RDMA 達到 6.30GB/s,比 TCP 的 4.77GB/s 高出約 32%。
隨著工作負載的增加,兩種協定之間的效能差距有所縮小,但 RDMA 始終展現出明顯的優勢。 TCP 在多個測試點上始終徘徊在 8.5 到 8.8GB/s 之間,而 RDMA 則頻繁突破 10.5GB/s 大關,峰值略高於 11GB/s。
1M 順序寫入延遲
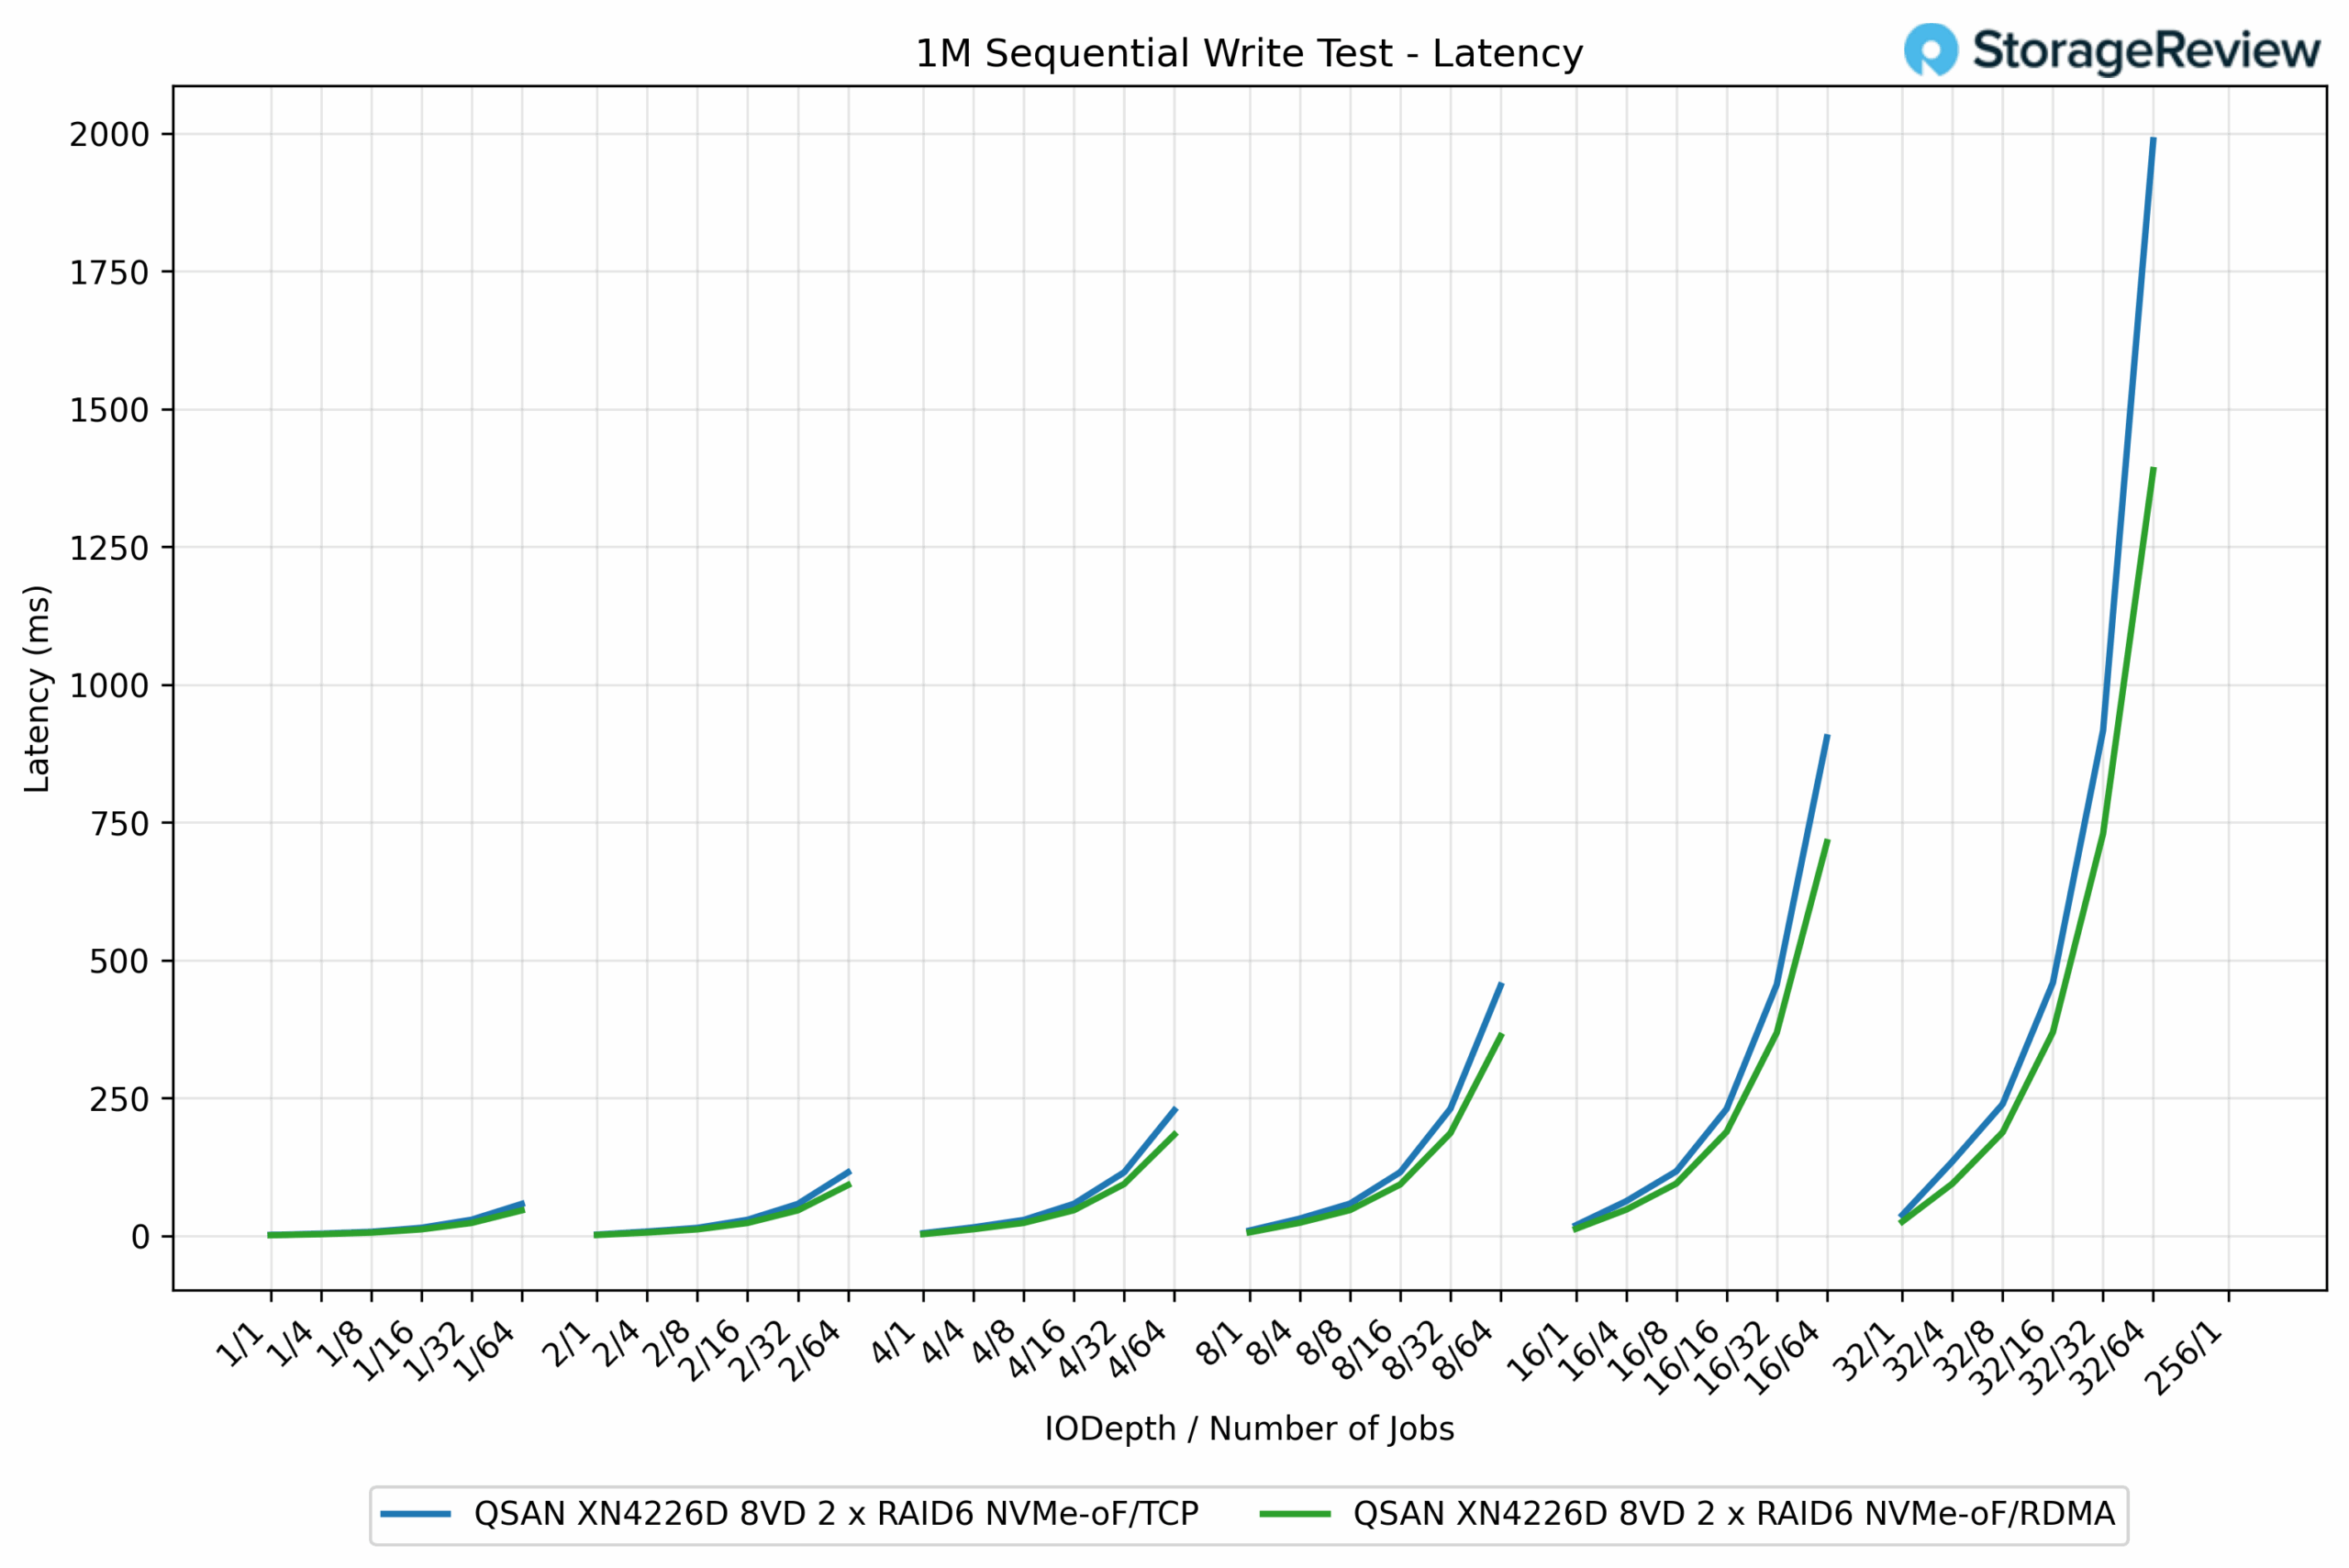
在 1M 順序寫入延遲測試中,RDMA 在大多數佇列深度和作業數量下再次保持了優於 TCP 的顯著效率優勢。在較輕的工作負載下,兩種協定的效能表現相當接近,均實現了低於 5 毫秒的延遲。然而,隨著並發量的增加,差異變得更加明顯。例如,在 QD16/16 作業中,RDMA 的延遲為 368.48 毫秒,而 TCP 的延遲為 455.95 毫秒,RDMA 的延遲提高了 19%。
在極端規模下,這種差異更加明顯。在 QD256/1 作業中,RDMA 的完成時間為 1,389.16 毫秒,而 TCP 的完成時間為 1,987.39 毫秒,RDMA 的延遲降低了 43%。這一趨勢凸顯了 RDMA 在保持高吞吐量的同時控制延遲的能力,尤其是在高負載場景下。
1M 順序讀取頻寬
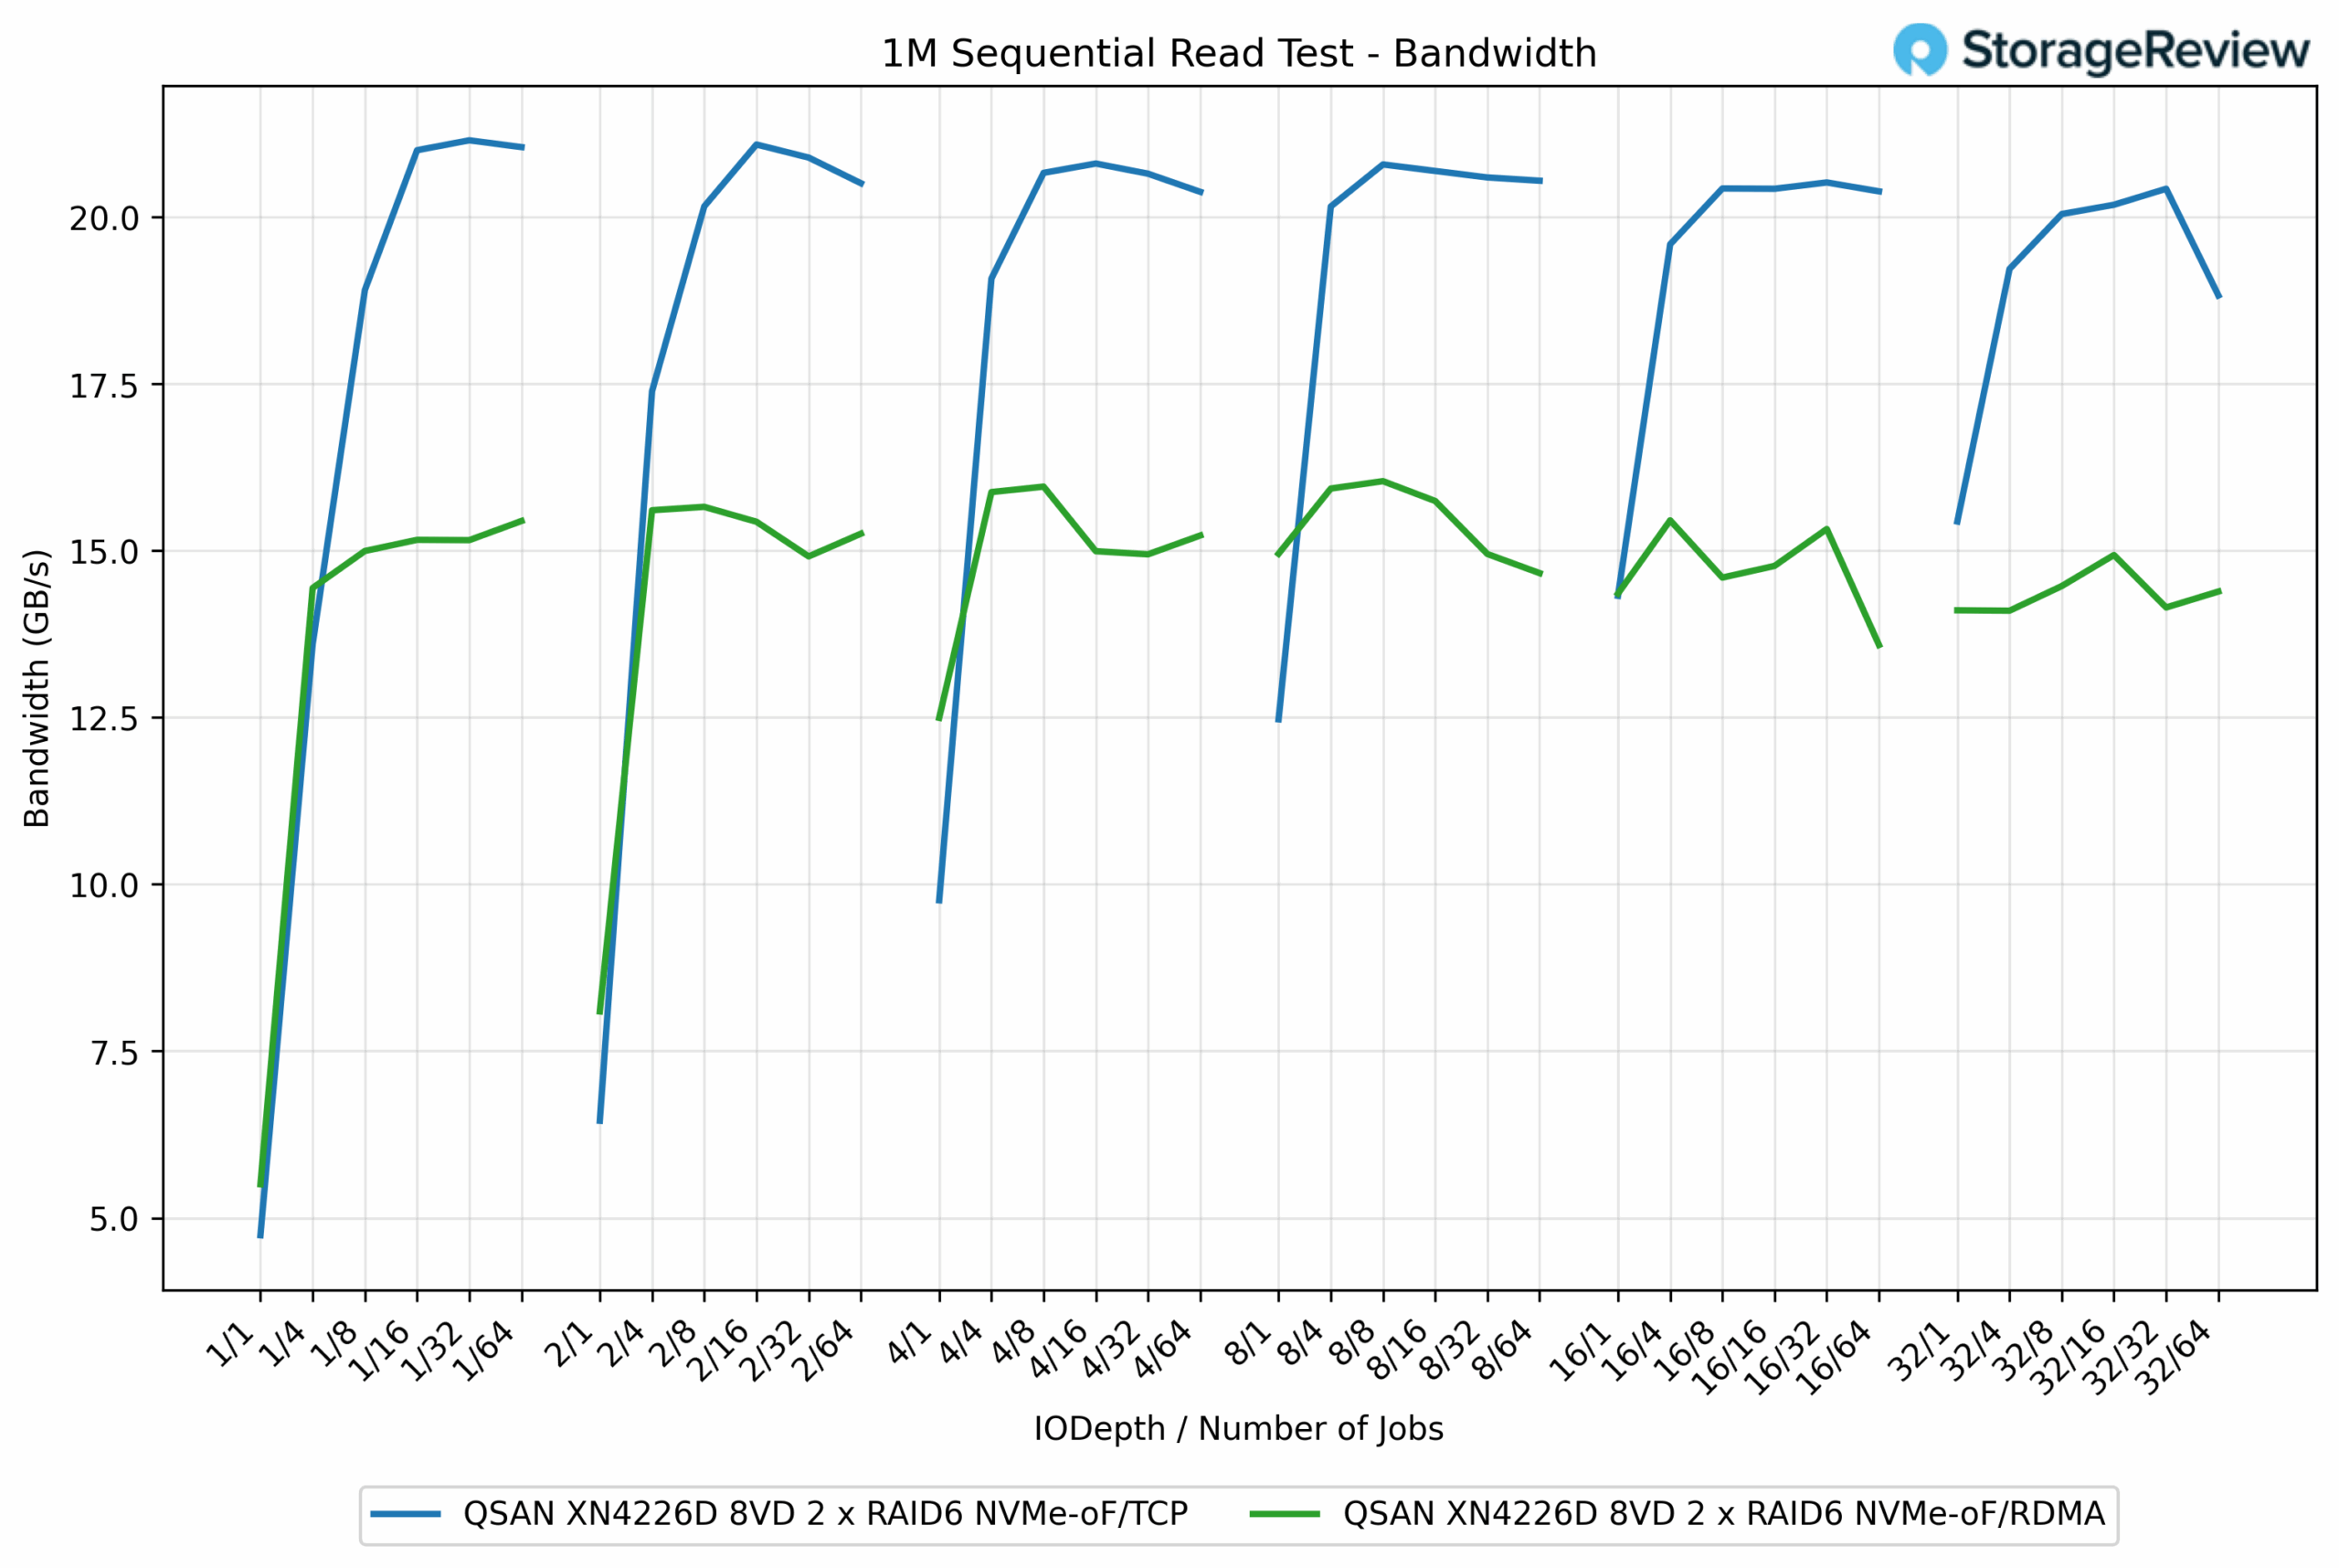
在 1M 順序讀取測試中,效能動態發生了變化,TCP 的效能在各方面均明顯優於 RDMA。 TCP 的峰值達到了 21.21GB/s,而 RDMA 的最高速度達到了 15.96GB/s,兩者相差約 33%。即使在較低的隊列深度下,TCP 也能迅速領先。例如,在 QD1/4 作業中,TCP 的傳輸速度為 18.91GB/s,而 RDMA 的傳輸速度為 15.05GB/s,兩者相差超過 25%。
TCP 的優勢幾乎在所有工作負載規模上都保持一致。一旦達到飽和狀態,TCP 的速率仍保持在 20-21GB/s 範圍內,而 RDMA 的速率則穩定在 15GB/s 左右。這表明,雖然 RDMA 在寫入密集型和延遲敏感型操作中表現出色,但在測試的 RAID6 NVMe 配置下,TCP 展現出更強大的順序讀取頻寬效率。
1M 順序讀取延遲
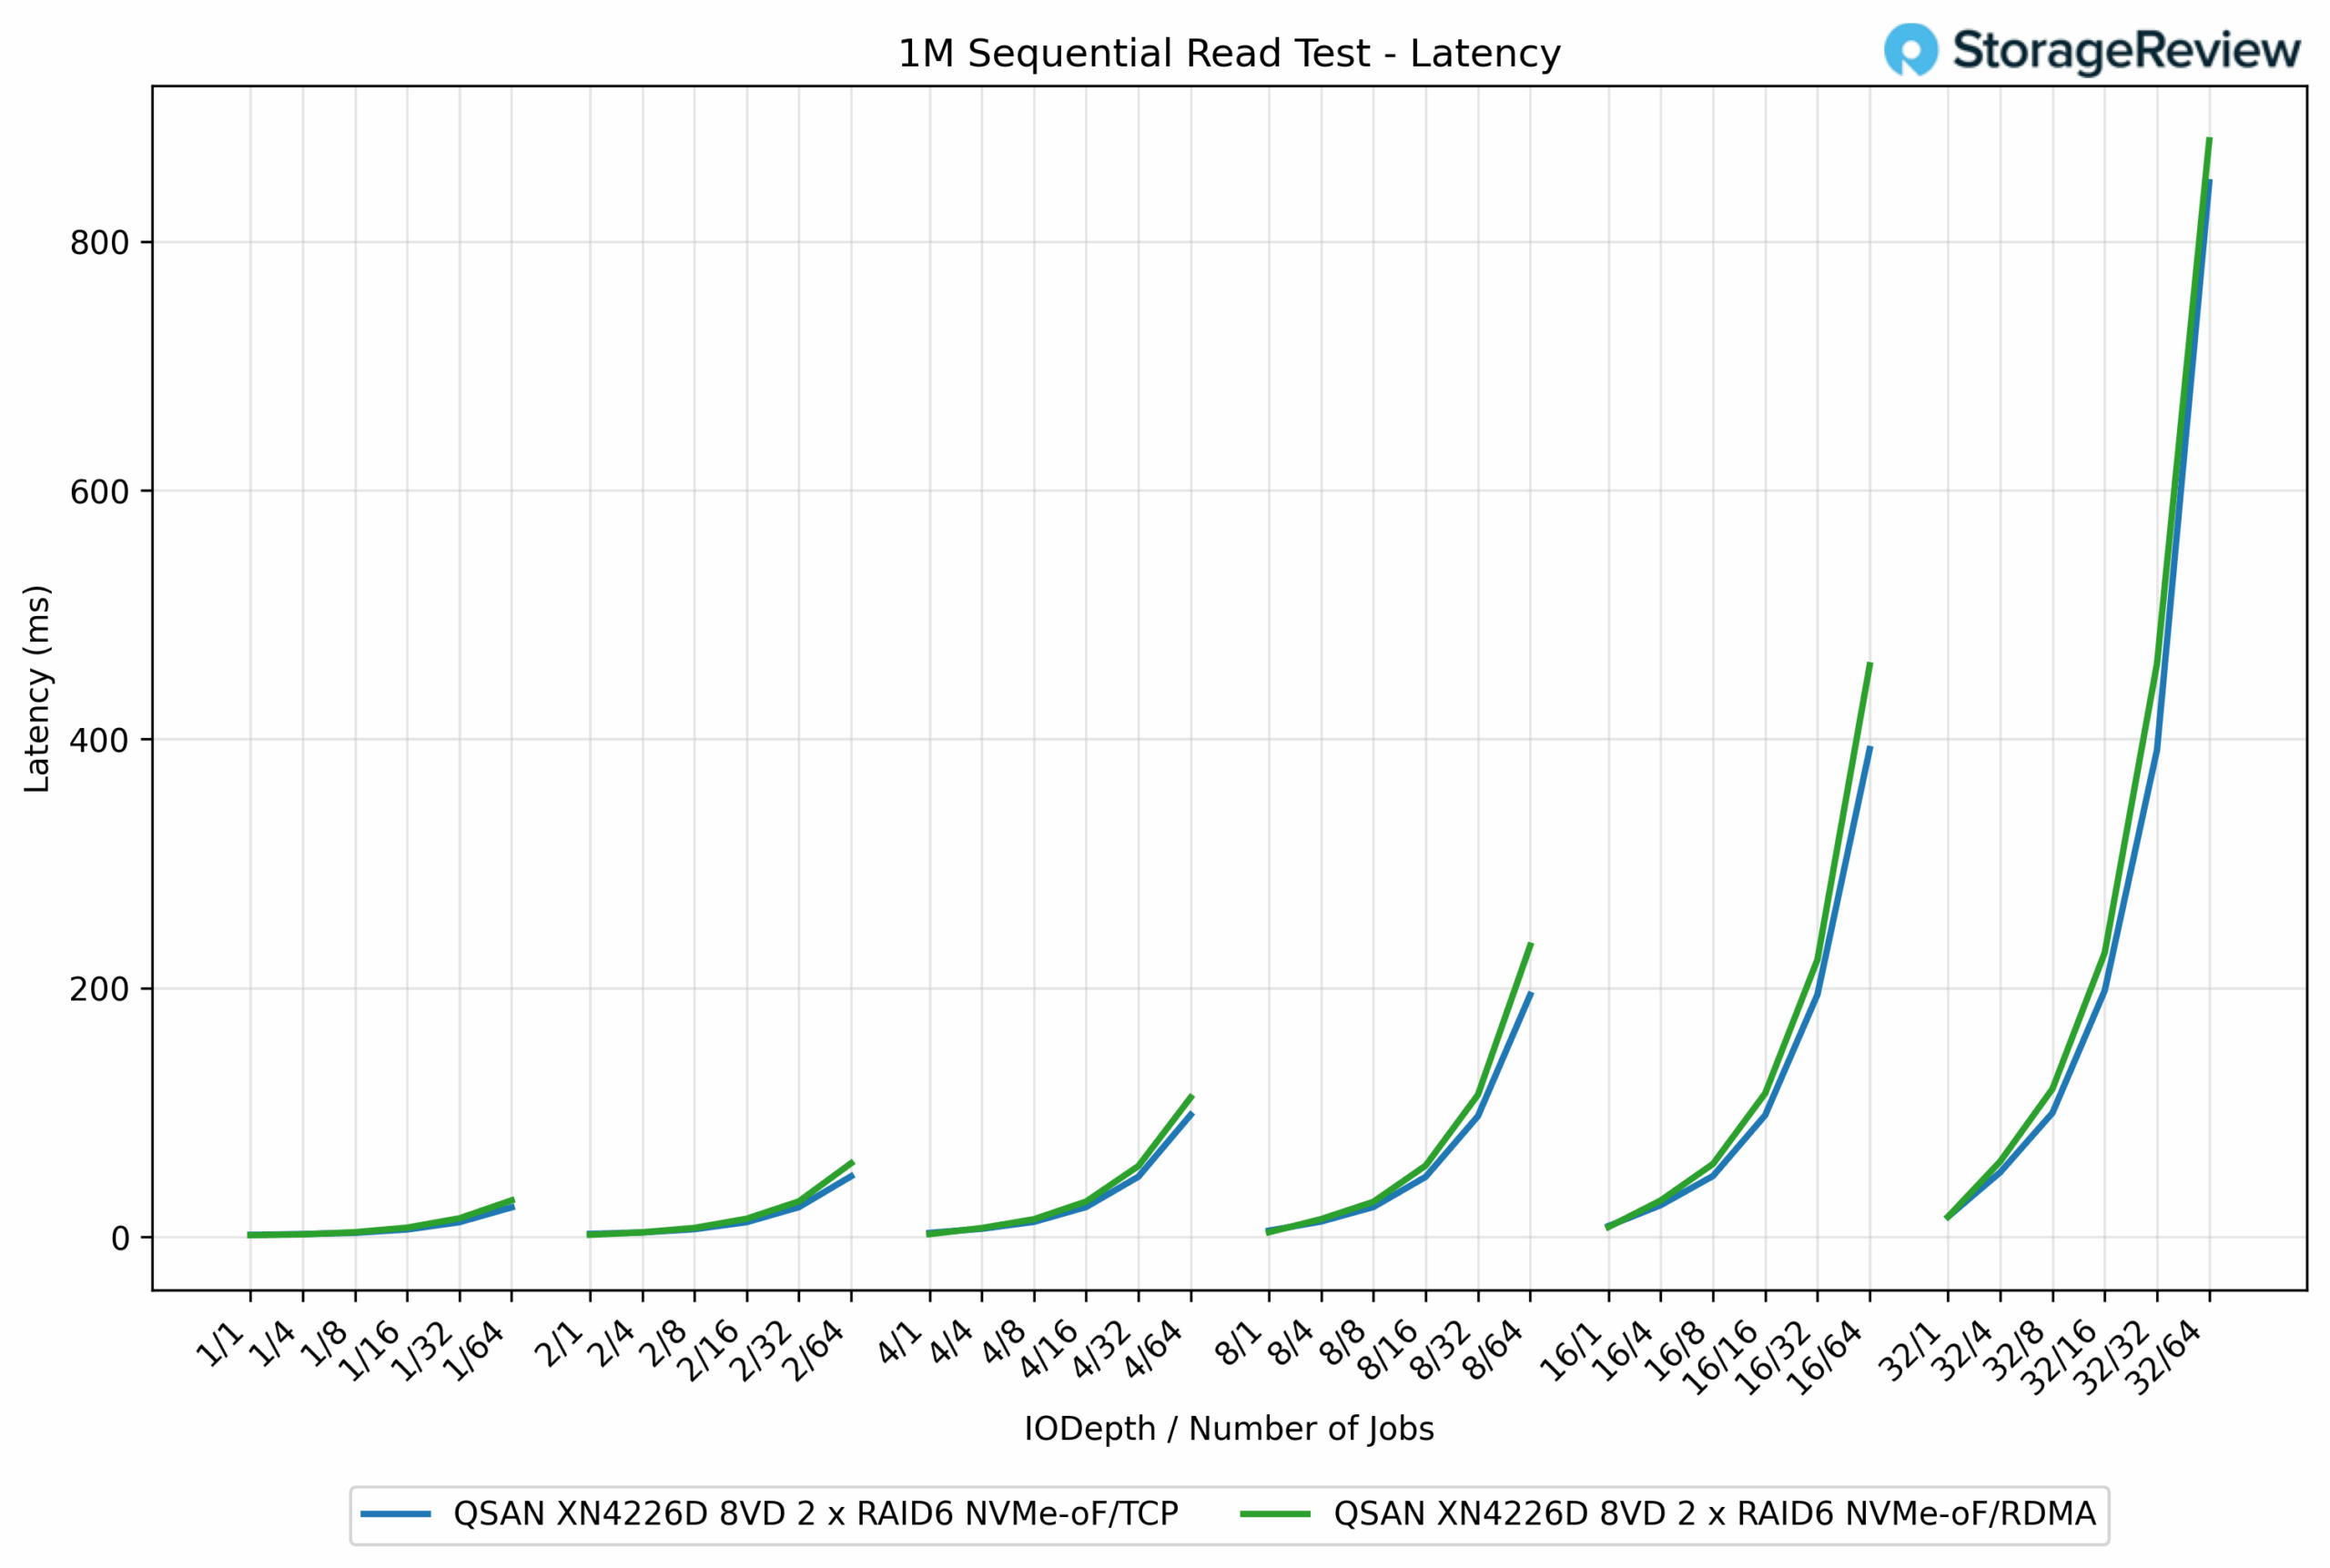
在 1M 順序讀取延遲測試中,兩種協定的結果較為接近,儘管 RDMA 在較高的佇列深度下通常略佔優勢。在較輕的工作負載下,延遲曲線幾乎相同,兩者都保持在 5 毫秒以下,直到並發性開始增加。例如,在 QD8/64 作業中,TCP 的延遲為 234.09 毫秒,而 RDMA 的延遲較低,為 194.54 毫秒,減少了 17%。
這種趨勢在負載更重時依然持續。在 QD32/64 作業中,RDMA 測得的延遲為 847.59 毫秒,而 TCP 的延遲為 881.31 毫秒,略有提升,僅 3.8%,但仍與 RDMA 較低的堆疊開銷保持一致。也就是說,兩種協定的擴展模式相似,隨著工作負載的增加,延遲會可預測地上升。
64k 隨機寫入 IOPS
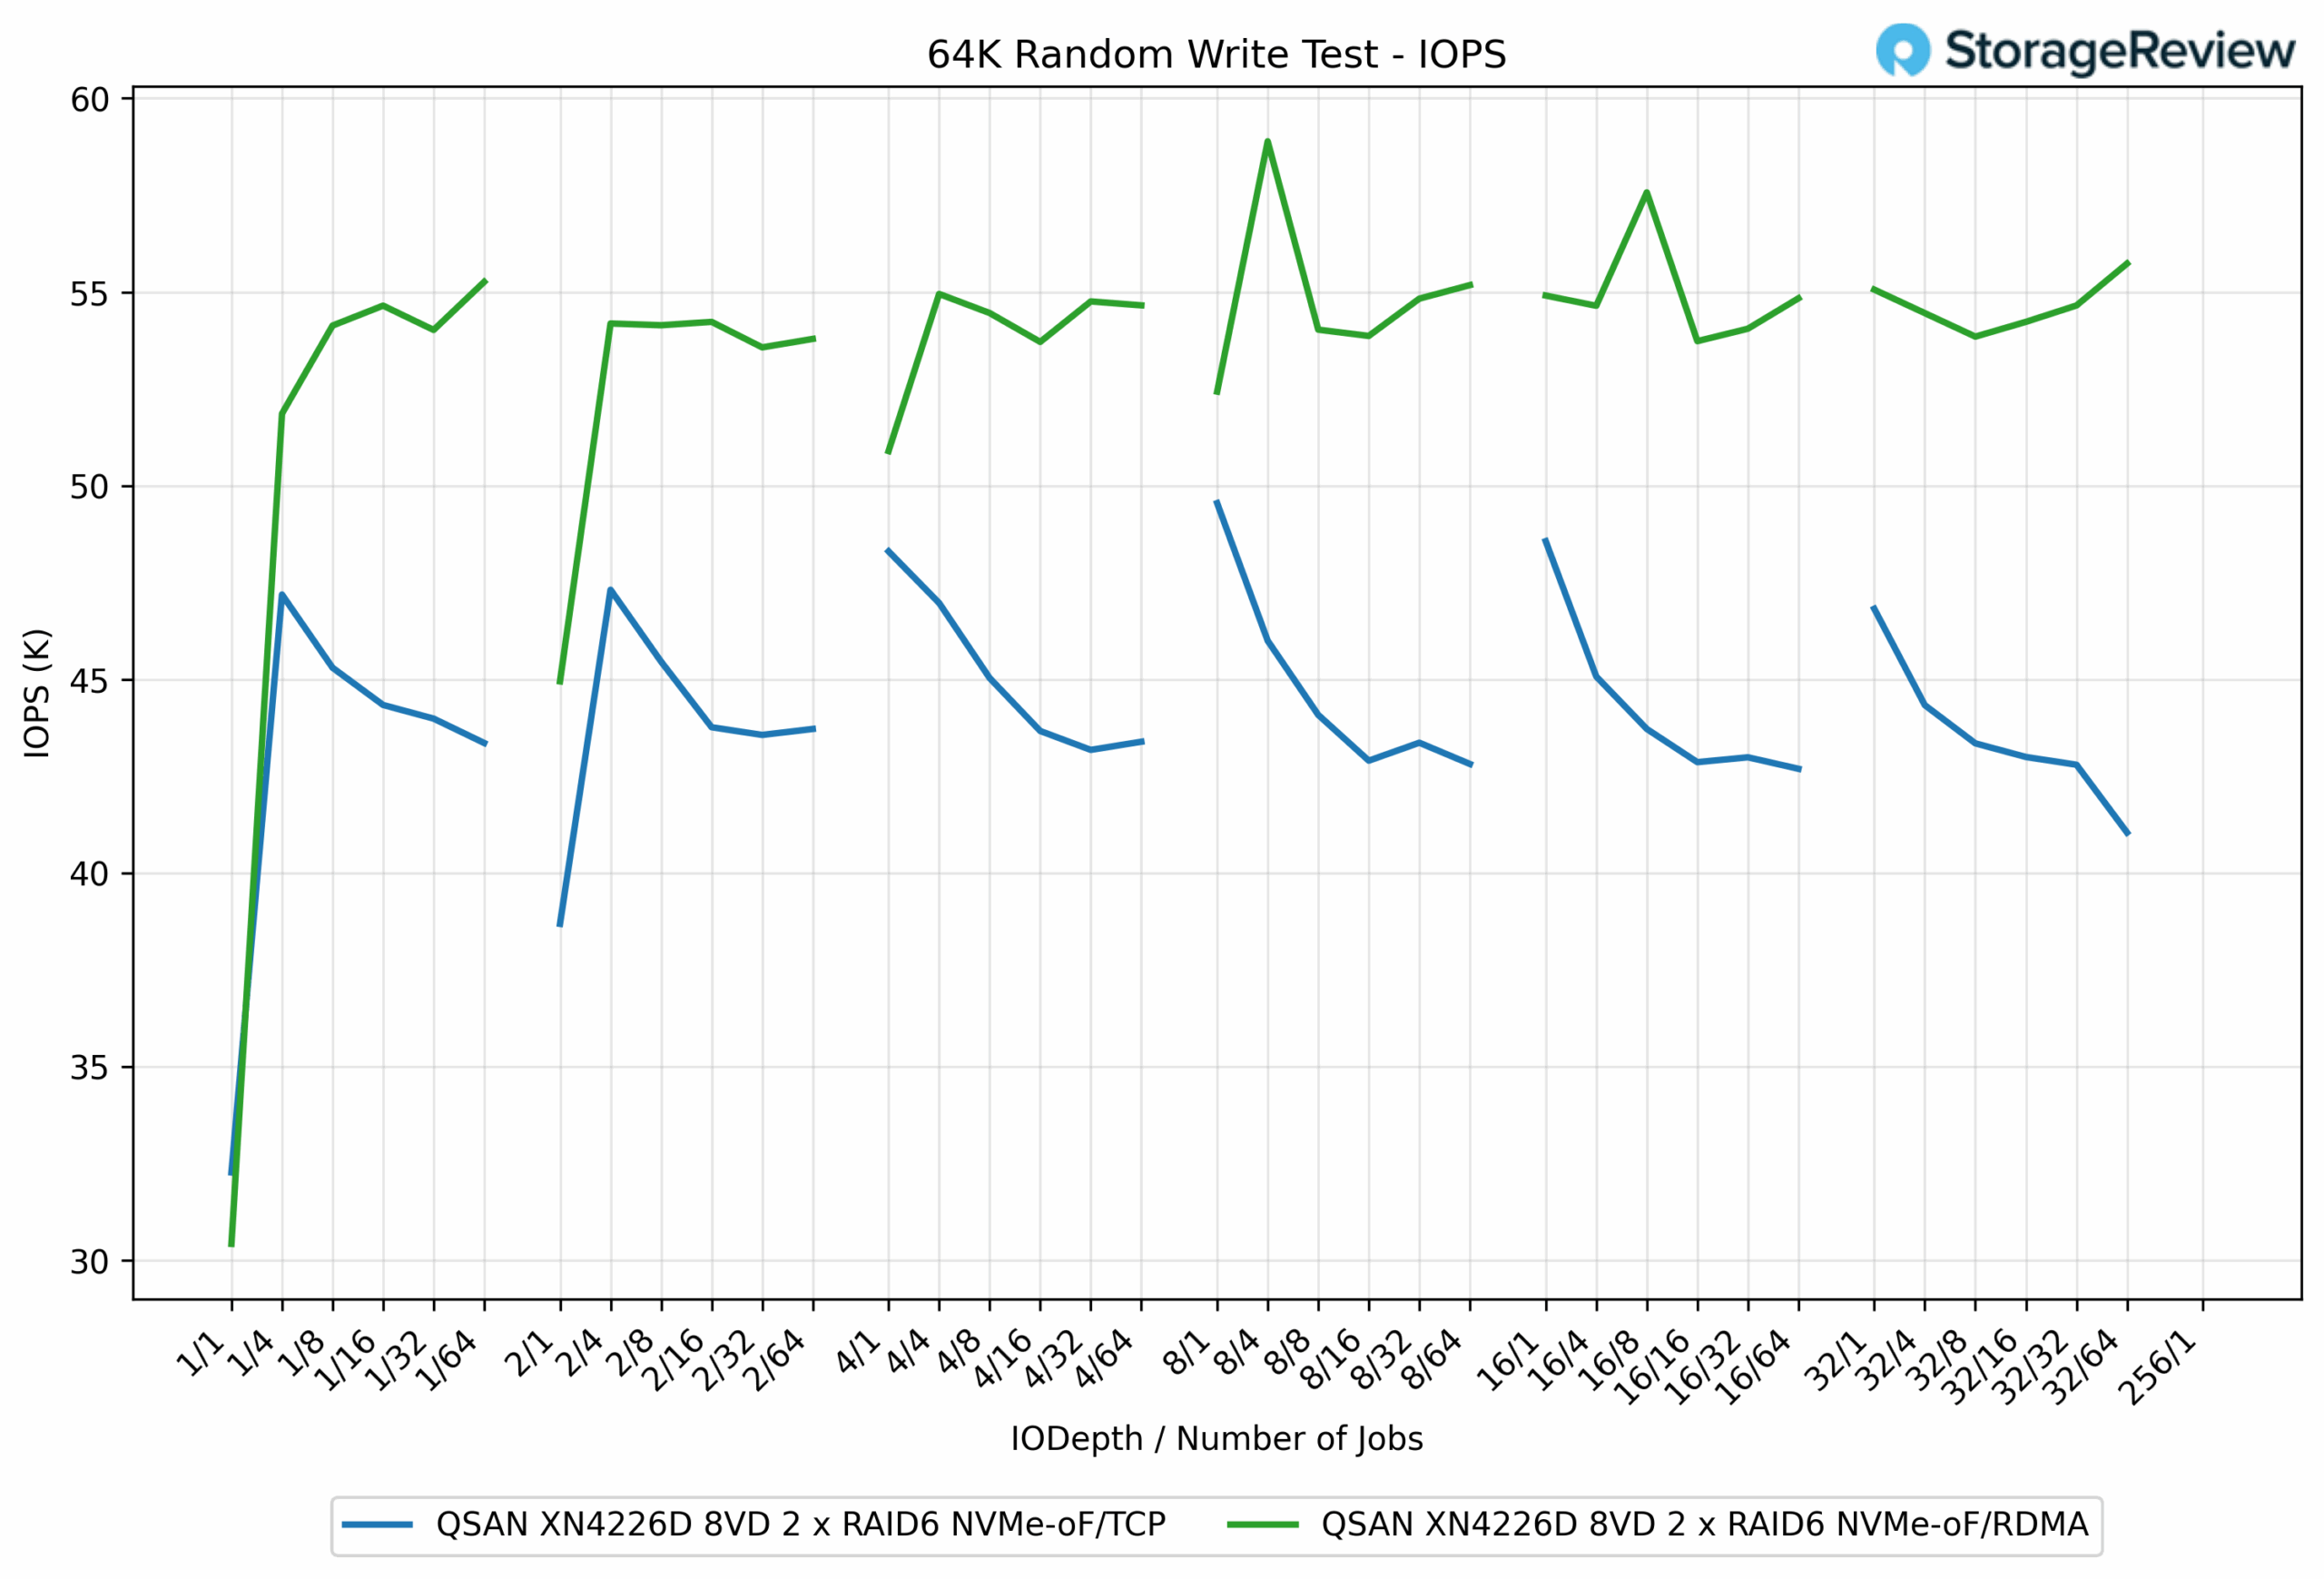
在 64K 隨機寫入測試中,RDMA 的 IOPS 始終高於 TCP,凸顯了其在處理平行隨機操作方面的高效性。在高峰時,RDMA 達到了 58.89K IOPS,而 TCP 僅為 48.57K IOPS,兩者效能優勢高達 21%。
在整個測試過程中,兩種協定之間的差距一直存在。例如,在 QD1/16 作業中,RDMA 的 IOPS 為 54.13K,而 TCP 的 IOPS 為 45.30K,差距接近 16%。隨著工作負載的進一步擴展,RDMA 的 IOPS 保持在 53K 到 55K 之間,而 TCP 的 IOPS 則保持在 42K 到 46K 之間。
64K隨機寫入延遲
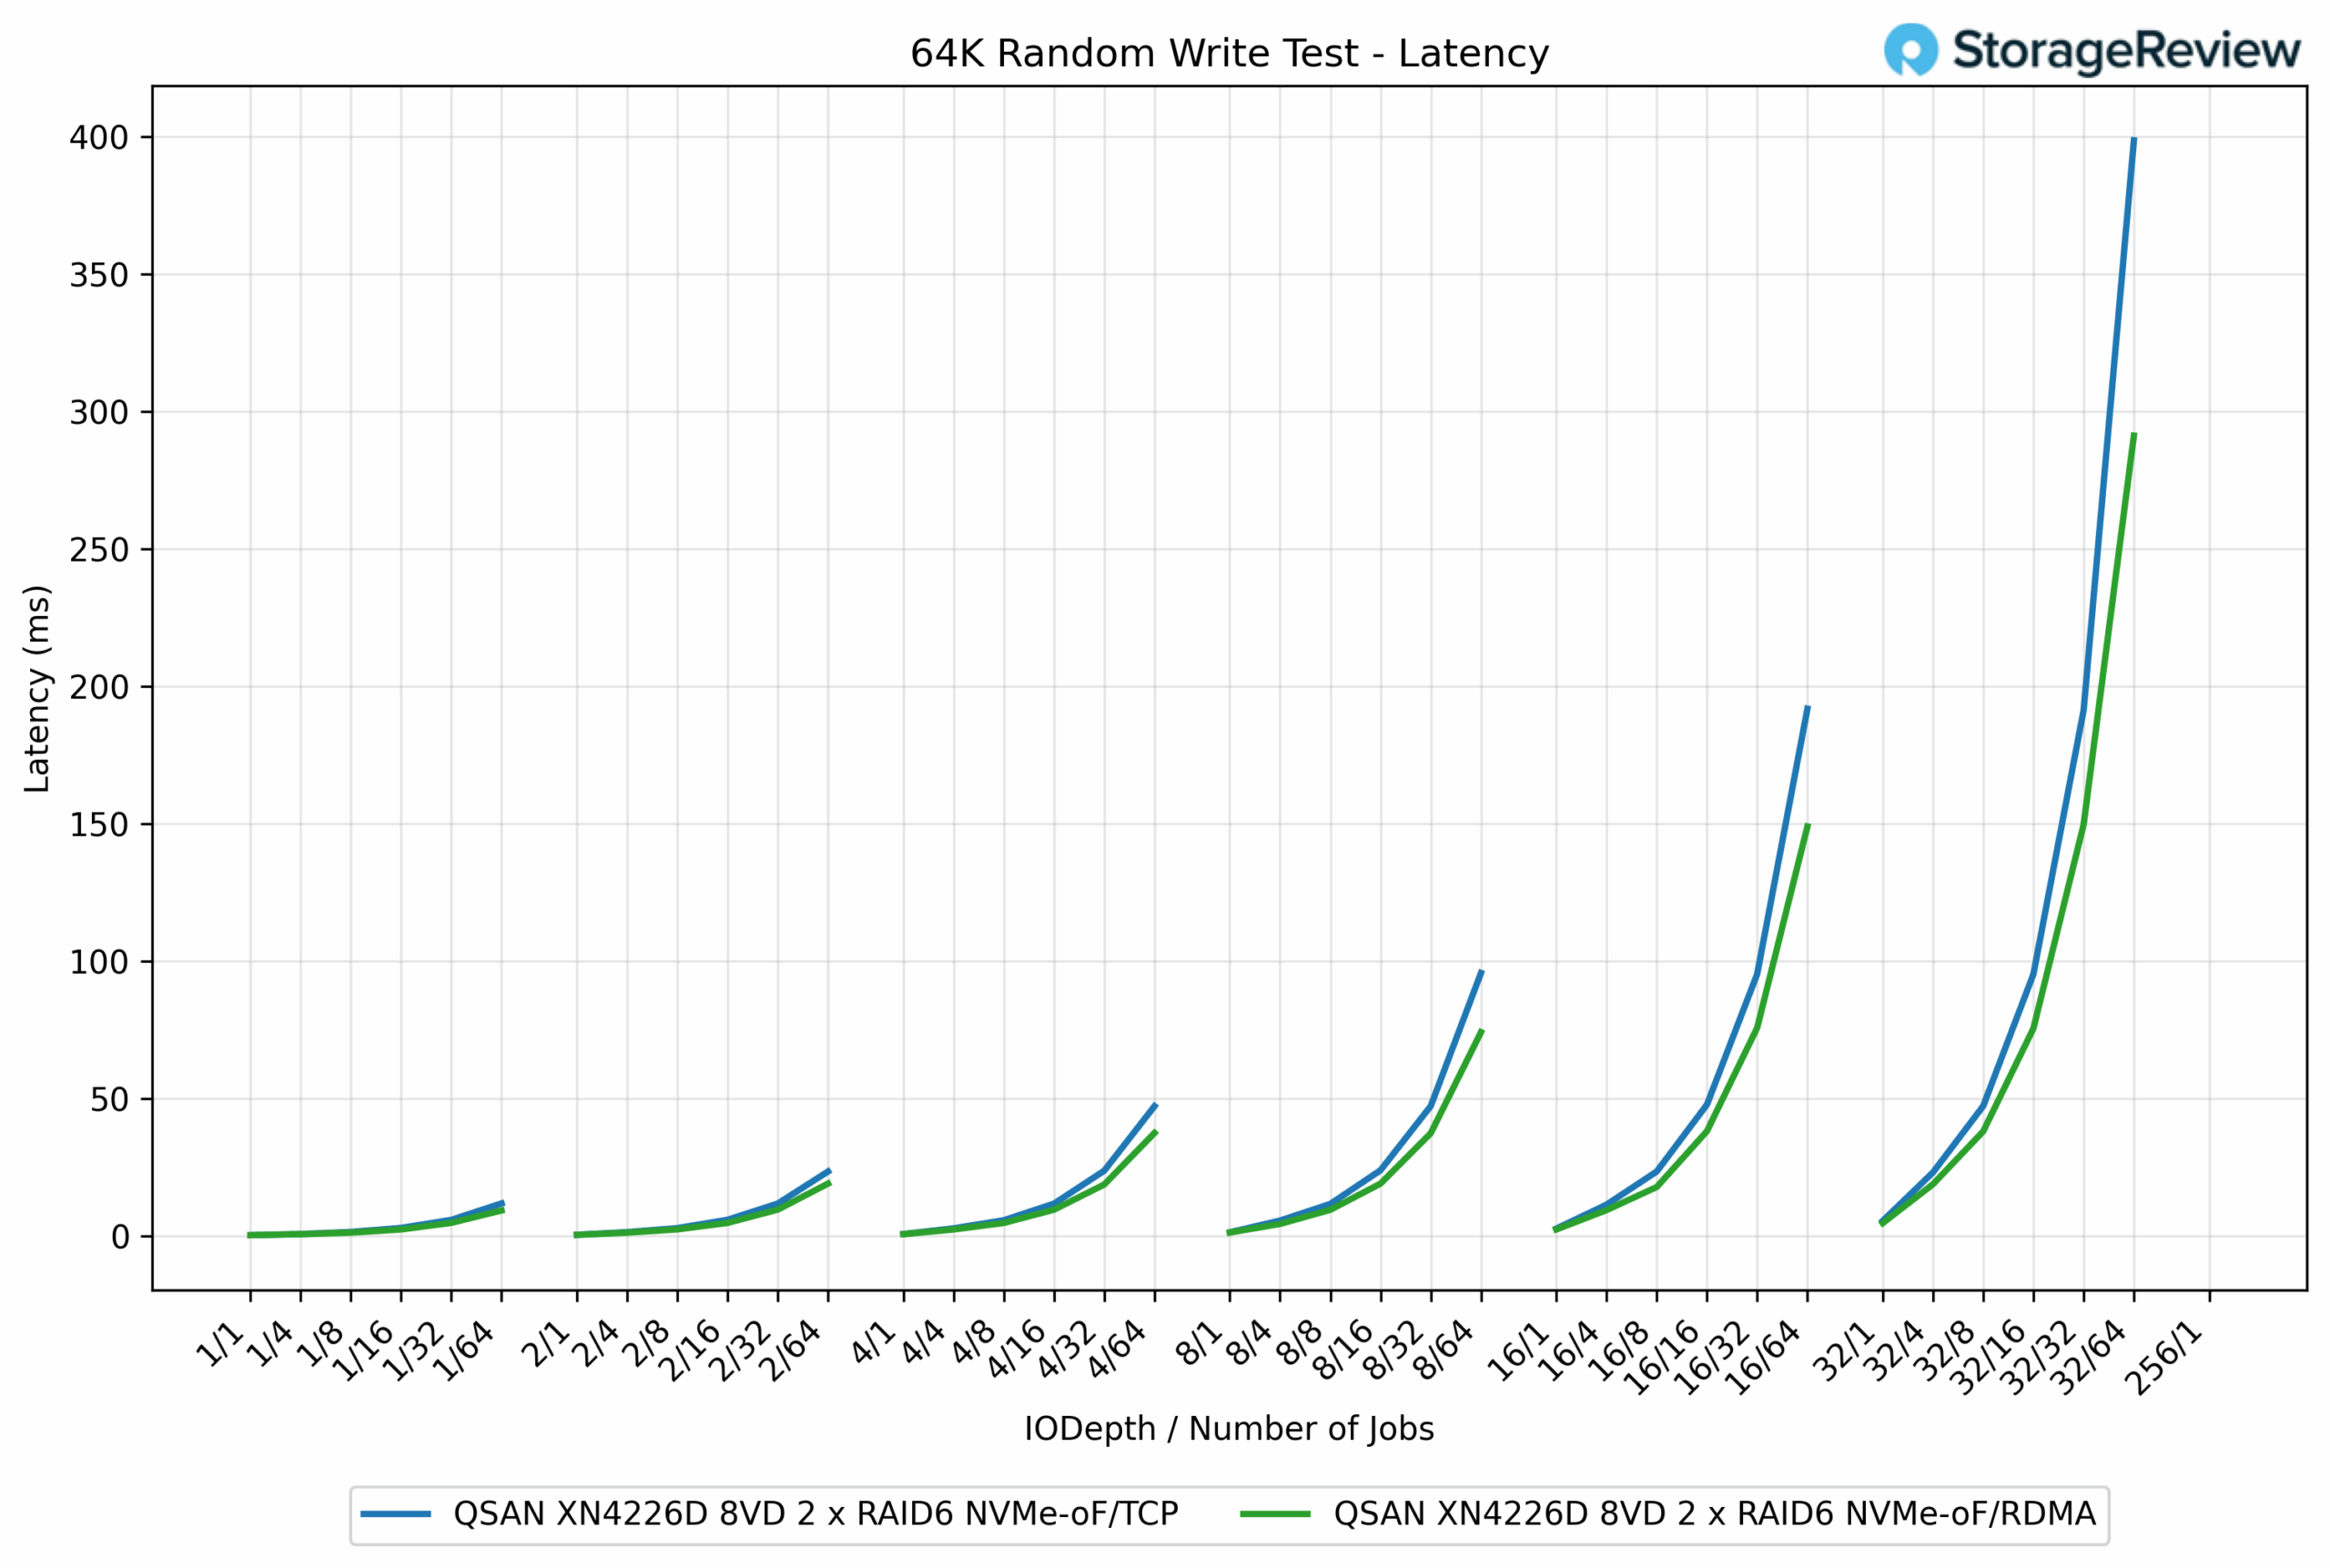
在 64K 隨機寫入延遲測試中,RDMA 再次展現出比 TCP 更低的回應時間,尤其是在佇列深度和作業數量增加的情況下。在較低負載下,兩種協定的表現幾乎相同,均保持在 1 毫秒以下。例如,在 QD1/1 作業中,TCP 測得的回應時間為 0.26 毫秒,而 RDMA 基本上相同,為 0.25 毫秒。
然而,隨著工作負載的增加,RDMA 仍然保持其效率優勢。在 QD16/64 作業中,RDMA 的耗時為 74.09 毫秒,而 TCP 的耗時為 95.64 毫秒,兩者相差約 23%。在 QD256/1 作業的最大壓力下,兩者之間的差距進一步擴大,RDMA 的耗時為 291.13 毫秒,而 TCP 則飆升至 398.56 毫秒,高出近 37%。
64K 隨機讀取 IOPS
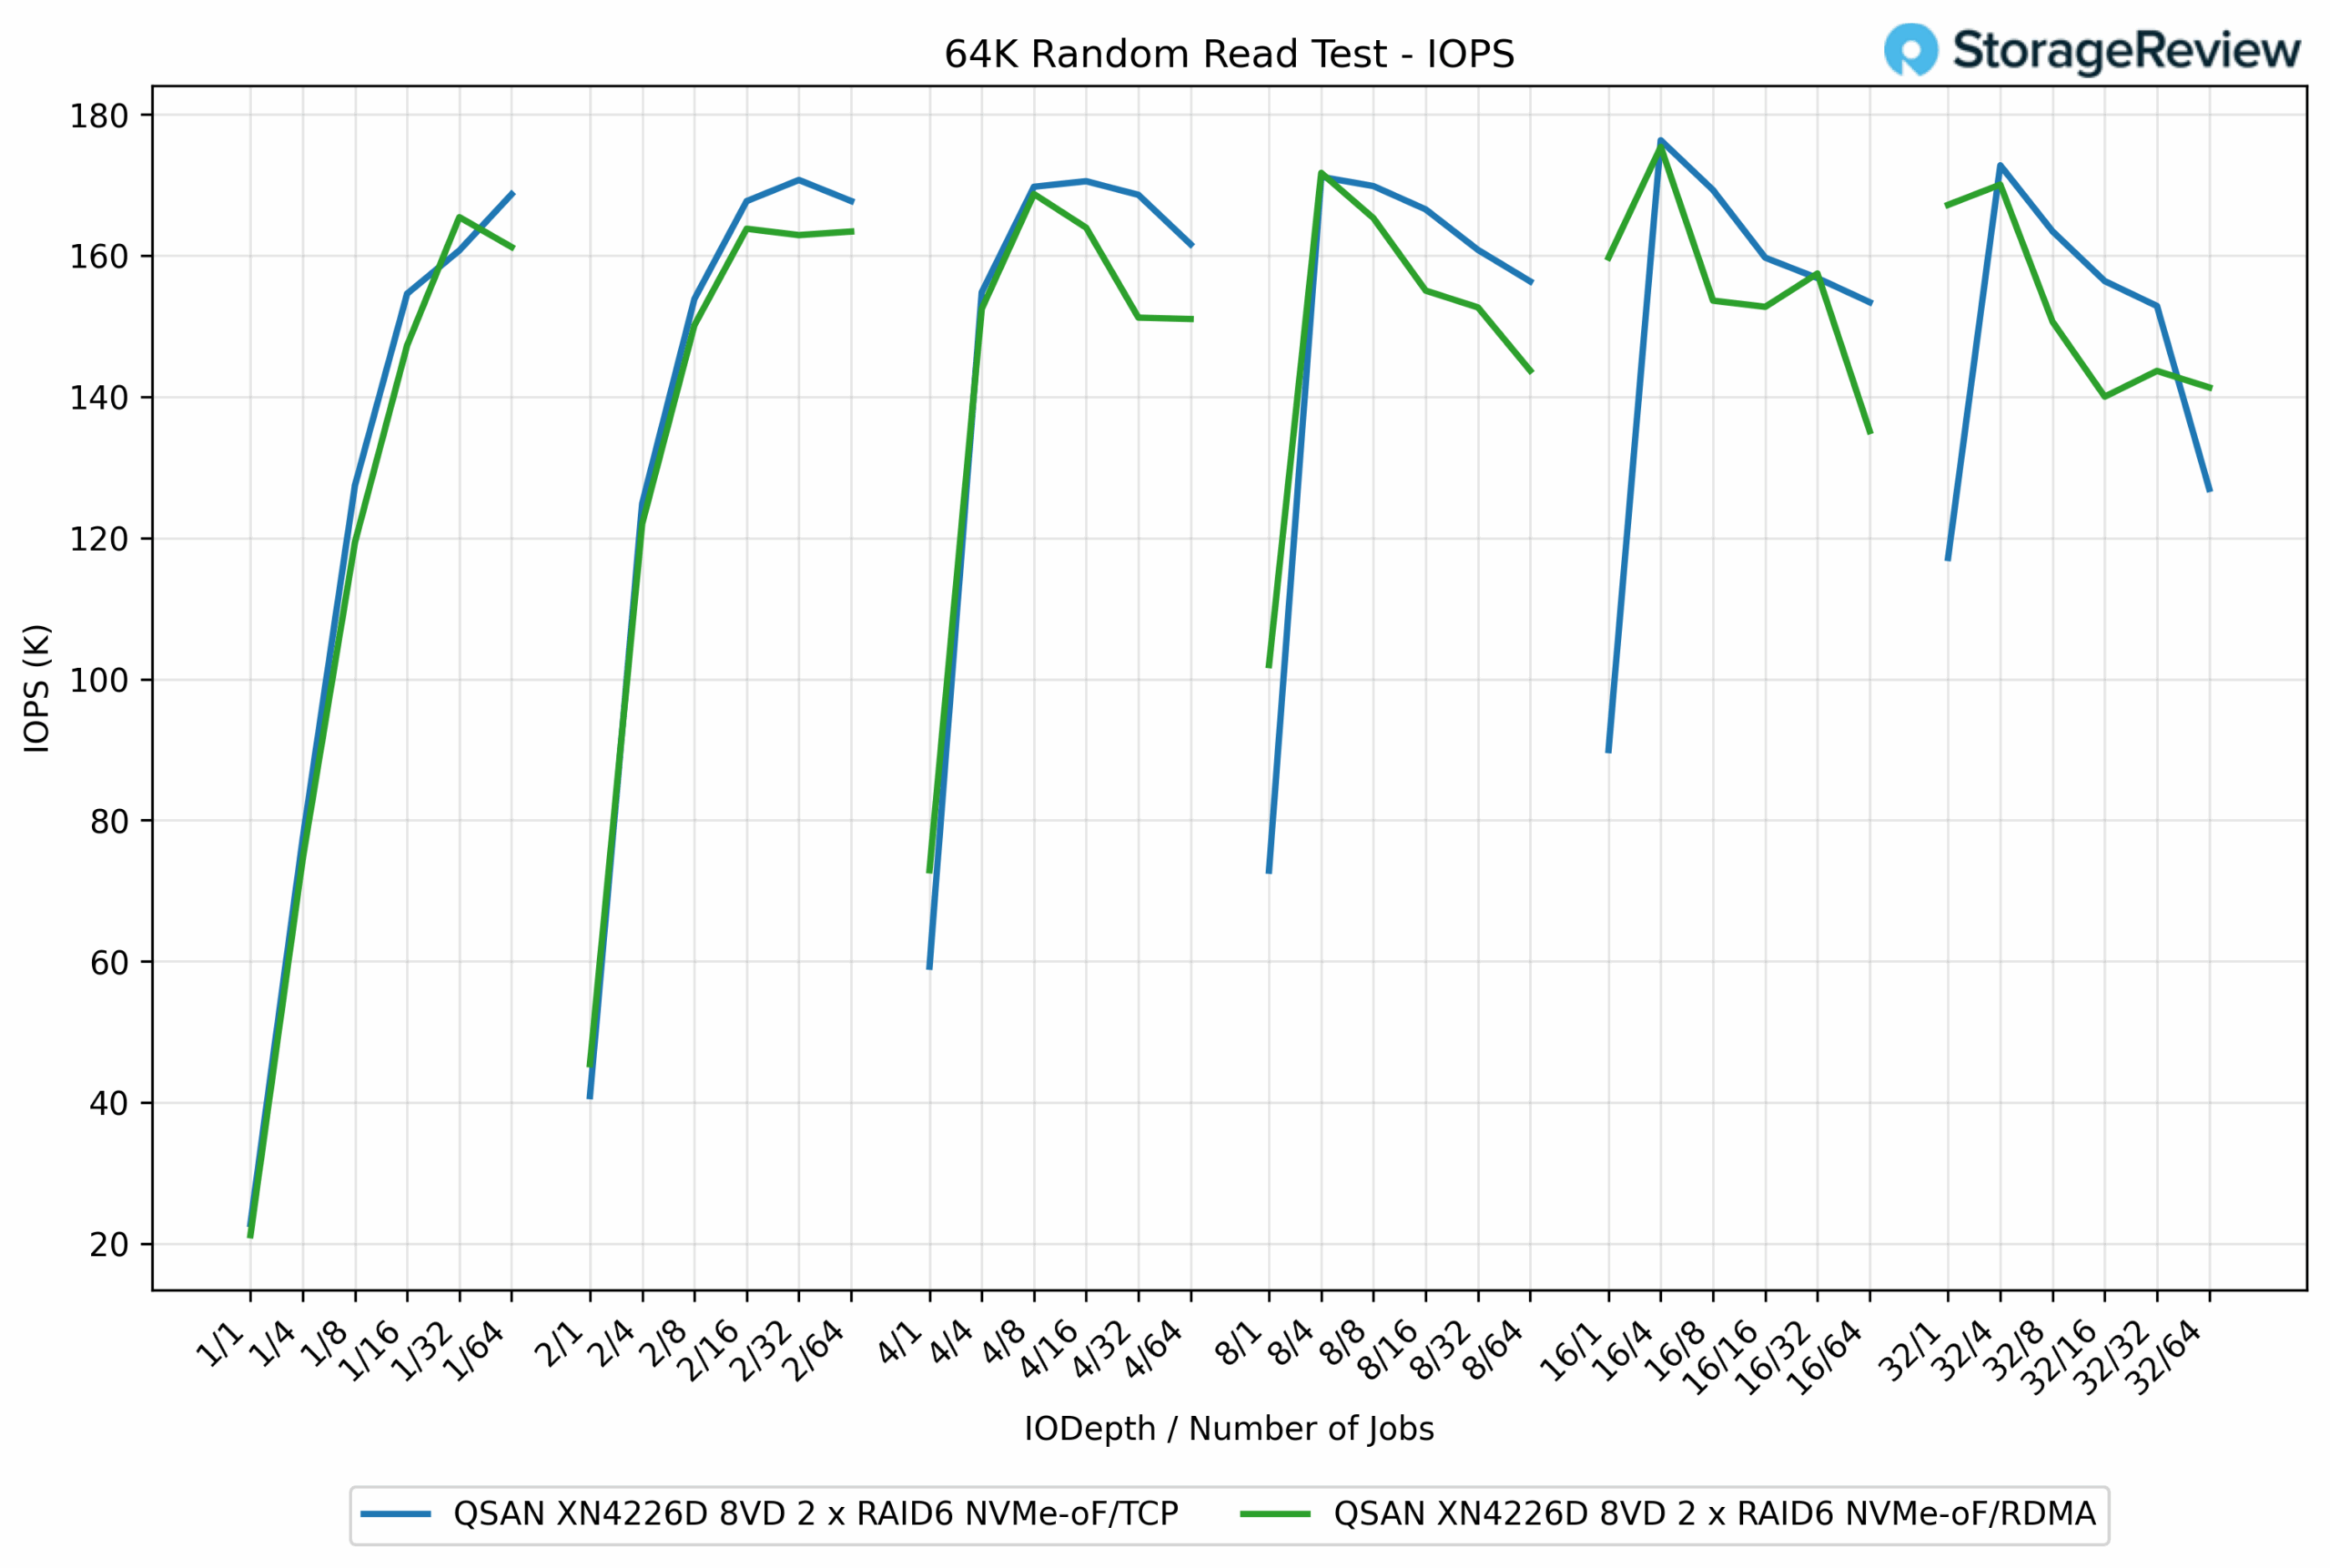
在 64K 隨機讀取測試中,TCP 和 RDMA 的整體效能非常相似,根據工作負載的不同,兩種協定之間的領先優勢略有不同。 TCP 的峰值達到了 176.33K IOPS,而 RDMA 緊隨其後,達到了 175.40K IOPS,兩者之間僅相差 0.5%。
在中等深度下,結果仍然緊密相關。例如,在 QD4/16 作業中,TCP 的 IOPS 為 168.60K,而 RDMA 緊隨其後,為 163.94K IOPS,差距不到 2.8%。在其他情況下,RDMA 略勝一籌,例如 QD8/1 作業,其 IOPS 為 171.71K,而 TCP 為 171.15K IOPS,基本上打成平手。
64K隨機讀取延遲
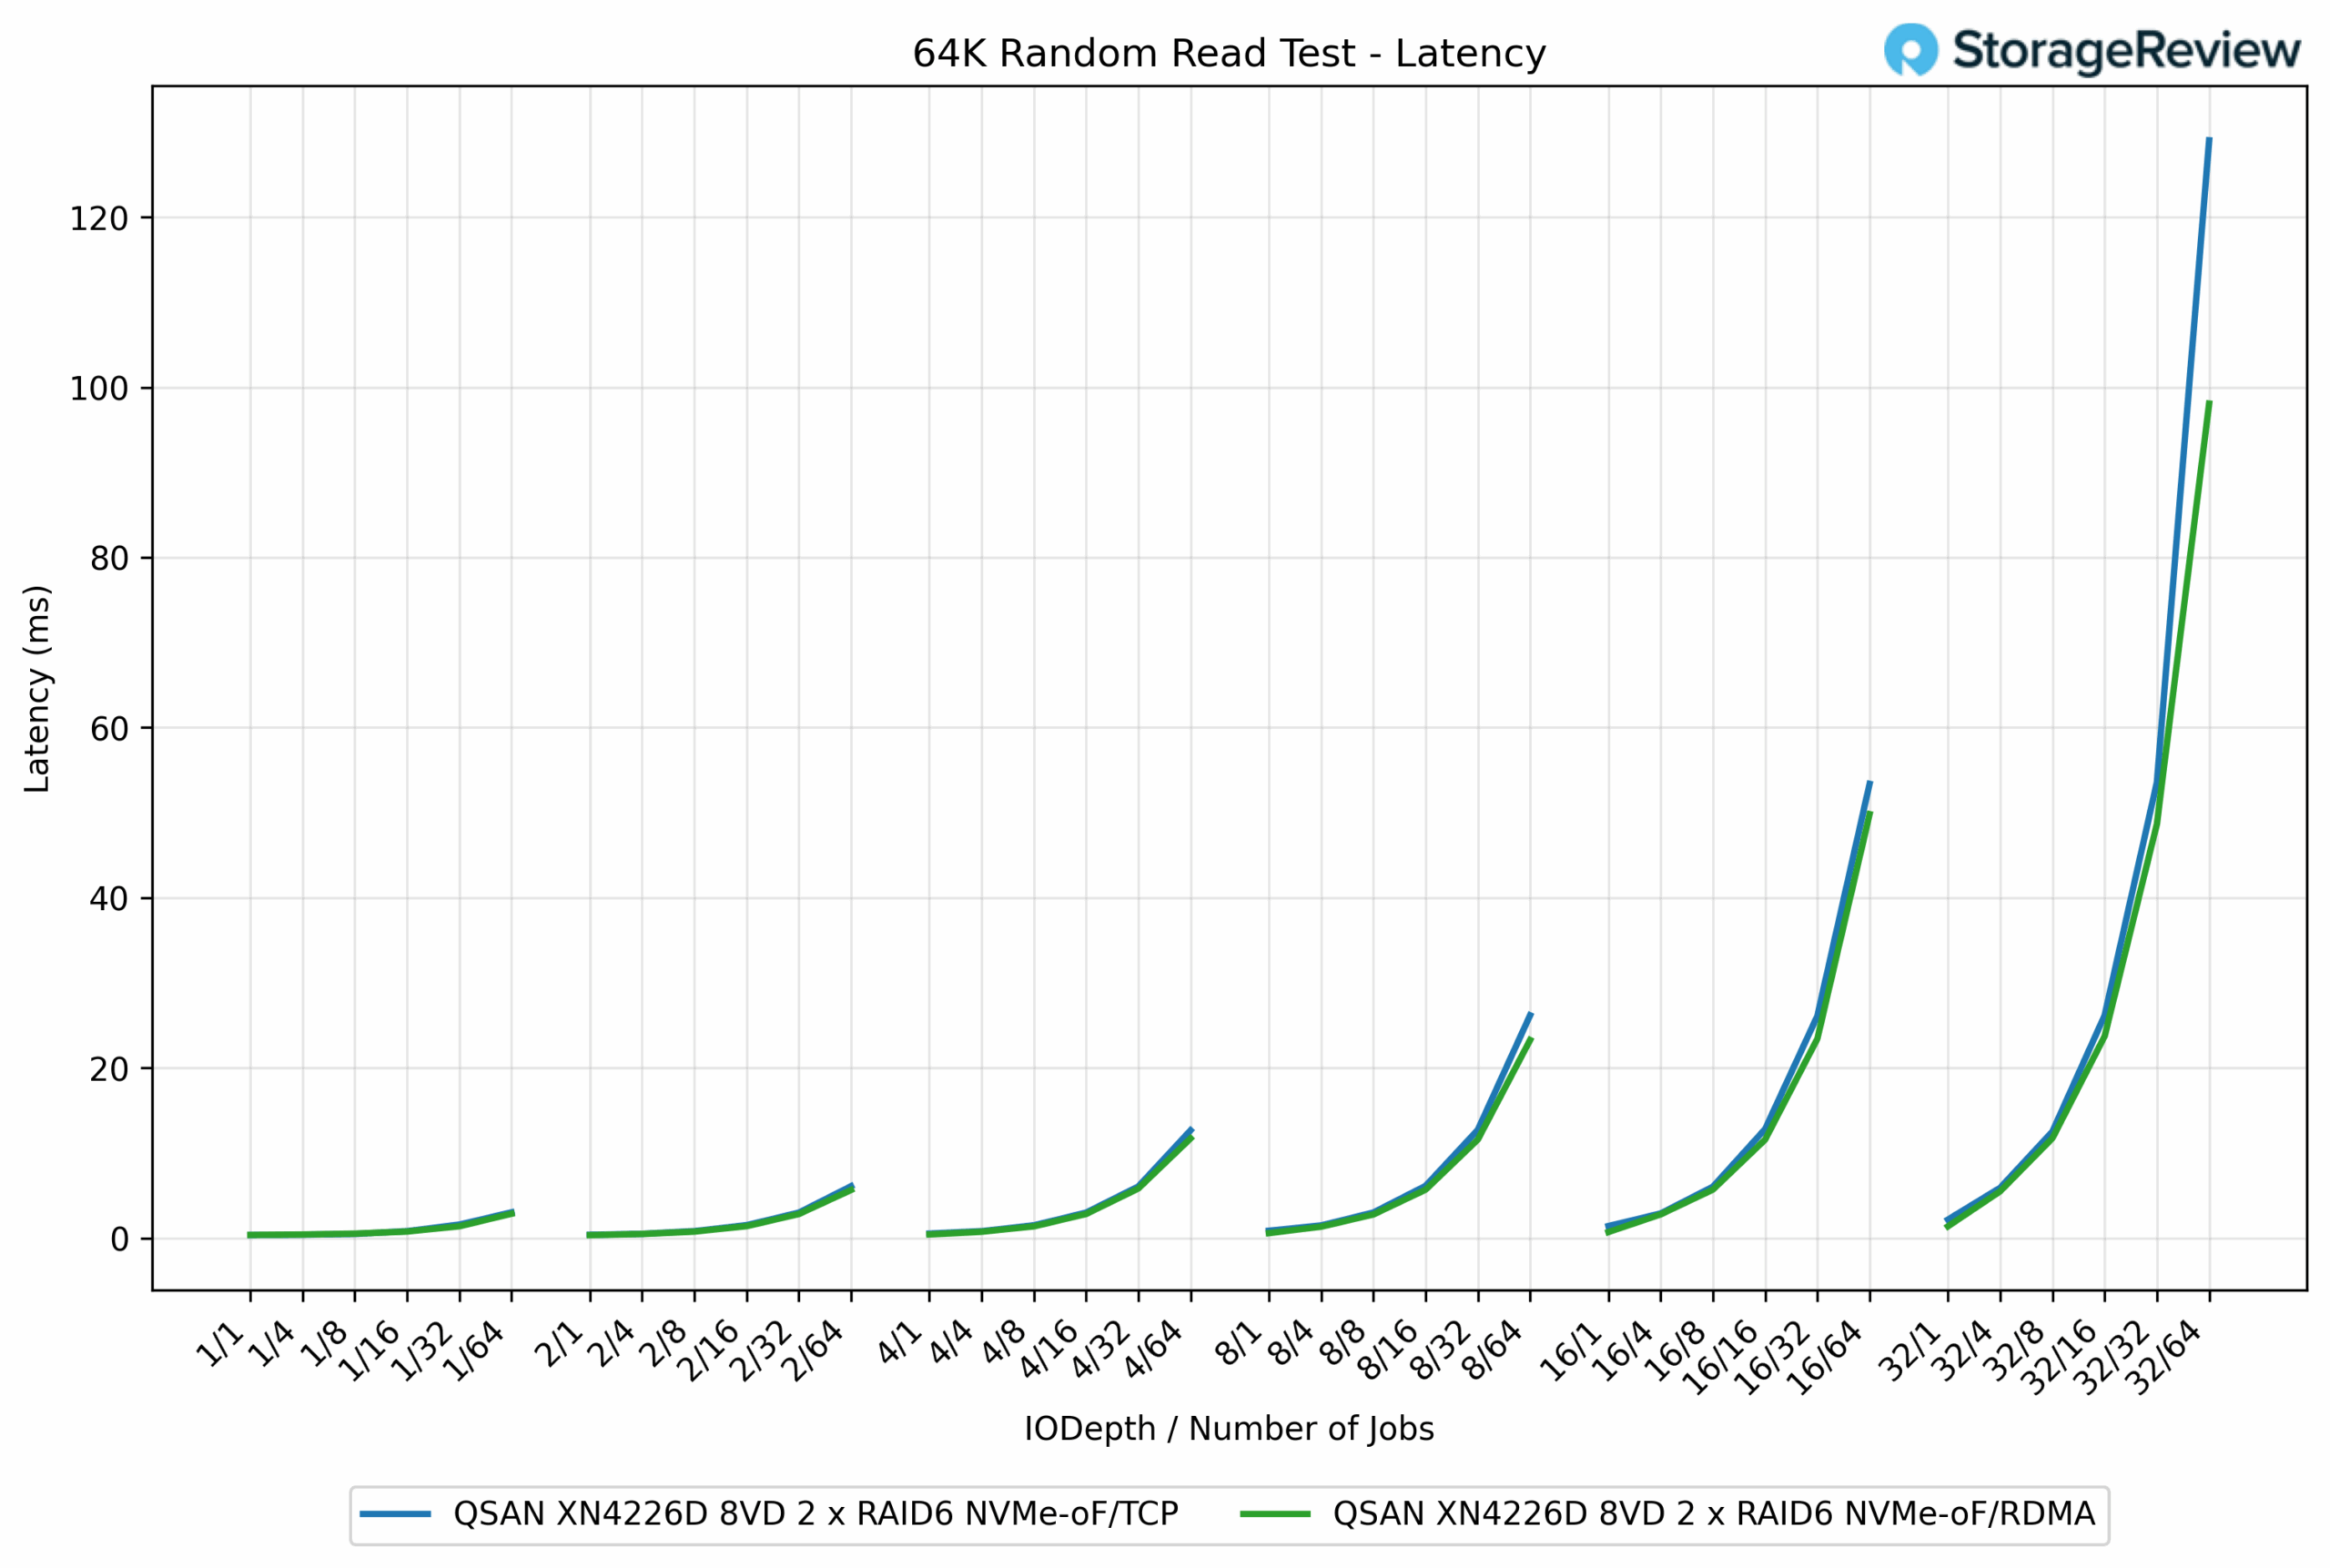
在 64K 隨機讀取延遲測試中,兩種協定的表現非常接近,不過 RDMA 在高負載下略佔優勢。在輕負載下,TCP 和 RDMA 的延遲均低於 1 毫秒,基本上難以區分。例如,在 QD1/1 作業中,TCP 的延遲為 0.43 毫秒,而 RDMA 的延遲為 0.38 毫秒。
隨著並發性的增加,差異變得更加明顯。在 QD16/64 作業中,RDMA 耗時 23.28 毫秒,而 TCP 耗時 26.19 毫秒,提升了 12%。在最大壓力下,兩者差距進一步拉大,RDMA 耗時 98.08 毫秒,而 TCP 耗時 129.02 毫秒,降低了 24%。
16K隨機寫入IOPS
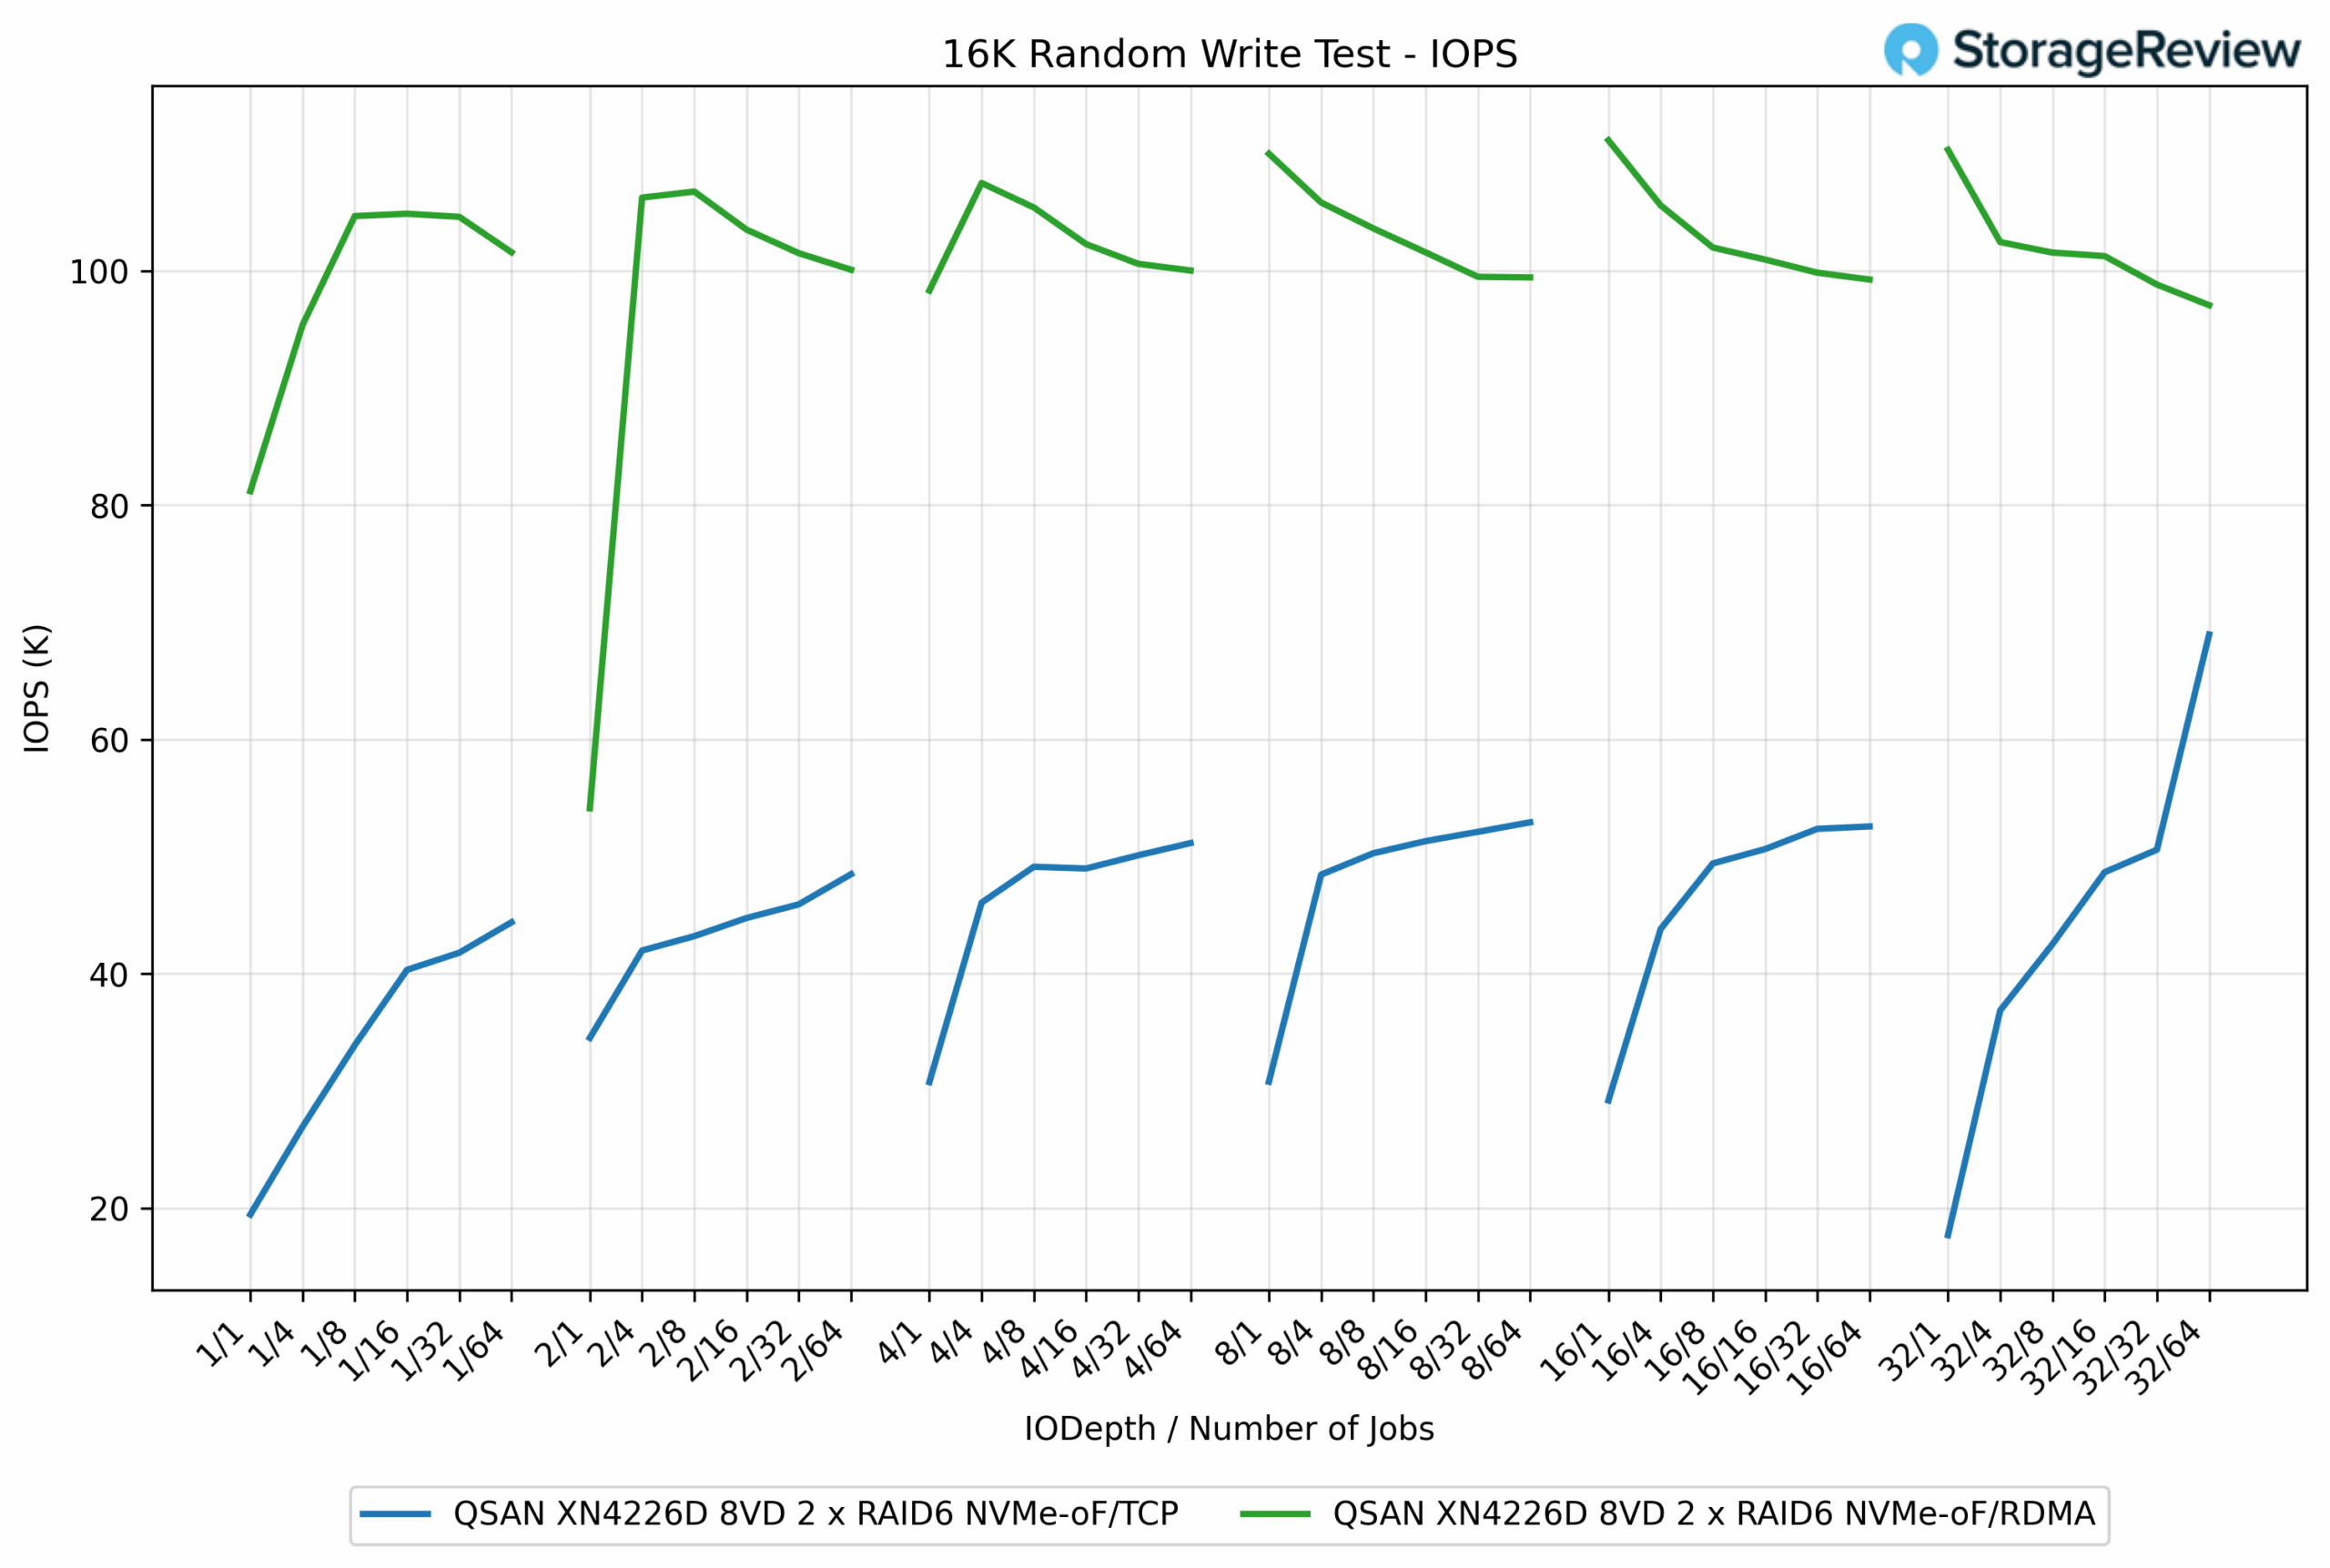
在 16K 隨機寫入測試中,兩種協定之間的效能差距顯著,在大多數情況下,RDMA 提供的 IOPS 是 TCP 的兩倍以上。 RDMA 的峰值為 111.13K IOPS,而 TCP 的最高值為 68.95K IOPS,RDMA 的優勢達到 61%。
在較低的隊列深度下,差異更加明顯。例如,在 QD1/16 作業中,RDMA 測得 104.86K IOPS,而 TCP 為 41.78K IOPS,這表示 RDMA 的效能提升了 151%。在整個工作負載範圍內,RDMA 的效能始終保持在 100K 到 111K IOPS 範圍內,而 TCP 的效能通常保持在 40K 到 50K IOPS 範圍內,除了在最大深度時出現後期激增。
16K隨機寫入延遲
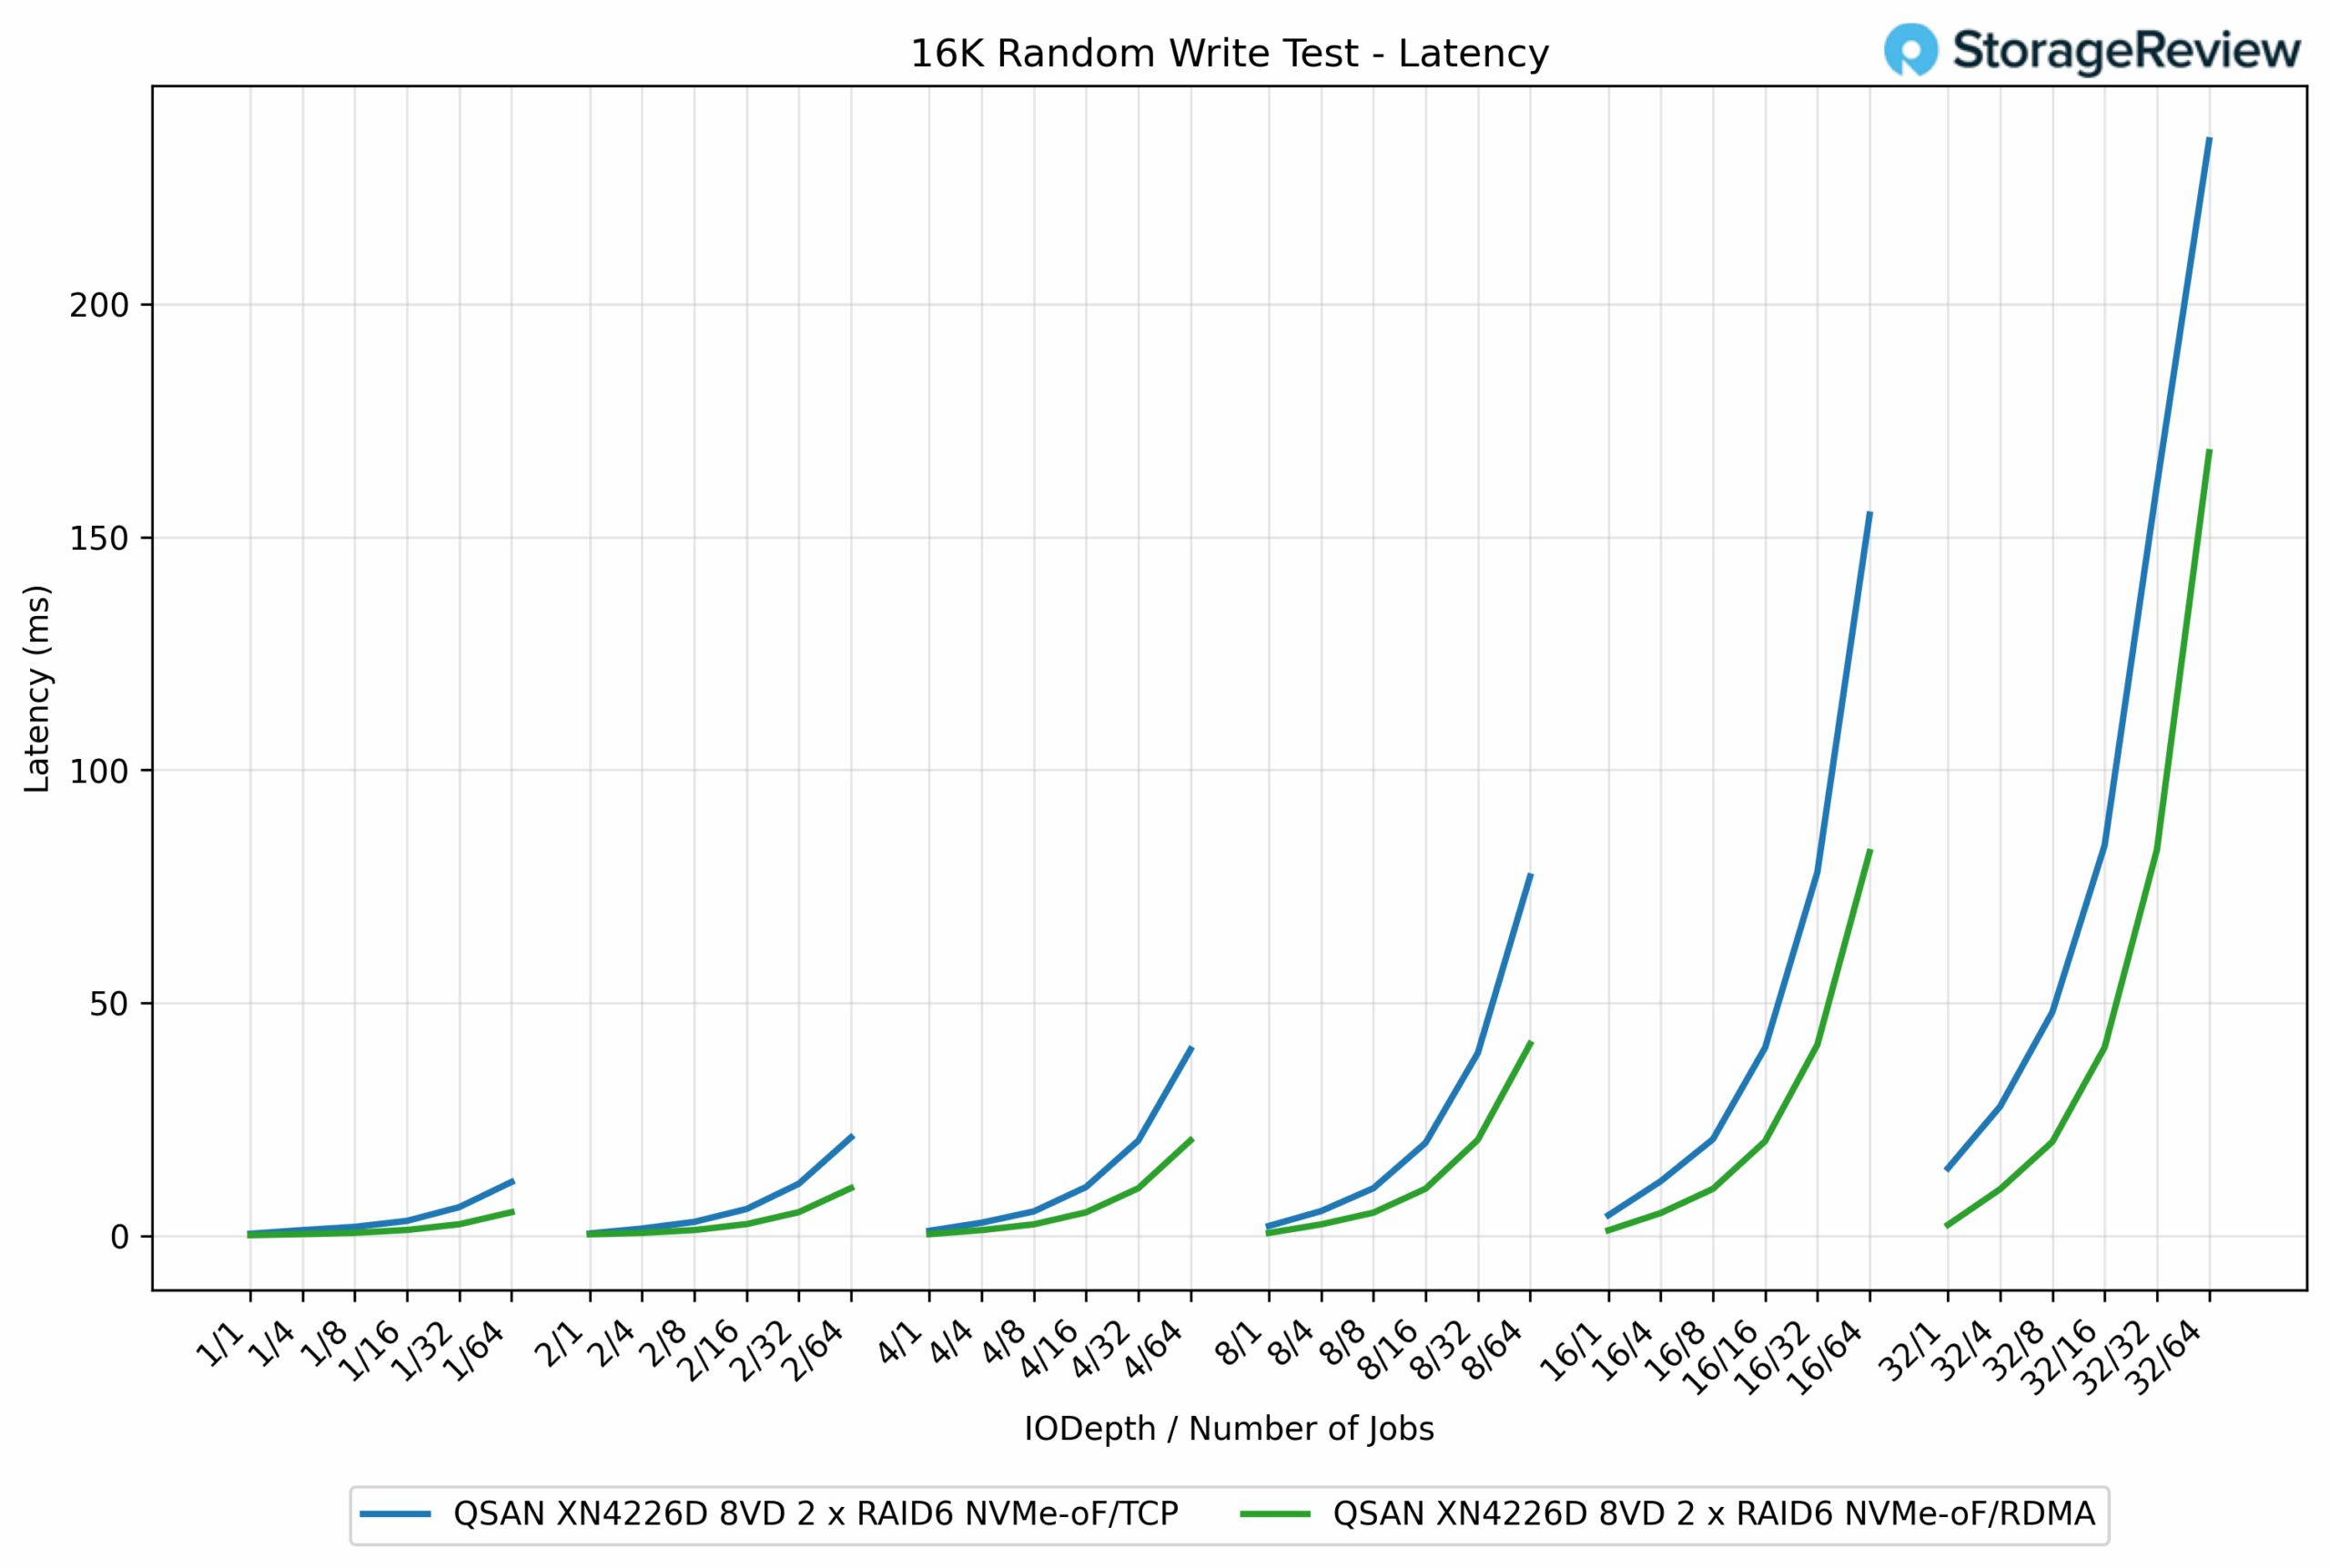
在 16K 隨機寫入延遲測試中,隨著工作負載的擴展,RDMA 再次保持了優於 TCP 的明顯優勢。在較輕負載下,兩種協定幾乎相同,回應時間均保持在 2 毫秒以下。例如,在 QD1/1 作業中,TCP 的回應時間為 0.40 毫秒,而 RDMA 的回應時間為 0.41 毫秒。
隨著並發度的提高,RDMA 開始分出高低。在 QD16/64 作業中,RDMA 的耗時為 21.15 毫秒,而 TCP 的耗時為 77.12 毫秒,大幅縮短了 72%。這種優勢在最高深度下依然保持。在 QD32/64 作業中,RDMA 的完成時間為 161.13 毫秒,而 TCP 的完成時間為 235.17 毫秒,縮短了 31%。
16K 隨機讀取 IOPS
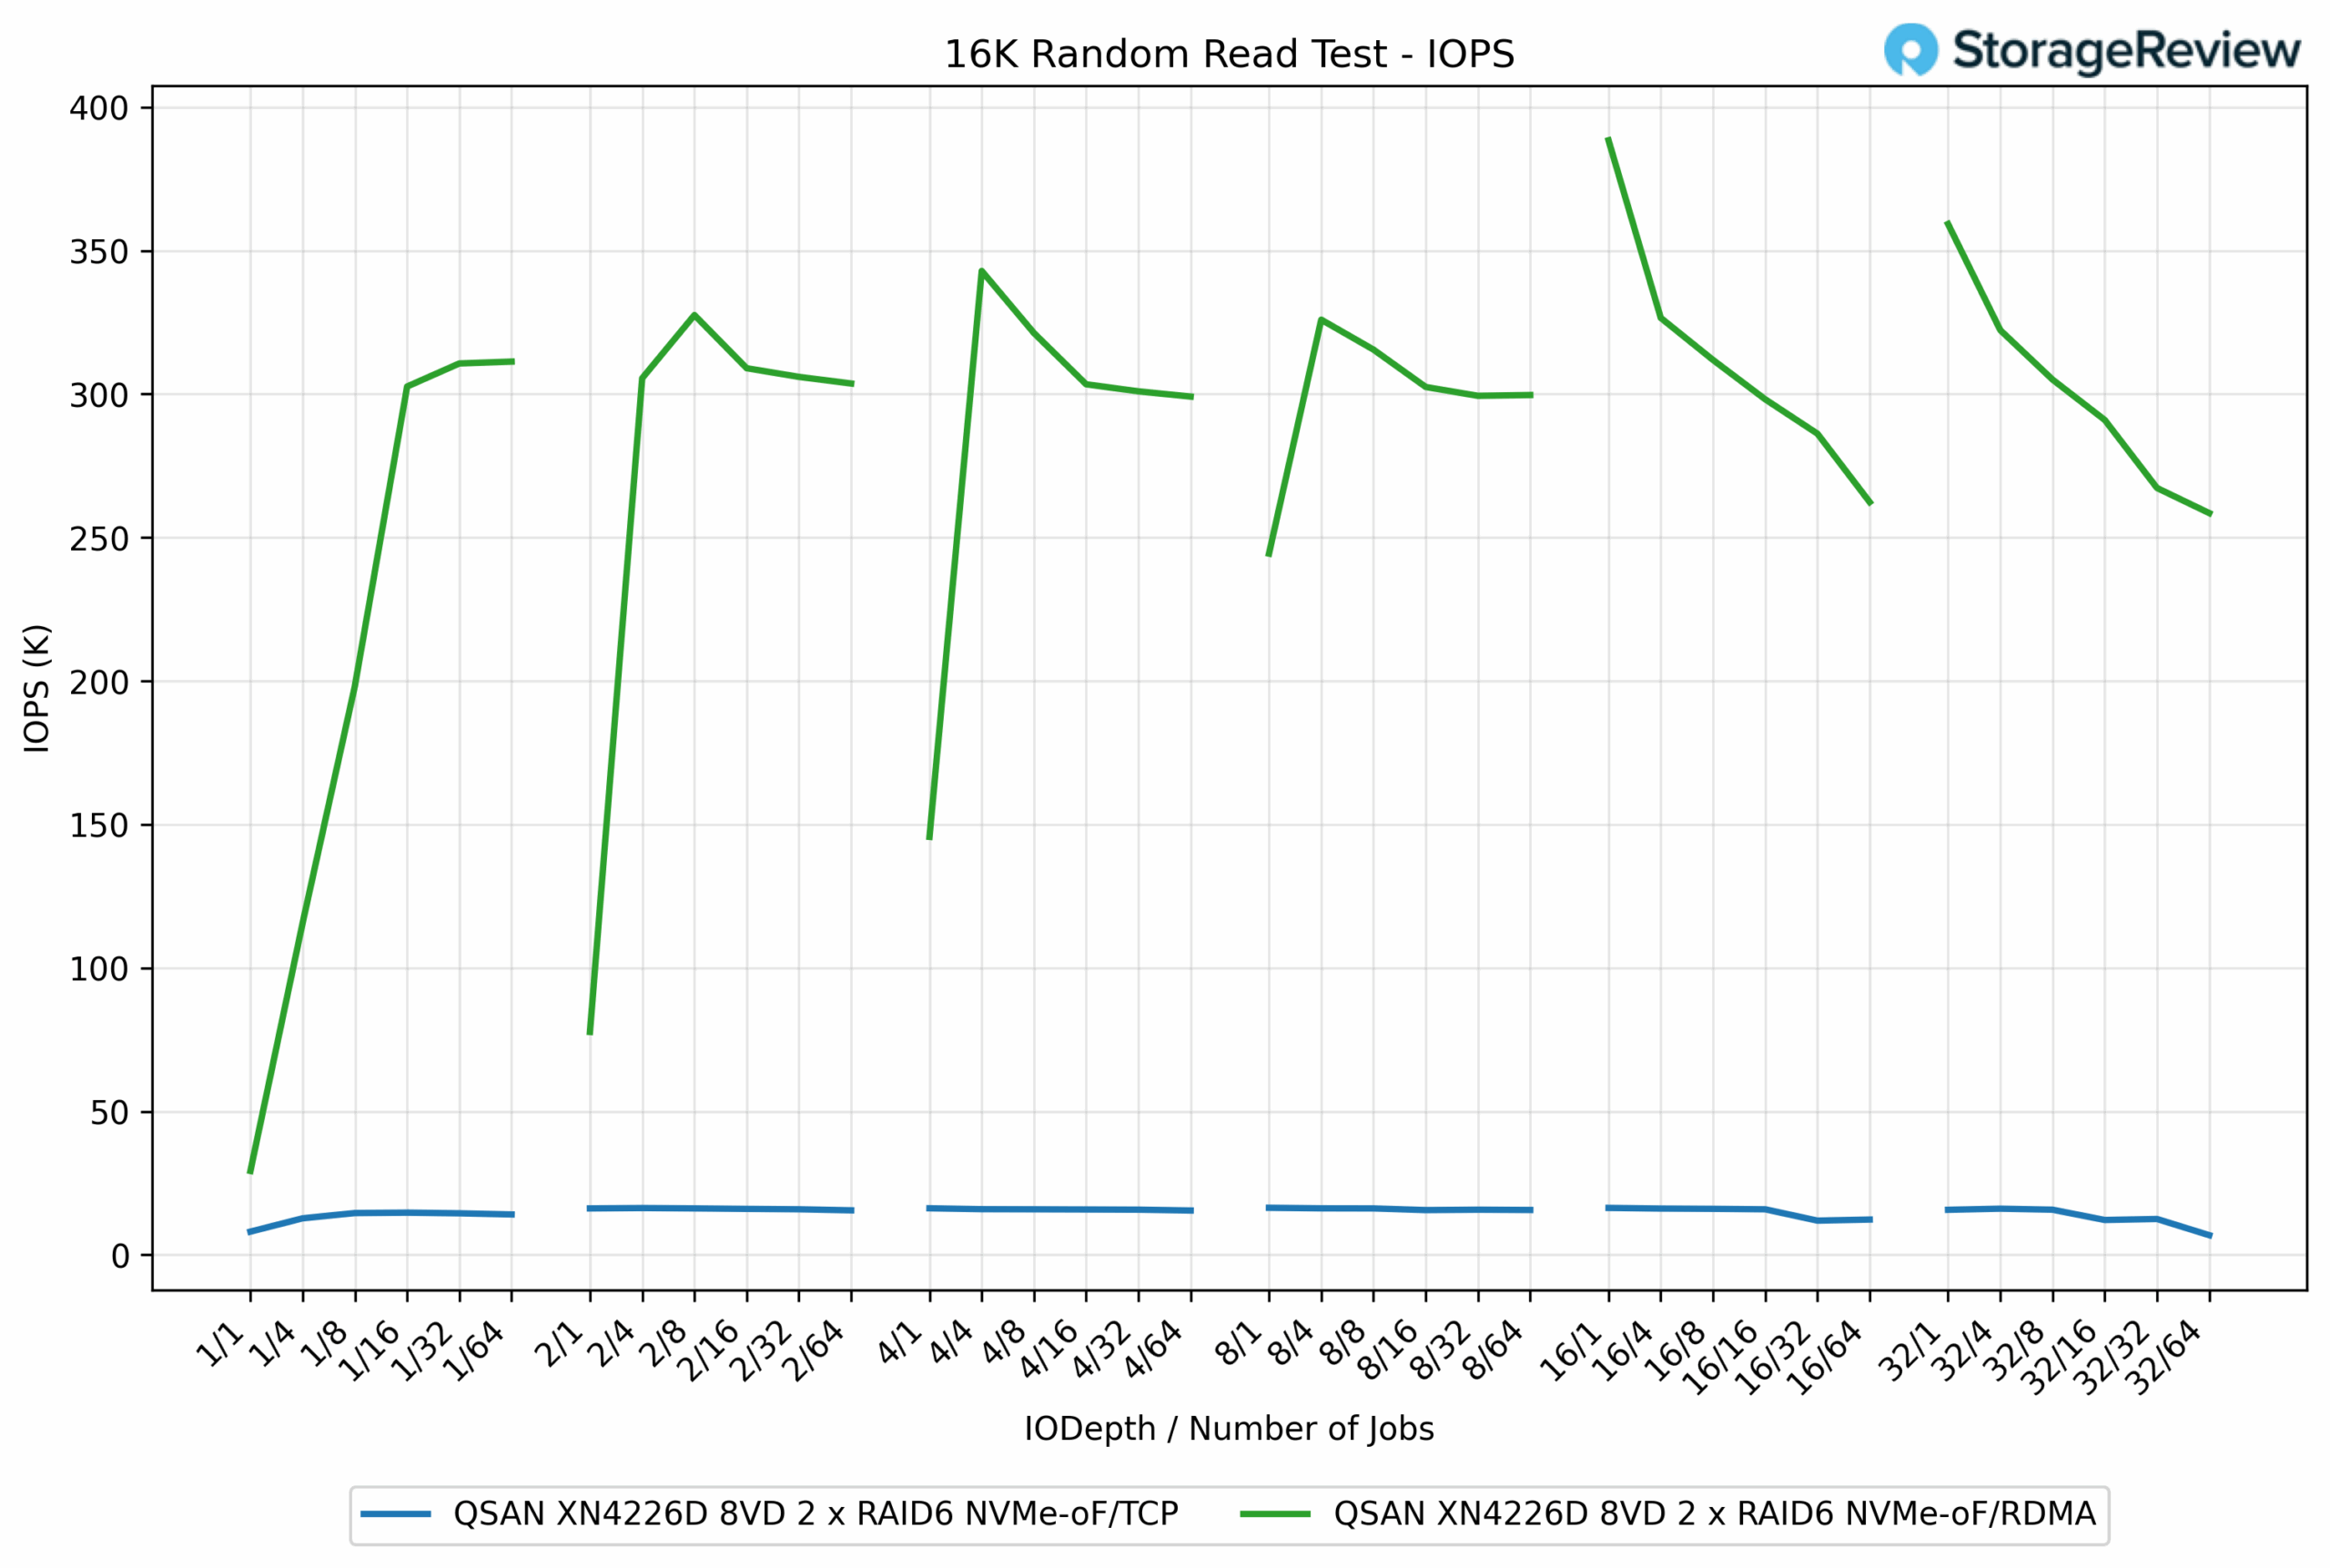
在 16K 隨機讀取測試中,RDMA 在整個工作負載範圍內完全超越 TCP。 RDMA 的峰值達到了 388.44K IOPS,而 TCP 的最高速度僅為 16.42K IOPS,RDMA 的優勢超過 TCP 的 23 倍。
這種差異從一開始就顯而易見。在 QD1/1 作業中,RDMA 提供了 29.27K IOPS,而 TCP 僅提供了 8.10K IOPS。隨著併發性的增加,RDMA 迅速擴展到 300K 到 380K IOPS 的範圍,而 TCP 則穩定在 15K 到 16K IOPS 左右,即使在更高的佇列深度下也是如此。
16K隨機讀取延遲
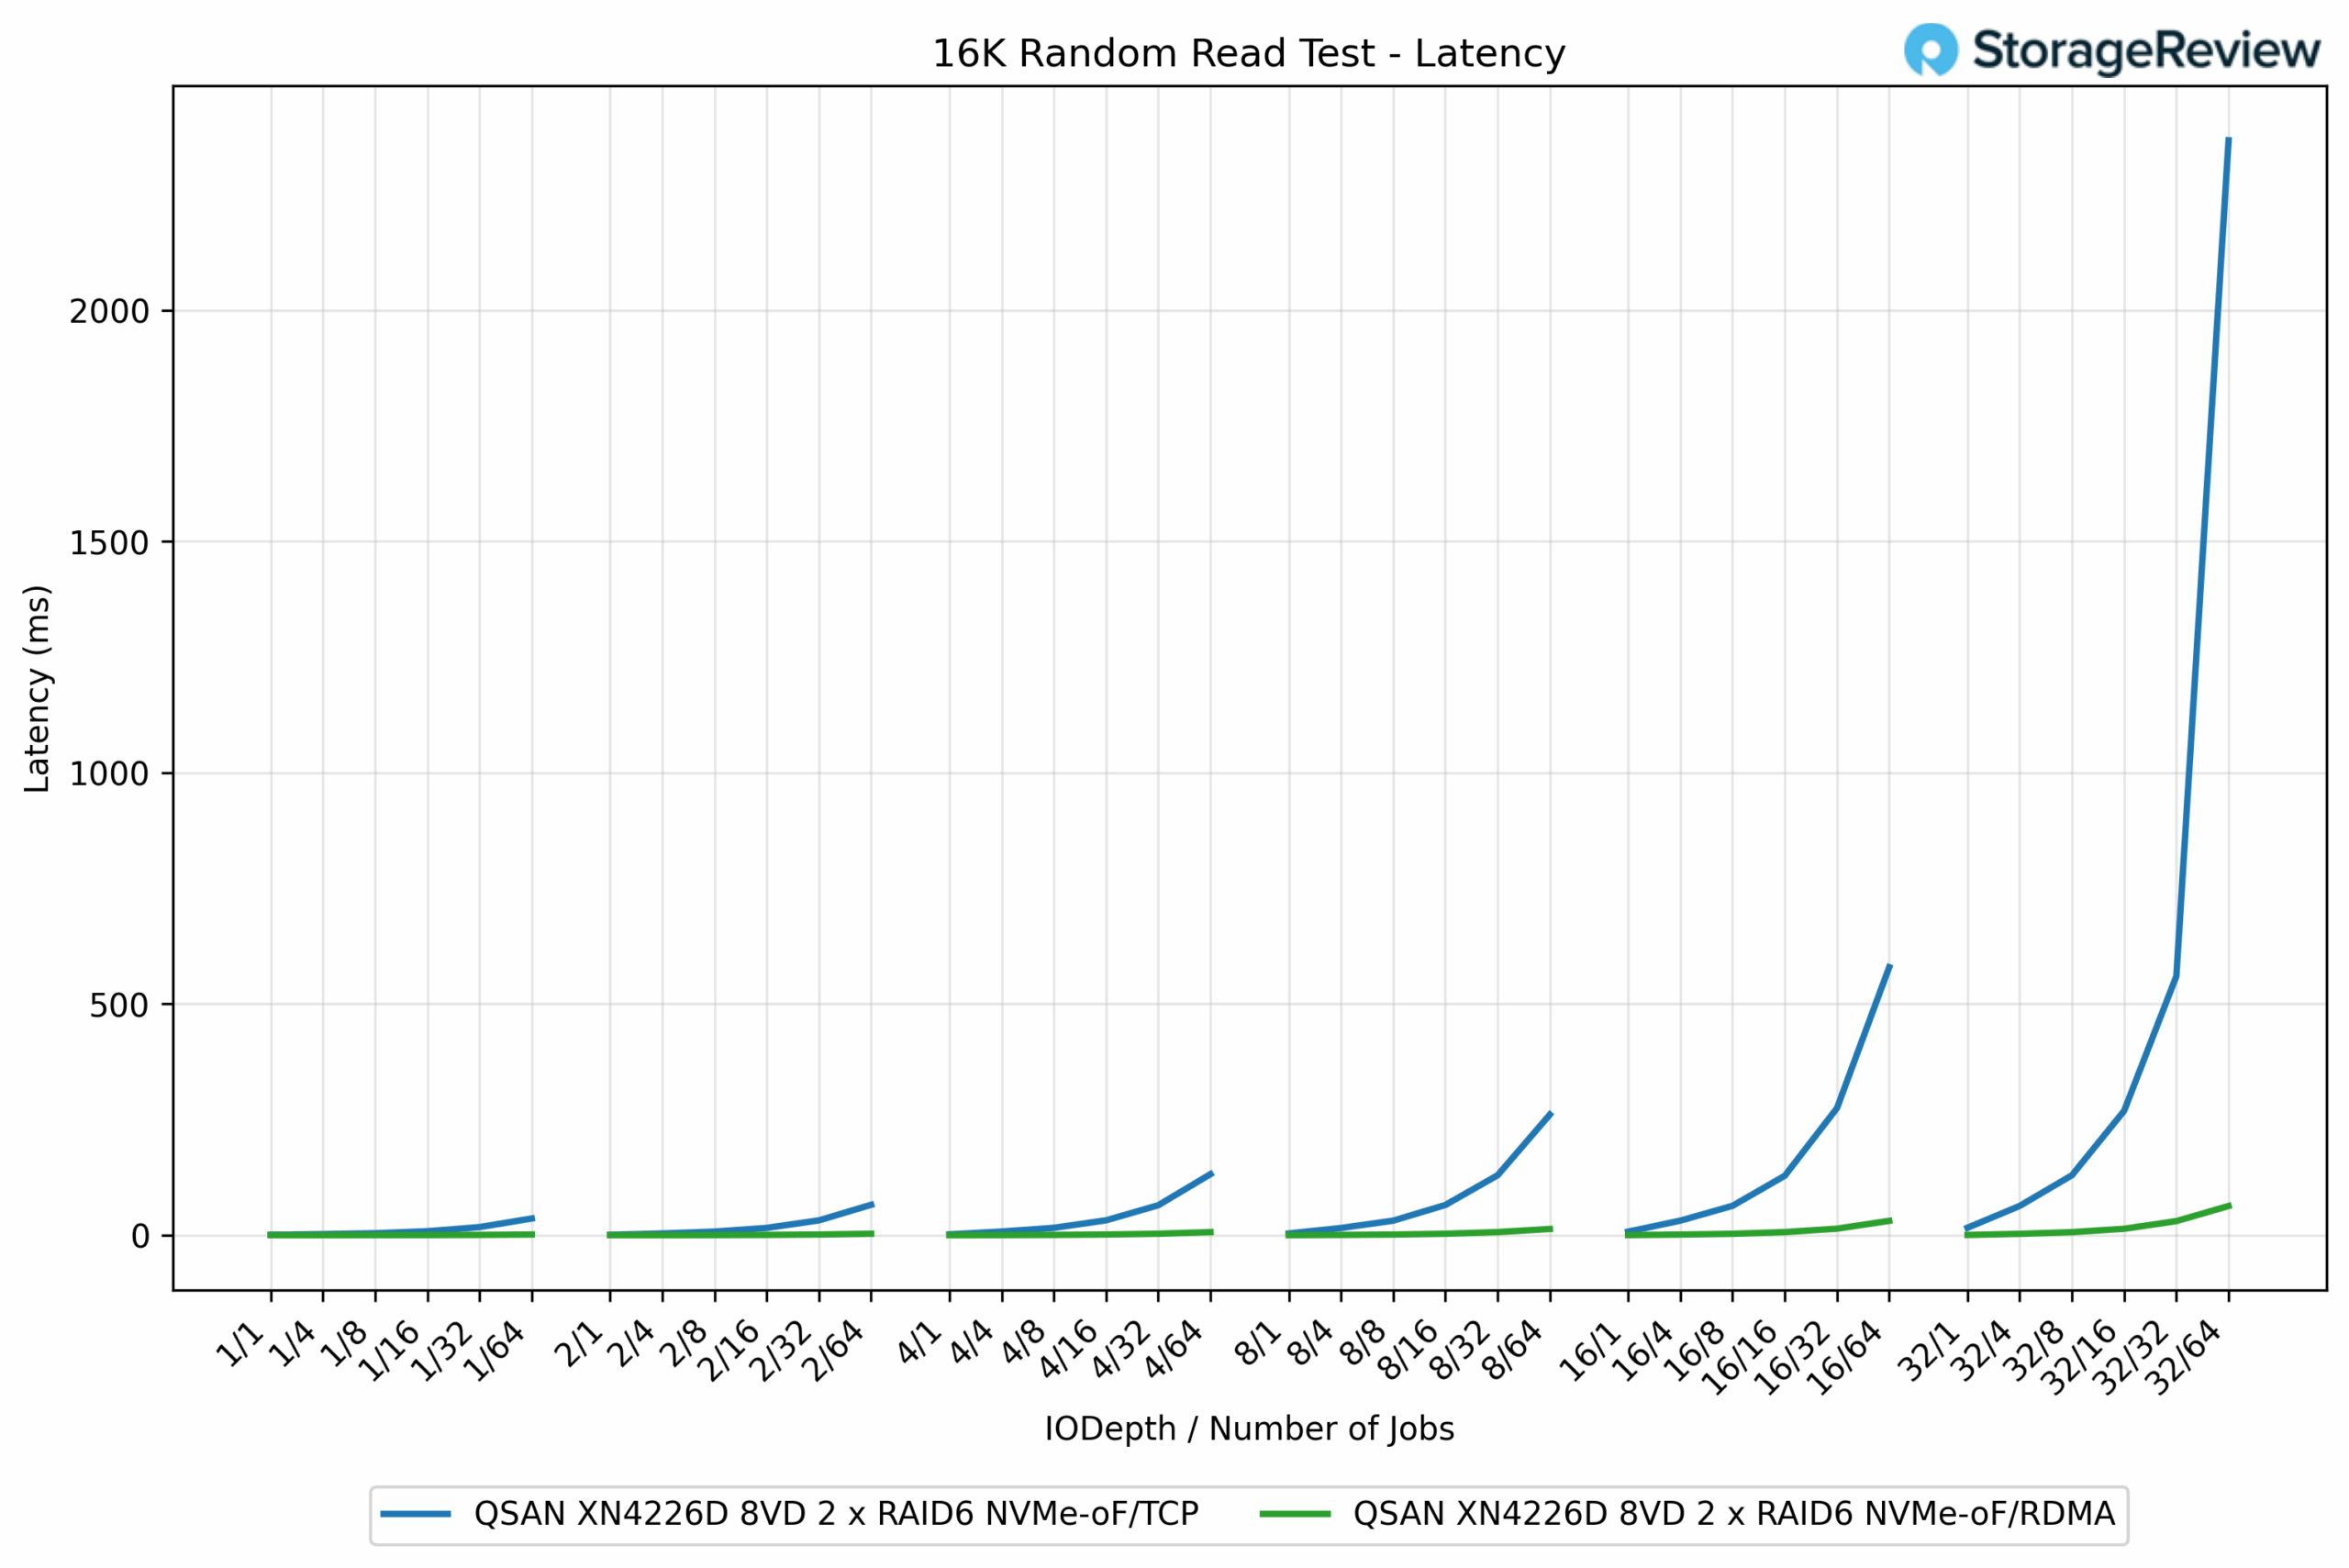
在 16K 隨機讀取延遲測試中,RDMA 和 TCP 之間的差異非常顯著,這與 IOPS 結果相符。在輕負載下,兩種協定幾乎相同,延遲範圍從 1 到 10 毫秒。
隨著工作負載的擴展,RDMA 的延遲得到了良好的控制,而 TCP 的延遲則顯著下降。在 Q8/64 作業中,RDMA 的測量時間為 13.65 毫秒,而 TCP 的測量時間為 260.90 毫秒,兩者相比提升了近 19 倍。最終,QD32/64 作業在 63.28 毫秒內完成了 RDMA,而 TCP 則耗時 2,366.99 毫秒,幾乎是後者的 37 倍。
4K隨機寫入IOPS
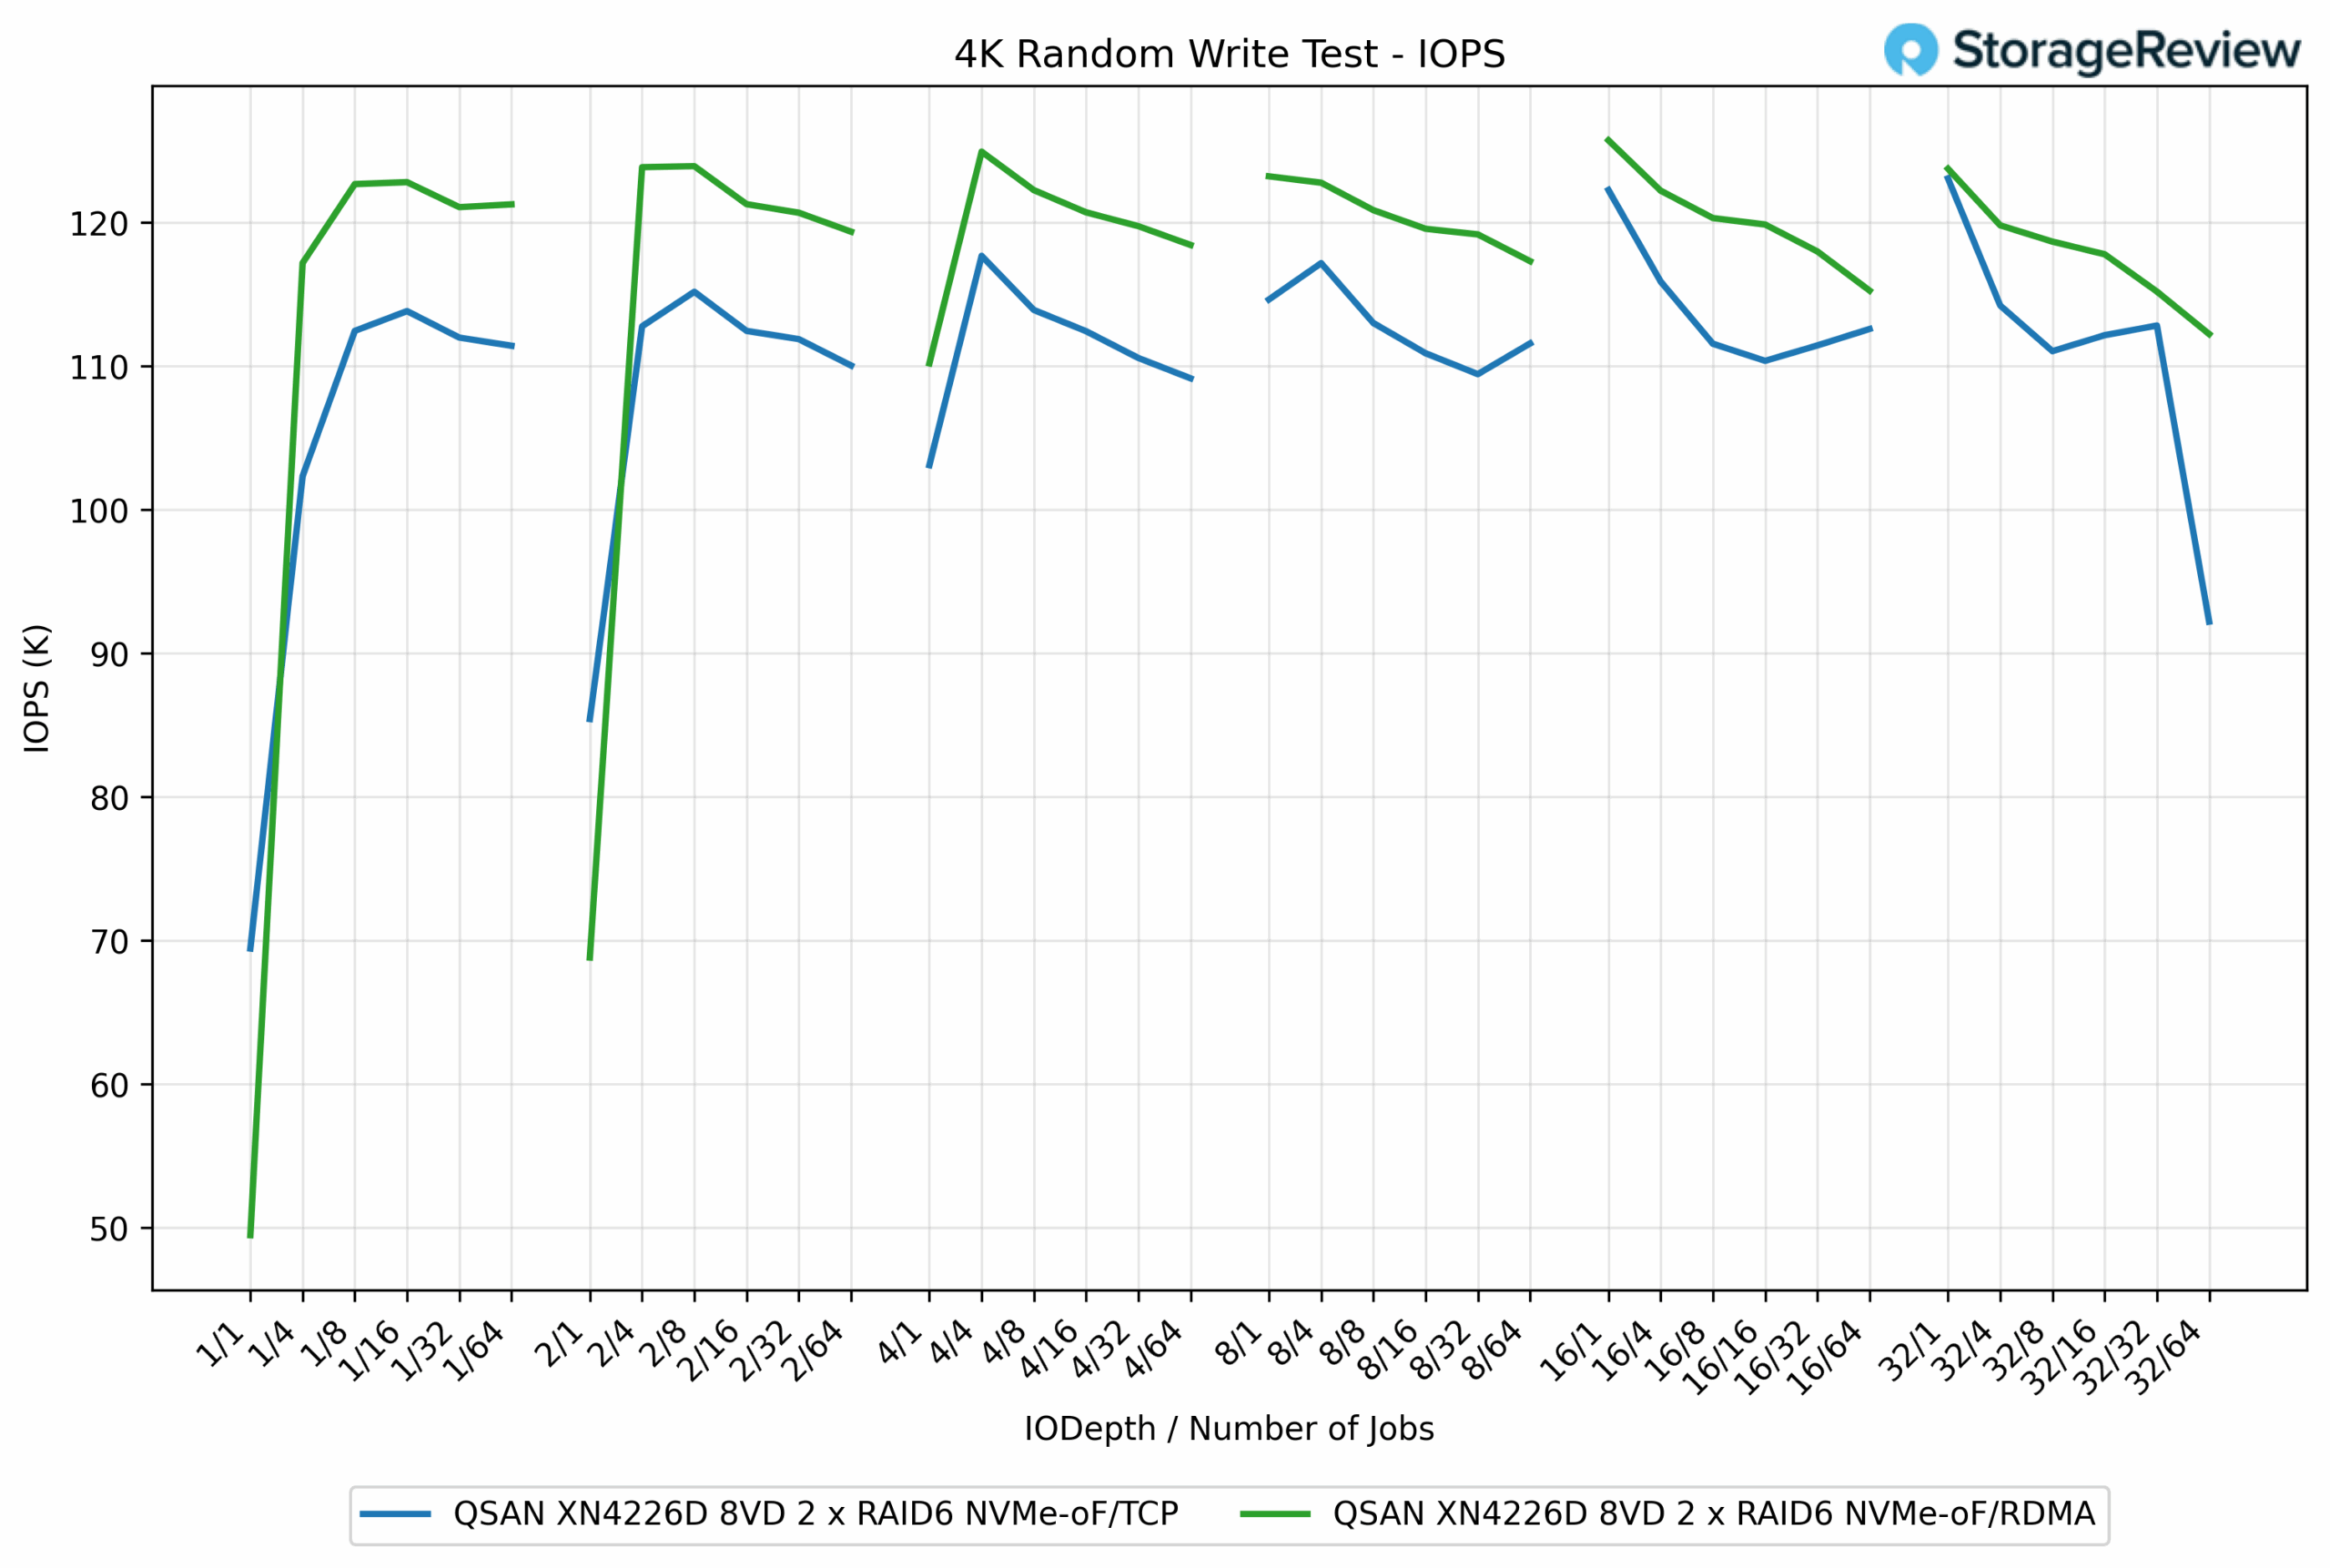
在 4K 隨機寫入測試中,RDMA 的表現始終優於 TCP,儘管與較大區塊大小的工作負載相比,兩者之間的差距較小。 RDMA 的峰值達到了 125.73K IOPS,而 TCP 達到了 115.89K IOPS,RDMA 的優勢約為 8.5%。
在較低的隊列深度下,TCP 略遜於 RDMA,但仍具有相當不錯的效能。例如,在 QD1/16 作業中,RDMA 達到了 122.82K IOPS,而 TCP 僅有 111.91K IOPS,兩者效能提升了近 10%。在大多數測試點上,RDMA 的 IOPS 徘徊在 120K 到 125K IOPS 之間,而 TCP 的 IOPS 則保持在 110K 到 116K IOPS 之間,在 QD32/64 作業中略有下降,降至 92.21K IOPS。
4K隨機寫入延遲
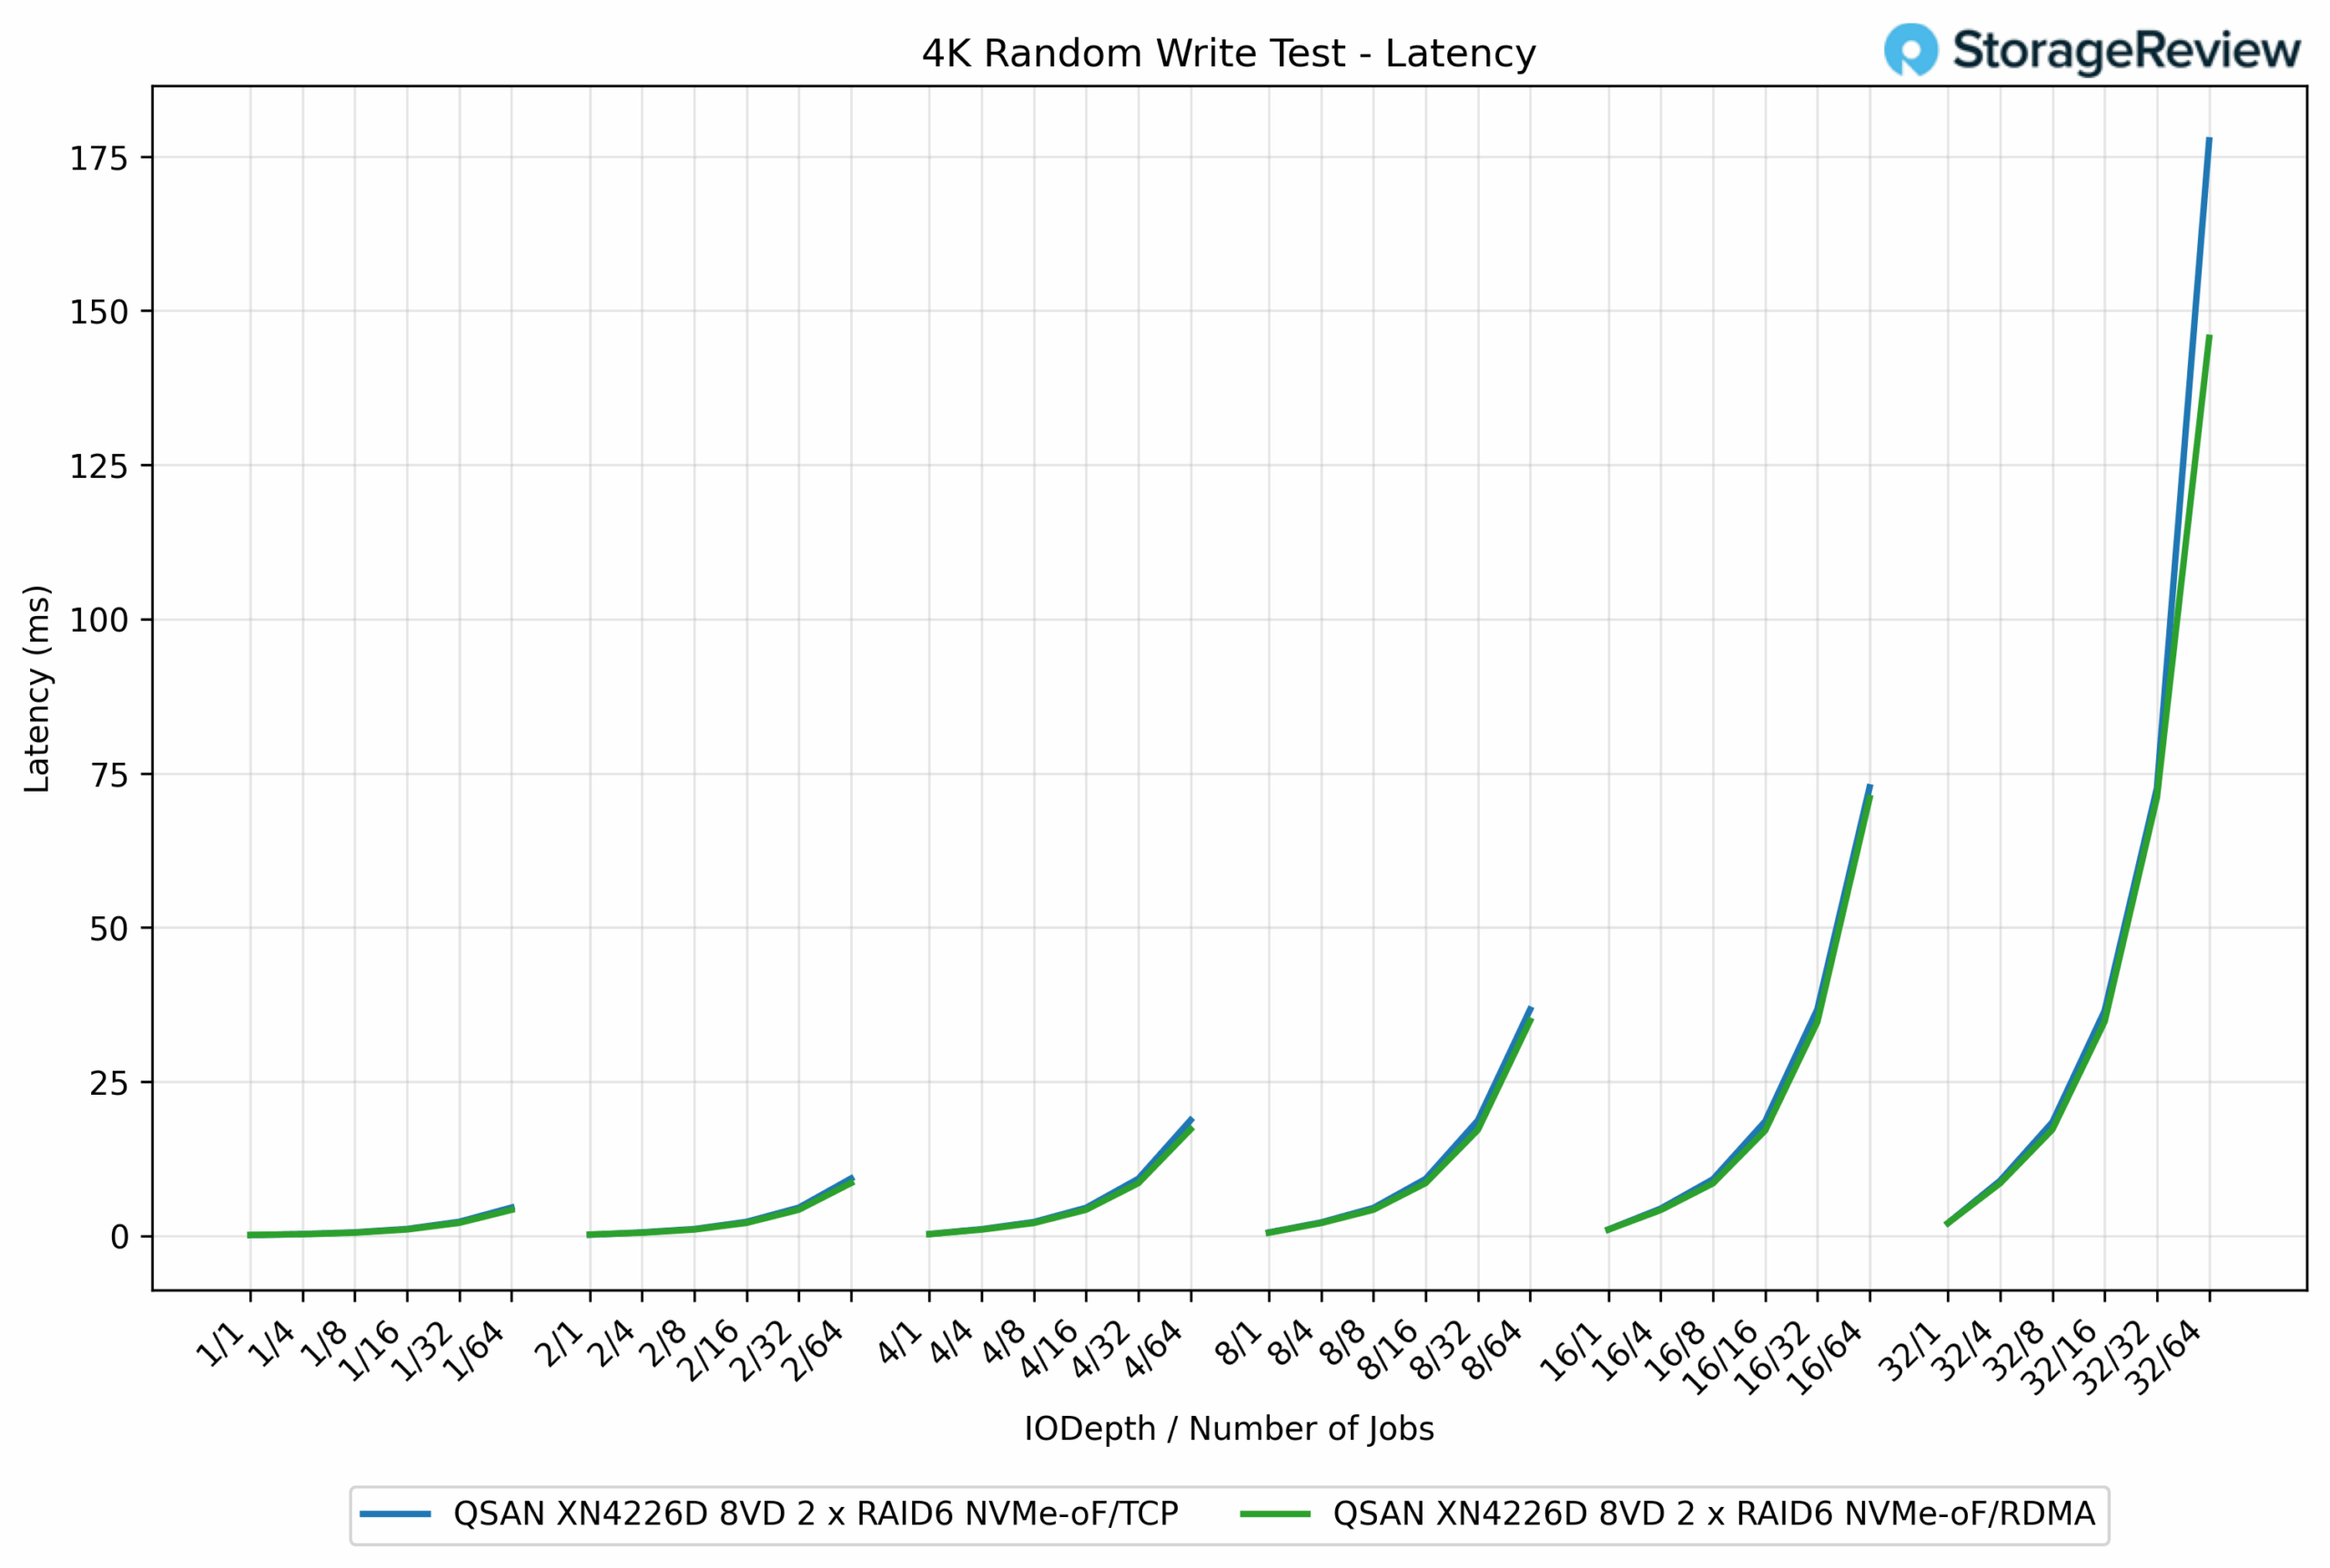
在 4K 隨機寫入延遲測試中,RDMA 的回應時間始終低於 TCP,儘管與較大的區塊工作負載相比,差距較小。在較輕負載下,兩種協定幾乎相同,均保持在 1 毫秒以下。例如,在 QD1/1 下,TCP 測得的延遲為 0.16 毫秒,而 RDMA 測得的延遲為 0.21 毫秒。
隨著並發性的增加,差異變得更加明顯。在 QD16/64 作業中,RDMA 的延遲為 19.36 毫秒,而 TCP 的延遲為 36.20 毫秒,RDMA 的延遲降低了 46%。在最大深度下,RDMA 的完成時間為 145.61 毫秒,而 TCP 的完成時間為 177.62 毫秒,RDMA 的延遲降低了 22%。
4K 隨機讀取 IOPS
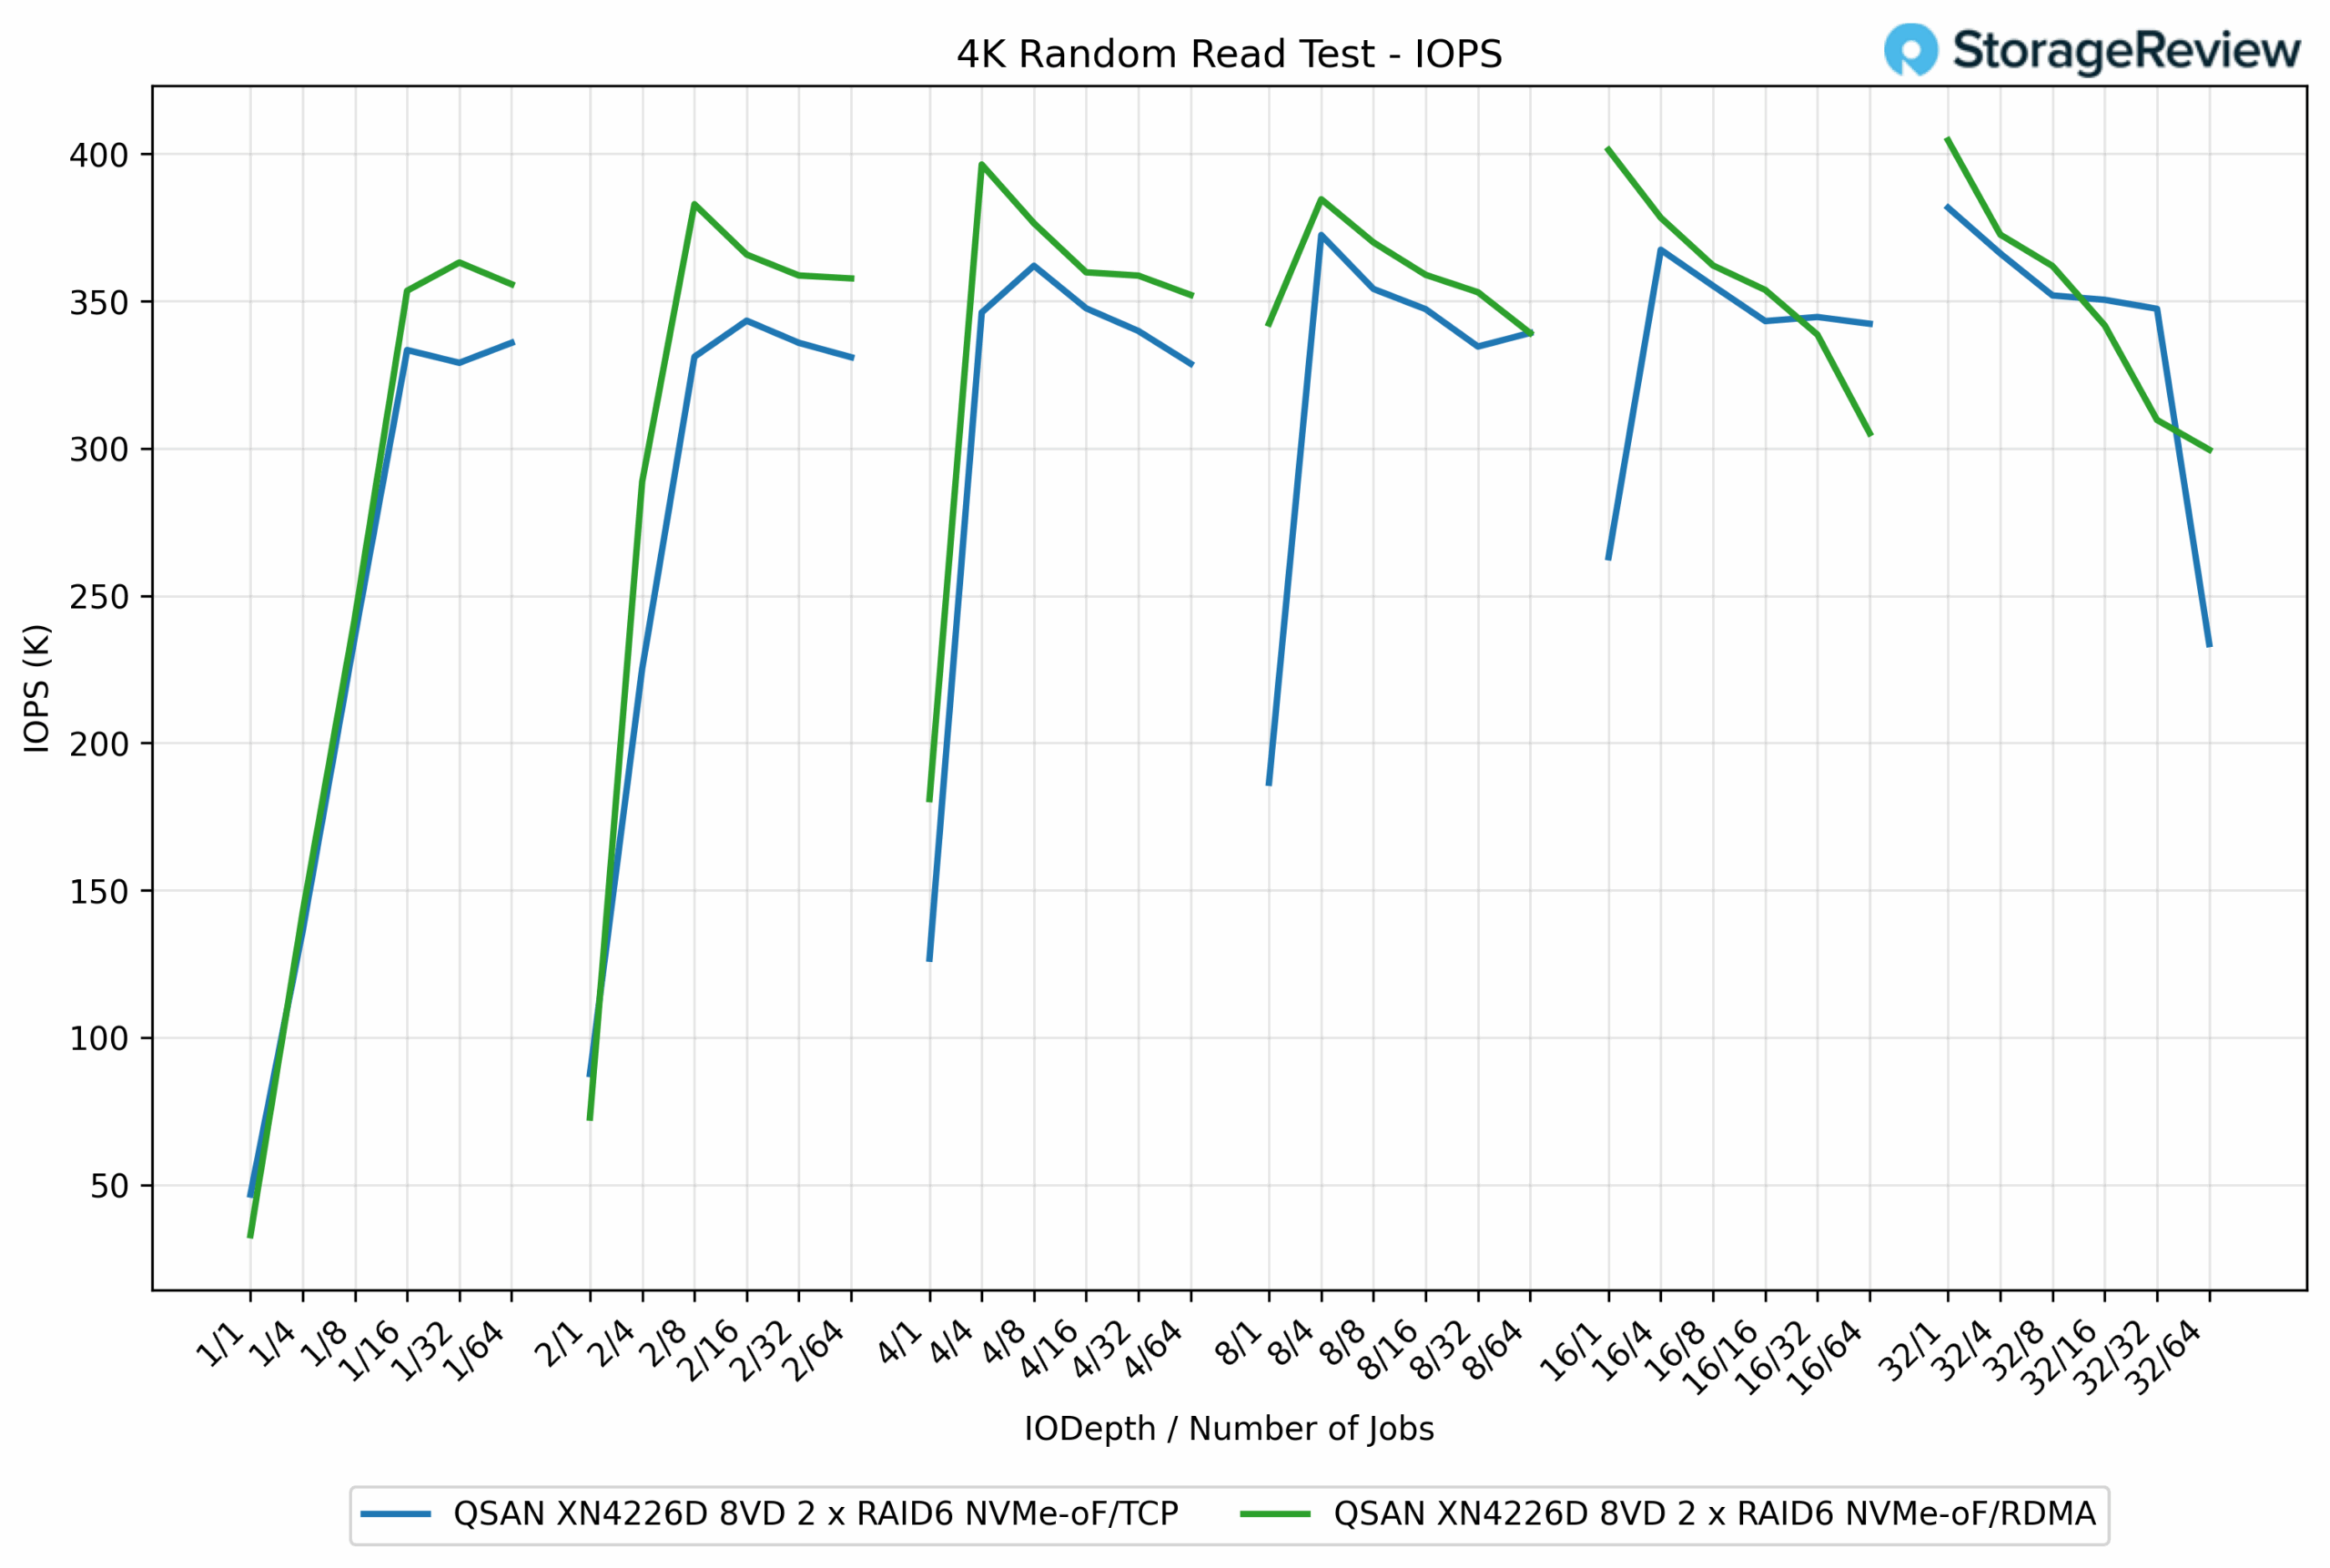
在 4K 隨機讀取測試中,兩種協定都表現出色,但 RDMA 始終略勝 TCP 一籌。 RDMA 的峰值達到了 404.64K IOPS,而 TCP 的最高峰值為 382.96K IOPS,RDMA 領先 5.7%。
在較低深度下,結果已經對 RDMA 有利。例如,在 QD1/16 作業中,RDMA 實現了 353.57K IOPS,而 TCP 為 329.10K IOPS,兩者相差約 7.5%。隨著工作負載的擴展,RDMA 保持領先,通常在 360K 到 400K IOPS 範圍內運行,而 TCP 則保持在 330K 到 380K IOPS 左右。
4K隨機讀取延遲
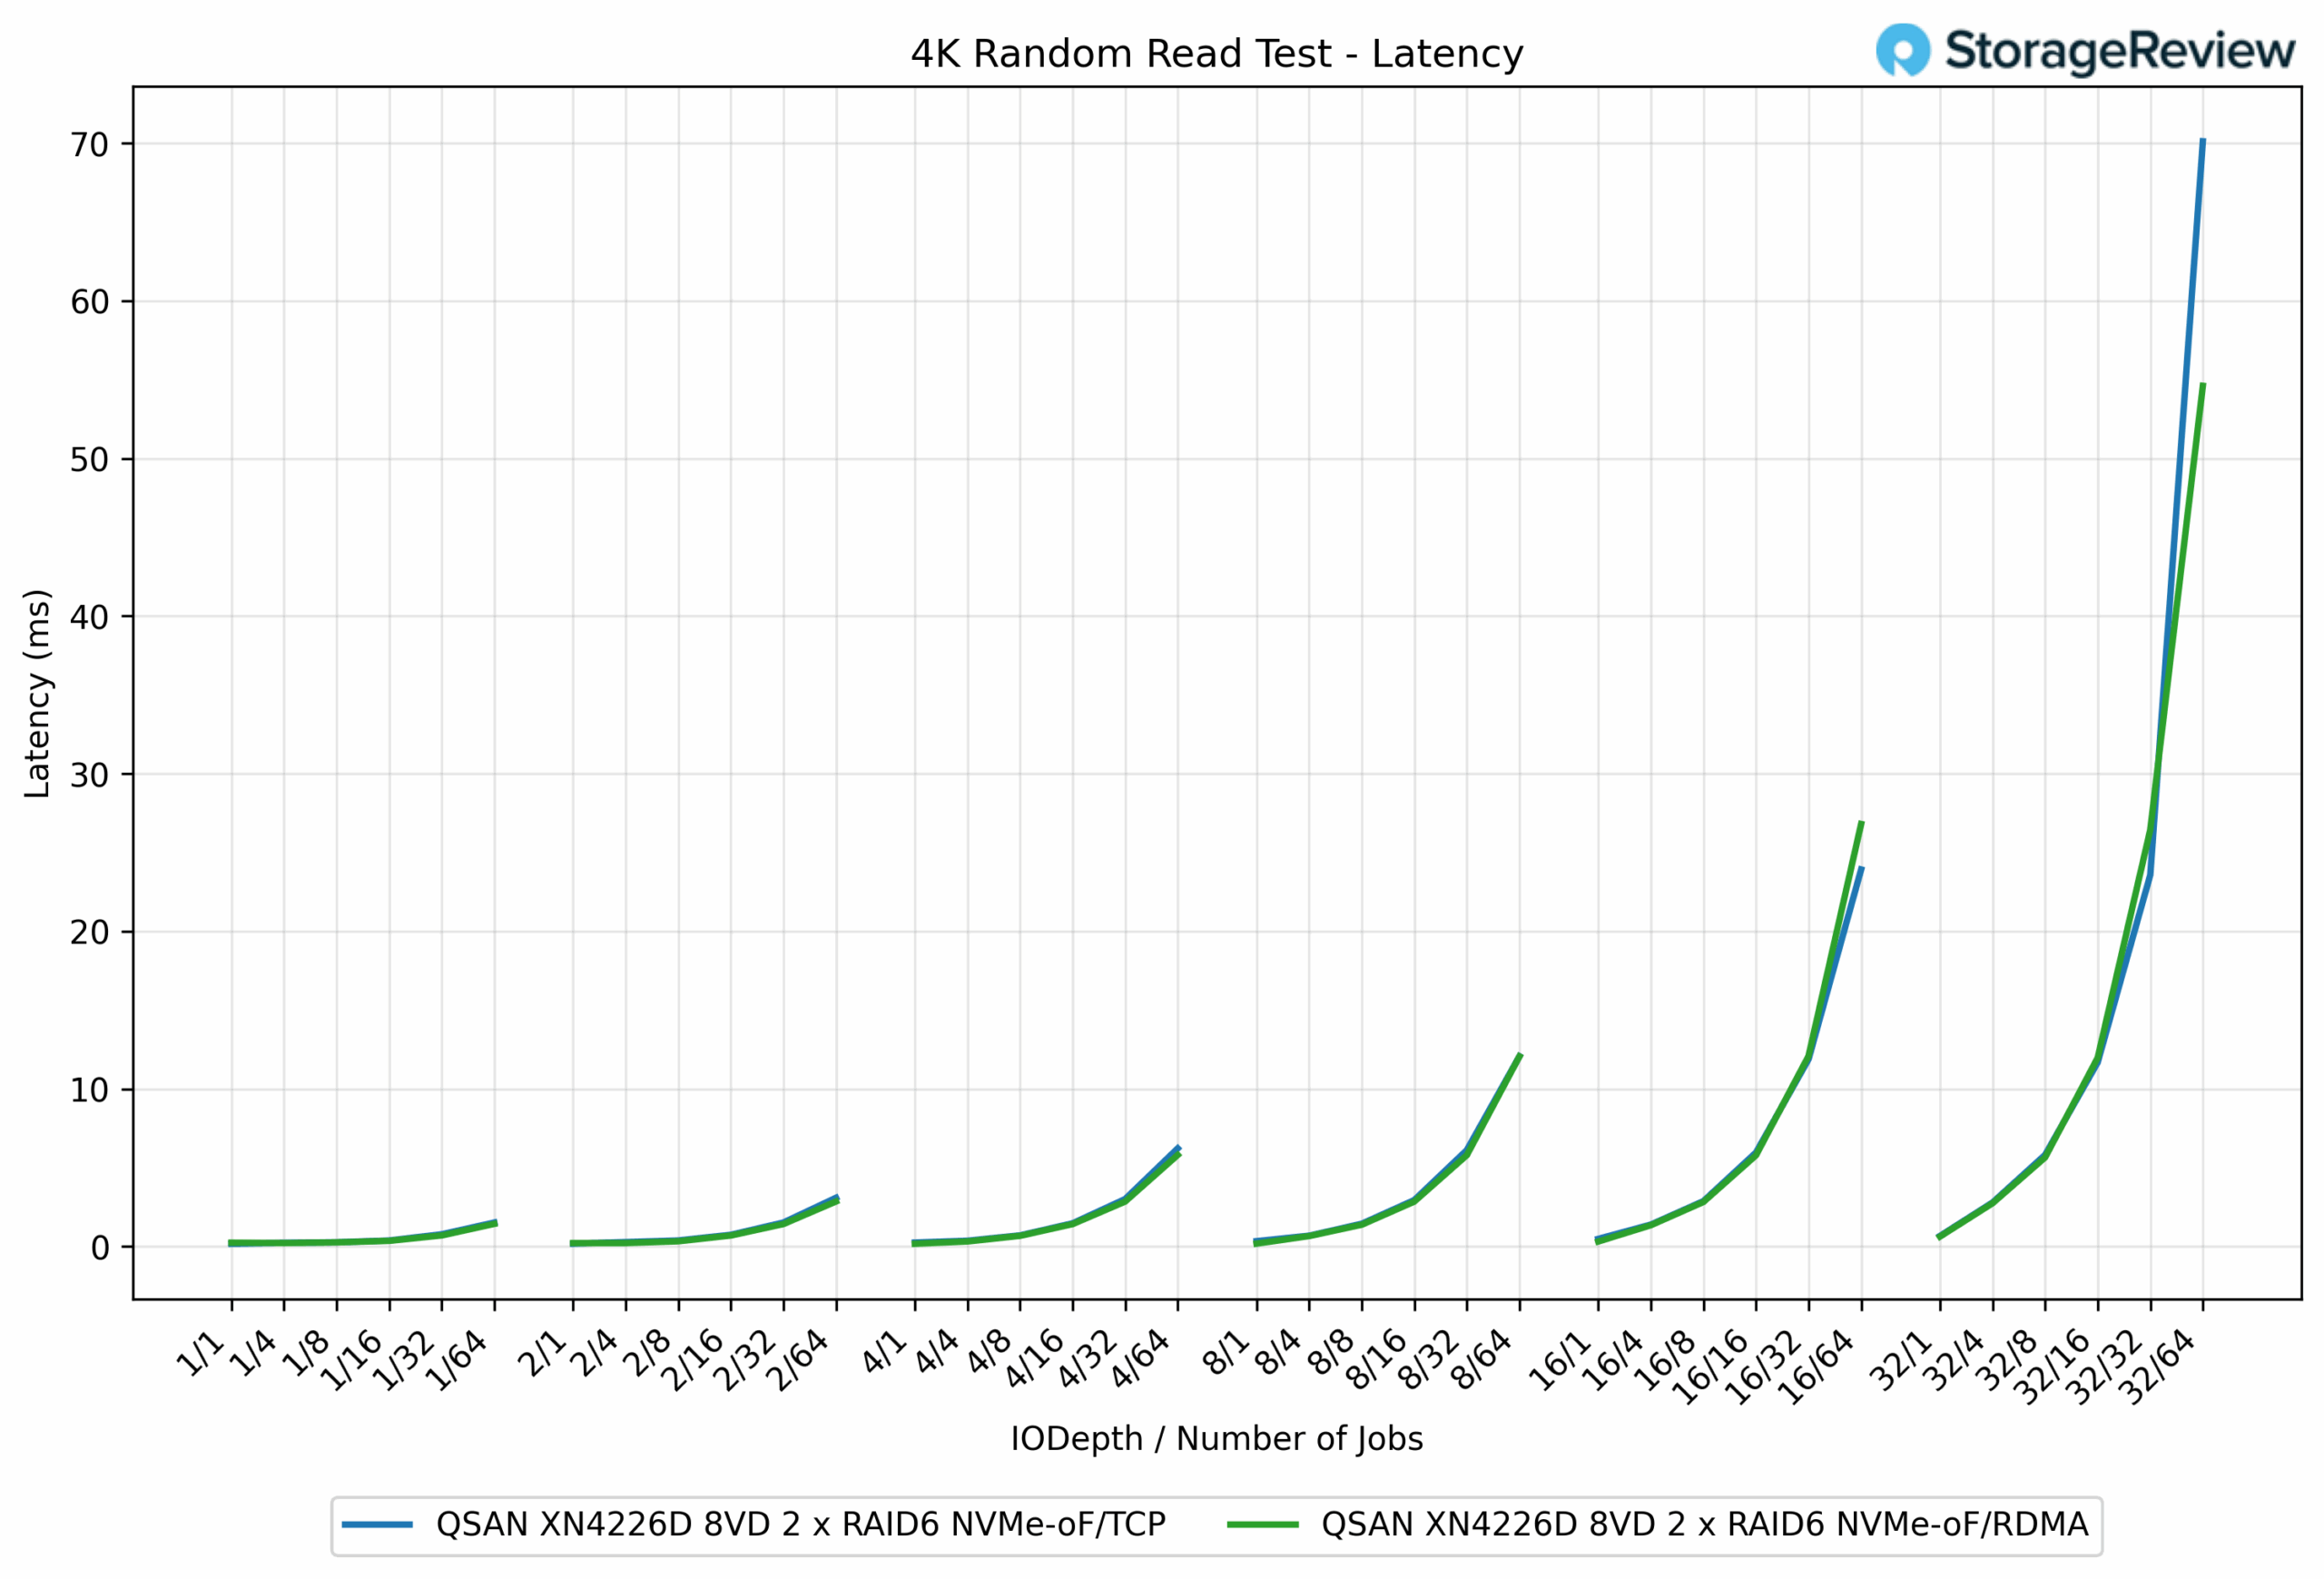
在 4K 隨機讀取延遲測試中,RDMA 展現出優於 TCP 的明顯效率優勢,尤其是在工作負載規模增加的情況下。在佇列深度較小的情況下,兩種協定的效能幾乎相同。例如,在 QD1/1 作業中,TCP 的延遲為 0.24 毫秒,而 RDMA 的延遲僅為 0.27 毫秒。
隨著並發性的增加,RDMA 逐漸領先。在 QD16/64 作業中,RDMA 的延遲為 23.92 毫秒,而 TCP 的延遲為 26.81 毫秒,提升了 10.8%。在 QD32/64 作業的最高負載下,RDMA 的完成時間為 54.61 毫秒,而 TCP 的延遲則飆升至 70.12 毫秒,RDMA 的延遲降低了 22%。
GPUDirect儲存效能
我們在此測試平台上進行的測試之一是 Magnum IO GPU 直接儲存 (GDS) 測試。 GDS 是 NVIDIA 開發的一項功能,可讓 GPU 在存取 NVMe 磁碟機或其他高速儲存裝置上儲存的資料時繞過 CPU。 GDS 無需透過 CPU 和系統記憶體路由數據,而是支援 GPU 和儲存設備之間的直接通信,從而顯著降低延遲並提高數據吞吐量。
GPUDirect 儲存的工作原理
傳統上,當 GPU 處理儲存在 NVMe 磁碟機上的資料時,資料必須先經過 CPU 和系統內存,才能到達 GPU。這個過程會引入瓶頸,因為 CPU 充當了中間人的角色,增加了延遲並消耗了寶貴的系統資源。 GPUDirect Storage 允許 GPU 透過 PCIe 匯流排直接從儲存裝置存取數據,從而消除了這種低效率。這種直接路徑減少了與資料移動相關的開銷,從而實現了更快、更有效率的資料傳輸。
AI 工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理數 TB 的數據,任何資料傳輸延遲都可能導致 GPU 無法充分利用並延長訓練時間。 GPUDirect Storage 透過確保資料盡快傳輸到 GPU,最大限度地減少空閒時間並最大限度地提高運算效率,解決了這項挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
除了原始頻寬之外,搭載 NVMe-oF (TCP/RDMA) 的 GPUDirect 還能提供超低延遲 I/O。這確保 GPU 永遠不會缺少數據,使該系統成為即時 AI 推理、分析管道和視訊回放的理想選擇。
對於許多實際部署,這相當於 100-200 GbE 可用吞吐量,與 AI 推理(2-4 個 GPU)、媒體製作(廣播重播、OTT 邊緣快取)、監控視訊分析和 HPC 檢查點等工作負載完美匹配。
讀取吞吐量
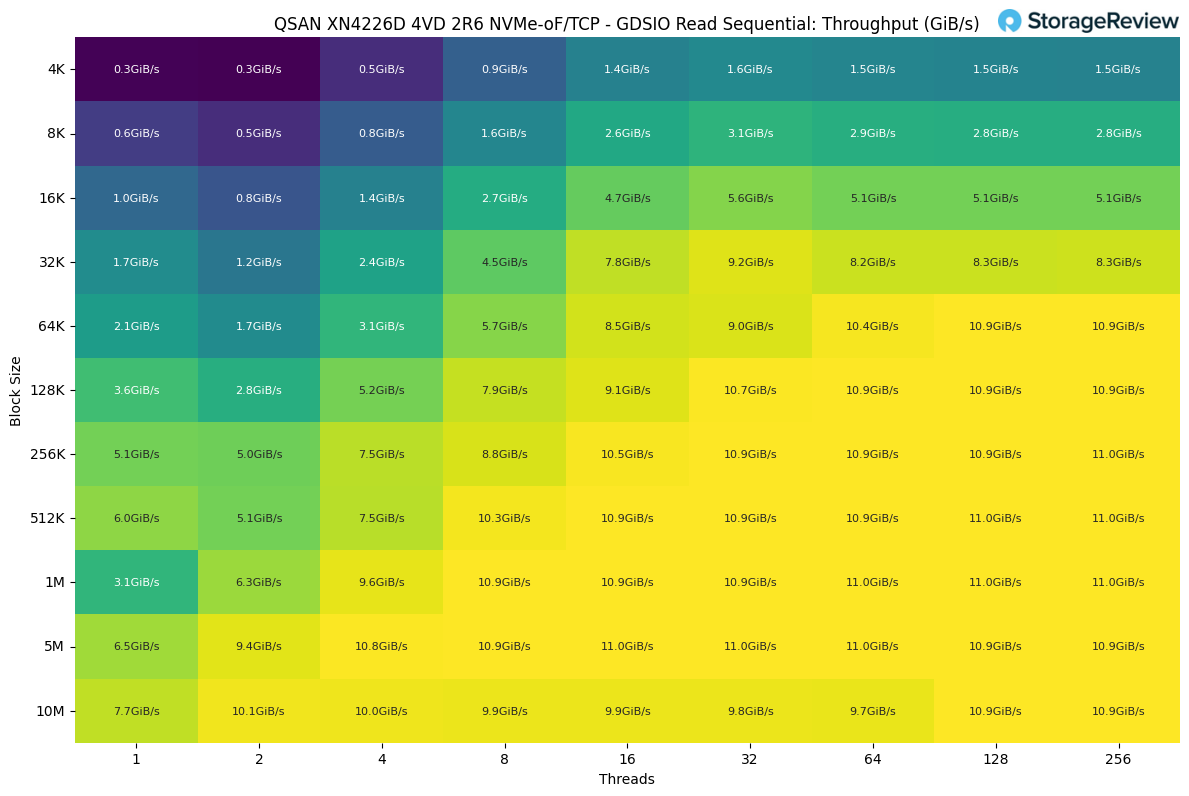
在 GDSIO 順序讀取工作負載中,吞吐量隨區塊大小和執行緒數的增加而穩定成長,在多個測試點上達到了 11.0GiB/s 的最高值。當區塊大小達到 512K 及以上時,吞吐量始終穩定在 10.9 到 11.0GiB/s 之間,無論執行緒數多少。
在較小的區塊大小下,效能一開始會低得多。例如,對於 4K 區塊,單執行緒吞吐量一開始僅為 0.3GiB/s,即使在 256 個執行緒的情況下也能穩定在 1.5GiB/s。相較之下,將區塊大小增加到 64K 後,系統可以擴展到 10.9GiB/s,隨著執行緒數量的增加,吞吐量幾乎達到飽和狀態。
最佳效能點似乎在 128K 到 256K 區塊之間,此時吞吐量在 32 個或更多執行緒的情況下超過 10GiB/s,並且在測試的最大區塊大小下保持一致。這表明,一旦區塊大小足夠大,平台就會達到頻寬飽和,而 256K 以上僅略有提升。
閱讀延遲
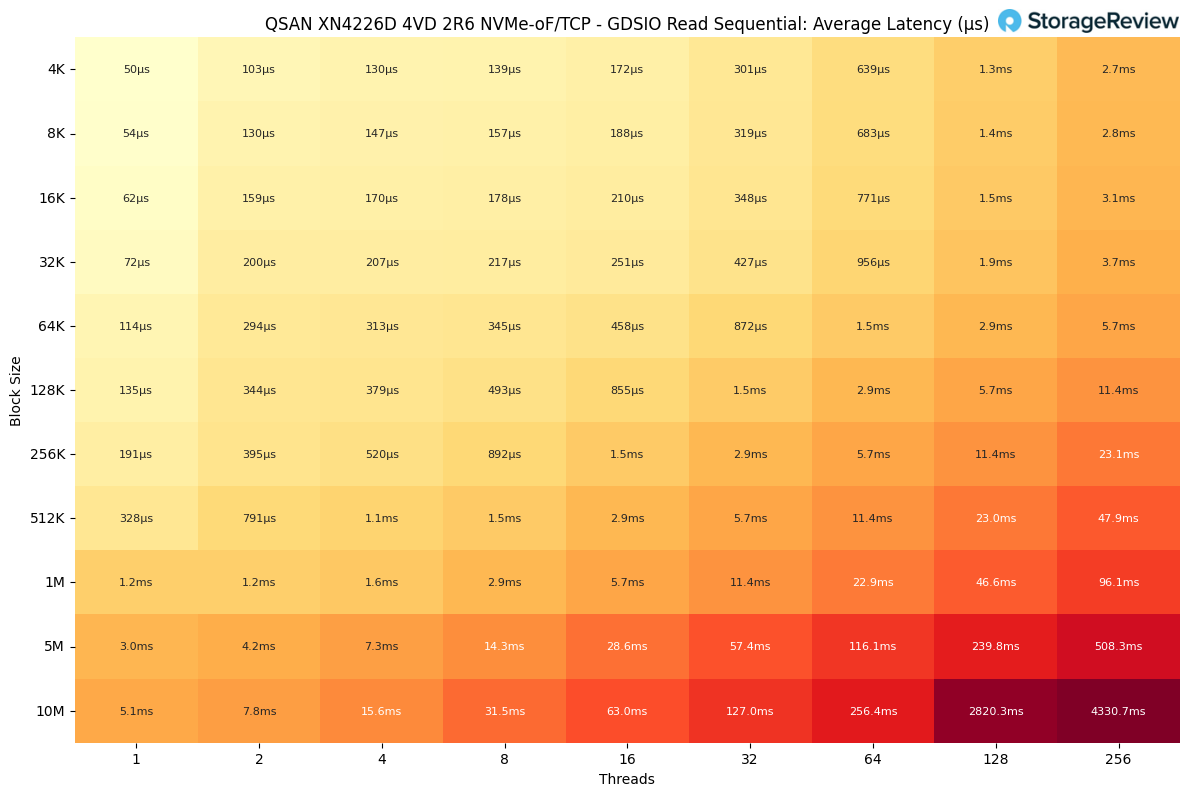
在 GDSIO 順序讀取延遲測試結果中,回應時間隨區塊大小和執行緒數的變化而變化,且呈現可預測性。在最小工作負載下,延遲仍保持極低。例如,在單線程 4K 區塊的情況下,延遲僅為 50µs;在最小並發性下,區塊大小達到 32K 時,延遲保持在 200µs 以下。
隨著線程數量的增加,延遲開始更加明顯。在 64K 區塊和 64 個執行緒的情況下,延遲達到 1.5 毫秒,在 128 個執行緒的情況下翻倍至 2.9 毫秒,在 256 個執行緒的情況下則攀升至 5.7 毫秒。相較之下,即使在最多 256 個執行緒的情況下,較小的區塊大小(例如 4K 和 8K)也僅在 2.7-2.8 毫秒範圍內,這表明在更精細的粒度下控制更為嚴格。
更大的塊大小帶來了更劇烈的跳躍。在 1M 區塊和 256 個執行緒的情況下,延遲達到了 96.1 毫秒,而 10M 區塊和 256 個執行緒的情況下,延遲飆升至 4.3 秒,這清楚地表明了系統在極端條件下的擴展極限。
寫吞吐量
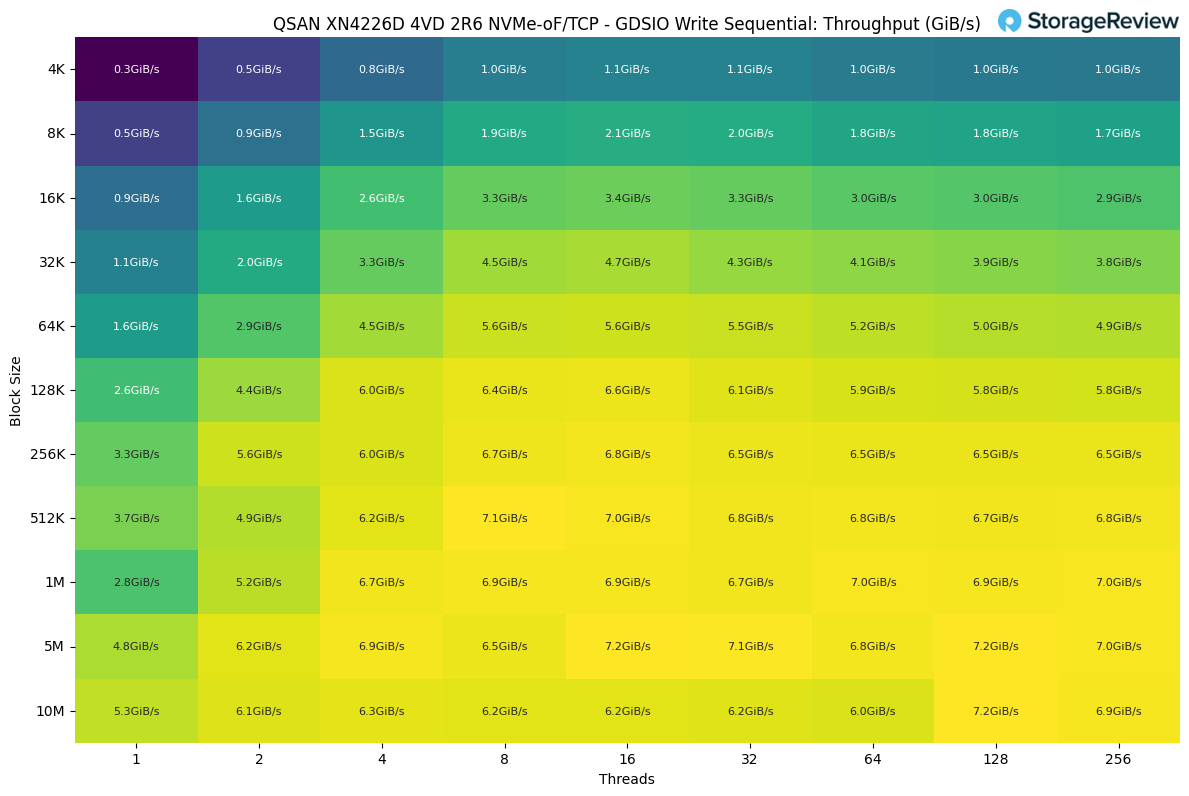
在 GDSIO 順序寫入工作負載中,吞吐量隨區塊大小和執行緒數而變化,但遠低於讀取效能上限。系統在 128 個執行緒下使用較大的區塊大小(例如 5M 和 10M)時,峰值達到了 7.2 GiB/s。
在最小區塊大小下,吞吐量適中。使用 4K 區塊時,單執行緒效能初始為 0.3GiB/s,32 執行緒時擴展到 1.0GiB/s,然後趨於平穩。將區塊大小增加到 64K 後,頻寬進一步提升,8 執行緒時達到 5.6GiB/s,之後並發度增加時略有下降。
最佳平衡出現在 512K 到 1M 區塊左右,不同執行緒數下的吞吐量範圍為 6.7 到 7.1GiB/s,表示系統在此範圍內達到飽和。超過該值後,增加執行緒並不能帶來顯著的效能提升,在某些情況下,由於開銷增加,效能實際上略有下降。
寫入延遲
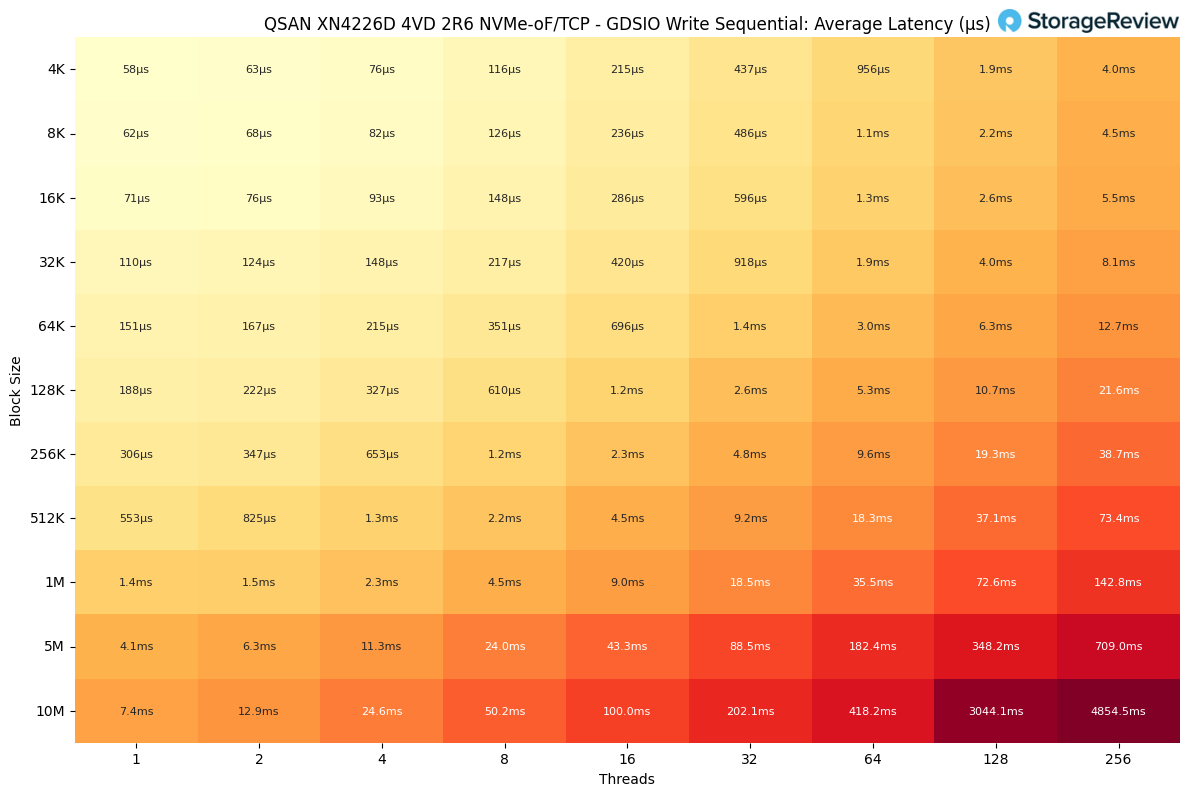
在 GDSIO 順序寫入延遲結果中,反應時間在較低的區塊大小下平穩擴展,但一旦區塊大小和執行緒數增加,回應時間就會急劇增加。
在最小工作負載下,延遲極低。在 4K 區塊和單線程下,平均延遲僅為 58µs;在 16K 區塊和最多四線程下,延遲保持在 200µs 以下。即使在 32K 區塊和中等並發性下,延遲也保持在 1ms 以下。
隨著系統轉換為更大的區塊大小,延遲變得更加明顯。在 128K 區塊和 64 個執行緒的情況下,延遲達到 5.3 毫秒,在 128 個執行緒的情況下再次翻倍至 10.7 毫秒。當區塊大小為 512K 時,延遲進一步增加,在 256 個執行緒的情況下攀升至 73.4 毫秒。
最重的情況是 256 個執行緒的 5M 和 10M 區塊,延遲分別急劇上升至 709 毫秒和 4.8 秒,揭示了順序寫入擴展的上限。
最後的思考
QSAN 的 XN4226D 恰好滿足了許多 IT 團隊的需求。它是一個統一的雙控制器 NVMe 平台,無需架構變更即可支援現代和傳統協定。在我們的測試中,TCP 以 21.21 GB/s 的速度領先於大型順序讀取,而 RDMA 則以 11.14 GB/s 的速度實現了最強的大型順序寫入,並且隨著並發性的擴展,延遲也保持在較低水平。在較小的區塊大小下,RDMA 持續提升了隨機寫入效率,並有效控制了尾部行為。結論很簡單:使用 NVMe-oF TCP 可獲得廣泛的相容性和高讀取頻寬,而當寫入延遲和一致性至關重要時,則選擇 RDMA。
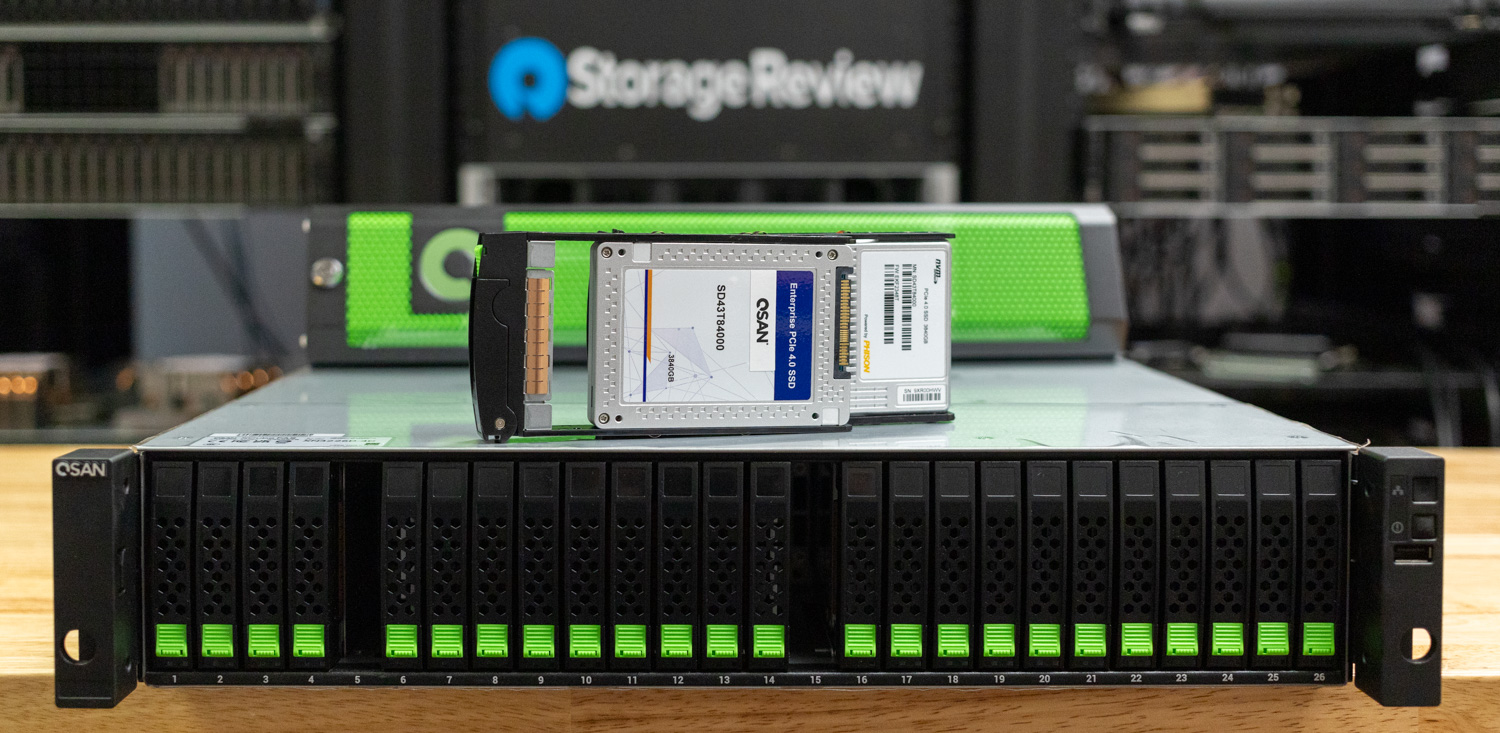
硬體佔用空間實用。 2U 機殼內配備 26 個用於 U.2 或 U.3 NVMe 硬碟的前置托架,具有主動高可用性,並且在容量優先於原始 NVMe 速度的情況下,可輕鬆擴展至 SAS 碟架。 QSM 4 提供預期的資料服務和簡潔的使用者介面,以及 REST API,可與現有自動化系統無縫整合。小型 IT 團隊應該會發現 QSM 4 易於配置和管理。為了驗證這一點,我們輕鬆整合了 Proxmox 集群,為這些虛擬機器提供高速儲存存取。對於更進階的工作負載,QSAN 完全可以滿足中小企業的 AI 需求。
對於專注於可預測效能、清晰管理和多協定覆蓋的企業,XN4226D 值得推薦。它提供真正的 NVMe 吞吐量、強大的 RDMA 寫入延遲以及不會拖慢您速度的軟體體驗。加上合理的價格,這款 QSAN 平台能夠輕鬆應對混合環境。


 Amazon