

今年 8 月,NVIDIA 將其頂級 Blackwell 桌上型電腦產品分割為兩個面向專業人士的系列:工作站和伺服器。 RTX PRO 6000 工作站顯示卡專為需要在塔式或桌上型電腦機箱內實現最大運算能力和顯存的創作者、工程師和 AI 開發者而設計。 RTX PRO 6000 Blackwell 伺服器版則專為機架式伺服器以及資料中心的無頭推理或渲染節點而設計。既然我們已經在測試中測試了這款工作站顯示卡,那麼本次評測將重點放在它。
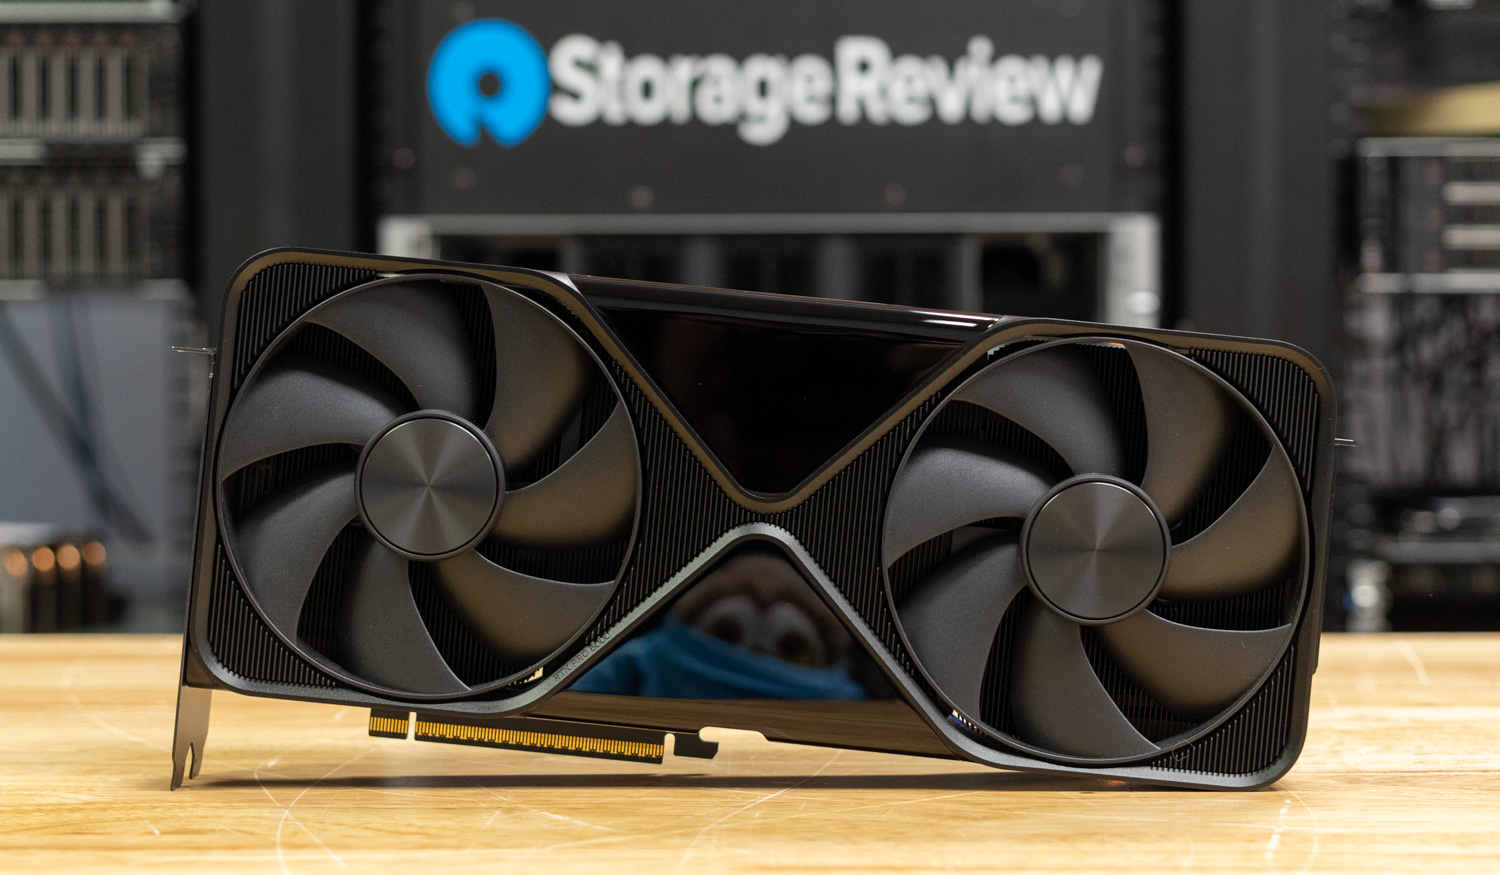
RTX PRO 6000 售價 8,500 美元,配備滿配的 GB202 顯存,包含 24,064 個 CUDA 核心、752 個第五代 Tensor 核心、188 個第四代 RT 核心以及 96 GB GDDR7 ECC 顯存。其吸引力顯而易見。它具有消費級顯示卡無法比擬的記憶體容量、專業的驅動程式以及雙插槽的外形,非常適合對電源或氣流沒有特殊要求的實際工作站。
NVIDIA 將此 GPU 定位於混合式工作流程。這包括具有長上下文的本地 LLM 推理、大型場景渲染、複雜模擬以及多 GPU 研究平台。實用性至關重要。該卡採用標準 PCIe 5.0 x16 接口,提供四個 DisplayPort 2.1b 輸出,可實現高分辨率、高刷新率的可視化,並提供 600 W 可配置 TDP,允許集成商進行調整,以獲得最佳的散熱、聲學或密度。
我們的目標是評估該工作站版本在實驗室中在 AI、渲染和通用計算方面的表現,並量化 96 GB 池對單一桌面節點功能的影響。
NVIDIA RTX PRO 6000 工作站版與伺服器版
RTX PRO 6000 的變體是基於相同的 Blackwell GB202 基礎架構,因此其原始運算能力在紙面上看起來很相似。差別在於它們的部署方式和位置。我們正在測試的工作站卡是一款獨立的、主動散熱的雙插槽主機板,配備四個 DisplayPort 2.1b 輸出和工作室級驅動程式。它可以插入塔式或桌邊工作站,驅動本機面板,並執行 ISV 認證的 DCC 和 CAD 應用程式以及 CUDA、TensorRT 和 cuDNN。如果工作流程融合了互動式視窗工作、本地視覺化和機載 AI,那麼這條路徑可以將所有功能整合到一個機箱中,並具有可預測的聲學和散熱性能。
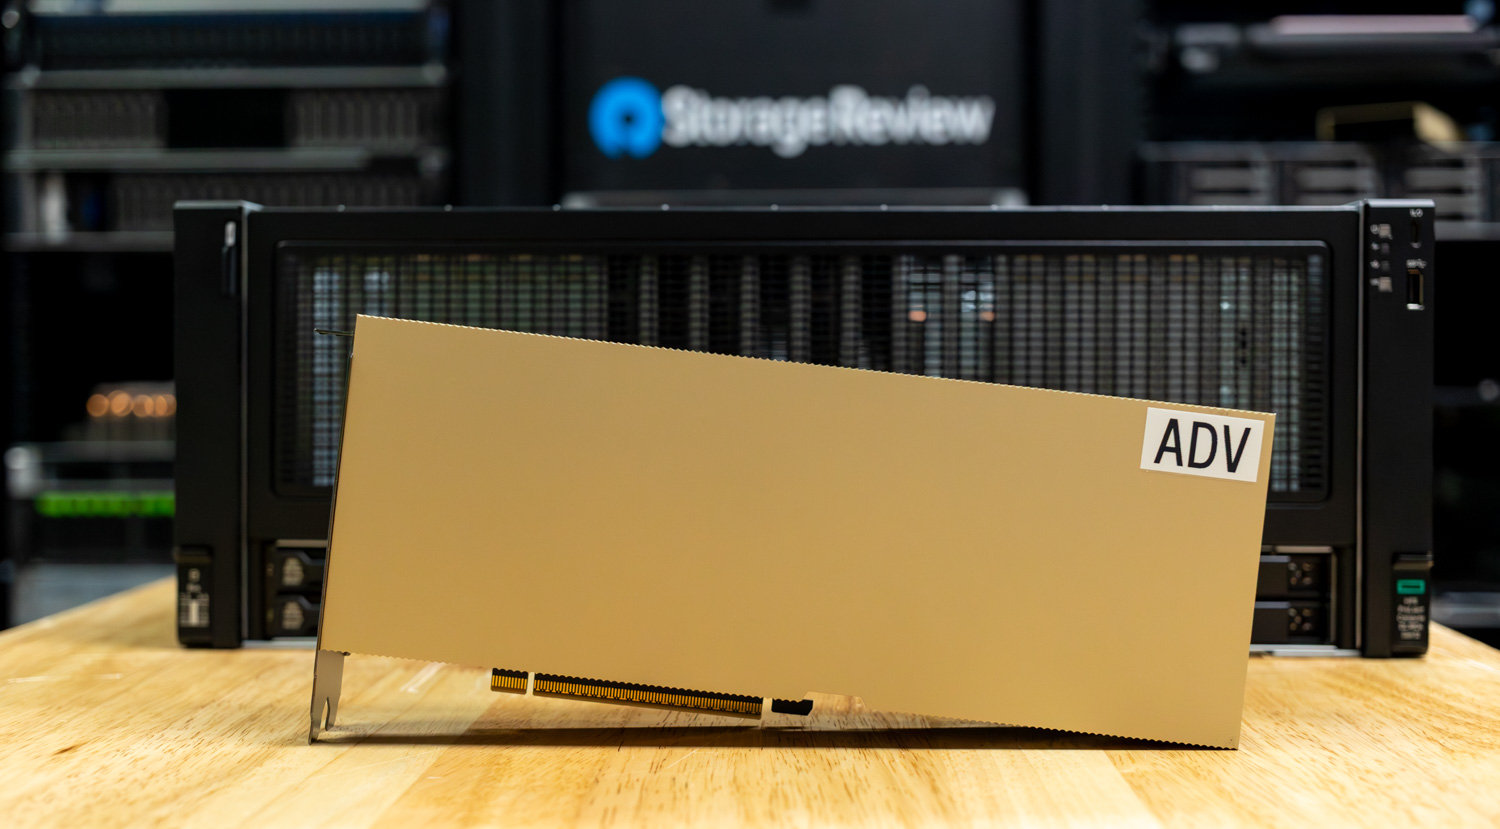
RTX PRO 6000 Blackwell 伺服器版的設計用途截然不同。它採用無頭機架式設計,專為伺服器打造,具備前後貫通的散熱氣流和遠端管理功能。由於作業透過網路調度,結果遠端顯示,因此沒有主動顯示輸出。韌體、功耗和散熱特性均針對調度器下的 24×7 全天候運作進行了最佳化,通常與 NVIDIA AI Enterprise、容器編排和虛擬機器管理程式直通功能配合使用。簡而言之,當創作者和工程師需要在本地查看和處理工作,同時運行大型推理或模擬批次時,工作站版本是理想之選。而當需要在資料中心按佇列橫向擴展相同節點時,伺服器版本則更具優勢,因為在資料中心,每一瓦的功耗、每條線纜和每條氣流路徑都必須符合 OEM 服務計畫的要求。
NVIDIA RTX PRO 6000 規格
下表概述了 NVIDIA RTX PRO 6000 與 RTX 5090 和上一代 RTX 4090 的規格比較。
| GPU比較 | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 |
| GPU名稱 | GB202 | GB202 | AD102 |
| 卓越的建築 | 布萊克威爾2.0 | 布萊克威爾2.0 | 艾達洛夫萊斯 |
| 進程大小 | 5納米 | 5納米 | 5納米 |
| 晶體管 | 92,200百萬 | 92,200百萬 | 76,300百萬 |
| 密度 | 122.9M/平方毫米 | 122.9M/平方毫米 | 125.3M/平方毫米 |
| 模具尺寸 | 750平方毫米 | 750平方毫米 | 609平方毫米 |
| 槽寬 | 雙槽 | 雙槽 | 三槽 |
| 尺寸 | 304 mm x 137 mm x 40 mm | 304 mm x 137 mm x 48 mm | 304 mm x 137 mm x 61 mm |
| TDP | 600W | 575W | 450W |
| 輸出 | 4台DisplayPort 2.1b | 1 個 HDMI 2.1b,3 個 DisplayPort 2.1b | 1個HDMI 2.1、3個DisplayPort 1.4a |
| 電源連接器 | 1x 16 針 | 1x 16 針 | 1x 16 針 |
| 總線接口 | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 4.0 x16 |
| 基地時鐘 | 1590 MHz | 2017 MHz | 2235 MHz |
| 提升時鐘 | 2617 MHz | 2407 MHz | 2520 MHz |
| 記憶時鐘 | 1750 MHz(28 Gbps 有效) | 2209 MHz(28 Gbps 有效) | 1313 MHz(21 Gbps 有效) |
| 內存大小 | GB 96 | GB 32 | GB 24 |
| 內存類型 | GDDR7 ECC | GDDR7 | GDDR6X |
| 內存總線 | 512位 | 512位 | 384位 |
| 內存帶寬 | 1.79 TB / s | 1.79 TB / s | 1.01 TB / s |
| CUDA核心 | 24,064 | 21,760 | 16,384 |
| 張量核心 | 752 | 680 | 512 |
| 個ROPs | 192 | 192 | 176 |
| SM 計數 | 188 | 170 | 128 |
| RT核心 | 188 | 170 | 128 |
| L1緩存 | 128 KB(每個 SM) | 128 KB(每個 SM) | 128 KB(每個 SM) |
| L2緩存 | 128 MB | 88 MB | 72 MB |
| 像素率 | 502.5 G像素/秒 | 462.1 G像素/秒 | 443.5 G像素/秒 |
| 紋理速率 | 1,968.0 GTexel/秒 | 1,637 GTexel/秒 | 1,290 GTexel/秒 |
| FP16(半) | 126.0 兆次浮點運算 (1:1) | 104.8 兆次浮點運算 (1:1) | 82.58 兆次浮點運算 (1:1) |
| FP32(浮點) | 126.0 TFLOPS | 104.8 TFLOPS | 82.58 TFLOPS |
| FP64(雙) | 1.968 兆次浮點運算 (1:64) | 1.637 兆次浮點運算 (1:64) | 1,290 GFLOPS (1:64) |
| 發行價(美元) | $8,500 | $1,999 | $1,599 |
構建和設計
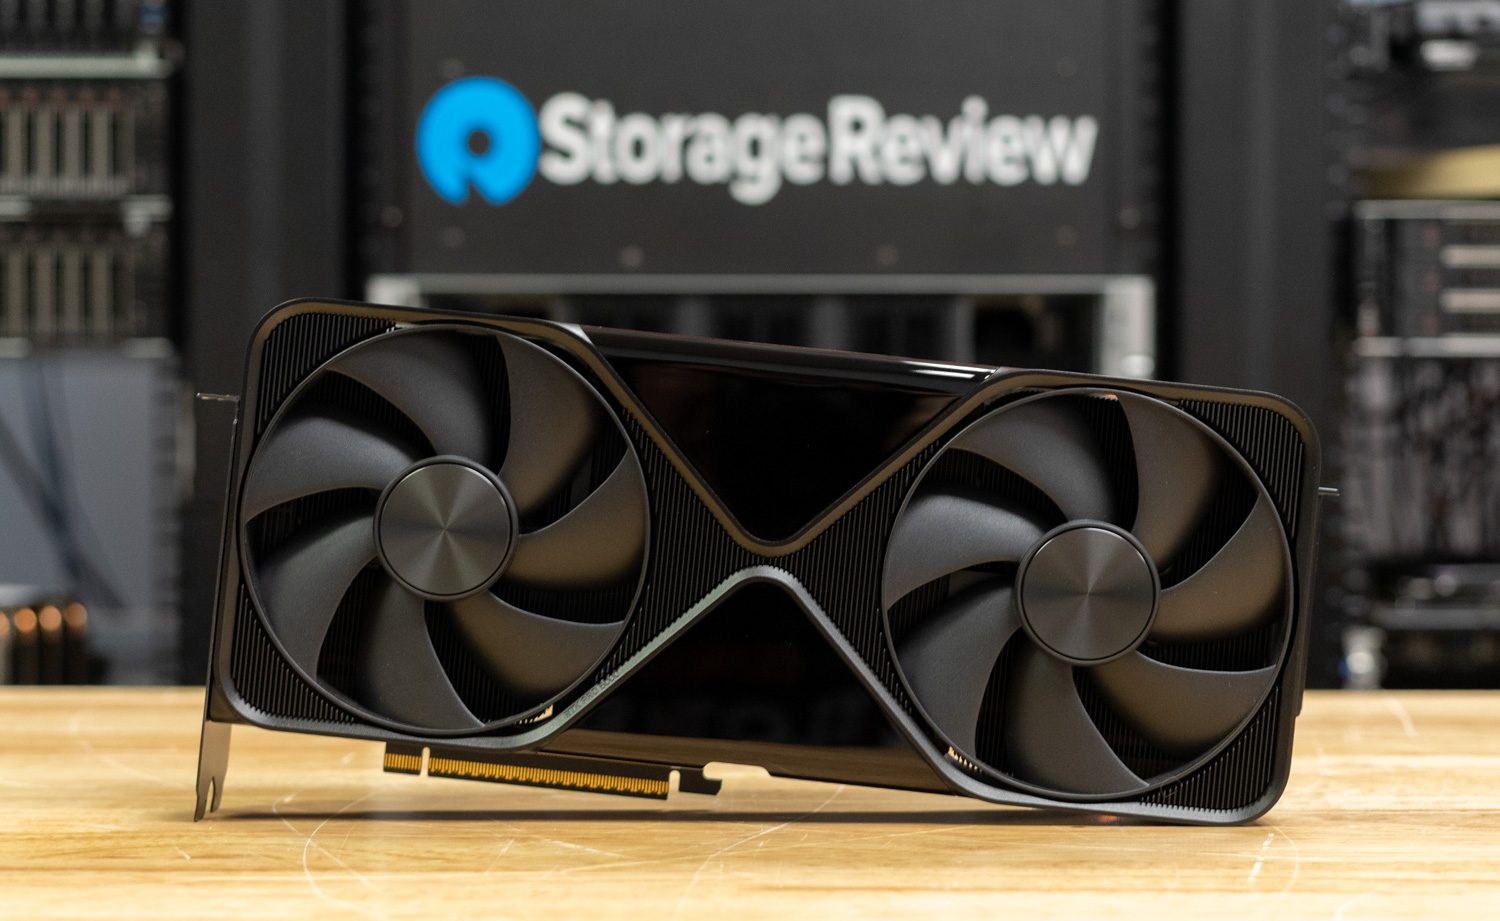
RTX PRO 6000 工作站 GPU 秉持了 NVIDIA 簡潔實用的設計理念,與 RTX 5090 FE 一脈相承,採用工業啞光黑色外觀,並採用針對工作站環境優化的雙軸流風扇佈局。每個風扇都經過精心設計,可將氣流推過全長 3D 均熱板,在持續負載下保持熱平衡。其尺寸為 304 毫米 × 137 毫米 × 40 毫米,可輕鬆安裝於雙插槽配置中,並憑藉 600 瓦的 TDP 額定值提供卓越的性能密度。
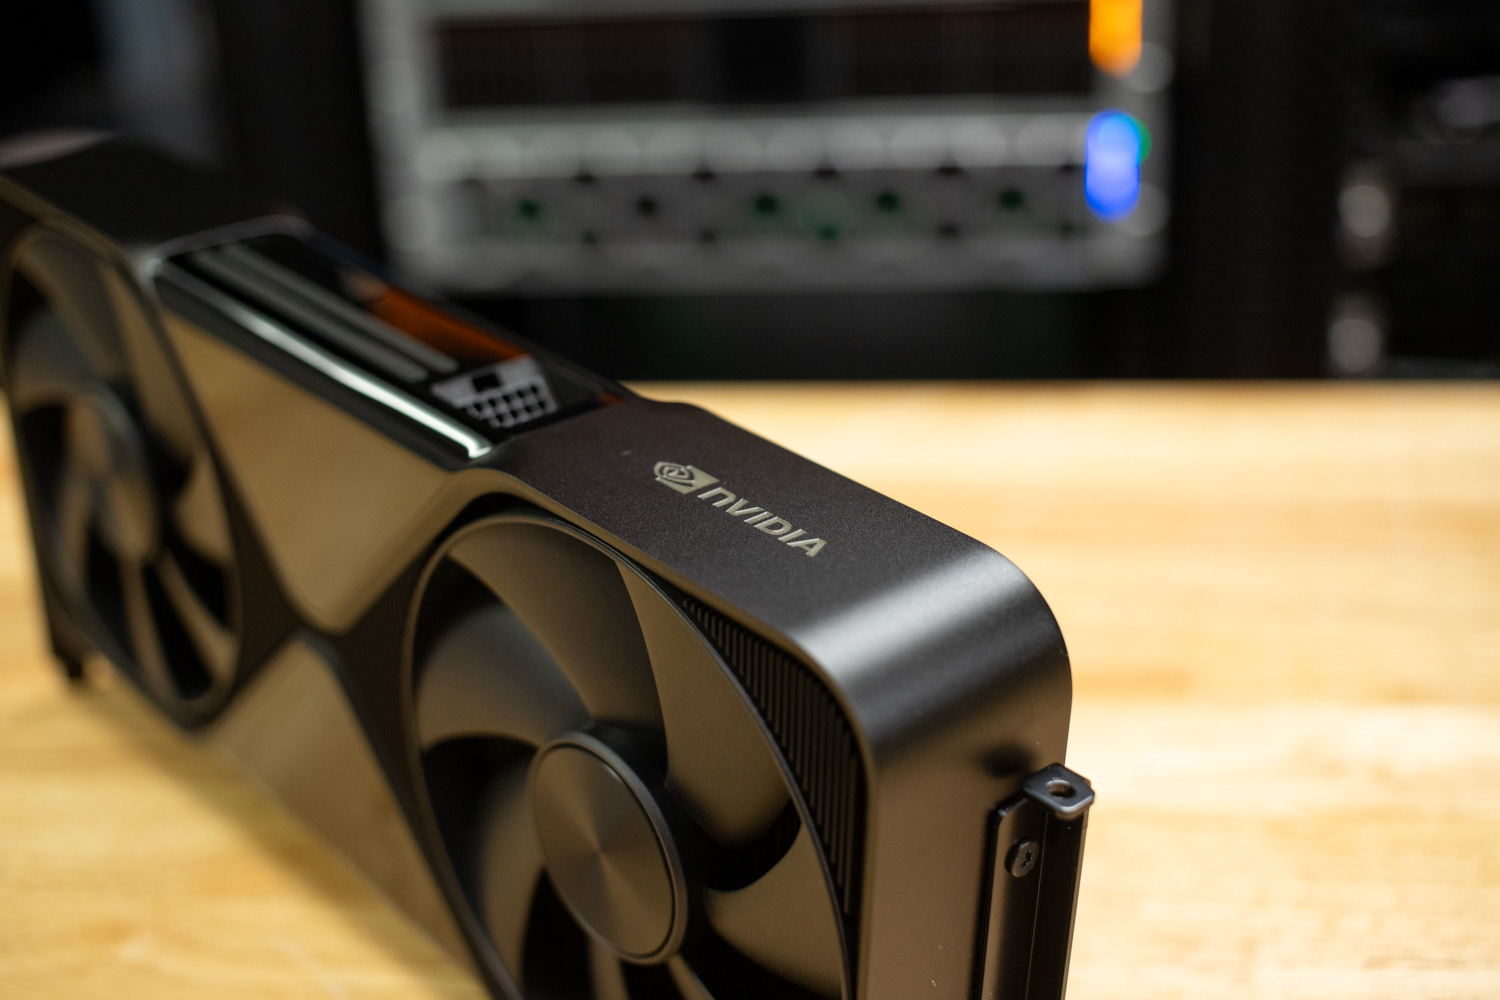
PRO 6000 的頂部邊緣配備一個 16 針電源接口,可為 96 GB GDDR7 記憶體和 Blackwell 2.0 架構提供所需的電流。其做工質感高端堅固,鋁製外殼可有效引導氣流穿過散熱片。 NVIDIA 的低調品牌標誌與專業美學相得益彰,沒有 RGB 燈效或遊戲特效,更強調了對散熱性能要求極高的工作站機箱的可靠性和性能。
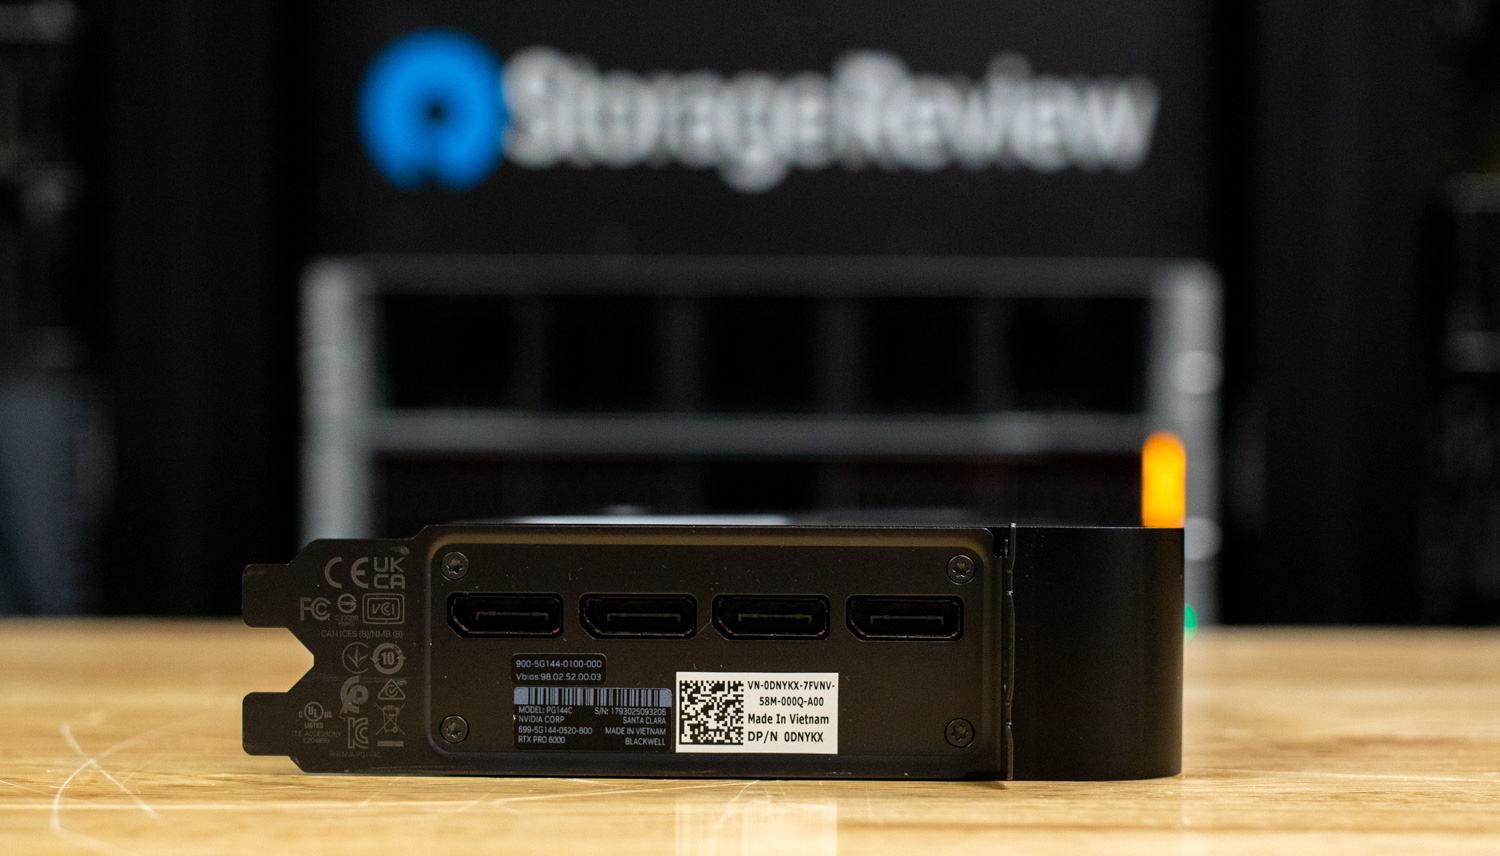
在 I/O 方面,NVIDIA 提供四個 DisplayPort 2.1b 輸出,確保相容於多顯示器 8K 設定、色彩精準的 HDR 工作流程以及進階渲染環境。 DisplayPort 2.1b 取代 HDMI 體現了其專業定位,並增強了頻寬,適用於高更新率和高解析度顯示器。
性能測試
為了評估 NVIDIA RTX PRO 6000 樣品的性能,我們將其與 NVIDIA 的旗艦消費級顯示卡 RTX 5090 Founders Edition 和 RTX 4090 Founders Edition 進行了直接比較。測試涵蓋了多種專業工作負載和 AI 驅動的工作負載,以突出其原始運算能力和實際應用效能。基準測試包括 UL Procyon AI 文字產生、UL Procyon AI 影像生成、LuxMark、Geekbench 6 和 V-Ray,從而提供了渲染、推理和生產力性能的均衡概覽。
除了這些標準工作負載之外,我們還進行了有針對性的測試,旨在展示 RTX PRO 6000 中的 96 GB GDDR7 內存,展示其在處理大型模型、高分辨率數據集和專業可視化工作負載方面的優勢,其中容量和持續吞吐量至關重要。
- RTX PRO 6000
- GeForce RTX 5090FE
- GeForce RTX 4090FE
- RTX 6000 ADA
為了充分利用全新 NVIDIA RTX PRO 6000 的優勢,我們採用了 AMD ThreadRipper 平台。該系統配置了 64 核 CPU 和水冷系統。它擁有充足的 CPU 底層處理能力,足以讓 GPU 高效運作。完整的系統配置如下所示。
StorageReview AMD ThreadRipper 測試平台
- 主板: 華碩 Pro WS TRX50-SAGE WIFI
- 中央處理器: AMD 銳龍 Threadripper 7980X 64 核心
- 隨機存取存儲器: 32GB DDR5 4800MT/秒
- 貯存: 2TB 三星 980 Pro
- 操作系統: Windows 11 Pro for Workstations
UL Procyon:人工智慧文字生成
Procyon AI 文字產生基準測試透過提供簡潔一致的評估方法,簡化了 AI LLM 效能測試。它允許對多個 LLM 模型進行重複測試,同時最大限度地降低大型模型規模和可變因素帶來的複雜性。此基準測試由 AI 硬體領域的領導企業共同開發,優化了本地 AI 加速器的使用,從而實現更可靠、更有效率的效能評估。以下測試結果均使用 TensorRT 進行測試。
在所有四項模型測試中,NVIDIA RTX PRO 6000 始終領先。從 Phi 開始,PRO 6000 的總分達到 6,775,超過了 RTX 5090(5,749)、RTX 4090(4,958)和 RTX 6000 Ada(4,508)。其更快的令牌生成速率(每秒 325.9 個令牌)和更低的延遲(產生第一個令牌僅需 0.182 秒)突顯了其在即時文字生成和基於聊天的 AI 工作負載中的響應能力。
Mistral 也延續了這一趨勢,PRO 6000 的得分為 7,346,與 5090(6,267)、4090(5,094)和 6000 Ada(4,255)保持了相當大的領先優勢。其 271.8 個 token/s 的吞吐量展現了其更大的 96 GB 記憶體池和針對高上下文推理優化的工作站調優的優勢。
在 Llama3 測試中,PRO 6000 以 6,501 的得分保持領先,而 RTX 5090 為 6,104,4090 為 4,849,6000 Ada 為 4,026。這凸顯了 NVIDIA Blackwell 架構的一致性,並且隨著變壓器工作負載的複雜性和上下文長度的擴展,PRO 6000 仍能維持效能優勢。
最後,在強調長上下文推理和持續性能的 Llama2 測試中,PRO 6000 達到了 8,008 分,而 5090、4090 和 6000 Ada 則分別以 6,591、5,013 和 3,957 分落後。即使序列長度和推理時間增加,PRO 6000 在速度和穩定性方面仍保持著明顯的優勢,運行速度比測試中的任何其他 GPU 都更快,吞吐量也更流暢。
| UL Procyon:人工智慧文字生成 | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Phi 總分 | 6,775 | 5,749 | 4,958 | 4,508 |
| Phi 輸出到第一個代幣的時間 | 0.182小號 | 0.244小號 | 0.255小號 | 0.288小號 |
| Phi 每秒輸出令牌 | 325.855 噸/秒 | 314.435 噸/秒 | 244.343 噸/秒 | 228.359 噸/秒 |
| Phi 總持續時間 | 9.498小號 | 10.280小號 | 12.872小號 | 13.869小號 |
| 米斯特拉爾總分 | 7,346 | 6,267 | 5,094 | 4,255 |
| 米斯特拉爾輸出第一個令牌的時間 | 0.229小號 | 0.297小號 | 0.322小號 | 0.419小號 |
| 米斯特拉爾每秒輸出令牌 | 271.779 噸/秒 | 255.945 噸/秒 | 183.266 噸/秒 | 166.633 噸/秒 |
| 米斯特拉爾總持續時間 | 11.493小號 | 12.593小號 | 17.010小號 | 19.092小號 |
| Llama3 總分 | 6,501 | 6,104 | 4,849 | 4,026 |
| Llama3 輸出第一個令牌的時間 | 0.218小號 | 0.234小號 | 0.259小號 | 0.348小號 |
| Llama3 每秒輸出令牌 | 226.407 噸/秒 | 214.285 噸/秒 | 150.039 噸/秒 | 138.620 噸/秒 |
| Llama3 整體持續時間 | 13.554小號 | 14.304小號 | 19.991小號 | 22.062小號 |
| Llama2 總分 | 8,008 | 6,591 | 5,013 | 3,957 |
| Llama2 輸出第一個令牌的時間 | 0.307小號 | 0.419小號 | 0.500小號 | 0.679小號 |
| Llama2 每秒輸出令牌 | 145.595 噸/秒 | 134.502 噸/秒 | 92.853 噸/秒 | 78.532 噸/秒 |
| Llama2 整體持續時間 | 20.712小號 | 23.018小號 | 32.448小號 | 38.923小號 |
UL Procyon: 人工智能圖像生成
Procyon AI 影像產生基準測試提供了一種一致且精確的方法,用於衡量各種硬體(從低功耗 NPU 到高階 GPU)上的 AI 推理效能。它包含三個測試:針對高階 GPU 的 Stable Diffusion XL (FP16)、針對中等效能 GPU 的 Stable Diffusion 1.5 (FP16) 以及針對低功耗裝置的 Stable Diffusion 1.5 (INT8)。此基準測試會針對每個系統使用最佳推理引擎,確保結果的公平性和可比較性。
從穩定擴散 1.5 (FP16) 開始,NVIDIA RTX PRO 6000 的總得分高達 8,869,遠超 RTX 5090 的 8,193、RTX 4090 的 5,260 和 RTX 6000 Ada 的 4,230。 PRO 6000 的影像產生耗時 11.27 秒,平均每張影像耗時 0.705 秒,是本次測試中最快的顯示卡。這充分證明了其針對工作站最佳化的調校和 96 GB GDDR7 記憶體能夠在不影響效率的情況下實現持續的高精度輸出。
在衡量輕量級量化推理效能的穩定擴散 1.5 (INT8) 測試中,所有 GPU 的表現都相當接近。 PRO 6000 的得分為 79,064,與 RTX 5090 的 79,272 幾乎相同,同時領先於 RTX 4090(62,160)和 RTX 6000 Ada(55,901)。由於 INT8 工作負載對記憶體頻寬和容量的依賴程度較低,因此差異很小,但 PRO 6000 保持了一致的結果,平均每張影像的產生時間為 0.395 秒。
穩定擴散 XL (FP16) 測試要求 GPU 進行更長、更苛刻的推理運行,這不僅對記憶體效能,也對持續運算吞吐量提出了更高的要求。 PRO 6000 的總得分為 6,991 分,略低於 RTX 5090 的 7,179 分,但遠高於 RTX 4090 的 5,025 分和 RTX 6000 Ada 的 3,043 分。它的總渲染時間為 85.8 秒,即每個影像 5.36 秒,這表明 PRO 6000 能夠有效率地處理擴展的生成工作負載,且不會出現速度下降的情況。
| UL Procyon:AI 影像生成 | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 穩定擴散 1.5 (FP16) – 總分 | 8,869 | 8,193 | 5,260 | 4,230 |
| 穩定擴散 1.5 (FP16) – 總時間 | 11.274小號 | 12.204小號 | 19.011小號 | 23.639小號 |
| 穩定擴散 1.5 (FP16) – 影像產生速度 | 0.705 秒/影像 | 0.763 秒/影像 | 1.188 秒/影像 | 1.477 秒/影像 |
| 穩定擴散 1.5 (INT8) – 總分 | 79,064 | 79,272 | 62,160 | 55,901 |
| 穩定擴散 1.5 (INT8) – 總時間 | 3.162小號 | 3.154小號 | 4.022小號 | 4.472小號 |
| 穩定擴散 1.5 (INT8) – 影像生成速度 | 0.395 秒/影像 | 0.394 秒/影像 | 0.503 秒/影像 | 0.559 秒/影像 |
| 穩定擴散 XL (FP16) – 總分 | 6,991 | 7,179 | 5,025 | 3,043 |
| 穩定擴散 XL (FP16) – 總時間 | 85.819小號 | 83.573小號 | 119.379小號 | 197.172小號 |
| 穩定擴散 XL (FP16) – 影像產生速度 | 5.364 秒/影像 | 5.223 秒/影像 | 7.461 秒/影像 | 12.323 秒/影像 |
攪拌機4.4
Blender 是一款開源 3D 建模應用程式。本次基準測試使用 Blender Benchmark 實用程式運行。分數以每分鐘採樣數計算,數值越高,效能越好。
在所有三個場景中,NVIDIA RTX PRO 6000 均佔據榜首,展現了其 Blackwell 架構和更大顯存容量的優勢。在怪獸場景中,PRO 6000 的取樣率為每分鐘 7,870.17 個樣本,領先 RTX 5090 的 7,421.50 個樣本,而 RTX 4090 和 RTX 6000 Ada 分別以 5,733.97 個樣本和 5,632.60.
在「舊貨店」場景中,PRO 6000 繼續保持領先,採樣率為每分鐘 4,158.91 次,而 RTX 5090 為 3,980.15 次,RTX 4090 為 2,827.83 次,RTX 6000 Ada 為 2,663.77 次。最後,在傾向於同時強調著色和記憶體效率的「課堂」場景中,PRO 6000 的採樣率達到了每分鐘 4,041.11 次,再次領先於 RTX 5090 的 3,732.63 次,並顯著優於 RTX 4090 和 RTX 6000 Ada 2,909.35(2,818.83 次)。
| Blender 4.4(越高越好) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| Monster | 7,870.17 | 7,421.50 | 5,733.97 | 5,632.60 |
| 舊貨店 | 4,158.91 | 3,980.15 | 2,827.83 | 2,663.77 |
| 課堂 | 4,041.11 | 3,732.63 | 2,909.35 | 2,818.83 |
樂士馬克
Luxmark 是一款 GPU 基準測試,利用開源光線追蹤渲染器 LuxRender 來評估系統處理高精細 3D 場景的效能。此基準測試尤其適用於評估伺服器和工作站的圖形渲染能力,尤其是在視覺效果和建築視覺化應用中,精確的光線模擬至關重要。
在食物場景測試中,NVIDIA RTX PRO 6000 以 24,287 分的成績領先,略勝 RTX 5090 的 23,141 分,而 RTX 4090 和 RTX 6000 Ada 則分別以 17,171 分和 14,873 分緊隨其後。這表明 PRO 6000 能夠在高度精細的幾何和光照工作負載下保持流暢的光線追蹤性能,且不會降低穩定性或降低散熱性能。
在要求更高的 Hall 場景中,該場景強調大規模幾何形狀和複雜的全局照明,PRO 6000 再次以 52,588 的成績獲得最高分,略高於 RTX 5090 的 51,725,遠高於 RTX 4090(38,887)和 RTX 6000 Ada(32,132)。
| Luxmark(越高越好) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 食物評分 | 24,287 | 23,141 | 17,171 | 14,873 |
| 霍爾分數 | 52,588 | 51,725 | 38,887 | 32,132 |
Geekbench 6
Geekbench 6是一款跨平台基準測試軟體,用於衡量系統整體效能。 Geekbench 瀏覽器可讓您將任何系統與 Geekbench 6 進行比較。
在本次測試中,NVIDIA RTX PRO 6000 的 GPU OpenCL 分數高達 384,158,超越了 RTX 5090(374,807)、RTX 4090(333,384)和 RTX 6000 Ada(336,882)。 PRO 6000 更高的得分反映了其最佳化的工作站設計、增強的記憶體頻寬和專業的驅動程式堆疊,這些特性共同使其能夠在各種運算密集型工作負載下保持穩定的效能。
| Geekbench(越高越好) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| GPU OpenCL 分數 | 384,158 | 374,807 | 333,384 | 336,882 |
的V-Ray
V -Ray基準測試使用先進的 V-Ray 6 引擎,測量 CPU、NVIDIA GPU 或兩者的渲染效能。它採用快速測試和簡單的評分系統,使用戶能夠評估和比較系統的渲染能力。對於尋求高效性能洞察的專業人士而言,它是一款必不可少的工具。
在我們的測試中,NVIDIA RTX PRO 6000 的 vpaths 得分為 12,128,介於 RTX 5090(14,764)和 RTX 4090(10,847)之間。 RTX 6000 Ada 得分為 10,766,略微落後。雖然 RTX 5090 在這項 GPU 密集型渲染測試中保持略微領先,但 PRO 6000 展現了強勁而穩定的性能,進一步證明了其面向工作站的調校能力以及在滿載渲染下的持續效率。
| V-Ray(越高越好) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 虛擬路徑 | 12,128 | 14,764 | 10,847 | 10,766 |
LM Studio 多模型推理測試
在本輪測試中,我們使用 LM Studio 評估了 NVIDIA RTX PRO 6000 在一系列流行的大型語言模型中的表現,包括 GPT-OSS 120B、Gemma 3(4B、12B 和 27B)、Llama 3.1(8B 和 70B)以及 Llama 3.3 70B3 70B)以及 Llama 3.3 70B)以及 Llama 3.3 70B)以及 Llama 3.3 70B)以及 Llama 3.3 70B)以及 Llama 3.3 70B)以及 Llama 3.3 70B)以及 Llama 3.3 70B)以及 Llama 3.3 70B。每個模型都使用相同的指令進行提示:
“寫一篇500字的關於樹懶歷史的學術論文。”
本次測試主要關注每秒令牌數(吞吐量)和總時間(完成時間),它們共同凸顯了 RTX PRO 6000 在相同生成條件下處理不同模型大小和複雜性的效率。
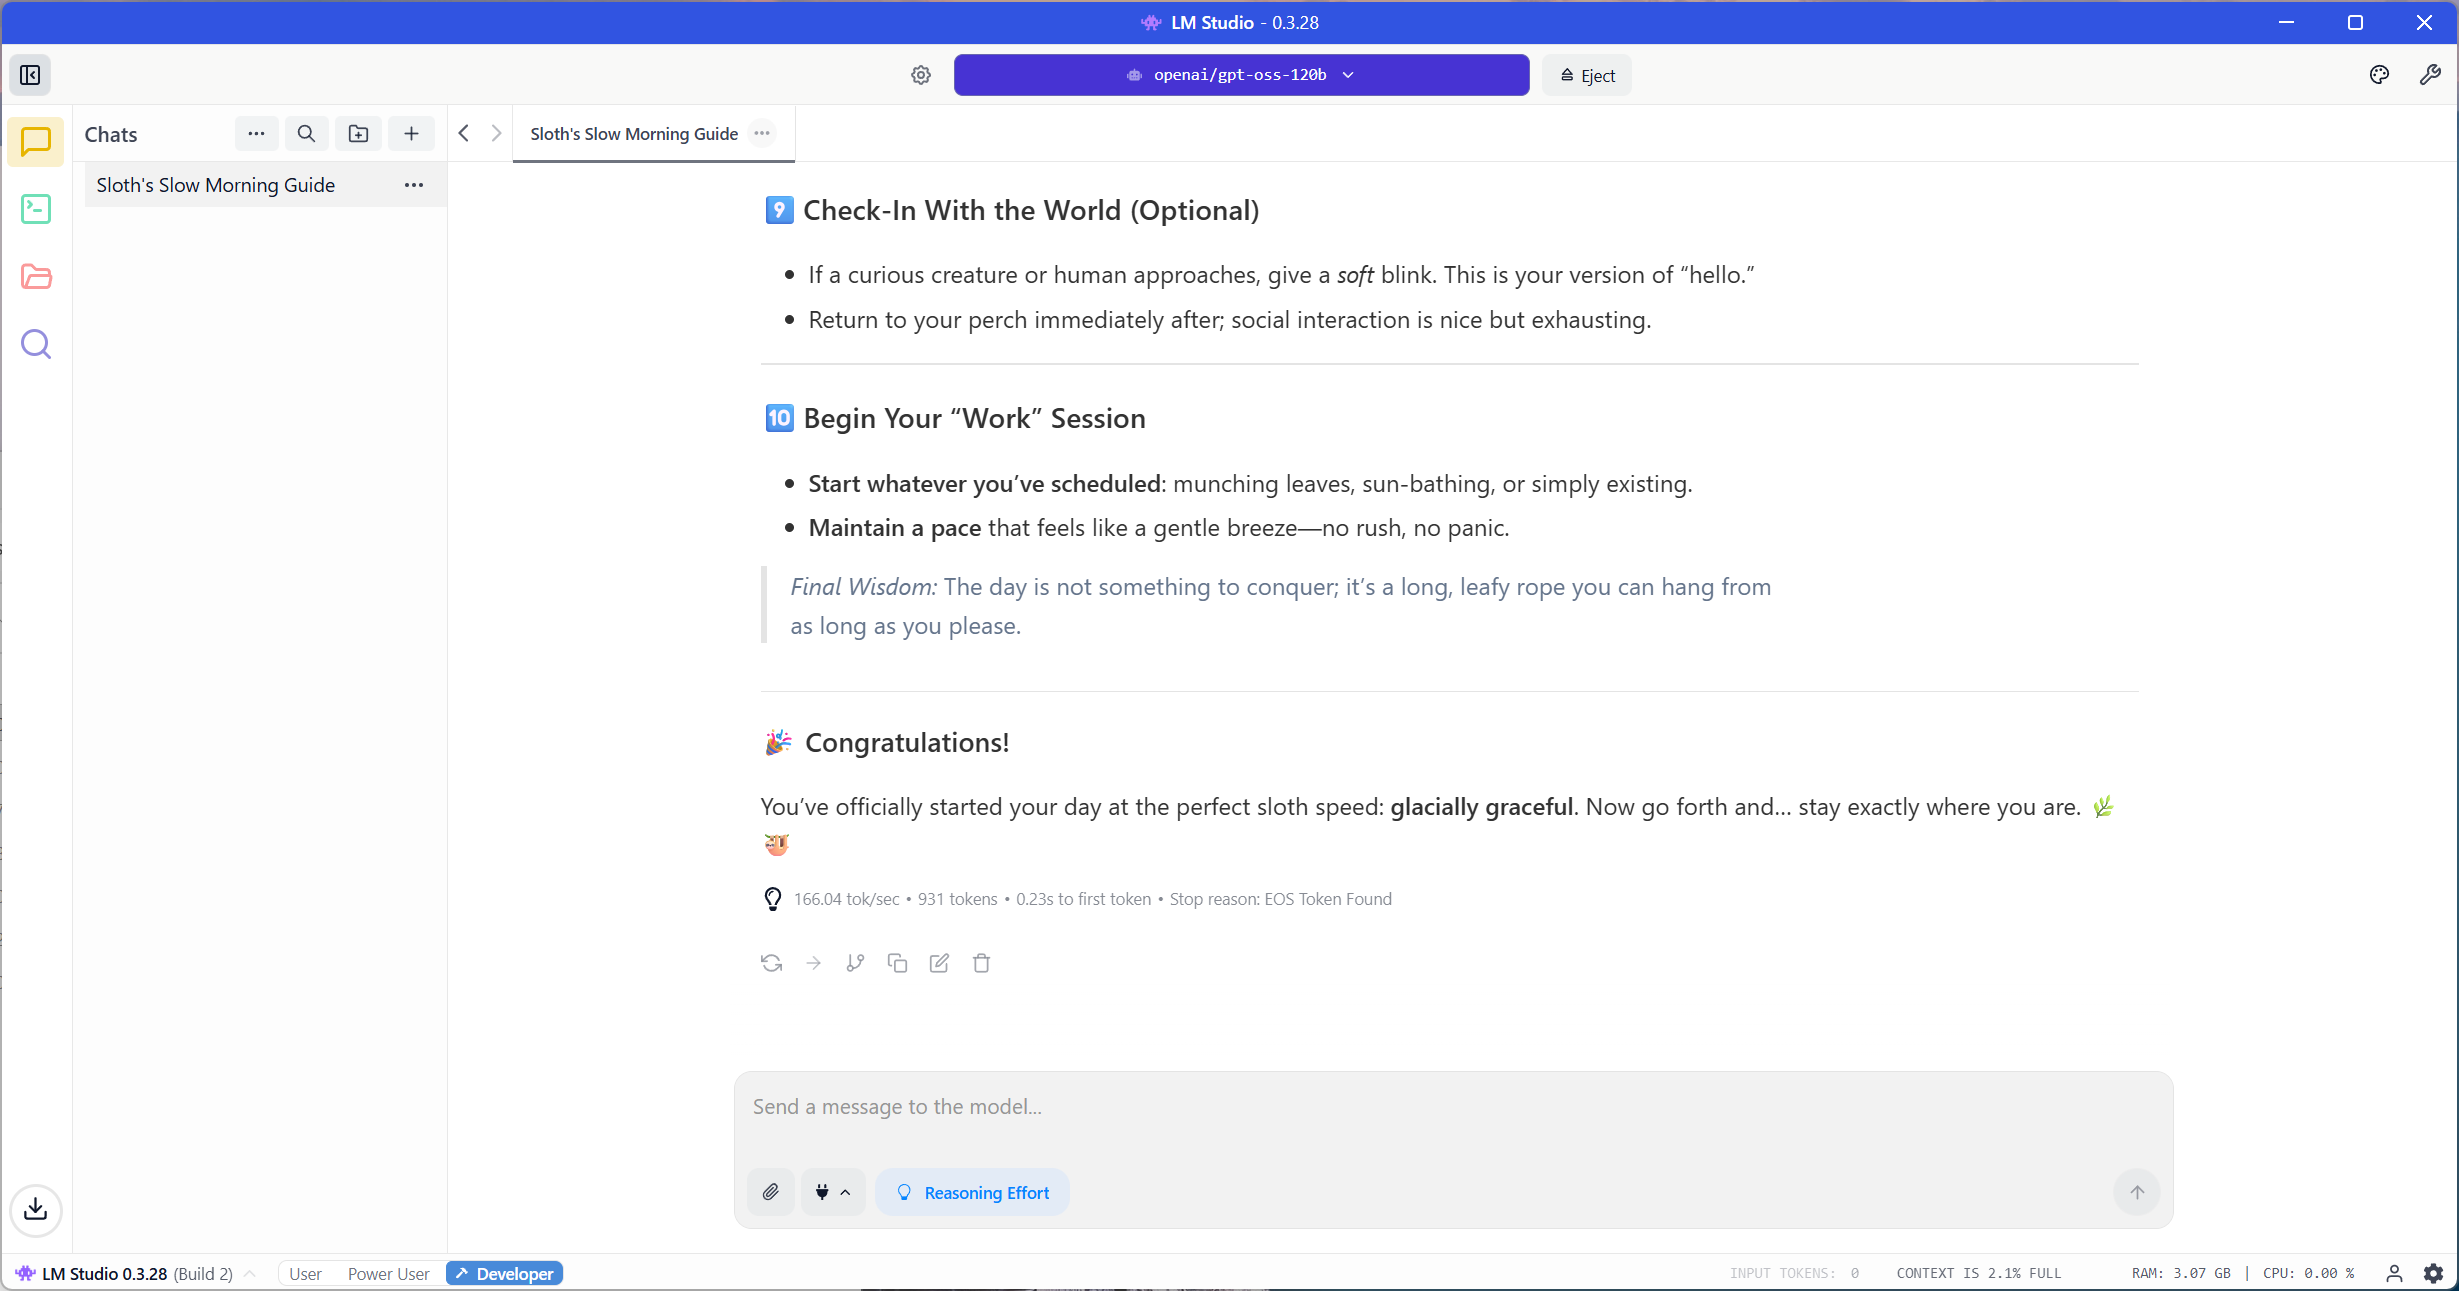
在 LM Studio 推理測試中,NVIDIA RTX PRO 6000 在各種模型尺寸(從較小的 4B 參數模型到大規模 120B 級配置)中表現出色,具有出色的性能和可擴展性。
本次測試的亮點是 OpenAI GPT-OSS 120B 模型,RTX PRO 6000 每秒產生 163.1 個 token,並在 9.54 秒內完成了 500 個單字的生成。這結果之所以引人注目,是因為 RTX 5090 等顯示卡無法載入或執行 120B 模型,甚至由於 VRAM 有限,甚至連 70B 模型都經常無法處理。 PRO 6000 的 96 GB GDDR7 顯存使其能夠在本地處理這些龐大的模型,使其在工作站 GPU 中獨樹一幟。
對於較小的模型,Gemma 3.4 B 實現了最高的吞吐量,以每秒 226.7 個令牌的速度在 3.51 秒內完成任務。 Llama 3.1 8B Instruct 緊跟在後,每秒 197.1 個令牌,總時間為 4.17 秒。這些運行顯示了 PRO 6000 在中端推理工作負載下的強大效率和快速響應。
在高端,Llama 3.1 70B Instruct 和 Llama 3.3 70B 型號平均每秒生成 31.8 個令牌,總生成時間分別為 27.2 秒和 25.3 秒,儘管尺寸較大,但仍顯示出一致的輸出。
整體而言,RTX PRO 6000 在運行大規模機型時展現出卓越的穩定性、吞吐量和處理能力。其 96 GB 的記憶體容量使其能夠處理超出消費級 GPU 極限的工作負載,使其成為需要可靠本地性能進行高級 AI 和生成模型開發的開發者、研究人員和專業人士的理想選擇。
| LM Studio(模型推理結果) | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| 型號名稱 | 令牌/秒 | 第一個令牌的時間 | 總時間(秒) | 提示符 | 預測標記 | 代幣總數 | |||
| OpenAI GPT-OSS 120B | 163.15 | 0.193 | 9.543 | 81 | 1,557 | 1,638 | |||
| 傑瑪3 4B | 226.73 | 0.113 | 3.51 | 25 | 796 | 821 | |||
| 傑瑪3 12B | 117.15 | 0.068 | 8.06 | 25 | 944 | 969 | |||
| 傑瑪3 27B | 68.06 | 0.221 | 12.048 | 25 | 820 | 845 | |||
| 元駱駝 3.1 8B 指導 | 197.07 | 0.062 | 4.171 | 49 | 822 | 871 | |||
| 元駱駝 3.1 70B 指導 | 31.84 | 0.159 | 27.227 | 49 | 867 | 916 | |||
| 梅塔駱駝 3.3 70B | 31.74 | 0.323 | 25.329 | 49 | 804 | 853 | |||
NVIDIA RTX PRO 6000 功耗
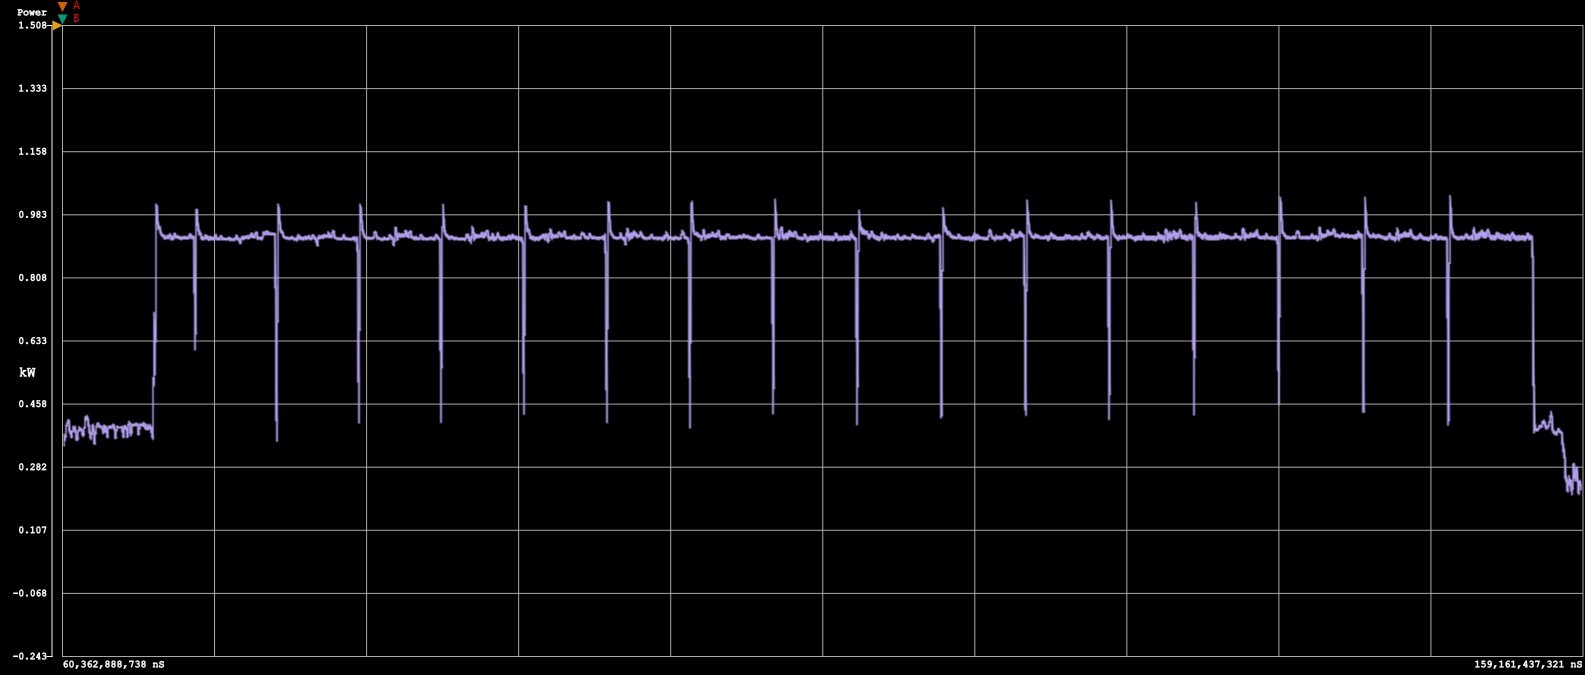
為了評估 AI 工作負載的實際效率,我們利用了 UL Procyon AI 影像來產生基準測試,特別是 Stable Diffusion XL FP16 測試。此測試重點在於第二張和最後一張生成影像之間的時間間隔,記錄完成時間間隔所需的時間、峰值和持續功耗,以及完成後的系統空閒功耗。
在我們的測試中,RTX PRO 6000 在持續負載下的平均係統功耗為 918.5 W,峰值為 1,036.3 W,工作負載完成後,空閒功耗穩定在 152.3 W。整個測試間隔持續 5.3 秒,總功耗為 1.35 Wh。這些結果展現了工作站級 GPU 卓越的功耗效能比,在長時間推理工作負載下保持功耗良好控制的同時,也能保持高輸出。
與其他 GPU 相比,RTX PRO 6000 的總能耗與 RTX 4090 接近,同時保持了更快的完成時間,並且在能源效率和速度方面均顯著優於 RTX 6000 Ada。有趣的是,共用 GB202 晶片的新 Blackwell 顯示卡在這種工作負載下表現出非常相似的能源效率特性,總能耗僅略有差異,這可能是由於 PRO 6000 的 TDP 更高。這顯示 NVIDIA 的最新一代顯示卡仍在持續優化每瓦效能,而非大幅提升效能。
| 穩定擴散 XL FP16 影像功率使用情況(越低越好) | NVIDIA RTX PRO 6000 | NVIDIA RTX 5090 | NVIDIA RTX 4090 | NVIDIA RTX 6000 Ada |
| 耗電量 | 1.35Wh | 1.16Wh | 1.35Wh | 1.76Wh |
| 測試時間 | 5.3s | 5.1s | 7.3s | 12.6s |
結語
整體而言,NVIDIA RTX PRO 6000 是目前適用於專業工作流程的、效能最強的工作站 GPU,它以桌上型設計提供資料中心級的效能。測試時的零售價約為 8,500 美元,它的目標客戶是那些需要可靠性、高運算密度和大量 ECC 記憶體池來處理生產工作的團隊。憑藉 24,064 個 CUDA 核心、752 個 Tensor 核心、96 GB GDDR7 ECC 和 Blackwell 架構,它能夠處理超出 GeForce RTX 5090 或 4090 等消費級顯示卡實際極限的工作負載。單一基準測試可能顯示消費級顯示卡在原始速度方面略勝一籌,但從容量、穩定性、驅動程式和 ISV 支援等方面綜合來看,RTX PRO 6000 更適合專業用途。
對於 AI 和 ML 而言,96 GB 的池容量至關重要。它支援本地進行長上下文推理和超大型檢查點,我們透過運行 70B 到 120B 級別的模型,同時保持每秒強大的令牌數,證明了這一點。更大的二級快取和記憶體頻寬也為渲染和模擬帶來了優勢,使其在 Blender、V-Ray 和 LuxMark 的長時間負載下也能提供可預測且持續的效能。
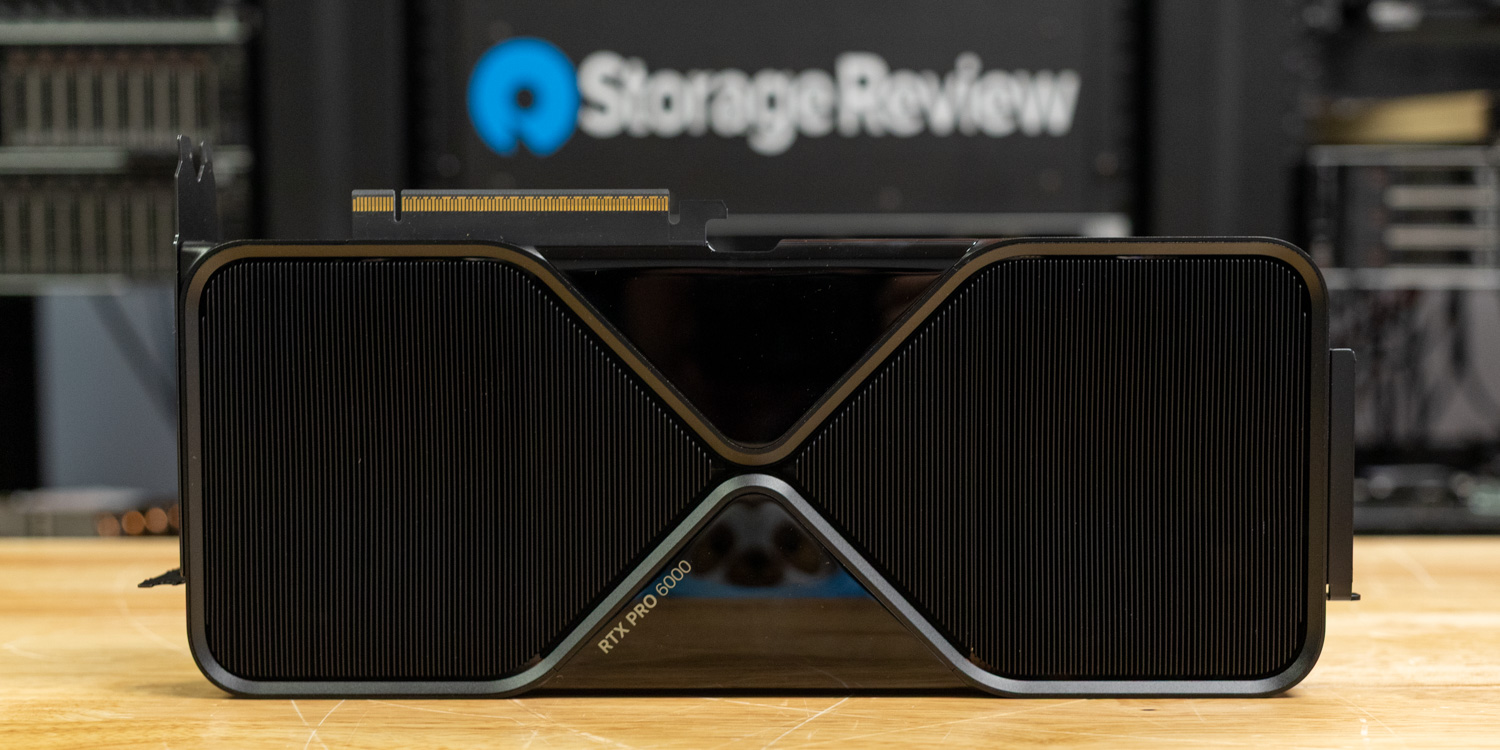
該卡適用於真正的工作站。它採用真正的雙插槽設計,配備 PCIe 5.0 x16 介面、四個 DisplayPort 2.1b 輸出和一個 16 針電源輸入。請規劃優質電源和機箱氣流,以支援 600W 的主機板功率。多 GPU 支援也非常簡單,OEM 和 ISV 支援 2 到 8 個 GPU,涵蓋 AI、渲染和運算堆疊。
如果您的工作涉及長上下文 LLM、非常大的場景或單個節點上的高精度模擬,RTX PRO 6000 憑藉其他卡無法比擬的容量和一致性證明了其優勢。


 Amazon