

Společnost VAST Data oznámila, že DeepL nasazovala operační systém VAST AI jako datový základ pro výzkumná prostředí, která stojí za jejím překladem psaného a hlasového překladu v reálném čase. Na základě současných plánů nasazení očekává DeepL zhruba trojnásobnou úložnou kapacitu oproti hardwaru NVMe, který již používá, a k migraci dat ze svého stávajícího prostředí využije SyncEngine od VAST. Platforma DeepL slouží více než 200 000 obchodním týmům a společnost uvádí, že právě školení hlasového překladu v reálném čase je to, co pohání novou poptávku po datech.
Cíle konsolidace NVMe: 3x větší využitelná kapacita
Trojnásobné číslo zahrnuje stávající NVMe infrastrukturu společnosti DeepL a DeepL tento zisk chápe jako prostor pro vývoj modelů s možností škálování bez odpovídajícího nárůstu fyzického hardwaru. Ani jedna ze společností tento zisk nerozděluje mezi redukci dat, kódování s mazáním a konsolidaci samostatných fondů na jednu platformu a VAST toto číslo nespojila s programem Amplify , který spustila v lednu s tvrzením o až 6násobné efektivní kapacitě ze stávajících SSD disků. Modely disků, hrubé kapacity a časový harmonogram nasazení nebyly zveřejněny.
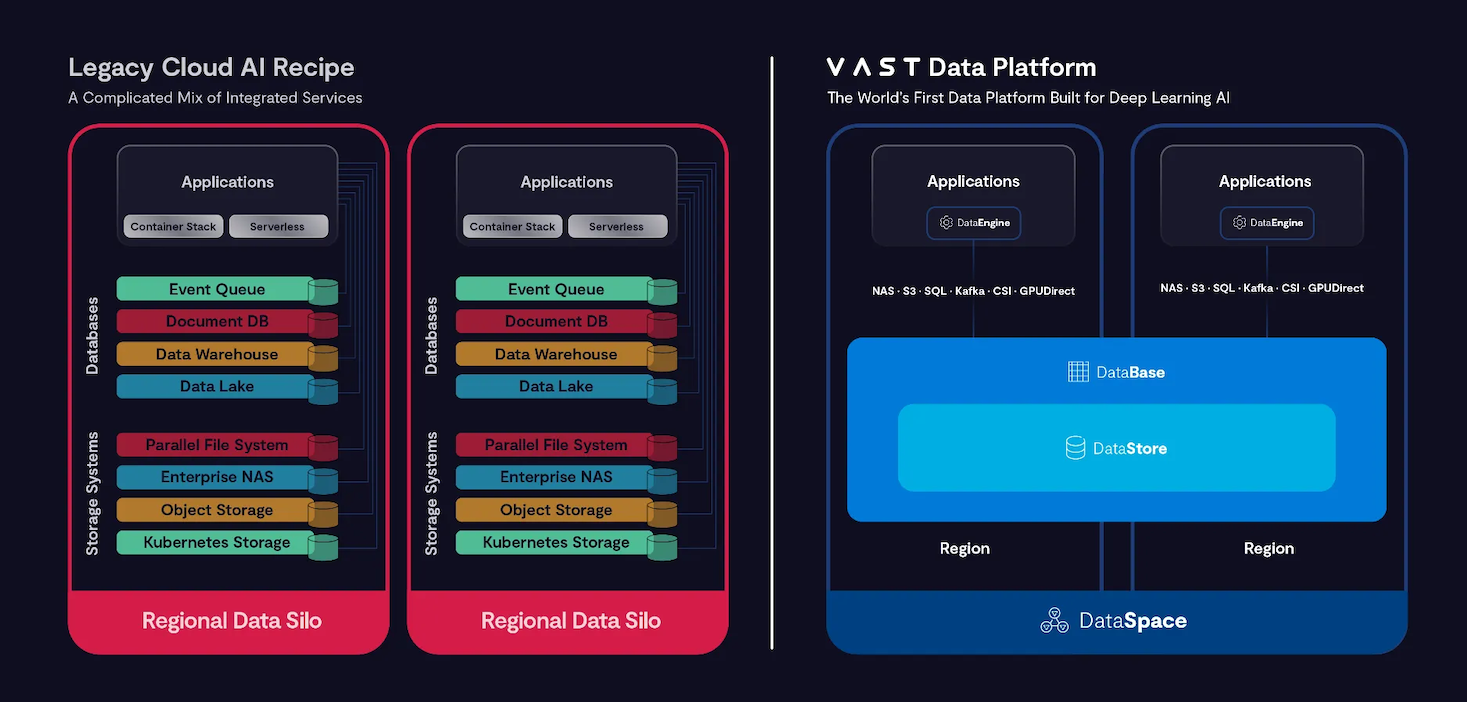
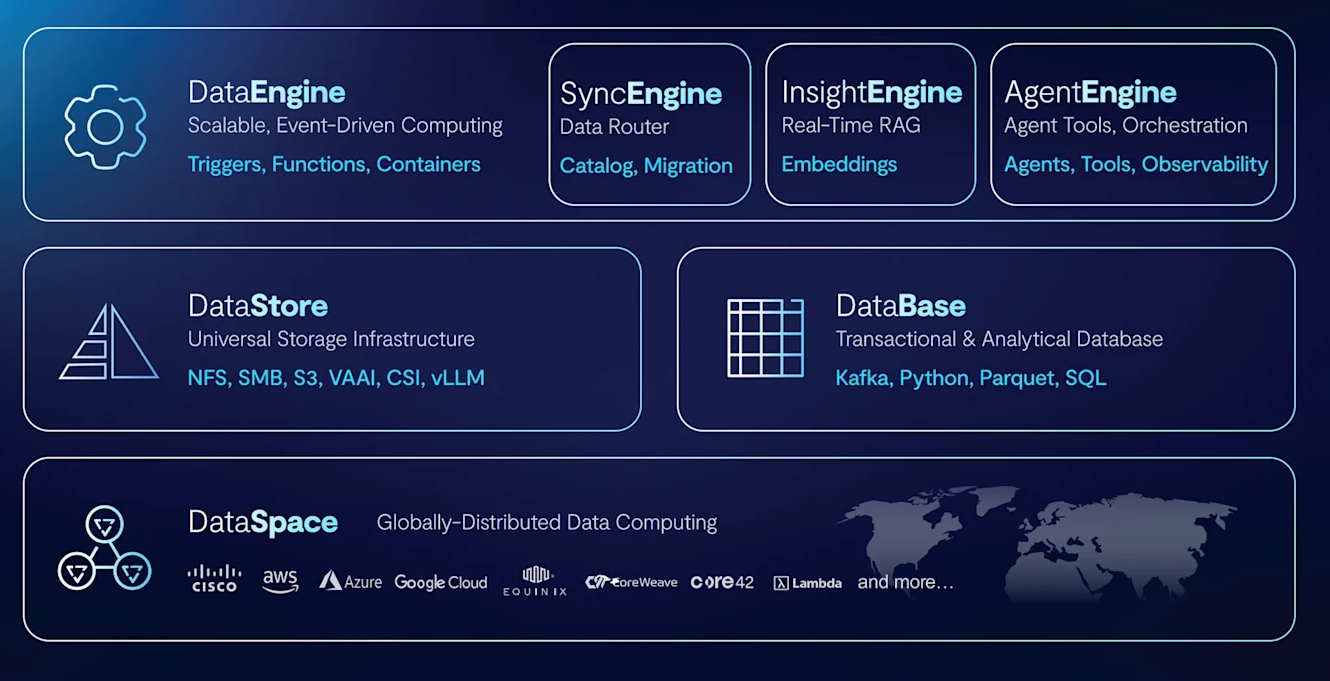
SyncEngine, komponenta operačního systému s umělou inteligencí, která katalogizuje a migruje data, přesouvá data DeepL z existujícího prostředí na platformu VAST. Odtud platforma slouží k ukládání souborů a objektů z jednoho systému, což podle DeepL zjednodušuje datovou strukturu pod výzkumnými týmy a poskytuje jim flexibilitu při změně pracovní zátěže s modely.
„VAST nám poskytuje výkon a spolehlivost, které potřebujeme, a zároveň nám umožňuje výrazně efektivněji využívat infrastrukturu, kterou již provozujeme,“ řekl Stefan Andresen, hlavní vědecký pracovník společnosti DeepL. „Stejně důležité je, že nám dává cestu k tomu, jak usnadnit přístup k datům v našich vlastních datových centrech a časem i v cloudových prostředích, čímž se snižuje ruční přesun dat, který může bránit výzkumu.“
DeepL Voice, představený v listopadu 2024 pro živé vícejazyčné konverzace, představuje pracovní zátěž, která splňuje požadavky. Nedávné aktualizace mu umožňují zachovat charakteristiky hlasu mluvčího napříč jazyky a DeepL tvrdí, že školení těchto funkcí klade vyšší nároky na přístup k datům a výkon infrastruktury než text, přičemž prioritou je efektivní přesun mezi školicím a produkčním prostředím.
Hybridní správa dat zahrnuje lokální i cloudové prostředí
Nasazení začíná v datových centrech společnosti DeepL s plány na postupné rozšíření VAST do cloudových prostředí, aby výzkumníci získali stejný přístup k datovým sadám bez ohledu na to, kde se nachází školicí klastr, a přestali ručně kopírovat data mezi pracovišti. Ani jedna ze společností zatím neuvedla, které služby VAST bude cloudová fáze využívat ani kdy začne.
„S postupným zaváděním umělé inteligence do produkčního prostředí se spolehlivost infrastruktury stává stejně důležitou jako hrubý výkon,“ řekl Jeff Denworth, spoluzakladatel společnosti VAST Data. „Psaný jazyk, hlasová komunikace v reálném čase a nová generace umělé inteligence kladou na data odlišné nároky, ale výzkumníci by neměli muset pokaždé, když se změní model nebo produkt, přepracovávat základní infrastrukturu.“
VAST pozicionuje operační systém umělé inteligence jako společný datový základ pro vývoj modelů, trénování a inferenci, konsoliduje souborové a objektové služby s konzistentním přístupem napříč distribuovanou infrastrukturou. DeepL navazuje na sérii oznámení VAST z letošního podzimu, včetně DataEnclave pro spouštění modelů na regulovaných datech v rámci důvěrných výpočtů NVIDIA a integrace CrowdStrike , která byla spuštěna v září.


 Amazon