

Google přidal do své řady TPU osmé generace dva systémy: TPU 8tx, systém pro důvěrné výpočty postavený na křemíku TPU 8t, a TPU 8i Max, který v jednom pouzdře pro dlouhodobou inferenci spojuje dva čipy TPU 8i. Doplňují se o trénovací čip TPU 8t a inferenční čip TPU 8i, které Google představil na konferenci Cloud Next v dubnu, a Google uvádí, že je to poprvé, co v jednom roce představil čtyři systémy TPU.
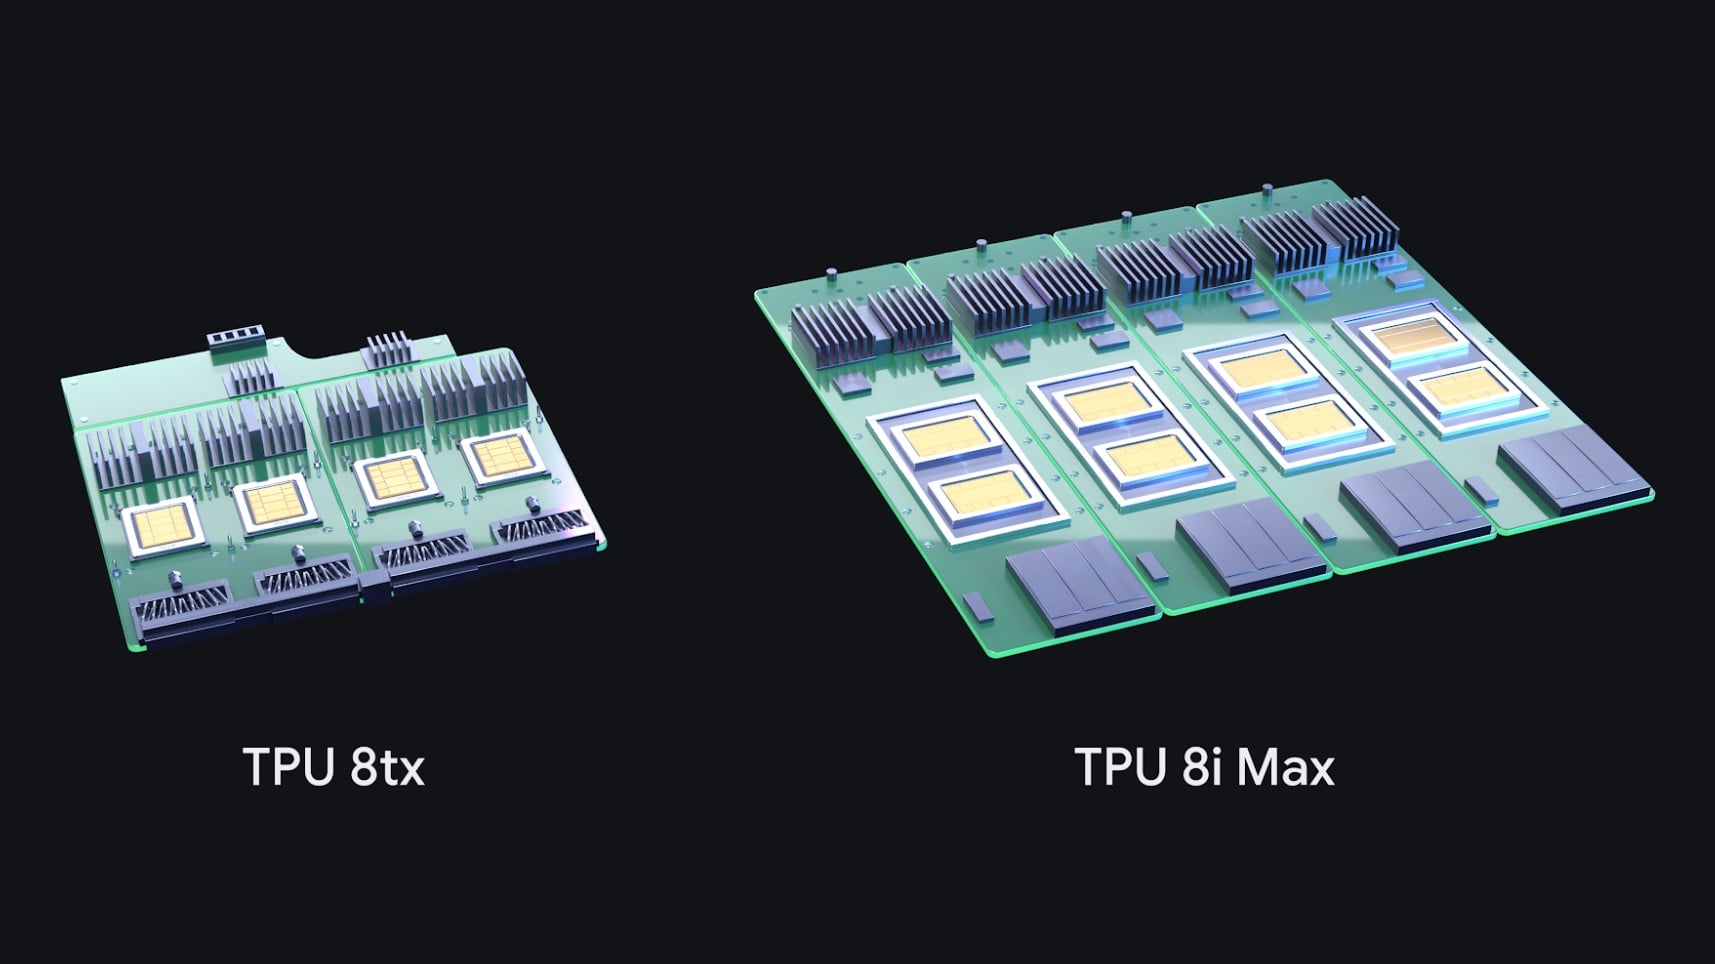
Google popisuje tyto dva přírůstky jako nové systémy postavené na stávajících čipech, které mění pouzdro, vysokorychlostní paměť, síťové připojení a zabezpečení křemíku tak, aby odpovídaly pracovní zátěži, a připisuje tomuto modulárnímu přístupu zásluhy za dodání specializovaných konfigurací během několika měsíců. Podle Googlu mají TPU nyní téměř 100 zákazníků, včetně hraničních laboratoří, obchodních firem, maloobchodníků a univerzit, a někteří zákazníci nyní mohou nasadit TPU přímo ve svých datových centrech.
TPU 8tx: Důvěrné výpočty na křemíkovém TPU 8t
TPU 8tx používá stejný křemík jako TPU 8t, spáruje ho s hostitelskými procesory AMD EPYC 5. generace a do hardwaru integruje důvěrné výpočty, takže data a váhy modelů zůstávají během používání chráněny a izolované. Google mezi svými bezpečnostními funkcemi uvádí šifrování PCIe link, kryptografickou ověření a bezpečné paměťové enklávy a systém zaměřuje na regulované podniky a vlády, které provozují hraniční nebo proprietární modely a agenty spolu s citlivými daty.

TPU 8tx také využívá nízkolatenční síť Boardfly, kterou Google vytvořil pro TPU 8i. Google tvrdí, že nabízí až 2x nižší latenci než TPU 8t s téměř nulovým snížením výkonu. Google ji umisťuje pro bezpečnou inferenci a školení v malém měřítku, takže tým může doladit soukromá data, rozdělit velký model na menší a školit agenty pomocí posilovacího učení, aniž by musel přesouvat citlivá data mezi samostatnými clustery.
TPU 8i Max: Dva inferenční čipy v jednom pouzdře
TPU 8i Max cílí na šířku pásma paměti pro úlohy, jako jsou desítky agentů pracujících napříč celou kódovou základnou nebo hodiny videa. Google zkombinoval dva čipy TPU 8i v jednom pouzdře, čímž zdvojnásobil šířku pásma výpočetní kapacity, integrované paměti SRAM a paměti HBM oproti TPU 8i. Google při uvedení na trh uváděl 384 MB SRAM pro TPU 8i, takže dvojnásobné číslo odpovídá 768 MB na pouzdro 8i Max a Google neuvedl kapacitu HBM pouzdra. Protože se do stávajícího racku vejde dvakrát více křemíku, Google uvádí, že poskytuje více výpočetních výkonů na čtvereční stopu a na watt.

Google nyní mapuje čtyři systémy osmé generace na fáze práce agentů: TPU 8t pro školení s možností škálování, TPU 8i pro uvažování s nízkou latencí, TPU 8tx pro důvěrné výpočty a TPU 8i Max pro masivní kontextová okna a nejvyšší výpočetní hustotu na rack. Google zatím neuvedl, kdy se TPU 8tx a TPU 8i Max dostanou k zákazníkům Google Cloudu, ani nezveřejnil ceny obou systémů.

Synchronizace TPU, cloudové cesty a dynamické krájení GKE
Google také zveřejnil TPU Sync, knihovnu v C++, která zachází s čipovou HBM, hostitelskou DRAM, sdíleným úložištěm a sítí datového centra jako s jedinou hierarchií paměti. Odděluje mezipaměti KV mimo čip, streamuje kontext z uzlů prefill do dekódovacích uzlů a synchronizuje váhy posilovacího učení z trenérů do samplerů. Google uvádí, že TPU Sync snižuje latenci přenosu KV o více než 90 procent a zkracuje dobu do prvního tokenu v průměru o 90 procent na modelech směsi expertů s otevřenou váhou a parametry 235B až 480B.
Cloud Pathways, běhové prostředí Google DeepMind, které stojí za platformou Gemini, je nyní všeobecně dostupné na platformě Google Kubernetes Engine. Používá jeden řadič k orchestraci systémů TPU napříč více segmenty pro předtrénování, posilovací učení a inferenci multihostů a udržuje dlouhodobě běžící úlohy v chodu i přes hardwarové výpadky pomocí hot-swappingu segmentů v kratších intervalech a elastického reshardingu.
Dynamické krájení GKE, které je také běžně dostupné, využívá optické přepínání obvodů k sestavování kostek TPU do větších topologií nebo k jejich rozdělení do menších izolovaných úloh bez nutnosti opětovného vytváření uzlových fondů. Google uvádí, že zkracuje dobu spouštění úloh až 5krát a urychluje zotavení po chybě až 4.5krát. Sada agentů TPU v náhledové verzi se zapojuje do kódovacích nástrojů, jako jsou Claude Code, Cursor a Google Antigravity, k integraci úloh, diagnostice úzkých míst a automatickému ladění jader. Nový open-source XLA Serving Engine obsluhuje modely trénované v Pythonu z běhového prostředí C++ napříč TPU, GPU a CPU.



 Amazon