

Společnost MLCommons publikovala MLPerf Inference v6.1 a toto kolo testování překonalo rekord v účasti s 30 organizacemi, které se zúčastnily, a 486 výsledků z datových center a edge sítí. Do sady se přidaly dva nové testy: end-to-end RAG pipeline pro datová centra a benchmark Edge Agentic Inference pro zařízení s jedním uživatelem. Výsledky obsahují první recenzovaná čísla pro NVIDIA Vera Rubin NVL72, AMD Instinct MI350P, Intel Arc Pro B70 a AMD Ryzen AI Max+ 395. Pokud jde o tempo zlepšování, MLCommons uvádí, že nejlepší výsledek DeepSeek-R1 na akcelerátor v serverovém scénáři je 5.7krát lepší než ve verzi 5.1 před rokem a nejlepší výsledek VLM se za šest měsíců od verze 6.0 zlepšil 2.99krát.
Dva nové testy: End-to-End RAG a Edge Agent Inference
Benchmark End-to-End RAG měří kompletní proces otázek a odpovědí, několik modelů a vektorovou databázi, které spolupracují. Referenční implementace provozuje čtyři modely společně: gpt-oss-120B zpracovává dekompozici dotazů, kontrolu dostatečnosti a generování odpovědí; gpt-oss-20B hodnotí načtené dokumenty; e5-base-v2 vytváří vnoření; a ColBERTv2 přehodnocuje pasáže. Korpus obsahuje 107 484 pasáží, rozdělených do bloků z 2 515 HTML souborů; otázky jsou 824 víceskokových úloh z datové sady Google FRAMES; a každá úloha může projít až 5 koly vyhledávání, než proces rozhodne, že má dostatek důkazů. Objevují se dvě metriky: počet dokumentů za sekundu pro sestavení vektorové databáze FAISS HNSW a počet úloh za sekundu pro zodpovězení otázek v ní. Porotce Llama 3.1-8B hodnotí konečné odpovědi s cílem přesnosti 97 % a hodnocení není časově omezeno.
Benchmark Edge Agentic Inference se zaměřuje na vzorec kódovacího asistenta, který se přesunul na pracovní stanice a stolní počítače s umělou inteligencí. Model je Qwen3.6-27B s funkcí thinking off, v referenci běží jako Q4_K_M GGUF pod llama.cpp, s kontextovým oknem o velikosti 32K obslouženým na kolo. Pracovní zátěž je zaznamenaný záznam 20 trajektorií agentického kódování odvozených z SWE-bench Verified, celkem 1 007 kol, řízených v jednom streamu s jedním spuštěným požadavkem, způsobem, jakým vývojář na notebooku spouští agenta. Uváděnou metrikou je průměrná latence na kolo, s rozdělením času do prvního tokenu a času na výstupní token a přesnost je samostatně měřena pomocí BFCL v4 na 97 % referenčního skóre. MLCommons adaptoval framework z připravovaného benchmarku MLPerf Agentic pro datová centra.
„Přidali jsme test End-to-end RAG, protože je zřejmé, že odpovídání na dotazy se vyvinulo za hranice pouhého LLM trénovaného na korpusu; zúčastněné strany potřebují pochopit reálný výkon typů vícekrokových, vícekomponentních pipeliningů, které se dnes budují,“ řekl Miro Hodak, spolupředseda pracovní skupiny MLPerf Inference. „Podobně jsme přidali test Edge Agentic Inference, protože komplexní inferenční systémy s agentickými vlastnostmi jsou stále častěji hostovány na edge computingových zařízeních, což vytváří novou sadu výkonnostních výzev, kterým dnes naši zákazníci čelí.“
Toto kolo také rozšiřuje podporu spekulativního dekódování, dříve omezenou na DeepSeek-R1, na benchmark GPT-OSS v interaktivním scénáři a definuje nový interaktivní scénář pro test VLM s odpověďmi cílenými na přibližně 1.5 sekundy.
Nový křemík od stolního počítače až po rack
NVIDIA Vera Rubin NVL72 debutuje v kategorii preview v MLPerf, kterou předložily společnosti NVIDIA a Nebius na svém VR200 NVL72. NVIDIA hlásí až 2.5x vyšší propustnost tokenů než GB300 NVL72 na DeepSeek-R1 v offline, serverových a interaktivních scénářích s využitím TensorRT-LLM a až 3.7x na modelu Qwen3 s využitím vLLM s NVIDIA Dynamo. Toto jsou srovnání NVIDIA s její vlastní předchozí generací a označení preview znamená, že se očekává, že platforma bude komerčně dostupná v dalším kole.
Společnost AMD rozšířila svůj test MLPerf Inference 6.1 na šest modelových rodin napříč úlohami jazyka, uvažování, převodu textu na video a doporučování a nasadila procesory Instinct MI355X, MI350X a novou kartu MI350P PCIe. Níže je popsán cluster Crusoe s 512 GPU postavený na MI355X spolu s vlastním rozborem kola od společnosti AMD.
Intel Arc Pro B70 se objevuje v uzlu se čtyřmi GPU a 128 GB kombinované VRAM, kterou Intel použil pro Llama 3.1-8B, Llama 2-70B, gpt-oss-120B, Whisper a nový test E2E-RAG; Intel uvádí, že gpt-oss-120B se zlepšil o 36 % v serverovém režimu a o 27 % v offline režimu oproti verzi 6.0 na stejném hardwaru. Co se týče CPU, Intel uvádí, že propustnost serveru Xeon 6980P Llama 3.1-8B se na identickém křemíku zvýšila 2.4krát oproti verzi 6.0, což je pouze softwarový nárůst.
Ryzen AI Max+ 395 se objevuje v testech Atlas Inference, což je poprvé použitý benchmark, který spustil novou zátěž Edge Agentic na desktopových počítačích NVIDIA DGX Spark a AMD Strix Halo se stejným enginem a kvantizačním receptem. Atlas hlásí 20.1 tokenů za sekundu na DGX Spark, přičemž všech 1 007 tahů dokončí za méně než 64 minut, a 19.63 tokenů za sekundu na Strix Halo. To je menší rozdíl, než jaký jsme mezi těmito dvěma platformami naměřili s běžnými běhovými časy v našich recenzích Ryzen AI Halo a DGX Spark , a právě takový výsledek má nový benchmark ukázat.
Větší, rozmanitější a distribuovanější
Počet víceuzlových odeslaných projektů v tomto kole dosáhl rekordního počtu, oproti nule ve verzi 4.0, a tři z nich vynikají. Crusoe, další odesílatel, který se zúčastnil prvního projektu, spustil s AMD největší systém v historii MLPerf Inference: 512 GPU Instinct MI355X napříč 64 uzly na standardní ethernetové síti RoCE, odeslaných pro gpt-oss-120b a DeepSeek-R1. AMD hlásí 5.75 milionu tokenů za sekundu v offline scénáři a 5.39 milionu na serveru na gpt-oss-120b z tohoto clusteru a 2.90 milionu offline a 2.41 milionu serverů na DeepSeek-R1, což AMD označuje za nejvyšší agregovanou propustnost tokenů v historii MLPerf, s propustností škálovanou téměř lineárně od 1 do 64 uzlů. Běh gpt-oss-120b sloužil modelu jako 512 nezávislých replik s jednou GPU v nativním MXFP4; DeepSeek-R1 používal SGLang s jednou replikou s osmi GPU na uzel. AMD samostatně uvádí podání GPT-OSS-120B se 72 GPU s 95% efektivitou škálování a 1 milionem tokenů za sekundu, což je stejný titulek, jaký se objevil i u MI355X ve verzi 6.0.
Společnost Cisco předložila první heterogenní systém pro tento benchmark, který využívá platformu Cisco Silicon One G200 a osm grafických procesorů AMD Instinct MI350X a sdružuje osm grafických procesorů NVIDIA H200 a osm grafických procesorů AMD Instinct MI350X do jednoho inferenčního fondu. Tento přístup se smíšeným akcelerátorem je stejný a prodává se prostřednictvím její platformy Secure AI Factory . Geograficky distribuovaný systém pochází od společnosti MangoBoost se společností Dell: čtyři lokality na dvou kontinentech, hostované společnostmi MangoBoost, Dell, TensorWave a Microsoft Azure, rozprostírající se v Pacifiku a běžící jako jeden koncový bod s efektivitou škálování, kterou MangoBoost uvádí jako 97 %. Společnost MangoBoost také tvrdí, že dosáhla prvních výsledků disagregovaných předfillem/dekódováním na grafických procesorech AMD Instinct.
Jinde ve výsledcích CoreWeave uvádí souhrnně 1.16 milionu tokenů za sekundu na GB300 NVL72 s offline propustností na GPU o 17 % vyšší než v6.0, HPE uvádí 8 500 tokenů za sekundu na GPU na DeepSeek-R1 napříč dvěma servery Compute XD690 s Blackwell Ultra a Google se ve svém příspěvku zaměřil na DeepSeek-R1 s odkazem na posun odvětví k modelům s velkým počtem expertů. gpt-oss-120b přilákal 112 příspěvků, což je nejvíce ze všech úloh MLPerf.
Dva tvarové faktory CDNA 4 od AMD: OAM a dvouslotový PCIe
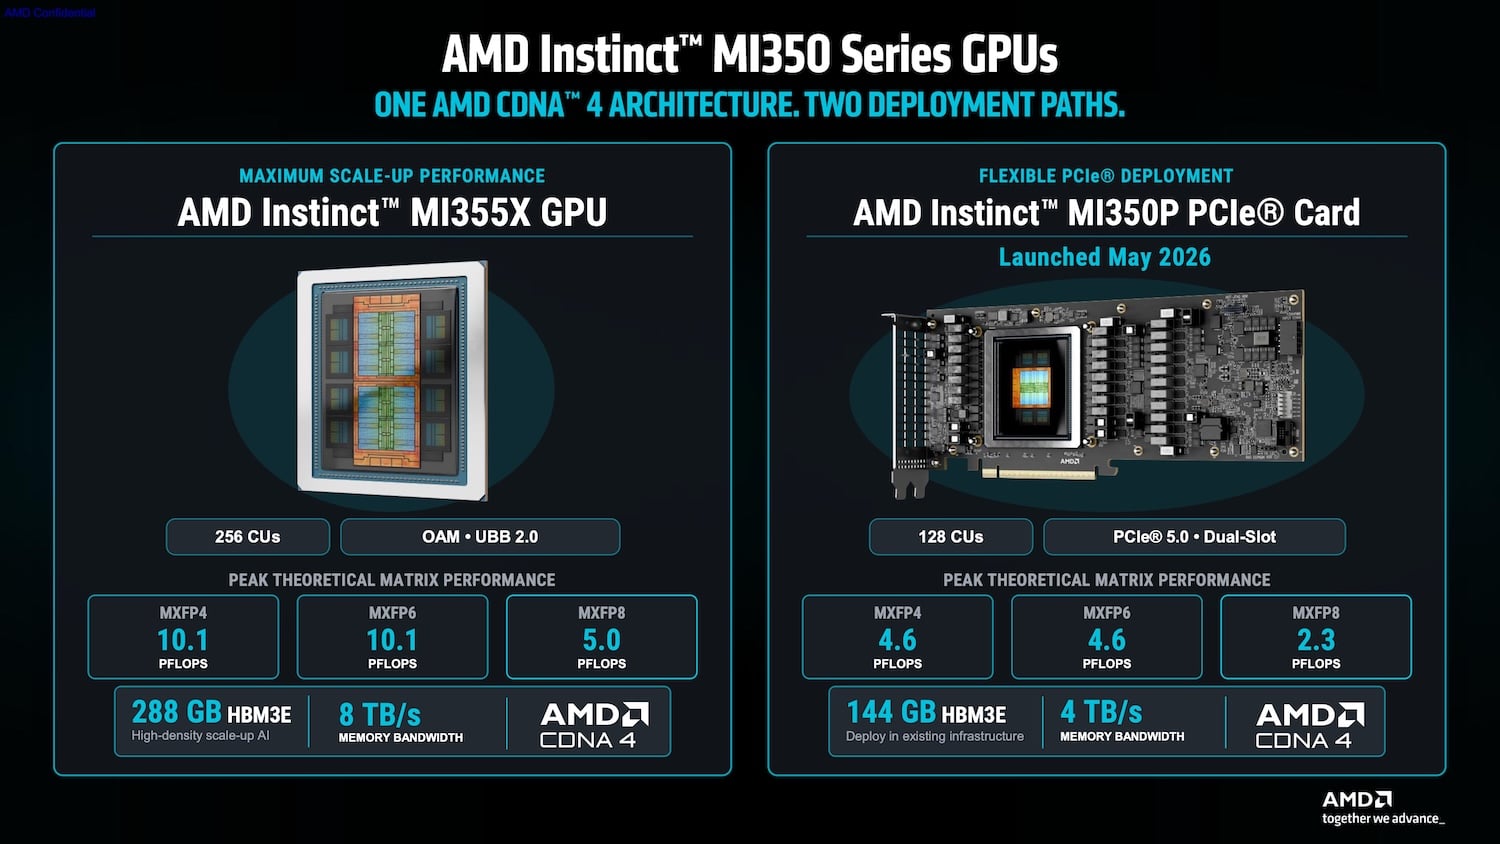
Architektura AMD CDNA 4 je k dispozici ve dvou fyzických provedeních, aby splňovala specifická omezení napájení a chlazení datových center. Vlajková loď Instinct MI355X je zaměřena na výpočetní uzly s vysokou hustotou s využitím provedení OAM na platformě OCP Universal Baseboard (UBB 2.0) a nabízí 256 výpočetních jednotek, 288 GB paměti HBM3E a celkovou šířku pásma paměti 8 TB/s. Nabízí až 10.1 PFLOPS špičkového teoretického výpočetního výkonu pro matice MXFP4 a MXFP6. Nově představený Instinct MI350P adaptuje stejný křemík CDNA 4 do dvouslotové rozšiřující karty PCIe 5.0 pro standardní podnikové šasi, která obsahuje 128 výpočetních jednotek, 144 GB paměti HBM3E, šířku pásma 4 TB/s a poskytuje až 4.6 PFLOPS špičkového teoretického výkonu pro matice MXFP4 a MXFP6.
Softwarově řízený generační vzestup na identickém křemíku
Optimalizace softwaru v AMD ROCm v7 přinesly měřitelné zvýšení propustnosti na identickém hardwaru MI355X během jediného cyklu MLPerf. Testování na uzlu MI355X s osmi GPU ukázalo, že propustnost GPT-OSS-120B se zvýšila o 28 % v offline scénáři a o 38 % ve scénáři Server, zatímco výkon Wan-2.2 SingleStream se zlepšil o 70 %. V měřítku clusteru dosáhlo 72 akcelerátorů MI355X v MLPerf 6.1 vyšší celkové propustnosti GPT-OSS-120B než konfigurace s 94 GPU uvedená v kole 6.0. V konkurenčních srovnáních publikovaných společností AMD vedl osmi GPU MI355X v odevzdaných výsledcích proti NVIDIA B200 a B300 na GPT-OSS-120B, zatímco cluster s 72 GPU vedl v porovnání s NVIDIA GB200.
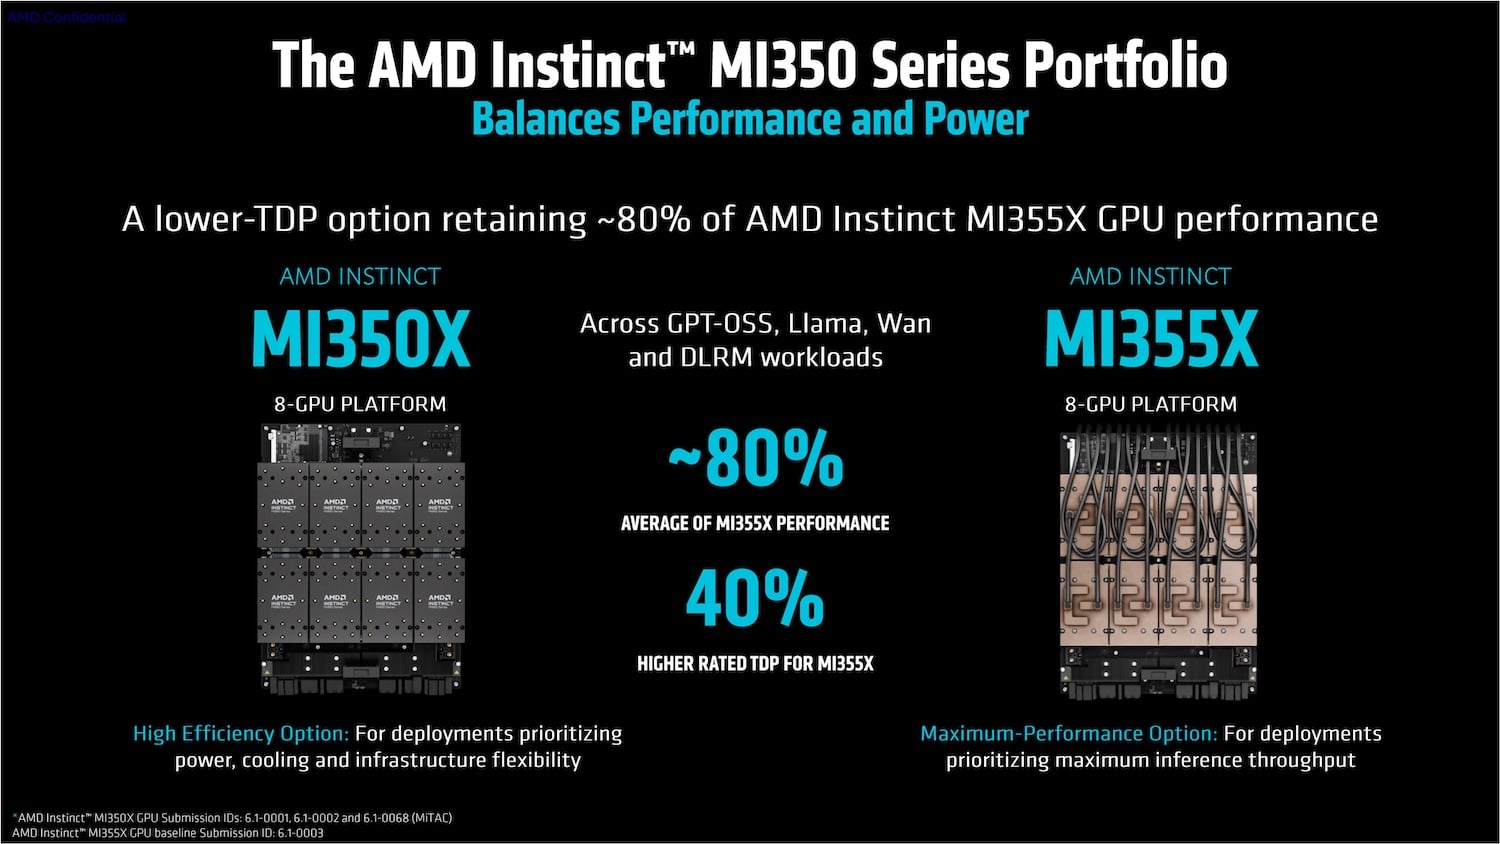
V prvním kole MLPerf se dvouslotový MI350P podrobil testům v pěti uzavřených úlohách a dosáhl nejlepších výsledků oproti vybraným grafickým kartám NVIDIA RTX PRO 6000 Server Edition a H200 NVL. V nasazeních citlivých na rozpočty na napájení a chlazení si osminásobný systém MI350X udržel přibližně 80 % výkonu benchmarku platformy MI355X v rámci úloh GPT-OSS, Llama, Wan a DLRM, zatímco MI355X má o 40 % vyšší jmenovité TDP. Studie zadaná společností Signal65 uvádí, že tato čísla propustnosti se promítla do nižších provozních nákladů na dokument a vyššího výstupu tokenů na dolar v rámci pevných limitů latence.
Výsledky partnerů AMD a klastr Korea-USA
Společnost AMD uvádí, že srovnatelné výsledky procesorů MI355X od sedmi partnerů, Dell Technologies, Oracle, Hewlett Packard Enterprise, Supermicro, MangoBoost, Crusoe a MiTAC, se v průměru odchylovaly do 4 % od výsledků referenčních systémů, přičemž některé běhy je shodovaly nebo mírně překračovaly.
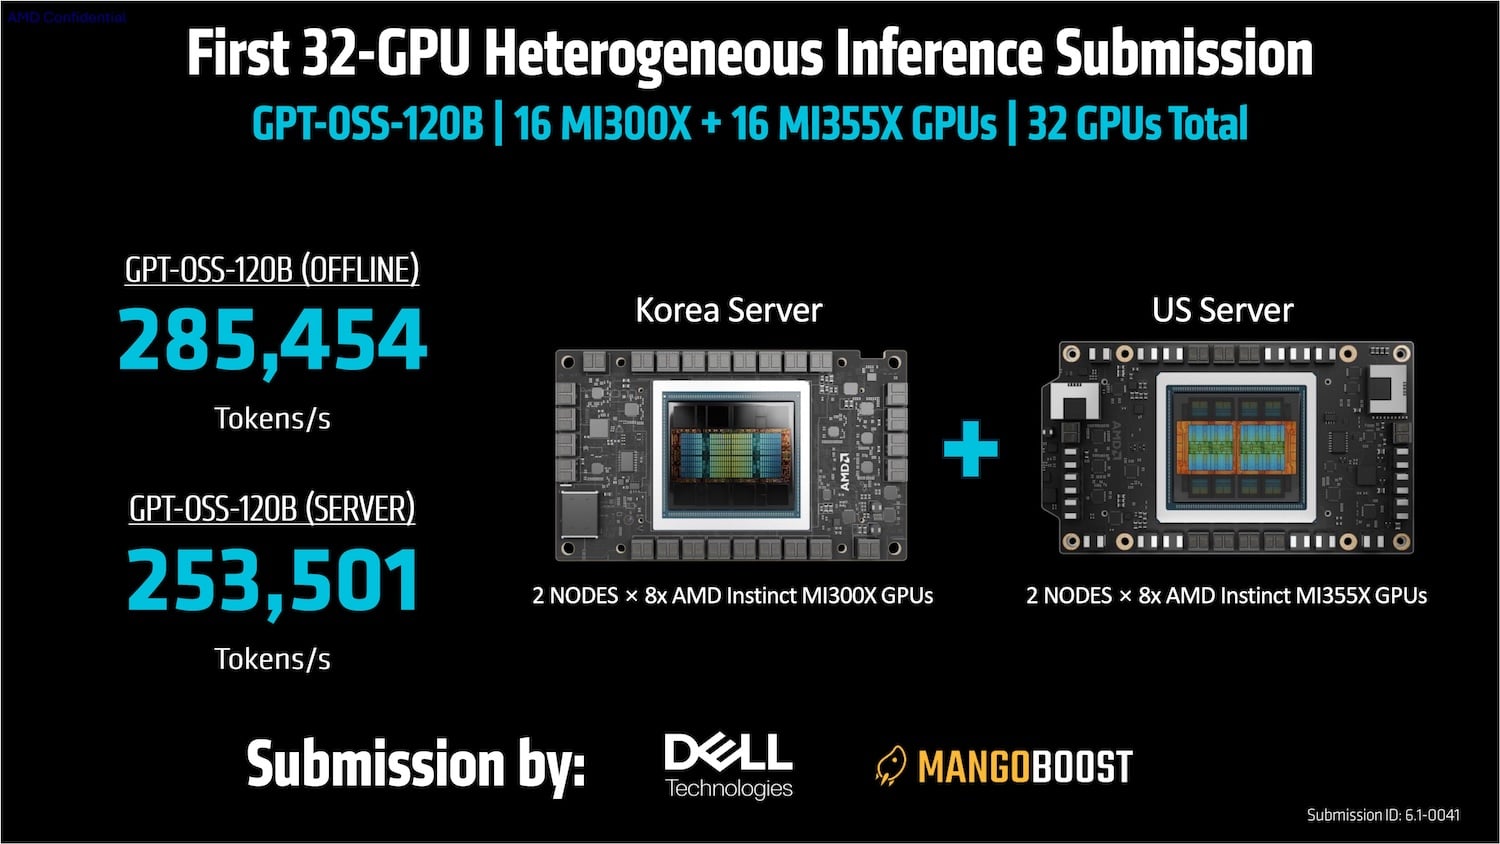
Výše uvedený záznam od MangoBoost a Dell je první heterogenní konfigurací benchmarku s 32 GPU, která propojuje 16 GPU Instinct MI300X předchozí generace v Koreji s 16 GPU Instinct MI355X ve Spojených státech do jednotného koncového bodu GPT-OSS-120B. Konfigurace s rozděleným clusterem dodávala 285 454 offline tokenů za sekundu a 253 501 serverových tokenů za sekundu. Odesílání dat probíhalo na platformě ROCm 7; AMD poukazuje na verzi ROCm 10 s profilovacími nástroji vLLM, SGLang a ROCm.AI jako na cestu vpřed pro řadu MI400 založenou na HBM4 a generaci MI500, která následuje.
Postroj, který nahrazuje inferenci MLPerf v datovém centru
Šestnáct z 30 odesílatelů v tomto kole použilo rozhraní MLPerf zaměřené na API, oproti jedinému odesílateli s otevřenou divizí ve verzi 6.0. Toto rozhraní spouští skutečné nastavení klient/server přes standardní API na hostovaném koncovém bodu, což je způsob nasazení inference v datovém centru, a již obsahuje nový test Edge Agentic, VLM-Interactive, gpt-oss, DeepSeek-R1, Llama 3.1-8B a převod textu na video. Je základem MLPerf Endpoints, který v říjnu 2026 zahájí průběžné odesílání na vyžádání a v roce 2027 nahradí MLPerf Inference jako benchmark pro datová centra, s normalizovanými výsledky a rozšířenou agentickou zátěží plánovanou pro Endpoints v1.0.
„V budoucnu MLPerf Endpoints nahradí Inference v naší rodině benchmarků pro datová centra a rychlé přijetí našich technologií zaměřených na API přispěje k bezproblémovému přechodu,“ uvedl David Kanter, vedoucí MLPerf. Šestici subjektů, které v tomto kole poprvé předložily výsledky, jsou Atlas Inference, Crusoe, Orrick Industries, ScitiX, VibeHPC a individuální přispěvatel Naeem Khoshnevis z Harvardova Kempnerova institutu, který předložil jediný výsledek H200 Llama 3.1-8B.
Kolo odvozování navazuje na výsledky MLPerf Storage v3.0 zveřejněné před dvěma týdny a kompletní tabulky datových center a okrajových sítí spolu s doplňkovými informacemi pro odesílatele jsou k dispozici na stránkách s výsledky MLCommons.


 Amazon